Analiza cantitativă a piețelor de energie

Cursul 7: Învățarea automată pe piețele de energie

Cursul 7

Învățarea automată pe piețele de energie

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București, Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică

Învățarea automată (ML, machine learning) promite prognoze mai precise ale prețului energiei electrice, iar mulți furnizori de modele o vînd tocmai cu această promisiune. Cursul pune o întrebare lucidă: pe piața pentru ziua următoare (PZU) din România, administrată de operatorul pieței de energie electrică și de gaze naturale (OPCOM), o rețea neuronală profundă (DNN) calibrată, un ansamblu de arbori de decizie construiți secvențial (gradient boosting) și un model fundațional preantrenat prognozează oare mai bine cele 24 de prețuri orare de mîine decît modelele statistice de referință din cursul 2? Iar dacă da, cu cît, cu ce cost și cum putem explica de ce?

Răspunsul contează pentru orice companie care tranzacționează pe PZU. Un furnizor cumpără cu o zi înainte orele de care are nevoie, un producător hotărăște cînd să vîndă, iar proprietarul unei baterii alege cînd să o încarce și cînd să o descarce. Fiecare plătește erorile de prognoză în euro pe megawatt-oră (EUR/MWh). Un model care pare mai bun decît este, pentru că a fost evaluat pe zilele greșite sau cu informații care nu existau la momentul licitației, costă de două ori: o dată la cumpărare și încă o dată cînd cedează în producție.

Cursul folosește aceleași date reale și același an de test ca în cursul 2: prețurile orare de pe PZU, împreună cu consumul, producția eoliană și solară și alte variabile fundamentale, descărcate de pe energy-charts.info (Fraunhofer ISE) și Yahoo Finance, pînă la 31 octombrie 2026. Se adaugă un singur ingredient, de care învățarea automată are nevoie: un an de validare separat, pe care se aleg setările modelelor înainte de a deschide anul de test.

Rezultatele învățării

  • Organizați corect un experiment de învățare automată: eșantioane de antrenare, de validare și de test care se succed în timp, cu prognoze care folosesc numai informația cunoscută la ora 12:00 a Europei Centrale (CET) în ziua dinaintea livrării.
  • Construiți și calibrați o rețea neuronală profundă și un model gradient boosting pentru cele 24 de prețuri orare ale zilei următoare și încercați un model fundațional preantrenat.
  • Comparați aceste modele cu modelele de referință din cursul 2, pe același an de test, cu eroarea absolută medie (MAE), rădăcina erorii pătratice medii (RMSE), MAE relativă (rMAE) și testul Diebold–Mariano (DM), și combinați învățarea automată cu modelele statistice.
  • Explicați prognozele, anticipați vîrfurile de preț și prețurile negative și recunoașteți capcanele care fac un model să pară mai bun decît este.

Planul cursului

  1. Modelele de învățare automată și evaluarea lorModelele flexibile pot învăța tipare pe care un model liniar nu le vede, dar pot învăța și zgomotul trecutului; secțiunea stabilește regulile care păstrează evaluarea corectă.
  2. Rețele neuronale profundeO rețea neuronală este un lanț de regresii, fiecare urmată de o transformare neliniară, antrenat prin pași mici împotriva erorii.
  3. Gradient boosting și modele fundaționaleArborii pun întrebări cu răspuns da/nu despre variabile și surprind de la sine pragurile și interacțiunile; gradient boosting adună mulți arbori mici, fiecare corectînd erorile celor dinainte.
  4. Compararea modelelor, combinarea lor și costul de calculToate modelele sînt comparate acum pe același an de test, cu aceleași măsuri ale erorii și cu teste DM față de AW-LEAR.
  5. Explicarea prognozelorO prognoză care nu poate fi explicată este greu de acceptat și imposibil de auditat.
  6. Vîrfuri de preț, prețuri negative și un studiu de cazPentru mulți utilizatori, orele extreme contează mai mult decît eroarea medie: o baterie sau un consumator flexibil își cîștigă banii în orele cu vîrfuri și cu prețuri negative.
  7. Erori de evaluare care supraestimează preciziaCele mai multe promisiuni de cîștiguri mari din învățarea automată provin din greșeli de evaluare, nu din modele mai bune.
  8. RecapitulareCursul se încheie cu cinci întrebări cu care se poate confrunta un manager, o sinteză a rezultatelor, cercetările grupului nostru și resurse pentru studiu suplimentar.
  9. AnexăAnexa prezintă derivările din spatele antrenării rețelei și a arborilor, conversia valorilor SHAP în euro și spațiile de căutare ale hiperparametrilor.

Modelele de învățare automată și evaluarea lor

Modelele flexibile pot învăța tipare pe care un model liniar nu le vede, dar pot învăța și zgomotul trecutului; secțiunea stabilește regulile care păstrează evaluarea corectă. Datele sînt împărțite în eșantioane de antrenare, de validare și de test, în ordine cronologică, iar setările se aleg prin căutare aleatoare numai pe anul de validare.

Datele: eșantionul și anul de test din cursul 2, cu un an suplimentar de validare

Slide-ul 5 în PDF

Variabila prognozată este prețul orar de pe PZU pentru zona de ofertare România (RO). Variabilele explicative sînt cele din cursul 2: prețurile pînă în ziua \(d-1\); consumul, producția eoliană și solară, hidro, nucleară și importul net pînă în ziua \(d-2\), de la Rețeaua europeană a operatorilor de transport și de sistem pentru energie electrică (ENTSO-E); și prețul certificatelor de emisii (EUA) ale Uniunii Europene (UE), printr-un titlu tranzacționat la bursă, garantat cu mărfuri (ETC). Datele acoperă perioada pînă la 31 octombrie 2026 și au fost descărcate la 4 noiembrie 2026 de pe energy-charts.info, portalul de date al Institutului Fraunhofer pentru Sisteme de Energie Solară (ISE), și de pe Yahoo Finance.

Timpul este împărțit în trei. Antrenarea începe la 8 ianuarie 2022 și crește cu o lună la fiecare reestimare. Anul de validare, 1 noiembrie 2024 – 31 octombrie 2025, este folosit numai pentru alegerea setărilor modelelor. Anul de test, 1 noiembrie 2025 – 31 octombrie 2026, are 8 760 de ore, iar modelele sînt reestimate lunar.

Modelele de referință sînt prognozele din cursul 2, preluate din fișierele acestuia: modelul naiv; modelul autoregresiv cu variabile exogene (ARX); operatorul de contracție și selecție în normă absolută (LASSO); autoregresia estimată cu LASSO (LEAR); ARX și LEAR mediate pe mai multe ferestre de calibrare (AW-ARX și AW-LEAR); ansamblul de 4 modele. Fiindcă anul de test este același, fiecare eroare din acest curs se poate compara direct cu cele din cursul 2.
Flexibilitatea și varianța modelelor de învățare automată

Slide-ul 7 în PDF

Un model flexibil poate învăța praguri și interacțiuni pe care LEAR nu le vede, dar poate învăța și zgomotul din anii de antrenare. Toate modelele din acest curs, statistice sau nu, se estimează după același principiu: se minimizează potrivirea pe zilele de antrenare plus o penalizare a complexității,

\[\hat\theta=\arg\min_{\theta}\ \underbrace{\frac1n\sum_{i=1}^{n}\ell\big(Y_i,f_\theta(\mathbf x_i)\big)}_{\text{potrivirea pe zilele de antrenare}}+\underbrace{\lambda\,\Omega(\theta)}_{\text{penalizare}}\]
(7.1)

unde \(f_\theta\) este modelul, cu parametrii \(\theta\), \(\mathbf x_i\) sînt variabilele cunoscute la închiderea licitației, \(Y_i\) este prețul, \(\ell\) funcția de pierdere (aici eroarea absolută), \(n\) numărul de observații de antrenare, \(\Omega\) complexitatea modelului, iar \(\lambda\) ponderea ei.

Modelele diferă prin gradul de flexibilitate. LEAR are cel mult 247 de coeficienți pentru fiecare oră. Rețeaua noastră DNN are 141 336 de parametri, pentru 1 727 de zile de antrenare la ultima reestimare. Cu atîția parametri, eroarea pe datele de antrenare nu spune nimic despre viitor: modelul poate fi judecat numai pe date pe care nu le-a văzut. Penalizarea din (7.1) și regulile de oprire din secțiunea următoare limitează cît de mult se poate apleca rețeaua spre zgomot, dar verdictul final vine întotdeauna din zilele păstrate deoparte.

În practică: întrebați furnizorul de prognoze cîți parametri are modelul pentru fiecare zi de istoric și pe ce zile a fost măsurată eroarea.

Trei eșantioane în ordine cronologică: antrenare, validare, test

Slide-ul 8 în PDF

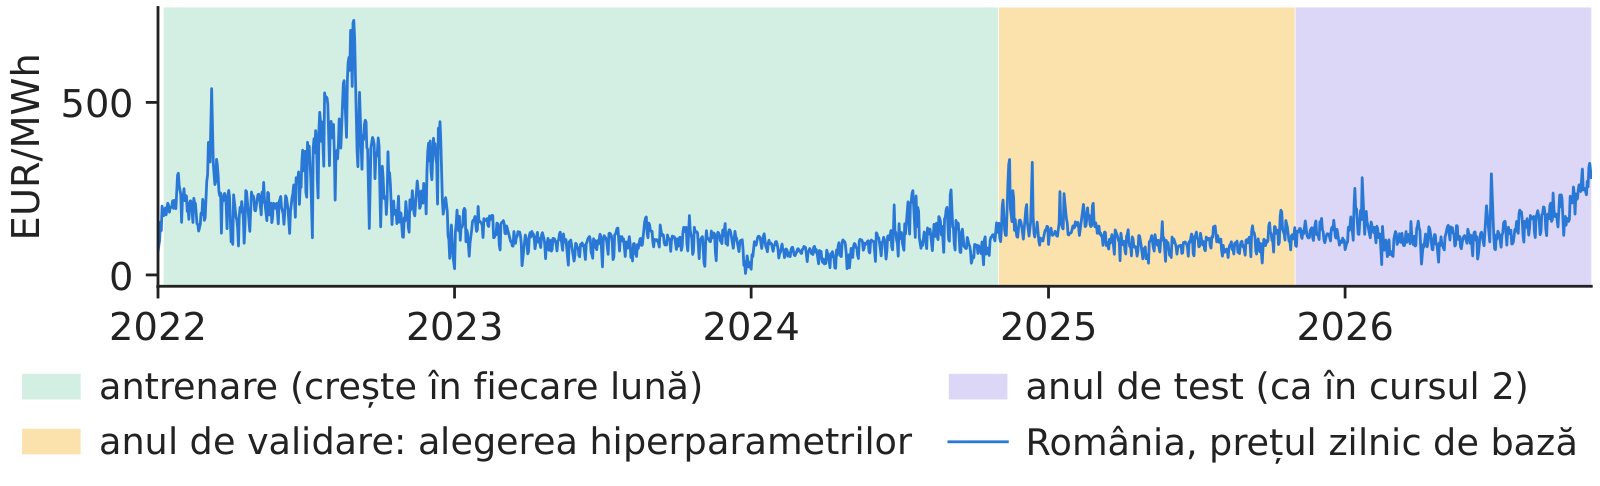
Graficul arată cum este împărțit istoricul. În anul de validare se compară 25 de setări pentru fiecare model, reestimate la fiecare 3 luni; setarea cu cea mai mică MAE este fixată înainte de începutul anului de test. În anul de test, modelele sînt reestimate la începutul fiecărei luni, pe toate zilele anterioare.

Anul de test nu se folosește pentru nicio alegere. Este același an ca în cursul 2, deci erorile se pot compara direct. Ordinea contează: amestecarea zilelor între eșantioane, așa cum face validarea încrucișată obișnuită, ar permite modelului să învețe din zile care vin după cele pe care le prognozează (Bergmeir și Benítez, 2012). Ultima secțiune a cursului măsoară cît de mult avantajează o asemenea greșeală un model.

În practică: tratați anul de test ca pe un plic sigilat: se deschide o singură dată, după ce toate alegerile au fost făcute.
Grafic: Trei eșantioane în ordine cronologică: antrenare, validare, test

Prețul de bază zilnic din România, 2022–2026, cu perioadele de antrenare, validare și test marcate.

Sursa: energy-charts.info (Fraunhofer ISE): prețuri OPCOM. Date: preț zilnic de bază, 2022-01-01 - 2026-10-31.

Hiperparametrii se aleg prin căutare aleatoare pe anul de validare

Slide-ul 9 în PDF

Setări precum numărul de neuroni sau de arbori nu sînt estimate de model; încercăm mai multe și o păstrăm pe cea care prognozează cel mai bine zilele nevăzute. Formal,

unde \(\gamma\) este o setare (vectorul hiperparametrilor), \(\gamma_0\) setarea din cursul 2, celelalte fiind extrase aleator, \(\mathcal V\) mulțimea zilelor anului de validare, \(|\mathcal V|\) numărul lor, \(P_{d,h}\) prețul din ziua \(d\) și ora \(h\), iar \(\hat P_{d,h}(\gamma)\) prognoza lui cu setarea \(\gamma\).

De ce aleator și nu pe o grilă completă? Doar cîteva setări contează cu adevărat, iar extragerile aleatoare le acoperă mai bine, cu același număr de încercări (Bergstra și Bengio, 2012). Bugetul nostru este de 24 de setări aleatoare plus setarea din cursul 2, pentru fiecare dintre cele două modele, iar întreaga căutare durează 7,3 minute pe un nucleu al unității centrale de procesare (CPU). Spațiile de căutare și valorile alese sînt prezentate în anexa D.

În practică: o căutare modestă, dar documentată, este suficientă. O căutare fără un eșantion de validare separat nu este o căutare, ci o scurgere de informație.

Sinteza secțiunii

Învățarea automată se judecă numai pe date nevăzute. Setările se aleg pe un an de validare, iar anul de test se deschide o singură dată, după ce toate alegerile au fost făcute.

Rețele neuronale profunde

O rețea neuronală este un lanț de regresii, fiecare urmată de o transformare neliniară, antrenat prin pași mici împotriva erorii. Secțiunea construiește rețeaua folosită în curs, arată cum este antrenată și oprită la timp și măsoară ce aduce calibrarea.

Structura unei rețele neuronale cu propagare înainte

Slide-ul 11 în PDF

Fiecare neuron transformă neliniar o combinație liniară a intrărilor; stratul de ieșire dă deodată cele 24 de prețuri ale zilei \(d\). Cu un singur strat ascuns,

\[\mathbf z=\phi\big(W_1\mathbf x_d+\mathbf b_1\big),\qquad \hat{\mathbf Y}_d=W_2\,\mathbf z+\mathbf b_2\in\mathbb R^{24}\]
(7.3)
\[\phi(u)=\max(0,u)\quad\text{sau}\quad \phi(u)=\ln(1+e^{u})\]
(7.4)

unde \(\mathbf x_d\) sînt intrările zilei \(d\) (prețuri, consum, producție eoliană și solară, variabile fundamentale, ziua săptămînii), \(W_1\) și \(W_2\) ponderile, \(\mathbf b_1\) și \(\mathbf b_2\) termenii liberi, \(\mathbf z\) ieșirile neuronilor ascunși, \(\phi\) funcția de activare, adică unitatea liniară rectificată (ReLU, rectified linear unit) sau varianta ei netedă, softplus ((7.4)), iar \(\hat{\mathbf Y}_d\) prețurile transformate cu asinh, ca în cursul 2.

Rețeaua aleasă pe anul de validare are 251 de intrări, un strat ascuns de 512 neuroni cu funcția softplus și 24 de ieșiri: în total 141 336 de parametri. Rețelele cu două straturi au fost mai slabe la validare. Rețeaua este vizibil mai bună decît perceptronul multistrat (MLP) din cursul 2: în anul de test are MAE 22,95 EUR/MWh, față de 25,54 pentru MLP.

În practică: o rețea neuronală este o regresie cu mult mai mulți coeficienți: are nevoie de aceeași disciplină a datelor, nu de mai puțină.

Antrenarea: metoda gradientului descendent stocastic, cu oprire timpurie

Slide-ul 12 în PDF

Ponderile se modifică puțin, în direcția care reduce eroarea pe un grup aleator de zile. Funcția de pierdere pe un grup și pasul de actualizare sînt

\[\mathcal L(\theta)=\frac{1}{24\,|B|}\sum_{d\in B}\sum_{h=0}^{23}\big|Y_{d,h}-\hat Y_{d,h}(\theta)\big|\]
(7.5)
\[\theta\leftarrow\theta-\eta\,\widehat{\nabla\mathcal L}\]
(7.6)

unde \(B\) este un grup de 64 de zile (mini-batch), \(Y_{d,h}\) și \(\hat Y_{d,h}(\theta)\) prețul transformat și prognoza lui, \(\eta\) rata de învățare (\(3\cdot10^{-4}\)), iar \(\widehat{\nabla\mathcal L}\) gradientul, rescalat prin metoda Adam (Kingma și Ba, 2015; detalii în anexa A). O epocă înseamnă o parcurgere a tuturor zilelor de antrenare.

Pentru a decide cînd ne oprim (early stopping), rețeaua este antrenată pe primele 85% din zilele de antrenare, iar eroarea ei este urmărită pe ultimele 15%. Se păstrează epoca cea mai bună, apoi rețeaua se reestimează pe toate zilele, cu același număr de epoci. Pe datele noastre, epocile păstrate au mediana 56 și variază între 23 și 92, pe 12 reestimări \(\times\) 4 inițializări. O a doua protecție împotriva memorării este dropout: în timpul antrenării, fiecare neuron este dezactivat aleator, cu probabilitatea 0,1 (Srivastava et al., 2014).

În practică: regula de oprire folosește numai zile din trecut: face parte din model și se verifică la fel ca restul.

Oprirea timpurie pe baza erorii din zilele recente

Slide-ul 13 în PDF

Graficul arată curba de învățare pentru reestimarea din octombrie 2026. Eroarea pe zilele de antrenare continuă să scadă, dar eroarea pe ultimele 15% din zile atinge minimul la epoca 51, la 24,50 EUR/MWh, iar antrenarea se oprește la epoca 76.

După acest punct, rețeaua reproduce tot mai bine trecutul și tot mai slab zilele recente: începe să memoreze. Distanța dintre cele două curbe este varianța din (7.1), făcută vizibilă. Oprirea timpurie păstrează rețeaua în punctul în care a învățat tiparele regulate ale pieței, dar nu și accidentele anilor de antrenare.

În practică: dacă un furnizor nu vă poate arăta această curbă, rețeaua a fost probabil antrenată pînă a reprodus trecutul.

Graficul interactivPagina interactivă →

    Codul acestei figuri: EMQA_L7_learning_curve · deschide în Colab

    Eroarea pe zilele de antrenare și eroarea pe ultimele 15% din zile, pe epoci, pentru rețeaua DNN aleasă, reestimarea din octombrie 2026, inițializarea 1; epoca cea mai bună este marcată.

    Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: rețeaua DNN aleasă, reestimarea pentru 2026-10, inițializarea 1.

    Întrebare pentru sală Rețeaua DNN aleasă, reestimată pentru octombrie 2026, este antrenată cu oprire timpurie (early stopping): antrenarea se oprește după 25 de epoci fără o eroare mai mică pe ultimele 15% dintre zile, iar ponderile celei mai bune epoci sînt păstrate. Ar da antrenarea pînă la capăt (epoca 76) o eroare mai mică pe aceste zile recente?
    Răspuns

    Nu. Eroarea de antrenare continuă să scadă, pînă la 23,06 EUR/MWh în epoca 76, dar eroarea pe zilele recente este minimă în epoca 51 (24,50 EUR/MWh) și ajunge la 25,07 EUR/MWh în epoca 76: după epoca 51, rețeaua memorează trecutul. Cu o răbdare scurtă, căutarea se oprește prea devreme: cu 5 epoci se oprește în epoca 30 și păstrează epoca 25 (24,91 EUR/MWh).

    Căutarea aleatoare reduce eroarea de validare a ambelor modele

    Slide-ul 14 în PDF

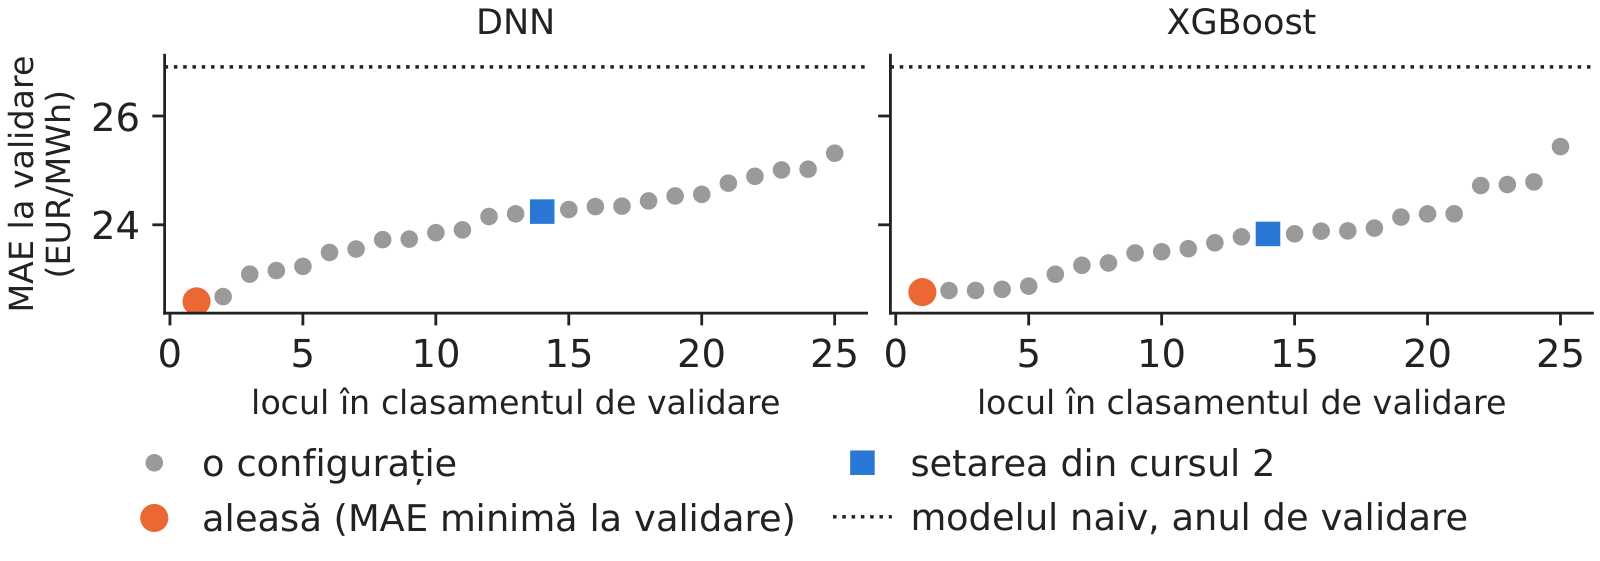
    Graficul ordonează cele 25 de setări încercate pentru fiecare model după MAE din anul de validare. Pentru rețeaua DNN, cea mai bună setare are 22,59 EUR/MWh, în timp ce setarea din cursul 2 are 24,24 și se află pe locul 14 din 25. Pentru eXtreme Gradient Boosting (XGBoost), cea mai bună setare are 22,76, față de 23,83 pentru setarea din cursul 2, tot pe locul 14.

    Toate cele 25 de setări ale ambelor modele sînt mai precise decît modelul naiv în anul de validare (26,90 EUR/MWh), deci modelele sînt utile chiar și prost calibrate; dar abia calibrarea le aduce aproape de modelele statistice de referință.

    În practică: prevedeți un an de validare pentru calibrare înainte de a avea încredere într-o prognoză de învățare automată.

    Sinteza secțiunii

    Calibrată pe anul de validare, rețeaua este clar mai bună decît perceptronul multistrat din cursul 2. Oprirea timpurie și dropout o împiedică să memoreze trecutul.

    Gradient boosting și modele fundaționale

    Arborii pun întrebări cu răspuns da/nu despre variabile și surprind de la sine pragurile și interacțiunile; gradient boosting adună mulți arbori mici, fiecare corectînd erorile celor dinainte. Secțiunea se încheie cu modelele fundaționale, rețele preantrenate care prognozează prețurile din România fără să fi fost antrenate pe ele.

    Un arbore de regresie împarte intrările în căsuțe, cu cîte un preț fiecare

    Slide-ul 16 în PDF

    Un arbore pune întrebări cu răspuns da/nu; fiecare frunză finală conține o valoare, deci pragurile și interacțiunile apar de la sine. Un arbore cu \(J\) frunze prognozează

    \[f(\mathbf x)=\textstyle\sum_{j=1}^{J}w_j\,\mathbb 1\{\mathbf x\in R_j\}\]
    (7.7)
    \[\text{Gain}=\frac{G_L^2}{H_L+\lambda}+\frac{G_R^2}{H_R+\lambda}-\frac{(G_L+G_R)^2}{H_L+H_R+\lambda}-\gamma\]
    (7.8)

    unde \(R_j\) este frunza \(j\) (o căsuță în spațiul variabilelor), \(w_j\) valoarea ei, \(\mathbb 1\{\cdot\}\) funcția indicator, \(G\) și \(H\) sumele derivatelor de ordinul 1 și 2 ale pierderii pentru observațiile care merg la stînga (\(L\)) sau la dreapta (\(R\)) unei împărțiri candidate, iar \(\lambda\) și \(\gamma\) penalizări pentru valorile frunzelor și pentru numărul lor. Arborele crește păstrînd, la fiecare pas, împărțirea cu cel mai mare cîștig ((7.8)); anexa B arată de unde provine formula.

    Pe datele noastre, în reestimarea pentru octombrie 2026, primul arbore întreabă: prețul din \(d-1\), aceeași oră, este sub 119,5 EUR/MWh? Acest arbore are 233 de frunze, iar modelul adună 1 500 de asemenea arbori.

    În practică: un arbore gîndește ca un trader: dacă ieri prețul a trecut de un prag, diseară urmează o primă.

    Gradient boosting: fiecare arbore nou corectează erorile rămase

    Slide-ul 17 în PDF

    Gradient boosting potrivește un arbore mic pe ceea ce este încă greșit, îl adaugă cu o pondere mică și repetă procedeul, aici de peste o mie de ori (Friedman, 2001; Chen și Guestrin, 2016):

    \[F_m(\mathbf x)=F_{m-1}(\mathbf x)+\eta\,f_m(\mathbf x),\qquad w_j^{*}=-\frac{G_j}{H_j+\lambda}\]
    (7.9)
    \[\min\ \textstyle\sum_{i}\ell\big(Y_i,F_M(\mathbf x_i)\big)+\sum_{m}\big(\gamma J_m+\tfrac{\lambda}{2}\sum_j w_{mj}^2\big)\]
    (7.10)

    unde \(F_m\) este prognoza după \(m\) arbori, \(F_M\) prognoza finală după toți cei \(M\) arbori, \(f_m\) arborele \(m\), cu \(J_m\) frunze și valorile frunzelor \(w_{mj}\), \(\eta\) rata de învățare, \(w_j^{*}\) valoarea optimă a frunzei \(j\) (anexa B), \(G_j\) și \(H_j\) sumele derivatelor de ordinul 1 și 2 ale pierderii în acea frunză, iar \(\ell\) eroarea absolută.

    Setarea aleasă pe anul de validare are 1 500 de arbori de adîncime 8, \(\eta\) = 0,02, fiecare arbore fiind estimat pe o fracțiune 0,8 din rînduri. În anul de test, XGBoost calibrat are MAE 23,26 EUR/MWh, față de 24,05 pentru modelul gradient boosting (GBM) necalibrat din cursul 2, un cîștig semnificativ (DM: \(p<0{,}001\)). AW-LEAR, cu 22,53, rămîne mai precis (DM: \(p\) = 0,016).

    În practică: calibrarea contează mai mult decît programul: același tip de arbori a cîștigat aproape un euro pe MWh prin setări bune.

    Modelele fundaționale prognozează prețurile fără nicio antrenare

    Slide-ul 18 în PDF

    Modelele Chronos au fost antrenate de Amazon pe colecții mari de serii de timp (Ansari et al., 2024; Ansari et al., 2025). Noi le dăm doar prețurile recente și le cerem următoarele 24 de ore, fără nicio antrenare pe datele din România (zero-shot):

    \[\big(\hat q^{\tau}_{d,h}\big)_{h=0,\dots,23}^{\tau=0{,}1;\,0{,}5;\,0{,}9}=g\big(P_{t-2047},\dots,P_{t}\big)\]
    (7.11)

    unde \(P_{t-2047},\dots,P_t\) sînt ultimele 2048 de prețuri orare, pînă la sfîrșitul zilei \(d-1\) (85 de zile), \(g\) este rețeaua preantrenată, folosită ca atare, iar \(\hat q^{\tau}_{d,h}\) cuantila de nivel \(\tau\) prognozată pentru ora \(h\) a zilei \(d\). Prognoza punctuală este mediana \(\hat q^{0{,}5}\).

    În anul de test, numai cu prețuri și fără variabile fundamentale, Chronos-2 are MAE 20,82 EUR/MWh, Chronos-Bolt 22,15, iar AW-LEAR 22,53. Chronos-2 este mai precis decît AW-LEAR (DM: \(p<0{,}001\)), și asta în toate cele 24 de ore. Rezultatul este robust: în anul de validare, Chronos-2 avea 21,05, față de 22,59 pentru cea mai bună rețea DNN calibrată, iar modelul a fost publicat în octombrie 2025, înaintea anului de test, deci nu putea să fi văzut aceste prețuri.

    În practică: testați un model fundațional înainte de a construi propria rețea: costă puțin, iar aici a fost cel mai precis model individual.

    Chronos-2 este mai precis decît AW-LEAR în fiecare oră a zilei

    Slide-ul 19 în PDF

    Graficul compară, oră cu oră, MAE a celor două modele Chronos cu cea a modelului AW-LEAR, în anul de test. Chronos-2 se află sub AW-LEAR în fiecare oră. Chronos-Bolt, mai mic și mai vechi, este la egalitate cu AW-LEAR (DM: \(p\) = 0,220).

    Cuantilele din (7.11) dau și un interval de prognoză. Intervalul 10%–90% al modelului Chronos-2 ar trebui să conțină 80% din prețuri, dar conține 76,5%: este prea îngust, deci modelul își subestimează propria incertitudine.

    În practică: folosiți mediana și recalibrați intervalele (cursul 2) înainte de a dimensiona riscul cu ele.

    Graficul interactivPagina interactivă →

    Modele

      Codul acestei figuri: EMQA_L7_foundation_hour · deschide în Colab

      MAE pe ore ale zilei în anul de test, pentru Chronos-2, Chronos-Bolt și AW-LEAR.

      Sursa: energy-charts.info (Fraunhofer ISE): prețuri OPCOM. Date: anul de test 2025-11-01 - 2026-10-31; fără reantrenare, context = ultimele 2048 de prețuri orare.

      Întrebare pentru sală Chronos-2 este un model fundație: prognozează din ultimele 2048 de prețuri orare, fără să fi fost antrenat pe date românești. În cîte dintre cele 24 de ore bate AW-LEAR pe anul de test și sînt benzile sale 10%–90% bine calibrate?
      Răspuns

      Bate AW-LEAR în toate cele 24 de ore (MAE anual 20,82 față de 22,53 EUR/MWh). Banda sa 10%–90% conține însă 76,5% dintre prețuri, nu 80%: este prea îngustă și trebuie recalibrată (Cursul 2) înainte de a fi folosită pentru risc. Chronos-Bolt, mai mic și mai vechi, este la egalitate cu AW-LEAR (22,15 EUR/MWh, DM p = 0,220).

      AIDA 2026: rețele neuronale profunde, LEAR și modele preantrenate

      Slide-ul 20 în PDF

      La conferința AIDA 2026 (Academia de Studii Economice din București, iunie 2026), conferința invitată a lui Rafał Weron (diapozitive) a urmărit evoluția modelelor pentru prețul energiei electrice, de la modelele ARX și medierea pe ferestre de calibrare la LEAR și apoi la rețelele neuronale profunde și interpretabile. Rezultatele și cifrele de mai jos sînt cele de pe diapozitivele conferinței.

      • Rețelele profunde față de LEAR. În evaluarea deschisă care însoțește codurile LEAR și DNN din biblioteca epftoolbox, rețeaua DNN a avut rMAE mai mică decît LEAR pe toate cele cinci piețe prezentate (Lago et al., 2021).
      • Rețele interpretabile. NBEATSx descompune prognoza în blocuri de trend, sezonalitate și variabile exogene, astfel încît o rețea profundă poate fi citită ca o descompunere (Olivares et al., 2023).
      • Modele zero-shot. Modelele preantrenate, folosite fără reantrenare, au fost comparate cu LEAR și cu rețele DNN distribuționale pentru cele 24 de prețuri orare ale zilei următoare, cu o fereastră de antrenare glisantă de 4 ani și un test între 2021 și 2025. În 2022, RMSE a fost 45,71 pentru LEAR cu predicție conformală, 41,07 pentru Chronos 2 și 34,39 pentru TabPFN v3.0 ts; în 2025 a fost 20,38, 20,58 și, respectiv, 17,66. O versiune TabPFN a avut cea mai mică RMSE în fiecare an, dar clasamentele se schimbă: TabPFN v2.0 a avut RMSE 68,85 în 2022 și 17,52 în 2025.

      Anul nostru de test arată același lucru: Chronos-2, folosit fără reantrenare, este cel mai precis model individual (MAE 20,82 EUR/MWh, față de 22,53 pentru AW-LEAR). Rezultatele conferinței adaugă avertismentul că un singur an nu ajunge pentru a ordona modelele.

      În practică: păstrați LEAR ca reper și testați modelele zero-shot alături de el, pe mai mulți ani.

      AIDA 2026: patru generații de modele pe 27 de serii europene de prețuri

      Slide-ul 21 în PDF

      La aceeași conferință, Alexandru-Victor Andrei (diapozitive) a prezentat o comparație a patru generații de metode de prognoză a seriilor de timp pe prețurile energiei electrice (Andrei, Velev, Toma, Pele și Lessmann, 2024). Cifrele de mai jos sînt cele de pe diapozitive.

      • Patru generații. Au fost comparate unsprezece modele: modele econometrice, precum modelul autoregresiv integrat cu medie mobilă (ARIMA); modele de învățare profundă (DLinear, NLinear, TSMixer); transformere (Autoformer, Basisformer, Informer, PatchTST, Quatformer); și modele preantrenate adaptate din modelele mari de limbaj (LLM), Chronos și TimesFM, folosite fără reantrenare.
      • Date și validare walk-forward. Prețurile angro ale energiei electrice pentru 27 de țări ale Uniunii Europene (UE) provin de pe platforma Ember (sursa inițială: ENTSO-E). Fiecare model citește 96 de pași de timp și îi prognozează pe următorii 96; fiecare fereastră de antrenare are 2000 de ore (83 de zile), fiecare fereastră de test 500 de ore (20 de zile), iar ferestrele avansează în timp. Modelele sînt clasate după scorul (100·SMAPE + RMSE)/2, unde SMAPE este eroarea procentuală absolută medie simetrică.
      • Rezultate. PatchTST este pe primul sau al doilea loc în toate cele 27 de țări. Pentru România, locurile sînt: PatchTST 1, TimesFM 2, Chronos 8 și ARIMA 9; pentru Germania: PatchTST 1, TimesFM 5 și Chronos 10. Transformerele (PatchTST) și modelele fundaționale (TimesFM) conduc, dar cîștigurile depind de model și nu sînt uniforme în generația a patra.

      În acest curs, mai noul Chronos-2 (2025), folosit fără reantrenare pe prețurile românești pentru ziua următoare, este cel mai precis model individual (MAE 20,82 EUR/MWh).

      În practică: comparați generațiile de modele prin validare walk-forward, pe mai multe piețe, înainte de a alege.

      Sinteza secțiunii

      Arborii construiți secvențial și calibrați sînt mai buni decît modelul GBM din cursul 2, dar rămîn în urma modelului AW-LEAR. Chronos-2, preantrenat și fără nicio antrenare pe datele noastre, este mai precis decît AW-LEAR în fiecare oră.

      Compararea modelelor, combinarea lor și costul de calcul

      Toate modelele sînt comparate acum pe același an de test, cu aceleași măsuri ale erorii și cu teste DM față de AW-LEAR. Secțiunea arată că combinațiile dintre învățarea automată și modelele statistice sînt semnificativ mai bune, explică de ce funcționează media și pune acuratețea în balanță cu costul de calcul.

      Clasamentul: Chronos-2 este cel mai bun model individual

      Slide-ul 23 în PDF

      Tabelul reunește toate modelele, în anul de test. RMSE penalizează erorile mari mai mult decît MAE; rMAE împarte MAE la cea a modelului naiv; coloana „față de AW-LEAR” dă cîștigul procentual față de AW-LEAR; iar „DM, p” este valoarea p a unui test unilateral că modelul este mai precis decît AW-LEAR, calculat pe eroarea absolută medie zilnică, cu varianță Newey–West, ca în cursul 2 (Diebold și Mariano, 1995).

      ModelMAERMSErMAEfață de AW-LEAR, %DM, p
      Naiv27,8244,541,000−23,5–
      AW-ARX22,3036,340,802+1,00,203
      AW-LEAR22,5336,350,810+0,0–
      Ansamblul de 4 (cursul 2)22,1335,760,795+1,80,014
      GBM (cursul 2)24,0537,730,864−6,71,000
      MLP (cursul 2)25,5440,050,918−13,31,000
      XGBoost, calibrat23,2636,940,836−3,20,984
      DNN, calibrată22,9536,420,825−1,80,944
      Chronos-Bolt, fără antrenare22,1535,650,796+1,70,220
      Chronos-2, fără antrenare20,8234,320,748+7,6<0,001
      AW-LEAR + DNN + XGBoost21,9735,420,790+2,50,001
      AW-ARX + AW-LEAR + DNN + XGBoost21,6935,250,779+3,8<0,001
      AW-LEAR + Chronos-220,8134,110,748+7,6–
      Ansamblul de 5 (cu Chronos-2)21,1234,500,759+6,3<0,001

      Se desprind trei concluzii. Calibrate, rețeaua DNN și XGBoost sînt mai bune decît versiunile lor din cursul 2, dar, luate separat, rămîn puțin în urma modelului AW-LEAR. Chronos-2, fără antrenare, este cel mai bun model individual, cu 7,6% sub AW-LEAR. Iar orice combinație care amestecă învățarea automată cu modelele statistice este semnificativ mai precisă decît AW-LEAR.

      Testele DM: combinațiile cu ML sînt semnificativ mai precise decît AW-LEAR

      Slide-ul 24 în PDF

      Graficul este o matrice de teste DM unilaterale pe cele 365 de zile ale anului de test: fiecare celulă dă valoarea p a testului că modelul de pe rînd este mai precis decît modelul de pe coloană. Valorile p mici marchează cîștiguri greu de pus pe seama întîmplării.

      Combinația AW-LEAR + DNN + XGBoost este mai precisă decît AW-LEAR (\(p\) = 0,001), deși niciunul dintre modelele de învățare automată nu reușește acest lucru singur. Cu AW-ARX adăugat, MAE scade la 21,69, sub ansamblul din cursul 2 (\(p<0{,}001\)). În schimb, adăugarea AW-LEAR la Chronos-2 nu schimbă nimic (\(p\) = 0,491): în zilele dificile, cele două modele greșesc asemănător, așa că media lor nu aduce un cîștig de acuratețe.

      Graficul interactivPagina interactivă →

        Codul acestei figuri: EMQA_L7_dm_matrix · deschide în Colab

        Matricea valorilor p ale testelor DM unilaterale între toate modelele, în anul de test (modelul de pe rînd mai precis decît cel de pe coloană).

        Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31, 365 de zile; valori p unilaterale.

        Întrebare pentru sală Media cu ponderi egale AW-LEAR + DNN + XGBoost are un MAE cu 0,56 EUR/MWh mai mic decît AW-LEAR. Este diferența semnificativă în testul Diebold–Mariano (DM) unilateral, la 5%?
        Răspuns

        Da: p = 0,001 (statistica DM 3,09, cu 7 laguri Newey–West). Testul folosește cele 365 de erori absolute medii zilnice; diferența cumulată din dreapta crește constant de-a lungul anului, nu doar în cîteva zile. În schimb, adăugarea AW-LEAR la Chronos-2 nu schimbă nimic (p = 0,491). Modificați numărul de laguri: concluzia pentru această pereche nu depinde de el.

        Medierea prognozelor și diferențele dintre erorile modelelor

        Slide-ul 25 în PDF

        De ce media a două modele le depășește pe amîndouă? Pentru două erori de prognoză \(e_1\) și \(e_2\), cu abaterile standard \(\sigma_1\), \(\sigma_2\) și corelația \(\rho\),

        \[\Var\Big(\tfrac{e_1+e_2}{2}\Big)=\tfrac14\big(\sigma_1^2+\sigma_2^2+2\rho\sigma_1\sigma_2\big)\]
        (7.12)

        astfel încît, atîta timp cît \(\rho<1\), media greșește mai puțin decît ar greși, în medie, cele două modele luate separat (Bates și Granger, 1969). Pe datele noastre, corelația erorilor cu AW-LEAR este 0,94 pentru rețeaua DNN și 0,89 pentru XGBoost: mare, dar sub 1, și asta este suficient.

        Graficul arată MAE a combinației în funcție de ponderea dată modelului de învățare automată. Ponderile egale sînt aproape la fel de bune ca ponderea optimă văzută ulterior (0,40). Această pondere optimă este doar o ilustrare, fiindcă este citită din anul de test; în practică nu putea fi cunoscută dinainte.

        În practică: faceți media cu ponderi egale înainte de a estima ponderi „inteligente”.

        Graficul interactivPagina interactivă →

          Codul acestei figuri: EMQA_L7_combo_weight · deschide în Colab

          MAE în anul de test a combinației dintre AW-LEAR și un model de învățare automată, în funcție de ponderea acestuia din urmă; ponderile egale și ponderea optimă văzută ulterior sînt marcate.

          Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31; ilustrare, ponderea nu se alege pe anul de test.

          Întrebare pentru sală Erorile AW-LEAR și XGBoost au corelația 0,89. Merită estimată ponderea combinației în locul ponderilor egale?
          Răspuns

          Aproape deloc. Cea mai bună pondere văzută ulterior pe anul de test este w = 0,40 (MAE 22,06 EUR/MWh), față de 22,10 EUR/MWh cu w = 0,5, iar ponderea cea mai bună nu este cunoscută dinainte. Deoarece corelația este sub 1, media greșește mai puțin decît fiecare model (23,26 pentru XGBoost, 22,53 pentru AW-LEAR). Pentru AW-LEAR + Chronos-2, ponderea văzută ulterior ar fi w = 0,75 (20,57 EUR/MWh, față de 20,81 cu ponderi egale).

          Combinația este mai precisă decît AW-LEAR în 10 din 12 luni

          Slide-ul 26 în PDF

          O medie anuală poate ascunde luni în care un model este mult mai slab. Graficul arată MAE a fiecărui model în fiecare lună a anului de test. Luate separat, XGBoost și rețeaua DNN depășesc AW-LEAR fiecare doar în 3 luni; în medie cu acesta, în 10 luni.

          Toate modelele greșesc mai mult în aceleași luni, ianuarie, iunie și octombrie: zilele dificile sînt dificile pentru toate. De aceea combinația ajută în lunile obișnuite, dar nu poate elimina erorile mari din lunile grele.

          În practică: raportați comitetului de risc acuratețea lună de lună, nu doar media anuală.

          Graficul interactivPagina interactivă →

          Modele

            Codul acestei figuri: EMQA_L7_monthly_ml · deschide în Colab

            MAE lunară în anul de test pentru AW-LEAR, rețeaua DNN, XGBoost și combinația lor.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31.

            Întrebare pentru sală Singure, XGBoost și DNN au un MAE anual mai mare decît AW-LEAR (23,26 și 22,95 față de 22,53 EUR/MWh). În cîte dintre cele 12 luni bate AW-LEAR media lor cu ponderi egale cu AW-LEAR?
            Răspuns

            În 10 din 12 luni (MAE anual 21,97 EUR/MWh); singure, XGBoost și DNN bat AW-LEAR doar în cîte 3 luni. Toate modelele greșesc cel mai mult în aceleași luni: octombrie 2026 este luna cea mai slabă pentru AW-LEAR (34,9 EUR/MWh). Chronos-2, un model fundație folosit fără antrenare pe aceste date, are cel mai mic MAE anual, 20,82 EUR/MWh.

            Costul de calcul al modelului LEAR zilnic și al modelelor ML

            Slide-ul 27 în PDF

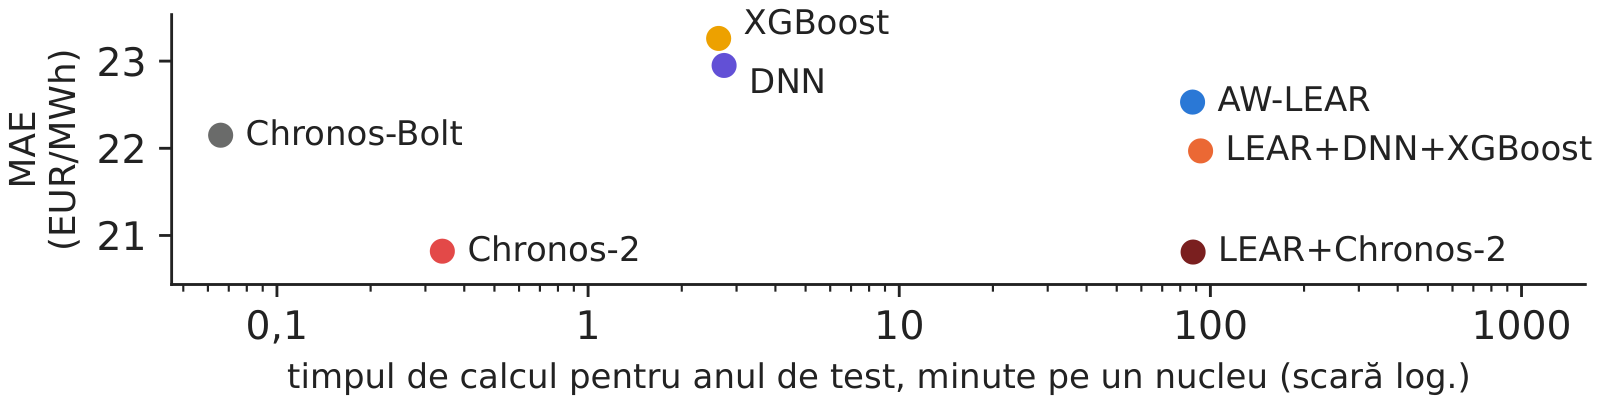
            Acuratețea este doar jumătate din alegerea unui model; cealaltă jumătate este costul. Pe tot anul de test, pe un singur nucleu, AW-LEAR are nevoie de 87,6 minute, pentru că este reestimat pentru 365 de zile \(\times\) 3 ferestre \(\times\) 24 de ore. XGBoost are nevoie de 2,6 minute, rețeaua DNN de 2,7, iar Chronos-2 de numai 0,3, fiindcă nu este antrenat niciodată.

            Acești timpi nu includ costurile ascunse: căutarea setărilor (7,3 minute), preantrenarea modelelor Chronos (făcută de alții) și, mai ales, oamenii care întrețin zilnic fluxul de date. Comparația răstoarnă o idee răspîndită: pe această problemă, modelul statistic de referință, reestimat în fiecare zi, este cel scump, iar învățarea automată reestimată lunar costă cîteva minute.

            În practică: comparați modelele după eroare raportată la costul total de utilizare, nu doar după eroare.
            Grafic: Costul de calcul al modelului LEAR zilnic și al modelelor ML

            Timpul de calcul în anul de test (un nucleu al unui laptop cu 18 nuclee) față de cîștigul de MAE în raport cu AW-LEAR, pe modele.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31; un nucleu de procesor.

            Sinteza secțiunii

            Combinațiile dintre învățarea automată și modelele statistice sînt semnificativ mai precise decît AW-LEAR, pentru că erorile lor nu sînt perfect corelate. Chronos-2 este cel mai precis model individual, iar modelele de învățare automată costă doar minute de calcul.

            Explicarea prognozelor

            O prognoză care nu poate fi explicată este greu de acceptat și imposibil de auditat. Secțiunea descompune fiecare prognoză a arborilor în contribuțiile variabilelor, cu valorile Shapley, și măsoară de ce depinde rețeaua neuronală prin importanța calculată prin permutare.

            Valorile Shapley descompun fiecare prognoză în contribuțiile variabilelor

            Slide-ul 29 în PDF

            Contribuția unei variabile este efectul ei mediu atunci cînd este adăugată în model, calculat pe toate ordinile posibile de adăugare a variabilelor (Shapley, 1953; Lundberg et al., 2020):

            \[\phi_j=\sum_{S\not\ni j}\tfrac{|S|!\,(p-|S|-1)!}{p!}\big[v(S\cup\{j\})-v(S)\big]\]
            (7.13)
            \[\hat f(\mathbf x)=\phi_0+\textstyle\sum_{j}\phi_j\]
            (7.14)

            unde \(\phi_j\) este valoarea variabilei \(j\) după metoda explicațiilor aditive bazate pe valorile Shapley (SHAP, SHapley Additive exPlanations), \(S\) o submulțime a celorlalte variabile, \(|S|\) numărul ei de elemente, \(v(S)\) prognoza așteptată cînd se cunosc doar variabilele din \(S\), \(\phi_0\) prognoza medie, \(\hat f(\mathbf x)\) prognoza pentru intrările \(\mathbf x\), iar \(p\) = 20 numărul de variabile.

            Valorile Shapley sînt singura împărțire echitabilă în sensul teoriei jocurilor, iar (7.14) arată că se adună exact la prognoză. Pe datele noastre, pentru XGBoost, pe cele 8 760 de ore de test, cea mai mare diferență dintre \(\hat f\) și \(\phi_0+\sum\phi_j\) este 0,000009. Prețurile din zilele anterioare au 69,3% din contribuția totală.

            În practică: cereți explicația fiecărei alerte, nu doar un clasament global.

            Principala variabilă a modelelor cu arbori: prețul de ieri, la aceeași oră

            Slide-ul 30 în PDF

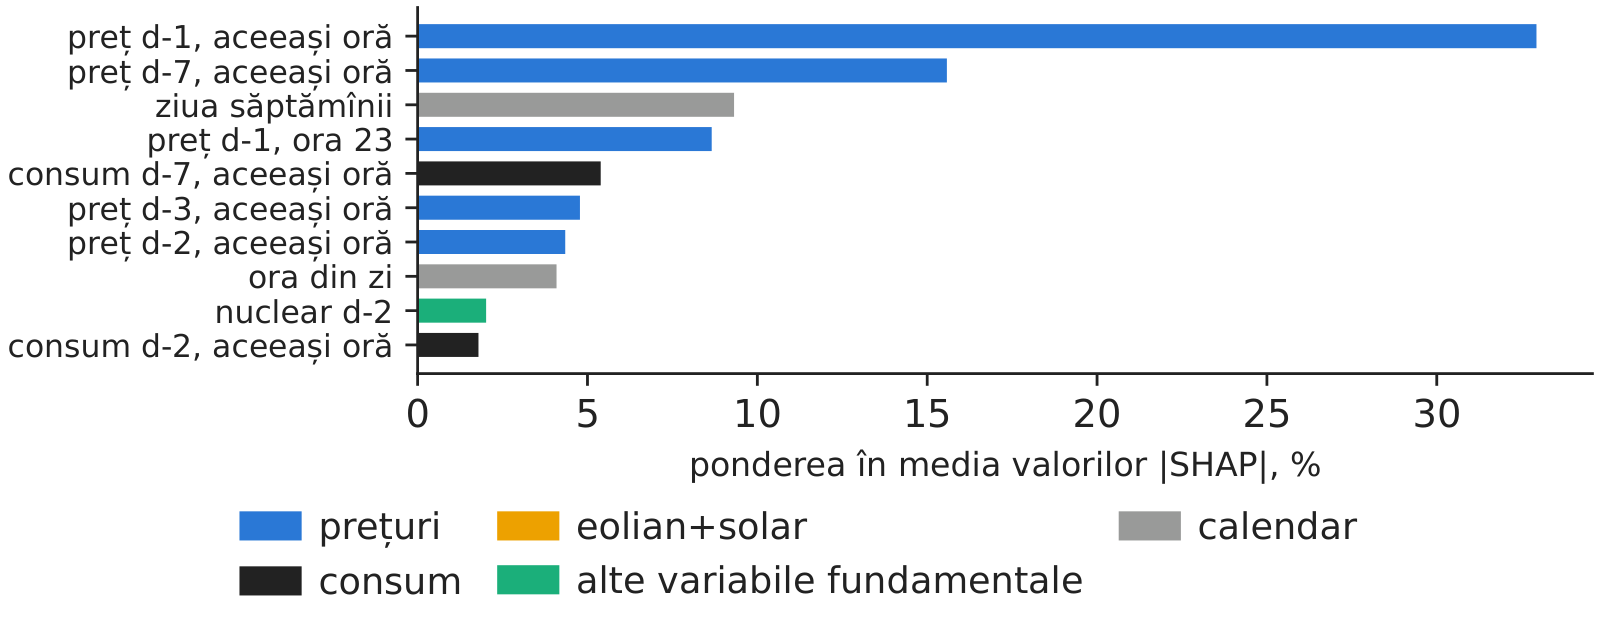
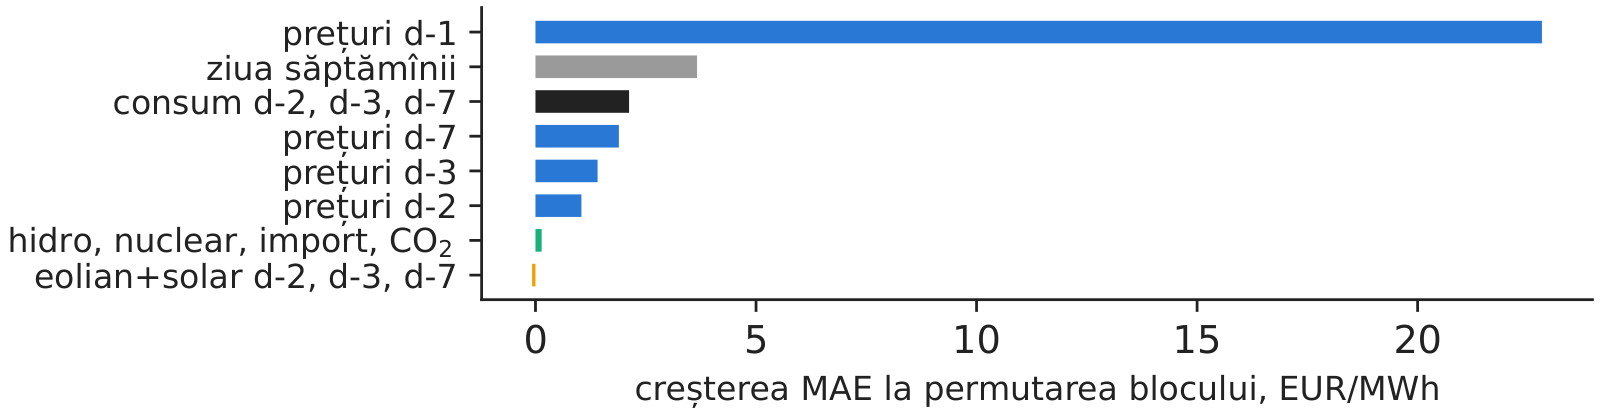
            Graficul ordonează variabilele modelului XGBoost după media valorii absolute SHAP, \(|\phi|\), în anul de test. Pe primele locuri se află prețul din \(d-1\), aceeași oră, cu 32,9% din media \(|\phi|\), prețul din \(d-7\), aceeași oră, cu 15,6%, și ziua săptămînii, cu 9,3%.

            Consumul are 8,5%, iar producția eoliană și solară 2,5%. Aceste ponderi mici nu înseamnă că variabilele fundamentale nu contează pentru piață: ele sînt cunoscute doar pînă în \(d-2\), deci la închiderea licitației sînt informații vechi, reflectate deja în prețurile de ieri. Intrări mai bune, cum ar fi prognozele consumului și ale producției eoliene pentru ziua de mîine, ar aduce mai multă informație.

            În practică: cumpărați întîi intrări mai bune: prognozele operatorului de transport și de sistem (TSO).
            Grafic: Principala variabilă a modelelor cu arbori: prețul de ieri, la aceeași oră

            Media valorii absolute SHAP a fiecărei variabile a modelului XGBoost, ca pondere din total, în anul de test, 8 760 de ore.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31, 8760 de ore.

            Producția eoliană și solară scade prețul doar în orele în care este mare

            Slide-ul 31 în PDF

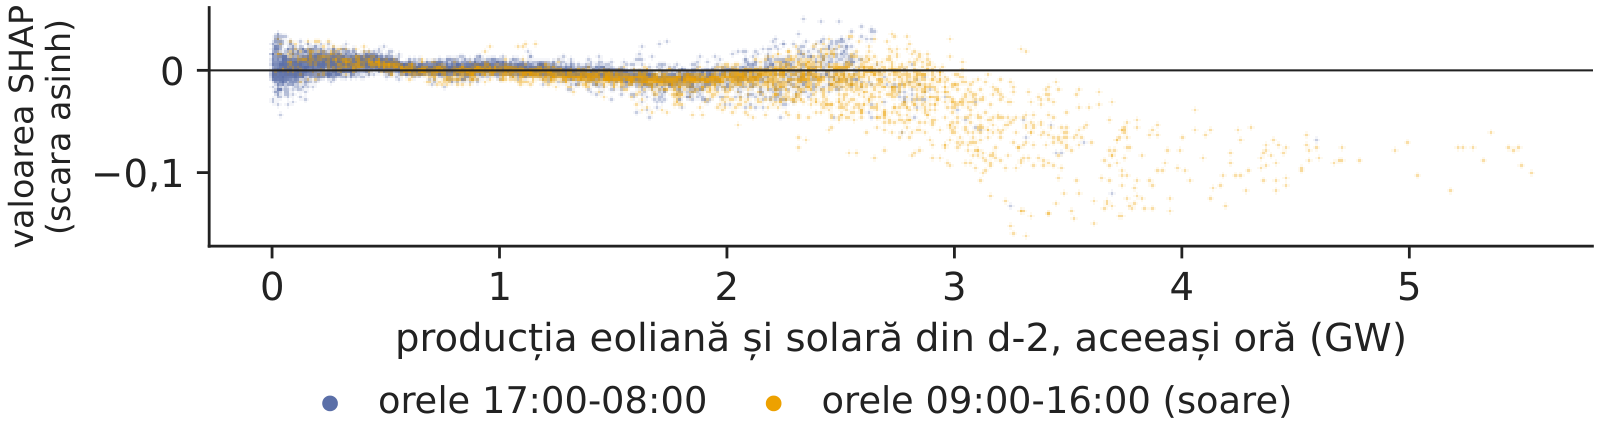
            Fiecare punct din grafic este o oră din anul de test: pe axa orizontală, producția eoliană și solară din \(d-2\) la acea oră; pe axa verticală, contribuția ei SHAP la prognoză. Cu cît producția eoliană și solară este mai mare, cu atît contribuția este mai negativă (corelație −0,64).

            Relația nu este o linie dreaptă. Efectul apare peste aproximativ 2 gigawați (GW), mai ales la prînz, și este aproape nul sub acest nivel: un prag pe care un model liniar nu îl poate exprima, dar pe care arborii îl învață singuri.

            În practică: un dezvoltator de parcuri solare poate citi aici reducerea de preț la care contribuie chiar producția sa.
            Grafic: Producția eoliană și solară scade prețul doar în orele în care este mare

            Contribuția SHAP a producției eoliene și solare în funcție de nivelul ei din \(d-2\), cîte un punct pentru fiecare oră de test.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31, 8760 de ore.

            Rețeaua neuronală se bazează și mai mult pe prețurile de ieri

            Slide-ul 32 în PDF

            Valorile Shapley se calculează ușor pentru arbori, dar greu pentru o rețea. O măsură mai simplă se aplică oricărui model: importanța prin permutare (Breiman, 2001),

            \[I_b=\text{MAE}_{b\ \text{amestecat}}-\text{MAE}\]

            unde \(I_b\) este importanța blocului de variabile \(b\), \(\text{MAE}_{b\ \text{amestecat}}\) eroarea atunci cînd valorile blocului \(b\) sînt amestecate între zilele de test, iar \(\text{MAE}\) eroarea fără amestecare; rezultatul este o medie pe 5 permutări.

            Pentru rețeaua DNN, amestecarea prețurilor din \(d-1\) crește MAE cu 22,82 EUR/MWh, a zilei săptămînii cu 3,66, a consumului cu 2,12, în timp ce producția eoliană și solară o modifică cu −0,08, adică deloc. Rețeaua depinde de prețurile de ieri chiar mai mult decît arborii.

            În practică: monitorizați întîi fluxul prețurilor din \(d-1\): fără el, rețeaua cedează.
            Grafic: Rețeaua neuronală se bazează și mai mult pe prețurile de ieri

            Importanța prin permutare a blocurilor de variabile ale rețelei DNN în anul de test, creșterea MAE în EUR/MWh, 5 permutări.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31.

            Învățarea automată în finanțele energiei: o analiză sistematică a literaturii

            Slide-ul 33 în PDF

            La aceeași conferință, Roxana Clodnitchi (diapozitive) a prezentat o analiză sistematică a literaturii despre inteligența artificială (AI) în finanțele energiei (Anagnoste et al., 2025). Au fost examinate circa 700 de articole din Web of Science, iar 232 de articole evaluate colegial, din perioada 2020–2025, au fost reținute și grupate pe șase piloni ai finanțelor energiei. Cifrele de mai jos sînt cele de pe diapozitive.

            • Unde se folosește AI. Ponderea lucrărilor care folosesc AI sau învățare automată este 100% pentru mecanismele de preț și pentru derivatele pe energie, 97,5% pentru piețele energetice și financiare, 93,0% pentru gestiunea riscului, 60,4% pentru finanțele verzi și 0% pentru finanțele corporative ale firmelor de energie, care se bazează pe econometria datelor panel.
            • Ce metode. Domină rețelele neuronale: le folosesc 88,2% din lucrările despre derivate și 72,1% din cele despre gestiunea riscului.
            • Ce lipsește. AI explicabilă apare în 19,6% din lucrările despre derivate și în 0–5% din lucrările celorlalți piloni; analiza propune ca pas următor AI explicabilă și învățarea automată cauzală, pentru autoritățile de reglementare și pentru evaluarea politicilor.

            Valorile SHAP și importanța prin permutare din această secțiune sînt tocmai tipul de explicație pe care analiza îl găsește rar.

            În practică: cereți explicația odată cu prognoza: autoritățile și consiliile de administrație o vor cere.

            Sinteza secțiunii

            Ambele modele de învățare automată se bazează în primul rînd pe prețul de ieri, la aceeași oră. Producția eoliană și solară contează doar peste un prag, pe care un model liniar nu îl poate surprinde.

            Vîrfuri de preț, prețuri negative și un studiu de caz

            Pentru mulți utilizatori, orele extreme contează mai mult decît eroarea medie: o baterie sau un consumator flexibil își cîștigă banii în orele cu vîrfuri și cu prețuri negative. Secțiunea definește aceste evenimente, construiește clasificatori care le dau probabilitatea, transformă probabilitățile în decizii cu o regulă cost–pierdere și analizează, într-un studiu de caz, cel mai mare preț din anul de test.

            Vîrfurile de preț apar seara, prețurile negative la prînz

            Slide-ul 35 în PDF

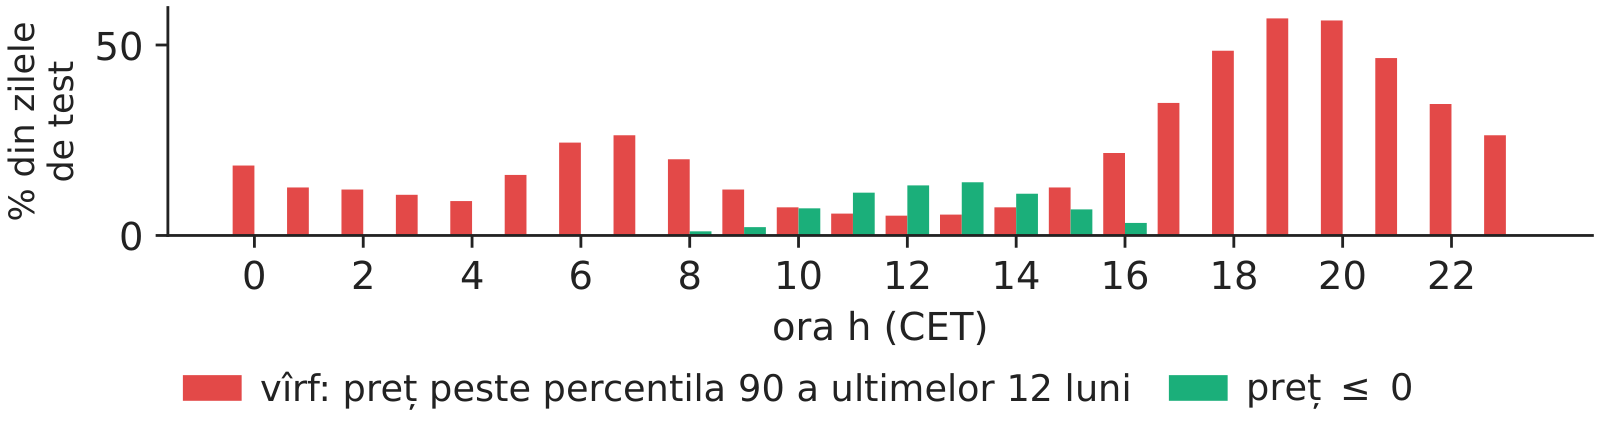
            Un vîrf de preț este o oră cu preț peste \(\theta\), percentila 90 a prețurilor orare din cele 12 luni dinaintea lunii de livrare. Pragul urmărește piața, așa că se mișcă de-a lungul anului de test, între 166,8 și 202,4 EUR/MWh. Cu această definiție, 22,1% din orele de test sînt vîrfuri, mult peste una din zece cît ar da definiția pe o piață stabilă; cele mai multe apar la ora 19, cînd 57,0% din zile au un vîrf.

            Prețurile mai mici sau egale cu zero sînt evenimentul opus: 255 de ore, în 53 de zile din anul de test, mai ales în jurul orei 13, cînd producția solară este maximă. Graficul arată ponderea zilelor cu fiecare eveniment, pe ore ale zilei.

            În practică: o baterie se încarcă la prînz și se descarcă la orele 19–20: cele două evenimente sînt chiar modelul ei de afaceri.
            Grafic: Vîrfurile de preț apar seara, prețurile negative la prînz

            Ponderea zilelor din anul de test cu vîrf de preț și cu preț mai mic sau egal cu zero, pe ore ale zilei.

            Sursa: energy-charts.info (Fraunhofer ISE): prețuri OPCOM. Date: anul de test 2025-11-01 - 2026-10-31.

            Clasificatorii de vîrfuri și detectarea vîrfurilor din prognozele de preț

            Slide-ul 36 în PDF

            Un clasificator dă probabilitatea ca o oră să fie un vîrf; judecăm cît de bine ordonează orele și cît de corecte sînt probabilitățile lui:

            \[\hat\pi_{d,h}=\Pr\big(P_{d,h}>\theta_d\mid\mathbf x_{d,h}\big)\]
            (7.15)
            \[\text{Brier}=\frac{1}{n}\sum_{d,h}\big(\hat\pi_{d,h}-S_{d,h}\big)^2\]
            (7.16)

            unde \(\hat\pi_{d,h}\) este probabilitatea prognozată a unui vîrf în ora \(h\) a zilei \(d\), \(\theta_d\) pragul de vîrf, \(\mathbf x_{d,h}\) variabilele explicative, \(S_{d,h}\) este 1 dacă ora este un vîrf și 0 altfel, iar \(n\) numărul de ore (Brier, 1950). După ce probabilitățile sînt transformate în alerte, precizia este ponderea alertelor urmate de vîrfuri, sensibilitatea este ponderea vîrfurilor semnalate, iar F1 media lor armonică. Aria de sub curbă (AUC) este probabilitatea ca o oră cu vîrf să primească un scor mai mare decît o oră obișnuită (Fawcett, 2006).

            Pe datele noastre, clasificatorii XGBoost și logistic sînt reestimați lunar. Vîrfurile apar în 22,1% din orele de test, dar numai în 14,3% din ultimul eșantion de antrenare. Scorul Brier al modelului XGBoost este 0,072, față de 0,172 pentru o constantă egală cu ponderea vîrfurilor. Se adaugă două repere: persistența, adică ponderea vîrfurilor la aceeași oră în ultimele 7 zile, și chiar prognoza de preț AW-LEAR, comparată cu \(\theta\).

            În practică: judecați o alertă după probabilitățile ei, nu doar după cîte vîrfuri semnalează.

            Alertele din anul de test: AW-LEAR egalează un clasificator dedicat

            Slide-ul 37 în PDF

            Tabelul prezintă scorurile din anul de test: coloanele 2–6 pentru vîrfuri (1 938 de ore), coloanele 7–8 pentru prețurile mai mici sau egale cu zero (255 de ore). O alertă se emite cînd probabilitatea depășește 0,5; pentru AW-LEAR, cînd prognoza prețului depășește \(\theta\) (sau este mai mică sau egală cu zero).

            ModelAUC, vîrfuriPrecizieSensibilitateF1BrierAUC, preț ≤ 0F1, preț ≤ 0
            XGBoost0,9530,8260,6850,7490,0720,9800,571
            Regresie logistică0,9530,8470,6410,7300,0720,9800,581
            Persistență, 7 zile0,9180,7610,6810,7190,0830,8470,205
            Prognoza AW-LEAR > θ0,9590,8510,7330,788–0,9830,558

            Surpriza este pe ultimul rînd: prognoza de preț AW-LEAR, comparată cu pragul, detectează vîrfurile cel puțin la fel de bine ca clasificatorii dedicați, cu cea mai mare AUC (0,959) și cel mai mare F1 (0,788). La prețurile negative, toate modelele se descurcă mai slab; XGBoost semnalează doar o fracțiune 0,467 din evenimente la pragul 0,5, pentru că aceste ore sînt rare și depind de vremea de mîine.

            În practică: cumpărați un serviciu de alertă pentru vîrfuri doar dacă depășește semnalul ascuns deja în prognoza dumneavoastră de preț.

            Persistența detectează vîrfurile, dar nu și prețurile negative

            Slide-ul 38 în PDF

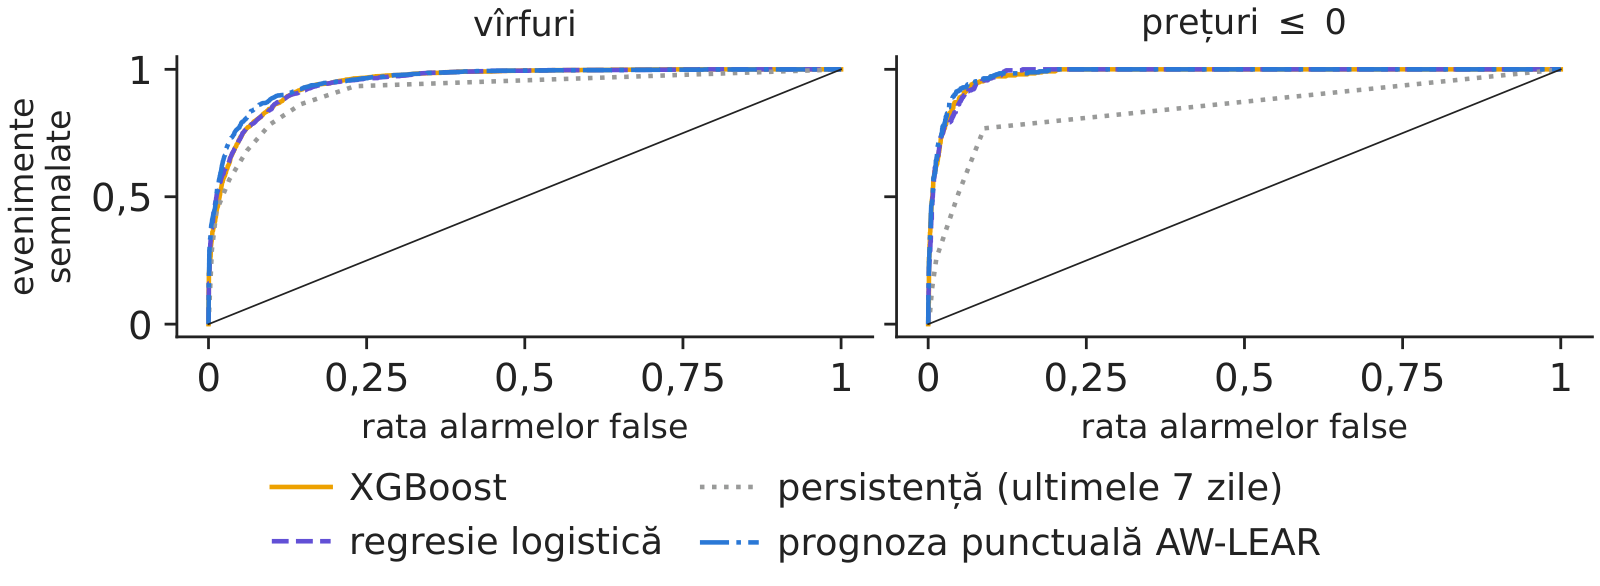
            Graficul prezintă curbele caracteristice de operare a receptorului (ROC, receiver operating characteristic): pentru fiecare prag de alertă, ponderea evenimentelor semnalate față de ponderea alarmelor false. La vîrfuri, AUC variază între 0,918 pentru persistență și 0,959 pentru AW-LEAR. Chiar și persistența se descurcă bine, deoarece vîrful de seară se repetă de la o zi la alta.

            La prețurile negative imaginea se schimbă: persistența are AUC 0,847, față de 0,980 pentru XGBoost. Prețurile negative depind de soarele și vîntul de mîine, nu de ziua de ieri, așa că o regulă care privește doar trecutul ratează multe dintre ele.

            Grafic: Persistența detectează vîrfurile, dar nu și prețurile negative

            Curbele ROC ale clasificatorilor și ale reperelor în anul de test, pentru vîrfuri (stînga) și pentru prețuri mai mici sau egale cu zero (dreapta), 8 760 de ore.

            Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31, 8760 de ore.

            Regula cost–pierdere: reacționați cînd probabilitatea depășește C/L

            Slide-ul 39 în PDF

            O probabilitate devine utilă numai cînd este transformată într-o decizie. Să luăm 1 MW de consum flexibil, care poate fi mutat dintr-o oră cu alertă. Reacția costă \(C\); un vîrf ratat costă în medie \(\bar L\). Regula clasică cost–pierdere (Murphy, 1977) spune să reacționăm atunci cînd

            \[\hat\pi_{d,h}>\frac{C}{\bar L}=\frac{30}{72{,}5}=0{,}414\]
            (7.17)

            unde \(C\) = 30 EUR/MWh este costul presupus al reacției, iar \(\bar L\) = 72,5 EUR/MWh este depășirea medie a pragului \(\theta\) în anul de validare. Mutarea a 1 MWh dintr-o oră cu alertă aduce \(P_{d,h}-\theta_d-C\).

            Graficul arată valoarea regulii în anul de test, în funcție de prag. Pe MW și an, regula la pragul C/L aduce 33,0 mii EUR, persistența 11,8, iar informația perfectă 62,4. Cel mai bun prag văzut ulterior (0,64) ar fi adus mai mult, dar este înțelepciune retrospectivă și nu putea fi ales dinainte.

            În practică: stabiliți pragul din propriile costuri; cel mai bun prag văzut ulterior este înțelepciune retrospectivă.

            Graficul interactivPagina interactivă →

              Codul acestei figuri: EMQA_L7_decision · deschide în Colab

              Valoarea pe MW și an a reacției la alertele de vîrf, în funcție de pragul de probabilitate, cu pragul C/L, persistența și informația perfectă marcate; 1 MW de consum flexibil, C = 30 EUR/MWh.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31; 1 MW de consum flexibil.

              Întrebare pentru sală Un cumpărător cu 1 MW de consum flexibil poate muta consumul dintr-o oră cu alertă; acțiunea costă C = 30 EUR/MWh, iar un salt de preț ratat costă în medie L̄ = 72,5 EUR/MWh (excesul mediu peste pragul de salt în anul de validare). Ce prag de probabilitate ar trebui să declanșeze o alertă: 0,5, C/L̄ = 0,414 sau pragul care s-a dovedit cel mai bun ulterior?
              Răspuns

              C/L̄ = 30/72,5 = 0,414, fixat dinaintea anului de test, din costuri. Cu XGBoost dă 1806 alerte și 33,0 mii EUR pe MW și an; persistența dă 11,8, iar previziunea perfectă 62,4. Pe acest an de test, pragul 0,5 a ieșit puțin mai bine (36,7), iar 0,64 cel mai bine: acestea sînt alegeri făcute ulterior. Măriți C: regula cere o probabilitate mai mare înainte de a acționa.

              Studiu de caz, 30 iunie 2026: modelele au anticipat vîrful, dar i-au subestimat amplitudinea

              Slide-ul 40 în PDF

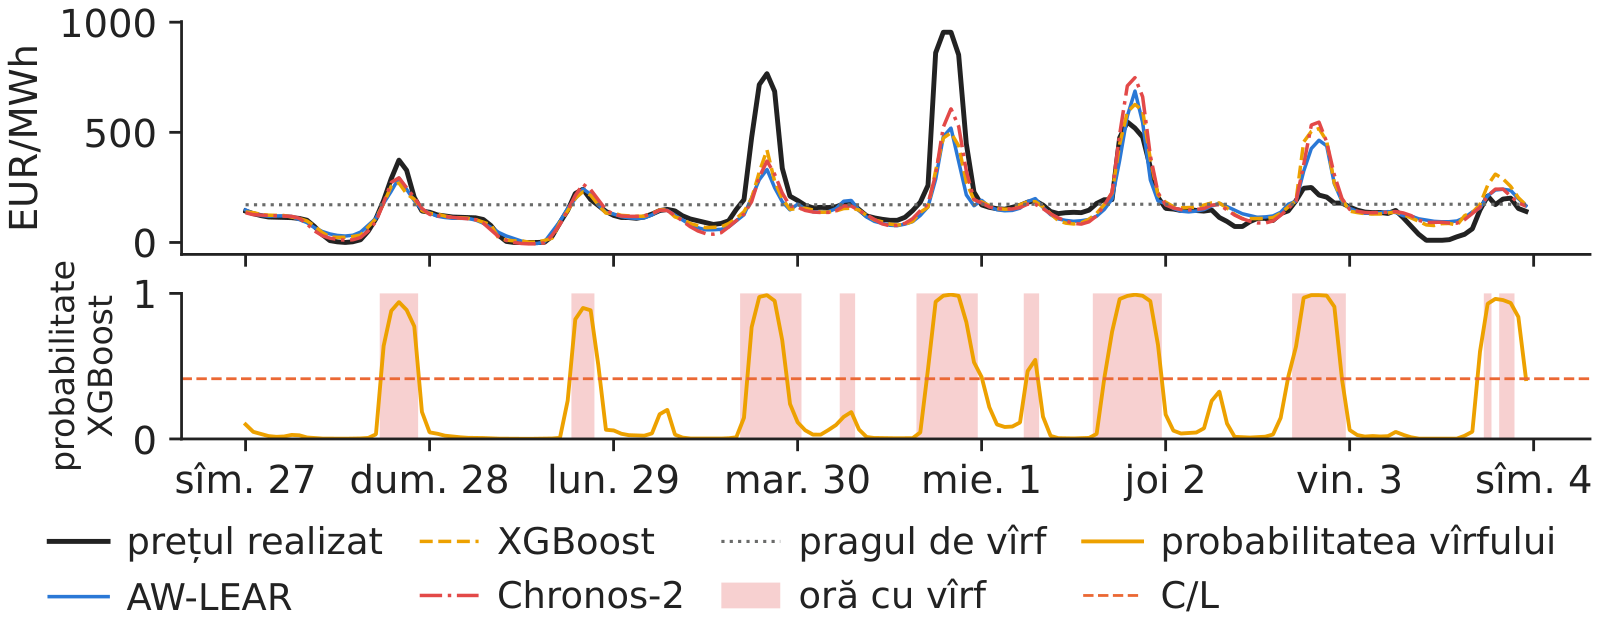
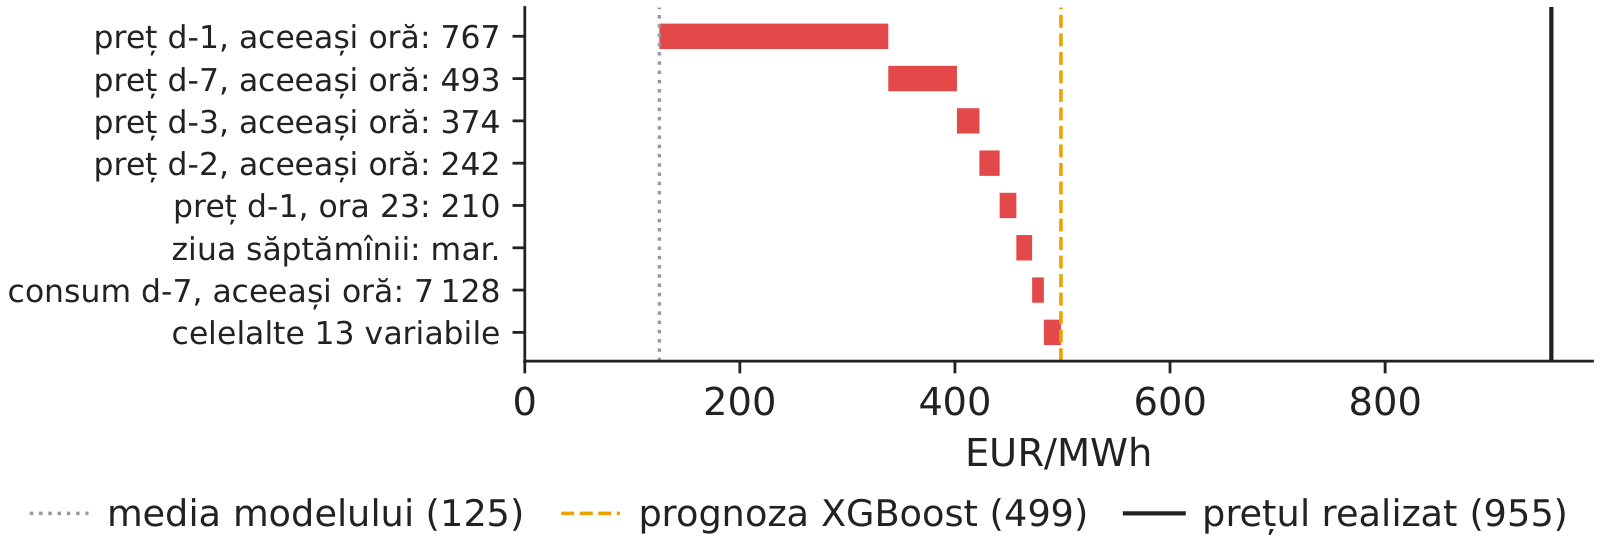
              Studiul de caz privește săptămîna 27 iunie 2026 – 3 iulie 2026. La 30 iunie 2026, ora 20:00 CET, prețul a atins 954,59 EUR/MWh, cel mai mare preț din anul de test. Toate modelele se așteptau la un preț ridicat: AW-LEAR a prognozat 520, XGBoost 499, rețeaua DNN 614, iar Chronos-2 607 EUR/MWh, în timp ce probabilitatea vîrfului era 0,992. Niciun model nu s-a apropiat însă de nivelul efectiv.

              În întreaga săptămînă au fost 47 de ore cu vîrfuri; regula la pragul C/L a emis 45 de alerte, iar 39 dintre ele au fost corecte. Alerta a funcționat; amploarea vîrfului a fost ratată de toate modelele.

              În practică: probabilitatea arată dacă reacționați, prognoza punctuală arată cît.
              Grafic: Studiu de caz, 30 iunie 2026: modelele au anticipat vîrful, dar i-au subestimat amplitudinea

              Prețurile orare și prognozele AW-LEAR, XGBoost, DNN și Chronos-2, 27 iunie – 3 iulie 2026, cu orele cu alertă marcate.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: 2026-06-27 - 2026-07-03, date orare.

              Studiu de caz: arborii au urmat seara extremă din ziua precedentă

              Slide-ul 41 în PDF

              Graficul descompune prognoza modelului XGBoost pentru 30 iunie 2026, ora 20:00 CET, în contribuții SHAP exprimate în EUR/MWh (anexa C explică trecerea de la scara asinh). Prognoza urcă de la 125 EUR/MWh, prognoza medie a modelului, la 499. Prețul din \(d-1\), aceeași oră, adaugă 213, iar prețul din \(d-7\) adaugă 64: arborii au urmat seara extremă din ziua precedentă.

              Descompunerea arată și o limită a arborilor: ei nu pot depăși prețurile memorate în frunze, deci valorile extreme sînt plafonate. Un preț mult peste tot ce s-a văzut în antrenare nu poate fi prognozat de o sumă de valori ale frunzelor învățate din trecut.

              În practică: prezentați consiliului de administrație această descompunere pentru fiecare alertă importantă.
              Grafic: Studiu de caz: arborii au urmat seara extremă din ziua precedentă

              Contribuțiile SHAP în EUR/MWh la prognoza XGBoost pentru 30 iunie 2026, ora 20:00 CET, de la prognoza medie a modelului la prognoza finală.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: 2026-06-30, ora 20:00 CET; contribuții exprimate în EUR/MWh (anexa C).

              Avertizarea timpurie a vîrfurilor: lucrarea grupului și replicarea ei

              Slide-ul 42 în PDF

              Andrei, Pele, Cramer, Amza și Diaconu (2026) au construit un sistem de avertizare timpurie a vîrfurilor pentru PZU din România. Au folosit 5 000 de ore din 2024, cu date despre consum, surse regenerabile și combustibili, au definit vîrful drept un preț peste percentila 90 și au combinat păduri aleatoare și XGBoost, explicate cu SHAP, într-un scor de avertizare construit din pragurile mai multor indicatori. Rezultatul lor: prețul anterior și prognoza consumului rezidual sînt principalii factori ai vîrfurilor.

              Replicarea noastră, studiul de caz C7, folosește numai informația de la închiderea licitației. În perioada de test iulie 2025 – octombrie 2026, vîrfurile apar în 22,1% din ore (10,0% în antrenare). XGBoost atinge o AUC de 0,946, iar principalii săi factori sînt prețul de ieri și cel de acum o săptămînă, la aceeași oră, ca pe diapozitivele anterioare. Rezultatele lucrării sînt cele raportate de autori; cifrele replicării sînt calculate cu notebook-ul Jupyter al studiului de caz C7, pe datele noastre.

              În practică: prognoza consumului rezidual este variabila de care un model de vîrfuri are cea mai mare nevoie și care lipsește din datele noastre publice.

              Sinteza secțiunii

              Vîrfurile de preț apar seara, iar prețurile negative la prînz. O prognoză bună de preț detectează deja vîrfurile, regula cost–pierdere transformă probabilitățile în bani, iar niciun model nu a anticipat amploarea celui mai mare vîrf.

              Erori de evaluare care supraestimează precizia

              Cele mai multe promisiuni de cîștiguri mari din învățarea automată provin din greșeli de evaluare, nu din modele mai bune. Secțiunea reproduce pe datele noastre trei asemenea greșeli, informația din viitor, alegerea pe anul de test și modelele neactualizate, măsoară cît de mult avantajează fiecare rezultatul și se încheie cu un test de scurgere a informației.

              Informația din viitor: două evaluări invalide avantajează XGBoost

              Slide-ul 44 în PDF

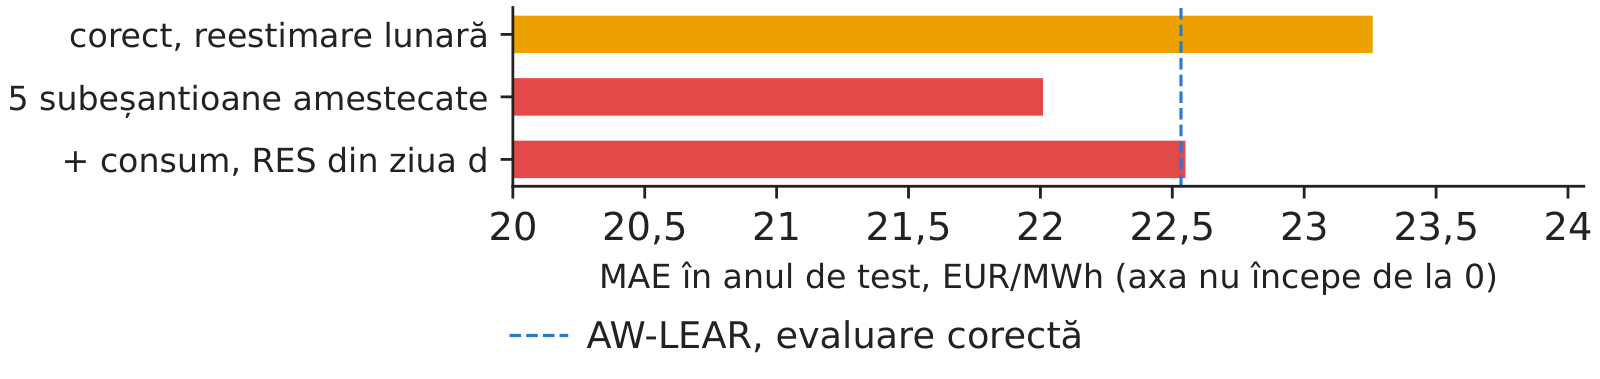
              Graficul compară MAE corectă a modelului XGBoost, 23,26 EUR/MWh, cu două evaluări invalide. Prima este validarea încrucișată cu 5 subeșantioane amestecate: zilele sînt amestecate înainte de împărțire, așa că zile din viitor ajung în eșantionul de antrenare. MAE scade la 22,01, cu 5,4% mai bine, dar doar pe hîrtie.

              A doua folosește drept intrări consumul și producția eoliană și solară din ziua \(d\), notate în grafic surse regenerabile de energie (RES). Aceste valori nu sînt cunoscute la ora 12:00 în ziua \(d-1\). MAE devine 22,55, un cîștig aparent de 3,1%; aceasta este totodată limita superioară a ceea ce ar putea aduce prognoze perfecte ale acestor variabile.

              În practică: cereți oricărui furnizor o testare cronologică, cu fiecare intrare datată la momentul închiderii licitației.
              Grafic: Informația din viitor: două evaluări invalide avantajează XGBoost

              MAE a modelului XGBoost în anul de test, la evaluarea cronologică corectă, la validarea încrucișată cu 5 subeșantioane amestecate și cu consumul și RES din aceeași zi ca intrări.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31.

              Data snooping: selecția pe anul de test produce un avantaj aparent față de LEAR

              Slide-ul 45 în PDF

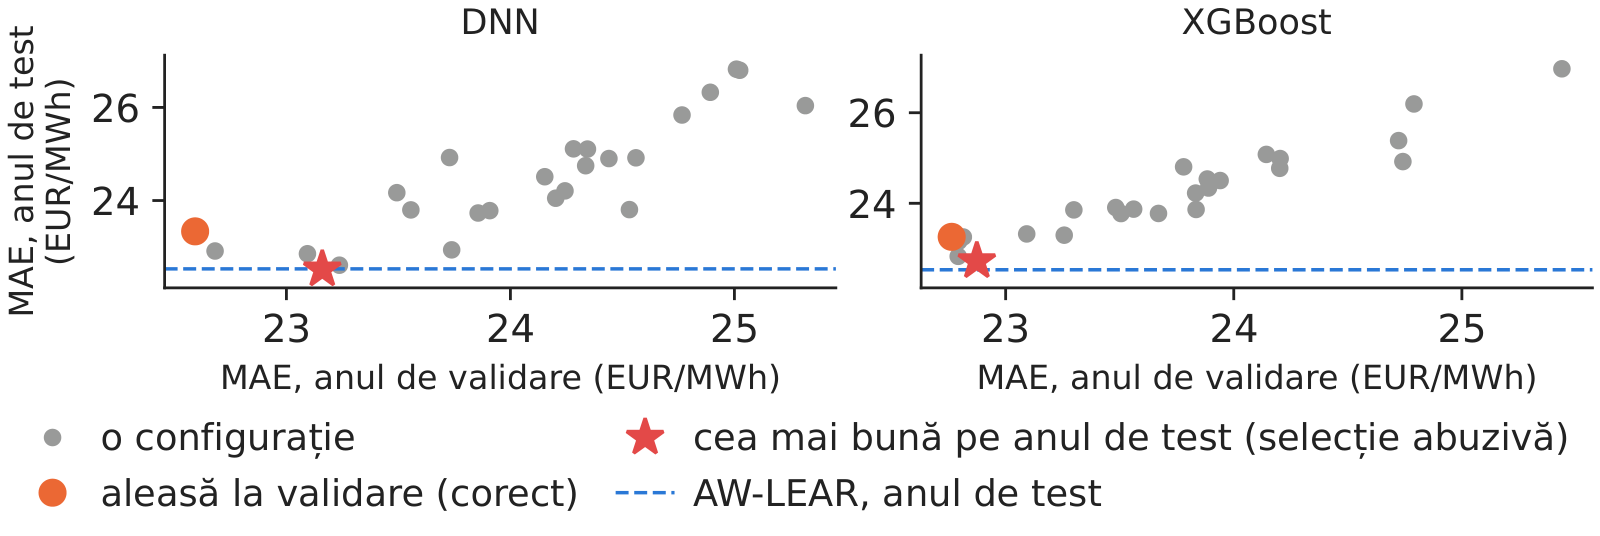
              Rețeaua DNN aleasă corect, la validare, cu o singură inițializare, are MAE 23,34 EUR/MWh în anul de test. Dacă alegem în schimb cea mai bună dintre cele 25 de setări direct pe anul de test, obținem 22,52, chiar sub AW-LEAR (22,53): o victorie aparentă asupra modelului statistic de referință, creată doar prin alegerea pe datele folosite pentru evaluare (White, 2000).

              Graficul pune față în față MAE a fiecărei setări în anul de validare și MAE ei în anul de test. Clasamentele sînt apropiate, cu o corelație Spearman de 0,86 pentru rețeaua DNN și 0,94 pentru XGBoost: validarea funcționează, dar nu este perfectă, iar tocmai această diferență este exploatată de alegerea pe anul de test.

              În practică: întrebați cîte modele au fost încercate înaintea celui prezentat: cu cît sînt mai multe încercări, cu atît cel mai bun pare mai bun decît este.
              Grafic: Data snooping: selecția pe anul de test produce un avantaj aparent față de LEAR

              MAE din anul de validare față de MAE din anul de test pentru cele 25 de setări ale fiecărui model, cîte o inițializare pe configurație, cu AW-LEAR marcat.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de validare și anul de test 2025-11-01 - 2026-10-31.

              Cel mai bun dintre multe modele trebuie testat față de reper

              Slide-ul 46 în PDF

              Alegerea celui mai bun dintre multe modele pe aceleași date este o problemă de testare multiplă. Cu \(m\) teste independente la pragul de 5%, probabilitatea a cel puțin unei victorii false este \(1-0{,}95^m\): 0,401 pentru \(m=10\) și 0,994 pentru \(m=100\). Conferința invitată a lui Chung-Ming Kuan la AIDA 2026 (diapozitive) a prezentat testele care controlează acest risc; conținutul de mai jos urmează diapozitivele conferinței.

              Testul Reality Check (RC) al lui White compară simultan toate modelele cu reperul,

              \[\mathrm{RC}_n=\max_{k=1,\dots,m}\sqrt{n}\,\bar d_k,\qquad \bar d_k=\frac1n\sum_{t=1}^{n}d_{k,t}\]

              unde \(d_{k,t}\) este pierderea reperului minus pierderea modelului \(k\) în ziua \(t\), iar ipoteza nulă \(E(d_{k,t})\le 0\) pentru orice \(k\) spune că niciun model nu întrece reperul. Valoarea critică se obține prin bootstrap pe întregul vector \((d_{1,t},\dots,d_{m,t})\), care păstrează corelația dintre modele (White, 2000).

              • Testul Reality Check este conservator: modelele slabe adăugate în set îi reduc puterea (Hansen, 2005).
              • Testul abilității predictive superioare (SPA) al lui Hansen (2005) recentrează modelele slabe și este mai puternic.
              • Variantele pas cu pas, Step-RC (Romano & Wolf, 2005) și Step-SPA (Hsu, Hsu & Kuan, 2010), identifică modelele care întrec reperul, controlînd rata erorii la nivelul familiei de ipoteze (FWER).

              Pe datele noastre, cea mai bună dintre cele 25 de setări DNN pe anul de test trece chiar sub AW-LEAR: exact selecția pe care o corectează testele Reality Check și SPA.

              În practică: cînd vi se arată cel mai bun dintre multe modele, cereți valoarea p a testului RC sau SPA.

              Reestimarea: pierdere de precizie de 4,2% după un an fără actualizare

              Slide-ul 47 în PDF

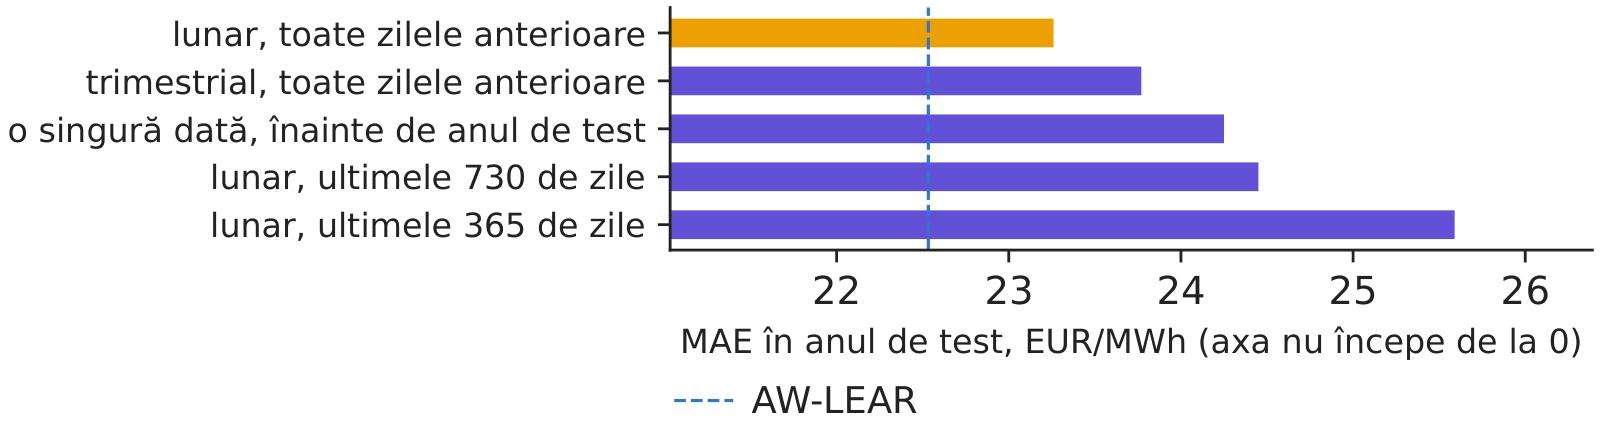
              Piețele se schimbă, așa că un model trebuie reestimat. Graficul compară modelul XGBoost reestimat lunar cu o versiune estimată o singură dată, înaintea anului de test, și cu o versiune estimată pe o fereastră glisantă scurtă. Modelul neactualizat are MAE 24,25, cu 4,2% mai slab. Pierderea crește în timp: +0,15 EUR/MWh în primele 3 luni și +3,70 în ultimele 3.

              O fereastră glisantă scurtă, de 365 de zile, este chiar mai slabă (MAE 25,59) decît întregul istoric: arborii au nevoie de multe vîrfuri din trecut pentru a învăța, iar un singur an nu conține destule.

              În practică: includeți reestimarea lunară în calendarul operațional, cu un responsabil, ca pe orice alt control.
              Grafic: Reestimarea: pierdere de precizie de 4,2% după un an fără actualizare

              MAE a modelului XGBoost în anul de test, cu reestimare lunară pe tot istoricul, estimat o singură dată și cu fereastră glisantă de 365 de zile, plus diferența lunară a modelului neactualizat.

              Sursa: energy-charts.info (Fraunhofer ISE); Yahoo Finance (EUA). Date: anul de test 2025-11-01 - 2026-10-31.

              Testul privind informația din viitor: prognozele recalculate fără datele viitoare rămîn neschimbate

              Slide-ul 48 în PDF

              Un test simplu arată dacă un flux de prelucrare a datelor folosește, fără să vrea, informație din viitor. Pentru prima zi din fiecare dintre cele 12 luni de test, toate datele de după ora 12:00 din ziua \(d-1\) sînt șterse, apoi înlocuite cu 10 000 EUR/MWh. XGBoost, rețeaua DNN și clasificatorul de vîrfuri sînt reestimate și trebuie să dea aceleași prognoze.

              Așa se întîmplă. Arborii și clasificatorul dau prognoze identice, iar rețeaua DNN diferă cu mai puțin de 0,001 EUR/MWh, din cauza rotunjirilor calculelor paralele. Pentru Chronos, codul verifică faptul că contextul este construit numai din zilele dinaintea zilei \(d\).

              Testul încheie o listă de verificare valabilă înainte de a avea încredere în orice model:

              • fiecare intrare datată la momentul închiderii licitației;
              • setări alese pe un an de validare;
              • un singur an de test, deschis o singură dată, cu teste DM față de LEAR;
              • reestimări lunare și un test de perturbare ca acesta.
              În practică: includeți această verificare în evaluarea oricărui model, statistic sau de învățare automată.

              Sinteza secțiunii

              Validarea încrucișată cu amestecare, intrările din aceeași zi și alegerea pe anul de test fac toate un model să pară mai bun decît este. Un model neactualizat se degradează, iar un test cu valori viitoare imposibile arată că fluxul de date este curat.

              Recapitulare

              Cursul se încheie cu cinci întrebări cu care se poate confrunta un manager, o sinteză a rezultatelor, cercetările grupului nostru și resurse pentru studiu suplimentar.

              Întrebări de autoevaluare

              Slide-ul 49 în PDF
              1. Un start-up prezintă o rețea neuronală cu rMAE 0,70 pentru România, testată prin validare încrucișată cu 5 subeșantioane amestecate. Ce cereți?
                Răspuns: o testare cronologică pe un an neatins, cu intrări cunoscute la ora 12:00 în ziua \(d-1\). Pe datele noastre, doar amestecarea a făcut XGBoost să pară cu 5,4% mai bun.
              2. Chronos-2 are cea mai mică MAE dintre modelele individuale, iar combinația AW-LEAR + Chronos-2 are aceeași MAE. Pe care o puneți în producție?
                Răspuns: combinația. Are aceeași acuratețe (DM: \(p\) = 0,491), dar dacă modelul preantrenat se degradează sau devine indisponibil, LEAR asigură în continuare jumătate din prognoză.
              3. Consumul are o pondere SHAP mică (8,5%). Putem concluziona că acesta nu influențează prețul?
                Răspuns: nu. SHAP explică modelul, nu piața; consumul intră doar cu valoarea din ziua \(d-2\), deja reflectată în prețul de ieri.
              4. Mutarea a 1 MWh vă costă 60 EUR în loc de 30. Cum se schimbă pragul de alertă?
                Răspuns: se dublează. C/L crește de la 0,414 la aproximativ dublul acestei valori, deci reacționați numai la vîrfurile mai sigure.
              5. Echipa de date propune ca modelul să fie antrenat o dată pe an, pentru a economisi efort. Ce arată anul de test?
                Răspuns: un model neactualizat un an a fost cu 4,2% mai puțin precis, iar diferența a crescut în ultimele luni, în timp ce o reestimare lunară a modelului XGBoost durează circa 13 secunde.

              Calibrate, rețeaua DNN și XGBoost sînt mai precise decît în cursul 2, dar nu depășesc singure AW-LEAR; în medie cu acesta, îl depășesc, iar cîștigul este semnificativ. Chronos-2, fără nicio antrenare, este cel mai precis model individual, cu MAE 20,82, cu 7,6% sub AW-LEAR.

              Cealaltă lecție privește disciplina. Orice model, statistic sau de învățare automată, trebuie explicat, validat pe date pe care nu le-a văzut și reestimat periodic. Capcanele din ultima secțiune arată că o greșeală de evaluare poate produce ușor un cîștig mai mare decît cîștigul real al celui mai bun model.

              Cercetările grupului nostru: învățarea automată pe piața din România

              Slide-ul 55 în PDF
              • Avertizarea timpurie a vîrfurilor de preț (Andrei, Pele, Cramer, Amza și Diaconu, 2026, PICBE): a construit un sistem explicabil de inteligență artificială (AI) pentru PZU din România și arată că prețul anterior și consumul rezidual sînt principalii factori ai vîrfurilor; lucrarea este replicată în studiul de caz C7.
              • Explicarea prognozelor de preț pe mai multe orizonturi (Andrei, Pele și Cramer, 2026, PICBE): a explicat prognozele de învățare automată pentru prețurile orare din România și arată ce factori contează la fiecare orizont și în fiecare regim de preț.
              • Patru generații de modele pentru prețul energiei (Andrei, Velev, Toma, Pele și Lessmann, 2024, arXiv): a comparat patru generații de metode de prognoză a prețurilor energiei, de la modelele statistice la învățarea profundă, oferind un reper pentru alegerea familiei de modele.
              • Modele fundaționale pentru riscul extrem (Jheng, Tak, Găman, Mazurencu-Marinescu-Pele și Pele, 2026, ECECSR): a folosit modele fundaționale preantrenate, fără reantrenare și cu calibrare conformală, pentru prognoza pierderilor extreme pe piețele din Europa Centrală și de Est.

              Rezultatele de mai sus sînt cele raportate în lucrări; celelalte cifre din curs provin din calculele noastre.

              Lecturi și resurse suplimentare

              Slide-ul 56 în PDF

              Anexă

              Anexa prezintă derivările din spatele antrenării rețelei și a arborilor, conversia valorilor SHAP în euro și spațiile de căutare ale hiperparametrilor.

              Anexa A: propagarea înapoi a erorii și pasul Adam

              Slide-ul 61 în PDF

              Gradientul funcției de pierdere în raport cu ponderile rețelei din (7.3) se obține cu regula de derivare a funcțiilor compuse, de la ieșire spre intrări:

              \[\frac{\partial\mathcal L}{\partial W_2}=\boldsymbol\delta\,\mathbf z^{\top},\quad \boldsymbol\delta=\frac{\partial\mathcal L}{\partial\hat{\mathbf Y}}\]
              (7.18)
              \[\frac{\partial\mathcal L}{\partial W_1}=\big[(W_2^{\top}\boldsymbol\delta)\odot\phi'(\mathbf u)\big]\mathbf x^{\top}\]
              (7.19)

              unde \(\boldsymbol\delta\) este derivata pierderii în raport cu ieșirile, \(\mathbf u=W_1\mathbf x+\mathbf b_1\) intrarea funcției de activare, \(\odot\) produsul element cu element, iar \(\phi'\) derivata funcției de activare. Pentru eroarea absolută, \(\partial|y-\hat y|/\partial\hat y=-\operatorname{sign}(y-\hat y)\); pentru softplus, \(\phi'(u)=1/(1+e^{-u})\).

              Metoda Adam (Kingma și Ba, 2015) rescalează acest gradient, astfel încît fiecare pondere are propriul pas:

              \[m_k=\beta_1m_{k-1}+(1-\beta_1)g_k\]
              (7.20)
              \[v_k=\beta_2v_{k-1}+(1-\beta_2)g_k^2\]
              (7.21)
              \[\theta_k=\theta_{k-1}-\eta\,\frac{m_k/(1-\beta_1^k)}{\sqrt{v_k/(1-\beta_2^k)}+\varepsilon}\]
              (7.22)

              unde \(g_k\) este gradientul pe grupul de zile \(k\), \(m_k\) și \(v_k\) mediile mobile ale gradientului și ale pătratului său, \(\eta\) rata de învățare, iar \(\beta_1=0{,}9\), \(\beta_2=0{,}999\), \(\varepsilon=10^{-8}\) sînt valorile implicite. Penalizarea ponderilor adaugă \(\lambda\theta\) la \(g_k\), o penalizare pătratică, aici cu \(\lambda\) = \(10^{-5}\).

              Anexa B: derivarea valorii optime a unei frunze, −G/(H+λ)

              Slide-ul 62 în PDF

              XGBoost aproximează funcția de pierdere în jurul prognozei curente \(F_{m-1}\) printr-o dezvoltare Taylor de ordinul doi:

              \[\ell\big(Y_i,F_{m-1}+f\big)\approx\ell_i+g_i f(\mathbf x_i)+\tfrac12h_i f(\mathbf x_i)^2\]
              (7.23)
              \[\sum_{j}\Big[G_jw_j+\tfrac12(H_j+\lambda)w_j^2\Big]+\gamma J,\quad G_j=\textstyle\sum_{i\in R_j}g_i\]
              (7.24)
              \[w_j^{*}=-\frac{G_j}{H_j+\lambda},\qquad \text{scor}=-\tfrac12\sum_j\frac{G_j^2}{H_j+\lambda}+\gamma J\]
              (7.25)

              unde \(\ell_i\) este pierderea curentă a observației \(i\), \(g_i\) și \(h_i\) derivatele de ordinul întîi și al doilea ale pierderii, \(G_j\) și \(H_j\) sumele lui \(g_i\) și \(h_i\) din frunza \(j\), \(J\) numărul de frunze, iar \(\lambda\), \(\gamma\) penalizările din (7.10).

              În fiecare frunză, obiectivul (7.24) este o parabolă în \(w_j\); anulînd derivata, se obține \(w_j^*\). Cîștigul unei împărțiri din (7.8) este scorul dinainte minus scorul de după împărțire. Pentru eroarea absolută, \(h_i=0\), iar XGBoost calculează atunci valorile frunzelor printr-o căutare unidimensională.

              Anexa C: valori SHAP exprimate în EUR/MWh

              Slide-ul 63 în PDF

              Arborii prognozează prețul transformat cu asinh, iar valorile SHAP se adună pe această scară. Pentru a raporta contribuțiile în euro, prognoza și prognoza medie sînt transformate înapoi,

              \[\hat P=m+s\,\sinh\Big(\phi_0+\textstyle\sum_j\phi_j\Big),\qquad P_0=m+s\,\sinh\phi_0\]
              (7.26)
              \[\phi_j^{\text{EUR}}=\phi_j\,\frac{\hat P-P_0}{\sum_k\phi_k}\ \Rightarrow\ \sum_j\phi_j^{\text{EUR}}=\hat P-P_0\]
              (7.27)

              unde \(m\) și \(s\) sînt mediana și abaterea absolută mediană (MAD), scalată, a prețurilor de antrenare, \(\hat P\) prognoza în EUR/MWh, \(P_0\) prognoza medie în EUR/MWh, iar \(\phi_j^{\text{EUR}}\) contribuția variabilei \(j\) în euro. Diferența în euro \(\hat P-P_0\) se împarte proporțional cu \(\phi_j\). Semnele și ordinea nu se schimbă, iar contribuțiile se adună exact la prognoza în EUR/MWh.

              Anexa D: spațiile de căutare și setările alese

              Slide-ul 64 în PDF

              Pentru fiecare model au fost evaluate 24 de extrageri aleatoare (cu valoare inițială fixată) și setarea din cursul 2; setarea aleasă este cea cu MAE minimă în anul de validare.

              Setare DNNValori încercateAleasă
              neuroni, stratul 164, 128, 256, 512512
              neuroni, stratul 20, 32, 64, 128, 256niciunul
              funcția de activareReLU, softplussoftplus
              dropout0,0; 0,1; 0,2; 0,30,1
              rata de învățare\(3\cdot10^{-4}\); \(10^{-3}\); \(3\cdot10^{-3}\)\(3\cdot10^{-4}\)
              penalizare L1, intrări0; \(10^{-3}\); \(10^{-2}\); \(10^{-1}\)0
              grup (zile)32, 64, 12864
              consum/RES/variabile fundamentaleda sau nuda/da/da
              Setare XGBoostValori încercateAleasă
              arbori300, 600, 1000, 15001500
              rata de învățare \(\eta\)0,02; 0,05; 0,100,02
              adîncimea3, 4, 5, 6, 88
              ponderea min. în frunză1, 5, 20, 505
              rînduri pe arbore0,6; 0,8; 1,00,8
              \(\lambda\)0,1; 1,0; 10,00,1
              funcția de pierderepătrat, abs., Huberabsolută

              Abrevieri

              AIinteligență artificială
              ARIMAmodel autoregresiv integrat cu medie mobilă
              ARXmodel autoregresiv cu variabile exogene
              AUCaria de sub curba ROC
              AWmedierea prognozelor obținute pe mai multe ferestre de calibrare
              AW-ARXARX mediat pe ferestre de calibrare
              AW-LEARLEAR mediat pe ferestre de calibrare
              CETora Europei Centrale
              CPUunitatea centrală de procesare (nucleu de procesor)
              DMtestul Diebold–Mariano
              DNNrețea neuronală profundă
              DSTora de vară
              ENTSO-ERețeaua europeană a operatorilor de transport și de sistem pentru energie electrică
              ETCtitlu tranzacționat la bursă, garantat cu mărfuri (exchange-traded commodity)
              EUAcertificat de emisii al UE (1 t CO_2)
              EUReuro
              FWERrata erorii la nivelul familiei de ipoteze
              GBMgradient boosting (ansamblu de arbori de decizie construiți secvențial)
              GWgigawatt
              ISEInstitutul Fraunhofer pentru Sisteme de Energie Solară
              LASSOoperatorul de contracție și selecție în normă absolută
              LEARautoregresie estimată cu LASSO
              LLMmodel mare de limbaj
              MADabaterea absolută mediană
              MAEeroarea absolută medie
              MLînvățare automată
              MLPperceptron multistrat (rețea neuronală directă)
              MWmegawatt
              MWhmegawatt-oră
              OPCOMoperatorul pieței de energie electrică și de gaze naturale din România
              PZUpiața pentru ziua următoare
              RCtestul Reality Check (testul de selecție abuzivă al lui White, 2000)
              ReLUunitate liniară rectificată (rectified linear unit)
              RESsurse regenerabile de energie (aici: eolian + solar)
              rMAEMAE relativă (MAE a modelului / MAE a modelului naiv)
              RMSErădăcina erorii pătratice medii
              RORomânia (zonă de ofertare)
              ROCcaracteristica de operare a receptorului (receiver operating characteristic)
              SHAPexplicații aditive bazate pe valorile Shapley (SHapley Additive exPlanations)
              SMAPEeroarea procentuală absolută medie simetrică
              SPAabilitate predictivă superioară (testul lui Hansen, 2005)
              TSOoperator de transport și de sistem
              UEUniunea Europeană
              XGBoosteXtreme Gradient Boosting (bibliotecă de programe)

              Bibliografie

              • Anagnoste, S., Andrei, A.-V., Bolovăneanu, V., Cepoi, C.-O., Clodnitchi, R., Cramer, A.-A., Grecu, R.-A., Lessmann, S., Pele, D. T., Petukhina, A. & Strat, V. A. (2025). The role of AI in (re)shaping energy finance: A systematic literature review. Energy Strategy Reviews, 61, 101833. doi:10.1016/j.esr.2025.101833
              • Andrei, A.-V., Pele, D.-T. & Cramer, A.-A. (2026). Multi-horizon explainability in energy price forecasting: Disentangling market dynamics and renewable intermittency in Romania's liberalized electricity market. Proceedings of the International Conference on Business Excellence, 20(1), 104–117. doi:10.2478/picbe-2026-0014
              • Andrei, A.-V., Pele, D.-T., Cramer, A.-A., Amza, A. & Diaconu, D. (2026). Explainable AI-based early warning system for electricity price spikes: Evidence from the Romanian market. Proceedings of the International Conference on Business Excellence, 20(1), 4820–4836. doi:10.2478/picbe-2026-0352
              • Andrei, A.-V., Velev, G., Toma, F.-M., Pele, D. T. & Lessmann, S. (2024). Energy price modelling: A comparative evaluation of four generations of forecasting methods. arXiv:2411.03372
              • Andrei, A.-V., Velev, G., Toma, F.-M., Pele, D. T. & Lessmann, S. (2026). Energy price modelling: A comparative evaluation of four generations of forecasting methods. Talk, AIDA Conference, Bucharest University of Economic Studies, 3 June 2026. github.com/danpele/EMQA/resources/aida2026
              • Ansari, A. F., Stella, L., Turkmen, C. et al. (2024). Chronos: Learning the language of time series. Transactions on Machine Learning Research. arXiv:2403.07815
              • Ansari, A. F., Shchur, O., Küken, J. et al. (2025). Chronos-2: From univariate to universal forecasting. arXiv:2510.15821
              • Bates, J. M. & Granger, C. W. J. (1969). The combination of forecasts. Journal of the Operational Research Society, 20(4), 451–468. doi:10.1057/jors.1969.103
              • Bergmeir, C. & Benítez, J. M. (2012). On the use of cross-validation for time series predictor evaluation. Information Sciences, 191, 192–213. doi:10.1016/j.ins.2011.12.028
              • Bergstra, J. & Bengio, Y. (2012). Random search for hyper-parameter optimization. Journal of Machine Learning Research, 13, 281–305. jmlr.org/papers/v13/bergstra12a.html
              • Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. doi:10.1023/A:1010933404324
              • Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1–3. doi:10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
              • Chen, T. & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. Proceedings of the 22nd ACM SIGKDD Conference, 785–794. doi:10.1145/2939672.2939785
              • Clodnitchi, R. (2026). The role of AI in (re)shaping energy finance: A systematic literature review. Talk, AIDA Conference, Bucharest University of Economic Studies, 3 June 2026. github.com/danpele/EMQA/resources/aida2026
              • Diebold, F. X. & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. doi:10.1080/07350015.1995.10524599
              • Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874. doi:10.1016/j.patrec.2005.10.010
              • Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. Annals of Statistics, 29(5), 1189–1232. doi:10.1214/aos/1013203451
              • Hansen, P. R. (2005). A test for superior predictive ability. Journal of Business & Economic Statistics, 23(4), 365–380. doi:10.1198/073500105000000063
              • Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning, 2nd ed. Springer. doi:10.1007/978-0-387-84858-7
              • Hsu, P.-H., Hsu, Y.-C. & Kuan, C.-M. (2010). Testing the predictive ability of technical analysis using a new stepwise test without data snooping bias. Journal of Empirical Finance, 17(3), 471–484. doi:10.1016/j.jempfin.2010.01.001
              • Jheng, S., Tak, R., Găman, Ș., Mazurencu-Marinescu-Pele, M. & Pele, D. T. (2026). Can foundation models manage risk? Zero-shot VaR and ES forecasting with conformal calibration in CEE markets. Economic Computation and Economic Cybernetics Studies and Research, 60(2), 267–290. doi:10.24818/18423264/60.2.26.14
              • Kingma, D. P. & Ba, J. (2015). Adam: A method for stochastic optimization. International Conference on Learning Representations. arXiv:1412.6980
              • Kuan, C.-M. (2026). Large-scale multiple inequality testing without data snooping bias. Keynote, AIDA Conference, Bucharest University of Economic Studies, 4 June 2026. github.com/danpele/EMQA/resources/aida2026
              • Lago, J., De Ridder, F. & De Schutter, B. (2018). Forecasting spot electricity prices: Deep learning approaches and empirical comparison of traditional algorithms. Applied Energy, 221, 386–405. doi:10.1016/j.apenergy.2018.02.069
              • Lago, J., Marcjasz, G., De Schutter, B. & Weron, R. (2021). Forecasting day-ahead electricity prices: A review of state-of-the-art algorithms, best practices and an open-access benchmark. Applied Energy, 293, 116983. doi:10.1016/j.apenergy.2021.116983
              • Lundberg, S. M., Erion, G., Chen, H. et al. (2020). From local explanations to global understanding with explainable AI for trees. Nature Machine Intelligence, 2(1), 56–67. doi:10.1038/s42256-019-0138-9
              • Marcjasz, G., Narajewski, M., Weron, R. & Ziel, F. (2023). Distributional neural networks for electricity price forecasting. Energy Economics, 125, 106843. doi:10.1016/j.eneco.2023.106843
              • Murphy, A. H. (1977). The value of climatological, categorical and probabilistic forecasts in the cost-loss ratio situation. Monthly Weather Review, 105(7), 803–816. doi:10.1175/1520-0493(1977)105<0803:TVOCCA>2.0.CO;2
              • Olivares, K. G., Challu, C., Marcjasz, G., Weron, R. & Dubrawski, A. (2023). Neural basis expansion analysis with exogenous variables: Forecasting electricity prices with NBEATSx. International Journal of Forecasting, 39(2), 884–900. doi:10.1016/j.ijforecast.2022.03.001
              • Romano, J. P. & Wolf, M. (2005). Stepwise multiple testing as formalized data snooping. Econometrica, 73(4), 1237–1282. doi:10.1111/j.1468-0262.2005.00615.x
              • Shapley, L. S. (1953). A value for n-person games. In Contributions to the Theory of Games II, 307–317. Princeton University Press. doi:10.1515/9781400881970-018
              • Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I. & Salakhutdinov, R. (2014). Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15, 1929–1958. jmlr.org/papers/v15/srivastava14a.html
              • Weron, R. (2014). Electricity price forecasting: A review of the state-of-the-art with a look into the future. International Journal of Forecasting, 30(4), 1030–1081. doi:10.1016/j.ijforecast.2014.08.008
              • Weron, R. (2026). Machine learning for electricity price forecasting. Keynote, AIDA Conference, Bucharest University of Economic Studies, 4 June 2026. github.com/danpele/EMQA/resources/aida2026
              • White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097–1126. doi:10.1111/1468-0262.00152

              Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.