Rețele neuronale și deep learning

Cursul 12: Modele lingvistice mari în finanțe și formularea instrucțiunilor (prompt engineering)

Cursul 12

Modele lingvistice mari în finanțe și formularea instrucțiunilor (prompt engineering)

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

Textul este cel mai mare set de date al unei instituții financiare care este încă citit mai ales de oameni: știri, discursuri ale băncilor centrale, rapoarte anuale, dosare de credit. Modelele lingvistice mari (LLM) citesc text la scară mare, dar sînt și sigure pe ele, costisitoare și ușor de păcălit. Cursul tratează un LLM ca ceea ce este, un model de probabilitate a următorului token, și verifică fiecare afirmație pe date financiare etichetate, cu modele deschise care rulează pe un laptop.

Pornim de la obiectivul unui model de limbaj, de la tokeni, perplexitate și temperatură, măsurate pe 400 de discursuri ale Băncii Centrale Europene (BCE). Explicăm apoi preantrenarea, ajustarea pe instrucțiuni și alinierea. Miezul cursului este formularea instrucțiunilor (prompt engineering) ca activitate măsurabilă: prompturi zero-shot, few-shot și chain-of-thought pe Financial PhraseBank și pe tweet-uri financiare, cu intervale bootstrap, rulări repetate, reformulări, calibrare și cost. Construim generarea augmentată prin regăsire (RAG) pe discursurile BCE și măsurăm halucinațiile, iar la final testăm retrospectiv un model de limbaj folosit pentru valoarea expusă la risc (VaR), după cadrul LLM-VaR al grupului nostru.


Ce veți ști să faceți

  • Să scrieți obiectivul unui model de limbaj, perplexitatea și temperatura de eșantionare și să le măsurați pe text real.
  • Să explicați preantrenarea, ajustarea pe instrucțiuni și alinierea la preferințele umane, cu funcțiile lor de pierdere.
  • Să transformați un prompt într-un clasificator și să evaluați prompturile zero-shot, few-shot și chain-of-thought, cu intervale de încredere.
  • Să construiți și să evaluați generarea augmentată prin regăsire pe discursuri reale și să măsurați halucinațiile.
  • Să testați retrospectiv un model de limbaj folosit pentru valoarea expusă la risc și să cunoașteți riscurile: scurgerea de date, costul, calibrarea.

Planul cursului

  1. Prezicerea următorului token și modelele lingvistice mariUn LLM este antrenat să prezică următorul token.
  2. Preantrenare, ajustare pe instrucțiuni și aliniere
  3. Evaluarea formulării instrucțiunilor pe date etichetateUn prompt este un model.
  4. Generare augmentată prin regăsire pe discursurile BCE
  5. Modelele de limbaj ca modele de risc: LLM-VaR
  6. Riscuri și guvernanță

Prezicerea următorului token și modelele lingvistice mari

Un LLM este antrenat să prezică următorul token. Tot restul, de la răspunsuri la întrebări pînă la redactarea unui raport de risc, înseamnă folosirea repetată a acestei singure probabilități.

Datele de tip text în instituțiile financiare

Slide-ul 5 în PDF

Prețurile reacționează la știri în cîteva minute, băncile centrale ghidează așteptările prin cuvinte, iar dosarele de credit și rapoartele anuale costă ore de analiză. Toate modelele din acest curs sînt deschise și rulează local (Qwen2.5-Instruct cu 0,5, 1,5 și 3 miliarde de parametri), deci niciun text nu părăsește calculatorul și nu se plătește nicio interfață de programare a aplicațiilor (API).

Obiectivul modelului de limbaj

Slide-ul 6 în PDF
\[p_{\boldsymbol\theta}(x_1,\dots,x_T)=\prod_{t=1}^{T}p_{\boldsymbol\theta}(x_t\mid x_{<t}),\qquad \mathcal L=-\frac{1}{T}\sum_{t=1}^{T}\log p_{\boldsymbol\theta}(x_t\mid x_{<t}),\qquad \mathrm{PPL}=e^{\mathcal L}\]

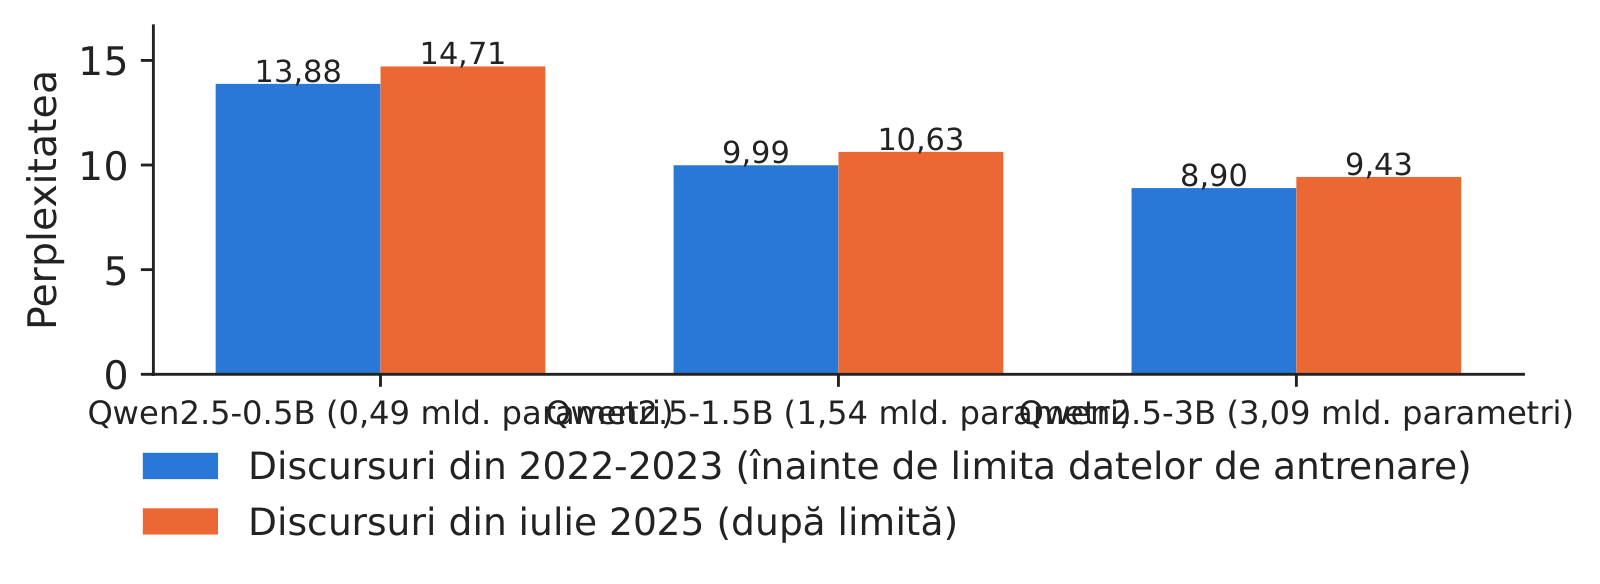
Perplexitatea este numărul efectiv de tokeni următori echiprobabili. Pe discursurile BCE publicate după iulie 2025 (primii 1 024 de tokeni din 40 de discursuri), perplexitatea este 14,71 pentru modelul de 0,5B, 10,63 pentru 1,5B și 9,43 pentru 3B.

Tokenii ca fragmente de cuvinte

Slide-ul 7 în PDF

Codificarea byte-pair (BPE) pornește de la octeți și unește repetat perechea vecină cea mai frecventă, pînă cînd vocabularul este complet: Qwen2.5 are 151 665 de tokeni, iar vocabularul WordPiece al FinBERT, o versiune financiară a modelului de reprezentări bidirecționale ale codificatorului transformer (BERT), are 30 522. Pe Financial PhraseBank revin 1,35 tokeni Qwen pe cuvînt.

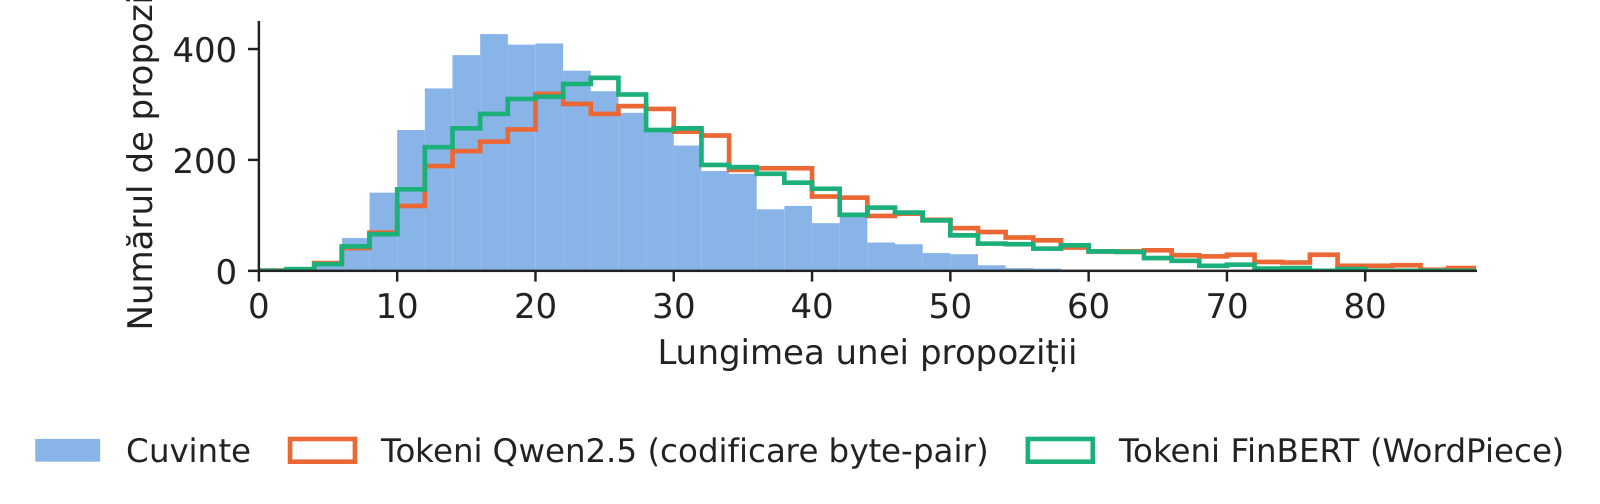
Lungimea propozițiilor în cuvinte și în tokeni

Slide-ul 8 în PDF
Grafic: Lungimea propozițiilor în cuvinte și în tokeni: două metode de tokenizare

Lungimea propozițiilor din Financial PhraseBank, în cuvinte și în tokeni.

Sursa: Financial PhraseBank (Malo et al., 2014). Date: 4.838 de propoziții.

O propoziție are în medie 23,1 cuvinte și 31,1 tokeni Qwen; un discurs BCE are în medie 4 143 de tokeni. Costurile și limitele contextului se numără în tokeni.

\[p_T(v\mid x_{<t})=\frac{\exp(z_v/T)}{\sum_u\exp(z_u/T)},\qquad H_T=-\sum_v p_T(v)\log p_T(v)\]

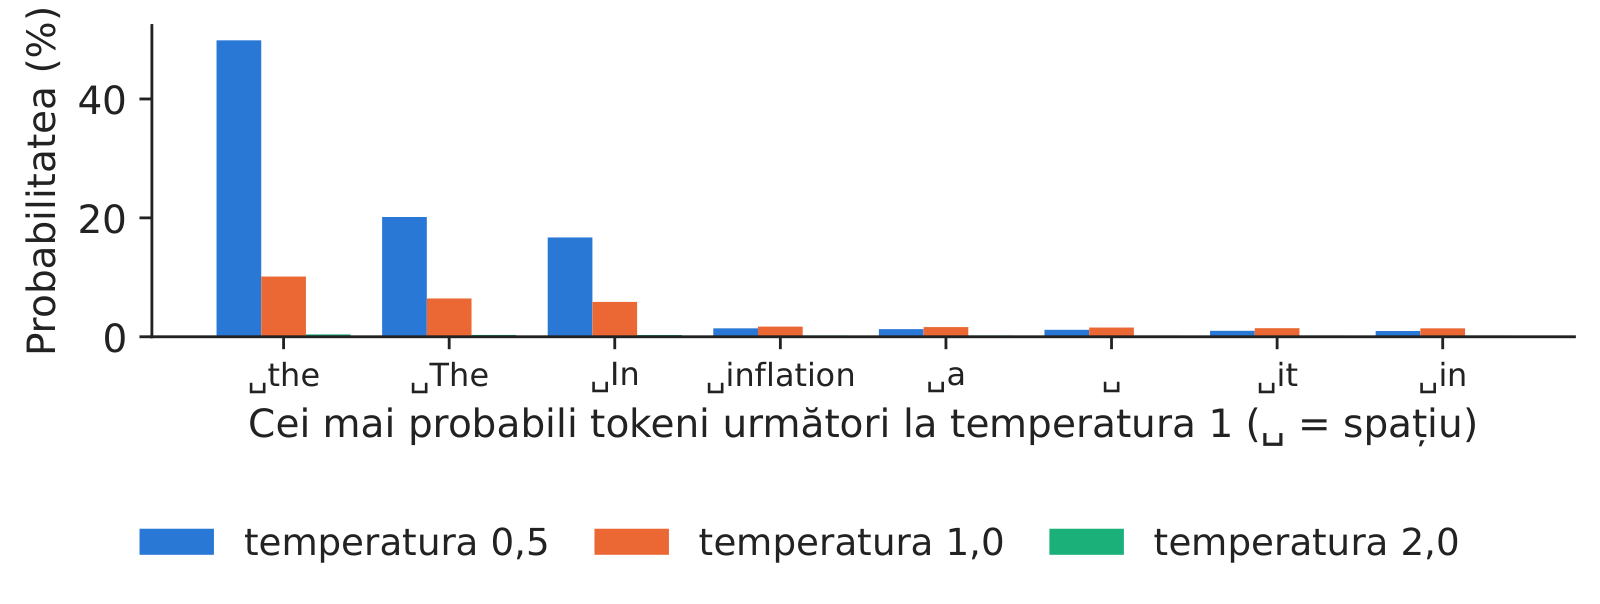
Cu promptul „The inflation impact is limited:”, luat din discursul BCE din 30 octombrie 2026, cel mai probabil token următor, „the”, are probabilitatea 49,9 % la temperatura 0,5, 10,1 % la 1 și 0,4 % la 2; entropia crește de la 1,74 la 10,29 nats.

Probabilitățile următorului token pentru un model real

Slide-ul 10 în PDF
Grafic: Probabilitățile următorului token: un model real, o frază reală

Cei mai probabili tokeni următori ai Qwen2.5-1.5B-Instruct, la trei temperaturi.

Sursa: Banca Centrală Europeană, setul de discursuri. Date: începutul unei fraze din discursul BCE din 30 octombrie 2026; modelul Qwen2.5-1.5B-Instruct.

În practică: pentru clasificare și extragere folosiți temperatura 0; temperaturile mari sînt pentru generarea de idei.

Pierderea scade ca o putere a dimensiunii modelului și a datelor, \(\mathcal L(P,D)=E+A/P^{\alpha}+B/D^{\beta}\) (Kaplan et al., 2020; Hoffmann et al., 2022). Pe cele trei dimensiuni ale modelului nostru, panta logaritmului pierderii în raport cu logaritmul numărului de parametri este −0,100: trei puncte descriu eșantionul, nu o lege.

Limita datelor de antrenare

Slide-ul 12 în PDF
Grafic: Limita datelor de antrenare și ușurința aparentă a discursurilor mai vechi

Perplexitatea pe discursurile BCE din 2022–2023 și din iulie 2025.

Sursa: Banca Centrală Europeană, setul de discursuri. Date: 40 + 40 de discursuri, primii 1.024 de tokeni din fiecare.

Pentru modelul de 3B, perplexitatea este 8,90 pe discursurile din 2022–2023 și 9,43 pe cele din iulie 2025, ulterioare datelor de antrenare. Și temele s-au schimbat, așa că diferența este un simptom, nu o dovadă, a memorării; este un motiv să evaluați LLM-urile pe documente scrise după limita datelor lor de antrenare.

Preantrenare, ajustare pe instrucțiuni și aliniere

Trei etape de antrenare

Slide-ul 14 în PDF

Un transformer generativ preantrenat (GPT) este antrenat întîi pe trilioane de tokeni, cu pierderea next-token; ajustarea fină supervizată (SFT) îl învață apoi formatul răspunsurilor, iar reinforcement learning from human feedback (RLHF) sau optimizarea directă a preferințelor (DPO) îl învață ce răspunsuri preferă oamenii (Ouyang et al., 2022).

Ajustarea pe instrucțiuni

Slide-ul 15 în PDF
\[\mathcal L_{\text{SFT}}(\boldsymbol\theta)=-\sum_{(\mathbf x,\mathbf y)}\sum_{t=1}^{|\mathbf y|}\log p_{\boldsymbol\theta}(y_t\mid\mathbf x,\mathbf y_{<t})\]

Pierderea se calculează doar pe tokenii răspunsului. Adaptarea de rang mic (LoRA) antrenează \(\mathbf W=\mathbf W_0+\mathbf B\mathbf A\), cu un rang \(r\) mic: un strat de 4096 × 4096 cu \(r=8\) are 65 536 de ponderi antrenabile în loc de 16,8 milioane (Hu et al., 2022).

Oamenii aleg răspunsul mai bun dintr-o pereche; un model de recompensă \(r_\phi\) se estimează cu \(\Pr(y_w\succ y_l)=\sigma(r_\phi(x,y_w)-r_\phi(x,y_l))\), iar politica maximizează recompensa cu o penalizare Kullback–Leibler care o ține aproape de modelul SFT. DPO optimizează același obiectiv direct din perechile de preferințe (Rafailov et al., 2023). Alinierea stabilește tonul și siguranța; nu adaugă cunoștințe financiare.

Modelele deschise folosite

Slide-ul 17 în PDF

Qwen2.5-Instruct cu 0,49, 1,54 și 3,09 miliarde de parametri (Qwen Team, 2024), modelul de embedding bge-small pentru regăsire și reprezentarea frecvența termenului–frecvența inversă în documente (TF-IDF), cu regresie logistică, drept reper clasic.

Evaluarea formulării instrucțiunilor pe date etichetate

Un prompt este un model. Se alege pe date de validare și se evaluează o singură dată pe un set de test separat, cu aceleași statistici ca orice clasificator.

Promptul ca clasificator

Slide-ul 20 în PDF
\[\hat p(c\mid x)=\frac{\sum_{v\in\mathcal V_c}p_{\boldsymbol\theta}(v\mid\mathrm{prompt}(x))}{\sum_{c'}\sum_{v\in\mathcal V_{c'}}p_{\boldsymbol\theta}(v\mid\mathrm{prompt}(x))},\qquad \hat c=\arg\max_c\hat p(c\mid x)\]

unde \(\mathcal V_c\) sînt primii tokeni ai cuvîntului-etichetă \(c\) în toate formele lui. O singură trecere înainte pe propoziție este suficientă, iar instrucțiunea și exemplele comune se codifică o singură dată.

Două seturi de date etichetate

Slide-ul 21 în PDF

Financial PhraseBank (Malo et al., 2014) conține 4 838 de propoziții din știri despre companii listate în Finlanda; folosim cele 2 259 cu etichete unanime, împărțite în 1 581 de propoziții de antrenare și 678 de test. Setul Twitter financial news oferă 9 543 tweet-uri de antrenare și un eșantion de test stratificat de 900 de tweet-uri.

LLM-uri cu prompt comparate cu un reper antrenat

Slide-ul 22 în PDF
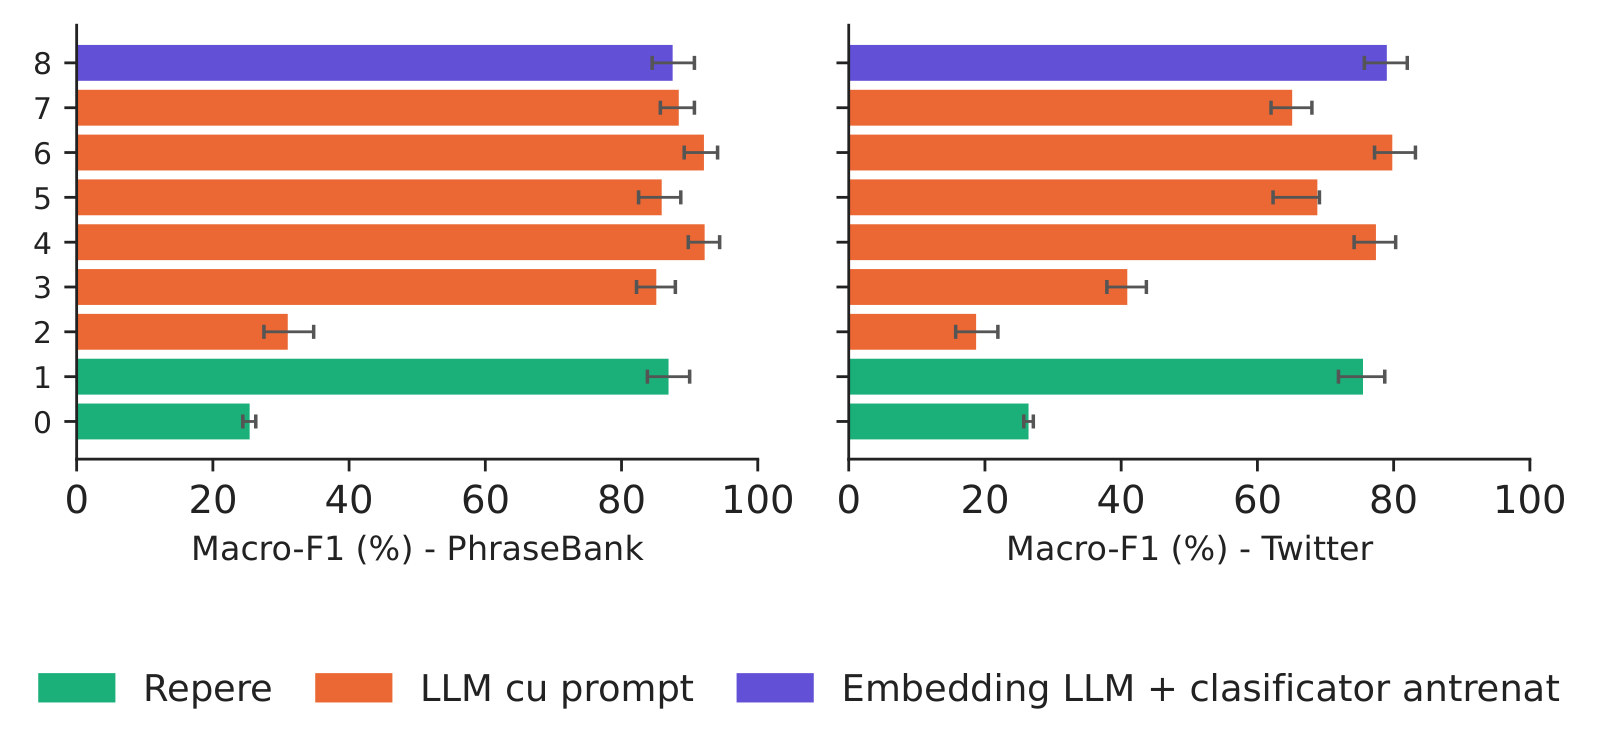
Grafic: LLM-uri cu prompt comparate cu un reper antrenat

Macro-F1 cu intervale bootstrap de 95 % pe ambele seturi de date.

Sursa: Financial PhraseBank (Malo et al., 2014) și Twitter financial news (zeroshot). Date: seturi de test: 678 de propoziții (acord 100 %) și 900 de tweet-uri; intervale bootstrap de 95 %.

MetodaMacro-F1 PhraseBank (%)Macro-F1 Twitter (%)
TF-IDF + regresie logistică86,975,5
Zero-shot 0,5B31,018,7
Zero-shot 1,5B85,140,9
Zero-shot 3B92,277,4
Few-shot 3B (12 exemple)92,179,8
Chain-of-thought 3B88,465,1
Embedding LLM + logistică87,579,0

Pe PhraseBank, modelul de 3B ajunge la 92,2 % macro-F1 fără exemple, peste clasificatorul TF-IDF antrenat pe 1 581 de propoziții etichetate (86,9 %). Pe tweet-uri, mai scurte și mai zgomotoase, cele mai bune rezultate le dau modelul de 3B cu exemple (79,8 %) și embedding-urile LLM cu un clasificator antrenat (79,0 %). Modelul de 0,5B este aproape de clasa majoritară.

Acuratețea și macro-F1, cu intervale bootstrap

Slide-ul 23 în PDF

Macro-F1 face media celor trei scoruri F1 pe clase, astfel încît clasa mică negativă contează cît cea neutră. Intervalele de 95 % provin din 1 000 de reeșantionări bootstrap ale setului de test: pentru zero-shot 3B pe PhraseBank intervalul este [89,8; 94,4] %, pentru TF-IDF [83,8; 90,0] %.

Exemple în prompt

Slide-ul 24 în PDF
Grafic: Efectul numărului de exemple din prompt

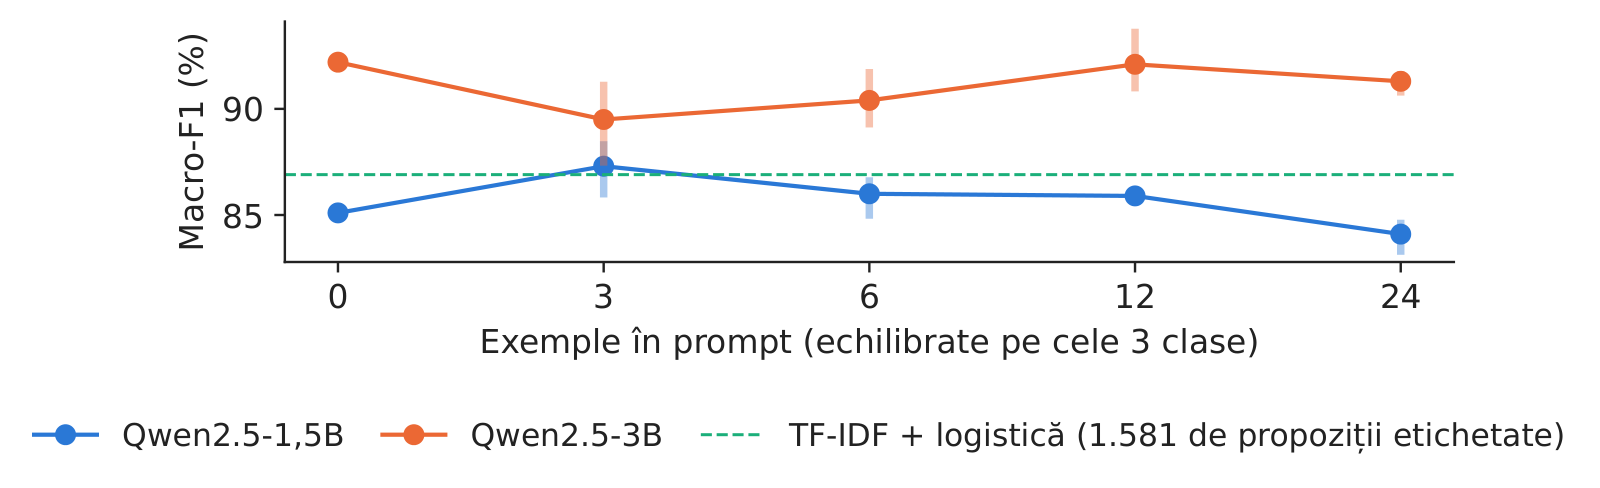
Macro-F1 în funcție de numărul de exemple din prompt, trei rulări.

Sursa: Financial PhraseBank (Malo et al., 2014). Date: setul de test de 678 de propoziții; barele = intervalul pe 3 valori ale generatorului aleator.

Învățarea în context schimbă răspunsul fără să modifice nicio pondere. Pentru modelul de 1,5B, macro-F1 trece de la 85,1 % fără exemple la 84,1 % cu 24 de exemple; pentru modelul de 3B, de la 92,2 % la 91,3 %. Pe această sarcină instrucțiunea fără exemple este deja puternică, iar alegerea exemplelor mută scorul cu cîteva puncte.

Sensibilitatea la prompt

Slide-ul 25 în PDF
Grafic: Sensibilitatea la prompt: efectul reformulării instrucțiunii

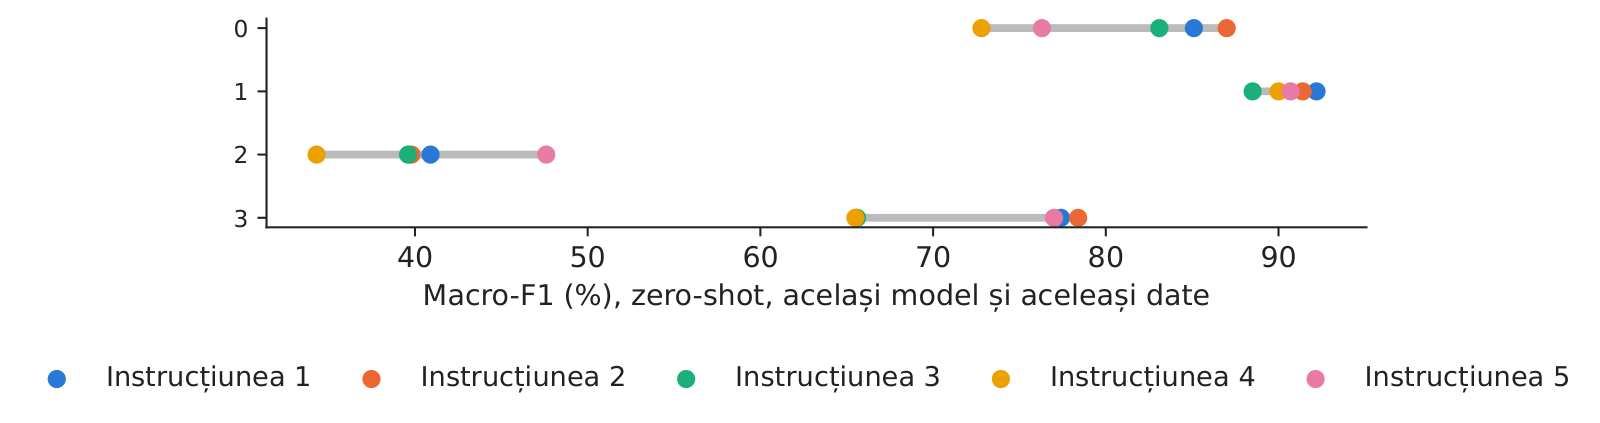
Macro-F1 pentru cinci reformulări ale aceleiași instrucțiuni.

Sursa: Financial PhraseBank și Twitter financial news. Date: seturile de test de mai sus; cinci reformulări ale instrucțiunii.

Cinci instrucțiuni cu același sens dau o amplitudine de 3,6 puncte pe PhraseBank și de 12,9 puncte pe Twitter pentru modelul de 3B și de 14,2 puncte pe PhraseBank pentru modelul de 1,5B. Formularea promptului este un hiperparametru: alegeți-o pe date de validare și fixați-o.

Chain-of-thought

Slide-ul 26 în PDF

Dacă îl lăsăm pe model să scrie două propoziții de raționament înainte de etichetă (Wei et al., 2022), obținem 88,4 % macro-F1 pe PhraseBank și 65,1 % pe Twitter, sub răspunsul direct zero-shot, cu circa 389 ms pe propoziție în loc de 48,5 ms. Chain-of-thought ajută la raționamentele în mai mulți pași, nu la etichete de un cuvînt pe propoziții scurte.

Grafic: Calibrarea probabilităților etichetelor pe date reale

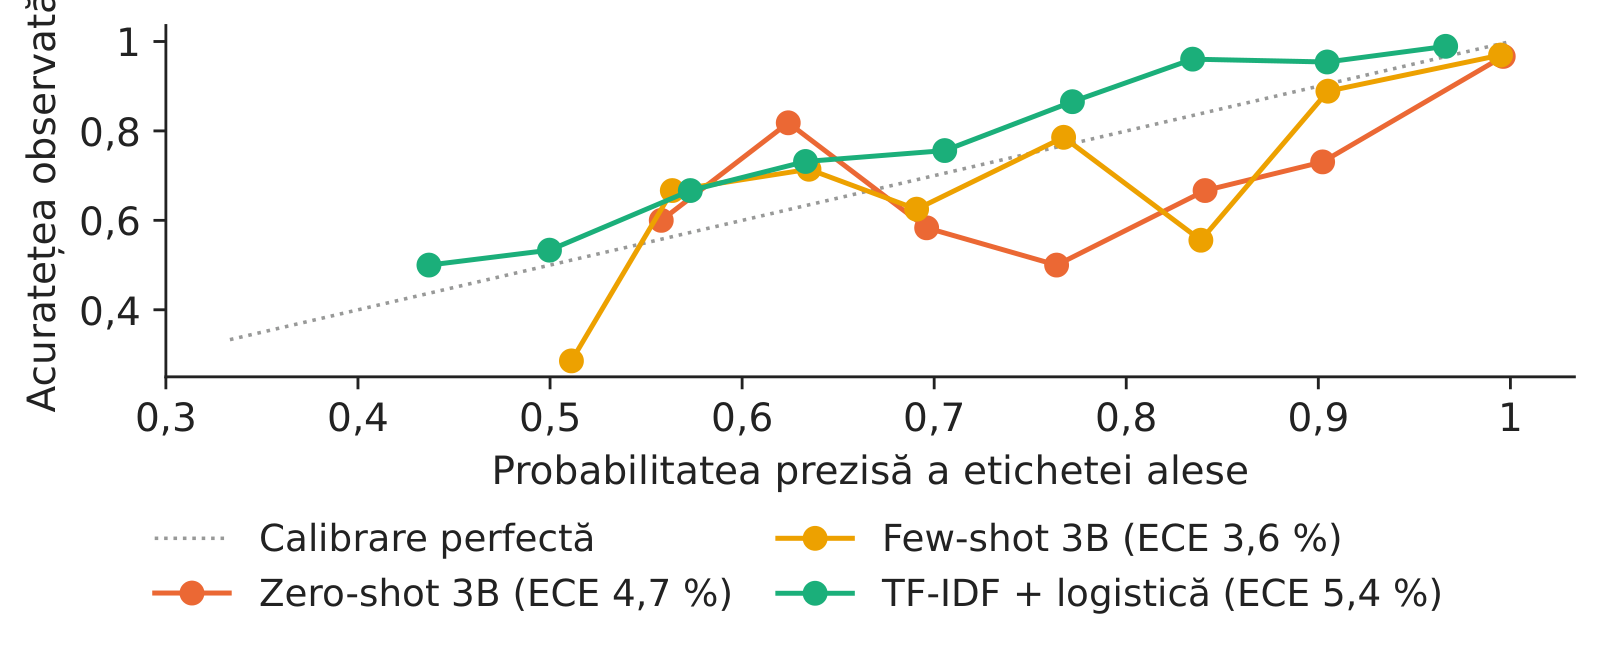
Diagrama de fiabilitate a probabilităților prezise ale etichetelor.

Sursa: Financial PhraseBank (Malo et al., 2014). Date: setul de test de 678 de propoziții, 10 intervale.

Eroarea de calibrare așteptată (ECE) este 4,7 % pentru zero-shot 3B, 3,6 % pentru few-shot 3B și 5,4 % pentru TF-IDF cu regresie logistică: pe această sarcină, probabilitățile etichetelor date de LLM sînt aproximativ la fel de fiabile ca ale clasificatorului antrenat. Calibrarea trebuie totuși verificată pe date de validare înainte ca scorurile să fie folosite ca probabilități de risc (Guo et al., 2017).

Acuratețea în funcție de gradul de acord al adnotatorilor

Slide-ul 29 în PDF
Grafic: Acuratețea în funcție de gradul de acord al adnotatorilor

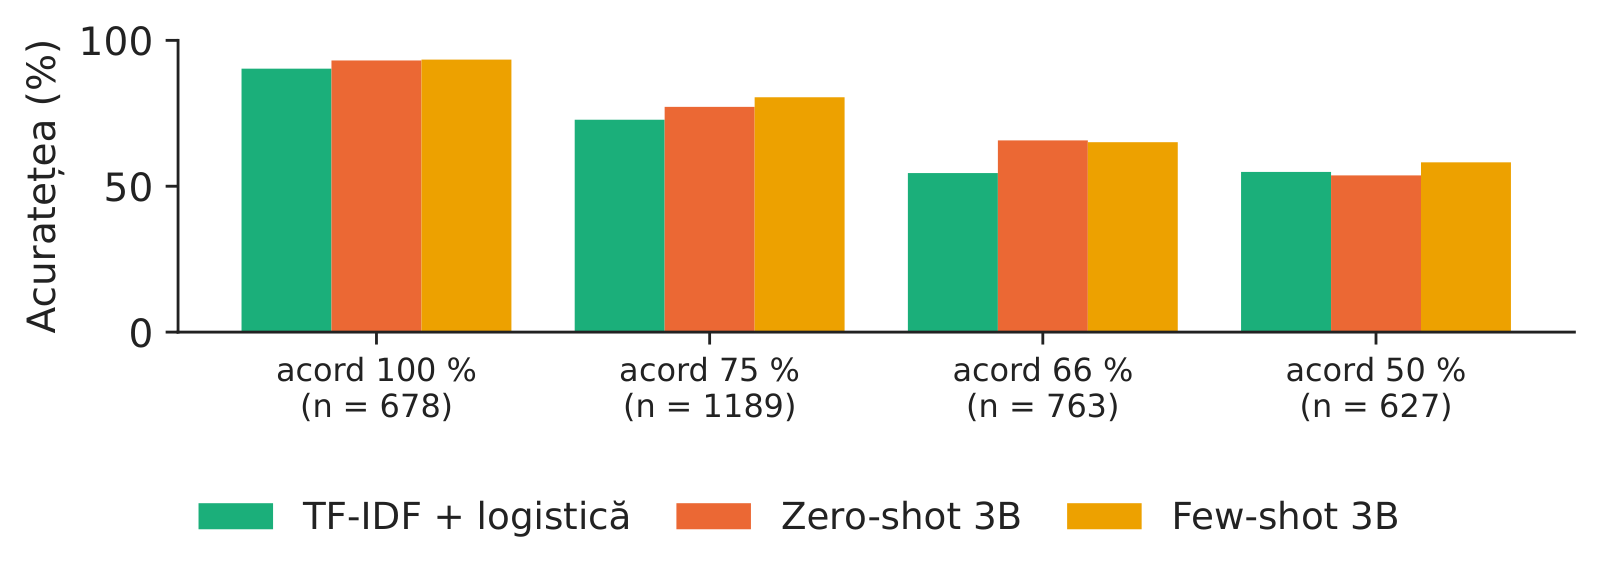
Acuratețea în funcție de acordul adnotatorilor.

Sursa: Financial PhraseBank (Malo et al., 2014). Date: propoziții nefolosite nici la antrenare, nici ca exemple.

Modelul zero-shot de 3B are dreptate pentru 93,1 % din propozițiile de test unanime, dar doar pentru 53,7 % din propozițiile asupra cărora jumătate dintre adnotatori nu au fost de acord. Un model nu poate fi mai sigur decît oamenii care au etichetat datele.

Matricea de confuzie

Slide-ul 30 în PDF

Pentru cel mai bun model cu prompt pe PhraseBank, 20 de propoziții neutre au fost citite ca pozitive, iar 13 propoziții pozitive ca neutre, în timp ce pozitivul și negativul s-au confundat rar. Erorile stau la granița cu neutrul.

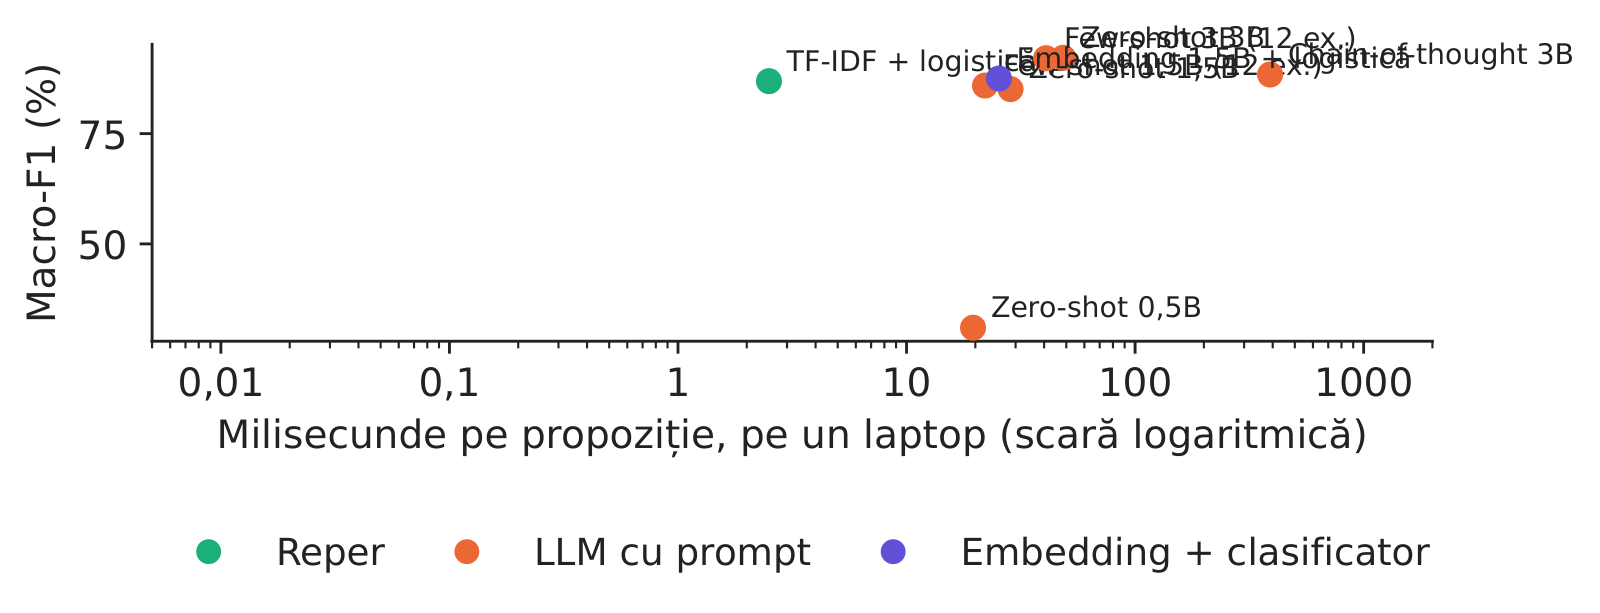
Costul față de precizie

Slide-ul 31 în PDF
Grafic: Costul față de precizie: milisecunde pe propoziție, pe un laptop

Macro-F1 în funcție de milisecundele pe propoziție, pe un laptop.

Sursa: Financial PhraseBank (Malo et al., 2014). Date: setul de test de 678 de propoziții; timp măsurat pe procesorul grafic al unui laptop.

TF-IDF are nevoie de 2,50 ms pe propoziție, zero-shot 3B de 48,5 ms, iar chain-of-thought de circa 389 ms. Cu etichete, un model mic antrenat este greu de depășit; fără etichete, un prompt este un început solid; pentru milioane de documente, costul decide.

Embedding-uri LLM cu un clasificator mic

Slide-ul 32 în PDF

Media ultimelor stări ascunse ale Qwen2.5-1.5B, cu o regresie logistică deasupra, dă 87,5 % pe PhraseBank și 79,0 % pe Twitter: cea mai ieftină formă de ajustare fină.

Generare augmentată prin regăsire pe discursurile BCE

Regăsirea urmată de generare

Slide-ul 34 în PDF
\[p(y\mid q)\approx\sum_{z\in\mathrm{top}_k(q)}p_\eta(z\mid q)\,p_{\boldsymbol\theta}(y\mid q,z)\]

Corpusul are 400 de discursuri BCE, tăiate în 8 400 de fragmente de 200 de cuvinte (Lewis et al., 2020).

Trei metode de regăsire

Slide-ul 35 în PDF

Scorul Best Matching 25 (BM25) ponderează cuvintele comune după raritatea lor și saturează aparițiile repetate; regăsirea densă compară embedding-uri prin similaritatea cosinus; metoda hibridă combină cele două clasamente prin fuziunea rangurilor reciproce. Rangul reciproc mediu (MRR): BM25 0,515, dense 0,567, hibrid 0,622.

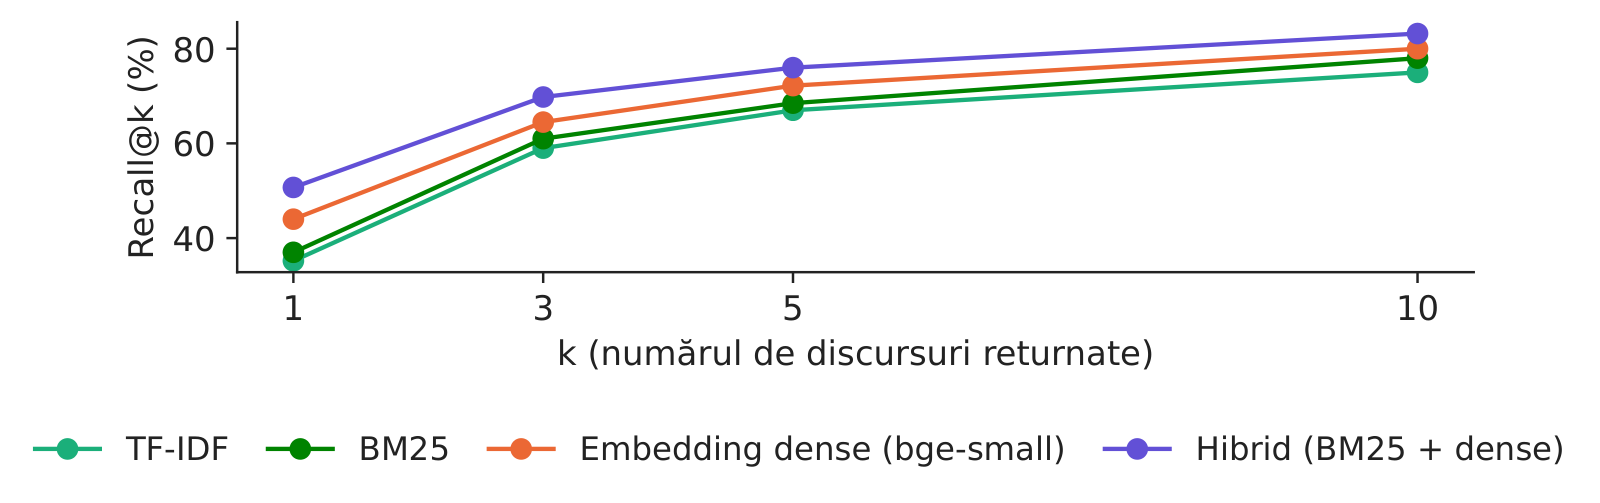
Regăsirea discursului corect după titlu

Slide-ul 36 în PDF
Grafic: Regăsirea discursului corect după titlu

Recall@k pentru cele patru metode de regăsire.

Sursa: Banca Centrală Europeană, setul de discursuri. Date: 400 de discursuri, 8400 de fragmente; interogarea = titlul discursului.

Metoda hibridă pune discursul corect pe primul loc pentru 50,7 % din titluri și între primele zece pentru 83,2 %.

Răspunsurile cu și fără documente regăsite

Slide-ul 37 în PDF
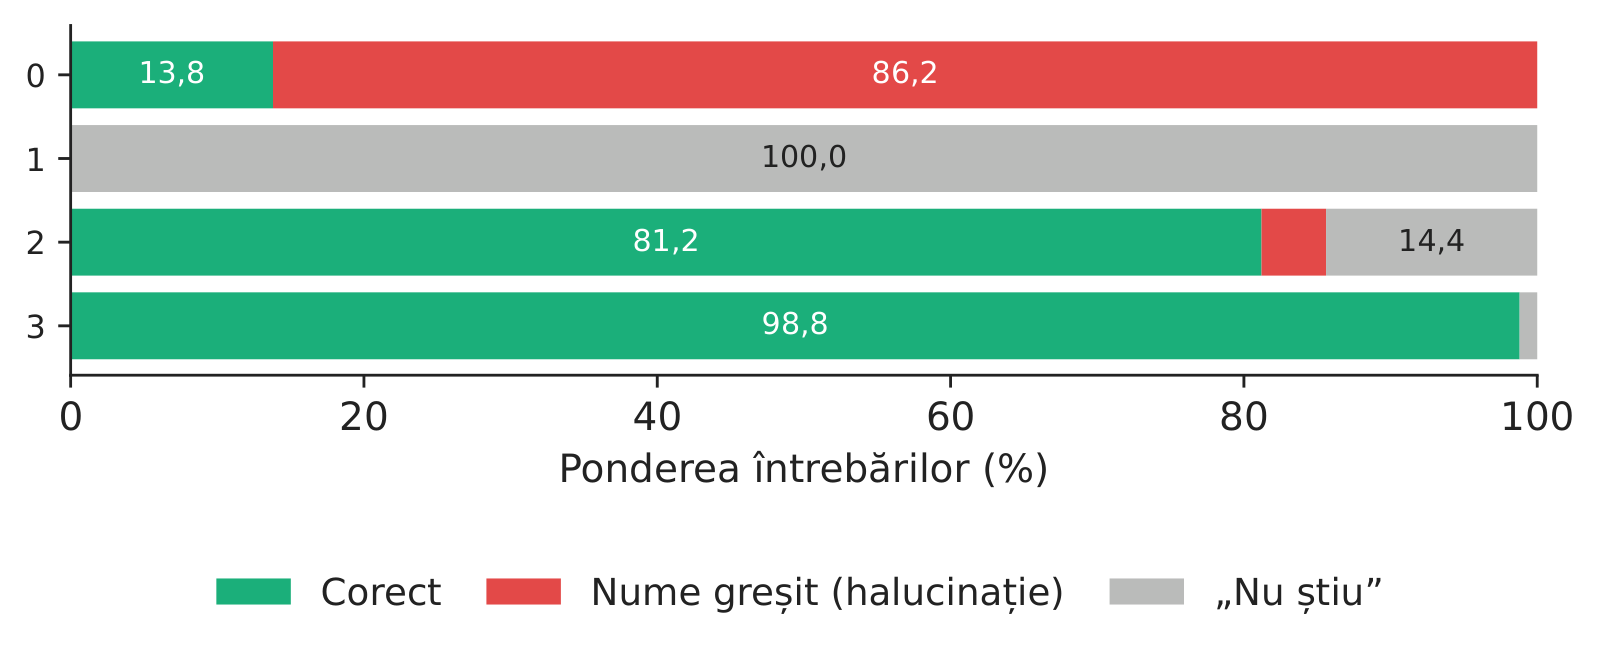
Grafic: Răspunsurile cu și fără documente regăsite

Cine a ținut discursul? Răspunsuri fără documente, cu RAG și cu discursul corect.

Sursa: Banca Centrală Europeană, setul de discursuri. Date: 160 de discursuri cu un singur vorbitor, 15 ianuarie 2025 - 30 octombrie 2026; modelul Qwen2.5-3B-Instruct.

Pe 160 de discursuri ținute după datele de antrenare ale modelului, un răspuns obligatoriu fără documente este greșit în 86,2 % din cazuri (modelul a răspuns „Philip Lane” de 137 de ori). Cînd „nu știu” este permis, se abține la 100,0 % din întrebări. Cu primele 3 discursuri regăsite răspunde corect în 81,2 % din cazuri, iar cu discursul corect în 98,8 %.

În practică: un nume greșit spus cu siguranță este eșecul costisitor: cereți surse în fiecare răspuns și verificați-le.

Proiectarea unui sistem RAG pentru o bancă

Slide-ul 38 în PDF

Dimensiunea fragmentelor, metadatele care însoțesc fiecare fragment, o metodă de regăsire hibridă (recall@3 de 73,1 % pe setul de întrebări), permisiunea de a se abține și un set fix de evaluare, rulat din nou după fiecare schimbare, sînt deciziile care contează.

Modelele de limbaj ca modele de risc: LLM-VaR

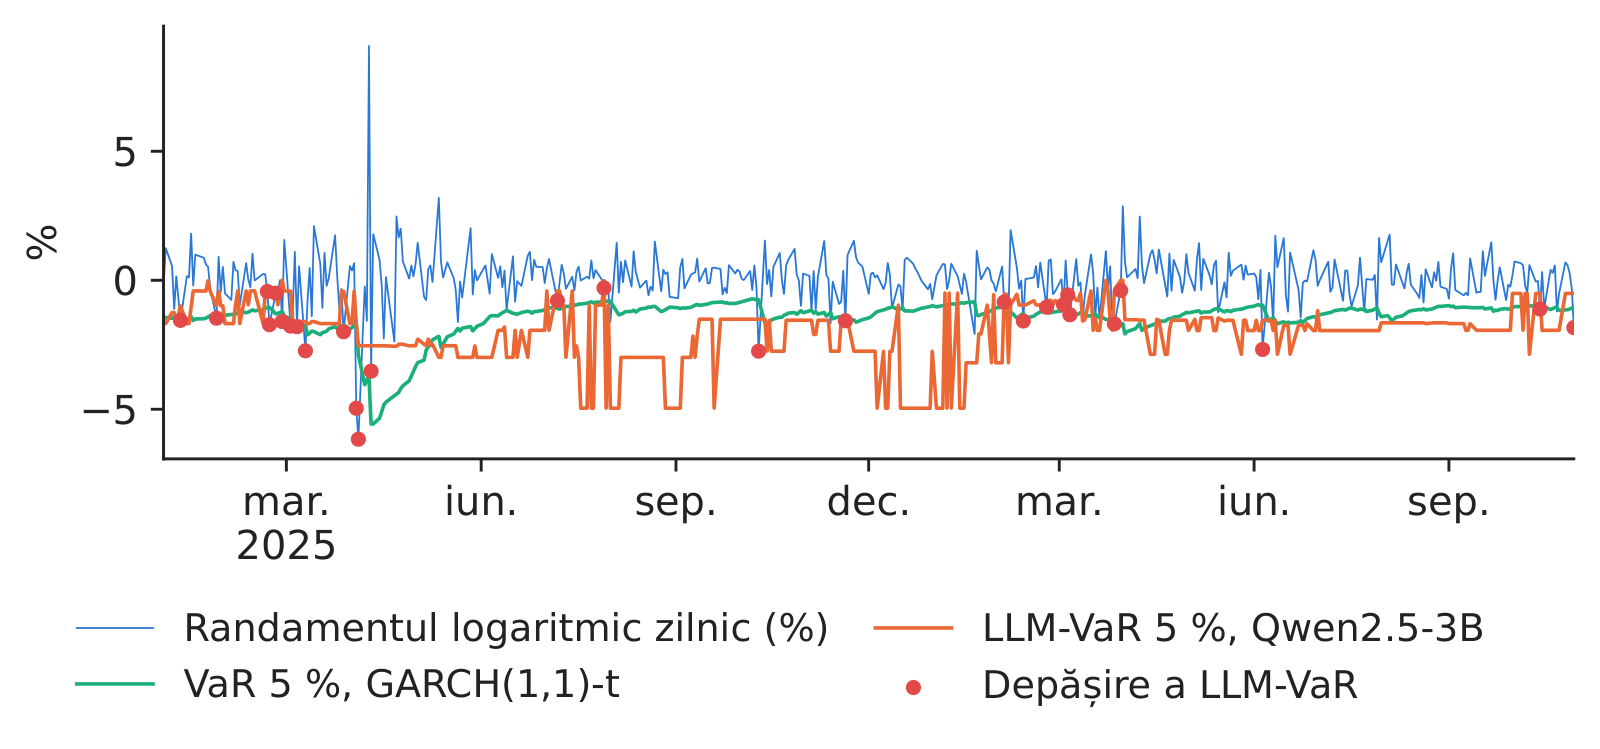
În cadrul LLM-VaR (Pele et al., 2026), un model general citește ultimele 250 de randamente zilnice într-un prompt și scrie valoarea expusă la risc, fără estimare și fără ajustare fină. Testăm ideea cu un model deschis de 3B pe S&P 500, din 2 ianuarie 2025 pînă la 30 octombrie 2026 (459 de zile), față de simularea istorică (HS) și un model GARCH(1,1) cu erori Student-t, cu testul Kupiec al acoperirii.

LLM-VaR cu un model deschis de 3B

Slide-ul 41 în PDF
Grafic: LLM-VaR cu un model deschis de 3B pe S&amp;P 500

Randamentele S&P 500 cu LLM-VaR de 5 % și VaR GARCH.

Sursa: Yahoo Finance, cotații zilnice. Date: 2 ianuarie 2025 - 30 octombrie 2026, S&P 500, zile de tranzacționare.

La 5 %, LLM-VaR a fost depășită de 28 de ori, GARCH de 35 de ori, iar simularea istorică de 23 de ori, față de 23,0 depășiri așteptate. VaR medie de 5 % a modelului mic este −1,99 %, față de −1,42 % pentru GARCH, iar cele două serii sînt aproape necorelate (0,05): modelul de 3B obține acoperirea fiind prudent, nu urmărind volatilitatea.

Testarea retrospectivă

Slide-ul 42 în PDF
ModelDepășiri 1 %p Kupiec (1 %)Depășiri 5 %p Kupiec (5 %)
LLM-VaR (Qwen2.5-3B)40,777280,295
Simularea istorică60,528230,991
GARCH(1,1)-t90,067350,016

Studiul publicat a evaluat modele generale mult mai mari; rezultatele de aici descriu doar un model de 3B rulat pe laptop.

Riscuri și guvernanță

Șase riscuri și testul pentru fiecare

Slide-ul 44 în PDF

Halucinațiile (86,2 % nume greșite fără documente) se controlează prin RAG cu surse; scurgerea datelor, prin testare pe texte scrise după limita datelor de antrenare; sensibilitatea la prompt (12,9 puncte), prin alegerea și fixarea prompturilor pe date de validare; calibrarea (ECE 4,7 % zero-shot), prin verificare și, la nevoie, recalibrare pe date de validare; costul, prin cel mai mic model care trece testul; protecția datelor, prin modele locale și prin obligațiile din Regulamentul Uniunii Europene (UE) privind inteligența artificială (AI), pentru utilizările cu risc ridicat precum scoringul de credit.

Explorați vizual

Instrumente interactive gratuite și ghiduri ilustrate pentru acest curs; cele mai multe rulează în browser.

  • Transformer Explainer: temperatura din acest curs pe un GPT-2 care rulează în browser: la temperatură mică o continuare ia aproape toată probabilitatea, la temperatură mare tokenii improbabili devin plauzibili.
  • Mixture of experts (M. Grootendorst): un router trimite fiecare token la cîțiva experți, astfel că modelul poate avea mulți parametri, dar folosește doar o parte dintre ei pentru fiecare token.
  • LLM Inference Handbook: ce se întîmplă între prompt și răspuns: procesarea promptului (prefill), decodarea token cu token, memoria cache pentru keys și values și timpul pînă la primul token.
  • LLM Visualization (B. Bycroft): aceeași arhitectură la mai multe dimensiuni, de la un GPT mic la GPT-2 și GPT-3.

Sinteza secțiunii

Un prompt este un model: măsurați-l pe date etichetate, cu intervale, rulări repetate și reformulări; ancorați răspunsurile în documente; testați retrospectiv orice cifră de risc.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

AIinteligență artificială
APIinterfață de programare a aplicațiilor
ASEAcademia de Studii Economice din București
BCEBanca Centrală Europeană
BERTreprezentări bidirecționale ale codificatorului transformer
BM25funcția de ordonare Best Matching 25
BPEcodificare prin perechi de octeți (byte-pair encoding)
DPOoptimizarea directă a preferințelor
ECEeroarea de calibrare așteptată
ESpierderea așteptată în coada distribuției (expected shortfall)
FinBERTmodel BERT adaptat textelor financiare
GARCHheteroscedasticitate condiționată autoregresivă generalizată
GPTtransformer generativ preantrenat
HSsimulare istorică
IPEInstitutul de Prognoză Economică, Academia Română
KLdivergența Kullback–Leibler
LLMmodel lingvistic mare
LoRAadaptare de rang mic (low-rank adaptation)
LRraportul de verosimilitate
MRRrangul reciproc mediu
RAGgenerare augmentată prin regăsire (retrieval-augmented generation)
RLHFreinforcement learning from human feedback
SFTajustare fină supervizată
TF-IDFfrecvența termenului–frecvența inversă în documente
UEUniunea Europeană
VaRvaloarea expusă la risc (Value-at-Risk)

Bibliografie

  • Amza, A., Bolovăneanu, V. & Pele, D. T. (2026). Inflation forecasting with monetary policy narratives: Evidence from an emerging economy. Proceedings of the International Conference on Business Excellence, 20(1), 75–83. doi:10.2478/picbe-2026-0012
  • Brown, T. B. et al. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33. arXiv:2005.14165
  • Guo, C., Pleiss, G., Sun, Y. & Weinberger, K. Q. (2017). On calibration of modern neural networks. Proceedings of the 34th International Conference on Machine Learning, 1321–1330. arXiv:1706.04599
  • Hoffmann, J. et al. (2022). Training compute-optimal large language models. Advances in Neural Information Processing Systems, 35. arXiv:2203.15556
  • Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L. & Chen, W. (2022). LoRA: Low-rank adaptation of large language models. International Conference on Learning Representations. arXiv:2106.09685
  • Kaplan, J. et al. (2020). Scaling laws for neural language models. arXiv:2001.08361
  • Kupiec, P. H. (1995). Techniques for verifying the accuracy of risk measurement models. The Journal of Derivatives, 3(2), 73–84. doi:10.3905/jod.1995.407942
  • Lewis, P. et al. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33. arXiv:2005.11401
  • Malo, P., Sinha, A., Korhonen, P., Wallenius, J. & Takala, P. (2014). Good debt or bad debt: Detecting semantic orientations in economic texts. Journal of the Association for Information Science and Technology, 65(4), 782–796. doi:10.1002/asi.23062
  • Ouyang, L. et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35. arXiv:2203.02155
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the Word: LLM-VaR and LLM-ES. Expert Systems with Applications, 295, 128676. doi:10.1016/j.eswa.2025.128676
  • Qwen Team (2024). Qwen2.5 technical report. arXiv:2412.15115
  • Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D. & Finn, C. (2023). Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36. arXiv:2305.18290
  • Robertson, S. & Zaragoza, H. (2009). The probabilistic relevance framework: BM25 and beyond. Foundations and Trends in Information Retrieval, 3(4), 333–389. doi:10.1561/1500000019
  • Sennrich, R., Haddow, B. & Birch, A. (2016). Neural machine translation of rare words with subword units. Proceedings of the 54th Annual Meeting of the ACL, 1715–1725. doi:10.18653/v1/P16-1162
  • Tak, R. & Pele, D. T. (2025). LLM-driven stock prediction: Capturing market trends with LLaMA. Proceedings of the International Conference on Business Excellence, 19(1), 529–540. doi:10.2478/picbe-2025-0043
  • Wei, J. et al. (2022). Chain-of-thought prompting elicits reasoning in large language models. Advances in Neural Information Processing Systems, 35. arXiv:2201.11903
  • Xiao, S., Liu, Z., Zhang, P. & Muennighoff, N. (2023). C-Pack: Packaged resources to advance general Chinese embedding (BAAI general embedding). arXiv:2309.07597
  • Zhao, Z., Wallace, E., Feng, S., Klein, D. & Singh, S. (2021). Calibrate before use: Improving few-shot performance of language models. Proceedings of the 38th International Conference on Machine Learning, 12697–12706. arXiv:2102.09690

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.