Cursul 3
Regularizare și generalizare
Prof. dr. Daniel Traian PELE
Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)
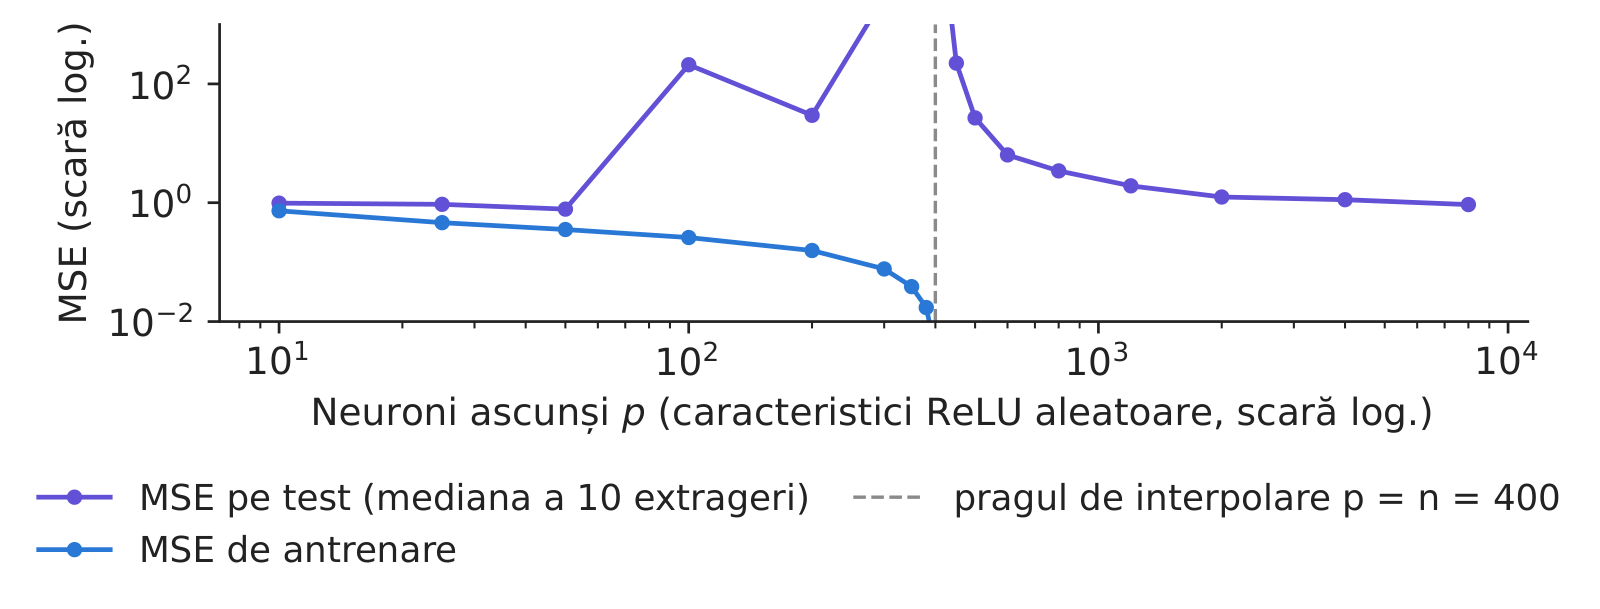
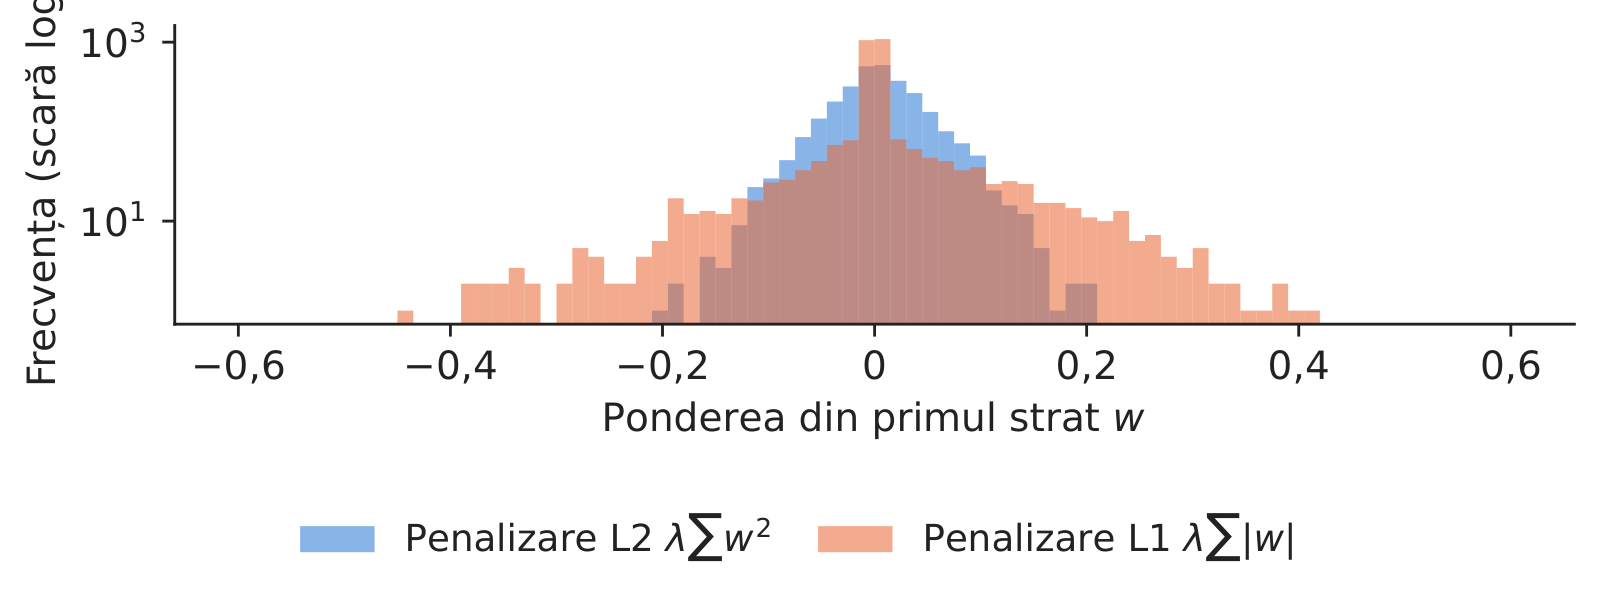
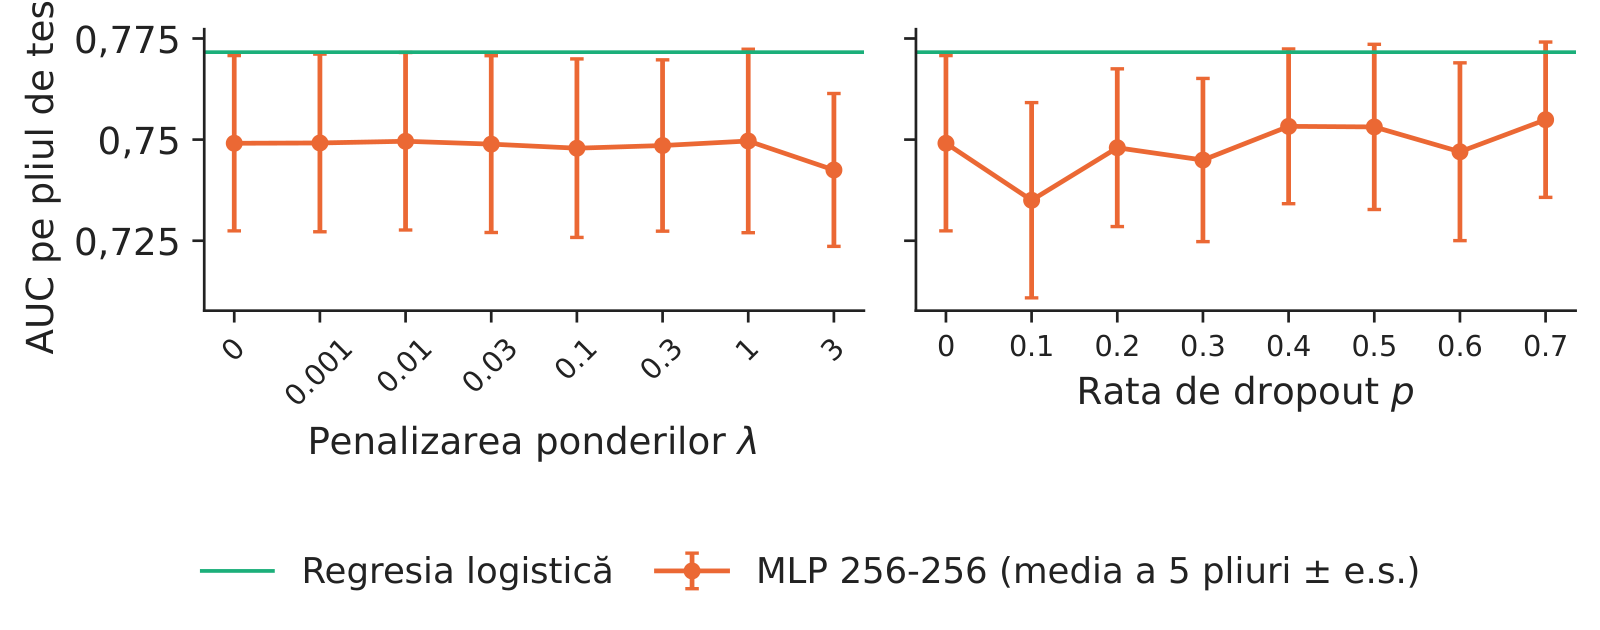
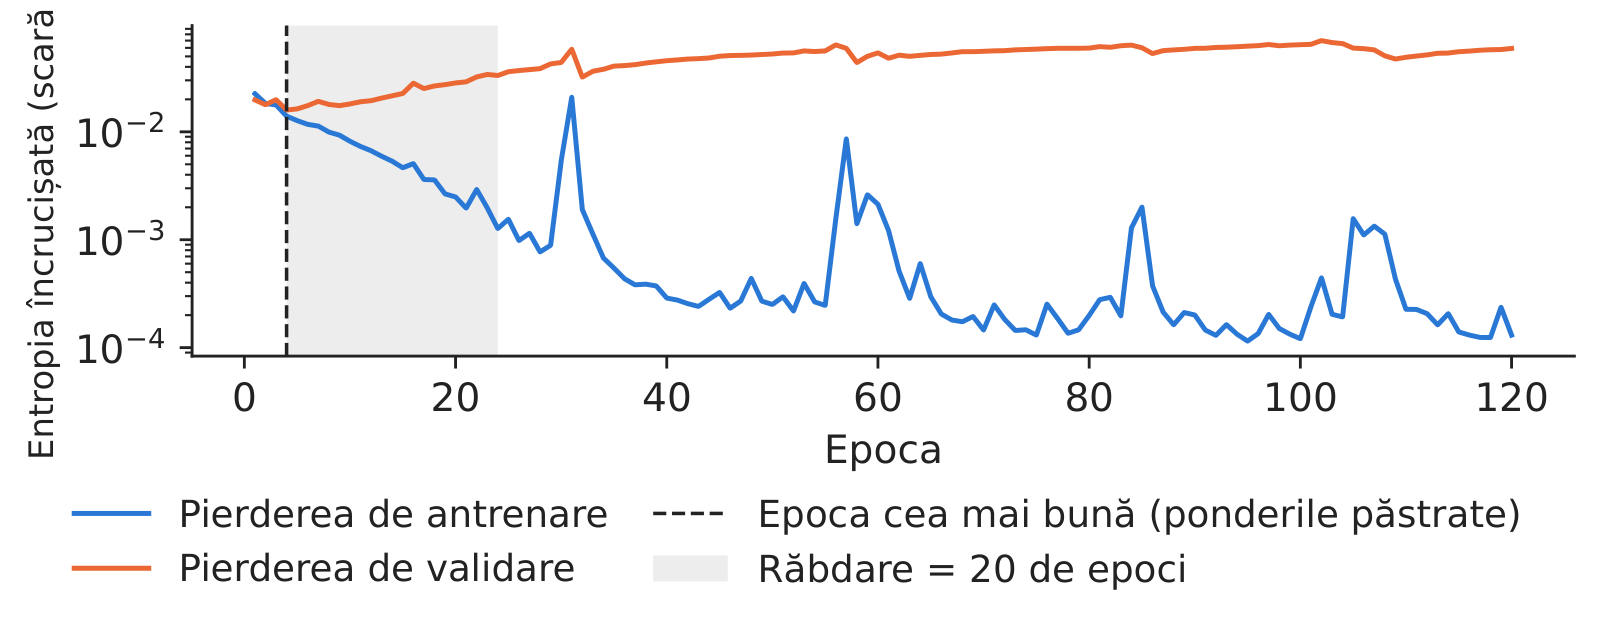
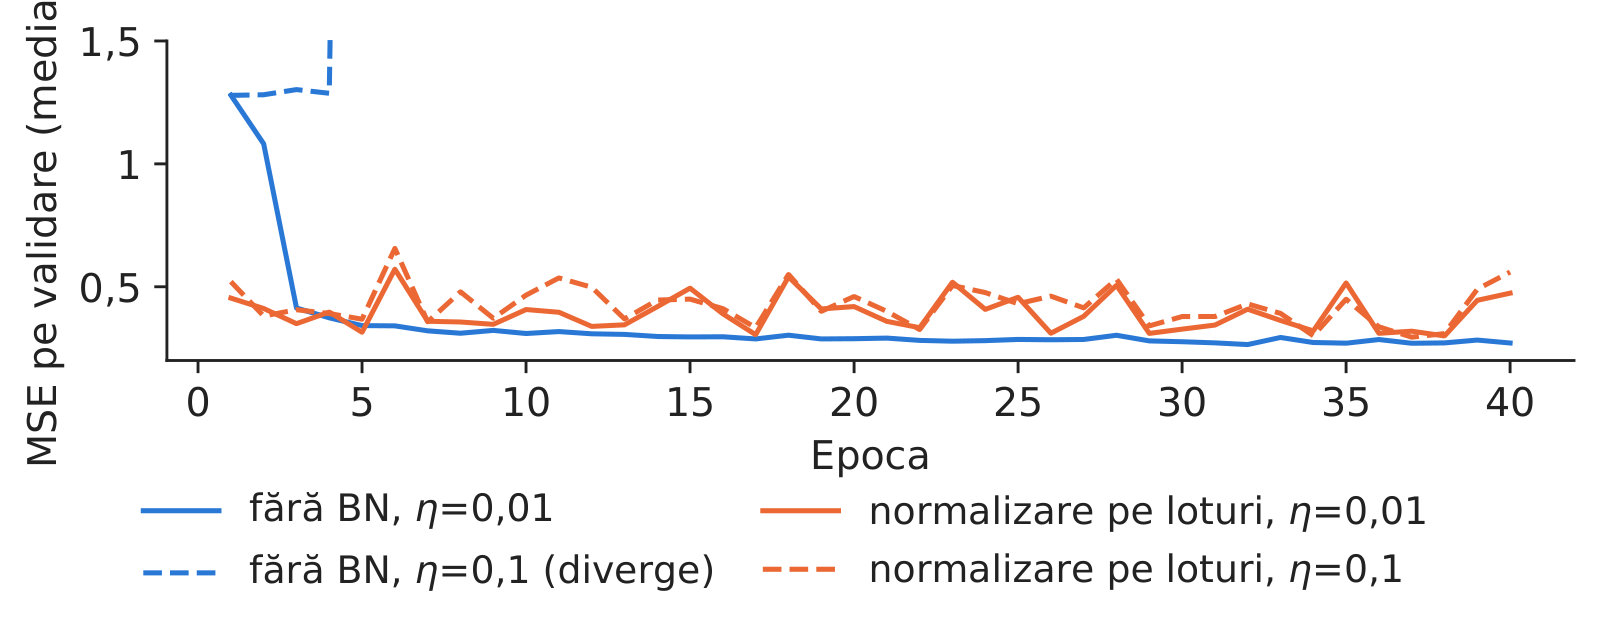
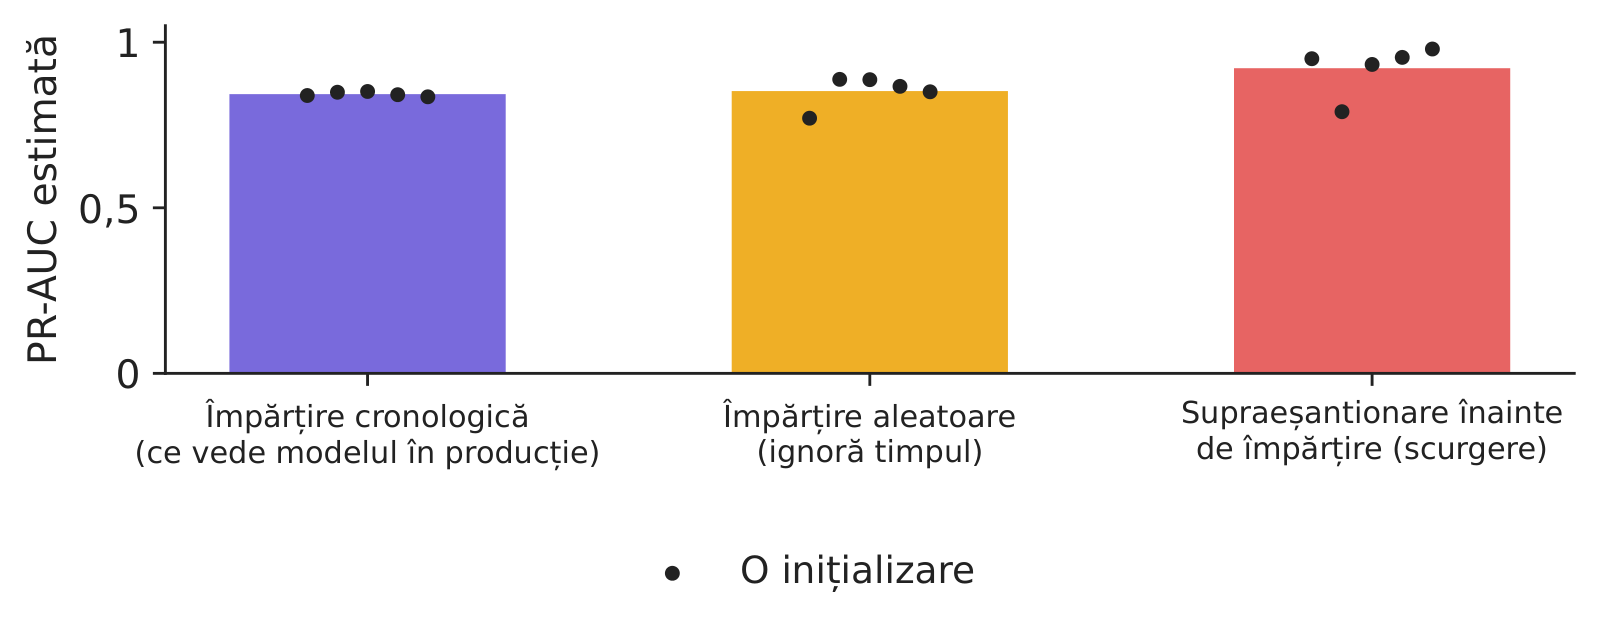
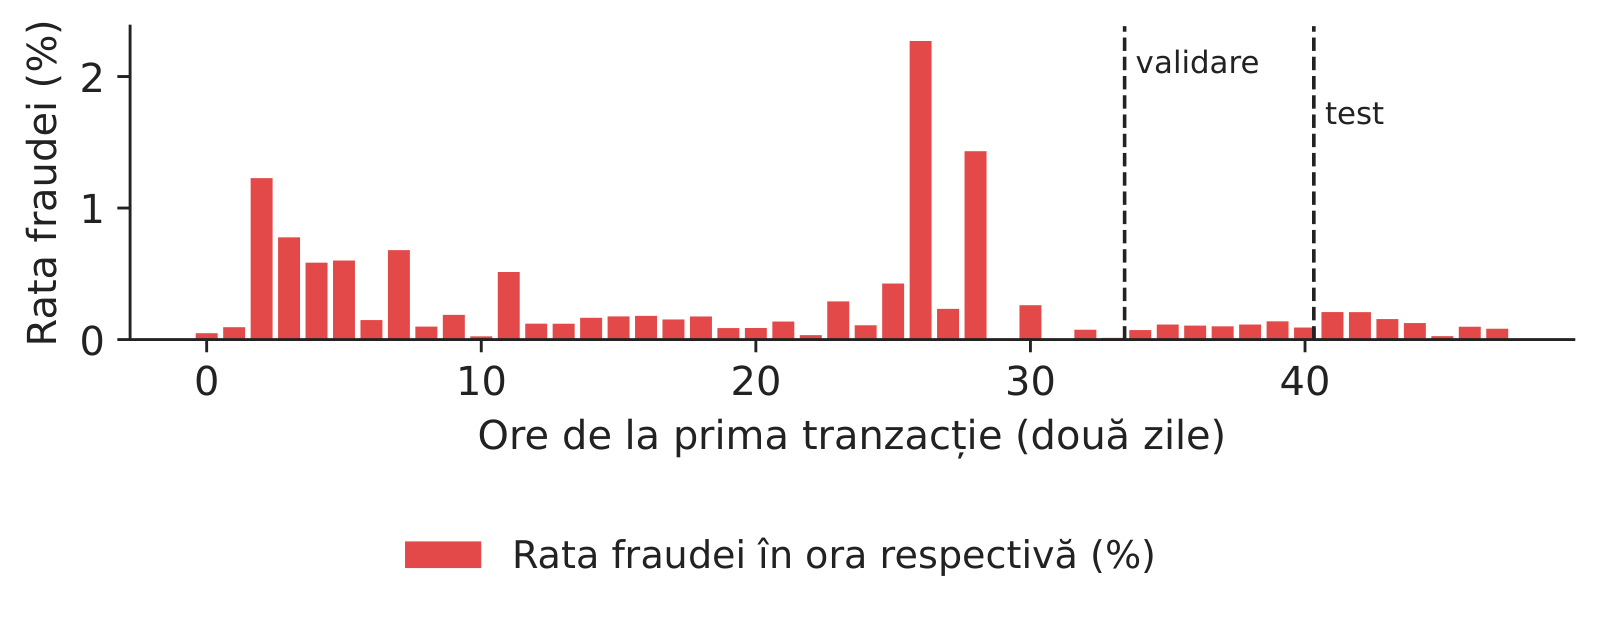
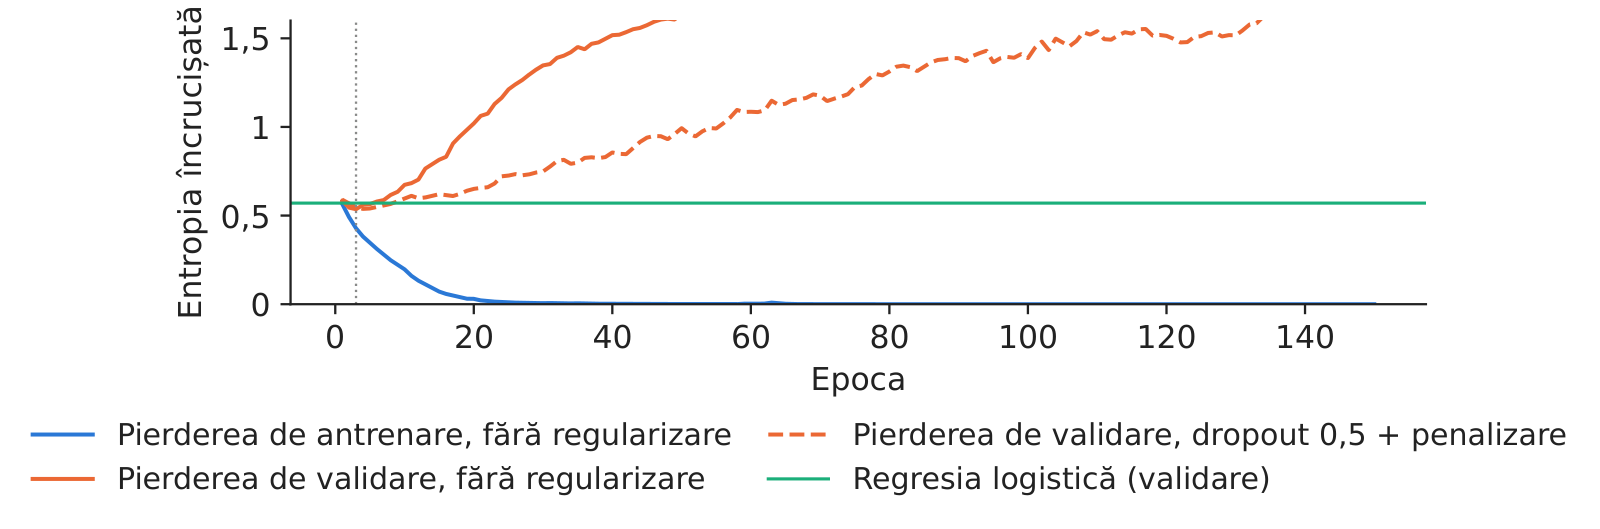
O rețea care se potrivește perfect datelor de antrenare poate eșua totuși la următorul solicitant sau la următoarea plată. Acest curs tratează diferența dintre cele două situații: de ce apare, cum o reduc penalizările, dropout, oprirea timpurie și normalizarea pe loturi și cum se proiectează o schemă de validare care o măsoară corect. Studiul de caz este frauda cu carduri, unde evenimentul este rar, datele sosesc în ordine cronologică, iar o împărțire neatentă poate face ca un detector mediocru să pară excelent.
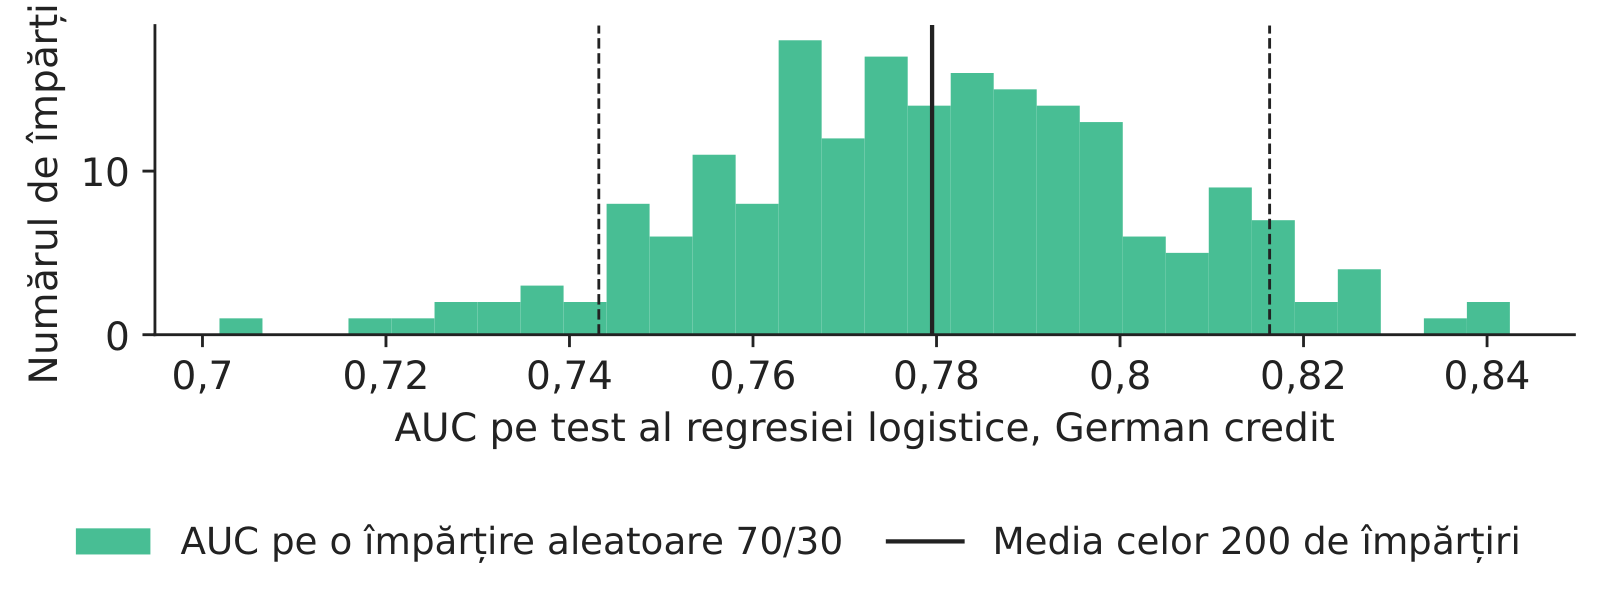
Folosim trei seturi de date reale: 600 de solicitanți de antrenare din German credit, din colecția Universității California din Irvine (UCI), grupurile de locuințe din recensămîntul Californiei și 28 924 de plăți cu cardul de la Université libre de Bruxelles (ULB) și Worldline, cu toate cele 492 de fraude. Fiecare model este un perceptron multistrat (MLP) antrenat în PyTorch, comparat cu regresia logistică și, pentru fraudă, cu extreme gradient boosting (XGBoost), întotdeauna cu mai multe inițializări.


 NN_L3_overfit_german