Cursul 4: Rețele neuronale convoluționale (CNN) și transferul învățării
Cursul 4
Rețele neuronale convoluționale (CNN) și transferul învățării
Prof. dr. Daniel Traian PELE
Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie Academia Română, Institutul de Prognoză Economică (IPE)
O fotografie de produs, o imagine satelitară sau un document scanat sînt tabele de numere, iar o firmă care primește mii de astfel de imagini pe zi vrea un model care să le claseze. Un perceptron multistrat (MLP), rețeaua din cursurile 1–3, poate primi pixelii ca intrări, dar tratează pixelii vecini ca fiind fără legătură și are nevoie de o pondere pentru fiecare pixel și fiecare unitate ascunsă. O rețea neuronală convoluțională (CNN) glisează în schimb același filtru mic peste întreaga imagine. Are nevoie de mult mai puțini parametri, recunoaște un tipar oriunde ar apărea și, cu cîteva straturi, construiește din muchii părți, iar din părți obiecte.
Cursul scrie stratul convoluțional ca formulă, antrenează trei modele pe 50 000 de fotografii reale de produse din catalogul Zalando, urmărește arhitecturile clasice, de la LeNet la ResNet, pe fotografiile CIFAR-10 ale Canadian Institute for Advanced Research (CIFAR), și se încheie cu transferul învățării pe imaginile satelitare Sentinel-2 privind utilizarea terenului (EuroSAT), tipul de date folosit de creditorii agricoli, de asigurători și de investitorii imobiliari.
Ce veți ști să faceți
Să scrieți un strat convoluțional ca formulă: nucleu, completarea marginilor, pas, canale, parametri și cîmp receptiv.
Să explicați de ce o CNN are nevoie de mult mai puțini parametri decît un MLP pe imagini și să verificați acest lucru pe date reale.
Să citiți arhitecturile clasice și conexiunea reziduală care face antrenabile rețelele adînci.
Să folosiți transferul învățării atunci cînd imaginile etichetate sînt scumpe și să măsurați cît economisește.
Să explicați o predicție cu o hartă de activare a clasei și să transformați predicțiile pe imagini în cifre utile în afaceri.
Arhitecturi: de la LeNet la ResNetLeNet-5 (1998) a introdus convoluția și subeșantionarea pentru cifre; AlexNet (2012) a antrenat o CNN adîncă pe procesoare grafice; rețelele Visual Geometry Group (VGG, 2015) folosesc numai nuclee de 3 × 3; ResNet (2016) a adăugat conexiunile reziduale, care fac antrenabile rețelele cu peste o sută de straturi.
Cercetări ale grupului nostruCadrul multimodal viziune–limbaj pentru detectarea anomaliilor financiare al lui Jheng, Pele, Tak și Găman (2026), distins cu premiul Best Paper la International Conference on Business Excellence (ICBE) 2026, proiectează indicatorii de piață într-o imagine standardizată cu mai multe panouri și lasă un model viziune–limbaj (GPT-4.1) să clasifice regimurile pieței, cu etichete din cuantile glisante și justificări structurate în limbaj natural; testele în afara eșantionului pe S&P 500 arată o fidelitate promițătoare în detectarea anomaliilor sistemice.
Imaginile ca date și motivarea convoluțiilor
O imagine este o matrice de numere, iar prima întrebare este cum ar trebui s-o privească un model.
O fotografie de produs este o matrice de numere
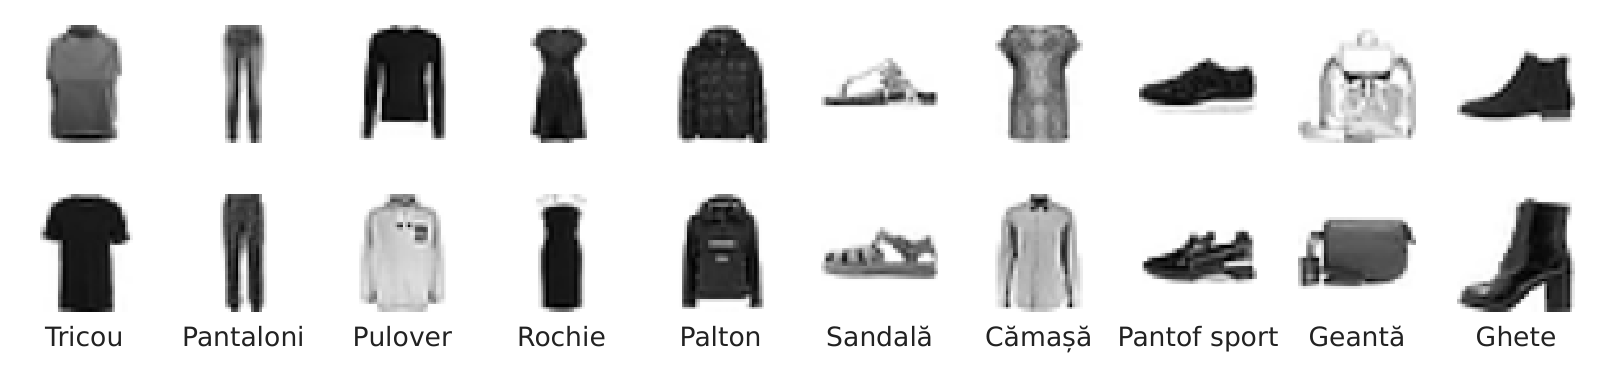
Fiecare imagine Fashion-MNIST este o matrice de 28 × 28 de niveluri de gri, provenită dintr-o fotografie de produs din catalogul online Zalando, iar sarcina este de a o asocia unuia dintre cele zece tipuri de produse. Păstrăm 50 000 de imagini pentru antrenare, 10 000 pentru validare (oprirea timpurie) și 10 000 pentru testul final, folosit o singură dată.
Două imagini de antrenare pentru fiecare dintre cele zece tipuri de produse.
Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: 60.000 de imagini de antrenare, 28 x 28 niveluri de gri.
În practică: un magazin online etichetează zilnic mii de fotografii noi de produse; clasificatorul stabilește categoria, iar un operator verifică doar cazurile îndoielnice.
Un strat dens pe pixeli irosește parametri și ignoră spațiul
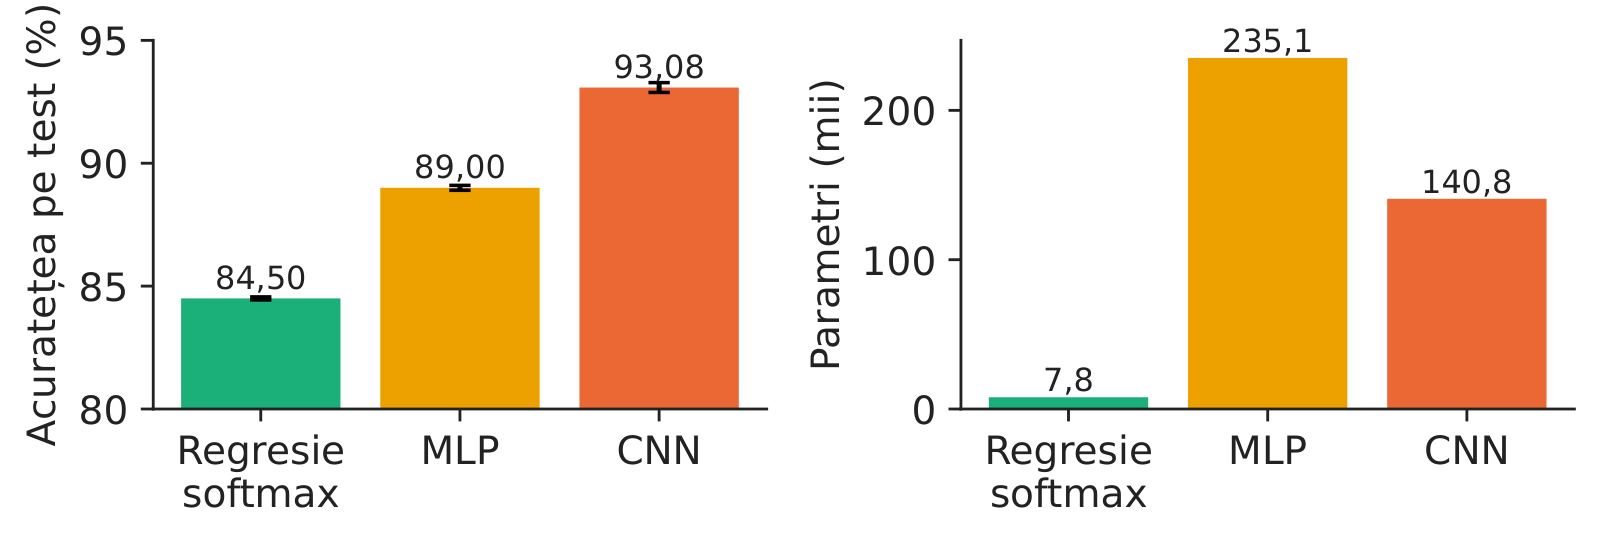
Un strat dens calculează \(\mathbf h=\sigma(\mathbf W\,\mathrm{vec}(\mathbf X)+\mathbf b)\), cu o pondere pentru fiecare pixel și fiecare unitate. Pentru o imagine color de 224 × 224 și 1 000 de unități ascunse, rezultă aproximativ 150 de milioane de ponderi numai în primul strat. O CNN se sprijină pe trei idei: conectivitatea locală (o unitate vede o zonă mică), partajarea ponderilor (același filtru în toate pozițiile) și echivarianța (o deplasare a intrării deplasează harta de trăsături). Pe datele noastre, MLP are 235 146 de parametri, iar CNN 140 778, de 1,67 ori mai puțini.
Stratul convoluțional
Convoluția: același filtru mic glisează peste imagine
Fiecare valoare de ieșire este o sumă ponderată a unei vecinătăți de \(k\times k\) din fiecare canal de intrare, plus un termen liber:
unde \(X_c\) este canalul de intrare \(c\), \(K_{o,c}\) nucleul de la canalul \(c\) la harta de ieșire \(o\), \(s\) pasul (stride), iar \(p\) completarea cu zerouri (padding). Rezultatul trece printr-o unitate liniară rectificată (ReLU), \(\max(0,z)\). Nucleele sînt învățate prin propagarea înapoi a erorii.
Filtrele construite de mînă găsesc deja drumurile și marginile parcelelor
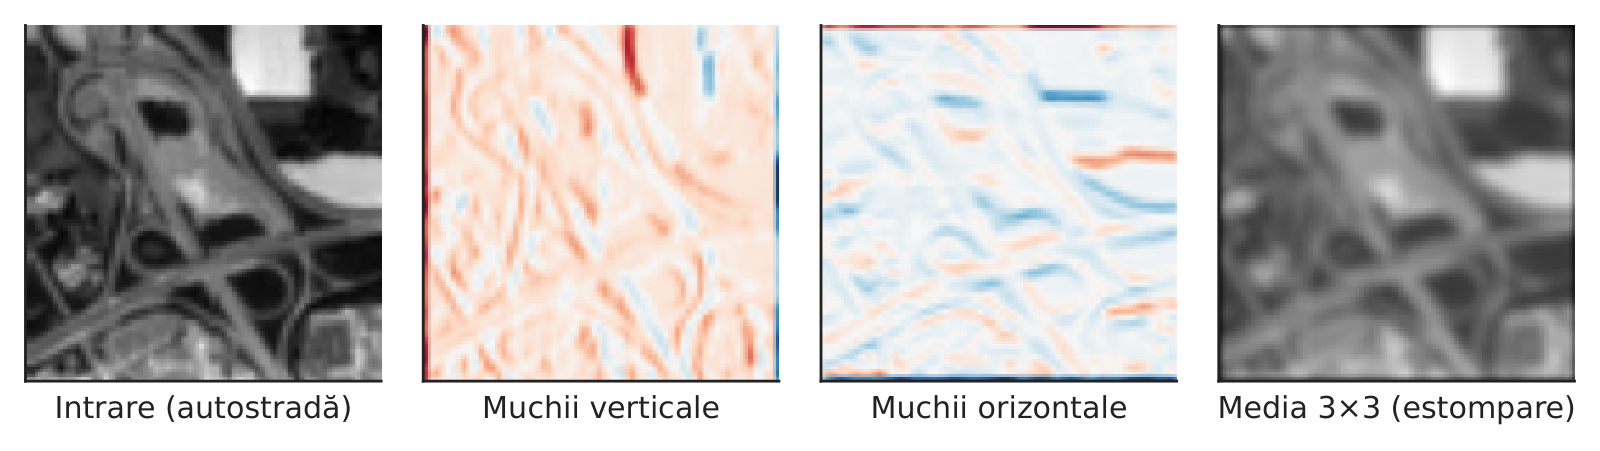
Înainte de orice învățare, un nucleu Sobel fix arată ce face un filtru: răspunde acolo unde luminozitatea se schimbă pe o direcție. Pe o imagine Sentinel-2 reală cu o autostradă, filtrele pentru muchii verticale și orizontale evidențiază drumul și marginile parcelelor, iar filtrul de medie estompează imaginea. O CNN învață zeci de astfel de nuclee în fiecare strat, în loc să le fixeze de mînă.
O imagine Sentinel-2 de 64 × 64 (clasa Autostradă) și trei nuclee fixe de 3 × 3, aplicate cu completare 1.
Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: o imagine Sentinel-2 de 64 x 64 (clasa Autostradă), niveluri de gri.
Înălțimea ieșirii este \(\lfloor (H_{\mathrm{in}}+2p-k)/s\rfloor+1\). Pentru o intrare de 64 de pixeli și un nucleu de 3 × 3, completarea 1 și pasul 1 păstrează 64 de pixeli, fără completare rămîn 62, iar pasul 2 înjumătățește harta, la 32. Un strat are \((k^2C_{\mathrm{in}}+1)C_{\mathrm{out}}\) parametri, oricare ar fi dimensiunea imaginii.
Agregarea, agregarea globală și cîmpul receptiv
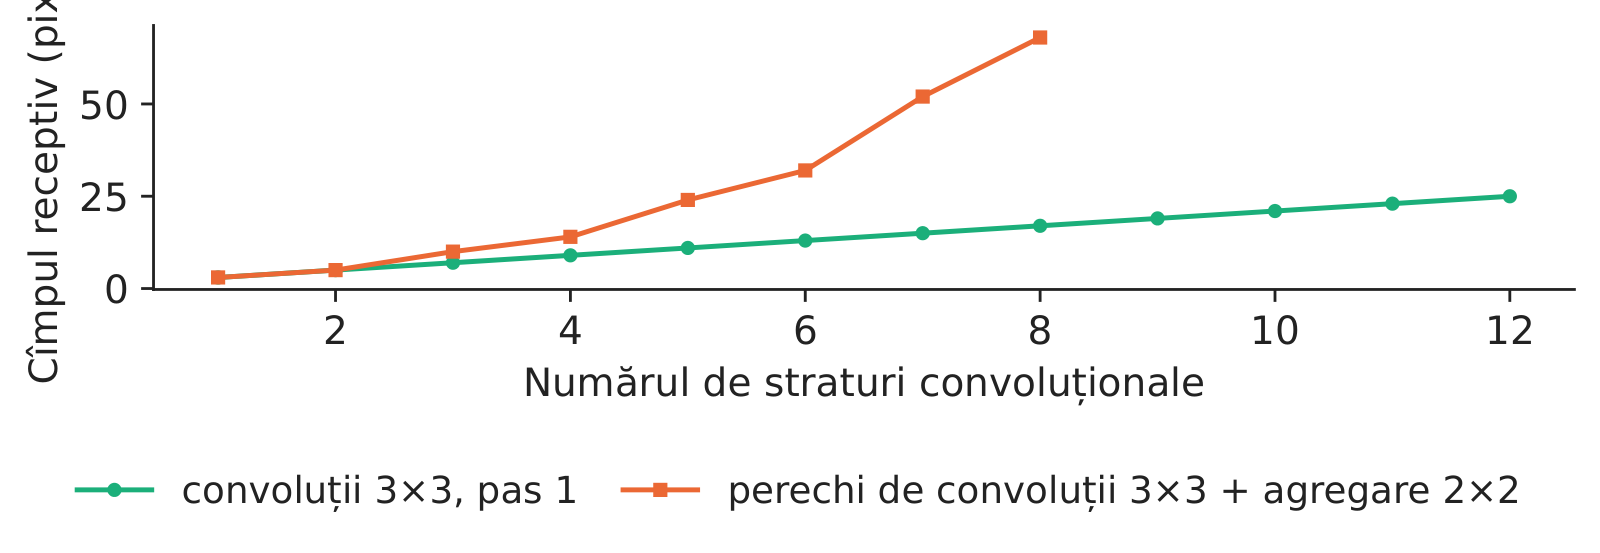
Agregarea prin maxim păstrează cel mai puternic răspuns din fiecare fereastră de 2 × 2 și înjumătățește harta; agregarea prin medie globală (GAP) reduce fiecare canal la un singur număr, astfel încît partea finală a rețelei nu mai are nevoie de un strat dens mare. Cîmpul receptiv, zona din intrare care poate influența o unitate, crește după recurența \(r_l=r_{l-1}+(k_l-1)\prod_{i<l}s_i\). Douăsprezece straturi 3 × 3 cu pasul 1 văd doar 25 × 25 pixeli; opt straturi cu agregare după fiecare pereche văd 68 × 68.
Cîmpul receptiv în funcție de adîncime, cu și fără agregare (calcul propriu din recurență).
Sursa: calcul propriu din recurența cîmpului receptiv. Date: recurența cîmpului receptiv, fără date.
Pentru că nucleul este partajat, gradientul lui adună contribuțiile tuturor pozițiilor, \(\partial\mathcal L/\partial K_{o,c}(u,v)=\sum_{i,j}\delta_o(i,j)X_c(is+u-p,js+v-p)\), iar gradientul în raport cu intrarea este tot o convoluție. Toate rețelele din curs folosesc normalizarea pe loturi (BN) după fiecare convoluție: fiecare canal este standardizat pe lot și pe poziții, apoi rescalat cu doi parametri învățați. La predicție, mediile mobile înlocuiesc statisticile lotului; de aceea trebuie apelat `model.eval()` înainte de predicție.
Studiu de caz: clasificarea fotografiilor de produse cu regresie softmax și CNN
Protocolul experimental pentru cele trei modele
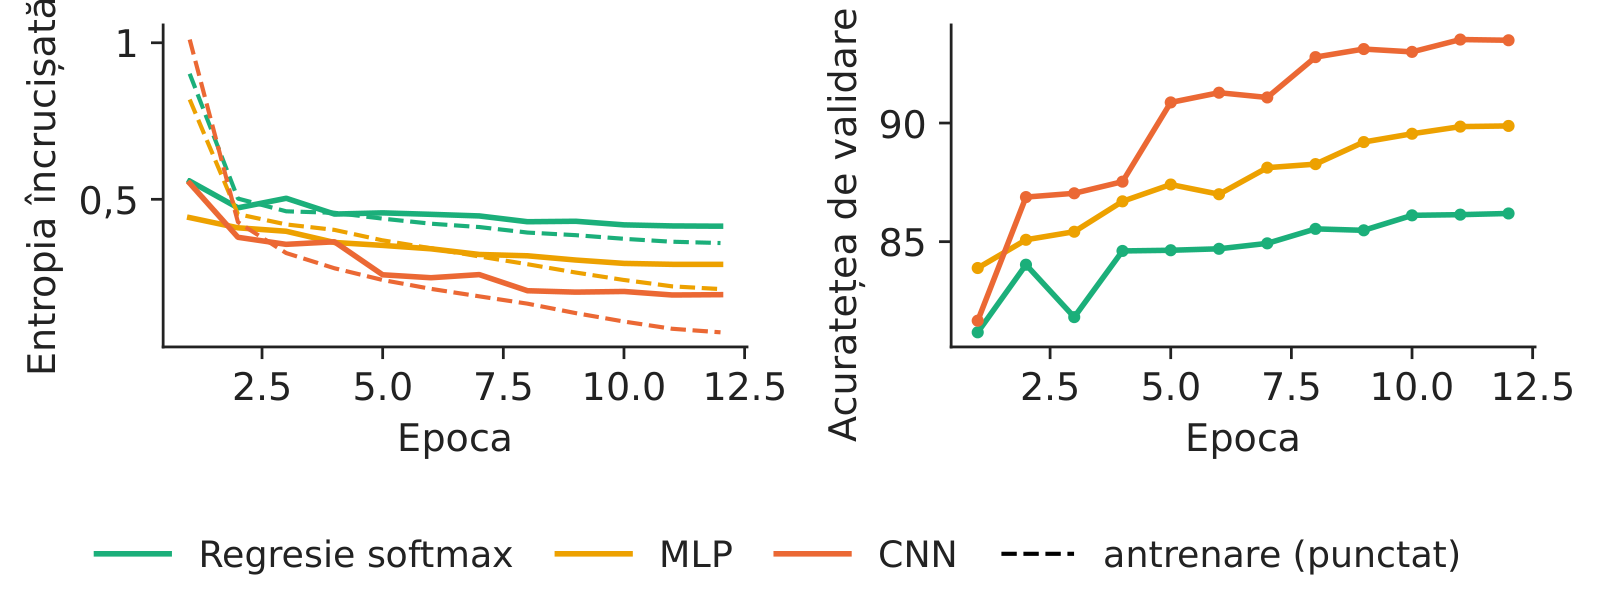
Modelul de referință este o regresie softmax (logistică multinomială) cu 7 850 de parametri; MLP are două straturi ascunse (256 și 128 de unități, 235 146 de parametri); CNN are două blocuri cu cîte două convoluții 3 × 3, normalizare pe loturi și agregare prin maxim, o a treia convoluție și agregare prin medie globală (140 778 de parametri). Toate trei sînt antrenate cu același optimizator (AdamW), loturi de 128, 12 epoci și oprire timpurie pe imaginile de validare, cu cîte trei semințe.
Entropia încrucișată la antrenare (punctat) și la validare (linie continuă) și acuratețea de validare, pe epoci (sămînța 20261108).
Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: 50.000 de imagini de antrenare și 10.000 de validare; sămînța 20261108.
Acuratețea și numărul de parametri ai celor trei modele
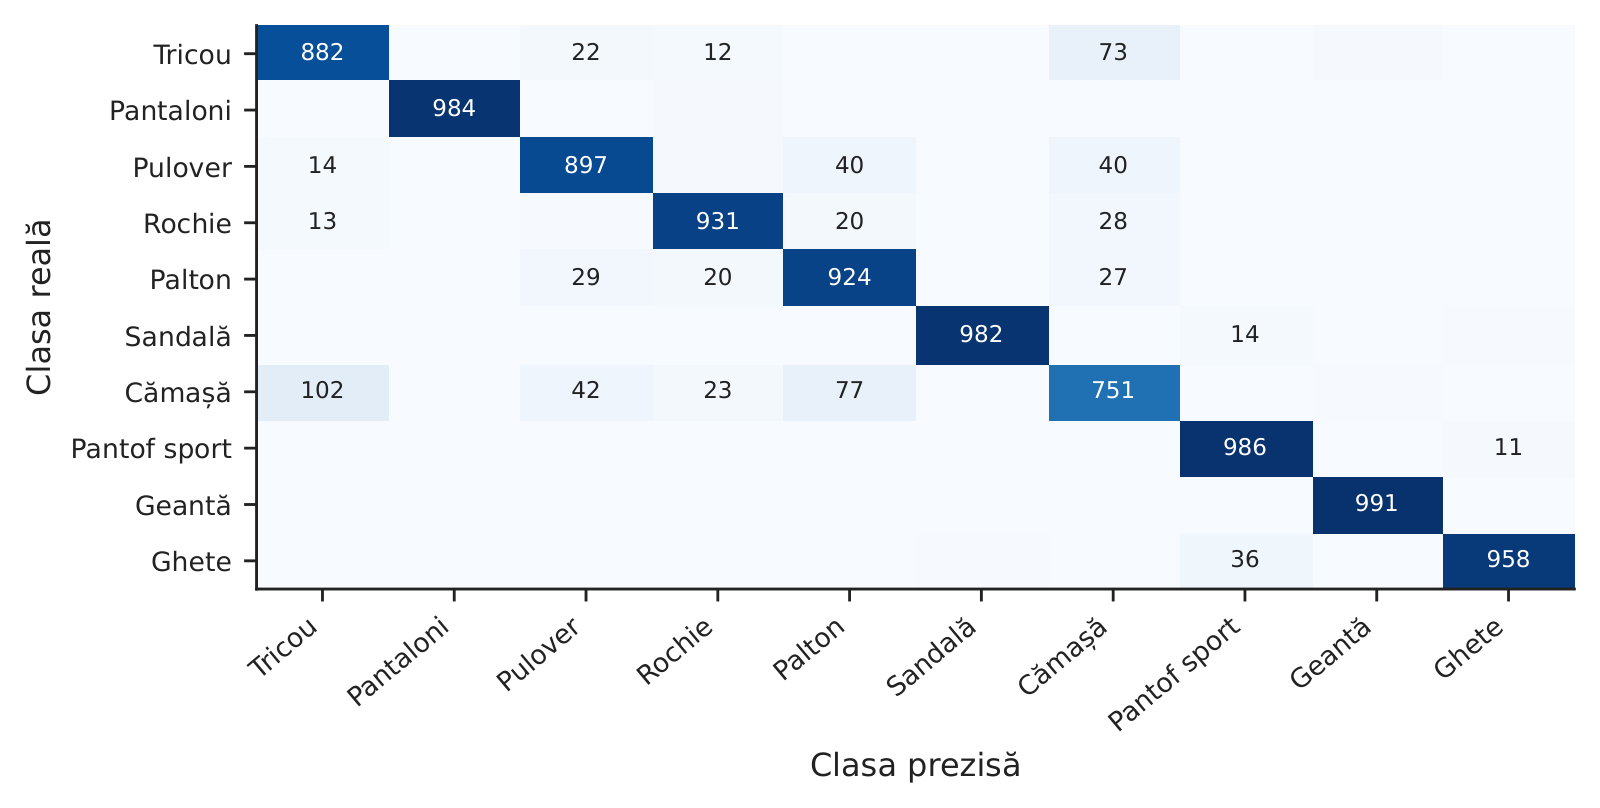
CNN atinge o acuratețe pe test de 93,08% (abaterea standard pe semințe 0,20), față de 89,00% pentru MLP și 84,50% pentru regresia softmax. Elimină 37,1% din erorile MLP, cu de 1,67 ori mai puțini parametri. Testul McNemar pe aceleași 10 000 de imagini de test (sămînța 20261108) numără 614 de imagini corecte doar pentru CNN și 226 de imagini corecte doar pentru MLP, o statistică de 178,3, mult peste valoarea critică de 3,84 la pragul de 5%.
Acuratețea pe test (media și abaterea standard pe trei semințe) și numărul de parametri.
Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: 10.000 de imagini de test; media și abaterea standard pe 3 semințe.
În practică: trimiteți la verificare umană doar fotografiile cu încredere scăzută din clasele slabe: costul erorilor scade acolo unde este cel mai mare.
Filtrele învățate și hărțile de trăsături
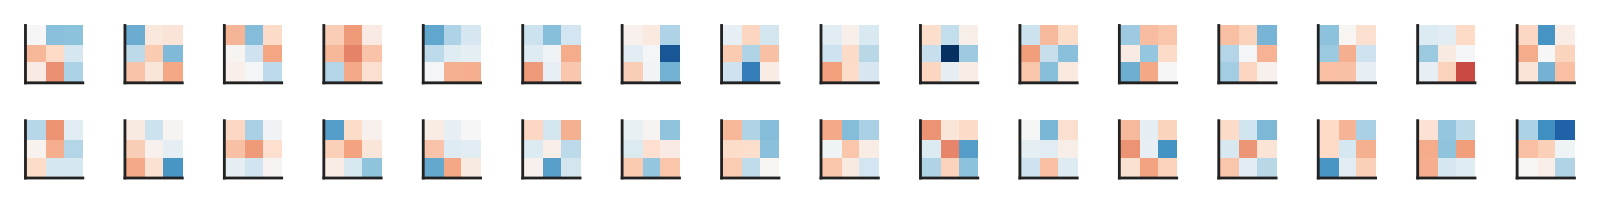
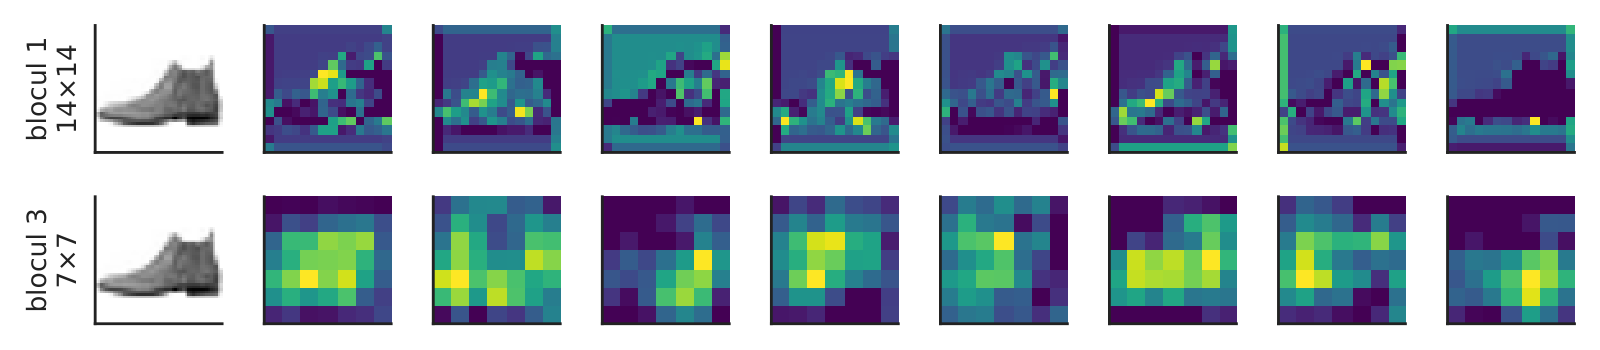
Filtrele din primul strat sînt mici detectori de muchii și contraste, găsiți de coborîrea pe gradient fără să fi fost ceruți. Straturile mai adînci le combină: hărțile de trăsături din blocul 1 păstrează conturul ghetei, iar cele din blocul 3 sînt mici (7 × 7), dar marchează locul părților informative.
Cele 32 de filtre de 3 × 3 din primul strat convoluțional (roșu: ponderi pozitive, albastru: negative).
Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: primul strat convoluțional al CNN (32 de filtre de 3 x 3), sămînța 20261108.
LeNet-5 (1998) a introdus convoluția și subeșantionarea pentru cifre; AlexNet (2012) a antrenat o CNN adîncă pe procesoare grafice; rețelele Visual Geometry Group (VGG, 2015) folosesc numai nuclee de 3 × 3; ResNet (2016) a adăugat conexiunile reziduale, care fac antrenabile rețelele cu peste o sută de straturi.
Conexiunile reziduale și augmentarea datelor pe CIFAR-10
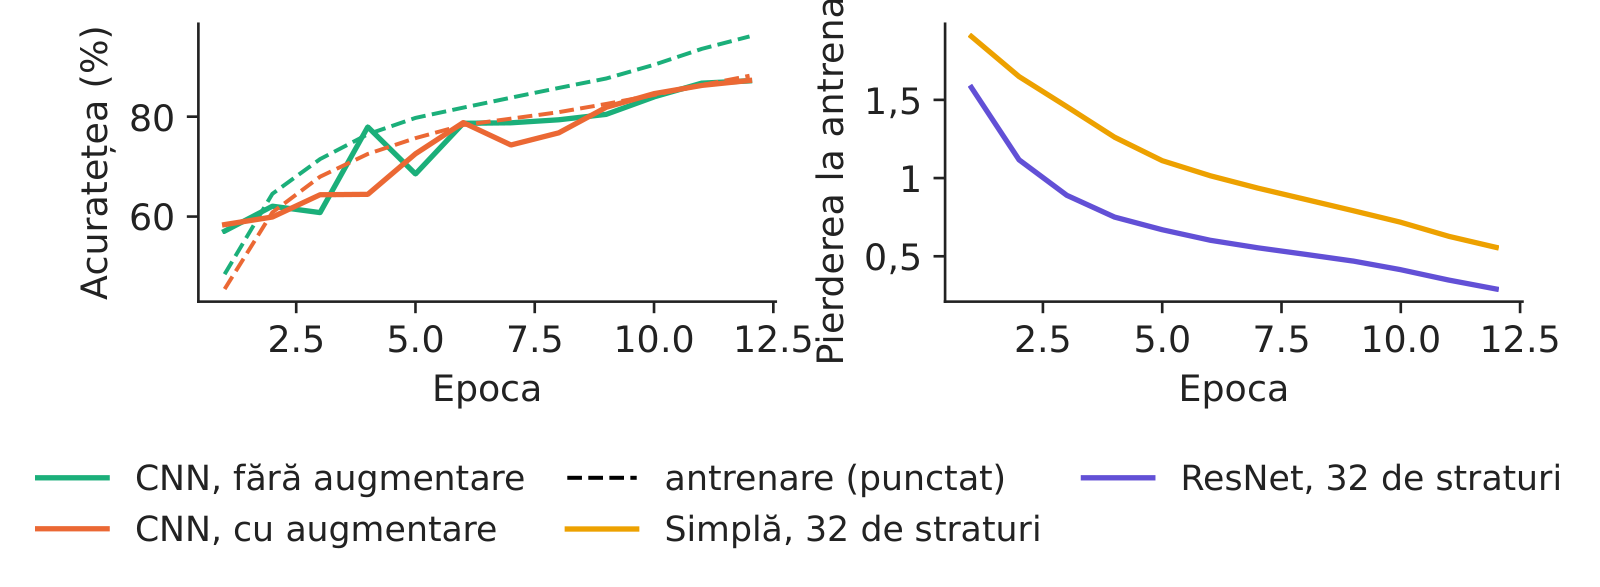
Un bloc rezidual își adună ieșirea la intrare, \(\mathbf y=\mathrm{ReLU}(\mathbf x+F(\mathbf x))\), astfel încît gradientul are mereu un drum direct înapoi. Fără el, rețelele adînci simple suferă de degradare: o rețea mai adîncă are o eroare de antrenare mai mare, o problemă de optimizare, nu de supraînvățare. Pe CIFAR-10, două rețele de 32 de straturi care diferă doar prin scurtătură ajung la o pierdere la antrenare de 0,557 (simplă) și 0,291 (reziduală) și la acurateți pe test de 79,96% și 87,81%.
Augmentarea datelor antrenează rețeaua pe transformări aleatoare care păstrează eticheta (decupări după completare, oglindiri orizontale). Pentru aceeași CNN mică și același buget, acuratețea pe test crește de la 86,56% la 86,86%, iar decalajul dintre acuratețea de antrenare și cea de validare scade de la 8,9 la 0,9 puncte.
Stînga: aceeași CNN, cu și fără augmentare (antrenare punctat, validare linie continuă). Dreapta: pierderea la antrenare a rețelelor simple și reziduale de 32 de straturi.
Sursa: CIFAR-10 (Krizhevsky, 2009). Date: 45.000 de imagini de antrenare și 5.000 de validare; sămînța 20261108.
Transferul învățării: utilizarea terenului din imagini satelitare
Imagini satelitare pentru creditori, asigurători și investitori
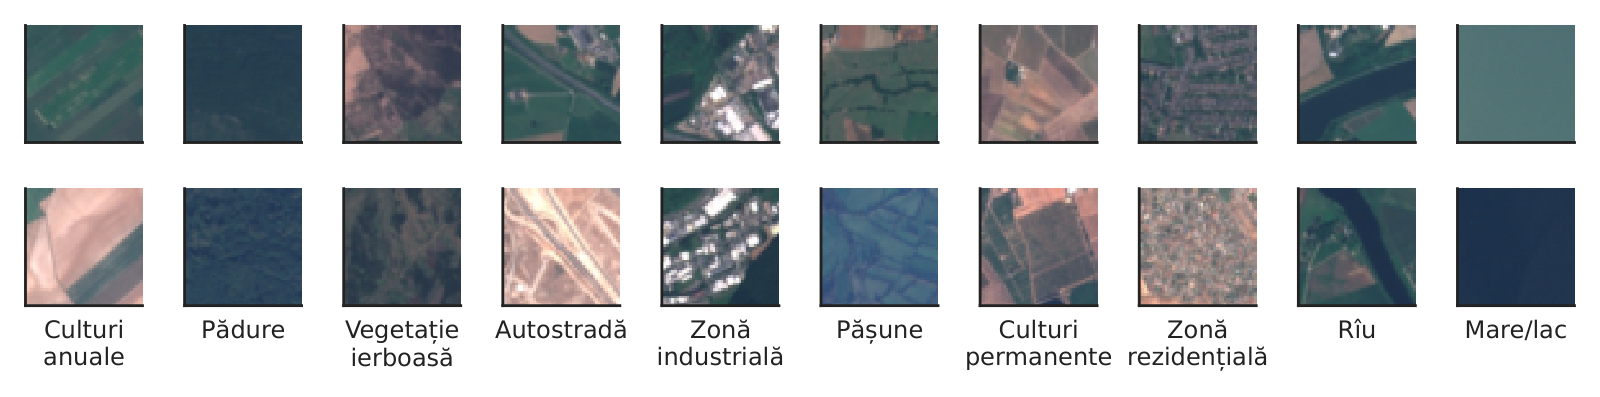
EuroSAT conține 27 000 de imagini Sentinel-2 de 64 × 64 pixeli, în zece clase de utilizare a terenului. Un creditor agricol poate verifica dacă un împrumut finanțează culturi; un asigurător poate cartografia zonele rezidențiale expuse inundațiilor. Etichetarea imaginilor cere timpul unui expert, deci întrebarea este cîte etichete sînt suficiente.
Două imagini de antrenare pentru fiecare dintre cele zece clase de utilizare a terenului.
Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 27.000 de imagini de 64 x 64 pixeli, 10 clase.
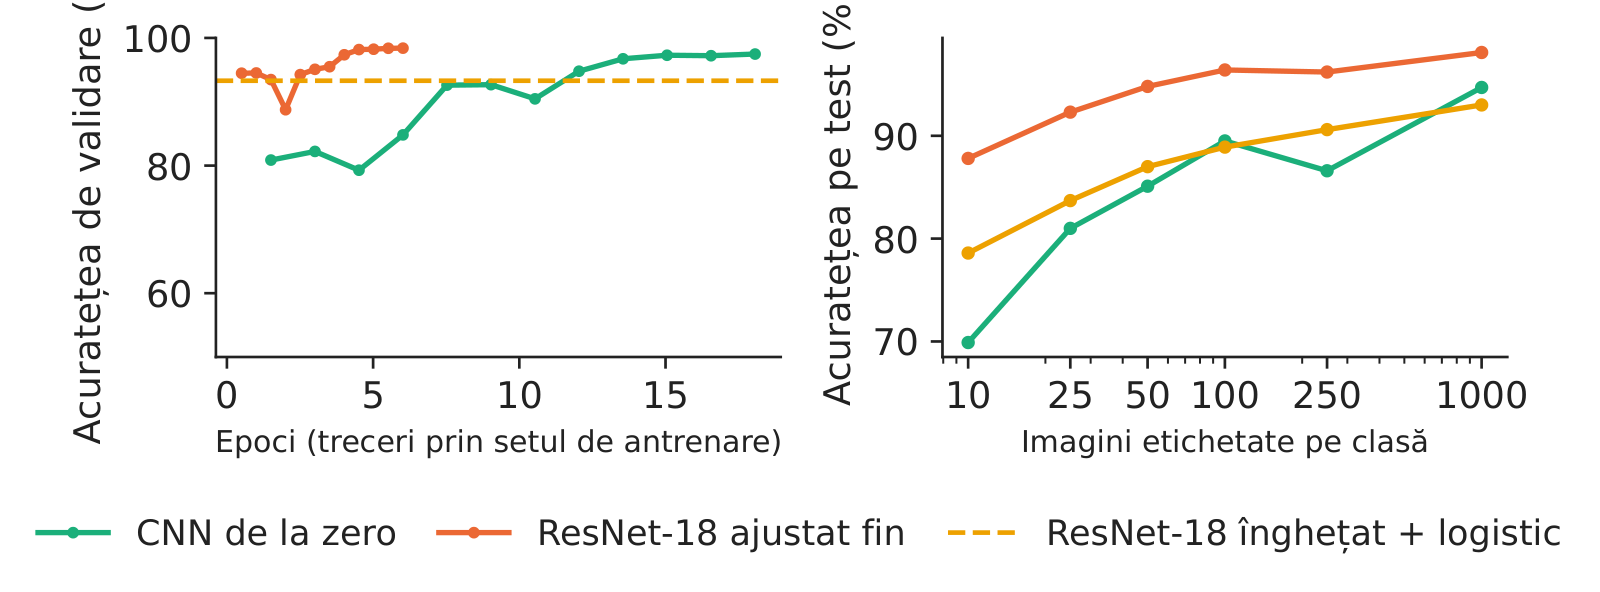
Transferul învățării împarte rețeaua într-un corp \(\phi_{\omega}\), preantrenat pe fotografiile ImageNet, și un nou strat final \(g_{\psi}\) cu zece ieșiri. Extragerea trăsăturilor îngheață corpul și estimează doar stratul final (aici, o regresie logistică pe 512 trăsături); ajustarea fină antrenează toate ponderile, cu o rată de învățare mai mică pentru corp. Modelul de referință este o CNN antrenată de la zero pe aceleași imagini. Împărțirea este stratificată: 16 200 de imagini de antrenare, 5 400 de validare și 5 400 de test.
Cu toate etichetele, CNN antrenată de la zero atinge 97,78% pe imaginile de test, ResNet-18 înghețat cu strat final logistic 93,48%, iar ResNet-18 ajustat fin 98,76%. Cu doar 10 imagini etichetate pe clasă, valorile sînt 69,9%, 78,6% și 87,8%: transferul contează cel mai mult cînd etichetele sînt rare.
Stînga: acuratețea de validare în timpul antrenării. Dreapta: acuratețea pe test în funcție de numărul de imagini etichetate pe clasă (media a două extrageri aleatoare).
Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 16.200 de imagini de antrenare, 5.400 de validare, 5.400 de test; dreapta: media pe 2 semințe.
În practică: etichetarea unei imagini costă un minut de lucru al unui expert; transferul învățării transformă săptămîni de etichetare într-o după-amiază.
Erorile rămase și explicațiile
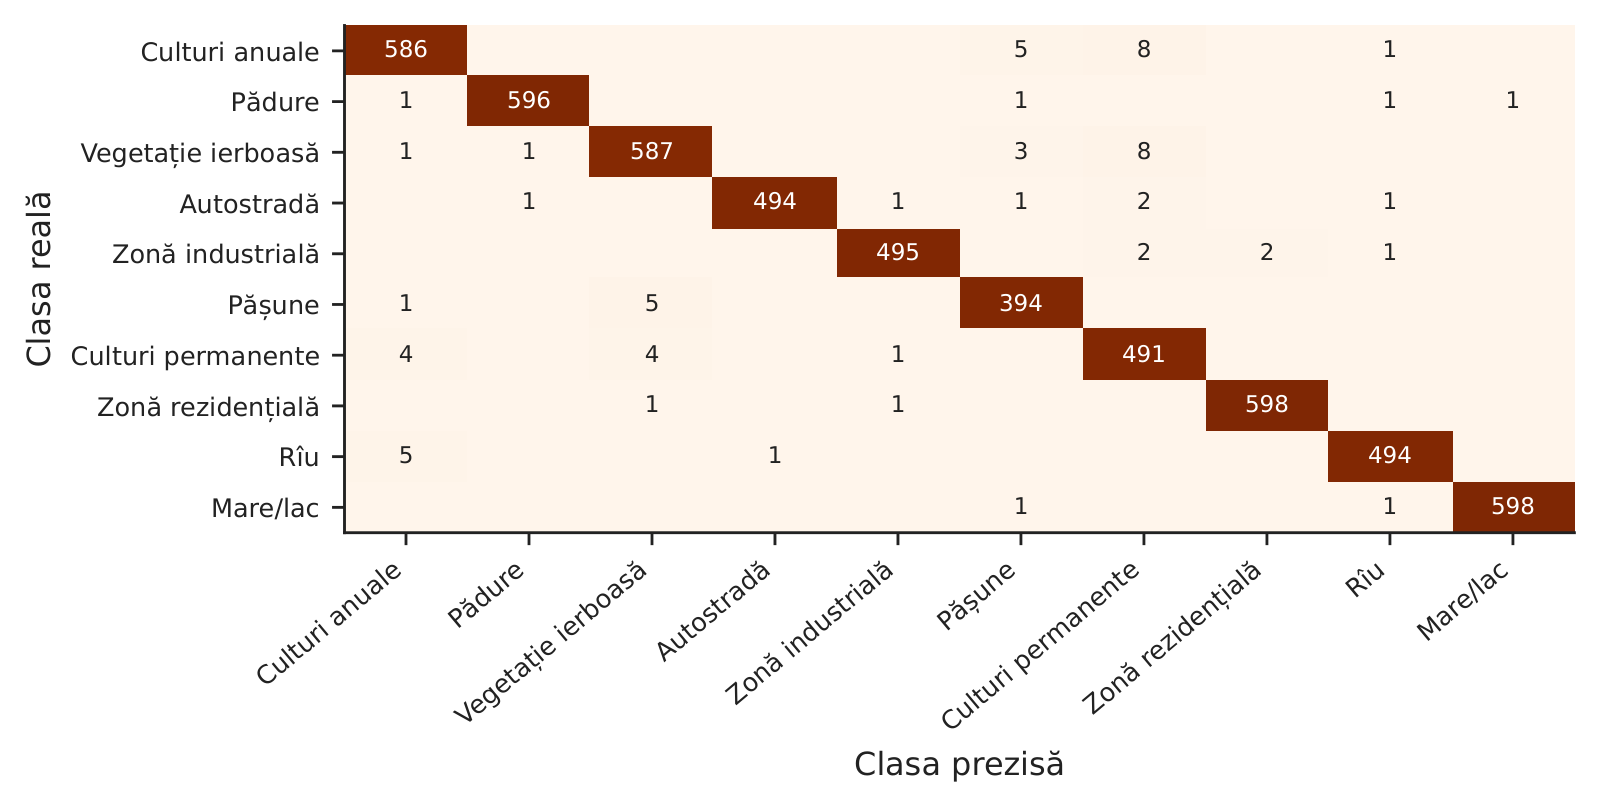
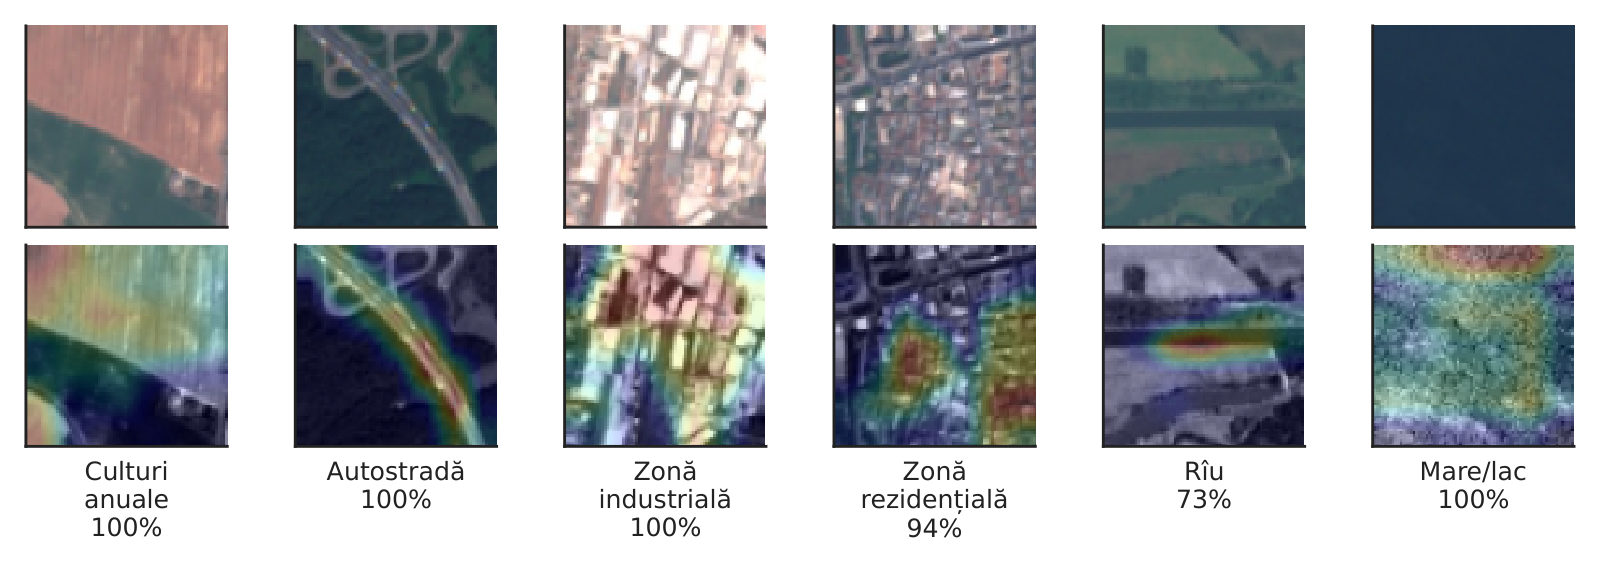
Rețeaua ajustată fin face 67 de erori la 5 400 de imagini de test (macro-F1 98,72%); cea mai mare confuzie este Culturi anuale clasificat drept Culturi permanente (8 imagini). Harta de activare a clasei ponderată cu gradienți (Grad-CAM) arată de unde vine o decizie: fiecare hartă de trăsături este ponderată cu gradientul mediu al scorului clasei, \(M^c=\mathrm{ReLU}(\sum_o\alpha_o^cA_o)\).
Matricea de confuzie a ResNet-18 ajustat fin pe imaginile de test.
Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 5.400 de imagini de test, ResNet-18 ajustat fin, sămînța 20261108.
Șase imagini de test și hărțile lor Grad-CAM, cu clasa prezisă și probabilitatea ei.
Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: șase imagini de test; Grad-CAM pe hărțile de 7 x 7 ale blocului 3 din ResNet-18 ajustat fin.
Ponderile utilizării terenului din imagini satelitare
O întrebare de portofoliu privește ponderi, nu imagini individuale. Pe imaginile de test, culturile (anuale și permanente) reprezintă 20,37% din imagini, iar modelul prezice 20,54%; cea mai mare eroare a ponderii vreunei clase este de 0,20 puncte procentuale. Înainte de a folosi modelul într-o regiune sau un anotimp nou, etichetați acolo un mic eșantion și măsurați din nou.
Cercetări ale grupului nostru
Cadrul multimodal viziune–limbaj pentru detectarea anomaliilor financiare al lui Jheng, Pele, Tak și Găman (2026), distins cu premiul Best Paper la International Conference on Business Excellence (ICBE) 2026, proiectează indicatorii de piață într-o imagine standardizată cu mai multe panouri și lasă un model viziune–limbaj (GPT-4.1) să clasifice regimurile pieței, cu etichete din cuantile glisante și justificări structurate în limbaj natural; testele în afara eșantionului pe S&P 500 arată o fidelitate promițătoare în detectarea anomaliilor sistemice. Fiecare grafic al acestui curs este publicat ca Quantlet reproductibil, pe platforma descrisă de Găman, Winkel, Zuo, Härdle și Pele (2026).
Sinteza secțiunii
O convoluție este un filtru local partajat. Pe imagini reale, depășește o rețea densă cu mai puțini parametri, conexiunile reziduale fac adîncimea antrenabilă, augmentarea înseamnă date gratuite, iar transferul învățării cîștigă atunci cînd etichetele sînt rare. Cursul 5 trece de la spațiu la timp, cu rețelele recurente.
Video: intuiția din spatele matematicii (în engleză)
Canadian Institute for Advanced Research (setul de imagini CIFAR-10)
CNN
rețea neuronală convoluțională
CPU
procesor central
GAP
agregare prin medie globală (global average pooling)
GPT
transformer generativ preantrenat
GPU
procesor grafic
ICBE
International Conference on Business Excellence
IPE
Institutul de Prognoză Economică, Academia Română
MLP
perceptron multistrat
MNIST
Modified National Institute of Standards and Technology (imagini cu cifre)
MPS
Metal Performance Shaders (procesorul grafic Apple, în PyTorch)
ReLU
unitate liniară rectificată
RGB
roșu, verde, albastru (canalele de culoare)
SGD
coborîre stohastică pe gradient
UE
Uniunea Europeană
VGG
Visual Geometry Group, Universitatea Oxford
VLM
model viziune–limbaj
Bibliografie
Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts, ch. 10. Springer. doi:10.1007/978-3-031-45468-4
Goodfellow, I., Bengio, Y. & Courville, A. (2016). Deep Learning, ch. 9. MIT Press. deeplearningbook.org
He, K., Zhang, X., Ren, S. & Sun, J. (2016). Deep residual learning for image recognition. CVPR, 770–778. doi:10.1109/CVPR.2016.90
Helber, P., Bischke, B., Dengel, A. & Borth, D. (2019). EuroSAT: A novel dataset and deep learning benchmark for land use and land cover classification. IEEE JSTARS, 12(7), 2217–2226. doi:10.1109/JSTARS.2019.2918242
Ioffe, S. & Szegedy, C. (2015). Batch normalization: Accelerating deep network training by reducing internal covariate shift. ICML, PMLR 37, 448–456. arXiv:1502.03167
Jheng, S.-L., Pele, D. T., Tak, R. & Găman, Ș. (2026). A multimodal vision-language framework for financial anomaly detection. Proceedings of the International Conference on Business Excellence, 20(1), 191–201. doi:10.2478/picbe-2026-0020
Găman, Ș., Winkel, J., Zuo, X., Härdle, W. K. & Pele, D. T. (2026). Quantlet: the code snippet knowledge platform. Computational Statistics, 41(3), 66. doi:10.1007/s00180-026-01742-6
Krizhevsky, A. (2009). Learning multiple layers of features from tiny images. Technical report, University of Toronto. cs.toronto.edu
Krizhevsky, A., Sutskever, I. & Hinton, G. E. (2012). ImageNet classification with deep convolutional neural networks. NIPS, 25, 1097–1105. doi:10.1145/3065386
LeCun, Y., Bottou, L., Bengio, Y. & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324. doi:10.1109/5.726791
McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. doi:10.1007/BF02295996
Selvaraju, R. R., Cogswell, M., Das, A., Vedantam, R., Parikh, D. & Batra, D. (2017). Grad-CAM: Visual explanations from deep networks via gradient-based localization. ICCV, 618–626. doi:10.1109/ICCV.2017.74
Simonyan, K. & Zisserman, A. (2015). Very deep convolutional networks for large-scale image recognition. ICLR. arXiv:1409.1556
Xiao, H., Rasul, K. & Vollgraf, R. (2017). Fashion-MNIST: A novel image dataset for benchmarking machine learning algorithms. arXiv:1708.07747
Yosinski, J., Clune, J., Bengio, Y. & Lipson, H. (2014). How transferable are features in deep neural networks? NIPS, 27, 3320–3328. arXiv:1411.1792
Zeiler, M. D. & Fergus, R. (2014). Visualizing and understanding convolutional networks. ECCV, 818–833. doi:10.1007/978-3-319-10590-1_53
Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.


 NN_L4_fmnist_samples