

În stînga este slide-ul din curs, în dreapta aceeași figură, calculată în browser din aceleași date. Butonul ▶ modifică parametrul pas cu pas.
VaR și Expected Shortfall · Măsuri de risc coerente · Metode de estimare · Precizia estimărilor VaR și ES · VaR și ES condiționate · Teoria valorilor extreme · Orizontul: regula rădăcinii pătrate · VaR de portofoliu și contribuțiile la risc · Lichiditate și reglementare · Studii de caz: rețele neuronale și forma dinamică a cozii · AI pentru descoperire științifică
VaR și Expected Shortfall
VaR și ES pentru S&P 500
Răspuns
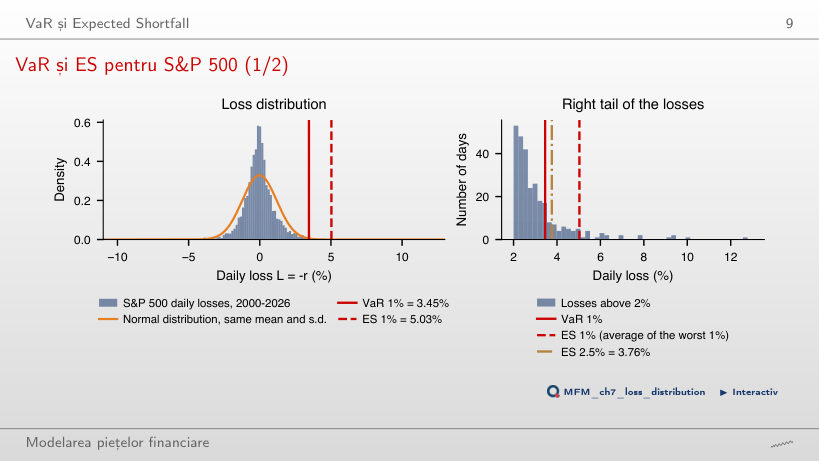
VaR rămîne 3,45%, iar ES crește de la 5,03% la circa 5,18%. Cele zece pierderi modificate sînt deasupra observațiilor care determină cuantila, deci VaR nu se schimbă. ES 1% este media celor mai mari nα = 67,17 pierderi (ultima cu ponderea 0,17); toate cele zece intră cu ponderea 1, deci ES crește cu 10/67,17 ≈ 0,15 pp. VaR localizează pragul; ES ține cont și de severitatea pierderilor de dincolo de el. Distribuția Normală cu aceeași medie și abatere standard dă VaR 1% de 2,80% și ES 1% de 3,21%.
Măsuri de risc coerente
Subaditivitatea VaR și ES: un contraexemplu
Răspuns
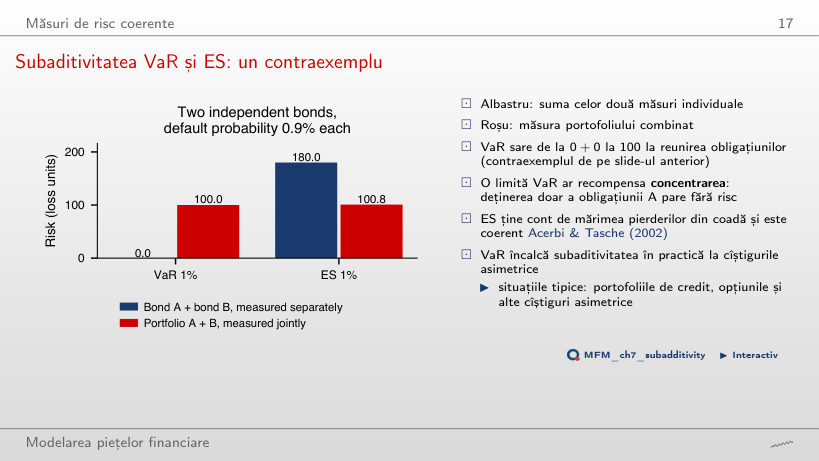
100. Probabilitatea ca cel puțin una să intre în default devine 2,19%, peste 1%, dar probabilitatea a două defaulturi este doar 0,012%, sub 1%; VaR 1% al portofoliului rămîne 100. Fiecare VaR individual devine 100, deci suma lor este 200 ≥ 100 și subaditivitatea este respectată: 200 este suma VaR-urilor individuale, nu VaR-ul portofoliului, iar 0 era VaR-ul individual la 0,9%. La 0,9% (slide-ul), probabilitatea cel puțin unui default este 1,79%, iar VaR-ul portofoliului, 100, depășește suma 0 + 0. În acest exemplu, VaR încalcă subaditivitatea doar cînd probabilitatea de default este între circa 0,5% și 1%. ES este subaditiv: la 0,9%, 100,8 pentru portofoliu, față de 90 + 90 = 180.
Metode de estimare
Cinci metode la diferite niveluri de risc
Răspuns
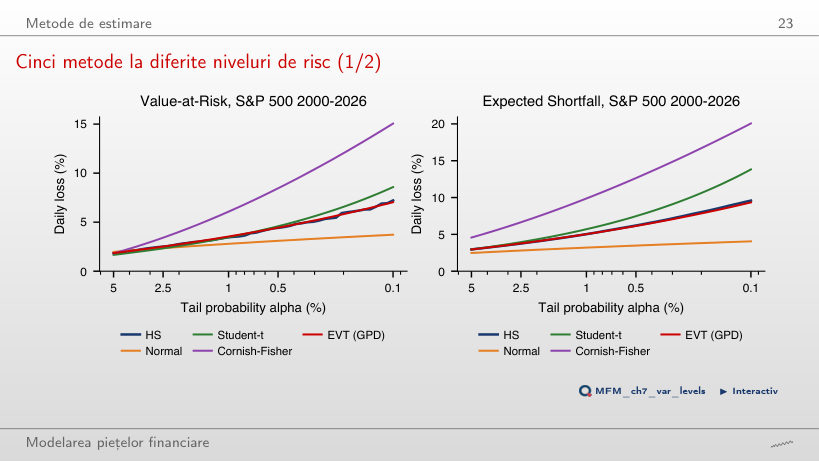
La α = 0,1%: diferența este 11,34 pp (Cornish–Fisher 15,06% minus distribuția Normală 3,72%), față de 0,30 pp la α = 5%, unde toate cele cinci valori sînt între 1,67% și 1,97%. La α = 0,1%, VaR este 7,22% istoric, 7,04% cu EVT și 8,58% cu Student-t. Acolo unde datele sînt puține, ipotezele despre coadă decid estimarea: aceeași țintă statistică nu obligă modele diferite să dea valori apropiate.
Precizia estimărilor VaR și ES
Precizia pentru S&P 500
Răspuns
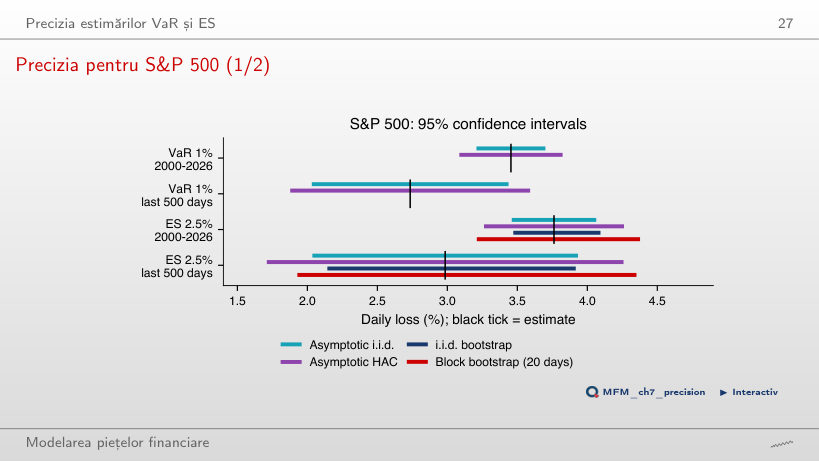
Masa cozii este 500 × 0,025 = 12,5 observații: adunăm cele mai mari 12 pierderi și 0,5 din a 13-a, apoi împărțim la 12,5. Cu 13 ponderi egale, nivelul efectiv al cozii devine 13/500 = 2,6%. Intervalul HAC de 95% al acestui ES are lățimea de 2,55 pp, iar cel bootstrap pe blocuri 2,42 pp. Pe selecția 2000–2026, volatility clustering lărgește intervalul ES de la 0,60 pp (i.i.d.) la 1,00 pp (HAC), iar bootstrap-ul de la 0,62 pp la 1,17 pp.
VaR și ES condiționate
Simularea istorică și simularea istorică filtrată: S&P 500
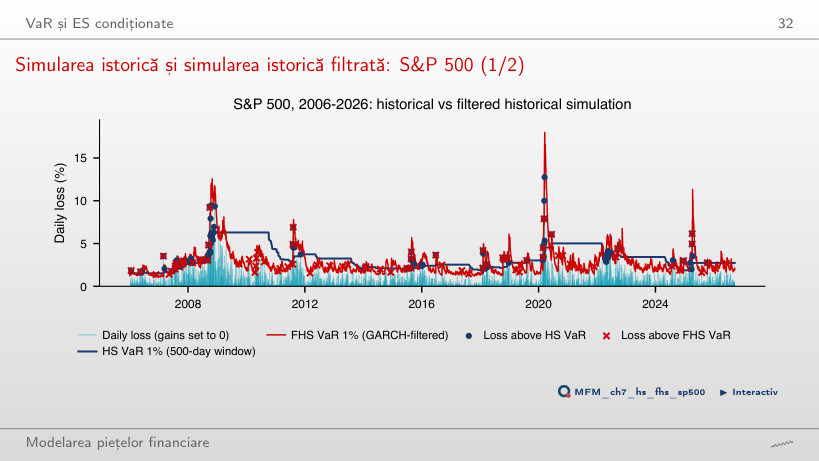
Răspuns
FHS este cea mai apropiată de ținta de 1%: 80 din 5 210 zile, adică 1,54%, față de 1,67% pentru simularea istorică pe 500 de zile și 2,34% pentru GARCH cu șocuri Normale. Fereastra istorică se actualizează zilnic, dar dă ponderi egale observațiilor din regimuri de volatilitate diferite și se poate adapta lent; depășirile ei apar în grupuri, în 2008 și 2020. Apropierea frecvenței de 1% nu verifică singură independența depășirilor.
CAViaR față de simularea istorică filtrată out-of-sample
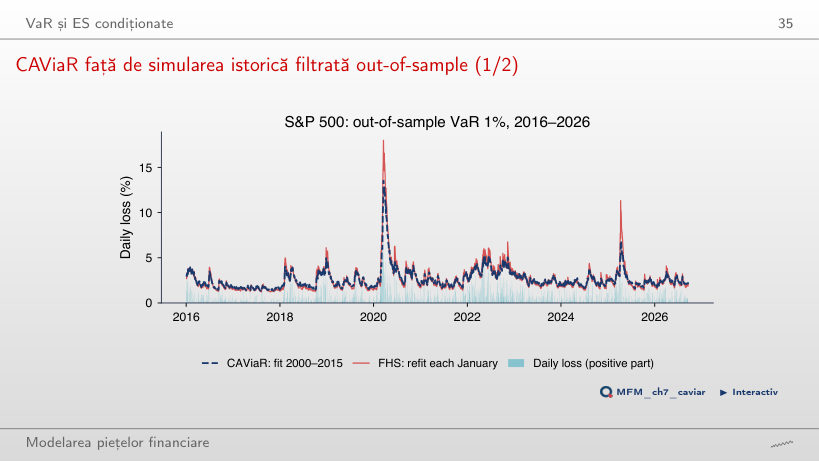
Răspuns
În circa 6,4 zile: timpul de înjumătățire este ln 0,5 / ln β₁, cu β₁ = 0,897. Out-of-sample, în 2016–2026, CAViaR și FHS au fiecare 35 de depășiri (1,30%), iar pierderea pinball medie este 0,039 pentru CAViaR și 0,037 pentru FHS.
Teoria valorilor extreme
Maximele lunare ale pierderilor S&P 500
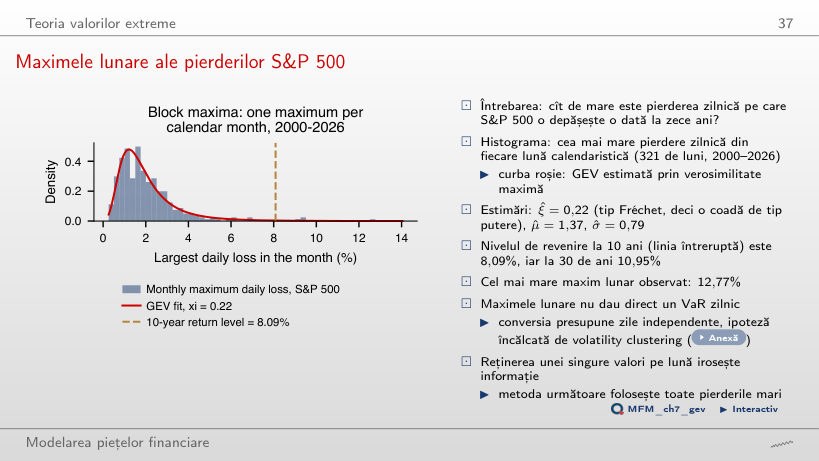
Răspuns
1/120 ≈ 0,83%. Blocurile sînt luni, deci zece ani înseamnă 120 de blocuri; nivelul de revenire 8,09% (ξ = 0,22) satisface P(maximul lunar > 8,09%) = 1/120 în modelul estimat. 1/10 confundă anii cu blocurile; 1/2 520 tratează zilele (252 pe an) drept blocuri. Nivelul nu înseamnă că depășirile apar periodic, iar o lună cu depășire poate avea mai multe zile peste prag. Patru dintre cele 321 de maxime lunare îl depășesc; cel mai mare maxim lunar observat este 12,77%.
Graficul excesului mediu: S&P 500
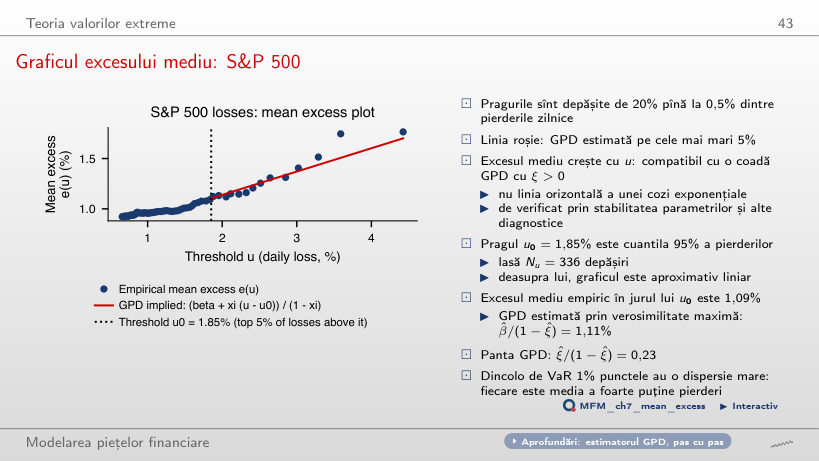
Răspuns
Este compatibilă cu o coadă GPD cu 0 < ξ < 1: atunci excesul mediu este finit și liniar în prag, cu panta ξ/(1 − ξ) > 0; la ξ ≥ 1, excesul mediu teoretic este infinit. Estimarea curentă dă ξ = 0,19 și panta 0,23. La pragul u₀ = 1,85% (cele mai mari 5% dintre pierderi, 336 de depășiri), excesul mediu empiric este 1,09%, iar GPD dă 1,11%. Graficul susține această aproximație, dar nu o dovedește; alegerea pragului cere și verificarea stabilității parametrilor. Pentru o coadă exponențială, graficul ar fi orizontal.
Cozi GPD: S&P 500 și Bitcoin
Răspuns
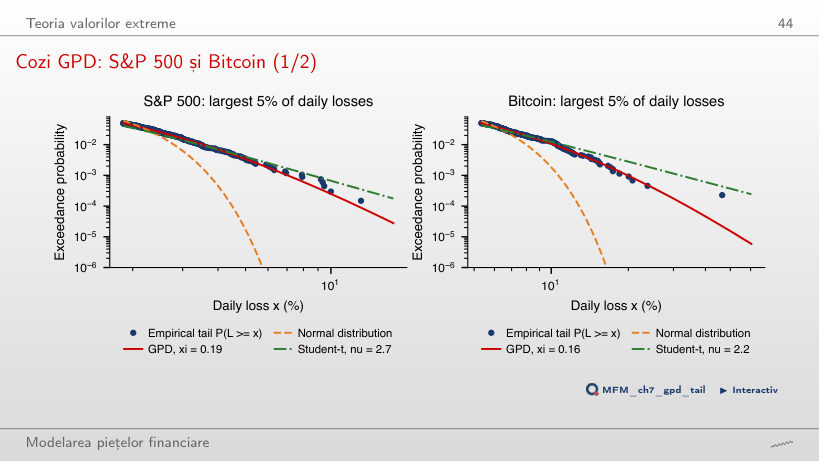
Nu: VaR depinde de prag, de scală și de formă. Estimările formei sînt ξ = 0,16 (SE 0,078) pentru Bitcoin și ξ = 0,19 (SE 0,065) pentru S&P 500; diferența mare de VaR vine din scala mult mai mare a Bitcoin. Erorile standard individuale presupun depășiri independente, iar pagina nu calculează un test al diferenței dintre cele două ξ; nici estimările apropiate nu demonstrează forme egale. O concluzie inferențială cere incertitudinea diferenței, ținînd cont de dependența datelor.
EVT condiționată pentru S&P 500
Răspuns
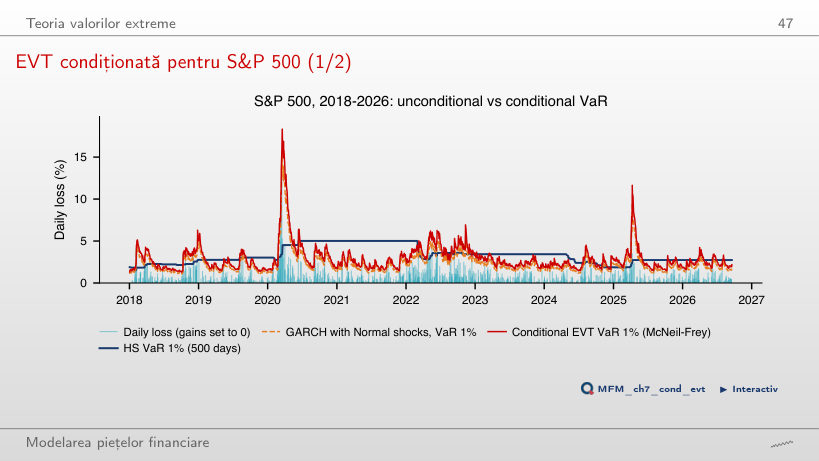
Modelul cozii pierderilor standardizate. EVT condiționată păstrează filtrul GARCH și nivelul α, dar înlocuiește coada Normală a șocurilor standardizate cu o aproximație GPD. În 2018–2026 (2 190 de zile, 21,9 depășiri așteptate), frecvența depășirilor VaR 1% scade de la 2,42% (53 de zile) cu GARCH-Normal la 1,23% (27) cu EVT condiționată; simularea istorică pe 500 de zile are 1,60% (35). Comparația singură nu arată că întreaga specificație este corectă.
Orizontul: regula rădăcinii pătrate
Regula rădăcinii pătrate în date
Răspuns
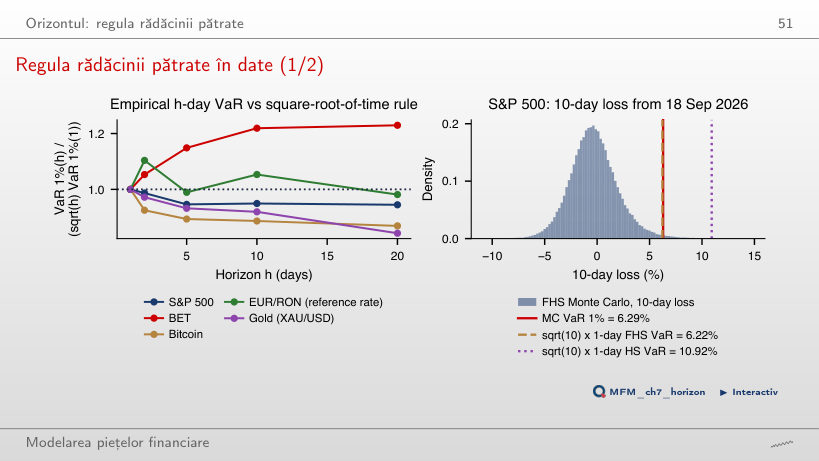
Nu. Fără autocorelație și cu varianța constantă, varianța pe h zile este h ori cea zilnică, dar cuantila sumei depinde și de forma distribuției ei, care se schimbă cu h (cozi groase, volatility clustering). Regula este exactă, de exemplu, pentru pierderi i.i.d. cu distribuția Normală și media zero. În date, raportul la h = 10 este 1,22 pentru BET (autocorelația de ordinul 1: 0,109) și 1,05 pentru EUR/RON, deci regula subestimează riscul; pentru S&P 500 (0,95), aur (0,92) și Bitcoin (0,89) regula este conservatoare. Pentru S&P 500, Monte Carlo filtrat dă 6,29%, față de 6,22% pentru √10 × VaR filtrat pe o zi.
VaR de portofoliu și contribuțiile la risc
Contribuțiile activelor la risc
Răspuns
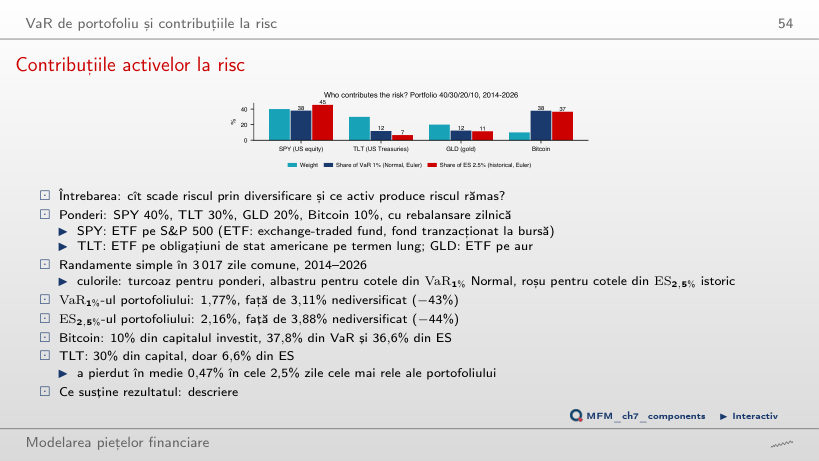
Crește de la 36,6% la 87,0%: ponderea în capital se triplează, partea din ES crește de 2,4 ori. Contribuția Euler la ES este ponderea înmulțită cu pierderea medie a Bitcoin în zilele din coada portofoliului, iar aceste zile se schimbă odată cu ponderea; partea din risc nu este ponderea în capital și nu crește proporțional cu ea. La ponderea din slide, 10%, Bitcoin aduce 37,8% din VaR 1% (Normal, Euler) și 36,6% din ES 2,5% (istoric); TLT, cu 30% din capital, aduce doar 6,6% din ES. Diversificarea reduce VaR 1% de la 3,11% (suma VaR-urilor individuale) la 1,77%.
Lichiditate și reglementare
VaR 1% față de ES 2,5% pe cinci active
Răspuns
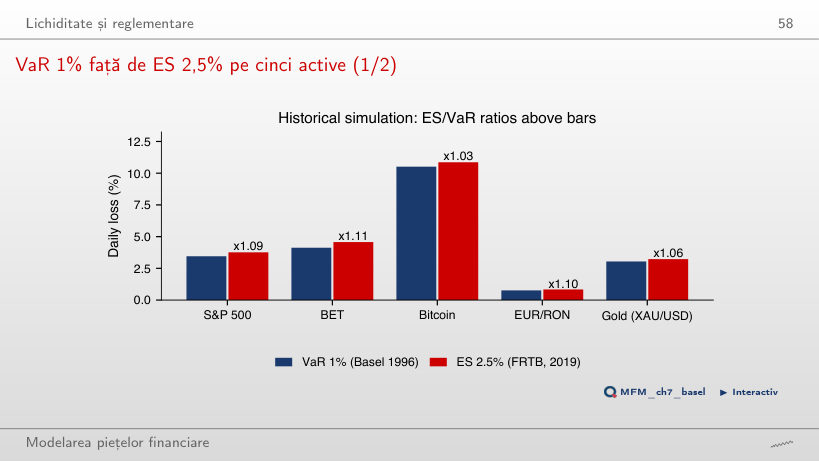
Scad sub 1: la ES 5%, rapoartele sînt între 0,81 (Bitcoin) și 0,86 (S&P 500), iar sub distribuția Normală cu media zero 0,887. ES ≥ VaR doar la același nivel α; ES 5% face media pe cel mai rău 5% dintre zile, o coadă mai puțin extremă decît cea a VaR 1%. La nivelul Basel, ES 2,5%, rapoartele sînt între 1,03 (Bitcoin) și 1,11 (BET): 1,09 pentru S&P 500, 1,10 pentru EUR/RON și 1,06 pentru aur. Reperul Normal cu media zero este φ(z₀,₉₇₅)/(0,025 × z₀,₉₉) = 2,338/2,326 ≈ 1,005; cu o medie nenulă, aceasta intră atît în ES, cît și în VaR, iar raportul se schimbă.
Studii de caz: rețele neuronale și forma dinamică a cozii
Studiu de caz: erorile relative, α = 1%
Răspuns
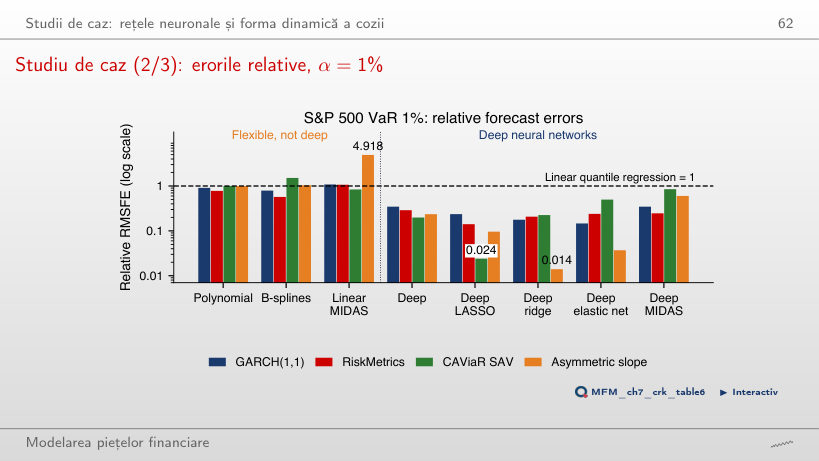
Nu direct. Toate cele 20 de bare ale rețelelor adînci (inclusiv MIDAS adînc) sînt sub 1, între 0,014 și 0,850, dar RMSFE este minimizată de media condiționată, nu de cuantilă. Precizia unei prognoze de cuantilă se compară prin pierderea pinball. În plus, rezultatul provine dintr-o singură fereastră fixă de calibrare.
Al doilea studiu de caz (2/4): forma și scala cozii S&P 500, 2000–2026
Răspuns
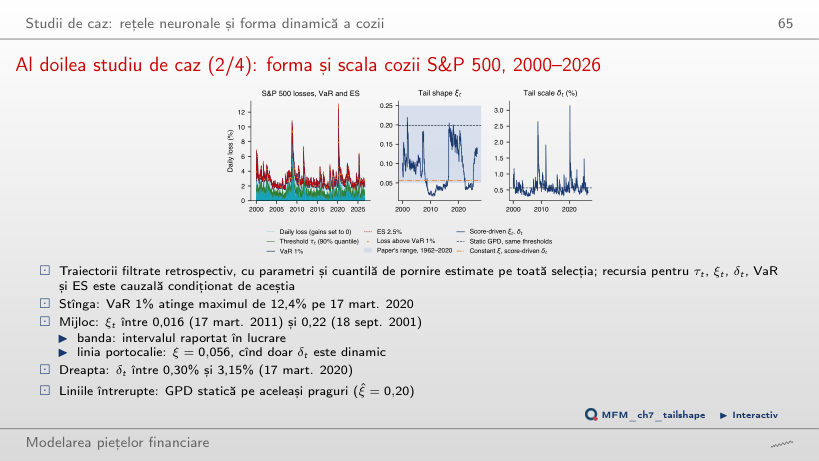
Crește cu circa 1,92: ΔAIC = 2 × 2 − 2 × 1,04 = 1,92, deci AIC dezavantajează modelul cu ξt dinamic (774 față de 772). −2,08 ignoră penalizarea parametrilor; 2,96 omite factorul 2 din termenul log-verosimilității. Log-verosimilitatea este −380,85 cu ξt și δt dinamice, față de −381,89 cu ξ constant (0,056) și δt dinamic. GPD statică are AIC 853, deci scăderea 853 → 774 vine din dinamica scalei δt. Cu aξ = 0, ξt rămîne fix la 0,083. VaR 1% filtrat este depășit în 61 din 6 717 zile (0,91%).
AI pentru descoperire științifică
Mini-studiu de caz: ordonarea modelelor ES
Răspuns
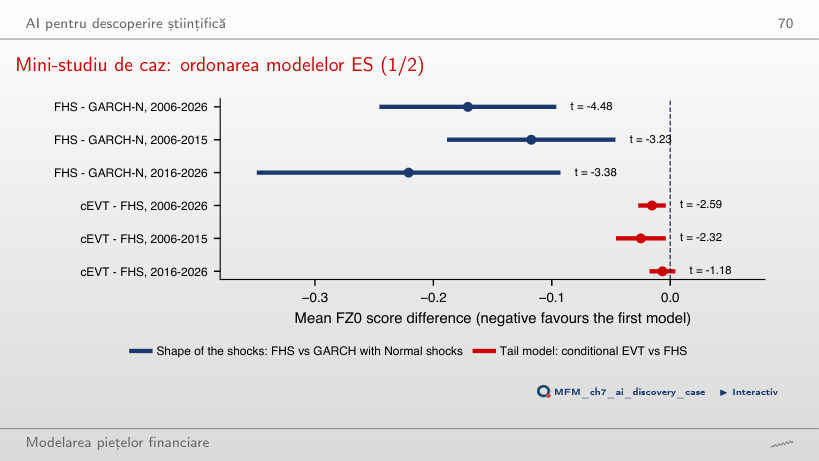
Nu stabilește nici avantajul EVT, nici echivalența. Intervalul conține zero și diferențe de ambele semne (t = −1,18), deci avantajul EVT condiționate nu este semnificativ în 2016–2026. Regula pre-înregistrată cere t < −1,96 (test bilateral la 5%) în ambele subperioade; în 2006–2015, t = −2,32, iar pe 2006–2026, t = −2,59. Echivalența ar cere o marjă stabilită dinainte și o analiză dedicată. FHS față de GARCH–Normal îndeplinește regula: t = −3,23 și t = −3,38.
Pierderi zilnice L = −r, în %, pînă la 18 septembrie 2026. S&P 500, BET, Bitcoin, aur (XAU/USD) și ETF-urile SPY, TLT, GLD: prețuri zilnice EODHD; EUR/RON: cursul de referință BNR. Studiile de caz: Tabelul 6 din Chronopoulos, Raftapostolos și Kapetanios (2024), Journal of Financial Econometrics; modelul GPD score-driven din D’Innocenzo, Lucas, Schwaab și Zhang (2024), Journal of Business & Economic Statistics, estimat pe datele cursului.