Rețele neuronale și deep learning

Cursul 10: Reinforcement learning: tranzacționare, acoperirea riscului și dispecerizarea bateriilor

Cursul 10

Reinforcement learning: tranzacționare, acoperirea riscului și dispecerizarea bateriilor

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

Unele decizii economice schimbă situația în care se ia decizia următoare. O baterie care se încarcă acum nu se mai poate încărca peste o oră; un trader care vinde azi plătește un cost ca să cumpere înapoi mîine; un desk care acoperă riscul unei opțiuni își ajustează acoperirea în fiecare zi. Reinforcement learning (RL) este ramura învățării automate construită pentru asemenea decizii secvențiale: un agent observă o stare, alege o acțiune, primește o recompensă și trece într-o stare nouă, învățînd o politică ce maximizează recompensa totală.

Cursul formulează în acest limbaj trei probleme economice reale și le rezolvă pe date reale. Prima este dispecerizarea unei baterii de 2 MWh pe prețurile pentru ziua următoare din România, rezolvată exact prin programare dinamică (DP) și apoi învățată prin Q-learning tabelar și printr-o rețea Q profundă (DQN). A doua este tranzacționarea indicelui S&P 500 cu optimizarea proximală a politicii (PPO), o metodă actor-critic. A treia este acoperirea riscului unei opțiuni pe o lună cu o politică neuronală care minimizează pierderea așteptată în coada distribuției (ES). Fiecare agent este antrenat cu cinci valori inițiale și comparat cu regula pe care un practician o folosește deja. Verdictul este mixt și instructiv: pentru baterie cîștigă regula simplă, avantajul PPO la tranzacționare nu este stabilit statistic, iar acoperirea învățată bate delta din manual pentru fiecare valoare inițială.

Ce veți ști să faceți

  • Să formulați o decizie economică drept proces decizional Markov (MDP): stare, acțiune, recompensă, tranziție și factor de actualizare.
  • Să rezolvați exact un MDP mic cu ecuația Bellman și programarea dinamică și să interpretați funcția de valoare.
  • Să antrenați agenți bazați pe valoare (Q-learning, DQN) și un agent cu gradient de politică (PPO) pe prețuri reale, cu mai multe valori inițiale și un reper corect.
  • Să acoperiți riscul unei opțiuni cu o politică neuronală care minimizează pierderea așteptată în coadă și să o comparați cu delta Black-Scholes.
  • Să judecați cînd aduce RL valoare într-o afacere și cînd ajunge o regulă simplă.

Planul cursului

  1. Decizii secvențiale în afaceriReinforcement learning privește ce trebuie făcut, nu ce se va întîmpla.
  2. Procese decizionale Markov și ecuația BellmanUn MDP formalizează o decizie secvențială; ecuația Bellman o descompune în probleme de un pas, pe care programarea dinamică le rezolvă exact atunci cînd modelul este cunoscut.
  3. Învățarea bazată pe valoare: Q-learning și DQNQ-learning și rețeaua Q profundă învață \(Q^*\) din eșantioane, fără să cunoască dinainte prețurile zilei.
  4. Gradienți de politică și PPO: tranzacționarea indicelui S&P 500Metodele bazate pe gradientul politicii parametrizează direct politica.
  5. Acoperirea neuronală: o politică ce minimizează riscul din coadăAcoperirea neuronală (deep hedging, Buehler et al., 2019) antrenează o politică neuronală de acoperire pe măsura de risc raportată de desk.

Decizii secvențiale în afaceri

Reinforcement learning privește ce trebuie făcut, nu ce se va întîmpla. Secțiunea prezintă bucla agent-mediu și cele trei probleme ale cursului.

Reinforcement learning și învățarea supervizată

Slide-ul 6 în PDF

Învățarea supervizată are o etichetă pentru fiecare exemplu, iar prognozele ei nu schimbă exemplul următor. În reinforcement learning, agentul vede o stare \(s_t\), alege o acțiune \(a_t\) și primește o recompensă \(r_{t+1}\); acțiunea schimbă starea următoare și nimeni nu spune care ar fi fost acțiunea corectă, ci doar ce recompensă a urmat. Stocarea, tranzacționarea, acoperirea riscului, stocurile, prețurile și limitele de credit au toate această structură. Cînd acțiunea de azi nu schimbă opțiunile de mîine, ajung o prognoză și o regulă.

În practică: folosiți RL doar cînd acțiunea de azi schimbă opțiunile de mîine.
Bucla agent-mediu

Slide-ul 7 în PDF

Agentul urmează o politică \(\pi_\theta(a\mid s)\); mediul răspunde la fiecare acțiune cu o recompensă și o stare nouă. Un episod este o zi de livrare pentru baterie, o fereastră de 126 de zile de tranzacționare pentru trader și durata de 21 de zile a unei opțiuni pentru cel care acoperă riscul. Toți cei trei agenți sînt fără model (învață din tranziții eșantionate \((s_t,a_t,r_{t+1},s_{t+1})\), nu din legea pieței) și offline (învață din date istorice).

În practică: scrieți starea, acțiunea și recompensa înainte de orice antrenare.

Trei aplicații economice ale reinforcement learning

Slide-ul 8 în PDF
ProblemaStarea \(s_t\)Acțiunea \(a_t\)Recompensa \(r_{t+1}\)
Baterieora, energia stocată, prețurile de ieriîncărcare / inactiv / descărcarefluxul de numerar al orei (EUR)
Tranzacționarerandamente trecute, volatilitate, VIX, trend, poziția curentăîn afara pieței / longpoziția × randamentul următor − cost
Acoperirenivelul indicelui, timpul pînă la scadență, VIX, acoperirea anterioarăraportul de acoperire în [0, 1]rezultatul final, evaluat prin ES

Datele sînt reale: prețurile orare pentru ziua următoare din România (RO), Ungaria (HU), Germania–Luxemburg (DE-LU) și Bulgaria (BG), de pe energy-charts.info, portalul Institutului Fraunhofer pentru Sisteme de Energie Solară (ISE), pe baza datelor Rețelei europene a operatorilor de transport și de sistem pentru energie electrică (ENTSO-E); și închiderile zilnice ale indicelui S&P 500 și ale indicelui de volatilitate Cboe (VIX), de pe Yahoo Finance, pînă la 31 octombrie 2026. Fiecare problemă este împărțită în ordine cronologică în perioade de antrenare, validare și test. Reperele sînt reguli pe care un manager le folosește deja: planul optim de ieri, strategia cumpără și păstrează, media mobilă de 200 de zile și delta Black-Scholes.

În practică: un agent RL merită folosit doar dacă bate regula deja folosită, după costuri și pe mai multe valori inițiale.

Venitul bateriilor din diferența zilnică de preț și creșterea acestei diferențe

Slide-ul 9 în PDF

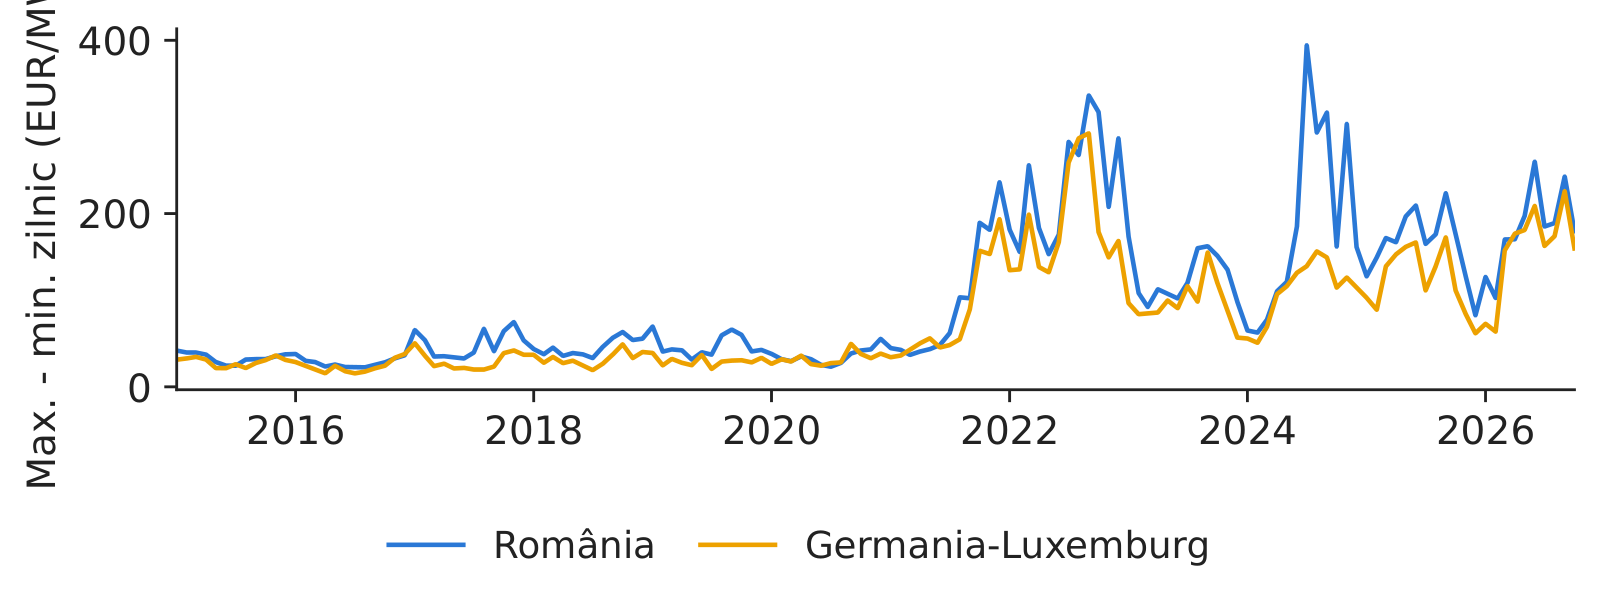
O baterie cumpără în orele cele mai ieftine și vinde în cele mai scumpe, deci venitul ei depinde de diferența zilnică dintre prețul maxim și cel minim, nu de nivelul prețului. În România, diferența zilnică medie a fost 47,9 EUR/MWh în 2019, 164,3 în 2025 și 182,8 în 2026 pînă acum; luna de vîrf a fost iulie 2024, cu 394,4 EUR/MWh. Producția solară coboară acum prețurile de la prînz, iar vîrfurile de seară rămîn.

Grafic: Venitul bateriilor din diferența zilnică de preț și creșterea acestei diferențe

Media lunară a diferenței zilnice maxim–minim a prețurilor pentru ziua următoare în România și în Germania–Luxemburg.

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: 2 ianuarie 2015 - 31 octombrie 2026, media lunară a diferenței zilnice.

În practică: rentabilitatea unei baterii depinde de diferențele viitoare de preț, nu de nivelul prețului.

Procese decizionale Markov și ecuația Bellman

Un MDP formalizează o decizie secvențială; ecuația Bellman o descompune în probleme de un pas, pe care programarea dinamică le rezolvă exact atunci cînd modelul este cunoscut.

Cele cinci elemente ale unui proces decizional Markov

Slide-ul 11 în PDF

Un MDP este \(\mathcal M=(\mathcal S,\mathcal A,P,R,\gamma)\): stări, acțiuni, legea de tranziție \(P(s'\mid s,a)\), recompensa așteptată \(R(s,a)\) și factorul de actualizare \(\gamma\in[0,1]\). Agentul maximizează cîștigul cumulat așteptat

\[G_t=\sum_{k=0}^{T-t-1}\gamma^{k}r_{t+k+1},\qquad \pi^{*}=\arg\max_{\pi}\mathbb E_{\pi}[G_0]\]
(10.1)

Proprietatea Markov cere ca starea să conțină tot ce contează: pentru baterie, ora și energia stocată; pentru trader, poziția curentă, deoarece ea determină costul tranzacției următoare. Episoadele bateriei au 24 de pași și folosesc \(\gamma=1\); tranzacționarea folosește \(\gamma=0{,}99\).

În practică: o variabilă de stare omisă, de exemplu poziția curentă, face agentul instabil.

Funcțiile de valoare măsoară cît de bună este o stare

Slide-ul 12 în PDF

Valoarea stării \(V^{\pi}(s)=\mathbb E_\pi[G_t\mid s_t=s]\) este recompensa viitoare așteptată dintr-o stare; valoarea acțiunii \(Q^{\pi}(s,a)\) este același lucru după o primă acțiune dată, iar avantajul \(A^{\pi}(s,a)=Q^{\pi}(s,a)-V^{\pi}(s)\) compară o acțiune cu media politicii. Metodele bazate pe valoare (Q-learning, DQN) estimează \(Q^*\) și acționează lacom; metodele bazate pe politică (REINFORCE, PPO) parametrizează direct politica și folosesc \(V\) doar ca reper. Pentru baterie, \(V_h(s)\) este numărul de euro care mai pot fi cîștigați azi de la ora \(h\), cu \(s\) MWh stocați.

Ecuația Bellman: descompunerea recursivă a funcției de valoare

Slide-ul 13 în PDF

Valoarea optimă de acum este cea mai bună recompensă imediată plus valoarea optimă actualizată a stării următoare:

\[V^{*}(s)=\max_{a}\Big\{R(s,a)+\gamma\sum_{s'}P(s'\mid s,a)\,V^{*}(s')\Big\},\qquad Q^{*}(s,a)=R(s,a)+\gamma\,\mathbb E_{s'}\big[\max_{a'}Q^{*}(s',a')\big]\]
(10.2)

Pentru \(\gamma<1\), membrul drept este o contracție, deci iterarea valorii converge la un punct fix unic; pe un orizont finit, o singură trecere înapoi dă soluția exactă (Bellman, 1957). Fiecare algoritm din acest curs este o metodă aproximativă de rezolvare a acestei ecuații atunci cînd modelul nu este cunoscut sau starea este prea mare pentru un tabel.

Bateria ca proces decizional Markov

Slide-ul 14 în PDF

Starea este ora și energia stocată \(s_h\in\{0,1,2\}\) MWh; acțiunea \(a_h\in\{-1,0,+1\}\) încarcă, lasă inactivă sau descarcă un MWh de energie stocată; recompensa este fluxul de numerar al orei:

\[r_h(a_h)=\begin{cases}\eta_d\,p_h & a_h=+1\ \text{(vînzare)}\\ -p_h/\eta_c & a_h=-1\ \text{(cumpărare)}\\ 0 & a_h=0\end{cases},\qquad s_{h+1}=s_h-a_h\]
(10.3)

unde \(p_h\) este prețul pentru ziua următoare al orei \(h\), iar \(\eta_c=\eta_d=\sqrt{0{,}85}\), deci un ciclu complet returnează 85 % din energie. Bateria pornește goală în fiecare zi, nu se poate încărca atunci cînd este plină și nu se poate descărca atunci cînd este goală (mascarea acțiunilor), nu influențează prețul și nu are cost de degradare sau tarife de rețea. Datele acoperă 4 292 de zile de livrare din România cu 24 de ore complete, între 2 ianuarie 2015 și 31 octombrie 2026; din octombrie 2025, fiecare oră este media a patru prețuri de 15 minute.

În practică: energia stocată este cea care face decizia secvențială.

Programarea dinamică rezolvă exact ziua bateriei

Slide-ul 15 în PDF

Mergînd înapoi de la miezul nopții, cu \(V_{24}(s)=0\),

\[V_h(s)=\max_{a:\,0\le s-a\le 2}\big\{r_h(a)+V_{h+1}(s-a)\big\},\qquad h=23,\dots,0\]
(10.4)

iar venitul zilei este \(V_0(0)\). Toate cele 4 292 de zile se rezolvă în cîteva milisecunde. Deoarece DP folosește cele 24 de prețuri ale zilei înainte ca ele să fie cunoscute, venitul său este o limită superioară pentru orice strategie reală. Reperul naiv calculează planul optim de ieri și îl aplică azi. Fiecare agent care învață este evaluat prin rata de captare, adică venitul său împărțit la venitul cu previziune perfectă.

În practică: DP dă plafonul față de care se evaluează orice agent care învață.

Programul optim al bateriei pentru o zi

Slide-ul 16 în PDF

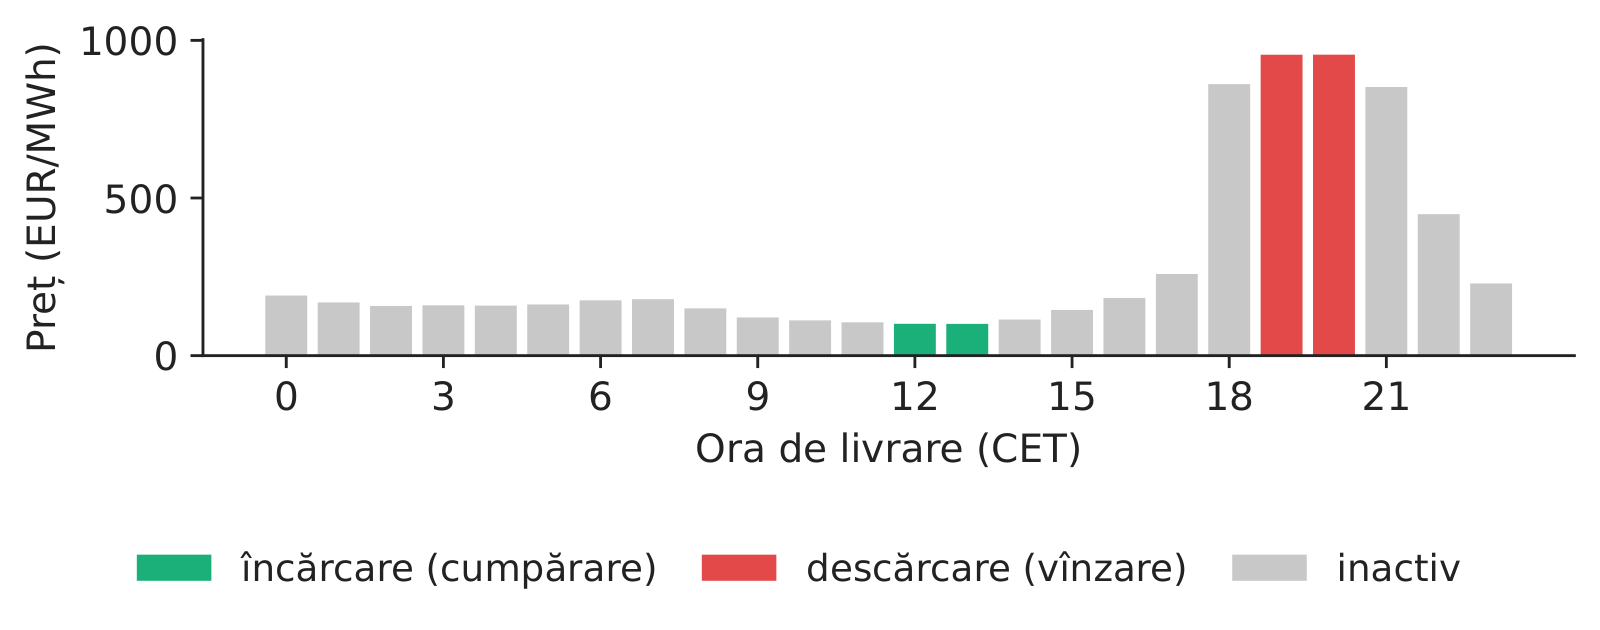
Pe 30 iunie 2026, ziua din 2026 cu cea mai mare diferență de preț, prețurile au variat de la 100,65 EUR/MWh la ora 13:00 la 954,59 EUR/MWh la ora 20:00. Planul optim încarcă în cele mai ieftine două ore din jurul prînzului și descarcă în două ore de seară, cu un venit de 1 541 EUR.

Grafic: Programul optim al bateriei pentru o zi

Prețurile orare pentru ziua următoare din România pe 30 iunie 2026, colorate după acțiunea optimă a bateriei.

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: România, 30 iunie 2026, prețuri orare pentru ziua următoare.

Funcția de valoare evaluează energia stocată oră de oră

Slide-ul 17 în PDF

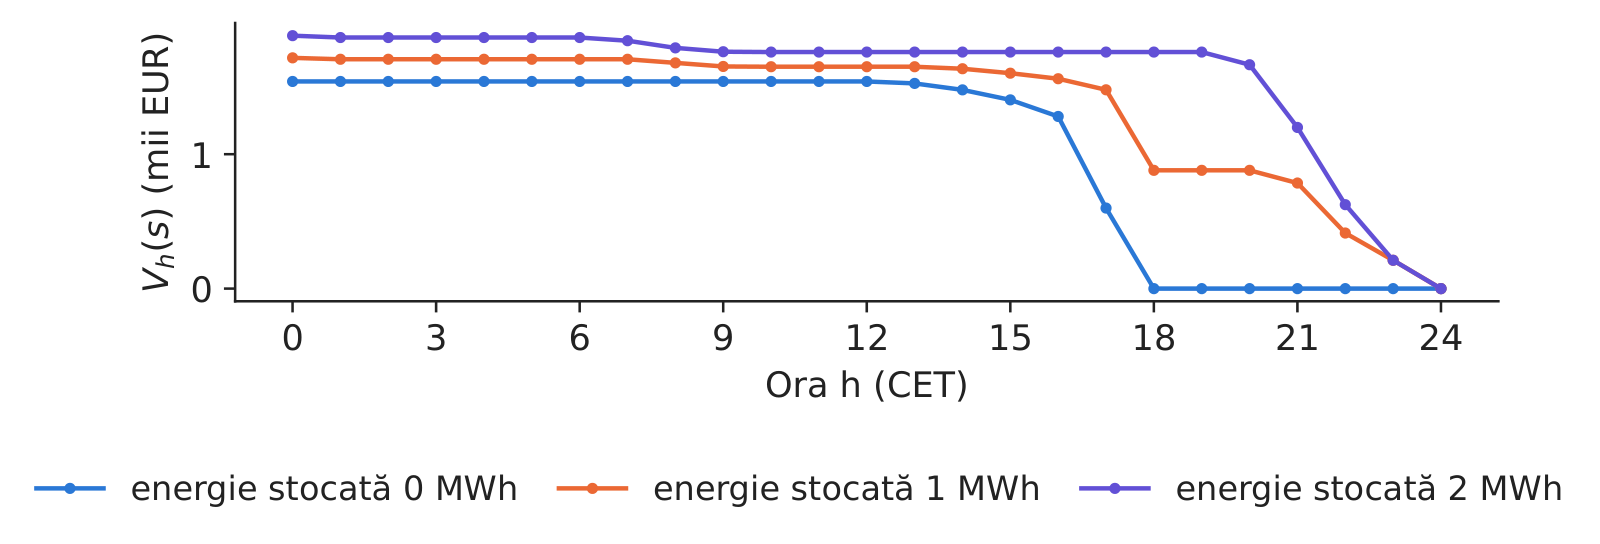
La ora 12:00 din aceeași zi, \(V_{12}(0)\) = 1 541 EUR și \(V_{12}(2)\) = 1 760 EUR: jumătate din diferență, 109,38 EUR, este valoarea unui MWh stocat, prețul-umbră al energiei din baterie la prînz. După vîrful de seară, energia stocată nu mai valorează nimic. Un \(Q\) bine învățat trebuie să reproducă această formă fără să vadă prețurile zilei.

Grafic: Funcția de valoare evaluează energia stocată oră de oră

Funcția de valoare \(V_h(s)\) a problemei bateriei pe 30 iunie 2026, pentru 0, 1 și 2 MWh stocați.

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: România, 30 iunie 2026; calcul propriu (inducție înapoi).

Venitul unei baterii de 2 MWh în condiții de previziune perfectă

Slide-ul 18 în PDF

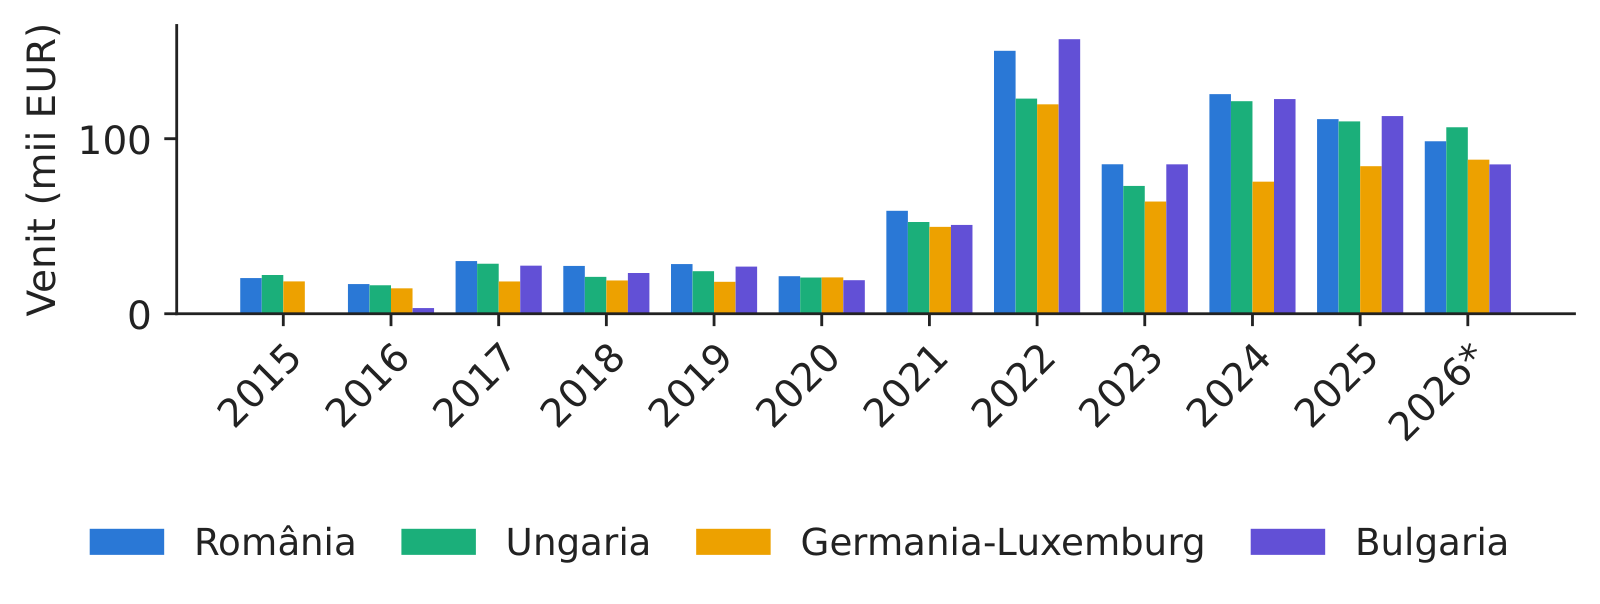
Cu previziune perfectă, bateria ar fi cîștigat în România 28,4 mii EUR în 2019, 150,2 în 2022, 111,2 în 2025 și 98,5 în ianuarie–octombrie 2026 (302 zile cu 24 de ore complete). În 2025, aceeași baterie ar fi cîștigat 109,9 mii EUR în Ungaria, 112,9 în Bulgaria și 84,3 în Germania–Luxemburg. Acestea sînt plafoane: ele urmează diferențele de preț, nu nivelul prețului.

Grafic: Venitul unei baterii de 2 MWh în condiții de previziune perfectă

Venitul cu previziune perfectă al unei baterii de 2 MWh, pe ani și pe zone de ofertare (2026: ianuarie–octombrie).

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: 2015-2026 (*2026: ianuarie-octombrie); zile cu 24 de ore complete.

În practică: investitorii dimensionează stocarea pe baza acestor cifre; un operator real obține doar o parte din ele.

Învățarea bazată pe valoare: Q-learning și DQN

Q-learning și rețeaua Q profundă învață \(Q^*\) din eșantioane, fără să cunoască dinainte prețurile zilei.

Q-learning: Q* învățat din eșantioane, fără model

Slide-ul 20 în PDF

Q-learning (Watkins & Dayan, 1992) deplasează \(Q(s,a)\) spre recompensă plus cea mai bună valoare a stării următoare:

\[Q(s_t,a_t)\leftarrow Q(s_t,a_t)+\alpha\big[r_{t+1}+\gamma\max_{a'}Q(s_{t+1},a')-Q(s_t,a_t)\big]\]
(10.5)

Paranteza este eroarea de diferență temporală (TD), un semnal de învățare disponibil după fiecare oră. Ținta folosește acțiunea lacomă, indiferent ce face agentul în continuare, deci Q-learning este off-policy. Metoda converge dacă fiecare pereche este vizitată de o infinitate de ori și pașii respectă condițiile Robbins–Monro. Explorarea este \(\varepsilon\)-lacomă, cu \(\varepsilon\) redus de la 1 la 0,05.

Definirea stării: informația disponibilă agentului

Slide-ul 21 în PDF

Operatorul planifică înainte să cunoască prețurile zilei, deci starea agentului este \((h,\ \text{energia stocată},\ q_h)\), unde \(q_h\) este quartila orei \(h\) între cele 24 de prețuri de ieri: 288 de stări și 3 acțiuni. Agentul este antrenat pe 1 746 de zile din 2019–2023, în 40 de treceri; se păstrează epoca cu cel mai mare venit pe anul de validare 2024, iar cele 638 de zile de test, între 1 ianuarie 2025 și 24 octombrie 2026, sînt folosite o singură dată.

În practică: o stare care include prețurile de azi ar da un test retrospectiv perfect, dar inutil.

Politica învățată prin Q-learning tabelar

Slide-ul 22 în PDF

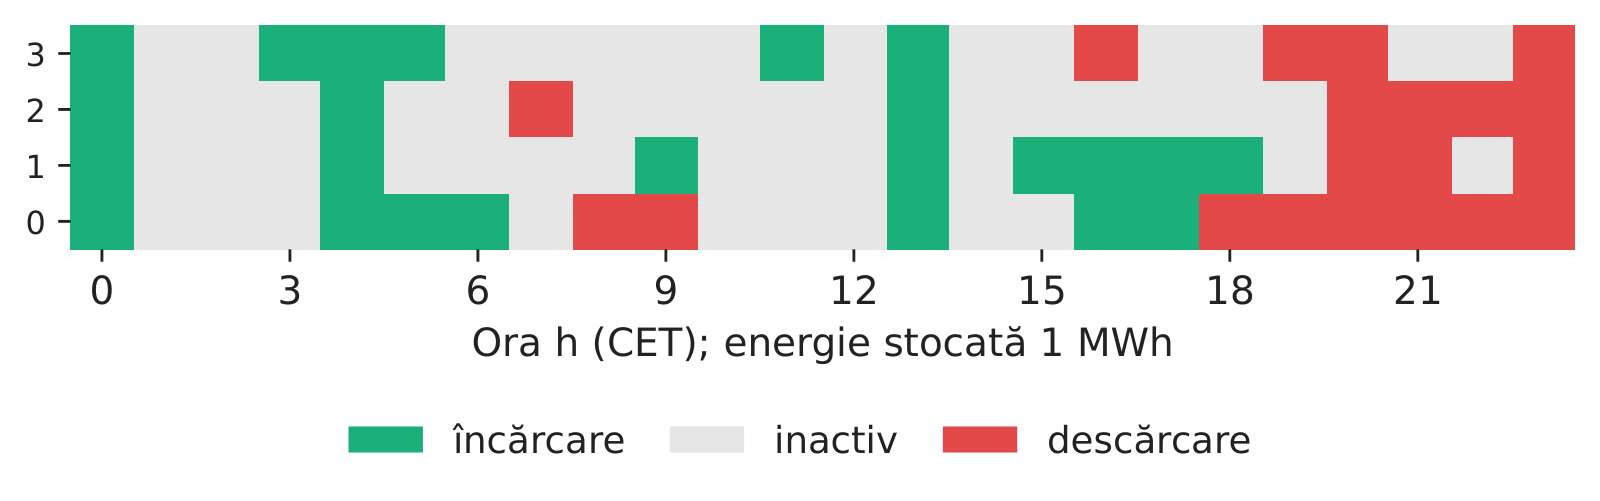
Cu un MWh stocat, agentul încarcă mai ales în golul solar de la începutul după-amiezii și descarcă seara; clasamentul de ieri mută momentul încărcării. Tabelul poate fi tipărit și verificat oră cu oră, un avantaj al metodelor tabelare.

Grafic: Politica învățată prin Q-learning tabelar

Acțiunea agentului Q-learning tabelar cu 1 MWh stocat, pe ore și pe quartila de ieri a prețului orei respective (prima valoare inițială).

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: rînduri = quartila prețului orei respective în ziua precedentă; valoarea inițială 20261108.

Rețeaua Q profundă: aproximarea tabelului Q printr-o rețea neuronală

Slide-ul 23 în PDF

DQN înlocuiește tabelul cu o rețea \(Q_\theta(s,a)\), ajustată prin regresie pe ținta TD (Mnih et al., 2015). DQN dublu lasă rețeaua online să aleagă acțiunea următoare și o rețea-țintă, actualizată lent, să o evalueze, ceea ce elimină deplasarea în sus a maximului unor estimări zgomotoase (van Hasselt, Guez & Silver, 2016):

\[y=r+\gamma\,Q_{\theta^{-}}\big(s',\arg\max_{a'}Q_{\theta}(s',a')\big),\qquad \mathcal L(\theta)=\mathbb E\big[\ell_{\text{Huber}}(y-Q_\theta(s,a))\big]\]
(10.6)

Rețeaua noastră are 82 de intrări (cele 24 de prețuri standardizate de ieri și din aceeași zi a săptămînii trecute, ziua săptămînii, ora și energia stocată) și două straturi de cîte 128 de unități liniare rectificate (ReLU). O memorie de reluare cu ultimele patru epoci elimină corelația dintre orele consecutive.

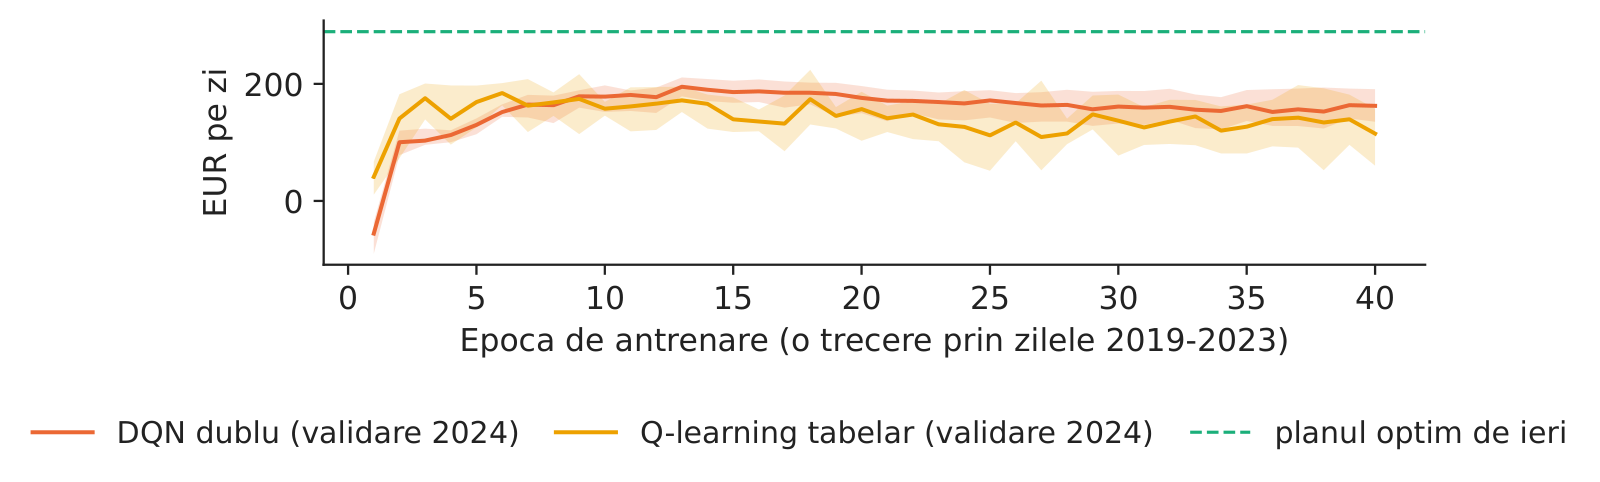
Curbele de învățare: venitul de validare pe epoci

Slide-ul 24 în PDF

Ambii agenți progresează repede, dar pe anul de validare 2024 rămîn sub planul optim de ieri: cel mai bun venit de validare pe zi, mediat pe cinci valori inițiale, este 200 EUR pentru DQN și 211 EUR pentru Q-learning, față de 289 EUR pentru planul naiv.

Grafic: Curbele de învățare: venitul de validare pe epoci

Venitul de validare pe zi (2024) după fiecare epocă de antrenare; linia = media, banda = intervalul celor cinci valori inițiale.

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: anul de validare 2024; banda = intervalul celor 5 valori inițiale.

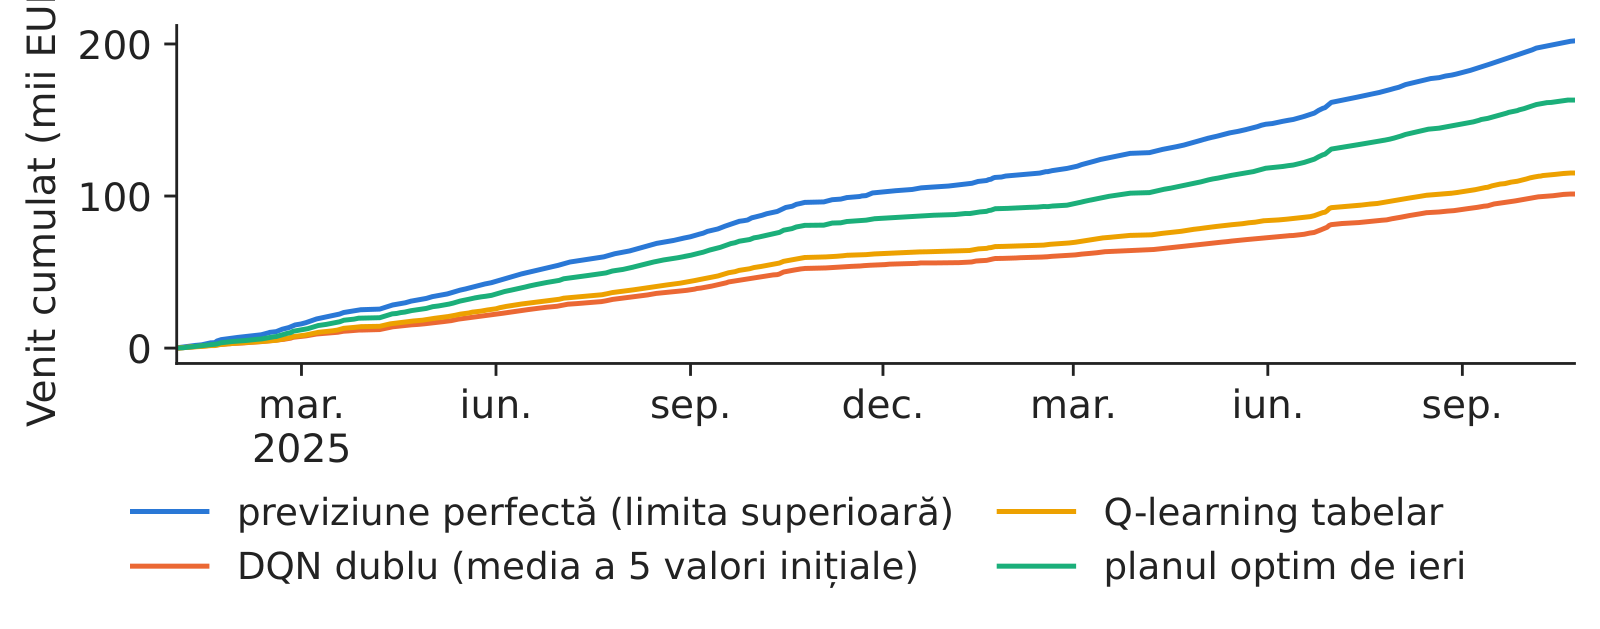
Ponderea venitului cu previziune perfectă obținută în anii de test

Slide-ul 25 în PDF

În zilele de test, venitul cu previziune perfectă este 202,1 mii EUR. Planul optim de ieri obține 163,1, Q-learning tabelar 115,2, iar DQN dublu 101,3 (medii pe cinci valori inițiale).

Grafic: Ponderea venitului cu previziune perfectă obținută în anii de test

Venitul cumulat în zilele de test (2025 – octombrie 2026): previziunea perfectă, cei doi agenți care învață și planul optim de ieri.

Sursa: energy-charts.info (Fraunhofer ISE), din datele burselor și ale ENTSO-E. Date: 1 ianuarie 2025 - 24 octombrie 2026 (test); antrenare 2019-2023, validare 2024.

Rezultatele bateriei pe anii de test, cinci valori inițiale

Slide-ul 26 în PDF
StrategiaVenit (mii EUR)Captare (%)Interval pe valori inițiale (%)
Previziune perfectă (limita superioară)202,1100–
DQN dublu101,350,143,9 – 58,5
Q-learning tabelar115,257,050,2 – 61,9
Planul optim de ieri163,180,7–

Un test Diebold–Mariano (DM) pe diferențele zilnice de venit dintre DQN și planul naiv, cu varianță Newey–West, dă \(t=-18{,}99\): DQN cîștigă cu 96,8 EUR mai puțin pe zi, iar niciunul dintre agenți nu bate planul naiv pentru vreo valoare inițială. Regula cîștigă pentru că optimizează pe toate cele 24 de prețuri de ieri, în timp ce agenții învață o politică medie dintr-o stare comprimată. Lecția nu este că RL eșuează, ci că trebuie comparat cu regula folosită deja; stări mai bogate (o prognoză de preț, chiar planul naiv ca intrare) sînt pasul următor firesc.

În practică: raportați rata de captare cu intervalul pe valori inițiale și un test față de planul naiv, niciodată doar cea mai bună rulare.

Gradienți de politică și PPO: tranzacționarea indicelui S&P 500

Metodele bazate pe gradientul politicii parametrizează direct politica. PPO este cea mai folosită dintre ele.

Metodele de gradient al politicii

Slide-ul 28 în PDF

Teorema gradientului politicii (Sutton et al., 2000) dă

\[\nabla_{\theta}J(\theta)=\mathbb E_{\pi_{\theta}}\Big[\sum_{t}\nabla_{\theta}\log\pi_{\theta}(a_t\mid s_t)\,\big(G_t-b(s_t)\big)\Big]\]
(10.7)

unde \(b(s_t)\) este o funcție oarecare de stare, un reper care lasă gradientul nedeplasat și îi reduce varianța. REINFORCE (Williams, 1992) folosește cîștigul Monte Carlo \(G_t\). Gradientul nu cere derivata legii de tranziție, deci piața poate rămîne o cutie neagră, iar politicile stocastice explorează singure.

Actor-critic și estimarea avantajului

Slide-ul 29 în PDF

Un critic \(V_\phi\) prognozează cîștigul, iar actorul învață din surpriză. Estimarea generalizată a avantajului (GAE) (Schulman et al., 2016) mediază erorile TD \(\delta_t=r_{t+1}+\gamma V_\phi(s_{t+1})-V_\phi(s_t)\):

\[\hat A_t=\sum_{l\ge0}(\gamma\lambda)^{l}\,\delta_{t+l}\]
(10.8)

unde \(\lambda=0\) dă avantajul TD de un pas, iar \(\lambda=1\) avantajul Monte Carlo; folosim \(\gamma=0{,}99\) și \(\lambda=0{,}95\). Actorul și criticul împart două straturi de cîte 64 de unități tanh, iar un bonus de entropie de 0,01 împiedică politica să devină deterministă prea devreme.

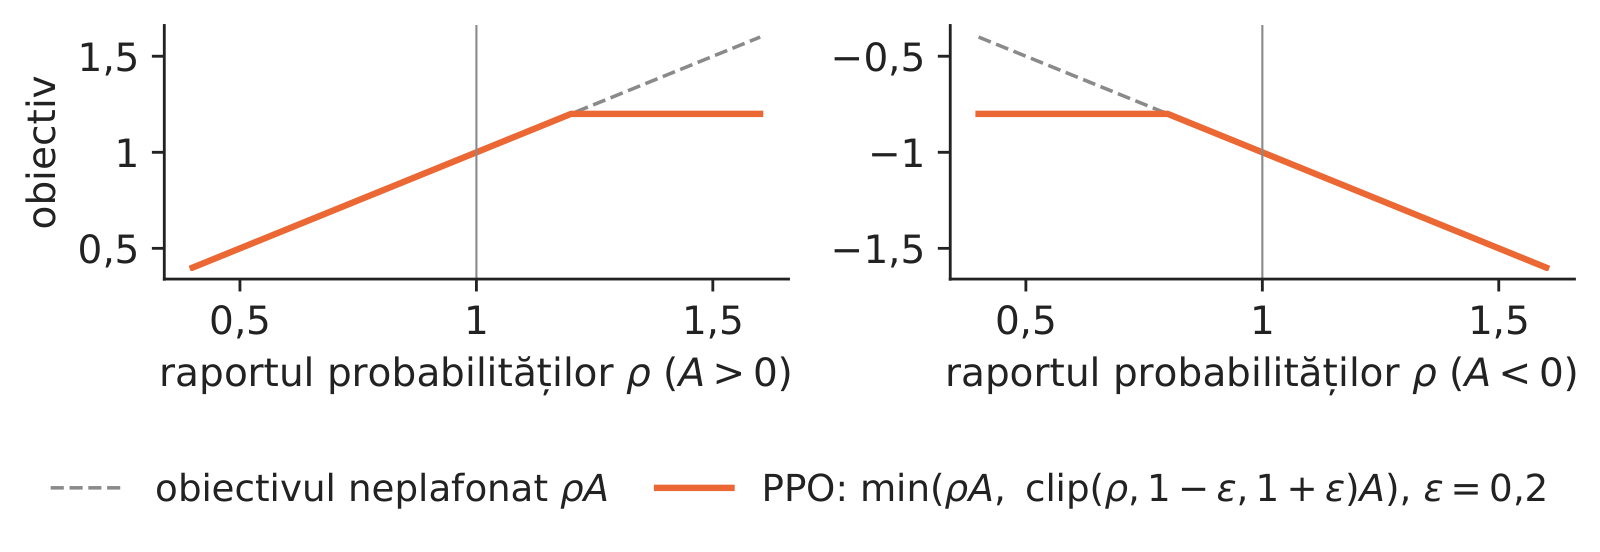
PPO: actualizarea plafonată a politicii

Slide-ul 30 în PDF

PPO (Schulman et al., 2017) maximizează obiectivul plafonat

\[\mathcal L^{\text{CLIP}}(\theta)=\mathbb E_t\big[\min\big(\rho_t\hat A_t,\ \mathrm{clip}(\rho_t,1-\epsilon,1+\epsilon)\hat A_t\big)\big],\qquad \rho_t=\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)}\]
(10.9)

Cu \(\epsilon=0{,}2\), odată ce raportul probabilităților iese din \([1-\epsilon,1+\epsilon]\) în direcția favorabilă, gradientul eșantionului devine zero: un înlocuitor ieftin al regiunii de încredere bazate pe divergența Kullback–Leibler (KL) din optimizarea politicii în regiune de încredere (TRPO). Graficul este o ilustrare analitică a mecanismului, nu un rezultat pe date.

Grafic: PPO: actualizarea plafonată a politicii

Obiectivul surogat plafonat în funcție de raportul probabilităților, pentru un avantaj pozitiv și unul negativ (funcție analitică).

Sursa: Schulman et al. (2017), obiectivul surogat plafonat. Date: funcție analitică, fără date.

Tranzacționarea ca MDP: în afara pieței sau long pe S&P 500

Slide-ul 31 în PDF

În fiecare seară agentul alege poziția de mîine \(a_t\in\{0,1\}\) și primește

\[r_{t+1}=a_t\ln\frac{P_{t+1}}{P_t}-c\,|a_t-a_{t-1}|,\qquad c=5\ \text{pb}\]
(10.10)

Starea conține șapte variabile standardizate doar cu momentele din 2005–2016 (randamentele logaritmice pe 1, 5, 21 și 63 de zile, volatilitatea realizată pe 21 de zile, VIX și distanța față de media mobilă de 200 de zile) și poziția anterioară. Fiecare dintre cele 150 de iterații PPO folosește 64 de ferestre aleatoare de 126 de zile din 2005–2016; se păstrează iterația cu cel mai bun raport Sharpe în 2017–2019, iar cele 1 716 zile de test de la 2 ianuarie 2020 sînt folosite o singură dată, pentru cinci valori inițiale.

În practică: includeți costul în recompensă, altfel agentul tranzacționează mult prea des.

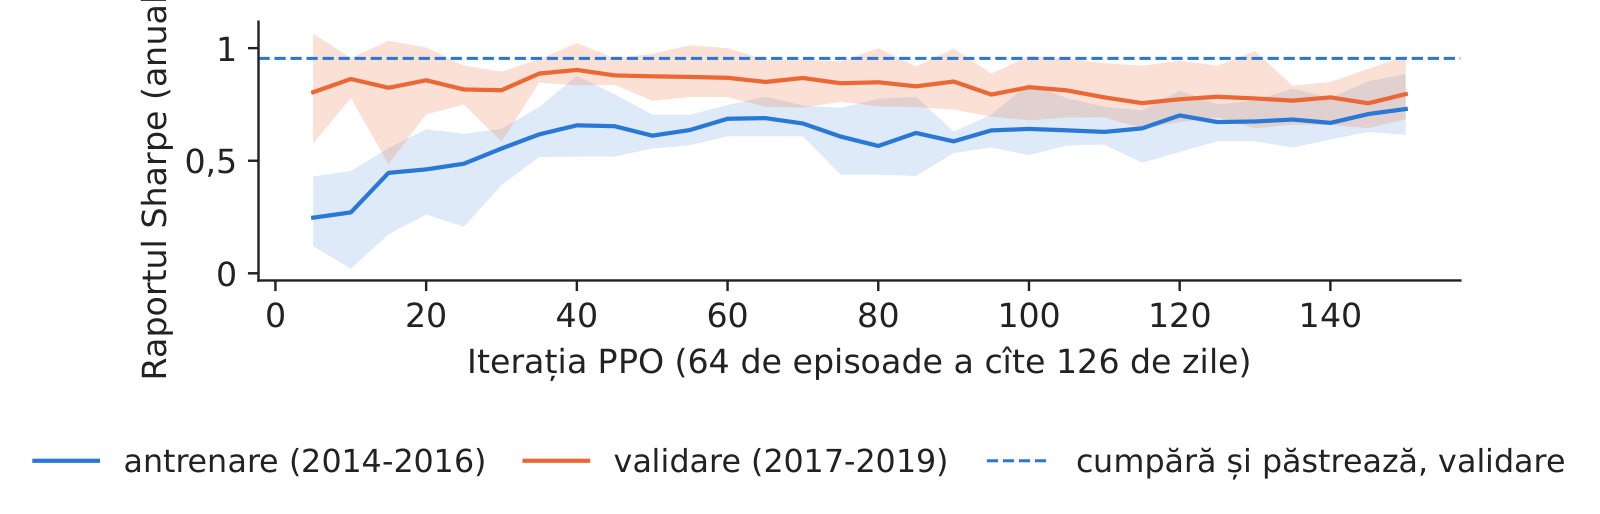
Raportul Sharpe la antrenare și validare în timpul antrenării PPO

Slide-ul 32 în PDF

Raportul Sharpe de antrenare crește cu iterațiile, iar cel de validare este zgomotos; strategia cumpără și păstrează a avut un raport Sharpe de 0,95 în anii de validare, iar iterația selectată este, în medie, a 48-a.

Grafic: Raportul Sharpe la antrenare și validare în timpul antrenării PPO

Raportul Sharpe anualizat al politicii lacome pe ultimii trei ani de antrenare și pe anii de validare, în timpul antrenării; banda = intervalul celor cinci valori inițiale.

Sursa: Yahoo Finance, cotații zilnice. Date: ferestre de antrenare din 17 octombrie 2005 - 30 decembrie 2016; banda = intervalul celor 5 valori inițiale.

Perioada de test: agentul PPO față de două reguli simple

Slide-ul 33 în PDF

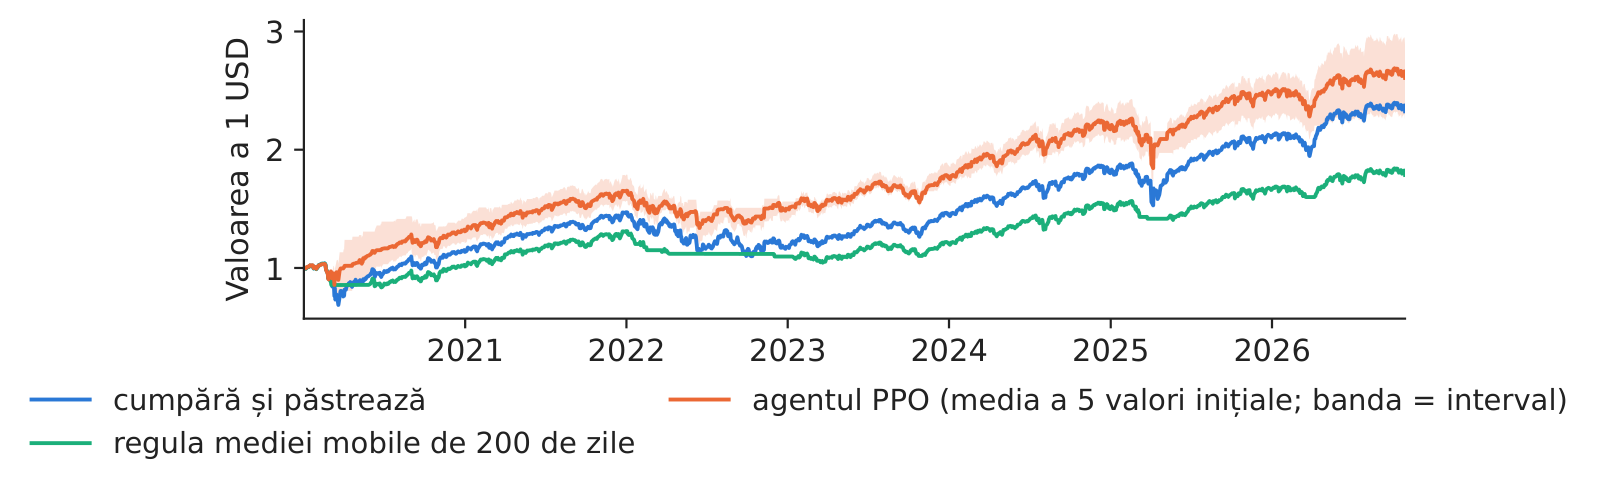
În perioada de test, raportul Sharpe este 0,61 pentru cumpără și păstrează, 0,68 pentru regula mediei mobile și 0,83 pentru PPO, mediat pe valori inițiale care variază între 0,72 și 0,95.

Grafic: Perioada de test: agentul PPO față de două reguli simple

Valoarea unui USD investit la 2 ianuarie 2020 în fiecare strategie, după un cost de 5 puncte de bază la fiecare schimbare de poziție; banda = intervalul celor cinci valori inițiale PPO.

Sursa: Yahoo Finance, cotații zilnice. Date: 2 ianuarie 2020 - 29 octombrie 2026 (test), S&P 500, cost de 5 pb pe tranzacție.

Rezultatele tranzacționării pe perioada de test

Slide-ul 34 în PDF
StrategiaRandament %/anVolatilitate %/anSharpeScădere max. %Investit %Tranzacții
Cumpără și păstrează13,220,20,61−33,91001
Media mobilă de 200 de zile8,912,40,68−20,57941
PPO (media a 5 valori inițiale)15,117,00,83−23,282147

PPO are raportul Sharpe mai mare pentru toate cele cinci valori inițiale, dar bootstrap-ul staționar pe blocuri (Politis & Romano, 1994) al diferenței de raport Sharpe dintre strategia PPO mediată și cumpără și păstrează, +0,26, dă un interval de 95 % de [−0,08; 0,56]. Intervalul conține zero: datele nu arată că agentul aduce valoare.

În practică: un interval care conține zero înseamnă că nu există dovezi că agentul aduce valoare, orice ar sugera graficul retrospectiv.

Perioadele în care agentul este în afara pieței

Slide-ul 35 în PDF

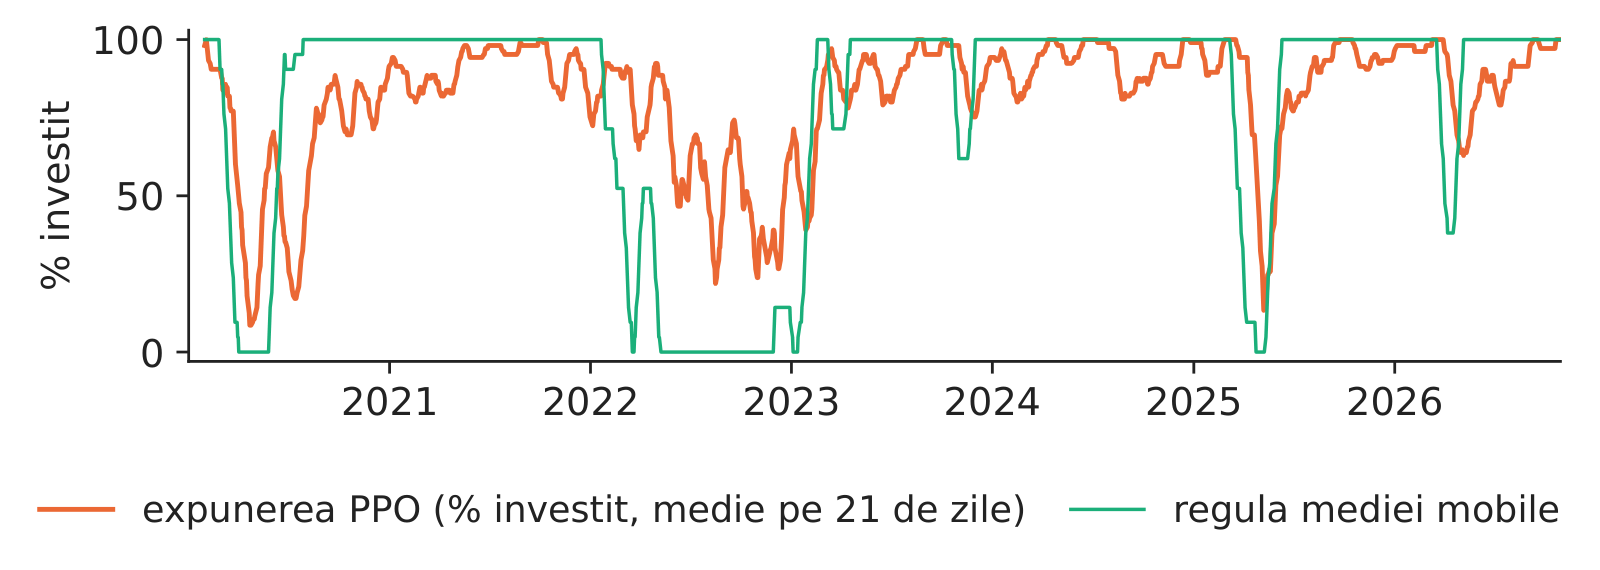
Citirea pozițiilor arată ce face efectiv agentul. PPO a fost investit în 82 % din zilele de test. Între 20 februarie și 30 aprilie 2020 a fost investit 42 % din timp, față de 14 % pentru regula mediei mobile; în 2022, 63 % din timp, față de 15 %. Agentul își reduce expunerea în perioadele de stres, dar mai puțin decît regula de trend.

Grafic: Perioadele în care agentul este în afara pieței

Ponderea capitalului investit de agentul PPO (media pe valori inițiale, medie pe 21 de zile) și de regula mediei mobile.

Sursa: Yahoo Finance, cotații zilnice. Date: 2 ianuarie 2020 - 29 octombrie 2026 (test).

În practică: citiți politica, nu doar profitul: un agent care este pur și simplu mereu investit este o strategie cumpără și păstrează cu risc de model suplimentar.

Limitele testelor retrospective pentru agenții de tranzacționare

Slide-ul 36 în PDF

Randamentele zilnice ale acțiunilor sînt aproape imprevizibile, deci agentul învață mai ales zgomotul ferestrelor de antrenare. Piețele sînt nestaționare: anii de antrenare conțin 2008, iar anii de test o prăbușire în pandemie, un șoc al inflației și o creștere lungă. Cinci valori inițiale dau deja un interval de rapoarte Sharpe, iar raportarea celei mai bune este supraajustare retrospectivă. Un simulator în care agentul nu influențează prețul ignoră impactul asupra pieței, iar costurile trebuie incluse în recompensă. RL ajută mai mult în probleme cu o stare reală și o recompensă cunoscută: execuția ordinelor, crearea de piață, acoperirea riscului și stocarea (Hambly, Xu & Yang, 2023).

În practică: cereți distribuția pe valori inițiale, ipoteza de cost și un interval bootstrap înainte de a avea încredere într-un rezultat RL de tranzacționare.

Acoperirea neuronală: o politică ce minimizează riscul din coadă

Acoperirea neuronală (deep hedging, Buehler et al., 2019) antrenează o politică neuronală de acoperire pe măsura de risc raportată de desk.

Acoperirea unei opțiuni call vîndute: rezultatul desk-ului

Slide-ul 38 în PDF

Desk-ul vinde o opțiune call la bani (ATM) pe o lună pe indicele S&P 500 și tranzacționează zilnic indicele:

\[\mathrm{PL}(\delta)=C_0+\sum_{k=0}^{20}\delta_k(S_{k+1}-S_k)-(S_{21}-K)^{+}-c\sum_{k=0}^{21}S_k|\delta_k-\delta_{k-1}|\]
(10.11)

unde \(S_k\) este indicele în ziua \(k\) a unei traiectorii reale de 21 de zile (scalată astfel încît \(S_0=K=1\)), \(C_0\) este prima Black-Scholes cu VIX-ul din ziua 0 ca volatilitate și o rată zero, \(\delta_k\) sînt unitățile deținute pe \((k,k+1]\), iar \(c=10\) puncte de bază. Există o traiectorie pentru fiecare zi de început: 3 021 pentru antrenare (2005–2016), 754 pentru validare și 1 696 pentru test (din 2020). Pe traiectoriile de test, prima medie este 2,38 % din indice, iar plata medie 2,53 %, cu un VIX mediu de 20,7. Traiectoriile sînt reale, nu simulate, deci păstrează salturile și grupările de volatilitate din 2008, 2020 și 2022.

În practică: prima abia acoperă plata medie; departamentul de risc gestionează coada.

Delta Black-Scholes și obiectivul acoperirii neuronale

Slide-ul 39 în PDF

Reperul deține delta Black-Scholes \(\delta_k=\Phi(d_1)\), \(d_1=[\ln(S_k/K)+\tfrac12\sigma_k^2\tau_k]/(\sigma_k\sqrt{\tau_k})\), cu \(\sigma_k\) VIX-ul din ziua \(k\) și \(\tau_k=(21-k)/252\). Rețeaua \(\delta_\theta(\ln S_k,\tau_k,\sigma_k,\delta_{k-1})\in[0,1]\) minimizează în schimb pierderea așteptată din coadă a pierderii, în forma Rockafellar & Uryasev (2000):

\[\min_{\theta,w}\ w+\frac{1}{1-\alpha}\mathbb E\big[(-\mathrm{PL}(\delta_\theta)-w)^{+}\big]=\min_\theta\mathrm{ES}_\alpha\big(-\mathrm{PL}(\delta_\theta)\big),\qquad \alpha=0{,}95\]
(10.12)

La optim, \(w\) este valoarea la risc (VaR). Rezultatul este diferențiabil în \(\theta\), deci gradientul se propagă înapoi prin toate cele 21 de zile; acoperirea anterioară ca intrare permite rețelei să învețe o bandă fără tranzacții atunci cînd costurile sînt mari.

În practică: obiectivul este chiar măsura de risc raportată de desk.

Rezultatul acoperirii pe traiectoriile de test

Slide-ul 40 în PDF

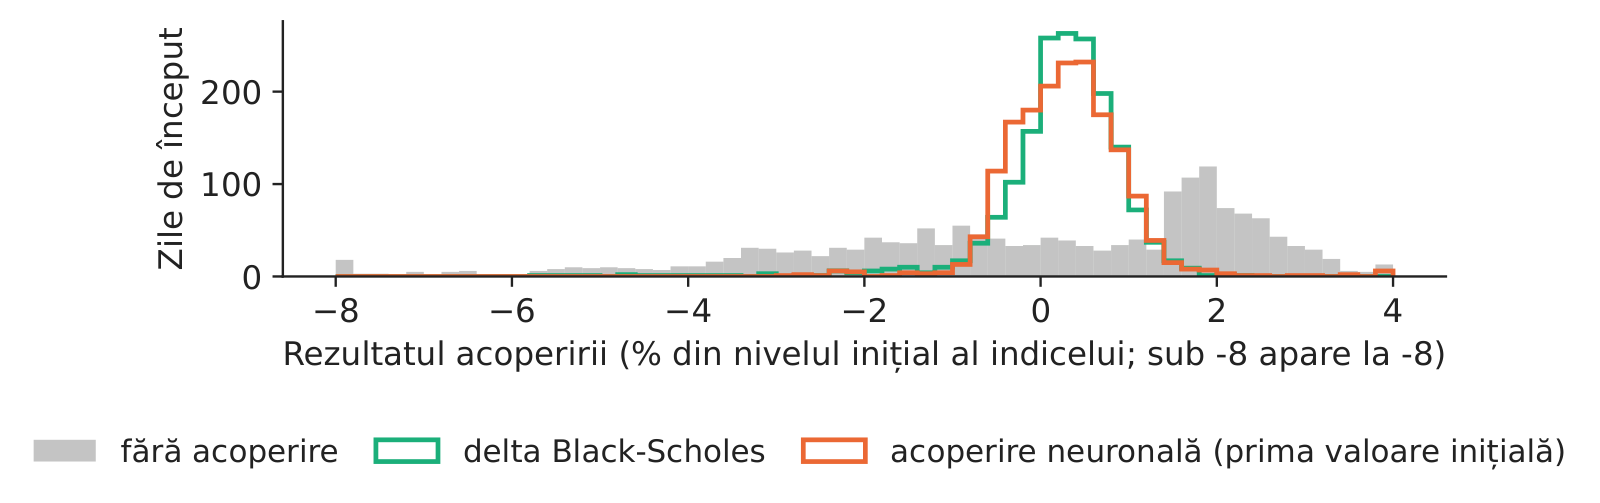
Acoperirea elimină cea mai mare parte a cozii din stînga. Abaterea standard a rezultatului este 2,60 % din indice fără acoperire, 0,74 % cu acoperirea delta și 0,69 % cu acoperirea neuronală.

Grafic: Rezultatul acoperirii pe traiectoriile de test

Distribuția rezultatului acoperirii pe traiectoriile de test, în % din nivelul inițial al indicelui: fără acoperire, delta Black-Scholes, acoperire neuronală (prima valoare inițială).

Sursa: Yahoo Finance, cotații zilnice. Date: traiectorii de 21 de zile începute 2 ianuarie 2020 - 1 octombrie 2026 (test); S&P 500 și VIX; cost 10 pb.

Rezultatele acoperirii pe traiectoriile de test, cost de 10 pb

Slide-ul 41 în PDF
StrategiaPL mediu (%)Abatere std. (%)ES95 al pierderii (%)Volum tranzacționat
Fără acoperire−0,152,606,820
Delta Black-Scholes (VIX)0,240,741,941,71
Acoperire neuronală (media a 5 valori inițiale)0,270,691,151,32

ES-ul acoperirii neuronale variază între 1,10 și 1,24 pe valori inițiale și este sub cel al acoperirii delta pentru toate cele cinci, iar acoperirea neuronală tranzacționează și mai puțin.

În practică: judecați o acoperire după coada pierderii și după volumul tranzacționat, nu după profitul mediu.

Raportul de acoperire învățat: mai plat și ajustat pentru costuri

Slide-ul 42 în PDF

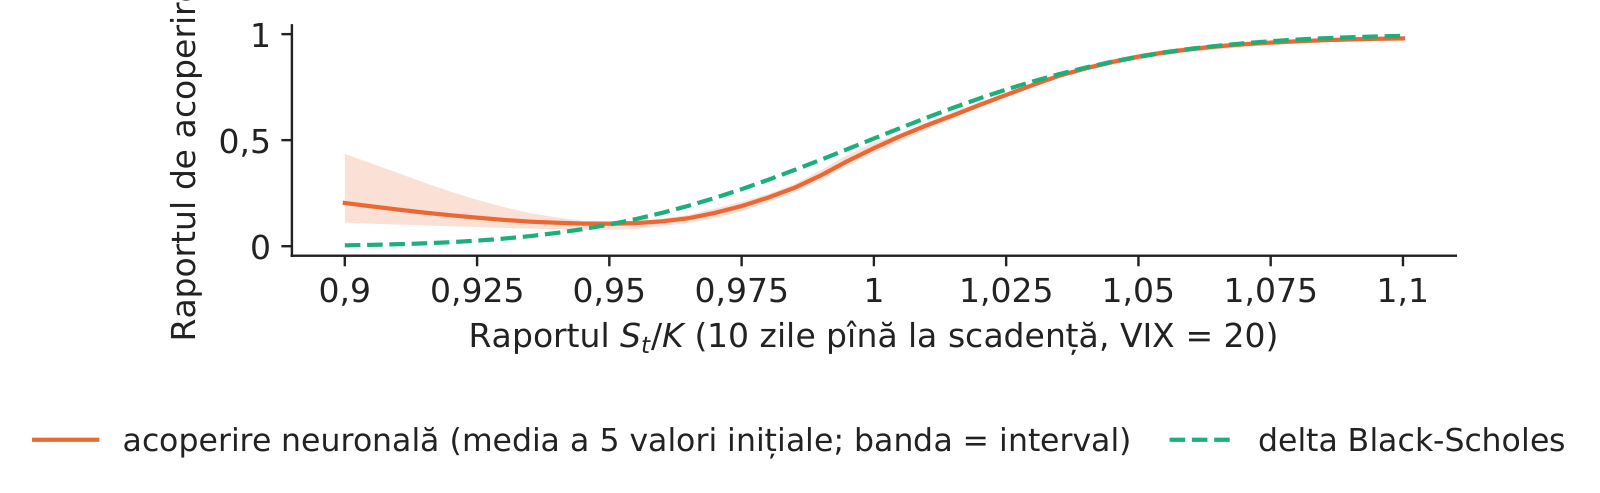
Cu zece zile înainte de scadență și cu VIX la 20, raportul de acoperire învățat este mai plat decît delta în jurul prețului de exercitare: 0,46 la bani, față de 0,51 pentru Black-Scholes. Rețeaua a învățat să tranzacționeze mai puțin acolo unde tranzacțiile sînt scumpe și plata incertă.

Grafic: Raportul de acoperire învățat: mai plat și ajustat pentru costuri

Raportul de acoperire al acoperirii neuronale (media și intervalul a cinci valori inițiale) și delta Black-Scholes, în funcție de raportul \(S_t/K\).

Sursa: Yahoo Finance, cotații zilnice. Date: politică antrenată pe traiectorii de 21 de zile începute în 2005-2016.

Costurile de tranzacționare și avantajul acoperirii învățate

Slide-ul 43 în PDF

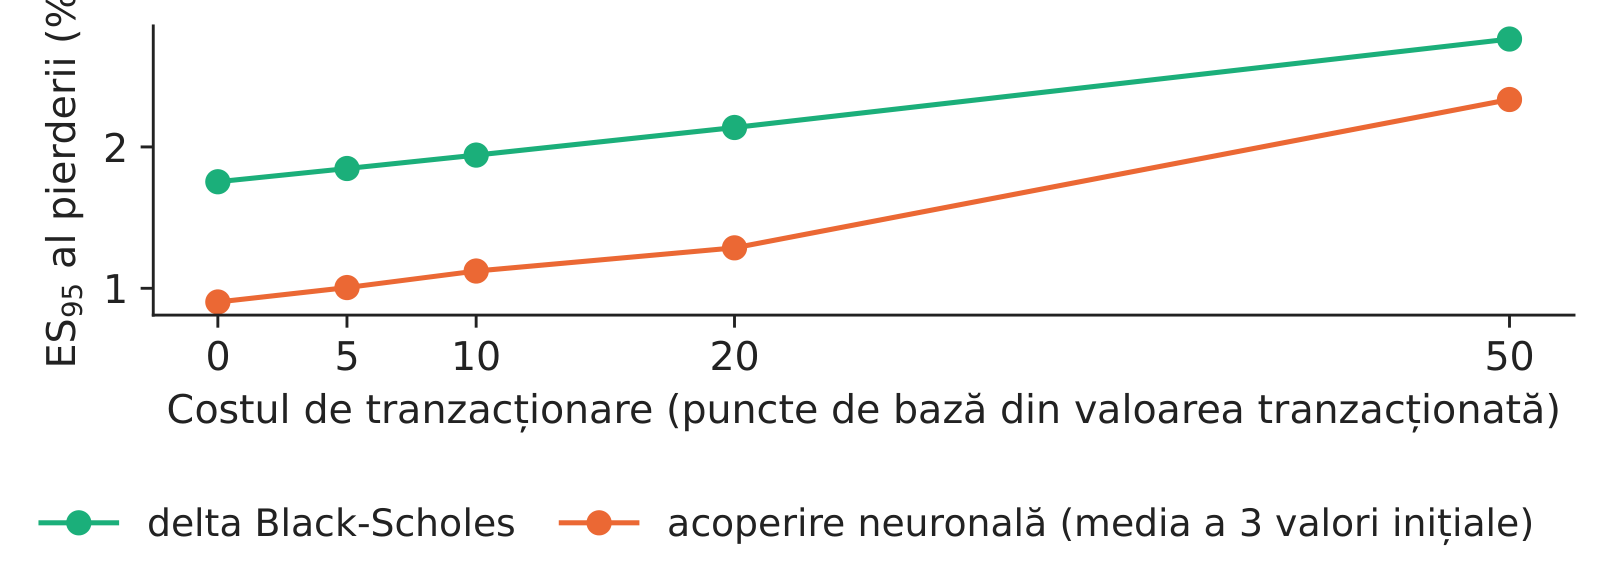
Am antrenat cîte o rețea pentru fiecare nivel de cost, de la 0 la 50 de puncte de bază. Fără costuri, ES95 este 1,75 % pentru delta și 0,90 % pentru acoperirea neuronală; la 50 de puncte de bază, 2,76 % și 2,34 %. Acoperirea învățată se adaptează și la traiectoriile reale, cu cozi groase, nu doar la costuri.

Grafic: Costurile de tranzacționare și avantajul acoperirii învățate

ES95 al pierderii din acoperire pe traiectoriile de test, în funcție de costul de tranzacționare: delta Black-Scholes și acoperirea neuronală (media a trei valori inițiale pentru fiecare cost).

Sursa: Yahoo Finance, cotații zilnice. Date: traiectorii de test începute 2 ianuarie 2020 - 1 octombrie 2026.

În practică: valoarea unei acoperiri învățate crește cu fricțiunile: active suport nelichide, diferențe mari între cotații, acoperiri pe energie și mărfuri.

Reinforcement learning în producție: riscul de model

Slide-ul 44 în PDF

Agentul optimizează exact recompensa primită: dacă omiteți costurile, riscul sau restricțiile, va exploata lipsa. O reluare istorică ignoră impactul propriu asupra prețului și regimurile viitoare. Evaluarea offline cere o singură perioadă de test, folosită o dată, mai multe valori inițiale și un test față de regula folosită deja. În producție, măștile de acțiune, limitele de poziție, oprirea de urgență și aprobarea umană limitează pagubele; un tabel sau o curbă a raportului de acoperire pot fi auditate, iar cursul 11 explică politicile neuronale; rata de captare și volumul tranzacționat trebuie comparate lunar cu testul retrospectiv.

În practică: tratați o politică RL ca pe orice model al băncii: documentată, validată independent, monitorizată și cu o regulă de rezervă.

Sinteza secțiunii

Pe date reale, cele trei probleme dau trei verdicte: pentru baterie cîștigă regula simplă; la tranzacționare, raportul Sharpe mai mare al PPO nu este semnificativ; la acoperire, politica învățată cîștigă pentru fiecare valoare inițială. Cursul 11 deschide cutia neagră și explică ce a învățat o rețea neuronală.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

A2Cactor-critic cu avantaj (advantage actor-critic)
AIinteligență artificială
ASEAcademia de Studii Economice din București
ATMla bani (prețul de exercitare = prețul curent)
BGBulgaria (zonă de ofertare)
CETora Europei Centrale
CPUprocesor central
DE-LUzona de ofertare Germania-Luxemburg
DMtestul Diebold-Mariano
DPprogramare dinamică
DQNrețea Q profundă (deep Q-network)
ENTSO-ERețeaua europeană a operatorilor de transport și de sistem pentru energie electrică
ESpierderea așteptată în coada distribuției (expected shortfall)
EUReuro
GAEestimarea generalizată a avantajului
HUUngaria (zonă de ofertare)
IPEInstitutul de Prognoză Economică, Academia Română
ISEInstitutul Fraunhofer pentru Sisteme de Energie Solară
KLdivergența Kullback-Leibler
MDPproces decizional Markov
MLPperceptron multistrat
MWmegawatt
MWhmegawatt-oră
PPOoptimizarea proximală a politicii (proximal policy optimisation)
ReLUunitate liniară rectificată
RLreinforcement learning
RORomânia (zonă de ofertare)
SSRNSocial Science Research Network
TDdiferență temporală
TRPOoptimizarea politicii în regiune de încredere
UEUniunea Europeană
USDdolar american
VaRvaloarea la risc (value at risk)
VIXindicele de volatilitate Cboe (volatilitatea implicită pe 30 de zile a indicelui S&P 500)

Bibliografie

  • Andrei, A.-V., Cepoi, C. O., Dumitrescu, B. A., Lessmann, S., Chiriac (Luchian), A.-C., Pele, D. T. & Petukhina, A. (2026). Joint probabilistic forecasting for battery arbitrage in day-ahead power markets. SSRN Working Paper 6872381. doi:10.2139/ssrn.6872381
  • Anagnoste, S., Andrei, A.-V., Bolovăneanu, V., Cepoi, C.-O., Clodnitchi, R., Cramer, A.-A., Grecu, R.-A., Lessmann, S., Pele, D. T., Petukhina, A. & Strat, V. A. (2025). The role of AI in (re)shaping energy finance: A systematic literature review. Energy Strategy Reviews, 61, 101833. doi:10.1016/j.esr.2025.101833
  • Andrei, A.-V., Velev, G., Toma, F.-M., Pele, D. T. & Lessmann, S. (2024). Energy price modelling: A comparative evaluation of four generations of forecasting methods. arXiv:2411.03372
  • Bellman, R. (1957). Dynamic Programming. Princeton University Press.
  • Buehler, H., Gonon, L., Teichmann, J. & Wood, B. (2019). Deep hedging. Quantitative Finance, 19(8), 1271–1291. doi:10.1080/14697688.2019.1571683
  • Diebold, F. X. & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. doi:10.1080/07350015.1995.10524599
  • Hambly, B., Xu, R. & Yang, H. (2023). Recent advances in reinforcement learning in finance. Mathematical Finance, 33(3), 437–503. doi:10.1111/mafi.12382
  • Mnih, V. et al. (2015). Human-level control through deep reinforcement learning. Nature, 518, 529–533. doi:10.1038/nature14236
  • Moody, J. & Saffell, M. (2001). Learning to trade via direct reinforcement. IEEE Transactions on Neural Networks, 12(4), 875–889. doi:10.1109/72.935097
  • Politis, D. N. & Romano, J. P. (1994). The stationary bootstrap. Journal of the American Statistical Association, 89(428), 1303–1313. doi:10.1080/01621459.1994.10476870
  • Rockafellar, R. T. & Uryasev, S. (2000). Optimization of conditional value-at-risk. Journal of Risk, 2(3), 21–41. doi:10.21314/JOR.2000.038
  • Schulman, J., Moritz, P., Levine, S., Jordan, M. & Abbeel, P. (2016). High-dimensional continuous control using generalized advantage estimation. ICLR. arXiv:1506.02438
  • Schulman, J., Wolski, F., Dhariwal, P., Radford, A. & Klimov, O. (2017). Proximal policy optimization algorithms. arXiv:1707.06347
  • Sutton, R. S. & Barto, A. G. (2018). Reinforcement Learning: An Introduction, 2nd ed. MIT Press. incompleteideas.net/book
  • Sutton, R. S., McAllester, D., Singh, S. & Mansour, Y. (2000). Policy gradient methods for reinforcement learning with function approximation. Advances in Neural Information Processing Systems, 12, 1057–1063.
  • van Hasselt, H., Guez, A. & Silver, D. (2016). Deep reinforcement learning with double Q-learning. Proceedings of the AAAI Conference on Artificial Intelligence, 30(1). doi:10.1609/aaai.v30i1.10295
  • Watkins, C. J. C. H. & Dayan, P. (1992). Q-learning. Machine Learning, 8, 279–292. doi:10.1007/BF00992698
  • Williams, R. J. (1992). Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 8, 229–256. doi:10.1007/BF00992696

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.