Rețele neuronale și deep learning

Cursul 11: Inteligența artificială explicabilă: SHAP, LIME, metode bazate pe gradient și stabilitatea explicațiilor

Cursul 11

Inteligența artificială explicabilă: SHAP, LIME, metode bazate pe gradient și stabilitatea explicațiilor

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

O bancă ce respinge un solicitant de credit cu ajutorul unei rețele neuronale trebuie să poată spune de ce. Regulamentul Uniunii Europene (UE) privind inteligența artificială (AI) încadrează evaluarea bonității persoanelor fizice în categoria cu risc ridicat, Regulamentul general privind protecția datelor (GDPR) protejează persoanele față de deciziile luate exclusiv de calculator, iar supraveghetorii riscului de model cer modele care pot fi validate și monitorizate. Acest curs arată cum se deschide cutia neagră cu metodele inteligenței artificiale explicabile (XAI): explicațiile aditive Shapley (SHAP), explicațiile locale interpretabile, independente de model (LIME), metodele bazate pe gradient, precum gradienții integrați (IG), dependența parțială și explicațiile contrafactuale.

Fiecare metodă este calculată pe date reale. Studiul de caz pentru credit folosește setul de date privind creditele garantate cu locuința (HMEQ): 5 960 de credite, dintre care 19,9 % neplătite, evaluate de un perceptron multistrat (MLP), de o regresie logistică și de un model extreme gradient boosting (XGBoost). Studiul de caz pentru fraudă folosește două zile de tranzacții cu carduri publicate de Université Libre de Bruxelles (ULB): o rețea antrenată pe prima zi este explicată pe a doua. Studiul de caz pentru locuințe folosește recensămîntul din 1990 din California. A doua parte a cursului pune o întrebare des ocolită: sînt explicațiile fidele modelului și rămîn ele aceleași atunci cînd nu se schimbă nimic important?

Ce veți ști să faceți

  • Să explicați de ce băncile, asigurătorii și autoritățile cer explicații și să clasificați metodele de explicare.
  • Să calculați și să interpretați explicațiile SHAP și LIME, cu formulele complete, pentru un client și pentru un portofoliu.
  • Să folosiți saliența, gradienții integrați și SmoothGrad și să verificați axioma completitudinii pe un model real de fraudă.
  • Să testați dacă explicațiile sînt concordante, fidele și stabile la schimbarea valorii inițiale, a eșantionului și a perioadei.
  • Să formulați o explicație contrafactuală pe care un solicitant respins o poate pune în practică.

Planul cursului

  1. Motivele explicării rețelelor neuronaleExplicațiile sînt cerute de lege și de buna gestiune a riscului, dar o explicație este ea însăși un model al modelului.
  2. Valorile Shapley și SHAPValorile Shapley provin din teoria jocurilor cooperative: ele împart un cîștig total între jucători în singurul mod care respectă patru axiome de echitate.
  3. LIME, contrafactuale și efecte globaleLIME explică o prognoză printr-un model simplu estimat în jurul ei; contrafactualele arată ce ar trebui să se schimbe; dependența parțială arată efectul mediu al unei variabile.
  4. Metode bazate pe gradient pentru rețele neuronaleO rețea își dă gradienții gratuit: o singură trecere înapoi dă sensibilitatea ieșirii la fiecare intrare.
  5. Concordanța, fidelitatea și stabilitatea explicațiilorTrei teste ar trebui să însoțească orice explicație: concordanța între metode, fidelitatea față de model și stabilitatea atunci cînd nu se schimbă nimic important.
  6. Explicabilitatea în guvernanța modelelor

Motivele explicării rețelelor neuronale

Explicațiile sînt cerute de lege și de buna gestiune a riscului, dar o explicație este ea însăși un model al modelului. Secțiunea prezintă regulile, o clasificare a metodelor și studiul de caz pentru credit, care străbate tot cursul.

Reglementările cer explicarea deciziilor automate

Slide-ul 6 în PDF

Trei texte definesc practica europeană. Regulamentul privind inteligența artificială (Regulamentul 2024/1689) include evaluarea bonității persoanelor fizice printre utilizările cu risc ridicat (anexa III), cere furnizorilor să facă sistemul transparent pentru cei care îl folosesc (articolul 13) și dă persoanei afectate de o decizie dreptul la explicarea rolului pe care sistemul l-a avut (articolul 86). GDPR, prin articolul 22 și considerentul 71, adaugă garanții față de deciziile bazate exclusiv pe prelucrarea automată. Ghidul Autorității Bancare Europene (EBA) privind acordarea și monitorizarea creditelor (2020) cere ca modelele folosite în decizia de creditare să poată fi explicate. În afara UE, ghidul de supraveghere al Federal Reserve privind riscul de model (SR 11-7) cere fundamentare conceptuală, validare independentă și monitorizare continuă pentru orice model.

Există și motive de afaceri: explicațiile scot la iveală scurgerile de informație (o variabilă care nu ar trebui să fie acolo), îi ajută pe analiștii de credit să aibă încredere în scor și permit băncii să îi spună clientului de ce răspunsul a fost negativ. Precauția străbate tot cursul: o explicație care se schimbă fără ca ceva important să se schimbe este un risc de conformitate, nu o garanție.

În practică: o explicație care se schimbă fără ca ceva important să se schimbe este un risc de conformitate, nu o garanție.

O clasificare a metodelor de explicare

Slide-ul 7 în PDF

Metodele diferă prin domeniu și prin ce le este necesar. Metodele globale descriu modelul pe întreaga populație (coeficienți, valorile SHAP absolute medii, dependența parțială, importanța prin permutare); metodele locale explică o singură decizie (diagrama cascadă SHAP, LIME, gradienții, un contrafactual). Metodele independente de model doar apelează modelul (Kernel SHAP, LIME, dependența parțială); metodele specifice folosesc structura lui (TreeSHAP pentru arbori, gradienții pentru rețele). În sfîrșit, metodele post-hoc explică un model deja antrenat, în timp ce modelele interpretabile, de exemplu o grilă de scor, sînt transparente prin construcție. Rudin (2019) susține că în deciziile cu miză mare a doua cale trebuie încercată prima; vom vedea cîtă acuratețe costă ea pe datele noastre.

Studiul de caz pentru credit: compararea a trei modele de scoring

Slide-ul 8 în PDF

Rețeaua are două straturi ascunse, cu 64 și 32 de unități liniare rectificate (ReLU):

\[\mathbf h_1=\mathrm{ReLU}(\mathbf W_1\mathbf x+\mathbf b_1),\quad \mathbf h_2=\mathrm{ReLU}(\mathbf W_2\mathbf h_1+\mathbf b_2),\quad f(\mathbf x)=\mathbf w_3^{\top}\mathbf h_2+b_3,\quad \mathrm{PD}(\mathbf x)=\sigma(f(\mathbf x))\]
(11.1)

unde \(\mathbf x\) conține 18 variabile standardizate (zece variabile numerice imputate cu mediana din antrenare, un indicator pentru raportul datorie/venit lipsă, DEBTINC, motivul creditului și ocupația), \(f\) este log-șansele de neplată, iar PD este probabilitatea de nerambursare. Creditele sînt împărțite 60/20/20, stratificat; standardizarea și medianele se estimează doar pe partea de antrenare.

Model (test)AUCPR-AUCBrier
Regresie logistică0,9090,7850,080
MLP, media a 10 valori inițiale0,9350,8420,068
XGBoost, media a 10 valori inițiale0,9590,8890,058

AUC este aria de sub curba caracteristicii de operare a receptorului (ROC), iar PR-AUC este aria de sub curba precizie-sensibilitate; un scor aleator are PR-AUC egal cu rata de neplată, 0,200. Rețeaua este net superioară grilei logistice, iar arborii amplificați sînt și mai buni. La modelul logistic coeficienții sînt explicația; pentru rețea, explicația trebuie calculată.

În practică: la modelul logistic coeficienții sînt explicația; pentru MLP explicația trebuie calculată.

Valorile Shapley și SHAP

Valorile Shapley provin din teoria jocurilor cooperative: ele împart un cîștig total între jucători în singurul mod care respectă patru axiome de echitate. SHAP le aplică variabilelor unei prognoze.

Valorile Shapley: o împărțire echitabilă a prognozei între variabile

Slide-ul 10 în PDF

Pentru \(d\) variabile și o funcție de valoare \(v(S)\), care arată ce prognozează modelul cînd sînt cunoscute doar variabilele din \(S\), valoarea Shapley a variabilei \(j\) este contribuția ei marginală, mediată pe toate ordinile în care variabilele ar putea fi adăugate:

\[\phi_j=\sum_{S\subseteq\{1,\dots,d\}\setminus\{j\}}\frac{|S|!\,(d-|S|-1)!}{d!}\big[v(S\cup\{j\})-v(S)\big]\]
(11.2)

Ponderile sînt proporția ordinilor în care \(j\) sosește imediat după membrii lui \(S\). Shapley (1953) a arătat că aceasta este singura împărțire cu patru proprietăți: eficiența (contribuțiile se adună la \(v\) al tuturor variabilelor minus \(v\) al niciuneia), simetria (două variabile care contribuie la fel primesc aceeași cotă), variabila nulă (o variabilă care nu schimbă niciodată \(v\) primește zero) și aditivitatea. Prețul este computațional: cu 18 variabile există \(2^{18}\) coaliții pentru fiecare solicitant.

În practică: eficiența este ceea ce îi trebuie analistului de credit: părțile se adună exact la scor.

SHAP: valoarea unei coaliții de variabile

Slide-ul 11 în PDF

SHAP (Lundberg & Lee, 2017) definește valoarea unei coaliții ca ieșirea așteptată a modelului atunci cînd variabilele lipsă sînt extrase dintr-un eșantion de referință \(\mathcal B\) de 100 de solicitanți din setul de antrenare:

\[v(S)=\mathbb E_{\mathbf x_{\bar S}\sim\mathcal B}\big[f(\mathbf x_S,\mathbf x_{\bar S})\big],\qquad f(\mathbf x)=\phi_0+\sum_{j=1}^{d}\phi_j(\mathbf x),\quad \phi_0=\mathbb E_{\mathcal B}[f]\]
(11.3)

Explicăm log-șansele, unde efectele se adună. Pe 400 de solicitanți din test, eroarea maximă de aditivitate este \(2{,}9\cdot10^{-6}\), adică doar eroare de rotunjire. Pentru un model liniar formula are o soluție explicită, \(\phi_j=\beta_j(x_j-\mathbb E x_j)\) (SHAP liniar). Înlocuirea variabilelor lipsă este intervențională, adică independentă de cele cunoscute; cînd variabilele sînt corelate, ea poate crea solicitanți care nu există, o limită ce trebuie menționată în documentația modelului.

În practică: eșantionul de referință definește „solicitantul mediu”; documentați-l ca pe orice intrare a modelului.

Kernel SHAP și TreeSHAP: cum se calculează SHAP

Slide-ul 12 în PDF

Kernel SHAP estimează o regresie liniară ponderată a valorilor coalițiilor pe indicatorii coalițiilor \(\mathbf z\in\{0,1\}^d\), cu nucleul Shapley

\[\pi(\mathbf z)=\frac{d-1}{\binom{d}{|\mathbf z|}\,|\mathbf z|\,(d-|\mathbf z|)}\]
(11.4)

iar soluția celor mai mici pătrate ponderate este egală cu valorile Shapley (demonstrația se află în anexa A a slide-urilor). Eșantionăm 600 de coaliții pentru fiecare solicitant; cei 400 de solicitanți cer 16 secunde. Pentru ansamblurile de arbori, TreeSHAP calculează valorile exacte în timp polinomial (Lundberg et al., 2020); așa explicăm XGBoost. Kernel SHAP are zgomot de eșantionare, de aceea valoarea inițială și numărul de eșantioane trebuie trecute în documentație.

Importanța globală: lipsa raportului datorie/venit domină

Slide-ul 13 în PDF

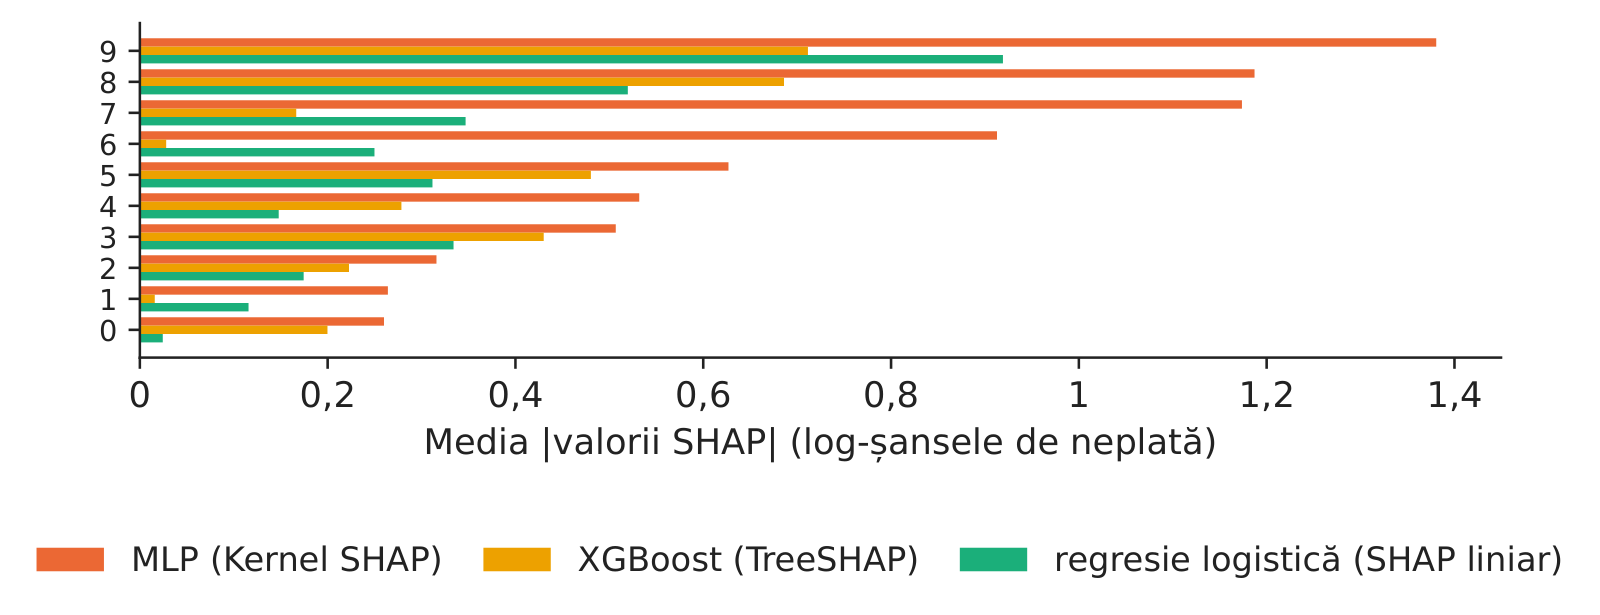
Valoarea SHAP absolută medie a fiecărei variabile ordonează factorii de risc ai portofoliului. Toate cele trei modele pun pe primul loc indicatorul DEBTINC_missing; la rețea urmează DELINQ, numărul liniilor de credit cu restanțe, și categoria de ocupație „Other”. Corelația Spearman a importanțelor este 0,55 între MLP și XGBoost și 0,79 între MLP și regresia logistică.

Explicația se află în date: raportul datorie/venit lipsește la 21,3 % dintre credite, iar rata de neplată este 62,0 % cînd lipsește, față de 8,6 % cînd este raportat. Rețeaua a învățat că un dosar incomplet este un semnal puternic de risc.

Grafic: Importanța globală: lipsa raportului datorie/venit domină

Valoarea SHAP absolută medie a celor mai importante zece variabile pentru MLP (Kernel SHAP), XGBoost (TreeSHAP) și regresia logistică (SHAP liniar), pe 400 de solicitanți din test.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 400 de solicitanți din test, 100 de solicitanți de referință.

În practică: o explicație poate arăta că modelul notează dosarul, nu debitorul; decideți dacă acest lucru este acceptabil.

Diagrama roi: sensul și dispersia fiecărui efect

Slide-ul 14 în PDF

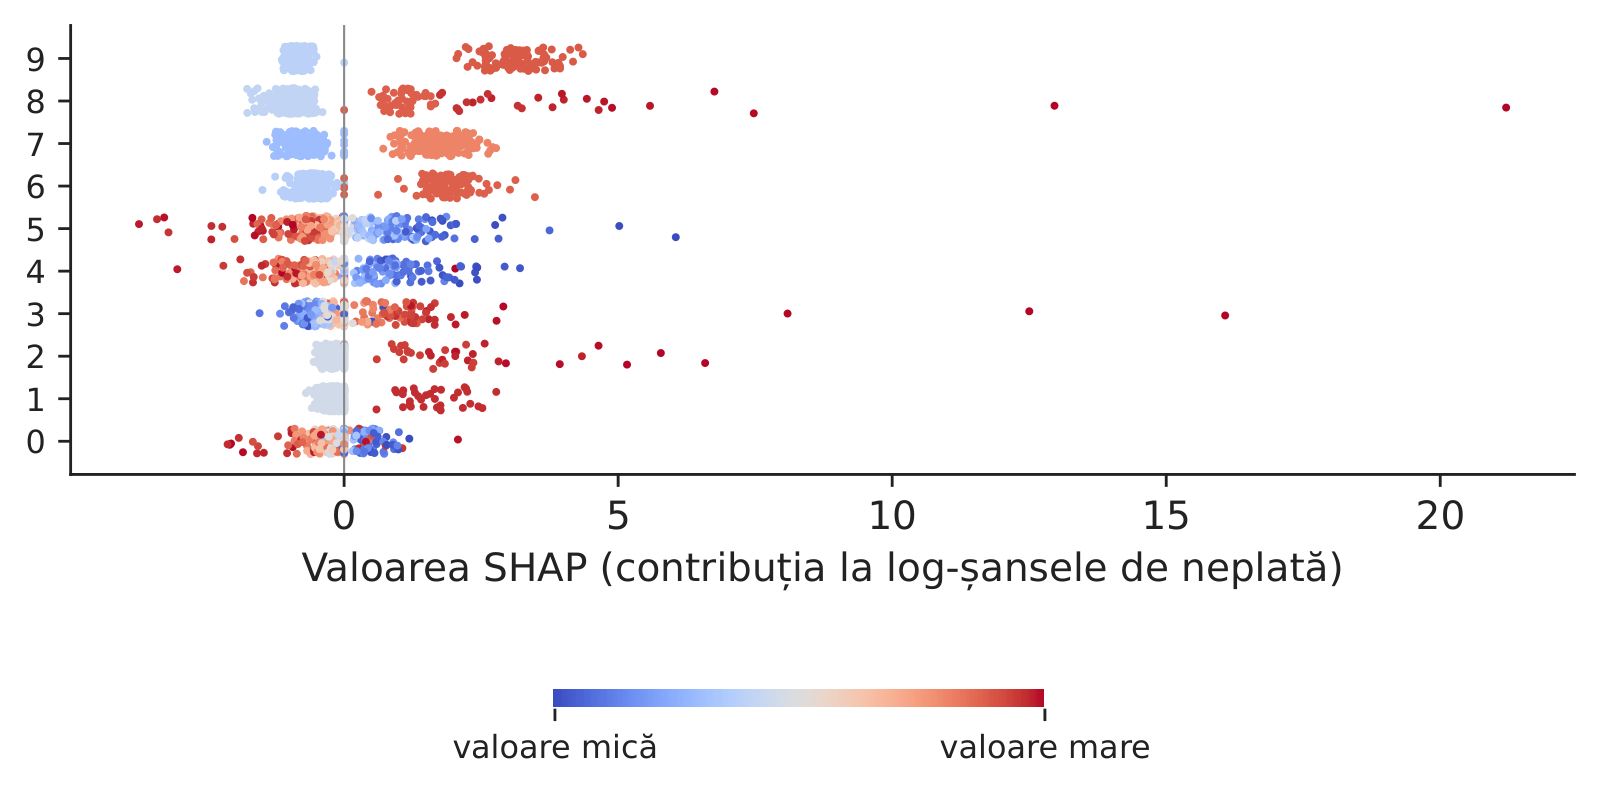
Diagrama roi reprezintă fiecare solicitant printr-un punct, poziționat la valoarea sa SHAP și colorat după rangul valorii variabilei. Ea adaugă ceea ce graficul cu bare ascunde: sensul efectului și dispersia lui. Valorile mari ale DELINQ și ale DEROG, numărul rapoartelor negative majore, cresc riscul, așa cum se așteaptă în teoria creditului; un raport datorie/venit declarat îl reduce pentru majoritatea solicitanților.

Grafic: Diagrama roi: sensul și dispersia fiecărui efect

Valorile SHAP ale celor mai importante zece variabile pentru 400 de solicitanți din test; culoarea merge de la albastru (valoare mică) la roșu (valoare mare).

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 400 de solicitanți din test; culoarea = rangul valorii variabilei.

Explicația locală pentru un solicitant respins: diagrama cascadă SHAP

Slide-ul 15 în PDF

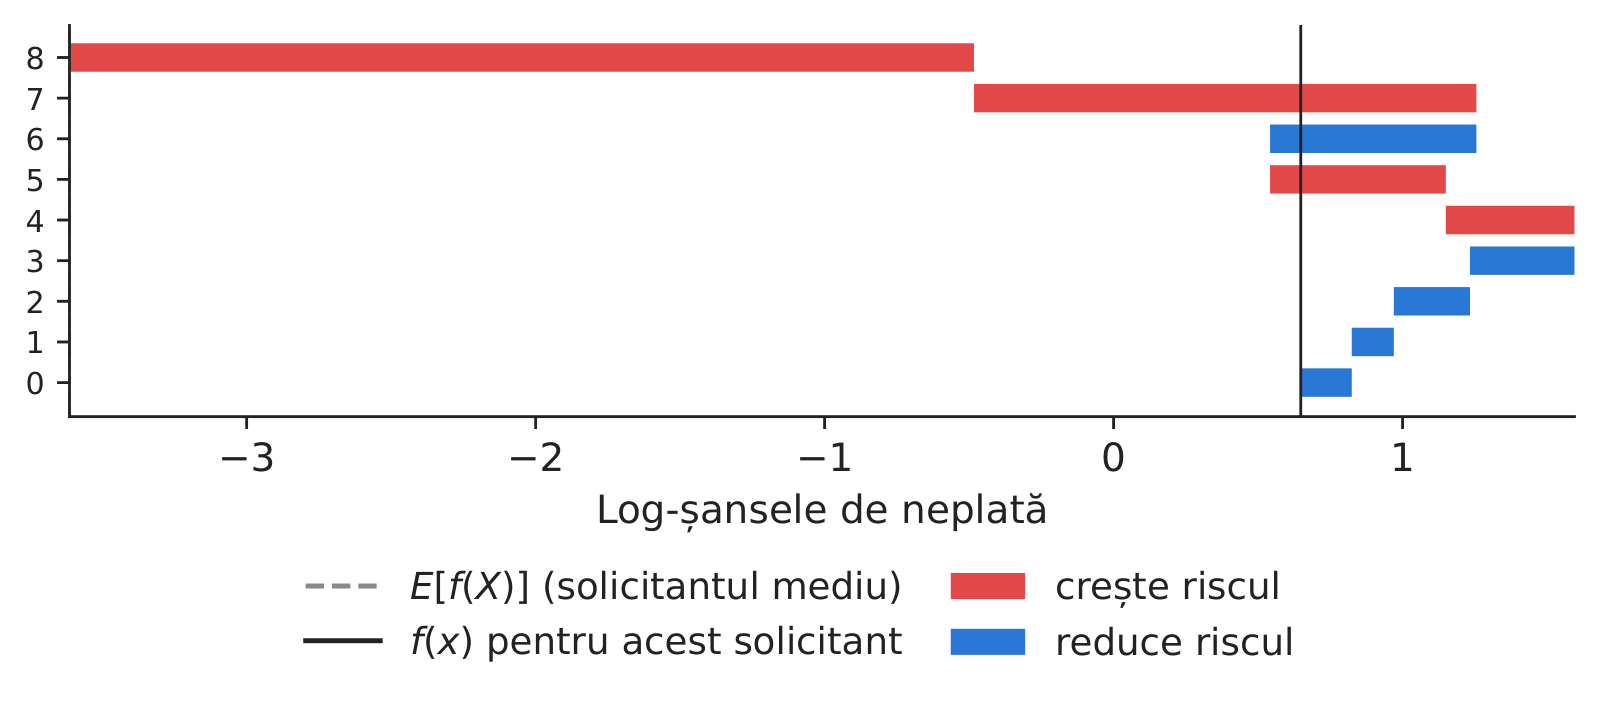
Pentru un solicitant din test (rîndul 2411 al datelor), rețeaua dă o PD de 65,6 %, cu log-șansele 0,648. Diagrama cascadă pornește de la log-șansele medii \(\phi_0=-3{,}613\) și adaugă contribuțiile una cîte una pînă la scorul solicitantului: \(-3{,}613+4{,}261=0{,}648\). Cele mai mari contribuții sînt DEBTINC_missing (\(+3{,}13\)), ocupația „Other” (\(+1{,}74\)) și DELINQ (\(-0{,}71\); acest solicitant nu are linii cu restanțe).

Grafic: Explicația locală pentru un solicitant respins: diagrama cascadă SHAP

Contribuțiile celor mai importante opt variabile (valori în unitățile originale) și ale celorlalte zece, de la log-șansele medii la log-șansele solicitantului.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: solicitant din test (rîndul 2411); valori în unitățile originale.

În practică: notificarea de respingere enumeră principalele motive în această ordine, în cuvinte pe care clientul le înțelege.

Graficul de dependență: rețeaua a învățat semnalul valorii lipsă

Slide-ul 16 în PDF

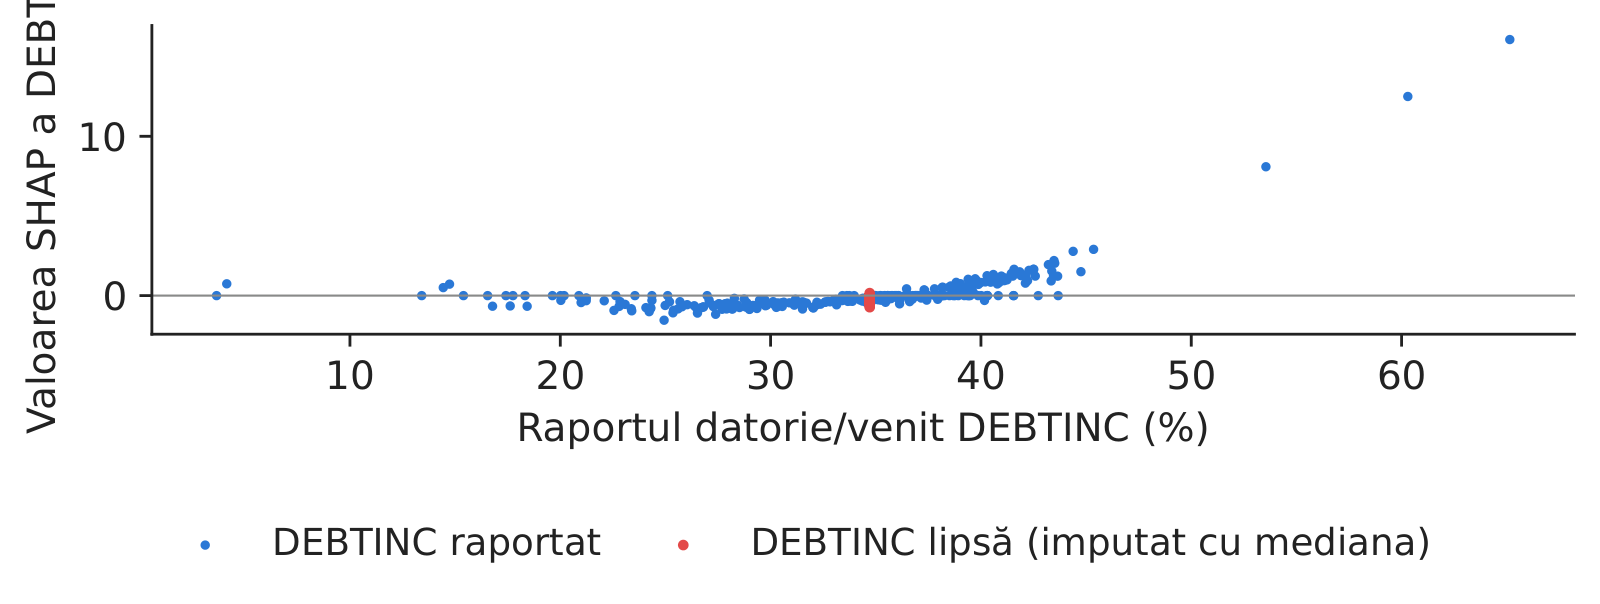
Graficul valorii SHAP a DEBTINC în funcție de DEBTINC arată un al doilea efect al imputării. Solicitanții la care raportul lipsește se află toți la mediana din antrenare, iar valoarea lor SHAP pentru DEBTINC este mică: riscul acestor dosare este preluat de indicatorul de lipsă, a cărui valoare SHAP medie este \(+3{,}13\). Fără indicator, rețeaua ar trebui să ghicească riscul din valoarea imputată, iar explicația ar da vina pe un raport datorie/venit pe care solicitantul nu l-a declarat niciodată.

Grafic: Graficul de dependență: rețeaua a învățat semnalul valorii lipsă

Valoarea SHAP a DEBTINC în funcție de raportul declarat (albastru) și pentru dosarele cu raport lipsă, imputat cu mediana (roșu).

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 400 de solicitanți din test, MLP.

În practică: alegerea metodei de imputare schimbă explicațiile; păstrați un indicator de lipsă pentru ca motivul să poată fi numit.

LIME, contrafactuale și efecte globale

LIME explică o prognoză printr-un model simplu estimat în jurul ei; contrafactualele arată ce ar trebui să se schimbe; dependența parțială arată efectul mediu al unei variabile.

LIME: un model simplu, fidel în jurul unui punct

Slide-ul 18 în PDF

LIME (Ribeiro, Singh & Guestrin, 2016) perturbă solicitantul, ponderează perturbările după distanță și estimează un model liniar pe răspunsurile rețelei:

\[\xi(\mathbf x)=\arg\min_{g\in\mathcal G}\sum_{\mathbf z}\pi_{\mathbf x}(\mathbf z)\big[f(\mathbf z)-g(\mathbf z)\big]^2+\Omega(g),\qquad \pi_{\mathbf x}(\mathbf z)=\exp\!\Big(-\frac{\|\mathbf z-\mathbf x\|^2}{\sigma^2}\Big)\]
(11.5)

unde \(\mathcal G\) este mulțimea modelelor liniare, \(\Omega\) o penalizare a complexității, iar \(\sigma\) lățimea nucleului, implicit \(0{,}75\sqrt d=3{,}18\). LIME dă o pantă locală, nu o împărțire a prognozei, deci coeficienții săi nu se adună la \(f(\mathbf x)\). Pentru solicitantul nostru, variabila de top la LIME este DELINQ, iar la SHAP este DEBTINC_missing: un indicator binar este departe de o funcție liniară, iar cele două metode răspund la întrebări diferite.

În practică: LIME răspunde la „ce mișcă scorul în jurul acestui client?”, iar SHAP la „de ce este acest client departe de medie?”.

LIME și SHAP pentru același solicitant

Slide-ul 19 în PDF

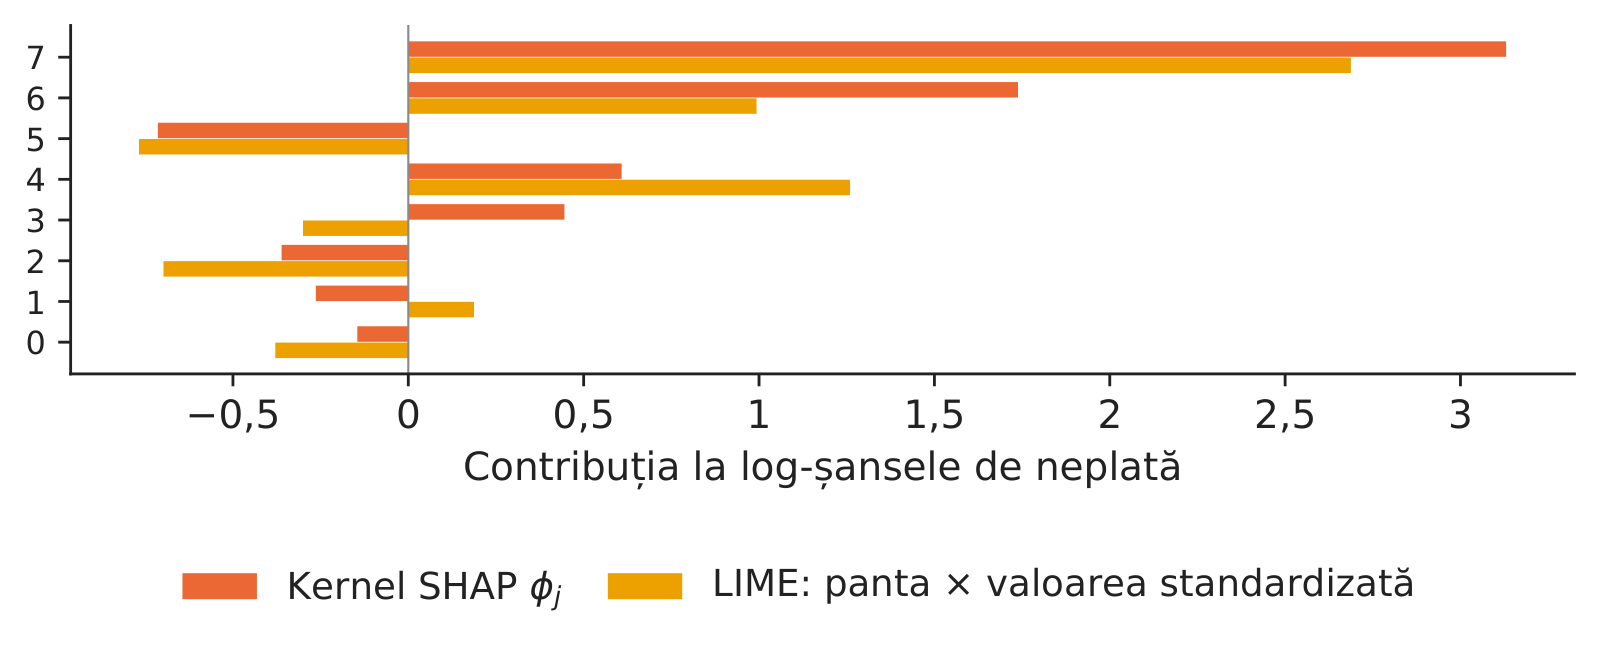
Ca să comparăm cele două metode pe aceeași scară, înmulțim fiecare pantă LIME cu valoarea standardizată a variabilei, ceea ce dă o contribuție față de solicitantul mediu. Corelația Spearman a contribuțiilor absolute este 0,80: metodele sînt de acord asupra celei mai mari părți a clasamentului, dar nu asupra variabilei de top.

Grafic: LIME și SHAP pentru același solicitant

Contribuția Kernel SHAP și panta LIME × valoarea standardizată pentru cele mai importante opt variabile SHAP ale aceluiași solicitant (LIME cu 5 000 de eșantioane).

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: solicitant din test (rîndul 2411); LIME cu 5 000 de eșantioane.

Sensibilitatea LIME la propriile setări

Slide-ul 20 în PDF

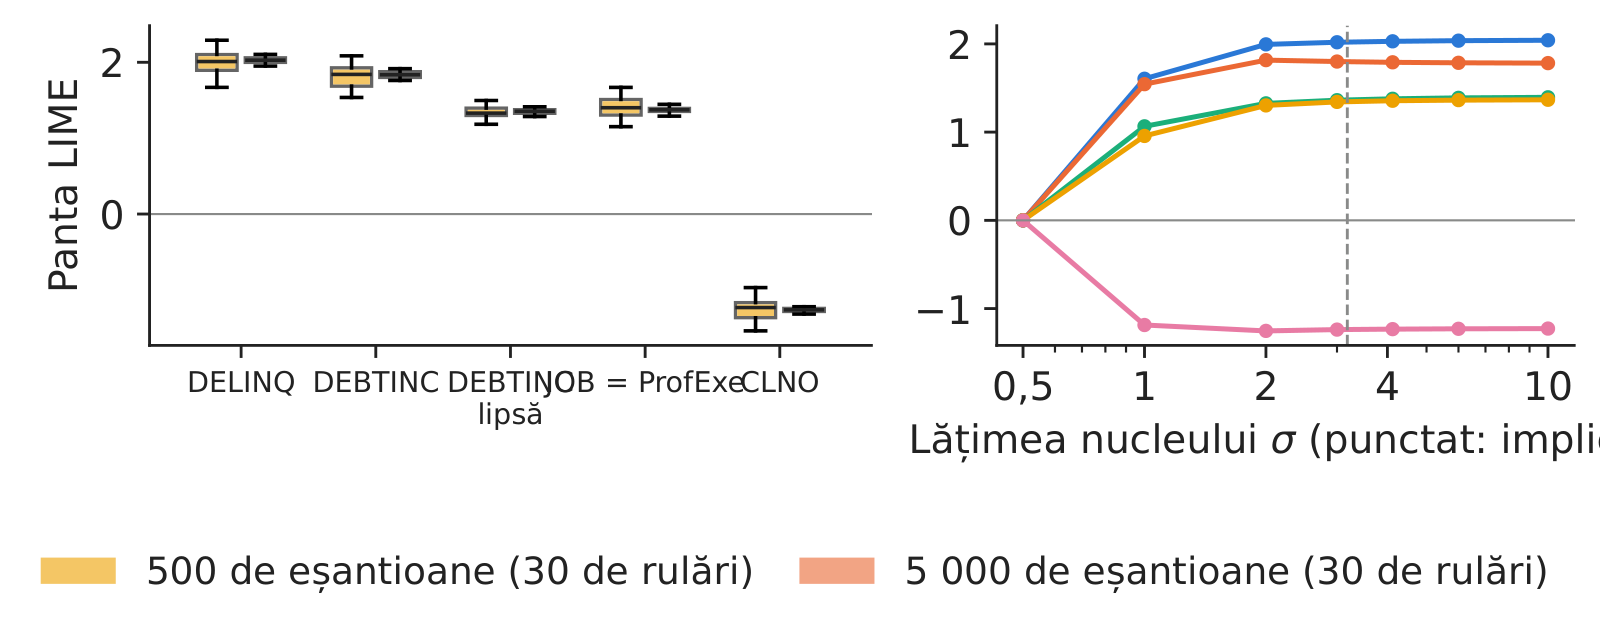
Am repetat LIME de 30 de ori, cu valori inițiale diferite. Cu 500 de eșantioane, variabila de top a fost aceeași în 73 % din rulări, iar suprapunerea Jaccard a primelor cinci variabile a fost 0,72; cu 5 000 de eșantioane, în 100 % din rulări, cu suprapunerea 1,00. Coeficientul de variație al celor mai mari cinci pante scade de la 10 % la 2 %. Lățimea nucleului contează la fel de mult: panta variabilei de top se mută între \(0{,}001\) și \(2{,}042\) cînd \(\sigma\) variază de la 0,5 la 10.

Grafic: Sensibilitatea LIME la propriile setări

Stînga: pantele LIME ale cinci variabile în 30 de rulări, cu 500 și cu 5 000 de eșantioane. Dreapta: aceleași pante în funcție de lățimea nucleului (linia punctată: valoarea implicită).

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: solicitant din test (rîndul 2411); dreapta: aceleași cinci variabile, 5 000 de eșantioane.

În practică: fixați și raportați valoarea inițială, mărimea eșantionului și lățimea nucleului pentru orice explicație LIME care ajunge la un client sau la un auditor.

Explicații contrafactuale: modificările minime care schimbă decizia

Slide-ul 21 în PDF

Un contrafactual (Wachter, Mittelstadt & Russell, 2017) caută cel mai apropiat solicitant pe care modelul l-ar accepta, schimbînd doar variabilele asupra cărora solicitantul poate acționa:

\[\mathbf x'=\arg\min_{\mathbf x'}\ \lambda\,\big(f(\mathbf x')-t\big)_+^{2}+\sum_{j\in\mathcal A}\frac{|x'_j-x_j|}{\mathrm{MAD}_j}\]
(11.6)

unde \(t=-0{,}5\) este log-șansele-țintă, sub pragul PD de 0,5, \(\mathcal A\) sînt variabilele acționabile (LOAN, DEBTINC, NINQ, DELINQ, DEROG, CLNO, MORTDUE), iar abaterea absolută mediană (MAD) aduce toate distanțele pe o scară comparabilă. Valorile brute rămîn nenegative, iar numărătorile sînt rotunjite. Pentru solicitantul nostru, optimizarea reduce ipoteca rămasă de la 69 115 la 57 456,5, raportul datorie/venit de la 34,7 la 33,4 și schimbă suma creditului de la 14 500 la 15 700; PD scade de la 65,6 % la 39,2 %.

Un al doilea contrafactual, mai simplu, este mai util: dacă solicitantul declară raportul datorie/venit (la valoarea mediană, 34,7), PD devine 5,1 %. Explicația arată documentul lipsă, nu situația financiară a solicitantului.

În practică: „aduceți documentul de venit care lipsește” este un răspuns mai bun pentru client decît orice listă de valori SHAP.

Efecte globale: dependența parțială și ICE

Slide-ul 22 în PDF

Dependența parțială a variabilei \(j\) mediază prognoza pe date atunci cînd \(j\) este fixată la o valoare din grilă; așteptarea condiționată individuală (ICE) păstrează cîte o curbă pentru fiecare observație (Friedman, 2001; Goldstein et al., 2015):

\[\mathrm{PD}_j(z)=\frac1n\sum_{i=1}^{n}f(z,\mathbf x_{i,-j}),\qquad \mathrm{ICE}_{i,j}(z)=f(z,\mathbf x_{i,-j})\]
(11.7)

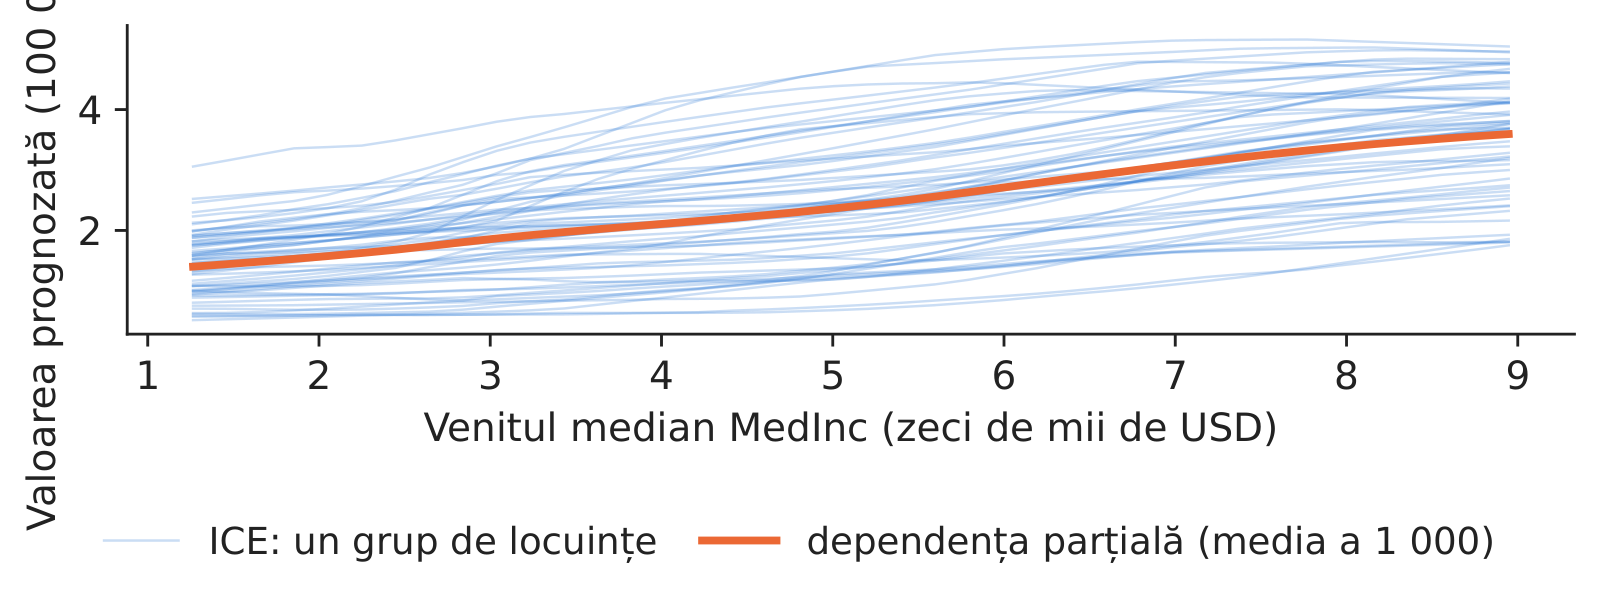
Pe locuințele din California, MLP-ul explică valoarea locuințelor mult mai bine decît o regresie liniară (\(R^2\) de test 0,819, față de 0,620). Dependența parțială de venitul median crește de la 1,40 la 3,60 (sute de mii de dolari americani, USD) pe grila de venit și se aplatizează la capăt, unde sursa datelor plafonează valoarea la 5. Curbele ICE se răsfiră: la capătul grilei, abaterea lor standard este 0,95, deci același efect al venitului nu este comun tuturor cartierelor. Graficul dependenței parțiale presupune că venitul se poate schimba în timp ce restul rămîne fix; cu variabile corelate (venitul și numărul de camere pe gospodărie, corelație 0,33), el mediază combinații care pot fi rare.

Grafic: Efecte globale: dependența parțială și ICE

Dependența parțială (portocaliu, media pe 1 000 de grupuri de test) și curbele ICE (60 de grupuri) ale valorii prognozate a locuinței în funcție de venitul median.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: MLP; 60 de grupuri de test (ICE), 1 000 pentru PDP.

Metode bazate pe gradient pentru rețele neuronale

O rețea își dă gradienții gratuit: o singură trecere înapoi dă sensibilitatea ieșirii la fiecare intrare. Secțiunea explică un model de fraudă cu ajutorul gradienților.

Studiul de caz pentru fraudă: o rețea antrenată pe ziua 1 și explicată pe ziua 2

Slide-ul 24 în PDF

Datele despre carduri acoperă două zile din septembrie 2013. Variabilele V1–V28 sînt componente ale analizei componentelor principale (PCA) publicate de proprietarul datelor, la care se adaugă suma tranzacției; fraudele reprezintă 0,15 % din tranzacțiile zilei a doua, după ce ponderile de eșantionare refac datele complete. Antrenăm un MLP pe ziua 1, cu oprire timpurie după PR-AUC ponderat de validare, și îl testăm pe ziua 2: PR-AUC 0,815, față de 0,742 pentru regresia logistică.

Cele mai simple explicații sînt saliența \(|\partial f/\partial x_j|\) (Simonyan, Vedaldi & Zisserman, 2014) și produsul gradient × intrare, \((x_j-x'_j)\,\partial f/\partial x_j\), unde \(\mathbf x'\) este o referință, aici tranzacția legitimă medie din ziua 1. Ambele suferă de saturare: într-o zonă plată a lui \(f\) gradientul este aproape zero chiar și pentru o variabilă decisivă.

În practică: un analist de fraudă primește lista ordonată a intrărilor care au declanșat alerta, în milisecunde pe tranzacție.

Gradienții integrați și completitudinea atribuirilor

Slide-ul 25 în PDF

Gradienții integrați (Sundararajan, Taly & Yan, 2017) integrează gradientul pe drumul drept de la referință la intrare:

\[\mathrm{IG}_j(\mathbf x)=(x_j-x'_j)\int_0^1\frac{\partial f\big(\mathbf x'+\alpha(\mathbf x-\mathbf x')\big)}{\partial x_j}\,d\alpha\]
(11.8)

Din teorema fundamentală a calculului integral pe drumuri, atribuirile se adună la \(f(\mathbf x)-f(\mathbf x')\) (completitudinea). IG satisface și sensibilitatea și invarianța la implementare, fiind valoarea Aumann–Shapley a jocului continuu de-a lungul drumului. În practică, integrala este o sumă Riemann cu \(m\) pași. Referința definește întrebarea: cu tranzacția legitimă medie întrebăm „de ce nu este aceasta o plată normală?”.

În practică: scrieți referința în documentația modelului: o altă referință înseamnă o altă întrebare.

Completitudinea se verifică atunci cînd integrala este calculată precis

Slide-ul 26 în PDF

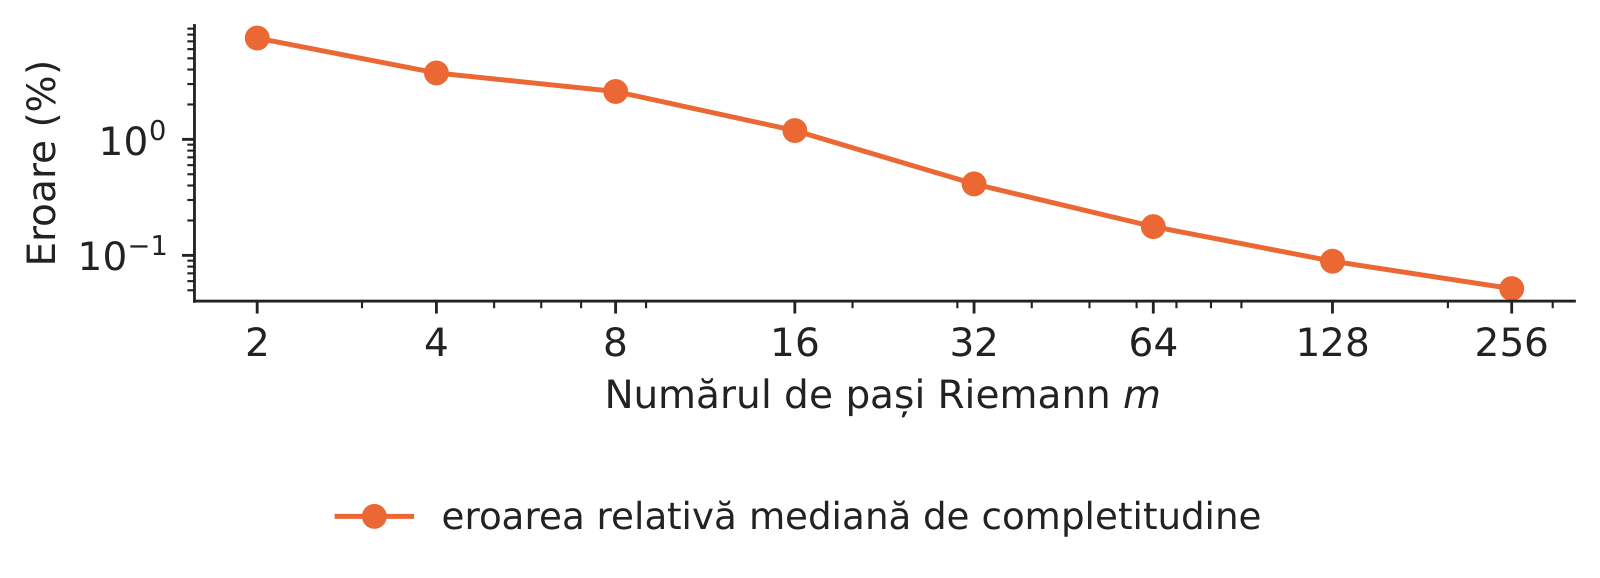
Pe cele 211 fraude din ziua 2, eroarea relativă mediană de completitudine este 3,7 % cu 4 pași și 0,18 % cu 64 de pași; ea scade aproximativ ca \(1/m^2\), viteza regulii punctului de mijloc.

Grafic: Completitudinea se verifică atunci cînd integrala este calculată precis

Eroarea relativă mediană de completitudine a gradienților integrați în funcție de numărul de pași Riemann (scări logaritmice).

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: 211 fraude din ziua a doua; referința = tranzacția legitimă medie din ziua întîi.

SmoothGrad și explicațiile la nivel de concept

Slide-ul 27 în PDF

SmoothGrad (Smilkov et al., 2017) mediază gradienții pe copii perturbate ale intrării, ceea ce elimină oscilațiile unei rețele ReLU. Testarea cu vectori de activare a conceptelor (TCAV) (Kim et al., 2018) pune o altă întrebare: un concept uman, învățat ca direcție \(\mathbf v_C\) într-un strat ascuns, mișcă ieșirea? Conceptele trebuie etichetate, ceea ce nu este posibil cu componente PCA anonimizate; ele trebuie planificate încă de la colectarea datelor.

Patru metode de explicare aplicate unei tranzacții frauduloase

Slide-ul 28 în PDF

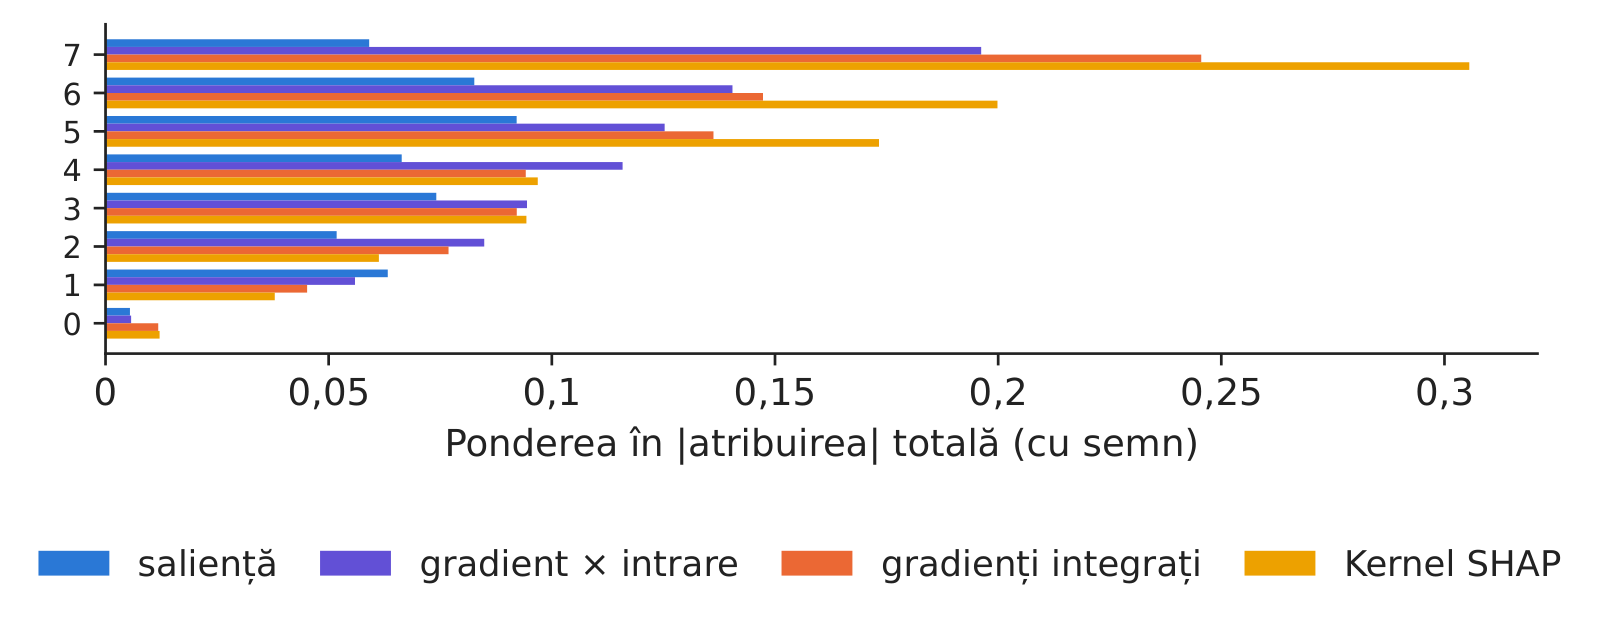
Pentru frauda cu scorul median din ziua 2 (scor de fraudă 99,9 %), Kernel SHAP și gradienții integrați indică amîndoi V14 ca variabilă principală, în timp ce saliența indică V12: saliența măsoară cît de sensibil este scorul, nu cît de departe este tranzacția de normal.

Grafic: Patru metode de explicare aplicate unei tranzacții frauduloase

Atribuirile cu semn ale salienței, ale produsului gradient × intrare, ale gradienților integrați și ale Kernel SHAP pentru o fraudă, ca ponderi în atribuirea absolută totală.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: o fraudă din ziua a doua (scorul median al fraudelor).

Concordanța, fidelitatea și stabilitatea explicațiilor

Trei teste ar trebui să însoțească orice explicație: concordanța între metode, fidelitatea față de model și stabilitatea atunci cînd nu se schimbă nimic important.

Concordanța metodelor de explicare

Slide-ul 30 în PDF

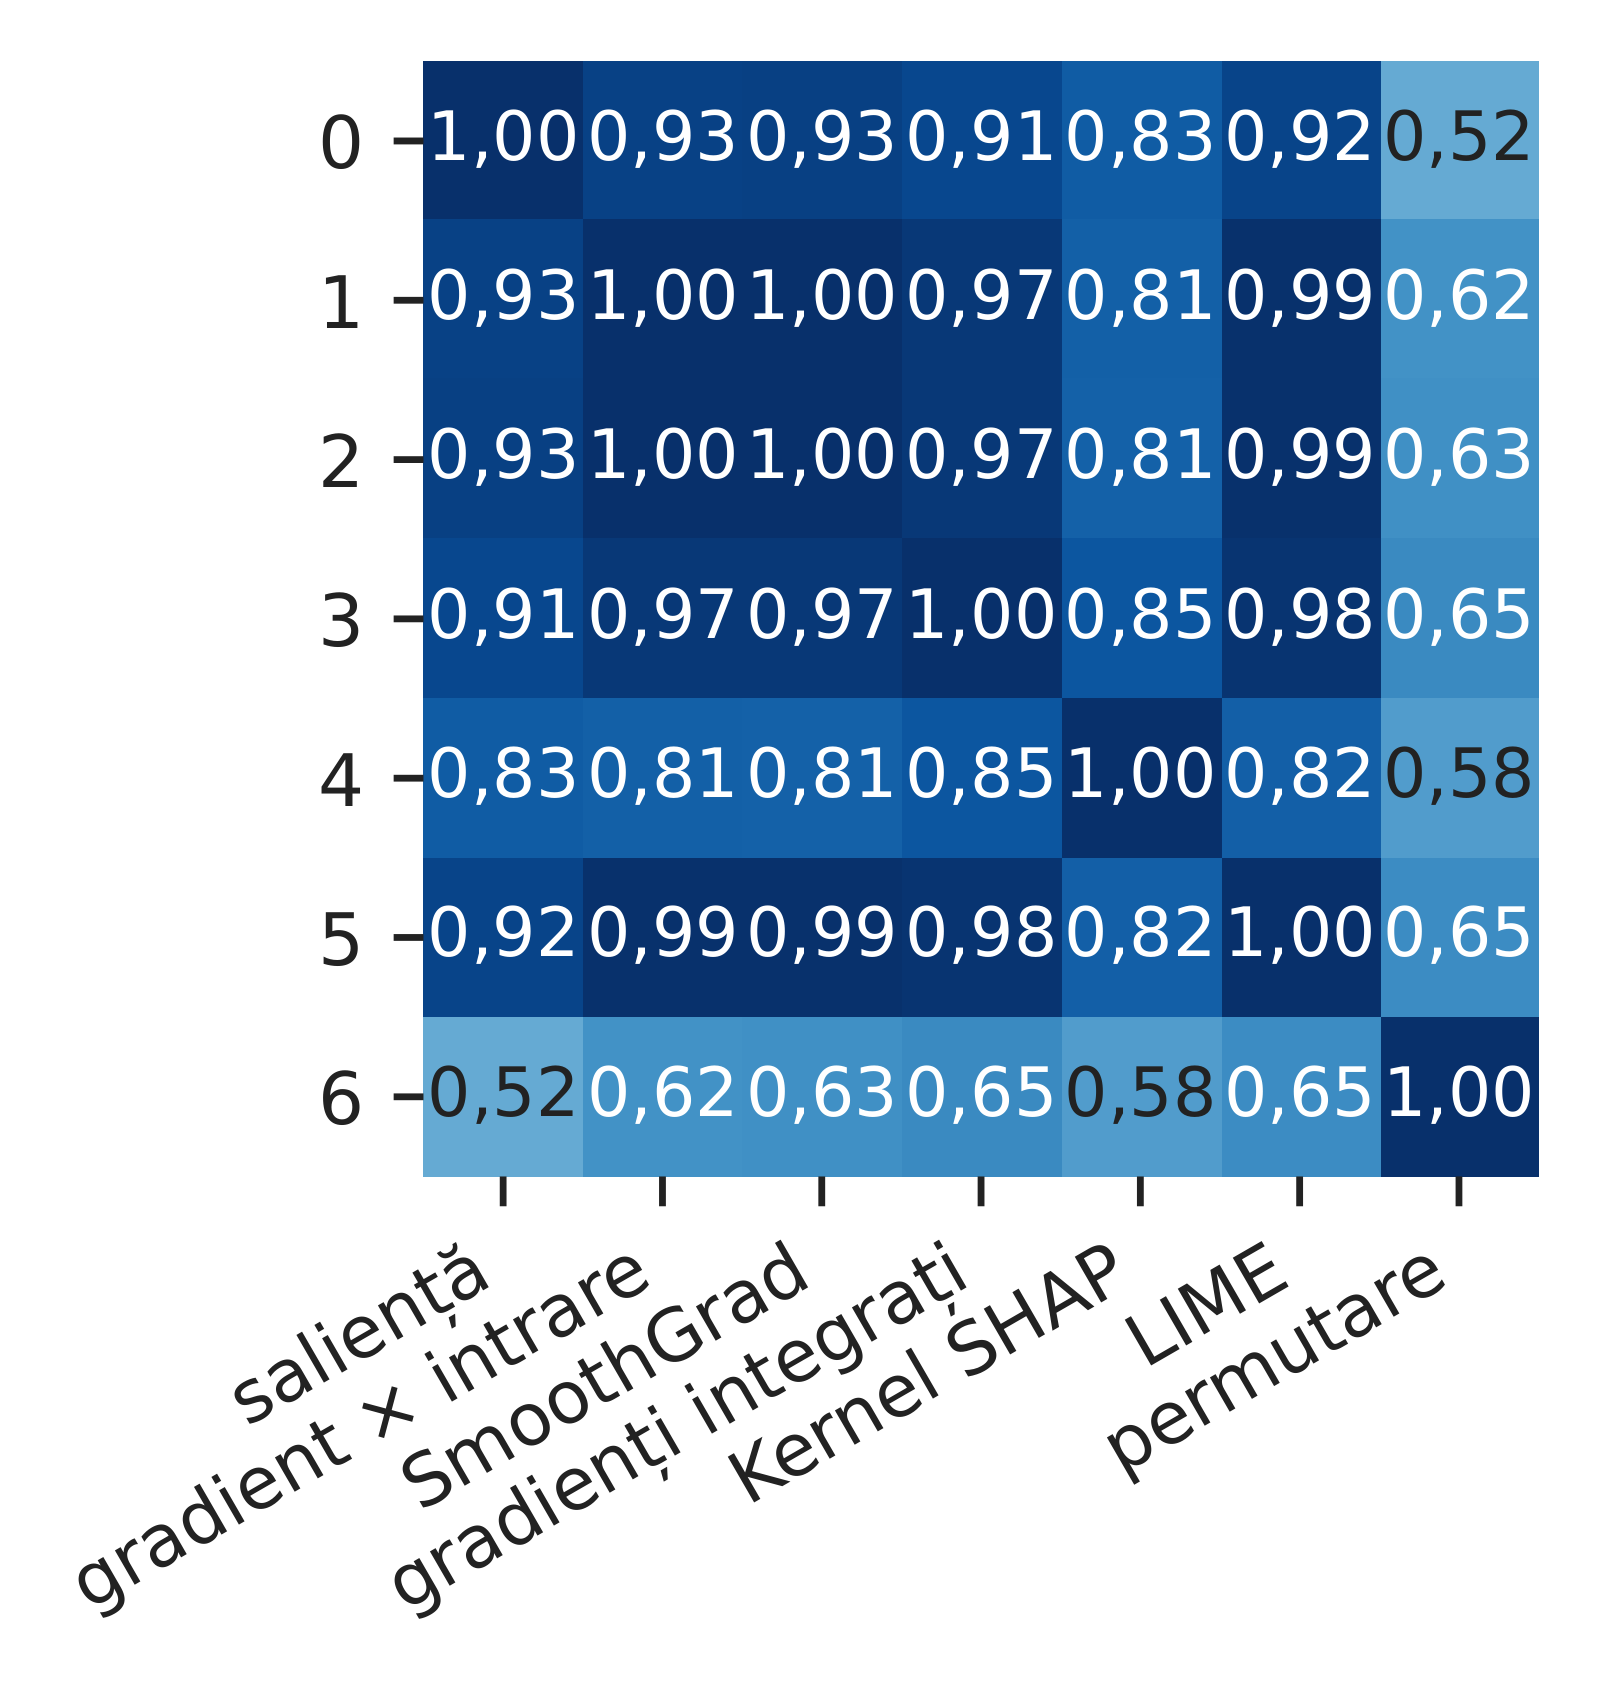
Pe aceleași 211 fraude comparăm importanțele globale date de șapte metode. Corelația Spearman este 0,85 între IG și SHAP, 0,83 între saliență și SHAP, 0,82 între LIME și SHAP și doar 0,58 între importanța prin permutare și SHAP; toate metodele pun V12 pe primul loc. Dezacordul este informativ: importanța prin permutare (Breiman, 2001) măsoară cît de mult are nevoie modelul de o variabilă ca să rămînă precis, iar atribuirile măsoară cît o folosește pentru fraude.

Grafic: Concordanța metodelor de explicare

Corelația Spearman a importanțelor globale (atribuirea absolută medie) pentru șapte metode de explicare.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: corelația Spearman a importanțelor globale; 211 fraude din ziua a doua.

În practică: dezacordul este informație: importanța prin permutare arată de ce are nevoie modelul, atribuirile arată ce folosește.

Fidelitatea explicațiilor: testul eliminării variabilelor

Slide-ul 31 în PDF

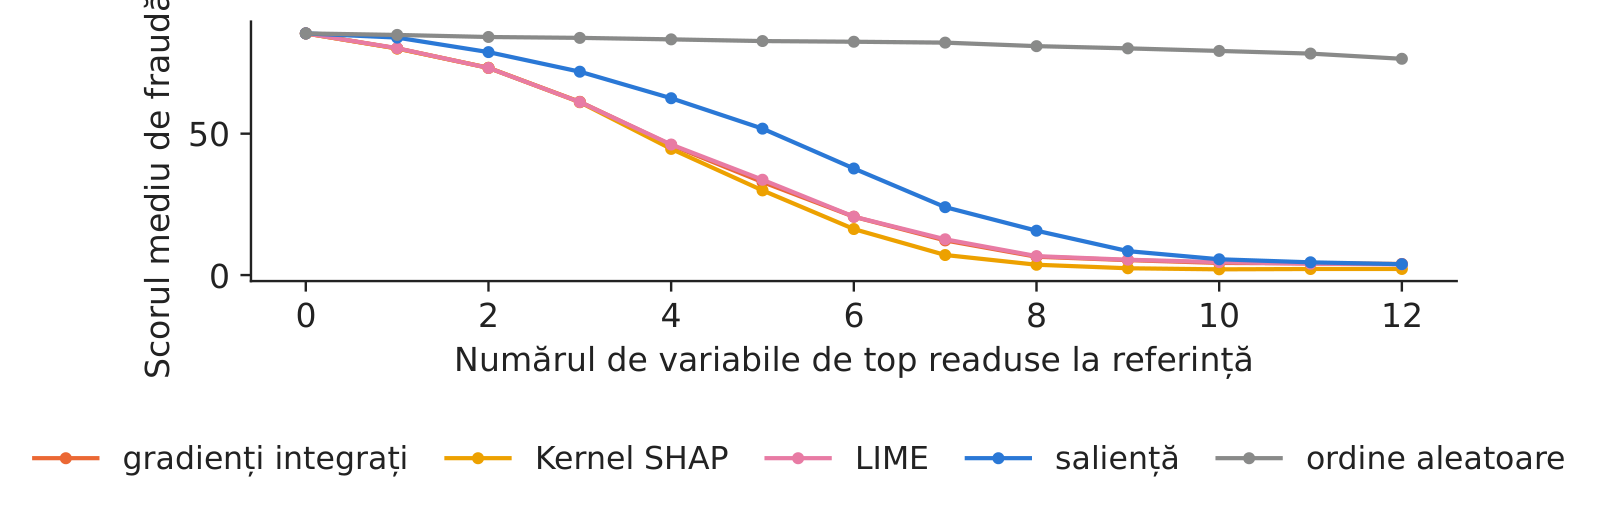
O explicație fidelă numește variabilele a căror eliminare schimbă prognoza. Readucem la referință primele \(k\) variabile ale fiecărei fraude și urmărim scorul mediu de fraudă; aria de deasupra curbei de perturbare (AOPC) rezumă scăderea (Samek et al., 2017). În puncte de scor de fraudă: IG 56,2, SHAP 58,4, LIME 56,1, saliență 48,0, ordine aleatoare 3,9. SHAP, IG și LIME sînt aici la fel de fidele, saliența mai puțin, iar toate metodele sînt mult mai bune decît hazardul.

Grafic: Fidelitatea explicațiilor: testul eliminării variabilelor

Scorul mediu de fraudă al fraudelor din ziua 2 după readucerea la referință a primelor \(k\) variabile, pentru patru metode și o ordine aleatoare.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: 211 fraude din ziua a doua.

Robustețea locală a explicațiilor la mici modificări ale intrării

Slide-ul 32 în PDF

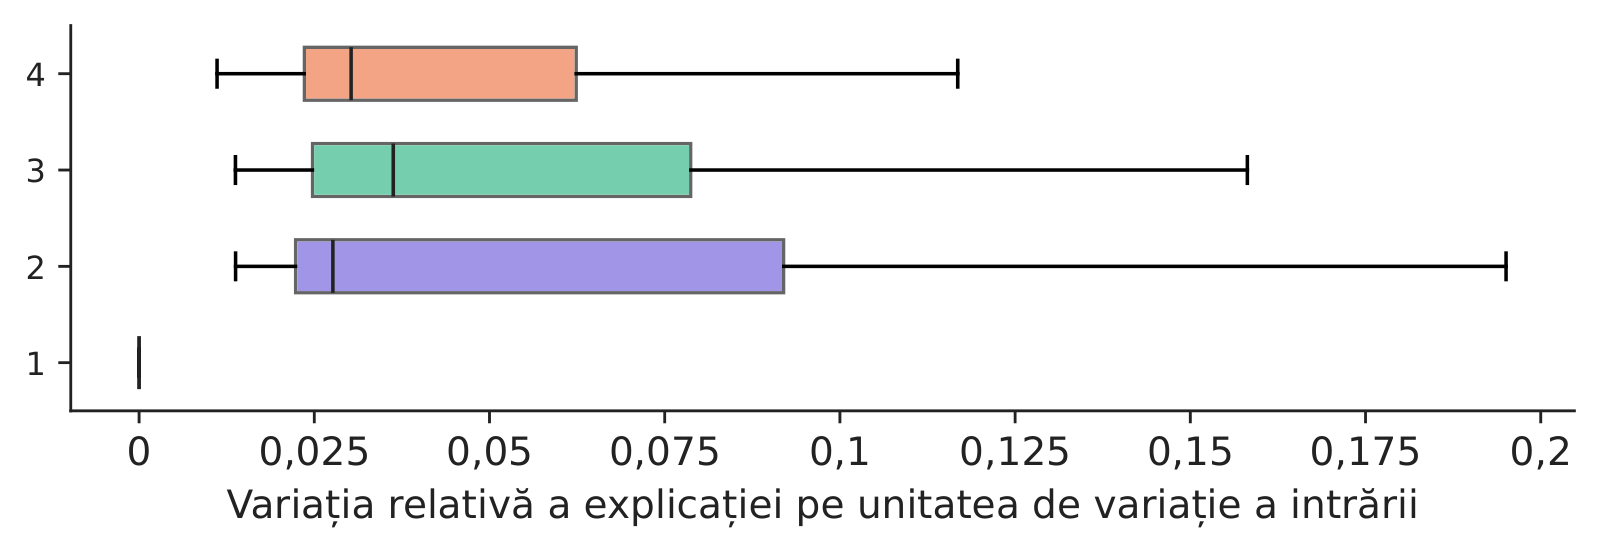
Adăugăm de zece ori zgomot gaussian cu abaterea standard 0,05 pentru 60 de fraude și măsurăm variația relativă a atribuirii pe unitatea de variație a intrării (Alvarez-Melis & Jaakkola, 2018). Medianele sînt 0,000 pentru saliență, 0,028 pentru gradient × intrare, 0,030 pentru IG și 0,036 pentru SmoothGrad. Saliența nu se mișcă deoarece, în interiorul unei regiuni liniare a unei rețele ReLU, gradientul este constant: robustețea la zgomot mic vine împreună cu salturi bruște între regiuni.

Grafic: Robustețea locală a explicațiilor la mici modificări ale intrării

Variația relativă a explicației pe unitatea de variație a intrării pentru patru metode bazate pe gradient (60 de fraude × 10 perturbări).

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: 60 de fraude din ziua a doua x 10 perturbări (sigma = 0,05 abateri standard).

Efectul Rashomon: modele la fel de precise, cu explicații diferite

Slide-ul 33 în PDF

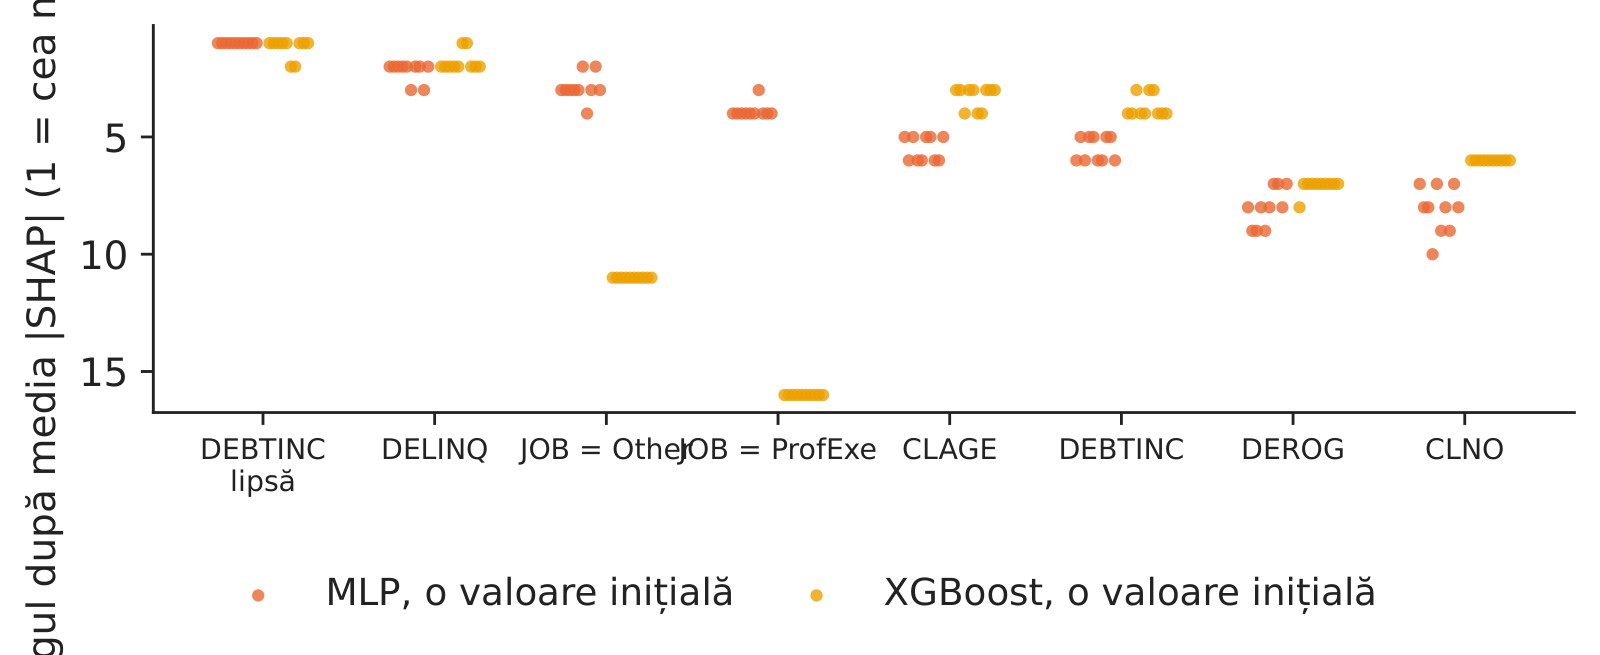
Am reantrenat modelele de credit cu zece valori inițiale. AUC-ul de test al rețelei rămîne între 0,929 și 0,941, dar ordinea variabilelor se schimbă: tau Kendall mediu pe perechi al importanțelor globale este 0,83 pentru MLP și 0,97 pentru XGBoost. Pentru un singur solicitant, variabila de top este aceeași în 78 % din perechile de valori inițiale la rețea și în 83 % la XGBoost. Multe modele se potrivesc la fel de bine datelor, dar nu toate spun aceeași poveste.

Grafic: Efectul Rashomon: modele la fel de precise, cu explicații diferite

Rangul fiecărei variabile după valoarea SHAP absolută medie pentru zece MLP-uri și zece modele XGBoost care diferă doar prin valoarea inițială de antrenare.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 10 valori inițiale de antrenare; 200 de solicitanți din test.

Explicațiile în timp: ziua 1 față de ziua 2

Slide-ul 34 în PDF

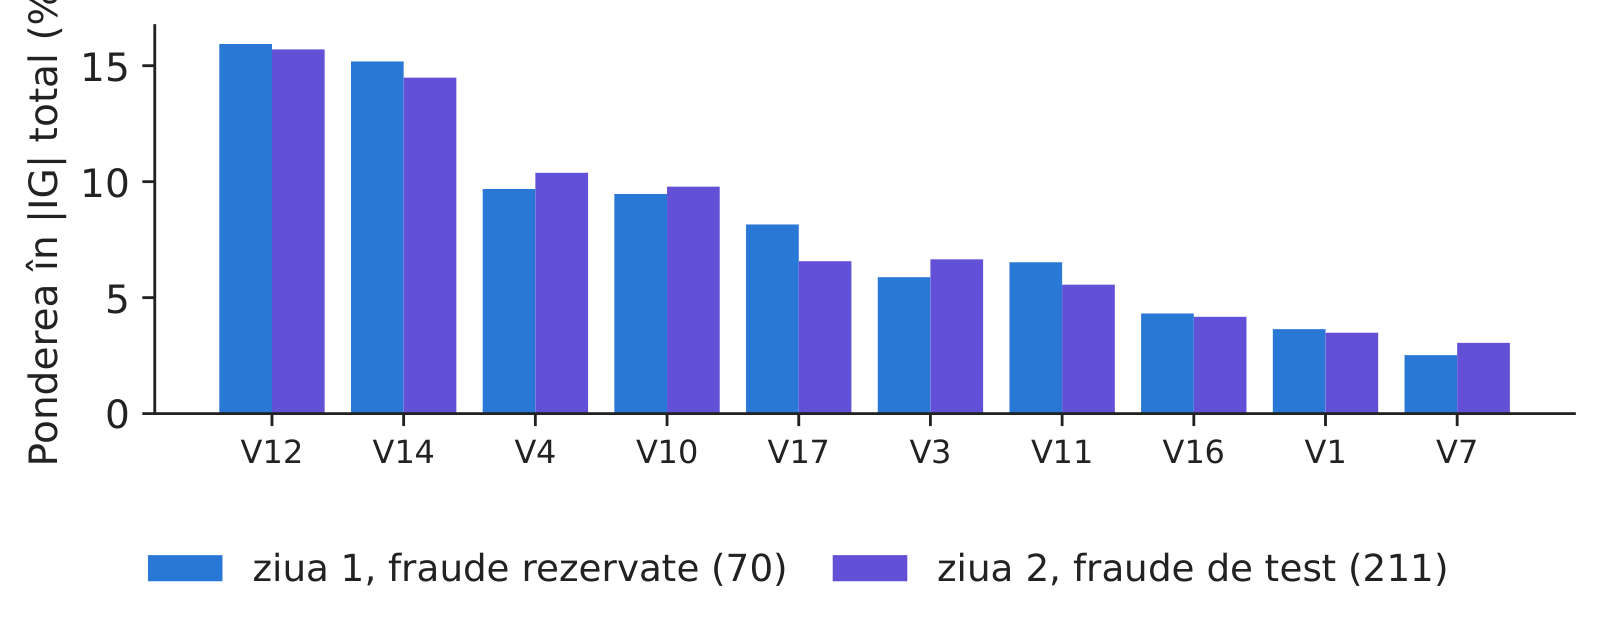
Deplasarea distribuției poate schimba explicațiile chiar și cînd modelul este fix. Comparăm gradienții integrați ai celor 70 de fraude rezervate din ziua 1 cu cei ai celor 211 fraude din ziua 2. Corelația Spearman a importanțelor este 0,98, divergența Jensen–Shannon (JS), construită pe divergența Kullback–Leibler (KL), este 0,003, iar patru dintre primele cinci variabile sînt comune: după o zi, explicația acestui model este stabilă. Grupul nostru studiază aceeași întrebare pe orizonturi mai lungi și cu variabile din graf (vezi slide-ul despre cercetările grupului).

Grafic: Explicațiile în timp: ziua 1 față de ziua 2

Ponderea în totalul gradienților integrați absoluți, pe variabile, pentru fraudele rezervate din ziua 1 și pentru fraudele din ziua 2.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: model antrenat pe ziua 1; gradienți integrați.

În practică: monitorizați lunar distribuția atribuirilor, alături de distribuția scorurilor; o deplasare a motivelor poate preceda o scădere a acurateței.

Fișa de stabilitate a acestui curs

Slide-ul 35 în PDF
Sursa schimbăriiMăsuraRezultat
Aleatorismul explicației (LIME)aceeași variabilă de top în 30 de rulări73 % (500 de eșantioane), 100 % (5 000)
Valoarea inițială de antrenaretau Kendall al importanțelor globaleMLP 0,83, XGBoost 0,97
Valoarea inițială, un solicitantaceeași variabilă de topMLP 78 %, XGBoost 83 %
MetodaSpearman al importanțelorîntre 0,52 și 1,00
Zgomotul la intrarevariația relativă medianăIG 0,030, SmoothGrad 0,036
Timpul (ziua 1 → ziua 2)Spearman, divergența JS0,98; 0,003
În practică: raportați orice explicație împreună cu stabilitatea ei: ce valoare inițială, ce eșantion, ce perioadă și cît se modifică.

Sinteza secțiunii

Explicațiile sînt estimări. SHAP se adună exact, LIME depinde de setări, gradienții sînt ieftini și, în forma gradienților integrați, completi; dar orice explicație se mișcă odată cu valoarea inițială, eșantionul și perioada și trebuie testată ca un model.

Explicabilitatea în guvernanța modelelor

Lista de verificare pentru un audit al explicabilității

Slide-ul 37 în PDF

Un audit al explicațiilor pornește de la scop: cine citește explicația (client, analist, validator, autoritate) și ce decizie susține. Setările (eșantionul de referință, referința, valoarea inițială, numărul de eșantioane, lățimea nucleului) se versionează odată cu modelul. Verificările sînt cele din acest curs: aditivitatea sau completitudinea, fidelitatea, stabilitatea la valori inițiale și în timp, concordanța a două metode. Echitatea cere o privire asupra variabilelor protejate și a substitutelor lor, ținînd minte că o explicație arată cum folosește modelul o variabilă, nu că variabila cauzează neplata. Pentru clienți, cîteva motive și un contrafactual acționabil sînt mai utile decît numele brute ale componentelor. Iar dacă un model interpretabil este aproape la fel de precis (aici AUC logistic 0,909, față de 0,935 pentru rețea), merită luat în considerare.

În practică: raportul de validare trebuie să conțină explicațiile și testele lor de stabilitate, nu doar acuratețea.

Explorați vizual

Instrumente interactive gratuite și ghiduri ilustrate pentru acest curs; cele mai multe rulează în browser.

  • Neuronpedia: platformă open-source pentru interpretabilitatea modelelor lingvistice: autoencoderele rare descompun activările unui strat în trăsături, iar pagina fiecărei trăsături arată textele pe care se activează cel mai puternic.
  • Neuronpedia: comparați cele două perspective: SHAP și LIME atribuie o predicție intrărilor, pe cînd aceste trăsături descriu ce reprezintă interiorul modelului.

Sinteza secțiunii

Cursul 12 trece la modelele lingvistice mari, unde explicațiile înseși devin text, cu noi întrebări despre fidelitate.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

AIinteligență artificială
AOPCaria de deasupra curbei de perturbare
ASEAcademia de Studii Economice din București
AUCaria de sub curba ROC
EBAAutoritatea Bancară Europeană
EUUniunea Europeană (abrevierea engleză, în citări)
EUReuro
GDPRRegulamentul general privind protecția datelor
GNNrețea neuronală pe grafuri
HMEQsetul de date privind creditele garantate cu locuința
ICEașteptarea condiționată individuală
IGgradienți integrați
IPEInstitutul de Prognoză Economică, Academia Română
JSdivergența Jensen-Shannon
KLdivergența Kullback-Leibler
LIMEexplicații locale interpretabile, independente de model
MADabaterea absolută mediană
MLPperceptron multistrat
PCAanaliza componentelor principale
PDprobabilitatea de nerambursare
PDPgraficul dependenței parțiale
PICBEProceedings of the International Conference on Business Excellence
PR-AUCaria de sub curba precizie-sensibilitate
ReLUunitate liniară rectificată
ROCcaracteristica de operare a receptorului
SHAPexplicații aditive Shapley
SRghidul de supraveghere privind riscul de model (Federal Reserve SR 11-7)
TCAVtestarea cu vectori de activare a conceptelor
UEUniunea Europeană
ULBUniversité Libre de Bruxelles
USDdolar american
XAIinteligență artificială explicabilă
XGBoostextreme gradient boosting (arbori amplificați prin gradient)

Bibliografie

  • Alvarez-Melis, D. & Jaakkola, T. S. (2018). On the robustness of interpretability methods. ICML Workshop on Human Interpretability in Machine Learning. arXiv:1806.08049
  • Andrei, A.-V. & Pele, D. T. (2025). Explainable AI for electricity price anomaly detection: A SHAP-driven approach in Romania's energy market. Preprints. doi:10.20944/preprints202508.0410.v1
  • Andrei, A.-V., Pele, D.-T. & Cramer, A.-A. (2026). Multi-horizon explainability in energy price forecasting: Disentangling market dynamics and renewable intermittency in Romania's liberalized electricity market. Proceedings of the International Conference on Business Excellence, 20(1), 104–117. doi:10.2478/picbe-2026-0014
  • Andrei, A.-V., Pele, D.-T., Cramer, A.-A., Amza, A. & Diaconu, D. (2026). Explainable AI-based early warning system for electricity price spikes: Evidence from the Romanian market. Proceedings of the International Conference on Business Excellence, 20(1), 4820–4836. doi:10.2478/picbe-2026-0352
  • Baesens, B., Roesch, D. & Scheule, H. (2016). Credit Risk Analytics: Measurement Techniques, Applications, and Examples in SAS. Wiley.
  • Breiman, L. (2001). Random forests. Machine Learning, 45, 5–32. doi:10.1023/A:1010933404324
  • Dal Pozzolo, A., Caelen, O., Johnson, R. A. & Bontempi, G. (2015). Calibrating probability with undersampling for unbalanced classification. IEEE SSCI, 159–166. doi:10.1109/SSCI.2015.33
  • Diaconu, D. & Pele, D. T. (2026). SHAP stability across random and forward-time validation in graph-augmented fraud detection. Submitted to Expert Systems with Applications. Code: github.com/QuantLet/GNN_XAI_Stability
  • Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. Annals of Statistics, 29(5), 1189–1232. doi:10.1214/aos/1013203451
  • Goldstein, A., Kapelner, A., Bleich, J. & Pitkin, E. (2015). Peeking inside the black box: Visualizing statistical learning with plots of individual conditional expectation. Journal of Computational and Graphical Statistics, 24(1), 44–65. doi:10.1080/10618600.2014.907095
  • Kim, B. et al. (2018). Interpretability beyond feature attribution: Quantitative testing with concept activation vectors (TCAV). ICML. arXiv:1711.11279
  • Lundberg, S. M. & Lee, S.-I. (2017). A unified approach to interpreting model predictions. Advances in Neural Information Processing Systems, 30. arXiv:1705.07874
  • Lundberg, S. M. et al. (2020). From local explanations to global understanding with explainable AI for trees. Nature Machine Intelligence, 2, 56–67. doi:10.1038/s42256-019-0138-9
  • Ribeiro, M. T., Singh, S. & Guestrin, C. (2016). “Why should I trust you?” Explaining the predictions of any classifier. KDD, 1135–1144. doi:10.1145/2939672.2939778
  • Rudin, C. (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence, 1, 206–215. doi:10.1038/s42256-019-0048-x
  • Samek, W., Binder, A., Montavon, G., Lapuschkin, S. & Müller, K.-R. (2017). Evaluating the visualization of what a deep neural network has learned. IEEE Transactions on Neural Networks and Learning Systems, 28(11), 2660–2673. doi:10.1109/TNNLS.2016.2599820
  • Shapley, L. S. (1953). A value for n-person games. In Contributions to the Theory of Games II, 307–317. Princeton University Press.
  • Simonyan, K., Vedaldi, A. & Zisserman, A. (2014). Deep inside convolutional networks: Visualising image classification models and saliency maps. ICLR Workshop. arXiv:1312.6034
  • Smilkov, D., Thorat, N., Kim, B., Viégas, F. & Wattenberg, M. (2017). SmoothGrad: Removing noise by adding noise. arXiv:1706.03825
  • Sundararajan, M., Taly, A. & Yan, Q. (2017). Axiomatic attribution for deep networks. ICML, 3319–3328. arXiv:1703.01365
  • Wachter, S., Mittelstadt, B. & Russell, C. (2017). Counterfactual explanations without opening the black box: Automated decisions and the GDPR. Harvard Journal of Law & Technology, 31(2), 841–887. doi:10.2139/ssrn.3063289
  • Regulation (EU) 2024/1689 (Artificial Intelligence Act), Official Journal of the European Union, L, 12 July 2024. data.europa.eu/eli/reg/2024/1689/oj
  • Board of Governors of the Federal Reserve System (2011). SR 11-7: Supervisory guidance on model risk management. federalreserve.gov

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.