Rețele neuronale și deep learning

Cursul 14: Modele multimodale și vizual-lingvistice; sinteza cursului

Cursul 14

Modele multimodale și vizual-lingvistice; sinteza cursului

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

Datele de afaceri nu sînt doar tabele. Băncile și asigurătorii se uită la imagini satelitare ale terenurilor pe care le finanțează, citesc contracte scanate și rapoarte anuale, iar analiștii citesc grafice de preț. Modelele multimodale pun imaginile și textul în aceeași reprezentare: preantrenarea contrastivă limbaj–imagine (CLIP) învață din perechi imagine–descriere, iar modelele vizual-lingvistice (VLM) permit unui model lingvistic mare să citească o imagine. Acest ultim curs măsoară ce pot și ce nu pot face aceste modele pe date reale, apoi trage concluziile întregului curs.

Clasificăm 5 400 de imagini de test din setul EuroSAT (imagini satelitare Sentinel-2 ale utilizării terenului în Europa) cu CLIP, fără niciun exemplu etichetat, îl comparăm cu o rețea neuronală convoluțională (CNN) antrenată de la zero pe măsură ce numărul etichetelor crește, căutăm imagini cu ajutorul cuvintelor și cerem unui VLM de 2 miliarde de parametri să citească grafice de piață și tabele ale curbei randamentelor. Experimentul privind crizele de piață urmează cadrul de detectare multimodală a anomaliilor propus de grupul nostru, cu modele deschise.


Ce veți ști să faceți

  • Să explicați cum transformă un transformer pentru imagini o imagine în tokeni și unde se îndreaptă atenția sa.
  • Să scrieți pierderea contrastivă a CLIP, să o folosiți ca clasificator zero-shot și să o comparați cu o CNN antrenată pe imagini etichetate.
  • Să descrieți cum leagă un VLM un codificator de imagini de un model de limbaj și să testați ce citește din grafice și tabele.
  • Să sintetizați cursul: să alegeți modelul pentru o problemă de afaceri, de la regresia logistică la modelele fundație, cu evaluarea potrivită.

Planul cursului

  1. Datele multimodale în afaceri
  2. Transformere pentru imagini
  3. CLIP: imagini și text în același spațiu
  4. Modele vizual-lingvistice: citirea graficelor și a tabelelor
  5. Sinteza cursului

Datele multimodale în afaceri

Imagini, documente și grafice ca date economice

Slide-ul 5 în PDF

Imaginile satelitare servesc creditul agricol, asigurările și raportările de mediu, sociale și de guvernanță (ESG); documentele combină text, tabele și așezare în pagină; graficele rezumă piețele pentru oameni. Cînd cifrele din spatele unei imagini există, ele sînt de obicei intrări mai bune; cînd nu există, un model multimodal este singura cale de a folosi imaginea.

Aplicația economică: utilizarea terenului

Slide-ul 6 în PDF

O bancă ce finanțează ferme verifică dacă parcelele sînt teren arabil; un asigurător compară imagini de dinainte și de după o inundație sau o secetă; un administrator de active măsoară suprafața împădurită și zonele industriale din jurul activelor sale. Imaginile sînt gratuite și frecvente (Sentinel-2 revine la cîteva zile), etichetele sînt scumpe: de aici modelele zero-shot și cele cu puține exemple.

EuroSAT (Helber et al., 2019) conține 27 000 de imagini de 64 × 64 de pixeli, în 10 clase de utilizare a terenului, împărțite 80/20 în 21 600 de imagini de antrenare și 5 400 de test. Experimentul de piață folosește 945 de ferestre de 120 de zile de tranzacționare ale S&P 500 (Yahoo Finance), iar experimentul cu tabele 60 de curbe ale randamentelor AAA din zona euro, publicate de Banca Centrală Europeană (BCE).

Transformere pentru imagini

Un transformer pentru imagini aplicat pe petice

Slide-ul 9 în PDF

Un transformer pentru imagini (ViT) taie o imagine de 224 × 224 în 14 × 14 = 196 de petice de 16 × 16 pixeli, proiectează liniar fiecare petic, adaugă un token de clasă și codificări de poziție și aplică 12 straturi transformer cu 12 capete de atenție (Dosovitskiy et al., 2021):

\[\mathbf z_0=[\mathbf x_{\text{cls}};\ \mathbf E\mathbf p_1;\ \dots;\ \mathbf E\mathbf p_{196}]+\mathbf E_{\text{pos}}\]

Fără convoluții, localitatea trebuie învățată din date; de aceea un ViT are nevoie de o preantrenare foarte mare.

Petice și atenție pe imagini reale

Slide-ul 10 în PDF
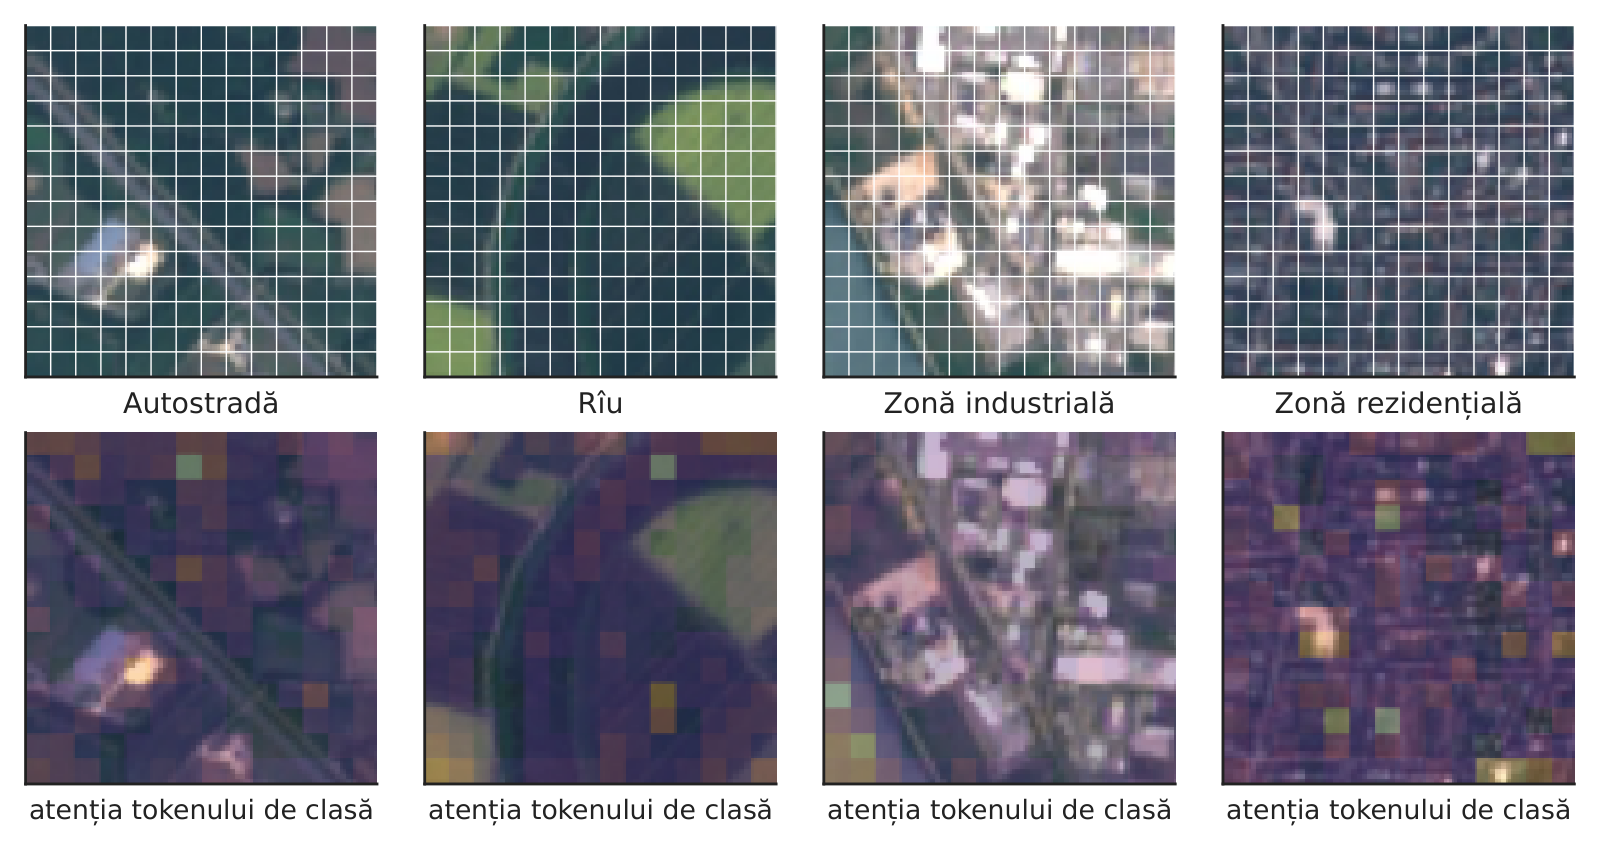
Grafic: Petice și atenție pe imagini EuroSAT reale

Grila de petice și atenția tokenului de clasă (propagarea atenției) pentru CLIP ViT-B/16, pe patru imagini de test EuroSAT.

Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 4 imagini de test mărite la 224 x 224 de pixeli = 14 x 14 petice de 16 x 16; modelul CLIP ViT-B/16.

Propagarea atenției (attention rollout) înmulțește matricele de atenție mediate pe capete din toate straturile, cu identitatea adăugată pentru conexiunea reziduală (Abnar și Zuidema, 2020).

CLIP: imagini și text în același spațiu

CLIP învață potrivind imaginile cu descrierile lor

Slide-ul 12 în PDF
\[s_{ij}=\frac{\mathbf u_i^{\top}\mathbf v_j}{\tau},\qquad \mathcal L=-\frac{1}{2n}\sum_{i=1}^{n}\Big[\log\frac{e^{s_{ii}}}{\sum_j e^{s_{ij}}}+\log\frac{e^{s_{ii}}}{\sum_j e^{s_{ji}}}\Big]\]

unde \(\mathbf u_i\) și \(\mathbf v_j\) sînt embedding-urile normalizate ale imaginii și textului, iar \(\tau\) este o temperatură învățată (Radford et al., 2021). Modelul ViT-B/32 are 151,3 milioane de parametri, iar modelul ViT-B/16 are 149,6 milioane.

Clasificarea zero-shot

Slide-ul 13 în PDF

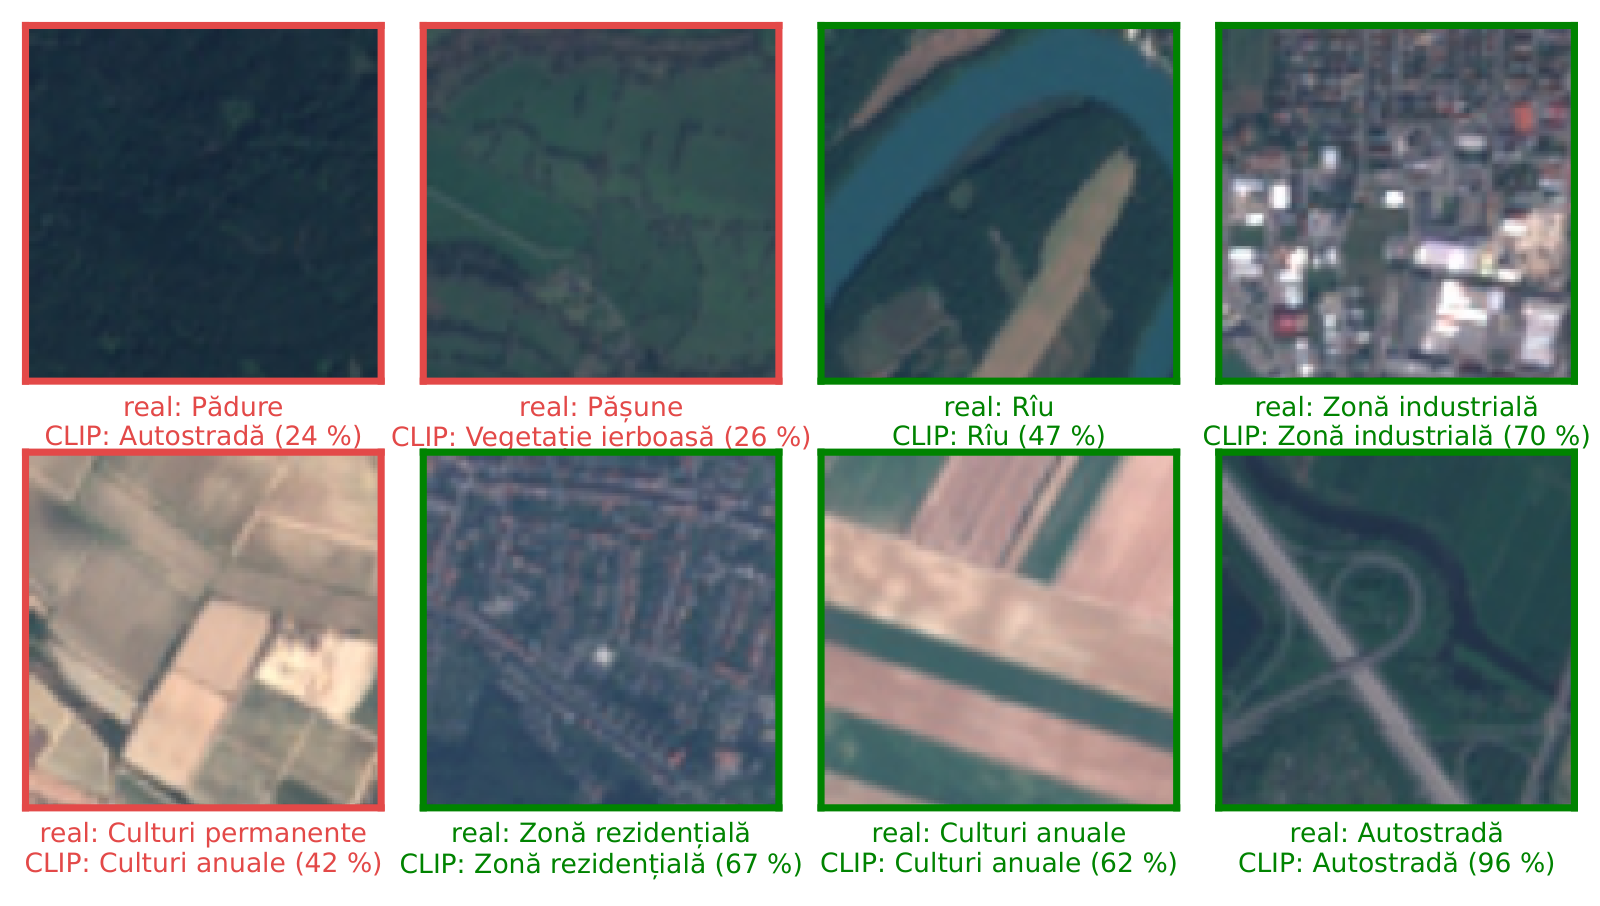
Fiecare clasă este descrisă prin propoziții ca „a satellite photo of {class}.”; embedding-ul lor mediu \(\mathbf w_c\) devine vectorul de ponderi al clasei, iar imaginea merge la clasa cu cea mai mare similaritate cosinus. Cel mai bun model zero-shot, CLIP ViT-B/16 cu un ansamblu de cinci șabloane, clasifică corect 56,4 % din imaginile de test, față de 10 % prin hazard.

Cuvintele din prompt schimbă acuratețea

Slide-ul 14 în PDF
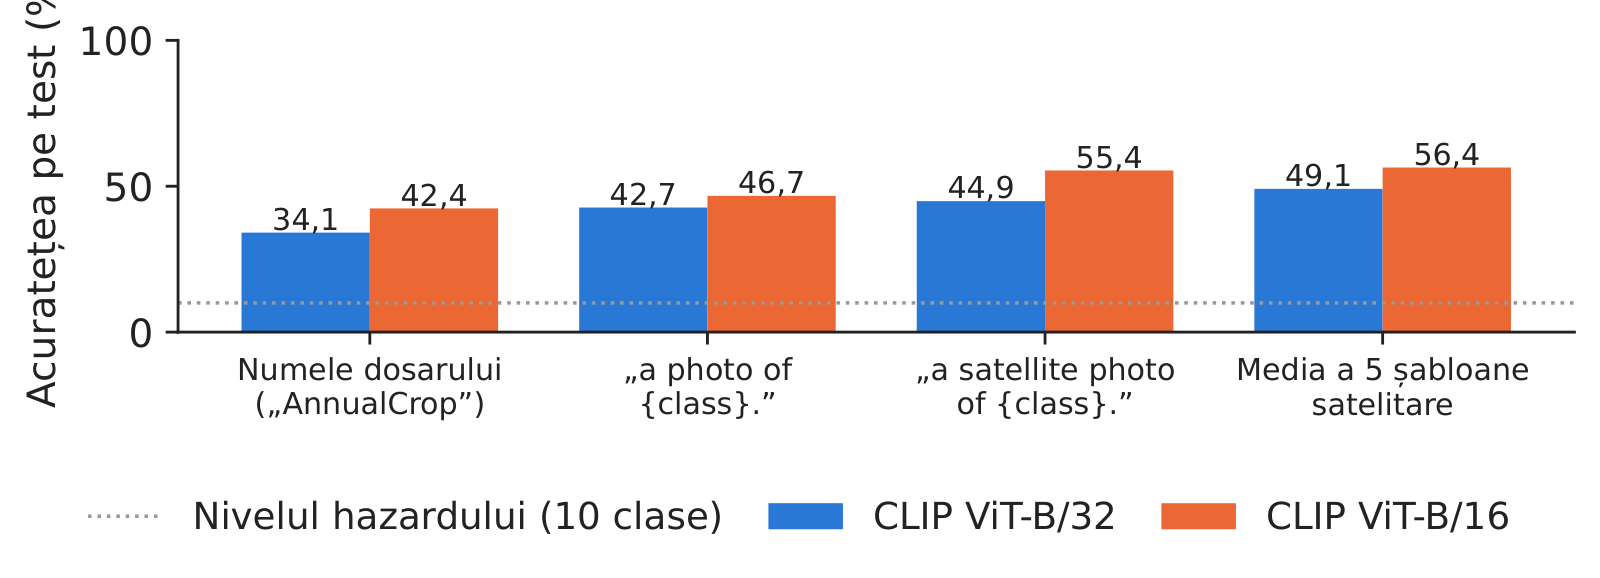
Grafic: Cuvintele din prompt schimbă acuratețea zero-shot

Acuratețea zero-shot pentru patru tipuri de prompt și două modele CLIP.

Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 5400 de imagini de test, fără antrenare.

Cu numele simple ale dosarelor, ViT-B/16 ajunge la 42,4 %; „a satellite photo of” o ridică la 55,4 %, iar ansamblul de cinci șabloane la 56,4 %. A-i spune modelului ce fel de imagine vede contează mai mult decît dimensiunea modelului.

Erorile zero-shot

Slide-ul 16 în PDF
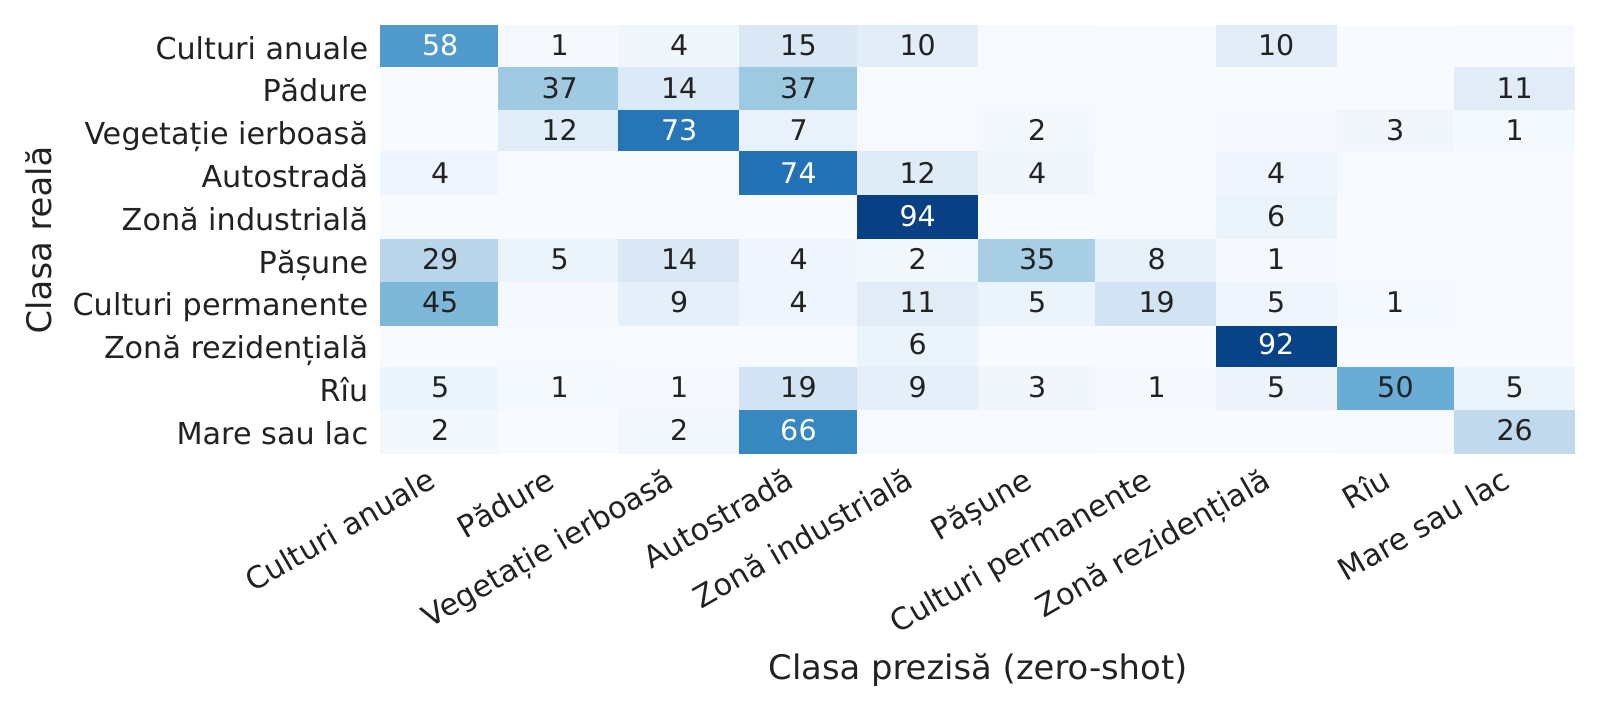
Grafic: Erorile zero-shot la utilizări ale terenului asemănătoare vizual

Matricea de confuzie a celui mai bun model zero-shot, procente pe rînd.

Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 5400 de imagini de test; procente pe rînd.

Zonele industriale și rezidențiale sînt recunoscute în peste nouă cazuri din zece (93,6 % și 92,3 %), dar culturile permanente doar în 18,6 % din cazuri, iar 399 dintre cele 600 de imagini cu mare sau lac au fost clasificate drept autostradă. Clasele care arată la fel au nevoie de exemple.

Căutarea imaginilor după text

Slide-ul 17 în PDF

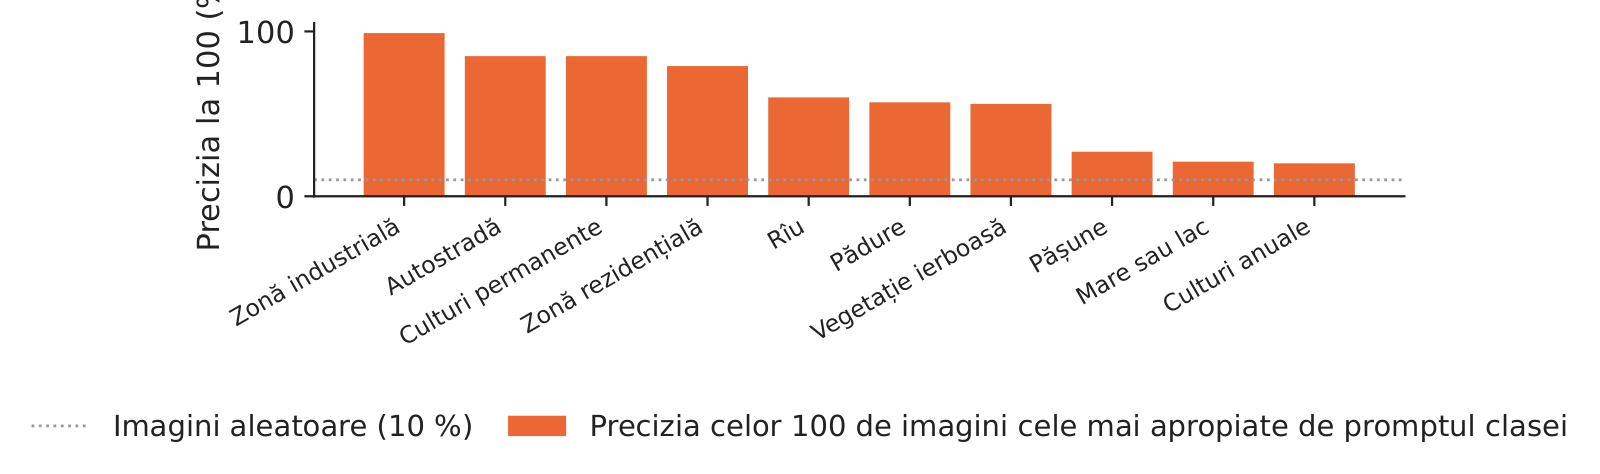
Aceleași embedding-uri, folosite invers, transformă o propoziție într-o căutare de imagini: în medie, 58,9 % dintre cele 100 de imagini cele mai apropiate de promptul unei clase aparțin cu adevărat clasei, de la 99,0 % pentru zonele industriale la 20,0 % pentru culturile anuale. Căutarea urmată de etichetarea rezultatelor este cea mai ieftină cale spre un set de imagini etichetate.

Un clasificator liniar pe trăsăturile CLIP

Slide-ul 18 în PDF

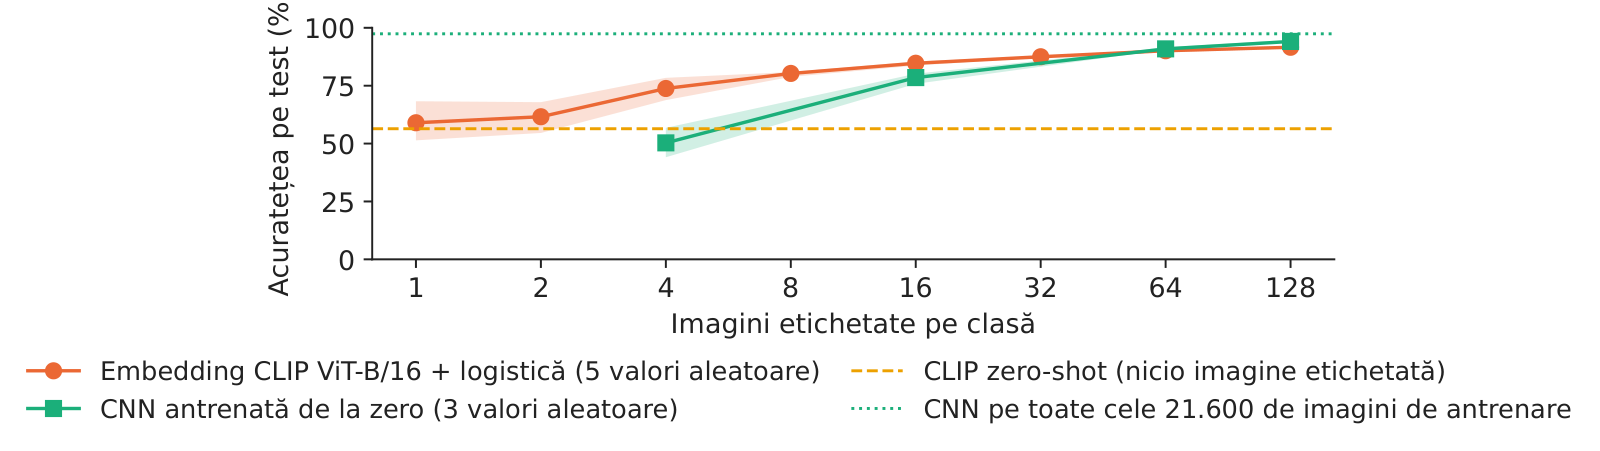
Dacă păstrăm CLIP fix și antrenăm doar o regresie logistică pe embedding-urile imaginilor, depășim deja zero-shot cu o singură imagine etichetată pe clasă (59,0 %) și ajungem la 95,5 % cu toate cele 21 600 de imagini de antrenare.

Trăsăturile preantrenate și numărul de etichete

Slide-ul 19 în PDF
Grafic: Trăsăturile preantrenate și o CNN antrenată de la zero, după numărul de etichete

Acuratețea pe test în funcție de numărul de imagini etichetate pe clasă: clasificator pe CLIP, CNN de la zero, zero-shot.

Sursa: EuroSAT, imagini Sentinel-2 (Helber et al., 2019). Date: 5400 de imagini de test; zona colorată = intervalul pe valorile generatorului aleator.

Cu 16 imagini etichetate pe clasă, clasificatorul pe embedding ajunge la 84,7 %, față de 78,5 % pentru o CNN antrenată de la zero; de la circa 64 pe clasă, CNN recuperează diferența, iar cu 128 este înainte (94,1 % față de 91,6 %). Pe toate imaginile de antrenare, CNN ajunge la 97,4 %. Modelele fundație merită cînd etichetele sînt puține.

Dimensiune și viteză

Slide-ul 20 în PDF

CNN are 289,2 mii de parametri; CLIP ViT-B/32 calculează embedding-ul unei imagini în 4,23 ms pe un laptop, iar ViT-B/16 în 20,49 ms; modelul VLM are nevoie de circa 262 ms pentru o imagine și o întrebare.

Modele vizual-lingvistice: citirea graficelor și a tabelelor

Un VLM: un codificator de imagini conectat la un model de limbaj

Slide-ul 22 în PDF
\[\mathbf H_v=\mathbf W_p\,f_{\text{ViT}}(I),\qquad p(y_t\mid y_{<t},I,q)=\mathrm{LLM}_{\boldsymbol\theta}\big([\mathbf H_v;\ \mathbf e(q);\ \mathbf e(y_{<t})]\big)\]

Peticele imaginii sînt proiectate în spațiul embedding-urilor de cuvinte al unui model lingvistic mare (LLM), care le citește ca tokeni suplimentari (Liu et al., 2023). Folosim Qwen2-VL-2B-Instruct, cu 2,21 miliarde de parametri (Wang et al., 2024).

Regimurile pieței ca problemă de recunoaștere vizuală

Slide-ul 23 în PDF

După Jheng, Pele, Tak și Găman (2026), fiecare fereastră de 120 de zile de tranzacționare a S&P 500 este desenată ca imagine cu două panouri (prețul și scăderea de la maxim) și etichetată „criză” cînd volatilitatea pe 20 de zile de la sfîrșitul ei depășește percentila 90 glisantă din ultimii trei ani. Modelele se antrenează pe ferestrele de pînă în 2018 și se testează pe 394 de ferestre din 2019, unde ponderea crizelor este 8,4 %.

Detectarea crizelor din grafice și din cifre

Slide-ul 24 în PDF
Grafic: Detectarea crizelor de piață din grafice și din cifre

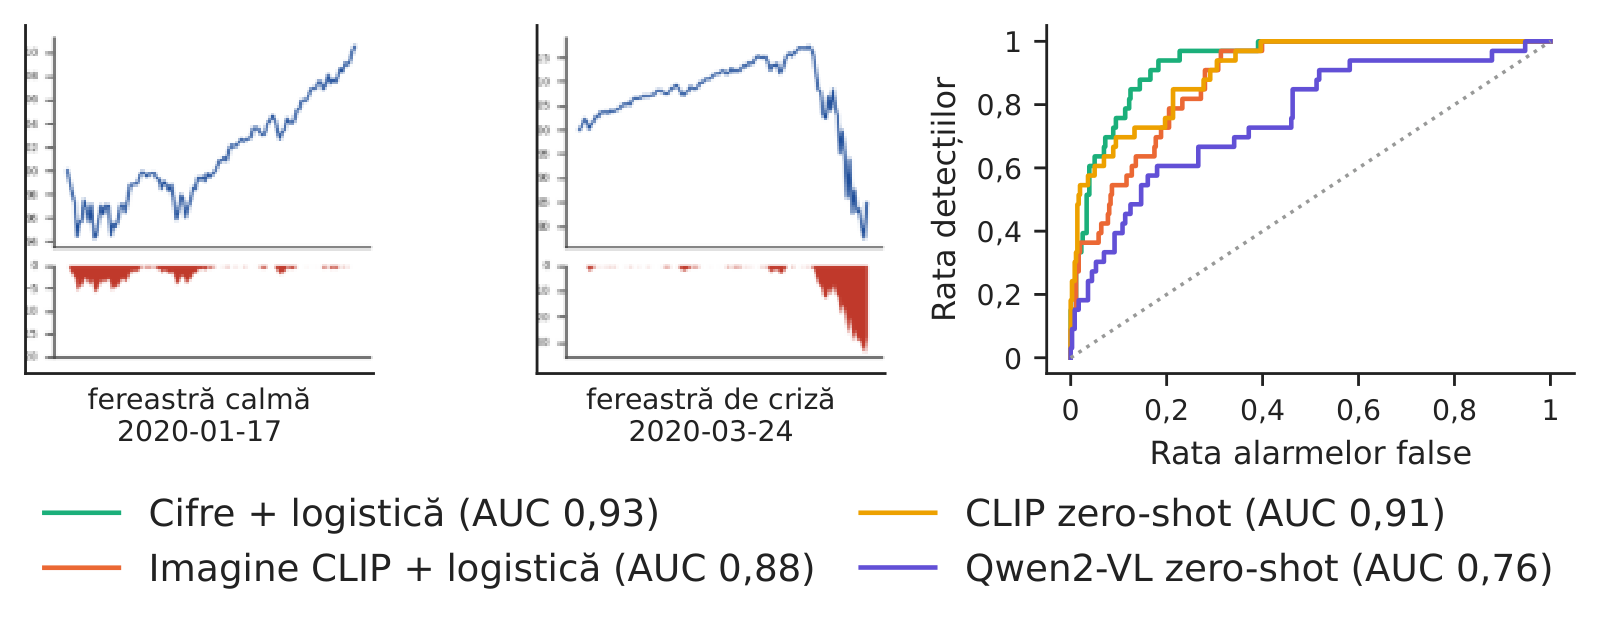
O fereastră calmă și una de criză și curbele ROC ale celor patru detectoare pe anii de test.

Sursa: Yahoo Finance, cotații zilnice. Date: S&P 500, ferestre de 120 de zile de tranzacționare la fiecare 5 zile; test 7 ianuarie 2019 - 30 octombrie 2026.

Aria de sub curba caracteristică de operare a receptorului (AUC) este 0,933 pentru regresia logistică pe randamente, volatilitate și scăderea de la maxim, 0,907 pentru CLIP zero-shot, 0,880 pentru regresia logistică pe embedding-urile CLIP ale imaginilor și 0,758 pentru Qwen2-VL zero-shot.

Capacitatea de separare și precizia

Slide-ul 25 în PDF

Precizia medie, care contează pentru un eveniment rar, este 0,578 pentru cifre, 0,605 pentru CLIP zero-shot, 0,449 pentru clasificatorul pe CLIP și 0,302 pentru VLM. Cînd cifrele există, imaginea adaugă un pas cu pierdere de informație; imaginile își au locul cînd cifrele lipsesc.

Citirea graficelor și a tabelelor cu un VLM mic

Slide-ul 26 în PDF

Întrebat dacă prețul a încheiat fereastra mai sus sau mai jos, modelul VLM are dreptate în 57,1 % din cele 394 de grafice la pragul de 0,5, sub cele 74,9 % ale răspunsului constant cu clasa majoritară, dar AUC este 0,974: ordonarea este corectă, iar pragul este deplasat, deci recalibrarea pe grafice de validare rezolvă cea mai mare parte a problemei. Cînd citește randamentul la 10 ani din 60 de tabele desenate, dă valoarea exactă în 25,0 % din cazuri, cu o eroare absolută medie de 0,192 puncte procentuale.

Fluxul documentelor într-o bancă

Slide-ul 27 în PDF

Șabloanele cunoscute merg la un program de citire bazat pe reguli; recunoașterea optică a caracterelor și analiza așezării în pagină tratează textul și tabelele; un VLM citește paginile libere și graficele; verificările de totaluri, date și intervale trimit eșecurile la un om; iar rata de potrivire exactă pe fiecare cîmp se măsoară pe un eșantion etichetat.

Sinteza cursului

Metodele cursului după tipul de date

Slide-ul 30 în PDF

Tabele (cursurile 1–3), imagini (4, 14), secvențe (5, 13), text (6, 7, 12), generare (8), grafuri (9), decizii (10) și încredere (11): fiecare tip de date are arhitectura sa, iar fiecare curs a comparat-o cu un reper, pe date reale.

Alegerea modelului

Slide-ul 31 în PDF

Porniți de la decizie și de la costul erorilor, estimați întîi reperul, numărați etichetele (puține etichete: un model fundație zero-shot sau cu un clasificator pe embedding; multe etichete: o rețea antrenată), potriviți arhitectura cu datele și demonstrați rezultatul cu un test, mai multe rulări, calibrare și o explicație.

Cinci reguli de evaluare

Slide-ul 32 în PDF

Fără scurgeri de informație; un reper lîngă fiecare rețea; rulări repetate și intervale; metrici pentru evenimente rare; date reale și programe reproductibile.

Modelele fundație pentru imagini, text și serii de timp

Slide-ul 33 în PDF

Același tipar, preantrenare o singură dată și utilizare zero-shot sau cu un mic clasificator, a funcționat pentru text (cursul 12), serii de timp (cursul 13) și imagini (acest curs: 56,4 % zero-shot, 95,5 % cu un clasificator pe toate etichetele). Avertismentul comun este că datele de preantrenare pot conține setul de test.

Utilizarea responsabilă

Slide-ul 36 în PDF

Regulamentul Uniunii Europene privind inteligența artificială include scoringul de credit printre utilizările cu risc ridicat; o fișă a modelului documentează datele, perioada, metrica, reperul, rulările și cazurile cunoscute de eșec; modelele se retestează pe date noi; modelele deschise rulate local păstrează datele clienților în instituție.

Sinteza secțiunii

Modelele multimodale etichetează și caută imagini fără etichete și citesc imperfect graficele și tabelele; cînd există cifre, cifrele cîștigă. În tot cursul se aplică aceeași disciplină: întîi reperul, date reale, fără scurgeri de informație, mai multe rulări, un test, o explicație.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

ASEAcademia de Studii Economice din București
AUCaria de sub curba caracteristică de operare (ROC)
BCEBanca Centrală Europeană
CLIPpreantrenare contrastivă limbaj–imagine
CNNrețea neuronală convoluțională
ESGcriterii de mediu, sociale și de guvernanță
GANrețea generativă adversarială
GNNrețea neuronală pe grafuri
GPTtransformer generativ preantrenat
ICBEConferința internațională Business Excellence
InfoNCEfuncția de pierdere contrastivă InfoNCE (information noise-contrastive estimation)
IPEInstitutul de Prognoză Economică, Academia Română
LLaVAasistentul lingvistic și vizual LLaVA (large language and vision assistant)
LLMmodel lingvistic mare
LSTMrețea cu memorie pe termen scurt și lung
MLPperceptron multistrat
OCRrecunoașterea optică a caracterelor
RAGgenerare augmentată prin regăsire
RGBroșu, verde, albastru (canalele de culoare)
RLreinforcement learning
ROCcaracteristica de operare a receptorului
SHAPexplicații aditive Shapley
VAEautoencoder variațional
VaRvaloarea expusă la risc (Value-at-Risk)
ViTtransformer pentru imagini (vision transformer)
VLMmodel vizual-lingvistic
XAIinteligență artificială explicabilă

Bibliografie

  • Abnar, S. & Zuidema, W. (2020). Quantifying attention flow in transformers. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 4190–4197. doi:10.18653/v1/2020.acl-main.385
  • Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts. Springer. doi:10.1007/978-3-031-45468-4
  • Diaconu, D. & Pele, D. T. (2026). Explainable AI in financial fraud detection: Evidence from the IEEE-CIS fraud dataset. Proceedings of the International Conference on Business Excellence, 20(1), 118–132. doi:10.2478/picbe-2026-0015
  • Dosovitskiy, A. et al. (2021). An image is worth 16x16 words: Transformers for image recognition at scale. International Conference on Learning Representations. arXiv:2010.11929
  • Găman, Ș., Tak, R., Jheng, S.-L. & Pele, D. T. (2026). ESG-aware asset selection and portfolio optimization: A comparative study of multi-criteria decision-making methods. Proceedings of the International Conference on Business Excellence, 20(1), 133–147. doi:10.2478/picbe-2026-0016
  • Helber, P., Bischke, B., Dengel, A. & Borth, D. (2019). EuroSAT: A novel dataset and deep learning benchmark for land use and land cover classification. IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing, 12(7), 2217–2226. doi:10.1109/JSTARS.2019.2918242
  • Jheng, S.-L., Pele, D. T., Tak, R. & Găman, Ș. (2026). A multimodal vision-language framework for financial anomaly detection. Proceedings of the International Conference on Business Excellence, 20(1), 191–201. doi:10.2478/picbe-2026-0020
  • Liu, H., Li, C., Wu, Q. & Lee, Y. J. (2023). Visual instruction tuning. Advances in Neural Information Processing Systems, 36. arXiv:2304.08485
  • Oord, A. van den, Li, Y. & Vinyals, O. (2018). Representation learning with contrastive predictive coding. arXiv:1807.03748
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the Word: LLM-VaR and LLM-ES. Expert Systems with Applications, 295, 128676. doi:10.1016/j.eswa.2025.128676
  • Radford, A. et al. (2021). Learning transferable visual models from natural language supervision. Proceedings of the 38th International Conference on Machine Learning, 8748–8763. arXiv:2103.00020
  • Wang, P. et al. (2024). Qwen2-VL: Enhancing vision-language model's perception of the world at any resolution. arXiv:2409.12191

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.