Rețele neuronale și deep learning

Cursul 1: Deep learning pentru afaceri: de la modelele liniare la perceptron și la perceptronul multistrat (MLP)

Cursul 1

Deep learning pentru afaceri: de la modelele liniare la perceptron și la perceptronul multistrat (MLP)

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

O bancă decide în fiecare zi cui acordă credite, un emitent de carduri ce plăți blochează, un trader cît risc își asumă. Deep learning, ramura inteligenței artificiale (AI) care estimează din date lanțuri lungi de funcții simple, stă acum în spatele multora dintre aceste decizii. Primul curs pornește de la modelele pe care orice analist le cunoaște deja, regresia liniară și regresia logistică, și arată că ele sînt rețele neuronale cu un singur neuron. De aici construim perceptronul lui Rosenblatt, vedem unde eșuează și ajungem la perceptronul multistrat (MLP), rețeaua din spatele tuturor cursurilor următoare.

Toate cifrele de pe această pagină sînt calculate pe date de credit reale și publice: 1 000 de solicitanți din setul German credit, 5 960 de credite garantate cu locuința (HMEQ, home equity) și, pentru o imagine a aproximării funcțiilor, 20 640 de grupuri de locuințe din recensămîntul Californiei. Studiul de caz compară regresia logistică, un MLP și gradient boosting după același protocol, cu mai multe inițializări aleatoare, intervale și costul erorilor, pentru că alegerea unui model într-o bancă este o decizie în condiții de incertitudine, nu o competiție între cifre izolate.

Ce veți ști să faceți

  • Situați deep learning printre instrumentele unui analist de afaceri: unde creează valoare și unde un model liniar este suficient.
  • Scrieți regresia liniară și regresia logistică drept rețele cu un neuron, cu pierderile lor ca verosimilități.
  • Explicați perceptronul, regula lui de învățare, teorema de convergență și de ce nu poate reprezenta sau-ul exclusiv (XOR).
  • Construiți un MLP: propagarea înainte, funcțiile de activare, numărul de parametri, aproximarea universală.
  • Comparați un MLP cu regresia logistică și cu gradient boosting pe credite reale, cu inițializări multiple, intervale, calibrare și costuri.

Planul cursului

  1. Deep learning pentru afaceriDe ce contează deep learning acum, unde creează valoare în finanțe și afaceri, unde un model mai simplu este suficient și ce date folosim.
  2. Modelele liniare sînt rețele cu un singur neuronRegresia liniară și regresia logistică sînt un singur neuron, cu ieșire identitate sau sigmoidă; pierderile lor sînt verosimilități, iar gradienții lor au forma pe care propagarea înapoi o va repeta în fiecare strat.
  3. PerceptronulPerceptronul lui Rosenblatt învață o frontieră liniară din propriile greșeli.
  4. Perceptronul multistratPrin suprapunerea transformărilor afine și a activărilor neliniare obținem MLP: scriem propagarea înainte, alegem activările și ieșirile, numărăm parametrii și vedem ce promite și ce nu promite teorema aproximării universale.
  5. Studiu de caz: scoringul de credit pe credite realeRegresia logistică, un MLP și extreme gradient boosting (XGBoost) sînt comparate pe HMEQ și German credit cu aceleași împărțiri, intrări și metrici, cu mai multe inițializări, intervale bootstrap, un test corectat, calibrare și costul erorilor.

Deep learning pentru afaceri

De ce contează deep learning acum, unde creează valoare în finanțe și afaceri, unde un model mai simplu este suficient și ce date folosim.

Deep learning învață singur variabilele pe care analiștii le construiau manual

Slide-ul 5 în PDF

O rețea adîncă este o compunere de straturi, \(f(\mathbf x;\boldsymbol\theta)=f^{(L)}(f^{(L-1)}(\cdots f^{(1)}(\mathbf x)))\), ai cărei parametri \(\boldsymbol\theta\) sînt aleși astfel încît să minimizeze pierderea medie pe datele de antrenare. În ultimii cincisprezece ani nu s-a schimbat ideea, ci scara ei: seturi mari de date etichetate, procesoare grafice (GPU) și software care derivează automat, precum PyTorch. Rețeaua nu mai are nevoie de variabile construite de un analist; își învață singură reprezentările din datele brute (LeCun, Bengio și Hinton, 2015).

În practică: întrebați ce ar învăța rețeaua în plus față de ce poate scrie manual un analist de scoring.

Unde creează valoare deep learning în afaceri și finanțe

Slide-ul 6 în PDF

Cursul este organizat după decizie și tipul datelor. Creditul și plățile sînt probleme tabelare (cursurile 1--3); prognoza piețelor și a energiei lucrează cu secvențe (cursurile 5 și 13); știrile, rapoartele și discursurile băncilor centrale sînt text (cursurile 6, 7 și 12); rețelele de plăți sînt grafuri (cursul 9). Regula este mereu aceeași: porniți de la decizie și de la costul ei, apoi alegeți rețeaua potrivită datelor.

Pentru date tabelare puține, un model liniar sau boosting este adesea suficient

Slide-ul 7 în PDF

Deep learning nu este automat mai bun. În comparația amplă a metodelor de scoring de credit realizată de Lessmann et al. (2015), regresia logistică rămîne o referință solidă, iar ansamblurile de modele conduc; pe date tabelare obișnuite, de mărime medie, ansamblurile de arbori încă depășesc rețelele adînci (Grinsztajn, Oyallon și Varoquaux, 2022). Deciziile de creditare trebuie, în plus, explicate solicitantului. De aceea, în acest curs fiecare rețea este raportată alături de un model de referință liniar și de unul de boosting.

Datele: trei seturi reale de date de credit

Slide-ul 8 în PDF

German credit provine din Machine Learning Repository al Universității California din Irvine (UCI): 1 000 de solicitanți, 20 de atribute, sume în mărci germane (DM) și o rată de neplată de 30,0 %. HMEQ (Baesens, Rösch și Scheule, 2016) are 5 960 de credite, o rată de neplată de 19,9 % și multe valori lipsă, pe care le păstrăm. Datele California dau valoarea mediană a locuințelor în sute de mii de dolari americani (USD).

În practică: verificați sursa, unitatea de observație și frecvența evenimentului înaintea oricărui model.

Ratele de neplată diferă puternic între grupuri simple de solicitanți

Slide-ul 9 în PDF

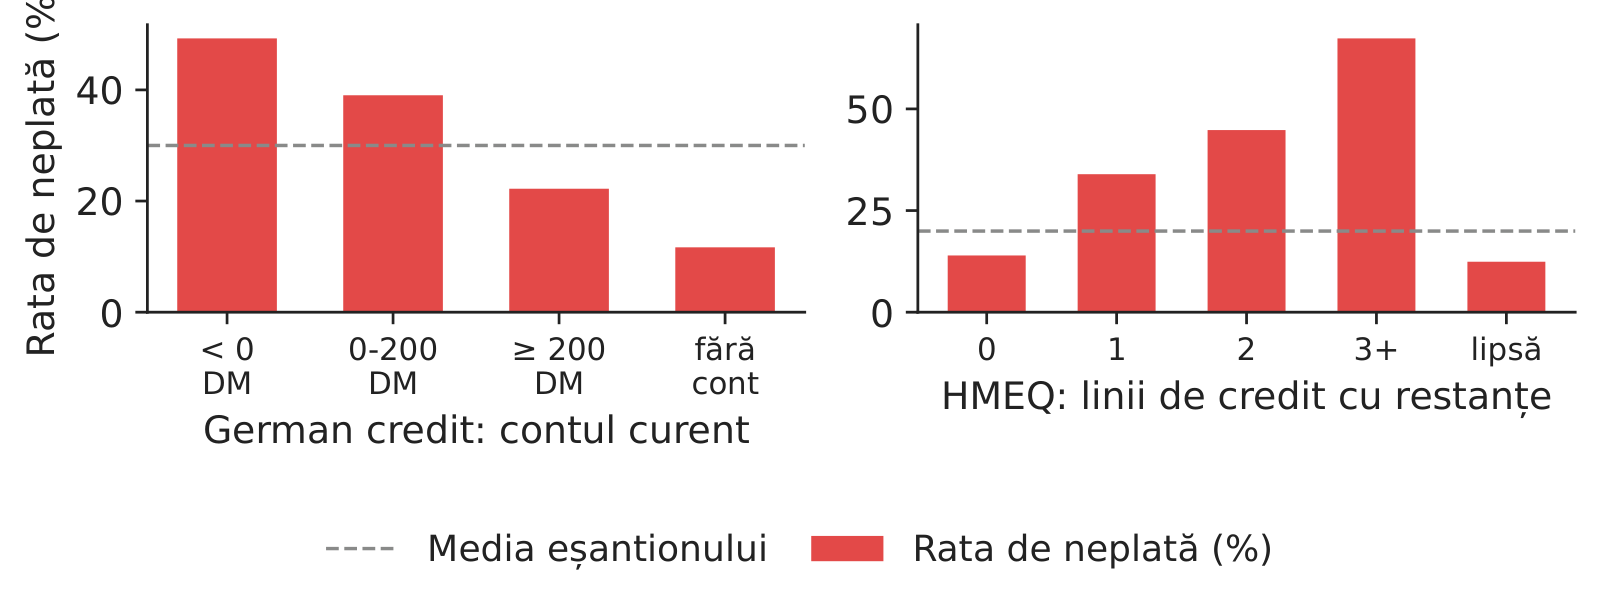
Cel mai simplu model de risc este rata de neplată pe grup, \(\widehat{\mathrm{PD}}_g=\frac1{n_g}\sum_{i\in g}y_i\), unde probabilitatea de neplată (PD) a grupului \(g\) este ponderea creditelor lui cu \(y_i=1\). În German credit, solicitanții cu sold negativ în contul curent intră în neplată în 49,3 % din cazuri, cei fără cont curent în 11,7 %. În HMEQ, rata crește de la 14,0 % fără linii de credit cu restanțe la 67,3 % cu trei sau mai multe.

Grafic: Ratele de neplată diferă puternic între grupuri simple de solicitanți

Rata de neplată după starea contului curent (German credit) și după numărul de linii de credit cu restanțe (HMEQ); linia punctată: media eșantionului.

Sursa: UCI Statlog German credit; Baesens, Roesch și Scheule (2016), HMEQ. Date: 1 000 de solicitanți (German credit); 5 960 de credite (HMEQ).

În practică: un model trebuie să reproducă cel puțin aceste rate pe setul de validare.

Învățarea ca minimizare a pierderii medii pe datele de antrenare, evaluată pe date noi

Slide-ul 10 în PDF

Antrenarea minimizează riscul empiric \(\hat R_n(\boldsymbol\theta)=\frac1n\sum_i\ell(y_i,f(\mathbf x_i;\boldsymbol\theta))\), dar banca plătește riscul pe solicitanții viitori, \(R(\boldsymbol\theta)=\mathbb E\,\ell(y,f(\mathbf x;\boldsymbol\theta))\). De aceea împărțim datele în trei: antrenare (\(\boldsymbol\theta\)), validare (alegerea modelului și oprirea) și testare (raportată o singură dată). Pentru HMEQ, împărțirea stratificată dă 3 576, 1 192 și 1 192 de credite; medianele și standardizarea se estimează doar pe partea de antrenare, astfel încît nicio informație nu scapă din setul de testare.

Sinteza secțiunii

Deep learning creează cea mai multă valoare pe date brute, de dimensiune mare; pe tabele mici, cu variabile construite, trebuie să depășească regresia logistică și boosting după un protocol fix, pe date care rămîn reale de la primul tabel pînă la ultimul test.

Modelele liniare sînt rețele cu un singur neuron

Regresia liniară și regresia logistică sînt un singur neuron, cu ieșire identitate sau sigmoidă; pierderile lor sînt verosimilități, iar gradienții lor au forma pe care propagarea înapoi o va repeta în fiecare strat.

Regresia liniară este un neuron fără funcție de activare

Slide-ul 12 în PDF

Un neuron fără activare calculează \(\hat y=\mathbf w^\top\mathbf x+b\). Cu erori gaussiene, maximizarea verosimilității este același lucru cu minimizarea erorii pătratice medii (MSE), \(\frac1n\sum(y_i-\mathbf w^\top\mathbf x_i-b)^2\), care are soluția explicită \(\hat{\mathbf w}=(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y\). Rețelele pierd această formulă explicită și se antrenează prin coborîre pe gradient (cursul 2).

Regresia logistică este un neuron cu funcție sigmoidă

Slide-ul 13 în PDF

Cu ieșire sigmoidă, \(p_i=\sigma(\mathbf w^\top\mathbf x_i+b)\), și cu minus log-verosimilitatea Bernoulli (entropia încrucișată) ca pierdere, neuronul este regresia logistică:

\[\mathcal L(\mathbf w,b)=-\frac1n\sum_{i=1}^n\big[y_i\log p_i+(1-y_i)\log(1-p_i)\big],\qquad \nabla_{\mathbf w}\mathcal L=\frac1n\sum_{i=1}^n(p_i-y_i)\,\mathbf x_i\]
(1.1)

Gradientul (1.1) este eroarea înmulțită cu intrarea; pierderea este convexă, deci are un singur minim, iar \(e^{w_j}\) este raportul șanselor pentru intrarea \(j\).

Restanțele și lipsa raportului datorii/venit cresc cel mai mult șansa de neplată

Slide-ul 14 în PDF

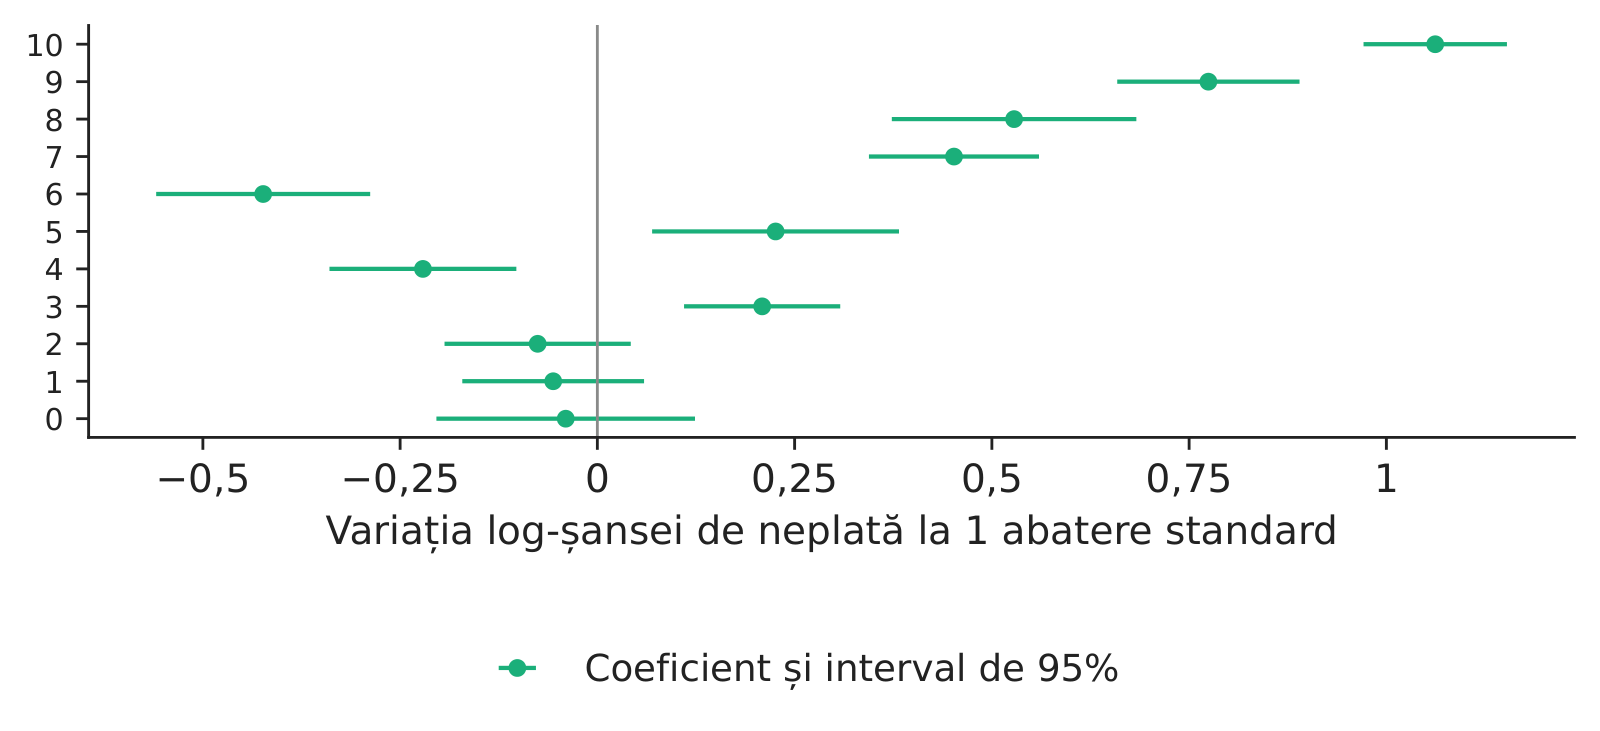
Cu intrări standardizate, coeficienții sînt variații ale log-șansei la o abatere standard și pot fi comparați. Rapoartele șanselor sînt 2,89 pentru un raport datorii/venit lipsă, 2,17 pentru mai multe linii cu restanțe și 0,65 pentru un istoric de credit mai vechi; pseudo-\(R^2\) McFadden este 0,374.

Grafic: Restanțele și lipsa raportului datorii/venit cresc cel mai mult șansa de neplată

Regresia logistică pe HMEQ: coeficienți standardizați cu intervale de încredere de 95 %.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 3 576 de credite de antrenare.

În practică: un semn contrar intuiției de credit este un motiv să analizați datele, nu să renunțați la model.

Propagarea înainte pentru un solicitant real, pas cu pas

Slide-ul 15 în PDF

Pentru un solicitant din setul de testare care a intrat ulterior în neplată (un credit de 15 400 USD, raport datorii/venit 36,4 %, 2 linii cu restanțe), scorul este suma contribuțiilor \(w_jx_j\) plus termenul liber, \(z=\) −1,71, iar neuronul produce \(p=\sigma(z)=\) 15,3 %. Solicitantul ar trece de un prag de 50 %; secțiunea 5 arată de ce pragul trebuie stabilit din costuri.

Valorile lipsă ca predictori ai neplății

Slide-ul 16 în PDF

Raportul datorii/venit lipsește pentru 21,3 % dintre creditele HMEQ, iar acestea intră în neplată în 62,0 % din cazuri, față de 8,6 % cînd raportul este declarat. Eliminarea rîndurilor incomplete ar elimina solicitanții cei mai riscanți. Completăm fiecare intrare numerică cu mediana de antrenare și adăugăm un indicator de valoare lipsă, ceea ce dă \(d=\) 28 de intrări.

În practică: nu eliminați rîndurile cu valori lipsă din datele de credit.

Sinteza secțiunii

Un neuron cu ieșirea și pierderea potrivite este un model statistic clasic; perspectiva de rețea nu adaugă încă nimic, dar fixează notația și gradientul pe care le refolosește orice model mai adînc.

Perceptronul

Perceptronul lui Rosenblatt învață o frontieră liniară din propriile greșeli. Converge cînd clasele sînt separabile și eșuează în caz contrar, care este situația obișnuită în credit, și nu poate reprezenta XOR.

De la neuronul McCulloch–Pitts la perceptron

Slide-ul 18 în PDF

McCulloch și Pitts (1943) au scris neuronul ca unitate cu prag, \(\hat y=\operatorname{step}(\mathbf w^\top\mathbf x+b)\); Rosenblatt (1958) a făcut ca ponderile lui să învețe din exemple etichetate. Minsky și Papert (1969) au demonstrat că un singur strat nu poate reprezenta XOR, iar domeniul și-a revenit abia cînd propagarea înapoi a erorii a permis antrenarea mai multor straturi (Rumelhart, Hinton și Williams, 1986).

Perceptronul își actualizează ponderile numai pe exemplele clasificate greșit

Slide-ul 19 în PDF

Dacă exemplul \(i\) este clasificat greșit, \(y_i(\mathbf w^\top\mathbf x_i+b)\le0\) cu \(y_i\in\{-1,+1\}\), ponderile se mută spre el: \(\mathbf w\leftarrow\mathbf w+\eta y_i\mathbf x_i\). Este un pas de coborîre stohastică pe gradient (SGD) pe criteriul perceptronului. Exemplele corecte nu dau gradient, iar ieșirea este o clasă, nu o probabilitate, pe care un creditor nu o poate evalua.

Dacă clasele pot fi separate, perceptronul se oprește după un număr finit de greșeli

Slide-ul 20 în PDF

Novikoff (1962): dacă un vector unitar \(\mathbf w^*\) separă datele cu marginea \(\gamma\) și toate intrările se află în raza \(R\), perceptronul face cel mult \((R/\gamma)^2\) greșeli, oricîte exemple și oricare ar fi dimensiunea. Fără un hiperplan separator, teorema nu spune nimic.

Perceptronul nu converge pe date de credit neseparabile

Slide-ul 21 în PDF

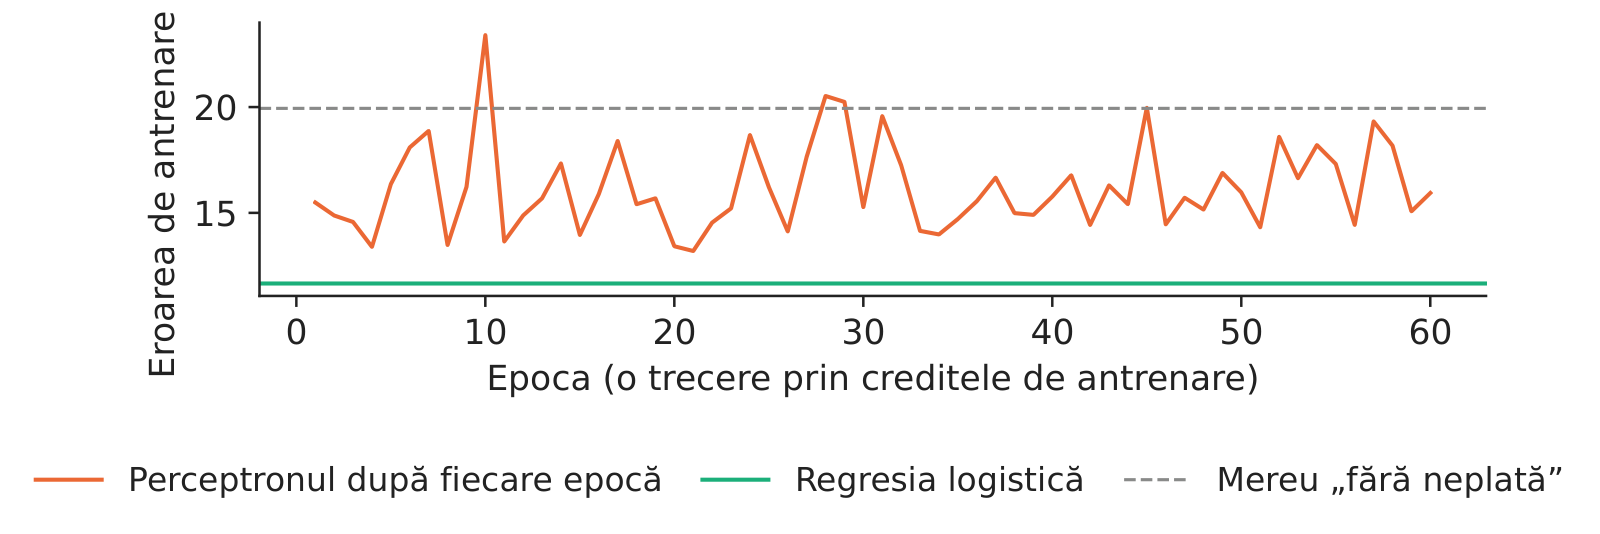
Pe creditele HMEQ de antrenare, clasele se suprapun. În 60 de epoci, eroarea de antrenare sare între 13,2 % și 23,4 %, după 35 876 de actualizări, în timp ce regresia logistică pe aceleași intrări ajunge la 11,7 %, iar regula „mereu fără neplată” la 19,9 %.

Grafic: Perceptronul nu converge pe date de credit neseparabile

Eroarea de antrenare a perceptronului după fiecare epocă pe HMEQ, comparată cu regresia logistică și cu regula majorității.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 3 576 de credite de antrenare.

În practică: o pierdere netedă și o ieșire probabilistă rezolvă ambele probleme.

Problema XOR și stratul ascuns

Slide-ul 22 în PDF

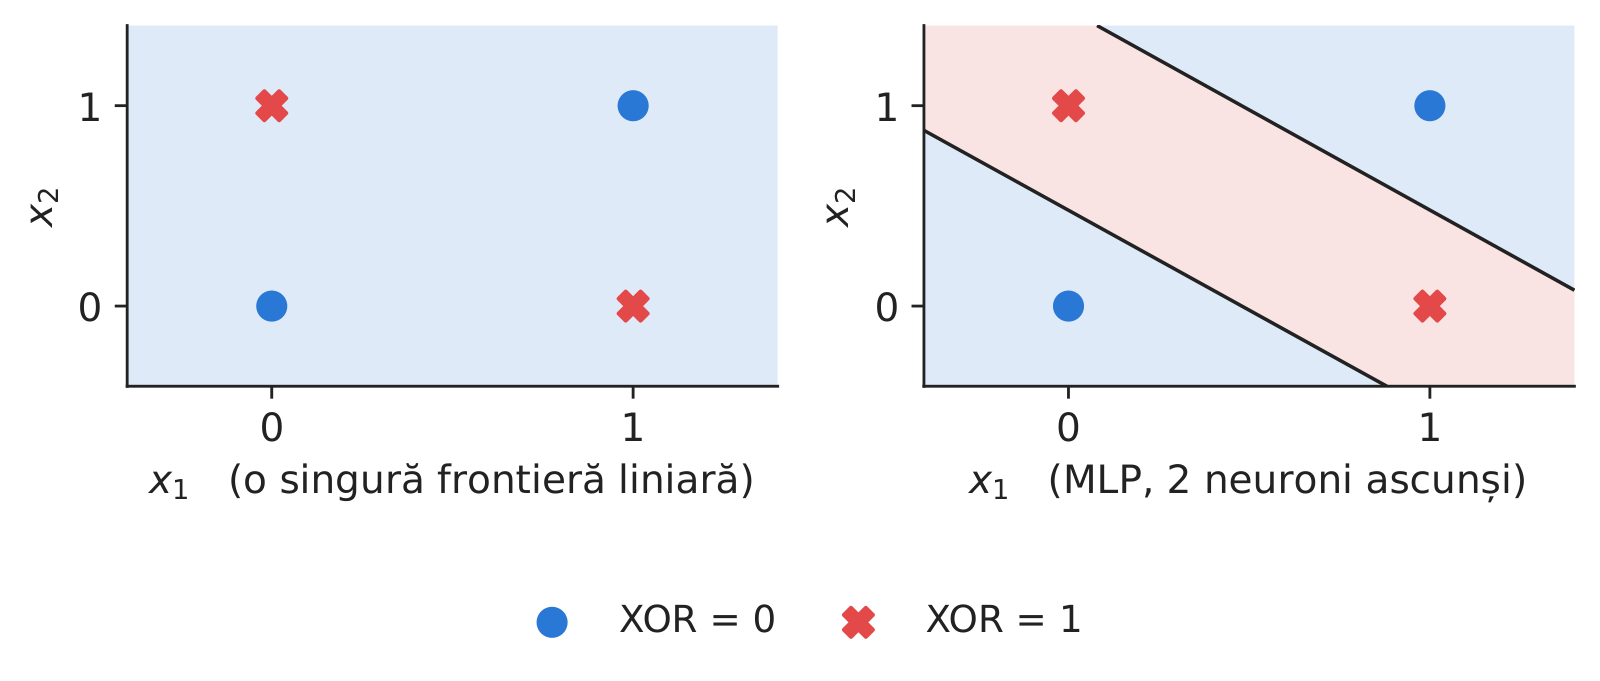
XOR este adevărat cînd exact o intrare este activă. Orice frontieră liniară clasifică corect cel mult trei dintre cele patru puncte (aici 50 %), în timp ce un MLP cu doi neuroni ascunși tanh ajunge la 100 %: stratul ascuns duce intrările într-un spațiu în care clasele devin separabile. Interacțiunile de tipul „datorii mari și istoric scurt” sînt de acest fel. Este o ilustrare a mecanismului pe tabelul logic, nu un rezultat pe date.

Grafic: Problema XOR și stratul ascuns

XOR: o singură frontieră liniară (stînga) și un MLP cu doi neuroni ascunși (dreapta).

Sursa: tabelul funcției logice XOR (fără date). Date: cele patru intrări XOR.

Sinteza secțiunii

Perceptronul este un clasificator liniar care învață doar din greșeli; converge pe date separabile și se rotește la nesfîrșit pe clase reale, care se suprapun. Pierderile netede, ieșirile probabiliste și straturile ascunse elimină aceste limite.

Perceptronul multistrat

Prin suprapunerea transformărilor afine și a activărilor neliniare obținem MLP: scriem propagarea înainte, alegem activările și ieșirile, numărăm parametrii și vedem ce promite și ce nu promite teorema aproximării universale.

Un MLP alternează transformări afine și activări neliniare

Slide-ul 24 în PDF

Fiecare strat ascuns calculează \(\mathbf h^{(l)}=a(\mathbf W^{(l)}\mathbf h^{(l-1)}+\mathbf b^{(l)})\), pornind de la \(\mathbf h^{(0)}=\mathbf x\), iar stratul de ieșire este o regresie logistică pe ultimele variabile ascunse. Fără activarea \(a\), straturile se reduc la o singură transformare liniară. Rețeaua noastră de credit are \(d=\) 28 de intrări și două straturi ascunse a cîte 64 de unități liniare rectificate (ReLU).

Funcțiile de activare și proprietățile lor

Slide-ul 25 în PDF

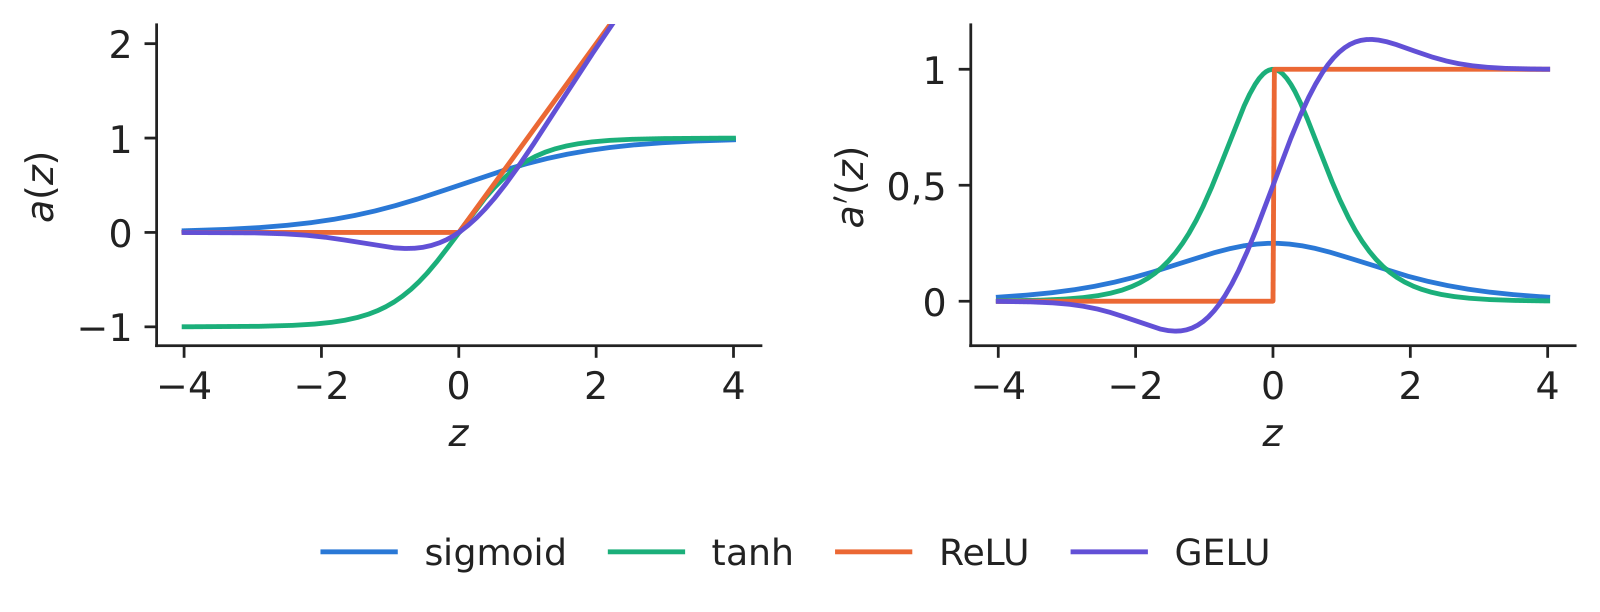
Sigmoida și tanh se saturează: derivata sigmoidei este cel mult 0,25, iar ambele derivate dispar pentru intrări mari, ceea ce încetinește învățarea în rețelele adînci (cursul 2). ReLU, \(\max(0,z)\), are panta 1 pentru intrări pozitive și este alegerea implicită în straturile ascunse; unitatea liniară cu eroare gaussiană (GELU), \(z\Phi(z)\), este varianta ei netedă, folosită în arhitecturile transformer.

Grafic: Funcțiile de activare și proprietățile lor

Funcțiile de activare (stînga) și derivatele lor (dreapta); curbe analitice.

Sursa: funcții analitice (fără date). Date: funcții reprezentate pe [-4, 4].

Stratul de ieșire și pierderea decurg din tipul variabilei țintă

Slide-ul 26 în PDF

Ieșirea și pierderea decurg din distribuția țintei: identitate și MSE pentru un număr real, sigmoidă și entropie încrucișată pentru un eveniment binar, softmax și entropie încrucișată categorială pentru \(K\) clase și pierderea pinball pentru o cuantilă, de exemplu valoarea la risc (VaR) din cursul 2. Fiecare pereche este un estimator de verosimilitate maximă.

Un MLP mic are deja de sute de ori mai mulți parametri decît scorul logistic

Slide-ul 27 în PDF

Numărul de parametri este \(\sum_l(H_{l-1}+1)H_l\). Pe HMEQ, modelul logistic are 29 de parametri, iar MLP 64-64 are 6 081, pentru 3 576 de credite de antrenare: suficient pentru a memora neplățile din antrenare, motiv pentru care fiecare rețea păstrează ponderile din epoca cea mai bună pe validare.

Un singur strat ascuns poate aproxima orice funcție continuă

Slide-ul 28 în PDF

Pentru orice funcție continuă pe o mulțime compactă și orice toleranță, o rețea cu un singur strat ascuns și suficienți neuroni o aproximează (Cybenko, 1989; Hornik, 1991). Teorema nu spune cîți neuroni sînt necesari, dacă coborîrea pe gradient găsește ponderile sau dacă acestea generalizează.

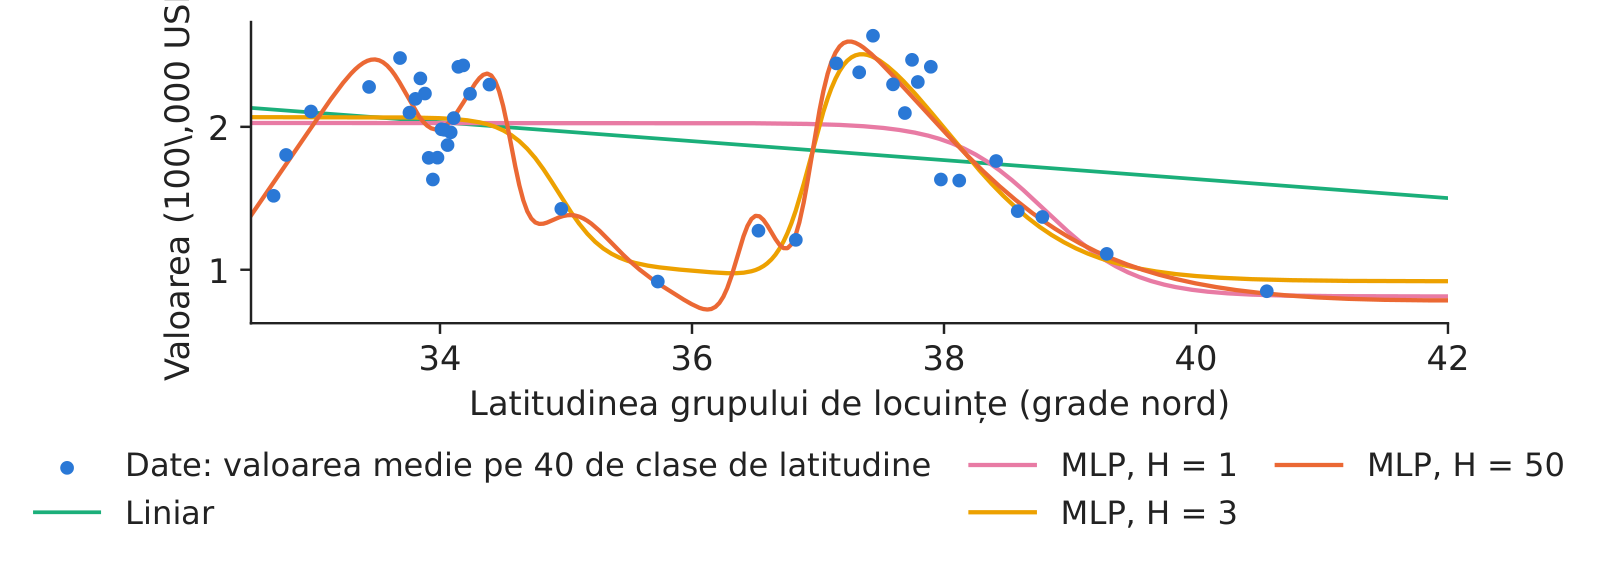
Mai mulți neuroni ascunși urmăresc geografia prețurilor din California

Slide-ul 29 în PDF

Valorile locuințelor din California au vîrfuri în jurul orașelor Los Angeles și San Francisco. Estimîndu-le doar din latitudine, MSE pe datele păstrate deoparte scade de la 0,896 pentru o dreaptă la 0,855, 0,757 și 0,731 cu 1, 3 și 50 de neuroni sigmoizi. Cele 992 de grupuri aflate la plafonul sursei, de 500 000 USD, sînt excluse.

Grafic: Mai mulți neuroni ascunși urmăresc geografia prețurilor din California

Valoarea locuințelor în funcție de latitudine: medii pe clase și rețele estimate cu 1, 3 și 50 de neuroni ascunși.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 19 648 de grupuri de locuințe sub plafonul sursei.

În practică: efectele de localizare sînt neliniare: un termen liniar nu le poate surprinde.

Adîncimea și lățimea unei rețele

Slide-ul 30 în PDF

O rețea ReLU este liniară pe porțiuni, iar numărul regiunilor ei liniare poate crește exponențial cu adîncimea, la un număr fix de neuroni (Montúfar et al., 2014). Pe datele tabelare de credit, două sau trei straturi ascunse sînt de obicei suficiente; adîncimea contează la imagini, text și secvențe.

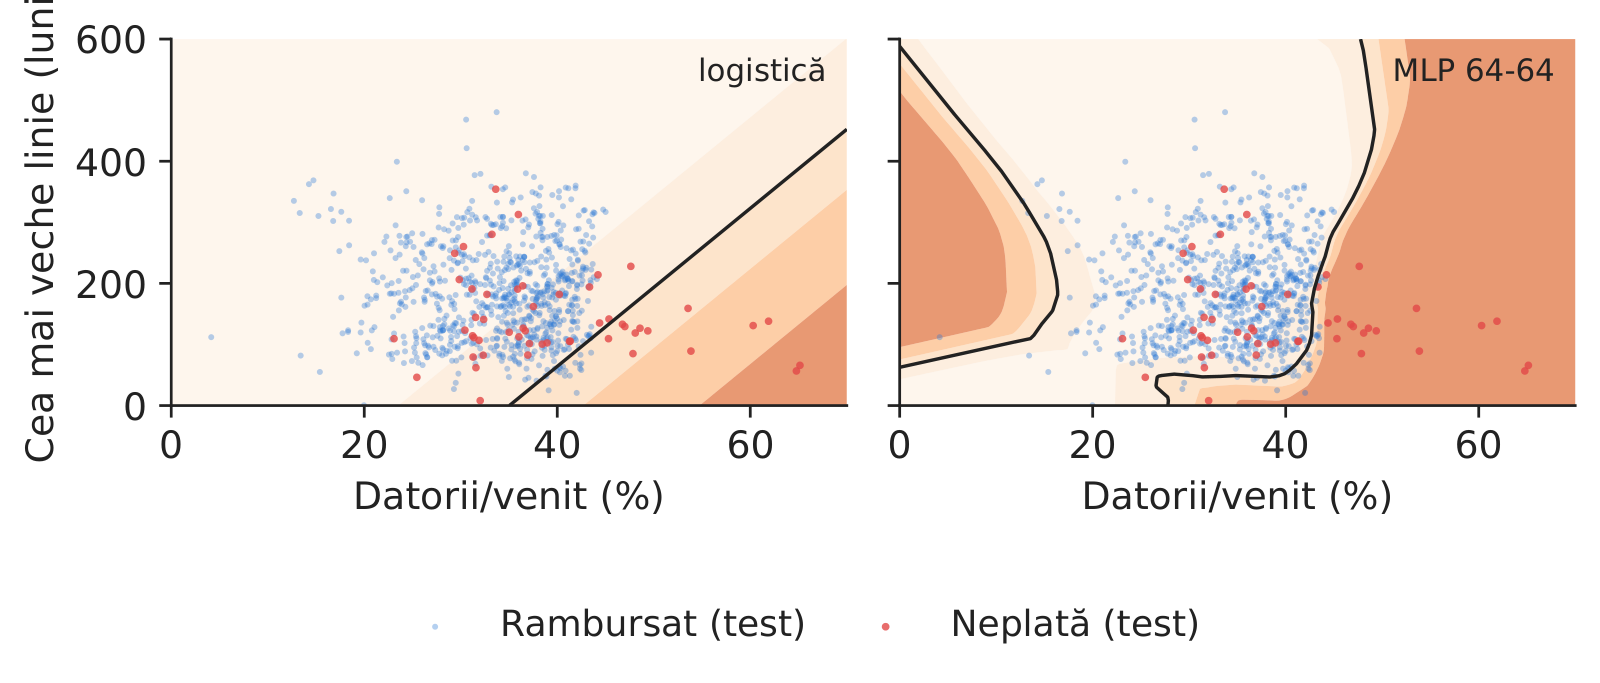
Frontiera de decizie neliniară a unui MLP cu două intrări

Slide-ul 31 în PDF

Cu două intrări HMEQ, raportul datorii/venit și vechimea celei mai vechi linii de credit, modelul logistic desenează benzi drepte de probabilitate, iar MLP regiuni curbe. Aria de sub curbă (AUC) a caracteristicii de operare a receptorului (ROC), adică probabilitatea ca un client în neplată ales la întîmplare să aibă un scor mai mare decît un credit bun, este 0,744 pentru modelul logistic și 0,736 pentru MLP: flexibilitatea nu ajută cînd cele două intrări aduc puțin semnal.

Grafic: Frontiera de decizie neliniară a unui MLP cu două intrări

PD prezisă pe două variabile HMEQ: regresia logistică (stînga) și MLP 64-64 (dreapta), cu creditele de test.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 2 708 de credite de antrenare și 871 de testare cu ambele variabile.

Sinteza secțiunii

Un MLP este o suprapunere de transformări afine și activări; ReLU în straturile ascunse, o ieșire și o pierdere potrivite țintei și un număr de parametri care arată de cîte date și de cîtă regularizare este nevoie.

Studiu de caz: scoringul de credit pe credite reale

Regresia logistică, un MLP și extreme gradient boosting (XGBoost) sînt comparate pe HMEQ și German credit cu aceleași împărțiri, intrări și metrici, cu mai multe inițializări, intervale bootstrap, un test corectat, calibrare și costul erorilor.

Protocolul experimental: aceeași împărțire și aceleași intrări pentru trei modele

Slide-ul 33 în PDF

MLP-urile folosesc straturi ReLU, Adam cu rata de învățare 0,001 și ponderile din epoca cea mai bună pe validare, fiecare cu 5 inițializări; XGBoost folosește adîncimea 4, rata de învățare 0,03 și oprire timpurie pe validare. HMEQ are o împărțire stratificată 60/20/20; German credit folosește validarea încrucișată cu 5 pliuri repetată de 5 ori (25 de pliuri de test). Toate modelele au fost antrenate pe procesorul central (CPU), cu valoarea inițială 20261108.

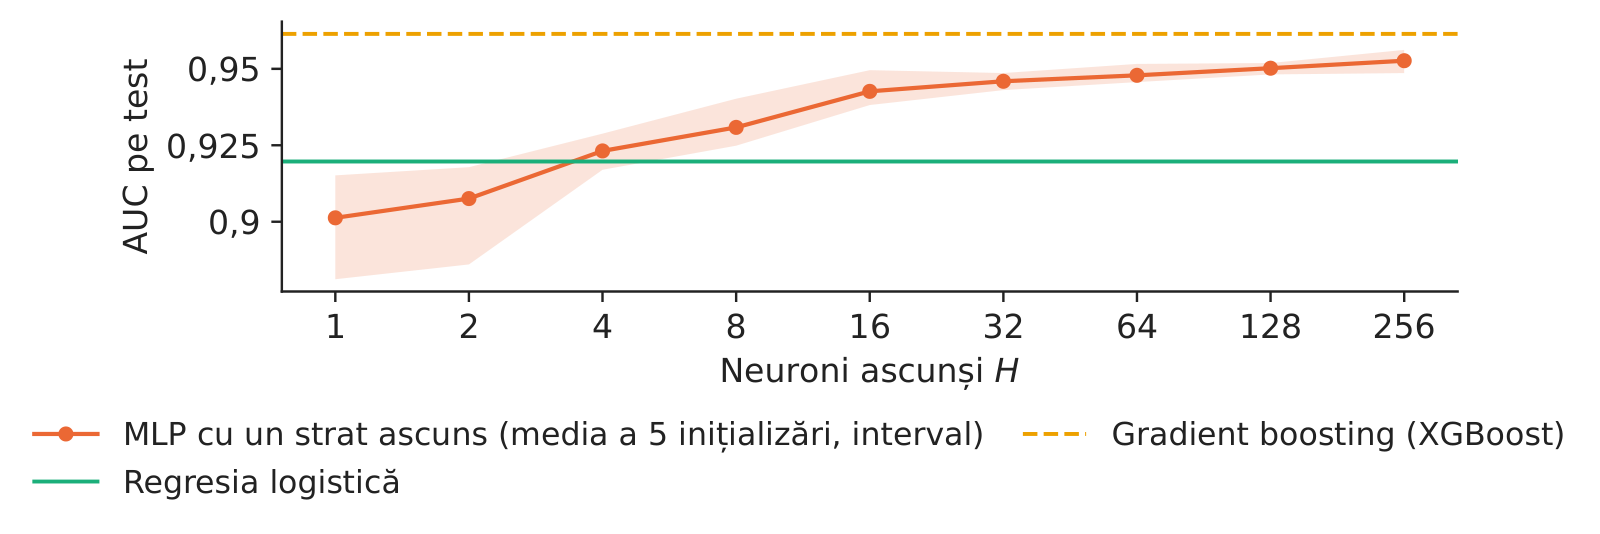
Pe HMEQ, un strat ascuns mai lat crește AUC pe test peste scorul logistic

Slide-ul 34 în PDF

Cu un strat ascuns, AUC pe test crește de la 0,901 cu un neuron, practic un model logistic, la 0,953 cu 256 de neuroni; regresia logistică ajunge la 0,920, iar XGBoost la 0,961. Cîștigul se aplatizează după circa 16 neuroni, iar variația dintre inițializări scade pe măsură ce rețeaua se lărgește.

Grafic: Pe HMEQ, un strat ascuns mai lat crește AUC pe test peste scorul logistic

AUC pe test pe HMEQ în funcție de numărul de neuroni ascunși (media și intervalul a 5 inițializări), cu cele două repere.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 3 576 de credite de antrenare 1 192 de validare 1 192 de testare.

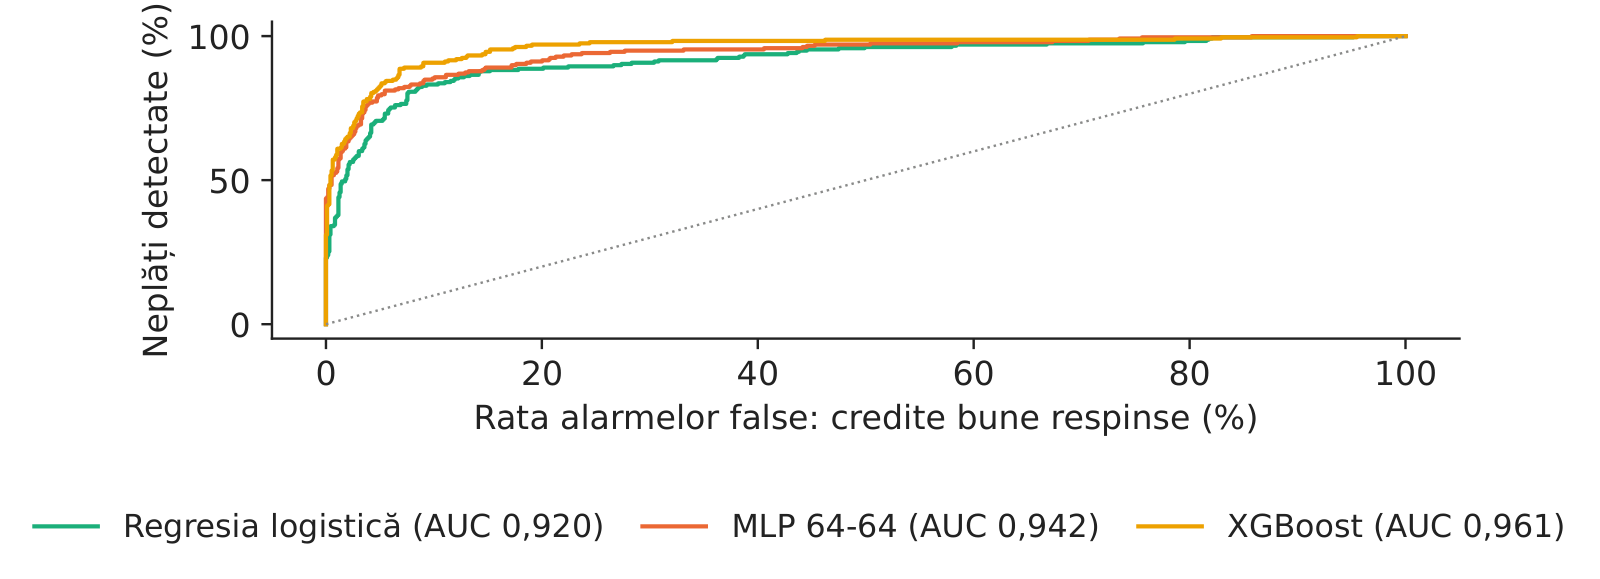
La 10 % alarme false, MLP detectează mai multe neplăți decît scorul logistic

Slide-ul 35 în PDF

Curba ROC reprezintă ponderea neplăților detectate în funcție de ponderea creditelor bune respinse, pentru fiecare prag. Cînd respingem 10 % dintre creditele bune, regresia logistică detectează 83,2 % dintre cele 238 de neplăți din test, MLP 85,3 %, iar XGBoost 90,8 %.

Grafic: La 10 % alarme false, MLP detectează mai multe neplăți decît scorul logistic

Curbele ROC pe setul de test HMEQ.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 1 192 de credite de testare (238 de neplăți).

În practică: citiți curba la rata de respingere acceptată de afacere.

Cîștigul MLP pe HMEQ depășește zgomotul inițializării și al setului de testare

Slide-ul 36 în PDF

MLP 64-64 atinge o AUC medie pe test de 0,945 pe 5 inițializări (abaterea standard 0,004). Un bootstrap pe perechi al creditelor de test dă pentru cîștigul de AUC față de regresia logistică, 0,023, intervalul de 95 % [0,008; 0,037], care exclude zero.

Scorurile sînt apropiate de probabilități calibrate

Slide-ul 37 în PDF

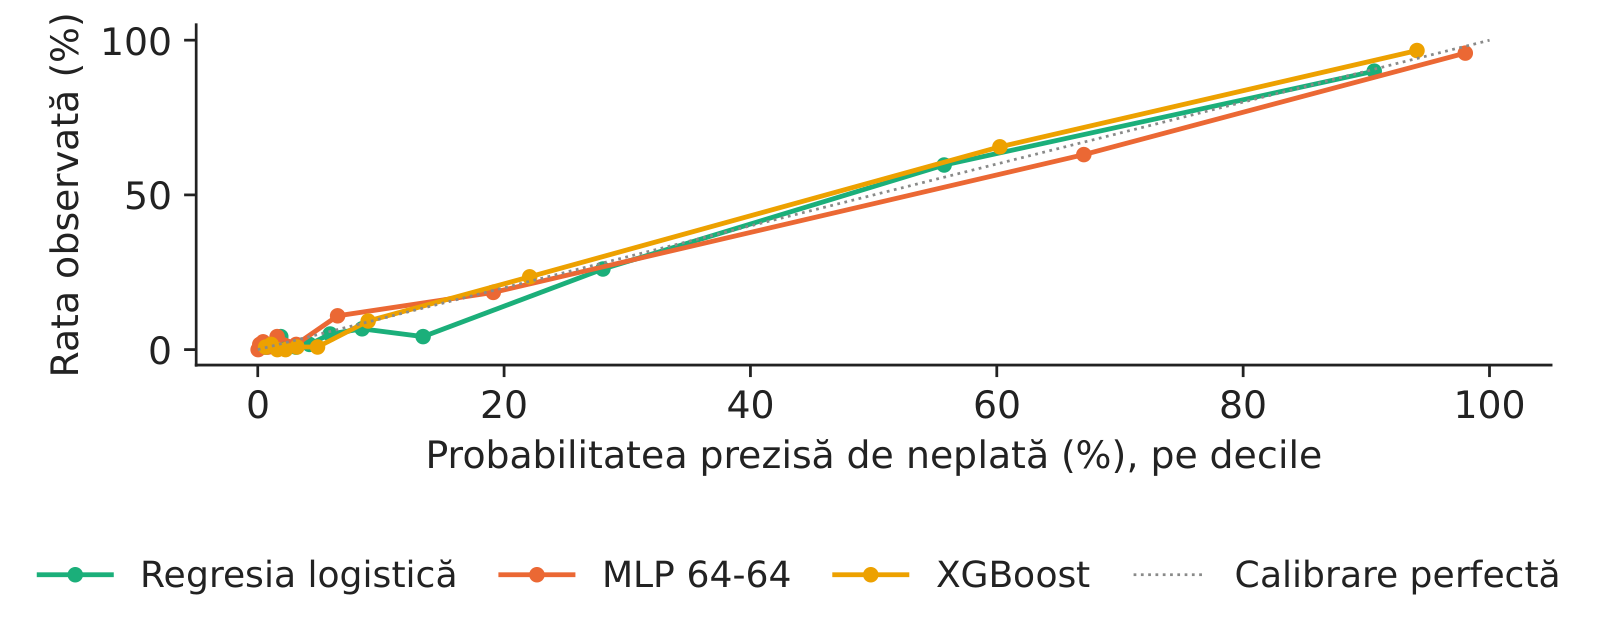
Provizioanele și prețurile creditelor folosesc PD ca atare, deci probabilitățile trebuie să fie corecte ca nivel, nu doar ca ordine. În fiecare decilă a PD prezise, rata observată de neplată este apropiată de cea prezisă; scorurile Brier sînt 0,0742 pentru regresia logistică, 0,0625 pentru MLP și 0,0549 pentru XGBoost, față de 0,1598 pentru o rată constantă.

Grafic: Scorurile sînt apropiate de probabilități calibrate

Diagrama de calibrare pe setul de test HMEQ: rata de neplată prezisă și observată, pe decile.

Sursa: Baesens, Roesch și Scheule (2016), datele HMEQ. Date: 1 192 de credite de testare.

Pe 1 000 de solicitanți germani, MLP nu depășește regresia logistică

Slide-ul 38 în PDF

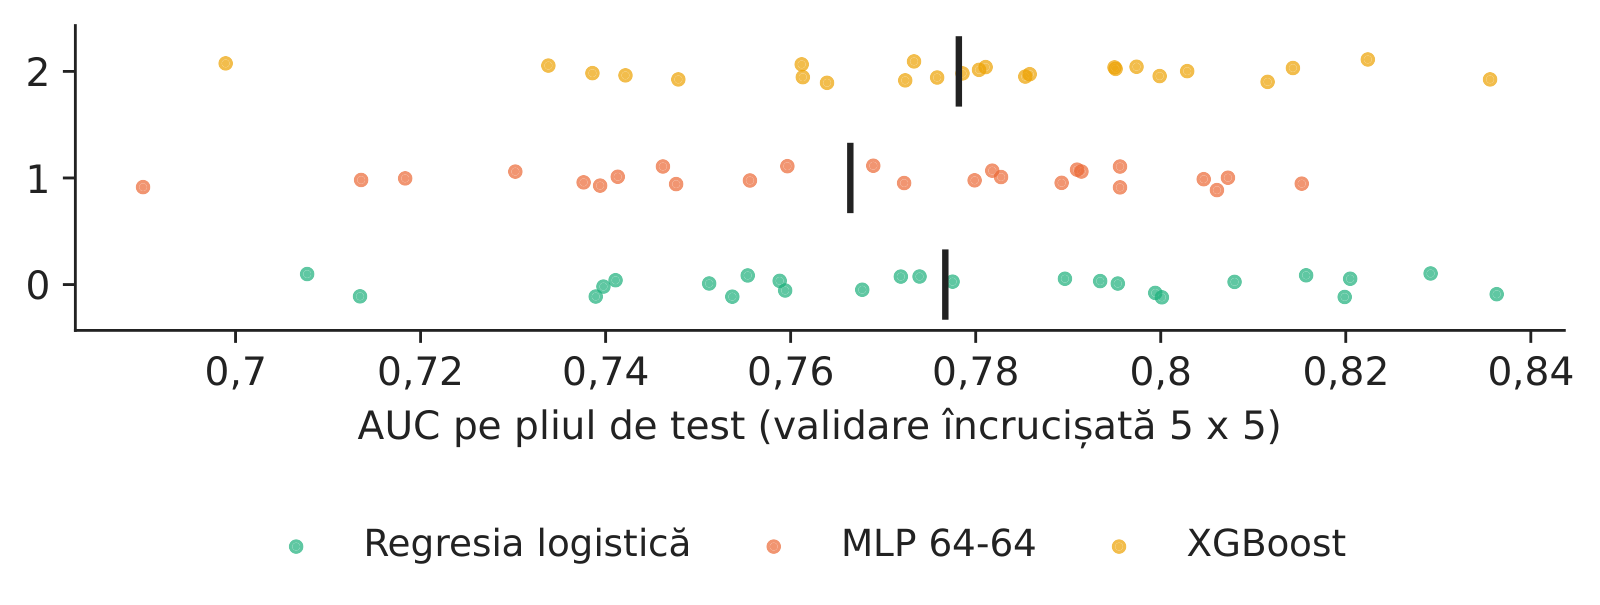
Pe German credit situația se schimbă: AUC medie 0,777 pentru regresia logistică, 0,766 pentru MLP și 0,778 pentru XGBoost, pe 25 de pliuri de test. Cu atît de puțini solicitanți, rețeaua nu are ce să adauge.

Grafic: Pe 1 000 de solicitanți germani, MLP nu depășește regresia logistică

AUC pe fiecare pliu de test în validarea încrucișată 5 x 5 pe German credit; barele sînt mediile.

Sursa: UCI Machine Learning Repository, Statlog German credit. Date: 1 000 de solicitanți, 25 de pliuri de test.

De ce testul t obișnuit exagerează diferențele în validarea încrucișată

Slide-ul 39 în PDF

Scorurile pliurilor sînt corelate pentru că seturile de antrenare se suprapun, deci testul t naiv este prea optimist. Corecția Nadeau-Bengio mărește varianța cu \(1/J+n_{\text{test}}/n_{\text{train}}\); MLP față de regresia logistică dă \(t=\) −0,93 și \(p=\) 0,362, deci nu există dovezi ale unei diferențe.

Pragul de 1/6, sensibil la costuri, cînd o neplată ratată costă de cinci ori cît un client bun respins

Slide-ul 40 în PDF

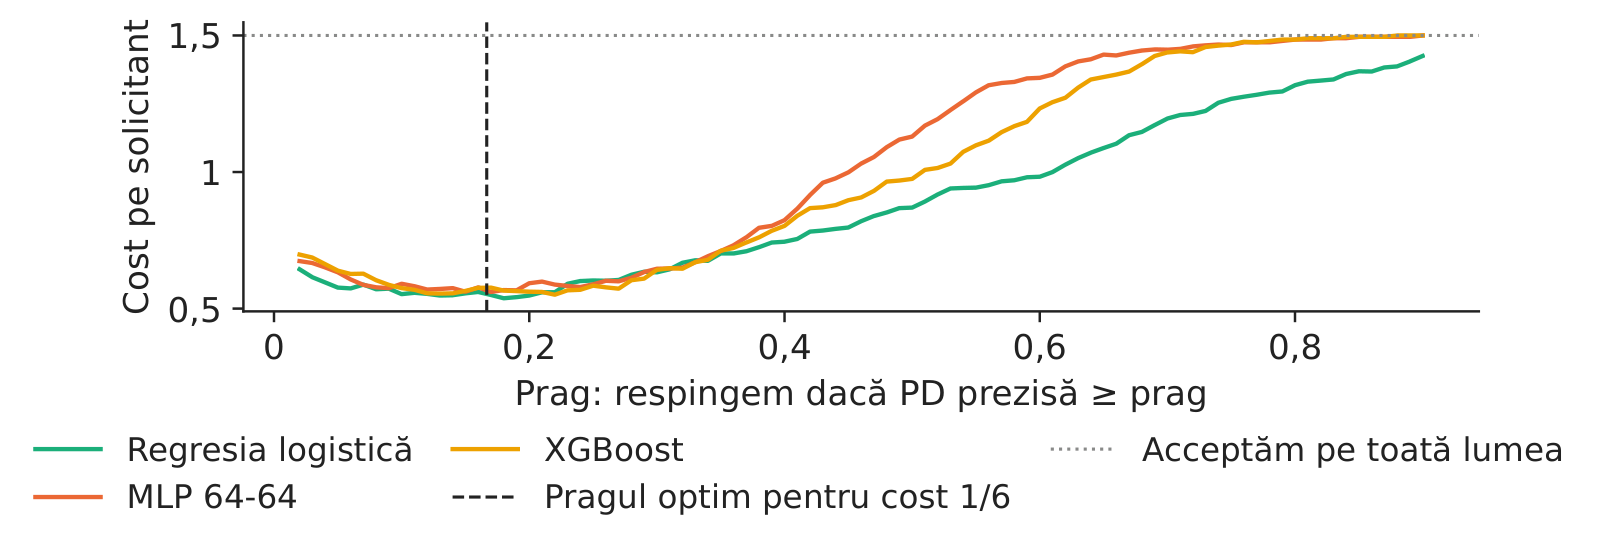
Matricea de cost UCI ponderează un risc prost acceptat de 5 ori mai mult decît un client bun respins. Respingerea cînd \(5p\ge1-p\) dă pragul \(1/6\). Cu predicții în afara pliului, modelul logistic costă 0,554 pe solicitant la 1/6 și 0,870 la 1/2; MLP 0,568 și 1,130; acceptarea tuturor costă 1,50.

Grafic: Pragul de 1/6, sensibil la costuri, cînd o neplată ratată costă de cinci ori cît un client bun respins

Costul pe solicitant German credit în funcție de prag, cu predicții în afara pliului; linia punctată: pragul 1/6.

Sursa: UCI Machine Learning Repository, Statlog German credit. Date: 1 000 de solicitanți, predicții în afara pliului.

În practică: pragul este locul unde se pierd sau se cîștigă cei mai mulți bani.

Implementarea minimală a unui MLP în PyTorch

Slide-ul 41 în PDF

Cincisprezece rînduri sînt suficiente: un `nn.Sequential` de straturi liniare și ReLU, `BCEWithLogitsLoss` (sigmoida și entropia încrucișată într-o singură funcție stabilă), optimizatorul Adam și o buclă cu `zero_grad`, `backward` și `step`. Notebook-ul acestui curs adaugă pregătirea datelor, oprirea pe baza validării și inițializările.

Explorați vizual

Instrumente interactive gratuite și ghiduri ilustrate pentru acest curs; cele mai multe rulează în browser.

  • TensorFlow Playground: alegeți setul de date în formă de cerc și păstrați doar intrările \(x_1, x_2\). Fără strat ascuns, frontiera rămîne o dreaptă, ca la regresia logistică; adăugați un strat ascuns cu patru neuroni și frontiera se închide în jurul cercului.
  • TensorFlow Playground: păstrați stratul ascuns și setați activarea la Linear: frontiera redevine dreaptă, pentru că o compunere de funcții liniare este liniară.
  • 3Blue1Brown, capitolul 1: ce calculează ponderile, termenii liberi și straturile unei rețele, pe cifre scrise de mînă.

Sinteza secțiunii

Pe 3 576 de credite HMEQ, MLP depășește scorul logistic (AUC 0,945 față de 0,920), iar boosting le depășește pe amîndouă; pe 1 000 de solicitanți germani, niciun model nu depășește semnificativ regresia logistică. În ambele cazuri, pragul stabilit din costuri contează mai mult decît modelul.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

AIinteligență artificială
AUCaria de sub curba caracteristică de operare a receptorului
CPUprocesor central
DMmarca germană
ESpierderea așteptată în coada distribuției (expected shortfall)
GELUunitate liniară cu eroare gaussiană
GNNrețea neuronală pe grafuri
GPUprocesor grafic
GraphSAGEeșantionare și agregare pe graf (o arhitectură GNN)
HMEQsetul de date despre creditele garantate cu locuința (home equity)
ICBEInternational Conference on Business Excellence (conferința internațională de excelență în afaceri)
IEEE-CISInstitute of Electrical and Electronics Engineers, Computational Intelligence Society
LLMmodel lingvistic mare
MLPperceptron multistrat
MSEeroarea pătratică medie
PDprobabilitatea de neplată
ReLUunitate liniară rectificată
ROCcaracteristica de operare a receptorului
SGDcoborîrea stohastică pe gradient
SHAPexplicații aditive Shapley
UCIUniversitatea California din Irvine (Machine Learning Repository)
USDdolar american
VaRvaloarea la risc
VLMmodel vizual-lingvistic
XAIinteligență artificială explicabilă
XGBoostextreme gradient boosting (arbori de decizie cu amplificare pe gradient)
XORsau exclusiv

Bibliografie

  • Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts. Springer. doi:10.1007/978-3-031-45468-4
  • Baesens, B., Rösch, D. & Scheule, H. (2016). Credit Risk Analytics. Wiley. doi:10.1002/9781119449560
  • Będowska-Sójka, B., Wójcik, P. & Pele, D. T. (2026). Early warning systems for cryptocurrency markets: Predicting `zombie' assets using machine learning. The North American Journal of Economics and Finance, 81, 102543. doi:10.1016/j.najef.2025.102543
  • Chen, T. & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. Proceedings of KDD 2016, 785–794. doi:10.1145/2939672.2939785
  • Cybenko, G. (1989). Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals and Systems, 2(4), 303–314. doi:10.1007/BF02551274
  • Diaconu, D. & Pele, D. T. (2026). Explainable AI in financial fraud detection: Evidence from the IEEE-CIS fraud dataset. Proceedings of the International Conference on Business Excellence, 20(1), 118–132. doi:10.2478/picbe-2026-0015
  • Grinsztajn, L., Oyallon, E. & Varoquaux, G. (2022). Why do tree-based models still outperform deep learning on typical tabular data? Advances in Neural Information Processing Systems, 35. arXiv:2207.08815
  • Hofmann, H. (1994). Statlog (German Credit Data). UCI Machine Learning Repository. doi:10.24432/C5NC77
  • Hornik, K. (1991). Approximation capabilities of multilayer feedforward networks. Neural Networks, 4(2), 251–257. doi:10.1016/0893-6080(91)90009-T
  • Jheng, S.-L., Pele, D. T., Tak, R. & Găman, Ș. (2026). A multimodal vision-language framework for financial anomaly detection. Proceedings of the International Conference on Business Excellence, 20(1), 191–201. doi:10.2478/picbe-2026-0020
  • Jheng, S.-L., Tak, R., Găman, Ș., Mazurencu-Marinescu-Pele, M. & Pele, D. T. (2026). Can foundation models manage risk? Zero-shot VaR and ES forecasting with conformal calibration in CEE markets. Economic Computation and Economic Cybernetics Studies and Research, 60(2), 267–290. doi:10.24818/18423264/60.2.26.14
  • LeCun, Y., Bengio, Y. & Hinton, G. (2015). Deep learning. Nature, 521, 436–444. doi:10.1038/nature14539
  • Lessmann, S., Baesens, B., Seow, H.-V. & Thomas, L. C. (2015). Benchmarking state-of-the-art classification algorithms for credit scoring: An update of research. European Journal of Operational Research, 247(1), 124–136. doi:10.1016/j.ejor.2015.05.030
  • McCulloch, W. S. & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115–133. doi:10.1007/BF02478259
  • Minsky, M. & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
  • Nadeau, C. & Bengio, Y. (2003). Inference for the generalization error. Machine Learning, 52(3), 239–281. doi:10.1023/A:1024068626366
  • Novikoff, A. B. J. (1962). On convergence proofs on perceptrons. Proceedings of the Symposium on the Mathematical Theory of Automata, 12, 615–622. Polytechnic Institute of Brooklyn.
  • Pace, R. K. & Barry, R. (1997). Sparse spatial autoregressions. Statistics & Probability Letters, 33(3), 291–297. doi:10.1016/S0167-7152(96)00140-X
  • Montúfar, G., Pascanu, R., Cho, K. & Bengio, Y. (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems, 27. arXiv:1402.1869
  • Paszke, A. et al. (2019). PyTorch: An imperative style, high-performance deep learning library. Advances in Neural Information Processing Systems, 32. arXiv:1912.01703
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the Word: LLM-VaR and LLM-ES. Expert Systems with Applications, 295, 128676. doi:10.1016/j.eswa.2025.128676
  • Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386–408. doi:10.1037/h0042519
  • Rumelhart, D. E., Hinton, G. E. & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. doi:10.1038/323533a0

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.