Rețele neuronale și deep learning

Cursul 2: Antrenarea rețelelor: propagarea înapoi a erorii și optimizarea

Cursul 2

Antrenarea rețelelor: propagarea înapoi a erorii și optimizarea

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

O rețea neuronală este atît de bună cît este antrenarea ei. Acest curs deschide „cutia neagră” a instrucțiunilor `loss.backward()` și `optimizer.step()`: cum se calculează exact, prin propagarea înapoi a erorii, gradientul unei pierderi cu mii sau milioane de ponderi și cum coborîrea pe gradient (GD) și variantele ei stohastice, cu moment sau adaptive transformă acest gradient în ponderi bune. Fiecare afirmație este măsurată pe date reale: 20 640 de grupuri de locuințe din recensămîntul Californiei pentru regresie, 28 924 de plăți cu cardul pentru detectarea fraudei și indicele S&P 500 zilnic pentru valoarea la risc (VaR) pe o zi.

Ce veți ști să faceți

  • Scrieți coborîrea pe gradient ca metodă de rezolvare a minimizării riscului empiric și explicați de ce condiționarea îi stabilește viteza.
  • Derivați propagarea înapoi pentru un perceptron multistrat (MLP), calculați-o de mînă și verificați-o cu diferențierea automată.
  • Explicați dispariția gradienților și alegeți o inițializare care păstrează semnalul.
  • Comparați coborîrea stohastică pe gradient (SGD), metoda momentului, propagarea cu medie pătratică (RMSProp), Adam și programele ratei de învățare, cu mai multe inițializări.
  • Antrenați și testați retroactiv o rețea cuantilică pentru VaR de 99 % al indicelui S&P 500.

Planul cursului

  1. De la pierdere la gradientAntrenarea este minimizarea unei pierderi medii după milioane de parametri; coborîrea pe gradient o rezolvă pas cu pas, iar forma suprafeței pierderii decide cît de repede.
  2. Propagarea înapoi a eroriiPropagarea înapoi este regula de derivare a funcțiilor compuse, aplicată de la pierdere înapoi; dă toate derivatele parțiale pentru costul a încă o propagare înainte.
  3. Optimizarea stohasticăMini-loturile, rata de învățare, momentul, pașii adaptivi și programele ratei decid cît de repede și cît de sigur învață rețeaua; le măsurăm pe fiecare pe datele California și pe fraudele cu carduri, cu mai multe inițializări.
  4. Studiu de caz: valoarea la risc cu o rețea cuantilicăAceeași rețea, antrenată cu altă pierdere, devine un model de risc: cu pierderea pinball, un MLP prognozează cuantila de 1 % a randamentului S&P 500 din ziua următoare, iar noi îl testăm retroactiv începînd din 2020.

De la pierdere la gradient

Antrenarea este minimizarea unei pierderi medii după milioane de parametri; coborîrea pe gradient o rezolvă pas cu pas, iar forma suprafeței pierderii decide cît de repede.

Antrenarea unei rețele este o minimizare nonconvexă, în dimensiune mare

Slide-ul 5 în PDF

Nu există o formulă pentru ponderile unei rețele. Pornim de undeva și repetăm \(\boldsymbol\theta_{t+1}=\boldsymbol\theta_t-\eta\nabla\mathcal L(\boldsymbol\theta_t)\): în prima aproximare, \(\mathcal L(\boldsymbol\theta-\eta\mathbf g)=\mathcal L(\boldsymbol\theta)-\eta\|\mathbf g\|^2\), deci un pas mic contra gradientului scade pierderea. MLP 64-64 are 4 801 de parametri pentru 12 384 de grupuri de antrenare.
Datele acestui curs: locuințe, plăți cu cardul și indicele S&P 500

Slide-ul 6 în PDF

Datele California sînt împărțite aleator 60/20/20 în 12 384, 4 128 și 4 128 de grupuri. Datele despre fraude cu carduri ale Université libre de Bruxelles (ULB) și Worldline, publicate pe platforma Open Machine Learning (OpenML), păstrează toate cele 492 de fraude și un eșantion de 10 % din plățile legitime; intrările sînt scoruri de analiză a componentelor principale (PCA), iar ponderile refac rata reală a fraudei, de 0,173 %. Frauda și S&P 500 sînt împărțite cronologic.

Intrările nescalate transformă pierderea într-o vale îngustă

Slide-ul 7 în PDF

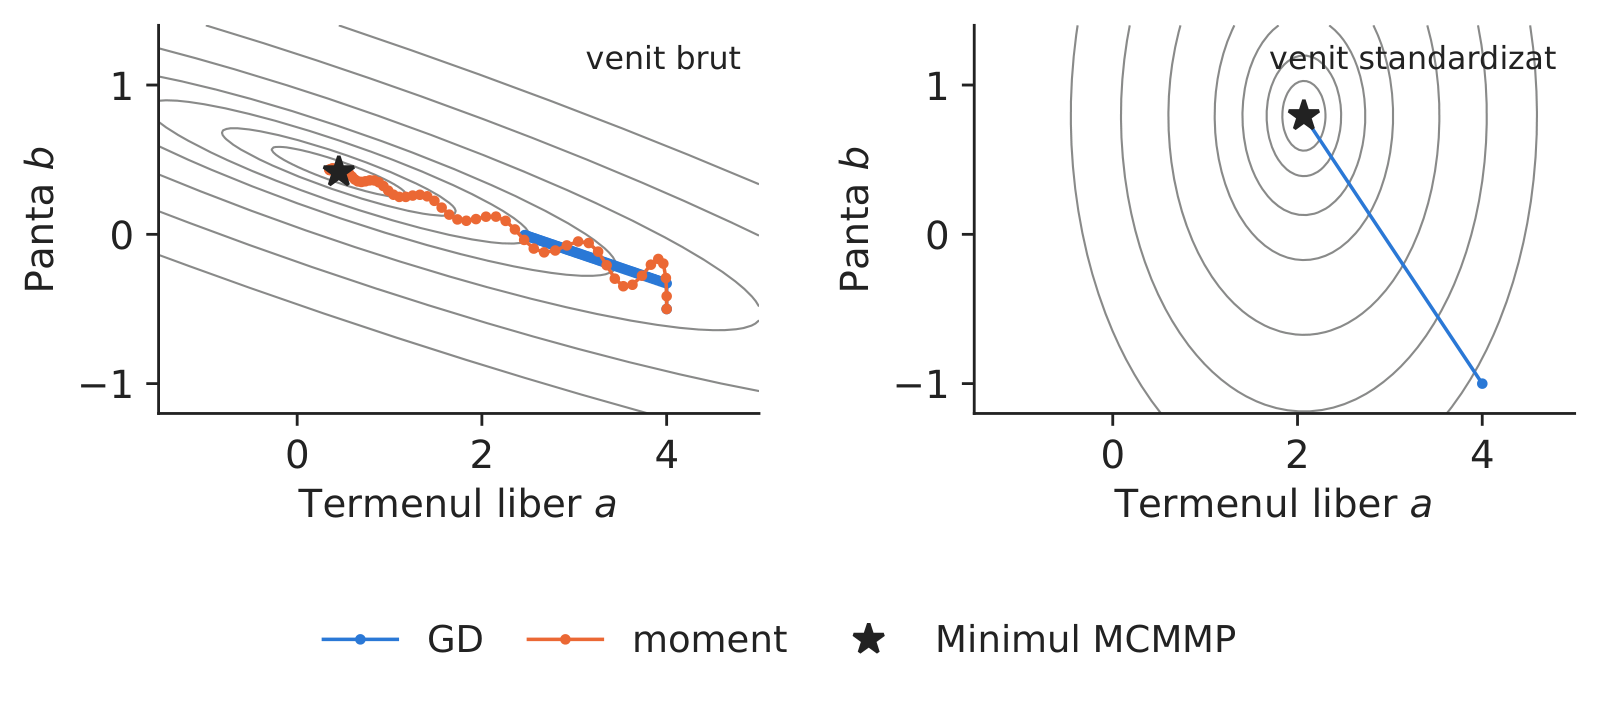
Eroarea pătratică medie (MSE) a regresiei cu o variabilă \(\hat y=a+b\cdot\text{venit}\) este o suprafață pătratică reală. Pe venitul brut, hessiana are numărul de condiționare 104,3: conturul este format din elipse alungite, iar după 60 de pași GD simplu are încă MSE 1,486, iar metoda momentului 0,704. Pe venitul standardizat, numărul de condiționare este 1, iar GD ajunge aproape imediat la minim, 0,701.

Grafic: Intrările nescalate transformă pierderea într-o vale îngustă

Coborîrea pe gradient și metoda momentului pe suprafața reală a pierderii, cu venitul brut și standardizat.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 20 640 de grupuri de locuințe recensămîntul din 1990.

În practică: standardizați fiecare intrare pe setul de antrenare înainte de a antrena orice rețea.

Pe o funcție pătratică, pasul trebuie să rămînă sub 2/lambda_max

Slide-ul 8 în PDF

Lîngă un minim, \(\mathcal L\approx\mathcal L^*+\tfrac12(\boldsymbol\theta-\boldsymbol\theta^*)^\top\mathbf H(\boldsymbol\theta-\boldsymbol\theta^*)\), iar fiecare direcție proprie a hessianei se contractă cu \(1-\eta\lambda_k\) la fiecare pas. Convergența cere \(0<\eta<2/\lambda_{\max}\), iar cu cel mai bun pas fix eroarea scade cu factorul \((\kappa-1)/(\kappa+1)\), lent cînd numărul de condiționare \(\kappa\) este mare.

Sinteza secțiunii

Coborîrea pe gradient se deplasează contra gradientului; rata de învățare trebuie să respecte curbura cea mai mare, iar intrările nescalate fac direcțiile plate foarte lente.

Propagarea înapoi a erorii

Propagarea înapoi este regula de derivare a funcțiilor compuse, aplicată de la pierdere înapoi; dă toate derivatele parțiale pentru costul a încă o propagare înainte. O calculăm de mînă, o verificăm numeric și vedem de ce rețelele adînci cu sigmoide nu mai învață.

Propagarea înapoi este regula de derivare a funcțiilor compuse, aplicată de la pierdere înapoi

Slide-ul 10 în PDF

Cu \(\mathbf z^{(l)}=\mathbf W^{(l)}\mathbf h^{(l-1)}+\mathbf b^{(l)}\) și \(\mathbf h^{(l)}=a(\mathbf z^{(l)})\), semnalul de eroare circulă înapoi astfel:

\[\boldsymbol\delta^{(l)}=\big(\mathbf W^{(l+1)\top}\boldsymbol\delta^{(l+1)}\big)\odot a'(\mathbf z^{(l)}),\qquad \frac{\partial\ell}{\partial\mathbf W^{(l)}}=\boldsymbol\delta^{(l)}\mathbf h^{(l-1)\top}\]
(2.1)

Fiecare gradient de pondere din (2.1) este eroarea stratului înmulțită cu intrarea lui, aceeași formă ca gradientul logistic din cursul 1. Propagarea înainte trebuie să păstreze toate \(\mathbf z^{(l)}\) și \(\mathbf h^{(l)}\), de aceea memoria limitează mărimea lotului pe un procesor grafic (GPU).

Propagarea înapoi, de mînă, pentru un grup real de locuințe

Slide-ul 11 în PDF

Pentru un grup real de locuințe din setul de test, cu venitul standardizat −0,21 și latitudinea −0,67, o rețea cu două unități liniare rectificate (ReLU) calculează \(z_1=\) 0,433 și \(z_2=\) −0,093, produce \(\hat y=\) −0,377 față de \(y=\) 2,067 și are eroarea de ieșire \(\delta^{(2)}=\) −2,444. Neuronul 2 este oprit (\(z_2<0\)), deci nu transmite gradient, iar ponderile lui nu se modifică; diferențierea automată din PyTorch dă aceleași cifre.

Modul invers costă cam încă o propagare înainte, oricîte ponderi ar fi

Slide-ul 12 în PDF

O singură trecere înapoi dă toate cele \(P\) derivate parțiale ale unei pierderi scalare; diferențele finite ar cere \(P\) treceri suplimentare. Verificarea gradientului pe MLP 64-64, cu diferențe centrale în dublă precizie pe 30 de ponderi alese aleator, găsește o eroare relativă maximă de \(7,0\times10^{-7}\).

Dispariția gradientului în rețelele adînci cu activare sigmoidă

Slide-ul 13 în PDF

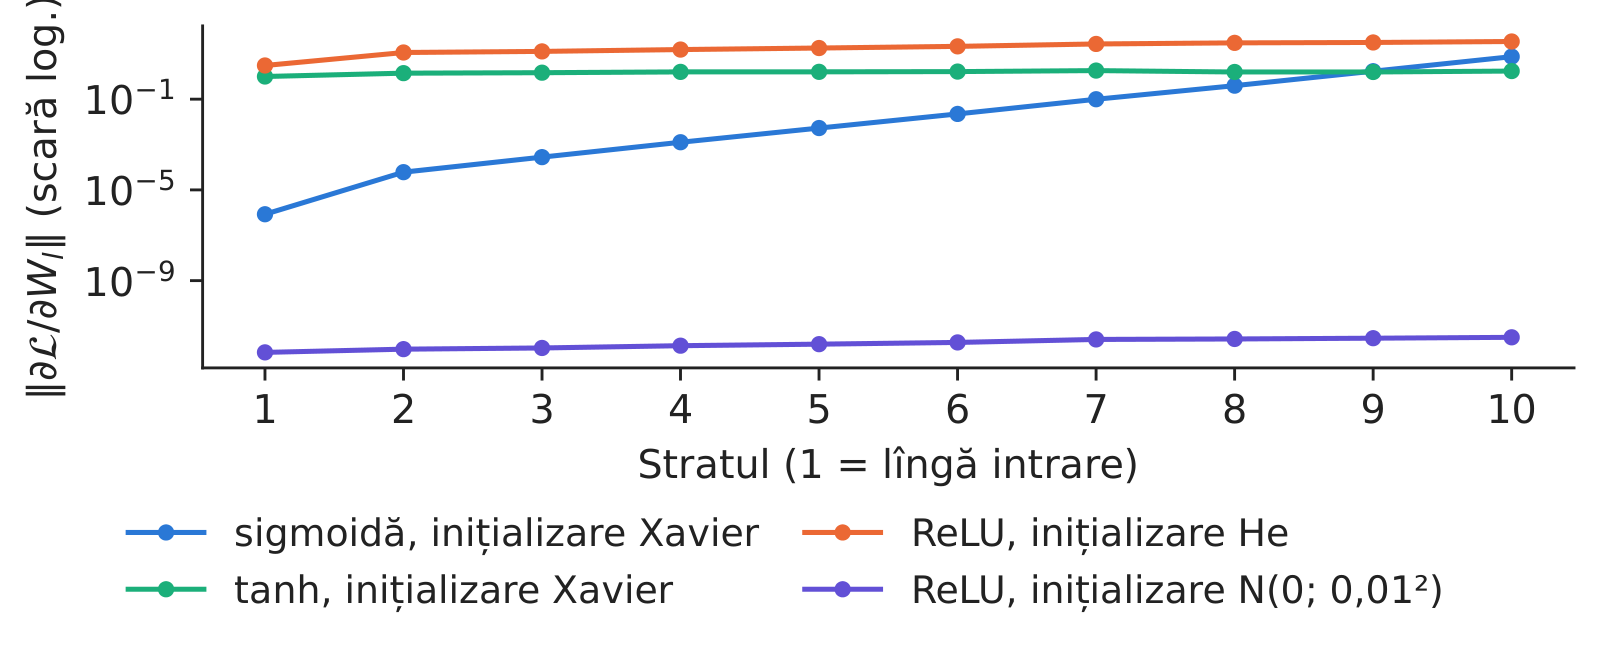
Semnalul înapoi este un produs de jacobiene \(\mathbf W^\top\operatorname{diag}(a')\). Într-o rețea cu 10 straturi, pe un lot real, norma gradientului în primul strat este \(8,5\times10^{-7}\) cu sigmoide, față de \(7,5\times10^{0}\) în ultimul strat; cu ReLU și inițializare He, primul strat primește încă \(3,1\times10^{0}\).

Grafic: Dispariția gradientului în rețelele adînci cu activare sigmoidă

Norma gradientului pe straturi la inițializare, 10 straturi ascunse, media a 5 inițializări.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 10 straturi ascunse de 64 de neuroni, un lot de 512 grupuri de antrenare, 5 inițializări.

Inițializarea păstrează constantă varianța semnalului între straturi

Slide-ul 14 în PDF

Pentru ca \(\operatorname{Var}(z^{(l)})=n_{l-1}\operatorname{Var}(W)\,\mathbb E[(h^{(l-1)})^2]\) să rămînă constantă, inițializarea Xavier alege \(\operatorname{Var}(W)=2/(n_{l-1}+n_l)\) pentru tanh și sigmoidă, iar inițializarea He \(\operatorname{Var}(W)=2/n_{l-1}\) pentru ReLU. Ponderile extrase din \(N(0;\,0{,}01^2)\) dau în primul strat un gradient de doar \(6,9\times10^{-13}\): rețeaua nu învață.

Sinteza secțiunii

Propagarea înapoi dă ieftin gradienți exacți; dacă aceștia ajung la primele straturi depinde de activare și de scara ponderilor inițiale.

Optimizarea stohastică

Mini-loturile, rata de învățare, momentul, pașii adaptivi și programele ratei decid cît de repede și cît de sigur învață rețeaua; le măsurăm pe fiecare pe datele California și pe fraudele cu carduri, cu mai multe inițializări.

Un mini-lot dă un gradient nedeplasat și zgomotos, la o fracțiune din cost

Slide-ul 16 în PDF

Gradientul pe mini-lot \(\mathbf g_t=\frac1B\sum_{i\in\mathcal B_t}\nabla\ell_i\) este nedeplasat pentru gradientul complet, iar varianța lui scade aproximativ ca \(1/B\). Cu pași care satisfac \(\sum\eta_t=\infty\) și \(\sum\eta_t^2<\infty\), coborîrea stohastică pe gradient converge către un punct staționar (Robbins și Monro, 1951).

Efectul ratei de învățare asupra antrenării

Slide-ul 17 în PDF

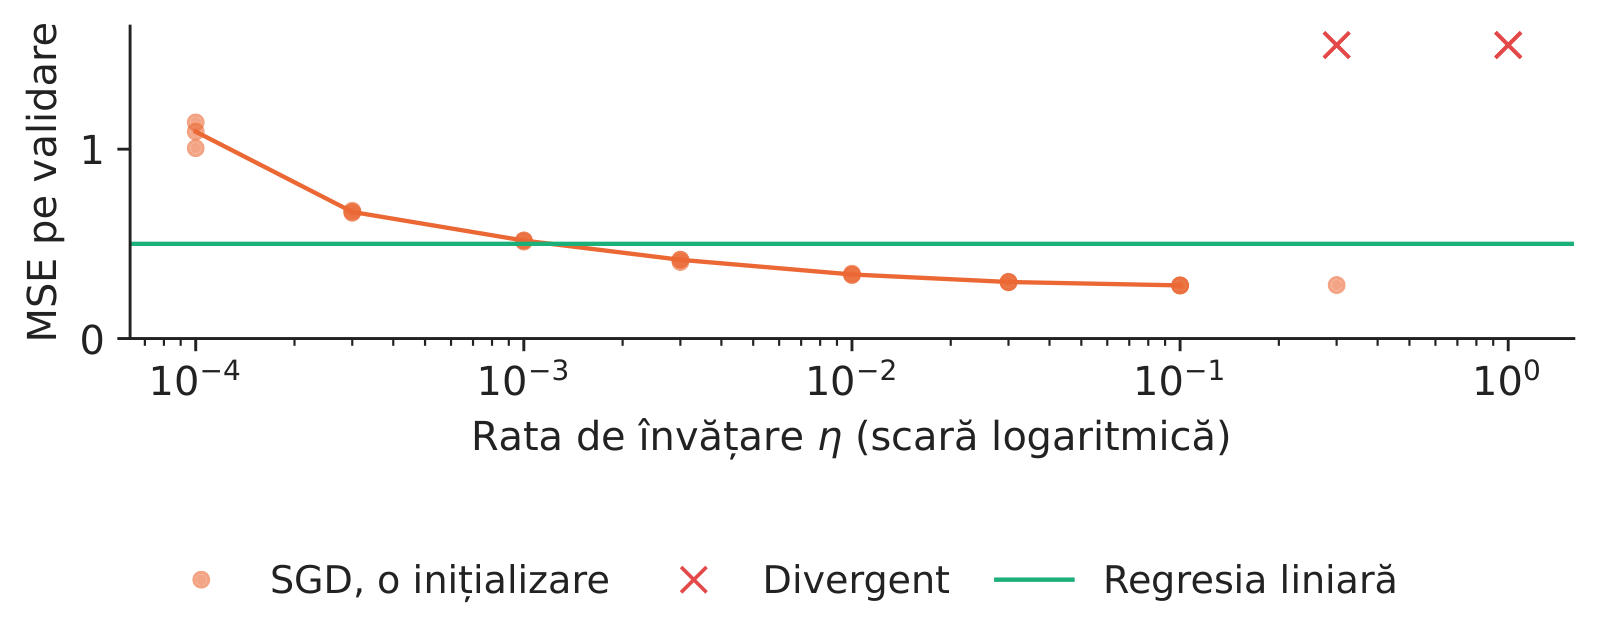
Cu SGD simplu, 30 de epoci și loturi de 128, MSE pe validare este 1,093 la \(\eta=10^{-4}\), mai slab decît regresia liniară (0,500), și 0,281 la \(\eta=\) 0,1; de la \(\eta=\) 0,3, cel puțin o inițializare diverge.

Grafic: Efectul ratei de învățare asupra antrenării

MSE pe validare după 30 de epoci de SGD, pentru nouă rate de învățare și trei inițializări.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 12 384 de grupuri de antrenare și 4 128 de validare; 30 de epoci.

În practică: ajustați mai întîi rata de învățare, pe o grilă logaritmică.

Efectul dimensiunii lotului: progresul pe epocă și pe secundă

Slide-ul 18 în PDF

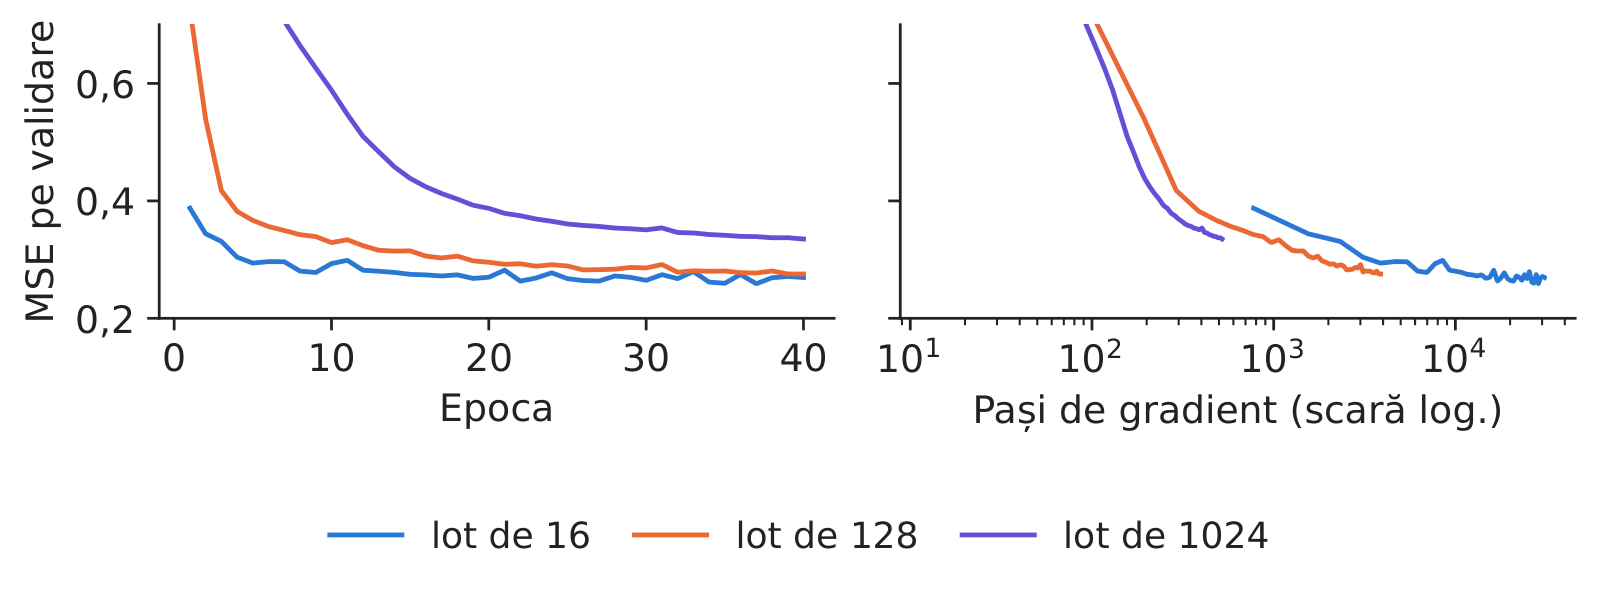
După 5 epoci cu Adam, MSE pe validare este 0,294 cu loturi de 16, 0,367 cu 128 și 0,870 cu 1 024: loturile mici fac 774 de pași pe epocă, cele mari 13. Pe secundă situația se inversează: 40 de epoci durează 25,8, 3,7 și 1,0 secunde.

Grafic: Efectul dimensiunii lotului: progresul pe epocă și pe secundă

MSE pe validare pe epoci (stînga) și pe pași de gradient (dreapta), pentru trei mărimi ale lotului.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: Adam, rata de învățare 0,001, 40 de epoci.

Metoda momentului: media mobilă a gradienților trecuți

Slide-ul 19 în PDF

Metoda momentului păstrează o viteză \(\mathbf v_{t+1}=\beta\mathbf v_t+\mathbf g_t\) și face pași în direcția ei. Componentele în zigzag se anulează, direcția constantă se acumulează, iar pe o funcție pătratică momentul optim îmbunătățește contracția de la \((\kappa-1)/(\kappa+1)\) la \((\sqrt\kappa-1)/(\sqrt\kappa+1)\) (Polyak, 1964).

Metodele adaptive dau fiecărei ponderi propriul pas

Slide-ul 20 în PDF

AdaGrad împarte pasul fiecărei ponderi la rădăcina sumei pătratelor gradienților ei, care doar crește; propagarea cu medie pătratică (RMSProp) înlocuiește suma cu o medie exponențială, \(s_t=\rho s_{t-1}+(1-\rho)g_t^2\), astfel încît pasul se adaptează regiunii curente.

Adam: moment, RMSProp și corecția deplasării

Slide-ul 21 în PDF

Adam păstrează medii exponențiale ale gradientului și ale pătratului său, le corectează pentru pornirea de la zero și face un pas egal cu raportul lor:

\[\hat m_t=\frac{m_t}{1-\beta_1^t},\quad \hat v_t=\frac{v_t}{1-\beta_2^t},\quad \theta_{t+1}=\theta_t-\eta\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon}\]
(2.2)

Cu valorile implicite \(\beta_1=0{,}9\), \(\beta_2=0{,}999\), pasul (2.2) este aproximativ limitat la \(\eta\) pentru fiecare pondere. Adam cu penalizarea ponderilor decuplată (AdamW) micșorează direct ponderile, în loc să adauge penalizarea la gradient (Loshchilov și Hutter, 2019).

Pe datele California, optimizatorii ajustați ating erori apropiate, iar metodele adaptive converg mai sigur

Slide-ul 22 în PDF

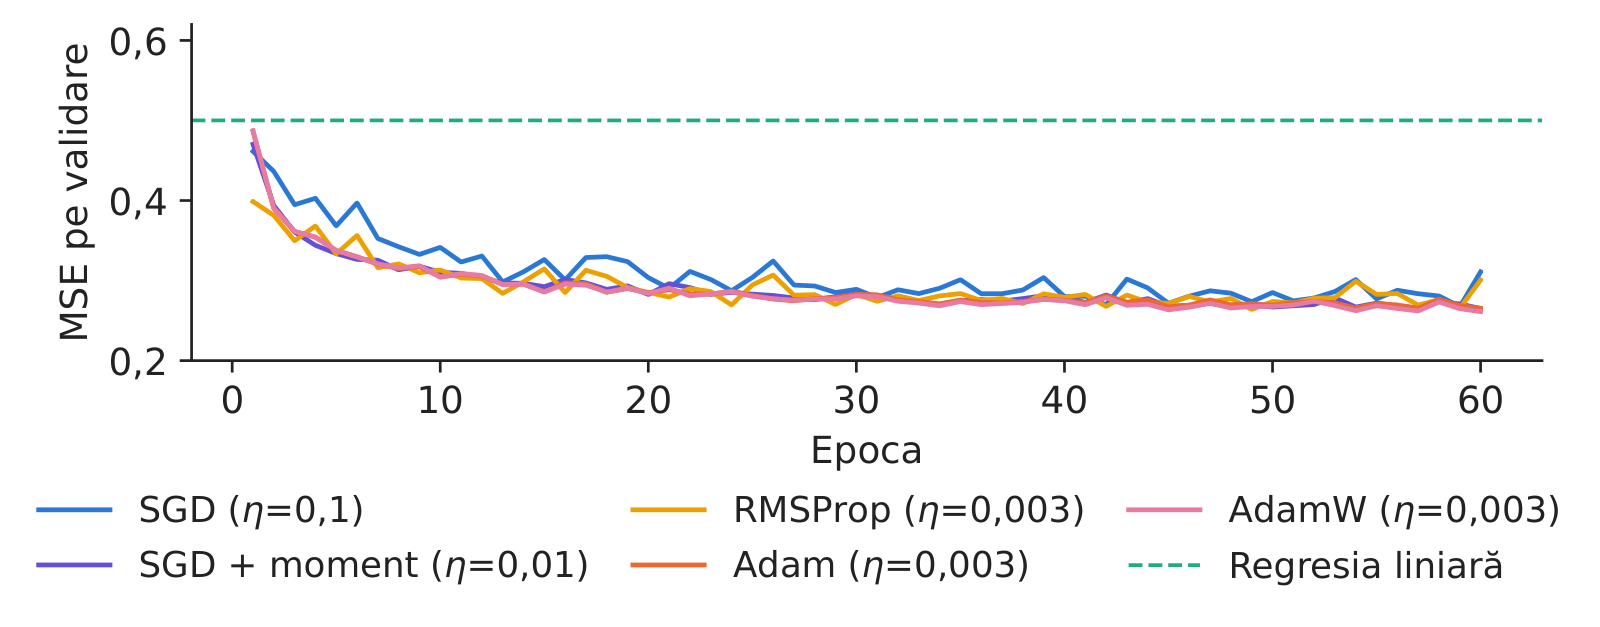
Fiecare optimizator primește cea mai bună dintre trei rate de învățare pe validare, apoi 5 inițializări noi. După 10 epoci, MSE pe validare este 0,342 pentru SGD, 0,310 cu moment, 0,313 pentru RMSProp, 0,305 pentru Adam și 0,304 pentru AdamW; regresia liniară rămîne la 0,500.

Grafic: Pe datele California, optimizatorii ajustați ating erori apropiate, iar metodele adaptive converg mai sigur

MSE pe validare pe epoci pentru cinci optimizatori, la ratele de învățare ajustate, media a 5 inițializări.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 12 384 de grupuri de antrenare și 4 128 de validare.

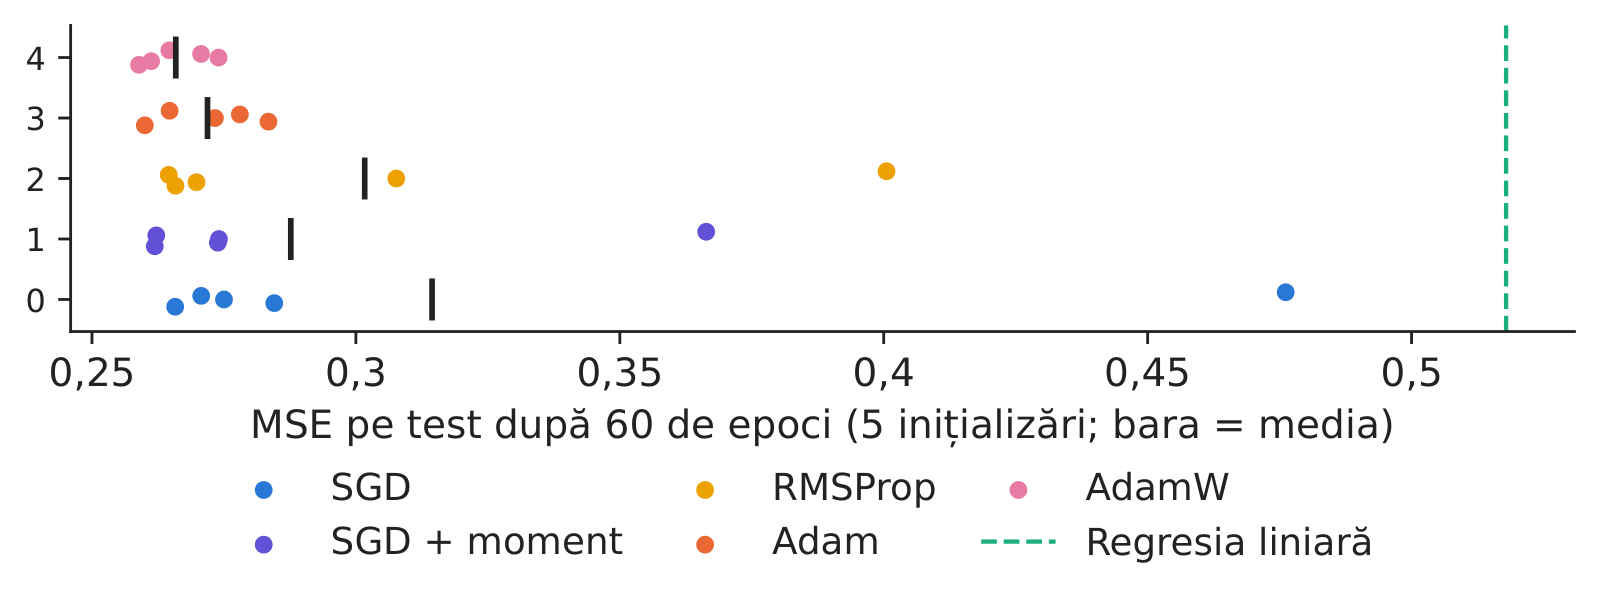
De la o inițializare la alta, Adam și AdamW sînt mult mai stabile decît SGD simplu

Slide-ul 23 în PDF

MSE pe test pe 5 inițializări este 0,314 (abaterea standard 0,091) pentru SGD, 0,272 (0,010) pentru Adam și 0,266 (0,006) pentru AdamW. Testul t pe perechi, SGD față de Adam, dă \(t=\) 1,01 și \(p=\) 0,371: cîștigul mediu nu este demonstrat cu 5 inițializări, dar cîștigul de stabilitate este evident.

Grafic: De la o inițializare la alta, Adam și AdamW sînt mult mai stabile decît SGD simplu

MSE pe test pentru cinci inițializări la fiecare optimizator; barele sînt mediile; linia punctată: regresia liniară.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: 4 128 de grupuri de testare.

Programele ratei de învățare: în trepte, cosinus și one-cycle

Slide-ul 24 în PDF

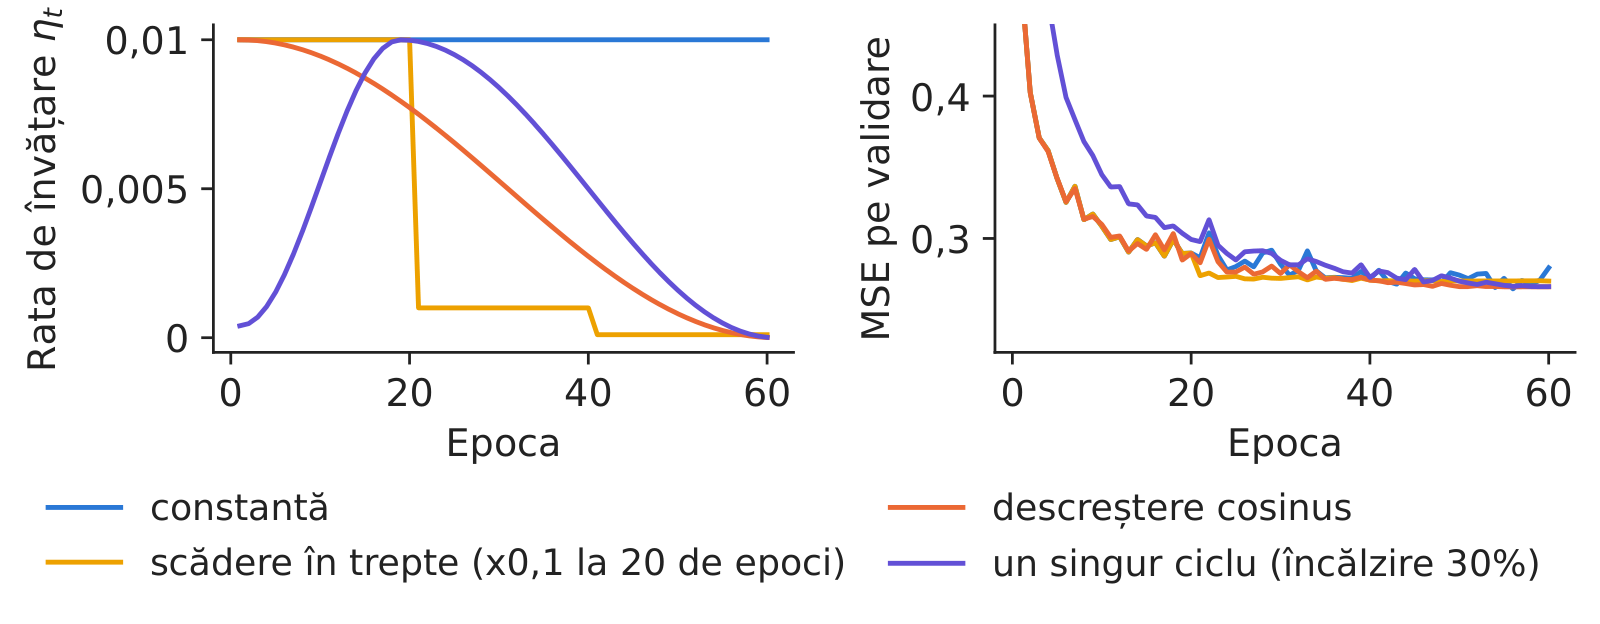
Scăderea în trepte înmulțește rata cu \(\gamma\) la fiecare \(s\) pași, descreșterea cosinus urmează \(\eta_t=\tfrac{\eta_0}{2}(1+\cos\pi t/T)\) (Loshchilov și Hutter, 2017), iar programul cu un singur ciclu crește liniar, apoi scade (Smith și Topin, 2019). Încălzirea protejează primii pași, cînd statisticile optimizatorului nu sînt încă fiabile.

Scăderea ratei de învățare reduce eroarea finală

Slide-ul 25 în PDF

Cu SGD și moment, la o rată maximă de 0,01, MSE final pe validare este 0,279 cu rată constantă, 0,270 cu scădere în trepte, 0,266 cu descreștere cosinus și 0,266 cu un singur ciclu; pe setul de test, 0,286 față de 0,265 pentru rata constantă și cosinus.

Grafic: Scăderea ratei de învățare reduce eroarea finală

Programele ratei de învățare (stînga) și MSE pe validare (dreapta), media a 3 inițializări.

Sursa: StatLib, locuințe din California, recensămîntul din 1990 (Pace și Barry, 1997). Date: SGD cu moment 0,9, rata maximă 0,01, 3 inițializări.

La fraudele cu carduri, optimizatorul determină viteza învățării

Slide-ul 26 în PDF

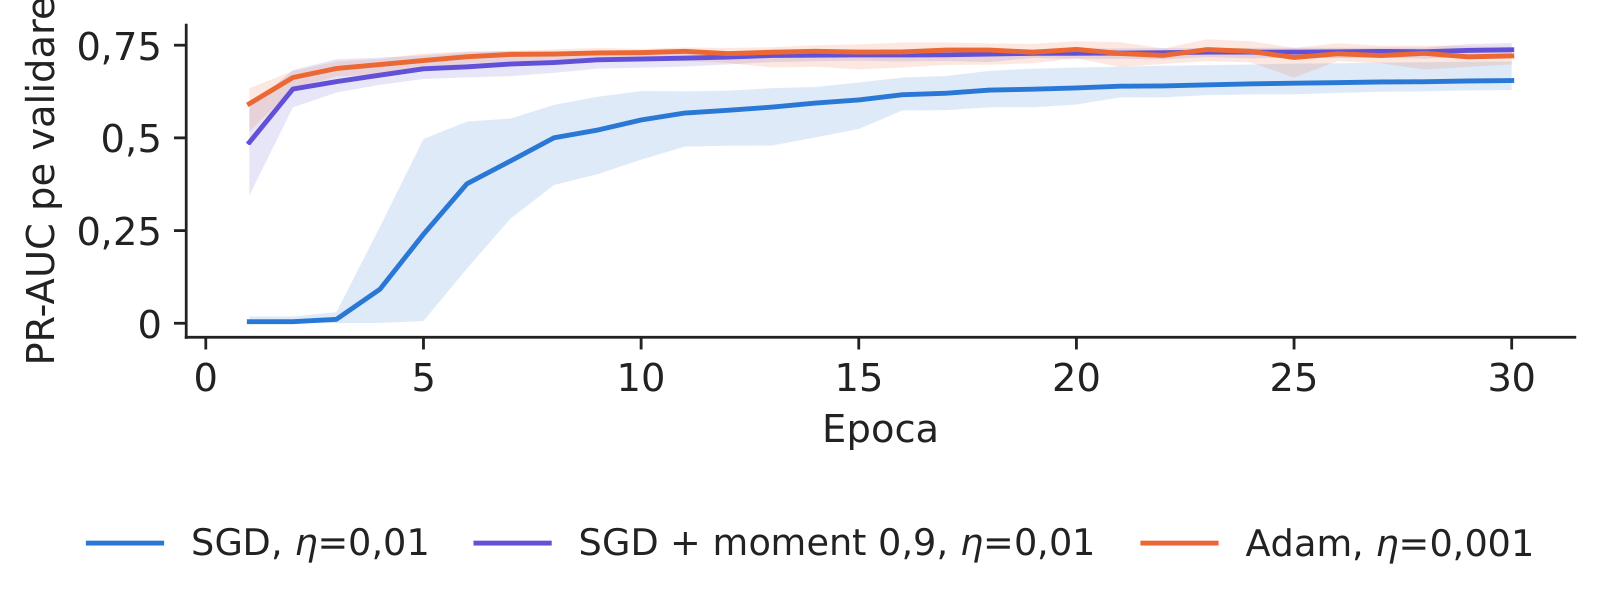
Cu doar 360 de fraude în primele 60 % din cele două zile, aria de sub curba precizie-sensibilitate (PR-AUC) pe orele de validare, după o epocă, este 0,004 pentru SGD simplu, 0,488 cu moment și 0,592 cu Adam; pe orele de test, cele trei ajung la 0,786, 0,823 și 0,803, față de 0,789 pentru regresia logistică.

Grafic: La fraudele cu carduri, optimizatorul determină viteza învățării

PR-AUC pe validare pe epoci la fraudele cu carduri, trei optimizatori, media și intervalul a 5 inițializări.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: septembrie 2013, 2 zile; antrenare = primele 33,4 ore, validare pînă la ora 40,3; 5 inițializări.

Sinteza secțiunii

Ajustați mai întîi rata de învățare; momentul și metodele adaptive converg mai repede și mai sigur; un program descrescător reduce eroarea finală; iar orice comparație cere mai multe inițializări.

Studiu de caz: valoarea la risc cu o rețea cuantilică

Aceeași rețea, antrenată cu altă pierdere, devine un model de risc: cu pierderea pinball, un MLP prognozează cuantila de 1 % a randamentului S&P 500 din ziua următoare, iar noi îl testăm retroactiv începînd din 2020.

Pierderea pinball transformă orice rețea într-un model de prognoză a cuantilelor

Slide-ul 29 în PDF

VaR este minus cuantila condiționată \(\tau\) a randamentului de a doua zi, iar pierderea pinball \(\rho_\tau(u)=u(\tau-\mathbb 1\{u<0\})\) are minimul în această cuantilă (Koenker și Bassett, 1978). MLP 32-32 folosește ultimul randament, valoarea lui absolută, media pe 5 zile și volatilitatea pe 5, 22 și 66 de zile; este antrenat de la 8 aprilie 2005 pînă în 2016, oprit pe baza perioadei 2017--2019 și mediat pe 5 inițializări. Reperele sînt simularea istorică pe 250 de zile și volatilitatea calculată cu o medie mobilă ponderată exponențial (EWMA), cu cuantila normală.

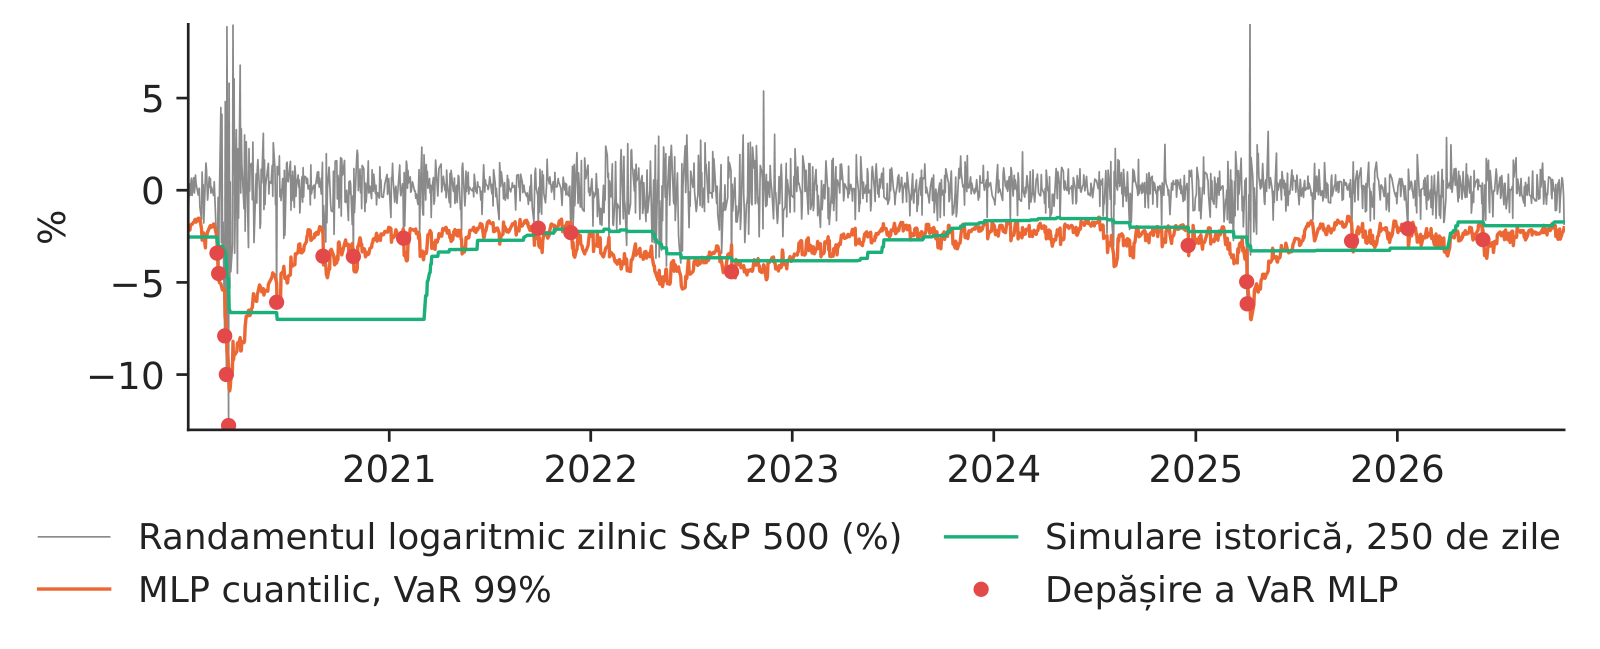
Depășirile VaR-ului MLP cuantilic în pandemia din 2020 și după aceasta sînt apropiate de rata nominală

Slide-ul 30 în PDF

Pe 1 716 de zile de test, de la 3 ianuarie 2020 la 30 octombrie 2026, un VaR corect de 99 % ar trebui depășit de circa 17,2 ori. MLP cuantilic este depășit de 18 ori, simularea istorică de 31 ori, iar EWMA de 41 ori; VaR-ul MLP crește în cîteva zile cînd volatilitatea sare, ca în martie 2020.

Grafic: Depășirile VaR-ului MLP cuantilic în pandemia din 2020 și după aceasta sînt apropiate de rata nominală

Randamentele logaritmice zilnice S&P 500 în perioada de test, cu VaR de 99 % al MLP cuantilic și al simulării istorice; roșu: depășirile VaR-ului MLP.

Sursa: Yahoo Finance, cotații zilnice. Date: 3 ianuarie 2020 - 30 octombrie 2026, zile de tranzacționare (perioada de test).

Testul Kupiec acceptă MLP și respinge ambele modele de referință

Slide-ul 31 în PDF

Pentru un VaR corect, depășirile sînt de tip Bernoulli cu probabilitatea \(\tau\); statistica raportului de verosimilitate a lui Kupiec dă \(p=\) 0,840 pentru MLP, 0,003 pentru simularea istorică și 0,000 pentru EWMA. Pierderile pinball, scorul potrivit pentru cuantile, sînt 0,0420, 0,0577 și 0,0473.

Echipamentul de calcul: procesorul grafic al unui laptop este de zece ori mai rapid decît procesorul central pe un MLP mare

Slide-ul 32 în PDF

Pe laptopul cursului, un pas Adam pentru un MLP 2048-2048 durează 333,6 ms pe procesorul central (CPU) și 32,5 ms pe GPU prin Metal Performance Shaders (MPS), de 10,3 ori mai repede. Rețelele tabelare mici din cursurile 1--3 sînt mai rapide pe un singur fir al procesorului: copierea loturilor mici costă mai mult decît economisește.

Explorați vizual

Instrumente interactive gratuite și ghiduri ilustrate pentru acest curs; cele mai multe rulează în browser.

  • TensorFlow Playground: apăsați butonul de pas pentru a vedea cîte o actualizare a gradientului, apoi comparați ratele de învățare 0,03, 3 și 0,0001: pierderea se stabilizează, oscilează sau abia se mișcă.
  • 3Blue1Brown, capitolele 2–4: coborîrea pe gradient, intuiția propagării înapoi și calculul ei, cu animații ale regulii de derivare a funcțiilor compuse.

Sinteza secțiunii

Pierderea definește produsul: cu pierderea pinball, MLP dă un VaR de 99 % care trece testul Kupiec, în timp ce ambele repere standard îl pică pe aceleași zile.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

AdamWAdam cu penalizarea ponderilor decuplată
CPUprocesor central
ESpierderea așteptată în coada distribuției (expected shortfall)
EWMAmedie mobilă ponderată exponențial
GDcoborîrea pe gradient
GPUprocesor grafic
LLMmodel lingvistic mare
MLPperceptron multistrat
MPSMetal Performance Shaders (interfața PyTorch pentru procesorul grafic Apple)
MSEeroarea pătratică medie
OpenMLplatforma Open Machine Learning
PCAanaliza componentelor principale
PR-AUCaria de sub curba precizie-sensibilitate
ReLUunitate liniară rectificată
RMSProppropagarea cu medie pătratică (root mean square propagation)
SGDcoborîrea stohastică pe gradient
ULBUniversité libre de Bruxelles
VaRvaloarea la risc

Bibliografie

  • Baydin, A. G., Pearlmutter, B. A., Radul, A. A. & Siskind, J. M. (2018). Automatic differentiation in machine learning: a survey. Journal of Machine Learning Research, 18(153), 1–43. arXiv:1502.05767
  • Bengio, Y., Simard, P. & Frasconi, P. (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks, 5(2), 157–166. doi:10.1109/72.279181
  • Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts. Springer. doi:10.1007/978-3-031-45468-4
  • Dal Pozzolo, A., Caelen, O., Johnson, R. A. & Bontempi, G. (2015). Calibrating probability with undersampling for unbalanced classification. IEEE Symposium Series on Computational Intelligence, 159–166. doi:10.1109/SSCI.2015.33
  • Duchi, J., Hazan, E. & Singer, Y. (2011). Adaptive subgradient methods for online learning and stochastic optimization. Journal of Machine Learning Research, 12, 2121–2159.
  • Glorot, X. & Bengio, Y. (2010). Understanding the difficulty of training deep feedforward neural networks. Proceedings of AISTATS, PMLR 9, 249–256.
  • He, K., Zhang, X., Ren, S. & Sun, J. (2015). Delving deep into rectifiers. IEEE International Conference on Computer Vision, 1026–1034. doi:10.1109/ICCV.2015.123
  • Jheng, S.-L., Tak, R., Găman, Ș., Mazurencu-Marinescu-Pele, M. & Pele, D. T. (2026). Can foundation models manage risk? Zero-shot VaR and ES forecasting with conformal calibration in CEE markets. Economic Computation and Economic Cybernetics Studies and Research, 60(2), 267–290. doi:10.24818/18423264/60.2.26.14
  • Keskar, N. S., Mudigere, D., Nocedal, J., Smelyanskiy, M. & Tang, P. T. P. (2017). On large-batch training for deep learning: Generalization gap and sharp minima. International Conference on Learning Representations. arXiv:1609.04836
  • Kingma, D. P. & Ba, J. (2015). Adam: A method for stochastic optimization. International Conference on Learning Representations. arXiv:1412.6980
  • Koenker, R. & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. doi:10.2307/1913643
  • Kupiec, P. H. (1995). Techniques for verifying the accuracy of risk measurement models. The Journal of Derivatives, 3(2), 73–84. doi:10.3905/jod.1995.407942
  • Loshchilov, I. & Hutter, F. (2017). SGDR: Stochastic gradient descent with warm restarts. International Conference on Learning Representations. arXiv:1608.03983
  • Loshchilov, I. & Hutter, F. (2019). Decoupled weight decay regularization. International Conference on Learning Representations. arXiv:1711.05101
  • Pace, R. K. & Barry, R. (1997). Sparse spatial autoregressions. Statistics & Probability Letters, 33(3), 291–297. doi:10.1016/S0167-7152(96)00140-X
  • Paszke, A. et al. (2019). PyTorch: An imperative style, high-performance deep learning library. Advances in Neural Information Processing Systems, 32. arXiv:1912.01703
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the Word: LLM-VaR and LLM-ES. Expert Systems with Applications, 295, 128676. doi:10.1016/j.eswa.2025.128676
  • Polyak, B. T. (1964). Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 4(5), 1–17. doi:10.1016/0041-5553(64)90137-5
  • Robbins, H. & Monro, S. (1951). A stochastic approximation method. The Annals of Mathematical Statistics, 22(3), 400–407. doi:10.1214/aoms/1177729586
  • Rumelhart, D. E., Hinton, G. E. & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. doi:10.1038/323533a0
  • Smith, L. N. & Topin, N. (2019). Super-convergence: Very fast training of neural networks using large learning rates. Proceedings of SPIE, 11006. arXiv:1708.07120
  • Tieleman, T. & Hinton, G. (2012). Lecture 6.5 — RMSProp: Divide the gradient by a running average of its recent magnitude. COURSERA: Neural Networks for Machine Learning.

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.