Rețele neuronale și deep learning

Cursul 7: Atenția și transformerele

Cursul 7

Atenția și transformerele

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

Fiecare mesă de tranzacționare, echipă de credit sau analist al băncilor centrale citește text: știri, postări, rapoarte, discursuri. Din 2017, aproape orice mașină care citește text la scară mare este construită din aceeași componentă, transformerul, a cărui operație de bază este atenția: fiecare cuvînt se uită la toate celelalte și decide cît să împrumute de la fiecare.

Cursul scrie atenția și blocul transformer cu toate simbolurile definite și le testează pe 9 543 de tweet-uri financiare etichetate: un transformer mic antrenat de la zero, un model BERT preantrenat pentru finanțe (FinBERT), folosit ca atare, înghețat și ajustat, și un model de referință bazat pe frecvența termenilor și inversul frecvenței în documente (TF-IDF). Rezultatul arată de unde vine puterea transformerelor: din preantrenare.

Ce veți ști să faceți

  • Explicați de ce atenția a înlocuit recurența pentru text: un singur pas între oricare două cuvinte, calculat în paralel.
  • Scrieți atenția cu produs scalar scalat, atenția cu mai multe capete, codificarea poziției și blocul transformer.
  • Comparați un transformer de la zero, FinBERT și un model de referință TF-IDF pe tweet-uri financiare reale, cu intervale bootstrap.
  • Citiți cu atenție hărțile de atenție și decideți cînd preantrenarea, ajustarea fină sau un model simplu sînt alegerea potrivită.

Planul cursului

  1. Motivația mecanismului de atențieTextul sosește repede și conține informație la care prețurile reacționează; rețelele recurente îl citesc încet și uită.
  2. Mecanismul atențieiÎntrebări, chei și valori; scalarea; mai multe capete; ce arată și ce nu arată hărțile de atenție.
  3. Arhitectura transformerPozițiile, blocul, cele două familii și tokenizatorul.
  4. Studiu de caz: sentimentul tweet-urilor financiareȘapte modele pe un singur set de test păstrat deoparte, cu intervale bootstrap și erori pe clase.
  5. Transformerele în practicăDe la scoruri la semnale, documente lungi și transformere dincolo de text.

Motivația mecanismului de atenție

Textul sosește repede și conține informație la care prețurile reacționează; rețelele recurente îl citesc încet și uită.

Știrile financiare ca date de intrare pentru modele

Slide-ul 5 în PDF

Un model de sentiment duce un text \(x_{1:n}\) într-o reprezentare de dimensiune fixă \(\mathbf h\) și apoi în probabilitățile a trei clase, \(\hat{\mathbf p}=\operatorname{softmax}(W_o\mathbf h+\mathbf b_o)\); tot cursul este despre cum se calculează \(\mathbf h\). Datele noastre sînt tweet-uri financiare etichetate negativ (bearish), pozitiv (bullish) sau neutru: 9 543 pentru antrenare și 2 388 pentru test, dintre care 14,5 % negative, 19,9 % pozitive și 65,6 % neutre. Pesimismul din presă anticipează randamentele și volumul din ziua următoare (Tetlock, 2007), deci un astfel de model este un instrument de măsură.

În practică: un model de sentiment trebuie să fie precis pe știrile negative rare, nu doar în medie.

Limitele rețelelor recurente pentru textele lungi

Slide-ul 6 în PDF

O rețea recurentă actualizează un singur vector de stare, token cu token, \(\mathbf h_t=\phi(W_h\mathbf h_{t-1}+W_x\mathbf x_t+\mathbf b)\), deci gradientul dintre cuvintele 1 și \(n\) este un produs de \(n-1\) matrice jacobiene, care scade sau explodează odată cu distanța. Drumul dintre cuvintele \(i\) și \(j\) are \(|i-j|\) pași, iar cei \(n\) pași nu pot rula în paralel. Rețeaua cu memorie pe termen lung și scurt (LSTM) din cursul 5 atenuează prima problemă, dar o păstrează pe a doua. În „profitul a scăzut, dar prognoza a fost majorată”, verdictul depinde de un cuvînt aflat departe de subiect.

Lungimea tweet-urilor și a discursurilor băncilor centrale, în tokeni

Slide-ul 7 în PDF

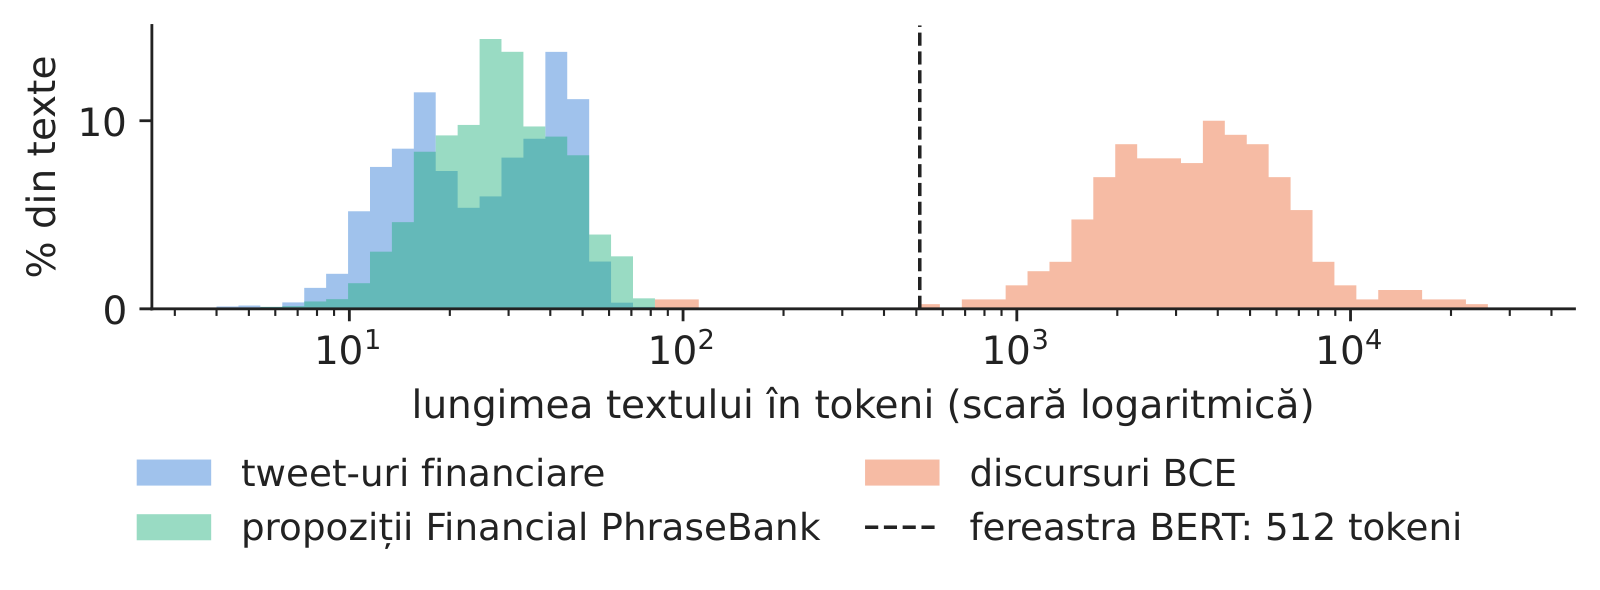
În tokeni WordPiece, tweet-ul median are 25 de tokeni, propoziția mediană din Financial PhraseBank 28, iar discursul median al Băncii Centrale Europene (BCE) 3 338. Dintre cele 400 de discursuri, 98,8 % depășesc fereastra de 512 tokeni a modelului BERT; doar 0,19 % dintre tweet-uri depășesc 64 de tokeni.

Grafic: Lungimea tweet-urilor și a discursurilor băncilor centrale, în tokeni

Lungimea în tokeni a tweet-urilor financiare, a propozițiilor Financial PhraseBank și a discursurilor BCE, pe scară logaritmică.

Sursa: Twitter financial news (zeroshot); Malo et al. (2014); discursurile Băncii Centrale Europene; tokenizatorul modelului ProsusAI. Date: tweet-uri financiare; Financial PhraseBank; discursurile Băncii Centrale Europene 8 ianuarie 2022 - 30 octombrie 2026.

În practică: potriviți modelul cu lungimea textului: un tweet încape în orice transformer, un discurs cere împărțire sau un model cu context lung.

Sinteza secțiunii

Recurența leagă cuvintele îndepărtate prin drumuri secvențiale lungi; atenția leagă orice pereche într-un singur pas.

Mecanismul atenției

Întrebări, chei și valori; scalarea; mai multe capete; ce arată și ce nu arată hărțile de atenție.

Atenția este o căutare aproximativă într-un dicționar

Slide-ul 9 în PDF

Fiecare token \(i\) pune o întrebare \(\mathbf q_i=W_Q^\top\mathbf x_i\), fiecare token \(j\) oferă o cheie \(\mathbf k_j=W_K^\top\mathbf x_j\) și o valoare \(\mathbf v_j=W_V^\top\mathbf x_j\), iar ieșirea este

\[\mathbf y_i=\sum_{j=1}^n a_{ij}\mathbf v_j,\qquad a_{ij}=\frac{\exp(\mathbf q_i^\top\mathbf k_j/\sqrt{d_k})}{\sum_{l}\exp(\mathbf q_i^\top\mathbf k_l/\sqrt{d_k})}.\]
(7.1)

Un dicționar întoarce valoarea singurei chei potrivite; atenția întoarce un amestec al tuturor valorilor, ponderat după cît de bine se potrivesc cheile. Amestecul este derivabil, deci proiecțiile se învață, iar oricare două cuvinte sînt la un singur pas.

În practică: fiecare cuvînt de ieșire este un amestec care ține cont de context: „prognoza” poate împrumuta sens de la „majorată”, aflat zece cuvinte mai departe.

Atenția în formă matriceală, pentru toate cuvintele simultan

Slide-ul 10 în PDF

Așezînd tokenii în \(X\in\mathbb R^{n\times d}\) obținem \(\operatorname{Attention}(Q,K,V)=\operatorname{softmax}(QK^\top/\sqrt{d_k}+\mathbf M)V\), cu o mască \(\mathbf M\) egală cu \(-\infty\) pentru completare sau, într-un decodor, pentru tokenii viitori. Costul pe strat este \(O(n^2d)\) operații și memorie \(O(n^2)\): atenția pe un discurs median al BCE costă de circa 17 828 de ori mai mult decît pe un tweet median. În schimb nu există nicio buclă pe poziții, iar procesoarele grafice înmulțesc toată propoziția deodată.

Scalarea cu √d_k și saturația softmax-ului

Slide-ul 11 în PDF

Dacă elementele lui \(\mathbf q\) și \(\mathbf k\) sînt independente, cu media 0 și varianța 1, atunci \(\operatorname{Var}(\mathbf q^\top\mathbf k)=d_k\). Cu \(d_k=64\), ca în fiecare cap BERT, scorurile brute au abaterea standard 8, deci un singur cuvînt ia aproape toată ponderea, iar jacobianul softmax-ului \(\operatorname{diag}(\mathbf a)-\mathbf a\mathbf a^\top\) este aproape zero: întrebările și cheile nu mai învață. Împărțirea la \(\sqrt{d_k}\) readuce varianța la unu, pentru orice \(d_k\).

Atenția cu mai multe capete: mai multe relații simultan

Slide-ul 12 în PDF

Atenția cu mai multe capete rulează \(h\) atenții cu proiecții de dimensiune \(d/h\) și le concatenează: \(\operatorname{MHA}(X)=[\mathbf H_1\|\cdots\|\mathbf H_h]W_O\), cu \(4d^2\) parametri, ca la un singur cap mare. BERT-base are 12 straturi cu cîte 12 capete, \(d\) = 768 și 64 de dimensiuni pe cap; transformerul nostru mic are 2 straturi cu cîte 4 capete și \(d=64\).

La ce este atent FinBERT într-un tweet negativ real

Slide-ul 13 în PDF

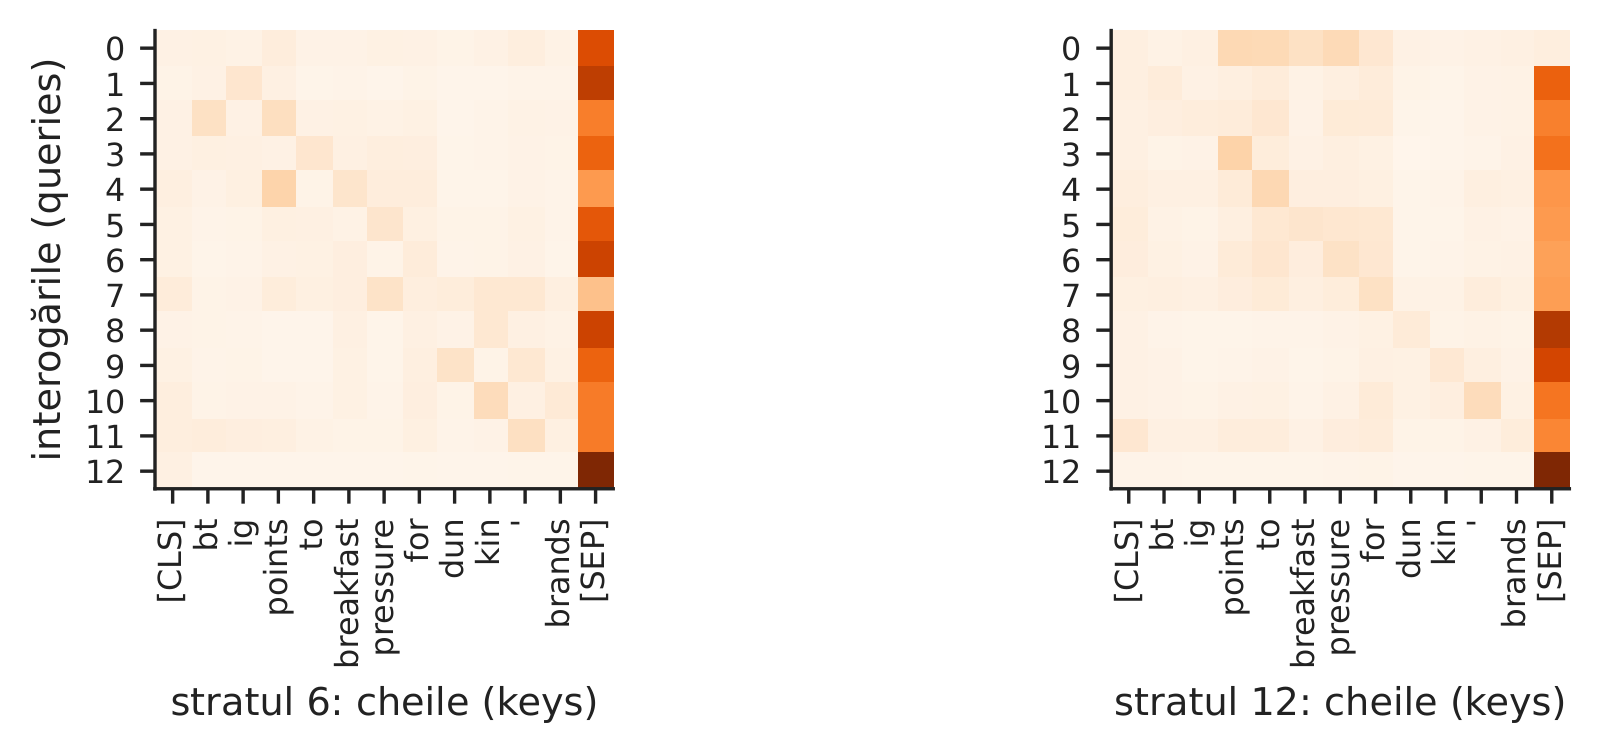
Pentru tweet-ul negativ de test prezentat, FinBERT preantrenat dă doar 7,3 % probabilitate de a fi negativ: tonul negativ este implicit, iar modelul fără antrenare nu îl vede. În stratul 6, tokenul de rezumat [CLS] pune 5,7 % din atenție pe „points”; în stratul 12, cea mai mare parte a ponderii merge spre tokenii separatori.

Grafic: La ce este atent FinBERT într-un tweet negativ real

Atenția FinBERT preantrenat, mediată pe cele 12 capete, straturile 6 și 12; rîndurile sînt întrebările, coloanele cheile.

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: un tweet de test; FinBERT preantrenat, atenția mediată pe 12 capete.

De la un strat la altul, atenția se concentrează pe tokenii separatori

Slide-ul 14 în PDF

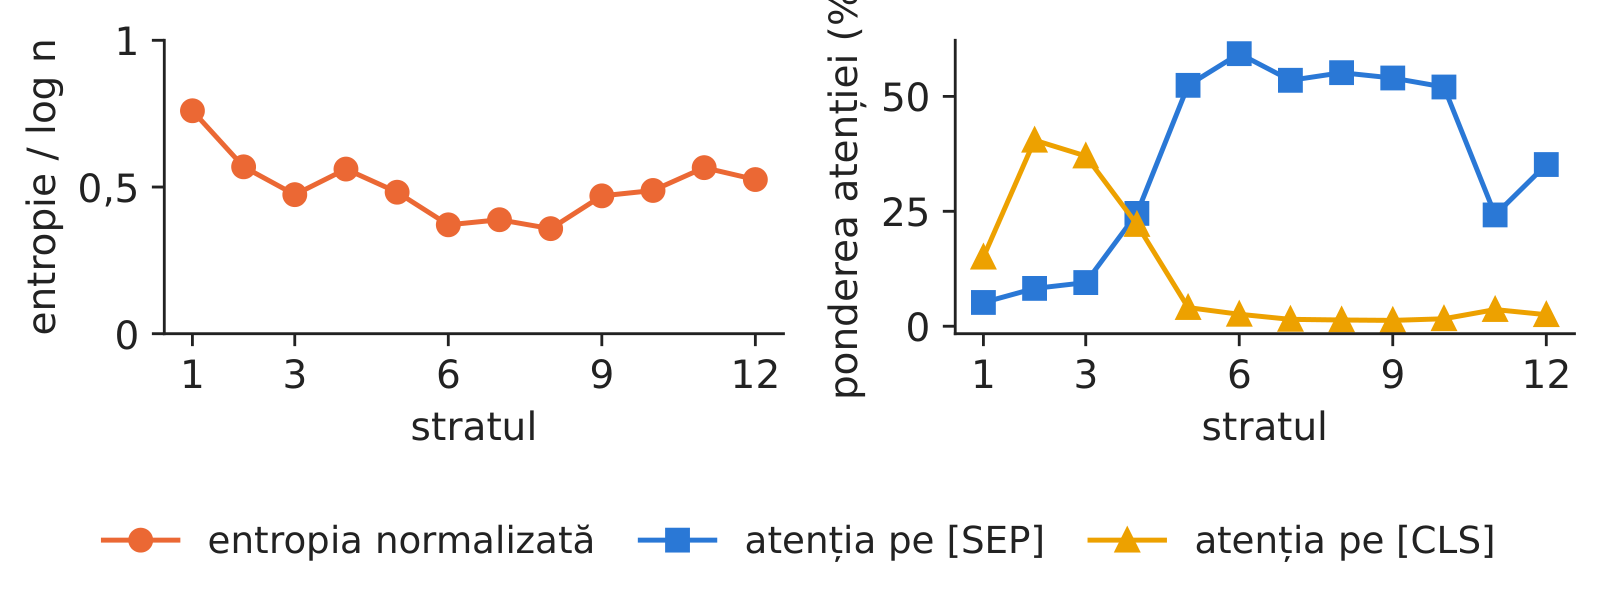
Pe 500 de tweet-uri de test, entropia rîndurilor de atenție împărțită la \(\log n\) este 0,76 în stratul 1 și scade la 0,36 în stratul 8 (1 ar însemna atenție uniformă). Pînă la 59,3 % din toată atenția (stratul 6) merge spre separatorul [SEP], o operație nulă pe care un cap o folosește cînd nu are nimic de adăugat (Clark et al., 2019).

Grafic: De la un strat la altul, atenția se concentrează pe tokenii separatori

Entropia normalizată a atenției și ponderea atenției pe [CLS] și [SEP], pe straturile FinBERT.

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: 500 de tweet-uri de test; FinBERT preantrenat.

Ponderile de atenție ca explicații: limite

Slide-ul 15 în PDF

Contribuția cuvîntului \(j\) la cuvîntul \(i\) este \(a_{ij}\) înmulțit cu un vector de valori a cărui normă poate fi mare sau mică, iar fluxul rezidual duce informație pe care atenția nu o atinge. Hărți de atenție diferite pot da aceeași predicție (Jain și Wallace, 2019), iar atenția mare pe [SEP] nu poartă aproape nicio informație. Atribuirile bazate pe gradient și testele de ocluzie (cursul 11) sînt instrumente mai bune.

În practică: nu prezentați niciodată unui supraveghetor o hartă de atenție drept „motivul” unei decizii.

Sinteza secțiunii

Atenția = softmax al scorurilor întrebare–cheie scalate, înmulțit cu valorile; capetele se specializează; hărțile de atenție sînt indicii, nu explicații.

Arhitectura transformer

Pozițiile, blocul, cele două familii și tokenizatorul.

Codificarea sinusoidală a poziției

Slide-ul 17 în PDF

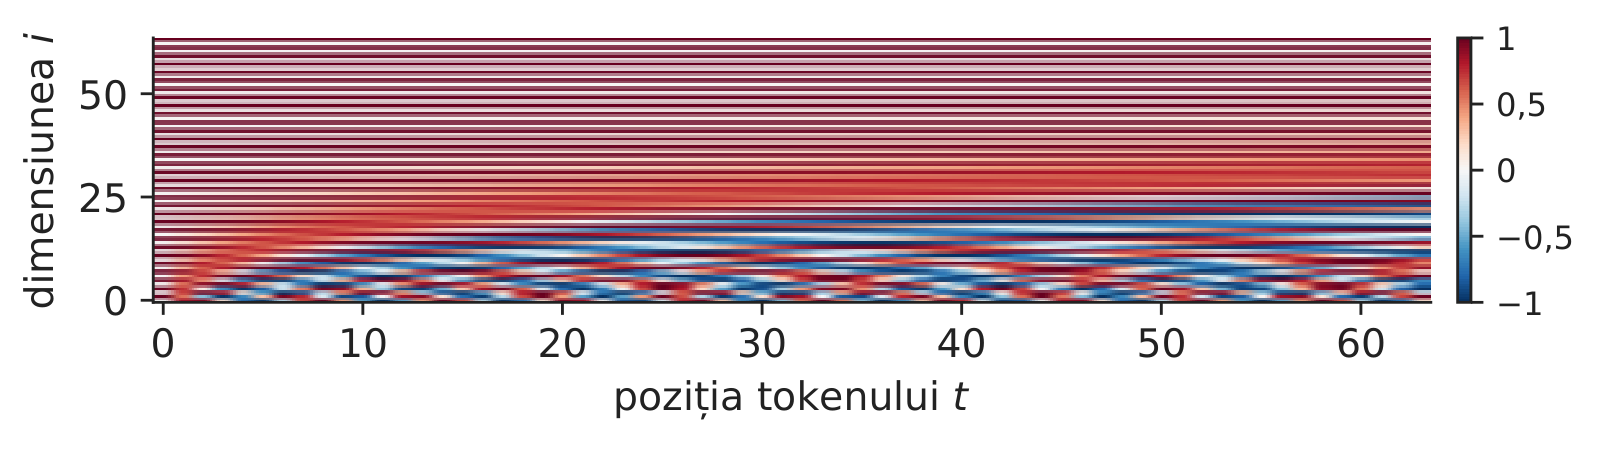
Auto-atenția este echivariantă la permutări: fără poziții, „dobînzile scad, acțiunile cresc” ar fi totuna cu „acțiunile scad, dobînzile cresc”. Transformerul original adaugă la reprezentarea fiecărui token vectorul \(p_{t,2i}=\sin(t/10000^{2i/d})\), \(p_{t,2i+1}=\cos(t/10000^{2i/d})\); dimensiunile mici se schimbă repede cu poziția, cele mari încet, deci fiecare poziție are un cod unic, iar deplasările relative sînt aplicații liniare.

Grafic: Codificarea sinusoidală a poziției

Codificarea sinusoidală a poziției pentru 64 de poziții și 64 de dimensiuni (ilustrarea mecanismului).

Sursa: Vaswani et al. (2017), formula sinusoidală. Date: ilustrarea mecanismului, d=64, 64 de poziții.

Un bloc transformer: atenție, rețea directă, conexiuni reziduale, normalizare

Slide-ul 18 în PDF

În forma cu normalizare înainte, un bloc calculează

\[Z=X+\operatorname{MHA}(\operatorname{LN}(X)),\qquad X'=Z+\operatorname{FFN}(\operatorname{LN}(Z)),\]
(7.2)

unde rețeaua directă aplicată fiecărei poziții (FFN) este \(W_2\,\mathrm{GELU}(W_1\mathbf z+\mathbf b_1)+\mathbf b_2\), cu unitatea liniară cu eroare gaussiană (GELU), iar LN este normalizarea pe variabilele unui token. Un bloc are circa \(12d^2\) parametri, două treimi dintre ei în partea directă. Blocul nostru are \(d=64\), o rețea FFN de lățime 128 și dropout 0,1; două blocuri au 67 139 de parametri în afara reprezentărilor.

Codificatoare și decodoare: două obiective de preantrenare

Slide-ul 19 în PDF

Bidirectional Encoder Representations from Transformers (BERT) se preantrenează prin modelarea limbajului cu cuvinte mascate (MLM): 15 % dintre tokeni sînt ascunși și preziși din ambele părți. Generative Pre-trained Transformer (GPT) prezice tokenul următor cu o mască cauzală, \(M_{ij}=-\infty\) pentru \(j>i\), iar modelele mari de limbaj (LLM) de azi urmează această schemă. Codificatoarele se potrivesc clasificării și extragerii de informații, decodoarele generării; transformerul original le avea pe amîndouă, pentru traducere.

În practică: pentru etichetarea textelor folosiți un codificator; pentru redactarea rapoartelor, un decodor (cursul 12).

Tokenizarea textului în subcuvinte

Slide-ul 20 în PDF

Un tokenizator WordPiece împarte cuvintele rare în bucăți frecvente, astfel încît un vocabular fix, de 30 522 de bucăți pentru FinBERT, acoperă orice cuvînt, inclusiv simbolurile bursiere și numele noi de firme. Textul devine [CLS], bucățile și [SEP], iar fiecare token primește reprezentarea lui, plus un vector de poziție și unul de segment. Tweet-urile noastre au o mediană de 25 de tokeni, percentila 99 de 57 și un maxim de 82; tăiem la 64 de tokeni. În modelele mici domină tabelul reprezentărilor: transformerul nostru mic are 2 020 547 de parametri, doar 67 139 în afara tabelului.

Atenția, recurența și convoluția comparate

Slide-ul 21 în PDF
StratCost pe stratPași secvențialiDrumul cel mai lung
Auto-atenție\(O(n^2d)\)\(O(1)\)\(O(1)\)
Recurent\(O(nd^2)\)\(O(n)\)\(O(n)\)
Convoluție, nucleu \(k\)\(O(knd^2)\)\(O(1)\)\(O(\log_kn)\)

O rețea neuronală recurentă (RNN) este ieftină pe pas, dar lentă pe propoziție; o rețea neuronală convoluțională (CNN) este paralelă, dar are nevoie de adîncime ca să lege cuvinte îndepărtate; auto-atenția are un drum constant și paralelism complet, plătite cu memorie \(n^2\), neglijabilă pentru tweet-uri de circa 25 de tokeni.

Sinteza secțiunii

Un transformer suprapune blocuri de atenție și rețele directe, cu conexiuni reziduale și normalizare; pozițiile se adaugă, tokenii sînt subcuvinte.

Studiu de caz: sentimentul tweet-urilor financiare

Șapte modele pe un singur set de test păstrat deoparte, cu intervale bootstrap și erori pe clase.

Șapte modele evaluate pe același set de test

Slide-ul 23 în PDF

Tweet-urile de antrenare publicate se împart în 8 588 pentru antrenare și 955 pentru validare (10 %, stratificat); setul de validare publicat este setul nostru de test, cu 2 388 de tweet-uri, folosit o singură dată. Modelele sînt: o regresie logistică TF-IDF pe secvențe de 1–2 cuvinte (17 119 de variabile); media reprezentărilor învățate ale tokenilor, fără atenție; transformerul nostru mic, cu și fără poziții; și FinBERT, un model BERT antrenat suplimentar pe texte financiare (Araci, 2019), folosit fără antrenare, înghețat cu o regresie logistică pe vectorii lui de 768 de dimensiuni și ajustat. Nu testăm pe Financial PhraseBank: FinBERT a fost ajustat pe aceste date, deci testul ar fi contaminat.

Transformerul nostru mic, antrenat de la zero

Slide-ul 24 în PDF

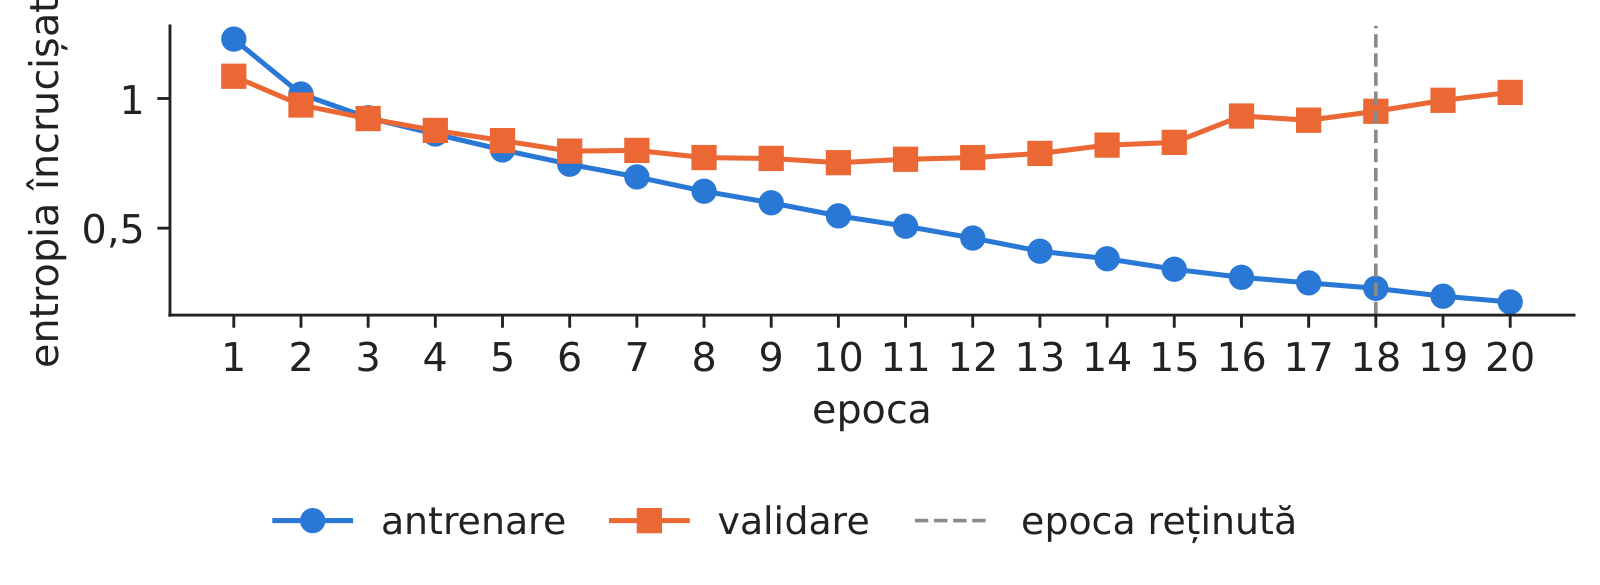
Două blocuri stau peste reprezentările tokenilor și ale pozițiilor; ieșirile se mediază pe tokenii reali și trec printr-un strat liniar cu trei clase, antrenat cu entropie încrucișată ponderată pe clase, Adam cu penalizare decuplată a ponderilor (AdamW), rata de învățare \(5\cdot10^{-4}\) și oprire timpurie după macro-F1 pe validare, media celor trei scoruri F1 pe clase. Modelul are 2 020 547 de parametri și se antrenează în circa 44 de secunde pe sămînță. Pentru sămînța 1, pierderea pe validare este minimă la epoca 10 și apoi crește, iar macro-F1 pe validare atinge totuși maximul la epoca 18: modelul devine prea sigur pe el înainte să se oprească din progres.

Grafic: Transformerul mic supraînvață: pierderea pe validare crește după cîteva epoci

Entropia încrucișată pe antrenare și pe validare, pe epoci, sămînța 1; linia punctată marchează epoca reținută.

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: estimări proprii; transformer mic, sămînța 1.

În practică: macro-F1 este măsura potrivită cînd clasa rară, știrile negative, este cea care costă bani.

Compararea modelelor: macro-F1 pe setul de test

Slide-ul 26 în PDF

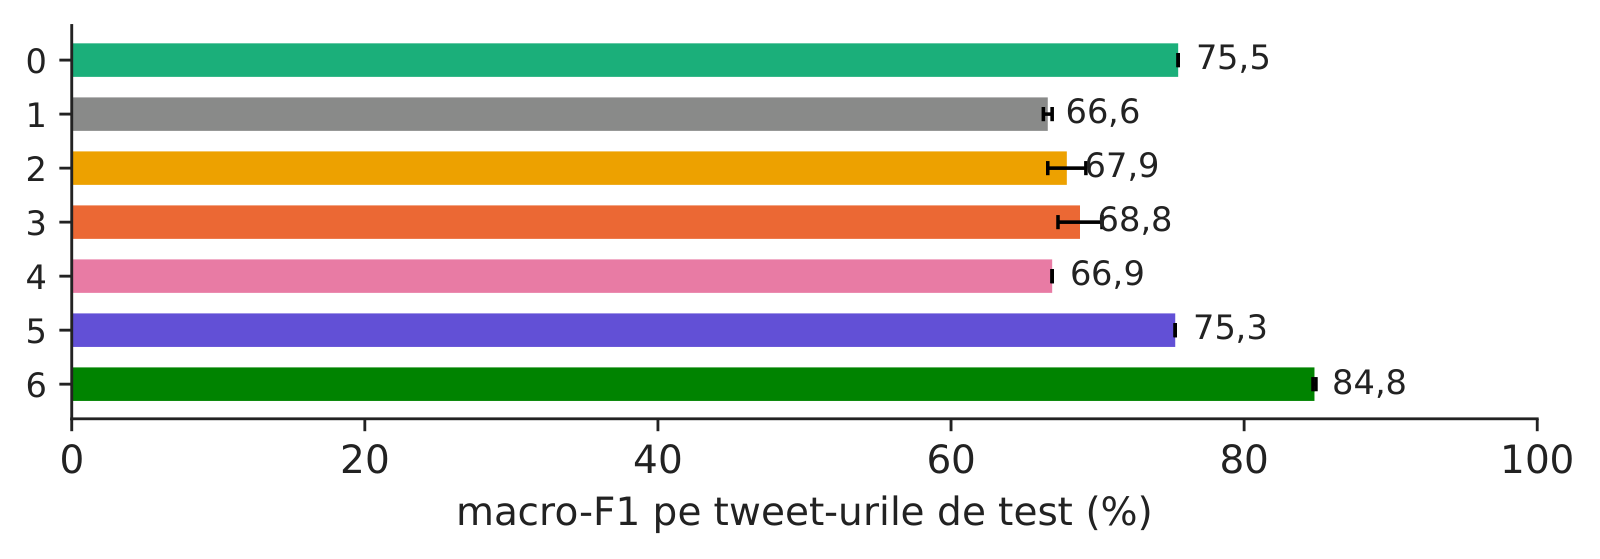
Pe cele 2 388 de tweet-uri de test, macro-F1 este 84,8 % pentru FinBERT ajustat, 75,5 % pentru TF-IDF și 68,8 % pentru transformerul mic (abatere standard 1,5 pe 3 semințe). FinBERT fără nicio antrenare pe tweet-uri atinge 66,9 %, iar FinBERT înghețat cu o regresie logistică 75,3 %.

Grafic: Compararea modelelor: macro-F1 pe setul de test

Macro-F1 pe tweet-urile de test, media pe semințe, cu abaterea standard.

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: estimări proprii; 2.388 tweet-uri de test (setul de validare publicat).

Clasa negativă este cea în care modelele diferă cel mai mult

Slide-ul 27 în PDF

FinBERT ajustat găsește 82,9 % dintre tweet-urile negative, cu o precizie de 77,9 %; TF-IDF găsește 70,3 %, cu 63,5 %, iar transformerul mic 59,7 %, cu 51,1 %.

În practică: raportați recall-ul și precizia pe clase: o medie poate ascunde un model care ratează știrile importante.

Testul bootstrap pereche al diferențelor pe tweet-urile de test

Slide-ul 28 în PDF

Reeșantionînd tweet-urile de test de 1 000 de ori, cu aceeași extragere pentru ambele modele, obținem aceste diferențe de macro-F1 (puncte procentuale, intervalul de 95 %): FinBERT ajustat minus TF-IDF +9,3 [+7,3; +11,3]; transformerul mic minus TF-IDF −6,6 [−8,3; −4,9]; FinBERT înghețat minus TF-IDF −0,2 [−2,5; +2,0].

În practică: un interval care nu conține zero este dovada minimă înainte de a înlocui un model aflat în producție.

Cu puține date etichetate, reprezentările preantrenate contează cel mai mult

Slide-ul 29 în PDF

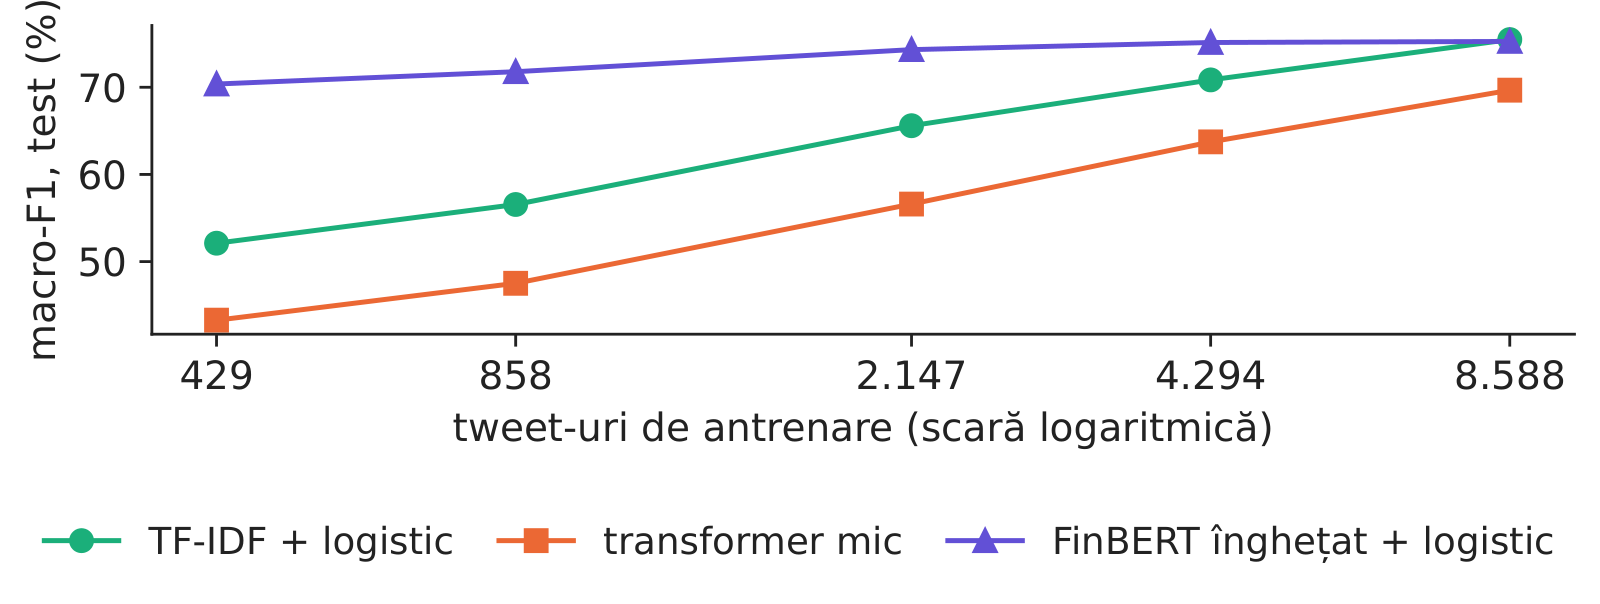
Cu doar 429 de tweet-uri de antrenare, FinBERT înghețat cu o regresie logistică atinge 70,4 % macro-F1, TF-IDF 52,1 %, iar transformerul mic 43,3 %. Preantrenarea înseamnă date pe care nu a trebuit să le etichetați: miliarde de cuvinte au format deja vectorii FinBERT, pe cînd un model de la zero trebuie să învețe deodată limba și sarcina.

Grafic: Cu puține date etichetate, reprezentările preantrenate contează cel mai mult

Macro-F1 de test după numărul de tweet-uri de antrenare (sămînța 1).

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: estimări proprii; 2.388 tweet-uri de test (setul de validare publicat).

Erorile modelului fără antrenare corectate prin ajustare fină

Slide-ul 30 în PDF

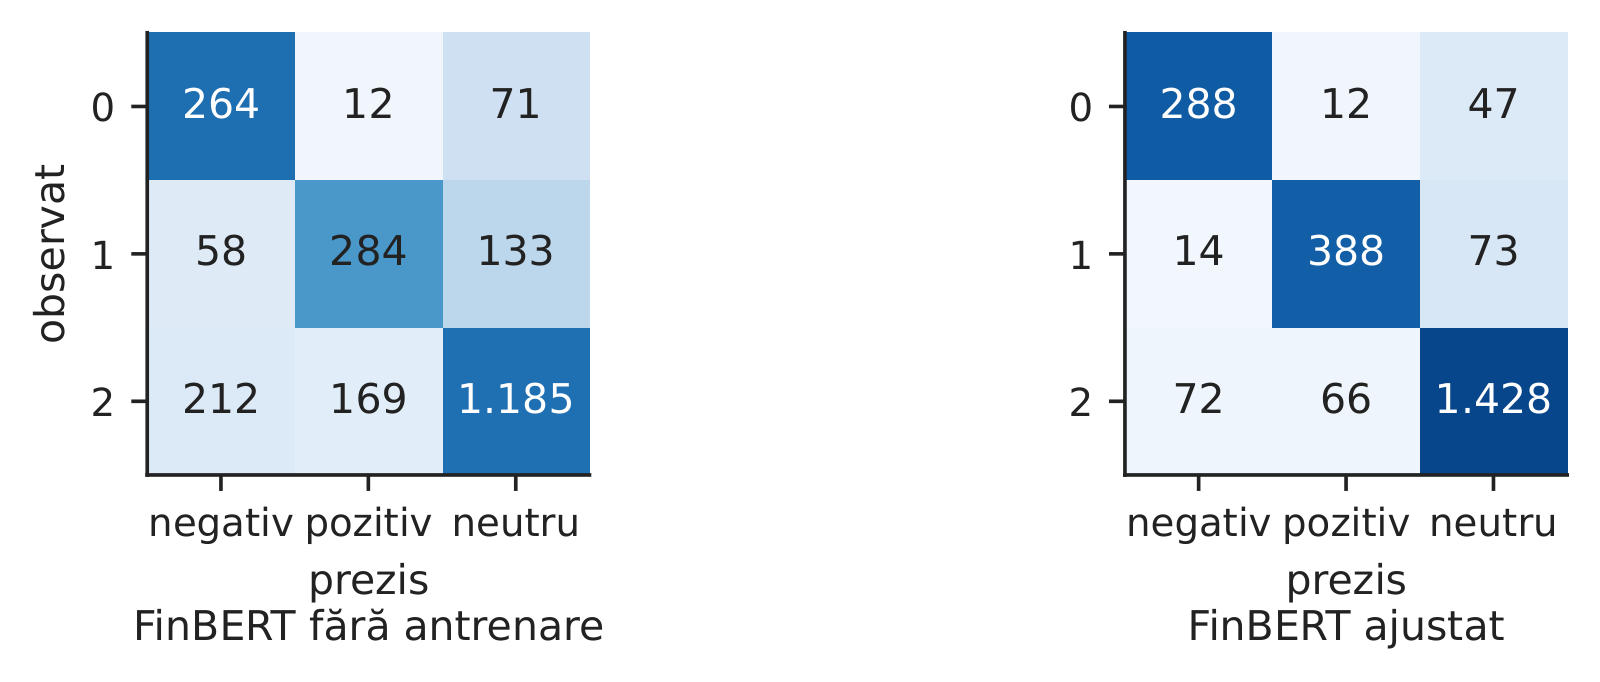
FinBERT a fost antrenat pe propoziții din știri, nu pe tweet-uri. Fără antrenare pe tweet-uri găsește 264 dintre cele 347 de tweet-uri negative de test; după ajustare găsește 288. Erorile rămase sînt mai ales confuzii cu clasa neutră: 47 tweet-uri negative și 73 pozitive citite ca neutre și doar 12 negative citite ca pozitive.

Grafic: Erorile modelului fără antrenare corectate prin ajustare fină

Matricele de confuzie ale FinBERT pe tweet-urile de test, fără antrenare și ajustat (sămînța 1).

Sursa: Seturile Twitter financial news (Hugging Face, zeroshot). Date: estimări proprii; 2.388 tweet-uri de test (setul de validare publicat).

Ajustarea fină: ponderi inițiale preantrenate și rate de învățare mici

Slide-ul 31 în PDF

Ajustarea fină pornește de la \(\boldsymbol\theta_0=\boldsymbol\theta_{\text{FinBERT}}\) și mișcă toate cele 109,5 milioane de ponderi cu o rată de învățare mică, \(2\cdot10^{-5}\), care scade liniar pe 3 epoci; se păstrează epoca cu cel mai bun macro-F1 pe validare. Cîștigă +17,9 puncte față de modelul fără antrenare și +9,3 față de TF-IDF, cu un cost de circa 5,2 minute pe sămînță, pe procesorul grafic al unui laptop. O rată de învățare prea mare șterge ce a învățat preantrenarea (uitare catastrofală).

În practică: ajustarea fină a unui codificator preantrenat este azi alegerea implicită pentru orice sarcină pe text etichetat, cu cîteva mii de exemple.

Rolul ordinii cuvintelor în clasificarea tweet-urilor

Slide-ul 32 în PDF

Același transformer mic atinge 68,8 % macro-F1 cu poziții și 67,9 % fără ele, o diferență de +0,9 puncte, cu intervalul bootstrap [+0,1; +1,7]; media reprezentărilor, fără nicio atenție, atinge 66,6 %. Tweet-urile scurte și formulaice sînt mai ales colecții de cuvinte-semnal; ordinea contează pentru negație, contrast, documente lungi și cifre legate de entitatea corectă.

În practică: testați mai întîi versiunea simplă a modelului: pe texte scurte o mare parte din puterea transformerului rămîne nefolosită.

Sinteza secțiunii

Preantrenarea decide: FinBERT ajustat conduce, TF-IDF este un model de referință puternic, iar un transformer de la zero are nevoie de mult mai multe date.

Transformerele în practică

De la scoruri la semnale, documente lungi și transformere dincolo de text.

Scorurile de sentiment ca semnal de afaceri

Slide-ul 34 în PDF

Un flux de producție trece știrile și postările prin tokenizator și printr-un codificator ajustat, apoi agregă probabilitățile claselor pe firmă și zi, de exemplu ponderea mesajelor negative minus a celor pozitive, ponderată cu audiența. Astfel de semnale servesc monitorizării riscului unui portofoliu de credite, avertizării timpurii pentru emitenți sau ajustării valorii la risc (VaR). Capcanele sînt informația din viitor (folosiți doar texte cu marcaj de timp anterior deciziei), schimbarea domeniului (un model pentru propoziții din știri citește greșit tweet-urile), zgomotul din etichete, sarcasmul și deriva vocabularului pieței.

În practică: un scor de sentiment este o intrare într-un model, nu o decizie de tranzacționare: testați-l retrospectiv înainte de folosire.

Documentele lungi: discursurile băncilor centrale și rapoartele anuale

Slide-ul 35 în PDF

Cele 400 de discursuri ale BCE, din 8 ianuarie 2022 pînă în 30 octombrie 2026, au o mediană de 3 338 de tokeni și ajung pînă la 22 646. Variantele sînt împărțirea în ferestre de 512 tokeni cu agregarea scorurilor pe bucăți, modelele ierarhice cu atenție pe vectori de propoziții și modelele cu context lung, cu atenție rară sau eficientă ca memorie.

În practică: pentru o echipă de politică monetară, împărțirea în bucăți plus un codificator bine testat bate de obicei un model cu context lung netestat.

Transformerele pentru alte date decît textul

Slide-ul 36 în PDF

Fragmentele unei serii de timp devin tokeni în modelele de prognoză preantrenate (cursul 13); coloanele sau plățile anterioare devin tokeni pentru datele tabelare și tranzacții; atenția restrînsă la muchiile unui graf este rețeaua cu atenție pe graf (cursul 9); fragmentele de imagine devin tokeni în modelele viziune-limbaj care citesc grafice și rapoarte (cursul 14).

În practică: oricare ar fi datele, întrebarea este aceeași: care sînt tokenii și ce perechi au voie să-și acorde atenție?

Explorați vizual

Instrumente interactive gratuite și ghiduri ilustrate pentru acest curs; cele mai multe rulează în browser.

  • Transformer Explainer: un model GPT-2 care rulează în browser: scrieți o propoziție, deschideți un cap de atenție și urmăriți scorurile \(\mathbf q^{\top}\mathbf k\), softmax-ul și suma ponderată a valorilor; mutați temperatura ca distribuția următorului token să devină mai ascuțită sau mai plată.
  • LLM Visualization (B. Bycroft): o parcurgere 3D a unui GPT mic, bloc cu bloc: fiecare produs de matrice din normalizare, atenție și stratul feed-forward.
  • The Illustrated Transformer (J. Alammar): queries, keys și values desenate pas cu pas pentru o propoziție.
  • Variante ale atenției (S. Raschka): de la atenția multi-head la grouped-query și latent attention, ferestre glisante și atenție rară: cum reduc modelele recente memoria pentru keys și values.

Sinteza secțiunii

Folosiți transformerele ca instrumente de măsură: marcați în timp intrările, împărțiți textele lungi și testați retrospectiv semnalul.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

ASEAcademia de Studii Economice din București
BCEBanca Centrală Europeană
BERTBidirectional Encoder Representations from Transformers (reprezentări bidirecționale ale codificatorului transformer)
CNNrețea neuronală convoluțională
ESpierderea așteptată în coadă (expected shortfall)
FFNrețea directă aplicată fiecărei poziții (feed-forward)
FinBERTBERT antrenat suplimentar pe texte financiare
GELUunitate liniară cu eroare gaussiană (Gaussian error linear unit)
GPTGenerative Pre-trained Transformer (transformer generativ preantrenat)
IPEInstitutul de Prognoză Economică, Academia Română
LLMmodel mare de limbaj
LNnormalizarea pe strat (layer normalisation)
LSTMrețea cu memorie pe termen lung și scurt (long short-term memory)
MHAatenția cu mai multe capete (multi-head attention)
MLMmodelarea limbajului cu cuvinte mascate (masked language modelling)
MPSMetal Performance Shaders (interfața procesorului grafic Apple)
NLPprelucrarea limbajului natural
ReLUunitate liniară rectificată (rectified linear unit)
RNNrețea neuronală recurentă
TF-IDFfrecvența termenului–inversul frecvenței în documente (TF-IDF)
VaRvaloarea la risc (Value-at-Risk)

Bibliografie

  • Araci, D. (2019). FinBERT: Financial sentiment analysis with pre-trained language models. arXiv:1908.10063
  • Ba, J. L., Kiros, J. R. & Hinton, G. E. (2016). Layer normalization. arXiv:1607.06450
  • Bahdanau, D., Cho, K. & Bengio, Y. (2015). Neural machine translation by jointly learning to align and translate. International Conference on Learning Representations. arXiv:1409.0473
  • Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts, ch. 12. Springer. doi:10.1007/978-3-031-45468-4
  • Clark, K., Khandelwal, U., Levy, O. & Manning, C. D. (2019). What does BERT look at? An analysis of BERT's attention. BlackboxNLP Workshop, 276–286. doi:10.18653/v1/W19-4828
  • Devlin, J., Chang, M.-W., Lee, K. & Toutanova, K. (2019). BERT: Pre-training of deep bidirectional transformers for language understanding. Proceedings of NAACL, 4171–4186. doi:10.18653/v1/N19-1423
  • Efron, B. & Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall. doi:10.1201/9780429246593
  • Jain, S. & Wallace, B. C. (2019). Attention is not explanation. Proceedings of NAACL, 3543–3556. doi:10.18653/v1/N19-1357
  • Jheng, S.-L., Tak, R., Găman, Ș., Mazurencu-Marinescu-Pele, M. & Pele, D. T. (2026). Can foundation models manage risk? Zero-shot VaR and ES forecasting with conformal calibration in CEE markets. Economic Computation and Economic Cybernetics Studies and Research, 60(2), 267–290. doi:10.24818/18423264/60.2.26.14
  • Loshchilov, I. & Hutter, F. (2019). Decoupled weight decay regularization. International Conference on Learning Representations. arXiv:1711.05101
  • Malo, P., Sinha, A., Korhonen, P., Wallenius, J. & Takala, P. (2014). Good debt or bad debt: Detecting semantic orientations in economic texts. Journal of the Association for Information Science and Technology, 65(4), 782–796. doi:10.1002/asi.23062
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the word: LLM-VaR and LLM-ES. SSRN Working Paper 5104383. doi:10.2139/ssrn.5104383
  • Radford, A., Narasimhan, K., Salimans, T. & Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI technical report. openai.com/research/language-unsupervised
  • Tetlock, P. C. (2007). Giving content to investor sentiment: The role of media in the stock market. Journal of Finance, 62(3), 1139–1168. doi:10.1111/j.1540-6261.2007.01232.x
  • Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł. & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. arXiv:1706.03762
  • Wu, Y., Schuster, M., Chen, Z. et al. (2016). Google's neural machine translation system: Bridging the gap between human and machine translation. arXiv:1609.08144

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.