Rețele neuronale și deep learning

Cursul 8: Modele generative: autoencodere, VAE, GAN, difuzie

Cursul 8

Modele generative: autoencodere, VAE, GAN, difuzie

Prof. dr. Daniel Traian PELE

Academia de Studii Economice din București (ASE), Departamentul de Statistică și Econometrie
Academia Română, Institutul de Prognoză Economică (IPE)

Un clasificator răspunde la o întrebare îngustă: este această tranzacție o fraudă? Un model generativ răspunde la una mai largă: cum arată tranzacțiile, imaginile, randamentele zilnice sau curbele randamentelor și cum ar mai putea arăta? Odată ce a învățat distribuția datelor, modelul poate semnala observațiile care nu se potrivesc, poate simula scenarii pentru teste de stres, poate produce date sintetice care se pot partaja fără înregistrări despre clienți și poate comprima multe serii în cîțiva factori interpretabili.

Cursul construiește cele patru familii principale de modele generative profunde, autoencoderul (AE), autoencoderul variațional (VAE), rețeaua generativă adversarială (GAN) și modelul probabilistic de difuzie cu eliminarea zgomotului (DDPM), și testează fiecare familie pe date reale, alături de un model clasic de referință: fraudele cu carduri de la ULB Machine Learning Group, imaginile de îmbrăcăminte Fashion-MNIST, randamentele zilnice ale indicelui S&P 500 și curba zilnică a randamentelor AAA din zona euro, publicată de Banca Centrală Europeană.

Ce veți ști să faceți

  • Explicați diferența dintre un model discriminativ \(p(y\mid\mathbf x)\) și un model generativ \(p(\mathbf x)\) și de ce finanțele au nevoie de amîndouă.
  • Derivați și antrenați un autoencoder, un VAE, un GAN și un model de difuzie.
  • Folosiți-le pentru detectarea fraudei, generarea de imagini, randamente sintetice și scenarii ale curbei randamentelor, fiecare comparat cu un model de referință.
  • Judecați datele sintetice după cozi, gruparea volatilității, testele retrospective ale valorii la risc (VaR) și regimurile pe care le reproduc.

Planul cursului

  1. Principiile modelării generativeUn model generativ învață întreaga distribuție a datelor, nu doar granița dintre clase.
  2. Autoencodere: detectarea anomaliilor la fraude cu carduriUn autoencoder antrenat pe tranzacții normale le semnalează pe cele pe care nu le poate reconstrui.
  3. Autoencodere variaționaleVAE transformă autoencoderul într-un generator probabilist, învățînd o distribuție a codurilor.
  4. Rețele generative adversarialeUn GAN învață să extragă din distribuția datelor jucînd împotriva unui discriminator.
  5. Modele de difuzieUn model de difuzie învață să inverseze, pas cu pas, un proces care transformă datele în zgomot.
  6. Modelele generative în practicăDatele sintetice sînt utile numai după ce trec aceleași verificări ca datele reale.

Principiile modelării generative

Un model generativ învață întreaga distribuție a datelor, nu doar granița dintre clase.

Un model generativ învață cum apar datele

Slide-ul 5 în PDF

Un model discriminativ estimează \(p(y\mid\mathbf x)\), probabilitatea unei etichete dat fiind inputul. Un model generativ estimează \(p(\mathbf x)\) sau distribuția comună \(p(\mathbf x,y)=p(\mathbf x\mid y)p(y)\) și se estimează de obicei prin verosimilitate maximă,

\[\hat{\boldsymbol\theta}=\arg\max_{\boldsymbol\theta}\sum_{i=1}^{n}\log p_{\boldsymbol\theta}(\mathbf x_i).\]
(8.1)

Cunoașterea lui \(p(\mathbf x)\) aduce patru utilizări în finanțe: o densitate mică marchează o observație suspectă (detectarea anomaliilor); extragerile din model sînt scenarii pentru teste de stres și măsuri de risc; eșantioanele sintetice se pot partaja fără înregistrări despre clienți; iar o reprezentare latentă comprimă multe serii corelate în cîțiva factori.

În practică: un clasificator ordonează clienții, un model generativ arată și ce s-ar putea întîmpla.

Modele cu variabile latente

Slide-ul 6 în PDF

Unsprezece randamente sau 784 de pixeli sînt determinate de cîțiva factori ascunși. Un model cu variabile latente scrie \(p(\mathbf x)=\int p(\mathbf x\mid\mathbf z)p(\mathbf z)\,d\mathbf z\), cu \(\mathbf z\in\mathbb R^k\) și \(k\) mult mai mic decît dimensiunea datelor. În cazul liniar-gaussian, \(\mathbf x=W\mathbf z+\boldsymbol\mu+\boldsymbol\varepsilon\), se obține analiza probabilistă a componentelor principale (PCA), cu verosimilitate în formă închisă. Cu un decodor neuronal integrala nu mai are formă închisă, iar fiecare familie din acest curs plătește altfel pentru flexibilitate: VAE maximizează o margine inferioară, GAN renunță la verosimilitate, iar difuzia construiește o margine pas cu pas.

Patru familii de modele generative

Slide-ul 7 în PDF
FamiliaCe se optimizeazăVerosimilitateGenerarea
AEeroarea de reconstrucțienunu este generator
VAEmarginea inferioară a verosimilitățiimargine inferioarăo trecere, imagini neclare
GANjoc contra unui discriminatornuo trecere, imagini clare
DDPMeroarea de eliminare a zgomotuluimargine inferioarămulți pași, fidel

Verosimilitatea, calitatea eșantioanelor și viteza rareori vin împreună; fluxurile de normalizare, cu verosimilitate exactă, completează tabloul.

Sinteza secțiunii

Modelele generative învață \(p(\mathbf x)\); familiile diferă prin felul în care tratează verosimilitatea greu de calculat.

Autoencodere: detectarea anomaliilor la fraude cu carduri

Un autoencoder antrenat pe tranzacții normale le semnalează pe cele pe care nu le poate reconstrui.

Un autoencoder comprimă datele printr-un strat îngust și le reconstruiește

Slide-ul 9 în PDF

Un codificator \(f_\phi\) duce inputul într-un cod \(\mathbf z\in\mathbb R^k\), iar un decodor \(g_\psi\) îl aduce înapoi; ambele sînt perceptroni multistrat (MLP) mici, cu unități liniare rectificate (ReLU). Antrenarea minimizează eroarea de reconstrucție, iar aceeași eroare este scorul de anomalie:

\[\min_{\phi,\psi}\frac1n\sum_{i=1}^n\big\|\mathbf x_i-g_\psi(f_\phi(\mathbf x_i))\big\|^2,\qquad s(\mathbf x)=\tfrac1d\|\mathbf x-\hat{\mathbf x}\|^2.\]
(8.2)

Cu \(f\) și \(g\) liniare, optimul generează același subspațiu ca PCA cu \(k\) componente, deci PCA este modelul de referință firesc. Autoencoderul nostru are 29 de intrări (cele 28 de componente anonimizate și logaritmul sumei), un strat îngust de 8 și 1 253 de parametri și este antrenat numai pe tranzacții legitime.

Experimentul de fraudă: două zile de plăți cu cardul, împărțite în timp

Slide-ul 10 în PDF

Datele sînt tranzacțiile cu carduri ale unor deținători europeni, publicate de ULB Machine Learning Group și Worldline (Dal Pozzolo et al., 2015). Fișierul nostru păstrează toate cele 492 de fraude și 10 % dintre tranzacțiile legitime, 28 924 de rînduri, cu ponderi care refac datele complete. Primele 60 % din interval sînt partea de antrenare (numai tranzacții legitime, 16 994 de rînduri), următoarele 20 % partea de validare pentru oprirea timpurie, iar ultimele 20 % partea de test: 57 174 de tranzacții din datele complete, cu 75 de fraude (0,131 %). Măsurile sînt aria de sub curba precizie-recall (PR-AUC) și aria de sub curba caracteristicii de operare a receptorului (ROC-AUC), ponderate la datele complete.

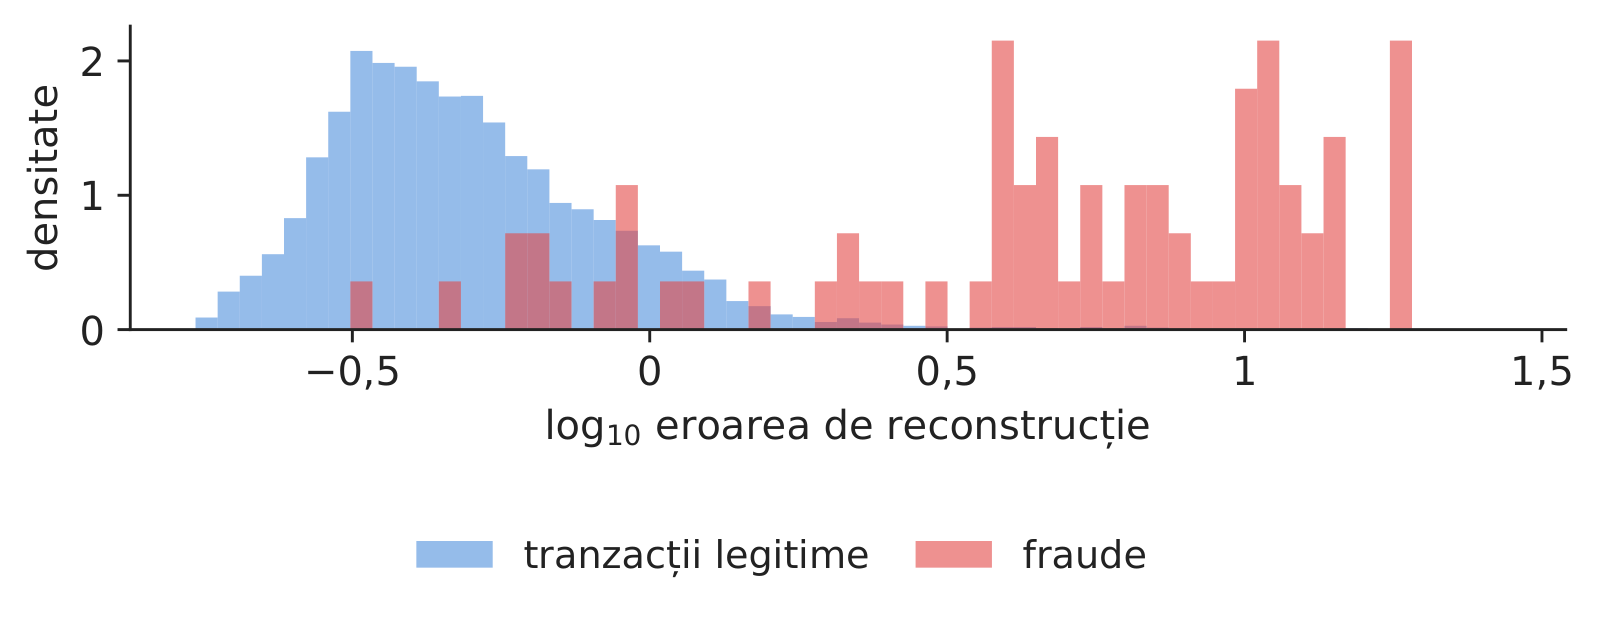
Eroarea de reconstrucție a plăților frauduloase și a celor legitime

Slide-ul 11 în PDF

Pe partea de test, eroarea mediană de reconstrucție a unei fraude este de 12,7 ori mai mare decît a unei tranzacții legitime. Cele două distribuții se suprapun totuși: multe fraude par normale unui model care cunoaște doar comportamentul normal.

Grafic: Eroarea de reconstrucție a plăților frauduloase și a celor legitime

Eroarea de reconstrucție a autoencoderului pe partea de test, tranzacții legitime (ponderate) și fraude.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: estimări proprii; două zile din septembrie 2013; test = ultimele 20 % din interval.

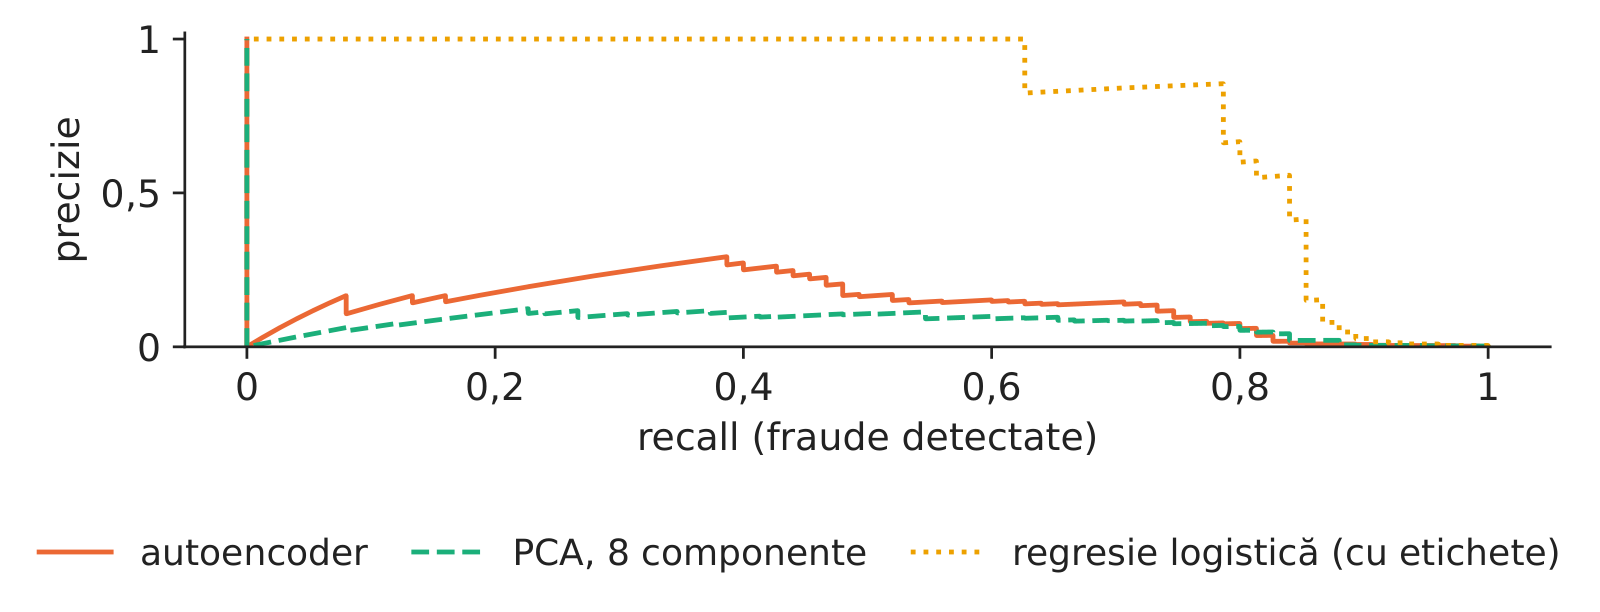
Autoencoderul fără etichete comparat cu un clasificator supervizat

Slide-ul 12 în PDF

PR-AUC pe partea de test este 14,2 % pentru autoencoder (abatere standard 2,9 pe 3 semințe), 7,6 % pentru PCA și 80,4 % pentru o regresie logistică ce folosește etichetele; un scor aleator ar da 0,131 %. ROC-AUC este mare pentru toate trei (94,4, 95,3 și 98,2 %): la o fraudă la cîteva sute de tranzacții ascunde diferențele pe care le arată PR-AUC.

Grafic: Autoencoderul fără etichete comparat cu un clasificator supervizat

Curbele precizie-recall pe partea de test, ponderate la datele complete.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: estimări proprii; două zile din septembrie 2013; test = ultimele 20 % din interval.

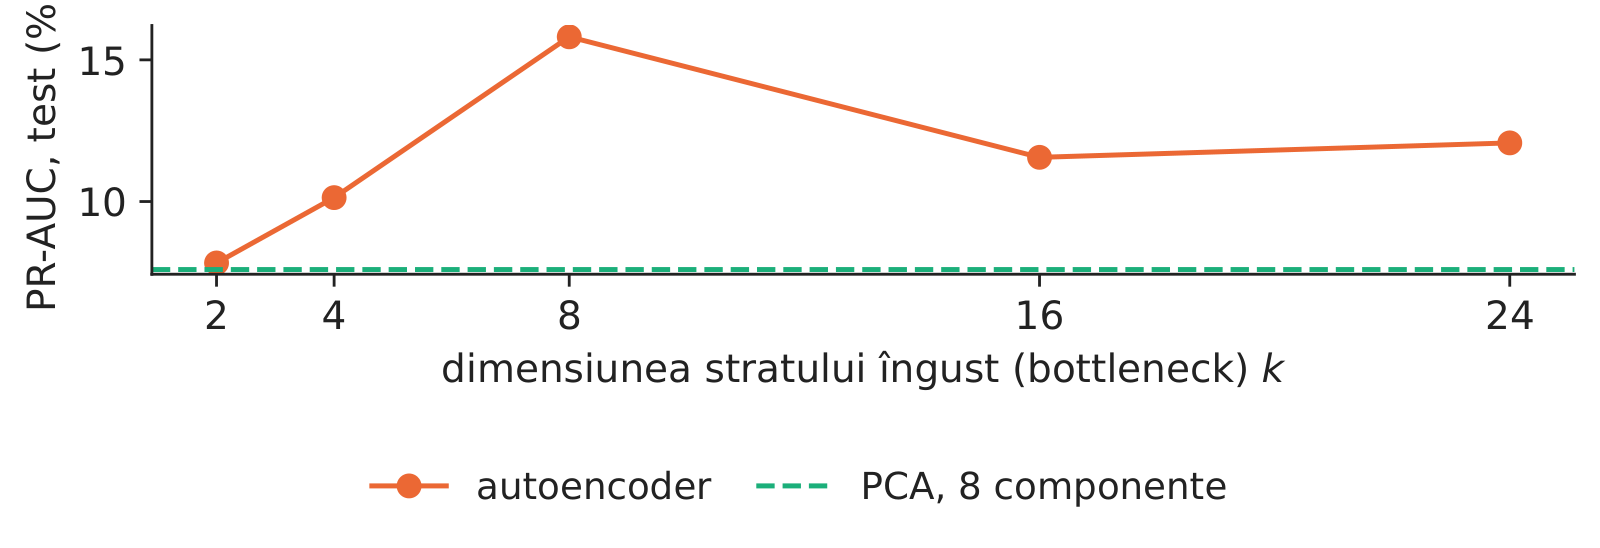
Dimensiunea stratului îngust și detectarea anomaliilor

Slide-ul 13 în PDF

Cu un strat îngust de 2, PR-AUC este 7,8 %, cu 8 este 15,8 %, iar cu 24 este 12,1 % (media pe 2 semințe); dimensiunea cea mai bună este 8. Prea îngust, și chiar plățile normale sînt reconstruite prost; prea larg, și rețeaua învață să copieze și fraudele.

Grafic: Dimensiunea stratului îngust și detectarea anomaliilor

PR-AUC de test al autoencoderului după dimensiunea stratului îngust, cu PCA ca model de referință.

Sursa: ULB Machine Learning Group și Worldline, tranzacții cu carduri (OpenML 1597). Date: estimări proprii; două zile din septembrie 2013; test = ultimele 20 % din interval.

În practică: alegeți \(k\) pe o perioadă de validare, niciodată pe fraudele despre care veți raporta.

Fraudele identificate în primele 0,1 % dintre scoruri

Slide-ul 14 în PDF

Dacă echipa verifică primele 0,1 % scoruri din partea de test, 57 de alerte, găsește 8 fraude cu autoencoderul (10,7 % din toate fraudele de test), 0 cu PCA și 48 cu regresia logistică (64,0 %). Etichetele valorează mult: învățarea supervizată cîștigă ori de cîte ori există fraude confirmate. Autoencoderul este detectorul necunoscutului, un complement, nu un înlocuitor.

În practică: folosiți-le pe amîndouă: clasificatorul pentru tiparele cunoscute, autoencoderul pentru a scoate la iveală tipare noi, pe care investigatorii le etichetează.

Sinteza secțiunii

Un autoencoder este un model al comportamentului normal; fără etichete găsește o parte din fraude, cu etichete un model supervizat găsește mult mai multe.

Autoencodere variaționale

VAE transformă autoencoderul într-un generator probabilist, învățînd o distribuție a codurilor.

VAE transformă autoencoderul într-un generator probabilist

Slide-ul 16 în PDF

Codificatorul produce o gaussiană \(q_\phi(\mathbf z\mid\mathbf x)=\mathcal N(\boldsymbol\mu_\phi(\mathbf x),\operatorname{diag}\boldsymbol\sigma_\phi^2(\mathbf x))\), iar decodorul o verosimilitate \(p_\theta(\mathbf x\mid\mathbf z)\). Log-verosimilitatea este mărginită inferior de marginea inferioară a verosimilității (ELBO):

\[\log p_\theta(\mathbf x)\ge\mathbb E_{q_\phi(\mathbf z\mid\mathbf x)}\big[\log p_\theta(\mathbf x\mid\mathbf z)\big]-\mathrm{KL}\big(q_\phi(\mathbf z\mid\mathbf x)\,\|\,p(\mathbf z)\big).\]
(8.3)

Primul termen răsplătește reconstrucțiile bune; al doilea, divergența Kullback–Leibler (KL) față de distribuția a priori \(p(\mathbf z)=\mathcal N(0,I)\), adună toate codurile în jurul originii, astfel încît un cod aleator să producă o imagine realistă. Pentru gaussiene are forma închisă \(\tfrac12\sum_j(\mu_j^2+\sigma_j^2-\log\sigma_j^2-1)\).

Trucul reparametrizării

Slide-ul 17 în PDF

Extragerea lui \(\mathbf z\) nu este derivabilă, dar \(\mathbf z=\boldsymbol\mu_\phi(\mathbf x)+\boldsymbol\sigma_\phi(\mathbf x)\odot\boldsymbol\varepsilon\), cu \(\boldsymbol\varepsilon\sim\mathcal N(0,I)\), este: hazardul stă în \(\boldsymbol\varepsilon\), care nu depinde de parametri. VAE-ul nostru este antrenat pe Fashion-MNIST, 60 000 de imagini de antrenare și 10 000 de test, gri, de 28 × 28 de pixeli, cu 10 tipuri de îmbrăcăminte, și are un decodor Bernoulli; rețeaua 784–400–200–\(k\) are 798 816 de parametri pentru \(k=16\) și este antrenată 20 de epoci.

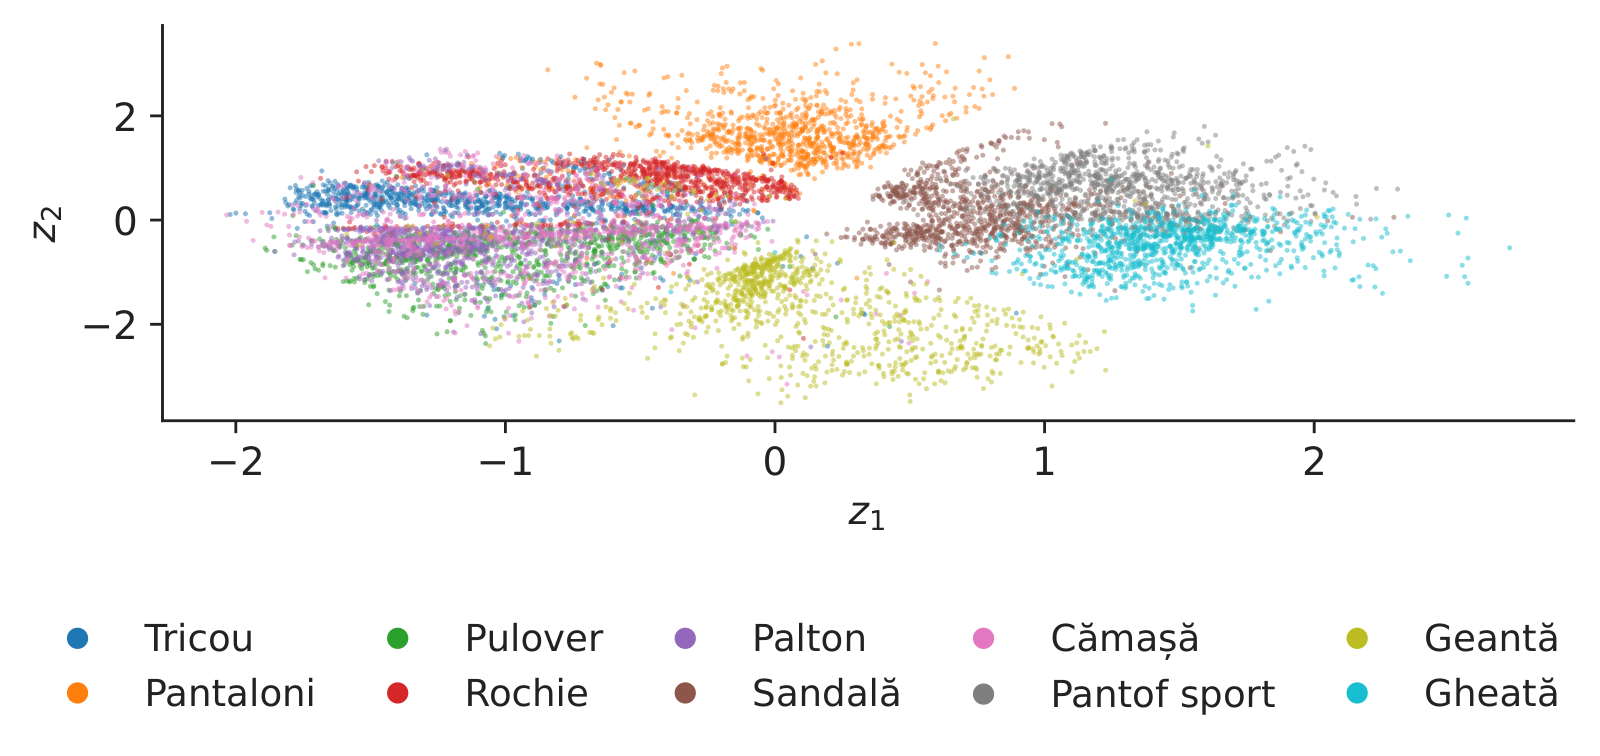
Un spațiu latent cu două dimensiuni separă tipurile de produse

Slide-ul 18 în PDF

Cu doar două dimensiuni latente și fără etichete, încălțămintea, gențile și hainele ajung în regiuni separate. Un clasificator cu 15 vecini pe cele două medii latente atinge o acuratețe de 71,7 % (5 partiții, imaginile de test): VAE a învățat o organizare a produselor fără să i se spună ce sînt.

Grafic: Un spațiu latent cu două dimensiuni separă tipurile de produse

Mediile latente ale celor 10 000 de imagini de test, VAE cu \(k=2\), colorate după clasă.

Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: estimări proprii; 60.000 de imagini de antrenare și 10.000 de test.

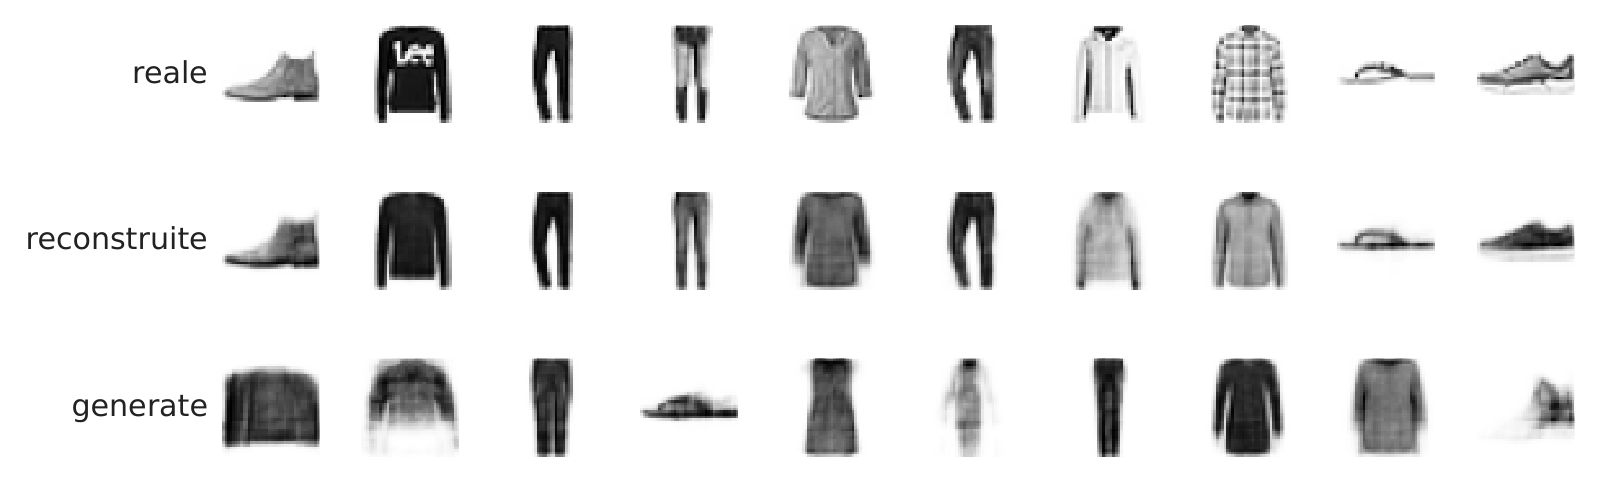
Calitatea reconstrucțiilor VAE și a eșantioanelor generate

Slide-ul 19 în PDF

Primul rînd arată imagini reale de test, al doilea reconstrucția lor printr-un cod cu 16 dimensiuni, al treilea imagini noi, decodate din coduri aleatoare. Neclaritatea vine din distribuția a posteriori gaussiană și din pierderea calculată pixel cu pixel: decodorul face media detaliilor plauzibile.

Grafic: Calitatea reconstrucțiilor VAE și a eșantioanelor generate

Imagini reale, reconstruite și generate, VAE cu \(k=16\).

Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: estimări proprii; 60.000 de imagini de antrenare și 10.000 de test.

Compromisul dintre reconstrucție și penalizarea KL în timpul antrenării

Slide-ul 20 în PDF

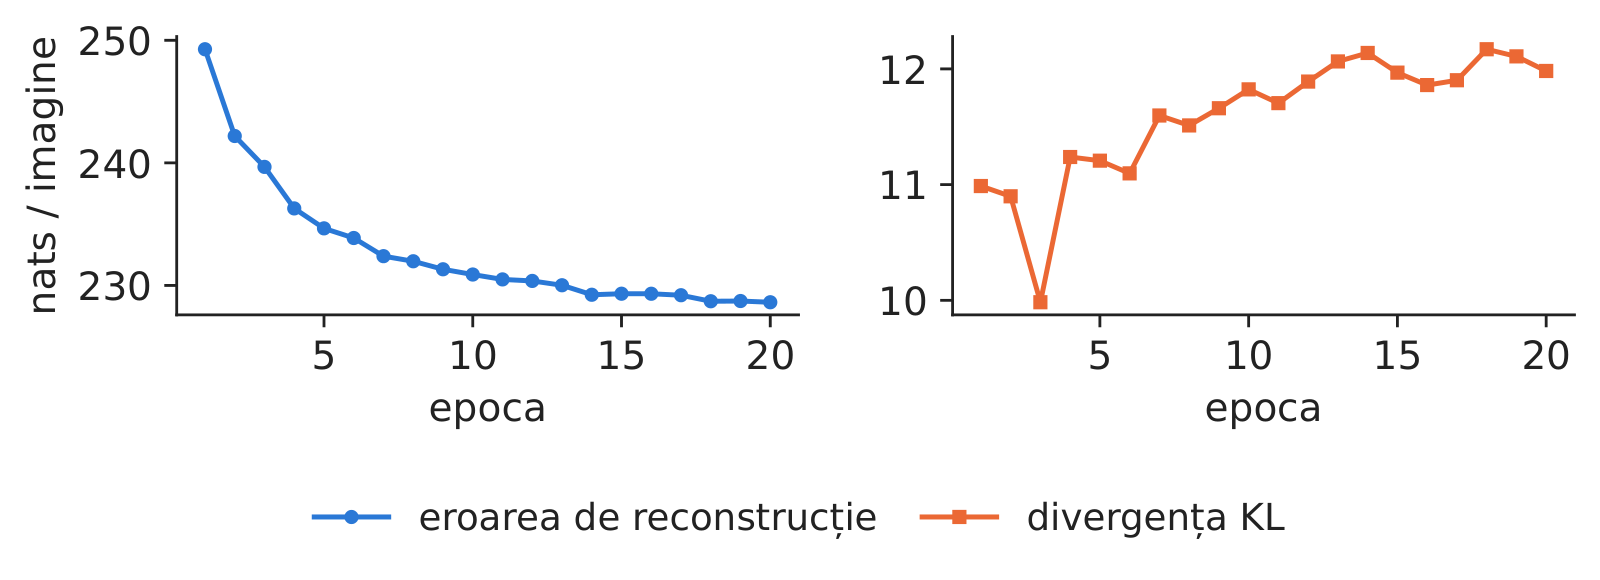
Pe imaginile de test, după ultima epocă, termenul de reconstrucție este 228,6 nats pe imagine, iar termenul KL 12,0 nats, deci ELBO este −240,6 nats. KL crește cînd eroarea scade: codificatorul folosește mai multă informație pentru fiecare imagine pe măsură ce învață.

Grafic: Compromisul dintre reconstrucție și penalizarea KL în timpul antrenării

Termenii de reconstrucție și KL ai ELBO pe imaginile de test, pe epoci.

Sursa: Fashion-MNIST, Zalando Research (Xiao et al., 2017). Date: estimări proprii; 60.000 de imagini de antrenare și 10.000 de test.

β-VAE: calitatea reconstrucției și structura spațiului latent

Slide-ul 21 în PDF

Înmulțirea termenului KL cu \(\beta\) schimbă echilibrul. Cu \(\beta=0{,}5\), termenul de reconstrucție este 222,5 nats și 9 dintre cele 16 dimensiuni latente sînt active (KL peste 0,05); cu \(\beta=4\), reconstrucția se înrăutățește la 242,5 nats și rămîn active doar 4 dimensiuni. Un \(\beta\) mai mare dă coduri mai netede și mai separate; unul mai mic dă copii mai bune și eșantioane mai slabe.

În practică: pentru generarea de scenarii preferați un spațiu latent ordonat (\(\beta\ge1\)); pentru comprimare, reconstrucția (\(\beta<1\)).

Sinteza secțiunii

VAE maximizează ELBO = reconstrucție − KL; trucul reparametrizării îl face antrenabil, iar β stabilește echilibrul.

Rețele generative adversariale

Un GAN învață să extragă din distribuția datelor jucînd împotriva unui discriminator.

Rețelele generative adversariale: generatorul și discriminatorul

Slide-ul 23 în PDF

Generatorul \(G\) transformă zgomotul \(\mathbf z\) în date false; discriminatorul \(D\) dă probabilitatea ca inputul să fie real. Ei joacă

\[\min_G\max_D\ \mathbb E_{\mathbf x\sim p_{data}}[\log D(\mathbf x)]+\mathbb E_{\mathbf z}[\log(1-D(G(\mathbf z)))].\]
(8.4)

Pentru un generator fixat, cel mai bun discriminator este \(D^*(\mathbf x)=p_{data}(\mathbf x)/(p_{data}(\mathbf x)+p_G(\mathbf x))\), iar valoarea jocului devine \(-\log 4+2\,\mathrm{JS}(p_{data}\|p_G)\), unde divergența Jensen–Shannon (JS) este nulă numai cînd generatorul reproduce datele. Atunci \(D^*=1/2\) peste tot. Un GAN nu scrie niciodată o verosimilitate; se judecă după ce reproduc corect eșantioanele lui.

Antrenarea unui GAN: pași alternativi și pierderea nesaturată

Slide-ul 24 în PDF

La fiecare pas se actualizează întîi discriminatorul, pe un lot de 256 de zile reale și 256 false, apoi generatorul, pe zgomot nou. Generatorul minimizează \(-\log D(G(\mathbf z))\) în loc de \(\log(1-D(G(\mathbf z)))\), al cărui gradient dispare cînd discriminatorul cîștigă devreme. GAN-ul nostru învață randamentele logaritmice zilnice standardizate ale indicelui S&P 500 din 4 ianuarie 2005 pînă la sfîrșitul lui 2019, 3 774 de zile; generatorul are 4 801 de parametri, iar discriminatorul 4 353, antrenați 6 000 de pași, cu 3 semințe.

Cele două pierderi se stabilizează lîngă valorile de echilibru

Slide-ul 25 în PDF

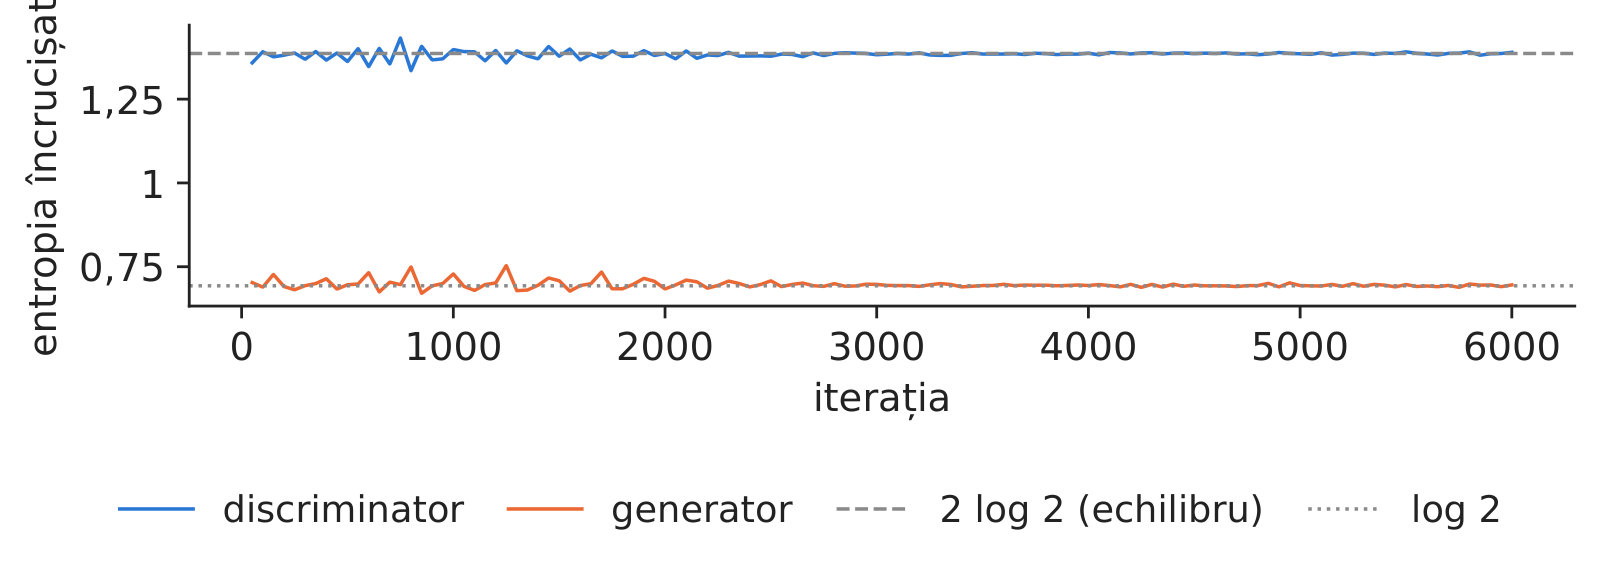
Pierderea discriminatorului oscilează în jurul lui \(2\log 2\), iar a generatorului în jurul lui \(\log 2\), valorile care corespund lui \(D^*=1/2\). Nu există o demonstrație a convergenței pentru jocul pe gradienți, iar curbele nu măsoară calitatea eșantioanelor: arată doar că niciun jucător nu a cîștigat.

Grafic: Cele două pierderi se stabilizează lîngă valorile de echilibru

Pierderile discriminatorului și generatorului în timpul antrenării, sămînța 1.

Sursa: Yahoo Finance, cotații zilnice. Date: estimări proprii; S&P 500 4 ianuarie 2005 - 31 decembrie 2019, zile de tranzacționare.

GAN-ul reproduce cozile groase pe care modelul gaussian nu le surprinde

Slide-ul 26 în PDF

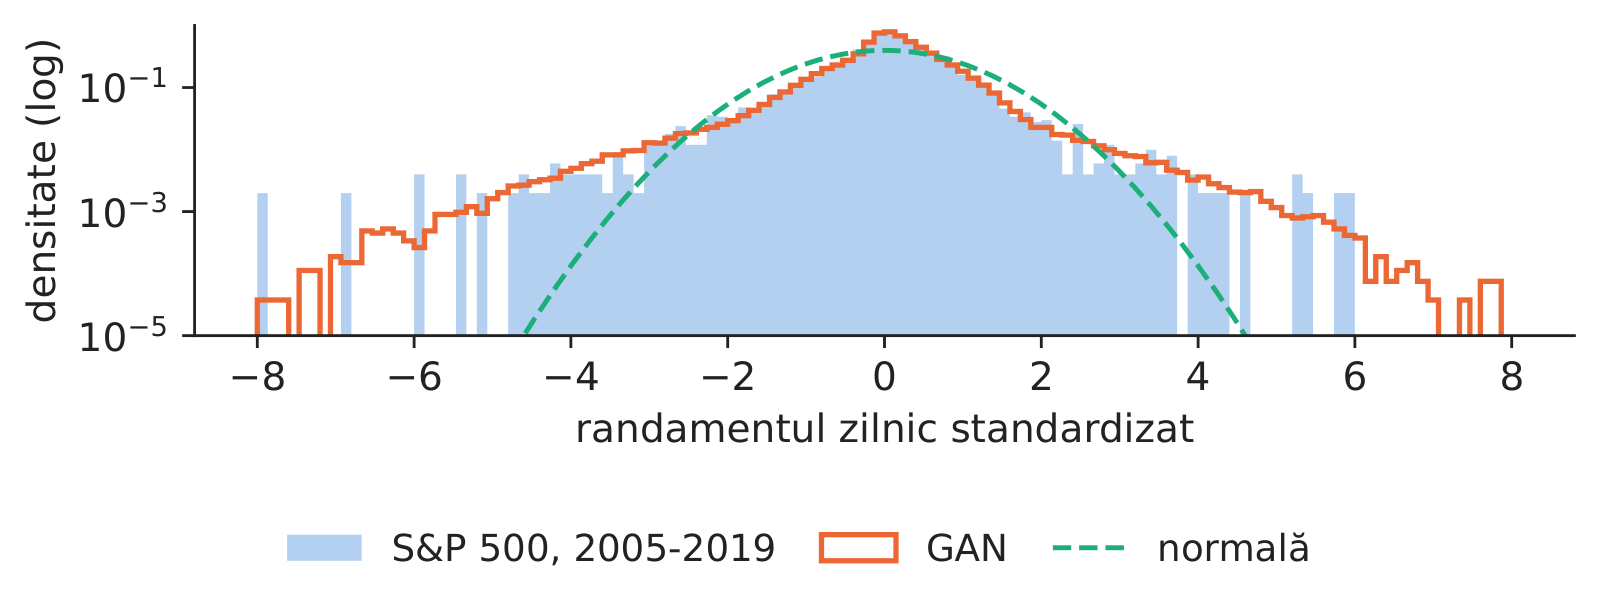
Excesul de aplatizare al randamentelor reale este 11,86; eșantioanele GAN ajung la 6,65 (abatere standard 0,48 pe 3 semințe), față de 0 pentru normală. Distanța Kolmogorov–Smirnov față de randamentele reale este 0,030 pentru GAN și 0,115 pentru normala estimată.

Grafic: GAN-ul reproduce cozile groase pe care modelul gaussian nu le surprinde

Densitatea, pe scară logaritmică, a randamentelor reale standardizate, a eșantioanelor GAN și a normalei.

Sursa: Yahoo Finance, cotații zilnice. Date: estimări proprii; S&P 500 4 ianuarie 2005 - 31 decembrie 2019, zile de tranzacționare.

Un test de risc: valoarea la risc de 1 % în anii de după antrenare

Slide-ul 27 în PDF

Cuantila de 1 % a randamentelor zilnice estimată pe 2005–2019 este −3,48 % prin simulare istorică, −3,61 % din eșantioanele GAN și −2,67 % pentru normală. Pe cele 1 717 de zile dintre 2 ianuarie 2020 și 30 octombrie 2026, o valoare VaR corectă de 1 % este depășită în circa 17 zile. Ratele depășirilor sînt 1,11 % (istorică), 0,95 % (GAN) și 2,39 % (normală). Pierderea așteptată în coadă (ES), media pierderilor dincolo de VaR, depinde de aceeași coadă. Acestea sînt cuantile necondiționate: niciuna dintre cele trei metode nu reacționează la volatilitate.

În practică: un generator este atît de bun cît măsura de risc pe care o reproduce: testați-l retrospectiv ca pe orice model VaR.

Un GAN pe zile izolate nu poate învăța gruparea volatilității

Slide-ul 28 în PDF

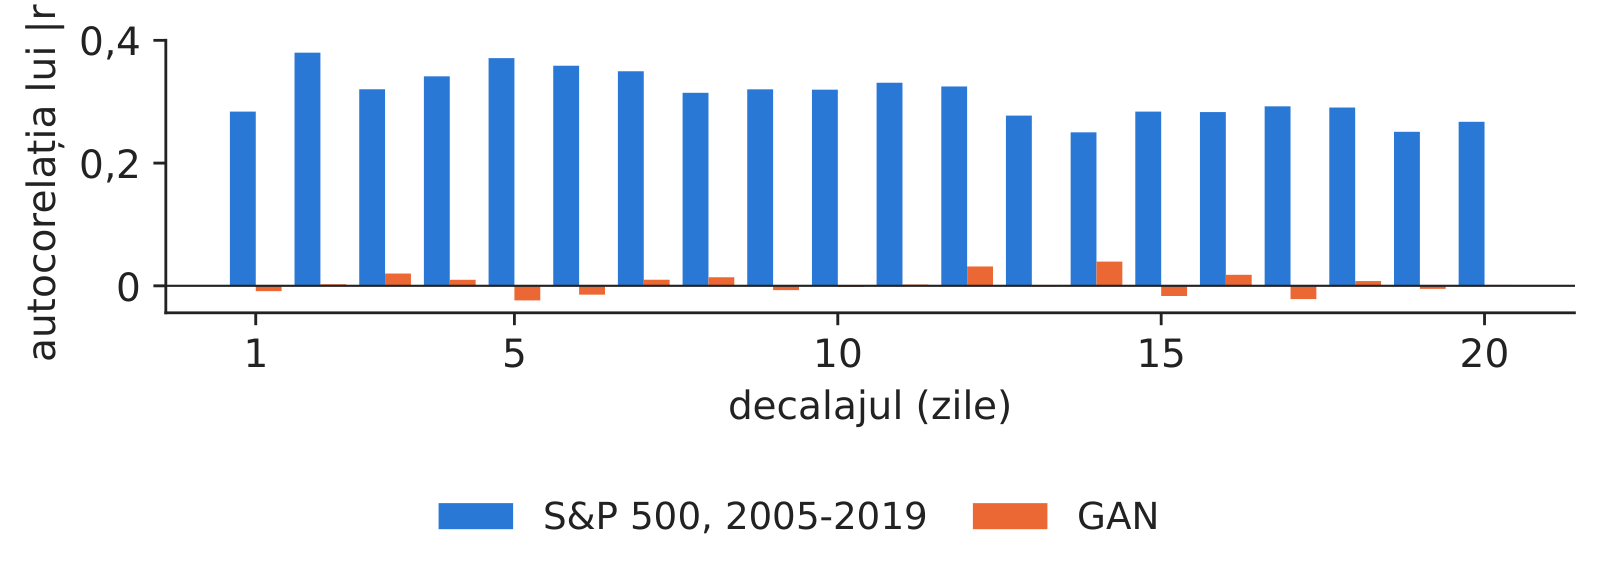
Autocorelația randamentelor reale în valoare absolută este 0,28 la decalajul 1 și încă 0,27 la decalajul 20: perioadele calme și cele agitate se grupează. GAN-ul extrage zilele independent, deci autocorelația lui este −0,01: distribuția marginală corectă, cu dinamica greșită. De aceea generatoarele de secvențe, ca TimeGAN sau Quant GANs, generează traiectorii întregi.

Grafic: Un GAN pe zile izolate nu poate învăța gruparea volatilității

Autocorelația randamentelor în valoare absolută, decalajele 1–20, randamente reale și eșantioane GAN.

Sursa: Yahoo Finance, cotații zilnice. Date: estimări proprii; S&P 500 4 ianuarie 2005 - 31 decembrie 2019, zile de tranzacționare.

Colapsul modurilor și GAN-ul Wasserstein

Slide-ul 29 în PDF

Un generator poate cîștiga producînd doar cîteva eșantioane convingătoare, de exemplu numai zile calme și niciodată o prăbușire: colapsul modurilor. GAN-ul Wasserstein (WGAN) înlocuiește divergența Jensen–Shannon cu distanța Wasserstein \(W_1(p_{data},p_G)=\sup_{\|f\|_L\le1}\mathbb E_{p_{data}}[f]-\mathbb E_{p_G}[f]\), calculată de o rețea critic 1-Lipschitz, care dă gradienți utili chiar cînd cele două distribuții nu se suprapun.

În practică: un generator pentru teste de stres care a colapsat pe zilele calme este mai rău decît lipsa unui generator.

Sinteza secțiunii

Un GAN reproduce cozile groase ale randamentelor și o valoare VaR de 1 % utilizabilă, dar nu și gruparea volatilității cînd este antrenat pe zile izolate.

Modele de difuzie

Un model de difuzie învață să inverseze, pas cu pas, un proces care transformă datele în zgomot.

Modelele de difuzie: adăugarea și eliminarea treptată a zgomotului

Slide-ul 31 în PDF

Procesul înainte adaugă puțin zgomot gaussian la fiecare dintre cei \(T\) = 200 de pași, \(q(\mathbf x_t\mid\mathbf x_{t-1})=\mathcal N(\sqrt{1-\beta_t}\,\mathbf x_{t-1},\beta_tI)\), cu \(\beta_t\) crescînd liniar de la \(10^{-4}\) la 0,02. Orice pas se obține dintr-o singură extragere,

\[\mathbf x_t=\sqrt{\bar\alpha_t}\,\mathbf x_0+\sqrt{1-\bar\alpha_t}\,\boldsymbol\varepsilon,\qquad \bar\alpha_t=\prod_{s=1}^t(1-\beta_s),\]
(8.5)

iar la ultimul pas \(\mathbf x_T\) este aproape normal standard. Procesul înainte nu are parametri: se învață numai procesul invers.

Procesul înainte pe o curbă reală a randamentelor

Slide-ul 32 în PDF

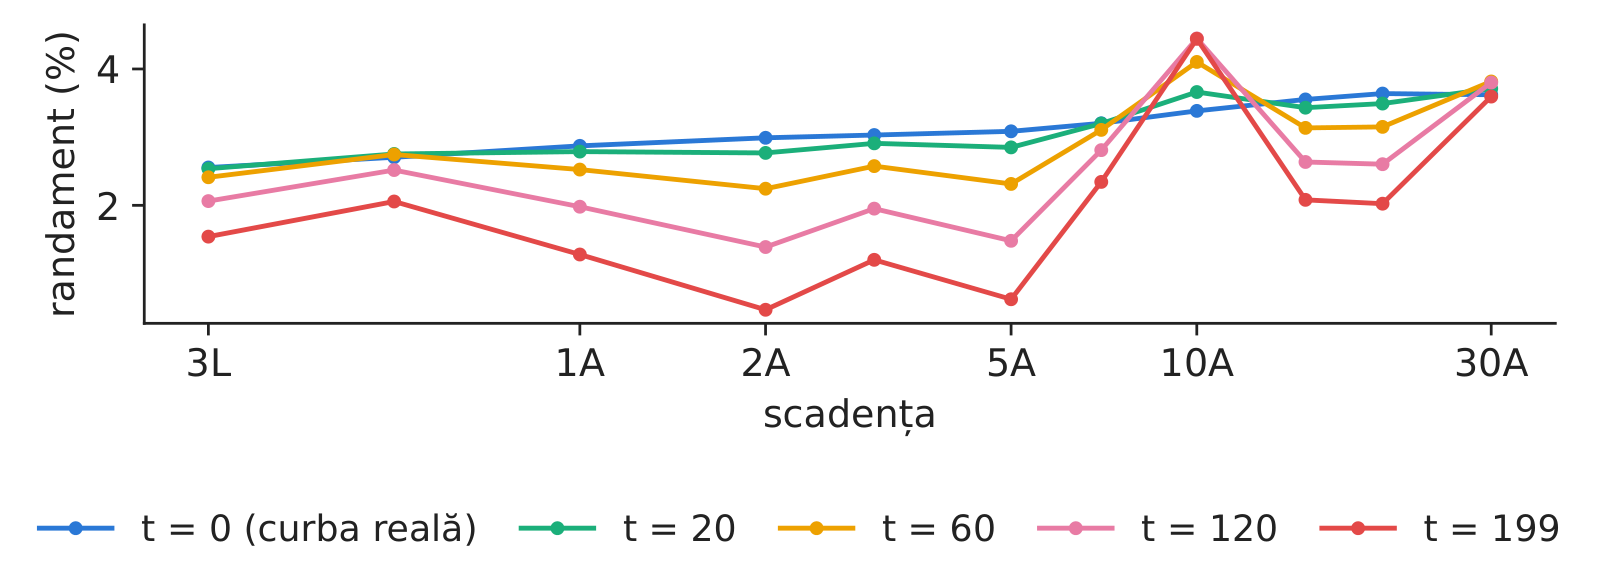
Graficul aplică (8.5) curbei AAA din zona euro din 30 octombrie 2026, cu 11 scadențe de la 3 luni la 30 de ani. La pasul 199 forma a dispărut și a rămas doar zgomot; rețeaua trebuie să învețe drumul înapoi, cîte un pas mic.

Grafic: Procesul înainte pe o curbă reală a randamentelor

Curba la pașii de zgomot 0, 20, 60, 120 și 199 (o singură extragere a zgomotului).

Sursa: Banca Centrală Europeană, curba randamentelor AAA din zona euro. Date: curba din 30 octombrie 2026; programul de zgomot din curs (mecanism).

Învățarea eliminării zgomotului: prezicem zgomotul adăugat

Slide-ul 33 în PDF

O rețea \(\boldsymbol\varepsilon_\theta(\mathbf x_t,t)\) vede o curbă cu zgomot și pasul și prezice zgomotul:

\[\mathcal L(\theta)=\mathbb E_{t,\mathbf x_0,\boldsymbol\varepsilon}\big\|\boldsymbol\varepsilon-\boldsymbol\varepsilon_\theta(\sqrt{\bar\alpha_t}\mathbf x_0+\sqrt{1-\bar\alpha_t}\boldsymbol\varepsilon,t)\big\|^2,\]
(8.6)

un ELBO simplificat și reponderat. Generarea pornește de la zgomot pur și aplică \(\mathbf x_{t-1}=\big(\mathbf x_t-\beta_t\boldsymbol\varepsilon_\theta/\sqrt{1-\bar\alpha_t}\big)/\sqrt{\alpha_t}+\sqrt{\beta_t}\mathbf u\) pînă la \(t=0\). Rețeaua noastră este un MLP cu trei straturi ascunse de 256 de unități și o reprezentare sinusoidală a lui \(t\), cu 145 675 de parametri, antrenată 12 000 de pași pe cele 5 664 de curbe zilnice ale Băncii Centrale Europene, din 6 septembrie 2004 pînă în 30 octombrie 2026.

Cele două regimuri ale dobînzilor euro în eșantioanele generate prin difuzie și de modelul gaussian

Slide-ul 34 în PDF

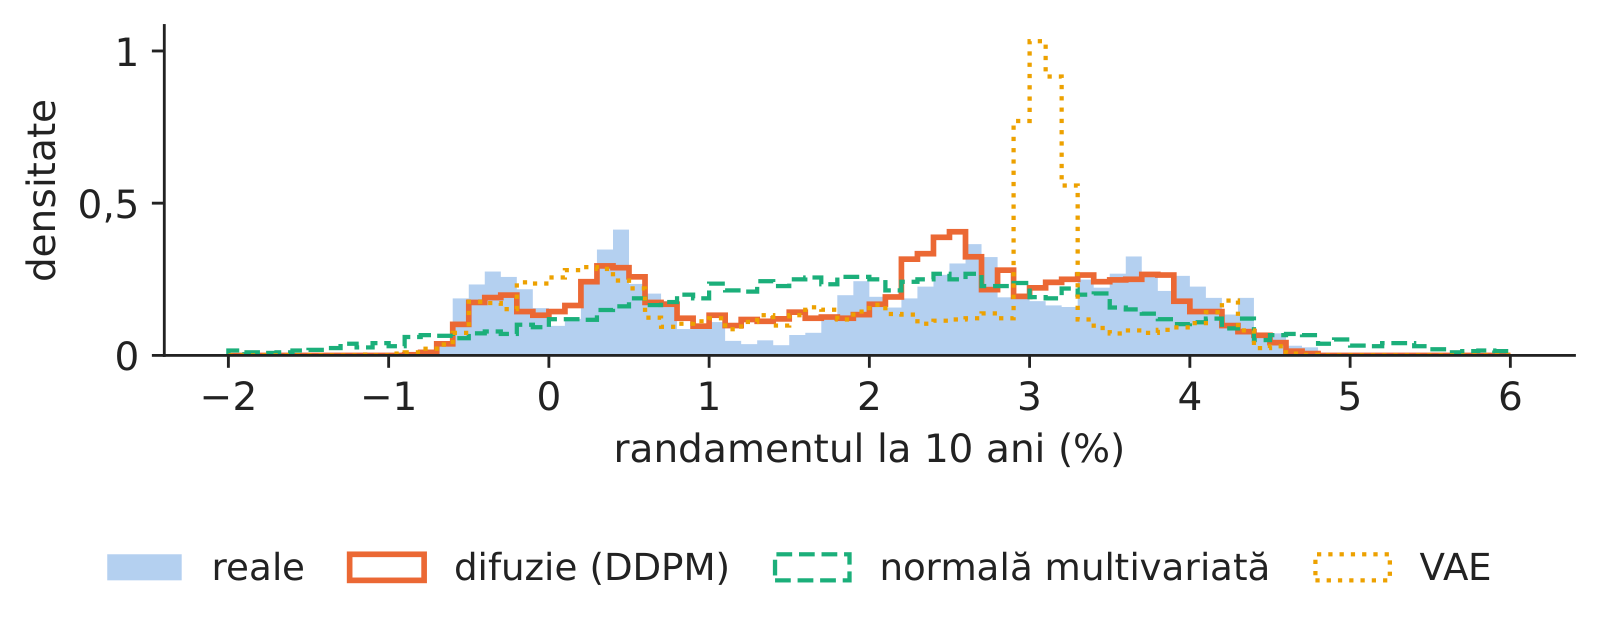
Randamentul real la 10 ani variază între −0,82 % și 4,78 % și este negativ în 13,8 % dintre zile: există un regim de dobînzi scăzute și unul de dobînzi normale. Distanța Wasserstein dintre randamentul generat și cel real la 10 ani este 0,149 puncte procentuale pentru modelul de difuzie, 0,191 pentru un VAE cu doi factori și 0,325 pentru o normală multivariată.

Grafic: Cele două regimuri ale dobînzilor euro în eșantioanele generate prin difuzie și de modelul gaussian

Densitatea randamentului la 10 ani, curbele reale și cîte 5 000 de curbe din fiecare generator.

Sursa: Banca Centrală Europeană, curba randamentelor AAA din zona euro. Date: estimări proprii; 6 septembrie 2004 - 30 octombrie 2026, zile lucrătoare.

Difuzia păstrează dependența neliniară dintre nivel și pantă

Slide-ul 35 în PDF

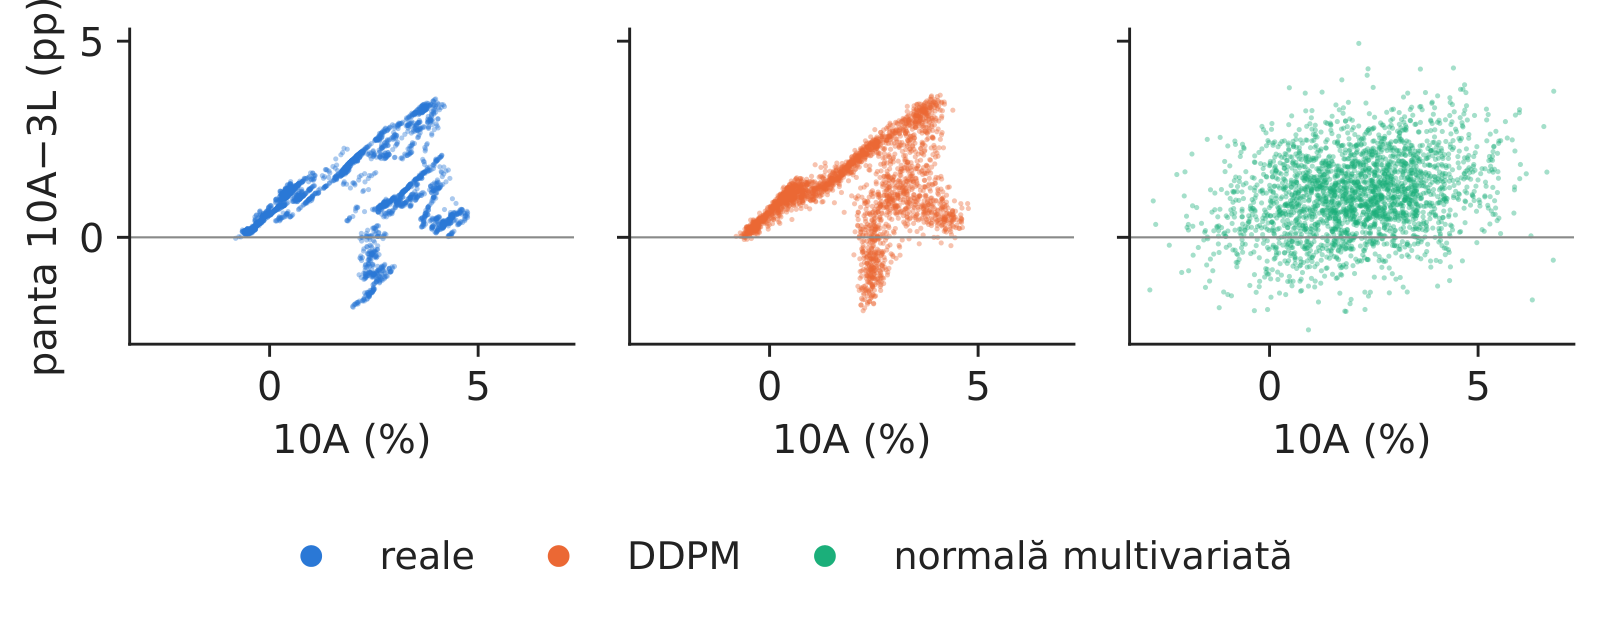
O curbă este inversată cînd randamentul la 10 ani este sub cel la 3 luni. Acest lucru s-a întîmplat în 8,7 % dintre zilele reale; 10,2 % dintre eșantioanele difuziei și 14,7 % dintre cele normale sînt inversate. Distanța Wasserstein a pantei este 0,099 pentru modelul de difuzie, 0,242 pentru VAE și 0,113 pentru normală.

Grafic: Difuzia păstrează dependența neliniară dintre nivel și pantă

Nivelul (randamentul la 10 ani) față de pantă (10 ani minus 3 luni): curbe reale, eșantioane ale difuziei și eșantioane normale.

Sursa: Banca Centrală Europeană, curba randamentelor AAA din zona euro. Date: estimări proprii; 6 septembrie 2004 - 30 octombrie 2026, zile lucrătoare.

Un VAE cu doi factori ai curbei redescoperă nivelul și panta

Slide-ul 36 în PDF

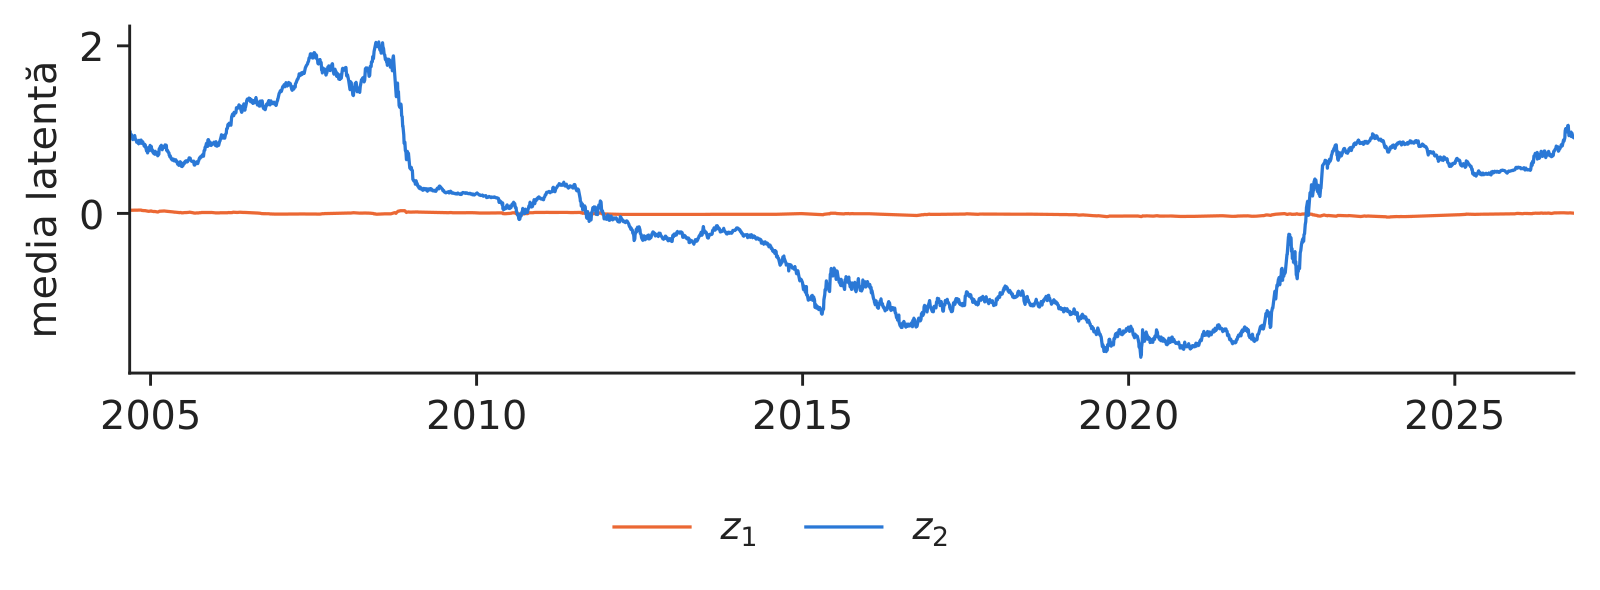
VAE-ul folosit ca model de referință comprimă fiecare curbă în două numere latente. Corelațiile lor cu nivelul (media celor 11 randamente) și cu panta ajung la 0,99 și 0,66 în valoare absolută: fără să i se spună, traiectoria latentă urmărește perioada de dobînzi scăzute 2014–2021 și înăsprirea din 2022.

Grafic: Un VAE cu doi factori ai curbei redescoperă nivelul și panta

Mediile latente ale VAE-ului cu doi factori, în timp.

Sursa: Banca Centrală Europeană, curba randamentelor AAA din zona euro. Date: estimări proprii; 6 septembrie 2004 - 30 octombrie 2026, zile lucrătoare.

Sinteza secțiunii

Difuzia învață să elimine zgomotul; pe curbele euro păstrează ambele regimuri de dobîndă și inversările pe care distribuția normală nu le vede.

Modelele generative în practică

Datele sintetice sînt utile numai după ce trec aceleași verificări ca datele reale.

Criterii de evaluare a datelor financiare sintetice

Slide-ul 38 în PDF

Patru întrebări. Fidelitatea: se potrivesc distribuțiile marginale, cozile și dependența între active și în timp? Diversitatea: apar zilele extreme și regimurile în proporțiile corecte, fără colaps al modurilor? Utilitatea: funcționează un model antrenat pe date sintetice și testat pe date reale (TSTR)? Confidențialitatea: este vreun eșantion prea aproape de o înregistrare reală? Pe datele noastre, GAN-ul reproduce corect cozile și greșește gruparea volatilității; modelul de difuzie reproduce regimurile și inversările, normala nu.

În practică: nu folosiți date sintetice într-o decizie înainte ca ele să treacă aceleași teste retrospective ca modelul pe care îl alimentează.

Alegerea unui model generativ

Slide-ul 39 în PDF

Autoencoderele sînt instrumentul de monitorizare (un scor de anomalie), VAE pentru comprimare și explorare (factori latenți netezi), modelele de difuzie pentru simulări fidele, cu prețul a 200 de treceri prin rețea pentru fiecare eșantion, iar GAN cînd generarea trebuie să fie rapidă și antrenarea poate fi urmărită îndeaproape.

Sinteza secțiunii

Alegeți familia după utilizare: monitorizare, comprimare, simulare fidelă sau generare rapidă; apoi testați retrospectiv rezultatul.

Video: intuiția din spatele matematicii (în engleză)

Abrevieri

AEautoencoder (rețea de autocodificare)
ASEAcademia de Studii Economice din București
DDPMmodel probabilistic de difuzie cu eliminarea zgomotului (denoising diffusion)
ELBOmarginea inferioară a verosimilității (evidence lower bound)
ESpierderea așteptată în coadă (expected shortfall)
GANrețea generativă adversarială
IPEInstitutul de Prognoză Economică, Academia Română
JSdivergența Jensen–Shannon
KLdivergența Kullback–Leibler
LLMmodel mare de limbaj
MLPperceptron multistrat
MNISTcifrele scrise de mînă ale Modified National Institute of Standards and Technology
PCAanaliza componentelor principale
PR-AUCaria de sub curba precizie-recall
ReLUunitate liniară rectificată (rectified linear unit)
ROCcaracteristica de operare a receptorului (receiver operating characteristic)
ROC-AUCaria de sub curba ROC
TSTRantrenare pe date sintetice, test pe date reale (train on synthetic, test on real)
VAEautoencoder variațional
VaRvaloarea la risc (Value-at-Risk)
WGANGAN Wasserstein

Bibliografie

  • Arjovsky, M., Chintala, S. & Bottou, L. (2017). Wasserstein generative adversarial networks. Proceedings of ICML, PMLR 70, 214–223. arXiv:1701.07875
  • Bishop, C. M. & Bishop, H. (2024). Deep Learning: Foundations and Concepts, ch. 16–20. Springer. doi:10.1007/978-3-031-45468-4
  • Cont, R. (2001). Empirical properties of asset returns: stylized facts and statistical issues. Quantitative Finance, 1(2), 223–236. doi:10.1080/713665670
  • Dal Pozzolo, A., Caelen, O., Johnson, R. A. & Bontempi, G. (2015). Calibrating probability with undersampling for unbalanced classification. IEEE Symposium Series on Computational Intelligence, 159–166. doi:10.1109/SSCI.2015.33
  • Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., Courville, A. & Bengio, Y. (2014). Generative adversarial nets. Advances in Neural Information Processing Systems, 27. arXiv:1406.2661
  • Higgins, I., Matthey, L., Pal, A. et al. (2017). beta-VAE: Learning basic visual concepts with a constrained variational framework. International Conference on Learning Representations. openreview.net
  • Ho, J., Jain, A. & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33. arXiv:2006.11239
  • Jheng, S.-L., Tak, R., Găman, Ș., Mazurencu-Marinescu-Pele, M. & Pele, D. T. (2026). Can foundation models manage risk? Zero-shot VaR and ES forecasting with conformal calibration in CEE markets. Economic Computation and Economic Cybernetics Studies and Research, 60(2), 267–290. doi:10.24818/18423264/60.2.26.14
  • Kingma, D. P. & Welling, M. (2014). Auto-encoding variational Bayes. International Conference on Learning Representations. arXiv:1312.6114
  • Kupiec, P. H. (1995). Techniques for verifying the accuracy of risk measurement models. Journal of Derivatives, 3(2), 73–84. doi:10.3905/jod.1995.407942
  • Pele, D. T., Bolovăneanu, V., Lin, M.-B., Ren, R., Ginavar, A. T., Spilak, B., Andrei, A.-V., Toma, F.-M., Lessmann, S. & Härdle, W. K. (2026). In the beginning was the word: LLM-VaR and LLM-ES. SSRN Working Paper 5104383. doi:10.2139/ssrn.5104383
  • Sohl-Dickstein, J., Weiss, E., Maheswaranathan, N. & Ganguli, S. (2015). Deep unsupervised learning using nonequilibrium thermodynamics. Proceedings of ICML, PMLR 37, 2256–2265. arXiv:1503.03585
  • Svensson, L. E. O. (1994). Estimating and interpreting forward interest rates: Sweden 1992–1994. NBER Working Paper 4871. doi:10.3386/w4871
  • Wiese, M., Knobloch, R., Korn, R. & Kretschmer, P. (2020). Quant GANs: Deep generation of financial time series. Quantitative Finance, 20(9), 1419–1440. doi:10.1080/14697688.2020.1730426
  • Xiao, H., Rasul, K. & Vollgraf, R. (2017). Fashion-MNIST: A novel image dataset for benchmarking machine learning algorithms. arXiv:1708.07747
  • Yoon, J., Jarrett, D. & van der Schaar, M. (2019). Time-series generative adversarial networks. Advances in Neural Information Processing Systems, 32. papers.nips.cc/paper/8789

Text scris pentru versiunea web a cursului; cifrele, graficele și sursele provin din slide-uri și din Quantlet-urile lor.