

Statistica piețelor financiare

Capitolul 13 · Învățarea automată în finanțe

În stînga este slide-ul din curs, în dreapta aceeași figură sau același tabel, calculat în browser din aceleași date. Butonul ▶ modifică parametrul pas cu pas; tabelele și exemplele lucrate se recalculează odată cu el. Abrevieri: ML (machine learning, învățare automată), OLS (ordinary least squares, metoda celor mai mici pătrate), CV (cross-validation, validare încrucișată), SSE (suma pătratelor erorilor), MSE (mean squared error, eroarea pătratică medie), RMSE (rădăcina erorii pătratice medii), RV (varianța realizată), HAR (heterogeneous autoregressive, modelul autoregresiv heterogen), RF (random forest), GB (gradient boosting), MLP (multilayer perceptron, perceptron multistrat), ReLU (rectified linear unit), RBF (radial basis function, funcție de bază radială), GARCH (generalised autoregressive conditional heteroskedasticity), QLIKE (pierderea quasi-likelihood), DM (testul Diebold–Mariano), LRV (long-run variance, varianța pe termen lung), OOS (out-of-sample, în afara eșantionului), AUC (area under the curve, aria de sub curba ROC), VaR (value at risk), QR (regresie cuantilică), QGB (quantile gradient boosting), HS (simulare istorică), SR (raportul Sharpe), PSR (probabilistic Sharpe ratio), DSR (deflated Sharpe ratio, raportul Sharpe deflatat), MA (medie mobilă), H-L (decila de sus minus decila de jos), BET (indicele Bursei de Valori București), pp (puncte procentuale).

Overfitting, deplasare și varianță · Validarea pentru serii de timp · Regresia penalizată: ridge și lasso · Arbori de decizie, random forest și gradient boosting · Rețele neuronale · Aplicație: prognoza volatilității realizate · Aplicație: semnul randamentului de mîine · Aplicație: VaR 1% prin metode cuantilice · Data snooping și raportul Sharpe deflatat · Studiu de caz: Gu, Kelly și Xiu (2020)

Overfitting, deplasare și varianță

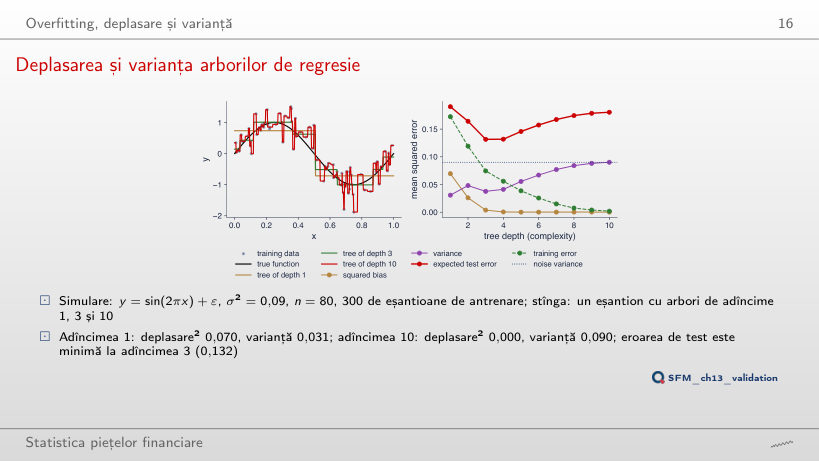
Deplasarea și varianța arborilor de regresie
Slide-ul 16: Deplasarea și varianța arborilor de regresie
Slide-ul 16
    Întrebare pentru sală Cu varianța zgomotului σ² = 0,04 în loc de 0,09 (rulare suplimentară), la ce adîncime este minimă eroarea de test așteptată?
    Răspuns

    La adîncimea 4 (0,063), față de adîncimea 3 (0,132) cu σ² = 0,09. Cu mai puțin zgomot, varianța arborilor adînci costă mai puțin, deci optimul se mută spre un model mai flexibil; cu σ² = 0,25 minimul rămîne la adîncimea 3 (0,329).

    Validarea pentru serii de timp

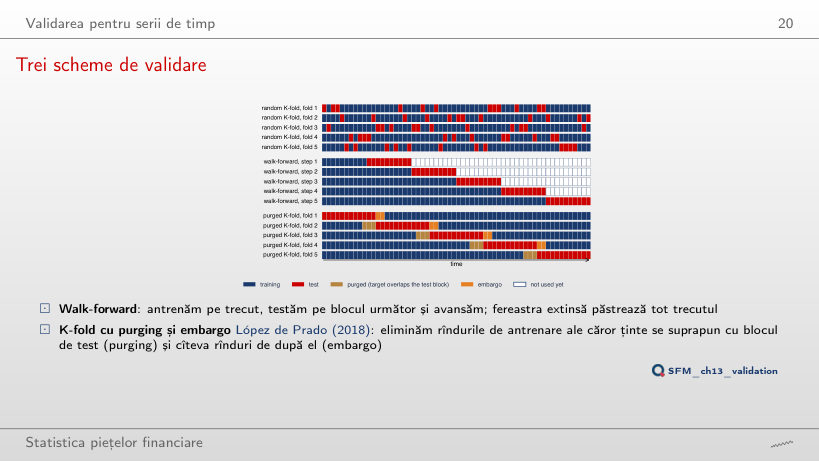
    Trei scheme de validare
    Slide-ul 20: Trei scheme de validare
    Slide-ul 20
      Întrebare pentru sală K-fold aleator, partiția 1 (K = 5): din cele 12 observații de test, cîte au cel puțin o vecină (ziua dinainte sau ziua de după) în antrenare?
      Răspuns

      11 din 12. Partiția aleatoare împrăștie testul printre zilele de antrenare, iar cu ținte suprapuse vecina are aproape aceeași țintă: modelul a văzut practic răspunsul. Cu K = 8 situația este aceeași, 7 din 8.

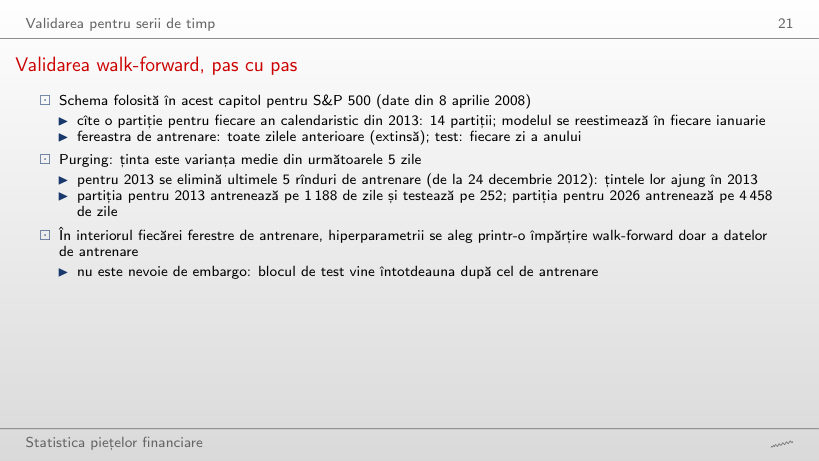
      Validarea walk-forward, pas cu pas
      Slide-ul 21: Validarea walk-forward, pas cu pas
      Slide-ul 21

      Cele 14 partiții walk-forward (S&P 500)

      Exemplu lucrat: o partiție walk-forward cu purging

      \[\text{antrenare}_Y = \{t < 1\,\text{ian.}\,Y\} \setminus \{\text{ultimele } h \text{ rînduri}\}, \qquad \text{test}_Y = \{t \in Y\}, \qquad y_t = \ln\Big(\tfrac1h\sum_{j=1}^{h} v_{t+j}\Big)\]
          Întrebare pentru sală Cu ținta pe 22 de zile (h = 22, rulare suplimentară), cîte zile de antrenare are partiția 2013?
          Răspuns

          1171: purging-ul elimină 22 de rînduri în loc de 5, deci cu 17 mai puține decît cele 1188 de zile cu h = 5; ultima zi de antrenare devine 28 noiembrie 2012. Testul rămîne cele 252 de zile din 2013.

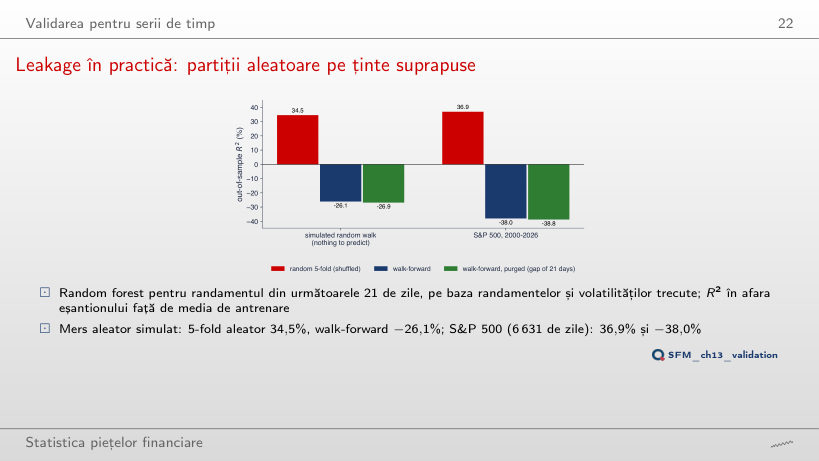
          Leakage în practică: partiții aleatoare pe ținte suprapuse
          Slide-ul 22: Leakage în practică: partiții aleatoare pe ținte suprapuse
          Slide-ul 22
            Întrebare pentru sală Cu ținta pe 5 zile în loc de 21 (rulare suplimentară), ce R² raportează K-fold aleator pentru mersul aleator simulat?
            Răspuns

            17,8%, față de 34,5% cu 21 de zile: țintele a două zile vecine au acum 4 din 5 randamente comune, nu 20 din 21, deci leakage-ul este mai mic, dar tot mare. Walk-forward rămîne negativ (−17,5%); cu 63 de zile, K-fold aleator urcă la 35,8%.

            Regresia penalizată: ridge și lasso

            Regresia ridge (2/2)
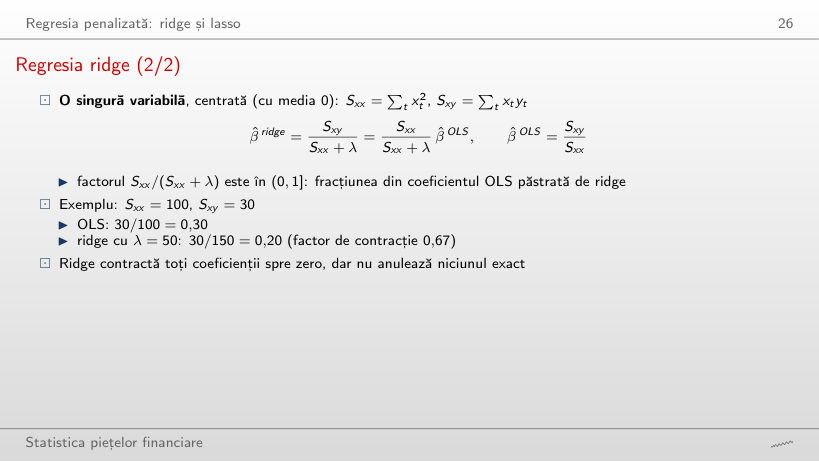
            Slide-ul 26: Regresia ridge (2/2)
            Slide-ul 26

            Exemplu lucrat: ridge cu o singură variabilă

            \[\hat\beta^{\,ridge} = \frac{S_{xy}}{S_{xx} + \lambda} = \frac{S_{xx}}{S_{xx} + \lambda}\,\hat\beta^{\,OLS}, \qquad \hat\beta^{\,OLS} = \frac{S_{xy}}{S_{xx}}\]
                Întrebare pentru sală ▶ crește λ de la 50 la 200. Cît devine β̂ ridge?
                Răspuns

                0,10 = 30/(100 + 200); factorul de contracție scade de la 0,67 la 0,33. Coeficientul se apropie de zero, dar nu devine zero pentru niciun λ finit; lasso cu λ = 200 este deja 0.

                Lasso
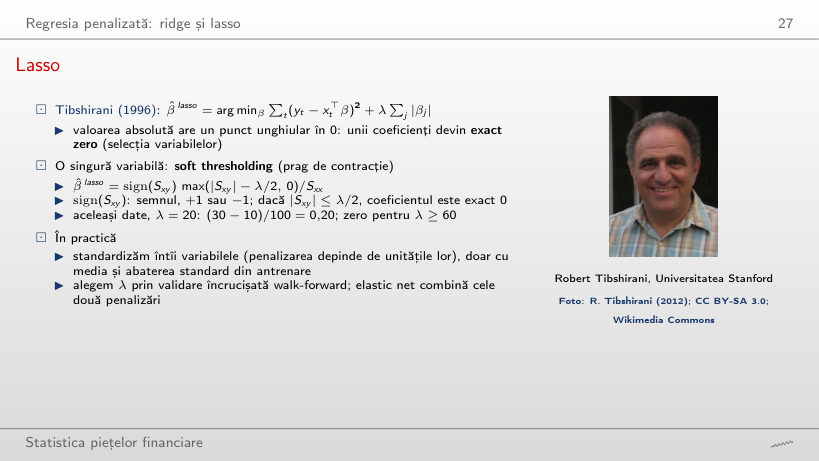
                Slide-ul 27: Lasso
                Slide-ul 27

                Exemplu lucrat: soft thresholding

                \[\hat\beta^{\,lasso} = \mathrm{sign}(S_{xy})\,\frac{\max(|S_{xy}| - \lambda/2,\, 0)}{S_{xx}}, \qquad S_{xx} = 100\]
                    Întrebare pentru sală ▶ crește λ de la 20 la 60. Cît devine β̂ lasso?
                    Răspuns

                    Exact 0: λ/2 = 30 = |S_xy|, deci max(30 − 30, 0) = 0, și rămîne 0 pentru orice λ ≥ 60. Ridge cu același λ ar da 30/160 = 0,19.

                    Traiectoriile ridge și lasso pentru variabilele de volatilitate
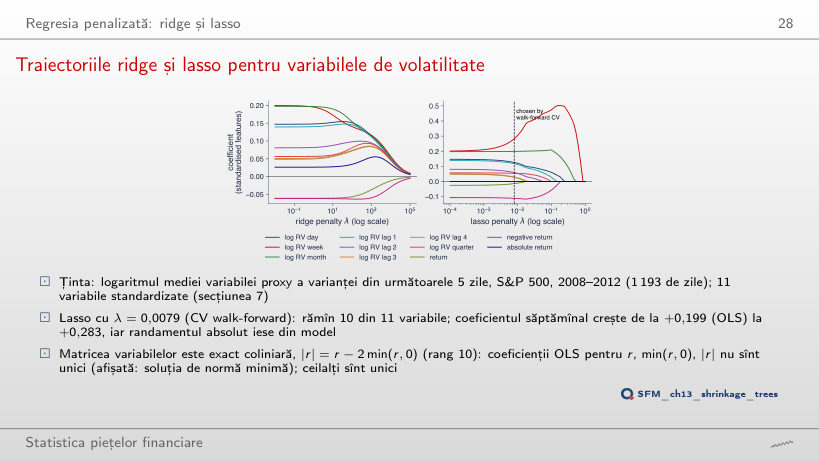
                    Slide-ul 28: Traiectoriile ridge și lasso pentru variabilele de volatilitate
                    Slide-ul 28
                      Întrebare pentru sală ▶ mărește penalizarea lasso pînă la λ = 1. Care variabilă rămîne ultima cu coeficient nenul?
                      Răspuns

                      Log RV săptămînal: rămîne nenul pînă la λ = 0,86 pe grilă, după log RV lunar (0,46), log RV zilnic (0,21) și randamentul negativ (0,18). Luată singură, varianța săptămînală este cea mai informativă variabilă; ridge, în stînga, nu anulează niciun coeficient.

                      Arbori de decizie, random forest și gradient boosting

                      Exemplu rezolvat: o împărțire, pas cu pas
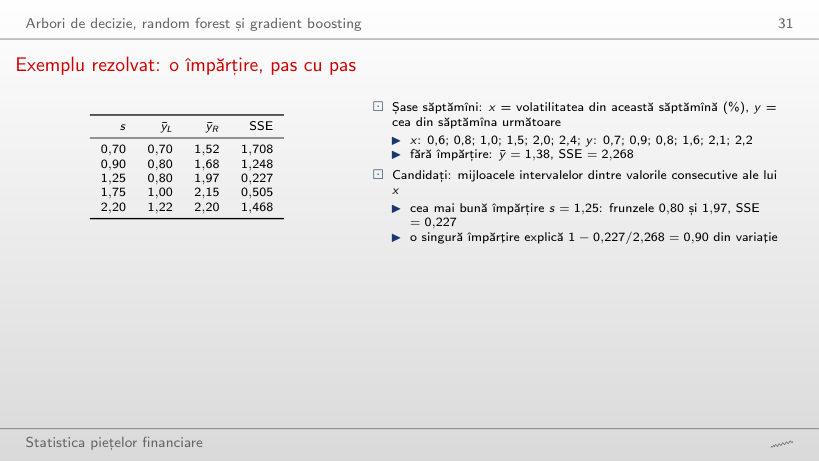
                      Slide-ul 31: Exemplu rezolvat: o împărțire, pas cu pas
                      Slide-ul 31

                      Împărțirile candidate (tabelul de pe slide)

                      Exemplu lucrat: alegerea pragului

                      \[\mathrm{SSE}(s) = \sum_{x_t \le s}(y_t - \bar y_L)^2 + \sum_{x_t > s}(y_t - \bar y_R)^2\]
                          Întrebare pentru sală Ce pondere din variație explică pragul s = 1,75, al doilea cel mai bun din tabel?
                          Răspuns

                          0,78 = 1 − 0,505/2,268, față de 0,90 pentru s = 1,25. Pragul 1,75 trece săptămîna cu x = 1,5 (y = 1,6) în frunza din stînga, unde media urcă la 1,00 și abaterile cresc.

                          Un arbore de adîncime 2 pentru volatilitatea săptămînii viitoare
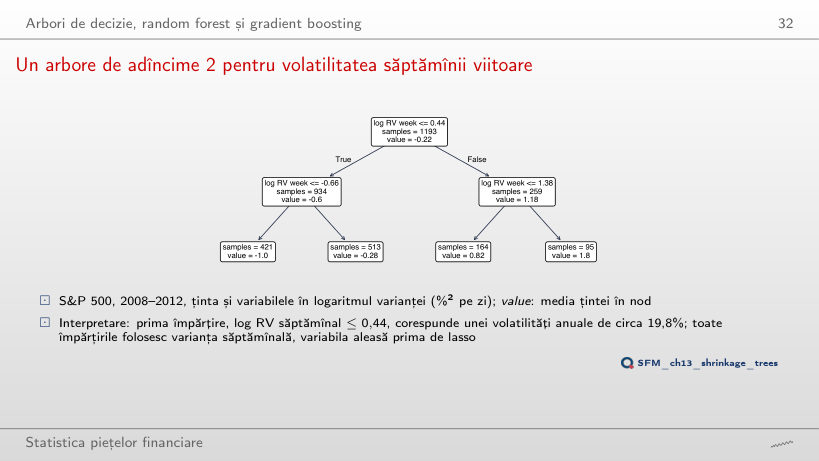
                          Slide-ul 32: Un arbore de adîncime 2 pentru volatilitatea săptămînii viitoare
                          Slide-ul 32
                            Întrebare pentru sală ▶ trece la adîncimea 3 (rulare suplimentară). Folosesc toate împărțirile tot log RV săptămînal?
                            Răspuns

                            Nu: 5 din cele 6 împărțiri folosesc log RV săptămînal, una folosește log RV lunar (≤ 0,069), în ramura cu volatilitate săptămînală moderată. Prima împărțire rămîne log RV săptămînal ≤ 0,44, pentru că un arbore greedy nu își revizuiește alegerile de sus.

                            Random forest
                            Slide-ul 33: Random forest
                            Slide-ul 33

                            Exemplu lucrat: varianța unei medii de arbori

                            \[\mathrm{Var}\Big(\frac1B\sum_{b=1}^{B}\hat f_b\Big) = \rho\sigma^2 + \frac{(1 - \rho)\,\sigma^2}{B}\]
                                Întrebare pentru sală ▶ crește B de la 10 la 300, cu ρ = 0,3 și σ² = 1. Cît devine varianța mediei?
                                Răspuns

                                0,302 = 0,3 + 0,7/300, față de 0,370 la B = 10. Partea comună ρσ² = 0,3 nu dispare oricîți arbori am adăuga; pragul coboară doar dacă arborii devin mai puțin corelați.

                                Gradient boosting
                                Slide-ul 34: Gradient boosting
                                Slide-ul 34

                                Exemplu lucrat: boosting cu arbori de adîncime 1 pe cele șase săptămîni (calcul suplimentar)

                                \[F_0 = \bar y, \qquad h_m = \arg\min_{h}\sum_t \big(y_t - F_{m-1}(x_t) - h(x_t)\big)^2, \qquad F_m = F_{m-1} + \nu\,h_m\]
                                    Întrebare pentru sală Calcul suplimentar, ν = 0,1: după cîți pași scade SSE de antrenare sub jumătate din 2,268?
                                    Răspuns

                                    După 4 pași: SSE scade la 1,880, 1,566, 1,312 și 1,101. Fiecare pas aplică doar ν = 10% din ajustarea arborelui pe reziduurile curente, deci eroarea scade geometric, nu liniar. După 50 de pași SSE = 0,007: pe datele de antrenare boosting ajunge aproape la zero, de aceea numărul de pași se alege pe validare.

                                    Un arbore, un random forest și boosting pe date de volatilitate
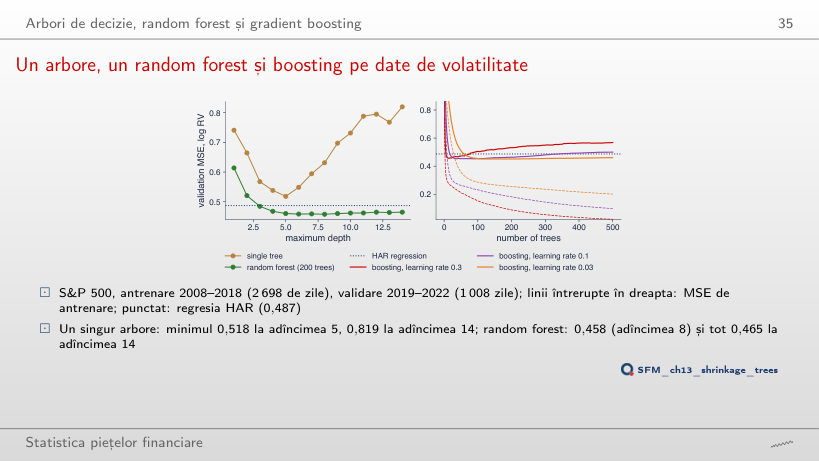
                                    Slide-ul 35: Un arbore, un random forest și boosting pe date de volatilitate
                                    Slide-ul 35
                                      Întrebare pentru sală ▶ reduce pădurea la un singur arbore (B = 1). Cît este MSE de validare la adîncimea 8?
                                      Răspuns

                                      0,670, mai mult decît arborele simplu de aceeași adîncime (0,631) și mult peste 0,458 cu 200 de arbori. Fiecare arbore al pădurii vede un eșantion bootstrap și doar jumătate din variabile la o împărțire, deci singur este mai slab decît un arbore obișnuit; media îi elimină varianța, iar cu 10 arbori MSE este deja 0,478.

                                      Rețele neuronale

                                      Perceptronul și perceptronul multistrat (2/2)
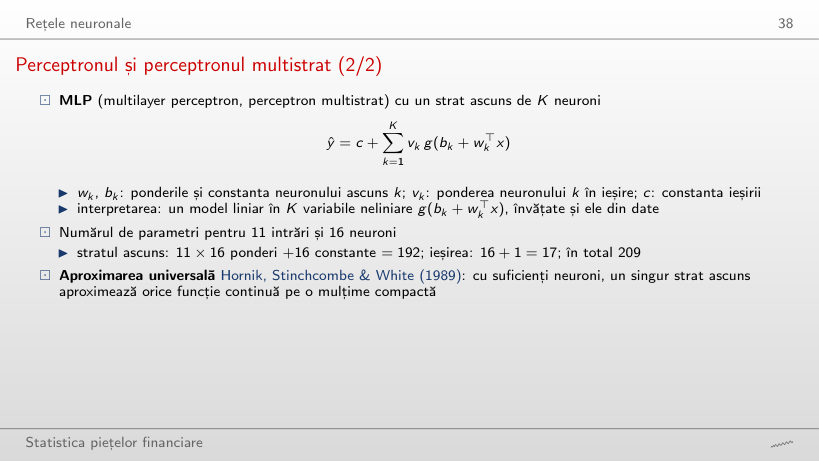
                                      Slide-ul 38: Perceptronul și perceptronul multistrat (2/2)
                                      Slide-ul 38

                                      Exemplu lucrat: numărul de parametri

                                      \[\hat y = c + \sum_{k=1}^{K} v_k\, g(b_k + w_k^\top x), \qquad \#\theta = \underbrace{pK + K}_{\text{strat ascuns}} + \underbrace{K + 1}_{\text{ieșire}}\]
                                          Întrebare pentru sală Cu 11 intrări și K = 32 de neuroni ascunși, cîți parametri are rețeaua?
                                          Răspuns

                                          417 = 11 × 32 + 32 + 32 + 1. Nu se dublează față de 209: fiecare neuron în plus adaugă p + 2 = 13 parametri, iar constanta ieșirii nu depinde de K.

                                          O rețea mică și funcțiile ei de activare
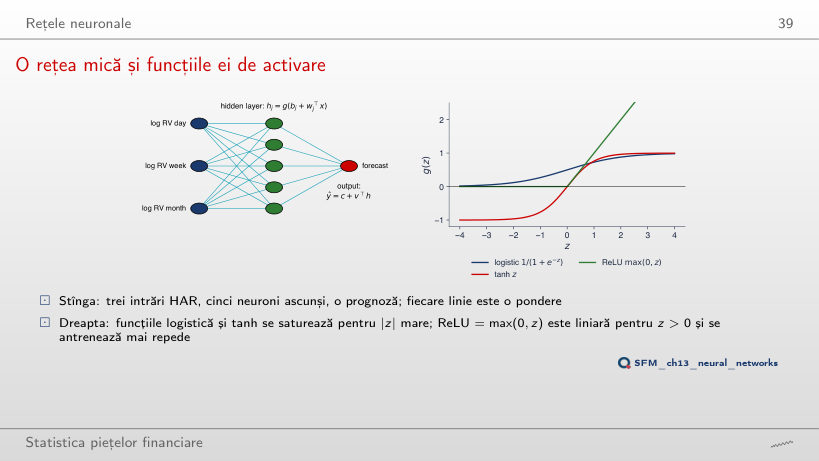
                                          Slide-ul 39: O rețea mică și funcțiile ei de activare
                                          Slide-ul 39
                                            Întrebare pentru sală Pentru z = 4, care funcție de activare are cel mai mare gradient g′(z)?
                                            Răspuns

                                            ReLU: g′(4) = 1. Logistica are g′(4) = 0,018, iar tanh 0,0013: ambele se saturează pentru |z| mare, deci gradientul care trece prin neuron aproape dispare. De aceea rețelele cu ReLU se antrenează mai repede.

                                            ARCH cu rețea neuronală pentru GBP/USD
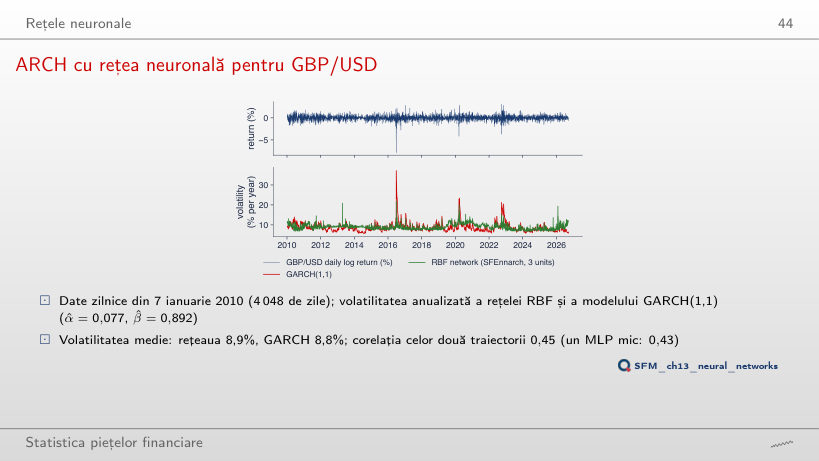
                                            Slide-ul 44: ARCH cu rețea neuronală pentru GBP/USD
                                            Slide-ul 44
                                              Întrebare pentru sală Cu 5 unități RBF în loc de 3 (rulare suplimentară), crește sau scade corelația volatilității rețelei cu GARCH (0,45 cu 3 unități)?
                                              Răspuns

                                              Crește la 0,61, iar maximul rețelei urcă de la 22,0% la 27,6%; cu 2 unități corelația scade la 0,26. Mai multe unități dau o formă mai flexibilă, dar rețeaua vede tot doar ultimele 3 randamente: maximul GARCH de după votul pentru Brexit, 37,3%, rămîne departe.

                                              Rețeaua RBF comparată cu mersul aleator
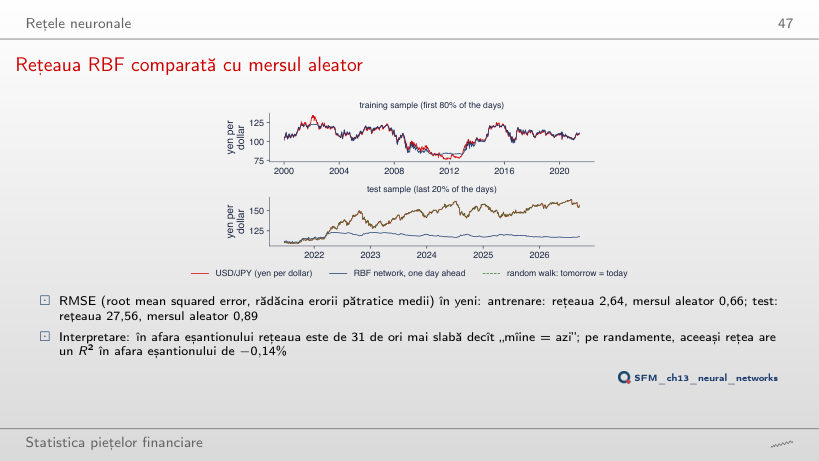
                                              Slide-ul 47: Rețeaua RBF comparată cu mersul aleator
                                              Slide-ul 47
                                                Întrebare pentru sală Cu 90% din zile la antrenare (rulare suplimentară), de cîte ori este RMSE de test al rețelei mai mare decît al mersului aleator?
                                                Răspuns

                                                De 13 ori (12,12 față de 0,91 yeni), față de 31 de ori cu 80%. Maximul din antrenare urcă la 151,6, dar testul ajunge la 163,9: rețeaua tot nu poate extrapola dincolo de nivelurile văzute.

                                                Aplicație: prognoza volatilității realizate

                                                Reperul HAR (1/2)
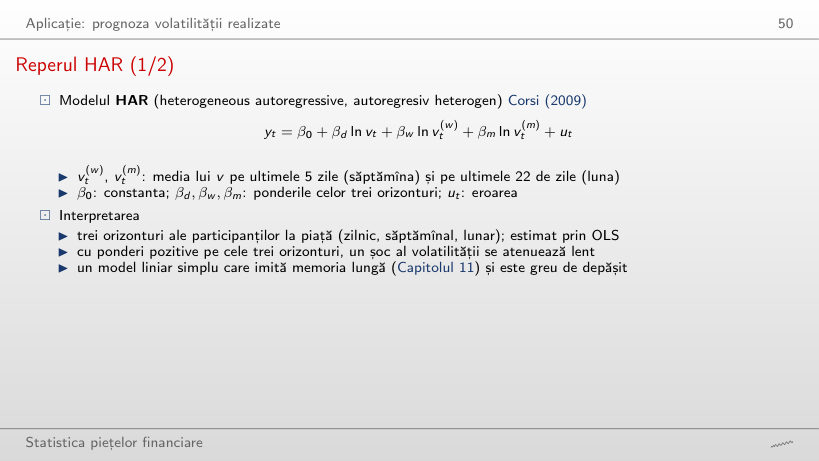
                                                Slide-ul 50: Reperul HAR (1/2)
                                                Slide-ul 50

                                                Exemplu lucrat: o prognoză HAR

                                                \[\hat y_t = \hat\beta_0 + \hat\beta_d\ln v_t + \hat\beta_w\ln v_t^{(w)} + \hat\beta_m\ln v_t^{(m)}, \qquad \hat h_t = \exp(\hat y_t + \hat s^2/2)\]
                                                    Întrebare pentru sală Partiția 2020, ziua cu prognoza HAR maximă (18 martie 2020): este prognoza peste sau sub volatilitatea realizată în următoarele 5 zile?
                                                    Răspuns

                                                    Puțin peste: 69,3% față de 66,1% pe an. Maximul volatilității realizate în 2020, 102,4%, a venit însă înaintea vîrfului prognozei: HAR reacționează după șoc, nu îl anticipează.

                                                    Evaluarea (1/3): R² în afara eșantionului
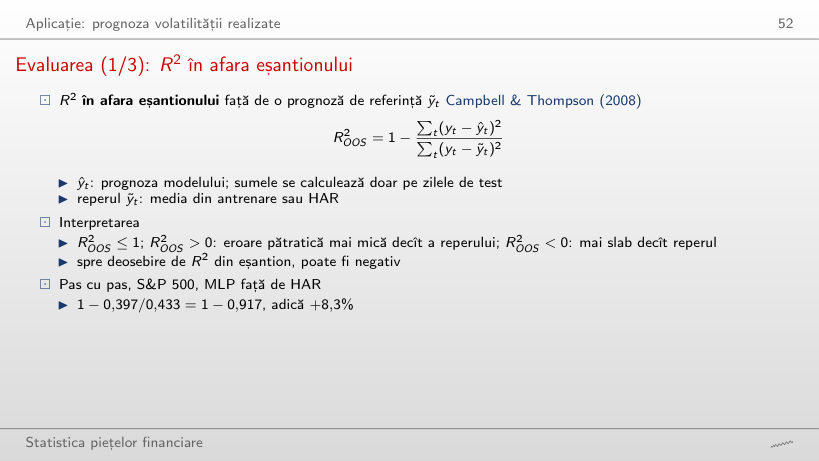
                                                    Slide-ul 52: Evaluarea (1/3): R² în afara eșantionului
                                                    Slide-ul 52

                                                    Exemplu lucrat: R² în afara eșantionului

                                                    \[R^2_{OOS} = 1 - \frac{\sum_t (y_t - \hat y_t)^2}{\sum_t (y_t - \tilde y_t)^2}\]
                                                        Întrebare pentru sală ▶ trece la random forest (S&P 500, față de HAR). Cît este R²_OOS?
                                                        Răspuns

                                                        +1,0%: MSE 0,429 față de 0,433. Față de media de antrenare, același model are 61,9%: R²_OOS depinde de reper, iar HAR este un reper mult mai exigent. Testul DM nu separă acest cîștig de zgomot (p = 0,747).

                                                        Evaluarea (2/3): QLIKE
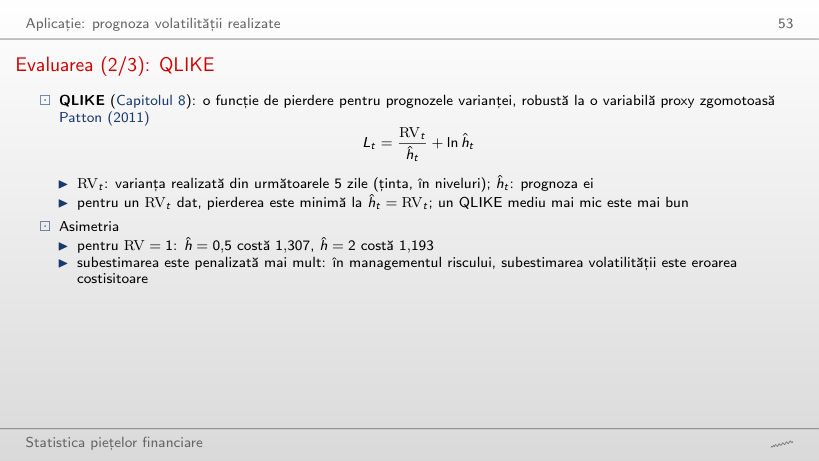
                                                        Slide-ul 53: Evaluarea (2/3): QLIKE
                                                        Slide-ul 53

                                                        Exemplu lucrat: pierderea QLIKE

                                                        \[L_t = \frac{\mathrm{RV}_t}{\hat h_t} + \ln\hat h_t\]
                                                            Întrebare pentru sală RV = 1: care prognoză costă mai mult în QLIKE, ĥ = 1/3 sau ĥ = 3?
                                                            Răspuns

                                                            ĥ = 1/3: 3 + ln(1/3) = 1,901, față de 1/3 + ln 3 = 1,432. Subestimarea de trei ori costă mai mult decît supraestimarea de trei ori, deși eroarea pătratică ordonează invers: (1 − 1/3)² = 0,444 și (1 − 3)² = 4.

                                                            Evaluarea (3/3): testul Diebold–Mariano
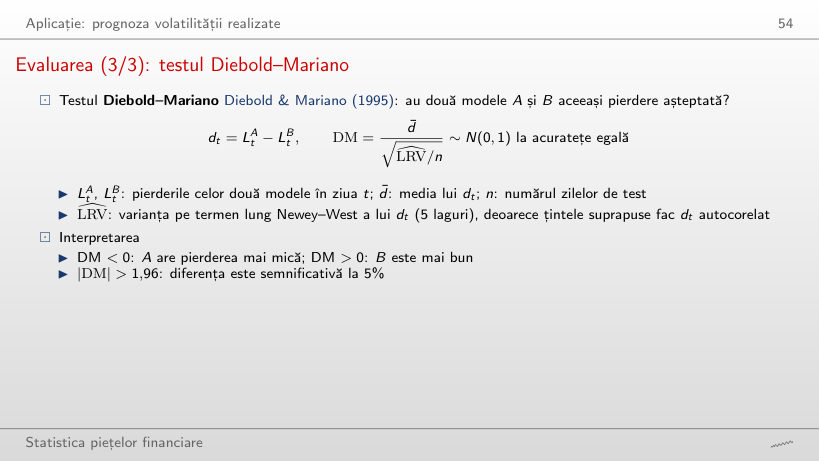
                                                            Slide-ul 54: Evaluarea (3/3): testul Diebold–Mariano
                                                            Slide-ul 54

                                                            Exemplu lucrat: statistica Diebold–Mariano

                                                            \[d_t = L_t^{A} - L_t^{HAR}, \qquad \widehat{\mathrm{LRV}} = \hat\gamma_0 + 2\sum_{j=1}^{q}\Big(1 - \frac{j}{q + 1}\Big)\hat\gamma_j, \qquad \mathrm{DM} = \frac{\bar d}{\sqrt{\widehat{\mathrm{LRV}}/n}}\]
                                                                Întrebare pentru sală ▶ coboară numărul de laguri Newey–West de la 5 la 0. Ce se întîmplă cu statistica DM a MLP față de HAR (S&P 500, −3,96)?
                                                                Răspuns

                                                                Crește în valoare absolută, la −4,61: varianța pe termen lung cu 5 laguri este de 1,35 ori varianța simplă, pentru că țintele pe 5 zile se suprapun și fac d_t autocorelat. Fără corecție testul pare mai sigur decît este; aici concluzia (MLP mai bun) rămîne aceeași.

                                                                Rezultatele: S&P 500 și Bitcoin
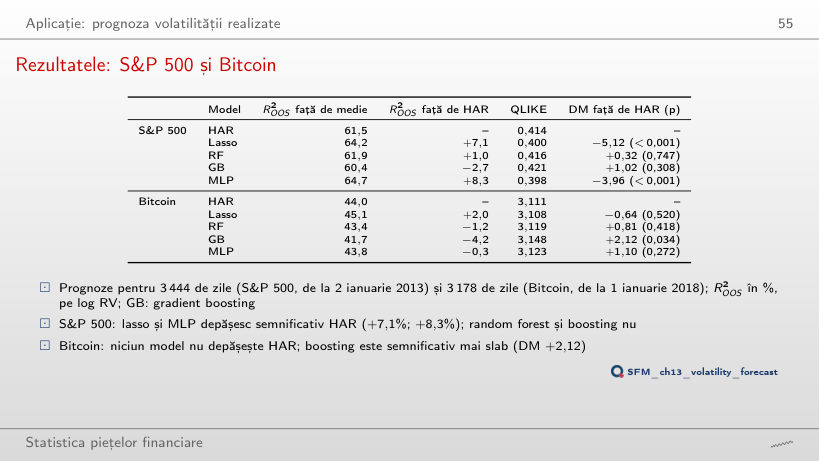
                                                                Slide-ul 55: Rezultatele: S&P 500 și Bitcoin
                                                                Slide-ul 55

                                                                Rezultatele în afara eșantionului: R²_OOS pe log RV (%), QLIKE, statistica DM față de HAR (p-value)

                                                                  Întrebare pentru sală ▶ trece la zilele de test din 2020. Mai este MLP semnificativ mai bun decît HAR pe S&P 500 la 5%?
                                                                  Răspuns

                                                                  Da: R²_OOS +7,9%, DM −2,28 (p = 0,023); lasso +7,4%, DM −3,42. Random forest și boosting nu sînt semnificativ mai bune decît HAR în nicio subperioadă: pînă în 2019 au −1,5% și −11,0%, din 2020 +3,5% și +5,8%, cu p peste 0,6.

                                                                  Prognozele în perioadele turbulente din 2020 și 2025
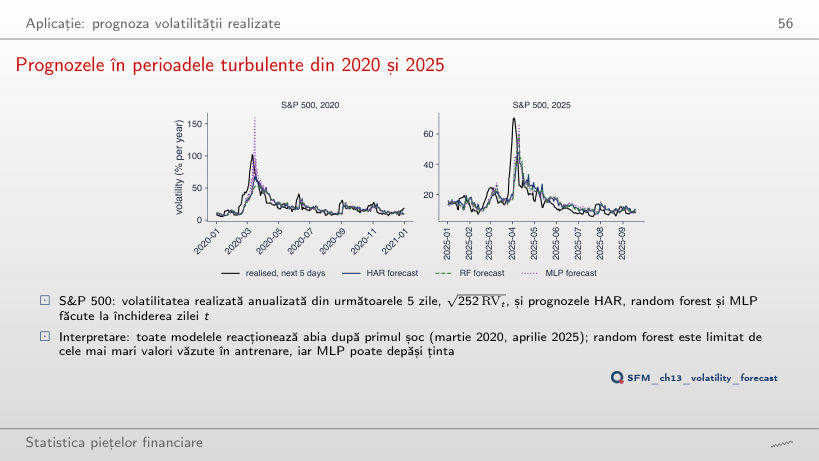
                                                                  Slide-ul 56: Prognozele în perioadele turbulente din 2020 și 2025
                                                                  Slide-ul 56
                                                                    Întrebare pentru sală În 2020, este maximul prognozei random forest peste sau sub maximul volatilității realizate (102% pe an)?
                                                                    Răspuns

                                                                    Mult sub: 53%, față de 69% pentru HAR și 159% pentru MLP. Un random forest prezice medii ale frunzelor din antrenare, deci rămîne sub valorile extreme; MLP și lasso (172%) extrapolează și pot depăși ținta.

                                                                    Variabilele folosite de random forest
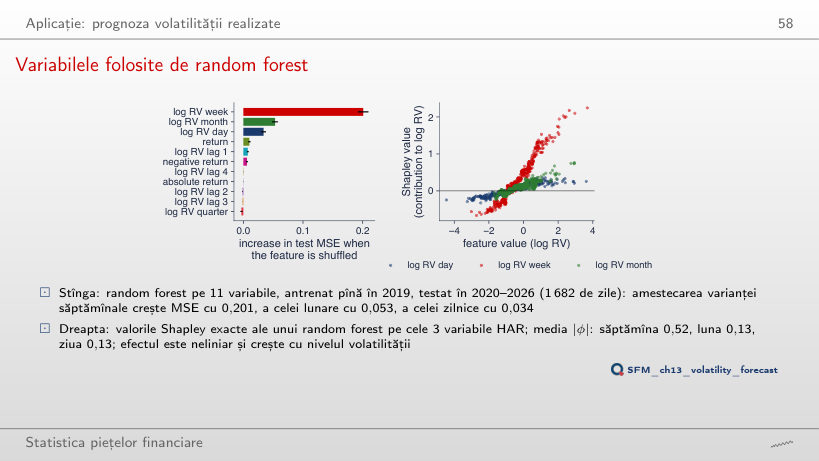
                                                                    Slide-ul 58: Variabilele folosite de random forest
                                                                    Slide-ul 58

                                                                    Importanța prin permutare (10 amestecări) și media |φ| (random forest pe cele 3 variabile HAR)

                                                                      Întrebare pentru sală ▶ afișează doar log RV zilnic. Este intervalul valorilor Shapley mai larg sau mai îngust decît la log RV săptămînal?
                                                                      Răspuns

                                                                      Mai îngust: φ zilnic între −0,32 și 0,35, față de −0,66 și 2,25 pentru săptămînă; media |φ| este 0,13, față de 0,52. Pădurea se bazează pe varianța săptămînală, care conține deja o parte din informația zilei.

                                                                      Aplicație: semnul randamentului de mîine

                                                                      Reperul clasei majoritare
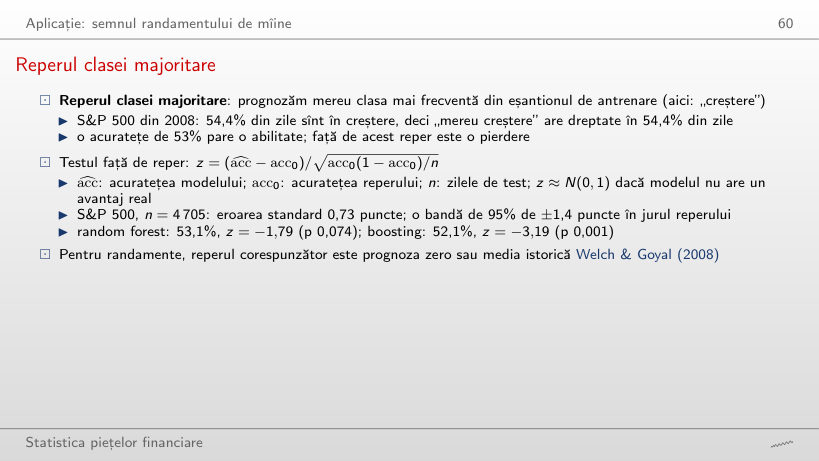
                                                                      Slide-ul 60: Reperul clasei majoritare
                                                                      Slide-ul 60

                                                                      Exemplu lucrat: testul față de reper

                                                                      \[z = \frac{\widehat{\mathrm{acc}} - \mathrm{acc}_0}{\sqrt{\mathrm{acc}_0(1 - \mathrm{acc}_0)/n}} \approx N(0, 1)\]
                                                                          Întrebare pentru sală BET în loc de S&P 500, random forest: cît este statistica z față de reper?
                                                                          Răspuns

                                                                          −0,21 (53,6% față de 53,8%, p = 0,84). Pe S&P 500 random forest are z = −1,79, pe Bitcoin −0,99: pe nicio piață un model nu este semnificativ mai bun decît „mereu creștere”.

                                                                          Acuratețea față de reper
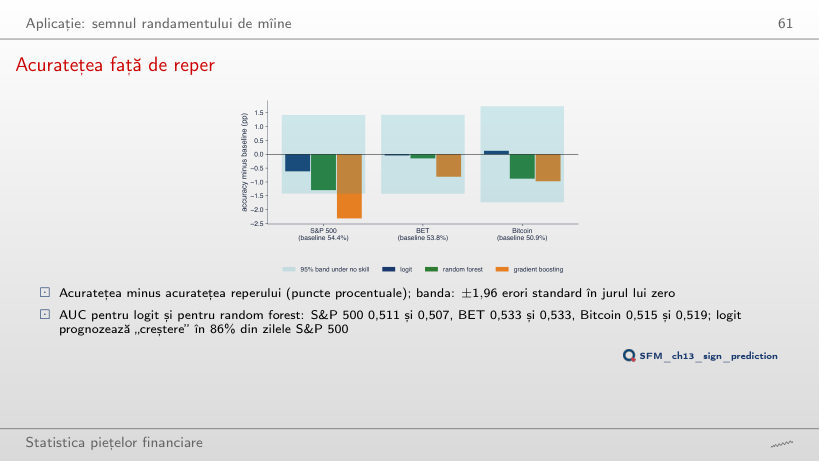
                                                                          Slide-ul 61: Acuratețea față de reper
                                                                          Slide-ul 61
                                                                            Întrebare pentru sală ▶ testează doar pînă în 2012 (5 ani). Este vreun model semnificativ mai slab decît reperul pe S&P 500?
                                                                            Răspuns

                                                                            Da: gradient boosting, −3,9 puncte, z = −2,77; logit și random forest au z = −1,36 și −1,30. Banda de 95% este mai largă cu mai puține zile, totuși boosting rămîne în afara ei: modelul învață tipare din zgomotul anilor de antrenare.

                                                                            Aplicație: VaR 1% prin metode cuantilice

                                                                            Regresia cuantilică (1/2)
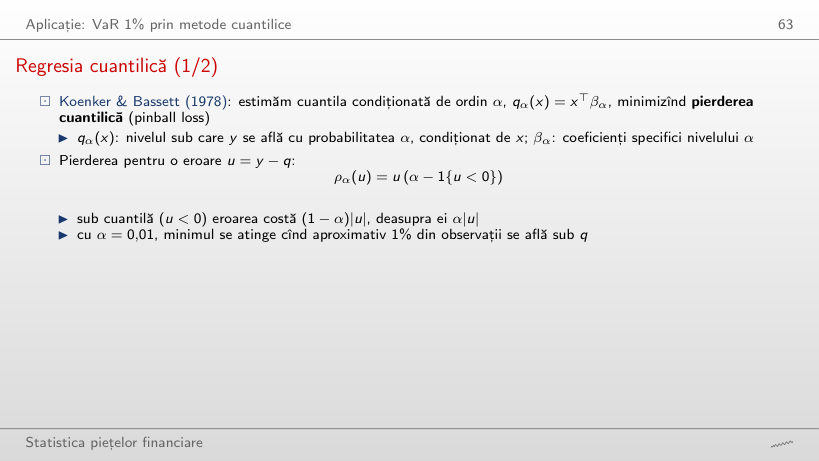
                                                                            Slide-ul 63: Regresia cuantilică (1/2)
                                                                            Slide-ul 63

                                                                            Exemplu lucrat: pierderea cuantilică pe randamentele S&P 500

                                                                            \[\rho_\alpha(u) = u\,(\alpha - \mathbf{1}\{u < 0\}), \qquad u = y - q, \qquad \hat q = \arg\min_q \frac1n\sum_t \rho_\alpha(y_t - q)\]
                                                                                Întrebare pentru sală Cu α = 0,05, ce prognoză constantă q minimizează pierderea medie pe randamentele de test ale S&P 500?
                                                                                Răspuns

                                                                                q = −1,59%, cuantila empirică de 5%: 4,99% din zile se află sub ea. Pentru α = 0,01 minimul este la −3,07% (0,99% din zile sub el). Media randamentelor, 0,05%, minimizează eroarea pătratică, nu pierderea cuantilică.

                                                                                Backtesting pentru VaR 1%: metode cuantilice, HS și GARCH-t (1/2)
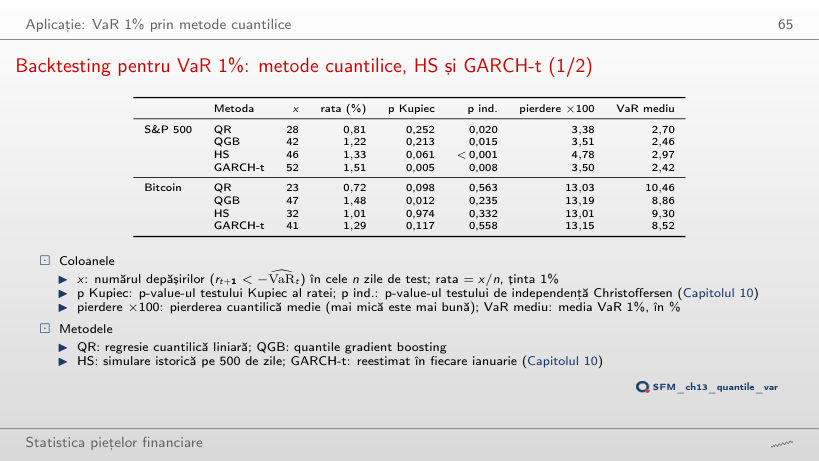
                                                                                Slide-ul 65: Backtesting pentru VaR 1%: metode cuantilice, HS și GARCH-t (1/2)
                                                                                Slide-ul 65

                                                                                Backtesting pentru VaR 1% (tabelul de pe slide)

                                                                                  Întrebare pentru sală ▶ trece la zilele de test din 2020. Respinge testul Kupiec la 5% rata depășirilor GARCH-t pe S&P 500?
                                                                                  Răspuns

                                                                                  Da: 1,60% (27 din 1686 de zile), p = 0,022. QR are 0,71% (p = 0,21), iar depășirile HS apar grupat (p ind. 0,005). Pentru Bitcoin din 2020, QR este depășit prea rar: 0,45%, p Kupiec 0,002.

                                                                                  Prognozele VaR 1% în 2020 și 2025
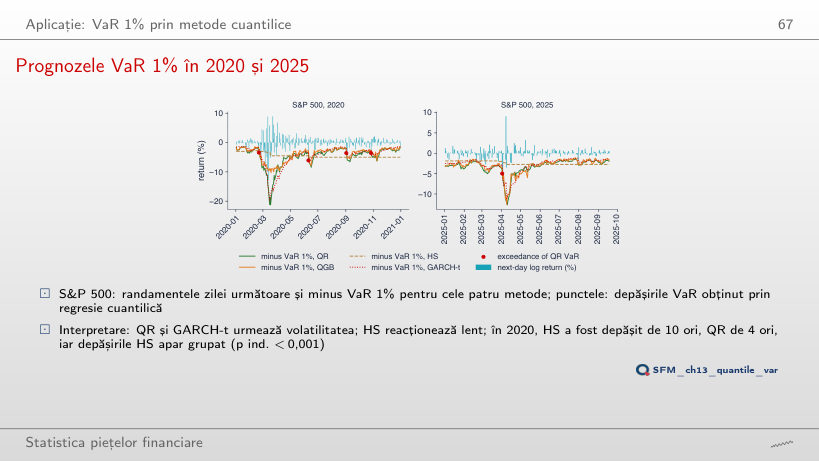
                                                                                  Slide-ul 67: Prognozele VaR 1% în 2020 și 2025
                                                                                  Slide-ul 67
                                                                                    Întrebare pentru sală În 2025 (pînă în septembrie), care metodă are cele mai multe depășiri pe S&P 500?
                                                                                    Răspuns

                                                                                    HS: 5 depășiri, față de 4 pentru GARCH-t și cîte 1 pentru QR și QGB. După 500 de zile liniștite, simularea istorică intră în aprilie 2025 cu un VaR prea mic și reacționează lent.

                                                                                    Data snooping și raportul Sharpe deflatat

                                                                                    Cea mai bună dintre N strategii (2/2)
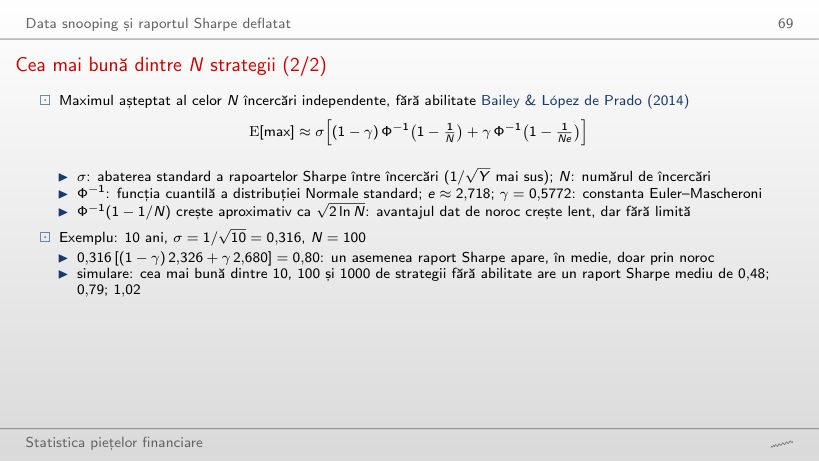
                                                                                    Slide-ul 69: Cea mai bună dintre N strategii (2/2)
                                                                                    Slide-ul 69

                                                                                    Exemplu lucrat: maximul așteptat al celor N rapoarte Sharpe

                                                                                    \[\mathrm{E}[\max] \approx \sigma\Big[(1 - \gamma)\,\Phi^{-1}\big(1 - \tfrac1N\big) + \gamma\,\Phi^{-1}\big(1 - \tfrac{1}{Ne}\big)\Big], \qquad \sigma = 1/\sqrt{Y}\]
                                                                                        Întrebare pentru sală Cu 20 de ani de date în loc de 10, cît este maximul așteptat pentru N = 100?
                                                                                        Răspuns

                                                                                        0,566 = 0,800/√2, pentru că σ = 1/√20 = 0,224; simularea dă 0,559. Mai mulți ani reduc distorsiunea de selecție doar cu √Y: cu N = 1000 maximul este tot 0,728.

                                                                                        Distorsiunea de selecție în practică
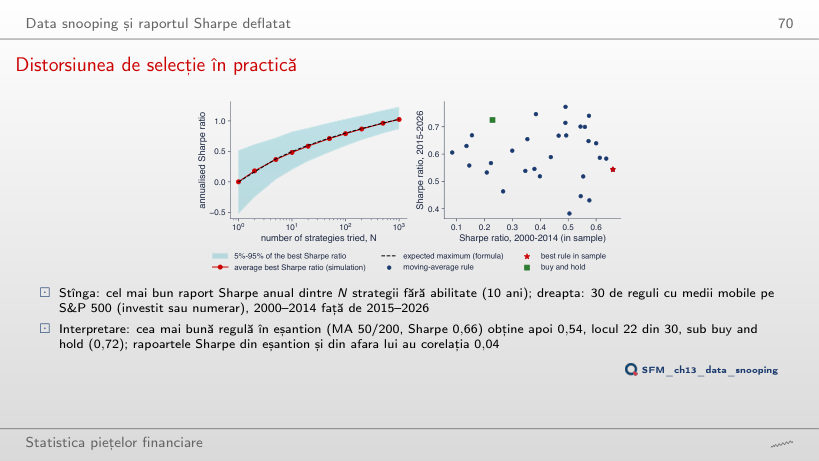
                                                                                        Slide-ul 70: Distorsiunea de selecție în practică
                                                                                        Slide-ul 70
                                                                                          Întrebare pentru sală ▶ încearcă doar primele 10 reguli. Care este cea mai bună în eșantion și ce loc ocupă după 2014?
                                                                                          Răspuns

                                                                                          MA 5/200 (Sharpe 0,57 în eșantion), cu 0,74 după 2014, locul 3 din 30. Cu toate cele 30 de reguli, cîștigătoarea, MA 50/200 (0,66), ajunge pe locul 22: alegerea dintre mai multe reguli ridică raportul Sharpe din eșantion, nu pe cel viitor.

                                                                                          Raportul Sharpe deflatat (2/2)
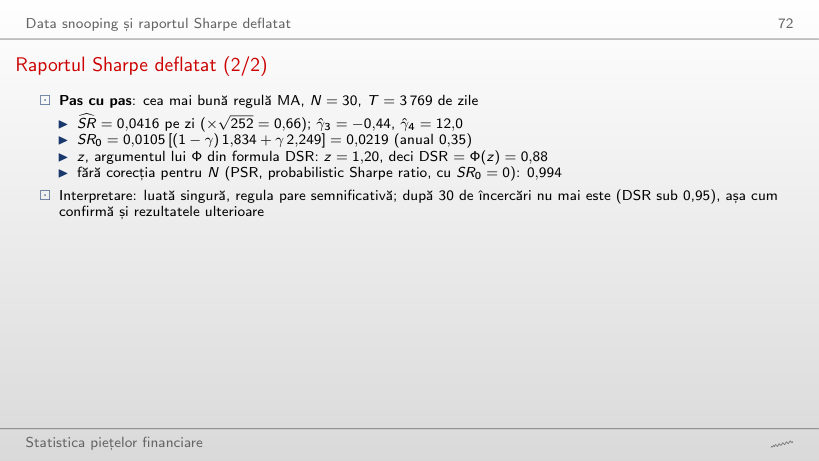
                                                                                          Slide-ul 72: Raportul Sharpe deflatat (2/2)
                                                                                          Slide-ul 72

                                                                                          Exemplu lucrat: raportul Sharpe deflatat al celei mai bune reguli MA

                                                                                          \[\mathrm{DSR} = \Phi\Big(\frac{(\widehat{SR} - SR_0)\sqrt{T - 1}}{\sqrt{1 - \hat\gamma_3\widehat{SR} + \frac{\hat\gamma_4 - 1}{4}\widehat{SR}^2}}\Big)\]
                                                                                              Întrebare pentru sală Pînă la ce număr de reguli încercate rămîne cea mai bună regulă MA semnificativă (DSR > 0,95)?
                                                                                              Răspuns

                                                                                              Pînă la N = 6: DSR = 0,961 la N = 5, 0,955 la N = 6 și 0,949 la N = 7; la N = 30, 0,884. Fără corecție (PSR) regula ar părea semnificativă, cu 0,994: SR₀ crește lent cu N, dar SR̂ = 0,0416 pe zi are o margine mică.

                                                                                              Studiu de caz: Gu, Kelly și Xiu (2020)

                                                                                              Rezultatele: R² predictiv și valoarea economică
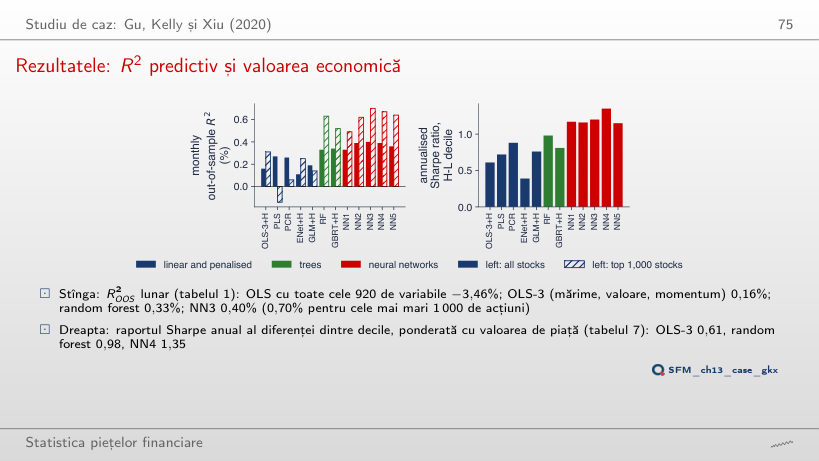
                                                                                              Slide-ul 75: Rezultatele: R² predictiv și valoarea economică
                                                                                              Slide-ul 75
                                                                                                Întrebare pentru sală Este modelul cu cel mai mare R²_OOS pe toate acțiunile și modelul cu cel mai mare raport Sharpe același?
                                                                                                Răspuns

                                                                                                Nu: NN3 are cel mai mare R² (0,40%), NN4 cel mai mare raport Sharpe (1,35, față de 1,20 pentru NN3). Diferențele de R² dintre rețele sînt de cîteva sutimi de punct procentual, iar clasamentul după valoarea economică poate diferi.

                                                                                                Datele cursului din data/market (pînă la 18 septembrie 2026): S&P 500 și Bitcoin (prețuri de deschidere, maxim, minim și închidere), BET, GBP/USD, randamentul obligațiunilor germane pe 10 ani, aurul, USD/JPY. Simularea deplasare–varianță, schema de validare, traiectoriile ridge și lasso, arborii, curbele random forest și boosting, rețelele RBF și MLP, prognozele walk-forward ale celor șase modele de volatilitate, ale clasificatorilor de semn și ale celor patru metode VaR vin din codul din curs (Quantlets/Ch_13, semințele 2026 și 3); modelele grele nu sînt reestimate în browser. Browserul recalculează din aceste prognoze HAR, R² în afara eșantionului, QLIKE, testul Diebold–Mariano, acuratețea, testul z, AUC, testele Kupiec și Christoffersen, pierderea cuantilică, maximul așteptat al raportului Sharpe și DSR. Gu, Kelly și Xiu (2020): valorile publicate în tabelele 1 și 7 ale lucrării. Alte niveluri de zgomot, orizonturi, adîncimi, numere de arbori și de unități, ponderi de antrenare, perioade și ani de separare sînt rulări suplimentare ale aceluiași cod; exemplul de boosting pe cele șase săptămîni este un calcul suplimentar.