

Statistica piețelor financiare

Capitolul 6 · Selecția modelului și managementul riscului

În stînga este slide-ul din curs, în dreapta aceeași figură sau același tabel, calculat în browser din aceleași date. Butonul ▶ modifică parametrul pas cu pas; tabelele și exemplele lucrate se recalculează odată cu el.

Distribuțiile candidate · Recapitulare: metoda verosimilității maxime · Modele imbricate: testul raportului de verosimilitate · Criterii informaționale: AIC și BIC · Teste de concordanță · Grafice PP și QQ · Compararea modelelor după VaR 1% · În afara eșantionului: validare și supraajustare · Incertitudinea de model

Distribuțiile candidate

Compararea distribuțiilor candidate
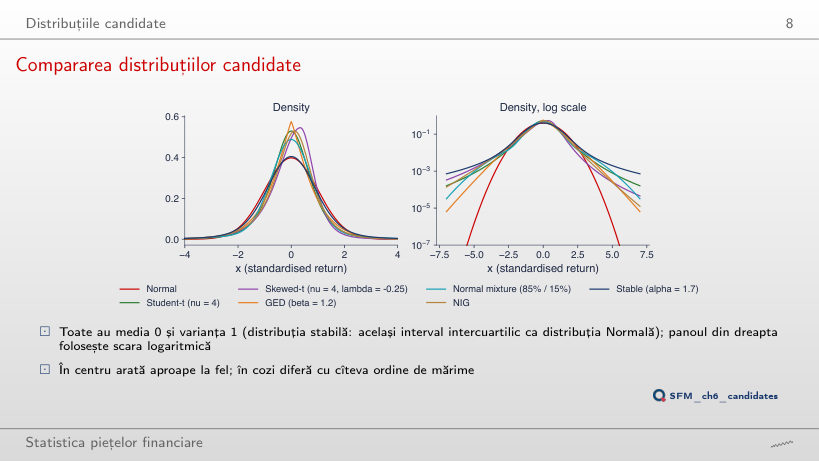
Slide-ul 8: Compararea distribuțiilor candidate
Slide-ul 8

P(X < −x) pentru fiecare candidat (media 0, varianța 1)

    Întrebare pentru sală La x = 4, distribuția Student-t (ν = 4) dă o probabilitate P(X < −4) de 76 de ori mai mare decît distribuția Normală. Butonul ▶ mută pragul de la 2 la 6. De cîte ori mai mare este probabilitatea Student-t la x = 6?
    Răspuns

    De circa 536 000 de ori: 5,3 × 10⁻⁴ față de 9,9 × 10⁻¹⁰. La x = 2 cele două probabilități sînt aproape egale (raportul 1,0), la x = 3 raportul este 4,9, la x = 5 este 3 682. Coada Normală scade ca e−x²/2, coada Student-t ca o putere a lui x, deci raportul crește tot mai repede cu pragul. Media și varianța sînt aceleași; diferența stă numai în coadă, acolo unde se află VaR 1%.

    Statisticile de referință pentru modele: SFESumm
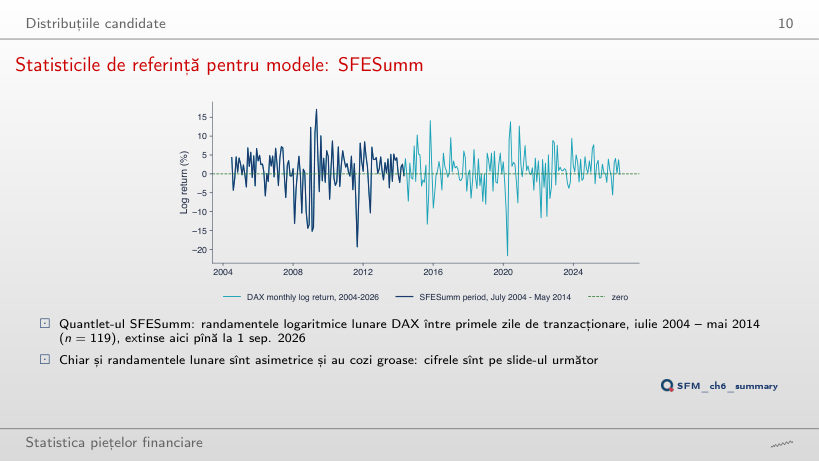
    Slide-ul 10: Statisticile de referință pentru modele: SFESumm
    Slide-ul 10

    Statistici descriptive, randamente logaritmice lunare DAX (%)

      Întrebare pentru sală Boltirea randamentelor lunare DAX este 4,60 pe eșantionul SFESumm (iulie 2004 – mai 2014) și 5,06 pe 2004–2026. Butonul ▶ extinde eșantionul cu cîte un an. Crește boltirea treptat, pe măsură ce se adaugă ani?
      Răspuns

      Nu. Între 2014 și 2019 scade, pînă la 4,30 în mai 2016, pentru că lunile adăugate sînt liniștite. Urcă brusc la 4,93 cînd intră randamentul dintre începutul lui martie și începutul lui aprilie 2020, −21,70%, noul minim al eșantionului (cel vechi era −19,35%). Boltirea depinde de cîteva luni extreme, nu de numărul de luni. Pe 2004–2026 asimetria rămîne negativă (−0,72), iar testul Jarque–Bera respinge normalitatea cu JB = 70,2.

      Statistici descriptive: DAX lunar și randamente zilnice
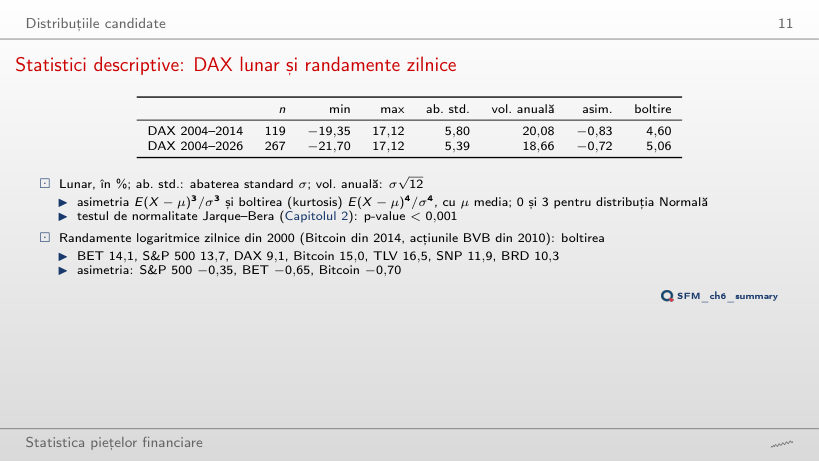
      Slide-ul 11: Statistici descriptive: DAX lunar și randamente zilnice
      Slide-ul 11

      Randamente logaritmice zilnice (%)

      Exemplu lucrat: testul Jarque–Bera

      \[JB = \frac{n}{6}\Big[S^2 + \frac{(K-3)^2}{4}\Big] \approx \chi^2(2)\]
          Întrebare pentru sală Fără cele două zile greșite din mai 2016, boltirea randamentelor zilnice TLV este 16,5. Cît devine dacă cele două zile, −15,0% și +20,5%, rămîn în date?
          Răspuns

          20,5. Boltirea folosește puterea a patra a abaterilor de la medie, deci două zile extreme o mută mult, chiar dacă suma lor, +5,5%, este mică. Asimetria trece de la −0,87 la −0,58. În curs, ν̂ al distribuției Student-t scade de la 3,44 la 3,33, iar clasamentul AIC nu se schimbă (cîștigă Student-t în ambele cazuri). JB al TLV crește și el, pentru că (K − 3)² crește.

          Recapitulare: metoda verosimilității maxime

          Estimarea ML numerică pentru ceilalți candidați (S&P 500)
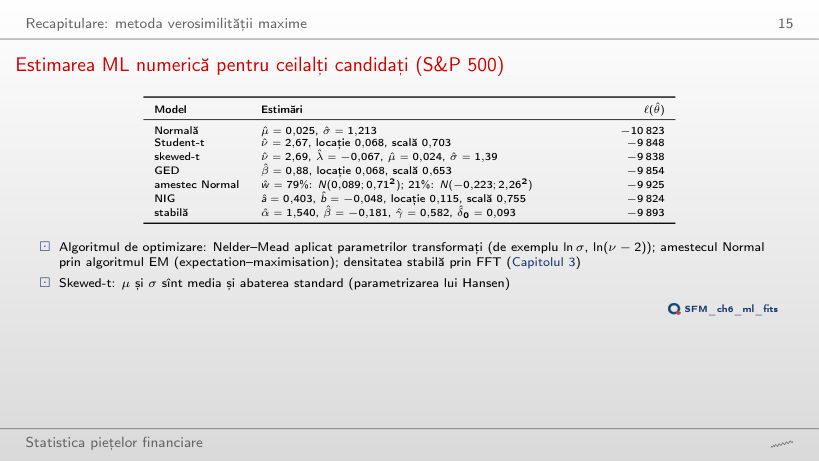
          Slide-ul 15: Estimarea ML numerică pentru ceilalți candidați (S&P 500)
          Slide-ul 15

          Estimări ML și log-verosimilitatea maximizată

          Exemplu lucrat: modelul Normal, pas cu pas

          \[\ell(\hat\mu, \hat\sigma) = -\frac{n}{2}\big[\ln(2\pi\hat\sigma^2) + 1\big], \quad \hat\sigma^2 = \frac{1}{n}\sum_t (r_t - \bar r)^2\]
              Întrebare pentru sală Pentru S&P 500, ν̂ al distribuției Student-t este 2,67. Bitcoin are o boltire de selecție mai mare (15,0 față de 13,7). Este ν̂ al Bitcoin mai mic sau mai mare?
              Răspuns

              Mai mic: 2,23, cel mai mic dintre cele șapte serii, deci coada cea mai groasă. BET are 2,43, DAX 3,09, BRD 4,67. Un ν̂ apropiat de 2 înseamnă o varianță abia finită. Abaterea standard mare a Bitcoin (3,5% pe zi) intră în scală, nu în ν: scala Student-t a Bitcoin este 1,85, iar abaterea standard implicată, scală·√(ν/(ν − 2)), este 5,75%, peste abaterea standard de selecție (3,49%), pentru că ν̂ este aproape de 2.

              Precizia lui ν: log-verosimilitatea profil
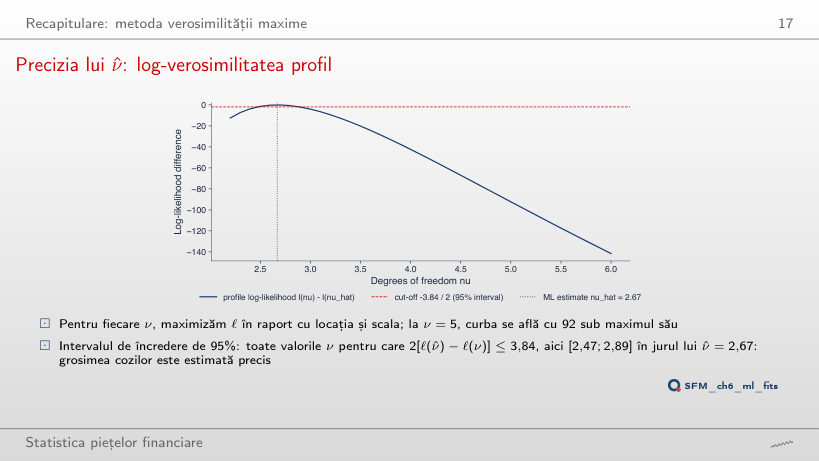
              Slide-ul 17: Precizia lui ν: log-verosimilitatea profil
              Slide-ul 17

              Exemplu lucrat: este ν testat în interval?

              \[LR(\nu) = 2\big[\ell(\hat\nu) - \ell(\nu)\big] \le \chi^2_{1-a}(1)\]
                  Întrebare pentru sală Slide-ul dă intervalul de 95% pentru ν al S&P 500, [2,47; 2,89], unde profilul intersectează pragul. Ce puncte ale grilei cu pasul 0,1 folosite în grafic se află în interval?
                  Răspuns

                  De la 2,5 la 2,8. Capetele adevărate, 2,47 și 2,89, se află între punctele grilei (2,4–2,5 și 2,8–2,9); o grilă de 0,1 citită direct ar da [2,5; 2,8], un interval prea îngust. Intervalul nu este simetric în jurul lui ν̂ = 2,67: 0,20 la stînga, 0,22 la dreapta, pentru că profilul nu este o parabolă. La ν = 5, log-verosimilitatea profil este cu 92,3 sub maxim.

                  Modele imbricate: testul raportului de verosimilitate

                  Exemplu lucrat: testarea parametrului de asimetrie
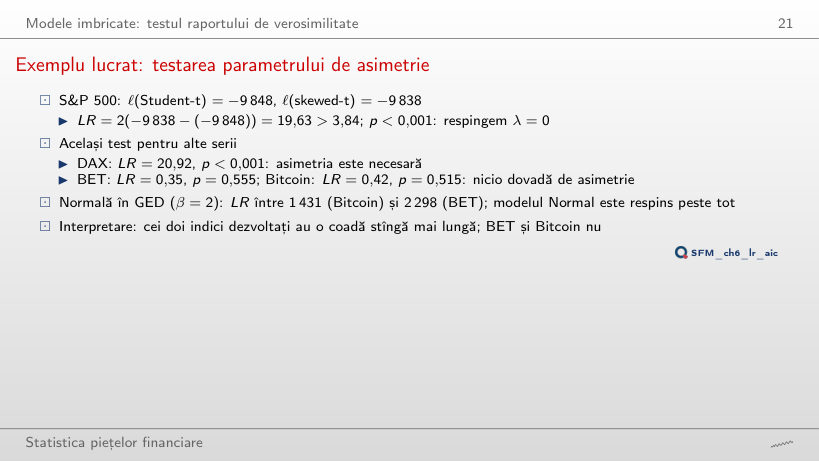
                  Slide-ul 21: Exemplu lucrat: testarea parametrului de asimetrie
                  Slide-ul 21

                  Exemplu lucrat: testul raportului de verosimilitate

                  \[LR = 2\,[\ell_1(\hat\theta_1) - \ell_0(\hat\theta_0)] \approx \chi^2(k_1 - k_0)\]

                    Același test pe cele șapte serii

                    p-value ca funcție de LR

                      Întrebare pentru sală Pentru BRD, testul Student-t în skewed-t (λ = 0) dă LR = 3,01. Este parametrul de asimetrie necesar la 5%?
                      Răspuns

                      Nu: 3,01 < 3,84, p = 0,083. Valoarea fixată λ = 0 este în interiorul intervalului (−1, 1), deci teorema lui Wilks se aplică și valoarea critică este 3,84; 2,71 este valoarea pentru frontieră (Normală în Student-t). AIC preferă totuși skewed-t (ΔAIC al Student-t: 1,0), pentru că AIC nu este un test: penalizează un parametru cu 2, iar LR > 2. Asimetria este semnificativă doar pentru S&P 500 (LR = 19,63) și DAX (20,92).

                      Modele neimbricate: testul Vuong
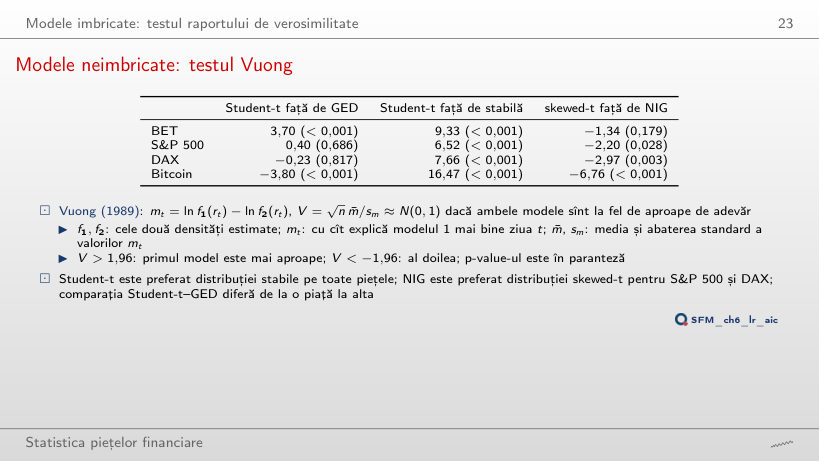
                      Slide-ul 23: Modele neimbricate: testul Vuong
                      Slide-ul 23

                      Exemplu lucrat: statistica Vuong

                      \[m_t = \ln f_1(r_t) - \ln f_2(r_t), \qquad V = \frac{\sqrt{n}\,\bar m}{s_m} \approx N(0, 1)\]

                        Statistica V și p-value pe cele șapte serii

                        Suma cumulată a diferențelor zilnice mt

                          Întrebare pentru sală Pe slide, Student-t este preferat distribuției stabile pe toate cele patru piețe. Pentru BRD, V = 1,89. Este preferința semnificativă la 5%?
                          Răspuns

                          Nu: |V| = 1,89 < 1,96, p = 0,059. Student-t explică în medie mai bine zilele BRD, dar diferența nu este separată de zgomot. Ziua cu cea mai mare |mt| este 19 decembrie 2018 (mt = −2,48: distribuția stabilă explică mai bine această cădere). Pentru TLV și SNP, V = 3,77 și 4,16. Suma diferențelor zilnice este exact diferența log-verosimilităților, ℓ(Student-t) − ℓ(stabilă).

                          Criterii informaționale: AIC și BIC

                          Exemplu lucrat: șapte modele pentru S&P 500
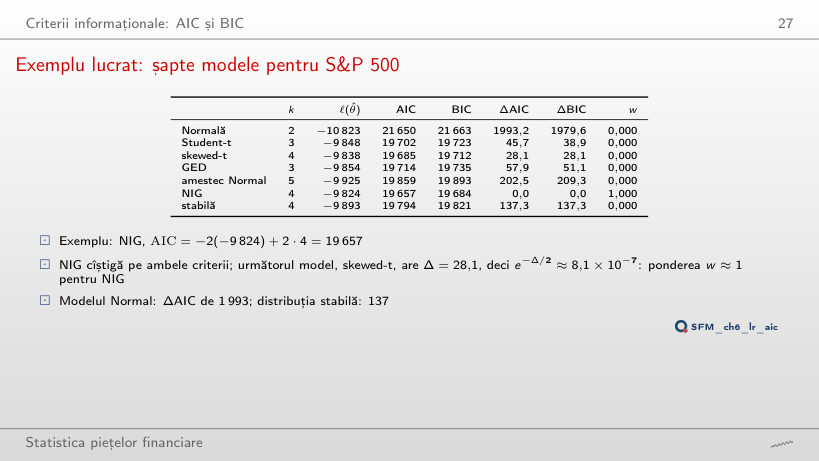
                          Slide-ul 27: Exemplu lucrat: șapte modele pentru S&P 500
                          Slide-ul 27

                          Exemplu lucrat: AIC, BIC și ponderea Akaike

                          \[\mathrm{AIC} = -2\ell(\hat\theta) + 2k, \quad \mathrm{BIC} = -2\ell(\hat\theta) + k\ln n, \quad w_i = \frac{e^{-\Delta_i/2}}{\sum_j e^{-\Delta_j/2}}\]
                              Întrebare pentru sală Pentru BRD, AIC preferă skewed-t, iar Student-t are ΔAIC = 1,0. Ce ponderi Akaike primesc cele două modele?
                              Răspuns

                              0,62 pentru skewed-t și 0,38 pentru Student-t (celelalte cinci modele au ponderi practic nule): w = e−Δ/2/Σ e−Δj/2, cu e−0,5 = 0,61. O diferență de 1 lasă ambele modele plauzibile; AIC nu este un test. Cu ponderile BIC, ordinea se inversează: 0,93 pentru Student-t.

                              ΔAIC pentru șapte serii
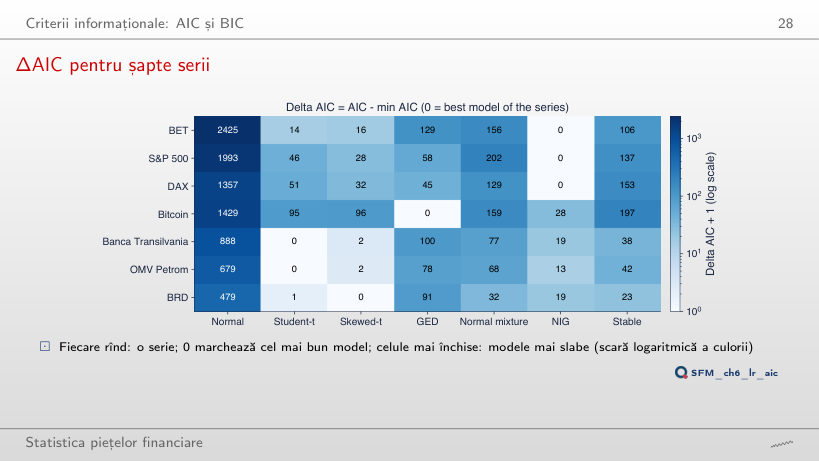
                              Slide-ul 28: ΔAIC pentru șapte serii
                              Slide-ul 28

                              Cel mai bun model după fiecare criteriu

                                Întrebare pentru sală Pentru BRD, AIC preferă skewed-t (ΔAIC al Student-t: 1,0). Butonul ▶ trece la BIC. Ce model preferă BIC?
                                Răspuns

                                Student-t, cu ΔBIC = 5,2 pentru skewed-t. BIC penalizează parametrul suplimentar cu ln 3 771 = 8,24, mai mult decît cîștigul de ajustare (LR = 3,01). Pentru TLV și SNP, ambele criterii aleg Student-t; pentru BET, S&P 500 și DAX, NIG; pentru Bitcoin, GED. Modelul Normal are ΔBIC între 472 și 2 412.

                                Teste de concordanță

                                Exemplu lucrat: KS pe cinci randamente
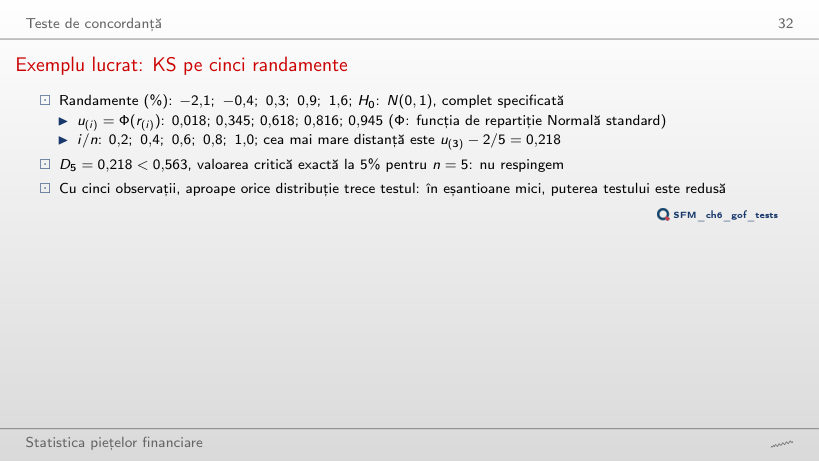
                                Slide-ul 32: Exemplu lucrat: KS pe cinci randamente
                                Slide-ul 32

                                Exemplu lucrat: statistica KS

                                \[D_n = \max_i \max\Big\{\frac{i}{n} - u_{(i)},\ u_{(i)} - \frac{i-1}{n}\Big\}, \quad u_{(i)} = F(r_{(i)})\]
                                    Întrebare pentru sală Cu H0: N(0, 1), D5 = 0,218 < 0,563. Butonul ▶ mută σ din ipoteza nulă de la 0,5 la 2. Pentru ce σ din acest interval respinge testul la 5%?
                                    Răspuns

                                    Pentru niciunul: D5 este între 0,188 (σ = 1,4) și 0,364 (σ = 0,5), mereu sub 0,563. Cu cinci observații, testul nu separă o abatere standard de 0,5% de una de 2%: puterea lui este foarte mică. Cu μ și σ estimate din cele cinci randamente (Lilliefors), D5 = 0,175, iar valoarea critică scade la 0,351 (simularea din curs, ca pe slide).

                                    Puterea redusă a testului KS în cozi
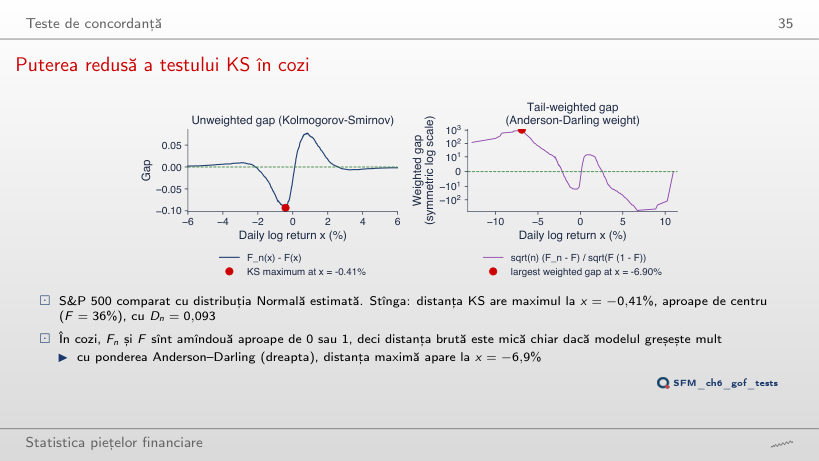
                                    Slide-ul 35: Puterea redusă a testului KS în cozi
                                    Slide-ul 35

                                    Exemplu lucrat: distanța KS în punctul de maxim

                                    \[D_n = \max_i \max\Big\{\frac{i}{n} - u_{(i)},\ u_{(i)} - \frac{i-1}{n}\Big\}, \qquad c_{0{,}05} = \frac{1{,}358}{\sqrt n}\]
                                        Întrebare pentru sală Pentru S&P 500, distanța KS dintre distribuția empirică și distribuția Normală estimată are maximul la x = −0,41%, aproape de centru. Unde este maximul pentru Bitcoin?
                                        Răspuns

                                        Tot în corpul distribuției: la x = −1,69% (F = 30%), cu Dn = 0,099. Pentru toate cele șapte serii, maximul KS este între x = −1,7% și +1,0%, unde funcțiile de repartiție au pante mari. Distanța ponderată Anderson–Darling are maximul în coadă: −6,9% pentru S&P 500, −20,1% pentru Bitcoin. KS măsoară forma corpului, AD forma cozilor.

                                        Puterea celor trei teste
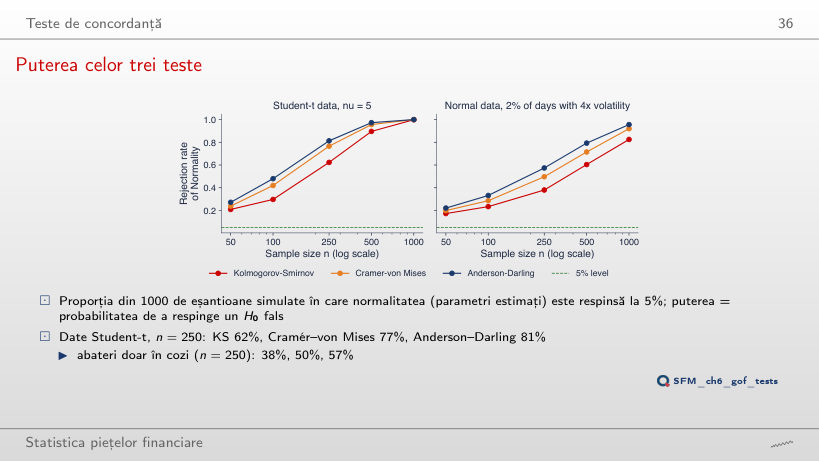
                                        Slide-ul 36: Puterea celor trei teste
                                        Slide-ul 36

                                        Puterea la 5%: date Student-t (ν = 5) și date Normale cu 2% din zile de 4 ori mai volatile

                                        Valori critice KS la 5%: parametri estimați (simulare, 4 000 de eșantioane) și F cunoscută

                                          Întrebare pentru sală La n = 250, cînd abaterile de la distribuția Normală sînt doar în cozi, puterea este 38% (KS), 50% (CvM) și 57% (AD). Butonul ▶ crește n pînă la 1 000. Cît devine puterea testului KS?
                                          Răspuns

                                          82,5%, sub cea a testului AD (95,6%) și CvM (92,0%). Cu date Student-t (ν = 5), la n = 1 000 toate trei resping aproape mereu (99,9%–100%). Testul AD pune o pondere mai mare pe cozi, acolo unde se află abaterea. La n = 100, KS respinge datele Student-t doar în 30% din eșantioane: un test KS pe 100 de randamente care nu respinge distribuția Normală nu spune mare lucru despre VaR 1%.

                                          Teste EDF pe S&P 500
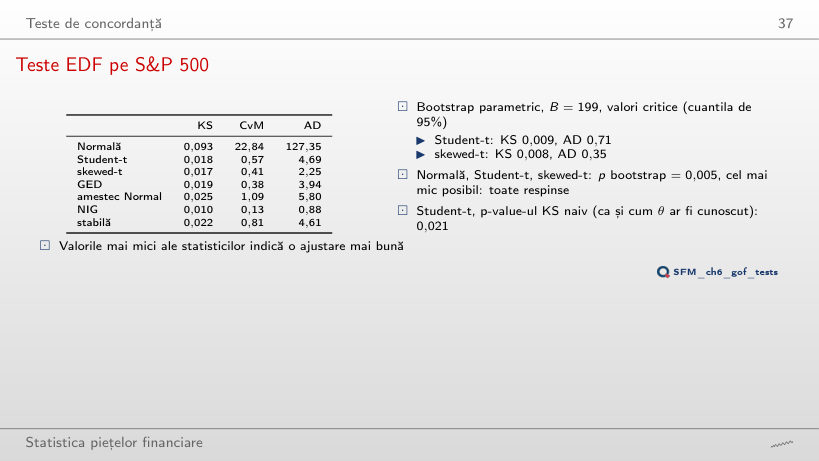
                                          Slide-ul 37: Teste EDF pe S&P 500
                                          Slide-ul 37

                                          Statisticile EDF ale modelelor estimate; clasamentul după AD și după AIC

                                            Întrebare pentru sală Ordonează statistica AD modelele S&P 500 în aceeași ordine ca AIC?
                                            Răspuns

                                            Nu exact. După AD: NIG (0,88), skewed-t (2,25), GED (3,94), stabilă (4,61), Student-t (4,69), amestec Normal (5,80), Normală (127,35). După AIC: NIG, skewed-t, Student-t, GED, stabilă, amestec Normal, Normală. Primele două și ultimele două locuri coincid; Student-t coboară de pe locul 3 pe locul 5. AD și AIC măsoară lucruri diferite: AD distanța ponderată dintre funcțiile de repartiție, AIC densitatea în punctele observate.

                                            Grafice PP și QQ

                                            Grafice PP: S&P 500
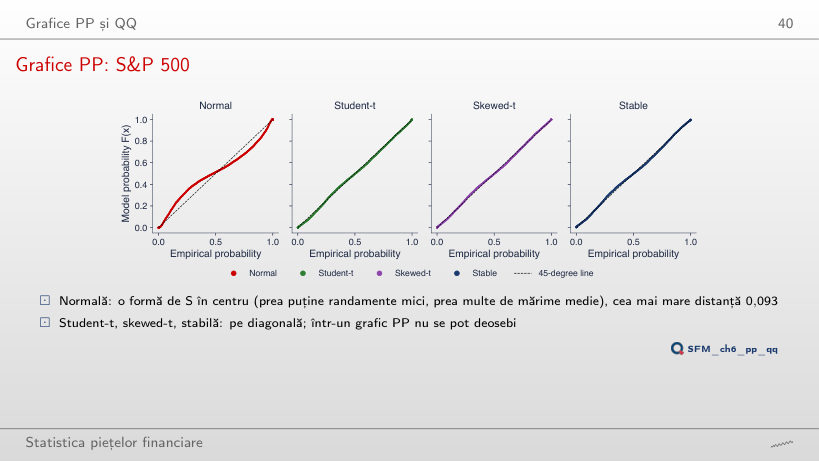
                                            Slide-ul 40: Grafice PP: S&P 500
                                            Slide-ul 40
                                              Întrebare pentru sală În graficul PP al S&P 500, cea mai mare distanță pe verticală a modelului Normal este 0,093. Cît este pentru Student-t?
                                              Răspuns

                                              0,018, practic statistica KS (0,018). Skewed-t are 0,017, distribuția stabilă 0,022: în graficul PP cele trei nu se pot deosebi, deși cozile lor diferă cu ordine de mărime. Graficul PP comprimă cozile în colțuri; graficul QQ de pe slide-ul următor le dilată.

                                              Grafice QQ: S&P 500
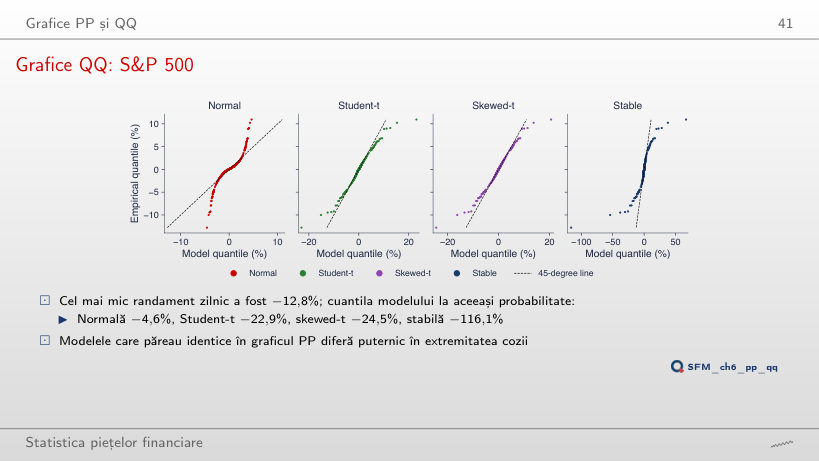
                                              Slide-ul 41: Grafice QQ: S&P 500
                                              Slide-ul 41

                                              Cuantila fiecărui model la probabilitatea celui mai mic randament, 0,5/n (%)

                                                Întrebare pentru sală Pentru S&P 500, cuantila distribuției stabile la probabilitatea celui mai mic randament (−12,8%) este −116,1%. Pentru Bitcoin, cu cel mai mic randament −46,5% (12 martie 2020), cît dă distribuția stabilă?
                                                Răspuns

                                                −385,6%, de peste 8 ori mai mult decît s-a observat. Student-t dă −85,0%, NIG −31,3%, GED −24,2%, modelul Normal −12,7%. La probabilitatea 0,5/n = 1,1 × 10⁻⁴, modelele diferă cel mai mult, iar datele conțin un singur punct: acolo incertitudinea este cea mai mare.

                                                Grafice QQ pentru BET, Bitcoin și Banca Transilvania
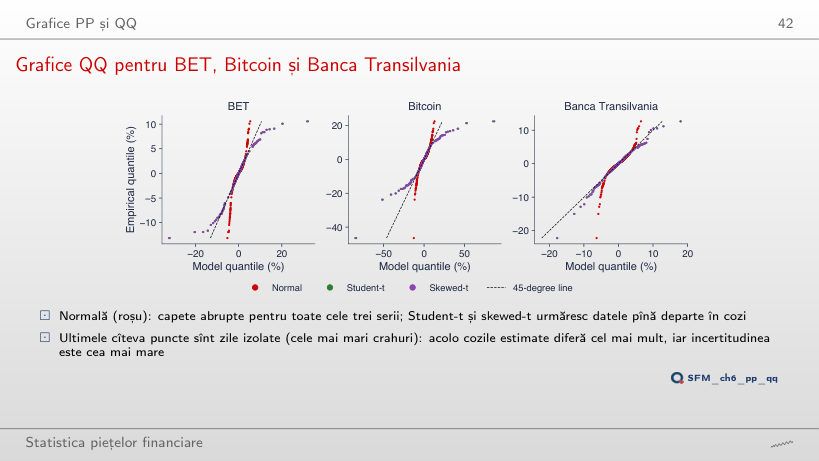
                                                Slide-ul 42: Grafice QQ pentru BET, Bitcoin și Banca Transilvania
                                                Slide-ul 42
                                                  Întrebare pentru sală Pentru Bitcoin, cea mai mare scădere zilnică (12 martie 2020, −46,5%) are în modelul Student-t cuantila −85,0%. Butonul ▶ trece la al doilea, al treilea… cel mai mic randament. Ce cuantilă Student-t are al doilea cel mai mic randament, −23,8%?
                                                  Răspuns

                                                  −51,9%, de peste două ori randamentul observat; la al zecelea (−15,5%), −22,5%. Coada Student-t estimată pe Bitcoin (ν̂ = 2,23) este mai lungă decît cea a datelor. Pentru TLV situația este inversă: cea mai mare scădere, −22,2%, are cuantila Student-t −17,8%. Modelul Normal rămîne mult sub date pentru toate cele trei serii (Bitcoin: −12,7%).

                                                  Compararea modelelor după VaR 1%

                                                  VaR 1% și ES 2,5% pentru fiecare model (în eșantion)
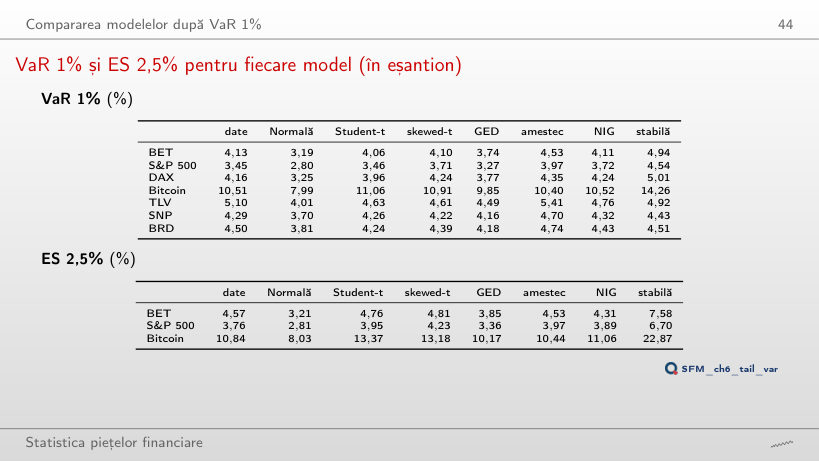
                                                  Slide-ul 44: VaR 1% și ES 2,5% pentru fiecare model (în eșantion)
                                                  Slide-ul 44

                                                  Exemplu lucrat: VaR și ES ale modelului Normal

                                                  \[\mathrm{VaR}_\alpha = -(\hat\mu + \hat\sigma z_\alpha), \qquad \mathrm{ES}_\alpha = -\hat\mu + \hat\sigma\,\frac{\varphi(z_\alpha)}{\alpha}\]
                                                      Întrebare pentru sală La VaR 1%, modelul Normal dă pentru S&P 500 2,80%, iar datele 3,45%. Butonul ▶ trece prin niveluri. La VaR 0,1%, cît dă modelul Normal și cît dau datele?
                                                      Răspuns

                                                      Modelul Normal 3,72%, datele 7,22%: la 0,1% modelul Normal acoperă doar jumătate din pierdere. Student-t dă 8,58%, NIG 6,98%, distribuția stabilă 19,70%. La VaR 5%, ordinea se inversează: modelul Normal dă 1,97%, peste datele (1,85%). ES 2,5% al modelului Normal din formula φ(z)/α (2,81%) coincide cu valoarea obținută prin integrarea cuantilei.

                                                      VaR 1% al modelelor raportat la date
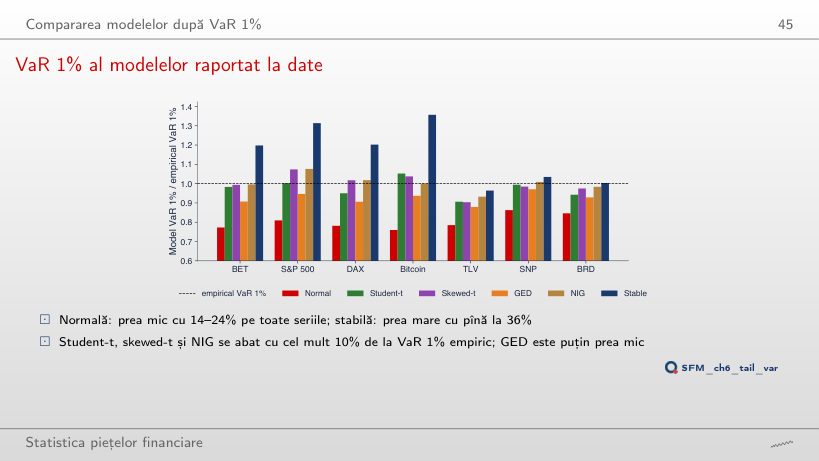
                                                      Slide-ul 45: VaR 1% al modelelor raportat la date
                                                      Slide-ul 45
                                                        Întrebare pentru sală La VaR 1%, raportul dintre VaR al modelului Normal și VaR empiric este între 0,76 și 0,86 pe cele șapte serii. Butonul ▶ trece prin niveluri. Ce devine raportul la VaR 5%?
                                                        Răspuns

                                                        Peste 1 pe toate seriile, între 1,03 (DAX) și 1,16 (BET): la 5% modelul Normal supraestimează pierderea. Aceeași abatere standard σ̂ este prea mare pentru corpul distribuției și prea mică pentru coada ei; cele două erori se compensează pe undeva între 2,5% și 5%. La 0,1% raportul scade la 0,45–0,65.

                                                        Coada stîngă pe axe log-log (S&P 500)
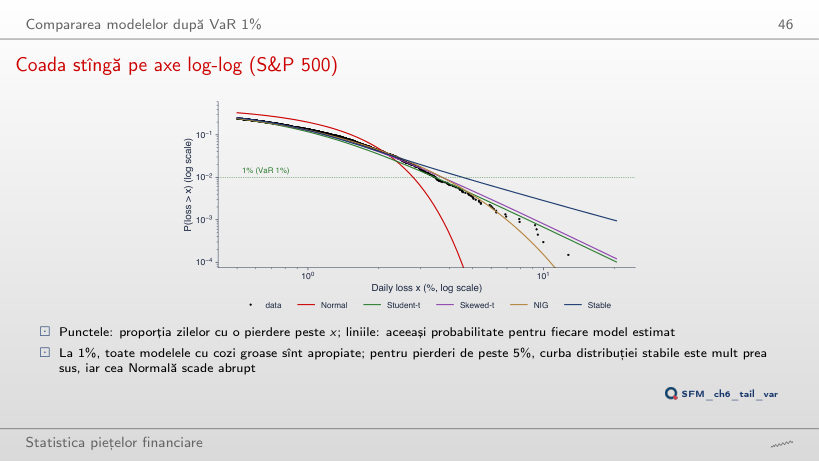
                                                        Slide-ul 46: Coada stîngă pe axe log-log (S&P 500)
                                                        Slide-ul 46
                                                          Întrebare pentru sală S&P 500 are o singură zi cu o pierdere de peste 10% (16 martie 2020) în 6 714 zile. Cîte astfel de zile așteaptă în eșantion distribuția stabilă estimată?
                                                          Răspuns

                                                          Circa 19. Modelul Normal așteaptă practic zero (probabilitatea 7 × 10⁻¹⁷), Student-t 4,5, NIG 1,0, GED 0,08. Pentru pierderi de peste 5%, datele au 23 de zile, stabila așteaptă 57, Student-t 27, NIG 26. Coada stabilă (α̂ = 1,54) este mult prea groasă pentru S&P 500.

                                                          Numărarea depășirilor: testul Kupiec
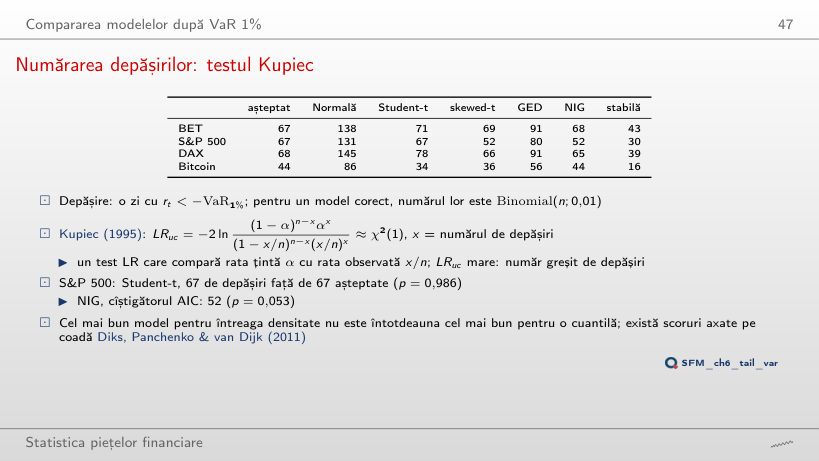
                                                          Slide-ul 47: Numărarea depășirilor: testul Kupiec
                                                          Slide-ul 47

                                                          Depășiri în eșantion (p-value Kupiec în paranteză)

                                                          Exemplu lucrat: testul Kupiec

                                                          \[LR_{uc} = -2\ln\frac{(1-\alpha)^{n-x}\alpha^x}{(1 - x/n)^{n-x}(x/n)^x} \approx \chi^2(1)\]
                                                              Întrebare pentru sală La VaR 1%, NIG (cîștigătorul AIC) are pentru S&P 500 52 de depășiri față de 67 așteptate (p = 0,053). Butonul ▶ trece prin niveluri. La VaR 2,5%, este numărul depășirilor NIG respins la 5%?
                                                              Răspuns

                                                              Nu: 151 de depășiri față de 167,9 așteptate, p = 0,18. Student-t, perfect la 1% (67 față de 67), este respins la 2,5%: 211 depășiri, p = 0,001. Un model bun pentru o cuantilă nu este neapărat bun pentru alta. La VaR 0,1%, NIG are 7 depășiri față de 6,7 așteptate, iar modelul Normal 52.

                                                              În afara eșantionului: validare și supraajustare

                                                              Rezultate în afara eșantionului, 2020–2026
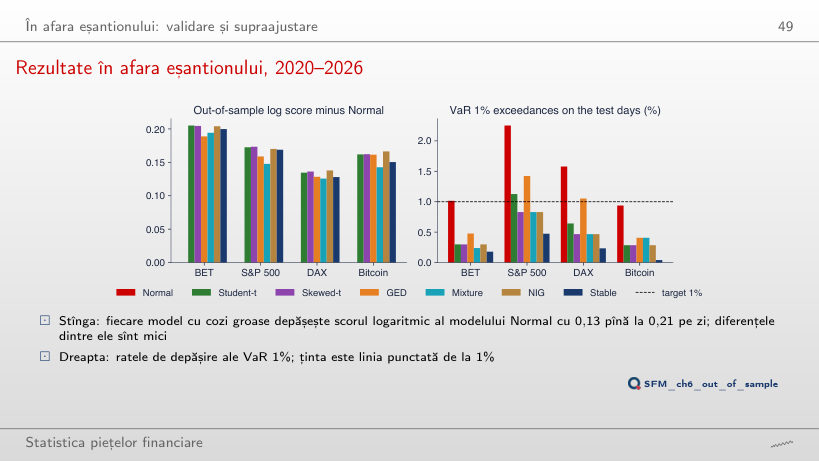
                                                              Slide-ul 49: Rezultate în afara eșantionului, 2020–2026
                                                              Slide-ul 49

                                                              Depășiri ale VaR 1% în zilele de test, 2020–2026 (p-value Kupiec în paranteză)

                                                              Exemplu lucrat: pierderea pinball a cuantilei de 1%

                                                              \[\frac{1}{n}\sum_t \big(\alpha - \mathbf{1}\{r_t < q\}\big)(r_t - q), \qquad \alpha = 0{,}01\]
                                                                  Întrebare pentru sală Pe perioada de test 2020–2026, care metodă are cea mai mică pierdere pinball a cuantilei de 1% pentru BET?
                                                                  Răspuns

                                                                  Modelul Normal (0,0475), urmat de GED (0,0494); Student-t, cel mai bun după scorul logaritmic, are 0,0517, iar NIG, cîștigătorul AIC pe 2000–2019, 0,0513. Perioada de test a fost mai calmă pentru BET, iar VaR Normal, mai mic, a avut 17 depășiri față de 16,7 așteptate. Numărul potrivit vine dintr-un motiv greșit: un model static nu urmărește volatilitatea.

                                                                  Supraajustare: amestecuri Normale cu 1 pînă la 6 componente
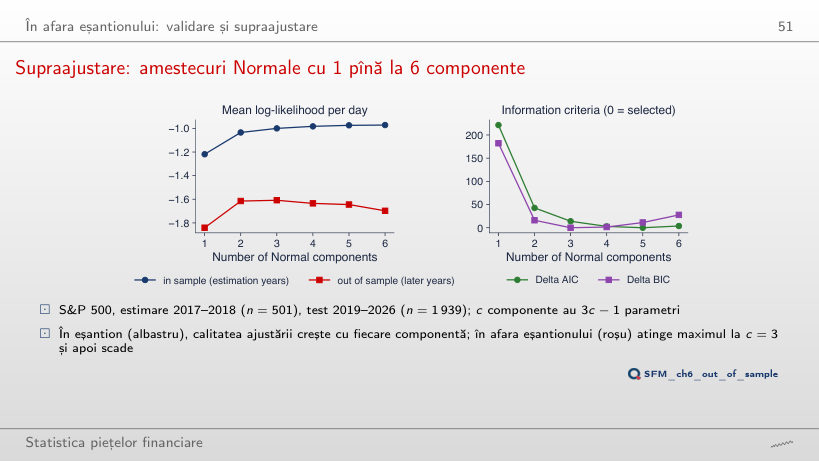
                                                                  Slide-ul 51: Supraajustare: amestecuri Normale cu 1 pînă la 6 componente
                                                                  Slide-ul 51

                                                                  Exemplu lucrat: AIC și BIC

                                                                  \[\mathrm{AIC} = -2\ell + 2k, \quad \mathrm{BIC} = -2\ell + k\ln n, \quad k = 3c - 1\]
                                                                      Întrebare pentru sală Cu penalizarea 2 pe parametru (AIC), criteriul alege c = 5 componente; cu ln 501 = 6,22 (BIC), c = 3. Butonul ▶ crește penalizarea de la 0 la 10. De la ce penalizare alegerea coboară la c = 3?
                                                                      Răspuns

                                                                      De la 5,71 (pe pașii de 0,1 ai cursorului, de la 5,8): trecerea de la 3 la 4 componente aduce 2(ℓ4 − ℓ3) = 17,14 pentru 3 parametri în plus, adică 5,71 pe parametru. Sub 0,8 se alege c = 6, între 0,8 și 3 c = 5, între 3 și 5,71 c = 4. În afara eșantionului cel mai bun este c = 3 (−1,608 pe zi), iar c = 6 dă −1,698.

                                                                      VaR 1% pe fereastră mobilă: reestimare lunară
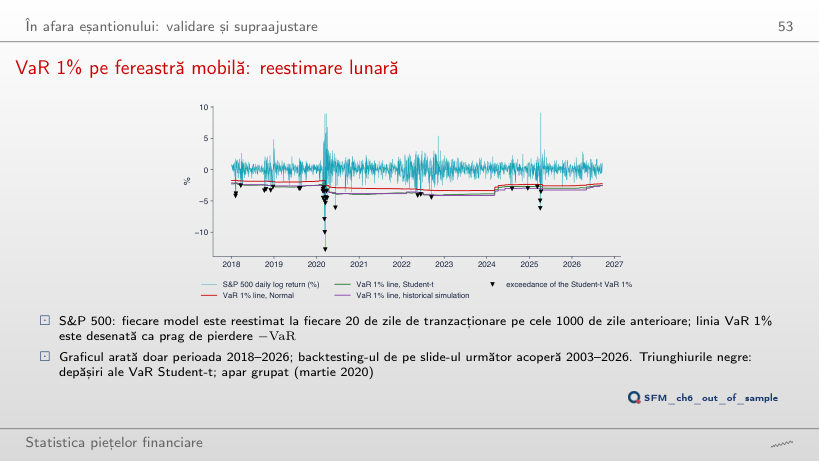
                                                                      Slide-ul 53: VaR 1% pe fereastră mobilă: reestimare lunară
                                                                      Slide-ul 53

                                                                      Depășiri pe an

                                                                      Backtesting pe toată perioada de test

                                                                      Exemplu lucrat: testul de independență Christoffersen (rulare suplimentară)

                                                                      \[LR_{ind} = -2\ln\frac{(1-\hat\pi)^{n_{00}+n_{10}}\,\hat\pi^{\,n_{01}+n_{11}}}{(1-\hat\pi_{01})^{n_{00}}\hat\pi_{01}^{\,n_{01}}(1-\hat\pi_{11})^{n_{10}}\hat\pi_{11}^{\,n_{11}}} \approx \chi^2(1)\]
                                                                          Întrebare pentru sală S&P 500, VaR 1% Student-t pe fereastră mobilă: 89 de depășiri în 5 714 zile (1,56%), Kupiec p < 0,001. Sînt depășirile independente în timp? (testul Christoffersen, rulare suplimentară)
                                                                          Răspuns

                                                                          Nu: LRind = 19,81, p < 0,001. După o zi cu depășire urmează o altă depășire în 10,1% din cazuri (9 din 89), față de 1,4% după o zi fără depășire. Depășirile se adună în august 2007, septembrie–noiembrie 2008 (6, 9 și 6) și martie 2020 (9). Pentru BET, simularea istorică trece testul Kupiec (p = 0,066), dar nu și testul de independență (p = 0,014).

                                                                          Graficul de fiabilitate VaR (SFEVaRqqplot)
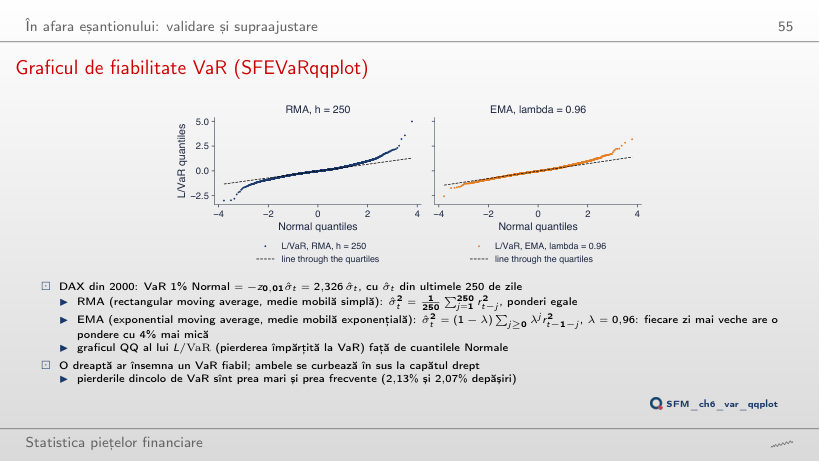
                                                                          Slide-ul 55: Graficul de fiabilitate VaR (SFEVaRqqplot)
                                                                          Slide-ul 55
                                                                            Întrebare pentru sală Cu λ = 0,96, VaR Normal cu volatilitatea EMA este depășit în 2,07% din zilele DAX. Butonul ▶ mută λ de la 0,90 la 0,99. Se apropie rata de 1% pentru vreun λ?
                                                                            Răspuns

                                                                            Nu: rata rămîne între 1,96% (λ = 0,97) și 2,40% (λ = 0,99). Volatilitatea EMA se adaptează, dar cuantila Normală z0,01 = −2,326 rămîne prea mică pentru randamentele standardizate, care au cozi mai groase decît distribuția Normală: capătul drept al graficului QQ se curbează în sus pentru orice λ. RMA cu h = 250 are 2,13%; cu h = 125, 2,21%.

                                                                            Incertitudinea de model

                                                                            Incertitudinea clasamentului modelelor
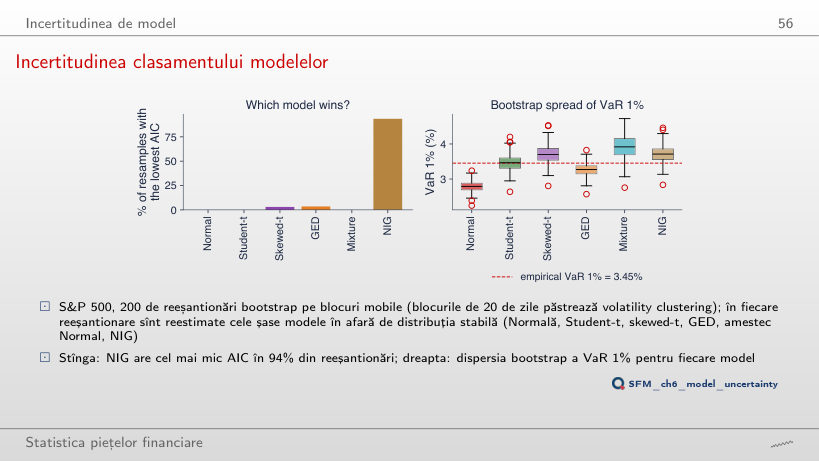
                                                                            Slide-ul 56: Incertitudinea clasamentului modelelor
                                                                            Slide-ul 56

                                                                            Reeșantionările bootstrap pe blocuri mobile, S&P 500

                                                                              Întrebare pentru sală Cu toate cele 200 de reeșantionări, NIG are cel mai mic AIC în 93,5% dintre ele. Butonul ▶ crește B de la 20 la 200. Ce proporție dau primele 20 de reeșantionări?
                                                                              Răspuns

                                                                              100%: NIG cîștigă în toate primele 20. Cu B = 40, 95%; cu B = 100, 95%; cu B = 200, 93,5% (GED 3,5%, skewed-t 3%). Un număr mic de reeșantionări supraestimează siguranța cîștigătorului. Intervalele de 90% ale VaR 1% (Student-t [3,14; 3,87]%, NIG [3,34; 4,18]%) se suprapun: incertitudinea dintre modele este comparabilă cu cea din interiorul unui model.

                                                                              Medierea modelelor și riscul de model
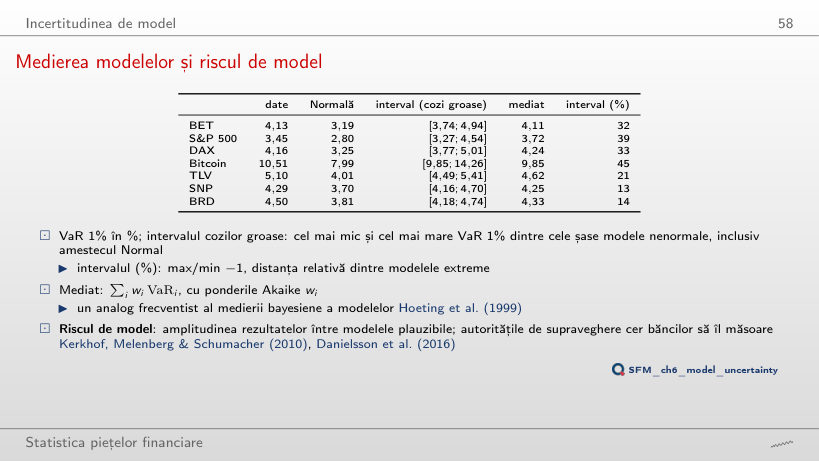
                                                                              Slide-ul 58: Medierea modelelor și riscul de model
                                                                              Slide-ul 58

                                                                              VaR (%) al datelor, al modelelor și mediat

                                                                              Exemplu lucrat: VaR mediat

                                                                              \[\mathrm{VaR}^{avg}_\alpha = \sum_i w_i\,\mathrm{VaR}_{\alpha,i}, \qquad \text{interval} = \frac{\max_i \mathrm{VaR}_i}{\min_i \mathrm{VaR}_i} - 1\]
                                                                                  Întrebare pentru sală Pentru TLV, intervalul VaR 1% al modelelor cu cozi groase este [4,49; 5,41]. Distribuția stabilă, cu cozile cele mai groase, dă 4,92%. Ce model dă capătul de sus, 5,41%?
                                                                                  Răspuns

                                                                                  Amestecul Normal (coloana „amestec” din tabelul VaR al cursului), unul dintre cele șase modele nenormale. Fără el, intervalul TLV devine [4,49; 4,92], adică 10% în loc de 21%. La fel pentru SNP (4,70%) și BRD (4,74%). Pentru indici și Bitcoin, capătul de sus vine de la distribuția stabilă.

                                                                                  Randamente logaritmice zilnice, în %: BET, S&P 500 și DAX din ianuarie 2000, Bitcoin din septembrie 2014 (7 zile pe săptămînă), Banca Transilvania (TLV), OMV Petrom (SNP) și BRD din 2010, din prețul ajustat, pînă la 18 septembrie 2026; cele două zile greșite ale TLV din mai 2016 sînt eliminate. DAX lunar: prima zi de tranzacționare a fiecărei luni (SFESumm). Prețuri de închidere EODHD. Parametrii estimați, log-verosimilitățile, cuantilele modelelor, VaR pe fereastră mobilă și reeșantionările bootstrap sînt cele din curs (același cod, aceeași sămînță a generatorului); statisticile descriptive, VaR și ES empirice, depășirile, testele Kupiec, scorurile pinball și graficul SFEVaRqqplot sînt recalculate în browser din aceleași randamente. Nivelurile VaR diferite de 1%, celelalte serii ale profilului lui ν, testul Christoffersen și ponderile BIC sînt rulări suplimentare ale aceluiași cod.