Capitolul 4: Sezonalitate și prognoză: SARIMA, TBATS, Prophet
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
DM: Diebold–Mariano (test) — testul Diebold–Mariano de comparare a prognozelor
ENTSO-E: European Network of Transmission System Operators for Electricity (rețeaua europeană a operatorilor de transport și de sistem pentru energie electrică)
ETS: Error, Trend, Seasonality (exponential smoothing state space models) — eroare, trend, sezonalitate (modele de netezire exponențială)
PACF: Partial AutoCorrelation Function (funcția de autocorelație parțială)
PIB: Produsul intern brut
RMSE: Root Mean Squared Error (rădăcina erorii pătratice medii)
SARIMA: Seasonal ARIMA (model) — model ARIMA sezonier
SCA: Seasonally and Calendar Adjusted (ajustat sezonier și pentru efectele de calendar)
SEATS: Signal Extraction in ARIMA Time Series (extragerea semnalului din serii de timp ARIMA)
STL: Seasonal and Trend decomposition using Loess (descompunerea în sezonalitate și trend cu Loess)
TBATS: Trigonometric seasonality, Box–Cox, ARMA errors, Trend, Seasonal components (model) — model cu sezonalitate trigonometrică, transformare Box–Cox, erori ARMA, trend și componente sezoniere
TRAMO-SEATS: Time series Regression with ARIMA noise, Missing values and Outliers; Signal Extraction in ARIMA Time Series (metodă de ajustare sezonieră pe baza modelelor ARIMA)
TVA: Taxa pe valoarea adăugată
UE: Uniunea Europeană
US: United States (Statele Unite ale Americii)
UTC: Coordinated Universal Time (Temps Universel Coordonné) — timpul universal coordonat
Capitolul pornește de la o întrebare practică: cum se modelează, cum se prognozează și cum se evaluează o serie care repetă un tipar în fiecare an, săptămînă sau zi. Cele trei răspunsuri posibile corespund celor trei părți ale capitolului. Tiparul poate fi eliminat prin diferențiere, ca în modelele SARIMA; poate fi descris prin regresori, ca în termenii Fourier, TBATS și Prophet; sau poate fi estimat și scos din date, ca în ajustarea sezonieră a seriilor oficiale.
Instrumentele sînt cele din capitolele anterioare, aplicate la lagul sezonier \(s\). Descompunerea în componente, metoda Holt–Winters și MASE vin din Capitolul 0; modelele ARMA, rădăcinile unitare și modelele ARIMA din Capitolul 2 și Capitolul 3. Seminarul 4 prezintă formulele înaintea cursului; aici ele sînt deduse și aplicate pe date.
Pe scurt
Întrebarea: multe serii economice repetă un tipar în fiecare an, săptămînă sau zi; cum modelăm acest tipar, cum prognozăm cu el și cum decidem care prognoză este mai bună?
trei răspunsuri: eliminăm tiparul prin diferențiere (SARIMA), îl modelăm cu regresori (termeni Fourier, TBATS, Prophet) sau îl scoatem din date (ajustarea sezonieră)
Traseul capitolului
diferențe sezoniere și rădăcini unitare sezoniere (HEGY, Canova–Hansen, OCSB)
SARIMA\((p,d,q)(P,D,Q)_s\): identificare, estimare, diagnosticare, prognoze; modelul airline și PIB-ul României
ajustarea sezonieră în practică (X-13ARIMA-SEATS, Eurostat), termeni Fourier și efecte de calendar (Paștele ortodox)
sezonalitatea multiplă a consumului de electricitate: MSTL, regresia armonică dinamică, TBATS, Prophet
evaluarea prognozelor (validare încrucișată pentru serii de timp, testul Diebold–Mariano) și combinarea prognozelor
Capitolul se sprijină pe Capitolul 0 (componente, Holt–Winters, MASE) și pe Capitolele 2–3 (ARMA, rădăcini unitare, ARIMA): aceleași idei, la lagul sezonier \(s\)
Seminarul 4 are loc înaintea acestui curs: dă formulele; aici le deducem și le aplicăm pe date
Rezultatele învățării descriu cinci competențe. Prima este diagnosticul: distincția dintre sezonalitatea deterministă și cea stochastică și alegerea diferențierii sezoniere pe baza testelor. A doua este ciclul complet Box–Jenkins pentru un model SARIMA, de la scrierea polinoamelor la prognoză. A treia este citirea corectă a seriilor oficiale ajustate și neajustate. A patra este modelarea efectelor de calendar și a sezonalității multiple, iar a cincea este compararea și combinarea prognozelor după criterii statistice.
Pe scurt
Recunoașteți sezonalitatea deterministă și pe cea stochastică și alegeți diferențierea sezonieră cu testele HEGY, Canova–Hansen și OCSB
Scrieți, identificați, estimați, verificați și prognozați un model SARIMA\((p,d,q)(P,D,Q)_s\) și dezvoltați polinoamele lui
Interpretați corect seriile oficiale ajustate sezonier și neajustate și explicați ce face X-13ARIMA-SEATS
Modelați efectele de calendar (zile lucrătoare, Paștele ortodox) și sezonalitatea multiplă cu termeni Fourier, MSTL, TBATS și Prophet
Comparați prognozele cu validarea încrucișată pentru serii de timp, MASE și testul Diebold–Mariano și combinați-le
Calculele capitolului folosesc biblioteca Python statsmodels (clasele SARIMAX, MSTL și ExponentialSmoothing) și pachetele opționale tbats și prophet. Codul fiecărui grafic se află în Quantlet-urile capitolului, iar notebook-ul cursului poate fi deschis în Google Colab.
Two separate sets of forecasts of airline passenger data have been combined to form a composite set of forecasts. The main conclusion is that the composite set of forecasts can yield lower mean-square error than either of the original forecasts.
Multe serii economice repetă un tipar cu o perioadă cunoscută: producția scade în fiecare prim trimestru, turismul are un vîrf în fiecare august, consumul de electricitate coboară în fiecare duminică și în fiecare noapte. Acest tipar este de obicei cea mai mare sursă de variație a seriei. Diferența dintre trimestrul al patrulea și primul trimestru al anului următor ajunge, pentru PIB-ul neajustat al României, la peste 40%, în timp ce creșterea economică anuală se măsoară în cîteva procente. Un model care ignoră tiparul sezonier nu poate prognoza seria, iar o comparație care confundă sezonul cu ciclul economic duce la concluzii greșite despre economie.
Capitolul tratează trei moduri de lucru cu sezonalitatea. Primul o elimină prin diferențiere sezonieră și modelează ce rămîne: modelele SARIMA, cu modelul airline al lui Box, Jenkins și Reinsel (2008) ca reper. Al doilea o modelează cu regresori: variabile dummy, termeni Fourier, efecte de calendar precum Paștele ortodox, iar pentru serii cu mai multe perioade simultan regresia armonică dinamică, TBATS și Prophet. Al treilea o scoate din date pentru a publica serii ajustate sezonier, ca în statistica oficială. Toate se aplică pe date din România: PIB-ul trimestrial, comerțul cu amănuntul, turismul și consumul de electricitate.
A doua întrebare a capitolului este cum se decide care prognoză este mai bună. Răspunsul cere o evaluare în afara eșantionului (out-of-sample), cu origini de prognoză mobile, o măsură a erorii comparabilă între serii și un test care separă un cîștig real de un efect al întîmplării. Citatul de mai sus, din articolul lui Bates și Granger (1969) despre aceleași date ale pasagerilor aerieni, introduce ultima idee a capitolului: o combinație de prognoze poate fi mai precisă decît fiecare dintre prognozele combinate.
Șase serii sezoniere din România: PIB-ul real trimestrial neajustat (mld. EUR, prețuri 2010), volumul comerțului cu amănuntul și producția industrială (indici, 2021 = 100), înnoptările în unitățile de cazare turistică (milioane), inflația lunară IAPC (%) și consumul mediu zilnic de electricitate (GW).
Ce veți putea face
Testați prezența rădăcinilor unitare sezoniere cu testele HEGY, Canova–Hansen și OCSB și alegeți ordinul de diferențiere sezonieră.
Derivați autocorelațiile și prognozele unui model SARIMA, în particular ale modelului airline.
Estimați și diagnosticați un model SARIMA și o regresie cu erori SARIMA cu efecte de calendar.
Modelați sezonalitatea multiplă cu termeni Fourier, MSTL, regresia armonică dinamică, TBATS și Prophet.
Comparați prognoze prin validare încrucișată pentru serii de timp, MASE și testul Diebold–Mariano și combinați-le.
Planul capitolului
Sezonalitatea în datele economiceDefiniția și sursele sezonalității, șase serii din România, graficul sezonier și graficul pe subserii.
RezumatIdeile și formulele de reținut și întrebări de autoevaluare.
Sezonalitatea în datele economice
Prima secțiune definește sezonalitatea și o separă de ciclul economic. Ea arată, pe șase serii din România, cît de mare este componenta sezonieră și cît de diferite sînt sursele ei: vremea, calendarul și instituțiile. Două grafice specializate, graficul sezonier și graficul pe subserii, arată dacă tiparul este stabil de la un an la altul. Răspunsul la această întrebare decide instrumentul folosit în secțiunea următoare: variabile dummy pentru un tipar stabil sau diferențe sezoniere pentru un tipar care se deplasează.
Sezonalitatea (seasonality) este un tipar care se repetă cu o perioadă \(s\) fixă și cunoscută dinainte, măsurată în numărul de observații dintr-un ciclu complet. Pentru date trimestriale \(s = 4\), pentru date lunare \(s = 12\), pentru date zilnice cu tipar săptămînal \(s = 7\), iar pentru date orare \(s = 24\) (ziua) și \(s = 168\) (săptămîna). Ciclul economic (business cycle) este diferit: el are și el expansiuni și contracții, dar durata lor este neregulată și nu se cunoaște dinainte. Din acest motiv, sezonalitatea poate fi prognozată mult mai sigur decît ciclul.
Sursele sezonalității sînt de trei feluri. Vremea produce consumul de energie pentru încălzire iarna, vîrful turismului de pe litoral în august și calendarul recoltelor. Calendarul produce diferențe între luni prin numărul de zile lucrătoare și de sărbători legale; sărbătorile mobile (moving holidays), precum Paștele ortodox, cad în luni diferite de la un an la altul și mută activitatea între martie, aprilie și mai. Instituțiile și obiceiurile adaugă anul școlar, termenele fiscale, primele de sfîrșit de an și ritmul săptămînii de lucru.
Forma sezonalității poate fi aditivă, \(y_t = T_t + S_t + R_t\), cînd amplitudinea tiparului nu depinde de nivelul seriei, sau multiplicativă, \(y_t = T_tS_tR_t\), cînd tiparul este o proporție fixă din nivel; \(T_t\) este trendul, \(S_t\) componenta sezonieră și \(R_t\) restul. Logaritmarea transformă forma multiplicativă în formă aditivă, \(\ln y_t = \ln T_t + \ln S_t + \ln R_t\). De aceea, în acest capitol seriile a căror amplitudine sezonieră crește cu nivelul sînt modelate în logaritmi, ca în Capitolul 0.
Pe scurt
Sezonalitatea: un tipar care se repetă cu o perioadă\(s\) fixă și cunoscută (observații pe ciclu)
\(s = 4\) (trimestre), \(s = 12\) (luni), \(s = 7\) (zile într-o săptămînă), \(s = 24\) și \(s = 168\) (ore într-o zi și într-o săptămînă)
spre deosebire de ciclu, a cărui lungime este neregulată și necunoscută (Capitolul 0)
Surse
vremea: încălzirea iarna, litoralul în august, recoltele
calendarul: zilele lucrătoare, sărbătorile legale, sărbătorile mobile, precum Paștele ortodox
instituțiile și obiceiurile: anul școlar, termenele fiscale, primele de sfîrșit de an, săptămîna de lucru
Aditivă (\(y_t = T_t + S_t + R_t\)) sau multiplicativă (\(y_t = T_tS_tR_t\), aditivă după logaritmare): Capitolul 0; aici lucrăm cu logaritmi cînd amplitudinea crește cu nivelul
Întrebare pentru sală În 2010–2019, în ce lună este cea mai mare inflația lunară medie a IAPC?
Răspuns
În ianuarie: 0,575% în medie, urmată de octombrie, 0,487%; cea mai mică este în iunie, −0,368% (alimentele proaspete). Ordinea depinde de perioadă: pe 2015–2019, octombrie are 0,575% și mai 0,457%. Pentru PIB, media trimestrului 4 este cu 57% peste media trimestrului 1 (27,8 și 43,6 mld. EUR, 2000–2026); pentru turism, august are de 3,7 ori mai multe înnoptări decît ianuarie (2015–2019).
Graficul reunește șase serii cu frecvențe și surse de sezonalitate diferite. PIB-ul real neajustat este trimestrial, din 2000 pînă în al doilea trimestru din 2026, în miliarde de euro la prețurile din 2010. Comerțul cu amănuntul, producția industrială, înnoptările turistice și inflația lunară măsurată prin indicele armonizat al prețurilor de consum (IAPC) sînt serii lunare de la Eurostat, din 2010. Consumul de electricitate este o serie zilnică, media consumului orar raportat de ENTSO-E, din 2022 pînă în iunie 2026.
Fiecare panou se citește separat. La PIB, dinții de fierăstrău sînt tiparul trimestrial: fiecare an începe cu un minim în primul trimestru și urcă pînă în al patrulea. La turism, vîrfurile de vară domină seria, iar anul 2020 se vede ca o prăbușire. Comerțul și producția industrială au un tipar lunar mai puțin vizibil, suprapus pe trend, iar la producție scăderea din aprilie 2020 este cea mai mare abatere. Inflația lunară oscilează în jurul unei medii pozitive, fără trend. Consumul de electricitate are oscilații dese, de la o săptămînă la alta, și valuri anuale, cu vîrfuri iarna.
Pe scurt
Eurostat: PIB (trimestrial, neajustat), comerțul cu amănuntul, producția industrială, înnoptările turistice, IAPC; ENTSO-E: consumul zilnic de electricitate
Pentru PIB, media trimestrului al patrulea este cu 57% mai mare decît media primului trimestru, pe perioada 2000–2026. Mediile trimestriale sînt 27,8 miliarde de euro în primul trimestru, 33,6 în al doilea, 39,5 în al treilea și 43,6 în al patrulea, la prețurile din 2010. Creșterea din al doilea și al treilea trimestru reflectă în mare parte construcțiile și agricultura. Amplitudinea tiparului crește odată cu nivelul seriei, deci sezonalitatea este multiplicativă, iar PIB-ul se modelează în logaritmi.
La turism, numărul de înnoptări din august este de 3,7 ori mai mare decît cel din ianuarie, în medie pe 2015–2019. Restricțiile din 2020 (lockdown) au întrerupt acest tipar, iar o serie cu o asemenea întrerupere cere variabile dummy pentru valorile aberante. Inflația lunară are și ea un tipar sezonier: între 2010 și 2019 ea a fost în medie negativă în iunie, −0,37%, ca efect al prețurilor alimentelor proaspete. Cea mai mare a fost în ianuarie, 0,575%, cînd intră în vigoare prețuri și accize noi, și din nou ridicată în octombrie, 0,49%.
Electricitatea are două tipare simultan: oscilația deasă din grafic este ciclul săptămînal, iar vîrfurile de iarnă formează ciclul anual. O serie cu mai multe perioade sezoniere are sezonalitate multiplă (multiple seasonality), iar instrumentele pentru ea sînt subiectul secțiunii 8.
Pe scurt
PIB: media trimestrului 4 este cu 57% peste media trimestrului 1 (2000–2026); amplitudinea crește cu nivelul: multiplicativă, folosim logaritmi
mediile trimestriale (mld. EUR, prețuri 2010): 27,8; 33,6; 39,5; 43,6: construcțiile și agricultura în T2–T3
Turismul: august are de 3,7 ori mai multe înnoptări decît ianuarie (2015–2019); restricțiile din 2020 (lockdown) întrerup tiparul
IAPC: inflația lunară este mai mică în iunie (în medie \(-\)0,37%, 2010–2019, alimentele proaspete) și cea mai mare în ianuarie (0,575%, prețuri și accize noi), din nou ridicată în octombrie (0,49%)
Electricitatea: două tipare simultan, săptămîna (oscilația deasă) și anul (vîrfurile de iarnă): sezonalitate multiplă, secțiunea 8
Întrebare pentru sală Butonul ▶ trece prin anii 2012–2025. În ce an este cel mai mare raportul dintre înnoptările din august și cele din ianuarie?
Răspuns
În 2021: 5,3, față de 3,4 în 2019 și 2,2 în 2020. În ianuarie 2021 restricțiile țineau încă turismul jos, iar vara a revenit; în 2020 a fost afectată și vara, iar aprilie 2020 a avut doar 0,045 milioane de înnoptări. Forma anului rămîne aceeași: august este luna de vîrf în fiecare an. La PIB, cele patru subserii păstrează ordinea T1 < T2 < T3 < T4 în toți cei 21 de ani din 2005–2025.
Graficul sezonier (seasonal plot), în stînga, desenează fiecare an ca o linie separată, cu lunile pe axa orizontală. Dacă liniile au aceeași formă, tiparul este stabil; dacă forma se schimbă, tiparul evoluează în timp. Pentru înnoptările turistice, cele 14 linii, din 2012 pînă în 2025, au aceeași formă: un minim iarna și un vîrf în august. Anul 2020, linia roșie întreruptă, este singura excepție.
Graficul pe subserii (subseries plot), în dreapta, separă seria după sezon: fiecare trimestru al PIB-ului este urmărit de-a lungul anilor ca o linie proprie, iar linia orizontală arată media lui. Axa verticală este PIB-ul în miliarde de euro, între 2005 și 2026. Diferența dintre mediile celor patru trimestre măsoară mărimea efectului sezonier, iar evoluția fiecărei linii arată dacă efectul sezonier se schimbă în timp.
Pe scurt
Stînga: o linie pentru fiecare an (graficul sezonier); dreapta: fiecare trimestru al PIB-ului urmărit de-a lungul anilor, cu media lui (graficul pe subserii)
În 2019, înnoptările turistice au fost 5,06 milioane în august și 1,47 milioane în ianuarie. În aprilie 2020 au fost doar 0,045 milioane, față de 1,76 milioane în aprilie 2019. Această scădere este o valoare aberantă (outlier) produsă de un eveniment unic, nu un tipar sezonier nou: după 2021, liniile revin la forma dinainte. Un model sezonier trebuie să trateze asemenea luni separat, de exemplu cu o variabilă dummy, altfel ele deformează estimarea tiparului.
Pe graficul pe subserii, cele patru trimestre ale PIB-ului cresc paralel. Tiparul sezonier este deci stabil, suprapus pe un trend comun. Dacă liniile s-ar apropia, s-ar depărta sau s-ar intersecta, ordinea trimestrelor s-ar schimba în timp; aceasta este semnătura sezonalității stochastice, tratată în secțiunea următoare. Graficul nu este un test, dar arată ce ipoteză este plauzibilă înainte de testele formale.
Pe scurt
Turismul: aceeași formă în fiecare an, un vîrf vara și un minim iarna
2019: 5,06 milioane de înnoptări în august, 1,47 milioane în ianuarie
aprilie 2020: 0,045 milioane (1,76 milioane în aprilie 2019): o valoare aberantă, nu un sezon nou
Subseriile PIB: toate cele patru trimestre cresc paralel
Sezonalitatea are o perioadă cunoscută, iar ciclul economic nu; de aici diferența dintre ele în ce privește prognoza. Vremea, calendarul și instituțiile produc tiparele sezoniere, iar sărbătorile mobile mută o parte din activitate dintr-o lună în alta. Toate cele șase serii din România sînt sezoniere, iar consumul de electricitate are mai multe perioade simultan. Graficul sezonier și graficul pe subserii arată dacă tiparul este stabil, ceea ce orientează alegerea dintre modelarea deterministă și diferențierea sezonieră.
Pe scurt
Sezonalitatea se repetă cu o perioadă cunoscută \(s\); ciclul nu
Vremea, calendarul și instituțiile o creează; sărbătorile mobile o mută între luni
PIB-ul, turismul, inflația și consumul de electricitate din România sînt toate sezoniere; electricitatea are mai multe perioade simultan
Graficele sezoniere și pe subserii arată dacă tiparul este stabil
Sinteza secțiunii
Sezonalitatea este cea mai mare sursă de variație în seriile economice din România: media celui de-al patrulea trimestru al PIB-ului este cu 57% peste media primului, iar turismul din august este de 3,7 ori mai mare decît cel din ianuarie. Tiparul este multiplicativ pentru PIB și turism, deci aceste serii se modelează în logaritmi. Graficele arată tipare în general stabile, întrerupte de valori aberante precum anul 2020. Secțiunea următoare formalizează distincția dintre un tipar stabil și unul care se deplasează și dă testele care decid între ele.
Diferențierea sezonieră și rădăcinile unitare sezoniere
În Capitolul 3, diferența obișnuită \(\Delta = 1 - L\) elimina o rădăcină unitară, adică un trend stochastic. Această secțiune extinde ideea la lagul sezonier. Diferența sezonieră \(\Delta_s = 1 - L^s\) are \(s\) rădăcini unitare (seasonal unit roots), cîte una pentru fiecare frecvență sezonieră, iar o serie poate avea doar o parte dintre ele. Secțiunea definește operatorul, distinge sezonalitatea deterministă de cea stochastică, explică rădăcinile pe cercul unitate și prezintă trei teste, aplicate apoi pe date din România.
unde \(L\) este operatorul de întîrziere (lag operator), \(L^s y_t = y_{t-s}\). Pentru o serie trimestrială în logaritmi, \(100\,\Delta_4 \ln Y_t\) este creșterea față de același trimestru al anului anterior, în procente: rata de creștere anuală publicată de institutele de statistică.
Efectul lui \(\Delta_s\) se vede pe o serie cu un tipar sezonier fix și un trend liniar, \(y_t = a + bt + S_t + \varepsilon_t\), unde \(a\) este termenul liber, \(b\) panta trendului și \(S_t = S_{t-s}\) efectul sezonier al perioadei \(t\). Deoarece tiparul se repetă exact, el dispare prin diferențiere:
Diferența sezonieră elimină tiparul și transformă trendul liniar într-o constantă, \(bs\). Prețul este termenul \(\varepsilon_t - \varepsilon_{t-s}\): un MA sezonier cu coeficientul \(-1\), a cărui rădăcină se află pe cercul unitate. Un asemenea proces nu este invertibil (non-invertible), iar situația este supradiferențierea sezonieră (seasonal over-differencing), analogul sezonier al supradiferențierii din Capitolul 3.
Cînd și trendul este stochastic, seria cere ambele diferențe: \(\Delta\Delta_s = (1 - L)(1 - L^s) = 1 - L - L^s + L^{s+1}\). Polinoamele în \(L\) comută, deci ordinea în care se aplică cele două diferențe nu schimbă rezultatul.
În modelul cu sezonalitate deterministă (deterministic seasonality), media seriei depinde doar de sezon: \(y_t = \sum_{j=1}^{s}\gamma_jD_{jt} + u_t\), unde \(D_{jt}\) este 1 dacă perioada \(t\) se află în sezonul \(j\) și 0 altfel, iar \(u_t\) este staționar. Mediile sezoniere \(\gamma_j\) sînt constante pe tot eșantionul, deci ianuarie rămîne mereu cu aceeași distanță sub iulie. Instrumentul potrivit este regresia pe variabile dummy sezoniere sau pe termeni Fourier, tratați în secțiunea 7.
Modelul de bază pentru sezonalitatea stochastică (stochastic seasonality) este mersul aleator sezonier (seasonal random walk), \(y_t = y_{t-s} + \varepsilon_t\). Fiecare sezon evoluează ca propriul său mers aleator: valorile din ianuarie formează un mers aleator, cele din februarie altul, iar seria observată le intercalează pe toate cele \(s\). Varianța lui \(y_t\) crește nelimitat cu numărul de ani, iar diferențele dintre sezoane se acumulează: după suficient de mult timp, un sezon de vîrf poate deveni un sezon de minim, adică „vara poate deveni iarnă”. Instrumentul potrivit este diferența sezonieră \(\Delta_s\), care transformă mersul aleator sezonier în zgomot alb (white noise).
Alegerea între cele două modele are consecințe în ambele direcții. Diferențierea unei serii cu tipar determinist produce un MA neinvertibil, ca în (4.2), și prognoze cu intervale inutil de largi. Modelarea cu variabile dummy a unei serii cu tipar stochastic lasă o rădăcină unitară sezonieră în reziduuri, iar inferența bazată pe ele nu mai este validă. Testele din slide-urile următoare decid între cele două ipoteze.
Pe scurt
Deterministă: \(y_t = \sum_{j=1}^{s}\gamma_jD_{jt} + u_t\), cu \(D_{jt} = 1\) în sezonul \(j\) și \(u_t\) staționar
mediile sezoniere \(\gamma_j\) nu se schimbă niciodată; instrumentul potrivit: variabile dummy sezoniere sau termeni Fourier (secțiunea 7)
Alegerea contează: diferențierea unui tipar determinist duce la supradiferențiere; modelarea unuia stochastic cu variabile dummy lasă o rădăcină unitară în reziduuri
Rădăcinile lui \(1 - z^s\): rădăcini unitare sezoniere
Întrebare pentru sală În T2 2026, Δy = 17,9, iar Δ₄y = −1,96. A crescut PIB-ul?
Răspuns
Nu: 17,9 este saltul sezonier de la T1 la T2 (factorii NSA/SCA ai PIB sînt 0,78 în T1 și 0,93 în T2). Comparația cu același trimestru elimină sezonul: PIB-ul din T2 2026, 45,88 mld. EUR, este cu 1,96 puncte logaritmice sub cel din T2 2025, 46,79 mld. EUR. ΔΔ₄y = −0,46 arată că scăderea anuală s-a adîncit, de la −1,50 în T1 2026 la −1,96.
Întrebare pentru sală Pentru date lunare (s = 12), ce perioadă are rădăcina k = 1 și ce factor real dă împreună cu conjugata ei?
Răspuns
Perioada 12/1 = 12 luni, ciclul anual: z₁ = 0,866 + 0,500i, iar perechea (k = 1, k = 11) dă factorul 1 − 1,732z + z². Pentru s = 12 există 12 rădăcini: două reale (1 și −1, perioada de 2 luni) și cinci perechi complex conjugate, cu perioadele 12, 6, 4, 3 și 2,4 luni.
Întrebare pentru sală Pentru date zilnice cu tipar săptămînal, s = 7. Cîte rădăcini reale are 1 − z⁷?
Răspuns
Una singură, z = 1. Rădăcina z = −1 (perioada de 2) există doar cînd s este par; pentru s = 7 celelalte șase rădăcini formează trei perechi complex conjugate, cu perioadele 7, 3,5 și 2,33 zile. Pentru s = 4: 1, −1 și ±i; pentru s = 12: 1, −1 și cinci perechi.
Rădăcinile unitare ale operatorului \(\Delta_s\) sînt soluțiile ecuației \(1 - z^s = 0\), adică rădăcinile de ordinul \(s\) ale unității, \(z_k = e^{2\pi i k/s}\),\(k = 0, \dots, s-1\). Toate au modulul 1 și sînt egal distanțate pe cercul unitate. Pentru date trimestriale, polinomul se descompune în factori ca \(1 - z^4 = (1 - z)(1 + z)(1 + z^2)\), cu rădăcinile \(1\),\(-1\) și \(\pm i\).
Graficul arată aceste rădăcini în planul complex: axa orizontală este partea reală, axa verticală partea imaginară. În stînga, cele patru rădăcini ale lui \(1 - z^4\); în dreapta, cele 12 rădăcini ale lui \(1 - z^{12}\), pentru date lunare. Cercul verde marchează rădăcina \(z = 1\), de frecvență zero, care corespunde trendului; pătratul portocaliu marchează rădăcina \(z = -1\), de frecvență 1/2, care corespunde unui ciclu de două perioade. Celelalte rădăcini formează perechi complex conjugate, fiecare pereche corespunzînd unei frecvențe sezoniere.
Pe scurt
\(1 - z^4 = (1 - z)(1 + z)(1 + z^2)\): rădăcinile \(1\), \(-1\), \(\pm i\), toate pe cercul unitate
Diferența \(\Delta_s\) impune simultan \(s\) rădăcini unitare, cîte una pentru fiecare frecvență \(k/s\) cicluri pe perioadă, \(k = 0, \dots, s-1\). În cazul trimestrial, rădăcina \(z = 1\) are frecvența 0 și corespunde trendului stochastic; rădăcina \(z = -1\) corespunde unei jumătăți de ciclu pe trimestru, adică unui ciclu cu perioada de două trimestre; perechea \(z = \pm i\) corespunde unui sfert de ciclu pe trimestru, adică ciclului anual de patru trimestre.
O serie poate avea unele dintre aceste rădăcini și nu pe celelalte. De exemplu, o serie poate avea un trend stochastic (rădăcina 1) și un tipar anual stabil (fără rădăcinile \(\pm i\)). Aplicarea lui \(\Delta_4\) asupra unei asemenea serii supradiferențiază la frecvențele la care seria nu are rădăcini unitare. Testele de rădăcină unitară sezonieră întreabă, frecvență cu frecvență, care rădăcini sînt prezente; primul și cel mai cunoscut este testul HEGY.
Pe scurt
\(\Delta_s\) impune simultan \(s\) rădăcini unitare, cîte una pentru fiecare frecvență\(k/s\), \(k = 0, \dots, s - 1\)
trimestrial: \(z = 1\) (frecvența 0, trendul), \(z = -1\) (o jumătate de ciclu pe trimestru: perioada de 2 trimestre), \(z = \pm i\) (perioada de 4 trimestre: ciclul anual)
O serie poate avea unele dintre aceste rădăcini și nu pe altele: atunci \(\Delta_4\) supradiferențiază la frecvențele de care nu are nevoie
Testele de rădăcină unitară sezonieră întreabă, frecvență cu frecvență, ce rădăcini sînt prezente: testul HEGY (slide-urile următoare)
Întrebare pentru sală Cu 0 laguri ale lui Δ₄y în loc de 1 (ales după AIC), pe 2000–2019, mai rămîn nerespinse toate cele trei ipoteze nule?
Răspuns
Nu: cu k = 0, t(π₂) = −3,34 < −2,77 și F(π₃, π₄) = 17,25 > 6,64, deci rădăcinile −1 și ±i sînt respinse; rămîne doar rădăcina 1 (t(π₁) = −1,46). Cu k = 1, ales după AIC, nicio ipoteză nu este respinsă (−1,97; −2,19; 6,12). Autocorelația lăsată în reziduuri de regresia fără laguri schimbă decizia. Și sfîrșitul eșantionului contează: pînă în T4 2025, cu k = 1, t(π₂) = −2,88 și F = 8,38 resping două ipoteze.
Întrebare pentru sală Pentru ce serii se schimbă decizia cînd mutăm sfîrșitul eșantionului între 2012 și 2025?
Răspuns
Pentru PIB nu se schimbă: OCSB dă D = 1, Canova–Hansen D = 0 și KPSS d = 1 pentru orice sfîrșit. Se schimbă la înnoptările turistice (OCSB dă D = 1 pentru 2012 și 2020, iar d trece între 0 și 1), la producția industrială (D = 1 după OCSB pentru 2012 și 2014) și la IAPC (d = 1 pentru 2012, apoi d = 2). Canova–Hansen nu respinge sezonalitatea stabilă pentru nicio serie și niciun sfîrșit.
Întrebare pentru sală Pe tot eșantionul, ACF pentru ΔΔ₄ ln Y este −0,40 la lagul 4. Rămîne semnificativă dacă eșantionul se oprește în T4 2019, înainte de pandemie?
Răspuns
Da: −0,34, în afara benzii ±0,23 (T = 75). Valoarea negativă la lagul sezonier nu vine din 2020, ci din tiparul sezonier care se modifică lent: semnătura unui MA sezonier. La Δ ln Y, ACF rămîne 0,94 la lagul 4 și pe eșantionul scurt; la Δ₄ ln Y, ACF la lagul 1 este 0,68.
Graficul aplică trei transformări logaritmului PIB-ului real neajustat, pe 106 trimestre pînă în al doilea trimestru din 2026. Rîndul de sus arată seriile transformate, în procente: creșterea față de trimestrul anterior, \(100\,\Delta\ln Y_t\); creșterea față de același trimestru al anului anterior, \(100\,\Delta_4\ln Y_t\); și diferența dublă \(100\,\Delta\Delta_4\ln Y_t\). Rîndul de jos arată funcția de autocorelație (ACF, autocorrelation function) de selecție a fiecărei serii, pînă la lagul 16.
Pe panourile ACF, liniile roșii întrerupte sînt banda \(\pm 1{,}96/\sqrt{T}\): o autocorelație de selecție în afara benzii este semnificativ diferită de zero la 5%, în ipoteza de zgomot alb. Liniile verticale punctate marchează lagurile sezoniere 4, 8, 12 și 16. O serie bine diferențiată are autocorelații mici la aceste laguri, iar valorile mari și persistente la lagurile sezoniere arată că sezonalitatea nu a fost eliminată.
Pe scurt
\(\ln\) din PIB-ul real neajustat, 106 de trimestre pînă în T2 2026; sus: trei transformări; jos: ACF de selecție pînă la 16 trimestre
Prima diferență \(\Delta\ln Y\) este dominată de sezon: ACF este 0,95 la lagul 4 și 0,90 la lagul 8 și scade foarte lent la lagurile 12 și 16. Abaterea standard a seriei este 26,5%, aproape în întregime variație sezonieră. Este analogul sezonier al descreșterii lente a ACF pentru un mers aleator din Capitolul 3: diferența obișnuită nu elimină rădăcinile unitare sezoniere.
Diferența sezonieră \(\Delta_4\ln Y\), creșterea anuală, are abaterea standard 4,4%. ACF ei este 0,66 la lagul 1 și scade apoi treptat, pînă la 0,01 la lagul 4. Tiparul sezonier a dispărut, iar ce rămîne este persistența ciclului economic: o descreștere geometrică de tip AR la primele laguri.
Diferența dublă \(\Delta\Delta_4\ln Y\) are ACF −0,11 la lagul 1 și −0,40 la lagul 4, iar banda de semnificație este \(\pm 0{,}20\). Singura valoare semnificativă este cea negativă de la lagul sezonier. Aceasta este semnătura unui MA(1) sezonier, iar împreună cu dubla diferențiere ea indică modelul airline din secțiunea 3. Rămîne de decis dacă diferența sezonieră este justificată; la această întrebare răspund testele următoare.
Pe scurt
\(\Delta\ln Y\): dominată de sezon: ACF \(0{,}95\) la lagul 4 și \(0{,}90\) la lagul 8, cu o descreștere foarte lentă; abaterea standard 26,5%
analogul sezonier al descreșterii lente a ACF pentru un mers aleator (Capitolul 3)
\(\Delta_4\ln Y\) (creșterea anuală): abaterea standard 4,4%; ACF \(0{,}66\) la lagul 1, \(0{,}01\) la lagul 4: un tipar de tip AR
\(\Delta\Delta_4\ln Y\): ACF \(\ensuremath{-}0{,}11\) la lagul 1 și \(\ensuremath{-}0{,}40\) la lagul 4 (banda \(\pm 0{,}20\))
o singură valoare negativă semnificativă la lagul sezonier: un MA(1) sezonier, semnătura modelului airline (secțiunea 3)
Testul lui Hylleberg, Engle, Granger și Yoo (1990) (HEGY) testează într-o singură regresie fiecare rădăcină unitară sezonieră a unei serii trimestriale. Seria este trecută prin trei filtre, fiecare construit astfel încît să păstreze o singură frecvență și să elimine celelalte rădăcini: \(y_{1t} = (1 + L + L^2 + L^3)y_t\) păstrează frecvența zero, \(y_{2t} = -(1 - L + L^2 - L^3)y_t\) păstrează frecvența de două trimestre, iar \(y_{3t} = -(1 - L^2)y_t\) păstrează frecvența anuală. Regresia testului este
Fiecare coeficient \(\pi_k\) corespunde unei frecvențe. Ipoteza nulă \(\pi_1 = 0\) înseamnă o rădăcină unitară la \(z = 1\) și se testează cu statistica \(t\) a lui \(\pi_1\). Ipoteza \(\pi_2 = 0\) înseamnă o rădăcină la \(z = -1\), tot cu un test \(t\). Perechea de rădăcini \(\pm i\) corespunde ipotezei comune \(\pi_3 = \pi_4 = 0\), testată cu o statistică \(F\). Termenii determiniști (constantă, variabile dummy sezoniere, trend) și lagurile lui \(\Delta_4 y_t\) joacă același rol ca în testul Dickey–Fuller augmentat: primii fixează ipoteza alternativă, ultimii elimină autocorelația erorilor.
Sub ipoteza nulă, statisticile nu au distribuțiile standard \(t\) și \(F\), la fel ca statistica Dickey–Fuller; valorile critice se iau din tabele sau se obțin prin simulare. Decizia se citește frecvență cu frecvență. Dacă toate cele trei ipoteze nule sînt respinse, seria nu are rădăcini unitare sezoniere și nu are nevoie de diferențiere sezonieră. Dacă niciuna nu este respinsă, toate cele patru rădăcini ale lui \(1 - z^4\) sînt plauzibile, iar \(\Delta_4\) este justificată.
Testul lui Canova și Hansen (1995) inversează ipotezele: ipoteza nulă este sezonalitatea stabilă, deterministă, iar alternativa este un tipar sezonier care se schimbă în timp, adică o rădăcină unitară sezonieră. El este analogul sezonier al testului KPSS din Capitolul 3. Respingerea înseamnă că tiparul sezonier nu este constant pe eșantion.
Testul lui Osborn, Chui, Smith și Birchenhall (1988) (OCSB) are ca ipoteză nulă o rădăcină unitară sezonieră. Regresia lui explică \(\Delta\Delta_s y_t\) prin \(\Delta_s y_{t-1}\) și \(\Delta y_{t-s}\); dacă ambii coeficienți sînt zero, seria are nevoie de ambele diferențe. Testul este criteriul sezonier implicit al funcției auto_arima din pachetul Python pmdarima, prin funcția nsdiffs, care alege numărul de diferențe sezoniere.
Ca la testele ADF și KPSS, testele cu ipoteze nule opuse răspund la întrebări diferite și se folosesc împreună. Dacă un test nu respinge rădăcina unitară, iar celălalt nu respinge stabilitatea, datele nu disting între cele două ipoteze. Decizia se completează cu informația din date: graficele sezoniere, ACF la lagurile \(s\),\(2s\) și \(3s\) și mărimea coeficientului MA sezonier estimat \(\hat\Theta\) după diferențiere. O valoare \(\hat\Theta\) apropiată de \(-1\) arată că \(\Delta_s\) a fost aplicată unei serii cu tipar determinist, ca în (4.2).
Pe scurt
Canova–Hansen (Canova și Hansen (1995)): ipoteza nulă este sezonalitatea stabilă (deterministă)
analogul sezonier al testului KPSS (Capitolul 3): respingerea înseamnă că tiparul se schimbă în timp
OCSB (Osborn, Chui, Smith și Birchenhall (1988)): ipoteza nulă este o rădăcină unitară sezonieră; o regresie a lui \(\Delta\Delta_s y_t\) pe \(\Delta_s y_{t-1}\) și \(\Delta y_{t-s}\)
testul sezonier implicit al funcției auto_arima din pachetul Python pmdarima (nsdiffs)
Ca în Capitolul 3: testele cu ipoteze nule opuse răspund la întrebări diferite; folosiți-le împreună
și priviți datele: graficele sezoniere, ACF la lagurile \(s, 2s, 3s\) și mărimea lui \(\hat\Theta\) după \(\Delta_s\) (\(\hat\Theta \approx -1\) semnalează supradiferențierea)
Teste de rădăcină unitară sezonieră pe date din România
Primul tabel conține testul HEGY pentru logaritmul PIB-ului, pe perioada 2000–2019, oprită înainte de 2020 pentru ca valoarea aberantă din pandemie să nu influențeze testul. Regresia conține constantă, variabile dummy sezoniere și trend, plus un lag al lui \(\Delta_4 y\) ales cu criteriul Akaike (AIC), cu \(n = 75\) de observații. Valorile critice provin din 4 000 de simulări ale procesului \(\Delta_4 y_t = \varepsilon_t\), care are toate cele patru rădăcini unitare. Statistica \(t(\pi_1)\) este −1,97, cu valoarea critică de 5% −3,39; \(t(\pi_2)\) este −2,19, cu valoarea critică −2,77; iar \(F(\pi_3, \pi_4)\) este 6,12, cu valoarea critică 6,64. Niciuna dintre cele trei ipoteze nule nu este respinsă, deci datele sînt compatibile cu toate rădăcinile lui \(1 - z^4\).
Al doilea tabel dă, pentru cinci serii în logaritmi pe 2005–2019, numărul de diferențe sezoniere \(D\) ales de testul OCSB și de testul Canova–Hansen și numărul de diferențe obișnuite \(d\) ales de testul KPSS. Pentru PIB, OCSB alege \(D = 1\), iar Canova–Hansen \(D = 0\). Cu 20 de ani de date trimestriale, ambele concluzii sînt plauzibile: testele nu au suficientă putere pentru a distinge un tipar stabil de unul care se deplasează lent. Alegerea practică este \(\Delta_4\), iar mărimea lui \(\hat\Theta\) în modelul estimat arată apoi cît de stabil este tiparul (secțiunea 5).
Pentru cele patru serii lunare, ambele teste aleg \(D = 0\), adică un tipar sezonier stabil, pe care îl pot descrie variabile dummy sau termeni Fourier. KPSS cere o diferență obișnuită pentru toate seriile, cu excepția IAPC în logaritmi, care cere \(d = 2\). Nivelul prețurilor are deci nevoie de două diferențe: inflația însăși, prima diferență a logaritmului prețurilor, este aproape de o rădăcină unitară, ca în Capitolul 3.
Pe scurt
HEGY, \(\ln\) PIB, 2000–2019
statistica
valoarea critică 5%
decizia
\(t(\pi_1)\), rădăcina \(1\)
\(\ensuremath{-}1{,}97\)
\(\ensuremath{-}3{,}39\)
nu se respinge
\(t(\pi_2)\), rădăcina \(-1\)
\(\ensuremath{-}2{,}19\)
\(\ensuremath{-}2{,}77\)
nu se respinge
\(F(\pi_3, \pi_4)\), rădăcinile \(\pm i\)
\(6{,}12\)
\(6{,}64\)
nu se respinge
Seria (logaritmi, 2005–2019)
\(D\) după OCSB
\(D\) după Canova–Hansen
\(d\) după KPSS
PIB (trimestrial)
1
0
1
Comerțul cu amănuntul
0
0
1
Producția industrială
0
0
1
Înnoptări turistice
0
0
1
IAPC
0
0
2
HEGY: constantă, variabile dummy sezoniere și trend, 1 lag al lui \(\Delta_4y\) (AIC), \(n = 75\); valori critice din 4 000 de simulări ale lui \(\Delta_4y_t = \varepsilon_t\)
Interpretare: pentru PIB, HEGY și OCSB susțin \(\Delta_4\), în timp ce Canova–Hansen nu respinge un tipar stabil; cu 20 de ani de date trimestriale ambele perspective se potrivesc, deci folosim \(\Delta_4\) și lăsăm \(\hat\Theta\) să arate cît de stabil este tiparul (secțiunea 5)
Seriile lunare: ambele teste aleg \(D = 0\), un tipar stabil; IAPC are nevoie de \(d = 2\) în logaritmi: inflația însăși este aproape de o rădăcină unitară (Capitolul 3)
Recapitulare: diferențierea sezonieră și rădăcinile unitare sezoniere
Operatorul \(\Delta_s = 1 - L^s\) are \(s\) rădăcini unitare pe cercul unitate, cîte una pentru fiecare frecvență sezonieră. Un tipar determinist se modelează cu variabile dummy sau termeni Fourier, iar unul stochastic cu \(\Delta_s\); o alegere greșită duce fie la supradiferențiere, fie la o rădăcină unitară rămasă în reziduuri. HEGY și OCSB au ca ipoteză nulă rădăcina unitară sezonieră, iar Canova–Hansen un tipar stabil. Pentru PIB-ul României, \(\Delta\Delta_4\ln Y\) lasă o singură autocorelație semnificativă, la lagul 4: un MA sezonier.
Pe scurt
\(\Delta_s = 1 - L^s\) are \(s\) rădăcini unitare pe cerc, cîte una pentru fiecare frecvență sezonieră
Sezonalitatea deterministă: variabile dummy sau termeni Fourier; sezonalitatea stochastică: \(\Delta_s\)
HEGY și OCSB testează rădăcinile unitare sezoniere; Canova–Hansen testează un tipar stabil
PIB-ul României: \(\Delta\Delta_4\ln Y\) lasă o singură valoare semnificativă la lagul 4, un MA sezonier
Sinteza secțiunii
Diferențierea sezonieră elimină simultan toate rădăcinile de pe cercul unitate, chiar și pe cele pe care seria nu le are. De aceea alegerea lui \(D\) se bazează pe teste frecvență cu frecvență și pe teste cu ipoteze nule opuse. Pentru PIB-ul României, HEGY și OCSB nu resping rădăcinile unitare sezoniere, iar Canova–Hansen nu respinge stabilitatea. Diferența \(\Delta\Delta_4\) este alegerea practică, iar seria rezultată are structura unui MA(1) sezonier. Secțiunea următoare construiește modelul care descrie această structură.
Modele SARIMA
Modelul SARIMA extinde modelul ARIMA din Capitolul 3 cu polinoame în operatorul sezonier \(L^s\). Secțiunea scrie forma multiplicativă a modelului, deduce autocorelațiile modelului airline, dă regulile de identificare din ACF și PACF, apoi tratează estimarea, alegerea modelului cu criterii informaționale și prognoza. Toate rezultatele sînt cele din capitolele 2 și 3, aplicate și la multiplii perioadei \(s\).
Polinoamele obișnuite \(\phi(L)\), de ordinul \(p\), și \(\theta(L)\), de ordinul \(q\), sînt cele din Capitolul 2. Polinoamele sezoniere sînt polinoame în \(L^s\):\(\Phi(L^s) = 1 - \Phi_1L^s - \dots - \Phi_PL^{Ps}\), de ordinul \(P\), și \(\Theta(L^s) = 1 + \Theta_1L^s + \dots + \Theta_QL^{Qs}\), de ordinul \(Q\). Numerele \(d\) și \(D\) sînt numărul de diferențe obișnuite și numărul de diferențe sezoniere, de obicei 0 sau 1, iar \(c\) este o constantă.
Forma de produs are o justificare dată de Box, Jenkins și Reinsel (2008). Într-o serie lunară, ianuarie depinde de decembrie, observația precedentă, și de ianuarie din anul anterior, observația din același sezon. Datele pot fi așezate într-un tabel cu două intrări, cu lunile pe coloane și anii pe rînduri: partea sezonieră modelează legătura pe coloane, de la un an la altul, iar partea obișnuită legătura pe rînduri, de la o lună la alta. Produsul celor două polinoame combină cele două direcții cu un număr mic de parametri.
Condițiile de staționaritate și invertibilitate sînt cele din Capitolul 2, aplicate produsului. Partea AR este staționară dacă toate rădăcinile lui \(\phi(z)\Phi(z^s)\) se află în afara cercului unitate, iar partea MA este invertibilă dacă toate rădăcinile lui \(\theta(z)\Theta(z^s)\) se află în afara lui. Pentru un AR(1) sezonier, \(1 - \Phi z^s = 0\) are \(s\) rădăcini cu modulul \(|\Phi|^{-1/s}\), deci condiția este \(|\Phi| < 1\).
\(d\), \(D\): numerele de diferențe obișnuite și sezoniere, de obicei 0 sau 1
Motivul produsului (Box, Jenkins și Reinsel (2008)): într-o serie lunară, ianuarie depinde de decembrie (partea obișnuită) și de ianuarie anul trecut (partea sezonieră)
un tabel cu două intrări: lunile pe coloane, anii pe rînduri; cîte un model pe fiecare direcție
Staționaritatea: rădăcinile lui \(\phi(z)\Phi(z^s)\) în afara cercului unitate; invertibilitatea: rădăcinile lui \(\theta(z)\Theta(z^s)\) în afara lui; pentru un AR(1) sezonier aceasta înseamnă \(|\Phi| < 1\)
Modelul airline (airline model) este SARIMA\((0,1,1)(0,1,1)_{12}\). Cu \(\theta = -0{,}4\) și \(\Theta = -0{,}6\), el se scrie \((1 - L)(1 - L^{12})y_t = (1 - 0{,}4L)(1 - 0{,}6L^{12})\varepsilon_t\). Dezvoltînd ambele produse, se obține ecuația
Coeficientul lui \(\varepsilon_{t-13}\) este produsul \(\theta\Theta = 0{,}24\), nu un parametru nou: modelul are doi parametri MA și varianța \(\sigma^2\). Un MA(13) general ar avea 13 coeficienți; structura multiplicativă îi reduce la doi.
Seria diferențiată \(w_t = \Delta\Delta_{12}y_t\) este un MA(13) cu doar patru ponderi nenule, la lagurile 0, 1, 12 și 13. Autocovarianțele ei se calculează ca în Capitolul 2, din produsele ponderilor. Varianța este \(\gamma(0) = \sigma^2(1 + \theta^2)(1 + \Theta^2) = 1{,}5776\,\sigma^2\), iar autocorelațiile nenule sînt
Toate celelalte autocorelații sînt zero. Valorile de la lagurile 1 și 12 sînt cele ale unui MA(1) obișnuit și ale unui MA(1) sezonier luate separat, iar valorile de la lagurile 11 și 13 apar doar pentru că cele două polinoame se înmulțesc.
Întrebare pentru sală Modelul airline dă aceeași autocorelație la lagurile 11 și 13. Arată datele pasagerilor aerieni același lucru?
Răspuns
Nu exact: estimațiile pe 1949–1960, θ̂ = −0,402 și Θ̂ = −0,557, implică ρ₁₁ = ρ₁₃ = 0,147, iar ACF de selecție a lui w_t este 0,064 la lagul 11 și 0,152 la lagul 13. Ambele valori sînt în banda ±0,17, deci testul nu le separă de valoarea modelului. La lagurile 1 și 12 modelul implică −0,346 și −0,425, iar datele dau −0,341 și −0,387.
Întrebare pentru sală Din decembrie 1958, cît adaugă termenii MA la prognoza pentru ianuarie 1959 și de la ce orizont dispar?
Răspuns
+0,0220 în logaritmi, adică circa 2,2%: prognoza este 348,6 mii, față de 341,0 fără termenii MA; valoarea reală a fost 360. Termenii MA folosesc reziduuri cel mult pînă la lagul 13, deci de la h = 14 sînt 0 și prognoza repetă tiparul pe dreaptă (februarie 1960: 354,6 față de 391 real).
Întrebare pentru sală Cu θ = −0,4 și Θ = −0,6, sateliții de la lagurile 11 și 13 au 0,152. Ce se întîmplă cu ei dacă θ devine +0,4?
Răspuns
Își schimbă semnul: −0,152. Sateliții sînt produsul ρ₁ρ₁₂, iar ρ₁ = θ/(1 + θ²) trece de la −0,345 la 0,345, în timp ce ρ₁₂ = −0,441 rămîne. La SAR(1)₁₂ cu Φ = 0,8, ACF descrește 0,8; 0,64; 0,512 la lagurile 12, 24, 36; la SMA(1)₁₂ cu Θ = −0,6, PACF este −0,242 la lagul 24.
Graficul arată ACF (rîndul de sus) și funcția de autocorelație parțială (PACF, partial autocorrelation function, rîndul de jos) teoretice pentru trei modele lunare. Axa orizontală este lagul, în luni, pînă la 40; liniile verticale punctate marchează lagurile sezoniere 12, 24 și 36. Prima coloană este un AR(1) sezonier cu \(\Phi = 0{,}8\), a doua un MA(1) sezonier cu \(\Theta = -0{,}6\), iar a treia modelul airline cu \(\theta = -0{,}4\) și \(\Theta = -0{,}6\).
Pentru modelul airline, graficul arată partea staționară \(w_t = \Delta\Delta_{12}y_t\), singura pentru care ACF și PACF sînt definite. Cele trei modele sînt modelele de referință pentru identificare: corelogramele seriilor reale diferențiate se compară cu aceste forme.
Pe scurt
Lunar, \(s = 12\); panoul airline arată partea staționară \(w_t = \Delta\Delta_{12}y_t\)
Pentru AR(1) sezonier, ACF este nenulă doar la multiplii lui 12 și descrește geometric: 0,8 la lagul 12, 0,64 la lagul 24 și 0,512 la lagul 36, adică \(\Phi\),\(\Phi^2\) și \(\Phi^3\). PACF are o singură valoare nenulă, la lagul 12. Este regula pentru AR(1) din Capitolul 2, citită doar la multiplii lui \(s\).
Pentru MA(1) sezonier, regula se inversează. ACF are o singură valoare nenulă, \(\Theta/(1 + \Theta^2) = -0{,}441\) la lagul 12, și este zero după acest lag. PACF descrește în valoare absolută la lagurile 12, 24 și 36; la lagul 24 ea este −0,242.
Modelul airline are în ACF valori nenule la lagul 1, −0,345, și la lagul 12, −0,441, plus doi „sateliți” la lagurile 11 și 13, fiecare egal cu 0,152. Sateliții sînt produsul \(\rho_1\rho_{12}\) din (4.6) și sînt amprenta structurii multiplicative: un model aditiv, cu termeni MA doar la lagurile 1 și 12, nu i-ar produce. PACF a modelului airline descrește atît la primele laguri, cît și în jurul fiecărui multiplu al lui 12, ceea ce indică termeni MA, nu termeni AR.
Pe scurt
AR(1) sezonier: ACF descrește geometric la lagurile 12, 24, 36 (\(0{,}8\); \(0{,}64\); \(0{,}512\)); PACF are o singură valoare nenulă la lagul 12
regula AR din Capitolul 2, citită doar la multiplii lui \(s\)
MA(1) sezonier: ACF se anulează după lagul 12; PACF descrește la 12, 24, 36 (\(-\)0,242 la lagul 24)
Airline: valori nenule la 1 (\(-\)0,345) și 12 (\(-\)0,441), cu „sateliți” la 11 și 13 (0,152)
Tabelul rezumă regulile de identificare pentru seria diferențiată. Partea sezonieră se citește doar la lagurile \(s, 2s, 3s, \dots\): un AR(\(P\)) sezonier are o ACF care descrește la aceste laguri și o PACF care se anulează după lagul \(Ps\), iar un MA(\(Q\)) sezonier are o ACF care se anulează după lagul \(Qs\) și o PACF care descrește. Partea obișnuită se citește la primele laguri, cu regulile din Capitolul 2. Produsul celor două părți adaugă sateliți la lagurile \(ks \pm j\), unde \(j\) ține de ordinul părții obișnuite.
Procedura are patru pași. Primul stabilizează varianța, prin logaritmi sau printr-o transformare Box–Cox (Box și Cox, 1964), atunci cînd amplitudinea sezonieră crește cu nivelul. Al doilea alege mai întîi \(D\), pe baza graficului sezonier și a testelor HEGY sau OCSB, apoi \(d\), cu testele din Capitolul 3; ordinea contează, deoarece o diferență sezonieră elimină și rădăcina de frecvență zero. Al treilea citește \(P\) și \(Q\) la lagurile sezoniere și \(p\) și \(q\) la primele laguri. Al patrulea păstrează ordinele mici: în practică, \(P \le 1\) și \(Q \le 1\) sînt aproape întotdeauna suficiente, deoarece o serie lunară are relativ puține cicluri anuale complete pentru a estima mai mulți parametri sezonieri.
Parametrii se estimează prin verosimilitate maximă (maximum likelihood) pentru seria diferențiată, scrisă în forma în spațiul stărilor (state-space form); în Python, clasa SARIMAX din statsmodels. Diferența \(\Delta\Delta_s\) consumă primele \(s + 1\) observații. Constanta \(c\) se omite cînd \(d + D \ge 2\): în seria inițială ea ar corespunde unui trend pătratic, rareori plauzibil pentru date economice.
Modelele candidate se compară cu criteriul Akaike corectat pentru eșantioane mici și cu criteriul bayesian (BIC):
unde \(k\) este numărul parametrilor estimați și \(n\) numărul de observații după diferențiere. Criteriile se compară doar între modele cu aceleași \(d\) și \(D\). Diferențierea schimbă datele pe care se calculează verosimilitatea, iar valorile verosimilității pentru două serii diferite nu sînt comparabile.
Procedura automată a lui Hyndman și Khandakar (2008) alege mai întîi \(d\) și \(D\) prin teste, apoi caută pas cu pas ordinele \((p, q, P, Q)\) care minimizează AICc. În Python ea este disponibilă ca pmdarima.auto_arima(y, m=12). Rezultatul ei este un punct de plecare: reziduurile modelului ales trebuie verificate, iar prognozele lui trebuie comparate cu un reper simplu.
Diagnosticarea folosește testul Ljung–Box (Ljung și Box, 1978) pe reziduuri, cu un număr de laguri \(m\) care depășește perioada, de exemplu \(m = 2s\), pentru ca testul să acopere lagurile sezoniere. Statistica are \(m - p - q - P - Q\) grade de libertate, deoarece fiecare parametru ARMA estimat consumă un grad de libertate.
Pe scurt
Verosimilitatea maximă pentru seria diferențiată (forma în spațiul stărilor, SARIMAX din statsmodels)
se pierd \(s + 1\) observații prin \(\Delta\Delta_s\); constanta lipsește cînd \(d + D \ge 2\) (ar însemna un trend pătratic)
Criteriile informaționale: AICc \(=\) AIC \(+ \frac{2k(k + 1)}{n - k - 1}\) și BIC, comparate doar între modele cu aceleași \(d\) și \(D\)
\(k\): numărul parametrilor estimați; \(n\): numărul de observații după diferențiere
diferențierea schimbă datele pe care se calculează verosimilitatea
SARIMA automat: o căutare pas cu pas după \((p, q, P, Q)\) cu AICc, după alegerea lui \(d\) și \(D\) prin teste (Hyndman și Khandakar (2008))
în Python: pmdarima.auto_arima(y, m=12); verificați întotdeauna reziduurile și comparați cu un reper
Diagnosticarea: Ljung–Box cu laguri dincolo de \(s\) (de exemplu \(m = 2s\)) și \(m - p - q - P - Q\) grade de libertate (Ljung și Box (1978))
Prognozele se calculează ca pentru modelele ARIMA din Capitolul 3. Modelul se scrie ca ecuație pentru \(y_t\), iar la orizontul \(h\) șocurile viitoare se înlocuiesc cu media lor, zero, valorile viitoare ale seriei cu prognozele lor, iar șocurile trecute cu reziduurile estimate. Pentru modelul airline, din (4.5) rezultă \(\hat y_{T+h} = \hat y_{T+h-1} + \hat y_{T+h-s} - \hat y_{T+h-s-1}\) plus termenii MA, care contribuie doar cît timp \(h \le s + 1\), adică atît timp cît șocurile din ecuație sînt încă observate.
După orizontul \(s + 1\), prognozele urmează ecuația omogenă \((1 - L)(1 - L^s)\hat y_{T+h} = 0\). Soluția ei este funcția de prognoză pe termen lung (eventual forecast function): o dreaptă, care provine din rădăcina dublă \(z = 1\), plus un tipar sezonier fix, care provine din celelalte \(s - 1\) rădăcini ale lui \(1 - z^s\). Tiparul nu este cel al ultimului an, ci o medie ponderată exponențial a tiparelor anilor trecuți, cu ponderea \(1 + \Theta\) pentru anul cel mai recent. Cînd \(\Theta \to -1\), ponderea anului recent tinde la zero, iar tiparul devine fix, adică determinist. Cînd \(\Theta = 0\), tiparul este cel de anul trecut repetat, ca în metoda sezonieră naivă.
Intervalele de prognoză se lărgesc cu orizontul, deoarece modelul are două rădăcini unitare la frecvența zero. Cînd modelul este estimat pentru \(\ln y\),\(\exp(\hat y_{T+h})\) este mediana prognozei pentru \(y\), nu media ei. Dacă eroarea de prognoză pentru \(\ln y\) urmează distribuția Normală cu varianța \(\sigma_h^2\), media prognozei este \(\exp(\hat y_{T+h} + \sigma_h^2/2)\), puțin mai mare decît mediana, iar diferența crește cu orizontul.
Pe scurt
Ca pentru ARIMA (Capitolul 3): scriem modelul ca ecuație pentru \(y_t\); înlocuim șocurile viitoare cu 0, valorile viitoare cu prognozele lor și șocurile trecute cu reziduuri
airline: \(\hat y_{T+h} = \hat y_{T+h-1} + \hat y_{T+h-s} - \hat y_{T+h-s-1} + (\text{termeni MA cît timp } h \le s + 1)\)
Funcția de prognoză pe termen lung a modelului airline: un tipar sezonier fix pe o dreaptă
tiparul este o medie ponderată exponențial a tiparelor trecute, cu ponderea \(1 + \Theta\) pentru anul cel mai recent
\(\Theta \to -1\): un tipar fix (determinist); \(\Theta = 0\): tiparul de anul trecut repetat (sezonier naiv)
Intervalele se lărgesc cu \(h\) (două rădăcini unitare); pentru \(\ln y\), \(\exp(\hat y_{T+h})\) este mediana prognozei
media este \(\exp(\hat y_{T+h} + \sigma_h^2/2)\), puțin mai mare; \(\sigma_h^2\): varianța erorii de prognoză la orizontul \(h\)
Exemplul folosește modelul trimestrial SARIMA\((0,0,0)(0,1,1)_4\),\(y_t = y_{t-4} + \varepsilon_t + \Theta\varepsilon_{t-4}\), cu \(\Theta = -0{,}6\). Ultimele patru observații sînt \(y_{T-3}, \dots, y_T = 100;\ 120;\ 130;\ 140\), iar reziduurile corespunzătoare sînt \(\hat\varepsilon_{T-3}, \dots, \hat\varepsilon_T = 2;\ -1;\ 0;\ 3\).
Prognoza pentru primul trimestru viitor folosește observația din același trimestru al anului anterior și reziduul ei: \(\hat y_{T+1} = y_{T-3} + \Theta\hat\varepsilon_{T-3} = 100 - 0{,}6 \cdot 2 = 98{,}8\). La fel, \(\hat y_{T+2} = 120 - 0{,}6 \cdot (-1) = 120{,}6\),\(\hat y_{T+3} = 130{,}0\) și \(\hat y_{T+4} = 140 - 0{,}6 \cdot 3 = 138{,}2\). Pentru \(h = 5\), șocul \(\varepsilon_{T+1}\) nu este observat și se înlocuiește cu zero, deci \(\hat y_{T+5} = \hat y_{T+1} = 98{,}8\): după un an termenul MA dispare, iar tiparul prognozei se repetă.
Exemplul arată cum lucrează coeficientul \(\Theta\). O surpriză pozitivă mare în ultimul trimestru, \(\hat\varepsilon_T = 3\), scade prognoza pentru același trimestru al anului următor cu \(0{,}6 \cdot 3 = 1{,}8\) față de valoarea observată. Modelul tratează deci surpriza ca parțial trecătoare: doar fracțiunea \(1 + \Theta = 0{,}4\) din ea se transmite în tiparul sezonier al prognozei.
Modelul SARIMA înmulțește polinoame obișnuite și sezoniere, ca în (4.4), ceea ce descrie dependența de la o perioadă la alta și de la un an la altul cu puțini parametri. Identificarea folosește regulile din Capitolul 2 la lagurile \(s, 2s, \dots\) și sateliții de la lagurile \(ks \pm j\). AICc se compară doar între modele cu aceleași \(d\) și \(D\), iar testul Ljung–Box se aplică pe un număr de laguri mai mare decît \(s\). Prognoza pe termen lung a modelului airline este un tipar sezonier pe o dreaptă, actualizat cu ponderea \(1 + \Theta\).
Pe scurt
SARIMA înmulțește polinoame obișnuite și sezoniere: \(\phi(L)\Phi(L^s)\Delta^d\Delta_s^Dy_t = \theta(L)\Theta(L^s)\varepsilon_t\)
Identificarea: regulile din Capitolul 2 la lagurile \(s, 2s, \dots\), plus sateliții de la \(ks \pm j\)
Comparați AICc doar pentru aceleași \(d\) și \(D\); verificați Ljung–Box dincolo de lagul \(s\)
Prognoza airline: un tipar sezonier pe o dreaptă, actualizat cu ponderea \(1 + \Theta\)
Sinteza secțiunii
Modelul SARIMA descrie dependența în două direcții: de la o perioadă la alta și de la un an la altul. Modelul airline are doar doi parametri, iar autocorelațiile lui, (4.6), au valori la lagurile 1 și \(s\) și sateliți la \(s \pm 1\). Coeficientul \(\Theta\) controlează cît de repede se actualizează tiparul sezonier în prognoză: la \(-1\) tiparul este fix, la zero el repetă ultimul an. Următoarele două secțiuni aplică acest model pe seria clasică a pasagerilor aerieni și pe PIB-ul României.
Studiu de caz: modelul airline
Seria lunară a pasagerilor internaționali din 1949–1960 este exemplul clasic al lui Box, Jenkins și Reinsel (2008) și a dat numele modelului airline. Studiul de caz parcurge pe această serie toți pașii din secțiunea anterioară: transformarea logaritmică, dubla diferențiere, identificarea din corelograme, estimarea și prognoza pe doi ani în afara eșantionului, comparată cu metoda sezonieră naivă.
Box, Jenkins și Reinsel (2008), a căror primă ediție a apărut în 1970, au modelat totalurile lunare ale pasagerilor internaționali ai companiilor aeriene din perioada 1949–1960, adică 144 de luni. Seria are două caracteristici: o creștere susținută, din perioada de expansiune a transportului aerian cu avioane cu reacție, și un vîrf de vară a cărui mărime crește odată cu nivelul seriei. Modelul ales de ei, SARIMA\((0,1,1)(0,1,1)_{12}\) pentru \(\ln y_t\), poartă de atunci numele de „model airline”.
Modelul a rămas în uz din două motive. Primul este că doi parametri descriu bine multe serii sezoniere din comerț, producție, vînzări cu amănuntul și energie: orice serie cu trend și cu un tipar sezonier care evoluează lent are aceeași structură. Al doilea este că modelul airline este modelul implicit al etapei regARIMA din programele de ajustare sezonieră precum X-13ARIMA-SEATS, tratate în secțiunea 6.
Pe scurt
Box, Jenkins și Reinsel (2008) (prima ediție în 1970) au modelat totalurile lunare ale pasagerilor internaționali, 1949–1960 (144 de luni)
creștere plus un vîrf de vară a cărui mărime crește cu nivelul
modelul lor, SARIMA\((0,1,1)(0,1,1)_{12}\) pentru \(\ln y_t\), poartă de atunci numele de „model airline”
Motivele longevității modelului
doi parametri se potrivesc multor serii sezoniere: comerț, producție, vînzări cu amănuntul, energie
este modelul de referință al etapei regARIMA din programele de ajustare sezonieră (secțiunea 6)
Întrebare pentru sală Fără diferența obișnuită, doar cu Δ₁₂ ln y, cum arată ACF?
Răspuns
Autocorelații pozitive care scad încet: 0,71 la lagul 1, 0,48 la lagul 3, încă 0,19 la lagul 8. Trendul nu este eliminat, iar seria rămîne nestaționară. Cu ΔΔ₁₂ ln y rămîn valori nenule la lagurile 1 (−0,34) și 12 (−0,39); în afara benzii ±0,17 mai ies lagurile 3, 9, 23 și 32. PACF are −0,341, −0,013 și −0,193 la lagurile 1, 2 și 3: valoarea de la lagul 2 este practic zero.
Panoul din stînga arată numărul de pasageri, în mii (axa din stînga), și logaritmul lui (axa din dreapta). Seria inițială are un vîrf de vară tot mai înalt, iar logaritmul are vîrfuri de înălțime aproximativ constantă. Panourile din mijloc și din dreapta arată ACF și PACF de selecție pentru seria \(w_t = \Delta\Delta_{12}\ln y_t\), care are 131 de observații după cele 13 pierdute prin diferențiere. Liniile roșii întrerupte sînt banda \(\pm 1{,}96/\sqrt{T}\), iar liniile verticale punctate marchează lagurile 12, 24 și 36.
Corelogramele se compară cu cele teoretice din secțiunea anterioară. Se caută valorile mari la lagurile 1 și 12, sateliții la 11 și 13 și forma PACF la primele laguri și în jurul lagului 12. Printre cele 36 de laguri afișate, cîteva valori izolate pot atinge banda doar din întîmplare, deoarece banda are nivelul de 5% pentru fiecare lag luat separat.
Pe scurt
Stînga: pasagerii și logaritmul lor; mijloc și dreapta: ACF și PACF pentru \(w_t = \Delta\Delta_{12}\ln y_t\), 131 de observații
Logaritmul face constantă amplitudinea vîrfului de vară: tiparul multiplicativ al seriei inițiale devine aditiv, iar diferențele \(\Delta\Delta_{12}\) se pot aplica fără ca varianța să crească în timp. Pentru seria diferențiată \(w_t\), ACF este −0,34 la lagul 1 și −0,39 la lagul 12, ambele în afara benzii \(\pm 0{,}17\). Aceste două valori corespund unui MA(1) obișnuit și unui MA(1) sezonier. Valoarea de la lagul 3, −0,20, este la limita benzii. Barele izolate de la lagurile 9, 23 și 32 depășesc și ele banda; cu 36 de laguri și o bandă de 5%, sînt așteptate din întîmplare aproximativ două asemenea depășiri, iar ele nu au o structură pe care un termen al modelului să o poată surprinde.
PACF are valori negative mari la lagurile 1 și 12 și una mai mică la lagul 3, în timp ce la lagul 2 este aproape 0; nu se anulează după cîteva laguri. Această formă se potrivește cu termeni MA și nu cu termeni AR, pentru care PACF s-ar anula după ultimul lag al modelului. Concluzia identificării este SARIMA\((0,1,1)(0,1,1)_{12}\) pentru \(\ln y_t\), exact modelul ales de Box și Jenkins. Valorile teoretice din (4.6), −0,345 și −0,441, sînt apropiate de cele observate, iar estimarea din slide-ul următor confirmă ordinul de mărime al parametrilor.
Pe scurt
Logaritmul face constantă amplitudinea verii: tiparul multiplicativ devine aditiv
ACF pentru \(w_t\): \(\ensuremath{-}0{,}34\) la lagul 1 și \(\ensuremath{-}0{,}39\) la lagul 12, în afara benzii \(\pm 0{,}17\)
un MA(1) obișnuit și un MA(1) sezonier; lagul 3 (\(\ensuremath{-}0{,}20\)) este la limită
barele izolate de la lagurile 9, 23 și 32 depășesc și ele banda: cu 36 de laguri, aproximativ două depășiri sînt așteptate din întîmplare
PACF: valori negative mari la lagurile 1, 3 și 12, aproape 0 la lagul 2 și nicio anulare clară după cîteva laguri: în acord cu termeni MA, nu cu termeni AR
Concluzia: SARIMA\((0,1,1)(0,1,1)_{12}\), exact modelul lui Box și Jenkins
Întrebare pentru sală Slide-ul dă Ljung–Box p = 0,37. Este acesta testul modelului estimat pe 1949–1958?
Răspuns
Nu: pentru 1949–1958, p = 0,71; p = 0,37 este testul pe eșantionul complet, 1949–1960. Estimațiile depind de lungimea eșantionului: pe 1949–1952, Θ̂ = −0,904 cu SE 3,39 (aproape neidentificat), pe 1949–1958, Θ̂ = −0,541 cu SE 0,105. Cu originea în decembrie 1952, MAPE pînă în decembrie 1960 este 16,8% pentru modelul airline și 38,2% pentru metoda sezonieră naivă.
Întrebare pentru sală Cu originea în decembrie 1958, intervalul de 95% pentru decembrie 1960 are lățimea 239. Ce lățime are dacă originea este decembrie 1954, cu 72 de luni înainte?
Răspuns
Mult mai mare: 852 (intervalul [201; 1053]), deoarece cele două rădăcini unitare fac varianța erorii să crească cu orizontul. Valoarea reală, 432, rămîne în interval de la orice origine. Din 1958: prognoza 388, intervalul [286; 526], MAPE 8,5% față de 15,5% pentru metoda sezonieră naivă.
Pentru evaluarea prognozelor, modelul este estimat doar pe perioada 1949–1958, iar ultimii doi ani, 1959 și 1960, sînt păstrați ca perioadă de test. Din decembrie 1958 se calculează prognoze pentru toate cele 24 de luni, fără a reestima modelul, apoi prognozele pentru \(\ln y\) sînt transformate înapoi în numere de pasageri.
În grafic, linia albastră este seria observată, în mii de pasageri, iar linia verticală punctată marchează originea prognozei. Linia roșie este prognoza modelului airline, zona roșie deschisă intervalul de 95%, iar linia maro întreruptă prognoza sezonieră naivă, care repetă valorile din 1958. Ambele metode reproduc forma vîrfului de vară, dar prognoza naivă rămîne la nivelul din 1958, în timp ce modelul airline extrapolează și creșterea.
Pe scurt
Estimat pe 1949–1958, prognoze pentru cele 24 de luni din 1959–1960, transformate înapoi din \(\ln y\)
Pe perioada 1949–1958, estimările sînt \(\hat\theta = -0{,}342\), cu eroarea standard 0,087, și \(\hat\Theta = -0{,}541\), cu eroarea standard 0,105. Pe întregul eșantion, ele devin \(\hat\theta = -0{,}402\), cu eroarea standard 0,073, și \(\hat\Theta = -0{,}557\), cu eroarea standard 0,096. Abaterea standard a reziduurilor este 3,7% pe lună. Aceste valori se referă la întregul eșantion: testul Ljung–Box pe 24 de laguri, cu 22 de grade de libertate, are p-value 0,37; pentru estimarea pe 1949–1958, folosită la prognoze, p-value-ul este 0,71. În ambele cazuri, reziduurile nu au autocorelație detectabilă.
Eroarea procentuală absolută medie (MAPE, mean absolute percentage error) pe 1959–1960 este 8,5% pentru modelul airline și 15,5% pentru prognoza sezonieră naivă, care ignoră creșterea. Pentru decembrie 1960, ultima lună prognozată, modelul dă 388 de mii de pasageri, cu intervalul de 95% între 286 și 526 de mii, iar valoarea observată a fost 432 de mii. Valoarea reală se află în interval, dar prognoza subestimează sistematic seria: creșterea din 1959–1960 a fost mai rapidă decît cea extrapolată de model, iar linia observată stă deasupra prognozei în aproape toate lunile.
Lățimea intervalului de 95% crește de la 51 de mii de pasageri în prima lună la 239 de mii în luna 24. Creșterea rapidă provine din cele două rădăcini unitare la frecvența zero, \(\Delta\) și componenta de frecvență zero a lui \(\Delta_{12}\), și din transformarea exponențială, care lărgește intervalul în partea superioară.
întregul eșantion: abaterea standard a reziduurilor 3,7% pe lună; Ljung–Box \(Q^*(24)\) cu 22 de grade de libertate, p = 0,37
MAPE pe 1959–1960: 8,5% pentru modelul airline, 15,5% pentru prognoza sezonieră naivă (care ignoră creșterea)
Decembrie 1960: prognoza 388, intervalul [286; 526], valoarea reală 432: în interior, dar modelul subestimează creșterea din 1959–1960
lățimea intervalului crește de la 51 (prima lună) la 239 (luna 24): două rădăcini unitare
Sinteza secțiunii
Pe seria pasagerilor aerieni, corelogramele seriei \(\Delta\Delta_{12}\ln y_t\) indică direct modelul airline: valori negative la lagurile 1 și 12, cu PACF descrescătoare. Modelul estimat are reziduuri fără autocorelație detectabilă și reduce MAPE pe doi ani de la 15,5% la 8,5% față de metoda sezonieră naivă. Prognozele sale subestimează totuși creșterea din 1959–1960, ceea ce arată limita oricărui model care extrapolează trendul trecut.
Studiu de caz: PIB-ul neajustat al României
Al doilea studiu de caz aplică aceeași procedură pe PIB-ul real trimestrial neajustat al României, T1 2000–T2 2026. Secțiunea compară opt modele SARIMA cu criterii informaționale, diagnostichează reziduurile modelului ales și interpretează prognozele pe opt trimestre. Comparativ cu seria pasagerilor, PIB-ul are mai puține observații, o perioadă \(s = 4\) și o valoare aberantă mare în 2020.
Seria modelată este \(y_t = 100\ln Y_t\), unde \(Y_t\) este PIB-ul real neajustat, cu \(T = 106\) trimestre; factorul 100 face ca erorile să se citească în procente. Toate cele opt modele au \(d = D = 1\), deci criteriile informaționale sînt calculate pe aceeași serie diferențiată și sînt comparabile. Pentru fiecare model, tabelul dă AICc, BIC, p-value-ul testului Ljung–Box pe 8 laguri, cu \(8 - p - q - P - Q\) grade de libertate, și abaterea standard estimată a erorilor \(\hat\sigma\), în procente.
Primele cinci rînduri păstrează MA(1) sezonier și variază partea obișnuită: modelul airline \((0,1,1)(0,1,1)_4\), modelul fără parte obișnuită \((0,1,0)(0,1,1)_4\), un AR(1), un ARMA(1,1) și un MA(2). Ultimele trei rînduri variază partea sezonieră: un AR(1) sezonier în locul MA, un ARMA(1,1) sezonier și un model fără niciun termen sezonier. Cea mai mică valoare a fiecărui criteriu este marcată cu caractere aldine.
Pe scurt
Modelul
AICc
BIC
LB(8), p
\(\hat\sigma\) (%)
\((0,1,1)(0,1,1)_4\)
520,1
527,6
0,157
3,05
\((0,1,0)(0,1,1)_4\)
519,7
524,8
0,286
3,08
\((1,1,0)(0,1,1)_4\)
520,7
528,3
0,156
3,06
\((1,1,1)(0,1,1)_4\)
518,3
528,4
0,467
2,98
\((0,1,2)(0,1,1)_4\)
518,8
528,8
0,575
3,00
\((0,1,1)(1,1,0)_4\)
529,9
537,5
0,003
3,22
\((0,1,1)(1,1,1)_4\)
522,2
532,2
0,118
3,05
\((0,1,1)(0,1,0)_4\)
545,1
550,2
0,005
3,52
\(y_t = 100\ln Y_t\), PIB real neajustat, T1 2000–T2 2026, \(T = 106\); verosimilitate maximă; toate cu \(d = D = 1\), deci criteriile sînt comparabile
Ljung–Box pe 8 laguri, cu \(8 - p - q - P - Q\) grade de libertate
BIC alege modelul \((0,1,0)(0,1,1)_4\), cu valoarea 524,8, care conține doar termenul MA sezonier. AICc alege modelul \((1,1,1)(0,1,1)_4\), cu valoarea 518,3, dar estimările acestuia sînt \(\hat\phi = 0{,}78\) și \(\hat\theta = -0{,}94\): rădăcinile polinoamelor AR și MA sînt apropiate, deci cei doi factori aproape se simplifică, ca în exemplul factorului comun din Capitolul 2. Cîștigul de AICc față de modelul ales de BIC, 1,4 puncte, este mic. În modelul airline, coeficientul MA obișnuit este \(\hat\theta = -0{,}171\), cu eroarea standard 0,109, deci nu este separat de zero, iar \(\hat\Theta = -0{,}585\).
Partea sezonieră este bine determinată. Un AR(1) sezonier în locul MA sezonier are AICc 529,9 și p-value Ljung–Box 0,003, iar modelul fără termen sezonier are AICc 545,1 și p-value 0,005: ambele au criterii mult mai slabe și reziduuri corelate. Modelul păstrat este cel ales de BIC: un singur parametru ARMA, \(\hat\Theta = -0{,}577\), cu eroarea standard 0,075, și \(\hat\sigma = 3{,}08\%\).
Valoarea lui \(\hat\Theta\) răspunde și întrebării lăsate deschise de teste în secțiunea 2. Ea este departe de \(-1\), deci diferența sezonieră nu a fost aplicată unui tipar determinist: tiparul sezonier al PIB-ului se schimbă lent în timp.
Pe scurt
BIC alege \((0,1,0)(0,1,1)_4\): doar termenul MA sezonier; AICc alege \((1,1,1)(0,1,1)_4\)
modelul AICc are \(\hat\phi = 0{,}78\) și \(\hat\theta = \ensuremath{-}0{,}94\): aproape un factor comun (Capitolul 2), cu un cîștig mic
Întrebare pentru sală Care modele nu trec testul Ljung–Box la 5% cu m = 8 și trece modelul ales după BIC cu m = 12?
Răspuns
Nu trec cele trei fără MA sezonier: (0,1,1)(1,1,0)₄ cu p = 0,003, (1,1,0)(1,1,0)₄ cu p = 0,004 și (0,1,1)(0,1,0)₄ cu p = 0,005. Modelul ales după BIC, (0,1,0)(0,1,1)₄, are p = 0,286 cu m = 8 și p = 0,526 cu m = 12. AICc diferă cu doar 1,4 între acest model și (1,1,1)(0,1,1)₄; BIC penalizează mai mult parametrul în plus.
Întrebare pentru sală SARIMA(0,1,1)(1,1,0)₄ înlocuiește MA-ul sezonier cu un AR sezonier. Sînt reziduurile lui necorelate după testul Ljung–Box?
Răspuns
Nu: Q*(8) = 19,5 cu 6 grade de libertate, p = 0,003, iar AICc crește la 529,9, față de 519,7. Pentru SARIMA(0,1,0)(0,1,1)₄: Q*(8) = 8,55 cu 7 grade de libertate, p = 0,286, și Q*(12) cu p = 0,526. În toate modelele reziduurile nu urmează distribuția Normală: pentru modelul BIC, Jarque–Bera 22,0 și reziduul −11,4% în T2 2020.
Graficul arată trei diagnostice ale reziduurilor modelului SARIMA\((0,1,0)(0,1,1)_4\) pentru \(100\ln Y_t\). Panoul din stînga este seria reziduurilor, în procente: dacă modelul este corect, ea seamănă cu zgomotul alb, fără tipare sau grupuri de valori mari. Panoul din mijloc este ACF reziduurilor, cu banda \(\pm 1{,}96/\sqrt{T}\) și lagurile sezoniere marcate. Panoul din dreapta este histograma reziduurilor, comparată cu densitatea distribuției Normale cu aceeași medie și aceeași abatere standard.
Cele trei panouri verifică ipoteze diferite. Seria în timp arată valorile aberante și schimbările de varianță, ACF arată autocorelația rămasă, iar histograma arată dacă distribuția Normală este o aproximare acceptabilă pentru intervalele de prognoză.
Pe scurt
SARIMA\((0,1,0)(0,1,1)_4\) pentru \(100\ln Y_t\): reziduurile, ACF a lor și distribuția lor
Reziduurile nu au autocorelație detectabilă. Statistica Ljung–Box pe 8 laguri este \(Q^*(8) = 8{,}55\), cu 7 grade de libertate și p-value 0,286; pe 12 laguri, p-value-ul este 0,526. Nicio autocorelație nu iese din bandă la lagurile sezoniere 4, 8, 12 și 16, deci structura sezonieră este descrisă complet de diferențe și de termenul \(\Theta\).
Distribuția reziduurilor nu este distribuția Normală. Statistica Jarque–Bera este 22,0, cu p-value sub 0,001. Cel mai mare reziduu este −11,4% în al doilea trimestru din 2020, adică 3,6 abateri standard sub zero, în perioada de lockdown. Fără anul 2020, statistica Jarque–Bera scade la 13,4, dar rămîne peste valoarea critică de 5% a distribuției \(\chi^2(2)\), 5,99: coada stîngă rămîne mai groasă decît cea a distribuției Normale.
Consecința practică privește intervalele de prognoză, nu prognoza punctuală. Intervalele calculate cu distribuția Normală pot fi prea înguste pentru șocuri mari. Pasul următor ar fi o variabilă dummy pentru valoarea aberantă din 2020, în regresia cu erori SARIMA din secțiunea 7.
Pe scurt
Nu rămîne autocorelație: \(Q^*(8) = 8{,}55\) cu 7 grade de libertate, p = 0,286; \(Q^*(12)\): p = 0,526
nicio valoare semnificativă la lagurile sezoniere 4, 8, 12, 16: structura sezonieră este surprinsă
Nu este distribuția Normală: Jarque–Bera 22,0 (p \(<\) 0,001); cel mai mare reziduu este \(-\)11,4% în T2 2020 (\(\ensuremath{-}3{,}6\) abateri standard): perioada de lockdown
fără 2020, Jarque–Bera scade la 13,4: o variabilă dummy pentru valoarea aberantă ar fi pasul următor
Întrebare pentru sală Θ = 0 înseamnă că tiparul de anul trecut se repetă. Cum se schimbă prognozele și intervalul de 95% pentru T2 2028?
Răspuns
Prognozele scad puțin: 52,5; 57,3; 37,6 și 45,0 mld. EUR, față de 53,1; 58,7; 38,7 și 46,1 cu Θ = −0,577; intervalul pentru T2 2028 devine 32,4–60,0, față de 37,6–57,2. Cu Θ = −0,95 (tipar aproape fix) intervalul este 37,3–66,1: abaterea standard a reziduurilor crește cînd Θ se depărtează de estimația de verosimilitate maximă.
Întrebare pentru sală Butonul ▶ mișcă Θ de la −0,95 la 0. Ce devine creșterea anuală prognozată cînd Θ = 0?
Răspuns
Aceeași în fiecare trimestru: −1,96%, creșterea anuală din T2 2026. Cu Θ = 0, modelul este Δ₄y_t = Δ₄y_{t−1} + ε_t, iar prognoza repetă ultima creștere anuală. Cu Θ̂ = −0,577, tiparul are ponderea 1 + Θ̂ = 0,42 pentru anul cel mai recent: creșterea implicată −0,81%; 0,53%; 0,83%; 0,55%, apoi 0,55%. Cu Θ = −0,95, tiparul este aproape fix, iar creșterea implicată urcă la 3,99%.
Panoul din stînga arată PIB-ul neajustat din 2016, în miliarde de euro, și prognozele modelului SARIMA\((0,1,0)(0,1,1)_4\) pentru 8 trimestre, din T3 2026 pînă în T2 2028. Zona roșie închisă este intervalul de 80%, iar zona roșie deschisă intervalul de 95%; ambele au fost calculate pentru \(100\ln Y\) și transformate înapoi, deci sînt asimetrice. Panoul din dreapta arată creșterea anuală, \(100\,\Delta_4\ln Y\): barele albastre sînt valorile observate, iar barele roșii creșterea implicată de prognoză.
Prognozele păstrează tiparul de fierăstrău: un vîrf în al patrulea trimestru și un minim în primul. Panoul din dreapta elimină acest tipar și arată ce spune modelul despre economie: după trei trimestre de scădere anuală în 2025–2026, creșterea anuală implicată rămîne aproape de zero.
Pe scurt
SARIMA\((0,1,0)(0,1,1)_4\), 8 trimestre, din T3 2026 pînă în T2 2028, intervale de 80% și 95%; dreapta: creșterea anuală implicată
Ultima valoare observată este 45,9 miliarde de euro, în al doilea trimestru din 2026. Prognozele pentru următoarele patru trimestre sînt 53,1, 58,7, 38,7 și 46,1 miliarde de euro. Intervalul de 95% este între 50,0 și 56,4 miliarde pentru primul trimestru prognozat și între 37,6 și 57,2 miliarde pentru al optulea: incertitudinea crește repede cu orizontul.
Creșterea anuală implicată este −0,81% în primul trimestru prognozat, 0,53% în al doilea, 0,83% în al treilea și 0,55% în al patrulea, apoi rămîne constantă la 0,55%. Modelul extrapolează creșterea slabă din ultimii ani. El nu conține informații despre politica fiscală, fondurile europene sau economia externă; o prognoză macroeconomică le-ar adăuga ca regresori sau prin judecata experților.
Tiparul sezonier al prognozei este o medie ponderată a tiparelor din anii trecuți. Ponderea anului cel mai recent este \(1 + \hat\Theta = 0{,}42\), iar ponderile anilor anteriori scad geometric. Tiparul se actualizează deci moderat: nici atît de lent ca un tipar fix, nici atît de repede ca o repetare a ultimului an.
Pe scurt
Ultima valoare: 45,9 mld. EUR în T2 2026; prognozele 53,1; 58,7; 38,7; 46,1 mld. EUR pentru următoarele patru trimestre
intervalul de 95% pentru primul trimestru [50,0; 56,4], pentru al optulea [37,6; 57,2]
Creșterea anuală implicată: \(-\)0,81%; 0,53%; 0,83%; 0,55%, apoi constant 0,55%
modelul extrapolează creșterea slabă recentă; nu conține informații despre politica fiscală sau fondurile europene
Tiparul sezonier al prognozei este o medie ponderată a anilor trecuți, cu ponderea \(1 + \hat\Theta = 0{,}42\) pentru anul cel mai recent
Recapitulare: pasagerii aerieni și PIB-ul României
Rețeta este aceeași pentru ambele serii: logaritmi, apoi \(\Delta\Delta_s\), apoi termeni MA la lagurile 1 și \(s\). Pentru PIB, BIC renunță la termenul MA obișnuit, iar AICc alege un ARMA(1,1) cu un factor aproape comun, deci aproape redundant. Reziduurile modelului ales sînt fără autocorelație, cu excepția valorii aberante din 2020, care afectează distribuția lor. Prognozele repetă un tipar sezonier netezit pe o dreaptă de trend, cu intervale tot mai largi.
Pe scurt
Logaritmi, apoi \(\Delta\Delta_s\), apoi termeni MA la lagurile 1 și \(s\): rețeta airline funcționează pentru ambele serii
Pentru PIB, BIC renunță la termenul MA obișnuit; AICc alege un ARMA(1,1) aproape redundant
Reziduurile sînt curate, cu excepția valorii aberante din 2020
Prognozele repetă un tipar sezonier netezit pe o linie de trend, cu intervale tot mai largi
Sinteza secțiunii
Pentru PIB-ul României, un singur parametru, MA sezonier \(\hat\Theta = -0{,}577\), descrie toată dinamica seriei diferențiate, cu \(\hat\sigma = 3{,}08\%\) și reziduuri fără autocorelație. Valoarea lui \(\hat\Theta\) arată un tipar sezonier care evoluează lent. Prognoza implică o creștere anuală de aproximativ 0,55%, adică o extrapolare a stagnării recente, cu intervale care se lărgesc repede. Modelul are două limite vizibile: valoarea aberantă din 2020 și lipsa informațiilor din afara seriei.
Ajustarea sezonieră în practică
Institutele de statistică publică, pe lîngă seriile brute, serii ajustate sezonier. Această secțiune explică de ce, cum funcționează programele folosite, X-11 și X-13ARIMA-SEATS, și ce variantă a unei serii Eurostat se potrivește fiecărei întrebări. Ultimele două cadre compară seriile neajustate și ajustate pentru PIB și comerțul cu amănuntul și citesc factorii sezonieri implicați.
Utilizatorii statisticilor economice vor să știe dacă economia a crescut în ultimul trimestru, nu dacă trimestrul al treilea este mai mare decît al doilea. Seria brută amestecă cele două întrebări. În primul trimestru din 2026, PIB-ul neajustat s-a modificat cu −42,1% față de trimestrul anterior, în puncte logaritmice, iar seria ajustată cu −0,06%. Prima cifră este aproape în întregime efect sezonier; doar a doua spune ceva despre ciclul economic.
Ajustarea sezonieră (seasonal adjustment) estimează componenta sezonieră \(\hat S_t\) și componenta de calendar \(\hat C_t\) și le elimină din serie. În forma aditivă, seria ajustată este \(y_t^{SA} = y_t - \hat S_t - \hat C_t\), iar în forma multiplicativă \(y_t^{SA} = y_t / (\hat S_t\hat C_t)\). Descompunerea clasică și metoda STL din Capitolul 0 sînt variante simple ale acestei idei.
Pentru prognoza cu SARIMA se folosește totuși seria neajustată. Filtrele de ajustare sînt medii mobile lungi, care schimbă structura de autocorelație a seriei. În plus, seria ajustată este revizuită cînd apar date noi, pentru că factorii sezonieri de la capătul seriei se reestimează. Un model estimat pe seria ajustată ar descrie deci în parte efectul filtrelor, nu doar dinamica datelor.
Pe scurt
Utilizatorii vor să știe dacă economia a crescut în acest trimestru, nu dacă T3 este mai mare decît T2
T1 2026: PIB-ul neajustat s-a modificat cu \(-\)42,1% (puncte logaritmice) față de trimestrul anterior; seria ajustată cu \(-\)0,06%
prima cifră este doar sezon; doar a doua spune ceva despre ciclul economic
Ajustarea sezonieră: estimăm componentele sezonieră și de calendar și le eliminăm: \(y_t^{SA} = y_t - \hat S_t - \hat C_t\) (sau \(y_t/(\hat S_t\hat C_t)\))
descompunerea clasică și STL din Capitolul 0 sînt variante simple ale acestei idei
Pentru prognoza cu SARIMA folosim seria neajustată: filtrele de ajustare schimbă autocorelațiile și sînt revizuite cînd apar date noi
Metoda X-11, dezvoltată la US Census Bureau în anii 1960 și descrisă în detaliu de Ladiray și Quenneville (2001), aplică iterativ medii mobile. Pentru date lunare, o medie mobilă centrată \(2 \times 12\) estimează trendul; ea are 13 termeni, cu ponderea 1/24 la capete și 1/12 în rest, și elimină exact un tipar sezonier fix de perioadă 12. Raportul dintre serie și trend conține componentele sezonieră și neregulată. Factorii sezonieri se obțin apoi netezind, separat pentru fiecare lună, valorile acestui raport de-a lungul anilor, cu medii mobile \(3 \times 3\) și \(3 \times 5\). Procedura se repetă, cu o estimare a trendului îmbunătățită la fiecare pas.
Mediile mobile simetrice nu se pot calcula la capătul seriei, unde lipsesc observațiile viitoare. X-12-ARIMA (Findley et al., 1998) și succesorul său, X-13ARIMA-SEATS, au adăugat o preajustare regARIMA: o regresie cu erori SARIMA, adesea modelul airline, care estimează efectele valorilor aberante, ale zilelor lucrătoare și ale Paștelui. Prognozele modelului ARIMA prelungesc seria, astfel încît filtrele simetrice pot fi aplicate și la capăt, iar revizuirile ulterioare sînt mai mici. Pe seria preajustată se aplică apoi filtrele X-11 sau metoda SEATS, care descompune seria pe baza modelului ARIMA estimat.
În Uniunea Europeană, Eurostat și institutele naționale de statistică urmează ghidul Eurostat (2024). Programul oficial este JDemetra+, care implementează atît X-13, cît și TRAMO-SEATS, metoda cu preajustare și descompunere bazate pe modele ARIMA.
o medie mobilă centrată \(2 \times 12\) pentru trend, apoi medii mobile \(3 \times 3\) și \(3 \times 5\) ale fiecărei luni de-a lungul anilor pentru factorii sezonieri
X-12-ARIMA (Findley et al. (1998)) și X-13ARIMA-SEATS adaugă o preajustare regARIMA:
regresie cu erori SARIMA (adesea modelul airline) pentru valori aberante, zile lucrătoare, Paște
prognozele ARIMA prelungesc seria, astfel încît filtrele simetrice funcționează și la capăt: revizuiri mai mici
apoi filtrele X-11 sau SEATS (descompunerea pe baza modelului ARIMA)
UE: Eurostat și institutele naționale urmează Eurostat (2024), cu programul JDemetra+ (X-13 și TRAMO-SEATS)
Fiecare serie Eurostat este publicată în mai multe variante, selectate prin dimensiunea s_adj. Varianta NSA (not seasonally adjusted) conține datele brute. Varianta CA (calendar adjusted) este ajustată doar pentru efectele de calendar, adică pentru numărul de zile lucrătoare și pentru sărbători. Varianta SA (seasonally adjusted) este ajustată sezonier, iar varianta SCA (seasonally and calendar adjusted) este ajustată atît sezonier, cît și pentru efectele de calendar.
Fiecare întrebare are varianta ei. Creșterea față de trimestrul sau luna anterioară se calculează pe SCA, deoarece pe datele brute ea ar fi dominată de sezon. Creșterea față de același trimestru al anului anterior se poate calcula pe NSA sau pe CA: tiparul sezonier se anulează prin diferența de un an, dar efectul de calendar nu, deoarece numărul de zile lucrătoare și data Paștelui diferă de la un an la altul. Modelarea și prognoza cu SARIMA se fac pe NSA, cu regresori de calendar.
Ajustarea mută producția între trimestre, nu o creează și nici nu o elimină. Totalurile anuale ale variantelor NSA și SCA sînt de aceea apropiate: pentru 2024, ambele sînt 196,4 miliarde de euro.
Pe scurt
Fiecare serie apare în mai multe variante (dimensiunea s_adj):
NSA: neajustată sezonier (datele brute)
CA: ajustată doar pentru efectele de calendar (zile lucrătoare, sărbători)
SA: ajustată sezonier; SCA: ajustată sezonier și pentru efectele de calendar
Varianta potrivită pentru fiecare întrebare
creșterea față de trimestrul sau luna anterioară: SCA
creșterea față de anul anterior: NSA sau CA (tiparul sezonier se anulează, calendarul nu)
modelarea și prognoza SARIMA: NSA, cu regresori de calendar
Totalurile anuale NSA și SCA sînt apropiate (2024: 196,4 și 196,4 mld. EUR): ajustarea mută producția între trimestre, nu o creează
Întrebare pentru sală S-au schimbat factorii sezonieri ai PIB între 2010–2014 și 2020–2025?
Răspuns
Foarte puțin: T1 0,77 și 0,79, T2 0,93 și 0,93, T3 1,09 și 1,08, T4 1,20 și 1,20. Tiparul se mișcă încet, cum indică Θ̂ = −0,577. La comerțul cu amănuntul, factorul din ianuarie urcă de la 0,84 (2015–2019) la 0,86 (2020–2025), iar cel din decembrie rămîne 1,10.
Întrebare pentru sală În T1 2026, PIB-ul neajustat scade cu 42,1% (puncte logaritmice) față de trimestrul anterior. Cît s-a modificat seria SCA?
Răspuns
Cu −0,06%: practic deloc. Scăderea seriei neajustate este tiparul sezonier, cu factorul NSA/SCA 0,786 în T1 și 1,197 în T4 2025. Creșterea anuală spune același lucru în ambele serii: −1,50% (NSA) și −1,14% (SCA). Totalurile anuale coincid: 196,4 mld. EUR în 2024.
Panourile de sus compară seriile NSA, în albastru, și SCA, în roșu: PIB-ul în miliarde de euro la prețurile din 2010, în stînga, și volumul comerțului cu amănuntul, indice cu 2021 = 100, în dreapta. Seria ajustată trece prin mijlocul oscilațiilor sezoniere și urmărește trendul și ciclul.
Panourile de jos arată raportul NSA/SCA, adică factorul sezonier și de calendar combinat. Un factor de 1,2 înseamnă că seria brută este cu 20% peste nivelul ajustat în acea perioadă. Pentru PIB, fiecare trimestru are linia lui, de la 2010 la 2026; pentru comerț, factorul lunar este o singură linie.
Pe scurt
Eurostat NSA și SCA: PIB (stînga sus) și comerțul cu amănuntul (dreapta sus); jos: factorii sezonieri și de calendar implicați, NSA/SCA
Pentru PIB, factorii medii pe 2015–2019 sînt 0,78 în primul trimestru, 0,93 în al doilea, 1,10 în al treilea și 1,19 în al patrulea. Producția din primul trimestru este deci cu aproximativ o cincime sub un trimestru mediu, iar cea din al patrulea trimestru cu aproximativ o cincime peste. Factorii se mișcă lent de-a lungul anilor, de exemplu factorul trimestrului al patrulea scade ușor după 2010. Această mișcare lentă este sezonalitatea stochastică pe care o măsoară \(\hat\Theta\) în modelul SARIMA.
Pentru comerțul cu amănuntul, factorul mediu pe 2016–2019 este 1,10 pentru decembrie și 0,84 pentru ianuarie: cumpărăturile de Crăciun, urmate de minimul din ianuarie. Factorul comerțului sare și de la o lună la alta, din cauza numărului de zile lucrătoare și a datei Paștelui; aceasta este partea de calendar a ajustării SCA, modelată explicit în secțiunea 7.
Seria ajustată a PIB-ului arată două episoade pe care seria brută le ascunde: scăderea din 2020 și stagnarea din 2025–2026. În seria brută, ambele sînt mai mici decît oscilația sezonieră obișnuită și nu se pot distinge cu ochiul liber.
Pe scurt
Factorii PIB 2015–2019: T1 0,78, T2 0,93, T3 1,10, T4 1,19: producția din T1 este cu aproximativ o cincime sub un trimestru mediu
factorii se mișcă lent de-a lungul anilor: sezonalitatea stochastică măsurată de \(\hat\Theta\)
Comerțul cu amănuntul: factorul pentru decembrie 1,10, pentru ianuarie 0,84 (2016–2019): cumpărăturile de Crăciun, apoi minimul din ianuarie
Factorul pentru comerț sare și de la o lună la alta din cauza zilelor lucrătoare și a Paștelui: partea de calendar a SCA (secțiunea 7)
PIB-ul ajustat arată scăderea din 2020 și stagnarea din 2025–2026 pe care seria brută le ascunde
Ajustarea sezonieră elimină componentele estimate \(\hat S_t\) și \(\hat C_t\) pentru a arăta trendul și ciclul. X-13ARIMA-SEATS face mai întîi o preajustare regARIMA, cu valori aberante, efecte de calendar și prognoze care prelungesc seria, apoi aplică filtrele X-11 sau SEATS; în Uniunea Europeană, programul folosit este JDemetra+. Creșterea față de trimestrul anterior se calculează pe SCA, creșterea anuală pe NSA sau CA, iar prognoza SARIMA pe NSA.
Pe scurt
Ajustarea sezonieră elimină \(\hat S_t\) și \(\hat C_t\) pentru a arăta trendul și ciclul
X-13ARIMA-SEATS: preajustare regARIMA (valori aberante, calendar, prognoze), apoi X-11 sau SEATS; în UE, JDemetra+
Creșterea față de trimestrul anterior: SCA; creșterea anuală: NSA sau CA; prognoza SARIMA: NSA
Sinteza secțiunii
Seriile ajustate sezonier răspund la întrebarea despre ciclul economic, seriile neajustate la întrebarea despre prognoză. Pentru PIB-ul României, factorii sezonieri merg de la 0,78 în primul trimestru la 1,19 în al patrulea, iar ajustarea transformă o scădere de −42,1% față de trimestrul anterior într-una de −0,06%. Preajustarea regARIMA a programelor oficiale este chiar o regresie cu erori SARIMA, iar secțiunea următoare construiește o asemenea regresie pentru efectul Paștelui.
Termeni Fourier și efecte de calendar
Această secțiune tratează sezonalitatea ca o funcție deterministă de timp și calendar, descrisă prin regresori. Variabilele dummy sezoniere descriu orice formă, dar cer \(s - 1\) coeficienți; termenii Fourier descriu tipare netede cu mult mai puțini coeficienți și funcționează pentru orice perioadă, inclusiv una neîntreagă. Efectele de calendar, adică zilele lucrătoare și sărbătorile mobile, sînt cunoscute dinainte și intră în model ca regresori. Secțiunea se încheie cu o regresie cu erori SARIMA care măsoară efectul Paștelui ortodox asupra comerțului cu amănuntul din România.
Modelul cu variabile dummy sezoniere este \(y_t = \beta_0 + \sum_{j=2}^{s}\gamma_jD_{jt} + u_t\), cu \(s - 1\) coeficienți sezonieri. Aici \(\beta_0\) este nivelul sezonului 1, care servește drept bază, iar \(\gamma_j\) diferența dintre sezonul \(j\) și sezonul 1; o variabilă dummy pentru fiecare sezon plus constanta ar fi perfect coliniare. Modelul descrie orice formă a tiparului, dar numărul de coeficienți crește cu perioada: 51 pentru \(s = 52\) de săptămîni, 167 pentru \(s = 168\) de ore, 364 pentru \(s = 365\) de zile. Pentru perioada anuală a datelor zilnice, 365,25 de zile, variabilele dummy nici nu se pot defini.
Termenii Fourier pentru o perioadă \(m\) înlocuiesc variabilele dummy cu perechi de sinusuri și cosinusuri:
Armonica \(k\) este o undă cu \(k\) cicluri pe perioadă, iar \(\alpha_k\) și \(\beta_k\) sînt coeficienții ei; împreună, ei fixează amplitudinea și faza undei. \(K\) este numărul de perechi sinus–cosinus, deci modelul are \(2K\) coeficienți. Pentru \(m\) par, \(K = m/2\) reproduce exact modelul cu variabile dummy (ultima armonică are doar termenul cosinus, deoarece sinusul ei este zero în toate punctele), iar un \(K\) mic dă un tipar neted.
Termenii Fourier au două avantaje. Perioada \(m\) poate fi neîntreagă, de exemplu 365,25 de zile, iar mai multe perioade se pot combina în aceeași regresie. Pentru date orare, \(K = 5\) armonici pentru perioada de 24 de ore și \(K = 4\) pentru perioada de 168 de ore dau 18 regresori, în locul celor \(23 + 167\) de variabile dummy. Numărul \(K\) se alege cu AICc sau prin validare încrucișată. Aceiași termeni stau la baza modelelor TBATS și Prophet din secțiunea 9.
Pe scurt
Variabile dummy: \(y_t = \beta_0 + \sum_{j=2}^{s}\gamma_jD_{jt} + u_t\): \(s - 1\) coeficienți, orice formă
\(\beta_0\): nivelul sezonului 1; \(\gamma_j\): diferența dintre sezonul \(j\) și sezonul 1
prea mulți pentru \(s = 52\) de săptămîni, \(s = 168\) ore sau \(s = 365\) de zile; imposibil pentru \(s = 365{,}25\)
Termeni Fourier pentru o perioadă \(m\): \(\sum_{k=1}^{K}\left[\alpha_k\sin\frac{2\pi kt}{m} + \beta_k\cos\frac{2\pi kt}{m}\right]\)
\(\alpha_k, \beta_k\): coeficienții armonicei \(k\), o undă cu \(k\) cicluri pe perioadă; \(K\): numărul de perechi sinus–cosinus
\(2K\) coeficienți; \(K = m/2\) reproduce exact variabilele dummy (pentru \(m\) par); un \(K\) mic dă un tipar neted
\(m\) poate fi neîntreg și se pot combina mai multe perioade: de exemplu \(K = 5\) pentru \(m = 24\) și \(K = 4\) pentru \(m = 168\) dau 18 regresori în locul a \(23 + 167\)
\(K\) se alege cu AICc sau prin validare încrucișată; aceiași termeni se află în TBATS și Prophet (secțiunea 9)
Întrebare pentru sală Pentru consumul zilnic, în ce zi din 2025 este maximă componenta Fourier anuală a DHR și cît este?
Răspuns
Pe 1 februarie 2025: +0,64 GW (644 MW), cu toate cele patru perechi; minimul este pe 13 mai 2025, −0,60 GW. Prima pereche are amplitudinea 0,499 GW. La turism, ajustarea cu K = 3 dă pentru august 0,765, față de efectul observat 0,847.
Întrebare pentru sală Ce K alege AICc pentru tiparul lunar al turismului?
Răspuns
K = 1 (AICc −41,5, față de −40,1 la K = 2 și −32,0 la K = 3), deși R² crește de la 0,925 la 0,989 și vîrful din august cere K ≥ 3. Cu doar 12 puncte, corecția 2k(k + 1)/(12 − k − 1) crește repede: 28 la K = 3; la K = 5 și K = 6 AICc nu mai este definit. K = 5 dă R² = 0,999; K = 6 (11 coeficienți) trece prin toate punctele, R² = 1.
Întrebare pentru sală Cîte armonici sînt necesare pentru R² ≥ 0,98?
Răspuns
Trei: K = 3, șase coeficienți, R² = 0,989. K = 1 dă 0,925, K = 2 dă 0,966. K = 5, cu zece coeficienți, dă 0,999. Pentru K = 6, sin(2π6t/12) este zero în fiecare lună și este omis: cu cos(2π6t/12), cei 11 coeficienți trec prin toate cele 12 puncte (R² = 1), ca 11 variabile dummy.
Panoul din stînga arată efectul sezonier lunar al logaritmului înnoptărilor turistice, pe 2012–2019, obținut după eliminarea trendului cu o medie mobilă centrată pe 13 luni. Cele 12 puncte sînt efectele lunare, în unități logaritmice: ianuarie este cu aproximativ 0,55 sub medie, august cu aproximativ 0,85 peste. Cele patru curbe sînt ajustări Fourier cu \(K = 1, 2, 3\) și 6 armonici, iar legenda dă numărul de coeficienți și coeficientul de determinare \(R^2\) al fiecărei ajustări.
Panoul din dreapta arată primele trei armonici: perechile \(\cos(2\pi kt/12)\) și \(\sin(2\pi kt/12)\) pentru \(k = 1, 2, 3\). Prima armonică face un singur ciclu pe an, a doua două cicluri, a treia trei. O combinație liniară a acestor unde, cu coeficienții estimați prin cele mai mici pătrate, dă curbele din panoul din stînga.
Pe scurt
Efectul sezonier lunar al \(\ln\)(înnoptări turistice), 2012–2019, după eliminarea unei medii centrate pe 13 luni; ajustări cu \(K = 1, 2, 3, 6\); pentru \(K = 6\), \(\sin(\pi t)\) este 0 în fiecare lună și este omis (11 coeficienți)
O singură armonică, \(K = 1\), cu doi coeficienți, explică deja 92,5% din variația efectelor lunare (\(R^2 = 0{,}925\)): vîrful de vară este aproape o singură undă sinusoidală pe an. Cu \(K = 2\),\(R^2\) crește la 0,966, iar cu \(K = 3\) la 0,989, folosind șase coeficienți în loc de unsprezece.
Cu \(K = 5\), zece coeficienți, \(R^2 = 0{,}999\). Curba roșie este \(K = 6\): termenul \(\sin(2\pi 6t/12) = \sin(\pi t)\) este 0 în fiecare lună și este omis, deci \(\cos(\pi t)\) este al 11-lea coeficient, iar curba trece prin toate cele 12 puncte lunare, la fel ca modelul cu 11 variabile dummy, cu \(R^2 = 1\). Armonicele superioare adaugă detalii tot mai fine. Vîrful ascuțit din august cere cel puțin \(K = 3\): cu una sau două armonici, curba aplatizează vîrful și îl mută spre iulie.
Alegerea lui \(K\) este un compromis între deplasare și varianță. Un \(K\) mic dă un tipar neted, robust la zgomot; un \(K\) mare reproduce fiecare lună, inclusiv zgomotul. Pentru 12 luni diferența de parametri este mică, dar pentru perioade de 168 sau 365,25 diferența dintre cîteva armonici și sute de variabile dummy este decisivă.
Pe scurt
\(K = 1\) (doi coeficienți) dă deja \(R^2 = 0{,}925\): vîrful de vară este aproape o singură undă
\(K = 2\): 0,966; \(K = 3\): 0,989 cu șase coeficienți în loc de unsprezece
\(K = 5\) (10 coeficienți): \(R^2 = 0{,}999\); \(K = 6\) adaugă \(\cos(\pi t)\), 11 coeficienți, și trece prin cele 12 puncte, ca 11 variabile dummy (\(R^2 = 1{,}000\))
Armonicele superioare adaugă detalii mai fine: vîrful din august cere \(K \ge 3\)
Efectele de calendar (calendar effects) provin din compunerea fiecărei luni. O lună cu mai multe zile lucrătoare, adică zile de luni pînă vineri care nu sînt sărbători legale, produce și vinde mai mult decît o lună cu mai puține. Numărul de zile lucrătoare se cunoaște dinainte pentru orice lună viitoare, deci este un regresor care poate fi folosit în prognoze fără a fi el însuși prognozat.
Sărbătorile mobile sînt mai greu de tratat. Paștele ortodox cade între 4 aprilie și 8 mai: pe 5 mai în 2024, pe 20 aprilie în 2025, pe 12 aprilie în 2026 și pe 2 mai în 2027. Cumpărăturile dinaintea Paștelui se mută astfel între martie, aprilie și mai de la un an la altul. În Python, data se calculează cu dateutil.easter.easter(y, EASTER_ORTHODOX), iar Rusaliile cad la 49 de zile după Paști.
Regresorul pentru Paște din X-13, easter[w], presupune că efectul se distribuie uniform pe cele \(w\) zile dinaintea Duminicii Paștelui. Valoarea lui \(E_t\) este partea din aceste \(w\) zile care cade în luna \(t\). Pentru \(w = 10\), Paștele pe 20 aprilie dă \(E_{\text{aprilie}} = 1\), deoarece zilele 10–19 aprilie sînt toate în aprilie. Paștele pe 5 mai dă \(E_{\text{aprilie}} = 0{,}6\) și \(E_{\text{mai}} = 0{,}4\): șase dintre cele zece zile, 25–30 aprilie, sînt în aprilie, iar patru, 1–4 mai, în mai.
Pe scurt
Zilele lucrătoare: o lună cu mai multe zile de luni pînă vineri care nu sînt sărbători produce și vinde mai mult
cunoscute dinainte: un regresor care poate fi folosit în prognoze
Sărbătorile mobile: Paștele ortodox cade între 4 aprilie și 8 mai
5 mai 2024, 20 aprilie 2025, 12 aprilie 2026, 2 mai 2027: cumpărăturile se mută între martie, aprilie și mai
în Python: dateutil.easter.easter(y, EASTER_ORTHODOX); Rusaliile sînt cu 49 de zile mai tîrziu
Regresorul Paște (easter[w] din X-13): \(E_t\) = partea din cele \(w\) zile dinaintea Duminicii Paștelui care cade în luna \(t\)
\(w = 10\): Paștele pe 20 aprilie dă \(E_{\text{aprilie}} = 1\); pe 5 mai, \(E_{\text{aprilie}} = 0{,}6\) și \(E_{\text{mai}} = 0{,}4\)
\(E_t\) este regresorul Paște definit mai sus, \(\mathrm{WD}_t\) numărul de zile lucrătoare din luna \(t\), iar \(\beta_E\) și \(\beta_W\) sînt efectele lor, în procente. Erorile \(u_t\) urmează modelul airline, deci regresia descrie efectele de calendar, iar modelul SARIMA descrie tot restul: trendul, tiparul sezonier și dinamica.
Acesta este modelul regARIMA din X-13. El se estimează într-un singur pas prin verosimilitate maximă, de exemplu cu SARIMAX și argumentul exog. Estimarea prin cele mai mici pătrate obișnuite, care ignoră erorile SARIMA, ar da erori standard greșite: erorile \(u_t\) sînt nestaționare și autocorelate, iar regresia ar suferi de problema regresiei false din Capitolul 3.
Datele sînt volumul comerțului cu amănuntul din România, neajustat, de la Eurostat, din ianuarie 2010 pînă în iulie 2026, pentru două agregate: alimente (G47_FOOD) și totalul comerțului (G47). Lunile aprilie și mai 2020, din perioada de lockdown, au variabile dummy proprii, pentru ca scăderea lor să nu influențeze estimarea celorlalte efecte.
Pe scurt
\(100\ln y_t = \beta_EE_t + \beta_W\,\mathrm{WD}_t + \text{variabile dummy pentru valori aberante} + u_t\), cu \(u_t \sim\) SARIMA\((0,1,1)(0,1,1)_{12}\)
\(E_t\): regresorul Paște; \(\mathrm{WD}_t\): numărul de zile lucrătoare din luna \(t\); \(\beta_E\), \(\beta_W\): efectele lor, în %
modelul „regARIMA” din X-13; estimat într-un singur pas prin verosimilitate maximă (SARIMAX cu exog)
metoda celor mai mici pătrate care ignoră erorile SARIMA ar da erori standard greșite (Capitolul 3, regresia falsă)
Datele: volumul comerțului cu amănuntul, Eurostat, România, neajustat, ianuarie 2010–iulie 2026: alimente (G47_FOOD) și total (G47)
variabile dummy pentru aprilie și mai 2020 (lockdown)
Întrebare pentru sală În 2027 Paștele este pe 2 mai. Cum se împarte regresorul cu w = 10?
Răspuns
Fereastra merge de la 22 aprilie la 1 mai: 9 zile în aprilie (E = 0,9) și 1 zi în mai (E = 0,1). Cu β̂_E = 5,95% pentru alimente, efectul este +5,35% în aprilie și +0,59% în mai. În 2024 (5 mai): 0,6 în aprilie și 0,4 în mai; în 2025 (20 aprilie): 1 în aprilie.
Întrebare pentru sală Depinde efectul Paștelui asupra comerțului cu alimente de fereastra w?
Răspuns
Da: cu w = 5, β̂_E = 3,0% (SE 1,8, t = 1,7), nesemnificativ la 5%; cu w = 10, 5,9% (SE 2,3, t = 2,6); cu w = 20, 5,4% (SE 1,4, t = 3,8). Pentru tot comerțul, efectul rămîne mic (−0,1%; 0,8%; 1,5%), în timp ce zilele lucrătoare contează la orice w (circa +1% pe zi).
Întrebare pentru sală Cu fereastra w = 3 (doar cele trei zile dinaintea Paștelui), efectul estimat al Paștelui asupra vînzărilor de alimente crește sau scade?
Răspuns
Scade la 1,6% (eroarea standard 1,6, t = 1,0) și nu se mai separă de zgomot. Cu w = 10 (curs): 5,9% (2,3; t = 2,6); cu w = 12: 6,1% (t = 2,9). Cumpărăturile de Paște se întind pe mai multe zile; un regresor prea îngust pune o parte din ele în luna greșită. Zilele lucrătoare rămîn în jur de +0,6% pentru alimente și +1,0% pentru total, pentru orice w.
Panoul din stînga arată data Duminicii Paștelui ortodox între 2000 și 2030, ca zi din aprilie: o valoare peste 30 înseamnă o dată în mai, iar punctele roșii marchează anii cu Paștele în mai. Data variază cu peste o lună de la un an la altul, fără un tipar simplu.
Panoul din dreapta leagă data Paștelui de vînzări. Pe axa orizontală se află modificarea față de anul anterior a ponderii Paștelui în luna respectivă, \(E_t - E_{t-12}\); pe axa verticală, creșterea anuală a vînzărilor de alimente din luna respectivă, în procente. Fiecare punct este o lună martie, aprilie sau mai, iar anii 2020 și 2021 sînt excluși din cauza pandemiei. Linia întreruptă este dreapta de regresie prin cele mai mici pătrate.
Pe scurt
Stînga: Duminica Paștelui ortodox ca zi din aprilie (peste 30: mai); dreapta: creșterea anuală a vînzărilor de alimente în martie–mai față de modificarea ponderii Paștelui (fără 2020–2021)
Pentru vînzările de alimente, coeficientul estimat al Paștelui este \(\hat\beta_E = 5{,}9\%\), cu eroarea standard 2,3 și statistica \(t = 2{,}6\). O lună care cuprinde toate cele 10 zile dinaintea Paștelui vinde cu aproximativ 5,9% mai multe alimente decît aceeași lună fără Paște. O zi lucrătoare în plus crește vînzările de alimente cu 0,59%, cu eroarea standard 0,17, iar variabila dummy pentru aprilie 2020 este −15%.
Pentru totalul comerțului, efectul Paștelui este 0,8%, cu eroarea standard 1,9, deci nu este separat de zero, în timp ce efectul unei zile lucrătoare este 1,02%, cu eroarea standard 0,15. Efectul Paștelui se concentrează în vînzările de alimente, iar efectul zilelor lucrătoare se regăsește în toate vînzările.
Norul de puncte brut din panoul din dreapta este zgomotos, iar panta dreptei de regresie simple este 4,6 puncte procentuale. Creșterea anuală a vînzărilor depinde și de modificările cotei de TVA, de prețuri și de ciclul economic, care nu apar pe axa orizontală. Regresia cu erori SARIMA separă aceste efecte, iar estimarea ei este mai precisă decît panta norului de puncte. Paștele a căzut în mai în 2002, 2005, 2013, 2016, 2021 și 2024; o prognoză care ignoră data Paștelui greșește sistematic în aprilie și mai în acești ani.
Pe scurt
Alimente: \(\hat\beta_E = 5{,}9\%\) (eroarea standard 2,3, \(t = 2{,}6\)): o lună care cuprinde cele 10 zile dinaintea Paștelui vinde cu aproximativ 5,9% mai multe alimente
o zi lucrătoare în plus: \(+0{,}59\%\) (eroarea standard 0,17); aprilie 2020: \(\ensuremath{-}15\%\)
Totalul comerțului: Paștele \(0{,}8\%\) (eroarea standard 1,9), nesemnificativ; zilele lucrătoare \(+1{,}02\%\) (eroarea standard 0,15)
efectul Paștelui se află în alimente, efectul zilelor lucrătoare în toate vînzările
Norul de puncte brut este zgomotos (panta 4,6 puncte procentuale): modificările TVA și prețurile mișcă și ele creșterea anuală; regresia separă efectele
Paștele a căzut în mai în 2002; 2005; 2013; 2016; 2021; 2024: cine ignoră acest lucru greșește prognozele pentru aprilie și mai
Recapitulare: termeni Fourier și efecte de calendar
Termenii Fourier descriu un tipar sezonier cu \(2K\) coeficienți, pentru orice perioadă, chiar neîntreagă. Zilele lucrătoare și sărbătorile mobile sînt cunoscute dinainte și se modelează ca regresori. Vînzările de alimente din România cresc cu aproximativ 5,9% în luna Paștelui, iar totalul comerțului urmează numărul de zile lucrătoare. Regresia cu erori SARIMA estimează împreună efectele regresorilor și dinamica seriei, cu erori standard corecte.
Pe scurt
Termenii Fourier descriu un tipar sezonier cu \(2K\) coeficienți, pentru orice perioadă, chiar neîntreagă
Zilele lucrătoare și sărbătorile mobile sînt cunoscute dinainte: le modelăm ca regresori
Vînzările de alimente din România cresc cu aproximativ 5,9% în luna Paștelui; totalul comerțului urmează zilele lucrătoare
Regresia cu erori SARIMA: estimăm împreună regresorii și dinamica
Sinteza secțiunii
Sezonalitatea poate fi tratată și ca funcție deterministă de timp. Termenii Fourier o descriu cu puțini parametri: o singură armonică explică 92,5% din tiparul lunar al turismului. Efectele de calendar se modelează ca regresori cunoscuți dinainte, iar pentru vînzările de alimente efectul Paștelui, 5,9%, este de ordinul de mărime al creșterii anuale. Seriile cu perioade lungi sau neîntregi, ca în secțiunea următoare, pot fi modelate doar astfel.
Sezonalitate multiplă: consumul de electricitate
Consumul de electricitate are simultan mai multe perioade: ziua, săptămîna și anul. Modelele SARIMA nu sînt potrivite pentru o asemenea serie, deoarece au o singură perioadă întreagă. Această secțiune descrie consumul orar și zilnic din România, îl descompune cu MSTL și construiește o regresie armonică dinamică pentru consumul zilnic, cu termeni Fourier anuali, variabile dummy pentru zilele săptămînii și sărbători.
Consumul (load) este energia electrică consumată în sistemul energetic, măsurată în MW ca medie pe fiecare oră. Electricitatea nu se stochează la scară mare, deci producția trebuie să egaleze consumul în fiecare moment. Operatorii au nevoie de prognoze pentru fiecare oră a zilei următoare: pentru piața pentru ziua următoare (day-ahead market), pentru dimensionarea rezervelor și pentru planificarea rețelei.
Datele provin de la ENTSO-E, rețeaua europeană a operatorilor de transport și de sistem pentru energie electrică, din seria „monthly hourly load values” pentru România. Ele acoperă 39 406 ore din 2022–2026. Toate orele sînt exprimate în ora de iarnă a României (UTC+2), pentru ca trecerile la ora de vară și înapoi să nu creeze ore lipsă sau duble.
Prognoza consumului de electricitate este un domeniu cu propriile competiții, precum GEFCom2014, descrisă de Hong et al. (2016), în care metode diferite au fost comparate pe aceleași date, în condiții identice.
Pe scurt
Consumul (sarcina): energia electrică consumată în sistem, în MW (medii orare); trebuie egalat de producție în fiecare moment
prognozele sînt necesare pentru fiecare oră a zilei următoare: piața pentru ziua următoare, rezerve, planificarea rețelei
Datele: ENTSO-E (rețeaua europeană a operatorilor de transport și de sistem), „monthly hourly load values”, România
39 406 de ore, 2022–2026, ora de iarnă a României (UTC+2), pentru a evita schimbările de oră
Prognoza consumului are propriile competiții: GEFCom2014 (Hong et al. (2016))
Întrebare pentru sală Pentru 2025, care autocorelație este mai mare: la lagul 24 (aceeași oră ieri) sau la lagul 168 (aceeași oră acum o săptămînă)?
Răspuns
La lagul 168: 0,817 față de 0,811. Diferența este mai mare în 2023 (0,841 și 0,800) și 2024 (0,846 și 0,804). La lagul 84 (o jumătate de săptămînă) ACF este doar 0,22. Ciclul zilnic: minimul la ora 3:00 (5,3 GW), maximul la ora 19:00 (7,3 GW).
Panoul din stînga arată consumul orar, în GW, pe trei săptămîni, de la 13 ianuarie la 2 februarie 2025; zonele bej marchează weekendurile. Fiecare zi are o formă proprie: o scădere noaptea, o creștere dimineața și un vîrf seara. Zilele de weekend au aceeași formă, dar la un nivel mai jos.
Panoul din dreapta arată ACF de selecție a consumului orar din 2025, pînă la lagul 400, adică peste două săptămîni. Liniile verticale punctate marchează lagurile 24, 168 și 336 de ore: o zi, o săptămînă și două săptămîni. Oscilațiile dese ale ACF cu perioada de 24 de ore reflectă ciclul zilnic, iar vîrfurile mai înalte de la 168 și 336 reflectă ciclul săptămînal.
Pe scurt
Stînga: trei săptămîni din ianuarie 2025; dreapta: ACF de selecție pentru toate orele din 2025, pînă la lagul 400
Ciclul zilnic are minimul în jurul orei 3:00, cu un consum mediu de 5,3 GW în 2025, și maximul în jurul orei 19:00, cu 7,3 GW. Autocorelația este 0,81 la lagul 24 și 0,43 la lagul 12: consumul de la aceeași oră a zilei anterioare este un predictor bun, iar cel de acum 12 ore, care cade în cealaltă jumătate a ciclului zilnic, unul mai slab.
Ciclul săptămînal se vede în nivelul mai scăzut al weekendurilor. Autocorelația la lagul 168, adică la o săptămînă, este 0,82, puțin peste cea de la lagul 24. Aceeași oră de acum o săptămînă este deci cel mai bun predictor individual: consumul de luni seamănă cu cel de lunea trecută, nu cu cel de duminică.
Peste aceste două cicluri se suprapune un ciclu anual, produs de încălzire iarna și de aerul condiționat vara. Seria are deci trei perioade: 24, 168 și aproximativ 8 766 de ore. Un model SARIMA are o singură perioadă întreagă \(s\) și nu este potrivit: un polinom în \(L^{168}\) este lent de estimat și instabil, perioada anuală de 365,25 de zile nu este un număr întreg, iar sărbătorile rup tiparul săptămînal. Instrumentele potrivite sînt MSTL, regresia armonică dinamică (DHR, dynamic harmonic regression), TBATS și Prophet.
Pe scurt
Ciclul zilnic: minimul în jurul orei 3:00 (în medie 5,3 GW în 2025), maximul în jurul orei 19:00 (7,3 GW)
ACF \(0{,}81\) la lagul 24, \(0{,}43\) la lagul 12
Ciclul săptămînal: weekendurile sînt mai joase; ACF \(0{,}82\) la lagul 168 (o săptămînă), peste valoarea de la lagul 24
aceeași oră de acum o săptămînă este cel mai bun predictor individual: lunea seamănă cu lunea trecută, nu cu duminica
Și un ciclu anual peste acestea (încălzire și aer condiționat): trei perioade, 24, 168 și aproximativ 8766 de ore
SARIMA nu este suficient: are o singură perioadă întreagă \(s\), în timp ce aici acționează simultan \(s = 24\), \(168\) și \(8766\)
un polinom în \(L^{168}\) este lent și instabil, 365,25 nu este un număr întreg, iar sărbătorile rup tiparul săptămînal
Întrebare pentru sală În fereastra din februarie 2025, componenta neregulată are 2% din varianța din jurul trendului. Cît are în fereastra 7 aprilie – 4 mai 2025, care cuprinde Paștele?
Răspuns
13%: Paștele (20 aprilie) și 1 Mai nu urmează tiparul zilnic sau săptămînal, deci ajung în componenta neregulată. În februarie: 70% componenta zilnică, 29% cea săptămînală. Ponderea componentei săptămînale variază între 20% (august) și 43% (iunie).
MSTL (Bandara, Hyndman și Bergmeir, 2025) extinde descompunerea STL din Capitolul 0 la mai multe perioade. Algoritmul aplică STL în mod repetat, cîte o dată pentru fiecare perioadă, aici 24 și 168 de ore, începînd cu perioada cea mai scurtă. La fiecare pas, componenta sezonieră a unei perioade se estimează din serie după ce s-au scăzut componentele celorlalte perioade estimate la pasul anterior. Iterațiile continuă pînă cînd componentele se stabilizează.
Graficul arată descompunerea pentru patru săptămîni, de la 3 februarie la 2 martie 2025. Primul panou este consumul, în GW. Al doilea este trendul, care variază lent între aproximativ 7,0 și 7,3 GW. Al treilea este componenta zilnică, de perioadă 24, al patrulea componenta săptămînală, de perioadă 168, iar al cincilea componenta neregulată (remainder). Consumul este suma acestor patru componente.
Din varianța consumului în jurul trendului, componenta zilnică explică 70%, componenta săptămînală 29%, iar componenta neregulată 2%. Amplitudinea componentei zilnice, diferența dintre maxim și minim, este 2,8 GW în prima săptămînă, iar cea a componentei săptămînale 2,1 GW. Cele două cicluri explică împreună aproape toată variația pe termen scurt a consumului.
Componenta săptămînală este aproape plată de luni pînă vineri și scade sîmbăta, iar duminica și mai mult. Componenta neregulată este mică, dar nu este zgomot alb: ea are episoade de valori pozitive și negative care durează cîteva zile, produse de valurile de frig și de sărbători. O descompunere nu este un model de prognoză; un model de prognoză adaugă acestor componente dinamica erorilor și regresori pentru zilele speciale.
Pe scurt
Din varianța în jurul trendului: 70% componenta zilnică, 29% componenta săptămînală, 2% componenta neregulată
amplitudinea componentei zilnice în prima săptămînă: 2,8 GW; a celei săptămînale: 2,1 GW
Componenta săptămînală este plată de luni pînă vineri și scade sîmbăta și mai mult duminica
Componenta neregulată este mică, dar nu este zgomot alb: valuri de frig și sărbători; un model de prognoză adaugă dinamică și regresori
Întrebare pentru sală Ce dă partea deterministă a DHR pentru Lunea Paștelui, 21 aprilie 2025, față de o duminică la media anuală?
Răspuns
−0,145 GW: efectul zilei de luni, +0,884, plus componenta anuală, −0,448, plus variabila dummy a Paștelui, −0,581. O luni obișnuită din aceeași perioadă ar avea circa +0,44 GW. Nivelul seriei vine din erorile ARIMA(1,1,1), cu AR 0,80 și MA −0,98.
Întrebare pentru sală Care este ziua cu cel mai mic consum din 2023?
Răspuns
Duminica Rusaliilor, 4 iunie 2023: 4,37 GW, sub Duminica Paștelui, 16 aprilie 2023 (4,48 GW). În 2022, 2024 și 2025 cea mai joasă zi este Duminica Paștelui; pe tot eșantionul, 20 aprilie 2025 (3,79 GW, media 6,18 GW). Sîmbăta este cu 9%, duminica cu 17% sub miercuri, iar ianuarie cu 25% peste mai.
Panoul din stînga arată consumul mediu zilnic, în GW, pentru cele 1 642 de zile din 2022–2026. Punctele portocalii marchează sărbătorile legale, iar punctele roșii cele patru zile ale Paștelui ortodox, de vineri pînă luni. Oscilația deasă este ciclul săptămînal, iar valurile cu vîrfuri în ianuarie sînt ciclul anual.
Panoul din dreapta arată consumul mediu pentru fiecare zi a săptămînii, fără sărbătorile legale. Zilele lucrătoare sînt apropiate între ele, între aproximativ 6,35 și 6,5 GW, cu lunea puțin mai jos, sîmbăta este vizibil mai jos, iar duminica este cea mai joasă zi.
Pe scurt
Consumul mediu zilnic, 2022–2026, 1 642 de zile; sărbătorile legale marcate; dreapta: media pe zile ale săptămînii, fără sărbători
În ciclul săptămînal, consumul de sîmbătă este cu 9%, iar cel de duminică cu 17% sub cel de miercuri. În ciclul anual, consumul din ianuarie este cu 25% peste cel din mai, iar vara are un vîrf secundar, mai mic, produs de aerul condiționat.
Sărbătorile produc cele mai mari abateri. Cea mai joasă zi din eșantion este Duminica Paștelui din 20 aprilie 2025, cu 3,79 GW, față de o medie a eșantionului de 6,18 GW. Cele patru zile ale Paștelui, de vineri pînă luni, au în medie 4,62 GW, iar perioada dintre Crăciun și Anul Nou și Rusaliile sînt și ele joase: în 2023, cea mai joasă zi a anului a fost Duminica Rusaliilor, 4 iunie, cu 4,37 GW, sub Duminica Paștelui. Asemenea zile nu urmează tiparul săptămînal și au nevoie de regresori proprii.
Nivelul consumului scade în 2022–2026. Două cauze posibile sînt șocul de preț din 2022 și panourile solare de pe acoperișuri: energia produsă și consumată pe loc acoperă o parte din cerere fără a trece prin rețea, deci nu apare în consumul măsurat de operatorul de sistem.
Pe scurt
Săptămîna: sîmbăta cu 9%, iar duminica cu 17% sub miercuri
Anul: ianuarie cu 25% peste mai; un vîrf mai mic vara (aerul condiționat)
Sărbătorile: cea mai joasă zi din eșantion este Duminica Paștelui, 20 aprilie 2025 (3,79 GW, media 6,18 GW)
cele patru zile de Paște (vineri–luni) au în medie 4,62 GW; perioada Crăciun–Anul Nou și Rusaliile sînt și ele joase (Duminica Rusaliilor a fost cea mai joasă zi din 2023)
Nivelul scade în 2022–2026; cauze posibile: șocul de preț din 2022 și panourile solare de pe acoperișuri, care acoperă o parte din cerere fără a trece prin rețea
O regresie armonică dinamică pentru consumul zilnic
Primii termeni sînt patru armonici Fourier anuale, cu coeficienții \(\alpha_k\) și \(\beta_k\). Variabilele \(D^{\mathrm{zi}}_{jt}\) sînt variabile dummy pentru zilele săptămînii, cu duminica drept bază, deci \(\delta_j\) este efectul zilei \(j\) față de duminică. \(H_t\) marchează sărbătorile legale, \(E_t\) cele patru zile ale Paștelui, de vineri pînă luni, iar \(X_t\) perioada 24 decembrie–2 ianuarie; \(\lambda_1\),\(\lambda_2\) și \(\lambda_3\) sînt efectele lor, în GW. Erorile \(u_t\) urmează un model ARIMA(1,1,1), ales cu AIC. Un model de acest tip, cu termeni Fourier și erori ARIMA, este o regresie armonică dinamică, descrisă în Hyndman și Athanasopoulos (2021), secțiunea 10.5.
Coeficienții sînt estimați pe datele de pînă la prima origine de prognoză, 30 iunie 2025. Față de duminică, consumul este mai mare cu 1,08 GW miercuri, cu 0,88 GW luni și cu 0,50 GW sîmbătă. O sărbătoare legală scade consumul cu 0,38 GW, cu eroarea standard 0,02. Zilele Paștelui îl scad cu încă 0,58 GW, peste efectul de sărbătoare, iar perioada Crăciun–Anul Nou cu 0,61 GW.
Modelul erorilor are coeficientul AR 0,80 și coeficientul MA −0,98, iar abaterea standard a erorilor este \(\hat\sigma = 186\) MW. Coeficientul MA apropiat de −1 compensează aproape în întregime diferența aplicată erorilor, ceea ce arată un nivel care variază lent, nu un mers aleator. Testul Ljung–Box pe 14 laguri are p-value sub 0,001: în reziduuri rămîne puțină dinamică, dar detectabilă cu un eșantion atît de lung.
Consumul orar are cicluri zilnice, săptămînale și anuale, iar consumul zilnic cicluri săptămînale și anuale. SARIMA tratează o singură perioadă întreagă, iar MSTL descompune seria în cîte o componentă pentru fiecare perioadă. Sărbătorile, mai ales Paștele, produc cele mai mari abateri și au nevoie de regresori. Regresia armonică dinamică, (4.10), combină termeni Fourier, variabile dummy de calendar și erori ARIMA într-un model flexibil, ale cărui componente se pot citi direct.
Pe scurt
Consumul orar are cicluri zilnice, săptămînale și anuale; consumul zilnic are cicluri săptămînale și anuale
SARIMA tratează o singură perioadă întreagă; MSTL descompune mai multe
Sărbătorile, mai ales Paștele, sînt cele mai mari abateri: au nevoie de regresori
DHR = termeni Fourier + variabile dummy de calendar + erori ARIMA: flexibilă și transparentă
Sinteza secțiunii
Pentru consumul de electricitate, componenta zilnică și cea săptămînală explică împreună 99% din varianța în jurul trendului, iar sărbătorile sînt cele mai mari abateri de la tipar: Duminica Paștelui din 2025 a avut 3,79 GW, față de o medie de 6,18 GW. Regresia armonică dinamică descrie ciclul anual cu opt coeficienți Fourier, ciclul săptămînal cu variabile dummy și sărbătorile cu trei regresori, iar dinamica rămasă cu erori ARIMA. Secțiunea următoare prezintă două modele care automatizează o parte din aceste alegeri.
TBATS și Prophet
Două modele construite pentru sezonalitate complexă sînt larg folosite în practică. TBATS extinde netezirea exponențială cu termeni Fourier care evoluează în timp, iar Prophet este o regresie cu trend pe porțiuni, termeni Fourier și efecte de sărbătoare. Secțiunea descrie ambele modele, citește componentele Prophet pentru consumul zilnic din România și compară cele două modele cu regresia armonică dinamică.
TBATS (De Livera, Hyndman și Snyder, 2011) extinde netezirea exponențială (ETS, exponential smoothing) din Capitolul 0 la serii cu sezonalitate complexă. Numele enumeră părțile modelului: sezonalitatea trigonometrică (T), transformarea Box–Cox (B), erorile ARMA (A), trendul (T) și componentele sezoniere (S). Ecuația de măsurare este
unde \(y_t^{(\omega)}\) este seria după o transformare Box–Cox cu parametrul \(\omega\),\(\ell_t\) nivelul, \(b_t\) panta, \(\phi\) factorul de amortizare a pantei, \(s^{(i)}_t\) componenta sezonieră \(i\), iar \(d_t\) eroarea, care urmează un proces ARMA. Nivelul și panta se actualizează la fiecare pas ca în metoda Holt.
Fiecare perioadă \(m_i\) are \(K_i\) armonici. Armonica \(j\) este o pereche (cosinus, sinus) care se rotește la fiecare pas cu unghiul \(2\pi j/m_i\) și care este corectată de eroarea curentă. Rezultatul este un tipar Fourier ca în (4.8), dar cu coeficienți care evoluează în timp, deci un tipar sezonier stochastic. Perioadele pot fi neîntregi, iar numărul de parametri nu crește cu lungimea perioadei.
Modelul face automat alegerile, cu AIC: dacă folosește transformarea Box–Cox, dacă are trend, trend amortizat sau niciun trend, cîte armonici \(K_i\) are fiecare perioadă și ce ordine ARMA au erorile. Pentru consumul zilnic pînă în iunie 2025, cu perioadele 7 și 365,25, modelul ales nu are transformare Box–Cox și nici trend și are \(K = 3\) armonici săptămînale, \(K = 9\) armonici anuale și erori ARMA(1,2), în total 28 de stări. Limitele lui sînt lipsa regresorilor, deci a sărbătorilor și a Paștelui, și viteza mică pe serii lungi; în Python, modelul este disponibil în pachetul tbats.
sezonalitate trigonometrică (T), transformare Box–Cox (B), erori ARMA (A), trend (T), componente sezoniere (S)
\(y_t^{(\omega)} = \ell_{t-1} + \phi b_{t-1} + \sum_{i}s^{(i)}_{t-1} + d_t\), \(d_t\) ARMA(\(p,q\)); nivelul și trendul se actualizează ca în metoda Holt
\(y_t^{(\omega)}\): seria după o transformare Box–Cox cu parametrul \(\omega\); \(\ell_t\): nivelul; \(b_t\): panta; \(\phi\): factorul de amortizare; \(s^{(i)}_t\): componenta sezonieră \(i\)
fiecare perioadă \(m_i\) are \(K_i\) armonici \(s^{(i)}_{j,t}\), fiecare o pereche rotitoare (cosinus, sinus) actualizată de erori: un tipar Fourier care poate evolua
Alegeri automate cu AIC: Box–Cox sau nu, trend, trend amortizat sau fără trend, valorile \(K_i\), ordinele ARMA
consumul zilnic pînă în iunie 2025, perioadele 7 și 365,25 (fără Box–Cox, fără trend): \(K = 3\) armonici săptămînale și \(K = 9\) anuale, ARMA(1,2), 28 de stări
Limite: fără regresori, deci fără sărbători sau Paște; lent pe serii lungi; pachetul Python tbats
Prophet (Taylor și Letham, 2018), dezvoltat la Meta, este o regresie în timp cu trei componente:
\[y(t) = g(t) + s(t) + h(t) + \varepsilon_t.\]
(4.12)
Trendul \(g(t)\) este liniar pe porțiuni (sau logistic, pentru serii cu saturație), cu o pantă care se poate schimba în puncte de schimbare (changepoints). Modelul pornește de la multe puncte de schimbare candidate, iar o distribuție a priori Laplace asupra modificărilor de pantă le aduce pe cele mai multe la zero, ca o penalizare de tip lasso. Componenta sezonieră \(s(t)\) este formată din termeni Fourier, cu \(K = 10\) armonici pentru an și \(K = 3\) pentru săptămînă în varianta implicită. Componenta \(h(t)\) conține cîte un efect pentru fiecare sărbătoare dintr-o listă de date, opțional cu ferestre de cîteva zile în jurul ei.
Modelul se estimează cu Stan, prin maximul distribuției a posteriori. Intervalele de prognoză se obțin prin simulare: ele includ zgomotul și puncte de schimbare viitoare generate cu frecvența și mărimea celor din trecut. Prophet nu are o parte autoregresivă: eroarea de azi nu modifică prognoza de mîine, iar toată dinamica este descrisă de funcțiile de timp.
Prophet a fost construit pentru volume mari de serii economice cu efecte puternice de calendar și date lipsă, pentru care un analist nu poate identifica manual fiecare model. În Python, el este disponibil în pachetul prophet.
Pe scurt
Taylor și Letham (2018) (Meta): o regresie în timp, \(y(t) = g(t) + s(t) + h(t) + \varepsilon_t\)
\(g(t)\): trend liniar pe porțiuni (sau logistic) a cărui pantă se poate schimba în puncte de schimbare; o distribuție a priori Laplace aduce cele mai multe schimbări la zero
\(s(t)\): termeni Fourier, implicit \(K = 10\) pentru an și \(K = 3\) pentru săptămînă
\(h(t)\): un efect pentru fiecare sărbătoare (cu ferestre opționale în jurul ei), dintr-o listă de date
Estimat cu Stan (maximul a posteriori); intervalele simulează punctele de schimbare viitoare și zgomotul
fără parte autoregresivă: eroarea de azi nu modifică prognoza de mîine
Construit pentru multe serii economice cu efecte puternice de calendar și date lipsă; pachetul Python prophet
Întrebare pentru sală Dacă Prophet este estimat fără lista sărbătorilor, ce se întîmplă cu eroarea medie absolută în eșantion?
Răspuns
Crește de la 197 la 226 MW. Fără sărbători, zilele de Crăciun și Paște rămîn în reziduuri, iar componenta anuală se deformează: maximul ei trece de la 7 decembrie la 24 ianuarie 2024. Cu sărbătorile, efectele sînt −1,24 GW (Crăciunul), −1,10 GW (Anul Nou) și −1,04 GW (Paștele).
Graficul arată componentele modelului Prophet estimat pe consumul zilnic din ianuarie 2022 pînă în iunie 2025, cu lista sărbătorilor legale din România. Panoul din stînga sus arată consumul zilnic și trendul \(g(t)\), în GW; liniile verticale punctate sînt punctele de schimbare folosite efectiv. Panoul din dreapta sus arată componenta săptămînală, ca abatere în GW pentru fiecare zi.
Panoul din stînga jos arată componenta anuală pentru anul 2024, ca abatere în GW de la trend. Panoul din dreapta jos arată efectele estimate ale sărbătorilor, în GW, ordonate după mărime. Fiecare componentă se adună la trend, deci prognoza pentru o zi este trendul plus efectul zilei din săptămînă, plus efectul anual al datei, plus efectul sărbătorii, dacă ziua este sărbătoare.
Pe scurt
Prophet cu sărbătorile legale din România, consumul zilnic 2022 – iunie 2025
Trendul scade de la 6,89 la 6,07 GW și este mai plat după 2023. Modelul pornește de la 25 de puncte de schimbare candidate, iar distribuția a priori le aduce pe cele mai multe la zero; doar cîteva modificări de pantă rămîn active. Componenta săptămînală este +0,27 GW miercuri, −0,32 GW sîmbătă și −0,80 GW duminică, valori apropiate de diferențele dintre zile din graficul consumului zilnic.
Componenta anuală are, în 2024, maximul la începutul lui decembrie, +0,93 GW pe 7 decembrie, și minimul la mijlocul lui septembrie, −0,62 GW pe 18 septembrie. Între ele, curba are un vîrf secundar în iulie, produs de aerul condiționat. Efectele sărbătorilor sînt −1,24 GW pentru Crăciun, −1,10 GW pentru Anul Nou și −1,04 GW pentru Paște; Ziua Copilului, 1 iunie, scade consumul doar cu 0,37 GW.
Avantajul principal al modelului este că fiecare componentă are o interpretare directă și poate fi comparată cu ceea ce se știe despre economie: ziua de duminică, sărbătorile de iarnă și încălzirea au efectele cele mai mari, iar o zi liberă la început de vară are un efect mic.
Pe scurt
Trendul de la 6,89 la 6,07 GW, mai plat după 2023; 25 de puncte de schimbare candidate, cele mai multe aduse la zero
Anual: maximul la începutul lui decembrie (\(+0{,}93\) GW, 7 decembrie 2024), minimul la mijlocul lui septembrie (\(\ensuremath{-}0{,}62\) GW, 18 septembrie 2024), arătat pentru 2024
Sărbătorile: Crăciunul \(\ensuremath{-}1{,}24\), Anul Nou \(\ensuremath{-}1{,}10\), Paștele \(\ensuremath{-}1{,}04\) GW; Ziua Copilului doar \(\ensuremath{-}0{,}37\) GW
Fiecare componentă poate fi citită și verificată cu ceea ce știm despre economie
Tabelul compară cele trei modele pe șase dimensiuni. Toate descriu sezonalitatea cu termeni Fourier și acceptă mai multe perioade. În DHR și Prophet tiparul este fix, iar în TBATS el evoluează în timp. DHR și Prophet acceptă regresori, deci sărbători, iar TBATS nu. Dinamica pe termen scurt este descrisă prin erori ARMA în DHR și TBATS și lipsește din Prophet. Trendul este descris prin erorile ARIMA în DHR, printr-un nivel și o pantă locale, ca în metoda Holt, în TBATS și printr-o funcție liniară pe porțiuni în Prophet. DHR și Prophet se estimează repede, TBATS lent.
În esență, toate trei sînt regresii pe sinusuri și cosinusuri și diferă prin ceea ce mai modelează: dinamica erorilor, evoluția tiparului, trendul și calendarul. Care dintre ele prognozează mai bine este o întrebare empirică, iar secțiunea următoare îi răspunde în afara eșantionului.
Pe scurt
DHR
TBATS
Prophet
Sezonalitatea
Fourier, fixă
Fourier, evolutivă
Fourier, fixă
Mai multe perioade
da
da
da
Sărbători, regresori
da
nu
da
Dinamica pe termen scurt
erori ARMA
erori ARMA
niciuna
Trendul
prin erori (ARIMA)
local (Holt)
liniar pe porțiuni
Viteza
rapidă
lentă
rapidă
În esență, toate trei sînt regresii pe sinusuri și cosinusuri; diferă prin ceea ce mai modelează
Care dintre ele prognozează mai bine este o întrebare empirică: secțiunea următoare îi răspunde în afara eșantionului
Sinteza secțiunii
TBATS, Prophet și regresia armonică dinamică folosesc aceleași funcții de bază, sinusuri și cosinusuri, dar fac alegeri diferite pentru restul modelului. Pentru consumul zilnic din România, componentele Prophet sînt ușor de interpretat: duminica scade consumul cu 0,80 GW, Crăciunul cu 1,24 GW, Paștele cu 1,04 GW. Interpretabilitatea nu garantează însă acuratețea prognozelor, iar comparația dintre modele se face pe date pe care modelele nu le-au văzut.
Evaluarea prognozelor
Această secțiune răspunde întrebării care metodă prognozează mai bine. Ea descrie validarea încrucișată pentru serii de timp, testul Diebold–Mariano pentru diferența de acuratețe și corecția lui pentru eșantioane mici, apoi aplică schema pe consumul zilnic de electricitate, cu șapte metode, și pe PIB-ul României, cu patru metode.
Întrebare pentru sală Global, DHR bate metoda sezonieră naivă (HLN −4,42). La ce orizonturi respinge testul făcut orizont cu orizont?
Răspuns
Doar la h = 8 și h = 10–14 (|HLN| > 2,06); la h = 1–7 și h = 9 nu. O singură zi pentru fiecare origine are mai mult zgomot decît media pe 14 zile. DHR față de Prophet: respins la h = 1, 2 și 12–14.
Întrebare pentru sală Cu cele 26 de ferestre reale, DHR față de metoda sezonieră naivă: cît sînt DM și HLN și de ce diferă puțin?
Răspuns
DM = −4,51, HLN = −4,42, p < 0,001; DHR are pierderea mai mică în 22 din 26 de ferestre (d̄ = −0,157 GW²). Corecția HLN este √(25/26) = 0,981, deci contează puțin la n = 26; în exemplul cu cinci ferestre este √(4/5) = 0,894, iar valoarea critică t(4) = 2,78 în loc de 1,96 schimbă decizia.
Întrebare pentru sală Cu pasul 1 între origini și orizontul h = 3, în cîte ferestre de prognoză apare aceeași dată?
Răspuns
În trei: ferestrele consecutive se suprapun pe h − 1 = 2 perioade, deci erorile sînt corelate pînă la lagul h − 1, iar testul Diebold–Mariano folosește h − 1 autocovarianțe. În schema cursului originile sînt la 14 zile, iar h = 14: ferestrele nu se suprapun, deci testul are o valoare pe fereastră și h = 1 în formulă.
Validarea încrucișată pentru serii de timp (time-series cross-validation) folosește o origine de prognoză mobilă (rolling origin), descrisă de Tashman (2000) și de Hyndman și Athanasopoulos (2021), secțiunea 5.10. La fiecare origine, modelul se estimează pe datele de pînă la origine, se calculează prognoze pentru \(h\) pași înainte, apoi originea se mută înainte și modelul se reestimează. Erorile tuturor originilor și orizonturilor formează eșantionul de evaluare.
Graficul ilustrează schema cu șase origini și orizontul \(h = 3\). Fiecare rînd este o origine: segmentul albastru este eșantionul de estimare, segmentul roșu fereastra de prognoză, iar segmentul bej datele nefolosite la acea origine. În schema din figură, fereastra de estimare se extinde (expanding window): fiecare origine adaugă observații noi. Varianta alternativă este o fereastră glisantă de lungime fixă (sliding window), care renunță la observațiile cele mai vechi.
Regula de bază este că estimarea nu folosește niciodată date de după origine. Astfel, fiecare prognoză este calculată în aceleași condiții ca o prognoză reală, iar eroarea ei măsoară performanța pe care metoda ar fi avut-o în practică.
Pe scurt
Origine de prognoză mobilă (Tashman (2000); FPP3, secțiunea 5.10): estimăm pe datele pînă la origine, prognozăm \(h\) pași, mutăm originea, reestimăm
Fereastră care se extinde (în figură) sau fereastră glisantă de lungime fixă; nu folosim niciodată date viitoare la estimare
Pentru consumul zilnic, evaluarea are 26 de origini, la intervale de 14 zile, de la 30 iunie 2025 la 15 iunie 2026, iar orizontul este \(h = 14\) zile. Ferestrele de prognoză acoperă împreună un an, cu toate anotimpurile și toate sărbătorile, inclusiv Paștele din 2026.
Sînt comparate șapte metode, toate reestimate la fiecare origine. Metoda sezonieră naivă repetă ultima săptămînă (perioada 7). ETS este metoda Holt–Winters cu trend amortizat și perioada 7. SARIMA este modelul SARIMA\((2,0,1)(0,1,1)_7\). DHR este regresia armonică dinamică (4.10), iar TBATS și Prophet sînt modelele din secțiunea anterioară. A șaptea metodă, combinarea, este media simplă a prognozelor celor cinci modele, adică toate metodele cu excepția celei sezoniere naive.
Ordinele modelului SARIMA și ale erorilor DHR sînt alese o singură dată, cu AIC, pe datele dinaintea primei origini. Perioada de test nu influențează astfel alegerea modelului. Ordinea în timp contează: validarea încrucișată obișnuită, care împarte observațiile în grupuri aleatoare, este validă pentru serii de timp doar în cazul autoregresiilor pure cu erori de tip zgomot alb (Bergmeir, Hyndman și Koo, 2018).
Pe scurt
Consumul zilnic: 26 de origini la 14 zile, de la 30 iunie 2025 la 15 iunie 2026; orizontul \(h = 14\) zile
un an de prognoze în afara eșantionului, toate anotimpurile și toate sărbătorile, inclusiv Paștele din 2026
Combinarea: media simplă a prognozelor celor cinci modele (toate, cu excepția celei sezoniere naive)
Ordinele SARIMA și ale erorilor DHR se aleg o singură dată, cu AIC, pe datele dinaintea primei origini: fără a privi perioada de test
Validarea încrucișată care ignoră ordinea în timp (grupuri aleatoare) este validă doar pentru autoregresii pure cu erori de tip zgomot alb (Bergmeir, Hyndman și Koo (2018))
Testul lui Diebold și Mariano (1995) răspunde la întrebarea dacă diferența de acuratețe dintre două prognoze este mai mare decît ar rezulta din întîmplare. Fie \(e_{1t}\) și \(e_{2t}\) erorile celor două prognoze și \(L\) o funcție de pierdere, de exemplu \(L(e) = e^2\) sau \(L(e) = |e|\). Diferența de pierdere este \(d_t = L(e_{1t}) - L(e_{2t})\), iar ipoteza nulă de acuratețe egală este \(\mathbb{E}[d_t] = 0\). Statistica testului este
\[\mathrm{DM} = \frac{\bar d}{\sqrt{\hat V/n}},\]
(4.13)
unde varianța pe termen lung (long-run variance) a lui \(d_t\) se estimează prin
\[\hat V = \hat\gamma_d(0) + 2\sum_{k=1}^{h-1}\hat\gamma_d(k),\]
\(\bar d\) este media celor \(n\) diferențe, iar \(\hat\gamma_d(k)\) autocovarianța lor de selecție la lagul \(k\). O valoare negativă a lui DM favorizează prognoza 1. Suma autocovarianțelor apare deoarece erorile de prognoză la \(h\) pași se suprapun: două prognoze consecutive la \(h\) pași au în comun \(h - 1\) șocuri viitoare, deci \(d_t\) este autocorelat pînă la lagul \(h - 1\).
comparată cu distribuția \(t\) cu \(n - 1\) grade de libertate. Corecția reduce valoarea absolută a statisticii și folosește valori critice mai mari, deci respinge mai rar ipoteza nulă cînd \(n\) este mic.
În schema din acest capitol, fiecare origine contribuie cu o singură valoare, \(d_j\), diferența medie de pierdere pe fereastra ei de 14 zile. Ferestrele nu se suprapun, deci în formulă \(h = 1\), iar \(\hat V = \hat\gamma_d(0)\). Testul compară prognoze, nu modele: zgomotul reestimării la fiecare origine face parte din ceea ce se testează.
Pe scurt
Diebold și Mariano (1995): este diferența de acuratețe dintre două prognoze mai mare decît ar rezulta din întîmplare?
\(e_{1t}\), \(e_{2t}\): erorile celor două prognoze; \(L\): funcția de pierdere
diferența de pierdere \(d_t = L(e_{1t}) - L(e_{2t})\), \(L(e) = e^2\) sau \(|e|\); \(H_0\): \(E[d_t] = 0\)
Schema noastră: o valoare pe origine, \(d_j\) = diferența medie de pierdere în fereastra de 14 zile; ferestrele nu se suprapun, deci \(h = 1\) în formulă
testul compară prognoze, nu modele: zgomotul reestimării face parte din ceea ce se testează
Exemplul are cinci ferestre. Diferențele medii ale erorilor pătratice, metoda 1 minus metoda 2, sînt −0,30, 0,10, −0,50, −0,20 și −0,40. Media lor este \(\bar d = -0{,}26\): metoda 1 are pierderi mai mici în patru ferestre din cinci și o pierdere medie mai mică cu 0,26.
Varianța diferențelor, cu ferestre care nu se suprapun, este \(\hat\gamma_d(0) = \frac15\sum_j(d_j - \bar d)^2 = 0{,}042\). Statistica este \(\mathrm{DM} = -0{,}26/\sqrt{0{,}042/5} = -2{,}82\). Cu \(n = 5\) și \(h = 1\), factorul de corecție din (4.14) este \(\sqrt{4/5}\), deci \(\mathrm{HLN} = -2{,}53\).
Valoarea critică bilaterală de 5% a distribuției \(t\) cu 4 grade de libertate este \(t_{0{,}975}(4) = 2{,}78\). Deoarece \(|-2{,}53| < 2{,}78\), cu p-value 0,065, ipoteza de acuratețe egală nu se respinge la 5%: metoda 1 este mai bună în medie, dar diferența nu este separată de zgomot cu cinci ferestre. Valoarea critică a distribuției Normale, 1,96, ar fi dus la respingere; cu puține ferestre, corecția schimbă concluzia.
Pe scurt
Cinci ferestre; diferențele medii ale erorilor pătratice, metoda 1 minus metoda 2: \(-0{,}30; 0{,}10; -0{,}50; -0{,}20; -0{,}40\)
\(\bar d = \ensuremath{-}0{,}26\): metoda 1 are pierderi mai mici în patru ferestre din cinci
Întrebare pentru sală În fereastra Paștelui (originea 6 aprilie 2026), care model are cea mai mică MAE?
Răspuns
ETS, cu 299 MW, urmat de TBATS (309) și DHR (344); metoda sezonieră naivă are 686, Prophet 616. ETS nu are o linie în graficul din slide, deși are cea mai mică eroare în această fereastră. După Paște consumul rămîne sub toate prognozele, iar ETS și TBATS urmează nivelul ultimelor zile.
Graficul arată o singură fereastră de evaluare: prognozele făcute pe 6 aprilie 2026 pentru următoarele 14 zile, comparate cu consumul observat. Duminica Paștelui ortodox a fost pe 12 aprilie 2026, deci fereastra conține toate cele patru zile ale Paștelui. Linia neagră cu puncte este consumul zilnic observat, în GW, din martie pînă pe 20 aprilie; linia verticală punctată marchează originea, iar liniile colorate sînt prognozele metodelor. ETS nu este desenat; eroarea lui în această fereastră se află pe slide-ul următor.
Fereastra a fost aleasă pentru că este cea mai dificilă din an: Vinerea Mare și a doua zi de Paște sînt zile libere care cad în zile lucrătoare, iar o metodă care cunoaște doar tiparul săptămînal le tratează ca zile obișnuite.
Pe scurt
Originea 6 aprilie 2026, 14 zile înainte; Duminica Paștelui ortodox a fost pe 12 aprilie 2026; ETS nu este desenat (MAE-ul lui se află pe slide-ul următor)
Eroarea absolută medie (MAE, mean absolute error) în această fereastră, în MW, este 299 pentru ETS, 309 pentru TBATS, 344 pentru DHR, 394 pentru combinare, 584 pentru SARIMA, 616 pentru Prophet și 686 pentru metoda sezonieră naivă. Metoda sezonieră naivă copiază săptămîna normală dinaintea originii în săptămîna Paștelui și are de aceea cea mai mare eroare.
Toate modelele prevăd scăderea de duminică. DHR și Prophet, care au regresori de sărbătoare, coboară și în Vinerea Mare și în a doua zi de Paște, pe care modelele cu tipar doar săptămînal le tratează ca zile lucrătoare. După Paște, consumul observat rămîne sub toate prognozele pînă la sfîrșitul săptămînii. Modelele ETS și TBATS, al căror nivel se adaptează la ultimele zile observate, au aici erorile cele mai mici, deși nu cunosc sărbătorile.
O singură fereastră este un caz izolat, iar clasamentul ei poate fi întîmplător. Concluziile despre metode se trag din media pe toate cele 26 de ferestre, în slide-urile următoare.
Pe scurt
MAE în această fereastră (MW): ETS 299, TBATS 309, DHR 344, Combinarea 394, SARIMA 584, Prophet 616, sezonieră naivă 686
metoda sezonieră naivă copiază săptămîna normală anterioară în săptămîna Paștelui
Toate modelele văd scăderea de duminică; DHR și Prophet coboară și Vinerea Mare și a doua zi de Paște, pe care modelele săptămînale le tratează ca zile lucrătoare
După Paște, consumul rămîne sub toate prognozele pînă la sfîrșitul săptămînii; ETS și TBATS, al căror nivel urmează ultimele zile, au aici erorile cele mai mici
O singură fereastră este un caz izolat; slide-urile următoare fac media pe toate cele 26 de ferestre
Rezultatele validării încrucișate pentru consumul zilnic
Întrebare pentru sală Fără cele 8 ferestre cu sărbători, rămîne DHR cea mai bună și ce se întîmplă în ferestrele cu sărbători?
Răspuns
Fără sărbători (18 ferestre), DHR are MAE 258 MW și MASE 0,83, iar combinarea 0,94. În cele 8 ferestre cu sărbători nicio metodă nu are MASE sub 1: TBATS 317 MW, DHR 318 MW, combinarea 340 MW. Pe orizonturile 8–14 nici DHR nu mai are MASE sub 1 (1,02).
Întrebare pentru sală Fără 2019–2020, SARIMA are MAE 1,89 la h = 4, față de 2,44 pentru ETS. Este diferența semnificativă?
Răspuns
Nu: HLN = −1,11 (p = 0,275) la h = 4 și −1,47 (p = 0,148) la h = 1, cu 43 de origini. Cu toate cele 51 de origini, la h = 4 SARIMA are chiar MAE 2,70 față de 2,84, iar HLN = 0,50 (p = 0,620): pierderea pătratică a SARIMA este mai mare în anii pandemiei.
Întrebare pentru sală În cele 8 ferestre care cuprind o sărbătoare, mai are DHR cea mai mică MAE?
Răspuns
Nu: TBATS 317 MW și DHR 318 MW sînt la egalitate, iar testul DM nu le separă (HLN 0,83, p = 0,431). În cele 18 ferestre fără sărbători, DHR are 258 MW, înaintea combinării (290). Pe toate cele 26 de ferestre: DHR 276, combinarea 305, Prophet 328 MW; ETS, SARIMA și TBATS nu sînt separate de metoda sezonieră naivă (p = 0,431; 0,231; 0,145).
Graficul rezumă cele 26 de origini × 14 orizonturi pentru fiecare metodă. Panoul din stînga arată MAE totală, în MW, pe toate originile și orizonturile; barele mai scurte înseamnă prognoze mai precise. Panoul din dreapta arată MAE pentru fiecare orizont, de la 1 la 14 zile.
Pe panoul din dreapta, erorile tuturor metodelor cresc cu orizontul, iar diferențele dintre metode cresc și ele. DHR are cea mai mică eroare la majoritatea orizonturilor, iar la orizonturile de 12–14 zile distanța față de celelalte metode este cea mai mare. Curbele nu cresc monoton: fiecare orizont are doar 26 de erori, cîte una pentru fiecare origine, iar cîteva zile dificile pot muta media unui orizont.
Pe scurt
26 de origini \(\times\) 14 orizonturi pentru fiecare metodă; stînga: MAE totală; dreapta: MAE pe orizonturi
Tabelul dă pentru fiecare metodă MAE, rădăcina erorii pătratice medii (RMSE, root mean squared error) și eroarea absolută medie scalată (MASE, mean absolute scaled error), propusă de Hyndman și Koehler (2006). MASE împarte MAE la 309 MW, eroarea absolută medie în eșantion a metodei sezoniere naive săptămînale:
cu \(m = 7\). O valoare sub 1 înseamnă că metoda este mai precisă decît metoda sezonieră naivă în eșantion. Ultimele două coloane dau statistica HLN și p-value-ul ei, calculate pe media erorilor pătratice din fiecare fereastră, pentru metoda de pe rînd minus metoda din coloană; o valoare negativă favorizează metoda de pe rînd.
DHR are cea mai mică eroare: MAE 276 MW, RMSE 350 MW și MASE 0,89. Împreună cu combinarea, care are MASE 0,99, este singura metodă cu MASE sub 1. Prophet este al doilea model individual, cu MAE 328 MW. DHR și Prophet sînt singurele modele care includ sărbătorile. Toate metodele sînt semnificativ mai puțin precise decît DHR la 5%, cu excepția combinării, pentru care statistica HLN este 1,89, cu p-value 0,070.
ETS, SARIMA și TBATS nu sînt separate de metoda sezonieră naivă: statisticile HLN sînt −0,80, −1,23 și −1,50, cu p-value 0,431, 0,231 și 0,145. Trei modele cu parametri estimați nu se disting, pe un an de prognoze, de o metodă care repetă săptămîna trecută. Pentru consumul zilnic, informația de calendar contează mai mult decît clasa de modele.
Pe scurt
Metoda
MAE
RMSE
MASE
DM față de s. naivă
DM față de DHR
Sezonieră naivă
396
529
1,28
–
\(4{,}42\) (\(<\) 0,001)
ETS
381
492
1,23
\(\ensuremath{-}0{,}80\) (0,431)
\(3{,}08\) (0,005)
SARIMA
384
477
1,24
\(\ensuremath{-}1{,}23\) (0,231)
\(3{,}29\) (0,003)
DHR
276
350
0,89
\(\ensuremath{-}4{,}42\) (\(<\) 0,001)
–
TBATS
363
468
1,18
\(\ensuremath{-}1{,}50\) (0,145)
\(3{,}02\) (0,006)
Prophet
328
412
1,06
\(\ensuremath{-}2{,}99\) (0,006)
\(2{,}76\) (0,011)
Combinarea
305
380
0,99
\(\ensuremath{-}3{,}82\) (\(<\) 0,001)
\(1{,}89\) (0,070)
MAE și RMSE în MW; MASE (Hyndman și Koehler (2006)) = MAE / 309 MW, MAE în eșantion a metodei sezoniere naive săptămînale; DM: statistica HLN (p-value-ul) pe media erorilor pătratice din fiecare fereastră, metoda de pe rînd minus metoda de pe coloană
DHR cîștigă; împreună cu combinarea, este singura metodă cu MASE sub 1; Prophet este al doilea model individual: singurele două care includ sărbătorile
ETS, SARIMA și TBATS nu sînt semnificativ mai bune decît metoda sezonieră naivă
A doua evaluare folosește PIB-ul trimestrial \(100\ln Y\), cu erorile exprimate în procente. Ea are 51 de origini trimestriale, de la T4 2012 la T2 2025, cu fereastră care se extinde, și compară modelul airline, ETS, metoda sezonieră naivă și combinarea SARIMA–ETS. Tabelul dă MAE la orizonturile de 1 și 4 trimestre, pentru toate originile și pentru cele 43 de origini rămase după eliminarea anilor 2019–2020.
Pe toate originile, la \(h = 1\), MAE este 1,69% pentru SARIMA, 1,76% pentru ETS, 3,81% pentru metoda sezonieră naivă și 1,70% pentru combinare. Testul HLN dă pentru SARIMA față de ETS −1,46 (p-value 0,150) la \(h = 1\) și 0,50 (p-value 0,620) la \(h = 4\). Pentru SARIMA față de metoda sezonieră naivă, statistica este −4,00 (p-value sub 0,001) la \(h = 1\) și −0,54 (p-value 0,591) la \(h = 4\).
La un trimestru înainte, SARIMA și ETS sînt clar mai bune decît metoda sezonieră naivă, dar nu se disting între ele. La un an înainte, erorile din perioada pandemiei domină media, iar nicio diferență nu este semnificativă. Fără anii 2019–2020, SARIMA are cea mai mică MAE la \(h = 4\), 1,89%, față de 2,44% pentru ETS și 2,02% pentru combinare.
Pe scurt
Metoda
MAE, \(h = 1\)
MAE, \(h = 4\)
fără 2019–2020, \(h = 1\)
fără 2019–2020, \(h = 4\)
SARIMA (airline)
1,69
2,70
1,32
1,89
ETS
1,76
2,84
1,41
2,44
Sezonieră naivă
3,81
3,74
3,80
3,49
Combinarea (SARIMA, ETS)
1,70
2,65
1,34
2,02
\(100\ln Y\), erori în %; 51 de origini trimestriale, T4 2012–T2 2025, fereastră care se extinde; 43 de origini fără 2019–2020
DM (HLN), SARIMA față de ETS: \(h = 1\): \(\ensuremath{-}1{,}46\) (p = 0,150); \(h = 4\): \(0{,}50\) (p = 0,620)
SARIMA față de metoda sezonieră naivă: \(h = 1\): \(\ensuremath{-}4{,}00\) (p \(<\) 0,001); \(h = 4\): \(\ensuremath{-}0{,}54\) (p = 0,591)
La un an înainte, erorile din pandemie domină și nicio diferență nu este semnificativă; fără ele, SARIMA are cea mai mică MAE la \(h = 4\)
Prognozele se evaluează în afara eșantionului, cu origini mobile, iar ordinele modelelor se aleg înaintea perioadei de test. MASE compară fiecare metodă cu metoda sezonieră naivă și permite comparații între serii. Testul DM, cu corecția HLN, arată dacă un cîștig de acuratețe este mai mult decît un efect al întîmplării. Pentru consumul zilnic, modelele care includ calendarul, DHR și Prophet, sînt cele mai precise; pentru PIB, SARIMA și ETS sînt apropiate.
Pe scurt
Evaluați în afara eșantionului, cu origini mobile; alegeți ordinele modelelor înaintea perioadei de test
MASE compară cu metoda sezonieră naivă și între serii
Testul DM (cu corecția HLN) arată dacă un cîștig este mai mult decît un efect al întîmplării
Consumul zilnic: modelele care includ calendarul (DHR, Prophet) cîștigă; pentru PIB, SARIMA și ETS sînt apropiate
Sinteza secțiunii
Pe un an de prognoze în afara eșantionului pentru consumul zilnic, DHR are MAE 276 MW, cu 30% sub metoda sezonieră naivă, iar diferența este semnificativă. ETS, SARIMA și TBATS nu se separă de metoda sezonieră naivă, deși sînt modele mai complexe. Pentru PIB, la orizontul de un trimestru, SARIMA și ETS bat clar metoda sezonieră naivă, dar nu se disting între ele. O singură fereastră, ca cea a Paștelui din 2026, poate da un clasament opus mediei, iar media pe multe origini, împreună cu un test, este baza deciziei.
Combinarea prognozelor
Cînd nu se știe dinainte care metodă va fi cea mai precisă, o alternativă la alegerea unei singure metode este combinarea mai multor prognoze. Secțiunea dă rezultatul teoretic al lui Bates și Granger (1969) pentru ponderea optimă, explică de ce ponderile egale sînt greu de depășit în practică și aplică ideea pe prognozele DHR și Prophet pentru consumul zilnic.
Bates și Granger (1969) combină două prognoze nedeplasate \(f_1\) și \(f_2\) într-o medie ponderată \(f_c = wf_1 + (1 - w)f_2\), unde \(w\) este ponderea prognozei 1. Dacă \(\sigma_1\) și \(\sigma_2\) sînt abaterile standard ale celor două erori, iar \(\rho\) corelația lor, eroarea pătratică medie a combinației este
Numitorul este varianța diferenței celor două erori. Cîștigul combinării față de prognoza mai bună este mare cînd \(\rho\) este mic, adică atunci cînd cele două prognoze greșesc în momente diferite.
Exemplul numeric are \(\sigma_1 = 1\),\(\sigma_2 = 1{,}2\) și \(\rho = 0{,}75\). Ponderile egale dau \(\mathrm{MSE}(0{,}5) = 0{,}25 + 0{,}36 + 0{,}45 = 1{,}060\), mai mult decît eroarea pătratică medie a prognozei mai bune, \(\sigma_1^2 = 1\). Ponderea optimă este \(w^* = 0{,}54/0{,}64 = 0{,}84\), cu \(\mathrm{MSE}(w^*) = 0{,}984\): un cîștig de doar 1,6% față de prognoza 1. Cu erori puternic corelate, chiar ponderea optimă aduce puțin.
Paradoxul combinării prognozelor (forecast combination puzzle) este constatarea empirică, documentată de Stock și Watson (2004) și explicată de Smith și Wallis (2009), că ponderile estimate sînt rareori mai bune decît ponderile egale. Explicația este că \(w^*\) depinde de \(\sigma_1\),\(\sigma_2\) și \(\rho\), care trebuie estimate din erorile trecute, iar eroarea de estimare a ponderilor consumă cîștigul teoretic. Ponderile egale nu estimează nimic și nu au această eroare.
Pe scurt
Bates și Granger (1969): o medie ponderată a două prognoze nedeplasate, \(f_c = wf_1 + (1 - w)f_2\)
\(w\): ponderea prognozei 1; \(\sigma_1\), \(\sigma_2\): abaterile standard ale celor două erori; \(\rho\): corelația lor
ponderea optimă \(w^* = \dfrac{\sigma_2^2 - \rho\sigma_1\sigma_2}{\sigma_1^2 + \sigma_2^2 - 2\rho\sigma_1\sigma_2}\); cîștigul este mare cînd \(\rho\) este mic
Întrebare pentru sală Cu erorile reale ale DHR și Prophet, bate media cu ponderi egale DHR singur?
Răspuns
Nu: σ₁ = 348 MW, σ₂ = 411 MW, ρ = 0,75; varianța combinării egale este 126 036 MW², peste σ₁² = 120 854. Ponderea optimă este w* = 0,82 (MSE 118 370), aproape de DHR singur. În MAE, combinarea egală are 283 MW, DHR singur 276. Erorile puternic corelate lasă puțin loc pentru cîștig, ca în exemplul din slide (1,060 față de 1).
Întrebare pentru sală Bat ponderile estimate din ferestrele anterioare ponderile egale pentru cele cinci modele?
Răspuns
Puțin: MAE 299 MW, față de 305 cu ponderi egale; ponderile alese a posteriori dau 296, iar DHR singur 276. Pentru DHR și Prophet: 283 cu ponderi egale, 281 din ferestrele anterioare, 274 cu cea mai bună pondere a posteriori (w = 0,86). Cîștigul ponderilor estimate este mic, cum spune „forecast combination puzzle”.
Întrebare pentru sală Combinați ETS (MAE 381 MW) și Prophet (328 MW), ale căror erori au corelația 0,36. Ce MAE are media cu ponderi egale?
Răspuns
295 MW: sub ambele componente. Cu erori slab corelate, greșelile se compensează parțial; ponderea cea mai bună retrospectiv este w = 0,37 (MAE 286). Pentru DHR și Prophet (ρ = 0,75): 283 MW cu ponderi egale, față de 276 pentru DHR singur; pentru ETS și TBATS (ρ = 0,98), media cu ponderi egale (370) este mai slabă decît TBATS singur (363).
Graficul arată erorile combinației DHR–Prophet în validarea încrucișată pentru consumul zilnic, ca funcție de ponderea \(w\) a prognozei DHR; restul, \(1 - w\), revine prognozei Prophet. Linia albastră este MAE, iar linia roșie RMSE, ambele în MW. Capătul din stînga, \(w = 0\), este doar Prophet, capătul din dreapta, \(w = 1\), doar DHR, iar linia verticală întreruptă marchează ponderile egale.
Ambele curbe sînt convexe și au minimul aproape de capătul DHR. Curbele sînt calculate pe aceleași erori pe care se face evaluarea, deci minimul lor arată cea mai bună pondere retrospectiv, nu o pondere care ar fi putut fi aleasă dinainte.
Pe scurt
Erorile din validarea încrucișată pentru consumul zilnic; \(w\) este ponderea DHR
MAE este 328 MW doar pentru Prophet (\(w = 0\)), 276 MW doar pentru DHR (\(w = 1\)) și 283 MW pentru ponderile egale. Cea mai bună pondere retrospectiv este \(w = 0{,}86\), cu MAE 274 MW: un cîștig de 2 MW față de DHR, obținut cu o pondere aleasă după ce s-au văzut datele de test. Cîștigul combinării este mic deoarece erorile celor două metode sînt puternic corelate, cu \(\rho = 0{,}75\): ambele ratează aceleași valuri de frig, pe care niciuna nu le poate anticipa fără date despre temperatură.
Media celor cinci modele, cu MAE 305 MW, este a doua metodă din evaluare, după DHR, și este mai precisă decît patru dintre cele cinci componente ale ei. Este o asigurare ieftină cînd cîștigătorul nu se cunoaște dinainte: un analist care ar fi ales unul dintre cele cinci modele la întîmplare ar fi avut, cu probabilitatea de 4/5, o eroare mai mare decît combinarea.
Rezultatul se potrivește cu experiența competițiilor de prognoză. Makridakis, Spiliotis și Assimakopoulos (2020) descriu competiția M4, în care cele mai multe dintre metodele de top au fost combinații. O sinteză a cinci decenii de cercetare despre combinarea prognozelor este Wang et al. (2023).
Pe scurt
MAE: doar Prophet (w = 0) 328 MW, doar DHR (w = 1) 276 MW, ponderi egale 283 MW
cea mai bună retrospectiv: \(w = 0{,}86\), MAE 274 MW, un cîștig mic ales după ce am văzut datele de test
Erorile celor două metode sînt puternic corelate (\(\rho = 0{,}75\)): ambele ratează aceleași valuri de frig
Media celor cinci modele (MAE 305) este a doua, după DHR, și mai bună decît patru dintre cele cinci componente: o asigurare ieftină cînd cîștigătorul nu este cunoscut dinainte
Combinarea reduce eroarea cînd prognozele greșesc în momente diferite, iar cîștigul scade cînd erorile sînt corelate. Pentru DHR și Prophet, cu \(\rho = 0{,}75\), ponderile egale dau MAE 283 MW, față de 276 MW pentru DHR singur. Media celor cinci modele este a doua cea mai precisă metodă, cu MAE 305 MW. Ponderile estimate aduc rareori mai mult decît ponderile egale, deoarece și ele trebuie estimate.
Contribuția posibilă a AI
Un asistent AI poate accelera o parte din munca din acest capitol: scrierea codului de evaluare, compilarea calendarelor de sărbători și verificarea derivărilor. Secțiunea descrie aceste utilizări și verificările pe care analistul trebuie să le facă înainte de a folosi rezultatele.
Prima utilizare este codul. Un asistent poate scrie o primă versiune a buclei cu origini mobile care reestimează SARIMA, DHR, TBATS și Prophet la fiecare origine și păstrează erorile pentru fiecare orizont. Codul de acest tip are multe detalii repetitive, iar o primă versiune generată economisește timp, cu condiția ca fiecare pas să fie verificat.
A doua utilizare sînt calendarele: liste de sărbători legale și de sărbători mobile pentru alte țări, necesare pentru a aplica modelele DHR sau Prophet în afara României. Aceste liste trebuie verificate cu sursele oficiale, deoarece o dată greșită introduce o eroare sistematică exact în zilele cu cele mai mari abateri. A treia utilizare sînt explicațiile: o a doua deducere a ACF pentru modelul airline sau a funcției de prognoză pe termen lung, comparată cu cea din curs.
Promptul din slide cere cod Python pentru prognoza consumului zilnic pe 14 zile, cu o regresie pe termeni Fourier anuali, variabile dummy pentru zilele săptămînii și sărbătorile legale din România, cu erori ARMA, evaluată față de SARIMA prin origini mobile și un test Diebold–Mariano. Promptul precizează toate elementele modelului și ale evaluării, deci rezultatul poate fi verificat punct cu punct.
Pe scurt
Cod: o primă versiune a unei bucle cu origini mobile care reestimează SARIMA, DHR, TBATS și Prophet și păstrează erorile pe orizonturi
Calendare: liste de sărbători și sărbători mobile pentru alte țări, care trebuie verificate cu sursele oficiale
Explicații: o a doua deducere a ACF pentru modelul airline sau a funcției de prognoză pe termen lung
Exemplu de prompt
Write Python code that forecasts daily electricity load 14 days ahead with a regression on annual Fourier terms, weekday dummies and Romanian public holidays (Orthodox Easter from dateutil) with ARMA errors, and evaluates it against SARIMA by rolling origins and a Diebold-Mariano test.
Primele verificări privesc datele. Data Paștelui trebuie să fie cea ortodoxă, nu cea occidentală (EASTER_ORTHODOX în dateutil); în 2024, cele două date au diferit cu cinci săptămîni. Toate variabilele, ordinele modelelor și listele de sărbători trebuie să fie disponibile la fiecare origine, fără informații din viitor (look-ahead). Pentru SARIMA se folosește seria NSA, iar ratele de creștere se calculează pe varianta potrivită a seriei.
Următoarele verificări privesc convențiile și testele. Programele folosesc convenții diferite pentru semnul coeficienților \(\theta\) și \(\Theta\), iar o eroare de semn schimbă interpretarea modelului. Gradele de libertate ale testului Ljung–Box trebuie reduse cu numărul parametrilor ARMA. Testul DM trebuie să folosească pierderile din aceleași ferestre pentru ambele metode și corecția HLN cînd numărul ferestrelor este mic.
Ultima verificare privește referințele: fiecare lucrare citată de un asistent trebuie să existe, iar DOI-ul ei trebuie verificat. Asistenții AI pot genera referințe plauzibile care nu există.
Pe scurt
Data Paștelui: ortodox, nu occidental (EASTER_ORTHODOX); în 2024 cele două diferă cu cinci săptămîni
Fără informații din viitor: variabilele, ordinele modelelor și listele de sărbători trebuie să fie disponibile la fiecare origine
Convențiile de semn pentru \(\theta\) și \(\Theta\) în program și gradele de libertate ale testului Ljung–Box
Date ajustate sau neajustate: SARIMA pe NSA; ratele de creștere pe varianta potrivită
Că testul DM folosește pierderile din aceleași ferestre pentru ambele metode și corecția HLN pentru \(n\) mic
Fiecare referință citată: trebuie să existe; verificați DOI-ul
Sinteza secțiunii
Asistentul AI poate scrie codul de evaluare, poate compila calendare și poate oferi o a doua derivare, dar verificările rămîn ale analistului: data Paștelui ortodox, absența informațiilor din viitor, convențiile de semn, gradele de libertate, construcția testului DM și existența referințelor.
Rezumat
Ultima secțiune adună ideile, formulele și întrebările de autoevaluare ale capitolului.
Sezonalitatea se repetă cu o perioadă cunoscută și poate fi deterministă, modelată cu variabile dummy sau termeni Fourier, sau stochastică, eliminată cu \(\Delta_s\); testele HEGY, OCSB și Canova–Hansen decid între cele două. Modelul SARIMA înmulțește polinoame obișnuite și sezoniere, iar modelul airline, cu doi parametri, se potrivește multor serii, de la pasagerii aerieni la PIB-ul României.
În datele oficiale, seria SCA se folosește pentru creșterea pe termen scurt, iar seria NSA, cu regresori de calendar, pentru prognoza SARIMA. Efectele de calendar, adică zilele lucrătoare, Paștele ortodox și sărbătorile, sînt cunoscute dinainte și contează adesea mai mult decît clasa de modele. Pentru sezonalitatea multiplă, instrumentele sînt MSTL, DHR, TBATS și Prophet; pentru consumul zilnic din România, DHR are cele mai bune prognoze în afara eșantionului.
Prognozele se judecă cu origini mobile, MASE și testul DM, iar cînd cîștigătorul este incert, ele se combină.
Pe scurt
Sezonalitatea se repetă cu o perioadă cunoscută; poate fi deterministă (variabile dummy, Fourier) sau stochastică (\(\Delta_s\))
SARIMA înmulțește polinoame obișnuite și sezoniere; modelul airline se potrivește multor serii, cu doi parametri
Datele oficiale: SCA pentru creșterea pe termen scurt, NSA cu regresori de calendar pentru prognoza SARIMA
Efectele de calendar (zile lucrătoare, Paștele ortodox, sărbători) sînt cunoscute dinainte și contează adesea mai mult decît clasa de modele
Sezonalitatea multiplă: MSTL, DHR, TBATS, Prophet; pentru consumul zilnic din România, DHR cîștigă în afara eșantionului
Judecați prognozele cu origini mobile, MASE și testul DM; combinați-le cînd cîștigătorul este incert
Tabelul reunește formulele capitolului. Diferența sezonieră și diferența dublă sînt (4.1) și \(\Delta\Delta_s = 1 - L - L^s + L^{s+1}\). Modelul SARIMA este (4.4), iar autocorelațiile modelului airline sînt (4.6), cu sateliții \(\rho_{s \pm 1} = \rho_1\rho_s\). Termenii Fourier sînt (4.8), iar modelul Prophet (4.12).
Pentru evaluare, MASE este (4.15): eroarea absolută medie a prognozei, împărțită la eroarea absolută medie în eșantion a metodei sezoniere naive. Statistica Diebold–Mariano este (4.13), iar ponderea optimă a combinării a două prognoze este (4.17).
Prima întrebare cere numărul de parametri ai modelului SARIMA\((1,1,1)(0,1,1)_{12}\) și lagurile la care apar șocurile. Modelul are patru parametri, \(\phi\),\(\theta\),\(\Theta\) și \(\sigma^2\), iar șocul \(\varepsilon\) apare la lagurile 0, 1, 12 și 13, ultimul cu coeficientul \(\theta\Theta\), ca în (4.5).
A doua întrebare: PIB-ul neajustat scade cu 40% din trimestrul al patrulea în primul trimestru; este o recesiune? Nu: scăderea este tiparul sezonier obișnuit. Starea economiei se citește pe seria SCA sau pe creșterea față de același trimestru al anului anterior.
A treia întrebare: un test DM cu 26 de ferestre dă statistica HLN −1,93; este prima prognoză semnificativ mai bună la 5%? Nu, deoarece \(|-1{,}93| < t_{0{,}975}(25) = 2{,}06\): prima prognoză este mai bună în medie, dar diferența nu este separată de zgomot de acest test.
Ideea de proiect extinde analiza capitolului la consumul orar: o regresie armonică dinamică cu termeni Fourier zilnici, săptămînali și anuali, sărbători și temperatură, comparată cu TBATS, Prophet și o combinare, prin origini mobile și teste DM. Capitolul 5 trece de la media condiționată la varianța condiționată, cu modelele ARCH și GARCH.
Pe scurt
Întrebare: cîți parametri are SARIMA\((1,1,1)(0,1,1)_{12}\) și la ce laguri apare \(\varepsilon\)?
Răspuns: \(\phi, \theta, \Theta, \sigma^2\), patru; \(\varepsilon\) la lagurile 0, 1, 12, 13 (ultimul cu coeficientul \(\theta\Theta\))
Întrebare: PIB-ul neajustat scade cu 40% din T4 în T1. Este o recesiune?
Răspuns: nu; este tiparul sezonier; priviți seria SCA sau creșterea față de anul anterior
Întrebare: un test DM cu 26 de ferestre dă HLN \(= -1{,}93\). Este prima prognoză semnificativ mai bună la 5%?
Răspuns: nu: \(|-1{,}93| < t_{0{,}975}(25) = 2{,}06\); este mai bună în medie, dar nu semnificativ
Idee de proiect: prognozați consumul orar de electricitate din România cu o DHR (termeni Fourier zilnici, săptămînali și anuali, sărbători, temperatură), comparată cu TBATS, Prophet și o combinare, prin origini mobile și teste DM
Urmează: Capitolul 5, volatilitatea condiționată: modelele ARCH și GARCH
Sinteza secțiunii
Capitolul a tratat sezonalitatea în trei moduri: eliminată prin diferențiere în modelele SARIMA, modelată cu regresori Fourier și de calendar în DHR, TBATS și Prophet, și scoasă din date în seriile ajustate oficiale. Evaluarea în afara eșantionului a arătat că, pentru consumul de electricitate, informația de calendar contează mai mult decît clasa de modele, iar pentru PIB modelele simple sînt greu de depășit.
Bandara, K., Hyndman, R. J., & Bergmeir, C. (2025). MSTL: A seasonal-trend decomposition algorithm for time series with multiple seasonal patterns. International Journal of Operational Research, 52(1), 79–98. doi:10.1504/ijor.2025.143957
Bates, J. M., & Granger, C. W. J. (1969). The combination of forecasts. Journal of the Operational Research Society, 20(4), 451–468. doi:10.1057/jors.1969.103
Bergmeir, C., Hyndman, R. J., & Koo, B. (2018). A note on the validity of cross-validation for evaluating autoregressive time series prediction. Computational Statistics & Data Analysis, 120, 70–83. doi:10.1016/j.csda.2017.11.003
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society, Series B, 26(2), 211–243. doi:10.1111/j.2517-6161.1964.tb00553.x
Box, G. E. P., Jenkins, G. M., & Reinsel, G. C. (2008). Time Series Analysis: Forecasting and Control (4th ed.). Wiley. doi:10.1002/9781118619193
Brockwell, P. J., & Davis, R. A. (2016). Introduction to Time Series and Forecasting (3rd ed.). Springer. doi:10.1007/978-3-319-29854-2
Canova, F., & Hansen, B. E. (1995). Are seasonal patterns constant over time? A test for seasonal stability. Journal of Business & Economic Statistics, 13(3), 237–252. doi:10.1080/07350015.1995.10524598
Dagum, E. B., & Bianconcini, S. (2016). Seasonal Adjustment Methods and Real Time Trend-Cycle Estimation. Springer. doi:10.1007/978-3-319-31822-6
De Livera, A. M., Hyndman, R. J., & Snyder, R. D. (2011). Forecasting time series with complex seasonal patterns using exponential smoothing. Journal of the American Statistical Association, 106(496), 1513–1527. doi:10.1198/jasa.2011.tm09771
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. doi:10.1080/07350015.1995.10524599
Eurostat (2024). ESS Guidelines on Seasonal Adjustment, 2024 edition. Publications Office of the European Union. ec.europa.eu/eurostat
Findley, D. F., Monsell, B. C., Bell, W. R., Otto, M. C., & Chen, B.-C. (1998). New capabilities and methods of the X-12-ARIMA seasonal-adjustment program. Journal of Business & Economic Statistics, 16(2), 127–152. doi:10.1080/07350015.1998.10524743
Harvey, D., Leybourne, S., & Newbold, P. (1997). Testing the equality of prediction mean squared errors. International Journal of Forecasting, 13(2), 281–291. doi:10.1016/S0169-2070(96)00719-4
Hong, T., Pinson, P., Fan, S., Zareipour, H., Troccoli, A., & Hyndman, R. J. (2016). Probabilistic energy forecasting: Global Energy Forecasting Competition 2014 and beyond. International Journal of Forecasting, 32(3), 896–913. doi:10.1016/j.ijforecast.2016.02.001
Huang, C., & Petukhina, A. (2022). Applied Time Series Analysis and Forecasting with Python. Springer. doi:10.1007/978-3-031-13584-2
Hylleberg, S., Engle, R. F., Granger, C. W. J., & Yoo, B. S. (1990). Seasonal integration and cointegration. Journal of Econometrics, 44(1–2), 215–238. doi:10.1016/0304-4076(90)90080-D
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3rd ed.). OTexts. otexts.com/fpp3
Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. doi:10.18637/jss.v027.i03
Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. doi:10.1016/j.ijforecast.2006.03.001
Ladiray, D., & Quenneville, B. (2001). Seasonal Adjustment with the X-11 Method. Lecture Notes in Statistics 158. Springer. doi:10.1007/978-1-4613-0175-2
Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. doi:10.1093/biomet/65.2.297
Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2020). The M4 Competition: 100,000 time series and 61 forecasting methods. International Journal of Forecasting, 36(1), 54–74. doi:10.1016/j.ijforecast.2019.04.014
Osborn, D. R., Chui, A. P. L., Smith, J. P., & Birchenhall, C. R. (1988). Seasonality and the order of integration for consumption. Oxford Bulletin of Economics and Statistics, 50(4), 361–377. doi:10.1111/j.1468-0084.1988.mp50004002.x
Petropoulos, F., et al. (2022). Forecasting: theory and practice. International Journal of Forecasting, 38(3), 705–871. doi:10.1016/j.ijforecast.2021.11.001
Smith, J., & Wallis, K. F. (2009). A simple explanation of the forecast combination puzzle. Oxford Bulletin of Economics and Statistics, 71(3), 331–355. doi:10.1111/j.1468-0084.2008.00541.x
Stock, J. H., & Watson, M. W. (2004). Combination forecasts of output growth in a seven-country data set. Journal of Forecasting, 23(6), 405–430. doi:10.1002/for.928
Tashman, L. J. (2000). Out-of-sample tests of forecasting accuracy: an analysis and review. International Journal of Forecasting, 16(4), 437–450. doi:10.1016/S0169-2070(00)00065-0
Taylor, S. J., & Letham, B. (2018). Forecasting at scale. The American Statistician, 72(1), 37–45. doi:10.1080/00031305.2017.1380080
Wang, X., Hyndman, R. J., Li, F., & Kang, Y. (2023). Forecast combinations: An over 50-year review. International Journal of Forecasting, 39(4), 1518–1547. doi:10.1016/j.ijforecast.2022.11.005
PIB-ul României: Eurostat, volume înlănțuite (prețuri 2010), serie neajustată (NSA) și ajustată sezonier și pentru efectele de calendar (SCA), în versiunea folosită în curs. Comerțul cu amănuntul, producția industrială și înnoptările turistice: Eurostat, pînă în iulie 2026; IAPC: Eurostat, pînă în august 2026. Consumul de electricitate: ENTSO-E, „monthly hourly load values”, România, 1 ianuarie 2022 – 30 iunie 2026, ora de iarnă a României. Pasagerii aerieni: setul de date AirPassengers (Box și Jenkins), 1949–1960. Prognozele validării încrucișate sînt cele din curs; variantele care nu apar în curs sînt rulări suplimentare ale codului capitolului, cu aceleași date.
Bibliografie
Bandara, K., Hyndman, R. J., & Bergmeir, C. (2025). MSTL: A seasonal-trend decomposition algorithm for time series with multiple seasonal patterns. International Journal of Operational Research, 52(1), 79–98. https://doi.org/10.1504/ijor.2025.143957
Bates, J. M., & Granger, C. W. J. (1969). The combination of forecasts. Journal of the Operational Research Society, 20(4), 451–468. https://doi.org/10.1057/jors.1969.103
Bergmeir, C., Hyndman, R. J., & Koo, B. (2018). A note on the validity of cross-validation for evaluating autoregressive time series prediction. Computational Statistics & Data Analysis, 120, 70–83. https://doi.org/10.1016/j.csda.2017.11.003
Box, G. E. P., Jenkins, G. M., & Reinsel, G. C. (2008). Time Series Analysis: Forecasting and Control (4th ed.). Wiley. https://doi.org/10.1002/9781118619193
Canova, F., & Hansen, B. E. (1995). Are seasonal patterns constant over time? A test for seasonal stability. Journal of Business & Economic Statistics, 13(3), 237–252. https://doi.org/10.1080/07350015.1995.10524598
De Livera, A. M., Hyndman, R. J., & Snyder, R. D. (2011). Forecasting time series with complex seasonal patterns using exponential smoothing. Journal of the American Statistical Association, 106(496), 1513–1527. https://doi.org/10.1198/jasa.2011.tm09771
Findley, D. F., Monsell, B. C., Bell, W. R., Otto, M. C., & Chen, B.-C. (1998). New capabilities and methods of the X-12-ARIMA seasonal-adjustment program. Journal of Business & Economic Statistics, 16(2), 127–152. https://doi.org/10.1080/07350015.1998.10524743
Harvey, D., Leybourne, S., & Newbold, P. (1997). Testing the equality of prediction mean squared errors. International Journal of Forecasting, 13(2), 281–291. https://doi.org/10.1016/S0169-2070(96)00719-4
Hong, T., Pinson, P., Fan, S., Zareipour, H., Troccoli, A., & Hyndman, R. J. (2016). Probabilistic energy forecasting: Global Energy Forecasting Competition 2014 and beyond. International Journal of Forecasting, 32(3), 896–913. https://doi.org/10.1016/j.ijforecast.2016.02.001
Hylleberg, S., Engle, R. F., Granger, C. W. J., & Yoo, B. S. (1990). Seasonal integration and cointegration. Journal of Econometrics, 44(1–2), 215–238. https://doi.org/10.1016/0304-4076(90)90080-D
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3rd ed.). OTexts. https://otexts.com/fpp3/
Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03
Ladiray, D., & Quenneville, B. (2001). Seasonal Adjustment with the X-11 Method. Lecture Notes in Statistics 158. Springer. https://doi.org/10.1007/978-1-4613-0175-2
Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2020). The M4 Competition: 100,000 time series and 61 forecasting methods. International Journal of Forecasting, 36(1), 54–74. https://doi.org/10.1016/j.ijforecast.2019.04.014
Osborn, D. R., Chui, A. P. L., Smith, J. P., & Birchenhall, C. R. (1988). Seasonality and the order of integration for consumption. Oxford Bulletin of Economics and Statistics, 50(4), 361–377. https://doi.org/10.1111/j.1468-0084.1988.mp50004002.x
Smith, J., & Wallis, K. F. (2009). A simple explanation of the forecast combination puzzle. Oxford Bulletin of Economics and Statistics, 71(3), 331–355. https://doi.org/10.1111/j.1468-0084.2008.00541.x
Stock, J. H., & Watson, M. W. (2004). Combination forecasts of output growth in a seven-country data set. Journal of Forecasting, 23(6), 405–430. https://doi.org/10.1002/for.928
Tashman, L. J. (2000). Out-of-sample tests of forecasting accuracy: an analysis and review. International Journal of Forecasting, 16(4), 437–450. https://doi.org/10.1016/S0169-2070(00)00065-0
Wang, X., Hyndman, R. J., Li, F., & Kang, Y. (2023). Forecast combinations: An over 50-year review. International Journal of Forecasting, 39(4), 1518–1547. https://doi.org/10.1016/j.ijforecast.2022.11.005


 Applied Time Series Analysis with Python
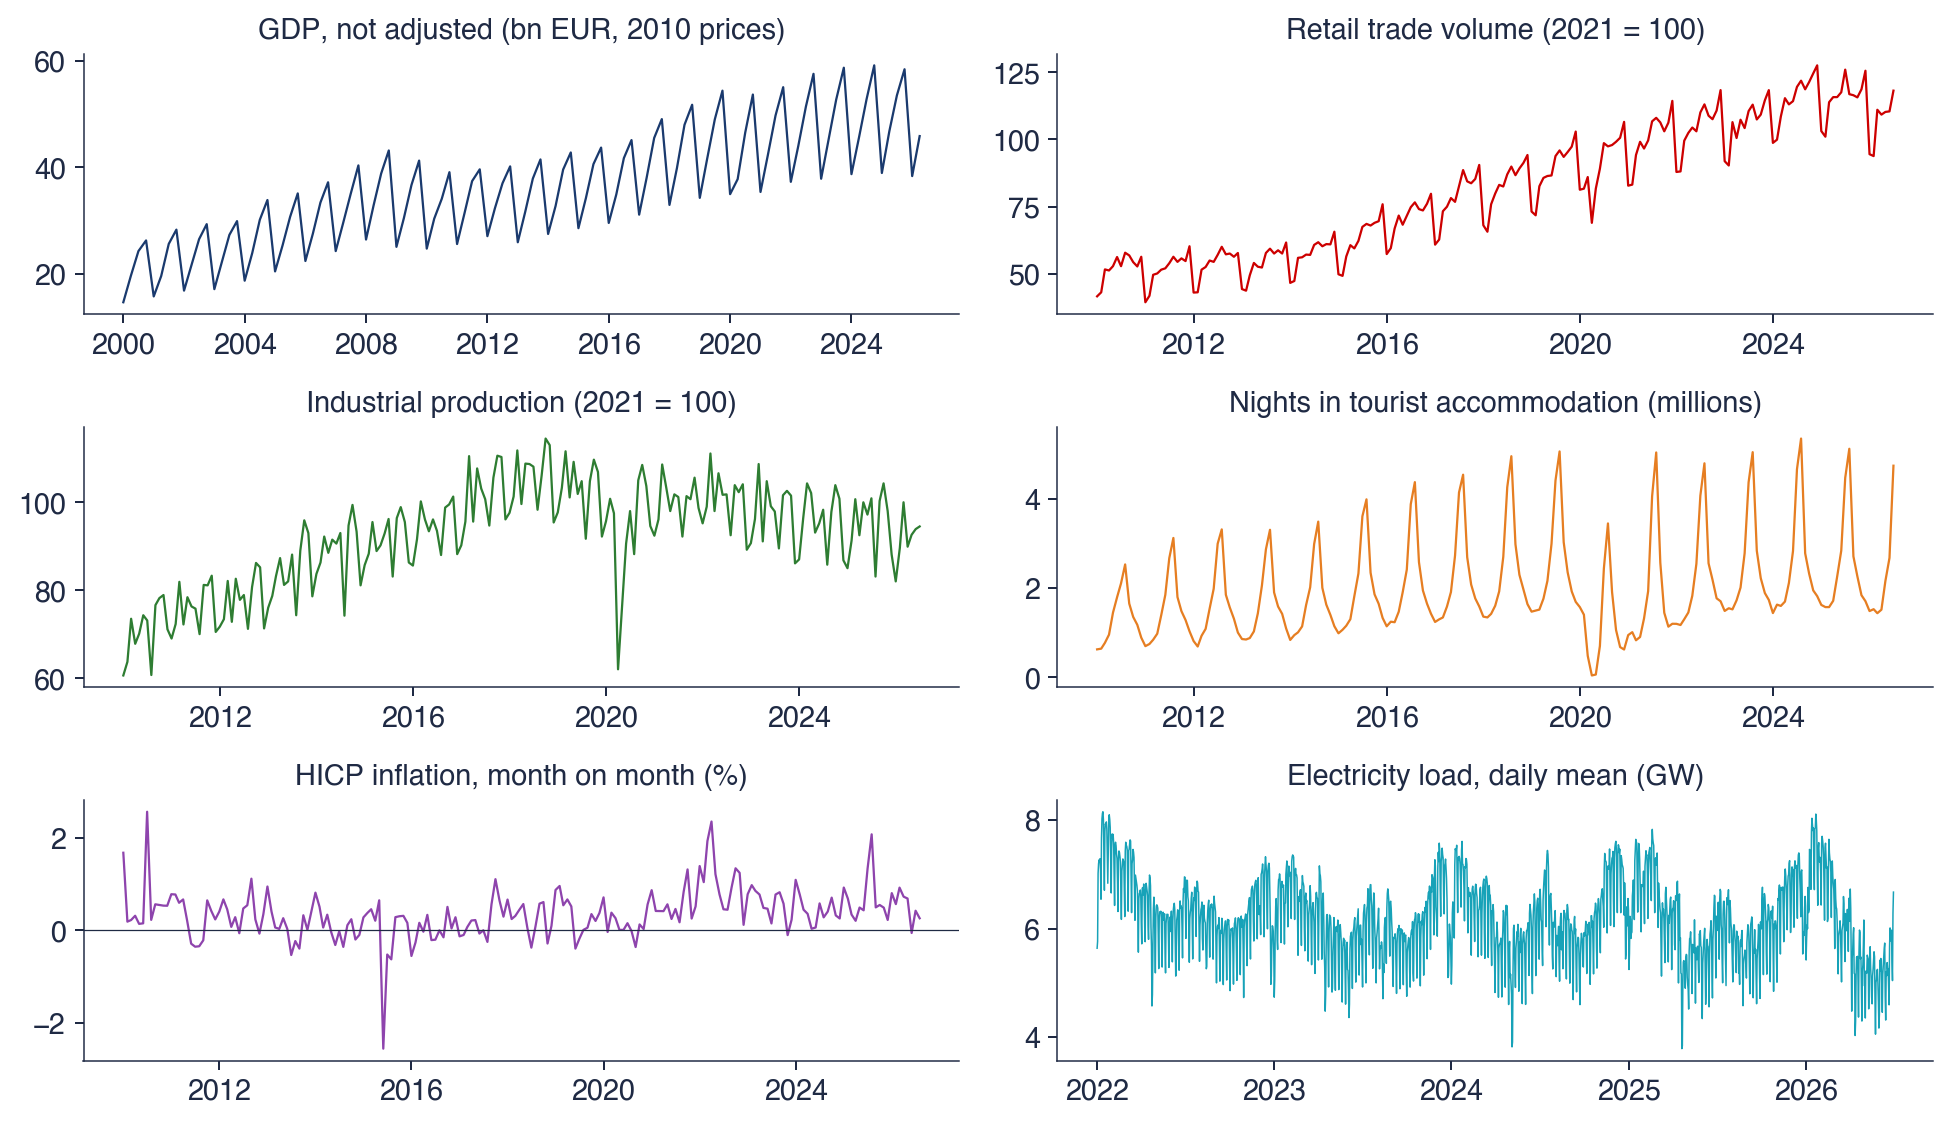
 TSA_ch4_seasonal_data