Capitolul 8: Backtesting și evaluarea prognozelor de risc
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“The elicitability of a functional opens the possibility to compare competing forecasts and to rank them in terms of their realized scores.” — Fissler & Ziegel (2016)
GARCH-EVT (volatilitate GARCH cu o coadă din teoria valorilor extreme): VaR (Value-at-Risk, valoarea expusă la risc) 1% este depășit în 1,15% din zile pe S&P 500 (Standard & Poor's) și în 0,97% pe BET (ținta: 1%)
este suficientă o rată apropiată de 1% ca să numim modelul bun?
Cu \(T = 250\) de zile și o rată adevărată de depășire de 2%, testul POF al lui Kupiec (proportion of failures, proporția depășirilor) respinge doar în 24% din cazuri
o rată de depășire dublă nu este respinsă în trei ani din patru
Testul DQ (dynamic quantile, cuantila dinamică) respinge toate modelele pe S&P 500, inclusiv simularea istorică filtrată (FHS)
ES (Expected Shortfall) nu poate fi ordonat singur, dar perechea (VaR, ES) poate, cu scorul consistent FZ0 (funcția de pierdere Fissler–Ziegel omogenă de grad zero)
FHS are cea mai mică pierdere FZ0 medie pe S&P 500 și pe BET
O prognoză de risc nu poate fi verificată într-o singură zi: o pierdere peste VaR (Value-at-Risk, valoarea la risc) 1% este un eveniment care trebuie să apară în aproximativ 1% din zile. Întrebarea capitolului este dacă o prognoză de risc poate fi totuși infirmată și pe ce dovezi alegem între mai multe prognoze. Backtesting-ul compară prognozele făcute cu informația din ziua precedentă cu rezultatele care au urmat. Calibrarea condiționată (conditional calibration) a lui Christoffersen (1998) cere ca depășirile să fie variabile Bernoulli independente, cu probabilitatea \(\alpha\): numărul lor trebuie să fie cel corect, iar ele nu trebuie să se grupeze. Pentru modelul GARCH-EVT, cu volatilitate GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată) și o coadă din teoria valorilor extreme, VaR 1% este depășit în 1,15% din zile pe S&P 500 (Standard & Poor's) și în 0,97% pe BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București).
O rată apropiată de 1% nu ajunge pentru a numi un model bun. Cu 250 de zile și o rată adevărată de depășire de 2%, testul POF (proportion of failures) al lui Kupiec (1995) respinge doar în 24% din cazuri: o rată dublă trece nerespinsă în trei ani din patru. Pentru o putere de 50% ar fi nevoie de o rată adevărată de aproximativ 2,7% la 250 de zile și de 1,7% la 1 000 de zile. Testele diferite examinează eșecuri diferite: testul DQ (dynamic quantile) respinge toate modelele pe S&P 500, inclusiv simularea istorică filtrată (FHS, filtered historical simulation), deoarece depășirile pot fi prevăzute din nivelul VaR și din depășirile anterioare. Nerespingerea nu este validare.
Expected Shortfall (ES) se testează prin reziduurile depășirilor și prin statistica \(Z_2\) a lui Acerbi & Szekely (2014), cu valori p obținute prin simulare. Pe S&P 500 și BET, FHS și GARCH-EVT nu sînt respinse la 5%, iar GARCH-t este respins de \(Z_2\) pe ambele piețe. ES singur nu poate fi însă ordonat: nu există o funcție de scor consistentă doar pentru ES. Fissler & Ziegel (2016) arată că perechea (VaR, ES) este elicitabilă (elicitable), iar scorul FZ0 (Fissler–Ziegel loss, zero-homogeneous version, funcția de pierdere Fissler–Ziegel, varianta omogenă de grad zero) permite compararea prognozelor prin teste Diebold–Mariano și mulțimea de modele de încredere (Model Confidence Set). FHS are cea mai mică pierdere FZ0 medie pe S&P 500 și pe BET.
Probabilitatea de respingere la 5% a testului POF în funcție de probabilitatea reală de depășire a unei prognoze VaR 1%: puterea exactă (linii continue) și puterea asimptotică locală (linii întrerupte), pentru \(T = 250\) (albastru) și \(T = 1\,000\) de zile (roșu). Graficul interactiv: „Puterea testului POF” →
Rezultatele învățării
Derivați puterea locală a testului POF și minimizantul pierderii pinball (pinball loss).
Calculați testele numărului și momentului depășirilor VaR, cu nivelul și puterea fiecărui test la numărul de zile disponibil.
Calculați backtesturile ES: reziduurile depășirilor, \(Z_2\) prin simulare și statisticile bazate pe PIT (probability integral transform).
Interpretați ordonarea prognozelor (VaR, ES) după un scor consistent, testele Diebold–Mariano și Model Confidence Set.
Interpretați ce garantează și ce nu garantează un VaR conformal.
O prognoză de Value-at-Risk (VaR) sau de Expected Shortfall (ES) este o afirmație despre coada distribuției pierderii de mîine. În fiecare zi pierderea realizată este o singură extragere din această distribuție, astfel că o zi nu poate nici confirma, nici infirma prognoza. Dovezile despre un model de risc se acumulează deci doar pe multe zile, iar coada, prin construcție, conține puține dintre ele. Capitolul tratează pe rînd trei probleme: calibrarea, compararea prognozelor concurente și decizia pe care un manager de risc sau un supraveghetor o ia pe baza dovezilor disponibile.
Calibrarea (calibration): dacă o prognoză VaR sau ES este corectă zi de zi și dacă un backtest poate stabili acest lucru. O prognoză este calibrată atunci cînd pierderile care îi urmează se comportă așa cum spune prognoza, în medie și, de asemenea, condiționat de ceea ce se știa cînd a fost făcută. Calibrarea este o proprietate a unei singure prognoze, iar mai multe prognoze pot fi calibrate în același timp.
Compararea. Cînd două sau mai multe prognoze trec testele de calibrare, sau cînd toate eșuează, întrebarea devine care este mai bună și dacă diferența dintre ele depășește zgomotul de eșantionare. Ierarhizarea cere o funcție de scor care recompensează măsura de risc adevărată și un test al diferenței dintre scorurile medii.
Decizia: ce putem concluziona cînd coada care ne interesează conține doar cîteva zile pe an. Pentru VaR 1%, un an de 250 de zile de tranzacționare conține în medie aproximativ 2,5 depășiri, iar puterea oricărui test construit pe atît de puține evenimente este limitată.
Exercițiile rezolvate din Seminarul 8 urmează aceeași ordine: testul Kupiec (A1), testul Christoffersen (A2), statistica \(Z_2\) (A4) și pierderea FZ0 cu testul Diebold–Mariano (DM) (B2). Lecturile și derivările sînt în Anexă.
Pe scurt
Calibrare
este o prognoză VaR (Value-at-Risk) sau ES (Expected Shortfall) corectă, zi de zi?
poate un backtest să o arate?
Comparație
care dintre mai multe prognoze este mai bună?
este diferența semnificativă?
Decizie: ce putem concluziona cînd coada conține doar cîteva zile pe an?
Exerciții rezolvate: Seminarul 8, A1 (Kupiec), A2 (Christoffersen), A4 (\(Z_2\)), B2 (FZ0 și DM); lecturi și demonstrații: Anexă
derivați puterea locală a testului POF și minimul pierderii pinball
calculați testele pentru numărul și momentul depășirilor VaR
cu mărimea și puterea fiecărui test pentru \(T\)-ul de care dispuneți
calculați backtesting-ul ES cu reziduuri, cu \(Z_2\) prin simulare și cu statistici construite pe PIT
PIT: probability integral transform, transformarea integrală a probabilității
interpretați ierarhizarea prognozelor (VaR, ES) cu un scor consistent, cu teste DM și cu MCS
DM: Diebold–Mariano
MCS: model confidence set, mulțimea de încredere a modelelor
interpretați ce garantează și ce nu garantează un VaR fără ipoteze de distribuție (conformal)
Exemplele detaliate și subiectele avansate sînt în Aprofundări, înainte de Anexă
butonul din subsol duce la ele, iar butonul Înapoi revine la slide-ul de plecare
Aprofundări și Anexa: lectură pentru familiarizare
Rolul backtesting-ului pentru prognozele de risc
Backtesting-ul compară prognozele de risc făcute cu informația disponibilă la închiderea zilei \(t-1\) cu rezultatele observate în ziua \(t\). Secțiunea fixează obiectele testate (pierderile, VaR și ES), enunță proprietatea pe care trebuie să o aibă un șir de prognoze corecte și prezintă cele șase metode de prognoză și cele patru piețe folosite în tot capitolul.
Fie \(P_t\) prețul de închidere din ziua \(t\) și \(X_t = r_t = \ln(P_t/P_{t-1})\) randamentul logaritmic zilnic. Capitolul lucrează cu pierderea zilnică \(L_t = -r_t\), astfel încît o valoare pozitivă înseamnă bani pierduți. Mulțimea de informație \(\mathcal{F}_{t-1}\) conține tot ce se cunoaște la închiderea zilei \(t-1\); orice prognoză pentru ziua \(t\) este o funcție doar de \(\mathcal{F}_{t-1}\).
VaR la nivelul \(\alpha\) este pierderea depășită cu probabilitatea \(\alpha\). Cu \(q_\alpha(X)\) cuantila de ordin \(\alpha\) a randamentului, ca în capitolul 7,
Echivalent, (8.1) este cuantila de ordin \(1-\alpha\) a pierderii \(L_t\). Nivelul se indică prin probabilitatea din coadă: VaR 1% este pierderea depășită în 1% din zile. Dacă VaR 1% este 3%, pierderea ar trebui să depășească 3% în aproximativ o zi din o sută. Convenția contează pentru backtesting, deoarece numărul așteptat de depășiri în \(T\) zile este \(\alpha T\).
Pe scurt
Backtesting: compararea prognozelor de risc făcute cu informația \(\mathcal{F}_{t-1}\) cu rezultatele care au urmat
\(\mathcal{F}_{t-1}\): tot ce se cunoaște la închiderea zilei \(t-1\)
Randamentul logaritmic zilnic: \(X_t=r_t=\ln(P_t/P_{t-1})\), unde \(P_t\) este prețul de închidere din ziua \(t\)
Pierderea zilnică: \(L_t=-r_t\) (o valoare pozitivă indică o pierdere)
VaR (valoarea expusă la risc): pierderea depășită cu probabilitatea \(\alpha\) (Capitolul 7)
adică cuantila \(q_\alpha\) a randamentului, cu semn schimbat
VaR arată unde începe coada, dar nu cît de adîncă este. Expected Shortfall face media cuantilelor \(q_u\) pe toate nivelurile din coadă \(u \le \alpha\); pentru o distribuție continuă, este media pierderilor dincolo de VaR:
Deoarece (8.2) face media unor pierderi care depășesc toate VaR, ES nu este niciodată sub VaR la același nivel. Pentru pierderi Student-t cu \(\nu = 4\) grade de libertate, abatere standard 1% și \(\alpha = 2{,}5\%\), VaR este 1,96%, iar ES este 2,82%; diferența reflectă coada groasă a distribuției t.
Cele două niveluri folosite în capitol provin din reglementarea bancară. VaR 1% este nivelul cadrului de backtesting Basel din 1996, iar ES 2,5% este măsura de capital din Fundamental Review of the Trading Book (FRTB), din 2019. Pentru distribuția Normală cu abaterea standard \(\sigma\), ES 2,5% este \(2{,}338\,\sigma\), iar VaR 1% este \(2{,}326\,\sigma\). Schimbarea măsurii păstrează deci aproximativ același grad de prudență pentru pierderi cu distribuția Normală, în timp ce ES 2,5% ține cont și de adîncimea cozii atunci cînd pierderile au cozi groase.
Pe scurt
ES (pierderea așteptată în coadă): media cuantilelor \(q_u\) pe toate nivelurile cozii \(u\le\alpha\)
O depășire (excepție, breach) are loc în ziua \(t\) cînd pierderea depășește prognoza VaR făcută în ziua \(t-1\) pentru ziua \(t\):\(I_t = \mathbf{1}\{L_t > \mathrm{VaR}_t\}\). Capitolul folosește peste tot prognoze la o zi. Prognozele pe 10 zile, orizontul cerinței de capital Basel, s-ar suprapune de la o zi la alta, iar depășirile lor ar fi dependente prin construcție.
Un șir de prognoze VaR este calibrat condiționat în sensul lui Christoffersen (1998) dacă
Condiția (8.3) implică faptul că indicatorii de depășire \(I_t\) sînt Bernoulli(\(\alpha\)) i.i.d.: probabilitatea unei depășiri este \(\alpha\) indiferent de ce s-a întîmplat înainte, deci indicatorii sînt independenți și de propriul trecut. Rezultă două consecințe testabile. Acoperirea necondiționată (unconditional coverage) cere aproximativ \(\alpha T\) depășiri în \(T\) zile. Independența cere ca depășirile să nu se grupeze: o depășire azi nu trebuie să facă mai probabilă o depășire mîine. Testele din secțiunea următoare examinează aceste două consecințe separat și împreună.
Pe scurt
O depășire (excepție): \(I_t=\mathbf{1}\{L_t>\mathrm{VaR}_t\}\), unde \(\mathrm{VaR}_t\) este prognoza făcută în ziua \(t-1\) pentru ziua \(t\)
Folosim prognoze la o zi: prognozele pe 10 zile s-ar suprapune și ar produce depășiri dependente
Calibrarea condiționată (Christoffersen (1998)): \(P(I_t=1\mid\mathcal{F}_{t-1})=\alpha\) pentru orice \(t\)
deci \(I_t\) sînt Bernoulli(\(\alpha\)) i.i.d.
Două consecințe testabile
Acoperire necondiționată: aproximativ \(\alpha T\) depășiri în \(T\) zile
Capitolul testează șase metode, toate estimate pe o fereastră rolling cu ultimele 1 000 de observații zilnice; datele și fereastra sînt descrise în Aprofundări. Trei metode sînt necondiționate:
Simularea istorică (HS, historical simulation) ia cuantila empirică a ultimelor 1 000 de pierderi;
Metoda Normală folosește distribuția Normală cu media și abaterea standard din fereastră;
Metoda Student-t ajustează la fereastră un parametru de locație, unul de scală și gradele de libertate \(\nu\).
Fiecare dă aceeași pondere tuturor zilelor din fereastră, așa că prognoza reacționează lent la o creștere bruscă a volatilității.
Celelalte trei sînt condiționate, sau filtrate: ele înmulțesc o scală \(\sigma_t\), actualizată zilnic de un model GARCH (generalised autoregressive conditional heteroskedasticity) din capitolul 5, cu o coadă standardizată. Varianța urmează \(\sigma_t^2 = \omega + a\,\varepsilon_{t-1}^2 + b\,\sigma_{t-1}^2\), cu \(\varepsilon_{t-1} = r_{t-1} - \mu\);\(a\) măsoară reacția la șocul de ieri, iar \(b\) persistența. Cele trei metode filtrate diferă prin coadă:
GARCH-t folosește șocuri Student-t.
Simularea istorică filtrată (FHS) folosește cuantilele empirice ale reziduurilor standardizate \(z_t = \varepsilon_t/\sigma_t\).
GARCH-EVT ajustează o distribuție Pareto generalizată (GPD, generalised Pareto distribution), din teoria valorilor extreme (EVT, extreme value theory), la cele mai mari 10% dintre pierderile standardizate, adică 100 de excedențe din 1 000, după McNeil & Frey (2000).
Designul separă cele două ingrediente ale unei prognoze de risc: scala, fixă sau variabilă în timp, și forma cozii, Normală, Student-t, empirică sau GPD. Compararea modelelor GARCH-t, FHS și GARCH-EVT, care au același filtru de volatilitate, izolează efectul cozii; compararea Student-t cu GARCH-t izolează efectul scalei variabile în timp.
Pe scurt
Model
VaR și ES la o zi din
HS
simularea istorică (historical simulation): cuantila empirică de ordin \(1-\alpha\) a ultimelor 1 000 de pierderi
Normal
distribuția Normală cu media și abaterea standard din fereastră
Student-t
o distribuție Student-t estimată pe fereastră (locație, scală, grade de libertate \(\nu\))
GARCH-t
GARCH (heteroscedasticitate condiționată autoregresivă generalizată, Capitolul 5): \(\sigma_t^2=\omega+a\,\varepsilon_{t-1}^2+b\,\sigma_{t-1}^2\), cu \(\varepsilon_{t-1}=r_{t-1}-\mu\); \(a\): reacția la șocul de ieri; \(b\): persistența; șocuri Student-t
FHS
HS filtrată (filtered historical simulation): volatilitatea GARCH \(\times\) cuantilele empirice ale lui \(z_t=\varepsilon_t/\sigma_t\)
GARCH-EVT
coadă EVT (extreme value theory, teoria valorilor extreme): volatilitatea GARCH \(\times\) o coadă GPD (Pareto generalizată) estimată pe cele mai mari 10% pierderi standardizate (100 de excese din 1 000) (McNeil & Frey (2000))
Necondiționate (HS, Normal, Student-t): o singură distribuție pentru întreaga fereastră de 1 000 de zile
toate zilele din fereastră au aceeași pondere, deci prognoza reacționează lent la un salt al volatilității
Condiționate sau filtrate (GARCH-t, FHS, GARCH-EVT)
o scală \(\sigma_t\) actualizată zilnic prin GARCH \(\times\) o coadă standardizată
Graficul arată prognozele GARCH-EVT pe cele patru piețe ale capitolului: indicele S&P 500, indicele BET al Bursei de Valori București, Bitcoin și cursul EUR (euro, moneda euro)/RON. Fiecare panou reprezintă pierderile zilnice, prognoza VaR pentru aceeași zi și zilele în care pierderea a depășit prognoza. Selectorul alege nivelul VaR (1%, 2,5% sau 5%), iar cursorul fixează sfîrșitul perioadei de evaluare; butonul ▶ îl avansează an cu an, din 2007 pînă în 2026.
Întrebare pentru sală Rata de depășire a VaR 1% GARCH-EVT este 1,15% pe S&P 500. Este suficientă o rată apropiată de 1% pentru a considera modelul adecvat?
Răspuns
Nu. Rata verifică doar numărul depășirilor: 57 în 4 959 de zile. Testul Kupiec nu respinge GARCH-EVT pe S&P 500 (p = 0,302), dar testul DQ îl respinge (p asimptotic < 0,001; frecvența simulată sub procesul Monte Carlo al capitolului: 0,5%): depășirile sînt previzibile din nivelul VaR și din depășirile trecute.
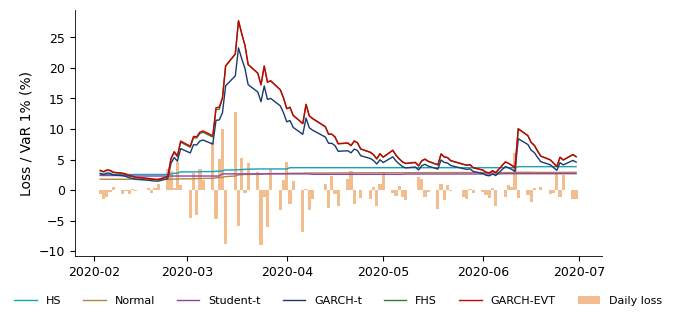
VaR se mișcă odată cu volatilitatea: se dublează sau se triplează în 2008, în martie 2020 și în prăbușirea pieței cripto din 2022. VaR 1% al modelului GARCH-EVT este depășit în 1,15% din zile pe S&P 500, adică 57 de depășiri în 4 959 de zile, și în 0,97% pe BET, față de o țintă de 1%. Pe S&P 500 testul Kupiec nu respinge GARCH-EVT (\(p = 0{,}302\)), dar testul DQ (dynamic quantile) îl respinge: depășirile pot fi prevăzute din nivelul VaR și din depășirile anterioare. O rată de depășire apropiată de țintă este o afirmație despre numărul depășirilor, nu despre momentul în care apar.
În grafic, portocaliul marchează pierderile zilnice, roșul prognoza VaR 1% a modelului GARCH-EVT, iar punctele albastre depășirile, zilele cu \(L_t > \mathrm{VaR}_t\). Prognoza crește în cîteva zile după un șoc de volatilitate și scade pe măsură ce șocul se estompează, exact comportamentul pentru care este construit un model filtrat.
Pe Bitcoin și EUR/RON linia VaR începe mai tîrziu decît pierderile. Pe aceste două piețe primele estimări GARCH nu sînt admisibile, iar prognozele bazate pe GARCH pentru acele zile sînt reținute, nu imputate; regula este explicată în Aprofundări. EUR/RON are o scală mult mai mică decît celelalte trei serii: este un curs de schimb administrat, cu perioade calme lungi și salturi rare.
Graficul susține o descriere, nu un test. Ratele de 1,15% și 0,97% par apropiate de țintă, iar întrebarea la care trebuie să răspundă capitolul este dacă o rată apropiată de 1% este suficientă pentru a numi un model bun.
Pe scurt
Pe grafic: pierderile zilnice (portocaliu), VaR 1% prognozat de GARCH-EVT (roșu) și depășirile (puncte albastre)
depășirile: zilele cu \(L_t>\mathrm{VaR}_t\)
VaR urmează volatilitatea: se dublează sau se triplează în 2008, martie 2020 și la crahul cripto din 2022
Rata de depășire a VaR 1% GARCH-EVT: 1,15% pe S&P 500 și 0,97% pe BET (ținta: 1%)
Pe Bitcoin și EUR (moneda euro)/RON (euro/leu), curba VaR începe după perioada cu prognoze GARCH necalculate (Aprofundări)
EUR/RON are o scară mult mai mică: un curs cu flotare administrată (managed float), perioade lungi de calm, salturi rare
Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei)
Întrebarea capitolului: este suficientă o rată apropiată de 1% pentru a considera un model adecvat?
Fiecare backtest verifică o consecință a calibrării condiționate (8.3): numărul depășirilor, dependența lor de depășirea de ieri, distanța dintre ele sau adîncimea pierderilor dincolo de VaR. Niciun test nu le verifică pe toate. Un model care trece un test poate pica altul, iar tiparul rezultatelor pe mai multe teste conține mai multă informație decît orice p-value luat separat.
Nerespingerea nu înseamnă validare. Un test care nu respinge este informativ doar dacă are putere împotriva alternativelor relevante la lungimea disponibilă a eșantionului \(T\); cu cîteva depășiri pe an, multe modele greșite trec. Ipoteza nulă este, în plus, comună (joint): ea privește întreaga procedură de prognoză, adică distribuția, dinamica volatilității, parametrii estimați, lungimea ferestrei și regula de reestimare. O respingere arată că procedura eșuează, nu care dintre aceste componente a eșuat.
Alte două limite decurg din natura datelor. Există un singur rezultat pe zi, deci dovezile se acumulează doar pe multe zile. Iar limitele \(\chi^2\) din manuale pentru testele de raport de verosimilitate tratează \(\mathrm{VaR}_t\) ca fiind cunoscut, în timp ce în practică el se calculează din parametri estimați; efectul estimării este discutat la backtesting sub riscul de estimare.
Pe scurt
Fiecare backtest verifică o consecință a calibrării condiționate
Nerespingerea nu înseamnă validare
este informativă doar dacă testul are putere împotriva alternativelor relevante, la \(T\) disponibil
\(H_0\) este o ipoteză comună despre întreaga procedură de prognoză
distribuția, dinamica volatilității, parametrii estimați, lungimea ferestrei și regula de reestimare
O respingere nu indică ce componentă este greșit specificată
Un singur rezultat pe zi: dovezile se acumulează doar pe multe zile
Limitele \(\chi^2\) din manuale tratează \(\mathrm{VaR}_t\) ca fiind cunoscut
Obiectele backtesting-ului sînt pierderea zilnică, prognozele VaR și ES făcute cu informația de ieri și indicatorii de depășire. Calibrarea condiționată cere ca depășirile să fie Bernoulli(\(\alpha\)) i.i.d., de unde rezultă două proprietăți testabile: numărul corect de depășiri și absența grupărilor. Șase metode, trei necondiționate și trei filtrate, sînt evaluate pe patru piețe cu regimuri de volatilitate diferite.
Backtesting pentru VaR: acoperire și independență
Testele din această secțiune folosesc doar șirul depășirilor \(I_1, \dots, I_T\). Fiecare este prezentat cu ipoteza nulă, statistica, distribuția statisticii sub ipoteza nulă și, acolo unde contează, mărimea (size) și puterea lui la \(T\) disponibil. Calculele de putere arată cît de puțin poate dezvălui un singur an de date despre o prognoză VaR 1%.
Are VaR numărul corect de depășiri, la momentele corecte?
Sînt prezentate patru teste, fiecare pentru o altă consecință a calibrării condiționate. Testul lui Kupiec (1995) verifică numărul depășirilor. Testul lui Christoffersen (1998) verifică memoria de ordinul întîi: dacă o depășire azi depinde de o depășire ieri. Testele de durată verifică distanța dintre depășiri, folosind fiecare interval dintre două depășiri consecutive. Testul DQ al lui Engle & Manganelli (2004) verifică dacă vreun predictor cunoscut ieri poate prognoza depășirea de azi.
Pentru fiecare test se precizează ipoteza nulă, statistica, distribuția ei sub \(H_0\), precum și mărimea și puterea la \(T\) disponibil. Secțiunea începe cu un exemplu empiric: două prognoze pentru S&P 500 cu aproape același număr de depășiri, ale căror depășiri cad totuși în momente foarte diferite.
Pe scurt
Kupiec: numărul depășirilor
Christoffersen: memoria de ordinul întîi
Testele de durată: distanțele dintre depășiri
DQ (Dynamic Quantile): orice predictor cunoscut ieri
Pentru fiecare test: ipoteza nulă, statistica, distribuția ei sub \(H_0\), mărimea și puterea la \(T\) disponibil
Începem cu două prognoze S&P 500 care au aproape același număr de depășiri
Graficul compară două prognoze VaR 1% pentru S&P 500: simularea istorică, o metodă necondiționată, și GARCH-t, o metodă filtrată. Panoul de sus arată pierderile zilnice și cele două linii VaR, cu depășirile fiecărui model marcate; panoul de jos arată cînd apar depășirile. Cursorul alege perioada afișată (la stînga, toată perioada), iar butonul ▶ parcurge anii.
Întrebare pentru sală HS are 83 de depășiri, iar GARCH-t 88, în aceleași 4 959 de zile. Putem stabili doar din aceste numere care prognoză este mai bună?
Răspuns
Nu. Ambele rate, 1,67% și 1,77%, depășesc ținta de 1%, iar Kupiec le respinge pe amîndouă (p < 0,001). Depășirile diferă ca moment: HS are 26 de depășiri în 2008 și 12 în 2020, GARCH-t 8 și 6. Testul independenței respinge HS (LR_ind = 15,90, p < 0,001), dar nu GARCH-t (p = 0,095): este o diferență de diagnostic, nu o dovadă că GARCH-t este superior după orice criteriu.
HS are 83 de depășiri, iar GARCH-t 88, în aceleași 4 959 de zile. Ambele rate, 1,67% și 1,77%, depășesc ținta de 1%, iar testul Kupiec le respinge pe amîndouă (\(p < 0{,}001\)). Depășirile diferă însă ca momente: HS are 26 de depășiri în 2008 și 12 în 2020, GARCH-t 8 și 6. Testul de independență respinge HS (\(\mathrm{LR}_{ind} = 15{,}90\),\(p < 0{,}001\)), dar nu GARCH-t (\(p = 0{,}095\)). Este o diferență de diagnostic între cele două proceduri, nu o dovadă că GARCH-t este mai bun după orice criteriu.
Prognoza HS este o funcție în trepte. Ea se schimbă doar cînd o zi extremă intră în fereastra de 1 000 de zile sau iese din ea, așa că după o perioadă calmă rămîne jos cînd volatilitatea crește, iar după o criză rămîne sus timp de patru ani. GARCH-t crește din ziua de după un șoc de volatilitate. Deoarece depășirile HS vin în rafale, în 2008 și 2020, trebuie testat și momentul depășirilor, nu doar numărul lor. Un zoom pe martie 2020 este în Aprofundări.
Pe scurt
Pe grafic: VaR 1% al HS (turcoaz) și al GARCH-t (albastru)
pierderile zilnice (portocaliu) și depășirile fiecărui model (marcaje)
HS este o funcție în trepte
se schimbă doar cînd zile extreme intră în fereastra de 1 000 de zile sau ies din ea
GARCH-t crește din ziua următoare unui șoc de volatilitate
Depășiri: 83 pentru HS și 88 pentru GARCH-t, în 4 959 de zile
Depășirile HS apar în rafale (2008, 2020), deci trebuie testat și cînd apar
Testul POF al lui Kupiec (1995) verifică acoperirea necondiționată: dacă rata depășirilor este egală cu \(\alpha\), indiferent de momentul depășirilor. Datele sînt numărul de depășiri \(x = \sum_t I_t\) în \(T\) zile și rata estimată \(\hat\pi = x/T\). Ipoteza nulă este \(H_0: \pi = \alpha\), cu alternativa \(H_1: \pi \ne \alpha\), unde \(\pi\) este probabilitatea adevărată de depășire.
Sub \(H_0\) și independență, \(x\) urmează o distribuție Binomială(\(T\),\(\alpha\)). Statistica raportului de verosimilitate (likelihood ratio) compară verosimilitatea Binomială a lui \(x\) sub \(\alpha\) cu cea sub estimația \(\hat\pi\):
Statistica (8.4) este nenegativă. Ea este 0 cînd \(\hat\pi = \alpha\), deoarece cele două verosimilități coincid atunci, și crește pe măsură ce \(\hat\pi\) se îndepărtează de \(\alpha\), în oricare direcție. Testul ignoră ordinea depășirilor: orice permutare a aceluiași șir dă aceeași valoare \(\mathrm{LR}_{uc}\).
Pe scurt
Ce testează: dacă rata depășirilor este egală cu \(\alpha\) (acoperirea necondiționată), indiferent de momentul lor
Date: \(x=\sum_t I_t\) depășiri în \(T\) zile; rata estimată de depășire: \(\hat\pi=x/T\)
\(H_0\): \(\pi=\alpha\), față de \(H_1\): \(\pi\neq\alpha\); \(\pi\): probabilitatea reală de depășire
Statistica raportului de verosimilitate (Kupiec (1995))
compară verosimilitatea Binomială a lui \(x\) sub \(\alpha\) cu cea sub \(\hat\pi\)
La pragul de 5%, testul respinge cînd \(\mathrm{LR}_{uc} > 3{,}84\), cuantila de 95% a distribuției \(\chi^2_1\), egală cu \(1{,}96^2\). Testul este bilateral: și prea puține depășiri duc la respingere, deoarece un VaR depășit prea rar este prea conservator și imobilizează capital. Pentru \(T\) mic, limita \(\chi^2_1\) este o aproximare slabă și se folosește în schimb distribuția exactă a lui \(x\), Binomială(\(T\),\(\alpha\)). Mărimea efectivă a unei reguli este atunci suma probabilităților Binomiale ale numerelor de depășiri respinse. Deoarece \(x\) este discret, nicio regulă nu are mărimea exact 5%.
Exemplul este prognoza GARCH-t pentru S&P 500 în 2008: \(x = 8\) depășiri în \(T = 253\) de zile, față de \(2{,}53\) așteptate sub \(H_0\). Statistica este \(\mathrm{LR}_{uc} = 7{,}60\), cu \(p = 0{,}0058\) din aproximarea \(\chi^2_1\). P-value-ul Binomial exact bilateral, obținut prin dublarea cozii mai mici, este \(2P(X \ge 8) = 0{,}009\).
Ambele p-value-uri sînt sub 5%: în 2008, VaR-ul GARCH-t a fost depășit prea des. Cele două calcule concordă aici deoarece numărul observat se află departe în coadă; aproape de marginea regiunii de acceptare ele pot da decizii diferite, iar calculul exact este atunci referința.
Pe scurt
Respingem la 5% dacă \(\mathrm{LR}_{uc}>3{,}84\) (\(=1{,}96^2\), cuantila de 95% a lui \(\chi^2_1\))
Testul este bilateral: și un număr prea mic de depășiri duce la respingere
Pentru \(T\) mic folosim distribuția Binomială(\(T,\alpha\)) exactă a lui \(x\)
Mărimea efectivă: suma probabilităților Binomiale ale valorilor \(x\) respinse
cu \(x\) discret, nicio regulă nu are mărimea exact 5%
Exemplu: S&P 500, GARCH-t, anul 2008: \(x=8\) depășiri în \(T=253\) de zile, față de 2,53 așteptate
\(\mathrm{LR}_{uc}=7{,}60\), cu \(p=0{,}0058\) (aproximarea \(\chi^2_1\))
valoarea p (p-value) Binomială exactă, bilaterală (dublarea cozii mai mici): \(2P(X\ge 8)=0{,}009\)
Ambele resping la 5%: în 2008, VaR-ul GARCH-t a fost depășit prea des
Graficul reprezintă \(\mathrm{LR}_{uc}\) din (8.4) în funcție de numărul de depășiri \(x\), pentru un an de date (\(T = 250\), graficul din stînga) și pentru o lungime a eșantionului aleasă cu cursorul (graficul din dreapta). Linia orizontală de la 3,84 este valoarea critică la 5%; numerele de depășiri de sub ea sînt cele pe care testul nu le respinge. Selectorul alege nivelul \(\alpha\) al VaR (1%, 2,5% sau 5%), iar butonul ▶ crește \(T\) din graficul din dreapta de la 250 la 5 000 de zile.
Întrebare pentru sală ▶ mărește T al graficului de jos de la 250 la 5 000 de zile. Ce se întîmplă cu intervalul de depășiri pe care regula LR_uc > 3,84 nu le respinge, raportat la T?
Răspuns
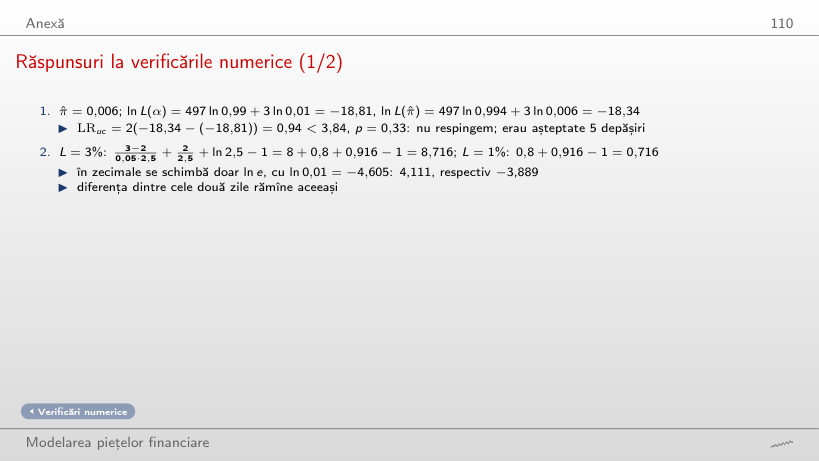
Intervalul acceptat este 1–6 depășiri la T = 250 (0,4%–2,4% din zile), 5–16 la T = 1 000 și 37–64 la T = 5 000 (0,74%–1,28%): numărul crește, iar rata se concentrează în jurul lui 1%. La T = 250, x = 0 dă LR_uc = −500 ln 0,99 = 5,03 > 3,84: regula respinge și în direcția prea puținelor depășiri. P(x = 0) = 8,1% nu este p-value-ul Kupiec. Mărimea efectivă a regulii este 9,5% la T = 250 și 4,6% la T = 5 000; o respingere nu dovedește singură că modelul este greșit.
Intervalul acceptat este de 1–6 depășiri la \(T = 250\), adică 0,4%–2,4% din zile, de 5–16 la \(T = 1\,000\) și de 37–64 la \(T = 5\,000\), adică 0,74%–1,28%. Numărul acceptat crește cu \(T\), iar rata acceptată se concentrează în jurul lui 1%. Mărimea efectivă a regulii \(\mathrm{LR}_{uc} > 3{,}84\) este 9,5% la \(T = 250\) și 4,6% la \(T = 5\,000\), așa că, într-un singur an, o respingere nu dovedește singură că modelul este greșit.
Pentru VaR 1%, testul acceptă \(x\) de la 1 la 6 într-un an (\(T = 250\)) și de la 5 la 16 în patru ani (\(T = 1\,000\)). Limita inferioară este cea mai puțin intuitivă: chiar și \(x = 0\) este respins într-un an, deoarece \(\mathrm{LR}_{uc} = -500\ln 0{,}99 = 5{,}03 > 3{,}84\). Un VaR care nu este depășit niciodată într-un an este considerat prea conservator. Probabilitatea a zero depășiri pentru un VaR 1% corect este \(0{,}99^{250} = 8{,}1\%\); aceasta este probabilitatea unui eveniment, nu p-value-ul testului Kupiec.
Un an conține aproximativ 2,5 zile informative pentru VaR 1%. O decizie bazată pe atît de puține evenimente are putere mică, iar recomandările practice decurg de aici: eșantioane lungi, testare la două niveluri (\(\alpha = 1\%\) și \(2{,}5\%\)) și combinarea mai multor teste care examinează proprietăți diferite ale șirului depășirilor.
Pe scurt
\(\mathrm{LR}_{uc}\) în funcție de numărul de depășiri \(x\), un an (sus) și patru ani (jos) de VaR 1%
Testul acceptă între 1 și 6 depășiri într-un an (\(T=250\)) și între 5 și 16 în patru ani (\(T=1000\))
Chiar și \(x=0\) este respins pe un an
\(\mathrm{LR}_{uc}=-500\ln 0{,}99=5{,}03\): un VaR niciodată depășit este prea conservator
Un an conține aproximativ 2,5 zile informative pentru VaR 1%
folosim eșantioane lungi, două niveluri (\(\alpha=1\%\) și \(2{,}5\%\)) și mai multe teste
Graficul arată puterea testului POF, probabilitatea de respingere la 5% în funcție de rata adevărată de depășire \(\pi\) (axa orizontală), pentru o prognoză VaR 1%. Liniile continue dau puterea exactă, din distribuția Binomială; liniile întrerupte dau aproximarea locală \(\chi^2_1(\lambda)\), cu parametrul de necentralitate \(\lambda = T(\pi-\alpha)^2/(\alpha(1-\alpha))\), derivată pe slide-ul următor. Curbele albastre corespund lui \(T = 250\); cursorul fixează \(T\) pentru curbele roșii, iar butonul ▶ îl crește de la 250 la 5 000 de zile.
Întrebare pentru sală ▶ mărește T al curbelor roșii de la 250 la 5 000 de zile. Cît devine, la sfîrșit, puterea exactă a testului POF cînd rata reală de depășire este π = 2%?
Răspuns
Practic 100%. Puterea exactă (Binomială) la π = 2% este 24% la T = 250, 54% la T = 500, 78% la T = 1 000, 96% la T = 2 000 și practic 100% la T = 5 000; aproximarea locală χ²₁(λ) dă 36%, 61%, 89%, 99% și 100%. Mărimea efectivă a regulii LR_uc > 3,84 este 9,5% la T = 250 și 4,6% la T = 5 000: pragul 3,84 corespunde nivelului nominal de 5%, nu unei mărimi efective exact egale cu 5%.
La \(T = 250\) și \(\pi = 2\%\), puterea exactă este 24%, iar puterea locală 36%. O rată de depășire dublă trece deci nerespinsă în trei ani din patru. La \(\pi = 2\%\), puterea exactă este 54% la \(T = 500\), 78% la \(T = 1\,000\), 96% la \(T = 2\,000\) și practic 100% la \(T = 5\,000\); aproximarea locală dă 61%, 89%, 99% și 100%.
Regula \(\mathrm{LR}_{uc} > 3{,}84\) are o mărime efectivă de 9,5% la \(T = 250\), din care \(P(x = 0) = 8{,}1\%\) singură. O putere de 50% cere \(\pi \approx 2{,}7\%\) la \(T = 250\) și \(\pi \approx 1{,}7\%\) la \(T = 1\,000\). Pragul 3,84 corespunde unui nivel nominal de 5%, nu unei mărimi efective de exact 5%.
Pe scurt
Axe: rata reală de depășire (orizontal) și probabilitatea de respingere la 5% (vertical)
Linia continuă: calculul Binomial exact; linia întreruptă: aproximarea locală \(\chi^2_1(\lambda)\)
\(\lambda=T(\pi-\alpha)^2/(\alpha(1-\alpha))\)
\(T=250\), \(\pi=2\%\): puterea exactă este 24%, iar cea locală 36%
Deci o rată de depășire dublă nu este respinsă în trei ani din patru
Regula \(\mathrm{LR}_{uc}>3{,}84\) are mărimea efectivă 9,5% la \(T=250\), din care \(P(x=0)=8{,}1\%\)
Pentru o putere de 50%: \(\pi\approx 2{,}7\%\) la \(T=250\) și \(\pi\approx 1{,}7\%\) la \(T=1000\)
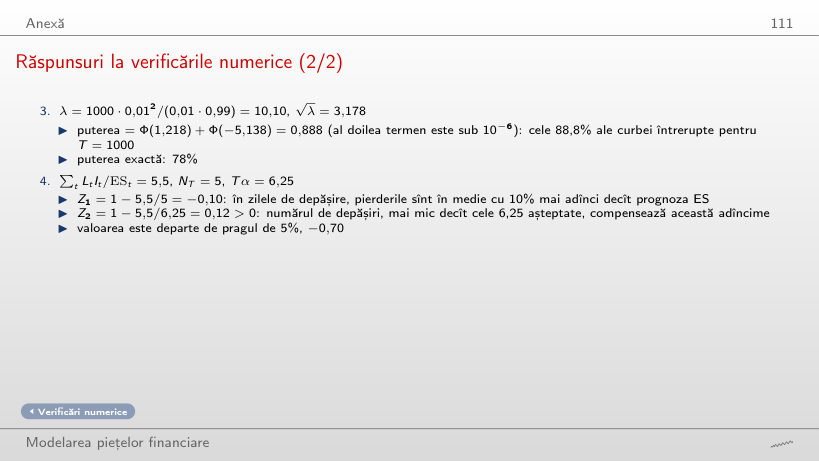
Pentru o rată adevărată fixă \(\pi \ne \alpha\), puterea unui test consistent tinde la 1 cînd \(T\) crește, ceea ce nu spune nimic util despre eșantioanele finite. Alternativele locale (local alternatives) lasă rata adevărată să se apropie de \(\alpha\) cu viteza \(1/\sqrt T\):\(\pi_T = \alpha + h/\sqrt T\), unde \(h\) este o distanță fixă pe scara \(\sqrt T\). Sub astfel de alternative, puterea rămîne strict între 0 și 1 și poate fi calculată în formă închisă.
O dezvoltare de ordinul doi a lui (8.4) în jurul lui \(\hat\pi = \alpha\) dă
Parametrul de necentralitate \(\lambda\) crește cu \(T\) și cu distanța la pătrat \((\pi-\alpha)^2\), raportată la varianța Bernoulli \(\alpha(1-\alpha)\). Puterea este \(P(\chi^2_1(\lambda) > 3{,}84)\) și crește cu \(\lambda\). Calculul de mînă și motivul pentru care puterea exactă la \(T = 250\) este mai mică decît cea locală sînt în Aprofundări.
Pe scurt
Alternative locale: rata reală se apropie de \(\alpha\) cînd \(T\) crește, \(\pi_T=\alpha+h/\sqrt T\), cu \(h\) o distanță fixă pe scara \(\sqrt T\)
De ce: cu \(\pi\ne\alpha\) fix, puterea tinde la 1
alternativele locale o țin între 0 și 1 și o fac calculabilă
Graficul dă, pentru fiecare dintre cele șase modele și patru piețe, ponderea zilelor cu \(L_t > \mathrm{VaR}_t\), împreună cu p-value-ul testului Kupiec. Selectorul alege nivelul VaR, cursorul fixează primul an al evaluării, iar butonul ▶ îl avansează an cu an. Valorile GARCH lipsă pe Bitcoin și EUR/RON sînt prognozele reținute.
Întrebare pentru sală Pe EUR/RON, modelul Normal are rata de depășire a VaR 1% de 1,06% și p-value Kupiec 0,708. Ce putem concluziona la 5%?
Răspuns
Nu respingem frecvența nominală de 1%. Kupiec verifică doar acoperirea necondiționată: p = 0,708 nu dovedește independența depășirilor și nu este probabilitatea ca modelul să fie corect. Pe S&P 500 (2,70%), BET (1,90%) și Bitcoin (1,74%), modelul Normal este respins.
Pe EUR/RON, modelul Normal are o rată de depășire a VaR 1% de 1,06% și un p-value Kupiec de 0,708. La 5% nu respingem frecvența nominală. Această nerespingere privește doar acoperirea necondiționată: ea nu stabilește nici independența depășirilor, nici probabilitatea ca modelul să fie corect. Pe S&P 500 (2,70%), pe BET (1,90%) și pe Bitcoin (1,74%), modelul Normal este respins.
Pentru VaR 1%, distribuția Normală eșuează peste tot în afară de EUR/RON, cu rate de depășire de 2,70% pe S&P 500, 1,90% pe BET și 1,74% pe Bitcoin. Coada ei este prea subțire pentru pierderile zilnice pe acțiuni și pe cripto: cuantila prognozată este prea aproape de centru, iar pierderea o depășește de aproximativ două ori mai des decît ar trebui.
Comparația dintre GARCH-t și FHS izolează forma cozii, deoarece ambele folosesc aceeași volatilitate GARCH-t. Pe S&P 500 și pe BET, GARCH-t este depășit în 1,77% și 1,46% din zile, față de 1,23% și 1,20% pentru FHS. Coada Student-t simetrică, ajustată pe ambele părți ale distribuției, subestimează partea pierderilor; cuantilele empirice ale reziduurilor standardizate surprind asimetria.
HS este prea conservator pe EUR/RON, cu o rată de depășire de 0,51%. O criză veche rămasă în fereastra de 1 000 de zile menține cuantila empirică ridicată mult timp după ce piața s-a calmat. Același mecanism care face ca HS să crească prea încet după o perioadă calmă îl face să scadă prea încet după o criză.
Pe scurt
Pe grafic: ponderea zilelor cu \(L_t>\mathrm{VaR}_t\), pentru VaR 1%
Modelul Normal este respins pe S&P 500 (2,70%), BET (1,90%) și Bitcoin (1,74%), dar nu pe EUR/RON
GARCH-t și FHS: aceeași volatilitate GARCH, altă coadă (t, respectiv empirică), pe S&P 500 și BET
GARCH-t are rate de 1,77%, respectiv 1,46%
FHS are 1,23%, respectiv 1,20%
Datele pun sub semnul întrebării coada t simetrică
HS este prea conservator pe EUR/RON (0,51%): o criză veche din fereastră îi menține VaR ridicat
Testul Kupiec ignoră ordinea depășirilor. Christoffersen (1998) testează dacă depășirea de azi depinde de cea de ieri, modelînd \(I_t\) ca un lanț Markov de ordinul întîi cu probabilitățile de tranziție \(\pi_{ij} = P(I_t = j \mid I_{t-1} = i)\). Fie \(n_{ij}\) numărul zilelor în care starea \(i\) de ieri este urmată de starea \(j\) azi. Probabilitățile estimate ale unei depășiri după o zi calmă și după o depășire sînt
Ipoteza nulă a absenței memoriei este \(H_0: \pi_{01} = \pi_{11} = \pi\), estimată prin \(\hat\pi = (n_{01}+n_{11})/\sum n_{ij}\). Raportul de verosimilitate compară o singură probabilitate de depășire (numărătorul) cu două probabilități care depind de starea de ieri (numitorul):
Testul respinge la 5% peste 3,84. Prin adunarea celor două statistici se obține testul de acoperire condiționată (conditional coverage), care verifică ambele proprietăți deodată:
cu valoarea critică la 5% egală cu 5,99. Testul comun are două grade de libertate, așa că un semnal puternic într-o componentă poate fi diluat cînd cealaltă este aproape de ipoteza ei nulă.
Pe scurt
Ce testează: dacă o depășire azi depinde de depășirea de ieri
testul Kupiec nu vede ordinea depășirilor
Modelăm \(I_t\) ca lanț Markov de ordinul întîi, cu \(\pi_{ij}=P(I_t=j\mid I_{t-1}=i)\)
\(n_{ij}\): tranzițiile din starea \(i\) ieri în starea \(j\) azi
Graficul este o axă a timpului cu depășirile VaR 1% pe S&P 500: fiecare marcaj este o depășire, cîte un rînd pentru fiecare model. Selectorul alege modelul testat, iar două cursoare fixează primul an și lungimea, în ani, a unui subeșantion; numerele de tranziții \(n_{ij}\) și statistica Christoffersen se calculează pe acest subeșantion. Butonul ▶ mută subeșantionul an cu an.
Întrebare pentru sală Pentru HS pe 2007–2010, π̂₁₁ = 0,0732, aproape dublu față de π̂₀₁ = 0,0393. Respinge testul Christoffersen independența?
Răspuns
Nu: LR_ind = 0,95, cu p = 0,33. Estimarea π̂₁₁ se sprijină doar pe 3 perechi de depășiri consecutive (n₁₁ = 3, n₁₀ = 38). Pe întregul eșantion 2007–2026, același test respinge independența pentru HS: LR_ind = 15,90, p < 0,001.
Pentru HS în 2007–2010, \(\hat\pi_{11} = 0{,}0732\) este aproape dublu față de \(\hat\pi_{01} = 0{,}0393\), totuși testul Christoffersen nu respinge independența: \(\mathrm{LR}_{ind} = 0{,}95\), cu \(p = 0{,}33\). Estimația \(\hat\pi_{11}\) se sprijină pe doar 3 perechi de depășiri consecutive (\(n_{11} = 3\),\(n_{10} = 38\)). Pe întregul eșantion 2007–2026, același test respinge independența pentru HS: \(\mathrm{LR}_{ind} = 15{,}90\),\(p < 0{,}001\).
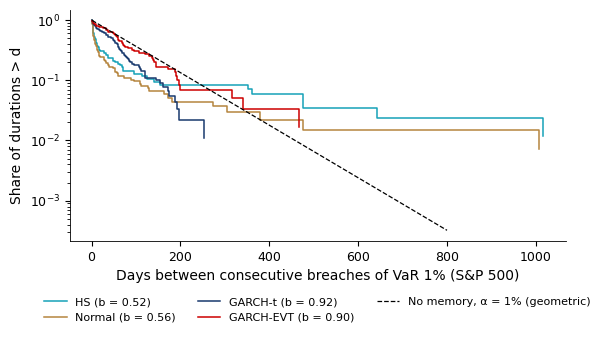
Modelele necondiționate, HS, Normal și Student-t, au rafale de depășiri în 2008, 2015–2016, 2018, 2020 și 2022. VaR-ul lor nu reacționează la creșterea volatilității, așa că depășirile se adună în săptămînile de după un șoc. Modelele GARCH filtrate nu au rafale de mai multe luni, dar rămîn unele depășiri consecutive: o volatilitate GARCH crește abia după prima pierdere mare.
Un test pe un subeșantion poate rata gruparea. Pentru HS în 2007–2010, numerele de tranziții sînt \(n_{00} = 928\),\(n_{01} = 38\),\(n_{10} = 38\) și \(n_{11} = 3\), deci \(\hat\pi_{11} = 0{,}0732\) față de \(\hat\pi_{01} = 0{,}0393\). Raportul este aproape doi, totuși \(\mathrm{LR}_{ind} = 0{,}95\) și \(p = 0{,}33\). Motivul este că \(\hat\pi_{11}\) se sprijină pe doar 3 perechi consecutive: eroarea lui standard este de același ordin cu valoarea. O grupare care nu ia forma unor depășiri în zile consecutive nu este surprinsă nici ea de un lanț Markov de ordinul întîi; testele de durată și testul DQ din Aprofundări o tratează.
Pe scurt
Fiecare linie verticală marchează o depășire a VaR 1% pe S&P 500; un rînd pentru fiecare model
HS, Normal și Student-t: rafale de depășiri în 2008, 2015–2016, 2018, 2020, 2022
Modelele filtrate (GARCH): fără rafale de mai multe luni, dar cu cîteva depășiri în zile consecutive
Un test pe subeșantion poate rata gruparea: HS, 2007–2010, \(n_{00}=928\), \(n_{01}=38\), \(n_{10}=38\), \(n_{11}=3\)
\(\hat\pi_{11}=0{,}0732\), față de \(\hat\pi_{01}=0{,}0393\), totuși \(\mathrm{LR}_{ind}=0{,}95\), cu \(p=0{,}33\)
Motivul: \(\hat\pi_{11}\) se sprijină doar pe 3 perechi de depășiri consecutive
Harta termică dă p-value-urile a trei teste pentru VaR 1%, pentru fiecare model și piață: testul POF al lui Kupiec, testul de acoperire condiționată (CC) și testul de durată Weibull. O celulă roșie este o respingere, iar una verde o nerespingere la pragul de semnificație ales cu cursorul; butonul ▶ crește pragul de la 1% la 10%. O liniuță marchează o prognoză GARCH reținută.
Întrebare pentru sală Pentru FHS pe S&P 500, Kupiec dă p = 0,116, iar testul acoperirii condiționate p = 0,040. Cum interpretăm diferența la 5%?
Răspuns
Nerespingerea frecvenței nominale nu exclude abateri de la acoperirea condiționată. Kupiec folosește numărul depășirilor; testul acoperirii condiționate folosește și succesiunea lor, deci verdictele diferite nu se contrazic. p = 0,040 nu este probabilitatea ipotezei nule. Testul DQ respinge și el FHS (p asimptotic < 0,001; frecvența simulată: 0,6%), iar testul duratelor nu (p = 0,527).
Pentru FHS pe S&P 500, testul Kupiec dă \(p = 0{,}116\), iar testul de acoperire condiționată \(p = 0{,}040\). La 5%, nerespingerea frecvenței nominale nu exclude abateri de la acoperirea condiționată. Testul Kupiec folosește doar numărul depășirilor, iar testul de acoperire condiționată și succesiunea lor, așa că deciziile diferite nu se contrazic; iar \(p = 0{,}040\) nu este probabilitatea ipotezei nule. Testul DQ respinge și el FHS (p-value asimptotic \(< 0{,}001\); frecvență simulată 0,6%), în timp ce testul de durată nu îl respinge (\(p = 0{,}527\)).
Testul DQ nu apare în harta termică; p-value-urile lui asimptotice \(\chi^2_6\) sînt raportate separat. El respinge toate modelele pe S&P 500, inclusiv FHS (\(p < 0{,}001\)) și GARCH-EVT (\(p < 0{,}001\)). Pe BET nu respinge FHS (\(p = 0{,}200\)) și nici GARCH-EVT (\(p = 0{,}279\)). Pe S&P 500, depășirile pot fi prevăzute din nivelul VaR și din depășirile anterioare, un eșec pe care numărarea depășirilor nu îl poate detecta. Aproximarea \(\chi^2_6\) respinge prea des în eșantioane finite, iar valorile critice simulate sînt discutate în Aprofundări.
Testele diferite examinează eșecuri diferite, iar tiparul deciziilor conține mai multă informație decît un singur p-value. Modelele necondiționate pică testul de durată aproape peste tot, așa cum sugerează rafalele de pe axa timpului. GARCH-EVT nu este respins de testele de acoperire condiționată sau de durată pe BET. Rezultatul susține o comparație între proceduri: el ordonează metodele după eșecurile detectate, nu după un singur criteriu. Mărimea și puterea fiecărui test, măsurate prin Monte Carlo, sînt în Aprofundări.
Pe scurt
Graficul: valorile p ale testelor Kupiec POF, de acoperire condiționată (CC) și de durată (Weibull), pentru VaR 1%
Numărul depășirilor este testat de testul POF al lui Kupiec (8.4), memoria de ordinul întîi de testul Christoffersen (8.6), iar ambele împreună de (8.7). Pe un an de date, testul POF are putere mică: o rată de depășire dublă este respinsă doar în 24% din cazuri. Pe datele capitolului, metodele necondiționate pică testele de independență și de durată, coada Normală pică testul de acoperire pe trei piețe, iar testul DQ respinge toate modelele pe S&P 500.
Perspectiva reglementatorului: semaforul Basel și FRTB
Băncile care calculează capitalul cu modele interne trebuie să-și testeze VaR după regulile stabilite de Comitetul de la Basel pentru Supraveghere Bancară (BCBS, Basel Committee on Banking Supervision). Regulile sînt intenționat simple: ele numără excepțiile din ultimele 250 de zile și transformă numărul într-un multiplicator de capital. Secțiunea prezintă regulile din 1996 și 2019, urmărește semaforul în timp pe S&P 500 și aplică limitele FRTB la nivel de birou de tranzacționare pe ultimul an al eșantionului.
În cadrul BCBS (1996), o bancă cu model intern compară zilnic VaR 1% cu profitul și pierderea efective (P&L, profit and loss) din fiecare dintre ultimele 250 de zile. O excepție este o zi în care pierderea depășește VaR. Regula testează doar numărul excepțiilor, nu mărimea și nici momentul lor.
Dacă VaR 1% este corect și excepțiile sînt independente, numărul de excepții în 250 de zile este \(X \sim \text{Binomial}(250; 0{,}01)\), iar funcția lui de repartiție este
a doua coloană a tabelului. Zonele sînt definite prin această probabilitate: zona galbenă începe unde \(P(X \le x) \ge 95\%\), la 5 excepții, iar zona roșie unde \(P(X \le x) \ge 99{,}99\%\), la 10 excepții. Zero excepții au probabilitatea 8,11%, iar cel mult patru 89,22%.
Supraveghetorul a ales o regulă de numărare pentru că este simplă, automată și greu de manipulat: banca nu poate contesta interpretarea unui număr. Prețul acestei simplități este puterea mică, calculată în secțiunea precedentă, și ignorarea mărimii pierderilor de dincolo de VaR.
Pe scurt
Excepții
\(P(X\le x)\)
Zona
0
8,11%
verde
2
54,32%
verde
4
89,22%
verde
5
95,88%
galben
7
99,60%
galben
9
99,97%
galben
10
99,99%
roșu
Băncile cu modele interne compară zilnic VaR 1% cu P&L-ul efectiv din ultimele 250 de zile (BCBS (1996))
P&L: profitul și pierderea
Ce testează: doar numărul excepțiilor, nu mărimea sau momentul lor
\(X\sim\) Binomială\((250; 0{,}01)\): excepțiile unui VaR 1% corect în 250 de zile
\(P(X\le x)=\sum_{k=0}^{x}\binom{250}{k}0{,}01^{k}\,0{,}99^{250-k}\): coloana a doua a tabelului
Zona galbenă începe unde \(P(X\le x)\ge 95\%\), cea roșie unde \(P(X\le x)\ge 99{,}99\%\)
De ce o regulă de numărare: simplă, automată, greu de manipulat
În cadrul BCBS (1996), capitalul se baza pe VaR 1% la 10 zile, cu multiplicatorul 3. Multiplicatorul creștea cu 0,40–0,85 în zona galbenă, în funcție de numărul excepțiilor, și cu 1 în zona roșie. Backtestul intra astfel direct în capital: un model cu prea multe excepții costa banca mai mult.
Fundamental Review of the Trading Book (BCBS, 2019) a mutat capitalul pe ES 2,5%, dar a păstrat backtesting-ul pe VaR 1% din ultimele 250 de zile. Multiplicatorul FRTB este 1,50 în zona verde (0–4 excepții), 1,70–1,92 în zona galbenă (5–9) și 2,00 în zona roșie (10 sau mai multe). În plus, fiecare birou de tranzacționare (trading desk) este verificat separat: un birou trece la abordarea standardizată dacă, în 12 luni, are mai mult de 12 excepții ale VaR 1% sau mai mult de 30 ale VaR 2,5%. Aprobarea abordării prin modele interne (IMA, internal models approach) cere și un test de atribuire a P&L (P&L attribution test).
Regula Basel numără excepțiile VaR, iar ES nu este testat direct. Aceasta este o alegere de reglementare, nu o necesitate matematică. Faptul că ES nu este elicitabil singur nu împiedică backtesting-ul ES, așa cum arată testele lui Acerbi & Szekely (2014) din secțiunea despre ES. Elicitabilitatea privește compararea prognozelor, tratată în secțiunea despre elicitabilitate.
Graficul aplică regula de numărare Basel celor șase modele pe fiecare piață: pentru fiecare zi numără excepțiile VaR 1% din ultimele 250 de zile, cu benzi pentru zonele verde, galbenă și roșie. Selectorul alege piața, cursorul fixează ziua în care se încheie fereastra de 250 de zile, iar butonul ▶ mută această zi de-a lungul eșantionului.
Întrebare pentru sală Un model este astăzi în zona roșie. Dacă mîine nu apare nicio depășire, poate rămîne în zona roșie?
Răspuns
Da, dacă fereastra actualizată de 250 de zile conține încă cel puțin 10 depășiri. Fereastra avansează cu o zi: intră observația nouă și iese cea mai veche, deci o zi calmă scade numărul excepțiilor doar dacă ziua ieșită avea o depășire. Pe S&P 500, Normal petrece 22,3% din zile în zona roșie, HS 14,7%, GARCH-t 2,0% și FHS 0,8%; maximele Normal (37) și HS (27) cad în fereastra încheiată la 01.12.2008.
Pe S&P 500, ponderea zilelor petrecute în zona roșie este 22,3% pentru modelul Normal, 14,7% pentru HS, 2,0% pentru GARCH-t și 0,8% pentru FHS; GARCH-t este în zona galbenă în 46,5% din timp. Vîrfurile sînt 37 de excepții pentru modelul Normal și 27 pentru HS, ambele în cele 250 de zile încheiate la 1 decembrie 2008. Un model poate rămîne în zona roșie într-o zi fără depășire: fereastra avansează cu o zi, iar o zi calmă scade numărul doar dacă ziua care iese din fereastră avea o depășire.
Pe scurt
Excepțiile VaR 1% în ultimele 250 de zile, S&P 500; benzi: zonele verde, galbenă, roșie
Ponderea zilelor aflate în zona roșie: Normal 22,3%, HS 14,7%, GARCH-t 2,0%, FHS 0,8%
GARCH-t se află în zona galbenă 46,5% din timp
Maximul: 37 de excepții pentru Normal și 27 pentru HS, în cele 250 de zile încheiate la 01.12.2008
Ferestrele se suprapun: penalizarea durează un an după criză, cînd capitalul este deja sub presiune
Tabelul aplică limitele FRTB pentru birourile de tranzacționare ultimelor 250 de zile ale fiecărei serii, pînă la 18 septembrie 2026. Fiecare celulă dă numărul de excepții ale VaR 1% și ale VaR 2,5%; în aceste zile există prognoze GARCH pe toate cele patru piețe. Cele mai mari numere sînt 6 excepții ale VaR 1% (modelul Normal pe BET) și 9 ale VaR 2,5% (mai multe modele pe BET), așa că toate modelele se încadrează lejer în limitele 12 și 30.
Verificarea este ilustrativă. FRTB aplică limitele la P&L-ul unui birou de tranzacționare, efectiv și ipotetic, nu la randamentele unui indice. Ultimul an al eșantionului a fost, în plus, calm, iar o zonă verde astăzi spune puțin despre următoarea criză: semaforul din 2008 arată cît de repede crește numărul cînd se schimbă volatilitatea.
Pe scurt
Model
S&P 500
BET
Bitcoin
EUR/RON
HS
0 / 2
4 / 7
3 / 4
1 / 5
Normal
2 / 2
6 / 9
3 / 5
1 / 4
Student-t
0 / 2
4 / 9
1 / 4
5 / 8
GARCH-t
3 / 6
4 / 9
3 / 5
4 / 5
FHS
3 / 4
4 / 6
4 / 5
3 / 4
GARCH-EVT
3 / 3
2 / 7
4 / 5
3 / 4
Celule: excepții ale VaR 1% / VaR 2,5% în ultimele 250 de zile ale fiecărei serii, pînă la 18.09.2026
În aceste zile, prognozele GARCH există pe toate cele patru piețe
Toate modelele se încadrează confortabil în limitele 12 și 30
Doar ilustrativ: FRTB aplică limitele P&L-ului birourilor (efectiv și ipotetic), nu randamentelor de indici
Ultimul an a fost calm: o zonă verde în prezent spune puțin despre următoarea criză
Sinteza secțiunii
Backtestul de reglementare este o numărare a excepțiilor VaR 1% pe 250 de zile, transformată în zone prin distribuția Binomială (8.8). Din 2019 capitalul se bazează pe ES 2,5%, dar backtestul numără tot excepțiile VaR, la nivel de bancă și la nivel de birou. Pe S&P 500, modelele necondiționate petrec perioade lungi în zona roșie, iar ferestrele de 250 de zile suprapuse mențin penalizarea un an după o criză.
Backtesting pentru Expected Shortfall
ES este media pierderilor dincolo de VaR, deci informația pentru testarea lui vine doar din cele aproximativ \(\alpha T\) zile din coadă. Secțiunea prezintă trei familii de teste: reziduurile de depășire ale lui McNeil & Frey (2000), statisticile \(Z\) ale lui Acerbi & Szekely (2014), cu p-value-uri obținute prin simulare, și testele construite pe transformarea integrală a probabilității (PIT, probability integral transform). Toate trei au nevoie de mai mult decît prognoza ES.
Informația despre ES vine doar din zilele din coadă. Pe S&P 500, cu \(\alpha = 2{,}5\%\), din cele 4 959 de zile de evaluare aproximativ 124 sînt așteptate în coadă; într-un singur an, 6,25 zile. Pe un an, eroarea standard a mediei din coadă este deci de ordinul \(1/\sqrt{6{,}25} = 0{,}40\) abateri standard ale pierderilor din coadă. O prognoză ES greșită cu o fracțiune din dispersia cozii nu poate fi detectată într-un an.
Trei familii de teste folosesc aceste zile în moduri diferite. Reziduurile de depășire (McNeil & Frey, 2000) compară pierderile din zilele de depășire cu ES prognozat, pe scara volatilității. Statisticile \(Z_1\) și \(Z_2\) (Acerbi & Szekely, 2014) compară direct pierderile din coadă realizate și prognozate. Statisticile bazate pe PIT, depășirile cumulate ale lui Du & Escanciano (2017) și testele multinomiale ale lui Kratz, Lok & McNeil (2018), folosesc întreaga distribuție prognozată în coadă.
Toate au nevoie de mai mult decît prognoza ES: de VaR, de volatilitate sau de întreaga distribuție prognozată. O respingere este deci respingerea unei prognoze comune. Un test care folosește doar prognozele ES face obiectul studiului de caz.
Pe scurt
ES este media pierderilor dincolo de VaR: informația vine doar din aproximativ \(\alpha T\) zile din coadă
S&P 500, \(\alpha=2{,}5\%\): aproximativ 124 de zile din 4 959; într-un an, 6,25 zile
Pe un an, eroarea standard a mediei din coadă este de ordinul \(1/\sqrt{6{,}25}=0{,}40\) abateri standard ale pierderilor din coadă
Trei familii de teste
reziduurile de depășire (McNeil–Frey)
statisticile \(Z_1\), \(Z_2\) (Acerbi–Szekely)
statisticile pe PIT (Du–Escanciano, teste multinomiale)
Toate cer mai mult decît prognoza ES: VaR, volatilitatea sau întreaga distribuție prognozată
Testul lui McNeil & Frey (2000) verifică dacă pierderea medie din zilele de depășire este cea prognozată de ES, măsurată pe scara volatilității. În zilele cu \(L_t > \mathrm{VaR}_t\), la nivelul VaR 2,5%, reziduul de depășire (exceedance residual) este
\[e_t = \frac{L_t - \mathrm{ES}_t}{\sigma_t} ,\]
(8.9)
unde \(\sigma_t > 0\) este prognoza de volatilitate făcută la \(t-1\). Dacă atît VaR, cît și ES sînt corecte, \(E[e_t \mid L_t > \mathrm{VaR}_t, \mathcal{F}_{t-1}] = 0\), din definiția (8.2) a ES ca medie condiționată dincolo de VaR. Un VaR greșit schimbă evenimentul de condiționare, deci testul privește perechea.
Ipoteza nulă este \(H_0: E[e_t] = 0\), cu alternativa unilaterală \(H_1: E[e_t] > 0\), adică ES subestimat. Statistica este \(t = \bar e/(s_e/\sqrt N)\), unde \(\bar e\) și \(s_e\) sînt media și abaterea standard a celor \(N\) reziduuri. Deoarece reziduurile sînt puține și au cozi groase, p-value-ul se obține printr-un bootstrap i.i.d. al reziduurilor centrate, cu 5 000 de replicări. Bootstrapul i.i.d. presupune reziduuri independente; pentru reziduuri dependente este nevoie de un bootstrap pe blocuri (block bootstrap).
Pe scurt
Ce testează: dacă pierderea medie în zilele de depășire este cea prognozată de ES, pe scala volatilității
Reziduul de depășire: \(e_t=(L_t-\mathrm{ES}_t)/\sigma_t\) în zilele cu \(L_t>\mathrm{VaR}_t\) (VaR 2,5%)
\(\sigma_t>0\): volatilitatea prognozată la \(t-1\)
Dacă VaR și ES sînt corecte: \(E[e_t\mid L_t>\mathrm{VaR}_t,\mathcal{F}_{t-1}]=0\)
un VaR greșit schimbă evenimentul de condiționare
\(H_0\): \(E[e_t]=0\) față de \(H_1\): \(E[e_t]>0\) (ES subestimat)
Statistica: \(t=\bar e/(s_e/\sqrt N)\), cu \(\bar e\) și \(s_e\) media și abaterea standard a celor \(N\) reziduuri
valoarea p: bootstrap i.i.d. al reziduurilor centrate (5 000 de replicări) (McNeil & Frey (2000))
pentru că reziduurile sînt puține și au cozi groase
Bootstrap-ul presupune reziduuri independente
cu reziduuri dependente se folosește un bootstrap pe blocuri
Graficul arată distribuția reziduurilor (8.9) în zilele de depășire a VaR 2,5%, cîte o cutie pentru fiecare model, cu romburi pentru medii. Selectorul alege piața, cursorul fixează sfîrșitul perioadei de evaluare, iar butonul ▶ îl extinde an cu an.
Întrebare pentru sală Mediile reziduurilor de depășire sînt 0,100 pentru GARCH-t și 0,104 pentru FHS. Ce mai trebuie luat în calcul pentru a explica deciziile McNeil–Frey diferite?
Răspuns
Erorile standard ale mediilor și distribuțiile bootstrap ale statisticilor. GARCH-t are N = 198 și abaterea standard s ≈ 0,814, iar FHS N = 128 și s ≈ 0,878; erorile standard ale mediilor sînt aproximativ 0,058 și 0,078. Rezultă t = 1,73 și 1,34, iar p-value-urile bootstrap sînt 0,025 și 0,072. Numărul observațiilor contribuie la diferență, dar nu o determină singur.
Pe S&P 500, reziduurile medii sînt 0,875 pentru modelul Normal, 0,363 pentru HS, 0,082 pentru Student-t, 0,100 pentru GARCH-t, 0,104 pentru FHS și 0,068 pentru GARCH-EVT. P-value-urile bootstrap sînt sub 0,001 pentru Normal și HS, 0,173 pentru Student-t, 0,025 pentru GARCH-t, 0,072 pentru FHS și 0,157 pentru GARCH-EVT.
GARCH-t și FHS au aproape aceeași medie, totuși doar GARCH-t este respins la 5%. Diferența vine din precizia mediilor: GARCH-t are \(N = 198\) de reziduuri cu abaterea standard \(s \approx 0{,}814\), FHS \(N = 128\) cu \(s \approx 0{,}878\), deci erorile standard sînt aproximativ 0,058 și 0,078, iar statisticile \(t\) 1,73 și 1,34. Media din coadă a modelului Normal este prea mică cu aproape o unitate de volatilitate, iar reziduurile extreme, de pînă la 10 volatilități, sînt cele care contează cel mai mult pentru capital.
Pe scurt
Distribuția lui \((L_t-\mathrm{ES}_t)/\sigma_t\) în zilele de depășire a VaR 2,5% (romburile marchează mediile)
Acerbi & Szekely (2014) propun statistici care compară pierderile din coadă realizate cu ES prognozat. Fie \(I_t = \mathbf{1}\{L_t > \mathrm{VaR}^{\alpha}_t\}\) indicatorul de depășire a VaR 2,5%, cu \(\alpha = 0{,}025\),\(N_T = \sum_t I_t\) numărul de depășiri în \(T\) zile și \(\mathrm{ES}_t\) prognoza ES pentru ziua \(t\). Cele două statistici sînt
\(Z_1\) este condiționată de depășiri: ea întreabă dacă pierderea medie din coadă, raportată la prognoză, este atît de mare cît s-a prognozat. \(Z_2\) împarte la numărul așteptat de depășiri \(T\alpha\), nu la numărul observat \(N_T\), deci testează împreună frecvența și mărimea pierderilor din coadă: atît prea multe depășiri, cît și depășiri prea adînci o împing în jos.
Sub \(H_0\), o distribuție prognozată corectă, \(E[Z_2] = 0\), iar un risc subestimat dă \(Z_2 < 0\). Pentru \(T = 250\) și multe distribuții, valorile critice de 5% și 0,01% sînt apropiate de \(-0{,}70\) și \(-1{,}8\). Aceste valori pot servi drept praguri de referință pentru un semafor ES, la fel cum 5 și 10 excepții servesc pentru VaR.
Pe scurt
Indicatorul de depășire a VaR 2,5%: \(I_t=\mathbf{1}\{L_t>\mathrm{VaR}_t^{\alpha}\}\), cu \(\alpha=0{,}025\)
\(N_T=\sum_t I_t\): numărul de depășiri în \(T\) zile
\(\mathrm{ES}_t\): prognoza ES pentru ziua \(t\)
\(Z_1=1-\dfrac{1}{N_T}\sum_{t}\dfrac{L_t I_t}{\mathrm{ES}_t}\), condiționat de depășiri
este pierderea medie din coadă atît de mare cît s-a prognozat?
\(Z_2=1-\dfrac{1}{T\alpha}\sum_{t}\dfrac{L_t I_t}{\mathrm{ES}_t}\): testează frecvența și mărimea împreună
Sub \(H_0\) (distribuția prognozată este corectă) \(E[Z_2]=0\); riscul subestimat dă \(Z_2<0\) (Acerbi & Szekely (2014))
Pentru \(T=250\) și multe distribuții, valorile critice de 5% și 0,01% sînt apropiate de \(-0{,}70\) și \(-1{,}8\)
Distribuția lui \(Z_2\) sub ipoteza nulă depinde de distribuțiile prognozate \(F_t\), funcțiile de repartiție ale lui \(L_t\) prognozate în ziua \(t-1\), așa că valorile critice trebuie simulate. Fiecare dintre cele \(M = 2\,000\) de replicări extrage, pentru fiecare zi, \(U_t \sim\) Uniform(0,1) și pune \(L^*_t = F_t^{-1}(U_t)\), unde \(F_t^{-1}\) este funcția cuantilă. Apoi calculează \(Z_2^*\) din pierderile simulate, cu aceleași prognoze VaR și ES. Este o calibrare cu distribuțiile prognozate ținute fixe și cu \(U_t\) independente: riscul de estimare și reestimarea GARCH sînt ignorate.
P-value-ul este ponderea valorilor simulate \(Z_2^*\) mai mici sau egale cu \(Z_2\) observat. Cu \(M = 2\,000\), cel mai mic p-value nenul este 0,0005, iar cînd nicio valoare simulată nu este mai extremă raportarea corectă este \(p < 0{,}0005\), nu \(p = 0\). În \(Z_2\) intră doar extragerile din coadă, ceea ce face simularea ieftină: pentru HS și FHS se păstrează doar cele mai mari 25 de pierderi din fereastra fiecărei zile, deoarece \(25 = 2{,}5\% \times 1\,000\).
Pe întregul eșantion S&P 500, \(Z_2 = -0{,}664\) pentru GARCH-t (\(p < 0{,}001\)) și \(-0{,}079\) pentru FHS (\(p = 0{,}209\)). Valoarea critică de 5% la \(T = 4\,959\) este aproximativ \(-0{,}150\), mai aproape de 0 decît \(-0{,}70\) de la \(T = 250\): pe un eșantion mai lung, statistica este mai concentrată în jurul lui zero sub ipoteza nulă.
Pe scurt
Distribuția lui \(Z_2\) sub \(H_0\) depinde de distribuțiile prognozate \(F_t\), deci valorile critice se simulează
\(F_t\): funcția de repartiție a lui \(L_t\), prognozată în ziua \(t-1\)
Pasul 1, repetat de \(M=2\,000\) de ori: pentru fiecare zi extragem \(U_t\sim\) Uniform(0,1)
calculăm \(L_t^{*}=F_t^{-1}(U_t)\) (\(F_t^{-1}\): funcția cuantilă)
Pasul 2: calculăm \(Z_2^{*}\) din pierderile simulate, cu aceleași prognoze VaR și ES
o calibrare cu distribuțiile prognozate fixate și \(U_t\) independente: riscul de estimare și reestimarea GARCH sînt ignorate
valoarea p \(=\) ponderea valorilor \(Z_2^{*}\le Z_2\) observat
cu \(M=2\,000\), cea mai mică valoare p nenulă este 0,0005; nicio valoare simulată mai extremă înseamnă \(p<0{,}0005\), nu \(p=0\)
Contează doar extragerile din coadă
pentru HS și FHS păstrăm cele mai mari 25 de pierderi din fereastra fiecărei zile (\(25=2{,}5\%\times 1\,000\))
S&P 500, întreg eșantionul
\(Z_2=\ensuremath{-}0{,}664\) pentru GARCH-t (\(p\)\(<\)0,001)
\(Z_2=\ensuremath{-}0{,}079\) pentru FHS (\(p=0{,}209\))
Valoarea critică de 5% la \(T=4\,959\) este de circa \(\ensuremath{-}0{,}150\), mai aproape de 0 decît \(-0{,}70\) la \(T=250\)
Graficul recalculează zilnic \(Z_2\) pentru ES 2,5% pe ultimele 250 de zile, pentru fiecare model; liniile orizontale sînt pragurile de referință \(-0{,}70\) și \(-1{,}8\). Selectorul alege piața (S&P 500 sau BET), iar cursorul fixează lungimea ferestrei, de la 125 la 1 000 de zile; butonul ▶ o mărește pas cu pas.
Întrebare pentru sală Pe S&P 500, Z₂ al GARCH-t este sub −0,70 în 44,3% dintre ferestrele de 250 de zile. Ce reprezintă acest procent?
Răspuns
Ponderea observată a ferestrelor care trec sub pragul ales: o frecvență descriptivă pe ferestre suprapuse (ferestrele vecine au 249 de zile comune), nu probabilitatea unei alarme false și nici probabilitatea ca prognozele ES să fie greșite. Pragul −0,70 aproximează valoarea critică de 5% pentru T = 250 la multe distribuții (Acerbi–Szekely); nivelul efectiv depinde de distribuțiile prognozate. Sub −1,8 GARCH-t este în 3,0% din ferestre; minimul, −2,52, este în fereastra încheiată la 05.02.2008.
Pe S&P 500, \(Z_2\) al modelului GARCH-t este sub \(-0{,}70\) în 44,3% dintre ferestrele de 250 de zile. Aceasta este o frecvență descriptivă pe ferestre suprapuse, care au 249 de zile comune cu vecinele lor; nu este nici probabilitatea unei alarme false, nici probabilitatea ca prognozele ES să fie greșite. GARCH-t este sub \(-1{,}8\) în 3,0% dintre ferestre, cu un minim de \(-2{,}52\) în fereastra încheiată la 5 februarie 2008.
Minimele lui \(Z_2\) arată adîncimea eșecului din 2008: \(-11{,}13\) pentru modelul Normal în fereastra încheiată la 4 decembrie 2008, \(-7{,}30\) pentru HS la 1 decembrie 2008, \(-2{,}52\) pentru GARCH-t la 5 februarie 2008 și \(-1{,}97\) pentru FHS la 17 ianuarie 2008. Ponderea ferestrelor cu \(Z_2 < -1{,}8\) este 21,9% pentru modelul Normal, 15,8% pentru HS, 3,0% pentru GARCH-t și 0,7% pentru FHS.
Verificarea zilnică a lui \(Z_2\) înseamnă testare repetată: fiecare fereastră este un test la un nivel nominal, iar alarmele false se acumulează de la o zi la alta. Procedurile de monitorizare care controlează probabilitatea oricărei alarme false pe întregul orizont sînt descrise în Anexă; e-backtestul din studiile de caz este un alt răspuns la aceeași problemă. Testul Du–Escanciano este în Aprofundări.
Pe scurt
\(Z_2\) pentru ES 2,5% pe S&P 500, recalculat zilnic pe ultimele 250 de zile
liniile orizontale: pragurile \(-0{,}70\) și \(-1{,}8\)
Minim: Normal \(-\)11,13 (fereastra încheiată la 04.12.2008), HS \(-\)7,30 (01.12.2008)
Harta termică adună testele ES 2,5% pentru fiecare model și piață: testul bootstrap McNeil–Frey, \(Z_2\) prin simulare și testul necondiționat Du–Escanciano \(U\). Primul selector afișează fie p-value-urile, fie statisticile testelor; cursorul fixează pragul de semnificație, iar butonul ▶ îl crește de la 1% la 10%.
Întrebare pentru sală Pe S&P 500, McNeil–Frey nu respinge Student-t (p = 0,173). De ce poate Z₂ să îl respingă?
Răspuns
Z₂ combină frecvența depășirilor cu mărimea pierderilor raportată la ES: Z₂ = −0,723, cu p = 0,002. Sînt 208 depășiri în 4 959 de zile, adică 4,19%, față de ținta de 2,5%; media raportului L/ES în acele zile este aproximativ 1,027. Astfel, Z₂ = 1 − [208/(4 959 × 0,025)] × 1,027 ≈ −0,723. McNeil–Frey testează media reziduurilor condiționat de depășire și nu impune separat frecvența nominală.
Pe S&P 500, testul McNeil–Frey nu respinge Student-t (\(p = 0{,}173\)), dar \(Z_2\) îl respinge: \(Z_2 = -0{,}723\), cu \(p = 0{,}002\). Există 208 depășiri ale VaR 2,5% în 4 959 de zile, adică 4,19%, față de o țintă de 2,5%, iar raportul mediu \(L_t/\mathrm{ES}_t\) în aceste zile este aproximativ 1,027. Rezultă \(Z_2 = 1 - [208/(4\,959 \times 0{,}025)] \times 1{,}027 \approx -0{,}723\). McNeil–Frey testează reziduul mediu de depășire condiționat de o depășire și nu impune separat frecvența nominală; \(Z_2\) combină frecvența cu mărimea.
La pragul de 5%, FHS și GARCH-EVT nu sînt respinse pe S&P 500 și BET de niciunul dintre cele trei teste luate separat: McNeil–Frey, \(Z_2\) sau Du–Escanciano \(U\). GARCH-t este respins de \(Z_2\) pe ambele piețe (\(p < 0{,}001\)). Coada lui este prea subțire pe partea pierderilor, așa cum sugerau deja ratele de depășire ale VaR.
Ipoteze nule și date de intrare diferite duc la decizii diferite. Student-t pe S&P 500 are un p-value McNeil–Frey de 0,173, dar un p-value \(Z_2\) de 0,002, din motivul calculat mai sus. Testele sînt teste de calibrare, nu clasamente: un model care le trece pe toate este acceptabil, nu mai bun decît alt model care le trece și el.
Statistica \(U\) trebuie citită împreună cu semnul ei. Pe EUR/RON, HS are \(U = -3{,}68\)(\(p < 0{,}001\)): respingerea apare pentru că pierderile rămîn mai puțin adînci decît s-a prognozat, ceea ce concordă cu p-value-ul \(Z_2\) de 1,000 și cu rata de depășire a VaR 1% de 0,51%. Un p-value bilateral ascunde această direcție. Testele multinomiale sînt în Aprofundări.
Pe scurt
La pragul de semnificație de 5%, FHS și GARCH-EVT nu sînt respinse pe S&P 500 și BET
nici de McNeil–Frey, nici de \(Z_2\), nici de Du–Escanciano \(U\), luate separat
Ipoteze nule și date diferite dau decizii diferite
pentru Student-t pe S&P 500, McNeil–Frey dă \(p=0{,}173\), dar \(Z_2\) dă \(p=0{,}002\)
Acestea sînt teste de calibrare, nu clasamente
GARCH-t este respins de \(Z_2\) pe S&P 500 (\(p\)\(<\)0,001) și BET (\(p\)\(<\)0,001)
Semnul lui \(U\) contează: pe EUR/RON, HS are \(U=\ensuremath{-}3{,}68\) (\(p\)\(<\)0,001)
o respingere pentru că pierderile rămîn mai puțin adînci decît s-a prognozat
în acord cu \(Z_2\) (\(p=1{,}000\)) și cu rata de depășire a VaR 1% de 0,51%
ES poate fi testat prin backtesting, dar fiecare test cere mai mult decît prognoza ES: VaR și volatilitatea pentru reziduurile de depășire (8.9), întreaga distribuție prognozată pentru p-value-urile simulate ale lui \(Z_2\)(8.10) și pentru testele bazate pe PIT. Pe S&P 500 și BET, FHS și GARCH-EVT trec toate cele trei teste la 5%, în timp ce GARCH-t este respins de \(Z_2\). Testele de calibrare nu ierarhizează modelele care le trec; ierarhizarea face obiectul următoarelor două secțiuni.
Elicitabilitate și funcții de scor
Un backtest întreabă dacă un model este acceptabil. Evaluarea comparativă întreabă care dintre mai multe modele este mai bun și are nevoie de o funcție de scor a cărei valoare medie este minimizată de măsura de risc adevărată. Secțiunea definește consistența și elicitabilitatea, arată că VaR este elicitabil prin pierderea pinball, în timp ce ES singur nu este, și introduce scorul comun FZ0 pentru perechea (VaR, ES).
Un backtest întreabă dacă un model este acceptabil: mai multe modele pot trece sau toate pot eșua. Backtesting-ul comparativ, în sensul lui Nolde & Ziegel (2017), întreabă care model este mai bun. Ierarhizarea cere o funcție de scor (scoring function) \(S(x, L)\), penalizarea pentru raportarea lui \(x\) cînd se realizează pierderea \(L\). Prognozele se compară prin scorul lor mediu \(\bar S = \frac{1}{T}\sum_t S(x_t, L_t)\), iar un scor mediu mai mic este mai bun.
Nu orice funcție de scor dă o ierarhizare cu sens. Fie \(\theta(F)\) funcționala-țintă, de exemplu VaR, a distribuției pierderii \(F\), și \(E_F\) media cînd \(L \sim F\). După Gneiting (2011),\(S\) este consistentă pentru \(\theta\), iar \(\theta\) este elicitabilă (elicitable), dacă
\[\theta(F) \in \arg\min_{x}\ E_F[S(x, L)]\]
(8.11)
pentru orice \(F\) din clasa relevantă. Un prognozist care cunoaște \(F\) își minimizează scorul așteptat raportînd valoarea adevărată. Ierarhizarea cere mai mult: valoarea adevărată trebuie să fie unicul punct de minim, proprietate numită consistență strictă. Altfel, o prognoză greșită poate egala prognoza corectă.
Pe scurt
Un backtest întreabă dacă un model este acceptabil
mai multe modele pot fi acceptate sau toate pot fi respinse
Dacă \(E|L| < \infty\) și densitatea \(f\) este pozitivă în cuantilă, derivarea scorului așteptat dă \(\frac{\partial}{\partial v}E_F[S(v,L)] = F(v) - (1-\alpha)\). Condiția de ordinul întîi \(F(v) = 1-\alpha\) dă \(v = F^{-1}(1-\alpha) = \mathrm{VaR}_\alpha\), iar derivata a doua \(f(v) > 0\) face minimul unic. Pierderea pinball (8.12) este deci strict consistentă pentru VaR.
ES singur nu este elicitabil: nicio funcție de scor care depinde doar de ES-ul raportat \(e\) nu este strict consistentă pentru ES pe clasa relevantă de distribuții (Gneiting, 2011). Motivul este o proprietate a mulțimilor de nivel. Pentru o funcțională elicitabilă, mulțimea distribuțiilor cu aceeași valoare a funcționalei este convexă la amestecuri; pentru ES nu este, așa cum se arată în Anexă. Soluția este ierarhizarea ES împreună cu VaR.
Pe scurt
VaR este elicitabil, cu pierderea pinball \(S(v,L)=\left(\mathbf{1}\{L>v\}-\alpha\right)(L-v)\), unde \(v\) este prognoza VaR
Dacă \(E|L|<\infty\) și densitatea \(f>0\) în cuantilă: \(\dfrac{\partial}{\partial v}E_F[S(v,L)]=F(v)-(1-\alpha)=0\ \Rightarrow\ v=F^{-1}(1-\alpha)=\mathrm{VaR}_\alpha\)
A doua derivată este \(f(v)>0\), deci minimul este unic
Fissler & Ziegel (2016) arată că perechea (VaR, ES) este elicitabilă împreună și caracterizează întreaga familie de funcții de scor consistente, familia FZ (Fissler–Ziegel, family of scoring functions for VaR and ES, familia Fissler–Ziegel de funcții de scor pentru VaR și ES). Membrul folosit în capitol este FZ0, cel cu diferențe de scor omogene de grad zero (Patton, Ziegel & Chen, 2019). El este definit pentru pierderi pozitive, cu \(0 < v \le e\) și \(E|L| < \infty\):
unde \(v\) și \(e\) sînt prognozele VaR și ES pe scara pierderilor, iar \(L\) este pierderea realizată.
Primul termen din (8.13) penalizează depășirile, raportate la ES: o pierdere mult dincolo de VaR costă mai mult cînd ES prognozat este mic. Ultimii termeni penalizează raportarea unui ES mare, deci un prognozist nu își poate micșora scorul umflînd ES. Un FZ0 mediu mai mic înseamnă o prognoză comună mai bună a VaR și a ES.
Scorul are o invarianță utilă: \(\mathrm{FZ0}(cv, ce; cL) = \mathrm{FZ0}(v, e; L) + \ln c\) pentru \(c > 0\). Înmulțirea tuturor prognozelor și pierderilor cu \(c\) deplasează fiecare scor cu aceeași constantă, deci diferențele dintre modele nu depind de scara pierderilor. Acest lucru contează cînd pierderile sînt măsurate într-un loc în procente și în altul în zecimale.
Pe scurt
Perechea (VaR, ES) este elicitabilă împreună: Fissler & Ziegel (2016) caracterizează familia FZ (familia Fissler–Ziegel de funcții de scor pentru VaR și ES) a funcțiilor de scor consistente
FZ0: membrul familiei FZ cu diferențe de scor omogene de grad zero (Patton, Ziegel & Chen (2019)), pentru pierderi pozitive, \(0<v\le e\) și \(E|L|<\infty\)
Fie \(\alpha = 2{,}5\%\), prognozele \(v = 3\%\) și \(e = 3{,}9\%\) și pierderile în procente. Dacă pierderea este \(L = 4{,}5\%\), o depășire, primul termen din (8.13) este \((4{,}5-3)/(0{,}025 \times 3{,}9) = 15{,}385\), iar scorul este \(15{,}385 + 1{,}130 = 16{,}515\). Dacă pierderea este \(L = 1\%\), fără depășire, rămîne doar \(v/e + \ln e - 1 = 0{,}769 + 1{,}361 - 1 = 1{,}130\).
În zecimale, \(v = 0{,}03\) și \(e = 0{,}039\), rapoartele \(v/e\) și \((L-v)/(\alpha e)\) nu se schimbă și se modifică doar \(\ln e\). Fiecare valoare scade cu \(\ln 100 = 4{,}605\), la \(-3{,}475\) fără depășire și la \(11{,}910\) cu depășire. De aceea pierderile FZ0 medii calculate pe randamente în zecimale sînt negative: pe S&P 500, pierderea FZ0 medie a FHS este \(-3{,}551\). Un scor negativ nu indică o eroare, iar diferențele dintre modele nu depind de alegerea unităților.
Pe scurt
\(\alpha=2{,}5\%\), prognozele \(v=3\%\) și \(e=3{,}9\%\), pierderi în procente
Graficul reprezintă scorurile așteptate pentru pierderi Student-t cu varianță unitară și \(\alpha = 2{,}5\%\). Panoul din stînga arată pierderea pinball așteptată (8.12) în funcție de VaR-ul raportat; panoul din dreapta arată curbele de nivel ale pierderii FZ0 așteptate (8.13) pe perechi de VaR și ES raportate, cu minimul marcat. Cursorul fixează gradele de libertate \(\nu\), iar selectorul nivelul \(\alpha\) (1%, 2,5% sau 5%); butonul ▶ mută \(\nu\) de la 2,5 la 30.
Întrebare pentru sală ▶ schimbă ν de la 2,5 la 30 (pierderi Student-t cu dispersie unitară, α = 2,5%). Unde rămîne minimul pierderii pinball așteptate?
Răspuns
În VaR 2,5% adevărat, pentru fiecare ν: derivata F(v) − (1 − α) se anulează în cuantilă. Pe grilă, minimul este 1,596 pentru VaR adevărat 1,599 la ν = 2,5, 1,960 pentru 1,963 la ν = 4 și 1,970 pentru 1,973 la ν = 30. Pierderea FZ0 așteptată are minimul în perechea (VaR, ES) adevărată: la ν = 4, (1,960; 2,818) pe grilă, față de (1,963; 2,824). ES singur nu are o funcție de scor cu această proprietate.
Minimul pierderii pinball așteptate rămîne în VaR 2,5% adevărat pentru orice \(\nu\), deoarece derivata \(F(v) - (1-\alpha)\) se anulează în cuantilă. Pe grilă, minimul este 1,596 pentru un VaR adevărat de 1,599 la \(\nu = 2{,}5\), 1,960 pentru 1,963 la \(\nu = 4\) și 1,970 pentru 1,973 la \(\nu = 30\). Pierderea FZ0 așteptată este minimă în perechea (VaR, ES) adevărată: la \(\nu = 4\), (1,960; 2,818) pe grilă, față de (1,963; 2,824). ES singur nu are o funcție de scor cu această proprietate.
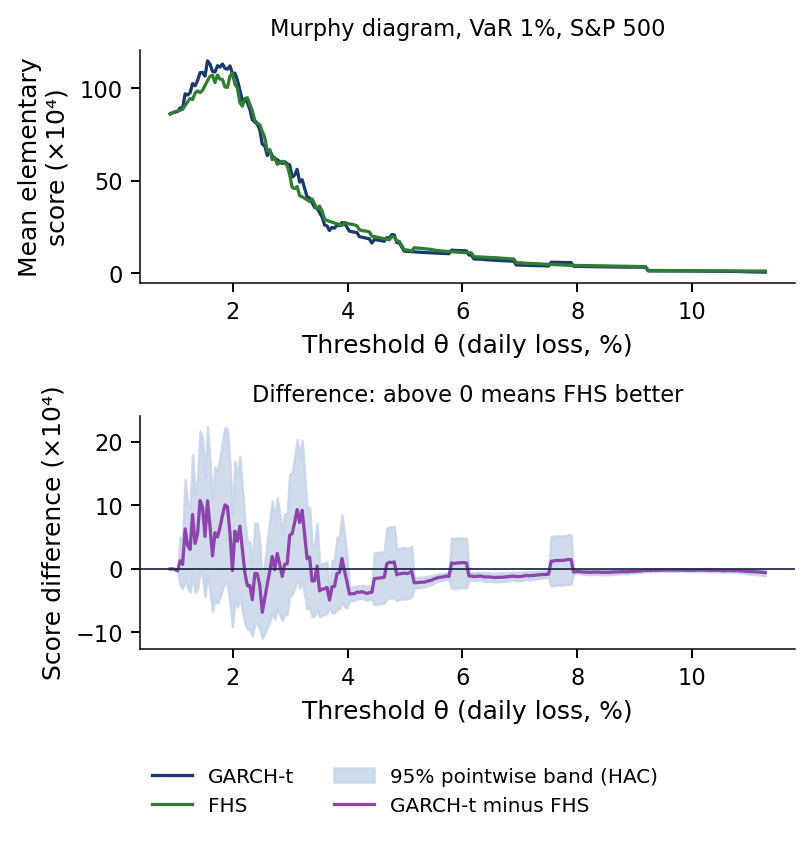
Un prognozist care cunoaște adevărul nu are niciun motiv să raporteze altceva. Aceasta dă sens ierarhizării după scorul mediu: scorul recompensează prognozele corecte, nu pe cele norocoase. Diagrama Murphy, care verifică dacă un clasament se menține pentru toate scorurile consistente, este în Aprofundări.
Pe scurt
Pierderi Student-t cu \(\nu=4\) și dispersie unitară, \(\alpha=2{,}5\%\)
Stînga: pierderea pinball așteptată este minimă în VaR 2,5% adevărat, 1,96
Dreapta: pierderea FZ0 așteptată este minimă în (1,96; 2,82)
adică în perechea (VaR, ES) adevărată, în limita grilei
Un prognozator care cunoaște adevărul nu are motiv să raporteze altceva: de aceea ordonarea după scorul mediu are sens
O funcție de scor este consistentă pentru o funcțională dacă valoarea adevărată minimizează scorul așteptat (8.11). VaR este elicitabil prin pierderea pinball (8.12); ES singur nu este, dar perechea (VaR, ES) este, iar scorul FZ0 (8.13) ierarhizează prognozele comune, cu diferențe care nu depind de scara pierderilor.
Backtesting comparativ
Scorurile medii ierarhizează prognozele, dar o diferență mică între două medii poate fi zgomot de eșantionare. Secțiunea testează diferențele: testul Diebold–Mariano pentru perechi de prognoze și mulțimea de încredere a modelelor (MCS, Model Confidence Set) pentru întregul set de modele. Toate comparațiile folosesc pierderea FZ0 a perechii (VaR 2,5%, ES 2,5%).
Este diferența dintre două prognoze semnificativă?
Scorul mediu ierarhizează prognozele, dar diferențele mici dintre medii pot apărea doar din zgomotul de eșantionare. Mai multe teste tratează variante diferite ale întrebării. Testul lui Diebold & Mariano (1995) întreabă dacă două prognoze au aceeași pierdere medie. Testul lui Giacomini & White (2006) întreabă dacă informația de ieri poate prognoza diferența de pierdere. Abordarea lui Nolde & Ziegel (2017) întreabă dacă modelul intern al unei bănci este mai bun decît un model standard, cu sarcina probei la bancă. Mulțimea de încredere a modelelor a lui Hansen, Lunde & Nason (2011) întreabă care mulțime conține cele mai bune modele cu o probabilitate dată.
Toate sînt aplicate aici pierderii FZ0 (8.13) a perechii (VaR 2,5%, ES 2,5%). Testul Diebold–Mariano și MCS sînt prezentate în această secțiune; testul Giacomini–White și abordarea în trei zone sînt în Aprofundări.
Pe scurt
Scorul mediu ierarhizează prognozele, dar diferențele mici pot fi zgomot de eșantionare
Diebold–Mariano: au două prognoze aceeași pierdere medie?
Giacomini–White: poate fi prezisă diferența de pierdere din informația de ieri?
Nolde–Ziegel: este modelul intern mai bun decît un model standard?
MCS: ce mulțime conține, cu o probabilitate dată, cele mai bune modele?
Toate folosesc pierderea FZ0 a perechii (VaR 2,5%, ES 2,5%)
Fie \(d_t = \mathrm{FZ0}_{A,t} - \mathrm{FZ0}_{B,t}\) diferența zilnică de pierdere dintre prognozele \(A\) și \(B\). Ipoteza nulă a acurateței predictive egale este \(H_0: E[d_t] = 0\)(Diebold & Mariano, 1995). Statistica standardizează diferența medie \(\bar d\) printr-o estimație a varianței ei pe termen lung (long-run variance):
unde \(\hat\gamma_k\) este autocovarianța lui \(d_t\) la lagul \(k\), iar ponderile sînt cele ale lui Newey & West (1987).
Varianța pe termen lung este necesară pentru că pierderile din coadă se grupează: în zilele de după o pierdere mare ambele modele au șanse să fie depășite din nou, iar \(d_t\) este autocorelat. Varianța obișnuită \(\hat\gamma_0\) singură ar subestima incertitudinea lui \(\bar d\). Numărul de laguri urmează regula \(q = \lfloor 4(T/100)^{2/9}\rfloor\), care dă \(q = 9\) pentru \(T = 4\,959\).
Semnul statisticii DM arată direcția: \(\mathrm{DM} > 0\) înseamnă că modelul \(A\) are pierderea medie mai mare, deci este mai slab. Cu \(|\mathrm{DM}| > 1{,}96\), diferența este semnificativă la 5% într-un test bilateral.
Pe scurt
Ce testează: dacă două prognoze au aceeași pierdere medie
\(\widehat{\mathrm{LRV}}=\hat\gamma_0+2\sum_{k=1}^{q}\left(1-\frac{k}{q+1}\right)\hat\gamma_k\): dispersia pe termen lung, cu ponderi Newey–West (Newey & West (1987))
\(\hat\gamma_k\): autocovarianța lui \(d_t\) la lagul \(k\)
De ce: pierderile din coadă se grupează, deci \(d_t\) este autocorelat
Regula lagurilor: \(q=\lfloor 4(T/100)^{2/9}\rfloor=9\) pentru \(T=4\,959\)
\(\mathrm{DM}>0\): modelul \(A\) are pierderea medie mai mare (mai slab)
\(|\mathrm{DM}|>1{,}96\): diferență semnificativă la 5%
Graficul arată, pentru fiecare piață, pierderea FZ0 medie a prognozelor (VaR 2,5%, ES 2,5%) ale fiecărui model minus cea a celui mai bun model de pe acea piață, astfel încît cel mai bun model se află la zero. Pe S&P 500 și BET, toate cele șase modele sînt comparate pe aceleași zile de evaluare. Cursorul alege primul an al evaluării, iar butonul ▶ îl avansează.
Întrebare pentru sală Pe S&P 500, pierderea FZ0 medie a GARCH-t depășește pe cea a FHS cu 0,040. Doar din această diferență putem decide dacă modelele diferă semnificativ?
Răspuns
Nu: trebuie estimată și eroarea standard a diferenței medii. Pe aceste date, testul DM cu q = 9 laguri Newey–West dă 2,66 și p ≈ 0,008, deci respinge egalitatea la nivelul individual de 5%. GARCH-EVT diferă de FHS doar cu 0,003 (DM = 1,24, p = 0,21). Semnul negativ al scorurilor FZ0 nu împiedică testarea.
Cea mai mică pierdere FZ0 medie aparține modelului FHS pe S&P 500 și pe BET. Pierderea FZ0 medie a modelului GARCH-t o depășește pe cea a FHS cu 0,040 pe S&P 500. Mărimea diferenței nu arată singură dacă datele separă modelele: trebuie estimată și eroarea standard a diferenței medii. Pentru aceste date, testul DM cu \(q = 9\) laguri Newey–West dă 2,66, cu \(p \approx 0{,}008\), și respinge egalitatea la pragul individual de 5%. GARCH-EVT diferă de FHS cu doar 0,003 (\(\mathrm{DM} = 1{,}24\),\(p = 0{,}21\)).
Pe scurt
Pierderea FZ0 medie a prognozelor (VaR 2,5%, ES 2,5%) minus cea a celui mai bun model de pe fiecare piață
Pe S&P 500 și BET, toate cele șase modele sînt comparate pe aceleași zile de evaluare
Cea mai mică pierdere FZ0: FHS pe S&P 500 și BET
Pierderea FZ0 medie a GARCH-t depășește pe cea a FHS cu 0,040 pe S&P 500
Mărimea diferenței nu arată dacă datele separă modelele: o testăm
Matricea dă statistica DM (8.14) pentru fiecare pereche de modele pe S&P 500, modelul \(A\) de pe rînd minus modelul \(B\) din coloană. Celulele roșii înseamnă că \(A\) este mai slab, iar cele verzi că \(A\) este mai bun. Cursorul fixează numărul de laguri Newey–West \(q\), de la 0 la 40, iar butonul ▶ îl crește; un al doilea control alege începutul perioadei de evaluare.
Întrebare pentru sală Normal minus HS: DM = 2,88. Ce înseamnă semnul pozitiv?
Răspuns
În această comparație pe S&P 500, Normal are pierderea FZ0 medie mai mare decît HS. DM = 2,88 depășește pragul bilateral 1,96 pentru un test individual la 5%. Aceasta nu este o superioritate generală a HS față de modelele cu distribuția Normală. Cele 13 din 15 comparații semnificative sînt rezultate individuale, fără ajustare pentru testare multiplă; excepțiile sînt Normal–Student-t (1,94) și FHS–GARCH-EVT (−1,24).
Normal minus HS dă \(\mathrm{DM} = 2{,}88\): în această comparație pe S&P 500, modelul Normal are o pierdere FZ0 medie mai mare decît HS. Valoarea depășește pragul bilateral de 1,96 pentru un test individual la 5%. Dintre cele 15 comparații, 13 sînt semnificative individual, fără nicio ajustare pentru testarea multiplă; excepțiile sînt Normal–Student-t (1,94) și FHS–GARCH-EVT (\(-1{,}24\)).
Față de FHS, modelul cu cea mai mică pierdere medie, HS are \(\mathrm{DM} = 4{,}69\), iar GARCH-t \(\mathrm{DM} = 2{,}66\): ambele sînt semnificativ mai slabe. GARCH-EVT are \(\mathrm{DM} = 1{,}24\) și nu poate fi distins de FHS după pierderea medie. Testul condiționat Giacomini–White respinge totuși capacitatea predictivă condiționată egală a modelelor GARCH-EVT și FHS (\(p = 0{,}035\),Aprofundări): diferența de pierdere nu are o medie semnificativă, dar este previzibilă.
Comparația dintre Normal și HS, cu \(\mathrm{DM} = 2{,}88\), arată că o cuantilă empirică lentă bate totuși o coadă parametrică subțire sub scorul FZ0. HS reacționează prost la volatilitate, dar coada lui are în medie forma corectă; modelul Normal nu reacționează mai bine și are o formă greșită.
Cincisprezece teste pe perechi creează o problemă de testare multiplă: la 5% fiecare, unele respingeri sînt așteptate din întîmplare chiar dacă toate modelele sînt la fel de bune. Întrebarea relevantă devine care modele rezistă împreună, iar mulțimea de încredere a modelelor răspunde la ea.
Pe scurt
DM pentru modelul \(A\) (rînd) minus \(B\) (coloană) pe pierderile FZ0
roșu: \(A\) mai slab, verde: \(A\) mai bun
Față de FHS
HS \(\mathrm{DM}=4{,}69\), GARCH-t \(\mathrm{DM}=2{,}66\): ambele semnificativ mai slabe
GARCH-EVT \(\mathrm{DM}=1{,}24\): nu se deosebește
dar testul condiționat Giacomini–White îl respinge față de FHS (\(p=0{,}035\), Aprofundări)
Normal minus HS: \(\mathrm{DM}=2{,}88\)
o cuantilă empirică, deși se ajustează lent, este totuși superioară unei cozi subțiri
Cincisprezece teste pe perechi: o problemă de testare multiplă
Mulțimea de încredere a modelelor a lui Hansen, Lunde & Nason (2011) este o mulțime de modele care conține cele mai bune modele cu o probabilitate asimptotică de cel puțin \(1 - \alpha_{MCS}\). Ea joacă pentru compararea modelelor rolul pe care un interval de încredere îl joacă pentru un parametru. MCS corectează problema din slide-ul anterior: cele 15 teste DM pe perechi nu controlează eroarea pe întreaga familie, în timp ce MCS compară toate modelele împreună și le elimină pe rînd.
Garanția cere condițiile de regularitate ale metodei, în special diferențe de pierdere staționare și cu dependență slabă. Capitolul folosește \(\alpha_{MCS} = 10\%\) și păstrează modelele cu un p-value MCS de cel puțin 0,10; statistica și regula de eliminare sînt în Aprofundări.
O mulțime MCS mare este un rezultat informativ, nu un eșec al metodei. Ea spune că datele nu separă modelele: cu eșantionul disponibil, mai multe prognoze sînt compatibile cu statutul de cea mai bună. O mulțime MCS mică spune că datele sînt suficient de puternice pentru a elimina majoritatea candidaților.
Pe scurt
MCS (Hansen, Lunde & Nason (2011)): mulțimea care conține cele mai bune modele cu o probabilitate asimptotică de cel puțin \(1-\alpha_{MCS}\)
Ce corectează: cele 15 teste DM pe perechi nu controlează eroarea pe întreaga familie
MCS compară toate modelele împreună
Garanția cere condițiile de regularitate ale metodei
diferențe de pierdere staționare, cu dependență slabă
Folosim \(\alpha_{MCS}=10\%\): păstrăm modelele cu valoarea p MCS \(\ge 0{,}10\)
O mulțime MCS mare este un rezultat informativ: datele nu separă modelele
Graficul dă p-value-ul MCS al fiecărui model pe pierderea FZ0 a perechii (VaR 2,5%, ES 2,5%), pentru S&P 500 și BET; modelele cu \(p \ge \alpha_{MCS}\) formează MCS. Cursorul fixează \(\alpha_{MCS}\), iar butonul ▶ îl crește de la 1% la 30%, astfel încît mulțimea se micșorează pe măsură ce încrederea cerută scade.
Întrebare pentru sală Pe S&P 500 și pe BET, MCS de 90% păstrează FHS și GARCH-EVT. Cum interpretăm această păstrare?
Răspuns
Procedura nu elimină niciunul dintre cele două modele: FHS are p = 1,000 pe ambele piețe, GARCH-EVT p = 0,211 pe S&P 500 și peste 0,96 pe BET. MCS compară pierderile FZ0 ale modelelor candidate; păstrarea împreună nu demonstrează egalitatea performanțelor și nu înlocuiește testele de calibrare. GARCH-t este exclus pe S&P 500 (p = 0,010) și pe BET (p = 0,096).
Pe S&P 500 și pe BET, MCS de 90% reține FHS și GARCH-EVT. FHS are \(p = 1{,}000\) pe ambele piețe, iar GARCH-EVT \(p = 0{,}211\) pe S&P 500 și peste 0,96 pe BET. MCS compară pierderile FZ0 între modelele candidate: reținerea comună nu dovedește nici performanțe egale, nici calibrare corectă. GARCH-t este exclus pe S&P 500 (\(p = 0{,}010\)) și, la limită, pe BET (\(p = 0{,}096\)). HS, Normal și Student-t au \(p \le 0{,}001\) pe ambele piețe.
Pe Bitcoin și EUR/RON nu există MCS, deoarece prognozele GARCH sînt reținute pe o parte a eșantionului, iar MCS are nevoie de toate cele șase modele în aceleași zile (prognozele reținute). Rezultatul susține o comparație între proceduri, condiționată de cei șase candidați și de scorul FZ0.
Pe scurt
valorile p MCS pe pierderea FZ0 a perechii (VaR 2,5%, ES 2,5%)
modelele cu \(p\ge 0{,}10\) formează MCS de 90%
S&P 500 și BET: MCS conține FHS și GARCH-EVT
GARCH-t este exclus pe S&P 500 (\(p=0{,}010\)) și, la limită, pe BET (\(p=0{,}096\))
HS, Normal și Student-t: \(p\le 0{,}001\) pe ambele piețe
Statistica Diebold–Mariano (8.14) testează o diferență între pierderile FZ0 medii, cu o varianță pe termen lung care ține cont de gruparea pierderilor din coadă. Pe S&P 500, FHS are cea mai mică pierdere medie, iar GARCH-EVT nu poate fi distins de el prin DM. Mulțimea de încredere a modelelor, care tratează multiplicitatea testelor pe perechi, reține FHS și GARCH-EVT atît pe S&P 500, cît și pe BET.
Predicția conformală pentru riscul de coadă (pierderi extreme)
Toate metodele de pînă acum presupun o distribuție, Normală, Student-t sau GPD, ori un trecut stabil, ca HS. Predicția conformală transformă orice prognoză într-o cuantilă cu o garanție de acoperire care nu depinde de distribuția datelor. Secțiunea enunță garanția predicției conformale split și a versiunii ei adaptive și măsoară ce oferă aceste garanții pe datele capitolului, în perioade calme și în crize.
Se poate garanta acoperirea fără ipoteze de distribuție?
Predicția conformală (conformal prediction) (Lei et al., 2018; Angelopoulos & Bates, 2021) construiește o mulțime de predicție din distribuția empirică a unui scor calculat pe date trecute. Pentru tail risk, scorul este pierderea împărțită la o scală, \(s_t = L_t/\hat\sigma_t\), unde \(\hat\sigma_t\) este abaterea standard a celor 250 de randamente anterioare. Mulțimea de calibrare conține ultimele \(n = 250\) de scoruri, un an de tranzacționare, ordonate \(s_{(1)} \le \dots \le s_{(n)}\).
VaR-ul conformal split (split conformal) rescalează o statistică de ordine a scorurilor de calibrare cu scala de azi:
unde \(\lceil x \rceil\) este cel mai mic întreg mai mare sau egal cu \(x\). Pentru \(n = 250\) și \(\alpha = 0{,}01\),\(k = \lceil 248{,}49 \rceil = 249\): VaR 1% este al doilea cel mai mare scor de calibrare înmulțit cu scala curentă. Factorul \(n+1\) în loc de \(n\) ține cont de observația nouă, tratată ca încă un membru al eșantionului.
Pe scurt
Modelele de pînă acum presupun o distribuție (Normală, t, GPD) sau un trecut stabil (HS)
Scorul: \(s_t=L_t/\hat\sigma_t\), unde \(\hat\sigma_t\) este abaterea standard a celor 250 de randamente anterioare
Mulțimea de calibrare: ultimele \(n=250\) de scoruri (un an de tranzacționare), ordonate \(s_{(1)}\le\dots\le s_{(n)}\)
VaR conformal split: \(\mathrm{VaR}_t=\hat\sigma_t\, s_{(k)}\), cu \(k=\lceil (n+1)(1-\alpha)\rceil\) (\(\lceil x\rceil\): cel mai mic întreg \(\ge x\))
Pentru \(n=250\) și \(\alpha=0{,}01\): \(k=249\), adică al doilea cel mai mare scor
Dacă cele \(n+1\) scoruri, cele \(n\) de calibrare și scorul zilei noi, sînt schimbabile (exchangeable), adică distribuția lor comună este invariantă la permutări, și nu există egalități, atunci
Limita (8.16) este valabilă oricare ar fi distribuția scorurilor: sub schimbabilitate, rangul scorului nou printre cele \(n+1\) este uniform, iar alegerea lui \(k\) din (8.15) transformă acest rang uniform într-o acoperire de cel puțin \(1-\alpha\).
Pe randamente financiare garanția este doar aproximativă. Volatility clustering încalcă schimbabilitatea: un scor dintr-o lună agitată și unul dintr-o lună calmă nu au aceeași distribuție. În plus, \(\hat\sigma_t\) provine din ferestre rolling suprapuse, deci scorurile nu sînt independente. O procedură conformală split propriu-zisă ar ajusta scorul o singură dată, pe un eșantion separat, și ar calibra pe altul. Extensiile fără schimbabilitate sînt în Anexă.
Pe scurt
Garanția, dacă cele \(n+1\) scoruri sînt schimbabile: \(1-\alpha\le P(L_t\le\mathrm{VaR}_t)\le 1-\alpha+\frac{1}{n+1}\) (fără valori egale)
schimbabile: legea comună nu se schimbă la permutare
Aici garanția este doar aproximativă, din două motive (extinderi: Anexă)
Inferența conformală adaptivă (ACI, adaptive conformal inference) (Gibbs & Candès, 2021) înlocuiește nivelul fix din (8.15) cu un nivel de lucru \(\alpha_t\), actualizat după fiecare zi. Cu \(\mathrm{err}_t = \mathbf{1}\{L_t > \mathrm{VaR}_t\}\) indicatorul de depășire și \(\gamma > 0\) un pas,
După o depășire, \(\alpha_t\) scade cu \(\gamma(1-\alpha)\), deci următorul VaR se calculează la un nivel mai extrem și crește; după o zi calmă, \(\alpha_t\) crește încet la loc, cu \(\gamma\alpha\). Capitolul folosește \(\gamma = 0{,}005\): un pas mic stabilizează nivelul, în timp ce un pas mare reacționează mai repede, dar duce mai des la un VaR infinit.
Garanția este valabilă pentru orice șir de date, schimbabil sau nu:
unde \(\alpha_1\) este nivelul inițial. Limita (8.18) privește rata medie de depășire pe termen lung, nu rata din fiecare zi sau din fiecare criză. Ea cere două convenții: dacă \(\alpha_t < 1/(n+1)\), statistica de ordine cerută nu există și VaR este pus \(+\infty\); dacă \(\alpha_t \ge 1\), pragul este \(-\infty\) și depășirea este sigură.
Graficul urmărește S&P 500 din iulie 2019 pînă în iunie 2021. Panoul de sus arată pierderile zilnice și trei prognoze VaR, conformal split (8.15), ACI (8.17) și GARCH-t; panoul de jos arată nivelul de lucru ACI \(\alpha_t\). Cursorul fixează pasul ACI \(\gamma\), iar selectorul nivelul VaR; butonul ▶ crește \(\gamma\) de la 0,001 la 0,05.
Întrebare pentru sală Cu α = 1% și γ = 0,005, ACI are 4 depășiri în cele 50 de zile dintre 20.02 și 30.04.2020 și VaR = ∞ în 37 dintre ele. Sînt compatibile aceste rezultate?
Răspuns
Da: depășirile apar în zile dintre cele 13 cu VaR finit. VaR = ∞ împiedică o depășire numai în ziua respectivă și nu oferă un prag finit utilizabil; α_t a coborît pînă la 0,09%. Conformal split are 6 depășiri în aceleași zile, față de 0,5 așteptate. Separat, valoarea VaR 1% conformal split rămîne apoi în jur de 18% timp de un an, pentru că scorurile din martie 2020 rămîn în mulțimea de calibrare de 250 de zile.
Cu \(\alpha = 1\%\) și \(\gamma = 0{,}005\), ACI are 4 depășiri în cele 50 de zile dintre 20 februarie și 30 aprilie 2020 și VaR \(= \infty\) în 37 dintre ele. Cele două fapte sînt compatibile: depășirile apar printre cele 13 zile cu VaR finit. Un VaR infinit împiedică depășirea în acea zi, dar nu oferă niciun prag utilizabil; \(\alpha_t\) a coborît la 0,09%. Conformal split are 6 depășiri în aceleași zile, față de 0,5 așteptate.
Între 20 februarie și 30 aprilie 2020, 50 de zile de tranzacționare, un VaR 1% corect ar avea 0,5 depășiri așteptate. Conformal split are 6, iar ACI 4, adică 8% din zile. ACI a evitat alte depășiri punînd VaR \(= \infty\) în 37 dintre aceste zile, iar un VaR infinit nu transmite nicio informație unui manager de risc.
După prăbușire, VaR 1% conformal split rămîne în jur de 18% timp de un an. Ambele ingrediente ale lui folosesc ultimele 250 de zile: \(\hat\sigma_t\) și statistica de ordine \(s_{(249)}\) păstrează observațiile din martie 2020 pînă în martie 2021. Metoda care a crescut prea încet scade apoi prea încet.
GARCH-t se adaptează în cîteva zile. După zile calme, ponderea unui șoc trecut în \(\sigma_t^2\) scade cu factorul \(b\) pe zi; cu parametrii estimați pe S&P 500 în 1990–2026, \(b = 0{,}892\), un timp de înjumătățire (half-life) de aproximativ 6 zile. Prognoza de varianță revine spre nivelul ei de lungă durată cu rata \(a + b = 0{,}994\), un timp de înjumătățire de aproximativ 124 de zile. Garanția fără ipoteze de distribuție costă viteză de reacție, pe care un model de volatilitate o oferă.
Pe scurt
S&P 500, iulie 2019–iunie 2021, VaR 1%
sus: conformal split, ACI și GARCH-t
jos: nivelul ACI \(\alpha_t\)
Între 20.02 și 30.04.2020: 50 de zile, cu 0,5 depășiri așteptate
Depășiri observate: conformal split 6, ACI 4 (8% din zile)
ACI a stabilit VaR \(=\infty\) în 37 din aceste zile: nicio depășire nouă, dar un VaR infinit nu aduce informație
VaR 1% conformal split rămîne în jur de 18% timp de un an
\(\hat\sigma_t\) și \(s_{(249)}\) folosesc ultimele 250 de zile, deci păstrează crahul pînă în martie 2021
GARCH-t se adaptează în cîteva zile: după zile calme, ponderea unui șoc trecut în \(\sigma_t^2\) scade cu factorul \(b\) pe zi
cu parametrii estimați pe S&P 500, 1990–2026: \(b=0{,}892\), înjumătățire în circa 6 zile
prognoza varianței revine în medie cu rata \(a+b=0{,}994\): înjumătățire în circa 124 de zile
Graficul compară rata de depășire a VaR 5% pe piețe și metode, în zile calme și în zile de criză. O zi de criză este definită dinainte: volatilitatea pe 20 de zile depășește o percentilă a celor 1 000 de zile anterioare, implicit a 90-a. Se folosește nivelul de 5% pentru că zilele de criză sînt puține: cele 713 zile de criză de pe S&P 500 dau aproximativ 36 de depășiri așteptate ale VaR 5%, față de 7 pentru VaR 1%. Cursorul fixează percentila care definește criza, de la a 75-a la a 95-a, iar butonul ▶ o crește.
Întrebare pentru sală Pe S&P 500, conformal split are o rată totală de depășire a VaR 5% de 5,34%, apropiată de țintă. Garantează aceasta o rată apropiată de 5% și în zilele de criză?
Răspuns
Nu: rata totală este o medie ponderată a ratelor din regimuri diferite. Cu definiția crizei bazată pe percentila 90, conformal split are 7,29% în cele 713 zile de criză; pe EUR/RON ajunge la 11,43%. ACI coboară rata în criză la 4,49% pe S&P 500 și la 5,38% pe BET. Acoperirea marginală nu garantează acoperirea în fiecare regim.
Pe toate zilele, conformal split este aproape de țintă: 5,34% pe S&P 500, 5,63% pe BET, 4,58% pe Bitcoin și 5,06% pe EUR/RON. În zilele de criză ratele urcă la 7,29%, 8,08%, 7,95% și 11,43%. Rata totală este o medie ponderată a ratelor din regimuri diferite, așa că apropierea de țintă pe întregul eșantion nu se transmite fiecărui regim.
ACI coboară rata din criză la 4,49% pe S&P 500 și la 5,38% pe BET. Pentru VaR 1%, face acest lucru doar cu un VaR infinit în 13,4% din zile. Acoperirea marginală nu este acoperire în criză. Rezultatul susține o comparație între proceduri; dacă o metodă fără ipoteze de distribuție poate atinge o acoperire condiționată de criză este întrebarea deschisă din secțiunea AI.
Pe scurt
Pe grafic: rata de depășire a VaR 5% pe piețe și metode, în zile calme și de criză
Zi de criză, definită dinainte
volatilitatea pe 20 de zile depășește percentila 90 a celor 1 000 de zile anterioare
De ce VaR 5%: în 713 zile de criză S&P 500, circa 36 de depășiri așteptate, față de 7 la VaR 1%
Conformal split, toate zilele: S&P 500 5,34%, BET 5,63%, Bitcoin 4,58%, EUR/RON 5,06%
Conformal split, zilele de criză: S&P 500 7,29%, BET 8,08%, Bitcoin 7,95%, EUR/RON 11,43%
ACI, zilele de criză: S&P 500 4,49%, BET 5,38%
la VaR 1%, acest rezultat cere un VaR infinit în 13,4% din zilele de evaluare S&P 500
Predicția conformală split (8.15) garantează acoperirea (8.16) sub schimbabilitate, pe care volatility clustering o încalcă; ACI (8.17) garantează doar rata medie de depășire pe termen lung (8.18). Pe datele capitolului, conformal split are rate de depășire peste țintă în zilele de criză pe toate cele patru piețe, iar ACI își atinge ținta medie în martie 2020 doar prin zile cu VaR infinit.
Studii de caz: testarea ES din propriile prognoze și e-backtesting
Testele ES din secțiunile anterioare au nevoie de VaR, de volatilitate sau de întreaga distribuție prognozată. Cele două studii de caz tratează două limite ale acestor teste. Bayer & Dimitriadis (2022) construiesc un backtest al ES doar din prognozele ES și din randamentele realizate. Wang, Wang & Ziegel (2026) construiesc un backtest al ES care rămîne valid atunci cînd este verificat în fiecare zi.
Studiu de caz (1/4): testarea ES doar pe baza prognozelor ES
Bayer & Dimitriadis (2022) întreabă dacă prognozele ES pot fi testate doar cu randamentele observate și cu prognozele însele. Întrebarea contează pentru că FRTB stabilește capitalul din ES 2,5% (perspectiva reglementatorului). Testele ES de mai sus au nevoie și de VaR, de volatilitate sau de distribuția prognozată, pe care supraveghetorii s-ar putea să nu le primească. Respingerea unui astfel de test comun nu spune care dintre prognoze este greșită.
Ideea este o regresie Mincer–Zarnowitz: se regresează randamentele pe prognozele ES și se testează dacă prognozele au nevoie de corecție. Sub \(H_0\), interceptul este 0 și panta 1, deoarece o prognoză corectă nu are nevoie de corecție. O regresie obișnuită nu poate fi folosită, deoarece ES nu este media condiționată a randamentelor. Regresia poate fi estimată pentru că (VaR, ES) este elicitabilă împreună(Fissler & Ziegel, 2016): este o regresie comună cuantilă–ES în sensul lui Patton, Ziegel & Chen (2019), estimată prin minimizarea unui scor consistent.
Pe scurt
Bayer & Dimitriadis (2022): pot fi testate prognozele ES folosind doar randamentele observate și aceste prognoze?
Lucrarea folosește scara randamentelor. Prognoza ES este \(\hat e_t = -\widehat{\mathrm{ES}}_t < 0\), la nivelul \(\tau = \alpha = 2{,}5\%\). Ecuația ES este
astfel încît \(\gamma_1 + \gamma_2\hat e_t\) este ES condiționat adevărat al lui \(r_t\). Prognozele corecte au \(\gamma_1 = 0\) și \(\gamma_2 = 1\).
Regresia ES (ESR, expected shortfall regression) are nevoie și de o ecuație de cuantilă, deoarece ES se estimează împreună cu VaR. Cele trei variante diferă prin ce intră în această ecuație. ESR auxiliară pune \((1, \hat v_t)\) în ecuația de cuantilă, deci are nevoie și de prognozele VaR \(\hat v_t\).ESR strictă pune \((1, \hat e_t)\), deci are nevoie doar de prognozele ES. ESR cu intercept fixează panta la 1 și estimează \(r_t - \hat e_t = \gamma_1 + u^e_t\); ea folosește un test \(t\) unilateral al ipotezei \(H_0: \gamma_1 \ge 0\) față de \(\gamma_1 < 0\), adică ES subestimat. Ipotezele și simulările lucrării sînt în Aprofundări.
Pe scurt
Convenția randamentelor: \(\hat e_t=-\widehat{\mathrm{ES}}_t<0\) este prognoza ES pe scala randamentelor, cu \(\tau=\alpha=2{,}5\%\)
Ecuația ES: \(r_t=\gamma_1+\gamma_2\hat e_t+u^e_t\), cu \(\mathrm{ES}_\tau(u^e_t\mid\mathcal F_{t-1})=0\), deci \(\gamma_1+\gamma_2\hat e_t\) este ES condiționat adevărat
\(\gamma_1\): termenul liber; \(\gamma_2\): panta; prognoze corecte: \(\gamma_1=0\), \(\gamma_2=1\)
ESR (regresia expected shortfall) cere și o ecuație a cuantilei, deoarece ES se estimează împreună cu VaR
ESR auxiliar: ecuația cuantilei pe \((1,\hat v_t)\), deci cere și prognoze VaR \(\hat v_t\)
ESR strict: ecuația cuantilei pe \((1,\hat e_t)\), deci cere doar prognoze ES
ESR cu termen liber: \(r_t-\hat e_t=\gamma_1+u^e_t\) (panta fixată la 1)
test \(t\) unilateral pentru \(H_0\): \(\gamma_1\ge 0\) față de \(\gamma_1<0\) (ES subestimat)
Graficul reproduce Tabelul 3 din Bayer & Dimitriadis (2022): pentru cele mai mari 200 de acțiuni din S&P 500 în 2010–2019, ponderea acțiunilor ale căror prognoze ES 2,5% sînt respinse de ESR cu intercept unilaterală la 5%, în funcție de fereastra de estimare (axa orizontală, 250–2 000 de zile). Curbele sînt trasate pentru inovații Normale și Student-t; linia continuă reestimează la fiecare 5 zile. Selectorul comută între tabelul lucrării și replicarea cursului pe 11 acțiuni, iar cursorul fixează frecvența reestimării pentru linia întreruptă; butonul ▶ parcurge frecvențele.
Întrebare pentru sală În Tabelul 3 din Bayer–Dimitriadis, prognozele ES 2,5% sînt respinse pentru 0,80–0,96 din acțiuni cu inovații Normale și pentru cel mult 0,12 cu inovații Student-t. Ce explică diferența?
Răspuns
Distribuția inovațiilor: tabelul compară cele două distribuții pe aceleași 50 de combinații (5 ferestre × 5 frecvențe ale reestimării × GARCH/GJR-GARCH), deci fereastra și frecvența reestimării nu diferă între ele. Un model corect ar fi respins, la nivelul 5%, pentru circa 5% din acțiuni, nu pentru 80%–96%. Cu inovații Student-t, ponderea este cel mult 0,01 la ferestre de cel puțin 1 000 de zile. Readout-ul pentru reestimarea la 250 de zile raportează doar acele configurații: 0,80–0,92 cu inovații Normale.
Diferența dintre curbe este explicată de distribuția inovațiilor. Tabelul compară cele două distribuții pe aceleași 50 de combinații, 5 ferestre × 5 frecvențe de reestimare × GARCH sau GJR-GARCH, deci fereastra și frecvența reestimării nu diferă între ele. Un model corect ar fi respins, la pragul de 5%, pentru aproximativ 5% din acțiuni, nu pentru 80%–96%. Cu inovații Student-t, ponderea este cel mult 0,01 pentru ferestre de cel puțin 1 000 de zile.
În Tabelul 3 din Bayer & Dimitriadis (2022), care raportează și frecvențe de reestimare de 21, 62 și 125 de zile, ponderea respinsă cu inovații Normale este 0,80–0,96 în toate cele 50 de celule. GJR-GARCH (GARCH Glosten–Jagannathan–Runkle) adaugă la GARCH un răspuns suplimentar al varianței la șocurile negative și nu schimbă imaginea. Cu inovații Student-t, ponderea este cel mult 0,12 cu ferestre de 250 de zile și cel mult 0,01 cu ferestre de cel puțin 1 000 de zile.
Cozile groase și o fereastră lungă contează cel mai mult; frecvența reestimării contează doar pentru ferestre scurte. Rezultatul susține o comparație între proceduri: coada Normală eșuează pentru aproape fiecare acțiune, indiferent de fereastră și de reestimare, în timp ce coada Student-t trece odată ce fereastra este lungă. Autorii notează că matricea de covarianță clasică respinge prea des în eșantioane mici. Replicarea cursului pe 11 acțiuni este în Aprofundări.
Lucrarea lui Wang, Wang & Ziegel (2026), publicată în Management Science, propune un backtest al ES care poate fi verificat zilnic fără să-și piardă validitatea. Testele ES de mai sus produc p-value-uri valide pentru un eșantion fixat dinainte. Un supraveghetor care repetă testul în fiecare zi și se oprește la prima respingere are o eroare de tip I peste 5%, deoarece fiecare zi aduce o nouă șansă de alarmă falsă.
Instrumentul este e-value-ul (e-value): o statistică nenegativă a cărei medie este cel mult 1 sub \(H_0\). Un e-value mare este o dovadă împotriva lui \(H_0\), la fel cum este un p-value mic. Produsele de e-values calculate secvențial rămîn e-values, așa că dovezile pot fi acumulate zi de zi.
Lucrarea face trei afirmații:
Testul are nevoie doar de prognozele (VaR, ES) și de pierderile realizate, nu de modelul care le-a produs.
Validitatea lui nu cere nicio aproximare asimptotică și se menține la orice moment de oprire, proprietate numită validitate în orice moment (anytime validity).
Pentru o pierdere și un VaR fixate, un ES mai mare, mai prudent, dă o statistică e mai mică.
În aplicația empirică a lucrării, prognozele ES 2,5% ale unui model AR(1)-GARCH(1,1) pentru NASDAQ (National Association of Securities Dealers Automated Quotations, bursa americană NASDAQ, cotații automate ale Asociației Naționale a Dealerilor de Valori Mobiliare) Composite, începînd cu 3 ianuarie 2005, sînt monitorizate cu e-procesul GREM (growth rate with a mixture). Cu inovații Normale, pragul 2 este atins după 540 de zile de tranzacționare, iar pragul 10 după 713. Cu inovații skewed-t și ES mărit cu 10%, niciun prag nu este atins pînă la 31 decembrie 2021.
Pe scurt
Wang, Wang & Ziegel (2026), Management Science: un backtest al ES care poate fi verificat zilnic fără să-și piardă validitatea
Problema testelor ES de mai sus: valoarea p este validă pentru un eșantion fixat dinainte
un supraveghetor care repetă testul în fiecare zi și se oprește la prima respingere are o eroare de tip I peste 5%
E-value: o statistică nenegativă cu media cel mult 1 sub \(H_0\)
o valoare mare este o dovadă împotriva lui \(H_0\), așa cum este o valoare p mică
Afirmațiile lucrării
testul cere doar prognozele (VaR, ES) și pierderile realizate, nu modelul care le-a produs
validitatea nu cere aproximări asimptotice și se păstrează la orice moment de oprire (anytime-valid)
pentru pierdere și VaR fixate, un ES mai mare, deci mai prudent, dă o statistică \(e_t\) mai mică
Rezultatul empiric al lucrării: indicele NASDAQ Composite (NASDAQ: National Association of Securities Dealers Automated Quotations, bursa americană), ES 2,5% din AR(1)-GARCH(1,1), din 3 ian. 2005
inovații Normale, e-procesul GREM (growth rate with a mixture; dovada cumulată împotriva lui \(H_0\), definit mai jos): pragul 2 este atins după 540 de zile de tranzacționare, pragul 10 după 713
inovații skewed-t cu ES majorat cu 10%: niciun prag atins pînă la 31 dec. 2021
E-backtesting: e-procesele ES 2,5% pe S&P 500 și BET
Graficul reprezintă e-procesul GREM al fiecărui model pentru ES 2,5% pe zilele de evaluare, din ianuarie 2007 pînă în septembrie 2026: 4 959 de zile pe S&P 500 și 4 937 pe BET. Axa verticală este logaritmică, iar procesul pornește de la 1, adică nicio dovadă. Banda marchează pragurile 2, 5 și 10; atingerea lui \(1/a\) respinge prognozele cu o eroare de tip I de cel mult \(a\), adică 50%, 20% și 10%. Selectorul alege modul în care sînt fixate pariurile \(\lambda\), GREM, GREE (Growth Rate with Empirical E-statistics, rata de creștere cu e-statistici empirice) sau GREL, iar cursorul înmulțește prognoza ES cu un factor de la 1 la 1,3; butonul ▶ crește factorul.
Întrebare pentru sală Pe S&P 500, maximul e-procesului GREM pentru FHS este 8,55. La un nivel de 5%, ce verdict dă regula bazată pe pragul 1/a?
Răspuns
Nu respinge: pentru a = 0,05, pragul este 1/a = 20, iar maximul 8,55 (29.09.2008) nu îl atinge; valoarea finală este 3,31. Pragul 10 corespunde lui a = 10%, pragul 5 lui a = 20% (atins la 01.11.2007). Garanția P(sup M_t ≥ 1/a) ≤ a presupune ipoteza nulă din curs: VaR condiționat corect, ES cel puțin egal cu cel adevărat și pariuri alese din informația trecută. Cu ES majorat cu 10%, maximul scade la 3,38.
Pe S&P 500, e-procesul GREM al FHS atinge un vîrf de 8,55, la 29 septembrie 2008, și se încheie la 3,31. La pragul de 5%, limita este \(1/a = 20\), deci regula nu respinge; pragul 10 corespunde lui \(a = 10\%\), iar pragul 5, atins la 1 noiembrie 2007, lui \(a = 20\%\). Garanția \(P(\sup_t M_t \ge 1/a) \le a\) cere ipoteza nulă a cursului: un VaR condiționat corect, un ES cel puțin egal cu ES adevărat și pariuri alese din informația trecută. Cu ES mărit cu 10%, vîrful scade la 3,38.
Peste \(10^6\), partea de sus a axei, se află procesele Normal, Student-t și HS pe S&P 500, care o depășesc la 4 septembrie 2008, 6 octombrie 2008 și 15 octombrie 2008, și procesul Normal pe BET, la 7 ianuarie 2009. FHS și GARCH-EVT rămîn sub 10 pe S&P 500 și sub 2,3 pe BET.
Ipoteza nulă este că, pentru orice \(t\),\(z_t = \mathrm{VaR}_t\),\(r_t \ge \mathrm{ES}_t\) și \(r_t > z_t\), cu prognoze cunoscute la \(t-1\). Sub \(H_0\), media condiționată a lui \(e_t\) este cel mult 1: din (8.2), media lui \((L_t - z_t)_+\) este \(0{,}025(\mathrm{ES}_t - z_t)\) cînd \(z_t\) este VaR-ul adevărat. Un VaR greșit poate împinge media peste 1 chiar și cu ES corect, deci testul privește ES condiționat de un VaR corect.
fiecare pariu \(\lambda_s\) fiind ales doar din datele pînă la \(s-1\). Sub \(H_0\),\(M_t\) este un supermartingal nenegativ, iar inegalitatea lui Ville dă \(P(\sup_t M_t \ge 1/a) \le a\): probabilitatea ca procesul să atingă vreodată \(1/a\) este cel mult \(a\), oricînd ar fi citit. Pariurile maximizează creșterea logaritmică a lui \(M_t\), prin aproximarea Taylor din lucrare. GREE (growth rate with empirical e-statistics) le fixează din e-values-urile ultimelor 500 de zile, GREL (growth rate with empirical losses) din pierderile ultimelor 500 de zile la prognoza de azi, iar GREM face media celor două e-procese, alegerea recomandată de autori.
Replicarea cursului diferă de lucrare în trei privințe:
Folosește cele șase modele ale capitolului, cu o fereastră rolling de 1 000 de zile, în timp ce lucrarea folosește AR(1)-GARCH(1,1) cu 500 de zile.
Acoperă S&P 500 și BET în 2007–2026, în timp ce lucrarea acoperă NASDAQ Composite în 2005–2021; Bitcoin și EUR/RON au prognoze GARCH reținute.
GREE pornește în ianuarie 2007 fără e-values anterioare, în timp ce lucrarea avea cinci ani de prognoze înainte de 2005.
Pe scurt
Statistica e pentru ES 2,5%: \(e_t=\dfrac{(L_t-v_t)_+}{0{,}025\,(s_t-v_t)}\), cu \((x)_+=\max(x,0)\)
\(L_t\): pierderea zilei \(t\); \(v_t\): prognoza VaR 2,5%; \(s_t\): prognoza ES 2,5% (în lucrare: \(z_t\), \(r_t\))
\(H_0\): pentru fiecare \(t\), \(v_t=\mathrm{VaR}_t\), \(s_t\ge\mathrm{ES}_t\) și \(s_t>v_t\), cu prognoze cunoscute la \(t-1\)
sub \(H_0\), media condiționată a lui \(e_t\) este cel mult 1; un VaR greșit o poate ridica peste 1 chiar cu ES corect
E-procesul: \(M_t=\prod_{s\le t}(1-\lambda_s+\lambda_s e_s)\), cu \(\lambda_s\in[0;\,0{,}5]\) ales doar din datele de pînă la \(s-1\)
sub \(H_0\), \(M_t\) este un supermartingal nenegativ, iar inegalitatea lui Ville dă \(P(\sup_t M_t\ge 1/\delta)\le\delta\)
\(\lambda_s\) maximizează creșterea logaritmică a lui \(M_t\) (aproximarea Taylor din lucrare)
GREE (growth rate with empirical e-statistics): din e-values ale ultimelor 500 de zile
GREL (growth rate with empirical losses): din pierderile ultimelor 500 de zile, la prognoza de azi
GREM (growth rate with a mixture): media celor două e-procese, varianta recomandată de autori
Replicarea din curs, față de lucrare
prognozele capitolului: șase modele, fereastră mobilă de 1 000 de zile (lucrarea: AR(1)-GARCH(1,1), 500 de zile)
S&P 500 și BET, 2007–2026 (lucrarea: NASDAQ Composite, 2005–2021); Bitcoin și EUR/RON au prognoze GARCH necalculate
GREE pornește în ian. 2007 fără e-values anterioare; lucrarea avea cinci ani de prognoze înainte de 2005
E-backtesting: dovezile apar din 2007, cu excepția FHS și GARCH-EVT
Tabelul dă, pentru fiecare model, maximul e-procesului GREM (8.21) și prima zi în care acesta atinge 10, pe S&P 500 și pe BET. Pe S&P 500, modelul Normal atinge pragul 2 la 26 iulie 2007 și pragul 10 la 9 august 2007, HS atinge 10 la 19 octombrie 2007, iar GARCH-t la 6 iunie 2008. Media lui \(e_t\) este 1,89 pentru GARCH-t și 1,33 pentru FHS, față de o valoare așteptată de cel mult 1 pentru un ES corect.
FHS și GARCH-EVT nu ating niciodată 10. Pe S&P 500 au vîrfuri de 8,55 și 7,47, ambele la 29 septembrie 2008; pe BET, de 2,16 și 2,28. HS pe BET arată ce adaugă e-procesul: \(Z_2\) nu îl respinge pe întregul eșantion (\(p = 0{,}134\)), dar e-procesul atinge 10 la 10 octombrie 2008, cu un vîrf de 237. Un test pe întregul eșantion face media dintre criză și anii calmi care urmează; e-procesul înregistrează dovezile în momentul în care apar.
Cu ES mărit cu 10%, FHS și GARCH-EVT pe S&P 500 rămîn sub 5, cu vîrfuri de 3,38 și 3,46, iar GARCH-t pe BET rămîne sub 2, la 1,79. Este un rezultat empiric: pariurile \(\lambda_s\) sînt estimate din trecut, deci e-procesul GREM nu este garantat monoton în ES.
Rezultatul susține un test al ES condiționat de un VaR 2,5% corect, valid în orice zi în care este citit. El nu ierarhizează modelele, aceasta fiind sarcina backtesting-ului comparativ și a MCS. Limitele lui sînt practice: după o perioadă prudentă, \(M_t\) scade și are nevoie de timp ca să crească din nou, iar pragurile 2 și 5 au erori de tip I mari, 50% și 20%.
Pe scurt
Model
S&P 500: max. \(M_t\)
prima zi cu \(M_t\ge 10\)
BET: max. \(M_t\)
prima zi cu \(M_t\ge 10\)
HS
\(1{,}5\cdot 10^{9}\)
19 oct. 2007
237
10 oct. 2008
Normal
\(1{,}5\cdot 10^{21}\)
9 aug. 2007
\(9{,}3\cdot 10^{10}\)
21 ian. 2008
Student-t
\(4{,}7\cdot 10^{11}\)
15 aug. 2007
\(4{,}1\cdot 10^{4}\)
6 oct. 2008
GARCH-t
\(2{,}2\cdot 10^{4}\)
6 iun. 2008
218
17 feb. 2009
FHS
8,55
—
2,16
—
GARCH-EVT
7,47
—
2,28
—
S&P 500: Normal atinge pragul 2 la 26 iul. 2007 și pragul 10 la 9 aug. 2007; HS la 19 oct. 2007; GARCH-t la 6 iun. 2008
media lui \(e_t\): 1,89 pentru GARCH-t și 1,33 pentru FHS (valoarea așteptată pentru un ES corect: 1)
FHS și GARCH-EVT pe S&P 500: maximele 8,55 și 7,47 (29 sept. 2008); pe BET: 2,16 și 2,28
HS pe BET: \(Z_2\) nu respinge pe întreg eșantionul (p = 0,134), dar e-procesul atinge 10 la 10 oct. 2008 (maximul 237)
ES majorat cu 10%: FHS și GARCH-EVT pe S&P 500 rămîn sub 5 (maximele 3,38 și 3,46); GARCH-t pe BET rămîne sub 2 (1,79)
rezultat empiric: pariurile \(\lambda_s\) se estimează din trecut, deci e-procesul GREM nu este garantat monoton în ES
Tipul de dovadă: un test al ES condiționat de ipoteza că VaR 2,5% este corect, valid în orice zi în care este citit
Limite: după o perioadă prudentă, \(M_t\) scade și are nevoie de timp ca să crească din nou; pragurile 2 și 5 au eroarea de tip I mare (50%, 20%)
Sinteza secțiunii
Regresia ES (8.19) testează prognozele ES doar cu randamentele și cu prognozele; în Tabelul 3 al lucrării, coada Normală este respinsă pentru 80%–96% din acțiuni, iar coada Student-t cu ferestre lungi pentru cel mult 1%. E-backtestul (8.21) monitorizează ES 2,5% zilnic, cu o eroare de tip I controlată la orice moment de oprire; pe S&P 500 și BET el acumulează dovezi puternice împotriva modelelor necondiționate și a GARCH-t în 2007–2009, dar nu împotriva FHS și GARCH-EVT.
AI pentru descoperire științifică
Partea principală a capitolului se încheie cu o întrebare de cercetare deschisă, cu modul în care un cercetător poate folosi un asistent AI (Artificial Intelligence, inteligență artificială) pentru a lucra la ea și cu un mini-studiu de caz pe datele capitolului.
O întrebare deschisă: acoperirea condiționată în criză
Garanțiile VaR fără ipoteze de distribuție sînt marginale. Conformal split cere schimbabilitate, iar ACI controlează doar rata medie de depășire pe termen lung, așa cum arată secțiunea Predicția conformală pentru tail risk. Niciuna nu spune ceva despre rata de depășire din zilele în care riscul contează cel mai mult.
Întrebarea formală folosește un indicator de criză \(C_t \in \mathcal{F}_{t-1}\), cunoscut ex ante, cu \(C_t = 1\) într-o zi de criză și 0 în rest. Ipoteza este \(H_0: P(L_t > \mathrm{VaR}_t \mid C_t = 1) = \alpha\), cu alternativa \(H_1: P(L_t > \mathrm{VaR}_t \mid C_t = 1) \ne \alpha\). Ea se testează prin condiția de moment
\[E\left[C_t\,(I_t - \alpha)\right] = 0 ,\]
(8.22)
unde \(I_t\) este indicatorul de depășire. Deoarece depășirile din criză se grupează, inferența folosește erori standard HAC (heteroskedasticity and autocorrelation consistent) sau un bootstrap pe blocuri, iar apoi corecția Holm pe piețe și metode. Miza este concretă: capitalul este necesar exact în zilele despre care garanțiile marginale spun cel mai puțin.
Pe scurt
Garanțiile VaR fără ipoteze de distribuție sînt marginale
Întrebarea formală: rămîne rata de depășire în criză egală cu \(\alpha\)?
cu un indicator de criză \(C_t\in\mathcal{F}_{t-1}\) cunoscut ex ante
\(C_t=1\) într-o zi de criză, 0 altfel
\(H_0\): \(P(L_t>\mathrm{VaR}_t\mid C_t=1)=\alpha\) față de \(H_1\): \(P(L_t>\mathrm{VaR}_t\mid C_t=1)\neq\alpha\)
Testată prin momentul \(E[C_t(I_t-\alpha)]=0\), cu \(I_t\) depășirea din ziua \(t\)
inferență HAC (robustă la heteroscedasticitate și autocorelație) sau bootstrap pe blocuri, deoarece depășirile din criză sînt grupate; apoi corecția Holm
Miza: capitalul este necesar exact în zilele în care garanțiile marginale spun cel mai puțin
Asistentul AI (inteligență artificială) este un model lingvistic mare (LLM, large language model), precum Claude, ChatGPT sau Gemini. El este util în mai mulți pași ai buclei, cu condiția ca fiecare pas să fie verificat. Literatura pe care o propune trebuie verificată: fiecare DOI (Digital Object Identifier, identificatorul digital al unei publicații) se verifică pe Crossref. Înaintea oricărei analize noi se replică un număr cunoscut, aici ratele de depășire din criză din secțiunea conformală.
Asistentul poate propune explicații rivale pentru depășirile excesive din criză: o scală învechită, o schimbare a formei cozii sau un artefact al modului în care sînt selectate regimurile de criză. Fiecare explicație prezice un alt tipar al ratelor de depășire, iar testele care le deosebesc sînt preînregistrate înainte de examinarea datelor. La final, asistentului i se poate cere un raport de recenzent ostil asupra rezultatului. Prompturile sînt în Anexă.
Pe scurt
Asistentul AI: un LLM precum Claude, ChatGPT sau Gemini
Mini-studiul testează prima explicație rivală, scala învechită. Scorul conformal alternativ folosește prognozele GARCH-t ale mediei și volatilității, \(\mu_t\) și \(\sigma_t\):\(s_t = (L_t + \mu_t)/\sigma_t\). Dacă depășirile excesive din criză ale conformal split provin dintr-o scală care reacționează prea încet, o scală GARCH ar trebui să le elimine.
Ipoteza nulă este \(H_0: E[C_t(I_t - 0{,}05)] = 0\), adică rata de depășire a VaR 5% în criză este 5%, un caz particular al lui (8.22). Ea se testează cu o statistică \(t\) și o varianță HAC (Newey–West), deoarece depășirile din criză se grupează. Corecția Holm, o ajustare descendentă (step-down) a p-value-urilor, se aplică în interiorul fiecărui experiment: pe cele patru piețe pentru conformal split și pe piețele cu prognoze GARCH complete pentru scala GARCH.
Tabelul dă, pentru fiecare piață, numărul zilelor de criză, rata de depășire în criză și p-value-ul ajustat Holm. Pentru conformal split pe calendarul complet, ratele sînt 7,29% în 713 zile de criză pe S&P 500, 8,08% în 520 de zile pe BET, 7,95% în 264 de zile pe Bitcoin și 11,43% în 245 de zile pe EUR/RON. Pentru scala GARCH pe calendarul comun, ele sînt 2,77% în 613 zile pe S&P 500 și 3,95% în 506 zile pe BET.
Pe scurt
Scorul alternativ: pierderea standardizată \(s_t=(L_t+\mu_t)/\sigma_t\), cu \(\mu_t\), \(\sigma_t\) prognozele GARCH-t ale mediei și volatilității
\(H_0\): \(E[C_t(I_t-0{,}05)]=0\), adică rata de depășire a VaR 5% în zilele de criză este 5%
test \(t\) cu varianță HAC (Newey–West), deoarece depășirile din criză sînt grupate
corecția Holm (ajustarea în trepte a valorilor p) separat în fiecare experiment: patru piețe, respectiv piețele cu prognoze GARCH complete (n/a: prognoze GARCH necalculate)
Cele două metode folosesc calendare diferite. Conformal split rulează pe calendarul complet din secțiunea conformală. Scala GARCH are nevoie de 250 de zile de calibrare, așa că pe S&P 500 acoperă 4 709 zile, dintre care 613 sînt zile de criză; în aceleași zile, rata de criză a conformal split este 7,01%.
Conformal split are rate de criză peste 5% pe toate piețele, de la 7,29% la 11,43%. Cu inferență HAC și corecția Holm nu există nicio respingere la 5%; cel mai mic p-value Holm este 0,119, pe EUR/RON. Scala GARCH pe S&P 500 dă 2,77% în criză, sub 5%, cu un p-value Holm de 0,003: ea corectează prea mult, iar VaR devine prea conservator în criză. Pe BET dă 3,95%, iar abaterea de la 5% nu este semnificativă (p-value Holm 0,233).
Nerespingerea nu dovedește acoperirea în criză: eșantioanele de criză sînt mici, iar inferența HAC este asimptotică. Rezultatul susține o comparație între proceduri. O scală GARCH schimbă rata de depășire din criză, dar pe S&P 500 o duce dincolo de țintă, nu pe țintă.
scala GARCH cere 250 de zile de calibrare: S&P 500 are 4 709 de zile, dintre care 613 de criză
pe aceste zile, rata conformal split în criză este 7,01%
Conformal split: rate de criză peste 5% pe toate piețele, între 7,29% și 11,43%
cu inferența HAC și corecția Holm, nicio respingere la 5% (cel mai mic \(p\) Holm: 0,119, EUR/RON)
Scala GARCH pe S&P 500: 2,77% în criză, sub 5% (\(p\) Holm 0,003), deci prea conservatoare în criză
Scala GARCH pe BET: 3,95%, diferența față de 5% nu este semnificativă (\(p\) Holm 0,233)
Nerespingerea nu dovedește acoperirea în criză: eșantioanele de criză sînt mici, iar inferența HAC este asimptotică
Tipul de dovadă: comparație între proceduri
Sinteza secțiunii
Garanțiile marginale nu controlează rata de depășire în criză, iar condiția de moment (8.22) transformă acoperirea condiționată de criză într-o ipoteză testabilă. Pe datele capitolului, conformal split este depășit în criză mai des de 5% pe toate piețele, fără o respingere semnificativă după corecția Holm, iar o scală GARCH face VaR-ul S&P 500 prea conservator în criză.
Concluzii: alegerea modelului de risc
Capitolul se încheie cu decizia pe care un manager de risc o ia pe baza dovezilor din secțiunile anterioare, cu întrebări care verifică rezultatele principale și cu exerciții numerice, cu răspunsurile în Anexă.
Pe baza dovezilor capitolului, alegerea este FHS ca model principal și GARCH-EVT ca alternativă, revizuită pe măsură ce se acumulează dovezi. FHS are cea mai mică pierdere FZ0 medie pe S&P 500; pe BET, FHS și GARCH-EVT sînt la egalitate pînă la a treia zecimală. Ambele trec \(Z_2\) la 5% și rămîn în MCS de 90% pe S&P 500 și pe BET; tabloul de bord complet este în Anexă. Dovezile provin din eșantioane lungi, 4 959 de zile de evaluare pe S&P 500 și 4 937 pe BET: un an de date are putere mică.
Decizia precizează dinainte rezultatele care ar schimba-o. O respingere \(Z_2\) la 5% sau o ieșire din MCS de 90%, la date de evaluare fixate dinainte și cu ajustare pentru repetarea testelor. În monitorizarea zilnică, un e-proces ES peste 20, ceea ce corespunde nivelului de 5%. O respingere a momentului de criză (8.22), cu inferență HAC și corecția Holm.
Un rezultat contează deja împotriva alegerii: testul DQ respinge toate modelele pe S&P 500, inclusiv FHS. Depășirile FHS pot fi prevăzute din nivelul VaR și din depășirile anterioare, așa că alegerea este cea mai bună dintre cele șase candidate, nu un model validat. Un portofoliu românesc, pe BET și EUR/RON, este analizat în Seminarul 8, exercițiul C2.
Întrebările de verificare trimit la rezultatele centrale ale capitolului. Regula \(\mathrm{LR}_{uc} > 3{,}84\) respinge un VaR 1% corect în aproximativ un an din zece, deoarece mărimea ei efectivă la \(T = 250\) este 9,5% (vezi puterea testului POF). Un model cu numărul corect de depășiri poate totuși eșua, deoarece numărul nu spune nimic despre momentul în care apar depășirile. ES poate fi testat prin backtesting, dar nu poate fi ierarhizat singur, deoarece testarea cere doar o statistică cu un comportament cunoscut sub ipoteza nulă, în timp ce ierarhizarea cere un scor consistent. ACI garantează o rată medie de depășire pe termen lung, nu rata dintr-o criză.
Capitolul 9 măsoară varianța zilnică din randamente intrazilnice, adică volatilitatea realizată, și evaluează prognozele de volatilitate cu scoruri robuste precum QLIKE (quasi-likelihood loss) și cu MCS. Instrumentele de comparare din acest capitol, scorurile consistente, testele Diebold–Mariano și mulțimea de încredere a modelelor, se aplică direct.
Pe scurt
Întrebări de verificare
De ce respinge regula „\(\mathrm{LR}_{uc}>3{,}84\)” un VaR 1% corect în aproximativ un an din zece?
De ce poate fi respins un model cu numărul corect de depășiri?
De ce poate fi testat ES, dar nu poate fi ierarhizat singur?
Cele patru exerciții folosesc formulele capitolului cu numere mici:
Se aplică statistica Kupiec (8.4) la 3 depășiri ale VaR 1% în 500 de zile.
Se calculează scorul FZ0 (8.13) pentru o zi, în procente și în zecimale, pentru a verifica invarianța la scară.
Se calculează puterea locală (8.5) la \(T = 1\,000\) și \(\pi = 2\%\) și se compară cu curba întreruptă din graficul puterii.
Se calculează \(Z_1\) și \(Z_2\) din (8.10) pentru cinci depășiri într-un an și se întreabă de ce semnele lor diferă.
Răspunsurile cu pașii intermediari sînt în Anexă; exercițiile A1, A4 și B2 din Seminarul 8 aplică aceleași teste pe datele cursului.
Pe scurt
Kupiec: \(x=3\) depășiri ale VaR 1% în \(T=500\) de zile
calculați \(\hat\pi\) și \(\mathrm{LR}_{uc}\), apoi decideți la 5%
FZ0: o zi, \(\alpha=5\%\), \(v=2\%\), \(e=2{,}5\%\)
calculați scorul pentru \(L=3\%\) și pentru \(L=1\%\), în procente și în zecimale
Puterea locală: \(T=1000\), \(\alpha=1\%\), rata reală \(\pi=2\%\)
calculați \(\lambda\) și puterea, apoi comparați cu curba întreruptă din graficul puterii
\(Z_1\) și \(Z_2\): \(T=250\), \(\alpha=2{,}5\%\), cinci depășiri cu \(L_t/\mathrm{ES}_t=1{,}1;\ 0{,}9;\ 1{,}3;\ 1{,}0;\ 1{,}2\)
calculați ambele statistici și explicați semnele lor
Răspunsuri, cu pașii intermediari: Anexă. Exerciții rezolvate pe datele cursului: Seminarul 8, A1, A4, B2
Sinteza secțiunii
Decizia se sprijină pe eșantioane lungi și pe mai multe teste: FHS ca model principal și GARCH-EVT ca alternativă, cu condițiile care ar schimba alegerea precizate înainte de următoarea evaluare. Respingerea DQ pe S&P 500 este o slăbiciune cunoscută a amîndurora.
Aprofundări
Cadrele din această parte dau detaliile din spatele textului principal: datele și fereastra rolling, regula pentru prognozele GARCH reținute, episodul din martie 2020, puterea locală calculată de mînă, rezultatele de independență pe întregul eșantion, testele de durată și testul DQ, un studiu Monte Carlo al mărimii și puterii, riscul de estimare, testele ES bazate pe PIT, robustețea clasamentelor la alegerea scorului, testul Giacomini–White și testul în trei zone, statistica MCS și detaliile studiului de caz despre regresia ES.
Cele patru piețe acoperă patru regimuri diferite de volatilitate și de cozi:
S&P 500 este o piață de acțiuni dezvoltată și lichidă;
BET (indicele Bucharest Exchange Trading) este o piață emergentă, mai puțin lichidă;
Bitcoin se tranzacționează în fiecare zi și are cozi foarte groase;
EUR/RON este cursul de referință al Băncii Naționale a României (BNR), un regim de flotare administrată.
Aceleași teste se pot comporta diferit pe fiecare. Pentru S&P 500, BET și Bitcoin datele sînt prețuri zilnice de închidere, iar fiecare serie își păstrează propriul calendar de tranzacționare.
Pe scurt
S&P 500: piață de acțiuni dezvoltată și lichidă
BET (indicele Bursei de Valori București): piață emergentă, mai puțin lichidă
Bitcoin: se tranzacționează în fiecare zi și are cozi foarte groase
EUR/RON: cursul de referință BNR (Banca Națională a României), un curs cu flotare administrată
De ce acestea: patru regimuri diferite de volatilitate și de coadă
pe aceste regimuri, aceleași teste se pot comporta diferit
S&P 500, BET și Bitcoin: închideri zilnice
fiecare serie își păstrează propriul calendar de tranzacționare
Toate prognozele folosesc o fereastră rolling de 1 000 de observații, aproximativ patru ani de tranzacționare pe acțiuni: suficiente date pentru estimarea unui model GARCH și pentru 100 de excedențe în coada GPD. Fiecare prognoză folosește doar date pînă în ziua anterioară, deci nu există look-ahead bias. Parametrii GARCH, Student-t și EVT se reestimează la fiecare 20 de zile, aproximativ o lună de tranzacționare, în timp ce volatilitatea GARCH se actualizează zilnic. Evaluarea începe la 1 ianuarie 2007 sau, pentru o serie mai scurtă, după primele ei 1 000 de observații, și se încheie la 18 septembrie 2026. Rezultă 4 959 de zile de evaluare pentru S&P 500, 4 937 pentru BET, 4 352 pentru EUR/RON (curs din iulie 2005, evaluat din 2009) și 3 384 pentru Bitcoin (date din septembrie 2014, evaluat din 2017).
Pe scurt
Fereastră mobilă de 1 000 de observații (circa patru ani de tranzacționare pe acțiuni)
destule date pentru GARCH și 100 de excese pentru coada GPD
Fiecare prognoză folosește doar datele pînă în ziua precedentă (fără deplasarea de anticipare, look-ahead bias)
Parametrii GARCH, Student-t și EVT (Extreme Value Theory, teoria valorilor extreme) se reestimează la fiecare 20 de zile (circa o lună de tranzacționare)
volatilitatea GARCH se actualizează zilnic
Evaluarea începe la 01.01.2007 sau, la o serie mai scurtă, după primele 1 000 de observații
ultima zi: 18.09.2026
S&P 500 și BET (din 2007): 4 959, respectiv 4 937 de zile de evaluare
EUR/RON (curs din iulie 2005, deci evaluare din 2009): 4 352 de zile
Bitcoin (date din septembrie 2014, deci evaluare din 2017): 3 384 de zile
O estimare GARCH(1,1)-t este admisibilă dacă optimizatorul a convers și \(\omega > 0\),\(a, b \ge 0\),\(\nu > 2\) și \(a + b < 1\), cu o marjă numerică de \(10^{-8}\); ultima condiție face finită varianța necondiționată \(\omega/(1-a-b)\). La o reestimare inadmisibilă se păstrează ultimii parametri admisibili, iar volatilitatea este filtrată în continuare pe datele curente. Fără o estimare admisibilă anterioară, prognozele GARCH-t, FHS și GARCH-EVT sînt reținute, adică nici calculate, nici imputate. Aceasta afectează primele 1 660 dintre cele 3 384 de zile de evaluare pe Bitcoin, unde primele 83 de reestimări au toate \(a + b \ge 1 - 10^{-8}\), și primele 20 dintre cele 4 352 de zile pe EUR/RON, adică prima reestimare. Rezultatele GARCH pe întregul eșantion și MCS, care are nevoie de toate cele șase modele, sînt deci raportate doar pentru S&P 500 și BET; tabelele arată „n/a”, iar graficele o liniuță.
Pe scurt
O estimare GARCH(1,1)-t este admisibilă dacă optimizarea a convers și \(\omega>0\), \(a,b\ge 0\), \(\nu>2\), \(a+b<1\)
cu o marjă numerică de \(10^{-8}\)
adică dispersia necondiționată \(\omega/(1-a-b)\) este finită
La o reestimare neadmisibilă păstrăm ultimii parametri admisibili
volatilitatea se filtrează în continuare pe datele curente
Fără nicio estimare admisibilă anterioară, prognozele GARCH-t, FHS și GARCH-EVT sînt necalculate
nu le înlocuim cu alte prognoze
Bitcoin: primele 1 660 din 3 384 de zile de evaluare
primele 83 de reestimări au toate \(a+b\ge 1-10^{-8}\)
EUR/RON: primele 20 din 4 352 de zile de evaluare (prima reestimare)
Rezultatele GARCH pe eșantionul complet și MCS se raportează doar pe S&P 500 și BET
Între februarie și iunie 2020, S&P 500 a avut cea mai mare pierdere zilnică din eșantion, 12,77% la 16 martie 2020. Un VaR 1% corect ar avea 1,04 depășiri așteptate în aceste 104 zile. Modelele necondiționate au avut 12 (HS), 17 (Normal) și 17 (Student-t); modelele condiționate 3 (GARCH-t), 2 (FHS) și 2 (GARCH-EVT). Student-t, cu o coadă groasă dar o scală fixă, a avut rezultate la fel de slabe ca modelul Normal: în acest episod, o scală variabilă în timp a contat mai mult decît forma cozii.
Pe scurt
S&P 500, februarie–iunie 2020: pierderile zilnice (bare) și VaR 1% al celor șase modele
Cea mai mare pierdere: 12,77%, la 16.03.2020
Un VaR 1% corect are 1,04 depășiri așteptate în aceste 104 zile
Depășiri, modele necondiționate: HS 12, Normal 17, Student-t 17
Distribuția \(\chi^2_1(\lambda)\) necentrală este distribuția lui \((Z + \sqrt\lambda)^2\) cu \(Z \sim N(0,1)\), iar \(3{,}84 = 1{,}96^2\). Puterea locală din (8.5) este deci \(P(|Z + \sqrt\lambda| > 1{,}96) = \Phi(\sqrt\lambda - 1{,}96) + \Phi(-\sqrt\lambda - 1{,}96)\), cu \(\Phi\) funcția de repartiție a distribuției Normale standard. Pentru \(T = 250\) și \(\pi = 2\%\),\(\lambda = 2{,}525\) și \(\sqrt\lambda = 1{,}589\), deci puterea este \(\Phi(-0{,}371) + \Phi(-3{,}549) = 0{,}355 + 0{,}0002 = 0{,}356\), cei 36% de pe curba întreruptă. Puterea exactă este mai mică, 24%, deoarece testul acceptă \(x\) de la 1 la 6, un eveniment cu probabilitatea 75,7% cînd \(\pi = 2\%\): cu 2,5 depășiri așteptate pe an, numărul este prea discret și prea asimetric pentru aproximarea prin distribuția Normală din spatele lui \(\chi^2_1(\lambda)\).
Pe scurt
\(\chi^2_1(\lambda)\) este legea lui \((Z+\sqrt\lambda)^2\), cu \(Z\sim N(0,1)\), iar \(3{,}84=1{,}96^2\), deci
puterea \(=P(|Z+\sqrt\lambda|>1{,}96)=\Phi(\sqrt\lambda-1{,}96)+\Phi(-\sqrt\lambda-1{,}96)\), unde \(\Phi\) este funcția de repartiție \(N(0,1)\)
Pe întregul eșantion S&P 500, p-value-urile lui \(\mathrm{LR}_{ind}\)(8.6) pentru VaR 1% sînt sub 0,001 pentru HS, Normal și Student-t, 0,031 pentru GARCH-EVT, 0,046 pentru FHS și 0,095 pentru GARCH-t. Independența este respinsă la 5% pentru toate modelele în afară de GARCH-t, dar după o corecție Holm pentru cele șase teste rămîn respinse doar HS, Normal și Student-t. Pentru GARCH-EVT, o depășire urmează unei depășiri cu probabilitatea 0,053, față de 0,011 după o zi calmă. Testul comun de acoperire condiționată (8.7) nu respinge GARCH-EVT (\(p = 0{,}058\)): componenta lui de acoperire corectă diluează semnalul de independență.
Pe scurt
valorile p \(\mathrm{LR}_{ind}\), VaR 1%: HS, Normal și Student-t \(<\)0,001
GARCH-EVT 0,031; FHS 0,046; GARCH-t 0,095
Independența este respinsă la 5% pentru toate modelele, cu excepția GARCH-t
După o corecție Holm pentru cele șase teste, rămîn respinse doar HS, Normal și Student-t
La GARCH-EVT, o depășire urmează unei depășiri cu probabilitatea 0,053, față de 0,011 după o zi fără depășire
Testul comun CC nu respinge GARCH-EVT (\(p=0{,}058\)): componenta de acoperire, corectă, diluează semnalul
Testele de durată verifică dacă intervalele dintre depășiri sînt cele ale unui proces fără memorie, folosind fiecare interval, nu doar perechile consecutive. Durata \(D_i\) este numărul de zile dintre depășirea \(i-1\) și depășirea \(i\); pentru un VaR corect ea este geometrică, cu media \(1/\alpha\), adică 100 de zile pentru \(\alpha = 1\%\).Christoffersen & Pelletier (2004) aproximează duratele discrete prin densitatea Weibull \(f(D; a, b) = a^{b}\,b\,D^{b-1}e^{-(aD)^{b}}\), cu rata \(a > 0\) și forma \(b > 0\). Valoarea \(b = 1\) dă cazul exponențial, fără memorie; \(b < 1\) înseamnă că duratele scurte sînt prea frecvente, adică depășirile se grupează.
Pe scurt
Ce testează: dacă distanțele dintre depășiri sînt cele ale unui proces fără memorie
folosește toate distanțele, nu doar perechile de zile consecutive
Durata \(D_i\): numărul de zile dintre depășirea \(i-1\) și depășirea \(i\)
Pentru un VaR corect, \(D_i\) urmează distribuția geometrică, cu media \(1/\alpha\) (100 de zile pentru \(\alpha=1\%\))
Testul ipotezei \(H_0: b = 1\), cu \(a\) liber, față de \(b \ne 1\) este raportul de verosimilitate \(\mathrm{LR}_{dur} = 2[\ell(\hat a, \hat b) - \ell(\tilde a, 1)] \to \chi^2_1\), unde \(\tilde a\) maximizează verosimilitatea cu \(b = 1\). Log-verosimilitatea \(\ell(a,b) = \sum_i [C_i \ln S(D_i) + (1 - C_i)\ln f(D_i)]\) folosește funcția de supraviețuire \(S(D) = e^{-(aD)^b}\) pentru prima și ultima durată, care sînt cenzurate (\(C_i = 1\)): prima nu începe cu o depășire, iar ultima nu se termină cu una. Testul nu verifică media \(1/\alpha\), lăsată testului Kupiec. La \(T \ge 1\,000\) detectează gruparea mai bine decît testul de acoperire condiționată, dar la \(T = 250\) nu, așa cum arată experimentul Monte Carlo de la sfîrșitul acestei părți.
Pe scurt
\(H_0\): \(b=1\), cu \(a\) liber, față de \(H_1\): \(b\neq 1\)
\(\mathrm{LR}_{dur}=2\left[\ell(\hat a,\hat b)-\ell(\tilde a,1)\right]\ \xrightarrow{d}\ \chi^2_1\), unde \(\tilde a\) maximizează verosimilitatea cu \(b=1\)
\(\ell(a,b)=\sum_i\left[C_i\ln S(D_i)+(1-C_i)\ln f(D_i)\right]\), cu \(S(D)=e^{-(aD)^{b}}\) funcția de supraviețuire
\(C_i=1\) pentru prima și ultima durată, cenzurate: prima nu începe la o depășire, ultima nu se încheie la o depășire
Testul nu verifică media \(1/\alpha\): acoperirea rămîne în seama testului Kupiec
La \(T\ge 1\,000\) detectează gruparea mai bine decît testul de acoperire condiționată
la \(T=250\) nu (experimentul Monte Carlo de la sfîrșitul secțiunii)
Graficul arată, pe scară logaritmică, ponderea duratelor dintre depășirile VaR 1% pe S&P 500 mai lungi de \(d\) zile, față de referința geometrică (fără memorie) pentru \(\alpha = 1\%\), trasată punctat. HS are \(b = 0{,}52\)(\(p < 0{,}001\)) și o durată mediană de 7 zile, iar modelul Normal \(b = 0{,}56\): ambele se grupează puternic. GARCH-t are \(b = 0{,}92\)(\(p = 0{,}344\)) și o durată mediană de 45 de zile, iar GARCH-EVT \(b = 0{,}90\)(\(p = 0{,}317\)). HS are și o coadă lungă a duratelor: după o criză, VaR-ul ridicat rămas în fereastră produce ani fără depășiri.
Pe scurt
Axe: durata \(d\) în zile (orizontal) și ponderea duratelor mai lungi decît \(d\) (vertical)
axa verticală are scală logaritmică
Linia punctată: fără memorie (geometrică), cu \(\alpha=1\%\)
HS: \(b=0{,}52\), \(p\)\(<\)0,001; durata mediană: 7 zile
Normal: \(b=0{,}56\)
GARCH-t: \(b=0{,}92\), \(p=0{,}344\); durata mediană: 45 de zile
GARCH-EVT: \(b=0{,}90\), \(p=0{,}317\)
Coada lungă a duratelor HS: ani fără depășiri după ce o criză lasă un VaR ridicat în fereastră
Testul DQ al lui Engle & Manganelli (2004) întreabă dacă depășirile pot fi prevăzute din orice informație cunoscută ieri, nu doar din depășirea de ieri. Sub calibrare condiționată, depășirea centrată \(\mathrm{Hit}_t = I_t - \alpha\) este o diferență de martingal, cu \(E[\mathrm{Hit}_t \mid \mathcal{F}_{t-1}] = 0\) și \(\mathrm{Var}(\mathrm{Hit}_t \mid \mathcal{F}_{t-1}) = \alpha(1-\alpha)\). Testul regresează \(\mathrm{Hit}_t = X_t\beta + u_t\) pe \(X_t = (1, \mathrm{Hit}_{t-1}, \dots, \mathrm{Hit}_{t-4}, \mathrm{VaR}_t)\) prin metoda celor mai mici pătrate (OLS, ordinary least squares) și testează \(\beta = 0\) cu \(\mathrm{DQ} = \mathrm{Hit}'X(X'X)^{-1}X'\mathrm{Hit}/(\alpha(1-\alpha)) \to \chi^2_6\), suma pătratelor explicată raportată la varianța de sub ipoteza nulă.
Pe scurt
Ce testează: dacă depășirile pot fi prezise din orice informație cunoscută ieri, nu doar din depășirea de ieri
Sub calibrarea condiționată, \(\mathrm{Hit}_t=I_t-\alpha\) este o diferență de martingal
Cu \(X_t = 1\), statistica DQ este forma de tip scor a testului Kupiec, \(T(\hat\pi - \alpha)^2/(\alpha(1-\alpha))\); cu \(X_t = (1, \mathrm{Hit}_{t-1})\), este un analog cu două grade de libertate al lui \(\mathrm{LR}_{cc}\), echivalent asimptotic, dar nu egal numeric, iar coeficientul lagului singur corespunde lui \(\mathrm{LR}_{ind}\). Ce adaugă DQ este puterea împotriva memoriei dincolo de lagul 1 și împotriva depășirilor care depind de nivelul VaR. Limita lui este că aproximarea \(\chi^2_6\) respinge prea des un model corect. Sub procesul generator al experimentului Monte Carlo al capitolului, cuantila de 95% a lui DQ la \(T = 4\,959\) este 14,2, față de 12,59 pentru \(\chi^2_6\); pentru FHS și GARCH-EVT pe S&P 500, frecvențele simulate sînt 0,6% și 0,5%, față de p-value-uri asimptotice de 0,014% și 0,011%. Acestea sînt repere sub procesul didactic, nu p-value-uri definitive pentru datele empirice.
Pe scurt
Cu \(X_t=1\) obținem forma scor a testului Kupiec: \(T(\hat\pi-\alpha)^2/(\alpha(1-\alpha))\)
Cu \(X_t=(1,\mathrm{Hit}_{t-1})\) obținem un analog cu 2 grade de libertate al \(\mathrm{LR}_{cc}\)
asimptotic echivalent, dar nu egal numeric
Testarea doar a coeficientului lagului corespunde lui \(\mathrm{LR}_{ind}\)
Ce adaugă: putere împotriva memoriei dincolo de lagul 1 și a depășirilor care depind de nivelul VaR
Limita: aproximarea \(\chi^2_6\) respinge prea des un model corect
experimentul Monte Carlo de la sfîrșitul secțiunii
valorile p DQ din acest capitol sînt asimptotice; valorile critice trebuie simulate
sub procesul generator al datelor din experimentul Monte Carlo, cuantila de 95% a DQ pentru \(T=4\,959\) este 14,2, față de 12,59 pentru \(\chi^2_6\)
FHS și GARCH-EVT pe S&P 500: frecvențe simulate 0,6% și 0,5%, față de valorile p asimptotice 0,014% și 0,011%
un reper sub acest proces didactic, nu valori p definitive pentru datele empirice
Procesul generator de date (DGP, data-generating process), adevărul simulat, este un model GARCH(1,1)-t estimat pe S&P 500 în 1990–2026, cu \(a = 0{,}102\),\(b = 0{,}892\) și \(\nu = 6{,}1\). Pentru VaR 1% și 1 000 de traiectorii simulate la fiecare lungime a eșantionului, tabelul raportează ratele de respingere, în procente, la 5% ale testelor POF, de acoperire condiționată, de durată și DQ, pentru trei prognozatori: cel corect, care dă mărimea, și doi greșiți, care dau puterea.
Pe scurt
DGP (procesul generator al datelor, adevărul simulat): GARCH(1,1)-t estimat pe S&P 500 1990–2026
\(a=0{,}102\), \(b=0{,}892\), \(\nu=6{,}1\)
Simulăm 1 000 de traiectorii și raportăm ratele de respingere (%) ale testelor la 5%, pentru VaR 1%
Prognozatorul corect folosește parametrii adevărați și \(\sigma_t\), deci rata lui de respingere este mărimea, cu ținta de 5%. Prognozatorul Normal-GARCH folosește \(\sigma_t\) adevărat cu o coadă Normală, iar HS pe 1 000 de zile nu are dinamică a volatilității; ratele lor de respingere măsoară puterea. Un p-value de durată nedefinit, care apare cu mai puțin de 3 durate, în 28% dintre eșantioanele corecte la \(T = 250\), se numără ca nerespingere. Eroarea standard Monte Carlo este de 0,7 puncte procentuale la o rată de 5% și de 1,6 la 50%; în celula POF evidențiată, 9,7%, ea este 0,9, deci mărimea este clar peste 5%.
Pe scurt
Corect: parametrii și \(\sigma_t\) adevărați; rata de respingere este mărimea (ținta: 5%)
Normal-GARCH: \(\sigma_t\) adevărat, coadă Normală; rata de respingere este puterea
HS, 1 000 de zile: fără dinamica volatilității; rata de respingere este puterea
O valoare p nedefinită a testului de durată se numără ca nerespingere
nedefinit: sub 3 durate, în 28% din eșantioanele corecte la \(T=250\)
Eroarea standard Monte Carlo: 0,7 puncte procentuale la 5% și 1,6 la 50%
În celula POF cu aldine (9,7%), eroarea standard este 0,9: mărimea depășește clar 5%
Pe un an, o coadă Normală pe volatilitatea corectă este aproape invizibilă: POF o respinge în 10,6% din cazuri, cam cît mărimea lui de 9,7%. Gruparea HS este rar detectată de testul de durată la \(T = 250\) (12,0%), dar la \(T = 1\,000\) testul de durată (68,3%) și DQ (73,8%) detectează HS mult mai bine decît POF (46,4%). Testul de acoperire condiționată este conservator, cu o mărime de 1,1% la \(T = 250\), iar DQ respinge prea des un model corect chiar și la \(T = 5\,000\) (8,8%), deci valorile lui critice ar trebui simulate. La \(T = 250\), niciun test nu are simultan mărimea corectă și o putere mare.
Pe scurt
Într-un an, o coadă Normală pe volatilitatea corectă este aproape invizibilă
POF respinge în 10,6% din cazuri, cît mărimea (9,7%)
Gruparea depășirilor HS este rar detectată de testul duratelor la \(T=250\) (12,0%)
La \(T=1\,000\), testul duratelor (68,3%) și DQ (73,8%) detectează HS mult mai bine decît POF (46,4%)
Testul de acoperire condiționată este conservator: mărimea 1,1% la \(T=250\)
DQ respinge prea des un model corect chiar la \(T=5\,000\) (8,8%): valorile lui critice ar trebui simulate
La \(T=250\), niciun test nu are simultan mărime corectă și putere mare
Prognozele folosesc parametri \(\hat\theta\) estimați pe \(R\) zile, iar testul folosește \(P\) zile out-of-sample, așa că depășirile \(\hat I_t = \mathbf{1}\{L_t > \mathrm{VaR}_t(\hat\theta)\}\) nu sînt Bernoulli(\(\alpha\)) nici sub un model corect. Escanciano & Olmo (2010) arată că corecția depinde de schema de prognoză, fixă, rolling sau recursivă, și crește cu \(P/R\); dezvoltarea este în Anexă. Un experiment cu schemă fixă, cu 400 de traiectorii GARCH(1,1)-t și \(R = 1\,000\), dă o estimare admisibilă pe 324 dintre ele (rezultatele simulării). Capitolul folosește o fereastră rolling (\(R = 1\,000\), reestimată la fiecare 20 de zile), deci un experiment cu schemă fixă nu măsoară mărimea testelor lui. Remediul este reproducerea estimării în interiorul calibrării, de exemplu printr-un bootstrap parametric care reestimează modelul pe fiecare traiectorie simulată; Seminarul 8, exercițiul B9, discută și selecția traiectoriilor admisibile.
Pe scurt
Prognozele folosesc \(\hat\theta\) estimat pe \(R\) zile, iar testul folosește \(P\) zile în afara eșantionului (out-of-sample)
depășirile \(\hat I_t=\mathbf{1}\{L_t>\mathrm{VaR}_t(\hat\theta)\}\) nu sînt Bernoulli(\(\alpha\)) nici sub un model corect
Corecția depinde de schema de prognoză (fixă, mobilă, recursivă) și crește cu \(P/R\) (Escanciano & Olmo (2010))
Testul lui Du & Escanciano (2017) măsoară cît de adînc în coadă ajung pierderile, prin PIT \(u_t = F_t(L_t)\), uniform pe \((0,1)\) dacă distribuția prognozată \(F_t\) este corectă. Depășirea cumulată (cumulative violation) \(H_t = \frac{1}{\alpha}(u_t - (1-\alpha))\mathbf{1}\{u_t > 1-\alpha\}\) are sub \(H_0\) media \(\alpha/2\) și varianța \(\alpha(1/3 - \alpha/4)\). Testul necondiționat este \(U = \sqrt{T}(\bar H - \alpha/2)/\sqrt{\alpha(1/3 - \alpha/4)} \to N(0,1)\):\(U > 0\) înseamnă pierderi mai adînci decît s-a prognozat, iar \(U < 0\) mai puțin adînci. Harta termică din sinteza testelor ES dă p-value-ul bilateral \(p = 2\Phi(-|U|)\), în timp ce testul unilateral la 5% respinge pentru \(U > 1{,}645\). Testul condiționat este statistica Box–Pierce \(C_5 = T\sum_{j=1}^{5}\hat\rho_j^2 \to \chi^2_5\), cu \(\hat\rho_j\) autocorelațiile lui \(H_t\).
Pe scurt
Ce testează: cît de adînc în coadă ajung pierderile, nu doar dacă depășesc VaR
folosește distribuția prognozată prin PIT
PIT: \(u_t=F_t(L_t)\), uniformă pe \((0,1)\) dacă distribuția prognozată \(F_t\) este corectă
sub \(H_0\): \(E[H_t]=\alpha/2\), \(\mathrm{Var}(H_t)=\alpha(1/3-\alpha/4)\)
Testul necondiționat: \(U=\sqrt{T}\,(\bar H-\alpha/2)/\sqrt{\alpha(1/3-\alpha/4)}\ \xrightarrow{d}\ N(0,1)\), cu \(\bar H\) media empirică a lui \(H_t\)
Semnul lui \(U\)
\(U>0\): pierderi mai adînci decît s-a prognozat (risc subestimat)
Deoarece ES 2,5% face media cuantilelor de dincolo de VaR 2,5%, testarea simultană a mai multor niveluri VaR este un test implicit pentru ES (Kratz, Lok & McNeil, 2018). Cu \(N = 4\) niveluri, 2,5%, 1,875%, 1,25% și 0,625%, fiecare zi cade după PIT-ul ei în una dintre 5 celule, cu probabilitatea 97,5% pentru prima și 0,625% pentru fiecare dintre cele patru celule din coadă. Statistica Pearson \(S = \sum_{j=0}^{4}(O_j - Tp_j)^2/(Tp_j) \to \chi^2_4\) compară numerele observate \(O_j\) cu cele așteptate \(Tp_j\). Modelul Normal este respins pe toate cele patru piețe (\(p < 0{,}001\)), iar GARCH-t pe S&P 500 și pe BET; GARCH-EVT nu este respins pe niciuna (0,378 și 0,853), iar FHS doar pe S&P 500 (\(p = 0{,}003\)).
Pe scurt
ES 2,5% este media cuantilelor dincolo de VaR 2,5%: testăm simultan mai multe niveluri VaR (Kratz, Lok & McNeil (2018))
\(N=4\) niveluri \(\alpha_j=2{,}5\%\,(1-(j-1)/4)\): 2,5%, 1,875%, 1,25% și 0,625%
după PIT-ul \(u_t\), fiecare zi cade într-una din 5 celule
Statistica Pearson: \(S=\sum_{j=0}^{4}(O_j-Tp_j)^2/(Tp_j)\xrightarrow{d}\chi^2_4\), cu \(O_j\) zilele observate și \(Tp_j\) zilele așteptate în celula \(j\)
Frecvențele pe celule arată unde eșuează GARCH-t pe S&P 500. Prima celulă, în afara cozii superioare de 2,5% a pierderilor, are 4 761 de zile, față de 4 835,02 așteptate. Fiecare dintre cele patru celule din coadă, în care se așteaptă 30,99 zile, are mai multe: 39, 46, 52 și 61, de la cea mai puțin extremă la cea mai extremă. Excesul crește cu adîncimea cozii, semnul unei cozi prea subțiri.
Pe scurt
Interval PIT
Zile observate
Zile așteptate
\([0;\,0{,}975]\)
4 761
4 835,02
\((0{,}975;\,0{,}98125]\)
39
30,99
\((0{,}98125;\,0{,}9875]\)
46
30,99
\((0{,}9875;\,0{,}99375]\)
52
30,99
\((0{,}99375;\,1]\)
61
30,99
Prima celulă este în afara cozii superioare a pierderilor, de 2,5%
Fiecare dintre cele patru celule din coadă conține mai multe zile decît s-ar aștepta dacă modelul ar fi calibrat
O cuantilă are o infinitate de scoruri consistente, \(S(v, L) = (\mathbf{1}\{L \le v\} - \tau)(g(v) - g(L))\), cu \(g\) crescătoare și \(\tau = 1 - \alpha\), iar un clasament obținut cu unul dintre ele se poate inversa cu altul. Ehm, Gneiting, Jordan & Krüger (2016) arată că fiecare este un amestec de scoruri elementare (elementary scores) \(S_\theta(v, L) = (\mathbf{1}\{L < v\} - \tau)(\mathbf{1}\{\theta < v\} - \mathbf{1}\{\theta < L\})\), indexate printr-un prag \(\theta\) pe scara pierderilor; \(S_\theta\) penalizează o prognoză doar cînd \(v\) și \(L\) cad de o parte și de alta a lui \(\theta\), iar pierderea pinball este \(\int S_\theta\,d\theta\). Prognoza \(A\) este preferată lui \(B\) sub orice scor consistent dacă și numai dacă scorul ei elementar mediu este mai mic pentru orice \(\theta\).Diagrama Murphy reprezintă \(\bar S_\theta\) în funcție de \(\theta\); dacă curbele se intersectează, clasamentul depinde de scorul ales.
Pe scurt
Pentru o cuantilă există o infinitate de scoruri consistente
\(S(v,L)=(\mathbf{1}\{L\le v\}-\tau)(g(v)-g(L))\), cu \(g\) crescătoare și \(\tau=1-\alpha\)
Diagrama Murphy compară prognozele VaR 1% ale modelelor GARCH-t și FHS pe S&P 500 în 2007–2026, pentru praguri \(\theta\) de la 0,9% la 11,3%, cu benzi punctuale de 95% pentru diferență.
Sub pierderea pinball obișnuită, cele două prognoze sînt la egalitate: 3,852 pentru GARCH-t și 3,861 pentru FHS, în unități de \(10^{-4}\). Diagrama Murphy arată de ce: sub \(\theta = 5\%\) curbele se intersectează, FHS este mai bun pe 47% dintre praguri, iar banda conține zero pe 86%, în timp ce peste 5% GARCH-t este mai mic pe 89% dintre praguri. Niciuna dintre prognoze nu domină. Benzile de 95% folosesc erori standard HAC și sînt punctuale, nu un test simultan de dominanță. Regula practică este ca scorul să fie fixat înainte de a privi rezultatele.
Pe scurt
S&P 500, VaR 1%, 2007–2026, cu pragul \(\theta\) între 0,9% și 11,3%
Pierderea pinball medie (\(\times 10^4\)): GARCH-t 3,852, FHS 3,861, deci egalitate sub scorul obișnuit
Sub \(\theta=5\%\) curbele se intersectează
FHS este mai bun pe 47% dintre praguri, iar banda conține zero pe 86%
peste \(\theta=5\%\), GARCH-t are scorul mai mic pe 89% dintre praguri
niciun model nu îl domină pe celălalt
Benzile de 95% folosesc erori standard HAC și sînt punctuale, nu un test simultan de dominare
HAC: robuste la heteroscedasticitate și autocorelație
Testul Diebold–Mariano vizează acuratețea în populație a modelelor. Cu ferestre rolling de 1 000 de zile și reestimări periodice, capitolul compară metode de prognoză, a căror eroare de estimare nu dispare cînd \(T\) crește. Giacomini & White (2006) testează \(H_0: E[d_t \mid \mathcal{F}_{t-1}] = 0\) pentru \(d_t = \mathrm{FZ0}_{A,t} - \mathrm{FZ0}_{B,t}\); testul este valid și pentru modele imbricate, cu ferestre rolling finite, dar nu cu ferestre recursive. El întreabă dacă diferența de pierdere poate fi prevăzută din informația cunoscută la \(t-1\), nu doar dacă media ei este zero.
Pe scurt
DM vizează acuratețea populațională a modelelor
Cu ferestre mobile de 1 000 de zile și reestimări comparăm metode de prognoză
eroarea de estimare nu dispare cînd \(T\) crește
Giacomini & White (2006): \(H_0\): \(E[d_t\mid\mathcal{F}_{t-1}]=0\) pentru \(d_t=\mathrm{FZ0}_{A,t}-\mathrm{FZ0}_{B,t}\)
Testul este valid și pentru modele imbricate, cu ferestre mobile de lungime finită (nu cu ferestre recursive)
Ce adaugă: testează dacă diferența de pierdere poate fi prezisă din informația cunoscută la \(t-1\)
Cu funcția de test \(h_{t-1} = (1, d_{t-1})'\), cunoscută la \(t-1\), și \(Z_t = h_{t-1}d_t\), statistica este \(\mathrm{GW} = T\bar Z'\hat\Omega^{-1}\bar Z \to \chi^2_2\), unde \(\hat\Omega = T^{-1}\sum_t Z_t Z_t'\) pentru prognoze la un pas, iar cele două grade de libertate corespund celor două instrumente; \(h_{t-1} = 1\) dă forma DM. Pe S&P 500, față de FHS, GARCH-EVT are \(\mathrm{GW} = 6{,}71\)(\(p = 0{,}035\)), GARCH-t 7,60 (\(p = 0{,}022\)) și HS 53,16 (\(p < 0{,}001\)). GARCH-EVT, la egalitate cu FHS sub DM, este respins condiționat: capacitatea predictivă condiționată egală nu se menține pentru instrumentele \(h_{t-1}\). Respingerea singură nu arată cînd FHS are scorul mai mic; ce instrument o produce se vede doar dacă fiecare este testat separat.
Pe scurt
Funcția test \(h_{t-1}=(1,d_{t-1})^{\prime}\), cunoscută la \(t-1\); \(Z_t=h_{t-1}d_t\)
\(\mathrm{GW}=T\,\bar Z^{\prime}\hat\Omega^{-1}\bar Z\xrightarrow{d}\chi^2_2\), \(\hat\Omega=T^{-1}\sum_t Z_tZ_t^{\prime}\) (prognoze la un pas)
\(\bar Z\): media lui \(Z_t\); 2 grade de libertate, cîte unul pentru fiecare instrument
cu \(h_{t-1}=1\) obținem forma DM
S&P 500, față de FHS
GARCH-EVT: \(\mathrm{GW}=6{,}71\) (\(p=0{,}035\))
GARCH-t: 7,60 (\(p=0{,}022\))
HS: 53,16 (\(p\)\(<\)0,001)
GARCH-EVT, la egalitate după DM, este respins condiționat
se respinge capacitatea predictivă condiționată egală pentru instrumentele \(h_{t-1}\)
Respingerea, singură, nu arată cînd FHS are scorul mai mic
Care instrument determină respingerea se vede doar testîndu-le separat
Nolde & Ziegel (2017) compară modelul intern \(A\) cu un model standard \(S\), aici HS, după pierderea FZ0 medie, cu două teste unilaterale la 5%: \(H_0^-\),\(A\) cel puțin la fel de bun ca \(S\), și \(H_0^+\),\(A\) cel mult la fel de bun. Zona este verde dacă \(H_0^+\) este respinsă (\(\mathrm{DM} < -1{,}645\)), roșie dacă \(H_0^-\) este respinsă (\(\mathrm{DM} > 1{,}645\)) și galbenă în rest; o valoare de \(-1{,}8\) este verde, deși \(|\mathrm{DM}| < 1{,}96\). Sarcina probei se inversează: banca trebuie să arate că modelul ei este mai bun, nu supraveghetorul că este mai slab. Pe S&P 500 și BET, GARCH-t (\(-4{,}21\),\(-5{,}25\)), FHS (\(-4{,}69\),\(-5{,}53\)) și GARCH-EVT (\(-4{,}67\),\(-5{,}57\)) sînt toate în zona verde față de HS.
Pe scurt
Comparăm modelul intern \(A\) cu un model standard \(S\) (aici HS) după pierderea FZ0 medie (Nolde & Ziegel (2017))
prin două teste unilaterale la 5%
\(H_0^{-}\): \(A\) este cel puțin la fel de bun ca \(S\); \(H_0^{+}\): \(A\) este cel mult la fel de bun
Pentru modelul \(i\) din mulțimea curentă \(\mathcal{M}\),\(d_{i\cdot} = \bar L_i - \frac{1}{|\mathcal{M}|}\sum_{j \in \mathcal{M}}\bar L_j\) este pierderea lui medie față de media mulțimii, \(t_i = d_{i\cdot}/\widehat{\mathrm{se}}(d_{i\cdot})\), iar \(T_{\max} = \max_{i \in \mathcal{M}} t_i\) testează \(H_0\): toate modelele din \(\mathcal{M}\) au aceeași pierdere așteptată. Erorile standard și distribuția lui \(T_{\max}\) sub ipoteza nulă provin dintr-un bootstrap circular pe blocuri de 10 zile, cu 1 000 de replicări. Dacă \(H_0\) este respinsă, se elimină modelul cu cel mai mare \(t_i\) și testul se repetă; p-value-ul MCS al unui model este cel mai mare p-value al testelor pînă la eliminarea lui. Cu 1 000 de replicări, cel mai mic p-value care poate fi rezolvat este aproximativ 0,001, deci un „0,000” în grafic înseamnă \(p \le 0{,}001\).
Pe scurt
Pentru modelul \(i\) din mulțimea curentă \(\mathcal{M}\): \(d_{i\cdot}=\bar L_i-\frac{1}{|\mathcal{M}|}\sum_{j\in\mathcal{M}}\bar L_j\)
pierderea medie față de media mulțimii
\(t_i=d_{i\cdot}/\widehat{\mathrm{se}}(d_{i\cdot})\) și \(T_{\max}=\max_{i\in\mathcal{M}}t_i\)
\(H_0\): toate modelele din \(\mathcal{M}\) au aceeași pierdere așteptată
\(\widehat{\mathrm{se}}\) și distribuția lui \(T_{\max}\) sub \(H_0\) provin dintr-un bootstrap circular pe blocuri de 10 zile
cu 1 000 de replicări
Dacă respingem \(H_0\), eliminăm modelul cu cel mai mare \(t_i\) și repetăm
valoarea p MCS a unui model: cea mai mare valoare p a testelor pînă la eliminarea lui
Cu 1 000 de replicări, cea mai mică valoare p rezolvabilă este de circa 0,001
Regresia ES este un M-estimator: parametrii ei minimizează media de eșantion a unei pierderi de tip FZ0, iar Teorema 1.4 din Bayer & Dimitriadis (2022) dă teoria ei asimptotică sub specificare greșită; pachetele R esback și esreg o implementează. Pentru ESR strictă și ESR cu intercept, Ipoteza 1 cere ca ecuația de cuantilă să fie corectă, ceea ce se întîmplă doar dacă VaR este o funcție afină de ES, ca în modelele de scală pură. Estimatorul de covarianță folosit aici estimează unele componente sub o ipoteză de locație-scală, \(r_t = \mu_t + \sigma_t z_t\) cu șocuri standardizate i.i.d. \(z_t\), deși covarianța sandwich \(A^{-1}BA^{-1}\) sub specificare greșită, cu \(A\) curbura pierderii medii și \(B\) varianța gradientului ei, nu are nevoie în general de această ipoteză.
Pe scurt
Estimator M: parametrii minimizează media empirică a unei pierderi de tip FZ0
Teorie asimptotică sub specificare greșită (lucrarea, Teorema 1.4)
Secțiunea 2 a lucrării rulează 10 000 de replicări, cu \(T\) de la 250 la 5 000. Procesele generatoare sînt un model EGARCH-t (GARCH exponențial cu șocuri Student-t) calibrat pe S&P 500, un model AR(1)-GARCH(1,1) cu medie autoregresivă de ordinul întîi și două modele GAS (generalised autoregressive score) Student-t. Reperele de comparație sînt testul lui McNeil & Frey (2000) și testele de calibrare ale lui Nolde & Ziegel (2017).
Pe scurt
Lucrarea, Secț. 2: 10 000 de replicări, \(T\) de la 250 la 5 000
EGARCH-t (GARCH exponențial, șocuri Student-t), calibrat pe S&P 500
AR(1)-GARCH(1,1): medie autoregresivă de ordinul 1, dispersie GARCH
În Tabelul 1, pentru EGARCH-t la nivelul nominal de 5%, mărimea efectivă la \(T = 250\) și \(T = 1\,000\) este 0,09 și 0,05 pentru ESR strictă cu covarianța robustă, 0,24 și 0,11 cu covarianța clasică și 0,29 și 0,14 pentru testul simplu de calibrare condiționată. În Fig. 3, testele pe reziduurile de depășire abia reacționează la două tipuri de eroare, o dinamică greșită a volatilității și un nivel greșit \(\tilde\tau \ne \tau\), în timp ce ESR le detectează pe amîndouă. O bancă ar putea deci raporta ES la un nivel mai puțin extrem fără să fie respinsă de testele mai vechi.
Pe scurt
Mărimea efectivă la nivelul nominal de 5%, EGARCH-t, \(T=250\) și \(T=1\,000\) (Tabelul 1)
ESR strict, covarianța robustă: 0,09, respectiv 0,05
ESR strict, covarianța clasică: 0,24, respectiv 0,11
testul simplu de calibrare condiționată: 0,29, respectiv 0,14
Puterea (Fig. 3): testele reziduurilor de depășire aproape nu reacționează la două erori
o dinamică greșită a volatilității sau un nivel greșit \(\tilde\tau\ne\tau\)
ESR le detectează pe amîndouă
O bancă ar putea raporta ES pentru un nivel mai puțin extrem fără a fi respinsă de testele mai vechi
Graficul compară Tabelul 3 din lucrare (linia întreruptă) cu replicarea cursului pe 11 acțiuni mari din S&P 500, din ianuarie 2010 pînă în august 2019 (linia continuă): ponderea acțiunilor al căror ES 2,5% este respins de ESR cu intercept unilaterală, pe ferestre de estimare și distribuții ale inovațiilor.
Replicarea folosește 2 432 de zile, un model GARCH(1,1) cu medie constantă și cele 25 de combinații fereastră–reestimare din grila 5 × 5, cu ESR cu intercept calculată prin esback. Cu inovații Normale, ponderea respinsă este 0,82–1,00, față de 0,80–0,96 în lucrare. Cu inovații Student-t și ferestre de cel puțin 1 000 de zile, nicio acțiune nu este respinsă (în lucrare: cel mult 0,01); cu ferestre de 250 de zile, ponderea este 0,09–0,55 (în lucrare: 0,00–0,12). Cu 11 acțiuni, fiecare respingere adaugă \(1/11 \approx 0{,}09\), iar eroarea standard a unei ponderi ajunge la \(\sqrt{0{,}25/11} \approx 0{,}15\) sub o referință i.i.d. care ignoră șocurile de piață comune acțiunilor. Rezultatul central se replică, iar diferența de la fereastra de 250 de zile este mare chiar și față de această eroare standard.
Pe scurt
Linia continuă: 11 acțiuni mari din S&P 500, ianuarie 2010 – august 2019 (2 432 de zile)
Anexa adună lecturile suplimentare, dezvoltarea pentru riscul de estimare și simularea ei, principiul lui Osband, monitorizarea secvențială, predicția conformală fără schimbabilitate, alte rezultate ale studiului de caz, tabloul de bord pe cele patru piețe, răspunsurile la verificările numerice și prompturile și verificările buclei de cercetare.
În schema fixă a lui Escanciano & Olmo (2010),\(\frac{1}{\sqrt P}\sum_t(\hat I_t - \alpha) = \frac{1}{\sqrt P}\sum_t(I_t - \alpha) + \sqrt{P/R}\,D'\sqrt R(\hat\theta - \theta_0) + o_p(1)\). Primul termen conține depășirile centrate la parametrii adevărați \(\theta_0\); al doilea este efectul erorii de estimare, ponderat cu \(D\), sensibilitatea probabilității de depășire la parametri în \(\theta_0\). Termenul de estimare adaugă o varianță de ordinul \(P/R\) la \(\sqrt P(\hat\pi - \alpha)\) și dispare doar dacă \(P/R \to 0\), deci valorile critice \(\chi^2\) sînt prea mici cînd \(P/R\) este mare. Dezvoltarea presupune un \(\mathrm{VaR}_t(\theta)\) neted, un \(\hat\theta\) consistent cu viteza \(\sqrt R\) și staționaritate; schemele rolling și recursivă schimbă forma corecției. Remediile sînt varianța corectată sau subeșantionarea (subsampling) din Escanciano & Olmo (2010), ori un bootstrap parametric care reestimează modelul pe fiecare traiectorie simulată.
Primul termen: depășirile centrate cu parametrii adevărați \(\theta_0\)
al doilea: efectul erorii de estimare \(\hat\theta-\theta_0\)
\(D=E\left[\partial P(L_t>\mathrm{VaR}_t(\theta)\mid\mathcal{F}_{t-1})/\partial\theta\right]\) în \(\theta_0\): sensibilitatea probabilității de depășire la parametri
Termenul de estimare adaugă o dispersie de ordinul \(P/R\) la \(\sqrt P(\hat\pi-\alpha)\) și dispare doar dacă \(P/R\to 0\)
Deci valorile critice \(\chi^2\) sînt prea mici cînd \(P/R\) este mare
Ipoteze: \(\mathrm{VaR}_t(\theta)\) netedă, \(\hat\theta\) consistent cu rata \(\sqrt R\), staționaritate
schemele cu fereastră mobilă și recursive schimbă forma corecției
În experimentul cu schemă fixă, cu 400 de traiectorii, \(R = 1\,000\) și testul Kupiec la 5%, 324 de estimări sînt admisibile, 75 sînt neidentificate numeric și una nu satisface condiția de varianță finită. Se raportează doar ratele cu parametrii adevărați, pe toate cele 400 de traiectorii, deoarece o rată pe cele 324 de traiectorii admisibile ar fi condiționată de reușita estimării. Aceste rate sînt 10,0% la \(P = 250\), 5,2% la \(P = 1\,000\) și 4,0% la \(P = 5\,000\), cu o eroare standard Monte Carlo de aproximativ 1,1 puncte procentuale la o probabilitate de respingere de 5%.
Pe scurt
Schema fixă: 400 de traiectorii, \(R=1\,000\), testul Kupiec la 5%
324 de estimări admisibile
75 de estimări neidentificate numeric
O estimare nu îndeplinește condiția de admisibilitate pentru dispersie finită
Aici raportăm doar ratele cu parametrii adevărați, pe toate cele 400 de traiectorii
o rată pe cele 324 de traiectorii admisibile ar fi condiționată de succesul estimării
Cu parametrii adevărați: 10,0% la \(P=250\), 5,2% la \(P=1\,000\), 4,0% la \(P=5\,000\)
Eroarea standard Monte Carlo la o probabilitate de respingere de 5%: circa 1,1 puncte procentuale
După principiul lui Osband, folosit de Fissler & Ziegel (2016), scorurile consistente se construiesc dintr-o funcție de identificare (identification function) \(V\), a cărei medie \(E_F[V(x, L)]\) se anulează doar în valoarea adevărată. Pentru VaR, \(V(v, L) = \mathbf{1}\{L \le v\} - (1-\alpha)\), iar pierderea pinball (8.12) este integrala ei în \(v\). Pentru (VaR, ES), perechea \(V_1 = \alpha - \mathbf{1}\{L > v\}\) și \(V_2 = e - v - \frac{1}{\alpha}\mathbf{1}\{L > v\}(L - v)\) are medii care se anulează doar în perechea adevărată. Mulțimile de nivel ale ES nu sînt convexe la amestecuri, deci nu există o funcție de identificare doar a lui \(e\) (Seminarul 8, exercițiul A8). FZ0 este membrul familiei FZ ale cărui diferențe sînt invariante la scara pierderilor (Patton, Ziegel & Chen, 2019).
Pe scurt
Principiul lui Osband (Fissler & Ziegel (2016)): scorurile consistente se construiesc dintr-o funcție de identificare \(V\)
\(V\) are \(E_F[V(x,L)]=0\) doar în valoarea adevărată
VaR: \(V(v,L)=\mathbf{1}\{L\le v\}-(1-\alpha)\); pierderea pinball este integrala ei în \(v\)
(VaR, ES): \(V_1=\alpha-\mathbf{1}\{L>v\}\) și \(V_2=e-v-\frac{1}{\alpha}\mathbf{1}\{L>v\}(L-v)\)
mediile lor se anulează doar în perechea adevărată
Mulțimile de nivel ale ES nu sînt convexe la mixturi
deci nu există o funcție de identificare doar în \(e\) (Seminarul 8, A8)
Un reglementator care verifică zilnic prognozele repetînd un test pe eșantion fix, precum \(Z_2\) pe ferestre rolling, crește probabilitatea a cel puțin unei alarme false. Hoga & Demetrescu (2023) propun statistici de monitorizare pentru VaR și ES cu funcții de frontieră care mențin probabilitatea oricărei alarme false pe întregul orizont sub nivelul nominal. Față de semafor, dovezile se acumulează de la începutul monitorizării, nu dintr-o singură imagine pe 250 de zile. Backtestul prin regresia ES al lui Bayer & Dimitriadis (2022) poate fi monitorizat în același mod; ambele răspund designului de tip „o singură verificare” al semaforului.
Pe scurt
Reglementatorul verifică prognozele zilnic
repetarea unui test pe eșantion fix (de exemplu, \(Z_2\) pe ferestre mobile) mărește probabilitatea a cel puțin unei alarme false
Barber, Candès, Ramdas & Tibshirani (2023) obțin acoperire fără schimbabilitate: abaterea de la acoperire este mărginită de distanțe ponderate în variație totală între vectorul scorurilor și același vector în care scorul de test este schimbat cu scorul de calibrare \(i\). Cît de mari sînt aceste distanțe sub volatility clustering este o întrebare empirică. Gibbs, Cherian & Candès (2025) arată că o acoperire exactă condiționată de o clasă prespecificată de deplasări ale covariatelor (covariate shifts) poate fi atinsă; ce clasă descrie o criză financiară este o întrebare deschisă. Pentru alegerea pasului ACI \(\gamma\),Zaffran et al. (2022) agregă experți ACI pe o grilă de valori \(\gamma\).
Două rezultate suplimentare din Bayer & Dimitriadis (2022) nuanțează studiul de caz. În Tabelul 1, mărimile ESR stricte și auxiliare diferă cu cel mult 0,01 pentru fiecare proces și lungime a eșantionului, inclusiv AR(1)-GARCH cu \(\phi = 0{,}5\): în aceste designuri, renunțarea la prognozele VaR abia schimbă mărimea, iar puterea este comparată separat în Fig. 2–3. În Tabelul 3, ponderea de 0,12 pentru Student-t cu fereastra de 250 de zile provine din GARCH cu reestimare anuală, iar de la 500 de zile GJR-GARCH-t și GARCH-t diferă cu cel mult 0,01: efectul de pîrghie (leverage) din ecuația varianței abia schimbă ponderile respinse odată ce fereastra este lungă.
Pe scurt
Rezultat
Sursa
Interpretare
Mărimile ESR strict și ESR auxiliar diferă cu cel mult 0,01 pentru fiecare proces și mărime a eșantionului, inclusiv AR(1)-GARCH cu \(\phi=0{,}5\)
Tabelul 1
În aceste simulări, renunțarea la prognozele VaR aproape nu schimbă mărimea; puterea se compară separat (Fig. 2–3)
Student-t, fereastră de 250 de zile: ponderea de 0,12 provine din GARCH cu reestimare anuală; de la 500 de zile, GJR-GARCH-t și GARCH-t diferă cu cel mult 0,01
Tabelul 3
Efectul de levier din ecuația dispersiei aproape nu schimbă ponderile de respingere cînd fereastra este lungă
Autorii menționează două limite: ESR auxiliară și cea strictă sînt doar bilaterale (Sec. 1.3), iar covarianța clasică respinge prea des în eșantioane mici. Seminarul 8, exercițiul C3, aplică ESR strictă (bilaterală) și ESR cu intercept (unilaterală) prognozelor ES 2,5% ale celor șase modele pe cele patru piețe și le compară cu \(Z_2\) și McNeil–Frey. O extindere este replicarea Tabelului 3 cu GJR-GARCH, mai multe acțiuni și perioada de după august 2019. O întrebare deschisă privește mărimea ESR cu intercept bilaterale la \(T = 250\), 0,04 cu covarianța robustă și 0,15 cu cea clasică (Tabelul 1, EGARCH-t): mărimea unilaterală este raportată doar pentru \(T = 2\,500\), 0,02 (Tabelul 2), și nu se știe dacă un bootstrap al statisticii \(t\) ar putea-o menține la 5% pe un an fără a pierde puterea din Fig. 4.
Pe scurt
Limită precizată de autori: ESR auxiliar și ESR strict sînt doar bilaterale (lucrarea, Secț. 1.3)
Limită precizată de autori: covarianța clasică respinge prea des în eșantioane mici
Replicare (Seminarul 8, C3): ESR strict (bilateral) și ESR cu termen liber (unilateral)
aplicați-le prognozelor ES 2,5% ale celor șase modele pe cele patru piețe
comparați cu \(Z_2\) și McNeil–Frey
Extindere: replicarea Tabelului 3 cu GJR-GARCH, mai multe acțiuni și perioada de după august 2019
Întrebare deschisă: mărimea ESR cu termen liber bilateral la \(T=250\) (Tabelul 1, EGARCH-t)
0,04 cu covarianța robustă
0,15 cu cea clasică
Mărimea unilaterală este raportată doar pentru \(T=2\,500\), 0,02 (Tabelul 2): care este ea pe un an?
Poate un bootstrap al statisticii \(t\) să o mențină la 5% fără a pierde puterea din Fig. 4?
Tabloul de bord dă, pentru fiecare model și piață, rata de depășire a VaR 1% în procente, p-value-ul \(Z_2\) și p-value-ul MCS pe pierderea FZ0; „≤0,001” este rezoluția celor 1 000 de replicări bootstrap. Pe S&P 500 și BET, doar FHS și GARCH-EVT combină un p-value \(Z_2\) peste 0,05 cu apartenența la MCS (1,000 și 0,211 pe S&P 500, 1,000 și 0,966 pe BET). Pe Bitcoin și EUR/RON prognozele GARCH sînt reținute și nu există MCS.
Pe scurt
Fiecare celulă: rata de depășire a VaR 1% în % / valoarea p pentru \(Z_2\) / valoarea p MCS (FZ0)
\(\le\)0,001: la rezoluția celor 1 000 de replicări bootstrap
Primul răspuns aplică (8.4) cu \(\hat\pi = 0{,}006\); al doilea evaluează (8.13) în două zile și arată că trecerea de la procente la zecimale deplasează ambele scoruri cu aceeași constantă.
Al treilea răspuns evaluează puterea locală din (8.5) la \(\lambda = 10{,}10\) și o compară cu puterea exactă; al patrulea calculează \(Z_1\) și \(Z_2\) din (8.10) și explică de ce au semne opuse.
Enumeră lucrările evaluate de specialiști, din 2019 încoace, despre predicția conformală sub dependență serială, cu DOI, garanția exactă și ipotezele.
Dă trei explicații rivale pentru depășirile excesive în criză ale VaR conformal split și ce implică fiecare pentru ratele pe regimuri.
Joacă rolul unui referent critic: enumeră cele mai puternice motive pentru care acest efect de criză este un artefact și testul care ar tranșa fiecare motiv.
Pe rezultatele asistentului se rulează trei verificări. Look-ahead bias: modificarea observațiilor de după ziua \(t-1\) nu trebuie să schimbe \(\mathrm{VaR}_t\), scala sau indicatorul de criză. Depășiri dependente: testele Christoffersen și de durată sau un bootstrap pe blocuri al șirului depășirilor. Puterea: 613 zile de criză dau 6,1 depășiri așteptate ale VaR 1%, iar o rată adevărată de 2% este detectată cu probabilitatea 57% de un test Binomial exact bilateral la 5%, presupunînd depășiri i.i.d.
Pe scurt
Deplasarea de anticipare: informație din viitor
modificăm observațiile de după ziua \(t-1\) și confirmăm că \(\mathrm{VaR}_t\), scala și indicatorul de criză nu se schimbă
Depășiri dependente
testele Christoffersen și de durată sau un bootstrap pe blocuri al șirului depășirilor
Puterea
613 de zile de criză dau 6,1 depășiri așteptate ale VaR 1%
o rată reală de 2% este detectată cu probabilitatea 57% de un test Binomial exact bilateral la 5% (cu depășiri presupuse i.i.d.)
Designul implică 4 piețe × 2 niveluri × 3 metode, adică 24 de teste. Procedura Holm controlează rata erorii pe familie (FWER, family-wise error rate); Benjamini–Hochberg controlează rata descoperirilor false (FDR, false discovery rate) sub independență sau dependență de regresie pozitivă pe o submulțime (PRDS, positive regression dependency on a subset); Benjamini–Yekutieli o controlează sub dependență arbitrară. Alte două erori sînt frecvente în răspunsurile asistentului: teoreme enunțate greșit, precum „ACI garantează acoperirea condiționată”, și cuantile decalate cu o poziție, deoarece \(k = \lceil (n+1)(1-\alpha)\rceil\) nu este valoarea implicită a funcției np.quantile.
Pe scurt
Testarea multiplă: 4 piețe \(\times\) 2 niveluri \(\times\) 3 metode = 24 de teste
Holm controlează FWER (rata erorii pe familia de teste)
Benjamini–Hochberg controlează FDR (rata descoperirilor false) sub independență sau dependență pozitivă (PRDS: positive regression dependency on a subset)
pentru dependență arbitrară: Benjamini–Yekutieli
Teoreme enunțate greșit
de exemplu, „ACI garantează acoperirea condiționată”
Cuantile decalate
\(k=\lceil (n+1)(1-\alpha)\rceil\) nu este implicit în np.quantile
Proiectul întreabă dacă o prognoză VaR 1% și ES 2,5% fără ipoteze de distribuție poate atinge o acoperire condiționată de criză și dacă aceasta se menține pe toate cele patru piețe sub un test preînregistrat. El începe prin replicarea ratelor de criză ale VaR 5% conformal split (7,29% pe S&P 500, 11,43% pe EUR/RON) și a ponderii VaR 1% infinit în ACI (13,4% din zilele de evaluare de pe S&P 500). Livrabilele sînt o preînregistrare datată înainte de prima rulare, o metodă candidată, precum cea a lui Gibbs, Cherian & Candès (2025) cu regimul de volatilitate drept clasă de condiționare, testată pe regimuri pentru VaR și cu regresia ES sau \(Z_2\) pentru ES, și codul, cu un raport de două pagini care enumeră fiecare specificație încercată și o critică de tip recenzent a rezultatului. Prompturile care au influențat alegerile de design se notează în AI_USE.md, iar erorile asistentului în AI_ERRORS.md.
Pe scurt
Întrebare: poate o prognoză VaR 1% și ES 2,5% fără ipoteze de distribuție să atingă acoperirea condiționată de criză?
Întrebare: se menține această acoperire pe toate cele patru piețe, cu un test pre-înregistrat?
Replicați mai întîi
ratele în criză ale VaR 5% conformal split (S&P 500 7,29%, EUR/RON 11,43%)
ponderea VaR 1% infinit la ACI (13,4% din zilele de evaluare S&P 500)
Livrabil: o pre-înregistrare (ipoteze, teste, corecții, putere) datată înainte de prima rulare
Livrabil: o metodă candidată, de exemplu Gibbs, Cherian & Candès (2025) cu regimul de volatilitate drept clasă de condiționare
HAC: Heteroskedasticity and Autocorrelation Consistent (standard errors) — erori standard robuste la heteroscedasticitate și autocorelație
HS: Historical Simulation — simulare istorică
IMA: Internal Models Approach — abordarea bazată pe modele interne
LLM: Large Language Model — model lingvistic mare
LR: Likelihood Ratio — raportul de verosimilitate
LRV: Long-Run Variance — dispersia pe termen lung
MCS: Model Confidence Set — mulțimea de încredere a modelelor
NASDAQ: National Association of Securities Dealers Automated Quotations — bursa americană NASDAQ (cotații automate ale Asociației Naționale a Dealerilor de Valori Mobiliare)
OLS: Ordinary Least Squares — metoda celor mai mici pătrate
P&L: Profit and Loss — profitul și pierderea
PIT: Probability Integral Transform — transformarea integrală a probabilității
POF: Proportion Of Failures (test) — testul proporției de depășiri
QLIKE: Quasi-LIKElihood (loss function) — funcția de pierdere de tip cvasi-verosimilitate
RON: Romanian leu — leul românesc
S&P 500: Standard & Poor's 500 (index) — indicele celor 500 de companii americane mari
Wang, Q., Wang, R., Ziegel, J. (2026). E-backtesting. Management Science, 72(6), 4952–4973.
Zaffran, M., Féron, O., Goude, Y., Josse, J., Dieuleveut, A. (2022). Adaptive conformal predictions for time series. Proceedings of the 39th International Conference on Machine Learning; arXiv:2202.07282.
Pierderi zilnice (randamente logaritmice cu semn schimbat) pentru S&P 500, BET și Bitcoin, prețuri EODHD, și pentru EUR/RON, cursul de referință BNR. Prognoze VaR și ES la o zi pe o fereastră rolling de 1 000 de zile, evaluate din ianuarie 2007 (EUR/RON din iunie 2009, Bitcoin din iunie 2017) pînă la 18 septembrie 2026. Studiile de caz: Tabelul 3 din Bayer și Dimitriadis (2022) și replicarea lui pe 11 acțiuni din S&P 500; e-procesele din Wang, Wang și Ziegel (2026), calculate din prognozele ES 2,5% ale capitolului.


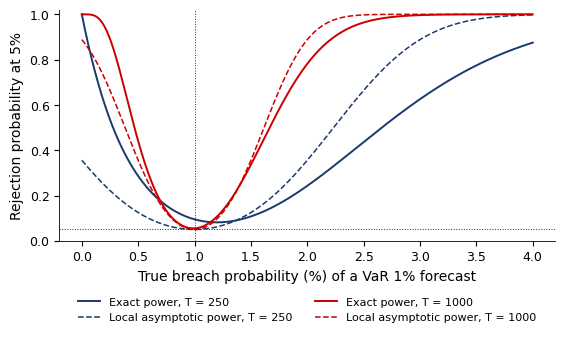
 MFM_ch8_four_assets