Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
LDA: Linear Discriminant Analysis (analiza discriminantă liniară)
LGD: Loss Given Default (pierderea în caz de nerambursare)
LR: Likelihood Ratio (test) — testul raportului de verosimilitate
MVA: Applied Multivariate Statistical Analysis (Härdle and Simar) — manualul de analiză statistică multivariată al lui Härdle și Simar
NYU: New York University (Universitatea din New York)
PD: Probability of Default (probabilitatea de nerambursare)
PDO: Points to Double the Odds (punctele care dublează șansa bun:rău)
ROC: Receiver Operating Characteristic (curve) — curba caracteristică de operare
RWA: Risk-Weighted Assets (activele ponderate la risc)
SFE: Statistics of Financial Markets, Exercises (Quantlet collection of the textbook) — colecția de Quantlet-uri a manualului Statistics of Financial Markets
SUA: Statele Unite ale Americii
TA: Total Assets (activele totale)
TN: True Negative (adevărat negativ)
TP: True Positive (adevărat pozitiv)
TPR: True Positive Rate — rata adevărat pozitivelor (sensibilitatea)
UCI: University of California, Irvine (Machine Learning Repository) — Universitatea din California, Irvine (arhiva de date pentru învățare automată)
Capitolele 2–10 au măsurat riscul prețurilor: distribuția randamentelor, volatilitatea lor, cozile și VaR și ES care le rezumă. O bancă are însă și un al doilea tip de risc, adesea mai mare decît riscul de piață: riscul ca un debitor să nu își ramburseze creditul. În fiecare zi, un creditor trebuie să decidă dacă acceptă o cerere de credit și cu ce dobîndă, iar decizia se sprijină pe un număr, probabilitatea de nerambursare (PD, probability of default) a solicitantului. Capitolul întreabă cum transformă o bancă datele unui solicitant în această probabilitate și de unde știe că cifra este corectă.
Răspunsul este un lanț de instrumente statistice. Pierderea așteptată a unui credit și capitalul Basel care acoperă pierderile de peste acest nivel pornesc amîndouă de la PD. PD se estimează din creditele trecute cu regresia logistică sau cu analiza discriminantă a lui Fisher, după ce fiecare variabilă a fost recodificată prin Weight of Evidence; modelul estimat este apoi scris ca un scorecard de puncte. Ca dovezi empirice, capitolul folosește 1 000 de credite de consum ale unei bănci germane și 30 000 de deținători de carduri de credit din Taiwan. O singură variabilă, starea contului curent, mută deja ponderea creditelor neperformante de la 11,7% la 49,3%, iar un scorecard cu șase variabile plasează un credit neperformant ales la întîmplare deasupra unui credit performant ales la întîmplare în aproximativ 80% din perechile unui eșantion de test.
O cifră care arată bine nu face încă un model bun, iar a doua jumătate a capitolului este despre validare: discriminarea și calibrarea măsurate în afara eșantionului, un prag ales din costurile celor două tipuri de eroare, distorsiunea creată de solicitanții pe care banca i-a respins și întrebarea dacă un scor precis tratează echitabil grupurile de solicitanți. Capitolul se încheie cu două modele clasice ale nerambursării companiilor: scorul Z al lui Altman, construit din indicatori contabili, și distanța pînă la nerambursare a lui Merton, construită din prețuri de piață.
Ponderea creditelor neperformante după starea contului curent în datele South German Credit (1 000 de credite de consum, 1973–1975). Linia întreruptă este media eșantionului, 30%.
Rezultatele învățării
Definiți PD, LGD, EAD și pierderea așteptată și explicați ce adaugă capitalul IRB din Basel față de pierderea așteptată.
Calculați Weight of Evidence și Information Value ale unei variabile dintr-un tabel de frecvențe.
Estimați o regresie logistică și interpretați coeficienții ca modificări ale logaritmului șansei și ca rapoarte ale șanselor.
Deduceți discriminantul liniar al lui Fisher și comparați-l cu modelul logit.
Scalați un scorecard și validați-l în afara eșantionului cu matricea de confuzie, AUC, Gini, KS, scorul Brier și diagrama de calibrare.
Seminarul 12 precede acest curs și exersează aceleași instrumente pe date.
Planul capitolului
Scorul de credit: definițieDecizia de creditare, istoria scoringului, PD, LGD, EAD, pierderea așteptată și capitalul IRB din Basel.
Datele de nerambursareDatele South German Credit, erorile de codificare din datele originale, dezechilibrul claselor și împărțirea în eșantion de estimare și eșantion de test.
Weight of Evidence și Information ValueRecodificarea unei variabile prin dovada pe care o aduce despre nerambursare, regulile de discretizare și ordonarea celor 20 de variabile.
Regresia logisticăȘansa și logaritmul șansei, modelul logit, rapoartele șanselor, un scorecard WoE și corecția pentru suprareprezentare.
AI pentru descoperire științificăO întrebare deschisă despre scorurile de învățare automată, ce poate face AI și ce trebuie verificat.
RezumatIdei de reținut, formule de reținut și întrebări de autoevaluare.
Scorul de credit: definiție
Un scor de credit este un număr care ordonează solicitanții după riscul lor de a nu rambursa. Secțiunea prezintă decizia pe care o servește scorul, amintește cum scoringul statistic a înlocuit judecata ofițerilor de credit și definește cei trei parametri de risc ai unui credit: probabilitatea de nerambursare, pierderea în caz de nerambursare și expunerea în momentul nerambursării. Produsul lor este pierderea așteptată, pe care banca o include în preț; formula de capital din Basel măsoară apoi pierderea de peste acest nivel într-un an prost.
Cînd un solicitant cere un credit, banca ia două decizii: acceptă sau respinge cererea și, dacă o acceptă, stabilește dobînda. Ambele decizii depind de cît de probabil este ca solicitantul să intre în nerambursare (default). În termeni obișnuiți, nerambursarea înseamnă că debitorul nu plătește conform contractului. Cadrul Basel II al Comitetului de la Basel pentru Supraveghere Bancară (paragraful 452) dă definiția de reglementare: nerambursarea are loc cînd banca apreciază că debitorul nu va plăti integral sau cînd debitorul întîrzie mai mult de 90 de zile o obligație semnificativă.
Un scor de credit este un număr calculat din datele unui solicitant, care ordonează solicitanții după riscul lor de nerambursare. Probabilitatea de nerambursare (PD) este probabilitatea ca debitorul să intre în nerambursare pe un orizont fix, de obicei un an. Un scor poate fi bun în două sensuri diferite. El discriminează bine dacă ordonează corect solicitanții, astfel încît cei care vor intra mai tîrziu în nerambursare să aibă de regulă scoruri mai proaste decît cei care rambursează. El este calibrat dacă PD pe care o implică are nivelul corect: dintre solicitanții cu PD de 5%, aproximativ 5% ar trebui să intre în nerambursare. Ordonarea este suficientă pentru a accepta sau a respinge; prețul, provizioanele și capitalul au nevoie și de nivel, iar capitolul le măsoară pe amîndouă.
Scorurile diferă după client și după informația pe care o folosesc. Scorurile de aplicare (application scores) se calculează pentru clienții noi, din datele din cererea lor; scorurile comportamentale (behavioural scores) se calculează pentru clienții existenți, din istoricul plăților lor. Scorurile pentru persoane fizice se sprijină pe modele statistice estimate pe multe credite mici, iar scorurile pentru companii folosesc indicatori contabili și prețuri de piață, ca în modelele Altman și Merton din secțiunea 9.
Pe scurt
Un solicitant cere un credit; banca trebuie să decidă acceptarea sau respingerea și dobînda
nerambursarea (default): debitorul nu plătește conform contractului; Basel: banca apreciază că debitorul nu va plăti sau debitorul întîrzie peste 90 de zile o obligație semnificativă Comitetul de la Basel (2006), ¶452
Scorul de credit: un număr calculat din datele solicitantului, care ordonează solicitanții după riscul lor de nerambursare
PD (probability of default): probabilitatea de nerambursare pe un orizont, de obicei un an
un scor bun ordonează corect (discriminare) și dă nivelul corect al PD (calibrare)
Tipuri de scoruri
scoruri de aplicare (clienți noi) și scoruri comportamentale (clienți existenți, din istoricul plăților)
scoruri pentru persoane fizice (modele statistice pe multe credite mici) și pentru companii (indicatori contabili, prețuri de piață)
Începuturile scoringului de credit: Durand și FICO
Scoringul statistic de credit este mai vechi decît calculatorul. În 1941, Durand (1941) a studiat creditele în rate ale creditorilor americani și a separat creditele bune de cele rele cu analiza discriminantă pe care Fisher o propusese cu cinci ani mai devreme; acesta este primul studiu statistic de scoring de credit. În 1956, inginerul Bill Fair și matematicianul Earl Isaac au înființat Fair, Isaac and Company, azi FICO. În 1989, compania a introdus scorul FICO, calculat din rapoartele birourilor de credit și cuprins între 300 și 850 de puncte, care a devenit scorul standard pentru persoane fizice în Statele Unite.
Articolul de sinteză al lui Hand & Henley (1997) descrie ce s-a schimbat. Înainte de scoring, un ofițer de credit judeca fiecare cerere din experiență; scoringul statistic a înlocuit această judecată cu o regulă identică pentru toți solicitanții. Regula este mai ieftină și mai rapidă și, spre deosebire de o judecată personală, poate fi testată: ratele ei de eroare se pot măsura pe creditele trecute. O regulă identică pentru toți nu este însă automat echitabilă, deoarece variabilele pe care le folosește pot ține locul unor caracteristici protejate de lege; secțiunea 8 revine la această întrebare.
Pe scurt
1941: Durand (1941) separă creditele bune de cele rele ale creditorilor americani cu analiza discriminantă a lui Fisher
Basel II descrie riscul de credit al unui împrumut prin trei parametri. PD este probabilitatea de nerambursare într-un an. Pierderea în caz de nerambursare (LGD, loss given default) este partea din expunere pe care banca o pierde dacă are loc nerambursarea, după ce recuperează ce poate din garanții sau din vînzarea creanței. Expunerea în momentul nerambursării (EAD, exposure at default) este suma datorată în momentul nerambursării; pentru un credit fix este soldul rămas, iar pentru o linie de credit include și partea pe care debitorul o poate trage înainte de nerambursare.
Pierderea așteptată (EL, expected loss) este media pierderii pe un an. Dacă nerambursarea este un eveniment cu probabilitatea PD, iar pierderea, cînd apare, este \(\mathrm{LGD} \times \mathrm{EAD}\), atunci
un produs valabil cînd PD și LGD sînt independente. Un credit de 100 000 de lei cu PD de 2% și LGD de 45% are o pierdere așteptată de \(0{,}02 \times 0{,}45 \times 100\,000 = 900\) de lei pe an.
Pierderea așteptată este un cost al activității, ca salariile personalului: banca o include în dobîndă și o acoperă prin provizioane. Pericolul este în altă parte. Într-un an prost, nerambursările multor debitori cresc împreună, iar pierderea poate depăși cu mult media ei. Această parte, pierderea neașteptată (unexpected loss), trebuie absorbită de capitalul băncii, iar slide-urile următoare o măsoară.
În abordarea bazată pe ratinguri interne (IRB, internal ratings-based) din Basel II, banca estimează PD a fiecărei expuneri cu propriile modele (iar în varianta avansată și LGD și EAD), în timp ce autoritatea de reglementare stabilește formula care transformă aceste estimări în capital (paragrafele 328–330 din cadrul Basel II). Pentru o expunere de retail, capitalul pe unitatea de EAD este
unde \(\Phi\) și \(\Phi^{-1}\) sînt funcția de repartiție (distribution function) a distribuției Normale standard \(N(0,1)\) și inversa ei, iar \(R\) este corelația debitorilor cu un factor comun, starea economiei. Activele ponderate la risc (RWA, risk-weighted assets) sînt de \(12{,}5 = 1/0{,}08\) ori capitalul, deoarece banca trebuie să dețină capital de cel puțin 8% din activele ponderate la risc.
Logica formulei provine de la Gordy (2003). Termenul \(\Phi(z^*)\) este rata de nerambursare a portofoliului într-un an al cărui factor comun este atît de prost încît este depășit doar cu probabilitatea 0,1%, un an care apare o dată la 1 000 de ani. Înmulțit cu LGD, el dă pierderea într-un astfel de an; scăzînd pierderea așteptată, rămîne pierderea neașteptată. \(K\) este deci VaR 0,1% al pierderii din credit minus pierderea așteptată, aceeași idee de cuantilă ca VaR din Capitolul 10, aplicată unui portofoliu de credite.
Pe scurt
Abordarea IRB (internal ratings-based): banca estimează PD (și eventual LGD, EAD); autoritatea de reglementare dă formula Comitetul de la Basel (2006), ¶328–330
\(K\): capitalul pe unitatea de EAD; \(\Phi\), \(\Phi^{-1}\): funcția de repartiție \(N(0,1)\) și inversa ei; 0,999: un an prost apare o dată la 1000 de ani
\(R\): corelația debitorilor cu un factor comun; RWA (risk-weighted assets): activele ponderate la risc, din care banca deține cel puțin 8%
Logica Gordy (2003): termenul din \(\Phi(\cdot)\) este PD într-un an al cărui factor comun este depășit doar cu probabilitatea 0,1%
deci \(K\) este VaR 0,1% al pierderii din credit minus EL: pierderea neașteptată (Capitolul 10)
Întrebare pentru sală ▶ crește ρ de la 0,2 la 0,5. Ce se întîmplă cu probabilitatea ca un credit cu PD = 2% să intre în nerambursare într-un an prost (y = −3)?
Răspuns
Crește de la 21,3% la 53,8%; într-un an obișnuit (y = 0) scade de la 1,08% la 0,18%. O pondere mai mare a factorului comun concentrează nerambursările în anii proști, iar media peste toți anii rămîne 2%.
Modelul din spatele formulei IRB este un model cu un factor. Debitorul \(i\) intră în nerambursare cînd un indice latent al sănătății lui financiare scade sub un prag:
unde \(Y\) este starea economiei, comună tuturor debitorilor, \(\varepsilon_i\) este șocul propriu al debitorului, \(Y\) și \(\varepsilon_i\) sînt variabile \(N(0,1)\) independente, iar \(\rho\) este ponderea factorului comun. Indicele este el însuși \(N(0,1)\), astfel încît probabilitatea necondiționată de nerambursare este exact PD. Pentru un an anume, \(Y = y\), doar \(\varepsilon_i\) este aleator, iar PD condiționată este
Graficul reprezintă această PD condiționată în funcție de PD necondiționată, cu \(\rho = 0{,}2\), pentru trei stări ale economiei: un an prost (\(y = -3\)), un an obișnuit (\(y = 0\)) și un an bun (\(y = 3\)). Un credit cu PD = 2% intră în nerambursare cu probabilitatea 21,3% într-un an prost (\(y = -3\)), cu 1,1% într-un an obișnuit (\(y = 0\), mediana factorului) și aproape niciodată într-un an bun. Media pe toți anii este 2%, dar anii înșiși diferă foarte mult: nerambursările vin în grupuri. Formula IRB evaluează (12.3) în \(y = \Phi^{-1}(0{,}001)\), anul mai prost decît 99,9% din toți anii, cu corelația \(R\) în locul lui \(\rho\).
Pe scurt
Debitorul \(i\) intră în nerambursare dacă \(\sqrt{\rho}\,Y + \sqrt{1 - \rho}\,\varepsilon_i < \Phi^{-1}(\mathrm{PD})\); \(Y\): starea economiei; dat fiind \(Y = y\): PD\((y) = \Phi\big((\Phi^{-1}(\mathrm{PD}) - \sqrt{\rho}\,y)/\sqrt{1 - \rho}\big)\), \(\rho = 0{,}2\)
\(\varepsilon_i\): șocul propriu al debitorului; \(Y\) și \(\varepsilon_i\) independente, \(N(0,1)\); \(\rho\): ponderea factorului comun
Interpretare: un credit cu PD \(= 2\%\) intră în nerambursare cu probabilitatea 21,3% într-un an prost (\(y = -3\)), 1,1% într-un an obișnuit și aproape niciodată într-un an bun; IRB folosește \(y = \Phi^{-1}(0{,}001)\)
Ponderea \(w\) ia valori în \([0, 1]\) și crește cu PD, astfel încît \(R\) scade de la 0,16 pentru creditele foarte sigure la 0,03 pentru cele foarte riscante: nerambursarea unui debitor sigur este determinată mai ales de economie, cea a unui debitor riscant mai ales de propria lui situație. Pentru PD = 2%, formula dă \(R = 0{,}095\); cele două cuantile ale distribuției Normale necesare sînt \(\Phi^{-1}(0{,}02) = -2{,}054\) și \(\Phi^{-1}(0{,}999) = 3{,}090\).
Argumentul lui \(\Phi\) este \((-2{,}054 + \sqrt{0{,}095} \times 3{,}090)/\sqrt{1 - 0{,}095} = -1{,}160\), iar \(\Phi(-1{,}160) = 12{,}31\%\): aceasta este PD a creditului în anul prost al formulei. Capitalul este \(K = 0{,}45 \times (12{,}31\% - 2\%) = 4{,}64\%\) din EAD, adică 4 639 de lei pentru creditul de 100 000 de lei. Activele ponderate la risc sînt \(12{,}5 \times 4\,639 = 57\,986\) de lei, o pondere de risc de 58%.
Cele două cifre ale creditului au acum roluri distincte. Pierderea așteptată de 900 de lei intră în dobîndă; capitalul de 4 639 de lei rămîne în bancă pentru a absorbi un an în care nerambursările ajung la 12,31% din astfel de credite în loc de 2%.
Pe scurt
Alte expuneri de retail: \(R = 0{,}03\,w + 0{,}16\,(1 - w)\), \(w = (1 - e^{-35\,\mathrm{PD}})/(1 - e^{-35})\)Comitetul de la Basel (2006), ¶330
\(w \in [0, 1]\) crește cu PD, deci \(R\) scade de la 0,16 (credite foarte sigure) la 0,03 (credite foarte riscante)
Întrebare pentru sală ▶ crește PD de la 2% la 4%. Se dublează capitalul K?
Răspuns
Nu: crește de la 4,64% la 5,20% din EAD (+12%), în timp ce EL se dublează, de la 0,90% la 1,80%. Corelația R scade de la 0,095 la 0,062 cînd PD crește, iar nerambursările în plus sînt tot mai mult așteptate, nu neașteptate.
Întrebare pentru sală Alte expuneri de retail, LGD 45%: PD crește de la 5% la 10%, deci EL se dublează (de la 2,25% la 4,50% din EAD). Ce se întîmplă cu capitalul K?
Răspuns
Crește doar de la 5,31% la 6,04% din EAD (+14%). K acoperă pierderea neașteptată: cu cît PD este mai mare, cu atît o parte mai mare din pierdere este așteptată și inclusă în preț, iar R scade de la 0,053 la 0,034. Peste o PD de aproximativ 16%, K este chiar mai mic decît EL.
Graficul repetă calculul pentru fiecare PD, cu LGD = 45%, pentru trei clase de expuneri de retail: alte expuneri de retail, unde \(R\) scade de la 0,16 la 0,03 ca mai sus; creditele ipotecare rezidențiale, cu \(R = 0{,}15\) fix; și expunerile revolving calificate, precum cardurile de credit, cu \(R = 0{,}04\) fix. Pierderea așteptată, \(0{,}45 \times \mathrm{PD}\) pe unitatea de expunere, este o dreaptă.
Curbele de capital se comportă altfel. Ele cresc repede la PD mici, unde o creștere mică a PD mută mult rata de nerambursare din anul prost, și apoi se aplatizează. Un credit foarte riscant este în mare parte o pierdere așteptată: o mare parte din ce va pierde este deja cunoscută, inclusă în preț și acoperită prin provizioane, și doar partea de peste această medie are nevoie de capital. Pentru alte expuneri de retail, dreapta pierderii așteptate intersectează curba de capital la o PD de aproximativ 16%; peste acest nivel, creditul are o pierdere așteptată mai mare decît capitalul păstrat pentru un an prost. Curba creditelor ipotecare este cea mai înaltă, deoarece corelația lor mare le face să intre în nerambursare împreună într-un an prost.
Pe scurt
LGD \(= 45\%\); capitalul \(K\) pentru alte expuneri de retail (\(R\) de la 0,16 la 0,03), credite ipotecare (\(R = 0{,}15\)) și expuneri revolving (\(R = 0{,}04\))
Interpretare: EL crește liniar cu PD; \(K\) crește repede la PD mici și apoi se aplatizează, deoarece un credit foarte riscant este în mare parte o pierdere așteptată (inclusă în preț)
Un scor de credit ordonează solicitanții după riscul de nerambursare, iar PD a lui ar trebui să aibă și nivelul corect. Pierderea așteptată, PD × LGD × EAD, intră în preț; capitalul IRB acoperă pierderea neașteptată, calculată din PD într-un an prost care apare o dată la 1 000 de ani într-un model cu un factor. Pentru un credit de retail de 100 000 de lei cu PD 2% și LGD 45%, pierderea așteptată este 900 de lei, iar capitalul 4 639 de lei. Ambele cifre pornesc de la PD, iar secțiunea următoare prezintă datele din care se estimează PD.
Datele de nerambursare
Un model de scoring se estimează pe credite trecute al căror rezultat este cunoscut. Secțiunea prezintă cele două seturi de date ale capitolului, datele South German Credit și datele cardurilor de credit din Taiwan, și trăsăturile care fac speciale datele de nerambursare: istoria lungă a unei versiuni etichetate greșit a datelor germane, raritatea nerambursărilor și suprareprezentarea la care duce ea, și împărțirea într-un eșantion pentru estimare și un eșantion pentru test.
Setul principal de date al capitolului conține 1 000 de credite de consum acordate de o mare bancă regională din sudul Germaniei între 1973 și 1975 (South German Credit, 2020; Grömping, 2019). Rezultatul este binar: contractul a fost respectat, un credit performant al unui bun-platnic, sau nu a fost respectat, un credit neperformant al unui rău-platnic, codificat nerambursare = 1. Eșantionul are 300 de credite neperformante și 700 performante. Fiecare credit este descris de 20 de variabile, printre care starea contului curent, durata creditului, istoricul de credit, scopul împrumutului, suma în mărci germane (DM), economiile, vechimea în muncă și vîrsta.
Eșantionul este stratificat: creditele neperformante sînt puternic suprareprezentate. Ponderea lor în eșantion este 30%, în timp ce rata creditelor neperformante din portofoliul băncii era de aproximativ 5%. Toți debitorii din date trecuseră de verificările băncii, deci solicitanții respinși de bancă lipsesc; secțiunea 8 discută ce face această selecție unui model. Documentația fixează și un raport al costurilor: acceptarea unui credit neperformant costă de cinci ori mai mult decît respingerea unuia performant, cifră pe care capitolul o folosește pentru alegerea pragurilor.
Datele sînt publicate sub licența CC BY 4.0. Sînt suficient de mici pentru a fi inspectate rînd cu rînd, ceea ce le face un bun teren de exercițiu, și suficient de vechi pentru a avea o istorie proprie, spusă pe slide-ul următor.
Timp de decenii, aceleași credite au circulat în UCI Machine Learning Repository sub numele „Statlog (German Credit)”, unul dintre cele mai folosite seturi de date din literatura de clasificare. Grömping (2019) a arătat că etichetele codurilor din acea versiune erau greșite. În versiunea veche, grupul „fără cont curent” era cel mai sigur: 394 de credite, dintre care 11,7% neperformante. În datele corectate, aceste 394 de credite sînt cele cu un sold de cel puțin 200 DM sau cu un cont de salariu, iar „fără cont curent” este grupul cel mai riscant, cu 49,3% credite neperformante.
Cifrele din fișier erau corecte; greșite erau doar etichetele atașate lor. Orice model estimat pe versiunea veche prognoza deci la fel de bine, iar orice interpretare a acestei variabile era inversată. Un model care „găsea” că clienții fără cont curent sînt cei mai siguri ar fi trecut orice test de acuratețe a prognozei.
Două verificări ar fi descoperit eroarea. Prima este compararea tabelelor de frecvențe cu sursa originală, aici cartea lui Fahrmeir și Hamerle în care datele au fost publicate prima dată. A doua este întrebarea dacă semnele au sens economic: este greu de explicat de ce clienții fără niciun cont ar rambursa mai des decît clienții cu sold negativ. Capitolul folosește peste tot datele corectate South German Credit.
Pe scurt
Datele au fost folosite zeci de ani în versiunea UCI „Statlog (German Credit)”, cu etichete greșite ale codurilor Grömping (2019)
în acea versiune, „fără cont curent” era grupul cel mai sigur: 394 de credite, 11,7% neperformante
în datele corectate, acele 394 de credite au un sold de cel puțin 200 DM sau un cont de salariu; „fără cont curent” este grupul cel mai riscant (49,3% neperformante)
Cifrele erau corecte, etichetele greșite: fiecare model funcționa, fiecare interpretare a acestei variabile era inversată
verificări: comparăm tabelele de frecvențe cu sursa originală (aici cartea lui Fahrmeir și Hamerle) și ne întrebăm dacă semnele au sens economic
Folosim în tot capitolul datele corectate South German Credit
Întrebare pentru sală În etichetele vechi Statlog, cele 394 de credite cu un sold de cel puțin 200 DM se numeau „fără cont curent” și păreau grupul cel mai sigur (11,7%). În datele corectate, care este rata creditelor neperformante fără cont curent?
Răspuns
49,3% (274 de credite), grupul cel mai riscant, față de 11,7% pentru un sold de cel puțin 200 DM sau un cont de salariu: un raport de 4,2. Cifrele erau corecte în ambele versiuni; doar etichetele erau inversate.
Graficul arată ponderea creditelor neperformante în fiecare dintre cele patru grupuri ale variabilei cont curent, cu media eșantionului de 30% ca linie întreruptă. Rata creditelor neperformante scade constant cu puterea contului: 49,3% pentru clienții fără cont curent, 39,0% pentru un sold negativ, 22,2% pentru un sold între 0 și 200 DM și 11,7% pentru un sold de cel puțin 200 DM sau un cont de salariu.
O singură variabilă separă deci bine solicitanții: grupul cel mai riscant intră în nerambursare de aproximativ patru ori mai des decît cel mai sigur. O bancă ce nu ar ști nimic altceva ar putea deja să refuze grupul cel mai riscant și să accepte grupul cel mai sigur. Secțiunile următoare transformă astfel de diferențe într-un model: secțiunea 3 măsoară informația din fiecare variabilă, iar secțiunea 4 combină mai multe variabile într-o regresie.
Pe scurt
Ponderea creditelor neperformante în fiecare grup; linia întreruptă: media eșantionului, 30%
Interpretare: riscul scade de la 49,3% (fără cont) la 11,7% (sold de cel puțin 200 DM): o singură variabilă separă deja bine solicitanții
Nerambursările sînt rare: o bancă ale cărei credite ar intra în nerambursare în proporție de 30% nu ar supraviețui, iar portofoliile obișnuite au cîteva procente de credite neperformante. Un eșantion aleator din creditele băncii ar conține deci puțini rău-platnici și ar spune puțin despre ei. De aceea băncile suprareprezintă rău-platnicii (oversampling); în datele germane, ponderea lor este 30% în loc de aproximativ 5%.
Dezechilibrul claselor (class imbalance) creează paradoxul acurateței. Acuratețea, ponderea clasificărilor corecte, recompensează o regulă care ignoră clasa minoritară: regula „toți sînt bun-platnici” are dreptate pentru 70% din eșantionul german și pentru 77,9% din datele din Taiwan, fără să identifice niciun rău-platnic. O măsură care numără toate erorile împreună ascunde erorile care contează cel mai mult, de aceea secțiunea 7 folosește măsuri care privesc separat rău-platnicii și bun-platnicii.
Al doilea set de date al capitolului sînt datele cardurilor de credit din Taiwan (Default of Credit Card Clients, 2009; Yeh & Lien, 2009): 30 000 de deținători de card, cu rezultatul nerambursarea plății din octombrie 2005, care a avut loc la 22,1% dintre ei. Variabilele explicative sînt limita de credit, vîrsta, starea rambursării în fiecare lună din aprilie pînă în septembrie 2005, facturile lunare și plățile lunare. Cu de 30 de ori mai multe observații decît datele germane, datele din Taiwan servesc analizelor de calibrare și de echitate, unde grupurile mici ar fi prea zgomotoase.
Pe scurt
Nerambursările sînt rare: cîteva procente din creditele unei bănci; un eșantion cu puțini rău-platnici spune puțin despre ei
de aceea băncile suprareprezintă rău-platnicii (aici 30% în loc de circa 5%)
Paradoxul acurateței: regula „toți sînt bun-platnici” are dreptate pentru 70% din acest eșantion și pentru 77,9% din datele din Taiwan
deci acuratețea singură este o măsură slabă; avem nevoie de măsuri care privesc separat rău-platnicii și bun-platnicii (secțiunea 7)
Datele germane se împart aleator în 700 de credite pentru estimare, eșantionul de estimare (training sample), și 300 pentru test, cu ponderea de 30% rău-platnici păstrată în ambele: o împărțire stratificată. Fiecare alegere făcută în construcția modelului, intervalele fiecărei variabile, Weight of Evidence al lor, selecția variabilelor și coeficienții, folosește doar eșantionul de estimare. Eșantionul de test se folosește o singură dată, la final, și joacă rolul viitorilor solicitanți pe care îi va întîlni modelul.
Regula protejează împotriva scurgerii de informație (leakage): informație din eșantionul de test care intră în model. Un caz tipic este alegerea intervalelor pe toate datele și abia apoi împărțirea; intervalele au „văzut” atunci rezultatele de test, iar rezultatul testului este prea optimist. Leakage este greu de observat, pentru că nimic nu se strică: modelul pare pur și simplu mai bun decît este.
O a doua limită este mărimea. Cu 300 de credite de test, dintre care 90 neperformante, o singură împărțire dă o estimare zgomotoasă a performanței; o altă împărțire aleatoare ar da o altă cifră. De aceea secțiunea 7 adaugă validarea încrucișată repetată, care face media pe multe împărțiri.
Pe scurt
Împărțire stratificată: 700 de credite pentru estimare, 300 pentru test, cu 30% rău-platnici în ambele
orice alegere (intervale, WoE, variabile, coeficienți) se face doar pe eșantionul de estimare
eșantionul de test se folosește o singură dată, la final: joacă rolul viitorilor solicitanți
Leakage (scurgerea de informație): informație din eșantionul de test care intră în model, de exemplu intervale alese pe toate datele
face rezultatul testului prea optimist; cu 300 de credite de test, o singură împărțire este și zgomotoasă, așa că adăugăm validarea încrucișată (secțiunea 7)
Sinteza secțiunii
Datele South German Credit conțin 1 000 de credite cu 30% rău-platnici, suprareprezentați față de o bancă a cărei rată a creditelor neperformante era de aproximativ 5%, și toate au trecut de verificările băncii. Etichetele corectate inversează concluzia a decenii de lucru pe versiunea veche: „fără cont curent” este grupul cel mai riscant, cu 49,3% rău-platnici. Pentru că nerambursările sînt rare, acuratețea este o măsură slabă, iar fiecare alegere de modelare se face pe un eșantion de estimare de 700 de credite și se judecă pe un eșantion de test de 300. Secțiunea următoare măsoară cît spune fiecare variabilă despre nerambursare.
Weight of Evidence și Information Value
Înaintea oricărei regresii, un analist de credit întreabă cît spune fiecare variabilă despre nerambursare. Secțiunea introduce Weight of Evidence (WoE), care recodifică fiecare interval al unei variabile prin dovada pe care o aduce despre șansa de a fi bun-platnic, și Information Value (IV), care rezumă această dovadă într-un singur număr pe variabilă. Contul curent este lucrat de mînă, sînt enunțate regulile de construcție a intervalelor și sînt ordonate cele 20 de variabile ale datelor germane.
Împărțim o variabilă în intervale (bins) \(i = 1, \dots, m\) și notăm cu \(g_i\) și \(b_i\) numărul de bun-platnici și de rău-platnici din intervalul \(i\), cu totalurile \(G\) și \(B\). Weight of Evidence al intervalului \(i\) compară ponderea tuturor bun-platnicilor care cad în interval cu ponderea tuturor rău-platnicilor:
A doua formă dă sensul. \(\ln(g_i/b_i)\) este logaritmul șansei de a fi bun-platnic în interval, \(\ln(G/B)\) același logaritm al șansei în întregul eșantion, deci WoE măsoară cît de mult mută intervalul șansa față de medie. Un WoE pozitiv marchează un interval mai sigur decît media, un WoE negativ unul mai riscant, iar WoE = 0 un interval care nu aduce informație. Un interval fără bun-platnici sau fără rău-platnici ar da \(\pm\infty\); remediul obișnuit este adăugarea valorii 0,5 la ambele frecvențe.
Information Value însumează dovada pe intervale, fiecare termen fiind ponderat cu diferența celor două ponderi:
Fiecare termen este nenegativ, deoarece diferența și logaritmul raportului acelorași două ponderi au mereu același semn. IV este divergența Kullback–Leibler simetrică dintre distribuția bun-platnicilor și distribuția rău-platnicilor pe intervale: este zero cînd cele două distribuții coincid și crește pe măsură ce ele se separă. Regula practică a lui Siddiqi (2006) citește un IV sub 0,02 ca inutil, între 0,02 și 0,1 ca slab, între 0,1 și 0,3 ca mediu și peste 0,3 ca puternic.
Pe scurt
Împărțim o variabilă în intervale (clase) \(i = 1, \dots, m\); \(g_i\), \(b_i\): bun-platnicii și rău-platnicii din intervalul \(i\); \(G\), \(B\): totalurile lor
\(\mathrm{WoE}_i = \ln\dfrac{g_i/G}{b_i/B}\): logaritmul raportului dintre ponderea bun-platnicilor și ponderea rău-platnicilor în interval
Sensul: \(\mathrm{WoE}_i = \ln\dfrac{g_i}{b_i} - \ln\dfrac{G}{B}\): logaritmul șansei de a fi bun-platnic în interval minus cel din întregul eșantion
\(\mathrm{WoE} > 0\): mai sigur decît media; \(\mathrm{WoE} < 0\): mai riscant; \(\mathrm{WoE} = 0\): nicio informație
un interval fără bun-platnici sau fără rău-platnici ar da \(\pm\infty\): adăugăm 0,5 la ambele frecvențe
Information Value: \(\mathrm{IV} = \sum_i \left(\dfrac{g_i}{G} - \dfrac{b_i}{B}\right)\mathrm{WoE}_i \ge 0\)
o divergență Kullback–Leibler simetrică între distribuțiile bun-platnicilor și ale rău-platnicilor pe intervale
regula practică Siddiqi (2006): sub 0,02 inutilă, 0,02–0,1 slabă, 0,1–0,3 medie, peste 0,3 puternică
Tabelul aplică (12.4) și (12.5) celor patru grupuri ale contului curent, pe eșantionul complet de 700 de bun-platnici și 300 de rău-platnici. Luăm ultimul rînd, un sold de cel puțin 200 DM sau un cont de salariu: el conține 348 de bun-platnici și 46 de rău-platnici. Ponderea lui în totalul bun-platnicilor este \(348/700 = 0{,}497\), iar ponderea în totalul rău-platnicilor este \(46/300 = 0{,}153\). WoE este \(\ln(0{,}497/0{,}153) = 1{,}176\), iar termenul IV este \((0{,}497 - 0{,}153) \times 1{,}176 = 0{,}404\).
Celelalte rînduri se calculează la fel. Clienții fără cont curent reprezintă 19,9% din bun-platnici, dar 45,0% din rău-platnici, deci WoE al lor este \(-0{,}818\); un sold negativ dă \(-0{,}401\), un sold între 0 și 200 DM dă \(+0{,}405\). WoE scade monoton de la grupul cel mai sigur la cel mai riscant, ordinea la care se așteaptă bunul-simț economic.
Adunînd cei patru termeni IV obținem IV = 0,666, mult peste pragul de 0,3: contul curent este o variabilă puternică. Cea mai mare parte din această valoare provine din cele două grupuri extreme, care au ponderi mari și foarte inegale de bun-platnici și de rău-platnici; grupul mic cu sold între 0 și 200 DM contribuie doar cu 0,009.
Pe scurt
Contul curent
bun-pl.
rău-pl.
\(g_i/G\)
\(b_i/B\)
WoE
termen IV
fără cont curent
139
135
\(0{,}199\)
\(0{,}450\)
\(-0{,}818\)
\(0{,}206\)
sold \(<\) 0 DM
164
105
\(0{,}234\)
\(0{,}350\)
\(-0{,}401\)
\(0{,}046\)
0–200 DM
49
14
\(0{,}070\)
\(0{,}047\)
\(0{,}405\)
\(0{,}009\)
\(\ge\) 200 DM sau salariu
348
46
\(0{,}497\)
\(0{,}153\)
\(1{,}176\)
\(0{,}404\)
total
700
300
1
1
\(0{,}666\)
Pas cu pas, ultimul rînd: \(g/G = 348/700 = 0{,}497\), \(b/B = 46/300 = 0{,}153\)
WoE \(= \ln(0{,}497/0{,}153) = 1{,}176\); termenul IV \(= (0{,}497 - 0{,}153) \times 1{,}176 = 0{,}404\)
Interpretare: IV \(= 0{,}666 > 0{,}3\): o variabilă puternică; WoE scade monoton de la grupul cel mai sigur la cel mai riscant
Variabilele numerice sînt discretizate înainte de calculul WoE. Intervalele surprind efectele neliniare fără o formă funcțională, limitează influența valorilor extreme, deoarece o valoare extremă cade pur și simplu în ultimul interval, și transformă fiecare variabilă într-un tabel scurt din care se pot citi punctele unui solicitant. Pentru durata creditului, capitolul folosește cinci intervale: pînă la 12 luni, 13–18, 19–24, 25–36 și peste 36 de luni. Variabilele categoriale își folosesc categoriile.
Regulile standard provin din practica construirii scorecard-urilor (Siddiqi, 2006; Thomas, Crook & Edelman, 2017). Fiecare interval ar trebui să conțină cel puțin aproximativ 5% din eșantion, pentru ca WoE al lui să nu fie zgomot, iar categoriile mici se unesc. WoE ar trebui să varieze între intervale într-un mod care are sens economic, adesea monoton; un tipar în zigzag reflectă de obicei zgomot, nu risc. Intervalele și WoE se estimează pe eșantionul de estimare și se aplică neschimbate noilor solicitanți.
Odată ce o variabilă este înlocuită cu WoE al intervalului ei, ea intră în modelul logit cu un singur coeficient. Scorecard-ul rămîne aditiv: fiecare variabilă contribuie cu un număr de puncte care depinde doar de propriul ei interval, ceea ce face scorul ușor de citit și de explicat unui solicitant.
Pe scurt
Rolul intervalelor: surprind efectele neliniare, limitează influența valorilor extreme și dau fiecărui solicitant un tabel mic de puncte
Întrebare pentru sală Grupul „≥ 200 DM sau cont de salariu”: 348 din cei 700 de bun-platnici și 46 din cei 300 de rău-platnici. Cît este WoE?
Răspuns
ln(0,497/0,153) = 1,176: ponderea bun-platnicilor este de 3,2 ori ponderea rău-platnicilor. Termenul IV, (0,497 − 0,153) × 1,176 = 0,404, este cel mai mare dintre cele patru; IV total este 0,666, o variabilă puternică.
Întrebare pentru sală ▶ trece la suma creditului (intervale pînă la 1300, 2000, 3000, 5000 DM și peste). Crește rata creditelor neperformante constant cu suma?
Răspuns
Nu: este 30,9% la creditele cele mai mici, scade la 23,9% la 2001–3000 DM și urcă la 41,5% peste 5000 DM (WoE de la 0,31 la −0,50). Relația are forma unui U, pe care un singur termen liniar într-un logit nu o surprinde, iar intervalele da; IV = 0,082, o variabilă slabă.
Graficul arată cele cinci intervale de durată pe eșantionul complet: barele dau WoE al fiecărui interval, iar linia rata creditelor neperformante, pe axa din dreapta. Creditele de pînă la un an sînt cele mai sigure, cu un WoE de 0,47 și 21% credite neperformante. Creditele mai lungi de trei ani sînt cele mai riscante: 52% dintre ele sînt neperformante, iar WoE al lor este \(-0{,}92\). Intervalele între 13 și 24 de luni sînt aproape de medie, cu WoE apropiat de zero.
Tiparul este monoton și are o lectură economică: cu cît creditul este mai lung, cu atît situația debitorului are mai mult timp să se schimbe și cu atît, de regulă, suma în joc este mai mare. IV al duratei este 0,182, o variabilă medie pe scala lui Siddiqi (2006), cam un sfert din IV al contului curent.
Pe scurt
Eșantionul complet; bare: WoE pentru fiecare interval de durată; linia: rata creditelor neperformante (axa din dreapta); IV \(= 0{,}182\) (medie)
Interpretare: creditele de pînă la un an sînt mai sigure (WoE \(= 0{,}47\), 21% neperformante); peste trei ani, rata ajunge la 52% (WoE \(= -0{,}92\)); 13–24 de luni sînt în medie
Întrebare pentru sală Pe eșantionul complet, proprietatea are IV = 0,113 ≥ 0,1. Trece de pragul 0,1 și pe eșantionul de estimare, unde se aleg variabilele scorecard-ului?
Răspuns
Nu: pe eșantionul de estimare IV este 0,082, iar vechimea la angajator (0,086 pe eșantionul complet, 0,122 pe cel de estimare) îi ia locul. Șase variabile trec pragul în ambele cazuri. IV calculat pe cîteva sute de credite variază cu cîteva sutimi între eșantioane: pe cele 300 de credite de test, IV al contului curent este 0,913, față de 0,666 pe toate cele 1000.
Graficul ordonează toate cele 20 de variabile după IV pe eșantionul complet, cu pragurile 0,02, 0,1 și 0,3 ca linii punctate. Două variabile domină: contul curent, cu IV = 0,666, și istoricul de credit, cu 0,293. La celălalt capăt, telefonul, vechimea la adresa actuală și numărul persoanelor în întreținere nu aduc nicio informație despre nerambursare.
IV servește drept filtru. Pe eșantionul de estimare, șase variabile au IV de cel puțin 0,1 și intră în scorecard-ul din secțiunea 4: contul curent, istoricul de credit, scopul, economiile, durata și vechimea la angajator. IV calculate pe eșantionul de estimare diferă puțin de cele din grafic, care folosește toate cele 1 000 de credite.
IV are o limită pe care o regresie o înlătură: privește o singură variabilă odată. Două variabile puternice, dar corelate, nu își adună informația; mare parte din ce spune a doua este deja cunoscut din prima. Coeficienții modelului logit multivariat, din secțiunea următoare, măsoară ce adaugă fiecare variabilă date fiind celelalte.
Pe scurt
Eșantionul complet; linii punctate: pragurile 0,02; 0,1 și 0,3; pe eșantionul de estimare, 6 variabile au IV \(\ge 0{,}1\) și intră în scorecard
Interpretare: contul curent (IV \(= 0{,}666\)) și istoricul de credit (\(0{,}293\)) domină; telefonul, vechimea la adresă și persoanele în întreținere nu aduc informație
IV privește o singură variabilă: două variabile puternice, dar corelate, nu își adună informația
Weight of Evidence recodifică fiecare interval al unei variabile ca diferența dintre logaritmul șansei de a fi bun-platnic în interval și logaritmul șansei în întregul eșantion, iar Information Value însumează această dovadă într-un singur număr pe variabilă. Contul curent are IV = 0,666, o variabilă puternică, cu WoE monoton; durata are 0,182; șase variabile trec de pragul de 0,1 pe eșantionul de estimare. Intervalele și WoE se fixează pe eșantionul de estimare. Secțiunea următoare combină variabilele într-o regresie logistică.
Regresia logistică
Regresia logistică este modelul standard al scoringului de credit. Secțiunea îl construiește din șansa de nerambursare, îl estimează prin verosimilitate maximă și arată cum se citesc coeficienții ca modificări ale logaritmului șansei și ca rapoarte ale șanselor. Modelul este aplicat mai întîi cîtorva variabile brute, apoi celor șase variabile WoE care formează scorecard-ul, iar secțiunea se încheie cu corecția care transformă PD dintr-un set de date cu rău-platnici suprareprezentați în PD ale populației băncii.
Fie \(x = (x_1, \dots, x_k)^\top\) vectorul celor \(k\) caracteristici ale unui solicitant (durata, suma, vîrsta, situația contului curent etc.) și \(\beta = (\beta_1, \dots, \beta_k)^\top\) vectorul coeficienților lor, cîte unul pentru fiecare caracteristică; produsul \(x^\top\beta = \beta_1 x_1 + \dots + \beta_k x_k\) este deci un singur număr. Un model liniar al probabilității, \(P(Y = 1) = \beta_0 + x^\top\beta\), are un defect evident: nimic nu îi ține prognozele între 0 și 1, iar pentru solicitanții extremi dă probabilități negative sau mai mari decît unu. Remediul este modelarea unei transformări a lui \(p\) care poate lua orice valoare reală, iar predictorul liniar acționează pe această scală.
Șansa (odds) de nerambursare este \(p/(1 - p)\), cu valori în \((0, \infty)\); logaritmul șansei (log-odds), sau logit-ul, \(\ln[p/(1 - p)]\), ia valori pe toată dreapta reală. Pentru \(p = 0{,}20\), șansa este \(0{,}2/0{,}8 = 0{,}25\), o nerambursare la patru credite rambursate, iar logaritmul șansei este \(\ln 0{,}25 = -1{,}386\). Pentru \(p = 0{,}5\), șansa este 1, iar logaritmul șansei 0. Logit-ul este simetric față de o jumătate: \(\mathrm{logit}(1 - p) = -\mathrm{logit}(p)\), deci logaritmul șansei de a fi bun-platnic este minus logaritmul șansei de nerambursare.
Bancherii vorbesc adesea despre șansa bun:rău (good:bad odds), \((1 - p)/p\), numărul de credite bune la unul rău: pentru \(p = 0{,}20\) ea este 4:1. Scorecard-urile din secțiunea 6 sînt construite pe această scală.
Pe scurt
Un model liniar \(P(Y = 1) = \beta_0 + x^\top\beta\) poate da probabilități sub 0 sau peste 1
modelăm o transformare a lui \(p\) care poate lua orice valoare reală
Aici \(x_i\) este vectorul caracteristicilor solicitantului \(i\),\(\beta\) vectorul coeficienților definit mai sus (același pentru toți solicitanții), \(\beta_0\) termenul liber, iar \(\eta_i\) predictorul liniar, un singur număr pentru fiecare solicitant, care este logaritmul șansei solicitantului \(i\). Funcția logistică duce orice \(\eta_i\) în \((0, 1)\), deci fiecare prognoză este o probabilitate.
Parametrii se estimează prin verosimilitate maximă, ca în Capitolul 6. Fiecare observație este o probă Bernoulli cu probabilitatea \(p_i\), deci log-verosimilitatea este \(\ell(\beta) = \sum_i [y_i\ln p_i + (1 - y_i)\ln(1 - p_i)]\). Condiția de ordinul întîi, \(\sum_i (y_i - p_i)x_i = 0\), spune că reziduurile sînt ortogonale pe fiecare variabilă; ea nu are soluție explicită și se rezolvă iterativ prin metoda Newton–Raphson. Erorile standard provin din inversa matricei de informație \(\sum_i p_i(1 - p_i)x_ix_i^\top\), iar statistica Wald \(z = \hat\beta_j/\mathrm{se}(\hat\beta_j)\) testează dacă un coeficient este zero.
Același model servește pentru falimentul companiilor, începînd cu Ohlson (1980). Ruda lui cea mai apropiată, modelul probit, folosește funcția de repartiție a distribuției Normale, \(p = \Phi(\eta)\), în locul funcției logistice. După rescalare, cele două curbe sînt atît de apropiate încît logit și probit dau aproape aceleași PD; logit-ul este preferat în scoringul de credit pentru că coeficienții lui au interpretarea prin șanse din slide-urile următoare.
\(x_i = (x_{i1}, \dots, x_{ik})^\top\): vectorul celor \(k\) caracteristici ale solicitantului \(i\); \(\beta = (\beta_1, \dots, \beta_k)^\top\): vectorul coeficienților lor, același pentru toți solicitanții
condiția de ordinul întîi \(\sum_i (y_i - p_i)x_i = 0\): fără formulă explicită, se rezolvă prin Newton–Raphson
erorile standard din inversa lui \(\sum_i p_i(1 - p_i)x_ix_i^\top\); testul Wald \(z = \hat\beta_j/\mathrm{se}(\hat\beta_j)\)
Modelul logit este folosit și pentru falimentul companiilor, începînd cu Ohlson (1980); modelul probit folosește \(\Phi(\eta)\) în locul funcției logistice
logit și probit dau aproape aceleași PD; logit-ul are interpretarea prin șanse
Întrebare pentru sală p = 0,2 dă logaritmul șansei −1,386. ▶ duce p la 0,8. Cît este logaritmul șansei acolo?
Răspuns
+1,386: logit(1 − p) = −logit(p), logit-ul este simetric față de p = 0,5. Șansa este 4 (patru nerambursări la un credit rambursat), inversul lui 0,25.
Întrebare pentru sală ▶ estimează logit-ul doar cu vîrsta. Cu cît înmulțesc zece ani în plus șansa de nerambursare?
Răspuns
Cu e^(10 × (−0,0185)) = 0,83, adică −17%: PD scade de la 34,0% la 25 de ani la 21,3% la 60 de ani. Durata singură dă 1,57 pe an: solicitanții mai în vîrstă sînt mai siguri, creditele mai lungi mai riscante.
Graficul estimează un logit cu o singură variabilă, durata în luni. Estimările sînt \(\hat\beta_0 = -1{,}666\) și \(\hat\beta_1 = 0{,}0375\) pe lună, cu o eroare standard de 0,0057 pentru pantă, deci \(z \approx 6{,}6\), iar durata este clar semnificativă. Punctele sînt ratele observate ale creditelor neperformante în grupuri de durată, curba este PD estimată.
Pe scala logaritmului șansei, efectul duratei este constant: fiecare lună în plus adaugă 0,0375, fiecare an în plus \(12 \times 0{,}0375 = 0{,}45\), ceea ce înmulțește șansa de nerambursare cu \(e^{0{,}45} = 1{,}57\). Pe scala probabilității, efectul nu este constant. PD crește de la 22,9% pentru un credit pe 12 luni la 53,4% pentru un credit pe 48 de luni, iar curba este cea mai abruptă în jurul lui \(p = 0{,}5\), unde funcția logistică se schimbă cel mai repede; pe intervalul datelor arată aproape dreaptă, începutul unei forme de S care s-ar aplatiza pentru durate foarte lungi.
Pe scurt
Logit doar cu durata: \(\hat\beta_0 = -1{,}666\), \(\hat\beta_1 = 0{,}0375\) pe lună (se \(0{,}0057\)); punctele: ratele observate
Interpretare: fiecare an în plus înmulțește șansa de nerambursare cu \(e^{12 \times 0{,}0375} = 1{,}57\); PD crește de la 22,9% la 12 luni la 53,4% la 48 de luni
Un coeficient \(\beta_j\) este modificarea logaritmului șansei de nerambursare cînd \(x_j\) crește cu o unitate, celelalte variabile rămînînd fixe. Prin exponențiere, el devine o afirmație despre șansă: \(e^{\beta_j}\), raportul șanselor (odds ratio), este factorul cu care se înmulțește șansa, iar \(100(e^{\beta_j} - 1)\%\) este modificarea procentuală a șansei. Un interval de încredere de 95% pentru raportul șanselor se obține prin exponențierea intervalului coeficientului, \(\exp(\hat\beta_j \pm 1{,}96\,\mathrm{se})\); el nu este simetric în jurul lui \(e^{\hat\beta_j}\).
Efectul asupra probabilității însăși depinde de poziția solicitantului. Derivînd (12.6) obținem
care este maxim la \(p = 0{,}5\) și mic pentru solicitanții foarte siguri sau foarte riscanți. Aceeași variabilă poate deci muta PD a unui solicitant mediu cu cîteva puncte procentuale, iar pe cea a unui solicitant excelent cu o fracțiune de punct.
Pentru o variabilă indicator (dummy), codificată 0 sau 1, \(e^{\beta_j}\) compară șansa grupului cu șansa grupului de referință, cel codificat 0. Toate aceste lecturi sînt condiționate de celelalte variabile din model. Un coeficient este efectul lui \(x_j\) cu variabilele incluse ținute fixe; dacă o variabilă relevantă corelată cu \(x_j\) este omisă, o parte din efectul ei este atribuită lui \(x_j\), iar coeficientul se schimbă.
Pe scurt
\(\beta_j\): modificarea logaritmului șansei cînd \(x_j\) crește cu o unitate, celelalte variabile fiind fixe
\(e^{\beta_j}\): raportul șanselor (odds ratio): șansa se înmulțește cu \(e^{\beta_j}\); \(100(e^{\beta_j} - 1)\%\) este modificarea șansei
un interval de încredere de 95%: \(\exp(\hat\beta_j \pm 1{,}96\,\mathrm{se})\)
Efectul asupra probabilității depinde de poziția solicitantului
\(\partial p/\partial x_j = p(1 - p)\beta_j\): maxim la \(p = 0{,}5\), mic pentru solicitanții foarte siguri sau foarte riscanți
O variabilă indicator (0/1): \(e^{\beta_j}\) compară șansa grupului cu cea a grupului de referință
interpretarea cere un model care conține variabilele relevante: o variabilă omisă schimbă coeficienții
Tabelul estimează un logit pe toate cele 1 000 de credite cu cinci variabile: durata în ani, vîrsta în decenii, suma în mii de DM și doi indicatori pentru grupurile de cont curent cele mai riscante, fără cont curent și sold negativ. Grupul de referință al celor doi indicatori este un sold nenegativ, care reunește un sold între 0 și 200 DM cu un sold de cel puțin 200 DM sau un cont de salariu. Unitățile sînt alese astfel încît o unitate să fie o schimbare cu sens.
Patru dintre cele cinci variabile sînt semnificative. Durata are un coeficient de 0,385 pe an (\(z = 4{,}17\)), vîrsta \(-0{,}159\) pe deceniu (\(z = -2{,}30\), p = 0,022), iar cei doi indicatori de cont 1,859 și 1,338, cu statisticile \(z\) de 9,89 și 6,99. Suma, cu un coeficient de 0,029 la 1 000 DM și \(z = 0{,}90\) (p = 0,368), nu adaugă nimic odată ce celelalte variabile sînt în model. Coloana rapoartelor șanselor exponențiază coeficienții și intervalele lor de încredere.
Modelul în ansamblu se testează față de modelul doar cu termenul liber. Log-verosimilitatea crește de la \(-610{,}9\) la \(-526{,}1\), deci statistica raportului de verosimilitate este \(\mathrm{LR} = 2 \times (610{,}9 - 526{,}1) = 169{,}6\); comparată cu o distribuție \(\chi^2\) cu 5 grade de libertate, cîte unul pentru fiecare variabilă adăugată, ea respinge cu o marjă foarte mare ipoteza că cele cinci variabile nu aduc informație.
Pe scurt
Variabila
\(\hat\beta\)
se
\(z\)
p
raportul șanselor (CI 95%)
termenul liber
\(-2{,}101\)
\(0{,}311\)
\(-6{,}75\)
\(<\) 0,001
durata (ani)
\(0{,}385\)
\(0{,}092\)
\(4{,}17\)
\(<\) 0,001
\(1{,}47\) (\(1{,}23\)–\(1{,}76\))
vîrsta (decenii)
\(-0{,}159\)
\(0{,}069\)
\(-2{,}30\)
0,022
\(0{,}85\) (\(0{,}74\)–\(0{,}98\))
suma (1000 DM)
\(0{,}029\)
\(0{,}032\)
\(0{,}90\)
0,368
\(1{,}03\) (\(0{,}97\)–\(1{,}10\))
fără cont curent
\(1{,}859\)
\(0{,}188\)
\(9{,}89\)
\(<\) 0,001
\(6{,}42\) (\(4{,}44\)–\(9{,}28\))
sold \(<\) 0 DM
\(1{,}338\)
\(0{,}192\)
\(6{,}99\)
\(<\) 0,001
\(3{,}81\) (\(2{,}62\)–\(5{,}55\))
\(n = 1\,000\); log-verosimilitatea \(-526{,}1\) față de \(-610{,}9\) doar cu termenul liber: LR \(= 169{,}6\) cu 5 grade de libertate
Grupul de referință al indicatorilor de cont: un sold nenegativ (0–200 DM, sau cel puțin 200 DM ori cont de salariu)
Coeficienții, eșantionul complet (1000 de credite)
Întrebare pentru sală ▶ scoate durata din model. Ce se întîmplă cu coeficientul sumei (0,029, p = 0,368)?
Răspuns
Crește la 0,112 pe 1000 DM, p < 0,001: fără durată, suma preia riscul creditelor lungi, cu care este corelată. Un coeficient este efectul cu celelalte variabile fixate; omiterea unei variabile corelate îl schimbă.
Exemplu lucrat: PD a unui solicitant (coeficienți rotunjiți)
Întrebare pentru sală ▶ crește durata de la 36 la 48 de luni pentru același solicitant. Cît este PD?
Răspuns
71,8%: η crește cu 0,385, la 0,937. Aproximarea p(1 − p)β = 8,9 puncte de la 63,5% dă 72,4%, aproape, dar modificarea exactă, 8,3 puncte, este mai mică, pentru că curba logistică se aplatizează cînd p se îndepărtează de 0,5.
Scorecard-ul logit pe variabile WoE (eșantionul de estimare, 700 de credite)
Întrebare pentru sală ▶ coboară pragul IV la 0,02, deci intră 15 variabile WoE în loc de 6. Crește AUC de test?
Răspuns
Nu: scade de la 0,801 la 0,787, în timp ce AUC de estimare crește de la 0,789 la 0,825. Cele nouă variabile slabe se adaptează la zgomotul celor 700 de credite de estimare.
Întrebare pentru sală ▶ coboară rata rău-platnicilor din populație π. Pentru solicitantul cu PD de 63,5% în eșantion, cît este PD la π = 1%?
Răspuns
3,9%: corecția este ln(0,01/0,99) − ln(0,3/0,7) = −3,748, deci η = 0,552 − 3,748 = −3,196. Se mută doar termenul liber; ordonarea solicitanților, deci și AUC, rămîne aceeași.
Întrebare pentru sală Intervalul de 95% pentru vîrstă (+10 ani) este 0,74–0,98. Conține intervalul de 99% valoarea 1?
Răspuns
Da: 0,71–1,02. Efectul vîrstei are p = 0,022: semnificativ la 5%, nu și la 1%. Intervalele duratei și ale celor doi indicatori de cont exclud 1 și la 99%; suma conține 1 la orice nivel.
Graficul afișează rapoartele șanselor din tabel pe o scală logaritmică, astfel încît o dublare și o înjumătățire a șansei se află la aceeași distanță de linia verticală de la 1, care marchează lipsa efectului. Fiecare punct este \(e^{\hat\beta}\), fiecare bară un interval de încredere de 95%. O bară care nu traversează valoarea 1 corespunde unui coeficient semnificativ la 5%.
Contul curent domină. Fără cont curent, șansa de nerambursare este de 6,42 ori cea a grupului de referință, cu un interval de la 4,44 la 9,28; un sold negativ o înmulțește cu 3,81. Un an în plus de durată crește șansa cu 47%, iar zece ani în plus de vîrstă o reduc cu aproximativ 15% (raportul șanselor 0,85).
Suma este singura bară care traversează valoarea 1: raportul ei al șanselor este 1,03, cu un interval de la 0,97 la 1,10. Aceasta nu înseamnă că suma nu are legătură cu nerambursarea; creditele mai mari tind să fie mai lungi, iar odată ce durata este în model, suma nu mai aduce informație separată. Este un exemplu al lecturii condiționate a coeficienților.
Pe scurt
Fiecare punct: \(e^{\hat\beta}\); bare: intervale de 95%; scală logaritmică; linia verticală: niciun efect (1)
Interpretare: fără cont curent, șansa de nerambursare este de 6,42 ori cea a grupului de referință; un sold negativ o înmulțește cu 3,81
Un an în plus de durată crește șansa cu 47%; zece ani în plus de vîrstă o reduc cu aproximativ 15%
Suma nu este semnificativă odată ce durata este în model (cele două sînt corelate)
Considerăm un solicitant care cere 4 000 DM pe 36 de luni, are 30 de ani și nu are cont curent. În unitățile modelului, durata este 3 ani, vîrsta 3 decenii, iar suma 4 mii de DM. Cu coeficienții rotunjiți din tabel, predictorul liniar este
PD este \(1/(1 + e^{-0{,}552}) = 63{,}5\%\), iar șansa de nerambursare este \(e^{0{,}552} = 1{,}74\). Același solicitant cu un sold nenegativ pierde termenul indicatorului, 1,859, deci \(\eta = -1{,}307\), iar PD scade la 21,3%: doar contul curent triplează riscul prognozat. Un an în plus de durată schimbă PD cu aproximativ \(p(1 - p)\beta = 0{,}635 \times 0{,}365 \times 0{,}385\), adică circa 8,9 puncte procentuale.
Aceste PD sînt PD ale eșantionului, în care 30% din credite sînt neperformante. În populația băncii, cu aproximativ 5% rău-platnici, același solicitant este mult mai puțin riscant. Corecția este subiectul slide-ului de după cel următor.
Pe scurt
Solicitantul: 36 de luni, 30 de ani, 4000 DM, fără cont curent; coeficienții din tabelul anterior, rotunjiți
Modelul scorecard înlocuiește fiecare dintre cele șase variabile selectate cu WoE al intervalului ei, calculat pe eșantionul de estimare, și estimează un logit pentru nerambursare pe cele 700 de credite de estimare. Tabelul dă pentru fiecare variabilă IV pe eșantionul de estimare, coeficientul și eroarea standard. Contul curent păstrează cel mai mare IV, 0,591, urmat de istoricul de credit (0,215), scop (0,205), economii (0,166), durată (0,159) și vechimea la angajator (0,122).
Toți coeficienții sînt negativi. Acesta este semnul așteptat: WoE a fost definit cu bun-platnicii la numărător, deci un WoE mai mare marchează un interval mai sigur, iar un interval mai sigur ar trebui să reducă logaritmul șansei de nerambursare. Un coeficient de exact \(-1\) ar însemna că variabila mută logaritmul șansei de nerambursare cu exact minus propriul WoE, ca și cum ar fi singura variabilă. Estimările se află între \(-0{,}68\) și \(-1{,}08\): o parte din dovada fiecărei variabile se suprapune cu cea a celorlalte, iar modelul o reduce corespunzător.
Log-verosimilitatea în eșantion este \(-347{,}2\). În afara eșantionului, pe cele 300 de credite de test, scorecard-ul atinge un AUC de 0,801, o măsură a ordonării definită în secțiunea 7: un credit neperformant ales la întîmplare primește o PD mai mare decît un credit performant ales la întîmplare în aproximativ 80% din perechi.
Pe scurt
Variabila WoE
IV (estimare)
\(\hat\beta\)
se
termenul liber
\(-0{,}850\)
\(0{,}095\)
contul curent
\(0{,}591\)
\(-0{,}829\)
\(0{,}127\)
istoricul de credit
\(0{,}215\)
\(-0{,}675\)
\(0{,}206\)
destinația creditului
\(0{,}205\)
\(-0{,}937\)
\(0{,}217\)
economiile
\(0{,}166\)
\(-0{,}726\)
\(0{,}246\)
durata
\(0{,}159\)
\(-1{,}082\)
\(0{,}239\)
vechimea la angajator
\(0{,}122\)
\(-0{,}873\)
\(0{,}265\)
Eșantionul de estimare (700 de credite); fiecare variabilă este înlocuită cu WoE al intervalului ei; logit pentru nerambursare
toți coeficienții sînt negativi: un WoE mai mare (interval mai sigur) reduce logaritmul șansei de nerambursare
un coeficient de \(-1\) ar însemna că variabila adaugă exact propriul WoE; valorile între \(-0{,}7\) și \(-1{,}1\) reflectă suprapunerea dintre variabile
Eșantionul de test: AUC \(= 0{,}801\) (secțiunea 7); log-verosimilitatea în eșantion \(-347{,}2\)
Să presupunem că rău-platnicii și bun-platnicii din populație sînt eșantionați cu rate diferite, ca în datele germane. Un rezultat clasic pentru regresia logistică spune că se schimbă doar termenul liber: logaritmii șansei din populație și din eșantion diferă printr-o constantă,
unde \(\pi\) este rata rău-platnicilor din populație, iar \(\pi_s\) cea din eșantion. Pantele rămîn neschimbate, deci ordonarea solicitanților nu depinde de eșantionare; depinde doar nivelul PD.
Cu \(\pi_s = 0{,}30\) și \(\pi = 0{,}05\), deplasarea este \(\ln(0{,}05/0{,}95) - \ln(0{,}30/0{,}70) = -2{,}944 - (-0{,}847) = -2{,}097\). O PD de 30% în eșantion devine 5%, cum trebuie, iar o PD de 50% devine 10,9%. Solicitantul din exemplul rezolvat are în populația băncii logaritmul șansei \(0{,}552 - 2{,}097 = -1{,}545\), adică o PD de 17,6% în loc de 63,5%.
Corecția separă două utilizări ale modelului. Măsurile ordonării, precum AUC și Gini, nu se schimbă, deoarece toți logaritmii șansei se deplasează cu aceeași constantă. Pierderea așteptată din (12.1) și capitalul IRB din (12.2) depind de nivelul PD, iar calculate din PD ale eșantionului ar fi de cîteva ori prea mari.
Pe scurt
Dacă rău-platnicii și bun-platnicii sînt eșantionați cu rate diferite, se schimbă doar termenul liber al modelului logit
\(\ln\mathrm{șansa}_{\text{pop}} = \ln\mathrm{șansa}_{\text{eșantion}} + \ln\dfrac{\pi/(1 - \pi)}{\pi_s/(1 - \pi_s)}\); \(\pi\): rata din populație, \(\pi_s\): rata din eșantion
pantele rămîn neschimbate: ordonarea solicitanților nu depinde de eșantionare
Pas cu pas: \(\pi_s = 0{,}30\), \(\pi = 0{,}05\): corecția \(= \ln(0{,}05/0{,}95) - \ln(0{,}30/0{,}70) = -2{,}944 - (-0{,}847) = -2{,}097\)
o PD de 30% în eșantion devine 5%; o PD de 50% devine 10,9%
solicitantul din exemplul rezolvat: \(0{,}552 - 2{,}097 = -1{,}545\), PD \(= 17{,}6\%\) în populația băncii, în loc de 63,5%
Interpretare: AUC și Gini nu sînt afectate de corecție; EL și capitalul sînt afectate
Sinteza secțiunii
Modelul logit exprimă logaritmul șansei de nerambursare ca funcție liniară de variabile și se estimează prin verosimilitate maximă. Un coeficient este o modificare a logaritmului șansei; exponențiala lui este un raport al șanselor: fără cont curent, șansa de nerambursare este de 6,42 ori cea a grupului de referință, iar fiecare an în plus de durată o crește cu 47%. Scorecard-ul WoE cu șase variabile atinge un AUC de test de 0,801. PD dintr-un eșantion cu rău-platnici suprareprezentați au nevoie de corecția a priori a termenului liber, aici \(-2{,}097\), înainte de a intra în orice pierdere așteptată sau calcul de capital. Secțiunea următoare deduce alternativa mai veche a modelului logit, discriminantul lui Fisher.
Analiza discriminantă liniară
Discriminantul liniar al lui Fisher a fost prima metodă statistică de scoring de credit și rămîne metoda din spatele scorului Z al lui Altman. Secțiunea prezintă criteriul lui Fisher, arată că, pentru variabile cu distribuția Normală și aceeași matrice de covarianță în ambele grupuri, el dă un logaritm al șansei liniar în variabile, exact ca modelul logit, calculează de mînă direcția discriminantă pentru două variabile și compară cele două metode pe eșantionul de test.
Fisher (1936) a întrebat care combinație liniară \(w^\top x\) a mai multor măsurători separă cel mai bine două grupuri. El a lucrat cu măsurători ale florilor de iris din specii diferite; cinci ani mai tîrziu, Durand a aplicat aceeași metodă creditelor. Răspunsul depinde de ce înseamnă „cel mai bine”, iar alegerea lui Fisher a fost să compare distanța dintre mediile grupurilor cu dispersia din interiorul grupurilor, ambele măsurate de-a lungul direcției \(w\):
unde \(m_0\) și \(m_1\) sînt vectorii mediilor pentru bun-platnici și rău-platnici, iar \(S_W\) este matricea de covarianță comună din interiorul grupurilor.
Numărătorul singur ar favoriza orice direcție în care mediile sînt departe una de alta, chiar dacă grupurile sînt foarte împrăștiate în acea direcție; numitorul penalizează o astfel de împrăștiere. Maximizarea lui \(J(w)\) dă
\[w \propto S_W^{-1}(m_1 - m_0),\]
(12.8)
dedusă în Härdle & Simar (2019), capitolul 14. Direcția este diferența mediilor, rotită și rescalată prin inversa covarianței, astfel încît variabilele cu dispersie mare sau puternic corelate cu altele primesc o pondere mai mică.
Niciun fel de ipoteză asupra distribuției nu intră în acest criteriu. Discriminantul lui Fisher este o proiecție care maximizează distanța dintre grupuri raportată la dispersia lor; probabilitățile apar abia cînd se presupune o distribuție, pe slide-ul următor.
Pe scurt
Fisher (1936): găsim combinația liniară \(w^\top x\) care separă cel mai bine două grupuri
a folosit măsurători ale florilor de iris; Durand a aplicat metoda creditelor cinci ani mai tîrziu
Analiza discriminantă liniară (LDA, linear discriminant analysis) dă direcției lui Fisher un sens probabilistic. Presupunem că, în fiecare grup, variabilele au distribuția Normală, \(x \mid Y = k \sim N(m_k, \Sigma)\), cu aceeași matrice de covarianță \(\Sigma\) în ambele grupuri, și că probabilitatea a priori a unui rău-platnic este \(\pi_1 = P(Y = 1)\). Regula lui Bayes dă atunci logaritmul șansei a posteriori
\[\ln\frac{P(Y = 1 \mid x)}{P(Y = 0 \mid x)} = c + w^\top x, \qquad w = \Sigma^{-1}(m_1 - m_0),\]
cu constanta \(c = \ln[\pi_1/(1 - \pi_1)] - \tfrac12(m_1 + m_0)^\top w\). Termenii pătratici ai celor două densități Normale se reduc, pentru că matricele de covarianță sînt egale, iar ce rămîne este liniar în \(x\), exact forma modelului logit. Probabilitatea a priori intră doar în constantă, ca în corecția pentru suprareprezentare din (12.7).
Cele două metode diferă prin modul în care estimează aceeași formă liniară. LDA introduce în formulă mediile de selecție și matricea de covarianță comună: o estimare cu formulă explicită, care folosește distribuția comună a lui \(x\) și \(Y\). Logit-ul maximizează verosimilitatea condiționată a lui \(Y\) dat fiind \(x\) și nu face nicio ipoteză asupra distribuției lui \(x\).
Din costurile celor două erori, discutate în secțiunea 7, rezultă o regulă de clasificare. Dacă \(C_{FP}\) este costul respingerii unui bun-platnic, iar \(C_{FN}\) costul acceptării unui rău-platnic, solicitantul este clasificat ca rău-platnic cînd \(c + w^\top x > \ln(C_{FP}/C_{FN})\), adică atunci cînd șansa a posteriori de nerambursare depășește raportul costurilor.
Pe scurt
Presupunem \(x \mid Y = k \sim N(m_k, \Sigma)\), aceeași \(\Sigma\) în ambele grupuri, și probabilitatea a priori \(\pi_1 = P(Y = 1)\)
Luăm două variabile, durata în luni și vîrsta în ani, pe eșantionul complet de 700 de bun-platnici și 300 de rău-platnici. Vectorii mediilor sînt \(m_0 = (19{,}21; 36{,}22)\) pentru bun-platnici și \(m_1 = (24{,}86; 33{,}96)\) pentru rău-platnici: creditele neperformante sînt în medie cu 5,65 luni mai lungi, iar rău-platnicii sînt cu 2,26 ani mai tineri. Matricea de covarianță comună din interiorul grupurilor este
cu determinantul 17 756; cele două variabile sînt aproape necorelate în interiorul grupurilor.
Inversa unei matrice \(2 \times 2\) schimbă între ele elementele diagonale, schimbă semnul celor din afara diagonalei și împarte la determinant. Aplicată lui \(m_1 - m_0 = (5{,}65; -2{,}26)\), ea dă direcția lui Fisher \(w = S_W^{-1}(m_1 - m_0) = (0{,}0404; -0{,}0169)\): riscul crește cu durata și scade cu vîrsta. Un logit cu aceleași două variabile are pantele \((0{,}0375; -0{,}0183)\).
Direcțiile sînt definite doar pînă la un factor de scală, așa că comparația se face prin raportul celor două ponderi: \(-2{,}39\) pentru LDA și \(-2{,}05\) pentru logit. În ambele metode, o lună de durată cîntărește cam cît doi ani de vîrstă, în sens invers. Cele două metode sînt de acord asupra formei scorului și diferă doar în detalii.
Pe scurt
\(x = \) (durata în luni, vîrsta în ani), eșantionul complet: 700 de bun-platnici, 300 de rău-platnici
Întrebare pentru sală Doar cu durata și vîrsta: ce AUC în eșantion atinge discriminantul Fisher pe cele 1000 de credite?
Răspuns
0,640, exact cît logit-ul cu aceleași două variabile. Scorecard-ul cu șase variabile WoE atinge 0,801 pe eșantionul de test: două variabile sînt departe de a fi suficiente, cum arată și norii care se suprapun.
Logit și LDA pe aceleași șase variabile WoE
Întrebare pentru sală Pe eșantionul de estimare (700 de credite), este AUC al logit-ului mai mare decît al LDA?
Răspuns
Nu, este puțin mai mic: 0,789 față de 0,790, DeLong z = −0,48, p = 0,63. Pe eșantionul de test, logit-ul este puțin înainte (0,8013 față de 0,8009, z = 0,18). Cele două scoruri au corelația 0,999; niciuna dintre ordonări nu este separată de zgomot de acest test.
Întrebare pentru sală ▶ mută PD de pe frontieră de la 30% la 50%. Ce se întîmplă cu cele două drepte?
Răspuns
Se deplasează paralel spre durate mai lungi: la 30 de ani, de la aproximativ 20 de luni (19,9 LDA, 19,4 logit) la aproximativ 41 de luni (40,9 și 42,0). Panta nu depinde de nivelul PD; se schimbă doar termenul liber.
Graficul reprezintă durata în funcție de vîrstă pentru fiecare credit, cu o mică perturbare aleatoare (jitter), pentru ca creditele cu valori identice să rămînă vizibile. Fiecare linie este mulțimea punctelor în care un model dă o PD de 30%, rata creditelor neperformante din eșantion: de o parte a liniei, modelul prognozează un risc mai mare decît media, de cealaltă parte unul mai mic. Linia LDA și linia logit au aproape aceeași pantă, adică raportul de pe slide-ul anterior văzut geometric.
Trăsătura mai izbitoare este suprapunerea celor doi nori: creditele performante și cele neperformante ocupă în mare parte aceeași regiune a planului. Durata și vîrsta aduc informație, dar mult prea puțină pentru a separa grupurile; un scorecard util are nevoie de mai multe variabile, precum contul curent și istoricul de credit. Alegerea dintre LDA și logit contează mult mai puțin decît alegerea variabilelor.
Pe scurt
Durata și vîrsta fiecărui credit (cu o mică perturbare); liniile: punctele cu PD \(= 30\%\) (rata din eșantion) pentru LDA și pentru logit
Interpretare: ambele frontiere sînt drepte cu aproape aceeași pantă; cei doi nori se suprapun mult, deci două variabile sînt departe de a fi suficiente
Tabelul pune cele două metode alături. Logit-ul modelează doar \(P(Y \mid x)\); LDA modelează distribuția lui \(x\) în fiecare grup, ca Normală cu o matrice \(\Sigma\) comună. Logit-ul se estimează iterativ prin verosimilitate maximă, LDA cu formule explicite din medii și covarianțe. Cînd \(x\) are într-adevăr distribuția Normală, ambele sînt consistente, iar LDA este mai eficientă, pentru că folosește informația din distribuția lui \(x\). Cînd \(x\) conține variabile indicator, valori WoE sau variabile asimetrice, ipoteza distribuției Normale nu mai este îndeplinită: ordonarea dată de LDA rămîne de obicei bună, dar PD ei pot fi deplasate, în timp ce logit-ul nu este afectat.
Pe eșantionul de test, ambele metode folosesc cele șase variabile WoE și ating același AUC, 0,801. Corelația dintre cele două scoruri exprimate ca logaritm al șansei este 0,999, iar testul lui DeLong et al. (1988) pentru egalitatea AUC dă \(z = 0{,}18\), cu un p-value de 0,86: nicio diferență detectabilă.
Pentru ordonarea solicitanților, cele două metode sînt aici practic identice. Pentru PD, logit-ul este preferat, deoarece nu cere variabile cu distribuția Normală; LDA rămîne utilă ca reper rapid, cu formulă explicită, și ca metoda scorului Z al lui Altman din secțiunea 9.
Pe scurt
Logit
LDA (Fisher)
modelul
doar \(P(Y \mid x)\)
\(P(x \mid Y)\) Normală, \(\Sigma\) comun
estimarea
verosimilitate maximă, iterativ
medii și covarianță, formulă explicită
dacă \(x\) este Normal
consistent, mai puțin eficient
mai eficient
indicatori, WoE, \(x\) asimetric
potrivit
ordonarea bună, PD pot fi greșite
AUC de test (variabile WoE)
\(0{,}801\)
\(0{,}801\)
Eșantionul de test: corelația dintre cele două scoruri (logaritmul șansei) este \(0{,}999\); testul DeLong de egalitate a AUC: \(z = 0{,}18\), p \(= 0{,}86\)DeLong et al. (1988)
Interpretare: pentru ordonare, cele două metode sînt practic identice; logit-ul este preferat pentru PD, deoarece nu cere variabile Normale
Discriminantul lui Fisher alege direcția \(w \propto S_W^{-1}(m_1 - m_0)\), care maximizează distanța dintre mediile grupurilor raportată la dispersia din interiorul grupurilor. Pentru variabile cu distribuția Normală și o matrice de covarianță comună, el dă un logaritm al șansei liniar în \(x\), aceeași formă ca la logit, estimată altfel. Cu durata și vîrsta, ambele metode echivalează o lună de durată cu aproximativ doi ani de vîrstă; cu cele șase variabile WoE, ambele ating un AUC de test de 0,801, iar testul DeLong nu găsește nicio diferență. Secțiunea următoare transformă logaritmul șansei estimat într-un scorecard de puncte.
Construirea scorecard-ului
Băncile arată rareori PD personalului sau solicitanților; ele arată scoruri. Secțiunea explică cum se rescalează logaritmul șansei dat de un model în puncte cu două convenții, un scor de bază la o șansă dată și numărul de puncte necesar pentru dublarea șansei, cum primește fiecare atribut al unui solicitant propriile puncte și cum sînt distribuite scorurile eșantionului de test.
Un scorecard (grilă de punctaj) este un tabel care dă puncte fiecărui atribut al unui solicitant, precum „fără cont curent” sau „durată de 13–18 luni”; scorul unui solicitant este suma punctelor atributelor lui (Siddiqi, 2006). Prin convenție, un scor mai mare înseamnă un risc mai mic. Scorul este o funcție liniară de logaritmul șansei bun:rău,
Prima este numărul de puncte pentru dublarea șansei (PDO, points to double the odds): adăugarea a PDO puncte la un scor dublează șansa bun:rău. Cum dublarea șansei adaugă \(\ln 2\) la logaritmul șansei, Factor este egal cu \(\text{PDO}/\ln 2\). A doua fixează un scor de bază la o șansă dată, \(\text{șansa}_0\); rezolvînd (12.9) pentru constantă obținem \(\text{Offset} = \text{Baza} - \text{Factor} \times \ln(\text{șansa}_0)\).
Capitolul folosește PDO = 20 și un scor de 600 de puncte la șansa 50:1. Atunci \(\text{Factor} = 20/\ln 2 = 28{,}85\) și \(\text{Offset} = 600 - 28{,}85 \times \ln 50 = 600 - 28{,}85 \times 3{,}912 = 487{,}12\). Scala este arbitrară în sensul că orice altă pereche de convenții ordonează solicitanții exact la fel; ea este aleasă astfel încît scorurile să fie pozitive, de o mărime familiară și comparabile între scorecard-urile unei bănci.
Pe scurt
Scorecard (grila de punctaj): un tabel care dă puncte fiecărui atribut; scorul unui solicitant este suma punctelor Siddiqi (2006)
scor mai mare \(=\) risc mai mic; scorul este o funcție liniară de logaritmul șansei bun:rău
De la PD la scor: un solicitant cu PD = 5% are șansa bun:rău 19:1, deci scorul lui este \(487{,}12 + 28{,}85 \times \ln 19 = 487{,}12 + 28{,}85 \times 2{,}944 = 572{,}1\). Un solicitant cu PD = 30%, cu șansa 7:3, are scorul \(487{,}12 + 28{,}85 \times 0{,}847 = 511{,}6\). De la scor la PD: 560 de puncte corespund unui logaritm al șansei de \((560 - 487{,}12)/28{,}85 = 2{,}526\), unei șanse bun:rău de 12,5:1 și unei PD de \(1/13{,}5 = 7{,}4\%\).
Pentru a construi tabelul de puncte, scorul se împarte între cele \(k = 6\) variabile ale logit-ului WoE, al cărui termen liber este \(\beta_0\) și a cărui pantă pentru variabila \(j\) este \(\beta_j\). Atributul \(i\) al variabilei \(j\) primește
termenul liber și Offset fiind împărțite în mod egal între variabile. Semnul minus transformă logaritmul șansei de nerambursare, pe care îl modelează logit-ul, în logaritmul șansei bun:rău, pe care îl măsoară scorul. Pentru contul curent, cu WoE din eșantionul de estimare, cele patru grupuri primesc 66 de puncte (fără cont), 77 (sold negativ), 97 (0–200 DM) și 110 (cel puțin 200 DM sau cont de salariu). Scorul unui solicitant este suma a șase astfel de numere.
Corecția a priori din (12.7) are și ea o formă simplă în puncte. Pentru o populație cu 5% rău-platnici, logaritmul șansei de nerambursare scade cu 2,097, deci logaritmul șansei bun:rău crește cu 2,097, iar fiecare scor crește cu \(28{,}85 \times 2{,}097 = 60{,}5\) puncte. Tabelul de puncte rămîne altfel neschimbat.
Pe scurt
De la PD la scor: PD \(= 5\%\), șansa 19:1: Scorul \(= 487{,}12 + 28{,}85 \times \ln 19 = 487{,}12 + 28{,}85 \times 2{,}944 = 572{,}1\)
De la scor la PD: 560 de puncte: \(\ln\) șansa \(= (560 - 487{,}12)/28{,}85 = 2{,}526\), șansa \(12{,}5\):1, PD \(= 7{,}4\%\)
Punctele unui atribut (\(k = 6\) variabile; logit pentru nerambursare cu termenul liber \(\beta_0\) și panta \(\beta_j\))
\(\text{puncte}_{ij} = -(\beta_j\,\mathrm{WoE}_{ij} + \beta_0/k)\,\text{Factor} + \text{Offset}/k\); semnul minus transformă logaritmul șansei de nerambursare în logaritmul șansei bun:rău
contul curent (WoE din estimare): fără cont 66 de puncte, sold \(<\) 0 77, 0–200 DM 97, cel puțin 200 DM sau salariu 110
Corecția a priori în puncte: pentru o populație cu 5% rău-platnici, logaritmul șansei de nerambursare scade cu \(2{,}097\), deci logaritmul șansei bun:rău crește cu \(2{,}097\) și fiecare scor crește cu \(28{,}85 \times 2{,}097 = 60{,}5\) puncte
Întrebare pentru sală ▶ fixează PDO la 40 de puncte. Ce scor primește acum o PD de 5% (572,1 cu PDO = 20)?
Răspuns
544,2: Factor 57,71, Offset 374,25. Punctul de bază rămîne 600 la șansa 50:1; o PD de 5% înseamnă șansa 19:1, sub bază, iar cu o scală mai abruptă scorul coboară și mai mult sub 600.
Întrebare pentru sală Pragul la PD = 1/6 este 534 de puncte. Cîți dintre cei 90 de rău-platnici de test au cel puțin 534 de puncte și ar fi acceptați?
Răspuns
8 (FN): 82 din cei 90 de rău-platnici sînt respinși. Prețul: 112 din cei 210 bun-platnici sînt respinși. Cele două distribuții se suprapun, deci orice prag schimbă o eroare pe cealaltă.
Graficul arată scorurile celor 300 de credite de test, separat pentru bun-platnici și rău-platnici. Scorurile merg de la 422 la 607 puncte; bun-platnicii au în medie 529 de puncte, rău-platnicii 492. Linia întreruptă este pragul (cut-off) la o PD de 1/6, dedus din costuri în secțiunea 7, care corespunde unei șanse bun:rău de 5:1 și unui scor de 534 de puncte.
Cele două distribuții sînt deplasate una față de cealaltă, dar se suprapun mult. Orice prag face deci ambele tipuri de eroare: oriunde ar fi plasat, respinge unii bun-platnici și acceptă unii rău-platnici. Mutarea pragului schimbă o eroare pe cealaltă. Măsurile de validare din secțiunea următoare cuantifică această suprapunere și acest compromis, mai întîi la un singur prag și apoi pentru toate pragurile deodată.
Pe scurt
300 de credite de test; scoruri de la 422 la 607 puncte; media: bun-platnici 529, rău-platnici 492; linia întreruptă: pragul la PD \(= 1/6\) (secțiunea 7), 534 de puncte
Interpretare: cele două distribuții sînt deplasate, dar se suprapun: orice prag respinge unii bun-platnici și acceptă unii rău-platnici; măsurile de validare cuantifică această suprapunere
Un scorecard rescalează logaritmul șansei bun:rău în puncte: cu PDO = 20 și 600 de puncte la șansa 50:1, Factor = 28,85 și Offset = 487,12. Fiecare atribut primește propriile puncte, iar scorul unui solicitant este suma lor; corectarea PD pentru o populație cu 5% rău-platnici adaugă 60,5 puncte fiecărui scor. Pe eșantionul de test, scorurile bun-platnicilor și ale rău-platnicilor se suprapun, deci orice prag face erori de ambele tipuri. Secțiunea următoare măsoară aceste erori.
Validarea
Un scorecard este atît de bun cît este performanța lui pe solicitanți pe care nu i-a văzut. Secțiunea definește matricea de confuzie și ratele de eroare la un prag, alege pragul din costurile celor două erori și introduce măsurile care rezumă toate pragurile deodată: curba ROC și AUC, coeficientul Gini, curba CAP, raportul de acuratețe și statistica Kolmogorov–Smirnov. Trece apoi de la ordonare la calibrare, cu scorul Brier și testul Hosmer–Lemeshow, și se încheie cu validarea încrucișată, validarea out-of-time și un studiu comparativ de mari dimensiuni.
Un scorecard devine o decizie printr-un prag \(c\): solicitantul este respins dacă PD depășește \(c\). În limbajul clasificării, un „pozitiv” este o prognoză de rău-platnic. Încrucișarea prognozei cu rezultatul efectiv dă patru celule, matricea de confuzie (confusion matrix): un adevărat pozitiv (TP, true positive) este un rău-platnic respins, un fals negativ (FN, false negative) un rău-platnic acceptat, un fals pozitiv (FP, false positive) un bun-platnic respins, iar un adevărat negativ (TN, true negative) un bun-platnic acceptat.
Celulele se rezumă prin rate. Rata adevăraților pozitivi (TPR, true positive rate), numită și sensibilitate, \(\mathrm{TP}/(\mathrm{TP} + \mathrm{FN})\), este ponderea rău-platnicilor pe care regula îi identifică. Rata falșilor pozitivi (FPR, false positive rate), \(\mathrm{FP}/(\mathrm{FP} + \mathrm{TN})\), este ponderea bun-platnicilor pe care îi respinge; unu minus FPR este specificitatea. Precizia, \(\mathrm{TP}/(\mathrm{TP} + \mathrm{FP})\), este ponderea rău-platnicilor printre cei respinși, iar acuratețea, \((\mathrm{TP} + \mathrm{TN})/n\), ponderea deciziilor corecte.
Fiecare dintre aceste rate depinde de \(c\). Un prag jos respinge mulți solicitanți și identifică majoritatea rău-platnicilor cu prețul multor bun-platnici respinși; un prag înalt face invers. Alegerea lui \(c\) este o decizie de afaceri, iar măsurile care urmează fie îl aleg din costuri, fie rezumă toate pragurile deodată.
Pe scurt
prezis rău (respins)
prezis bun (acceptat)
rău-platnic real
TP
FN
bun-platnic real
FP
TN
Un prag \(c\): respingem dacă PD \(> c\)
TP (true positive): un rău-platnic respins; FN (false negative): un rău-platnic acceptat
FP (false positive): un bun-platnic respins; TN (true negative): un bun-platnic acceptat
Tabelul aplică două praguri celor 300 de credite de test, 90 neperformante și 210 performante. Cu pragul PD > 0,5, regula respinge 68 de solicitanți: identifică 43 de rău-platnici (TPR = 47,8%) și respinge 25 de bun-platnici (FPR = 11,9%), cu o acuratețe de 76,0%. Cu pragul PD > 1/6, respinge 194 de solicitanți: identifică 82 din cei 90 de rău-platnici (TPR = 91,1%), dar respinge și 112 bun-platnici (FPR = 53,3%), iar acuratețea scade la 60,0%.
Care regulă este mai bună depinde de costuri. Conform documentației datelor (Grömping, 2019), acceptarea unui rău-platnic costă de cinci ori mai mult decît respingerea unui bun-platnic, deci costul pe solicitant este \((5\,\mathrm{FN} + 1\,\mathrm{FP})/n\). Pentru un solicitant cu PD \(p\), respingerea costă în medie \((1 - p)\,C_{FP}\), iar acceptarea \(p\,C_{FN}\). Pragul Bayes respinge ori de cîte ori acceptarea este mai scumpă:
Comparația inversează verdictul acurateței. Pragul de 1/6 este mai puțin precis, 60,0% față de 76,0%, dar costul lui pe solicitant este 0,507 față de 0,867, pentru că acceptă doar 8 rău-platnici în loc de 47. Cînd erorile au costuri diferite, acuratețea este criteriul greșit.
Pe scurt
prag
TP
FN
FP
TN
acuratețe
TPR
FPR
cost
PD \(> 0{,}5\)
43
47
25
185
\(76{,}0\%\)
\(47{,}8\%\)
\(11{,}9\%\)
\(0{,}867\)
PD \(> 1/6\)
82
8
112
98
\(60{,}0\%\)
\(91{,}1\%\)
\(53{,}3\%\)
\(0{,}507\)
Costul pe solicitant \(= (5\,\mathrm{FN} + 1\,\mathrm{FP})/n\): acceptarea unui rău-platnic costă de cinci ori mai mult decît respingerea unui bun-platnic Grömping (2019)
pragul Bayes minimizează costul așteptat: respingem dacă \(p\,C_{FN} > (1 - p)\,C_{FP}\), adică \(p > C_{FP}/(C_{FP} + C_{FN}) = 1/6\)
Interpretare: pragul de 1/6 are o acuratețe mai mică (60,0% față de 76,0%), dar un cost mult mai mic (0,507 față de 0,867): identifică 91,1% din rău-platnici
Întrebare pentru sală ▶ coboară pragul de la 0,5 la 0,3. Crește sau scade acuratețea și ce se întîmplă cu costul?
Răspuns
Acuratețea scade de la 76,0% la 72,7%, costul scade de la 0,867 la 0,527: TPR crește de la 47,8% la 78,9%, FPR de la 11,9% la 30,0%. Acuratețea cîntărește la fel cele două erori; costul cîntărește de cinci ori un rău-platnic acceptat.
Întrebare pentru sală ▶ crește costul acceptării unui rău-platnic de la 5 la 10. Ce pondere din solicitanți respinge pragul Bayes?
Răspuns
81%: pragul scade de la 1/6 la 1/11 = 0,091, iar ponderea respinșilor crește de la 64,7% la 81,0%; costul așteptat este 0,620, sub 0,700, costul respingerii tuturor.
Graficul arată costul pe solicitant pe eșantionul de test (roșu) pentru fiecare prag între 0 și 1, împreună cu ponderea solicitanților respinși (albastru, axa din dreapta). Cele două linii întrerupte sînt politicile extreme: acceptarea tuturor costă 1,50 pe solicitant, cinci unități pentru fiecare dintre cei 90 de rău-platnici, împărțite la 300 de solicitanți; respingerea tuturor costă 0,70, o unitate pentru fiecare dintre cei 210 bun-platnici.
Curba costului este plată între PD de aproximativ 0,1 și 0,3: în acest interval, rău-platnicii acceptați în plus și bun-platnicii respinși în plus se compensează aproximativ. Pe aceste 300 de credite, minimul se află la 0,27, în regiunea plată care conține și pragul Bayes de 1/6. Pragul Bayes are avantajul că se alege din costuri înainte de a vedea datele de test; minimul empiric este ajustat pe aceste 300 de credite și s-ar muta pe un alt eșantion.
Pe scurt
Eșantionul de test; roșu: costul pe solicitant; linii întrerupte: acceptăm pe toată lumea (1,50) sau respingem pe toată lumea (0,70); albastru: ponderea respinșilor (axa din dreapta)
Interpretare: costul este aproape constant între PD 0,1 și 0,3; minimul pe aceste 300 de credite este la 0,27, aproape de pragul Bayes de 1/6, care se alege înainte de a vedea datele de test
Curba ROC (receiver operating characteristic) reprezintă, pentru fiecare prag \(c\), punctul \((\mathrm{FPR}(c), \mathrm{TPR}(c))\). Ea pornește din \((0, 0)\), unde nu este respins nimeni, și se termină în \((1, 1)\), unde sînt respinși toți. Un scor care ordonează solicitanții la întîmplare respinge bun-platnicii și rău-platnicii în aceeași proporție, deci curba lui este diagonala; un scor perfect atinge TPR = 1 cînd FPR este încă 0, iar curba lui merge de-a lungul marginilor din stînga și de sus.
Aria de sub curbă (AUC, area under the curve) rezumă curba într-un singur număr cu o interpretare directă (Hanley & McNeil, 1982):
unde \(s\) este scorul de risc, aici PD. AUC este probabilitatea ca un rău-platnic ales la întîmplare să primească o PD mai mare decît un bun-platnic ales la întîmplare, egalitățile fiind numărate cu o jumătate. Se poate calcula prin numărare: se formează toate perechile (rău, bun) și se ia ponderea celor ordonate corect. Această pondere este statistica Mann–Whitney împărțită la \(n_1 n_0\), numărul de perechi. Un AUC de 0,5 înseamnă lipsa discriminării, iar 1 o discriminare perfectă.
Coeficientul Gini este o rescalare, \(\mathrm{Gini} = 2\,\mathrm{AUC} - 1\), care merge de la 0 pentru un scor aleator la 1 pentru unul perfect. Pentru că AUC depinde doar de ordinea rău-platnicilor față de bun-platnici, el nu se schimbă cu rata rău-platnicilor din eșantion și nici cu o transformare monotonă a scorului: PD, logaritmul șansei și punctele dau același AUC. Eroarea standard a AUC și testele pentru compararea a două AUC pe aceiași solicitanți se datorează lui DeLong et al. (1988).
Pe scurt
ROC (receiver operating characteristic): punctele (FPR\((c)\), TPR\((c)\)) pentru toate pragurile \(c\)
de la (0, 0) (nu respingem pe nimeni) la (1, 1) (respingem pe toată lumea); diagonala este un scor aleator
AUC (aria de sub curbă) \(= P(s_{\text{rău}} > s_{\text{bun}}) + \tfrac12 P(s_{\text{rău}} = s_{\text{bun}})\)Hanley & McNeil (1982)
\(s\): scorul de risc (aici PD); se calculează numărînd perechile: ponderea perechilor (rău, bun) ordonate corect
Întrebare pentru sală Contul curent singur are patru valori. Ce pondere din cele 18 900 de perechi (rău, bun) au scoruri egale?
Răspuns
23,1% (4362 de perechi); fiecare contează 1/2, deci AUC = (11 579 + 2181)/18 900 = 0,728. Logit-ul WoE are doar 12 perechi egale (0,06%).
Întrebare pentru sală Pe eșantionul de estimare (700 de credite), AUC al logit-ului WoE este peste sau sub 0,801, valoarea de pe eșantionul de test?
Răspuns
Sub: 0,789. Performanța în eșantion este de obicei optimistă, dar această împărțire a fost norocoasă: în cele 100 de părți ale validării încrucișate, AUC medie de test este 0,764.
Graficul trasează două curbe ROC pe cele 300 de credite de test, care formează \(90 \times 210 = 18\,900\) de perechi (rău, bun). Scorecard-ul logit WoE are AUC = 0,801, cu un interval de încredere de 95% de la 0,749 la 0,854, bazat pe o eroare standard DeLong de 0,027; Gini al lui este 0,603. Un scor bazat doar pe contul curent are AUC = 0,728.
Scorecard-ul plasează deci un rău-platnic ales la întîmplare deasupra unui bun-platnic ales la întîmplare în aproximativ 80% din perechi. Este avantajul lui față de contul curent singur real sau o chestiune de noroc pe 300 de credite? Testul DeLong, care ține seama de faptul că ambele scoruri sînt evaluate pe aceiași solicitanți, dă \(z = 2{,}86\) și un p-value de 0,004: celelalte cinci variabile aduc o îmbunătățire semnificativă.
Pe scurt
300 de credite de test, 18 900 de perechi (rău, bun)
Logit WoE: AUC \(= 0{,}801\), CI 95% \([0{,}749; 0{,}854]\) (DeLong, se \(0{,}027\)); Gini \(= 0{,}603\)
Doar contul curent: AUC \(= 0{,}728\); testul DeLong față de scorecard: \(z = 2{,}86\), p \(= 0{,}004\)
Interpretare: un rău-platnic ales la întîmplare are o PD mai mare decît un bun-platnic ales la întîmplare în aproximativ 80% din perechi; celelalte cinci variabile aduc o îmbunătățire semnificativă față de contul curent
Profilul cumulativ al acurateței (CAP, cumulative accuracy profile) este ruda apropiată a curbei ROC, frecvent folosită în bănci. Se ordonează solicitanții de la cel mai riscant la cel mai sigur și se reprezintă, în funcție de ponderea \(x\) a solicitanților considerați, ponderea tuturor rău-platnicilor găsiți printre primii \(x\%\). O ordonare aleatoare dă diagonala. Un model perfect pune toți rău-platnicii primii, deci curba lui urcă la 1 în \(x\) egal cu rata rău-platnicilor și rămîne acolo. Raportul de acuratețe (AR, accuracy ratio) compară modelul cu aceste două extreme: este aria dintre CAP-ul modelului și diagonală împărțită la aria dintre CAP-ul perfect și diagonală. Pentru un scor continuu, AR este egal cu coeficientul Gini.
Statistica Kolmogorov–Smirnov (KS) a unui scorecard este cea mai mare distanță verticală dintre distribuțiile scorurilor rău-platnicilor și ale bun-platnicilor,
unde \(F_{\text{rău}}\) și \(F_{\text{bun}}\) sînt funcțiile de repartiție empirice ale scorurilor în cele două grupuri; KS ia valori între 0 și 1. Pe curba ROC, KS este cea mai mare distanță verticală dintre curbă și diagonală, \(\max_c (\mathrm{TPR} - \mathrm{FPR})\), iar scorul la care apare este o primă alegere naturală a pragului cînd costurile nu sînt cunoscute.
ROC, AUC, Gini, CAP, AR și KS măsoară toate discriminarea, adică ordonarea solicitanților. Niciuna nu spune dacă PD au nivelul corect: înmulțirea tuturor PD cu doi le lasă neschimbate. Calibrarea are nevoie de propriile măsuri, cu două slide-uri mai jos.
Pe scurt
CAP (cumulative accuracy profile): ordonăm solicitanții de la cel mai riscant; reprezentăm ponderea tuturor rău-platnicilor printre primii \(x\%\)
modelul perfect: toți rău-platnicii primii, curba atinge 1 la \(x = \) rata rău-platnicilor; aleator: diagonala
AR (accuracy ratio, raportul de acuratețe) \(= \dfrac{\text{aria dintre CAP-ul modelului și diagonală}}{\text{aria dintre CAP-ul perfect și diagonală}}\); pentru un scor continuu AR \(=\) Gini
KS (Kolmogorov–Smirnov): \(\max_s |F_{\text{rău}}(s) - F_{\text{bun}}(s)|\), cea mai mare distanță dintre distribuțiile scorurilor rău-platnicilor și bun-platnicilor
\(F_{\text{rău}}\), \(F_{\text{bun}}\): funcțiile de repartiție empirice ale scorurilor în cele două grupuri; KS \(\in [0, 1]\)
citit pe curba ROC: KS \(= \max_c\,(\mathrm{TPR} - \mathrm{FPR})\); scorul la care apare este un prim prag natural
Toate cele trei măsoară discriminarea (ordonarea), nu calibrarea
Întrebare pentru sală Contul curent singur: este raportul de acuratețe AR egal cu indicele Gini, 0,456?
Răspuns
Nu: AR = 0,240. Cu doar patru valori ale scorului, CAP ordonează solicitanții cu același scor în ordinea din fișier, care este arbitrară; AR = Gini este valabil pentru un scor continuu (logit WoE: 0,602 și 0,603). KS este 0,410, față de 0,511.
Întrebare pentru sală Respingînd cei mai riscanți 30% dintre cei 300 de solicitanți de test, ce pondere din cei 90 de rău-platnici identificăm?
Răspuns
60% (54 din 90). Modelul perfect i-ar identifica pe toți, deoarece 30% este exact rata rău-platnicilor; un scor aleator ar identifica 30%.
Întrebare pentru sală La pragul Bayes, 534 de puncte, cît este diferența F_rău(s) − F_bun(s), față de KS = 0,511 la 516 puncte?
Răspuns
0,373: 91,1% din rău-platnici și 53,8% din bun-platnici au cel mult 534 de puncte. Aceasta este TPR − FPR la acest prag; KS este maximul ei peste toate pragurile. Pragul care minimizează costul așteptat nu este cel care maximizează KS, pentru că KS cîntărește la fel cele două erori.
Graficul din stînga este curba CAP a scorecard-ului pe eșantionul de test, cel din dreapta cele două funcții de repartiție empirice ale scorurilor. Raportul de acuratețe este 0,602, același cu coeficientul Gini de 0,603 pînă la rotunjire, cum spune teoria. Citind CAP la \(x = 30\%\): respingerea celor mai riscanți 30% dintre solicitanți identifică 60% din toți rău-platnicii (54 din cei 90), față de 30% pentru o ordonare aleatoare și 100% pentru una perfectă.
Statistica KS este 0,511 și este atinsă la 516 puncte: la acest scor, ponderea rău-platnicilor cu scoruri sub el depășește ponderea bun-platnicilor sub el cu 51 de puncte procentuale. La 516 puncte, scorecard-ul separă cel mai bine rău-platnicii de bun-platnici. Exprimat ca PD, punctul se află aproape de 27%, lîngă minimul costului găsit cu două slide-uri mai devreme.
Pe scurt
AR \(= 0{,}602\) (Gini \(= 0{,}603\): același, cu excepția rotunjirii); KS \(= 0{,}511\) la 516 puncte
Interpretare: respingînd cei mai riscanți 30%, identificăm 60% din rău-platnici (54 din 90); la 516 puncte, scorecard-ul separă cel mai bine rău-platnicii de bun-platnici
Un model este calibrat dacă, dintre solicitanții cu o PD apropiată de \(p\), o pondere de aproximativ \(p\) intră în nerambursare. Diagrama de calibrare (reliability diagram) verifică acest lucru vizual: se ordonează solicitanții după PD, se formează grupuri, de exemplu zece grupuri de mărime egală, și se reprezintă PD medie a fiecărui grup față de rata lui observată de nerambursare. Un model calibrat pune punctele pe diagonală. Testul lui Hosmer & Lemeshow (1980) transformă diagrama într-o statistică,
unde \(G\) este numărul de grupuri, \(n_g\) mărimea grupului \(g\),\(O_g\) nerambursările lui observate, iar \(\bar p_g\) PD lui medie. Fiecare termen compară nerambursările observate cu cele așteptate într-un grup; o valoare mare semnalează o calibrare slabă.
Scorul Brier al lui Brier (1950) este eroarea pătratică medie a PD ca prognoze ale rezultatelor 0/1:
o valoare mai mică fiind mai bună. Referința lui naturală este o PD constantă egală cu rata rău-platnicilor din eșantionul de estimare, prognoza unui model care nu știe nimic despre solicitanți; cîștigul (skill score) \(1 - \mathrm{BS}/\mathrm{BS}_{\text{ref}}\) este ponderea din eroarea de referință pe care o elimină modelul.
Pe eșantionul de test german, scorecard-ul are BS = 0,162 față de 0,210 pentru PD constantă de 30%, un cîștig de 23%. Statistica Hosmer–Lemeshow cu zece grupuri este 6,520, cu un p-value de 0,589: nicio dovadă de calibrare greșită. Spre deosebire de AUC, care vede doar ordonarea, scorul Brier recompensează atît ordonarea, cît și calibrarea: un model cu o ordonare perfectă, dar cu PD la un nivel greșit, are totuși un scor Brier mare.
Pe scurt
Calibrarea: dintre solicitanții cu PD \(\approx p\), aproximativ o pondere \(p\) intră în nerambursare
diagrama de calibrare: ordonăm după PD, formăm grupuri (de exemplu zece), reprezentăm PD medie față de rata observată
Tabelul de calibrare al scorecard-ului (eșantionul de test)
Întrebare pentru sală Eșantionul de test al scorecard-ului: cu 5 grupuri de cîte 60 de credite în loc de 10, ce p-value dă testul Hosmer–Lemeshow?
Răspuns
0,90 (HL = 0,589, 3 grade de libertate); 0,59 cu 10 grupuri, 0,82 cu 20. Nerespins în nicio grupare: cu 300 de credite testul are o putere mică, deci „nerespins” nu dovedește că PD sînt exacte.
Întrebare pentru sală Cu 5 grupuri de cîte 1800 de clienți în loc de 10, mai respinge testul Hosmer–Lemeshow calibrarea la 5%?
Răspuns
Da: HL = 22,6 cu 3 grade de libertate, p < 0,001 (cu 20 de grupuri, 67,5, p < 0,001). Cu 9000 de clienți, testul detectează abateri de unul sau două puncte procentuale; contează mărimea abaterilor, nu doar p-value-ul.
Graficul este diagrama de calibrare a unui logit estimat pe 70% din cei 30 000 de deținători de card din Taiwan și evaluat pe un eșantion de test de 9 000. Clienții de test sînt ordonați după PD în zece grupuri de cîte 900; fiecare punct compară PD medie a unui grup cu rata lui observată de nerambursare, iar barele sînt intervale de 95% pentru rata observată. Modelul ordonează bine, cu un AUC de test de 0,777 (0,774 pe eșantionul de estimare), iar scorul Brier de 0,136 față de 0,172 pentru PD constantă înseamnă un cîștig de 21%.
Punctele sînt aproape de diagonală, totuși statistica Hosmer–Lemeshow este 40,660, cu un p-value sub 0,001: testul respinge calibrarea. Cu 900 de clienți pe grup, testul are puterea de a detecta abateri mici. Cea mai mare este în grupul cel mai sigur, unde PD medie este 7,8%, iar rata observată 5,9%.
Lecția privește semnificația și mărimea. Un test pe 9 000 de clienți detectează abateri care s-ar putea să nu conteze pentru decizie; un test pe 300 de credite poate rata abateri care contează. Calibrarea trebuie judecată după mărimea abaterilor, citită pe diagramă și exprimată în puncte procentuale de PD, nu doar după p-value.
Pe scurt
Logit pe 30 000 de deținători de card (70% estimare); eșantion de test de 9 000; zece grupuri de cîte 900 după PD; bare: intervale de 95%
AUC de test \(= 0{,}777\) (estimare \(0{,}774\)); Brier \(= 0{,}136\) față de \(0{,}172\) (cîștig 21%)
Hosmer–Lemeshow \(= 40{,}660\), p \(<\) 0,001: respins, deși punctele sînt aproape de diagonală
Interpretare: cu 9000 de clienți, testul detectează abateri mici (grupul cel mai sigur: PD 7,8%, observat 5,9%); judecăm mărimea abaterilor, nu doar p-value-ul
Performanța măsurată pe datele de estimare este optimistă: modelul s-a adaptat atît la structura acestor date, cît și la zgomotul lor, fenomen numit supraajustare (overfitting). Un eșantion de test elimină această distorsiune, dar un singur eșantion de test este zgomotos. AUC de test de 0,801 pe 300 de credite are o eroare standard de 0,027, deci o altă împărțire aleatoare ar putea da ușor o valoare cu cîteva sutimi mai mare sau mai mică.
Validarea încrucișată în \(k\) părți (k-fold cross-validation) folosește fiecare observație pentru test. Datele se împart în \(k = 5\) părți; modelul se estimează pe patru părți și se testează pe a cincea, iar rolurile se rotesc pînă cînd fiecare parte a servit o dată ca set de test. Întregul ciclu se repetă de 20 de ori cu împărțiri aleatoare diferite, ceea ce dă 100 de AUC de test. Întreaga procedură de modelare se repetă în interiorul fiecărui set de estimare: intervalele, WoE, selecția după IV și coeficienții. Repetarea doar a ultimului pas ar scurge informație din părțile de test în intervale.
Rezultatele se raportează ca media și dispersia celor 100 de AUC de test, împreună cu diferența dintre AUC de estimare și de test, care măsoară supraajustarea. O schemă diferită, validarea out-of-time, testează pe cereri care sosesc mai tîrziu decît cele folosite la estimare; ea este subiectul slide-ului de după cel următor.
Pe scurt
Performanța în eșantion este optimistă: modelul s-a adaptat la zgomotul datelor de estimare (supraajustare)
un eșantion de test de 300 de credite dă AUC \(= 0{,}801\) cu o eroare standard de \(0{,}027\): o singură împărțire este zgomotoasă
Validarea încrucișată în \(k\) părți: împărțim în \(k = 5\) părți; estimăm pe patru, testăm pe a cincea; rotim; repetăm de 20 de ori
întreaga procedură se repetă în fiecare parte: intervale, WoE, selecția după IV și coeficienții
raportăm media și dispersia celor 100 de AUC de test, precum și diferența dintre AUC de estimare și de test
Validarea out-of-time: estimăm pe cereri mai vechi, testăm pe cereri ulterioare (peste două slide-uri)
AUC de estimare și de test în validarea încrucișată repetată
Întrebare pentru sală ▶ arată primele 1, 5, 10 și 20 de repetări. Cît se mișcă AUC medie de test a logit-ului WoE?
Răspuns
Foarte puțin: 0,766; 0,767; 0,766; 0,764. O singură rulare cu 5 părți face deja media a cinci părți de test; împărțirea unică din curs (0,801) este o singură extragere dintr-o distribuție cu abaterea standard 0,032.
Graficul arată cele 100 de AUC de estimare (puncte) și cele 100 de AUC de test (cruci) pentru patru modele, cu mediile lor ca linii negre. Scorecard-ul logit WoE are un AUC mediu de estimare de 0,804 și un AUC mediu de test de 0,764, cu o deviație standard de 0,032 între părțile de test. LDA pe aceleași variabile WoE dă 0,804 și 0,765. Logit-ul mic din secțiunea 4, cu cinci variabile brute, dă 0,749 și 0,744, iar contul curent singur 0,708.
Diferența dintre AUC de estimare și de test măsoară supraajustarea. Scorecard-ul pierde aproximativ 0,04 din AUC în afara eșantionului, pentru că intervalele, valorile WoE și selecția variabilelor se adaptează toate la datele de estimare; logit-ul cu cinci variabile, cu puțini parametri și fără discretizare dictată de date, nu pierde aproape nimic. Scorecard-ul rămîne cel mai bun model în afara eșantionului, dar cu mai puțin decît sugerează AUC de estimare.
Media din validarea încrucișată pune și împărțirea unică din slide-urile anterioare în perspectivă. AUC de test al acesteia, 0,801, se află peste media de 0,764 pe 100 de părți de test: acea împărțire a fost norocoasă. Un singur eșantion de test de 300 de credite este o verificare rezonabilă, dar cifra care trebuie raportată este cea din validarea încrucișată.
Pe scurt
20 de repetări a cîte 5 părți; puncte: părțile de estimare, cruci: părțile de test; liniile negre: mediile
Interpretare: scorecard-ul pierde 0,039 din AUC în afara eșantionului, logit-ul cu cinci variabile aproape nimic; împărțirea unică de mai sus a fost norocoasă (\(0{,}801\) față de \(0{,}764\) în medie)
Un scorecard este folosit ani de zile pe solicitanți care sosesc după perioada de estimare. În acest timp economia se schimbă, produsele băncii se schimbă și populația solicitanților se schimbă, astfel încît relația dintre variabile și nerambursare derivă (drift). O împărțire aleatoare nu poate detecta acest lucru, pentru că eșantioanele ei de estimare și de test provin din aceeași perioadă. Validarea out-of-time estimează modelul pe cereri mai vechi, de exemplu din 2019–2021, și îl testează pe cereri ulterioare, de exemplu din 2022–2023, comparînd AUC și calibrarea de la un an la altul.
Odată ce scorecard-ul este în uz, monitorizarea compară distribuția scorurilor și a fiecărei variabile cu perioada de estimare. Diagnosticul ghidează răspunsul. Dacă scorurile se deplasează, dar ordonarea rămîne stabilă, nivelul PD este greșit și este suficientă o recalibrare a termenului liber, ca în corecția a priori din (12.7); dacă ordonarea se deteriorează, modelul trebuie reconstruit.
Niciunul dintre seturile de date ale capitolului nu conține data cererilor, deci un test out-of-time nu este posibil aici, iar împărțirile aleatoare sînt cea mai bună schemă disponibilă. O schemă out-of-time într-un alt context, prognoza activelor cripto „zombie”, este prezentată în Będowska-Sójka, Wójcik & Pele (2026).
Pe scurt
Un scorecard este folosit ani de zile pe solicitanți care vin după perioada de estimare
economia, produsele și solicitanții se schimbă: relația dintre \(x\) și nerambursare se modifică în timp
testul out-of-time: estimăm, de exemplu, pe 2019–2021, testăm pe 2022–2023; comparăm AUC și calibrarea de la un an la altul
Monitorizarea: distribuția scorurilor și a fiecărei variabile se compară cu perioada de estimare
o deplasare cu ordonare stabilă cere recalibrare (termenul liber); o pierdere a ordonării cere un model nou
Limitarea datelor: niciunul dintre seturile de date ale capitolului nu conține data cererilor, deci un test out-of-time nu este posibil aici; putem folosi doar împărțiri aleatoare
Cum se compară logit-ul cu numeroșii clasificatori dezvoltați de atunci? Lessmann et al. (2015) au comparat 41 de clasificatori, cu șase măsuri de acuratețe, pe opt seturi de date de credit de retail, printre care datele germane de credit din repository-ul UCI. Studiul actualizează, după zece ani, comparația publicată de Baesens și coautorii săi în 2003.
Trei rezultate ies în evidență. Mai mulți clasificatori prognozează semnificativ mai bine decît regresia logistică, standardul industriei, iar ansamblurile eterogene (heterogeneous ensembles), care combină modele de tipuri diferite, au cea mai bună performanță. Scorecard-urile mai precise pot aduce cîștiguri financiare importante unui creditor. Măsurile uzuale de acuratețe dau semnale asemănătoare, iar autorii recomandă random forests ca reper (benchmark) față de care trebuie testată orice metodă nouă.
Studiul schimbă ce se consideră progres: a învinge doar logit-ul nu mai este o dovadă că o metodă nouă este utilă. Pe cele 1 000 de credite germane ale acestui capitol, logit și LDA diferă cu mai puțin de o eroare standard a AUC, iar pentru a separa metodele bune este nevoie de seturi de date mult mai mari. Capitolul 13 adaugă la comparație arborii de clasificare și rețelele neuronale.
Pe scurt
Lessmann et al. (2015): 41 de clasificatori, șase măsuri de acuratețe, opt seturi de date de retail (printre ele datele germane de credit din UCI)
o actualizare, după zece ani, a comparației lui Baesens et al. (2003)
Rezultatele
mai mulți clasificatori prezic semnificativ mai bine decît regresia logistică, standardul industriei; ansamblurile eterogene sînt cele mai bune
scorecard-urile mai precise pot aduce cîștiguri financiare importante
măsurile uzuale de acuratețe dau semnale asemănătoare; random forests sînt recomandate ca reper pentru orice metodă nouă
A învinge doar logit-ul nu mai este o dovadă de progres; pe cele 1000 de credite, logit și LDA diferă cu mai puțin de o eroare standard a AUC; Capitolul 13 adaugă arbori și rețele neuronale
Sinteza secțiunii
La un prag dat, matricea de confuzie dă ratele adevăraților și falșilor pozitivi; cu un cost de 5 pentru un rău-platnic acceptat și de 1 pentru un bun-platnic respins, pragul Bayes PD > 1/6 reduce costul pe solicitant de la 0,867 la 0,507, cu prețul unei acurateți mai mici. Pe toate pragurile, scorecard-ul atinge un AUC de test de 0,801 (Gini 0,603, AR 0,602, KS 0,511) și un cîștig Brier de 23%, fără dovezi de calibrare greșită. Validarea încrucișată repetată dă un AUC de test mai fiabil, de 0,764, iar comparațiile pe date mari arată că ansamblurile întrec modelul logit. Secțiunea următoare trece la două probleme pe care niciun eșantion de test nu le poate arăta: solicitanții care au fost respinși și echitatea deciziilor.
Reject inference și echitatea
Validarea din secțiunea anterioară măsoară cît de bine prognozează un scor rezultatele solicitanților din date. Două întrebări rămîn în afara acestui cadru. Datele conțin doar solicitanți care au fost acceptați, în timp ce modelul se folosește pe toți solicitanții; iar un model care prognozează bine poate totuși să trateze inegal grupuri de solicitanți. Secțiunea discută reject inference, face un experiment pe datele din Taiwan, definește trei criterii de echitate și le citește pe aceleași date.
O bancă observă rezultatul unui credit doar dacă l-a acordat. Modelul de scoring se aplică însă fiecărui solicitant care trece „pragul ușii” (through the door). Datele de estimare sînt deci un eșantion selectat de scorul anterior al băncii: solicitanții cei mai riscanți au fost respinși, iar rezultatele lor lipsesc. Debitorii din South German Credit trecuseră toți de verificările băncii (Grömping, 2019), deci datele nu spun nimic direct despre solicitanții pe care banca i-a refuzat.
Reject inference este numele metodelor care încearcă să corecteze aceste rezultate lipsă (Banasik, Crook & Thomas, 2003; Thomas, Crook & Edelman, 2017). Reponderarea (reweighting) dă o pondere mai mare solicitanților acceptați care seamănă cu cei respinși, astfel încît eșantionul de estimare să semene mai mult cu populația solicitanților. Augmentarea (augmentation) și parcelarea (parcelling) atribuie solicitanților respinși rezultate imputate dintr-un model și le adaugă la datele de estimare.
Toate aceste metode se sprijină pe ipoteze pe care datele nu le pot verifica, deoarece rezultatele de care au nevoie sînt exact cele care lipsesc. Sursa de informație cea mai fiabilă este de aceea un experiment: un mic eșantion aleator de solicitanți acceptați indiferent de scorul lor, ale căror rezultate arată cum s-ar fi comportat cei respinși. Experimentul costă banca pierderile din aceste credite și îi oferă o imagine nedistorsionată a întregii populații.
Pe scurt
Rezultatul este cunoscut doar pentru solicitanții acceptați; modelul se folosește pe toți solicitanții („through the door”)
un eșantion selectat de scorul vechi: lipsesc solicitanții cei mai riscanți și rezultatele lor
debitorii din South German Credit trecuseră toți de verificările băncii Grömping (2019)
Datele din Taiwan permit un experiment controlat, pentru că rezultatul este cunoscut pentru fiecare client. Un „scor vechi”, construit din întîrzierea la plată din septembrie și din limita de credit, acceptă cei mai buni 70% dintre clienții de estimare, 15 085 de persoane. Rata de nerambursare a celor acceptați este 13,2%, a celor respinși 44,9%. Printre acceptați, nimeni nu a întîrziat în septembrie; cea mai puternică variabilă a datelor ia o singură valoare în eșantionul de estimare și dispare din orice model estimat pe el.
Toate modelele sînt apoi evaluate pe un eșantion de test care conține toți solicitanții, acceptați și respinși. Modelul estimat doar pe clienții acceptați atinge un AUC de 0,736, modelul estimat pe toți solicitanții 0,777, iar scorul vechi însuși 0,743. Pentru clienții de test respinși, rata observată de nerambursare este 46,1%; modelul estimat pe acceptați le dă o PD medie de 29,6%, modelul complet 44,1%.
Experimentul arată ambele costuri ale selecției. Estimat doar pe solicitanții acceptați, noul model ordonează mai slab decît scorul vechi pe care trebuia să îl înlocuiască și subestimează riscul solicitanților respinși cu aproximativ 36% (o PD medie de 29,6% față de o rată observată de 46,1%). O bancă ce l-ar folosi pentru a accepta o parte dintre solicitanții respinși anterior și-ar asuma un risc mult mai mare decît se aștepta.
Pe scurt
Un „scor vechi” (întîrzierea din septembrie și limita) acceptă cei mai buni 70% dintre clienții de estimare (15 085); rata lor de nerambursare este 13,2%, a respinșilor 44,9%
printre acceptați nimeni nu a întîrziat în septembrie: variabila cea mai puternică nu poate fi estimată și iese din model
Eșantionul de test (toți solicitanții): AUC al modelului estimat doar pe acceptați \(0{,}736\), al celui estimat pe toți \(0{,}777\), al scorului vechi \(0{,}743\)
clienții de test respinși: rata observată 46,1%; PD medie a modelului estimat pe acceptați 29,6%, a modelului complet 44,1%
Interpretare: estimat doar pe acceptați, noul model ordonează mai slab decît scorul vechi și subestimează riscul respinșilor cu aproximativ 36%
Deciziile de creditare sînt reglementate. În Statele Unite, Equal Credit Opportunity Act interzice discriminarea în creditare după sex, stare civilă, rasă, religie, origine națională sau vîrstă. În Uniunea Europeană, AI Act clasifică scoringul de credit al persoanelor drept o utilizare cu risc ridicat a inteligenței artificiale, care cere documentare și supraveghere umană.
Excluderea variabilei protejate din model nu este suficientă, pentru că alte variabile îi pot ține locul: venitul, tipul de slujbă sau locul de reședință pot fi corelate cu sexul, vîrsta sau originea. Echitatea trebuie deci măsurată pe decizii. Trei criterii sînt uzuale. Paritatea demografică (demographic parity) cere rate egale de aprobare între grupuri. Egalitatea de șanse (equal opportunity), în sensul lui Hardt, Price & Srebro (2016), cere rate egale de aprobare printre bun-platnicii fiecărui grup, astfel încît o persoană care ar rambursa să aibă aceeași șansă de a primi un credit, oricare ar fi grupul ei. Calibrarea în fiecare grup cere ca aceeași PD să însemne același risc în fiecare grup.
Aceste criterii intră în conflict. Cînd ratele de nerambursare diferă între grupuri, un model calibrat dă în medie PD diferite grupurilor și le aprobă deci în proporții diferite, ceea ce încalcă paritatea demografică; cu excepția cazurilor degenerate, precum un predictor perfect, criteriile nu pot fi îndeplinite toate simultan. La care dintre ele se renunță nu este o întrebare statistică, ci o chestiune de politică pentru bănci și autoritățile de reglementare. Sarcina statisticianului este să le măsoare pe toate și să raporteze compromisul.
Pe scurt
Legea americană interzice discriminarea în creditare după sex, stare civilă, rasă, religie, origine națională sau vîrstă Equal Credit Opportunity Act (FTC)
UE: scoringul de credit al persoanelor este o utilizare cu risc ridicat a AI (documentare, supraveghere umană) Comisia Europeană, AI Act
Excluderea variabilei protejate nu este suficientă: alte variabile o pot înlocui
paritatea demografică: rate egale de aprobare între grupuri
calibrarea în fiecare grup: aceeași PD înseamnă același risc în fiecare grup
Cînd ratele de nerambursare diferă între grupuri, aceste criterii nu pot fi toate îndeplinite simultan: alegerea ține de politica băncii și a autorităților
Experimentul de reject inference (eșantionul de test, 9000 de clienți)
Întrebare pentru sală ▶ lasă scorul vechi să accepte 90% în loc de 70%. Mai subestimează modelul estimat pe acceptați riscul respinșilor?
Răspuns
Nu, acum îl supraestimează: PD medie 80,0% față de 69,4% observat, iar AUC pe toți solicitanții (0,777) este cel al modelului complet. La 90%, printre acceptați sînt și clienți care au întîrziat în septembrie, deci nicio variabilă nu iese din model; cei 10% respinși se află dincolo de datele de estimare, iar logit-ul extrapolează.
Întrebare pentru sală ▶ crește ponderea aprobaților de la 75% la 90%. Crește sau scade diferența dintre ratele de aprobare ale femeilor și bărbaților?
Răspuns
Scade de la 4,1 la 2,2 puncte procentuale (90,9% față de 88,7%). Ordinea grupurilor rămîne aceeași, pentru că modelul este calibrat în fiecare grup, iar bărbații intră mai des în nerambursare (24,7% față de 20,5%).
Graficul citește cele trei criterii pe eșantionul de test din Taiwan. Sexul și vîrsta nu sînt variabile ale modelului, iar pragul aprobă cei 75% dintre solicitanți cu PD cea mai mică. Femeile intră în nerambursare cu o rată de 20,5%, iar 76,6% dintre ele sînt aprobate; bărbații intră în nerambursare cu 24,7%, iar 72,5% sînt aprobați. Printre bun-platnici sînt aprobate 85,1% dintre femei și 83,2% dintre bărbați.
Modelul este calibrat în fiecare grup: PD medie a fiecărui grup este apropiată de rata lui observată de nerambursare. Un model calibrat trebuie atunci să aprobe mai rar grupurile care intră mai des în nerambursare, aici bărbații și grupele de vîrstă cele mai tinere și cele mai în vîrstă. Paritatea demografică este încălcată cu aproximativ patru puncte procentuale între femei și bărbați; egalitatea de șanse cu aproximativ două puncte.
Graficul ilustrează astfel în cifre conflictul de pe slide-ul anterior. Egalizarea ratelor de aprobare ar cere praguri diferite după sex, ceea ce ar strica calibrarea în fiecare grup și ar folosi explicit variabila protejată.
Pe scurt
Eșantionul de test; sexul și vîrsta nu sînt variabile ale modelului; pragul: aprobăm cei 75% cu PD cea mai mică
Femei: rata de nerambursare 20,5%, aprobate 76,6%; bărbați: 24,7%, 72,5%; bun-platnici aprobați: femei 85,1%, bărbați 83,2%
Interpretare: modelul este calibrat în fiecare grup (PD medie apropiată de rata observată), deci grupurile cu mai multe nerambursări (bărbații, cei mai tineri și cei mai în vîrstă) sînt aprobate mai rar
Fuster et al. (2022) au studiat creditele ipotecare din SUA și au prognozat nerambursarea atît cu un logit tradițional, cît și cu modele de învățare automată (machine learning). Întrebarea lor merge dincolo de acuratețe: cînd un creditor trece la modelul mai precis, cine cîștigă și cine pierde?
Modelele flexibile prognozează mai bine nerambursarea. Cîștigurile sînt însă inegal distribuite: debitorii de culoare și cei hispanici au mai puține șanse să beneficieze de noua tehnologie. Într-un model de echilibru al pieței creditelor ipotecare, disparitatea dobînzilor între grupuri și în interiorul grupurilor crește, mai ales pentru că flexibilitatea mai mare a modelelor le permite să exploateze combinații de variabile corelate cu apartenența la grup.
Lecția pentru scoringul de credit este că acuratețea și echitatea trebuie măsurate împreună. Un AUC mai bun este un argument necesar pentru un model nou, dar nu unul suficient.
Pe scurt
Fuster et al. (2022): credite ipotecare din SUA; nerambursarea prezisă cu un logit tradițional și cu modele de învățare automată
întrebarea: cine cîștigă și cine pierde cînd creditorul trece la modelul mai precis?
Rezultatele
modelele flexibile prezic mai bine nerambursarea
debitorii de culoare și cei hispanici au mai puține șanse să cîștige din noua tehnologie
într-un model de echilibru, disparitatea dobînzilor între grupuri și în interiorul lor crește, mai ales din cauza flexibilității mai mari
Lecția: acuratețea și echitatea trebuie măsurate împreună; un AUC mai bun nu este un argument suficient
Sinteza secțiunii
Datele unei bănci conțin doar solicitanți acceptați. Pe datele din Taiwan, un model estimat pe solicitanții acceptați ordonează mai slab decît scorul vechi (AUC 0,736 față de 0,743) și subestimează riscul celor respinși cu aproximativ 36%; un mic eșantion aleator de solicitanți acceptați necondiționat este corecția cea mai fiabilă. Echitatea se măsoară pe decizii, prin paritatea demografică, egalitatea de șanse și calibrarea în fiecare grup, iar cînd ratele de nerambursare diferă, aceste criterii intră în conflict. Un model mai precis poate mări disparitățile. Secțiunea următoare trece de la nerambursarea persoanelor fizice la cea a companiilor.
Nerambursarea companiilor: Altman și Merton
Și companiile intră în nerambursare, iar pentru companiile listate există două surse de informație pe care scoringul persoanelor fizice nu le are: situațiile financiare publicate și prețurile de piață. Secțiunea prezintă cele două modele clasice construite pe ele, scorul Z al lui Altman, un scor discriminant din indicatori contabili, și distanța pînă la nerambursare a lui Merton, un model structural în care capitalurile proprii sînt o opțiune pe activele companiei. Ea se încheie cu un test empiric al modelului Merton.
Altman (1968) a studiat 66 de companii industriale americane: 33 care au intrat în faliment între 1946 și 1965 și 33 de companii pereche care au supraviețuit. El a aplicat analiza discriminantă a lui Fisher din secțiunea 5 la cinci indicatori contabili și a obținut scorul
\(X_1\) este capitalul de lucru raportat la activele totale (TA, total assets), o măsură a lichidității; \(X_2\) profitul reinvestit raportat la TA, profiturile acumulate de-a lungul vieții companiei; \(X_3\) profitul înainte de dobînzi și impozite (EBIT, earnings before interest and taxes) raportat la TA, profitabilitatea curentă a activelor; \(X_4\) valoarea de piață a capitalurilor proprii raportată la valoarea contabilă a datoriilor, rezerva pe care o asigură acționarii; iar \(X_5\) cifra de afaceri raportată la TA, rotația activelor.
Altman a împărțit scala în zone: sub 1,81, dificultate financiară; între 1,81 și 2,99, o zonă gri a companiilor incerte; peste 2,99, zona sigură. Cu un an înainte de faliment, aproximativ 95% din companiile din eșantion erau clasificate corect. Acuratețea scădea repede pentru orizonturi mai lungi: situațiile contabile dezvăluie mai degrabă dificultăți deja în curs decît dificultăți care urmează să vină.
Pe scurt
Altman (1968): 66 de companii industriale americane, 33 care au intrat în faliment în 1946–1965 și 33 de companii pereche care au supraviețuit
analiza discriminantă a lui Fisher pe cinci indicatori contabili
Considerăm o companie ipotetică cu \(X_1 = 0{,}15\),\(X_2 = 0{,}20\),\(X_3 = 0{,}08\),\(X_4 = 0{,}90\) și \(X_5 = 1{,}10\). Cei cinci termeni din (12.13) sînt \(1{,}2 \times 0{,}15 = 0{,}180\),\(1{,}4 \times 0{,}20 = 0{,}280\),\(3{,}3 \times 0{,}08 = 0{,}264\),\(0{,}6 \times 0{,}90 = 0{,}540\) și \(1{,}0 \times 1{,}10 = 1{,}100\), iar suma lor este \(Z = 2{,}364\): compania se află în zona gri.
Care indicator ar muta compania în zona sigură? Profitabilitatea are cea mai mare pondere. Un EBIT/TA de 0,27 în loc de 0,08 adaugă \(3{,}3 \times 0{,}19 \approx 0{,}63\) la scor și aduce \(Z\) la aproximativ 2,99, marginea zonei sigure. Aceeași creștere a scorului prin cifra de afaceri ar cere o creștere a lui \(X_5\) cu 0,63, mai mult de jumătate din valoarea actuală.
Modelul are limite clare. Ponderile lui au fost estimate pe 66 de companii industriale americane din 1946–1965; companiile din alte sectoare, din alte țări și din alte decenii au nevoie de un model reestimat. Z este un scor discriminant, nu o probabilitate; modelele ulterioare dau direct PD, cu un logit la Ohlson (1980) și cu modele de hazard (hazard models), care folosesc întreaga istorie a fiecărei companii, la Shumway (2001).
Pe scurt
O companie ipotetică: \(X_1 = 0{,}15\), \(X_2 = 0{,}20\), \(X_3 = 0{,}08\), \(X_4 = 0{,}90\), \(X_5 = 1{,}10\)
Merton (1974) privește compania prin bilanțul ei. Valoarea \(V_t\) a activelor companiei urmează o mișcare browniană geometrică (GBM, geometric Brownian motion), ca prețurile acțiunilor din Capitolul 4, cu rata de creștere (drift) \(\mu\) și volatilitatea \(\sigma_V\). Compania are o datorie cu valoarea nominală \(D\), scadentă la momentul \(T\). Dacă la scadență activele valorează mai puțin decît datoria, \(V_T < D\), compania intră în nerambursare, iar creditorii preiau activele; altfel, acționarii plătesc datoria și păstrează restul. Capitalurile proprii sînt deci o opțiune call pe active, cu prețul de exercitare \(D\).
Sub GBM, \(\ln V_T \sim N\big(\ln V_0 + (\mu - \sigma_V^2/2)T,\ \sigma_V^2T\big)\), deci probabilitatea de nerambursare este probabilitatea ca această variabilă cu distribuția Normală să scadă sub \(\ln D\):
Distanța pînă la nerambursare (DD, distance to default) este numărul de abateri standard cu care valoarea logaritmică așteptată a activelor la \(T\) depășește logaritmul datoriei. Ea combină îndatorarea (leverage), prin \(\ln(V_0/D)\), cu riscul, prin \(\sigma_V\): o companie poate fi sigură cu o îndatorare mare dacă activele ei sînt stabile și riscantă cu o îndatorare mică dacă ele sînt volatile.
Valoarea activelor \(V\) și volatilitatea lor \(\sigma_V\) nu sînt observate. Ele se obțin din ce se observă, valoarea de piață a capitalurilor proprii și volatilitatea prețului acțiunii, prin inversarea relațiilor de evaluare a opțiunilor, cum arată slide-ul următor.
Pe scurt
Merton (1974): valoarea \(V_t\) a activelor companiei urmează o GBM (mișcarea browniană geometrică, Capitolul 4) cu rata de creștere (drift) \(\mu\) și volatilitatea \(\sigma_V\)
datorie cu valoarea nominală \(D\) scadentă la \(T\); nerambursare dacă \(V_T < D\); capitalurile proprii sînt o opțiune call pe active
Luăm \(V_0 = 100\),\(D = 70\),\(\sigma_V = 25\%\),\(\mu = 5\%\) și \(T = 1\) an. Termenul de îndatorare este \(\ln(100/70) = 0{,}3567\), iar termenul de drift \(\mu - \sigma_V^2/2 = 0{,}05 - 0{,}03125 = 0{,}01875\), deci numărătorul din (12.14) este 0,3754, iar \(\mathrm{DD} = 0{,}3754/0{,}25 = 1{,}502\). PD este \(\Phi(-1{,}502) = 6{,}66\%\).
În practică, datele de intrare vin din piață. Să presupunem că valoarea capitalurilor proprii este \(E = 40\), volatilitatea lor este \(\sigma_E = 50\%\), datoria este 70, iar rata fără risc este \(r = 3\%\). Două ecuații leagă mărimile observate de cele neobservate: prețul Black–Scholes al capitalurilor proprii ca opțiune call, \(E = V\Phi(d_1) - De^{-rT}\Phi(d_2)\), și relația dintre cele două volatilități, \(\sigma_E E = \Phi(d_1)\sigma_V V\), unde \(d_1\) și \(d_2\) sînt termenii Black–Scholes din Capitolul 4, cu \(V\) în locul prețului acțiunii. Rezolvarea lor dă \(V = 107{,}9\) și \(\sigma_V = 18{,}6\%\). Cu rata fără risc ca drift, distanța pînă la nerambursare este atunci \(d_2 = 2{,}39\), iar PD este 0,84%.
Cele două părți ale exemplului măsoară același tip de companie în două moduri, iar a doua este cea folosită în practică. O PD obținută din piață reacționează zilnic la prețul acțiunii și la volatilitatea lui; un scor contabil precum Z se schimbă o dată pe an, cînd se publică noile situații financiare.
\(E\), \(\sigma_E\): valoarea și volatilitatea capitalurilor proprii; \(r\): rata fără risc; \(d_1\), \(d_2\): termenii Black–Scholes din Capitolul 4, cu \(V\) în locul prețului acțiunii
Interpretare: o PD din piață reacționează zilnic la prețuri; un scor contabil se schimbă o dată pe an
Întrebare pentru sală ▶ crește EBIT/TA de la 0. La ce valoare iese compania din zona gri (Z > 2,99)?
Răspuns
Peste 0,27 (exact 0,2697): ceilalți patru termeni dau 2,100, iar 3,3 X₃ trebuie să adauge 0,890. EBIT/TA are cea mai mare pondere, 3,3, deci profitabilitatea mișcă cel mai mult scorul Z.
Întrebare pentru sală ▶ crește σ_V. Cît este PD pe un an la σ_V = 40% (6,66% la 25%)?
Răspuns
20,7%: DD scade la (0,3567 + 0,05 − 0,08)/0,40 = 0,817. Volatilitatea intră de două ori: micșorează termenul de creștere și împarte distanța.
Întrebare pentru sală Aceleași 40 de traiectorii, σ_V = 40% în loc de 25%: cîte se termină sub datoria de 70?
Răspuns
8 din 40, față de 3 la 25% și niciuna la 15%; PD a modelului la D/V = 70% este 20,7%, 6,66% și 0,42%. Cu 40 de traiectorii, numărătorile sînt zgomotoase: 8/40 = 20%.
Panoul din stînga al graficului simulează 40 de traiectorii ale valorii activelor pe un an, cu \(V_0 = 100\),\(\mu = 5\%\) și \(\sigma_V = 25\%\), datele de intrare din prima parte a exemplului rezolvat. Traiectoriile roșii se termină sub datoria de 70: aceste companii intră în nerambursare la scadență. Ponderea lor în simulare este o imagine aproximativă a PD de 6,66% calculate din (12.14).
Panoul din dreapta reprezintă PD pe un an în funcție de gradul de îndatorare \(D/V\) pentru trei volatilități ale activelor. PD este aproape zero la îndatorare mică și crește abrupt între o îndatorare de 70% și una de 90%. Cu cît volatilitatea este mai mare, cu atît creșterea începe mai devreme: o companie cu active volatile devine riscantă la o îndatorare care ar fi inofensivă pentru o companie cu active stabile. Acesta este conținutul distanței pînă la nerambursare: îndatorarea raportată la volatilitate.
Pe scurt
Stînga: 40 de traiectorii simulate ale activelor (\(V_0 = 100\), \(\mu = 5\%\), \(\sigma_V = 25\%\)); roșu: traiectoriile care se termină sub datoria de 70
Dreapta: PD pe un an în funcție de gradul de îndatorare \(D/V\) pentru trei volatilități ale activelor
Interpretare: PD este aproape zero la îndatorare mică și crește abrupt între 70% și 90%; cu cît volatilitatea este mai mare, cu atît creșterea începe mai devreme
Bharath & Shumway (2008) au testat modelul Merton pe companii americane. Ei au comparat DD Merton, obținut prin rezolvarea ecuațiilor de evaluare a opțiunilor, cu un DD „naiv”, care are aceeași formă funcțională, dar înlocuiește soluția cu aproximări simple ale valorii activelor și ale volatilității lor. Ambele au fost folosite în modele de hazard ale nerambursării și în prognoze în afara eșantionului și comparate cu informația din spread-urile swap-urilor pe riscul de nerambursare (CDS, credit default swap) și din randamentele obligațiunilor.
DD naiv funcționează puțin mai bine decît DD Merton în afara eșantionului. Alte variabile, precum randamentele trecute ale acțiunilor companiei, adaugă informație oricăruia dintre cele două DD, deci distanța pînă la nerambursare nu este o statistică suficientă pentru probabilitatea de nerambursare. Ceea ce face DD util este forma lui funcțională, îndatorarea raportată la volatilitate, nu soluția modelului.
Lecția depășește modelul Merton: teoria dă o variabilă bună, iar statistica decide cum este folosită. Același lucru este valabil pentru scorul Z, ai cărui indicatori rămîn date de intrare utile mult după ce ponderile lui originale s-au învechit.
Pe scurt
Bharath & Shumway (2008): companii americane; DD Merton față de un DD „naiv”, cu aceeași formă funcțională, dar fără rezolvarea modelului
metoda: modele de hazard ale nerambursării și prognoze în afara eșantionului; comparație cu spread-urile CDS (credit default swap) și randamentele obligațiunilor
Rezultatele
DD naiv funcționează puțin mai bine decît DD Merton în afara eșantionului
alte variabile (de exemplu randamentele trecute) aduc informație: DD nu este o statistică suficientă pentru PD
forma sa funcțională (îndatorarea raportată la volatilitate) este ceea ce îl face util
Lecția: teoria dă o variabilă bună, statistica decide cum o folosim; la fel pentru scorul Z
Sinteza secțiunii
Scorul Z al lui Altman este discriminantul lui Fisher aplicat la cinci indicatori contabili: compania ipotetică din exemplu are scorul 2,364, în zona gri dintre 1,81 și 2,99. Modelul Merton tratează capitalurile proprii ca pe o opțiune call pe active și măsoară distanța pînă la nerambursare, îndatorarea raportată la volatilitatea activelor; compania din exemplu are DD = 1,502 și PD = 6,66%. Empiric, valoarea DD stă mai mult în forma lui funcțională decît în soluția modelului, iar PD obținute din piață se actualizează zilnic. Secțiunea următoare privește o întrebare de cercetare deschisă a capitolului.
AI pentru descoperire științifică
Ultima secțiune a fiecărui capitol ia o întrebare de cercetare deschisă din domeniul lui și arată cum pot instrumentele AI să accelereze un studiu al ei și ce verificări rămîn sarcina cercetătorului. Pentru scoringul de credit, întrebarea este dacă scorurile flexibile de învățare automată îmbunătățesc prognoza nerambursării suficient pentru a justifica ce costă ele ca transparență și echitate.
Întrebarea acestui capitol este: îmbunătățesc scorurile flexibile de învățare automată prognoza nerambursării suficient pentru a justifica costul lor în transparență și echitate? Rezultatele capitolului o încadrează. Logit-ul WoE și LDA ating pe datele germane un AUC de test din validarea încrucișată de aproximativ 0,764. Comparațiile de mari dimensiuni găsesc cîștiguri semnificative pentru ansamblurile de clasificatori (Lessmann et al., 2015); cîștigurile pot fi inegale între grupurile de debitori (Fuster et al., 2022); iar mașinile cu vectori suport (support vector machines) au fost aplicate prognozei nerambursării de Chen, Härdle & Moro (2011).
Întrebarea rămîne deschisă din două motive. Cîștigurile depind de setul de date, de măsura performanței și de populație, astfel încît un rezultat obținut pe un portofoliu nu se transferă la altul. Iar rezultatele solicitanților respinși nu se văd niciodată, deci fiecare comparație se face pe un eșantion selectat, problema din secțiunea 8.
Instrumentele AI pot accelera un astfel de studiu, de la căutarea literaturii pînă la prima versiune a codului, dar rezultatele lor trebuie verificate ca orice alt rezultat (Wang et al., 2023).
Pe scurt
Îmbunătățesc scorurile flexibile de învățare automată prognoza nerambursării suficient pentru a justifica pierderea de transparență și de echitate?
azi: logit-ul WoE și LDA ating un AUC de test de aproximativ 0,764; comparațiile găsesc cîștiguri semnificative pentru ansambluri Lessmann et al. (2015)
Trei părți ale studiului pot fi accelerate. Pentru literatură, un asistent AI poate întocmi o primă listă a studiilor comparative de scoring de credit și a studiilor despre echitatea creditării, împreună cu seturile de date pe care le folosesc; fiecare intrare trebuie apoi găsită și citită. Pentru cod, el poate scrie o primă versiune a unei comparații prin validare încrucișată a logit-ului WoE cu gradient boosting, un ansamblu de arbori de clasificare, pe datele din Taiwan. Pentru robustețe, el poate extinde comparația la alte praguri, la alte măsuri, precum scorul Brier și costul, și la AUC și calibrarea calculate separat pentru fiecare grup.
Exemplul de prompt de pe slide este specific în felul care contează pentru această întrebare. El cere validare încrucișată stratificată repetată în 5 părți, cere ca intervalele WoE să fie recalculate în interiorul fiecărei părți, ceea ce previne leakage, și cere scorul Brier și ratele de aprobare ale bărbaților și femeilor la o rată de aprobare fixă, astfel încît rezultatul să vorbească despre calibrare și echitate, nu doar despre ordonare.
Pe scurt
Literatura: o listă a comparațiilor de metode de scoring și a studiilor despre echitatea creditării, cu seturile lor de date
Cod: o primă versiune a unei comparații prin validare încrucișată a logit-ului WoE cu gradient boosting pe datele din Taiwan
Robustețe: alte praguri, alte măsuri (Brier, cost), AUC și calibrare pe grupuri
Exemplu de prompt
Write Python code that compares a WoE logistic regression with gradient boosting on the Taiwan credit card default data by repeated stratified 5-fold cross-validation, recomputing the WoE bins inside each fold, and reports AUC, Brier score and the approval rates of men and women at a 75 percent approval cut-off.
Verificările decurg din capcanele întîlnite în acest capitol. Codificarea rezultatului trebuie să fie nerambursare = 1; o codificare inversă schimbă semnul fiecărui coeficient și fiecare curbă fără niciun mesaj de eroare. Convenția de semn pentru WoE trebuie cunoscută: capitolul folosește \(\ln(\text{bun-platnici}/\text{rău-platnici})\), în timp ce unele surse folosesc \(\ln(\text{rău-platnici}/\text{bun-platnici})\), ceea ce inversează semnele coeficienților scorecard-ului.
Scurgerea de informație trebuie să lipsească: intervalele, WoE și selecția variabilelor trebuie calculate în interiorul fiecărei părți de estimare, niciodată pe toate datele. Măsurile trebuie să fie cele corecte: AUC nu este acuratețea, iar \(\mathrm{Gini} = 2\,\mathrm{AUC} - 1\), nu \(\mathrm{AUC} - 0{,}5\). PD estimate pe un set de date cu rău-platnici suprareprezentați au nevoie de corecția a priori din (12.7) înainte de a calcula din ele orice pierdere așteptată sau capital.
În sfîrșit, fiecare lucrare și fiecare set de date citat trebuie să existe și să spună ceea ce i se atribuie; un DOI care duce la lucrarea corectă este cea mai simplă verificare, iar asistenții AI sînt cunoscuți pentru faptul că inventează referințe plauzibile.
Pe scurt
Codificarea rezultatului: nerambursare \(= 1\); o codificare inversă schimbă fiecare semn și fiecare curbă
Convenția de semn pentru WoE: aici ln(bun/rău); unele surse folosesc ln(rău/bun)
Fără scurgere de informație: intervalele, WoE și selecția variabilelor în fiecare parte de estimare
AUC nu este acuratețea, iar Gini \(= 2\,\)AUC \(- 1\), nu AUC \(- 0{,}5\)
PD-urile estimate pe un set de date cu rău-platnici suprareprezentați cer corecția a priori înaintea oricărei cifre de EL sau capital
Referințele: fiecare lucrare și set de date citat trebuie să existe; verificați DOI-ul
Proiectul pune o versiune concretă a întrebării deschise: pe datele cardurilor de credit din Taiwan (Default of Credit Card Clients, 2009), publicate sub licența CC BY 4.0, cît adaugă gradient boosting la AUC față de logit-ul WoE și ce se întîmplă cu ratele de aprobare pe sexe și pe grupe de vîrstă?
Pașii urmează capitolul. Mai întîi se construiesc intervalele WoE și se calculează IV al fiecărei variabile, apoi se estimează un logit WoE și un model gradient boosting cu setările implicite. În al doilea rînd, cele două modele se compară prin validare încrucișată stratificată repetată, raportînd AUC cu intervale DeLong, scorul Brier și calibrarea. În al treilea rînd, se fixează un prag și se măsoară echitatea prin paritatea demografică și egalitatea de șanse pentru grupuri de sex și de vîrstă.
Livrabilul este scurt: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele, în special despre ce înseamnă pentru concluzii absența solicitanților respinși. Orice utilizare a instrumentelor AI se declară, împreună cu o listă a erorilor acestora care au fost găsite și corectate.
Pe scurt
Întrebarea: pe datele cardurilor din Taiwan, cît adaugă gradient boosting la AUC față de logit-ul WoE și ce se întîmplă cu ratele de aprobare pe sexe și vîrste?
echitatea la un prag: paritatea demografică și egalitatea de șanse pentru sexe și grupe de vîrstă
Livrabil: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele
Declarați orice utilizare a instrumentelor AI și enumerați erorile acestora pe care le-ați corectat
Sinteza secțiunii
Întrebarea deschisă este dacă scorurile de învățare automată îmbunătățesc logit-ul WoE suficient pentru a justifica costul lor în transparență și echitate; comparațiile arată că ele ordonează adesea mai bine, iar studiile pe creditele ipotecare arată că cîștigurile pot fi inegale. Instrumentele AI pot întocmi lista literaturii, codul și verificările de robustețe, în timp ce codificarea rezultatului, semnul WoE, leakage, definițiile măsurilor, corecția a priori și referințele rămîn de verificat de cercetător.
Rezumat
Rezumatul adună ideile și formulele capitolului și se încheie cu trei întrebări de autoevaluare.
Pierderea așteptată, \(\mathrm{EL} = \mathrm{PD} \times \mathrm{LGD} \times \mathrm{EAD}\), este un cost pe care banca îl include în dobîndă; capitalul IRB acoperă pierderea neașteptată, pierderea de peste EL într-un an prost care apare o dată la 1 000 de ani în modelul cu un factor. Ambele pornesc de la PD, pe care o estimează un model de scoring.
Weight of Evidence transformă fiecare interval al unei variabile într-o dovadă pe scala logaritmului șansei, iar Information Value ordonează variabilele. În modelul logit, \(e^{\beta}\) este un raport al șanselor; LDA a lui Fisher dă același logaritm liniar al șansei pentru variabile cu distribuția Normală și o matrice de covarianță comună, iar pe datele germane ordonează solicitanții la fel de bine. Un scorecard rescalează logaritmul șansei în puncte, Scor = Offset + Factor × ln(șansa bun:rău), aici cu 20 de puncte pentru fiecare dublare a șansei.
Validarea măsoară discriminarea (AUC, Gini, KS) și calibrarea (scorul Brier, diagrama de calibrare) în afara eșantionului, iar pragul se alege din costurile celor două erori, nu din acuratețe. Solicitanții respinși și grupurile protejate cer verificări explicite, pentru că niciun eșantion de test nu îi arată. Pentru companii, scorul Z al lui Altman și distanța pînă la nerambursare a lui Merton adaugă informație contabilă și de piață.
Pe scurt
EL \(=\) PD \(\times\) LGD \(\times\) EAD intră în preț; capitalul IRB acoperă pierderea neașteptată
WoE transformă fiecare variabilă într-o dovadă pe scala logaritmului șansei; IV ordonează variabilele
Logit: \(e^{\beta}\) este un raport al șanselor; LDA (Fisher) dă același logaritm liniar al șansei sub ipoteza de normalitate și ordonează la fel de bine aici
Un scorecard: Scorul \(=\) Offset \(+\) Factor \(\ln\)(șansa bun:rău), PDO \(= 20\) de puncte pentru o dublare
Validăm discriminarea (AUC, Gini, KS) și calibrarea (Brier, diagrama de calibrare) în afara eșantionului; alegem pragul din costuri
Solicitanții respinși și grupurile protejate cer verificări explicite; Altman și Merton adaugă informație contabilă și de piață
Tabelul adună formulele capitolului. Pierderea așteptată este (12.1); Weight of Evidence și Information Value sînt (12.4) și (12.5); modelul logit este (12.6); direcția lui Fisher este (12.8); corecția pentru suprareprezentare adaugă termenului liber constanta din (12.7); scorecard-ul este (12.9), cu Factor = PDO/ln 2.
Pentru validare, AUC este probabilitatea (12.11) ca un rău-platnic ales la întîmplare să aibă un scor de risc mai mare decît un bun-platnic ales la întîmplare, Gini este \(2\,\mathrm{AUC} - 1\), KS este cea mai mare distanță dintre distribuțiile scorurilor rău-platnicilor și ale bun-platnicilor, iar scorul Brier (12.12) este eroarea pătratică medie a PD. Pragul Bayes (12.10) respinge cînd PD depășește \(C_{FP}/(C_{FP} + C_{FN})\). Distanța pînă la nerambursare a lui Merton și PD corespunzătoare sînt date de (12.14).
Întrebare pentru sală: un model are o acuratețe de 70% pe eșantionul de test South German Credit. Este bun? Răspuns: nu neapărat. Regula „toți sînt bun-platnici” atinge deja 70%, pentru că 30% din credite sînt neperformante. Modelul trebuie judecat după AUC, după TPR și FPR la pragul ales și după costul erorilor lui.
Întrebare pentru sală: coeficientul unei variabile indicator într-un logit este 0,69. Ce înseamnă? Răspuns: pentru grupul codificat cu 1, șansa de nerambursare se înmulțește cu \(e^{0{,}69} \approx 2\) față de grupul de referință, celelalte variabile fiind fixe.
Întrebare pentru sală: schimbă corecția PD pentru suprareprezentare valoarea AUC? Răspuns: nu. Corecția deplasează toți logaritmii șansei cu aceeași constantă, deci ordonarea solicitanților și, odată cu ea, AUC nu se schimbă; se schimbă doar nivelul PD.
Capitolul 13 continuă cu învățarea automată: arbori de clasificare, ansambluri și rețele neuronale pentru același tip de problemă.
Pe scurt
Întrebare: un model are o acuratețe de 70% pe eșantionul de test South German Credit. Este bun?
Răspuns: nu neapărat: regula „toți sînt bun-platnici” atinge deja 70%; ne uităm la AUC, TPR, FPR și cost
Întrebare: coeficientul unei variabile indicator într-un logit este 0,69. Ce înseamnă?
Răspuns: șansa de nerambursare se înmulțește cu \(e^{0{,}69} \approx 2\) pentru grup, față de grupul de referință
Întrebare: schimbă corecția pentru suprareprezentare valoarea AUC?
Răspuns: nu: deplasează toți logaritmii șansei cu aceeași constantă, deci ordonarea nu se schimbă
Un scor de credit este un model de probabilitate pentru nerambursare, judecat după ordonare și după nivel. Capitolul l-a construit din variabile WoE și un model logit, l-a scalat în puncte, l-a validat în afara eșantionului și a verificat ce nu pot arăta datele: solicitanții respinși și echitatea între grupuri. Aceleași idei statistice se extind la companii prin indicatori contabili și prețuri de piață.
South German Credit (Grömping, 2019; UCI, doi:10.24432/C5QG88): 1000 de credite de consum din 1973–1975, 300 neperformante; împărțirea stratificată 700/300 (sămînța 2026). Cardurile de credit din Taiwan (Yeh și Lien, 2009; UCI, doi:10.24432/C55S3H): 30 000 de clienți, eșantion de test de 9000. Ambele seturi sînt salvate în data/credit. Browserul calculează din înregistrările South German Credit tabelele WoE, IV, modelele logit și LDA, scorecard-ul, matricile de confuzie, ROC, AUC, DeLong, Gini, CAP, KS, Brier și Hosmer–Lemeshow; din PD, rezultatul, sexul și vîrsta celor 9000 de clienți de test din Taiwan, calibrarea și echitatea. AUC din cele 100 de părți ale validării încrucișate, traiectoriile Merton (sămînța 2026) și experimentul de reject inference vin din codul din curs. Alte variabile, alte eșantioane, praguri, costuri, niveluri de încredere, ponderi de aprobare și acceptare (50, 60, 80 și 90%) sînt rulări suplimentare ale aceluiași cod.


 MVA Multivariate Statistical Analysis
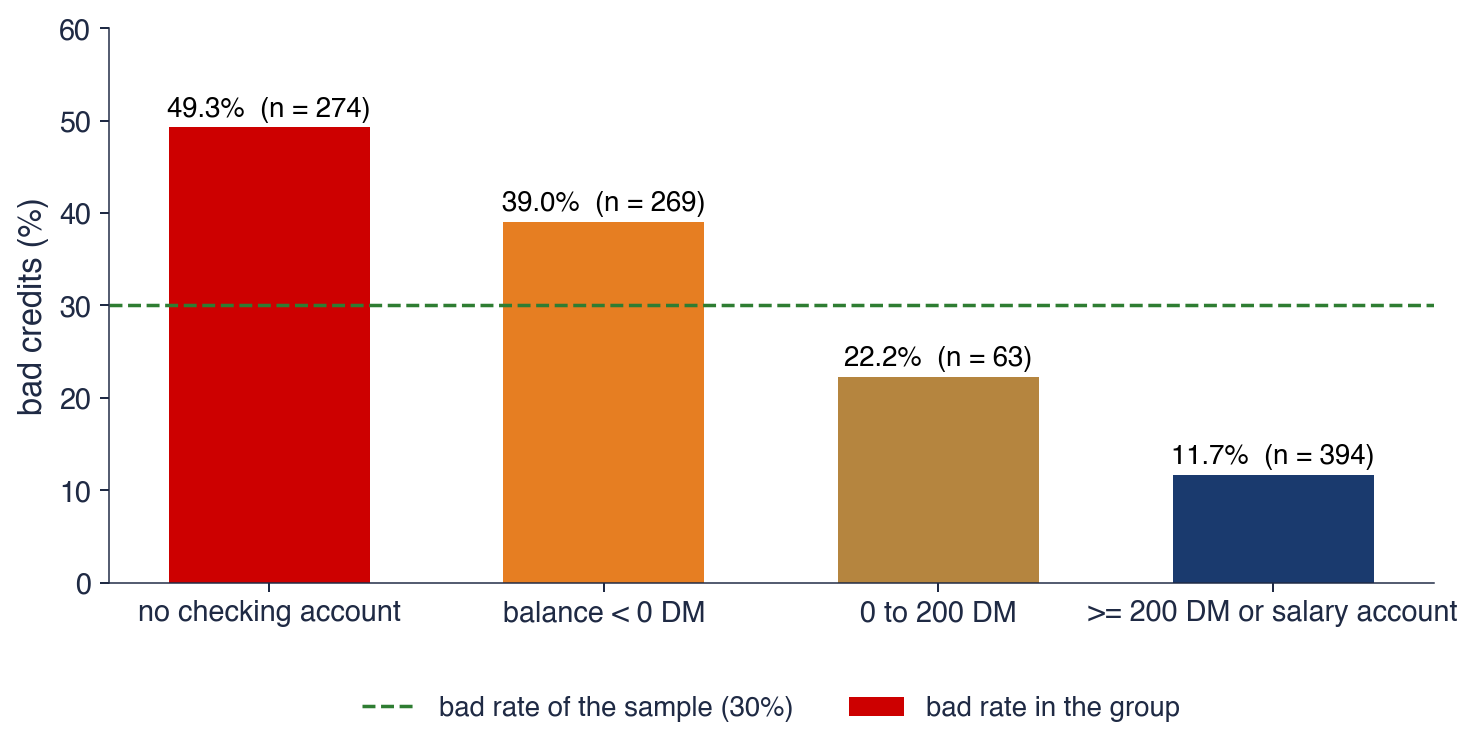
 SFM_ch12_validation_irb