Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Capitolul 2 a arătat că randamentele zilnice au cozi mai groase (heavy tails) decît distribuția Normală. Un model pentru randamentele zilnice nu este însă niciodată doar un model pentru o singură zi. Randamentele logaritmice se adună în timp, astfel că un randament logaritmic lunar este suma a circa 21 de randamente logaritmice zilnice, iar legea randamentului zilnic fixează legea oricărui orizont mai lung. Capitolul pune întrebarea: ce legi de probabilitate pot descrie randamentele zilnice și, în același timp, sumele lor săptămînale și lunare?
Răspunsul teoriei probabilităților este familia legilor stabile (stable laws). Ele sînt singurele legi ale căror sume își păstrează forma și, conform teoremei limită centrale generalizate (GCLT, generalised central limit theorem), singurele limite posibile ale sumelor normalizate de variabile independente și identic distribuite (i.i.d.). Mandelbrot (1963) le-a propus pentru prețurile bumbacului, cu un indice de stabilitate \(\alpha \approx 1{,}7\), ceea ce implică o varianță infinită. Capitolul dezvoltă teoria acestor legi, simularea și estimarea lor, apoi le estimează pe randamentele logaritmice zilnice a patru serii: indicele BET al Bursei de Valori București, S&P 500, DAX și Bitcoin.
Pe aceste serii, estimările de verosimilitate maximă (ML, maximum likelihood) ale lui \(\alpha\) se află între 1,410 și 1,606, departe de valoarea 2 a distribuției Normale, iar legea stabilă descrie centrul distribuției mult mai bine decît distribuția Normală. În cozile îndepărtate însă, ea prevede mult mai multe pierderi extreme decît s-au observat: pentru S&P 500, 19,1 zile cu o pierdere de peste 10% în 6 714 zile, față de o singură zi observată. Ultima parte a capitolului testează direct ipoteza varianței infinite și conchide că randamentele zilnice au cozi groase, dar varianță finită.
Randamentele logaritmice zilnice ale BET și S&P 500 (puncte, histogramă pe scară logaritmică) și trei legi estimate: Normală (roșu), Student-t (verde) și stabilă, estimată prin verosimilitate maximă (albastru); pe axa orizontală este randamentul logaritmic zilnic în %, pe cea verticală densitatea pe scară logaritmică.
Rezultatele învățării
Enunțați proprietatea de stabilitate și calculați scala unei sume de variabile stabile.
Explicați teorema limită centrală generalizată și situațiile în care sumele nu se apropie de distribuția Normală.
Interpretați cei patru parametri \((\alpha, \beta, \gamma, \delta)\) și faceți conversia între parametrizările S0 și S1.
Stabiliți ce momente există pentru un \(\alpha\) dat și comparați probabilitățile din cozi cu cele ale distribuției Normale.
Simulați variabile stabile și estimați parametrii lor prin cuantile și prin verosimilitate maximă.
Evaluați, pe randamentele BET, S&P 500, DAX și Bitcoin, unde funcționează modelul stabil și unde eșuează.
Planul capitolului
Mandelbrot și prețurile bumbaculuiOriginea istorică: prețurile bumbacului, ipoteza lui Mandelbrot, testele lui Fama și întrebarea despre legea unei sume.
Stabilitatea la adunareDefiniția legilor stabile, regula scalei \(c^\alpha = a^\alpha + b^\alpha\) și consecințele ei pentru orizonturi și diversificare.
RezumatFormulele capitolului și întrebări de autoevaluare.
Mandelbrot și prețurile bumbacului
Legile stabile au intrat în finanțe printr-o observație empirică, nu prin teorie. Secțiunea arată cum a ajuns Benoit Mandelbrot să le propună, cum a testat Eugene Fama propunerea pe randamentele acțiunilor și de ce întrebarea privește, de fapt, legea unei sume de randamente.
Bumbacul: o piață veche, cu serii lungi de prețuri
În secolul al XIX-lea, bumbacul era una dintre cele mai tranzacționate mărfuri din lume. Bursele din New Orleans, New York și Liverpool cotau prețuri în fiecare zi, iar aceste cotații au produs unele dintre cele mai lungi serii zilnice și lunare de prețuri din economie. Seriile lungi contează pentru studiul cozilor: variațiile extreme sînt rare prin definiție și doar o serie lungă conține destule pentru a spune cît de des apar.
La începutul anilor 1960, aceste serii au ajuns la Benoit Mandelbrot, pe atunci cercetător la IBM (International Business Machines). El nu a studiat nivelul prețului, ci variațiile logaritmului prețului, adică randamentele logaritmice din Capitolul 1. Lucrarea lui, Mandelbrot (1963), este punctul de plecare al studiului cozilor groase în finanțe: a întrebat ce lege de probabilitate descrie aceste variații și a dat un răspuns care se îndepărta de distribuția Normală folosită pînă atunci.
Tabloul de pe slide, Un birou de bumbac din New Orleans (1873) de Edgar Degas, înfățișează comerțul care a generat aceste serii.
Pe scurt
În secolul al XIX-lea, bumbacul era una dintre cele mai tranzacționate mărfuri din lume
bursele din New Orleans, New York și Liverpool cotau prețuri în fiecare zi
rezultatul: unele dintre cele mai lungi serii zilnice și lunare de prețuri din economie
La începutul anilor 1960, aceste serii au ajuns la Benoit Mandelbrot, pe atunci la IBM
el a studiat variațiile logaritmului prețului, adică randamentele logaritmice
Lucrarea lui, Mandelbrot (1963), a deschis studiul cozilor groase în finanțe
Prima observație a lui Mandelbrot a fost că seriile de bumbac conțineau mult mai multe variații mari decît permite distribuția Normală. Un simptom înrudit era că varianța de selecție (sample variance) nu se stabiliza pe măsură ce creștea eșantionul: fiecare nouă variație extremă o împingea din nou în sus, în loc să o lase să conveargă către o valoare fixă, cum s-ar întîmpla pentru o variabilă cu varianță finită.
A doua observație a fost că forma distribuției era aceeași la orice orizont. După rescalare, variațiile zilnice și cele lunare arătau la fel, ceea ce înseamnă că suma multor variații zilnice păstra forma unei singure variații zilnice. Pentru distribuția Normală, proprietatea este cunoscută, fiindcă o sumă de variabile Normale este tot Normală. Mandelbrot a văzut-o însă împreună cu cozi groase, pe care distribuția Normală nu le poate produce.
Propunerea lui a reunit cele două observații: variațiile de preț urmează legi stabile de tip Pareto (stable Paretian laws) cu un indice \(\alpha \approx 1{,}7\)(Mandelbrot, 1963). „De tip Pareto” se referă la cozi care scad ca o putere a lui \(x\), ca în legea veniturilor a lui Pareto. Consecința, discutată pe tot parcursul capitolului, este că varianța variațiilor de preț ar fi infinită.
Pe scurt
Prea multe variații mari: mult mai multe variații mari decît permite distribuția Normală
varianța de selecție nu se stabiliza pe măsură ce creștea eșantionul
Aceeași formă la orice orizont: variațiile zilnice și cele lunare arătau la fel după rescalare
o sumă de multe variații zilnice păstra forma unei singure variații zilnice
Propunerea lui: legi stabile de tip Pareto, cu \(\alpha \approx 1{,}7\)Mandelbrot (1963)
„de tip Pareto”: cozile scad ca o putere a lui \(x\), ca în legea veniturilor a lui Pareto
consecință: varianța variațiilor de preț ar fi infinită
Fama (1965) a mutat ipoteza de pe mărfuri pe acțiuni. El a studiat randamentele zilnice ale celor 30 de acțiuni din Dow Jones Industrial Average și a găsit, pentru fiecare acțiune, mai multe randamente mari decît prevede distribuția Normală. Estimările lui pentru indicele \(\alpha\) erau sub 2, ceea ce susținea ipoteza lui Mandelbrot.
Au urmat metode de estimare pentru legile stabile simetrice. Fama & Roll (1968) și Fama & Roll (1971) au construit estimatori bazați pe cuantilele de selecție, împreună cu tabelele necesare pentru a-i folosi. Aceste metode sînt precursoarele estimatorului prin cuantile al lui McCulloch, prezentat în secțiunea despre estimare.
În mai puțin de zece ani, dovezile au început să se întoarcă împotriva varianței infinite. Secțiunea de critică de la finalul capitolului revine la aceste studii și le repetă testele pe date actuale.
Pe scurt
Fama (1965): randamentele zilnice ale celor 30 de acțiuni din Dow Jones Industrial Average
mai multe randamente mari decît permite distribuția Normală, pentru fiecare acțiune
estimări ale lui \(\alpha\) sub 2: sprijin pentru ipoteza lui Mandelbrot
Au urmat metode de estimare pentru legile stabile simetrice
Un randament logaritmic lunar este suma a circa 21 de randamente logaritmice zilnice. Un model pentru randamentele zilnice implică deci un model pentru randamentele săptămînale, lunare și anuale, iar un model bun trebuie să rămînă coerent de la un orizont la altul. Distribuția Normală trece acest test, pentru că își păstrează forma la adunare (Capitolul 2), dar are cozi subțiri și nu surprinde variațiile zilnice mari.
Un candidat firesc cu cozi groase este distribuția Student-t. Întrebare pentru sală: este suma a 21 de variabile Student-t independente tot o variabilă Student-t? Răspunsul este nu. Familia Student-t nu este închisă la adunare, iar dacă varianța ei este finită, teorema limită centrală (CLT, central limit theorem) împinge suma către distribuția Normală. Un model Student-t pentru randamentele zilnice implică așadar un model aproximativ Normal pentru randamentele lunare.
Obiectivul secțiunilor următoare decurge din acest răspuns: identificarea tuturor legilor ale căror sume își păstrează forma. Acestea sînt legile stabile.
Pe scurt
Un randament logaritmic lunar este suma a circa 21 de randamente logaritmice zilnice
un model pentru randamentele zilnice implică un model pentru randamentele săptămînale, lunare și anuale
Distribuția Normală își păstrează forma la adunare (Capitolul 2)
dar are cozi subțiri: nu surprinde variațiile zilnice mari
Întrebare pentru sală: distribuția Student-t are cozi groase; este suma a 21 de variabile Student-t independente tot Student-t?
Răspuns
nu: familia Student-t nu este închisă la adunare
dacă varianța ei este finită, suma se apropie de distribuția Normală (teorema limită centrală)
Obiectivul: identificarea tuturor legilor ale căror sume își păstrează forma
Sinteza secțiunii
Cele două observații ale lui Mandelbrot, prea multe variații mari și aceeași formă la orice orizont, au condus la ipoteza legilor stabile de tip Pareto, cu \(\alpha \approx 1{,}7\) și varianță infinită. Studiul lui Fama pe acțiunile din Dow Jones a susținut-o, iar întrebarea pe care o ridică privește legea unei sume de randamente. Secțiunea următoare definește legile care își păstrează forma la adunare.
Stabilitatea la adunare
Secțiunea definește legile stabile prin comportamentul lor la adunare și deduce regula care dă scala unei sume. Regula depinde de un singur număr, indicele de stabilitate \(\alpha\), și are consecințe directe pentru riscul pe orizonturi lungi și pentru diversificare.
O variabilă aleatoare \(X\) este stabilă dacă, pentru două copii independente \(X_1, X_2\) ale lui \(X\) și orice ponderi \(a, b > 0\), există o scală \(c > 0\) și o deplasare \(d\) astfel încît
\[aX_1 + bX_2 \overset{d}{=} cX + d,\]
(3.1)
unde \(\overset{d}{=}\) înseamnă „are aceeași distribuție ca”. Altfel spus, o sumă ponderată a două copii are aceeași formă ca o copie; se schimbă doar scala \(c\) și poziția \(d\). Dacă \(d = 0\) pentru orice \(a\) și \(b\), legea este strict stabilă.
Prin inducție, proprietatea se extinde la \(n\) copii independente: \(X_1 + \dots + X_n \overset{d}{=} c_n X + d_n\). Factorul de scală nu poate fi oarecare. Singurul factor posibil este \(c_n = n^{1/\alpha}\), cu \(0 < \alpha \le 2\)(Nolan, 2020). Exponentul \(\alpha\) se numește indicele de stabilitate (index of stability), sau exponentul caracteristic, sau tail index, și indexează întreaga familie.
Limita superioară \(\alpha \le 2\) nu este o convenție. Pentru \(\alpha = 2\) factorul este \(\sqrt{n}\), regula cunoscută pentru sume de variabile cu varianță finită; nicio lege stabilă nu are un factor care să crească mai încet decît \(\sqrt{n}\).
Pe scurt
\(X\) este stabilă dacă, pentru \(X_1, X_2\) copii independente ale lui \(X\) și orice \(a, b > 0\), există \(c > 0\) și \(d\) astfel încît
\(aX_1 + bX_2 \overset{d}{=} cX + d\), unde \(\overset{d}{=}\) înseamnă „are aceeași distribuție ca”
\(a, b\): ponderile celor două copii; \(c\): scala și \(d\): deplasarea rezultatului
strict stabilă dacă \(d = 0\) pentru orice \(a, b\)
Altfel spus: o sumă ponderată a două copii are aceeași formă ca o copie
se schimbă doar scala (\(c\)) și poziția (\(d\))
Prin inducție, pentru \(n\) copii independente: \(X_1 + \dots + X_n \overset{d}{=} c_n X + d_n\)
singurul factor de scală posibil este \(c_n = n^{1/\alpha}\), cu \(0 < \alpha \le 2\)Nolan (2020)
\(\alpha\) se numește indicele de stabilitate (sau exponentul caracteristic, sau tail index)
Două exemple: distribuția Normală și distribuția Cauchy
Distribuția Normală este primul exemplu. Dacă \(X_1, X_2 \sim N(0, \sigma^2)\) sînt independente, atunci \(aX_1 + bX_2 \sim N(0, (a^2 + b^2)\sigma^2)\), care are forma lui \(X\) cu scala \(c = \sqrt{a^2 + b^2}\). Varianțele se adună, deci \(c^2 = a^2 + b^2\): acesta este cazul \(\alpha = 2\).
Al doilea exemplu este distribuția Cauchy, cu densitatea \(f(x) = 1/(\pi(1 + x^2))\). O sumă ponderată \(aX_1 + bX_2\) a două variabile Cauchy standard independente este Cauchy cu scala \(c = a + b\). Scalele se adună liniar, \(c^1 = a^1 + b^1\): acesta este cazul \(\alpha = 1\).
Cazul Cauchy are o consecință surprinzătoare. Luînd \(a = b = 1/n\) pentru \(n\) copii, media a \(n\) extrageri Cauchy este tot Cauchy standard: medierea nu reduce deloc dispersia. Legea numerelor mari nu se aplică, pentru că distribuția Cauchy nu are medie.
Cele două exemple sînt cazuri particulare ale unei singure reguli. Pentru copii independente \(X_1, X_2\) ale unei \(X\) strict stabile cu indicele \(\alpha\), scala sumei ponderate satisface
Exemplul lucrat ia \(a = 3\) și \(b = 4\). Pentru \(\alpha = 2\), scala sumei este \(c = \sqrt{9 + 16} = 5{,}00\); pentru \(\alpha = 1{,}5\) este \(c = (3^{1{,}5} + 4^{1{,}5})^{1/1{,}5} = 5{,}58\); pentru \(\alpha = 1\) este \(c = 3 + 4 = 7{,}00\). Cu cît \(\alpha\) este mai mic, cu atît scala sumei este mai mare. Cu cozi groase, un singur termen mare poate domina întreaga sumă, astfel că suma este mai largă decît indică regula distribuției Normale.
Ce credeți? Pentru \(\alpha = 1{,}5\), care este factorul de scală al sumei a două copii? Cu \(a = b = 1\) în (3.2) se obține \(c_2 = 2^{1/1{,}5} = 2^{2/3} = 1{,}59\), mai mare decît factorul \(\sqrt{2} \approx 1{,}41\) al distribuției Normale.
Pe scurt
Pentru \(X_1, X_2\) copii independente ale unei \(X\) strict stabile cu indicele \(\alpha\):
Întrebare pentru sală Pe slide, cu α = 1,5 scala sumei pe 20 de zile este 7,37γ, de 1,65 ori factorul √20 = 4,47. Butonul ▶ mută orizontul n pînă la 250 de zile. De cîte ori este scala pentru α = 1,5 mai mare decît cea dată de regula rădăcinii pătrate a timpului la n = 250?
Răspuns
De 2,51 ori: 2501/1,5 = 39,69, față de √250 = 15,81. Raportul este n1/α − 1/2 = 2501/6, deci crește cu orizontul. Cu α̂ = 1,540 estimat pentru S&P 500, raportul este 1,56 la 20 de zile și 2,28 la 250 de zile. Pentru un portofoliu cu ponderi egale din N = 10 active, scala scade la 0,46γ pentru α = 1,5, față de 0,32γ pentru distribuția Normală.
Întrebare pentru sală Pe slide, suma a 10 extrageri din S(1,7; 0; 1; 0) împărțită la √10 are cuantila de 99% egală cu 6,31, față de 5,04 pentru o singură extragere. Cît devine această cuantilă dacă adunăm 50 de extrageri și împărțim tot la √n?
Răspuns
Circa 7,27. Împărțită la 501/1,7 = 9,98, aceeași sumă are cuantila de 99% egală cu 5,15, adică legea unei singure extrageri. Regula √n subestimează scala sumei cu factorul n1/α − 1/2, care crește cu n: 100,088 = 1,23 și 500,088 = 1,41. Cu varianță infinită, mai mulți termeni nu aduc suma mai aproape de regula distribuției Normale.
Graficul verifică proprietatea de stabilitate prin simulare. El folosește notația din secțiunea despre parametri: \(S(\alpha; \beta; \gamma; \delta)\) este legea stabilă cu indicele \(\alpha\), asimetria \(\beta\), scala \(\gamma\) și poziția \(\delta\). Fiecare punct este o pereche de cuantile: pe axa orizontală, o cuantilă a unei singure extrageri din \(S(1{,}7; 0; 1; 0)\), pe axa verticală aceeași cuantilă a unei sume rescalate de 10 extrageri. Dacă cele două legi coincid, punctele se află pe prima bisectoare (45-degree line).
Punctele albastre împart suma celor 10 extrageri la \(10^{1/1{,}7} = 3{,}87\), factorul \(n^{1/\alpha}\) al stabilității. Ele se află pe prima bisectoare pe tot domeniul: suma rescalată are aceeași lege ca o singură extragere. Punctele roșii împart aceleași sume la \(\sqrt{10} = 3{,}16\), regula distribuției Normale. Împărțirea este prea slabă, astfel că sumei rescalate îi rămîn cozi prea largi: cuantila ei de 99% este 6,31, față de 5,04 pentru o singură extragere.
Lecția pentru randamente este că regula rădăcinii pătrate, folosită pentru a trece volatilitatea de la un orizont la altul, este o proprietate a cazului \(\alpha = 2\). Sub o lege stabilă cu \(\alpha < 2\), ea subestimează dispersia sumei.
Pe scurt
Notație (secțiunea 4): \(S(\alpha; \beta; \gamma; \delta)\) este legea stabilă cu indicele \(\alpha\), asimetria \(\beta\), scala \(\gamma\) și poziția \(\delta\)
Albastru: sumele a 10 extrageri din \(S(1{,}7; 0; 1; 0)\) împărțite la \(10^{1/1{,}7} = 3{,}87\) se află pe prima bisectoare: aceeași lege ca o singură extragere
Roșu: împărțirea la \(\sqrt{10} = 3{,}16\) (regula distribuției Normale) lasă cozile prea largi: cuantila de 99% este \(6{,}31\), față de \(5{,}04\)
Prima consecință privește orizontul. Dacă randamentele zilnice sînt i.i.d. \(S(\alpha; 0; \gamma; 0)\), suma pe 20 de zile are scala \(20^{1/\alpha}\gamma\). Pentru \(\alpha = 2\) aceasta este \(4{,}47\,\gamma\), regula rădăcinii pătrate a timpului (square-root-of-time rule); pentru \(\alpha = 1{,}7\) este \(5{,}83\,\gamma\); pentru \(\alpha = 1{,}5\) este \(7{,}37\,\gamma\). Cu \(\alpha < 2\), riscul pe orizonturi lungi crește mai repede decît \(\sqrt{n}\).
A doua consecință privește diversificarea. Un portofoliu cu ponderi egale din \(N\) active stabile i.i.d. este \(\frac{1}{N}(X_1 + \dots + X_N)\), cu scala \(N^{1/\alpha}\gamma/N = N^{1/\alpha - 1}\gamma\). Pentru \(N = 10\) active, \(\alpha = 2\) dă \(0{,}32\,\gamma\),\(\alpha = 1{,}5\) dă \(0{,}46\,\gamma\), iar \(\alpha = 1\) dă \(1{,}00\,\gamma\).
Cu \(\alpha = 1\), diversificarea nu reduce deloc scala: portofoliul este la fel de dispersat ca un singur activ. Fama (1965) a discutat această consecință a ipotezei stabile pentru alegerea portofoliului. Pentru \(1 < \alpha < 2\), diversificarea ajută în continuare, dar mai puțin decît sub distribuția Normală.
Pe scurt
Orizontul: dacă randamentele zilnice sînt i.i.d. (independente și identic distribuite) \(S(\alpha; 0; \gamma; 0)\), suma pe 20 de zile are scala \(20^{1/\alpha}\gamma\)
O lege stabilă este o lege ale cărei sume de copii independente își păstrează forma, fiind doar rescalate și deplasate. Scala unei sume ponderate urmează (3.2), iar suma a \(n\) copii are factorul \(n^{1/\alpha}\), cu \(0 < \alpha \le 2\). Distribuția Normală este cazul \(\alpha = 2\), iar distribuția Cauchy cazul \(\alpha = 1\).
Cu cît \(\alpha\) este mai mic, cu atît riscul crește mai repede cu orizontul și diversificarea ajută mai puțin. Ambele efecte contează pentru randamente numai dacă un \(\alpha < 2\) le descrie cu adevărat, lucru pe care ultimele secțiuni ale capitolului îl testează.
Pe scurt
Lege stabilă: o sumă de copii independente are aceeași formă, doar rescalată și deplasată
\(\alpha\) mic: riscul crește mai repede cu orizontul, iar diversificarea ajută mai puțin
Sinteza secțiunii
Stabilitatea la adunare impune o regulă cu un singur parametru pentru scale: \(c^\alpha = a^\alpha + b^\alpha\), respectiv \(n^{1/\alpha}\) pentru \(n\) copii. Simularea a confirmat că suma a 10 extrageri cu \(\alpha = 1{,}7\), împărțită la \(10^{1/1{,}7}\), are legea unei singure extrageri, în timp ce factorul Normal \(\sqrt{10}\) îi lasă cozi prea largi. Secțiunea următoare arată de ce aceste legi nu sînt doar comode, ci inevitabile ca limite ale sumelor.
Teorema limită centrală generalizată
Teorema limită centrală clasică explică de ce distribuția Normală apare oriunde se adună multe efecte mici și independente. Secțiunea enunță generalizarea ei, care acoperă și variabilele cu varianță infinită, și arată că o coadă a distribuției unui singur randament determină legea sumelor lungi.
în distribuție. Dacă varianța este infinită, enunțul nu mai are conținut: \(\sigma\) nu există, iar normalizarea cu \(\sqrt{n}\) are o rată greșită.
Teorema limită centrală generalizată (Gnedenko & Kolmogorov, 1954) răspunde la întrebare fără a presupune varianța finită. Dacă, pentru niște constante \(a_n > 0\) și \(b_n\) care rescalează și recentrează suma, suma normalizată \((X_1 + \dots + X_n - b_n)/a_n\) converge către o lege nedegenerată, atunci acea lege este stabilă. Pentru CLT clasică, constantele sînt \(a_n = \sigma\sqrt{n}\) și \(b_n = n\mu\).
Legile stabile sînt așadar singurele limite posibile ale sumelor normalizate de variabile i.i.d., iar distribuția Normală este cazul particular \(\alpha = 2\). Acesta este motivul de fond pentru studiul lor: orice model în care randamentele sînt sume ale multor șocuri independente conduce, la limită, la o lege stabilă.
Pe scurt
CLT clasică (teorema limită centrală, Capitolul 2): \(X_i\) i.i.d. cu media \(\mu\) și varianța finită \(\sigma^2\)
Ce se întîmplă dacă varianța este infinită? Normalizarea cu \(\sqrt{n}\) nu mai este potrivită
GCLT (teorema limită centrală generalizată) Gnedenko & Kolmogorov (1954): dacă \((X_1 + \dots + X_n - b_n)/a_n\) converge către o lege nedegenerată, acea lege este stabilă
\(a_n > 0\), \(b_n\): constante de normalizare care rescalează și recentrează suma (pentru CLT clasică, \(a_n = \sigma\sqrt{n}\), \(b_n = n\mu\))
legile stabile sînt singurele limite posibile ale sumelor normalizate de variabile i.i.d.
distribuția Normală este cazul particular \(\alpha = 2\)
Domeniul de atracție (domain of attraction) al unei legi stabile este mulțimea tuturor legilor ale căror sume normalizate converg către ea. Dacă varianța este finită, legea aparține domeniului de atracție al distribuției Normale, iar constanta de normalizare crește ca \(\sqrt{n}\). Dacă cozile urmează o lege de tip putere, \(P(|X| > x) \approx C x^{-\alpha}\), cu o constantă \(C > 0\) și \(0 < \alpha < 2\), legea aparține domeniului de atracție al legii stabile cu același \(\alpha\), iar \(a_n \propto n^{1/\alpha}\), unde \(\propto\) înseamnă „proporțional cu”.
Consecința este că o coadă a distribuției unui randament determină legea sumelor cu mulți termeni. Centrul distribuției nu contează la limită; contează doar viteza cu care valorile mari devin rare. O lege cu o coadă de tip putere de indice sub 2 conduce la o limită stabilă diferită de distribuția Normală, oricare ar fi forma ei în jurul lui zero.
Paul Lévy a caracterizat legile stabile în anii 1920, iar teoria completă a legilor limită pentru sume se găsește în Gnedenko & Kolmogorov (1954).
Pe scurt
Domeniul de atracție al unei legi stabile: toate legile ale căror sume normalizate converg către ea
varianță finită: domeniul de atracție al distribuției Normale, \(a_n \propto \sqrt{n}\)
cozi de tip putere \(P(|X| > x) \approx C x^{-\alpha}\) cu \(0 < \alpha < 2\): legea stabilă cu același \(\alpha\), \(a_n \propto n^{1/\alpha}\)
\(C > 0\): o constantă; \(\propto\): proporțional cu
Prin urmare, coada distribuției unui randament determină legea sumelor cu mulți termeni
Paul Lévy a caracterizat legile stabile în anii 1920; teoria completă se găsește în Gnedenko & Kolmogorov (1954)
Întrebare pentru sală La pragul 10, distribuția Normală cu același interval intercuartilic ca limita stabilă dă P(|·| > 10) = 0,0005%, față de 2,64% la limită. Ce probabilitate dă aceeași distribuție Normală la pragul 3?
Răspuns
17,2%, aproape de 19,2% pentru sumele cu n = 100 și de 21,7% pentru limita stabilă. Același interval intercuartilic face corpurile celor două legi asemănătoare; diferența apare departe în cozi: la pragul 10, 0,0005% față de 2,73% în simulare. Butonul ▶ arată cum raportul crește odată cu pragul.
Graficul ilustrează GCLT cu o lege care nu este stabilă: distribuția Student-t cu \(\nu = 1{,}5\) grade de libertate. Ea are varianță infinită și cozi proporționale cu \(x^{-1{,}5}\), deci aparține domeniului de atracție al legii stabile cu \(\alpha = 1{,}5\). Sumele a \(n\) extrageri sînt împărțite la \(n^{1/1{,}5}\), iar histogramele lor sînt desenate pe scară logaritmică, pentru \(n = 1\), 10 și 100.
Pe măsură ce \(n\) crește, histogramele se apropie de limita stabilă \(S(1{,}5; 0; 1{,}53; 0)\), linia continuă închisă la culoare. Converg și probabilitățile din cozi: probabilitatea ca suma normalizată să depășească 10 în valoare absolută este 2,73% pentru \(n = 100\) și 2,64% sub legea limită. Histograma pentru \(n = 1\) are un vîrf vizibil mai înalt decît limita, dar cozile ei au deja panta limitei.
Curba roșie punctată este o distribuție Normală cu același interval intercuartilic (interquartile range) ca limita. Probabilitatea ei pentru o valoare absolută de peste 10 este 0,0005%: pe scara logaritmică, ea coboară sub histograme cu mult înainte de capătul cozilor. O aproximare Normală, potrivită pe centru, nu surprinde deloc cozile.
Pe scurt
Student-t cu \(\nu = 1{,}5\) grade de libertate: varianță infinită, cozi \(\propto x^{-1{,}5}\); sumele a \(n\) extrageri împărțite la \(n^{1/1{,}5}\)
\(n = 1, 10, 100\): histogramele se apropie de limita stabilă \(S(1{,}5; 0; 1{,}53; 0)\); \(P(|\cdot| > 10)\): \(2{,}73\%\) pentru \(n = 100\), \(2{,}64\%\) la limită
O distribuție Normală cu același interval intercuartilic dă \(0{,}0005\%\): nu surprinde deloc cozile
GCLT împarte modelele posibile pentru randamentele zilnice în două lumi. Dacă tail index-ul randamentelor zilnice este sub 2, varianța este infinită, iar randamentele lunare sînt stabile cu același \(\alpha\) ca randamentele zilnice. Dacă tail index-ul este peste 2, varianța este finită, iar randamentele lunare se apropie de distribuția Normală.
Cele două lumi dau predicții diferite și testabile despre randamentele pe orizonturi mai lungi: în prima, \(\alpha\) estimat ar trebui să rămînă același pe măsură ce orizontul crește; în a doua, ar trebui să urce către 2. Întrebare pentru sală: căreia dintre cele două lumi îi aparțin randamentele S&P 500?
Răspunsul cere date. Secțiunea de critică estimează \(\alpha\) pe randamentele zilnice, săptămînale și lunare ale celor patru serii din capitol și compară cele două predicții.
Pe scurt
Două lumi posibile pentru randamentele zilnice
tail index sub 2 (varianță infinită): randamentele lunare sînt stabile cu același\(\alpha\)
tail index peste 2 (varianță finită): randamentele lunare se apropie de distribuția Normală
Cele două lumi conduc la predicții diferite și testabile despre randamentele pe orizonturi mai lungi
Întrebare pentru sală: căreia dintre cele două lumi îi aparțin randamentele S&P 500?
Răspuns
o testăm cu date reale în ultimele secțiuni: estimări ale lui \(\alpha\) la orizont zilnic, săptămînal și lunar
CLT clasică cere varianță finită, folosește normalizarea \(\sqrt{n}\) și dă o limită Normală. GCLT renunță la ipoteza despre varianță și arată că legile stabile sînt singurele limite posibile ale sumelor normalizate.
Legile cu cozi de tip putere de indice \(\alpha < 2\) cer normalizarea \(n^{1/\alpha}\), iar sumele lor converg către legea stabilă cu același \(\alpha\). Coada distribuției unui singur randament determină deci legea sumelor lungi.
GCLT: legile stabile sînt singurele limite ale sumelor normalizate
Cozi de tip putere cu indicele \(\alpha < 2\): normalizare \(n^{1/\alpha}\), limită stabilă cu același \(\alpha\)
Coada distribuției unui singur randament determină legea sumelor cu mulți termeni
Sinteza secțiunii
GCLT face din legile stabile limitele naturale ale sumelor de șocuri i.i.d., cu distribuția Normală ca singurul caz cu varianță finită. Limita care se aplică depinde doar de coada unui randament: un tail index sub 2 conduce la o limită stabilă cu același \(\alpha\), un tail index peste 2 la distribuția Normală. Cele două cazuri dau predicții testabile despre evoluția lui \(\hat\alpha\) cu orizontul, pe care secțiunea de critică le verifică. Pentru a lucra cu legile stabile este nevoie mai întîi de un mod de a le scrie, subiectul secțiunii următoare.
Parametrii și funcția caracteristică
Cu excepția a trei cazuri, legile stabile nu au densitate în formă închisă. Ele se definesc în schimb prin funcția caracteristică, care are o formă simplă și face vizibilă proprietatea de stabilitate. Secțiunea introduce cei patru parametri, cele două parametrizări folosite în practică și capcanele pe care acestea le creează în software.
Funcția caracteristică (characteristic function) a unei variabile aleatoare \(X\) este \(\varphi_X(t) = E[e^{itX}] = E[\cos(tX)] + i\,E[\sin(tX)]\), pentru \(t\) real, unde \(i = \sqrt{-1}\) este unitatea imaginară, iar \(t\) este un argument real, nu timpul. Ea există întotdeauna, pentru că \(|e^{itX}| = 1\), chiar și cînd \(X\) nu are niciun moment, și determină distribuția în mod unic. Ambele proprietăți o fac instrumentul natural pentru legile cu varianță infinită.
Capitolul folosește două proprietăți. Pentru \(X\) și \(Y\) independente, \(\varphi_{X+Y}(t) = \varphi_X(t)\,\varphi_Y(t)\): sumele de variabile independente devin produse de funcții caracteristice. Pentru constantele \(a\) și \(b\),\(\varphi_{aX+b}(t) = e^{ibt}\varphi_X(at)\), deci rescalarea și deplasarea au un efect simplu. Pentru distribuția Normală \(N(\mu, \sigma^2)\),\(\varphi(t) = \exp(i\mu t - \sigma^2 t^2/2)\).
Motivul pentru care se lucrează cu \(\varphi\) este practic: cu excepția a trei cazuri, legile stabile nu au densitate în formă închisă. Ele sînt definite prin funcția caracteristică, iar densitățile, funcțiile de repartiție și cuantilele se calculează numeric din ea.
Pe scurt
Funcția caracteristică a lui \(X\): \(\varphi_X(t) = E[e^{itX}] = E[\cos(tX)] + i\,E[\sin(tX)]\), \(t \in \mathbb{R}\)
\(i = \sqrt{-1}\): unitatea imaginară; \(t\): un argument real, nu timpul
există întotdeauna, pentru că \(|e^{itX}| = 1\), chiar și cînd nu există niciun moment
determină distribuția în mod unic
Două proprietăți folosite în capitol
\(X, Y\) independente: \(\varphi_{X+Y}(t) = \varphi_X(t)\,\varphi_Y(t)\): sumele devin produse
\(\varphi_{aX+b}(t) = e^{ibt}\varphi_X(at)\)
Normală \(N(\mu, \sigma^2)\): \(\varphi(t) = \exp(i\mu t - \sigma^2 t^2/2)\)
Utilitatea ei: cu excepția a trei cazuri, legile stabile nu au densitate în formă închisă; sînt definite prin \(\varphi\)
iar, pentru \(\alpha = 1\),\(\varphi(t) = \exp\{-\gamma |t| [1 + i\beta\,\frac{2}{\pi}\mathrm{sign}(t)\ln|t|] + i\delta t\}\). Aici \(\mathrm{sign}(t)\) este \(+1\) pentru \(t > 0\) și \(-1\) pentru \(t < 0\); termenul cu \(\beta\) este partea imaginară care face legea asimetrică.
Cei patru parametri au roluri distincte. Indicele de stabilitate \(\alpha \in (0, 2]\) controlează cozile: cu cît \(\alpha\) este mai mic, cu atît cozile sînt mai groase. Asimetria (skewness) \(\beta \in [-1, 1]\) controlează asimetria cozilor: \(\beta > 0\) dă o coadă dreaptă mai groasă, iar \(\beta < 0\) o coadă stîngă mai groasă. Scala (scale) \(\gamma > 0\) joacă rolul abaterii standard \(\sigma\), iar poziția (location) \(\delta\) este o deplasare reală.
Stabilitatea se citește direct din (3.3). Suma a \(n\) copii independente are funcția caracteristică \(\varphi(t)^n\), care are aceeași formă, cu \(\gamma^\alpha\) înlocuit de \(n\gamma^\alpha\) (și \(\delta\) de \(n\delta\)). Scala sumei este deci \(n^{1/\alpha}\gamma\), ca în secțiunea despre stabilitate.
Întrebare pentru sală De la α = 2 la α = 1,5, ce se schimbă mai mult: densitatea în x = 0 sau densitatea în x = 5?
Răspuns
Densitatea în x = 5. f(0) crește de la 0,2821 la 0,2874, cu 1,9%, iar f(5) crește de la 0,000545 la 0,00711, de 13 ori. Pe scara liniară curbele par apropiate; pe scara logaritmică se vede că α schimbă mai ales cozile. P(|X| > 5) este 0,041% pentru α = 2 și 4,14% pentru α = 1,5.
Graficul arată densități stabile simetrice \(S(\alpha; 0; 1; 0)\) pentru \(\alpha\) între 0,7 și 2, pe scară liniară (stînga) și pe scară logaritmică (dreapta). Pe scara liniară, un \(\alpha\) mai mic dă un vîrf mai înalt și mai îngust; masa luată din „umeri” se mută parțial spre centru și parțial spre cozi.
Scara logaritmică arată cozile, pe care scara liniară le ascunde. Densitatea Normală (\(\alpha = 2\), aici cu varianța 2) scade ca \(e^{-x^2/4}\), o parabolă cu ramurile în jos pe scara logaritmică. Toate celelalte curbe scad ca o putere a lui \(x\), ceea ce pe această scară arată ca o coborîre lentă, aproape plată. La \(|x| = 8\), densitatea Normală este deja cu cîteva ordine de mărime sub cele stabile.
Pe scurt
Legi simetrice \(S(\alpha; 0; 1; 0)\): \(\alpha\) mai mic dă un vîrf mai înalt și mai îngust și cozi mult mai groase
Scara logaritmică: coada distribuției Normale (\(\alpha = 2\)) scade ca \(e^{-x^2/4}\); celelalte scad ca o putere a lui \(x\)
Întrebare pentru sală Pentru α = 1,3 și β = 0,5, de cîte ori este mai probabilă o valoare peste 10 decît o valoare sub −10?
Răspuns
De circa 3 ori: raportul este 3,29 la pragul 10 și tinde la (1 + β)/(1 − β) = 1,5/0,5 = 3, din formula cozilor P(X > x) ∼ cα(1 + β)x−α și P(X < −x) ∼ cα(1 − β)x−α. La pragul 3 probabilitățile sînt 10,8% și 3,37%. Cu β = 1, coada stîngă scade mult mai repede decît x−α.
Panoul din stînga variază asimetria \(\beta\) pentru \(\alpha = 1{,}3\) și \(\gamma = 1\). Parametrul mută masa între cele două cozi: \(\beta = 1\) (verde) are coada dreaptă mai groasă, iar \(\beta = -1\) (roșu) coada stîngă mai groasă, în timp ce centrul densității se schimbă puțin. Pentru randamente, un \(\beta\) negativ este descrierea stabilă a riscului de crah: o coadă stîngă mai groasă decît cea dreaptă.
Panoul din dreapta variază scala \(\gamma\) pentru \(\alpha = 1{,}7\) și \(\beta = 0\). Scala întinde densitatea: dublarea lui \(\gamma\) dublează fiecare cuantilă în jurul lui \(\delta\) și înjumătățește înălțimea vîrfului. Din acest punct de vedere, \(\gamma\) se comportă ca o abatere standard, dar rămîne bine definită și cînd varianța este infinită.
Pe scurt
\(\beta\) redistribuie masa între cozi: \(\beta = 1\) (verde) are coada dreaptă mai groasă, \(\beta = -1\) (roșu) coada stîngă mai groasă
\(\gamma\) întinde densitatea: dublarea lui \(\gamma\) dublează fiecare cuantilă în jurul lui \(\delta\)
Între cele două parametrizări diferă doar poziția. Parametrii \(\alpha\),\(\beta\) și \(\gamma\) sînt aceiași în ambele, iar pozițiile \(\delta_0\) (în S0) și \(\delta_1\) (în S1) sînt legate prin
Fiecare parametrizare are rolul ei. S1 dă o algebră mai simplă pentru sume și este folosită în majoritatea cărților de teorie (Samorodnitsky & Taqqu, 1994). În S0, densitatea se schimbă continuu cu \(\alpha\) și \(\beta\), ceea ce o face mai potrivită pentru estimare și pentru grafice (Nolan, 2020).Slide-ul următor arată de ce continuitatea este proprietatea decisivă.
Pe scurt
S0 (recomandarea lui Nolan pentru analiza datelor), \(\alpha \ne 1\):
Întrebare pentru sală Butonul ▶ mută α de la 0,80 la 1,20, cu β = 0,8. Unde se află modul densității în parametrizarea S1 pentru α = 0,99?
Răspuns
La circa 50,5, departe în afara graficului. Deplasarea dintre cele două parametrizări este β tan(πα/2) = 0,8 × 63,66 = 50,93, iar modul în S0 este −0,38. La α = 1,01 tangenta își schimbă semnul și modul în S1 ajunge la circa −51. În S0 modul rămîne între −0,48 și −0,26 pe tot intervalul.
Graficul desenează patru legi cu \(\beta = 0{,}8\),\(\gamma = 1\) și poziția 0, pentru \(\alpha = 0{,}8\), 0,95, 1,05 și 1,2, întîi în S1 (stînga), apoi în S0 (dreapta). În S1, densitatea fuge spre \(+\infty\) cînd \(\alpha \uparrow 1\) și revine dinspre \(-\infty\) cînd \(\alpha \downarrow 1\). Cauza este termenul \(\tan\frac{\pi\alpha}{2}\) din (3.4), care tinde la infinit cînd \(\alpha\) se apropie de 1: o mică schimbare a lui \(\alpha\) mută întreaga lege departe pe axă.
În S0, aceleași patru legi sînt deplasate astfel încît modul rămîne lîngă 0 și se schimbă lin cu \(\alpha\). Pentru estimare, aceasta este proprietatea decisivă: un algoritm de optimizare care modifică puțin pe \(\alpha\) vede o densitate puțin diferită, nu o lege care a sărit de pe o parte pe alta a axei. De aceea S0 se folosește pentru estimare, iar S1 pentru algebră.
Pe scurt
S1 (stînga): cu \(\beta = 0{,}8\), densitatea se deplasează spre \(+\infty\) cînd \(\alpha \uparrow 1\) și revine dinspre \(-\infty\) cînd \(\alpha \downarrow 1\), pentru că \(\tan\frac{\pi\alpha}{2}\) tinde la infinit
S0 (dreapta): aceleași patru legi, deplasate; modul rămîne lîngă 0 și se schimbă lin
Parametrizarea este o sursă frecventă de erori în software. Funcția scipy.stats.levy_stable folosește implicit S1; trece la S0 cu levy_stable.parameterization = 'S0', iar argumentele ei sînt levy_stable.pdf(x, alpha, beta, loc=delta, scale=gamma). Lucrările și programele raportează \(\delta\) în S0, în S1 sau în alte parametrizări, așa că parametrizarea trebuie verificată înainte de a compara rezultatele.
A doua capcană privește scala. Legea stabilă cu \(\alpha = 2\),\(S(2; 0; \gamma; \delta)\), este \(N(\delta, 2\gamma^2)\), nu \(N(\delta, \gamma^2)\). Pentru distribuția Normală, așadar, \(\gamma = \sigma/\sqrt{2}\), iar un \(\hat\gamma\) stabil nu se poate compara direct cu o abatere standard de selecție.
În acest curs, estimările sînt raportate în S0, iar \(\delta_1\) este raportat separat, astfel încît rezultatele să poată fi comparate cu programele care folosesc S1.
Trei legi stabile au densitate în formă închisă. Distribuția Normală este cazul \(\alpha = 2\), în care \(\beta\) nu are niciun rol: \(\varphi(t) = \exp(-\gamma^2 t^2 + i\delta t)\), adică \(N(\delta, 2\gamma^2)\). Distribuția Cauchy este cazul \(\alpha = 1\),\(\beta = 0\), cu densitatea \(f(x) = \gamma/(\pi(\gamma^2 + (x - \delta)^2))\) și \(\varphi(t) = \exp(-\gamma|t| + i\delta t)\).
Distribuția Lévy este cazul \(\alpha = 1/2\),\(\beta = 1\) (în S1), complet asimetrică la dreapta. Densitatea ei este
Ea are o interpretare probabilistă: momentul în care o mișcare browniană atinge prima dată un nivel dat are o lege Lévy.
Toate celelalte densități stabile se calculează numeric din \(\varphi\), fie prin integrare directă (Nolan, 1997), fie cu transformata Fourier rapidă (Mittnik, Doganoglu & Chenyao, 1999).
Pe scurt
Distribuția Normală: \(\alpha = 2\) (\(\beta\) nu are niciun rol)
\(\varphi(t) = \exp(-\gamma^2 t^2 + i\delta t)\), adică \(N(\delta, 2\gamma^2)\)
Întrebare pentru sală Pe slide, α = 1,5 și β = 0,3 dau δ0 − δ1 = −0,3. Butonul ▶ crește α de la 1,1 la 1,9, cu β = 0,3. Pentru care valoare este diferența dintre cele două locații mai mare în valoare absolută: α = 1,1 sau α = 1,9?
Răspuns
Pentru α = 1,1: β tan(πα/2) = 0,3 × (−6,314) = −1,894, față de 0,3 × (−0,158) = −0,048 pentru α = 1,9. Tangenta tinde la infinit cînd α se apropie de 1, de aceea parametrizarea S1 deplasează densitatea foarte mult în jurul lui α = 1, iar S0 nu. Modulul |φ(t)| = e−|t|α este același în ambele parametrizări; diferă doar argumentul, printr-un termen liniar în t.
Întrebare pentru sală Pentru pragul x = 20, care dintre cele trei legi are cea mai mare probabilitate P(X > x)?
Răspuns
Legea Lévy: 17,7%, față de 1,59% pentru Cauchy și circa 3 × 10−87% pentru distribuția Normală. Coada Lévy scade ca x−1/2 (α = 1/2), coada Cauchy ca x−1. Pentru x = 3 probabilitățile sînt 43,6% (Lévy), 10,2% (Cauchy) și 0,13% (distribuția Normală).
Graficul compară cele trei legi cu formă închisă: distribuția Normală cu varianța 1 (\(\alpha = 2\),\(\gamma = 1/\sqrt{2}\)), distribuția Cauchy cu \(\gamma = 1\) și distribuția Lévy cu \(\gamma = 1\) în S1. Densitatea Cauchy are un vîrf mai jos decît densitatea Normală și cozi mult mai groase: dincolo de \(|x| \approx 2\), curba ei rămîne clar deasupra celei Normale.
Densitatea Lévy ia doar valori pozitive. Ea urcă abrupt imediat după zero și apoi scade lent, cu o coadă dreaptă lungă. Pentru că indicele ei este \(\alpha = 1/2\), sub 1, media ei este infinită, după cum explică secțiunea despre cozi.
Pe scurt
Cauchy: vîrf mai jos, cozi mult mai groase decît distribuția Normală cu varianța 1
Lévy: doar valori pozitive, o coadă dreaptă lungă; media ei este infinită
Exemplul lucrat compară S1 și S0 într-un singur punct, \(t = 1\), pentru \(X\) cu \(\alpha = 1{,}5\),\(\beta = 0{,}3\),\(\gamma = 1\) și \(\delta = 0\). O valoare utilă este \(\tan\frac{3\pi}{4} = -1\). În S1, (3.3) dă \(\ln\varphi(1) = -1\cdot[1 - i \cdot 0{,}3 \cdot (-1)] = -1 - 0{,}3i\), deci \(\varphi(1) = e^{-1}(\cos 0{,}3 - i \sin 0{,}3) = 0{,}351 - 0{,}109i\), cu modulul \(|\varphi(1)| = e^{-1} = 0{,}368\).
În S0, factorul \(|t|^{1-\alpha} - 1\) este zero în \(t = 1\), deci partea imaginară dispare și \(\varphi(1) = e^{-1} = 0{,}368\), un număr real. Cele două funcții caracteristice au același modul. Așa acționează o deplasare pură: din \(\varphi_{X+b}(t) = e^{ibt}\varphi_X(t)\), o deplasare înmulțește \(\varphi\) cu un număr complex de modul 1 și lasă modulul neschimbat.
Mărimea deplasării rezultă din (3.4):\(\beta\gamma\tan\frac{\pi\alpha}{2} = 0{,}3 \cdot 1 \cdot (-1) = -0{,}3\). Legea S1 cu \(\delta_1 = 0\) este deci legea S0 cu \(\delta_0 = -0{,}3\).
Pe scurt
\(X\) cu \(\alpha = 1{,}5\), \(\beta = 0{,}3\), \(\gamma = 1\), \(\delta = 0\); observați că \(\tan\frac{3\pi}{4} = -1\)
Legile stabile se definesc prin funcția lor caracteristică (3.3), iar densitățile lor se calculează numeric. Cei patru parametri au roluri separate: \(\alpha\) cozile, \(\beta\) asimetria, \(\gamma\) scala și \(\delta\) poziția.
Parametrizările S0 și S1 diferă doar prin \(\delta\), conform (3.4), iar scipy folosește implicit S1. Formele închise sînt distribuția Normală (\(\alpha = 2\), varianța \(2\gamma^2\)), distribuția Cauchy și distribuția Lévy.
Pe scurt
Legile stabile se definesc prin \(\varphi(t)\); densitatea se calculează numeric
S0 și S1: diferă doar \(\delta\), \(\delta_0 = \delta_1 + \beta\gamma\tan\frac{\pi\alpha}{2}\); scipy folosește implicit S1
Forme închise: Normală (\(\alpha = 2\), varianța \(2\gamma^2\)), Cauchy, Lévy
Sinteza secțiunii
Funcția caracteristică transformă proprietatea de stabilitate într-un enunț despre un singur parametru, \(\gamma^\alpha\), care crește liniar cu numărul de termeni. Cei patru parametri separă cozile, asimetria, scala și poziția, iar alegerea între S0 și S1 afectează doar poziția, dar într-un mod care devine instabil în S1 în apropiere de \(\alpha = 1\).Secțiunea următoare studiază ce implică \(\alpha\) pentru cozi și pentru existența momentelor.
Cozi și momente
Indicele \(\alpha\) fixează viteza cu care scad cozile unei legi stabile și, prin cozi, ce momente există. Secțiunea deduce cozile de tip putere, condiția \(p < \alpha\) pentru momente și consecințele lor pentru măsurarea riscului.
cu \(c_\alpha = \Gamma(\alpha)\sin(\pi\alpha/2)/\pi\), unde \(\Gamma\) este funcția gamma, iar \(f \sim g\) înseamnă \(f/g \to 1\). Asimetria \(\beta\) intră doar prin constante: ea schimbă cîtă masă poartă fiecare coadă, nu cît de repede scade aceasta.
Pe axe log-log, o coadă de tip putere este o dreaptă cu panta \(-\alpha\). Dublarea pragului împarte probabilitatea din coadă la \(2^\alpha\): pentru \(\alpha = 1{,}7\), probabilitatea se înmulțește cu 0,31. Coada distribuției Normale se comportă altfel: scade ca \(e^{-x^2/(4\gamma^2)}\), iar dublarea pragului o face practic nulă.
Cînd \(\beta = \pm 1\) și \(\alpha < 1\), una dintre cozi lipsește cu totul: suportul legii este o semidreaptă. Distribuția Lévy din secțiunea anterioară este un exemplu.
Pe scurt
Pentru \(\alpha < 2\), cînd \(x \to \infty\)Nolan (2020):
Întrebare pentru sală Pentru α = 1,9, P(X > 10) = 0,064%. Cît este P(X > 20)?
Răspuns
0,0165%: dublarea pragului împarte probabilitatea la circa 21,9 = 3,7 (raportul exact este 0,256, legea de tip putere dă 2−1,9 = 0,268). Cu α aproape de 2 coada rămîne de tip putere, departe de distribuția Normală, pentru care P(X > 10) este de ordinul 10−12.
Graficul reprezintă probabilitatea din coadă \(P(X > x)\) pentru legi simetrice \(S(\alpha; 0; 1; 0)\) pe axe log-log, pentru \(\alpha = 2\); 1,9; 1,7 și 1,5. Liniile continue sînt probabilitățile exacte, iar liniile punctate legile de tip putere \(c_\alpha x^{-\alpha}\) din (3.5). Pentru \(\alpha = 1{,}7\) și 1,5, liniile continue își ating asimptotele punctate deja în jurul lui \(x = 5\); pentru \(\alpha = 1{,}9\), abia mai departe. Curba Normală se îndoaie în jos și iese din grafic înainte de \(x = 10\).
Valorile arată mărimea diferenței. Probabilitatea de a depăși 10 este 0,279% pentru \(\alpha = 1{,}7\), 0,667% pentru \(\alpha = 1{,}5\) și circa \(8\times 10^{-11}\%\) pentru distribuția Normală cu același \(\gamma\). O variație de zece unități de scală este un eveniment rar, dar regulat, sub o lege stabilă cu \(\alpha = 1{,}7\) și practic imposibil sub distribuția Normală.
Pe scurt
Linie continuă: \(P(X > x)\) pentru \(S(\alpha; 0; 1; 0)\); linie punctată: legea de tip putere \(c_\alpha x^{-\alpha}\), atinsă deja în jurul lui \(x = 5\)
\(P(X > 10)\): \(0{,}279\%\) pentru \(\alpha = 1{,}7\), \(0{,}667\%\) pentru \(\alpha = 1{,}5\), circa \(8\times 10^{-11}\%\) pentru distribuția Normală
Pentru \(0 < \alpha < 2\), momentul absolut de ordin \(p > 0\),\(E|X|^p\), este finit dacă și numai dacă
\[p < \alpha.\]
(3.6)
Cazul \(p = 1\) corespunde mediei, iar \(p = 2\) varianței. Motivul este coada: densitatea unei legi stabile scade ca \(|x|^{-\alpha-1}\), iar \(|x|^p\) înmulțit cu o astfel de densitate este integrabil la infinit doar dacă \(p < \alpha\).
Consecințele rezultă din compararea lui \(\alpha\) cu 1 și cu 2. Pentru \(\alpha < 2\), varianța este infinită, iar asimetria și boltirea (coeficienții de skewness și kurtosis) nu sînt definite. Pentru \(1 < \alpha < 2\), media există și, în S1, este egală cu \(\delta_1\). Pentru \(\alpha \le 1\), nici media nu există; legile Cauchy și Lévy sînt exemple. Pentru \(\alpha = 2\), cazul Normal, toate momentele există.
Ce credeți? Mandelbrot a găsit \(\alpha \approx 1{,}7\) pentru bumbac. Există media variației zilnice? Da, pentru că \(1 < 1{,}7\). Varianța însă nu există, pentru că \(2 > 1{,}7\).
Pe scurt
Pentru \(0 < \alpha < 2\): \(E|X|^p < \infty\) dacă și numai dacă \(p < \alpha\)
\(E|X|^p\): momentul absolut de ordin \(p > 0\); \(p = 1\) corespunde mediei, \(p = 2\) varianței
motivul: \(|x|^p\) înmulțit cu o densitate de ordinul \(|x|^{-\alpha-1}\) este integrabil doar dacă \(p < \alpha\)
Consecințe
\(\alpha < 2\): varianță infinită; asimetria și boltirea nu sînt definite
\(1 < \alpha < 2\): media există; în S1 este egală cu \(\delta_1\)
\(\alpha \le 1\): nici media nu există (Cauchy, Lévy)
\(\alpha = 2\): toate momentele există
Ce credeți? Mandelbrot a găsit \(\alpha \approx 1{,}7\) pentru bumbac. Există media variației zilnice?
Răspuns
da, pentru că \(1 < 1{,}7\); dar varianța nu există, pentru că \(2 > 1{,}7\)
P(|X| > k): distribuția Normală N(0, 2) și legea stabilă S(α; 0; 1; 0)
Întrebare pentru sală Pe slide, pentru α = 1,7 și k = 10, P(|X| > k) este 0,56%. Cît dă legea de tip putere 2cαk−α, cu c1,7 = 0,1313?
Răspuns
0,52%, adică 94% din valoarea exactă. La k = 20 aproximarea dă 0,161% față de 0,166% exact (97%), iar la k = 2 doar 8,1% față de 18,6%: formula cozii este asimptotică și devine precisă departe în coadă. Raportul față de distribuția Normală N(0, 2) este 1,2 la k = 2 și 3,6 × 10⁹ la k = 10.
Întrebare pentru sală Butonul ▶ trece α de la 1,1 la 2. Pentru α = 1,9, ajung cele trei varianțe de selecție lîngă 2 după 20 000 de extrageri, ca în cazul distribuției Normale?
Răspuns
Nu: 3,16, 2,62 și 4,12, față de 1,96 pentru distribuția Normală. Pentru orice α < 2 varianța este infinită și fiecare extragere mare produce un salt. Cu α = 1,95 valorile finale sînt 2,46, 2,22 și 2,83; numai α = 2 dă 2,00, 1,97 și 1,99. Cu α = 1,7 (slide-ul): 10,4, 6,6 și 20,2.
Graficul arată cum arată o varianță infinită într-un eșantion. El reprezintă varianța de selecție în funcție de mărimea eșantionului, ambele pe scară logaritmică, pentru un eșantion Normal (albastru), din legea \(S(2; 0; 1; 0)\) cu varianța adevărată 2, și pentru trei eșantioane independente dintr-o lege stabilă cu \(\alpha = 1{,}7\).
Varianța de selecție a eșantionului Normal converge la valoarea adevărată 2 și rămîne acolo. Traiectoriile stabile se comportă altfel: fiecare extragere mare produce un salt al varianței, după care aceasta scade lent pînă la următoarea extragere mare. După 20 000 de extrageri, cele trei traiectorii stabile ajung la 10,4, 6,6 și 20,2, fără niciun semn de convergență; un eșantion mai lung ar adăuga doar noi salturi.
Este fenomenul observat de Mandelbrot în prețurile bumbacului. Varianța de selecție a unui eșantion stabil este un număr care se poate calcula întotdeauna, dar care nu estimează nicio mărime a populației.
Pe scurt
Distribuția Normală (albastru): varianța de selecție converge la valoarea adevărată 2
Stabilă \(\alpha = 1{,}7\): fiecare extragere mare produce un salt al varianței; după 20 000 de extrageri, cele trei traiectorii ajung la \(10{,}4\), \(6{,}6\), \(20{,}2\)
Același fenomen l-a observat Mandelbrot în prețurile bumbacului
Tabelul compară probabilitățile \(P(|X| > k)\) sub o lege stabilă cu \(\alpha = 1{,}7\) și sub distribuția Normală, ambele cu \(\beta = 0\),\(\gamma = 1\) și \(\delta = 0\); legea Normală este deci \(N(0, 2)\). Pentru \(k = 2\), probabilitățile sînt apropiate: 15,73% pentru legea Normală și 18,59% pentru cea stabilă, un raport de 1,2. Pentru \(k = 3\), ele sînt 3,39% și 7,25%, un raport de 2,1.
Mai departe în cozi, diferența se adîncește. Pentru \(k = 5\), probabilitatea Normală este 0,041%, iar cea stabilă 2,13%, un raport de 52,4. Pentru \(k = 10\), probabilitatea Normală este \(1{,}5\times 10^{-10}\%\), iar cea stabilă 0,56%, un raport de \(3{,}6\times 10^{9}\).
În jurul centrului, cele două legi sînt aproape interschimbabile; departe în cozi, ele diferă prin ordine de mărime. Un model de risc se evaluează în cozi, unde alegerea legii contează cel mai mult, iar o potrivire bună în centru spune puțin despre ele.
Pe scurt
\(k\)
\(P(|X| > k)\), Normală %
\(P(|X| > k)\), \(\alpha = 1{,}7\) %
raport
\(2\)
\(15{,}73\)
\(18{,}59\)
\(1{,}2\)
\(3\)
\(3{,}39\)
\(7{,}25\)
\(2{,}1\)
\(5\)
\(0{,}041\)
\(2{,}13\)
\(52{,}4\)
\(10\)
\(1{,}5\times 10^{-10}\)
\(0{,}56\)
\(3{,}6\times 10^{9}\)
Ambele legi au \(\beta = 0\), \(\gamma = 1\), \(\delta = 0\); legea Normală este deci \(N(0, 2)\)
În jurul centrului, cele două legi sînt apropiate; departe în cozi, diferă prin ordine de mărime
Un model de risc se evaluează în cozi, unde alegerea legii contează cel mai mult
Mai multe instrumente din capitolele anterioare au nevoie de varianță finită: volatilitatea, raportul Sharpe și eroarea lui standard (Capitolul 1), portofoliile medie–varianță și intervalele de încredere obținute din CLT. Cu \(\alpha < 2\), aceste mărimi se pot calcula pe orice eșantion, dar nu estimează nimic, cum a arătat graficul anterior pentru varianță.
Alte instrumente rămîn valabile. Cuantilele există întotdeauna, deci valoarea la risc (VaR, value at risk) este bine definită: \(\mathrm{VaR}_{1\%} = -q_{1\%}\), negativul cuantilei de 1% a randamentelor, este pierderea depășită cu probabilitatea 1%. Pierderea așteptată în coadă (ES, expected shortfall) la 2,5%, \(\mathrm{ES}_{2{,}5\%}\), adică pierderea medie dincolo de VaR, cere o medie finită și există deci doar dacă \(\alpha > 1\). Scala \(\gamma\) și intervalul intercuartilic înlocuiesc abaterea standard ca măsuri ale dispersiei.
Cozile stabile scad ca \(P(|X| > x) \propto x^{-\alpha}\), o dreaptă pe axe log-log. Momentul absolut de ordin \(p\) este finit dacă și numai dacă \(p < \alpha\), deci \(\alpha < 2\) înseamnă varianță infinită.
Varianța de selecție a unui eșantion stabil sare la fiecare extragere mare și nu se stabilizează. Cuantilele, VaR și scala \(\gamma\) își păstrează sensul.
Pe scurt
Cozi: \(P(|X| > x) \propto x^{-\alpha}\); o dreaptă pe axe log-log
Momente: \(E|X|^p < \infty\) dacă și numai dacă \(p < \alpha\); \(\alpha < 2\) înseamnă varianță infinită
Varianța de selecție a unui eșantion stabil are salturi și nu se stabilizează
Cuantilele, VaR și scala \(\gamma\) își păstrează sensul
Sinteza secțiunii
Indicele \(\alpha\) este în același timp panta cozilor pe axe log-log și pragul pentru existența momentelor. Sub o lege stabilă cu \(\alpha = 1{,}7\), o variație absolută de peste zece unități de scală are probabilitatea 0,56%, față de \(1{,}5\times 10^{-10}\%\) sub distribuția Normală, iar varianța de selecție nu se stabilizează niciodată. Măsurile bazate pe cuantile, precum VaR, rămîn valabile. Aceleași proprietăți dau testele din secțiunea de critică: un model stabil prevede atît o varianță de selecție care nu se stabilizează, cît și un anumit număr de pierderi extreme. Înainte de estimarea modelului, secțiunea următoare arată cum se simulează.
Simulare
Legile stabile nu au densitate în formă închisă, dar se simulează ușor. Secțiunea prezintă metoda Chambers–Mallows–Stuck (CMS), care transformă o extragere uniformă și una exponențială într-o extragere stabilă, întîi în cazul simetric, apoi în cel general.
Metoda CMS (Chambers, Mallows & Stuck, 1976) produce o extragere din \(S(\alpha; 0; 1; 0)\) pornind de la două variabile independente: un unghi uniform \(V \sim U(-\pi/2, \pi/2)\) și o variabilă exponențială \(W \sim \mathrm{Exp}(1)\) cu media 1. Extragerea stabilă este
iar \(\gamma X + \delta \sim S(\alpha; 0; \gamma; \delta)\) dă orice scală și orice poziție.
Formula se poate verifica pe cele două cazuri particulare cu lege cunoscută. Pentru \(\alpha = 1\), exponentul \((1 - \alpha)/\alpha\) este zero și \(X = \sin V/\cos V = \tan V\); tangenta unui unghi uniform este o variabilă Cauchy standard. Pentru \(\alpha = 2\),\(\cos((1-\alpha)V) = \cos V\) și \(X = \sin(2V)\,(\cos V)^{-1/2}(\cos V/W)^{-1/2} = 2\sin V\sqrt{W}\), o variabilă \(N(0, 2)\), în acord cu convenția de scală \(S(2; 0; 1; 0) = N(0, 2)\).
Metoda nu are nevoie de densitate, de inversarea unei funcții de repartiție sau de un pas de respingere: fiecare pereche \((V, W)\) dă exact o extragere.
Pentru \(\beta \ne 0\) și \(\alpha \ne 1\), formula generală în parametrizarea S1 (Weron, 1996) folosește două constante auxiliare care depind doar de \(\alpha\) și \(\beta\):
\[B = \frac{\arctan(\beta\tan\frac{\pi\alpha}{2})}{\alpha}, \qquad S = \Big(1 + \beta^2\tan^2\tfrac{\pi\alpha}{2}\Big)^{1/(2\alpha)}.\]
Extragerea este atunci \(X = S\,\sin(\alpha(V + B))/(\cos V)^{1/\alpha} \cdot (\cos(V - \alpha(V + B))/W)^{(1 - \alpha)/\alpha}\), care urmează legea \(S(\alpha; \beta; 1; 0 \mid 1)\). Pentru \(\beta = 0\),\(B = 0\) și \(S = 1\), iar formula se reduce la (3.7).
Din extragerea standard se obțin orice parametri prin rescalare și deplasare: \(\gamma X + \delta_1\) în S1, respectiv \(\gamma X + \delta_0 - \beta\gamma\tan\frac{\pi\alpha}{2}\) în S0, conform (3.4).Weron (1996) a corectat o formulă din lucrarea originală pentru \(\beta \ne 0\); scipy.stats.levy_stable.rvs folosește aceeași metodă.
Pe scurt
Pentru \(\alpha \ne 1\), parametrizarea S1 Weron (1996):
Exemplul lucrat produce o extragere cu \(\alpha = 1{,}5\) și \(\beta = 0\), dintr-o extragere uniformă \(U = 0{,}8\) și o extragere exponențială \(W = 1{,}2\). Primul pas transformă \(U\), uniformă pe \((0, 1)\), într-un unghi uniform pe \((-\pi/2, \pi/2)\):\(V = \pi(U - 1/2) = 0{,}942\).
Al doilea pas evaluează factorii din (3.7):\(\sin(\alpha V) = 0{,}988\),\((\cos V)^{1/\alpha} = 0{,}702\) și \(\big(\cos((1 - \alpha)V)/W\big)^{(1 - \alpha)/\alpha} = 1{,}104\). Extragerea este \(X = 0{,}988/0{,}702 \times 1{,}104 = 1{,}554\).
Un eșantion de orice mărime se obține repetînd calculul cu noi perechi \((U, W)\). Pentru că fiecare extragere este o funcție explicită de două variabile standard, simularea a milioane de extrageri stabile nu durează mai mult decît simularea unor extrageri Normale.
Pe scurt
\(\alpha = 1{,}5\), \(\beta = 0\); o extragere uniformă \(U = 0{,}8\) și o extragere exponențială \(W = 1{,}2\)
Pași
\(V = \pi(U - 1/2) = 0{,}942\): transformă \(U\), uniformă pe \((0, 1)\), într-un unghi uniform pe \((-\pi/2, \pi/2)\)
Întrebare pentru sală Pe slide, U = 0,8 și W = 1,2 dau X = 1,554 pentru α = 1,5 și β = 0. Ce devine X dacă W crește la 2, cu același U?
Răspuns
1,843. Pentru β = 0, W intră doar prin factorul (cos((1 − α)V)/W)(1 − α)/α; exponentul (1 − α)/α = −1/3 este negativ, deci X crește proporțional cu W1/3: 1,554 × (2/1,2)1/3 = 1,843. Un W mai mic micșorează extragerea: W = 0,5 dă 1,161. Pentru α = 2 formula devine 2 sin V √W, o extragere din N(0, 2): 1,772 pentru U = 0,8 și W = 1,2.
Întrebare pentru sală Pentru α = 1,5 și β = 0,5, cuantilele exacte de 1% și 99% sînt −5,39 și 9,79 (grila FFT a graficului dă −5,40 și 9,76). Ce devin ele pentru β = −0,5?
Răspuns
În oglindă: −9,79 și 5,39 exact, −9,81 și 5,38 pe grila FFT a graficului (în eșantionul simulat −9,99 și 5,21). În S1 cu δ = 0, legea cu −β este legea cu β reflectată față de 0, deci β schimbă coada mai lungă, nu doar poziția. Histograma urmează densitatea exactă pentru fiecare combinație de α și β.
Graficul compară histograma a 100 000 de extrageri CMS din \(S(1{,}5; 0{,}5; 1; 0 \mid 1)\) cu densitatea exactă, calculată numeric din \(\varphi\). Histograma urmează îndeaproape densitatea, inclusiv asimetria ei: cu \(\beta = 0{,}5\), coada dreaptă este mai groasă, iar în S1 modul se află sub zero.
Cuantilele confirmă acordul în cozi. Cuantilele de selecție de 1% și 99% sînt −5,47 și 9,52; cele exacte, calculate prin integrare numerică cu scipy.stats.levy_stable, sînt −5,39 și 9,79 (grila FFT a graficului dă −5,40 și 9,76). Testul Kolmogorov–Smirnov (KS) cu două eșantioane, aplicat extragerilor CMS și unor extrageri din levy_stable.rvs, dă statistica 0,0044 și un p-value de 0,30, deci testul nu găsește nicio diferență între cele două eșantioane.
Pe scurt
100 000 de extrageri CMS din \(S(1{,}5; 0{,}5; 1; 0 \mid 1)\): histograma urmează densitatea calculată din \(\varphi\)
Cuantilele de 1% și 99%: eșantion \(-5{,}47\) și \(9{,}52\), exact (scipy levy_stable) \(-5{,}39\) și \(9{,}79\)
Testul KS (Kolmogorov–Smirnov) cu două eșantioane față de levy_stable.rvs: statistica \(0{,}0044\), p-value \(0{,}30\), nicio diferență
Metoda CMS transformă un unghi uniform \(V\) și o variabilă exponențială \(W\) într-o extragere stabilă. Cazurile particulare verifică formula: \(\tan V\) dă distribuția Cauchy, iar \(2\sin V\sqrt{W}\) distribuția Normală \(N(0, 2)\).
Cazul asimetric folosește formula din Weron (1996), iar o extragere în S0 se obține printr-o deplasare cu \(\beta\gamma\tan\frac{\pi\alpha}{2}\).
Pe scurt
CMS: un unghi uniform \(V\) și un \(W\) exponențial dau o extragere stabilă
Cazurile particulare verifică formula: \(\tan V\) (Cauchy), \(2\sin V\sqrt{W}\) (Normală)
Cazul asimetric: formula din Weron (1996); deplasare cu \(\beta\gamma\tan\frac{\pi\alpha}{2}\) pentru S0
Sinteza secțiunii
Simularea este partea ușoară a lucrului cu legile stabile: fiecare extragere este o funcție explicită de două variabile standard, iar 100 000 de extrageri reproduc densitatea exactă, inclusiv cuantilele ei. Simularea susține și restul capitolului: studiul Monte Carlo al estimatorilor din secțiunea următoare și traiectoriile simulate ale varianței din secțiunea de critică se bazează pe ea.
Estimare
Estimarea unei legi stabile este mai grea decît simularea ei, pentru că verosimilitatea cere densitatea, care nu are formă închisă. Secțiunea prezintă cele trei familii de estimatori și compară cei doi estimatori cei mai folosiți: metoda cuantilelor a lui McCulloch și verosimilitatea maximă.
Metodele cuantilelor potrivesc cuantilele (quantiles) de selecție cu cele ale legii stabile. Fama & Roll (1971) le-au dezvoltat pentru legi simetrice, iar McCulloch (1986) le-a extins la toți cei patru parametri. Ele cer doar datele ordonate și tabelele publicate.
Metodele funcției caracteristice folosesc funcția caracteristică empirică \(\hat\varphi(t) = \frac1n\sum_{j=1}^n e^{itr_j}\) a randamentelor \(r_1, \dots, r_n\). Pentru o lege stabilă, \(|\varphi(t)|^2 = e^{-2\gamma^\alpha|t|^\alpha}\), deci \(\ln(-\ln|\varphi(t)|^2) = \ln(2\gamma^\alpha) + \alpha\ln|t|\) este liniară în \(\ln|t|\). Regresia versiunii empirice pe \(\ln|t|\) dă o pantă care estimează \(\alpha\)(Koutrouvelis, 1980).
Verosimilitatea maximă (ML) este cea mai precisă metodă, odată ce densitatea poate fi calculată (Nolan, 2001; Mittnik et al., 1999). O implementare SAS (Statistical Analysis System) a acestor estimatori este descrisă în Pele (2014).
Pe scurt
Metodele cuantilelor: potrivesc cuantilele de selecție cu cele ale legii stabile
Metodele funcției caracteristice: regresia lui \(\ln(-\ln|\hat\varphi(t)|^2)\) empiric pe \(\ln|t|\)
\(\hat\varphi(t) = \frac1n\sum_{j=1}^n e^{itr_j}\): funcția caracteristică empirică; \(|\varphi(t)|^2 = e^{-2\gamma^\alpha|t|^\alpha}\), deci relația dublu logaritmică este liniară în \(\ln|t|\)
unde \(\hat q_p\) este cuantila de selecție de ordin \(p\), valoarea sub care se află o proporție \(p\) din randamente. Raportul \(\nu_\alpha\) măsoară lățimea cozilor față de corpul distribuției; \(\nu_\beta\) măsoară asimetria cozilor în jurul medianei.
Tabelele III și IV din lucrare transformă perechea \((\nu_\alpha, \nu_\beta)\) în estimațiile \((\hat\alpha, \hat\beta)\). Pentru distribuția Normală, \(\nu_\alpha = 2{,}439\), iar un \(\nu_\alpha\) mai mare înseamnă un \(\alpha\) mai mic. Scala rezultă apoi din intervalul intercuartilic, \(\hat\gamma = (\hat q_{0,75} - \hat q_{0,25})/\phi_3(\hat\alpha, \hat\beta)\), unde \(\phi_3\) este intervalul intercuartilic al lui \(S(\alpha; \beta; 1; 0)\) (Tabelul V), iar \(\hat\delta_0\) vine din Tabelul VII.
Metoda este rapidă și consistentă și este valabilă pentru \(0{,}6 \le \alpha \le 2\). Este mai puțin precisă decît ML, pentru că folosește doar cinci cuantile, și este un bun punct de plecare pentru ML.
Pe scurt
Două rapoarte de cuantile de selecție \(\hat q_p\), independente de poziție și de scală McCulloch (1986):
\(\nu_\alpha = \dfrac{\hat q_{0{,}95} - \hat q_{0{,}05}}{\hat q_{0{,}75} - \hat q_{0{,}25}}\) (lățimea cozilor față de corp)
\(\hat q_p\): cuantila de selecție de ordin \(p\), valoarea sub care se află o proporție \(p\) din randamente
Tabelele III și IV din lucrare transformă \((\nu_\alpha, \nu_\beta)\) în \((\hat\alpha, \hat\beta)\)
distribuția Normală: \(\nu_\alpha = 2{,}439\); un \(\nu_\alpha\) mai mare înseamnă un \(\alpha\) mai mic
Apoi \(\hat\gamma = (\hat q_{0{,}75} - \hat q_{0{,}25})/\phi_3(\hat\alpha, \hat\beta)\) (Tabelul V) și \(\hat\delta_0\) din Tabelul VII; \(\phi_3\): intervalul intercuartilic al lui \(S(\alpha; \beta; 1; 0)\)
Rapidă, consistentă, valabilă pentru \(0{,}6 \le \alpha \le 2\); mai puțin precisă decît ML; un bun punct de plecare pentru ML
Corespondența McCulloch între \(\nu_\alpha\) și \(\alpha\)
Întrebare pentru sală Pe slide, να = 3,425 al BET dă α̂ = 1,414. Butonul ▶ mută începutul eșantionului; din 2010, να al BET scade la 3,082. Ce α̂ dă Tabelul III?
Răspuns
Circa 1,53: între να = 3,0 ↦ 1,563 și να = 3,2 ↦ 1,484, interpolarea liniară dă 1,531, iar cu |νβ| = 0,036 rezultă α̂ = 1,529. Un να mai mic înseamnă o bandă 5–95% mai îngustă față de intervalul intercuartilic, deci cozi mai subțiri și α̂ mai mare. Distribuția Normală are να = 2,439 și α = 2.
Întrebare pentru sală Butonul ▶ mută începutul eșantionului de la 2000 la 2020. Eșantionul S&P 500 din 2020 are 1 687 de zile, iar criza din martie 2020 cîntărește mai mult în el. Scade α̂ McCulloch față de 1,438?
Răspuns
Nu, crește la 1,543: να scade de la 3,338 la 3,044. Estimatorul McCulloch folosește doar cuantilele de 5%, 25%, 50%, 75% și 95%, deci zilele extreme nu intră direct în calcul; contează cît de lată este banda 5–95% față de intervalul intercuartilic. DAX trece de la 1,455 la 1,590, BET de la 1,414 la 1,480, Bitcoin de la 1,322 la 1,400.
Graficul desenează Tabelul III din McCulloch (1986) pentru un eșantion simetric (\(\nu_\beta = 0\)): pe axa orizontală este \(\nu_\alpha\), iar pe cea verticală valoarea corespunzătoare a lui \(\alpha\). Curba pornește din \(\nu_\alpha = 2{,}439\) pentru \(\alpha = 2\) și coboară pe măsură ce \(\nu_\alpha\) crește; cozile mai groase lărgesc intervalul dintre cuantilele de 5% și 95% față de intervalul intercuartilic.
Stelele plasează randamentele logaritmice zilnice ale celor patru serii din capitol, indicii din 2000, iar Bitcoin din 2014. Valorile lor \(\nu_\alpha\) sînt 3,425 pentru BET, 3,338 pentru S&P 500, 3,285 pentru DAX și 3,803 pentru Bitcoin. Toate sînt mult peste 2,439, deci cozile tuturor celor patru serii sînt mult mai largi, în raport cu corpul distribuției, decît permite distribuția Normală. Bitcoin se află cel mai la dreapta, cu cel mai mic \(\alpha\) implicit.
Pe scurt
Linia: Tabelul III pentru un eșantion simetric (\(\nu_\beta = 0\))
Stelele: randamente logaritmice zilnice din 2000 (Bitcoin din 2014)
\(\nu_\alpha\): BET \(3{,}425\), S&P 500 \(3{,}338\), DAX \(3{,}285\), Bitcoin \(3{,}803\)
Toate mult peste 2,439: cozi mult mai largi decît permite distribuția Normală
Exemplul lucrat aplică metoda pe randamentele logaritmice zilnice BET în %, din 2000 pînă în 2026, \(n = 6\,670\) de observații. Primul pas calculează cele cinci cuantile de selecție: \(\hat q_{0,05} = -1{,}9345\),\(\hat q_{0,25} = -0{,}5025\),\(\hat q_{0,5} = 0{,}0771\),\(\hat q_{0,75} = 0{,}6649\) și \(\hat q_{0,95} = 2{,}0641\).
Al doilea pas formează rapoartele din (3.8):\(\nu_\alpha = 3{,}9986/1{,}1674 = 3{,}425\) și \(\nu_\beta = -0{,}006\), deci eșantionul este practic simetric. Al treilea pas citește Tabelul III în coloana \(\nu_\beta = 0\), unde \(\nu_\alpha = 3{,}2\) corespunde lui \(\alpha = 1{,}484\), iar \(\nu_\alpha = 3{,}5\) lui \(\alpha = 1{,}391\). Interpolarea liniară între cele două rînduri dă \(\hat\alpha \approx 1{,}414\).
Al patrulea pas folosește celelalte tabele: scala este \(\hat\gamma = 0{,}60\) (% pe zi), asimetria \(\hat\beta = -0{,}011\), iar poziția \(\hat\delta_0 = 0{,}079\). Estimarea \(\hat\alpha \approx 1{,}414\) se află mult sub valoarea 2 a distribuției Normale.
Pe scurt
Randamentele logaritmice zilnice BET (%), 2000–2026, \(n = 6\,670\)
Pentru un eșantion \(r_1, \dots, r_n\), log-verosimilitatea este \(\ell(\theta) = \sum_{t=1}^n \ln f(r_t; \theta)\), unde \(\theta = (\alpha, \beta, \gamma, \delta_0)\) este vectorul celor patru parametri, iar \(f(r_t; \theta)\) densitatea stabilă în \(r_t\). Estimarea ML \(\hat\theta\) maximizează numeric pe \(\ell\), pornind de la estimarea McCulloch. Erorile standard provin din curbura lui \(\ell\) în punctul de maxim: inversa hessianei, matricea derivatelor a doua ale lui \(\ell\).
Dificultatea este densitatea însăși, care trebuie calculată din \(\varphi\) prin formula de inversare \(f(x) = \frac{1}{2\pi}\int e^{-itx}\varphi(t)\,dt\). Ea se poate evalua pe o grilă cu transformata Fourier rapidă (FFT, fast Fourier transform) (Mittnik, Doganoglu & Chenyao, 1999) sau prin integrare numerică directă (Nolan, 1997). Funcția levy_stable.fit face acest calcul și durează cîteva minute pentru cîteva mii de randamente.
În parametrizarea S0, estimarea ML este regulată pentru \(\alpha \in (0, 2)\): estimatorul este asimptotic Normal, iar erorile lui standard scad ca \(1/\sqrt{n}\)(Nolan, 2001).
\(\theta\): vectorul celor patru parametri; \(f(r_t; \theta)\): densitatea stabilă în \(r_t\); \(\hat\theta\) maximizează numeric \(\ell\), pornind de la estimarea McCulloch
erorile standard din curbura lui \(\ell\): inversa hessianei, matricea derivatelor a doua ale lui \(\ell\)
Densitatea \(f\) se calculează din \(\varphi\)
\(f(x) = \frac{1}{2\pi}\int e^{-itx}\varphi(t)\,dt\), evaluată pe o grilă cu FFT (fast Fourier transform, transformata Fourier rapidă) Mittnik, Doganoglu & Chenyao (1999)
sau prin integrare directă Nolan (1997); levy_stable.fit face acest calcul și durează cîteva minute pentru cîteva mii de randamente
Estimarea ML în S0 este regulată pentru \(\alpha \in (0, 2)\): erorile standard scad ca \(1/\sqrt{n}\)Nolan (2001)
Întrebare pentru sală La 95%, intervalul ML pentru α al S&P 500 este [1,499; 1,581], iar α̂ McCulloch este 1,438, sub interval. Pentru cîte dintre cele patru serii este α̂ McCulloch sub intervalul ML de 99%?
Răspuns
Pentru toate patru. La 99% (±2,576 erori standard) intervalele sînt BET [1,435; 1,537], S&P 500 [1,486; 1,594], DAX [1,551; 1,661] și Bitcoin [1,343; 1,476], iar α̂ McCulloch este 1,414, 1,438, 1,455 și 1,322. Nici la 99,9% nu se schimbă concluzia (Bitcoin: limita inferioară 1,324). Cele două metode ponderează diferit cozile. Intervalele sînt asimptotice și nu includ incertitudinea estimației McCulloch.
Întrebare pentru sală Butonul ▶ crește numărul de eșantioane Monte Carlo de la 10 la 200. Se schimbă abaterea standard a lui α̂ ML pentru n = 500 între 100 și 200 de eșantioane?
Răspuns
Da: de la 0,050 la 0,061. Precizia lui α̂ depinde de mărimea eșantionului n; numărul de eșantioane Monte Carlo determină doar cît de bine este măsurată această precizie. Cu 100 de eșantioane, abaterea standard estimată are încă o eroare relativă de cel puțin 1/√(2 × 100) = 7%. Pentru McCulloch, 0,110 la 100 și 0,107 la 200.
Studiul Monte Carlo extrage 200 de eșantioane din \(S(1{,}7; 0; 1; 0)\) pentru fiecare mărime de eșantion, \(n = 500\) și \(n = 2500\), și estimează \(\alpha\) prin ambele metode. Diagramele box plot arată distribuția lui \(\hat\alpha\) pe cele 200 de eșantioane; linia punctată marchează valoarea adevărată 1,7. Ambii estimatori sînt centrați pe 1,7, deci niciunul nu are o deplasare vizibilă.
Precizia diferă. Abaterea standard a lui \(\hat\alpha\) este 0,1065 pentru McCulloch și 0,0611 pentru ML la \(n = 500\), respectiv 0,0462 față de 0,0298 la \(n = 2500\). ML este deci mai precisă pe aceleași date: abaterea standard McCulloch este de 1,74 ori cea ML la \(n = 500\) și de 1,55 ori la \(n = 2500\). Cu \(n = 500\), metoda lui McCulloch atinge uneori limita \(\alpha = 2\), vizibilă ca valori extreme în partea de sus a primei cutii.
Pe scurt
200 de eșantioane din \(S(1{,}7; 0; 1; 0)\) pentru fiecare mărime; ambii estimatori sînt centrați pe 1,7
Abaterea standard a lui \(\hat\alpha\): \(n = 500\): McCulloch \(0{,}1065\), ML \(0{,}0611\); \(n = 2500\): \(0{,}0462\) față de \(0{,}0298\)
ML este mai precisă pe aceleași date: abaterea standard McCulloch este de \(1{,}74\) ori cea ML la \(n = 500\) și de \(1{,}55\) ori la \(n = 2500\)
Metoda lui McCulloch are nevoie de cinci cuantile, două rapoarte și patru tabele; este rapidă și robustă. ML calculează densitatea numeric din \(\varphi\) și maximizează numeric verosimilitatea; este cea mai precisă.
Orice estimare trebuie să precizeze parametrizarea, S0 sau S1, și unitățile lui \(\gamma\) și \(\delta\), deoarece ambele se schimbă cînd randamentele sînt exprimate în % în loc de zecimale.
Pe scurt
McCulloch: cinci cuantile, două rapoarte, patru tabele; rapidă și robustă
ML: densitate numerică din \(\varphi\), maximizare numerică; cea mai precisă
Raportați parametrizarea (S0 sau S1) și unitățile lui \(\gamma\) și \(\delta\)
Sinteza secțiunii
Cei doi estimatori se completează: metoda cuantilelor a lui McCulloch dă o estimare rapidă și robustă din cinci cuantile, iar ML, pornită de la ea, cîștigă un factor de circa 1,7 în precizie pe eșantioanele din \(S(1{,}7; 0; 1; 0)\). Pe randamentele zilnice BET, metoda cuantilelor dă deja \(\hat\alpha \approx 1{,}414\), departe de valoarea Normală 2. Secțiunea următoare estimează legea stabilă prin ML pe toate cele patru serii și o confruntă cu datele și cu două legi alternative.
Estimarea pe randamente reale
Secțiunea estimează legea stabilă prin verosimilitate maximă pe randamentele logaritmice zilnice a patru serii: BET, S&P 500 și DAX din 2000 pînă în 2026 și Bitcoin din 2014 pînă în 2026. Estimarea stabilă este comparată cu două alternative: distribuția Normală și distribuția Student-t. Comparația folosește densități, QQ plots, probabilități din cozi, numărul pierderilor mari, VaR și un criteriu informațional.
Legi stabile estimate pe randamentele logaritmice zilnice
Tabelul raportează estimările pentru cele patru serii. Randamentele sînt randamente logaritmice zilnice în %; indicii acoperă perioada 2000–2026, iar Bitcoin perioada 2014–2026, cu șapte zile de tranzacționare pe săptămînă. Coloana „McC.” dă \(\hat\alpha\) prin metoda lui McCulloch; estimările ML sînt în S0, cu erorile standard (SE, standard errors) în paranteze; \(\hat\gamma\),\(\hat\delta_0\) și \(\hat\delta_1\) sînt în % pe zi.
Estimările ML ale lui \(\alpha\) sînt 1,486 (SE 0,020) pentru BET, cu \(n = 6\,670\) de zile; 1,540 (SE 0,021) pentru S&P 500, cu \(n = 6\,714\); 1,606 (SE 0,021) pentru DAX, cu \(n = 6\,786\); și 1,410 (SE 0,026) pentru Bitcoin, cu \(n = 4\,384\). Estimările ML ale lui \(\beta\) sînt −0,016 (SE 0,034) pentru BET, −0,181 (SE 0,036) pentru S&P 500, −0,179 (SE 0,040) pentru DAX și 0,019 (SE 0,036) pentru Bitcoin.
Scala \(\hat\gamma\) este 0,62% pe zi pentru BET, 0,58% pentru S&P 500, 0,74% pentru DAX și 1,54% pentru Bitcoin. Pozițiile diferă între cele două parametrizări exact cum prevede (3.4): pentru S&P 500, \(\hat\delta_0 = 0{,}093\) și \(\hat\delta_1 = 0{,}000\), diferența fiind \(\hat\beta\hat\gamma\tan\frac{\pi\hat\alpha}{2}\).
Pe scurt
\(n\)
\(\hat\alpha\) McC.
\(\hat\alpha\) ML (SE)
\(\hat\beta\) ML (SE)
\(\hat\gamma\)
\(\hat\delta_0\)
\(\hat\delta_1\)
BET
6 670
\(1{,}414\)
\(1{,}486\) (\(0{,}020\))
\(-0{,}016\) (\(0{,}034\))
\(0{,}62\)
\(0{,}088\)
\(0{,}078\)
S&P 500
6 714
\(1{,}438\)
\(1{,}540\) (\(0{,}021\))
\(-0{,}181\) (\(0{,}036\))
\(0{,}58\)
\(0{,}093\)
\(0{,}000\)
DAX
6 786
\(1{,}455\)
\(1{,}606\) (\(0{,}021\))
\(-0{,}179\) (\(0{,}040\))
\(0{,}74\)
\(0{,}090\)
\(-0{,}004\)
Bitcoin
4 384
\(1{,}322\)
\(1{,}410\) (\(0{,}026\))
\(0{,}019\) (\(0{,}036\))
\(1{,}54\)
\(0{,}132\)
\(0{,}171\)
Randamente logaritmice zilnice în %; indici 2000–2026, Bitcoin 2014–2026 (7 zile pe săptămînă); date: EODHD
McC.: McCulloch; ML în S0, cu erori standard; \(\hat\gamma\), \(\hat\delta_0\), \(\hat\delta_1\) în % pe zi
Toate cele patru estimări ale lui \(\alpha\) sînt mult sub 2. Pentru S&P 500, distanța față de cazul Normal este \((2 - 1{,}540)/0{,}021 \approx 22\) de erori standard, astfel că valoarea Normală este respinsă de orice test uzual. Cele mai groase cozi le are Bitcoin, cu \(\hat\alpha = 1{,}410\).
Asimetria este negativă pentru S&P 500 și DAX, circa −0,18 pentru amîndoi: coada stîngă este mai groasă, ceea ce reflectă crahurile. Pentru BET și Bitcoin, \(\hat\beta\) se află la mai puțin de două erori standard de 0, deci aceste serii nu au o asimetrie semnificativă.
Scala arată cît de diferite ca mărime sînt seriile: \(\hat\gamma\) este 1,54% pe zi pentru Bitcoin și 0,58% pentru S&P 500. Abaterile standard de selecție, 3,49% și 1,21%, sînt mai mari decît \(\sqrt{2}\hat\gamma\), abaterea standard a unei legi Normale cu același \(\gamma\), pentru că sînt umflate de cozi. În sfîrșit, metoda lui McCulloch dă un \(\hat\alpha\) mai mic decît ML pentru fiecare serie: cele două metode ponderează diferit cozile, prima prin cinci cuantile, a doua prin fiecare observație.
Pe scurt
\(\hat\alpha\) mult sub 2 pentru toate cele patru serii
S&P 500: \((2 - 1{,}540)/0{,}021 \approx 22\) erori standard față de cazul Normal
cele mai groase cozi: Bitcoin (\(\hat\alpha = 1{,}410\))
\(\hat\beta < 0\) pentru S&P 500 și DAX: coada stîngă este mai groasă (crahuri)
BET și Bitcoin: \(\hat\beta\) la mai puțin de două erori standard de 0
\(\hat\gamma\): Bitcoin \(1{,}54\%\) pe zi, față de \(0{,}58\%\) pentru S&P 500; comparați abaterile standard de selecție \(3{,}49\%\) și \(1{,}21\%\)
McCulloch dă un \(\hat\alpha\) mai mic decît ML pentru fiecare serie: cele două metode ponderează diferit cozile
Întrebare pentru sală La x = −6 abateri standard (−7,28% pe zi pentru S&P 500), de cîte ori este densitatea distribuției Normale estimate mai mică decît densitatea Student-t?
Răspuns
De circa 120 000 de ori: 4,4 × 10⁻⁹ față de 5,5 × 10⁻⁴. Densitatea stabilă este 1,0 × 10⁻³, aproape de două ori densitatea Student-t. Coada Normală scade ca e−x²/2, iar cozile celorlalte două ca o putere a lui x, deci raportul crește foarte repede cu |x|.
Graficul reprezintă densitatea empirică a randamentelor zilnice (puncte, dintr-o histogramă) pentru BET și S&P 500 pe scară logaritmică, împreună cu trei legi estimate: Normală (roșu), Student-t (verde) și stabilă, estimată prin ML (albastru). Scara logaritmică face vizibile cozile; pe o scară liniară ele nu s-ar distinge de zero.
Densitatea Normală este o parabolă pe această scară și eșuează din ambele puncte de vedere: este prea joasă în centru și coboară sub date dincolo de circa 4% în ambele direcții, deci prevede mult prea puține randamente mari. Densitățile Student-t și stabilă urmează îndeaproape corpul distribuției, de la vîrf pînă la densități de circa \(10^{-2}\).
Pe scurt
Distribuția Normală (roșu): mult prea puține randamente mari; distribuțiile Student-t (verde) și stabilă (albastru) descriu bine corpul
Întrebare pentru sală La x = −8 abateri standard pentru DAX (−11,26% pe zi), de cîte ori este densitatea stabilă mai mare decît densitatea Student-t?
Răspuns
De circa 2,9 ori: 3,7 × 10⁻⁴ față de 1,3 × 10⁻⁴. Coada stabilă scade ca |x|−α̂−1 cu α̂ = 1,61, coada Student-t ca |x|−ν̂−1 cu ν̂ = 3,09; un exponent mai mic înseamnă o coadă mai groasă. Raportul este 1,6 la −5 abateri standard și 3,9 la −10.
Aceeași comparație pentru DAX și Bitcoin arată mai clar cozile îndepărtate. Dincolo de zona în care ambele legi cu cozi groase se potrivesc, densitatea stabilă rămîne deasupra punctelor, iar densitatea Student-t este mai aproape de ele. Pentru Bitcoin, ale cărui randamente ajung pe grafic la circa ±20%, diferența se vede în ambele cozi.
Este primul semn al tiparului întîlnit în toată secțiunea: legea stabilă descrie bine centrul și cozile moderate, dar cozile ei de tip putere, cu \(\alpha\) în jur de 1,5, sînt prea groase pentru randamentele cele mai extreme.
Pe scurt
Cozile îndepărtate: densitatea stabilă rămîne deasupra punctelor; distribuția Student-t este mai aproape de ele
Întrebare pentru sală Butonul ▶ coboară nivelul p de la 5% la 0,1%. La p = 0,1%, ce VaR dă legea stabilă estimată pentru S&P 500, față de 7,22% în date?
Răspuns
19,70%, de 2,7 ori cuantila empirică. Student-t dă 8,58%, distribuția Normală 3,72%. La p = 1%, valorile sînt 3,45% (date), 4,54% (stabilă), 3,46% (Student-t) și 2,80% (Normală): legea stabilă exagerează deja, dar diferența crește cu cît p este mai mic.
Un QQ plot (graficul cuantilă–cuantilă, quantile–quantile plot) reprezintă cuantilele empirice ale randamentelor pe axa verticală în funcție de cuantilele unui model estimat pe axa orizontală. Dacă modelul este corect, punctele se află pe prima bisectoare. Abaterile de la capete arată ce coadă este greșit specificată și în ce sens.
Pentru BET și S&P 500, cele trei modele sînt de acord în centru, unde toate punctele se află pe dreaptă. Ele se despart la capete. Punctele modelului Normal (roșu) se îndepărtează abrupt de dreaptă: extremele empirice sînt mult mai mari decît cuantilele Normale. Punctele modelului stabil (albastru) se îndepărtează în sens opus și devin plate: modelul stabil își plasează cuantilele extreme mult dincolo de date, la circa −23% pentru BET, acolo unde cuantila empirică este de circa −10%. Punctele Student-t (verde) rămîn cel mai aproape de dreaptă.
Pe scurt
Un QQ plot (graficul cuantilă–cuantilă) reprezintă cuantilele empirice în funcție de cele ale modelului; pentru un model bun, punctele se află pe prima bisectoare
Întrebare pentru sală La p = 1%, VaR Bitcoin din date este 10,51%. Care model estimat dă valoarea cea mai apropiată?
Răspuns
Student-t: 11,06%. Legea stabilă dă 14,26%, distribuția Normală 7,99%. La p = 0,1%, datele dau 18,05%, Student-t 31,95% și legea stabilă 74,16%: și Student-t exagerează coada îndepărtată a Bitcoin, dar mult mai puțin decît legea stabilă.
DAX și Bitcoin arată aceleași trei tipare. Distribuția Normală are cozi prea scurte, care apar ca niște capete abrupte; distribuția stabilă are cozi prea lungi, care apar ca niște capete plate, cu cuantile ale modelului mult dincolo de date; distribuția Student-t este cea mai apropiată dintre cele trei. Pentru Bitcoin, cuantilele stabile cele mai extreme ajung la circa 70% în valoare absolută, față de cuantile empirice de circa 17%.
Un QQ plot de acest tip identifică eșecul fiecărui model fără niciun test: modelul Normal subestimează extremele, iar modelul stabil le supraestimează.
Pe scurt
Distribuția Normală: cozi prea scurte (capete abrupte); distribuția stabilă: cozi prea lungi (capete plate, cuantile ale modelului mult dincolo de date); Student-t: cea mai apropiată
Întrebare pentru sală S&P 500 are 23 de zile cu pierderi peste 5% în 6 714 zile. Cîte astfel de zile așteaptă legea stabilă estimată?
Răspuns
57,3, de 2,5 ori mai multe. Student-t așteaptă 27,0, distribuția Normală 0,1. Pentru pierderi peste 10%: o zi observată, 4,5 conform Student-t și 19,1 conform legii stabile. Raportul dintre zilele așteptate de legea stabilă și cele observate crește odată cu pragul.
Graficul privește coada stîngă pe axe log-log. Punctele arată, pentru fiecare nivel de pierdere \(x\) (în %, pe axa orizontală), proporția zilelor cu o pierdere mai mare decît \(x\); liniile arată aceeași probabilitate conform fiecărui model estimat. Linia orizontală punctată marchează probabilitatea unei singure zile din eșantion, cea mai mică frecvență empirică nenulă.
Pentru BET și S&P 500, toate cele trei modele sînt de acord cu datele pentru pierderi de pînă la circa 2–3%. Mai departe, curba Normală (roșu) cade vertical. Curba stabilă (albastru) continuă ca o dreaptă, cum prevede (3.5). Punctele datelor se îndoaie în jos sub ea, iar curba Student-t (verde) le urmează mai departe.
Pe scurt
Punctele: proporția zilelor cu o pierdere peste \(x\); liniile: aceeași probabilitate conform fiecărui model estimat
Întrebare pentru sală Legea stabilă estimată pe S&P 500 așteaptă 19,1 zile cu pierderi peste 10% în 6 714 zile. Cîte zile dă aproximarea cozii de tip putere cα(1 − β̂)z−α̂, cu z = (10 + δ̂0)/γ̂ = 17,33?
Răspuns
18,3 zile, 96% din valoarea exactă: c1,540 = 0,1868, P ≈ 0,1868 × 1,181 × 17,33−1,540 = 0,00273. Factorul 1 − β̂ = 1,181 vine din β̂ = −0,181: coada stîngă a legii estimate este mai groasă decît cea dreaptă. Observate: o singură zi. Pentru Bitcoin la 10%, aproximarea dă 68,2 zile, față de 73,9 exact și 56 observate.
VaRp = −qp din date și din cele trei modele estimate (% pe zi)
Exemplu lucrat: VaR din legea stabilă estimată și din distribuția Normală
Întrebare pentru sală La VaR 1% pentru S&P 500, legea stabilă dă 4,54%, de 1,62 ori VaR-ul distribuției Normale (2,80%). Butonul ▶ coboară nivelul celui de-al doilea grup de coloane. Cît devine raportul stabil/Normal la VaR 0,05%?
Răspuns
Circa 7,9: 31,21% față de 3,97%. Raportul crește pe măsură ce p scade, deoarece cuantila legii stabile crește ca p−1/α, iar cea Normală doar ca √(2 ln(1/p)). Cuantila empirică la 0,05% este 9,31%, deci legea stabilă depășește datele de 3,4 ori. La 5% raportul stabil/Normal este 0,91: în corpul distribuției, legea stabilă dă un VaR mai mic.
Criterii informaționale ale celor trei modele estimate
Întrebare pentru sală Pe slide, AIC preferă distribuția Student-t legii stabile cu 92 de puncte la S&P 500. Cît devine diferența dacă folosim BIC = k ln n − 2ℓ?
Răspuns
98,4 puncte. Legea stabilă are un parametru în plus (4 față de 3), iar BIC îl penalizează cu ln 6 714 = 8,81 în loc de 2: 91,6 + 6,8 = 98,4. Concluzia nu se schimbă. Față de distribuția Normală, diferențele AIC ale distribuției Student-t sînt între 1 306 (DAX) și 2 411 (BET) puncte, cele ale legii stabile între 1 204 și 2 319, exact ca pe slide.
Întrebare pentru sală Bitcoin are 4 zile cu pierderi peste 20% în 4 384 de zile. Cîte zile așteaptă Student-t și cîte legea stabilă?
Răspuns
12,3 conform Student-t și 26,9 conform legii stabile; distribuția Normală dă practic zero. Ambele modele cu cozi groase exagerează coada îndepărtată a Bitcoin, legea stabilă de peste 6 ori. Pentru pierderi peste 10%: 56 observate, 54,2 (Student-t), 73,9 (stabilă).
Pentru DAX și Bitcoin, imaginea este aceeași. Coada empirică se curbează în jos mai repede decît dreapta stabilă: pe axe log-log, panta ei devine mai abruptă decît \(-\hat\alpha\). În termeni de tail index, coada îndepărtată a datelor este mai subțire decît o coadă stabilă cu indicele \(\hat\alpha\), deci tail index-ul ei este mai mare decît \(\hat\alpha\).
Estimarea ML a lui \(\alpha\) este determinată mai ales de numeroasele observații din corp și din cozile moderate. Ea nu se poate adapta celor cîteva observații extreme, pentru că o lege stabilă leagă panta cozii îndepărtate de același \(\alpha\) care dă forma centrului.
Pe scurt
Coada empirică se curbează în jos mai repede decît dreapta stabilă: tail index-ul datelor este mai mare decît \(\hat\alpha\)
Tabelul transformă probabilitățile din cozi în număr de zile. Pentru fiecare model, numărul așteptat de zile cu o pierdere de peste \(x\) este \(n \times P(r < -x)\) conform legii estimate. Pentru S&P 500 s-au observat 23 de zile cu o pierdere de peste 5%; modelul Normal prevede 0,1 zile, Student-t 27,0, iar legea stabilă 57,3. Pentru pierderi de peste 10% s-a observat o zi, față de practic zero, 4,5 și 19,1 zile. Pentru pierderi de peste 15% nu s-a observat niciuna, față de practic zero, 1,5 și 10,2.
Celelalte serii confirmă tiparul. Pentru BET s-au observat 6 zile cu pierderi de peste 10%, față de practic zero conform modelului Normal, 8,2 conform Student-t și 22,8 conform legii stabile. Pentru Bitcoin s-au observat 56 de zile cu pierderi de peste 10%, față de 8,1, 54,2 și 73,9, și 4 zile cu pierderi de peste 20%, față de practic zero, 12,3 și 26,9.
Modelul Normal nu prevede aproape nicio pierdere mare. Legea stabilă prevede prea multe, iar diferența crește odată cu pragul. Student-t este cea mai apropiată de valorile observate. Pentru S&P 500, legea stabilă estimată prevede 19,1 zile sub −10% în 6 714 zile, acolo unde s-a observat una singură.
Pe scurt
pierdere peste
observate
Normală
Student-t
stabilă
S&P 500
\(5\%\)
23
\(0{,}1\)
\(27{,}0\)
\(57{,}3\)
S&P 500
\(10\%\)
1
\(\approx 0\)
\(4{,}5\)
\(19{,}1\)
S&P 500
\(15\%\)
0
\(\approx 0\)
\(1{,}5\)
\(10{,}2\)
BET
\(10\%\)
6
\(\approx 0\)
\(8{,}2\)
\(22{,}8\)
Bitcoin
\(10\%\)
56
\(8{,}1\)
\(54{,}2\)
\(73{,}9\)
Bitcoin
\(20\%\)
4
\(\approx 0\)
\(12{,}3\)
\(26{,}9\)
Numărul așteptat de zile \(= n \times P(r < -x)\) conform fiecărui model estimat
Distribuția Normală: aproape nicio pierdere mare; distribuția stabilă: prea multe, iar diferența crește odată cu pragul; Student-t: cea mai apropiată de valorile observate
S&P 500, 6 714 zile: zile sub \(-10\%\) observate 1, prevăzute de legea stabilă estimată \(19{,}1\)
Valoarea la risc la nivelul \(p\) este \(\mathrm{VaR}_p = -q_p\), pierderea zilnică depășită cu probabilitatea \(p\) (Capitolul 10). Nivelul este notat aici cu \(p\), pentru că \(\alpha\) desemnează deja indicele de stabilitate. Tabelul compară VaR empiric, obținut din cuantila de selecție, cu VaR al celor trei modele estimate, la nivelurile 1% și 0,1%.
La nivelul de 1%, modelul Normal dă valori prea mici, iar modelul stabil valori prea mari. Pentru S&P 500, VaR 1% empiric este 3,5%; modelul Normal dă 2,8%, Student-t 3,5%, iar legea stabilă 4,5%. Pentru Bitcoin, valoarea empirică este 10,5%, față de 8,0%, 11,1% și 14,3%.
La nivelul de 0,1%, modelul stabil depășește mult mai mult datele. VaR 0,1% al lui este de aproximativ două pînă la patru ori mai mare decît cuantila empirică: 23,1% față de 9,5% pentru BET, 19,7% față de 7,2% pentru S&P 500, 20,0% față de 7,1% pentru DAX și 74,2% față de 18,1% pentru Bitcoin. Modelul Normal, cu 3,7% pentru S&P 500, dă circa jumătate din valoarea empirică.
Pe scurt
VaR 1% (%)
VaR 0,1% (%)
date
Normală
t
stabilă
date
Normală
t
stabilă
BET
\(4{,}1\)
\(3{,}2\)
\(4{,}1\)
\(4{,}9\)
\(9{,}5\)
\(4{,}3\)
\(10{,}9\)
\(23{,}1\)
S&P 500
\(3{,}5\)
\(2{,}8\)
\(3{,}5\)
\(4{,}5\)
\(7{,}2\)
\(3{,}7\)
\(8{,}6\)
\(19{,}7\)
DAX
\(4{,}2\)
\(3{,}3\)
\(4{,}0\)
\(5{,}0\)
\(7{,}1\)
\(4{,}3\)
\(8{,}8\)
\(20{,}0\)
Bitcoin
\(10{,}5\)
\(8{,}0\)
\(11{,}1\)
\(14{,}3\)
\(18{,}1\)
\(10{,}7\)
\(31{,}9\)
\(74{,}2\)
VaR la nivelul \(p\): \(\mathrm{VaR}_p = -q_p\), pierderea zilnică depășită cu probabilitatea \(p\) (Capitolul 10); aici notăm nivelul cu \(p\), deoarece \(\alpha\) desemnează indicele de stabilitate
VaR 1%: modelul Normal dă valori prea mici, modelul stabil valori prea mari
VaR 0,1%: modelul stabil dă valori de aproximativ două pînă la patru ori mai mari decît cuantila empirică
Criteriul informațional Akaike (AIC, Akaike information criterion) este \(2k - 2\ell(\hat\theta)\), unde \(k\) este numărul de parametri, iar \(\ell(\hat\theta)\) log-verosimilitatea maximizată; se preferă valoarea mai mică. Criteriul penalizează parametrii suplimentari, astfel că un model cu mai mulți parametri trebuie să îmbunătățească destul verosimilitatea pentru a fi preferat.
Ambele modele cu cozi groase sînt preferate distribuției Normale, pentru fiecare serie: Student-t cu 1 306 (DAX) pînă la 2 411 (BET) puncte AIC, legea stabilă cu 1 204 pînă la 2 319; pentru S&P 500, AIC este 21 650 pentru modelul Normal, 19 702 pentru Student-t și 19 794 pentru legea stabilă. Student-t este preferată pentru fiecare serie, deși are mai puțini parametri decît legea stabilă. Pentru S&P 500, avantajul ei este de 92 de puncte.
Gradele de libertate estimate \(\hat\nu\) ale distribuției Student-t sînt 2,43 pentru BET, 2,67 pentru S&P 500, 3,09 pentru DAX și 2,23 pentru Bitcoin, toate între 2 și 3,1. O lege Student-t are momente finite doar de ordin mai mic decît \(\nu\): aceste estimări implică varianță finită, dar aproape niciun moment finit de ordin superior.
Pe scurt
AIC Normală
AIC Student-t
AIC stabilă
\(\hat\nu\) (Student-t)
BET
23 407
20 996
21 088
\(2{,}43\)
S&P 500
21 650
19 702
19 794
\(2{,}67\)
DAX
23 901
22 595
22 697
\(3{,}09\)
Bitcoin
23 391
22 056
22 159
\(2{,}23\)
AIC (Akaike information criterion, criteriul informațional Akaike) \(= 2k - 2\ell(\hat\theta)\), cu \(k\) numărul de parametri; se preferă valoarea mai mică
Ambele modele cu cozi groase sînt preferate distribuției Normale: Student-t cu 1 306 (DAX) pînă la 2 411 (BET) puncte AIC, cea stabilă cu 1 204 pînă la 2 319
Student-t este preferată pentru fiecare serie, deși are mai puțini parametri; la S&P 500, diferența este de 92 de puncte
\(\hat\nu\) între 2 și 3,1: varianță finită, dar aproape niciun moment finit de ordin superior
Pe toate cele patru serii, estimările ML ale lui \(\alpha\) se află între 1,410 și 1,606, departe de 2. Legea stabilă descrie corpul distribuției mult mai bine decît distribuția Normală.
Ea supraestimează cozile îndepărtate: prevede prea multe pierderi extreme și dă un VaR 0,1% prea mare. După AIC, distribuția Student-t este preferată pentru fiecare serie.
Pe scurt
Toate cele patru serii: \(\hat\alpha\) între 1,410 și 1,606, departe de 2
Legea stabilă descrie corpul distribuției mult mai bine decît distribuția Normală
Supraestimează cozile îndepărtate: prea multe pierderi extreme, VaR 0,1% prea mare
După AIC, distribuția Student-t este preferată
Sinteza secțiunii
Estimată pe randamente reale, legea stabilă este o îmbunătățire mare față de distribuția Normală și o descriere mai slabă decît distribuția Student-t. Valorile \(\hat\alpha\) între 1,410 și 1,606 surprind cozile groase din apropierea centrului, dar același \(\alpha\) impune cozi de tip putere prea groase în zona extremă: 19,1 zile așteptate cu pierderi de peste 10% pentru S&P 500, față de una observată, și un VaR 0,1% de două pînă la patru ori mai mare decît cel empiric. Estimările Student-t \(\hat\nu\) între 2,23 și 3,09 indică o varianță finită. Secțiunea următoare testează direct varianța infinită.
Critica modelului stabil: varianță finită sau infinită
Estimările din secțiunea anterioară sugerează că cozile îndepărtate ale randamentelor sînt mai subțiri decît orice coadă stabilă. Secțiunea testează direct ipoteza varianței infinite, cu trei teste derivate din teoria capitolului, apoi explică de ce randamentele zilnice par totuși stabile.
Testul 1: stabilitatea lui \(\alpha\) la agregarea randamentelor
Întrebare pentru sală Pe slide, intervalele de 95% ale lui α̂ ML pentru S&P 500 la orizontul zilnic (1,54) și lunar (1,82) nu se suprapun. Se suprapun la nivelul de încredere 99%?
Răspuns
Nu. La 99% (±2,576 erori standard), intervalul zilnic este [1,486; 1,594], iar cel lunar [1,655; 1,984]. Nici la 99,9% (±3,29 erori standard) nu se suprapun, deși distanța dintre ele ajunge aproape la zero. Pentru DAX și BET intervalele se suprapun deja la 95%. Intervalele sînt asimptotice, iar cel lunar se bazează pe 321 de luni.
Primul test folosește chiar proprietatea de stabilitate. Dacă randamentele zilnice ar fi i.i.d. stabile, sumele săptămînale și lunare ar fi stabile cu același \(\alpha\). Dacă, în schimb, randamentele zilnice au varianță finită, GCLT prevede că \(\alpha\) estimat urcă spre 2 pe măsură ce randamentele se adună pe orizonturi mai lungi.
Graficul raportează estimările ML ale lui \(\alpha\), cu intervale de încredere de 95%, pentru randamentele zilnice, săptămînale și lunare ale celor patru serii; linia punctată marchează \(\alpha = 2\). Pentru S&P 500, estimările cresc de la 1,54 (zilnic) la 1,64 (săptămînal) și 1,82 (lunar). Pentru Bitcoin, ele cresc de la 1,41 la 1,67 și apoi la 2,00, la limita 2: pentru randamentele lunare Bitcoin, estimarea stabilă ajunge în cazul Normal.
Pe scurt
Dacă randamentele zilnice ar fi i.i.d. stabile, sumele săptămînale și lunare ar avea același\(\alpha\) (stabilitatea)
\(\alpha\) estimat crește cu orizontul pentru S&P 500, DAX și Bitcoin. Pentru DAX, șirul este \(1{,}61 \to 1{,}72 \to 1{,}69\), deci creșterea are loc între randamentele zilnice și cele săptămînale. Pentru S&P 500, intervalele de 95% ale estimărilor zilnice și lunare nu se suprapun, astfel că creșterea este clară din punct de vedere statistic.
BET este excepția: \(1{,}49 \to 1{,}56 \to 1{,}50\), fără o creștere clară. Eșantionul lunar este scurt, 321 de luni, iar intervalul estimării lunare este larg, așa că testul are o putere mică pentru această serie.
Același tipar apare în studiile clasice ale lui Officer (1972) și Akgiray & Booth (1988). Un \(\alpha\) crescător este exact ceea ce prevede GCLT pentru sume de randamente cu varianță finită care converg lent la distribuția Normală: în această lume, estimarea stabilă pe date zilnice este o aproximare pe care agregarea o elimină treptat.
Pe scurt
\(\hat\alpha\) crește cu orizontul pentru S&P 500, DAX și Bitcoin
DAX: \(1{,}61 \to 1{,}72 \to 1{,}69\); pentru S&P 500, intervalele de încredere ale orizontului zilnic și lunar nu se suprapun
BET: \(1{,}49 \to 1{,}56 \to 1{,}50\), fără o creștere clară
eșantioanele lunare sînt scurte (321 de luni): intervale largi
Întrebare pentru sală Pentru Bitcoin (α̂ = 1,410), varianța cumulată a datelor la sfîrșitul eșantionului este 12,14. Unde ajung varianțele finale ale celor trei traiectorii simulate din legea stabilă estimată?
Răspuns
Mult mai sus: 252,1, 111,4 și 52,6, de 4 pînă la 21 de ori varianța datelor. La fel pentru S&P 500 (slide-ul): datele 1,47, traiectoriile 5,9, 5,4 și 15,6. O lege stabilă cu α̂ < 2 produce extreme pe care seriile reale nu le au, iar varianța lor de selecție nu se stabilizează.
Al doilea test repetă observația lui Mandelbrot pe date actuale. Graficul reprezintă varianța de selecție cumulată a randamentelor logaritmice zilnice ale S&P 500 (în %, linia albastră groasă) din 2000 pînă în 2026, pe scară logaritmică. Varianța sare în 2008 și în 2020, anii celor mai mari crize din eșantion, și apoi se stabilizează în jur de 1,47.
Liniile subțiri sînt traiectorii de aceeași lungime simulate din legea stabilă estimată. Ele se comportă ca în simularea din secțiunea despre cozi: salturi repetate, scădere lentă și nicio convergență. Varianțele lor finale se află între 5,4 și 15,6, mult peste valoarea datelor. Varianța observată este stabilă într-un mod pe care o lege stabilă cu \(\hat\alpha = 1{,}540\) nu îl permite.
Pe scurt
S&P 500 (albastru): după salturile din 2008 și 2020, varianța cumulată se stabilizează în jur de \(1{,}47\)
Traiectorii de aceeași lungime simulate din legea stabilă estimată: varianțe finale între \(5{,}4\) și \(15{,}6\), mult peste date
\(\alpha\) stabil este determinat de întreaga distribuție, mai ales de corpul ei, unde se află majoritatea observațiilor. Tail index-ul cozii îndepărtate se estimează separat, cu estimatorul Hill (Hill, 1975), care folosește doar observațiile cele mai mari; Capitolul 5 îl dezvoltă.
Pentru indicii bursieri, coada îndepărtată scade aproximativ ca \(x^{-3}\), „legea cubică inversă” (inverse cubic law) (Gopikrishnan et al., 1999). Un tail index în jur de 3 înseamnă varianță finită, iar nicio lege stabilă nu îl are, pentru că orice lege stabilă diferită de distribuția Normală are un tail index sub 2.
Numărul pierderilor mari din secțiunea anterioară confirmă: legile stabile estimate prevăd mult mai multe pierderi de peste 10% decît s-au observat. Lau, Lau & Wingender (1990) aduc alte dovezi împotriva modelului stabil, din comportamentul momentelor de selecție.
Pe scurt
\(\alpha\) stabil este determinat de întreaga distribuție, mai ales de corp
tail index-ul cozii îndepărtate se estimează separat, cu estimatorul Hill Hill (1975) (Capitolul 5)
Pentru indicii bursieri, coada îndepărtată scade aproximativ ca \(x^{-3}\), „legea cubică inversă” Gopikrishnan et al. (1999)
un tail index în jur de 3 înseamnă varianță finită, iar nicio lege stabilă nu îl are
Numărul pierderilor observate confirmă: legile stabile estimate prevăd mult mai multe pierderi peste \(10\%\) decît s-au observat
Lau, Lau & Wingender (1990): alte dovezi împotriva modelului stabil, din comportamentul momentelor de selecție
Originea aspectului stabil al randamentelor zilnice
Două explicații dau seama de aspectul stabil al randamentelor zilnice. Prima este volatility clustering (Capitolele 2 și 9): perioadele calme și cele agitate alternează. Un amestec de legi Normale cu varianță variabilă are cozi groase și varianță finită (Blattberg & Gonedes, 1974). Dacă pe datele generate de un astfel de amestec se estimează o singură lege stabilă, se obține \(\hat\alpha < 2\), deși nicio observație nu provine dintr-o lege cu varianță infinită.
A doua explicație o oferă legile stabile trunchiate și temperate (tempered stable laws). Ele se comportă ca legile stabile la scări moderate, dar au cozi mai subțiri în zona extremă, astfel că toate momentele lor sînt finite. Mantegna & Stanley (1995) au estimat un zbor Lévy trunchiat (truncated Lévy flight) pe S&P 500. Grabchak & Samorodnitsky (2010) arată că astfel de legi explică de ce randamentele par stabile pe orizonturi scurte și Normale pe orizonturi lungi, adică tiparul testului de agregare.
Pe scurt
Volatility clustering (Capitolele 2 și 9): perioadele calme și cele agitate alternează
un amestec de legi Normale cu varianță variabilă are cozi groase și varianță finită Blattberg & Gonedes (1974)
dacă pe datele generate de amestec se estimează o singură lege stabilă, se obține \(\hat\alpha < 2\)
Legi stabile trunchiate și temperate: stabile la scări moderate, cu cozi mai subțiri în zona extremă
Mandelbrot a avut dreptate în privința faptelor. Randamentele zilnice au cozi groase, iar distribuția Normală descrie foarte slab datele; fiecare estimare din acest capitol o confirmă.
Varianța infinită însă nu este susținută. \(\alpha\) estimat crește prin agregare, varianța de selecție a randamentelor reale se stabilizează, iar coada îndepărtată este mai subțire decît orice coadă stabilă. Toate cele trei teste indică aceeași direcție.
Legile stabile rămîn utile în mai multe roluri: ca etalon pentru cozi groase, ca instrument de simulare, prin ideea de scalare între orizonturi și pentru date cu varianță cu adevărat infinită, precum unele daune de asigurări și unele tokenuri cripto. GCLT rămîne o reamintire că regulile construite pe \(\sqrt{n}\) cer varianță finită. Capitolul 5 estimează direct tail index-ul, cu teoria valorilor extreme.
Pe scurt
Mandelbrot a avut dreptate în privința faptelor
randamentele zilnice au cozi groase; distribuția Normală descrie foarte slab datele
Varianța infinită nu este susținută
\(\hat\alpha\) crește prin agregare; varianța de selecție se stabilizează; coada îndepărtată este mai subțire decît orice coadă stabilă
Unde rămîn utile legile stabile
un etalon pentru cozi groase; simulare; ideea de scalare; date cu varianță cu adevărat infinită (unele daune de asigurări, unele tokenuri cripto)
GCLT: o reamintire că regulile cu \(\sqrt{n}\) cer varianță finită
Urmează: Capitolul 5 estimează direct tail index-ul cu teoria valorilor extreme
Stabilitatea prevede același \(\alpha\) la orice orizont, dar datele arată un \(\alpha\) care crește cu orizontul. Varianța de selecție a randamentelor reale se stabilizează, în timp ce aceea a eșantioanelor stabile nu.
Volatility clustering și cozile temperate explică valoarea aparentă \(\alpha < 2\) a randamentelor zilnice. Verdictul capitolului este: cozi groase, da; varianță infinită, nu.
Pe scurt
Stabilitatea implică același \(\alpha\) la orice orizont: datele arată un \(\alpha\) crescător
Varianța de selecție a randamentelor reale se stabilizează; cea a eșantioanelor stabile, nu
Cele trei teste resping varianța infinită fără a respinge cozile groase. Agregarea ridică \(\hat\alpha\) spre 2, cum prevede GCLT pentru randamente cu varianță finită; varianța cumulată a S&P 500 se stabilizează în jur de 1,47, în timp ce traiectoriile stabile ajung între 5,4 și 15,6; iar coada îndepărtată scade aproximativ ca \(x^{-3}\), cu un tail index în afara domeniului stabil. Volatility clustering și cozile temperate împacă aceste rezultate cu aspectul stabil al datelor zilnice.
AI pentru descoperire științifică
Instrumentele capitolului se pot aplica unor întrebări încă deschise. Secțiunea formulează o astfel de întrebare, despre cozile Bitcoin, descrie cum ar putea instrumentele AI (inteligență artificială) să sprijine studiul ei, enumeră verificările de care are nevoie și propune o idee de proiect.
Întrebarea deschisă este dacă cozile randamentelor Bitcoin au devenit mai subțiri pe măsură ce piața s-a maturizat. Piața a cîștigat mai mulți participanți, contracte futures din 2017 și fonduri spot tranzacționate la bursă (ETF, exchange-traded funds) din 2024. Dacă cozile au devenit mai subțiri, modelele de risc estimate pe date vechi supraestimează riscul de azi.
Întrebarea rămîne deschisă din două motive. \(\alpha\) estimat variază odată cu regimurile de volatilitate, astfel că o schimbare a lui \(\hat\alpha\) poate reflecta o perioadă mai calmă, nu o coadă mai subțire. În plus, eșantioanele anuale sînt scurte, iar estimările au intervale largi.
Pe eșantionul complet, Bitcoin are \(\hat\alpha = 1{,}410\) (SE 0,026), cel mai mic dintre cele patru serii ale capitolului. Instrumentele AI pot accelera un astfel de studiu; ele nu înlocuiesc verificarea lui (Wang et al., 2023).
Pe scurt
Au devenit mai subțiri cozile Bitcoin pe măsură ce piața s-a maturizat?
mai mulți participanți, contracte futures (din 2017) și ETF-uri spot (exchange-traded funds, fonduri tranzacționate la bursă, din 2024)
dacă cozile au devenit mai subțiri, modelele de risc estimate pe date vechi supraestimează riscul de azi
De ce rămîne deschisă: \(\hat\alpha\) variază odată cu regimurile de volatilitate, iar eșantioanele anuale sînt scurte
Eșantionul complet: \(\hat\alpha = 1{,}410\) (SE \(0{,}026\)), cel mai mic dintre cele patru serii
Instrumentele AI pot accelera un astfel de studiu; nu înlocuiesc verificarea lui Wang et al. (2023)
Instrumentele AI pot contribui în patru etape. Pentru literatură, ele pot inventaria lucrările despre estimarea cozilor activelor cripto și pot rezuma metodele lor. Pentru cod, pot scrie o primă versiune a unui estimator McCulloch pe ferestre mobile, cu intervale bootstrap. Pentru robustețe, pot propune alte ferestre, ML în loc de cuantile sau \(\nu\) din Student-t în loc de \(\alpha\). Pentru explicație, pot scrie o primă versiune a interpretării unui tabel de estimări anuale.
Exemplul de prompt de pe slide cere exact a doua contribuție: o funcție Python care estimează \(\alpha\) stabil al randamentelor logaritmice zilnice pe ferestre mobile de 365 de zile, prin metoda din McCulloch (1986), și adaugă intervale bootstrap de 95%. Fiecare dintre aceste rezultate este o schiță, iar slide-ul următor enumeră ce trebuie verificat înainte de a o folosi.
Pe scurt
Literatura: inventarierea lucrărilor despre estimarea cozilor activelor cripto și rezumarea metodelor lor
Cod: o primă versiune a unui estimator McCulloch pe ferestre mobile, cu intervale bootstrap
Robustețe: propunerea altor ferestre, ML în loc de cuantile, \(\nu\) din Student-t în loc de \(\alpha\)
Explicație: o primă versiune a interpretării unui tabel de estimări anuale
Exemplu de prompt
Write a Python function that estimates the stable alpha of daily log returns on rolling 365-day windows with McCulloch (1986), and adds 95% bootstrap intervals.
Parametrizarea vine prima: codul trebuie să precizeze dacă folosește S0 sau S1; scipy folosește implicit S1, iar poziția diferă cu \(\beta\gamma\tan\frac{\pi\alpha}{2}\). Unitățile vin a doua: cu randamente în % sau în zecimale, \(\gamma\) și \(\delta\) se schimbă, în timp ce \(\alpha\) și \(\beta\) nu.
Ferestrele suprapuse nu sînt independente, așa că estimările mobile nu trebuie citite ca teste separate; o tendință a lui \(\hat\alpha\) pe ferestre mobile poate proveni din cîteva zile extreme care rămîn în multe ferestre. Rezultatele numerice trebuie recalculate pentru cel puțin o fereastră cu o a doua metodă, ML sau tabelele de cuantile. În sfîrșit, fiecare lucrare citată trebuie să existe, iar DOI-ul ei trebuie verificat.
Pe scurt
Parametrizarea: S0 sau S1; scipy folosește implicit S1; poziția diferă cu \(\beta\gamma\tan\frac{\pi\alpha}{2}\)
Unitățile: randamente în % sau în zecimale; \(\gamma\) și \(\delta\) se schimbă, \(\alpha\) și \(\beta\) nu
Ferestrele suprapuse nu sînt independente: nu citiți estimările mobile ca teste separate
Rezultatele numerice: recalculați o fereastră cu o a doua metodă (ML sau tabelele de cuantile)
Referințele: fiecare lucrare citată trebuie să existe; verificați DOI-ul
Proiectul întreabă dacă coada randamentelor Bitcoin este acum mai subțire decît în 2014–2018. Datele sînt prețurile de închidere zilnice ale Bitcoin din datele cursului, 2014–2026.
Pașii urmează capitolul. Estimați \(\alpha\) prin metoda lui McCulloch și prin ML pentru fiecare an calendaristic, cu intervale bootstrap. Repetați estimarea pe randamente împărțite la o volatilitate mobilă, pentru a vedea dacă tendința se menține după eliminarea efectului de volatility clustering. Comparați rezultatele cu \(\hat\nu\) din Student-t pentru fiecare an.
Livrabilele sînt un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele. Orice folosire a AI trebuie declarată, împreună cu lista erorilor AI care au fost corectate.
Pe scurt
Întrebarea: este coada randamentelor Bitcoin mai subțire acum decît în 2014–2018?
date: prețurile de închidere zilnice ale Bitcoin din datele cursului (EODHD), 2014–2026
Pași
estimați \(\alpha\) prin McCulloch și prin ML pentru fiecare an calendaristic, cu intervale bootstrap
repetați pe randamente împărțite la o volatilitate mobilă: se menține tendința?
comparați cu \(\hat\nu\) din Student-t pentru fiecare an
Livrabile: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele
Declarați orice folosire a AI și listați erorile AI pe care le-ați corectat
Sinteza secțiunii
Întrebarea despre cozile Bitcoin folosește toate instrumentele capitolului: ambii estimatori, distincția dintre S0 și S1, legătura dintre volatility clustering și cozile groase aparente și comparația cu Student-t. Instrumentele AI pot scrie o primă versiune a codului și a trecerii în revistă a literaturii, dar verificările privind parametrizarea, unitățile, ferestrele suprapuse și referințele rămîn sarcina cercetătorului.
Rezumat
Rezumatul adună formulele capitolului și trei întrebări de autoevaluare.
Tabelul reunește formulele capitolului. Stabilitatea este proprietatea (3.1), cu regula scalei \(c^\alpha = a^\alpha + b^\alpha\)(3.2), iar suma a \(n\) copii are factorul de scală \(n^{1/\alpha}\). Funcția caracteristică în S1 este (3.3), iar pozițiile din S0 și S1 sînt legate prin (3.4). Cazul Normal este \(S(2; \beta; \gamma; \delta) = N(\delta, 2\gamma^2)\).
Cozile scad ca în (3.5),\(P(X > x) \sim \gamma^\alpha c_\alpha(1 + \beta)x^{-\alpha}\), iar pentru \(\alpha < 2\) momentul absolut de ordin \(p\) este finit dacă și numai dacă \(p < \alpha\)(3.6). Formula CMS (3.7) simulează cazul simetric, iar rapoartele lui McCulloch (3.8) sînt punctul de plecare al estimării.
Prima întrebare: randamentele zilnice sînt i.i.d. \(S(1{,}5; 0; \gamma; 0)\); de cîte ori crește scala de la 1 zi la 20 de zile? Cu factorul \(20^{1/1{,}5} = 7{,}37\), adică de 1,65 ori mai mult decît factorul \(\sqrt{20}\) al regulii rădăcinii pătrate a timpului.
A doua întrebare: o lege estimată are \(\alpha = 1{,}2\); există media și varianța? Conform (3.6), media există, pentru că \(1 < 1{,}2\), iar varianța nu, pentru că \(2 > 1{,}2\).
A treia întrebare: scipy raportează \(\delta = 0{,}05\) cu \(\alpha = 1{,}7\),\(\beta = -0{,}2\) și \(\gamma = 0{,}6\); cît este \(\delta_0\)? Scipy folosește S1, deci (3.4) dă \(\delta_0 = 0{,}05 + (-0{,}2)(0{,}6)\tan(0{,}85\pi) = 0{,}05 + 0{,}061 = 0{,}111\). Capitolul următor, Capitolul 4, tratează probabilitățile pentru finanțe.
Pe scurt
Întrebare: randamentele zilnice sînt i.i.d. \(S(1{,}5; 0; \gamma; 0)\); de cîte ori crește scala de la 1 zi la 20 de zile?
Răspuns: \(20^{1/1{,}5} = 7{,}37\), adică de \(1{,}65\) ori mai mult decît factorul \(\sqrt{20}\) al regulii rădăcinii pătrate a timpului
Întrebare: o lege estimată are \(\alpha = 1{,}2\); există media și varianța?
Răspuns: media există (\(1 < 1{,}2\)), varianța nu (\(2 > 1{,}2\))
Întrebare: scipy raportează \(\delta = 0{,}05\) cu \(\alpha = 1{,}7\), \(\beta = -0{,}2\), \(\gamma = 0{,}6\); cît este \(\delta_0\)?
Răspuns: scipy folosește S1, deci \(\delta_0 = 0{,}05 + (-0{,}2)(0{,}6)\tan(0{,}85\pi) = 0{,}05 + 0{,}061 = 0{,}111\)
Urmează: Capitolul 4, probabilități pentru finanțe
Sinteza secțiunii
Legile stabile sînt singurele legi închise la adunare și singurele limite ale sumelor normalizate. Ele descriu cozile groase ale randamentelor zilnice mult mai bine decît distribuția Normală, dar varianța lor infinită este contrazisă de agregare, de comportamentul varianței de selecție și de cozile îndepărtate. Capitolul 5 estimează direct coada îndepărtată, cu teoria valorilor extreme.
Borak, S., Härdle, W., Weron, R. (2005). Stable distributions. In Čížek, P., Härdle, W., Weron, R. (eds.), Statistical Tools for Finance and Insurance, 21–44. Springer.
Borak, S., Misiorek, A., Weron, R. (2011). Models for heavy-tailed asset returns. In Čížek, P., Härdle, W.K., Weron, R. (eds.), Statistical Tools for Finance and Insurance, 2nd ed., 21–55. Springer.
Randamente logaritmice zilnice, în %: BET, S&P 500 și DAX din ianuarie 2000, Bitcoin din septembrie 2014 (7 zile pe săptămînă), pînă la 18 septembrie 2026. Prețuri de închidere EODHD. Legile estimate sînt cele din curs: distribuția Normală, Student-t și legea stabilă estimată prin verosimilitate maximă în parametrizarea S0.


 Stable Distribution
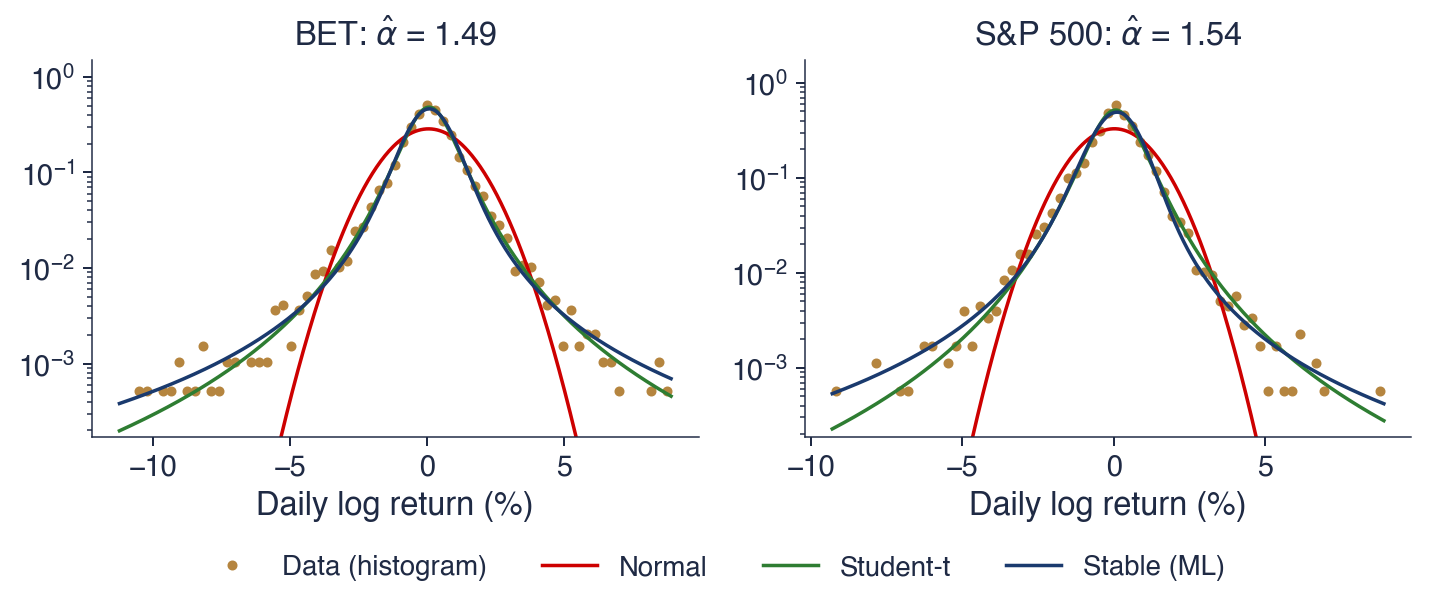
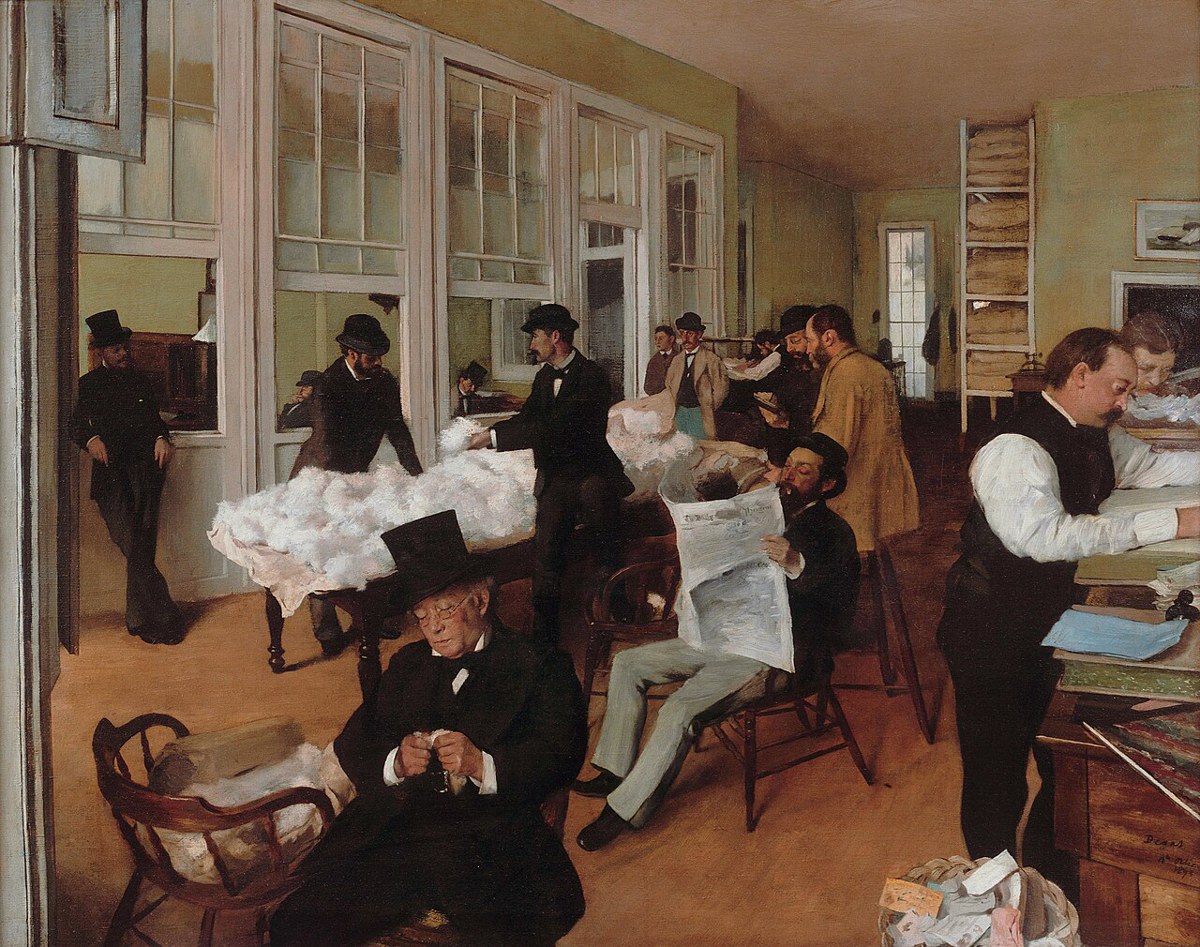
 SFM_ch3_stability_gclt