Capitolul 11: Foundation models pentru serii de timp
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
CRPS: Continuous Ranked Probability Score (scorul de probabilitate continuu pe ranguri)
ENTSO-E: European Network of Transmission System Operators for Electricity (rețeaua europeană a operatorilor de transport și de sistem pentru energie electrică)
ETS: Error, Trend, Seasonality (exponential smoothing state space models) — eroare, trend, sezonalitate (modele de netezire exponențială)
FRED: Federal Reserve Economic Data (baza de date economice a Rezervei Federale din St. Louis)
Capitolul pune o singură întrebare: poate un model mare, pre-antrenat pe multe serii, să prognozeze o serie pe care nu a văzut-o la fel de bine ca un model construit pentru acea serie? În capitolele 0–10, răspunsul implicit a fost „nu se pune problema”: fiecare model, fie el ETS, ARIMA, GARCH sau VAR, se estimează pe seria pe care o prognozează. Capitolul 9 a introdus modelele globale, antrenate pe toate seriile unui set de date, dar tot pe datele problemei.
Traseul are patru etape. Prima definește ideea de foundation model și prezintă, pe scurt, rețeaua pe care se sprijină aproape toate aceste modele, Transformer-ul. A doua arată cum devine o serie de numere o secvență de intrări pentru această rețea și descrie principalele familii de modele. A treia definește scorurile pentru prognoze probabiliste și aplică modelele pe serii din România și din SUA, într-un test cu origine mobilă. A patra discută leakage-ul și contaminarea, adică motivele pentru care un scor poate părea mai bun decît este, și situațiile în care aceste modele ajută.
Pe scurt
Întrebarea: poate un singur model mare, pre-antrenat pe multe serii, să prognozeze o serie pe care nu a văzut-o la fel de bine ca un model construit pentru acea serie?
pînă acum (capitolele 0–10): un model pentru fiecare serie, estimat pe acea serie (ETS, ARIMA, GARCH, VAR)
Capitolul 9: modele globale de învățare automată, antrenate pe seriile unui singur set de date
Traseul capitolului (studiu individual)
ideea de foundation model; Transformer-ul și atenția, pe scurt
de la numere la tokeni: scalare, cuantizare, patching; principalele familii de modele
prognozele probabiliste și scorurile lor; un test corect pe serii din România și din SUA
leakage-ul și contaminarea; situațiile în care aceste modele ajută și cele în care nu ajută
Primul grup de rezultate este conceptual. Cititorul trebuie să poată defini un foundation model, prognoza zero-shot și fine-tuning-ul și să explice cum devine o serie intrarea unui Transformer, prin scalarea prin medie, cuantizare și patching. Al doilea grup privește modelele concrete: Chronos, TimesFM, Moirai, Lag-Llama și TimeGPT diferă prin arhitectură, prin forma intrării, prin forma ieșirii și prin licență, iar aceste diferențe au consecințe practice.
Al treilea grup este empiric. O prognoză cuantilă se evaluează cu pierderea pinball, cu CRPS, cu MASE pentru mediană și cu acoperirea intervalului de 80%. Un model deschis rulează pe procesorul unui laptop, iar comparația lui cu prognoza sezonieră naivă, cu ETS și cu ARIMA trebuie făcută pe aceleași origini, cu același context și cu aceleași scoruri. În sfîrșit, cititorul trebuie să recunoască situațiile în care un scor bun poate proveni din contaminare, nu din capacitatea de prognoză.
Pe scurt
Definiți un foundation model, prognoza zero-shot și fine-tuning-ul
Explicați cum devine o serie intrarea unui Transformer: scalarea prin medie, cuantizarea, patching-ul
Descrieți Chronos, TimesFM, Moirai, Lag-Llama și TimeGPT și spuneți prin ce diferă
Evaluați o prognoză cuantilă cu pierderea pinball, CRPS, MASE și acoperirea unui interval
Rulați un model deschis pe un CPU, comparați-l corect cu prognoza sezonieră naivă, ETS și ARIMA și recunoașteți contaminarea
Capitolul folosește reperele de prognoză din Capitolul 0 și Capitolul 4. Cel mai important este prognoza sezonieră naivă (seasonal naive), \(\hat y_{T+h} = y_{T+h-m}\): valoarea prognozată pentru perioada \(T+h\) este valoarea observată în același sezon al ciclului anterior. Aici \(T\) este ultima perioadă observată, \(h\) orizontul, iar \(m\) lungimea sezonului, de exemplu 12 pentru date lunare sau 168 pentru date orare cu ciclu săptămînal. Pentru seriile fără sezonalitate, \(m = 1\), iar prognoza sezonieră naivă devine prognoza naivă, care repetă ultima valoare.
Din aceleași capitole provin modelele ETS și ARIMA, validarea încrucișată cu origine mobilă (rolling-origin cross-validation) și măsurile de eroare MAE, RMSE și MASE, iar din Capitolul 9 împărțirea datelor în eșantioane de antrenare, validare și test și ideea de rețea neuronală ca funcție flexibilă cu mulți parametri, estimați din date.
Ultima noțiune este cuantila. Cuantila de nivel \(\tau\), notată \(q_\tau\), este valoarea sub care variabila se află cu probabilitatea \(\tau\), unde \(\tau \in (0, 1)\). Mediana este \(q_{0{,}5}\), iar cuantilele \(q_{0{,}1}\) și \(q_{0{,}9}\) delimitează un interval central care conține variabila cu probabilitatea 80%. Prognozele foundation models se raportează exact în această formă, ca mulțime de cuantile.
Pe scurt
Reperele de prognoză și evaluarea lor (capitolele 0 și 4)
prognoza sezonieră naivă \(\hat y_{T+h} = y_{T+h-m}\): prognoza repetă valoarea din același sezon al ciclului anterior
\(T\): ultima perioadă observată; \(h\): orizontul; \(m\): lungimea sezonului (12 pentru date lunare, 168 pentru date orare cu ciclu săptămînal); notația \(\hat{\ }\) indică o prognoză
ETS; validarea încrucișată cu origine mobilă; MAE, RMSE, MASE; testul Diebold–Mariano
eșantioanele de antrenare, validare și test; o rețea neuronală ca funcție flexibilă cu mulți parametri
modelele globale: un model antrenat pe multe serii
Cuantilele: \(q_\tau\) este valoarea sub care variabila se află cu probabilitatea \(\tau\)
\(\tau \in (0, 1)\): nivelul; \(q_{0{,}5}\) este mediana, \(q_{0{,}1}\) și \(q_{0{,}9}\) delimitează un interval central de 80%
AI is undergoing a paradigm shift with the rise of models (e.g., BERT, DALL-E, GPT-3) that are trained on broad data at scale and are adaptable to a wide range of downstream tasks. We call these models foundation models to underscore their critically central yet incomplete character.
Pînă la acest capitol, fiecare prognoză din curs a pornit de la un model construit pentru o singură serie. Modelele ETS, ARIMA, GARCH sau VAR se estimează pe datele seriei, iar parametrii lor descriu acea serie și numai pe ea. Modelele de învățare automată din Capitolul 9 au făcut un prim pas mai departe: un singur model, antrenat pe toate seriile unui set de date. Foundation models pentru serii de timp duc ideea la capăt. Un model mare este antrenat o singură dată, de dezvoltatorul lui, pe un corpus foarte larg de serii din multe domenii, iar apoi prognozează serii pe care nu le-a văzut niciodată, fără nicio estimare pe ele.
Citatul de mai sus, din raportul lui Bommasani et al. (2021), a dat numele acestei clase de modele în domeniul limbajului și al imaginilor. Întrebarea capitolului este dacă ideea funcționează și pentru serii de timp: poate un model pre-antrenat să prognozeze consumul de energie electrică al României, producția industrială sau cursul EUR/RON la fel de bine ca un model estimat chiar pe aceste serii? Răspunsul cere trei ingrediente: o înțelegere a modului în care o serie de numere devine intrarea unei rețele neuronale, scoruri potrivite pentru prognoze probabiliste și un test corect, pe aceleași origini, împotriva reperelor clasice.
Răspunsul obținut pe cele șapte serii ale capitolului este nuanțat. Pe consumul orar de energie electrică, cel mai bun foundation model reduce pierderea cuantilă ponderată cu 42% față de prognoza sezonieră naivă; pe PIB-ul trimestrial, un model ARIMA rămîne mai bun; pe cursul EUR/RON și pe rata șomajului, niciun model nu se îndepărtează mult de prognoza naivă. Capitolul arată de ce apare fiecare dintre aceste rezultate și ce trebuie verificat înainte de a crede un scor publicat.
Cele șapte serii ale testului: consumul orar de energie electrică al României (ENTSO-E, iunie 2026), producția industrială, PIB-ul real trimestrial neajustat sezonier, inflația lunară IAPC și rata șomajului ale României (Eurostat), cursul de referință EUR/RON al BNR și vînzările cu amănuntul din SUA (FRED).
Ce veți putea face
Definiți un foundation model, prognoza zero-shot și fine-tuning-ul și deosebiți-le de modelele locale și globale.
Explicați cum devine o serie intrarea unui Transformer: atenția, scalarea prin medie, cuantizarea și patching-ul.
Descrieți familiile Chronos, TimesFM, Lag-Llama, Moirai și TimeGPT și spuneți prin ce diferă.
Evaluați o prognoză cuantilă cu pierderea pinball, CRPS, WQL, MASE și acoperirea intervalului de 80%.
Comparați corect un model zero-shot cu prognoza sezonieră naivă, ETS și ARIMA și recunoașteți leakage-ul și contaminarea.
Planul capitolului
Ideea de foundation modelModele locale, globale și pre-antrenate; zero-shot și fine-tuning; pre-antrenarea la scară mare.
Transformer-ul, pe scurtArhitectura encoder–decoder, self-attention și un exemplu numeric al ponderilor atenției.
De la numere la tokeniScalarea prin medie, cuantizarea din Chronos și patching-ul, pe date din România.
RezumatIdeile principale, formulele și întrebările de autoevaluare.
Ideea de foundation model
Secțiunea definește trei moduri de a prognoza multe serii, care diferă prin datele pe care se antrenează modelul, și vocabularul de bază al capitolului: contextul, prognoza zero-shot și fine-tuning-ul. Apoi descrie pre-antrenarea, etapa costisitoare pe care o face o singură dată dezvoltatorul modelului.
Un model local (local model) se estimează separat pentru fiecare serie, numai pe datele ei. ETS și ARIMA sînt modele locale: au puțini parametri, fiecare cu o interpretare, de exemplu un coeficient autoregresiv sau o constantă de netezire. Prețul este că 10 000 de serii înseamnă 10 000 de estimări, iar o serie scurtă are prea puține observații pentru a învăța un tipar complicat.
Un model global (global model), ca în Capitolul 9, este unul singur, antrenat pe toate seriile unui set de date. Exemplul clasic este DeepAR al lui Salinas et al. (2020), o rețea neuronală recurentă antrenată pe istoricul vînzărilor tuturor produselor unui comerciant. Seriile își împrumută informație una alteia: un produs nou beneficiază de tiparele învățate pe produsele vechi. Modelul rămîne însă legat de setul de date pe care a fost antrenat.
Un foundation model merge cu un pas mai departe: este pre-antrenat o singură dată pe un corpus foarte larg de serii din multe domenii și se folosește apoi pe serii noi și pe seturi de date noi, fără reestimare. Termenul provine de la Bommasani et al. (2021), care l-au definit pentru modele antrenate pe date largi, la scară mare, și adaptabile la multe sarcini. Cele trei clase diferă deci prin datele de antrenare: seria însăși, setul de date al problemei sau un corpus general.
Pe scurt
Modele locale
cîte un model pentru fiecare serie, estimat doar pe acea serie
ETS, ARIMA: puțini parametri, interpretabile; 10 000 de serii înseamnă 10 000 de estimări
Contextul (context) este istoricul recent \(y_{T-C+1}, \dots, y_T\) pe care modelul îl primește în momentul prognozei, unde \(C\) este lungimea contextului. Contextul joacă rolul datelor de estimare dintr-un model clasic, cu o diferență esențială: modelul nu își schimbă parametrii pe baza lui, ci îl citește, așa cum un model de limbaj citește un text și îl continuă.
Prognoza zero-shot păstrează fixe ponderile pre-antrenate și folosește doar contextul seriei noi. Niciun parametru nu se estimează pe seria-țintă, astfel încît prognoza durează o fracțiune de secundă. Fine-tuning-ul este alternativa: ponderile pre-antrenate se antrenează în continuare pe datele-țintă. El poate ajuta pentru serii neobișnuite, care seamănă puțin cu cele din corpus, dar cere un eșantion de validare, pentru a ști cînd să oprească antrenarea, și mult mai mult calcul. Testele din acest capitol folosesc doar prognoza zero-shot.
Ieșirea acestor modele nu este de obicei un singur număr, ci o mulțime de cuantile \(\hat q_{0{,}1}, \dots, \hat q_{0{,}9}\) pentru fiecare pas viitor. O astfel de prognoză se numește probabilistă: spune nu doar unde se va afla probabil seria, ci și cît de incertă este această estimare. Din acest motiv, capitolul are nevoie de scoruri care evaluează distribuții întregi, nu doar puncte.
Pe scurt
Contextul
istoricul recent \(y_{T-C+1}, \dots, y_T\) transmis modelului în momentul prognozei (\(C\) = lungimea contextului)
Prognoza zero-shot
ponderile pre-antrenate rămîn fixe
se folosește doar contextul seriei noi
niciun parametru nu se estimează pe seria-țintă: prognoza durează o fracțiune de secundă
Fine-tuning
antrenarea suplimentară a ponderilor pre-antrenate pe datele-țintă
poate ajuta la serii neobișnuite; cere un eșantion de validare și mai mult calcul
Rezultatul este de obicei o mulțime de cuantile\(\hat q_{0{,}1}; \dots; \hat q_{0{,}9}\) pentru fiecare pas viitor, nu un singur număr
Corpusurile de pre-antrenare amestecă serii publice din multe domenii: energie, transport, comerț, vreme, trafic web, finanțe și economie. Varietatea este intenționată. Un model care a văzut cicluri zilnice în consumul de energie, cicluri săptămînale în traficul web și cicluri anuale în vînzări poate recunoaște un tipar asemănător într-o serie nouă. Pentru Chronos, Ansari et al. (2024) au adăugat și serii sintetice: amestecuri aleatoare de serii reale și serii generate din procese gaussiene (Gaussian processes), care acoperă forme pe care datele publice nu le conțin suficient de des.
Scara este mult peste cea a oricărui set de date din cursurile anterioare. TimesFM, de exemplu, a fost pre-antrenat pe circa \(10^{11}\) puncte de date (Das et al., 2024). Pre-antrenarea se face o singură dată, de dezvoltator, pe multe procesoare grafice (graphics processing units, GPU), iar fotografia unui centru de date Google amintește de infrastructura pe care o cere.
Utilizatorul nu repetă acest cost. El doar rulează modelul, iar versiunile mici rulează pe procesorul central (CPU) al unui calculator obișnuit. Această împărțire a costului este centrală pentru utilitatea practică a modelelor: un analist cu un laptop poate obține într-o fracțiune de secundă o prognoză probabilistă care ar fi cerut altfel estimarea unui model separat.
Modelele locale, globale și de tip foundation diferă prin datele pe care se antrenează: seria însăși, seriile unui set de date sau un corpus larg din multe domenii. Prognoza zero-shot folosește ponderi fixe și doar contextul seriei noi, iar rezultatul ei este o mulțime de cuantile, adică o prognoză probabilistă.
Pe scurt
Modelele locale, globale și de tip foundation diferă prin datele pe care se antrenează
Zero-shot: ponderi fixe, doar contextul seriei noi
Rezultatul este o mulțime de cuantile: o prognoză probabilistă
Sinteza secțiunii
Un foundation model mută estimarea din momentul prognozei în momentul pre-antrenării. Dezvoltatorul plătește costul o singură dată, pe un corpus foarte larg, iar utilizatorul obține o prognoză probabilistă dintr-un context, fără nicio estimare. Rămîne de văzut ce rețea face posibil acest lucru și cum se transformă o serie de numere într-o intrare pentru ea.
Transformer-ul, pe scurt
Aproape toate foundation models pentru serii de timp sînt construite pe Transformer, rețeaua introdusă de Vaswani et al. (2017) pentru traducerea automată. Secțiunea prezintă arhitectura, mecanismul ei central, atenția (self-attention), și un exemplu numeric, fără a intra în detaliile de antrenare ale rețelelor neuronale.
Vaswani et al. (2017) au propus o rețea pentru secvențe construită în întregime pe atenție, fără recurență. Rețelele recurente din Capitolul 9 citesc secvența pas cu pas și își poartă memoria într-o stare internă; Transformer-ul compară direct fiecare poziție cu toate celelalte. Rețeaua a fost creată pentru traducere și stă astăzi la baza majorității modelelor mari de limbaj (large language models, LLM).
Intrarea este o secvență de tokeni, adică unități discrete: într-un text, cuvinte sau fragmente de cuvinte. Fiecare token este transformat într-un vector de numere, numit embedding, pe care rețeaua îl învață la antrenare. Diagrama originală, reprodusă pe slide, are două părți. Encoder-ul (stînga) citește toată intrarea și o transformă într-o reprezentare internă. Decoder-ul (dreapta) produce ieșirea pas cu pas, folosind această reprezentare și ce a produs deja. Modelele doar cu decoder (decoder-only), precum GPT, TimesFM și Lag-Llama, renunță la encoder și prognozează tokenul următor din toți cei anteriori, ceea ce se potrivește natural cu prognoza unei serii.
Un detaliu tehnic are consecințe: atenția, așa cum va fi definită mai jos, ignoră ordinea intrărilor. Dacă permutăm pozițiile, ieșirea se permută la fel. Pentru o serie de timp ordinea este însă esențială, așa că fiecărui vector i se adaugă o informație despre poziția lui în secvență (positional encoding).
Self-attention produce, pentru fiecare poziție a secvenței, o medie ponderată a informației de la toate pozițiile. Fiecare vector de intrare \(x_i\) produce trei vectori, prin trei transformări liniare: o interogare (query) \(q_i = W_Q x_i\), care descrie ce caută poziția \(i\); o cheie (key) \(k_i = W_K x_i\), care descrie ce oferă poziția \(i\); și o valoare (value) \(v_i = W_V x_i\), care este informația transmisă de poziția \(i\). Matricele \(W_Q\),\(W_K\) și \(W_V\) sînt aceleași pentru toate pozițiile și se învață la antrenare.
unde indicii \(j\) și \(l\) parcurg toate pozițiile de intrare, iar \(w_{ij}\) este ponderea pe care poziția \(i\) o dă poziției \(j\). Produsul scalar \(q_i^\top k_j\) este un scor de similaritate: este mare cînd interogarea și cheia au aproximativ aceeași direcție. \(d\) este lungimea vectorilor-cheie; fără împărțirea la \(\sqrt{d}\), produsele scalare ar crește cu dimensiunea vectorilor, iar ponderile s-ar concentra aproape în întregime pe o singură poziție.
Funcția care transformă scorurile în ponderi este softmax. Exponențiala face toate ponderile pozitive, iar numitorul face ca ponderile poziției \(i\) să aibă suma 1. Ieșirea este deci o medie ponderată a valorilor, cu ponderi mai mari pentru pozițiile ale căror chei se potrivesc cu interogarea. Un model AR(\(p\)) face și el o medie ponderată a trecutului, dar cu aceleași ponderi la fiecare moment; în atenție, ponderile depind de conținutul secvenței.
Pe scurt
Fiecare vector de intrare \(x_i\) produce trei vectori, prin trei transformări liniare învățate la antrenare
o interogare \(q_i = W_Q x_i\) (ce caută poziția \(i\)), o cheie \(k_i = W_K x_i\) (ce oferă poziția \(i\)), o valoare \(v_i = W_V x_i\) (ce transmite poziția \(i\))
\(W_Q\), \(W_K\), \(W_V\): matrice de ponderi învățate la antrenare, aceleași pentru toate pozițiile
Ieșirea în poziția \(i\) este o medie ponderată a valorilor tuturor pozițiilor
Calculul din (11.1) se scrie compact în formă matricială: \(\text{softmax}(QK^\top/\sqrt{d})\,V\). Liniile matricelor \(Q\),\(K\) și \(V\) sînt vectorii \(q_i\),\(k_i\) și \(v_i\), iar produsul \(QK^\top\) conține toate scorurile \(q_i^\top k_j\) simultan. Softmax se aplică pe fiecare linie și dă ponderile \(w_{ij}\), iar înmulțirea cu \(V\) face mediile ponderate. Forma matricială este cea în care calculul rulează eficient pe procesoarele grafice.
Pentru o serie de timp, intuiția este următoarea. Pasul de azi poate „privi” aceeași oră de săptămîna trecută și îi poate da o pondere mare, dacă interogarea lui se potrivește cu cheia acelei ore. Spre deosebire de lagurile unui AR(\(p\)), fixate dinainte de analist, aceste legături sînt învățate din date și pot fi diferite pentru fiecare poziție și pentru fiecare serie.
Prețul este costul. Fiecare dintre cele \(n\) intrări se compară cu toate celelalte, deci atenția cere \(n^2\) comparații. Un context de 2048 de valori dă \(2048^2\), circa 4 milioane de comparații în fiecare strat de atenție. Această creștere pătratică este motivul pentru care modelele moderne grupează valorile în patch-uri, după cum arată secțiunea următoare.
Pe scurt
Forma matricială a aceluiași calcul: \(\text{softmax}(QK^\top/\sqrt{d})\,V\)
\(Q\), \(K\), \(V\): matrice ale căror linii sînt vectorii \(q_i\), \(k_i\), \(v_i\); \(QK^\top\) conține toate scorurile \(q_i^\top k_j\)
softmax: aplicată pe fiecare linie, transformă scorurile în ponderile \(w_{ij}\) de pe slide-ul anterior
Intuiția pentru serii: pasul de azi se poate uita la aceeași oră de săptămîna trecută și îi poate da o pondere mare
ponderile sînt învățate din date, nu fixate dinainte, ca lagurile unui AR(\(p\))
Costul: \(n\) intrări cer \(n^2\) comparații
un context de 2048 de valori dă circa 4 milioane de comparații în fiecare strat de atenție
Exemplul urmărește (11.1) pentru o singură interogare și trei chei. Scorurile scalate \(q^\top k_j/\sqrt{d}\) sînt 2, 1 și 0, iar valorile asociate cheilor sînt \(v_1 = 10\),\(v_2 = 20\) și \(v_3 = 30\). Primul pas aplică exponențiala: \(e^2 = 7{,}39\),\(e^1 = 2{,}72\) și \(e^0 = 1\), cu suma 11,11.
Al doilea pas împarte fiecare termen la sumă și dă ponderile 0,67, 0,24 și 0,09, a căror sumă este 1. Al treilea pas face media ponderată a valorilor: \(0{,}665 \times 10 + 0{,}245 \times 20\)\(+\, 0{,}090 \times 30 = 14{,}2\). Prima cheie, cu scorul cel mai mare, primește două treimi din pondere, iar ieșirea este apropiată de valoarea ei, 10. Celelalte două valori contribuie totuși și trag ieșirea în sus. Atenția este deci o selecție „moale”: favorizează pozițiile potrivite fără a le ignora pe celelalte.
Un foundation model suprapune multe astfel de straturi. În fiecare strat există mai multe capete de atenție (attention heads), fiecare cu propriile matrice \(W_Q\),\(W_K\) și \(W_V\), astfel încît un cap poate urmări ciclul zilnic, iar altul nivelul recent.
Pe scurt
O interogare și trei chei; scorurile \(q^\top k_j/\sqrt{d}\) = 2, 1, 0; valorile \(v_j\) = 10, 20, 30
Atenția face din fiecare pas o medie ponderată, învățată, a tuturor pașilor, cu ponderi date de potrivirea dintre interogări și chei. Chronos folosește o arhitectură encoder–decoder, iar TimesFM și Lag-Llama una doar cu decoder. Costul atenției crește cu pătratul numărului de intrări.
Pe scurt
Atenția: fiecare pas este o medie ponderată, învățată, a tuturor pașilor
Arhitecturi encoder–decoder (Chronos) și arhitecturi doar cu decoder (TimesFM, Lag-Llama)
Costul crește cu pătratul numărului de intrări
Sinteza secțiunii
Transformer-ul înlocuiește lagurile fixe ale unui model AR cu ponderi care depind de conținutul secvenței. Exemplul numeric arată că rezultatul este o medie ponderată, dominată de pozițiile cele mai potrivite. Rețeaua a fost construită însă pentru tokeni discreți, iar costul ei crește cu pătratul lungimii intrării, două probleme pe care o serie de timp lungă, formată din numere reale, le face imediat vizibile.
De la numere la tokeni
Un model de limbaj citește tokeni dintr-un vocabular fix, iar o serie de timp conține numere reale, în unități foarte diferite. Secțiunea prezintă cele trei soluții folosite în practică și le aplică pe două serii din România: scalarea prin medie și cuantizarea din Chronos, pe producția industrială, și patching-ul, pe consumul orar de energie electrică.
Reprezentarea seriilor numerice ca date de intrare
Seriile diferă prin unități și niveluri. Consumul de energie electrică al României se măsoară în gigawați (GW), cu valori orare între circa 3 și 8; un indice al producției industriale oscilează în jurul lui 100; cursul EUR/RON este în jur de 5. Un singur model, folosit pentru toate aceste serii, are nevoie de o scală comună. Altfel, aceeași formă, de exemplu o creștere de 10%, ar arăta complet diferit în fiecare serie.
Practica a produs trei soluții. Prima, din Chronos, combină scalarea cu cuantizarea: fiecare valoare devine un token dintr-un vocabular fix, exact ca un cuvînt. A doua, patching-ul, grupează valori consecutive într-un vector de intrare; o folosesc TimesFM, Moirai și Chronos-Bolt. A treia scrie cifrele ca text și le dă unui model de limbaj general, care le citește ca șiruri de caractere; Gruver et al. (2023) au arătat că un LLM poate produce astfel prognoze zero-shot.
În toate cele trei cazuri, modelul lucrează pe o reprezentare fără unități, iar prognozele se transformă la sfîrșit înapoi în unitățile inițiale. Pentru utilizator, transformarea este invizibilă; pentru înțelegerea rezultatelor, ea contează, deoarece explică ce poate și ce nu poate „vedea” modelul.
Pe scurt
Seriile diferă prin unități și niveluri: consumul în GW, un indice în jur de 100, un curs de schimb în jur de 5
un singur model pentru toate are nevoie de o scală comună
Trei soluții folosite în practică
scalare + cuantizare: fiecare valoare devine un token dintr-un vocabular fix (Chronos)
patching: grupuri de valori consecutive devin un vector de intrare (TimesFM, Moirai, Chronos-Bolt)
cifrele ca text: un LLM general citește numerele ca șiruri de caractere (Gruver et al. (2023))
În toate cazurile, prognozele se transformă înapoi în unitățile inițiale
Scalarea prin medie și cuantizarea (Chronos) (1/2)
Primul pas din Chronos este scalarea prin medie (mean scaling). Fiecare valoare a contextului se împarte la media valorilor absolute ale contextului:
\[\tilde x_t = \frac{x_t}{s}, \qquad s = \frac{1}{C}\sum_{t=1}^{C} |x_t|,\]
(11.2)
unde \(x_t\) este a \(t\)-a valoare a contextului, \(t = 1, \dots, C\),\(C\) este lungimea contextului, \(s\) este scala, iar \(\tilde x_t\) valoarea scalată. După scalare, contextul are valori de ordinul unității, oricare ar fi unitățile inițiale: o serie în GW și una în lei arată la fel dacă au aceeași formă. Spre deosebire de standardizarea obișnuită, scalarea prin medie nu scade media, deci păstrează semnul valorilor și raportul dintre ele.
Al doilea pas este cuantizarea (quantisation): fiecare valoare scalată este înlocuită cu numărul unui interval. Chronos împarte intervalul \([-15, 15]\) în 4093 de intervale egale, de lățime circa 0,0073, iar tokenul lui \(\tilde x_t\) este numărul celui mai apropiat centru de interval. Vocabularul mai conține cîțiva tokeni speciali, de exemplu pentru completarea unei secvențe prea scurte și pentru sfîrșitul secvenței. După acești doi pași, o serie este o secvență de numere întregi, exact ca un text tokenizat.
Pe scurt
Scalarea prin medie
fiecare valoare a contextului se împarte la media valorilor absolute ale contextului
Pe secvența de tokeni, Chronos antrenează un model de limbaj obișnuit, T5, să prognozeze tokenul următor. Funcția de pierdere este cross-entropy, \(-\log \hat p(z_{t+1})\), unde \(z_{t+1}\) este tokenul următor efectiv, iar \(\hat p(z_{t+1})\) probabilitatea atribuită lui de model. Pierderea este 0 cînd modelul atribuie probabilitatea 1 tokenului corect și crește pe măsură ce această probabilitate scade. Modelul învață astfel o distribuție de probabilitate peste cele 4093 de intervale, nu un singur număr.
Prognoza se face în trei pași. Întîi, se eșantionează din model multe traiectorii viitoare de tokeni, fiecare token fiind tras din distribuția prognozată, dat fiind tot ce precede. Apoi fiecare token se înlocuiește cu centrul intervalului său și se înmulțește cu scala \(s\), ceea ce readuce valorile în unitățile inițiale. În sfîrșit, la fiecare pas viitor se citesc cuantilele valorilor eșantionate: mediana, cuantila de 10%, cea de 90% și așa mai departe.
Construcția are o limită clară: o valoare scalată în afara intervalului \([-15, 15]\) nu poate fi produsă. O serie care ar urca la de 20 de ori nivelul mediu al contextului depășește vocabularul modelului. Pentru seriile economice obișnuite, limita este rar atinsă, dar ea arată că modelul prognozează forme relative la context, nu niveluri absolute.
Pe scurt
Antrenarea: un model de limbaj (T5) învață să prognozeze tokenul următor
funcția de pierdere: cross-entropy \(-\log \hat p(z_{t+1})\), unde \(z_{t+1}\) este tokenul următor efectiv, iar \(\hat p(z_{t+1})\) probabilitatea atribuită lui de model
este 0 cînd această probabilitate este 1 și crește cînd probabilitatea scade
Prognoza, în trei pași
se eșantionează din model multe traiectorii de tokeni
fiecare token se înlocuiește cu centrul intervalului său și se înmulțește cu \(s\)
se citesc cuantilele valorilor eșantionate la fiecare pas viitor
Limita: valorile scalate în afara intervalului \([-15, 15]\) nu pot fi produse
Contextul este rata șomajului din România, în procente, ajustată sezonier (Eurostat), pentru cele șase luni din martie pînă în august 2026: 6,5; 6,8; 6,7; 6,8; 6,4; 6,4. Primul pas calculează scala din (11.2): toate valorile sînt pozitive, deci \(s\) este media lor, \(39{,}6/6 = 6{,}60\).
Al doilea pas împarte fiecare valoare la 6,60 și dă 0,985; 1,030; 1,015; 1,030; 0,970; 0,970. Al treilea pas găsește cel mai apropiat centru de interval. Centrele sînt numerotate de la 0 la 4092 și sînt la distanța 0,0073 unul de altul, începînd de la \(-15\); valoarea 1 corespunde deci aproximativ centrului 2182, iar cele șase valori dau tokenii 2180, 2187, 2184, 2187, 2178 și 2178.
Două observații rezultă din exemplu. Valorile egale dau tokeni egali, iar o variație de 0,1 puncte procentuale a ratei șomajului, adică 1,5% din scală, mută tokenul cu două-trei intervale: grila este suficient de fină pentru variațiile tipice ale seriei. Mai important, modelul nu vede niciodată nivelul de 6,6%; vede doar forma seriei relativ la scală. Pentru el, un șomaj de 6,6% și unul de 13,2% cu aceeași formă relativă sînt identice.
Pe scurt
Contextul: rata șomajului din România (%, ajustată sezonier, Eurostat), martie 2026–august 2026
Întrebare pentru sală ▶ crește c pînă la 3 (scorurile 6, 3, 0). Ce se întîmplă cu ieșirea?
Răspuns
Scade la 10,5, aproape de valoarea primei chei (10): ponderea ei crește la 95%. Cu c = 0 toate ponderile sînt 1/3 și ieșirea este media, 20; împărțirea la √d ține scorurile moderate, astfel încît și celelalte poziții contribuie.
Întrebare pentru sală Alegeți 21 de intervale în [−15, 15]. Cîți tokeni distincți dau cele șase luni?
Răspuns
Unul singur: intervalele au lățimea 1,5, iar toate valorile scalate (de la 0,970 la 1,030) cad în același interval. Cu 4093 de intervale (lățimea 0,0073) sînt 4 tokeni; o variație de 0,1 puncte a ratei mută valoarea scalată cu 2,07 intervale.
Întrebare pentru sală ▶ scurtează contextul la 24 de luni (august 2024 – iulie 2026). Cîți tokeni distincți folosește contextul pe grila grosieră de 21 de intervale?
Răspuns
Doi (față de trei pentru 96 de luni): fără aprilie 2020, valorile scalate rămîn între 0,87 și 1,11, adică în două intervale de lățime 0,30. Scala se adaptează contextului (s = 94,1 în loc de 97,8), deci tokenii descriu forma relativă la nivelul recent, nu nivelul.
Graficul aplică cei doi pași pe producția industrială a României, un indice cu baza 2021 = 100, pentru ultimele 96 de luni ale seriei, din august 2018 pînă în iulie 2026. Panoul din stînga arată seria în unitățile ei, iar linia roșie întreruptă marchează scala \(s\), media valorilor absolute ale contextului, 97,8. Se văd sezonalitatea lunară, cu scăderi regulate, și căderea bruscă din aprilie 2020, cînd carantina a oprit o mare parte a industriei.
Panoul din dreapta arată contextul scalat, \(x_t/s\) (linia albastră), și tokenii lui (linia roșie în trepte), pe o grilă grosieră de doar 21 de intervale, aleasă pentru ca treptele să fie vizibile. Centrele intervalelor folosite sînt marcate cu linii punctate orizontale, la 0,6, 0,9 și 1,2. Fiecare valoare scalată este înlocuită cu centrul cel mai apropiat, de aceea linia roșie sare între cele trei niveluri.
După scalare, toate cele 96 de valori sînt între 0,63 și 1,17. Ele ocupă deci doar cîteva procente din intervalul \([-15, 15]\) pe care îl acoperă vocabularul Chronos; restul intervalului este rezervat seriilor cu salturi mari față de nivelul lor obișnuit. Pe grila grosieră de 21 de intervale, cele 96 de luni folosesc doar trei tokeni, iar căderea din aprilie 2020 este singura lună care primește un token separat.
Grila grosieră pierde aproape toată forma sezonieră: lunile obișnuite sînt fie „0,9”, fie „1,2”. Cu cele 4093 de intervale ale Chronos, distanța dintre centre este de circa 40 de ori mai mică decît cea dintre 0,9 și 1,2, iar grila este suficient de fină pentru a păstra forma sezonieră. Pierderea de informație prin cuantizare este, în practică, mult mai mică decît eroarea de prognoză.
Exemplul arată și o slăbiciune a scalării prin medie. Scala este media tuturor valorilor contextului, deci o valoare extremă o modifică. Un vîrf foarte mare mărește \(s\) și micșorează toate celelalte valori scalate; o cădere ca cea din 2020 o micșorează puțin. Valorile aberante din context contează așadar pentru întreaga prognoză, nu doar pentru perioada în care apar.
Pe scurt
Producția industrială a României (Eurostat, 2021 = 100), ultimele 96 de luni; scala \(s\) = 97,8
Dreapta: contextul scalat și tokenii lui pe o grilă grosieră de 21 de intervale (Chronos folosește 4093)
După scalare, toate valorile sînt între 0,63 și 1,17: cîteva procente din intervalul \([-15, 15]\)
Pe grila grosieră, cele 96 de luni folosesc doar 3 tokeni: căderea din aprilie 2020 (carantina) este un token separat
Cu 4093 de intervale, grila este suficient de fină pentru a păstra forma sezonieră
O valoare extremă mărește \(s\) și micșorează toate celelalte valori scalate: valorile aberante din context contează
Un patch este un bloc de \(P\) valori consecutive, transformat de o rețea mică într-un singur vector de intrare pentru Transformer. Ideea a fost popularizată de PatchTST al lui Nie et al. (2023), al cărui titlu, „o serie de timp valorează cît 64 de cuvinte”, rezumă analogia: un patch joacă rolul unui cuvînt, iar seria devine o propoziție scurtă.
Patching-ul are două avantaje. Primul este lungimea: 2048 de valori cu \(P = 16\) dau 128 de patch-uri, deci atenția cere \(128^2 = 16\,384\) de comparații în loc de \(2048^2\), adică de 256 de ori mai puține. Al doilea este conținutul: fiecare intrare poartă o formă locală, de exemplu o pantă sau un vîrf, nu un singur număr zgomotos. O valoare orară luată separat spune puțin; 16 valori consecutive arată dacă seria urcă spre vîrful de seară sau coboară spre minimul de noapte.
TimesFM folosește patch-uri de intrare de 32 de valori, Moirai alege mărimea patch-ului după frecvența seriei, iar Chronos-Bolt și Chronos-2 folosesc patch-uri de 16. Și ieșirea poate fi un patch întreg: modelul prognozează deodată un bloc de valori viitoare, ceea ce este mult mai rapid decît generarea lor una cîte una, token cu token, ca în Chronos.
Pe scurt
Patch
un bloc de \(P\) valori consecutive, transformat într-un vector de intrare de o rețea mică
PatchTST (Nie et al. (2023)): „o serie de timp valorează cît 64 de cuvinte”
Două avantaje
mai puține intrări: 2048 de valori cu \(P = 16\) dau 128 de patch-uri, deci atenția cere \(128^2\) în loc de \(2048^2\) comparații
fiecare intrare poartă o formă locală (o pantă, un vîrf), nu un singur număr zgomotos
Folosit de TimesFM (patch-uri de intrare de 32), Moirai (mărimea patch-ului după frecvență), Chronos-Bolt și Chronos-2 (16)
și ieșirea poate fi un patch întreg de valori viitoare, ceea ce este mai rapid decît token cu token
Patching-ul consumului de energie electrică al României
Întrebare pentru sală Puneți C = 512. Cîte patch-uri de 16 primește Chronos-Bolt?
Răspuns
32 = 512/16, cu 32² = 1024 de comparații într-un strat de atenție, față de 512² = 262 144 pentru un token pe valoare (Chronos). TimesFM, cu patch-uri de 32, primește 16.
Întrebare pentru sală Puneți P = 24 (un patch pe zi). Cîte patch-uri cere o săptămînă (168 de ore)?
Răspuns
7 = 168/24, față de 11 pentru P = 16 (168/16 = 10,5, rotunjit în sus). Cu P = 24 patch-urile se aliniază cu ciclul zilnic, iar cele 336 de ore dau 14 patch-uri; comparațiile atenției scad de la 441 la 196.
Graficul arată 336 de valori orare ale consumului de energie electrică al României, în GW, pentru primele două săptămîni din iunie 2026, cu date de la ENTSO-E, rețeaua europeană a operatorilor de transport și de sistem. Cele 336 de ore sînt împărțite în \(336/16 = 21\) de patch-uri de cîte 16 valori; patch-urile alternează culoarea, albastru și roșu, pe fundaluri gri și roz, pentru ca limitele lor să fie vizibile.
Seria are un tipar zilnic clar: un minim noaptea, în jur de 4 GW, și un vîrf seara, între 6 și 7 GW. Două dintre minime, în jurul datelor de 7 și 14 iunie, sînt mai adînci și mai lungi: sînt duminicile, cînd consumul industrial scade. Fiecare patch conține o bucată din acest tipar: unele cuprind doar urcarea de dimineață, altele vîrful și coborîrea de seară.
Pe scurt
336 de valori orare (două săptămîni din iunie 2026, ENTSO-E), împărțite în 21 de patch-uri de cîte 16 valori
O zi are 24 de ore, deci un patch de 16 ore acoperă două treimi dintr-o zi, iar patch-urile nu se aliniază cu ciclul zilnic. Același patch începe o dată la miezul nopții, altă dată la ora 16 și altă dată la ora 8. Modelul nu primește deci „ziua” ca unitate, ci fragmente de zile, decalate de la o zi la alta.
Atenția rezolvă această problemă. Ea leagă patch-urile între ele după conținut, nu după poziția lor fixă: creșterea de dimineață de luni poate fi pusă în legătură cu cea de lunea trecută, chiar dacă cele două creșteri cad în poziții diferite ale patch-urilor lor. Aceasta este aceeași intuiție ca în exemplul cu ora de săptămîna trecută, aplicată pe blocuri.
Atenția poate lega doar ce se află în context. Un ciclu săptămînal are 168 de ore, adică \(168/16 = 10{,}5\), deci 11 patch-uri. Modelul poate „vedea” diferența dintre zilele lucrătoare și weekend doar dacă contextul acoperă cel puțin o săptămînă întreagă; secțiunea despre evaluare confirmă empiric această regulă.
Pe scurt
O zi are 24 de ore, deci un patch de 16 acoperă două treimi dintr-o zi: patch-urile nu se aliniază cu ciclul zilnic
Atenția leagă patch-urile: creșterea de dimineață de luni poate fi pusă în legătură cu cea de lunea trecută
Un ciclu săptămînal (168 de ore) este vizibil doar dacă contextul acoperă cel puțin o săptămînă: 11 patch-uri
Scalarea prin medie elimină unitățile, iar cuantizarea transformă valorile scalate în tokeni dintr-un vocabular fix, ca în Chronos. Patching-ul grupează valorile consecutive, ceea ce scurtează secvența și dă fiecărei intrări o formă locală. Prognoza se transformă la sfîrșit înapoi în unitățile inițiale.
Pe scurt
Scalarea prin medie elimină unitățile; cuantizarea transformă valorile în tokeni (Chronos)
Patching-ul grupează valorile: secvențe mai scurte, forme locale
Prognoza se transformă înapoi în unitățile inițiale
Sinteza secțiunii
O serie devine intrarea unui Transformer printr-o reprezentare fără unități: tokeni de valori scalate sau patch-uri de valori consecutive. Reprezentarea explică două proprietăți pe care evaluarea le va confirma: modelul prognozează forma relativ la scală, nu nivelul, și poate folosi doar ciclurile pe care contextul le conține complet.
Principalele familii de modele
Între 2023 și 2025 au apărut mai multe familii de foundation models pentru serii de timp, construite de companii mari de tehnologie și de grupuri academice. Secțiunea le descrie pe cele mai citate, prin patru caracteristici care contează în practică: arhitectura, forma intrării, forma ieșirii și licența.
Chronos, publicat de Ansari et al. (2024) la Amazon, este modelul descris în secțiunea precedentă: un T5 encoder–decoder antrenat pe valori scalate și cuantizate, care eșantionează traiectorii de tokeni. Avantajul lui este simplitatea conceptuală, deoarece reutilizează fără modificări un model de limbaj; dezavantajul este viteza, deoarece fiecare traiectorie se generează token cu token.
Chronos-Bolt, lansat în noiembrie 2024, înlocuiește tokenii cu patch-uri de 16 valori și produce direct cuantilele de nivel 0,1, 0,2, …, 0,9, fără eșantionare. Capitolul folosește două dimensiuni: tiny, cu 9 milioane de parametri, și small, cu 48 de milioane; ambele acceptă un context de pînă la 2048 de valori. Chronos-2, descris de Ansari et al. (2025) și lansat în octombrie 2025, are 119 milioane de parametri, produce 21 de niveluri de cuantile și poate folosi covariate (covariates), adică variabile explicative, precum și grupuri de serii înrudite.
Toate trei au ponderi deschise, sub licența Apache-2.0, care permite și utilizarea comercială, și se instalează cu pachetul Python chronos-forecasting. Toate rulează pe un CPU, ceea ce le face potrivite pentru un curs: fiecare rezultat din acest capitol poate fi reprodus pe un laptop.
TimesFM, publicat de Das et al. (2024) la Google, este un Transformer doar cu decoder. Intrarea este formată din patch-uri de 32 de valori, iar ieșirea din patch-uri de 128 de valori: modelul prognozează deodată un bloc lung, ceea ce reduce numărul de pași necesari pentru un orizont mare. A fost pre-antrenat pe serii reale, de exemplu Google Trends și numărul de accesări ale paginilor Wikipedia, și pe serii sintetice, și are circa 200 de milioane de parametri. Ponderile sînt deschise (Apache-2.0); versiunile ulterioare adaugă ieșiri cuantile.
Lag-Llama, al lui Rasul et al. (2023), este tot un model doar cu decoder, construit pe arhitectura Llama a modelelor de limbaj. Intrarea lui este diferită: în locul patch-urilor, fiecare pas primește valorile seriei la laguri alese după frecvență, de exemplu 7 zile pentru date zilnice, 12 luni pentru date lunare sau 24 de ore pentru date orare, plus variabile de calendar. Construcția seamănă cu cea a unui model autoregresiv sezonier, în care lagurile sezoniere sînt date explicit.
Ieșirea Lag-Llama este parametrică: modelul prognozează parametrii unei distribuții Student-\(t\) pentru pasul următor, iar eșantionarea repetată dă traiectorii și, din ele, cuantile. Modelul este mic și deschis (Apache-2.0) și a fost gîndit mai ales ca punct de plecare pentru fine-tuning.
Moirai, al lui Woo et al. (2024) de la Salesforce, își propune să fie un model de prognoză „universal”. Poate primi orice număr de variabile într-o singură secvență, deci tratează în același fel o serie univariată și una multivariată, și alege mărimea patch-ului după frecvența datelor. Ieșirea este un amestec de distribuții (mixture distribution), care poate reprezenta forme variate, de exemplu distribuții asimetrice sau cu cozi groase. A fost pre-antrenat pe corpusul LOTSA, cu circa 27 de miliarde de observații. Ponderile sînt deschise, dar cu licență necomercială (CC BY-NC 4.0).
TimeGPT, al lui Garza et al. (2023), este un model închis, disponibil doar printr-o interfață de programare (application programming interface, API) cu plată. Ponderile și datele de antrenare nu pot fi inspectate, versiunea modelului se poate schimba fără anunț, iar datele utilizatorului pleacă de pe calculatorul lui spre serverele furnizorului.
Pentru un curs, aceste trei trăsături sînt decisive. Un rezultat obținut astăzi printr-un API poate să nu mai poată fi reprodus peste un an, iar întrebarea dacă seria de test a fost în datele de antrenare nu are răspuns. Din aceste motive, TimeGPT nu este folosit în testele capitolului.
Tabelul rezumă cele patru caracteristici. Pe coloana arhitecturii, modelele se împart în encoder–decoder (Chronos, Chronos-Bolt), doar encoder (Chronos-2, Moirai) și doar decoder (TimesFM, Lag-Llama). Pe coloana intrării, Chronos este singurul care folosește tokeni de valori; restul folosesc patch-uri, cu excepția Lag-Llama, care folosește valori la laguri fixe. Pe coloana ieșirii, formele sînt mai variate: traiectorii eșantionate, un număr fix de cuantile, patch-uri de valori, un amestec de distribuții sau o distribuție Student-\(t\). Pentru TimeGPT, articolul descrie arhitectura doar în linii mari, iar ieșirea este formată din prognoze punctuale și intervale.
Ultima coloană, accesul, decide ce se poate verifica. Ponderile sub licența Apache-2.0 pot fi descărcate, rulate și inspectate de oricine; licența CC BY-NC 4.0 a lui Moirai interzice utilizarea comercială; TimeGPT poate fi folosit doar prin API-ul cu plată.
O altă direcție folosește LLM-uri generale, care citesc cifrele seriei ca text (Gruver et al., 2023).Tan et al. (2024) au testat sistematic astfel de metode și au arătat că, atunci cînd partea de model de limbaj este eliminată sau înlocuită cu un strat simplu de atenție, precizia nu scade: componenta LLM adaugă cost de calcul, dar nu și precizie.
Pe scurt
Model
Arhitectura
Intrarea
Ieșirea
Acces
Chronos (2024)
encoder–decoder (T5)
tokeni (intervale)
traiectorii eșantionate
Apache-2.0
Chronos-Bolt (2024)
encoder–decoder
patch-uri de 16
9 cuantile
Apache-2.0
Chronos-2 (2025)
encoder
patch-uri + covariate
21 de cuantile
Apache-2.0
TimesFM (2024)
decoder
patch-uri de 32
patch-uri de 128
Apache-2.0
Moirai (2024)
encoder
patch-uri, orice variabile
amestec
CC BY-NC 4.0
Lag-Llama (2023)
decoder (Llama)
valori la laguri fixe
Student-\(t\)
Apache-2.0
TimeGPT (2023)
encoder–decoder (puține detalii)
–
puncte, intervale
API cu plată
O altă direcție dă cifrele unor LLM-uri generale (Gruver et al. (2023)); Tan et al. (2024) arată că partea de model de limbaj adaugă cost, dar nu și precizie
Chronos lucrează cu tokeni, iar Chronos-Bolt și Chronos-2 cu patch-uri și cuantile produse direct. TimesFM și Lag-Llama sînt modele doar cu decoder, iar Moirai acceptă orice număr de variabile. Ponderile deschise fac rezultatele reproductibile; un API cu plată nu le face.
Pe scurt
Chronos: tokeni; Chronos-Bolt și Chronos-2: patch-uri și cuantile directe
TimesFM și Lag-Llama: doar cu decoder; Moirai: orice număr de variabile
Ponderile deschise fac rezultatele reproductibile; un API cu plată, nu
Sinteza secțiunii
Familiile de modele diferă mai puțin prin idee decît prin detalii: cum se scalează și se grupează valorile, ce formă are prognoza și cine are acces la ponderi. Pentru testele capitolului contează două lucruri: toate modelele folosite au ponderi deschise și rulează pe un CPU, iar toate produc cuantile, ceea ce cere scoruri potrivite pentru prognoze probabiliste.
Prognozele probabiliste și scorurile lor
O prognoză punctuală se evaluează prin distanța dintre valoarea prognozată și cea observată. O prognoză probabilistă este o distribuție, iar valoarea observată este un singur număr, așa că este nevoie de scoruri care compară cele două obiecte. Secțiunea definește pierderea pinball pentru o cuantilă, CRPS pentru o distribuție întreagă, WQL ca versiune practică a CRPS, MASE pentru mediană și acoperirea pentru calibrarea intervalelor.
O prognoză probabilistă dă distribuția lui \(y_{T+h}\), condiționată de datele disponibile pînă la momentul \(T\). Foundation models raportează această distribuție prin cuantile \(\hat q_\tau\) la nivelurile \(\tau = 0{,}1; 0{,}2; \dots; 0{,}9\). Din ele se citesc direct prognoza punctuală, mediana \(\hat q_{0{,}5}\), și intervalul central de 80%, \([\hat q_{0{,}1}, \hat q_{0{,}9}]\). Un fan chart desenează mai multe astfel de benzi, de exemplu cele de 50% și de 80%, una peste alta.
O prognoză probabilistă bună are două calități, după Gneiting și Raftery (2007). Calibrarea (calibration) cere ca probabilitățile declarate să se potrivească cu frecvențele observate: un interval de 80% trebuie să conțină circa 80% din valorile observate. Finețea (sharpness) cere ca distribuția să fie concentrată: dintre două prognoze la fel de bine calibrate, cea mai îngustă este mai informativă. Principiul lui Gneiting și Raftery (2007) este să maximizăm finețea sub constrîngerea calibrării.
Reperele clasice nu produc cuantile direct, dar le obținem din distribuția Normală. Pentru ETS și ARIMA, \(\hat q_\tau = \hat y_{T+h} + z_\tau \hat\sigma_h\), unde \(\hat y_{T+h}\) este prognoza punctuală, \(z_\tau\) cuantila de nivel \(\tau\) a distribuției Normale standard (de exemplu \(z_{0{,}9} = 1{,}28\)), iar \(\hat\sigma_h\) abaterea standard estimată a erorii de prognoză la orizontul \(h\). Comparația dintre foundation models și repere se face astfel pe același tip de ieșire.
Pe scurt
O prognoză probabilistă dă distribuția lui \(y_{T+h}\), condiționată de datele pînă la \(T\)
foundation models o raportează prin cuantile \(\hat q_\tau\) la nivelurile \(\tau = 0{,}1; \dots; 0{,}9\)
Prognoza punctuală: mediana \(\hat q_{0{,}5}\)
Intervalul central de 80%: \([\hat q_{0{,}1}, \hat q_{0{,}9}]\); un fan chart desenează mai multe astfel de benzi
Două calități de verificat
calibrarea: intervalul de 80% conține circa 80% din valorile observate
finețea (sharpness): dintre prognozele calibrate, cea mai îngustă este mai bună (Gneiting și Raftery (2007))
Pentru ETS și ARIMA folosim cuantilele distribuției Normale, \(\hat q_\tau = \hat y_{T+h} + z_\tau \hat\sigma_h\)
\(z_\tau\): cuantila de nivel \(\tau\) a distribuției Normale standard (\(z_{0{,}9} = 1{,}28\)); \(\hat\sigma_h\): abaterea standard estimată a erorii de prognoză la orizontul \(h\)
Pierderea pinball (pinball loss), numită și pierdere cuantilă, evaluează o singură cuantilă prognozată \(\hat q_\tau\) față de valoarea observată ulterior \(y\):
Pierderea este 0 cînd cuantila coincide cu valoarea observată și crește liniar cu distanța dintre ele. Asimetria este însă esențială: o valoare observată peste cuantilă primește ponderea \(\tau\), iar una sub cuantilă primește ponderea \(1 - \tau\). Pentru \(\tau = 0{,}9\), a rata în sus costă 0,9 pe unitate de distanță, iar a rata în jos doar 0,1.
Proprietatea care justifică această funcție este că valoarea ei așteptată este minimă exact în cuantila adevărată de nivel \(\tau\). Un prognozator care știe distribuția adevărată nu are niciun motiv să raporteze altceva decît cuantila ei: orice deplasare în sus sau în jos crește pierderea medie. Un scor cu această proprietate se numește strict propriu (strictly proper), iar el împiedică „trișarea” prin intervale deliberat largi sau înguste.
Pe scurt
Pierderea pinball (cuantilă) evaluează o cuantilă prognozată \(\hat q_\tau\) față de valoarea observată \(y\)
Scorul de probabilitate continuu pe ranguri (continuous ranked probability score, CRPS), introdus de Matheson și Winkler (1976), evaluează o întreagă distribuție prognozată față de valoarea observată \(y\):
Aici \(F\) este funcția de repartiție prognozată, iar \(z\) variabila de integrare, care parcurge toate valorile posibile. Indicatorul \(\mathbf{1}\{z \ge y\}\) este 1 dacă \(z \ge y\) și 0 altfel; el este funcția de repartiție a unei prognoze care pune toată masa în valoarea observată \(y\). Prima formă măsoară deci distanța pătratică dintre funcția de repartiție prognozată și treapta din \(y\). A doua formă, în care \(F^{-1}(\tau)\) este cuantila de nivel \(\tau\) a lui \(F\), arată că CRPS este de două ori media pierderii pinball pe toate nivelurile.
CRPS este mai mare sau egal cu 0 și se exprimă în unitățile lui \(y\). Este 0 doar pentru o prognoză care pune toată masa exact în valoarea observată, iar o valoare mai mică înseamnă o prognoză mai bună. Pentru o prognoză punctuală, \(F\) este chiar o treaptă în \(\hat y\), iar CRPS devine \(|y - \hat y|\): CRPS generalizează eroarea absolută și se poate compara direct cu MAE al unei prognoze punctuale.
Pe scurt
CRPS (continuous ranked probability score, scorul de probabilitate continuu pe ranguri, Matheson și Winkler (1976)) evaluează o întreagă distribuție prognozată față de valoarea observată \(y\)
Integrala din (11.4) cere toată distribuția, dar foundation models raportează doar cîteva cuantile. Pierderea cuantilă ponderată (weighted quantile loss, WQL) aproximează CRPS cu cele 9 niveluri 0,1; …; 0,9 și împarte rezultatul la mărimea seriei:
Indicele \(\tau\) parcurge cele 9 niveluri, iar \(t\) parcurge toți pașii de prognoză de la toate originile testului. \(\hat q_{\tau,t}\) este cuantila de nivel \(\tau\) prognozată pentru pasul \(t\), iar \(y_t\) valoarea observată la acel pas. Numărătorul este, pentru fiecare nivel, dublul sumei pierderilor pinball, ca în a doua formă a CRPS.
Numitorul \(\sum_t |y_t|\) elimină unitățile: WQL este o pierdere relativă la nivelul seriei, deci se pot compara serii cu niveluri foarte diferite, de exemplu consumul în GW și cursul în lei. WQL este 0 pentru o prognoză perfectă, iar o valoare mai mică înseamnă o prognoză mai bună. Este scorul raportat de Chronos și de benchmark-ul GIFT-Eval, de aceea este și scorul principal al testului din acest capitol.
Întrebare pentru sală ▶ trece la EUR/RON. Cît este raportul WQL al Chronos-2 față de prognoza sezonieră naivă?
Răspuns
0,87: WQL 0,0019 față de 0,0022 pentru prognoza naivă, deși raportul MASE al medianei este 1,05. WQL evaluează toate cuantilele, iar benzile mai înguste ale Chronos-2 cîștigă chiar cînd mediana nu este mai bună.
Întrebare pentru sală Mutați y la 8,0, peste q̂0,9 = 7,6. Care nivel are cea mai mare pierdere?
Răspuns
Nivelul 0,5: 0,5·(8,0 − 7,0) = 0,50, față de 0,9·(8,0 − 7,6) = 0,36 și 0,1·(8,0 − 6,5) = 0,15. Depășirea cuantilei de 0,9 costă mult pe unitate, dar distanța pînă la ea este mică; CRPS aproximat crește la 0,673.
Întrebare pentru sală Alegeți m = 1 (prognoza naivă de o oră în numitor). Cît devine MASE pentru Chronos-Bolt small?
Răspuns
2,13 (1,31 cu m = 168): numitorul scade de la 0,421 GW la 0,260 GW, eroarea medie a prognozei de o oră în context, iar prognozele rămîn aceleași. Valoarea MASE și pragul 1 au sens doar împreună cu m-ul declarat.
Întrebare pentru sală ▶ trece prin modele. Ce acoperire are Chronos-Bolt tiny pe vînzările din SUA?
Răspuns
75,2%, cea mai mare dintre cele șase modele, dar tot sub 80%; Chronos-2 are 65,0%, prognoza sezonieră naivă 64,7%. Șocul din 2020 și saltul din 2021 ies din benzile tuturor modelelor.
Întrebare pentru sală Mutați valoarea observată la y = 0, mediana prognozei N(0, 1). Cît este CRPS?
Răspuns
0,234, nu 0: CRPS evaluează toată distribuția, iar o prognoză cu abaterea standard 1 rămîne incertă chiar dacă mediana nimerește valoarea. Doar o prognoză care pune toată masa în y are CRPS 0; în y = 1 scorul este 0,602.
Panoul din stînga desenează pierderea pinball (11.3) în funcție de diferența \(y - \hat q\) dintre valoarea observată și cuantila prognozată, pentru trei niveluri. Linia albastru închis, pentru \(\tau = 0{,}5\), este simetrică: are panta 0,5 de ambele părți. Linia roșie, pentru \(\tau = 0{,}9\), urcă abrupt la dreapta, cu panta 0,9, și foarte lent la stînga, cu panta 0,1; linia turcoaz, pentru \(\tau = 0{,}1\), este imaginea ei în oglindă. Cele trei linii se întîlnesc în 0, unde cuantila este exactă.
Panoul din dreapta ilustrează prima formă a (11.4). Prognoza este distribuția Normală cu media 0 și varianța 1, notată N(0, 1), iar funcția ei de repartiție este curba albastră. Valoarea observată este \(y = 1\), iar treapta roșie este funcția de repartiție a unei prognoze perfecte. Zona colorată este diferența dintre cele două curbe; CRPS este integrala pătratului acestei diferențe și are aici valoarea 0,602. Notația N(\(\mu\),\(\sigma^2\)) desemnează în general distribuția Normală cu media \(\mu\) și varianța \(\sigma^2\).
Pe scurt
Stînga: \(L_\tau\) în funcție de \(y - \hat q\) pentru \(\tau\) = 0,1; 0,5; 0,9. Dreapta: prognoza N(0, 1), valoarea observată \(y = 1\)
N(\(\mu\), \(\sigma^2\)): distribuția Normală cu media \(\mu\) și varianța \(\sigma^2\)
Asimetria pierderii pinball explică de ce scorul cere cuantila corectă. La \(\tau = 0{,}9\), o valoare observată peste cuantilă costă, pe unitate de distanță, de 9 ori mai mult decît una sub ea (\(0{,}9/0{,}1 = 9\)). Un prognozator minimizează pierderea medie doar dacă depășirile au loc în 10% din cazuri, exact definiția cuantilei de 0,9. La \(\tau = 0{,}5\), cele două ponderi sînt egale, iar pierderea este jumătate din eroarea absolută: mediana este evaluată ca o prognoză punctuală.
Trei valori ale CRPS arată ce răsplătește scorul. Pentru prognoza N(0, 1), CRPS este 0,234 dacă valoarea observată este \(y = 0\), centrul distribuției, și 0,602 dacă \(y = 1\), la o abatere standard distanță. Prognoza N(0, 4), cu abaterea standard 2, dă în \(y = 1\) un CRPS de 0,663, mai mare decît 0,602, deși banda ei acoperă mai bine valoarea observată.
Comparația ultimelor două cifre arată că o bandă mai largă este penalizată chiar dacă acoperă valoarea observată. CRPS răsplătește deci simultan calibrarea și finețea: nu se poate obține un scor bun nici prin intervale foarte largi, care acoperă totul, nici prin intervale foarte înguste, care ratează des.
Pe scurt
La \(\tau = 0{,}9\), o valoare peste cuantilă costă de 9 ori mai mult decît una sub ea: cuantila de 0,9 ar trebui depășită doar în 10% din cazuri
La \(\tau = 0{,}5\), pierderea este jumătate din eroarea absolută: mediana este evaluată ca o prognoză punctuală
CRPS pentru N(0, 1): 0,234 dacă \(y = 0\), 0,602 dacă \(y = 1\); N(0, 4) în \(y = 1\) dă 0,663: o bandă mai largă este penalizată chiar dacă acoperă valoarea
CRPS răsplătește în același timp calibrarea și finețea
Considerăm o prognoză a ratei șomajului pentru luna viitoare, cu trei cuantile: \(\hat q_{0{,}1} = 6{,}5\),\(\hat q_{0{,}5} = 7{,}0\) și \(\hat q_{0{,}9} = 7{,}6\), în procente. Valoarea observată ulterior este \(y = 7{,}2\). Fiecare pierdere se calculează cu (11.3), după poziția lui \(y\) față de cuantilă.
La \(\tau = 0{,}1\), valoarea observată este deasupra cuantilei, deci pierderea este \(0{,}1 \times (7{,}2 - 6{,}5) = 0{,}07\). La \(\tau = 0{,}5\), valoarea observată este tot deasupra, iar pierderea este \(0{,}5 \times (7{,}2 - 7{,}0) = 0{,}10\). La \(\tau = 0{,}9\), valoarea observată este dedesubt, deci se folosește ponderea \(1 - \tau\):\((1 - 0{,}9) \times (7{,}6 - 7{,}2) = 0{,}04\). Cea mai mare pierdere revine medianei, care este cea mai departe de valoarea observată în raport cu ponderea ei.
CRPS aproximat cu aceste trei niveluri este de două ori media pierderilor, \(\frac{2}{3}(0{,}07 + 0{,}10 + 0{,}04) = 0{,}140\) puncte procentuale. Valoarea observată, 7,2, se află în intervalul de 80%, [6,5; 7,6], deci în scorul de acoperire definit două slide-uri mai departe această prognoză contează ca acoperită.
Eroarea absolută medie scalată (mean absolute scaled error, MASE), propusă de Hyndman și Koehler (2006), evaluează prognoza punctuală, aici mediana. Ea împarte eroarea absolută medie (MAE) a prognozei la MAE în eșantion al prognozei sezoniere naive:
Numărătorul este eroarea absolută medie a prognozelor \(\hat y_{T+j}\) pe cei \(h\) pași de după originea \(T\). Numitorul este eroarea absolută medie a prognozei sezoniere naive \(y_{t-m}\) în interiorul eșantionului, pentru \(t = m+1, \dots, T\), unde \(m\) este lungimea sezonului. Numitorul măsoară deci cît de greu de prognozat este seria cu cea mai simplă metodă, calculat pe datele disponibile la origine.
MASE nu are unități. O valoare sub 1 înseamnă că prognoza este mai bună decît prognoza sezonieră naivă în eșantion, iar o valoare peste 1 că este mai slabă. De exemplu, o prognoză cu MAE 0,30 pentru o serie pe care prognoza sezonieră naivă are în eșantion MAE 0,25 are \(\text{MASE} = 0{,}30/0{,}25 = 1{,}2\). Pentru că numitorul este calculat în eșantion, cu un decalaj de un sezon, iar numărătorul în afara eșantionului, pe \(h\) pași, chiar și prognoza sezonieră naivă poate avea MASE diferit de 1 în test.
unde \(n\) este numărul de prognoze, \(\hat q_{\tau}^{(i)}\) cuantila prognozei \(i\), iar indicatorul este 1 dacă valoarea observată este în interval și 0 altfel. Ținta este 80%. Dacă 7 din 10 valori observate cad în interval, acoperirea este 70%, iar intervalele sînt puțin prea înguste; o acoperire de 95% ar indica intervale prea largi.
Scorurile relative fac comparabile seriile între ele. MASE sau WQL al unui model se împarte la scorul prognozei sezoniere naive, calculat pe aceleași origini; o valoare sub 1 înseamnă că modelul este mai bun decît prognoza sezonieră naivă. Rapoartele seriilor se mediază cu media geometrică \((r_1 r_2 \cdots r_S)^{1/S}\), unde \(r_k\) este raportul seriei \(k\), iar \(S\) numărul de serii. Media geometrică tratează simetric cîștigurile și pierderile relative: un raport de 2 pe o serie și unul de 0,5 pe alta se compensează exact și dau 1, în timp ce media aritmetică ar da 1,25.
Pe scurt
Acoperirea
proporția valorilor observate din intervalul de 80%
\(\text{Cov} = \frac1n\sum_{i=1}^{n} \mathbf{1}\{\hat q_{0{,}1}^{(i)} \le y_i \le \hat q_{0{,}9}^{(i)}\}\); \(n\): numărul de prognoze; \(\hat q_{\tau}^{(i)}\): cuantila prognozei \(i\); \(\mathbf{1}\{\cdot\}\): 1 dacă valoarea observată este în interval, 0 altfel
ținta este 80%; 7 din 10 în interval înseamnă 70%: intervale puțin prea înguste
Scorurile relative
MASE sau WQL al unui model împărțit la cel al prognozei sezoniere naive, pe aceleași origini
sub 1: modelul este mai bun decît prognoza sezonieră naivă
mediate pe cele \(S\) serii cu media geometrică \((r_1 r_2 \cdots r_S)^{1/S}\), \(r_k\): raportul seriei \(k\); astfel 2 și 0,5 se compensează
Pierderea pinball evaluează fiecare cuantilă, CRPS evaluează întreaga distribuție, iar WQL este aproximarea lui CRPS pe nouă cuantile, scalată cu nivelul seriei. MASE evaluează mediana, iar acoperirea verifică calibrarea intervalelor. Scorurile se raportează relativ la prognoza sezonieră naivă și se mediază geometric pe serii.
Pe scurt
Pierderea pinball pentru fiecare cuantilă; CRPS pentru întreaga distribuție; WQL ca aproximare scalată
MASE pentru mediană; acoperirea pentru calibrare
Raportați scorurile relativ la prognoza sezonieră naivă
Sinteza secțiunii
Scorurile secțiunii formează un sistem coerent. Pierderea pinball este strict proprie pentru o cuantilă, CRPS o integrează pe toate nivelurile și răsplătește simultan calibrarea și finețea, iar WQL o face comparabilă între serii. MASE și acoperirea completează imaginea: prima spune cît de bună este prognoza centrală, a doua dacă intervalele spun adevărul despre incertitudine.
Prognoze zero-shot pe date reale
Secțiunea aplică un foundation model, Chronos-Bolt small, pe serii pe care nu a fost antrenat, fără nicio estimare. Întîi prezintă cele șapte serii ale testului, apoi trei prognoze la cîte o singură origine, alese pentru a ilustra trei situații diferite: o serie cu sezonalitate puternică, o serie lunară cu șocuri și o serie apropiată de un mers aleator.
Întrebare pentru sală ▶ trece la diferențele sezoniere și apoi la primele diferențe. Pentru consumul orar din iunie 2026, media lui |yt − yt−168| este mai mare sau mai mică decît media lui |yt − yt−1|?
Răspuns
Mai mare: 0,43 GW față de 0,24 GW. Consumul variază puțin de la o oră la alta, iar într-o săptămînă se schimbă vremea și nivelul; de aceea numitorul MASE cu m = 168 este mai mare decît eroarea prognozei de o oră. La producția industrială este invers (4,86 cu m = 12, 6,37 cu m = 1), pentru că sezonalitatea anuală domină.
Graficul, împărțit pe două slide-uri, arată seriile testului. Primul panou este consumul orar de energie electrică al României în iunie 2026: un ciclu zilnic regulat, cu minimul noaptea și vîrful seara, și un ciclu săptămînal, cu duminici vizibil mai scăzute. Al doilea panou este producția industrială a României din 2005: o creștere de la circa 55 la circa 100 pînă în 2017, apoi un platou, o sezonalitate lunară puternică și căderea din aprilie 2020.
Al treilea panou este PIB-ul real trimestrial al României, neajustat sezonier, cu un tipar de „dinți de fierăstrău”: valoarea crește de la primul la al patrulea trimestru și scade brusc în primul trimestru al anului următor, iar nivelul crește în timp. Al patrulea panou este inflația lunară IAPC, în procente față de luna anterioară: o serie zgomotoasă în jurul unei medii mici, cu cîteva valori extreme și cu un episod de valori ridicate în 2022.
A doua parte a graficului arată celelalte trei serii. Rata șomajului din România se mișcă lent, în valuri de cîțiva ani: urcă după criza din 2008, coboară pînă în 2019, crește puțin în 2020 și rămîne apoi în jurul a 5–7%. Cursul de referință EUR/RON al BNR crește în trepte de la mai puțin de 3,5 lei în 2007 la peste 5,2 lei în 2026, cu perioade lungi de stabilitate.
Ultima serie, vînzările cu amănuntul din SUA, are un trend crescător, o sezonalitate anuală pronunțată, cu vîrful în decembrie, și două rupturi: căderea din primăvara lui 2020 și saltul din 2021. Este singura serie din afara României și este o serie publică foarte cunoscută, probabil prezentă în multe corpusuri de pre-antrenare, ceea ce va conta în secțiunea despre contaminare.
Sursele seriilor sînt publice. Consumul orar provine de la ENTSO-E; producția industrială, PIB-ul real neajustat sezonier, inflația IAPC (indicele armonizat al prețurilor de consum) și rata șomajului provin de la Eurostat; cursul EUR/RON este cursul de referință al BNR; vînzările cu amănuntul din SUA sînt seria RSXFSN din baza de date FRED a Rezervei Federale din St. Louis.
Seriile au fost alese pentru a acoperi comportamente diferite. Consumul, producția industrială, vînzările din SUA și PIB-ul au sezonalitate puternică: cicluri zilnice și săptămînale pentru consum, anuale pentru producție și vînzări, trimestriale pentru PIB. EUR/RON și rata șomajului sînt aproape de un mers aleator (random walk), deci cea mai bună prognoză este aproape ultima valoare. Inflația lunară este zgomotoasă și are memorie scurtă. Mai multe serii au rupturi: pandemia din 2020 pentru producție, PIB și vînzări, creșterea inflației din 2022.
Seriile diferă mult și ca lungime: de la 126 de trimestre pentru PIB la 39 408 ore pentru consum. Aceasta înseamnă cantități foarte diferite de context. Un model cu context de 2048 de valori vede 85 de zile din seria de consum, dar întreaga istorie a PIB-ului, care este totuși foarte scurtă pentru a învăța un tipar.
Pe scurt
România (ENTSO-E)
consumul orar de energie electrică
România (Eurostat)
producția industrială
PIB-ul real, neajustat sezonier
inflația IAPC; rata șomajului
EUR/RON (cursul de referință BNR)
Vînzările cu amănuntul din SUA (FRED RSXFSN)
Sezonalitate puternică: consumul (cicluri zilnice și săptămînale), producția industrială și vînzările din SUA (anuale), PIB-ul (trimestrial)
Aproape de un mers aleator: EUR/RON și rata șomajului; zgomotoasă și cu memorie scurtă: inflația lunară
Rupturi: pandemia din 2020 (producția industrială, PIB-ul, vînzările); creșterea inflației din 2022
Lungimi de la 126 de trimestre (PIB) la 39 408 ore (consumul): cantități foarte diferite de context
Întrebare pentru sală Mutați ora la 1 (22 iunie 2026, ora 00:00). Cît este indicatorul de acoperire?
Răspuns
1: valoarea observată este în banda de 80%, iar pierderile sînt mici (0,017; 0,010; 0,012 GW). Prognoza pornește de la ultimele valori; abia în cursul zilei consumul efectiv iese peste bandă, ca la ora 24 (0,062; 0,163; 0,025 GW).
Întrebare pentru sală ▶ evaluează doar primele 6 ore. Ce acoperire are banda de 80% a Chronos-Bolt în orele 1–6?
Răspuns
100% (6 din 6 ore), față de 29% pe 48 de ore; MASE este 0,11 în primele 6 ore. Prognoza pornește de la ultimele valori observate, iar abaterea consumului efectiv se acumulează în cursul zilei: acoperirea unei singure origini depinde mult de orizont.
Graficul arată o prognoză zero-shot a consumului de energie electrică pentru 48 de ore, de la originea 22 iunie 2026, ora 00:00. Linia neagră continuă este ultima săptămînă a contextului, iar linia neagră întreruptă este consumul efectiv din cele două zile prognozate. Linia albastră este mediana Chronos-Bolt small, iar benzile albastre sînt intervalele centrale de 50% (mai închisă) și de 80% (mai deschisă). Linia maro este prognoza sezonieră naivă, care repetă consumul din aceleași ore ale săptămînii anterioare.
Modelul urmează forma zilnică: minimul de noapte, urcarea de dimineață și vîrful de seară, la orele potrivite. Mediana lui este aproape de prognoza sezonieră naivă, dar puțin mai sus. În schimb, consumul efectiv, linia întreruptă, este peste ambele prognoze aproape tot timpul, mai ales în a doua zi, cînd urcă peste 7 GW.
Pe scurt
Consumul de energie electrică al României, prognoză pe 48 de ore (2/2)
Prognoza a folosit un context de 2048 de ore, adică 85 de zile, și nicio estimare pe această serie. Faptul că modelul reproduce forma zilnică, cu minimul de noapte și vîrful de seară, arată că a recunoscut tiparul din context: este exact capacitatea pe care pre-antrenarea pe serii de energie și trafic trebuia să o dea. MASE al medianei este 1,31, față de 1,61 pentru prognoza sezonieră naivă, deci modelul este mai bun decît simpla repetare a săptămînii trecute.
Intervalele spun însă o altă poveste. Consumul efectiv rămîne peste prognoză toată ziua, iar doar 29% din cele 48 de ore cad în banda de 80%, în loc de circa 80%. Explicația este informația pe care modelul nu o are. El primește doar valorile trecute ale consumului, fără temperatură sau calendar, iar o schimbare a vremii, de exemplu un val de căldură care crește consumul de aer condiționat, nu este anunțată de ultimele 85 de zile.
O singură origine dovedește însă puțin. Un rezultat bun sau slab la o dată poate fi o coincidență, așa că secțiunea următoare repetă prognoza la 52 de origini săptămînale și o compară cu mai multe repere.
Pe scurt
Chronos-Bolt small, zero-shot, context de 2048 de ore (85 de zile); originea 22 iunie 2026, ora 00:00; benzi: intervalele centrale de 50% și 80%
Modelul reproduce forma zilnică (minimul de noapte, vîrful de seară) fără nicio estimare pe această serie
MASE: Chronos-Bolt 1,31, prognoza sezonieră naivă 1,61: mai bun decît repetarea săptămînii trecute
Dar consumul efectiv rămîne peste prognoză toată ziua: doar 29% din cele 48 de ore cad în banda de 80%
Modelul nu primește temperatura sau calendarul: o schimbare a vremii pe care ultimele 85 de zile nu o anunță nu poate fi anticipată
O singură origine dovedește puțin: urmează testul sistematic
Exemplul evaluează ora 24 a prognozei, adică 22 iunie 2026, ora 23:00. Cuantilele prognozate de Chronos-Bolt small sînt \(\hat q_{0{,}1} = 5{,}1837\),\(\hat q_{0{,}5} = 5{,}4763\) și \(\hat q_{0{,}9} = 5{,}7758\) GW, iar consumul observat este 5,8033 GW. Toate cele trei cuantile sînt sub valoarea observată, deci fiecare pierdere din (11.3) are forma \(\tau\,(y - \hat q_\tau)\).
Pierderile sînt \(0{,}1 \times (5{,}8033 - 5{,}1837) = 0{,}062\) GW pentru \(\tau = 0{,}1\),\(0{,}5 \times (5{,}8033 - 5{,}4763) = 0{,}163\) GW pentru \(\tau = 0{,}5\) și \(0{,}9 \times (5{,}8033 - 5{,}7758) = 0{,}025\) GW pentru \(\tau = 0{,}9\). Cuantilele sînt date cu patru zecimale deoarece ultima diferență este mică: rotunjită la două zecimale, ar deveni \(0{,}9 \times 0{,}02 = 0{,}018\). Cea mai mare pierdere revine din nou medianei. Cuantila de 0,9 are o pierdere mică, deoarece valoarea observată o depășește cu foarte puțin.
Valoarea observată este totuși peste \(\hat q_{0{,}9}\), deci indicatorul de acoperire din (11.7) este 0 pentru această oră. Exemplul arată cum un model poate avea pierderi pinball mici și totuși o acoperire slabă: valoarea observată este aproape de marginea benzii, dar în afara ei. Mediate pe multe ore și origini, aceste pierderi dau WQL din secțiunea următoare.
Pe scurt
Ora 24 a prognozei consumului (22 iunie 2026, ora 23:00): \(\hat q_{0{,}1}\) = 5,1837, \(\hat q_{0{,}5}\) = 5,4763, \(\hat q_{0{,}9}\) = 5,7758 GW; valoarea observată 5,8033 GW
Toate cele trei cuantile sînt sub valoarea observată, deci fiecare pierdere este \(\tau\,(y - \hat q_\tau)\)
Întrebare pentru sală Puneți H = 3 (august–octombrie 2025). Care prognoză are cel mai mic MASE?
Răspuns
Prognoza sezonieră naivă: 0,43, față de 0,79 pentru ETS și 0,95 pentru Chronos-Bolt. Pentru această origine, anul precedent prognozează cel mai bine lunile următoare; pe 12 luni prognoza naivă rămîne prima (0,67), iar ETS (1,20) și Chronos-Bolt (1,04) își schimbă locurile.
Al doilea exemplu este o serie lunară. Graficul arată ultimii patru ani ai contextului producției industriale (linia neagră), apoi prognozele pe 12 luni de la originea din august 2025 și valorile efective (linia neagră întreruptă cu puncte). Două modele sînt comparate: Chronos-Bolt small, zero-shot, cu mediana albastră și banda albastră de 80%, și ETS, estimat pe serie, cu mediana verde și banda verde de 80%.
Ambele mediane urmează tiparul sezonier al seriei. Valorile efective sînt însă mai jos decît ambele prognoze în majoritatea lunilor: prima lună prognozată, august 2025, și ianuarie 2026 sînt mult sub mediane, iar ultimele luni din 2026 rămîn cu 5–6 puncte sub ele.
Pe scurt
Producția industrială a României, prognoză pe 12 luni (2/2)
Ambele modele copiază tiparul sezonier, cu scăderile din august și decembrie, și păstrează nivelul recent al seriei. Faptul că un model zero-shot și unul estimat pe serie produc prognoze atît de asemănătoare arată că ambele extrag aceeași informație din trecut: sezonalitatea și nivelul.
Scorurile la această origine favorizează însă cea mai simplă metodă. MASE este 1,04 pentru Chronos-Bolt, 1,20 pentru ETS și doar 0,67 pentru prognoza sezonieră naivă. Producția slabă din 2026 nu este anunțată de context, iar prognoza sezonieră naivă, care repetă valorile mai scăzute din anul anterior, a ajuns întîmplător mai aproape. Benzile de 80% acoperă 83% din luni pentru ambele modele, adică 10 din 12, o acoperire apropiată de țintă.
Diferența dintre modele apare la incertitudine. Benzile Chronos-Bolt sînt mai înguste decît cele ale ETS la orizonturi lungi: banda ETS se lărgește constant cu orizontul, în timp ce modelul pre-antrenat estimează o incertitudine mai stabilă. Cu aceeași acoperire, banda mai îngustă este mai informativă, deci CRPS o va favoriza.
Pe scurt
Originea august 2025, prognoze pînă în iulie 2026; Chronos-Bolt small (zero-shot) și ETS (estimat pe serie), ambele cu benzi de 80%
Ambele modele copiază tiparul sezonier (scăderile din august și decembrie) și păstrează nivelul recent
MASE: Chronos-Bolt 1,04, ETS 1,20, prognoza sezonieră naivă 0,67: pentru această origine cîștigă cea mai simplă prognoză
Producția slabă din 2026 nu este anunțată de context; benzile de 80% acoperă 83% (Chronos-Bolt) și 83% (ETS) din luni
Benzile Chronos-Bolt sînt mai înguste decît cele ale ETS la orizonturi lungi
Întrebare pentru sală Puneți H = 5. La ziua 5, banda de 80% a Chronos-Bolt este mai largă sau mai îngustă decît cea a mersului aleator?
Răspuns
Mai largă: 0,044 față de 0,031. Banda mersului aleator crește cu √h, de la 0,014 în prima zi, în timp ce banda Chronos-Bolt pornește de la 0,035; cele două ajung aproape egale abia la 20 de zile (0,064 și 0,063).
Al treilea exemplu este cursul de referință EUR/RON al BNR. Graficul arată ultimele 120 de zile ale contextului, cu o creștere bruscă a cursului la începutul lui mai 2026 de la circa 5,10 la peste 5,20 lei, urmată de o perioadă de stabilitate. Prognozele pentru cele 20 de zile lucrătoare de după originea din 24 august 2026 sînt desenate în dreapta.
Chronos-Bolt small (mediana albastră, banda albastră de 80%) este comparat cu mersul aleator, a cărui prognoză este ultima valoare, cu benzi Normale (mediana maro, banda maro de 80%). Cele două mediane sînt aproape orizontale și aproape suprapuse, iar benzile au aproape aceeași formă, lărgindu-se cu orizontul ca o pîlnie.
Ultima valoare dinaintea originii este 5,2581 lei, iar mediana Chronos-Bolt după 20 de zile este 5,2604 lei, practic aceeași. Modelul nu a fost antrenat explicit să trateze cursurile ca mers aleator; a învățat acest comportament din context, deoarece seria nu conține nicio regularitate exploatabilă. Lățimea benzii de 80% la 20 de zile este 0,064 lei pentru Chronos-Bolt și 0,063 lei pentru mersul aleator: cele două modele atribuie aproape aceeași incertitudine.
Precizia punctuală este și ea aproape egală. MAE pe cele 20 de zile este 0,0032 lei pentru Chronos-Bolt și 0,0035 lei pentru mersul aleator, o diferență prea mică pentru a însemna ceva la o singură origine. Rezultatul confirmă concluzia din Capitolul 1: variațiile cursurilor de schimb sînt aproape imprevizibile pe baza trecutului, iar un model, oricît de mare, nu poate extrage din context informația pe care contextul nu o conține.
Pe scurt
Cursul de referință BNR; originea 24 august 2026, ultima valoare dinaintea ei 5,2581; Chronos-Bolt small comparat cu mersul aleator cu benzi Normale
Mediana după 20 de zile este 5,2604, practic ultima valoare, 5,2581: modelul a învățat să se comporte ca un mers aleator
Lățimea benzii de 80% la 20 de zile: 0,064 (Chronos-Bolt) și 0,063 (mersul aleator): aproape aceeași incertitudine
MAE pe cele 20 de zile: 0,0032 față de 0,0035: practic egalitate
Un model nu poate extrage ce trecutul nu conține: cursurile de schimb rămîn aproape imprevizibile (Capitolul 1)
Fără nicio estimare, modelul copiază ciclurile și nivelurile din context. Nu poate anticipa ce contextul nu arată, de exemplu un val de căldură sau o recesiune. Pentru o serie apropiată de un mers aleator, prognoza lui coincide practic cu cea a mersului aleator.
Pe scurt
Fără estimare, modelul copiază ciclurile și nivelurile din context
Nu poate anticipa ce contextul nu arată (căldura, o recesiune)
Pentru un mers aleator, prognoza lui coincide practic cu cea a mersului aleator
Sinteza secțiunii
Cele trei exemple arată ce face un model zero-shot: recunoaște tiparele din context și le prelungește, cu o incertitudine plauzibilă. Consumul de energie arată puterea acestei abordări pentru o serie cu cicluri regulate, producția industrială arată limita ei în fața unui șoc neanunțat, iar EUR/RON arată că, atunci cînd trecutul nu conține informație, modelul se reduce corect la mersul aleator. Cîte o singură origine nu permite însă concluzii generale.
Evaluarea cu origine mobilă pe șapte serii
O comparație între modele este corectă doar dacă toate primesc aceleași informații și sînt evaluate pe aceleași prognoze. Secțiunea descrie protocolul testului, prezintă rezultatele pe cele șapte serii, analizează acoperirea, eroarea în funcție de orizont, lungimea necesară a contextului și relația dintre dimensiunea modelului și precizie, apoi plasează rezultatele în contextul benchmark-urilor publicate.
Testul folosește validarea încrucișată cu origine mobilă din Capitolul 4. La fiecare origine, fiecare model prognozează \(h\) pași folosind doar datele disponibile pînă la acea origine; apoi originea se mută înainte, iar procedura se repetă. Pentru consum, orizontul este de 48 de ore, cu origini săptămînale din iulie 2025 pînă în iunie 2026. Pentru seriile lunare, orizontul este de 12 luni, cu origini lunare din 2016. Pentru PIB, orizontul este de 4 trimestre, cu origini trimestriale din 2012, iar pentru EUR/RON de 20 de zile, cu o origine la fiecare 20 de zile din 2016. În total sînt 708 origini. Contextul este tot trecutul disponibil, dar cel mult 2048 de observații.
Reperele se reestimează la fiecare origine. Primul este prognoza sezonieră naivă; pentru șomaj și EUR/RON, care nu au sezonalitate, este prognoza naivă. Al doilea este un model ETS cu trend amortizat (damped trend) și sezonalitate aditivă. Al treilea este un ARIMA ale cărui ordine au fost alese o singură dată, după criteriul informațional Akaike (AIC), înainte de prima origine, și apoi păstrate; pentru consum, modelul este un ARIMA(2,0,2) pe diferențele săptămînale ale seriei. Alegerea ordinelor înaintea primei origini împiedică folosirea, chiar indirectă, a datelor de test.
Foundation models sînt Chronos-Bolt tiny, Chronos-Bolt small și Chronos-2, toate în regim zero-shot. Toate modelele primesc aceleași origini, același context și același orizont și sînt evaluate cu aceleași scoruri: MASE, WQL și acoperirea intervalului de 80%. Doar în aceste condiții o diferență de scor poate fi atribuită modelului, nu protocolului.
la fiecare origine, fiecare model prognozează \(h\) pași doar din datele pînă la origine
consumul: \(h\) = 48 de ore, origini săptămînale din iulie 2025 pînă în iunie 2026; seriile lunare: \(h\) = 12, origini lunare din 2016; PIB-ul: \(h\) = 4, din 2012; EUR/RON: \(h\) = 20 de zile, la fiecare 20 de zile din 2016
708 origini în total; contextul: tot trecutul, cel mult 2048 de observații
Reperele, reestimate la fiecare origine
prognoza sezonieră naivă (prognoza naivă pentru șomaj și EUR/RON)
ETS cu trend amortizat și sezonalitate aditivă; ARIMA cu ordinele alese o singură dată după AIC, înainte de prima origine (consumul: ARIMA(2,0,2) pe diferențele săptămînale)
Foundation models, zero-shot
Chronos-Bolt tiny și small, Chronos-2
Aceleași origini, același context, același orizont, aceleași scoruri: MASE, WQL, acoperirea
Rezultate: WQL relativ la prognoza sezonieră naivă
Tabelul arată, pentru fiecare serie și fiecare model, raportul dintre WQL al modelului și WQL al prognozei sezoniere naive pe aceleași origini. O valoare sub 1 înseamnă că modelul este mai bun decît prognoza sezonieră naivă; de exemplu, 0,58 înseamnă o pierdere cu 42% mai mică. Coloana „Origini” dă numărul de origini ale fiecărei serii, de la 52 pentru consum la 134 pentru EUR/RON. Ultima linie este media geometrică a rapoartelor pe cele șapte serii.
Consumul orar are cea mai mare împrăștiere: ETS are raportul 1,75, deci este mult mai slab decît prognoza sezonieră naivă, ARIMA are 0,96, iar cele trei foundation models au între 0,58 și 0,69. La PIB-ul real, ordinea se inversează: ARIMA are 0,72 și ETS 0,82, în timp ce Chronos-Bolt tiny are 1,48 și Bolt small 1,22. La vînzările din SUA, Chronos-2 are 0,60, dar ARIMA (0,66) și ETS (0,69) sînt mai bune decît cele două modele Bolt (0,84 și 0,90). La șomaj, toate rapoartele sînt între 0,96 și 1,03.
Pe medie geometrică, Chronos-2 are 0,78, adică o pierdere cu 22% mai mică decît prognoza sezonieră naivă, urmat de ARIMA cu 0,87, Bolt small cu 0,90, Bolt tiny cu 0,95 și ETS cu 0,97.
Pe scurt
Seria
Origini
ETS
ARIMA
Bolt tiny
Bolt small
Chronos-2
Consumul RO (orar)
52
1,75
0,96
0,69
0,66
0,58
Producția industrială RO
116
0,92
0,97
0,94
0,95
0,79
PIB-ul real RO
55
0,82
0,72
1,48
1,22
0,94
Inflația RO
117
0,88
0,87
0,81
0,82
0,81
Șomajul RO
117
1,00
0,99
1,03
0,99
0,96
EUR/RON (zilnic)
134
1,01
1,01
0,96
0,93
0,87
Vînzările cu amănuntul SUA
117
0,69
0,66
0,90
0,84
0,60
Media geometrică
0,97
0,87
0,95
0,90
0,78
Sub 1: mai bun decît prognoza sezonieră naivă; fiecare valoare este WQL al modelului împărțit la cel al prognozei sezoniere naive pe aceleași origini
Întrebare pentru sală Treceți harta la raportul MASE. Pe ce serie raportul MASE al Chronos-2 este peste 1?
Răspuns
EUR/RON: 1,05, deși raportul WQL este 0,87. Pe celelalte șase serii raportul MASE al Chronos-2 este sub 1, de la 0,59 (vînzările din SUA) pînă la 0,98 (șomajul).
Întrebare pentru sală Păstrați doar originile din 2024. Care model are cea mai mică medie geometrică a raportului WQL?
Răspuns
Tot Chronos-2 (0,78), urmat de ARIMA (0,92); Chronos-Bolt small trece la 1,06, mai slab decît prognoza sezonieră naivă, iar ETS la 1,01. Cu 175 de origini în loc de 708, ordinea celorlalte modele se schimbă: un singur clasament nu descrie toate perioadele.
Graficul arată aceleași rapoarte, pentru MASE (sus) și pentru WQL (jos), cu cîte un grup de bare pentru fiecare serie și cîte o bară pentru fiecare model. Axa verticală este logaritmică, astfel încît un raport de 2 și unul de 0,5 sînt la aceeași distanță de linia punctată, care marchează valoarea 1, nivelul prognozei sezoniere naive. Barele sub linie indică modele mai bune decît reperul.
Cele două panouri seamănă, deoarece o mediană bună contribuie și la o distribuție bună. Diferența cea mai clară apare la EUR/RON. Pe MASE, toate cele trei foundation models sînt peste 1, cu rapoartele 1,05 pentru Chronos-2, 1,07 pentru Bolt small și 1,17 pentru Bolt tiny: mediana lor este puțin mai slabă decît prognoza naivă. Pe WQL, aceleași modele sînt sub 1, cu 0,87 pentru Chronos-2. Cîștigul nu vine din prognoza centrală, ci din forma distribuției: benzile prognozei naive acoperă 94% din valori, mult peste ținta de 80%, deci sînt prea largi, iar benzile mai înguste ale modelelor pre-antrenate sînt răsplătite de WQL.
Pe scurt
Rapoarte față de prognoza sezonieră naivă (scală logaritmică; linia punctată este 1)
Consumul orar este seria pe care foundation models cîștigă clar: raportul WQL este 0,58 pentru Chronos-2 și 0,66 pentru Bolt small, față de 0,96 pentru ARIMA. ETS eșuează, cu 1,75, deoarece specificația lui are un singur sezon, cel zilnic, și nu poate reprezenta diferența dintre zilele lucrătoare și weekend. Seria are exact proprietățile pe care pre-antrenarea le favorizează: cicluri regulate, multe observații și un context lung.
PIB-ul României este opusul. Seria este trimestrială și scurtă, iar ARIMA este cel mai bun model, cu 0,72; Chronos-Bolt small, cu 1,22, este mai slab chiar decît prognoza sezonieră naivă. La șomaj, toate modelele sînt aproape de prognoza naivă. La EUR/RON, rapoartele sînt tot aproape de 1, cu excepția Chronos-2, cu un raport WQL de 0,87; raportul lui MASE, 1,05, arată că acest cîștig vine, după cum arată graficul anterior, din benzi mai înguste, nu dintr-o mediană mai bună. Pe aceste serii, nimic nu bate prognoza naivă cu mult la prognoza centrală.
Pe ansamblu, media geometrică a WQL ordonează modelele astfel: Chronos-2 0,78, ARIMA 0,87, Bolt small 0,90, Bolt tiny 0,95 și ETS 0,97. Chronos-2 este cel mai bun pe 5 din cele 7 serii. Un ARIMA bine specificat este însă la fel de bun ca foundation models mici, chiar puțin mai bun în medie, și nu există un cîștigător unic pe toate seriile. Concluzia practică este să comparăm modelele pe seriile noastre, nu să alegem unul după reputație.
Pe scurt
Consumul orar: foundation models cîștigă clar (raportul WQL 0,58 pentru Chronos-2, 0,66 pentru Bolt small, 0,96 pentru ARIMA); ETS, doar cu sezonul zilnic, eșuează (1,75)
PIB-ul României (serie trimestrială scurtă): ARIMA este cel mai bun (0,72); Chronos-Bolt este mai slab decît prognoza sezonieră naivă (1,22)
Șomajul: toate modelele sînt aproape de 1; EUR/RON: aproape de 1, cu excepția Chronos-2 (WQL 0,87), a cărui mediană nu este totuși mai bună decît prognoza naivă (MASE 1,05)
Media geometrică a WQL: Chronos-2 0,78, ARIMA 0,87, Bolt small 0,90, Bolt tiny 0,95, ETS 0,97; Chronos-2 este cel mai bun pe 5 din 7 serii
Un ARIMA bine specificat este la fel de bun ca foundation models mici; un cîștigător unic pe toate seriile nu există
Întrebare pentru sală Păstrați doar originile din 2024. Cît este acoperirea medie a prognozei sezoniere naive?
Răspuns
94%: intervalele naive devin prea largi, pentru că abaterea lor standard este estimată pe tot contextul, care include șocurile din 2020–2022. Chronos-2 ajunge la 83%: acoperirea depinde de perioada testată, nu doar de model.
Graficul arată acoperirea intervalului \([\hat q_{0{,}1}, \hat q_{0{,}9}]\), calculată cu (11.7) pe toate originile și toți pașii de prognoză, pentru fiecare serie și fiecare model. Linia punctată marchează ținta de 0,8. O bară peste linie indică intervale prea largi, iar una sub linie intervale prea înguste.
Cîteva tipare se văd imediat. La consum, ETS acoperă 97% din valori, deci intervalele lui sînt mult prea largi. La EUR/RON, reperele clasice acoperă circa 94%, iar Chronos-2 sub 80%. La vînzările din SUA, toate modelele sînt mult sub țintă. La producția industrială și la PIB, majoritatea barelor sînt aproape de 0,8.
Pe scurt
Proporția valorilor observate din \([\hat q_{0{,}1}, \hat q_{0{,}9}]\), pe toate originile și toți pașii; linia punctată este ținta de 0,8
Acoperirea medie pe cele șapte serii este 83% pentru prognoza sezonieră naivă, 84% pentru ETS, 84% pentru ARIMA, 80% pentru Bolt small și 76% pentru Chronos-2. Chronos-2 are cel mai bun WQL, dar intervale prea înguste: sînt fine, dar nu complet calibrate. WQL îl favorizează deoarece benzile lui înguste aduc cîștiguri mari de finețe, iar penalizarea pentru depășirile suplimentare este mai mică. Pentru un utilizator care are nevoie de intervale de încredere, de exemplu pentru a dimensiona o rezervă de capacitate, această lipsă de calibrare contează.
La vînzările din SUA, fiecare model acoperă mult sub 80%: de la 64,7% pentru prognoza sezonieră naivă și 65,0% pentru Chronos-2 pînă la 75,2% pentru Bolt tiny. Șocul din 2020 și saltul din 2021 îi surprind pe toți; niciun model care învață doar din trecutul seriei nu putea anticipa închiderea economiei. O acoperire slabă comună tuturor modelelor indică o perioadă de test cu evenimente excepționale, nu un defect al unui model anume.
Benzile ETS și ARIMA presupun erori Normale și o varianță constantă. Ele sînt deci prea largi în perioadele calme, ca la EUR/RON, unde varianța estimată include episoadele agitate din trecut, și prea înguste în crize, cînd erorile devin brusc mai mari. Este aceeași problemă pe care modelele GARCH din Capitolul 5 o rezolvă pentru randamente, printr-o varianță condiționată.
Chronos-2 are cel mai bun WQL, dar intervale prea înguste: fine, dar nu complet calibrate
Vînzările din SUA: fiecare model acoperă mult sub 80% (de la 64,7% pentru prognoza sezonieră naivă și 65,0% pentru Chronos-2 pînă la 75,2% pentru Bolt tiny): șocul din 2020 și saltul din 2021 îi surprind pe toți
Benzile ETS și ARIMA presupun erori Normale și varianță constantă: prea largi în perioadele calme, prea înguste în crize
Întrebare pentru sală Alegeți a doua jumătate a originilor (ianuarie–iunie 2026). De la ce oră ETS are, pînă la ora 48, cea mai mare eroare dintre cele șase modele?
Răspuns
De la ora 41, față de ora 4 pe toate originile. În a doua jumătate erorile tuturor modelelor sînt mai mari (prognoza naivă 0,32 GW la ora 24, față de 0,19 în prima jumătate), iar Chronos-2 rămîne la 0,15 GW.
Graficul arată, pentru consumul României, eroarea absolută medie a prognozei mediane, în GW, pentru fiecare dintre cele 48 de ore ale orizontului, mediată pe cele 52 de origini săptămînale. Axa orizontală este numărul de ore de la origine; fiecare linie este un model.
Toate curbele au două cocoașe, în jurul orelor 13 și 37. Originea este la miezul nopții, deci cocoașele corespund prînzului din fiecare dintre cele două zile, cînd consumul este mare și variabil, iar văile corespund nopților, cînd consumul este mic și previzibil. Curba ETS (verde) este cea mai sus aproape peste tot, curbele prognozei sezoniere naive (maro) și ARIMA (violet) se suprapun după primele ore, iar cele trei foundation models formează un grup mai jos, cu Chronos-2 (roșu) cel mai jos.
Pe scurt
Eroarea absolută medie (GW) a prognozei mediane pentru fiecare dintre cele 48 de ore, pe 52 de origini săptămînale
În prima oră, ARIMA și Chronos-2 au o eroare de 0,05 GW, mult sub prognoza sezonieră naivă, cu 0,17 GW. Pe orizonturi foarte scurte, ultima observație conține cea mai multă informație, iar ambele modele o folosesc; prognoza sezonieră naivă o ignoră, deoarece repetă săptămîna trecută.
După o zi, ARIMA revine la nivelul prognozei naive: 0,24 GW față de 0,25 GW la ora 24. Modelul ARIMA pe diferențe săptămînale prognozează, în esență, săptămîna trecută plus o corecție dată de abaterea recentă, iar această corecție se stinge rapid. Chronos-2 își păstrează avantajul pe tot orizontul, cu 0,14 GW la ora 48, față de 0,20 GW pentru prognoza naivă și pentru ARIMA: el combină informația recentă cu forma ciclurilor zilnice și săptămînale din context.
ETS este bun cîteva ore, cît timp nivelul recent domină, apoi devine cel mai slab model. Un sezon zilnic nu poate reprezenta weekendul, așa că, într-o duminică, ETS prognozează consumul unei zile lucrătoare. Graficul explică astfel raportul WQL de 1,75 din tabelul rezultatelor.
Pe scurt
Prima oră: ARIMA 0,05 și Chronos-2 0,05 GW, mult mai bine decît prognoza sezonieră naivă, 0,17: ultima observație contează cel mai mult
După o zi, ARIMA revine la nivelul prognozei naive (0,24 față de 0,25 GW): corecția lui se stinge
Chronos-2 își păstrează avantajul pe tot orizontul (0,14 GW la 48 de ore, față de 0,20)
ETS este bun cîteva ore, apoi cel mai slab: un sezon zilnic nu poate reprezenta weekendul
Întrebare pentru sală ▶ trece la 192 de ore (8 zile). Cîte dintre cele trei foundation models bat acum prognoza sezonieră naivă (MASE 1,16)?
Răspuns
Toate trei: Chronos-Bolt tiny 1,09, Chronos-Bolt small 0,98, Chronos-2 1,04. Cu 96 de ore niciunul nu reușea; contextul de 8 zile conține primul ciclu săptămînal complet. Chronos-2, cel mai bun cu 2048 de ore (0,63), este aici abia al doilea: el are nevoie de cel mai lung context.
Graficul arată MASE pentru consumul României în funcție de lungimea contextului primit de model: 96, 192, 336, 672, 1344 și 2048 de ore, adică de la 4 la 85 de zile. Testul folosește ultimele 26 de origini săptămînale, adică ultima jumătate de an. Fiecare linie cu puncte este un foundation model, iar linia orizontală întreruptă este prognoza sezonieră naivă, care nu depinde de context.
Toate cele trei curbe scad pe măsură ce contextul crește, cu o pantă mare la început și una mică la sfîrșit. Chronos-2 pornește cel mai sus și termină cel mai jos.
Cu un context de 96 de ore, adică 4 zile, fiecare model este mai slab decît prognoza sezonieră naivă, care are MASE 1,16: Chronos-Bolt small are 1,33, iar Chronos-2 are 2,04. Patru zile nu conțin o săptămînă întreagă, deci modelul nu poate ști cum arată weekendul; prognoza sezonieră naivă, care repetă săptămîna trecută din toată istoria seriei, are această informație.
De la 192 de ore, adică 8 zile, ciclul săptămînal intră complet în context, iar eroarea scade sub cea a prognozei naive pentru Bolt small, cu MASE 0,98. Este confirmarea empirică a regulii din secțiunea despre patching: atenția poate lega doar ce se află în context. Chronos-2 continuă să se îmbunătățească pînă la 1344 de ore, cînd ajunge la MASE 0,63, în timp ce Chronos-Bolt se stabilizează de la 672 de ore, la circa 0,78.
Regula practică este să dăm modelului mai multe cicluri sezoniere complete. Un model zero-shot repetă tiparele pe care le vede în context; dacă un ciclu lipsește din context, lipsește și din prognoză. Pentru o serie lunară cu sezonalitate anuală, aceasta înseamnă cîțiva ani de date, nu cîteva luni.
Pe scurt
MASE pentru consumul României cu contexte de 96 pînă la 2048 de ore; 26 de origini săptămînale (ultima jumătate de an); linia punctată este prognoza sezonieră naivă
Cu 96 de ore (4 zile), fiecare model este mai slab decît prognoza sezonieră naivă: Chronos-Bolt small 1,33, Chronos-2 2,04, naiv 1,16
De la 192 de ore (peste o săptămînă), ciclul săptămînal intră în context și eroarea scade
Chronos-2 se îmbunătățește pînă la 1344 de ore (0,63); Chronos-Bolt se stabilizează de la 672 de ore (0,78)
Regula: dați modelului mai multe cicluri sezoniere complete; un model zero-shot doar repetă ce vede
Întrebare pentru sală Păstrați doar originile din 2022. Chronos-Bolt small (48 de milioane de parametri) mai bate prognoza sezonieră naivă?
Răspuns
Nu: media geometrică a raportului WQL devine 1,04 (0,90 pe toate originile), în timp ce Chronos-2 rămîne la 0,83 și ARIMA la 0,91. Numărul de parametri nu garantează un cîștig; Chronos-2 diferă și prin arhitectură și date de antrenare.
Graficul pune pe axa orizontală numărul de parametri ai fiecărui foundation model, în milioane, pe scală logaritmică, și pe axa verticală media geometrică pe cele șapte serii a raportului WQL față de prognoza sezonieră naivă. Cele trei puncte sînt Chronos-Bolt tiny, Chronos-Bolt small și Chronos-2. Liniile orizontale marchează reperele, care au doar cîțiva parametri pe serie: prognoza sezonieră naivă la 1, ETS la 0,97 și ARIMA la 0,87.
Punctele coboară de la stînga la dreapta: 0,95 pentru Bolt tiny, 0,90 pentru Bolt small și 0,78 pentru Chronos-2. Doar Chronos-2 se află sub linia ARIMA.
Pe scurt
Media geometrică, pe cele șapte serii, a raportului WQL față de prognoza sezonieră naivă, în funcție de numărul de parametri
Cele trei modele au 9 milioane (Bolt tiny), 48 de milioane (Bolt small) și 119 milioane de parametri (Chronos-2); ETS și ARIMA au cîțiva parametri pe serie. Modelele mai mari obțin aici scoruri mai bune, dar ARIMA, cu 0,87, se situează între Bolt small și Chronos-2. Trei puncte nu stabilesc o lege, iar dimensiunea singură nu este cauza: Chronos-2 diferă de Chronos-Bolt nu doar prin dimensiune, ci și prin arhitectură și prin datele de antrenare, astfel încît o parte din cîștigul lui poate proveni din aceste diferențe.
Costul la utilizare este mic. Timpul pentru o prognoză a consumului pe procesorul unui laptop este de 19 milisecunde pentru Bolt small, 43 ms pentru Chronos-2, 114 ms pentru ARIMA și 411 ms pentru ETS. Modelele pre-antrenate sînt mai rapide decît reperele clasice, deoarece nu estimează nimic: o singură trecere prin rețea înlocuiește optimizarea verosimilității.
Inferența zero-shot este ieftină deoarece costul real a fost plătit o singură dată, la pre-antrenare, de dezvoltator. Pentru un utilizator cu mii de serii, acest lucru schimbă calculul: un reper puternic se obține în cîteva secunde pentru toate seriile, înaintea oricărui model dedicat.
Pe scurt
Parametri: Bolt tiny 9 milioane, Bolt small 48 de milioane, Chronos-2 119 milioane; ETS și ARIMA: cîțiva pe serie
Modelele mai mari obțin aici scoruri mai bune, dar Chronos-2 diferă și prin arhitectură și date de antrenare: dimensiunea singură nu este cauza; ARIMA (0,87) se situează între Bolt small și Chronos-2
Timpul pentru o prognoză a consumului pe procesorul unui laptop: Bolt small 19 ms, Chronos-2 43 ms, ARIMA 114 ms, ETS 411 ms
Inferența zero-shot este ieftină; costul a fost plătit o singură dată, la pre-antrenare
Testul capitolului are doar șapte serii. Concluziile generale despre metodele de prognoză se sprijină pe benchmark-uri mari. Competiția M3, descrisă de Makridakis și Hibon (2000), a folosit 3003 serii și a arătat că metodele sofisticate nu le bat, în medie, pe cele simple. Competiția M4 (Makridakis et al., 2020) a folosit 100 000 de serii; au cîștigat combinațiile de prognoze și un hibrid de netezire exponențială și rețea neuronală. Arhiva Monash (Godahewa et al., 2021) adună seturi publice de date cu orizonturi fixe și rezultate de referință.
Pentru foundation models, benchmark-ul de referință este GIFT-Eval, al lui Aksu et al. (2024). El acoperă multe domenii și frecvențe, raportează MASE și CRPS și publică un clasament al modelelor. Important pentru secțiunea următoare, GIFT-Eval separă datele de test de un corpus de pre-antrenare pus la dispoziție separat, pentru a limita contaminarea.
Literatura are și studii critice. Zeng et al. (2023) au arătat că modele liniare foarte simple au bătut primele modele de prognoză bazate pe Transformer pe benchmark-urile de prognoză pe termen lung folosite atunci. Tan et al. (2024) au arătat că, în metodele care adaptează LLM-uri la serii de timp, componenta de model de limbaj nu adaugă precizie. Ambele studii întăresc lecția testului din acest capitol: un model complex trebuie comparat cu repere simple înainte de a fi preferat.
multe domenii și frecvențe, MASE și CRPS, un clasament public al foundation models
separă datele de test de un corpus de pre-antrenare, pentru a limita contaminarea
Studii critice: modele liniare simple au bătut primele modele de prognoză cu Transformer (Zeng et al. (2023)); componentele LLM nu adaugă precizie (Tan et al. (2024))
Foundation models ajută în primul rînd cînd există multe serii și puțin timp pentru fiecare. Ele funcționează cel mai bine pe serii cu sezonalitate puternică și regulată și cu contexte lungi, ca în cazul consumului de energie, al vînzărilor sau al traficului. Sînt un reper rapid și puternic înaintea unui model dedicat și dau o prognoză probabilistă fără cost suplimentar.
Nu ajută pe serii apropiate de un mers aleator, ca în cazul cursurilor de schimb sau al randamentelor: din trecutul acestor serii nu este nimic de învățat. Nu ajută nici pe serii scurte, de cîteva zeci de trimestre, unde un ARIMA atent specificat este mai bun, așa cum arată PIB-ul României. Sînt limitate și atunci cînd contează factorii explicativi, precum temperatura, prețurile sau politicile, dacă aceștia nu sînt în context; modele precum Chronos-2, care acceptă covariate, pot reduce această limită. În sfîrșit, nu sînt potrivite cînd modelul trebuie explicat parametru cu parametru sau cînd se pune o întrebare cauzală, de exemplu efectul unei modificări de taxe.
Regula care rezultă din tot capitolul este una de metodă: comparați întotdeauna un foundation model cu prognoza sezonieră naivă, cu ETS și cu ARIMA pe aceleași origini și testați diferențele cu testul Diebold și Mariano (1995) din Capitolul 4, pentru a separa un cîștig real de zgomot.
Pe scurt
Ajută
multe serii, puțin timp pentru fiecare; sezonalitate puternică și regulată; contexte lungi (consum, vînzări, trafic)
un reper rapid și puternic înaintea unui model dedicat; ieșire probabilistă fără cost suplimentar
Nu ajută
serii apropiate de un mers aleator (cursuri de schimb, randamente): nu este nimic de învățat din trecut
serii scurte (cîteva zeci de trimestre), unde un ARIMA atent specificat este mai bun
cînd contează factorii explicativi (temperatura, prețurile, politicile), iar aceștia nu sînt în context
cînd modelul trebuie explicat parametru cu parametru sau se pune o întrebare cauzală
Comparați întotdeauna cu prognoza sezonieră naivă, ETS și ARIMA pe aceleași origini; testați diferențele cu Diebold–Mariano (Diebold și Mariano (1995))
Chronos-2 este cel mai bun în medie, mai ales pentru consumul orar, dar ARIMA este aproape și cîștigă la PIB. Pe seriile apropiate de un mers aleator, niciun model nu bate prognoza naivă la prognoza centrală. Intervalele foundation models tind să fie prea înguste, iar contextul trebuie să acopere ciclurile sezoniere complete.
Pe scurt
Chronos-2 este cel mai bun în medie, mai ales pentru consumul orar; ARIMA este aproape și cîștigă la PIB
Pe seriile apropiate de un mers aleator, niciun model nu bate prognoza naivă
Intervalele foundation models tind să fie prea înguste; contextul trebuie să acopere sezoanele
Sinteza secțiunii
Testul pe 708 origini dă un tablou mai nuanțat decît orice exemplu izolat. Cel mai mare foundation model reduce WQL mediu cu 22% față de prognoza sezonieră naivă, dar un ARIMA bine specificat obține 13%, iar pe serii scurte sau apropiate de un mers aleator avantajul dispare. Rezultatele depind de context, iar intervalele modelelor pre-antrenate sînt mai înguste decît ar trebui. Rămîne o întrebare: sînt aceste scoruri chiar prognoze, sau o parte din ele provin din date pe care modelul le-a văzut deja?
Leakage-ul și contaminarea
Un scor de test este credibil doar dacă prognoza nu a folosit informație din perioada de test. Secțiunea deosebește două surse ale acestei probleme. Leakage-ul apare în codul analistului și poate fi controlat. Contaminarea apare în corpusul de pre-antrenare al modelului și poate fi doar verificată, indirect, comparînd rezultatele de dinainte și de după lansarea modelului.
Leakage-ul (data leakage) înseamnă că informația din perioada de test ajunge, direct sau indirect, în prognoze (Hewamalage et al., 2023). Efectul este întotdeauna optimist: modelul pare mai bun decît va fi atunci cînd va prognoza un viitor necunoscut. Cauzele tipice sînt banale, de aceea sînt ușor de trecut cu vederea.
Patru greșeli apar des. Prima este scalarea sau standardizarea seriei cu media și abaterea standard ale întregului eșantion, inclusiv perioada de test. A doua este alegerea ordinelor ARIMA, a lungimii contextului sau a versiunii modelului după ce s-au văzut erorile de test: alegerea însăși folosește datele de test. A treia este folosirea datelor revizuite, de exemplu PIB-ul din ultima publicare, ca și cum ar fi fost cunoscute la origine, deși prima estimare publicată atunci era diferită. A patra, discutată în Capitolul 9, este împărțirea aleatoare a unei serii de timp în antrenare și test, care pune observații viitoare în eșantionul de antrenare.
Testul din acest capitol evită primele două greșeli: fiecare context se termină la origine, ordinele ARIMA au fost fixate înaintea primei origini, iar Chronos își calculează scala doar din context. A treia rămîne: PIB-ul și producția industrială de la Eurostat sînt ultima versiune revizuită, nu datele disponibile în timp real (real-time data). Efectul afectează însă toate modelele în același fel.
Contaminarea (contamination) înseamnă că seria de test, sau serii puternic corelate cu ea, s-au aflat în corpusul de pre-antrenare al modelului. Atunci scorul măsoară parțial memoria modelului, nu capacitatea lui de prognoză. Ca și leakage-ul, contaminarea produce o distorsiune optimistă, dar ea nu este sub controlul utilizatorului, care nu a ales datele de antrenare.
Dezvoltatorii serioși recunosc problema. Ansari et al. (2024) raportează pentru Chronos două benchmark-uri separate: unul în domeniu (in-domain), pe seturi de date folosite și la antrenare, cu perioade de test reținute, și unul zero-shot, pe seturi nefolosite deloc la antrenare. Pentru serii publice, granița este însă greu de trasat: seriile din M4 sau datele macroeconomice ale SUA sînt probabil prezente în multe corpusuri, iar FRED și Eurostat sînt publice.
Există trei remedii. Primul este testarea doar pe date publicate după data lansării ponderilor, care nu puteau fi în corpus. Al doilea sînt benchmark-urile live, în care prognozele se depun înainte ca rezultatul să existe. Al treilea este transparența: orice studiu ar trebui să raporteze corpusul de antrenare și data lansării fiecărui model folosit.
Pe scurt
Contaminarea
seria de test (sau serii puternic corelate cu ea) a fost în corpusul de pre-antrenare
scorul măsoară atunci memoria, nu prognoza: o distorsiune optimistă
Chronos raportează două benchmark-uri: în domeniu (seturi folosite la antrenare) și zero-shot (seturi nefolosite) (Ansari et al. (2024))
serii publice precum M4 sau datele macro din SUA sînt probabil în multe corpusuri; FRED este public, la fel și Eurostat
Remedii
testați doar pe date publicate după data lansării ponderilor
benchmark-uri live: prognoze depuse înainte ca rezultatul să existe
raportați corpusul de antrenare și data lansării fiecărui model folosit
O verificare a contaminării: înainte și după lansare
Întrebare pentru sală Alegeți tăierea placebo cu 6 luni înainte de lansare (25 mai 2024 pentru Chronos-Bolt small). Cît devine raportul WQL al Chronos-Bolt small pe vînzările din SUA după tăiere?
Răspuns
1,08, ca după lansarea reală (0,81 înainte): saltul apare și la o dată la care nu s-a întîmplat nimic. Diferența dintre perioade, nu neapărat contaminarea, poate produce un astfel de salt; de aceea o scădere este un semnal de alarmă, nu o dovadă.
Graficul aplică primul remediu. Pentru fiecare serie, el compară raportul WQL față de prognoza sezonieră naivă calculat pe originile dinainte de lansarea ponderilor (barele hașurate) cu cel calculat pe originile de după lansare (barele pline). Panoul din stînga privește Chronos-Bolt small, ale cărui ponderi au fost lansate la 25 noiembrie 2024, pe șase serii. Panoul din dreapta privește Chronos-2, lansat la 30 octombrie 2025, pe cele două serii care au origini după această dată: consumul și EUR/RON.
ETS, estimat pe aceleași origini, servește drept termen de comparație. ETS nu are corpus de pre-antrenare, deci nu poate fi contaminat; o schimbare a scorului său între cele două perioade arată cît de diferită este perioada de după lansare în sine. Raționamentul este cel al unei diferențe în diferențe: semnalul de contaminare este o înrăutățire a foundation model-ului mai mare decît cea a ETS.
Pe scurt
Raportul WQL față de prognoza sezonieră naivă pentru originile dinainte (hașurat) și de după (plin) lansarea ponderilor; ETS pe aceleași origini, ca termen de comparație
Chronos-2 pe EUR/RON are raportul WQL 0,86 pe cele 124 de origini dinaintea lansării și 1,02 pe cele 10 origini de după: avantajul dispare. Pe consum, rezultatul este invers: 0,68 înainte și 0,54 după, deci cîștigul este real și se menține pe date pe care modelul nu le putea vedea. Chronos-Bolt small pe vînzările din SUA trece de la 0,82 înainte la 1,08 după, în timp ce ETS rămîne stabil, cu 0,69 și 0,68. Vînzările din SUA, o serie publică foarte cunoscută, sînt exact tipul de serie care poate fi în corpus.
Concluziile trebuie formulate prudent. Între 3 și 35 de origini după lansare sînt puține, iar perioada de după, 2025–2026, diferă de cea de dinainte; la PIB, de exemplu, și ETS se înrăutățește după lansarea Chronos-Bolt. O scădere a performanței după lansare este un semnal de alarmă, nu o dovadă de contaminare.
Verificarea are o consecință pentru tabelul rezultatelor. Chronos-2 a fost lansat în octombrie 2025, iar ultimele origini ale seriilor lunare și trimestriale sînt din iulie, august și septembrie 2025, astfel încît toate rezultatele lui pe aceste serii folosesc doar origini dinaintea lansării. Ele pot fi deci parțial contaminate și trebuie citite ca margine optimistă a performanței lui.
Pe scurt
Chronos-2 pe EUR/RON: 0,86 înainte de lansare (124 de origini), 1,02 după (10 origini): avantajul dispare
Chronos-2 pe consum: 0,68 înainte, 0,54 după: cîștigul este real, și pe date pe care nu le-a putut vedea
Chronos-Bolt small, vînzările din SUA: 0,82 înainte, 1,08 după, în timp ce ETS este stabil (0,69; 0,68)
Atenție: 3–35 de origini după lansare sînt puține; și perioada de după diferă (2025–2026); o scădere este un semnal de alarmă, nu o dovadă
Chronos-2 a fost lansat în octombrie 2025: rezultatele lui lunare de mai sus folosesc doar origini dinaintea acestei date
Leakage-ul este sub controlul analistului: la fiecare origine se folosesc doar datele disponibile atunci. Contaminarea nu este, deoarece corpusul de pre-antrenare poate conține chiar seria testată. Rezultatele se verifică pe date publicate după lansarea modelului.
Pe scurt
Leakage-ul este sub controlul dumneavoastră: folosiți doar datele disponibile la fiecare origine
Contaminarea nu este: corpusul de pre-antrenare poate conține seria dumneavoastră
Verificați rezultatele pe date publicate după lansarea modelului
Sinteza secțiunii
Un scor bun al unui foundation model are trei explicații posibile: capacitatea reală de prognoză, leakage-ul din codul de evaluare și contaminarea corpusului de pre-antrenare. Prima se poate separa de celelalte două doar prin disciplină în cod și prin teste pe date apărute după lansarea modelului. Pe datele capitolului, cîștigul Chronos-2 pe consum rezistă acestui test, iar cel de pe EUR/RON nu.
Contribuția posibilă a AI
Un asistent AI poate accelera partea de rutină a lucrului cu foundation models: codul de evaluare, lectura articolelor și explorarea multor serii. Secțiunea enumeră aceste utilizări și verificările care rămîn în sarcina analistului, deoarece erorile tipice din acest domeniu, leakage-ul și contaminarea, nu produc mesaje de eroare.
Trei utilizări sînt realiste. Prima este codul: un asistent poate scrie o primă versiune a unui backtest cu origine mobilă, a funcțiilor pentru pierderea pinball și WQL sau a unui fan chart. A doua este lectura: un rezumat al articolului unui model nou, cu arhitectura, corpusul de antrenare, licența și data lansării, adică exact informațiile de care are nevoie o evaluare corectă. A treia este explorarea: rularea mai multor modele deschise pe multe serii românești de la Eurostat sau de la Institutul Național de Statistică (INS), o sarcină obositoare de făcut manual.
Exemplul de prompt de pe slide arată cum se formulează o cerere verificabilă. El precizează datele (producția industrială lunară a României, setul Eurostat sts_inpr_m, neajustat sezonier), protocolul (prognoze pe 12 luni de la origini lunare din 2016), modelele (Chronos-Bolt small din pachetul chronos-forecasting, pe CPU, ETS și prognoza sezonieră naivă) și scorurile (MASE, WQL și acoperirea intervalului de 80%). Un prompt atît de precis produce rezultate care pot fi comparate cu cele din acest capitol.
Pe scurt
Cod
o primă versiune a unui backtest cu origine mobilă, a pierderii pinball și a WQL, a unui fan chart
Lectură
un rezumat al articolului unui model (arhitectura, corpusul, licența, data lansării)
Explorare
rularea mai multor modele deschise pe multe serii românești de la Eurostat sau INS
Exemplu de prompt
Write Python code that downloads Romanian monthly industrial production (Eurostat sts_inpr_m, not seasonally adjusted), forecasts 12 months ahead from monthly origins since 2016 with amazon/chronos-bolt-small (package chronos-forecasting, CPU), ETS and the seasonal naive, and reports MASE, the weighted quantile loss and the coverage of the 80% interval.
Prima verificare privește numele: pachetul și modelele trebuie să existe, de exemplu clasa BaseChronosPipeline și modelul amazon/chronos-bolt-small. O clasă sau un nume de model inventat eșuează imediat, ceea ce este de fapt cazul fericit. Erorile periculoase sînt cele care nu opresc codul: o scalare sau o calibrare făcută cu date de după origine, care produce leakage, sau o cuantilă cerută în afara nivelurilor modelului. Chronos-Bolt produce doar cuantilele 0,1–0,9; o „cuantilă de 1%” obținută din el este o extrapolare, nu o prognoză a modelului.
Reperele trebuie să fie prezente: prognoza sezonieră naivă, ETS și ARIMA, pe aceleași origini, iar scorurile trebuie raportate relativ la prognoza naivă. Data lansării ponderilor trebuie comparată cu perioada de test, din motivele discutate în secțiunea despre contaminare, iar afirmațiile de tipul „cel mai bun model” au nevoie de o sursă, de exemplu un clasament publicat. În sfîrșit, fiecare articol citat de asistent trebuie să existe: numărul arXiv sau DOI-ul trebuie să ducă la lucrarea cu titlul declarat.
Pe scurt
Pachetul și numele modelelor: BaseChronosPipeline, amazon/chronos-bolt-small; o clasă sau un nume de model inventat eșuează imediat
Contextul se termină la origine: nicio scalare, ordonare sau calibrare cu date de test
Nivelurile cuantilelor: Chronos-Bolt dă doar 0,1–0,9; o „cuantilă de 1%” obținută din el este o extrapolare
Reperele: prognoza sezonieră naivă, ETS și ARIMA pe aceleași origini; scoruri relative la prognoza naivă
Data lansării ponderilor comparată cu perioada de test; afirmațiile de tip „cel mai bun model” au nevoie de o sursă
Fiecare articol citat: trebuie să existe; verificați numărul arXiv sau DOI-ul
Sinteza secțiunii
Un asistent poate scrie codul de evaluare, rezuma articolele și explora multe serii, dar rezultatul lui se acceptă doar după verificarea numelor de pachete și de modele, a absenței leakage-ului, a nivelurilor cuantilelor, a reperelor, a datei de lansare față de perioada de test și a referințelor.
Rezumat
Rezumatul adună ideile principale ale capitolului, formulele de reținut și întrebările de autoevaluare.
Un foundation model este pre-antrenat o singură dată pe multe serii și prognozează serii noi zero-shot, doar din context. Seriile devin intrări ale unui Transformer prin scalare și cuantizare, ca în Chronos, sau prin patching, ca în TimesFM, Moirai și Chronos-Bolt. Ieșirile sînt cuantile, evaluate cu pierderea pinball, CRPS sau WQL, iar calibrarea lor se verifică prin acoperire.
Pe cele șapte serii ale capitolului, cîștigurile sînt mari la consumul orar, inexistente la prognoza centrală a seriilor apropiate de un mers aleator și negative pentru modelele Bolt la PIB-ul trimestrial scurt, iar ARIMA rămîne un reper puternic. Contaminarea poate face scorurile publicate să pară mai bune decît sînt, de aceea rezultatele trebuie verificate pe date publicate după lansarea modelului.
Pe scurt
Un foundation model este pre-antrenat o singură dată pe multe serii și prognozează serii noi zero-shot, doar din context
Seriile devin intrări ale unui Transformer prin scalare, cuantizare (Chronos) sau patching (TimesFM, Moirai, Chronos-Bolt)
Ieșirile sînt cuantile: evaluați-le cu pierderea pinball, CRPS sau WQL și verificați acoperirea
Pe cele șapte serii: cîștiguri mari la consumul orar, niciunul la seriile apropiate de un mers aleator, pierderi la PIB-ul trimestrial scurt; ARIMA rămîne un reper puternic
Contaminarea poate face scorurile publicate să pară mai bune decît sînt: testați pe date publicate după lansarea modelului
Tabelul adună formulele capitolului în ordinea în care au fost introduse: atenția (11.1), în forma matricială \(\text{softmax}(QK^\top/\sqrt{d})\,V\); scalarea prin medie (11.2); pierderea pinball (11.3), scrisă în tabel compact, ca maximul dintre \(\tau(y - \hat q_\tau)\) și \((\tau - 1)(y - \hat q_\tau)\); CRPS (11.4); WQL (11.5); MASE (11.6) și acoperirea (11.7), cu ținta 0,8. Forma compactă a pierderii pinball este echivalentă cu cea pe cazuri: primul termen este cel pozitiv cînd valoarea observată depășește cuantila, al doilea cînd este sub ea.
Primele patru întrebări verifică definițiile și calculele de bază. Diferența dintre prognoza zero-shot și fine-tuning este dacă ponderile se schimbă: zero-shot le păstrează fixe și folosește doar contextul, fine-tuning-ul le antrenează în continuare pe datele-țintă. Pentru contextul 10, 20, 30, scala din (11.2) este \(s = 60/3 = 20\), iar valorile scalate sînt 0,5, 1 și 1,5.
Pentru \(\hat q_{0{,}9} = 5\) și \(y = 6\), valoarea observată este peste cuantilă, deci pierderea pinball este \(0{,}9 \times (6 - 5) = 0{,}9\); o depășire a cuantilei de 0,9 costă mult, după cum arată asimetria din (11.3). Un context de 512 valori, împărțit în patch-uri de 16, dă \(512/16 = 32\) de patch-uri, deci atenția compară 32 de intrări în loc de 512.
Pe scurt
Întrebare: care este diferența dintre prognoza zero-shot și fine-tuning?
Răspuns: zero-shot păstrează fixe ponderile pre-antrenate și folosește doar contextul; fine-tuning-ul antrenează în continuare ponderile pe datele-țintă
Întrebare: un context este 10, 20, 30. Cît sînt \(s\) și valorile scalate în Chronos?
Răspuns: \(s = 20\); valorile scalate 0,5; 1; 1,5
Întrebare: \(\hat q_{0{,}9} = 5\) și \(y = 6\). Cît este pierderea pinball?
Răspuns: \(0{,}9 \cdot (6 - 5) = 0{,}9\)
Întrebare: cîte patch-uri de 16 dă un context de 512 valori?
Un interval de 80% care acoperă 95% din valorile observate nu este un rezultat bun: intervalele sînt prea largi, deci le lipsește finețea, iar CRPS penalizează acest lucru. Un foundation model nu poate bate mersul aleator pe EUR/RON deoarece variațiile cursului sînt aproape imprevizibile pe baza trecutului, iar niciun model nu poate extrage informație pe care contextul nu o conține.
Un model lansat în 2025 care obține scoruri foarte bune pe date de test din 2018–2023 ridică întrebarea contaminării: acele serii ar fi putut face parte din corpusul lui de pre-antrenare. Verificarea constă în repetarea testului pe date publicate după lansare. Ideea de proiect a capitolului aplică exact această verificare: compararea Chronos-Bolt, Chronos-2 și ARIMA pe toate seriile lunare ale României dintr-un set de date Eurostat, înainte și după datele de lansare. Capitolul următor, Capitolul 12, trece la analiza spectrală.
Pe scurt
Întrebare: un interval de 80% acoperă 95% din valorile observate. Este un rezultat bun?
Răspuns: nu: intervalele sînt prea largi (lipsește finețea); CRPS penalizează acest lucru
Întrebare: de ce nu poate un foundation model să bată mersul aleator pe EUR/RON?
Răspuns: variațiile cursului sînt aproape imprevizibile pe baza trecutului; niciun model nu poate extrage informație pe care contextul nu o conține
Întrebare: un model lansat în 2025 obține scoruri foarte bune pe date de test din 2018–2023. Ce verificați?
Răspuns: dacă acele serii au fost în corpusul lui de pre-antrenare; repetați testul pe date publicate după lansare
Idee de proiect: comparați Chronos-Bolt, Chronos-2 și ARIMA pe toate seriile lunare ale României dintr-un set de date Eurostat, înainte și după datele de lansare
Capitolul a arătat că un model pre-antrenat poate prognoza zero-shot serii pe care nu le-a văzut, cu cîștiguri mari pe serii cu cicluri regulate și contexte lungi și fără cîștiguri pe serii scurte sau apropiate de un mers aleator. Instrumentele pentru a judeca aceste rezultate sînt aceleași ca în restul cursului, extinse la prognoze probabiliste: repere simple, origini mobile, scoruri strict proprii și disciplina de a folosi doar informația disponibilă la fiecare origine.
Aksu, T., Woo, G., Liu, J., Liu, X., et al. (2024). GIFT-Eval: A benchmark for general time series forecasting model evaluation. arXiv:2410.10393
Ansari, A. F., Stella, L., Turkmen, C., Zhang, X., et al. (2024). Chronos: Learning the language of time series. Transactions on Machine Learning Research. arXiv:2403.07815
Ansari, A. F., Shchur, O., Küken, J., Auer, A., et al. (2025). Chronos-2: From univariate to universal forecasting. arXiv:2510.15821
Bommasani, R., Hudson, D. A., Adeli, E., Altman, R., et al. (2021). On the opportunities and risks of foundation models. arXiv:2108.07258
Das, A., Kong, W., Sen, R., & Zhou, Y. (2024). A decoder-only foundation model for time-series forecasting. Proceedings of the 41st International Conference on Machine Learning (ICML). arXiv:2310.10688
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. doi:10.1080/07350015.1995.10524599
Garza, A., Challu, C., & Mergenthaler-Canseco, M. (2023). TimeGPT-1. arXiv:2310.03589
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. doi:10.1198/016214506000001437
Godahewa, R., Bergmeir, C., Webb, G. I., Hyndman, R. J., & Montero-Manso, P. (2021). Monash time series forecasting archive. NeurIPS Track on Datasets and Benchmarks. arXiv:2105.06643
Gruver, N., Finzi, M., Qiu, S., & Wilson, A. G. (2023). Large language models are zero-shot time series forecasters. Advances in Neural Information Processing Systems, 36. arXiv:2310.07820
Hewamalage, H., Ackermann, K., & Bergmeir, C. (2023). Forecast evaluation for data scientists: Common pitfalls and best practices. Data Mining and Knowledge Discovery, 37(2), 788–832. doi:10.1007/s10618-022-00894-5
Huang, C., & Petukhina, A. (2022). Applied Time Series Analysis and Forecasting with Python. Springer. doi:10.1007/978-3-031-13584-2
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3rd ed.). OTexts. otexts.com/fpp3
Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. doi:10.1016/j.ijforecast.2006.03.001
Makridakis, S., & Hibon, M. (2000). The M3-Competition: Results, conclusions and implications. International Journal of Forecasting, 16(4), 451–476. doi:10.1016/S0169-2070(00)00057-1
Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2020). The M4 Competition: 100,000 time series and 61 forecasting methods. International Journal of Forecasting, 36(1), 54–74. doi:10.1016/j.ijforecast.2019.04.014
Matheson, J. E., & Winkler, R. L. (1976). Scoring rules for continuous probability distributions. Management Science, 22(10), 1087–1096. doi:10.1287/mnsc.22.10.1087
Nie, Y., Nguyen, N. H., Sinthong, P., & Kalagnanam, J. (2023). A time series is worth 64 words: Long-term forecasting with Transformers. International Conference on Learning Representations (ICLR). arXiv:2211.14730
Rasul, K., Ashok, A., Williams, A. R., Ghonia, H., et al. (2023). Lag-Llama: Towards foundation models for probabilistic time series forecasting. arXiv:2310.08278
Salinas, D., Flunkert, V., Gasthaus, J., & Januschowski, T. (2020). DeepAR: Probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting, 36(3), 1181–1191. doi:10.1016/j.ijforecast.2019.07.001
Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are language models actually useful for time series forecasting? Advances in Neural Information Processing Systems, 37. arXiv:2406.16964
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., et al. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. arXiv:1706.03762
Woo, G., Liu, C., Kumar, A., Xiong, C., Savarese, S., & Sahoo, D. (2024). Unified training of universal time series forecasting Transformers. Proceedings of the 41st International Conference on Machine Learning (ICML). arXiv:2402.02592
Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers effective for time series forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121–11128. doi:10.1609/aaai.v37i9.26317
Rezultatele backtestului (Quantlets/Ch_11: ch11_backtest.csv, ch11_abs_err.json, ch11_numbers.json): MASE, părțile WQL, acoperirea intervalului de 80% și eroarea absolută a medianei la fiecare pas, pentru fiecare origine și fiecare model; reproduc exact cifrele din curs. Cuantilele zero-shot ale Chronos-Bolt small din cele trei fan charts (nivelurile 0,1; 0,3; 0,5; 0,7; 0,9) sînt citite din graficele vectoriale ale slide-urilor (charts/tsa_ch11_fan_load.pdf, tsa_ch11_fan_ip.pdf, tsa_ch11_fan_eurron.pdf), în care fiecare pas al prognozei este un vîrf al benzii și al medianei; reproduc cifrele din curs pînă la a cincea cifră semnificativă. Seriile, citite cu funcțiile capitolului pe 4 noiembrie 2026 și tăiate la ultima perioadă din slide-uri: consumul orar al României (extrasul ENTSO-E din Capitolul 4), inflația și rata șomajului (Eurostat), cursul EUR/RON (BNR) nu au fost revizuite și reproduc exact cifrele din curs. Producția industrială (Eurostat sts_inpr_m): valoarea din iulie 2026 a fost revizuită după realizarea slide-urilor (94,5 în slide, 94,6 cu datele din 4 noiembrie 2026); cele 96 de luni ale graficului tokenilor și cele 60 de luni ale fan chart-ului sînt citite din graficele slide-urilor (fiecare lună este un vîrf al liniei). PIB-ul real al României (Eurostat namq_10_gdp) a fost revizuit: graficul seriilor folosește linia din charts/tsa_ch11_series.pdf (toate trimestrele 2005–2026). Vînzările cu amănuntul din SUA (FRED RSXFSN): iulie și august 2026 au fost revizuite; graficul folosește datele din 4 noiembrie 2026, iar valorile din slide sînt date alături. Variantele care nu apar în curs (alte origini, alte orizonturi, alt context, altă dată de tăiere, alt sezon m, alte intervale de cuantizare) sînt rulări suplimentare ale codului capitolului pe rezultatele salvate; graficele din „Comparația familiilor de modele”, „Pierderea cuantilă ponderată (WQL)”, „Acoperirea și scorurile relative”, „Precizia punctuală: MASE” și „Rezultate: WQL relativ la prognoza sezonieră naivă” sînt grafice suplimentare pentru slide-uri care dau doar cifre.
Bibliografie
Aksu, T., Woo, G., Liu, J., Liu, X., et al. (2024). GIFT-Eval: A benchmark for general time series forecasting model evaluation. https://arxiv.org/abs/2410.10393
Ansari, A. F., Shchur, O., Küken, J., Auer, A., et al. (2025). Chronos-2: From univariate to universal forecasting. https://arxiv.org/abs/2510.15821
Ansari, A. F., Stella, L., Turkmen, C., Zhang, X., et al. (2024). Chronos: Learning the language of time series. Transactions on Machine Learning Research. https://arxiv.org/abs/2403.07815
Bommasani, R., Hudson, D. A., Adeli, E., Altman, R., et al. (2021). On the opportunities and risks of foundation models. https://arxiv.org/abs/2108.07258
Das, A., Kong, W., Sen, R., & Zhou, Y. (2024). A decoder-only foundation model for time-series forecasting. Proceedings of the 41st International Conference on Machine Learning (ICML). https://arxiv.org/abs/2310.10688
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. https://doi.org/10.1198/016214506000001437
Godahewa, R., Bergmeir, C., Webb, G. I., Hyndman, R. J., & Montero-Manso, P. (2021). Monash time series forecasting archive. NeurIPS Track on Datasets and Benchmarks. https://arxiv.org/abs/2105.06643
Gruver, N., Finzi, M., Qiu, S., & Wilson, A. G. (2023). Large language models are zero-shot time series forecasters. Advances in Neural Information Processing Systems, 36. https://arxiv.org/abs/2310.07820
Hewamalage, H., Ackermann, K., & Bergmeir, C. (2023). Forecast evaluation for data scientists: Common pitfalls and best practices. Data Mining and Knowledge Discovery, 37(2), 788–832. https://doi.org/10.1007/s10618-022-00894-5
Makridakis, S., & Hibon, M. (2000). The M3-Competition: Results, conclusions and implications. International Journal of Forecasting, 16(4), 451–476. https://doi.org/10.1016/S0169-2070(00)00057-1
Makridakis, S., Spiliotis, E., & Assimakopoulos, V. (2020). The M4 Competition: 100,000 time series and 61 forecasting methods. International Journal of Forecasting, 36(1), 54–74. https://doi.org/10.1016/j.ijforecast.2019.04.014
Matheson, J. E., & Winkler, R. L. (1976). Scoring rules for continuous probability distributions. Management Science, 22(10), 1087–1096. https://doi.org/10.1287/mnsc.22.10.1087
Nie, Y., Nguyen, N. H., Sinthong, P., & Kalagnanam, J. (2023). A time series is worth 64 words: Long-term forecasting with Transformers. International Conference on Learning Representations (ICLR). https://arxiv.org/abs/2211.14730
Rasul, K., Ashok, A., Williams, A. R., Ghonia, H., et al. (2023). Lag-Llama: Towards foundation models for probabilistic time series forecasting. https://arxiv.org/abs/2310.08278
Salinas, D., Flunkert, V., Gasthaus, J., & Januschowski, T. (2020). DeepAR: Probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting, 36(3), 1181–1191. https://doi.org/10.1016/j.ijforecast.2019.07.001
Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are language models actually useful for time series forecasting? Advances in Neural Information Processing Systems, 37. https://arxiv.org/abs/2406.16964
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., et al. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.03762
Woo, G., Liu, C., Kumar, A., Xiong, C., Savarese, S., & Sahoo, D. (2024). Unified training of universal time series forecasting Transformers. Proceedings of the 41st International Conference on Machine Learning (ICML). https://arxiv.org/abs/2402.02592
Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers effective for time series forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121–11128. https://doi.org/10.1609/aaai.v37i9.26317


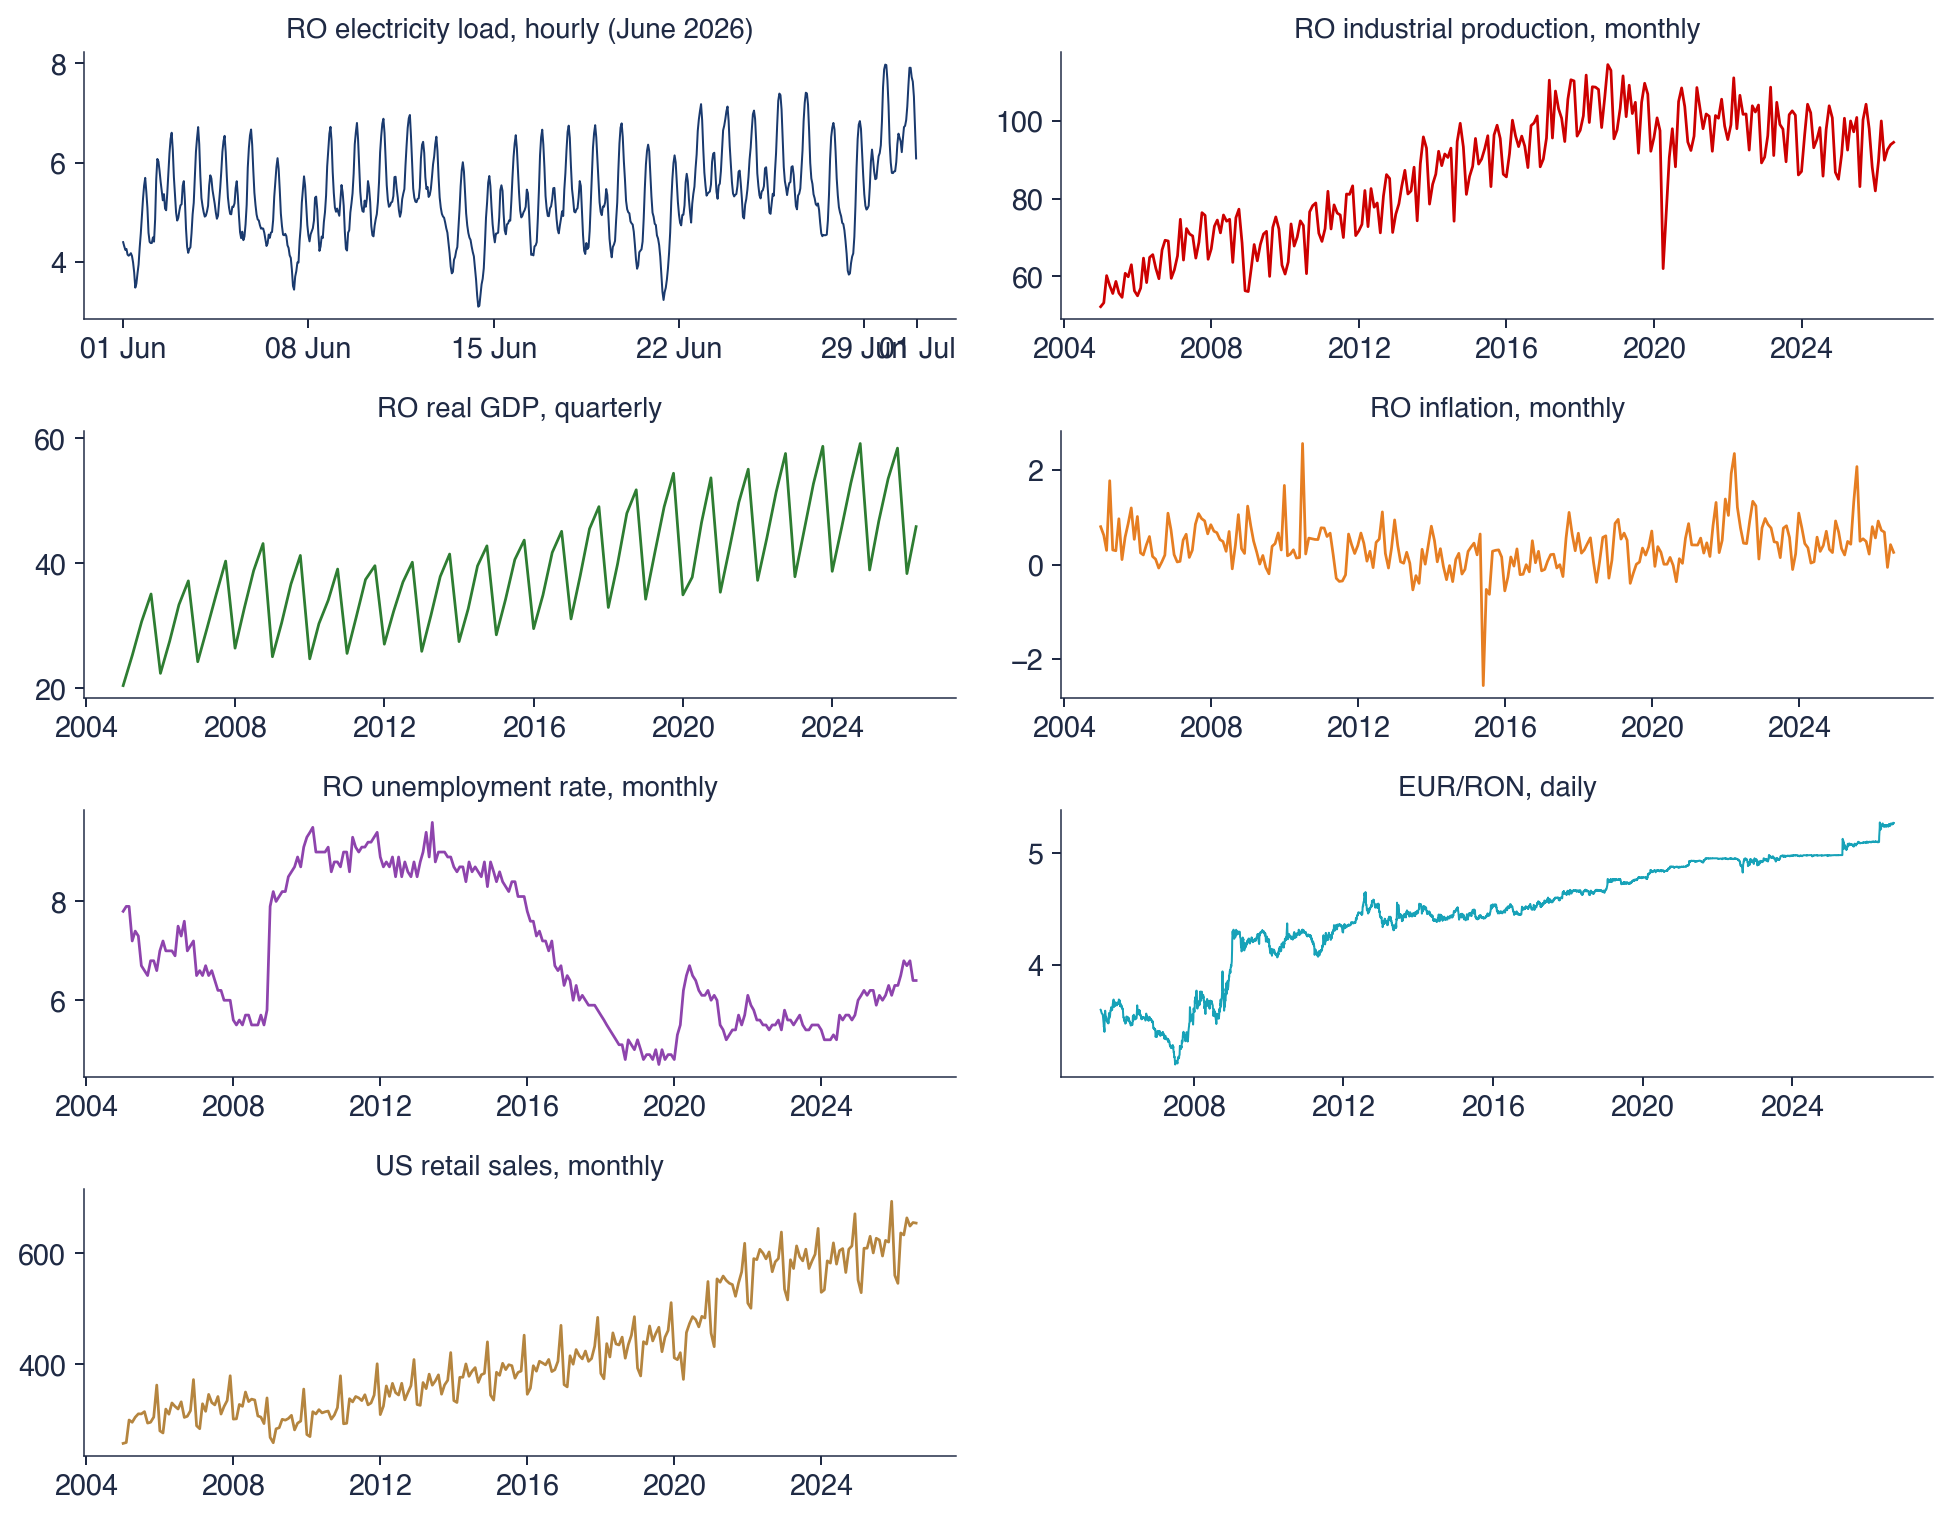
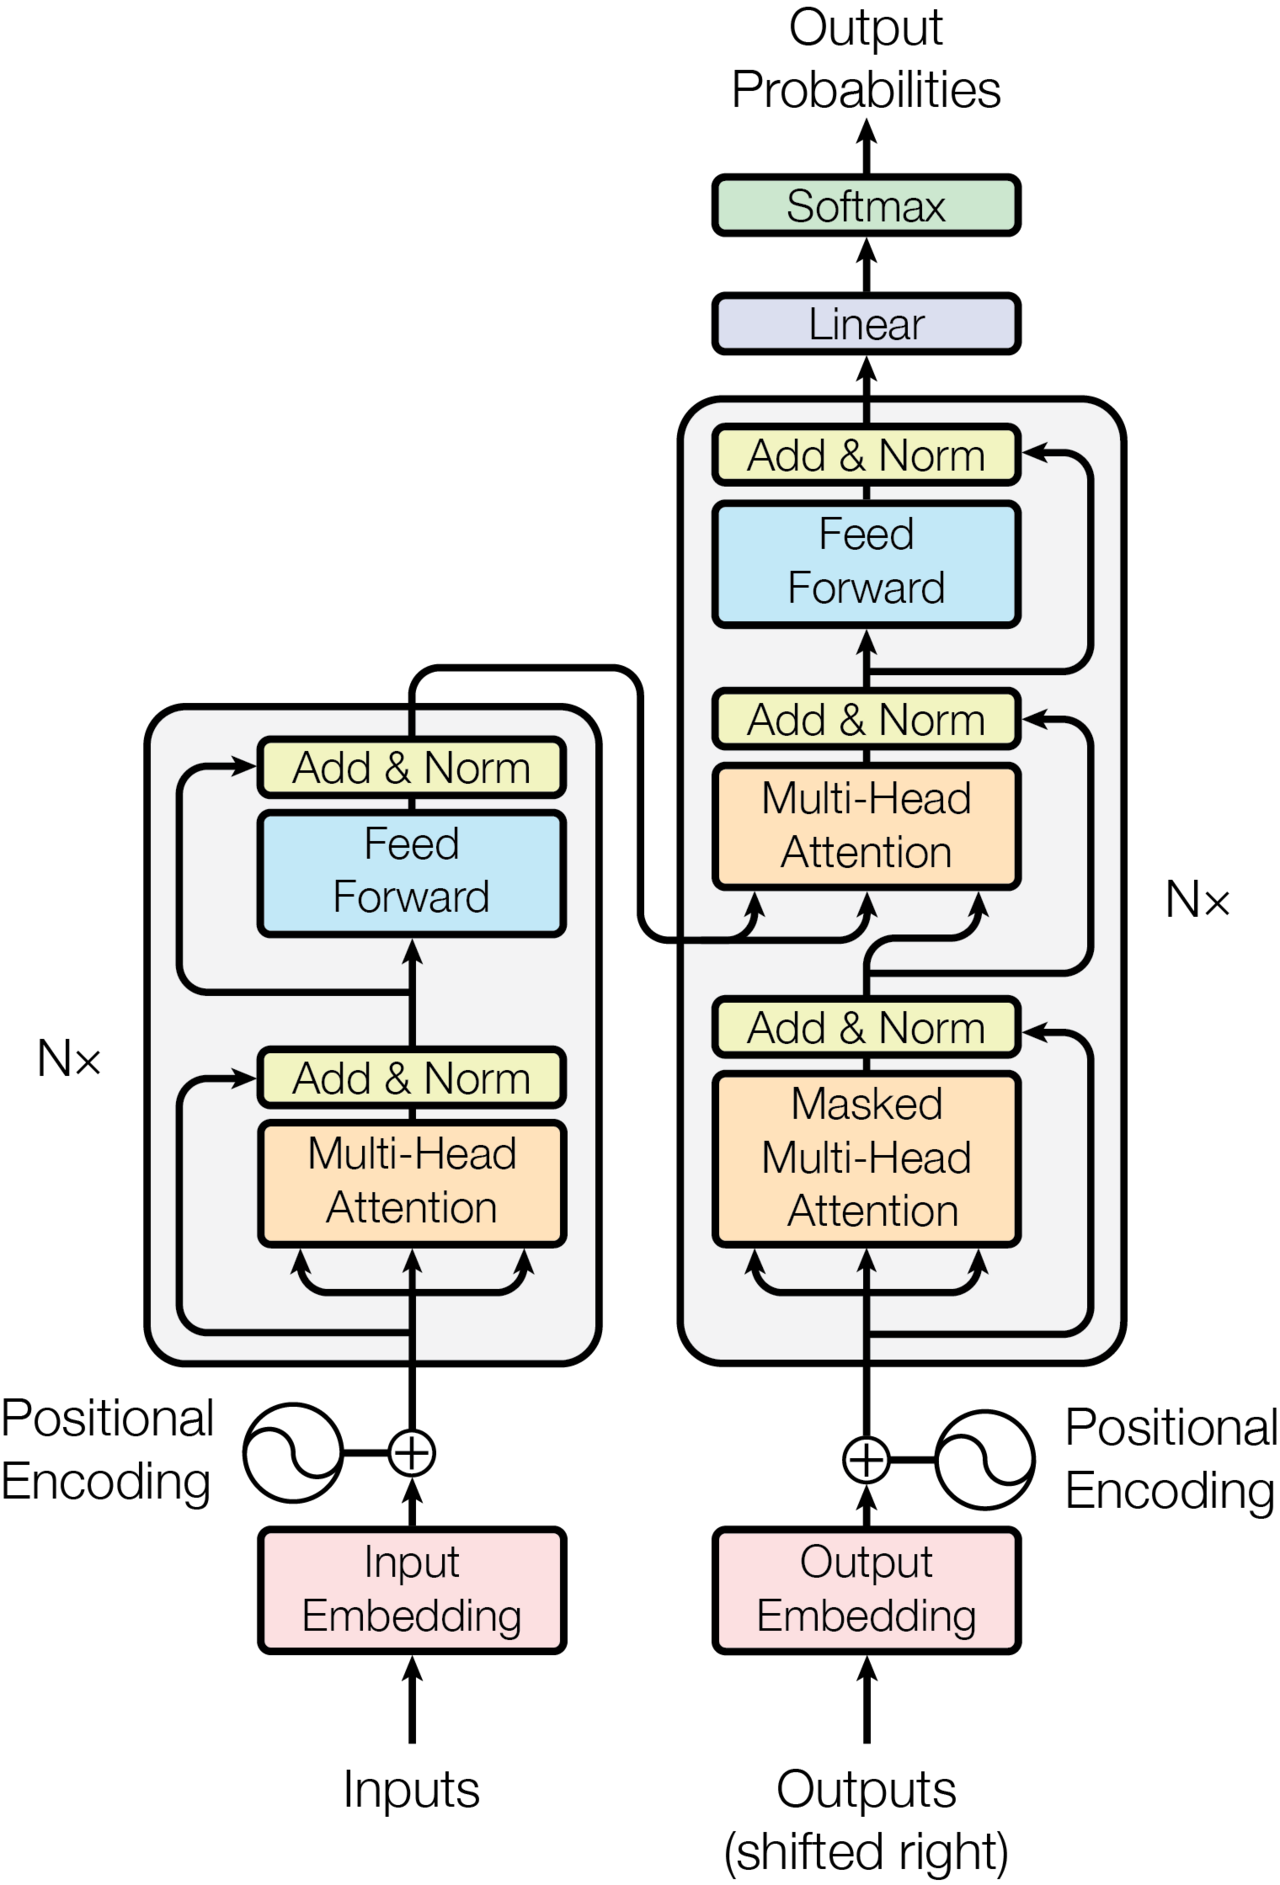
 TSA_ch11_tokens_scores