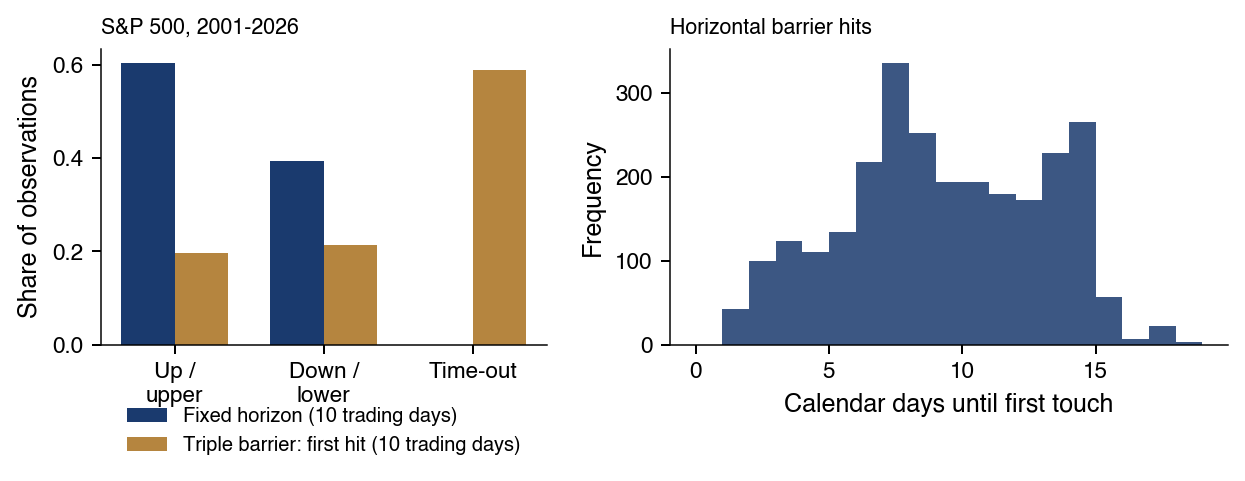Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“Hundreds of papers and factors attempt to explain the cross-section of expected returns. Given this extensive data mining, it does not make sense to use the usual criteria for establishing significance.” — Harvey, Liu & Zhu (2016)
După sute de factori testați pe aceleași date, un factor nou are nevoie de \(t > 3\), nu de \(t > 2\)
Direcția S&P 500 (Standard & Poor's) pe 5 zile, \(n = 6\,269\): niciun model nu depășește reperul „mereu în sus”
reperul are acuratețea 58,1%; logit-ul are 57,7% și prezice „sus” în 98,3% din zile
Backtest pe ferestre succesive (walk-forward) 2010–2026: raportul Sharpe al strategiei GBM (Gradient Boosting Machine, model de boosting pe gradient) este 0,33
raportul Sharpe al buy-and-hold este 0,66
Pe o țintă fără predictibilitate, K-fold amestecat raportează acuratețea 69,4%
Hundreds of papers and factors attempt to explain the cross-section of expected returns. Given this extensive data mining, it does not make sense to use the usual criteria for establishing significance.
Harvey, Liu & Zhu (2016) arată că, după sute de factori testați pe aceleași date, pragul uzual \(t > 2\) nu mai separă descoperirile de norocul selecției: un factor nou are nevoie de \(t > 3\). Machine learning aduce în finanțe forme funcționale flexibile, neliniare, și sute de predictori candidați, deci aceeași problemă la o scară mai mare. Datele financiare au un raport semnal-zgomot (signal-to-noise ratio) foarte mic și o singură istorie, dependentă serial. Pe randamentele zilnice S&P 500 (Standard & Poor's) din 2000–2026, autocorelațiile randamentelor sînt mici, autocorelația de ordin 1 este \(-0{,}099\), iar autocorelațiile valorilor absolute ale randamentelor sînt mari și persistente: riscul are structură predictibilă, direcția aproape deloc.
Studiul de caz al capitolului pune întrebarea direct: poate fi prezisă direcția S&P 500 pe 5 zile? Pe 6 269 de observații zilnice, patru modele (logit penalizat, random forest, gradient boosting și o rețea neuronală) sînt validate cu aceleași 5 pliuri, cu purjare (purging) și embargo. Niciun model nu depășește reperul „mereu în sus”, care are acuratețea 58,1%. Logit-ul are acuratețea 57,7% pentru că prezice „sus” în 98,3% din zile. În backtest-ul walk-forward 2010–2026, strategia GBM (Gradient Boosting Machine, model de boosting pe gradient) are raportul Sharpe (Sharpe ratio) 0,33, iar buy-and-hold 0,66.
Cele mai multe rezultate false vin din proces, nu din algoritm. Pe o țintă fără nicio predictibilitate, K-fold cu observațiile amestecate raportează o acuratețe de 69,4%, iar K-fold cu purjare și embargo 49,6%. Pe o grilă de 1 284 de reguli de tranzacționare pe Bitcoin, regula selectată are raportul Sharpe 2,02 in-sample și 0,03 out-of-sample. Capitolul construiește de aceea, pas cu pas, caracteristicile, etichetele, validarea și testele care separă o predicție reală de cea mai bună dintre multe încercări.
Acuratețea și AUC (aria de sub curba ROC) ale celor patru modele pentru direcția S&P 500 pe 5 zile, media pe cele 5 pliuri purjate, cu mustăți de \(\pm 1\) abatere standard între pliuri; reperul „mereu în sus” are acuratețea 58,1%, iar AUC \(= 0{,}5\) înseamnă nicio abilitate. Graficul interactiv: „Compararea modelelor: mediile pe pliuri” →
Rezultatele învățării
Calculați caracteristici și etichete fără informație din viitor (look-ahead bias).
Calculați scorul unui model validat cu purjare și embargo.
Derivați de ce diferențierea fracționară cu fereastră fixă (FFD, fixed-width window fractional differencing) trunchiată a unui preț \(I(1)\) rămîne \(I(1)\).
Interpretați testele unui clasificator și ale unui backtest față de un reper.
Metode de machine learningPierderea, penalizarea și cinci familii de modele; traiectoria de regularizare LASSO (Least Absolute Shrinkage and Selection Operator, regresie penalizată L1 cu selecția variabilelor).
Machine learning pentru inferențăSelecția dublă, machine learning dublu (DML) și puterea predictivă a VIX (CBOE Volatility IndeX, indicele de volatilitate CBOE).
Machine learning (ML) estimează din date o funcție de predicție, cu puține restricții asupra formei ei. Capitolul îl aplică randamentelor financiare, unde semnalul este slab, iar istoria este scurtă și dependentă serial. În acest context domină două erori ale procesului de cercetare (López de Prado, 2018).Look-ahead bias este folosirea unor informații care nu erau disponibile la data deciziei. Biasul de selecție (selection bias) este raportarea celei mai bune dintre multe încercări ca și cum ar fi fost singura. Prima secțiune separă ce este predictibil într-o serie de randamente de ce nu este și stabilește cît valorează un cîștig predictiv mic.
calculați caracteristici și etichete fără informație din viitor
calculați scorul unui model validat cu purjare și embargo
derivați de ce FFD (Fixed-width window Fractional Differentiation, diferențiere fracționară cu fereastră fixă) trunchiată a unui preț \(I(1)\) rămîne \(I(1)\)
interpretați testele unui clasificator și ale unui backtest față de un reper
Aprofundări și Anexa: lectură pentru familiarizare
Testele folosite pentru această comparație
testele Pesaran–Timmermann (PT) și Diebold–Mariano (DM)
raportul Sharpe deflatat (DSR)
testul de abilitate predictivă superioară (SPA)
probabilitatea de supraajustare a backtest-ului (PBO)
Exemplele detaliate și subiectele avansate sînt în Aprofundări, după Concluzii
butonul din subsol duce la ele, iar butonul Înapoi revine la slide-ul de plecare
Majoritatea eșecurilor țin de proces, nu de algoritm (López de Prado (2018)); două erori domină
deplasarea de anticipare (look-ahead bias): folosirea unor informații indisponibile la momentul deciziei
deplasarea de selecție (selection bias): raportarea celei mai bune dintre multe încercări
Firul capitolului: de la date la o afirmație testată
Schema arată etapele prin care prețurile brute devin o afirmație care poate fi testată. Prețurile sînt eșantionate în bare (bars), în acest capitol bare zilnice. Caracteristicile (features) se calculează din bare doar cu informația disponibilă la data deciziei, iar unele dintre ele păstrează o parte din memoria nivelului prețului. Etichetele (labels) definesc ce învață modelul: eticheta cu trei bariere și meta-eticheta sînt două alternative la simplul semn al unui randament viitor. Modelele sînt LASSO (least absolute shrinkage and selection operator), random forest (RF), gradient boosting machine (GBM) și perceptronul multistrat (MLP, multilayer perceptron).
Al doilea rînd al schemei este cel în care majoritatea erorilor sînt prinse sau scapă. Validarea folosește validarea încrucișată (CV, cross-validation) cu purjare (purging) și embargo, care împiedică seturile de antrenare și de test să împartă informație. O direcție prezisă devine o tranzacție doar într-un backtest cu costuri, iar backtest-ul devine dovadă doar după inferența formală. Capitolul folosește testul Diebold–Mariano (DM), testul de abilitate predictivă superioară (SPA, superior predictive ability), raportul Sharpe deflatat (DSR, deflated Sharpe ratio) și probabilitatea de overfitting a backtest-ului (PBO, probability of backtest overfitting). Implementarea și monitorizarea închid lanțul.
Fiecare etapă răspunde unei întrebări precise. Caracteristicile trebuie să folosească doar informația disponibilă la data deciziei. Validarea măsoară ce rămîne valabil pe observații pe care modelul nu le-a văzut. Inferența decide dacă o diferență față de un reper este mai mare decît eroarea de eșantionare și decît costul tranzacționării.
Formele funcționale flexibile, neliniare, găsesc interacțiuni între predictori fără ca analistul să le specifice.
Sînt disponibili sute de predictori candidați, „factor zoo” din Capitolul 3.
Datele alternative, precum textul, imaginile, registrele de ordine (order books) și datele on-chain, adaugă alți predictori.
Constrîngerile sînt la fel de puternice. Raportul semnal-zgomot (signal-to-noise ratio) al randamentelor este foarte mic, iar istoria este una singură, dependentă serial, care nu poate fi repetată. Piețele sînt nestaționare: regimurile se schimbă, apar rupturi structurale, iar piețele se adaptează strategiilor care le exploatează. Etichetele nu sînt date, ci trebuie construite explicit, iar erorile au costuri financiare reale.
Împreună, aceste trăsături creează un risc foarte mare de overfitting, adică de ajustare a zgomotului. Un model flexibil, aplicat pe un semnal slab și pe o singură istorie, găsește cu ușurință regularități care nu se repetă.
Ipoteza piețelor adaptive (Adaptive Markets Hypothesis) a lui Lo (2004) descrie predictibilitatea ca fiind trecătoare: ea apare, este eliminată prin arbitraj și reapare. Un model care a funcționat ieri este deci o ipoteză, nu o lege; eficiența pieței este subiectul Capitolului 2.
Dificultatea nu constă în estimarea modelului, ci în evitarea concluziilor false. Aceasta cere etichete corecte, validare corectă și backtest-uri oneste, iar restul capitolului construiește, pe rînd, fiecare dintre aceste condiții.
Ce parte a unei serii financiare este predictibilă se vede mai întîi din autocorelațiile ei. Autocorelația de ordinul \(k\) este
\[\rho_k = \mathrm{Corr}(x_t, x_{t-k}),\]
(13.1)
calculată aici pentru randamentul logaritmic zilnic \(r_t = \log P_t - \log P_{t-1}\) și pentru valoarea lui absolută \(|r_t|\), unde \(P_t\) este prețul de închidere din ziua \(t\). În ipoteza absenței autocorelației, fiecare estimare \(\hat\rho_k\) se află în intervalul \(\pm 1{,}96/\sqrt{T}\) cu probabilitatea 95%, unde \(T\) este numărul de observații. Pentru \(|r_t|\), banda cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării.
Pe S&P 500, autocorelațiile randamentelor sînt mai mici decît cele ale randamentelor absolute. Chiar și așa, 13 dintre cele 40 de autocorelații ale randamentelor ies din bandă, iar la lagul 1 estimarea este \(\hat\rho_1 = -0{,}099\). Se impun trei rezerve. Banda nu este simultană pentru 40 de laguri; nu este robustă la heteroscedasticitate; iar un coeficient din afara benzii nu arată că o regulă de tranzacționare este profitabilă după costuri.
Autocorelațiile lui \(|r_t|\) sînt mari și persistente. Mărimea randamentelor, adică riscul, are o structură predictibilă, în timp ce direcția lor aproape deloc. ML are deci cele mai mari șanse acolo unde există o astfel de structură: volatilitatea, riscul, lichiditatea și ordonarea transversală (cross-sectional ranking) a activelor.
Pe scurt
Întrebarea: ce parte a unei serii financiare este, în principiu, predictibilă?
Autocorelația de ordin \(k\): \(\rho_k = \Corr(x_t, x_{t-k})\)
pentru randamentul logaritmic zilnic \(r_t = \log P_t - \log P_{t-1}\) și pentru \(|r_t|\)
Graficul următor: lagul \(k\) pe axa orizontală, \(\hat\rho_k\) pe axa verticală
bare albastre pentru \(r_t\), maro pentru \(|r_t|\)
Banda albastru deschis, \(\pm 1{,}96/\sqrt{T}\), este banda de 95% în absența autocorelației
\(T\): numărul de observații
pentru \(|r_t|\), banda presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Autocorelațiile randamentelor \(r_t\) sînt mai mici decît cele ale lui \(|r_t|\), dar 13 din cele 40 ies din bandă
la lagul 1, \(\hat\rho_1 = -0{,}099\)
banda nu este simultană pentru 40 de laguri și nu este robustă la heteroscedasticitate
depășirea benzii nu demonstrează profitabilitate după costuri
Autocorelațiile lui \(|r_t|\) sînt mari și persistente
ML este cel mai util acolo unde datele au structură predictibilă
Graficul arată lagul \(k\) pe axa orizontală și autocorelația estimată \(\hat\rho_k\) pe axa verticală. Barele albastre sînt autocorelațiile lui \(r_t\), barele maro cele ale seriei transformate, iar banda albastru deschis este \(\pm 1{,}96/\sqrt{T}\), banda de 95% în absența autocorelației. Primul cursor fixează puterea \(p\) din \(|r_t|^p\):\(p = 1\) dă randamentele absolute, iar \(p = 2\) randamentele la pătrat. Meniul restrînge eșantionul la 2000–2012 sau la 2013–2026, iar butonul ▶ modifică puterea pas cu pas.
Întrebare pentru sală Pentru S&P 500, în 2000–2026, autocorelațiile randamentelor zilnice sînt mici la majoritatea lagurilor. Cum arată autocorelațiile randamentelor absolute |r_t|?
Răspuns
Pentru |r_t|, autocorelația este 0,29 la lagul 1 și 0,16 la lagul 40; toate cele 40 ies din banda ±0,024. La randamente, autocorelația de ordinul 1 este −0,10, iar 13 din 40 ies din bandă. Autocorelația liniară redusă nu implică independență, iar aplicarea modulului nu transformă ACF (AutoCorrelation Function, funcția de autocorelație) prin simpla ridicare la pătrat. Rezultatul indică persistența amplitudinii randamentelor. Banda ±0,024 este un reper punctual i.i.d., nu o bandă simultană robustă la heteroscedasticitate.
La \(p = 1\), pe 2000–2026, barele lui \(|r_t|\) sînt mari și scad lent cu lagul, în timp ce barele lui \(r_t\) sînt mici, cu \(\hat\rho_1 = -0{,}099\) și 13 din 40 în afara benzii. Schimbarea puterii modifică înălțimea barelor maro, dar nu și persistența lor: structura predictibilă se află în mărimea randamentelor, nu în semnul lor.
Cea mai amplă comparație a metodelor ML pentru randamente este cea a lui Gu, Kelly & Xiu (2020). Autorii folosesc randamentele lunare ale acțiunilor americane individuale din 1957–2016 și compară modele liniare, regresii penalizate, regresia pe componente principale (PCR, principal component regression), metoda celor mai mici pătrate parțiale (PLS, partial least squares), random forests, gradient boosting și rețele neuronale. Măsura lor de ajustare este \(R^2\) out-of-sample (OOS),
unde \(r_t\) este randamentul realizat în luna \(t\) a perioadei de test, iar \(\hat r_t\) prognoza făcută cu informația pînă la \(t-1\). Numitorul din (13.2) este eroarea pătratică a prognozei zero, \(\hat r_t = 0\):\(R^2_{OOS} > 0\) cînd modelul o depășește și \(R^2_{OOS} < 0\) cînd este mai slab.
Valorile lunare din Tabelul 1 al lucrării sînt mici. O rețea cu trei straturi atinge 0,40%, gradient boosting 0,34%, iar random forest 0,33%. Metoda celor mai mici pătrate (OLS, ordinary least squares) cu 3 predictori atinge 0,16%, iar OLS cu toți cei peste 900 de predictori dă −3,46%. Arborii și rețelele cîștigă prin interacțiuni neliniare, iar predictorii dominanți sînt momentum-ul, lichiditatea și volatilitatea.
Randamentele nu au aproape nicio direcție predictibilă, în timp ce mărimea lor este puternic persistentă. Cîștigurile out-of-sample ale prognozelor de randament se măsoară în zecimi de procent de \(R^2\), iar mărimea lor depinde de reper, prognoza zero sau media istorică. Secțiunea următoare introduce modelele care produc astfel de prognoze și penalizările care le țin varianța sub control.
Metode de machine learning
Trusa are trei componente:
o funcție de pierdere (loss), care măsoară eroarea unei predicții;
o penalizare, care limitează complexitatea funcției estimate;
o schemă de validare, care alege intensitatea penalizării.
O completează cinci familii de modele: modelele liniare penalizate, arborii individuali, random forests, gradient boosting și rețelele neuronale. Cu un semnal slab, controlul varianței estimării contează mai mult decît flexibilitatea suplimentară, iar descompunerea bias–varianță face această afirmație precisă.
Pierdere, penalizare și cinci familii de modele (1/5)
Învățarea supervizată (supervised learning) alege, într-o familie de modele, funcția care se potrivește cel mai bine datelor de antrenare după o penalizare pentru complexitate:
Aici \((y_i, \mathbf{x}_i)\),\(i = 1,\dots,n\), sînt ținta și vectorul de caracteristici al observației \(i\), iar \(\mathcal{F}\) este familia de modele, de exemplu toți arborii de adîncime 3. Pierderea \(L\) este eroarea pătratică \((y - f)^2\) sau, pentru o probabilitate \(f\) ca \(y = 1\), log-loss-ul \(-[y\log f + (1-y)\log(1-f)]\). Termenul \(\Omega(f)\) penalizează complexitatea cu ponderea \(\lambda \ge 0\):\(\lambda = 0\) înseamnă fără penalizare, iar un \(\lambda\) mare dă un model mai simplu.
Ponderea \(\lambda\) nu poate fi aleasă chiar prin (13.3), deoarece pierderea de antrenare preferă întotdeauna \(\lambda = 0\). Ea se alege prin validare încrucișată \(K\)-fold pe pliurile (folds) \(\mathcal{P}_1, \dots, \mathcal{P}_K\):
unde \(n_k\) este numărul de observații din pliul \(k\), iar \(\hat f^{(-k)}_\lambda\) modelul estimat pe celelalte \(K-1\) pliuri. Fiecare observație este prezisă de un model care nu a văzut-o. Dacă acest lucru este suficient pentru serii financiare, ale căror observații vecine împart informație, este subiectul secțiunii despre validarea onestă.
Pe scurt
Întrebarea secțiunii: de ce, cu un semnal slab, controlul varianței contează mai mult decît flexibilitatea?
Învățarea supervizată alege funcția care se potrivește cel mai bine datelor de antrenare
dintr-o familie de modele, după o penalizare a complexității
\((y_i, \mathbf{x}_i)\), \(i = 1,\dots,n\): ținta și vectorul de caracteristici ale observației \(i\); \(\mathcal{F}\): familia de modele (de ex. toți arborii de adîncime 3)
\(L\): pierderea, eroarea pătratică \((y - f)^2\) sau, pentru o probabilitate \(f\) ca \(y = 1\), log-loss-ul \(-[y\log f + (1-y)\log(1-f)]\)
\(\Omega(f)\): penalizarea complexității, cu ponderea \(\lambda \ge 0\); \(\lambda = 0\): fără penalizare, \(\lambda\) mare: un model mai simplu
\(\lambda\) se alege prin validare încrucișată (CV) în \(K\) pliuri \(\mathcal{P}_1, \dots, \mathcal{P}_K\):
Motivul penalizării este descompunerea erorii de test așteptate, derivată în capitolul 7 din Hastie, Tibshirani & Friedman (2009). Fie \(y = f(\mathbf{x}) + \varepsilon\), cu \(\mathbb{E}[\varepsilon] = 0\) și \(\mathrm{Var}(\varepsilon) = \sigma^2\). Într-un punct \(\mathbf{x}_0\),
unde media se ia peste eșantioanele de antrenare posibile și peste zgomotul noii observații \(y_0 = f(\mathbf{x}_0) + \varepsilon_0\). Cei trei termeni sînt zgomotul, biasul la pătrat și varianța. Biasul este eroarea sistematică a unei familii prea simple. Varianța este sensibilitatea lui \(\hat f\) la eșantionul de antrenare și crește cu flexibilitatea modelului. Zgomotul \(\sigma^2\) este varianța părții nepredictibile a lui \(y\), pe care niciun model nu o poate reduce.
Derivarea adună și scade \(\mathbb{E}[\hat f(\mathbf{x}_0)]\) în \(y_0 - \hat f(\mathbf{x}_0)\) și dezvoltă pătratul. Termenii încrucișați au media zero, deoarece \(\varepsilon_0\) este independent de eșantionul de antrenare.
În finanțe, prognozele de randament reduc foarte puțin eroarea. Un \(R^2\) out-of-sample sub 1% înseamnă că modelul elimină mai puțin de 1% din pierderea pătratică a reperului. Aceasta nu identifică \(\sigma^2\), deoarece eroarea rămasă conține și specificarea greșită, variabilele omise și eroarea de estimare. Explică însă construcția modelelor care urmează: penalizările și medierea arborilor reduc varianța cu prețul unui bias mic.
Regresiile penalizate aplică (13.3) unui model liniar cu \(p\) caracteristici standardizate și coeficienții \(\boldsymbol\beta = (\beta_1, \dots, \beta_p)\):
cu \(\|\boldsymbol\beta\|_1 = \sum_j |\beta_j|\),\(\|\boldsymbol\beta\|_2^2 = \sum_j \beta_j^2\) și \(\alpha \in [0,1]\) ponderea penalizării în valoare absolută. Regresia ridge, \(\alpha = 0\)(Hoerl & Kennard, 1970), are forma închisă \(\hat{\boldsymbol\beta} = (\mathbf{X}^\top\mathbf{X} + \tfrac{n\lambda}{2}\mathbf{I})^{-1}\mathbf{X}^\top\mathbf{y}\). Ea micșorează toți coeficienții, pe niciunul exact pînă la zero, și stabilizează estimarea cînd predictorii sînt corelați.
LASSO, \(\alpha = 1\)(Tibshirani, 1996), folosește penalizarea \(|\beta_j|\), care are un punct unghiular în zero. De aceea unii coeficienți devin exact zero, iar LASSO selectează caracteristici. Elastic net, \(0 < \alpha < 1\)(Zou & Hastie, 2005), păstrează împreună grupurile de predictori corelați, în timp ce LASSO îl păstrează arbitrar pe unul dintre ei.
Reperul liniar al capitolului este logit-ul penalizat. El modelează probabilitatea \(p = P(y = 1 \mid \mathbf{x}) = 1/(1+e^{-\mathbf{x}^\top\boldsymbol\beta})\) și înlocuiește pierderea pătratică din (13.6) cu log-loss-ul.
Pe scurt
Regresiile penalizate, cu \(p\) caracteristici standardizate și coeficienții \(\bm\beta = (\beta_1, \dots, \beta_p)\):
Un arbore de clasificare împarte recursiv spațiul caracteristicilor. În fiecare nod \(v\) alege caracteristica \(j\) și pragul \(s\) care reduc cel mai mult impuritatea Gini \(G = 1 - \sum_c \hat\pi_c^2\):
\[(j^*, s^*) = \arg\min_{j,\,s}\ \Big[\frac{n_L}{n_v}\,G(L) + \frac{n_R}{n_v}\,G(R)\Big], \qquad L = \{x_j \le s\},\ R = \{x_j > s\}.\]
(13.7)
Aici \(\hat\pi_c\) este ponderea clasei \(c\) în nod, iar \(n_v\),\(n_L\),\(n_R\) sînt numerele de observații din nod și din cei doi descendenți ai lui. Un nod pur are \(G = 0\). Cu două clase, \(G = 2\hat\pi(1-\hat\pi)\), care atinge maximul de 0,5 la o împărțire 50/50. O frunză prezice ponderea clasei 1 printre observațiile ei.
Un random forest (RF) (Breiman, 2001) mediază \(B\) arbori, \(\hat f_{RF}(\mathbf{x}) = \frac1B\sum_{b=1}^{B} T_b(\mathbf{x})\). Fiecare arbore \(T_b\) crește pe un eșantion bootstrap, cu o submulțime aleatoare de caracteristici la fiecare împărțire. Dacă un arbore are varianța \(\sigma_T^2\), iar doi arbori au corelația \(\rho\), capitolul 15 din Hastie, Tibshirani & Friedman (2009) dă
Mai mulți arbori elimină al doilea termen din (13.8), dar nu și primul. Submulțimile aleatoare de caracteristici reduc \(\rho\), singurul termen pe care numărul de arbori nu îl poate elimina. Eroarea out-of-bag a pădurii, calculată pe observațiile lăsate în afara fiecărui eșantion bootstrap, este optimistă cînd etichetele se suprapun.
Pe scurt
Arbori: la fiecare nod \(v\) alegem caracteristica \(j\) și pragul \(s\) care reduc cel mai mult impuritatea Gini
\[
(j^*, s^*) = \arg\min_{j,\,s}\ \Big[\frac{n_L}{n_v}\,G(L) + \frac{n_R}{n_v}\,G(R)\Big], \qquad L = \{x_j \le s\},\ R = \{x_j > s\}
\]
impuritatea Gini: \(G = 1 - \sum_c \hat\pi_c^2\)
\(\hat\pi_c\): proporția clasei \(c\) în nod; \(n_v\), \(n_L\), \(n_R\): numărul de observații din nod și din cei doi fii
\(G = 0\) pentru un nod pur; pentru două clase \(G = 2\hat\pi(1-\hat\pi)\), maxim \(0{,}5\) la 50/50; o frunză prezice proporția clasei 1
Random forest (RF, Breiman (2001)): \(\hat f_{RF}(\mathbf{x}) = \frac1B\sum_{b=1}^{B} T_b(\mathbf{x})\)
fiecare arbore \(T_b\) crescut pe un eșantion bootstrap (extras cu revenire din datele de antrenare), cu o submulțime aleatoare de caracteristici la fiecare împărțire
Gradient boosting machine (GBM) (Friedman, 2001) construiește modelul pas cu pas, adăugînd la fiecare pas un arbore mic care corectează erorile modelului curent:
\(F_m\) este modelul după \(m\) pași, \(h_m\) arborele estimat pe pseudo-reziduurile \(r_{im}\), iar \(\eta \in (0, 1]\) rata de învățare (learning rate). Pentru log-loss pe scorul logit, pseudo-reziduul este \(r_{im} = y_i - \hat p_{m-1}(\mathbf{x}_i)\), diferența dintre rezultat și probabilitatea prezisă curentă. Un \(\eta\) mic învață încet și face mai puțin overfitting.
Perceptronul multistrat (MLP) suprapune straturi ascunse \(\mathbf{h}^{(\ell)} = g(\mathbf{W}^{(\ell)}\mathbf{h}^{(\ell-1)} + \mathbf{b}^{(\ell)})\), pornind de la \(\mathbf{h}^{(0)} = \mathbf{x}\), și se încheie cu ieșirea \(\hat p = 1/(1 + e^{-(\mathbf{w}^\top\mathbf{h}^{(D)} + b)})\).\(\mathbf{W}^{(\ell)}\) și \(\mathbf{b}^{(\ell)}\) sînt ponderile și termenii liberi ai stratului \(\ell\),\(D\) este numărul de straturi ascunse, iar \(g(z) = \max(0, z)\) este unitatea liniară rectificată (ReLU, rectified linear unit), aplicată element cu element. Ponderile minimizează log-loss-ul prin coborîre pe gradient (gradient descent).
MLP este regularizat prin oprire timpurie (early stopping). Se păstrează deoparte un set de validare cronologic, ultimele 10% din datele de antrenare, purjate, iar antrenarea se oprește cînd log-loss-ul de validare nu mai scade. Arhitecturile mai bogate sînt tratate în Capitolul 14.
Pe scurt
Gradient boosting machine (GBM, Friedman (2001)): adăugăm, pas cu pas, cîte un arbore mic
ieșirea: \(\hat p = 1/\big(1 + e^{-(\mathbf{w}^\top\mathbf{h}^{(D)} + b)}\big)\)
\(\mathbf{W}^{(\ell)}\), \(\mathbf{b}^{(\ell)}\): ponderile și termenii liberi ai stratului \(\ell\); \(D\): numărul de straturi ascunse; \(g(z) = \max(0, z)\): funcția ReLU (rectified linear unit), element cu element
ponderile minimizează log-loss-ul prin gradient descendent
oprirea timpurie: validare cronologică (ultimele 10% din antrenare, purjate); antrenarea se oprește cînd log-loss-ul pe validare nu mai scade
Traiectoria de regularizare (regularisation path) arată coeficienții unui model penalizat ca funcții de penalizare. Modelul este o regresie logistică penalizată \(L_1\) pentru direcția S&P 500 pe 5 zile, cu 14 caracteristici standardizate, cele ale studiului de caz. În graficul din stînga, axa orizontală este penalizarea \(\lambda = 1/C\) pe scară logaritmică, cu penalizarea mai puternică spre stînga, iar axa verticală este coeficientul standardizat al fiecărei caracteristici. Graficul din dreapta arată coeficienții la penalizarea aleasă cu cursorul.
Meniul comută între penalizarea LASSO (\(L_1\)) și ridge (\(L_2\)). Cursorul mută penalizarea de la puternică la slabă, iar butonul ▶ o parcurge de-a lungul traiectoriei. Cu LASSO, coeficienții devin nenuli unul cîte unul pe măsură ce penalizarea slăbește; cu ridge, toți coeficienții sînt nenuli și se micșorează împreună.
Întrebare pentru sală Pe traiectoria LASSO estimată pe întregul eșantion, ce caracteristică devine prima nenulă cînd penalizarea scade?
Răspuns
Prima caracteristică este ffd_price. vol_20 are cel mai mare coeficient în valoare absolută la penalizare slabă, ceea ce nu stabilește ordinea intrării. Nici autocorelația de ordinul 1 a randamentelor nu stabilește această ordine. Filtrul FFD trunchiat păstrează o componentă proporțională cu nivelul log-prețului. Intrarea timpurie nu dovedește abilitate predictivă: AUC mediu în CV cu purjare, cu scalarea estimată în fiecare pliu, este între 0,476 și 0,486 pentru penalizările cu cel puțin un coeficient nenul.
La o penalizare puternică toți coeficienții sînt zero. Prima caracteristică intrată este prețul logaritmic FFD, ffd_price. La o penalizare slabă, caracteristicile de volatilitate primesc cei mai mari coeficienți. Toți coeficienții rămîn mici în valoare absolută, cum se întîmplă cînd semnalul este slab.
Etichetele graficului se referă la caracteristicile studiului de caz. vol_20, vol_60 și vol_ratio sînt volatilitățile pe 20 și 60 de zile și raportul lor; mom_20 și mom_60 sînt randamentele logaritmice din ultimele 20 și 60 de zile; ffd_price este prețul logaritmic după diferențierea fracționară cu fereastră fixă (FFD, fixed-width window fractional differentiation).
La o penalizare puternică, în stînga graficului, toți coeficienții sînt zero. Prima caracteristică intrată este prețul logaritmic FFD, despre care secțiunea următoare arată că este un nivel de preț scalat. La o penalizare slabă, caracteristicile de volatilitate primesc cei mai mari coeficienți.
Toți coeficienții sînt mici în valoare absolută, în acord cu un semnal slab pe o piață aproape eficientă. Ordinea intrării descrie penalizarea, nu valoarea predictivă a unei caracteristici; dacă o variabilă selectată are un efect semnificativ este o întrebare separată, tratată în secțiunea despre machine learning pentru inferență.
Pe scurt
Regresie logistică penalizată \(L_1\) pentru direcția pe 5 zile a S&P 500, 14 caracteristici standardizate
Etichetele graficului
vol_20, vol_60, vol_ratio: volatilitățile pe 20 și 60 de zile și raportul lor
mom_20, mom_60: randamentele logaritmice pe ultimele 20 și 60 de zile
ffd_price: log-prețul FFD
Axa orizontală: penalizarea \(\lambda = 1/C\), pe scară logaritmică, mai puternică spre stînga
axa verticală: coeficientul standardizat
Penalizare puternică (stînga graficului): toți coeficienții sînt zero
prima caracteristică care intră în model este log-prețul FFD (diferențiere fracționară cu fereastră fixă)
acesta este un nivel de preț scalat (secțiunea următoare)
Penalizare slabă: caracteristicile de volatilitate au cei mai mari coeficienți
Modelele liniare penalizate, arborii, pădurile, boosting-ul și rețelele neuronale minimizează toate o pierdere plus o penalizare și diferă prin familia \(\mathcal{F}\) și prin forma lui \(\Omega\). Cu un \(R^2\) out-of-sample sub 1%, termenul de varianță din (13.5) este cel care trebuie controlat, iar shrinkage-ul și medierea sînt instrumentele principale. Traiectoria LASSO pe S&P 500 arată coeficienți mici și o intrare timpurie a prețului logaritmic FFD, a cărui construcție este subiectul secțiunii următoare.
Caracteristici: diferențierea fracționară și limitele ei
O caracteristică ar trebui să fie staționară, pentru ca o relație învățată pe trecut să se poată menține în viitor, dar diferențierea unui preț în randamente șterge memoria nivelului lui. Diferențierea fracționară (fractional differencing), propusă în acest scop de López de Prado (2018), diferențiază cu un ordin mai mic decît unu. Secțiunea definește varianta cu fereastră fixă, aplică pe S&P 500 regula propusă pentru alegerea ordinului \(d\) și arată de ce rezultatul este tot o serie nestaționară.
Staționaritate, memorie și diferențierea fracționară (1/2)
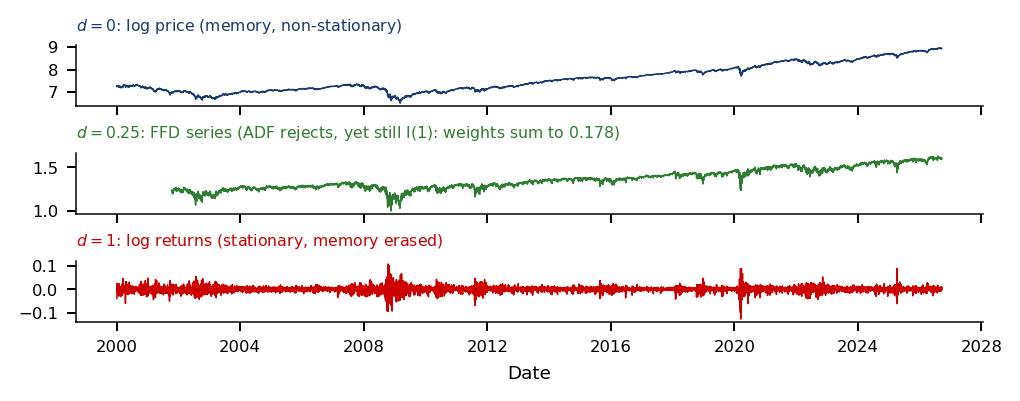
Prețurile logaritmice \(X_t = \log P_t\), cu \(P_t\) prețul de închidere din ziua \(t\), se comportă ca serii \(I(1)\). Randamentele \(\Delta\log P_t = \log P_t - \log P_{t-1}\) sînt \(I(0)\), dar șterg memoria nivelului prețului. Întrebarea este cum transformăm un preț într-o caracteristică staționară fără să-i ștergem această memorie.
Ordinul de integrare se definește cu operatorul de întîrziere (backshift operator) \(B\),\(BX_t = X_{t-1}\). O serie \(X_t\) este \(I(\delta)\) dacă \((1-B)^{\delta}X_t\) este \(I(0)\), adică staționară cu memorie scurtă. O serie \(I(1)\) este de tip mers aleator (random walk) și devine staționară după o diferențiere. Ordinul \(\delta\) poate fi fracționar: seria este atunci staționară doar pentru \(\delta < \tfrac12\), cu memorie lungă cînd \(0 < \delta < \tfrac12\)(Hosking, 1981).
Diferențierea fracționară aplică \((1-B)^d\) cu un \(d\) neîntreg, deci diferențiază cu mai puțin de 1. Scopul este eliminarea rădăcinii unitare cu păstrarea unei părți din memoria nivelului, pe care randamentele obișnuite, \(d = 1\), o elimină.
Pe scurt
Întrebarea secțiunii: cum facem dintr-un preț o caracteristică staționară, fără să-i ștergem memoria?
Log-prețurile \(X_t = \log P_t\) se comportă ca \(I(1)\)
Ordinul de integrare: o serie \(X_t\) este \(I(\delta)\) dacă \((1-B)^{\delta} X_t\) este \(I(0)\)
\(B\): operatorul lag, \(B X_t = X_{t-1}\)
\(I(0)\): serie staționară, cu memorie scurtă; \(I(1)\): serie de tip mers aleator (random walk), staționară după o diferențiere
\(\delta\) poate fi fracționar: seria este staționară doar pentru \(\delta < \tfrac12\), cu memorie lungă cînd \(0 < \delta < \tfrac12\) (Hosking (1981))
Ideea diferențierii fracționare: diferențiem cu mai puțin de 1
eliminăm rădăcina unitară și păstrăm o parte din memorie
Staționaritate, memorie și diferențierea fracționară (2/2)
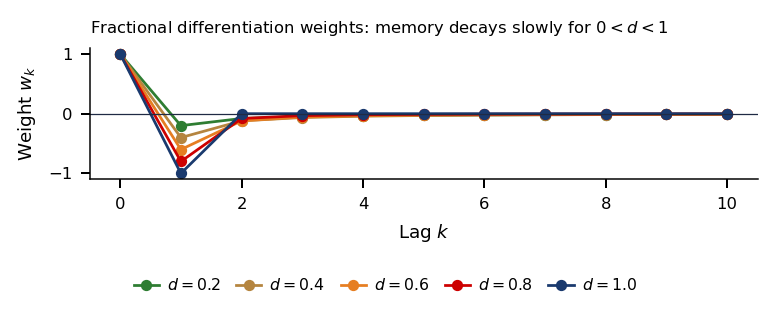
Aici \(d\) este ordinul de diferențiere ales de analist, \(k\) lagul în zile, iar \(w_k\) ponderea valorii de acum \(k\) zile. Pentru \(d = 1\), ponderile sînt \((1, -1, 0, \dots)\), adică randamentele obișnuite. Pentru \(0 < d < 1\), ponderile scad hiperbolic, deci valorile îndepărtate păstrează o pondere nenulă, iar memoria se păstrează.
Un preț logaritmic \(I(1)\) diferențiat cu ordinul \(d\) este \(I(1-d)\). El este deci tot nestaționar pentru \(d \le \tfrac12\) și staționar cu memorie lungă pentru \(\tfrac12 < d < 1\). Ponderile infinite din (13.10) au suma \((1-1)^d = 0\), deci nivelul se anulează, dar doar la limită; comportamentul asimptotic al ponderilor este în Anexă.
López de Prado (2018) propune cel mai mic \(d\) la care un test de rădăcină unitară Augmented Dickey–Fuller (ADF) respinge. Ecuația testului și valoarea lui critică vin două slide-uri mai tîrziu, iar restul secțiunii arată de ce această regulă eșuează.
Pe scurt
Definiție (Diferența fracționară de ordin \(d\)).
\(\tilde X_t = (1-B)^d X_t = \sum_{k=0}^{\infty} w_k X_{t-k}\), cu \(w_0 = 1\) și \(w_k = -\,w_{k-1}\,\frac{d-k+1}{k}\)
Notațiile
\(d\): ordinul de diferențiere ales de analist; \(k\): lagul, în zile
\(w_k\): ponderea valorii de acum \(k\) zile, din dezvoltarea binomială a lui \((1-B)^d\)
Suma infinită din (13.10) nu poate fi calculată pe un eșantion finit. Diferențierea fracționară cu fereastră fixă (FFD) trunchiază ponderile (López de Prado, 2018): păstrează \(w_0, \dots, w_K\) cu \(|w_k| \ge \tau\), de exemplu \(\tau = 10^{-4}\), și le elimină pe celelalte, astfel încît
\[\tilde X_t = \sum_{k=0}^{K} w_k X_{t-k}, \qquad t > K.\]
(13.11)
\(\tau\) este cea mai mică pondere păstrată, iar \(K\) ultimul lag păstrat, adică lungimea ferestrei. Primele \(K\) zile au prea puțină istorie și se elimină.
Fiecare \(\tilde X_t\) folosește același număr de laguri și intră doar valori trecute, deci caracteristica nu conține informație din viitor. Prețul trunchierii este lungimea ferestrei: cu cît \(d\) este mai mic, cu atît sînt necesare mai multe laguri. La \(d = 0{,}25\) și \(\tau = 10^{-4}\), fereastra are \(K = 444\) de laguri.
Ponderile trunchiate nu mai au suma zero. Suma lor este 0,178 la \(d = 0{,}25\) și 0,040 la \(d = 0{,}5\). Acest număr decide ordinul de integrare al seriei FFD, cum arată ultimul slide al secțiunii.
Pe scurt
Definiție (Diferențiere fracționară cu fereastră fixă (FFD)).
Trunchiem ponderile (López de Prado (2018)): păstrăm \(w_0,\dots,w_{l^*}\) cu \(|w_k| \ge \tau\), renunțăm la rest
de exemplu \(\tau = 10^{-4}\)
\(\tilde X_t = \sum_{k=0}^{l^*} w_k X_{t-k}\) pentru orice \(t > l^*\)
\(\tau\): cea mai mică pondere păstrată; \(l^*\): ultimul lag păstrat, adică lungimea ferestrei
primele \(l^*\) zile nu au suficient istoric și sînt eliminate
Fiecare \(\tilde X_t\) folosește același număr de laguri și doar valori trecute
deci nu conține informație din viitor
Cu cît \(d\) este mai mic, cu atît trebuie mai multe laguri
pentru \(d = 0{,}25\) și \(\tau = 10^{-4}\) fereastra are \(l^* = 444\) de laguri
Ponderile trunchiate nu mai au suma zero
suma lor \(\sum_{k=0}^{l^*} w_k\) este \(0{,}178\) la \(d = 0{,}25\) și \(0{,}040\) la \(d = 0{,}5\)
Ipoteza nulă este \(\gamma = 0\), o rădăcină unitară. Cele \(p\) diferențe întîrziate absorb autocorelația lui \(e_t\). Cu o constantă, testul respinge \(H_0\) la 5% cînd statistica este sub aproximativ \(-2{,}86\).
Regula lui López de Prado (2018) calculează seria FFD pe o grilă de valori \(d\) între 0 și 1 și alege cel mai mic \(d\) la care testul ADF respinge. Ordinul ales ar trebui să dea o caracteristică staționară cu cît mai multă memorie.
Graficul următor pune \(d\) pe axa orizontală. Statistica ADF este desenată cu albastru pe axa din stînga, iar corelația seriei FFD cu prețul logaritmic cu verde pe axa din dreapta. Linia roșie punctată este valoarea critică de 5%, iar linia verticală marchează \(d^* = 0{,}25\).
Pe scurt
Testul de rădăcină unitară Dickey–Fuller augmentat (ADF): statistica \(t\) a lui \(\gamma\) în
Graficul din stînga arată statistica ADF în funcție de \(d\), cu valoarea critică de 5%; graficul din dreapta arată seria FFD la \(d\) ales, împreună cu prețul logaritmic. Cursorul fixează ordinul de diferențiere \(d\), iar meniul lagurile testului ADF: un lag sau numărul ales prin criteriul informațional Akaike (AIC, Akaike information criterion). Butonul ▶ crește \(d\) pas cu pas.
Întrebare pentru sală La d = 0,25, ADF cu un lag respinge rădăcina unitate. Este această respingere suficientă pentru a considera seria FFD staționară?
Răspuns
ADF cu un lag respinge: −2,96 < −2,86. Cu 34 de laguri alese prin AIC, statistica este −0,72 și nu respinge. Niciun verdict nu este o demonstrație. Argumentul structural este că, pentru un log-preț I(1), filtrul finit cu suma ponderilor 0,178 păstrează componenta I(1). Corelația 0,98 cu log-prețul este un semnal de alarmă, nu un test de staționaritate.
Cu un lag, statistica ADF coboară sub valoarea critică de la \(d = 0{,}25\), unde este egală cu \(-2{,}96\); la acest ordin, seria FFD are corelația 0,98 cu prețul logaritmic. Cu lagurile alese prin AIC, aceeași serie nu respinge. Graficul din dreapta arată de ce verdictul este fragil: la \(d^*\), seria FFD urmează încă trendul prețului.
Pentru prețul logaritmic S&P 500 din 2000–2026, regresia ADF cu constantă și un lag dă \(-2{,}96\) la \(d = 0{,}25\), sub valoarea critică. Regula respinge deci de la \(d = 0{,}25\). La acest ordin, corelația dintre seria FFD și prețul logaritmic este \(\mathrm{Corr}(\tilde X_t, \log P_t) = 0{,}98\): seria FFD este aproape prețul logaritmic.
Aceeași serie, testată cu 34 de laguri alese prin AIC, dă o statistică ADF de \(-0{,}72\), iar rădăcina unitară nu este respinsă. Verdictul depinde deci de numărul de laguri. O corelație de 0,98 cu un preț \(I(1)\) este un semnal de alarmă, nu o calitate.
Rezultatul susține o comparație de proceduri: același preț logaritmic, două alegeri ale lagurilor și două verdicte. El nu stabilește că seria FFD la \(d = 0{,}25\) este staționară.
Primul termen este nivelul de azi înmulțit cu suma ponderilor trunchiate. Al doilea este o sumă ponderată a variațiilor pe \(k\) zile, \(X_t - X_{t-k}\). Dacă \(X_t\) este \(I(1)\), fiecare variație este \(I(0)\), la fel și suma lor ponderată finită. Primul termen este \(0{,}178\,X_t\) la \(d = 0{,}25\): un mers aleator scalat. Seria FFD este deci \(I(1)\).
Componenta cu rădăcină unitară are o varianță mică față de partea staționară, așa că un test ADF cu puține laguri le confundă. Un experiment Monte Carlo măsoară amploarea problemei. Pentru un mers aleator pur de \(T = 6\,274\) de zile, filtrat prin FFD cu \(d = 0{,}25\), testul ADF cu un lag respinge rădăcina unitară în 97,8% din 500 de eșantioane, la un nivel nominal de 5%.
Enunțul general este că un filtru finit ale cărui ponderi nu au suma zero păstrează o componentă de nivel, oricare ar fi valoarea \(p\) a testului ADF. Prețul logaritmic FFD din studiul de caz este deci un nivel de preț scalat, nu o caracteristică staționară. Memoria seriei se măsoară direct, cu estimatorul local Whittle, în Aprofundări.
Diferențierea fracționară trunchiată a unui preț \(I(1)\) păstrează nivelul cu ponderea \(\sum_{k \le K} w_k\), 0,178 la \(d = 0{,}25\), iar seria rămîne \(I(1)\). Regula de alegere a lui \(d\) pe baza testului ADF respinge cu un lag și nu respinge cu 34, iar pe un mers aleator pur respinge în 97,8% din eșantioane la un nivel nominal de 5%. Memoria lungă a S&P 500 se află în volatilitate, deci filtrele fracționare au sens pentru randamentele absolute, nu pentru preț.
Etichete: definirea variabilei țintă
Un model supervizat învață eticheta pe care o primește, deci definiția etichetei fixează întrebarea la care răspunde modelul. Simplul semn al unui randament viitor ignoră volatilitatea și traiectoria prețului înainte de orizont. Eticheta cu trei bariere (triple-barrier label) a lui López de Prado (2018) reproduce decizia reală a unui trader, cu un nivel de profit, un stop-loss și o perioadă maximă de deținere. Meta-etichetarea (meta-labelling) separă apoi decizia asupra sensului tranzacției de decizia asupra mărimii ei.
De la etichete cu orizont fix la etichete cu trei bariere (1/2)
\(P_t\) este prețul de închidere din ziua \(t\),\(h\) orizontul în zile, iar \(\tau \ge 0\) un prag; variațiile mai mici decît \(\tau\) în valoare absolută primesc eticheta 0.
Eticheta din (13.14) are trei probleme. Un \(\tau\) constant ignoră volatilitatea variabilă în timp, astfel că același prag este o mișcare mare într-un an calm și una mică într-o criză. Traiectoria este ignorată: un stop-loss ar fi putut fi atins înainte de \(t + h\), iar eticheta ar reține totuși doar randamentul de la orizont. Clasele sînt dezechilibrate: pentru S&P 500, cu \(h = 10\) și \(\tau = 0\), 60,5% dintre etichete sînt „sus” și 39,5% „jos”.
Pe scurt
Întrebarea secțiunii: ce etichetă reproduce decizia reală a unui trader?
decizia are un prag de profit (take-profit), un prag de pierdere (stop-loss) și o durată maximă de deținere
Orizont fix: eticheta este semnul randamentului logaritmic pe \(h\) zile
Eticheta cu trei bariere (López de Prado, 2018) pornește de la un moment al evenimentului \(t_0\), cu volatilitatea zilnică \(\sigma_{t_0}\) și orizontul \(h\). Bariera superioară, de profit, este atinsă cînd \(\log P_t - \log P_{t_0} \ge \pi_u \sigma_{t_0}\sqrt{h}\); bariera inferioară, stop-loss-ul, cînd aceeași diferență este \(\le -\pi_l \sigma_{t_0}\sqrt{h}\); iar bariera verticală este data \(t = t_0 + h\). Eticheta este dată de prima barieră atinsă, la momentul \(t_1\):\(+1\) pentru bariera superioară, \(-1\) pentru cea inferioară, iar la bariera verticală semnul lui \(r_{t_0,t_1}\) sau 0, după o convenție alternativă.
Mărimea \(\sigma_{t_0}\sqrt{h}\) este variația tipică pe \(h\) zile, iar \(\pi_u, \pi_l > 0\) sînt lățimile barierelor în unități ale acesteia. Fiecare etichetă are un interval \([t_0, t_1]\), care reține zilele ale căror randamente le folosește; intervalul este datele de intrare pentru purjarea din validare.
Volatilitatea zilnică \(\sigma_{t_0}\) este o medie mobilă ponderată exponențial (EWMA, exponentially weighted moving average) cu span 50, definită în Aprofundări. Barierele scalate cu volatilitatea sînt necesare deoarece un prag fix ar fi atins aproape zilnic în 2008 sau în martie 2020 și rar în anii calmi.
Graficul arată nivelul S&P 500 în piața descendentă (bear market) din 2022, cu cinci evenimente de etichetare. Pentru fiecare eveniment, punctul marchează intrarea, linia verde bariera superioară, linia roșie bariera inferioară, iar linia maro orizontul; steaua marchează prima barieră atinsă, iar culoarea ei arată care. Primul cursor fixează lățimea barierelor \(\pi = \pi_u = \pi_l\) în unități de \(\sigma\sqrt{h}\), al doilea orizontul \(h\) în zile de tranzacționare, iar butonul ▶ lărgește barierele pas cu pas.
Întrebare pentru sală Un eveniment atinge mai întîi bariera de profit, în ziua 5. În ziua 15, prețul este sub nivelul de intrare. Ce etichetă primește în implementarea paginii?
Răspuns
Evenimentul se încheie în ziua 5 și primește +1. Mișcarea ulterioară nu schimbă eticheta. Semnul randamentului la orizont se folosește numai dacă nu a fost atinsă anterior nicio barieră orizontală; nu există o regulă de anulare a semnelor. Pe grafic, doar evenimentul din martie atinge bariera de profit; cele din mai, august și noiembrie primesc +1 prin semnul randamentului la bariera verticală, iar cel din ianuarie atinge stop-loss-ul (−1).
La \(\pi_u = \pi_l = 1\) și \(h = 15\) zile, evenimentul din ianuarie atinge stop-loss-ul și primește \(-1\), iar cel din martie atinge bariera de profit și primește \(+1\). Celelalte trei evenimente se încheie la bariera verticală, marcate cu stele chihlimbarii, peste nivelul de intrare, așa că regula semnului le etichetează cu \(+1\). Barierele mai înguste transformă mai multe evenimente în ieșiri orizontale; barierele mai largi trimit mai multe dintre ele la bariera verticală.
Cele cinci evenimente din piața descendentă din 2022 folosesc \(\pi_u = \pi_l = 1\) și \(h = 15\) zile. Graficul arată nivelul indicelui, cu linii verzi pentru barierele superioare, linii roșii pentru barierele inferioare și linii maro pentru orizonturi; punctele sînt intrările, iar stelele prima barieră atinsă, colorate după tipul ei.
În ianuarie este atins mai întîi stop-loss-ul, iar eticheta este \(-1\). În martie este atinsă mai întîi bariera de profit, iar eticheta este \(+1\). Celelalte trei evenimente se încheie la bariera verticală, peste nivelul de intrare, așa că regula semnului le etichetează cu \(+1\).
O etichetă \(+1\) nu înseamnă deci că bariera de profit a fost atinsă. Cu regula semnului, trei dintre cele patru etichete pozitive din exemplu vin de la bariera verticală. Distribuția tipurilor de ieșire pe întregul eșantion este în Aprofundări.
Pe scurt
Cinci evenimente în piața descendentă din 2022, \(\pi_u = \pi_l = 1\), \(h = 15\) zile
culoarea fiecărei stele este bariera atinsă prima
Graficul: nivelul indicelui
linii verzi: bariera superioară, roșii: bariera inferioară, maro: orizontul
punctele: intrarea, stelele: prima barieră atinsă
Evenimentul din ianuarie atinge stop-loss-ul (eticheta \(-1\))
Evenimentul din martie atinge bariera de profit (eticheta \(+1\))
Celelalte trei se termină la bariera verticală (stele galben-portocalii) peste nivelul de intrare
deci regula semnului le dă eticheta \(+1\)
o etichetă \(+1\) nu înseamnă că bariera de profit a fost atinsă
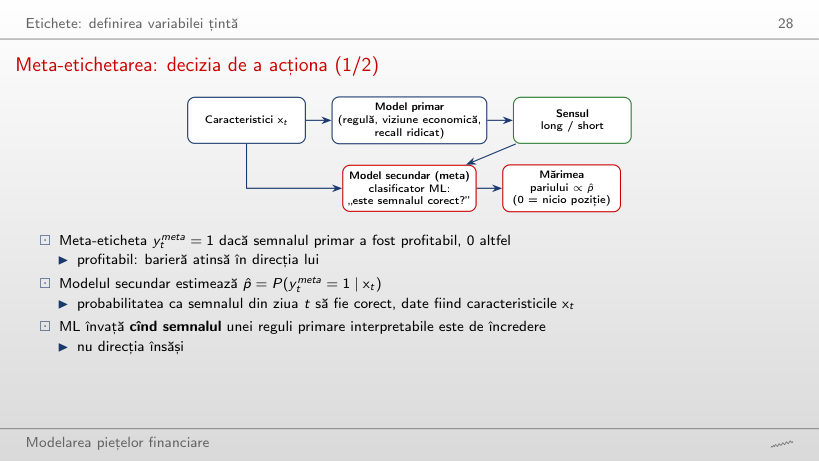
Meta-etichetarea împarte o decizie de tranzacționare între două modele. Un model primar, care poate fi o regulă simplă sau o viziune economică aleasă pentru o rată mare de recuperare (recall), folosește caracteristicile \(\mathbf{x}_t\) pentru a stabili sensul tranzacției, long sau short. Un model secundar, sau meta-model, este un clasificator ML care primește aceleași caracteristici și semnalul primar și răspunde unei întrebări mai înguste: este semnalul corect? Ieșirea lui stabilește mărimea pariului, proporțională cu probabilitatea prezisă, iar zero înseamnă că semnalul este ignorat.
Meta-eticheta este \(y^{meta}_t = 1\) dacă semnalul primar a fost profitabil, adică dacă bariera a fost atinsă în sensul lui, și \(0\) altfel. Modelul secundar estimează \(\hat p = P(y^{meta}_t = 1 \mid \mathbf{x}_t)\), probabilitatea ca semnalul din ziua \(t\) să fie corect, dată fiind valoarea caracteristicilor.
Împărțirea sarcinilor este rostul metodei. ML învață cînd să aibă încredere într-o regulă primară interpretabilă, nu direcția pieței, despre care secțiunile anterioare au arătat că este aproape nepredictibilă.
TP (adevărat pozitive, true positives) numără semnalele profitabile urmate, FP (fals pozitive) semnalele neprofitabile urmate, iar FN (fals negative) semnalele profitabile ignorate. Urmarea tuturor semnalelor dă recall 1. \(F_1\) este media armonică a preciziei și a recall-ului și se află între 0 și 1.
Exemplul vine din Seminarul 13, exercițiul B11: încrucișarea mediilor mobile pe 20 și 50 de zile (MA20/MA50) pe Bitcoin, cu 1 660 de tranzacții de test. Cu meta-filtrul, precizia crește de la 0,475 la 0,517, recall-ul scade de la 1 la 0,541, iar \(F_1\) scade de la 0,644 la 0,529. Randamentul logaritmic brut mediu pe tranzacție, înainte de costuri, trece de la −0,27% la +0,19%.
Meta-etichetarea crește precizia cu prețul recall-ului. Cu un cost pe tranzacție, contează precizia și randamentul pe tranzacție, nu \(F_1\), care penalizează tranzacțiile ignorate la fel de mult ca pe cele pierzătoare urmate.
Pe scurt
Un filtru decide pe ce semnale acționăm; trei scoruri îl descriu
Eticheta fixează ce învață modelul. Etichetele cu orizont fix pe S&P 500 sînt dezechilibrate, 60,5% „sus” la \(h = 10\), și ignoră traiectoria; etichetele cu trei bariere scalează barierele cu volatilitatea și rețin un interval pentru fiecare etichetă. Meta-etichetarea folosește ML pentru a decide cînd se acționează pe baza unei reguli primare; pe încrucișarea de medii pentru Bitcoin, crește precizia de la 0,475 la 0,517 și schimbă randamentul brut mediu pe tranzacție de la −0,27% la +0,19%.
Validarea fără informație din viitor
Validarea încrucișată estimează cum se comportă un model pe date pe care nu le-a văzut, dar doar dacă seturile de antrenare și de test nu împart informație. În datele financiare de obicei o împart: caracteristicile sînt corelate serial, iar etichetele se suprapun în timp. Secțiunea definește leakage-ul, prezintă K-fold cu purjare și embargo (López de Prado, 2018) și măsoară, pe o țintă fără nicio predictibilitate, cît supraestimează K-fold-ul obișnuit, cu observațiile amestecate, abilitatea modelului.
Leakage-ul apare cînd setul de antrenare conține informație prezentă și în setul de test, astfel încît scorul de test nu mai măsoară performanța pe date cu adevărat noi. Întrebarea secțiunii este de ce K-fold-ul obișnuit supraestimează abilitatea unui model pe serii financiare.
Două proprietăți ale datelor financiare creează leakage. Caracteristicile sînt corelate serial, \(\mathbf{x}_t \approx \mathbf{x}_{t+1}\), pentru că sînt construite pe ferestre rolling, iar etichetele se suprapun, \(y_t \approx y_{t+1}\), pentru că randamentele consecutive pe mai multe zile împart majoritatea randamentelor zilnice. Un K-fold cu observațiile amestecate pune deci zile aproape identice de ambele părți ale graniței. Un model flexibil, precum RF sau GBM, memorează vecinul și obține un scor „out-of-sample” excelent; calibrarea pe o astfel de CV cu leakage alege modelul cu cel mai mult overfitting.
Alte surse de leakage sînt transformările estimate pe întregul eșantion, precum scalarea, analiza componentelor principale sau alegerea lui \(d\) pentru FFD. Biasul de supraviețuire (survivorship bias), revizuirile datelor și marcajele de timp greșite adaugă informație care nu era disponibilă la data deciziei.
Pe scurt
Întrebarea secțiunii: de ce K-fold obișnuit supraestimează abilitatea unui model pe serii financiare?
Definiție (Scurgerea de informație (leakage)).
Setul de antrenare conține informații prezente și în setul de test
scorul de test nu mai măsoară rezultatele pe date cu adevărat noi
Caracteristici corelate serial (\(\mathbf{x}_t \approx \mathbf{x}_{t+1}\)) și etichete suprapuse (\(y_t \approx y_{t+1}\))
un \(K\)-fold amestecat pune zile aproape identice de ambele părți
Un model flexibil (RF, GBM) memorează observația vecină și obține un scor excelent în afara eșantionului
Reglarea hiperparametrilor pe un CV cu scurgere de informație selectează modelul cu cea mai mare supraajustare
Alte surse de scurgere de informație
transformări estimate pe tot eșantionul (scalare, analiza componentelor principale, alegerea lui \(d\) pentru FFD)
deplasarea de supraviețuire (survivorship bias), revizuiri ale datelor, marcaje de timp greșite
K-fold cu purjare folosește drept pliuri blocuri contigue în timp (López de Prado, 2018). Pliul de test \(k\) conține observațiile \(t^{a}_k, \dots, t^{b}_k\), ale căror etichete se încheie cel tîrziu la \(T_k = \max_{i \in \text{test}_k} t_{1,i}\). Setul de antrenare păstrează doar observațiile care nu ating pliul de test:
Mulțimea de antrenare (13.16) se bazează pe două condiții:
Purjarea: elimină etichetele de antrenare al căror interval se suprapune cu intervalul etichetelor de test.
Embargoul: elimină cele \(e\) observații care încep imediat după \(T_k\), sfîrșitul ultimei etichete de test, de exemplu 1% din eșantion. Embargoul este necesar pentru că, atunci cînd caracteristicile privesc înapoi în timp, observațiile de imediat după blocul de test poartă încă informație din el.
Scorul CV cu purjare este media celor \(K\) scoruri, fiecare obținut de un model estimat pe \(\mathcal{A}_k\) și evaluat pe pliul \(k\). Cu etichete de lungime \(h\), o graniță elimină \(h\) observații înainte de blocul de test și \(h + e\) după el, deci un pliu interior pierde din antrenare \(2h + e\) observații. Un exemplu cu 10 observații este lucrat în Anexă.
Graficul următor arată cinci pliuri pe rînduri, cu indicele observației pe axa orizontală. Albastrul marchează observațiile de antrenare, roșul cele de test, violetul pe cele purjate, iar maroul embargoul.
prima condiție este purjarea: elimină etichetele care se suprapun cu intervalul etichetelor de test
a doua este embargoul: \(e\) observații după sfîrșitul ultimei etichete de test, \(T_k\) (de exemplu 1%), necesar deoarece caracteristicile folosesc observații anterioare
Scorul CV cu purjare este media celor \(K\) scoruri ale modelelor estimate pe \(\mathcal{A}_k\) și evaluate pe pliul \(k\)
Cu etichete de lungime \(h\), o frontieră elimină \(h\) observații înainte de blocul de test și \(h + e\) după el
Fiecare rînd al graficului este o împărțire a eșantionului: blocul de test cu roșu, observațiile de antrenare cu albastru, cele eliminate prin purjare cu violet și cele eliminate prin embargo cu maro. Cele trei cursoare fixează numărul de pliuri \(K\), lungimea etichetei \(h\) și embargoul \(e\), toate în observații; butonul ▶ parcurge setările.
Întrebare pentru sală În schema cu 100 de observații și 5 pliuri, păstrăm embargoul e = 3. Dacă lungimea etichetei crește de la h = 4 la h = 6, cîte observații de antrenare sînt eliminate în jurul pliului central?
Răspuns
Se elimină 2h + e = 15 observații: h = 6 înainte de bloc, ale căror etichete se termină în test, și h + e = 9 după el, adică 6 purjate și 3 sub embargo. Valoarea 13 actualizează numai frontiera din stînga; valoarea 12 omite embargoul. Cele 20 de observații de test nu intră în acest total.
Cu etichete de lungime \(h\), fiecare bloc de test interior pierde \(h\) observații de antrenare înaintea lui și \(h + e\) după el, în total \(2h + e\); primul și ultimul pliu pierd doar pe o parte. Creșterea lui \(h\) lărgește benzile violete de ambele părți ale fiecărui bloc de test, iar creșterea lui \(e\) lărgește doar banda maro de după el. Cu puține pliuri, observațiile eliminate sînt o parte mică a setului de antrenare; cu multe pliuri, ele devin o parte mare.
Experimentul construiește o țintă fără nicio predictibilitate. Prețul este un mers aleator pur, eticheta este semnul randamentului pe următoarele 20 de zile, iar cele 5 caracteristici sînt medii rolling pe 20 de zile ale unui zgomot independent. Acuratețea reală este deci 50% prin construcție. Un random forest este evaluat cu 5 pliuri, după trei scheme. Cursorul fixează lungimea comună \(h\) a etichetelor și a mediilor rolling, iar graficele arată acuratețea fiecărei scheme.
Întrebare pentru sală În simularea cu incrementări independente și simetrice și caracteristici de zgomot, K-fold amestecat dă 69,4%, față de 49,6% cu purjare și embargo. Ce explică diferența?
Răspuns
La h = 20, zilele vecine au etichete suprapuse și caracteristici similare. Amestecarea le distribuie între antrenare și test. Dezechilibrul claselor nu explică diferența dintre evaluări pe aceleași observații, iar repetarea împărțirii nu înlătură acest mecanism. Pliurile contigue dau 50,0%, iar purjarea și embargoul 49,6%; aceste valori sînt rezultate ale simulării, nu garanții exacte. Cu h = 2, K-fold amestecat dă 49,9%; cu h = 60 ajunge la 84,5%.
K-fold cu observațiile amestecate raportează o acuratețe de 69,4%, K-fold cu pliuri contigue 50,0%, iar K-fold cu purjare și embargo 49,6%. Amestecarea eșuează pentru că etichetele se suprapun și caracteristicile sînt persistente, așa că zilele de test au aproape-duplicate în setul de antrenare. Aici pliurile contigue elimină deja cea mai mare parte a leakage-ului, deoarece doar granițele pliurilor împart randamente, iar purjarea le curăță și pe acestea.
Un rezultat care pare prea bun este de obicei leakage. Experimentul susține o comparație de proceduri pe aceleași date, nu o afirmație despre vreun predictor real.
Pe scurt
Date simulate: prețul este un mers aleator pur
eticheta: semnul randamentului pe următoarele 20 de zile
5 caracteristici: medii mobile pe 20 de zile ale unui zgomot independent
Prin construcție, acuratețea reală este 50%
modelul: un random forest validat în 5 pliuri
Acuratețea măsurată
K-fold amestecat 69,4%
K-fold contiguu 50,0%
K-fold cu purjare și embargo 49,6%
Amestecarea eșuează pentru că etichetele se suprapun și caracteristicile sînt persistente
Pliurile contigue elimină deja majoritatea scurgerii
doar frontierele dintre pliuri au randamente comune, iar purjarea le curăță
Un rezultat neverosimil de bun indică de obicei o scurgere de informație
K-fold-ul obișnuit nu este întotdeauna invalid pentru serii de timp. Bergmeir, Hyndman & Koo (2018) arată că este valid pentru un model pur autoregresiv cu erori necorelate serial. Condițiile în care eșuează și modul de verificare sînt în Anexă.
Două sarcini cer scheme diferite. Selecția modelului, adică alegerea caracteristicilor, a familiei și a calibrării, folosește K-fold cu purjare sau CV combinatorică cu purjare (CPCV, combinatorial purged cross-validation). CPCV testează pe multe combinații de grupuri și dă o distribuție a rapoartelor Sharpe în loc de un singur număr.
Implementarea se evaluează prin walk-forward (WF): modelul se antrenează pe \([0, T_k]\), se testează pe \((T_k, T_{k+1}]\) și se deplasează înainte, unde \(T_k\) este sfîrșitul ferestrei de antrenare \(k\). Walk-forward-ul este realist, dar produce o singură traiectorie, cu varianță mare, deci servește evaluării finale, nu alegerii modelului. Cele două scheme sînt comparate în Anexă.
Selecția modelului: K-fold cu purjare sau CV combinatorică cu purjare (CPCV)
CPCV testează pe multe combinații de grupuri și dă o distribuție de rapoarte Sharpe în locul unui singur număr
Utilizarea: evaluarea pe ferestre succesive (WF)
antrenare pe \([0, T_k]\), test pe \((T_k, T_{k+1}]\), apoi avansăm
\(T_k\): sfîrșitul celei de-a \(k\)-a ferestre de antrenare
realist, dar o singură traiectorie, cu varianță mare
servește evaluării finale, nu alegerii (WF și CPCV: Anexă)
Sinteza secțiunii
K-fold cu observațiile amestecate găsește o acuratețe de 69,4% în zgomot pur, în timp ce pliurile contigue și cele purjate raportează 50,0% și 49,6%. Purjarea elimină etichetele de antrenare care se suprapun cu intervalul de test, iar embargoul observațiile de imediat după el, \(2h + e\) observații pentru fiecare pliu interior. Studiul de caz care urmează folosește CV cu purjare pe 5 pliuri și embargo de 1% pentru fiecare model.
Studiu de caz: predicția S&P 500
Studiul de caz aplică trusa de unelte și schema de validare unei singure întrebări: poate fi prezisă direcția S&P 500 pe 5 zile? Patru modele sînt comparate pe aceleași pliuri purjate cu un reper naiv, diferențele sînt testate cu proceduri care respectă etichetele suprapuse, iar cel mai bun model este tranzacționat într-un backtest walk-forward cu costuri. Un al doilea studiu de caz, pe lucrarea lui Dong, Li, Rapach & Zhou (2022), întreabă dacă anomaliile transversale prezic randamentul pieței.
Studiu de caz: poate fi prezisă direcția S&P 500 pe 5 zile?
Datele sînt închiderile zilnice ale indicelui S&P 500 și ale VIX din datele cursului, 2001–2026, cu \(n = 6\,269\) de observații. VIX este indicele de volatilitate al Chicago Board Options Exchange (CBOE), volatilitatea implicită pe 30 de zile a opțiunilor pe S&P 500. S&P 500 este cel mai lichid indice bursier și are o istorie lungă a VIX; dacă direcția lui ar fi predictibilă, arbitrajul ar fi ieftin.
Ținta este eticheta cu orizont fix pentru \(h = 5\) și \(\tau = 0\):
egală cu 1 dacă indicele este mai sus după 5 zile. Cinci zile corespund unui orizont de tranzacționare săptămînal și dau aproximativ \(6\,269/5 \approx 1\,250\) de etichete nesuprapuse. Intervalul etichetei, \([t, t+5]\), se folosește la purjare.
Validarea este CV cu purjare pe 5 pliuri, cu embargo de 1%, cu aceleași pliuri pentru fiecare model. Fiecare pliu acoperă aproximativ 5 ani, deci cel puțin un episod de criză.
Pe scurt
Indicele S&P 500 și VIX, închideri zilnice din datele cursului, 2001–2026: \(n = 6\,269\) de observații
eșantionul începe în octombrie 2001: primele 444 de zile din 2000–2001 alimentează fereastra FFD
VIX: indicele de volatilitate CBOE (Chicago Board Options Exchange, bursa de opțiuni din Chicago), volatilitatea implicită pe 30 de zile a opțiunilor pe S&P 500
De ce S&P 500: cel mai lichid indice de acțiuni, cu o istorie VIX lungă
dacă direcția lui ar fi predictibilă, arbitrajul ar fi ieftin
Ținta: \(y_t = \mathbf{1}\{\log P_{t+5} - \log P_t > 0\}\), egală cu 1 dacă indicele este mai sus peste 5 zile
eticheta cu orizont fix, cu \(h = 5\) și \(\kappa = 0\)
De ce 5 zile: un orizont săptămînal de tranzacționare
circa \(6\,269/5 \approx 1\,250\) de etichete fără suprapunere
Intervalul etichetei, \([t, t+5]\), este folosit la purjare
Validare: CV cu purjare în 5 pliuri și embargo de 1%, cu aceleași pliuri pentru toate modelele
fiecare pliu acoperă circa 5 ani, deci cel puțin un episod de criză
Studiu de caz: metricile, față de reperul „mereu în sus”
Acuratețea (accuracy) este ponderea zilelor a căror direcție este prezisă corect. Aria de sub curba ROC (AUC, area under the curve; ROC, receiver operating characteristic) este probabilitatea ca o zi „sus” aleasă la întîmplare să primească o probabilitate prezisă mai mare decît o zi „jos” aleasă la întîmplare. AUC \(= 0{,}5\) înseamnă nicio abilitate, iar AUC \(= 1\) o ordonare perfectă.
Un exemplu mic fixează definiția. Fie zilele „sus” cu probabilitățile prezise 0,7 și 0,4, iar zilele „jos” cu 0,5 și 0,2. Dintre cele patru perechi („sus”, „jos”), trei sînt ordonate corect, toate în afară de (0,4; 0,5), deci AUC \(= 0{,}75\). Sînt necesare ambele metrici: acuratețea depinde de pragul 0,5 care transformă o probabilitate într-o direcție prezisă, în timp ce AUC compară doar ordonarea probabilităților.
Se folosesc două moduri de agregare peste pliuri. Media pe pliuri calculează metrica în fiecare dintre cele 5 pliuri de test și mediază cele cinci valori. Metrica cumulată (pooled) se calculează o singură dată pe toate predicțiile out-of-fold împreună și este datele de intrare ale testelor formale.
Pe scurt
Acuratețea: proporția zilelor a căror direcție este prezisă corect
Aria de sub curba ROC (receiver operating characteristic), AUC
probabilitatea ca o zi de creștere aleasă la întîmplare să primească o probabilitate prezisă mai mare
decît o zi de scădere aleasă la întîmplare
AUC \(= 0{,}5\) înseamnă nicio abilitate, iar AUC \(= 1\) înseamnă ordonare perfectă
Exemplu: zile „sus” cu probabilitățile 0,7 și 0,4, zile „jos” cu 0,5 și 0,2
3 din cele 4 perechi sînt ordonate corect, deci AUC \(= 0{,}75\)
De ce ambele: acuratețea depinde de pragul \(0{,}5\)
AUC compară doar ordinea probabilităților
Media pe pliuri: metrica calculată în fiecare dintre cele 5 pliuri de test, apoi mediată
Agregat: metrica calculată o singură dată pe toate predicțiile din afara pliurilor de antrenare
Toate cele 14 caracteristici folosesc doar informația pînă în ziua \(t\). Momentum-ul este randamentul logaritmic din ultimele \(h\) zile, \(\log P_t - \log P_{t-h}\), pentru \(h \in \{1,5,20,60,120\}\). Volatilitatea realizată este abaterea standard (SD) anualizată a randamentelor logaritmice zilnice pe 20 și 60 de zile, împreună cu raportul lor. Distanța față de media mobilă este \(\log P_t\) minus media lui \(\log P\) pe 50 sau 200 de zile.
Indicele de forță relativă, RSI(14) (relative strength index), este \(100 - 100/(1+RS)\), unde \(RS\) este cîștigul mediu netezit raportat la pierderea medie pe 14 zile; el se află între 0 și 100 și este mare după creșteri. VIX intră prin logaritmul nivelului și prin variația pe 5 zile. Ultima caracteristică este prețul logaritmic FFD cu \(d = 0{,}25\), ales pe întregul eșantion; un test fără această caracteristică urmează după compararea modelelor.
Cele patru modele sînt deliberat conservatoare. Logit-ul este penalizat L2 (ridge), pe caracteristici standardizate. RF are 400 de arbori, cu dimensiunea minimă a frunzei de 100. GBM este bazat pe histograme, cu adîncimea 3, rata de învățare 0,03 și 200 de arbori. MLP are straturi ascunse de 32 și 16 unități și oprire timpurie pe un set de validare cronologic purjat. Frunzele mari și arborii puțin adînci limitează varianța, în acord cu (13.5).
Matricea de confuzie a logit-ului penalizat L2, din predicțiile out-of-fold cumulate ale CV cu purjare pe 5 pliuri, cu \(n = 6\,269\), are patru celule. TP (adevărat pozitive) numără zilele „sus” prezise „sus”, 3 575; FN (fals negative) zilele „sus” prezise „jos”, 65; FP (fals pozitive) zilele „jos” prezise „sus”, 2 589; iar TN (adevărat negative) zilele „jos” prezise „jos”, 40.
Scorurile rezultă din tabel. Acuratețea este \((TP + TN)/n = 57{,}7\%\). Precizia este \(TP/(TP+FP) = 0{,}580\), recall-ul \(TP/(TP+FN) = 0{,}982\), iar \(F_1 = 0{,}729\) după (13.15).
Modelul prezice „sus” în 98,3% din zile. A învățat, în esență, regula „mereu în sus”, iar recall-ul și \(F_1\) ridicate sînt o consecință a acestei reguli, nu a abilității.
Pe scurt
Prezis sus
Prezis jos
Real sus
TP \(=3\,575\)
FN \(=65\)
Real jos
FP \(=2\,589\)
TN \(=40\)
Logit penalizat L2, \(n = 6\,269\)
predicții agregate în afara pliurilor din CV cu purjare în 5 pliuri
Reperul majoritar rezultă din același tabel. Zilele „sus” reale sînt \((3\,575 + 65)/6\,269 = 3\,640/6\,269 = 58{,}1\%\) din eșantion, adică acuratețea obținută prezicînd „sus” în fiecare zi, fără niciun model. Un model cu acuratețea 57,7% este deci mai slab decît a nu face nimic.
Cauza este dezechilibrul claselor. Cu caracteristici slabe, probabilitățile prezise rămîn aproape de rata de bază 0,58, peste pragul 0,5, așa că aproape fiecare zi este clasificată „sus”. Studiul de caz păstrează intenționat eticheta cu orizont fix, pentru ca reperul să fie transparent; etichetele cu trei bariere schimbă echilibrul claselor pe care îl vede clasificatorul, cum arată Seminarul 13 în exercițiile B1 și B8.
Sînt posibile și alte repere: direcția de ieri, o regulă de medii mobile și, pentru tranzacționare, buy-and-hold. Oricare ar fi reperul, un model are valoare doar dacă îl depășește out-of-sample, după costuri, cu mai mult decît eroarea de eșantionare.
Graficul din stînga arată acuratețea celor patru modele, iar cel din dreapta AUC-ul lor, ca medii pe cele 5 pliuri purjate, cu mustăți de \(\pm 1\) SD între pliuri. Linia punctată din graficul acurateței este reperul „mereu în sus”. Cursorul fixează pragul de probabilitate peste care o zi este prezisă „sus”, iar graficul de jos arată acuratețea medie pe pliuri a fiecărui model în funcție de acest prag; AUC nu depinde de el.
Întrebare pentru sală La pragul 0,5, logit-ul are acuratețea 57,7%. Demonstrează acest rezultat un avantaj de acuratețe față de regula „mereu în sus”?
Răspuns
Nu. Regula „mereu în sus” are 58,1%, deci logit-ul are cu aproximativ 0,4 puncte procentuale mai puțin decît reperul. Depășirea nivelului de 50% sau clasarea înaintea celorlalte trei modele nu demonstrează depășirea acestui reper. Predicția „sus” în 98,3% din zile (TP = 3 575, FP = 2 589) arată apropierea de regula majoritară; nu dovedește că modelul reproduce exact această regulă. AUC-urile medii pe pliuri sînt între 0,477 și 0,508.
La pragul 0,5, acuratețile medii pe pliuri sînt 57,7% pentru logit, 56,3% pentru RF, 54,4% pentru GBM și 56,6% pentru MLP, toate sub cele 58,1% ale regulii „mereu în sus”. AUC-urile medii pe pliuri sînt 0,477, 0,501, 0,507 și 0,508, toate apropiate de 0,5. Niciun model nu depășește reperul.
Coborîrea pragului face ca modelele să prezică „sus” în mai multe zile, iar acuratețea lor se apropie de cea a reperului; ridicarea lui produce mai multe predicții „jos”. Cu AUC-uri apropiate de 0,5, pragul schimbă zilele declarate „sus”, dar nu poate adăuga abilitate de ordonare. Testul fără FFD din Aprofundări ajunge la aceeași concluzie negativă fără prețul logaritmic FFD.
Pe scurt
Media pe pliuri
Logit
RF
GBM
MLP
Acuratețe
57,7%
56,3%
54,4%
56,6%
AUC
0,477
0,501
0,507
0,508
Barele: media pe cele 5 pliuri purjate
Mustățile: \(\pm 1\) abatere standard între pliuri
\(\hat P\) este ponderea zilelor cu semnul corect, \(\hat p_y\) și \(\hat p_x\) sînt ponderile zilelor „sus” realizate și prezise, iar \(\hat P^*\) este ponderea corectă așteptată dacă predicțiile ar fi independente de rezultate. Sub \(H_0\) de independență, \(\widehat{\mathrm{SE}}\) este eroarea standard a lui \(\hat P - \hat P^*\), dată în Anexă. O valoare \(PT > 1{,}645\) indică abilitate la 5% (unilateral), iar \(PT < 0\) înseamnă mai puține nimeriri decît la întîmplare.
PT presupune zile independente, ipoteză pe care etichetele suprapuse pe 5 zile o încalcă. Studiul de caz folosește de aceea și statistica \(t\) a pantei din \(y_t = a + b\,x_t + u_t\), cu \(x_t\) direcția prezisă și \(y_t\) cea realizată, calculată cu erori standard Newey–West cu \(q = 4\) laguri (Aprofundări); \(b > 0\) înseamnă abilitate.
Pentru AUC, eroarea standard DeLong presupune zile independente (Anexă). Intervalele se calculează de aceea printr-un bootstrap circular pe blocuri (circular block bootstrap) (Künsch, 1989), cu blocuri de \(L = 20\) de zile consecutive, de patru ori lungimea etichetei, ceea ce păstrează dependența serială în interiorul fiecărui bloc.
\(\hat P\): proporția zilelor cu semnul corect; \(\hat p_y\), \(\hat p_x\): proporțiile zilelor „sus” realizate și prezise; \(\hat P^*\): proporția corectă așteptată dacă predicțiile ar fi independente de rezultate
\(H_0\): predicțiile sînt independente de rezultate; \(\widehat{\mathrm{SE}}\): eroarea standard a lui \(\hat P - \hat P^*\) sub \(H_0\) (Anexă)
\(PT > 1{,}645\) indică abilitate la 5% (test unilateral); \(PT < 0\) înseamnă mai puține potriviri decît la întîmplare
PT presupune zile independente
cu etichete suprapuse folosim și statistica \(t\) a pantei în \(y_t = a + b\,x_t + u_t\)
Tabelul folosește predicțiile out-of-fold cumulate. Ratele de nimerire \(\hat P\) sînt ușor sub ratele \(\hat P^*\) așteptate sub independență pentru fiecare model: 0,577 față de 0,578 pentru logit, 0,563 față de 0,570 pentru RF, 0,544 față de 0,554 pentru GBM și 0,566 față de 0,569 pentru MLP. Toate statisticile PT și toate statisticile \(t\) HAC (Heteroskedasticity and Autocorrelation Consistent, standard errors, erori standard robuste la heteroscedasticitate și autocorelație) sînt negative. AUC-urile cumulate sînt 0,480, 0,495, 0,501 și 0,497, iar fiecare interval de încredere (CI) bootstrap pe blocuri de 95% conține 0,5; intervalul logit-ului, de exemplu, este \([0{,}456;\ 0{,}505]\).
Nu există deci o abilitate direcțională pozitivă semnificativă. Cu erori robuste la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent) la lagul 4, niciun model nu diferă semnificativ de întîmplare, \(|t| \le 1{,}67\). Statistica PT, care tratează zilele ca independente, dă \(-2{,}27\) pentru RF, față de un \(t\) HAC de \(-1{,}67\): etichetele suprapuse umflă semnificația.
Logit-ul oferă un al doilea contrast. Intervalul DeLong de 95% pentru AUC-ul lui este \([0{,}466;\ 0{,}494]\) și exclude 0,5, ceea ce s-ar citi ca un model semnificativ mai slab decît întîmplarea. Intervalul DeLong tratează zilele ca independente; bootstrap-ul pe blocuri nu, iar intervalul lui conține 0,5.
Niciun model nu are o abilitate direcțională pozitivă semnificativă
fiecare interval bootstrap pentru AUC conține 0,5
Cu erori standard HAC (Heteroskedasticity and Autocorrelation Consistent, robuste la heteroscedasticitate și autocorelație) cu 4 laguri, niciun model nu diferă semnificativ de întîmplare (\(|t| \le 1{,}67\))
PT, care tratează zilele ca independente, dă \(-2{,}27\) pentru RF: etichetele suprapuse exagerează semnificația
Pentru logit, intervalul DeLong de 95% este \([0{,}466;\ 0{,}494]\) și nu conține 0,5
dar acest interval tratează zilele ca independente; intervalul bootstrap pe blocuri conține 0,5
Rezultatul este în acord cu eficiența în formă slabă (Capitolul 2)
Backtest-ul întreabă dacă un trader care ar fi urmat modelul ar fi cîștigat mai mult, după costuri, decît deținînd pur și simplu indicele. Poziția este \(w_t \in \{0,1\}\): long pe S&P 500 dacă probabilitatea „sus” a modelului este \(\hat p_t > 0{,}5\), altfel numerar, decisă cu informația pînă la \(t\). Decizia de la închiderea zilei \(t\) se tranzacționează la închiderea zilei \(t+1\), așa că randamentul strategiei este
unde \(r_{t+2}\) este randamentul logaritmic al indicelui de la închiderea lui \(t+1\) la cea a lui \(t+2\). Rulajul (turnover) \(|w_t - w_{t-1}|\) este 1 în zilele în care poziția se schimbă. Costul este \(c = 5\) puncte de bază (bp), adică 0,05% pe unitatea tranzacționată, un cost prudent pentru un fond tranzacționat la bursă pe S&P 500; \(r - c\) aproximează \(\log((1-c)\,e^{r}) = r + \log(1-c)\), randamentul logaritmic după plata costului.
Expunerea \(\bar w = \frac{1}{T}\sum_t w_t\) este ponderea celor \(T\) zile petrecute în piață. Numerarul are randament 0, deci dobînda din zilele în numerar este ignorată, iar ambele rapoarte Sharpe folosesc randamente logaritmice zilnice cu rata fără risc 0, anualizate cu \(\sqrt{252}\).
Modelul este GBM, reestimat în fiecare ianuarie din 2010–2026 pe toate datele trecute, cu purjarea etichetelor care se suprapun cu anul de test. Prețul logaritmic FFD folosește \(d = 0{,}15\), ales doar pe datele pînă în 2009. Reperul este buy-and-hold, \(w_t = 1\), cu expunere de 100% și fără rulaj.
Pe scurt
Întrebarea: ar fi cîștigat un trader care urma modelul mai mult decît prin simpla deținere a indicelui?
comparația se face după costuri
Poziția \(w_t \in \{0,1\}\): long pe S&P 500 dacă \(\hat p_t > 0{,}5\), altfel numerar
decisă la închiderea zilei \(t\), cu informații pînă la \(t\); \(\hat p_t\): probabilitatea de „sus” dată de model
tranzacția se execută la închiderea zilei \(t+1\)
Randamentul strategiei: randamentul indicelui cînd sîntem investiți, minus un cost la fiecare schimbare de poziție
Graficul arată evoluția unui dolar investit, pe scară logaritmică: buy-and-hold cu maro și strategia GBM cu albastru. Primul cursor fixează pragul probabilității prezise peste care strategia este long, al doilea costul pe schimbare de poziție, în puncte de bază, iar butonul ▶ modifică pragul.
Întrebare pentru sală Expunerea medie a strategiei GBM long/cash este 76%. Putem trata strategia ca pe buy-and-hold cu expunere constantă de 76% atunci cînd comparăm rapoartele Sharpe?
Răspuns
Nu. Invarianța raportului Sharpe la scalare se referă la înmulțirea tuturor randamentelor cu aceeași constantă pozitivă. O poziție care alternează între 0 și 1 nu este o astfel de scalare. În exemplu, cu tranzacția la închiderea următoare, la pragul 0,5 și costul de 5 bp, strategia are SR (Sharpe Ratio, raportul Sharpe) 0,33, iar buy-and-hold 0,66. Diferența, −0,33, are p = 0,001 (test HAC Ledoit–Wolf). Log-prețul FFD folosește d = 0,15, ales doar pe datele pînă în 2009.
În 2010–2026, la pragul 0,5 și un cost de 5 bp, raportul Sharpe anualizat al strategiei este 0,33, față de 0,66 pentru buy-and-hold. Expunerea medie este 76%. Modelul a stat în mare parte long, iar ieșirile lui din piață, în 24% din zile, au scăzut raportul Sharpe în loc să-l crească.
Diferența dintre cele două rapoarte Sharpe, \(-0{,}33\), are \(p = 0{,}001\) în testul HAC Ledoit–Wolf (Ledoit & Wolf, 2008), discutat în Aprofundări. Testul cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării. Strategia este semnificativ mai slabă decît buy-and-hold și nu există dovezi de abilitate. Rezultatul susține o comparație de proceduri: strategia GBM față de buy-and-hold.
Raportul Sharpe al strategiei este sensibil la trei alegeri de construcție. Cu \(d = 0{,}25\), ales pe întregul eșantion, deci cu informație din perioada de test, el este 0,31. Fără prețul logaritmic FFD este 0,48. Cînd tranzacția se execută la aceeași închidere cu decizia, o idealizare fără întîrziere de execuție, este 0,43. Niciuna dintre aceste variante nu se apropie de 0,66, valoarea pentru buy-and-hold.
Testele prognozelor față de o prognoză constantă, cu testele Diebold–Mariano, Clark–West și Giacomini–White, sînt în Aprofundări.
Pe scurt
2010–2026: raportul Sharpe anualizat al strategiei este 0,33, față de 0,66 pentru buy-and-hold
expunerea medie: 76%
modelul a rămas în principal long
ieșirile din piață (24% din zile) au redus raportul Sharpe
Graficul: creșterea unui dolar investit, pe scară logaritmică
maro buy-and-hold, albastru strategia GBM
Diferența dintre cele două rapoarte Sharpe, \(-0{,}33\), are \(p = 0{,}001\)
Dong, Li, Rapach & Zhou (2022) întreabă dacă randamentele long-short ale anomaliilor prezic randamentul în exces al pieței din luna următoare. O anomalie este un portofoliu long pe acțiunile cu randamente medii mari după o caracteristică și short pe cele cu randamente medii mici; exemple sînt valoarea (raportul dintre valoarea contabilă și cea de piață), momentum-ul, acumulările contabile (accruals) și emisiunea netă de acțiuni. Literatura transversală și predictibilitatea randamentului pieței fuseseră studiate separat.
Reperul este greu de depășit: Welch & Goyal (2008) arată că majoritatea predictorilor publicați nu depășesc media istorică. Datele lucrării sînt 100 de anomalii americane cu randamente lunare, ianuarie 1970 – decembrie 2017. Prima prognoză out-of-sample are 180 de luni pentru 100 de predictori, așa că regresia pe toți predictorii învață zgomot. Metoda este de aceea shrinkage-ul: elastic net, combinarea prognozelor și reducerea dimensiunii.
Afirmația principală este că anomaliile au o putere predictivă out-of-sample semnificativă statistic și economic pentru piață. Explicația propusă sînt limitele asimetrice ale arbitrajului și corecția persistentă a supraevaluării. Supraevaluarea este mai greu de arbitrat decît subevaluarea, deoarece vînzarea în lipsă este costisitoare, așa că piciorul short al anomaliilor poartă cea mai mare parte a informației.
Pe scurt
Dong, Li, Rapach & Zhou (2022): prezic randamentele long-short ale anomaliilor randamentul în exces al pieței din luna următoare?
anomalie: portofoliu long pe acțiunile cu randament mediu ridicat după o caracteristică și short pe cele cu randament mediu scăzut
Graficul de sus cumulează, lună de lună, erorile pătratice ale prognozei prin media istorică minus cele ale fiecărui model, astfel încît o curbă crescătoare marchează lunile în care modelul depășește media istorică, iar una descrescătoare lunile în care pierde. Graficul de jos arată \(R^2_{OOS}\) al prognozelor bazate pe cîte o singură anomalie. Cursorul fixează sfîrșitul perioadei de evaluare, în decembrie al anului ales, iar meniul alege anomaliile din combinație: toate cele 15, cei 7 factori sau cele 8 diferențe de decile.
Întrebare pentru sală OLS cu toate cele 15 anomalii are R²OOS −7,41% în 1985–2026. De ce media celor 15 prognoze univariate face mai bine, cu 0,41%?
Răspuns
Comb este media prognozelor univariate: contribuția fiecărei pante univariate este ponderată cu 1/15. Nu este OLS multivariat împărțit la 15. Combinarea poate reduce varianța erorilor, fără a garanta un cîștig. Multicoliniaritatea nu produce singură bias OLS. În acest eșantion, Comb are R²OOS 0,41%, față de −7,41% pentru OLS; semnificația cîștigului Comb este sensibilă la lagurile HAC (p unilateral Clark–West 0,045 cu 5 laguri, 0,063 cu 3 laguri). În lucrare, cu 100 de anomalii, OLS ajunge la −2 513,86%, iar combinația simplă la 0,89%.
Pe 1985–2026, cu toate cele 15 anomalii, combinația simplă (Comb) se încheie cu un \(R^2_{OOS}\) de 0,41%, iar combinația elastic net (C-ENet) cu 0,08%. Încheierea evaluării în 2017 dă cifrele replicării pentru eșantionul lucrării; setul complet de numere și testele lor sînt pe slide-ul „rezultatul și limitele”.
unde \(r_{t+1}\) este randamentul în exces al pieței (Mkt-RF) în luna \(t+1\), iar \(x_{i,t}\) randamentul long-short al anomaliei \(i\) în luna \(t\). Combinația simplă (Comb) este media celor \(N\) prognoze \(\hat r^{(i)}_{t+1}\). Combinația elastic net (C-ENet) aplică elastic net regresiei lui \(r_t\) pe cele \(N\) prognoze, cu coeficienți nenegativi, și prognozează prin media prognozelor selectate. ENet este elastic net pe toți predictorii, iar OLS regresia pe toți.
Lucrarea antrenează pe 1970–1979, validează pe 1980–1984 și evaluează out-of-sample pe 1985–2017. Replicarea folosește Kenneth French Data Library și 15 anomalii în loc de 100: SMB (Small Minus Big, size factor, factorul mărime: firme mici minus mari), HML (High Minus Low, value factor, factorul valoare: B/M mare minus mic), RMW (Robust Minus Weak, profitability factor, factorul profitabilitate: firme robuste minus slabe) și CMA (Fama & French, 2015), momentum-ul și reversal-ul pe termen scurt și lung, plus diferențele dintre decilele extreme pentru acumulările contabile, emisiunea netă, beta, varianță, varianța reziduală, E/P, CF (Cornish–Fisher, expansion, dezvoltarea Cornish–Fisher)/P și D/P.
În replicare, penalizarea elastic net combină \(\ell_1\) și \(\ell_2\) în proporții egale și este aleasă prin AIC corectat pentru eșantioane mici. Perioada out-of-sample este extinsă pînă în septembrie 2026.
Pe scurt
Regresia predictivă a anomaliei \(i\), estimată pe o fereastră extinsă și reestimată lunar
15 anomalii în loc de 100: SMB (Small Minus Big, factorul mărime: firme mici minus mari), HML (High Minus Low, factorul valoare: B/M mare minus mic), RMW (Robust Minus Weak, factorul profitabilitate: firme robuste minus slabe), CMA (Fama & French (2015)), momentum, inversarea (reversal) pe termen scurt și lung
și diferența dintre decilele extreme pentru acumulări contabile, emisiuni nete, beta, varianță, varianță reziduală, E/P, CF/P (fluxul de numerar, CF, raportat la preț), D/P
penalizarea elastic net (\(\ell_1\) și \(\ell_2\) în proporții egale) aleasă prin AIC corectat pentru eșantioane mici
perioada în afara eșantionului prelungită pînă în septembrie 2026
Spre deosebire de (13.2), reperul din (13.21) este media istorică. Graficul cumulează erorile pătratice ale mediei istorice minus cele ale modelului, iar curba urcă în lunile în care modelul depășește media istorică.
Cifrele lucrării, din versiunea publicată (Tabelul II) pentru 1985–2017, sînt 2,81% pentru C-ENet, 2,03% pentru ENet, 0,89% pentru Comb și −2 513,86% pentru OLS. Replicarea pe 1985–2017 dă 0,35% pentru Comb, 0,18% pentru C-ENet, −4,75% pentru ENet și −6,84% pentru OLS. Pe 1985–2026, Comb atinge 0,41%, cu valoarea \(p\) Clark–West unilaterală 0,045, iar C-ENet 0,08%, cu \(p = 0{,}15\). Testul Clark–West (Clark & West, 2007) regresează diferența ajustată a pierderilor pe o constantă, cu erori Newey–West cu \(\lfloor 4(T/100)^{2/9}\rfloor = 5\) laguri; cu 3, 6 și 12 laguri, valoarea \(p\) a lui Comb este 0,063, 0,044 și 0,032, iar fără corecția HAC 0,068. Numărul de laguri este fixat de regulă, nu ales după semnificație, iar testul cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării.
După eșantionul lucrării, pe 2018–2026, Comb are 0,61%, cu \(p = 0{,}12\), iar C-ENet −0,23%. Rezultatul susține ordonarea procedurilor, combinarea prognozelor înaintea regresiei pe toți predictorii, nu mărimea cîștigurilor din lucrare. Limita principală este că 15 anomalii nu reproduc cele 100: cu 15 prognoze, C-ENet nu selectează nicio prognoză în 57% din luni și folosește atunci media istorică.
Pe scurt
Măsura: \(R^2_{OOS}\) față de media istorică \(\bar r_t\), calculată pînă în luna \(t-1\) (Campbell & Thompson (2008))
Pe S&P 500, niciun model nu depășește reperul „mereu în sus” de 58,1%: logit-ul atinge 57,7% prezicînd „sus” în 98,3% din zile, fiecare interval bootstrap pe blocuri pentru AUC conține 0,5, iar nicio statistică \(t\) HAC nu depășește 1,67 în valoare absolută. În backtest-ul walk-forward, strategia GBM are raportul Sharpe 0,33, față de 0,66 pentru buy-and-hold, o diferență cu \(p = 0{,}001\). Replicarea anomaliilor păstrează ordonarea procedurilor, combinarea prognozelor înaintea OLS, cu cîștiguri mult mai mici decît cele din lucrare.
Selecție și supraajustarea backtest-ului
Un cercetător care încearcă multe strategii și o raportează pe cea mai bună raportează o estimare deplasată, chiar dacă fiecare strategie are abilitate reală zero. Secțiunea măsoară această deplasare prin teorema strategiei false, o arată pe o grilă de 1 284 de reguli de tranzacționare pentru Bitcoin și o corectează prin raportul Sharpe probabilistic și prin raportul Sharpe deflatat ale lui Bailey & López de Prado (2012) și Bailey & López de Prado (2014).
Deplasarea de selecție și teorema strategiei false (1/2)
Întrebarea secțiunii este cît de mare este cel mai bun raport Sharpe dintre \(N\) încercări cînd niciuna nu are abilitate. Un cercetător care încearcă \(N\) strategii și o raportează pe cea mai bună comite biasul de selecție: chiar dacă toate au raportul Sharpe real zero, maximul \(\max_n \widehat{SR}_n\) al rapoartelor estimate crește cu \(N\). În secțiunea transversală a randamentelor, Harvey, Liu & Zhu (2016) conchid că, față de sutele de factori publicați, un factor nou are nevoie de \(t > 3\), nu de 2.
Teorema strategiei false (False Strategy Theorem) (Bailey & López de Prado, 2014) dă mărimea maximului. Dacă estimările \(\widehat{SR}_n\),\(n=1,\dots,N\), sînt independente și aproximativ \(N(0, \mathrm{Var}[\widehat{SR}])\), raportul Sharpe maxim așteptat este
Dacă \(\widehat{SR}_n\), \(n=1,\dots,N\), sînt independente și aproximativ \(N\big(0, \Var[\widehat{SR}]\big)\) (fără abilitate), raportul Sharpe maxim așteptat este
În (13.22),\(\widehat{SR}_n\) este raportul Sharpe estimat al strategiei \(n\),\(\Phi\) funcția de repartiție a distribuției Normale standard, iar \(\Phi^{-1}\) funcția ei cuantilă. \(\mathrm{Var}[\widehat{SR}]\) este varianța de eșantionare a unui raport Sharpe estimat, aproximativ \(1/T\) pe perioadă pentru randamente i.i.d., cu \(T\) numărul de perioade, iar \(\gamma_E \approx 0{,}5772\) este constanta Euler–Mascheroni.
\(SR_0\) este raportul Sharpe pe care este de așteptat să-l arate cea mai norocoasă dintre \(N\) strategii fără valoare. După (13.22), el crește cu \(N\), prin cuantilele Normale, și cu zgomotul de eșantionare \(\sqrt{\mathrm{Var}[\widehat{SR}]}\), care scade cu lungimea eșantionului.
Pe scurt
Notațiile
\(\widehat{SR}_n\): raportul Sharpe estimat al strategiei \(n\)
\(\Var[\widehat{SR}]\): varianța de eșantionare a unui raport Sharpe (SR, Sharpe Ratio) estimat, \(\approx 1/T\) pe perioadă pentru randamente i.i.d., \(T\) fiind numărul de perioade
\(\Phi\): funcția de repartiție a distribuției Normale standard; \(\Phi^{-1}\): funcția ei cuantilă; \(\gamma_E \approx 0{,}5772\): constanta Euler–Mascheroni
\(SR_0\): raportul Sharpe așteptat de la cea mai norocoasă dintre \(N\) strategii fără valoare
crește cu \(N\) și cu zgomotul de eșantionare \(\sqrt{\Var[\widehat{SR}]}\)
Cea mai bună dintre \(N\) strategii fără abilitate
Graficul din stînga arată cel mai bun raport Sharpe anualizat pe axa verticală, în funcție de numărul de strategii \(N\), pe scară logaritmică. Linia roșie este (13.22), iar punctele sînt mediile Monte Carlo cu \(\pm\) o abatere standard. Strategiile au randamente i.i.d. de medie zero pe 5 ani de date zilnice, deci \(\mathrm{Var}[\widehat{SR}]\) anualizat \(\approx 1/5\). Cursorul fixează \(N\), graficul din dreapta arată distribuția celui mai bun raport Sharpe pe 200 de eșantioane Monte Carlo pentru acel \(N\), iar butonul ▶ crește \(N\) pas cu pas.
Întrebare pentru sală Pentru 1 000 de strategii independente fără abilitate, fiecare evaluată pe 5 ani de randamente zilnice i.i.d., care este aproximativ media maximului raporturilor Sharpe anualizate?
Răspuns
Aproximativ 1,45: aproximarea teoretică dă 1,46, iar media celor 200 de simulări este 1,43. Zero este media unei strategii individuale; 0,45 = √(1/5) este abaterea sa standard aproximativă. Maximul unei realizări variază de la un eșantion la altul. Valoarea crește cu N și scade cu lungimea eșantionului.
Din \(N = 1000\) de variante rezultă un raport Sharpe maxim de aproximativ 1,45, fără nicio abilitate. Mediile Monte Carlo se află pe curba teoremei. Histograma arată că maximul realizat variază de la un eșantion la altul în jurul acestei valori și că se deplasează spre dreapta pe măsură ce \(N\) crește.
Pe scurt
Strategii cu randamente i.i.d. de medie zero, 5 ani de date zilnice (\(\Var[\widehat{SR}]\) anualizat \(\approx 1/5\))
Din \(N=1000\) de variante rezultă un raport Sharpe maxim de \(\approx 1{,}45\) — fără nicio abilitate
Axa orizontală: numărul de strategii \(N\) (scară logaritmică); axa verticală: cel mai bun SR anualizat
linia roșie: teorema; punctele: media Monte Carlo \(\pm\) o abatere standard, în acord cu teorema
Căutarea pe grilă (grid search) folosește o încrucișare de medii mobile (MA, moving average) pe Bitcoin: regula este long cînd media mobilă rapidă a prețului logaritmic depășește media lentă cu mai mult decît o bandă. Grila are 1 284 de configurații (rapidă, lentă, bandă). Perioada in-sample (IS) merge de la 16 mai 2015 pînă în 2020, iar perioada out-of-sample (OOS) acoperă 2021–2026. Familia testată, fixată doar in-sample, este formată din cele 1 282 de reguli cu varianță in-sample nenulă. Trei dintre ele stau în numerar pe toată perioada OOS; raportul lor Sharpe OOS este nedefinit și se numără ca 0. Ca în backtest-ul pe S&P 500, decizia de la închiderea zilei \(t\) se tranzacționează la închiderea lui \(t+1\).
Regula selectată in-sample, cu medii mobile de 11 și 20 de zile, are raportul Sharpe anualizat 2,02 in-sample și 0,03 out-of-sample, ambele anualizate cu \(\sqrt{365}\). Pe toate regulile, corelația de rang Spearman dintre rapoartele Sharpe IS și OOS este \(\rho = 0{,}13\). Raportul Sharpe OOS median este 0,50 pentru primele 10% in-sample și 0,41 pentru toate regulile.
Rezultatul este compatibil cu overfitting-ul regulii selectate. Un raport Sharpe pozitiv al familiei nu arată informație predictivă incrementală, deoarece o regulă de trend pe un activ care a crescut cîștigă o parte din randamentul propriu al activului; abilitatea față de buy-and-hold cere un test separat, testul SPA din Aprofundări. Rezultatul susține o comparație de proceduri: o alegere făcută in-sample și judecată out-of-sample.
Pe scurt
Încrucișare de medii mobile (MA) pe Bitcoin
long cînd MA rapidă a log-prețului depășește MA lentă cu mai mult decît o bandă
1 284 de configurații: combinații de lungimi ale celor două MA și de lățimi ale benzii
în eșantion (in-sample, IS): 16 mai 2015 – 2020; în afara eșantionului (OOS): 2021–2026
familia testată, fixată doar din IS: cele 1 282 de reguli cu varianță nenulă în eșantion
3 dintre ele stau în numerar tot OOS: SR OOS nedefinit, numărat ca 0
decizia la închiderea zilei \(t\), tranzacția la închiderea \(t+1\)
Graficul următor: SR IS pe axa orizontală, SR OOS pe axa verticală
punctele maro: cele mai bune 10% IS; steaua roșie: regula selectată; linia punctată: SR egale
Regula selectată (MA de 11 și 20 de zile): SR 2,02 în eșantion și doar 0,03 în afara eșantionului
raportul Sharpe anualizat cu \(\sqrt{365}\)
Corelația de rang Spearman dintre SR IS și SR OOS este \(\rho = 0{,}13\)
SR median OOS: 0,50 pentru cele mai bune 10% dintre reguli IS
și 0,41 pentru toate regulile
Rezultatul este compatibil cu supraoptimizarea regulii selectate
Un SR pozitiv al familiei nu demonstrează informație predictivă incrementală
abilitatea față de buy-and-hold cere un test separat (SPA, în Aprofundări)
Tipul de dovadă: comparație între proceduri (alegerea în eșantion, judecată în afara lui)
Fiecare punct al graficului este o regulă, cu raportul ei Sharpe IS pe axa orizontală și raportul Sharpe OOS pe axa verticală. Punctele maro sînt cele mai bune reguli in-sample, steaua roșie este regula selectată, iar linia punctată marchează rapoarte Sharpe egale. Primul cursor mută începutul perioadei out-of-sample, la 1 ianuarie al anului ales, iar al doilea fixează ponderea \(q\) a celor mai bune reguli in-sample care sînt evidențiate.
Întrebare pentru sală Selectăm exclusiv pe perioada mai 2015–decembrie 2020 regula cu SR in-sample maxim, 2,02. Ce SR are această regulă în 2021–2026?
Răspuns
Regula MA 11/20, cu bandă 0%, are SR out-of-sample 0,03. Valorile 0,50 și 0,41 descriu mediane ale unor grupuri (cele mai bune 10% reguli in-sample, respectiv toate regulile), nu performanța acestei reguli. Corelația de rang Spearman dintre SR in-sample și out-of-sample este 0,13. Scăderea este compatibilă cu overfitting; comparația cu buy-and-hold cere o evaluare separată.
Cu perioada OOS începînd în 2021 și \(q = 10\%\), norul de puncte este aproape plat: corelația Spearman dintre rapoartele Sharpe IS și OOS este 0,13. Regula selectată scade de la 2,02 in-sample la 0,03 out-of-sample, iar primele 10% in-sample au un raport Sharpe OOS median de 0,50, față de 0,41 pentru toate regulile.
Două întrebări preced orice corecție pentru selecție: cît de precis este un raport Sharpe estimat și cum îl comparăm cu un reper. Raportul Sharpe pe perioadă al randamentelor logaritmice zilnice, cu rata fără risc 0, este \(\widehat{SR} = \bar r/\hat\sigma\). Forma distribuției randamentelor intră prin asimetria (skewness) \(\gamma_3 = \mathbb{E}[(r-\mu)^3]/\sigma^3\) și prin kurtosis-ul obișnuit \(\gamma_4 = \mathbb{E}[(r-\mu)^4]/\sigma^4\), egal cu 3 pentru distribuția Normală, unde \(\mu\) și \(\sigma\) sînt media și SD ale lui \(r\).
Pentru randamente i.i.d., metoda delta dă varianța de eșantionare (Lo, 2002; Opdyke, 2007)
unde \(T\) este numărul de randamente, iar \(SR\) raportul Sharpe real pe perioadă. Asimetria negativă și cozile groase măresc incertitudinea. Pentru distribuția Normală, \(\gamma_3 = 0\) și \(\gamma_4 = 3\), iar (13.23) se reduce la \((1 + \frac12 SR^2)/T\).
Formula cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării. Anualizarea cu \(\sqrt{A}\), unde \(A\) este numărul de perioade pe an, presupune și ea autocorelație zero; corecția este în Aprofundări.
Pe scurt
Întrebarea: cît de precis este un raport Sharpe estimat și cum îl comparăm cu un reper?
Raportul Sharpe pe perioadă: \(\widehat{SR} = \bar r/\hat\sigma\)
randamente logaritmice zilnice, rata fără risc 0
Forma distribuției, cu \(\mu\), \(\sigma\) media și abaterea standard a lui \(r\)
asimetria \(\gamma_3 = \E[(r-\mu)^3]/\sigma^3\)
kurtosis-ul obișnuit \(\gamma_4 = \E[(r-\mu)^4]/\sigma^4\) (\(3\) pentru distribuția Normală)
Varianța de eșantionare a lui \(\widehat{SR}\), randamente i.i.d., metoda delta (Lo (2002); Opdyke (2007)):
Raportul Sharpe probabilistic (PSR, probabilistic Sharpe ratio) al lui Bailey & López de Prado (2012) este numit de autori probabilitatea ca raportul Sharpe real să depășească un reper \(SR^*\). Formal, el este \(\Phi\) aplicat unei statistici \(z\) al cărei numitor este abaterea standard din (13.23):
\(SR^*\) este reperul, de exemplu 0 sau maximul așteptat \(SR_0\) din (13.22), iar \(\hat\gamma_3\),\(\hat\gamma_4\) sînt asimetria și kurtosis-ul de eșantion.
Citirea rezultă din construcție: \(\widehat{PSR} = 1 - p\), unde \(p\) este valoarea \(p\) unilaterală a lui \(H_0: SR \le SR^*\). O valoare \(\widehat{PSR} > 0{,}95\) înseamnă deci respingerea lui \(H_0\) la 5%, sub randamente i.i.d. și aproximarea prin metoda delta. Ea nu este o probabilitate de 95% pentru raportul Sharpe real, care în acest cadru frecventist este un număr fix.
Raportul Sharpe deflatat (DSR) (Bailey & López de Prado, 2014) este PSR cu reperul fixat la maximul așteptat din teorema strategiei false, \(DSR = \widehat{PSR}(SR_0)\), cu \(SR_0\) calculat din varianța \(\mathrm{Var}[\widehat{SR}_n]\) a încercărilor. El corectează simultan pentru selecția dintre \(N\) încercări, pentru abaterea de la distribuția Normală și pentru lungimea eșantionului, așa că \(N\) trebuie raportat întotdeauna. O valoare \(DSR \le 0{,}95\) înseamnă dovezi insuficiente la pragul ales, nu dovada că strategia nu are abilitate.
Exemplul lucrat este cea mai bună regulă in-sample pe Bitcoin, cu \(T = 2\,057\) zile. Raportul ei Sharpe este \(\widehat{SR} = 0{,}1055\) pe zi, 2,02 anualizat, cu \(\hat\gamma_3 = 0{,}16\) și \(\hat\gamma_4 = 12{,}23\);\(\hat\gamma_4\) și DSR cer un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării. Numitorul din (13.24) este \(\sqrt{1 - 0{,}16\cdot 0{,}1055 + \frac{12{,}23-1}{4}\cdot 0{,}1055^2} = 1{,}007\), iar familia are \(N = 1\,282\) de încercări. Argumentul lui \(\Phi\) este \(z = (\widehat{SR} - SR_0)\sqrt{T-1}/1{,}007\).
Verdictul depinde de felul în care se măsoară \(\mathrm{Var}[\widehat{SR}_n]\). Luată din dispersia observată a celor 1 282 de rapoarte Sharpe, SD este 0,0109, \(SR_0 = 0{,}036\) pe zi, \(z = 3{,}11\) și \(DSR = 0{,}999\); această dispersie include corelația dintre reguli. Tratînd regulile ca independente, cu \(\mathrm{Var} = 1/T\), SD este 0,0220, \(SR_0 = 0{,}073\),\(z = 1{,}45\) și \(DSR = 0{,}926\), varianta conservatoare. Raportul Sharpe out-of-sample de 0,03 este de partea valorii conservatoare; alegerea dintre cele două este discutată în Aprofundări.
Cu 1 000 de strategii fără abilitate pe 5 ani de date zilnice, cel mai bun raport Sharpe așteptat este aproximativ 1,45. Pe grila Bitcoin, regula selectată in-sample scade de la un raport Sharpe de 2,02 la 0,03 out-of-sample, iar corelația Spearman dintre rapoartele IS și OOS este 0,13. DSR al acestei reguli este 0,999 sau 0,926, după cum varianța încercărilor se ia din dispersia lor sau se fixează la \(1/T\); doar a doua valoare, cea conservatoare, este în acord cu rezultatul out-of-sample.
Machine learning pentru inferență
Predicția și inferența au ținte diferite. Un model poate prezice bine și totuși da o estimare deplasată a efectului unei variabile, iar o variabilă aleasă de LASSO nu este prin aceasta semnificativă. Secțiunea prezintă două metode care folosesc ML pentru partea de perturbare (nuisance) a unui model și păstrează inferența validă pentru un parametru de interes: selecția dublă (post-double selection) (Belloni, Chernozhukov & Hansen, 2014) și machine learning dublu (double/debiased machine learning) (Chernozhukov et al., 2018). Un exemplu lucrat întreabă dacă VIX prezice randamentele S&P 500.
Inferența după selecția variabilelor: selecția dublă (1/2)
Întrebarea secțiunii este cum obținem un interval de încredere valid pentru efectul unei variabile după ce ML a ales variabilele de control. Traiectoria LASSO răspunde la întrebarea „ce caracteristică intră prima”, nu „ce caracteristică contează”, iar statisticile \(t\) OLS calculate după un LASSO ignoră pasul de selecție. O variabilă de control corelată cu regresorul de interes \(d_t\), dar doar slab cu rezultatul \(y_t\), este eliminată, iar efectul ei trece în coeficientul lui \(d_t\): biasul variabilei omise (omitted-variable bias).
Cadrul este modelul parțial liniar (partially linear model), în care efectul lui \(d_t\) este liniar, iar variabilele de control intră prin funcții necunoscute:
\(y_t\) este rezultatul, \(d_t\) regresorul de interes, iar \(\theta\) efectul lui, parametrul de estimat. \(\mathbf{x}_t\) conține cele \(p\) variabile de control, \(g\) este efectul lor asupra lui \(y_t\),\(m\) descrie cum prezic ele \(d_t\), iar \(\varepsilon_t\),\(v_t\) sînt erori. Modelul este aproximativ rar (approximately sparse) cînd puține variabile de control explică cea mai mare parte din \(g\) și \(m\).
Pe scurt
Întrebarea secțiunii: cum obținem un interval de încredere valid pentru efectul unei variabile?
după ce ML a ales controalele
Traiectoria coeficienților LASSO răspunde la „ce caracteristică intră prima”
nu la „ce caracteristică contează”
statisticile \(t\) OLS calculate după LASSO ignoră pasul de selecție
O variabilă de control corelată cu regresorul de interes \(d_t\), dar doar slab cu \(y_t\), este eliminată
efectul ei trece în coeficientul lui \(d_t\) (deplasare de variabilă omisă)
Model parțial liniar: efectul lui \(d_t\) este liniar, controalele intră prin funcții necunoscute
Un LASSO al lui \(y_t\) pe \(\mathbf{x}_t\), care selectează mulțimea \(\hat S_y\).
Un LASSO al lui \(d_t\) pe \(\mathbf{x}_t\), care selectează \(\hat S_d\).
O regresie OLS a lui \(y_t\) pe \(d_t\) și pe variabilele de control păstrate de oricare dintre cele două LASSO, \(\mathbf{x}_{\hat S_y \cup \hat S_d}\), cu eroare standard robustă.
Al doilea pas este cel care face inferența validă. O variabilă de control este omisă doar dacă nu contează pentru niciuna dintre ecuațiile din (13.25): dacă este slab legată de \(y_t\), dar puternic de \(d_t\), LASSO-ul lui \(d_t\) o păstrează. Biasul provenit din variabilele de control omise totuși este atunci de ordinul doi.
Metoda este validă sub eșantionare independentă și raritate. Cu erori standard HAC, ea este o aproximare pentru seriile de timp. Nivelul penalizării și condițiile formale sînt în Anexă.
Machine learning dublu (DML) (Chernozhukov et al., 2018) reziduează ambele variabile cu orice algoritm de învățare, LASSO, random forest sau boosting, și apoi regresează reziduul pe reziduu:
\(\hat\ell(\mathbf{x}) = \hat{\mathbb{E}}[y \mid \mathbf{x}]\) este predicția ML a lui \(y_t\) din variabilele de control, iar \(\hat m(\mathbf{x})\) predicția ML a lui \(d_t\). Reziduurile \(\tilde y_t\) și \(\tilde v_t\) sînt părțile lui \(y_t\) și \(d_t\) pe care variabilele de control nu le explică, iar \(\hat\theta\) este panta OLS a lui \(\tilde y_t\) pe \(\tilde v_t\).
Estimatorul rezolvă versiunea de eșantion a scorului Neyman-ortogonal \(\psi = (\tilde y - \theta \tilde v)\,\tilde v\), a cărui medie este zero la adevăratul \(\theta\). Ortogonalitatea înseamnă că erorile de ordinul întîi din \(\hat\ell\) și \(\hat m\) nu deplasează \(\hat\theta\); condițiile de rată sînt în Anexă. Cross-fitting-ul estimează \(\hat\ell\) și \(\hat m\) pe \(K-1\) pliuri, reziduează pliul păstrat deoparte și repetă pe toate pliurile, ceea ce elimină biasul provenit din potrivirea excesivă a fiecărei observații cu propria valoare.
Teoria publicată presupune eșantionare independentă. Cu etichete suprapuse pe 5 zile, capitolul folosește pliuri contigue purjate cu 5 zile în jurul pliului de test și erori standard HAC. Aceasta este o adaptare la dependența serială, în afara teoriei publicate.
Întrebarea este dacă nivelul VIX prezice randamentul S&P 500 pe următoarele 5 zile, dat fiind un set mare de variabile de control. Rezultatul \(y_t\) este randamentul logaritmic pe următoarele 5 zile, în puncte de bază. Regresorul de interes \(d_t\) este logaritmul VIX, standardizat, cu 1 SD \(= 0{,}356\).
Există 90 de variabile de control: 12 caracteristici tehnice, pătratele lor și produsele lor două cîte două. Eșantionul are \(n = 6\,269\) de zile, iar erorile standard sînt HAC cu 4 laguri.
LASSO-ul simplu elimină VIX și toate variabilele de control. El raportează „niciun efect”, fără eroare standard. Selecția dublă păstrează \(|\hat S_y| = 0\) variabile de control în ecuația lui \(y_t\) și \(|\hat S_d| = 15\) în ecuația lui \(d_t\), unde \(|\cdot|\) este numărul de elemente: niciuna dintre variabilele de control nu prezice randamentul, în timp ce 15 dintre ele prezic VIX.
Pe scurt
Întrebarea: prezice nivelul VIX randamentul S&P 500 pe următoarele 5 zile?
dat fiind un set mare de variabile de control
\(y_t\): randamentul logaritmic pe următoarele 5 zile, în puncte de bază (bp)
\(d_t\): logaritmul VIX, standardizat (o abatere standard, SD, este \(0{,}356\))
90 de controale: 12 caracteristici tehnice, pătratele lor și produsele lor două cîte două
\(n = 6\,269\) de zile; erori HAC cu 4 laguri
LASSO-ul simplu elimină VIX și toate controalele
concluzia ar fi „niciun efect”, fără nicio eroare standard
Selecția dublă păstrează 0 controale în ecuația lui \(y_t\) (\(|\hat S_y| = 0\))
și 15 în ecuația lui \(d_t\) (\(|\hat S_d| = 15\))
Graficul următor: pe fiecare rînd un estimator
punctul este estimarea lui \(\theta\) (bp pe săptămînă la o creștere cu o SD a log VIX)
bara este CI (Confidence Interval, interval de încredere) HAC de 95%, linia punctată este efectul zero
Exemplu rezolvat: puterea predictivă a VIX pentru randamentele S&P 500 (2/3)
Graficul are cîte un estimator pe fiecare rînd. Punctul este estimarea lui \(\theta\), în puncte de bază pe săptămînă pentru o abatere standard a logaritmului VIX, bara este intervalul de încredere HAC de 95%, iar linia punctată marchează absența efectului. Cursorul fixează numărul de laguri Newey–West ale erorilor standard HAC, iar butonul ▶ îl crește pas cu pas.
Întrebare pentru sală OLS doar cu log VIX dă 7,5 bp, cu intervalul [−10,3; 25,2]. De ce intervalul selecției duble este de aproape două ori mai larg?
Răspuns
La 4 laguri HAC, intervalul selecției duble, [−22,1; 40,8] bp, este de aproximativ 1,8 ori mai larg. Cele 15 controale selectate pentru log VIX reduc variația acestuia rămasă după control, ceea ce poate mări eroarea standard. Metodele folosesc același eșantion, iar ambele intervale au corecție HAC. Mărimea coeficientului nu determină proporțional lățimea intervalului. Intervalul [−22,1; 40,8] bp nu separă coeficientul predictiv de zero la nivelul de 5%.
Cu 4 laguri, OLS doar cu logaritmul VIX dă 7,5, cu intervalul \([-10{,}3;\ 25{,}2]\), iar selecția dublă dă intervalul \([-22{,}1;\ 40{,}8]\). OLS cu toate cele 90 de variabile de control, selecția dublă și DML dau estimările punctuale −0,7, 9,4, 4,8 (LASSO) și −11,7 (random forests), toate cu intervale de aproximativ două ori mai largi decît intervalul OLS simplu. Intervalele oneste conțin zero.
Selecția dublă dă un interval de încredere de 95% pentru \(\theta\) de \([-22{,}1;\ 40{,}8]\) puncte de bază pe săptămînă pentru o abatere standard a logaritmului VIX. OLS doar cu logaritmul VIX dă 7,5, cu intervalul \([-10{,}3;\ 25{,}2]\). OLS cu toate cele 90 de variabile de control, selecția dublă și DML dau \(-0{,}7\),\(9{,}4\),\(4{,}8\) (LASSO) și \(-11{,}7\) (random forests), toate cu intervale de aproximativ două ori mai largi.
Intervalele mai largi au o cauză. Variabilele de control care prezic \(d_t\) absorb o parte din variația logaritmului VIX, iar mai puțină variație proprie în \(d_t\) înseamnă un interval mai larg. Acesta este prețul protecției împotriva biasului variabilei omise. Schimbarea de semn sub DML cu random forests este zgomot: fiecare estimare punctuală se află în intervalele selecției duble și ale DML.
Intervalele oneste conțin zero și efecte mari de ambele semne, așa că datele nu pot decide. Rezultatul susține o asociere: modelul este o regresie predictivă, iar chiar și un \(\theta\) nenul nu ar arăta că VIX cauzează randamentele.
Pe scurt
CI de 95% pentru \(\theta\) prin selecție dublă: între \(-22{,}1\) și \(40{,}8\) bp pe săptămînă
la o creștere cu o abatere standard a log VIX
OLS doar cu log VIX dă \(7{,}5\)\([-10{,}3;\ 25{,}2]\)
OLS cu toate cele 90 de controale, selecția dublă și DML (Double/Debiased Machine Learning, machine learning dublu, fără deplasare, debiased) dau \(-0{,}7\), \(9{,}4\), \(4{,}8\) (LASSO) și \(-11{,}7\) (pădure aleatoare)
toate cu intervale de circa două ori mai largi
Controalele care prezic pe \(d_t\) absorb o parte din variația log VIX
mai puțină variație proprie a lui \(d_t\) înseamnă un interval mai larg
prețul protecției împotriva deplasării de variabilă omisă
Schimbarea de semn la DML-RF (DML cu păduri aleatoare) este zgomot
fiecare estimare punctuală se află în intervalele selecției duble și DML
Intervalele corecte conțin zero și efecte mari de ambele semne
datele nu permit o concluzie
Tipul de dovadă: asociere (variabilele se mișcă împreună; nu dovedește o relație cauzală)
o regresie predictivă: chiar un \(\theta\) nenul nu ar arăta că VIX cauzează randamentele
Traiectoria LASSO și importanța unei caracteristici nu sînt dovezi ale unui efect. Selecția dublă și DML dau intervale valide pentru un parametru după ce ML a tratat variabilele de control. Pentru VIX și randamentul S&P 500 pe 5 zile, fiecare interval conține zero, iar intervalul selecției duble, \([-22{,}1;\ 40{,}8]\) bp pe săptămînă pentru o SD, este de aproximativ două ori mai larg decît cel al OLS simplu.
Direcții actuale de cercetare: modele structurale și modele flexibile
Frontiera ML în evaluarea activelor se împarte după rolul complexității modelului. O direcție de cercetare susține că modelele puternic supraparametrizate pot totuși prognoza bine; lecturile critice atribuie cîștigurile unor strategii simple sau acțiunilor greu de arbitrat. Studiul de caz al lui Chen, Pelger & Zhu (2024) urmează o a treia cale: impune unei rețele adînci o structură economică, condiția de absență a arbitrajului.
Virtutea complexității și o lectură critică [aprofundare]
Kelly, Malamud & Zhou (2024) estimează regresii ridge pe \(P\) caracteristici Fourier aleatoare (random Fourier features) ale cîtorva predictori, în ferestre rolling de doar \(T = 12\) luni, cu \(P\) de ordinul miilor. Caracteristicile Fourier aleatoare sînt sinusuri și cosinusuri ale unor combinații liniare aleatoare ale predictorilor. Teoria lor arată că, pentru \(P > T\), soluția de normă minimă, potrivirea exactă cu cel mai mic \(\|\boldsymbol\beta\|_2\), face implicit shrinkage, fenomen numit „double descent”. \(R^2_{OOS}\) poate fi negativ, în timp ce raportul Sharpe al sincronizării cu piața (market timing) crește cu complexitatea, deci complexitatea nu înseamnă automat overfitting.
Nagel (2025) oferă o lectură critică. Pentru \(P \gg T\), prognoza este o medie a celor \(T\) randamente de antrenare, ponderată după similaritate. În ferestre scurte, similaritatea este mai ales vecinătatea în timp, așa că metoda devine o strategie de momentum ajustată după volatilitate, care pierde pe date artificiale cu inversări.
Avramov, Cheng & Metzker (2023) găsesc că profiturile semnalelor de deep learning provin din acțiuni greu de arbitrat: excluderea acțiunilor cu capitalizare foarte mică, a firmelor în dificultate sau a episoadelor de volatilitate mare le atenuează, iar costurile le erodează și mai mult. Chen, Pelger & Zhu (2024) impun în schimb o structură economică, folosind condițiile de moment ale absenței arbitrajului ca funcție de pierdere a unei rețele adînci. O sinteză a domeniului este Kelly & Xiu (2023), iar un manual este Dixon, Halperin & Bilokon (2020).
ferestre mobile (rolling) de doar \(T = 12\) luni, \(P\) de ordinul miilor
caracteristici Fourier aleatoare: \(\sin\) și \(\cos\) ale unor combinații liniare aleatoare de predictori
teorie: pentru \(P > T\), soluția de normă minimă (potrivirea exactă cu cel mai mic \(\|\bm\beta\|_2\)) induce implicit o contracție a coeficienților („double descent”)
\(R^2_{OOS}\) poate fi negativ, în timp ce raportul Sharpe al sincronizării pieței crește cu complexitatea
complexitatea nu înseamnă automat supraajustare
Nagel (2025): pentru \(P \gg T\) prognoza este o medie ponderată după similaritate
media celor \(T\) randamente de antrenare
în ferestre scurte similaritatea înseamnă mai ales apropiere în timp
metoda devine o strategie de momentum ajustat la volatilitate
această strategie pierde pe date simulate cu reveniri la medie
Chen, Pelger & Zhu (2024) estimează factorul de actualizare stocastic (SDF, stochastic discount factor) \(M_{t+1}\) care evaluează toate acțiunile americane individuale, condiționînd pe 46 de caracteristici ale firmelor și pe istoria a 178 de serii macroeconomice. În absența arbitrajului, SDF evaluează fiecare randament în exces (Secțiunea I.A, ec. 1 din lucrare):
\(R^e_{t+1,i}\) este randamentul în exces al acțiunii \(i\) peste titlul de trezorerie, din luna \(t\) în luna \(t+1\), iar \(R^e_{t+1}\) vectorul tuturor acțiunilor. \(E_t\) este media condiționată de informația de la \(t\), iar \(\omega_t\) sînt ponderi de portofoliu, funcții de caracteristici și de stările macroeconomice.
Portofoliul \(F_{t+1} = \omega_t^\top R^e_{t+1}\), portofoliul SDF, este portofoliul tangent condiționat, cel cu cel mai mare raport Sharpe condiționat. Condiția (13.27) implică reprezentarea beta
\[E_t[R^e_{t+1,i}] = \beta_{t,i}\,E_t[F_{t+1}],\]
(13.28)
unde \(\beta_{t,i}\) este expunerea (loading) acțiunii \(i\) la \(F\). Randamentul în exces așteptat al unei acțiuni este expunerea ei înmulțită cu prima lui \(F\); derivarea este în Aprofundări.
Graficul din stînga arată rapoartele Sharpe lunare out-of-sample ale portofoliului SDF. Barele albastre sînt cifrele lucrării pentru 1992–2016; barele roșii sînt portofoliile tangente ale modelelor Fama–French cu trei și cu cinci factori (FF3, FF5), calculate pe factorii din Kenneth French Data Library, cu ponderile \(w \propto \hat\Sigma^{-1}\hat\mu\), unde \(\hat\mu\) și \(\hat\Sigma\) sînt vectorul mediilor și matricea de covarianță de eșantion ale randamentelor factorilor. Graficul din dreapta arată aceste ponderi. Cursorul fixează ultimul an al perioadei pe care se estimează ponderile, iar meniul perioada de test: 1992–2016, 2017–2026 sau 1992–2026.
Întrebare pentru sală Cu ponderi FF5 estimate pe 1967–1986 și apoi fixate, care este raportul Sharpe lunar în perioada de test 1992–2016?
Răspuns
FF5 are SR lunar 0,22, cu interval aproximativ de 95% [0,11; 0,34]. Pagina folosește eroarea standard √((1 + SR²/2)/T), sub aproximarea i.i.d. Normală. Valorile 0,75 și 0,15 aparțin GAN (Generative Adversarial Network, rețea generativă adversarială) din lucrare, respectiv pieței din replicare. În lucrare, EN are 0,50 și FFN (FeedForward Network, rețea neuronală feedforward, fără bucle) 0,44: modelul liniar regularizat depășește această rețea de prognoză în comparația raportată, fără a demonstra o regulă universală despre structură și flexibilitate.
Cu ponderile estimate pe 1967–1986 și perioada de test 1992–2016, portofoliile tangente replicate au rapoarte Sharpe lunare de 0,22 pentru FF5 și 0,20 pentru FF3, alături de valorile din lucrare, 0,22 și 0,19. Trecerea perioadei de test la 2017–2026 le coboară la 0,06 și 0,03.
Cifrele lucrării, din versiunea publicată, sînt rapoarte Sharpe lunare out-of-sample pe 1992–2016. Modelul complet, numit GAN (generative adversarial network), atinge 0,75; SDF-ul liniar elastic net (EN) 0,50; rețeaua feedforward de prognoză (FFN, feedforward network) 0,44; iar SDF-ul liniar neregularizat (LS) 0,42 (Tabelul I). Portofoliile tangente Fama–French ating 0,22 pentru FF5 și 0,19 pentru FF3 (Tabelul A.VI). Modelul liniar regularizat de absență a arbitrajului depășește deja rețeaua de prognoză.
Replicarea calculează portofoliile tangente FF3 și FF5 cu ponderile fixate pe 1967–1986. FF5 are 0,22, cu intervalul de 95% \([0{,}11;\ 0{,}34]\), iar FF3 0,20, cu intervalul \([0{,}08;\ 0{,}31]\); eroarea standard este 0,058 (Lo, 2002) și cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune sub semnul întrebării.
Rezultatul susține o comparație de proceduri, rapoartele Sharpe out-of-sample ale modelelor. După 2016, aceleași ponderi fixe dau un raport Sharpe lunar de 0,06 pentru FF5 și 0,03 pentru FF3, cum se arată în Aprofundări.
Pe scurt
Albastru: cifrele lucrării (versiunea publicată), SR lunar în afara eșantionului, 1992–2016 (Tabelul I)
GAN (rețeaua generativă adversarială a lucrării) \(0{,}75\), EN (SDF liniar cu elastic net) \(0{,}50\), FFN (rețeaua de prognoză feedforward) \(0{,}44\), LS (SDF liniar fără regularizare) \(0{,}42\)
FF5 (Fama–French five-factor model, modelul Fama–French cu cinci factori) \(0{,}22\), FF3 \(0{,}19\) (Tabelul A.VI)
modelul fără arbitraj regularizat întrece deja rețeaua de prognoză
Roșu: replicarea, portofoliile tangente FF3 și FF5, \(w \propto \hat\Sigma^{-1}\hat\mu\)
pe factorii Kenneth French, cu ponderi fixate pe 1967–1986
SR lunar, cu CI de 95%: FF5 \(0{,}22\)\([0{,}11;\ 0{,}34]\), FF3 \(0{,}20\)\([0{,}08;\ 0{,}31]\)
eroarea standard: \(0{,}058\) (Lo (2002)), care presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
\(\hat\mu\), \(\hat\Sigma\): vectorul mediilor și matricea de covarianță empirică ale randamentelor factorilor
Tipul de dovadă: comparație între proceduri (SR în afara eșantionului ale modelelor)
după 2016, aceleași ponderi fixe dau SR lunar \(0{,}06\) (FF5) și \(0{,}03\) (FF3): Aprofundări
Complexitatea singură nu tranșează întrebarea: rezultatul despre virtutea complexității are o lectură critică drept momentum ajustat după volatilitate, iar profiturile deep learning se concentrează în acțiuni greu de arbitrat. Impunerea condiției de absență a arbitrajului dă modelului GAN al lui Chen, Pelger & Zhu (2024) un raport Sharpe lunar out-of-sample de 0,75 pe 1992–2016, față de 0,22 pentru FF5. Reperele bazate pe date publice se replică, iar rapoartele lor Sharpe scad la 0,06 și 0,03 după 2016.
AI pentru descoperire științifică
Asistenții de inteligență artificială (AI) pot propune caracteristici, scrie cod și redacta articole la o scară care face greu de numărat încercările. Secțiunea formulează întrebarea deschisă, descrie bucla descoperirii și verificările care rămîn în sarcina cercetătorului și prezintă un mini-studiu de caz în care propunerea unui asistent produce 102 teste.
Descoperire sau căutare oportunistă în date la scară mare?
Chen, Lopez-Lira & Zimmermann (2022) caută, prin data mining, în 29 000 de rapoarte contabile semnale cu \(t > 2\). Semnalele găsite dau o predictibilitate transversală asemănătoare cu cea a predictorilor publicați după evaluare colegială, iar pentru ambele grupuri aproximativ jumătate din predictibilitate rămîne după eșantioanele inițiale. Novy-Marx & Velikov (2025) merg mai departe: un sistem bazat pe un model lingvistic mare (LLM, large language model) caută peste 30 000 de semnale, păstrează 96 care trec un protocol fix și scrie sute de articole complete, cu motivații inventate și unele citări imaginare. Este formularea ipotezelor după cunoașterea rezultatelor (HARKing, hypothesising after the results are known) la scară mare.
Întrebarea deschisă este care este numărul de încercări cînd o mașină propune caracteristicile, modelul și explicația și ce separă atunci o descoperire de cea mai bună dintre multe extrageri. Bucla descoperirii oferă o structură: literatură, ipoteze concurente, date și cod, robustețe fixată dinainte, o critică în stilul unui referent și raportarea fiecărui test. Prompturi reutilizabile pentru fiecare pas sînt în Anexă.
Unele verificări rămîn în sarcina omului. Fiecare referință trebuie să se rezolve, prin identificatorul DOI (digital object identifier) sau arXiv. Fiecare încercare este înregistrată, astfel încît \(M\) din corecția pentru testare multiplă să le numere pe toate. Testele corelate primesc un etalon comun, precum un placebo sau un bootstrap comun al scorurilor. Transformările se estimează în interiorul pliului de antrenare.
Mini-studiul de caz pornește de la o propunere tipică a unui asistent: „adaugă mai mulți indicatori”, adică momentum, distanțe față de mediile mobile, rapoarte de volatilitate, RSI și variații ale VIX pe mai multe ferestre. Rezultatul este 34 de caracteristici înmulțite cu 3 orizonturi, de 1, 5 și 20 de zile, adică 102 regresii predictive pe 2001–2015, cu statistici \(t\) Newey–West. Se folosesc doar țintele a căror fereastră se încheie pînă la 31 decembrie 2015, așa că ultimele 1, 5 și 20 de zile se elimină la graniță. Regresia \(j\) este \(r_{t,t+h} = \alpha_j + \beta_j x_{j,t} + e_t\), cu \(x_{j,t}\) caracteristica \(j\) și \(r_{t,t+h}\) randamentul pe următoarele \(h\) zile, iar ipoteza ei nulă este \(H_{0,j}: \beta_j = 0\).
Cele \(M = 102\) valori \(p\) se ordonează, \(p_{(1)} \le \dots \le p_{(M)}\), și se aplică trei corecții:
Procedura Holm respinge cît timp \(p_{(j)} \le 0{,}05/(M - j + 1)\) și controlează rata erorii pe familie (FWER, family-wise error rate), probabilitatea a cel puțin unei respingeri false.
Procedura Benjamini–Hochberg (BH) (Benjamini & Hochberg, 1995) respinge cele mai mici \(j\) valori \(p\), pentru cel mai mare \(j\) cu \(p_{(j)} \le j\,q/M\). Ea controlează rata descoperirilor false (FDR, false discovery rate) la nivelul \(q\), ponderea așteptată a respingerilor false în totalul respingerilor.
Un placebo prin deplasare, cuantila de 95% a lui \(\max_j |t_j|\) cînd ținta este deplasată circular în timp. Deplasarea păstrează corelația dintre caracteristici, dar le schimbă și legătura cu volatilitatea condiționată, așa că placebo-ul este un etalon euristic, nu un test exact.
Pe scurt
O propunere tipică a unui asistent: „adaugă mai mulți indicatori”
„momentum, distanțe față de mediile mobile, rapoarte de volatilitate, RSI și variații ale VIX pe mai multe ferestre”
34 de variabile \(\times\) 3 orizonturi (1, 5, 20 de zile) = 102 regresii predictive pe 2001–2015
statistici \(t\) Newey–West
doar ținte a căror fereastră se încheie pînă la 31 decembrie 2015: 1, 5 și 20 de zile eliminate la graniță
La pragul \(|t| > 1{,}96\), 22 dintre cele 102 regresii sînt semnificative, față de 5,1 așteptate sub ipoteza nulă globală la 5%. Holm, la o FWER de 5%, nu păstrează niciuna, BH, la o FDR de 10%, păstrează 13, iar pragul \(|t| > 3\) al lui Harvey, Liu & Zhu (2016) păstrează 4. Placebo-ul prin deplasare, cu 500 de deplasări circulare ale țintei, dă o cuantilă de 95% a lui \(\max_j |t_j|\) de 3,32. Un singur predictor o depășește: randamentul pe 1 zi ca predictor al randamentului din ziua următoare, cu \(t = -3{,}38\), adică reversal-ul pe termen scurt, un efect cunoscut.
Perioada de verificare (holdout), 2016–2026, testează cele 22 de semnale rămase. Trei dintre ele își păstrează semnul cu \(|t| > 1{,}96\); toate trei sînt variante ale reversal-ului, iar „descoperirile” bazate pe VIX eșuează. Cu Holm la 5% pentru cele 22 de verificări, niciunul nu trece: cea mai mică valoare \(p\) este 0,019, față de un prag de \(0{,}05/22 = 0{,}0023\).
BH cere independența sau dependența pozitivă a valorilor \(p\) ale ipotezelor nule adevărate, pe care predictorii corelați nu o asigură. Rezultatul susține o asociere: reversal-ul pe termen scurt este o regularitate predictivă, nu un mecanism identificat.
Pe scurt
22 din cele 102 teste au \(|t| > 1{,}96\), față de 5,1 așteptate sub ipoteza nulă globală la 5%
Proiectul întreabă dacă o căutare de caracteristici asistată de AI poate găsi un predictor al randamentelor unui indice, pentru S&P 500, pentru BET, indicele de referință al Bursei de Valori București, sau pentru Bitcoin. Predictorul trebuie să supraviețuiască unei corecții preînregistrate și unei perioade de verificare și să meargă dincolo de reversal-ul pe termen scurt.
S&P 500 și Bitcoin se află în datele cursului; BET nu. O echipă care alege BET numește sursa, de exemplu Bursa de Valori București, îngheață eșantionul și înregistrează data descărcării, \(n\) și prima și ultima închidere.
Livrabilele sînt o listă de caracteristici fixată înainte de atingerea datelor, toate testele cu Holm, BH și ipoteza nulă max-\(|t|\), o perioadă de verificare separată și DSR și PBO pentru orice strategie construită pe semnalele rămase. Fiecare prompt care a influențat o decizie se înregistrează în `AI_USE.md`, iar fiecare referință inventată, leakage sau încercare nenumărată în `AI_ERRORS.md`, cu testul care a prins-o; există șabloane.
Pe scurt
Întrebările
poate o căutare de variabile asistată de AI să găsească un predictor al randamentelor indicilor?
indicii: S&P 500, BET – indicele de referință al Bursei de Valori București, Bitcoin
rămîne acesta semnificativ după o corecție preînregistrată și pe o perioadă de verificare?
adaugă el informație dincolo de inversarea pe termen scurt?
Datele: S&P 500 și Bitcoin sînt în datele cursului; BET nu este
fiecare prompt care a influențat o decizie, în AI_USE.md
fiecare referință inventată, scurgere de informație sau încercare omisă, în AI_ERRORS.md, cu testul care a identificat-o
Sinteza secțiunii
Din 102 teste propuse de un asistent, 22 trec pragul \(|t| > 1{,}96\), niciunul nu trece Holm, iar doar reversal-ul pe termen scurt, deja cunoscut, depășește cuantila placebo de 3,32; în perioada de verificare, cele trei replicări nominale sînt variante ale reversal-ului și niciuna nu trece Holm. Numărul de încercări este mărimea pe care o căutare asistată de AI o face cel mai greu de numărat, iar fiecare corecție depinde de el.
Concluzii
Capitolul a aplicat ML direcției S&P 500 și unei grile de reguli de tranzacționare pentru Bitcoin, cu validare și teste construite pentru date dependente serial. Concluziile privesc procesul mai mult decît algoritmii: cum pot caracteristicile, etichetele, validarea și selecția să producă o abilitate aparentă și ce teste o elimină.
Patru lecții empirice se detașează. O respingere ADF nu înseamnă staționaritate: FFD trunchiată a prețului logaritmic S&P 500 rămîne \(I(1)\), iar memoria trebuie estimată direct, cu estimatorul local Whittle. K-fold cu observațiile amestecate „găsește” abilitate în zgomot pur, o acuratețe de 69,4% pe o țintă fără nicio predictibilitate.
Pe S&P 500, niciun model nu depășește regula „mereu în sus”, fie după testul PT, fie, în Aprofundări, după testele DM și Giacomini–White (GW). Cel mai bun dintre multe backtest-uri trebuie deflatat sau evaluat prin bootstrap: pe grila Bitcoin, cea mai bună regulă in-sample nu păstrează nimic out-of-sample.
Capitolele următoare continuă tema. Capitolul 14 tratează deep learning și modelele fundaționale pentru serii de timp, iar Capitolul 15 modelele lingvistice mari și sentimentul.
Pe scurt
Patru lecții empirice
O respingere ADF nu înseamnă staționaritate
FFD trunchiată a log-prețului S&P 500 rămîne \(I(1)\)
memoria trebuie estimată direct, cu local Whittle
K-fold amestecat „găsește” abilitate pe zgomot pur
Pe S&P 500 niciun model nu depășește „mereu în sus” (testele PT, DM, GW)
Cel mai bun dintre multe backtest-uri trebuie deflatat sau testat prin bootstrap
pe grila Bitcoin, cea mai bună regulă în eșantion nu păstrează nimic în afara lui
Lista de verificare adună condițiile în care o afirmație predictivă poate fi luată în serios. Datele sînt la data respectivă (point-in-time), iar fiecare transformare se estimează doar pe pliurile de antrenare. Etichetele sînt scalate cu volatilitatea, iar intervalele lor sînt înregistrate. Selecția modelului folosește K-fold cu purjare sau CPCV, cu embargo, iar testul final este un walk-forward.
Evaluarea include un reper naiv, testul PT, testele DM, Clark–West (CW) sau GW și intervale bootstrap pe blocuri. Costurile sînt incluse, iar fiecare încercare este înregistrată. Strategia selectată este evaluată prin DSR, testul SPA și PBO.
Ultimul punct separă predicția de inferență: „selectat” sau „important” nu înseamnă „semnificativ”, iar inferența asupra unui efect cere selecția dublă sau DML.
Pe scurt
Date disponibile la momentul deciziei, transformări estimate doar pe pliurile de antrenare
Etichete scalate cu volatilitatea, cu intervalele înregistrate
K-fold cu purjare sau CPCV cu embargo pentru selecție, WF pentru testul final
Un reper naiv, testele PT, DM / CW (testul Clark–West pentru modele imbricate) / GW și intervale bootstrap pe blocuri
Costuri incluse și fiecare încercare înregistrată
DSR, SPA și PBO pentru strategia selectată
„Selectat” sau „important” nu înseamnă „semnificativ”: selecție dublă sau DML pentru inferență
Întrebările revin la numerele principale ale capitolului: cele 57,7% ale logit-ului față de reperul de 58,1%, corelația de 0,98 dintre seria FFD și prețul logaritmic, cele 69,4% ale K-fold-ului cu observații amestecate față de 49,6% cu purjare, creșterea lui \(SR_0\) cu \(N\), cele două valori DSR ale celei mai bune reguli pe Bitcoin, cele două intervale AUC ale logit-ului și întrebarea la care răspunde selecția dublă în cazul VIX. Fiecare răspuns se sprijină pe un slide din secțiunea corespunzătoare.
Pe scurt
De ce logit-ul cu acuratețea de 57,7% nu are abilitate, cînd 58,1% dintre zile sînt „sus”?
Ce spune o corelație de 0,98 între seria FFD (\(d = 0{,}25\)) și log-preț despre o respingere ADF?
De ce K-fold amestecat dă 69,4% pe o țintă fără predictibilitate, iar K-fold cu purjare și embargo 49,6%?
Cum se schimbă \(SR_0\), maximul așteptat al celor \(N\) strategii fără abilitate, cînd \(N\) crește de la 10 la 1 000?
De ce cea mai bună regulă pe Bitcoin, cu SR de 2,02 în eșantion, are DSR 0,999 sau 0,926, după varianța aleasă?
De ce intervalul DeLong pentru AUC, \([0{,}466;\ 0{,}494]\), și cel bootstrap pe blocuri, \([0{,}456;\ 0{,}505]\), duc la concluzii diferite?
Ce întrebare despre VIX rezolvă selecția dublă și nu o rezolvă traiectoria LASSO?
Pentru direcția S&P 500 pe 5 zile, alegerea este buy-and-hold, nu strategia GBM: în walk-forward-ul 2010–2026, raportul Sharpe este 0,66 pentru buy-and-hold și 0,33 pentru GBM. Pentru orice model, selecția folosește CV cu purjare și embargo, iar evaluarea finală un walk-forward.
Alegerea rămîne valabilă în trei condiții. Semnalul direcțional rămîne slab, astfel încît niciun model nu depășește reperul „mereu în sus” de 58,1%. Fiecare schimbare de poziție costă 5 bp. Fiecare încercare este înregistrată, iar numărul de încercări \(N\) este raportat.
Alegerea ar fi abandonată pentru un model care depășește buy-and-hold out-of-sample, după costuri, cu o statistică PT peste 1,645, un interval bootstrap pe blocuri pentru AUC aflat în întregime peste 0,5 și un DSR peste 0,95 cu varianța conservatoare \(1/T\). Cea mai bună regulă pe Bitcoin, pentru comparație, are DSR 0,926.
Pe scurt
Ce aleg
pentru direcția S&P 500 pe 5 zile: buy-and-hold, nu strategia GBM
pe ferestre succesive, 2010–2026, raportul Sharpe este 0,66 pentru buy-and-hold și 0,33 pentru GBM
pentru orice model: CV cu purjare și embargo la selecție, ferestre succesive la evaluarea finală
În ce condiții
semnalul direcțional rămîne slab: niciun model nu depășește reperul „mereu în sus”, de 58,1%
fiecare schimbare de poziție costă 5 bp
fiecare încercare este înregistrată, iar numărul de încercări \(N\) este raportat
Ce rezultat m-ar face să renunț
un model care depășește buy-and-hold în afara eșantionului, după costuri
cu statistica PT peste 1,645
cu intervalul bootstrap pe blocuri pentru AUC în întregime peste 0,5
cu DSR peste 0,95 la varianța conservatoare \(1/T\) (cea mai bună regulă pe Bitcoin are 0,926)
Sinteza secțiunii
Pe datele capitolului, niciun model nu prezice direcția S&P 500 pe 5 zile mai bine decît regula „mereu în sus”, iar strategia GBM obține jumătate din raportul Sharpe al buy-and-hold. Succesele aparente din capitol, respingerea ADF la \(d = 0{,}25\), cele 69,4% ale K-fold-ului cu observații amestecate și raportul Sharpe in-sample de 2,02 pe Bitcoin, dispar toate sub un test care respectă dependența din date și numărul de încercări.
Aprofundări
Cadrele din această parte extind subiecte tratate pe scurt în corpul capitolului: valoarea economică a unui \(R^2\) mic, adîncimea arborilor, ponderile diferenței fracționare și estimarea directă a memoriei, volatilitatea EWMA, distribuția și suprapunerea etichetelor, varianța de lungă durată Newey–West, testele care compară prognoze, importanța caracteristicilor, inferența pentru rapoartele Sharpe și testele de data snooping pe grila Bitcoin, precum și detaliile studiilor de caz despre deep learning și despre descoperirea asistată de AI.
Dovezi și valoarea economică a unui \(R^2_{OOS}\) mic (1/2)
Campbell & Thompson (2008) întreabă cît valorează pentru un investitor un \(R^2\) mic. Randamentele se împart într-o parte predictibilă \(x_t\), cunoscută la \(t\) și de medie zero, și un șoc, \(r_{t+1} = \mu + x_t + \varepsilon_{t+1}\), cu \(R^2 = \mathrm{Var}(x_t)/\mathrm{Var}(r_{t+1})\). Un investitor medie–varianță fără restricții, care cunoaște \(x_t\) și reoptimizează în fiecare perioadă, fără costuri și fără eroare de estimare, are un raport Sharpe condiționat \(SR_t\) al cărui pătrat mediu este
unde \(SR_{BH}\) este raportul Sharpe al strategiei buy-and-hold, care ignoră \(x_t\). Cum utilitatea medie–varianță optimă la \(t\) este \(SR_t^2/(2\gamma)\), cu \(\gamma\) aversiunea față de risc, (13.29) se citește ca un cîștig de utilitate medie; ea nu este, în general, pătratul raportului Sharpe necondiționat al strategiei dinamice.
Pentru S&P 500, cu randamente logaritmice lunare din 2001–2026, \(SR_{BH} = 0{,}128\) pe lună, 0,44 anualizat cu \(\sqrt{12}\). Un \(R^2\) lunar de 0,5% dă \(\sqrt{\mathbb{E}[SR_t^2]} = 0{,}51\) anualizat, cu 15% peste \(SR_{BH}\), iar \(R^2 = 1\%\) dă 0,57, cu aproximativ 27% peste. Pentru un singur indice, însă, eșantionul efectiv este mult mai mic decît pentru mii de acțiuni, care este situația studiului de caz pe S&P 500.
Pe scurt
S&P 500, randamente logaritmice lunare 2001–2026: buy-and-hold are \(SR_{BH} = 0{,}128\) pe lună
adică \(0{,}44\) anualizat cu \(\sqrt{12}\)
un predictor cu \(R^2 = 0{,}5\%\) pe lună dă \(\sqrt{\E[SR_t^2]} = 0{,}51\) anualizat (cu 15% peste \(SR_{BH}\))
un predictor cu \(R^2 = 1\%\) dă \(0{,}57\) (cu circa 27% peste \(SR_{BH}\))
Pentru un singur indice, eșantionul efectiv este mult mai mic decît pentru mii de acțiuni
Derivarea are patru pași. Cum \(\varepsilon_{t+1}\) este independent de \(x_t\),\(\sigma_\varepsilon^2 = (1 - R^2)\,\sigma_r^2\), riscul pe care investitorul informat îl suportă în continuare. Condiționat de \(x_t\), investitorul are media \(\mu + x_t\) și varianța \(\sigma_\varepsilon^2\); medierea lui \((\mu + x_t)^2\) după \(t\) dă \(\mu^2 + R^2\sigma_r^2\), iar împărțirea la \(\sigma_\varepsilon^2\), cu \(SR_{BH} = \mu/\sigma_r\), dă (13.29). Cu \(R^2 = 0{,}005\),\(\mathbb{E}[SR_t^2] = (0{,}128^2 + 0{,}005)/0{,}995 = 0{,}02149\), deci \(\sqrt{\mathbb{E}[SR_t^2]} = 0{,}1466\) pe lună, 0,51 pe an și de 1,15 ori \(SR_{BH}\).
Pe scurt
Același model: \(r_{t+1} = \mu + x_t + \varepsilon_{t+1}\), \(\E[x_t] = 0\), \(\varepsilon_{t+1}\) independent de \(x_t\)
notăm \(\sigma_r^2 = \Var(r_{t+1})\)
Pasul 1, riscul pe care îl suportă în continuare investitorul informat
\(\Var(r_{t+1}) = \Var(x_t) + \sigma_\varepsilon^2\) și \(R^2 = \Var(x_t)/\sigma_r^2\), deci
Graficul arată acuratețea în funcție de adîncimea maximă a arborelui pentru direcția S&P 500 pe 5 zile: acuratețea de antrenare cu roșu, acuratețea CV cu purjare a unui arbore cu albastru și a pădurii cu verde, iar reperul „mereu în sus” punctat. Acuratețea de antrenare crește cu adîncimea pînă la aproximativ 88% la adîncimea 15, în timp ce acuratețea CV cu purjare scade spre 50%, tiparul prezis de (13.5). Random forests se degradează mai lent, dar nu depășesc niciodată reperul.
Pe scurt
S&P 500, direcția pe 5 zile, cînd adîncimea crește
acuratețea pe antrenare urcă la \(\approx 88\%\) la adîncimea 15
acuratețea CV cu purjare scade spre 50%
CV cu purjare: antrenarea exclude etichetele suprapuse cu testul (Secțiunea 5)
Axa orizontală: adîncimea maximă a arborelui; axa verticală: acuratețea
roșu antrenarea, albastru CV al unui arbore, verde CV al pădurii
Random forest se degradează mai lent, dar nu depășește niciodată reperul „mereu în sus” (linia punctată)
Graficul arată ponderea \(w_k\) din (13.10) în funcție de lagul \(k\), pentru cinci valori ale lui \(d\). Pentru \(d = 1\) contează doar primul lag; pentru \(d\) mic, ponderile lagurilor îndepărtate rămîn nenule. Toate ponderile de după \(w_0\) sînt negative, deci \(\tilde X_t\) compară nivelul de azi cu o istorie ponderată.
Pe scurt
Axa orizontală: lagul \(k\); axa verticală: ponderea \(w_k\), pentru cinci valori ale lui \(d\)
Pentru \(d=1\) contează doar primul lag
Pentru \(d\) mic ponderile lagurilor îndepărtate rămîn nenule
Toate ponderile după \(w_0\) sînt negative
\(\tilde X_t\) compară nivelul de azi cu o istorie ponderată
O serie cu memorie lungă are cea mai mare parte a varianței în ciclurile lente, iar panta densității ei spectrale lîngă frecvența 0 dezvăluie \(\delta\):\(f(\lambda) \sim G\,\lambda^{-2\delta}\) cînd \(\lambda \to 0\), cu \(G > 0\). Estimatorul local Whittle (LW) (Robinson, 1995) potrivește această lege pe primele \(m = n^{a}\) frecvențe Fourier \(\lambda_j = 2\pi j/n\), unde \(n\) este volumul eșantionului, iar \(a \in (0,1)\) exponentul lățimii de bandă (bandwidth); un \(a\) mai mare înseamnă varianță mai mică și bias mai mare din dinamica pe termen scurt. Estimatorul local Whittle exact (ELW) (Shimotsu & Phillips, 2005) este valid și pentru \(\delta \ge \tfrac12\), nestaționar, iar intervalul de încredere de 95% este \(\hat\delta \pm 1{,}96/(2\sqrt m)\).
Pe scurt
Ideea: o serie cu memorie lungă are cea mai mare parte a varianței în ciclurile lente
panta spectrului lîngă frecvența 0 arată \(\delta\) (aici \(\lambda\) este frecvența, nu penalizarea)
\(f(\lambda)\): densitatea spectrală, varianța adusă de ciclurile de frecvență \(\lambda\) (perioadă de \(2\pi/\lambda\) zile); \(G > 0\): o constantă de scală; \(\sim\): raportul celor doi membri tinde la 1
\(n\): mărimea eșantionului; \(a \in (0,1)\): exponentul lățimii de bandă; un \(a\) mai mare folosește mai multe frecvențe: varianța scade, dar crește deplasarea din dinamica pe termen scurt
Local Whittle exact (ELW, Shimotsu & Phillips (2005)): valid și pentru \(\delta \ge \frac12\) (serii nestaționare)
Graficul arată memoria estimată \(\hat\delta\) în funcție de exponentul lățimii de bandă \(a\), cu banda ei de încredere de 95%, pentru prețul logaritmic S&P 500, seria FFD, randamente și randamentele absolute din 2000–2026. Linia verticală marchează \(a = 0{,}65\), valoarea folosită pentru estimările de pe slide-ul următor.
La \(a = 0{,}65\), estimarea ELW este \(\hat\delta = 0{,}99\) pentru prețul logaritmic, cu CI \([0{,}94;\ 1{,}05]\), și 0,75 pentru seria FFD, cu CI \([0{,}69;\ 0{,}81]\). Randamentele au \(\hat\delta = -0{,}01\), CI \([-0{,}07;\ 0{,}04]\), iar randamentele absolute \(|r_t|\) au \(\hat\delta = 0{,}53\), CI \([0{,}47;\ 0{,}59]\). Seria FFD arată ca \(1 - d\) pe banda de frecvențe folosită, deși ordinul ei de integrare este tot 1. Memoria lungă se află în volatilitate (Capitolele 5 și 9), deci filtrele fracționare au sens pentru \(|r_t|\), nu pentru preț.
Pe scurt
Graficul: exponentul \(a\) (cu \(m = n^{a}\)) pe axa orizontală, \(\hat\delta\) pe axa verticală
banda CI de 95% în jurul estimării
linia verticală marchează \(a = 0{,}65\), valoarea folosită mai jos (S&P 500, 2000–2026)
Log-prețul (ELW): \(\hat\delta = 0{,}99\), CI \([0{,}94;\ 1{,}05]\)
Seria FFD (ELW): \(\hat\delta = 0{,}75\), CI \([0{,}69;\ 0{,}81]\)
Randamentele: \(\hat\delta = -0{,}01\), CI \([-0{,}07;\ 0{,}04]\)
Randamentele absolute \(|r_t|\): \(\hat\delta = 0{,}53\), CI \([0{,}47;\ 0{,}59]\)
Pentru seria FFD estimarea rămîne aproape de \(1 - d\) în banda de frecvențe folosită
deși ordinul de integrare este tot 1
Memoria lungă este în volatilitate (Capitolele 5 și 9)
deci filtrele fracționare au sens pentru \(|r_t|\), nu pentru preț
Prețul logaritmic din panoul de sus este o serie \(I(1)\). Seria FFD din panoul din mijloc arată încă trendul prețului, deoarece este egală cu \(0{,}178\,\log P_t\) plus o parte staționară, după (13.13). Randamentele din panoul de jos nu au trend; se vede doar volatility clustering.
Pe scurt
Panoul de sus arată log-prețul S&P 500, o serie \(I(1)\)
Panoul din mijloc arată seria FFD cu \(d = 0{,}25\)
trendul prețului rămîne vizibil, pentru că seria este \(0{,}178\,\log P_t\) plus o parte staționară
Panoul de jos arată randamentele logaritmice, fără trend
se vede doar gruparea volatilității (volatility clustering)
Volatilitatea zilnică \(\sigma_{t_0}\) din eticheta cu trei bariere este rădăcina unei medii mobile ponderate exponențial (EWMA) a abaterilor pătratice ale randamentelor logaritmice zilnice, cu span 50:
unde \(\bar r_t\) este media ponderată exponențial a randamentelor; span 50 înseamnă o memorie efectivă de circa două luni de tranzacționare. Barierele scalate cu volatilitatea sînt necesare deoarece un prag fix ar fi atins aproape zilnic în 2008 sau în martie 2020 și rar în anii calmi.
Pe scurt
\(\sigma_{t_0}\): rădăcina mediei mobile ponderate exponențial (EWMA), cu span 50
Pentru S&P 500 din 2001–2026, cu \(h = 10\) și bariere la \(\pm 1\,\sigma\sqrt{h}\), 19,6% dintre evenimente ies la bariera superioară, 21,3% la bariera inferioară și 59,0% la bariera verticală (expirare, time-out). După regula semnului la bariera verticală, etichetele sînt 59,1% \(+1\) și 40,9% \(-1\), față de 60,5% „sus” la orizontul fix; cu convenția „0”, expirările formează o a treia clasă. Panoul din dreapta este histograma zilelor calendaristice pînă la atingerea primei bariere orizontale, de obicei după 1–2 săptămîni.
Cînd eticheta \(i\) acoperă intervalul \([t_{0,i}, t_{1,i}]\), etichetele consecutive împart randamente, iar eșantioanele nu sînt i.i.d. Concurența (concurrency) \(c_t = \sum_i \mathbf{1}\{t_{0,i} \le t \le t_{1,i}\}\) numără etichetele al căror interval conține ziua \(t\), iar unicitatea medie (average uniqueness) a etichetei \(i\) este \(\bar u_i = \frac{1}{t_{1,i}-t_{0,i}+1}\sum_{t = t_{0,i}}^{t_{1,i}} 1/c_t\). Ea este 1 cînd niciun randament nu este împărțit și \(1/5\) cînd media armonică a lui \(c_t\) pe interval este cinci.
Volumul efectiv al eșantionului este aproximativ \(\sum_i \bar u_i\), mult mai mic decît numărul de etichete \(n\); aceasta este o euristică a suprapunerii, nu o măsură bazată pe varianță. Bagging-ul extrage atunci aproape-duplicate, iar scorurile CV sînt prea optimiste. Remediile sînt ponderarea eșantioanelor cu \(\bar u_i\), și cu \(|r|\), și bootstrap-ul secvențial; într-un random forest, fracțiunea de observații extrase pentru fiecare arbore poate fi fixată la aproximativ unicitatea medie \(\bar u\).
Pe scurt
Consecințe
Mărimea efectivă a eșantionului \(\approx \sum_i \bar u_i \ll n\)
\(n\): numărul de etichete
o euristică a suprapunerii, nu o măsură bazată pe varianță
Bagging-ul extrage observații aproape identice
scorurile CV sînt supraestimate
Remedii
Ponderare cu \(\bar u_i\) (și cu \(|r|\))
Bootstrap secvențial
În RF, fracția de observații extrase pentru fiecare arbore
„Cel mai mic \(d\)” din studiul de caz a fost ales pe 2000–2026 și apoi folosit în CV cu purjare, deci pliurile de test au contribuit la alegerea unei caracteristici; aceeași regulă ADF pe datele pînă în 2009 dă \(d = 0{,}15\). Fără prețul logaritmic FFD, acuratețile medii pe pliuri sînt 57,5% pentru logit, 56,4% pentru RF, 55,6% pentru GBM și 56,5% pentru MLP, toate sub 58,1%, iar AUC-urile sînt 0,483, 0,520, 0,514 și 0,526. Concluzia negativă nu depinde de această caracteristică. Protocolul corect estimează \(d\), prin local Whittle cu intervalul lui de încredere, doar în interiorul fiecărui pliu de antrenare și preferă caracteristici cu sens economic.
Pe scurt
„\(d\) minim” a fost ales pe 2000–2026 și apoi folosit în CV cu purjare
pliurile de test au influențat alegerea unei caracteristici
aceeași regulă ADF dă \(d = 0{,}15\) pe datele pînă în 2009 și \(d = 0{,}25\) pe tot eșantionul
Studiul de caz fără log-prețul FFD (CV cu purjare în 5 pliuri, media pe pliuri)
Testele de semnificație din studiul de caz mediază o serie zilnică \(z_t\), precum o nimerire, o diferență de pierderi sau un scor de regresie. Cu etichete pe 5 zile, valorile vecine ale lui \(z_t\) împart randamente, deci \(\mathrm{Var}(\bar z) \ne \mathrm{Var}(z_t)/n\), iar varianța de lungă durată (long-run variance) se estimează cu estimatorul HAC al lui Newey & West (1987), cu ponderi Bartlett:
cu \(\widehat{\mathrm{SE}}(\bar z) = \sqrt{\hat\Omega_{NW}/n}\). Cum etichetele pe \(h\) zile împart randamente pînă la o distanță de \(h - 1\) zile, \(q \ge h - 1 = 4\) este minimul aici. Într-un exemplu simplu, cu \(z_t\) suma următoarelor 5 randamente zilnice i.i.d. de varianță \(\sigma^2\), varianța de lungă durată adevărată este \(25\sigma^2\), față de \(\Gamma_0 = 5\sigma^2\), deci un \(t\) i.i.d. este de \(\sqrt5 \approx 2{,}2\) ori prea mare; ponderile Bartlett cu \(q = 4\) dau \(17\sigma^2\), așa că \(q = h - 1\) este un minim, nu o alegere generoasă.
Pe scurt
Testele de semnificație ale studiului de caz (Pesaran–Timmermann) fac media unei serii zilnice \(z_t\)
de exemplu o potrivire, o diferență de pierderi \(d_t\), un scor de regresie
cu etichete pe 5 zile, valorile \(z_t\) vecine au randamente comune, deci \(\Var(\bar z) \ne \Var(z_t)/n\)
Varianța de lungă durată Newey–West (Newey & West (1987)), cu ponderi Bartlett
robustă la heteroscedasticitate și autocorelație (HAC)
\(\hat\Gamma_j\): autocovarianța empirică a lui \(z_t\) la lagul \(j\); \(q\): numărul de laguri („lag 4” în tabele); \(\widehat{\mathrm{SE}}(\bar z) = \sqrt{\hat\Omega_{NW}/n}\)
regula pentru laguri: etichetele pe \(h\) zile au randamente comune pînă la \(h - 1\) zile distanță, deci \(q \ge h - 1 = 4\) este minimul aici
\(\Gamma_j = (5 - j)\sigma^2\) pentru \(j \le 4\), \(0\) după
formula i.i.d.: \(\Gamma_0 = 5\sigma^2\); varianța de lungă durată reală: \(\Gamma_0 + 2(4 + 3 + 2 + 1)\sigma^2 = 25\sigma^2\), deci un \(t\) i.i.d. este de \(\sqrt5 \approx 2{,}2\) ori prea mare
Bartlett cu \(q = 4\): \(5 + 2(0{,}8\cdot4 + 0{,}6\cdot3 + 0{,}4\cdot2 + 0{,}2\cdot1) = 17\sigma^2\); ponderile atenuează lagurile îndepărtate, deci \(q = h-1\) este un minim, nu o alegere generoasă
Două prognoze de probabilitate pentru \(y_t \in \{0, 1\}\),\(\hat p_{1,t}\) de la modelul 1 și \(\hat p_{0,t}\) de la un reper precum o constantă, se compară prin diferența de pierderi \(d_t = L(y_t, \hat p_{1,t}) - L(y_t, \hat p_{0,t})\), cu \(L\) log-loss-ul sau pierderea Brier \((y_t - \hat p_t)^2\). Testul Diebold–Mariano (DM) (Diebold & Mariano, 1995) folosește \(DM = \bar d/\sqrt{\hat\Omega_{NW}/n}\), asimptotic \(N(0,1)\) sub \(H_0: \mathbb{E}[d_t] = 0\), cu \(\hat\Omega_{NW}\) din (13.30) aplicat lui \(d_t\).\(DM > 1{,}96\) înseamnă că modelul 1 este semnificativ mai slab la 5%, iar \(DM < -1{,}96\) că este semnificativ mai bun.
Pe scurt
Două prognoze de probabilitate pentru \(y_t \in \{0, 1\}\)
modelul 1 dă \(\hat p_{1,t}\), reperul (modelul 0, de ex. o constantă) dă \(\hat p_{0,t}\)
Pierderea unei prognoze \(\hat p_t\)
log-loss-ul de pe slide-ul despre pierdere și penalizare, cu \(f = \hat p_t\), sau pierderea Brier \((y_t - \hat p_t)^2\)
Diferența pierderilor (alt \(d_t\) decît în FFD și DML): \(d_t = L(y_t, \hat p_{1,t}) - L(y_t, \hat p_{0,t})\)
\(d_t > 0\) înseamnă că modelul 1 este mai slab în ziua \(t\)
Cînd modelele sînt imbricate (nested), cum logit-ul cu 14 caracteristici include constanta la \(\boldsymbol\beta = 0\), modelul mare estimează zerouri cu zgomot sub \(H_0\), deci \(\mathbb{E}[d_t] > 0\), iar DM îl favorizează rar. Testul Clark–West (CW) (Clark & West, 2007) adaugă termenul \((\hat p_{0,t} - \hat p_{1,t})^2\), care elimină acest cost al zgomotului, și aplică un test \(t\) HAC unilateral; el este derivat pentru modele liniare imbricate estimate prin OLS și este o aproximare pentru probabilitățile unui logit penalizat. Testul Giacomini–White (GW) (Giacomini & White, 2006) testează metoda de prognoză așa cum este folosită, cu o fereastră de estimare mărginită, în timp ce CW întreabă dacă modelul populației adaugă informație; statistica GW este în Anexă.
Pe scurt
Modele imbricate: logit-ul cu 14 caracteristici include constanta, \(\bm\beta = 0\)
sub \(H_0\) modelul extins estimează cu zgomot coeficienți nuli, \(\E[d_t] > 0\)
DM rareori îl favorizează
Clark–West (CW, Clark & West (2007)): test \(t\) HAC unilateral pentru \(\E[f_t] = 0\) față de \(\E[f_t] > 0\)
Scăderea medie a impurității (MDI, mean decrease impurity) se aplică doar arborilor și se calculează in-sample: însumează reducerile Gini din (13.7) din nodurile care împart după caracteristica \(j\), ponderate cu ponderea \(n_v/n\) a observațiilor care ajung în fiecare nod, și mediază peste arbori. Ea favorizează caracteristicile continue, cu multe praguri posibile. Scăderea medie a acurateței (MDA, mean decrease accuracy) se aplică oricărui model și se calculează pe datele de test, ca scădere a scorului, aici AUC, cînd coloana \(j\) este permutată aleator; un MDA negativ mic, citit împreună cu dispersia peste permutări, nu arată singur că o caracteristică dăunează.
Pe scurt
Întrebarea: pe ce caracteristici se sprijină modelul și care dintre ele ajută predicția pe date noi?
Scăderea medie a impurității (MDI), doar pentru arbori, calculată în eșantion:
Valoarea SHAP (Shapley additive explanations) a lui Lundberg & Lee (2017),\(\phi_j(\mathbf{x})\), este contribuția marginală medie a caracteristicii \(j\) la predicția din \(\mathbf{x}\), peste toate coalițiile celorlalte caracteristici, și este aditivă: \(\hat f(\mathbf{x}) = \phi_0 + \sum_j \phi_j(\mathbf{x})\), cu \(\phi_0\) predicția medie. Importanța globală este media lui \(|\phi_j(\mathbf{x}_i)|\) pe datele de test. MDI răspunde la întrebarea ce a folosit modelul, SHAP atribuie predicția fără să folosească rezultatul realizat, iar MDA măsoară schimbarea scorului pe setul evaluat; caracteristicile corelate își împart și își diluează importanța, deci ar trebui grupate mai întîi (López de Prado, 2020).
Cele trei panouri arată MDI (in-sample), MDA și media lui \(|\phi_j|\) (out-of-sample) pentru cele 14 caracteristici ale studiului de caz; în panoul MDA, barele roșii sînt negative.
Modelele se estimează pe primele 70% din eșantion și se evaluează pe ultimele 30%, după o purjare; RF dă MDI și MDA, iar GBM dă SHAP, deci diferențele nu sînt pur metodologice. MDI pune volatilitatea pe primul loc, în timp ce MDA și SHAP indică momentum-ul pe 20 de zile și distanța față de media mobilă pe 200 de zile. Volatilitatea pe 20 de zile are un MDI ridicat și un MDA negativ, un semn de overfitting, dar nu o dovadă. Toate importanțele sînt foarte mici, cu \(\Delta\)AUC \(< 0{,}01\), iar cu caracteristici corelate MDA și SHAP extrapolează în puncte din afara distribuției datelor (off-manifold) (Hooker, Mentch & Zhou, 2021).
Pe scurt
Estimare pe primele 70%, evaluare pe ultimele 30% după purjare
RF dă MDI și MDA, GBM dă SHAP
deci diferențele țin și de model, nu doar de metodă
Panourile: MDI (în eșantion), MDA și media lui \(|\phi_j|\) (în afara eșantionului)
MDA: scăderea AUC în afara eșantionului; barele roșii sînt negative
Etichetele noi față de traiectoria LASSO
mom_\(h\): momentum-ul pe \(h\) zile; dist_ma50, dist_ma200: distanța față de media mobilă
rsi_14: indicele RSI(14); vix_level, vix_chg_5: nivelul VIX și variația lui pe 5 zile
MDI pune volatilitatea pe primul loc
MDA și SHAP indică momentum-ul pe 20 de zile și distanța față de media mobilă pe 200 de zile
Volatilitatea pe 20 de zile are MDI ridicat, dar MDA negativ
un semn de supraajustare, nu o dovadă
Toate importanțele sînt foarte mici
permutarea oricărei caracteristici schimbă AUC cu mai puțin de \(0{,}01\) (interpretarea: Anexă)
În walk-forward-ul 2010–2026, cu \(n = 4\,198\) zile, dintre care 60,2% „sus”, reperul este prognoza constantă egală cu ponderea zilelor „sus” din antrenare. Logit-ul are un log-loss de 0,6824, față de 0,6756 pentru constantă; DM dă \(t = 2{,}50\)(\(p = 0{,}012\)), deci logit-ul este semnificativ mai slab, Clark–West dă \(t = -0{,}36\)(\(p\) unilateral 0,64), iar Giacomini–White dă 6,29 (\(\chi^2_2\),\(p = 0{,}043\)), aproximativ pentru că fereastra se extinde. GBM are un log-loss de 0,7027, cu DM \(t = 5{,}81\), GW \(= 33{,}6\)(\(p < 0{,}001\)) și o statistică PT de \(-2{,}74\). Niciun model nu depășește regula „mereu în sus” sau o prognoză constantă.
Pe scurt
Ferestre succesive 2010–2026: \(n = 4\,198\) de zile, dintre care 60,2% „sus”
Reperul: prognoza constantă egală cu proporția zilelor „sus” din antrenare
DM, Clark–West și GW folosesc Newey–West cu 4 laguri
Logit (include constanta): log-loss \(0{,}6824\) față de \(0{,}6756\)
DM \(t = 2{,}50\) (\(p = 0{,}012\)): logit-ul estimat este semnificativ mai slab
Anualizarea cu \(\sqrt{A}\), unde \(A\) este numărul de perioade pe an (252 de zile de tranzacționare, 365 pentru Bitcoin), cere autocorelație zero; altfel \(SR_A = \eta(A)\,SR\), cu \(\eta(A) = A/\sqrt{A + 2\sum_{k=1}^{A-1}(A-k)\rho_k}\)(Lo, 2002). Cu randamente lunare și \(\rho_1 = 0{,}2\),\(\eta = 12/\sqrt{16{,}4} = 2{,}96\), față de \(\sqrt{12} = 3{,}46\), deci raportul Sharpe anual este cu aproximativ 15% mai mic. Două strategii pe aceleași zile se compară testînd \(SR_a - SR_b\) prin metoda delta HAC sau printr-un bootstrap pe blocuri studentizat (Ledoit & Wolf, 2008), nu prin două intervale separate.
Pe scurt
Anualizarea cu \(\sqrt{A}\) cere absența autocorelației; altfel \(SR_A = \eta(A)\,SR\) (Lo (2002))
\(A\): numărul de perioade pe an (252 de zile de tranzacționare, 365 pentru Bitcoin)
\(\eta(A) = A\big/\sqrt{A + 2\sum_{k=1}^{A-1}(A-k)\rho_k}\), cu \(\rho_k\) autocorelația randamentelor de ordin \(k\)
autocorelațiile pozitive, \(\rho_k > 0\), fac ca \(\eta(A) < \sqrt A\)
Exemplu: randamente lunare, \(A = 12\), cu \(\rho_1 = 0{,}2\) și celelalte autocorelații nule
\(\eta = 12/\sqrt{12 + 2\cdot 11 \cdot 0{,}2} = 12/\sqrt{16{,}4} = 2{,}96\), față de \(\sqrt{12} = 3{,}46\)
deci SR anual este cu circa 15% mai mic
Două strategii pe aceleași zile: testăm \(SR_a - SR_b\) direct
cu metoda delta HAC sau cu un bootstrap pe blocuri studentizat (Ledoit & Wolf (2008))
Cele două rînduri ale tabelului DSR pentru Bitcoin se bazează pe ipoteze diferite:
(a) \(N\) brut, cu \(\mathrm{Var}[\widehat{SR}_n]\) din dispersia rapoartelor Sharpe ale încercărilor;
(b) \(\mathrm{Var} = 1/T\), cu un număr efectiv de încercări independente \(\hat N < N\) (Seminarul 13, exercițiul B6).
Combinate, ele pot corecta de două ori același efect al dependenței. Într-un model simplu cu \(N\) încercări fără abilitate și corelația \(\rho\) între oricare două, șocul comun nu creează selecție, deci maximul așteptat este de \(\sqrt{1-\rho}\) ori valoarea pentru încercări independente, iar dispersia între încercări este \((1-\rho)\sigma^2\), pe care (a) o surprinde. Raportul SD al celor două rînduri, \(0{,}0109/0{,}0220 = 0{,}50\), se citește în acest model ca \(\rho \approx 0{,}75\).
Pe scurt
Două aproximări, cu ipoteze diferite
(a) \(N\) brut, cu \(\Var[\widehat{SR}_n]\) = dispersia SR între încercări
Dispersia conține și diferențe reale între reguli, așa că pentru reguli reale (a) este o aproximare. Recomandarea este raportarea rîndului conservator și a uneia dintre variantele (a) sau (b), împreună cu \(N\), iar o regulă este numită descoperire doar dacă trece și de rîndul conservator.
Pe scurt
Dispersia conține și diferențe reale între reguli
pentru reguli reale, (a) este o aproximare
Recomandare: raportăm rîndul conservator și una dintre variantele (a) sau (b), împreună cu \(N\)
numim o regulă descoperire doar dacă trece și de rîndul conservator
Graficul arată DSR în funcție de numărul de încercări \(N\) pe scară logaritmică, pentru 5 ani de randamente zilnice cu asimetria \(-0{,}5\) și kurtosis 6, cu pragul de 0,95 punctat. La \(N = 1\) nu există selecție, \(SR_0 = 0\) și \(DSR = \widehat{PSR}(0)\), care este 0,986 pentru un raport Sharpe anualizat de 1,0; acest raport rămîne peste 0,95 la \(N = 2\) (0,954) și scade sub prag de la \(N = 3\) (0,913). Un raport Sharpe de 1,5 rămîne semnificativ pînă la aproximativ 10 încercări, 2,0 pînă la aproximativ 200, iar 2,5 și la 1 000.
Pe scurt
5 ani de randamente zilnice, asimetrie \(-0{,}5\), kurtosis 6
axa orizontală: numărul de încercări \(N\) (scară logaritmică), axa verticală: DSR
linia punctată: pragul de 0,95
\(N = 1\): fără selecție, \(SR_0 = 0\), deci \(DSR = \widehat{PSR}(0)\); pentru SR anualizat 1,0, DSR \(= 0{,}986\)
SR = 1,0 rămîne peste 0,95 la \(N = 2\) (0,954) și scade sub prag de la \(N = 3\) (0,913)
SR = 1,5 rămîne semnificativ pînă la \(\approx 10\) încercări
SR = 2,0 pînă la \(\approx 200\), iar SR = 2,5 și la 1 000
Întrebarea este dacă vreuna dintre cele \(K\) reguli depășește reperul după ce se ține cont de căutarea printre toate. Cu \(d_{k,t} = r_{k,t} - r_{0,t}\) excesul regulii \(k\) față de reper în ziua \(t\) și \(\bar d_k\) media lui, ipoteza nulă este \(H_0: \max_k \mathbb{E}[d_{k,t}] \le 0\). Distribuția sub ipoteza nulă vine dintr-un bootstrap staționar (stationary bootstrap) (Politis & Romano, 1994), care reeșantionează blocuri de zile întregi, de lungime aleatoare, deci corelația dintre reguli se păstrează și nu este nevoie de un \(N\) efectiv. Reality Check (RC) al lui White (2000) folosește \(T^{RC} = \max_k \sqrt n\,\bar d_k\), cu valoarea \(p\) egală cu ponderea replicărilor în care \(\max_k \sqrt n\,(\bar d^*_k - \bar d_k) \ge T^{RC}\).
Pe scurt
Întrebarea: depășește vreuna dintre cele \(N\) reguli reperul, după ce ținem cont că le-am încercat pe toate?
Notațiile: \(d_{k,t} = r_{k,t} - r_{0,t}\), cu media \(\bar d_k\) pe cele \(n\) zile
\(r_{k,t}\): randamentul regulii \(k\) în ziua \(t\); \(r_{0,t}\): randamentul reperului
\(H_0: \max_k \E[d_{k,t}] \le 0\): nicio regulă nu depășește reperul
Testul SPA al lui Hansen (2005) studentizează fiecare medie prin abaterea ei standard bootstrap \(\hat\omega_k\) și recentrează doar regulile care nu sînt în mod clar slabe, astfel încît adăugarea unor reguli fără valoare nu distruge puterea testului. Procedura StepM a lui Romano & Wolf (2005) numește regulile care depășesc reperul, cu controlul ratei erorii pe familie: respinge fiecare regulă a cărei medie studentizată depășește cuantila \(1-\alpha\) a maximului bootstrap, recalculează cuantila pe regulile încă nerespinse și se oprește cînd nu mai este respinsă nicio regulă.
Cu 1 282 de reguli, \(n = 2\,057\) zile in-sample, un bloc mediu de 20 de zile și 2 000 de replicări, testele față de numerar dau cea mai mare medie studentizată 4,20, RC \(p = 0{,}001\), SPA \(p = 0{,}002\) și 117 reguli păstrate de StepM. Față de buy-and-hold, cea mai mare medie studentizată este 1,36, pentru regula 11/20, cu RC \(p = 0{,}60\), SPA \(p = 0{,}50\) și nicio regulă păstrată. O regulă de trend obține o medie pozitivă față de numerar, trendul propriu al Bitcoin, dar nicio regulă nu depășește deținerea Bitcoin, nici măcar in-sample, în acord cu raportul Sharpe OOS de 0,03; spre deosebire de DSR, SPA ia \(N\) și dependența din date.
Pe scurt
Configurația: 1 282 de reguli, \(n = 2\,057\) de zile în eșantion
blocuri de 20 de zile în medie, 2 000 de replici bootstrap
Reper
cea mai mare medie studentizată
\(p\) RC
\(p\) SPA
reguli păstrate de StepM
numerar (\(r_0 = 0\))
4,20
0,001
0,002
117
buy-and-hold
1,36 (regula 11/20)
0,60
0,50
0
Față de numerar, regulile de trend au medii pozitive, care reflectă trendul propriu al Bitcoin
Față de buy-and-hold, nicio regulă nu depășește deținerea Bitcoin, nici măcar în eșantion
în acord cu SR de 0,03 în afara eșantionului
DSR are nevoie de \(N\) și de \(\Var[\widehat{SR}]\), de unde cele două verdicte
Validarea încrucișată combinatorică simetrică (CSCV, combinatorially symmetric cross-validation) (Bailey, Borwein, López de Prado & Zhu, 2017) împarte o matrice de randamente \(T \times N\) în \(S\) blocuri contigue și, pentru fiecare dintre cele \(\binom{S}{S/2}\) alegeri, folosește jumătate din blocuri in-sample și restul out-of-sample. Pentru fiecare împărțire reține rangul relativ OOS \(\bar\omega\) al celei mai bune configurații IS și logit-ul lui, \(\lambda = \log(\bar\omega/(1-\bar\omega))\); PBO este \(\Pr[\lambda \le 0]\), ponderea împărțirilor în care cîștigătorul IS se află la sau sub mediana OOS. Un PBO aproape de 0 înseamnă că cîștigătorul IS rămîne sigur peste mediană, iar un PBO de 0,5 sau mai mare că selecția nu este mai bună decît întîmplarea. PBO evaluează procedura de cercetare, nu o strategie, și, ca DSR, cere înregistrarea fiecărei încercări.
Cu \(M = 1 - F\), condiția \(E[(1 - F)R^e_i] = 0\) dă \(E[R^e_i] = E[R^e_i F]\) pentru fiecare acțiune; aplicată lui \(R^e_i = F\), dă \(E[F] = E[F^2]\); iar cu \(\beta_i = E[R^e_i F]/E[F^2]\) rezultă \(E[R^e_i] = \beta_i E[F]\), adică (13.28) scrisă necondiționat. Cînd condiția de evaluare este satisfăcută, acest beta definit prin momente de ordinul doi este egal cu beta de regresie; pe date cu erori de evaluare, cele două pot diferi, așa că rețeaua de expuneri a lucrării calculează forma cu momente de ordinul doi. În exemplul cu \(E[F] = E[F^2] = 0{,}01\) și \(E[R^e_i F] = 0{,}005\), ambele forme dau \(\beta_i = 0{,}5\) și \(E[R^e_i] = 0{,}5\%\) pe lună.
Pe scurt
Trei pași (scriși necondiționat; în varianta condiționată înlocuim \(E\) cu \(E_t\))
Cu \(M = 1 - F\): \(E[(1 - F)R^e_i] = 0\), deci \(E[R^e_i] = E[R^e_i F]\) pentru orice acțiune
\(F\) este el însuși un randament în exces; aplicăm pasul 1 pentru \(R^e_i = F\): \(E[F] = E[F^2]\)
Prognoza, ca în rețeaua feedforward (FFN) a lui Gu, Kelly & Xiu (2020), potrivește un moment de ordinul doi acolo unde raportul semnal-zgomot este mic, în timp ce condiția de absență a arbitrajului vizează un moment de ordinul întîi, din care medierea în timp elimină o mare parte a zgomotului. Metoda este o metodă generalizată a momentelor (GMM, generalized method of moments) adversarială, după Hansen & Jagannathan (1997):\(\omega\) minimizează cea mai mare eroare de evaluare \(\frac1N\sum_j (E[M_{t+1}R^e_{t+1,j}\,g(I_t, I_{t,j})])^2\) pe care o poate produce un adversar care alege funcția-instrument \(g\) a informației macroeconomice \(I_t\) și a caracteristicilor \(I_{t,j}\) ale acțiunii \(j\).
Pe scurt
Motivația: prognoza ajustează un moment de ordinul doi acolo unde raportul semnal/zgomot este mic
O FFN produce ponderile \(\omega\), o rețea adversarială \(g\) construiește cele mai dificile active de test, iar o rețea cu memorie lungă pe termen scurt (LSTM, long short-term memory) transformă istoria macroeconomică în 4 stări; modelul complet este numit GAN. Împărțirea este cronologică, cu antrenare pe 1967–1986, validare pe 1987–1991 și test pe 1992–2016. Reperele sînt SDF-urile liniare neregularizat (LS) și elastic net (EN) și portofoliile tangente ale modelelor Fama–French cu trei și cu cinci factori (Fama & French, 2015), iar configurațiile sînt ordonate după raportul Sharpe de validare.
Pe scurt
Rețelele
o FFN pentru ponderile \(\omega\) și un adversar \(g\) care construiește cele mai dificile active de test
o rețea LSTM (long short-term memory) care sintetizează istoricul macro în 4 stări
modelul complet se numește GAN (generative adversarial network)
Împărțire cronologică: antrenare 1967–1986, validare 1987–1991, test 1992–2016
Repere
SDF liniar fără regularizare (LS) sau cu elastic net (EN)
portofoliile tangente ale modelelor Fama–French cu trei și cinci factori (FF3, FF5, Fama & French (2015))
Configurațiile sînt ordonate după raportul Sharpe pe validare
Graficul extinde portofoliile tangente FF3 și FF5, cu ponderile fixate pe 1967–1986, la ianuarie 1992 – august 2026, alături de randamentul în exces al pieței (Mkt-RF); fiecare serie este scalată la volatilitatea randamentului în exces al pieței din 1992–2016.
Pe 2017–2026, cu \(T = 116\) luni și o eroare standard de aproximativ 0,09, rapoartele Sharpe lunare sînt 0,06 pentru FF5, 0,03 pentru FF3 și 0,24 pentru piață, față de 0,22, 0,20 și 0,15 pe 1992–2016. Reperele Fama–French se pot replica din date publice; GAN, LS și EN la nivel de acțiune nu, deoarece panelul Center for Research in Security Prices (CRSP) nu se află în datele cursului. Scăderea de după 2016 este un semnal de avertizare, încă nu un test, iar aceeași întrebare se aplică unui GAN înghețat în 1991.
Pe scurt
Aceleași ponderi fixe, ianuarie 1992 – august 2026
fiecare serie scalată la volatilitatea randamentului în exces al pieței pe 1992–2016
SR lunar 2017–2026 (\(T = 116\) luni, eroare standard \(\approx 0{,}09\)): FF5 \(0{,}06\), FF3 \(0{,}03\), piața \(0{,}24\)
în grafic, Mkt-RF: randamentul în exces al pieței
pentru comparație, pe 1992–2016: FF5 \(0{,}22\), FF3 \(0{,}20\), piața \(0{,}15\)
Replicabile cu date publice: reperele Fama–French
nereplicabile: GAN, LS și EN la nivel de acțiune
panelul CRSP (Center for Research in Security Prices) nu este în datele cursului
scăderea de după 2016 este un semnal de alarmă, încă nu un test
aceeași întrebare se pune pentru un GAN fixat în 1991 (detalii în Anexă)
Panoul din stînga arată cele 102 statistici \(|t|\) din perioada de descoperire ale mini-studiului de caz, în ordine descrescătoare, împreună cu pragurile; panoul din dreapta pune statistica \(t\) din descoperire față de cea din perioada de verificare.
Cele trei replicări nominale din perioada de verificare, marcate cu roșu, sînt toate reversal pe termen scurt, iar niciuna nu trece Holm la 5%. Caracteristicile VIX care erau semnificative în perioada de descoperire se prăbușesc spre zero în perioada de verificare.
Pe scurt
Stînga: cele 102 valori \(|t|\) din perioada de descoperire, în ordine descrescătoare
Dreapta: statistica \(t\) din perioada de descoperire față de cea din perioada de verificare
cele trei replicări nominale (roșu) sînt toate inversare pe termen scurt; niciuna nu trece Holm la 5%
Anexa conține derivările, estimatorii și detaliile la care trimite corpul capitolului: contextul istoric, eșantionarea datelor financiare, comportamentul asimptotic al ponderilor fracționare și estimatorii local Whittle, validitatea K-fold pentru serii de timp, testele PT, AUC și GW, SHAP, condițiile pentru selecția dublă și DML, subiecte avansate de deep learning, detaliile studiului de caz despre deep learning și prompturile buclei descoperirii.
Cursurile de pe quantinar.com extind subiectele capitolului: random forests, valorile și curbele Shapley, machine learning în riscul financiar, reinforcement learning, rețelele generative adversariale, AI explicabilă, analitica de afaceri, criteriile de selecție a modelelor și învățarea PAC (probably approximately correct).
Perceptronul lui Rosenblatt (1958) a fost o regulă de învățare pentru un singur neuron artificial, iar Mark I a fost hardware construit pentru a recunoaște imagini simple. În 1997, Deep Blue de la IBM (International Business Machines, Corporation, compania International Business Machines) l-a învins pe campionul mondial de șah Garry Kasparov (Campbell, Hoane & Hsu, 2002), căutînd cu reguli construite manual, în timp ce metodele din acest capitol învață regulile din date.
Un \(R^2\) lunar de 0,5% este mare din punct de vedere economic, dar zgomotul de eșantionare are același ordin de mărime. Pentru un predictor fără abilitate, cu constantă, erori independente și \(n \approx 300\) de luni, \(nR^2 \approx \chi^2_1\), care are media 1 și varianța 2; \(R^2\) in-sample are deci media \(1/n \approx 0{,}3\%\) și abaterea standard \(\sqrt2/n \approx 0{,}5\%\).\(R^2_{OOS}\) poate fi negativ și nu are o astfel de distribuție sub ipoteza nulă, deci are nevoie de propriul test, precum Clark–West.
Pe scurt
Un \(R^2\) lunar de \(0{,}5\%\) este mare economic
dar zgomotul de eșantionare are același ordin de mărime
\(R^2\) OLS în eșantion al unui predictor fără abilitate: \(nR^2 \approx \chi^2_1\)
termen liber, erori independente, \(n \approx 300\) de luni
\(n\): numărul de luni; \(\chi^2_1\): distribuția hi-pătrat cu 1 grad de libertate, cu media 1 și varianța 2
deci \(R^2\) are media \(1/n \approx 0{,}3\%\) și abaterea standard \(\sqrt2/n \approx 0{,}5\%\)
\(R^2_{OOS}\) poate fi negativ
nu are această distribuție sub ipoteza nulă și cere un test propriu (Clark–West)
Random forest-ul studiului de caz, cu 400 de arbori și dimensiunea minimă a frunzei de 100, este antrenat pe primele patru pliuri purjate și prezice ultima observație, 11 septembrie 2026. Arborii individuali dau probabilități „sus în 5 zile” între 0,31 și 0,88, cu abaterea standard 0,11, iar 81,5% dintre ei votează „sus”; probabilitatea pădurii, media celor 400 de arbori, este 0,608. Media este mult mai stabilă decît arborii individuali, dar stabilitatea nu este acuratețe: pădurea tot nu depășește regula „mereu în sus”.
Pe scurt
Random forest-ul din studiul de caz, antrenat pe primele patru pliuri purjate
400 de arbori, dimensiune minimă a frunzei 100
Predicția pentru ultima observație (11 septembrie 2026)
\(P(\text{creștere în 5 zile})\) dată de fiecare arbore
probabilitățile estimate de arborii individuali variază între \(0{,}31\) și \(0{,}88\) (abatere standard \(0{,}11\))
\(81{,}5\%\) dintre arbori votează „sus” (\(p > 0{,}5\))
probabilitatea estimată de pădure: media celor 400 de probabilități ale arborilor \(= 0{,}608\)
Predicțiile arborilor diferă mult
Media lor este mult mai stabilă
Stabilitatea nu înseamnă acuratețe
nici pădurea nu depășește „mereu în sus” (studiul de caz)
O bară este un rînd care rezumă un interval de eșantionare, cu deschiderea, maximul, minimul, închiderea și volumul. Barele de timp, la un interval fix, supraeșantionează perioadele liniștite și dau randamente cu cozi groase; barele de tranzacții (tick bars), de volum și de valoare eșantionează după sosirea informației și dau randamente mai apropiate de extrageri i.i.d. din distribuția Normală (Clark, 1973; Ané & Geman, 2000), iar barele de dezechilibru și de serii (imbalance/runs bars) eșantionează cînd fluxul de ordine devine unilateral. Acest capitol folosește bare de timp zilnice; datele la nivel de tranzacție sînt folosite în Capitolele 10 și 16.
Pe scurt
Bare de timp și de tranzacții
O bară = un rînd care rezumă un interval de eșantionare
deschidere, maxim, minim, închidere, volum
Bare de timp: la interval fix (1 minut, 1 zi)
supraeșantionează perioadele liniștite și dau randamente cu cozi groase
Bare de tranzacții (tick): o bară la fiecare \(N\) tranzacții
Bare de volum, valoare și informaționale
O bară la fiecare \(V\) acțiuni sau la fiecare \(D\) dolari tranzacționați
eșantionare după sosirea informației
Randamente mai apropiate de extrageri i.i.d. din distribuția Normală
Ponderile din \((1-B)^d = \sum_k \binom{d}{k}(-B)^k\) sînt, pentru \(d \notin \{0, 1, 2, \dots\}\),\(w_k = \Gamma(k-d)/(\Gamma(-d)\,\Gamma(k+1))\), cu \(\Gamma\) funcția gamma, și scad ca \(k^{-(1+d)}/\Gamma(-d)\), mai lent pentru \(d\) mai mic. Pentru \(0 < d < 1\), suma lor este \((1-1)^d = 0\), din seria binomială la \(B = 1\), care converge pentru \(d > 0\); pentru \(d = 0\) suma este 1, iar pentru \(d < 0\) seria ponderilor nu converge.
Pe scurt
Definiție (Operatorul de diferențiere fracționară).
Local Whittle (Robinson (1995)): alegem \(\delta\) astfel încît \(f(\lambda) \approx G\lambda^{-2\delta}\) să se potrivească pe primele \(m\) frecvențe
Estimatorul local Whittle exact (Shimotsu & Phillips, 2005), cu Shimotsu (2010) pentru o medie necunoscută, folosește periodograma lui \((1-B)^{\delta}X_t\) și este valid și pentru \(\delta \ge \tfrac12\). Seria FFD arată ca \(\hat\delta \approx 0{,}75\) deoarece, peste frecvența \(1/K\), filtrul trunchiat acționează ca \((1-B)^{0{,}25}\), iar doar \(n/(2\pi K) \approx 2\) dintre cele \(m = 294\) de frecvențe se află sub \(1/K\), unde revine rădăcina unitară; \(K\) este fereastra de 444 de laguri. Estimarea este memoria aparentă pe bandă, nu ordinul de integrare.
Cu observațiile \(t = 0,\dots,9\), etichete care se încheie la \(t+2\) (cel mult 9), 5 pliuri contigue de cîte 2 și un embargo de o observație, pliul de test \(\{4,5\}\) purjează observațiile 2 și 3, ale căror etichete se încheie la 4 și 5, și 6 și 7, care încep în ziua 7 sau înainte, cînd se încheie ultima etichetă de test; embargoul elimină observația 8. Setul de antrenare este \(\{0, 1, 9\}\): pliul interior pierde \(2h + e = 5\) din cele 10 observații.
Pe scurt
Observații \(t = 0,\dots,9\)
Eticheta lui \(t\) se termină la \(t+2\) (plafonat la 9)
5 pliuri contigue de cîte 2
Embargo = 1 observație
Test
Eliminate
Antrenare
0, 1
2, 3, 4
5–9
2, 3
0, 1, 4, 5, 6
7–9
4, 5
2, 3, 6, 7, 8
0, 1, 9
6, 7
4, 5, 8, 9
0–3
8, 9
6, 7
0–5
Pentru testul \(\{4,5\}\)
etichetele observațiilor 2 și 3 se termină la 4 și 5, deci sînt purjate
observațiile 6 și 7 încep în ziua 7 sau înainte de ea, deci sînt purjate
ziua 7: ziua în care se termină ultima etichetă de test
embargoul elimină observația 8, prima care începe după ziua 7
Cu etichete suprapuse și embargo, un pliu interior pierde \(2h + e = 5\) din 10 observații
Bergmeir, Hyndman & Koo (2018) arată că K-fold CV standard este valid pentru un model pur autoregresiv \(y_t = g(y_{t-1},\dots,y_{t-p}) + \varepsilon_t\) cu erori necorelate serial, deoarece erorile de test sînt atunci necorelate cu cele de antrenare. El eșuează cînd erorile sînt corelate serial: cu etichete suprapuse, cu caracteristici persistente din afara mulțimii de laguri a modelului, precum mediile rolling sau prețul logaritmic FFD, și cu prea puține laguri. Verificarea înainte de alegere este autocorelația reziduurilor CV; dacă este semnificativă, se aplică purjarea și embargoul.
Walk-forward-ul imită implementarea în timp real, fără date viitoare în antrenare, dar dă o singură traiectorie, cu varianță mare, ușor de supraajustat prin încercări repetate. CV combinatorică cu purjare formează \(N\) grupuri contigue și testează pe toate cele \(\binom{N}{k}\) combinații de \(k\) grupuri, cu purjare și embargo; cele \(\varphi = \frac{k}{N}\binom{N}{k}\) traiectorii complete de backtest dau o distribuție a rapoartelor Sharpe, de exemplu 15 împărțiri și 5 traiectorii pentru \(N = 6\),\(k = 2\).
Pe scurt
Ferestre succesive (WF)
Imită implementarea în timp real, fără date viitoare în antrenare
Dar o singură traiectorie
varianță mare și risc de supraajustare prin încercări repetate
CV combinatorică cu purjare (CPCV)
\(N\) grupuri contigue
testăm pe toate cele \(\binom{N}{k}\) combinații de \(k\) grupuri, cu purjare și embargo
\(\varphi = \frac{k}{N}\binom{N}{k}\): numărul de traiectorii complete de backtest
De exemplu, \(N=6\) și \(k=2\) dau 15 împărțiri și 5 traiectorii
O distribuție de rapoarte Sharpe în loc de un singur număr
Fiecare grup este testat de \(\varphi\) ori, deci predicțiile de test formează \(\varphi\) istorii complete
Sub \(H_0\) că semnul prezis este independent de semnul realizat, numitorul din (13.18) este \(\sqrt{\widehat{V}(\hat P) - \widehat{V}(\hat P^*)}\), cu \(\widehat{V}(\hat P) = \hat P^*(1-\hat P^*)/n\) și un al doilea termen care ține cont de faptul că \(\hat P^*\) este estimat. PT condiționează automat pe frecvențele marginale, deci reperul nu trebuie ghicit. Pentru logit-ul studiului de caz, \(\hat p_y = 0{,}581\) și \(\hat p_x = 0{,}983\), iar \(PT = -0{,}80\) are o valoare \(p\) unilaterală de 0,79.
Curba ROC reprezintă rata adevărat pozitivelor \(TP/(TP+FN)\) în funcție de rata fals pozitivelor \(FP/(FP+TN)\), pentru toate pragurile, iar AUC este egală cu \(U/(n_1 n_0)\), unde \(U\) este statistica Mann–Whitney, iar \(n_1\),\(n_0\) numerele de pozitive și de negative. Eroarea standard DeLong (DeLong, DeLong & Clarke-Pearson, 1988) folosește valorile de poziționare (placement values) și presupune observații independente. Pentru logit, AUC cumulată de 0,480 are un CI DeLong de 95% de \([0{,}466;\ 0{,}494]\), „semnificativ mai slab decît întîmplarea”, și un CI bootstrap pe blocuri de \([0{,}456;\ 0{,}505]\), zgomot în jurul lui 0,5; o AUC sub 0,5 înseamnă ordonare inversă doar dacă rezistă unui test care respectă dependența.
Pe scurt
Curba ROC (Receiver Operating Characteristic), pentru toate pragurile
rata rezultatelor adevărat pozitive \(TP/(TP+FN)\)
în funcție de rata rezultatelor fals pozitive \(FP/(FP+TN)\)
Ipoteza nulă a lui Giacomini & White (2006) privește metoda de prognoză, adică modelul împreună cu fereastra de estimare și regula de reestimare: \(\mathbb{E}[d_{t+\tau} \mid \mathcal{F}_t] = 0\), testată prin funcții-test \(\mathbf{h}_t\) cunoscute la \(t\), aici 1 și diferența de pierderi întîrziată, cu \(GW = n\,\bar{\mathbf{Z}}^\top \hat\Omega^{-1} \bar{\mathbf{Z}} \to \chi^2_2\). Teoria cere o fereastră de estimare mărginită, rolling, astfel încît zgomotul de estimare să nu dispară; cu o fereastră rolling de 8 ani, logit-ul pe S&P 500 dă \(GW = 26{,}7\)(\(p < 0{,}001\)) și prognozează mai slab decît constanta.
\(d_{t+\tau}\): diferența pierderilor celor două prognoze făcute la \(t\) pentru orizontul \(\tau = 5\) zile (aici \(\tau\) este orizontul, nu un prag)
\(\mathcal{F}_t\): informația disponibilă la \(t\)
\(\mathbf{h}_t\): funcții-test cunoscute la \(t\), aici constanta \(1\) și diferența pierderilor întîrziată, deci \(q = 2\)
\(\mathbf{Z}_t = \mathbf{h}_t d_{t+\tau}\); \(\bar{\mathbf{Z}}\): media lui \(\mathbf{Z}_t\) pe cele \(n\) prognoze; \(\hat\Omega\): matricea de covarianță HAC a lui \(\mathbf{Z}_t\)
Interpretare: sub \(H_0\), nicio informație de la \(t\) nu prezice care metodă va fi mai bună
Teorema cere o fereastră de estimare mărginită (mobilă)
astfel încît zgomotul de estimare să nu dispară
o fereastră care se extinde iese din cadrul ei
S&P 500, fereastră mobilă de 8 ani: GW \(= 26{,}7\) (\(p < 0{,}001\))
Valoarea Shapley a caracteristicii \(j\) mediază contribuția ei marginală \(v(S\cup\{j\}) - v(S)\) peste toate coalițiile \(S\) ale celorlalte \(p - 1\) caracteristici, cu ponderea \(|S|!\,(p-|S|-1)!/p!\), probabilitatea ca exact caracteristicile din \(S\) să vină înaintea lui \(j\) într-o ordonare aleatoare. SHAP intervențional fixează \(v(S) = \mathbb{E}[\hat f(\mathbf{x}_S, \mathbf{X}_{\bar S})]\), extrăgînd caracteristicile din afara lui \(S\) dintr-un eșantion de fundal, în timp ce SHAP condiționat folosește \(\mathbb{E}[\hat f(\mathbf{X}) \mid \mathbf{X}_S = \mathbf{x}_S]\); cele două diferă cînd caracteristicile sînt dependente.
SHAP intervențional: \(v(S) = \E[\hat f(\mathbf{x}_S, \mathbf{X}_{\bar S})]\), media lui \(\hat f\) cu caracteristicile din afara lui \(S\) extrase dintr-un eșantion de referință
\(\phi_0 = v(\emptyset)\) este predicția medie
Notații
\(p\): numărul de caracteristici; \(\hat f(\mathbf{x})\): predicția modelului pentru \(\mathbf{x}\)
\(S\): o coaliție, adică o submulțime a celorlalte caracteristici; \(|S|\): mărimea ei; \(\bar S\): caracteristicile din afara ei
\(v(S)\): predicția cînd sînt cunoscute doar caracteristicile din \(S\)
Ponderea este probabilitatea ca exact \(S\) să preceadă \(j\) într-o permutare aleatoare a celor \(p\) caracteristici
Pentru caracteristici corelate, coloanele unui grup pot fi permutate împreună, cu aceeași permutare a rîndurilor, sau modelul poate fi reestimat fără caracteristică. Importanțele sînt estimări și au nevoie de propria analiză a incertitudinii: arborii onești (honest trees) dau predicții ale pădurii asimptotic Normale și intervale de încredere pentru ele (Wager & Athey, 2018), dar nu intervale pentru importanțe. După López de Prado (2018), backtesting-ul nu este un instrument de cercetare, analiza importanței este.
Pe scurt
Soluții pentru caracteristicile corelate
permutați împreună coloanele unui grup, cu aceeași permutare a rîndurilor, sau reestimați fără caracteristică
permutările condiționate și cele pe blocuri temporale sînt variante separate
Importanțele sînt estimări și cer o analiză proprie a incertitudinii
Arborii „onești” dau predicții de pădure asimptotic normale și CI pentru ele (Wager & Athey (2018))
dar nu CI pentru importanțe
Backtest-ul nu este un instrument de cercetare, analiza importanței este (López de Prado (2018))
Modelul parțial liniar (13.25) cere \(\mathbb{E}[\varepsilon_t \mid d_t, \mathbf{x}_t] = 0\),\(\mathbb{E}[v_t \mid \mathbf{x}_t] = 0\) și \(\mathrm{Var}(v_t) > 0\), cu \(g\) și \(m\) aproximativ rare. Selecția dublă dă o eroare standard robustă la heteroscedasticitate validă sub eșantionare independentă, condiții de regularitate și \(s^2\log^2(p \vee n)/n \to 0\), unde \(s\) este numărul variabilelor de control care contează (Belloni, Chernozhukov & Hansen, 2014). LASSO folosește ponderi de penalizare specifice fiecărei caracteristici, \(\hat\psi_j\), și penalizarea \(\lambda = 2c\sqrt n\,\Phi^{-1}(1 - \gamma/(2p))\), cu constantele \(c = 1{,}1\) și \(\gamma = 0{,}1/\log n\).
Pentru DML (Chernozhukov et al., 2018), cu consistență și regularitate, este suficient ca \(\|\hat m - m\|\,(\|\hat\ell - \ell\| + \|\hat m - m\|) = o_P(n^{-1/2})\), unde normele sînt erorile de estimare medii pătratice. Ambele erori pot fi atunci \(o_P(n^{-1/4})\): fiecare algoritm de învățare poate converge mai lent decît un model parametric, pentru că doar produsul erorilor contează.
Feng, Giglio & Xiu (2020) întreabă dacă un factor nou adaugă informație de evaluare față de sute de factori existenți; ei folosesc selecția dublă a factorilor de control din „zoo” și apoi un test \(t\) valid pentru prețul riscului noului factor, răspunsul inferențial la Harvey, Liu & Zhu (2016). Pădurile cauzale oneste (honest causal forests) (Wager & Athey, 2018) dau intervale de încredere pentru efecte care variază cu covariatele. Rezultă trei reguli: predicția și inferența au ținte diferite, ortogonalizarea precede testarea, iar cross-fitting-ul folosește pliuri care respectă timpul, iar intervalele de încredere se raportează, deoarece „selectat” sau „important” nu înseamnă „semnificativ”.
Pe scurt
Feng, Giglio & Xiu (2020): adaugă un factor nou informație de evaluare, date fiind sutele de factori existenți?
selecție dublă a factorilor de control din „factor zoo”, apoi un test \(t\) valid pentru prețul de risc al factorului nou
Rețelele recurente, precum LSTM și unitatea recurentă cu porți (GRU, gated recurrent unit), poartă memoria într-o stare ascunsă \(\mathbf{h}_t = g(\mathbf{h}_{t-1}, \mathbf{x}_t)\), cu porți care controlează ce se păstrează și ce se uită, și sînt folosite pentru prognoza volatilității, a registrului de ordine și intraday. Transformerele folosesc auto-atenția (self-attention), \(\operatorname{softmax}(QK^\top/\sqrt{d_k})V\), cu matricele de interogare, cheie și valoare obținute ca transformări liniare ale intrărilor, și surprind dependența pe distanțe lungi, cu antrenare paralelă; ele stau la baza modelelor lingvistice mari din Capitolul 15.
Modelele fundaționale (foundation models) precum Chronos, TimesFM, Moirai și Lag-Llama sînt preantrenate pe colecții mari de serii și folosite zero-shot, fără reantrenare. Ele sînt repere utile pentru volatilitate și volum, dar pentru randamente moștenesc aceleași limite ale raportului semnal-zgomot, iar datele lor de preantrenare se pot suprapune cu perioada de test, o formă nouă de leakage. Sînt tratate în Capitolul 14, cu instrumentele de evaluare a prognozelor de risc din Capitolul 8.
Pe scurt
Modele de prognoză pre-antrenate
Pre-antrenate pe colecții mari de serii, folosite zero-shot (fără reantrenare)
În reinforcement learning (RL), o politică \(\pi(a\mid s)\) alege acțiuni în stări pentru a maximiza recompensa cumulată, cu aplicații la execuția optimă, market making și deep hedging (Buehler et al., 2019). Modelele generative, GAN, autoencoderele variaționale (VAE, variational autoencoders) și modelele de difuzie, produc scenarii sintetice pentru teste de stres, iar AI explicabilă, prin SHAP, LIME (local interpretable model-agnostic explanations) și dependența parțială, este cerută de autorități.
Pe scurt
Reinforcement learning (RL)
O politică \(\pi(a\mid s)\) alege acțiuni \(a\) în stări \(s\)
scopul: maximizarea recompensei cumulate
Execuție optimă, activitatea formatorilor de piață (market making), deep hedging: Buehler et al. (2019)
Modele generative
GAN, autoencodere variaționale (VAE), modele de difuzie
scenarii sintetice pentru teste de stres
AI explicabilă
Cerută de autorități (EU AI Act, scoring de credit, riscul de model)
SHAP, LIME, dependență parțială
LIME: explicații locale interpretabile, independente de model
Pentru risc, ML estimează Value-at-Risk (VaR) ca o cuantilă condiționată, prin păduri de regresie cuantilică sau boosting cu pierdere cuantilică, Expected Shortfall (ES) prin media cuantilelor estimate din coadă sau printr-o pierdere comună VaR–ES, iar volatilitatea dintr-o țintă pe randamentele la pătrat (Capitolele 5 și 9).
Pe scurt
ML pentru risc
Value-at-Risk (VaR): cuantile condiționate
păduri de regresie cuantilică, boosting cu pierdere cuantilică
Expected Shortfall (ES)
media cuantilelor estimate din coadă sau o pierdere comună VaR–ES
Volatilitatea: o țintă pe randamentele la pătrat (Capitolele 5 și 9)
Datele lui Chen, Pelger & Zhu (2024) sînt randamentele lunare ale tuturor acțiunilor CRSP, ianuarie 1967 – decembrie 2016, în exces față de rata titlurilor de trezorerie pe o lună, cu 46 de caracteristici ale firmelor în șase grupuri, transformate lunar în cuantile transversale; intră doar lunile-acțiune cu toate cele 46 disponibile, aproximativ 10 000 din 31 000 de acțiuni. Cele 178 de serii macroeconomice, transformate pentru staționaritate, sînt 124 de serii din FRED-MD, baza de date macroeconomice lunare a Fed din St. Louis (McCracken & Ng, 2016), cele 46 de mediane lunare ale caracteristicilor și 8 predictori ai lui Welch & Goyal (2008).
Pe scurt
Randamente lunare ale tuturor acțiunilor din CRSP, ianuarie 1967 – decembrie 2016
în exces față de dobînda la titlurile de stat pe o lună
46 de caracteristici ale firmelor, în șase grupe (Tabelul A.II)
randamente trecute, investiții, profitabilitate, active necorporale, valoare, fricțiuni de tranzacționare
sînt păstrate doar lunile cu toate cele 46 de caracteristici, adică circa 10 000 din 31 000 de acțiuni
Adversarul \(g\) folosește 8 instrumente, iar estimarea are trei pași: un SDF necondiționat, maximizarea după \(g\) și din nou minimizarea. Calibrarea ordonează 384 de configurații după raportul Sharpe de validare; rețeaua aleasă are 2 straturi de 64 de unități, dropout și optimizatorul Adam, într-un ansamblu de 9 estimări, iar o a doua FFN estimează expunerile. Reperul liniar LS/EN fixează \(\omega_{t,i} = \theta^\top I_{t,i}\) pe picioarele long și short ale caracteristicilor, cu un coeficient pentru fiecare caracteristică.
Pe scurt
Obiectivul (ec. 3) și rețelele sînt pe slide-ul principal
adversarul \(g\) folosește 8 instrumente
Antrenarea are trei pași (Secțiunea II.D)
SDF necondiționat, maximizare după \(g\), apoi din nou minimizare
Hiperparametri: 384 de configurații, ordonate după raportul Sharpe (SR) pe validare
configurația aleasă: 2 straturi de cîte 64 de unități, dropout, optimizatorul Adam
ansamblu de 9 estimări (Tabelul A.VIII)
coeficienții beta: o a doua FFN estimează \(E_t[R^e_{t+1,i}F_{t+1}] \propto \beta_{t,i}\)
Pe lîngă raportul Sharpe al lui \(F\), lucrarea raportează două măsuri de ajustare bazate pe eroarea de evaluare \(\hat\epsilon_{t+1,i}\), partea din \(R^e_{t+1,i}\) neexplicată de \(\hat\beta_{t,i}F_{t+1}\). Variația explicată (EV, explained variation) este unu minus media erorilor de evaluare la pătrat raportată la media randamentelor în exces la pătrat, iar \(R^2\) transversal măsoară cît de bine explică modelul randamentele medii, ponderînd fiecare acțiune cu numărul lunilor ei de date.
Pe scurt
Măsuri (Secțiunea II.F): SR al lui \(F\) și două măsuri de potrivire
\(\hat\epsilon_{t+1,i}\): eroarea de evaluare, partea din \(R^e_{t+1,i}\) neexplicată de \(\hat\beta_{t,i}F_{t+1}\)
Anualizate, rapoartele Sharpe out-of-sample ale SDF din Tabelul I sînt 2,6 pentru GAN, 1,7 pentru EN și 1,5 pentru FFN. Pentru acțiunile individuale, GAN explică 8% din variație, față de 3–4%, și are un \(R^2\) transversal de 23%, față de 14–19%. Decilele sortate după expuneri au un randament „sus minus jos” de 0,39 și un alpha FF5 de 0,39, cu \(t = 9{,}96\), testul Gibbons–Ross–Shanken (GRS) respinge modelul de evaluare a activelor financiare (CAPM, capital asset pricing model), FF3 și FF5, iar randamentul mediu al decilelor este liniar în \(\beta\), cu \(R^2 = 0{,}97\).
Pe 46 de seturi de decile sortate după caracteristici, GAN are un \(R^2\) transversal de peste 90% pentru toate și o EV de 0,70 față de 0,43 pentru EN la reversal-ul pe termen scurt și de 0,54 față de 0,26 la momentum, cîștiguri care vin din decilele extreme și din interacțiuni. Introducerea celor 178 de serii macroeconomice brute face ca raportul Sharpe out-of-sample să se prăbușească, iar GAN pierde aproximativ 10% fără stări macroeconomice și 20% doar cu momente necondiționate. Printre cele mai mari acțiuni avantajul se îngustează: aproximativ 1 500 de acțiuni dau rapoarte Sharpe lunare de 0,41, 0,30 și 0,15 pentru GAN, FFN și EN, aproximativ 550 de acțiuni dau 0,26, 0,24 și 0,23, iar reestimarea pe cele 1 500 dă 0,42, 0,28 și 0,42.
Pe scurt
46 de seturi de decile sortate după caracteristici (Tabelul III)
\(R^2\) transversal al GAN peste \(90\%\) pentru toate seturile
variația explicată a decilelor de inversare pe termen scurt: \(0{,}70\) pentru GAN, față de \(0{,}43\) pentru EN
variația explicată a decilelor de momentum: \(0{,}54\) față de \(0{,}26\)
Interpretare: cîștigurile vin din decilele extreme și din interacțiuni
Stări macro (Figura 6)
includerea directă a celor 178 de serii reduce puternic SR în afara eșantionului
SR al GAN scade cu circa \(10\%\) fără stările macro și cu circa \(20\%\) dacă folosește doar momente necondiționate
Interpretare: LSTM surprinde dinamica macroeconomică pe care ultima variație observată nu o poate reda
Acțiuni cu capitalizare mare (Tabelul IV, SR lunar)
modele estimate pe toate acțiunile, evaluate pe subeșantion
cele mai mari circa 1 500 de acțiuni: GAN \(0{,}41\), FFN \(0{,}30\), EN \(0{,}15\)
cele mai mari circa 550 de acțiuni: GAN \(0{,}26\), FFN \(0{,}24\), EN \(0{,}23\)
modele reestimate doar pe cele 1 500 de acțiuni: GAN \(0{,}42\), FFN \(0{,}28\), EN \(0{,}42\)
Interpretare: avantajul GAN scade puternic pentru acțiunile cu cea mai mare capitalizare
EN recuperează diferența cînd este reestimat pe aceste acțiuni
Cu Kenneth French Data Library și FRED-MD, pe împărțirea publicată, ponderile tangente FF3 și FF5 estimate pe 1967–1986 și rapoartele lor Sharpe lunare pe 1992–2016 se pot replica. LS și EN publicate, care folosesc picioare ponderate după rang ale celor 46 de caracteristici și beta la nivel de acțiune, nu se pot replica cu datele cursului. Un analog pe date de portofoliu, SDF-ul liniar pe jumătățile celor 15 caracteristici pe care biblioteca le sortează în decile, este o extindere, nu o replicare, iar nivelurile lui nu sînt comparabile cu tabelele lucrării.
Replicabile: ponderile tangente FF3 și FF5 estimate pe 1967–1986 (nota 23), SR lunar pe 1992–2016, alături de Tabelul A.VI
Nereplicabile cu datele cursului: LS și EN publicate (Tabelele I și III) folosesc componente long și short ponderate după rang pentru 46 de caracteristici și coeficienți beta la nivel de acțiune
Analog pe date de portofoliu, o extindere, nu o replicare
SDF liniar (\(\hat\theta_{LS}\) în formă închisă, \(\hat\theta_{EN}\) cu obiectivul din Secțiunea II.F) pe jumătățile (decilele 1–5, 6–10) celor 15 caracteristici pe care biblioteca le sortează în decile
nivelurile nu sînt comparabile cu Tabelele I și III
Autorii enunță mai multe limite: pozitivitatea SDF nu este impusă, intră doar lunile-acțiune cu toate caracteristicile, iar cu fricțiuni raportul Sharpe anual este 1,73 fără cele mai mici 40% dintre acțiuni, 2,07 fără cele 40% cu cele mai mari diferențe bid–ask și 1,87 fără cele 40% cu cel mai mic rulaj; vezi și Avramov, Cheng & Metzker (2023). Metricile in-sample le depășesc pe cele out-of-sample, iar stările ascunse nu pot fi mediate între estimări. Extinderea deschisă îngheață construcția din 1967–1991 și evaluează 2017–2026: mai depășește SDF-ul liniar de absență a arbitrajului modelul FF5 și adaugă ceva stările LSTM din FRED-MD?
Pe scurt
Limite declarate de autori
Pozitivitatea SDF nu este impusă (nota 9)
Sînt păstrate doar lunile cu toate caracteristicile, ceea ce elimină mai ales acțiunile foarte mici (Secțiunea III.A)
Fricțiuni (Secțiunea III.I, Figura 17): SR anual al GAN este \(1{,}73\) fără cele mai mici \(40\%\) dintre acțiuni, \(2{,}07\) fără cele \(40\%\) cu cele mai mari spread-uri bid–ask și \(1{,}87\) fără cele \(40\%\) cu turnover-ul cel mai mic (vezi și Avramov, Cheng & Metzker (2023))
Valorile indicatorilor sînt mai mari în eșantion decît în afara lui, semn de o anumită supraajustare (Secțiunea III.C)
Stările ascunse nu sînt comparabile între estimări, deci nu pot fi mediate (Secțiunea II.E)
Extindere deschisă: păstrați specificația aleasă pe 1967–1991
evaluați-o pe 2017–2026, după eșantionul lucrării
mai întrece SDF-ul liniar fără arbitraj modelul FF5?
Valorile 0,75 pentru GAN și 0,22 pentru FF5, cu erorile standard Lo de 0,065 și 0,058, dau o diferență a cărei eroare standard este cel mult 0,12, oricare ar fi corelația, deci decalajul depășește 4 erori standard sub randamente i.i.d. Normale; un test pereche pe randamente aliniate (Ledoit & Wolf, 2008) este mai precis. Ponderile FF5 fixe, scalate la \(\sum|w| = 1\), se încarcă mai ales pe profitabilitate (RMW, 0,42) și pe investiții (CMA, 0,30), iar FF3 pune 0,61 pe HML; ambele combinații au fost alese pe 1967–1986.
Pe scurt
GAN \(0{,}75\) față de FF5 \(0{,}22\)
cu erorile standard Lo \(0{,}065\) și \(0{,}058\), SE a diferenței este cel mult \(0{,}12\), oricare ar fi corelația
diferența depășește 4 SE (randamente i.i.d. cu distribuția Normală)
un test pe perechi, cu randamente aliniate (Ledoit & Wolf (2008)) este mai precis
Ponderile fixe, scalate astfel încît \(\sum|w| = 1\)
FF5 se concentrează pe profitabilitate și investiții: factorul RMW (robust minus weak) are ponderea \(0{,}42\), iar CMA (conservative minus aggressive) \(0{,}30\)
FF3 alocă \(0{,}61\) factorului HML (high minus low, valoare)
Primii trei pași ai buclei au prompturi reutilizabile:
o sinteză a literaturii cu identificatori, eșantioane și estimări ale scăderii predictibilității, în care fiecare identificator este verificat;
ipoteze concurente pentru o caracteristică predictivă, cu ce prezice fiecare pentru 2016–2026 și pentru alți indici;
cod care construiește cele 34 de caracteristici doar cu informația pînă în ziua \(t\) și raportează statistici \(t\) Newey–West.
Orice asistent le poate rula.
Pe scurt
Literatura
„Rezumă dovezile despre cît din predictibilitatea publicată a randamentelor rezistă out-of-sample și după publicare: DOI sau id arXiv, eșantion, estimarea principală a scăderii.”
Verificați fiecare identificator
Pentru căutare: Semantic Scholar, Google Scholar, Elicit
Ipoteze
„Pentru o variabilă care prognozează randamentele S&P 500 în 2001–2015, dă explicații concurente (primă de risc, reversal, microstructură, data mining) și ce prezice fiecare pentru 2016–2026 și pentru alți indici.”
Date și cod
„Scrie cod Python care construiește 34 de variabile tehnice din închiderile zilnice S&P 500 și VIX ale cursului doar cu informația pînă în ziua t și raportează statisticile t Newey-West pentru randamentele la 1, 5 și 20 de zile în 2001–2015.”
Orice asistent (Claude, ChatGPT, Gemini, GitHub Copilot)
Robustețea se fixează dinainte într-un plan de analiză, cu lista completă de caracteristici și orizonturi, perioada de verificare, corecțiile și rezultatul care ar conta ca eșec. Placebo-ul prin deplasare circulară, cu deplasări de 250–3 000 de zile, rupe alinierea țintei cu caracteristicile, dar păstrează dependența proprie a fiecărei serii, deci este un etalon euristic; un bootstrap comun al scorurilor, centrat sub ipoteza nulă, este o alternativă. O critică în stilul unui referent întreabă care caracteristici semnificative sînt un singur efect numărat de mai multe ori, iar raportul enumeră toate cele \(M\) teste și toate încercările, cu DSR și PBO pentru orice strategie construită pe ele.
Pe scurt
Robustețea, fixată dinainte
„Scrie planul de analiză: lista completă de variabile și orizonturi, perioada de verificare, corecțiile (Holm, BH, max-t) și rezultatul care ar conta drept eșec.”
Placebo: deplasarea circulară a țintei (cu 250–3 000 de zile) rupe alinierea cu variabilele
deplasarea păstrează dependența proprie a fiecărei serii
staționaritatea țintei nu ajunge pentru nulul comun al tuturor pantelor: deplasarea schimbă și relația variabilelor cu volatilitatea condiționată
deci un reper euristic; o alternativă: bootstrap comun al scorurilor, centrat sub nul, cu ipoteze explicite
Critica
„Joacă rolul unui recenzent: care dintre aceste variabile semnificative sînt un singur efect numărat de mai multe ori și care sînt anomalii cunoscute, nu noi?”
Raportul
toate cele \(M\) teste, toate încercările, inclusiv cele abandonate
DSR și PBO pentru orice strategie construită pe ele
S&P 500 și VIX: închideri zilnice, ianuarie 2000 – septembrie 2026; Bitcoin: închideri zilnice din septembrie 2014; prețuri EODHD. Factorii Fama–French: Kenneth French Data Library. Rapoartele Sharpe ale modelelor SDF: Chen, Pelger și Zhu (2024), Tabelul I și Tabelul A.VI. Anomaliile long-short (factori și diferențe de decile): Kenneth French Data Library; R²OOS din lucrare: Dong, Li, Rapach și Zhou (2022), Tabelul 2.


 Campbell R. Harvey.
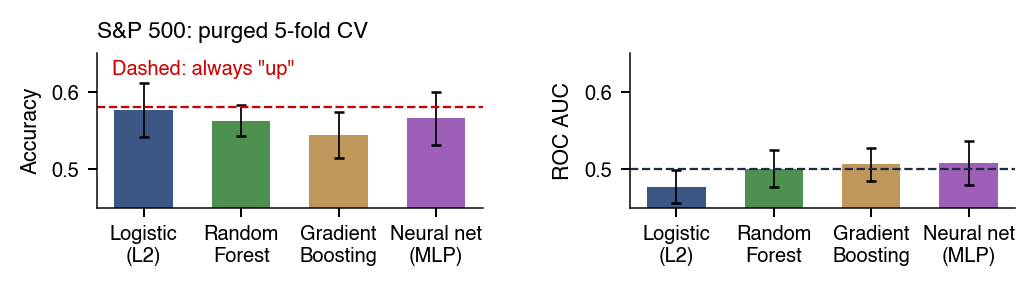
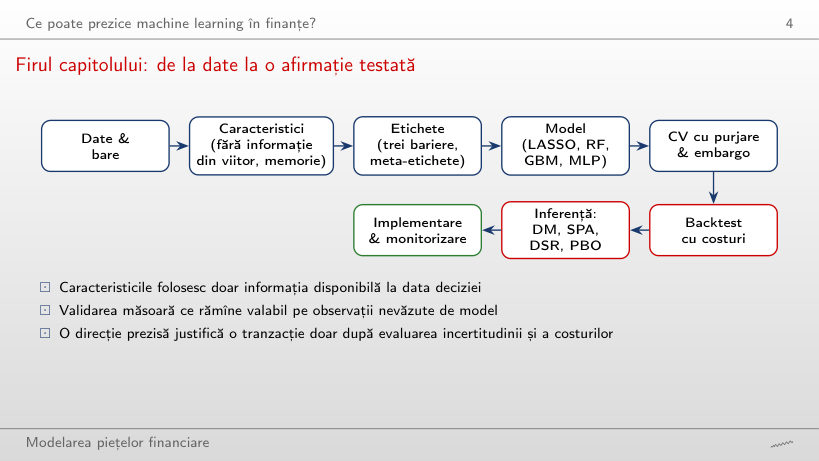
 MFM_ch13_model_comparison
 Random Forests