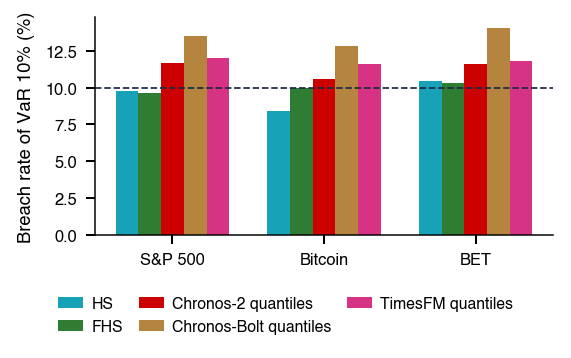Capitolul 14: Deep learning și modele fundaționale pentru serii de timp
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Prognozează rețelele profunde mai bine decît modelele clasice?
“Deep learning allows computational models that are composed of multiple processing layers to learn representations of data with multiple levels of abstraction.” — LeCun, Bengio & Hinton (2015)
Semnalul este în volatilitate, nu în medie (S&P 500 din 2000, 6 718 zile)
Autocorelația de ordinul 1: \(-\)0,099 pentru randamente, 0,29 pentru randamentele absolute
Randamente: niciun model nu depășește prognoza zero pe S&P 500 și Bitcoin
După corecția pentru teste multiple
Volatilitate (SPY, 979 de zile): pierderea medie QLIKE (quasi-likelihood, de tip cvasi-verosimilitate) este 0,223 pentru Chronos-2 și 0,226 pentru log-HAR
Diferența nu este semnificativă (testul Diebold–Mariano, \(p\) = 0,539)
Coada stîngă: Chronos-2 folosit direct depășește VaR (Value-at-Risk, valoarea la risc) 1% în 1,67% din zilele S&P 500
Pe S&P 500, simularea istorică filtrată (FHS) are cea mai mică pierdere a perechii (VaR, ES)
Deep learning allows computational models that are composed of multiple processing layers to learn representations of data with multiple levels of abstraction.
LeCun, Bengio & Hinton (2015) descriu deep learning ca învățarea unor reprezentări ale datelor prin straturi succesive de procesare. Capitolul întreabă dacă aceste modele prognozează seriile financiare mai bine decît modelele clasice din capitolele 5–9. Testăm și modelele fundaționale pentru serii de timp (time-series foundation models), apărute din 2024: rețele pre-antrenate pe miliarde de observații din alte serii și folosite zero-shot, adică fără nicio estimare pe seria-țintă. Corpusurile lor de pre-antrenare sînt dominate de serii nefinanciare (energie, transport, vreme, web).
Un model flexibil poate învăța doar semnalul care există în date. Pe randamentele zilnice ale S&P 500 (Standard & Poor's) din 2000 (6 718 zile), autocorelația (autocorrelation) de ordinul 1 a randamentelor este −0,099, iar cele 15 lag-uri din 50 care depășesc banda de 95% au valori mici și semne diferite. Autocorelația randamentelor absolute este 0,29 la lag-ul 1 și 0,13 la lag-ul 50, iar toate cele 50 de lag-uri depășesc banda. Semnalul se află deci în volatilitate, nu în medie.
Rezultatele celor trei teste urmează acest tipar. Pentru randamente, după corecția pentru testarea multiplă (multiple testing), niciun model nu depășește prognoza zero pe S&P 500 și Bitcoin; pe S&P 500, TimesFM-2.5 este chiar semnificativ mai slab decît ea (\(R^2\) out-of-sample −3,35%, testul Diebold–Mariano, DM, cu \(p\) = 0,001). Pentru varianța realizată (realised variance) a SPY, pe 979 de zile de test, Chronos-2 are pierderea QLIKE (Quasi-LIKElihood, loss function, funcția de pierdere de tip cvasi-verosimilitate) medie 0,223, iar log-HAR 0,226, o diferență nesemnificativă (DM \(p\) = 0,539). Pentru coada stîngă, Chronos-2 folosit direct are prea multe depășiri (breaches) ale VaR (Value-at-Risk, valoarea la risc) 1% pe S&P 500 (1,67% dintre zile, \(p\) Kupiec = 0,001), iar simularea istorică filtrată (FHS, filtered historical simulation) are cea mai mică pierdere FZ0 (Fissler–Ziegel loss, zero-homogeneous version, funcția de pierdere Fissler–Ziegel, varianta omogenă de grad zero). Capitolul arată de aceea cum se evaluează un model nou: față de reperul potrivit fiecărei ținte, după publicarea ponderilor lui și cu inferența potrivită tipului de comparație.
Pierderile QLIKE medii (o valoare mai mică este mai bună) ale celor opt modele de volatilitate pentru varianța realizată a SPY, cu prognoze la o zi: în stînga toată perioada de test (979 de zile), în dreapta doar zilele de după 3 noiembrie 2025 (218 zile), cînd fuseseră publicate ponderile celor trei modele fundaționale. Graficul interactiv: „Pierderile QLIKE ale celor opt modele de volatilitate (1/3)” →
Rezultatele învățării
Derivați dispariția gradientului din răspunsurile la impuls ale unui model vector autoregresiv (VAR) și starea celulei LSTM (long short-term memory) ca un proces AR(1).
Calculați, dintr-o grilă de cuantile zero-shot, prognoze punctuale, de volatilitate și VaR/ES.
Interpretați comparația cu reperul potrivit fiecărei ținte: prognoza zero pentru randamente, log-HAR pentru volatilitate, FHS pentru cozi.
Interpretați testele unui model nou: imbricare, teste multiple, calibrare, contaminare și putere.
Capitolul întreabă dacă rețelele neuronale profunde și modelele fundaționale pentru serii de timp construite din ele prognozează seriile financiare mai bine decît modelele clasice din capitolele 5–9. Întrebarea se pune separat pentru trei ținte: media condiționată a randamentelor, varianța condiționată și coada stîngă a distribuției condiționate. Fiecare țintă are reperul ei (benchmark), ales pentru că este greu de depășit pe ținta respectivă, iar fiecare comparație folosește instrumentele de evaluare din Capitolul 8: diferențe de pierdere, teste de egalitate a acurateței predictive și backtesting.
Secțiunea fixează țintele și reperele lor și arată apoi, cu funcția de autocorelație a S&P 500, unde se află partea predictibilă a randamentelor zilnice.
Pot rețelele profunde prognoza mai bine decît modelele clasice?
Deep learning (învățarea profundă) desemnează modele construite din multe straturi de unități neliniare simple, ale căror parametri sînt estimați din date. Din 2024 există pentru serii de timp o clasă nouă de astfel de modele: modelele fundaționale (foundation models), rețele pre-antrenate o singură dată pe miliarde de observații din alte serii și aplicate apoi unei serii noi fără nicio estimare pe ea. Corpusurile lor de pre-antrenare sînt dominate de serii nefinanciare din energie, transport, vreme și traficul web. Dacă ceea ce învață acolo se transferă la randamentele financiare este o întrebare empirică, iar capitolul îi răspunde cu aceleași teste aplicate în capitolele anterioare modelelor GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată), HAR și modelelor de risc.
Capitolul are două părți:
Rețelele pentru secvențe, atenția și modelele fundaționale, cu Testul 1, pe randamente.
Testul 2, pe volatilitatea realizată, și Testul 3, pe riscul din coada stîngă, măsurat prin value-at-risk (VaR) la nivelul de 1% și expected shortfall (ES) la nivelul de 2,5%, urmate de două studii de caz și o secțiune despre inteligența artificială (AI, artificial intelligence) pentru descoperire științifică.
Comparațiile sînt construite astfel încît designul să nu favorizeze un model nou. Fiecare model prognozează cu o zi înainte, fiecare prognoză folosește doar informația disponibilă la momentul prognozei, iar fiecare comparație se face cu reperul cel mai greu de depășit pe ținta respectivă.
Pe scurt
Întrebarea: prognozează rețelele profunde și modelele fundaționale pentru serii de timp mai bine decît modelele clasice?
Țintele: randamentele, volatilitatea și riscul de coadă (tail risk, coada stîngă)
Randamentul logaritmic zilnic, în procente, \(r_t = 100\ln(P_t/P_{t-1})\), unde \(P_t\) este prețul de închidere din ziua \(t\). Media lui condiționată are un raport semnal-zgomot foarte mic: tiparele predictibile atrag tranzacții, iar tranzacțiile le elimină, cum s-a discutat la eficiența pieței în Capitolul 2. Reperul pentru medie este de aceea prognoza zero, care nu estimează nimic și nu poate supraajusta datele.
Varianța condiționată. Volatilitatea este persistentă și apare în episoade (capitolele 1 și 5), deci există un semnal pe care un model flexibil îl poate învăța. Reperul este log-HAR, modelul autoregresiv eterogen (heterogeneous autoregressive) în logaritmi: logaritmul varianței realizate este regresat pe propriile medii zilnică, săptămînală și lunară. Forma lui exactă este dată la Testul 2.
Forma cozii stîngi. Value-at-risk la nivelul de 1%, VaR 1%, este pierderea zilnică depășită cu probabilitatea de 1%, iar expected shortfall la nivelul de 2,5%, ES 2,5%, este pierderea medie în cele mai proaste 2,5% dintre zile (Capitolul 7). Reperul este simularea istorică filtrată (FHS, filtered historical simulation): randamentele sînt standardizate cu volatilitatea unui model GARCH (generalised autoregressive conditional heteroskedasticity, Capitolul 5), se ia cuantila empirică a randamentelor standardizate și se înmulțește cu volatilitatea prognozată.
Înainte de estimarea oricărui model, funcția de autocorelație arată unde poate găsi un model flexibil o structură predictibilă. Pentru o serie de \(T\) observații independente și identic distribuite (i.i.d.), cu varianță finită, autocorelația de selecție la orice lag fixat urmează aproximativ distribuția Normală cu media zero și abaterea standard \(1/\sqrt{T}\). Banda \(\pm 1{,}96/\sqrt{T}\) este deci un interval punctual de 95% pentru fiecare lag sub această ipoteză nulă; nu este o bandă simultană pentru toate lag-urile.
Autocorelațiile randamentelor măsoară predictibilitatea liniară a mediei. Autocorelațiile randamentelor absolute \(|r_t|\) măsoară persistența mărimii mișcărilor, adică a volatilității. Pentru randamentele absolute, banda este valabilă sub ipoteza nulă că \(|r_t|\) este i.i.d. și \(E[r_t^2] < \infty\); cînd aceste condiții nu sînt îndeplinite, este nevoie de o bandă robustă. Cele două funcții răspund la întrebări diferite, iar un semnal slab în una nu spune nimic despre cealaltă.
Graficul interactiv are pe axa orizontală lag-ul, în zile de tranzacționare, și pe axa verticală autocorelația, cu banda albastru deschis la \(\pm 1{,}96/\sqrt{T}\). Primul cursor fixează primul an al eșantionului, al doilea numărul de lag-uri afișate, iar selectorul alege seria de volatilitate: randamentele absolute sau pătratele lor. Butonul ▶ mută începutul eșantionului an cu an.
Întrebare pentru sală Pe S&P 500 din 2000, care serie prezintă persistență liniară mai pronunțată în primele 50 de lag-uri: randamentele sau valorile lor absolute?
Răspuns
Valorile absolute. Autocorelația lor este 0,29 la lag-ul 1 și 0,13 la lag-ul 50, iar toate cele 50 de valori sînt în afara benzii ±0,024. Randamentele au autocorelația −0,099 la lag-ul 1 și 15 lag-uri în afara benzii, mici și cu semne diferite. Semnul negativ nu înseamnă persistență mai puternică, iar predictibilitatea mediei și cea a volatilității sînt probleme distincte. Graficul sugerează volatility clustering; utilitatea prognozelor se verifică out-of-sample. Banda este o referință punctuală sub ipoteza i.i.d., nu o bandă simultană pentru toate lag-urile.
Pe randamentele zilnice ale S&P 500 din ianuarie 2000, 6 718 zile, banda este \(\pm 0{,}024\). Autocorelația de ordinul 1 a randamentelor este −0,099, iar 15 dintre primele 50 de lag-uri ies din bandă; valorile sînt mici, iar semnul lor se schimbă de la un lag la altul. Autocorelația randamentelor absolute este 0,29 la lag-ul 1 și încă 0,13 la lag-ul 50, iar toate cele 50 de lag-uri sînt în afara benzii.
Structura predictibilă a randamentelor zilnice se află deci în volatilitate, nu în medie. Modelele flexibile pot găsi semnalul din volatilitate; în medie este puțin de găsit. Dacă oricare dintre semnale produce prognoze utile se decide out-of-sample, în testele 1 și 2.
Pe scurt
Randamentele zilnice ale S&P 500 din 2000 (6 718 zile), lag-urile 1–50
Banda albastru deschis: \(\pm 1{,}96/\sqrt{T} = \pm\)0,024 (\(T\): numărul de zile), intervalul de 95% al unei autocorelații sub ipoteza i.i.d. (randamente independente și identic distribuite)
Randamentele: autocorelația de ordinul 1 este \(-\)0,099
15 din 50 de lag-uri depășesc banda, dar sînt mici și au semne diferite
Randamentele absolute: autocorelația este 0,29 la lag-ul 1 și 0,13 la lag-ul 50
Toate cele 50 de lag-uri depășesc banda: gruparea volatilității (volatility clustering) este persistentă
Banda presupune \(|r_t|\) i.i.d. cu \(E[r_t^2] < \infty\); altfel se folosește o bandă robustă
Modelele flexibile pot extrage semnalul din volatilitate, dar aproape nimic din medie
Cele trei ținte conțin cantități diferite de semnal, iar fiecare este comparată cu reperul ei: prognoza zero pentru randamente, log-HAR pentru varianța realizată și FHS pentru coadă. Autocorelațiile sugerează deja tiparul rezultatelor: puțină structură liniară în medie, o structură puternică și persistentă în volatilitate.
Rețele neuronale pentru secvențe
Secțiunea construiește rețelele recurente folosite în capitol pornind de la perceptronul multistrat din Capitolul 13. Dificultatea centrală este memoria: o rețea care parcurge o secvență pas cu pas trebuie să ducă informația din zile îndepărtate pînă astăzi, iar gradientul care o antrenează trebuie să parcurgă înapoi aceeași distanță. Secțiunea arată de ce gradientul unei rețele recurente simple dispare, legîndu-l de răspunsurile la impuls ale unui model vector autoregresiv, și de ce starea celulei LSTM se comportă ca un proces AR(1) al cărui coeficient poate fi adus de rețea aproape de 1.
De la perceptronul multistrat la deep learning (1/3)
Perceptronul multistrat (MLP, multilayer perceptron) din Capitolul 13 este elementul de bază. Fiecare strat aplică o funcție neliniară unei combinații liniare a ieșirii stratului anterior:
În (14.1),\(x\) este vectorul de intrare, \(h^{(\ell)}\) ieșirea stratului \(\ell\), iar \(W^{(\ell)}\) și \(b^{(\ell)}\) sînt matricea de ponderi și vectorul de termeni liberi ai acestui strat, estimate din date. Funcția de activare (activation function) \(\varphi\) se aplică element cu element. Alegerile uzuale sînt unitatea liniară rectificată (ReLU, rectified linear unit) \(\max(0, z)\), tangenta hiperbolică \(\tanh\) și sigmoida \(\sigma(z) = 1/(1+e^{-z})\), care duce axa reală în \((0, 1)\) și este folosită mai jos pentru porțile LSTM.
Un MLP primește o intrare de lungime fixă. Aplicat unei serii de timp, vede o fereastră cu ultimele \(p\) observații și nimic dinaintea ei, la fel ca o autoregresie de ordin \(p\). O rețea pentru secvențe trebuie în schimb să ducă informația de la un pas la următorul, astfel încît prognoza de la \(t\) să poată depinde de întregul trecut. Întrebarea secțiunii este cum poate o rețea să folosească informația din zile îndepărtate și de ce cea mai simplă rețea recurentă nu reușește.
Pe scurt
Întrebarea secțiunii: cum poate o rețea să folosească informația din zile îndepărtate?
\(x\) este vectorul de intrare, iar \(h^{(\ell)}\) este ieșirea stratului \(\ell\)
\(W^{(\ell)}\), \(b^{(\ell)}\): matricea de ponderi și vectorul de termeni liberi ai stratului \(\ell\), estimate din date
\(\varphi\): funcția de activare, aplicată element cu element: ReLU (rectified linear unit) \(\max(0, z)\), \(\tanh\) sau sigmoida \(\sigma(z) = 1/(1+e^{-z}) \in (0, 1)\)
Un MLP primește o fereastră fixă de intrări
O rețea pentru secvențe trebuie să rețină informația de la un pas la altul
De la perceptronul multistrat la deep learning (2/3)
Parametrii unei rețele se estimează minimizînd o funcție de pierdere pe eșantionul de antrenare. Propagarea înapoi (backpropagation) (Rumelhart, Hinton & Williams, 1986) calculează gradientul pierderii în raport cu fiecare pondere prin regula lanțului, strat cu strat, de la ieșire spre intrare. Ponderile sînt apoi actualizate cu Adam (adaptive moment estimation) (Kingma & Ba, 2015): un pas de gradient normalizat prin mediile exponențiale ale gradienților anteriori și ale pătratelor lor, astfel încît fiecare pondere are propriul pas efectiv.
Pierderea determină ce funcțională a distribuției condiționate învață rețeaua. Pentru prognoze punctuale, pierderea este eroarea pătratică medie (MSE, mean squared error), a cărei medie este minimizată de media condiționată. Pentru o cuantilă de nivel \(u\), pierderea este pierderea pinball (pinball loss):
unde \(y\) este valoarea realizată și \(q\) prognoza cuantilei. Pierderea (14.2) este asimetrică: un rezultat peste \(q\) costă \(u\) pe unitatea de distanță, unul sub \(q\) costă \(1-u\). Media ei este minimizată de cuantila reală de nivel \(u\), motiv pentru care o rețea antrenată cu (14.2) la mai multe niveluri returnează o grilă de cuantile. Modelele fundaționale din capitol sînt antrenate astfel, iar aceeași pierdere reapare ca regulă de scor pentru VaR.
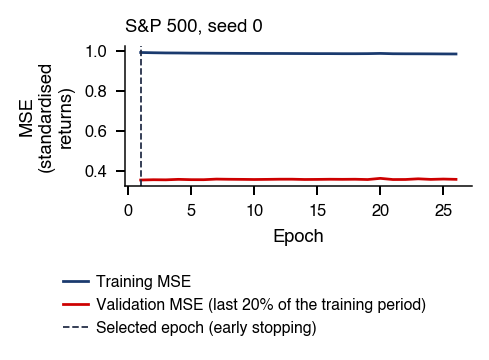
Teorema aproximării universale a lui Hornik, Stinchcombe & White (1989) afirmă că o rețea suficient de largă aproximează oricît de bine orice funcție continuă pe o mulțime compactă. Teorema nu spune nimic despre mărimea eșantionului necesar pentru a estima o astfel de rețea. Cu o singură serie financiară de cîteva mii de observații zilnice, mărimea eșantionului este constrîngerea decisivă, iar rețeaua trebuie regularizată: prin early stopping, prin weight decay, o penalizare a mărimii ponderilor, și prin medierea prognozelor peste mai multe inițializări aleatoare (seed-uri). Pentru că datele sînt o serie de timp, blocul de validare folosit la early stopping trebuie să urmeze în timp blocului de antrenare.
Metodele care au făcut deep learning practic sînt sintetizate de LeCun, Bengio & Hinton (2015); Hopfield și Hinton au primit Premiul Nobel pentru Fizică în 2024. În finanțe, cîștigurile documentate sînt transversale. Gu, Kelly & Xiu (2020) le obțin pe o secțiune transversală de mii de acțiuni, nu pe un singur indice, iar Fischer & Krauss (2018) aplică LSTM pe acțiunile din S&P 500 pentru a prognoza care dintre ele depășesc a doua zi mediana secțiunii transversale. Capitolul prognozează serii agregate individuale: doi indici și Bitcoin.
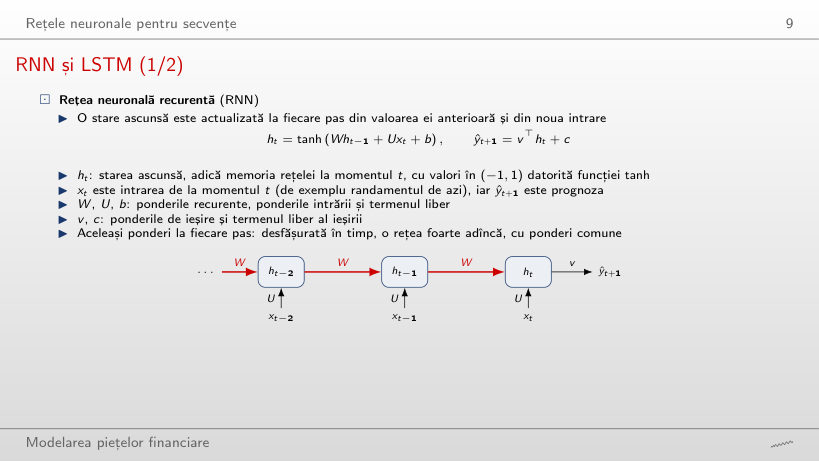
O rețea neuronală recurentă (RNN, recurrent neural network) păstrează o stare ascunsă \(h_t\), memoria rețelei la momentul \(t\), și o actualizează la fiecare pas din valoarea ei anterioară și din noua intrare:
În (14.3),\(x_t\) este intrarea de la \(t\), de exemplu randamentul de azi, \(W\) matricea ponderilor recurente, \(U\) ponderile intrării și \(b\) un termen liber; \(v\) și \(c\) sînt ponderile de ieșire și termenul liber care transformă starea în prognoza \(\hat y_{t+1}\). Funcția \(\tanh\) ține fiecare componentă a lui \(h_t\) în \((-1, 1)\).
Aceleași ponderi se folosesc la fiecare pas. Desfășurată în timp, ca în diagramă, RNN este o rețea foarte adîncă în care toate straturile au ponderile comune \(W\) și \(U\): starea de acum \(k\) pași ajunge la starea de azi prin \(k\) aplicări ale aceleiași transformări. Această adîncime permite rețelei să-și amintească și este totodată sursa problemei de antrenare analizate două slide-uri mai jos.
Rețeaua long short-term memory (LSTM) a lui Hochreiter & Schmidhuber (1997) adaugă o a doua stare, starea celulei \(c_t\), și trei porți (gates) care decid ce se uită, ce se scrie și ce se afișează:
Aici \(f_t\) este poarta de uitare (forget gate), \(i_t\) poarta de intrare și \(o_t\) poarta de ieșire; fiecare are propriile ponderi \(W_\bullet\),\(U_\bullet\),\(b_\bullet\), cu \(\bullet \in \{f, i, o\}\). În (14.4),\(W_\bullet\) ponderează intrarea, iar \(U_\bullet\) starea anterioară, invers față de literele din (14.3). Pentru că porțile trec prin sigmoidă, fiecare componentă este în \((0, 1)\): o poartă apropiată de 0 blochează, una apropiată de 1 lasă să treacă. Vectorul \(g_t\) este conținutul nou candidat, \(c_t\) memoria pe termen lung, \(h_t\) ieșirea, iar \(\odot\) produsul element cu element.
Rîndul esențial din (14.4) este actualizarea celulei, \(c_t = f_t \odot c_{t-1} + i_t \odot g_t\). Memoria veche este transmisă mai departe înmulțită doar cu poarta de uitare, nu cu o matrice de ponderi urmată de o funcție de saturare. Unitatea recurentă cu porți (GRU, gated recurrent unit) este o variantă mai ușoară, cu două porți, care păstrează această structură aditivă.
\(W_\bullet\) ponderează aici intrarea, iar \(U_\bullet\) starea anterioară, cu literele inversate față de RNN; \(f_t\), \(i_t\), \(o_t\): poarta de uitare, poarta de intrare și poarta de ieșire
Fiecare poartă are propriile ponderi \(W_\bullet\), \(U_\bullet\), \(b_\bullet\), cu \(\bullet \in \{f, i, o\}\)
\(\sigma\): sigmoida; o poartă apropiată de 0 blochează, una apropiată de 1 lasă să treacă
\(g_t\): conținutul nou candidat
\(c_t\): starea celulei, adică memoria pe termen lung
\(h_t\): ieșirea celulei
\(\odot\): produsul element cu element
GRU (gated recurrent unit, unitate recurentă cu porți): o variantă mai ușoară, cu două porți
Dispariția gradientului: o majorare și un VAR(1) (1/2)
Antrenarea unei RNN are nevoie de efectul stărilor vechi asupra stării de azi. Propagarea înapoi în timp (backpropagation through time) îl calculează prin regula lanțului, înmulțind cîte o matrice jacobiană la fiecare pas:
Matricea \(\partial h_T/\partial h_{T-k}\) dă variația lui \(h_T\) la o variație unitară a stării de acum \(k\) pași, iar \(D_t\) este matricea diagonală a pantelor \(\varphi'\) ale funcției de activare la pasul \(t\). Din submultiplicativitatea normei spectrale, \(\lVert AB\rVert_2 \le \lVert A\rVert_2\lVert B\rVert_2\), produsul din (14.5) este majorat (Pascanu, Mikolov & Bengio, 2013):
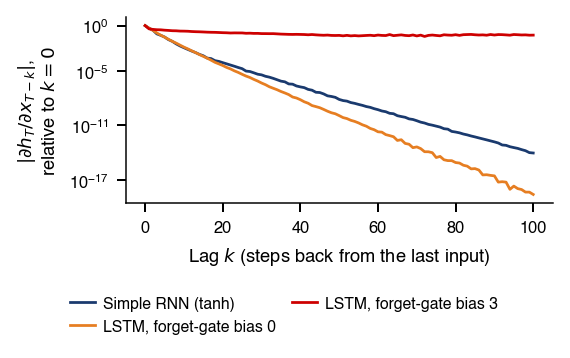
Norma spectrală \(\lVert W\rVert_2\) este cel mai mare factor cu care \(W\) alungește un vector, iar \(\gamma_\varphi\) este cea mai mare pantă a funcției de activare, egală cu 1 pentru \(\tanh\). Dacă \(\gamma_\varphi \lVert W\rVert_2 < 1\), majorarea (14.6) scade geometric în \(k\): gradientul dispare (vanishing gradient), iar rețeaua nu poate învăța dependența de pași îndepărtați. Cazul scalar arată viteza (Bengio, Simard & Frasconi, 1994): cu \(|w| = 0{,}9\), gradientul scade la 0,12 după 20 de pași și la 0,005 după 50 de pași.
Cazul opus, un produs care crește nemărginit, este explozia gradientului (exploding gradient). Ea se tratează prin limitarea normei gradientului (gradient clipping) înainte de fiecare actualizare. Dispariția este problema mai grea, iar remediul ei ține de arhitectură: porțile, ca în LSTM.
Pe scurt
Antrenarea are nevoie de efectul stărilor vechi asupra stării de azi
Propagarea înapoi în timp înmulțește cîte o matrice jacobiană la fiecare pas
Majorarea (14.6) are o interpretare cunoscută din seriile de timp. Fie \(h^*\) un punct fix al rețelei, o stare care se reproduce cînd intrarea este zero, și \(D\) matricea diagonală a pantelor funcției de activare în \(h^*\). Liniarizînd (14.3) în jurul lui \(h^*\) obținem
\[h_t - h^* \approx A\,(h_{t-1} - h^*) + D U x_t, \qquad A = D W.\]
(14.7)
În jurul punctului fix, starea ascunsă urmează un model vector autoregresiv de ordinul 1, VAR(1), cu matricea coeficienților \(A\) și intrarea \(D U x_t\).
În această aproximare, \(\partial h_T/\partial h_{T-k} = A^k\), adică exact răspunsul la impuls (impulse response) al VAR-ului la orizontul \(k\), iar teoria uzuală a VAR-urilor stabile se aplică. Fie \(\rho(A)\) raza spectrală (spectral radius), cea mai mare valoare proprie a lui \(A\) în valoare absolută. Dacă \(\rho(A) < 1\), VAR-ul este stabil și \(\lVert A^k\rVert \to 0\) geometric cînd \(k \to \infty\); dacă \(\rho(A) > 1\), răspunsurile explodează. La orizonturi finite, \(\lVert A^k\rVert\) poate crește temporar cînd \(A\) nu este normală, adică \(AA^\top \ne A^\top A\).
O RNN stabilă în jurul punctului fix este deci un model cu memorie scurtă, ca orice VAR staționar: influența unui șoc, și odată cu ea gradientul, scade geometric. Derivarea este exercițiul A4 din Seminarul 14, iar legătura dintre norme, raza spectrală și explozie este detaliată în Anexă.
Pe scurt
Liniarizăm în jurul unui punct fix \(h^*\) al rețelei
\[
h_t - h^* \approx A\,(h_{t-1} - h^*) + D U x_t, \qquad A = D W
\]
Punctul fix: o stare care se reproduce cînd intrarea este zero
\(D\): pantele funcției de activare în \(h^*\)
Starea ascunsă urmează deci un VAR(1) (autoregresie vectorială) cu matricea coeficienților \(A\)
\(\partial h_T / \partial h_{T-k} = A^k\) este răspunsul la impuls al acestui VAR la orizontul \(k\)
\(\rho(A)\): raza spectrală, cea mai mare valoare proprie a lui \(A\) în valoare absolută
\(\rho(A) < 1\): VAR-ul este stabil, iar \(\lVert A^k\rVert \to 0\) geometric cînd \(k \to \infty\)
La orizont finit, \(\lVert A^k\rVert\) poate crește temporar dacă \(A\) nu este normală (\(A A^\top \ne A^\top A\))
\(\rho(A) > 1\): gradienții explodează
O RNN stabilă în jurul punctului fix este un model cu memorie scurtă, ca orice VAR staționar
Pe starea celulei din (14.4), singurul factor multiplicativ este poarta de uitare. Pe drumul direct, \(\partial c_T/\partial c_{T-k} = \prod_{j=0}^{k-1} f_{T-j}\), fără nicio matrice de ponderi și nicio pantă a funcției de activare în produs. Actualizarea celulei, \(c_t = f_t \odot c_{t-1} + i_t \odot g_t\), este o autoregresie de ordinul 1 cu coeficient aleator \(f_t\).
O celulă scalară simplificată, cu poarta de uitare constantă \(f\), face argumentul exact. Cînd intrările porții sînt nule, \(f = \sigma(b_f)\), unde \(b_f\) este termenul liber al porții, iar celula este un AR(1) cu coeficientul \(f\). Cu intrarea \(i_t g_t\) zgomot alb și o inițializare staționară,
unde \(k_{1/2}\) este timpul de înjumătățire, lag-ul la care mai rămîne jumătate din memorie. Cu \(b_f = 0\), poarta este \(f = 0{,}5\), iar după 50 de pași rămîne \(0{,}5^{50} \approx 9 \times 10^{-16}\) din memorie. Cu \(b_f = 3\),\(f = 0{,}953\), după 50 de pași rămîne \(0{,}953^{50} \approx 0{,}09\) din memorie, iar timpul de înjumătățire este de 14 pași. Un termen liber mare al porții de uitare este ceea ce permite LSTM să-și amintească.
Descreșterea din (14.8) rămîne însă geometrică. Memoria lungă (long memory) scade hiperbolic: \(\rho_k \sim C k^{2d-1}\), unde \(\rho_k\) este autocorelația la lag-ul \(k\),\(d \in (0, \tfrac12)\) parametrul de memorie și \(C > 0\) o constantă. Pe randamentele absolute ale S&P 500, descreșterea geometrică ajustată dă \(\rho_{150} = 0{,}027\), față de 0,059 observat (Anexă). O singură celulă LSTM poate fi persistentă, dar nu are memorie lungă; modelul HAR din Testul 2 aproximează memoria lungă în schimb cu trei medii.
Pe scurt
Pe calea directă prin starea celulei, singurul factor multiplicativ este poarta de uitare
\(\partial c_T / \partial c_{T-k} = \prod_{j=0}^{k-1} f_{T-j}\) pe drumul direct
\(c_t = f_t \odot c_{t-1} + i_t \odot g_t\): un AR(1) cu coeficient aleator
Celulă scalară simplificată, cu poarta de uitare constantă \(f\): un AR(1) cu coeficientul \(f\)
\(f = \sigma(b_f)\) cînd intrările porții sînt nule; \(b_f\): termenul ei liber
Cu intrarea \(i_t g_t\) zgomot alb și inițializare staționară, \(\operatorname{Corr}(c_t, c_{t-k}) = f^k\) scade geometric
Cu \(b_f = 0\), poarta de uitare este \(f = 0{,}5\), iar după 50 de pași rămîne \(0{,}5^{50} \approx 9 \times 10^{-16}\) din memorie
Cu \(b_f = 3\), poarta de uitare este \(f = 0{,}953\), iar după 50 de pași rămîne \(0{,}953^{50} \approx 0{,}09\) din memorie
Timpul de înjumătățire este de 14 pași (\(k\) pentru care \(f^k = \frac12\), adică \(k = \ln 0{,}5/\ln f\))
Memoria lungă scade hiperbolic: \(\rho_k \sim C k^{2d-1}\)
\(\rho_k\): autocorelația de ordin \(k\); \(d \in (0, \frac12)\): parametrul de memorie; \(C > 0\): o constantă
Randamentele absolute ale S&P 500: descreșterea geometrică ajustată dă \(\rho_{150}\) = 0,027, față de 0,059 observată (Anexă)
O RNN simplă în jurul punctului fix este un VAR(1) stabil, iar gradientul ei scade la fel ca răspunsurile la impuls ale acestui VAR. LSTM scapă de această descreștere pe starea celulei, care este un AR(1) al cărui coeficient poate fi adus de poarta de uitare aproape de 1, dar descreșterea rămîne geometrică. Secțiunea următoare renunță cu totul la recurență.
Atenția și Transformerele
Atenția leagă direct oricare doi pași de timp, fără produsul de matrice jacobiene care face să dispară gradientul unei RNN. Prețul este un cost care crește cu pătratul numărului de intrări. Secțiunea definește atenția, arată cum reduce împărțirea în patch-uri acest cost și explică felul în care pozițiile sînt adăugate unui mecanism care, prin el însuși, ignoră ordinea. Acestea sînt componentele modelelor fundaționale testate în restul capitolului.
Întrebarea secțiunii este cum poate o rețea să lege ziua de azi direct de o zi de acum 500 de zile. Atenția (attention) (Vaswani et al., 2017) răspunde fără recurență. Fiecare pas de timp formează o interogare (query) și o compară cu cheia (key) fiecărui pas pe care îl poate vedea; răspunsul este o medie ponderată a valorilor (values) acestor pași, cu ponderi care cresc cu similaritatea dintre interogare și cheie:
\[\operatorname{Attention}(Q, K, V) = \operatorname{softmax}\!\left(\frac{Q K^\top}{\sqrt{d_k}}\right) V, \qquad Q = XW_Q,\; K = XW_K,\; V = XW_V.\]
(14.9)
În (14.9),\(X\) conține intrările, cîte un rînd pentru fiecare pas de timp, iar \(W_Q\),\(W_K\),\(W_V\) sînt matrice de ponderi învățate care produc interogările \(Q\), cheile \(K\) și valorile \(V\). Cele trei matrice sînt proiecții diferite ale acelorași intrări, astfel încît un pas poate căuta un anumit tip de tipar (prin interogarea lui) și poate fi găsit de alți pași prin altă proiecție (prin cheia lui).
Pe scurt
Întrebarea secțiunii: cum poate o rețea să lege direct ziua de azi de o zi de acum 500 de zile?
Fără produsul de jacobiene care face gradientul unei RNN să dispară
Matricea \(QK^\top\) conține scorul de similaritate al fiecărei perechi de pași. Scorurile sînt împărțite la \(\sqrt{d_k}\), unde \(d_k\) este lungimea unui vector-cheie: varianța unui produs scalar crește cu \(d_k\), iar fără această scalare softmax s-ar satura, dînd aproape toată ponderea unui singur pas și un gradient aproape nul celorlalți. Softmax transformă apoi fiecare rînd de scoruri \(s_1, \dots, s_n\) în ponderi pozitive cu suma 1:
Rezultă două proprietăți. Nu există niciun produs de matrice jacobiene în timp: orice pas trecut este la un singur salt de ziua de azi, deci drumul gradientului nu se lungește cu lag-ul. Iar costul este \(O(n^2)\): numărul de scoruri, și odată cu el calculul, crește cu pătratul numărului de intrări \(n\). Un exemplu numeric cu trei pași și o mască cauzală (causal mask), care interzice unui pas să folosească viitorul, este în Aprofundări.
Pe scurt
\(QK^\top\): scorul de similaritate pentru fiecare pereche de pași
\(d_k\) este lungimea unui vector-cheie
Împărțirea la \(\sqrt{d_k}\) împiedică saturarea funcției softmax
softmax transformă fiecare rînd de scoruri \(s_1, \dots, s_n\) în ponderi pozitive cu suma 1
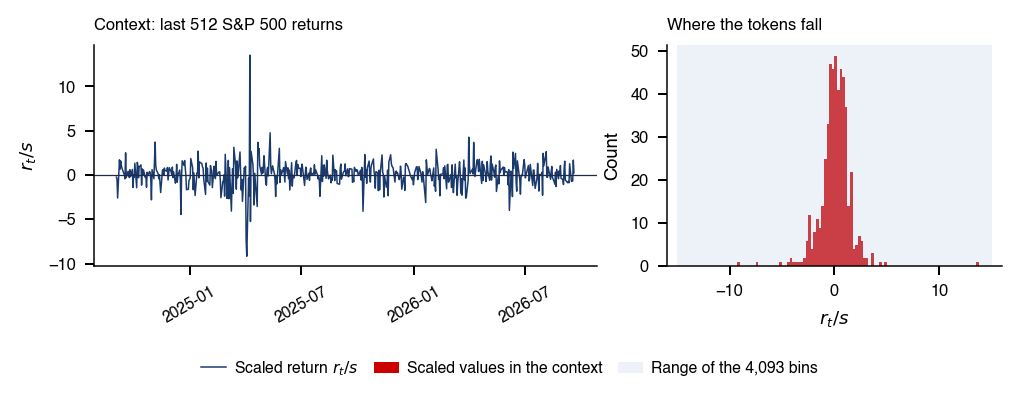
Costul pătratic din (14.9) face scump un token pentru fiecare zi cînd contextul este lung. Împărțirea în patch-uri (patching) grupează observații consecutive într-un singur token, astfel încît numărul de tokeni, și odată cu el numărul de scoruri de atenție, scade. Graficul arată cum citesc același context de randamente zilnice ale S&P 500 cele două modele fundaționale din capitol care folosesc patch-uri.
Graficul interactiv are două panouri, cu ziua relativă la momentul prognozei pe axa orizontală și randamentul zilnic, în procente, pe axa verticală; fiecare bloc umbrit este un patch și devine un token. Primul cursor fixează lungimea patch-ului în panoul de sus (de la 2 la 64 de zile), al doilea lungimea contextului (de la 128 la 512 zile); panoul de jos păstrează patch-urile de 32 de zile ale TimesFM-2.5. Butonul ▶ parcurge lungimile patch-ului.
Întrebare pentru sală În schema ilustrată, 512 zile formează patch-uri de 16 zile. Cîte intrări are matricea de atenție a unui singur head, cu atenție completă numai între tokenii de context?
Răspuns
Sînt 512/16 = 32 de tokeni și 32² = 1 024 de perechi ordonate, față de 512² = 262 144 dacă fiecare zi ar fi un token: de 16² = 256 de ori mai puține. TimesFM-2.5 folosește patch-uri de 32 de zile: 16 tokeni și 256 de intrări. Este calculul simplificat pentru un head, fără tokeni suplimentari; un strat multi-head are cîte o astfel de matrice pentru fiecare head.
Cu un context de 512 zile și patch-uri de 16 zile, ca în Chronos-2, rezultă 512/16 = 32 de tokeni și \(32^2 = 1\,024\) de perechi ordonate în matricea de atenție a unui head, față de \(512^2 = 262\,144\) dacă fiecare zi ar fi un token: de \(16^2 = 256\) de ori mai puține. TimesFM-2.5 folosește patch-uri de 32 de zile: 16 tokeni și 256 de intrări. Calculul este pentru un singur head, cu atenție doar între tokenii de context; un strat multi-head are cîte o astfel de matrice pentru fiecare head.
Atenția tratează intrările ca pe o mulțime: o permutare a rîndurilor lui \(X\) permută la fel ieșirea, deci ordinea zilelor se pierde. O codificare pozițională (positional encoding) o adaugă înapoi. Transformerul original adaugă intrărilor sinusoide ale poziției; Chronos-2 folosește rotații (RoPE, rotary positional embeddings), care rotesc fiecare interogare și fiecare cheie cu un unghi proporțional cu poziția. Cu rotații, scorul a doi pași depinde de distanța dintre ei, nu de locul lor în context, ceea ce se potrivește unei serii a cărei dinamică nu depinde de poziția în calendar.
Împărțirea în patch-uri (Nie et al., 2023) face un token dintr-un bloc de observații consecutive. O transformare învățată duce fiecare bloc într-un vector de lungime fixă, numit embedding. Cu 512 randamente zilnice în patch-uri de 16 zile, atenția lucrează pe 32 de tokeni și calculează \(32^2\) scoruri în loc de \(512^2\), de 256 de ori mai puține. Graficul de pe slide-ul anterior arată ultimele 512 randamente zilnice ale S&P 500 împărțite așa cum le citesc Chronos-2 (16 zile) și TimesFM-2.5 (32 de zile).
Modelele globale, antrenate pe multe serii în loc de una singură, au precedat modelele fundaționale: DeepAR (Salinas et al., 2020), N-BEATS (Oreshkin et al., 2020) și PatchTST (Nie et al., 2023). Modelele fundaționale duc aceeași idee la corpusuri foarte mari și foarte diverse.
Pe scurt
Codificarea poziției: atenția tratează intrările ca pe o mulțime, deci ordinea trebuie adăugată
Sinusoide în Transformerul original
Codificări rotative în Chronos-2
Codificările rotative (RoPE, rotary position embeddings): fiecare interogare și cheie este rotită cu un unghi proporțional cu poziția ei, deci scorul a doi pași depinde de distanța dintre ei, nu de locul lor în context
Împărțirea în patch-uri (Nie et al. (2023)): un token este un bloc de observații consecutive
O funcție învățată transformă blocul într-un vector de lungime fixă (embedding)
512 randamente zilnice împărțite în patch-uri de 16 zile dau 32 de tokeni și de 256 de ori mai puține scoruri de atenție (\(32^2\) în loc de \(512^2\))
Graficul: ultimele 512 randamente zilnice ale S&P 500
Împărțite așa cum le citesc Chronos-2 (16 zile) și TimesFM-2.5 (32 de zile)
Atenția elimină drumul lung al gradientului din RNN cu un cost pătratic, patch-urile reduc acest cost grupînd zilele în tokeni, iar codificările poziționale refac ordinea pe care atenția o ignoră. Secțiunea următoare asamblează aceste componente în modele pre-antrenate și precizează ce primesc și ce returnează ele.
Modele fundaționale pentru serii de timp
Un model fundațional este estimat o singură dată, pe un corpus de multe serii, și folosit apoi fără altă estimare pe serii pe care nu a fost antrenat. Secțiunea definește prognoza zero-shot, descrie cele trei modele testate în capitol și arată cum rezultatul lor, o grilă de cuantile, dă prognoze punctuale, prognoze de volatilitate, VaR și ES. Ea se încheie cu riscul specific al acestor modele: ca perioada de test să fi fost deja văzută la pre-antrenare.
Întrebarea secțiunii este dacă un model pre-antrenat pe alte serii poate prognoza o serie financiară pe care nu a văzut-o la antrenare. Un model fundațional este o rețea mare, pre-antrenată o singură dată pe un corpus foarte larg și folosită apoi pentru sarcini noi. Ideea vine de la modelele mari de limbaj (LLM, large language models), pre-antrenate pe text și aplicate apoi unor sarcini pentru care nu au fost antrenate anume. Pentru finanțe, avantajul este practic: un singur model pentru mii de serii, fără estimare separată pentru fiecare serie.
Sînt discutate trei familii de modele fundaționale pentru serii de timp. Chronos (Ansari et al., 2024) transformă valorile în tokenii unui model de limbaj. TimesFM (Das et al., 2024) este un Transformer doar cu decodor (decoder-only), care citește seria pe patch-uri. Moirai (Woo et al., 2024) acceptă orice număr de variabile și returnează un amestec de distribuții (Anexă); nu este testat în capitol, pentru că are licență necomercială.
Pe scurt
Întrebarea secțiunii: poate un model pre-antrenat pe alte serii să prognozeze o serie financiară nouă?
Nouă: una pe care nu a văzut-o la antrenare
Modelul fundațional: o rețea mare, pre-antrenată o singură dată pe un corpus foarte larg
Apoi folosită pentru sarcini noi
Idee preluată de la modelele mari de limbaj (LLM, large language models)
Avantajul pentru finanțe: un singur model pentru mii de serii
TimesFM (Das et al. (2024)): un Transformer doar cu decodor, care citește seria pe patch-uri
Moirai (Woo et al. (2024)): orice număr de variabile și o ieșire de tip amestec de distribuții (Anexă); nu îl testăm, pentru că are licență necomercială
Prognoza zero-shot: ce primește și ce returnează modelul
În prognoza zero-shot, parametrii \(\hat\theta\) ai rețelei sînt fixați la pre-antrenare și nu sînt reestimați pe seria-țintă. La momentul \(T\), modelul primește doar istoricul recent al seriei, contextul, și returnează o grilă de cuantile pentru fiecare orizont:
În (14.11),\(F_{\hat\theta}\) este rețeaua pre-antrenată, aceeași pentru orice serie; \(C\) este lungimea contextului, 512 zile în acest capitol; \(H\) este orizontul de prognoză; iar \(\hat q_{u_k, T+h}\) este cuantila prognozată de nivel \(u_k\) a valorii de la \(T+h\). Rezultatul este o distribuție descrisă prin \(K\) cuantile, nu doar un punct.
Ajustarea fină (fine-tuning), adică antrenarea suplimentară pe seria-țintă, este posibilă, dar nu este folosită. Capitolul testează chiar promisiunea „fără estimare”. Riscul specific al abordării este ca seria-țintă, sau perioada de test, să facă parte din corpusul de pre-antrenare; acesta este subiectul slide-ului despre leakage.
Pe scurt
Prognoza zero-shot: parametrii \(\hat\theta\) sînt fixați la pre-antrenare
La momentul \(T\), modelul primește doar istoricul recent al seriei (contextul)
Ansari et al. (2024) transformă valorile unei serii în tokeni și antrenează un model de limbaj, T5 (Text-to-Text Transfer Transformer), cu entropia încrucișată (cross-entropy). Păstrînd tokenii, arhitectura modelului de limbaj rămîne neschimbată. O distribuție pe tokeni nu impune prognozei o formă parametrică: ea poate fi asimetrică sau cu mai multe moduri.
Valorile sînt mai întîi scalate cu media valorilor absolute din context și apoi cuantizate la cel mai apropiat dintre centrele unei mulțimi fixe:
În (14.12),\(s\) este media valorilor absolute ale celor \(C\) valori din context, \(c_j\),\(j = 1, \dots, 4\,093\), sînt centre echidistante în \([-15, 15]\), la distanța \(30/4\,092 = 0{,}0073\), la care se adaugă tokeni speciali, iar \(z_t\) este tokenul lui \(x_t\), adică indicele centrului cel mai apropiat. Pentru prognoză, modelul eșantionează tokeni viitori \(z\), îi transformă înapoi în valori \(s\,c_z\) și citește cuantilele din eșantioane. Ce fac scalarea și centrele cu randamentele zilnice se vede în Aprofundări.
Corpusul de pre-antrenare este format din seturi publice de date din energie, transport, comerț, vreme, web, finanțe și economie. El este completat cu două tipuri de serii sintetice: seriile TSMixup, combinații convexe aleatoare ale unor serii reale, și seriile KernelSynth, traiectorii ale unor procese gaussiene cu nuclee de covarianță combinate aleator. Modelele Chronos originale, bazate pe T5, au între 8 și 710 milioane de parametri; Chronos-Bolt, testat aici, are între 9 și 205 milioane.
Capitolul testează trei modele, toate rulate pe un CPU (central processing unit, procesorul central obișnuit), cu un context de 512 zile. Chronos-Bolt înlocuiește eșantionarea de tokeni cu patch-uri și o estimare directă a cuantilelor; versiunea mică folosită aici are 48 de milioane de parametri, patch-uri de 16 zile și cuantile de la 10% la 90%, iar ponderile ei au fost publicate la 25 noiembrie 2024. Chronos-2 (Ansari et al., 2025) folosește o scalare robustă și atenție atît în timp, cît și între grupuri de serii înrudite; are 119 milioane de parametri, patch-uri de 16 zile și 21 de niveluri de cuantile, de la 1% la 99% (1%, 5%, 10%, …, 95%, 99%), iar ponderile au fost publicate la 30 octombrie 2025.
TimesFM (Das et al., 2024) a fost pre-antrenat pe circa \(10^{11}\) puncte de timp. Versiunea 2.5, publicată ca timesfm-2.5-200m, are 231 de milioane de parametri numărați pe modelul încărcat, folosește patch-uri de 32 de zile, returnează o medie și cuantilele de la 10% la 90%, iar ponderile au fost publicate la 1 octombrie 2025. Numerele de parametri din tabel sînt cele ale modelelor încărcate.
Datele de publicare a ponderilor contează pentru evaluare: ele delimitează ce ar fi putut vedea modelele. Zilele de după ultima publicare sînt ferite de o formă de contaminare, iar slide-ul despre leakage le folosește pentru a defini o fereastră de după publicare. Alte modele fundaționale și corpusurile lor sînt prezentate în Anexă.
Pe scurt
Model
Parametri
Patch
Niveluri de cuantile
Data publicării ponderilor
Chronos-Bolt (small)
48 M
16
10%–90%
25.11.2024
TimesFM-2.5
231 M
32
medie, 10%–90%
01.10.2025
Chronos-2
119 M
16
21: 1%, 5%, 10%, …, 95%, 99%
30.10.2025
Chronos-Bolt: patch-uri și estimarea directă a cuantilelor, în locul eșantionării de tokeni
Chronos-2 (Ansari et al. (2025)): scalare robustă, atenție în timp și între grupuri de serii înrudite
TimesFM (Das et al. (2024)): pre-antrenat pe circa \(10^{11}\) puncte
Parametrii sînt numărați pe modelele încărcate
TimesFM-2.5 este publicat ca timesfm-2.5-200m
Toate rulează pe un CPU (procesor central obișnuit), cu un context de 512 zile
Datele de publicare a ponderilor delimitează ce date ar fi putut vedea modelele la antrenare
Alte modele și corpusurile lor sînt prezentate în Anexă
Modelul returnează cuantilele \(q_u\) la nivelurile \(u_1 < \dots < u_K\), cu \(P(Y \le q_u) = u\), unde \(Y\) este valoarea viitoare și \(K\) numărul de niveluri. O grilă este utilă pentru că din aceleași cuantile rezultă prognoza punctuală, prognoza de volatilitate și riscul din coadă, deci același model servește toate cele trei teste ale capitolului.
Din grilă se pot citi două prognoze punctuale: mediana \(q_{0{,}5}\) și media \(\int_0^1 q_u\,du\), adică media tuturor cuantilelor. Mai general, pentru orice funcție \(g\) pentru care media există,
\[E[g(Y)] = \int_0^1 g(q_u)\,du,\]
(14.13)
deoarece \(Y\) are aceeași distribuție ca \(q_U\), cu \(U\) uniformă pe \((0,1)\). Aceasta este formula folosită cînd \(Y\) este logaritmul unei varianțe, iar ținta este varianța însăși, cu \(g = \exp\). Dacă \(g\) este crescătoare, \(g(q_u)\) este și cuantila de nivel \(u\) a lui \(g(Y)\); formula (14.13) nu are nevoie de această proprietate.
O verificare arată diferența. Fie \(Y\) uniformă pe \((-1, 1)\), deci \(q_u = 2u - 1\), și \(g(y) = y^2\). Atunci \(\int_0^1 (2u-1)^2\,du = 1/3 = E[Y^2]\), deși \((2u-1)^2\) nu este funcția cuantilă a lui \(Y^2\): ea scade și apoi crește în \(u\).
\(Y\): valoarea viitoare; \(K\): numărul de niveluri
De ce o grilă: din aceleași cuantile obținem prognoza punctuală, volatilitatea și riscul din coadă
Deci același model servește toate cele trei teste
Prognoze punctuale din grilă
mediana \(q_{0{,}5}\) sau media \(\int_0^1 q_u\,du\), media tuturor cuantilelor
pentru orice funcție \(g\) cu medie finită: \(E[g(Y)] = \int_0^1 g(q_u)\,du\), deoarece \(Y\) are aceeași distribuție ca \(q_U\), cu \(U\) uniformă (de exemplu \(g = \exp\) cînd \(Y\) este logaritmul unei varianțe)
Dacă \(g\) este crescătoare, \(g(q_u)\) este și cuantila de nivel \(u\) a lui \(g(Y)\)
Verificare: \(Y\) uniformă pe \((-1;\ 1)\), \(q_u = 2u - 1\), \(g(y) = y^2\): \(\int_0^1 (2u-1)^2\,du = 1/3 = E[Y^2]\), deși \((2u-1)^2\) nu este o cuantilă a lui \(Y^2\) (scade, apoi crește în \(u\))
Sub cel mai mic nivel al grilei, modelul nu oferă nicio informație, iar regula aleasă acolo schimbă rezultatul. Păstrarea lui \(q_u\) constant la \(q_{0{,}01}\) sub 1% subestimează ES, pentru că adevăratele cuantile de acolo sînt mai mici; extrapolarea poate greși în ambele sensuri (exercițiile A1 și A7 din Seminarul 14).
Problema este acută pentru cele două modele a căror grilă se oprește la 10%. Pentru Chronos-Bolt și TimesFM, o cerere de VaR 1% returnează cuantila de 10%. Regula din capitol este interpolarea liniară între nivelurile grilei, cu \(q_u\) constant sub cel mai mic nivel. Un exemplu rezolvat este în Aprofundări.
Pe scurt
Riscul de coadă la nivelul \(\alpha\) (Capitolul 7), pentru un randament \(Y\)
Un test este out-of-sample doar dacă perioada de test nu a fost văzută la antrenare. Pentru un model fundațional, ea poate fi văzută în patru moduri:
(i) aceeași serie este în corpusul de pre-antrenare;
(ii) serii corelate din corpus conțin aceleași șocuri;
(iii) dezvoltatorii aleg versiunile modelului după benchmark-uri publice care se suprapun cu testul;
(iv) look-ahead-ul cercetătorului, cînd scalările, ferestrele, seed-urile sau contextele sînt alese cu date de test.
Corpusul Chronos include serii financiare, de exemplu cursuri de schimb zilnice din 1990–2016, deci nu se poate exclude ca seriile din acest capitol să fi fost văzute la pre-antrenare. Remediul pentru (i)–(iii) este o fereastră de după publicare care începe la 3 noiembrie 2025, o dată-limită comună după publicarea tuturor celor trei seturi de ponderi. Fereastra este scurtă: circa 220 de zile de tranzacționare, sau 320 de zile calendaristice pentru Bitcoin, care se tranzacționează în fiecare zi. Testele pe ea au putere mică, mai ales pentru VaR 1%. Fereastra este ferită de contaminarea ponderilor doar dacă checkpoint-ul folosit este anterior ei; de aceea revizia și amprenta (hash) ponderilor sînt fixate în cod (anexa despre corpusuri).
Canalul (iv) este sub controlul cercetătorului: fiecare scalare, fereastră și estimare din capitol folosește doar date trecute. Alegerea retrospectivă a lungimii contextului sau a hiperparametrilor rămîne posibilă și după publicare, deci este nevoie de un protocol formal; el este dat în Anexă.
Pe scurt
Scurgerea de informație: perioada de test a fost văzută la antrenare, deci testul nu mai este în afara eșantionului (out-of-sample)
Perioada de test poate fi „văzută” în patru moduri
(i) aceeași serie este în corpusul de pre-antrenare
(ii) serii corelate conțin aceleași șocuri
(iii) dezvoltatorii aleg versiunile după repere publice (benchmarks) care se suprapun cu datele de test
(iv) deplasarea de anticipare (look-ahead bias), prin folosirea datelor viitoare: scalări, ferestre, seed-uri sau contexte alese cu date de test
Corpusul Chronos include serii financiare (de exemplu cursuri de schimb zilnice 1990–2016)
Deci nu putem exclude ca seriile noastre să fi fost văzute la pre-antrenare
Remediul pentru (i)–(iii): o fereastră de după publicare, de la 3 noiembrie 2025
O dată-limită comună după publicarea tuturor celor trei seturi de ponderi
Scurtă: circa 220 de zile de tranzacționare (320 de zile calendaristice pentru Bitcoin), deci putere mică, mai ales pentru VaR 1%
Fără contaminare a ponderilor doar dacă checkpoint-ul folosit precedă fereastra: revizia și amprenta ponderilor sînt fixate în cod (anexa despre corpusuri)
(iv) este sub controlul nostru: scalările, ferestrele și estimările folosesc doar date trecute
Alegerea retrospectivă a contextului sau a hiperparametrilor rămîne posibilă și după publicare
Un model fundațional zero-shot este o transformare fixă de la o fereastră de context la o grilă de cuantile. Din grilă rezultă media, mediana, volatilitatea și perechea (VaR, ES), dar coada de dincolo de ultima cuantilă rămîne o alegere de modelare. Pentru că corpusurile pot conține seriile de test, rezultatele sînt raportate și pe fereastra de după 3 noiembrie 2025.
Testul 1: prognoza randamentelor
Primul test pune cea mai veche întrebare a finanțelor empirice celor mai noi modele: prognozează vreun model randamentul de mîine mai bine decît prognoza zero? Secțiunea descrie designul, \(R^2\) out-of-sample și testul Diebold–Mariano, apoi cele două corecții pe care le cere compararea multor modele cu un reper simplu: ajustarea Clark–West pentru modele imbricate (nested) și ajustările pentru testarea multiplă (multiple testing).
Testul folosește randamentele zilnice a trei piețe. S&P 500 și BET, indicele Bursei de Valori București, încep la 4 ianuarie 2016; Bitcoin începe la 1 ianuarie 2019. Eșantioanele de test au 2 693 de zile pentru S&P 500, 2 675 de zile pentru BET și 2 818 zile pentru Bitcoin, circa zece ani pentru cei doi indici și opt pentru Bitcoin, și includ crahul din martie 2020 și anul 2022.
Cele trei piețe sînt alese pentru diferențele dintre ele:
S&P 500 este cea mai lichidă piață de acțiuni, unde un semnal simplu ar fi fost deja exploatat.
BET este o piață mai mică și mai puțin lichidă, unde prețurile vechi (stale prices) pot crea predictibilitate.
Bitcoin se tranzacționează non-stop, iar abaterea standard zilnică este de aproape trei ori mai mare: 3,21%, față de 1,13% pentru S&P 500.
Șase modele sînt comparate cu prognoza zero:
media istorică;
un AR(1), \(\hat r_t = \hat a + \hat b\, r_{t-1}\), estimat prin cele mai mici pătrate pe ultimele 1 000 de zile și reestimat zilnic;
un LSTM;
cele trei modele fundaționale.
Pentru modelele fundaționale, prognoza punctuală este mediana grilei, pe care valorile extreme nu o mișcă; prognozele obținute din mediile grilelor sînt raportate separat. Fiecare prognoză folosește doar date pînă la închiderea din ziua anterioară.
Pe scurt
Întrebarea: prognozează vreun model randamentul zilnic de mîine mai bine decît prognoza zero?
Perioada de test: S&P 500 și BET de la 04.01.2016, Bitcoin de la 01.01.2019, pînă la 18.09.2026
BET: indicele Bursei de Valori București; 2 693 de zile (S&P 500), 2 675 (BET) și 2 818 (Bitcoin)
Circa zece ani (opt pentru Bitcoin), inclusiv crahul din martie 2020 și anul 2022
Estimarea folosește și datele dinainte: seriile încep în 1990 (S&P 500), 1997 (BET) și 2014 (Bitcoin)
De ce trei piețe
S&P 500: piața de acțiuni cea mai lichidă, unde un semnal simplu ar fi fost deja exploatat
BET: o piață mai mică și mai puțin lichidă, unde prețurile neactualizate (stale) pot crea predictibilitate
Bitcoin: tranzacționat continuu, cu o abatere standard zilnică de aproape trei ori mai mare (3,21%, față de 1,13% pentru S&P 500)
Modele: media istorică, AR(1), LSTM, Chronos-2, Chronos-Bolt și TimesFM-2.5
AR(1): \(\hat r_t = \hat a + \hat b\, r_{t-1}\), estimat prin cele mai mici pătrate pe ultimele 1 000 de zile, reestimat zilnic
Modelele fundaționale: mediana grilei, o prognoză punctuală pe care valorile extreme nu o mută; mediile din grilă sînt raportate separat
Fiecare prognoză folosește doar date pînă la închiderea precedentă
unde \(r_t\) este randamentul realizat, iar \(\hat r_t\) prognoza făcută cu date pînă la \(t-1\). O valoare pozitivă în (14.15) înseamnă că modelul are erori pătratice mai mici decît prognoza zero; spre deosebire de \(R^2\) in-sample, poate fi negativă, și este negativă ori de cîte ori modelul face mai rău decît zero.
Prognoza zero este preferată mediei istorice ca reper pentru că media estimată adaugă zgomot de estimare. Literatura le folosește pe amîndouă: zero este reperul lui Gu, Kelly & Xiu (2020), iar media istorică al lui Campbell & Thompson (2008). Cu zero ca reper, media istorică devine ea însăși unul dintre modelele concurente.
Folosirea mediei grilei, \(\int_0^1 q_u\,du\), în locul medianei face modelele fundaționale mai slabe. Pe S&P 500, \(R^2\) out-of-sample al mediei grilei este −0,77% pentru Chronos-2 și −3,42% pentru TimesFM-2.5. Media este trasă de cuantilele extreme, iar în media randamentelor zilnice este prea puțin semnal pentru a compensa varianța adăugată.
Pe scurt
Reperul este prognoza zero, iar \(R^2\) în afara eșantionului se calculează ca
Incertitudinea lui \(R^2_{\text{OOS}}\) este măsurată printr-un interval de încredere (CI, confidence interval) obținut prin bootstrap pe blocuri (block bootstrap). O perioadă de test de aceeași lungime este reconstruită din blocuri de 20 de zile consecutive extrase cu revenire, de 1 000 de ori, iar percentilele de 2,5% și 97,5% ale valorilor \(R^2\) obținute formează intervalul. Se extrag blocuri, nu zile izolate, pentru ca episoadele de volatilitate să rămînă întregi.
Testul acurateței egale este testul Diebold–Mariano (DM) (Diebold & Mariano, 1995) pe erorile pătratice:
În (14.16),\(\bar d\) este media diferenței de pierdere \(d_t\) pe cele \(n\) prognoze, iar \(\hat V_{NW}\) este varianța pe termen lung a lui \(d_t\), estimată cu estimatorul Newey–West, consistent în prezența heteroscedasticității și a autocorelației (HAC, heteroskedasticity and autocorrelation consistent). Un DM pozitiv înseamnă că modelul are erori mai mari decît prognoza zero. Sub \(H_0\colon E[d_t] = 0\), DM urmează aproximativ distribuția Normală standard.
Aproximarea cere o varianță pe termen lung a lui \(d_t\) finită și nenulă și o dependență slabă. Aici \(d_t = \hat r_t^2 - 2 r_t \hat r_t\), deci contează momentele lui \(r_t \hat r_t\), nu neapărat momentul de ordinul patru al randamentelor, \(E[r_t^4]\), care poate să nu existe pentru randamente zilnice cu cozi groase. Felul în care este antrenat LSTM-ul din test este arătat în Aprofundări.
Pe scurt
Interval de încredere (CI, confidence interval) bootstrap pe blocuri pentru \(R^2\)
Reconstruim o perioadă de test de aceeași lungime din blocuri de 20 de zile consecutive, extrase cu întoarcere
De 1 000 de ori, apoi păstrăm percentilele de 2,5% și 97,5%
\(\bar d\): media lui \(d_t\) pe cele \(n\) prognoze; \(\mathrm{DM} > 0\): modelul are erori mai mari decît prognoza zero
\(\hat V_{NW}\): varianța de termen lung a lui \(d_t\), estimată Newey–West, un estimator HAC (heteroskedasticity and autocorrelation consistent, robust la heteroscedasticitate și autocorelație)
Sub \(H_0\colon E[d_t] = 0\), DM are aproximativ distribuția Normală standard
Aproximarea cere ca \(d_t\) să aibă varianță de termen lung finită și nenulă și dependență slabă
Aici \(d_t = \hat r_t^2 - 2 r_t \hat r_t\): contează momentele lui \(r_t \hat r_t\), nu neapărat \(E[r_t^4]\)
Graficul sintetizează Testul 1 pe cele trei piețe. El compară fiecare model cu prognoza zero prin \(R^2_{\text{OOS}}\) din (14.15) și arată incertitudinea fiecărei estimări prin intervalul ei bootstrap de 95%. Tabelul complet, cu p-value-urile DM, este în Anexă.
Graficul interactiv grupează barele pe piețe pe axa orizontală; axa verticală este \(R^2_{\text{OOS}}\) față de prognoza zero, în procente, iar fiecare bară are intervalul ei bootstrap circular de 95%, cu blocuri de 20 de observații. Trecînd cu mouse-ul peste o bară se văd intervalul și p-value-ul DM. Cursorul mută începutul evaluării din 2016 pînă la fereastra de după publicare, de la 3 noiembrie 2025, iar butonul ▶ parcurge anii de început.
Întrebare pentru sală Pe perioada completă de test pentru S&P 500, testul DM bilateral la 5% stabilește superioritatea AR(1) sau a LSTM față de prognoza zero?
Răspuns
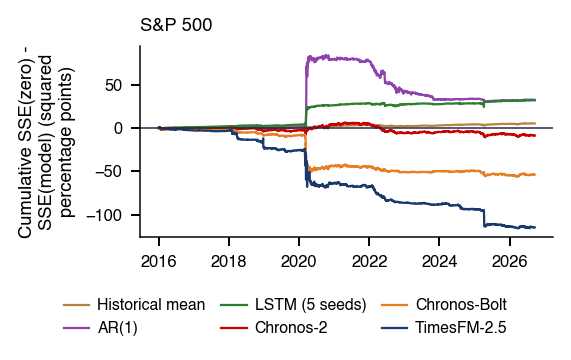
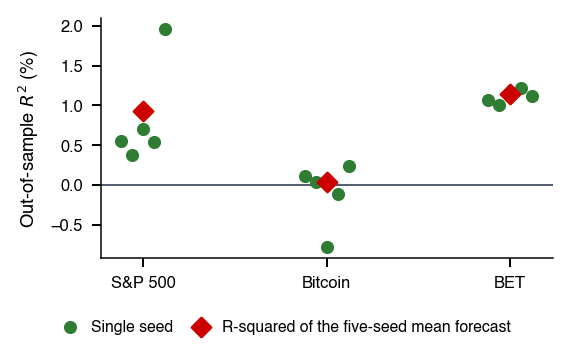
Nu. AR(1) și LSTM reduc eroarea pătratică medie observată cu 0,94%, respectiv 0,93% (R² out-of-sample), dar p-value-urile DM bilaterale sînt 0,639 și 0,090. Testul nu stabilește superioritatea la 5% și nici nu demonstrează egalitatea. TimesFM-2.5 este semnificativ mai slab decît zero (R² −3,35%, p DM = 0,001). Doar pe BET LSTM trece la 5% (R² +1,15%, p = 0,014), înainte de corecția pentru testele multiple.
Pe S&P 500 și Bitcoin, niciun model nu depășește prognoza zero în testul DM bilateral. Pe S&P 500, AR(1) și LSTM reduc eroarea pătratică medie cu 0,94%, respectiv 0,93% față de zero, dar p-value-urile DM bilaterale sînt 0,639 și 0,090; testul nu stabilește nici superioritatea la 5%, nici egalitatea. Media istorică trece testul Clark–West pentru modele imbricate (\(p\) = 0,007), dar nu și testul comun SPA (\(p\) = 0,130); ambele teste sînt explicate pe slide-urile următoare.
TimesFM-2.5 este semnificativ mai slab decît zero pe S&P 500: \(R^2_{\text{OOS}}\) este −3,35%, cu \(p\) DM = 0,001. Abaterea standard a prognozelor lui este 0,141%, de trei ori mai mare decît a LSTM, iar variația suplimentară a prognozelor se adaugă la erorile lui pătratice.
Pe BET, LSTM are \(R^2_{\text{OOS}}\) = +1,15%, cu un \(p\) DM bilateral de 0,014 și unul unilateral de 0,007. Semnalul este mic, iar slide-urile următoare îl testează pentru imbricare, pentru testarea multiplă și, în Aprofundări, pentru prețurile vechi.
Pe scurt
\(R^2\) față de prognoza zero (%), CI bootstrap de 95% (blocuri de 20 de zile)
Prognoza zero este imbricată în media istorică și în AR(1): fiecare dintre ele devine prognoza zero cînd coeficienții săi sînt nuli. Sub ipoteza nulă că modelul mai mare nu are informație, el doar adaugă zgomot de estimare prognozelor, ceea ce îi mărește erorile pătratice. Testul DM respinge atunci prea rar, pentru că diferența din populație este zero, în timp ce diferența din eșantion este deplasată în defavoarea modelului mai mare.
Clark & West (2007) adaugă înapoi termenul de zgomot și testează media diferenței ajustate cu un test \(t\) HAC unilateral:
În (14.17),\(\hat r_{0,t}\) este prognoza zero a modelului mic, \(\hat r_{1,t}\) prognoza modelului mare, iar \(e_{0,t}\),\(e_{1,t}\) erorile lor \(r_t - \hat r_{\cdot,t}\). Termenul \((\hat r_{0,t} - \hat r_{1,t})^2\) este costul estimării unor coeficienți care sînt nuli sub \(H_0\). Ipoteza nulă este \(E[\tilde d_t] = 0\), iar un \(t\) mare și pozitiv înseamnă că modelul mare adaugă informație. Față de prognoza zero, \(\tilde d_t = 2 r_t \hat r_t\); ambele teste cer o varianță pe termen lung a diferenței finită și nenulă.
Corecția schimbă concluziile. Pentru media istorică, p-value-ul unilateral scade de la 0,048 (DM) la 0,007 (Clark–West) pe S&P 500 și de la 0,041 la 0,003 pe BET. Pentru AR(1) pe S&P 500 scade de la 0,320 la 0,055. Cu această corecție, media istorică este semnificativă pe ambele piețe, dar cîștigul rămîne mic: \(R^2_{\text{OOS}}\) de 0,15% pe S&P 500 și de 0,30% pe BET. AR(1) pe BET și ferestrele rolling sînt în Anexă.
Pe scurt
Problema: prognoza zero este imbricată în media istorică și în AR(1)
Sub \(H_0\), modelul mai mare doar adaugă zgomot de estimare, deci DM respinge prea rar
Testul 1 aplică 6 modele pe 3 piețe, deci 18 teste în total, iar cel mai mic p-value DM unilateral este al LSTM pe BET, 0,007. Un p-value mic printre multe este o dovadă mai slabă decît un singur p-value mic. Dacă niciun model nu ar avea semnal și cele 18 teste ar fi independente, cel puțin un \(p < 0{,}05\) ar apărea cu probabilitatea \(1 - 0{,}95^{18} = 0{,}60\).
Corecția Bonferroni controlează probabilitatea oricărei respingeri false, rata erorii pe familie (family-wise error rate), respingînd doar cînd \(p < 0{,}05/M\) pentru \(M\) teste; aici pragul este \(0{,}05/18 = 0{,}0028\). Procedura Holm aplică aceeași idee pas cu pas: cel mai mic p-value este comparat cu \(0{,}05/M\), următorul cu \(0{,}05/(M-1)\) și așa mai departe, oprindu-se la prima nerespingere. Ea controlează aceeași rată de eroare și respinge cel puțin la fel de des ca Bonferroni.
Pe cele 18 teste, p-value-ul ajustat Holm al LSTM pe BET este 0,130. Nu este semnificativ: semnalul de pe BET nu rezistă cînd sînt luate în calcul toate comparațiile efectuate.
Pe scurt
6 modele \(\times\) 3 piețe = 18 teste
Cea mai mică valoare \(p\) DM unilaterală, 0,007, o are LSTM pe BET
Problema: cel puțin un \(p < 0{,}05\) ar apărea cu probabilitatea \(1 - 0{,}95^{18} = 0{,}60\)
Dacă niciun model nu ar avea semnal și testele ar fi independente
Bonferroni: cu \(M\) teste, respingem \(H_0\) doar dacă \(p < 0{,}05/M\)
Aici, pragul este 0,0028
Holm: aceeași idee, aplicată pas cu pas, începînd cu cel mai mic \(p\)
Ambele controlează probabilitatea de a face cel puțin o respingere falsă
Valoarea \(p\) ajustată Holm pe cele 18 teste este 0,130: nesemnificativă
Bonferroni și Holm ignoră corelația dintre teste, iar prognozele a șase modele pe aceeași piață sînt puternic corelate. Două proceduri bootstrap folosesc această corelație. Metoda pas cu pas a lui Romano & Wolf (2005) dă LSTM pe BET un p-value ajustat de 0,016 între cele șase modele de pe BET. Testul de abilitate predictivă superioară (SPA, superior predictive ability) al lui Hansen (2005) are ipoteza nulă că niciun model nu depășește prognoza zero; p-value-urile lui sînt 0,018 pe BET, 0,130 pe S&P 500 și 0,354 pe Bitcoin. Ambele proceduri cer varianțe pe termen lung ale diferențelor finite și nenule și un bootstrap staționar valid.
Concluzia depinde de familia de teste fixată dinainte. Afirmația „un model depășește prognoza zero pe BET” este valabilă dacă BET a fost ales dinainte ca familie de test. Dacă familia este formată din cele trei piețe, corecția Holm ridică p-value-ul SPA al BET la \(3 \times 0{,}0185 = 0{,}056\), puțin peste 5%. Afirmația „o anumită comparație din cele 18 este reală” nu este valabilă. Familia trebuie fixată înainte de a vedea rezultatele.
Rezultatul susține o comparație de proceduri, nu un semnal de tranzacționare. Pe S&P 500, o singură lună, martie 2020, decide clasamentul modelelor (Aprofundări). Felul în care funcționează Holm, Romano–Wolf și SPA, cu un exemplu cu trei teste, este arătat în Anexă.
Pe scurt
Pentru cele șase modele pe BET: teste care folosesc corelația dintre modele
Romano–Wolf (Romano & Wolf (2005)): valoarea \(p\) ajustată prin procedura descendentă (step-down) a LSTM pe BET este 0,016
Testul SPA (superior predictive ability, Hansen (2005)), cu \(H_0\): niciun model nu depășește prognoza zero
Valorile \(p\) SPA: BET 0,0185, S&P 500 0,130, Bitcoin 0,354
SPA și Romano–Wolf cer varianțe de termen lung finite și nenule ale diferențialelor și un bootstrap staționar valid
Afirmația „un model depășește prognoza zero pe BET” este valabilă dacă BET a fost ales dinainte ca familie de teste
Corectate Holm pentru cele trei piețe, valorile \(p\) SPA dau pentru BET \(3 \times 0{,}0185 = 0{,}056\)
Chiar peste pragul de 5%
Afirmația „o anumită comparație dintre cele 18 este semnificativă” nu este valabilă
Stabiliți familia de teste înainte de a examina rezultatele
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
Pe S&P 500, o singură lună, martie 2020, determină clasamentul (Aprofundări)
Cum funcționează Holm, Romano–Wolf și SPA, cu un exemplu cu trei teste, în Anexă
Pentru randamente, niciun model nu depășește prognoza zero pe S&P 500 și Bitcoin, iar TimesFM-2.5 este semnificativ mai slab decît zero pe S&P 500. Media istorică cîștigă puțin odată ce testul ține cont de imbricare, iar semnalul LSTM pe BET depinde de familia de teste aleasă. Media randamentelor zilnice nu este locul în care rețelele profunde sau modelele fundaționale aduc valoare.
Testul 2: prognoza volatilității realizate
Autocorelațiile din prima secțiune au arătat că partea predictibilă a randamentelor zilnice se află în mărimea lor. Al doilea test întreabă de aceea dacă modelele fundaționale, folosite zero-shot, prognozează varianța zilnică a S&P 500 mai bine decît reperul econometric standard. Ținta este varianța realizată calculată din prețuri intrazilnice, reperul este log-HAR, iar pierderea este QLIKE; fiecare alegere este justificată mai jos.
Întrebarea este dacă modelele fundaționale zero-shot prognozează varianța zilnică a S&P 500 mai bine decît log-HAR, reperul econometric standard. Varianța este măsurată pe SPY, fondul tranzacționat la bursă (ETF, exchange-traded fund) care replică S&P 500: este foarte lichid și are prețuri la 5 minute, din care se calculează varianța realizată.
Log-HAR este reperul pentru că aproximează memoria lungă a volatilității cu trei medii și doar patru coeficienți (Corsi, 2009). QLIKE este pierderea aleasă pentru că ordonează corect prognozele (Patton, 2011), chiar și atunci cînd varianța adevărată, care nu este observată, este înlocuită cu un proxy zgomotos. Orizontul este de o zi, același ca pentru VaR din Testul 3.
Pe scurt
Întrebarea: prognozează modelele fundaționale zero-shot varianța zilnică a S&P 500 mai bine decît log-HAR?
Log-HAR: reperul econometric standard
De ce SPY: ETF-ul (Exchange-Traded Fund, fond tranzacționat la bursă) pe S&P 500 este foarte lichid și are prețuri la 5 minute
Din ele se calculează varianța realizată
De ce log-HAR: aproximează memoria lungă cu trei medii și doar patru coeficienți (Corsi (2009))
De ce QLIKE (Patton (2011)): ordonează corect prognozele
Chiar cînd varianța adevărată este înlocuită de o aproximare zgomotoasă
Orizontul: o zi, același cu al VaR-ului din Testul 3
Varianța realizată, modelul HAR și pierderea QLIKE (1/2)
Varianța realizată (RV, realised variance) (Andersen et al., 2003) este suma pătratelor randamentelor logaritmice intrazilnice din ziua de tranzacționare:
\[\mathrm{RV}_t = \sum_{j=1}^{78} r_{t,j}^2,\]
(14.18)
unde \(r_{t,j}\) este randamentul logaritmic al intervalului de 5 minute \(j\) din ziua \(t\). Primul randament este luat în interiorul barei de la 09:30, \(r_{t,1} = \ln(C_{t,1}/O_{t,1})\), de la deschiderea \(O\) la închiderea \(C\) ei, deci mișcarea de peste noapte este exclusă; următoarele sînt \(r_{t,j} = \ln(C_{t,j}/C_{t,j-1})\). Ședința regulată a SPY, 09:30–16:00 ora New York-ului, are 78 de intervale, iar zilele fără grila completă sînt eliminate. Pe eșantionul de test, volatilitatea medie implicată de RV este de 12,1% pe an.
Modelul autoregresiv eterogen (HAR) al lui Corsi (2009) regresează RV de azi pe valoarea de ieri și pe mediile din ultima săptămînă și din ultima lună:
În (14.19),\(\overline{\mathrm{RV}}_{t-5:t-1}\) și \(\overline{\mathrm{RV}}_{t-22:t-1}\) sînt mediile pe ultimele 5 și 22 de zile de tranzacționare, iar \(\beta_d\),\(\beta_w\),\(\beta_m\) sînt ponderile zilnică, săptămînală și lunară. Cele trei medii se suprapun, deci modelul este un AR(22) restricționat, cu patru coeficienți, iar suma a trei componente cu persistențe diferite aproximează memoria lungă.
Reperul testului, log-HAR, aplică aceeași regresie lui \(\log \mathrm{RV}\). Prognoza lui pentru RV este \(\exp(\hat y + \hat s^2/2)\), unde \(\hat y\) este valoarea ajustată a lui log RV, iar \(\hat s^2\) varianța reziduurilor logaritmice. Factorul \(e^{\hat s^2/2}\) transformă o prognoză logaritmică într-o prognoză a mediei lui RV cînd eroarea logaritmică este condiționat Normală; fără el, \(\exp(\hat y)\) ar prognoza mediana.
Prognozele sînt comparate cu pierderea de cvasi-verosimilitate (QLIKE, quasi-likelihood) a lui Patton (2011). Pentru o prognoză de varianță \(\hat h_t\),
Pierderea (14.20) este nenegativă și este zero doar cînd \(\hat h_t = \mathrm{RV}_t\). Ea este asimetrică: o subestimare costă mai mult decît o supraestimare de aceeași mărime. Media ei este minimizată de media condiționată.
Proprietatea care justifică QLIKE privește proxy-ul. Fie \(\mathcal{F}_{t-1}\) informația pînă la \(t-1\). Dacă RV este un proxy condiționat nedeplasat al varianței adevărate \(\sigma^2_t\),\(E[\mathrm{RV}_t \mid \mathcal{F}_{t-1}] = \sigma^2_t\), atunci QLIKE ordonează prognozele la fel ca varianța adevărată; MSE are aceeași proprietate.
Pe scurt
log-HAR: aceeași regresie, estimată pe \(\log \mathrm{RV}\), cu prognoza \(\exp(\hat y + \hat s^2/2)\)
\(\hat y\): valoarea ajustată a log RV
\(\hat s^2\): varianța reziduurilor din regresia pe logaritmi
Factorul \(e^{\hat s^2/2}\) transformă prognoza logaritmică în media lui RV, dacă eroarea logaritmică are condiționat distribuția Normală
Pierderea QLIKE a unei prognoze de varianță \(\hat h_t\) (Patton (2011))
QLIKE: quasi-likelihood, de tip cvasi-verosimilitate
Subestimările costă mai mult decît supraestimările de aceeași mărime
Media pierderii QLIKE este minimizată de media condiționată
QLIKE ordonează prognozele la fel ca varianța adevărată \(\sigma_t^2\) cînd RV este o aproximare condiționat nedeplasată, \(E[\mathrm{RV}_t \mid \mathcal{F}_{t-1}] = \sigma_t^2\), cu \(\mathcal{F}_{t-1}\) informația pînă la \(t-1\) (la fel și MSE)
Testul produce prognoze cu o zi înainte ale varianței realizate a SPY între 11 octombrie 2022 și 18 septembrie 2026, adică 979 de zile. Modelele clasice sînt estimate pe ferestre rolling. HAR și log-HAR folosesc ultimele 500 de zile. Mersul aleator (random walk) prognozează valoarea de ieri, \(\hat h_t = \mathrm{RV}_{t-1}\). GARCH-t, un GARCH(1,1) cu inovații Student-\(t\), este estimat pe randamentele zilnice ale SPY și adus la unitățile lui RV prin raportul dintre RV medie și randamentul pătratic mediu pe 500 de zile. LSTM citește ultimele 22 de valori ale lui log RV și este reantrenat la fiecare 125 de zile pe 500 de zile, cu dimensiunea stării ascunse 8 și trei seed-uri.
Modelele fundaționale primesc \(\log \mathrm{RV}\) cu un context de 512 zile, iar prognoza lor este media lui RV calculată din grilă prin (14.13), cu \(g = \exp\):
\[\hat h_t = \int_0^1 \exp(q_u)\,du.\]
(14.21)
\(q_u\) sînt cuantile ale lui log RV, \(\exp(q_u)\) sînt cuantile ale lui RV, iar media lor este media lui RV. Pe grila discretă, integrala se calculează cu regula trapezului pe nivelurile returnate, cu \(q_u\) păstrat la valoarea de la cel mai mic nivel sub acesta și la valoarea de la cel mai mare nivel deasupra lui. Aceeași regulă se aplică tuturor celor trei modele, iar media returnată separat de TimesFM nu este folosită. Fereastra de după publicare are 218 zile, de la 3 noiembrie 2025.
Pe scurt
Varianța realizată a SPY, prognoze la o zi
De la 11.10.2022 pînă la 18.09.2026 (979 de zile)
HAR și log-HAR pe o fereastră mobilă de 500 de zile
GARCH-t (GARCH(1,1) cu inovații Student-\(t\)) pe randamentele zilnice ale SPY, rescalat în unități RV prin raportul dintre media RV și media randamentelor la pătrat pe 500 de zile
LSTM pe ultimele 22 de valori ale log RV, reantrenat la fiecare 125 de zile pe 500 de zile (stare ascunsă 8, trei seed-uri)
Modelele fundaționale pe \(\log \mathrm{RV}\) (context 512): prognoza \(\hat h_t = \int_0^1 \exp(q_u)\,du\) pe grila de cuantile
\(q_u\) sînt cuantilele log RV, \(\exp(q_u)\) cele ale RV
Media lor este media RV
Pe grilă: regula trapezului pe nivelurile furnizate, cu \(q_u\) păstrat la valoarea de la cel mai mic nivel sub acesta și la valoarea de la cel mai mare nivel deasupra lui
Aceeași regulă pentru toate cele trei modele, fără ieșirea de medie a TimesFM
Fereastra de după publicare: 218 zile de la 3 noiembrie 2025 (S&P 500 are 220: ședințele scurtate din 28.11 și 24.12.2025 nu au grila completă de 5 minute)
Un episod de stres arată cum reacționează prognozele înainte ca pierderile să fie mediate. La începutul lui aprilie 2025, după anunțurile tarifare din SUA, volatilitatea realizată a SPY a făcut un salt pe 4 aprilie și a atins vîrful pe 7 aprilie. O prognoză cu o zi înainte făcută după închiderea din 4 aprilie poate folosi saltul din acea zi, dar nu și știrile din zilele următoare.
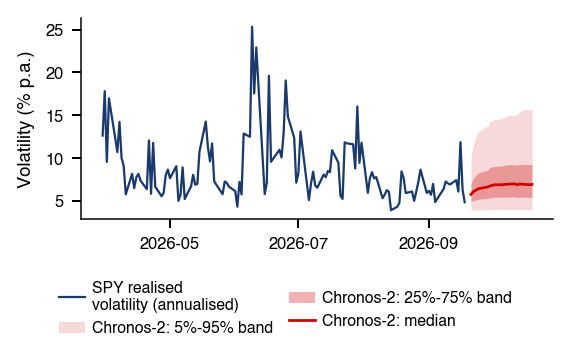
Graficul interactiv are datele pe axa orizontală și volatilitatea anualizată, în procente, pe axa verticală. Linia groasă este volatilitatea realizată, \(\sqrt{252\,\mathrm{RV}_t}\), iar liniile subțiri sînt prognozele cu o zi înainte ale log-HAR, GARCH-t, Chronos-2 și TimesFM-2.5; celelalte modele pot fi afișate din legendă. Cursorul mută o fereastră de 6 luni prin perioada de test, iar butonul ▶ o parcurge.
Întrebare pentru sală Care dintre modelele afișate implicit a anticipat amplitudinea vîrfului de volatilitate realizată a SPY din 7 aprilie 2025?
Răspuns
Niciunul. Volatilitatea realizată a fost 106,7% anualizat. Prognozele pentru acea zi au fost 27,5% pentru log-HAR, 29,9% pentru GARCH-t, 30,1% pentru Chronos-2 și 30,4% pentru TimesFM-2.5. Ele cresc deja față de ziua precedentă, după saltul din 4 aprilie (46,3%), dar subestimează vîrful de peste trei ori. Cozile groase și pre-antrenarea nu aduc informația din știrile tarifare încă neobservate.
În februarie–iulie 2025, volatilitatea realizată a atins vîrful de 106,7% pe an la 7 aprilie 2025. Niciun model nu a anticipat saltul din 4 aprilie, cînd volatilitatea a ajuns la 46,3%. Prognozele pentru 7 aprilie cresc după acest salt, la 27,5% pentru log-HAR, 29,9% pentru GARCH-t, 30,1% pentru Chronos-2 și 30,4% pentru TimesFM-2.5, dar toate subestimează vîrful de peste trei ori. Prognozele la o zi extrapolează trecutul, iar șocul a venit din știri încă neobservate; nici cozile groase, nici pre-antrenarea nu aduc această informație.
După șoc, modelele fundaționale și log-HAR revin cu viteze asemănătoare. GARCH-t reacționează la randamentele zilnice, nu la RV, și revine mai încet.
Pe scurt
Volatilitatea realizată a SPY (anualizată) și prognozele la o zi, februarie–iulie 2025
Vîrful: 107% pe an la 07.04.2025, după anunțurile tarifare ale Statelor Unite
Niciun model nu anticipează saltul din 04.04.2025 (46% pe an)
Prognozele pentru 07.04.2025 urcă la 27–30% pe an
Toate subestimează vîrful de 107%
Prognozele la o zi extrapolează trecutul, iar șocurile provin din știri
Modelele fundaționale și log-HAR revin cu viteze asemănătoare
GARCH-t reacționează la randamentele zilnice și revine mai lent
Rezultatul central al capitolului compară pierderile QLIKE medii (14.20) ale celor opt modele pe perioada de test. Comparația se face de două ori: pe toată perioada de test și pe fereastra de după publicare, cînd niciunul dintre modelele fundaționale nu ar fi putut vedea datele la pre-antrenare.
Graficul interactiv are două panouri cu bare orizontale, cîte una pentru fiecare model, cu pierderea medie pe axa orizontală; o bară mai scurtă este mai bună. Panoul din stînga acoperă perioada de test de la data fixată cu cursorul, iar cel din dreapta doar zilele de după 3 noiembrie 2025. Selectorul schimbă pierderea între QLIKE și MSE, iar butonul ▶ mută începutul panoului din stînga.
Întrebare pentru sală Pe cele 979 de zile de test SPY, ce concluzie permite testul DM bilateral la 5% despre Chronos-2 față de log-HAR, sub QLIKE?
Răspuns
QLIKE medie este 0,223 pentru Chronos-2 și 0,226 pentru log-HAR, dar p DM = 0,539. Avantajul descriptiv nu stabilește superioritatea statistică, iar nerespingerea nu demonstrează echivalența. După 3 noiembrie 2025, micul LSTM are cea mai mică medie observată, 0,217; aceasta este o clasare în eșantion.
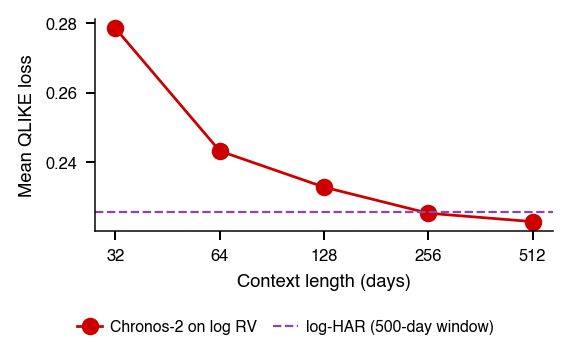
Pe toată perioada de 979 de zile, Chronos-2 are cea mai mică pierdere QLIKE medie, 0,223, iar log-HAR are 0,226. Testul DM pentru Chronos-2 față de log-HAR dă \(p\) = 0,539: avantajul descriptiv nu stabilește superioritatea, iar nerespingerea nu stabilește echivalența. După 3 noiembrie 2025, pe 218 zile, micul LSTM are cea mai mică pierdere medie, 0,217; este un clasament într-un singur eșantion.
iar testul cere ca momentele ei să fie finite, deci și ca prognozele să rămînă departe de zero. Chronos-2 (0,223), Chronos-Bolt, TimesFM-2.5 și log-HAR (0,226) nu diferă semnificativ în testele DM; pentru Chronos-2, \(p\) = 0,539.
Mulțimea de modele de încredere (MCS, model confidence set) a lui Hansen, Lunde & Nason (2011) consideră toate modelele deodată. Pornind de la mulțimea completă, ea testează dacă toate modelele au pierderi medii egale și, dacă egalitatea este respinsă, elimină modelul cel mai slab; repetă pînă cînd egalitatea nu mai este respinsă. Modelele rămase formează o mulțime care conține cel mai bun model cu o probabilitate dată, aici 90%. MCS de 90% păstrează șase dintre cele opt modele: sînt eliminate doar mersul aleator și GARCH-t.
Două rezultate suplimentare nuanțează clasamentul. HAR în niveluri supraestimează: prognoza lui medie este de 1,35 ori media lui RV. După publicare, micul LSTM este cel mai bun (0,217), deci clasamentele sînt instabile de la o perioadă la alta. Rezultatul susține o comparație de proceduri: modelele fundaționale zero-shot nu se disting de reperul econometric. Tabelul complet, cu p-value-urile DM și MCS, este în Anexă.
Pe scurt
Panoul din stînga arată toată perioada de test (979 de zile)
Cel din dreapta: doar zilele de după 3 noiembrie 2025 (218 zile)
Testele DM nu arată diferențe semnificative (\(p\) = 0,539 pentru Chronos-2)
DM și MCS cer momente finite ale diferențialului \(d_t = \mathrm{RV}_t(1/h_{A,t} - 1/h_{B,t}) + \ln(h_{A,t}/h_{B,t})\), deci și prognoze care nu se apropie de zero
Testul DM întreabă dacă două modele au pierderi medii egale. Testul lui Giacomini & White (2006) pune o întrebare condiționată: poate fi prognozată diferența de pierdere din informația de ieri? Dacă da, un model este mai bun în anumite stări identificabile, chiar dacă diferența medie este zero. Cu instrumentele \(1\) și \(d_{t-1}\),
unde \(d_t\) este pierderea QLIKE a modelului minus cea a log-HAR, \(\bar Z\) este media lui \(Z_t\) pe cele \(n\) prognoze, iar \(\hat\Omega\) varianța pe termen lung a lui \(Z_t\). Ipoteza nulă este \(E[d_t] = 0\) și \(E[d_{t-1} d_t] = 0\) simultan. Varianța \(\hat\Omega\) este o estimare HAC cu nucleu Bartlett și 6 lag-uri, pentru că \(E[Z_t] = 0\) nu exclude autocorelația lui \(Z_t\); testul cere ca această varianță pe termen lung să fie finită și nesingulară.
P-value-urile sînt 0,828 pentru Chronos-2 și 0,812 pentru TimesFM-2.5: nu respingem ipoteza nulă și nu detectăm nicio diferență condiționată față de log-HAR. O diferență nedetectată nu este o dovadă de egalitate; puterea unor astfel de teste este analizată în secțiunea despre AI pentru descoperire științifică.
Prognoza (14.21) folosește media lui RV calculată din grilă. Alternativa mai simplă este exponențiala medianei, \(\exp(q_{0{,}5})\). Alegerea contează din cauza unei teoreme: QLIKE este consistentă pentru medie (Gneiting, 2011). Prognoza \(h\) care minimizează media pierderii, dată fiind informația \(\mathcal{F}\), este media condiționată,
Transformările monotone păstrează cuantilele, nu mediile. Exponențiala medianei lui log RV este deci mediana lui RV, o funcțională obținută prin eroarea absolută, nu prin QLIKE. Dacă RV este lognormală și \(s^2\) este varianța lui log RV, raportul dintre mediană și medie este \(e^{-s^2/2} < 1\), deci mediana subestimează sistematic media, adică exact în sensul pe care QLIKE îl penalizează mai mult.
Tabelul confirmă acest lucru. Cu media grilei, Chronos-2 are QLIKE 0,223, iar prognoza lui medie este de 1,02 ori media lui RV; TimesFM-2.5 are 0,225 și 0,94. Cu mediana, QLIKE crește la 0,249 și 0,250, iar ambele prognoze medii sînt de 0,80 ori media lui RV. Varianta cu mediana este semnificativ mai slabă (DM +3,53 pentru Chronos-2) și mai slabă și decît log-HAR (0,226). Cum influențează rezultatul regula pentru cozile grilei și lungimea contextului se vede în Aprofundări.
Pe scurt
Chronos-2 și TimesFM-2.5 pe log RV
QLIKE
Media prognozei / media RV
Chronos-2, \(\int_0^1 \exp(q_u)\,du\)
0,223
1,02
Chronos-2, \(\exp(q_{0{,}5})\)
0,249
0,80
TimesFM-2.5, \(\int_0^1 \exp(q_u)\,du\)
0,225
0,94
TimesFM-2.5, \(\exp(q_{0{,}5})\)
0,250
0,80
Rezultat teoretic (Gneiting (2011)): QLIKE este consistentă pentru medie
Prognoza \(h\) care minimizează media pierderii, dată fiind informația \(\mathcal{F}\), este media condiționată, \(\arg\min_h E[L(\mathrm{RV}, h) \mid \mathcal{F}] = E[\mathrm{RV} \mid \mathcal{F}]\)
Transformările monotone păstrează cuantilele: \(\exp(\text{mediana lui } \log \mathrm{RV})\) este mediana lui RV, elicitată de eroarea absolută (o minimizează în medie), nu de QLIKE
Dacă RV este lognormală, cu \(s^2\) varianța lui log RV, atunci mediana/media \(= e^{-s^2/2}\)
Varianta cu mediana este semnificativ mai slabă (statistica DM +3,53 pentru Chronos-2) și mai slabă decît log-HAR (QLIKE 0,226)
Pentru varianța realizată, modelele fundaționale zero-shot nu se disting de log-HAR: Chronos-2 are cea mai mică pierdere QLIKE medie pe toată perioada de test, dar diferența nu este semnificativă, MCS păstrează șase din opt modele, iar testul GW (Giacomini–White, test, testul Giacomini–White) nu găsește nicio diferență condiționată. Rezultatul depinde de citirea mediei, nu a medianei, din grila de cuantile.
Testul 3: VaR 1% și ES 2,5%
Al treilea test trece de la centrul și scala distribuției la coada ei stîngă. El întreabă dacă modelele fundaționale dau prognoze mai bune pentru VaR 1% și ES 2,5% decît simularea istorică filtrată, fie direct din grila lor de cuantile, fie ca filtre de volatilitate în interiorul FHS. Evaluarea combină backtesting-ul din Capitolul 8 pentru secvența de depășiri, teste ale întregii distribuții predictive și o pierdere consistentă pentru perechea (VaR, ES). Secțiunea se încheie cu o metodă de recalibrare care corectează cuantilele unui model după fiecare depășire.
Protocolul testului pentru riscul de coadă (1/2): întrebarea și țintele
Țintele sînt \(\mathrm{VaR}_\alpha\) și \(\mathrm{ES}_\alpha\) din (14.14), calculate din cuantilele condiționate \(q_u(r_{t+1} \mid \mathcal{F}_t)\), cuantila de nivel \(u\) a randamentului de mîine, dată fiind informația de azi \(\mathcal{F}_t\); definițiile sînt pe slide-ul De la o grilă de cuantile la VaR și ES. Se folosesc două niveluri, fiecare legat de un standard de reglementare. VaR 1% este nivelul regulilor de backtesting Basel, care se bazează pe teste de acoperire (coverage tests). Perechea (VaR 2,5%, ES 2,5%) corespunde nivelului ES din standardul FRTB (Fundamental Review of the Trading Book).
Modelele clasice sînt simularea istorică (HS, historical simulation), care ia cuantila empirică a randamentelor trecute, GARCH(1,1) cu inovații Student-\(t\) și simularea istorică filtrată (FHS) a lui McNeil & Frey (2000). Toate sînt estimate pe o fereastră de 1 000 de zile și reestimate la fiecare 20 de zile.
FHS este reperul pentru că îmbină o volatilitate GARCH condiționată cu forma empirică a cozilor, fără să presupună o distribuție pentru randamentele standardizate. Ea reacționează la volatilitate ca GARCH și preia forma cozii din date ca HS.
Pe scurt
Întrebarea: dau modelele fundaționale prognoze VaR 1% și ES 2,5% mai bune decît FHS?
Fie direct, fie ca filtre de volatilitate
Țintele: VaR\(_\alpha\) și ES\(_\alpha\), calculate din cuantilele \(q_u(r_{t+1} \mid \mathcal{F}_t)\)
Modelele fundaționale intră în test în două feluri. Varianta directă ia cuantilele randamentului de mîine direct din grila Chronos-2, cu un context de 512 randamente. Varianta hibridă folosește modelul fundațional doar pentru scală: el citește seria randamentelor absolute \(|r|\), cu cele 512 randamente absolute dinaintea zilei \(t\) drept context, iar prognoza lui pentru \(|r_t|\) devine scala \(\hat\sigma_t\) (media grilei pentru Chronos-2, mediana pentru TimesFM). FHS se aplică apoi lui \(r_t/\hat\sigma_t\): VaR este cuantila empirică a randamentelor standardizate înmulțită cu \(\hat\sigma_t\).
Dacă scala este o mediană sau o medie contează aici puțin, spre deosebire de Testul 2, pentru că FHS nu depinde de scală. Înmulțirea scalei cu o constantă \(c > 0\) lasă VaR neschimbat:
Din (14.25), un factor constant în \(\hat\sigma\), cum ar fi un raport stabil între mediană și medie, se simplifică; doar un factor variabil în timp schimbă VaR.
Pe scurt
Direct: cuantilele Chronos-2 ale randamentului de mîine (context: 512 randamente)
Hibrid: scala \(\hat\sigma_t\) este prognoza lui \(|r_t|\)
Media din grilă pentru Chronos-2, mediana pentru TimesFM
Modelul fundațional citește seria \(|r|\): contextul este format din cele 512 randamente absolute dinaintea zilei \(t\)
Apoi FHS pe \(r_t/\hat\sigma_t\): cuantila empirică a randamentelor standardizate, înmulțită cu \(\hat\sigma_t\)
Mediana sau media contează puțin aici, spre deosebire de Testul 2
O funcțională a unei distribuții este elicitabilă (elicitable) dacă o anumită funcție de pierdere este minimizată, în medie, de valoarea ei adevărată: media de eroarea pătratică, o cuantilă de pierderea pinball (14.2). ES singur nu este elicitabil, deci nu există o pierdere care să compare prognozele de ES luate separat. Perechea (VaR, ES) este însă elicitabilă împreună (Fissler & Ziegel, 2016), iar prognozele perechii pot fi ordonate printr-o pierdere.
Capitolul folosește pierderea Fissler–Ziegel omogenă de grad zero, FZ0, a lui Patton, Ziegel & Chen (2019). Cu pierderea zilnică \(L_t = -r_t\), o prognoză VaR \(v\) și o prognoză ES \(e > 0\) la nivelul cozii \(\alpha\),
unde \(\mathbf{1}\{L_t > v\}\) este 1 într-o zi cu depășire. Valorile mai mici sînt mai bune. Primul termen penalizează depășirile proporțional cu mărimea lor relativă la ES, iar \(\log e\) penalizează prognozele mai largi decît este necesar.
Modelele sînt comparate cu teste DM pe diferențele FZ0 și cu mulțimea de modele de încredere din Testul 2.
Pe scurt
O caracteristică a distribuției este elicitabilă
Dacă o pierdere este minimizată, în medie, de valoarea ei adevărată
Prima verificare a unei prognoze VaR este acoperirea necondiționată: proporția zilelor cu o pierdere peste VaR trebuie să fie egală cu nivelul. Testul Kupiec din Capitolul 8 este un test de raport de verosimilitate (LR, likelihood ratio) al acestei ipoteze, cu \(x\) depășiri în \(T\) zile:
Prea multe depășiri indică subacoperire, un VaR care nu este suficient de extrem; prea puține indică un VaR mai larg decît este necesar.
Graficul interactiv arată, pentru fiecare piață de pe axa orizontală, rata de depășire a VaR 1% pentru fiecare model, pe o scală logaritmică pe axa verticală. Banda albastru deschis este intervalul de 95% al ratei de depășire dacă modelul ar fi corect, iar linia întreruptă marchează 1%. Cursorul mută începutul evaluării din 2016 pînă la fereastra de după publicare, iar butonul ▶ parcurge anii de început.
Întrebare pentru sală Cuantilele directe Chronos-2 dau 45 de depășiri ale VaR 1% în 2 693 de zile pe S&P 500. Respinge testul Kupiec, cu nivel nominal 5%, ipoteza unei rate de 1%?
Răspuns
Da. p Kupiec ≈ 0,001. Sub ipoteza depășirilor independente cu probabilitatea 1%, intervalul central binomial nominal de 95% este [17; 37]; cele 45 de depășiri (rata 1,67%) îl depășesc. Mai multe depășiri indică subacoperire, nu prudență. Intervalul este discret, iar pragul Kupiec este asimptotic. Folosit ca filtru de volatilitate pentru FHS, același model dă 0,93% (p = 0,71).
Chronos-2 direct are prea multe depășiri pe S&P 500: 45 de depășiri în 2 693 de zile, o rată de 1,67%, cu \(p\) Kupiec = 0,001. Sub ipoteza depășirilor independente cu probabilitatea de 1%, intervalul binomial central nominal de 95% este între 17 și 37 de depășiri, iar 45 este deasupra lui. Pe BET, rata directă este 1,50%. Chronos-Bolt, a cărui cea mai mică cuantilă, de 10%, este folosită drept „VaR 1%”, este depășit în 13,5% dintre zile.
Hibrizii au rate de depășire apropiate de 1% pe toate cele trei piețe; pe S&P 500, FHS cu volatilitatea Chronos-2 are 0,93% (\(p\) = 0,71). Aceasta verifică doar acoperirea medie. Tabelul complet este în Anexă.
Pe scurt
Ponderea zilelor cu o pierdere peste VaR 1% (scară logaritmică)
Banda albastru deschis este intervalul de 95% pentru un model corect
Kupiec (Capitolul 8): testul raportului de verosimilitate (LR) că rata depășirilor este \(\alpha\), cu distribuția \(\chi^2_1\) sub \(H_0\)
Chronos-2 direct: prea multe depășiri pe S&P 500 (1,67%, \(p\) Kupiec = 0,001) și pe BET (1,50%)
Chronos-Bolt, cea mai mică cuantilă (10%) folosită drept „VaR 1%”: 13,5%
Hibrizii: rate de depășire apropiate de 1% pe toate cele trei piețe
Crahul din februarie–iunie 2020 de pe S&P 500 este episodul cel mai dificil al eșantionului de test pentru un model VaR. Volatilitatea a crescut în cîteva zile, iar un model care își ajustează lent scala este depășit în mod repetat; un model care se ajustează prea puternic produce un VaR mult peste pierderile care apar.
Graficul interactiv are datele pe axa orizontală și pierderea, în procente, pe axa verticală. Barele sînt pierderile zilnice, cu cîștigurile puse la zero; liniile sînt prognozele VaR 1% ale FHS, ale Chronos-2 direct și ale FHS cu volatilitatea Chronos-2, iar punctele marchează depășirile. Celelalte modele pot fi afișate din legendă. Cursorul mută o fereastră de 5 luni prin perioada de test, iar butonul ▶ o parcurge.
Întrebare pentru sală În februarie–iunie 2020, FHS și hibridul FHS cu volatilitatea Chronos-2 au fiecare două depășiri. Este suficient acest număr pentru a le compara calitatea prognozelor?
Răspuns
Nu. Ambele au 2 depășiri în 104 zile, dar traiectorii diferite: VaR 1% maxim este 58,9% pentru hibrid (17.03.2020) și 26,4% pentru FHS, iar pierderea zilnică maximă observată este 12,8%. Aceste valori motivează evaluarea calibrării și a pierderii de prognoză. Nici egalitatea numărului de depășiri, nici un VaR peste pierderea maximă nu stabilesc singure clasamentul. Chronos-2 direct are 4 depășiri, iar HS 12.
În cele 104 zile din februarie–iunie 2020, FHS are 2 depășiri, Chronos-2 direct 4, FHS cu volatilitatea Chronos-2 2, iar HS 12. Toate modelele sînt depășite în primele zile ale crahului. Chronos-2 citește repede contextul, deci cuantilele lui se lărgesc rapid.
Hibridul exagerează: VaR 1% al lui ajunge la 58,9% la 17 martie 2020, față de cel mult 26,4% pentru FHS și o pierdere zilnică maximă de 12,8% (Anexă). FHS și hibridul au același număr de depășiri, dar traiectorii foarte diferite, deci numărul de depășiri nu este suficient pentru a le ordona; pentru aceasta sînt necesare teste de calibrare și o pierdere de prognoză.
Pe scurt
S&P 500, februarie–iunie 2020 (104 zile): pierderile zilnice și prognozele VaR 1%
Punctele marchează depășirile
Numărul de depășiri: FHS 2, Chronos-2 direct 4, FHS cu volatilitatea Chronos-2 2, HS 12
Toate modelele sînt depășite în primele zile ale crahului
Chronos-2 reacționează rapid la context, deci cuantilele lui se lărgesc repede
Hibridul reacționează excesiv: VaR 1% de 58,9% la 17.03.2020
Față de 26,4% pentru FHS și o pierdere maximă de 12,8% (Anexă)
Un VaR cu rata corectă de depășire poate fi totuși greșit condiționat: depășirile pot veni grupate, în zilele de după o primă depășire, cînd modelul nu s-a ajustat încă. Testul de independență al lui Christoffersen (1998) modelează indicatorul de depășire ca un lanț Markov de ordinul 1 și testează, cu o statistică LR care sub ipoteza nulă este \(\chi^2_1\), că o depășire azi nu schimbă probabilitatea uneia mîine. Combinat cu statistica Kupiec, el dă testul de acoperire condiționată (conditional coverage), \(\chi^2_2\).
Testul cuantilei dinamice (DQ, dynamic quantile) al lui Engle & Manganelli (2004) întreabă mai general dacă depășirile sînt predictibile din informația trecută:
unde \(I_t = 1\) într-o zi cu depășire. Cu o acoperire condiționată corectă, \(\mathrm{Hit}_t\) are media zero și nu este corelat cu nimic din ce se cunoaște la \(t-1\); testul este o statistică Wald pentru ipoteza că toți cei șase coeficienți din (14.28) sînt nuli, distribuită \(\chi^2_6\).
Tabelul dă p-value-urile testelor de independență și DQ. Pe S&P 500, hibrizii au rata corectă de depășire, dar pică testul de independență (\(p\) = 0,021 și 0,029) și testul DQ (\(p\) = 0,001 și sub 0,001), iar toate modelele pică DQ la 5%. Pe BET, FHS trece ambele teste (\(p\) = 0,409 și 0,650), în timp ce hibrizii pică DQ (\(p\) sub 0,001). A avea dreptate în medie nu înseamnă a avea dreptate condiționat. Aprofundările arată unde este suficientă grila de decile a celorlalte două modele: la VaR 10%.
Backtesting-ul VaR examinează o singură cuantilă. Transformarea integrală de probabilitate (PIT, probability integral transform) (Diebold, Gunther & Tay, 1998) examinează întreaga distribuție predictivă. Ea este probabilitatea prognozată a unui randament mai mic sau egal cu cel realizat:
\[u_t = \hat F_t(r_t).\]
(14.29)
Dacă funcția de repartiție predictivă \(\hat F_t\) este corectă, valorile \(u_t\) din (14.29) sînt i.i.d. uniforme pe \((0, 1)\). O histogramă a valorilor \(u_t\) arată deci unde distribuția prognozată este prea îngustă sau prea largă: o bară peste înălțimea ei așteptată înseamnă prea multe rezultate în acea regiune.
Graficul interactiv are trei panouri, pentru S&P 500, Bitcoin și BET. Axa orizontală este PIT, \(u = \hat F(r)\), iar axa verticală raportul dintre frecvența observată și cea așteptată în fiecare dintre cele 22 de intervale definite de nivelurile grilei Chronos-2; linia întreruptă de la 1 corespunde unei prognoze corecte. Cursorul mută începutul evaluării, iar butonul ▶ parcurge anii de început.
Întrebare pentru sală Pe S&P 500, cît de des cade randamentul realizat sub cuantila de 1% a Chronos-2?
Răspuns
În 1,67% dintre zile, deci prima bară PIT este de 1,67 ori înălțimea așteptată: subacoperire la cuantila de 1%. Această frecvență nu descrie singură forma întregii cozi. FHS dă 1,11%. Testul Berkowitz respinge Chronos-2 pe S&P 500 (p = 0,019, σ̂ = 1,03); în testele raportate pentru perioada completă, FHS nu este respins pe niciuna dintre cele trei piețe.
Pe S&P 500, randamentul realizat cade sub cuantila de 1% a Chronos-2 în 1,67% dintre zile, deci prima bară este de 1,67 ori înălțimea așteptată: subacoperire la cuantila de 1%. FHS dă 1,11%. Această frecvență nu descrie singură forma întregii cozi; testele de pe slide-ul următor folosesc toate valorile PIT.
Pe scurt
PIT (Probability Integral Transform, transformarea integrală de probabilitate) \(u_t = \hat F_t(r_t)\): probabilitatea prognozată a unui randament mai mic sau egal cu cel realizat (Diebold, Gunther & Tay (1998))
Dacă funcția de repartiție predictivă \(\hat F_t\) este corectă, valorile \(u_t\) sînt i.i.d. uniforme pe \((0, 1)\)
Barele: frecvența observată raportată la cea așteptată în cele 22 de intervale ale grilei Chronos-2
O bară peste 1 arată prea multe rezultate în acea zonă
Testul lui Berkowitz (2001) transformă PIT într-o variabilă Normală, \(z_t = \Phi^{-1}(u_t)\), unde \(\Phi^{-1}\) este funcția cuantilă a distribuției Normale standard. Dacă prognoza este corectă, \(z_t\) urmează distribuția Normală standard, iar testul este un test LR pentru \(\mu = 0\) și \(\sigma = 1\), unde \(\mu\) și \(\sigma\) sînt media și abaterea standard a lui \(z_t\); valorile din afara intervalului \([1\%, 99\%]\) sînt cenzurate. O estimare \(\hat\sigma > 1\) înseamnă că cozile prognozate sînt prea subțiri. Chronos-2 este respins pe S&P 500 (\(p\) = 0,019, \(\hat\sigma\) = 1,03) și pe BET; FHS nu este respins niciodată.
Calibrarea este o proprietate, finețea (sharpness) este alta. Scorul cuantilic (QS, quantile score) le măsoară pe amîndouă, ca medie a pierderii pinball pe cele \(K\) niveluri \(u_k\) ale grilei:
unde \(q_{u_k}\) este cuantila prognozată de nivel \(u_k\); valorile mai mici sînt mai bune. Scorul (14.30) este un analog pe grilă al scorului de probabilitate continuu pe ranguri (CRPS, continuous ranked probability score) al lui Gneiting & Raftery (2007).
Pe S&P 500 și BET, Chronos-2 este mai slab decît FHS atît în centru, cît și în cozi; pe S&P 500, statisticile DM sînt +2,51 și +3,65. Pe Bitcoin, diferența nu este semnificativă. Tabelul pentru cele trei piețe este în Anexă.
Pierderea FZ0 (14.26) ordonează prognozele perechii (VaR 2,5%, ES 2,5%), iar MCS din Testul 2 identifică modelele care nu pot fi separate de cel mai bun. Un model din mulțimea de 90% nu a fost dovedit mai slab decît celelalte; mai multe modele pot rămîne în mulțime fără a fi echivalente.
Graficul interactiv este un tabel cu p-value-urile MCS pentru pierderea FZ0, cu modelele pe rînduri și piețele pe coloane. Un verde mai închis înseamnă un p-value mai mare, iar un „×” marchează un model eliminat la nivelul ales. Cursorul mută începutul evaluării, selectorul fixează nivelul MCS (75%, 90% sau 95%), iar butonul ▶ parcurge anii de început.
Întrebare pentru sală Pe ferestrele complete de test ale celor trei piețe, ce modele elimină MCS de 90%, calculată cu FZ0 pentru VaR și ES la 2,5%?
Răspuns
Doar HS pe BET are p MCS < 0,10: valoarea este 0,015. MCS poate păstra mai multe modele fără a demonstra că sînt echivalente. Pe S&P 500, FHS are cea mai mică pierdere FZ0, iar testul DM, cu corecția Holm pe cele cinci comparații cu FHS, separă FHS de hibridul cu Chronos-2 (DM +2,65, p = 0,008 înainte de corecție, p Holm = 0,032). Pe BET, același test dă p Holm = 0,054.
Pe ferestrele complete de test, singurul model eliminat din mulțimea de 90% (\(p < 0{,}10\)) este HS pe BET, cu \(p\) = 0,015. Tabelul FZ0 este în Anexă.
Pe S&P 500, FHS are cea mai mică FZ0. Hibrizii au rata corectă de depășire, dar un VaR mai mare: pe cele 2 693 de zile de test, VaR 1% mediu este 3,20% pentru hibridul cu Chronos-2, față de 2,78% pentru FHS. Gruparea depășirilor nu îi deosebește de FHS, deoarece FHS și fiecare hibrid au cîte 2 depășiri consecutive. Familia de teste este fixată dinainte: cele cinci teste DM față de FHS pe fiecare piață, cu corecția Holm. Pe S&P 500, FHS bate hibridul cu Chronos-2 (DM +2,65, \(p\) = 0,008 înainte de corecție, \(p\) Holm = 0,032). Pe BET, DM este +2,36, cu \(p\) Holm = 0,054, deci superioritatea nu este stabilită la 5%. Pe cele 15 teste ale celor trei piețe, p-value-urile Holm sînt 0,096 și 0,180. Rezultatul susține o comparație de proceduri.
Pe scurt
Valorile \(p\) MCS de 90% (Hansen, Lunde & Nason (2011)) pentru pierderea FZ0 (verde mai închis: valori mai mari)
Singurul model eliminat (\(p < 0{,}10\)) este HS pe BET (\(p\) = 0,015, celula aproape albă)
Fereastra de după publicare elimină contaminarea ponderilor, dar lasă puține observații. După 3 noiembrie 2025, S&P 500 are 220 de zile, Bitcoin 320, iar BET 217, deci numărul așteptat de depășiri ale VaR 1% este 2,2, 3,2 și 2,2. Numerele observate din tabel sînt între 0 și 5. Ponderile folosite erau publice înainte de 3 noiembrie 2025: revizia Hugging Face este fixată și identificată prin amprenta ei SHA-256 (Secure Hash Algorithm, 256 bits, funcție criptografică de dispersie cu 256 de biți).
Puterea testului Kupiec pe o astfel de fereastră este mică. Cu pragul asimptotic \(\chi^2_1\) la nivelul nominal de 5%, și cu puterea calculată exact din distribuția binomială față de o rată reală de depășire de 1,67%, puterea este 0,19 la \(T = 220\) de zile. Mărimea efectivă (actual size), rata de respingere cînd modelul este corect, este 0,13. Puterea crește la 0,50 la \(T = 1\,000\) și la 0,87 la \(T = 2\,693\). O putere de 80% este atinsă prima dată la circa 2 130 de zile, adică 8,4 ani, și rămîne definitiv peste acest nivel de la 2 320 de zile; față de o rată reală de 2%, puterea la \(T = 220\) este 0,29 (exercițiile A2 și A9 din Seminarul 14).
Putere mică nu înseamnă putere zero. HS are 0 depășiri pe S&P 500 după publicare, iar \(x = 0\) este în regiunea de respingere Kupiec la \(T = 220\). Pentru celelalte modele, o nerespingere pe această fereastră nu stabilește calibrarea.
Ponderile folosite au fost publicate înainte de 3.11.2025 (revizie Hugging Face fixată, amprentă SHA-256), dar testele au putere mică
Regula Kupiec cu pragul asimptotic \(\chi^2_1\) (nivel nominal 5%), cu puterea calculată exact din distribuția binomială, cînd rata reală de depășire este 1,67% în loc de 1%
Puterea (probabilitatea de a respinge modelul): 0,19 la \(T = 220\) de zile, 0,50 la \(T = 1\,000\) de zile, 0,87 la \(T = 2\,693\) de zile
Nivelul efectiv al testului la \(T = 220\) (rata de respingere cînd modelul este corect): 0,13
Puterea atinge 80% prima dată la circa 2 130 de zile (8,4 ani) și rămîne peste acest prag de la 2 320 de zile
Dacă rata reală este 2%, puterea la \(T = 220\) este 0,29 (Seminarul 14, exercițiile A2 și A9)
Putere mică nu înseamnă putere zero
HS are 0 depășiri pe S&P 500
Zero depășiri (\(x = 0\)) cad în regiunea de respingere Kupiec la \(T = 220\), deci HS este respins
Cuantilele directe ale Chronos-2 sînt depășite prea des. O corecție fără model deplasează cuantila modelului cu eroarea pe care a făcut-o recent și adaptează nivelul după fiecare depășire. Definim scorul \(E_t = \hat q_{\alpha,t} - r_t\), unde \(\hat q_{\alpha,t}\) este cuantila de nivel \(\alpha\) a modelului pentru ziua \(t\);\(E_t > 0\) înseamnă că randamentul a căzut sub ea. Cuantila corectată este \(\hat q_{\alpha,t} - \hat Q_{1-\alpha_t}\), unde \(\hat Q_{1-\alpha_t}\) este cuantila empirică de nivel \(1-\alpha_t\) a ultimelor 250 de scoruri.
Inferența conformală adaptivă (ACI, adaptive conformal inference) a lui Gibbs & Candès (2021) actualizează nivelul \(\alpha_t\) după fiecare zi:
În (14.31),\(\alpha\) este nivelul-țintă, 1%, \(\mathrm{err}_t = 1\) la o depășire, iar \(\gamma > 0\) este pasul, aici 0,001. După o depășire, \(\alpha_t\) scade cu \(\gamma(1-\alpha)\), deci VaR-ul următor este mai larg; după o zi calmă, crește cu \(\gamma\alpha\), încet. Cu \(\gamma = 0\), metoda devine o calibrare rolling cu nivel fix, cu corecția recalculată zilnic din ultimele 250 de scoruri; aceasta nu este predicția conformală standard pe eșantion separat (split conformal).
Garanția ACI privește media pe termen lung a lui \(\mathrm{err}_t\), care converge la \(\alpha\) oricare ar fi datele, nu valoarea lui \(\alpha_t\) într-o anumită zi. Derivarea ei este în Aprofundări.
Pe scurt
Ideea: deplasăm cuantila modelului cu eroarea făcută recent
Și adaptăm nivelul după fiecare depășire
Scorul este \(E_t = \hat q_{\alpha,t} - r_t\), iar cuantila corectată este \(\hat q_{\alpha,t} - \hat Q_{1-\alpha_t}\)
\(\hat q_{\alpha,t}\): cuantila de nivel \(\alpha\) a modelului pentru ziua \(t\)
\(E_t > 0\): randamentul a scăzut sub această cuantilă
\(\hat Q_{1-\alpha_t}\): cuantila empirică de nivel \((1-\alpha_t)\) a ultimelor 250 de scoruri
Nivelul adaptiv al inferenței conformale adaptive (ACI, adaptive conformal inference, Gibbs & Candès (2021))
\(\alpha\): nivelul-țintă (1%), iar \(\mathrm{err}_t = 1\) într-o zi cu depășire
\(\gamma > 0\): pasul de ajustare, aici 0,001
Cu \(\gamma = 0\): calibrare pe fereastră mobilă cu nivel fix (corecția se recalculează zilnic din ultimele 250 de scoruri), nu split conformal standard
După o depășire \(\alpha_t\) scade (următorul VaR este mai larg); după o zi calmă crește încet
Graficul aplică (14.31) cuantilelor directe ale Chronos-2 și compară VaR 1% corectat cu cel direct și cu FHS. Panoul de sus arată nivelul \(\alpha_t\), pe care metoda îl mișcă în jurul țintei de 1%; panoul de jos arată cele trei serii VaR.
Graficul interactiv are datele pe axa orizontală. Panoul de sus are nivelul adaptiv \(\alpha_t\), în procente, cu o linie întreruptă la ținta de 1%; panoul de jos are VaR 1%, în procente, pe o scală logaritmică, pentru Chronos-2 direct, Chronos-2 cu ACI și FHS. Primul selector alege piața, cursorul alege pasul \(\gamma\) (de la 0, cînd metoda este o calibrare rolling cu nivel fix, pînă la 0,005), iar al doilea selector numărul de zile de calibrare (125, 250 sau 500). Butonul ▶ parcurge valorile pasului.
Întrebare pentru sală Pe S&P 500, cu γ = 0,001 și 250 de zile de calibrare, cum se compară VaR 1% mediu al corecției conformale cu al FHS, în aceleași zile?
Răspuns
Este mai mare: 3,36% pentru corecția conformală și 2,85% pentru FHS, pe 2 443 de zile, deși depășirile sînt 21 față de 24,4 așteptate. Rate apropiate de țintă nu impun medii egale. Separat, comparația perechii VaR–ES la 2,5% dă FZ0 medie 1,205 față de 1,013 și p DM = 0,001; acest rezultat nu se deduce numai din mediile VaR la 1%. Cu γ = 0 (calibrare rolling cu nivel fix) sînt 16 depășiri și un VaR mediu de 3,58%.
Pe S&P 500, cu \(\gamma\) = 0,001 și 250 de zile de calibrare, VaR-ul corectat are 21 de depășiri în 2 443 de zile, față de 24,4 așteptate. VaR 1% mediu al lui este 3,36%, față de 2,85% pentru FHS în aceleași zile: rate de depășire apropiate de țintă nu implică un VaR mediu egal. Cu \(\gamma = 0\) sînt 16 depășiri, iar VaR-ul mediu este 3,58%.
Panoul de sus arată că nivelul adaptiv \(\alpha_t\) rămîne în cea mai mare parte peste 1%. Deplasarea scorurilor singură ar face VaR-ul prea larg: cu \(\gamma = 0\), calibrare rolling cu nivel fix, sînt 16 depășiri, iar VaR 1% mediu este 3,58%. ACI compensează relaxînd nivelul.
Panoul de jos compară VaR 1% al Chronos-2 direct, al Chronos-2 cu ACI și al FHS, pe o scală logaritmică. ACI aduce depășirile aproape de 1%: pe S&P 500, 21 față de 24,4 așteptate, iar acoperirea condiționată nu este respinsă pe nicio piață. Testul DQ respinge totuși pe S&P 500 și pe BET. VaR-ul corectat este mai larg: în cele 2 443 de zile de după cele 250 de zile de calibrare, VaR 1% mediu al lui este 3,36%, față de 2,85% pentru FHS în aceleași zile, iar FZ0 este semnificativ mai mare.
Rezultatul susține o comparație de proceduri: ACI față de Chronos-2 direct și față de FHS. Regulile de scor proprii (proper scoring rules) răsplătesc finețea sub constrîngerea calibrării (Gneiting & Raftery, 2007). ACI repară calibrarea, dar calibrarea este necesară, nu suficientă; în aceleași zile, FHS are VaR-ul mai îngust și FZ0 mai mică.
Pe scurt
Panoul de sus: nivelul adaptiv \(\alpha_t\) (ținta 1%), care rămîne mai ales peste 1%
Deplasarea cu scorul singură ar lărgi prea mult VaR-ul
Cu \(\gamma = 0\) (calibrare pe fereastră mobilă cu nivel fix): 16 depășiri, VaR 1% mediu 3,58%
Deci ACI relaxează nivelul
Panoul de jos: VaR 1% (scară logaritmică)
Chronos-2 direct, Chronos-2 cu ACI, FHS
ACI aduce depășirile aproape de 1%
S&P 500: 21 de depășiri, față de 24,4 așteptate
Acoperirea condiționată nu este respinsă pe nicio piață
Testul DQ respinge totuși pe S&P 500 și pe BET
VaR-ul este mai larg, iar pierderea FZ0 este semnificativ mai mare
Media VaR 1% în cele 2 443 de zile de după cele 250 de zile de calibrare: 3,36%, față de 2,85% pentru FHS în aceleași zile
Garanția privește media lui \(\mathrm{err}_t\), nu valoarea lui \(\alpha_t\)
Tipul de dovadă: comparație între proceduri (ACI față de Chronos-2 direct și FHS)
În coadă, Chronos-2 direct are prea multe depășiri ale VaR 1% pe S&P 500 și BET și pică testul Berkowitz. Folosit ca filtru de volatilitate în FHS, dă rata corectă de depășire, dar un VaR mai larg, iar FHS păstrează cea mai mică pierdere FZ0 pe S&P 500. Fereastra de după publicare este prea scurtă pentru a testa VaR 1% cu o putere utilă, iar recalibrarea prin ACI repară acoperirea cu prețul fineții.
Studii de caz: avantajele complexității și competiția M6
Cele două studii de caz plasează testele capitolului în literatura recentă. Primul, Kelly, Malamud & Zhou (2024), argumentează teoretic și empiric că modelele de prognoză a randamentelor cu mai mulți parametri decît observații pot face mai bine out-of-sample, un argument pentru modelele mari din acest capitol și împotriva regulii parcimoniei din econometria clasică. Al doilea, competiția M6 a lui Makridakis et al. (2025), este un test out-of-sample în timp real al întrebării dacă vreo metodă de prognoză depășește probabilitățile egale în ordonarea randamentelor activelor. Ambele sînt replicate pe datele cursului.
Studiu de caz: rolul complexității în prognoza randamentelor (1/2)
Kelly, Malamud & Zhou (2024) pun două întrebări. Trebuie ca un model de prognoză a randamentelor să aibă mult mai puțini parametri \(P\) decît observații \(T\)? Și pot modelele cu complexitatea \(c = P/T > 1\) să facă mai bine out-of-sample? Cadrul, în ecuațiile 1–2 ale lucrării, este că randamentul lunii viitoare este o funcție necunoscută a predictorilor de azi, aproximată printr-o rețea largă:
În (14.32),\(R_{t+1}\) este randamentul în exces al pieței, \(G_t\) vectorul predictorilor cunoscuți la \(t\), iar \(\varepsilon_{t+1}\) partea nepredictibilă. Fiecare \(S_{i,t}\) este o trăsătură neliniară (feature) a lui \(G_t\), o unitate ascunsă a unei rețele cu un singur strat ascuns, iar \(\beta_i\) ponderea ei. Prin aproximarea universală (Hornik, Stinchcombe & White, 1989), suma se apropie de \(f\) cînd \(P\) crește.
Întrebarea contează pentru acest capitol pentru că modelele testate aici au mult mai mulți parametri decît observațiile oricărei serii financiare. Econometria clasică recomandă parcimonia; lucrarea oferă un argument teoretic pentru contrariu.
Legătura cu Testul 1 este directă. Acolo, niciun model nu depășește prognoza zero pe S&P 500 și Bitcoin după corecția pentru teste multiple. Lucrarea întreabă dacă un \(R^2\) out-of-sample negativ înseamnă că o prognoză nu are valoare economică. Valoarea economică este măsurată prin raportul Sharpe al randamentului de market timing \(\pi_t R_{t+1}\), cu poziția \(\pi_t = \hat\beta' S_t\) (ecuația 6 a lucrării), unde \(\hat\beta\) sînt ponderile estimate, iar \(S_t\) vectorul celor \(P\) trăsături la \(t\). Prognoza însăși este poziția.
Teoria, în secțiunile III–IV ale lucrării, arată că, pentru un model greșit specificat, cu o contracție ridge aleasă optim și sub ipotezele lucrării, \(R^2\) out-of-sample așteptat și raportul Sharpe al strategiei de timing cresc cu \(c\). În apropierea lui \(c = 1\), granița de interpolare (interpolation boundary), cele mai mici pătrate ajustează exact datele de antrenare, iar varianța lor explodează. Dincolo de ea, pe măsură ce \(c\) crește, performanța își revine.
Pe scurt
Legătura cu Testul 1: pe S&P 500 și Bitcoin, niciun model nu depășește prognoza zero
După corecția pentru teste multiple
Lucrarea întreabă dacă un \(R^2\) negativ în afara eșantionului înseamnă lipsa valorii economice
Valoarea economică: raportul Sharpe al randamentului strategiei de ajustare a expunerii la piață (market timing) \(\pi_t R_{t+1}\), cu poziția \(\pi_t = \hat\beta' S_t\) (ec. 6): prognoza însăși este poziția
\(\hat\beta\): ponderile estimate
\(S_t\): vectorul celor \(P\) trăsături la \(t\)
Teoria (Secțiunile III–IV): media lui \(R^2\) în afara eșantionului și media raportului Sharpe al strategiei cresc cu \(c\)
În ipotezele lucrării, pentru un model greșit specificat, cu penalizarea ridge \(z\) (micșorează ponderile \(\hat\beta\) spre zero) aleasă optim
Aproape de \(c = 1\) (pragul de interpolare), metoda celor mai mici pătrate ajustează exact datele de antrenare și varianța explodează; dincolo de prag, rezultatele se îmbunătățesc din nou
Datele, în secțiunea V.A a lucrării, sînt randamentele lunare în exces ale indicelui ponderat cu valoarea de piață al Center for Research in Security Prices (CRSP), 1926–2020. Predictorii sînt cei 15 ai lui Welch & Goyal (2008), 14 variabile și randamentul pieței din luna anterioară. Randamentele sînt scalate cu volatilitatea lor din ultimele 12 luni, predictorii cu o abatere standard pe o fereastră extinsă, iar 36 de luni de inițializare mută începutul eșantionului în 1930.
Trăsăturile sînt trăsături Fourier aleatoare (RFF, random Fourier features; ecuația 20 a lucrării, Rahimi & Recht (2007)):
Fiecare trăsătură din (14.33) este un sinus sau un cosinus al unei combinații aleatoare a predictorilor. Vectorul \(\omega_i\) este extras o singură dată din distribuția Normală standard, cu \(I\) matricea identitate, și apoi fixat; \(\gamma\) fixează gradul de neliniaritate, iar un \(\gamma\) mai mare dă trăsături care oscilează mai repede. Modelul este o rețea largă cu două straturi, ale cărei ponderi din primul strat sînt aleatoare; doar ponderile de ieșire \(\beta\) sînt estimate, prin regresie ridge cu penalizarea \(z\).
\(P\) numără coloanele: \(P/2\) vectori \(\omega_i\), fiecare dînd un sinus și un cosinus, deci \(P = 12\,000\) folosește 6 000 de vectori. Estimatorul ridge și designul sînt detaliate în Aprofundări.
Pe scurt
Date (Secțiunea V.A): randamentul lunar în exces al indicelui CRSP ponderat cu capitalizarea
CRSP: Center for Research in Security Prices
Cei 15 predictori din Welch & Goyal (2008) (14 variabile și randamentul întîrziat al pieței), perioada 1926–2020
Randamentele sînt scalate cu volatilitatea lor din ultimele 12 luni, predictorii cu abaterea standard calculată pe o fereastră cu început fix și lungime crescătoare
După 36 de luni de inițializare, eșantionul începe în 1930
Tabelul I, panoul A al lucrării raportează rezultatele pentru o fereastră de antrenare de \(T = 12\) luni. Raportul de informație (information ratio) este măsurat față de piață, pierderea maximă este cea mai mare pierdere lunară în abateri standard, iar statisticile \(t\) testează randamentul mediu al strategiei (coloana Sharpe) și alfa (coloana raportului de informație).
Modelul liniar cu toți cei 15 predictori și fără penalizare (ridgeless kitchen sink), cu \(P = 15 > T = 12\), are un \(R^2\) sub −100% și un raport Sharpe de −0,11. La granița de interpolare, prognozele explodează, ceea ce reproduce verdictul negativ al lui Welch & Goyal (2008). Cu aceiași predictori și o penalizare \(z = 10^3\),\(R^2\) este −3,8%, dar raportul Sharpe este 0,46 (\(t\) = 4,4). \(R^2\) penalizează scala prognozelor, în timp ce profiturile de timing depind de corelația lor cu randamentele (nota de subsol 5 a lucrării).
Modelul RFF cu \(c = 1\,000\) are un raport de informație de 0,26 (\(t\) = 2,5) față de cel mai bun model liniar. Cu \(T\) = 60 și 120 de luni, rapoartele lui de informație față de piață sînt 0,25 și 0,24 (\(t\) = 2,3 și 2,2; panourile B–C). Neliniaritatea extrage mai mult din aceiași predictori, cu o pierdere maximă mai mică și o asimetrie pozitivă.
Pozițiile (figura 10 a lucrării) sînt aproape mereu long și sînt reduse înaintea a 14 dintre cele 15 recesiuni datate de National Bureau of Economic Research (NBER), out-of-sample. Modelul învață restricția de semn a lui Campbell & Thompson (2008) fără să o primească. Rezultatul susține o comparație de proceduri: modele de complexitate diferită, out-of-sample.
Pe scurt
Model (\(T = 12\))
\(R^2\) (%)
Sharpe [\(t\)]
Raport inf. [\(t\)]
Pierdere max.
Asimetrie
Liniar, \(z = 0^+\)
\(<-100\)
\(-0{,}11\) [\(-1{,}0\)]
\(-0{,}16\) [\(-1{,}6\)]
\(98{,}5\)
\(-0{,}9\)
Liniar, \(z = 10^3\)
\(-3{,}8\)
\(0{,}46\) [\(4{,}4\)]
\(0{,}33\) [\(3{,}1\)]
\(2{,}4\)
\(-0{,}1\)
RFF, \(c = 1\,000\), \(z = 10^3\)
\(0{,}6\)
\(0{,}47\) [\(4{,}5\)]
\(0{,}31\) [\(2{,}9\)]
\(1{,}2\)
\(2{,}5\)
Sursa: Tabelul I, Panoul A. Raport inf. față de piață; pierdere în abateri standard; \(t\): media strategiei și alfa.
Regresia pe toți predictorii (kitchen sink), fără penalizare (\(P = 15 > T = 12\) luni): \(R^2\) sub \(-100\%\), raportul Sharpe \(-0{,}11\)
Interpretare: la pragul de interpolare prognozele explodează, ceea ce reproduce verdictul negativ din Welch & Goyal (2008)
Aceiași predictori cu \(z = 10^3\): \(R^2 = -3{,}8\%\), dar raportul Sharpe \(0{,}46\) (\(t = 4{,}4\))
Interpretare: \(R^2\) penalizează scala prognozelor, în timp ce profitul strategiei de market timing depinde de corelația lor cu randamentele (nota 5)
RFF, \(c = 1\,000\): raportul de informație față de cel mai bun model liniar este \(0{,}26\) (\(t = 2{,}5\))
Cu \(T\) = 60 și 120 de luni, raportul de informație față de piață este \(0{,}25\), respectiv \(0{,}24\) (\(t\) = \(2{,}3\) și \(2{,}2\), Panourile B–C)
Interpretare: neliniaritatea extrage mai mult din aceiași predictori, cu o pierdere maximă mai mică și asimetrie pozitivă
Pozițiile (Figura 10) sînt aproape mereu de cumpărare
Expunerea scade înainte de 14 din cele 15 recesiuni NBER (datate de National Bureau of Economic Research), în afara eșantionului
Graficul replică figurile 7–8 din Kelly, Malamud & Zhou (2024) pe datele cursului: randamentele în exces ale SPY cu 7 predictori, \(T = 12\) observații complete, \(\gamma = 2\) și 1 000 de extrageri ale trăsăturilor aleatoare, pe 354 de luni de test, din februarie 1997 pînă în august 2026.
Graficul interactiv are două panouri, cu complexitatea \(c = P/T\) pe o scală logaritmică pe axa orizontală și o linie pentru fiecare penalizare ridge \(z\). Panoul din stînga arată \(R^2\) out-of-sample, în procente, tăiat la −60%, sau, cu selectorul, norma pătratică medie \(\lVert\hat\beta\rVert^2\) a estimării ridge; panoul din dreapta arată raportul Sharpe anualizat al strategiei de timing. Linia punctată din panoul din dreapta este modelul liniar cu cei 7 predictori și \(z = 10^3\). Primul cursor alege penalizarea evidențiată, al doilea mută cursorul de-a lungul lui \(c\), iar butonul ▶ parcurge complexitățile.
Întrebare pentru sală Cu penalizarea fixată la z = 10³, cum evoluează raportul Sharpe al strategiei RFF de market timing pe grila testată, între c = 1 și c = 1 000?
Răspuns
Crește pînă la c = 50, apoi scade: 0,12 la c = 1, maximul grilei de 0,26 la c = 50 și 0,11 la c = 1 000 (t = 0,6). Modelul liniar cu aceiași 7 predictori și z = 10³ are 0,32. Este rezultatul pentru penalizarea și eșantionul indicate, nu o regulă generală despre complexitate.
Cu penalizarea fixată la \(z = 10^3\), raportul Sharpe este 0,12 la \(c = 1\), crește pînă la maximul grilei, 0,26, la \(c = 50\), și scade la 0,11 la \(c = 1\,000\)(\(t\) = 0,6). Modelul liniar cu aceiași 7 predictori și \(z = 10^3\) are 0,32. Rezultatul este valabil pentru penalizarea și eșantionul indicate, nu este o regulă generală despre complexitate.
Aproape fără penalizare, cu \(z = 10^{-3}\),\(R^2\) out-of-sample este −1 852% la \(c = 1\) și își revine la −16,6% la \(c = 1\,000\). Aceasta este dubla coborîre (double descent) din figura 7 a lucrării: eroarea atinge maximul la granița de interpolare și scade din nou dincolo de ea. Panoul din stînga este tăiat la −60% pentru ca celelalte curbe să rămînă vizibile. Datele sînt descrise în Anexă.
Cu \(z = 10^3\), raportul Sharpe este 0,12 la \(c = 1\), 0,26 la \(c = 50\) și 0,11 la \(c = 1\,000\)(\(t\) = 0,6). Modelul liniar cu \(z = 10^3\) are un raport Sharpe de 0,32 (\(t\) = 1,7) și nu este depășit de RFF. Statistica \(t\) testează randamentul mediu al strategiei, \(\sqrt{n}\,\bar R/s_R\), nu raportul Sharpe însuși; cu erori HAC (Newey–West cu 3, 6 și 12 lag-uri), ea este 1,75, 1,81 și 1,81. Raportul de informație al RFF este 0,07 față de modelul liniar (\(t\) = 0,4) și −0,12 față de SPY.
Pe datele cursului, complexitatea ajută pînă la \(c \approx 50\), nu pînă la \(c = 1\,000\). Rezultatul susține o comparație de proceduri. Legătura dintre poziții și recesiuni este arătată în Aprofundări.
Autorii precizează limitele rezultatelor lor. Teoria este pentru modele ridge liniare pe trăsături aleatoare fixe și un singur activ; un panel cu covarianțe între active rămîne deschis (Introducerea, nota de subsol 2). Se presupune că predictibilitatea este distribuită uniform între trăsături (ipoteza 4), iar modelele rare de tip LASSO (Least Absolute Shrinkage and Selection Operator, regresie penalizată L1 cu selecția variabilelor) sînt lăsate pentru cercetări viitoare (nota de subsol 22). Nu există un grad optim de neliniaritate \(\gamma\). Randamentele medii de timing sînt de circa două ori mai mici în 1975–2020 decît în 1930–1974 (secțiunea V.F).
Datele cursului sînt mai restrînse: 7 dintre cei 15 predictori și circa 30 de ani (exercițiul C3 din Seminarul 14). Cu ele, puterea unui test bilateral de 5% pentru un raport de informație de 0,31 este de doar circa 39%, pentru că statistica \(t\) așteptată este \(0{,}31\sqrt{29{,}5} \approx 1{,}7\). Un rezultat nesemnificativ pe datele cursului este deci o dovadă slabă împotriva lucrării.
Întrebarea deschisă este dacă trăsăturile învățate pot înlocui trăsăturile aleatoare: de exemplu, embedding-urile unui model fundațional pre-antrenat, cum este Chronos-2, folosite ca \(S_t\). Nu se știe dacă, cu astfel de trăsături și pe un panel de piețe din curs, complexitatea rămîne un avantaj.
Pe scurt
Limitele indicate de autori
Teoria acoperă modele ridge liniare pe trăsături aleatoare fixe și un singur activ; extinderea la un panel care ține cont de covarianțele dintre active rămîne deschisă (Introducerea, nota 2)
Predictibilitatea este distribuită uniform între trăsături (Ipoteza 4)
Modelele cu selecție de variabile, de tip LASSO (Least Absolute Shrinkage and Selection Operator), sînt lăsate pentru cercetări viitoare (nota 22)
Nu există un grad optim de neliniaritate \(\gamma\)
Randamentele medii ale strategiei sînt de circa două ori mai mici în 1975–2020 decît în 1930–1974 (Secțiunea V.F)
Datele cursului (Seminarul 14, exercițiul C3) au doar 7 din cei 15 predictori și circa 30 de ani
Puterea unui test bilateral la 5% pentru un raport de informație de 0,31 este de doar circa 39%
\(t \approx 0{,}31\sqrt{29{,}5} \approx 1{,}7\)
Întrebare deschisă: înlocuim trăsăturile aleatoare \(S_t\) cu trăsături învățate
De exemplu reprezentările interne (embeddings) ale unui model fundațional pre-antrenat precum Chronos-2
Mai este complexitatea o virtute pe un panel de piețe din datele cursului?
Makridakis et al. (2025) întreabă dacă o metodă de prognoză, oricît de complexă, poate depăși probabilitățile egale în prognoza performanței relative a activelor. M6 a fost o competiție în timp real, în 2022–2023, cu 226 de echipe și 100 de active, 50 de acțiuni din S&P 500 și 50 de ETF-uri internaționale. Sarcina era de a da, pentru fiecare activ, probabilitatea ca randamentul lui pe patru săptămîni să cadă în fiecare dintre cele cinci chintile ale universului. Echipele au folosit machine learning, modele de serii de timp și propria judecată.
Competiția contează pentru acest capitol pentru că este o evaluare out-of-sample în timp real: prognozele au fost trimise înainte să existe rezultatele, deci evaluarea este ferită de contaminarea prin pre-antrenare. Prognozele sînt evaluate cu scorul de probabilitate pe ranguri (RPS, ranked probability score), definit pe slide-ul despre replicare.
Afirmația principală este că probabilitățile egale sînt greu de depășit. Dintre cele 163 de echipe din clasamentul general, 38 (23,3%) au un RPS sub cel al reperului, 0,16, și doar 3 îl depășesc în toate cele 12 luni. Cele 11 echipe care depășesc reperul atît la prognoză, cît și la investiție reduc RPS cu cel mult 2,2%. Dintre primele 20% de echipe după RPS, 14 folosesc machine learning, iar 12 modele de serii de timp (tabelul 7 al lucrării). Corelația dintre RPS și raportul de informație (IR, information ratio) al portofoliului echipei este 0,04 (\(p\) = 0,601), pe cele 138 de echipe ale căror prognoze diferă de reper.
Pe scurt
Întrebarea (Makridakis et al. (2025)): poate o metodă de prognoză, oricît de complexă, să bată probabilitățile egale în prognoza performanței relative a activelor?
M6: competiție live, 2022–2023, 226 de echipe, 100 de active (50 de acțiuni din S&P 500 și 50 de ETF-uri internaționale)
Sarcina: probabilitatea ca randamentul pe patru săptămîni al fiecărui activ să cadă în fiecare dintre cele cinci chintile ale universului
Relevanța: o evaluare în afara eșantionului în timp real, deci fără contaminare prin pre-antrenare
Echipele au folosit și machine learning, și modele de serii de timp, și judecata proprie
Afirmația principală: probabilitățile egale sînt greu de bătut
Din cele 163 de echipe din clasamentul global, 38 (23,3%) au un RPS (ranked probability score) sub cel al reperului, 0,16; doar 3 îl bat în toate cele 12 luni
Cele 11 echipe care bat reperul și în prognoză, și în investiție reduc RPS cu cel mult 2,2%
Dintre primele 20% dintre echipe după RPS, 14 folosesc machine learning și 12 modele de serii de timp (Tabelul 7)
Corelația dintre RPS și raportul de informație (IR) al portofoliului echipei este 0,04 (\(p\) = 0,601), pe cele 138 de echipe cu prognoze diferite de reper
Graficul aplică sarcina M6 celor 19 active M6 din datele cursului și compară trei modele cu probabilitățile egale. Modelele și adaptarea sînt descrise pe slide-ul următor; aici se citește rezultatul.
Graficul interactiv are două panouri. Panoul din stînga arată, ca bare, reducerea RPS față de probabilitățile egale, în procente, în cele 12 perioade M6 și în cele 93 de perioade de patru săptămîni dintre 26 iulie 2019 și 11 septembrie 2026; linia punctată este echipa mediană din M6 (RPS 0,162, calculat în lucrare pe 162 din cele 163 de echipe; 100 de active), un reper de context, nu un prag comparabil. Panoul din dreapta arată reducerea cumulată a RPS, perioadă cu perioadă, cu zona albastră marcînd anul competiției. Cursorul fixează încrederea \(w\) în prognoză, de la 0 (probabilități egale) prin 1 (modelul) pînă la 2, iar butonul ▶ o parcurge.
Întrebare pentru sală Cu w = 1, care dintre cele trei modele are cea mai mică pierdere RPS medie pe cele 93 de perioade din 2019–2026, pe cele 19 active M6 din datele cursului?
Răspuns
Modelul care folosește doar volatilitatea. Reducerea RPS față de probabilitățile egale este 2,33% pentru el (DM −6,35, p < 0,001), 0,81% pentru media istorică (p = 0,358) și 1,72% pentru rețea (p = 0,016). Activele volatile primesc probabilități mai mari pentru chintilele extreme. Clasamentul nu rezultă din folosirea mediei sau din complexitatea modelului și se schimbă cu w: la w = 0,5, media istorică are 1,91%, ușor peste modelul volatilității (1,88%); la w = 2, modelul volatilității mai cîștigă doar 0,28%.
Cu \(w = 1\), modelul care folosește doar volatilitatea are cea mai mare reducere a RPS pe cele 93 de perioade: 2,33% (DM −6,35, \(p\) < 0,001), față de 0,81% pentru media istorică (\(p\) = 0,358) și 1,72% pentru rețea (\(p\) = 0,016). Activele volatile primesc probabilități mai mari pentru chintilele extreme. Clasamentul se schimbă cu \(w\): la \(w = 0{,}5\), media istorică cîștigă 1,91%, puțin peste modelul volatilității (1,88%), iar la \(w = 2\) modelul volatilității mai cîștigă doar 0,28%.
Pe scurt
Stînga: reducerea RPS față de probabilitățile egale (%), în cele 12 perioade M6 și în 93 de perioade de patru săptămîni (26.07.2019–11.09.2026); linia punctată: echipa mediană din M6 (RPS 0,162, calculat în lucrare pe 162 din cele 163 de echipe; 100 de active), reper de context, nu prag comparabil
Dreapta: suma reducerilor de RPS, perioadă cu perioadă; zona albastră marchează anul competiției
unde \(f_{ik}\) este probabilitatea prognozată ca activul \(i\) să cadă în chintila \(k\), iar \(q_{ik}\) este, în M6, 1 pentru chintila realizată și 0 în rest. Cu 19 active, chintilele nu pot conține numere egale de active, deci \(q_{ik}\) este partea din chintila \(k\) acoperită de intervalul de rang al activului, \([(r-1)/19,\, r/19]\), o pondere fracționară. Cu 100 de active, probabilitățile egale (\(f_{ik} = 0{,}2\)) dau un RPS de 0,16; cu ponderile fracționare folosite aici, 0,1516. Pentru că (14.34) compară probabilități cumulate, o prognoză care greșește cu o chintilă costă mai puțin decît una care greșește cu patru.
Adaptarea folosește cele 19 active M6 prezente în datele cursului: AMZN (Amazon.com, Inc., Nasdaq ticker, Amazon.com, Inc., simbolul bursier Nasdaq), JPM (JPMorgan Chase & Co., NYSE ticker, JPMorgan Chase & Co., simbolul bursier NYSE), META (Meta Platforms, Nasdaq ticker, Meta Platforms, simbolul bursier Nasdaq), HYG (iShares iBoxx High Yield Corporate Bond ETF, ETF de obligațiuni corporative americane cu randament ridicat, sub rating investițional), IEF (iShares 7–10 Year Treasury Bond ETF, ETF de obligațiuni de stat americane cu scadența 7–10 ani), IWM (iShares Russell 2000 ETF, ETF pe acțiunile americane mici, Russell 2000), LQD (iShares iBoxx Investment Grade Corporate Bond ETF, ETF de obligațiuni corporative americane cu rating investițional), SHY (iShares 1–3 Year Treasury Bond ETF, ETF pe obligațiuni de stat americane cu scadențe de 1–3 ani), TLT (iShares 20+ Year Treasury Bond ETF, ETF pe obligațiuni de stat americane cu scadențe de peste 20 de ani) și cele 10 ETF-uri sectoriale XL*, cu randamente totale calculate din prețuri ajustate. Calendarul M6 de patru săptămîni (tabelul 1 al lucrării) este extins înapoi pînă în 2019.
Sînt comparate trei modele. Modelul mediei istorice simulează randamente Normale cu media și covarianța ultimelor 250 de zile, de 20 000 de ori. Modelul care folosește doar volatilitatea are media zero și covarianța mediei mobile ponderate exponențial (EWMA, exponentially weighted moving average) cu \(\lambda = 0{,}94\). Rețeaua are 4 intrări (volatilitățile și randamentele pe 20 și 250 de zile), 8 neuroni și 5 probabilități la ieșire; este antrenată cu RPS ca pierdere și reestimată în fiecare an pe perioadele de după 2004.
Pe scurt
RPS (ec. 1): distanța dintre distribuția cumulată prognozată și cea realizată a chintilelor
\(f_{ik}\): probabilitatea prognozată ca activul \(i\) să cadă în chintila \(k\)
\(q_{ik}\) (notația din M6; aici nu este o cuantilă): în M6, 1 pentru chintila realizată și 0 în rest
Aici, cu 19 active: partea din chintila \(k\) acoperită de intervalul de rang \([(r-1)/19,\, r/19]\) al activului (ponderi fracționare)
Cu 100 de active, probabilitățile egale (\(f_{ik} = 0{,}2\)) dau RPS 0,16; cu ponderile fracționare de aici, 0,1516
Adaptarea: cele 19 active M6 din datele cursului (AMZN, JPM, META, HYG, IEF, IWM, LQD, SHY, TLT și cele 10 ETF-uri sectoriale XL*), randamente totale din prețuri ajustate
Calendarul M6 de patru săptămîni (Tabelul 1), extins din 2019; cu 19 active, chintilele realizate sînt fracționare
Media istorică: randamente din distribuția Normală, cu media și covarianța din ultimele 250 de zile, 20 000 de simulări
Doar volatilitatea: media zero și covarianța EWMA (exponentially weighted moving average, \(\lambda = 0{,}94\))
Rețeaua: 4 intrări (volatilitățile și randamentele pe 20 și 250 de zile), 8 neuroni, 5 probabilități; RPS ca pierdere, reestimată anual pe perioadele din 2004
Modelul care folosește doar volatilitatea depășește reperul: RPS-ul lui este cu 2,7% mai mic în anul M6, în 11 dintre cele 12 perioade, și cu 2,3% mai mic din 2019 (DM −6,35, \(p\) < 0,001). Valoarea de 2,7% de aici și cea de 2,2% din lucrare provin din universuri și ținte diferite și nu sînt direct comparabile. Mecanismul se vede în prima perioadă M6: META, cu o volatilitate EWMA de 76% pe an, are probabilitatea 0,82 de a ajunge într-o chintilă extremă, HYG, cu 7%, are 0,08, iar reperul dă 0,40.
Media istorică reduce RPS cu 1,9% în anul M6, dar doar cu 0,8% din 2019 (\(p\) = 0,358). Cu aceeași covarianță pe 250 de zile, o medie zero are un RPS cu 1,7% mai mic decît media estimată (DM −1,75, \(p\) = 0,080). Rețeaua crește RPS cu 1,4% în anul M6 și îl reduce cu 1,7% din 2019 (\(p\) = 0,016). Față de modelul volatilității, RPS-ul ei este cu 0,6% mai mare, o diferență nedetectată (DM 0,73, \(p\) = 0,466); fără intrările de randament, RPS-ul ei crește cu doar 0,05% (\(p\) = 0,70).
Rezultatul susține o comparație de proceduri. Ca în testele 1 și 2, informația utilă se află în dispersia randamentelor, nu în semnul lor. Limitele sînt clare: 19 active în loc de 100 și o singură piață. Pentru că RPS este mărginit, testul DM nu are nevoie de nicio ipoteză despre cozi. În lucrare, evaluarea acoperă un singur an, iar doar 26 dintre cele 163 de echipe au trimis prognoze noi la toate cele 12 termene; în plus, perioadele dinainte de 2022 folosesc, retrospectiv, universul ales pentru M6.
Pe scurt
Modelul care folosește doar volatilitatea bate reperul: RPS mai mic cu 2,7% în anul M6 (11 din 12 perioade) și cu 2,3% din 2019 (DM \(-\)6,35, \(p < 0{,}001\))
2,7% aici și 2,2% în lucrare provin din universuri și ținte diferite, deci nu sînt direct comparabile
Mecanismul: în prima perioadă M6, META (volatilitate EWMA 76% pe an) are probabilitatea 0,82 de a cădea într-o chintilă extremă, HYG (7%) are 0,08, iar reperul dă 0,40
Media istorică reduce RPS cu 1,9% în anul M6, dar doar cu 0,8% din 2019 (\(p\) = 0,358)
Cu aceeași covarianță pe 250 de zile, media zero are RPS mai mic cu 1,7% decît media estimată (DM \(-\)1,75, \(p\) = 0,080)
Rețeaua crește RPS cu 1,4% în anul M6 și reduce RPS cu 1,7% din 2019 (\(p\) = 0,016)
Față de modelul doar cu volatilitate: RPS mai mare cu 0,6%, diferență nedetectată (DM 0,73, \(p\) = 0,466)
Fără intrările de randament, RPS crește cu doar 0,05% (\(p\) = 0,70)
Tipul de dovadă: comparație între proceduri; informația utilă este în dispersia randamentelor, nu în semnul lor, ca în Testele 1 și 2
Limite: 19 active, nu 100, și o singură piață
RPS este mărginit, deci testul DM nu cere ipoteze despre cozile distribuției
În lucrare: un singur an, iar doar 26 din cele 163 de echipe au trimis prognoze noi la toate cele 12 termene
Perioadele dinainte de 2022 folosesc retrospectiv universul ales pentru M6
Studiul despre complexitate arată că un model mare poate avea valoare economică cu un \(R^2\) out-of-sample negativ, dar pe datele cursului cîștigul se oprește la o complexitate moderată, iar modelul liniar nu este depășit. Replicarea M6 arată că, în ordonarea activelor, semnalul util este dispersia, pe care un model de volatilitate cu media zero o captează fără nicio rețea.
AI pentru descoperire științifică
Testele capitolului lasă un rezultat neexplicat: pe varianța realizată a SPY, un model pre-antrenat mai ales pe serii nefinanciare nu se distinge de log-HAR. Secțiunea transformă acest rezultat într-o întrebare de cercetare, abilitate sau memorie, și arată cum poate ajuta un asistent AI la fiecare pas al buclei de cercetare și unde propunerile lui trebuie verificate. Mini-studiul de caz testează răspunsul tipic al asistentului și constată că datele disponibile nu pot decide.
Întrebare deschisă: capacitate de prognoză sau memorarea datelor de antrenare?
Testul 2 a arătat că Chronos-2 zero-shot nu se distinge de log-HAR pe varianța realizată a SPY. Alte rezultate indică altceva pentru randamente: Rahimikia, Ni & Wang (2025) constată că modelele fundaționale luate ca atare fac rezultate slabe pe randamentele zilnice în exces de pe piețele globale, atît zero-shot, cît și după fine-tuning, în timp ce modelele pre-antrenate de la zero pe date financiare cîștigă. Iar Lopez-Lira, Tang & Zhu (2025) arată că, odată ce un model a văzut valorile realizate, abilitatea lui contrafactuală de prognoză nu este identificată: memorarea (memorisation) detectată este doar o limită inferioară. Argumentul lor este formulat pentru LLM, dar logica se aplică oricărui model de prognoză pre-antrenat.
Rezultă două întrebări deschise. Este paritatea cu log-HAR o structură învățată, cum ar fi memoria lungă și revenirea la medie, sau amintirea perioadei de test? Și poate o fereastră scurtă de după publicare să le deosebească?
Un test poate fi construit din diferența de pierdere din Testul 2,
pierderea QLIKE \(L\) a modelului fundațional (FM, foundation model) minus cea a log-HAR. Memorarea implică \(E[d_t \mid \text{după}] > E[d_t \mid \text{înainte}]\): modelul fundațional își pierde avantajul după publicarea ponderilor. Ipoteza nulă este egalitatea. O respingere ar putea reflecta și o schimbare de regim a pieței la aceeași dată.
Pe scurt
Testul 2: Chronos-2 zero-shot nu se distinge de log-HAR pe varianța realizată a SPY
Rahimikia, Ni & Wang (2025): modelele fundaționale gata antrenate au rezultate slabe zero-shot și după fine-tuning
Pe randamentele zilnice în exces de pe piețele globale
Modelele pre-antrenate de la zero pe date financiare au rezultate mai bune
Literatura. Unui asistent i se pot cere evaluări ale modelelor fundaționale pentru serii de timp pe date financiare publicate din 2024, dar fiecare identificator arXiv returnat trebuie verificat, iar documentația corpusurilor de pre-antrenare trebuie citită direct.
Ipotezele: predicții care separă memorarea de abilitate, cum ar fi comparația înainte și după publicare, serii care nu au fost niciodată publice și serii simulate cu aceeași dinamică.
Datele și codul. Din prognozele de volatilitate ale capitolului se calculează diferența QLIKE dintre Chronos-2 și log-HAR, împreună cu un test înainte/după cu erori HAC și efectul lui minim detectabil (MDE, minimum detectable effect).
Robustețea, fixată dinainte: o dată de publicare placebo cu un an mai devreme nu trebuie să arate nicio ruptură, iar seriile simulate, care nu pot fi memorate, servesc drept control.
Critica. Asistentului i se cere să atace concluzia „nu există memorare, pentru că testul de după publicare este nesemnificativ”; o critică bună ar trebui să indice puterea mică și regimurile diferite dinainte și de după publicare.
Prompturi reutilizabile pentru cei cinci pași sînt în Anexă.
Pe scurt
Literatura: cereți unui asistent evaluări ale modelelor fundaționale pe date financiare din 2024 încoace
Apoi verificați fiecare identificator arXiv
Citiți direct documentația corpusului
Ipoteze: predicții care separă memorarea de abilitate
Înainte și după publicare
Serii niciodată publice
Serii simulate cu aceeași dinamică
Date și cod: din prognozele de volatilitate ale capitolului
Diferențialul QLIKE Chronos-2 minus log-HAR
Un test înainte/după cu erori HAC și efectul minim detectabil (MDE, minimum detectable effect)
Robustețea, fixată dinainte
O dată de publicare placebo, cu un an mai devreme, nu trebuie să arate nicio ruptură
Seriile simulate nu pot fi memorate
Critica: cereți asistentului să atace „nu există memorare, pentru că testul de după publicare este nesemnificativ”
Răspunsuri de așteptat: putere mică și regimuri diferite
O propunere tipică a unui asistent este că paritatea Chronos-2 vine din date memorate, deci avantajul lui față de log-HAR trebuie să dispară după publicare. Graficul testează această propunere cu diferența (14.35), împărțită la data publicării.
Graficul interactiv are pe axa orizontală diferența QLIKE medie \(d_t\), cu o linie întreruptă la zero. Primul rînd este media dinaintea datei rupturii, în verde, al doilea media de după ea, în portocaliu, fiecare cu intervalul ei HAC de 95%; rîndul de jos este schimbarea estimată \(\hat\beta_1\), după minus înainte, cu marcaje roșii la ±MDE, cea mai mică schimbare pe care testul o detectează cu o putere de 80%. Selectorul alege modelul fundațional, cursorul mută data rupturii, iar butonul ▶ mută data rupturii prin perioada de test.
Întrebare pentru sală Pentru Chronos-2 pe SPY, ce permite să concluzionăm comparația performanței înainte și după 3 noiembrie 2025 despre memorare?
Răspuns
Nici prezența, nici absența memorării. Schimbarea estimată a diferenței QLIKE față de log-HAR este +0,0074, cu t HAC = 0,88 și p = 0,38. MDE pentru o putere de 80% este 0,0234, mai mare decît schimbarea observată; chiar și cu o fereastră infinită după publicare, MDE ar rămîne 0,0157. Nerespingerea nu exclude memorarea, iar o schimbare semnificativă nu ar separa automat memorarea de o schimbare a regimului pieței.
Cu ruptura la 3 noiembrie 2025, media lui \(d_t\) pentru Chronos-2 este −0,0045 în cele 761 de zile dinainte și +0,0029 în cele 218 zile de după. Schimbarea estimată este +0,0074, cu \(t\) HAC = 0,88 și \(p\) = 0,38, iar MDE la o putere de 80% este 0,0234, mai mare decît schimbarea observată.
Graficul se citește astfel. Rîndurile verde și portocaliu sînt diferențele QLIKE medii ale Chronos-2 față de log-HAR înainte și după publicare, cu intervale HAC de 95%. Rîndul de jos este schimbarea estimată \(\hat\beta_1\), cu linii roșii la ±MDE.
Înainte de 3 noiembrie 2025, pe 761 de zile, media lui \(d_t\) este −0,0045: Chronos-2 are o pierdere puțin mai mică decît log-HAR. După această dată, pe 218 zile, media este +0,0029. Schimbarea este +0,0074, cu \(t\) HAC = 0,88 și \(p\) = 0,38, deci nu respingem egalitatea. Testul cere o varianță pe termen lung a lui \(d_t\) finită, deci prognoze care nu se apropie de zero.
Rezultatul susține o asociere, nu o relație cauzală. Chiar și o respingere ar lega diferența doar de data publicării, nu de memorare: orice altceva care s-a schimbat la acea dată ar produce același tipar.
Pe scurt
Propunere tipică a unui asistent
„Paritatea Chronos-2 vine din date memorate, deci avantajul trebuie să dispară după publicare”
Graficul: media diferențialului QLIKE \(d_t\) (Chronos-2 minus log-HAR) înainte (verde) și după (portocaliu) publicare
Cu intervalele HAC de 95%
Rîndul de jos: schimbarea estimată \(\hat\beta_1\), cu liniile roșii la \(\pm\)MDE
MDE: efectul minim pe care testul îl poate detecta
Media lui \(d_t\): \(-\)0,0045 înainte de 3 nov. 2025 (761 de zile) și +0,0029 după (218 zile)
Schimbarea mediei: +0,0074, cu \(t\) HAC = 0,88 și \(p\) = 0,38
Testul cere varianță de termen lung finită a lui \(d_t\), deci prognoze care nu se apropie de zero
Tipul de dovadă: asociere (variabilele se mișcă împreună; nu dovedește o relație cauzală)
Chiar o respingere ar lega diferența doar de data publicării, nu de memorare
unde \(z_{0{,}975} = 1{,}96\) și \(z_{0{,}8} = 0{,}84\) sînt cuantile ale distribuției Normale standard, \(\hat\beta_1\) este deplasarea estimată după publicare a mediei lui \(d_t\), iar \(\mathrm{SE}_{HAC}\) eroarea ei standard HAC. MDE este de 5,3 ori diferența dinainte de publicare și ar rămîne 0,0157 chiar cu o fereastră infinită după publicare.
Pragul minim vine din structura erorii standard. Erorile HAC dau fiecărei perioade propria varianță pe termen lung \(V\), iar
Mai multe zile după publicare elimină doar al doilea termen din (14.37), lăsînd un MDE de \(2{,}80\sqrt{V_{pre}/761}\). Așteptarea nu rezolvă problema.
„Nu există memorare” nu este deci o constatare a acestui test. Puterea trebuie să vină din secțiunea transversală, din multe serii testate deodată, nu din așteptarea unei ferestre mai lungi. Verificări metodologice pentru cercetător sînt enumerate în Aprofundări.
Proiectul întreabă unde este imposibilă memorarea: rezistă abilitatea zero-shot pentru varianța zilnică după publicare, pe serii simulate și pe piețe mai puțin acoperite? Primul pas este replicarea numerelor capitolului: QLIKE medie a log-HAR (0,226) și a Chronos-2 (0,223), p-value-ul DM de 0,539 și fereastra de 218 zile de după publicare.
Livrabilele sînt:
un calcul de putere preînregistrat;
un panel de serii din datele cursului, cu un proxy de varianță bazat pe amplitudine (range-based) și o pierdere robustă la proxy (Patton, 2011);
teste înainte/după cu date de publicare placebo și MCS pe modele;
o critică în stilul unui referent, cu un răspuns.
Fiecare prompt care a influențat o decizie se notează în `AI_USE.md`, iar fiecare referință inventată, scurgere de informație sau număr greșit detectat intră în `AI_ERRORS.md`, cu testul care l-a detectat. Șabloanele sînt în dosarul proiectului.
Pe scurt
Întrebări (acolo unde memorarea este imposibilă)
se menține abilitatea zero-shot pentru varianța zilnică după publicare?
se menține ea pe serii simulate?
se menține ea pe piețe mai puțin acoperite?
Replicați întîi: QLIKE din capitol pentru log-HAR (0,226) și Chronos-2 (0,223)
DM \(p\) = 0,539
Fereastra de 218 zile de după publicare
Livrabile
Un calcul de putere preînregistrat
Un panel de serii din datele cursului, cu o aproximare a varianței din amplitudinea zilnică și o pierdere robustă la aproximare (Patton (2011))
Teste înainte/după cu date de publicare placebo
MCS pentru toate modelele
O critică de tip recenzent și răspunsul echipei
Notați fiecare prompt care a influențat o decizie în AI_USE.md
Notați fiecare referință inventată, scurgere de informație sau cifră greșită identificată în AI_ERRORS.md
Paritatea Chronos-2 cu log-HAR nu poate fi atribuită nici abilității, nici memoriei cu datele capitolului: schimbarea de după publicare nu este semnificativă, iar testul nu ar fi putut detecta o schimbare de mărimea celei observate. Răspunsul cere multe serii, serii simulate și o putere preînregistrată, nu o așteptare mai lungă.
Arhitecturile din capitol tratează în moduri diferite problema memoriei. Porțile LSTM pot atenua dispariția gradientului, dar cu un termen liber 0 al porții de uitare gradientul tot dispare. Atenția leagă direct pași de timp îndepărtați. Modelele fundaționale prognozează zero-shot dintr-o fereastră de context și returnează cuantile, din care rezultă prognozele punctuale, de volatilitate și pentru coadă.
Cele trei teste dau trei răspunsuri diferite. Pentru randamente, după corecția pentru teste multiple, nimic nu depășește prognoza zero pe S&P 500 și Bitcoin. Pentru volatilitate, modelele fundaționale nu se disting de log-HAR. Pentru cozi, ele sînt utile doar ca filtre de volatilitate în FHS.
Metoda se generalizează dincolo de aceste modele. Orice model nou trebuie evaluat față de un reper puternic și după publicarea ponderilor lui, cu o inferență potrivită designului: Clark–West pentru modele imbricate, SPA sau Romano–Wolf pentru multe modele, iar PIT, scorurile cuantilice și testul DQ pentru distribuții. Lecturile suplimentare sînt în Anexă.
Pe scurt
Porțile LSTM pot atenua dispariția gradientului
Cu termenul liber al porții de uitare egal cu 0, gradientul tot dispare
Atenția conectează direct momente îndepărtate
Modelele fundaționale prognozează zero-shot dintr-o fereastră de context și furnizează cuantile
Cele trei teste
Randamente: după corecția pentru teste multiple, niciun model nu depășește prognoza zero pe S&P 500 și Bitcoin
Volatilitate: modelele fundaționale nu se disting de log-HAR
Cozi: FHS rămîne reperul; modelele fundaționale, cel mult ca filtre de volatilitate
Evaluați orice model nou față de un reper puternic și după publicarea ponderilor lui
Capitolul 15 întreabă dacă textul citit de un model mare de limbaj poate prognoza randamentele sau volatilitatea. Revin aceleași amenințări, look-ahead, memorarea perioadei de test și reperele slabe, și aceleași instrumente: ferestrele de după publicare, testul Clark–West și controlul testelor multiple.
Pe scurt
Întrebări de verificare
De ce uită o RNN stabilă în ritmul răspunsului la impuls \(A^k\) al unui VAR(1), nu neapărat ca \(\rho(A)^k\)?
De ce este \(\exp(q_{0{,}5})\) din log RV o prognoză deplasată sub QLIKE?
De ce poate un VaR hibrid să treacă testul Kupiec și totuși să piardă comparația FZ0?
De ce „nesemnificativ după publicare” nu este o dovadă împotriva memorării?
Pentru randamentele zilnice ale indicilor, alegerea este prognoza zero. Pentru volatilitatea realizată, este log-HAR, cu un model fundațional zero-shot atunci cînd trebuie prognozate mii de serii fără estimare. Pentru VaR 1% și ES 2,5%, este FHS, cu un model fundațional cel mult ca filtru de volatilitate sau cu recalibrare conformală.
Condițiile sînt cele ale eșantioanelor din capitol. Pe S&P 500 și Bitcoin, niciun model nu depășește prognoza zero după corecția pentru teste multiple; pe BET, p-value-ul SPA corectat Holm pentru cele trei piețe este 0,056. Pe SPY, Chronos-2 și log-HAR au QLIKE 0,223 și 0,226 (\(p\) DM = 0,539). Pe S&P 500, FHS are cea mai mică pierdere FZ0 (DM +2,65 față de hibridul cu Chronos-2).
Decizia trebuie revăzută dacă un model depășește prognoza zero după Holm sau SPA, într-o familie de teste fixată dinainte; dacă un model fundațional are o QLIKE semnificativ sub log-HAR în fereastra de după publicare; sau dacă un VaR hibrid trece, pe lîngă Kupiec, și testele de independență și DQ.
Pe scurt
Ce aleg
Randamente zilnice ale indicilor: prognoza zero
Volatilitate realizată: log-HAR; un model fundațional zero-shot cînd trebuie prognozate mii de serii fără estimare
VaR 1% și ES 2,5%: FHS, cu un model fundațional cel mult ca filtru de volatilitate sau cu recalibrare conformală
În ce condiții
Pe S&P 500 și Bitcoin, niciun model nu depășește prognoza zero după corecția pentru teste multiple
Pe BET, valoarea \(p\) SPA corectată Holm pentru cele trei piețe este 0,056
Pe SPY, Chronos-2 și log-HAR au QLIKE 0,223 și 0,226 (DM \(p\) = 0,539)
Pe S&P 500, FHS are cea mai mică pierdere FZ0 (DM +2,65 față de hibridul Chronos-2)
Ce rezultat m-ar face să renunț
Un model care depășește prognoza zero după Holm sau SPA, într-o familie de teste fixată dinainte
Un model fundațional cu QLIKE semnificativ sub log-HAR în fereastra de după publicare
Un VaR hibrid care trece și testele de independență și DQ, nu doar testul Kupiec
Sinteza secțiunii
Rețelele profunde și modelele fundaționale nu aduc valoare pentru media randamentelor zilnice ale indicilor, nu se disting de log-HAR pentru varianța realizată și sînt utile în coadă doar în interiorul FHS. Metoda de evaluare, cu repere puternice, ferestre de după publicare și o inferență potrivită designului, se aplică și modelelor de limbaj din capitolul următor.
Aprofundări
Slide-urile din această parte extind subiecte tratate pe scurt în corpul capitolului: dispariția gradientului măsurată prin diferențiere automată, un exemplu numeric de atenție cu mască cauzală, ce vede Chronos dintr-o serie de randamente, blocul Transformer și arhitecturile construite din el, un calcul rezolvat de VaR și ES dintr-o grilă de cuantile, un fan chart zero-shot pentru volatilitate, antrenarea LSTM și sensibilitatea lui la seed, prețurile vechi din spatele rezultatului pe BET, regula pentru cozile mediei din grilă, lungimea contextului, VaR 10%, garanția inferenței conformale adaptive, metoda și pozițiile din studiul despre complexitate și capcanele pe care cercetătorul trebuie să le verifice.
Graficul măsoară \(|\partial h_T/\partial x_{T-k}|\) prin diferențiere automată (automatic differentiation), relativ la valoarea de la \(k = 0\), pentru rețele cu 16 unități ascunse, mediat pe 50 de inițializări aleatoare, cu aceleași intrări Normale. RNN simplă păstrează \(8{,}3 \times 10^{-5}\) la lag-ul 20 și \(7{,}4 \times 10^{-9}\) la lag-ul 50, deci nu învață nimic din intrări mai vechi de cîteva săptămîni. LSTM cu termenul liber al porții de uitare 0 nu este mai bun (\(1{,}2 \times 10^{-10}\) la lag-ul 50), pentru că \(f \approx 0{,}5\) înjumătățește memoria la fiecare pas, în timp ce cu termenul liber 3 păstrează 8,4% la lag-ul 50, cum prezice \(0{,}953^{50} \approx 0{,}09\) din (14.8). Termenul liber al porții de uitare trebuie deci inițializat la o valoare pozitivă.
Pe scurt
\(|\partial h_T / \partial x_{T-k}|\) prin diferențiere automată, raportat la valoarea pentru \(k = 0\), ca pe axa verticală
16 unități ascunse, 50 de inițializări aleatoare, aceleași intrări din distribuția Normală
RNN simplă: gradientul este \(8{,}3 \times 10^{-5}\) la lag-ul 20 și \(7{,}4 \times 10^{-9}\) la lag-ul 50
Nu se învață nimic din intrări mai vechi de cîteva săptămîni
LSTM cu termenul liber al porții de uitare egal cu 0: gradientul este \(1{,}2 \times 10^{-10}\) la lag-ul 50
Nu este mai bun decît RNN: \(f \approx 0{,}5\) înjumătățește memoria la fiecare pas
LSTM cu termenul liber egal cu 3: gradientul este 8,4% la lag-ul 50
Conform valorii teoretice \(0{,}953^{50} \approx 0{,}09\)
Inițializați termenul liber al porții de uitare cu o valoare pozitivă
Cu trei pași de timp și \(d_k = 1\), interogările \(q = (1;\ 0;\ 2)\), cheile \(k = (0{,}5;\ 1;\ -1)\) și valorile \(v = (1;\ 2;\ 3)\), pasul 3 are scorurile \((1;\ 2;\ -2)\), ponderile softmax \((0{,}265;\ 0{,}721;\ 0{,}013)\) și ieșirea 1,75. El preia mai ales informația pasului 2, a cărui cheie se potrivește cel mai bine cu interogarea lui.
O mască cauzală adaugă scorurilor \(M_{tj} = -\infty\) pentru \(j > t\), astfel încît pasul \(t\) folosește doar pașii \(j \le t\); pasul 1 își acordă atunci ponderea 1, în timp ce fără mască 57% din ponderea lui ar veni de la pasul 2, o zi ulterioară, iar cu mască pasul 2 are ieșirea \((1 + 2)/2 = 1{,}5\). Într-un context de 512 zile, toate valorile sînt deja observate la momentul prognozei, deci un model care citește doar contextul poate folosi atenția în ambele sensuri; masca este necesară acolo unde modelul este antrenat să prognozeze pozițiile ulterioare din cele anterioare.
Pe scurt
Masca cauzală: pasul \(t\) poate folosi doar pașii \(j \le t\)
Într-un model care prognozează fiecare pas următor
Echivalent, adăugăm \(M_{tj} = 0\) pentru \(j \le t\) și \(M_{tj} = -\infty\) pentru \(j > t\)
\[
\operatorname{softmax}\!\left(\frac{Q K^\top}{\sqrt{d_k}} + M\right) V
\]
Pasul 1 își acordă atunci ponderea 1 (ieșirea 1)
Fără mască, scorurile lui \((0{,}5;\ 1;\ -1)\) dau ponderile \((0{,}35;\ 0{,}57;\ 0{,}08)\): 57% vine de la pasul 2, o zi ulterioară
Cu mască, pasul 2 (\(q_2 = 0\), scoruri egale pe pașii 1 și 2) are ieșirea \((1 + 2)/2 = 1{,}5\)
Toate valorile unui context de 512 zile sînt deja observate la momentul prognozei
Deci un model care citește doar contextul poate folosi atenția în ambele sensuri
Masca este necesară acolo unde modelul este antrenat să prognozeze pozițiile ulterioare din cele anterioare
Graficul arată ultimele 512 randamente zilnice ale S&P 500 după scalarea prin medie din (14.12) și centrele cărora le sînt atribuite. Scalarea împarte fiecare randament la randamentul absolut mediu din context, deci modelul vede o serie fără unități, iar cuantizarea duce fiecare valoare scalată la cel mai apropiat dintre cele 4 093 de centre.
Scala contextului este \(s\) = 0,672%, randamentele scalate sînt între −9,2 și 13,5, 96% dintre ele sînt în intervalul ±3, iar cele 512 randamente folosesc doar 336 dintre cele 4 093 de tokeni. Pentru că scalarea elimină unitățile, nivelul volatilității trebuie citit din context. Cînd o zi de crah cu randamentul \(M\) (în procente) intră în context și cel mai vechi randament \(x_{\text{out}}\) iese, \(s\) crește cu \((|M| - |x_{\text{out}}|)/C\), aproximativ \(|M|/C\), puncte procentuale; creșterea relativă, de circa \(|M|/(Cs)\), este mare într-un context scurt și mică într-unul de 512 zile (exercițiile A3 și A6 din Seminarul 14).
Pe scurt
Contextul: ultimele 512 randamente zilnice ale S&P 500, împărțite la scala \(s\) = 0,672%
Randamentele scalate sînt între \(-\)9,2 și 13,5
96% dintre ele se află în intervalul \(\pm 3\)
Cele 512 randamente folosesc 336 de tokeni distincți din 4 093
Scalarea face modelul independent de unități, deci nivelul volatilității trebuie citit din context
O zi de crah cu randamentul \(M\) (în %) intră în context, iar cel mai vechi randament \(x_{\text{out}}\) iese
\(s\) crește cu \((|M| - |x_{\text{out}}|)/C\) puncte procentuale, aproximativ \(|M|/C\)
Creșterea relativă, circa \(|M|/(C s)\), este mare într-un context scurt și mică într-unul de 512 zile
Un bloc Transformer (Vaswani et al., 2017) aplică atenția cu mai multe capete (MHA, multi-head attention) și apoi un MLP mic, separat pentru fiecare poziție, fiecare parte avînd o conexiune reziduală (skip connection) și o normalizare pe strat (LN, layer normalisation): \(Z = \mathrm{LN}(X + \mathrm{MHA}(X))\) și \(H = \mathrm{LN}(Z + \mathrm{MLP}(Z))\). Atenția cu mai multe capete rulează \(m\) atenții în paralel, fiecare cu propriile \(W_Q\),\(W_K\),\(W_V\), le concatenează și proiectează rezultatul cu \(W_O\); normalizarea pe strat standardizează fiecare rînd și îl rescalează cu parametri învățați. Conexiunea reziduală \(X + \mathrm{MHA}(X)\) lasă gradientul să treacă direct prin bloc, iar un model suprapune mai multe blocuri, cu \(H\) ca intrare a blocului următor.
Pe scurt
Blocul Transformer (Vaswani et al. (2017)): atenție cu mai multe capete, apoi un MLP mic
MLP-ul este aplicat separat fiecărei poziții
Fiecare parte are o conexiune reziduală și o normalizare
\[
Z = \mathrm{LN}\big(X + \mathrm{MHA}(X)\big), \qquad H = \mathrm{LN}\big(Z + \mathrm{MLP}(Z)\big)
\]
\(\mathrm{MHA}(X) = [\mathrm{head}_1, \dots, \mathrm{head}_m]\,W_O\) (multi-head attention): \(m\) atenții în paralel, fiecare cu propriile \(W_Q\), \(W_K\), \(W_V\), concatenate și proiectate cu \(W_O\)
\(\mathrm{LN}\) (layer normalization): fiecare rînd este standardizat, apoi rescalat cu parametri învățați
\(X + \mathrm{MHA}(X)\): conexiunea reziduală, care lasă gradientul să treacă direct prin bloc
Un model suprapune mai multe blocuri: \(H\) devine intrarea blocului următor
Blocurile se asamblează în trei feluri. Un codificator (encoder) folosește atenția în ambele sensuri în interiorul contextului; Chronos-2 are doar codificator și returnează grila de cuantile într-un singur pas (Ansari et al., 2025). Un model doar cu decodor, cum este TimesFM (Das et al., 2024), folosește o mască cauzală și este antrenat să prognozeze patch-ul următor la fiecare poziție. Un model codificator–decodor, cum este T5 din Chronos original, citește contextul cu codificatorul și scrie prognoza token cu token cu decodorul. Chronos original este antrenat cu entropia încrucișată, o clasificare în 4 093 de clase,
iar Chronos-2 folosește scalarea robustă \(\tilde x_t = \sinh^{-1}((x_t - \hat\mu)/\hat\sigma)\), cu \(\hat\mu\) și \(\hat\sigma\) media și abaterea standard a contextului; \(\sinh^{-1}\) crește ca un logaritm pentru valori mari și atenuează astfel valorile extreme.
Pe scurt
Trei moduri de a asambla blocurile
Encoder (codificator): atenție în ambele sensuri în interiorul contextului; Chronos-2 are doar encoder și furnizează grila de cuantile dintr-un singur pas (Ansari et al. (2025))
Doar decoder (decodor): mască cauzală, antrenat să prognozeze patch-ul următor la fiecare poziție: TimesFM (Das et al. (2024))
Encoder–decoder (T5, folosit de Chronos original): encoderul citește contextul, iar decoderul scrie prognoza token cu token
Entropia încrucișată (cross-entropy, la Chronos original)
Prognoza tokenului următor este o clasificare în 4 093 de clase
Pentru S&P 500 la 18 septembrie 2026, cu contextul pînă la 17 septembrie, Chronos-2 dă \(q_{0{,}01} = -2{,}704\%\) și \(q_{0{,}05} = -1{,}400\%\), deci VaR 1% este 2,704%. Interpolarea liniară dă \(q_{0{,}025} = q_{0{,}01} + \tfrac{0{,}015}{0{,}04}(q_{0{,}05} - q_{0{,}01}) = -2{,}215\%\), deci VaR 2,5% este 2,215%. Cu \(q_u\) constant sub 1% și regula trapezului între 1% și 2,5%, (14.14) dă \(\mathrm{ES}_{2{,}5\%} = 40 \times [0{,}01 \times 2{,}704 + 0{,}015 \times 2{,}459] = 2{,}56\%\). Raportul ES/VaR la 2,5% este 1,15, sub valoarea de 1,19 a distribuției Normale, deși această grilă are o coadă stîngă mai groasă decît distribuția Normală: coada constantă sub 1% subestimează ES (exercițiul A7 din Seminarul 14).
Pe scurt
Exemplu rezolvat, S&P 500, cuantilele pentru 18.09.2026 (context pînă la 17.09.2026): \(q_{0{,}01} = \)\(-\)2,704%, \(q_{0{,}05} = \)\(-\)1,400%
VaR 1% \(=\) 2,704%
interpolare liniară între cele două niveluri: \(q_{0{,}025} = q_{0{,}01} + \frac{0{,}015}{0{,}04}(q_{0{,}05} - q_{0{,}01}) = \)\(-\)2,215%, deci VaR 2,5% \(=\) 2,215%
ES 2,5%: \(q_u\) constant sub 1%, regula trapezului între 1% și 2,5%
Fan chart-ul arată o prognoză Chronos-2 a volatilității SPY pe 22 de zile de tranzacționare înainte, de la 18 septembrie 2026, făcută zero-shot pe logaritmul varianței realizate, cu un context de 512 zile. Linia este mediana, iar cele două benzi sînt intervalele dintre cuantilele de 5% și 95% și dintre cele de 25% și 75%, transformate în volatilitate anualizată.
Ultima volatilitate realizată este de 4,8% pe an, iar media ei pe 20 de zile de 6,8%; mediana prognozată la 22 de zile este 6,9%, cu o bandă de 90% între 4,0% și 15,8%. Prognoza revine la medie, cum fac GARCH și HAR (capitolele 5 și 9), fără nicio estimare pe SPY. Banda este asimetrică în sus în parte prin construcție, pentru că volatilitatea este \(\sqrt{252\,e^{q}}\) dintr-o cuantilă \(q\) a logaritmului varianței, iar o transformare convexă întinde partea de sus; dar pe scala logaritmului volatilității, jumătate din logaritmul varianței, banda este tot la 0,56 sub mediană și la 0,82 deasupra ei, deci și modelul însuși înclină spre salturi.
Pe scurt
Chronos-2 pe logaritmul varianței realizate a SPY (context de 512 zile)
SPY: fondul tranzacționat la bursă (ETF, exchange-traded fund) care replică S&P 500
22 de zile de tranzacționare de la 18.09.2026
Benzi: cuantilele 5–95% și 25–75%
Ultima volatilitate observată este 4,8% pe an
Media pe ultimele 20 de zile este 6,8%
Prognoza mediană la 22 de zile este 6,9%, cu banda de 90% între 4,0% și 15,8%
Revenire la medie, ca la GARCH și HAR (capitolele 5, 9)
Fără nicio estimare pe SPY
Banda este asimetrică în sus parțial prin construcție: volatilitatea este \(\sqrt{252\,e^{q}}\) dintr-o cuantilă \(q\) a log-varianței, iar o funcție convexă întinde partea de sus
Pe scara log-volatilității (jumătate din log-varianță), banda se află totuși la 0,56 sub mediană și la 0,82 deasupra ei, deci și modelul înclină spre salturi
Graficul arată eroarea pătratică medie de antrenare și de validare a LSTM pentru randamente, pe epoci, pe randamentele standardizate ale S&P 500 pentru seed-ul 0, cu o linie verticală punctată la epoca ale cărei ponderi sînt păstrate. Early stopping oprește antrenarea cînd MSE de validare nu s-a mai îmbunătățit un număr fixat de epoci.
LSTM citește ultimele 20 de randamente, standardizate pe perioada de antrenare, cu \(h = 16\) unități ascunse, o intrare pe pas și o ieșire liniară: \(4(hd + h^2 + 2h) + h + 1 = 1\,233\) de parametri, unde factorul 4 numără cele trei porți și candidatul. Este antrenat o singură dată pe cel mult 4 000 de zile, cu ultimele 20% ca bloc de validare, cu MSE și Adam și cu weight decay \(10^{-4}\); antrenarea se oprește după 25 de epoci fără un MSE de validare mai mic, iar prognoza este media a 5 seed-uri. Pe S&P 500, antrenarea se oprește după 26 de epoci și sînt păstrate ponderile din epoca 1, deci rețeaua a văzut datele o singură dată și rămîne aproape de punctul ei aleator de plecare, unul dintre motivele pentru care seed-ul contează; MSE de validare este mai mic decît cel de antrenare mai ales pentru că ultimii ani ai perioadei de antrenare au fost mai calmi. Este puțin de învățat: abaterea standard a prognozelor este 0,047%, față de 1,13% pentru randamente.
Pe scurt
Intrarea: ultimele 20 de randamente, standardizate pe perioada de antrenare
\(h = 16\) unități ascunse, \(d = 1\) intrare la fiecare pas, ieșire liniară
\(4(hd + h^2 + 2h) + h + 1\) = 1 233 de parametri (factorul 4: cele trei porți și conținutul candidat; \(2h\): doi vectori de termeni liberi pe poartă)
MSE, Adam, weight decay \(10^{-4}\)
Antrenat o singură dată pe cel mult 4 000 de zile, dintre care ultimele 20% sînt blocul de validare
Early stopping: antrenarea se oprește după 25 de epoci fără un MSE de validare mai mic (patience), iar ponderile cele mai bune sînt păstrate
Prognoza = media a 5 seed-uri
Graficul (S&P 500, seed-ul 0): MSE de antrenare și MSE de validare pe epoci
Pentru randamente standardizate
Linia verticală punctată marchează epoca păstrată
Antrenarea se oprește după 26 de epoci, iar ponderile păstrate sînt cele din epoca 1
Rețeaua păstrată a văzut datele de antrenare o singură dată și rămîne aproape de inițializarea aleatoare: un motiv pentru care seed-ul contează
MSE de validare este mai mic decît MSE de antrenare, în principal pentru că ultimii ani ai perioadei de antrenare au fost mai calmi
Semnal redus: abaterea standard a prognozei 0,047%, față de 1,13% pentru randamente
Graficul reprezintă, pentru fiecare model, SSE(zero) − SSE(model) \(= \sum_{s \le t}[r_s^2 - (r_s - \hat r_s)^2]\), unde SSE este suma erorilor pătratice în %²: curba crește cînd modelul depășește prognoza zero și scade cînd pierde. Toate curbele rămîn aproape de zero în anii calmi și fac un salt în martie 2020, deci o singură lună decide clasamentul. AR(1) cîștigă în 2020 din autocorelația negativă a zilelor de crah și apoi cedează o parte din cîștig, iar TimesFM-2.5 pierde constant. Traiectoria trebuie raportată împreună cu \(R^2\) final.
Graficul compară \(R^2\) out-of-sample a cinci LSTM care diferă doar prin seed-ul aleator și al mediei lor. Pentru seed-uri individuale, variația este la fel de mare ca efectul: de la −0,79% la +0,24% pe Bitcoin și de la +0,37% la +1,96% pe S&P 500. Pe BET, rezultatul este robust, toate cele 5 seed-uri fiind între +1,01% și +1,22%. Alegerea celui mai bun seed după ce s-a văzut testul este supraajustare în backtesting (backtest overfitting, Capitolul 13).
Pe scurt
\(R^2\) în afara eșantionului pentru cinci LSTM-uri care diferă doar prin seed-ul aleator și pentru media lor
Bitcoin: \(R^2\) al seed-urilor individuale este între \(-\)0,79% și +0,24%
Pe S&P 500: între +0,37% și +1,96%
Variația dintre seed-uri este la fel de mare ca efectul măsurat
BET: toate cele 5 seed-uri dau \(R^2\) între +1,01% și +1,22%
Rezultatul este robust la alegerea seed-ului
Alegerea celui mai bun seed după examinarea rezultatelor de test este supraajustarea (overfitting) backtest-ului (Capitolul 13)
Prețurile vechi ale componentelor puțin tranzacționate fac randamentele indicilor pozitiv autocorelate chiar dacă fiecare preț este eficient (Lo & MacKinlay, 1990). Din 2016, autocorelația de ordinul 1 este 0,06 pentru BET și −0,14 pentru S&P 500, iar prognoza LSTM are o corelație de 0,88 cu randamentul BET din ziua anterioară: a învățat în principal această autocorelație. Pe ETF-ul care replică BET, Patria-TVBETETF, pe 2 629 de zile comune, același semnal are un \(R^2\) în aceeași zi de 2,88% (1,26% pentru BET în aceleași zile), dar și ETF-ul este puțin tranzacționat (autocorelație 0,07, 4,2% zile cu randament zero). Executat cu o zi mai tîrziu, \(R^2\) este 0,57%, cu \(p\) Clark–West = 0,003. Dovezile sînt compatibile cu efectele prețurilor vechi; un semnal mic rezistă întîrzierii execuției, înainte de costurile de tranzacționare (Capitolul 2).
Pe scurt
Prețurile neactualizate induc autocorelație pozitivă în randamentele indicelui (Lo & MacKinlay (1990))
Prețurile neactualizate: ale acțiunilor tranzacționate rar
Chiar dacă fiecare preț este eficient
Autocorelația de ordinul 1 din 2016 încoace: 0,06 pentru BET și \(-0{,}14\) pentru S&P 500
Prognoza LSTM are corelația 0,88 cu randamentul BET din ziua precedentă: a învățat în principal această autocorelație
Verificare pe un instrument tranzacționabil: ETF-ul Patria-TVBETETF, care replică BET
2 629 de zile comune, același semnal LSTM
Execuție în aceeași zi: \(R^2\) = 2,88% (față de 1,26% pentru BET în aceleași 2 629 de zile)
Dar și ETF-ul se tranzacționează rar: autocorelația de ordinul 1 este 0,07, iar 4,2% din zile au randament zero
Execuție cu o zi întîrziere: \(R^2\) = 0,57%, \(p\) Clark–West = 0,003
Interpretare: rezultatele sînt compatibile cu efectul prețurilor neactualizate
Un semnal mic rămîne și cînd execuția este întîrziată cu o zi
Înainte de costurile de tranzacționare (Capitolul 2)
Fie o grilă de jucărie cu nivelurile 25%, 50% și 75% și log-cuantilele \(q = -1, 0, 1\), cu ținta \(E[Y] = \int_0^1 e^{q_u}\,du\). Ponderile egale pe cele trei puncte dau 1,36, iar regula din curs (trapezul, cu cozi constante sub 25% și peste 75%) dă 1,41, în timp ce un log \(Y\) Normal cu aceste cuartile, \(s = 1/z_{0{,}75} = 1/0{,}674 = 1{,}48\), are \(E[Y] = e^{s^2/2} = 3{,}00\): cozile constante ratează mai mult de jumătate din ea. Pentru că \(\exp\) este convexă și nemărginită, partea de sus a distribuției poartă o mare parte din medie, iar trunchierea cozii superioare o poate subestima puternic, deși semnul erorii totale nu este garantat. În Testul 2, raportul dintre prognoza medie și RV medie este 1,02 pentru Chronos-2 (grilă pînă la 99%), 0,97 pentru Chronos-Bolt și 0,94 pentru TimesFM-2.5 (grile pînă la 90%), ceea ce este compatibil cu o coadă superioară tăiată, deși și prognozele însele diferă. Regula trebuie raportată împreună cu prognozele.
Pe scurt
Grilă de exemplu: nivelurile 25%, 50%, 75%, cu log-cuantilele \(q = -1;\ 0;\ 1\)
Ținta este \(E[Y] = \int_0^1 e^{q_u}\,du\)
Ponderi egale pe cele trei puncte: \((e^{-1} + 1 + e)/3\) = 1,36
Regula din curs (trapez, constantă sub 25% și peste 75%): \(\frac14\left[e^{-1} + \frac{e^{-1} + 1}{2} + \frac{1 + e}{2} + e\right]\) = 1,41
O distribuție Normală pentru log \(Y\) cu aceste cuartile (\(s = 1/z_{0{,}75} = 1/0{,}674 = 1{,}48\), cu \(z_{0{,}75}\) cuantila de 75% a distribuției Normale standard) are \(E[Y] = e^{s^2/2}\) = 3,00: cozile constante pierd mai mult de jumătate din ea
Interpretare: \(\exp\) este convexă și nemărginită
Deci partea de sus a distribuției contribuie mult la medie
Trunchierea cozii superioare poate subestima puternic media; semnul erorii totale nu este garantat (fixarea cozii inferioare ridică integrala)
Testul 2: media prognozei / media RV este 1,02 pentru Chronos-2 (grilă pînă la 99%), 0,97 pentru Chronos-Bolt și 0,94 pentru TimesFM-2.5 (grile pînă la 90%)
Rezultatul este compatibil cu o coadă superioară tăiată, deși și prognozele în sine diferă
Graficul arată QLIKE a Chronos-2 pe log RV cu contexte de la 32 la 512 zile, în aceleași zile de prognoză. Pierderea scade de la 0,279 cu 32 de zile la 0,223 cu 512 zile, iar sub circa 256 de zile Chronos-2 este mai slab decît log-HAR (0,226). Lunile de istoric dezvăluie nivelul lent al volatilității, pe care HAR îl codifică explicit prin media lui pe 22 de zile. Lungimea contextului este o alegere de modelare care trebuie raportată și testată, ca lungimea unei ferestre.
Pe scurt
QLIKE pentru Chronos-2 pe log RV cu contexte de 32 pînă la 512 zile, în aceleași zile de prognoză
QLIKE scade de la 0,279 (32 de zile) la 0,223 (512 zile)
Sub circa 256 de zile, Chronos-2 este mai slab decît log-HAR (QLIKE 0,226)
Memorie lungă: mai multe luni de istorie relevă nivelul lent variabil
HAR îl codifică explicit prin media pe 22 de zile
Lungimea contextului este o alegere de modelare care trebuie raportată și testată
La nivelul de 10%, toate cele trei modele fundaționale au o cuantilă în grilă, deci comparația nu are problema de extrapolare a VaR 1%. Pe S&P 500, ratele de depășire ale cuantilei de 10% sînt 9,8% pentru HS și 9,6% pentru FHS, față de 11,7% pentru Chronos-2, 13,5% pentru Chronos-Bolt și 12,0% pentru TimesFM-2.5, iar testul Kupiec respinge modelele fundaționale în opt dintre cele nouă cazuri. Coada lor stîngă este prea sus, prin poziție, scală sau forma cozii; un motiv plauzibil este că corpusurile de pre-antrenare sînt dominate de serii mai netede. Ca filtre de volatilitate în FHS, modelele preiau cozile din date.
Pe scurt
Rata de depășire a cuantilei de 10% (ținta 10%) pentru HS, FHS și cele trei modele fundaționale
Marginea scade ca \(1/T\), deci este doar o afirmație pe termen lung și este largă pentru \(\gamma\) mic. Pentru ES 2,5%, ES-ul Chronos-2 este deplasat cu corecția VaR 2,5%, o euristică fără garanție conformală; regulile și tabelul complet sînt în Anexă.
Pe scurt
Garanție valabilă pentru orice secvență de randamente, fără ipoteze de model
Pe \(T\) zile rata de depășire se apropie de \(\alpha\)
unde \(z > 0\) contractă \(\hat\beta\) spre zero, iar \(z \to 0^+\) dă soluția fără penalizare, prin pseudoinversă. Designul (secțiunea V.C) folosește ferestre rolling de \(T\) = 12, 60 și 120 de luni, \(P\) de la 2 la 12 000 și \(\log_{10} z = -3, \ldots, 3\), cu rezultatele mediate pe 1 000 de extrageri independente ale trăsăturilor. \(R^2\) out-of-sample este \(1 - \mathrm{Var}(\text{eroare})/\mathrm{Var}(R)\) (nota de subsol 40), în timp ce teoria împarte MSE la \(E[R^2]\), prognoza zero din Testul 1; strategiile sînt evaluate prin raportul Sharpe anualizat și prin alfa și raportul de informație dintr-o regresie a randamentului de timing pe randamentul pieței, față de regresia liniară cu toți cei 15 predictori (kitchen sink, secțiunea V.D).
Graficul arată, pe datele cursului, poziția de timing \(\hat\beta' S_t\) a modelului RFF cu \(c = 1\,000\) și \(z = 10^3\), lună de lună, cu media ei mobilă pe 6 luni în roșu și recesiunile NBER umbrite (seria `USREC` din FRED, Federal Reserve Economic Data).
Poziția este long în 73% dintre luni, cu o medie de 0,13: o primă de risc a acțiunilor (equity premium) pozitivă, învățată fără o restricție de semn. Media ei este 0,05 în cele 6 luni dinaintea celor 3 recesiuni din eșantion și −0,01 în timpul lor, față de 0,14 în rest, iar șocul pandemiei din 2020 nu este anticipat. Trei recesiuni sînt o descriere, nu un test; lucrarea are 15 recesiuni și 90 de ani.
Pe scurt
Pe datele cursului, ca în Kelly, Malamud & Zhou (2024): poziția \(\hat\beta' S_t\) pentru RFF cu \(c = 1\,000\), \(z = 10^3\)
Zonele umbrite marchează recesiunile NBER
Seria USREC din FRED, Federal Reserve Economic Data
Linia roșie: media mobilă a poziției pe 6 luni
Poziții de cumpărare în 73% din luni, poziția medie 0,13
O primă de risc pozitivă învățată fără restricție de semn
Poziția medie 0,05 în cele 6 luni dinaintea celor 3 recesiuni și \(-0{,}01\) în timpul lor, față de 0,14 în rest
Șocul pandemic din 2020 nu este anticipat
Trei recesiuni permit doar o descriere, nu un test
Cinci capcane apar în mod repetat în evaluarea modelelor noi de prognoză:
Leakage-ul vine din suprapunerea cu pre-antrenarea, din scalarea pe tot eșantionul sau din mediile HAR care includ ziua \(t\); în exercițiul B10 din Seminarul 14 ele reduc QLIKE cu un sfert, iar testul este o fereastră de după publicare, serii simulate sau private și recalcularea prognozei pentru \(t\) din date trunchiate la \(t-1\).
Reperele slabe se evită prin comparația cu zero pentru randamente, cu log-HAR pentru volatilitate și cu FHS pentru cozi, nu cu un mers aleator.
Funcționala greșită înseamnă mediane folosite ca medii sau decile folosite drept cuantile de 1%; raportul dintre prognoza medie și RV medie trebuie să fie aproape de 1, iar pentru mediana Chronos-2 este 0,80.
Selecția seed-urilor, contextelor și modelelor după ce s-a văzut testul se controlează notînd fiecare încercare și comparînd întreaga mulțime cu MCS.
Inferența greșită înseamnă DM pe modele imbricate, lipsa controlului testelor multiple, acoperire fără independență sau „nesemnificativ” raportat fără MDE.
Pe scurt
Scurgerea de informație: suprapunerea cu pre-antrenarea, scalarea pe tot eșantionul, medii HAR care includ ziua \(t\)
Seminarul 14, exercițiul B10 arată că acestea reduc artificial QLIKE cu un sfert
Verificare: fereastra de după publicare, serii simulate sau private
Recalculați prognoza pentru \(t\) din date trunchiate la \(t-1\)
Repere slabe: comparați cu zero (randamente), log-HAR (volatilitate), FHS (cozi)
Nu cu un mers aleator
Funcționala greșită: mediane folosite ca medii sau decile folosite drept cuantile de 1%
Media prognozei / media RV trebuie să fie aproape de 1; mediana Chronos-2: 0,80
Selecția: seed-uri, contexte și modele alese după examinarea rezultatelor de test
Remediu: notați fiecare încercare și comparați întregul set de modele cu MCS
Anexa conține derivările și tabelele complete la care trimite corpul capitolului: norme, raza spectrală și explozia în rețelele recurente, ajustarea descreșterii geometrice față de cea hiperbolică, alte modele fundaționale și corpusurile lor, un protocol formal pentru contaminare, tabelele complete ale celor trei teste, reacția excesivă din crahul COVID-19, testele Berkowitz și scorurile cuantilice, regulile recalibrării conformale, datele replicării studiului despre complexitate și prompturile buclei descoperirii.
Condiția \(\gamma_\varphi \lVert W\rVert_2 < 1\) din (14.6) este suficientă pentru dispariția geometrică, deci \(\gamma_\varphi \lVert W\rVert_2 \ge 1\) este necesară pentru explozie (Pascanu, Mikolov & Bengio, 2013). Într-o RNN liniară, o rază spectrală \(\rho(W) > 1\) este necesară pentru explozia exponențială, iar \(\rho(W) = 1\) cu un bloc Jordan (Jordan block), o valoare proprie multiplă fără un set complet de vectori proprii, dă totuși o creștere polinomială; cu o funcție \(\varphi\) neliniară contează jacobienele locale \(D_t W\), iar \(\rho(W) = 0\) cu \(\rho(DW) > 1\) este posibil. Într-un VAR stabil, răspunsurile la impuls, și odată cu ele gradienții, scad asimptotic ca \(\rho(A)^k\), pînă la un factor \(k^{m-1}\) pentru un bloc Jordan de dimensiune \(m\), dar la orizonturi finite \(\lVert A^k\rVert_2\) poate depăși 1: \(A = \left(\begin{smallmatrix} 0{,}5 & 4 \\ 0 & 0{,}5 \end{smallmatrix}\right)\) are \(\rho(A) = 0{,}5\), dar \(\lVert A^2\rVert_2 \approx 4{,}0\). Termenul \(DUx_t\) din (14.7) este o inovație doar dacă intrările sînt zgomot alb centrat; intrările cu memorie lungă ar trece prin rețea.
Cu porți constante, o intrare candidată \(g_t\) i.i.d. și o inițializare staționară, celula LSTM are \(\operatorname{Corr}(c_t, c_{t-k}) = f^k\), în timp ce un proces autoregresiv fracționar integrat cu medie mobilă (ARFIMA, autoregressive fractionally integrated moving average) cu \(0 < d < 1/2\) are \(\rho_k \sim C k^{2d-1}\). Pentru randamentele absolute ale S&P 500 din 2000, autocorelația este 0,289 la lag-ul 1 și 0,132 la lag-ul 50. O descreștere geometrică cu propria amplitudine, \(\rho_k = \rho_1 f^{k-1}\), autocorelația unui semnal AR(1) observat cu zgomot, se potrivește cu ambele lag-uri pentru \(f\) = 0,984, adică \(b_f\) = 4,1 și un timp de înjumătățire de 43 de zile; dar acest \(f\) implică 0,027 la lag-ul 150, în timp ce datele arată 0,059, de peste două ori mai mult. O poartă constantă \(f < 1\) este un filtru cu memorie scurtă, iar un context lung sau mediile lungi explicite, ca în HAR, aproximează memoria lungă doar pe un interval finit de lag-uri.
Pe scurt
Cu porți constante: \(\operatorname{Corr}(c_t, c_{t-k}) = f^k\)
Valori candidate \(g_t\) i.i.d. și inițializare în distribuția staționară
Pentru un model ARFIMA cu \(0 < d < 1/2\): \(\rho_k \sim C k^{2d-1}\)
ARFIMA: autoregressive fractionally integrated moving average, autoregresiv fracționar integrat cu medie mobilă
Randamentele absolute ale S&P 500 din 2000: funcția de autocorelație (ACF)
ACF este 0,289 la lag-ul 1 și 0,132 la lag-ul 50
Descreșterea geometrică cu amplitudine proprie, \(\rho_k = \rho_1 f^{k-1}\) (un semnal AR(1) observat cu zgomot), reproduce autocorelațiile la ambele lag-uri pentru \(f\) = 0,984
Acestui \(f\) îi corespund \(b_f\) = 4,1 și un timp de înjumătățire de 43 de zile
Acest \(f\) implică o autocorelație de 0,027 la lag-ul 150
Datele arată 0,059, de peste două ori mai mult
O poartă constantă \(f < 1\) este un filtru cu memorie scurtă
Un context lung sau medii lungi explicite, ca în HAR (Testul 2), doar aproximează memoria lungă
Chronos-2 este antrenat pe seturi de date selectate din Chronos și GIFT-Eval (General Time Series Forecasting Model Evaluation, benchmark GIFT-Eval, setul de referință GIFT-Eval pentru evaluarea modelelor generale de prognoză a seriilor de timp), plus serii multivariate sintetice, și este evaluat pe GIFT-Eval (Aksu et al., 2024) și fev-bench; corpusul TimesFM conține Google Trends, vizualizări de pagini Wikipedia și serii sintetice, precum și seriile competiției de prognoză M4, electricitate, trafic și vreme. Potrivit depozitelor Hugging Face, ponderile actualizate ale TimesFM-2.5 au fost anunțate la 15 septembrie 2025 și publicate la 1 octombrie 2025, iar cele ale Chronos-2 anunțate la 20 octombrie 2025 și publicate la 30 octombrie 2025. Checkpoint-urile folosite sînt identificate prin revizia fixată în cod și primele 8 caractere ale amprentei SHA-256 a fișierului de ponderi: `ddcda3c7` pentru Chronos-2 (în depozit din 30 octombrie 2025), `06a6a19b` pentru Chronos-Bolt small (din 13 noiembrie 2024) și `2f776efe` pentru TimesFM-2.5 (din 1 octombrie 2025).
Pe scurt
Chronos-2: corpus format din seturi selectate din Chronos și GIFT-Eval, plus serii multivariate sintetice
Teste comparative (repere): GIFT-Eval (General Time Series Forecasting Model Evaluation, setul de referință GIFT-Eval pentru evaluarea modelelor generale de prognoză a seriilor de timp) (Aksu et al. (2024)) și fev-bench
Corpusul TimesFM
Google Trends, afișări de pagini Wikipedia, serii sintetice
Seriile competiției de prognoză M4, electricitate, trafic, vreme
Datele de publicare a ponderilor, din depozitele Hugging Face
TimesFM-2.5: versiunea actualizată a ponderilor a fost anunțată pe 15.09.2025 și publicată pe 01.10.2025
Chronos-2: anunțat pe 20.10.2025, publicat pe 30.10.2025
Checkpoint-urile folosite: revizia fixată în cod și primele 8 caractere ale amprentei SHA-256 a fișierului de ponderi
Moirai (Woo et al., 2024) este un singur Transformer pentru orice frecvență și orice număr de variabile, iar ieșirea lui este un amestec de patru distribuții, \(p(y) = \sum_{k=1}^{4} w_k\, p_k(y)\), cu \(w_k \ge 0\) și \(\sum_k w_k = 1\), unde \(p_k\) sînt densitățile Student-\(t\), lognormală, binomială negativă și Normală cu varianță mică. Ponderile \(w_k\) și parametrii componentelor sînt ieșiri ale rețelei, deci forma se adaptează seriei. Moirai 2.0 este descris de Liu et al. (2025), iar Lag-Llama (Rasul et al., 2023) este un model doar cu decodor, cu valorile întîrziate ca trăsături și o ieșire Student-\(t\).
Pe scurt
Moirai (Woo et al. (2024)): un singur Transformer pentru orice frecvență și orice număr de variabile
Protocolul regresează diferența de pierdere \(d_t = L^{FM}_t - L^{bench}_t\), pierderea modelului fundațional minus cea a reperului în ziua \(t\), pe o variabilă indicatoare a perioadei de după publicare, \(d_t = \beta_0 + \beta_1 \mathbf{1}\{t \ge \tau\} + u_t\), cu erori standard HAC, unde \(\tau\) este data publicării ponderilor sau o dată-limită comună cînd sînt comparate mai multe modele. Memorarea prezice \(\beta_1 > 0\), iar ipoteza nulă este \(\beta_1 = 0\). MDE pentru \(\beta_1\) trebuie raportat împreună cu testul: pragul lui minim de 0,0157 din mini-studiul de caz folosește varianța pe termen lung a lui \(d_t\) în fiecare perioadă, iar pentru că zilele dinainte de publicare, care includ șocul din aprilie 2025, sînt de circa 2,9 ori mai variabile decît cele de după, o varianță comună ar da un prag de 0,0111.
Pe scurt
Regresia înainte/după pe diferențialul de pierdere \(d_t = L^{FM}_t - L^{reper}_t\), cu erori standard HAC
Raportați efectul minim detectabil (MDE) al lui \(\beta_1\) (secțiunea AI)
Pragul de 0,0157 folosește varianța de termen lung a lui \(d_t\) în fiecare perioadă: zilele dinaintea publicării, care includ șocul din aprilie 2025, sînt de circa 2,9 ori mai variabile decît cele de după
Preînregistrarea face contaminarea imposibilă prin construcție: prognozele sînt trimise înainte să existe rezultatul, ca în benchmark-urile în timp real TS-Arena (Time Series, in the name TS-Arena, serii de timp, în numele platformei TS-Arena) (Meyer et al., 2025) și Impermanent (Garza et al., 2026); fereastra de după publicare din capitol este o versiune manuală a aceleiași idei. Ablațiile arată că eliminarea părții de model de limbaj din modelele de prognoză bazate pe LLM nu reduce acuratețea și adesea o îmbunătățește (Tan et al., 2024). Pentru prețurile energiei electrice, Pan & Ezzat (2026) fac evaluarea pe două seturi de date pentru a limita contaminarea și constată că modelele fundaționale sînt competitive, dar nu depășesc în mod constant metodele specifice domeniului.
Pe scurt
Preînregistrarea: prognoze depuse înainte ca rezultatul să existe
Tabelul dă \(R^2\) out-of-sample din (14.15), în procente, și, între paranteze, p-value-ul DM bilateral față de prognoza zero, cu varianța Newey–West, pentru cele șase modele pe cele trei piețe; prognozele punctuale ale modelelor fundaționale sînt medianele grilelor. TimesFM-2.5 are cel mai mic \(R^2\) pe fiecare piață (−3,35% pe S&P 500, −2,29% pe Bitcoin, −3,27% pe BET), iar singura valoare pozitivă cu \(p\) DM sub 5% este cea a LSTM pe BET, +1,15% (\(p\) = 0,014).
Pe scurt
\(R^2\) (%) [DM \(p\)]
Media istorică
AR(1)
LSTM (5 seed-uri)
Chronos-2
Chronos-Bolt
TimesFM-2.5
S&P 500
+0,15 [0,095]
+0,94 [0,639]
+0,93 [0,090]
\(-\)0,26 [0,418]
\(-\)1,57 [0,078]
\(-\)3,35 [0,001]
Bitcoin
+0,07 [0,691]
\(-\)0,28 [0,326]
+0,04 [0,243]
\(-\)0,35 [0,413]
\(-\)0,61 [0,070]
\(-\)2,29 [0,001]
BET
+0,30 [0,081]
\(-\)0,00 [1,000]
+1,15 [0,014]
\(-\)0,39 [0,562]
+0,12 [0,831]
\(-\)3,27 [0,070]
Prognoze punctuale: medianele din grilă (mediile din grilă: protocolul testului pentru randamente)
DM: test bilateral pe erorile pătratice față de prognoza zero, varianță Newey–West
AR(1) pe BET, cu \(R^2\) = −0,00% și \(p\) DM = 1,000, nu este o prognoză degenerată: abaterea ei standard este 0,074%, panta medie 0,046, iar cîștigurile de eroare pătratică de −12,7 în 2020 și +14,7 în 2026 se compensează; fără acești doi ani, \(R^2\) este −0,11%. Pentru modelele rolling sau reantrenate, testul lui Giacomini & White (2006) evaluează metoda de prognoză împreună cu fereastra ei de estimare, iar Diebold (2015) discută folosirea și abuzul testului DM. Testul SPA rafinează Reality Check-ul lui White (2000): modelele foarte slabe, cum este TimesFM, nu mai diluează testul; ambele folosesc un bootstrap staționar cu blocuri medii de 20 de zile.
Pe scurt
AR(1) pe BET (\(R^2 = \)\(-\)0,00%, \(p\) DM = 1,000) nu este o prognoză degenerată
Abaterea standard a prognozei este 0,074%, iar panta medie este 0,046
Reducerile erorii pătratice din 2020 (\(-\)12,7) și din 2026 (+14,7) se anulează reciproc
Procedura Holm ordonează cele \(M\) p-value-uri, \(p_{(1)} \le \dots \le p_{(M)}\), respinge cît timp \(p_{(j)} < 0{,}05/(M - j + 1)\) și se oprește la prima nerespingere; p-value-ul ajustat \(p_{(j)}\) este \(\max_{i \le j} \min\{1, (M - i + 1)\,p_{(i)}\}\). Într-un exemplu de jucărie cu \(M = 3\) și \(p = 0{,}01;\ 0{,}02;\ 0{,}04\), pragurile sînt 0,0167, 0,025 și 0,05, deci toate cele trei ipoteze sînt respinse, în timp ce Bonferroni, cu 0,0167 pentru toate, o respinge doar pe prima; p-value-urile ajustate sînt 0,03, 0,04 și 0,04. În capitol, LSTM pe BET are cel mai mic dintre cele 18 p-value-uri DM unilaterale, 0,0072, deci p-value-ul lui ajustat este \(18 \times 0{,}0072 = 0{,}130\).
Respingem cît timp \(p_{(j)} < 0{,}05/(M - j + 1)\)
Ne oprim la prima nerespingere
Valoarea \(p\) ajustată este \(\max_{i \le j} \min\{1, (M - i + 1)\,p_{(i)}\}\)
Exemplu, \(M = 3\), \(p = 0{,}01;\ 0{,}02;\ 0{,}04\): pragurile \(0{,}05/3 = 0{,}0167\), \(0{,}05/2 = 0{,}025\), \(0{,}05\): toate trei sînt respinse
Bonferroni (pragul \(0{,}0167\) pentru toate) o respinge doar pe prima
Valorile \(p\) ajustate: 0,03; 0,04; 0,04
În capitol: LSTM pe BET are cel mai mic dintre cele 18 valori \(p\) DM unilaterale, 0,0072, deci valoarea \(p\) ajustată este 18 \(\times\) 0,0072 = 0,130
Procedura Romano–Wolf ordonează statisticile \(t_k = \sqrt{T}\,\bar d_k/\hat\omega_k\), unde \(\bar d_k\) este cîștigul mediu de pierdere al modelului \(k\) față de prognoza zero, iar \(\hat\omega_k\) abaterea lui standard HAC, și calculează
cu \(\mathcal{A}_i\) ipotezele încă nerespinse la pasul \(i\) și \(P^*\) probabilitatea sub bootstrap-ul staționar. Pentru că pragul vine din maximul unor statistici corelate, procedura este mai puțin conservatoare decît Holm pentru prognozele de pe o singură piață. Testul SPA este un singur test comun al ipotezei nule că niciun model nu are o pierdere așteptată mai mică decît reperul, cu statistica \(\max(0, \max_k t_k)\) și un p-value bootstrap; modelele mult mai slabe, cu \(t_k \le -\sqrt{2\ln\ln T}\), nu sînt recentrate la zero și deci nu diluează testul. Holm și Romano–Wolf răspund care comparații sînt semnificative, cu cel mult 5% șansă de vreo respingere falsă; SPA răspunde dacă vreun model depășește reperul.
\(\mathcal{A}_i\): ipotezele încă nerespinse la pasul \(i\), adică \((i), \dots, (K)\); \(P^*\), \(\bar d_k^*\): probabilitatea și media sub bootstrap-ul staționar
Pragul vine din maximul statisticilor corelate, deci procedura este mai puțin conservatoare decît Holm pentru prognoze ale aceleiași piețe
SPA: un singur test, cu statistica \(\max\big(0, \max_k t_k\big)\)
\(H_0\): niciun model nu are o pierdere așteptată mai mică decît reperul
Valoarea \(p\) vine dintr-un bootstrap staționar; modelele mult mai slabe (\(t_k \le -\sqrt{2\ln\ln T}\)) nu sînt recentrate la zero, deci nu diluează testul
La ce întrebare răspunde fiecare
Holm și Romano–Wolf: care comparații sînt semnificative, cu o probabilitate de cel mult 5% a vreunei respingeri false
Tabelul dă, pentru cele opt modele de volatilitate, QLIKE medie pe cele 979 de zile de test, statistica DM și p-value-ul față de log-HAR, p-value-ul MCS și QLIKE medie după 3 noiembrie 2025. Doar mersul aleator (DM +4,44, \(p\) MCS = 0,005) și GARCH-t (DM +3,45, \(p\) MCS = 0,03) sînt semnificativ mai slabe decît log-HAR și în afara MCS de 90%; Chronos-2 are cel mai mare p-value MCS, 1,00. În literatură, Brini (2026) compară nouă modele fundaționale zero-shot cu opt modele de tip HAR pe 50 de active: pierderile agregate favorizează modelele fundaționale din cauza cîtorva active atipice, în timp ce activ cu activ un singur model mic depășește log-HAR la fiecare orizont, la limită. Goel et al. (2025) constată că TimesFM zero-shot este un punct de pornire rezonabil, dar că este nevoie de fine-tuning incremental pentru a depăși modelele econometrice.
Pe scurt
Model
QLIKE
DM față de log-HAR
\(p\)
MCS \(p\)
QLIKE după 3.11.2025
Mers aleator
0,313
+4,44
\(<\)0,001
0,005
0,356
HAR
0,238
+1,17
0,241
0,33
0,251
log-HAR
0,226
–
–
0,95
0,223
GARCH-t
0,273
+3,45
\(<\)0,001
0,03
0,279
LSTM
0,275
+1,66
0,097
0,29
0,217
Chronos-2
0,223
\(-\)0,61
0,539
1,00
0,226
Chronos-Bolt
0,224
\(-\)0,20
0,842
0,95
0,219
TimesFM-2.5
0,225
\(-\)0,07
0,948
0,95
0,226
Literatura: Brini (2026) compară nouă modele fundaționale zero-shot cu opt modele de tip HAR
Pe 50 de active
Pierderile agregate favorizează modelele fundaționale din cauza cîtorva active atipice
Activ cu activ, doar un model mic depășește log-HAR la toate orizonturile, la limită
Tabelul dă numărul de depășiri ale VaR 1% pentru fiecare model și, între paranteze, p-value-ul Kupiec din (14.27), cu numărul așteptat de depășiri, 1% din zile, lîngă fiecare piață: 26,9 pentru S&P 500, 28,2 pentru Bitcoin și 26,8 pentru BET. Testul Kupiec respinge la 5% GARCH-t și Chronos-2 direct pe S&P 500 (44 și 45 de depășiri) și pe BET (41 și 40), în timp ce FHS și cei doi hibrizi nu sînt respinși pe nicio piață.
Pe scurt
Depășiri [Kupiec \(p\)]
HS
GARCH-t
FHS
Cuantile Chronos-2
FHS + vol. Chronos-2
FHS + vol. TimesFM
S&P 500 (26,9)
37 [0,065]
44 [0,002]
30 [0,559]
45 [0,001]
25 [0,705]
27 [0,989]
Bitcoin (28,2)
19 [0,065]
27 [0,822]
25 [0,539]
33 [0,374]
27 [0,822]
27 [0,822]
BET (26,8)
32 [0,322]
41 [0,010]
30 [0,536]
40 [0,016]
26 [0,884]
32 [0,322]
În paranteză după piață: numărul așteptat de depășiri, 1% din zile
Kupiec: testul raportului de verosimilitate pentru o rată de depășire \(\alpha\) = 1%
Cu \(x\) depășiri în \(T\) zile și \(\hat\pi = x/T\)
Chronos-2 standardizează contextul cu media și abaterea standard și aplică apoi \(\sinh^{-1}\)(Ansari et al., 2025). La 16 martie 2020, crahul a crescut abaterea standard pe 512 zile cu 9,7%, iar scala prin medie absolută a Chronos este 3,2% (exercițiul A6 din Seminarul 14), deci lărgirea amestecă schimbarea de scală cu felul în care modelul citește zilele de crah, iar doar o ablație le-ar putea separa. Reacția excesivă nu este o eroare de unități: după ziua crahului, Chronos-2 a prognozat pentru ziua următoare un \(|r|\) mediu de 12,5%, pe care FHS îl înmulțește cu cuantila de 1% a lui \(r/\hat\sigma\), 4,7. Filtrul extrapolează un salt de o zi ca pe un nivel nou, ceea ce dă un VaR de 4,6 ori mai mare decît pierderea maximă, un cost de capital ridicat pe care pierderea FZ0 îl penalizează.
Pe scurt
Chronos-2 standardizează contextul prin media și abaterea standard, apoi aplică \(\sinh^{-1}\) (Ansari et al. (2025))
La 16.03.2020, crahul a mărit abaterea standard a contextului de 512 zile cu 9,7%
Scala din Chronos (media valorilor absolute) a crescut cu 3,2% (Seminarul 14, exercițiul A6)
Deci lărgirea combină schimbarea scalei cu citirea zilelor de crah
Doar o ablație le-ar putea separa
Nu este o eroare de unități
După ziua crahului Chronos-2 a prognozat o medie a lui \(|r|\) de 12,5% pentru ziua următoare
Apoi FHS o înmulțește cu cuantila de 1% a lui \(r/\hat\sigma\) (4,7)
Filtrul extrapolează un salt de o zi ca pe un nou nivel: VaR de 4,6 ori pierderea maximă, un cost de capital ridicat pe care pierderea FZ0 îl penalizează
Tabelul dă, pentru fiecare piață, p-value-urile Berkowitz ale Chronos-2 și FHS, proporția randamentelor sub cuantila de 1% a Chronos-2, scorurile cuantilice ale celor două modele și testul DM al diferenței lor. Chronos-2 este respins de testul Berkowitz pe S&P 500 (\(p\) = 0,019) și pe BET (\(p\) = 0,045) și are acolo un QS semnificativ mai mare (DM +3,06 și +3,48), în timp ce pe Bitcoin nu se detectează nicio diferență. Testul Berkowitz evaluează funcția de repartiție a grilei interpolate liniar și doar \(\mu\) și \(\sigma\), nu și independența serială a PIT; QS ponderează egal cele 21 de niveluri, în timp ce CRPS ar pondera fiecare nivel cu distanța dintre niveluri.
Pe scurt
Piața
\(p\) Berkowitz: Chronos-2
FHS
Sub \(q_{1\%}\) (C2)
QS: C2 / FHS
DM [\(p\)]
S&P 500
0,019
0,599
1,67%
0,510 / 0,506
+3,06 [0,002]
Bitcoin
0,595
0,306
1,17%
1,526 / 1,529
\(-\)0,90 [0,369]
BET
0,045
0,436
1,50%
0,465 / 0,460
+3,48 [\(<\)0,001]
Testul Berkowitz evaluează funcția de repartiție interpolată liniar pe grilă
Și doar \(\mu, \sigma\), nu independența în timp a PIT
QS ponderează egal cele 21 de niveluri
CRPS ar pondera fiecare nivel cu distanța dintre niveluri
C2: Chronos-2
Pe Bitcoin, nu detectăm o diferență între Chronos-2 și FHS
Tabelul dă pierderea FZ0 medie din (14.26) pentru perechea (VaR 2,5%, ES 2,5%) și, între paranteze, p-value-ul MCS, calculat cu statistica \(T_{\max}\) și un bootstrap pe blocuri. FHS are cea mai mică pierdere pe S&P 500 (0,999) și pe BET (0,963); pe Bitcoin, hibridul FHS cu volatilitatea Chronos-2 are cea mai mică pierdere (2,151), dar diferențele nu sînt semnificative. Singurul model din afara mulțimii de 90% este HS pe BET (\(p\) = 0,015).
Pe scurt
FZ0 [MCS \(p\)]
HS
GARCH-t
FHS
Cuantile Chronos-2
FHS + vol. Chronos-2
FHS + vol. TimesFM
S&P 500
1,309 [0,14]
1,026 [0,19]
0,999 [1,00]
1,147 [0,14]
1,084 [0,14]
1,059 [0,18]
Bitcoin
2,237 [0,34]
2,192 [0,60]
2,192 [0,60]
2,181 [0,64]
2,151 [1,00]
2,160 [0,70]
BET
1,230 [0,015]
1,001 [0,34]
0,963 [1,00]
1,032 [0,24]
1,007 [0,34]
1,027 [0,20]
Bitcoin: FHS hibrid cu volatilitatea Chronos-2 are cea mai mică pierdere FZ0
Dar diferențele nu sînt semnificative
FZ0 pentru (VaR 2,5%, ES 2,5%)
MCS folosește statistica \(T_{\max}\) și un bootstrap pe blocuri
După cele 250 de zile de calibrare, tabelul compară depășirile FHS, ale Chronos-2 direct, ale hibridului cu Chronos-2 și ale Chronos-2 cu ACI, cu p-value-urile testelor de acoperire condiționată (cc) și DQ și cu pierderile FZ0 pe S&P 500. Cuantila empirică \(\hat Q\) este al \(\lceil (1-\alpha_t)(250+1)\rceil\)-lea cel mai mic scor trecut, \(+\infty\) dacă acest rang depășește 250 sau \(\alpha_t \le 0\) și \(-\infty\) dacă \(\alpha_t \ge 1\); cu \(\gamma = 0{,}005\), VaR este infinit în 24 de zile pentru S&P 500, 100 pentru Bitcoin și 270 pentru BET. Cu \(T\) = 2 443 și \(\gamma = 0{,}001\), garanția mărginește abaterea la 0,41, ceea ce nu spune nimic pentru o rată de 1%; fără schimbabilitate (exchangeability), predicția conformală ponderată mărginește abaterea prin deriva distribuției (Barber et al., 2023). ES poate fi evaluat doar împreună cu VaR, prin pierderi consistente pentru pereche, cum este FZ0 (Nolde & Ziegel, 2017); comparațiile de ES au limite de precizie în eșantioane finite (Pele & Mazurencu-Marinescu-Pele, 2026), iar o coadă de tip distribuție Pareto generalizată (GPD, generalised Pareto distribution) (McNeil & Frey, 2000) este o alternativă pentru ES.
Pe scurt
După 250 de zile de calibrare: depășiri [\(p\) cc / \(p\) DQ]
FHS
Chronos-2 direct
FHS + vol. C2
Chronos-2 + ACI
S&P 500 (24,4)
28 [0,097 / 0,014]
42 [0,002 / \(<\)0,001]
23 [0,058 / \(<\)0,001]
21 [0,307 / 0,049]
Bitcoin (25,7)
24 [0,449 / 0,108]
31 [0,410 / 0,026]
26 [0,087 / 0,004]
24 [0,449 / 0,191]
BET (24,2)
26 [0,709 / 0,727]
36 [0,048 / 0,184]
23 [0,776 / 0,011]
25 [0,762 / 0,032]
FZ0, S&P 500 [\(p\) DM]
1,013
1,142 [0,009]
1,087 [0,022]
1,205 [0,001]
\(\hat Q\): al \(\lceil (1-\alpha_t)(250+1)\rceil\)-lea cel mai mic scor trecut (\(\lceil\cdot\rceil\): rotunjirea în sus)
\(\hat Q = +\infty\) dacă rangul depășește 250 sau \(\alpha_t \le 0\), iar \(\hat Q = -\infty\) dacă \(\alpha_t \ge 1\)
Cu \(\gamma = 0{,}005\), VaR-ul este infinit în 24 de zile pe S&P 500, 100 pe Bitcoin și 270 pe BET
Garanția teoretică pentru \(T\) = 2 443 și \(\gamma = 0{,}001\): limita este 0,41, neinformativă pentru o rată de 1%
Metoda conformală ponderată limitează abaterea produsă de drift (Barber et al. (2023))
Replicarea folosește randamentele totale lunare ale SPY din 1993, în exces față de rata titlurilor de stat pe 3 luni (FRED `TB3MS`), și 7 dintre cei 15 predictori ai lui Welch & Goyal (2008): rata titlurilor de stat pe termen scurt, randamentul pe termen lung, panta curbei, spread-ul de randament al obligațiunilor corporative și inflația, toate din FRED, varianța acțiunilor din randamentele zilnice ale S&P 500 și randamentul în exces din luna anterioară. Rapoartele de evaluare, emisiunile nete de acțiuni și randamentele obligațiunilor nu sînt în datele cursului, iar eșantionul acoperă circa 30 de ani în loc de 90; metoda este neschimbată (\(\gamma = 2\),\(T = 12\),\(P \le 12\,000\),\(\log_{10} z = -3, \ldots, 3\), 1 000 de extrageri). Modelul liniar cu toți predictorii și \(z = 0^+\)(\(c = 7/12\)) are \(R^2 = -847\%\) și un raport Sharpe de −0,03; modelul liniar cu \(z = 10^3\) are \(R^2\) = 0,26% și un raport de informație de 0,25 (\(t\) = 1,3) față de SPY; iar RFF cu \(c = 1\,000\) și \(z = 10^3\) are \(R^2 = -5{,}7\%\) și rapoarte de informație de −0,12 (\(t\) = −0,6) față de SPY și de 0,07 (\(t\) = 0,4) față de modelul liniar.
Pe scurt
Randamentele totale lunare ale SPY din 1993 (datele cursului)
În exces față de randamentul titlurilor de stat americane la 3 luni (FRED TB3MS)
Predictorii din Welch & Goyal (2008) disponibili în datele cursului sînt 7 din cei 15
Din FRED: dobînda la titlurile de stat pe termen scurt (tbl), randamentul pe termen lung (lty), panta curbei (tms), spread-ul de credit (dfy), inflația (infl)
Varianța acțiunilor (svar), calculată din randamentele zilnice ale S&P 500
Randamentul în exces întîrziat
Limitarea datelor: rapoartele de evaluare (dividend/preț dp, randamentul dividendului dy, cîștig/preț ep, rata de distribuire de, valoare contabilă/de piață b/m), emisiunile nete de acțiuni (ntis) și randamentele obligațiunilor (pe termen lung ltr, spread-ul randamentelor corporative dfr) nu sînt în datele cursului
Eșantionul acoperă circa 30 de ani, în loc de 90
Metoda rămîne aceeași: \(\gamma = 2\), \(T = 12\), \(P \le 12\,000\), \(\log_{10} z = -3, \ldots, 3\), 1 000 de extrageri
liniar, \(z = 10^3\): \(R^2\) = 0,26%, raportul de informație față de SPY 0,25 (\(t\) = 1,3)
RFF, \(c = 1\,000\), \(z = 10^3\): \(R^2\) = \(-5{,}7\%\), raportul de informație față de SPY \(-0{,}12\) (\(t\) = \(-0{,}6\)) și față de modelul liniar 0,07 (\(t\) = 0,4)
Fiecare lună a predictorilor prognozează randamentul lunii calendaristice următoare, iar un predictor lipsă nu mută ținta într-o lună ulterioară, deci lag-urile și țintele păstrează calendarul lunar. Inflația este valoarea cunoscută la sfîrșitul fiecărei luni, vintage-ul ALFRED (ArchivaL Federal Reserve Economic Data, arhiva versiunilor istorice ale seriilor FRED) al seriei CPIAUCSL (FRED series: Consumer Price Index for All Urban Consumers, all items, seria FRED a indicelui prețurilor de consum din SUA) din acea zi, fără revizuirile ulterioare, pentru că seria revizuită de azi ar adăuga look-ahead (corelația ei lunară cu seria în timp real este 0,94); octombrie 2025 nu a fost publicat niciodată, deci în decembrie 2025 inflația din noiembrie nu poate fi calculată și nu este imputată. Țintele de test sînt din februarie 1997 pînă în august 2026, 354 de prognoze, fără ianuarie 2026; scalarea cu volatilitatea folosește 12 luni calendaristice înainte de eliminarea rîndurilor incomplete, iar regresia folosește cele mai recente 12 observații complete, deci în jurul datelor lipsă fereastra ei acoperă mai mult de 12 luni.
Pe scurt
Fiecare lună a predictorilor prognozează randamentul lunii calendaristice următoare
Un predictor lipsă nu mută ținta într-o lună ulterioară
Lag-urile și țintele păstrează calendarul lunar
Inflația este cea cunoscută la sfîrșitul fiecărei luni: vintage-ul ALFRED (ArchivaL Federal Reserve Economic Data, arhiva versiunilor istorice ale seriilor FRED) al seriei CPIAUCSL (FRED series: Consumer Price Index for All Urban Consumers, all items, seria FRED a indicelui prețurilor de consum din SUA (Statele Unite ale Americii)) din acea zi, fără revizii ulterioare
Seria revizuită de azi ar introduce deplasarea de anticipare (corelația lunară cu seria în timp real: 0,94)
Octombrie 2025 nu a fost publicat: în decembrie 2025 inflația din noiembrie nu se poate calcula și nu se imputează
Țintele de test merg din februarie 1997 pînă în august 2026: 354 de prognoze
Fără ianuarie 2026
Scalarea volatilității folosește 12 luni calendaristice, înainte de eliminarea rîndurilor incomplete
Regresia folosește ultimele 12 observații complete
În jurul datelor lipsă, fereastra acoperă mai mult de 12 luni
Primele trei prompturi acoperă literatura, ipotezele și codul mini-studiului de caz. Promptul pentru literatură cere evaluările din 2024 încoace, cu modelele, datele, pierderea, reperul și suprapunerea cu corpusul de pre-antrenare; instrumente de căutare precum Semantic Scholar, Google Scholar și Elicit ajută. Ipotezele produse sînt diagnostice, nu dovezi: o traiectorie log-HAR simulată testează doar transferul la acel proces, iar o diferență înainte/după poate reflecta și o schimbare de regim. Promptul pentru cod reproduce testul înainte/după al diferenței QLIKE, cu erori HAC și MDE la o putere de 80%, și poate fi dat oricărui asistent.
Pe scurt
Literatura: "Găsește evaluări ale modelelor fundaționale pentru serii de timp pe randamente sau volatilitate financiară din 2024 încoace: modele, date, pierdere, reper și dacă perioada de test se suprapune cu corpusul de pre-antrenare."
Semantic Scholar, Google Scholar, Elicit ajută la căutare
Ipoteze: "Enumeră predicțiile care separă memorarea de abilitate pentru un model zero-shot de volatilitate: înainte și după publicare, serii niciodată publice, serii simulate cu aceeași dinamică."
Diagnostice, nu dovezi: o traiectorie log-HAR simulată testează transferul la acel proces
O diferență înainte/după poate reflecta și o schimbare de regim
Date și cod: "Din prognozele zilnice ale varianței realizate SPY date de Chronos-2 și log-HAR, calculează diferențialul QLIKE Chronos-2 minus log-HAR, testează diferența dintre perioada de dinainte și cea de după 3 noiembrie 2025 cu erori HAC și raportează efectul minim detectabil la o putere de 80%."
Orice asistent (Claude, ChatGPT, Gemini, GitHub Copilot)
Promptul pentru robustețe cere un design preînregistrat cu mai multă putere: secțiunea transversală de serii, proxy-ul de varianță, testul DM pe panel și numărul de zile de după publicare. Promptul pentru critică îi cere asistentului să atace afirmația că nu există memorare pe baza unui test nesemnificativ de după publicare; un răspuns bun numește puterea mică, absența dovezilor și regimurile diferite, pentru că șocul tarifar din aprilie 2025 se află în eșantionul dinainte de publicare, iar fereastra de după publicare este mai calmă. Raportul trebuie să enumere versiunile modelelor și datele de publicare a ponderilor, lungimea contextului, alegerea dintre medie și mediană și fiecare seed și fereastră încercate.
Pe scurt
Robustețea: "Proiectează un test preînregistrat cu putere mai mare: ce secțiune transversală de serii, ce aproximare a varianței, ce test DM pe panel și cîte zile de după publicare."
Critica: "Atacă afirmația: nu există memorare, pentru că testul DM de după publicare este nesemnificativ. Ce este greșit în inferență?"
De așteptat: putere mică, absența dovezii și regimuri diferite: șocul tarifar din aprilie 2025 cade în perioada dinaintea publicării, fereastra de după publicare este mai calmă
Raportul: versiunile modelelor și datele publicării ponderilor
GIFT: General Time Series Forecasting Model Evaluation (benchmark GIFT-Eval) — setul de referință GIFT-Eval pentru evaluarea modelelor generale de prognoză a seriilor de timp
GPD: Generalised Pareto Distribution — distribuția Pareto generalizată
GRU: Gated Recurrent Unit — unitate recurentă cu porți
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?The European Journal of Finance, 29(10), 1064–1105.
Randamente zilnice S&P 500, Bitcoin și BET și prețuri SPY la 5 minute: EODHD. Prognozele la o zi: Quantlets/Ch_14 (run_forecasts.py). Studiile de caz: SPY și cele 19 active M6 (EODHD), seriile FRED; prognozele M6: Quantlets/Ch_14 (m6_case.py).


 Yann LeCun.
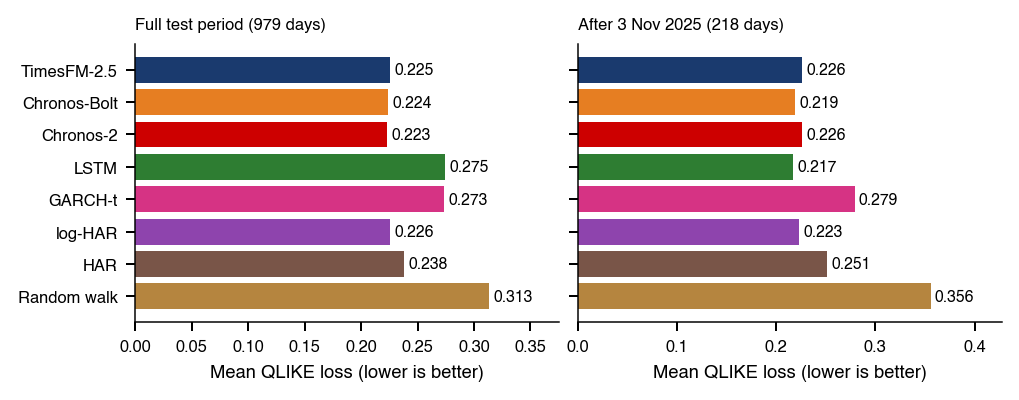
 MFM_ch14_acf_signal