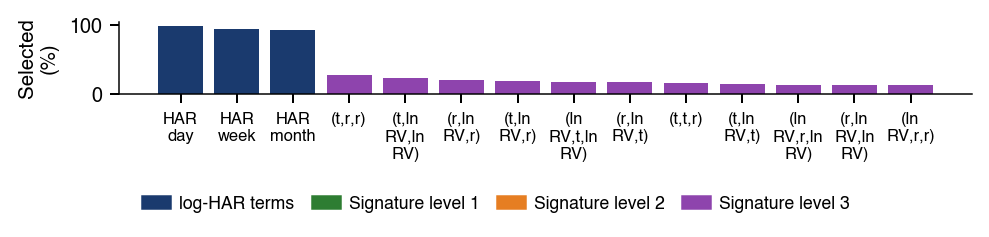Capitolul 20 (capitol special): Semnătura traiectoriilor și volatilitatea realizată — un studiu de cercetare
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“Signature-based techniques give mathematical insight into the interactions between complex streams of evolving data.” — Lyons & McLeod (2022)
Gu et al. (2024) rezumă o fereastră de date prin semnătura traiectoriei (engl. path signature)
pentru tarifele de transport, ei raportează o acuratețe de peste cinci ori mai bună decît o prognoză din industrie
Capitolul transferă metoda la varianța realizată (RV) zilnică a 50 de active din baza de date VOLARE (VOLatility Archive for Realized Estimates, arhiva de măsuri realizate ale volatilității)
Gu et al. (2024) descriu o fereastră recentă a unei serii ca o traiectorie și o rezumă prin semnătura traiectoriei (path signature). Trăsăturile de semnătură intră într-o regresie LASSO (Least Absolute Shrinkage and Selection Operator, regresie penalizată L1 cu selecția variabilelor) în doi pași, iar perioadele trecute a căror traiectorie seamănă cu cea curentă primesc o pondere mai mare, printr-un nucleu de semnătură (signature kernel). Pentru tarifele de transport, autorii raportează o acuratețe de peste cinci ori mai bună decît o prognoză din industrie. Capitolul întreabă dacă aceeași metodă îmbunătățește prognoza varianței realizate (realised variance, RV) zilnice, unde reperul este modelul HAR (heterogeneous autoregressive) al lui Corsi (2009) și, mai ales, varianta lui pe logaritmi, log-HAR.
Transferul este preînregistrat: patru ipoteze sînt fixate înaintea rezultatelor, iar datele sînt 50 de active din arhiva VOLARE, dintre care 40 de acțiuni. Fiecare componentă a metodei se testează separat, astfel încît un eventual cîștig să poată fi atribuit trăsăturilor sau ponderilor. Comparațiile folosesc pierderea QLIKE (quasi-likelihood loss), teste Diebold–Mariano activ cu activ și corecțiile Holm și Benjamini–Hochberg pentru testarea multiplă (multiple testing).
Rezultatul este nul. La orizontul de o zi, Sig-L, modelul cu trăsături de semnătură, are o pierdere QLIKE medie cu 0,4% mai mare decît log-HAR. Sig-L este semnificativ mai bun decît log-HAR pe 3 din 50 de active fără corecție și pe unul singur după corecția Holm, iar doar din întîmplare ne-am aștepta la aproximativ 2,5 respingeri necorectate. La o săptămînă și la o lună, modelul complet, Sig-LK, are o pierdere QLIKE mai mare decît log-HAR cu 28,0% și, respectiv, 92,9%. Cel mai puternic efect din studiu este cel mai vechi: log-HAR este semnificativ mai bun decît HAR în nivel pe 21 din 50 de active la o zi, fără corecție. Capitolul arată, prin ablații și prin mecanism, de ce metoda nu se transferă.
Raportul dintre pierderea QLIKE medie a fiecărui model și cea a modelului HAR, pentru fiecare dintre cele 50 de active; un raport sub 1 înseamnă un model mai precis decît HAR. Cutiile acoperă intervalul intercuartilic pe active, linia din cutie este mediana, iar rombul este media. Graficul interactiv: „QLIKE relativ la HAR, activ cu activ (1/2)” →
Rezultatele învățării
Calculați semnătura unei traiectorii liniare pe porțiuni și aria ei Lévy.
Calculați trăsăturile de semnătură și ponderile de nucleu pentru o prognoză a volatilității.
Interpretați comparații de prognoze pe multe active, cu teste Diebold–Mariano, mulțimi de încredere pentru modele și corecții Holm și Benjamini–Hochberg.
Interpretați rezultatul unui transfer preînregistrat într-un domeniu nou, inclusiv un rezultat nul, împreună cu mecanismul lui.
Aprofundările și Anexa sînt lectură pentru familiarizare.
Planul capitolului
Parcurs și motivațieÎntrebarea capitolului, cele două componente ale metodei și reperul HAR.
RezultateComparațiile QLIKE, testele DM (Diebold–Mariano, test, testul Diebold–Mariano de comparare a prognozelor) activ cu activ, mulțimile de încredere și testele pe panel.
AprofundăriExemple detaliate și subiecte avansate.
AnexăTrăsături, estimare, perioade de evaluare și verificări.
Parcurs și motivație
Capitolul testează dacă o metodă de prognoză publicată pentru tarifele de transport îmbunătățește prognozele varianței realizate zilnice. Metoda are două componente, trăsăturile de semnătură (signature features) ale unei ferestre recente de date și ponderile de nucleu (kernel weights), care favorizează ferestrele trecute asemănătoare, iar fiecare este testată separat față de modelele de referință din familia HAR. Transferul este preînregistrat: ipotezele, panelul și testele sînt fixate înainte de a vedea rezultatele.
Îmbunătățește o metodă construită pentru tarife de transport prognoza volatilității?
Metoda lui Gu et al. (2024) a fost construită pentru prognoza tarifelor de transport rutier la Amazon. Capitolul întreabă dacă ea îmbunătățește și prognozele varianței realizate, pe 50 de active din VOLARE (VOLatility Archive for Realized Estimates) (Cipollini et al., 2026). Este o întrebare de transfer: o metodă care funcționează într-un domeniu este mutată în altul, cu un plan fixat dinainte.
Capitolul dezvoltă patru deprinderi:
Calculul semnăturii unei traiectorii liniare pe porțiuni și al ariei ei Lévy.
Calculul trăsăturilor de semnătură și al ponderilor de nucleu pentru o prognoză a volatilității.
Interpretarea comparațiilor de prognoze pe multe active, cu teste Diebold–Mariano (DM), mulțimi de încredere pentru modele și corecțiile Holm și Benjamini–Hochberg (BH).
Interpretarea rezultatului unui transfer preînregistrat, inclusiv a unui rezultat nul și a mecanismului lui.
Exemplele detaliate sînt în Aprofundări, după Concluzii.
Pe scurt
Forma traiectoriilor și prognoza volatilității
Un studiu de cercetare: metoda lui Gu et al. (2024), aplicată varianței realizate zilnice
metoda a fost publicată pentru tarifele de transport de la Amazon
Volatilitatea intră în aproape toate măsurile de risc din curs: măsurile riscului din coadă din capitolul 7, prețurile opțiunilor din capitolul 12 și ponderile portofoliilor din capitolul 4. Datele intraday fac varianța zilnică aproape observabilă prin varianța realizată (RV, realised variance), măsura din capitolul 9. Prognoza volatilității devine astfel o problemă de regresie cu o țintă zgomotoasă, dar independentă de model.
Reperul este greu de depășit. Modelul HAR (heterogeneous autoregressive) al lui Corsi (2009) folosește trei medii ale RV trecute, este liniar și se estimează prin metoda celor mai mici pătrate (OLS, ordinary least squares) într-o secundă. O metodă nouă trebuie să depășească HAR out-of-sample, pe multe active și cu un test adecvat, înainte de a putea spune că îmbunătățește prognoza volatilității.
Pe scurt
Volatilitatea intră în aproape toți indicatorii de risc din acest curs
Gu et al. (2024) descriu o fereastră recentă a unei serii ca traiectorie (path) și o rezumă prin semnătura ei. Trăsăturile de semnătură intră într-o regresie liniară rară, un LASSO (least absolute shrinkage and selection operator) estimat în doi pași. Perioadele trecute a căror traiectorie seamănă cu cea curentă primesc o pondere mai mare printr-un nucleu de semnătură (signature kernel). Pentru tarifele de transport, autorii raportează o îmbunătățire a preciziei de peste cinci ori față de o prognoză din industrie.
Întrebarea capitolului este dacă aceeași rețetă depășește modelele de tip HAR pentru varianța realizată. Pentru că metoda combină două componente, fiecare este testată separat: un cîștig poate fi atribuit fie trăsăturilor, fie ponderilor, iar o pierdere poate fi localizată în una dintre ele.
Pe scurt
Gu et al. descriu o fereastră recentă a unei serii ca o traiectorie
o rezumă prin semnătura traiectoriei (engl. path signature)
Trăsăturile de semnătură intră într-o regresie liniară cu puțini coeficienți nenuli (LASSO, Least Absolute Shrinkage and Selection Operator, aplicat în doi pași)
Perioadele trecute a căror traiectorie seamănă cu cea curentă primesc o pondere mai mare (un nucleu de semnătură)
Ei raportează o creștere de peste cinci ori a acurateței
față de o prognoză din industrie pentru tarifele de transport
Întrebare: îmbunătățește aceeași metodă modelele de tip HAR pentru varianța realizată?
Fiecare componentă este testată separat
astfel încît un eventual cîștig poate fi atribuit trăsăturilor sau ponderilor
Înainte de a compara modele, trebuie definită ținta. Secțiunea formulează modelul de preț din spatele varianței realizate, eroarea de măsurare a RV și măsurile auxiliare din datele VOLARE, apoi fixează ținta prognozei, asocierea prognozelor cu țintele și funcțiile de pierdere folosite pentru ordonarea modelelor.
Varianța realizată și variația pătratică (1/2): modelul prețului și RV
Întrebarea este ce anume prognozăm și cum măsoară datele intraday varianța unei zile. Logaritmul prețului \(p_t\), cu timpul măsurat în zile, se mișcă printr-o derivă, un termen de difuzie și salturi:
\[dp_t = \mu_t\,dt + \sigma_t\,dW_t + dJ_t,\]
(20.1)
unde \(\mu_t\) este deriva, \(\sigma_t\) volatilitatea instantanee (spot volatility), \(W_t\) o mișcare browniană, iar \(J_t\) un proces de salturi pur, cu \(\Delta J_s\) mărimea saltului la momentul \(s\).
unde \(M\) este numărul de randamente intraday din ziua \(t\), iar \(r_{t,i}\) al \(i\)-lea randament logaritmic intraday; pentru o acțiune americană, \(M = 78\) de randamente la cinci minute acoperă ședința de 6,5 ore. Limita din (20.2) este variația pătratică (quadratic variation) a zilei: varianța integrată plus suma pătratelor salturilor.
Pe scurt
Întrebare: ce anume prognozăm și cum măsurăm, din date intraday, varianța unei zile?
Modelul prețului: prețul logaritmic se modifică printr-un drift, un termen de difuzie și salturi
Fără salturi și zgomot, pe o grilă echidistantă, limita RV este varianța integrată \(\mathrm{IV}_t = \int_{t-1}^{t}\sigma_s^2\,ds\), adevărata varianță a zilei \(t\), iar eroarea are o distribuție Normală mixtă:
unde \(\mathrm{IQ}_t\) este cvarticitatea integrată (integrated quarticity), iar \(\mathrm{MN}(0, V)\) o lege Normală cu varianța aleatoare \(V\): condiționat de traiectoria volatilității, eroarea este Normală, cu varianța \(2\,\mathrm{IQ}_t/M\).
RV este deci o măsurătoare zgomotoasă a lui \(\mathrm{IV}_t\), iar zgomotul este cel mai mare în zilele volatile, unde \(\mathrm{IQ}_t\) este mare. Această eroare de măsurare este cea pe care o corectează HARQ, modelul HAR cu cvarticitate realizată. În sens invers, zgomotul de microstructură face ca eșantionarea foarte fină să fie deplasată, iar randamentele la cinci minute sînt compromisul standard (capitolul 9).
Pe scurt
Fără salturi și fără zgomot, pe o grilă echidistantă, limita este varianța integrată
\(\mathrm{IV}_t\): varianța integrată, adică varianța adevărată a zilei \(t\); \(\mathrm{IQ}_t\): cvarticitatea integrată
\(\mathrm{MN}(0, V)\): distribuția Normală mixtă, cu varianță aleatoare \(V\); condiționat de traiectoria volatilității, eroarea are varianța \(2\,\mathrm{IQ}_t/M\)
RV este o măsurare zgomotoasă a lui \(\mathrm{IV}_t\)
zgomotul este cel mai mare în zilele volatile (\(\mathrm{IQ}_t\) mare)
Este eroarea de măsurare pe care o corectează HARQ (HAR model with Realised Quarticity), modelul HAR cu cvarticitatea realizată (secțiunea despre familia HAR)
Zgomotul de microstructură deplasează estimarea la frecvențe foarte mari
randamentele la cinci minute sînt compromisul standard (Capitolul 9)
Semivarianțele și cvarticitatea realizată din VOLARE
Semivarianțele realizate (Barndorff-Nielsen, Kinnebrock & Shephard, 2010) împart RV după semnul randamentelor intraday: \(\mathrm{RV}_t^{+} = \sum_i r_{t,i}^2\mathbf{1}\{r_{t,i}>0\}\) este varianța din mișcările în sus, iar \(\mathrm{RV}_t^{-} = \sum_i r_{t,i}^2\mathbf{1}\{r_{t,i}<0\}\) varianța din mișcările în jos; suma lor este \(\mathrm{RV}_t\).
Cvarticitatea realizată estimează \(\mathrm{IQ}_t\), scala erorii de măsurare a RV:
Factorul \(M/3\) provine din distribuția Normală: un randament cu varianța \(s^2\) are momentul de ordinul patru \(3s^4\), iar fiecare varianță pe cinci minute este aproximativ \(\mathrm{IV}_t/M\). Limita cere un preț continuu, fără zgomot, și o grilă echidistantă; un salt \(\Delta J\) adaugă aproximativ \(M(\Delta J)^4/3\), deci RQ (Realised Quarticity, cvarticitatea realizată) brută este sensibilă la salturi.
Factorul \(M/3\): un randament Normal cu varianța \(s^2\) are momentul de ordinul patru \(3s^4\), iar fiecare varianță la cinci minute este aproximativ \(\mathrm{IV}_t/M\)
Limita cere un preț continuu, fără zgomot, și o grilă echidistantă
Un salt \(\Delta J\) adaugă aproximativ \(M(\Delta J)^4/3\), deci RQ brută este sensibilă la salturi
Ținta la orizontul \(h\) este media RV din următoarele \(h\) zile,
\[\mathrm{RV}_{t+1:t+h} = \frac{1}{h}\sum_{j=1}^{h}\mathrm{RV}_{t+j}, \qquad h \in \{1, 5, 22\},\]
(20.5)
unde \(t\) este originea prognozei, ultima zi observată, iar \(h = 1, 5, 22\) înseamnă o zi, o săptămînă și o lună de zile de tranzacționare.
Modelele logaritmice prognozează \(y = \ln \mathrm{RV}_{t+1:t+h}\) și revin la niveluri cu o corecție de varianță, \(F_t = \exp(\hat y_t + \hat s^2/2)\), unde \(F_t\) este prognoza făcută la \(t\),\(\hat y_t\) prognoza logaritmică ajustată, iar \(\hat s^2\) varianța reziduurilor regresiei. Corecția decurge din \(\mathbb{E}[e^Z] = e^{\mu + s^2/2}\) pentru \(Z \sim N(\mu, s^2)\); este exactă dacă eroarea logaritmică este condiționat Normală, cu varianță constantă, și aproximativă în rest.
Pentru \(h > 1\) țintele consecutive se suprapun, ceea ce induce dependență serială pînă la lagul \(h-1\) prin construcție și posibil mai departe. De aceea fiecare test folosește o varianță HAC (heteroskedasticity and autocorrelation consistent).
Pe scurt
Ținta la orizontul \(h\) este media RV pe următoarele \(h\) zile
Indicii au două roluri. În definiția țintei, \(t\) este originea prognozei; în formulele pierderilor și ale testelor, indicele etichetează un rînd de evaluare, care asociază ținta realizată cu prognoza făcută înainte ca ținta să devină observabilă.
La orizontul de o zi, informația pînă la închiderea de luni prognozează RV de marți, iar prognoza este stocată lîngă realizarea de marți. La orizontul de cinci zile, aceeași origine prognozează media de marți pînă lunea următoare, iar originea următoare dă o țintă suprapusă. Testele de comparare a prognozelor folosesc, pe fiecare rînd, aceeași țintă realizată pentru ambele modele. Eticheta rîndului nu permite folosirea acelei ținte în estimare.
Pe scurt
În definiția țintei, indicele \(t\) este originea prognozei
În formulele pierderilor și ale testelor, indicele marchează o pereche de evaluare
ținta realizată și prognoza făcută înainte ca ținta să fie observabilă
Orizontul de o zi: informația pînă la închiderea de luni produce prognoza RV de marți
prognoza este stocată alături de RV realizată marți
Orizontul de cinci zile: aceeași origine prognozează media de marți pînă lunea următoare
originea următoare produce o țintă suprapusă
Testele de comparare a prognozelor folosesc pe fiecare rînd aceeași țintă realizată pentru ambele modele
Faptul că ținta stă pe rîndul prognozei nu permite folosirea ei la estimare
Ținte și funcții de pierdere (2/2): pierderi robuste
O pierdere este robustă în sensul lui Patton (2011) dacă, pentru un indicator condiționat nedeplasat, ordonarea modelelor după pierderea așteptată calculată cu \(\mathrm{RV}_t\) este aceeași ca la varianța adevărată. Nedeplasarea condiționată înseamnă \(\mathbb{E}_{t-1}[\mathrm{RV}_t] = \sigma_t^2\), unde \(\mathbb{E}_{t-1}\) este media condiționată de informația pînă la \(t-1\), iar \(\sigma_t^2\) varianța adevărată a zilei \(t\).
Capitolul folosește două pierderi robuste, scrise aici pentru \(h = 1\) (pentru \(h > 1\),\(\mathrm{RV}_t\) se înlocuiește cu ținta):
MSE (mean squared error) este eroarea pătratică. QLIKE (quasi-likelihood loss) este nulă doar dacă \(F_t = \mathrm{RV}_t\) și crește mai repede cînd prognoza este prea mică decît cînd este prea mare: cu \(\mathrm{RV}_t = 1\),\(F_t = 0{,}5\) dă \(2 - \ln 2 - 1 = 0{,}307\), iar \(F_t = 2\) dă \(0{,}5 - \ln 0{,}5 - 1 = 0{,}193\).
QLIKE depinde doar de raportul \(\mathrm{RV}_t/F_t\), deci aceeași eroare proporțională are aceeași pierdere într-o zi calmă și într-una agitată, în timp ce MSE este dominată de cîteva zile de criză. De aceea QLIKE este pierderea principală, iar MSE cea secundară.
Pe scurt
O funcție de pierdere este robustă dacă păstrează ordinea pierderilor așteptatePatton (2011)
pentru un proxy condiționat nedeplasat, ordinea pierderilor cu \(\RV_t\) coincide cu cea cu varianța adevărată
Condiționat nedeplasat: \(\E_{t-1}[\RV_t] = \sigma^2_t\), cu \(\E_{t-1}\) media condiționată de informația pînă la \(t - 1\) și \(\sigma^2_t\) varianța condiționată a zilei \(t\), distinctă de varianța integrată realizată ex post
Cele două pierderi robuste folosite (scrise pentru \(h = 1\); pentru \(h > 1\), \(\RV_t\) se înlocuiește cu ținta)
QLIKE (quasi-likelihood, pierderea de tip cvasi-verosimilitate) este zero doar dacă \(F_t = \RV_t\) și crește mai repede cînd prognoza este prea mică decît cînd este prea mare
Exemplu cu \(\RV_t = 1\): \(F_t = 0{,}5\) dă \(\QL_t = 2 - \ln 2 - 1 = 0{,}307\), iar \(F_t = 2\) dă \(0{,}5 - \ln 0{,}5 - 1 = 0{,}193\)
QLIKE depinde de raportul \(\RV_t/F_t\)
aceeași eroare proporțională produce aceeași pierdere într-o zi calmă ca într-o zi volatilă
MSE (Mean Squared Error, eroarea pătratică medie) este dominată de cîteva zile de criză
de aceea QLIKE este pierderea principală, iar MSE cea secundară
Baza de date VOLARE
Transferul este testat pe un panel din VOLARE, care furnizează măsuri realizate la cinci minute pentru multe active. Secțiunea descrie cele 50 de active din trei clase, variabilele folosite și comportamentul volatilității realizate în clasele de active.
Întrebarea este pe ce date testăm transferul și de ce pe trei clase de active. Panelul are:
40 de acțiuni americane cu capitalizare mare, 2 ianuarie 2015 – 30 ianuarie 2026, cu 111 440 de observații și o volatilitate anualizată mediană de 17,1%;
5 contracte futures, 28 septembrie 2009 – 30 ianuarie 2026, cu 21 059 de observații și 19,7%;
5 perechi valutare, 25 septembrie 2009 – 30 ianuarie 2026, cu 21 203 observații și 7,3%.
Trei clase protejează împotriva unui rezultat îngust: un cîștig care apare doar într-o clasă nu arată că metoda se transferă.
Acțiunile sînt 40 de componente ale Dow Jones 30 și S&P 100 (Standard & Poor's), notate prin simbolul bursier, de la AAPL (Apple) la XOM (Exxon Mobil). Contractele futures sînt pe porumb (C), petrol (CL), E-mini S&P 500 (ES), aur (GC) și gaze naturale (NG). Seriile FX (foreign exchange, piața valutară) sînt dolarul australian, euro, lira sterlină, dolarul canadian și yenul japonez față de dolarul american.
Volatilitatea mediană din tabel se calculează ca \(\sqrt{252\,\mathrm{mediana}(\mathrm{RV}_t)}\) pentru fiecare activ, apoi ca mediană pe clasă; 252 de zile de tranzacționare pe an transformă o varianță zilnică într-una anuală. Variabilele sînt RV la cinci minute, semivarianțele \(\mathrm{RV}^+\) și \(\mathrm{RV}^-\), cvarticitatea realizată (RQ) și prețurile zilnice de deschidere și de închidere.
Pe scurt
Clasa
Active
Eșantion
Observații
Volatilitate mediană
Acțiuni americane cu capitalizare mare
40
2 ian. 2015 – 30 ian. 2026
111 440
17,1%
Futures (C, CL, ES, GC, NG)
5
28 sept. 2009 – 30 ian. 2026
21 059
19,7%
FX (AUD, EUR, GBP, CAD, JPY față de USD)
5
25 sept. 2009 – 30 ian. 2026
21 203
7,3%
Întrebare: pe ce date testăm transferul și de ce pe trei clase de active?
Trei clase de active: un cîștig care apare doar pe o clasă nu arată că metoda se transferă
Acțiuni: 40 de componente ale Dow Jones 30 și S&P 100 (Standard & Poor's)
notate prin simbolul bursier, de la AAPL (Apple) la XOM (Exxon Mobil)
Futures: C = porumb, CL = petrol, ES = E-mini S&P 500, GC = aur, NG = gaze naturale
FX (foreign exchange, piața valutară): cinci valute față de dolarul american
dolarul australian, euro, lira sterlină, dolarul canadian și yenul japonez
Volatilitatea mediană: \(\sqrt{252\,\mathrm{mediana}(\RV_t)}\) pentru fiecare activ, apoi mediana clasei
252 de zile de tranzacționare pe an
Variabile: RV la cinci minute, semivarianțele RV\(^+\), RV\(^-\), cvarticitatea realizată (RQ)
și prețurile zilnice de deschidere și de închidere
Volatilitatea realizată în clasele de active (1/2)
Întrebare pentru sală Păstrăm aceeași scală. Cînd ▶ mărește fereastra mediei mobile a volatilității anualizate de la 5 la 65 de zile, ce se întîmplă cu maximul petrolului (CL) din prima jumătate a lui 2020?
Răspuns
Scade, de la 458% (cinci zile încheiate pe 22 aprilie 2020) la 152% (65 de zile încheiate pe 3 iunie 2020). Media pe o fereastră mai lungă combină valorile extreme cu zile mai liniștite. Varianta „neschimbat” confundă seria netezită cu observațiile inițiale; „crește” confundă media cu suma. Cu media pe cinci zile, ES ajunge la 115% în martie, JPM (JPMorgan Chase & Co., NYSE ticker, JPMorgan Chase & Co., simbolul bursier NYSE) la 111% și NVDA (NVIDIA Corporation, Nasdaq ticker, NVIDIA Corporation, simbolul bursier Nasdaq) la 118%, iar EURUSD (Euro / US dollar exchange rate, FX pair code, cursul euro / dolar american, codul perechii FX) și USDJPY (US dollar / Japanese yen exchange rate, FX pair code, cursul dolar american / yen japonez, codul perechii FX) rămîn în jur de 20%. Volatilitatea mediană pe clasă este 17,1% la acțiuni, 19,7% la futures și 7,3% la FX.
Graficul arată volatilitatea anualizată \(\sqrt{252\,\mathrm{RV}_t}\) în procente, ca medie pe cinci zile, pe scară logaritmică, pentru două active din fiecare clasă: JPMorgan Chase (JPM) și Nvidia (NVDA) dintre acțiuni, E-mini S&P 500 (ES) și petrolul (CL) dintre futures, EURUSD (dolari americani pentru un euro) și USDJPY (yeni pentru un dolar american) dintre valute. Toate clasele au un vîrf în martie 2020, iar petrolul atinge maximul în aprilie 2020, deci un model de prognoză trebuie să se adapteze în cîteva zile.
Pe scurt
Volatilitatea anualizată \(\sqrt{252\,\RV_t}\) în %, medie pe cinci zile, scală logaritmică, două active pe clasă
acțiuni: JPM = JPMorgan Chase, NVDA = Nvidia; futures: ES = E-mini S&P 500, CL = petrol
FX: EURUSD = dolari SUA (Statele Unite ale Americii) pentru un euro, USDJPY = yeni pentru un dolar SUA
Toate clasele au un vîrf în martie 2020
petrolul (CL) atinge maximul în aprilie 2020
un model de prognoză trebuie să se adapteze în cîteva zile
Volatilitatea realizată în clasele de active (2/2)
Seria continuă VOLARE pentru CL leagă contracte succesive: prețul negativ din 20 aprilie 2020 a privit doar contractul pe mai, aproape de expirare, iar prețurile seriei rămîn pozitive. Pe scară logaritmică volatilitatea este persistentă, memoria lungă pe care o aproximează HAR. Vîrfurile se disipă în cîteva săptămîni, așa că forma traiectoriei recente poate conține informație dincolo de cîteva medii; aceasta este posibilitatea pe care trăsăturile de semnătură încearcă să o exploateze.
Pe scurt
CL: seria continuă VOLARE leagă contracte succesive, iar prețurile seriei rămîn pozitive
prețul negativ din 20 aprilie 2020 a privit doar contractul pe mai, aproape de expirare
Pe scală logaritmică volatilitatea este persistentă (memoria lungă aproximată de HAR)
Vîrfurile se disipă în cîteva săptămîni, deci forma traiectoriei recente poate conține informație
Ținta este media RV pe 1, 5 sau 22 de zile, măsurată cu o eroare care este cea mai mare în zilele volatile și ordonată cu pierderea robustă QLIKE. Panelul acoperă 50 de active din trei clase, cu un vîrf comun al volatilității în martie 2020.
Reperele: familia HAR
O metodă nouă este interesantă doar dacă depășește modelele deja folosite. Secțiunea prezintă HAR, versiunea lui logaritmică și două extensii și ordonează cele șapte modele ale capitolului astfel încît contribuția fiecărei componente a metodei transferate să poată fi izolată.
Întrebarea este ce reper simplu trebuie depășit înainte de a crede într-o metodă nouă. În modelul HAR al lui Corsi (2009), RV viitoare este o funcție liniară de mediile zilnică, săptămînală și lunară ale RV trecute:
cu \(\mathrm{RV}_t^{(w)} = \frac{1}{5}\sum_{j=0}^{4}\mathrm{RV}_{t-j}\) și \(\mathrm{RV}_t^{(m)} = \frac{1}{22}\sum_{j=0}^{21}\mathrm{RV}_{t-j}\) mediile pe o săptămînă și pe o lună pînă în ziua \(t\), iar \(\varepsilon_{t+h}\) eroarea de prognoză.
\(\beta_0\) este constanta, iar \(\beta_d\),\(\beta_w\) și \(\beta_m\), în practică nenegativi, măsoară cît contează ziua de ieri, ultima săptămînă și ultima lună; se estimează prin OLS separat pentru fiecare orizont \(h\). O sumă \(\beta_d + \beta_w + \beta_m\) apropiată de 1 înseamnă persistență ridicată. Intuiția este o cascadă de participanți la piață care tranzacționează la orizonturi zilnice, săptămînale și lunare și care aproximează memoria lungă cu doar trei parametri.
Pe scurt
Întrebare: ce reper simplu trebuie depășit înainte de a crede într-o metodă nouă?
Modelul HAR Corsi (2009): RV viitoare este o funcție liniară de trei medii ale RV trecute
\(\beta_0\): constanta; \(\varepsilon_{t+h}\): eroarea de prognoză
\(\beta_d, \beta_w, \beta_m\) (în practică \(\ge 0\)): cît contează ziua de ieri, ultima săptămînă și ultima lună, estimați prin OLS separat pentru fiecare orizont \(h\)
\(\beta_d + \beta_w + \beta_m\) apropiat de 1: persistență ridicată a volatilității
Intuiția: participanții la piață tranzacționează la orizonturi zilnice, săptămînale și lunare
această cascadă aproximează memoria lungă cu doar trei parametri
HAR: trei medii ale trecutului (2/2): AR(22) restricționat și log-HAR
HAR este un AR(22) restricționat, o autoregresie cu 22 de laguri ai cărei coeficienți iau doar trei valori distincte: \(\phi_1 = \beta_d + \beta_w/5 + \beta_m/22\),\(\phi_{2..5} = \beta_w/5 + \beta_m/22\) și \(\phi_{6..22} = \beta_m/22\), unde \(\phi_j\) este coeficientul lui \(\mathrm{RV}_{t+1-j}\).
Modelul log-HAR aplică aceeași regresie în logaritmi,
ceea ce exclude prognozele negative și reduce influența vîrfurilor. Logaritmul mediei nu este media logaritmilor, deci acest log-HAR nu este exact un AR(22) restricționat în \(\ln \mathrm{RV}\) (Seminarul 20, A7). Extensiile HARQ și SHAR (Semivariance HAR model, model HAR cu semivarianțe) sînt în Anexă.
Pe scurt
HAR este un AR(22) restricționat: cei 22 de coeficienți ai lagurilor iau doar trei valori distincte
Tabelul enumeră cele șapte modele. HAR, HARQ și SHAR prognozează RV în niveluri, cu ponderi egale: HARQ adaugă la HAR termenul \(\mathrm{RV}_t(\mathrm{RQ}_t^{1/2} - \overline{\mathrm{RQ}^{1/2}})\), iar SHAR înlocuiește \(\mathrm{RV}_t\) cu semivarianțele \(\mathrm{RV}_t^+\) și \(\mathrm{RV}_t^-\). Celelalte patru modele prognozează \(\ln \mathrm{RV}\):
log-HAR, cu ponderi egale;
log-HAR-K, cu regresorii log-HAR și ponderi date de nucleul de semnătură;
Sig-L, cu regresorii log-HAR plus 36 de termeni neconstanți ai semnăturii (39 înaintea eliminării constantelor), selectați printr-un LASSO în doi pași;
Sig-LK, adică Sig-L cu ponderi de nucleu, metoda lui Gu et al. (2024).
În denumiri, L înseamnă LASSO, iar K ponderi de nucleu; în grafice, Sig-L apare ca „Signature LASSO”, Sig-LK ca „Signature LASSO + kernel weights”, iar log-HAR-K ca „log-HAR + kernel weights”.
Pe scurt
Model
Țintă
Ponderi
Regresori
HAR
\(\RV\)
egale
\(\RV_t, \RV_t^{(w)}, \RV_t^{(m)}\)
log-HAR
\(\ln \RV\)
egale
aceiași, în logaritmi
HARQ
\(\RV\)
egale
HAR + \(\RV_t\,(\mathrm{RQ}_t^{1/2} - \overline{\mathrm{RQ}^{1/2}})\)
log-HAR, log-HAR-K, Sig-L și Sig-LK formează o ablație (ablation) \(2\times2\), trăsături de semnătură (da/nu) încrucișate cu ponderi de nucleu (da/nu), în care fiecare componentă este inclusă sau exclusă pe rînd. log-HAR este reperul natural pentru modelele cu semnături, pentru că are aceeași țintă, iar regresorii lui se află printre candidați. LASSO poate elimina însă și termeni log-HAR, așa că Sig-L față de log-HAR compară două proceduri, nu doar două mulțimi de variabile.
Pe scurt
log-HAR, log-HAR-K, Sig-L și Sig-LK formează o analiză \(2 \times 2\) pe componente
ablație: fiecare componentă inclusă sau exclusă pe rînd
trăsături de semnătură (da/nu) \(\times\) ponderi de nucleu (da/nu)
Log-HAR este reperul natural pentru modelele cu semnături
are aceeași țintă, iar regresorii lui se află printre candidați
Totuși, LASSO poate elimina și termeni log-HAR
deci Sig-L față de log-HAR compară două proceduri, nu doar două mulțimi de variabile
Semnăturile traiectoriilor
Metoda transferată rezumă o fereastră de date prin semnătura traiectoriei (path signature). Secțiunea definește acest obiect: fereastra ca traiectorie, semnătura ca șir de integrale iterate, calculul ei pentru traiectorii liniare pe porțiuni prin identitatea lui Chen, aria Lévy ca măsură a ordinii și nucleul de semnătură, care măsoară asemănarea a două ferestre.
Întrebarea este cum rezumăm o fereastră de 22 de zile astfel încît să păstrăm ordinea mișcărilor, nu doar nivelurile lor. Se iau ultimele \(L\) zile din \(d-1\) serii, se adaugă timpul ca prim canal (time augmentation) și se unesc punctele prin segmente:
o traiectorie \(X: [0,1] \to \mathbb{R}^d\) cu \(L = 22\) de zile și \(d = 3\) canale: timpul, logaritmul RV și randamentul cumulat. Aici \(u_i \in [0,1]\) este timpul rescalat al punctului \(i\), iar \(r_j = \ln(C_j/O_j)\) randamentul logaritmic de la deschidere la închidere al zilei \(j\), cu \(O_j\) și \(C_j\) prețurile de deschidere și de închidere.
O regresie pe fereastră vede 22 de laguri; un rezumat al traiectoriei vede ordinea, viteza și mișcarea lor comună. El poate distinge, de exemplu, o fereastră în care RV a crescut în timp ce prețurile scădeau de una în care RV a crescut întîi, iar prețurile au scăzut mai tîrziu.
Pe scurt
Întrebare: cum rezumăm o fereastră de 22 de zile astfel încît să păstrăm ordinea mișcărilor, nu doar nivelurile lor?
Considerăm ultimele \(L\) zile ale celor \(d - 1\) serii și unim punctele prin segmente
adăugăm timpul ca prim canal (augmentarea cu timpul)
\(L\): lungimea ferestrei în zile (aici 22); \(u_i \in [0, 1]\): timpul rescalat al punctului \(i\)
\(d\): numărul de canale (aici \(d = 3\): timp, log RV, randament cumulat)
\(r_j = \ln(C_j/O_j)\): randamentul logaritmic de la deschidere la închidere al zilei \(j\), cu \(O_j\), \(C_j\) prețurile de deschidere și de închidere
O regresie pe fereastră folosește 22 de laguri
un rezumat al traiectoriei surprinde și ordinea, viteza și co-mișcarea lor
Exemplu: RV a crescut în timp ce prețurile scădeau, sau RV a crescut întîi și prețurile au scăzut mai tîrziu
Semnăturile provin din geometria spațiilor de bucle. Chen (1957) a arătat că integralele iterate ale unei traiectorii formează o algebră, iar Chen (1958) că ele determină traiectoria pînă la reparametrizare și porțiuni parcurse înapoi. În teoria traiectoriilor aspre (rough path theory) a lui Lyons (1998), semnătura este mulțimea naturală de trăsături pentru ecuațiile diferențiale controlate: răspunsul la o traiectorie depinde de ea, în prima aproximație, doar prin semnătura ei.
Nivelul 1 al semnăturii păstrează doar creșterile totale ale canalelor. Integralele pe momente ordonate păstrează, în plus, ordinea în care se mișcă canalele, de aceea semnătura se construiește din integrale iterate. Un termen al semnăturii este o integrală iterată a traiectoriei de-a lungul unui cuvînt de canale:
Aici \(X: [a,b] \to \mathbb{R}^d\) este o traiectorie cu variație mărginită (lungime totală finită), de exemplu liniară pe porțiuni, iar \(X^i_u\) canalul ei \(i\) la momentul \(u\). Cuvîntul \((i_1, \dots, i_k)\) este o listă ordonată de \(k\) canale, cu litere din \(\{1, \dots, d\}\), iar \(k\) este nivelul termenului. Integrala se ia pe momente ordonate \(u_1 < \dots < u_k\), iar \(dX^i_u\) este creșterea canalului \(i\) la momentul \(u\), pentru un segment liniar panta înmulțită cu \(du\).
Pe scurt
De ce integrale iterate
nivelul 1 reține doar incrementele totale
integralele pe momente ordonate rețin ordinea în care se mișcă canalele
Un termen al semnăturii este o integrală iterată a traiectoriei de-a lungul unui cuvînt de canale
\(X: [a, b] \to \mathbb{R}^d\): o traiectorie cu variație mărginită (lungime totală finită), de exemplu liniară pe porțiuni; \(X^i_u\): canalul \(i\) la momentul \(u\)
Cuvîntul \((i_1, \dots, i_k)\): o listă ordonată de \(k\) canale, cu litere din \(\{1, \dots, d\}\); \(k\) este nivelul termenului
\(dX^{i}_{u}\): incrementul canalului \(i\) la momentul \(u\) (pe un segment liniar, panta înmulțită cu \(du\)), integrat pe momentele ordonate \(u_1 < \dots < u_k\)
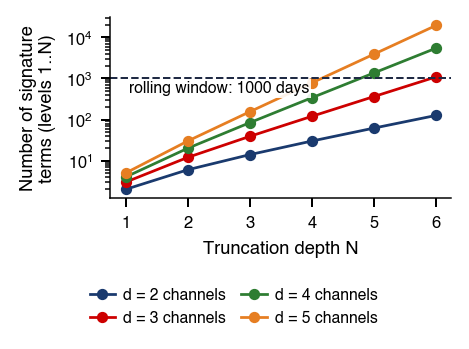
unde \(S^{(k)}\) reunește cei \(d^k\) termeni de nivel \(k\), cîte unul pentru fiecare cuvînt de lungime \(k\), stocați ca tensor (\(\otimes\) este produsul tensorial). Semnătura trunchiată \(\mathrm{Sig}^N(X)\) păstrează nivelurile de la 0 la \(N\);\(N\) este adîncimea (depth).
Nivelul 1 conține creșterile totale, \(S^i = X^i_b - X^i_a\). Nivelul 2 conține \(S^{ij} = \int_a^b (X^i_u - X^i_a)\,dX^j_u\), creșterile canalului \(j\) ponderate cu cît s-a mișcat deja canalul \(i\). Fiecare nivel următor adaugă o integrală și reține detalii mai fine ale ordinii mișcărilor.
\(S^{(k)}\): cei \(d^k\) termeni de nivelul \(k\), unul pentru fiecare cuvînt de lungime \(k\), aranjați ca un tablou \(k\)-dimensional (un tensor, iar \(\otimes\) este produsul tensorial)
\(\Sig^N(X)\): semnătura trunchiată, formată din nivelurile de la \(0\) la \(N\), unde \(N\) este adîncimea
Un segment liniar cu creșterea \(\Delta = X_b - X_a \in \mathbb{R}^d\) are ca semnătură exponențiala tensorială, \(\mathrm{Sig} = \exp_\otimes(\Delta) = (1, \Delta, \Delta^{\otimes2}/2!, \Delta^{\otimes3}/3!, \dots)\), unde \(\Delta^{\otimes k}\) este tabloul tuturor produselor \(\Delta^{i_1}\cdots\Delta^{i_k}\), astfel încît un termen de nivel \(k\) este \(\Delta^{i_1}\cdots\Delta^{i_k}/k!\).
Identitatea lui Chen (Chen, 1957) spune că semnătura a două traiectorii parcurse una după alta este produsul tensorial al semnăturilor lor:
unde \(X * Y\) este concatenarea, \(Y\) începînd unde se termină \(X\), iar \(A^{(k)}\) și \(B^{(k)}\) sînt nivelul \(k\) al semnăturilor \(A\) și \(B\), cu \(A^{(0)} = B^{(0)} = 1\). Nivelul \(k\) al întregii traiectorii adună toate felurile de a împărți un cuvînt de lungime \(k\) între prima și a doua porțiune.
Pe scurt
Un segment liniar cu incrementul \(\Delta \in \mathbb{R}^d\) are ca semnătură exponențiala tensorială
\(\Delta^{\otimes k}\): tabloul tuturor produselor \(\Delta^{i_1}\cdots\Delta^{i_k}\), deci un termen de nivelul \(k\) este \(\Delta^{i_1}\cdots\Delta^{i_k}/k!\)
Pentru o traiectorie liniară pe porțiuni cu \(m\) segmente și creșterile \(\Delta_1, \dots, \Delta_m\),(20.12) dă \(\mathrm{Sig} = \exp_\otimes(\Delta_1)\otimes\cdots\otimes\exp_\otimes(\Delta_m)\). Acesta este întregul algoritm: \(m\) actualizări, fiecare cu un cost de \(O(d^N)\) la adîncimea \(N\).
Ferestrele rolling folosesc identitatea lui Chen în sens invers, pentru a elimina o porțiune inițială: \(\mathrm{Sig}(X_{[s,t]}) = \mathrm{Sig}(X_{[a,s]})^{-1}\otimes\mathrm{Sig}(X_{[a,t]})\) pentru \(a \le s \le t\), unde inversul față de \(\otimes\) este semnătura porțiunii parcurse înapoi.
Pe scurt
O traiectorie liniară pe porțiuni cu \(m\) segmente, cu incrementele \(\Delta_1, \dots, \Delta_m\)
Exemplul rezolvat ia traiectoria \((0,0) \to (1,0) \to (1,2)\), cu creșterile \(\Delta_1 = (1,0)\) și \(\Delta_2 = (0,2)\). Nivelul 1 este \(S^{(1)} = \Delta_1 + \Delta_2 = (1,2)\). Nivelul 2 rezultă din identitatea lui Chen, \(S^{ij} = \tfrac12\Delta_1^i\Delta_1^j + \Delta_1^i\Delta_2^j + \tfrac12\Delta_2^i\Delta_2^j\), cu \(\Delta_m^i\) componenta \(i\) a creșterii segmentului \(m\), și dă \(S^{11} = 1/2\),\(S^{12} = 2\),\(S^{21} = 0\) și \(S^{22} = 2\).
Urmează două verificări:
\(S^{11} = (\Delta X^1)^2/2\) și \(S^{22} = (\Delta X^2)^2/2\), un caz al identității de amestecare (shuffle identity): produsul a două coordonate de nivel 1 este egal cu suma celor două ordonări ale lor la nivelul 2.
\(S^{12} \neq S^{21}\), pentru că canalul 1 se mișcă în primul segment și canalul 2 în al doilea. Nivelul 1 nu poate distinge această traiectorie de cea care urcă întîi și merge spre dreapta apoi, pentru că ambele au \(\Delta X = (1,2)\); nivelul 2 le deosebește.
Pe scurt
Traiectoria \(X: (0,0) \to (1,0) \to (1,2)\), cu incrementele \(\Delta_1 = (1, 0)\) și \(\Delta_2 = (0, 2)\)
Nivelul 1: \(S^{(1)} = \Delta_1 + \Delta_2 = (1, 2)\)
Nivelul 2 prin identitatea lui Chen: \(S^{ij} = \tfrac12\Delta_1^i\Delta_1^j + \Delta_1^i\Delta_2^j + \tfrac12\Delta_2^i\Delta_2^j\)
\(\Delta_m^i\): componenta \(i\) a incrementului segmentului \(m\)
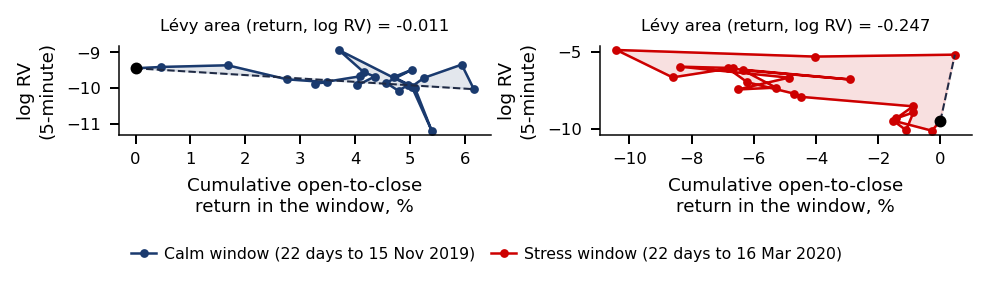
Aria Lévy (Lévy area) este partea antisimetrică a nivelului 2,
\[A^{ij} = \tfrac12\big(S^{ij} - S^{ji}\big),\]
(20.13)
egală cu aria cu semn dintre traiectorie, proiectată pe canalele \((i,j)\), și coarda ei, dreapta de la început la sfîrșit. \(A^{ij} > 0\) înseamnă că traiectoria se rotește în sens trigonometric în planul \((i,j)\). Partea simetrică, \(\tfrac12(S^{ij} + S^{ji}) = \tfrac12\Delta X^i\Delta X^j\), nu aduce informație nouă. În exemplul rezolvat, \(A^{12} = (2-0)/2 = 1\), aria triunghiului dintre traiectorie și coardă.
Ca statistică lead–lag, aria cere prudență. Lectura lead–lag presupune o asociere pozitivă: dacă \(i\) scade și apoi \(j\) crește, \(i\) se mișcă primul, dar \(A^{ij} < 0\). Pentru canalele (randament, logaritmul RV), o scădere a prețului urmată de o creștere a volatilității dă \(A < 0\), la fel ca o creștere a prețului urmată de o scădere a volatilității. Secvențele de tip efect de levier (capitolul 5) sînt una dintre sursele unei arii negative, dar semnul singur nu le identifică.
Pe scurt
Aria Lévy \(A^{ij}\): partea antisimetrică a nivelului 2
Nucleul de semnătură este produsul scalar al semnăturilor trunchiate (Király & Oberhauser, 2019), un scor de asemănare între două traiectorii \(X\) și \(Y\) cu aceleași canale:
unde \(w\) este un cuvînt, \(|w|\) lungimea lui, iar \(S(X)^w\) termenul cuvîntului \(w\); primul 1 este nivelul 0. Distanța indusă de nucleu (Gu et al., ec. 9) este distanța euclidiană la pătrat dintre semnăturile trunchiate, \(d_{\mathrm{Sig}}(X,Y) = k_N(X,X) - 2k_N(X,Y) + k_N(Y,Y) = \|\mathrm{Sig}^N(X) - \mathrm{Sig}^N(Y)\|^2\): nulă cînd cele două ferestre au aceeași semnătură pînă la adîncimea \(N\), mare cînd formele lor diferă.
Gu et al. (2024) și acest capitol folosesc acest nucleu trunchiat, cu aceeași adîncime \(N\) ca pentru trăsături. Nucleul netrunchiat rezolvă o ecuație cu derivate parțiale (EDP, partial differential equation) de tip Goursat (Salvi et al., 2021), pe care articolul o citează, dar nu o folosește. Canalele sînt rescalate înaintea calculului nucleului (Anexă); altfel domină canalul cu unitățile cele mai mari.
\(X\), \(Y\): două traiectorii cu aceleași canale; \(w\): un cuvînt de lungime \(|w|\) (nivelul), cu termenul \(S(X)^{w}\); termenul 1 corespunde nivelului 0
Distanța indusă de nucleu (Gu et al., ec. 9)
pătratul distanței euclidiene dintre semnăturile trunchiate
\(d_{\Sig} = 0\): aceeași semnătură pînă la adîncimea \(N\); \(d_{\Sig}\) mare: forme diferite
Gu et al. și acest capitol folosesc acest nucleu trunchiat, cu același \(N\) ca pentru trăsături
Nucleul netrunchiat rezolvă o ecuație cu derivate parțiale (PDE, Partial Differential Equation) de tip Goursat Salvi et al. (2021), citată, dar nefolosită de Gu et al.
O fereastră de date devine o traiectorie, iar semnătura ei reține, nivel cu nivel, creșterile și ordinea mișcărilor. Identitatea lui Chen face din semnătura unei traiectorii liniare pe porțiuni un produs de exponențiale tensoriale, aria Lévy transformă ordinea într-un număr, iar nucleul de semnătură compară ferestrele prin distanța dintre semnăturile lor trunchiate.
Articolul: Gu et al. (2024)
Înainte de transfer, secțiunea arată exact ce au făcut Gu et al. (2024) și cît de solide sînt dovezile lor: problema de prognoză, trăsăturile, LASSO în doi pași, ponderile de nucleu, cîștigurile raportate și limitele acestor dovezi.
Întrebarea este ce anume a făcut articolul și cît de solide sînt dovezile lui. Gu et al. (2024) prognozează tarifele săptămînale de transport rutier cu camion complet din America de Nord, la nivel național și pentru cinci regiuni, în 2018–2022, pînă la 12 săptămîni înainte. Peste 100 de factori candidați au fost reduși la aproximativ 40. Metoda este folosită în operațiunile Amazon din noiembrie 2022 și a fost publicată la KDD 2024 (Knowledge Discovery and Data Mining, conferința Association for Computing Machinery, ACM).
Designul este direct: cîte o regresie pentru fiecare orizont \(\Delta t\), în săptămîni, a tarifului \(y_{\tau+\Delta t}\) pe trăsăturile \(\xi_\tau\) observate în săptămîna \(\tau\).
Pe scurt
Întrebare: ce a făcut exact articolul și cît de solide sînt dovezile lui?
Tarife săptămînale pe piața nord-americană de transport rutier Gu et al. (2024)
la nivel național și în cinci regiuni, 2018–2022
prognozate pe pînă la 12 săptămîni
Peste 100 de factori candidați, reduși la aproximativ 40
Metoda este folosită în operațiunile Amazon din noiembrie 2022 și a fost publicată la KDD 2024, conferința ACM (Association for Computing Machinery) de Knowledge Discovery and Data Mining
Pentru fiecare orizont \(\Delta t\) (în săptămîni; notația articolului, nu un increment \(\Delta\)): o regresie directă
a lui \(y_{\tau + \Delta t}\) pe trăsăturile \(\xi_\tau\) (slide-ul următor)
unde \(y_{t_i}\) este tariful din săptămîna \(t_i\),\(\tau - l \le t_i \le \tau\), iar \(l\) orizontul de privire înapoi (lookback), în săptămîni. Factorii externi aduc nivelul și informație din afara seriei; semnătura aduce forma traiectoriei recente.
Pe scurt
Trăsăturile în săptămîna \(\tau\) (Secțiunea 4.1, ec. 14)
factorii externi \(x_\tau\) și semnătura traiectoriei țintei, augmentată cu timpul
cu \(\theta\) vectorul coeficienților, \(\|\theta\|_1 = \sum_j|\theta_j|\),\(w_\tau \ge 0\) ponderea săptămînii \(\tau\), egală sau dată de nucleu, și \(\lambda \ge 0\) penalizarea: un \(\lambda\) mai mare favorizează în general soluții mai rare, iar \(\lambda = 0\) dă OLS ponderat. Al doilea pas (ec. 15) reestimează prin OLS ponderat pe suportul selectat, adică pe coeficienții nenuli din primul pas.
Reestimarea este necesară pentru că LASSO contractă coeficienții păstrați spre zero; OLS după selecție elimină această contracție indusă de penalizare pe suportul selectat (Belloni & Chernozhukov, 2013), dar nu și deplasarea de selecție sau pe cea din variabile omise. Articolul numește metoda „adaptivă” din cauza ponderilor \(w_\tau\), nu în sensul LASSO-ului adaptiv al lui Zou (2006). În acest capitol, \(\lambda\) se alege în fiecare fereastră de antrenare ca suportul cu cel mai mic BIC (Bayesian Information Criterion) de-a lungul traiectoriei LARS (Least Angle Regression) (Efron et al., 2004); detaliile sînt în Anexă.
Pe scurt
Pasul 1, selecție printr-un LASSO ponderat Tibshirani (1996) (ec. 14)
Ponderile de nucleu pornesc de la distanța fiecărei ferestre trecute la ultima fereastră cu ținta observată (ec. 11), \(\delta_\tau = d_{\mathrm{Sig},N}(z_{\tau-l:\tau},\, z_{t-\Delta t-l:t-\Delta t})\). Aici \(z_\tau = (x_\tau, y_{\tau+\Delta t})\) sînt perechile de predictori și țintă ulterioară, nu trăsăturile \(\xi_\tau\) (algoritmul 1), \(t\) este săptămîna curentă, iar \(t - \Delta t\) ultima săptămînă a cărei țintă \(y_t\) este deja observată. Ponderile sînt un softmax cu temperatura \(\gamma \ge 0\) (ec. 12):
unde \(s\) parcurge toate săptămînile de antrenare, deci ponderile au suma 1. Ferestrele asemănătoare, cu \(\delta_\tau\) mic, primesc o pondere mai mare; \(\gamma = 0\) dă regresia obișnuită cu ponderi egale, iar \(\gamma \to \infty\) folosește doar fereastra trecută cea mai asemănătoare.
Ideea este o schemă de tip cel mai apropiat vecin (nearest neighbour) într-o regresie: învățăm din perioadele trecute care arătau ca astăzi. Costul ei este un eșantion efectiv mai mic, măsurat prin \(n_{\mathrm{eff}} = 1/\sum_\tau w_\tau^2\) al lui Kish, egal cu \(n\) pentru ponderi egale \(1/n\) și cu 1 dacă o singură săptămînă primește toată ponderea.
Pe scurt
Distanța fiecărei ferestre trecute față de ultima fereastră cu țintă observată (ec. 11)
\begin{equation*} \delta_\tau = d_{\Sig, N}\big(z_{\tau - l : \tau},\; z_{t - \Delta t - l : t - \Delta t}\big) \end{equation*}
\(z_\tau = (x_\tau, y_{\tau+\Delta t})\): perechile de predictori și țintă ulterioară, nu trăsăturile \(\xi_\tau\) (Algoritmul 1), cu traiectoria \(z_{\tau - l : \tau}\) pe \(l\) săptămîni
\(t\): săptămîna curentă; \(t - \Delta t\): ultima săptămînă a cărei țintă \(y_t\) este deja observată
Ponderi softmax cu temperatura \(\gamma \ge 0\) (ec. 12)
normalizate pe toate săptămînile de antrenare \(s\)
ferestrele asemănătoare (\(\delta_\tau\) mic) primesc o pondere mai mare
Cazuri-limită: \(\gamma = 0\) dă regresia obișnuită (ponderi egale), iar \(\gamma \to \infty\) păstrează doar cea mai asemănătoare fereastră trecută
O idee de tip cel mai apropiat vecin într-o regresie
învățăm din perioadele trecute care semănau cu prezentul
Costul ideii: mai puține observații efective, \(n_{\mathrm{eff}} = 1 / \sum_\tau w_\tau^2\) (Kish), cu \(n_{\mathrm{eff}} = n\) pentru ponderi egale \(1/n\) și \(n_{\mathrm{eff}} = 1\) dacă o singură săptămînă ia toată ponderea
Pentru tarifele naționale la trei luni, aprilie–noiembrie 2021 (tabelul 1), articolul raportează o eroare relativă \(|y - \hat y|/|y|\), cu \(y\) tariful realizat și \(\hat y\) prognoza lui, de aproximativ 1–2%, față de 13–27% pentru prognoza din industrie: „de peste cinci ori”. Pe orizonturi de 1–12 săptămîni (tabelul 2), erorile sînt de 1,06–2,60% la nivel național și de 1,05–5,69% pe regiuni, cu o economie anuală estimată de circa 50 de milioane de dolari.
Ablația nucleului (tabelul 3) folosește șase valori săptămînale, 31 octombrie – 5 decembrie 2021, pentru o singură regiune: erorile ajung la 9,85% fără nucleu și la 5,15% cu nucleu. Rezultatul susține o comparație de proceduri față de o singură prognoză comercială, fără erori standard.
Pe scurt
Tarife naționale, cu trei luni înainte, aprilie–noiembrie 2021 (Tabelul 1)
eroarea relativă \(|y - \hat y|/|y|\): aproximativ 1–2% față de 13–27% pentru prognoza din industrie, „de peste cinci ori”
\(y\): tariful realizat, \(\hat y\): prognoza lui
Orizonturi de 1–12 săptămîni (Tabelul 2): eroarea relativă este de 1,06–2,60% la nivel național și de 1,05–5,69% pe regiuni
Economia anuală estimată: aproximativ 50 de milioane de dolari
Ablația nucleului (Tabelul 3, șase valori săptămînale, 31 octombrie–5 decembrie 2021, o regiune): erori de pînă la 9,85% fără nucleu, față de pînă la 5,15% cu el
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
față de o singură prognoză comercială, fără erori standard (slide-ul următor)
Există un singur reper, o prognoză comercială nenumită, fără un model ARIMA (autoregressive integrated moving average), fără un LASSO fără semnături și fără un mers aleator.
Evaluarea este scurtă: cîteva luni și cîteva serii, fără erori standard și fără un test de precizie egală.
Calibrarea nu este publicată: orizontul \(l\), adîncimea \(N\), temperatura \(\gamma\), penalizarea \(\lambda\) și modul în care au fost alese.
Nimic din toate acestea nu face metoda greșită; face doar dovezile subțiri, motiv pentru care metoda este testată în alt domeniu. Ordinea este replicarea înaintea extinderii, ca în capitolul 19.
Pe scurt
Un singur reper: o prognoză comercială al cărei furnizor nu este precizat
Lipsesc comparațiile cu
un model ARIMA (AutoRegressive Integrated Moving Average)
un LASSO fără semnături
un mers aleator (random walk)
Evaluare scurtă: cîteva luni, cîteva serii
fără erori standard, fără un test de acuratețe egală
Calibrare nepublicată: \(l\), \(N\), \(\gamma\), \(\lambda\) și modul lor de alegere
Aceste limite nu invalidează metoda, dar slăbesc dovezile
Semnătura traiectoriei recente a țintei, augmentată cu timpul;
LASSO în doi pași, cu ponderi, și o regresie directă pentru fiecare orizont;
Ponderile softmax \(\exp(-\gamma\,\delta_\tau)\) cu nucleul de semnătură trunchiat.
Adaptările decurg din noua țintă. RV este zilnică și zgomotoasă, nu un tarif săptămînal, așa că modelele lucrează în logaritmi, inferența este HAC, iar pierderile sînt robuste. Factorii externi \(x_\tau\) sînt înlocuiți cu termenii log-HAR, care aduc nivelul.
Și nucleul este adaptat. El compară traiectoriile (timp, \(\ln\mathrm{RV}\), randament) care se termină la \(\tau\) și la originea \(t\), actualizate la fiecare 5 zile, nu perechile \((x_\tau, y_{\tau+\Delta t})\) care se termină la \(t - \Delta t\). Alegerile pe care articolul nu le-a publicat, \(l\),\(N\),\(\gamma\) și \(\lambda\), sînt fixate dinainte, iar repere puternice și teste formale înlocuiesc singura prognoză comercială.
Pe scurt
Se transferă
Semnătura traiectoriei recente a țintei
augmentată cu timpul
LASSO în doi pași cu ponderi
regresie directă pe orizont
Ponderi softmax \(\exp(-\gamma\,\delta_\tau)\)
cu nucleul de semnătură trunchiat
Trebuie adaptat
Țintă zilnică și zgomotoasă în loc de tarife săptămînale
de aici logaritmii, inferența HAC și pierderile robuste
Factorii externi \(x_\tau\) înlocuiți de termenii log-HAR
unica prognoză comercială este înlocuită de repere puternice și teste formale
Planul transferului (preînregistrat)
O metodă cu mai multe alegeri de calibrare poate fi făcută oricînd să arate bine pe un anumit activ, orizont sau perioadă. De aceea planul fixează, înainte de a vedea vreun rezultat, ipotezele, regula de alegere a temperaturii nucleului, schema de estimare rolling și protocolul de evaluare, și declară singura modificare făcută după o rulare de test.
Întrebarea este ce fixăm înaintea rezultatelor, astfel încît un cîștig să nu poată fi găsit prin căutare. Se formulează patru ipoteze:
H1 (trăsături): termenii semnăturii aduc informație dincolo de log-HAR, testat prin Sig-L față de log-HAR, cu aceeași țintă și aceleași ponderi egale.
H2 (ponderi): ponderile de nucleu îmbunătățesc o regresie dată, testat prin Sig-LK față de Sig-L și log-HAR-K față de log-HAR.
H3 (metodă): metoda completă a lui Gu et al. (2024) depășește familia HAR, testat prin Sig-LK față de HAR și față de log-HAR și prin mulțimea de încredere a modelelor (MCS, model confidence set) pentru toate cele șapte modele.
H4 (stres): orice cîștig este mai mare în perioadele de stres, crahul din pandemia COVID-19 și șocul tarifar american din 2–30 aprilie 2025, cînd ferestrele trecute asemănătoare ar trebui să conteze cel mai mult.
Pe scurt
Întrebare: ce fixăm înaintea rezultatelor, astfel încît un cîștig să nu poată fi găsit prin căutare?
H1 (trăsături): termenii semnăturii aduc informație dincolo de log-HAR
Test: Sig-L față de log-HAR, aceeași țintă, aceleași ponderi egale
H2 (ponderi): ponderile de nucleu îmbunătățesc o regresie dată
Teste: Sig-LK față de Sig-L și log-HAR-K față de log-HAR
H3 (metoda): metoda completă a lui Gu et al. depășește familia HAR
Teste: Sig-LK față de HAR și de log-HAR
mulțimea de încredere pentru modele (Model Confidence Set, MCS), pentru toate cele șapte modele
H4 (stres): orice cîștig este mai mare în perioadele de stres
crahul din pandemia COVID-19 și șocul tarifelor vamale americane din 2–30 aprilie 2025
acolo ferestrele trecute asemănătoare ar trebui să conteze cel mai mult
Temperatura nucleului: o constantă aleasă pe un bloc de validare
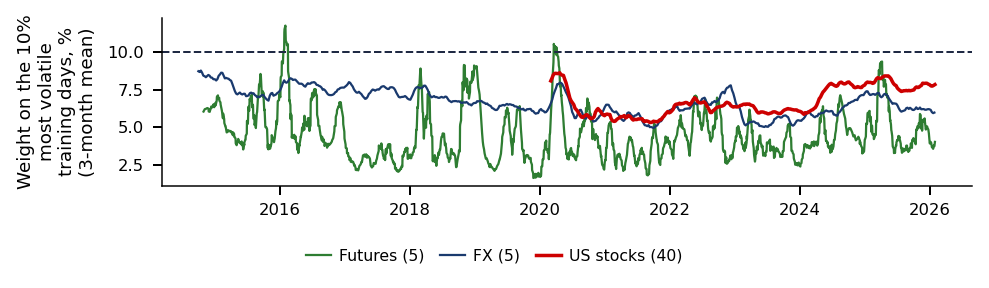
unde \(\delta_\tau\) sînt distanțele de nucleu ale zilelor de antrenare față de fereastra curentă, iar \(c > 0\) este o constantă adimensională, singurul parametru de calibrare. Cu \(c = 1\), o fereastră aflată la distanța mediană primește ponderea \(e^{-1}\) față de una identică; un \(c\) mai mare concentrează ponderile.
\(c\) se alege din grila \(\{0{,}5;\ 1;\ 2;\ 4\}\) pentru fiecare orizont și clasă de active, pe primele 250 de zile de prognoză ale fiecărui activ, cumulate în cadrul clasei. Criteriul este media pe clasă a lui QLIKE\((c)\) împărțit la media activului pe grilă. Evaluarea începe după ultima țintă de validare a clasei, deci nicio țintă de calibrare nu este ulterioară unei origini evaluate.
Pentru cele 40 de acțiuni cîștigă la fiecare orizont, pentru Sig-LK, cea mai mică temperatură, \(c = 0{,}5\), care dă ponderile cele mai apropiate de egalitate. Pentru futures și FX alegerea se schimbă de la un orizont la altul, semn al unui criteriu plat și zgomotos; toate valorile sînt în Anexă.
Pe scurt
Temperatură fără unități, fixată în fiecare fereastră de antrenare
\(\delta_\tau\): distanțele nucleului dintre zilele de antrenare și fereastra curentă; \(c > 0\): o constantă fără unități, singurul parametru de calibrare
Cu \(c = 1\), o fereastră aflată la distanța mediană primește ponderea \(e^{-1}\) față de una identică, iar un \(c\) mai mare concentrează ponderile
Valoarea lui \(c\) din grila \(\{0{,}5; 1; 2; 4\}\) se alege separat pentru fiecare orizont și clasă de active
pe primele 250 de zile de prognoză ale fiecărui activ, cumulate la nivelul clasei
Criteriul: QLIKE\((c)\) al fiecărui activ, împărțit la media QLIKE a activului pe toată grila, apoi mediat pe clasă
Evaluarea începe după ultima țintă de validare a clasei, deci nicio țintă folosită la calibrare nu este ulterioară unei origini evaluate
Pentru cele 40 de acțiuni Sig-LK alege la fiecare orizont \(c = 0{,}5\)
ponderile cele mai apropiate de cele egale
pentru futures și FX alegerea se schimbă cu orizontul, semn că criteriul este plat și zgomotos
Diagrama arată schema rolling. Modelele se reestimează la fiecare 5 zile de tranzacționare pe ultimele 1 000 de perechi complete \((\xi_\tau, y_{\tau+h})\) cu \(\tau + h \le t\), astfel încît orice țintă folosită în estimare este observată la originea \(t\). Între reestimări coeficienții sînt ficși, în timp ce regresorii se actualizează zilnic, iar prognozele de la \(t\) la \(t+4\) folosesc aceleași estimații. Distanțele de nucleu se recalculează la fiecare reestimare, față de fereastra care se termină la originea \(t\).
Întrebarea este dacă diferența de pierdere dintre două modele depășește zgomotul de eșantionare. Pentru fiecare activ și orizont, QLIKE și MSE medii ale două modele se compară prin testul DM (Diebold–Mariano) de precizie predictivă egală (Diebold & Mariano, 1995); eroarea relativă a articolului este raportată doar descriptiv (Anexă). Statistica este
unde \(L\) este pierderea (QLIKE sau MSE), \(F^A_t\) și \(F^B_t\) prognozele modelelor \(A\) și \(B\),\(\bar d\) media diferenței de pierdere pe cele \(T\) zile de evaluare, iar \(\hat\Omega\) varianța pe termen lung a lui \(d_t\) (Aprofundări).
Sub \(H_0: \mathbb{E}[d_t] = 0\), DM este aproximativ \(N(0,1)\), iar \(\mathrm{DM} < -1{,}645\) înseamnă că modelul \(A\) este semnificativ mai precis la 5%, unilateral. Pentru că estimarea este rolling, testul se citește ca testul GW (Giacomini–White) necondiționat; testul GW condiționat întreabă în plus dacă \(d_{t-h}\) prezice \(d_t\), cu instrumentele \((1, d_{t-h})\)(Giacomini & White, 2006).
Pe scurt
Întrebare: este diferența de pierdere dintre două modele mai mare decît zgomotul din eșantion?
\(L\): funcția de pierdere (QLIKE sau MSE); \(F^{A}_t\), \(F^{B}_t\): prognozele modelelor \(A\) și \(B\), iar \(d_t\) este diferența dintre pierderile lor
\(\bar d\): media lui \(d_t\) pe cele \(T\) zile de evaluare; \(\hat\Omega\): varianța de termen lung a lui \(d_t\) (Aprofundări)
Sub \(H_0\colon \E[d_t] = 0\), DM are aproximativ distribuția \(N(0, 1)\)
\(\mathrm{DM} < -1{,}645\) arată că \(A\) este semnificativ mai precis la 5% (test unilateral)
Estimarea se face pe fereastră mobilă
deci testul se interpretează ca testul GW (Giacomini–White) necondiționat
Testul GW condiționat verifică în plus dacă \(d_{t-h}\) prezice \(d_t\) (cu instrumentele \((1, d_{t-h})\)) Giacomini & White (2006)
Testul DM compară două modele, dar aici sînt șapte și niciun reper ales dinainte. Mulțimea de încredere a modelelor a lui Hansen, Lunde & Nason (2011) la 90% este mulțimea de modele care conține cel mai bun model cu probabilitate de cel puțin 90%. Se construiește prin eliminare: cît timp statistica \(T_{\max}\), cea mai mare diferență standardizată dintre pierderea medie a unui model și media modelelor rămase în mulțime, respinge precizia egală, cel mai slab model este eliminat.
Valorile p provin din bootstrap-ul staționar al lui Politis & Romano (1994), cu 1 000 de replicări și o lungime medie a blocurilor de \(\max(h, 10)\) zile. Seriile pierderilor tuturor modelelor sînt reeșantionate împreună, pentru a păstra dependența dintre modele.
Pe scurt
De ce o mulțime de modele: testul DM compară doar două modele
mulțimea de modele care conține cel mai bun model cu probabilitate de cel puțin 90%
Construită prin eliminare: cît timp statistica \(T_{\max}\) (cea mai mare diferență standardizată dintre pierderea medie a unui model și media modelelor aflate încă în mulțime) respinge acuratețea egală, se elimină cel mai slab model
Valorile \(p\) (p-values) se obțin prin bootstrap staționar Politis & Romano (1994), cu 1 000 de replicări și lungimea medie a blocului de \(\max(h, 10)\) zile
Seriile de pierdere se reeșantionează împreună, pentru a păstra dependența dintre modele
Protocolul de evaluare (3/3): testul pe panel și corecțiile
Testul pe panel aplică DM diferenței medii de pierdere pe secțiunea transversală, o singură serie cu o valoare pe dată. În plus, se numără activele, din 50, cu rezultate semnificativ mai bune, cu două corecții:
Corecția Holm (Holm, 1979) controlează FWER (family-wise error rate), probabilitatea a cel puțin unei respingeri false;
Procedura BH a lui Benjamini & Hochberg (1995) controlează FDR (false discovery rate), proporția așteptată a respingerilor false printre respingeri.
Rezultatele sînt raportate și pe subperioade: 20 februarie – 30 aprilie 2020 (crahul din pandemia COVID-19), 2–30 aprilie 2025 (șocul tarifar american) și toate celelalte zile. Perioadele de evaluare pe clase sînt în Anexă.
Pe scurt
Testul pe panel: testul DM aplicat diferenței medii de pierdere pe secțiune transversală
o singură serie, cu o valoare pe dată
Numărăm activele (din 50) cu rezultate semnificativ mai bune
Corecția Holm Holm (1979) controlează FWER (Family-Wise Error Rate, probabilitatea a cel puțin unei respingeri false)
Corecția BH Benjamini & Hochberg (1995) controlează FDR (False Discovery Rate, proporția așteptată de respingeri false printre respingeri)
Trei subperioade
20 feb.–30 apr. 2020 (crahul COVID-19)
2–30 apr. 2025 (șocul tarifelor americane)
toate celelalte zile (perioadele de evaluare pe clase: Anexă)
Preînregistrarea includea filtrul de prognoze aberante (insanity filter) al lui Bollerslev, Patton & Quaedvlieg (2016) (BPQ) pentru toate modelele. O rulare de test a codului pe JPM, un singur activ și înaintea oricărui rezultat pe panel, a arătat că filtrul înlocuia prognoze corecte de crah cu media calmă din eșantion: pe 12 martie 2020, RV realizată a JPM pentru ziua următoare a fost de aproximativ 40 de ori prognoza HAR filtrată.
Regula a fost de aceea schimbată înainte de estimarea modelelor pe panelul de 50 de active. Rezultatele principale impun doar pozitivitatea: o prognoză \(\le 0\) este înlocuită cu media din eșantion. Filtrul BPQ este păstrat ca verificare de robustețe și raportat integral.
Pe scurt
Preînregistrat: filtrul BPQ („insanity filter”) pe toate modelele: o prognoză în afara intervalului țintei din eșantionul de estimare devine media acestuia
Un test al codului pe JPM (un singur activ, înaintea oricărui rezultat pe panel) a arătat că înlocuiește prognoze corecte din perioada crahului cu media din eșantionul de estimare, dominată de perioada calmă
Pe 12 martie 2020, RV observată în ziua următoare pentru JPM a fost de aproximativ 40 de ori mai mare decît prognoza HAR filtrată
Modificare făcută înainte de estimarea pe panelul de 50 de active
rezultatele principale folosesc doar regula de pozitivitate (o prognoză \(\le 0\) devine media din eșantionul de estimare)
Filtrul BPQ rămîne ca verificare de robustețe și este raportat complet
Sinteza secțiunii
Planul fixează patru ipoteze, o constantă de calibrare pe clasă aleasă pe un bloc de validare, o schemă rolling cu reestimare la fiecare 5 zile și un protocol de evaluare cu teste DM, mulțimi de încredere pentru modele și corecțiile Holm și BH. Singura modificare a planului preînregistrat, filtrul prognozelor, a fost făcută înaintea oricărui rezultat pe panel și este declarată.
Rezultate
Secțiunea prezintă comparația preînregistrată pe cele 50 de active VOLARE: pierderile QLIKE ale fiecărui model relativ la HAR, testele Diebold–Mariano (DM) activ cu activ cu corecțiile Holm și Benjamini–Hochberg (BH), mulțimile de încredere pentru modele, testele pe panel, crahul din pandemia COVID-19 și ponderile nucleului în plin crah. Comparația principală este Sig-LK, metoda completă a lui Gu et al. (2024), față de log-HAR, cel mai simplu model pe logaritmi; HAR în nivel este reperul la care se raportează toate rapoartele.
Întrebare pentru sală La h = 1, pentru toate cele 50 de active, media rapoartelor QLIKE ale Sig-L față de HAR este 0,886. Schimbăm reperul din HAR în log-HAR. Unde se va afla media rapoartelor Sig-L?
Răspuns
Peste 1: media rapoartelor Sig-L/log-HAR este 1,004, deci Sig-L are o pierdere relativă ușor mai mare în acest eșantion; pentru Sig-LK, 1,045. La schimbarea reperului, pagina recalculează raportul fiecărui activ și apoi face media; nu împarte cele două medii. Valoarea 1 este garantată doar pentru reperul comparat cu el însuși. Față de HAR, mediile sînt 0,883 pentru log-HAR, 0,885 pentru log-HAR-K și 0,886 pentru Sig-L. Aceste medii nu sînt un test de semnificație.
Întrebarea este dacă metoda lui Gu et al. (2024) depășește modelele HAR și, mai ales, log-HAR. Pentru fiecare activ, graficul arată raportul dintre pierderea QLIKE medie a modelului și pierderea QLIKE medie a HAR, astfel încît o valoare sub 1 înseamnă o prognoză mai precisă decît HAR. Cutiile dau intervalul intercuartilic pe cele 50 de active, linia mediana, rombul media, iar mustățile se întind pe 1,5 intervale intercuartilice.
Pe scurt
Întrebare: depășește metoda lui Gu et al. modelele HAR și, mai ales, log-HAR?
Raportul pentru fiecare activ: QLIKE medie a modelului împărțită la QLIKE medie a HAR
un raport sub 1 înseamnă un model mai precis decît HAR
Fiecare cutie acoperă intervalul intercuartilic pe cele 50 de active, linia din cutie este mediana, rombul este media, iar mustățile se întind pe 1,5 intervale intercuartilice
Rapoartele se mediază pe active cu ponderi egale, aici ca și în ablație și în rezultatele filtrate. Media rapoartelor nu este raportul mediilor, așa că o schimbare a reperului produce rapoarte noi pe fiecare activ, nu o simplă rescalare. Medianele descriu un activ tipic, în timp ce mediile rămîn sensibile la cîteva pierderi mari.
Pe scurt
Rapoartele se mediază pe active cu ponderi egale
aici, în ablație și în rezultatele filtrate
media rapoartelor diferă de raportul mediilor
deci la schimbarea reperului se recalculează pe fiecare activ
Medianele descriu un activ tipic, iar mediile rămîn sensibile la cîteva pierderi mari
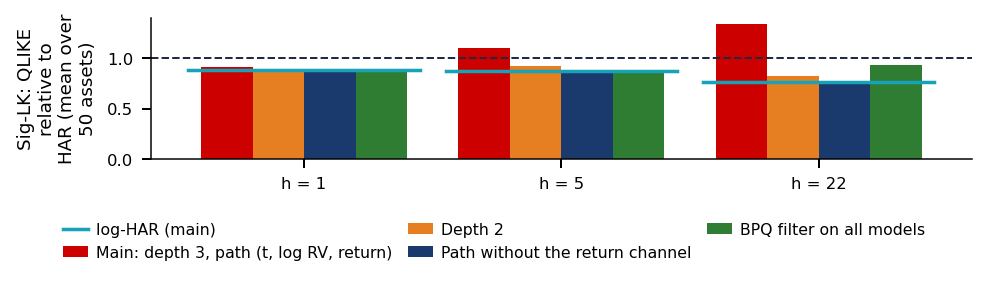
La orizontul de o zi, \(h = 1\), rapoartele medii ale log-HAR, log-HAR-K și Sig-L sînt apropiate: 0,883, 0,885 și 0,886. Trăsăturile singure, Sig-L față de log-HAR, cresc pierderea QLIKE cu 0,4%, deci cele 36 de trăsături de semnătură suplimentare nu aduc niciun cîștig; trăsăturile împreună cu ponderile nucleului, Sig-LK față de log-HAR, o cresc cu 4,5%.
La \(h = 5\) și \(h = 22\) de zile, Sig-LK rămîne în urma log-HAR, cu 28,0% și 92,9%. Rapoartele lui mediane față de HAR, 0,997 și 0,968, sînt mult mai bune decît mediile, deci cîteva active și cîteva zile produc pierderea. Fără canalul randamentelor în traiectorie, Sig-LK ajunge la rapoarte de 0,878 și 0,770, apropiate de cele ale log-HAR, 0,871 și 0,765.
HARQ și SHAR pierd aici în fața HAR în nivel, pentru că designul principal nu aplică filtrul BPQ (Bollerslev–Patton–Quaedvlieg); filtrul salvează HARQ (Anexă). Primul verdict este că metoda nu depășește cel mai simplu model pe logaritmi. O egalitate aproximativă nu dovedește o acuratețe egală, iar rezultatul susține o comparație de proceduri.
Pe scurt
La orizontul de o zi (\(h = 1\)), log-HAR, log-HAR-K și Sig-L au rapoarte apropiate
0,883, 0,885 și, respectiv, 0,886
Doar trăsăturile (Sig-L față de log-HAR): +0,4% la QLIKE, deci cele 36 de trăsături în plus nu aduc niciun cîștig
Trăsături și ponderi (Sig-LK față de log-HAR): +4,5%
La o săptămînă și la o lună, Sig-LK rămîne în urma log-HAR
diferența relativă de QLIKE: +28,0% la \(h = 5\)
+92,9% la \(h = 22\)
într-o variantă fără canalul randamentelor, Sig-LK față de HAR (0,878 și 0,770) se apropie de log-HAR (0,871 și 0,765)
Medianele rapoartelor față de HAR (0,997 la \(h = 5\) și 0,968 la \(h = 22\)) sînt mult mai bune decît mediile: pierderea provine de la cîteva active și zile
HARQ și SHAR (Semivariance HAR model, model HAR cu semivarianțe) sînt aici inferioare modelului HAR în nivel
deoarece specificația principală nu aplică filtrul BPQ
Tabelul numără, pentru fiecare comparație și orizont, activele pe care primul model este semnificativ mai bun și semnificativ mai slab după QLIKE, fiecare ca număr brut/Holm/BH. Testul este testul DM unilateral la 5% al lui Diebold & Mariano (1995), iar familia pentru corecții este formată din cele 50 de active. Testul DM cere momente finite de ordinul \(2 + \delta\) și o dependență slabă a diferenței de pierderi QLIKE \(d_t\), nu a randamentelor, iar prognozele apropiate de zero pot încălca aceste condiții.
Cele două corecții controlează rate de eroare diferite:
Procedura lui Holm (1979) controlează rata erorii pe familie (FWER, family-wise error rate), probabilitatea a cel puțin unei respingeri false, sub orice dependență.
Procedura lui Benjamini & Hochberg (1995) controlează rata descoperirilor false (FDR, false discovery rate), ponderea așteptată a respingerilor false printre respingeri, sub independență sau sub dependență de regresie pozitivă pe o submulțime (PRDS, positive regression dependence on a subset) (Benjamini & Yekutieli, 2001).
Pe scurt
Comparația (QLIKE)
\(h = 1\)
\(h = 5\)
\(h = 22\)
Sig-LK față de log-HAR
2/0/0 \(|\) 5/0/0
0/0/0 \(|\) 15/0/2
0/0/0 \(|\) 27/1/16
Sig-L față de log-HAR
3/1/1 \(|\) 5/0/0
0/0/0 \(|\) 9/0/0
1/0/0 \(|\) 21/0/0
log-HAR-K față de log-HAR
3/0/0 \(|\) 3/0/0
3/0/0 \(|\) 1/0/0
5/0/0 \(|\) 6/0/0
Sig-LK față de Sig-L
2/0/0 \(|\) 5/0/0
0/0/0 \(|\) 5/0/0
2/0/0 \(|\) 10/0/0
Sig-LK față de HAR
12/5/6 \(|\) 0/0/0
7/1/1 \(|\) 0/0/0
8/2/4 \(|\) 1/0/0
log-HAR față de HAR
21/5/17 \(|\) 0/0/0
23/13/20 \(|\) 0/0/0
42/25/42 \(|\) 0/0/0
Fiecare celulă are două părți, separate prin \(|\)
stînga: numărul de active semnificativ mai bune (fără corecție/Holm/BH)
dreapta: numărul de active semnificativ mai slabe (fără corecție/Holm/BH)
Test DM unilateral la 5%, pe o familie de 50 de active
testul DM cere momente finite de ordin mai mare decît 2 și dependență slabă pentru diferența de pierdere QLIKE \(d_t\), nu pentru randamente; prognozele apropiate de zero pot încălca aceste condiții
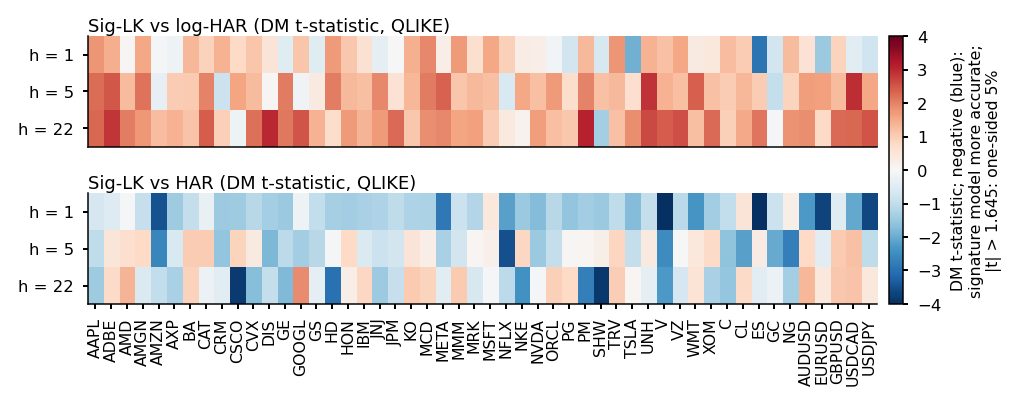
Pentru H1, ipoteza că trăsăturile de semnătură aduc informație, Sig-L depășește log-HAR pe 3 din cele 50 de active la \(h = 1\) fără corecție și pe 1 după Holm, în timp ce doar din întîmplare ne-am aștepta la aproximativ 2,5 cîștiguri necorectate. La același orizont, Sig-L pierde în fața log-HAR pe 5 active fără corecție și pe niciunul după Holm.
Pentru H2, ipoteza că ponderile nucleului ajută, nici log-HAR-K față de log-HAR, nici Sig-LK față de Sig-L nu arată o diferență semnificativă după Holm la vreun orizont. Față de HAR la \(h = 1\), Sig-LK cîștigă pe 12 active, dar log-HAR singur cîștigă pe 21. Reperul trebuie deci să izoleze ideea testată: o comparație cu HAR atribuie semnăturii un cîștig care aparține transformării logaritmice.
Pe scurt
H1 (semnături): la \(h = 1\), Sig-L este superior lui log-HAR pe puține active
pe 3 din 50 de active fără corecție
pe 1 după corecția Holm
Doar din întîmplare ne-am aștepta la aproximativ 2,5 respingeri necorectate
Tot la \(h = 1\), Sig-L este inferior lui log-HAR pe 5 active fără corecție și pe niciunul după Holm
H2 (ponderi): nicio diferență semnificativă după Holm, la niciun orizont
log-HAR-K față de log-HAR
Sig-LK față de Sig-L
Alegeți reperul care izolează ideea
față de HAR la \(h = 1\), Sig-LK este superior pe 12 active
Întrebare pentru sală Păstrăm QLIKE și toate cele 50 de active. Cînd ▶ ridică nivelul de încredere al MCS de la 90% la 99%, ce se întîmplă cu proporția activelor pentru care Sig-LK rămîne în mulțime?
Răspuns
Crește sau rămîne constantă. Pragul de eliminare α scade de la 0,10 la 0,01, iar pagina păstrează modelele cu p-value MCS peste prag, deci elimină mai puține. Pentru Sig-LK, proporțiile trec de la 100%, 94% și 88% la 100%, 100% și 100% la h = 1, 5 și 22; pentru log-HAR, de la 100%, 98% și 98% la 100%. Un nivel de încredere mai mare nu înseamnă o selecție mai restrictivă. Apartenența la MCS nu dovedește acuratețe egală: la 90%, cele patru modele logaritmice se separă rar, iar HAR, HARQ și SHAR sînt excluse pentru o cincime pînă la o treime dintre active.
Mulțimea de încredere pentru modele (MCS, model confidence set) a lui Hansen, Lunde & Nason (2011) este mulțimea modelelor care nu pot fi respinse drept cele mai bune la un nivel dat. Graficul arată, pentru fiecare model, ponderea celor 50 de active în care acesta face parte din MCS de 90% după QLIKE la \(h = 1\), 5 și 22. log-HAR face parte din ea pentru 100%, 98% și 98% dintre active, iar Sig-LK pentru 100%, 94% și 88%. MCS cere aceleași condiții de momente și de dependență pentru diferențele de pierderi dintre modele ca testul DM.
MCS separă rareori cele patru modele pe logaritmi. HAR, HARQ și SHAR sînt excluse pentru între o cincime și o treime dintre active, deci ținta în nivel este perdantul cel mai clar.
Pe scurt
Proporția activelor (din 50) pentru care fiecare model aparține MCS de 90% sub QLIKE
log-HAR, la \(h = 1\), 5 și 22: 100%, 98% și 98%
Sig-LK: 100%, 94% și 88%
MCS pe QLIKE cere aceleași condiții ca testul DM pentru diferențele de pierdere dintre modele, nu pentru randamente
Sub eroarea pătratică medie (MSE, mean squared error) aproape toate modelele rămîn în mulțime. Diferențele de pierdere MSE medie au erori standard mari, pentru că erorile pătratice ale prognozelor de varianță sînt dominate de cîteva zile extreme.
Pe scurt
MCS separă rar cele patru modele logaritmice
în schimb HAR, HARQ și SHAR sînt excluse pentru o cincime pînă la o treime dintre active
ținta în nivel este clar cea mai slabă alegere
Sub MSE aproape fiecare model rămîne în mulțime
diferențele de pierdere medie au erori standard mari
Testul pe panel cumulează dovezile: pentru fiecare zi, seria este diferența medie de pierderi QLIKE pe activele disponibile în acea zi, un panel neechilibrat, iar statistica DM se calculează pe această serie, un \(t\) negativ însemnînd că primul model este mai bun. Cumulat, doar transformarea logaritmică este clar semnificativă: log-HAR depășește HAR cu \(t = -3{,}09\),\(-3{,}95\) și \(-4{,}50\) la cele trei orizonturi, toate cu \(p < 0{,}001\).
Sig-L față de log-HAR la \(h = 1\) dă \(t = -1{,}91\), semnificativ într-un singur test unilateral (\(p = 0{,}028\)). Rezultatul este fragil:
Pentru cele 40 de acțiuni singure semnul se inversează, la \(t = +1{,}72\) în defavoarea Sig-L;
După o corecție Holm pe cele trei orizonturi, cu pragul \(0{,}05/3 \approx 0{,}017\), nu mai este semnificativ;
Dispare în panelul echilibrat de pe slide-ul următor.
Testul condiționat al lui Giacomini & White (2006) (GW), Sig-LK față de log-HAR, dă 0, 0 și 0 respingeri Holm din 50 de active.
Pe scurt
Comparația: DM \(t\) (\(p\) unilateral)
\(h = 1\)
\(h = 5\)
\(h = 22\)
Sig-LK față de log-HAR
+1,45 (0,927)
+1,68 (0,953)
+1,80 (0,964)
Sig-L față de log-HAR
-1,91 (0,028)
+1,48 (0,931)
+1,51 (0,935)
log-HAR-K față de log-HAR
+1,89 (0,971)
+0,40 (0,654)
+1,92 (0,973)
Sig-LK față de Sig-L
+1,74 (0,959)
+0,98 (0,837)
-0,77 (0,221)
log-HAR față de HAR
-3,09 (\(<\)0,001)
-3,95 (\(<\)0,001)
-4,50 (\(<\)0,001)
Seria testată: diferența medie de QLIKE pe activele disponibile în acea zi (panel neechilibrat)
un \(t\) negativ înseamnă că primul model este mai bun
testul DM cere momente finite de ordin mai mare decît 2 și dependență slabă pentru diferența de pierdere QLIKE \(d_t\), nu pentru randamente; prognozele apropiate de zero pot încălca aceste condiții
La nivel agregat, doar transformarea logaritmică este clar semnificativă
Sig-L față de log-HAR la \(h = 1\) este semnificativ într-un singur test unilateral
\(p = 0{,}028\), în panelul neechilibrat
pe panelul echilibrat rezultatul dispare (slide-ul următor)
Doar pentru cele 40 de acțiuni semnul se inversează: \(t = +1{,}72\) împotriva Sig-L
După corecția Holm pe cele trei orizonturi (pragul \(0{,}05/3 \approx 0{,}017\)), rezultatul nu mai este semnificativ
Testul GW condiționat pentru Sig-LK față de log-HAR, după corecția Holm
Panelul neechilibrat mediază activele disponibile în fiecare zi: contractele futures și cursurile de schimb (FX, foreign exchange) din 2014, acțiunile abia din 27 ianuarie 2020. Diferențele dintre clasele de active se amestecă astfel cu diferențele dintre perioade. Panelul echilibrat păstrează toate cele 50 de active, dar doar zilele în care toate au prognoze, 1 511 zile la \(h = 1\), între 27 ianuarie 2020 și 29 ianuarie 2026.
Pe panelul echilibrat, Sig-L față de log-HAR la \(h = 1\) dă \(t = +0{,}75\)(\(p = 0{,}773\)), față de \(t = -1{,}91\)(\(p = 0{,}028\)) în panelul neechilibrat; pe calendarul comun doar panelul celor 5 contracte futures favorizează Sig-L (\(t = -4{,}03\)). Avantajul log-HAR față de HAR rămîne, cu \(t\) între −4,76 și −2,21.
Pe scurt
Comparația: DM \(t\) (\(p\) unilateral)
\(h = 1\)
\(h = 5\)
\(h = 22\)
Sig-LK față de log-HAR
+1,19 (0,884)
+1,61 (0,946)
+1,41 (0,921)
Sig-L față de log-HAR
+0,75 (0,773)
+1,49 (0,932)
+1,24 (0,892)
log-HAR față de HAR
\(-\)2,21 (0,014)
\(-\)2,51 (0,006)
\(-\)4,76 (\(<\)0,001)
Panelul neechilibrat mediază activele disponibile în fiecare zi: futures și FX din 2014, acțiunile abia din 27 ian. 2020
diferențele dintre clase se amestecă astfel cu diferențele dintre perioade
Panelul echilibrat: toate cele 50 de active, doar zilele în care toate au prognoze (1 511 de zile la \(h = 1\), 27 ian. 2020 – 29 ian. 2026)
Sig-L față de log-HAR la \(h = 1\): \(t = +0{,}75\) (\(p = 0{,}773\)), față de \(t = -1{,}91\) (\(p = 0{,}028\)) în panelul neechilibrat
pe calendarul comun, doar panelul celor 5 contracte futures favorizează Sig-L (\(t = -4{,}03\))
Avantajul log-HAR față de HAR se păstrează: \(t\) între \(-\)4,76 și \(-\)2,21
Întrebare pentru sală La h = 1, care dintre cele trei prognoze afișate surprinde amplitudinea saltului țintei pentru originea din 11 martie 2020 a volatilității JPM?
Răspuns
Niciuna. La această origine, ținta pentru ziua următoare este aproximativ 139%, iar prognozele sînt 59% (HAR), 49% (log-HAR) și 60% (Sig-LK): toate subestimează puternic saltul. Reacția ulterioară ceva mai rapidă a Sig-LK la mijlocul lui martie și depășirea ulterioară a țintei de către HAR nu arată anticiparea acestui salt. Prognoza HAR brută devine negativă la sfîrșitul lui martie; graficul arată valoarea după regula de pozitivitate (media țintei în fereastra de antrenare), iar cele 7 origini înlocuite sînt marcate cu ×.
Graficul arată, pentru JPMorgan Chase (JPM) din februarie pînă în mai 2020, prognozele pe o zi ale modelelor și ținta, ambele ca volatilitate anualizată în procente, \(\sqrt{252F_t}\) și \(\sqrt{252\,\mathrm{RV}_{t+1}}\). Toate modelele rămîn în urma primului salt. Sig-LK reacționează ceva mai repede decît log-HAR la jumătatea lui martie, cînd traiectoria s-a întors deja, iar după vîrf amîndouă scad cu viteze asemănătoare.
Pe scurt
Toate modelele reacționează cu întîrziere la primul salt
volatilitatea anualizată în % a prognozelor, \(\sqrt{252 F_t}\), și a țintei, \(\sqrt{252\,\RV_{t+1}}\)
perioada: februarie–mai 2020
În crahul din pandemia COVID-19: JPM, ziua următoare (2/2)
HAR în nivel depășește ținta, iar la sfîrșitul lui martie prognoza lui brută devine negativă. Graficul arată valoarea după regula de pozitivitate, ținta medie a ferestrei de antrenare, care apare ca un segment orizontal; cele 7 origini înlocuite, 27 martie–6 aprilie 2020, sînt marcate cu o cruce. Un model în nivel poate produce prognoze de varianță imposibile exact într-o criză, ceea ce ținta logaritmică evită prin construcție.
Pe scurt
Sig-LK reacționează puțin mai repede decît log-HAR la mijlocul lui martie
atunci traiectoria și-a schimbat deja direcția
după vîrf ambele scad cu viteze asemănătoare
HAR în nivel depășește ținta, apoi prognoza HAR brută devine negativă la sfîrșitul lui martie
graficul arată valoarea după regula de pozitivitate: media țintei în fereastra de antrenare (segmentul plat)
cele 7 origini înlocuite, 27 martie – 6 aprilie 2020, sînt marcate cu \(\times\)
Întrebare pentru sală La h = 1, în crahul COVID-19, media rapoartelor QLIKE Sig-LK/HAR este 0,73. Este suficient pentru a atribui procedurii cu semnături un cîștig față de log-HAR?
Răspuns
Nu. Valoarea 0,73 arată un avantaj față de HAR; cu același reper, log-HAR are însă 0,70, deci rezultatele nu arată un avantaj suplimentar al Sig-LK. În celelalte zile, rapoartele sînt 0,94 (log-HAR) și 0,97 (Sig-LK). La h = 22, în același crah, Sig-LK are de 6,35 ori și Sig-L de 8,30 ori pierderea HAR. Rezultatele nu oferă sprijin descriptiv pentru H4; nu sînt un test formal al diferenței dintre perioade.
Graficul compară, în subperioade fixate înaintea evaluării, media pe active a pierderii QLIKE a fiecărui model relativ la HAR: crahul din pandemia COVID-19, șocul tarifar american din aprilie 2025 și celelalte zile. Valorile sînt pe slide-ul următor.
H4 afirmă că modelele cu semnături cîștigă cel mai mult în perioadele de stres, cînd ferestrele trecute asemănătoare ar trebui să ajute. La \(h = 1\), în crahul COVID-19, rapoartele față de HAR sînt 0,70 pentru log-HAR, 0,73 pentru Sig-LK și 1,89 pentru HARQ; în șocul tarifar american din 2–30 aprilie 2025 sînt 0,88 pentru log-HAR și 0,92 pentru Sig-LK, iar în celelalte zile 0,94 și 0,97.
La \(h = 22\), în crahul COVID-19, pierderile Sig-LK și Sig-L sînt de 6,35 și de 8,30 ori pierderea HAR. Exact acolo unde ferestrele trecute asemănătoare ar trebui să ajute, modelele cu semnături eșuează cel mai mult, deci H4 nu este susținută. Rezultatul susține o descriere, pentru că nu s-a făcut un test formal al interacțiunii dintre model și perioadă.
Pe scurt
Media pe active a QLIKE relativ la HAR în fiecare subperioadă fixată înaintea evaluării
La \(h = 1\), în crahul COVID-19: log-HAR 0,70, Sig-LK 0,73, HARQ 1,89
În 2–30 aprilie 2025 (șocul tarifelor americane): log-HAR 0,88, Sig-LK 0,92
În celelalte zile: log-HAR 0,94, Sig-LK 0,97
La \(h = 22\), în crahul COVID-19, modelele cu semnături au cele mai slabe rezultate
pierderea Sig-LK este de 6,35 ori pierderea HAR
pierderea Sig-L este de 8,30 ori pierderea HAR
tocmai acolo unde ferestrele trecute asemănătoare ar trebui să ajute
H4 nu este susținută
Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei)
Întrebare pentru sală La originea din 16 martie 2020, cu N = 3, ▶ crește c de la 0,5 la 8. Ce se întîmplă cu mărimea efectivă medie a eșantionului pe cele 40 de acțiuni?
Răspuns
Scade, de la aproximativ 975 la 36 din 1 000. Ponderile sînt proporționale cu exp(−c δ / mediana lui δ), unde δ este distanța dintre ferestre: un c mai mare le concentrează pe distanțele mici. Numărul observațiilor rămîne 1 000; mărimea efectivă scade. Cu c = 0,5, ponderea medie rămîne între 0,61 și 1,43 ori 1/n; cu c = 8, între 0,10 și 157 ori 1/n. Ponderile cele mai mari revin ultimelor zile dinaintea originii, ale căror ferestre de 22 de puncte se suprapun cu fereastra curentă. Invarianța la translație nu înseamnă distanțe egale între ferestre.
Graficul arată ponderile pe care Sig-LK (\(h = 1\)) le dă, la originea din 16 martie 2020, zilelor de antrenare, 24 martie 2016–13 martie 2020, înmulțite cu lungimea ferestrei, astfel încît 1 înseamnă ponderare egală. Ponderile sînt aproape egale, între 0,61 și 1,43 ori \(1/n\), iar mărimea efectivă a eșantionului este 975 din 1 000 de observații, în medie pe cele 40 de acțiuni.
Pe scurt
Ponderile Sig-LK (\(h = 1\)) la originea din 16 martie 2020 pe zilele de antrenare
zilele de antrenare: 24 mar. 2016 – 13 mar. 2020
ponderile sînt înmulțite cu lungimea ferestrei, astfel încît valoarea 1 corespunde ponderării egale
Ponderile sînt aproape egale, între 0,61 și 1,43 ori \(1/n\)
mărimea efectivă a eșantionului este 975 din 1 000 (media celor 40 de acțiuni)
Ponderile nucleului la originea din 16 martie 2020 (2/2)
Cele mai mari ponderi revin ultimelor zile dinaintea originii. Ferestrele recente de 22 de zile se suprapun cu fereastra curentă, deci asemănarea lor poate reflecta în parte suprapunerea, nu un regim economic distinct. Scăderea de la sfîrșitul lui 2018 primește o pondere mai mică, nu mai mare, iar ponderile sînt aproape necorelate cu logaritmul volatilității (corelație +0,04).
Motivul este invarianța la translație a semnăturii: ea descrie forma traiectoriei, nu nivelul ei. O criză trecută la un alt nivel de volatilitate nu seamănă cu cea curentă, așa că nucleul nu poate pune în practică ideea de „a învăța din crizele trecute”.
Pe scurt
Cele mai mari ponderi revin ultimelor zile dinaintea originii
Ferestrele recente de 22 de puncte se suprapun cu cea curentă
asemănarea poate reflecta parțial suprapunerea, nu un regim economic distinct
Semnătura depinde doar de incremente (invarianța la translație): reflectă forma, nu nivelul
scăderile de la sfîrșitul lui 2018 primesc o pondere mai mică
ponderile sînt aproape necorelate cu log-volatilitatea (corelația este +0,04)
Sig-LK nu depășește log-HAR: la o zi cele două sînt apropiate, iar la o săptămînă și la o lună modelul cu semnături pierde clar. Testele cumulate confirmă doar cîștigul transformării logaritmice față de HAR, cîștigul aparent al Sig-L la o zi nu rezistă în panelul echilibrat și nici la corecția pe orizonturi, iar în crahul COVID-19 ponderile nucleului rămîn aproape egale.
Ablații și robustețe
Un rezultat nul pentru metoda completă lasă deschisă întrebarea care dintre cele două ingrediente ale ei a eșuat. Ablația încrucișează trăsăturile (cu semnătură sau fără) cu ponderile (nucleu sau egale), iar rezultatele pe clase de active arată unde se concentrează un eventual cîștig.
Întrebare pentru sală La h = 1, media rapoartelor QLIKE Sig-LK/log-HAR pe cele 50 de active este 1,045, iar cel mai mare raport este al petrolului (CL). Dacă excludem CL, coboară media sub 1?
Răspuns
Nu: media scade de la 1,045 la 1,011, deci excluderea CL nu inversează clasamentul descriptiv. CL are raportul 2,71, dar efectul excluderii depinde și de celelalte 49 de rapoarte. Ponderile singure (log-HAR-K) dau 1,002, 1,002 și 1,004 față de log-HAR la h = 1, 5 și 22; Sig-L dă 1,004, 1,285 și 2,238; Sig-LK, 1,045, 1,280 și 1,929. Sig-L evaluează procedura cu semnături și selecție LASSO, deci diferența față de log-HAR nu poate fi atribuită exclusiv trăsăturilor.
Întrebarea este care ingredient produce rezultatul, trăsăturile de semnătură sau ponderile nucleului. Graficul arată media pe cele 50 de active a pierderii QLIKE a fiecărui model relativ la log-HAR, pentru cele patru combinații de trăsături (semnătură sau doar termenii log-HAR) și ponderi (nucleu sau egale). Linia punctată marchează 1, pierderea log-HAR, deci o bară deasupra ei înseamnă o prognoză mai slabă decît log-HAR.
Pe scurt
Întrebare: ce componentă produce rezultatul, trăsăturile de semnătură sau ponderile nucleului?
Media pe cele 50 de active a QLIKE relativ la log-HAR
trăsături (semnătură sau nu) încrucișate cu ponderi (nucleu sau egale)
Linia punctată marchează valoarea 1 (log-HAR)
o bară peste ea înseamnă o prognoză mai slabă decît log-HAR
Ponderile singure, log-HAR-K, dau rapoarte de 1,002, 1,002 și 1,004 la \(h = 1\), 5 și 22: niciun efect detectabil asupra pierderii medii. Trăsăturile singure, Sig-L, dau 1,004, 1,285 și 2,238, iar amîndouă împreună, Sig-LK, 1,045, 1,280 și 1,929. Mărimea efectivă medie a eșantionului cu ponderile Sig-LK este 816 din 1 000 de observații.
Adăugarea ponderilor la Sig-L reduce pierderea la \(h = 22\) fără să o elimine. La \(h = 1\) o măresc, mai ales prin țițeiul (CL), cu un raport de 2,71, spre deosebire de cîștigul nucleului raportat în tabelul 3 al lui Gu et al. (2024). Pierderea modelelor cu semnături la orizonturile lungi vine deci din trăsături, nu din ponderi.
Pe scurt
Doar ponderile (log-HAR-K): 1,002 la \(h = 1\), 1,002 la \(h = 5\) și 1,004 la \(h = 22\), deci niciun efect detectabil asupra pierderii medii
Doar trăsăturile (Sig-L): 1,004 la \(h = 1\), 1,285 la \(h = 5\) și 2,238 la \(h = 22\): termenii de nivelul 3 explodează în crahuri (Aprofundări)
Ambele componente (Sig-LK): 1,045 la \(h = 1\), 1,280 la \(h = 5\) și 1,929 la \(h = 22\)
Mărimea efectivă medie a eșantionului cu ponderile Sig-LK: 816 din 1 000
Adăugarea ponderilor la Sig-L reduce pierderea la \(h = 22\), fără a o elimina
În schimb, înrăutățesc rezultatul la \(h = 1\) din cauza petrolului (raportul pentru CL este 2,71), spre deosebire de cîștigul adus de nucleu în Tabelul 3 al lui Gu et al.
Pe clase de active, raportul Sig-L față de log-HAR este 1,009, 1,332 și 2,505 pentru cele 40 de acțiuni la \(h = 1\), 5 și 22, 0,965, 1,084 și 1,206 pentru cele 5 contracte futures și 0,996, 1,111 și 1,134 pentru cele 5 perechi FX. Singurul cîștig apare la futures pentru \(h = 1\), 3,5% în QLIKE, și marginal la FX.
Cinci contracte futures la un singur orizont sînt un candidat pentru un studiu nou, preînregistrat, nu un rezultat al acestuia. Acțiunile, 80% din panel, nu arată niciun cîștig, iar media rapoartelor pe active este dominată de ele. Testul DM pe panelul neechilibrat amestecă, în schimb, clasele cu perioadele, pentru că înainte de 2020 conține doar futures și FX.
Pe scurt
Sig-L relativ la log-HAR (QLIKE)
\(h = 1\)
\(h = 5\)
\(h = 22\)
Acțiuni (40)
1,009
1,332
2,505
Futures (5)
0,965
1,084
1,206
FX (5)
0,996
1,111
1,134
Singurul cîștig: futures la \(h = 1\) (-3,5%) și, marginal, FX
Rezultatul privește doar cinci contracte futures și un orizont: este un candidat pentru un nou studiu preînregistrat, nu o concluzie a acestuia
Acțiunile, 80% din panel, nu arată niciun cîștig
media rapoartelor pe active este dominată de acțiuni
testul DM pe panelul neechilibrat amestecă însă clasele cu perioadele: înainte de 2020 conține doar futures și FX
Sinteza secțiunii
Ponderile nucleului nu au un efect detectabil asupra pierderii medii, iar trăsăturile de semnătură produc pierderile la orizonturile de o săptămînă și o lună. Singurul cîștig, pentru futures la o zi, este prea îngust pentru a fi un rezultat al acestui studiu.
Studiul evaluează un singur design dintre multe, deci rezultatul lui nul nu este un rezultat nul pentru semnături în general. Designul fixează o fereastră de \(L = 22\) de zile, adîncimea \(N = 3\), trei canale, selecția prin criteriul informațional bayesian (BIC, Bayesian information criterion) și o grilă de patru puncte pentru temperatura nucleului \(c\). Se folosește doar nucleul trunchiat, iar factorii externi, centrali la Gu et al. (2024), cum ar fi volatilitatea implicită sau știrile macroeconomice, lipsesc.
Două familii de repere rămîn în afara comparației:
Un nucleu sensibil la nivel ar adăuga distanței augmentarea cu punct de bază (basepoint augmentation) sau nivelul lui \(\ln\mathrm{RV}\) (Seminarul 20, C2);
Traiectoria ar putea fi construită din randamente intraday la 5 minute;
Nucleul de semnătură ar putea fi calculat exact prin metoda cu ecuații cu derivate parțiale (PDE, partial differential equation) a lui Salvi et al. (2021);
Log-semnăturile sau canalele mărginite (tanh) ar putea îmblînzi termenii explozivi de nivelul 3 (Morrill et al., 2020).
Traiectoriile comune mai multor active sînt o altă direcție, pentru că ariile lor Lévy măsoară relațiile lead–lag dintre piețe, subiectul studiului de caz de mai jos. În sfîrșit, cîștigul la futures pentru \(h = 1\) ar putea fi testat pe un panel mai lung, cu acest design fixat dinainte.
Semnături logaritmice (log-signatures) și canale mărginite (tanh) împotriva termenilor explozivi de nivelul 3 Morrill et al. (2020)
Traiectorii între active, unde ariile Lévy măsoară relațiile lead-lag între piețe
Futures la \(h = 1\) pe un panel mai lung, cu această specificație fixată dinainte
Studiu de caz: semnătura ca măsură lead-lag
Studiul de caz folosește semnătura pentru o altă întrebare: nu pentru a prognoza o serie, ci pentru a măsura dacă un activ se mișcă înaintea altuia. Aria Lévy, un termen de nivelul 2 al semnăturii, este un candidat natural, iar studiul o ilustrează pe date intraday SPY și Bitcoin.
Întrebarea este dacă un activ se mișcă înaintea altuia și dacă semnătura traiectoriei lor comune poate măsura acest lucru. Relațiile lead–lag arată pe ce piață apare mai întîi informația, o problemă de formare a prețului (price discovery). Bennett, Cucuringu și Reinert (2022, Machine Learning) construiesc o rețea orientată din relațiile lead–lag pe perechi și o împart în grupuri de lideri și urmăritori, folosind cele 434 de acțiuni de la New York Stock Exchange (NYSE) cu cel mai mare volum și randamentele zilnice din 2000–2019.
Una dintre măsurile pe care le compară este dublul ariei Lévy a traiectoriei logaritmilor normalizați ai prețurilor pe \([t-m, t]\):
Un \(S^{ij}\) pozitiv înseamnă că mișcările lui \(i\) sînt urmate de mișcări ale lui \(j\) în același sens. Spre deosebire de corelațiile încrucișate, (20.20) nu cere alegerea unui decalaj maxim, dar presupune o asociere pozitivă: nu poate distinge „\(i\) conduce, cu asociere negativă” de „\(j\) conduce, cu asociere pozitivă”.
Pe scurt
Întrebare: se mișcă un activ înaintea altuia, iar semnătura traiectoriei lor comune poate măsura acest lucru?
relațiile lead-lag arată pe ce piață apare mai întîi informația (descoperirea prețului, price discovery)
Rezultatele empirice ale articolului provin dintr-o altă măsură decît semnătura (secțiunile 5–6 ale versiunii publicate): aria de sub funcția de corelație încrucișată, cu corelația distanțelor, cu decalaje de pînă la 5 zile, și gruparea rețelei prin mers aleator hermitian (RW, random walk). Grupurile lead–lag sînt semnificative într-un test de permutare care amestecă ordinea zilelor; permutarea distruge atît dependența decalată dintre active, cît și autocorelația fiecărui activ, deci singură nu le separă.
În comparațiile autorilor, grupurile nu corespund sectoarelor din Standard Industrial Classification (SIC), iar corelațiile lor cu volumul și cu capitalizarea bursieră sînt mici. În secțiunea 6.3, semnalul construit pe aceste grupuri are o rată Sharpe anualizată de 0,62, față de 0,40 pentru S&P 500 în aceeași perioadă, ambele înaintea costurilor de tranzacționare. Slide-urile următoare ilustrează aria Lévy pe date intraday; nu replică procedura articolului.
Pe scurt
Rezultatele empirice ale articolului vin din altă metrică decît semnătura (versiunea publicată, secțiunile 5–6)
metrica: ccf-auc (aria de sub funcția de corelație încrucișată) cu corelația de distanță (distance correlation), cu laguri de pînă la 5 zile
gruparea rețelei: Hermitian RW (RW: mers aleator)
Grupurile lead-lag sînt semnificative la un test de permutare a ordinii zilelor
permutarea distruge atît dependența decalată dintre active, cît și autocorelarea fiecărui activ: singur, testul nu le separă
În comparațiile autorilor, grupurile nu coincid cu sectoarele SIC (Standard Industrial Classification)
corelațiile cu volumul și cu capitalizarea sînt mici
Cifrele articolului (secțiunea 6.3): semnalul construit pe aceste grupuri are un raport Sharpe anualizat de 0,62
S&P 500 are 0,40 în aceeași perioadă
ambele cifre sînt fără costuri de tranzacționare
Slide-urile următoare: o ilustrare a ariei Lévy pe date intraday, nu procedura din articol
Întrebare pentru sală Pe toate cele 489 de zile, care este cea mai lungă fereastră testată pentru care aria Lévy medie dintre SPY și Bitcoin este pozitivă și semnificativă la 5% după corecția Holm pentru cele 20 de teste?
Răspuns
120 de minute: t NW (Newey–West, standard errors, erori standard Newey–West) ≈ 3,05 și p ajustat Holm ≈ 0,032. La 195 de minute, t NW ≈ 2,45 trece pragul punctual 1,96, dar p ajustat este 0,157. Varianta 10 minute confundă fereastra cu semnalul cel mai puternic (t = 9,6, aria pozitivă în 70% din zile) cu cea mai lungă fereastră semnificativă; 195 de minute folosește pragul punctual în locul corecției. Pe întreaga sesiune, t = 1,51. Corelația dintre SPY la t − 1 și BTC (Bitcoin) la t este 0,088 (t NW = 9,8), iar în sens invers −0,005. Cele 20 de teste (12 lag-uri și 8 ferestre) sînt exploratorii, iar rezultatul indică o asociere lead-lag, nu cauzalitate. Efectul slăbește în 2026: corelația la lag-ul +1 scade la 0,04.
Datele sînt bare de cinci minute pentru SPY, fondul tranzacționat la bursă (ETF, exchange-traded fund) pe S&P 500, și pentru Bitcoin (BTC, în USD), ora New York-ului, 09:30–16:00, în cele 489 de zile cu toate cele 78 de bare pentru ambele active, din 513 zile comune, 3 septembrie 2024–18 septembrie 2026. Panoul din stînga arată media pe zile a corelației dintre randamentul SPY la \(t-l\) și randamentul BTC la \(t\), cu intervale punctuale de 95% din erorile standard Newey–West (NW). Panoul din dreapta arată statistica \(t\) NW a ariei Lévy zilnice medii a perechii (SPY, BTC), pentru ferestre de la 10 minute la întreaga ședință; linia de la 1,96 este un prag punctual.
Pe scurt
SPY (ETF-ul pe S&P 500; ETF: Exchange-Traded Fund) și Bitcoin (BTC, în USD): bare de 5 minute, ora New York, 09:30–16:00
489 de zile cu toate cele 78 de bare pentru ambele active (din 513 de zile comune), 3 sep. 2024 – 18 sep. 2026
Stînga: corelația medie pe zile dintre randamentul SPY la \(t - l\) și randamentul BTC la \(t\); barele: intervale de 95% punctuale, cu eroarea standard Newey-West (NW) a testelor
Dreapta: statistica \(t\) NW a mediei zilnice a ariei Lévy (SPY, BTC), pentru ferestre de la 10 minute pînă la întreaga sesiune; pragul 1,96 este punctual
Traiectoria fiecărei zile este formată din sumele cumulate ale randamentelor SPY și BTC, fiecare randament împărțit la abaterea standard a activului său în ziua respectivă, cum recomandă autorii, pentru că altfel aria crește cu volatilitatea. Cele 78 de randamente merg de la deschiderea barei de 09:30 la închiderea fiecărei bare de la 09:30 la 15:55. Aria Lévy a unei ferestre de \(m\) pași este o sumă de produse decalate ale randamentelor SPY \(x_i\) și BTC \(y_i\):
În (20.21) decalajul \(l\) apare de \(m-l\) ori, deci o fereastră de 2 pași, 10 minute, păstrează doar decalajul 1, în timp ce o fereastră lungă adaugă multe decalaje fără efect, adică zgomot. Statistica zilnică este aria medie pe toate ferestrele de \(m\) pași din zi, iar testul este \(t\) NW cu 8 laguri pe cele 489 de valori zilnice (Newey & West, 1987). Ilustrarea diferă de articol: două active în loc de 434, bare de cinci minute în loc de randamente zilnice și nicio grupare a rețelei sau semnal de tranzacționare.
Pe scurt
Traiectoria zilei: sumele cumulate ale randamentelor SPY și BTC, fiecare randament împărțit la abaterea standard a activului în acea zi
78 de randamente: de la deschiderea barei de 09:30 la închiderea fiecărei bare 09:30–15:55
normalizarea recomandată de autori: altfel aria crește odată cu volatilitatea
Aria Lévy a unei ferestre de \(m\) pași este o sumă de produse decalate ale randamentelor \(x_i\) (SPY) și \(y_i\) (BTC)
SPY se mișcă înaintea Bitcoin cu un pas de cinci minute. Corelația la decalajul +1 este 0,088 (\(t\) NW = 9,8), iar la decalajul −1 este −0,005 (\(t\) = −0,71); testul direct al direcției, diferența dintre ele, este 0,093 (\(t\) NW = 9,5). Corelația contemporană este 0,40, iar la decalajele +2 pînă la +6 corelațiile sînt mici și negative, între −0,016 și −0,004.
Măsura bazată pe semnătură găsește efectul doar în ferestre scurte. Cu ferestre de 10 minute, \(t\) = 9,6 și aria este pozitivă în 70% din zile; cu ferestre de 2 ore, \(t\) = 3,0; pe întreaga ședință de 390 de minute, \(t\) = 1,51, iar aria este pozitivă în 51% din zile. Analiza este exploratorie, cu 20 de teste (12 decalaje nenule și 8 ferestre): valoarea p ajustată Holm este 0,032 pentru fereastra de 2 ore și 0,157 pentru 195 de minute. Efectul slăbește în 2026: corelația la decalajul +1 este 0,11 în 2024, 0,12 în 2025 și 0,04 în ianuarie–septembrie 2026.
Pe scurt
SPY se mișcă înaintea Bitcoin cu un pas de 5 minute
corelația la lagul \(+1\) este 0,088 (\(t\) NW = 9,8), iar la lagul \(-1\) este \(-\)0,005 (\(t\) = \(-\)0,71)
testul direct al direcției: diferența dintre corelațiile la lagurile \(+1\) și \(-1\) este 0,093 (\(t\) NW = 9,5)
corelația contemporană este 0,40; la lagurile \(+2\) pînă la \(+6\) corelațiile sînt mici și negative (între \(-\)0,016 și \(-\)0,004)
Măsura de semnătură găsește efectul doar pe ferestre scurte
10 minute: \(t\) = 9,6, iar aria este pozitivă în 70% din zile
2 ore: \(t\) = 3,0; întreaga sesiune (390 de minute): \(t\) = 1,51, aria pozitivă în 51% din zile
Analiza este exploratorie: 20 de teste (12 laguri nenule și 8 ferestre)
\(p\) ajustat Holm: 0,032 pentru fereastra de 2 ore, 0,157 pentru 195 de minute
Efectul scade în 2026: corelația la lagul \(+1\) este 0,11 în 2024, 0,12 în 2025 și 0,04 în 2026 (ianuarie–septembrie)
Rezultatul susține o asociere lead–lag de cinci minute între două active, nu o relație cauzală și nu un semnal profitabil demonstrat, pentru că lipsesc costurile de tranzacționare și nu există nicio evaluare out-of-sample. Semnul ariei măsoară orientarea traiectoriei, iar citirea lui ca „SPY conduce” presupune o asociere pozitivă între cele două active.
Rămîn trei limite:
Un decalaj de un pas apare și din marcaje de timp nesincronizate ale celor două surse de date, iar separarea celor două explicații cere date tick cu tick.
Lungimea ferestrei \(m\) joacă rolul decalajului maxim, deci semnătura nu elimină această alegere.
Testul \(t\) NW cere momente finite și o dependență slabă a statisticii zilnice testate, corelații mărginite și arii normalizate, nu a randamentelor brute.
Pe scurt
Tipul de dovadă: o asociere lead-lag de 5 minute între două active, nu o relație cauzală și nici un semnal profitabil
fără costuri de tranzacționare și fără evaluare în afara eșantionului
Semnul ariei măsoară orientarea traiectoriei; citirea „SPY conduce” presupune o asociere pozitivă între cele două active
Limite
un decalaj de un singur pas apare și din marcaje de timp nesincronizate între cele două surse; separarea cere date tick
lungimea ferestrei \(m\) joacă rolul lagului maxim: semnătura nu elimină această alegere
testul \(t\) NW cere momente finite și dependență slabă pentru statistica zilnică testată (corelații mărginite, arii normalizate), nu pentru randamentele brute
Sinteza secțiunii
Aria Lévy detectează avansul de cinci minute al SPY față de Bitcoin doar cînd fereastra este scurtă, pentru că ferestrele mai lungi adaugă decalaje fără semnal. Lungimea ferestrei joacă rolul decalajului maxim dintr-o analiză de corelații, iar asocierea nu este un rezultat de tranzacționare.
AI pentru descoperire științifică
Capitolul este el însuși un studiu de transfer: o metodă dintr-un articol de conferință de data mining aplicată unei probleme de prognoză financiară. Secțiunea transformă acest lucru într-o întrebare generală, enunță criteriul unui transfer reușit și arată cum a fost aplicată bucla asistată de AI (Artificial Intelligence, inteligență artificială) și unde poate induce în eroare.
Cînd se transferă o metodă dintr-un domeniu în altul?
Metodele circulă mai repede decît dovezile: un articol de la conferința Knowledge Discovery and Data Mining (KDD) despre tarifele de transport devine un candidat pentru volatilitate, credit sau energie. Două întrebări decid dacă un transfer poate funcționa:
Ce proprietăți ale problemei-sursă au făcut metoda să funcționeze;
Dacă ținta le are.
Finanțele adaugă un filtru sever: la Menkveld et al. (2024), 164 de echipe care lucrează pe aceleași date diferă între ele mai mult decît sugerează erorile lor standard.
Criteriul este că un transfer reușește dacă cîștigul față de cel mai puternic reper simplu rezistă pe o mulțime preînregistrată \(\mathcal{S}\) de designuri, active și orizonturi, cu familia corectată. În acest capitol, \(\mathcal{S}\) înseamnă 50 de active, 3 orizonturi și 4 variante. Holm și BH au fost aplicate pe fiecare comparație și orizont, pe familii de 50 de active, iar variantele sînt raportate descriptiv, fără o corecție comună pe toate cele 600 de celule.
Pe scurt
Metodele circulă mai repede decît dovezile
un articol KDD despre tarife de transport devine candidat pentru aplicații în volatilitate, credit sau energie
Ce proprietăți ale problemei-sursă au făcut metoda să funcționeze?
164 de echipe care analizează aceleași date obțin estimări care diferă mai mult decît sugerează erorile lor standard
Criteriu: un transfer reușește dacă cîștigul față de cel mai puternic reper simplu rămîne valabil
pe o mulțime preînregistrată \(\mathcal{S}\) de specificații, active și orizonturi
cu o corecție pentru testarea multiplă aplicată familiei de teste
În acest capitol: \(\mathcal{S}\) = 50 de active \(\times\) 3 orizonturi \(\times\) 4 variante
Holm și BH s-au aplicat pe fiecare comparație și orizont (familii de 50 de active), iar variantele sînt raportate descriptiv, fără o corecție comună pe toate cele 600 de celule
La citire, un asistent enumeră fiecare ecuație, hiperparametru și reper al articolului și marchează ce nu este declarat, iar fiecare element se verifică în PDF.
La corespondență se decide, pentru fiecare componentă, dacă se transferă, ce trebuie schimbat și ce reper o izolează.
Preînregistrarea fixează ipotezele, grila, testele și corecția într-un document datat, înaintea primului rezultat; asistentul redactează, echipa decide fiecare număr.
Piesele sînt construite și testate: semnăturile se verifică pe identități, de exemplu nivelul 1 egal cu incrementul și identitatea lui Chen pe o traiectorie împărțită, nu comparînd cu o altă bibliotecă.
Grila este rulată și apoi atacată, cu Holm pe 50 de active și cu căutarea activului unic care ar produce un titlu înșelător.
Rezultatul nul se explică cu date (lista de verificare este în Anexă): aici, ponderi aproape egale din cauza invarianței la translație și termeni explozivi de nivelul 3 din cauza legăturii exponențiale.
Pe scurt
Citim: un asistent listează fiecare ecuație, hiperparametru și reper din articol (cereri)
marchează ce nu este publicat
fiecare element se verifică în PDF
Stabilim corespondența pentru fiecare componentă
dacă se transferă, ce trebuie schimbat și ce reper o izolează
Preînregistrăm: ipotezele, grila, testele și corecția, înaintea primului rezultat
sînt fixate într-un document datat
asistentul face ciorna, iar echipa decide fiecare cifră
Construim și testăm piesele: semnăturile față de identități, nu față de altă bibliotecă
nivelul 1 = incrementul, Chen pe o traiectorie împărțită
Rulăm grila, apoi o supunem unor teste de rezistență (cereri)
corecția Holm pe 50 de active
căutarea activului care ar da un titlu înșelător
Explicăm rezultatul nul (lista de verificări: Anexă)
aici ponderi plate (invarianța la translație)
și termeni explozivi de nivelul 3 (legătura exponențială)
ambele verificate cu date
Mini studiu de caz: trei interpretări ale acelorași rezultate
„Semnăturile depășesc HAR pe 12 din 50 de active” (orizont de o zi, DM brut) este adevărat, dar log-HAR singur depășește HAR pe 21, deci cîștigul aparține transformării logaritmice.
„Semnăturile îmbunătățesc prognozele de volatilitate pentru E-mini S&P 500” (ES, \(h = 1\), DM \(t = -2{,}91\) față de log-HAR) se bazează pe o celulă din 150 de celule activ–orizont; după Holm, 0 din 50 de active sînt semnificative la \(h = 1\) și niciunul la \(h = 5\) sau 22.
Titlul evaluării preînregistrate: „niciun avantaj robust față de log-HAR în specificația evaluată; mai slab la orizonturi mai lungi; niciun efect detectabil al ponderilor nucleului”.
Un asistent AI rugat să „găsească unde funcționează metoda” va produce primele două titluri; planul îl protejează pe al treilea. Rezultatul susține o comparație de proceduri: aceleași rulări citite fără corecție, pe o singură celulă sau după planul preînregistrat.
Pe scurt
„Semnăturile depășesc HAR pe 12 din 50 de active” (Sig-LK, orizont de o zi, DM necorectat)
Adevărat, dar log-HAR singur este superior lui HAR pe 21: cîștigul aparține transformării logaritmice
„Semnăturile îmbunătățesc prognozele de volatilitate pentru E-mini S&P 500”
ES, \(h = 1\), DM \(t = -2{,}91\) pentru Sig-LK față de log-HAR
O celulă din 150 de celule activ-orizont: după Holm, Sig-LK nu are niciun cîștig din 50 la \(h = 1\) și niciunul la \(h = 5, 22\)
Titlul rezultat din evaluarea preînregistrată:
„niciun avantaj robust față de log-HAR în specificația evaluată; mai slab la orizonturi mai lungi; niciun efect detectabil al ponderilor nucleului”
Un asistent AI (Artificial Intelligence, inteligență artificială) rugat să „găsească unde funcționează metoda” le va produce pe primele două; planul îl protejează pe al treilea
Tipul de dovadă: comparație între proceduri
aceleași rulări, citite fără corecție, pe o singură celulă sau după planul preînregistrat
Proiectul alege o direcție deschisă a capitolului, cum ar fi un nucleu sensibil la nivel, semnături intraday, log-semnături sau doar contractele futures, și scrie \(H_0\) și \(H_1\), reperul care izolează ideea și rezultatul care ar duce la abandonarea ei. Un asistent enumeră ce poate merge prost în design, iar fiecare element primește un test unitar.
Preînregistrarea se fixează într-un document datat înaintea primului număr out-of-sample; apoi se rulează grila și se raportează distribuția rezultatelor pe \(\mathcal{S}\). Fiecare eroare a asistentului AI depistată intră în `AI_ERRORS.md`; Seminarul 20, C1, dă exemple tipice.
Pe scurt
Alegeți o direcție deschisă din acest capitol
nucleu sensibil la nivel, semnături intraday, semnături logaritmice, doar futures
Scrieți \(H_0\)/\(H_1\), reperul care o izolează și rezultatul care v-ar face să renunțați la ea
Folosiți un asistent pentru a lista ce poate merge prost în studiul dumneavoastră
apoi scrieți un test unitar pentru fiecare element
Fixați preînregistrarea într-un document datat înaintea primului rezultat în afara eșantionului
Rulați grila și raportați distribuția rezultatelor pe \(\mathcal{S}\)
Documentați fiecare eroare AI detectată în AI_ERRORS.md (Seminarul 20, C1 dă erori tipice)
Semnăturile transformă o fereastră într-un vector de trăsături susținut de o teorie: identitatea lui Chen, unicitatea și universalitatea. Transferată la varianța realizată, metoda lui Gu et al. (2024) nu depășește log-HAR:
H1, ipoteza că semnăturile aduc informație, nu este susținută, fără cîștig la o zi și cu o pierdere la o săptămînă și la o lună.
H2, ipoteza că ponderile nucleului ajută, nu este susținută: ponderile sînt aproape egale și dau mai puțină greutate stresului trecut.
H3 este valabilă doar față de HAR în nivel, prin ținta logaritmică.
H4, cîștigurile în perioadele de stres, nu este susținută.
Două mecanisme explică rezultatul nul: nucleul invariant la translație vede forma, nu nivelul, iar termenii de nivelul 3 explodează în crahuri. Cel mai puternic efect din studiu este cel mai vechi, modelarea logaritmului RV. Rezultatul nul este informativ, pentru că ablațiile și mecanismul explică de ce metoda nu se transferă.
Pe scurt
Semnăturile transformă o fereastră într-un vector de trăsături cu fundament teoretic
identitatea lui Chen; unicitate și universalitate (detalii în Aprofundări)
Aplicată varianței realizate, metoda lui Gu et al. nu depășește log-HAR
H1 (semnăturile aduc informație) nu este susținută: niciun cîștig la o zi, iar la o săptămînă și la o lună termenii de nivelul 3 iau valori explozive în crahuri
H2 (ponderile nucleului ajută) nu este susținută: nucleul invariant la translație reflectă forma, nu nivelul, iar ponderile sînt aproape plate
H3 (metoda depășește familia HAR): doar HAR în nivel este depășit, iar cel mai puternic efect din studiu este cel mai vechi: modelați logaritmul RV
H4 (cîștiguri mai mari în perioadele de stres) nu este susținută
Rezultatul nul este informativ: ablațiile și mecanismul explică de ce metoda nu se transferă
Capitolul alege log-HAR pentru prognoza varianței realizate zilnice; metoda lui Gu et al. (2024), Sig-LK, nu îl înlocuiește. log-HAR face parte din MCS de 90% pentru 100%, 98% și 98% dintre active la \(h = 1\), 5 și 22, iar pe panel depășește HAR la fiecare orizont, cu \(t\) DM între −3,09 și −4,50.
Alegerea este valabilă în trei condiții:
QLIKE ca pierdere principală, cu ținta logaritmică și corecția de varianță \(\hat s^2/2\);
Estimare pe fereastră mobilă, reestimată la fiecare 5 zile pe ultimele 1 000 de perechi;
Un panel dominat de acțiuni, 40 din cele 50 de active.
Ar fi abandonată dacă un cîștig al Sig-L sau Sig-LK față de log-HAR ar rezista corecției Holm într-un studiu preînregistrat, de exemplu cîștigul Sig-L la futures pentru \(h = 1\), −3,5% în QLIKE, confirmat pe un panel mai lung.
Pe scurt
Ce aleg: log-HAR pentru prognoza varianței realizate zilnice; metoda lui Gu et al. (Sig-LK) nu îl înlocuiește
log-HAR este în MCS de 90% pentru 100%, 98% și 98% dintre active, la \(h = 1\), 5 și 22
pe panel, log-HAR bate HAR la fiecare orizont (DM \(t\) între \(-3{,}09\) și \(-4{,}50\))
În ce condiții
QLIKE ca pierdere principală, cu ținta în logaritmi și corecția de varianță \(\hat s^2/2\)
estimare pe fereastră mobilă, reestimată la fiecare 5 zile pe ultimele 1 000 de perechi
un panel dominat de acțiuni (40 din 50 de active)
Ce rezultat m-ar face să renunț
un cîștig al Sig-L sau Sig-LK față de log-HAR care rămîne după corecția Holm, într-un studiu preînregistrat
de exemplu, cîștigul Sig-L pe futures la \(h = 1\) (\(-3{,}5\%\) la QLIKE), confirmat pe un panel mai lung
Aprofundări
Aprofundările conțin contextul datelor, cele două rafinări ale HAR, teoria semnăturilor și detalii ale evaluării. Sînt lectură de familiarizare.
De ce RV la cinci minute și de unde provin datele?
Alternativele la varianța realizată (RV) la cinci minute includ variația bipower, robustă la salturi, nucleul realizat (realised kernel), robust la zgomot (Barndorff-Nielsen et al., 2008), și estimatorii bazați pe amplitudine, dar pe 400 de active puține măsuri depășesc RV la cinci minute ca aproximare a varianței zilnice (Liu, Patton & Sheppard, 2015). Semivarianțele și cvarticitatea ei se calculează pe aceeași grilă, deci SHAR și HARQ folosesc date de intrare coerente, iar toate modelele sînt evaluate pe aceeași țintă. VOLARE este construită la universitățile din Messina și Florența din date tick cu tick, cu aceiași estimatori pentru toate clasele de active (Cipollini et al., 2026); este gratuită pentru cercetare la volare.unime.it și nu este redistribuită cu acest curs.
RV măsoară varianța integrată cu eroare, \(\mathrm{RV}_t = \mathrm{IV}_t + \eta_t\) cu \(\mathrm{Var}(\eta_t) \approx 2\,\mathrm{IQ}_t/M\), iar erorile în variabile trag coeficientul zilnic \(\beta_d\) spre zero, cel mai mult în zilele zgomotoase. HARQ (Bollerslev, Patton & Quaedvlieg, 2016) face ca ponderea RV de ieri să depindă de rădăcina pătrată a cvarticității realizate:
cu \(\beta_Q < 0\) așteptat, astfel încît o zi zgomotoasă primește o pondere mai mică. Filtrul BPQ („insanity filter”) înlocuiește o prognoză aflată în afara intervalului din eșantion al țintei cu media din eșantion.
Pe scurt
RV este o măsurare cu eroare a varianței adevărate
\(\mathrm{RQ}_t^{1/2}\): rădăcina pătrată a cvarticității realizate, o măsură a erorii lui \(\RV_t\); \(\overline{\mathrm{RQ}^{1/2}}\): media ei în eșantion (in-sample), deci \(\beta_d\) este ponderea într-o zi obișnuită
Se așteaptă \(\beta_Q < 0\): într-o zi zgomotoasă (\(\mathrm{RQ}_t\) peste medie) RV de ieri primește o pondere mai mică
Filtrul BPQ (Bollerslev, Patton și Quaedvlieg), „insanity filter”
o prognoză în afara intervalului țintei în eșantion este înlocuită cu media în eșantion
SHAR (Patton & Sheppard, 2015) împarte termenul zilnic după semnul randamentelor intraday, \(\mathrm{RV}_{t+1:t+h} = \beta_0 + \beta^{+}\mathrm{RV}_t^{+} + \beta^{-}\mathrm{RV}_t^{-} + \beta_w\mathrm{RV}_t^{(w)} + \beta_m\mathrm{RV}_t^{(m)} + \varepsilon_{t+h}\), unde \(\mathrm{RV}_t^{+}\) și \(\mathrm{RV}_t^{-}\) sînt semivarianțele pozitivă și negativă; \(\beta^{+} = \beta^{-}\) redă HAR. Patton și Sheppard găsesc \(\beta^{-} > \beta^{+}\), o versiune intraday a efectului de levier (leverage effect, capitolul 5), iar semnătura poate capta un efect înrudit din date zilnice, prin aria Lévy dintre randamente și logaritmul RV.
Graficul desenează două ferestre JPM de 22 de zile ca traiectorii în planul randamentului cumulat deschidere–închidere și al logaritmului RV, cu coarda de la început la sfîrșit și aria Lévy hașurată. În fereastra calmă, pînă la 15 noiembrie 2019, logaritmul RV variază cu −0,58, iar aria Lévy este −0,011; în fereastra de stres, pînă la 16 martie 2020, logaritmul RV crește cu +4,32, adică RV se înmulțește cu 75, în timp ce traiectoria randamentului intraday scade și revine, iar aria Lévy este −0,247.
Pe scurt
Traiectoria pe 22 de zile are două canale
randamentul cumulat de la deschidere la închidere și log RV
coarda punctată unește începutul și sfîrșitul, iar zona hașurată dă aria Lévy
Fereastra calmă (pînă la 15 nov. 2019): traiectoria fluctuează fără direcție
Randamentul intraday net al ferestrei de stres este de doar +0,5%, pentru că prăbușirea s-a produs în mare parte peste noapte, în afara canalului deschidere–închidere. Niciun nivel al semnăturii nu recuperează ceea ce lipsește din datele de intrare.
Pe scurt
Fereastra de stres (pînă la 16 mar. 2020): randamentele intraday scad și apoi recuperează
log RV crește cu +4,32 (RV se înmulțește cu 75)
aria Lévy este -0,247 (randamente zecimale la calculul ariei, procente pe axă)
Randamentul intraday net este doar +0,5%
crahul s-a produs în mare parte peste noapte, în afara acestui canal
nicio adîncime a semnăturii nu poate recupera informația absentă din date
Prin teorema de unicitate a lui Hambly & Lyons (2010), semnătura completă determină traiectoria pînă la echivalența de tip arbore și la translație, iar cu un canal de timp strict crescător rămîne doar translația; o trunchiere finită nu este injectivă. Identitatea shuffle, de exemplu \(S^iS^j = S^{ij} + S^{ji}\), scrie produsele termenilor semnăturii ca sume de termeni superiori, deci un model liniar în semnătura trunchiată conține deja polinoame ale incrementelor.
Universalitatea afirmă că orice funcție continuă a traiectoriei pe o mulțime compactă \(K\) de traiectorii augmentate cu timpul este aproximată uniform de o funcțională liniară \(\langle \ell, \mathrm{Sig}(X)\rangle\) a semnăturii, consecință a teoremei Stone–Weierstrass prin identitatea shuffle. Aceasta permite aproximări neliniare la o adîncime suficientă, dar nu garantează nimic la adîncimea 3 sau out-of-sample. Descreșterea factorială, \(\|S^{(k)}\| \le \|X\|_{1\text{-var}}^k/k!\), face nivelurile înalte mici pentru traiectorii de lungime moderată.
Pe scurt
Universalitate: orice funcție continuă de traiectorie este aproximativ liniară în semnătură
rezultatul vine din Stone–Weierstrass, prin identitatea shuffle
\(K\): o mulțime compactă de traiectorii augmentate cu timpul, cu start comun (în topologia 1-variației); \(f: K \to \mathbb{R}\): o funcție continuă de traiectorie
\(\langle \ell, \Sig(X)\rangle\): o regresie liniară pe un număr finit de termeni ai semnăturii
O adîncime suficientă permite aproximarea neliniară, dar nu garantează precizia la adîncimea 3 sau în afara eșantionului
Costul este de \(d^N\) trăsături, deci este necesară o soluție cu puțini coeficienți nenuli
Descreștere factorială: nivelurile înalte sînt mici
\(\|X\|_{1\text{-var}}\): lungimea totală a traiectoriei; \(\|S^{(k)}\|\): norma euclidiană a nivelului \(k\)
termeni. Cu \(d = 3\) canale (timp, logaritmul RV, randament cumulat) și \(N = 3\) rezultă \(3 + 9 + 27 = 39\) de termeni, dintre care 3 sînt constanți și 36 variază; \(d = 5\) și \(N = 4\) ar da 780 de termeni pentru 1 000 de observații, prea mulți pentru o selecție LASSO stabilă. \(N = 3\) și \(L = 22\) sînt fixate dinainte, cu \(N = 2\) ca verificare de robustețe.
Pe scurt
Numărul de termeni din nivelurile \(1..N\) ale unei traiectorii \(d\)-dimensionale
o sumă geometrică, deoarece nivelul \(k\) are \(d^k\) cuvinte
Semnătura este invariantă la translație, \(\mathrm{Sig}(X + c) = \mathrm{Sig}(X)\), deci nivelul volatilității intră separat, prin termenii log-HAR, care joacă rolul factorilor externi de la Gu et al. (2024). Augmentarea cu punct de bază (Morrill et al., 2020) adaugă originea la începutul traiectoriei, ceea ce face termenii de ordin superior să depindă de nivelul absolut și semnătura sensibilă la nivel; translatarea traiectoriei ca să înceapă în 0 nu are acest efect, pentru că este ea însăși o translație. Fără un canal de timp, semnătura este invariantă și la reparametrizare, așa că aceeași mișcare parcursă cu viteze diferite are aceeași semnătură.
Pe scurt
Invarianța la translație: \(\Sig(X + v) = \Sig(X)\), deci contează doar incrementele
\(v \in \mathbb{R}^d\): orice vector constant
Semnătura nu reflectă nivelul volatilității, deci nivelul intră separat: termenii log-HAR joacă rolul factorilor externi \(x_\tau\) ai lui Gu et al.
Nivelul 1 devine \(X_{u_0} + (X_{u_{L-1}} - X_{u_0}) = X_{u_{L-1}}\): punctul de start nu apare separat, dar termenii de ordin superior depind de nivelul absolut (de exemplu \(\ln\RV\)), deci semnătura devine sensibilă la nivel
Translatarea traiectoriei ca să pornească din 0 nu are acest efect: este ea însăși o translație (Seminarul 20, C2 folosește segmentul adăugat la început)
Invarianța la reparametrizare: \(X_{\psi(u)}\), cu \(\psi\) crescătoare, are aceeași semnătură
fără canal de timp, două evoluții cu aceeași formă spațială, parcurse în ritmuri diferite, au aceeași semnătură
canalul de timp le distinge raportîndu-le la un ceas fix; traiectoria augmentată rămîne invariantă la reparametrizarea ei în ansamblu
\(u_i = i/(L-1)\) duce fiecare fereastră pe \([0, 1]\): durata absolută (22 față de 2 zile) cere timp fizic sau un regresor separat
În acest capitol: augmentare cu timpul, fără punct de bază
deci nucleul compară forme, nu niveluri
consecința apare la ponderile nucleului, în secțiunea Rezultate
Cu trei ferestre la distanțele \(\delta = (0{,}1;\ 0{,}4;\ 0{,}9)\) și \(\gamma = 2\), ponderile nenormalizate sînt \((0{,}819;\ 0{,}449;\ 0{,}165)\), cu suma 1,433, iar ponderile normalizate \(w = (0{,}571;\ 0{,}313;\ 0{,}115)\). Mărimea efectivă a eșantionului este \(n_{\mathrm{eff}} = 1/\sum w_i^2 \approx 2{,}28\), față de 3 la ponderi egale; \(\gamma\) acționează ca o temperatură inversă, deci un \(\gamma\) mai mare concentrează ponderile, cîștigînd asemănare și pierzînd informație.
Pe scurt
Distanțele \(\delta=(0{,}1;\ 0{,}4;\ 0{,}9)\) și \(\gamma=2\)
Ponderile nenormalizate: \((0{,}819;\ 0{,}449;\ 0{,}165)\), cu suma \(1{,}433\)
Diferența de pierderi \(d_t\) este autocorelată, prin țintele suprapuse pînă la decalajul \(h - 1\) și prin volatility clustering în pierderi, deci varianța simplă subestimează incertitudinea lui \(\bar d\). Estimatorul Newey–West consistent la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent) (Newey & West, 1987) este
cu \(\hat\gamma_j\) autocovarianța de selecție a lui \(d_t\) la decalajul \(j\); ponderile Bartlett garantează \(\hat\Omega \ge 0\), iar \(q = \max(h, \lceil T^{1/3}\rceil)\) laguri acoperă cel puțin suprapunerea.
Pe scurt
De ce nu varianța empirică simplă: \(d_t\) este autocorelată
ținte suprapuse pînă la lagul \(h - 1\), gruparea volatilității (volatility clustering) în pierderi
\(\hat\Gamma_0/T\) subestimează incertitudinea lui \(\bar d\) (și respinge prea des) cînd suma autocovarianțelor este pozitivă, cazul tipic al țintelor suprapuse
Estimatorul Newey–West Newey & West (1987), robust la heteroscedasticitate și autocorelare (HAC)
Holm compară trei valori p ordonate, \((0{,}004;\ 0{,}023;\ 0{,}08)\), pe rînd cu \((0{,}05/3;\ 0{,}05/2;\ 0{,}05)\): primele două trec, a treia nu, iar procedura se oprește. BH le compară cu \((0{,}05/3;\ 2\cdot0{,}05/3;\ 0{,}05)\) și păstrează cel mai mare rang care trece, tot două; într-o familie de 50 de teste aceleași valori p pot să nu mai treacă. Pentru o MCS cu modelele A, B și C și diferențe standardizate de pierdere de 2,4, −0,5 și −0,7, valoarea p bootstrap de 0,04 elimină A la 10%, retestarea lui B și C dă 0,30, iar amîndouă rămîn, ceea ce nu dovedește că pierderile lor în populație sînt egale.
Pe scurt
Holm compară trei valori \(p\) ordonate, \((0{,}004;\ 0{,}023;\ 0{,}08)\)
succesiv cu \((0{,}05/3;\ 0{,}05/2;\ 0{,}05)\)
primele două trec, a treia nu, deci ne oprim
BH le compară cu \((0{,}05/3;\ 2 \cdot 0{,}05/3;\ 0{,}05)\)
alege cel mai mare rang care trece: tot două
Într-o familie de 50 de teste, aceleași valori \(p\) pot să nu mai treacă
de aceea familia se fixează înaintea rezultatelor
MCS cu trei modele A, B și C
diferențele standardizate de pierdere: 2,4; \(-0{,}5\); \(-0{,}7\)
valoarea \(p\) bootstrap este 0,04, deci la 10% eliminăm A
Recalculăm testul doar pentru B și C
noua valoare \(p\) este 0,30, deci ne oprim și rămîn B și C
Faptul că testul nu le separă nu dovedește că pierderile lor în populație sînt egale
Acoperirea de 90% este o garanție pe eșantioane repetate
nu o probabilitate a posteriori pentru mulțimea obținută
Harta dă statisticile \(t\) DM ale diferenței QLIKE a Sig-LK pentru fiecare dintre cele 40 de acțiuni, 5 contracte futures și 5 perechi FX, albastru unde Sig-LK este mai precis și roșu unde este mai puțin precis. Față de log-HAR harta este palidă la \(h = 1\) și roșie la \(h = 5\) și 22, cu excepțiile albastre ES, Tesla (TSLA) și EURUSD și cu cinci active semnificativ roșii înainte de corecție; față de HAR este albastră la \(h = 1\), pentru că Sig-LK moștenește ținta logaritmică.
Pe scurt
Statisticile \(t\) Diebold–Mariano ale diferenței de QLIKE, cîte o coloană pentru fiecare activ
40 de acțiuni, 5 futures, 5 perechi FX
albastru: Sig-LK este mai precis; roșu: mai puțin precis
Față de log-HAR (sus): culori palide la \(h = 1\), iar la \(h = 5, 22\) predomină roșul
excepțiile albastre: ES, TSLA (Tesla) și EURUSD
cinci active semnificativ roșii înaintea corecției
Față de HAR (jos): albastru la \(h = 1\) pentru că Sig-LK moștenește ținta logaritmică
Graficul arată ponderea pe care Sig-LK (\(h = 1\)) o pune pe cele mai volatile 10% dintre zilele ferestrei de antrenare, mediată pe clase pe trei luni. Pentru acțiuni media este 6,7% pe reestimare, sub cei 10% ai ponderării egale, între 4,4% și 9,9% (maximum pe 17 martie 2020); la FX rămîne sub 10% tot timpul, iar la futures depășește acest prag doar la începutul lui 2016 (pînă la 11,7%) și în martie–aprilie 2020.
Pe scurt
Ponderea pe care Sig-LK (\(h = 1\)) o atribuie celor mai volatile 10% dintre zile
zilele din fereastra de antrenare
mediată pe clasă și pe intervale de trei luni
Pentru acțiuni, ponderea rămîne sub cele 10% date de ponderarea egală
la fiecare reestimare, media este 6,7%
variază între 4,4% și 9,9% (maximul pe 17 mar. 2020)
Pe toate activele și orizonturile, LASSO, cu suportul ales prin BIC, păstrează cei trei termeni log-HAR în 99%, 94% și 93% dintre reestimări, deci redescoperă HAR. Suportul mediu are 8,7 regresori pentru Sig-L și 6,7 pentru Sig-LK.
Pe scurt
Proporția reestimărilor în care un regresor face parte din suportul ales prin BIC pentru Sig-LK
pe toate activele și orizonturile
etichete: HAR day/week/month = cei trei termeni log-HAR, t = timp, ln RV = \(\ln\RV\), r = randament cumulat
LASSO redescoperă HAR
termenii log-HAR zilnic, săptămînal și lunar sînt păstrați în 99%, 94% și, respectiv, 93% dintre reestimări
Suportul mediu are 8,7 regresori pentru Sig-L și 6,7 pentru Sig-LK
Cel mai frecvent termen al semnăturii, (t, r, r), ales în 27% dintre reestimări, și toți termenii frecvenți sînt de nivelul 3, cubici în incremente. Într-un crah ei ajung mult în afara intervalului din antrenare și sînt amplificați de legătura exponențială \(\exp(\cdot)\).
Pe scurt
Cel mai frecvent termen al semnăturii este (t,r,r) (în 27% dintre reestimări)
toți termenii frecvenți sînt de nivelul 3
Fiind cubici în incremente, într-un crah ajung mult în afara intervalului de antrenare
Graficul compară Sig-LK relativ la HAR, ca medie pe cele 50 de active, în designul principal, în două variante preînregistrate și cu filtrul BPQ; linia de referință marchează log-HAR, iar o bară sub 1 înseamnă o prognoză mai precisă decît HAR.
Pe scurt
Sig-LK relativ la HAR (media pe 50 de active)
în specificația principală
în două variante preînregistrate
cu filtrul BPQ (abaterea declarată)
Linia de referință marchează log-HAR, iar o bară sub 1 înseamnă o prognoză mai precisă decît HAR
La adîncimea 2, rapoartele la \(h = 5\) și 22 scad de la 1,104 și 1,334 în designul principal la 0,922 și 0,820, iar fără canalul randamentelor la 0,878 și 0,770, aproape de log-HAR (0,871 și 0,765). Ablațiile sugerează că eșecurile la orizonturi lungi sînt legate de termenii de nivelul 3 care conțin canalul randamentelor, deși eliminarea unor termeni schimbă și selecția, distanțele nucleului și ponderile. Ambele variante reduc instabilitatea; niciuna nu susține H1.
Pe scurt
Cu adîncimea 2, rapoartele sînt 0,922 la \(h = 5\) și 0,820 la \(h = 22\)
față de 1,104 și 1,334 în specificația principală
Fără canalul randamentelor: 0,878 la \(h = 5\) și 0,770 la \(h = 22\)
ablațiile sugerează că eșecurile la orizont lung sînt legate de termenii care conțin canalul randamentelor
Adîncimea 2 le reduce și ea: ablațiile sugerează un rol al termenilor de nivelul 3
eliminarea unor termeni schimbă însă și selecția, distanțele nucleului și ponderile
La \(h = 5\) și \(h = 22\), varianta fără randamente se apropie de log-HAR (0,871, 0,765)
adîncimea 2 rămîne inferioară
Ambele variante reduc instabilitatea, fără a confirma H1
Anexa conține detaliile trăsăturilor, ale estimării, ale perioadelor de evaluare și ale temperaturilor alese, metrica articolului pe datele VOLARE, rezultatele filtrate, lista de verificări a cercetătorului și cererile din bucla descoperirii.
Regresorii din ziua \(\tau\) sînt cei trei termeni log-HAR și cei 39 de termeni ai semnăturii de adîncime 3 a traiectoriei de 22 de puncte (timp, \(\ln\mathrm{RV}\), randament cumulat). Fiecare canal care nu este timpul se înmulțește cu \(\kappa_q = 1/(s_q\sqrt{L-1})\), unde \(s_q\) este abaterea standard a incrementelor lui zilnice în fereastra de antrenare, astfel încît mișcarea lui totală tipică pe fereastră este de aproximativ 1; timpul merge de la 0 la 1, un cuvînt se rescalează cu produsul factorilor săi, fiecare coloană se standardizează cu momente ponderate, iar coloanele constante sînt eliminate.
Fiecare canal \(q\) (altul decît timpul) se înmulțește cu \(\kappa_q = 1/(s_q\sqrt{L - 1})\)
astfel încît deplasarea lui totală tipică pe fereastră este aproximativ 1
\(s_q\): abaterea standard a incrementelor zilnice ale canalului \(q\), de la începutul ferestrei de antrenare pînă la originea \(t\) (\(W + h\) zile, \(W\): lungimea ferestrei de antrenare)
\(L - 1 = 21\): numărul de incremente dintr-o traiectorie, folosit doar în factorul \(\sqrt{L - 1}\)
Timpul nu se rescalează (incremente constante) și ia valori de la 0 la 1
Înaintea LASSO fiecare coloană este standardizată cu momentele ponderate ale ferestrei de antrenare
coloanele constante se elimină
coloane constante: cuvintele formate doar din litera timpului
Variabilele brute din \(\tau\) folosesc date pînă la \(\tau\)
scalele și standardizarea folosesc date pînă la originea \(t\)
Estimare: alegerea lui \(\lambda\) fără deplasarea de anticipare
În fiecare fereastră de antrenare se calculează întreaga traiectorie LASSO ponderată prin regresia cu unghi minim (LARS, least-angle regression), fiecare suport de pe traiectorie se reestimează prin OLS ponderat (pasul 2 de la Gu et al. (2024)), iar suportul care minimizează
este cel ales, cu \(\hat s^2_S\) varianța reziduală ponderată. Validarea încrucișată ar fi prea costisitoare pe 50 de active, 3 orizonturi și sute de reestimări; mărimea Kish \(n_{\mathrm{eff}}\) corectează pentru ponderile inegale, dar nu și pentru dependența serială, deci (20.25) este o euristică a designului, nu un BIC bazat pe verosimilitate.
Pe scurt
În fiecare fereastră de antrenare: întreaga traiectorie de regularizare LASSO ponderată, prin LARS
Pentru fiecare suport de pe traiectorie: reestimare OLS ponderată (pasul 2 din Gu et al.)
Alegem suportul care minimizează un criteriu de tip BIC
\(S\): un suport (mulțimea regresorilor păstrați), cu mărimea \(|S|\) (\(+1\) pentru constantă); \(\hat s^2_S\): varianța reziduală ponderată a reestimării pe \(S\)
Validarea încrucișată ar cere 50 de active \(\times\) 3 orizonturi \(\times\) sute de reestimări
în timp ce BIC folosește doar fereastra
Mărimea Kish corectează ponderile inegale, nu dependența serială (ținte suprapuse, \(h > 1\)), deci criteriul nu este un BIC bazat pe verosimilitate pentru aceste date
Evaluarea începe pe 27 ianuarie 2020 pentru acțiuni, pe 25 septembrie 2014 pentru futures și pe 27 august 2014 pentru FX și se termină pe 29 ianuarie 2026, cu lungimi mediane de 1 499, 2 919 și 2 952 de zile pe activ. Fiecare model produce 265 929 de prognoze pe cele trei orizonturi: 89 893 la \(h = 1\), 89 293 la \(h = 5\) și 86 743 la \(h = 22\). Pentru că datele acțiunilor încep în 2015, crahul COVID-19 se află în fiecare eșantion de evaluare al acțiunilor.
Pe scurt
Clasa
Evaluarea începe
Se termină
Zile pe activ (mediana)
Acțiuni
27 ian. 2020
29 ian. 2026
1 499
Futures
25 sept. 2014
29 ian. 2026
2 919
FX
27 aug. 2014
29 ian. 2026
2 952
265 929 de prognoze pentru fiecare model, pe cele trei orizonturi
Temperatura nucleului \(c\) se alege din grila {0,5; 1; 2; 4} pe blocul de validare al fiecărei clase și al fiecărui orizont. Pentru Sig-LK este 0,5 pentru acțiuni la toate orizonturile, 2,0, 1,0 și 0,5 pentru futures și 0,5, 2,0 și 0,5 pentru FX; log-HAR-K folosește cea mai mare valoare, 4,0, pentru futures la \(h = 22\) și pentru FX la \(h = 1\) și 22.
Pe scurt
Sig-LK
log-HAR-K
Clasa
\(h = 1\)
\(h = 5\)
\(h = 22\)
\(h = 1\)
\(h = 5\)
\(h = 22\)
Acțiuni
0,5
0,5
0,5
0,5
0,5
1,0
Futures
2,0
1,0
0,5
2,0
1,0
4,0
FX
0,5
2,0
0,5
4,0
2,0
4,0
Valoarea lui \(c\) din grila \(\{0{,}5; 1; 2; 4\}\)
aleasă pe blocul de validare al fiecărei clase și al fiecărui orizont
Pe metrica articolului, mediana pe active a erorii relative medii \(|\mathrm{RV} - F|/\mathrm{RV}\), log-HAR are 50,4%, 41,9% și 38,7% la \(h = 1\), 5 și 22, față de 57,2%, 48,9% și 51,7% pentru HAR, 50,1%, 42,6% și 42,6% pentru Sig-L și 50,6%, 43,6% și 43,7% pentru Sig-LK.
Pe scurt
Mediana erorilor medii pe active \(|\RV - F|/\RV\) (%)
\(h = 1\)
\(h = 5\)
\(h = 22\)
HAR
57,2
48,9
51,7
log-HAR
50,4
41,9
38,7
HARQ
55,0
49,0
50,7
SHAR
57,9
49,2
51,8
log-HAR-K
49,7
41,0
38,7
Sig-L
50,1
42,6
42,6
Sig-LK
50,6
43,6
43,7
Mediana pe active a erorii relative medii: aproximativ 40–60%
față de 1–2% pentru tarifele de transport la Gu et al.
RV zilnică este o țintă zgomotoasă, cu cozi groase
modelele evaluate au erori relative mult mai mari decît cele raportate pentru tarifele de transport
aceasta nu stabilește o limită inferioară a erorii posibile
Numărul prognozelor Sig-LK care depășesc de zece ori maximul în eșantion: 8 la \(h = 1\), 29 la \(h = 5\) (concentrate pe 10 active) și 36 la \(h = 22\)
Cu filtrul BPQ aplicat tuturor modelelor, rapoartele QLIKE față de HAR la \(h = 1\), 5 și 22 sînt 0,763, 0,654 și 0,778 pentru log-HAR, 0,995, 0,912 și 1,014 pentru HARQ, 0,871, 0,819 și 0,904 pentru Sig-L și 0,890, 0,867 și 0,930 pentru Sig-LK. Filtrul salvează HARQ, dar log-HAR păstrează cea mai mică pierdere la fiecare orizont.
Pe scurt
QLIKE relativ la HAR, filtrul BPQ pe toate modelele
\(h = 1\)
\(h = 5\)
\(h = 22\)
HAR
1,000
1,000
1,000
log-HAR
0,763
0,654
0,778
HARQ
0,995
0,912
1,014
SHAR
1,014
1,003
1,000
log-HAR-K
0,772
0,659
0,779
Sig-L
0,871
0,819
0,904
Sig-LK
0,890
0,867
0,930
Filtrul îmbunătățește HARQ față de HAR, așa cum au urmărit Bollerslev, Patton și Quaedvlieg
0,995 la \(h = 1\) în loc de 1,140
Sig-LK relativ la log-HAR, ambele filtrate: 1,238 la \(h = 1\), 1,424 la \(h = 5\) și 1,209 la \(h = 22\)
Cu filtru, distanța crește la \(h = 1, 5\) și scade la \(h = 22\)
Filtrul se aplică modelelor cu semnături mult mai des decît lui log-HAR
prognoze înlocuite la \(h = 1\) (din 89 893): HAR 180, HARQ 140, Sig-LK 143, log-HAR 29
Metoda trebuie să fie cea a articolului, fiecare componentă trimițînd la ecuația, tabelul sau secțiunea din care provine, iar alegerile nedeclarate fiind marcate ca alegeri ale studiului.
Nu trebuie să existe look-ahead: schimbarea tuturor valorilor de după origine, de exemplu înmulțirea RV viitoare cu 10, trebuie să lase prognoza neschimbată.
Reperul trebuie să izoleze ideea, prin ablația 2 × 2.
Pierderile și testele trebuie să aibă sensul corect, cu \(\mathrm{QL}(\mathrm{RV}, \mathrm{RV}) = 0\) și o varianță HAC cu lățimea de bandă de cel puțin \(h\).
Pe scurt
Metoda este cea din articol: nucleul, ponderile, reestimarea, ca în ecuațiile citate
Test: fiecare componentă a metodei indică ecuația, tabelul sau secțiunea articolului din care provine, iar deciziile nepublicate sînt marcate ca alegeri ale studiului
Fără deplasarea de anticipare (look-ahead bias): \(\lambda\), scalele, \(c\) și trăsăturile folosesc doar date disponibile la origine
Test: dacă modificați orice valoare de după origine (de exemplu, înmulțiți RV viitoare cu 10), prognoza făcută la origine nu trebuie să se schimbe
Reperul izolează ideea: ablația \(2 \times 2\) este raportată, nu doar modelul complet față de HAR
Funcțiile de pierdere și testele sînt aplicate corect: \(\QL(\RV, \RV) = 0\) și \(\QL(\RV, F) > 0\) în rest
Varianța DM este HAC, cu lățimea de bandă (bandwidth) de cel puțin \(h\)
Cererea de citire îi cere asistentului să enumere fiecare ecuație a estimatorului lui Gu et al. (2024), fiecare hiperparametru cu valoarea raportată și reperul fiecărui tabel, marcînd ce nu este declarat, iar fiecare element se verifică în PDF. Cererea de corespondență întreabă, pentru varianța realizată zilnică, dacă fiecare componentă se transferă, ce trebuie schimbat și ce reper o izolează; preînregistrarea se fixează apoi într-un document datat, semnat de echipă înaintea primului rezultat.
Pe scurt
Citim: extragem exact ce a făcut articolul
„Din Gu et al. (2024, KDD), listează fiecare ecuație a estimatorului, fiecare hiperparametru și valoarea raportată și reperul fiecărui tabel. Marchează ce nu este publicat.”
Verificați fiecare element în PDF: numerele ecuațiilor, ale tabelelor, nucleul folosit efectiv
Stabilim corespondența: ce se transferă, ce trebuie adaptat
„Ținta noastră este varianța realizată zilnică. Pentru fiecare componentă a metodei, spune dacă se transferă, ce trebuie schimbat și ce reper o izolează.”
Preînregistrăm: ipoteze, grilă, teste, corecție
fixate într-un document datat și semnat de echipă înaintea primului rezultat
Cererea de testare cere teste unitare pentru o semnătură de adîncime 3: nivelul 1 egal cu incrementul, partea simetrică a nivelului 2 egală cu jumătate din produsul exterior și identitatea lui Chen pe o traiectorie împărțită. Cererea de atac dă toate cele 600 de rulări, 50 de active, 3 orizonturi și 4 specificații, și întreabă ce concluzii rezistă la Holm pe 50 de active și ce activ sau subperioadă unică ar produce un titlu înșelător; ultimul pas explică rezultatul nul prin mecanismul lui, nu printr-o scuză.
Pe scurt
Construim și testăm piesele: semnăturile față de identități, nu față de altă bibliotecă
„Scrie teste unitare pentru o semnătură de adîncime 3: nivelul 1 egal cu incrementul, partea simetrică a nivelului 2 egală cu jumătate din produsul exterior, identitatea lui Chen pe o traiectorie împărțită.”
Rulăm grila, apoi o supunem unor teste de rezistență
„Iată toate cele 600 de rulări (50 de active \(\times\) 3 orizonturi \(\times\) 4 specificații: principală, adîncimea 2, fără canalul randamentelor, filtrul BPQ). Ce concluzii rămîn valabile după corecția Holm pe 50 de active? Ce activ sau ce subperioadă ar da un titlu înșelător?”
Explicăm rezultatul nul: identificăm mecanismul, nu o justificare
BIC: Bayesian Information Criterion — criteriul informațional bayesian
BPQ: Bollerslev–Patton–Quaedvlieg (insanity filter of the HARQ paper) — Bollerslev–Patton–Quaedvlieg (filtrul din articolul HARQ)
CAD: Canadian Dollar (ISO 4217 code) — dolarul canadian (cod ISO 4217)
CL: Crude oil (WTI light sweet) futures, NYMEX (New York Mercantile Exchange, bursa de mărfuri din New York) ticker — contractul futures pe petrol (WTI), simbolul NYMEX
COVID-19: COronaVIrus Disease 2019 — boala provocată de coronavirus, 2019
DM: Diebold–Mariano (test) — testul Diebold–Mariano de comparare a prognozelor
Barndorff-Nielsen, O.E., Kinnebrock, S., Shephard, N. (2010). Measuring downside risk: realised semivariance. In Volatility and Time Series Econometrics, Oxford University Press, 117–136.
Menkveld, A.J., Dreber, A., Holzmeister, F., Huber, J., Johannesson, M., Kirchler, M., et al. (2024). Nonstandard errors. Journal of Finance, 79(3), 2339–2390.
Varianța realizată din baza de date VOLARE (Cipollini et al., 2026): 40 de acțiuni americane (2015–2026), 5 futures și 5 perechi valutare (2009–2026), randamente de 5 minute. Datele VOLARE sînt licențiate pentru cercetare și nu se redistribuie; aici apar doar rezumate: pierderile medii și valorile p ale MCS pe fiecare activ, ponderile și distanțele nucleului, medii pe cinci zile ale volatilității pentru cele șase active din slide (o valoare pe săptămînă) și prognozele JPM din februarie–mai 2020. Studiul de caz lead-lag folosește barele de 5 minute ale SPY și Bitcoin (EODHD, data/market/intraday): corelațiile încrucișate și ariile Lévy medii ale fiecărei zile.


 Terry Lyons.
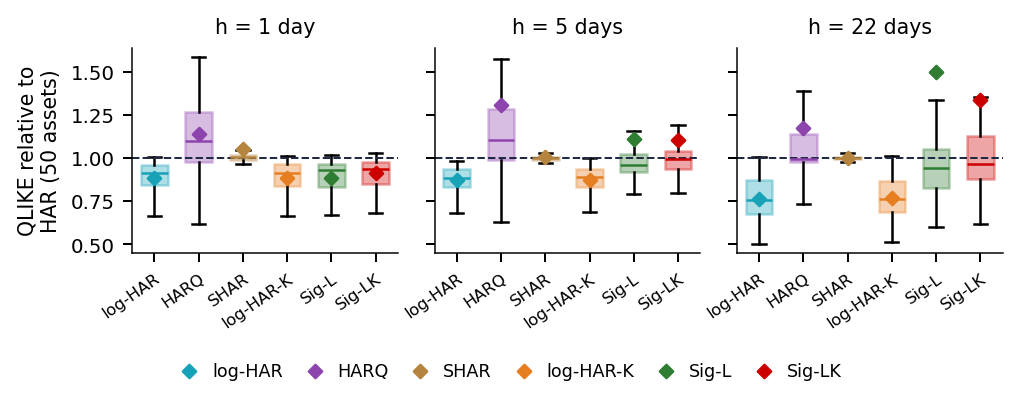
 MFM_ch20_case_study
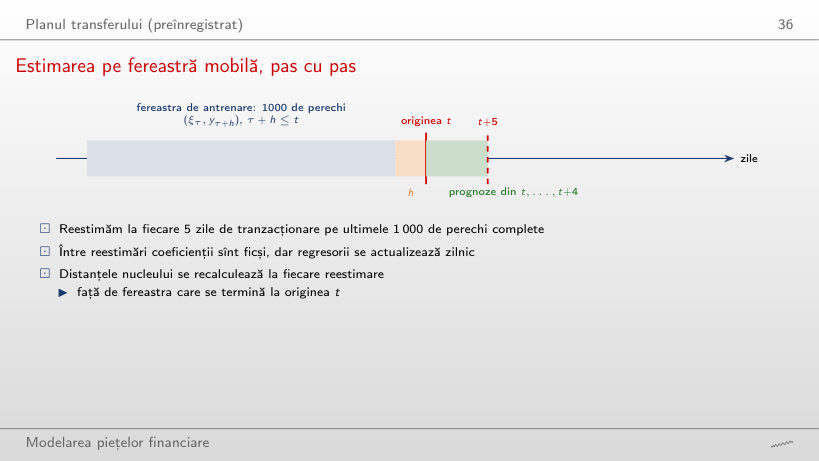
 Statistics of Financial Markets