Capitolul 2: Eficiența pieței — de la EMH la piețe adaptive
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Pot prețurile trecute și informațiile publice să prezică randamentele?
“A market in which prices always ‘fully reflect’ available information is called ‘efficient.’ ” — Fama (1970)
Autocorelația de lag 1 a randamentelor zilnice: \(-0{,}099\) la S&P 500 (Standard & Poor's) și \(0{,}109\) la BET (Bucharest Exchange Trading, indicele de referință al Bursei de Valori București), ambele semnificative
Bitcoin: \(-0{,}022\), în banda de test robustă, deci nu respingem \(\rho_1 = 0\)
Randamentul de ieri explică \(0{,}98\%\) din dispersia randamentului de azi la S&P 500 și \(1{,}19\%\) la BET
Raportul dividend–preț, 680 de prognoze lunare pentru S&P 500: \(R^2\) în afara eșantionului (out-of-sample) \(= -0{,}51\%\)
prognoza este mai slabă decît media istorică
Din 2 000 de reguli de tranzacționare aleatoare, \(5{,}2\%\) sînt „semnificative” la 5%
cea mai bună are \(|t| = 3{,}30\), deși este pur hazard
Întrebarea capitolului este dacă prețurile trecute, știrile sau alte informații publice pot prezice randamentele, după ajustarea la risc și la costuri. Definiția lui Fama (1970) depinde de mulțimea de informații: forma slabă a eficienței privește prețurile și randamentele trecute, forma semi-tare toată informația publică, iar forma tare și informația privilegiată. Orice test are nevoie și de un model al randamentului așteptat, deci o respingere nu dovedește singură ineficiența: aceasta este problema ipotezei comune (joint hypothesis problem).
Pe 16 serii de randamente logaritmice zilnice, autocorelația de lag 1 este pozitivă și semnificativă la BET (0,109), IPC (0,071), Nifty 50 (0,048) și EUR (euro, moneda euro)/RON (0,170) și negativă și semnificativă la S&P 500 (Standard & Poor's) (−0,099). Pentru Bitcoin (−0,022) și Ethereum (−0,012), ea rămîne în banda de test robustă. Efectul este mic: randamentul de ieri explică 0,98% din dispersia randamentului de azi la S&P 500 și 1,19% la BET. Mecanismele propuse, tranzacționarea rară, regimul de managed float și reacția excesivă, nu sînt testate aici.
Prognozele out-of-sample și testarea multiplă cer aceeași prudență. Cu raportul dividend–preț, cele 680 de prognoze lunare pentru S&P 500 au un \(R^2\) out-of-sample de −0,51%, iar testul Clark–West dă \(t = 0{,}42\), deci nu respingem lipsa predictibilității. Dintre 2 000 de reguli de tranzacționare aleatoare, 5,2% sînt „semnificative” la 5%, cît prevede nivelul testului, iar cea mai bună are \(|t| = 3{,}30\), deși este pur hazard. Numărul de reguli încercate contează la fel de mult ca pragul ales.
Autocorelația de lag 1, \(\hat\rho_1\), a randamentelor logaritmice zilnice pe 16 piețe, fiecare pe tot eșantionul ei: barele sînt intervalele de încredere de 95% cu erori standard HAC (heteroskedasticity and autocorrelation consistent), banda deschisă este banda de test robustă în jurul lui 0, iar liniuțele marchează banda i.i.d. Graficul interactiv: „Autocorelația de ordinul 1 pe piețe (1/3)” →
Rezultatele învățării
Derivați restricțiile random walk și variance ratio-ul din autocorelații.
Calculați autocorelația de lag 1 și variance ratio-ul cu erori standard robuste.
Calculați\(R^2\) out-of-sample și testul Clark–West.
Calculați randamentul anormal cumulat într-un studiu de eveniment.
Interpretați o anomalie după corecția Holm.
Aprofundările și Anexele sînt lectură pentru familiarizare.
Randamente și informațieEficiența și mulțimea de informații, problema ipotezei comune și modelele random walk RW1 (Random Walk 1, i.i.d. increments, mersul aleator 1, creșteri i.i.d.)–RW3 (Random Walk 3, uncorrelated increments, mersul aleator 3, creșteri necorelate).
AI pentru descoperire științificăDevine o piață mai eficientă după lansarea ETF-urilor (Exchange-Traded Fund, fond tranzacționat la bursă) spot Bitcoin? Ministudiu de caz și temă de proiect.
Capitolul întreabă dacă prețurile trecute, știrile sau alte informații publice pot prognoza randamentele după ajustarea la risc și la costuri. Secțiunile 1–5 conțin materia de bază și se încheie fiecare cu o scurtă verificare și cu răspunsurile ei. Temele pentru studiu suplimentar dau apoi demonstrațiile, celelalte teste și temele de proiect; exemplele detaliate și subiectele avansate sînt în Aprofundări, după sinteză.
derivați restricțiile mersului aleator (random walk) și raportul varianțelor (variance ratio) din autocorelații
calculați autocorelația de lag 1 și raportul varianțelor cu erori standard robuste
calculați \(R^2\) în afara eșantionului și testul Clark–West
calculați randamentul anormal cumulat într-un studiu de eveniment
interpretați o anomalie după corecția Holm
Aprofundări și Anexa: lectură pentru familiarizare
Randamente și informație
Secțiunea dă un sens precis afirmației „prețurile trecute nu conțin informație”. Eficiența pieței se definește în raport cu o mulțime de informații (information set), iar formele slabă, semi-tare și tare diferă prin ce conține această mulțime. Orice test de eficiență are nevoie și de un model al randamentelor așteptate, deci o respingere este întotdeauna o respingere comună. Secțiunea prezintă apoi modelul random walk al log-prețurilor și cele trei variante ale lui, RW1, RW2 (Random Walk 2, independent increments, mersul aleator 2, creșteri independente) și RW3, care diferă doar prin ce presupun despre șocuri, și arată pe serii simulate de ce contează, pentru randamente, diferența dintre corelația zero și independență.
Random walk-ul are trei variante, de la cea mai restrictivă la cea mai slabă:
RW1 (Random Walk 1) presupune variații independente și identic distribuite;
RW2 păstrează independența, dar permite ca distribuția să se schimbe în timp;
RW3 cere doar ca variațiile să fie necorelate, deci ele pot rămîne dependente.
Întrebarea secțiunii este ce înseamnă, precis, că prețurile trecute nu conțin informație despre randamentele viitoare.
Varianta contează pentru testare. Un test construit sub RW1 poate respinge doar pentru că volatilitatea variază în timp, deși variațiile rămîn necorelate. A doua dificultate nu depinde de variantă: orice test are nevoie și de un model al randamentului așteptat, deci o respingere nu dovedește singură că piața este ineficientă.
Pe scurt
RW1: Random Walk 1 — mers aleator cu variații independente și identic distribuite.
RW2: Random Walk 2 — mers aleator cu variații independente, fără cerința unei distribuții identice.
RW3: Random Walk 3 — mers aleator cu variații necorelate, care pot fi dependente.
Întrebarea: ce înseamnă, precis, că prețurile trecute nu conțin informație?
informație despre randamentele viitoare
Contează ce variantă de mers aleator testăm.
Un test construit sub RW1 poate respinge doar pentru că volatilitatea variază în timp.
Orice test are nevoie și de un model al randamentului așteptat.
Deci o respingere nu dovedește singură ineficiența.
O serie de prețuri reală printre mersuri aleatoare simulate (1/2)
Întrebare pentru sală Una dintre cele patru serii este S&P 500 între 2010 și 2026, celelalte trei sînt random walks cu același drift și aceeași volatilitate. În toate patru apar trenduri și scăderi puternice. Ce putem deduce doar din prezența acestor tipare?
Răspuns
Un random walk cu drift poate produce trenduri, iar inovațiile din distribuția Normală pot produce și variații mari. Aceste trăsături vizuale nu constituie singure o respingere statistică. Seria reală este D; recunoașterea ei nu dovedește predictibilitatea randamentelor. De aceea testăm eficiența cu statistici, nu prin inspecție vizuală.
Graficul arată patru traiectorii de preț. Una dintre ele este S&P 500 (Standard & Poor's 500), indicele acțiunilor a 500 de companii mari din Statele Unite; celelalte trei sînt random walks simulate. Cititorul alege seria reală înainte ca răspunsul să fie dat pe slide-ul următor.
În versiunea interactivă, cursorul mută ziua de tranzacționare de-a lungul celor patru traiectorii, iar lista arată seria reală. Butonul „Alte random walks” generează trei traiectorii simulate noi, astfel încît jocul poate fi reluat cu alte imagini.
Pe scurt
S&P 500: Standard & Poor's 500 — indice al acțiunilor a 500 de companii mari din Statele Unite. MFM_ch2_random_walk_game
O serie de prețuri reală printre mersuri aleatoare simulate (2/2)
Seria reală este panoul D. Scopul jocului nu este ghicirea ei: Roberts (1959) a arătat că random walk-urile simulate produc „tipare” din întîmplare, trenduri și scăderi puternice pe care ochiul le citește ca structură. Inspecția vizuală nu poate deci separa o piață de un random walk, iar capitolul se bazează pe teste statistice.
Argumentul economic vine de la Bachelier (1900) și Samuelson (1965): prețurile anticipate corect variază aleator. Dacă toată informația despre fluxurile de numerar viitoare este deja în prețul de azi, variația următoare a prețului reflectă doar știri, care nu pot fi anticipate. Imprevizibilitatea este atunci semnul unei piețe care funcționează bine, nu al uneia dezordonate.
Pe scurt
Care panou este S&P 500? Votați: A, B, C sau D?
<2-> Răspuns: D.
<2-> Roberts (1959): mersurile aleatoare simulate produc „tipare” din întîmplare
<2-> Avem nevoie de teste statistice, nu doar de inspecție vizuală
Fama (1970) numește o piață eficientă dacă prețurile „reflectă complet” toată informația disponibilă \(\mathcal{I}_t\); aceasta este ipoteza pieței eficiente (EMH, Efficient Market Hypothesis). Formal, nicio strategie bazată pe \(\mathcal{I}_t\) nu obține randamente așteptate peste randamentul de echilibru, ajustat la risc. Definiția se referă la randamente așteptate: o strategie poate avea noroc într-un eșantion dat fără să contrazică eficiența.
Definiția depinde de ce conține \(\mathcal{I}_t\). În forma slabă (weak form), mulțimea conține prețurile și randamentele trecute, iar testele tipice sînt autocorelațiile și variance ratio-ul, cu testele runs și de memorie lungă în anexă. În forma semi-tare (semi-strong form), ea conține toată informația publică, de exemplu știri și rapoarte, iar testul tipic este studiul de eveniment. În forma tare (strong form), ea conține și informația privată, a persoanelor din interior, iar testele privesc randamentele acestora și ale administratorilor de fonduri.
Cele trei forme sînt incluse una în alta. Forma tare implică forma semi-tare, iar aceasta implică forma slabă, deoarece fiecare mulțime de informații o conține pe cea precedentă. Ajustarea randamentelor la risc cu modele factoriale, de care are nevoie randamentul de echilibru, este subiectul Capitolului 3.
Pe scurt
Fama (1970): o piață este eficientă dacă prețurile „reflectă complet” toată informația disponibilă \(\mathcal{I}_t\)
„Randamentul de echilibru” din definiția eficienței cere un model al randamentelor așteptate, de exemplu Capital Asset Pricing Model (CAPM) din Capitolul 3, care leagă randamentul cerut de expunerea la riscul pieței. Orice test de eficiență este de aceea un test comun al eficienței și al modelului de evaluare (Fama, 1991): problema ipotezei comune (joint-hypothesis problem). O respingere poate însemna că piața este ineficientă sau că modelul de risc este greșit. Randamentele așteptate predictibile sînt permise într-o piață eficientă dacă ele compensează un risc variabil în timp.
Problema este cea mai mică la orizonturi scurte. La orizont zilnic randamentele așteptate sînt foarte mici, deci alegerea modelului contează puțin, iar testele formei slabe pe date zilnice depind cel mai puțin de model. Logica testării limitează și concluzia: un test nu poate demonstra eficiența pieței, poate doar să nu o respingă pe datele date.
Pe scurt
CAPM: Capital Asset Pricing Model — model care leagă randamentul cerut de expunerea la riscul pieței.
Pentru a stabili „randamentul de echilibru” avem nevoie de un model al randamentelor așteptate
„Trecutul nu conține informație” poate însemna două lucruri diferite: corelație zero sau independență. Autocorelația la lag \(k\) este corelația dintre un randament și randamentul de acum \(k\) perioade. Corelația zero exclude asocierea liniară dintre cele două, dar poate lăsa dependență între funcții neliniare ale randamentelor, de exemplu între pătratele lor.
Un exemplu ipotetic arată diferența. Fie \(X\) cu valorile \(-2, -1, 1, 2\), la fel de probabile, și \(Y = X^2\). Atunci \(\mathbb{E}[X] = 0\) și \(\mathbb{E}[XY] = (-8-1+1+8)/4 = 0\), deci covarianța și corelația sînt zero. Totuși, dacă știm \(X\), știm exact \(Y\): variabilele sînt cît se poate de dependente. Pentru randamente, analogul este o serie ale cărei niveluri sînt necorelate, în timp ce mărimile variațiilor, măsurate prin pătratele randamentelor, sînt dependente.
Fie \(P_t\) nivelul indicelui la închiderea zilei \(t\) și \(p_t = \ln P_t\) log-prețul. Random walk-ul cu drift este
\[p_t = \mu + p_{t-1} + \varepsilon_t,\]
(2.1)
unde \(\mu\) este drift-ul, creșterea medie pe zi, iar \(\varepsilon_t\) este șocul zilei, cu media zero și dispersia \(\sigma^2\). Prin substituții repetate, \(p_t = p_0 + \mu t + \sum_{s=1}^{t}\varepsilon_s\): log-prețul este un trend liniar plus suma tuturor șocurilor trecute. Echivalent, randamentul logaritmic este \(r_t = p_t - p_{t-1} = \mu + \varepsilon_t\).
Cu mulțimea de informații \(\mathcal{I}_t = \{p_t, p_{t-1}, \dots\}\), cea mai bună prognoză a log-prețului viitor este \(\mathbb{E}[p_{t+h} \mid \mathcal{I}_t] = p_t + \mu h\), prețul de azi plus drift-ul. Ea este valabilă dacă șocurile au media condiționată zero, \(\mathbb{E}[\varepsilon_{t+1} \mid \mathcal{I}_t] = 0\). Autocorelațiile nule (RW3) nu ajung: sub RW3 trecutul este, în general, inutil doar pentru prognoza liniară, iar o funcție neliniară a trecutului poate încă ajuta.
Dacă șocurile sînt necorelate, cu dispersia \(\sigma^2\), dispersia variației pe \(h\) zile este \(\mathrm{Var}(p_{t+h} - p_t) = h\,\sigma^2\): ea crește liniar cu orizontul. Această proprietate stă la baza variance ratio-ului din secțiunea 2. RW1, RW2 și RW3 diferă doar prin ce presupun despre șocurile \(\varepsilon_t\)(Campbell, Lo & MacKinlay, 1997).
Cele trei variante ale random walk-ului se deosebesc prin condiția impusă șocurilor:
Sub RW1, șocurile sînt independente și identic distribuite (i.i.d., independent and identically distributed), cu media 0 și dispersia \(\sigma^2\); un model ilustrativ este \(r_t = \mu + 0{,}01 z_t\), cu \(z_t\) i.i.d. cu distribuția Normală standard \(N(0,1)\).
Sub RW2, șocurile sînt independente, dar dispersia lor \(\sigma_t^2\) poate varia în timp; ilustrarea este \(r_t = \mu + \sigma_t z_t\), cu \(\sigma_t\) egal cu 1% și apoi 3%, fixat dinainte.
Sub RW3 se cere doar \(\mathrm{Cov}(\varepsilon_t, \varepsilon_{t-k}) = 0\) pentru orice \(k \ge 1\).
Exemplul de RW3 folosit în tot capitolul este modelul GARCH (Generalized AutoRegressive Conditional Heteroskedasticity), un model al dispersiei condiționate explicate prin șocuri și dispersii trecute,
în forma GARCH(1,1), cu \(\omega > 0\) și \(\alpha, \beta \ge 0\). Dispersia de azi depinde de pătratul șocului de ieri și de dispersia de ieri.
Variantele sînt incluse una în alta. RW1 implică RW2, deoarece randamentele i.i.d. sînt în particular independente; RW2 implică RW3, deoarece randamentele independente sînt în particular necorelate, dacă dispersia lor există. Un model GARCH păstrează corelația zero, dar încalcă RW2: mărimea variației de azi depinde de șocurile trecute. Iar RW3 nu garantează că media de mîine este imprevizibilă, deoarece o funcție neliniară a trecutului o poate prognoza.
Pe scurt
i.i.d.: independent and identically distributed — independente și identic distribuite.
Graficul arată trei serii simulate cu media zero, cîte una pentru fiecare variantă a random walk-ului: sus randamentele zilnice, jos abaterea standard condiționată (SD, standard deviation) folosită la simulare. Volatilitatea RW2 este fixată dinainte, 1% și apoi 3% de la mijlocul eșantionului, iar volatilitatea GARCH răspunde șocurilor trecute.
În versiunea interactivă, cursoarele fixează parametrii GARCH \(\alpha\), reacția la șocul de ieri, și \(\beta\), persistența dispersiei, precum și volatilitatea RW2 după ziua 450. Butonul ▶ modifică parametrul pas cu pas.
Întrebare pentru sală RW2 are randamente independente, cu abaterea standard 1% pînă la ziua 450 și 3% după; GARCH are perioade agitate după șocurile mari. Ce kurtosis are RW2 în această simulare?
Răspuns
Clar peste 3: 4,8, față de 3,0 pentru RW1 și 4,1 pentru GARCH. Amestecul unei perioade calme cu una agitată dă cozi groase fără nicio dependență, deci nici graficul randamentelor, nici kurtosis-ul nu deosebesc RW2 de GARCH. Diferența este alta: în RW2 volatilitatea crește la o dată fixată dinainte, iar randamentele rămîn independente; în GARCH volatilitatea de azi depinde de șocul de ieri (α = 0,08) și de volatilitatea de ieri (β = 0,90), deci randamentele sînt dependente.
Seria GARCH prezintă volatility clustering: variațiile mari tind să fie urmate de variații mari. Și seria RW2 are o perioadă agitată, deși randamentele ei sînt independente. Graficul singur nu deosebește deci o schimbare de regim fixată dinainte de volatility clustering; diferența stă în faptul că volatilitatea depinde sau nu de șocurile trecute.
Pe scurt
SD: Standard Deviation — abaterea standard a observațiilor.
Trei serii simulate, cu media zero.
Sus: randamentele zilnice; jos: abaterea standard condiționată folosită la simulare.
Volatilitatea RW2 este fixată dinainte, iar cea GARCH răspunde șocurilor trecute.
RW2: 1% apoi 3%, de la mijlocul eșantionului.
Gruparea volatilității (volatility clustering): variațiile mari tind să fie urmate de variații mari.
Și seria RW2 are o perioadă agitată, deși randamentele ei sînt independente.
Graficul singur nu deosebește o schimbare de regim fixată dinainte de gruparea volatilității.
Graficul compară două funcții de autocorelație ale aceleiași serii GARCH simulate. În stînga sînt autocorelațiile randamentelor, în dreapta cele ale pătratelor randamentelor, la laguri pînă la 20.
În versiunea interactivă, cursoarele fixează \(\alpha\) și \(\beta\), iar lista fixează lungimea \(T\) a seriei, de la 900 la 10 000 de zile.
Întrebare pentru sală Păstrăm β = 0,90 și seria de 900 de zile. Cînd α crește de la 0,08 la 0,095, cum se schimbă autocorelația empirică de lag 1 a pătratelor randamentelor?
Răspuns
Crește: în această simulare, autocorelația empirică trece de la 0,216 la 0,272. Dispersia pe termen lung egală cu 1 nu fixează dependența pătratelor. La α = 0,095, expresia 3α² + 2αβ + β² este 1,0081: momentul de ordin patru al modelului staționar nu există, deci ACF (AutoCorrelation Function, funcția de autocorelație) teoretică a pătratelor nu este definită. ACF empirică a seriei finite poate fi calculată în continuare. La α = 0, randamentele sînt independente: autocorelația empirică a pătratelor este 0,049 la lagul 1, iar între lagurile 1–20 coboară pînă la −0,050. Pentru α > 0, seria respectă RW3, dar încalcă RW2: mărimea variației de azi depinde de șocurile trecute.
Autocorelațiile randamentelor sînt aproape zero la toate lagurile, cum cere RW3. Autocorelațiile pătratelor sînt pozitive pînă la lagul 20: o zi cu variație mare este urmată de alte zile cu variații mari. Este exemplul ipotetic al corelației zero cu dependență, de data aceasta într-un model al randamentelor.
Pe scurt
Stînga: autocorelațiile randamentelor GARCH simulate sînt aproape zero la toate lagurile.
Dreapta: autocorelațiile pătratelor sînt pozitive pînă la lagul 20.
O zi cu variație mare este urmată de alte zile cu variații mari.
Cele trei întrebări verifică distincțiile secțiunii: între RW1 și RW2, între autocorelația zero și independență și între respingerea unui test și dovada ineficienței.
Pe scurt
Pot randamentele rămîne independente dacă abaterea lor standard trece de la 1% la 3%?
la o dată fixată dinainte
Autocorelația zero dovedește independența?
De ce respingerea unui test de eficiență nu dovedește, singură, că piața este ineficientă?
Randamentele pot rămîne independente cînd abaterea lor standard trece de la 1% la 3% la o dată fixată dinainte: seria respectă RW2, dar încalcă RW1, deoarece distribuția nu mai este identică în timp. Autocorelația zero nu dovedește independența; în exemplul GARCH randamentele sînt necorelate, iar pătratele lor sînt dependente. În sfîrșit, o respingere nu dovedește singură ineficiența, deoarece orice test de eficiență testează și modelul randamentului așteptat, iar un model de risc greșit poate produce respingerea.
Pe scurt
Da. Seria respectă RW2, dar încalcă RW1, deoarece distribuția nu mai este identică.
Nu. În exemplul GARCH, autocorelația randamentelor este zero, dar pătratele lor sînt dependente.
Orice test de eficiență testează și modelul randamentului așteptat.
Respingerea poate veni dintr-un model de risc greșit (problema ipotezei comune).
Sinteza secțiunii
Eficiența este o afirmație despre o mulțime de informații și despre randamentele așteptate și poate fi testată doar împreună cu un model de risc. Pentru forma slabă, cele trei variante ale random walk-ului separă corelația zero de independență: RW3, cea mai slabă, permite volatility clustering-ul observat în randamente. Secțiunea următoare testează RW3 cu autocorelații și cu variance ratio, folosind erori standard care rămîn valabile și în prezența acestui clustering.
Autocorelație și raportul varianțelor
Secțiunea testează forma slabă pe 16 serii zilnice: 13 indici bursieri, Bitcoin, Ethereum și cursul de referință EUR/RON. Prima statistică este autocorelația de lag 1, a doua variance ratio-ul, care cumulează autocorelațiile pînă la un orizont de \(q\) zile. Ambele sînt testate cu erori standard valabile și cînd volatilitatea se grupează, iar multiplicitatea orizonturilor este tratată cu testul Chow–Denning.
Întrebarea secțiunii este dacă randamentul de azi prognozează randamentul de mîine pe piețele de acțiuni, crypto și valutare. Autocorelația de lag 1, \(\rho_1\), măsoară dependența liniară dintre două zile consecutive, iar variance ratio-ul cumulează autocorelațiile pînă la orizontul \(q\).
Piețele sînt 13 indici bursieri, dezvoltați și emergenți, inclusiv BET, împreună cu Bitcoin, Ethereum și cursul de referință EUR/RON. Selecția include piețe unde predictibilitatea are mai multe șanse: acolo unde lichiditatea este mică, ca la BET și la criptoactive, sau unde cursul este administrat, ca la EUR/RON. Toate eșantioanele se termină la 18 septembrie 2026. Seriile de acțiuni încep în ianuarie 2000, EUR/RON în iulie 2005, Bitcoin în septembrie 2014 și Ethereum în ianuarie 2016.
Pe scurt
Întrebarea: prezice randamentul de azi randamentul de mîine?
pe piețele de acțiuni, criptoactive și valutare
Autocorelația de lag 1, \(\rho_1\), măsoară dependența liniară dintre două zile consecutive.
Raportul varianțelor cumulează autocorelațiile pînă la orizontul \(q\).
Piețele: 13 indici bursieri, Bitcoin, Ethereum și cursul de referință euro/leu (EUR/RON).
Indici dezvoltați și emergenți, inclusiv BET.
De ce această selecție: predictibilitatea are mai multe șanse pe unele piețe.
Acolo unde lichiditatea este mică (BET, criptoactive).
Sau unde cursul este administrat (EUR/RON).
Eșantioanele: toate pînă la 18 septembrie 2026.
Acțiuni din ianuarie 2000, EUR/RON din iulie 2005.
Bitcoin din septembrie 2014 și Ethereum din ianuarie 2016.
Graficul arată, pentru fiecare dintre cele 16 piețe, autocorelația de lag 1, \(\hat\rho_1\), a randamentelor logaritmice zilnice pe tot eșantionul, cu intervalul ei de încredere de 95%. În jurul lui zero, două benzi servesc la testare: banda de test robustă și banda mai îngustă care ar rezulta din randamente i.i.d. Slide-ul următor explică cum sînt construite și cum se citesc.
În versiunea interactivă, cursorul schimbă lagul \(k\) de la 1 la 10, iar butonul ▶ parcurge lagurile.
Întrebare pentru sală Într-un exemplu ipotetic, autocorelația estimată este −0,040, eroarea standard i.i.d. este 0,012, iar cea robustă sub H₀ este 0,027. Cu pragul bilateral asimptotic 1,96, ce test respinge H₀: ρ₁ = 0?
Răspuns
Doar testul cu eroarea i.i.d. Cu eroarea i.i.d., |z| = 0,040/0,012 = 3,33; cu cea robustă, |z| = 0,040/0,027 = 1,48. Decizia depinde de raportul dintre estimație și eroarea standard, nu doar de mărimea autocorelației. Pentru S&P 500, ρ̂₁ = −0,099 rămîne în afara ambelor benzi de test, cu aceleași erori standard (0,027 robustă, 0,012 i.i.d.); la Euro Stoxx 50 sau Nikkei 225, ρ̂₁ iese din banda i.i.d., dar rămîne în cea robustă. Barele din jurul estimațiilor sînt intervale de încredere cu eroarea HAC a estimatorului (S&P 500: 0,030); ele servesc la comparații, nu la testul ρ₁ = 0.
Regula de citire compară fiecare punct cu banda robustă, nu cu banda i.i.d. și nu cu intervalul de încredere. Piețele ale căror puncte ies din banda robustă sînt enumerate pe al treilea slide.
Fiecare punct este autocorelația de lag 1, \(\hat\rho_1\), a randamentelor logaritmice zilnice ale unei piețe. Bara colorată este intervalul de încredere de 95% \(\hat\rho_1 \pm 1{,}96\,\mathrm{SE}_{\mathrm{HAC}}\), unde \(\mathrm{SE}_{\mathrm{HAC}}\) este eroarea standard (SE, standard error) a estimatorului, consistentă la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent), valabilă și cînd \(\rho_1 \neq 0\). Banda deschisă este banda de test robustă \(0 \pm 1{,}96\,\mathrm{SE}_0\), unde \(\mathrm{SE}_0\) este calculată sub ipoteza nulă \(H_0\) a unei medii imprevizibile. Liniuțele marchează banda i.i.d. \(0 \pm 1{,}96/\sqrt{T}\), unde \(T\) este numărul de randamente zilnice.
Testul și intervalul răspund la întrebări diferite și pot da verdicte diferite. Respingem \(\rho_1 = 0\) la 5% dacă punctul iese din banda de test robustă. La Nikkei 225 și PX, intervalul HAC exclude 0, dar \(\hat\rho_1\) rămîne în banda de test, deci nu respingem.
Banda i.i.d. este prea îngustă cînd volatilitatea se grupează. La toate cele 16 serii, \(\mathrm{SE}_0\) depășește valoarea i.i.d.; la S&P 500, cu \(T = 6\,717\) randamente zilnice, ea este 0,027, față de 0,012. Abrevierile BIST (Borsa İstanbul, BIST 100 index, Bursa din Istanbul, indicele BIST 100), WIG20 (Warszawski Indeks Giełdowy 20, indicele celor mai mari 20 de companii de la Bursa din Varșovia), BUX (Budapesti Értéktőzsde index, indicele Bursei din Budapesta), PX, IPC și BET desemnează indicii burselor din Istanbul, Varșovia, Budapesta, Praga, Mexic și București, iar FX (foreign exchange) desemnează cursul de referință EUR/RON.
Pe scurt
SE: Standard Error — eroare standard; HAC: Heteroskedasticity and Autocorrelation Consistent — consistent la heteroscedasticitate și autocorelație; CI: Confidence Interval — interval de încredere.
Fiecare punct este autocorelația de lag 1, \(\hat\rho_1\), a unei piețe.
Randamente logaritmice zilnice, pe tot eșantionul ei.
Bara colorată este intervalul de încredere de 95% \(\hat\rho_1 \pm 1{,}96\,\text{SE}_{\text{HAC}}\).
\(\text{SE}_{\text{HAC}}\): eroarea standard HAC a estimatorului, valabilă și cînd \(\rho_1 \neq 0\) (formula).
Banda deschisă este banda de test robustă \(0 \pm 1{,}96\,\text{SE}_0\); liniuțele marchează banda i.i.d. \(0 \pm 1{,}96/\sqrt{T}\).
\(\text{SE}_0\): calculată sub \(H_0\) (medie imprevizibilă), Construcția testelor; \(T\): numărul de randamente zilnice.
Regula de citire: respingem \(\rho_1 = 0\) la 5% dacă punctul iese din banda de test robustă.
Nikkei 225 și PX (Prague Stock Exchange index, indicele Bursei din Praga): intervalul HAC exclude 0, dar \(\hat\rho_1\) rămîne în banda de test, deci nu respingem.
La toate cele 16 serii, \(\text{SE}_0\) depășește valoarea i.i.d.; la S&P 500 (\(T = 6\,717\)) este \(0{,}027\), față de \(0{,}012\).
BIST (Borsa İstanbul, indicele BIST 100), WIG20 (Warszawski Indeks Giełdowy 20, cele mai mari 20 de companii), BUX (Budapesti Értéktőzsde index), PX, IPC (Índice de Precios y Cotizaciones) și BET sînt indicii burselor din Istanbul, Varșovia, Budapesta, Praga, Mexic și București.
FX este piața valutară (cursul de referință EUR/RON).
Patru serii au autocorelații pozitive și semnificative: BET (\(\hat\rho_1 = 0{,}109\)), IPC (0,071), Nifty 50 (0,048) și EUR/RON (0,170). S&P 500 are o autocorelație negativă și semnificativă, \(\hat\rho_1 = -0{,}099\). La Bitcoin (\(-0{,}022\)) și Ethereum (\(-0{,}012\)), estimațiile rămîn în banda de test robustă, deci nu respingem \(\rho_1 = 0\).
Slide-ul propune cîte un mecanism pentru fiecare rezultat. La BET, persistența poate proveni din tranzacționarea rară a unor acțiuni, ale căror prețuri încorporează știrile cu întîrziere. La EUR/RON, ea poate proveni din regimul de managed float, în care banca centrală netezește variațiile cursului. La S&P 500, inversarea poate proveni din reacția excesivă pe termen scurt și din furnizarea de lichiditate. Aceste mecanisme nu sînt testate aici: rezultatul susține o descriere.
Efectele sînt și mici. Pătratul \(\hat\rho_1^2\), partea din dispersia randamentului de azi explicată de randamentul de ieri, este 0,98% la S&P 500 și 1,19% la BET. Ambele erori standard robuste presupun un moment de ordin patru finit al randamentelor, ipoteză pusă sub semnul întrebării în Capitolul 1.
Pe scurt
BET (\(\hat\rho_1 = 0{,}109\)), IPC (\(0{,}071\)), Nifty 50 (\(0{,}048\)) și EUR/RON (\(0{,}170\)): pozitive și semnificative.
S&P 500: \(\hat\rho_1 = -0{,}099\), negativă și semnificativă.
Bitcoin (\(-0{,}022\)) și Ethereum (\(-0{,}012\)): în banda de test robustă, deci nu respingem \(\rho_1 = 0\).
La BET, persistența poate proveni din tranzacționarea rară a unor acțiuni.
Prețurile lor încorporează știrile cu întîrziere.
La EUR/RON, ea poate proveni din regimul de flotare administrată (managed float).
În acest regim, banca centrală netezește variațiile cursului.
La S&P 500, inversarea poate proveni din reacția excesivă pe termen scurt și din furnizarea de lichiditate.
Efectul este mic: \(\hat\rho_1^2\) este \(0{,}98\%\) la S&P 500 și \(1{,}19\%\) la BET.
Este partea din dispersia randamentului de azi explicată de randamentul de ieri.
Ambele erori standard robuste presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1.
Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei).
Autocorelația de lag 1 privește un singur lag. Autocorelații mici la multe laguri pot trece fiecare testul și totuși se pot cumula pe orizonturi mai lungi. Variance ratio-ul (VR) al lui Lo & MacKinlay (1988) măsoară această cumulare. Pe un orizont de \(q\) zile,
adică dispersia randamentului pe \(q\) zile împărțită la \(q\) ori dispersia randamentului zilnic; \(q = 5\) este o săptămînă de tranzacționare. Fără autocorelație, dispersia crește liniar cu orizontul, ca în modelul random walk, iar \(\mathrm{VR}(q) = 1\). Estimația \(\widehat{\mathrm{VR}}(q)\) tinde la 1 și cînd volatilitatea variază în timp, ca sub RW2 și RW3.
Pentru o serie staționară în covarianță, raportul este o sumă ponderată a autocorelațiilor,
cu ponderi care scad cu lagul \(k\). O valoare \(\mathrm{VR}(q) > 1\) indică persistență, o valoare sub 1 inversare (mean reversion). Pentru \(q = 2\),(2.4) dă \(\mathrm{VR}(2) = 1 + \rho_1\): la S&P 500, \(1 - 0{,}099 = 0{,}901\), egal cu \(\widehat{\mathrm{VR}}(2)\) estimat direct din (2.3).
Pe scurt
VR: Variance Ratio — raportul dintre dispersia randamentului pe q zile și q ori dispersia randamentului pe o zi.
De ce încă un test: \(\hat\rho_1\) privește un singur lag.
Autocorelații mici la multe laguri pot trece fiecare testul.
Dar se cumulează pe orizonturi mai lungi.
Raportul varianțelor pe orizontul de \(q\) zile Lo & MacKinlay (1988): \(\text{VR}(q) = \dfrac{\Var(r_t + \dots + r_{t-q+1})}{q\,\Var(r_t)}\).
Egal cu 1 fără autocorelație.
\(q = 5\): o săptămînă de tranzacționare.
Fără autocorelație, \(\widehat{\text{VR}}(q)\) tinde la 1 și cînd volatilitatea variază în timp (RW2, RW3).
Pentru o serie staționară în covarianță, \(\text{VR}(q) = 1 + 2 \sum_{k=1}^{q-1} \big(1 - \tfrac{k}{q}\big) \rho_k\).
O sumă ponderată a autocorelațiilor, cu ponderi care scad cu lagul \(k\).
Testul variance ratio-ului folosește o bandă centrată în 1, valoarea sub ipoteza nulă. Cu \(T\) randamente zilnice, null band-ul robust de 95% este
\[1 \pm 1{,}96\sqrt{\hat\theta(q)/T},\]
(2.5)
unde \(\hat\theta(q)\) este dispersia estimată a lui \(\sqrt{T}\,(\widehat{\mathrm{VR}}(q) - 1)\), robustă la heteroscedasticitate. Dacă \(\widehat{\mathrm{VR}}(q)\) cade în afara benzii, respingem ipoteza nulă la 5%.
Null band-ul nu este un interval de încredere: un interval de încredere ar fi centrat în estimația \(\widehat{\mathrm{VR}}(q)\), nu în 1. Lățimea lui răspunde la două trăsături ale datelor. Cînd variațiile mari urmează altor variații mari (volatility clustering), \(\hat\theta(q)\) crește și banda se lărgește. \(\hat\theta(q)\) crește și cu \(q\), deci banda se lărgește la orizonturi lungi, deoarece un eșantion conține mai puține perioade independente de \(q\) zile.
Pe scurt
Banda robustă de 95% sub ipoteza nulă (null band), ca banda de test de la \(\hat\rho_1\), este centrată în 1, valoarea sub \(H_0\).
Dacă \(\widehat{\text{VR}}(q)\) cade în afara lui, respingem ipoteza nulă la 5%.
Banda sub ipoteza nulă nu este un interval de încredere.
Un interval de încredere ar fi centrat în estimația \(\widehat{\text{VR}}(q)\), nu în 1.
Banda robustă sub ipoteza nulă este \(1 \pm 1{,}96\sqrt{\hat\theta(q)/T}\) (Construcția testelor).
\(T\): numărul de randamente zilnice.
\(\hat\theta(q)\): dispersia estimată a lui \(\sqrt{T}\,(\widehat{\text{VR}}(q) - 1)\), robustă la heteroscedasticitate.
Cînd volatilitatea se grupează, \(\hat\theta(q)\) crește și banda sub ipoteza nulă se lărgește.
Gruparea volatilității: variațiile mari urmează altor variații mari.
\(\hat\theta(q)\) crește și cu \(q\), deci banda sub ipoteza nulă se lărgește la orizonturi lungi.
Un eșantion conține mai puține perioade independente de \(q\) zile.
Inversarea sau persistența pot apărea la o zi, la o săptămînă sau la o lună, iar dinainte nu știm la care. Capitolul testează patru orizonturi, \(q = 2, 5, 10, 20\) zile de tranzacționare: două zile, aproximativ o săptămînă, două săptămîni și o lună bursieră. Alegerea urmează Lo & MacKinlay (1988), care folosesc \(q = 2, 4, 8, 16\) pe date săptămînale; alte orizonturi pot da alt rezultat.
Null band-ul robust (2.5) are nivelul 5% la fiecare orizont separat. Cu patru teste, o respingere falsă apare mai des decît în 5% din cazuri. Testul Chow–Denning (Chow & Denning, 1993) corectează acest lucru folosind cea mai mare statistică robustă \(|z^*(q)|\) dintre cele patru orizonturi, cu valoarea critică 2,49 în loc de 1,96.
Cu această corecție, testul respinge RW3 pentru 5 din cele 16 serii, printre care BET și S&P 500. Pentru Bitcoin nu respinge RW3 (p-value 0,835). Ca și testul autocorelației, \(z^*\) și testul Chow–Denning presupun un moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1.
Pe scurt
De ce mai multe orizonturi: dinainte nu știm la care apare efectul.
Inversarea sau persistența pot apărea la o zi, la o săptămînă sau la o lună.
Testăm patru orizonturi, \(q = 2, 5, 10, 20\) zile de tranzacționare.
Două zile, aproximativ o săptămînă, două săptămîni și o lună bursieră.
Alegerea urmează Lo & MacKinlay (1988), care folosesc \(q = 2, 4, 8, 16\) pe date săptămînale.
Alte orizonturi pot da alt rezultat.
Banda robustă sub ipoteza nulă are nivelul 5% la fiecare orizont separat.
Cu patru teste, o respingere falsă apare mai des decît în 5% din cazuri.
Graficul arată profilul variance ratio-ului pentru mai multe piețe: estimația \(\widehat{\mathrm{VR}}(q)\) în funcție de orizontul \(q\), cu null band-ul robust de 95% în jurul valorii 1.
În versiunea interactivă, lista alege grupul de piețe (cele patru de pe slide, Europa Centrală și de Est, piețele dezvoltate sau piețele emergente împreună cu Ethereum), iar cursorul fixează orizontul \(q\) de la 2 la 60 de zile.
Întrebare pentru sală La S&P 500, variance ratio-ul la 20 de zile este 0,754. Pentru această valoare, care este limita erorii standard sub care |(VR − 1)/SE| depășește 1,96?
Răspuns
Limita este |0,754 − 1|/1,96 = 0,1255. Valoarea 0,2460 este abaterea față de ipoteza nulă, înainte de împărțirea la prag. Valoarea 0,1328 este eroarea standard robustă efectivă la 20 de zile; fiind mai mare decît limita, nu permite respingerea. Null band-ul se lărgește cu q: marginea de jos este 0,817 la 10 zile, unde VR = 0,767 este respins, și 0,740 la 20 de zile. Calculul folosește randamente agregate suprapuse și eroarea standard robustă Lo–MacKinlay.
Un profil deasupra benzii indică o persistență care se cumulează cu orizontul, un profil sub ea o inversare. Banda se lărgește cu \(q\), deci o abatere de aceeași mărime este mai puțin semnificativă la orizonturi lungi; valorile pentru fiecare piață sînt pe slide-ul următor.
Fiecare curbă arată \(\widehat{\mathrm{VR}}(q)\) pentru orizonturi de la 2 la 60 de zile; orizontul de 60 de zile, circa trei luni bursiere, este doar descriptiv. Zona hașurată este null band-ul robust de 95% în jurul valorii 1.
La S&P 500 profilul este sub 1, o inversare, și iese din bandă la 2, 5 și 10 zile: \(\widehat{\mathrm{VR}}(2) = 0{,}901\),\(\widehat{\mathrm{VR}}(5) = 0{,}829\) și \(\widehat{\mathrm{VR}}(10) = 0{,}767\). La 20 de zile rămîne chiar în interiorul benzii, \(0{,}754\) față de marginea \(0{,}740\); la 60 de zile este \(0{,}674\). La BET profilul este peste 1, o persistență care crește cu \(q\), și iese din bandă la toate cele patru orizonturi testate: \(\widehat{\mathrm{VR}}(2) = 1{,}108\),\(\widehat{\mathrm{VR}}(5) = 1{,}173\),\(\widehat{\mathrm{VR}}(10) = 1{,}225\) și \(\widehat{\mathrm{VR}}(20) = 1{,}377\), cu \(1{,}644\) la 60 de zile.
Bitcoin rămîne în interiorul benzii la toate orizonturile, deci nu respingem ipoteza nulă. La EUR/RON raportul rămîne peste 1 la toate orizonturile, dar iese din bandă doar la 2 și 5 zile, cu \(\widehat{\mathrm{VR}}(2) = 1{,}170\) și \(\widehat{\mathrm{VR}}(5) = 1{,}157\). Ca la autocorelații, rezultatul susține o descriere.
Pe scurt
Fiecare curbă arată raportul varianțelor estimat \(\widehat{\text{VR}}(q)\) pentru orizonturi \(q\) de la 2 la 60 de zile.
\(q = 60\), circa trei luni bursiere, este doar descriptiv.
Zona hașurată este banda robustă de 95% sub ipoteza nulă, în jurul valorii 1, valoarea fără autocorelație.
S&P 500: \(\widehat{\text{VR}}(q)\) este sub 1 (inversare) și iese din bandă la 2, 5 și 10 zile
la 20 de zile rămîne chiar în interiorul benzii (\(0{,}754\) față de marginea \(0{,}740\))
Întrebările privesc eroarea standard în prezența volatility clustering, diferența dintre semnificația statistică și cea economică, sensul unui variance ratio sub unu și un exercițiu de aplicare în care eroarea standard a unei estimații VR se dublează.
Pe scurt
De ce poate induce în eroare banda i.i.d. sub ipoteza nulă cînd volatilitatea se grupează?
O autocorelație pozitivă implică profit după costuri?
Ce sugerează un raport al varianțelor sub unu?
Aplicare: o statistică de test are modulul 2,4.
Dacă estimația VR rămîne aceeași, dar eroarea standard se dublează, cît devine modulul statisticii?
Se mai respinge ipoteza nulă la 5% (test bilateral)?
În prezența volatility clustering, eroarea standard i.i.d. ignoră dependența din pătratele randamentelor, deci este prea mică, iar testul respinge ipoteza nulă prea des. O autocorelație pozitivă nu implică profit după costuri: mai contează mărimea efectului, riscul, implementarea și costurile. Un variance ratio sub 1 sugerează inversare pe orizontul ales, iar pentru a afirma că abaterea este semnificativă avem nevoie de o eroare standard robustă. În exercițiul de aplicare, o statistică cu modulul 2,4 scade la 1,2 cînd eroarea standard se dublează; 1,2 nu depășește 1,96, deci ipoteza nulă nu mai este respinsă. Efectul estimat rămîne același; doar dovezile pentru el sînt mai slabe.
Pe scurt
Eroarea standard i.i.d. ignoră dependența din pătratele randamentelor, deci este prea mică.
Testul respinge ipoteza nulă prea des.
Nu: mai contează mărimea efectului, riscul, implementarea și costurile.
Un raport al varianțelor sub 1 sugerează inversare pe orizontul ales.
Pentru a afirma că abaterea este semnificativă avem nevoie de o eroare standard robustă.
Modulul statisticii scade la 1,2.
Nu: 1,2 nu depășește 1,96.
Efectul estimat rămîne același, dar dovezile sînt mai slabe.
Sinteza secțiunii
Patru dintre cele 16 serii au o autocorelație de lag 1 pozitivă și semnificativă, iar S&P 500 una negativă și semnificativă, în timp ce Bitcoin și Ethereum rămîn în banda robustă. Profilurile variance ratio-ului confirmă inversarea la S&P 500 și persistența la BET pe mai multe orizonturi. Efectele sînt mici, iar mecanismele propuse nu sînt testate. Secțiunea următoare pune o altă întrebare: dacă un predictor prognozează randamentele pe date nefolosite la estimarea lui.
Predictibilitate în afara eșantionului
Secțiunea trece de la dependența randamentelor de propriul trecut la prognoza cu o altă variabilă, logaritmul raportului dividend–preț (dividend–price ratio). Testul este out-of-sample: fiecare prognoză folosește doar datele disponibile în momentul în care este făcută și este comparată cu media istorică prin \(R^2\) out-of-sample și testul Clark–West.
Întrebarea este dacă o variabilă cunoscută azi prognozează randamentul pieței de luna viitoare. Candidatul clasic este \(dp\), logaritmul raportului dividend–preț: dividendele pe ultimele 12 luni împărțite la nivelul mediu al indicelui în luna respectivă.
In-sample, regresiile randamentelor pe astfel de variabile par să funcționeze. Pe date noi, majoritatea predictorilor publicați eșuează (Welch & Goyal, 2008). Testul corect este de aceea unul în care fiecare prognoză folosește doar datele disponibile în momentul în care este făcută.
Pe scurt
Întrebarea: prognozează o variabilă cunoscută azi randamentul pieței de luna viitoare?
Candidatul clasic este \(dp\), logaritmul raportului dividend–preț.
Dividendele pe ultimele 12 luni împărțite la nivelul mediu al indicelui în luna respectivă.
În eșantionul de estimare (in-sample), regresiile de acest tip par să funcționeze.
pe date noi, în afara eșantionului, majoritatea predictorilor publicați eșuează Welch & Goyal (2008).
Testul corect: fiecare prognoză folosește doar datele disponibile în momentul în care este făcută.
Fie \(r\) randamentul logaritmic lunar al S&P 500, cu dividende, minus dobînda la titlurile de stat americane pe 3 luni. În fiecare lună \(t\), regresia predictivă (predictive regression)
\[r_{s+1} = \alpha + \beta\, dp_s + u_{s+1}\]
(2.6)
este estimată pe toate lunile de pînă la \(t\); la pasul următor fereastra crește cu o lună (expanding window). Prognoza out-of-sample (OS) pentru luna \(t+1\) este \(\hat r_{t+1} = \hat\alpha + \hat\beta\, dp_t\).
Prognoza concurentă este media istorică \(\bar r_{t+1}\), media randamentelor de pînă în luna \(t\), care corespunde lipsei de predictibilitate. Prima prognoză este pentru ianuarie 1970, ceea ce dă 680 de prognoze lunare.
Se impune o rezervă. Dividendele lunare sînt interpolate din totaluri trimestriale, deci \(dp_t\) nu era cunoscut exact în luna \(t\), iar exercițiul este pseudo-out-of-sample.
Pe scurt
OS: Out-of-Sample.
\(r\): randamentul logaritmic lunar al S&P 500, cu dividende.
Minus dobînda la titlurile de stat americane pe 3 luni.
În fiecare lună \(t\) estimăm \(r_{s+1} = \alpha + \beta\, dp_s + u_{s+1}\) pe toate lunile de pînă la \(t\) (\(\alpha\), \(\beta\): interceptul și panta, nu parametrii GARCH).
La pasul următor fereastra crește cu o lună (fereastră extinsă, expanding window).
Prognoza cu \(dp\) pentru luna \(t+1\): \(\hat r_{t+1} = \hat\alpha + \hat\beta\, dp_t\).
Prognoza concurentă: media istorică \(\bar r_{t+1}\), media randamentelor de pînă în luna \(t\).
Ea corespunde lipsei de predictibilitate.
Prima prognoză este pentru ianuarie 1970.
Rezultă 680 de prognoze lunare.
Dividendele lunare sînt interpolate din totaluri trimestriale.
Deci \(dp_t\) nu era cunoscut exact în luna \(t\).
Exercițiul este doar aproximativ în afara eșantionului (pseudo-out-of-sample).
cu sumele pe lunile prognozate. Un \(R^2_{OS}\) pozitiv înseamnă că prognoza cu \(dp\) are erori pătratice mai mici decît media istorică; unul negativ, că media istorică prognozează mai bine. Spre deosebire de \(R^2\) in-sample, \(R^2_{OS}\) poate fi negativ.
Cele două măsuri diferă deoarece, in-sample, \(\hat\beta\) se potrivește și cu zgomotul lunilor pe care le explică. Un \(R^2_{OS}\) pozitiv poate apărea și din întîmplare, deci semnificația lui este testată separat, cu testul Clark–West prezentat la rezultate.
Pe scurt
\(R^2_{OS} = 1 - \sum_t (r_t - \hat r_t)^2 \big/ \sum_t (r_t - \bar r_t)^2\), cu sumele pe lunile prognozate.
\(R^2_{OS} > 0\): prognoza cu \(dp\) are erori pătratice mai mici decît media istorică.
\(R^2_{OS} < 0\): media istorică prognozează mai bine.
Spre deosebire de \(R^2\) în eșantion, \(R^2_{OS}\) poate fi negativ.
De ce diferă cele două: în eșantion, \(\hat\beta\) se potrivește și cu zgomotul lunilor pe care le explică.
Un \(R^2_{OS}\) pozitiv poate apărea și din întîmplare.
Semnificația lui o testăm separat (testul Clark–West, la rezultate).
Graficul de pe slide-ul următor cumulează lună de lună diferența dintre cele două prognoze. Fiecare lună, din 1970, adaugă \((r_t - \bar r_t)^2 - (r_t - \hat r_t)^2\), eroarea pătratică a mediei istorice minus cea a prognozei cu \(dp\).
Curba urcă deci în lunile în care \(dp\) prognozează mai bine și coboară în cele în care prognozează mai prost, iar valoarea ei finală are semnul lui \(R^2_{OS}\) din (2.7). Pe axa verticală este suma diferențelor, cu randamentele în fracții (0,01 = 1%), ridicate la pătrat.
Pe scurt
În fiecare lună, din 1970, adunăm diferența \((r_t - \bar r_t)^2 - (r_t - \hat r_t)^2\).
Eroarea pătratică a mediei istorice minus cea a prognozei cu \(dp\).
Curba urcă în lunile în care \(dp\) prognozează mai bine și coboară în cele în care prognozează mai prost.
Valoarea finală a curbei are semnul lui \(R^2_{OS}\).
Axa verticală: suma diferențelor, cu randamentele în fracții (0,01 = 1%), ridicate la pătrat.
Raportul dividend–preț: prognoze în afara eșantionului
Graficul arată diferența cumulată a erorilor pătratice dintre media istorică și prognoza cu \(dp\) pentru S&P 500, lună de lună din 1970.
În versiunea interactivă, cursorul fixează anul în care începe evaluarea, între 1970 și 2015, iar lista comută între prognoza cu \(dp\) fără restricții și prognoza cu restricțiile Campbell–Thompson.
Întrebare pentru sală Pe 680 de prognoze lunare din 1970, R²OS este −0,51%. Devine pozitiv dacă evaluarea începe mai tîrziu?
Răspuns
Nu. Pentru orice început între 1970 și 2015, R²OS rămîne negativ: −1,37% din 1990, −0,01% din 2000, −2,75% din 2010. Curba urcă pînă în 1990, iar boom-ul anilor 1990 șterge avantajul. Testul Clark–West pe 1970–2026 dă t = 0,42 (p = 0,34), deci nu respingem lipsa predictibilității.
Valoarea de la capătul din dreapta al curbei are semnul lui \(R^2_{OS}\), iar pantele curbei arată în ce perioade \(dp\) a ajutat sau a încurcat. Rezultatele pe tot eșantionul sînt pe slide-ul următor.
Curba se termină sub zero: pe cele 680 de prognoze lunare, \(R^2_{OS} = -0{,}51\%\). Media istorică a prognozat mai bine decît regresia cu \(dp\) pe întreaga perioadă de evaluare.
Testul Clark–West (Clark & West, 2007) compară erorile pătratice și corectează un dezavantaj al modelului cu \(dp\): chiar dacă \(\beta = 0\), estimarea lui \(\beta\) adaugă zgomot prognozei. Pe S&P 500, testul dă \(t = 0{,}42\), cu p-value unilateral 0,34, deci nu respingem lipsa predictibilității. Testul pe erori pătratice presupune un moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1.
Forma curbei arată cînd a funcționat relația. Pînă în 1990 curba urcă: \(dp\) a prognozat mai bine decît media istorică. În boom-ul anilor 1990, \(dp\) a coborît la minime record, iar prețurile au continuat să crească, astfel încît avantajul s-a pierdut. În anii 2000 avantajul a revenit parțial, iar după 2010 s-a pierdut din nou. Rezultatul susține o comparație între proceduri.
Pe scurt
Curba se termină sub zero: pe 680 de prognoze lunare, \(R^2_{OS} = -0{,}51\%\).
Testul Clark–West Clark & West (2007) compară erorile pătratice și corectează un dezavantaj al modelului cu \(dp\).
Chiar dacă \(\beta = 0\), estimarea lui \(\beta\) adaugă zgomot prognozei.
Pe S&P 500, testul dă \(t = 0{,}42\) (\(p\) unilateral \(= 0{,}34\)): nu respingem lipsa predictibilității.
Testul pe erori pătratice presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1.
Pînă în 1990 curba urcă: \(dp\) a prognozat mai bine decît media istorică.
În boom-ul anilor 1990, avantajul s-a pierdut.
\(dp\) a coborît la minime record, iar prețurile au continuat să crească.
În anii 2000 avantajul a revenit parțial, iar după 2010 s-a pierdut din nou.
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce).
Raportul dividend–preț: rezultatele pentru S&P 500 (2/2)
Un \(R^2_{OS}\) mic poate conta totuși economic. Campbell & Thompson (2008) arată că și 0,5% este mult pentru un investitor: un investitor medie–dispersie (mean–variance) care își mărește expunerea la acțiuni cînd prognoza este mare și o micșorează cînd este mică și-ar crește randamentul așteptat cu circa 20%. Calculul folosește raportul Sharpe lunar al pieței, 0,160; formula este în anexă.
Campbell și Thompson impun prognozei și două restricții: \(\hat\beta\) trebuie să aibă semnul prezis de teorie, iar prognoza primei de risc a acțiunilor (equity premium) trebuie să fie nenegativă. Pe S&P 500, restricțiile se activează în 5,7% din luni și lasă \(R^2_{OS}\) la \(-0{,}51\%\), deci cîștigul economic lipsește.
Pe scurt
Contează economic un \(R^2_{OS}\) mic? Campbell & Thompson (2008) arată că da: și 0,5% este mult pentru un investitor.
Un investitor medie–dispersie și-ar crește randamentul așteptat cu circa 20%.
Își mărește expunerea la acțiuni cînd prognoza este mare și o micșorează cînd este mică.
Întrebările cer sensul unui \(R^2_{OS}\) negativ, motivul pentru care o regresie bine potrivită in-sample poate eșua pe date noi, posibilitatea ca o strategie profitabilă să aibă \(R^2_{OS}\) negativ și ce spune pierderea avantajului lui \(dp\) în anii 1990 despre stabilitatea relației.
Pe scurt
Ce înseamnă un \(R^2_{OS}\) negativ?
De ce poate o regresie cu \(R^2\) bun în eșantion să eșueze pe date noi?
Poate o strategie profitabilă să aibă \(R^2_{OS}\) negativ?
Ce spune pierderea avantajului lui \(dp\) în anii 1990 despre stabilitatea relației?
Răspunsuri: predictibilitate în afara eșantionului
Un \(R^2_{OS}\) negativ înseamnă că media istorică a prognozat mai bine decît modelul pe lunile evaluate. O regresie cu \(R^2\) bun in-sample poate eșua pe date noi deoarece, in-sample, \(\hat\beta\) se potrivește și cu zgomotul, iar pe date noi zgomotul nu se repetă. O strategie profitabilă poate avea \(R^2_{OS}\) negativ: profitul ei poate veni din expunerea constantă la piață sau din cîteva prognoze corecte de semn, nu din erori pătratice mici. Pierderea avantajului în anii 1990 arată că relația nu este stabilă: un predictor util pînă în 1990 și-a pierdut tot avantajul cînd \(dp\) a coborît la minime record.
Pe scurt
Media istorică a prognozat mai bine decît modelul pe lunile evaluate.
În eșantion, \(\hat\beta\) se potrivește și cu zgomotul.
Pe date noi zgomotul nu se repetă.
Da: profitul nu vine neapărat din erori pătratice mici.
Poate veni din expunerea constantă la piață sau din cîteva prognoze corecte de semn.
Relația nu este stabilă.
Un predictor util pînă în 1990 își pierde tot avantajul cînd \(dp\) coboară la minime record.
Sinteza secțiunii
Pe 680 de prognoze lunare din 1970, raportul dividend–preț nu bate media istorică pentru S&P 500: \(R^2_{OS}\) este negativ, iar testul Clark–West nu respinge lipsa predictibilității. Relația a funcționat pînă în 1990 și a fost instabilă după aceea. Secțiunea următoare trece la forma semi-tare și întreabă cum reacționează prețurile la un anunț public anume.
Studii de eveniment
Testele de autocorelație și de predictibilitate din secțiunile anterioare folosesc istoria prețurilor. Un studiu de eveniment (event study) se ocupă de eficiența semi-tare: întreabă cum reacționează un preț la o singură știre publică, datată precis. Metoda separă partea din randament explicată de piață de partea anormală și însumează partea anormală pe o fereastră din jurul anunțului. Exemplul secțiunii este taxa pe activele bancare anunțată în România în decembrie 2018.
Întrebarea secțiunii este cît de repede și cît de complet încorporează prețul o știre publică datată precis. Răspunsul cere un contrafactual: randamentul pe care acțiunea l-ar fi avut dacă știrea nu ar fi apărut. Diferența dintre randamentul observat și acest randament așteptat este randamentul anormal (abnormal return, AR (AutoRegressive, model; in event studies: Abnormal Return, model autoregresiv; în studiile de eveniment: randament anormal)). Un event study măsoară randamentele anormale din jurul anunțului și este, prin urmare, un test al eficienței semi-tari, forma care privește toată informația publică (Fama, Fisher, Jensen & Roll, 1969).
Exemplul secțiunii este taxa pe activele bancare anunțată în decembrie 2018. Este un caz de test util, pentru că știrea nu a fost anticipată și a lovit direct băncile listate, așa că reacția acțiunilor lor poate fi datată într-o singură zi.
Pe scurt
Întrebarea: cît de repede și cît de complet încorporează prețul o știre publică datată precis?
Pentru răspuns avem nevoie de randamentul pe care acțiunea l-ar fi avut fără știre.
Diferența dintre randamentul observat și acest randament așteptat este randamentul anormal (abnormal return, AR).
Un studiu de eveniment (event study) măsoară AR în jurul știrii și testează astfel eficiența semi-tare Fama, Fisher, Jensen & Roll (1969).
Exemplul secțiunii: taxa bancară anunțată în decembrie 2018.
O știre neanticipată care a lovit direct băncile listate.
unde \(a_i\) este termenul liber, \(b_i\) beta de piață a firmei \(i\), iar \(r_{m,t}\) randamentul indicelui pieței în ziua \(t\). Modelul scoate din randamentul firmei partea explicată de mișcarea pieței din aceeași zi. La date zilnice, modelele cu mai mulți factori reduc doar puțin dispersia randamentului anormal (MacKinlay, 1997), de aceea modelul cu un singur factor este alegerea obișnuită.
Axa timpului separă două ferestre. Fereastra de estimare (estimation window), zilele \(-250\) pînă la \(-11\) față de eveniment, acoperă circa un an de tranzacționare și servește la estimarea lui \(a_i\) și \(b_i\). Ea se oprește cu zece zile înainte de eveniment, pentru ca o eventuală scurgere de informație dinaintea anunțului să nu intre în estimări. Fereastra evenimentului (event window), zilele \(0\) pînă la \(+5\), conține ziua anunțului și încă cinci zile de tranzacționare, ceea ce arată dacă reacția continuă sau se inversează.
Un test de primă aproximare împarte CAR la abaterea lui standard sub ipoteza nulă a lipsei efectului, \(t = CAR_i/(\hat\sigma_\varepsilon\sqrt{L})\)(MacKinlay, 1997), unde \(\hat\sigma_\varepsilon\) este abaterea standard a reziduurilor din fereastra de estimare, iar \(L\) numărul de zile însumate. Formula tratează \(\hat a_i\) și \(\hat b_i\) drept cunoscute și ignoră deci eroarea lor de estimare; exemplul rezolvat arată cînd contează corecția.
Pentru o știre neanticipată, eficiența prezice un salt în ziua 0 și nici o derivă previzibilă, nici o inversare după aceea. Datele zilnice pot arăta doar dacă știrea este absorbită în cursul zilei; viteza la scara microsecundelor cere date intraday, tratate în Capitolul 10. Literatura despre metodă este în Anexă, iar o aplicație la reacția prețului Ethereum la etapele de dezvoltare ale rețelei se găsește pe Quantinar.
Pe scurt
Randamentul anormal: \(AR_{i,t} = r_{i,t} - \hat a_i - \hat b_i r_{m,t}\), cu \(\hat a_i\), \(\hat b_i\) estimate în fereastra de estimare.
Guvernul a anunțat taxa pe activele bancare în seara de 18 decembrie 2018, așa că ziua 0 a evenimentului este 19 decembrie. Exemplul studiază Banca Transilvania (TLV), BRD (BRD–Groupe Société Générale, BVB ticker, BRD–Groupe Société Générale, simbolul bursier BVB) și portofoliul lor cu ponderi egale, cu randamentul indicelui BET drept randament al pieței \(r_{m,t}\).
Graficul are două panouri. Panoul din stînga arată randamentele anormale zilnice, în procente, din ziua \(-10\) pînă în ziua \(+5\). Banda albastru-deschis marchează \(\pm 1{,}96\) abateri standard ale erorii de predicție a portofoliului, așa că o bară a portofoliului aflată în afara benzii este semnificativă la 5%. Panoul din dreapta arată CAR din ziua 0 pînă în ziua de pe axa orizontală, în procente. O curbă care revine spre zero după ziua 0 indică o reacție inițială inversată.
Pe scurt
Guvernul a anunțat taxa pe activele bancare în seara de 18 decembrie 2018.
Ziua 0 a evenimentului este 19 decembrie.
Analizăm Banca Transilvania (simbol bursier TLV), BRD–Groupe Société Générale (simbol BRD) și portofoliul lor egal ponderat.
\(r_{m,t}\) este randamentul indicelui BET.
Panoul din stînga: \(AR\) zilnic, în procente, din ziua \(-10\) pînă în ziua \(+5\).
Banda albastră deschis: \(\pm 1{,}96\) abateri standard ale erorii de predicție a portofoliului.
O bară a portofoliului în afara ei este semnificativă la 5%.
Panoul din dreapta: \(CAR\) de la ziua 0 pînă la ziua de pe axa orizontală, în procente.
O curbă care revine spre zero după ziua 0 indică o reacție inversată.
Graficul interactiv reproduce cele două panouri. Primul cursor schimbă lungimea ferestrei de estimare, între 60 și 240 de zile; celelalte două fixează prima zi \(\tau_1\) și ultima zi \(\tau_2\) ale CAR. Butonul ▶ extinde fereastra CAR zi cu zi, pînă în ziua \(+5\).
Întrebare pentru sală CAR[0,5] al TLV este −1,1%, iar beta estimat este 1,18. Păstrăm randamentele TLV, alpha și beta neschimbate, dar mărim suma randamentelor logaritmice BET din fereastră cu 1 punct procentual. Cît devine CAR al TLV?
Răspuns
CAR scade cu 1,18 × 1 punct procentual, deoarece randamentul benchmark-ului se scade după înmulțirea cu beta: −1,1% − 1,18% = −2,28%. Varianta +0,08% inversează semnul ajustării. Varianta −1,1% ignoră benchmark-ul. CAR se poate schimba fără să se schimbe prețurile TLV. În date, AR₀ = −8,3%, iar CAR pe zilele +1 pînă la +5 este +7,2% (t = 3,82), deși pe zilele 0 pînă la +5 randamentul logaritmic este −15,6% la TLV și −12,7% la BET. Testul pentru CAR[0,5] dă t = −0,48 cu eroarea de predicție și t = −0,54 cu σ̂√L. Un singur eveniment nu separă reacția excesivă, știrile ulterioare și efectul benchmark-ului.
În ziua 0 toate barele se află mult în afara benzii, iar curba CAR a TLV revine spre zero în următoarele cinci ședințe. Cifrele din spatele graficului și cele trei explicații ale inversării sînt pe următoarele două slide-uri.
Pentru TLV, beta de piață estimată este \(1{,}18\), iar abaterea standard a reziduurilor din fereastra de estimare este \(0{,}83\%\) pe zi. În ziua 0, randamentul anormal al TLV este \(AR_0 = -8{,}3\%\), cu \(t = -10{,}0\) după formula de primă aproximare. Randamentele anormale din aceeași zi sînt \(-5{,}6\%\) pentru BRD și \(-6{,}9\%\) pentru portofoliul cu ponderi egale.
Piața însăși a scăzut puternic în acea zi: randamentul logaritmic al BET a fost \(-11{,}9\%\), o scădere a indicelui de \(11{,}2\%\). La un randament al pieței atît de extrem, incertitudinea lui \(\hat b\) contează, pentru că eroarea randamentului prezis crește cu distanța dintre \(r_{m,0}\) și media lui din fereastra de estimare. Pentru TLV, abaterea standard a erorii de predicție urcă de la \(0{,}83\%\) la \(1{,}21\%\), iar statistica \(t\) scade la \(-6{,}85\). Efectul rămîne puternic semnificativ.
O rezervă suplimentară privește reperul. TLV și BRD au ponderi mari în BET, așa că randamentul pieței din ziua 0 conține deja o parte din șocul suferit de bănci. Măsurat față de acest indice, \(AR_0\) subestimează scăderea.
Pe scurt
Pentru TLV, beta de piață estimat este \(1{,}18\).
Abaterea standard a reziduurilor din fereastra de estimare este \(0{,}83\%\) pe zi.
În ziua 0, randamentul anormal al TLV este \(AR_0 = -8{,}3\%\), cu \(t = -10{,}0\) după formula de primă aproximare.
Tot în ziua 0: \(AR_0 = -5{,}6\%\) pentru BRD și \(-6{,}9\%\) pentru portofoliul egal ponderat.
În aceeași zi, randamentul logaritmic al BET a fost \(-11{,}9\%\), adică o scădere a indicelui de \(11{,}2\%\).
Cu un randament al pieței atît de extrem, incertitudinea lui \(\hat b\) contează.
Eroarea standard a predicției pentru TLV crește de la \(0{,}83\%\) la \(1{,}21\%\).
Cu această eroare de predicție, \(t = -6{,}85\).
Efectul rămîne puternic semnificativ.
TLV și BRD au ponderi mari în BET, deci \(r_{m,0}\) conține deja o parte din șoc, iar \(AR_0\) subestimează scăderea.
Taxa bancară din decembrie 2018: rezultatele (2/2)
Pe zilele \(+1\) pînă la \(+5\), CAR al TLV este \(+7{,}2\%\)(\(t = 3{,}82\)), iar pe zilele \(0\) pînă la \(+5\) este doar \(-1{,}1\%\)(\(t = -0{,}54\)). Componenta anormală a scăderii, măsurată față de BET, este deci aproape compensată în următoarele cinci ședințe. Asta nu înseamnă că prețul acțiunii și-a recuperat pierderea: pe zilele 0 pînă la \(+5\), randamentul logaritmic este \(-15{,}6\%\) pentru TLV și \(-12{,}7\%\) pentru BET.
Trei explicații sînt compatibile cu această compensare:
O reacție exagerată (overreaction) în ziua 0, care ar contrazice eficiența semi-tare.
Știrile ulterioare despre forma finală a ordonanței.
Reperul s-a mișcat odată cu evenimentul: BET a scăzut cu \(11{,}9\%\) (logaritmic) în ziua 0, așa că randamentele anormale măsoară TLV față de un indice care conține deja șocul; BET nu a revenit, cu un randament logaritmic de \(-0{,}8\%\) pe zilele \(+1\) pînă la \(+5\).
Un singur eveniment nu poate separa cele trei explicații. Ce susține rezultatul este o identificare cauzală doar a reacției din ziua 0, cu condiția ca în acea zi să nu fi apărut alte știri; compensarea ulterioară rămîne neexplicată.
Pe scurt
În zilele \(+1, \dots, +5\), randamentul anormal cumulat al TLV este \(+7{,}2\%\) (\(t = 3{,}82\)).
Pe fereastra \(0, \dots, +5\), randamentul anormal cumulat este doar \(-1{,}1\%\) (\(t = -0{,}54\)).
Componenta anormală a scăderii TLV, măsurată față de BET, este aproape compensată în următoarele cinci ședințe de tranzacționare.
Asta nu arată că prețul acțiunii și-a recuperat pierderea: pe zilele 0 pînă la +5, randamentul logaritmic este \(-15{,}6\%\) la TLV și \(-12{,}7\%\) la indicele de referință BET.
Explicația 1: o reacție excesivă în ziua 0, incompatibilă cu eficiența semi-tare.
Explicația 2: știri ulterioare despre forma finală a ordonanței.
Explicația 3: indicele de referință s-a mișcat odată cu evenimentul.
TLV și BRD au ponderi mari în BET, care a scăzut cu \(11{,}9\%\) (logaritmic) în ziua 0.
Deci \(AR\) și \(CAR\) măsoară TLV față de un indice care conține deja șocul.
BET nu a revenit: în zilele \(+1\) pînă la \(+5\), randamentul lui logaritmic este \(-0{,}8\%\).
Un singur eveniment nu ne permite să alegem între cele trei explicații.
Tipul de dovadă: identificare cauzală, doar pentru reacția din ziua 0.
Dacă nicio altă știre nu a sosit în acea zi; compensarea ulterioară rămîne neexplicată.
Cele două întrebări verifică proiectarea unui event study: de ce fereastra evenimentului trebuie fixată dinainte și dacă un alt anunț ar putea explica aceeași mișcare a prețului.
CAR însumează randamentele anormale doar pe zilele ferestrei, așa că fereastra determină ce se măsoară. O fereastră aleasă după ce am văzut datele poate crea un efect sau îl poate ascunde. Știrile suprapuse sînt o explicație alternativă a oricărei reacții și, din acest motiv, reacția singură nu este o dovadă cauzală.
Pe scurt
CAR adună randamentele anormale doar din zilele ferestrei.
O fereastră aleasă după ce vedem datele poate crea sau ascunde un efect.
Da: știrile suprapuse sînt o explicație alternativă, deci reacția singură nu dovedește cauzalitatea.
Sinteza secțiunii
Un event study compară randamentul observat cu randamentul prezis de modelul de piață (2.8) și însumează randamentele anormale (2.9) pe o fereastră fixată dinainte (2.10). Pentru taxa bancară din decembrie 2018, randamentul anormal al TLV în ziua 0 este \(-8{,}3\%\), încă semnificativ (\(t = -6{,}85\)) după corecția pentru incertitudinea lui \(\hat b\). Pe zilele 0 pînă la \(+5\), CAR este doar \(-1{,}1\%\), iar un singur eveniment nu poate deosebi o reacție exagerată de știrile ulterioare sau de un reper care s-a mișcat odată cu evenimentul.
Testare multiplă și anomalii
O anomalie de calendar este un tipar al randamentelor medii legat de calendar. Multe astfel de tipare au fost testate pe aceleași date, așa că un \(p\)-value mic trebuie citit în raport cu numărul de teste efectuate. Secțiunea măsoară întîi cîte anomalii false produce hazardul, apoi corectează cincisprezece teste reale pe cinci piețe de acțiuni cu procedurile Bonferroni și Holm.
Întrebarea secțiunii este dacă o anomalie de calendar rămîne semnificativă după ce ținem seama de numărul de tipare căutate. Literatura a testat mii de tipare pe aceleași date, iar unele trec un test doar din întîmplare (Harvey, Liu & Zhu, 2016). Un \(p\)-value mic înseamnă deci altceva după cincisprezece teste decît după unul.
Secțiunea are doi pași. O simulare măsoară întîi cîte anomalii false produce hazardul atunci cînd toate ipotezele nule sînt adevărate. Testele reale ale efectelor de calendar sînt apoi corectate cu procedurile Bonferroni și Holm.
Pe scurt
Întrebarea: rămîne o anomalie de calendar semnificativă?
după ce ținem cont de cîte tipare au fost căutate
Literatura a testat mii de tipare pe aceleași date, iar unele trec testul doar din întîmplare Harvey, Liu & Zhu (2016).
O valoare p mică are alt sens după 15 teste decît după unul singur.
Întîi măsurăm cîte false anomalii produce hazardul, apoi corectăm testele reale cu Bonferroni și Holm.
Efecte de calendar și căutarea repetată în aceleași date
Un efect de calendar (calendar effect) este o diferență de randament mediu asociată unei zile sau unei luni. Capitolul testează trei efecte. Efectul zilei săptămînii este o diferență între randamentele medii de luni pînă vineri (French, 1980). Efectul lunii ianuarie este o diferență între randamentul mediu din ianuarie și cel din celelalte luni (Rozeff & Kinney, 1976). Efectul schimbării lunii (turn of the month, TOM) privește ultima zi de tranzacționare a unei luni și primele trei ale lunii următoare (Ariel, 1987).
Fiecare dintre aceste tipare a fost găsit privind datele. Data snooping înseamnă selectarea unui tipar după ce multe alternative au fost căutate pe aceleași date; tiparul selectat pare atunci semnificativ chiar dacă nu există niciun efect. Restul secțiunii cuantifică acest risc și îl corectează.
Pe scurt
Un efect de calendar (calendar effect) este o diferență de randament mediu asociată unei zile sau luni.
Efectul zilei săptămînii: randamentele medii diferă între luni, marți, …, vineri French (1980).
Efectul lunii ianuarie: randamentul mediu din ianuarie diferă de cel din celelalte luni Rozeff & Kinney (1976).
Efectul schimbării lunii (turn of the month, TOM): randamente medii mai mari în ultima zi de tranzacționare din lună și în primele trei ale lunii următoare Ariel (1987).
Căutarea repetată în aceleași date (data snooping): alegerea unui tipar după încercarea multor alternative.
O simulare este utilă aici pentru că în ea toate ipotezele nule sînt adevărate, deci orice respingere este falsă. Experimentul folosește 2 000 de reguli de tranzacționare fără conținut economic, aplicate randamentelor zilnice ale S&P 500. Fiecare regulă alege la întîmplare 20% din zile și le numește „zile bune”, iar un test \(t\) compară randamentul mediu din aceste zile cu media din celelalte zile.
Graficul arată histograma celor 2 000 de statistici \(t\) peste densitatea distribuției Normale standard. Două perechi de linii verticale marchează pragurile \(|t| = 1{,}96\), nivelul obișnuit de 5%, și \(|t| = 3{,}0\), pragul mai strict propus de Harvey, Liu & Zhu (2016).
Pe scurt
De ce simulăm: aici toate ipotezele nule sînt adevărate, deci orice respingere este falsă.
Experimentul: 2 000 de reguli de tranzacționare fără niciun conținut economic.
Pe randamentele zilnice ale S&P 500.
Fiecare regulă alege la întîmplare 20% din zile și le numește „zile bune”.
Pentru fiecare regulă, un test \(t\) compară randamentul mediu din „zilele bune” cu cel din celelalte zile.
Graficul: histograma celor 2 000 de statistici \(t\), peste densitatea distribuției Normale standard.
Liniile verticale: pragurile \(|t| = 1{,}96\) (5%) și \(|t| = 3{,}0\), pragul propus de Harvey, Liu & Zhu (2016).
În versiunea interactivă, primul cursor fixează numărul de reguli încercate, de la 20 la 2 000, iar meniul fixează ponderea „zilelor bune”, de la 5% la 50%. Butonul ▶ adaugă reguli pas cu pas, iar „Alte reguli” extrage un nou set de reguli aleatoare.
Întrebare pentru sală Pentru 2 000 de teste cu p-value-uri valide, ce prag individual Bonferroni garantează că probabilitatea cel puțin unei respingeri false este cel mult 5%, indiferent de dependența dintre teste?
Răspuns
Pragul este 0,05/2 000 = 0,000025. Valoarea 0,025 împarte nivelul la doi, nu la numărul testelor; p-value-ul bilateral include deja ambele cozi. Valoarea 0,05 păstrează nivelul individual, fără controlul familiei. Garanția Bonferroni nu cere independența testelor. În simulare, din 2 000 de reguli fără conținut economic, 104 (5,2%) au |t| > 1,96, șase au |t| > 3,0, iar cea mai bună are |t| = 3,30. Adăugarea unor reguli la aceeași familie nu poate micșora cel mai mare |t|.
Histograma urmează îndeaproape densitatea distribuției Normale standard: sub ipoteza nulă, statisticile \(t\) se comportă cum prezice teoria. Regulile aflate dincolo de liniile verticale sînt cele pe care un cercetător care raportează doar cel mai bun rezultat le-ar numi anomalii.
Rezultatul corespunde nivelului testului: \(5{,}2\%\) dintre regulile aleatoare sînt „semnificative” la 5%, cu \(|t| > 1{,}96\). Cea mai „spectaculoasă” regulă are \(|t| = 3{,}30\), deși este pur hazard; raportată singură, ar trece chiar și pragul strict \(|t| > 3{,}0\). Acest prag este trecut de \(0{,}30\%\) dintre regulile aleatoare, adică 6 reguli din 2 000.
Lecția este că numărul de reguli încercate, familia de teste, contează la fel de mult ca pragul ales. Un prag strict reduce ponderea descoperirilor false, dar nu le elimină atunci cînd căutarea este suficient de amplă. Sullivan, Timmermann & White (1999) arată cum se corectează data snooping-ul în regulile de tranzacționare.
Pe scurt
Rezultat: \(5{,}2\%\) dintre reguli sînt „semnificative” la 5% (\(|t| > 1{,}96\)).
Cît prevede nivelul testului.
Cea mai „spectaculoasă” regulă are \(|t| = 3{,}30\).
Raportată singură, ar trece chiar și pragul strict \(|t| > 3{,}0\), deși este pur hazard.
Pragul \(|t| > 3{,}0\) îl trec \(0{,}30\%\) dintre regulile aleatoare, adică 6 reguli din 2 000.
Numărul de reguli încercate (familia de teste) contează la fel de mult ca pragul ales.
Aceeași logică se aplică la 15 teste reale pe date zilnice din 2000: cinci piețe înmulțite cu trei efecte, ziua săptămînii, ianuarie și TOM. Piețele compară doi indici dezvoltați, S&P 500 și Euro Stoxx 50, cu trei piețe emergente din regiune, BET (România), WIG20 (Polonia) și BUX (Ungaria).
Diferența în ianuarie este randamentul mediu din ianuarie minus media celorlalte luni, în procente pe lună. Diferența TOM este randamentul mediu din zilele TOM minus media celorlalte zile, în puncte de bază pe zi (bp; 1 bp este 0,01 puncte procentuale).
Erorile standard sînt consistente la heteroscedasticitate și autocorelație (heteroskedasticity and autocorrelation consistent, HAC), pentru că randamentele au volatility clustering: erorile HAC rămîn valide în prezența lui, cele obișnuite nu. În aceste teste, erorile HAC sînt de 0,92 pînă la 1,54 ori cele obișnuite, așa că corecția le poate face atît mai mici, cît și mai mari.
Pe scurt
HAC: Heteroskedasticity and Autocorrelation Consistent — erori standard care permit dispersie variabilă și autocorelație.
Aplicăm aceeași logică la 15 teste reale: cinci piețe \(\times\) trei efecte.
Efectele: ziua săptămînii, ianuarie, TOM.
Pe date zilnice din 2000.
Comparăm piețe dezvoltate (S&P 500, Euro Stoxx 50) cu piețe emergente din regiune (BET, WIG20, BUX).
Diferența în ianuarie: randamentul mediu din ianuarie minus media celorlalte luni.
În procente pe lună.
Diferența TOM: randamentul mediu din zilele TOM minus media celorlalte zile.
În puncte de bază (bp) pe zi.
1 bp \(= 0{,}01\) puncte procentuale.
Folosim erori HAC pentru că volatilitatea randamentelor se grupează.
Erorile HAC rămîn valide în acest caz, cele obișnuite nu.
În aceste teste, erorile HAC sînt de \(0{,}92\)–\(1{,}54\) ori cele obișnuite: pot fi și mai mici, și mai mari.
Efectul lunii ianuarie și efectul schimbării lunii
Cele mai puternice rezultate privesc schimbarea lunii pe cele două piețe mai mici. Randamentul suplimentar TOM este \(+17{,}3\) bp pe zi pentru BET și \(+15{,}1\) bp pentru BUX, ambele cu \(|t| > 3{,}5\), peste pragul de \(3{,}0\) al lui Harvey, Liu & Zhu (2016). Pentru S&P 500, randamentul suplimentar TOM este doar \(+3{,}2\) bp pe zi și nu respingem ipoteza nulă (\(t = 0{,}92\)).
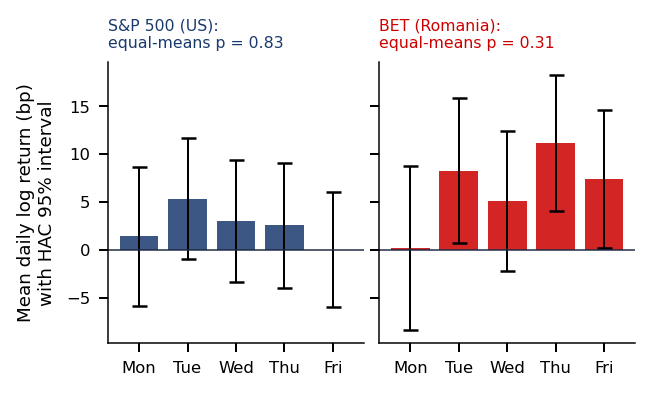
Efectul lunii ianuarie este mai slab. Pentru BET, ianuarie depășește celelalte luni cu \(3{,}48\) puncte procentuale, dar estimația este imprecisă (\(t = 1{,}49\)). BUX, cu \(t = 2{,}25\), este singura piață pentru care \(p\)-value-ul efectului lunii ianuarie este sub 0,05. Pentru efectul zilei săptămînii, nu respingem ipoteza nulă pe nicio piață; cel mai mic \(p\)-value este 0,2265, pentru WIG20.
Am efectuat cincisprezece teste, iar slide-ul următor întreabă care dintre ele rezistă unei corecții pentru testare multiplă. Chiar și pentru efectele care rezistă, rezultatul susține o asociere între calendar și randamente, nu un mecanism.
Pe scurt
Piața
Diferența în ianuarie (%/lună)
\(t_{HAC}\)
Diferența TOM (bp/zi)
\(t_{HAC}\)
S&P 500
\(-0{,}66\)
\(-0{,}80\)
\(3{,}2\)
\(0{,}92\)
BET (România)
\(3{,}48\)
\(1{,}49\)
\(17{,}3\)
\(3{,}62\)
Euro Stoxx 50
\(-0{,}30\)
\(-0{,}29\)
\(5{,}1\)
\(1{,}21\)
WIG20 (Polonia)
\(0{,}53\)
\(0{,}40\)
\(8{,}2\)
\(1{,}72\)
BUX (Ungaria)
\(2{,}66\)
\(2{,}25\)
\(15{,}1\)
\(3{,}63\)
TOM: randamentul suplimentar este \(+17{,}3\) bp pe zi pentru BET și \(+15{,}1\) bp pentru BUX
Rata de eroare controlată aici este rata erorii pe familie (family-wise error rate, FWER), probabilitatea cel puțin unei respingeri false în familia de teste. Este criteriul potrivit atunci cînd fiecare anomalie raportată trebuie să fie reală, nu doar majoritatea lor. Cu \(M\) teste independente la nivelul \(\alpha\),
\[\text{FWER} = 1 - (1-\alpha)^M,\]
(2.11)
așa că pentru \(M = 15\) și \(\alpha = 5\%\), FWER ar fi \(53{,}7\%\) dacă testele ar fi independente.
Procedura Bonferroni respinge o ipoteză doar dacă \(p_i < \alpha/M\); ea garantează \(\text{FWER} \le \alpha\) pentru orice dependență între teste. Procedura Holm ordonează \(p\)-value-urile, \(p_{(1)} \le \dots \le p_{(M)}\), și respinge pas cu pas cît timp
\[p_{(j)} < \frac{\alpha}{M - j + 1},\]
(2.12)
oprindu-se la prima nerespingere. Holm are aceeași garanție ca Bonferroni și respinge cel puțin toate ipotezele pe care le respinge Bonferroni. Aplicarea procedurii Holm pe testele de calendar este detaliată în Anexă, iar metodele bootstrap care folosesc corelația dintre teste, ca StepM, într-un alt slide din Anexă.
Pe scurt
FWER: Family-Wise Error Rate — probabilitatea cel puțin unei respingeri false în familia de teste.
De ce FWER: vrem ca fiecare anomalie raportată să fie reală, nu doar majoritatea lor.
Cu \(M\) teste independente la nivelul de semnificație \(\alpha\): \(\text{FWER} = 1 - (1 - \alpha)^M\).
Pentru \(M = 15\) și \(\alpha = 5\%\), FWER ar fi \(53{,}7\%\) dacă testele ar fi independente.
Bonferroni: respingem doar dacă \(p_i < \alpha / M\).
Garantează \(\text{FWER} \leq \alpha\) pentru orice dependență între teste.
Holm: ordonăm \(p_{(1)} \leq \dots \leq p_{(M)}\) și respingem cît timp \(p_{(j)} < \alpha/(M - j + 1)\).
Ne oprim la prima nerespingere.
Holm are aceeași garanție și respinge cel puțin tot ce respinge Bonferroni.
Metode bootstrap care folosesc corelația dintre teste (StepM): Anexa.
Cele trei întrebări privesc sensul unui \(p\)-value mic după o căutare printre multe reguli, sensul unei nerespingeri și tipul de dovezi noi care ar confirma o anomalie.
Pe scurt
De ce schimbă testarea multor reguli interpretarea unei valori p mici?
Nerespingerea dovedește eficiența?
Ce selecție nouă sau verificare de robustețe ai cere?
Căutarea printre multe reguli creează mai multe ocazii pentru o respingere falsă, așa că același \(p\)-value este o dovadă mai slabă. O nerespingere nu dovedește eficiența: un test cu putere mică poate să nu respingă chiar dacă piața este ineficientă, iar concluzia privește doar alternativa testată, nu orice formă de predictibilitate.
Verificarea de robustețe naturală este aceeași regulă pe date de după publicare sau pe o altă piață, unde un artefact al data snooping-ului dispare. Un efect real slăbește de obicei după publicare, dar nu dispare (McLean & Pontiff, 2016).
Pe scurt
Căutarea multor reguli creează mai multe ocazii de respingere falsă.
Nu. Un test cu putere mică poate să nu respingă chiar dacă piața este ineficientă.
Concluzia privește doar alternativa testată, nu orice formă de predictibilitate.
Exemplu: aceeași regulă pe date de după publicare sau pe altă piață.
Un artefact al căutării repetate în aceleași date dispare în afara eșantionului.
Partea de bază a capitolului dă cinci rezultate. S&P 500 arată o inversare a randamentelor la orizonturi de 2 pînă la 10 zile, cu variance ratio sub 1, în timp ce BET arată persistență, cu variance ratio peste 1 la toate cele patru orizonturi testate. Out-of-sample, raportul dividend–preț nu bate media istorică (\(R^2_{OS} < 0\)).
În studiul de eveniment, componenta anormală a scăderii TLV după taxa bancară, măsurată față de BET, a fost aproape compensată în următoarele cinci ședințe; un singur eveniment nu poate separa o reacție exagerată de știrile ulterioare. Dintre efectele de calendar, doar efectele TOM pentru BET și BUX rămîn semnificative după corecția Holm.
Pe scurt
S&P 500: inversare a randamentelor la orizonturi de 2–10 zile (raportul varianțelor sub 1).
BET: persistență (raportul varianțelor peste 1) la toate cele patru orizonturi testate.
Raportul dividend–preț nu bate media istorică în afara eșantionului (\(R^2_{OS} < 0\)).
Taxa bancară: componenta anormală a scăderii TLV, măsurată față de BET, a fost aproape compensată în următoarele cinci ședințe de tranzacționare.
Un singur eveniment nu separă reacția excesivă de știrile ulterioare.
După corecția Holm rămîn semnificative doar efectele TOM la BET și la BUX.
Sinteza secțiunii
Hazardul pur face ca \(5{,}2\%\) din 2 000 de reguli aleatoare să fie semnificative la 5% și lasă una dintre ele să ajungă la \(|t| = 3{,}30\). FWER pentru cincisprezece teste independente la 5% ar fi \(53{,}7\%\)(2.11), iar procedura Holm (2.12) îl ține sub 5% pentru orice dependență. Pe cele cincisprezece teste de calendar, doar efectele de schimbare a lunii pentru BET și BUX rezistă corecției; efectul lunii ianuarie pentru BUX (\(t = 2{,}25\)) nu rezistă.
Capitolul folosește 16 serii zilnice pînă la 18 septembrie 2026; dimensiunile eșantioanelor sînt în Anexă. Treisprezece sînt indici de acțiuni din 2000: patru piețe dezvoltate (S&P 500, Euro Stoxx 50, Nikkei 225, Hang Seng) și nouă piețe emergente sau de frontieră (BET, WIG20, BUX, PX, BIST 100, Bovespa, IPC, Nifty 50, Shanghai). Bitcoin intră în testele pe tot eșantionul și în cele rolling din 2014, iar analiza anuală a criptoactivelor începe în 2011. Ethereum începe în 2016, iar cursul EUR/RON, cursul de referință al Băncii Naționale a României (BNR), în iulie 2005.
Randamentele sînt randamente logaritmice zilnice, \(r_t = \ln P_t - \ln P_{t-1}\), unde \(P_t\) este prețul de închidere, nivelul indicelui sau cursul de schimb în ziua \(t\), fiecare serie pe propriul calendar. Indicii de acțiuni folosesc doar zilele de tranzacționare. O închidere repetată este eliminată doar dacă ziua nu arată tranzacții (volum zero sau deschidere = maxim = minim = închidere) ori dacă întregul rînd copiază ziua anterioară: o astfel de zi este o sărbătoare completată cu prețul anterior. O închidere nemodificată reală, cu volum și interval intraday, rămîne ca randament zero; S&P 500 are 3 astfel de zile din circa 6 700. Fișierul BET are doar închideri, așa că niciuna dintre zilele lui nu este eliminată.
IPC are 46 de astfel de zile (44 dintre ele în 2023–2026) cu volum aproape identic, probabil duplicate ale furnizorului de date; ele sînt păstrate, iar eliminarea lor schimbă \(\hat\rho_1\) cu \(0{,}001\),\(z^*(2)\) cu \(0{,}04\),\(\hat d\) cu \(0{,}014\) și \(AQ\) cu \(0{,}29\). Criptoactivele se tranzacționează șapte zile pe săptămînă, cu 365 de observații pe an. Analizele care combină mai multe serii, de exemplu studiile de eveniment, aliniază prețurile pe zilele comune de tranzacționare înainte de a calcula randamentele.
Pe scurt
BNR: Banca Națională a României.
Folosim 16 serii de prețuri zilnice, pînă la 18 septembrie 2026
numărul de observații al fiecărei serii este în Anexa
13 indici bursieri din 2000: 4 din piețe dezvoltate (S&P 500, Euro Stoxx 50, Nikkei 225, Hang Seng), 9 din piețe emergente sau de frontieră (BET, WIG20, BUX, PX, BIST 100, Bovespa, IPC, Nifty 50, Shanghai)
Bitcoin din 2014 în testele pe întreaga selecție și pe ferestre mobile (rolling windows); analiza anuală a criptoactivelor începe din 2011, ca să acopere și primii ani ai pieței
Ethereum din 2016 și EUR/RON, cursul de referință BNR, din iulie 2005
Randamente logaritmice zilnice \(r_t = \ln P_t - \ln P_{t-1}\), fiecare serie pe propriul calendar
\(P_t\): prețul de închidere (nivelul indicelui, cursul de schimb) din ziua \(t\)
Pentru indicii bursieri folosim doar zilele de tranzacționare
Răspunsul standard la întrebarea ce impune eficiența asupra prețurilor este fair game: randamentul care depășește randamentul cerut nu poate fi prognozat din mulțimea de informație. Testele de autocorelație din partea de bază verifică doar o consecință a acestei condiții. Deoarece randamentul cerut vine dintr-un model de evaluare, orice test de fair game este și un test al acelui model, problema ipotezei compuse (joint-hypothesis problem) (Fama, 1991).
Condiția lasă loc pentru rational bubbles, dar exclude abaterile de la valoarea fundamentală care revin previzibil, numite adesea fads. Abaterile nu dispar mereu, pentru că arbitrajul este riscant atunci cînd convergența prețurilor este nesigură (Shleifer & Vishny, 1997); limitele arbitrajului sînt tratate în Aprofundări.
Pe scurt
Întrebarea: ce restricție exactă impune eficiența asupra prețurilor și ce lasă liber?
Răspunsul standard este condiția de joc echitabil (fair game): randamentul peste cel cerut nu poate fi prognozat.
Testele de autocorelație din secțiunea 2 verifică doar o consecință a acestei condiții.
Randamentul cerut vine dintr-un model de evaluare Fama (1991).
Deci orice test al jocului echitabil este și un test al acelui model.
Jocul echitabil permite bule raționale (rational bubbles).
Dar exclude abaterile care revin previzibil la valoarea fundamentală (mode trecătoare, fads).
Abaterile nu dispar mereu: arbitrajul este riscant cînd convergența prețurilor este nesigură Shleifer & Vishny (1997)
Un test de eficiență este valid doar în anumite ipoteze, pe care datele le pot încălca. Erorile standard robuste ale autocorelațiilor, tratate în Aprofundări, cer un moment de ordinul patru finit, \(\mathbb{E}[r^4] < \infty\). Cozile groase (heavy tails) pot încălca această condiție: distribuția Student \(t\) cu patru grade de libertate are dispersie finită, dar moment de ordinul patru infinit, iar atunci eroarea standard robustă nu mai converge.
Valorile critice folosite, \(\pm 1{,}96\) sau cuantilele distribuției \(\chi^2\), sînt aproximații asimptotice. Ele sînt corecte cînd eșantionul crește, dar pot fi imprecise într-un eșantion scurt, de exemplu o fereastră de 500 de zile. Teoremele limită cer și dependență slabă, sau mixing: observațiile suficient de depărtate în timp devin aproape independente. Mixing-ul permite volatility clustering și dependență între zilele vecine.
Pe scurt
Întrebarea: ce ipoteze fac valid un test de eficiență și ce alternative poate detecta?
Erorile standard robuste ale autocorelațiilor (Aprofundări) cer un moment de ordin patru finit, \(\E[r^4]<\infty\)
cozi groase (heavy tails): distribuția Student \(t\) cu patru grade de libertate are dispersie finită, dar \(\E[r^4]=\infty\), iar atunci eroarea standard robustă nu mai converge
Un predictor persistent distorsionează inferența într-un eșantion finit. Un predictor este predeterminat (predetermined) atunci cînd este cunoscut înaintea șocului de randament pe care trebuie să-l prognozeze; exogenitatea strictă (strict exogeneity) exclude în plus corelația cu șocurile de la toate celelalte date. Raportul dividend–preț de azi poate prognoza randamentul lunii următoare, dar șocul de preț din luna următoare modifică și raportul, iar acest feedback exclude exogenitatea strictă.
Consistența nu este același lucru cu nedeplasarea. Cu un predictor doar predeterminat, estimatorul celor mai mici pătrate (ordinary least squares, OLS) converge la parametrul adevărat cînd eșantionul crește, dar are bias (deplasare) într-un eșantion finit.
Pe scurt
De ce distorsionează un predictor persistent inferența într-o selecție finită?
Un predictor predeterminat este cunoscut înaintea șocului randamentului prognozat
exogenitatea strictă exclude în plus corelația cu șocurile de la toate datele.
Raportul dividend–preț de azi poate prognoza randamentul lunii următoare.
Dar șocul de preț din luna următoare modifică și raportul.
Această retroacțiune (feedback) împiedică exogenitatea strictă.
Consistent nu înseamnă nedeplasat.
Cu un predictor doar predeterminat, OLS (Ordinary Least Squares, metoda celor mai mici pătrate) converge la parametrul adevărat.
Dar are o deplasare (bias) într-o selecție finită.
Întrebarea este dacă dependența persistă pe orizonturi și în regimuri de piață diferite. Un proces are memorie scurtă (short memory) atunci cînd autocovarianțele lui sînt absolut sumabile; un model autoregresiv de ordinul unu, AR(1), cu coeficientul 0,5 are corelațiile \(0{,}5^k\) la lagul \(k\). Memoria lungă (long memory) înseamnă aici o dependență pozitivă care scade atît de lent încît suma autocovarianțelor diverge, ceea ce poate produce o descreștere de tip power law.
Scaling-ul descrie cum crește cu orizontul o măsură a fluctuațiilor pe \(n\) zile, \(F(n)\), de exemplu abaterea standard a sumei a \(n\) randamente:
\[F(n) \propto n^H,\]
(2.13)
unde \(H\) este exponentul Hurst, estimat în Aprofundări. Dublarea orizontului multiplică fluctuațiile cu \(2^H\): cu circa 1,41 la \(H = 0{,}5\), fără memorie lungă, și cu 1,68 la \(H = 0{,}75\). Antipersistența (anti-persistence) descrie variații care se compensează reciproc, ca în fractional Gaussian noise (fGn) cu \(H < 0{,}5\); fGn este un model gaussian staționar al variațiilor, ale cărui sume parțiale au dispersia proporțională cu \(n^{2H}\).
Pe scurt
Persistă dependența pe orizonturi și în regimuri de piață diferite?
AR: AutoRegressive model — model autoregresiv; AR(p) are ordinul p.
Memoria scurtă (short memory) are o sumă finită a modulelor autocovarianțelor
un AR(1) cu coeficientul 0,5 are corelații \(0{,}5^k\) la lagul \(k\).
Memoria lungă (long memory) înseamnă aici dependență pozitivă care scade atît de lent încît suma autocovarianțelor diverge
descreșterea după o lege de putere (power law) poate produce acest lucru.
Scalarea (scaling): o măsură a fluctuațiilor pe \(n\) zile, \(F(n)\), crește ca \(n^H\)
de exemplu abaterea standard a sumei a \(n\) randamente
\(H\) este exponentul Hurst, estimat în Aprofundări
dublarea orizontului multiplică fluctuațiile cu \(2^H\): circa 1,41 la \(H = 0{,}5\) (fără memorie lungă) și 1,68 la \(H = 0{,}75\)
Antipersistența descrie variații care tind să se compenseze, ca în fractional Gaussian noise (fGn) cu \(H<0{,}5\)
fGn este un model de variații Gaussiene staționare cu dispersia sumelor proporțională cu \(n^{2H}\).
Pentru fGn, dispersia sumei a \(q\) randamente este \(\mathrm{Var}(r_t + \dots + r_{t-q+1}) = q^{2H}\,\mathrm{Var}(r_t)\), deci variance ratio-ul (VR) este \(\mathrm{VR}(q) = q^{2H-1}\). Inversînd relația, un variance ratio observat implică un exponent Hurst
La \(q = 20\) de zile, exponentul implicit este 0,553 pentru BET și 0,453 pentru S&P 500.
Dificultatea este că și un proces fără memorie lungă poate da \(H(q) \neq 0{,}5\). Un AR(1) cu \(\rho_1 = -0{,}1\) are autocorelațiile \(\rho_k = (-0{,}1)^k\), deci doar memorie scurtă, dar \(\mathrm{VR}(20) = 0{,}826\) dă \(H(20) = 0{,}468\): procesul pare antipersistent fără să aibă memorie lungă. La \(q = 250\), același proces dă \(H(250) = 0{,}482\); pentru memoria scurtă, \(H(q)\) se apropie de 0,5 cînd \(q\) crește.
Un AR(1) cu autocorelația de ordinul unu a BET, \(\hat\rho_1 = 0{,}109\), dă \(H(20) = 0{,}535\). Cea mai mare parte din abaterea lui \(H(20) = 0{,}553\) al BET față de 0,5 se explică deci prin memoria scurtă. Separarea memoriei lungi de cea scurtă cere o statistică construită în acest scop, statistica R/S modificată (modified rescaled range) a lui Lo (1991), tratată în Aprofundări.
Pe scurt
Pentru fGn: \(\Var(r_t + \dots + r_{t-q+1}) = q^{2H} \Var(r_t)\).
fGn: procesul exact autosimilar definit mai sus.
Membrul stîng: dispersia sumei a \(q\) randamente.
Rezultă \(\text{VR}(q) = q^{2H-1}\).
Deci din \(\text{VR}(q)\) observat deducem un exponent Hurst implicit, \(H(q) = 0{,}5 + \ln \text{VR}(q) / (2 \ln q)\).
La orizontul \(q = 20\) de zile, exponentul implicit este \(0{,}553\) pentru BET și \(0{,}453\) pentru S&P 500.
Problema: un proces fără memorie lungă poate da \(H(q) \neq 0{,}5\)
Exemplu: un AR(1) cu \(\rho_1 = -0{,}1\) are autocorelațiile \(\rho_k = (-0{,}1)^k\), deci doar memorie scurtă.
Pentru acest AR(1), \(\text{VR}(20) = 0{,}826\), deci \(H(20) = 0{,}468\): procesul pare „antipersistent”, deși nu are memorie lungă.
La orizontul \(q = 250\), același proces dă \(H(250) = 0{,}482\): pentru memoria scurtă, \(H(q)\) se apropie de \(0{,}5\) cînd \(q\) crește.
Un AR(1) cu autocorelația BET, \(\hat\rho_1 = 0{,}109\), dă \(H(20) = 0{,}535\).
Deci cea mai mare parte din abaterea lui \(H(20) = 0{,}553\) al BET față de \(0{,}5\) se explică prin memoria scurtă.
Pentru a separa memoria lungă de cea scurtă avem nevoie de o statistică construită special.
Coeficienții \(\hat a_i\) și \(\hat b_i\) sînt cunoscuți exact;
Firmele sînt independente;
Dispersia randamentelor anormale nu crește în ziua evenimentului.
Fiecare dintre ele poate fi încălcată.
Eroarea de estimare apare pentru că \(\hat a_i\) și \(\hat b_i\) provin dintr-o fereastră finită, așa că și randamentul normal prezis este incert. Dependența transversală (cross-sectional dependence) apare pentru că două bănci lovite de aceeași știre au randamente anormale care se mișcă împreună. Dispersia indusă de eveniment (event-induced variance) apare pentru că evenimentul însuși mărește dispersia, pe care zilele calme din fereastra de estimare o subestimează. Corecțiile sînt date în Anexă.
Pe scurt
Întrebarea: cît de sigure sînt statisticile \(t\) cînd ipotezele lor nu țin?
Întrebarea este dacă biasurile comportamentale pot explica anomaliile care rezistă corecției. Slide-ul începe cu momentum-ul, care are două forme. Momentum-ul transversal (cross-sectional momentum) ordonează activele unele față de altele: dacă activul A a cîștigat 10%, iar activul B 2%, o strategie relativă poate cumpăra A și vinde B în lipsă. Time-series momentum folosește semnul randamentului trecut al fiecărui activ, așa că în același exemplu atît A, cît și B ar primi semnale pozitive. Explicațiile comportamentale sînt în Anexă.
Pe scurt
Pot erorile comportamentale explica anomaliile care rezistă?
Momentum
Cross-sectional momentum ordonează activele.
dacă A a cîștigat 10%, iar B 2%, o strategie relativă poate cumpăra A și vinde B în lipsă.
Time-series momentum folosește semnul trecutului fiecărui activ.
în acel exemplu, atît A cît și B primesc semnal pozitiv.
Întrebarea este ce înseamnă o respingere in-sample atunci cînd eficiența este testată cu sute de predictori. Anomaliile sînt găsite căutînd printre mulți predictori, iar Harvey, Liu & Zhu (2016) numără peste 300 de factori publicați. Secțiunea despre testarea multiplă a arătat că 2 000 de reguli aleatoare produc „anomalii” in-sample. Slide-urile din Aprofundări arată cum se evaluează corect un model flexibil și de ce o respingere in-sample poate apărea chiar și cu investitori raționali (Martin & Nagel, 2022).
Pe scurt
Întrebarea: cînd testăm eficiența cu sute de predictori, ce înseamnă o respingere în eșantion?
Anomaliile se găsesc căutînd printre mulți predictori: Harvey, Liu & Zhu (2016) numără peste 300 de factori publicați.
Studiul de caz testează un rezultat publicat despre eficiența slabă pe o piață care nu exista cînd au fost proiectate testele clasice. Liu și Tsyvinski (2021) găsesc că randamentul săptămînal al Bitcoin prezice randamentele săptămînilor următoare. Datele cursului reproduc rezultatul în eșantionul autorilor și îl testează pe cei opt ani care au urmat.
Întrebarea: prezic randamentele trecute randamentul lui Bitcoin?
Întrebarea este dacă randamentul Bitcoin din această săptămînă prezice randamentele săptămînilor următoare. Dacă da, prețurile trecute conțin informație pe care piața nu a folosit-o, o abatere de la eficiența slabă. Liu și Tsyvinski (2021), în Review of Financial Studies, găsesc că randamentele criptomonedelor nu au expunere la factorii obișnuiți ai pieței de acțiuni sau la factorii macroeconomici. Ele sînt prezise în schimb de factori specifici piețelor cripto: time-series momentum (TSMOM) și atenția investitorilor.
TSMOM înseamnă că o săptămînă cu randament mare este urmată, în medie, de randamente mari în săptămînile următoare. În lucrarea de cercetare a autorilor publicată de National Bureau of Economic Research (NBER w24877), pe Bitcoin din ianuarie 2011 pînă în mai 2018, panta regresiei randamentului săptămînii viitoare pe randamentul din această săptămînă este 0,19 (\(t = 3{,}73\)). O abatere standard în plus a randamentului din această săptămînă (16,6%) adaugă 3,2% la randamentul săptămînii viitoare. Chintila săptămînilor cu cele mai mari randamente este urmată în medie de 11,2% pe săptămînă, cea cu cele mai mici de 2,6%.
Rezultatul contează pentru eficiență pentru că un efect exploatat de investitori ar trebui să slăbească după publicare (McLean & Pontiff, 2016). Cei opt ani de după eșantionul autorilor sînt un test out-of-sample natural.
Pe scurt
Întrebare: prezice randamentul lui Bitcoin din această săptămînă randamentul săptămînilor următoare?
dacă da, prețurile trecute conțin informație nefolosită: o abatere de la eficiența în formă slabă
Panoul din stînga arată panta \(b_h\) a regresiei predictive
\[R_{t+h} = a + b_h R_t + e_{t+h}, \qquad h = 1, \dots, 4 \text{ săptămîni},\]
(2.15)
cu intervale de 95% bazate pe erori standard Newey–West (NW), în eșantionul lucrării și după el; romburile sînt cifrele autorilor. Panoul din dreapta arată panta \(b_1\) pe ferestre rolling de 104 săptămîni (doi ani), fiecare datată la ultima săptămînă a ferestrei.
În versiunea interactivă, meniul comută între Bitcoin și Ethereum, primul cursor mută sfîrșitul primei perioade, iar al doilea fixează lungimea ferestrei rolling, de la 52 la 208 săptămîni. Butonul ▶ mută sfîrșitul primei perioade în timp.
Întrebare pentru sală După mai 2018, panta Bitcoin este b₁ = 0,115, cu t NW = 2,61. Ce concluzie susține această regresie?
Răspuns
Regresia susține o asociere predictivă la o săptămînă. O abatere standard în plus a randamentului curent corespunde unei creșteri estimate de 0,96 puncte procentuale a randamentului săptămînii următoare, față de 2,98 puncte procentuale în perioada anterioară. Nu sînt evaluate o regulă de tranzacționare după costuri sau erori de prognoză out-of-sample. Folosirea unui eșantion ulterior lucrării nu înlocuiește această evaluare. Pe ferestrele rolling de doi ani, b₁ este semnificativ în 13% din ferestre.
În eșantionul lucrării, estimația lui \(b_1\) din datele cursului este aproape de rombul autorilor. După eșantion, doar panta pe o săptămînă rămîne departe de zero, iar panoul rolling arată cît de rar dă o fereastră de doi ani o pantă semnificativă. Cifrele sînt pe slide-ul cu rezultatul.
Pe scurt
Stînga: panta \(b_h\) din \(R_{t+h} = a + b_h R_t + e_{t+h}\), cu intervale de 95% Newey–West (NW); romburile: cifrele autorilor
Dreapta: panta \(b_1\) pe ferestre mobile de 104 săptămîni (doi ani), datată la ultima săptămînă a ferestrei
\(R_t\) este randamentul simplu al Bitcoin în săptămîna \(t\), de la o închidere de duminică la următoarea, calculat din prețurile zilnice de închidere în timpul universal coordonat (UTC), ca în lucrare. Regresia predictivă (2.15) este estimată pentru \(h = 1\) pînă la 4 săptămîni în eșantionul lucrării, 9 ianuarie 2011 – 27 mai 2018 (386 de săptămîni), și după el, 3 iunie 2018 – 13 septembrie 2026 (433 de săptămîni). Este reprodusă și verificarea de robustețe a autorilor, aceeași regresie începînd din 2013. La sortare, săptămînile sînt împărțite în cinci chintile după \(R_t\), iar media lui \(R_{t+1}\) este comparată între chintila de sus și cea de jos.
Replicarea diferă de lucrare în trei privințe. Prețurile sînt cele din datele cursului, de la EODHD (EOD Historical Data), în locul prețurilor CoinDesk. Erorile standard sînt Newey–West cu 5 laguri în locul erorilor OLS și bootstrap ale autorilor. Factorii de atenție (căutările Google, Twitter) și Ripple sînt lăsați deoparte.
Pe scurt
\(R_t\): randamentul simplu al lui Bitcoin din săptămîna \(t\), de la închiderea de duminică la cea de duminica următoare
prețuri zilnice de închidere în UTC (timpul universal coordonat), ca în lucrare
Regresia predictivă \(R_{t+h} = a + b_h R_t + e_{t+h}\), pentru \(h = 1, \dots, 4\) săptămîni
eșantionul lucrării: 9 ian. 2011 – 27 mai 2018, 386 de săptămîni
după eșantion: 3 iun. 2018 – 13 sep. 2026, 433 de săptămîni
testul de robustețe al autorilor: aceeași regresie începînd din 2013
Sortarea: săptămînile sînt împărțite în cinci quintile după \(R_t\); comparăm media lui \(R_{t+1}\) în quintila de sus și în cea de jos
Diferențe față de lucrare
prețurile EODHD (EOD Historical Data) din datele cursului în locul celor CoinDesk
erori standard NW cu 5 laguri în locul erorilor OLS (ordinary least squares) și bootstrap ale autorilor
fără factorii de atenție (căutări Google, Twitter) și fără Ripple
Rezultatul: rămîne doar efectul de o săptămînă, de trei ori mai mic
În eșantionul lucrării, datele cursului reproduc rezultatul: \(b_1 = 0{,}168\) (OLS \(t = 3{,}33\), NW \(t = 2{,}75\)), față de 0,19 în lucrare. Chintila de sus este urmată de 9,9% pe săptămînă, iar cea de jos de 2,6%, cu o statistică \(t\) de 2,18 pentru diferență.
După eșantion, predictibilitatea rămîne doar la orizontul de o săptămînă. Panta este \(b_1 = 0{,}115\) (NW \(t = 2{,}61\)) și rezistă corecției Holm pe cele patru orizonturi (\(p = 0{,}009 < 0{,}05/4\)). La \(h = 2\), 3 și 4, pantele sînt între \(-0{,}026\) și \(0{,}072\), toate cu \(|t| \le 1{,}48\). O abatere standard în plus a randamentului din această săptămînă adaugă 0,96% la randamentul săptămînii viitoare, față de 2,98% în eșantionul lucrării, iar volatilitatea săptămînală a scăzut de la 17,7% la 8,3%. Pentru Ethereum după eșantion, \(b_1 = 0{,}107\) (NW \(t = 2{,}45\)).
Rezultatul susține predictibilitatea statistică a randamentului pe o săptămînă, nu o strategie profitabilă: regresia nu include costuri de tranzacționare, ajustare pentru risc sau prognoze out-of-sample. Rămîn trei limite:
Din 2013, în interiorul eșantionului lucrării, \(b_1\) nu mai este semnificativ (NW \(t = 1{,}06\)), așa că săptămînile extreme din 2011–2012 cîntăresc mult.
Panta este semnificativă doar în 13% dintre ferestrele rolling de doi ani.
Testul \(t\) NW cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială.
Pe scurt
În eșantionul lucrării, datele cursului reproduc rezultatul
\(b_1\) = 0,168 (\(t\) OLS = 3,33, \(t\) NW = 2,75), față de 0,19 în lucrare
după quintila de sus urmează 9,9% pe săptămînă, după cea de jos 2,6% (\(t\) al diferenței = 2,18)
După eșantion, predictibilitatea rămîne doar la orizontul de o săptămînă
\(b_1\) = 0,115 (\(t\) NW = 2,61); rezistă corecției Holm pe cele patru orizonturi (\(p\) = 0,009 \(<\) 0,05/4)
la \(h\) = 2, 3, 4: pante între \(-\)0,026 și 0,072, toate cu \(|t| \le\) 1,48
o abatere standard în plus azi adaugă 0,96% randamentului săptămînii următoare, față de 2,98% în eșantionul lucrării
volatilitatea săptămînală a scăzut de la 17,7% la 8,3%; Ethereum după eșantion: \(b_1\) = 0,107 (\(t\) NW = 2,45)
Tipul de dovadă: predictibilitate statistică a randamentului de o săptămînă, nu o strategie profitabilă
fără costuri de tranzacționare, fără ajustare la risc și fără prognoze în afara eșantionului
Limite
din 2013, în eșantionul lucrării, \(b_1\) nu mai este semnificativ (\(t\) NW = 1,06): săptămînile extreme din 2011–2012 cîntăresc mult
\(b_1\) este semnificativ în doar 13% din ferestrele mobile de doi ani
testul \(t\) NW presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Sinteza secțiunii
Datele cursului reproduc panta TSMOM a lui Liu și Tsyvinski în eșantionul lor (\(b_1 = 0{,}168\) față de 0,19). După mai 2018, doar panta pe o săptămînă rămîne semnificativă, \(b_1 = 0{,}115\), iar efectul unei abateri standard scade de la 2,98% la 0,96% pe săptămînă. Rezultatul este predictibilitate, nu profit, și depinde de săptămînile extreme din 2011–2012.
AI pentru descoperire științifică
Ultima parte a capitolului aplică instrumentele capitolului la o întrebare de cercetare deschisă, cu ajutorul unui asistent de inteligență artificială (AI). Întrebarea este dacă intrarea arbitrajorilor prin fondurile tranzacționate la bursă (exchange-traded funds, ETF-uri) spot a făcut Bitcoin mai eficient. Slide-urile arată cum o ipoteză propusă de asistent devine un test cu verificări fixate înainte de a vedea rezultatele.
O întrebare deschisă: devine o piață mai eficientă cînd intră arbitrajorii?
Întrebarea deschisă este dacă eficiența informațională a Bitcoin crește atunci cînd intră arbitrajori noi prin instrumente reglementate, de exemplu ETF-urile spot. Două direcții de cercetare sînt relevante. Tran & Leirvik (2020) găsesc că eficiența criptoactivelor variază în timp și crește. Kia, Liu, Li, Song & Xu (2026) găsesc că, după lansarea ETF-urilor spot, piața spot a redevenit locul dominant al formării prețului (price discovery).
Niciun rezultat nu spune dacă schimbarea vine de la ETF-uri sau de la maturizarea pieței. Aceasta este întrebarea testată în secțiune; datele despre ETF-uri și designul placebo sînt în Anexă.
Pe scurt
Întrebarea: crește eficiența informațională a lui Bitcoin cînd intră arbitrajori noi?
arbitrajorii noi sînt aduși de instrumente reglementate, precum ETF-urile (Exchange-Traded Fund, fond tranzacționat la bursă) spot
Tran & Leirvik (2020) găsesc că eficiența criptoactivelor variază în timp și crește.
Kia, Liu, Li, Song & Xu (2026) găsesc că, după ETF-urile spot, piața spot a redevenit locul dominant al descoperirii prețului.
Nu știm dacă schimbarea vine din ETF-uri sau din maturizarea pieței.
aceasta este întrebarea pe care o testăm în această secțiune.
Un asistent AI propune o ipoteză tipică: ETF-urile spot Bitcoin din SUA, tranzacționate din 11 ianuarie 2024, au adus arbitrajori, deci Bitcoin a devenit mai eficient. Bucla de descoperire transformă această afirmație într-un test, cu prompturi reutilizabile date în Anexă. Pasul de literatură folosește Kia, Liu, Li, Song & Xu (2026) și Tran & Leirvik (2020). Ipoteza este \(H_0: \rho_{1,\text{post}} = \rho_{1,\text{pre}}\), egalitatea autocorelației de ordinul unu în două ferestre de lungime egală în jurul datei lansării, prima zi de tranzacționare. Pasul de date și cod folosește prețul zilnic de închidere al Bitcoin în dolari americani și replică întîi estimația capitolului pe tot eșantionul, \(\hat\rho_1 = -0{,}022\).
Verificările sînt fixate înainte de a vedea orice rezultat; motivarea fiecăreia este în Anexă:
Erorile standard ale estimațiilor sînt HAC, nu \(1/\sqrt{T}\);
Cele două ferestre au lungime egală;
Testul folosește doar data lansării, plus date placebo;
Un activ de control preia factorii de confuzie, de exemplu halving-ul din aprilie 2024, dobînzile și intrările de capital în fonduri;
Fiecare statistică încercată intră într-o corecție pentru testare multiplă (Holm sau Chow–Denning) și se raportează efectul minim detectabil (minimum detectable effect, MDE).
Proiectul întreabă dacă ETF-urile spot au schimbat eficiența variabilă în timp a Bitcoin față de un activ de control. El folosește variance ratio-ul rolling și analiza fluctuațiilor fără trend (detrended fluctuation analysis, DFA) din acest capitol pe Bitcoin și Ethereum; Ethereum servește drept control pentru că nu este tratat pînă în iulie 2024. Dacă tendințele paralele, lipsa anticipării și lipsa efectelor de propagare nu sînt credibile, diferențele se raportează ca descriptive, nu cauzale.
Primul pas este replicarea: autocorelațiile anuale ale Bitcoin din capitol și cifrele ministudiului de caz, notînd ce serie de prețuri Bitcoin și ce primă dată folosește fiecare fereastră, inclusiv ferestrele placebo. Ipotezele \(H_0\) și \(H_1\), datele, ferestrele și corecțiile sînt apoi preînregistrate, fixate înainte de rezultate. Raportul conține inferență robustă, teste placebo și MDE, iar codul este publicat ca Quantlet. Prompturile folosite se notează în `AI_USE.md`, iar fiecare eroare a asistentului AI depistată, de exemplu o eroare standard i.i.d. sau o referință inventată, în `AI_ERRORS.md`.
Pe scurt
Întrebare: au schimbat ETF-urile spot eficiența variabilă în timp a lui Bitcoin?
în comparație cu un activ de control
VR și DFA (Detrended Fluctuation Analysis, analiza fluctuațiilor fără tendință) pe ferestre mobile (acest capitol) pentru Bitcoin și Ethereum
Ethereum nu este „tratat” pînă în iulie 2024
dacă tendințele paralele, absența anticipării și a efectelor de propagare (spillover) nu sînt plauzibile, raportați diferențe descriptive, nu cauzale
Replicați întîi: autocorelațiile anuale ale lui Bitcoin din capitol
cifrele din ministudiul de caz
Notați ce serie de prețuri Bitcoin și ce primă dată folosește fiecare fereastră, inclusiv ferestrele placebo
Preînregistrați: \(H_0\), \(H_1\), date, ferestre și corecții
înregistrate printr-un commit înainte de obținerea rezultatelor
Raportați: inferență robustă, teste placebo și MDE
Publicați codul sub formă de Quantlet
Jurnale: notați în AI_USE.md prompturile folosite
Notați în AI_ERRORS.md fiecare eroare a asistentului AI depistată
de exemplu o eroare standard i.i.d. sau o referință inventată
Sinteză și referințe tehnice
Sinteză, autoverificare și următorul pas: Capitolul 3
Orice afirmație despre eficiență din capitol poate fi verificată în cinci pași:
Mulțimea de informație \(\mathcal{I}_t\) pe care presupunem că o reflectă prețurile, prețurile trecute sau știrile publice.
Ipoteza nulă, RW1, RW3 sau diferența de martingală, formulată împreună cu modelul de risc.
Statistica, cu o dispersie care rămîne validă în prezența volatility clustering.
Incertitudinea creată de orizonturile, piețele și ferestrele încercate, împreună cu dovezile out-of-sample.
Pasul economic: o respingere statistică nu este un profit exploatabil după costuri, iar un profit nu dovedește că piața este irațională.
Întrebările de autoverificare cer să explicați de ce RW3 poate fi respinsă pentru S&P 500 în timp ce piața rămîne eficientă în sens economic, de ce \(H(20) > 0{,}5\) al BET nu dovedește memoria lungă și care dintre două rezultate, persistența BET sau nerespingerea pentru Bitcoin, ar rezista unei schimbări de test, de fereastră și de inferență. Capitolul 3 continuă cu randamentele ajustate la risc în modelele factoriale și cu factor zoo. Manualele de referință sînt Campbell, Lo & MacKinlay (1997), capitolul 2, și Franke, Härdle & Hafner (2019); cursurile avansate sînt în Anexă.
Pe scurt
Cinci pași pentru orice afirmație despre eficiență
Mulțimea de informații: ce informație \(\mathcal{I}_t\) presupunem că este reflectată în prețuri?
prețuri trecute, știri publice
Ipoteza nulă: RW1, RW3 sau diferența de martingal (\(\E[r_t \mid \mathcal{I}_{t-1}] = \mu\), detalii în Aprofundări), formulată împreună cu modelul de risc
Statistica: folosim o estimare a dispersiei validă cînd volatilitatea se grupează
Incertitudinea: orizonturile, piețele și ferestrele încercate, plus dovezi în afara eșantionului
Economia: o respingere statistică nu înseamnă profit exploatabil după costuri
profitul nu dovedește că piața este irațională
Autoverificare și următorul pas
De ce poate fi respinsă RW3 pentru S&P 500, deși piața rămîne eficientă în sens economic?
De ce \(H(20) > 0{,}5\) pentru BET (exponentul Hurst implicit din \(\text{VR}(20)\), Memorie lungă) nu dovedește memoria lungă?
Care dintre cele două rezultate ar rămîne valabil dacă schimbăm testul, fereastra și metoda de inferență?
persistența BET sau nerespingerea pentru Bitcoin
Următorul pas, Capitolul 3: randamente ajustate la risc cu modele factoriale și mulțimea factorilor propuși (factor zoo)
Decizia are trei părți: ce aleg, în ce condiții rămîne valabilă alegerea și ce rezultat m-ar face să renunț la ea.
Pentru testele de eficiență slabă aleg erori standard robuste, nu i.i.d.: pentru S&P 500, eroarea standard robustă a lui \(\hat\rho_1\) este \(0{,}027\), față de \(0{,}012\) în ipoteza i.i.d. Pe cele patru orizonturi ale variance ratio-ului folosesc testul Chow–Denning, iar pe cele 15 teste de calendar corecția Holm. Un predictor este judecat după \(R^2_{OS}\) și testul Clark–West față de media istorică, nu după \(R^2\) in-sample.
Alegerea este valabilă în anumite condiții. Erorile standard robuste cer un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială. O respingere testează și modelul randamentelor așteptate și nu este un profit după costuri.
Trei rezultate m-ar face să renunț la o concluzie. Pentru un predictor, \(R^2_{OS} < 0\) cu un test Clark–West nesemnificativ, ca pentru \(dp\) pe S&P 500 (\(-0{,}51\%\),\(t = 0{,}42\)). Pentru o anomalie, o respingere care nu rezistă corecției Holm, ca efectul lunii ianuarie pentru BUX (\(t = 2{,}25\)). Pentru persistența BET, un variance ratio care rămîne în interiorul benzii robuste pe ferestre noi.
Pe scurt
Ce aleg
testele formei slabe cu erori standard robuste, nu i.i.d. (S&P 500: SE robustă a lui \(\hat\rho_1\)\(0{,}027\), față de \(0{,}012\))
Chow–Denning pentru cele patru orizonturi ale raportului varianțelor, Holm pentru cele 15 teste de calendar
pentru un predictor: \(R^2_{OS}\) și testul Clark–West față de media istorică, nu \(R^2\) în eșantion
În ce condiții
erorile standard robuste presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
o respingere testează și modelul randamentului așteptat și nu înseamnă profit după costuri
Ce rezultat m-ar face să renunț
la un predictor: \(R^2_{OS} < 0\) cu Clark–West nesemnificativ, ca \(dp\) pe S&P 500 (\(-0{,}51\%\), \(t = 0{,}42\))
la o anomalie: o respingere care nu trece corecția Holm, ca efectul lunii ianuarie la BUX (\(t = 2{,}25\))
la persistența BET: un raport al varianțelor care rămîne în banda robustă sub ipoteza nulă pe ferestre noi
Sinteza secțiunii
Eficiența este o afirmație despre o mulțime de informație și un model al randamentelor așteptate, iar orice test al ei trebuie citit cu o dispersie robustă la volatility clustering, cu o corecție pentru familia de teste încercate și cu o verificare out-of-sample. Pe datele capitolului, S&P 500 arată inversare pe orizonturi scurte, BET o persistență care este în cea mai mare parte memorie scurtă, raportul dividend–preț eșuează out-of-sample, iar doar efectele de schimbare a lunii pentru BET și BUX rezistă corecției Holm.
Aprofundări
Cadrele din această parte dezvoltă teme tratate pe scurt în corpul capitolului, în ordinea în care corpul trimite la ele. Ele conțin:
Verificarea numerică din spatele benzii robuste a variance ratio-ului, argumentul pentru raportul dividend–preț ca predictor și procedura Holm pe testele de calendar;
Teoria jocului corect (fair game), a martingalului, a măsurii risk-neutral și a bulelor raționale;
Construcția testelor de autocorelație, portmanteau, a testului secvențelor și a variance ratio-ului, cu versiunile lor robuste;
Erorile standard HAC, bootstrap-ul și deplasarea Stambaugh a regresiilor predictive;
Memoria lungă măsurată prin R/S și prin detrended fluctuation analysis;
Ipoteza piețelor adaptive și măsurile rolling ale eficienței;
Inferența în studiile de eveniment;
Efectele de calendar, time-series momentum și explicațiile comportamentale;
Machine learning și învățarea rațională cu mulți predictori;
Analiza de putere pentru cazul ETF-urilor spot pe Bitcoin.
De ce banda robustă este mai largă: verificare numerică
Pentru un orizont de \(q = 2\) zile, statistica clasică este \(z = \sqrt{T}\,(\widehat{\text{VR}}(2) - 1)\), validă cînd randamentele sînt i.i.d. (RW1), iar statistica robustă \(z^*\) împarte același numărător la \(\sqrt{\hat\theta(2)}\). Fără volatility clustering, \(\hat\theta(2) \approx 1\) și cele două coincid; cu volatility clustering, \(\hat\theta(2) > 1\) și \(|z^*| < |z|\). Într-un exemplu didactic cu \(T = 400\) de zile și \(\widehat{\text{VR}}(2) = 0{,}90\),\(z = 20 \times (-0{,}10) = -2{,}0\) respinge ipoteza nulă la 5%, dar \(\hat\theta(2) = 4\) dă \(z^* = -1{,}0\), care nu o mai respinge: banda robustă din jurul lui 1 este de două ori mai largă. Pentru S&P 500, \(z = -8{,}15\) și \(z^* = -3{,}66\), de circa 2,2 ori mai mică, iar ipoteza nulă rămîne respinsă.
Pe scurt
Pentru \(q = 2\), statistica clasică este \(z = \sqrt{T}\,(\widehat{\text{VR}}(2) - 1)\).
Ea presupune randamente i.i.d. (RW1).
Statistica robustă \(z^*\) împarte același numărător la \(\sqrt{\hat\theta(2)}\).
Fără gruparea volatilității, \(\hat\theta(2) \approx 1\) și \(z^* \approx z\).
Cu gruparea volatilității, \(\hat\theta(2) > 1\) și \(|z^*| < |z|\).
Exemplu ipotetic: \(T = 400\) de zile și \(\widehat{\text{VR}}(2) = 0{,}90\).
Identitatea Campbell–Shiller, \(dp_t \approx c + \sum_{j \ge 0} \rho^j (r_{t+1+j} - \Delta d_{t+1+j})\), cu \(\rho\) puțin sub 1 și \(\Delta d\) creșterea logaritmică a dividendelor, rezultă din definiția randamentului printr-o aproximare log-liniară, fără niciun model economic. Dacă raportul logaritmic dividend–preț \(dp\) variază, el trebuie deci să prognozeze randamentele viitoare, creșterea viitoare a dividendelor sau pe amîndouă. În date, \(dp\) prognozează slab creșterea dividendelor, așa că variația lui ar trebui să prognozeze randamentele; de aceea este cel mai studiat predictor al pieței. Nici o prognoză reușită nu ar dovedi ineficiența, deoarece poate reflecta o primă de risc variabilă în timp.
Tabelul reunește p-value-urile bilaterale ale testelor de calendar pe cinci indici: statistica \(t\) HAC comparată cu distribuția Normală pentru ianuarie și pentru schimbarea lunii (TOM, turn of the month), respectiv testul Wald \(\chi^2_4\) al egalității celor cinci medii pe zile ale săptămînii. Procedura Holm ordonează cele 15 p-value-uri și compară al \(k\)-lea cel mai mic cu \(0{,}05/(16-k)\). Primele două, TOM pentru BET și TOM pentru BUX, ambele 0,0003, sînt sub 0,0033 și 0,0036 și sînt respinse. Al treilea, ianuarie pentru BUX, 0,0245, depășește 0,0038, deci procedura se oprește; fără corecție, el ar fi fost a treia respingere.
Pe scurt
Valori p bilaterale, din două teste.
Ianuarie, TOM: statistica \(t\) HAC față de distribuția Normală.
Zilele săptămînii: testul Wald \(\chi^2_4\) al egalității celor cinci medii zilnice.
Piața
Zilele săptămînii, medii egale
Ianuarie
TOM
S&P 500
\(0{,}8263\)
\(0{,}4257\)
\(0{,}3585\)
BET (România)
\(0{,}3052\)
\(0{,}1368\)
\(0{,}0003\)
Euro Stoxx 50
\(0{,}6319\)
\(0{,}7738\)
\(0{,}2266\)
WIG20 (Polonia)
\(0{,}2265\)
\(0{,}6865\)
\(0{,}0853\)
BUX (Ungaria)
\(0{,}9327\)
\(0{,}0245\)
\(0{,}0003\)
Cele mai mici două valori p sînt TOM la BET și TOM la BUX, ambele \(0{,}0003\).
Ele sînt sub pragurile Holm \(0{,}05/15 = 0{,}0033\) și \(0{,}05/14 = 0{,}0036\), deci ambele ipoteze nule se resping.
A treia valoare p, ianuarie la BUX (\(0{,}0245\)), depășește pragul \(0{,}05/13 = 0{,}0038\), deci Holm se oprește aici.
Fără corecție, ianuarie la BUX ar fi fost a treia respingere, pentru că \(0{,}0245 < 0{,}05\).
O observație cu același preț de închidere ca în ziua precedentă este eliminată doar dacă ziua nu arată tranzacționare: volum zero, open = high = low = close sau o copie a rîndului precedent, adică o zi nelucrătoare completată cu ultimul preț disponibil. O închidere neschimbată reală, cu volum și interval intrazilnic, rămîne ca zi cu randament zero (la S&P 500, 3 din circa 6 700 de zile). Fișierul BET conține doar prețurile de închidere, deci nu se elimină nicio zi. Fișierul IPC are 46 de astfel de zile (44 în 2023–2026), cu volum apropiat de cel din ziua precedentă, probabil dubluri ale furnizorului de date; regula le păstrează, iar fără ele statisticile IPC se schimbă puțin (\(\hat\rho_1\) cu 0,001, \(z^*(2)\) cu 0,04, \(\hat d\) cu 0,014, \(AQ\) cu 0,29). Criptoactivele se tranzacționează 7 zile din 7, cu 365 de observații pe an, iar analizele cu mai multe serii, ca studiile de eveniment, aliniază prețurile pe zilele comune de tranzacționare înainte de calculul randamentelor.
Pe scurt
Eliminăm o observație cu același preț de închidere ca în ziua precedentă doar dacă ziua nu arată tranzacționare
volum zero, open = high = low = close sau o copie a rîndului precedent
atunci este o zi nelucrătoare completată cu ultimul preț disponibil
o închidere neschimbată reală, cu volum și interval intrazilnic, rămîne în date ca zi cu randament zero (S&P 500: 3 din circa 6 700 de zile)
fișierul BET conține doar prețurile de închidere, deci nu eliminăm nicio zi
fișierul IPC are 46 de astfel de zile (44 în 2023–2026), cu volum apropiat de cel din ziua precedentă, probabil dubluri ale furnizorului de date; regula le păstrează
fără ele, statisticile IPC se schimbă puțin: \(\hat\rho_1\) cu \(0{,}001\), \(z^*(2)\) cu \(0{,}04\), \(\hat d\) cu \(0{,}014\), \(AQ\) cu \(0{,}29\)
Criptoactivele se tranzacționează 7 zile din 7: 365 de observații pe an
Analizele care folosesc mai multe serii simultan aliniază prețurile pe zilele comune de tranzacționare
de ex. studiile de eveniment
alinierea se face înainte de calculul randamentelor
Graficele capitolului notează piețele prin coduri scurte. US (United States, Statele Unite ale Americii) este seria indicelui S&P 500, iar HK (Hong Kong) seria indicelui Hang Seng; BIST, WIG20, BUX, PX și IPC sînt indicii de referință ai burselor din Istanbul, Varșovia, Budapesta, Praga și Mexic; BET este indicele de referință al Bursei de Valori București; FX desemnează seriile de pe piața valutară.
Pe scurt
US: United States — în grafice, seria indicelui S&P 500.
HK: Hong Kong — în grafice, seria indicelui Hang Seng.
BIST: Borsa İstanbul — Bursa din Istanbul (indicele BIST 100).
WIG20: Warszawski Indeks Giełdowy 20.
Indicele celor mai mari 20 de companii de la Bursa din Varșovia.
BUX: Budapesti Értéktőzsde index — indicele Bursei din Budapesta.
PX: Prague Stock Exchange index — indicele Bursei din Praga.
Index Burzy cenných papírů Praha.
IPC: Índice de Precios y Cotizaciones — indicele Bursei din Mexic.
BET: Bucharest Exchange Trading (index) — indicele de referință al Bursei de Valori București.
Un joc corect (fair game) pentru randamentele în exces cere \(\mathbb{E}[r_{t+1} - \mu_t \mid \mathcal{I}_t] = 0\), unde \(\mathcal{I}_t\) este informația disponibilă la sfîrșitul zilei \(t\), iar \(\mu_t\) randamentul cerut (de echilibru): randamentul de peste compensația pentru risc nu poate fi prognozat din \(\mathcal{I}_t\). Un martingal (martingale) este un proces a cărui valoare următoare așteptată, dat fiind trecutul, este egală cu valoarea curentă. Cu un randament simplu cerut constant \(m\), valoarea \(V_t\) a unei poziții cu dividendele reinvestite, actualizată cu \(m\),\(V_t/(1+m)^t\), este un martingal (Campbell, Lo & MacKinlay, 1997). Actualizarea cu rata fără risc dă un martingal doar sub măsura risk-neutral, iar prețul însuși este un martingal doar fără dividende și cu \(m = 0\).
Pe scurt
Joc echitabil pentru randamentele în exces: \(\E[r_{t+1} - \mu_t \mid \mathcal{I}_t] = 0\)
\(\mathcal{I}_t\): informația disponibilă la sfîrșitul zilei \(t\); \(\E[\cdot \mid \mathcal{I}_t]\): media condiționată de această informație
\(\mu_t\): randamentul cerut (de echilibru), compensația pentru risc
în cuvinte: randamentul peste \(\mu_t\) nu poate fi prognozat din \(\mathcal{I}_t\)
Martingal: valoarea așteptată la momentul următor este egală cu valoarea curentă
un proces pentru care această egalitate are loc dată fiind informația din trecut
cu un randament simplu cerut constant \(m\), valoarea \(V_t\) a unei poziții cu dividendele reinvestite, actualizată cu \(m\), \(V_t/(1 + m)^t\), este un martingal Campbell, Lo & MacKinlay (1997)
actualizarea cu dobînda fără risc dă un martingal doar sub măsura neutră la risc (risk-neutral measure), pe slide-ul dedicat
prețul \(P_t\) însuși este martingal doar dacă nu se plătesc dividende și \(m = 0\); atunci randamentul logaritmic așteptat este negativ (termenul lui Jensen, slide-ul următor)
Deoarece logaritmul este concav, media logaritmilor rezultatelor este mai mică decît logaritmul mediei lor, cu excepția rezultatelor constante. Randamentele simple de \(+10\%\) și \(-10\%\), egal probabile, au media zero, dar randamentul logaritmic mediu este \(\tfrac12\ln(0{,}99) \approx -0{,}00503\). Pe o traiectorie cu o creștere și o scădere, o avere de 100 devine \(100 \times 1{,}1 \times 0{,}9 = 99\): o medie aritmetică nulă nu conservă averea capitalizată.
Pe scurt
Logaritmul este concav: media logaritmilor este mai mică decît logaritmul mediei.
Egalitate pentru rezultate constante.
Randamentele simple egal probabile de \(+10\%\) și \(-10\%\) au media zero.
Media randamentului logaritmic este \(\tfrac12\ln(1{,}1)+\tfrac12\ln(0{,}9)=\tfrac12\ln(0{,}99)\approx-0{,}00503\).
Pe o traiectorie cu o creștere și o scădere, averea 100 devine \(100(1{,}1)(0{,}9)=99\).
Media aritmetică zero nu păstrează averea acumulată.
Un martingal în prețuri, \(\mathbb{E}[P_{t+1} \mid \mathcal{I}_t] = P_t\), și un randament logaritmic mediu constant, \(\mathbb{E}[\ln(P_{t+1}/P_t) \mid \mathcal{I}_t] = \mu\), sînt restricții diferite; ele diferă prin termenul lui Jensen, \(\mathbb{E}[\ln(1+R)] \approx \mathbb{E}[R] - \operatorname{Var}(R)/2\). Jocul corect implică faptul că randamentul neașteptat \(\varepsilon_{t+1} = r_{t+1} - \mu_t\) este necorelat cu orice funcție \(g(\mathcal{I}_t)\) a informației trecute. Cu \(\mu_t = \mu\) constant, toate autocorelațiile \(\rho_k\),\(k \ge 1\), sînt nule, ipoteza testată în secțiunea despre autocorelație și variance ratio. Reciproca nu este adevărată: autocorelații nule nu exclud o medie previzibilă neliniar, de unde ipoteza diferenței de martingal.
Pe scurt
Martingalul în prețuri și media constantă a randamentului logaritmic sînt restricții diferite
martingal în prețuri: \(\E[P_{t+1} \mid \mathcal{I}_t] = P_t\)
media constantă a randamentului logaritmic: \(\E[\ln(P_{t+1}/P_t) \mid \mathcal{I}_t] = \mu\)
diferența este termenul lui Jensen: \(\E[\ln(1 + R)] \approx \E[R] - \Var(R)/2\), cu \(R = P_{t+1}/P_t - 1\) randamentul simplu
Consecința condiției de joc echitabil: \(\text{corr}(\varepsilon_{t+1}, g(\mathcal{I}_t)) = 0\)
pentru orice funcție \(g\) a informației din trecut
\(\varepsilon_{t+1} = r_{t+1} - \mu_t\) este partea neașteptată a randamentului
Dacă \(\mu_t = \mu\) este constant, toate autocorelațiile \(\rho_k = \text{corr}(r_t, r_{t-k})\), \(k \geq 1\), sînt zero
aceasta este ipoteza testată în secțiunea 2
Reciproca nu este adevărată: autocorelațiile zero nu exclud o medie predictibilă neliniar
MDH (Martingale Difference Hypothesis, ipoteza diferenței de martingal), în tema următoare
Martingalul de mai sus folosește probabilitățile reale și randamentul cerut \(m\); teoria evaluării folosește, în mod echivalent, rata fără risc și probabilități ajustate pentru risc. O măsură risk-neutral (risk-neutral measure) este un set de probabilități de evaluare, într-un model fără arbitraj, sub care prețurile tranzacționate actualizate, inclusiv dividendele, sînt martingale. În exemplu, o acțiune fără dividende costă azi 100 și va valora peste un an 120 sau 80, cu o rată fără risc de 5%; probabilitatea de evaluare \(q = 0{,}625\) dă \(0{,}625 \times 120 + 0{,}375 \times 80 = 105\), iar \(105/1{,}05 = 100\). Acest \(q\) nu trebuie să fie egal cu probabilitatea reală a unei creșteri: probabilitățile de evaluare nu sînt prognoze ale frecvențelor.
Pe scurt
De ce: martingalul de mai sus folosește probabilitățile reale și randamentul cerut \(m\).
Teoria evaluării folosește, echivalent, dobînda fără risc și probabilități ajustate la risc.
Măsura neutră la risc folosește probabilități de evaluare.
Sub ele, prețurile tranzacționate, cu dividende incluse și actualizate, sînt martingale.
Într-un model fără arbitraj.
Exemplu: o acțiune fără dividende costă azi 100.
Peste un an valorează 120 sau 80.
Dobînda fără risc este 5%.
Probabilitatea de evaluare \(q=0{,}625\) dă \(q\,120+(1-q)80=105\), iar \(105/1{,}05 = 100\), prețul de azi.
Acest \(q\) nu trebuie să coincidă cu probabilitatea reală de creștere.
Probabilitățile de evaluare nu prognozează frecvențe.
Graficul pune alături cele două construcții din cadrele anterioare. În stînga, sub probabilitățile reale, media condiționată a valorii următoare rămîne 100; în dreapta, probabilitățile de evaluare dau o valoare așteptată de 105, a cărei valoare actualizată cu rata fără risc este din nou prețul de azi, 100.
Pe scurt
Stînga: media condiționată reală rămîne 100. Dreapta: probabilitățile de evaluare dau 105, cu valoarea actualizată 100.
Cu un randament cerut constant \(m\), jocul corect se scrie \(\mathbb{E}[P_{t+1} + D_{t+1} \mid \mathcal{I}_t] = (1+m) P_t\), unde \(D_{t+1}\) este dividendul plătit în \(t+1\). Valoarea fundamentală \(P^*_t = \mathbb{E}[\sum_{j \ge 1} D_{t+j}/(1+m)^j \mid \mathcal{I}_t]\) satisface aceeași ecuație, deci eroarea de evaluare \(B_t = P_t - P^*_t\) satisface \(\mathbb{E}[B_{t+1} \mid \mathcal{I}_t] = (1+m) B_t\). Jocul corect leagă prețul de valoarea fundamentală doar pînă la o bulă rațională (rational bubble), un decalaj susținut de așteptarea revînzării și admisibil doar dacă se așteaptă să crească în ritmul \(m\) (Capitolul 17). Un decalaj care revine la medie, un fad, face \(\varepsilon_{t+1}\) previzibil și încalcă jocul corect, deși testele pe orizont scurt au putere mică împotriva lui (Summers, 1986). Restricția privește doar media condiționată; volatilitatea poate fi previzibilă (Capitolul 1).
Pe scurt
Cu un randament simplu cerut constant \(m\), condiția de joc echitabil este \(\E[P_{t+1} + D_{t+1} \mid \mathcal{I}_t] = (1 + m)\,P_t\)
\(D_{t+1}\): fluxul de numerar (dividendul) plătit în \(t + 1\)
Valoarea fundamentală \(P^*_t\) satisface aceeași ecuație de joc echitabil ca prețul
Scăzînd cele două ecuații, abaterea \(B_t\) satisface \(\E[B_{t+1} \mid \mathcal{I}_t] = (1 + m)\,B_t\)
Condiția de joc echitabil nu impune egalitatea dintre preț și valoarea fundamentală
permite și o bulă rațională
o abatere \(B_t > 0\) susținută de anticiparea revînzării
O abatere \(B_t \neq 0\) este compatibilă cu modelul doar dacă, în medie, crește în ritmul randamentului cerut \(m\) (Capitolul 17)
O abatere care revine la medie (modă trecătoare) face \(\varepsilon_{t+1}\) predictibil și încalcă condiția de joc echitabil, deși testele pe orizont scurt au o capacitate redusă de a detecta această abatere Summers (1986)
Restricția privește doar media condiționată: dispersia nu este restricționată
O acțiune plătește 10 lei la sfîrșitul fiecărui an, la nesfîrșit, începînd peste un an, iar randamentul cerut este \(m = 10\%\), deci valoarea fundamentală este \(10/0{,}10 = 100\) de lei. Dacă prețul de azi este 120 de lei, bula este \(B_t = 20\) de lei. Fără crah, ea crește la \(1{,}1 \times 20 = 22\) de lei; după dividendul de anul viitor, valoarea fundamentală rămîne 100 de lei, iar prețul este 122 de lei. Randamentul simplu total, \((122 + 10 - 120)/120\), este exact randamentul cerut de 10%.
Pe scurt
O acțiune plătește 10 lei la sfîrșitul fiecărui an, la nesfîrșit.
Primul dividend se plătește peste un an.
Randamentul cerut constant este \(m=10\%\); valoarea fundamentală este \(P^*_t=10/0{,}10=100\) lei.
Astăzi \(P_t=120\) lei, deci \(B_t=20\) lei.
Fără crah, \(B_{t+1}=1{,}1\times20=22\) lei.
După plata dividendului de anul viitor, valoarea fundamentală rămîne 100 lei; prețul este deci 122 lei.
Randamentul simplu total este \((122+10-120)/120=10\%\).
Bula de 20 de lei supraviețuiește în fiecare an cu probabilitatea \(\pi = 0{,}8\) și dispare cu probabilitatea 0,2, iar investitorii cunosc ambele probabilități. Jocul corect pentru bulă cere în continuare o valoare așteptată de 22 de lei, deci, condiționat de supraviețuire, bula trebuie să ajungă la \(22/0{,}8 = 27{,}5\) lei, o creștere condiționată de 37,5%. Randamentul este de circa 14,6% dacă bula supraviețuiește (preț după dividend de 127,5 lei) și de circa \(-8{,}3\%\) dacă se sparge (preț de 100 de lei); randamentul așteptat, \(0{,}8 \times 14{,}6\% + 0{,}2 \times (-8{,}3\%)\), este din nou 10%. Mecanismul crahului este cel al lui Blanchard și Watson (1982): randamentul așteptat satisface jocul corect, iar oricare dintre randamentele realizate poate diferi de el.
Pe scurt
Bula inițială este \(B_t=20\) lei, iar randamentul cerut este \(m=10\%\).
Probabilitatea de supraviețuire este \(\pi=0{,}8\); probabilitatea de crah este \(1-\pi=0{,}2\).
În cazul unui crah, bula devine zero; investitorii cunosc probabilitățile.
Condiția de joc echitabil pentru bulă, \(\E[B_{t+1}\mid\mathcal I_t]=(1+m)B_t\), cere o bulă așteptată de \((1+m)B_t=22\) lei.
Condiționat de supraviețuire: \(B_{t+1}=22/0{,}8=27{,}5\) lei.
Creșterea condiționată este \(27{,}5/20-1=37{,}5\%\).
Jocul corect restricționează doar randamentul așteptat pe perioada următoare; el nu fixează nivelul prețului. Condiția de absență a bulei (no-bubble condition, numită și condiție de transversalitate), \(\lim_{k\to\infty} \mathbb{E}[P_{t+k} \mid \mathcal{I}_t]/(1+m)^k = 0\), cere ca prețul de revînzare așteptat și actualizat să tindă la zero cînd orizontul de revînzare \(k\) crește; sub ea, prețul este egal cu valoarea fundamentală, susținută integral de dividende. O bulă rațională încalcă condiția: din \(\mathbb{E}[B_{t+k} \mid \mathcal{I}_t] = (1+m)^k B_t\), valoarea ei actualizată rămîne \(B_t\) la orice orizont, așa că bula de 20 de lei din exemplu valorează tot 20 de lei în banii de azi, oricît de îndepărtată ar fi revînzarea. Tirole (1985) arată că, în modelele cu generații suprapuse, o bulă poate exista doar dacă rata dobînzii este sub rata de creștere a economiei.
Pe scurt
Jocul echitabil restricționează doar randamentul așteptat pe perioada următoare.
Nu fixează nivelul prețului.
Condiția de absență a bulelor (no-bubble condition): \(\displaystyle\lim_{k\to\infty}\frac{\E[P_{t+k}\mid\mathcal I_t]}{(1+m)^k}=0\)
condiția de absență a bulei, numită și condiție de transversalitate
\(k\): orizontul revînzării; valoarea actualizată a prețului de revînzare așteptat tinde la zero
Cu această condiție, prețul este egal cu valoarea fundamentală \(P^*_t\).
El este susținut integral de dividende.
O bulă rațională încalcă condiția.
Din \(\E[B_{t+k}\mid\mathcal I_t]=(1+m)^kB_t\), valoarea actualizată a bulei rămîne \(B_t\neq 0\) la orice orizont.
În exemplul numeric, bula de 20 de lei valorează tot 20 de lei în bani de azi.
Oricît de departe ar fi revînzarea.
Tirole (1985): în modelele cu generații suprapuse, o bulă poate exista doar în anumite condiții.
Rata dobînzii este sub rata de creștere a economiei.
Colectarea informației costă: analiști, date, putere de calcul. Dacă prețurile ar reflecta toată informația, nimeni nu ar fi plătit pentru colectarea ei, nimeni nu ar colecta-o, iar prețurile nu ar mai putea s-o reflecte (Grossman & Stiglitz, 1980). Soluția este un grad de ineficiență de echilibru, exact cît să compenseze costurile traderilor informați. Piețele mari și lichide, cu informație ieftină și costuri mici, ar trebui deci să fie mai aproape de eficiență, o predicție pentru comparația din capitol dintre piețele dezvoltate, emergente și cripto. Eficiența nu exclude nici bulele; ea spune doar că momentul lor este greu de anticipat (Capitolul 17).
Pe scurt
Colectarea informației este costisitoare (analiști, date, putere de calcul)
Dacă prețurile ar reflecta toată informația, nimeni nu ar fi plătit pentru colectarea ei Grossman & Stiglitz (1980)
Atunci nimeni nu ar colecta-o, iar prețurile nu ar mai putea să o reflecte
Soluția: un grad de ineficiență de echilibru, suficient pentru a acoperi costurile celor informați
Piețele mari și lichide, cu informație ieftină și costuri mici, ar trebui să fie mai aproape de eficiență
o predicție pentru comparația noastră între piețele dezvoltate, cele emergente și piețele de criptoactive
Eficiența nu exclude bulele: spune doar că momentul lor este greu de anticipat
Un arbitraj pur nu cere o investiție inițială pozitivă, nu poate pierde și cîștigă în cel puțin o stare. Tranzacționarea relative-value este diferită: ea pariază pe convergența a două prețuri, iar convergența este incertă. Un decalaj de preț de 20 de puncte se poate lărgi la 30 înainte să se închidă, iar poziția are atunci nevoie de garanții suplimentare (marjă) și poate fi lichidată. Cînd convergența este incertă, arbitrajorii cu capital limitat nu pot elimina abaterile de la valoarea fundamentală (Shleifer & Vishny, 1997); aceasta este legătura dintre arbitraj și eficiență.
Pe scurt
Arbitrajul pur este o strategie fără plată inițială netă pozitivă.
Fără pierdere posibilă.
Cu un cîștig pozitiv în cel puțin o stare.
Tranzacționarea pe valoare relativă (relative-value) este riscantă cînd convergența prețurilor nu este sigură.
Exemplu: un ecart de preț de 20 de puncte poate crește la 30 înainte să se închidă.
Poziția cere atunci garanții suplimentare (margin) și poate fi închisă forțat.
Legătura cu eficiența: cînd convergența este nesigură, abaterile pot persista Shleifer & Vishny (1997).
Arbitrajorii cu capital limitat nu pot elimina abaterile de la valoarea fundamentală.
Autocorelația de selecție la lagul \(k\) este \(\hat\rho_k = \sum_{t=k+1}^T e_t e_{t-k} / \sum_{t=1}^T e_t^2\), cu \(e_t = r_t - \bar r\) abaterile celor \(T\) randamente zilnice de la media lor; \(\hat\rho_k > 0\) indică persistență, iar \(\hat\rho_k < 0\) inversare. Pentru randamente i.i.d. (RW1), \(\text{SE}(\hat\rho_k) \approx 1/\sqrt{T}\), iar banda de 95% este \(\pm 1{,}96/\sqrt{T}\). Dacă media este imprevizibilă, dar volatilitatea apare în clustere (cu momente de ordinul patru finite), eroarea standard sub ipoteza nulă este \(\sqrt{\hat\tau_k}\):
Cînd mișcările mari se grupează, \(\hat\tau_k\) din (2.16) depășește \(1/T\), deci banda i.i.d. este prea îngustă, iar testele clasice resping prea des. Statisticile robuste \(\tilde Q\) (Ljung–Box) și \(z^*\) (variance ratio) folosesc \(\hat\tau_k\) în locul lui \(1/T\).
Pe scurt
Autocorelația de selecție: \(\hat\rho_k = \sum_{t=k+1}^T e_t e_{t-k} / \sum_{t=1}^T e_t^2\), cu \(e_t = r_t - \bar r\)
Sub RW1 (i.i.d.): \(\text{SE}(\hat\rho_k) \approx 1/\sqrt{T}\)
Banda de 95% sub ipoteza nulă \(\pm 1{,}96/\sqrt{T}\)
Eroarea standard robustă: \(\text{SE}(\hat\rho_k) \approx \sqrt{\hat\tau_k}\)
dacă media este imprevizibilă, dar volatilitatea se grupează și momentele de ordinul patru sînt finite
\(\hat\tau_k = \sum_t e_t^2 e_{t-k}^2 \,/\, \big(\sum_t e_t^2\big)^2\) (dispersia robustă sub \(H_0\); pentru benzile de test centrate în 0)
Cînd volatilitatea se grupează, \(\hat\tau_k > 1/T\): banda i.i.d. sub ipoteza nulă este prea îngustă, iar testele clasice resping ipoteza nulă prea des
Statisticile robuste \(\tilde Q\) (Ljung–Box) și \(z^*\) (raportul varianțelor) folosesc \(\hat\tau_k\) în locul lui \(1/T\)
Eroarea standard \(\sqrt{\hat\tau_k}\) este derivată sub ipoteza nulă, deci se potrivește unei benzi de test centrate în 0, nu unui interval în jurul unei estimații \(\hat\rho_k \neq 0\). În jurul estimației, capitolul folosește varianța HAC (heteroskedasticity- and autocorrelation-consistent) a estimatorului (Newey & West, 1987): fiecare zi contribuie cu \(\hat\psi_t = (e_t e_{t-k} - \hat\rho_k e_t^2)/\hat\gamma_0\) la \(\hat\rho_k - \rho_k\), iar varianța lui \(\hat\rho_k\) este varianța de termen lung a lui \(\hat\psi_t\), cu ponderi Bartlett, împărțită la \(T\), cu bandwidth-ul \(\ell = \lfloor 4(T/100)^{2/9} \rfloor\): 9–10 laguri pentru selecțiile complete, 4–5 pentru un an calendaristic și 6 pentru ferestrele ETF. Aceste intervale servesc la compararea perioadelor, de exemplu anii cripto sau ferestrele dinainte și de după ETF-uri. Un moving-block bootstrap dă valori apropiate (S&P 500: HAC 0,030, block bootstrap 0,031, față de \(\text{SE}_0 = 0{,}027\)), iar eroarea standard HAC este mai mică decît \(\text{SE}_0\) pentru 14 din cele 16 serii (BET: 0,023 față de 0,028).
Pe scurt
\(\sqrt{\hat\tau_k}\) este calculată sub \(H_0\): e valabilă pentru o bandă de test centrată în 0, nu pentru un interval în jurul lui \(\hat\rho_k \neq 0\).
În jurul estimației folosim dispersia HAC a estimatorului Newey & West (1987):
\(\hat\psi_t = (e_t e_{t-k} - \hat\rho_k e_t^2)/\hat\gamma_0\), cu \(\hat\gamma_0 = \tfrac{1}{T}\sum_t e_t^2\): contribuția zilei \(t\) la \(\hat\rho_k - \rho_k\).
\(\widehat{\Var}(\hat\rho_k) = \tfrac{1}{T}\big[\hat c_0 + 2\sum_{j=1}^{\ell}\big(1 - \tfrac{j}{\ell+1}\big)\hat c_j\big]\), cu \(\hat c_j\) autocovarianța de lag \(j\) a lui \(\hat\psi_t\).
lățimea de bandă (bandwidth) \(\ell = \lfloor 4 (T/100)^{2/9} \rfloor\): 9–10 laguri pe eșantioanele complete, 4–5 pentru un an calendaristic, 6 pentru ferestrele ETF.
Folosire: intervale în jurul lui \(\hat\rho_k\) și comparații între perioade (anii criptoactivelor, înainte/după ETF-uri).
Verificare: un moving block bootstrap (blocuri de \(T^{1/3}\) zile) dă valori apropiate.
S&P 500: HAC \(0{,}030\), block bootstrap \(0{,}031\), \(\text{SE}_0 = 0{,}027\).
SE HAC este mai mică decît \(\text{SE}_0\) la 14 din cele 16 serii (BET: \(0{,}023\), față de \(0{,}028\)).
Un test portmanteau combină mai multe corelații la laguri diferite într-o singură statistică, în loc să aleagă lagul cel mai izbitor, iar un test Wald face același lucru pentru restricții asupra coeficienților unei regresii. Mediile egale în cele cinci zile ale săptămînii impun patru restricții, \(\beta_1 = \beta_2\),\(\beta_1 = \beta_3\),\(\beta_1 = \beta_4\),\(\beta_1 = \beta_5\), deci distribuția de referință este \(\chi^2_4\), cu valoarea critică de 5% egală cu 9,49. Cinci restricții, toate \(\beta_d = 0\), ar testa o altă ipoteză nulă: că media fiecărei zile este zero.
Pe scurt
Un test portmanteau combină corelațiile la mai multe laguri într-o singură statistică.
În loc să alegem lagul cel mai spectaculos.
Un test Wald verifică în mod similar restricții comune asupra coeficienților
egalitatea celor cinci medii zilnice impune patru restricții, \(\beta_1=\beta_2\), \(\beta_1=\beta_3\), \(\beta_1=\beta_4\), \(\beta_1=\beta_5\), deci reperul este \(\chi^2_4\), cu valoarea critică de 5% egală cu 9,49.
Cinci restricții, toate \(\beta_d=0\), ar testa altă ipoteză nulă: media fiecărei zile egală cu zero.
Statistica Ljung–Box testează în comun \(H_0: \rho_1 = \dots = \rho_m = 0\) pentru randamente i.i.d. (Ljung & Box, 1978); versiunea ei robustă (Lobato, Nankervis & Savin, 2001) înlocuiește varianța i.i.d. cu \(\hat\tau_k\) din (2.16), ceea ce dă
ambele comparate cu \(\chi^2_m\). Limita robustă este valabilă sub RW3 cînd \(\hat\rho_k\) de la laguri diferite sînt asimptotic necorelate, ca la un GARCH cu inovații simetrice. La \(m = 10\) (valoarea critică 18,31), S&P 500 are \(Q = 97{,}1\), dar \(\tilde Q = 20{,}0\)(\(p = 0{,}029\)), BET are \(Q = 108{,}0\) și \(\tilde Q = 24{,}4\)(\(p = 0{,}007\)), iar Bitcoin are \(Q = 20{,}2\)(\(p = 0{,}028\)), dar \(\tilde Q = 11{,}9\)(\(p = 0{,}294\)). Testul robust păstrează respingerile pentru S&P 500 și BET, dar nu și pentru Bitcoin; \(\tilde Q\) cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială.
Testul secvențelor (Wald & Wolfowitz, 1940) folosește doar semnele randamentelor, fără zilele cu randament zero, așa că cozile groase nu îl afectează. O secvență (run) este un bloc maximal de semne egale. Cu \(n_1\) zile pozitive și \(n_2\) negative, \(n = n_1 + n_2\), semnele independente dau \(\mathbb{E}[R] = 2n_1 n_2/n + 1\) secvențe, iar numărul standardizat de secvențe este aproximativ Normal standard, presupunînd o probabilitate constantă a unei zile pozitive. Prea puține secvențe (\(z < 0\)) înseamnă semne persistente, prea multe (\(z > 0\)) semne care alternează. S&P 500 are \(z = 4{,}34\), alternanță compatibilă cu \(\hat\rho_1 < 0\); BET are \(z = -6{,}05\), persistență compatibilă cu \(\hat\rho_1 > 0\); Bitcoin are \(z = 2{,}68\), o respingere deși \(\hat\rho_1\) nu este semnificativ: semnele și mărimile poartă informații diferite.
Lo & MacKinlay (1988) estimează variance ratio-ul \(\text{VR}(q)\) din sumele suprapuse a cîte \(q\) randamente zilnice: \(\hat\sigma_a^2\) este varianța randamentelor pe o zi, \(\hat\sigma_c^2(q)\) varianța sumelor suprapuse pe \(q\) zile împărțită la \(q\), cu un divizor \(m = q(T-q+1)(1-q/T)\) care elimină deplasarea de selecție mică, iar \(\widehat{\text{VR}}(q) = \hat\sigma_c^2(q)/\hat\sigma_a^2\). Sub RW1 (randamente homoscedastice), statistica testului este
iar \(|z| > 1{,}96\) respinge \(\text{VR}(q) = 1\) la 5%. Statistica (2.18) respinge prea des în prezența volatility clustering, de unde nevoia versiunii robuste.
Pe scurt
Lo & MacKinlay (1988) estimează \(\text{VR}(q)\) din sume suprapuse de \(q\) randamente zilnice și corectează deplasarea din selecții mici
Sub RW3 și condițiile lui Lo & MacKinlay (1988) (momente finite, dependență slabă și \(\mathbb{E}[\varepsilon_t^2 \varepsilon_{t-j}\varepsilon_{t-k}] = 0\) pentru \(j \neq k\)), estimațiile \(\hat\rho_k\) sînt asimptotic necorelate, cu varianțele \(\hat\delta_k/T\), unde \(\hat\delta_k = T\hat\tau_k\) este 1 în absența volatility clustering. Cum \(\widehat{\text{VR}}(q) - 1\) ponderează \(\hat\rho_k\) cu \(2(q-k)/q\), statistica robustă este
RW3 singură nu ajunge: condițiile sînt îndeplinite de un GARCH cu inovații simetrice, dar pot eșua în prezența unui efect de levier (leverage effect), caz în care \(\hat\theta(q)\) are nevoie de întreaga matrice de covarianță a estimațiilor \(\hat\rho_k\). La \(q = 5\), S&P 500 are \(z^*(5) = -2{,}78\): inversarea rămîne semnificativă cu eroarea standard robustă.
Pe scurt
Sub RW3 plus condițiile din Lo & MacKinlay (1988), \(\hat\rho_k\) sînt asimptotic necorelate, cu dispersiile \(\hat\delta_k / T\)
\(\hat\delta_k = T\hat\tau_k\), cu \(\hat\tau_k\) de pe slide-ul autocorelației: dispersia robustă a lui \(\sqrt{T}\hat\rho_k\), egală cu 1 fără gruparea volatilității
Dispersia asimptotică a lui \(\widehat{\text{VR}}(q)\) și statistica testului
\(2(q-k)/q\): ponderea lui \(\hat\rho_k\) în \(\widehat{\text{VR}}(q)\)
\(|z^*| > 1{,}96\) respinge \(\text{VR}(q) = 1\) la 5%
RW3 singură nu este suficientă
condițiile sînt îndeplinite de GARCH cu inovații simetrice
dar pot să nu fie îndeplinite în prezența efectului de levier
Fără condiția \(\E[\varepsilon_t^2 \varepsilon_{t-j} \varepsilon_{t-k}] = 0\), calculul lui \(\hat\theta(q)\) necesită întreaga matrice de covarianță a estimatorilor \(\hat\rho_k\)
La \(q = 5\), S&P 500 are \(z^*(5) = -2{,}78\)
inversarea rămîne semnificativă și cu eroarea standard robustă
comparația lui \(z\) cu \(z^*\) la \(q = 2\): secțiunea 2
Graficul arată, pentru fiecare dintre cele 16 serii ale capitolului, statistica robustă \(z^*(5)\) din (2.19), cu linii întrerupte la \(\pm 1{,}96\). Barele de deasupra liniei superioare indică persistență pe cinci zile, cele de sub linia inferioară inversare.
La cinci zile, \(|z^*(5)| > 1{,}96\) pentru BET (2,98), S&P 500 (\(-2{,}78\)), EUR/RON (2,19) și Euro Stoxx 50 (\(-2{,}08\)). Testul comun al lui Chow & Denning (1993), care ia cel mai mare \(|z^*|\) de pe mai multe orizonturi și îl compară cu valoarea critică 2,49, respinge RW3 pentru 5 din cele 16 serii: BET, S&P 500, EUR/RON, IPC (la 2 zile, \(z^* = 3{,}72\)) și Ethereum (la 20 de zile, \(z^* = 2{,}70\)). Euro Stoxx 50 respinge la cinci zile, dar nu și în testul comun, deoarece cel mai mare \(|z^*|\) al lui este 2,24. Rezultatele nu dau o ierarhie de tipul „dezvoltat înseamnă eficient”: S&P 500 arată inversare, iar BET și EUR/RON persistență.
Pe scurt
Fiecare bară din graficul anterior este statistica robustă \(z^*(5)\) a uneia dintre cele 16 serii.
Liniile întrerupte marchează \(\pm 1{,}96\).
La 5 zile, \(|z^*(5)| > 1{,}96\) pentru BET (\(2{,}98\)), S&P 500 (\(-2{,}78\)), EUR/RON (\(2{,}19\)) și Euro Stoxx 50 (\(-2{,}08\)).
Ipoteza diferenței de martingal (MDH, martingale difference hypothesis), \(\mathbb{E}[r_t \mid \mathcal{I}_{t-1}] = \mu\), spune că nicio funcție a trecutului, liniară sau nu, nu prognozează media. RW3, care doar anulează toate \(\rho_k\), este mai slabă. În contraexemplul \(r_t = \varepsilon_t + \theta(\varepsilon_{t-1}^2 - \sigma^2)\), cu \(\varepsilon_t\) i.i.d. simetric și \(\sigma^2 = \operatorname{Var}(\varepsilon_t)\), toate autocorelațiile sînt nule, dar \(\mathbb{E}[r_t \mid \varepsilon_{t-1}] = \theta(\varepsilon_{t-1}^2 - \sigma^2)\) este previzibilă. Testul BDS (Brock–Dechert–Scheinkman) (Brock, Dechert, Scheinkman & LeBaron, 1996) compară frecvența secvențelor de randamente apropiate cu cea implicată de observații i.i.d.; el testează i.i.d., nu MDH, iar un GARCH singur îl face să respingă, deci o respingere BDS este o dovadă împotriva RW1, nu împotriva eficienței în formă slabă.
Pe scurt
MDH: \(\E[r_t \mid \mathcal{I}_{t-1}] = \mu\)
Martingale Difference Hypothesis, ipoteza diferenței de martingal
nicio funcție a trecutului, liniară sau nu, nu prezice media
RW3 (toate \(\rho_k = 0\)) este mai slabă. Contraexemplu: \(r_t = \varepsilon_t + \theta(\varepsilon_{t-1}^2 - \sigma^2)\), \(\varepsilon_t\) i.i.d. simetrice
\(\sigma^2 = \Var(\varepsilon_t)\), deci termenul suplimentar are media 0
\(\theta \neq 0\): cît de mult deplasează pătratul șocului de ieri media de azi
toate \(\rho_k = 0\), dar \(\E[r_t \mid \varepsilon_{t-1}] = \theta(\varepsilon_{t-1}^2 - \sigma^2)\) este predictibilă: testele de autocorelație nu o pot detecta
Testele MDH propriu-zise, pe slide-ul următor, caută exact acest tip de dependență (rezultate: Anexa)
Testul spectral generalizat (generalised spectral test) (Escanciano & Velasco, 2006) măsoară covarianța dintre \(r_t\) și funcții neliniare \(e^{\mathrm{i}x r_{t-j}}\) ale randamentelor trecute, la toate lagurile \(j\), așa că detectează contraexemplul din cadrul anterior, pe care autocorelațiile îl ratează. Testul portmanteau automat (Escanciano & Lobato, 2009) este un Ljung–Box robust la heteroscedasticitate, cu numărul de laguri ales din date printr-o penalizare; fiindcă testează doar autocorelații, el nu detectează contraexemplul neliniar.
Pe scurt
De ce: autocorelațiile zero nu exclud o medie predictibilă
o arată contraexemplul de pe slide-ul anterior
Testul spectral generalizat Escanciano & Velasco (2006) măsoară covarianța dintre \(r_t\) și funcții neliniare ale randamentelor trecute
\(e^{\mathrm{i}x r_{t-j}}\), la toate lagurile \(j\)
el detectează contraexemplul \(r_t = \varepsilon_t + \theta(\varepsilon_{t-1}^2 - \sigma^2)\), pe care autocorelațiile îl ratează
În regresiile predictive și pe ferestre rolling suprapuse, reziduurile sînt autocorelate și heteroscedastice, iar erorile standard clasice ale metodei celor mai mici pătrate (OLS, ordinary least squares) nu sînt valide. În regresia pe raportul dividend–preț ele sînt prea mici (OLS \(t = 1{,}16\), Newey–West \(t = 0{,}91\)), deși erorile HAC pot fi și mai mici decît cele OLS, ca în tabelul efectelor de calendar. Erorile standard HAC estimează varianța de termen lung, adică varianța plus de două ori suma autocovarianțelor; Newey & West (1987) ponderează autocovarianța de la lagul \(j\) cu \(1 - j/(\ell+1)\), astfel încît estimația să nu fie niciodată negativă. Bandwidth-ul \(\ell\) este numărul de laguri incluse: cu \(\ell = 5\), ponderile lagurilor 1–5 sînt \(5/6, 4/6, \dots, 1/6\).
Pe scurt
OLS: Ordinary Least Squares — metoda celor mai mici pătrate.
De ce: în regresiile predictive și pe ferestrele mobile suprapuse, reziduurile sînt autocorelate și heteroscedastice
erorile standard OLS clasice nu mai sînt valide
în regresia dividend–preț ele sînt prea mici (\(t\) OLS \(= 1{,}16\), \(t\) Newey–West \(= 0{,}91\))
erorile HAC pot fi și mai mici decît cele OLS (tabelul efectelor de calendar)
Erorile standard HAC estimează long-run variance: dispersia plus de două ori suma autocovarianțelor
Newey & West (1987) ponderează autocovarianța de la lagul \(j\) cu \(1 - j/(\ell + 1)\), astfel încît estimația să nu fie negativă
Lățimea de bandă \(\ell\) este numărul de laguri incluse
Nici deplasarea Stambaugh, nici banda nulă a DFA nu au o distribuție exactă cunoscută, iar bootstrap-ul o aproximează generînd multe selecții artificiale sub ipoteza nulă și recalculînd statistica în fiecare. Bootstrap-ul i.i.d. extrage observații cu întoarcere și distruge orice dependență, inclusiv volatility clustering. Block bootstrap-ul (Künsch, 1989) extrage blocuri consecutive și păstrează dependența din interiorul fiecărui bloc. Wild bootstrap-ul înmulțește fiecare randament centrat cu un semn aleator: păstrează volatilitatea fiecărei zile, dar distruge corelația serială, reproducînd o ipoteză nulă de tip RW3 cu semne simetrice; el este cel folosit pentru DFA.
Pe scurt
De ce: nici deplasarea Stambaugh, nici banda DFA sub ipoteza nulă nu au o distribuție exactă cunoscută
bootstrap o aproximează
Bootstrap generează multe selecții artificiale sub ipoteza nulă și recalculează statistica în fiecare
Bootstrap-ul i.i.d. extrage observații cu înlocuire
distruge orice dependență, inclusiv gruparea volatilității
Block bootstrap Künsch (1989) extrage blocuri consecutive și păstrează dependența din interiorul blocului
Wild bootstrap înmulțește fiecare randament centrat cu un semn aleator
păstrează volatilitatea fiecărei zile, dar distruge corelația serială: reproduce o ipoteză nulă de tip RW3 cu semne simetrice (folosită la DFA)
Diagrama compară selecțiile artificiale ale schemelor de bootstrap din cadrul anterior. Blocurile păstrează ordinea locală a randamentelor, iar schimbările de semn păstrează mărimile lor absolute; fiecare schemă impune deci o altă ipoteză asupra selecțiilor artificiale, iar alegerea ei determină ce ipoteză nulă reprezintă banda rezultată.
Pe scurt
Blocurile păstrează ordinea locală; schimbările de semn păstrează modulele. Cele două proceduri impun ipoteze diferite selecțiilor artificiale.
Întrebarea este de ce raportul dividend–preț din secțiunea despre predictibilitatea out-of-sample poate părea un predictor bun chiar cînd panta lui adevărată este zero. Modelul are două ecuații, \(r_{t+1} = \alpha + \beta x_t + u_{t+1}\) și \(x_{t+1} = \theta + \rho x_t + v_{t+1}\), cu \(\operatorname{Cov}(u, v) = \sigma_{uv}\). Aici \(r\) este randamentul în exces, \(x\) raportul logaritmic dividend–preț \(dp_t = \ln D_t - \ln P_t\), cu \(D_t\) dividendele din ultimul an, iar \(\rho \approx 1\) persistența lui, coeficientul AR(1) al lui \(dp\), distinct de autocorelațiile randamentelor \(\rho_k\) și de \(\rho\) din identitatea Campbell–Shiller.
Pe scurt
Revenim la regresia din secțiunea 3: de ce poate \(dp\) să pară un predictor bun chiar dacă \(\beta = 0\)?
\(\beta\): panta predictivă, 0 dacă randamentele sînt imprevizibile
\(\alpha\), \(\theta\): termeni liberi
\(\rho\): persistența lui \(x\), adică coeficientul AR(1) al lui \(dp\); nu este autocorelația \(\rho_k\) a randamentelor și nici \(\rho\) din identitatea Campbell–Shiller
Predictorul este predeterminat, dar nu strict exogen, deci OLS este consistent, dar deplasat (Stambaugh, 1999). Proiectînd \(u\) pe \(v\) se obține \(\hat\beta - \beta = (\sigma_{uv}/\sigma_v^2)(\hat\rho - \rho)\) plus un zgomot de medie zero, de exemplu cînd \((u, v)\) sînt i.i.d. cu distribuție Normală bivariată. Cum \(\hat\rho\) este deplasat în jos în selecții mici (Kendall, 1954),\(\mathbb{E}[\hat\rho - \rho] \approx -(1+3\rho)/T\), eroarea trece în pantă:
O creștere a prețului scade \(dp\), deci \(\sigma_{uv} < 0\), iar deplasarea din (2.20) este în sus: predictibilitatea pare mai puternică decît este. Lîngă o rădăcină unitară, nici statistica \(t\) nu are distribuție Normală standard, iar inferența validă folosește testul Bonferroni \(Q\) al lui Campbell & Yogo (2006).
estimatorul OLS este consistent, dar are deplasare în selecții finite
Proiectăm \(u\) pe \(v\): \(u = (\sigma_{uv}/\sigma_v^2)\, v + e\), deci \(\hat\beta - \beta = (\sigma_{uv}/\sigma_v^2)(\hat\rho - \rho) + \text{zgomot}\)
\(e\): partea lui \(u\) necorelată cu \(v\)
Ambele regresii folosesc aceleași luni și același \(x_t\), deci erorile de estimare \(\hat\beta - \beta\) și \(\hat\rho - \rho\) sînt legate prin corelația șocurilor \(u\) și \(v\)
Termenul de zgomot are media zero cînd \(e\) este independent de întreaga traiectorie a lui \(x\), de exemplu pentru \((u, v)\) i.i.d. cu distribuția Normală bivariată
\(\hat\rho\) este deplasat în jos în selecții mici Kendall (1954), iar această deplasare se transmite estimatorului \(\hat\beta\)
Inferența lui Campbell & Yogo (2006) ține seama de incertitudinea privind persistența predictorului, în loc să trateze estimația ei drept cunoscută: combină o mulțime de încredere pentru \(\rho\) cu teste ale pantei predictive pe acea mulțime, împărțind probabilitatea de eroare între pași. Pentru S&P 500, \(\hat\rho = 0{,}9988\) și \(T(1-\hat\rho) = 1{,}4\), deci un test de rădăcină unitară nu poate respinge \(\rho = 1\), tocmai zona în care statistica \(t\) a lui \(\hat\beta\) se îndepărtează cel mai mult de distribuția Normală standard. Acest test \(Q\) privește regresiile predictive și nu este statistica \(Q\) Ljung–Box.
Regresia folosește randamentul logaritmic lunar în exces al S&P 500 pe \(dp_t\) decalat, în 1934–2026, \(T = 1\,111\) luni. OLS dă \(\hat\beta = 0{,}267\) (procente pe lună pe unitate de \(dp\)), cu Newey–West \(t = 0{,}91\), nesemnificativ chiar înaintea oricărei corecții. Cu \(\hat\rho = 0{,}9988\),\(\operatorname{corr}(\hat u, \hat v) = -0{,}97\) și \(\hat\phi = \hat\sigma_{uv}/\hat\sigma_v^2 = -0{,}925\), formula (2.20) dă o deplasare de 0,333, deci panta corectată este \(0{,}267 - 0{,}333 = -0{,}066\): corecția estimată de ordinul întîi depășește panta estimată. Corecția este ea însăși estimată, iar formula lui Kendall este cel mai puțin precisă cînd \(T(1-\hat\rho)\) este mic, aici 1,4, deci \(-0{,}066\) indică semnul și mărimea, nu o pantă precisă. Într-o simulare cu același \(\rho\) și aceeași \(\operatorname{corr}(u, v)\), cu \(\beta = 0\) și 360 de luni, testul \(t\) cu nivel nominal de 5% respinge în 26,5% din selecții, de peste cinci ori prea des.
Pe scurt
Randamentul logaritmic lunar în exces, regresat pe \(dp_t\) decalat
Date de intrare: \(\hat\rho = 0{,}9988\), \(\text{corr}(\hat u, \hat v) = -0{,}97\), \(\hat\phi = \hat\sigma_{uv}/\hat\sigma_v^2 = -0{,}925\)
exprimate ca fracții, nu în procente
Calcul: deplasarea \(= -100\,\hat\phi\,(1 + 3\hat\rho)/T = 0{,}333\) (în %, ca \(\hat\beta\))
panta corectată \(= 0{,}267 - 0{,}333 = -0{,}066\): corecția de ordinul întîi estimată pentru deplasare depășește panta estimată
corecția este ea însăși estimată: pentru inferența formală se folosește Campbell & Yogo (2006) sau un bootstrap
Formula lui Kendall este de ordinul întîi în \(1/T\) și cea mai puțin precisă cînd \(T(1 - \hat\rho)\) este mic, aici \(1{,}4\): \(-0{,}066\) indică semnul și ordinul de mărime, nu o pantă precisă
Simulare cu aceleași \(\rho\) și \(\text{corr}(u, v)\), \(\beta = 0\) și o selecție de 30 de ani (\(T = 360\) de luni)
testul \(t\) cu nivel nominal de 5% respinge \(\beta = 0\) în \(26{,}5\%\) din selecții
Secțiunea despre predictibilitatea out-of-sample a definit \(R^2_{OS}\) și a aplicat testul Clark–West; acest cadru explică forma lui. Majoritatea predictorilor publicați au \(R^2_{OS} < 0\)(Welch & Goyal, 2008), iar actualizarea lui Goyal, Welch & Zafirov (2024) confirmă rezultatul. Testul lui Diebold & Mariano (1995) compară diferența medie dintre erorile pătratice ale celor două prognoze. Modelul cu \(dp\) include media istorică (modele imbricate, nested models): sub ipoteza nulă el estimează un \(\beta\) nul, zgomotul acestei estimații îi mărește eroarea medie pătratică de prognoză (MSPE, mean squared prediction error), iar testul Diebold–Mariano respinge mai rar decît nivelul nominal. Clark & West (2007) adaugă înapoi acest zgomot:
unde \((\bar r_t - \hat r_t)^2\) este partea din eroarea modelului datorată estimării lui \(\beta\); testul \(t\) pe media lui \(f_t\) din (2.21) este unilateral, deoarece doar un cîștig pozitiv este o dovadă în favoarea predictorului.
Pe scurt
Secțiunea 3 a definit \(R^2_{OS}\) și a aplicat testul Clark–West pe S&P 500
Diagrama compară memoria scurtă cu memoria lungă. Autocorelațiile unui proces AR(1) scad geometric, în timp ce ale exemplului de zgomot gaussian fracționar (fGn, fractional Gaussian noise) scad lent; panoul din dreapta compară cum cresc fluctuațiile cu orizontul în cele două cazuri, adică exact ce măsoară statisticile R/S și DFA de mai jos.
Pe scurt
Corelațiile AR(1) scad geometric; în exemplul fGn scad lent. Dreapta compară creșterea fluctuațiilor odată cu orizontul.
Folosind amplitudinea rescalată (rescaled range), Hurst (1951) a constatat că anii cu inundații mari ale Nilului urmau după alți ani cu inundații mari mai des decît ar permite întîmplarea. Pentru o fereastră de \(n\) randamente cu media \(\bar r_n\) și abaterea standard \(s_n\), abaterile cumulate sînt \(Y_k = \sum_{i=1}^k (r_i - \bar r_n)\), amplitudinea este \(R_n = \max_k Y_k - \min_k Y_k\), iar statistica este \(R_n/s_n\). Legea de scalare
\[\mathbb{E}[R_n/s_n] \approx c\,n^H\]
(2.22)
definește exponentul Hurst \(H\) ca panta lui \(\ln(R/S)\) în raport cu \(\ln n\), cu \(R/S\) mediat pe ferestre nesuprapuse. \(H = 0{,}5\) înseamnă absența memoriei lungi (dependența pe termen scurt este permisă), \(H > 0{,}5\) persistență, cu \(\rho_k \sim k^{2H-2}\), iar \(H < 0{,}5\) antipersistență.
Pe scurt
Hurst (1951) a constatat persistența revărsărilor Nilului cu ajutorul amplitudinii rescalate (rescaled range)
anii cu revărsări mari urmau altor ani cu revărsări mari mai des decît ar permite hazardul
Graficul arată, pentru S&P 500 și BET, media amplitudinii rescalate \(R/S\) pentru fiecare lungime de fereastră \(n\), împreună cu valoarea așteptată pentru randamente i.i.d. din distribuția Normală. Panta lui \(\ln(R/S)\) în raport cu \(\ln n\) estimează exponentul Hurst din (2.22).
Linia continuă din grafic este valoarea așteptată a lui Anis & Lloyd (1976) pentru randamente i.i.d. din distribuția Normală. În selecții mici, panta brută depășește 0,5 chiar pentru randamente i.i.d., iar corecția Anis–Lloyd elimină această deplasare: \(H_{AL}\) este 0,5 plus panta lui \(\ln(R/S) - \ln\mathbb{E}[R_n/s_n]\) în raport cu \(\ln n\). Pentru S&P 500, exponentul brut este 0,530, iar cel corectat 0,485, deci persistența aparentă venea din deplasarea de selecție mică. Pentru BET, exponentul brut este 0,578, iar cel corectat 0,533, deci persistența rămîne. Dacă aceasta reflectă memorie lungă sau doar autocorelația de lag 1, \(\hat\rho_1 = 0{,}109\), este o întrebare deschisă pe care statistica R/S clasică nu o poate tranșa.
Pe scurt
În graficul anterior, punctele arată \(R/S\) mediu pentru fiecare lungime \(n\) a ferestrei.
Linia continuă este media teoretică Anis & Lloyd (1976) pentru randamente i.i.d. din distribuția Normală.
Lo (1991) arată că autocorelația pe termen scurt umflă R/S și imită memoria lungă. Modificarea lui înlocuiește \(s_n\) cu o abatere standard de termen lung (HAC) \(\hat\sigma_\ell\), cu \(\hat\sigma_\ell^2 = \hat\gamma_0 + 2\sum_{j=1}^\ell (1 - j/(\ell+1))\hat\gamma_j\), și folosește întreaga selecție: \(V = (\max_k Y_k - \min_k Y_k)/(\hat\sigma_\ell\sqrt{T})\), cu bandwidth-ul ales ca la Andrews (1991). Sub memorie scurtă, \(V\) se află în \([0{,}809; 1{,}862]\) cu probabilitatea 95%. Nu respingem memoria scurtă pentru S&P 500 (\(V = 1{,}560\)), Bitcoin (1,547), PX (1,749) și EUR/RON (1,429); pentru BET (\(V = 1{,}961\),\(\ell = 7\)) și Ethereum (1,980), \(V\) este puțin peste limita superioară, o dovadă slabă de memorie lungă.
Pe scurt
Lo (1991): autocorelația pe termen scurt mărește artificial statistica R/S și imită memoria lungă
Modificarea: \(s_n\) este înlocuit cu o abatere standard pe termen lung (HAC) \(\hat\sigma_\ell\), cu \(\ell\) laguri
Detrended fluctuation analysis (DFA) (Peng et al., 1994) măsoară cum crește fluctuația randamentelor cumulate cu lungimea ferestrei. Profilul \(y_k = \sum_{t \le k}(r_t - \bar r)\) este împărțit în cutii de lungime \(n\); în fiecare cutie se ajustează un trend liniar, iar \(F(n)\) este rădăcina mediei pătratelor tuturor reziduurilor, calculată pentru multe valori \(n\). Eliminarea unui trend liniar din profil elimină o medie constantă a randamentelor în fiecare cutie; dacă media însăși are trend, este nevoie de DFA de ordin superior. Scalarea \(F(n) \propto n^{\alpha_{DFA}}\) definește exponentul \(\alpha_{DFA}\), care joacă rolul lui \(H\), iar \(\alpha_{DFA} = 0{,}5\) înseamnă absența memoriei lungi.
Pe scurt
Peng et al. (1994): DFA măsoară cum crește fluctuația randamentelor cumulate odată cu lungimea ferestrei.
Eliminarea unei tendințe liniare din profil înlătură o medie constantă a randamentelor în fiecare segment.
Dacă media randamentelor are ea însăși o tendință, este nevoie de DFA de ordin superior.
Algoritmul
Profilul \(y_k = \sum_{t \leq k} (r_t - \bar r)\) este suma abaterilor randamentelor de la medie, pe întreaga selecție.
Profilul se împarte în segmente de lungime \(n\).
În fiecare segment se estimează o tendință liniară și se păstrează reziduurile.
\(F(n)\) este rădăcina mediei pătratelor tuturor reziduurilor; calculul se repetă pentru mai multe valori ale lui \(n\).
\(F(n) \propto n^{\alpha_{DFA}}\): exponentul DFA \(\alpha_{DFA}\) joacă rolul lui \(H\) (\(\alpha_{DFA} = 0{,}5\): fără memorie lungă).
Banda nulă pentru \(\alpha_{DFA}\) provine dintr-un wild bootstrap cu 199 de replicări, în care fiecare reziduu \(e_t = r_t - \bar r\) este înmulțit cu un semn aleator \(\eta_t = \pm 1\), cu probabilitatea 1/2. Schimbarea semnului păstrează volatilitatea \(|e_t|\), permisă sub RW3, și distruge doar corelația serială, pe cînd o permutare le-ar distruge pe amîndouă. Ipoteza nulă implicită este mai strictă decît RW3, deoarece cere semne simetrice și independente, dată fiind volatilitatea, așa că banda este un reper, nu un test exact al RW3 și nici un interval de încredere pentru \(\alpha_{DFA}\).
Pe scurt
Banda de 95% sub ipoteza nulă se obține prin wild bootstrap (199 de replicări).
Fiecare reziduu \(e_t = r_t - \bar r\) este înmulțit cu un semn aleator \(\eta_t = \pm 1\), cu probabilitatea \(1/2\).
Schimbarea semnului păstrează volatilitatea \(|e_t|\) și distruge doar corelația serială.
Volatilitatea variabilă este permisă sub RW3.
O permutare le-ar distruge pe amîndouă.
Ipoteza nulă implicită este mai strictă decît RW3.
Semne simetrice și independente, dată fiind volatilitatea.
Banda este deci un reper, nu un test exact al RW3 și nici un interval de încredere pentru \(\alpha_{DFA}\).
Graficul arată exponentul DFA \(\alpha_{DFA}\) al fiecăreia dintre cele 16 serii ca punct, cu banda nulă wild bootstrap de 95% ca bară. Un punct în afara propriei bare indică o memorie pe care volatility clustering singur nu o explică.
S&P 500 (0,494), Euro Stoxx 50 (0,488) și Nikkei (0,503) sînt aproape de 0,5 și în interiorul benzilor. Trei din cele 16 serii depășesc banda: Ethereum (0,581), BET (0,580, față de o limită superioară de 0,561) și, la limită, Bitcoin (0,576 față de 0,575). PX (0,553) și Shanghai (0,554) depășesc doar o bandă construită prin permutare, care distruge și volatility clustering, deci memoria lor aparentă vine din volatility clustering. Estimatorul local Whittle (Robinson, 1995) estimează \(d = H - 0{,}5\) din frecvențele cele mai joase; pentru BET, \(\hat d = 0{,}118\), cu intervalul de 95% \([0{,}062; 0{,}174]\), dar intervalul presupune inovații condiționat homoscedastice, ipoteză încălcată de volatility clustering. Dovezile de memorie lungă în randamente sînt slabe și depind de metodă, în timp ce memoria volatilității (Capitolul 1) este puternică.
Pe scurt
Fiecare punct din graficul anterior este exponentul \(\alpha_{DFA}\) al unei serii.
Bara este banda wild bootstrap de 95% sub ipoteza nulă.
S&P 500 (\(0{,}494\)), Euro Stoxx 50 (\(0{,}488\)) și Nikkei (\(0{,}503\)) sînt aproape de \(0{,}5\), în interiorul benzii.
Trei din cele 16 serii depășesc banda.
Ethereum (\(0{,}581\)) și BET (\(0{,}580\), față de limita superioară \(0{,}561\)).
La limită, Bitcoin (\(0{,}576\), față de \(0{,}575\)).
PX (\(0{,}553\)) și Shanghai (\(0{,}554\)) depășesc doar o bandă obținută prin permutare.
Permutarea distruge și gruparea volatilității.
Memoria lor aparentă vine din gruparea volatilității.
Estimatorul local Whittle Robinson (1995) estimează \(d = H - 0{,}5\) din frecvențele cele mai joase.
Pentru BET, \(\hat d = 0{,}118\), cu intervalul de 95% \([0{,}062;\ 0{,}174]\) (Anexa).
Testele pe întreaga selecție dau dovezi slabe și instabile, iar un motiv posibil este că eficiența variază în timp. Andrew Lo a propus ipoteza piețelor adaptive (AMH, Adaptive Markets Hypothesis) în Lo (2004) și a dezvoltat-o în cartea Lo (2017). Piețele sînt descrise ca o ecologie de specii concurente, traderi, fonduri și algoritmi, care se adaptează prin încercare și eroare, nu prin optimizare perfectă; eficiența este o chestiune de grad și depinde de numărul de concurenți, de oportunitățile de profit și de mediu, iar anomaliile apar, slăbesc și pot reapărea. Statisticile variabile în timp nu identifică singure AMH, deoarece și o ipoteză a piețelor eficiente (EMH, Efficient Market Hypothesis) cu prime de risc variabile în timp le permite.
Două direcții de cercetare susțin variația în timp. Sinteza lui Lim & Brooks (2011) constată că eficiența piețelor de acțiuni variază în timp, mai ales în jurul crizelor. Urquhart & McGroarty (2016) constată, pe patru indici importanți (SUA, Regatul Unit, Japonia, zona euro), că dependența serială apare și dispare de la o subperioadă la alta, odată cu condițiile pieței.
Pe scurt
Anomaliile apar, slăbesc și pot reapărea
Variația în timp a statisticilor nu permite, singură, identificarea AMH
și o EMH cu prime de risc variabile o poate genera
Eficiența variabilă în timp se măsoară calculînd \(z^*(5)\) și exponentul DFA pe ferestre rolling de 500 de zile de tranzacționare, circa doi ani, deplasate cu cîte 21 de zile, o lună. Banda DFA se calculează prin schimbări aleatoare de semn, ca înainte, dar separat în fiecare fereastră, astfel încît să urmeze volatilitatea ferestrei. Pentru comparație, o bandă fixă \([0{,}380; 0{,}615]\) este simulată din randamente i.i.d. Student-\(t\) cu 4 grade de libertate: cozi groase fără volatility clustering. Fiindcă volatility clustering, permis sub RW3, crește \(\alpha_{DFA}\), banda fixă semnalează prea multe ferestre. Sînt necesare două precauții:
Ferestrele suprapuse sînt puternic corelate, deci șirurile de respingeri nu sînt dovezi independente;
Circa 5% din ferestre resping chiar sub ipoteza nulă, deci o proporție apropiată de 5% este o descriere, nu un test calibrat al stabilității.
Pe scurt
Calculăm o statistică pe o fereastră mobilă
500 de zile de tranzacționare (circa doi ani), deplasată cu 21 de zile (o lună)
Statistici: \(z^*(5)\) al testului raportului varianțelor și exponentul DFA
Banda DFA sub ipoteza nulă se calculează ca înainte, dar separat în fiecare fereastră
schimbări aleatoare de semn
deci urmează volatilitatea ferestrei
Pentru comparație, o bandă fixă este \([0{,}380;\ 0{,}615]\)
simulat din randamente i.i.d. Student-\(t\) cu 4 grade de libertate
cozi groase, fără gruparea volatilității
Banda fixă ignoră gruparea volatilității, permisă sub RW3
gruparea volatilității mărește \(\alpha_{DFA}\)
deci banda fixă semnalează prea multe ferestre
Două precauții la interpretarea rezultatelor
Ferestrele suprapuse sînt puternic corelate: seriile de respingeri nu sînt dovezi independente
Chiar sub ipoteza nulă, circa 5% din ferestre resping: o proporție apropiată de 5% este o descriere, nu un test calibrat al stabilității
Graficul arată \(z^*(5)\) calculat pe ferestre rolling de 500 de zile pentru S&P 500, BET și Bitcoin, fiecare punct fiind datat cu ultima zi a ferestrei, cu linii întrerupte la \(\pm 1{,}96\).
Proporția ferestrelor cu \(|z^*(5)| > 1{,}96\) este 6,7% pentru S&P 500, 22,4% pentru BET și 0% pentru Bitcoin. Pentru S&P 500, \(z^*(5)\) este negativ în aproape toate ferestrele, dar trece de \(-1{,}96\) doar în cele încheiate în 2008–2010, care cuprind criza financiară; respingerea pe întreaga selecție vine din puterea mai mare a celor circa 6 700 de zile. BET depășește 1,96 în episoade, separate de perioade apropiate de zero, în ferestrele încheiate în 2002–2005, 2013–2014, 2018 și după 2023. Reclasificarea României de către FTSE (Financial Times Stock Exchange, FTSE Russell, index provider, furnizorul de indici FTSE Russell) Russell, la 21 septembrie 2020, nu apare ca o ruptură: \(z^*(5)\) al BET era aproape de zero din 2016 și urcă din nou după 2023.
Pe scurt
Graficul anterior arată \(z^*(5)\) pe ferestre mobile de 500 de zile.
Fiecare punct este datat cu ultima zi a ferestrei.
Liniile întrerupte marchează \(\pm 1{,}96\).
Proporția ferestrelor cu \(|z^*(5)| > 1{,}96\) este \(6{,}7\%\) pentru S&P 500, \(22{,}4\%\) pentru BET și \(0\%\) pentru Bitcoin.
S&P 500: \(z^*(5)\) este negativ în aproape toate ferestrele.
Trece de \(-1{,}96\) doar în cele încheiate în 2008–2010, care cuprind criza financiară.
BET: \(z^*(5)\) depășește \(1{,}96\) în episoade, separate de perioade apropiate de zero.
Ferestre încheiate în 2002–2005, 2013–2014, 2018 și după 2023.
Reclasificarea României de către furnizorul de indici FTSE Russell (FTSE: Financial Times Stock Exchange), la 21 sept. 2020 (Anexa), nu apare ca o ruptură.
\(z^*(5)\) al BET era aproape de zero din 2016 și urcă din nou după 2023.
Graficul arată \(\alpha_{DFA}\) pe ferestre rolling de 500 de zile pentru S&P 500, BET și Bitcoin, cu banda nulă wild bootstrap de 95% a fiecărei ferestre hașurată în jurul lui.
În afara propriei benzi se află 1,7% din ferestre pentru S&P 500, 3,1% pentru BET și 0% pentru Bitcoin; cu banda fixă Student-\(t_4\), proporțiile sînt 6,7%, 11,2% și 1,1%. Banda fixă ignoră volatility clustering, iar depășirile suplimentare ale BET veneau din el. Episoadele BET din graficul variance ratio-ului rămîn, deoarece privesc autocorelația pe cîteva zile, adică memoria scurtă, pe care exponentul DFA nu o vizează. Puterea este mică: banda BET este în medie \([0{,}36; 0{,}64]\), iar 500 de observații nu pot fixa un exponent de scalare.
Pe scurt
În graficul anterior, zona hașurată este banda wild bootstrap de 95% sub ipoteza nulă.
calculat separat în fiecare fereastră de 500 de zile.
Exponentul iese din propria bandă în:
\(1{,}7\%\) din ferestre pentru S&P 500.
\(3{,}1\%\) pentru BET.
\(0\%\) pentru Bitcoin.
Cu o bandă fixă Student-\(t_4\), care ignoră gruparea volatilității, proporțiile ar fi \(6{,}7\%\), \(11{,}2\%\) și \(1{,}1\%\).
depășirile DFA suplimentare ale BET veneau din gruparea volatilității.
Episoadele BET din graficul raportului varianțelor rămîn.
ele privesc autocorelația pe cîteva zile (memorie scurtă), pe care exponentul DFA nu o vizează.
Testul are putere mică.
pentru BET, banda are în medie limitele \([0{,}36;\ 0{,}64]\).
Kim, Shamsuddin & Lim (2011) arată, pe un secol de date din Statele Unite, că predictibilitatea variază cu condițiile pieței, precum crizele și bulele, fără o tendință descrescătoare, și fac AMH testabilă legînd-o de variabile de stare. Versiunea din capitol regresează \(z^*(5)\) din fiecare fereastră rolling pe volatilitatea anualizată a ferestrei (în procente) și pe o variabilă indicator de criză, egală cu 1 dacă fereastra acoperă septembrie 2008–iunie 2009 sau februarie–iunie 2020, cu erori Newey–West cu 24 de laguri, pentru că ferestrele consecutive au în comun 95% din zile. Volatilitatea este variabila de control, astfel încît se compară ferestre cu volatilitate similară. Pentru S&P 500, coeficientul de criză este \(-0{,}71\)(\(t = -2{,}53\)), iar coeficientul volatilității 0,008 (\(t = 0{,}39\)),\(R^2 = 0{,}21\); pentru BET, ei sînt \(-0{,}82\)(\(t = -2{,}77\)) și \(-0{,}008\)(\(t = -0{,}36\)),\(R^2 = 0{,}15\).
În ferestrele de criză, \(z^*(5)\) este mai mic, adică mai aproape de inversare, chiar la volatilitate egală. Rezultatul susține o asociere condiționată de volatilitate, nu un efect cauzal. Dependența de starea pieței este compatibilă cu AMH, dar nu o identifică, deoarece o schimbare a lui \(z^*(5)\) poate veni din \(\widehat{\text{VR}}(5) - 1\) sau din eroarea lui standard.
Pe scurt
În ferestrele de criză, \(z^*(5)\) este mai mic, chiar la volatilitate egală.
adică mai aproape de inversare.
Tipul de dovadă: asociere.
condiționată de volatilitate, nu un efect cauzal.
Dependența de starea pieței este compatibilă cu AMH, dar nu o identifică.
o schimbare a lui \(z^*(5)\) poate veni din \(\widehat{\text{VR}}(5) - 1\) sau din eroarea lui standard.
AMH prezice că o piață nouă devine mai eficientă în timp: \(\hat\rho_1 \neq 0\) în primii ani ai Bitcoin și valori apropiate de zero mai tîrziu. Graficul arată \(\hat\rho_1\) al randamentelor zilnice în fiecare an calendaristic, cu intervalul HAC de 95%, pentru Bitcoin și Ethereum. Pentru Bitcoin în 2011–2013, intervalele sînt largi și includ zero, deci datele nu arată ineficiența timpurie pe care o prezice AMH.
Pe scurt
AMH prezice că o piață nouă devine mai eficientă în timp: \(\hat\rho_1 \neq 0\) în primii ani, apoi aproape de zero
Graficul: \(\hat\rho_1\) al randamentelor zilnice din fiecare an calendaristic, cu intervalul HAC de 95%, pentru comparația între ani
Bitcoin 2011–2013: intervalele sînt largi și includ zero
deci datele nu arată ineficiența timpurie prezisă de AMH
Doar una din cele 27 de autocorelații anuale este semnificativă la 5%
Ethereum în 2023, \(\hat\rho_1 = -0{,}107\)
din întîmplare ne-am aștepta la circa \(1{,}35\)
testul folosește \(\text{SE}_0\) (calculată sub \(H_0\)), barele graficului SE HAC: bara Ethereum 2020 exclude 0, cea din 2023 nu
Doar una dintre cele 27 de autocorelații anuale, 16 pentru Bitcoin și 11 pentru Ethereum, este semnificativă la 5%: Ethereum în 2023, \(\hat\rho_1 = -0{,}107\), față de circa 1,35 așteptate doar din întîmplare. Testul folosește \(\text{SE}_0\), derivată sub ipoteza nulă, iar barele din grafic eroarea standard HAC, motiv pentru care bara Ethereum din 2020 exclude 0, iar cea din 2023 nu. Urquhart (2016) respinge eficiența în primii ani cu alte teste, altă sursă de prețuri și erori standard clasice. Puterea este limitată: un an de 365 de randamente dă o eroare standard robustă de circa 0,05–0,13, deci efectele mici rămîn invizibile, iar eroarea robustă cere un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială.
unde \(T_0\) este numărul zilelor de estimare, \(\sigma_\varepsilon^2\) varianța reziduală, \(r_{m,\tau}\) randamentul pieței în ziua evenimentului, iar \(\hat\mu_m\) și \(\hat\sigma_m^2\) media și varianța randamentului pieței în fereastra de estimare. Paranteza din (2.23) crește cînd mișcarea pieței din ziua evenimentului este neobișnuită: pentru taxa pe active bancare din secțiunea despre studiile de eveniment, mișcarea extremă a BET o face 2,12, de unde \(t = -6{,}85\) în loc de \(-10{,}0\) pentru TLV, și \(t = -4{,}03\) pentru BRD. Boehmer, Musumeci & Poulsen (1991) standardizează fiecare randament anormal cu propria eroare de predicție și estimează varianța din valorile standardizate ale firmelor în ziua evenimentului, astfel încît testul rămîne valid dacă evenimentul crește varianța.
Cînd toate cele \(N\) firme au evenimentul în aceeași zi, randamentele lor anormale sînt corelate, cu o corelație medie \(\bar\varrho\) estimată în fereastra de estimare; pentru TLV și BRD, \(\bar\varrho = 0{,}153\). Un test care presupune independența ignoră covarianțele, iar varianța adevărată a mediei este de \(1 + (N-1)\bar\varrho\) ori mai mare. Pentru TLV și BRD, statistica \(t\) sub independență, \(-7{,}55\), împărțită la \(\sqrt{1 + \bar\varrho} = 1{,}074\), devine \(-7{,}03\), statistica portofoliului cu ponderi egale, care ține seama automat de corelație. O estimare transversală a varianței, ca la Boehmer, Musumeci & Poulsen (1991), subestimează în plus varianța cu factorul \(1 - \bar\varrho\), motiv pentru care Kolari & Pynnönen (2010) înmulțesc statistica cu \(\sqrt{(1-\bar\varrho)/(1+(N-1)\bar\varrho)}\). Cu zece firme și aceeași corelație, subestimarea este de 2,38 ori pentru testul bazat pe independență și de 2,81 ori pentru cel transversal.
Pe scurt
Întrebarea: ce se întîmplă cu testul pentru \(\overline{AR}_0\) cînd toate firmele au evenimentul în aceeași zi?
Fie \(N\) numărul de firme și \(\bar\varrho\) corelația medie dintre randamentele lor anormale.
estimată în fereastra de estimare.
pentru TLV și BRD, \(\bar\varrho = 0{,}153\).
Testul care presupune independența ignoră covarianțele.
cu \(\bar\varrho > 0\), dispersia reală a mediei este de \(1 + (N-1)\bar\varrho\) ori mai mare.
Pentru TLV și BRD, \(t\) calculat presupunînd independența este \(-7{,}55\).
împărțit la \(\sqrt{1 + \bar\varrho} = 1{,}074\) devine \(-7{,}03\).
Este statistica \(t\) a portofoliului egal ponderat, care ține cont automat de corelație.
O anomalie este un tipar al randamentelor pe care modelul de evaluare a activelor nu îl explică, cu trei explicații posibile: un factor de risc omis, o evaluare greșită datorată unei distorsiuni comportamentale sau data snooping. Anomaliile se grupează în familii:
Efecte transversale, ca size, value și momentum (Capitolul 3).
Randamentele anomaliilor publicate scad cu 26% după sfîrșitul perioadei studiate și cu 58% după publicare (McLean & Pontiff, 2016). Efectul zilei săptămînii se estimează din \(r_t = \sum_{d=1}^5 \beta_d D_{d,t} + u_t\), unde \(D_{d,t}\) marchează ziua \(d\), iar \(\beta_d\) este randamentul ei mediu; testul Wald al ipotezei \(\beta_1 = \dots = \beta_5\)(\(\chi^2_4\)) folosește erori HAC (Newey & West, 1987) cu 5 laguri, deoarece \(u_t\) este heteroscedastic și autocorelat.
Pe scurt
Întrebarea: ce tipare rezistă după corecția pentru testare multiplă și ce le explică?
O anomalie este un tipar al randamentelor pe care modelul de evaluare nu îl explică.
Graficul arată randamentul logaritmic zilnic mediu pe zile ale săptămînii în 2000–2026, în puncte de bază (bp, basis points; 1 bp = 0,01%), cu intervale HAC de 95%. Pentru S&P 500 nu există un efect al zilei de luni după 2000, spre deosebire de French (1980): mediile variază de la 0,0 bp vinerea la 5,3 bp marțea, iar testul egalității mediilor are \(p = 0{,}83\).
Pe scurt
Randamentul logaritmic zilnic mediu, pe zile ale săptămînii, 2000–2026
în puncte de bază (bp; 1 bp = 0,01%)
intervale HAC de 95%
S&P 500: randamentul mediu variază de la \(0{,}0\) bp (vineri) la \(5{,}3\) bp (marți)
valoarea p a testului de egalitate a mediilor \(= 0{,}83\)
după 2000 nu găsim un efect al zilei de luni, spre deosebire de French (1980)
Pentru BET, joia are 11,2 bp (\(t = 3{,}09\)), totuși testul comun dă \(p = 0{,}31\). Cele două rezultate răspund unor ipoteze nule diferite: că media unei zile este zero, ceea ce amestecă efectul zilei cu randamentul mediu pozitiv, și că toate cele cinci medii sînt egale, adică efectul zilei propriu-zis.
Pe scurt
BET: joi \(11{,}2\) bp (\(t = 3{,}09\)), totuși testul comun dă \(p = 0{,}31\)
Două ipoteze nule diferite:
media unei zile este zero (poate confunda efectul zilei cu randamentul mediu pozitiv)
toate cele cinci medii sînt egale (efectul zilei propriu-zis)
Time-series momentum (TSMOM) (Moskowitz, Ooi & Pedersen, 2012) ia o poziție long pe un indice cînd suma ultimelor 12 randamente logaritmice lunare este un cîștig și o poziție short în caz contrar: semnalul este \(s_t = \text{sign}(\sum_{j=1}^{12} r_{t-j})\), iar randamentul strategiei este \(s_t R_t\), cu \(R_t\) randamentul indicelui în luna \(t\). În graficul următor, fiecare bară este statistica \(t\) HAC (6 laguri) a randamentului lunar mediu al strategiei pe o piață.
Pe scurt
TSMOM: Time-Series MOMentum — momentum pe serii de timp.
Graficul arată, pentru fiecare dintre cele 15 piețe, statistica \(t\) HAC a randamentului lunar mediu al TSMOM. Barele dincolo de 1,96 sînt semnificative la 5% cînd fiecare piață este luată separat, înaintea oricărei corecții pentru testarea multiplă.
Luată separat, strategia are un randament mediu semnificativ la 5% pentru BET (1,40% pe lună, \(t = 2{,}68\)) și pentru S&P 500 (\(t = 2{,}22\)), în timp ce Bitcoin are \(t = 1{,}94\). Cu 15 piețe testate, primul prag Holm este \(0{,}05/15 = 0{,}0033\), iar cel mai mic p-value, al BET, este 0,007, deci nicio piață nu rămîne semnificativă după corecție. Raportul Sharpe anualizat al TSMOM, calculat pe indici de preț fără dividende și fără rata fără risc, este sub cel al strategiei buy-and-hold: 0,65 față de 0,75 pentru BET și 0,48 față de 0,52 pentru S&P 500. O parte din randamentul TSMOM poate fi prima de risc a acțiunilor (equity premium), cîștigată în lunile cu poziție long. Rezultatul susține o comparație de proceduri.
Pe scurt
Luată separat, strategia are un randament mediu semnificativ la 5%:
pentru BET (\(1{,}40\%\) pe lună, \(t = 2{,}68\)).
pentru S&P 500 (\(t = 2{,}22\)).
Pentru Bitcoin, \(t = 1{,}94\), sub pragul de \(1{,}96\).
Am testat însă 15 piețe.
primul prag Holm este \(0{,}05/15 = 0{,}0033\).
cea mai mică valoare p, a BET, este \(0{,}007\).
După corecția pentru testare multiplă, nicio piață nu rămîne semnificativă.
Raportul Sharpe al TSMOM este sub cel al strategiei buy-and-hold: \(0{,}65\) față de \(0{,}75\) pentru BET, \(0{,}48\) față de \(0{,}52\) pentru S&P 500.
Tipul de dovadă: comparație între proceduri.
O parte din randamentul TSMOM poate fi prima de risc a acțiunilor (equity premium), cîștigat în lunile cu poziție lungă.
randamentul mediu al acțiunilor peste dobînda fără risc.
Raportul Sharpe este anualizat (tabelul complet: Anexa).
\(\sqrt{12}\times\) media lunară împărțită la abaterea standard lunară.
pe indici de preț fără dividende și fără dobînda fără risc.
Explicațiile comportamentale ale anomaliilor se sprijină pe cîteva noțiuni:
În teoria perspectivei (prospect theory), cîștigurile și pierderile sînt judecate față de un punct de referință, pierderile cîntăresc mai mult decît cîștigurile egale (aversiunea față de pierderi, loss aversion), iar probabilitățile mici sînt supraponderate.
Efectul de dispoziție (disposition effect) este tendința de a vinde cîștigătorii și de a păstra perdanții.
Ancorarea (anchoring) este ponderea excesivă dată unui număr inițial, precum prețul de cumpărare.
Excesul de încredere (overconfidence) supraestimează precizia propriilor convingeri și duce la prea multe tranzacții.
Comportamentul de turmă (herding) urmează acțiunile altora fără o evaluare independentă.
Subreacția și suprareacția (underreaction, overreaction) descriu un preț care se ajustează la început prea puțin sau prea mult la știri, a doua fiind urmată de inversare.
Pe scurt
Prospect theory: cîștigurile și pierderile se evaluează față de un punct de referință.
pierderile cîntăresc mai mult decît cîștigurile egale (aversiunea față de pierderi, loss aversion).
probabilitățile mici sînt supraponderate.
Efectul de dispoziție (disposition effect): tendința de a vinde pozițiile pe cîștig și de a le păstra pe cele pe pierdere.
Ancorarea (anchoring): greutate excesivă acordată unui număr inițial, de exemplu prețul de cumpărare.
Încrederea excesivă (overconfidence): supraestimarea preciziei propriilor convingeri, care duce la prea multe tranzacții.
Shiller (1981) documentează volatilitatea excesivă (excess volatility): prețurile se mișcă mult mai mult decît dividendele care ar trebui să le justifice. De Bondt & Thaler (1985) folosesc suprareacția pentru a explica inversările randamentelor pe 3–5 ani, iar teoria perspectivei (Kahneman & Tversky, 1979) explică efectul de dispoziție. Într-o piață nelichidă precum Bursa de Valori București, comportamentul de turmă produce bule log-periodice, cu prețuri care cresc super-exponențial și oscilații tot mai rapide înaintea crahului (Pele, Mazurencu-Marinescu & Nijkamp, 2013); astăzi, canalele lui sînt registrele de ordine, algoritmii și rețelele sociale (Capitolul 10). Distorsiunile singure nu anulează eficiența, deoarece arbitrajorii raționali ar putea tranzacționa împotriva lor; cadrul următor discută dacă pot.
Arbitrajul real este riscant și cere capital (Shleifer & Vishny, 1997). Riscul traderilor de zgomot (noise-trader risk) înseamnă că evaluarea greșită se poate agrava înainte să se corecteze (De Long, Shleifer, Summers & Waldmann, 1990); traderii de zgomot tranzacționează pe semnale fără conținut informațional, precum sentimentul sau zvonurile. Constrîngerile de finanțare îi obligă pe administratorii care pierd clienți după pierderi să închidă pozițiile în cel mai prost moment, iar limitele vînzării în lipsă, marjele, costurile de tranzacționare și lipsa substituților perfecți adaugă costuri. Anomaliile pot deci persista acolo unde arbitrajul este dificil: pe piața românească, mică și nelichidă, BET are cea mai puternică persistență dintre indicii de acțiuni. AMH împacă cele două perspective: comportamentul rațional și cel distorsionat coexistă și evoluează.
Învățarea automată (ML, machine learning) învață o regulă de predicție din date (Capitolul 13) și poate surprinde tipare neliniare pe care testele de autocorelație le ratează. Pe secțiunea transversală a acțiunilor americane, Gu, Kelly & Xiu (2020) constată că arborii și rețelele neuronale aduc cîștiguri economice mari față de regresiile liniare, deși \(R^2\)-ul lor lunar out-of-sample este sub 1%. Modelele lingvistice mari citesc știri și raportări, iar Tak & Pele (2025) prognozează tendințele acțiunilor cu LLaMA (Large Language Model Meta AI, familia de modele lingvistice mari a Meta).
Pe scurt
ML: Machine Learning — învățare automată.
Metodele ML construiesc reguli de predicție din date
surprind tipare neliniare pe care testele de autocorelație le ratează (Capitolul 13)
Gu, Kelly & Xiu (2020): arborii și rețelele neuronale aduc cîștiguri economice mari față de regresiile liniare
pe secțiunea transversală a acțiunilor din Statele Unite ale Americii
deși \(R^2\) lunar al acestora în afara eșantionului este sub \(1\%\)
Modelele lingvistice mari citesc știri și raportări: Tak & Pele (2025) prognozează tendințele acțiunilor cu LLaMA (Large Language Model Meta AI, familia de modele lingvistice mari a Meta)
Modelele flexibile, precum arborii și rețelele neuronale, pot potrivi și tipare accidentale ale selecției (overfitting). Validarea walk-forward estimează modelul doar pe date anterioare perioadei de test, iar leakage apare cînd o prognoză folosește informație indisponibilă la data ei, de exemplu o cifră contabilă revizuită ulterior. Regresia ridge,
\[\hat g = \arg\min_g \sum_t (r_t - x_t^\prime g)^2 + \lambda\sum_j g_j^2 = (X^\prime X + \lambda I)^{-1}X^\prime r,\]
(2.24)
trage coeficienții spre zero pentru \(\lambda > 0\) (shrinkage) și reduce varianța estimării. Cu erori \(N(0, \sigma^2)\) și o distribuție a priori \(g \sim N(0, \tau^2 I)\), ridge cu \(\lambda = \sigma^2/\tau^2\) este media a posteriori a coeficienților, o formă de învățare bayesiană. Validarea încrucișată (cross-validation) alege \(\lambda\) lăsînd deoparte cîte un bloc de date, de exemplu un an, estimînd pe rest și alegînd \(\lambda\) cu cea mai mică eroare pe blocurile lăsate deoparte.
Pe scurt
Modelele flexibile pot potrivi și tipare accidentale în eșantion (supraajustare, overfitting).
precum arborii și rețelele neuronale.
Evaluarea pe ferestre succesive (walk-forward validation): modelul se estimează doar pe date anterioare perioadei de test.
Scurgerea de informație (leakage): o prognoză folosește informație indisponibilă la data ei.
\(\lambda > 0\) apropie coeficienții de zero (contracție, shrinkage).
reduce dispersia estimării.
Cu erori \(N(0, \sigma^2)\) și distribuția a priori \(g \sim N(0, \tau^2 I)\), ridge cu \(\lambda = \sigma^2/\tau^2\) este media a posteriori a coeficienților.
învățare bayesiană.
Validarea încrucișată (cross-validation): alegem \(\lambda\) cu cea mai mică eroare pe blocurile excluse.
excludem pe rînd cîte un bloc de date (de exemplu un an).
În modelul lui Martin & Nagel (2022), investitori neutri la risc evaluează \(N\) active ale căror fluxuri de numerar depind de \(J\) caracteristici cu coeficienți necunoscuți, pe care îi învață optim (prin regula lui Bayes) din datele trecute; media a posteriori este estimatorul ridge (2.24), iar neutralitatea la risc exclude o primă de risc. In-sample, testul absenței predictibilității respinge cu probabilitate care tinde la 1 cînd \(J/N\) tinde la o constantă \(\psi > 0\) (Propoziția 4 a lucrării). Prețul încorporează coeficienții „micșorați” prin shrinkage și subreacționează deci la caracteristici, care prognozează astfel randamentele ex post, deși investitorii sînt raționali. O respingere nu este o dovadă de iraționalitate: ipoteza nulă a așteptărilor raționale este reperul greșit cînd investitorii trebuie să învețe parametrii.
Pe scurt
Martin & Nagel (2022): investitorii evaluează \(N\) active ale căror fluxuri de numerar depind de \(J\) caracteristici
cu coeficienți necunoscuți, pe care îi învață optim (bayesian) din datele trecute
Out-of-sample, imaginea se schimbă. Un portofoliu construit cu coeficienți estimați în alte perioade are randamentul mediu \(\mathbb{E}[r_{\text{OOS}}] = 0\) (Propoziția 6 din Martin & Nagel (2022)), așa că testele out-of-sample își păstrează sensul economic: în acest model, ele testează eficiența. Pentru acțiunile americane, \(R^2\)-ul in-sample este de circa 1%, iar randamentul out-of-sample este mult mai mic decît cel in-sample, la mai puțin de două erori standard de zero după 2014.
Pe scurt
OOS: Out-of-Sample.
În eșantion, respingerea nu dovedește iraționalitatea.
ipoteza nulă a așteptărilor raționale este reperul greșit cînd investitorii trebuie să învețe parametrii.
Graficul replică pe portofolii industriale comparația in-sample și out-of-sample din Martin & Nagel (2022): o serie este randamentul portofoliului in-sample \(r_{\text{IS}}\), cealaltă media mobilă pe 10 ani a randamentului out-of-sample \(r_{\text{OOS}}\), cu o bandă descriptivă de \(\pm 2\) erori standard, ambele în unități de \(10^{-5}\) pe lună.
Datele sînt 40–49 de portofolii industriale din Kenneth French Data Library, iulie 1926 – august 2026, cu 238 de predictori (randamente decalate și pătratele lor, laguri 2–120) și OLS rolling pe 20 de ani, ca în Secțiunea 7 din Martin & Nagel (2022). În fiecare lună, fiecare industrie primește o pondere proporțională cu randamentul prognozat. \(r_{\text{IS}}\), cu coeficienți din aceeași fereastră, se află între 5,90 și 15,14 și este pozitiv prin construcție. \(r_{\text{OOS}}\), cu coeficienți din fereastra anterioară, are o medie de \(1{,}05 \times 10^{-5}\) pe 842 de luni, din iulie 1956, circa 11% din \(r_{\text{IS}}\); el este cu 4,16 erori standard peste zero în primii 30 de ani out-of-sample, pînă în iunie 1986, și doar cu 0,62 după aceea. Cu \(J/N \approx 5\), potrivirea in-sample este umflată, un \(R^2\) de 5,4% față de circa 1% în lucrare. Rezultatul susține o comparație de proceduri.
Pe scurt
Date: 40–49 de portofolii sectoriale, iulie 1926 – august 2026.
Graficul arată coeficientul ridge pe întreaga selecție al fiecărui predictor standardizat, randamente decalate și pătratele lor, după lagul în luni, pentru comparație cu Figura 7 din Martin & Nagel (2022).
Regresia ridge acoperă ianuarie 1971 – august 2026, cu penalizarea \(\lambda\) aleasă prin validare încrucișată cu lăsarea deoparte a cîte unui an, pe 56 de ani. Pentru lagurile 2–11, 8 din 10 coeficienți sînt pozitivi, în acord cu momentum (Jegadeesh & Titman, 1993); pentru multiplii lui 12, 9 din 10 sînt pozitivi, în acord cu sezonalitatea (Heston & Sadka, 2008); pentru celelalte laguri de peste 12, 67% sînt negativi, în acord cu inversarea pe termen lung (De Bondt & Thaler, 1985), iar coeficienții randamentelor la pătrat nu au un semn dominant. \(R^2\)-ul pe anii lăsați deoparte, \(1 - \sum(r - \hat r)^2/\sum r^2\), este 0,013% pentru ridge și \(-2{,}26\%\) pentru OLS. Ridge regăsește anomaliile cunoscute, dar ele nu prognozează aproape nimic în anii lăsați deoparte.
Pe scurt
Ridge pe întreaga selecție, ianuarie 1971 – august 2026.
penalizarea \(\lambda\) este aleasă prin validare încrucișată, cu cîte un an exclus (56 de ani).
Graficul anterior: coeficientul ridge al fiecărui predictor standardizat, pe lagul în luni.
Cazul ETF-urilor spot pe Bitcoin cere trei noțiuni. Un fond tranzacționat la bursă (ETF, exchange-traded fund) spot deține activul suport, aici Bitcoin, nu contracte futures ca ETF-urile pe Bitcoin lansate în 2021, astfel încît arbitrajul dintre fond și piața spot devine direct. Un placebo repetă analiza la o dată fără eveniment: o schimbare aparentă similară în 2019 ar slăbi afirmația că lansarea din 2024 a cauzat schimbarea. Price discovery este încorporarea informației în prețuri; dacă bursa A reacționează prima la știri, iar B o urmează, A poate contribui mai mult la price discovery.
Pe scurt
ETF: Exchange-Traded Fund — fond tranzacționat la bursă.
Un ETF spot deține activul suport (aici Bitcoin), nu contracte futures.
ca ETF-urile pe Bitcoin lansate în 2021.
arbitrajul dintre fond și piața spot devine direct.
Un placebo repetă analiza la o dată fără eveniment.
o schimbare aparentă similară în 2019 slăbește afirmația că lansarea din 2024 a produs schimbarea.
Descoperirea prețului (price discovery) este încorporarea informației în prețuri.
dacă piața A reacționează prima la știre și B o urmează, A poate contribui mai mult la descoperirea prețului.
Testul compară două ferestre nesuprapuse de 982 de zile, înainte și după 11 ianuarie 2024, prin \(z = \Delta\hat\rho_1/\sqrt{s_{\text{pre}}^2 + s_{\text{post}}^2}\), unde \(\Delta\hat\rho_1 = \hat\rho_{1,\text{post}} - \hat\rho_{1,\text{pre}}\), iar \(s\) sînt erorile standard HAC, valide și cînd \(\rho_1 \neq 0\). Efectul minim detectabil (MDE, minimum detectable effect) este cea mai mică schimbare adevărată detectată cu putere de 80% la nivelul de 5%:
cu \(z_p\) cuantila de ordin \(p\) a distribuției Normale standard, \(z_{0.975} = 1{,}96\) și \(z_{0.80} = 0{,}84\). Datele placebo sînt 11 ianuarie din fiecare an 2016–2021, cu ferestre de 982 de randamente.
Pe scurt
Testul: două ferestre de cîte 982 de zile, înainte și după 11 ianuarie 2024, care nu se suprapun.
\(z = \Delta\hat\rho_1 / \sqrt{s_{\text{pre}}^2 + s_{\text{post}}^2}\), cu \(\Delta\hat\rho_1 = \hat\rho_{1,\text{post}} - \hat\rho_{1,\text{pre}}\) și erorile standard HAC \(s\) ale celor două estimații (valabile și cînd \(\rho_1 \neq 0\)).
Efectul minim detectabil (MDE): cea mai mică schimbare reală care poate fi detectată.
Panoul din stînga al graficului arată \(\hat\rho_1\) al Bitcoin înainte și după lansarea ETF-urilor spot, cu intervale HAC de 95%, și diferența lor, cu o bară de \(\pm\)MDE; panoul din dreapta plasează statistica \(z\) a datei ETF printre cele ale celor șase date placebo.
Înainte de lansare (mai 2021 – ianuarie 2024), \(\hat\rho_1 = -0{,}036\)(\(s = 0{,}042\)) și VR(5) \(= 1{,}000\)(\(z^* = 0{,}00\)); după lansare (ianuarie 2024 – septembrie 2026), \(\hat\rho_1 = -0{,}050\)(\(s = 0{,}044\)) și VR(5) \(= 0{,}939\)(\(z^* = -0{,}64\)). Diferența \(\Delta\hat\rho_1 = -0{,}014\) dă \(z = -0{,}23\), deci nu respingem ipoteza unui \(\rho_1\) neschimbat; erorile standard HAC cer un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială. Niciuna dintre cele șase date placebo nu dă o schimbare semnificativă la 5%, cea mai mare statistică fiind \(|z| = 1{,}85\). Rezultatul este o descriere: o comparație înainte/după fără grup de control.
Pe scurt
Graficul anterior, stînga: \(\hat\rho_1\) înainte și după lansare, cu intervale HAC de 95%.
al treilea punct este diferența, cu bara \(\pm\)MDE.
Dreapta: statistica \(z\) pentru data ETF, printre valorile celor șase date placebo.
Aici \(\operatorname{SE}(\Delta\hat\rho_1) = \sqrt{0{,}042^2 + 0{,}044^2} \approx 0{,}060\), deci, după (2.25), MDE este de circa 0,17, de aproximativ 12 ori schimbarea estimată: „nesemnificativ” nu înseamnă „fără efect”. Înainte de 2024, \(\hat\rho_1 = -0{,}036\), așa că pînă și o trecere completă la \(\rho_1 = 0\) ar fi o schimbare de aproape cinci ori mai mică decît MDE, pe care acest design ar detecta-o cu o probabilitate mult sub 80%. O variabilă-rezultat mai bună ar fi price discovery-ul intrazilnic între platforme, nu \(\rho_1\) zilnic.
Pe scurt
Aici \(\operatorname{SE}(\Delta\hat\rho_1) = \sqrt{0{,}042^2 + 0{,}044^2} \approx 0{,}060\), deci MDE \(\approx 0{,}17\).
„Nesemnificativ” nu înseamnă „fără efect”.
MDE este de peste zece ori mai mare decît schimbarea estimată.
Înainte de 2024, \(\hat\rho_1 = -0{,}036\).
chiar și o trecere completă la \(\rho_1 = 0\) ar fi o schimbare de aproape cinci ori mai mică decît MDE.
deci acest plan ar detecta-o cu o probabilitate mult sub 80%.
O variabilă-rezultat mai bună: descoperirea prețului intrazilnic între piețe, nu \(\rho_1\) zilnic.
Testul înainte/după nu poate separa efectul ETF-urilor de alte schimbări din 2024; o concluzie cauzală cere un grup de control, de exemplu Ethereum înaintea propriilor ETF-uri, din iulie 2024. Difference-in-differences (DiD) scade schimbarea înainte–după a grupului de control din cea a grupului tratat. Metoda se sprijină pe:
Trendurile paralele (parallel trends), adică pe faptul că, fără tratament, cele două grupuri s-ar fi schimbat la fel, ipoteză pe care trendurile similare dinaintea tratamentului o susțin, dar nu o pot dovedi;
Absența anticipării, adică grupul tratat nu reacționează înaintea tratamentului;
Absența efectelor de propagare (spillover), adică tratamentul nu afectează grupul de control, deci un ETF pe Bitcoin nu trebuie să schimbe tranzacționarea Ethereum.
Pe scurt
Testul înainte/după nu poate separa efectul ETF-urilor de alte schimbări din 2024.
Pentru o concluzie cauzală avem nevoie de un grup de control.
de exemplu Ethereum înaintea propriilor ETF-uri (din iulie 2024).
Difference-in-differences (DiD) compară două schimbări înainte–după.
Scade schimbarea din grupul de control din schimbarea grupului tratat.
Tendințe paralele (parallel trends): fără tratament, grupul tratat și grupul de control ar fi avut aceeași schimbare.
Tendințe similare înainte de tratament susțin această ipoteză, dar nu o pot dovedi.
Fără anticipare (no anticipation): grupul tratat nu reacționează înainte de tratament.
Fără efecte de propagare: tratamentul nu afectează grupul de control.
de exemplu, un ETF pe Bitcoin nu trebuie să schimbe tranzacționarea Ethereum.
Anexele conțin materialul la care trimite corpul capitolului: pionierii teoriei piețelor eficiente, tabelul complet al testelor de eficiență slabă pe cele 16 serii, testul portmanteau automat, rezultatele complete ale regresiei predictive, valorile de referință exacte pentru analiza R/S și estimatorul Whittle local, procedurile de testare multiplă care țin seama de dependența dintre teste, time-series momentum pe toate piețele, metoda și rezultatele studiului de caz, precum și prompturile și verificările buclei de descoperire.
Bachelier (1900) a modelat prețurile obligațiunilor de stat franceze ca o plimbare aleatoare (random walk) și a scris că „the mathematical expectation of the speculator is zero” („media cîștigului speculatorului este zero”). Samuelson (1965) a dat argumentul economic: dacă prețurile sînt anticipate corect, variațiile lor sînt imprevizibile. Ambele rezultate stau la originea ipotezei piețelor eficiente (EMH, Efficient Market Hypothesis) studiate în capitol.
Fama (1970) a dat definiția eficienței folosită în acest capitol și cele trei forme ale eficienței: slabă, semi-tare și tare. Fama (1991) a actualizat și a sintetizat dovezile empirice, iar Malkiel (2003) a scris o apărare accesibilă a EMH în fața criticilor ei. Fama a primit Premiul Nobel în 2013, împreună cu Lars Peter Hansen și cu Robert Shiller, un sceptic al eficienței.
Tabelul adună, pentru cele 16 serii ale capitolului, statisticile zilnice de eficiență slabă: numărul de randamente zilnice \(T\), autocorelația de lag 1 \(\hat\rho_1\) cu două erori standard (SE, standard error), raportul de varianțe (variance ratio) \(\widehat{\text{VR}}(5)\) cu statistica sa robustă \(z^*(5)\), valoarea \(p\) a testului comun Chow–Denning (CD) pentru \(q = 2, 5, 10, 20\) și statistica testului secvențelor (runs test). SE\(_0\) este eroarea standard robustă sub \(H_0\), folosită pentru test, iar SE\(_{\text{HAC}}\) este eroarea standard a estimatorului consistentă la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent), folosită pentru intervale. Seria EUR/RON începe în iulie 2005, iar criptoactivele sînt măsurate pe 365 de zile pe an. Abaterile cele mai clare sînt cele ale BET, cu \(\hat\rho_1 = 0{,}109\),\(z^*(5) = 2{,}98\) și CD \(p = 0{,}001\), și ale S&P 500, cu \(\hat\rho_1 = -0{,}099\),\(z^*(5) = -2{,}78\) și CD \(p = 0{,}001\); pentru Bitcoin, \(z^*(5) = -0{,}19\) și CD \(p = 0{,}835\), deci nu respingem ipoteza nulă.
Pe scurt
Piața
\(T\)
\(\hat\rho_1\)
SE\(_0\)
SE\(_{\text{HAC}}\)
\(\widehat{\text{VR}}(5)\)
\(z^*(5)\)
CD \(p\)
Secvențe \(z\)
S&P 500
6 717
\(-0{,}099\)
\(0{,}027\)
\(0{,}030\)
\(0{,}829\)
\(-2{,}78\)
\(0{,}001\)
\(4{,}34\)
Euro Stoxx 50
6 836
\(-0{,}029\)
\(0{,}019\)
\(0{,}016\)
\(0{,}910\)
\(-2{,}08\)
\(0{,}097\)
\(3{,}41\)
Nikkei 225 (Japonia)
6 545
\(-0{,}038\)
\(0{,}024\)
\(0{,}018\)
\(0{,}923\)
\(-1{,}48\)
\(0{,}317\)
\(1{,}97\)
Hang Seng (HK)
6 583
\(-0{,}004\)
\(0{,}024\)
\(0{,}017\)
\(0{,}967\)
\(-0{,}64\)
\(0{,}872\)
\(-0{,}17\)
BET (România)
6 670
\(0{,}109\)
\(0{,}028\)
\(0{,}023\)
\(1{,}173\)
\(2{,}98\)
\(0{,}001\)
\(-6{,}05\)
WIG20 (Polonia)
6 686
\(0{,}018\)
\(0{,}018\)
\(0{,}016\)
\(1{,}010\)
\(0{,}25\)
\(0{,}775\)
\(2{,}25\)
BUX (Ungaria)
6 666
\(0{,}037\)
\(0{,}024\)
\(0{,}021\)
\(1{,}013\)
\(0{,}26\)
\(0{,}427\)
\(-0{,}42\)
PX (Cehia)
6 697
\(0{,}051\)
\(0{,}032\)
\(0{,}020\)
\(1{,}041\)
\(0{,}60\)
\(0{,}354\)
\(-2{,}53\)
BIST 100 (Turcia)
6 692
\(0{,}005\)
\(0{,}024\)
\(0{,}018\)
\(1{,}033\)
\(0{,}64\)
\(0{,}949\)
\(-0{,}63\)
Bovespa (Brazilia)
6 622
\(-0{,}028\)
\(0{,}025\)
\(0{,}027\)
\(0{,}928\)
\(-1{,}29\)
\(0{,}521\)
\(0{,}88\)
IPC (Mexic)
6 735
\(0{,}071\)
\(0{,}019\)
\(0{,}016\)
\(1{,}038\)
\(0{,}92\)
\(0{,}001\)
\(-3{,}27\)
Nifty 50 (India)
6 613
\(0{,}048\)
\(0{,}024\)
\(0{,}019\)
\(1{,}048\)
\(0{,}91\)
\(0{,}178\)
\(-5{,}46\)
Shanghai (China)
6 474
\(0{,}021\)
\(0{,}019\)
\(0{,}018\)
\(1{,}046\)
\(1{,}11\)
\(0{,}409\)
\(1{,}02\)
Bitcoin
4 384
\(-0{,}022\)
\(0{,}026\)
\(0{,}021\)
\(0{,}991\)
\(-0{,}19\)
\(0{,}835\)
\(2{,}68\)
Ethereum
3 913
\(-0{,}012\)
\(0{,}027\)
\(0{,}023\)
\(1{,}067\)
\(1{,}17\)
\(0{,}027\)
\(3{,}91\)
EUR/RON (curs de referință)
5 352
\(0{,}170\)
\(0{,}036\)
\(0{,}033\)
\(1{,}157\)
\(2{,}19\)
\(0{,}000\)
\(-1{,}66\)
\(T\): numărul de randamente zilnice
SE\(_0\): SE robustă a lui \(\hat\rho_1\) sub \(H_0\), pentru test; SE\(_{\text{HAC}}\): SE HAC a estimatorului, pentru intervale
CD: Chow–Denning pe \(q = 2, 5, 10, 20\)
EUR/RON din iulie 2005, criptoactivele pe 365 de zile pe an
Statisticile testului secvențelor din tabelul precedent aduc informație pe care autocorelația nu o conține întotdeauna. Nifty 50, cu \(z = -5{,}46\), și IPC, cu \(z = -3{,}27\), arată persistență pe piețele emergente, iar Ethereum are \(z = 3{,}91\), semnificativ deși \(\hat\rho_1\) nu este. Două extensii ale testului VR completează setul de instrumente: testul VR automat al lui Choi (1999), care alege orizontul din date printr-o estimare spectrală la frecvența zero, și versiunile cu wild bootstrap pentru eșantioane mici ale lui Kim (2006), aplicate piețelor asiatice de Kim & Shamsuddin (2008).
Pe scurt
\(z\) al testului secvențelor: Nifty 50 \(-5{,}46\), IPC \(-3{,}27\)
tabelul de pe slide-ul anterior
persistență pe piețele emergente
Pentru Ethereum, \(z\) al testului secvențelor este \(3{,}91\) (semnificativ), deși \(\hat\rho_1\) nu este
Choi (1999): un test VR automat care alege orizontul din date
estimare spectrală la frecvența zero
Versiuni wild bootstrap pentru selecții mici: Kim (2006)
Escanciano & Lobato (2009) propun un test portmanteau valid sub ipoteza diferenței de martingal (MDH, martingale difference hypothesis) cu heteroscedasticitate condiționată, care alege numărul de laguri din date. Cu \(e_t = r_t - \bar r\), autocovarianța de lag \(j\) este \(\hat\gamma_j = \tfrac{1}{T-j}\sum_t e_t e_{t-j}\), iar varianța ei robustă \(\hat\kappa_j = \tfrac{1}{T-j}\sum_t e_t^2 e_{t-j}^2\); statistica este
unde \(\tilde p \le 10\) maximizează \(T\sum_{j \le p} \tilde\rho_j^2\) minus o penalizare: penalizarea BIC (Bayesian Information Criterion, criteriul informațional bayesian), \(p \ln T\), înlocuită cu penalizarea AIC (Akaike Information Criterion, criteriul informațional Akaike), \(2p\), cînd \(\max_j \sqrt T|\tilde\rho_j|\) depășește \(\sqrt{2{,}4 \ln T}\). Sub MDH, \(\tilde p \to 1\) cu probabilitatea 1, deci (2.26) are o distribuție limită \(\chi^2_1\), iar o valoare mare a lui \(AQ\) respinge ipoteza. Pe datele cursului, \(AQ\) este 13,23 pentru S&P 500 (\(p = 0{,}0003\)), 14,92 pentru BET (\(p = 0{,}0001\)) și 0,75 pentru Bitcoin (\(p = 0{,}385\)); MDH este respinsă la 5% pentru 5 din cele 16 serii.
Pe scurt
Ce derivăm: un test portmanteau valid sub MDH cu heteroscedasticitate condiționată Escanciano & Lobato (2009).
Regresia predictivă a capitolului explică randamentul lunar logaritmic în exces al S&P 500, cu dividende incluse și net de rata titlurilor de stat pe 3 luni (T-bill), prin raportul logaritmic dividend–preț întîrziat, \(dp_t\). Datele sînt seria S&P Composite a lui Shiller (2026), pînă în iunie 2026, prelungită cu mediile lunare ale închiderilor zilnice S&P 500 din datele cursului și cu dividendele ETF-ului SPY, iar randamentul T-bill pe 3 luni provine din FRED (Federal Reserve Economic Data, seria TB3MS), transformat în rată lunară logaritmică \(\ln(1 + \text{TB3MS}/1200)\) și întîrziat cu o lună. Panta estimată prin metoda celor mai mici pătrate (OLS, ordinary least squares) este \(\hat\beta = 0{,}267\), cu o SE Newey–West de 0,293 (12 laguri), deci \(t = 0{,}91\) (OLS: \(t = 1{,}16\)) și \(R^2 = 0{,}12\%\); panta corectată pentru bias, împărțită la SE HAC neajustată, dă \(-0{,}22\), o cifră doar ilustrativă, deoarece ignoră incertitudinea corecției. Valoarea economică a lui Campbell & Thompson (2008) este creșterea proporțională a randamentului așteptat al unui investitor care face market timing, \(\tfrac{R^2}{1-R^2}\cdot\tfrac{1+S^2}{S^2}\), cu \(S\) raportul Sharpe lunar. Comparația out-of-sample cu media istorică dă \(t = -0{,}57\) în testul lui Diebold & Mariano (1995), care favorizează modelul mic cînd modelele sînt imbricate (nested); corecția lui Clark & West (2007) dă \(t = 0{,}42\).
Pe scurt
FRED: Federal Reserve Economic Data — baza de date economice a Rezervei Federale (St. Louis).
Randamentul logaritmic lunar în exces, regresat pe \(dp_t\) decalat
cu dividende, minus dobînda T-bill la 3 luni
Date: Shiller (2026) (S&P Composite, pînă în iunie 2026), prelungite cu mediile lunare ale închiderilor zilnice S&P 500 (scalate pe ultimele 12 luni comune) și cu dividendele fondului SPDR (Standard & Poor’s Depositary Receipts, certificate de depozit Standard & Poor’s, familia de ETF-uri SPDR) S&P 500 ETF (SPY)
Randamentul titlurilor de stat americane la 3 luni (FRED, seria TB3MS; % anual), rata logaritmică lunară \(\ln(1 + \text{TB3MS}/1\,200)\) decalată cu o lună
La frecvență înaltă, prețurile futures reacționează la știrile macroeconomice programate în microsecunde sau mai puțin; Tak, Schlamp, Osterrieder & Pele (2026) măsoară această cursă pe Eurex și pe Chicago Mercantile Exchange (CME). Pentru criptoactive, Pele, Lin, Wang & Gaman (2025) studiază reacțiile pieței la etapele de dezvoltare ale Ethereum. Viteza de ajustare este ea însăși o măsură a eficienței și depinde de tehnologia de tranzacționare, tema Capitolului 10 despre microstructura pieței.
Pe scurt
CME: Chicago Mercantile Exchange — Bursa de mărfuri din Chicago.
La frecvență înaltă, prețurile futures reacționează în microsecunde sau mai puțin la știrile macroeconomice programate
Hurst (1951) a proiectat rezervoare pe Nil și a constatat că amplitudinea debitelor cumulate ale Nilului crește cu orizontul \(n\) mai repede decît \(\sqrt n\): anii cu inundații mari tind să urmeze altor ani cu inundații mari. Această observație stă la originea statisticii amplitudinii rescalate (R/S, rescaled range), folosită în capitol pentru măsurarea memoriei lungi.
unde \(\Gamma\) este funcția gamma. Exponentul Hurst corectat \(H_{AL}\) din capitol scade această valoare de referință din R/S observat. Fără corecție, estimațiile supraevaluează memoria cu aproximativ 0,04–0,05 pe date zilnice.
Pe scurt
Anis & Lloyd (1976): \(\E[R_n/s_n]\) exact pentru randamente i.i.d. din distribuția Normală
Memoria lungă poate fi măsurată și prin parametrul fracționar \(d = H - 0{,}5\), definit de comportamentul densității spectrale în vecinătatea frecvenței zero, \(f(\lambda) \sim G\lambda^{-2d}\) cînd \(\lambda \to 0\), cu \(G > 0\) o constantă; pentru \(d > 0\), densitatea explodează la frecvențe joase. Estimatorul Whittle local (local Whittle estimator) folosește doar primele \(m\) frecvențe Fourier \(\lambda_j = 2\pi j/T\), unde \(m\) este bandwidth-ul, nu un număr de laguri, iar \(I\) este periodograma:
\[\hat d = \arg\min_d \left[\ln\!\left(\frac1m\sum_{j=1}^m \lambda_j^{2d} I(\lambda_j)\right) - \frac{2d}{m}\sum_{j=1}^m \ln\lambda_j\right].\]
(2.28)
Robinson (1995) arată că, pentru \(|d| < 1/2\),\(m \to \infty\),\(m/T \to 0\), o densitate \(f\) netedă în vecinătatea lui 0 și un proces liniar cu inovații de tip diferență de martingal, condiționat omoscedastice, \(\sqrt m(\hat d - d) \to N(0, 1/4)\) fără a presupune distribuția Normală. Rezultatul dă un interval de încredere pentru parametru, în locul unei benzi sub ipoteza nulă.
Pe scurt
\(d = H - 0{,}5\), iar densitatea spectrală \(f(\lambda) \sim G\lambda^{-2d}\) cînd \(\lambda \to 0\)
\(G > 0\) o constantă
\(d > 0\): densitatea explodează la frecvențe joase, memorie lungă
Estimarea folosește doar primele \(m\) frecvențe Fourier \(\lambda_j = 2\pi j/T\)
\(m\): lățimea de bandă, nu un număr de laguri
\(\hat d = \arg\min_d \Big[\ln\Big(\tfrac1m\sum_{j=1}^m \lambda_j^{2d} I(\lambda_j)\Big) - \tfrac{2d}{m}\sum_{j=1}^m \ln\lambda_j\Big]\) , \(I\): periodograma (densitatea spectrală de selecție)
Robinson (1995): pentru \(|d| < 1/2\), \(m \to \infty\), \(m/T \to 0\), \(f\) netedă în vecinătatea lui 0 și un proces liniar cu inovații de tip diferență de martingal, condiționat omoscedastice, \(\sqrt m(\hat d - d) \to N(0, 1/4)\) fără a presupune distribuția Normală: un interval de încredere pentru parametru, în locul unei benzi sub ipoteza nulă
Cu \(m = T^{0{,}65}\) și intervalul de încredere de 95% \(\hat d \pm 1{,}96/(2\sqrt m)\), S&P 500 are \(\hat d = -0{,}013\)\([-0{,}069; 0{,}043]\), Bitcoin 0,063 \([-0{,}002; 0{,}127]\), BET 0,118 \([0{,}062; 0{,}174]\) și Ethereum 0,112 \([0{,}045; 0{,}179]\). Un \(m\) mare include frecvențe la care autocorelația pe termen scurt deplasează \(\hat d\) în sus, o problemă pentru BET, care are \(\hat\rho_1 = 0{,}109\); cu \(m = T^{0{,}5}\), BET dă \(\hat d = 0{,}135\) (SE 0,056), o verificare de sensibilitate care susține, fără a demonstra, că valoarea \(d > 0\) nu reflectă doar memoria scurtă. Randamentele cu dinamică GARCH pot încălca și ele condițiile teoremei.
Pe scurt
Estimații cu \(m = T^{0{,}65}\) și intervalul de încredere de 95% \(\hat d \pm 1{,}96/(2\sqrt m)\)
S&P 500: \(\hat d = -0{,}013\), interval \([-0{,}069; 0{,}043]\)
Bitcoin: \(\hat d = 0{,}063\), interval \([-0{,}002; 0{,}127]\)
BET: \(\hat d = 0{,}118\), interval \([0{,}062; 0{,}174]\)
Ethereum: \(\hat d = 0{,}112\), interval \([0{,}045; 0{,}179]\)
Compromisul lățimii de bandă:
un \(m\) mare include frecvențe la care autocorelația pe termen scurt deplasează \(\hat d\) în sus
BET \(\hat\rho_1 = 0{,}109\)
cu \(m = T^{0{,}5}\), pentru BET se obține \(\hat d = 0{,}135\) (SE \(0{,}056\)): o verificare de sensibilitate care susține, fără a demonstra, că valoarea \(d > 0\) nu reflectă doar memoria scurtă
randamentele cu dinamică GARCH pot încălca și condițiile de mai sus
Tabelul compară EMH cu ipoteza piețelor adaptive (AMH, Adaptive Markets Hypothesis) pe cinci dimensiuni. În EMH, investitorii sînt raționali și optimizează, eficiența este o proprietate de echilibru testată ca restricție, primele de risc sînt prime de echilibru, eventual variabile în timp, iar anomaliile sînt factori de risc omiși sau rezultate ale data mining. În AMH, investitorii au raționalitate limitată și folosesc euristici, eficiența este o chestiune de grad, care se schimbă cu condițiile, relația risc–randament se schimbă cu populația de investitori, iar anomaliile sînt oportunități de profit trecătoare; instrumentul empiric corespunzător este un test al variației în timp și între stări, de exemplu pe ferestre mobile (rolling windows).
Pe scurt
EMH
AMH
Investitorii
Raționali, optimizează
Raționalitate limitată, euristici
Eficiența
O proprietate de echilibru, testată ca restricție
O chestiune de grad, care se schimbă odată cu condițiile
Risc–randament
Prime de risc de echilibru, posibil variabile în timp
Se schimbă odată cu populația de investitori
Anomaliile
Factori de risc omiși sau căutare oportunistă în date (data mining)
Oportunități de profit temporare
Instrument empiric
Teste ale unei restricții de echilibru
Teste ale variației în timp și în funcție de starea pieței (ferestre mobile)
Urquhart (2016) găsește Bitcoin ineficient în 2010–2016, unele teste indicînd eficiență în subperioada tîrzie; bateria lui de teste, Ljung–Box, testul secvențelor, testul de ranguri al lui Bartels (1982), testul VR automat, BDS și R/S, include testul BDS, care respinge doar din cauza volatility clustering și deci nu este un test al ipotezei de random walk RW3. Nadarajah & Chu (2017) găsesc Bitcoin eficient în formă slabă după o transformare putere a randamentelor, Kristoufek (2018) găsește piețele Bitcoin în mare parte ineficiente în 2010–2017, cu o eficiență care se schimbă în timp, iar Tran & Leirvik (2020) găsesc o eficiență variabilă în timp, în creștere, pe multe criptoactive. Pele et al. (2023) arată că criptoactivele au devenit o clasă de active distinctă, ale cărei randamente au aceleași fapte stilizate ca alte piețe. Estimațiile cursului, an calendaristic cu an calendaristic, dau pentru Bitcoin autocorelații de lag 1 de \(-0{,}002\) în 2011, \(-0{,}071\) în 2012 și \(0{,}069\) în 2013 și un \(|z^*(5)|\) robust de cel mult 1,71 în toți anii criptoactivelor, sub valoarea critică 1,96. În 2011–2013, eroarea standard robustă a lui \(\hat\rho_1\) este 0,09–0,11, astfel că nerespingerile anuale au putere mică și nu contrazic, prin ele însele, rezultatul lui Urquhart (2016).
Pe scurt
Urquhart (2016): Bitcoin a fost ineficient în perioada 2010–2016
unele teste indică eficiență în subperioada a doua
Setul său de teste (Ljung–Box, secvențe, testul rangurilor Bartels (1982), VR automat, BDS, R/S) include BDS, care poate respinge ipoteza nulă chiar și numai din cauza grupării volatilității: nu este un test al RW3
Nadarajah & Chu (2017): cu o transformare de putere a randamentelor, Bitcoin este eficient în formă slabă
Kristoufek (2018): piețele Bitcoin au fost în mare parte ineficiente în 2010–2017
Pele et al. (2023): criptoactivele au devenit o clasă de active distinctă
randamentele lor prezintă aceleași fapte stilizate ca alte piețe
Estimările noastre, separat pentru fiecare an calendaristic
slide-ul Eficiența criptoactivelor an de an
Bitcoin, autocorelația de ordinul 1 \(\hat\rho_1\): \(-0{,}002\) în 2011, \(-0{,}071\) în 2012, \(0{,}069\) în 2013, toate apropiate de zero
Statistica robustă a raportului varianțelor \(z^*(5)\): cel mult \(1{,}71\) în valoare absolută, în toți anii și pentru toate criptoactivele, sub valoarea critică \(1{,}96\)
În 2011–2013, eroarea standard robustă a lui \(\hat\rho_1\) este de \(0{,}09\)–\(0{,}11\): nerespingerea anuală are putere mică și nu contrazice singură Urquhart (2016)
FTSE Russell (2019) a reclasificat România din statutul Frontier în Secondary Emerging, decizie anunțată în septembrie 2019 și aplicată din 21 septembrie 2020. Canalele așteptate sînt mai mulți investitori străini, mai mulți analiști și mai multă lichiditate, deci o descoperire mai rapidă a prețurilor (price discovery) la Bursa de Valori București (BVB). Dovezile anterioare despre BVB privesc crahurile și bulele log-periodice (Pele & Mazurencu-Marinescu, 2012) și comportamentul de turmă (herding) pe o piață nelichidă (Pele, Mazurencu-Marinescu & Nijkamp, 2013). Seminarul C2 compară eficiența în cei cinci ani dinainte și de după reclasificare, cu WIG20 și BUX ca grup de comparație și cu un block bootstrap (Künsch, 1989); o astfel de comparație înainte/după rămîne descriptivă dacă factorii de confuzie nu sînt controlați.
Pe scurt
BVB: Bursa de Valori București.
FTSE Russell (2019): România a fost reclasificată din piață de frontieră în piață emergentă secundară
decizie anunțată în septembrie 2019
cu efect de la 21 septembrie 2020
Canale așteptate: mai mulți investitori străini, mai mulți analiști, mai multă lichiditate
\(\Rightarrow\) descoperirea mai rapidă a prețului
Trei proceduri testează împreună mai multe reguli de tranzacționare, ținînd seama de dependența dintre ele. Reality Check al lui White (2000) întreabă dacă cea mai bună dintre toate regulile încercate depășește un reper, folosind distribuția bootstrap a performanței lor maxime. Testul capacității predictive superioare (SPA, Superior Predictive Ability) al lui Hansen (2005) standardizează fiecare performanță prin incertitudinea ei (studentizare), ceea ce reduce distorsiunea produsă de regulile slabe. Procedura StepM a lui Romano & Wolf (2005) testează întîi statistica cea mai puternică, apoi restul familiei, cu valori critice obținute prin reeșantionare comună, și controlează rata erorii pe familie (FWER, familywise error rate) în condițiile ei. În exemplul capitolului, aceleași luni sînt extrase pentru toate cele 15 teste de calendar, astfel încît șocurile comune ale pieței sînt păstrate; reeșantionarea separată a fiecărui test ar distruge această dependență.
Pe scurt
SPA: Superior Predictive Ability (test) — testul abilității predictive superioare.
Reality Check întreabă dacă cea mai bună dintre toate regulile încercate depășește reperul. White (2000)
folosind distribuția bootstrap a performanței maxime.
SPA standardizează performanța prin incertitudinea ei (studentizare) și reduce influența regulilor slabe. Hansen (2005)
StepM testează întîi statistica cea mai puternică, apoi familia rămasă
Bonferroni și Holm ignoră corelația dintre testele făcute pe aceleași piețe și în aceleași zile, în timp ce Reality Check, SPA și StepM țin seama de ea. Capitolul aplică StepM celor 15 teste de calendar, cu un bootstrap pe blocuri de 3 luni calendaristice, comun tuturor piețelor, și 999 de replicări. Valoarea \(p\) critică la primul pas este 0,0016, mai strictă decît pragul Bonferroni de 0,0033, iar procedura dă 2 respingeri, efectele de turn of the month (TOM) ale BET și BUX, ca și Holm. StepM este aici mai strictă decît Bonferroni deoarece testele HAC resping prea des: la un nivel nominal de 5%, ratele lor de respingere în bootstrap sînt 6,0% pentru testul zilei săptămînii, 6,4% pentru TOM și 6,4% pentru ianuarie. Chordia, Goyal & Saretto (2020), pornind de la peste două milioane de strategii generate aleator din date contabile reale, propun pragurile \(|t| > 3{,}8\) pentru testele pe serii de timp și \(|t| > 3{,}4\) pentru cele transversale, fără de care circa 45% dintre respingeri sînt false; Harvey & Liu (2020) amintesc că reducerea descoperirilor false crește numărul descoperirilor ratate.
Pe scurt
Bonferroni și Holm ignoră corelația dintre teste (aceleași piețe, aceleași zile)
Reality Check, SPA și StepM țin cont de ea (explicația: slide-ul anterior)
Cele 15 teste de calendar: StepM cu bootstrap pe blocuri de 3 luni calendaristice
comune tuturor piețelor
999 de replicări
Pragul critic pentru valoarea p la primul pas: \(0{,}0016\) (Bonferroni: \(0{,}0033\))
2 respingeri (efectul TOM la BET și BUX), ca la Holm
StepM este mai strict decît Bonferroni deoarece, la nivelul nominal de 5%, ratele de respingere bootstrap ale testelor HAC sînt \(6{,}0\%\) (ziua săptămînii), \(6{,}4\%\) (TOM), \(6{,}4\%\) (ianuarie)
Tabelul extinde studiul de caz despre time-series momentum (TSMOM) la toate cele 15 piețe de acțiuni și criptoactive, pe 307 luni pentru acțiuni și mai puține pentru criptoactive. Pentru fiecare piață sînt raportate randamentul lunar mediu al strategiei, statistica \(t\) HAC, raportul Sharpe \(\sqrt{12}\,\bar x / s_x\) al strategiei și al strategiei buy-and-hold, calculat pe randamente de preț fără a scădea o rată fără risc (\(\bar x\) și \(s_x\) sînt media și abaterea standard a randamentelor lunare), și \(\hat\rho_1\) lunar. Doar S&P 500 (medie 0,61% pe lună, \(t_{HAC} = 2{,}22\)) și BET (1,40%, \(t_{HAC} = 2{,}68\)) au \(|t_{HAC}|\) peste 1,96; Bitcoin are media cea mai mare, 4,47% pe lună, cu \(t_{HAC} = 1{,}94\). Pe cele mai multe piețe, raportul Sharpe TSMOM este sub cel al strategiei buy-and-hold; excepțiile sînt WIG20 și Shanghai. Moskowitz, Ooi & Pedersen (2012) folosesc randamente în exces ale contractelor futures, scalate la o volatilitate ex-ante de 40%, deci cifrele lor nu sînt direct comparabile.
Pe scurt
Piața
Media (%/lună)
\(t_{HAC}\)
Sharpe TSMOM
Sharpe buy-and-hold
\(\hat\rho_1\) lunar
S&P 500
\(0{,}61\)
\(2{,}22\)
\(0{,}48\)
\(0{,}52\)
\(0{,}03\)
Euro Stoxx 50
\(0{,}16\)
\(0{,}51\)
\(0{,}11\)
\(0{,}16\)
\(0{,}05\)
Nikkei 225 (Japonia)
\(0{,}61\)
\(1{,}85\)
\(0{,}39\)
\(0{,}42\)
\(0{,}09\)
Hang Seng (HK)
\(0{,}18\)
\(0{,}53\)
\(0{,}10\)
\(0{,}19\)
\(0{,}04\)
BET (România)
\(1{,}40\)
\(2{,}68\)
\(0{,}65\)
\(0{,}75\)
\(0{,}19\)
WIG20 (Polonia)
\(0{,}67\)
\(1{,}86\)
\(0{,}36\)
\(0{,}26\)
\(0{,}02\)
BUX (Ungaria)
\(0{,}72\)
\(1{,}79\)
\(0{,}40\)
\(0{,}64\)
\(0{,}10\)
PX (Cehia)
\(0{,}38\)
\(0{,}99\)
\(0{,}24\)
\(0{,}45\)
\(0{,}10\)
BIST 100 (Turcia)
\(1{,}03\)
\(1{,}85\)
\(0{,}37\)
\(0{,}75\)
\(-0{,}08\)
Bovespa (Brazilia)
\(0{,}28\)
\(0{,}65\)
\(0{,}14\)
\(0{,}51\)
\(0{,}11\)
IPC (Mexic)
\(0{,}44\)
\(1{,}41\)
\(0{,}32\)
\(0{,}63\)
\(0{,}03\)
Nifty 50 (India)
\(0{,}50\)
\(1{,}29\)
\(0{,}28\)
\(0{,}64\)
\(0{,}02\)
Shanghai (China)
\(0{,}59\)
\(1{,}32\)
\(0{,}30\)
\(0{,}23\)
\(0{,}08\)
Bitcoin
\(4{,}47\)
\(1{,}94\)
\(0{,}72\)
\(1{,}08\)
\(0{,}13\)
Ethereum
\(6{,}50\)
\(1{,}28\)
\(0{,}57\)
\(0{,}90\)
\(0{,}16\)
307 de luni pentru indicii de acțiuni, mai puține pentru criptoactive
raportul Sharpe \(\sqrt{12}\,\bar x / s_x\), fără scăderea dobînzii fără risc
\(\bar x\), \(s_x\): media și abaterea standard lunare ale strategiei
Robert Shiller (Premiul Nobel 2013) și Richard Thaler (Premiul Nobel 2017) sînt autorii dovezilor comportamentale din capitol: volatilitatea excesivă a prețurilor acțiunilor față de dividende (Shiller, 1981) și reacția excesivă (overreaction) a randamentelor acțiunilor (De Bondt & Thaler, 1985), discutate pe slide-ul despre psihologia din prețuri.
Martin & Nagel (2022) se întreabă ce înseamnă respingerea unui test de absență a predictibilității cînd numărul \(J\) de caracteristici este comparabil cu numărul \(N\) de active, iar coeficienții trebuie învățați din datele trecute, o problemă de predicție în dimensiune mare, ca în machine learning. Eficiența semi-tare, prețuri care „reflectă pe deplin” informația publică (Fama, 1970), are atunci două lecturi: investitorii cunosc parametrii modelului fluxurilor de numerar, ipoteza nulă de așteptări raționale a celor mai multe teste de eficiență, sau investitorii își actualizează optim convingerile, în sens bayesian, cu datele disponibile în timp real. Întrebarea contează din cauza sutelor de predictori in-sample ai randamentelor din „factor zoo” (Harvey, Liu & Zhu, 2016), al căror număr \(J\) crește în continuare prin text, imagini satelitare și rețele sociale, și pentru că se leagă de predictibilitatea out-of-sample (Campbell & Thompson, 2008) și de scăderea anomaliilor după publicare (McLean & Pontiff, 2016).
Pe scurt
Întrebarea Martin & Nagel (2022): ce înseamnă respingerea ipotezei de absență a predictibilității?
în cazul în care numărul \(J\) al caracteristicilor este comparabil cu numărul \(N\) al activelor
coeficienții trebuie estimați din date istorice: o problemă de predicție cu multe variabile, ca în învățarea automată
Eficiența semi-tare: prețurile „reflectă complet” informația publică Fama (1970)
Două interpretări
investitorii cunosc parametrii modelului fluxurilor de numerar (așteptări raționale: ipoteza nulă a majorității testelor de eficiență)
investitorii își actualizează optim convingerile prin inferență bayesiană, folosind datele disponibile la momentul deciziei
De ce contează: sute de predictori ai randamentelor găsiți în eșantion, așa-numita mulțime a factorilor propuși Harvey, Liu & Zhu (2016)
Textele, imaginile din satelit și rețelele sociale măresc continuu \(J\)
fiecare predictor semnificativ are oare nevoie de o explicație prin risc sau de una comportamentală?
În modelul lui Martin & Nagel (2022) (Sec. 2), creșterea fluxurilor de numerar este \(\Delta y_t = Xg + e_t\), cu \(e_t \sim N(0, I)\) și o rată a dobînzii nulă, unde \(\Delta y_t\) conține cele \(N\) rate de creștere, \(X\) este matricea \(N \times J\) a caracteristicilor, \(g\) cei \(J\) coeficienți necunoscuți, iar \(I\) matricea identitate. Investitorii pornesc de la distribuția a priori \(g \sim N(0, (\theta/J)\,I)\), distribuția adevărată din care este extras \(g\), cu \(\theta\) intensitatea semnalului. Schematic, după \(t\) perioade prețul este \(X\hat g_t\), cu \(\hat g_t = (tX^\prime X + (J/\theta)I)^{-1}X^\prime\sum_{s \le t}\Delta y_s\), astfel încît \(\mathbb{E}[\hat g_t \mid g] = Ag\), cu \(A\) „mai mică” decît \(I\). Randamentul următor se descompune atunci în
suma dintre reacția insuficientă (underreaction) produsă de shrinkage, zgomotul de estimare și un șoc imprevizibil. Asimptotica (Sec. 4) ia \(N, J \to \infty\) cu \(J/N \to \psi > 0\), iar simulările folosesc \(N = 1000\), elemente ale lui \(X\) extrase din distribuția Normală standard și \(\theta = 1\).
creșterea fluxurilor de numerar \(\Delta y_t = Xg + e_t\), cu \(e_t \sim N(0, I)\) și o rată a dobînzii egală cu zero
\(\Delta y_t\): cele \(N\) rate de creștere ale fluxurilor de numerar
\(X\): matricea \(N \times J\) a caracteristicilor
\(g\): cei \(J\) coeficienți necunoscuți
\(I\): matricea identitate
Învățarea (Prop. 1–2)
distribuția a priori \(g \sim N(0, (\theta/J)\,I)\), care coincide cu distribuția reală din care este extras \(g\)
\(\theta\): intensitatea semnalului
schematic, cu o perioadă: prețul este \(X\hat g_t\), cu \(\hat g_t = (tX^\prime X + (J/\theta)I)^{-1}X^\prime\sum_{s \le t}\Delta y_s\), deci \(\E[\hat g_t \mid g] = Ag\), cu \(A\) „mai mică” decît \(I\)
Testul in-sample este o regresie OLS transversală a lui \(r_{t+1}\) pe \(X\), care cere \(J < N\), cu un test \(\chi^2\) comun. Testul out-of-sample folosește un portofoliu cu ponderile \(\frac{1}{N} X h_{s+1}\), construit din coeficienții \(h_{s+1}\) estimați în alte perioade, cu randamentul \(r_{\text{OOS},t+1} = \frac{1}{N}\, h_{s+1}^{\prime} X^{\prime} r_{t+1}\) pentru \(s \neq t\);\(r_{\text{IS}}\) este aceeași mărime cu \(s = t\). Designul empiric (Sec. 7) folosește acțiunile americane din CRSP (Center for Research in Security Prices), fără cele sub percentila 20 a capitalizării NYSE (New York Stock Exchange) sau cu prețul sub 1 dolar. Cei 238 de predictori sînt randamentele lunare simple și pătratele lor la lagurile \(t-2\) pînă la \(t-120\), centrate și standardizate transversal în fiecare lună. Estimarea pe tot eșantionul este o regresie ridge pe 1971 – iunie 2019, cu penalizarea aleasă prin validare încrucișată cu omiterea cîte unui an (leave-one-year-out cross-validation), iar o regresie OLS pe ferestre mobile de 20 de ani dă \(r_{\text{OOS}}\) din ianuarie 1956.
Pe scurt
CRSP: Center for Research in Security Prices (Universitatea din Chicago).
NYSE: New York Stock Exchange — Bursa din New York.
Teste
în eșantion: o regresie OLS transversală a lui \(r_{t+1}\) pe \(X\) (cere \(J < N\)), cu un test \(\chi^2\) comun
în afara eșantionului: un portofoliu cu ponderile \(\frac{1}{N} X h_{s+1}\), construite din coeficienți estimați în alte perioade
acțiunile americane din CRSP, fără cele sub percentila 20 a capitalizării NYSE sau cu prețul sub 1 $
predictori: randamentele lunare simple și pătratele lor, cu lagurile \(t - 2\) pînă la \(t - 120\) (238 de predictori), centrate și standardizate transversal în fiecare lună
regresie ridge pe întreaga selecție, 1971 – iunie 2019, cu penalizarea aleasă prin validare încrucișată cu cîte un an exclus
regresiile OLS pe ferestre mobile de 20 de ani dau \(r_{\text{OOS}}\) începînd din ianuarie 1956
In-sample, probabilitatea ca testul să nu respingă este de ordinul \(e^{-0{,}015N}\) pentru \(\psi > 0{,}4\), cu \(\theta = 1\) și o singură perioadă de învățare (Prop. 4 și Fig. 2 din Martin & Nagel (2022)). În simulări cu \(N = 1000\) și patru perioade de învățare, un test cu nivelul nominal de 5% respinge cu o probabilitate de peste 90% de îndată ce \(J > N/2\) (Fig. 3b). Nu este o distorsiune de nivel: componenta predictibilă in-sample se află efectiv în prețuri. Nici testele pe predictori individuali cu control \(k\)-FWER, care limitează la 5% probabilitatea a \(k\) sau mai multe respingeri false, nu ajută: pentru \(k = 20\) și \(J/N = 0{,}05\), probabilitatea a cel puțin \(k\) respingeri este 25% în loc de 5%, iar pentru \(J/N\) apropiat de 1, circa 80% (Fig. 4). Problema este ipoteza nulă, nu testul.
Pe scurt
În eșantion, probabilitatea de a nu respinge ipoteza nulă este de ordinul \(e^{-0{,}015N}\) (Fig. 2)
Out-of-sample, \(\mathbb{E}[r_{\text{OOS},t+1}] = 0\) este valabilă atît înainte, cît și înapoi în timp (Prop. 6); media este pozitivă doar dacă investitorii aplică un shrinkage mai puternic decît justifică datele (Fig. 6). Pe acțiunile americane, coeficienții ridge regăsesc trei tipare cunoscute, momentum, inversarea pe termen lung (long-run reversal) și sezonalitatea momentum-ului (Fig. 7), cu \(r_{\text{IS}} \approx 0{,}006\%\) pe lună (Fig. 8).
Pe scurt
În afara eșantionului: \(\E[r_{\text{OOS},t+1}] = 0\) (Prop. 6)
este valabil atît în ordine cronologică, cît și în ordine inversă
Media este pozitivă doar dacă investitorii aplică o contracție mai puternică decît justifică datele (Fig. 6)
În replicarea cursului pe portofolii de industrie, \(r_{\text{IS}} = b^{\prime} G^{-1} b / 240 \ge 0\) în fiecare fereastră de 20 de ani, prin construcție, unde \(G = \sum_s X_s^{\prime} X_s / N_s\) și \(b = \sum_s X_s^{\prime} r_s / N_s\) pe cele 240 de luni ale ferestrei, \(X_s\) este matricea \(N_s \times 238\) a predictorilor din luna \(s\),\(r_s\) randamentele celor \(N_s\) portofolii, iar \(G^{-1}b\) coeficienții OLS comuni. \(R^2\) in-sample mediu este 5,4%, față de circa 1% pentru acțiunile individuale din Martin & Nagel (2022): 238 de predictori pentru doar 40–49 de portofolii pe lună, cumulați pe 240 de luni, umflă potrivirea in-sample. Out-of-sample, din iulie 1956, media lui \(r_{\text{OOS}}\) este \(1{,}98 \times 10^{-5}\) pînă în iunie 1986, cu 4,16 erori standard peste zero, și \(0{,}36 \times 10^{-5}\) după aceea, doar 0,62 erori standard. Media pe 10 ani depășește ultima dată două erori standard în fereastra care se încheie în decembrie 1987, iar în ferestrele care se încheie în 2014–2019 raportul ei maxim față de eroarea standard este 1,25, ca pentru acțiuni. Martin & Nagel (2022) sugerează că diferența este compatibilă cu învățarea investitorilor, dar ea nu demonstrează învățarea și nici nu exclude primele de risc, iar cîștigurile out-of-sample timpurii sînt compatibile și cu un shrinkage excesiv înainte de era calculatoarelor.
Pe scurt
\(r_{\text{IS}} \geq 0\) în fiecare fereastră de 20 de ani prin construcție
\(r_{\text{IS}} = b^{\prime} G^{-1} b / 240\)
cu \(G = \sum_s X_s^{\prime} X_s / N_s\) și \(b = \sum_s X_s^{\prime} r_s / N_s\) pe cele 240 de luni \(s\) ale ferestrei
\(X_s\): matricea \(N_s \times 238\) a predictorilor din luna \(s\)
\(r_s\): cele \(N_s\) randamente ale portofoliilor
\(G^{-1}b\): coeficienții OLS estimați pe datele cumulate (pooled)
\(R^2\) mediu în eșantion de \(5{,}4\%\), față de circa 1% pentru acțiunile individuale în Martin & Nagel (2022): 238 de predictori față de doar 40–49 de portofolii pe lună, cumulate pe 240 de luni, exagerează ajustarea în eșantion
În afara eșantionului (din iulie 1956), pînă în iunie 1986: media \(r_{\text{OOS}} = 1{,}98 \times 10^{-5}\)
la \(4{,}16\) erori standard peste 0
După aceea, media este \(0{,}36 \times 10^{-5}\), la doar \(0{,}62\) erori standard
media pe 10 ani depășește ultima dată două erori standard în fereastra încheiată în decembrie 1987
în ferestrele încheiate în 2014–2019, cel mai mare raport față de eroarea standard este \(1{,}25\), ca pentru acțiuni
Interpretare sugerată de Martin & Nagel (2022): diferența este compatibilă cu învățarea investitorilor
dar nu o dovedește și nu exclude primele de risc
Cîștigurile timpurii în afara eșantionului sînt compatibile și cu o contracție excesivă a coeficienților (Fig. 6)
Datele cursului nu conțin fișierele CRSP la nivel de acțiune, așa că replicarea folosește cele 49 de portofolii de industrie ponderate cu capitalizarea, cu aceiași predictori, aceeași standardizare și aceleași ferestre; filtrele de mărime și de preț nu se aplică portofoliilor. Autorii precizează trei limite:
Randamentele întîrziate sînt rezultate de echilibru, nu caracteristicile exogene \(X\) ale modelului, deci aplicația ilustrează diferența dintre in-sample și out-of-sample, fără a testa modelul;
Un test \(t\) pe \(r_{\text{OOS}}\) lunar nu este un test valid al ipotezei \(\mathbb{E}[r_{\text{OOS}}] = 0\), o medie calculată și peste distribuția a priori a lui \(g\);
Rezultatul înapoi în timp se poate sprijini pe o creștere i.i.d. a fluxurilor de numerar, pe investitori omogeni și pe caracteristici constante.
Trei extinderi rămîn deschise:
De ce regresia dividend–preț, cu un singur predictor (\(J = 1\)), are totuși un \(R^2\) in-sample de 0,12% față de \(R^2_{OS} = -0{,}51\%\);
Dacă modelele neliniare, precum arborii și rețelele neuronale (Gu, Kelly & Xiu, 2020), care adaugă flexibilitate funcțională fără a schimba neapărat \(J\), măresc diferența;
Dacă, în sensul AMH, predictibilitatea out-of-sample timpurie reflectă shrinkage-ul excesiv al unor investitori cu putere de calcul mai mică.
Pe scurt
Aplicați metoda pe datele cursului
datele CRSP pentru acțiuni individuale nu sînt incluse
cele 49 de portofolii sectoriale de pe slide-urile de replicare, cu aceiași predictori, standardizare și ferestre
filtrele de capitalizare și de preț nu se aplică portofoliilor
Limite precizate de autori
randamentele decalate sînt rezultate de echilibru, nu matricea exogenă \(X\) din model: aplicația ilustrează diferența dintre predictibilitatea în eșantion și cea în afara eșantionului, nu testează modelul
un test \(t\) pe \(r_{\text{OOS}}\) lunar nu este un test valid pentru \(\E[r_{\text{OOS}}] = 0\), o medie calculată și peste distribuția a priori a lui \(g\)
rezultatul pentru ordinea temporală inversă poate depinde de ipoteza unor creșteri i.i.d. ale fluxurilor de numerar, iar modelul presupune investitori omogeni și caracteristici constante
Extinderi deschise
seriile de timp: regresia pe raportul dividend–preț din secțiunea 3 are un singur predictor (\(J = 1\)), dar \(R^2\) în eșantion de \(0{,}12\%\) și \(R^2_{OS} = -0{,}51\%\): ce explică diferența, dacă nu numărul de predictori?
modelele neliniare (arbori, rețele neuronale Gu, Kelly & Xiu (2020)) adaugă flexibilitate funcțională fără să schimbe neapărat \(J\): crește diferența?
AMH: poate contracția excesivă aplicată de investitori cu resurse de calcul limitate să explice predictibilitatea în afara eșantionului din perioada timpurie?
Primele trei etape ale buclei de descoperire sînt scrise ca prompturi aplicate unei singure întrebări: au schimbat ETF-urile spot pe Bitcoin dependența serială a lui Bitcoin? Promptul de literatură cere studii publicate în reviste cu evaluare colegială (peer-reviewed) din 2020 încoace despre introducerea ETF-urilor și eficiența activului-suport, cu DOI, design (event study, diferență în diferențe (DiD, difference-in-differences), ruptură structurală) și măsura eficienței, iar fiecare DOI este apoi verificat pe Crossref, cu titlul și autorii corespunzători. Promptul de ipoteză cere trei mecanisme, arbitrajul, structura investitorilor și orele de tranzacționare, fiecare cu semnul schimbării lui \(\rho_1\) și VR(\(q\)) și cu o variabilă care îl separă de celelalte. Promptul de date și cod calculează \(\rho_1\) cu o eroare standard HAC (Newey–West) și VR(5) Lo–MacKinlay cu \(z^*\), pe două ferestre de lungime egală în jurul datei de 11 ianuarie 2024.
Pe scurt
Literatură
Listează studii publicate în reviste cu evaluare de specialitate, începînd din 2020, despre cum schimbă lansarea unui ETF eficiența sau descoperirea prețului activului suport. Pentru fiecare: DOI, metoda (studiu de eveniment, difference-in-differences (DiD), ruptură structurală), măsura eficienței. Marchează orice intrare despre care nu ești sigur că există.
Verificați fiecare DOI (Digital Object Identifier, identificatorul digital al unei publicații) în Crossref
Titlul și autorii trebuie să coincidă cu cei ai lucrării citate
Ipoteză
Propune trei mecanisme prin care ETF-urile spot ar putea schimba dependența serială a lui Bitcoin (arbitraj, structura investitorilor, orele de tranzacționare). Pentru fiecare: semnul schimbării lui rho1 și VR(q) și o variabilă care îl deosebește de celelalte.
Date și cod
Citește prețurile zilnice de închidere ale lui Bitcoin din datele cursului; calculează randamentele logaritmice, rho1 cu eroarea standard HAC (Newey-West) a estimației și VR(5) Lo-MacKinlay cu z*, în două ferestre de aceeași lungime în jurul datei de 11 ianuarie 2024.
Promptul de robustețe cere un plan preînregistrat: lungimile ferestrelor, închideri doar din zilele lucrătoare, VR(\(q\)) pentru \(q = 2\) pînă la 20 cu Chow–Denning, date placebo și Ethereum ca activ de control pînă la propriile lui ETF-uri spot, din iulie 2024. Promptul de critică cere AI-ului să joace rolul unui referent ostil: dacă Bitcoin era deja eficient înainte de 2024, ce ar putea detecta testul, care este schimbarea minimă detectabilă a lui \(\rho_1\) și ce variabilă de rezultat ar fi mai bună. Raportul conține estimațiile, erorile standard robuste, distribuția placebo și toate testele făcute, cu o corecție pentru testarea multiplă, iar prompturile care au influențat o decizie intră în fișierul AI_USE.md.
Pe scurt
Robustețe
Scrie un plan de robustețe preînregistrat: lungimea ferestrelor, doar închiderile din zilele lucrătoare, VR(q) pentru q = 2 pînă la 20 cu Chow-Denning, date placebo și Ethereum ca activ de control pînă la propriile ETF-uri spot (iulie 2024).
Critică
Joacă rolul unui recenzent ostil: dacă Bitcoin era deja eficient înainte de 2024, ce ar putea detecta vreodată acest test? Calculează schimbarea minimă detectabilă a lui rho1 și propune o variabilă-rezultat mai bună.
Raport
Estimațiile, erorile standard robuste, distribuția placebo, toate testele efectuate (cu corecție pentru testare multiplă)
Prompturile care au influențat o decizie intră în AI_USE.md
Șase verificări se aplică unui studiu înainte/după al eficienței făcut cu ajutorul AI. Eroarea standard i.i.d. \(1/\sqrt T\) respinge prea des în prezența volatility clustering, de aceea testul folosește SE robustă sub \(H_0\) și \(z^*\), iar erorile standard HAC servesc pentru intervale și comparații înainte/după. Ferestrele inegale dau puteri diferite înainte și după, deci lungimile sînt egale și fixate dinainte. O dată a evenimentului aleasă din date este înlocuită cu data lansării (prima zi de tranzacționare) și cu o distribuție placebo la date fără eveniment. O diferență înainte/după nu este cauzală, așa că un activ de control, Ethereum înainte de iulie 2024, intră într-o analiză diferență în diferențe, cauzală doar în condițiile slide-ului despre diferența în diferențe și cu o perioadă comună de după eveniment scurtă, ianuarie–iulie 2024. Statisticile multiple, \(\rho_1\), VR(2–20) și testul secvențelor, cer Chow–Denning sau Holm, nu cea mai mică valoare \(p\) individuală, iar puterea mică cere raportarea efectului minim detectabil (MDE, minimum detectable effect) de pe slide-ul despre estimare și putere.
Pe scurt
Erori standard i.i.d.: \(1/\sqrt{T}\) duce la respingeri prea frecvente în prezența grupării volatilității
test: SE robustă sub \(H_0\) și \(z^*\), ca în testele de eficiență slabă din acest capitol; SE HAC pentru intervale și comparații înainte/după
Ferestre inegale: putere diferită înainte și după
test: lungimi egale, fixate dinainte
Data evenimentului aleasă din date
test: doar data lansării (prima zi de tranzacționare), plus o distribuție placebo la date fără eveniment
Factori de confuzie: o comparație înainte/după nu are interpretare cauzală
test: un activ de control (Ethereum înainte de iulie 2024) într-o difference-in-differences
Trei cursuri avansate de pe Quantinar extind capitolul: eficiența piețelor de criptomonede analizată cu metoda generalizată a momentelor (GMM, generalized method of moments), metoda GMM însăși și reacțiile pieței la etapele de dezvoltare ale Ethereum. Codul și datele tuturor graficelor și tabelelor se află în folderul Quantlets Ch_02 al depozitului cursului, iar manualele de referință sînt Campbell, Lo & MacKinlay (1997), cap. 2, și Franke, Härdle & Hafner (2019).
De Long, J.B., Shleifer, A., Summers, L.H., Waldmann, R.J. (1990). Noise trader risk in financial markets. Journal of Political Economy, 98(4), 703–738.
Diebold, F.X., Mariano, R.S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263.
Indici bursieri, Bitcoin, Ethereum, TLV, BRD și BET: prețuri zilnice EODHD, pînă la 18 septembrie 2026. EUR/RON: cursul de referință BNR. S&P 500 lunar cu dividende: datele publice ale lui Robert J. Shiller, prelungite cu prețurile zilnice ale S&P 500; dobînda la titlurile de stat pe 3 luni din FRED (TB3MS).


 Eugene F. Fama.
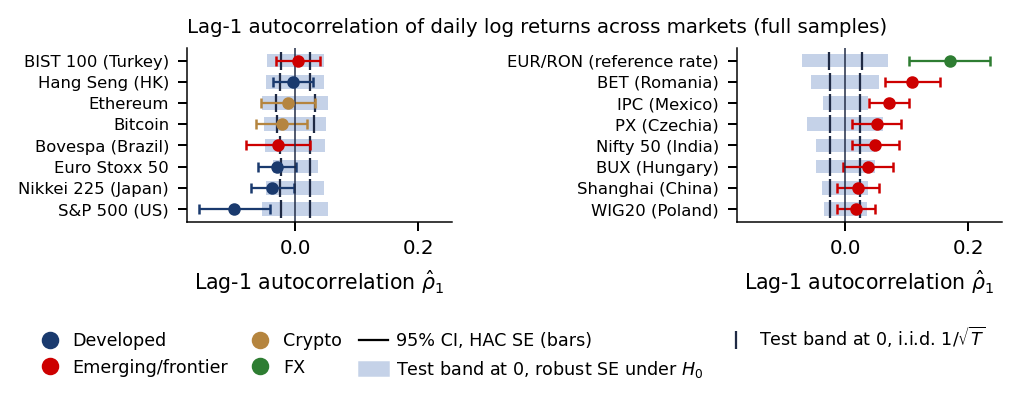
 MFM_ch2_random_walk_game
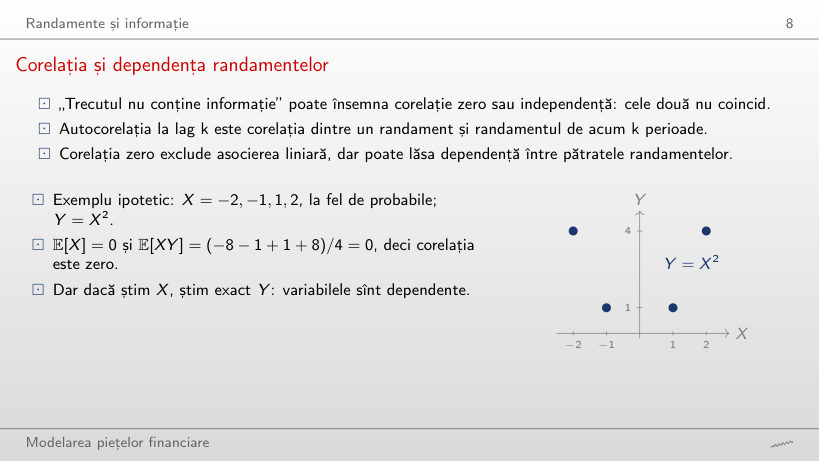
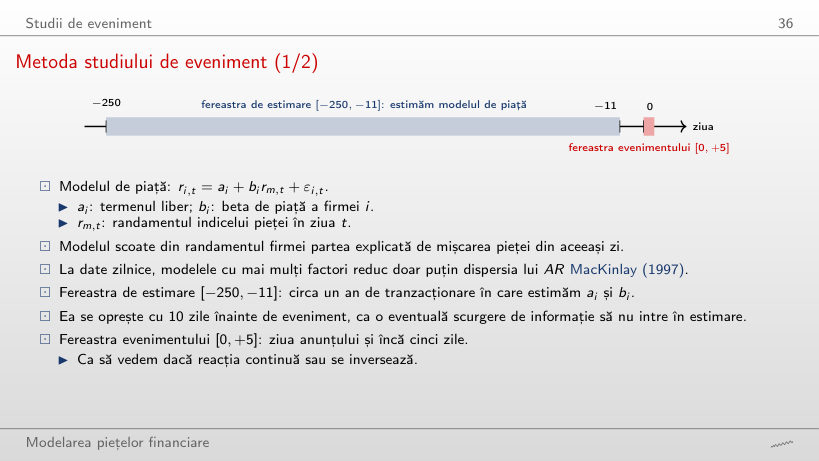
 Market Responses to ETH Development Milestones
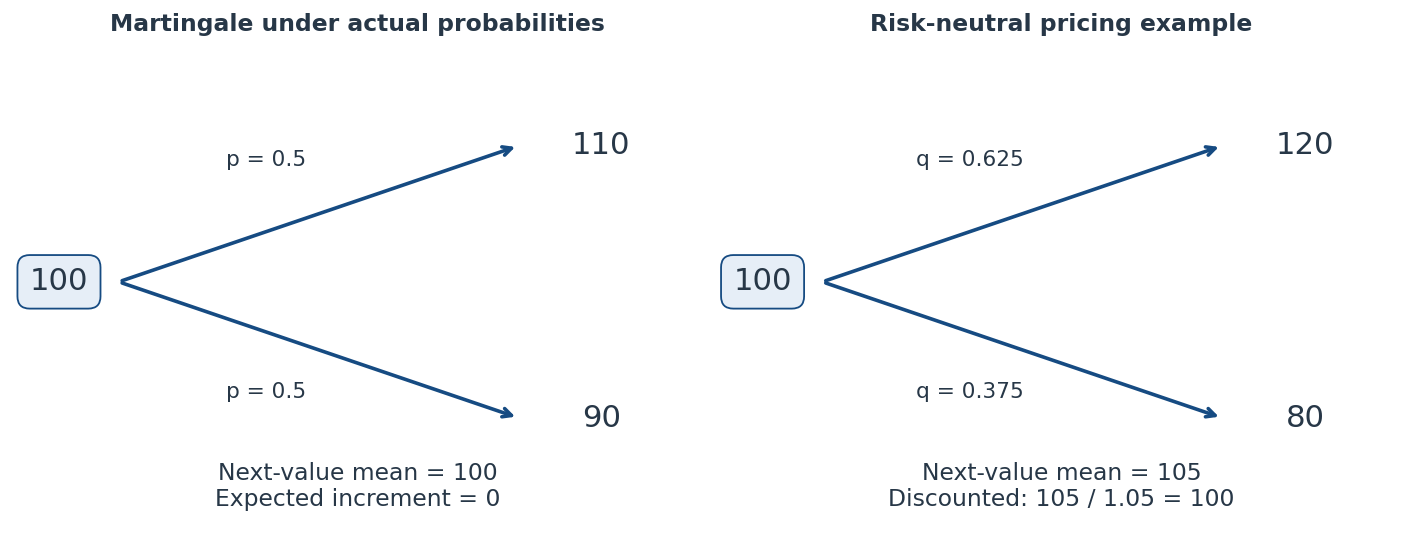 Stînga: media condiționată reală rămîne 100. Dreapta: probabilitățile de evaluare dau 105, cu valoarea actualizată 100.
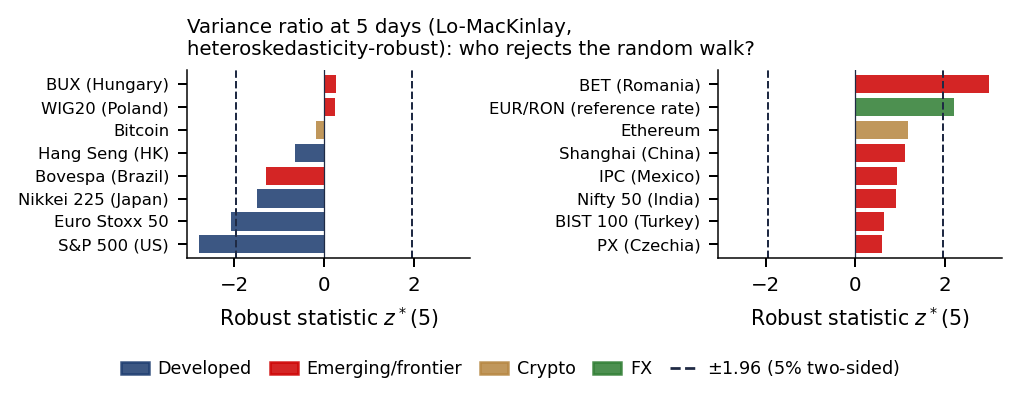
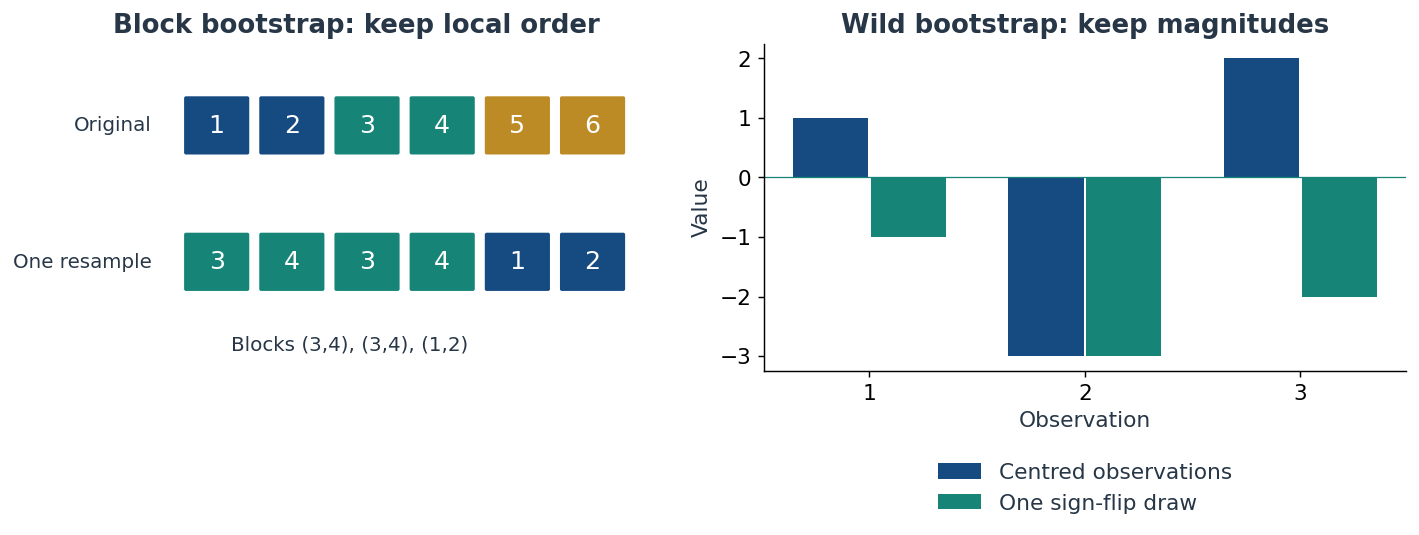 Blocurile păstrează ordinea locală; schimbările de semn păstrează modulele. Cele două proceduri impun ipoteze diferite selecțiilor artificiale.
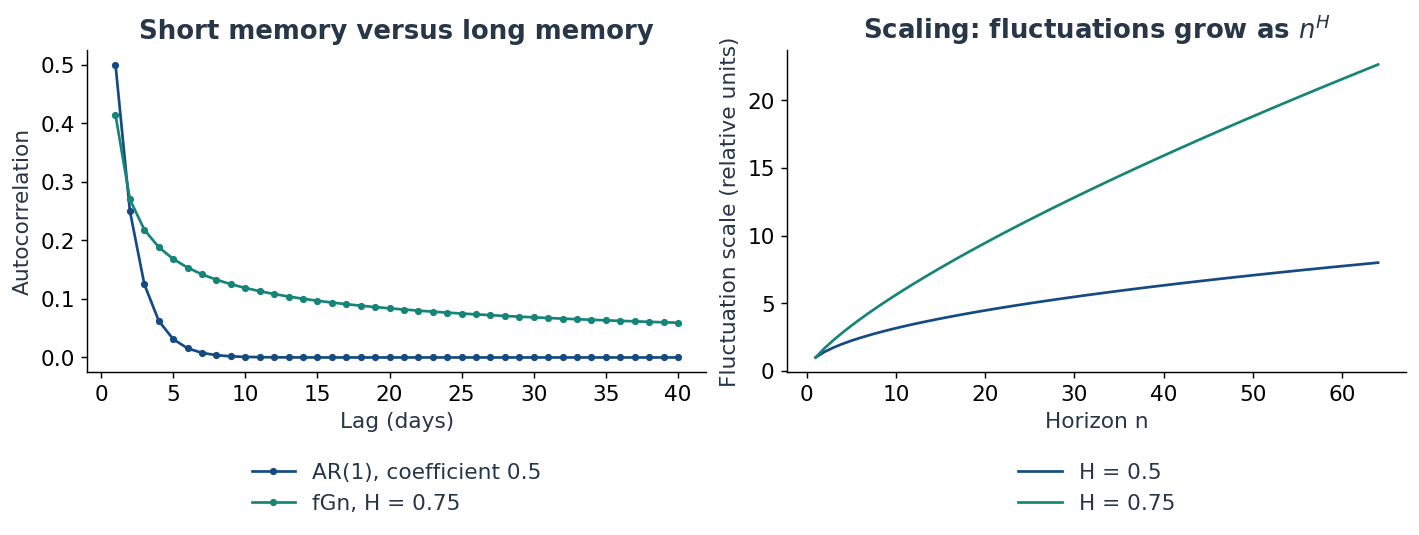 Corelațiile AR(1) scad geometric; în exemplul fGn scad lent. Dreapta compară creșterea fluctuațiilor odată cu orizontul.