Capitolul 3: Modele factoriale și evaluarea activelor
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“[W]hen the tests allow for variation in \(\beta\) that is unrelated to size, the relation between market \(\beta\) and average return is flat, even when \(\beta\) is the only explanatory variable.” — Fama & French (1992)
Problema capitolului: ce determină diferențele dintre randamentele medii ale activelor?
25 de portofolii americane sortate după capitalizare și raportul B/M (valoare contabilă / valoare de piață), iul. 1963 – iul. 2026
randamente medii în exces, anualizate: \(3{,}9\%\) pentru firmele mici de creștere (small growth), \(13{,}3\%\) pentru firmele mici de valoare (small value)
explică beta această diferență de aproximativ \(9{,}5\) puncte procentuale?
Răspunsul CAPM (Capital Asset Pricing Model): prima de risc a unui activ este proporțională cu expunerea la riscul de piață, beta
Structura argumentului
în CAPM, componenta randamentului în exces neexplicată de beta, alfa, este nulă
estimăm beta și alfa, apoi testăm ipoteza \(\alpha = 0\) pe datele empirice
respingerea ipotezei conduce la modelele multifactoriale și la evaluarea robusteții factorilor propuși
[W]hen the tests allow for variation in β that is unrelated to size, the relation between market β and average return is flat, even when β is the only explanatory variable.
Capitolul pornește de la o întrebare empirică: ce determină diferențele dintre randamentele medii ale activelor? Pentru 25 de portofolii de acțiuni americane sortate după capitalizare și după raportul dintre valoarea contabilă și valoarea de piață (B/M, book-to-market), randamentele medii în exces, anualizate, variază în perioada iulie 1963 – iulie 2026 de la 3,9% pentru firmele mici de creștere (small-growth) la 13,3% pentru firmele mici de valoare (small-value). Întrebarea este dacă beta explică această diferență de aproximativ 9,5 puncte procentuale.
Modelul de evaluare a activelor financiare (CAPM, Capital Asset Pricing Model) (Sharpe, 1964; Lintner, 1965; Black, 1972) răspunde că prima de risc a unui activ este proporțională cu expunerea lui la riscul de piață, beta. Componenta randamentului mediu în exces pe care beta nu o explică se numește alfa; în CAPM, alfa este nulă pentru orice activ.
Argumentul capitolului urmează această ipoteză. Se estimează beta și alfa, apoi se testează ipoteza că toate valorile alfa sînt nule. Respingerea ei conduce la modelele multifactoriale și la întrebarea dacă factorii propuși în literatură rezistă testării multiple și replicării.
Graficul de mai jos este dreapta pieței titlurilor (SML, security market line): randamentul mediu în exces al fiecărui portofoliu în funcție de beta lui. Pe axa orizontală, beta nu are unitate de măsură; numai randamentele sînt procente anualizate.
Dreapta pieței titlurilor (SML, security market line) pentru cele 25 de portofolii mărime × B/M, iulie 1963 – iulie 2026: stînga, randamentul mediu anual în exces în funcție de beta CAPM, cu dreapta CAPM (panta 7,2%) și dreapta estimată (panta −4,4%); dreapta, valorile alfa anuale, cu portofoliile din cvintila firmelor celor mai mici în roșu. Randamentele și valorile alfa sînt fracții anuale (0,05 = 5%); beta, pe axa orizontală din stînga, nu are unitate de măsură. Graficul interactiv: „Dreapta pieței titlurilor (SML) în date (1/2)” →
Rezultatele învățării
Calculați un beta cu erori robuste la heteroscedasticitate și autocorelație și aplicați-i shrinkage.
Calculați testul simultan al valorilor alfa ale CAPM și prime de risc cu erori robuste.
Interpretați un factor nou în raport cu pragurile testării multiple și cu dovezile de replicare.
Interpretați un ETF (Exchange-Traded Fund, fond tranzacționat la bursă) factorial ca expuneri la factori și alfa.
ConcluziiPașii unei analize factoriale, verificarea înțelegerii și decizia practică.
AprofundăriDatele, factorul stocastic de actualizare, PCA (Principal Component Analysis, analiza componentelor principale) și IPCA, factor momentum, AI (Artificial Intelligence, inteligență artificială) pentru cercetare și exemple detaliate.
Capitolul tratează secțiunea transversală (cross-section) a randamentelor medii: de ce unele active cîștigă în medie mai mult decît altele. Un model factorial atribuie diferența expunerilor la cîteva surse comune de risc, iar modelul de evaluare a activelor financiare (CAPM, Capital Asset Pricing Model) este cazul particular cu un singur factor, piața. Capitolul estimează aceste expuneri, testează restricțiile pe care modelele le impun randamentelor medii și verifică dacă factorii din literatură rezistă testării multiple și replicării.
Secțiunea formulează întrebarea și definește modelul factorial și utilizările lui. Datele și convențiile de randament folosite în tot capitolul sînt descrise în Aprofundări.
Ce explică randamentele așteptate: CAPM și modelele multifactoriale.
Cum se estimează expunerile. O expunere, sau beta, este un coeficient de regresie, iar capitolul tratează incertitudinea ei de eșantionare și shrinkage-ul ei, adică ajustarea unei estimări imprecise către o valoare de referință.
Cum se testează CAPM: testul simultan al valorilor alfa, termenii liberi ai regresiilor pe randamentul pieței.
Ce aduc factorii suplimentari și cum se estimează primele lor de risc, prin regresiile Fama–MacBeth.
Dacă factorii publicați rezistă după ce se iau în calcul testarea multiplă și replicarea.
Competențele corespunzătoare sînt:
calculul unui beta cu erori standard robuste la heteroscedasticitate și autocorelație și aplicarea shrinkage-ului;
calculul testului simultan al valorilor alfa ale CAPM și al primelor de risc cu erori robuste;
evaluarea unui factor nou față de pragurile testării multiple și de dovezile de replicare;
citirea unui fond tranzacționat la bursă (ETF, exchange-traded fund) factorial ca un set de expuneri factoriale plus o valoare alfa.
Aprofundările și Anexa sînt lectură de familiarizare.
Un model factorial explică randamentul activului \(i\) printr-un număr mic \(K\) de variabile comune \(f_{1,t},\dots,f_{K,t}\), numite factori. În forma cu randamente în exces,
unde \(R_{i,t}\) este randamentul activului \(i\) în perioada \(t\), iar \(R_{f,t}\) rata fără risc. Coeficientul \(\beta_{i,k}\) este loading-ul factorial (factor loading), expunerea activului \(i\) la factorul \(k\), iar \(\varepsilon_{i,t}\) este șocul specific activului, sau idiosincratic.
Termenul liber \(\alpha_i\) este partea randamentului mediu în exces pe care factorii nu o explică. Cînd factorii sînt chiar randamente în exces ale unor portofolii tranzacționate, un model care evaluează corect activul implică \(\alpha_i = 0\): randamentul mediu este explicat integral de expunerile \(\beta_{i,k}\) înmulțite cu randamentele medii ale factorilor. A testa un model de evaluare înseamnă, așadar, a testa dacă termenii liberi din (3.1) sînt nuli, simultan pentru toate activele.
Pe scurt
Un model factorial explică randamentul activului \(i\) prin cîteva variabile comune \(f_{1,t},\dots,f_{K,t}\), numite factori
Capitolul folosește modelele factoriale în două moduri:
Explicarea unui activ: pentru ETF-ul de tehnologie XLK, unei creșteri de un punct procentual a randamentului în exces al pieței americane îi corespunde o creștere estimată de 1,28 puncte, o estimație obținută în secțiunea despre estimarea lui beta.
Alte utilizări, tratate în Campbell, Lo & MacKinlay (1997), capitolele 5–6, sînt costul capitalului, construcția portofoliilor și managementul riscului.
În managementul riscului avantajul este numărul de parametri. Matricea de covarianță a \(N\) active are \(N(N+1)/2\) varianțe și covarianțe distincte. Un model cu \(K\) factori o înlocuiește cu cele \(NK\) loadings, cele \(K(K+1)/2\) elemente ale matricei de covarianță a factorilor și cele \(N\) varianțe specifice, în total \(NK + K(K+1)/2 + N\) parametri, un număr care crește liniar, nu pătratic, cu \(N\). Numărarea presupune că reziduurile activelor nu sînt corelate între ele; altfel, cele \(N\) varianțe specifice nu sînt suficiente.
Ideea economică a capitolului este că randamentul mediu este plata pentru risc. Investitorii cer o primă pentru riscurile comune pe care le poartă, factorii (piața, mărimea, valoarea și alții), iar restricția de evaluare este \(\mathbb{E}[R^e_i] = \boldsymbol\beta_i^\top\boldsymbol\lambda\). La expuneri egale la ceilalți factori, o expunere mai mare la un factor ridică randamentul mediu dacă prima acelui factor este pozitivă. Ce rămîne, în medie, neexplicat de expuneri este \(\alpha\).
Pe scurt
Ideea capitolului: randamentul mediu este plata pentru risc
investitorii cer o primă pentru riscurile comune: factorii (piața, mărimea, valoarea …)
la expuneri egale la ceilalți factori, o expunere \(\beta\) mai mare la un factor ridică randamentul mediu dacă prima acelui factor este pozitivă
restricția de evaluare este \(\mathbb{E}[R^e_i] = \boldsymbol\beta_i^\top\boldsymbol\lambda\), cu \(\boldsymbol\lambda\) primele factorilor; ce rămîne, în medie, neexplicat de expuneri este \(\alpha\)
Două utilizări în acest capitol
Explicarea unui activ: pentru XLK (Technology Select Sector SPDR Fund), ETF-ul sectorului de tehnologie, unei creșteri de un punct procentual a randamentului în exces al pieței americane îi corespunde o creștere estimată de \(1{,}28\) puncte (Secțiunea 3)
Evaluarea unui fond: rămîne \(\alpha_i\) pozitiv după ce ținem cont de expunerile lui (Secțiunile 4 și 8)?
Datele și notațiile pentru randamente sînt în Aprofundări
Sinteza secțiunii
Un model factorial scrie randamentul în exces ca expuneri înmulțite cu factori plus un termen liber, iar un model de evaluare este restricția \(\mathbb{E}[R^e_i] = \boldsymbol\beta_i^\top \boldsymbol\lambda\). Cînd factorii sînt randamente în exces ale unor portofolii tranzacționate, restricția implică termeni liberi nuli în regresia pe acești factori; pentru o surpriză macro centrată, termenul liber este chiar randamentul mediu în exces. Testele capitolului folosesc cele 25 de portofolii mărime × B/M și factorii French, în randamente simple lunare; ETF-urile sectoriale, ETF-urile factoriale și acțiunile de la BVB (Bursa de Valori București) oferă aplicațiile investibile și locale.
De la Markowitz la CAPM
Secțiunea derivă CAPM din alegerea medie–varianță. Dacă investitorii țin cont doar de media și de varianța randamentului portofoliului, toți combină activul fără risc cu un singur portofoliu riscant, portofoliul tangent. În echilibru, acest portofoliu trebuie să fie piața, iar randamentul așteptat în exces al fiecărui activ este atunci proporțional cu beta lui față de piață. Secțiunea aplică pasul medie–varianță celor nouă ETF-uri sectoriale din SUA (Statele Unite ale Americii) și enunță ipotezele și implicațiile CAPM pe care secțiunile următoare le testează.
Ce portofoliu deține un investitor medie–varianță?
Dacă investitorii aleg doar după medie și varianță, ce portofoliu dețin? Răspunsul este frontiera lui Markowitz (1952), care dă portofoliul cu cel mai mare raport Sharpe.
Ce randament mediu obține atunci fiecare activ? Răspunsul este CAPM (Sharpe, 1964),(Lintner, 1965), care afirmă că acest portofoliu este chiar portofoliul pieței.
Ambii pași se aplică celor nouă ETF-uri sectoriale americane cu istoric lung din familia Select Sector SPDR, disponibile din decembrie 1998. Ele sînt investibile, iar seriile lor sînt neîntrerupte între 1999 și 2026. Acoperirea lor s-a schimbat însă: reclasificările standardului global de clasificare a industriilor (GICS, Global Industry Classification Standard) din 2016, care a creat sectorul imobiliar, și din 2018, care a creat serviciile de comunicații, au mutat companii în afara acestor nouă fonduri. Cele nouă nu mai acoperă, așadar, întregul S&P 500 (Standard & Poor's).
Pe scurt
Întrebarea secțiunii: dacă investitorii aleg doar după medie și varianță, ce portofoliu dețin?
A doua întrebare: ce randament mediu rezultă atunci pentru fiecare activ?
Pasul 1: frontiera lui Markowitz (1952) dă portofoliul cu cel mai mare raport Sharpe
Aplicăm pe cele nouă ETF-uri sectoriale din SUA (Statele Unite ale Americii) cu istoric lung (Select Sector SPDR), disponibile din decembrie 1998
sînt investibile, iar seriile lor sînt continue din 1999 pînă în 2026
reclasificările GICS (Global Industry Classification Standard) din 2016 (imobiliare) și 2018 (servicii de comunicații) au mutat companii în afara acestor nouă fonduri
de aceea, cele nouă nu mai acoperă întregul indice S&P 500 (Standard & Poor's 500), al celor 500 de mari companii americane
Fie \(\mathbf{w}\) vectorul ponderilor portofoliului, \(\boldsymbol\mu\) vectorul randamentelor așteptate în exces și \(\boldsymbol\Sigma\) matricea de covarianță a randamentelor. Frontiera lui Markowitz (1952) este mulțimea portofoliilor complet investite cu cea mai mică varianță pentru fiecare medie-țintă \(\mu^*\):
Semnul ponderilor nu este restricționat; o pondere negativă este o poziție short.
Condițiile de ordinul întîi ale problemei (3.2) dau \(\mathbf{w}^* = \boldsymbol{\Sigma}^{-1}(\eta_1\boldsymbol{\mu} + \eta_2\mathbf{1})\), unde \(\eta_1\) și \(\eta_2\) sînt multiplicatorii Lagrange fixați de cele două restricții. Pentru că multiplicatorii sînt liniari în \(\mu^*\), la fel sînt și ponderile. Rezultă că orice portofoliu de pe frontieră este o combinație a oricăror două portofolii de pe frontieră, proprietate numită separarea în două fonduri (two-fund separation).
În planul volatilității \(\sigma_p\) și al mediei \(\mu_p\), frontiera este o hiperbolă. Punctul ei cel mai din stînga este portofoliul de varianță minimă. Sub acest punct, fiecare portofoliu este dominat de unul cu aceeași varianță și medie mai mare, deci doar ramura superioară, de deasupra portofoliului de varianță minimă, este frontiera eficientă.
Pe scurt
Markowitz (1952): portofoliile de pe frontieră se obțin rezolvînd
Raportul Sharpe al portofoliului \(p\),\(SR_p = \mathbb{E}[R_p - R_f]/\sigma_p\), este randamentul lui așteptat în exces pe unitatea de volatilitate, unde \(R_p\) și \(\sigma_p\) sînt randamentul și volatilitatea portofoliului. Cînd există un activ fără risc, problema investitorului se reduce la găsirea portofoliului riscant cu cel mai mare raport Sharpe, portofoliul tangent:
Formula este valabilă cînd \(\boldsymbol\Sigma\) este pozitiv definită și numitorul este pozitiv; numitorul doar rescalează \(\boldsymbol\Sigma^{-1}\boldsymbol\mu\) astfel încît ponderile să aibă suma 1.
Toate combinațiile dintre activul fără risc și portofoliul tangent se află pe dreapta pieței de capital (CML, Capital Market Line), \(\mu_p = SR_{\text{tan}}\,\sigma_p\), dreapta care pleacă de la rata fără risc și este tangentă la frontiera eficientă. Dacă portofoliul pieței este portofoliul tangent, condiția de ordinul întîi a problemei tangente implică faptul că randamentul mediu în exces al fiecărui activ este liniar în beta lui față de piață. Problema A2 din Seminarul 3 derivă acest rezultat.
Pe scurt
Raportul Sharpe\(SR_p = \mathbb{E}[R_p - R_f]/\sigma_p\): randamentul în exces pe unitatea de volatilitate
Portofoliul tangent: portofoliul cu cel mai mare raport Sharpe
Graficul estimează frontiera celor nouă ETF-uri sectoriale din date lunare, ianuarie 1999 – iulie 2026 (\(T = 331\) de luni). Pe axa orizontală este volatilitatea anualizată, iar pe cea verticală randamentul mediu anualizat în exces, ambele ca fracții (\(0{,}10 = 10\%\)). Frontiera este calculată in-sample, din mediile și covarianțele de eșantion, iar graficul marchează portofoliul tangent și SPY (SPDR S&P 500 ETF Trust, fondul tranzacționat la bursă pe indicele S&P 500), ETF-ul care replică S&P 500 și servește ca aproximare a pieței.
În versiunea interactivă, cursorul fixează ultima lună a eșantionului de estimare, de la luna 60 pînă la toate cele 331 de luni, iar butonul ▶ extinde eșantionul pas cu pas. Al doilea panou arată ponderile portofoliului tangent pentru eșantionul ales.
Întrebare pentru sală SPY are raportul Sharpe 0,49, iar portofoliul tangent al sectoarelor 0,66. Respinge această distanță CAPM?
Răspuns
Nu. Portofoliul tangent este optimizat in-sample, deci diferența trebuie evaluată statistic. Testul GRS pe cele nouă sectoare, cu Mkt-RF ca piață, dă GRS = 0,53, cu p = 0,85: nu respingem CAPM la 5%, ceea ce nu dovedește că modelul este corect. Portofoliul tangent are poziții short mari: −0,37 în XLF (Financial Select Sector SPDR Fund, ETF pe sectorul financiar) și −0,21 în XLB (Materials Select Sector SPDR Fund, ETF pe sectorul materiilor prime).
Portofoliul tangent are randamentul mediu în exces 8,55%, volatilitatea 12,96% și raportul Sharpe 0,66; SPY are 7,44%, 15,08% și 0,49. În acest eșantion SPY se află deci sub frontieră, în timp ce CAPM cere ca piața să fie chiar portofoliul tangent. Pentru că portofoliul tangent este optimizat pe aceleași date, rămîne întrebarea cît din această distanță este eroare de estimare; Secțiunea 4 o testează față de factorul de piață Mkt−RF (Risk-Free rate, rata fără risc).
Pe scurt
Legenda: Efficient frontier (risky sectors): frontiera eficientă a sectoarelor; Inefficient branch: ramura ineficientă a frontierei de varianță minimă; Tangency portfolio: portofoliul tangent; in-sample frontier: frontiera estimată în eșantion (in-sample), pe tot eșantionul 1999–2026 MFM_ch3_frontier
Portofoliul tangent al celor nouă sectoare are randamentul mediu în exces 8,55% pe an, volatilitatea 12,96% și raportul Sharpe 0,66. SPY are media 7,44%, volatilitatea 15,08% și raportul Sharpe 0,49, deci se află sub frontiera estimată. CAPM, introdus în cadrele următoare, cere ca piața să fie chiar portofoliul tangent.
Diferența de raport Sharpe, 0,66 față de 0,49, poate proveni în parte din eroarea de estimare: portofoliul tangent este optimizat pe aceleași date pe care este evaluat. Cît din diferență rămîne după eroarea de estimare? Testul din secțiunea despre testarea CAPM compară îmbunătățirea cu cea pe care ar produce-o zgomotul de estimare, cu factorul de piață Mkt−RF ca reper, nu cu SPY.
Portofoliul tangent conține și poziții short mari, \(-0{,}37\) în sectorul financiar (XLF) și \(-0{,}21\) în materiale (XLB); Aprofundările arată ce conține fiecare sector. Asemenea ponderi extreme apar pentru că mediile sînt estimate cu zgomot, problema studiată în Capitolul 4.
Pe scurt
Axele graficului: volatilitatea și randamentul mediu în exces, anualizate
ca fracții, cu punct zecimal, ca pe axe (\(0.10 = 10\%\))
9 ETF-uri sectoriale, lunar, ianuarie 1999 – iulie 2026 (\(T = 331\) luni)
CAPM a fost formulat de Sharpe (1964) și Lintner (1965). Dacă toți investitorii aleg portofolii eficiente în sens medie–varianță și au aceleași convingeri despre medii și covarianțe, toți dețin același portofoliu tangent, combinat cu activul fără risc în proporții date de aversiunea lor față de risc. Cum fiecare activ trebuie deținut de cineva, portofoliul tangent trebuie să fie atunci portofoliul pieței, în care fiecare activ are ponderea valorii lui de piață.
Implicația pentru evaluare este că randamentul așteptat în exces al fiecărui activ este proporțional cu beta lui:
unde \(R_i\) și \(R_m\) sînt randamentele activului \(i\) și ale portofoliului pieței, iar \(\mathbb{E}[R_m] - R_f\) este prima de risc a pieței. Beta măsoară sensibilitatea activului la piață; un activ cu \(\beta_i > 1\) amplifică mișcările pieței.
Black (1972) a derivat o versiune fără împrumut nelimitat la rata fără risc. În acest CAPM cu beta zero (zero-beta CAPM), rata fără risc din (3.4) este înlocuită cu randamentul așteptat al unui portofoliu necorelat cu piața; consecința lui, o SML mai plată, este discutată în Aprofundări.
Ipotezele sînt puternice: investitori medie–varianță cu aceleași convingeri și o singură perioadă, împrumut și plasament nelimitate la \(R_f\), fără taxe și fără costuri de tranzacționare. În aceste condiții doar beta aduce o primă de risc: la același beta, modelul prezice același randament așteptat, deci nicio altă caracteristică nu ar trebui să explice diferențele dintre randamentele așteptate ale activelor cu același beta. Riscul idiosincratic nu este remunerat, pentru că diversificarea îl elimină. Folosirea CAPM pentru costul capitalului și incertitudinea care contează acolo sînt tratate în Aprofundări.
Afirmația testabilă este dreapta pieței titlurilor (SML, Security Market Line): orice activ se află pe dreapta din planul (beta, medie), iar panta acestei drepte este egală cu prima pieței. SML și CML nu trebuie confundate. SML conține orice activ și orice portofoliu, eficient sau nu, și reprezintă media în funcție de beta; CML conține doar portofoliile eficiente și reprezintă media în funcție de volatilitate.
O ultimă întrebare este ce portofoliu este „piața”. Răspunsul determină ce poate stabili un test al CAPM, subiectul criticii lui Roll din Secțiunea 4.
Pe scurt
Ipotezele CAPM
investitori medie–varianță cu aceleași așteptări, o singură perioadă
împrumut și plasament nelimitate la \(R_f\)
fără taxe sau costuri de tranzacționare
Doar beta aduce o primă de risc: un randament mediu mai mare pentru riscul purtat
la același beta, modelul prezice același randament așteptat, oricare ar fi celelalte caracteristici ale activului
Riscul idiosincratic nu aduce nicio primă
se elimină prin diversificare, deci nimeni nu plătește pentru el
SML (Security Market Line, dreapta pieței titlurilor): orice activ se află pe dreapta (beta, medie)
CAPM este o afirmație despre medii: (3.4) leagă randamentul așteptat în exces al activului de cel al pieței; exprimată în randamente în exces, relația nu conține termen liber. În date se observă însă randamente lunare, nu medii adevărate, așa că relația se estimează ca regresie în serii de timp, modelul de piață (market model):
Termenul liber \(\alpha_i\), alfa, este randamentul mediu în exces pe care beta nu îl explică. Luînd media ambilor membri, \(\alpha_i = \mathbb{E}[R^e_i] - \beta_i\,\mathbb{E}[R^e_m]\), cu \(R^e = R - R_f\): alfa este distanța verticală dintre activ și dreapta pieței titlurilor (SML, security market line). Un alfa pozitiv înseamnă un randament mediu mai mare decît cel justificat de riscul de piață asumat.
De aceea alfa este mărimea pe care o urmăresc toți investitorii: ea măsoară performanța care rămîne după ajustarea pentru riscul de piață. Dintre două fonduri cu același beta, cel cu randament mediu mai mare are alfa mai mare. Expunerea la piață se poate obține cu costuri reduse printr-un fond indexat; administratorii activi de fonduri sînt plătiți pentru alfa, adică pentru randamentul obținut peste această expunere.
CAPM afirmă că, în echilibru, \(\alpha_i = 0\) pentru orice activ. Secțiunea următoare estimează \(\beta_i\) și \(\alpha_i\), iar secțiunea despre testarea CAPM testează dacă toate valorile alfa sînt simultan nule.
Pe scurt
CAPM este o afirmație despre medii; exprimată în randamente în exces, relația nu are termen liber
Secțiunea 4: testăm dacă toate valorile alfa sînt zero
Sinteza secțiunii
Frontiera medie–varianță și portofoliul tangent rezultă din (3.2) și (3.3); CAPM adaugă condiția de echilibru ca portofoliul tangent să fie piața, din care rezultă relația liniară (3.4) dintre randamentul mediu în exces și beta. Pe cele nouă sectoare americane, SPY se află sub frontiera in-sample; rămîne de văzut cît din această distanță este eroare de estimare. Scrisă ca regresie, relația CAPM capătă un termen liber, alfa, pe care CAPM îl cere nul. Secțiunea următoare estimează beta, singura mărime cu primă de risc în CAPM, împreună cu incertitudinea lui.
Estimarea lui beta
În CAPM, beta este singura caracteristică a unui activ care aduce o primă de risc și intră în costul capitalului și în deciziile de acoperire a riscului (hedging). Secțiunea estimează beta prin metoda celor mai mici pătrate, calculează erori standard robuste la heteroscedasticitate și autocorelație și examinează alegerile care schimbă estimația: frecvența, fereastra, aproximarea pieței, curățarea datelor și tranzacționarea asincronă. Arată apoi că valorile beta variază în timp și că shrinkage-ul spre o distribuție a priori transversală le îmbunătățește prognoza.
Secțiunea întreabă cu cît se mișcă un activ cînd piața se mișcă cu 1% și cît de sigur este acest număr. Beta intră în costul capitalului, unde înmulțește prima pieței, și în acoperirea riscului, unde fixează mărimea poziției compensatoare pe piață. Un beta imprecis își transmite deci eroarea în ambele.
Exemplul care parcurge secțiunea este XLK, ETF-ul de tehnologie, sectorul cu cel mai mare beta din eșantion. Pașii sînt erorile standard robuste și alegerile care schimbă beta, apoi valorile beta rolling, shrinkage-ul și aplicația la BVB.
Pe scurt
Întrebarea secțiunii: cu cît se mișcă un activ cînd piața se mișcă cu 1%?
cît de sigură este această cifră?
Beta intră în costul capitalului și în acoperirea riscului
Exemplul de lucru: XLK, ETF-ul de tehnologie, sectorul cu cel mai mare beta din eșantion
Pașii secțiunii
erori standard robuste
de ce depinde un beta estimat
beta pe ferestre mobile (rolling windows)
contracția: estimațiile sînt trase spre media activelor
Graficul are trei panouri, toate pe randamentele lunare ale XLK. Panoul din stînga arată regresia prin metoda celor mai mici pătrate (OLS, Ordinary Least Squares) a randamentului în exces al XLK pe randamentul în exces al pieței. Panoul din mijloc arată reziduurile OLS în timp, cu salturi în 2000–2002, 2008 și 2020. Panoul din dreapta arată distribuția bootstrap a valorii alfa estimate, cu intervalul ei de 95%.
Salturile reziduurilor sînt motivul pentru care erorile standard clasice sînt suspecte: varianța reziduală nu este constantă, un simptom al volatility clustering documentat în Capitolul 1. Bootstrap-ul din panoul din dreapta reeșantionează blocuri de luni consecutive, astfel încît dependența din interiorul unui bloc se păstrează.
În versiunea interactivă, primul cursor fixează lungimea blocului bootstrap, de la 1 la 36 de luni, iar al doilea numărul de laguri Newey–West \(L\), de la 0 la 12. Valorile afișate sînt alfa, beta și eroarea standard a lui beta cu formulele clasică, White și Newey–West.
Întrebare pentru sală Eroarea standard a lui beta XLK este 0,041 cu formula clasică și 0,082 cu Newey–West. Se schimbă și estimația beta = 1,277?
Răspuns
Nu. Calculul Newey–West păstrează coeficienții OLS și schimbă matricea estimată de covarianță a acestora; nu reponderează observațiile și nu aplică shrinkage. Beta rămîne 1,277. Alfa anual estimat este 0,33%, cu t = 0,13. Intervalul bootstrap de 95%, [−5,5%; 4,9%], include zero: nu respingem alfa zero la 5%.
Beta estimat este 1,277 și rămîne același pentru orice \(L\): calculul Newey–West păstrează coeficienții OLS și schimbă doar matricea lor de covarianță estimată. Eroarea standard a lui beta este 0,041 cu formula clasică și 0,082 cu Newey–West. Alfa anual estimat este 0,33%, cu \(t = 0{,}13\), iar intervalul bootstrap de 95% pentru alfa, de la −5,5% la 4,9%, include zero, deci nu respingem alfa zero la 5%.
Pe scurt
XLK pe Mkt-RF (randamentul în exces al pieței americane), randamente lunare în exces, ian. 1999 – iul. 2026. Stînga: dreapta OLS (Ordinary Least Squares, metoda celor mai mici pătrate), \(\hat\beta = 1{,}277\); mijloc: reziduurile OLS, cu vîrfuri în 2000–2002, 2008 și 2020; dreapta: distribuția bootstrap (prin reeșantionare) a lui alfa (detalii în Aprofundări) MFM_ch3_seminar
iar estimația OLS a pantei este analogul de eșantion al lui beta din CAPM, \(\hat\beta_i = \widehat{\operatorname{Cov}}(R^e_i, R^e_m)/\widehat{\operatorname{Var}}(R^e_m)\). Modelul împarte varianța activului în două părți, \(\sigma_i^2 = \beta_i^2 \sigma_m^2 + \sigma_{\varepsilon,i}^2\), unde \(\sigma_i^2\) și \(\sigma_m^2\) sînt varianțele activului și ale pieței, iar \(\sigma_{\varepsilon,i}^2\) varianța reziduală. Prima parte este riscul sistematic, cu primă de risc în CAPM; a doua este riscul idiosincratic, pe care diversificarea îl elimină. Coeficientul de determinare \(R^2 = \beta_i^2\sigma_m^2/\sigma_i^2\) este ponderea sistematică.
Eroarea standard OLS clasică presupune reziduuri cu varianță constantă și fără autocorelație. Niciuna dintre ipoteze nu este valabilă pentru randamentele activelor. Volatility clustering face reziduurile heteroscedastice, iar produsul \(R^e_{m,t}\varepsilon_{i,t}\), a cărui varianță determină precizia lui \(\hat\beta\), poate fi autocorelat. Pentru XLK pe Mkt-RF, lunar 1999–2026, \(\hat\beta = 1{,}277\), iar eroarea standard este 0,041 cu formula clasică, 0,054 cu erorile White și 0,082 cu Newey–West (5 laguri): estimația rămîne aceeași, se schimbă doar matricea de covarianță estimată a coeficienților. Erorile standard consistente la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent) (Newey & West, 1987) corectează ambele probleme.
Un beta estimat nu este doar o proprietate a activului; depinde și de alegerile analistului:
Frecvența și fereastra. Practica obișnuită folosește trei pînă la cinci ani de date lunare sau unul pînă la doi ani de date zilnice. O fereastră mai lungă reduce eroarea standard, dar amestecă perioade în care beta adevărat poate fi diferit, cum arată cadrele despre valorile beta variabile în timp.
Aproximarea pieței: SPY, care replică S&P 500, sau factorul de piață Fama–French Mkt-RF pentru activele americane și BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București) pentru acțiunile românești. Aproximări diferite dau valori beta diferite pentru același activ.
Curățarea datelor. Un eveniment de capital neajustat în seria de prețuri creează un randament fals. Pe 7 septembrie 2023, data ex-dividend a unui dividend special de 1,7225 lei pe acțiune al Fondului Proprietatea (FP), prețul de închidere a scăzut cu 81%, dar randamentul total al zilei, cu dividendul inclus, a fost +6,0%. O regresie pe prețuri neajustate ar trata scăderea ca pe o pierdere de 81% fără legătură cu piața și ar distorsiona atît beta, cît și varianța reziduală.
Pe scurt
Frecvența și fereastra: de obicei 3–5 ani de date lunare sau 1–2 ani de date zilnice
Aproximarea pieței: SPY (S&P 500) sau Mkt-RF pentru active din SUA, BET (Bucharest Exchange Trading, indicele de referință al Bursei de Valori București) pentru acțiuni românești
Curățarea datelor: un eveniment de capital neajustat creează un randament fals
Exemplu: 7 septembrie 2023 este data ex a dividendului special de 1,7225 lei pe acțiune al Fondului Proprietatea (FP)
În acea zi prețul de închidere scade cu \(81\%\) (randament fals, din prețuri), dar randamentul total al zilei, cu dividendul, este \(+6{,}0\%\)
A patra alegere privește tranzacționarea asincronă (asynchronous trading): prețurile de închidere ale activelor nu sînt înregistrate în același moment. O acțiune ilichidă, care nu se tranzacționează în fiecare zi, reacționează la știrile pieței cu întîrziere, deci o parte din răspunsul ei la randamentul pieței de azi apare într-un randament ulterior. Beta OLS zilnic, care surprinde doar răspunsul din aceeași zi, este atunci deplasat spre 0.
Beta lui Dimson (1979) corectează această deplasare prin regresia randamentului acțiunii pe trei zile de randamente ale pieței, ziua anterioară, aceeași zi și ziua următoare,
și prin adunarea celor trei pante. Graficul arată o simulare pentru o acțiune cu beta adevărat 1 care se tranzacționează doar în 75% din zile, cu pantele estimate pe cele trei randamente ale pieței și suma lor. Un exemplu detaliat pe XLK se află în Aprofundări.
În versiunea interactivă, primul cursor fixează probabilitatea ca acțiunea să se tranzacționeze într-o zi, iar al doilea beta adevărat; butonul ▶ crește probabilitatea de tranzacționare.
Întrebare pentru sală În această simulare, beta adevărat este 1, iar acțiunea se tranzacționează în 75% din zile; panta contemporană din regresia Dimson este 0,77. Cînd probabilitatea de tranzacționare ajunge de la 75% la 100%, cum se schimbă această pantă?
Răspuns
Panta contemporană crește de la 0,77 la aproximativ 1,00. Cu tranzacționare zilnică, reacția nu mai este amînată de zile fără tranzacții. Suma Dimson este aproximativ 0,98; într-un eșantion finit nu trebuie să fie exact 1. La 75%, panta pe randamentul pieței din ziua anterioară este 0,16, iar suma Dimson 0,93.
La o probabilitate de tranzacționare de 75%, panta pe randamentul pieței din aceeași zi este 0,77, deci regresia pe aceeași zi subestimează beta. Panta pe randamentul pieței din ziua anterioară este 0,16: o parte din reacție sosește cu o zi întîrziere. Beta Dimson este 0,93, mult mai aproape de 1. Cînd probabilitatea de tranzacționare urcă la 100%, panta din aceeași zi crește de la 0,77 la aproximativ 1,00, pentru că zilele fără tranzacții nu mai întîrzie răspunsul; suma Dimson este atunci aproximativ 0,98, iar într-un eșantion finit nu trebuie să fie exact 1.
Pe scurt
Tranzacționarea asincronă: prețurile de închidere ale activelor nu sînt înregistrate în același moment
O acțiune nelichidă reacționează cu întîrziere la știrile pieței, deci beta OLS zilnic este deplasat spre 0
Beta Dimson (Dimson (1979)) regresează randamentul acțiunii pe trei randamente ale pieței
din ziua anterioară, din aceeași zi și din ziua următoare
Graficul arată valorile beta OLS rolling ale ETF-urilor sectoriale, fiecare estimată pe o fereastră de 252 de randamente logaritmice zilnice, aproximativ un an de tranzacționare, față de piață. Pe axa orizontală este timpul, iar pe cea verticală beta estimat. Un beta rolling folosește la fiecare dată doar fereastra cea mai recentă, deci urmărește schimbările expunerii pe care o regresie pe întregul eșantion le mediază.
În versiunea interactivă, cursorul schimbă lungimea ferestrei, iar valorile afișate sînt minimul, maximul și ultima valoare a lui beta pentru fiecare sector.
Întrebare pentru sală În aceste date, cum se schimbă amplitudinea estimărilor rolling pentru beta XLE (Energy Select Sector SPDR Fund, ETF pe sectorul energiei) cînd fereastra crește de la 252 la 504 zile?
Răspuns
Intervalul estimărilor trece de la [−0,31; 1,49] la [0,20; 1,38]. Fereastra mai lungă netezește variația observată. Aceasta nu dovedește că beta adevărat este constant. Beta XLF variază între 0,60 și 2,17 la 252 de zile, cu maximul imediat după criza bancară din 2008–2009.
La 252 de zile, beta sectorului financiar (XLF) variază între 0,60 și 2,17, iar cel al energiei (XLE) între −0,31 și 1,49. Cu o fereastră de 504 zile, intervalul XLE devine 0,20 – 1,38: fereastra mai lungă netezește variația observată. Netezirea nu arată că beta adevărat este constant; fiecare fereastră mediază peste mai multe regimuri.
Valorile beta față de SPY, estimate pe ferestre mobile de 252 de randamente logaritmice zilnice, se mișcă în intervale largi. Beta sectorului financiar (XLF) a variat între 0,60 și 2,17, cu maximul imediat după criza bancară din 2008–2009. Beta tehnologiei (XLK) a variat între 0,86 și 1,90; a fost mare în bula dot-com din 2000–2001 și este 1,75 în ultima fereastră de 252 de zile.
Beta energiei (XLE) a variat între −0,31 și 1,49 și este negativ în ultima fereastră: covarianța randamentelor XLE cu SPY a devenit negativă. Beta utilităților (XLU), sectorul defensiv clasic, a variat între 0,06 și 1,00.
Un singur beta calculat pe întregul eșantion ascunde aceste regimuri. Pentru costul capitalului sau pentru acoperirea riscului, beta relevant este cel așteptat pe orizontul deciziei, care poate diferi mult de media eșantionului. Modelele cu beta variabil în timp sînt tratate în Capitolul 5 și în Capitolul 6.
Pe scurt
Graficul: beta OLS față de SPY pe ferestre mobile de 252 de randamente logaritmice zilnice (circa un an)
Beta sectorului financiar (XLF) a variat între \(0{,}60\) și \(2{,}17\)
Beta XLF a atins maximul imediat după criza bancară din 2008–2009
Beta sectorului tehnologic (XLK) a variat între \(0{,}86\) și \(1{,}90\)
Beta XLK a fost ridicat în anii bulei dot-com (2000–2001)
în ultima fereastră de 252 de zile este \(1{,}75\)
Beta sectorului energetic (XLE) a variat între \(-0{,}31\) și \(1{,}49\)
Beta XLE este negativ în ultima fereastră
covarianța randamentelor XLE cu SPY a devenit negativă
Beta utilităților (XLU), sectorul defensiv clasic, a variat între \(0{,}06\) și \(1{,}00\)
Un singur beta pe tot eșantionul ascunde aceste regimuri
Modelele cu beta variabil în timp sînt tratate în Capitolele 5–6
Valorile beta estimate regresează spre medie (regression to the mean). O estimație foarte mare sau foarte mică conține și zgomot, deci în perioada următoare estimația aceluiași activ tinde să se apropie de media secțiunii transversale, apropiată de 1. Blume (1971) a măsurat acest efect prin regresia valorilor beta dintr-o perioadă pe cele din perioada anterioară, iar regula practicienilor \(\beta^{\text{Blume}} = 0{,}33 + 0{,}67\,\hat\beta\) provine din această regresie.
Vasicek (1973) a dat versiunea bayesiană: o medie ponderată între estimația proprie a activului și o distribuție a priori,
Media a priori \(\bar\beta\) este media valorilor beta ale tuturor activelor, \(\sigma^2_\beta\) este varianța valorilor beta adevărate între active, iar \(\operatorname{se}(\hat\beta_i)\) este eroarea standard a estimației activului.
Ponderea \(w_i\) a estimației proprii este mai mare cînd \(\hat\beta_i\) este precis, adică atunci cînd eroarea lui standard este mică în raport cu dispersia valorilor beta adevărate. Spre deosebire de regula Blume, care aplică aceiași coeficienți tuturor activelor, regula Vasicek trage mai mult estimațiile zgomotoase și mai puțin pe cele precise.
Pe scurt
Regresia spre medie: un beta estimat foarte mare sau foarte mic conține și zgomot
deci în perioada următoare tinde să se apropie de media secțiunii transversale, apropiată de 1
contracția: estimația este trasă dinainte spre această medie
Blume (1971): regresia valorilor beta dintr-o perioadă pe cele din perioada anterioară
De aici regula folosită de practicieni: \(\beta^{\text{Blume}} = 0{,}33 + 0{,}67\,\hat\beta\)
Vasicek (1973): o medie ponderată între estimația activului și media \(\bar\beta\)
Varianța \(\sigma^2_\beta\) a valorilor beta adevărate nu este observată, dar poate fi estimată din secțiunea transversală. Varianța estimațiilor între active adună varianța adevărată și zgomotul, \(\operatorname{Var}_{cs}(\hat\beta) = \sigma^2_\beta + \overline{\operatorname{se}^2}\), unde \(\overline{\operatorname{se}^2}\) este media pătratelor erorilor standard. De aici estimația Bayes empirică (empirical Bayes)
În exemplu, XLK este regresat pe SPY, cu date lunare pentru 1999–2012. Estimația este \(\hat\beta = 1{,}415\), cu eroarea standard Newey–West 0,139; față de valoarea 1,277 obținută cu Mkt-RF diferă atît reperul (SPY), cît și perioada (1999–2012 față de 1999–iulie 2026). Distribuția a priori din cele nouă sectoare are \(\bar\beta = 0{,}949\) și, după (3.8),\(\sigma^2_\beta = 0{,}1159 - 0{,}0077 = 0{,}1082\). Ponderea estimației proprii este \(w = 0{,}1082/(0{,}1082 + 0{,}139^2) = 0{,}849\), deci beta Vasicek este \(\beta^{V} = 0{,}849 \times 1{,}415 + 0{,}151 \times 0{,}949 = 1{,}344\). Beta Blume este \(0{,}33 + 0{,}67 \times 1{,}415 = 1{,}278\).
Beta estimat pe perioada următoare, 2013–2026, este 1,172. Ambele ajustări sînt mai aproape de el decît estimația neajustată. Un singur activ nu este însă un criteriu: pe toate cele nouă sectoare, rădăcina erorii pătratice medii a prognozei (RMSE, root mean squared error) este 0,135 pentru OLS, 0,109 pentru Blume și 0,114 pentru Vasicek. Tragerea valorilor beta spre 1 pentru acțiunile de la BVB este tratată în Aprofundări.
Pe scurt
Varianța estimațiilor între active adună varianța adevărată și zgomotul
Beta estimat pe perioada următoare, 2013–2026: \(1{,}172\)
ambele ajustări sînt mai aproape de el decît beta neajustat
pe toate cele 9 sectoare, rădăcina erorii pătratice medii a prognozei (RMSE, root mean squared error): OLS \(0{,}135\), Blume \(0{,}109\), Vasicek \(0{,}114\)
Verificarea rapidă aplică cele trei instrumente ale secțiunii, în trei părți:
Compararea intervalelor clasic și Newey–West pentru un beta de 0,90 estimat din 120 de randamente lunare, cu erorile standard 0,05 și 0,09, cu întrebarea dacă concluzia că beta este sub 1 rezistă erorii robuste;
Calculul varianței Bayes empirice (3.8) și al valorilor beta Vasicek (3.7) pentru un activ cu \(\hat\beta = 1{,}6\) și două erori standard diferite;
Citirea unui beta Dimson (3.6) pentru o acțiune ilichidă de la BVB din trei pante pe BET.
O acțiune, 120 de randamente lunare: \(\hat\beta = 0{,}90\), SE clasică \(0{,}05\), SE Newey–West \(0{,}09\)
Calculați ambele intervale de 95%, cu multiplicatorul \(1{,}96\). Are acțiunea un risc sistematic mai mic decît piața (beta sub 1) după fiecare dintre ele?
Ce interval raportați și de ce nu se schimbă estimația punctuală?
O secțiune transversală de valori beta
\(\operatorname{Var}_{cs}(\hat\beta) = 0{,}10\), \(\overline{\operatorname{se}^2} = 0{,}02\), media \(\bar\beta = 1{,}0\)
Calculați \(\sigma^2_\beta\) și beta Vasicek pentru un activ cu \(\hat\beta = 1{,}6\), o dată cu SE \(0{,}2\) și o dată cu SE \(0{,}1\)
Care dintre cele două este contractată mai puternic și de ce? Comparați ambele cu beta Blume
O acțiune nelichidă de la BVB, randamente zilnice, pantele pe BET
din ziua anterioară: \(0{,}25\); din aceeași zi: \(0{,}55\); din ziua următoare: \(0{,}00\)
Ce beta Dimson raportați?
De ce este panta din aceeași zi mai mică decît beta Dimson?
Un beta estimat vine cu o eroare standard care trebuie calculată cu erori HAC, (3.24); el depinde de frecvență, de fereastră, de aproximarea pieței, de curățarea datelor și, pentru acțiunile ilichide, de tranzacționarea asincronă, pe care o tratează corecția Dimson (3.6). Valorile beta se schimbă în timp, iar shrinkage-ul spre o distribuție a priori transversală, (3.7), a îmbunătățit prognoza lui beta pentru XLK. Secțiunea următoare trece de la beta unui singur activ la testul simultan al CAPM pe multe active.
Testarea CAPM
CAPM implică faptul că orice activ se află pe dreapta pieței titlurilor sau, echivalent, că orice valoare alfa din modelul de piață este zero. Secțiunea testează această restricție pe cele 25 de portofolii mărime × B/M, mai întîi grafic, cu dreapta pieței titlurilor, apoi formal, cu testul simultan al lui Gibbons, Ross & Shanken (1989). Se încheie cu limitele unui asemenea test: critica lui Roll și dependența concluziei de alegerea activelor de test.
Întrebarea secțiunii este dacă randamentele medii se află pe dreapta \(\mathbb{E}[R^e_i] = \beta_i\,\mathbb{E}[R^e_m]\), ceea ce înseamnă același lucru cu a întreba dacă toate activele au alfa zero. Activele de test sînt cele 25 de portofolii sortate după mărime și B/M ale lui Fama & French (1993).
Aceste portofolii contrastează sistematic mărimea și B/M, caracteristici asociate în literatură cu randamente medii diferite; randamentele lor medii în exces, anualizate, variază de la 3,9% la 13,3%. Pașii sînt SML în date, testul GRS, care verifică simultan toate valorile alfa, și limitele testului.
Pe scurt
Întrebarea secțiunii: se află randamentele medii pe dreapta \(\mathbb{E}[R^e_i] = \beta_i\,\mathbb{E}[R^e_m]\)?
adică: au toate activele alfa zero?
Active de test: cele 25 de portofolii mărime \(\times\) B/M (Fama & French (1993))
De ce aceste portofolii: contrastează sistematic mărimea și B/M, caracteristici asociate în literatură cu randamente medii diferite
randamente medii în exces, anualizate, între \(3{,}9\%\) și \(13{,}3\%\)
Pașii secțiunii
SML în date
testul GRS (testul Gibbons–Ross–Shanken), care verifică simultan toate valorile alfa
Portofoliile se formează după Fama & French (1993). În fiecare iunie a anului \(t\), acțiunile de pe NYSE (New York Stock Exchange, Bursa din New York), AMEX (American Stock Exchange, Bursa Americană de Valori) și NASDAQ (National Association of Securities Dealers Automated Quotations, bursa americană NASDAQ, cotații automate ale Asociației Naționale a Dealerilor de Valori Mobiliare) sînt sortate de două ori, independent: după mărime, măsurată prin capitalizarea bursieră (ME, market equity) de la sfîrșitul lui iunie \(t\), și după B/M, capitalul propriu contabil din anul fiscal \(t-1\) împărțit la capitalizarea bursieră din decembrie \(t-1\). Pragurile sînt cvintilele NYSE, percentilele 20, 40, 60 și 80; cu praguri calculate pe toate acțiunile, numeroasele micro-capitalizări de pe NASDAQ ar umple grupele. Fiecare dintre cele 25 de intersecții este un portofoliu ponderat cu valoarea de piață, deținut din iulie \(t\) pînă în iunie \(t+1\).
Grila arată randamentul mediu anual în exces al fiecărui portofoliu, iulie 1963 – iulie 2026, cu cvintilele de mărime pe rînduri (de la ME1, cele mai mici, la ME5, cele mai mari) și cvintilele B/M pe coloane (de la BM1, growth, la BM5, value). Pe fiecare rînd, coloana value are un randament mediu mai mare decît coloana growth. Colțurile extreme sînt small-growth, 3,9% pe an, și small-value, 13,3% pe an.
O precauție privește orice model care folosește factorul de mărime SMB (Small Minus Big, size factor, factorul mărime: firme mici minus mari) și factorul de valoare HML (High Minus Low, value factor, factorul valoare: B/M mare minus mic). Acești factori, construiți în Secțiunea 5, folosesc aceleași caracteristici ca portofoliile, deși prin sortări \(2 \times 3\), nu \(5 \times 5\), deci un \(R^2\) mare al unui astfel de model pe aceste portofolii dovedește puțin (Lewellen, Nagel & Shanken, 2010).
În versiunea interactivă, meniul schimbă statistica din grilă între randamentul mediu anual în exces, alfa CAPM anual și statistica \(t\) Newey–West a lui alfa, iar cursorul mută începutul eșantionului între 1963 și 2006.
Pe iulie 1963 – iulie 2026, alfa CAPM este −6,3% pe an pentru small-growth și +5,7% pentru small-value, deci diferența dintre cele două colțuri crește de la aproximativ 9,46 puncte procentuale în randamentele medii la 12,00 în valorile alfa. Beta small-growth este aproximativ 1,42, iar beta small-value 1,06: CAPM atribuie o componentă de piață mai mare portofoliului cu randamentul mediu mai mic, ceea ce mărește diferența în loc să o închidă.
Panoul din stînga reprezintă randamentul mediu anual în exces al fiecăruia dintre cele 25 de portofolii în funcție de beta CAPM, iulie 1963 – iulie 2026, cu două drepte. Dreapta CAPM trece prin origine și are panta egală cu prima pieței. Dreapta estimată este regresia transversală a randamentelor medii pe valorile beta. Panoul din dreapta arată valorile alfa anuale ale celor 25 de portofolii, cu portofoliile din cvintila firmelor celor mai mici în roșu. Randamentele și valorile alfa sînt fracții anuale, \(0{,}05 = 5\%\); beta nu are unitate de măsură.
Dacă CAPM ar fi adevărat, punctele s-ar afla pe dreapta CAPM, iar valorile alfa ar fi apropiate de zero. Dreapta estimată din 1963 are panta −4,4% pe an, față de 7,2% pentru dreapta CAPM.
În versiunea interactivă, cursorul mută începutul eșantionului între 1963 și 2006, iar valorile afișate sînt cele două pante, intervalul valorilor beta și statistica GRS.
Întrebare pentru sală Din 1963, dreapta estimată pe cele 25 de portofolii are panta −4,4% pe an. Cînd începutul eșantionului ajunge la ianuarie 2003, ce se întîmplă cu această pantă?
Răspuns
Pentru ianuarie 2003–iulie 2026, panta estimată este aproximativ +2,0% pe an, iar prima pieței este 10,7%. Semnul pantei depinde de eșantion: este −4,4% cu începutul în 1963 și −1,0% cu începutul în 2006. Din 1963, valorile beta acoperă doar intervalul 0,86–1,42, iar GRS = 4,20, cu p = 7,5 × 10⁻¹¹ (rotunjit pe slide: 8 × 10⁻¹¹).
Cu eșantionul începînd în ianuarie 2003, panta estimată este aproximativ +2,0% pe an, în timp ce prima pieței este 10,7%; cu începutul în 2006, panta este −1,0%. Semnul pantei estimate depinde deci de eșantion, dar în niciunul dintre aceste eșantioane panta nu atinge prima pieței. Din 1963, valorile beta acoperă doar intervalul 0,86 – 1,42, un interval îngust pe care se estimează panta.
Pe scurt
Legenda: CAPM SML: dreapta CAPM, cu panta egală cu prima pieței; Fitted line: dreapta estimată pe date; Alphas: valorile alfa ale celor 25 de portofolii; Smallest-size quintile: cvintila firmelor celor mai mici MFM_ch3_sml
Eșantionul are \(T = 757\) de luni, iulie 1963 – iulie 2026, iar cele 25 de portofolii sînt resortate în fiecare iunie și ponderate cu valoarea de piață. Dreapta CAPM are panta 7,2% pe an, prima pieței. Dreapta estimată, din regresia transversală a randamentelor medii pe beta, are panta −4,4%: un beta mai mare merge împreună cu un randament mediu mai mic, relația plată sau negativă descrisă de Fama & French (1992).
Valorile beta acoperă doar intervalul 0,86 – 1,42, deci portofoliile diferă mult mai mult prin randamentele medii decît prin expunerea la piață. Valorile alfa sînt mari în colțuri: +5,7% pe an pentru firmele mici cu B/M mare (small-value) și −6,3% pentru firmele mici cu B/M mic (small-growth). Zece din cele 25 de valori alfa au \(|t| > 1{,}96\), cu erori HAC.
În acest eșantion, portofoliile cu beta mai mare nu au avut, în medie, randamente mai mari. Rămîne întrebarea dacă toate aceste abateri pot fi compatibile cu zero, la care răspunde testul GRS.
Pe scurt
Cele 25 de portofolii, resortate în fiecare iunie și ponderate după valoare
iulie 1963 – iulie 2026, \(T = 757\)
Dreapta CAPM are panta \(7{,}2\%\) pe an
randamentele și valorile alfa: fracții anuale, \(0{,}05 = 5\%\); beta nu are unitate de măsură
Dreapta estimată este regresia transversală a randamentelor medii pe beta
panta ei este \(-4{,}4\%\)
beta mai mare, randament mediu mai mic
Valorile beta acoperă doar \(0{,}86\)–\(1{,}42\)
Alfa este \(+5{,}7\%\) pe an pentru firmele mici cu B/M mare (de valoare)
și \(-6{,}3\%\) pe an pentru firmele mici cu B/M mic (de creștere)
10 din 25 de valori alfa au \(|t| > 1{,}96\) (erori HAC)
În acest eșantion, portofoliile cu beta mai mare nu au avut, în medie, randamente mai mari
Întrebarea următoare: pot fi toate aceste abateri compatibile cu zero?
Alfa lui Jensen (Jensen's alpha) (Jensen, 1968) este termenul liber \(\alpha_i\) al modelului de piață (3.5). CAPM implică \(\alpha_i = 0\) pentru orice activ. Pentru fiecare activ se poate face un test \(t\) separat; pentru XLK, \(t = 0{,}13\). Cu multe active, însă, unele valori alfa par semnificative doar din întîmplare, problema testării multiple din secțiunea despre testarea multiplă, iar testele separate nu folosesc corelația dintre reziduurile activelor.
Testul lui Gibbons, Ross & Shanken (1989) (GRS) testează toate activele simultan, \(H_0: \alpha_1 = \dots = \alpha_N = 0\), cu statistica
\[W = \frac{T - N - 1}{N}\; \frac{\hat{\boldsymbol\alpha}^\top \hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha}}{1 + \hat\mu_m^2/\hat\sigma_m^2} \;\sim\; F(N,\, T - N - 1),\]
(3.9)
unde \(N\) este numărul activelor de test, \(T\) numărul de luni, iar \(\hat{\boldsymbol\alpha}\) vectorul celor \(N\) valori alfa estimate. Matricea \(\hat{\boldsymbol\Sigma}\) este covarianța reziduală de verosimilitate maximă, cu împărțire la \(T\), iar \(\hat\mu_m/\hat\sigma_m\) este raportul Sharpe de eșantion al pieței.
Pe scurt
Alfa lui Jensen (Jensen (1968)): termenul liber al modelului de piață, \(\alpha_i\)
CAPM implică \(\alpha_i = 0\) pentru orice activ
Un test \(t\) separat pentru fiecare activ: alfa XLK are \(t = 0{,}13\)
Cu multe active, unele valori alfa par semnificative doar din întîmplare (Secțiunea 7)
\[ W = \frac{T - N - 1}{N}\; \frac{\hat{\boldsymbol\alpha}^\top \hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha}}{1 + \hat\mu_m^2/\hat\sigma_m^2} \;\sim\; F(N,\, T - N - 1) \]
Notațiile
\(N\): numărul activelor de test
\(T\): numărul de luni
\(\hat{\boldsymbol\alpha}\): cele \(N\) valori alfa estimate
\(\hat{\boldsymbol\Sigma}\): covarianța reziduurilor estimată prin verosimilitate maximă (împărțire la \(T\))
\(\hat\mu_m/\hat\sigma_m\): raportul Sharpe al pieței
Forma pătratică \(\hat{\boldsymbol\alpha}^\top \hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha}\) din (3.9) este o sumă ponderată a pătratelor valorilor alfa: o valoare alfa contează mai mult cînd reziduurile activului ei sînt mai puțin volatile, pentru că o asemenea valoare alfa este mai greu de atribuit zgomotului. Regula de decizie respinge \(H_0\) cînd \(W\) depășește cuantila de 95% a distribuției \(F(N, T - N - 1)\).
Distribuția \(F\) este exactă, condiționat de factori, cînd erorile sînt i.i.d. cu distribuția Normală multivariată, independente de factori, cu media zero și o matrice de covarianță constantă și nesingulară. În ipoteze mai slabe se aplică o versiune bazată pe metoda generalizată a momentelor (GMM, generalised method of moments); ea este tratată, împreună cu strategia betting against beta (BAB), în Aprofundări.
Statistica are și o formă cu rapoarte Sharpe. Cu rapoarte lunare și momente împărțite la \(T\),\(\hat{\boldsymbol\alpha}^\top \hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha} = \widehat{SR}^2(f, \text{active}) - \widehat{SR}^2(f)\), cîștigul de raport Sharpe maxim la pătrat obținut cînd activele de test se adaugă factorului; \(W\) este acest cîștig, normalizat. Un \(W\) mare înseamnă deci că portofoliul pieței este departe de frontiera eficientă construită din piață și din activele de test. Pentru \(N = 1\),\(W = t^2\), unde \(t\) este statistica \(t\) clasică (OLS, nu HAC) a lui alfa, iar \(F(1, T - 2)\) este distribuția pătratului unei variabile Student-\(t\) cu \(T - 2\) grade de libertate; testul GRS generalizează testul \(t\) la mai multe active.
Pe scurt
\(\hat{\boldsymbol\alpha}^\top \hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha}\): o sumă ponderată a pătratelor valorilor alfa
un alfa cîntărește mai mult cînd reziduurile activului sînt puțin volatile
Decizia: \(H_0\) se respinge cînd \(W\) depășește cuantila de 95% a distribuției \(F(N, T - N - 1)\)
Distribuția este exactă, condiționat de factori
erori i.i.d. cu distribuția Normală multivariată, independente de factori
medie zero și covarianță constantă nesingulară
Forma cu rapoarte Sharpe (lunare, momente împărțite la \(T\))
\(W\) este acest cîștig de raport Sharpe maxim la pătrat, normalizat: un \(W\) mare arată că piața este departe de frontiera construită din piață și activele de test
Pentru \(N = 1\), \(W = t^2\), pătratul statisticii \(t\) clasice (OLS, nu HAC) a lui alfa
\(F(1, T - 2)\) este distribuția pătratului unei variabile Student-\(t\) cu \(T - 2\) grade de libertate
Pe cele 25 de portofolii mărime × B/M, iulie 1963 – iulie 2026 (\(T = 757\),\(N = 25\)), statistica GRS este 4,20, cu \(p = 8 \times 10^{-11}\). CAPM este respins: abaterile valorilor alfa sînt mari în raport cu incertitudinea lor. Respingerea privește însă modelul împreună cu indicele folosit ca piață: indicele nu este eficient în sens medie–varianță față de aceste active. Dacă vina este a modelului sau a indicelui este subiectul criticii lui Roll.
Pe scurt
Cele 25 de portofolii mărime \(\times\) B/M, iulie 1963 – iulie 2026 (\(T = 757\), \(N = 25\))
\(W = 4{,}20\), cu \(p = 8 \times 10^{-11}\)
CAPM este respins: abaterile valorilor alfa sînt mari în raport cu incertitudinea lor
Respingerea privește modelul împreună cu indicele folosit ca piață
Roll (1977) a observat că CAPM este o afirmație despre adevăratul portofoliu al pieței, care cuprinde toată avuția. Indicii bursieri folosiți ca piață omit obligațiunile, imobilele, firmele private și capitalul uman, deci sînt cel mult aproximări.
Critica se sprijină pe un fapt matematic: valorile beta calculate față de orice portofoliu eficient în sens medie–varianță evaluează exact toate randamentele medii, rezultatul problemei A2 din Seminarul 3. Relația liniară dintre medie și beta este deci echivalentă cu eficiența portofoliului folosit pentru calculul valorilor beta, indiferent de mecanismul economic.
Rezultă că un test al CAPM verifică de fapt dacă indicele folosit ca piață este eficient față de activele de test. O respingere poate proveni din model sau din alegerea indicelui, iar testul singur nu le poate deosebi.
Pe scurt
Roll (1977): CAPM se referă la portofoliul adevărat al pieței, care cuprinde întreaga avuție
Indicii bursieri folosiți ca piață omit
obligațiunile, activele imobiliare, firmele private și capitalul uman
Beta calculat față de orice portofoliu eficient explică exact randamentele medii ale tuturor activelor
Concluzia testului depinde și de activele de test. Pe cele nouă ETF-uri sectoriale din Secțiunea 2, ianuarie 1999 – iulie 2026 (\(T = 331\)), cu Mkt-RF ca piață, CAPM nu este respins: GRS \(= 0{,}53\), cu \(p = 0{,}85\). Adăugarea sectoarelor la piață crește pătratul raportului Sharpe lunar cu 0,015, mai puțin decît valoarea de 0,029 pe care ar produce-o doar zgomotul (vezi Anexa).
Pe aceleași 331 de luni, cele 25 de portofolii mărime × B/M resping CAPM, cu GRS \(= 2{,}91\) și \(p = 9 \times 10^{-6}\). Sectoarele nu sînt construite pentru a contrasta mărimea și B/M: formarea după sector nu impune un contrast de capitalizare sau B/M comparabil cu sortarea 5×5.
O nerespingere nu confirmă CAPM și nici nu dovedește singură lipsa de putere. Puterea testului depinde de mărimea abaterilor de la model în raport cu covarianța reziduurilor, de \(T\) și de \(N\). De aceea activele de test se aleg pentru contraste economice stabilite înainte de test, nu după dispersia mediilor observate.
Pe scurt
Pe cele 9 ETF-uri sectoriale din Secțiunea 2, cu Mkt-RF ca piață, CAPM nu este respins
ianuarie 1999 – iulie 2026, \(T = 331\)
GRS \(= 0{,}53\), cu \(p = 0{,}85\)
Adăugarea sectoarelor crește pătratul raportului Sharpe lunar cu \(0{,}015\)
mai puțin decît \(0{,}029\), cît ar produce zgomotul singur (Anexă)
Pe aceleași 331 de luni, cele 25 de portofolii mărime \(\times\) B/M îl resping
GRS \(= 2{,}91\), \(p = 9 \times 10^{-6}\)
Sectoarele nu sînt construite pentru a contrasta mărimea și B/M
formarea după sector nu impune un contrast de capitalizare sau B/M comparabil cu sortarea 5×5
Puterea testului depinde de abaterile de la model în raport cu covarianța reziduurilor, de \(T\) și de \(N\)
O nerespingere nu confirmă CAPM și nu dovedește singură lipsa de putere
Activele de test se aleg pentru contraste economice stabilite înainte de test, nu după dispersia mediilor observate
Verificarea rapidă folosește forma cu rapoarte Sharpe a statisticii GRS (3.9), în care forma pătratică a valorilor alfa se scrie drept cîștigul în pătratul raportului Sharpe obținut prin adăugarea activelor de test la factor. Cu un factor, \(N = 4\) active de test și \(T = 65\) de luni, raportul Sharpe lunar este 0,15 pentru factorul singur și 0,25 pentru portofoliul tangent al factorului și al celor patru active. Sarcinile sînt:
Calculul lui \(W\) și compararea lui cu cuantila de 95% a distribuției \(F(4, 60)\), aproximativ 2,53;
Compararea cîștigului observat cu cîștigul așteptat sub \(H_0\),\(N(1 + \widehat{SR}^2(f))/(T - N - 3)\);
Recalcularea lui \(W\) cu aceleași rapoarte Sharpe și \(T = 650\) de luni, față de cuantila de 95% a distribuției \(F(4, 645)\), aproximativ 2,39, pentru a decide dacă s-a schimbat distanța sau dovada.
Un factor, \(N = 4\) active de test, \(T = 65\) de luni, rapoarte Sharpe lunare
factorul singur: \(0{,}15\)
portofoliul tangent al factorului și celor 4 active: \(0{,}25\)
Calculați \(W\) din forma cu rapoarte Sharpe. Cuantila de 95% a lui \(F(4, 60)\) este circa \(2{,}53\): respingeți?
Calculați creșterea așteptată sub \(H_0\) a pătratului raportului Sharpe, \(N(1 + \widehat{SR}^2(f))/(T - N - 3)\), și comparați-o cu cea observată
Aceleași rapoarte Sharpe, \(T = 650\) de luni: recalculați \(W\) (cuantila de 95% a lui \(F(4, 645)\): circa \(2{,}39\)). Ce s-a schimbat, distanța sau dovezile?
Pe cele 25 de portofolii mărime × B/M, dreapta estimată a pieței titlurilor este plată sau negativă, valorile alfa din colțurile firmelor mici sînt mari, iar testul GRS (3.9) respinge CAPM cu \(p = 8 \times 10^{-11}\). Pe cele nouă ETF-uri sectoriale, același test nu respinge. După critica lui Roll, o respingere arată că indicele nu este eficient față de activele de test, iar contrastul dintre cele două seturi de active arată că o nerespingere pe active cu randamente medii apropiate este o dovadă slabă. Secțiunea următoare adaugă factori pe lîngă piață și verifică dacă ei explică valorile alfa.
Modele multifactoriale
Secțiunea anterioară a arătat că beta de piață nu explică singur randamentele medii ale celor 25 de portofolii sortate după mărime și raportul dintre valoarea contabilă și cea de piață (B/M, book-to-market). Această secțiune întreabă de cîți factori este nevoie și care sînt aceștia. Teoria evaluării prin arbitraj dă forma unui model multifactorial, dar nu și identitatea factorilor, de aceea factorii folosiți în practică sînt construiți din date: portofolii long–short sortate după o caracteristică a firmelor. Secțiunea prezintă construcția lor, modelele standard care îi combină, de la modelul Fama–French cu trei factori pînă la modelul cu cinci factori și momentum, și randamentele cumulate ale șase factori în perioada 1963–2026.
Teoria evaluării prin arbitraj (Arbitrage Pricing Theory, APT), propusă de Ross (1976), înlocuiește argumentul de echilibru al modelului de evaluare a activelor financiare (CAPM, Capital Asset Pricing Model) cu o ipoteză statistică și o condiție de absență a arbitrajului. Se presupune că randamentele urmează un model cu \(K\) factori:
unde \(\boldsymbol\beta_i\) conține cele \(K\) loadings ale activului \(i\), iar \(\mathbf{f}_t\) este componenta neanticipată a factorilor, deci are media zero. Reziduul \(\varepsilon_{i,t}\) este riscul specific activului; teoria presupune că el poate fi eliminat prin diversificare în portofolii mari.
Un arbitraj este un profit sigur obținut fără capital investit. Dacă nu există asemenea oportunități, randamentele așteptate în exces trebuie să se alinieze după loadings:
unde \(\boldsymbol\lambda\) este vectorul primelor de risc (risk premia), randamentul așteptat suplimentar pe unitatea de expunere la fiecare factor. Relația (3.11) este aproximativă: ține pentru aproape toate activele, nu exact pentru fiecare, deoarece un număr finit de active se poate abate de la ea fără să creeze un arbitraj într-un portofoliu diversificat.
Teoria lasă deschise două întrebări: nu spune cîți factori există și nici care sînt. Ambele se rezolvă în date, iar restul capitolului face acest lucru în trei moduri:
Cu factori construiți din caracteristicile firmelor (această secțiune);
Cu factori latenți extrași din randamente (Aprofundări);
Cu teste care verifică dacă un factor candidat adaugă ceva față de ceilalți (Aprofundări).
Pe scurt
Întrebarea secțiunii: beta de piață nu explică randamentele medii (Secțiunea 4)
de cîți factori și de care avem nevoie?
APT: Arbitrage Pricing Theory (teoria evaluării prin arbitraj), Ross (1976)
Ipoteza: randamentele urmează un model cu \(K\) factori
Un factor construit prin sortare (characteristic-sorted factor) este diferența dintre randamentele a două portofolii de acțiuni sortate după o caracteristică a firmei, cu sensul fixat pentru fiecare factor: HML este B/M mare minus B/M mic, iar SMB capitalizare mică minus capitalizare mare. Ce se vinde finanțează ce se cumpără, deci factorul nu cere capital net, iar randamentul lui este o diferență de randamente, \(f_t = R_{\text{mare},t} - R_{\text{mic},t}\). Un factor construit astfel este un portofoliu tranzacționat, ceea ce contează mai departe: pentru un factor tranzacționat, prima de risc se citește direct din randamentul lui mediu.
Construcția Fama–French împarte acțiunile, în fiecare iunie, în \(2 \times 3\) grupe, prin două sortări:
După mărime, cu pragul dat de mediana capitalizării acțiunilor listate la New York Stock Exchange (NYSE).
După raportul B/M, cu percentilele 30 și 70 ale acțiunilor NYSE drept praguri, care dau grupele cu B/M mic (creștere, growth), neutru și mare (valoare, value).
Datele contabile provin din anul anterior, ca să fie cunoscute la data sortării, iar fiecare dintre cele șase grupe este un portofoliu ponderat după capitalizare.
Diagrama arată cele șase portofolii, de la \(S_L\) (firme mici, B/M mic) la \(B_H\) (firme mari, B/M mare), și cei doi factori construiți din ele:
SMB face media celor trei portofolii de firme mici minus media celor trei de firme mari;
HML face media celor două portofolii cu B/M mare minus media celor două cu B/M mic.
Cele două alegeri de construcție, pragurile NYSE și ponderarea după capitalizare, împiedică microcapitalizările să domine portofoliile. Rezultă cei doi factori ai modelului cu trei factori. SMB (Small Minus Big) este randamentul acțiunilor mici minus randamentul acțiunilor mari. HML (High Minus Low) este randamentul acțiunilor cu B/M mare (valoare) minus cel al acțiunilor cu B/M mic (creștere). Fiindcă HML este o medie pe firme mici și mari, el compară valoarea și creșterea la aceeași mărime. Aceeași construcție \(2 \times 3\), cu profitabilitatea operațională și investițiile în locul raportului B/M, dă factorii RMW (Robust Minus Weak, profitability factor, factorul profitabilitate: firme robuste minus slabe) și CMA (Conservative Minus Aggressive, investment factor, factorul investiții: firme conservatoare minus agresive) ai modelului cu cinci factori, definiți în slide-urile următoare.
Patru factori extind FF3 (Fama–French three-factor model, modelul Fama–French cu trei factori). RMW (Robust Minus Weak) este randamentul acțiunilor cu profitabilitate operațională mare minus cel al acțiunilor cu profitabilitate operațională mică. CMA (Conservative Minus Aggressive) este randamentul acțiunilor cu creștere mică a activelor minus cel al acțiunilor cu creștere mare a activelor. ROE (Return On Equity, rentabilitatea capitalului propriu) este factorul de profitabilitate al modelului q.
MOM (Momentum, factor, factorul momentum), notat și UMD (Up Minus Down), este factorul momentum: acțiunile cu randamente mari în lunile \(t-12\) pînă la \(t-2\) minus acțiunile cu randamente mici în aceleași luni, cu ultima lună omisă. Baza lui empirică este constatarea lui Jegadeesh & Titman (1993) că cîștigătorii trecuți continuă să cîștige timp de 3 pînă la 12 luni.
FF3 nu este un caz particular al FF5 (Fama–French five-factor model, modelul Fama–French cu cinci factori). SMB din FF3 provine dintr-o singură sortare, după mărime și B/M, pe cînd SMB din FF5 face media factorilor de mărime din trei sortări, după B/M, profitabilitate și investiții. Eliminarea lui RMW și CMA din FF5 nu dă deci FF3, iar cele două modele trebuie comparate ca modele diferite.
Pe scurt
RMW (Robust Minus Weak): profitabilitate operațională mare minus mică
CMA (Conservative Minus Aggressive): creștere mică minus mare a activelor
ROE (Return On Equity, rentabilitatea capitalului propriu): factorul de profitabilitate al modelului q
MOM (momentum, notat și UMD, Up Minus Down)
acțiunile cu randament mare minus cele cu randament mic în lunile \(t-12\) pînă la \(t-2\)
Tabelul prezintă cinci modele, în ordinea factorilor lor. CAPM (Sharpe, 1964) are doar randamentul în exces al pieței, Mkt-RF. Modelul Fama–French cu trei factori (FF3) al lui Fama & French (1993) adaugă SMB și HML, motivați de efectele de mărime și B/M documentate în Fama & French (1992). Modelul lui Carhart (1997) adaugă la FF3 factorul momentum (MOM), pentru evaluarea fondurilor de investiții. Modelul q al lui Hou, Xue & Zhang (2015) folosește factori de piață, mărime, investiții și rentabilitate a capitalului propriu, motivați de deciziile de investiții ale firmelor. Modelul cu cinci factori (FF5) al lui Fama & French (2015) folosește Mkt-RF, SMB, HML, RMW și CMA.
Fiecare model se testează printr-o regresie pe serii de timp a randamentelor în exces pe factorii lui. Pentru FF3, cu \(\text{MKT} = \) Mkt-RF,
unde \(b_i\),\(s_i\) și \(h_i\) sînt loadings. Un model bun lasă valori alfa \(\alpha_i\) apropiate de zero în aceste regresii, iar testul Gibbons–Ross–Shanken (GRS) din Secțiunea 4 verifică dacă aceste abateri sînt mari în raport cu incertitudinea lor.
Factorul momentum folosește aceeași sortare \(2 \times 3\) ca SMB și HML, cu randamentul trecut în locul raportului B/M. Pragul de mărime este tot mediana NYSE, iar pragurile de randament sînt percentilele 30 și 70 ale acțiunilor NYSE, care dau perdanții, acțiunile neutre și cîștigătorii. UMD face media celor două portofolii de cîștigători minus media celor două portofolii de perdanți, \(\text{UMD} = \tfrac12(S_W + B_W) - \tfrac12(S_L + B_L)\). Grupele se refac în fiecare lună, nu o dată pe an, deoarece randamentul trecut se schimbă lunar, iar datele contabile doar anual.
Perioada de formare (formation period) este randamentul cumulat în lunile \(t-12\) pînă la \(t-2\), în total 11 luni. Luna \(t-1\) se omite din cauza short-term reversal: la orizontul de o lună, randamentele tind să se inverseze Jegadeesh (1990). Două cauze sînt bid–ask bounce, oscilația prețului tranzacției între bid și ask, și presiunea de lichiditate. Inclusă, luna \(t-1\) ar amesteca într-un singur semnal două efecte de semn opus.
UMD este momentum transversal (cross-sectional): compară cîștigătorii cu perdanții la aceeași dată. Time-series momentum (Moskowitz, Ooi & Pedersen, 2012) compară fiecare activ cu propriul trecut: poziția este long dacă randamentul activului pe 12 luni este pozitiv și short altfel. Distincția revine în studiul de caz despre factor momentum, care aplică regula pe serii de timp factorilor.
Graficul arată randamentele lunare a șase factori din biblioteca de date a lui Kenneth French, cumulate pornind de la valoarea 1: randamentul în exces al pieței, Mkt-RF, și factorii long–short SMB, HML, RMW, CMA și MOM. Axa verticală este logaritmică, deci distanțe verticale egale corespund unor variații procentuale egale, iar panta fiecărei curbe este rata ei de creștere compusă. Cursorul mută începutul investiției din iulie 1963 pînă în 2016, cu sfîrșitul fixat în iulie 2026, iar butonul ▶ parcurge anii de început.
Întrebarea interactivă cere să alegeți care dintre doi factori termină mai sus cînd începutul se mută; răspunsul apare după alegere.
Întrebare pentru sală Din iulie 1963, MOM ajunge la 48,0, iar Mkt-RF la 43,2. Dacă mutăm începutul la ianuarie 2016 și păstrăm sfîrșitul în iulie 2026, care indice compus va avea valoarea finală mai mare?
Răspuns
Mkt-RF ajunge la aproximativ 3,4, iar MOM la 1,0. Din iulie 1963, ordinea era inversă: MOM 48,0 și Mkt-RF 43,2. Indicii sînt calculați ca produsul termenilor (1 + randamentul lunar al factorului), pornind de la 1; nu reprezintă automat strategii investibile cu aceeași finanțare. Momentum a pierdut mult la revenirea pieței din 2009.
Curbele nu reprezintă averea unui investitor real. Factorii sînt randamente în exces sau long–short, deci nu includ dobînda pe capital și nici dobînda pe garanția pozițiilor short. Clasamentul factorilor depinde de data de început: un eșantion lung avantajează factorii cu media cea mai mare, iar un eșantion scurt și recent reflectă mai ales episoadele ultimului deceniu, de exemplu pierderile factorului valoare după 2007.
Pe perioada iulie 1963 – iulie 2026, o unitate investită în fiecare factor ajunge la 43,2 pentru Mkt-RF, 48,0 pentru MOM, 6,9 pentru HML, 5,7 pentru RMW, 5,5 pentru CMA și 2,9 pentru SMB. Randamentele anuale medii au aceeași ordine: 7,2% pentru Mkt-RF, 7,3% pentru MOM, 3,6% pentru HML, 3,1% pentru RMW, 3,0% pentru CMA și 2,2% pentru SMB. Momentum și piața domină deci eșantionul lung, iar mărimea are media cea mai mică.
Traiectoriile sînt departe de a fi regulate. Momentum a atins maximul înainte de 2009 și a pierdut mult cînd piața și-a revenit brusc în 2009; un asemenea episod se numește crah de momentum (momentum crash). Factorul valoare a stagnat sau a pierdut aproximativ din 2007 pînă în 2020. Un factor cu medie pozitivă pe termen lung poate deci pierde mai mult de un deceniu, unul dintre motivele pentru care stabilitatea primelor este examinată în Aprofundări.
Pe scurt
Randamentele lunare ale factorilor, cumulate pornind de la 1, pe scară logaritmică
Factorii sînt randamente în exces sau long–short
curbele nu includ dobînda pe capital sau pe garanția pozițiilor short
deci nu arată averea unui investitor real
Valoarea finală a unei unități investite, iulie 1963 – iulie 2026
Mkt-RF \(43{,}2\), MOM \(48{,}0\), HML \(6{,}9\)
RMW \(5{,}7\), CMA \(5{,}5\), SMB \(2{,}9\)
Momentum a atins maximul înainte de 2009
a pierdut mult cînd piața și-a revenit brusc în 2009: un crah de momentum
Factorul valoare a stagnat sau a pierdut, aproximativ din 2007 pînă în 2020
Modelele multifactoriale adaugă pieței mai multe portofolii long–short tranzacționate. Construcția lor folosește pragurile NYSE și ponderarea după capitalizare, iar motivația lor vine din modelul de actualizare a dividendelor și din anomalii documentate, ca mărimea, valoarea și momentum. Dacă expunerile la acești factori sînt răsplătite, și cu cît, este o întrebare transversală, la care răspunde secțiunea următoare prin regresii Fama–MacBeth.
Regresii Fama–MacBeth
Regresiile pe serii de timp din secțiunile anterioare testează dacă valorile alfa sînt zero. Această secțiune estimează chiar primele de risc \(\boldsymbol\lambda\), prin metoda în două etape a lui Fama & MacBeth (1973), și derivă erorile lor standard. Sînt necesare trei corecții: una pentru folosirea valorilor beta estimate, una pentru un model posibil greșit specificat și una pentru dependența temporală. Estimările pe cele 25 de portofolii mărime × B/M arată că prima lui HML poate fi estimată precis, în timp ce prima pieței este slab identificată, iar secțiunea se încheie cu trei verificări care fac testul unui model factorial mai exigent.
Întrebarea este dacă expunerile la factori aduc o primă, adică dacă valorile beta explică diferențele dintre randamentele medii în exces ale activelor:
Pentru un factor tranzacționat, un model corect impune ca prima să fie randamentul lui mediu în exces, \(\lambda = \mathbb{E}[f]\); estimația liberă din regresia transversală poate însă diferi, iar diferența este un diagnostic. Pentru un factor netranzacționat, de exemplu inflația, doar regresia transversală (cross-sectional regression) dă \(\lambda\). Intuiția etapei a doua: într-o lună, se compară randamentele portofoliilor cu expuneri diferite la factor, de exemplu la HML; panta acelei luni este prima realizată, iar media celor \(T\) pante este prima estimată. Exemplul folosește beta din întregul eșantion, pentru descriere, nu pentru prognoză. Metoda lui Fama & MacBeth (1973) oferă această regresie împreună cu o eroare standard simplă. Pe cele 25 de portofolii, prima HML estimată este 4,0% pe an, față de media factorului de 3,6%. Cît de precisă este această estimare?
Etapa 1 este o regresie pe serii de timp pentru fiecare activ, \(R^e_{i,t} = a_i + \boldsymbol\beta_i^\top \mathbf{f}_t + \varepsilon_{i,t}\), unde \(a_i\) este termenul liber. Expunerile estimate formează matricea \(\hat{\mathbf{B}}\) de dimensiune \(N \times K\): fiecare rînd conține expunerile estimate pentru un portofoliu. Etapa 2 este o regresie transversală în fiecare lună \(t\) a randamentelor în exces pe \(\mathbf{X} = [\mathbf{1}, \hat{\mathbf{B}}]\):
unde \(u_{i,t}\) este reziduul din etapa 2. Estimația primelor este media celor \(T\) pante lunare.
Termenul liber \(\lambda_0\) este zero dacă modelul este corect. În versiunea lui Black (1972), fără activ fără risc, \(\lambda_0\) este randamentul portofoliului cu beta zero minus \(R_f\). Motivul pentru care se rulează cîte o regresie separată în fiecare lună, și nu o singură regresie pe randamentele medii, este că variația celor \(T\) pante \(\hat{\boldsymbol\lambda}_t\) dă direct eroarea standard, cum arată slide-ul următor.
unde \(s(\cdot)\) este abaterea standard empirică pe cele \(T\) luni. Fiindcă fiecare pantă lunară folosește toate activele din luna respectivă, (3.15) este robustă la corelația reziduurilor între active în aceeași lună, principala slăbiciune a erorii standard dintr-o regresie OLS (ordinary least squares) pe datele cumulate. Dacă seria \(\hat\lambda_{k,t}\) este autocorelată, pe această serie se aplică estimatorul Newey–West în locul abaterii standard simple.
Formula ignoră o sursă de eroare. Etapa 2 folosește valorile beta estimate \(\hat{\boldsymbol\beta}_i\) în locul celor adevărate, o problemă de erori în variabile (errors in variables). Eroarea de eșantionare a valorilor beta din etapa 1 nu apare în variația pantelor lunare, deci \(\operatorname{se}_{FM}\) subestimează incertitudinea lui \(\hat{\boldsymbol\lambda}\).
Pe scurt
Patru surse de incertitudine, patru corecții
Fama–MacBeth: variația lunară a pantelor
Shanken: valorile beta sînt estimate
HAC: dependența în timp
Kan–Robotti–Shanken (KRS): posibile erori de evaluare (model greșit)
Fama–MacBeth: estimațiile lunare \(\hat\lambda_{k,t}\) formează un eșantion de volum \(T\)
unde \(\operatorname{Var}_{FM} = s^2(\hat{\boldsymbol\lambda}_t)/T\) este varianța Fama–MacBeth, iar \(\boldsymbol\Sigma_f\) matricea de covarianță a factorilor. Scalarul \(c\) este pătratul raportului Sharpe al primelor, pe lună; pentru FF3 este 0,03. Mărimea lui \(c\) depinde de raportul dintre prime și volatilitatea factorilor, nu de faptul că factorul este tranzacționat. Cînd primele sînt mici față de volatilitate, ca la FF3 lunar, \(c\) este mic, la fel și corecția. Cînd un factor, de exemplu unul macroeconomic, are o volatilitate mică față de prima estimată, \(c\) este mare, iar statisticile \(t\) Fama–MacBeth sînt supraestimate. Erorile Fama–MacBeth, Newey–West și Shanken presupun că modelul este corect; corecția pentru un model greșit specificat este în Aprofundări.
Pe scurt
Corecția Shanken (1992) mărește cu factorul \((1 + c)\) partea varianței care nu provine din variabilitatea factorilor
Graficul arată primele Fama–MacBeth pentru trei modele, CAPM, FF3 și FF5, estimate pe cele 25 de portofolii sortate după mărime și B/M. Fiecare bară este un interval de încredere de 95% pentru o primă anuală, iar fiecare cruce marchează media în timp a unui factor tranzacționat, egală cu prima lui dacă modelul este corect. Meniul alege între erorile standard Shanken, Fama–MacBeth și Newey–West cu 6 laguri, iar cursorul mută începutul eșantionului din 1963 pînă în 2000.
Întrebarea interactivă privește distanța dintre prima estimată a pieței și media factorului de piață; răspunsul apare după alegere.
Întrebare pentru sală În FF3, prima de piață estimată prin Fama–MacBeth este −6,5% pe an, iar media factorului este 7,2%. De ce diferă atît de mult?
Răspuns
Beta de piață diferă puțin între portofolii: 0,89–1,14 în FF3. Această dispersie redusă face dificilă separarea primei de piață de termenul liber. Estimația negativă nu stabilește preferințele investitorilor pentru risc. Corecția Shanken schimbă erorile standard, nu estimația primei. Pentru HML, prima estimată (4,0%) este apropiată de media factorului (3,6%).
Graficul se citește în două feluri:
Comparați vizual fiecare interval cu crucea lui. Comparația nu este un test formal, pentru că și media factorului este estimată, din aceleași luni; un test estimează direct diferența \(\hat\lambda - \bar f\) și eroarea ei comună, de exemplu printr-un bootstrap pe blocuri care reestimează ambele etape.
Comparați lățimile pentru cele trei tipuri de erori standard: în exemplul FF3 lunar, \(c\) din (3.16) este mic (\(c \approx 0{,}03\); mărimea lui depinde de prime în raport cu matricea de covarianță a factorilor), deci intervalele Shanken sînt doar puțin mai largi decît cele Fama–MacBeth.
Meniul schimbă intervalele, nu estimațiile punctuale.
Pe scurt
Legenda: Fama-MacBeth risk premia: primele de risc Fama–MacBeth, cu intervale de 95%; Time-series mean of the factor: media factorului în timp MFM_ch3_fama_macbeth
Estimațiile pe cele 25 de portofolii în perioada 1963–2026, cu erorile standard (SE) în paranteză, sînt următoarele. În CAPM, termenul liber este 14,0% (4,4%) pe an, iar prima pieței −4,4% (4,8%). În FF3, SMB are prima 1,4% (1,4%), iar HML 4,0% (1,3%). În FF5, RMW are 5,3% (2,1%), iar CMA −1,4% (2,2%). Barele din grafic sînt intervale de 95% cu erori Shanken, în fracții anuale, deci 0,1 înseamnă 10%.
Pentru HML, prima transversală, 4,0%, este apropiată de media factorului, 3,6%. Pentru piață, în FF3, cele două valori sînt îndepărtate: o primă estimată de −6,5% față de o medie a factorului de 7,2%. Valorile beta de piață diferă puțin între portofolii, de la 0,86 la 1,42 în CAPM și de la 0,89 la 1,14 în FF3. Această dispersie mică face panta imprecisă, dar nu explică semnul sau mărimea diferenței: o pantă estimată din valori beta care aproape nu diferă este imprecisă, iar termenul liber preia nivelul mediu al randamentelor (Lewellen, Nagel & Shanken, 2010). Prima pieței este deci slab identificată (weakly identified) în această secțiune transversală.
Rezultatul arată o asociere între expuneri și randamentele medii, nu sursa economică a riscului. Factorii slabi, ale căror valori beta sînt apropiate de zero pentru toate activele, și o secțiune transversală de 30 de industrii sînt tratate în Aprofundări.
Pe scurt
Barele: intervale de încredere de 95% cu erori Shanken
în fracții anuale (\(0.1 = 10\%\))
Crucile: media în timp a fiecărui factor tranzacționat
egală cu \(\lambda\) dacă modelul este corect
comparația cu crucea este vizuală: și media este estimată, din aceleași luni
Prime estimate (25 de portofolii, 1963–2026), cu SE în paranteză
CAPM: termenul liber \(14{,}0\%\) (\(4{,}4\%\)), piața \(-4{,}4\%\) (\(4{,}8\%\))
Cele 25 de portofolii mărime × B/M au o structură factorială puternică: aproape orice set de factori corelați cu mărimea și valoarea explică o mare parte din randamentele lor medii. Lewellen, Nagel & Shanken (2010) propun de aceea trei verificări:
Lărgirea mulțimii activelor de test, de exemplu prin adăugarea portofoliilor pe industrii (Aprofundări);
Raportarea și a lui \(R^2\) GLS (generalised least squares), care ponderează erorile de evaluare cu inversa covarianței randamentelor, în timp ce testul GRS folosește inversa covarianței reziduurilor;
Impunerea ca prima fiecărui factor tranzacționat să fie egală cu media lui și eliminarea termenului liber.
\(R^2\) transversal compară mediile estimate de model cu simpla medie a activelor:
unde \(\bar R^e_i\) este randamentul mediu în exces al activului \(i\),\(\hat\mu_i\) media lui prezisă, iar \(\bar R^e\) media celor \(N\) active. O regresie OLS cu termen liber nu poate face mai rău decît simpla medie, deoarece pantele egale cu zero o reproduc. După ce primele sînt impuse și termenul liber eliminat, această garanție dispare, iar \(R^2 < 0\) înseamnă că modelul face mai rău decît media. FF3 pe 55 de active, cele 25 de portofolii împreună cu 30 de industrii, dă \(R^2 = -0{,}27\) la a treia verificare.
O altă alternativă este folosirea acțiunilor individuale în locul portofoliilor (Ang, Liu & Schwarz, 2020). Valorile beta ale acțiunilor individuale sînt mai dispersate, ceea ce ajută identificarea, dar sînt estimate mai zgomotos, ceea ce agravează problema erorilor în variabile.
Raportați și \(R^2\)GLS (Generalised Least Squares, metoda celor mai mici pătrate generalizate): ca GRS, ține cont de covarianțe, dar folosește inversa covarianței randamentelor activelor, nu a reziduurilor
Impuneți ca prima unui factor tranzacționat să fie media lui și eliminați termenul liber: FF3 pe cele 55 de active (25 de portofolii și 30 de industrii) dă \(R^2 = -0{,}27\) (nu este nici \(R^2\) GLS, nici \(R^2\) OLS liber)
Se aplică (3.15) și (3.16) unui factor netranzacționat, de exemplu creșterea producției industriale, cu volatilitatea lunară de 1%, un eșantion de 400 de luni, o primă estimată de 0,5% pe lună și o abatere standard a pantelor lunare de 3%. Întrebarea este dacă factorul trece pragul \(t > 3\) după corecția Shanken și de ce \(c\) ar fi foarte mic pentru un factor tranzacționat cu volatilitatea de 4,5% și aceeași primă.
Se aplică (3.17) unor trei portofolii cu randamente medii în exces de 2%, 4% și 6% pe an, pe care un model cu prime impuse și fără termen liber le estimează la 6%, 4% și 2%.
Un factor netranzacționat (de exemplu, creșterea producției industriale)
volatilitatea \(\sigma_f = 1\%\) pe lună, \(T = 400\) de luni
etapa 2 dă \(\hat\lambda = 0{,}5\%\) pe lună, cu \(s(\hat\lambda_t) = 3\%\)
Calculați \(\operatorname{se}_{FM}\) și statistica \(t\) Fama–MacBeth
Calculați \(c\), varianța Shanken și statistica \(t\) Shanken. Trece factorul pragul \(t > 3\) (ipoteza exercițiului; motivarea: Secțiunea 7)?
De ce ar fi \(c\) foarte mic pentru un factor tranzacționat cu \(\sigma_f = 4{,}5\%\) și același \(\hat\lambda\)?
Trei portofolii au randamentele medii în exces \(2\%\), \(4\%\), \(6\%\) pe an
un model cu prime impuse și fără termen liber estimează \(6\%\), \(4\%\), \(2\%\)
Calculați SST (Total Sum of Squares, suma totală a pătratelor abaterilor de la medie), SSE (Sum of Squared Errors, suma pătratelor erorilor) și \(R^2\)
De ce nu poate fi negativ \(R^2\)-ul unei regresii OLS cu termen liber?
Metoda Fama–MacBeth transformă întrebarea „sînt expunerile răsplătite?” într-o medie a pantelor transversale lunare. Eroarea ei standard trebuie să țină cont de valorile beta estimate (Shanken), de un model posibil greșit (Kan–Robotti–Shanken) și de dependența temporală (Newey–West). Pe cele 25 de portofolii, prima lui HML concordă cu media factorului, iar prima pieței este slab identificată, deoarece valorile beta de piață diferă puțin. Un \(R^2\) mare pe aceste portofolii nu dovedește mare lucru; activele de test mai diverse și primele impuse fac testul exigent.
Testarea multiplă și replicarea factorilor
Secțiunile 5 și 6 au folosit factori propuși în literatură. Au fost însă publicați sute de factori, fiecare testat ca și cum ar fi fost singurul, deci o parte dintre ei pot fi descoperiri false. Secțiunea pune două întrebări. Ce prag trebuie să treacă un factor nou cînd se testează mulți factori? Se replică factorii publicați în date noi?
Întrebarea secțiunii este cîți dintre factorii publicați sînt reali. Cochrane (2011) a numit lista tot mai lungă de factori un factor zoo, iar Harvey, Liu & Zhu (2016) catalogează 316 factori publicați. Inventarul publicațiilor nu spune însă cîte ipoteze au fost încercate: familia testată, din care provin factorii publicați, are o mărime necunoscută. Pragul obișnuit, \(|t| > 1{,}96\), corespunde unui nivel de semnificație de 5% pentru un singur test. Un experiment controlat arată problema: dacă testăm 300 de ipoteze nule adevărate la 5%, ne așteptăm, în medie, la 15 respingeri false.
Cînd se testează mulți factori, acest prag este prea jos. Ca exemplu ipotetic, dacă ar fi fost fixate în prealabil 316 teste și nicio ipoteză nulă nu ar fi falsă, aproximativ \(0{,}05 \times 316 \approx 16\) teste ar trece totuși din întîmplare. Problema este agravată de data mining, numit și p-hacking: căutarea printre multe variante ale unui factor, eșantion sau specificații pînă cînd una pare semnificativă. Factorii publicați sînt supraviețuitorii unor asemenea căutări, deci statisticile lor \(t\) supraevaluează dovezile.
Cea mai simplă corecție, Bonferroni, împarte nivelul de 5% la numărul de teste. Pentru aceleași 316 teste ipotetice rezultă \(p \le 0{,}00016\), adică \(|t| > 3{,}78\).Harvey, Liu & Zhu (2016) propun \(|t| > 3{,}0\) pentru un factor nou, pragul care rezultă din corecțiile pentru testarea multiplă din slide-ul următor aplicate tuturor factorilor testați. Pragul crește cu fiecare factor publicat, iar o parte dintre factorii publicați nu se replică, după cum arată studiul de caz despre replicare.
Pe scurt
Întrebarea: cîți dintre factorii publicați sînt reali?
fiecare a fost testat ca și cum ar fi fost singurul
Cochrane (2011) a numit lista tot mai lungă de factori un factor zoo
În testarea multiplă se controlează două rate de eroare. Rata erorii pe familia de teste (family-wise error rate, FWER) este probabilitatea de a avea cel puțin o respingere falsă printre toate testele (Capitolul 2). Rata descoperirilor false (false discovery rate, FDR) este ponderea așteptată a respingerilor false în totalul respingerilor. Controlul FWER la 5% este mai strict, pentru că o singură respingere falsă contează ca eroare, pe cînd FDR tolerează respingeri false atîta timp cît ele reprezintă o pondere mică.
Procedurile se formulează cu valorile p ordonate. Fie \(M\) numărul de teste, \(\alpha\) nivelul de semnificație al testelor (nu alfa lui Jensen), \(p_{(1)} \le \dots \le p_{(M)}\) valorile p ordonate și \(H_{(j)}\) ipoteza cu a \(j\)-a cea mai mică valoare p. BH desemnează procedura Benjamini–Hochberg, iar BY procedura Benjamini–Yekutieli; tabelul din slide-ul următor le compară cu Bonferroni și Holm.
Pe scurt
FDR: ponderea așteptată a respingerilor false în totalul respingerilor
FDR: False Discovery Rate, rata descoperirilor false
FWER: probabilitatea de a avea cel puțin o respingere falsă (Capitolul 2)
FWER: Family-Wise Error Rate, rata erorii pe familia de teste
Notațiile tabelului (slide-ul următor)
\(M\): numărul de teste
\(\alpha\): nivelul de semnificație al testelor (aici \(\alpha\) nu este alfa lui Jensen)
\(p_{(1)} \le \dots \le p_{(M)}\): valorile p (p-values) ordonate
\(H_{(j)}\): ipoteza cu a \(j\)-a cea mai mică valoare p
Bonferroni respinge \(H_{(j)}\) dacă \(p_{(j)} \le \alpha/M\). Procedura descendentă (step-down) a lui Holm (1979) respinge \(H_{(j)}\) dacă \(p_{(k)} \le \alpha/(M-k+1)\) pentru toți \(k \le j\); ea controlează FWER ca Bonferroni, dar respinge cel puțin la fel de des. Procedura lui Benjamini & Hochberg (1995) (BH) găsește cel mai mare \(k\) cu
\[p_{(k)} \le \frac{k\,\alpha}{M}\]
(3.18)
și respinge toate ipotezele pînă la acest \(k\); ea controlează FDR. Procedura lui Benjamini & Yekutieli (2001) (BY) folosește pragurile BH împărțite la \(\sum_{k=1}^{M} 1/k\). Ultima coloană a tabelului spune cînd este validă fiecare procedură: Bonferroni, Holm și BY sînt valide pentru orice dependență între teste, iar BH cere dependență pozitivă.
Dependența pozitivă înseamnă că statisticile de test tind să crească împreună; independența este un caz particular. Condiția tehnică este dependența de regresie pozitivă pe o submulțime (PRDS, positive regression dependence on a subset), dată de Benjamini & Yekutieli (2001). Cînd structura dependenței nu este cunoscută, pragurile BY asigură controlul FDR cu prețul unui număr mai mic de descoperiri.
Alegerea între cele două rate de eroare depinde de folosirea rezultatului. Controlul FWER se potrivește unei afirmații în care nicio descoperire falsă nu este acceptabilă, de exemplu cînd probabilitatea de a respinge cel puțin o ipoteză nulă adevărată trebuie limitată la 5%. Controlul FDR se potrivește unei căutări printre mulți factori candidați, în care se acceptă o mică proporție de descoperiri false în schimbul unei puteri mai mari. O simulare cu zece factori din Aprofundări compară procedurile.
Exercițiul aplică cele patru proceduri pentru cinci factori candidați, cu valorile p ordonate 0,004; 0,012; 0,020; 0,030 și 0,200, la nivelul de semnificație de 5%. El cere numărul de descoperiri după regula naivă, Bonferroni, Holm, BH și BY, cu fiecare prag scris explicit, probabilitatea de a avea cel puțin o respingere falsă dacă toate cele cinci ipoteze nule ar fi adevărate și testele independente, precum și procedura potrivită fiecăreia dintre cele două folosiri descrise mai sus. Răspunsurile sînt în Anexă.
Pe scurt
Cinci factori candidați
valori p ordonate: \(0{,}004;\ 0{,}012;\ 0{,}020;\ 0{,}030;\ 0{,}200\)
nivel de semnificație \(\alpha = 5\%\)
Cîte descoperiri dau regula naivă, Bonferroni, Holm și BH? Scrieți fiecare prag cu care comparați
La BY, pragurile BH se împart la \(1 + \tfrac12 + \tfrac13 + \tfrac14 + \tfrac15\): cîte descoperiri rămîn?
Dacă toate cele cinci ipoteze nule ar fi adevărate și testele independente, care este probabilitatea ca cel puțin o valoare p să fie sub \(0{,}05\)?
Ce procedură ați folosi într-o căutare printre mulți factori candidați?
Cum limitați la 5% probabilitatea de a respinge cel puțin o ipoteză nulă adevărată?
O anomalie este un randament mediu pe care CAPM nu îl explică. Jensen, Kelly & Pedersen (2023) pornesc de la două critici la adresa cercetării despre factori:
Rezultatele nu se pot reproduce: Hou, Xue & Zhang (2020) reușesc să replice doar 35% dintre anomaliile studiate.
Rezultatele sînt produsul testării multor factori fără corecție: Harvey, Liu & Zhu (2016) conchid că majoritatea descoperirilor raportate sînt probabil false.
Studiul de caz pune pe rînd trei întrebări. Au factorii publicați valori alfa CAPM semnificative în datele originale? Sînt aceste valori alfa semnificative out-of-sample și în alte țări? Rămîn ele semnificative după ce se ține cont de testarea multiplă? Răspunsurile depind de ce se testează, randamente brute sau alfa, și de modul în care se face corecția pentru testarea multiplă.
Pe scurt
Anomalie: un randament mediu pe care CAPM nu îl explică
Rezultatele nu se pot reproduce: Hou, Xue & Zhang (2020) reușesc să replice doar \(35\%\) dintre anomaliile studiate
Rezultatele sînt produsul testării multor factori fără corecție: Harvey, Liu & Zhu (2016) conchid că majoritatea descoperirilor raportate sînt probabil false
Întrebările
au factorii publicați valori alfa CAPM semnificative în datele originale?
sînt aceste valori alfa semnificative și în afara eșantionului inițial (out-of-sample) și în alte țări?
rămîn ele semnificative după ce se ține cont de testarea multiplă?
Dacă majoritatea factorilor ar fi descoperiri false, modelele multifactoriale din Secțiunea 5 și ETF-urile factoriale din Secțiunea 8 s-ar sprijini pe zgomot. Două viziuni asupra factor zoo se confruntă. Feng, Giglio & Xiu (2020) arată că majoritatea factorilor noi nu aduc nimic în plus față de cei existenți; metoda lor este în Anexă. Jensen, Kelly & Pedersen (2023) văd în schimb factor zoo ca pe multe măsurători corelate ale acelorași cîteva teme economice, astfel încît dovezile pentru o temă cumulează dovezile factorilor ei.
Studiul folosește două mărimi din secțiunile anterioare. Mărimea testată este alfa lui Jensen, termenul liber al regresiei CAPM (Secțiunea 4). Reperul clasic, non-bayesian, pentru testarea multiplă este corecția Benjamini–Yekutieli (Secțiunea 7), cu care se compară procedura bayesiană a autorilor. Metoda de shrinkage din spatele estimărilor bayesiene, aplicată pe 153 de factori, este în Aprofundări.
Pe scurt
Dacă majoritatea factorilor ar fi descoperiri false, s-ar sprijini pe zgomot
Tabelul prezintă pas cu pas ratele de replicare din Figura 1 a lucrării Jensen, Kelly & Pedersen (2023). Rata urcă de la 35% la Hou, Xue & Zhang (2020) pînă la 82,4%. Cu un eșantion mai lung, 15 factori în plus și o construcție diferită, rata pe randamentele brute urcă la 55,6%. Dacă se păstrează doar cei 119 factori semnificativi în studiile inițiale, rata devine 61,3%.
Cel mai mare pas este trecerea de la randamentele brute la alfa CAPM, estimat prin OLS: rata devine 82,4%. Cu corecția Benjamini–Yekutieli, rata pe alfa este 75,6%; cu metoda Bayes empiric (empirical Bayes) a autorilor este 82,4%, atît în Statele Unite, cît și în eșantionul global.
Bayes empiric dă aceeași rată ca OLS, 82,4%, din două motive care se compensează. Micșorarea fiecărui alfa spre zero pierde unele descoperiri, iar informația împrumutată de la ceilalți factori ai aceleiași teme adaugă altele. Rezultatele complete sînt în Anexă. Rata bayesiană a descoperirilor false, adică proporția estimată de descoperiri false, printre factorii cu \(z \ge 1{,}96\) este doar 0,1%. Pragul rămîne 1,96, dar proporția estimată de descoperiri false este mică, deoarece estimația fiecărui factor împrumută informație de la ceilalți factori ai temei lui, în loc să trateze fiecare test izolat. Rata de replicare se referă la cei 119 factori semnificativi în studiile inițiale, nu la toți factorii propuși.
Pe scurt
Bayes empiric dă tot \(82{,}4\%\) (rezultatele complete: Anexă)
micșorarea spre zero pierde unele descoperiri
informația împrumutată de la temă adaugă altele
efectele se compensează
Proporția estimată de descoperiri false (FDR bayesian) printre factorii cu \(z \ge 1{,}96\) este doar \(0{,}1\%\)
deși pragul rămîne \(1{,}96\)
Rata de replicare se referă la cei 119 factori semnificativi în studiile inițiale, nu la toți factorii propuși
Majoritatea factorilor se replică, dar alfa scade după eșantionul inițial (3/3)
Replicarea în eșantionul inițial nu spune însă totul. În medie, alfa unui factor scade de la 0,49% pe lună in-sample, adică în eșantionul studiului inițial, la 0,26% pe lună out-of-sample, o scădere de 47%. Panta regresiei alfa out-of-sample pe alfa in-sample (Figura 8) este 0,26, un coeficient distinct de media de 0,26% pe lună: un alfa inițial mai mare cu 1 punct procentual pe lună rămîne ulterior mai mare doar cu 0,26 puncte procentuale.
O parte dintr-o asemenea scădere este de așteptat doar din motive statistice: factorii cu cele mai mari valori alfa in-sample au fost selectați parțial datorită norocului. Shrinkage-ul statistic singur ar explica însă o pantă de circa 0,9, deci scăderea reală este mai mare decît zgomotul. Cei mai puternici factori scad cel mai mult, semn fie de arbitraj din partea investitorilor după publicare, fie de data mining înainte de ea; Aprofundări reia această întrebare pentru momentum. Replicarea acestor rezultate în curs este în Aprofundări.
Cele două rezultate răspund la întrebări diferite. Reproducerea: pentru 98 dintre cei 119 factori inițial semnificativi, alfa CAPM estimat prin OLS reproduce rezultatul (82,4%). Mărimea efectului: după eșantionul inițial, alfa mediu scade de la 0,49% la 0,26% pe lună (−47%), iar cauza scăderii rămîne deschisă.
Pe scurt
Scăderea după perioada studiului inițial
În medie, alfa unui factor scade de la \(0{,}49\%\) pe lună în eșantion (al studiului inițial) la \(0{,}26\%\) pe lună în afara eșantionului, adică cu \(47\%\)
Panta regresiei alfa în afara eșantionului pe alfa în eșantion este \(0{,}26\) (Figura 8), un coeficient distinct de media de \(0{,}26\%\) pe lună
un alfa inițial mai mare cu 1 punct procentual pe lună rămîne ulterior mai mare doar cu \(0{,}26\) puncte procentuale
Contracția statistică singură ar explica o pantă de circa \(0{,}9\), deci scăderea reală este mai mare decît zgomotul
Cei mai puternici factori scad cel mai mult
semn de arbitraj sau de căutare oportunistă în date (Aprofundări)
Un factor care trece pragul \(|t| > 1{,}96\) după o căutare printre sute de candidați este o dovadă slabă. Procedurile FWER (Bonferroni, Holm) protejează împotriva oricărei descoperiri false; procedurile FDR (BH, BY) permit o mică proporție de descoperiri false într-o căutare amplă. Pentru un factor nou, pragul \(|t| > 3{,}0\) al lui Harvey, Liu & Zhu (2016) este reperul practic. Majoritatea factorilor publicați se replică în datele originale, dar valorile lor alfa scad ulterior cu aproximativ jumătate, ceea ce cere prudență cînd prima istorică a unui factor este citită ca o prognoză.
Investiții factoriale
Un investitor poate cumpăra expunere la factori prin ETF-uri. Această secțiune compară randamentele totale a șapte ETF-uri factoriale și de stil cu cele ale indicelui S&P 500 din iulie 2013 și explică de ce comparația este o descriere, nu o dovadă despre primele factorilor.
Întrebarea acestui slide este dacă un investitor care cumpără factorii prin ETF-uri cîștigă mai mult decît cu piața. Graficul arată valoarea a 1 USD (US dollar, dolarul american) investit în fiecare ETF, cu dividendele reinvestite: SPY, care replică indicele S&P 500 și este trasat cu linia neagră groasă, ETF-ul momentum MTUM (iShares MSCI USA Momentum Factor ETF, ETF pe factorul momentum), ETF-ul valoare VLUE (iShares MSCI USA Value Factor ETF, ETF pe factorul valoare), ETF-ul calitate QUAL (iShares MSCI USA Quality Factor ETF, ETF pe factorul calitate), ETF-ul de volatilitate minimă USMV (iShares MSCI USA Min Vol Factor ETF, ETF de volatilitate minimă), ETF-ul de firme mici IWM (iShares Russell 2000 ETF, ETF pe acțiunile americane mici, Russell 2000) și ETF-urile de firme mari de valoare și de creștere, IWD (iShares Russell 1000 Value ETF, ETF pe acțiunile americane mari de tip valoare) și IWF, trasate punctat. Cursorul mută data investiției, iar butonul ▶ o deplasează înainte.
Întrebarea interactivă cere să decideți dacă diferența dintre ratele anuale compuse de creștere ale unui ETF și ale lui SPY estimează alfa CAPM al ETF-ului; răspunsul apare după alegere.
Întrebare pentru sală IWF are CAGR 16 (Compound Annual Growth Rate, rata anuală compusă de creștere),3%, iar SPY 14,0% pe aceeași perioadă. Este diferența de 2,3 puncte procentuale o estimație a alfa CAPM pentru IWF?
Răspuns
Nu. Diferența dintre CAGR-uri descrie performanța compusă realizată. Alfa CAPM este termenul liber al regresiei randamentelor în exces pe randamentul în exces al pieței. Diversificarea nu impune beta egal cu 1. Pentru o concluzie despre alfa sînt necesare estimarea și incertitudinea ei. Din iulie 2013, doar IWF și MTUM (15,5%) au CAGR peste SPY; QUAL are 13,5%, VLUE 13,1%, IWD 10,7%, USMV 10,5% și IWM 9,3%.
Graficul compară creșterea compusă, nu randamente ajustate la risc. Un ETF cu beta mai mare decît SPY poate termina mai sus pe o piață în creștere fără niciun alfa, dar nu obligatoriu pe o anumită traiectorie. Expunerile și alfa fiecărui ETF, estimate prin regresia zilnică pe cei cinci factori Fama–French și momentum, și o analiză a sincronizării (timing) sînt în Aprofundări.
Pe scurt
Întrebarea: cîștigă un investitor care cumpără factorii prin ETF-uri mai mult decît cu piața? MFM_ch3_factor_etfs
Aceste ETF-uri sînt produse smart beta: fonduri doar long care cumpără acțiuni după reguli fixe. Ele păstrează expunerea la piață și nu reproduc factorii academici long–short din Secțiunea 5, care iau poziții opuse în cele două grupe extreme: HML cumpără B/M mare, SMB capitalizare mică, CMA creștere mică a activelor. Indicii Russell definesc trei dintre ele: Russell 1000 cuprinde cele mai mari 1000 de acțiuni americane, cu subindicii de valoare (IWD) și de creștere (IWF), iar Russell 2000 cuprinde următoarele 2000 (IWM).
Comparația folosește rata anuală compusă de creștere (CAGR, compound annual growth rate), \(\text{CAGR} = (V_T/V_0)^{1/n} - 1\) pe \(n\) ani, unde \(V_0\) și \(V_T\) sînt prima și ultima valoare. De la 18 iulie 2013, SPY are CAGR 14,0%. Două ETF-uri sînt peste el: firmele mari de creștere (IWF), cu 16,3%, și momentum (MTUM), cu 15,5%. Celelalte sînt sub el: QUAL 13,5%, VLUE 13,1%, IWD 10,7%, USMV 10,5% și IWM 9,3%.
Treisprezece ani reprezintă o singură traiectorie istorică, prea scurtă pentru a respinge primele factorilor estimate pe șase decenii. În această perioadă, acțiunile mari de creștere au depășit piața, iar valoarea și firmele mici au rămas în urmă.
Exemplul MTUM arată de ce comparația brută nu este o dovadă de performanță anormală. CAGR-ul lui, 15,5%, depășește 14,0% al SPY pe intervalul comun 18 iulie 2013 – 18 septembrie 2026. În regresia zilnică pe cei cinci factori Fama–French și momentum, pe zilele disponibile pînă în iulie 2026, MTUM are expunere pozitivă la momentum (0,36). Alfa anualizat estimat este −0,2%, cu \(t = -0{,}11\), iar aceste date sînt compatibile cu alfa zero. Cele două calcule folosesc ferestre diferite, deci cifrele nu se scad una din alta.
Pe scurt
Graficul: valoarea a 1 dolar american (USD) investit la 18 iulie 2013
cu dividendele reinvestite (randament total)
SPY este linia neagră
Smart beta: ETF-uri doar long care cumpără acțiuni după reguli fixe
deci păstrează expunerea la piață și nu reproduc factorul academic long–short
IWD (iShares Russell 1000 Value ETF) și IWF (iShares Russell 1000 Growth ETF): acțiunile de valoare, respectiv de creștere din Russell 1000 (cele mai mari 1000 de acțiuni americane); IWM (iShares Russell 2000 ETF): Russell 2000 (următoarele 2000)
Ce explică o rată anuală compusă de creștere (CAGR) mai mare? Exemplul MTUM (iShares MSCI USA Momentum Factor ETF)
regresie zilnică pe FF5 + MOM, pînă în iulie 2026: expunere MOM \(0{,}36\)
alfa anualizat \(-0{,}2\%\), \(t = -0{,}11\): date compatibile cu alfa zero
CAGR (Compound Annual Growth Rate): \((V_T/V_0)^{1/n} - 1\) pe \(n\) ani
Peste SPY (\(14{,}0\%\))
firmele mari de creștere (IWF): \(16{,}3\%\)
momentum (MTUM): \(15{,}5\%\)
Sub SPY
QUAL (iShares MSCI USA Quality Factor ETF, ETF pe factorul calitate) \(13{,}5\%\), VLUE (iShares MSCI USA Value Factor ETF, ETF pe factorul valoare) \(13{,}1\%\), IWD \(10{,}7\%\)
USMV (iShares MSCI USA Min Vol Factor ETF, ETF de volatilitate minimă) \(10{,}5\%\), IWM \(9{,}3\%\)
Treisprezece ani reprezintă o singură traiectorie istorică
prea scurtă pentru a respinge primele factorilor estimate pe șase decenii
Concluziile reunesc pașii unei analize factoriale, întrebările care verifică înțelegerea capitolului și decizia practică, împreună cu condițiile în care ea trebuie revizuită.
Estimarea expunerilor cu erori HAC, raportarea eșantionului și a aproximării pieței și aplicarea de shrinkage valorilor beta extreme: spre 1 cu ajustarea lui Blume (1971), spre media a priori (0,949 pentru cele nouă sectoare) cu cea a lui Vasicek (1973).
Testarea tuturor valorilor alfa deodată: statistica GRS măsoară, normalizat, cît crește pătratul raportului Sharpe maxim cînd activele de test se adaugă factorilor. CAPM eșuează pe cele 25 de portofolii mărime × B/M, cu o dreaptă a pieței titlurilor (SML, security market line) plată și o respingere GRS.
Estimarea primelor în două etape, cu erori standard care țin cont că valorile beta sînt estimate și că modelul poate fi greșit; un \(R^2\) mare pe cele 25 de portofolii nu dovedește mare lucru.
Protecția împotriva factor zoo, cu praguri corectate pentru testarea multiplă.
Verificarea replicării: 82,4% dintre cei 119 factori inițial semnificativi se replică, dar alfa mediu scade cu 47% după eșantionul inițial.
Descompunerea ETF-urilor factoriale, care vînd în mare parte expuneri la factori cunoscuți, nu alfa.
Întrebările de verificare revin la patru rezultate ale capitolului:
De ce diferă eroarea standard HAC a unui beta de cea clasică, deși beta nu se schimbă (Aprofundări);
De ce poate GRS să nu respingă CAPM pe ETF-urile sectoriale, dar să-l respingă pe cele 25 de portofolii în aceleași luni (Secțiunea 4);
De ce pare să aibă o primă un factor inutil în etapa 2 (Aprofundări);
De ce poate rata de replicare Bayes empiric să depășească rata Benjamini–Yekutieli (Secțiunea 7).
Capitolul se leagă de alte părți ale cursului. Capitolul 2, deja parcurs, a arătat că un alfa nenul este fie o anomalie, fie semnul unui factor de risc omis: problema ipotezei comune. Capitolele următoare reiau instrumentele de aici. Capitolul 4 folosește modele factoriale de covarianță și shrinkage pentru portofoliile Markowitz. Capitolele 5 și 6 modelează volatilitatea, corelațiile și valorile beta variabile în timp. Capitolul 13 tratează overfitting-ul backtest-ului și machine learning pentru secțiunea transversală a randamentelor.
Pe scurt
Întrebări de verificare
De ce diferă eroarea standard HAC a unui beta de cea clasică, deși beta nu se schimbă? (Aprofundări)
De ce poate GRS să nu respingă CAPM pe ETF-urile sectoriale, dar să-l respingă pe cele 25 de portofolii?
Decizia practică are trei părți. Pentru beta, alegerea este o estimație cu erori HAC și shrinkage. Pentru XLK față de SPY, în perioada 1999–2012, estimația OLS este \(\hat\beta = 1{,}415\), beta ajustat Blume 1,278 și beta Vasicek 1,344, iar beta estimat pe perioada următoare, 2013–2026, este 1,172. Pentru testarea CAPM, alegerea este testul GRS pe active alese pentru contraste economice stabilite înainte: pe cele 25 de portofolii mărime × B/M, GRS este 2,91, față de 0,53 pe sectoare, pe aceleași 331 de luni. Pentru prime, alegerea este Fama–MacBeth cu erori Kan–Robotti–Shanken cu laguri Newey–West, cu erorile Fama–MacBeth și Shanken drept comparație și o verificare a sensibilității la numărul de laguri; un factor nou este acceptat doar peste pragul corectat pentru testarea multiplă. Robustețea la specificare greșită și la autocorelație nu rezolvă însă identificarea slabă.
Decizia este valabilă în trei condiții:
Erorile HAC presupun un moment de ordin patru finit al randamentelor, pus sub semnul întrebării în Capitolul 1.
GRS presupune erori cu distribuția Normală multivariată, independente de factori, iar o respingere privește și indicele folosit ca aproximare a pieței (Roll, 1977).
Prima pieței rămîne slab identificată cînd valorile beta diferă puțin, de la 0,89 la 1,14 pe cele 25 de portofolii în FF3.
Trei rezultate ar schimba decizia. Pentru shrinkage: o eroare de prognoză mai mare decît la OLS pe mai multe active și perioade; acum, pe cele nouă sectoare, RMSE este 0,135 pentru OLS, 0,109 pentru Blume și 0,114 pentru Vasicek. Pentru un model: un \(R^2\) transversal negativ cu primele impuse și fără termen liber, ca la FF3 pe 55 de active (\(-0{,}27\)). Pentru un factor publicat: un alfa out-of-sample mic din punct de vedere economic, citit împreună cu intervalul lui, nu doar unul nesemnificativ; în medie, valorile alfa scad cu 47% după eșantionul inițial.
Pe scurt
Ce aleg
beta cu erori HAC și contracție (XLK față de SPY, 1999–2012: \(\hat\beta = 1{,}415\), Blume \(1{,}278\), Vasicek \(1{,}344\); realizat 2013–2026: \(1{,}172\))
testul GRS pe active alese pentru contraste economice stabilite înainte: 25 de portofolii mărime \(\times\) B/M, nu doar sectoarele (GRS \(2{,}91\) față de \(0{,}53\), pe aceleași 331 de luni)
prime Fama–MacBeth cu erori KRS (cu laguri Newey–West); erorile FM și Shanken doar drept comparație; un factor nou doar peste pragul corectat pentru testarea multiplă
robustețea la specificare greșită și la autocorelație nu rezolvă identificarea slabă
În ce condiții
erorile HAC presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
GRS presupune erori cu distribuția Normală multivariată, independente de factori; respingerea privește și indicele folosit ca piață (Roll)
prima pieței rămîne slab identificată cînd valorile beta diferă puțin (\(0{,}89\)–\(1{,}14\) în FF3)
Ce rezultate ar schimba decizia
contracția: o eroare de prognoză mai mare decît la OLS pe mai multe active și perioade (acum, pe 9 sectoare, RMSE: OLS \(0{,}135\), Blume \(0{,}109\), Vasicek \(0{,}114\))
un model: un \(R^2\) transversal negativ cu primele impuse și fără termen liber (FF3 pe 55 de active: \(-0{,}27\))
un factor publicat: un alfa în afara eșantionului mic din punct de vedere economic, citit împreună cu intervalul lui (în medie, alfa scade cu \(47\%\))
Aprofundări
Prima parte reunește subiectele scoase din firul principal al capitolului: datele și randamentele folosite, factorul stocastic de actualizare, factorii latenți (PCA și IPCA), studiul de caz despre factor momentum și AI pentru descoperire științifică. Urmează cadrele care extind, în ordinea capitolului, teme tratate pe scurt în corpul lui: datele și notațiile, incertitudinea costului capitalului, o regresie beta rezolvată cu mai multe erori standard, shrinkage-ul valorilor beta și valorile beta de la Bursa de Valori București (BVB), dreapta pieței titlurilor (security market line, SML) plată, testul GRS ca test al raportului Sharpe și metoda generalizată a momentelor (generalized method of moments, GMM), stabilitatea primelor factoriale, factorii inutili și un test mai sever cu portofolii pe industrii, compararea modelelor prin rapoarte Sharpe maxime, testarea multiplă, numărul de factori, PCA instrumentată, valorile alfa ale ETF-urilor factoriale și detaliile studiului de caz despre replicare.
Capitolul lucrează cu șase grupuri de serii. Factorii Fama–French sînt randamentele lunare a cinci factori (piața, mărimea, valoarea, profitabilitatea și investițiile) între 1963 și 2026, iar factorul momentum este randamentul acțiunilor cu cele mai mari randamente în lunile \(t-12\) pînă la \(t-2\) minus cel al acțiunilor cu cele mai mici. Cele 25 de portofolii de test se formează prin sortarea independentă a acțiunilor americane în cinci grupe de mărime și cinci grupe după raportul dintre valoarea contabilă și valoarea de piață (B/M, book-to-market); cele 25 de intersecții sînt portofoliile, tot lunare, pe 1963–2026. Sursele și notațiile sînt detaliate în Aprofundări.
Seriile investibile sînt zilnice. ETF-urile sectoriale conțin fiecare cîte un sector al S&P 500, indicele a 500 de companii americane mari: nouă sectoare din 1999 și unsprezece din 2018. ETF-urile factoriale acoperă momentum, valoarea, calitatea și volatilitatea minimă din 2013, precum și indicii Russell de mărime, valoare și creștere din 2000. Aplicația locală folosește 11 acțiuni de tip blue chip ale Bursei de Valori București (BVB) și indicele ei, BET, între 2015 și 2026.
Cele nouă ETF-uri sectoriale cu istoric lung sînt XLB (materiale), XLE (energie), XLF (financiar), XLI (industrie), XLK (tehnologie), XLP (bunuri de consum de bază), XLU (utilități), XLV (sănătate) și XLY (bunuri de consum discreționare). Din 2018 li se adaugă XLRE (imobiliare) și XLC (servicii de comunicații).
Pe scurt
Serie
Ce conține
Frecvență
Perioadă
Factorii Fama–French
randamentele a cinci factori: piața, mărimea, valoarea, profitabilitatea și investițiile
lunară
1963–2026
Factorul momentum
acțiunile cu cele mai mari randamente în lunile \(t-12\) pînă la \(t-2\) minus cele cu cele mai mici
lunară
1963–2026
25 de portofolii
acțiuni americane sortate independent în 5 grupe după mărime și 5 după B/M (valoarea contabilă / valoarea de piață); cele 25 de intersecții formează portofoliile
lunară
1963–2026
ETF-uri sectoriale
cîte un ETF pentru fiecare sector din S&P 500 (indicele a 500 de mari companii americane): 9 sectoare din 1999, 11 din 2018
zilnică
1999–2026
ETF-uri factoriale
momentum, valoare, calitate, volatilitate minimă (din 2013); mărime, valoare și creștere, indici Russell (din 2000)
zilnică
2000–2026
Bursa de Valori București (BVB)
11 acțiuni mari (blue chips) și indicele bursei, BET
Fie \(P_{i,t}\) prețul activului \(i\), ajustat pentru dividende și divizări de acțiuni. Randamentul simplu este \(R_{i,t} = P_{i,t}/P_{i,t-1} - 1\), iar randamentul logaritmic \(r_{i,t} = \ln(1 + R_{i,t})\). Cele două servesc unor scopuri diferite, iar capitolul îl folosește pe fiecare acolo unde este potrivit.
Regresiile pe factorii French folosesc randamente simple lunare. Factorii sînt randamente ale unor portofolii, iar randamentul unui portofoliu este suma ponderată a randamentelor simple ale componentelor, nu a randamentelor lor logaritmice. Diferența nu este neglijabilă pentru medii: media randamentelor logaritmice este mai mică decît media randamentelor simple cu aproximativ \(\sigma^2/2\), adică, la o volatilitate anuală de 20%, cu circa 2 puncte procentuale pe an.
Valorile beta rolling, valorile beta de la BVB și analiza componentelor principale din factorii latenți din Aprofundări folosesc randamente logaritmice zilnice. La BVB, rata fără risc zilnică este tratată ca o constantă; o constantă scăzută atît din randamentul activului, cît și din cel al pieței nu schimbă panta regresiei, deci beta este același cu randamente brute sau în exces.
Tabelul arată, pentru fiecare ETF sectorial, industriile acoperite, cîteva companii mari și ponderea în portofoliul tangent. Sectoarele urmează clasificarea GICS a companiilor din S&P 500, iar componența s-a schimbat în timp, de exemplu sectorul imobiliar a ieșit din XLF în 2016. Ponderile merg de la \(-0{,}37\) pentru XLF pînă la \(+0{,}37\) pentru XLV.
Semnul fiecărei ponderi depinde de întreaga matrice de covarianță, nu de o singură pereche de sectoare. Un exemplu ajută la intuiție: XLB și XLI au corelația 0,85, iar XLI are o medie mai mare, 8,78% față de 8,19%, și o volatilitate mai mică, 18,71% față de 20,96%. XLF are cel mai mic raport Sharpe dintre cele nouă sectoare, 0,29. Compoziția sectoarelor s-a schimbat în timp: în 2018, Alphabet și Facebook (astăzi Meta), ambele din tehnologie, și Netflix și Comcast, din consum discreționar, au trecut în servicii de comunicații.
Pe scurt
ETF
Sector
Ce conține (exemple de companii)
Pondere
XLB
materiale
chimicale, materiale de construcții, ambalaje, metale și minerit (Linde, Sherwin-Williams, Freeport-McMoRan, Newmont)
\(-0{,}21\)
XLE
energie
petrol și gaze, servicii petroliere (Exxon Mobil, Chevron, ConocoPhillips)
\(+0{,}19\)
XLF
financiar
bănci, asigurări, administratori de active, procesatori de plăți (Berkshire Hathaway, JPMorgan Chase, Visa)
\(-0{,}37\)
XLI
industrie
aerospațial și apărare, utilaje, transport (GE Aerospace, Caterpillar, Union Pacific)
alimente, băuturi, produse de uz casnic (Procter & Gamble, Coca-Cola, Walmart)
\(+0{,}16\)
XLU
utilități
electricitate, gaze naturale, apă (NextEra Energy, Southern, Duke Energy)
\(+0{,}27\)
XLV
sănătate
farmaceutice, biotehnologie, echipamente medicale (Eli Lilly, UnitedHealth, Johnson & Johnson)
\(+0{,}37\)
XLY
consum discreționar
comerț, auto, hoteluri, restaurante (Amazon, Tesla, Home Depot)
\(+0{,}29\)
Sectoarele urmează clasificarea GICS (Global Industry Classification Standard) a companiilor din S&P 500
compoziția s-a schimbat: imobiliarele au ieșit din XLF în 2016; în 2018, Alphabet și Facebook (azi Meta), din XLK, și Netflix și Comcast, din XLY, au trecut în servicii de comunicații
Semnul fiecărei ponderi depinde de întreaga matrice de covarianță, nu de o singură pereche de sectoare
exemplu: XLB și XLI au corelația \(0{,}85\), iar XLI are medie mai mare (\(8{,}78\%\) față de \(8{,}19\%\)) și volatilitate mai mică (\(18{,}71\%\) față de \(20{,}96\%\))
XLF are cel mai mic raport Sharpe dintre cele 9 sectoare (\(0{,}29\)) și corelația \(0{,}80\) cu XLI
Relația de evaluare prin beta (3.13) poate fi scrisă într-o a doua formă, echivalentă, cu un factor stocastic de actualizare. Această formă separă două întrebări pe care primele de risc le amestecă: dacă expunerea la un factor este răsplătită și dacă factorul este necesar pentru evaluarea activelor după includerea celorlalți factori.
Întrebarea acestui slide este dacă un factor este necesar pentru evaluarea activelor atunci cînd ceilalți factori sînt deja prezenți; sinteza lui Cochrane (2011) o plasează în centrul evaluării empirice a activelor. Un factor stocastic de actualizare (stochastic discount factor, SDF) este o variabilă aleatoare \(m_t\) care evaluează toate randamentele în exces:
\[\mathbb{E}[m_t R^e_{i,t}] = 0 \quad \text{pentru fiecare activ } i.\]
(3.19)
SDF este mare în perioadele proaste. Un activ care plătește tocmai în acele stări este o asigurare, iar investitorii acceptă pentru el un randament mediu mic.
Un model factorial liniar este un SDF de forma \(m_t = 1 - \mathbf{b}^\top(\mathbf{f}_t - \mathbb{E}\mathbf{f})\), unde \(\mathbf{b}\) este vectorul coeficienților SDF. Înlocuirea în (3.19) dă
deci forma SDF și forma cu beta din Secțiunea 6 sînt același model, iar primele sînt egale cu matricea de covarianță a factorilor înmulțită cu coeficienții SDF.
Relația (3.20) conduce la două teste diferite. Ipoteza \(b_k = 0\) spune că factorul \(k\) nu ajută la evaluare, ținînd cont de ceilalți factori. Ipoteza \(\lambda_k = 0\) spune că expunerea la factorul \(k\) nu aduce nicio primă. Fiindcă \(\boldsymbol\Sigma_f\) nu este diagonală cînd factorii sînt corelați, \(\lambda_k \neq 0\) și \(b_k = 0\) pot coexista: un factor poate avea o primă doar pentru că este corelat cu alți factori care au primă. Compararea modelelor testează de aceea \(\mathbf{b}\), nu \(\boldsymbol\lambda\).
Coeficienții \(\mathbf{b}\) se estimează prin metoda generalizată a momentelor (GMM, generalised method of moments) a lui Hansen (1982), prezentată în Aprofundări: estimația face ca media empirică a lui \(m_t(\mathbf{b})\,\mathbf{R}^e_t\) să fie zero, sau cît mai aproape de zero, pentru fiecare activ. Legătura dintre SDF și raportul Sharpe maxim al factorilor este în Aprofundări.
În loc să fie aleși dinainte, factorii pot fi extrași chiar din randamente. Această secțiune aplică analiza componentelor principale pe unsprezece fonduri tranzacționate la bursă (ETF, exchange-traded funds) sectoriale din SUA, dă formulele și enumeră limitele PCA în evaluarea activelor, care motivează versiunea instrumentată (IPCA) prezentată în Aprofundări.
Întrebarea acestui slide este ce factori apar din randamente dacă nu îi alegem dinainte. Graficul arată o analiză a componentelor principale (PCA, principal component analysis) a randamentelor zilnice ale celor 11 ETF-uri sectoriale din SUA. Panoul din stînga, graficul scree (scree plot), arată ponderea din varianța totală explicată de fiecare componentă (barele) și ponderea cumulată (linia). Panoul din dreapta arată loadings, adică elementele vectorilor proprii, ale primelor trei componente pe fiecare ETF.
Meniul alege fereastra de estimare: întregul eșantion sau o fereastră mobilă de 504, 252 sau 126 de zile de tranzacționare. Cursorul mută sfîrșitul ferestrei, iar butonul ▶ o deplasează prin eșantion. Întrebarea interactivă privește modul în care se schimbă ponderea primei componente într-o fereastră scurtă și recentă; răspunsul apare după alegere.
Întrebare pentru sală Pe întregul eșantion, PC1 (first Principal Component, prima componentă principală) explică 66,0% din varianța randamentelor standardizate ale celor 11 sectoare. Dacă alegem fereastra de 252 de zile încheiată la 18 septembrie 2026, ce pondere explică PC1?
Răspuns
PC1 explică 36,6%, față de 66,0% pe întregul eșantion. Standardizarea egalizează varianțele celor 11 serii de intrare, nu varianțele componentelor principale. Ponderea PC1 se recalculează din corelațiile ferestrei selectate. Pe întregul eșantion, loadings PC1 sînt toate pozitive (0,24–0,34), iar corelația PC1 cu SPY este 0,954; pe fereastra de 252 de zile este 0,723.
Două trăsături ale graficului merită urmărite cînd fereastra se mută. Ponderea primei componente crește în perioadele de criză, cînd cresc corelațiile dintre sectoare. Semnele loadings se pot inversa de la o fereastră la alta fără nicio schimbare de fond, deoarece semnul unui vector propriu este arbitrar; interpretarea o dă configurația loadings, nu semnul lor.
PCA găsește combinațiile liniare ale randamentelor care explică, pe rînd, cea mai mare parte a varianței rămase; formula este în slide-ul următor. Datele sînt randamentele logaritmice zilnice a 11 ETF-uri sectoriale între 20 iunie 2018 și 18 septembrie 2026, \(T = 2\,073\) de zile de tranzacționare comune.
Primele trei componente explică împreună 83,1% din varianță:
Prima componentă (PC1) explică 66,0% din varianță. Toate loadings ale ei sînt pozitive, între 0,24 și 0,34, deci PC1 este o medie aproape egal ponderată a sectoarelor, iar corelația ei cu SPY, ETF-ul care replică indicele S&P 500, este 0,954: PC1 este factorul pieței.
A doua componentă (PC2) explică 9,7% și opune sectoarele defensive celor de creștere: utilitățile (+0,55), bunurile de larg consum (+0,42) și imobiliarele (+0,31) față de tehnologie (−0,40) și consumul discreționar (−0,33).
A treia componentă (PC3) explică 7,4% și este dominată de energie.
Rezultatul descrie eșantionul. Componentele rezumă covarianța sectoarelor pe acest eșantion, dar nimic din metodă nu spune că expunerile la ele sînt răsplătite cu o primă.
Factorii latenți (latent factors) sînt factori neobservați, estimați doar din randamente, fără a spune dinainte ce reprezintă. PCA este cel mai simplu estimator al lor. Aici se aplică matricei de corelație \(\mathbf{C}\) a randamentelor standardizate, astfel încît fiecare activ are varianța unu, iar sectoarele volatile nu domină. Descompunerea spectrală și componentele sînt
unde \(\mathbf{z}_t\) este vectorul randamentelor standardizate din ziua \(t\),\(\mathbf{y}_t\) vectorul componentelor, \(\boldsymbol\Gamma\) matricea care are pe coloane vectorii proprii, numiți loadings, iar \(\mathbf{D}\) matricea diagonală a valorilor proprii \(\ell_k\). Valorile proprii sînt ordonate, \(\ell_1 \ge \dots \ge \ell_N\), și notate cu \(\ell\) ca să nu se confunde cu primele de risc \(\lambda\).
Fiindcă randamentele standardizate au varianțe egale cu unu, varianța totală este urma lui \(\mathbf{C}\), egală cu \(N\), iar componenta \(k\) explică ponderea \(\ell_k/N\) din ea. Cazul cu două active arată structura. Cu corelația \(\rho\), valorile proprii sînt \(\ell = 1 \pm \rho\); vectorul propriu \((1, 1)/\sqrt2\) este „piața”, media celor două active, iar \((1, -1)/\sqrt2\) este diferența dintre ele. Cînd \(\rho\) crește, cum se întîmplă într-o criză, prima valoare proprie \(1 + \rho\) crește și prima componentă domină. Numărul de componente care trebuie păstrate este discutat în Aprofundări.
Pe scurt
Factori latenți: factori neobservați, estimați doar din randamente
fără a spune dinainte ce reprezintă
PCA a matricei de corelație \(\mathbf{C}\) a randamentelor standardizate
Ca instrument de evaluare a activelor, PCA are cinci limite. Loadings sînt constante, deci PCA nu poate urmări o acțiune a cărei mărime sau valoare se schimbă în timp. Componentele explică varianța, nu neapărat randamentele medii: o componentă cu valoare proprie mare poate să nu aibă nicio primă, iar un factor cu primă poate avea o valoare proprie mică. Acțiunile individuale intră și ies din eșantion prin listări și delistări, deci lipsesc multe observații, pe cînd PCA clasic cere un panel complet.
Celelalte două limite privesc interpretarea. Semnul fiecărei componente este arbitrar: schimbarea semnului unui vector propriu nu schimbă nimic în ajustare. Mai general, factorii latenți sînt determinați doar pînă la o rotație, deoarece orice combinație rotită a lor explică datele la fel de bine, deci denumirea lor este o alegere a cercetătorului.
Două extensii ale PCA țin cont și de randamentele medii: PCA cu primă de risc și estimatorul în trei etape; ambele sînt prezentate în Anexă. PCA instrumentată, în care loadings depind de caracteristicile firmelor, este în Aprofundări.
Pe scurt
Încărcările sînt constante
PCA nu poate urmări o acțiune a cărei mărime sau valoare se schimbă
Componentele explică varianța, nu neapărat randamentele medii
Acțiunile individuale intră și ies din eșantion (listări, delistări)
deci lipsesc multe observații
iar PCA clasic cere un panel complet
Semnul fiecărei componente este arbitrar
schimbarea semnului unui vector propriu nu schimbă nimic
Factorii latenți sînt determinați doar pînă la o rotație
orice combinație rotită a lor explică datele la fel de bine
deci interpretarea lor este o alegere
Două extensii ale PCA țin cont și de randamentele medii (Anexă)
Studiul de caz despre factor momentum completează studiul despre replicare din Secțiunea 7. El întreabă dacă randamentele factorilor sînt autocorelate și dacă factorul momentum MOM din Secțiunea 5 este doar un mod de a sincroniza ceilalți factori. Întrebarea contează pentru construcția modelelor. Modelul Carhart (FF3 + MOM) și FF5 + MOM adaugă MOM ca sursă separată de risc. Dacă MOM doar sincronizează alți factori, un model are nevoie de factor timing, adică de mutarea capitalului între factori după semnale, nu de un factor momentum separat.
Factorul mediu cîștigă 0,06% pe lună după un an cu pierderi și 0,51% pe lună după un an pozitiv.
Factor momentum se concentrează în factorii care explică mai mult din secțiunea transversală a randamentelor.
Momentum-ul factorilor din componentele principale cu valori proprii mari înglobează majoritatea formelor de momentum al acțiunilor.
Concluzia: momentum nu este un factor de risc distinct, ci un mod de a sincroniza ceilalți factori.
Pe scurt
Întrebarea: sînt randamentele factorilor autocorelate și este factorul momentum MOM (Secțiunea 5) doar o sincronizare a celorlalți factori?
De ce contează
modelul Carhart (FF3 \(+\) MOM) și FF5 \(+\) MOM adaugă MOM ca sursă separată de risc
dacă MOM doar sincronizează alți factori, modelul are nevoie de alocare dinamică între factori (factor timing: mutarea capitalului după semnale), nu de un factor momentum separat
Întrebarea acestui slide este dacă un factor care a crescut în ultimul an continuă să crească în luna următoare. Panoul din stînga arată, pentru fiecare factor și pentru factorul mediu, randamentul mediu din luna de după un randament anterior negativ (roșu) și de după unul pozitiv (verde), în procente pe lună. Panoul din dreapta arată creșterea lui 1 investit în strategia time-series factor momentum, definită în slide-ul următor, și în momentum-ul acțiunilor (MOM), pe scară logaritmică. Primul cursor fixează lungimea ferestrei semnalului, de la 1 la 36 de luni, iar al doilea începutul eșantionului.
Întrebarea interactivă cere să decideți dacă factor momentum explică tot alfa lui MOM; răspunsul apare după alegere.
Întrebare pentru sală Factorul mediu cîștigă 0,47% pe lună după un an anterior pozitiv și 0,05% după unul negativ. Explică acest factor momentum tot alfa lui MOM?
Răspuns
Nu. Alfa FF5 al lui MOM scade de la 0,74% pe lună (t = 4,18) la 0,32% (t = 2,27) cînd se adaugă TSFM, adică cu 57%. Cu șapte factori, factor momentum explică puțin peste jumătate din alfa lui MOM, iar restul rămîne semnificativ la 5%; lucrarea, cu mult mai mulți factori, explică majoritatea formelor de momentum.
Citiți panoul din stînga factor cu factor: cu un semnal de 12 luni, bara verde este peste cea roșie la fiecare factor. Panoul din dreapta arată că cele două strategii diferă cel mai mult prin drawdown: MOM pierde mult mai mult în 2009 decît strategia factor momentum. Regresiile de spanning care măsoară suprapunerea sînt în slide-ul cu rezultatele.
Pe scurt
Întrebarea: un factor care a crescut în ultimul an continuă să crească în luna următoare? MFM_ch3_factor_momentum
Replicarea din curs folosește șapte factori lunari din biblioteca de date a lui Kenneth French, iulie 1963 – iulie 2026: cei cinci factori din FF5 (Mkt-RF, SMB, HML, RMW, CMA) și doi factori de reversal. ST_Rev (short-term reversal) este long perdanții lunii \(t-1\) și short cîștigătorii ei. LT_Rev (long-term reversal) este long perdanții din lunile \(t-60\) pînă la \(t-13\) și short cîștigătorii lor. MOM rămîne în afara setului, pentru că este seria de explicat.
Semnalul \(s_{i,t}\) este randamentul compus al factorului \(i\) în lunile \(t-12\) pînă la \(t-1\), ca la time-series momentum (Moskowitz, Ooi & Pedersen, 2012). Strategia, time-series factor momentum (TSFM), este long factorii cu anul anterior pozitiv și short ceilalți, cu ponderi egale:
Diferența dintre randamentele medii după ani pozitivi și după ani negativi, pe toate perechile factor–lună, cu erori standard grupate pe luni.
Un set de regresii de spanning ale lui MOM pe FF5 și TSFM, cu erori Newey–West: dacă TSFM explică MOM, alfa lui MOM scade spre zero după adăugarea lui TSFM.
Replicarea diferă de lucrare într-un punct important: lucrarea folosește mult mai mulți factori, inclusiv factori din componente principale, deci șapte factori dau un test de spanning mai slab.
ST_Rev (short-term reversal): long perdanții lunii \(t-1\), short cîștigătorii ei
LT_Rev (long-term reversal): long perdanții din lunile de la \(t-60\) la \(t-13\), short cîștigătorii lor
MOM rămîne în afara setului: este seria de explicat
Semnalul\(s_{i,t}\): randamentul compus al factorului \(i\) în lunile de la \(t-12\) la \(t-1\), ca la time-series momentum (Moskowitz, Ooi & Pedersen (2012))
long factorii cu anul anterior pozitiv, short ceilalți; prima lună iulie 1964 (\(T = 745\))
Testele
diferența mediilor după ani pozitivi și negativi, pe toate perechile factor–lună, cu erori grupate pe luni
regresii de spanning ale lui MOM pe FF5 și TSFM, cu erori Newey–West
Diferența față de lucrare: lucrarea folosește mult mai mulți factori, inclusiv factori din componente principale; șapte factori dau un test de spanning mai slab
Factorul mediu cîștigă 0,05% pe lună după un an anterior negativ și 0,47% pe lună după unul pozitiv; diferența, de 0,42 puncte procentuale, are \(t = 3{,}62\). Lucrarea raportează 0,06% și 0,51%. Media este mai mare după un an pozitiv la fiecare dintre cei șapte factori. TSFM are media 0,28% pe lună (\(t = 5{,}48\)) și un raport Sharpe anual de 0,67, față de 0,49 pentru MOM; drawdown-ul lui maxim este −15%, față de −58% pentru MOM, atins în septembrie 2009.
Regresiile de spanning măsoară suprapunerea. Alfa FF5 al lui MOM este 0,74% pe lună (\(t = 4{,}18\)). Cu TSFM adăugat, el scade la 0,32% (\(t = 2{,}27\)), cu 57% mai puțin, iar panta pe TSFM este 1,76 (\(t = 13{,}8\)). În sens invers, alfa lui TSFM pe FF5 și MOM este 0,08% (\(t = 1{,}81\)).
Rezultatul descrie eșantionul. Randamentele factorilor sînt autocorelate pe orizontul de douăsprezece luni, iar șapte factori explică aproximativ jumătate din alfa lui MOM, nu tot. Replicarea are două limite: folosește un singur eșantion și nu include costuri de tranzacționare, iar cei doi factori de reversal sînt construiți tot din randamente trecute, deci o parte din suprapunerea dintre TSFM și MOM poate fi mecanică.
Pe scurt
Factorul mediu, randamentul mediu din luna următoare
Această secțiune aplică bucla de descoperire asistată de AI unei întrebări deschise a capitolului: de ce scad primele factorilor după publicare. Ea prezintă stadiul cunoașterii, împărțirea muncii între asistentul AI și cercetător, un ministudiu de caz despre momentum și o temă de proiect.
După studiile de caz rămîn deschise două întrebări. De ce scad primele factorilor după publicare: din cauza arbitrajului investitorilor, a data mining-ului cercetătorilor sau a unei schimbări a riscului? Și diferă scăderea între factori și piețe? Dovezile de pînă acum provin mai ales de la McLean & Pontiff (2016): pe 97 de predictori, randamentele sînt cu 26% mai mici out-of-sample și cu 58% mai mici după publicare. Autorii atribuie diferența dintre cele două valori investitorilor care tranzacționează pe baza articolelor publicate. Chen & Zimmermann (2022) oferă date și cod deschise pentru predictorii publicați, ceea ce face asemenea studii reproductibile.
Bucla descoperirii împarte munca. Asistentul AI propune un tabel al literaturii cu identificatori digitali de obiect (DOI, Digital Object Identifier), ipoteze concurente și ce prezice fiecare, codul regresiei și un plan de robustețe; prompturile sînt în Anexă. Cercetătorul fixează, înainte de orice rulare, datele evenimentelor, lista factorilor, corecția pentru testarea multiplă și testul placebo, un factor la care efectul nu ar trebui să apară. Fixarea acestor alegeri dinainte limitează data mining-ul împotriva căruia avertiza secțiunea despre factor zoo.
Înainte de interpretarea rezultatelor se fac trei verificări:
Fiecare DOI se deschide în Crossref;
Statisticile \(t\) pe subperioade din Aprofundări se reproduc;
Versiunea datelor French este notată.
Pe scurt
Întrebări deschise
de ce scad primele factorilor după publicare: arbitraj, căutare oportunistă în date sau o schimbare a riscului?
diferă scăderea între factori și piețe?
Stadiul cunoașterii
McLean & Pontiff (2016): pe 97 de predictori, randamentele sînt cu \(26\%\) mai mici în afara eșantionului și cu \(58\%\) mai mici după publicare
autorii atribuie diferența investitorilor care tranzacționează pe baza articolelor publicate
Asistentul AI propune: un tabel al literaturii cu DOI (Digital Object Identifier, identificator digital de obiect), ipoteze concurente și ce prezice fiecare, codul regresiei, un plan de robustețe (prompturi: Anexă)
Cercetătorul fixează înainte de rulare: datele evenimentelor, lista factorilor, corecția pentru testarea multiplă și testul placebo (un factor la care nu ar trebui să apară efectul)
Înainte de interpretare: fiecare DOI se deschide în Crossref, statisticile \(t\) pe subperioade din Aprofundări se reproduc, iar versiunea datelor French este notată
Ministudiu de caz: arbitrajul și declinul momentum-ului (1/3)
Ministudiul de caz aplică specificația lui McLean & Pontiff (2016) doar factorului momentum. Regresia este
\[\text{MOM}_t = a + b_1\,\text{PostSample}_t + b_2\,\text{PostPub}_t + e_t,\]
(3.23)
estimată pe date lunare din ianuarie 1965 pînă în august 2026 (\(T = 740\)), cu erori Newey–West.
Cele două variabile dummy împart eșantionul în trei perioade. \(\text{PostSample}_t = 1\) din ianuarie 1990 pînă în martie 1993, lunile de după eșantionul studiului inițial și dinaintea publicării lui. \(\text{PostPub}_t = 1\) din aprilie 1993, după publicare. Termenul liber \(a\) este deci media in-sample pe 1965–1989.
Coeficienții au interpretări directe. \(b_2\) este scăderea totală după publicare față de media in-sample. Diferența \(b_2 - b_1\) este efectul incremental al publicării, dincolo de scăderea observată deja după eșantion, dar înainte de publicare; aceasta este mărimea care separă arbitrajul, care are nevoie de publicare, de scăderea statistică, care nu are nevoie de ea.
Pe scurt
Specificația din McLean & Pontiff (2016): \(\text{MOM}_t = a + b_1 \text{PostSample}_t + b_2 \text{PostPub}_t + e_t\)
lunar, ianuarie 1965 – august 2026 (\(T = 740\))
erori Newey–West
Variabile dummy
\(\text{PostSample}_t = 1\) în ianuarie 1990 – martie 1993 (după eșantion)
\(\text{PostPub}_t = 1\) din aprilie 1993 (după publicare)
\(a\): media în eșantion (1965–1989)
\(b_2\): scăderea totală față de media în eșantion
\(b_2 - b_1\): efectul incremental al publicării
Ministudiu de caz: arbitrajul și declinul momentum-ului (2/3)
Panoul din stînga arată media lui MOM în fiecare dintre cele trei perioade, cu intervale de 95% bazate pe erori Newey–West. Panoul din dreapta arată cele două estimații ale scăderii, scăderea totală \(b_2\) și efectul incremental \(b_2 - b_1\), pentru MOM și pentru placebo Mkt-RF, tot cu intervale de 95%. Cursorul mută data presupusă a publicării și păstrează perioada de după eșantion la cele 39 de luni dinaintea ei.
Întrebarea interactivă privește statistica \(t\) a lui \(b_2\) cu o eroare standard mai mică; răspunsul apare după alegere.
Întrebare pentru sală După publicarea din 1993, media momentum scade cu 0,45 puncte procentuale pe lună, cu t = −1,45. Dacă estimația rămîne aceeași, dar eroarea standard se înjumătățește, respingem H₀: b₂ = 0 într-un test bilateral la 5%, folosind pragul asimptotic 1,96?
Răspuns
Da. Statistica t este estimația împărțită la eroarea standard. Înjumătățirea erorii standard dublează valoarea absolută a lui t: 2,90 > 1,96. În calculul actual, t = −1,45, intervalul de 95% este [−1,05%; 0,16%] și nu respingem. Nici semnificația statistică nu ar demonstra singură că publicarea a cauzat scăderea. Scăderea reprezintă 54% din media in-sample de 0,82% pe lună, apropiată de 58% în McLean și Pontiff (2016).
Intervalele sînt principala lectură. Dacă intervalul pentru \(b_2\) include zero, nu respingem la 5% ipoteza că nu există o scădere, oricît de mare ar fi estimația punctuală. Mutarea datei publicării arată cît de sensibilă este estimația la data evenimentului pe care cercetătorul o fixează dinainte.
Media momentum in-sample este \(a = 0{,}82\%\) pe lună (\(t = 4{,}32\)). După publicare media scade cu \(b_2 = -0{,}45\%\) pe lună, adică 54% din media in-sample, cu \(t = -1{,}45\) și un interval de 95% de \([-1{,}05\%; 0{,}16\%]\). Efectul incremental al publicării este \(b_2 - b_1 = -0{,}79\%\)(\(t = -1{,}17\)). Placebo pe Mkt-RF dă \(b_2 = +0{,}40\%\)(\(t = 1{,}12\)), deci factorul pieței nu arată o scădere comparabilă.
Scăderea de 54% este apropiată de cea de 58% raportată de McLean & Pontiff (2016) pe 97 de predictori. Cu un singur factor însă nu respingem \(H_0: b_2 = 0\) la 5%: studiul cumulat cîștigă putere din media pe mulți predictori, pe care un singur factor nu o poate oferi.
Rezultatul descrie eșantionul. Regresia este o comparație a mediilor înainte și după publicare; arbitrajul este o interpretare posibilă, nu o cauză demonstrată.
Pe scurt
Media momentum în eșantion: \(a = 0{,}82\%\) pe lună (\(t = 4{,}32\))
Scăderea după publicare: \(b_2 = -0{,}45\%\) pe lună (\(t = -1{,}45\))
Proiectul extinde ministudiul de caz la mai mulți factori. Întrebările lui sînt dacă factorii Fama–French și momentum scad după publicare și dacă scăderea diferă între factori.
Specificația este o singură regresie cumulată a lui SMB, HML, RMW, CMA și MOM, cu variabile dummy proprii fiecărui factor pentru perioadele de după eșantion și de după publicare, și cu Mkt-RF drept placebo. Erorile trebuie să fie robuste la corelația dintre factori și la autocorelație. Dacă scăderea este mai mare acolo unde arbitrajul este mai ușor se poate testa doar cu date la nivel de acțiune despre mărime, lichiditate și costurile vînzării în lipsă, pe care randamentele factorilor nu le conțin. Primul pas este replicarea statisticilor \(t\) pe subperioade și a estimărilor din ministudiul de caz; specificația completă este în Aprofundări.
Pe scurt
Întrebări
scad primele factorilor Fama–French și momentum după publicare?
diferă scăderea între factori?
Metoda
o regresie comună pentru SMB, HML, RMW, CMA și MOM, cu variabile dummy proprii fiecărui factor pentru perioadele după eșantion și după publicare
Mkt-RF ca placebo
Erori robuste la corelația dintre factori și la autocorelație
dacă scăderea este mai mare acolo unde arbitrajul este mai ușor se poate testa doar cu date la nivel de acțiune (mărime, lichiditate, costul vînzării în lipsă)
Factorii și cele 25 de portofolii mărime × book-to-market (B/M) sînt randamente lunare, în procente, din Kenneth French Data Library; ultima lună disponibilă este iulie 2026, iar pentru momentum august 2026. ETF-urile și acțiunile folosesc prețuri de închidere zilnice ajustate, cu dividendele reinvestite, pînă la 18 septembrie 2026. Randamentul în exces este \(R^e_{i,t} = R_{i,t} - R_{f,t}\), unde \(R_{f,t}\) este randamentul titlurilor de stat americane pe o lună (RF în datele French), iar Mkt-RF este randamentul în exces al pieței americane de acțiuni, ponderat cu capitalizarea. BET, indicele de referință al BVB, este un indice de preț, fără dividende. Cele 25 de portofolii au randamente medii foarte diferite, ceea ce face testul de evaluare exigent; ETF-urile sînt investibile, iar acțiunile BVB aplică metodele pe piața locală.
Costul capitalului după CAPM este \(R_f + \hat\beta_i(\widehat{\mathbb{E}[R_m] - R_f})\), deci preia eroarea de estimare atît a lui beta, cît și a primei pieței. Cu o volatilitate anuală a pieței de 15,4% și 63 de ani de date, eroarea standard (SE) a primei este \(15{,}4\%/\sqrt{63} = 1{,}9\%\) pe an; înmulțită cu beta ETF-ului de tehnologie XLK, \(\hat\beta = 1{,}28\), ea dă o incertitudine de 2,5% pe an în costul capitalului. Incertitudinea lui beta adaugă doar \(0{,}082 \times 7{,}2\% = 0{,}6\%\) pe an, adică SE a lui beta înmulțită cu prima. Incertitudinea primei pieței cîntărește, așadar, mult mai mult decît cea a lui beta.
Pe scurt
Costul capitalului prin CAPM: \(R_f + \hat\beta_i\,(\widehat{\mathbb{E}[R_m] - R_f})\)
Eroarea standard (SE) a primei pieței: \(15{,}4\%/\sqrt{63} = 1{,}9\%\) pe an
\(15{,}4\%\): volatilitatea anuală a pieței
63 de ani de date
Înmulțită cu beta XLK, această incertitudine dă \(2{,}5\%\) pe an în costul capitalului
Estimatorul Newey–West ponderează autocovarianțele lui \(R^e_{m,t}\varepsilon_{i,t}\) cu ponderi Bartlett pînă la lagul \(L\), ales după regula lui Newey & West (1994),
care dă \(L = 5\) pentru cele 331 de luni ale eșantionului sectorial și \(L = 6\) pentru cele 757 de luni ale celor 25 de portofolii. Estimațiile punctuale rămîn cele OLS; se schimbă doar erorile lor standard. Erorile HAC tratează dependența, dar presupun un moment de ordinul patru finit al randamentelor, ipoteză pusă sub semnul întrebării de estimările cozilor din Capitolul 1. Erorile HAC nu sînt obligatoriu mai mari decît cele clasice în orice eșantion.
Pe scurt
Estimatorul Newey–West (Newey & West (1987)) adună autocovarianțele momentelor \(R^e_{m,t}\varepsilon_{i,t}\) pînă la lagul \(L\)
cu ponderi Bartlett \(1 - \ell/(L+1)\), care fac matricea estimată pozitiv semidefinită
Regula pentru numărul de laguri: \(L = \lfloor 4 (T/100)^{2/9} \rfloor\) (Newey & West (1994))
pentru \(T = 331\) se obține \(L = 5\), pentru \(T = 757\) se obține \(L = 6\)
Estimațiile punctuale rămîn cele OLS
Erorile HAC nu sînt obligatoriu mai mari decît cele clasice în orice eșantion
Erorile HAC tratează dependența, dar presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Exemplu rezolvat: beta ETF-ului de tehnologie (1/2)
XLK se regresează pe Mkt-RF cu date lunare din ianuarie 1999 pînă în iulie 2026 (\(T = 331\),\(R^2 = 0{,}742\)); estimațiile sînt un alfa anual de 0,33% și un beta de 1,277. Tabelul compară trei erori standard:
Cea clasică, care presupune erori homoscedastice și necorelate în timp;
Eroarea White, robustă la heteroscedasticitate (White, 1980);
Eroarea Newey–West, robustă și la autocorelare, cu \(L = 5\) laguri (Newey & West, 1987).
SE robustă a lui beta, 0,082, este dublul celei clasice, 0,041: heteroscedasticitatea explică o parte din creștere, iar autocorelarea produsului \(R^e_{m,t}\varepsilon_t\) restul. Ambele erori robuste cer un moment de ordinul patru finit, pe care estimările cozilor din Capitolul 1 îl pun sub semnul întrebării.
Pe scurt
Eroare standard
Estimație
Clasică
White
Newey–West
\(\alpha\) (anual)
\(0{,}33\%\)
\(2{,}27\%\)
\(2{,}32\%\)
\(2{,}45\%\)
\(\beta\)
\(1{,}277\)
\(0{,}041\)
\(0{,}054\)
\(0{,}082\)
XLK pe Mkt-RF, lunar ianuarie 1999 – iulie 2026, \(T = 331\), \(R^2 = 0{,}742\)
Coloanele erorilor standard
Clasică: erori presupuse homoscedastice și neautocorelate
White: robustă la heteroscedasticitate (White (1980))
Newey–West: robustă și la autocorelație, \(L = 5\) laguri
Eroarea standard robustă a lui \(\beta\) este dublul celei clasice
Heteroscedasticitatea explică o parte din creștere (coloana White)
autocorelația produsului \(R^e_{m,t}\varepsilon_t\) explică restul
Erorile White și Newey–West presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Statistica \(t\) a lui alfa este \(0{,}33/2{,}45 = 0{,}13\), deci regresia nu arată un randament anormal. Un bootstrap pe blocuri suprapuse (moving-block bootstrap) de 12 luni din perechile \((R^e_{\text{XLK},t}, R^e_{m,t})\), care păstrează dependența în timp, cu 2 000 de reeșantionări, dă pentru alfa un interval de 95% de \([-5{,}5\%; 4{,}9\%]\) și o SE bootstrap de 2,61%, puțin peste valoarea Newey–West de 2,45%.
Pe scurt
Statistica \(t\) a lui alfa: \(t(\alpha) = 0{,}33/2{,}45 = 0{,}13\)
Intervalul bootstrap de 95% pentru alfa: \([-5{,}5\%; 4{,}9\%]\)
SE bootstrap \(2{,}61\%\), puțin peste \(2{,}45\%\)
bootstrap pe blocuri suprapuse de 12 luni din perechile \((R^e_{\text{XLK},t}, R^e_{m,t})\), care păstrează dependența în timp
Graficul pune valorile beta lunare ale celor 9 ETF-uri sectoriale față de SPY estimate pe 1999–2012 (axa orizontală) în fața celor estimate pe 2013–2026 (axa verticală). Dreapta estimată, \(\hat\beta_{\text{ulterior}} = 0{,}23 + 0{,}72\,\hat\beta_{\text{anterior}}\), este foarte aproape de regula lui Blume (1971),\(0{,}33 + 0{,}67\,\hat\beta\): valorile beta depărtate de unu în prima perioadă se apropie de unu în a doua. Măsurată prin rădăcina erorii pătratice medii (root mean squared error, RMSE) a prognozei, eroarea este 0,135 pentru beta neajustat, 0,109 pentru beta Blume și 0,114 pentru beta Vasicek (Vasicek, 1973), deci shrinkage-ul reduce eroarea de prognoză cu 15–20%. Cu doar 9 sectoare, concluzia este calitativă.
Pe scurt
Valori beta lunare ale celor 9 ETF-uri sectoriale față de SPY
Graficul arată, pentru fiecare acțiune de la BVB, beta estimat prin cele mai mici pătrate (ordinary least squares, OLS) pe BET, cu intervalul de încredere (CI) de 95% bazat pe erori Newey–West, alături de beta ajustat Vasicek. Următoarele două cadre dau eșantionul și citirea estimațiilor.
Pe scurt
Legenda: OLS beta, 95% CI: beta OLS cu intervalul de încredere (CI, confidence interval) de 95%, erori Newey–West; Vasicek-adjusted beta: beta ajustat Vasicek MFM_ch3_bvb_betas
Valorile beta folosesc randamente logaritmice zilnice pe BET, de la 6 ianuarie 2015 sau de la data listării (DIGI în mai 2017, H2O în iulie 2023); prețurile FP sînt ajustate pentru dividendul special. Băncile sînt cele mai sensibile la piață: Banca Transilvania (TLV) are beta 1,24 cu \(R^2 = 0{,}62\), iar BRD (BRD–Groupe Société Générale, BVB ticker, BRD–Groupe Société Générale, simbolul bursier BVB) 1,13. Cele mai puțin sensibile sînt Digi, 0,67 cu \(R^2 = 0{,}21\), Hidroelectrica, 0,74, și Transelectrica, 0,76. \(R^2\) mare al TLV vine în parte din ponderea ei mare în BET: acțiunea face parte din propriul reper.
Pe scurt
Randamente logaritmice zilnice pe BET, de la 6 ianuarie 2015 sau de la listare
DIGI: mai 2017, H2O (simbolul bursier al Hidroelectrica): iulie 2023
prețurile FP sînt ajustate pentru dividendul special
Băncile sînt cele mai sensibile la piață
Banca Transilvania (TLV): \(1{,}24\), cu \(R^2 = 0{,}62\)
Shrinkage-ul Vasicek schimbă puțin estimațiile, pentru că valorile beta zilnice sînt precise, cu SE între 0,04 și 0,07. Prețurile neactualizate (stale prices) deplasează beta zilnic spre zero; beta Dimson (Dimson, 1979), care adaugă pantele pe randamentele întîrziate ale pieței, urcă de la 0,80 la 0,94 la Nuclearelectrica și de la 0,81 la 0,905 la Transgaz. Deoarece BET este un indice de preț, iar prețurile acțiunilor includ dividendele, alfa este deplasat în sus cu aproximativ beta înmulțit cu randamentul dividendelor indicelui, în timp ce beta se schimbă puțin cu BET-TR (BET Total Return, index, indicele BET cu dividendele reinvestite).
Pe scurt
Contracția Vasicek schimbă puțin estimațiile
valorile beta zilnice sînt precise (SE între \(0{,}04\) și \(0{,}07\))
Prețurile neactualizate (stale prices) deplasează beta zilnic spre zero
beta Dimson urcă de la \(0{,}80\) la \(0{,}94\) la Nuclearelectrica
și de la \(0{,}81\) la \(0{,}905\) la Transgaz (Seminarul 3, problema B4)
BET este un indice de preț, iar prețurile acțiunilor includ dividendele
alfa este deplasat în sus cu aproximativ beta înmulțit cu randamentul dividendelor indicelui
beta se schimbă puțin cu BET-TR (BET Total Return, indicele BET cu dividendele reinvestite)
Black (1972) a arătat că, fără împrumut nelimitat la \(R_f\), randamentul așteptat rămîne liniar în beta, dar dreapta pornește de la randamentul unui portofoliu cu beta zero, mai mare decît \(R_f\); SML este deci mai plată decît dreapta CAPM. Frazzini & Pedersen (2014) propun un mecanism: investitorii care vor mai mult risc, dar nu se pot împrumuta, cumpără active cu beta mare, care devin scumpe și au randamente viitoare mai mici. Strategia lor, betting against beta (BAB), este
unde \(R_{L,t}\) și \(R_{H,t}\) sînt randamentele portofoliilor cu beta mic și cu beta mare, iar \(\beta_L\),\(\beta_H\) valorile lor beta. În (3.25) strategia este long \(1/\beta_L > 1\) unități în \(L\), finanțate la \(R_f\), și short \(1/\beta_H < 1\) unități în \(H\), cu încasările plasate la \(R_f\); ea are beta zero și un randament mediu pozitiv în datele lor. Simpla diferență beta mic minus beta mare, fără această scalare, are beta negativ, așa că media ei amestecă prima BAB cu o expunere negativă la piață.
Cu toate momentele estimate prin verosimilitate maximă, Gibbons, Ross & Shanken (1989) arată că \(\hat{\boldsymbol\alpha}^\top\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\alpha} = \widehat{SR}^2(f,\mathbf{R}) - \widehat{SR}^2(f)\): forma pătratică în valorile alfa este creșterea pătratului raportului Sharpe al portofoliului de tangență cînd cele \(N\) active de test se adaugă factorului. Statistica se poate scrie deci
Pentru cele 25 de portofolii, raportul Sharpe lunar al Mkt-RF singur este 0,134 (0,47 pe an), iar cel al portofoliului de tangență al pieței și al celor 25 de portofolii este 0,405 (1,40 pe an), deci (3.26) dă \(W = 29{,}24 \times (0{,}405^2 - 0{,}134^2)/(1 + 0{,}134^2) = 4{,}20\), cu \(29{,}24 = (757-25-1)/25\). Sub CAPM, zgomotul singur ar crește pătratul raportului Sharpe lunar în medie cu \(N(1+\widehat{SR}^2(f))/(T-N-3) = 0{,}035\); creșterea observată este 0,146 (derivarea în Anexă).
Un model economic implică adesea condiții de moment \(\mathbb{E}[\mathbf{g}_t(\boldsymbol\theta)] = \mathbf{0}\). GMM, metoda lui Hansen (1982), alege \(\hat{\boldsymbol\theta}\) astfel încît media de selecție \(\bar{\mathbf{g}}(\hat{\boldsymbol\theta}) = \frac1T\sum_t \mathbf{g}_t(\hat{\boldsymbol\theta})\) să fie zero cînd există tot atîtea momente cîți parametri; cu mai multe momente, \(\bar{\mathbf{g}}\) este făcut cît mai mic cu o matrice de ponderare. În cazul exact identificat, varianța are forma sandwich
unde \(\mathbf{D}\) este jacobianul momentelor în raport cu parametrii, iar \(\mathbf{S}\) varianța de termen lung a momentelor, cu autocovarianțele incluse, estimată prin Newey–West.
Pe scurt
Un model economic implică \(\mathbb{E}[\mathbf{g}_t(\boldsymbol\theta)] = \mathbf{0}\) pentru un vector de condiții de momente \(\mathbf{g}_t\)
GMM (Hansen (1982)) alege \(\hat{\boldsymbol\theta}\) astfel încît media empirică a momentelor să fie zero
Pentru o medie, \(g_t = R_t - \mu\) dă \(D = -1\) și \(\operatorname{Var}(\hat\mu) \approx S/T\), adică statistica \(t\) HAC a randamentului mediu al unui factor. Pentru OLS, \(\mathbf{g}_t = \mathbf{x}_t(y_t - \mathbf{x}_t^\top\boldsymbol\theta)\) dă \(\mathbf{D} = -\mathbb{E}[\mathbf{x}_t\mathbf{x}_t^\top]\), iar (3.27) conduce la erorile White cînd \(\mathbf{S}\) nu are laguri și la erorile Newey–West în caz contrar. Și problema GRS este un sistem GMM: cele \(2N\) momente \(\boldsymbol\varepsilon_t \otimes (1, f_t)\) identifică exact parametrii \((\alpha_i, \beta_i)\), deci estimațiile sînt cele OLS și GMM schimbă doar varianța lor; cu parametrii ordonați activ cu activ, \(\mathbf{D} = -\mathbf{I}_N \otimes (\mathbf{Z}^\top\mathbf{Z}/T)\). Statistica Wald \(\hat{\boldsymbol\alpha}^\top\hat{\mathbf{V}}_\alpha^{-1}\hat{\boldsymbol\alpha}\), cu blocul valorilor alfa din matricea sandwich calculat cu un \(\hat{\mathbf{S}}\) HAC, tinde la \(\chi^2_N\) sub \(H_0\). Același aparat dă erorile primelor robuste la specificarea greșită și estimează modelul cu factor de actualizare din Aprofundări.
Pe scurt
OLS: \(\mathbf{g}_t = \mathbf{x}_t(y_t - \mathbf{x}_t^\top\boldsymbol\theta)\) dă \(\mathbf{D} = -\mathbb{E}[\mathbf{x}_t\mathbf{x}_t^\top]\)
Cu cozi grele și volatility clustering, documentate în Capitolul 1, distribuția \(F\) a statisticii GRS nu mai este exactă. Un bootstrap al reziduurilor sub \(H_0\) reeșantionează rînduri întregi de reziduuri și reconstruiește randamentele cu \(\alpha = 0\), dar este robust la abaterea de la distribuția Normală doar dacă erorile sînt i.i.d. și independente de factori; testul Wald GMM cu un \(\hat{\mathbf{V}}_\alpha\) HAC este robust la heteroscedasticitate și autocorelare. Cînd sînt multe active față de numărul de luni, \(\hat{\boldsymbol\Sigma}\) are rangul cel mult \(T-2\): pentru \(N \ge T-1\) ea nu poate fi inversată și GRS nu poate fi calculat, iar puterea testului scade mult înainte de această limită. Există teste care nu inversează \(\hat{\boldsymbol\Sigma}\)(Pesaran & Yamagata, 2024).
Pe scurt
Cozi groase și gruparea volatilității (volatility clustering) (Capitolul 1): distribuția \(F\) nu mai este exactă
Bootstrap pe reziduuri sub \(H_0\): se reeșantionează rînduri întregi de reziduuri și se reconstruiesc randamentele cu \(\alpha = 0\) (Seminarul 3, problema B7)
Bootstrap-ul este robust la lipsa normalității doar dacă erorile sînt i.i.d. și independente de factori
Testul Wald GMM (Aprofundări), cu \(\hat{\mathbf{V}}_\alpha\) HAC: robust la heteroscedasticitate și autocorelație
Prea multe active față de numărul de luni: \(\hat{\boldsymbol\Sigma}\) are rangul cel mult \(T - 2\)
cînd \(N \ge T - 1\), \(\hat{\boldsymbol\Sigma}\) nu se poate inversa și GRS nu se poate calcula
puterea testului scade mult înainte de această limită
Motivația FF5 este modelul de actualizare a dividendelor scris în funcție de valoarea contabilă. Cu \(M\) capitalizarea, \(B\) valoarea contabilă, \(Y\) profitul și \(dB\) investițiile, raportul dintre valoarea de piață și cea contabilă este
unde \(r\) este randamentul așteptat. La \(M/B\) dat, un profit așteptat mai mare, adică o profitabilitate mai mare, cere un \(r\) mai mare pentru ca egalitatea să se păstreze; investiții așteptate mai mari cer un \(r\) mai mic. Factorul de profitabilitate (RMW) și cel de investiții (CMA) sînt corespondentele empirice ale acestor două implicații. Relația motivează factorii, dar nu arată că ei sînt riscuri cu primă.
Graficul compară statisticile \(t\) Newey–West ale randamentelor lunare medii ale factorilor în două subperioade, 1963–1999 și 2000–2026. Ghidul de citire este în cadrul următor.
Barele sînt statisticile \(t\) Newey–West pentru cele două perioade, despărțite la o dată arbitrară, nu la publicare; liniile marchează \(t = 1{,}96\), un singur test la 5%, și \(t = 3\), pragul pentru testarea multiplă al lui Harvey, Liu & Zhu (2016). Deoarece a doua perioadă are 319 luni față de 438, \(t\) scade cu factorul \(\sqrt{319/438} \approx 0{,}85\) chiar cu o medie neschimbată, așa că trebuie comparate și mediile. Momentum scade de la \(t = 5{,}53\) la 0,75, cu media anuală de la 10,7% la 2,5%; valoarea (HML) de la 2,39 la 1,02, cu media de la 4,2% la 2,8%. Profitabilitatea (RMW) este excepția, urcînd de la 1,90 la 2,31, iar prima pieței rămîne semnificativă în ambele perioade (\(t = 2{,}70\) și 2,39).
Pe scurt
Barele: statistica \(t\) Newey–West a randamentului lunar mediu
Erorile Fama–MacBeth, Newey–West și Shanken au o ipoteză comună: modelul este corect, deci erorile de evaluare sînt zero, \(\mathbf{e} = \boldsymbol\mu - \mathbf{X}\boldsymbol\gamma = \mathbf{0}\), unde \(\boldsymbol\mu\) este vectorul randamentelor medii în exces, iar \(\boldsymbol\gamma = (\lambda_0, \boldsymbol\lambda^\top)^\top\). Dacă modelul este greșit, \(\mathbf{e} \neq \mathbf{0}\), iar zgomotul din valorile beta estimate adaugă varianță primelor prin erorile de evaluare. Erorile standard robuste la această specificare greșită sînt cele ale lui Kan, Robotti & Shanken (2013); formula este în Anexă.
Robustețea la specificare greșită nu este același lucru cu robustețea la dependența temporală. Un estimator robust la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent) are nevoie și de autocovarianțele condițiilor de moment, pe care le furnizează ponderile Newey–West. În aplicații cele două corecții se combină, iar un exemplu numeric cu toate erorile standard este în Aprofundări.
Pe scurt
Erorile Fama–MacBeth, Newey–West și Shanken presupun că modelul este corect
adică erorile de evaluare sînt zero: \(\mathbf{e} = \boldsymbol\mu - \mathbf{X}\boldsymbol\gamma = \mathbf{0}\)
\(\boldsymbol\mu\): randamentele medii în exces, \(\boldsymbol\gamma = (\lambda_0, \boldsymbol\lambda^\top)^\top\)
Dacă modelul este greșit (\(\mathbf{e} \neq \mathbf{0}\)), zgomotul din valorile beta estimate adaugă varianță primelor
Pentru prima HML din modelul cu trei factori (FF3), pe cele 25 de portofolii mărime × B/M, 1963–2026, estimația este \(\hat\lambda = 3{,}97\%\) pe an, iar tabelul compară erorile ei standard. Corecția Shanken (Shanken, 1992) lasă neschimbată eroarea Fama–MacBeth de 1,33%, pentru că \(c = 0{,}03\) pe lună; eroarea Kan–Robotti–Shanken (Kan, Robotti & Shanken, 2013) fără laguri este 1,32%. Cel mai mult contează autocorelarea pantelor lunare: Newey–West cu 6 laguri ridică SE la 1,62%, iar \(t\) scade de la 2,99 la 2,45. Pentru RMW din modelul cu cinci factori (FF5), Kan–Robotti–Shanken ridică eroarea de la 2,1% la 2,6%, iar cu 6 laguri la 3,0%, deci \(t\) scade de la 2,5 la 2,1 și apoi la 1,8, sub 1,96; pragul \(t > 3\) nu este depășit clar cu nicio eroare standard.
Pe scurt
FF3, HML
\(\hat\lambda\)
SE
\(t\)
Semnificativ la 5%?
Fama–MacBeth
\(3{,}97\%\)
\(1{,}33\%\)
\(2{,}99\)
da
Newey–West (6 laguri)
\(3{,}97\%\)
\(1{,}62\%\)
\(2{,}45\)
da
Shanken
\(3{,}97\%\)
\(1{,}33\%\)
\(2{,}99\)
da
Kan–Robotti–Shanken (fără laguri)
\(3{,}97\%\)
\(1{,}32\%\)
\(3{,}00\)
da
Kan–Robotti–Shanken (6 laguri)
\(3{,}97\%\)
\(1{,}61\%\)
\(2{,}47\)
da
25 de portofolii mărime \(\times\) B/M, 1963–2026
Corecția Shanken nu schimbă eroarea, pentru că \(c = 0{,}03\) pe lună
Cel mai mult contează autocorelația pantelor lunare \(\hat\lambda_t\)
Newey–West cu 6 laguri mărește SE de la \(1{,}33\%\) la \(1{,}62\%\)
Pentru RMW din FF5, Kan–Robotti–Shanken crește eroarea de la \(2{,}1\%\) la \(2{,}6\%\), iar cu 6 laguri la \(3{,}0\%\)
\(t\) scade de la \(2{,}5\) la \(2{,}1\), apoi la \(1{,}8\), sub \(1{,}96\)
Pragul \(t > 3\) (Secțiunea 7) nu este depășit clar cu nicio eroare standard
Un factor inutil (useless factor) este independent de toate randamentele: valorile lui beta adevărate sînt zero, iar cele estimate sînt zgomot de ordinul \(1/\sqrt{T}\). Deoarece etapa a doua regresează randamentele medii pe acest zgomot, \(\hat\lambda_g\) nu tinde la zero, iar cînd modelul este greșit specificat testul \(t\) declară prea des factorul evaluat (Kan & Zhang, 1999). În experiment, CAPM, respins de GRS pe cele 25 de portofolii, se estimează cu un factor adăugat extras independent din distribuția Normală, de 2 000 de ori, testînd la 5% dacă prima lui este zero. Un test corect ar respinge în aproximativ 5% din repetări; cu erori Fama–MacBeth, prima falsă pare semnificativă în 60% din ele, iar cu erori Shanken în 27%.
Pe scurt
Un factor inutil\(g_t\) este independent de toate randamentele
toți parametrii \(\beta_i\) sînt zero
estimările \(\hat\beta_i\) sînt doar zgomot, de ordinul \(1/\sqrt{T}\)
Etapa 2 regresează randamentele pe acest zgomot
\(\hat\lambda_g\) nu tinde spre zero
testul \(t\) declară prea des că factorul are o primă cînd modelul este greșit (Kan & Zhang (1999))
Experimentul: pe cele 25 de portofolii, unde GRS respinge CAPM (Secțiunea 4)
estimăm CAPM plus un factor inventat, extras independent din distribuția Normală
Repetăm experimentul de 2 000 de ori și testăm la nivelul 5% dacă prima factorului inventat este zero
Un test corect ar respinge în aproximativ 5% din repetări
Cu erori Fama–MacBeth, prima falsă pare semnificativă în \(60\%\) din repetări
Cu erori Shanken, prima falsă pare semnificativă în \(27\%\) din repetări
Remediul este testarea, întîi, în etapa întîi, a ipotezei \(H_0: \boldsymbol\beta_g = \mathbf{0}\) pe toate cele \(N\) active, cu statistica Wald \(W = \hat{\boldsymbol\beta}_g^\top\widehat{\operatorname{Var}}(\hat{\boldsymbol\beta}_g)^{-1}\hat{\boldsymbol\beta}_g \sim \chi^2_N\); dacă nu respingem, prima factorului nu poate fi estimată. În experiment, testul Wald respinge doar în 6,7% din repetări, aproape de 5%. Identificarea slabă (weak identification) apare și cînd valorile beta sînt aproape de zero sau aproape egale între active, ca piața în acest exemplu; există teste robuste la ea (Kleibergen, 2009), iar cu multe active consistența etapei a doua depinde de tăria factorilor (Anatolyev & Mikusheva, 2022).
Pe scurt
Remediul: testați întîi, în etapa 1, \(H_0: \boldsymbol\beta_g = \mathbf{0}\) pe toate cele \(N\) active
Lewellen, Nagel & Shanken (2010) observă că cele 25 de portofolii au o structură factorială puternică: trei factori explică în medie 91% din variația lor în timp, între 79% și 95%, așa că mai multe modele care surprind variația comună de mărime și valoare pot obține un \(R^2\) transversal ridicat. Panoul din stînga pune randamentul mediu efectiv (vertical) în fața celui prezis de FF3 (orizontal), în % pe an; un model exact ar pune toate punctele pe diagonală, iar industriile (triunghiurile roșii) se împrăștie pe verticală.
Panoul din dreapta arată valorile \(R^2\) transversale cu intervale bootstrap de 95%. Cu cele 30 de industrii adăugate, \(R^2\) OLS al FF3 scade de la 0,66 la 0,22, iar cel al FF5 de la 0,76 la 0,24. Intervalele marginale, \([0{,}31; 0{,}84]\) pe 25 de portofolii și \([0{,}04; 0{,}52]\) pe 55 de active, nu stabilesc dacă diferența pentru FF3 este semnificativă; pentru asta e nevoie de aceleași luni reeșantionate pentru ambele seturi de active și de un interval direct pentru \(\Delta R^2\).\(R^2\) obținut prin cele mai mici pătrate generalizate (generalised least squares, GLS), care ponderează erorile cu inversa covarianței randamentelor, nu depășește niciodată 0,26.
Pe scurt
Dreapta: \(R^2\) transversal cu intervale bootstrap de 95%
cu 30 de industrii adăugate, \(R^2\) OLS al FF3 scade de la \(0{,}66\) la \(0{,}22\)
\(R^2\) OLS al FF5 scade de la \(0{,}76\) la \(0{,}24\)
Intervalele \(R^2\) FF3: \([0{,}31; 0{,}84]\) pe 25 de portofolii, \([0{,}04; 0{,}52]\) pe 55 de active
intervalele marginale nu stabilesc semnificația diferenței: un test cere aceleași luni extrase pentru ambele mulțimi de active și un interval direct pentru \(\Delta R^2\)
\(R^2\) GLS ponderează erorile cu inversa covarianței randamentelor
GLS: Generalised Least Squares, metoda celor mai mici pătrate generalizate
Barillas & Shanken (2018) arată că modelul mai bun este cel ai cărui factori permit cel mai mare raport Sharpe, \(SR^2(\mathbf{f}) = \boldsymbol\mu_f^\top\boldsymbol\Sigma_f^{-1}\boldsymbol\mu_f\), unde \(\boldsymbol\mu_f\) și \(\boldsymbol\Sigma_f\) sînt mediile și covarianța factorilor. Motivul vine din GRS: valorile alfa ale unui model sînt mici exact cînd factorii lui se apropie de raportul Sharpe maxim, așa că, comparînd direct \(SR^2(\mathbf{f})\), activele de test nu mai contează, spre deosebire de distanța Hansen–Jagannathan, calculată pe ele. Tabelul dă rapoartele Sharpe maxime anuale: pe 1963–2026 (\(T = 757\)) ele urcă de la 0,47 pentru CAPM la 1,16 pentru FF5 plus momentum, iar pe 2000–2026 (\(T = 319\)) de la 0,48 la 1,02.
Pe scurt
Raport Sharpe maxim (anual)
CAPM
FF3
Carhart
FF5
FF5 \(+\) MOM
1963–2026 (\(T = 757\))
\(0{,}47\)
\(0{,}66\)
\(0{,}97\)
\(0{,}97\)
\(1{,}16\)
2000–2026 (\(T = 319\))
\(0{,}48\)
\(0{,}54\)
\(0{,}67\)
\(0{,}97\)
\(1{,}02\)
Barillas & Shanken (2018): modelul mai bun este cel ai cărui factori permit cel mai mare raport Sharpe
Cînd un model îl include pe celălalt, \(SR^2\) in-sample nu poate decît să crească, așa că testul potrivit este o regresie de spanning a factorului adăugat pe ceilalți: un alfa nenul arată că el aduce ceva nou. HML pe ceilalți cinci factori are \(\alpha = 0{,}9\%\) pe an (\(t = 0{,}75\)), iar din 2000 \(-1{,}7\%\)(\(t = -0{,}81\)), deci HML nu aduce nicio contribuție incrementală semnificativă, ca în Fama & French (2015). FF5 și Carhart nu se includ unul pe altul; diferența dintre \(SR^2\) anuale este 0,00, cu intervalul de 95% \([-0{,}57; 0{,}66]\), iar din 2000 este 0,50, cu intervalul \([-0{,}24; 1{,}48]\), deci nici aici nu este semnificativă. Intervalele provin din bootstrap-ul staționar al lui Politis & Romano (1994).
Pe scurt
Cînd un model îl include pe celălalt, \(SR^2\) în eșantion nu poate decît să crească
Atunci se face o regresie de spanning: factorul adăugat se regresează pe ceilalți
un alfa nenul arată că el aduce ceva nou
HML pe ceilalți cinci factori: \(\alpha = 0{,}9\%\) pe an (\(t = 0{,}75\))
din 2000: \(\alpha = -1{,}7\%\) (\(t = -0{,}81\)), deci nicio contribuție incrementală semnificativă a HML, ca în Fama & French (2015)
FF5 față de Carhart (niciunul nu îl include pe celălalt): diferența dintre \(SR^2\) anuale este \(0{,}00\)
intervalul de 95%: \([-0{,}57; 0{,}66]\)
Din 2000: diferența este \(0{,}50\), cu intervalul de 95% \([-0{,}24; 1{,}48]\)
Zece factori candidați au p-value-urile ordonate 0,0004, 0,002, 0,006, 0,011, 0,018, 0,027, 0,041, 0,070, 0,15 și 0,62, testate la nivelul de 5%. Regula naivă respinge orice ipoteză nulă cu \(p \le 0{,}05\) și găsește 7 factori semnificativi. Bonferroni împarte 5% la cele 10 teste, deci pragul este 0,005, și păstrează doar 2 factori.
Metoda Holm (Holm, 1979) compară al \(j\)-lea p-value cu \(0{,}05/(11-j)\) și se oprește la primul care nu trece: primele trei trec, iar al patrulea, 0,011, depășește pragul 0,0071, deci Holm se oprește la 3 factori. Metoda Benjamini–Hochberg (BH) (Benjamini & Hochberg, 1995) compară al \(j\)-lea p-value cu \(0{,}005\,j\); cel mai mare \(j\) care trece este 6 (\(0{,}027 \le 0{,}030\)), deci BH declară semnificativi primii 6 factori.
Pe scurt
Holm compară a \(j\)-a valoare p cu \(0{,}05/(11-j)\)
se oprește la primul care nu trece
Primele trei valori p trec
\(0{,}0004 \le 0{,}005\)
\(0{,}002 \le 0{,}0056\)
\(0{,}006 \le 0{,}00625\)
Al patrulea, \(0{,}011\), depășește pragul \(0{,}0071\)
deci Holm se oprește la 3 factori
BH compară a \(j\)-a valoare p cu \(0{,}005\,j\)
cel mai mare \(j\) care trece este 6 (\(0{,}027 \le 0{,}030\))
Simularea creează 300 de factori fără nicio primă reală, fiecare cu o statistică \(t\) extrasă independent din distribuția Normală standard, și repetă experimentul de 2 000 de ori, numărînd de fiecare dată cîți factori trec un prag dat. Graficul arată distribuția acestor numere și a celui mai mare \(|t|\).
Pe scurt
Experimentul: 300 de factori fără nicio primă reală
statistica \(t\) a fiecăruia este o extragere independentă din distribuția Normală standard
Repetăm experimentul de 2 000 de ori și numărăm, de fiecare dată, cîți factori trec pragul
Legenda: false discoveries: descoperiri false; The best useless factor often looks strong: cel mai bun factor inutil pare adesea puternic; Bonferroni threshold: pragul Bonferroni lll MFM_ch3_false_discoveries
La pragul clasic \(|t| > 1{,}96\) trec, în medie, 15,0 factori inutili, adică 5% din 300; la \(|t| > 3\) trec, în medie, 0,83. Totuși, în 57% din repetări cel puțin un factor inutil trece pragul \(|t| > 3\), iar în jumătate din ele cel mai bun factor inutil are \(|t|\) peste 3,06. Pragul Bonferroni pentru 300 de teste este \(|t| > 3{,}76\). Pragul corect depinde de cîte teste s-au încercat efectiv, inclusiv cele nepublicate.
Pe scurt
La pragul clasic \(|t| > 1{,}96\) trec, în medie, \(15{,}0\) factori inutili, adică 5% din 300
La pragul \(|t| > 3\) trec, în medie, \(0{,}83\) factori inutili
În \(57\%\) din repetări, cel puțin un factor inutil trece pragul \(|t| > 3\)
În jumătate din repetări, cel mai bun factor inutil are \(|t|\) peste \(3{,}06\)
Pragul Bonferroni pentru 300 de teste este \(|t| > 3{,}76\)
Pragul corect depinde de cîte teste s-au încercat efectiv, inclusiv cele nepublicate
În modelul factorial aproximativ \(x_{it} = \boldsymbol\Lambda_i^\top\mathbf{F}_t + e_{it}\), cu randamente standardizate \(x_{it}\) și cu \(N\) și \(T\) ambele mari, numărul de factori trebuie estimat. Fie \(V(k)\) media pătratelor reziduurilor după primele \(k\) componente principale. Bai & Ng (2002) aleg \(k\) care minimizează criteriul de informație \(IC_{p2}(k) = \ln V(k) + k\,\frac{N+T}{NT}\ln\min(N,T)\), potrivire plus o penalizare pe factor; Ahn & Horenstein (2013) aleg \(k\) care maximizează raportul valorilor proprii \(\ell_k/\ell_{k+1}\), adică acolo unde valorile proprii scad cel mai brusc. Regula lui Kaiser (1960),\(\ell_k > 1\), nu are o justificare teoretică, pentru că și zgomotul pur produce valori proprii împrăștiate în jurul lui 1.
Pe scurt
Model factorial aproximativ \(x_{it} = \boldsymbol\Lambda_i^\top \mathbf{F}_t + e_{it}\)
numărul de active \(N\) și cel de perioade \(T\) sînt ambele mari
\(x_{it}\): randamentul standardizat, \(\mathbf{F}_t\): factorii, \(\boldsymbol\Lambda_i\): încărcările, \(e_{it}\): partea idiosincratică
\(V(k)\): media pătratelor reziduurilor după primele \(k\) componente
Bai & Ng (2002): alege \(k\) care minimizează \(\ln V(k) + k\,\frac{N+T}{NT}\ln\min(N,T)\)
criteriul de informație \(IC_{p2}\): potrivire plus o penalizare pe factor
Tabelul aplică cele trei reguli pe două paneluri de randamente standardizate: 11 ETF-uri sectoriale, zilnic 2018–2026 (\(T = 2\,073\), cel mult \(k = 5\)), și 95 dintre cele 100 de portofolii mărime × B/M, lunar 1963–2026 (\(T = 757\), cel mult \(k = 8\); 5 portofolii cu luni lipsă sînt eliminate). Pe portofolii, Ahn–Horenstein alege doar factorul pieței, cu raportul 14,6, iar al doilea vîrf este la \(k = 3\) (raport 3,5), ca în FF3; Kaiser alege 3, iar Bai–Ng 4. Pe cele 11 sectoare, Bai–Ng alege numărul maxim permis, \(k = 5\); penalizarea lui este gîndită pentru multe active, deci cu doar 11 răspunsul nu este de încredere.
Analiza în componente principale instrumentată (instrumented principal component analysis, IPCA) a lui Kelly, Pruitt & Su (2019) face din loadings funcții de \(L\) caracteristici observate \(\mathbf{z}_{i,t}\), precum mărimea, B/M și momentum:
Matricea \(\boldsymbol\Gamma_\beta\), de dimensiune \(L \times K\), și factorii minimizează suma pătratelor erorilor din (3.29) prin pași alternativi: cu \(\boldsymbol\Gamma_\beta\) fixată, factorii rezultă din regresii transversale, iar cu factorii ficși, \(\boldsymbol\Gamma_\beta\) rezultă dintr-o regresie de panel.
IPCA testează de ce caracteristicile prezic randamentele: pentru că măsoară expunerea la risc, prin beta, sau direct, ca alfa, \(\alpha_{i,t} = \mathbf{z}_{i,t}^\top\boldsymbol\Gamma_\alpha\). Pe acțiunile americane, cîțiva factori IPCA explică randamentele medii mai bine decît modele cu tot atîția factori observați, iar \(\boldsymbol\Gamma_\alpha\) nu este semnificativă, de unde concluzia lucrării că „caracteristicile sînt covarianțe”. IPCA înlătură și două limite ale PCA întîlnite mai devreme în capitol: loadings constante și nevoia unui panel complet.
Pe scurt
Întrebarea testată: prezic caracteristicile randamentele pentru că măsoară expunerea la risc (prin beta)?
sau direct, ca alfa (\(\alpha_{i,t} = \mathbf{z}_{i,t}^\top\boldsymbol\Gamma_\alpha\))?
Rezultatul, pe acțiuni americane: cîțiva factori IPCA explică randamentele medii mai bine
decît modelele cu tot atîția factori observați
\(\boldsymbol\Gamma_\alpha\) nu este semnificativ
de unde titlul articolului: „caracteristicile sînt covarianțe”
Întrebarea este dacă ETF-urile au un randament peste cel explicat de expunerile lor la factori. Randamentul zilnic în exces al fiecărui ETF se regresează pe cei șase factori (FF5 plus momentum), \(R^e_t = \alpha + \boldsymbol\beta^\top\mathbf{f}_t + \varepsilon_t\), pe propriile zile de tranzacționare din 2000–2026, cu erori Newey–West; graficul arată alfa anualizat cu intervalul de 95% (0,02 înseamnă 2%) și loadings. Loadings corespund denumirilor: MTUM are 0,36 pe MOM, VLUE 0,34 pe HML, IWM 0,85 pe SMB și IWF −0,28 pe HML, iar USMV (volatilitate minimă) are beta de piață 0,74.
Valorile alfa sînt aproape de zero: MTUM −0,2% pe an (\(t = -0{,}11\)) și QUAL −0,3% (\(t = -0{,}34\)). IWM și IWD au alfa negativ, semnificativ individual la 5%, −1,3% (\(t = -2{,}57\)) și −1,6% (\(t = -2{,}54\)), iar IWF are alfa pozitiv, nesemnificativ. Comisioanele, sub 0,2% pe an, explică doar o mică parte; reconstituirea periodică a indicilor Russell și diferențele de construcție față de portofoliile Fama–French sînt explicații posibile, pe care regresia nu le cuantifică separat. Cu \(R^2\) între 0,81 și 0,97, ETF-urile factoriale vînd, în mare parte, expuneri la factori cunoscuți.
Pe scurt
Întrebarea: au ETF-urile un randament peste cel explicat de expunerile lor?
\(R^e_t = \alpha + \boldsymbol\beta^\top\mathbf{f}_t + \varepsilon_t\), cu cei șase factori (FF5 \(+\) MOM)
Regresii zilnice, erori Newey–West
fiecare ETF pe propriile zile de tranzacționare din 2000–2026
graficul: alfa anualizat cu interval de 95% și încărcările; pe axă, \(0.02\) înseamnă 2%
Încărcările corespund denumirilor
MTUM pe MOM \(0{,}36\), VLUE pe HML \(0{,}34\)
IWM pe SMB \(0{,}85\), IWF pe HML \(-0{,}28\)
USMV (volatilitate minimă) are beta de piață \(0{,}74\)
Valori alfa aproape de zero
MTUM: \(-0{,}2\%\) (\(t = -0{,}11\))
QUAL: \(-0{,}3\%\) (\(t = -0{,}34\))
IWM și IWD au alfa negativ, semnificativ individual la 5%; IWF are alfa pozitiv, nesemnificativ
Factor timing mută capitalul între factori pe baza unor semnale, de exemplu cît de ieftin este un factor sau cum a evoluat recent; cum primele sînt incerte și istoriile scurte, este greu de arătat că timing-ul funcționează out-of-sample (Capitolul 13). Crowding-ul, situația în care mulți investitori dețin aceleași poziții factoriale, poate micșora primele (McLean & Pontiff, 2016) și poate amplifica pierderile în lichidările forțate. După o scădere a pieței, portofoliul momentum are beta negativ, așa că pierde mult cînd piața revine brusc, ca în 2009 (Daniel & Moskowitz, 2016). Randamentele academice ale factorilor nu scad nici costurile de tranzacționare, nici costul împrumutării acțiunilor vîndute short.
Pe scurt
Alocarea dinamică între factori: mutarea capitalului între factori după semnale
de exemplu, cît de ieftin este un factor sau cum a evoluat recent
Primele sînt incerte și seriile scurte, deci este greu de demonstrat că alocarea dinamică funcționează în afara eșantionului (Capitolul 13)
Aglomerarea pozițiilor (crowding): mulți investitori dețin aceleași poziții factoriale
Primele se pot micșora (McLean & Pontiff (2016)), iar aglomerarea poate amplifica pierderile la lichidări forțate
Crahul momentum-ului (momentum crash): după o scădere a pieței, portofoliul momentum are beta negativ, deci pierde mult cînd piața revine brusc, ca în 2009 (Daniel & Moskowitz (2016))
Implementarea: randamentele factorilor academici nu scad două costuri
Lucrarea studiului de caz, Jensen, Kelly & Pedersen (2023), construiește 153 de factori în 93 de țări: acțiunile sînt împărțite în treimi după fiecare caracteristică, cu ponderi după capitalizare plafonate, factorul cumpără treimea cu randamentul mai mare în studiul original și vinde cealaltă treime extremă, iar fiecare factor este scalat la o volatilitate idiosincratică de 10% pe an, ca valorile alfa să fie comparabile. Gruparea ierarhică (hierarchical clustering) a reziduurilor CAPM împarte factorii americani în 13 teme. Modelul este \(f_{i,t} = \alpha_i + \beta_i r^m_t + \varepsilon_{i,t}\), cu \(\alpha_i = c_j + s_n + w_i\), suma unei componente a temei, a unei componente a semnalului și a uneia specifice factorului, toate cu media a priori 0; după cum arată diagrama, alfa fiecărui factor împrumută informație de la ceilalți factori ai temei sale.
unde \(\sigma\) este volatilitatea reziduală, \(\tau\) dispersia valorilor alfa adevărate, iar \(T\) numărul de luni. În (3.30) eșantioanele scurte și zgomotoase sînt atrase mai mult, ca la beta Vasicek: \(\sigma^2/T\) joacă rolul lui \(\operatorname{se}(\hat\beta_i)^2\), iar \(\tau^2\) pe al lui \(\sigma^2_\beta\). Rata de replicare este ponderea factorilor semnificativi în studiile originale al căror alfa este semnificativ și în datele noi; în versiunea bayesiană, un factor este „semnificativ” dacă media a posteriori împărțită la abaterea standard a posteriori este cel puțin 1,96. Ierarhia completă este în Anexă.
Pe scurt
Cazul unui singur factor: alfa estimat este micșorat spre zero
eșantioanele scurte și zgomotoase sînt contractate mai puternic, ca la Vasicek (Secțiunea 3): \(\sigma^2/T\) joacă rolul lui \(\operatorname{se}(\hat\beta_i)^2\), iar \(\tau^2\) pe cel al lui \(\sigma^2_\beta\)
Rata de replicare
dintre factorii semnificativi în studiile inițiale, ce proporție are alfa semnificativ și în datele noi
în varianta bayesiană, un factor este „semnificativ” dacă media a posteriori împărțită la abaterea standard a posteriori este cel puțin \(1{,}96\)
Graficul aplică metoda studiului de caz pe 15 factori americani. Panourile lui sînt explicate în cadrul următor.
Pe scurt
Legenda: OLS alpha, 95% confidence interval: alfa OLS cu intervalul de încredere; Empirical Bayes posterior mean, 95% credible interval: media a posteriori Bayes empiric cu intervalul de credibilitate; OLS t versus posterior z: \(t\) OLS față de \(z\) a posteriori; Theme: tema MFM_ch3_jkp_replication
Panoul din stînga arată alfa CAPM al fiecărui factor, în % pe lună, scalat la o volatilitate idiosincratică de 10% pe an: albastru este alfa OLS cu intervalul de încredere de 95%, roșu media a posteriori empirical Bayes cu intervalul credibil de 95%. Panoul din dreapta arată \(t\) OLS (albastru) și \(z\) a posteriori, media a posteriori împărțită la abaterea standard a posteriori (roșu); liniile punctate sînt 1,96, un singur test la 5%, și 2,65, pragul Benjamini–Yekutieli la 5% (Benjamini & Yekutieli, 2001). Factorii sînt 15 factori americani long–short din sortări ponderate cu valoarea din Kenneth French Data Library, iulie 1963 – iulie 2026 (\(T = 757\)), grupați după temele lucrării.
Pe scurt
Panoul stîng: alfa CAPM al fiecărui factor, în % pe lună
scalat la o volatilitate idiosincratică de \(10\%\) pe an
albastru: alfa OLS cu intervalul de încredere de \(95\%\)
roșu: media a posteriori Bayes empiric cu intervalul de credibilitate de \(95\%\)
Panoul drept: \(t\) OLS (albastru) și \(z\) a posteriori (roșu)
\(z\) = media a posteriori împărțită la abaterea standard a posteriori
Rata de replicare este 73,3% cu OLS (11 din 15 factori), 53,3% cu Benjamini–Yekutieli (8 factori, \(|t|\) critic 2,65) și 86,7% cu empirical Bayes (13 factori). Shrinkage-ul atrage alfa spre media temei, nu doar spre zero: inversarea pe termen lung (long-term reversal), din tema investiții, urcă de la 0,13% la 0,23% pe lună, iar statistica \(t\) OLS de 1,25 devine un \(z\) a posteriori de 2,85. Beta pieței și inversarea pe termen scurt nu se replică (\(z \le 1{,}41\)), iar mărimea trece la limită (\(z = 1{,}96\)); și în lucrare, mărimea este una dintre cele două teme cu o rată sub 50%. Rata de aici folosește toate cele 15 semnale, fără a verifica dacă fiecare a fost semnificativ în studiul original.
Versiunea din curs folosește 15 semnale americane în loc de 153 în 93 de țări și portofoliile French în locul treimilor construite fără microcapitalizări (micro-caps). Cu o singură țară, fiecare semnal apare o dată, deci componenta semnalului nu poate fi estimată și dispersia ei este fixată la zero, iar rezultatul depinde de gruparea în teme: cu toți factorii într-o singură temă, rata empirical Bayes ar fi 100%. Limitele precizate de autori sînt că CAPM este singurul model de referință, că toate caracteristicile sînt construite prin aceeași metodă și că distribuția a priori ignoră factorii nepublicați.
Rămîn deschise două întrebări:
Dacă valorile alfa și rata de replicare s-au menținut în 2021–2026, datele lucrării oprindu-se în 2020;
Dacă factorii americani, folosiți ca distribuție a priori, pot îmbunătăți estimațiile factorilor de la BVB, ale căror istorii sînt scurte.
Pe scurt
Limitele versiunii de curs
15 semnale americane în loc de 153 în 93 de țări
portofoliile din Kenneth French Data Library, nu treimile construite fără firmele foarte mici (microcapitalizări)
o singură țară, deci fiecare semnal apare o singură dată și componenta semnalului nu se poate estima (dispersia ei se fixează la zero)
rezultatul depinde de gruparea pe teme: dacă toți factorii ar fi într-o singură temă, rata Bayes empiric ar fi \(100\%\)
Proiectul despre scăderea după publicare pornește de la un tabel de evenimente care dă, pentru fiecare factor, lucrarea originală cu DOI, sfîrșitul eșantionului ei și data publicării, toate citite din lucrare, cu momentum (Jegadeesh & Titman, 1993) ca rînd model. O notă de preînregistrare (pre-registration), cu \(H_0\),\(H_1\), datele, lista factorilor și corecțiile, se salvează în Git înainte de a vedea rezultatele. Codul este un Quantlet, iar raportul dă erori Newey–West, perioade placebo și puterea testului: probabilitatea de a respinge \(b_2 = 0\) la 5% dacă scăderea adevărată ar fi, de exemplu, cea de 58% din McLean & Pontiff (2016), aproximativ \(\Phi(|\delta|/s - 1{,}96) + \Phi(-|\delta|/s - 1{,}96)\), cu \(s = \operatorname{se}(\hat b_2)\). Prompturile intră în AI_USE.md, iar erorile depistate în AI_ERRORS.md.
Pe scurt
Livrabile
mai întîi, un tabel al evenimentelor: factorul, lucrarea inițială cu DOI, sfîrșitul eșantionului ei, data publicării, toate citite din lucrare (rîndul-model: MOM, Jegadeesh & Titman (1993))
o notă de preînregistrare (\(H_0\), \(H_1\), datele din tabel, lista factorilor, corecțiile), salvată în Git (commit) înainte de a vedea rezultatele
codul ca Quantlet: un director cu scriptul, sursa datelor și o scurtă descriere, ca în Quantlet-urile capitolului
un raport cu erori Newey–West, perioade placebo și puterea testului
puterea: probabilitatea de a respinge \(b_2 = 0\) la 5% dacă scăderea reală ar fi, de exemplu, cei \(58\%\) din McLean & Pontiff (2016)
puterea se obține prin simulare sau aproximativ \(\Phi(|\delta|/s - 1{,}96) + \Phi(-|\delta|/s - 1{,}96)\), cu \(s = \operatorname{se}(\hat b_2)\)
\(\delta\): scăderea presupusă, în unitățile lui \(b_2\) (o scădere de \(58\%\): \(\delta = -0{,}58 \times\) media de dinainte de publicare); \(\Phi\): funcția de repartiție a distribuției Normale standard
Jurnale: prompturile în AI_USE.md, erorile depistate în AI_ERRORS.md
Anexa conține derivările și detaliile la care trimit corpul capitolului și aprofundările: statistica GRS sub ipoteza nulă, testele pentru multe active, erorile standard robuste la specificarea greșită, distanța Hansen–Jagannathan și selecția bayesiană a modelelor, LASSO (Least Absolute Shrinkage and Selection Operator, regresie penalizată L1 cu selecția variabilelor) cu dublă selecție, estimatorii numărului de factori, PCA cu primă de risc, IPCA pentru criptoactive, construcția și ierarhia bayesiană din studiul de caz cu rezultatele complete, prompturile buclei descoperirii, verificările cercetătorului și răspunsurile la verificările rapide.
Adăugarea a \(N\) active crește întotdeauna raportul Sharpe in-sample, așa că testul întreabă dacă creșterea depășește ce ar produce zgomotul. Sub \(H_0\), cu reziduuri i.i.d. din distribuția Normală, \(W\) din (3.26) urmează \(F(N, T-N-1)\), cu media \((T-N-1)/(T-N-3)\); înmulțind cu \(N(1+\widehat{SR}^2(f))/(T-N-1)\) se obține cîștigul așteptat \(\mathbb{E}[\widehat{SR}^2(f,\mathbf{R}) - \widehat{SR}^2(f)] \approx N(1+\widehat{SR}^2(f))/(T-N-3)\). Pentru cele 25 de portofolii, cu \(T = 757\), acesta este \(25 \times 1{,}018/729 = 0{,}035\) pe lună, față de 0,146 observat; pentru cele 9 ETF-uri sectoriale, cu \(T = 331\), cîștigul observat, 0,015, este sub cel așteptat, \(9 \times 1{,}021/319 = 0{,}029\).
Pe scurt
Adăugarea a \(N\) active crește întotdeauna raportul Sharpe în eșantion
testul verifică dacă această creștere depășește ce ar produce zgomotul
Forma Sharpe: \(W = \frac{T-N-1}{N}\,\frac{\widehat{SR}^2(f,\mathbf{R}) - \widehat{SR}^2(f)}{1+\widehat{SR}^2(f)}\)
Sub \(H_0\), cu reziduuri Normale i.i.d., \(W \sim F(N, T-N-1)\)
deci \(\mathbb{E}[W] = \frac{T-N-1}{T-N-3}\)
Înmulțind cu \(\frac{N(1+\widehat{SR}^2(f))}{T-N-1}\)
Covarianța reziduurilor \(\hat{\boldsymbol\Sigma} = \hat{\mathbf{E}}^\top\hat{\mathbf{E}}/T\), unde \(\hat{\mathbf{E}}\) este matricea \(T \times N\) a reziduurilor, are rangul cel mult \(T - 2\), pentru că fiecare regresie estimează doi parametri. Cu 100 de portofolii mărime × B/M pe 8 ani de date lunare (\(T = 96\)),\(\hat{\boldsymbol\Sigma}\) este singulară și GRS nu există. Testele care evită \(\hat{\boldsymbol\Sigma}^{-1}\) folosesc sume standardizate ale pătratelor statisticilor \(t\)(Pesaran & Yamagata, 2024), iar puterea poate fi mărită prin selectarea valorilor alfa mari (power enhancement) (Fan, Liao & Yao, 2015).
Pe scurt
\(\hat{\boldsymbol\Sigma} = \hat{\mathbf{E}}^\top\hat{\mathbf{E}}/T\) are rangul cel mult \(T - 2\)
doi parametri în fiecare regresie
\(\hat{\mathbf{E}}\): matricea \(T \times N\) a reziduurilor
Exemplu: 100 de portofolii mărime \(\times\) B/M pe 8 ani de date lunare (\(T = 96\)): \(\hat{\boldsymbol\Sigma}\) este singulară, GRS nu există (Seminarul 3, problema B7)
Erorile Fama–MacBeth și Shanken presupun un model corect, cu toate erorile de evaluare \(\mathbf{e} = \boldsymbol\mu - \mathbf{X}\boldsymbol\gamma\) egale cu zero; cînd relația transversală este doar aproximativă, estimăm valoarea pseudo-adevărată care minimizează erorile de evaluare, iar zgomotul din \(\hat{\mathbf{B}}\) înmulțit cu \(\mathbf{e}\) adaugă un termen de varianță (Kan, Robotti & Shanken, 2013). Scriind ambele etape ca un singur sistem GMM exact identificat și folosind jacobianul complet, se obține varianța sandwich robustă; cu \(\mathbf{e} = \mathbf{0}\) în jacobian se obține versiunea pentru model corect, robustă la heteroscedasticitate, a lui Jagannathan & Wang (1998). Pentru FF5 pe cele 25 de portofolii, fără laguri, SE a CMA crește de la 2,2% la 2,7%, iar cea a interceptului de la 3,3% la 3,8%, în timp ce pentru HML schimbarea este sub 0,05 puncte procentuale; cu 6 laguri, RMW ajunge la 3,0%, iar CMA la 3,1%.
Pe scurt
Erorile Fama–MacBeth și Shanken presupun un model corect
toate erorile de evaluare \(\mathbf{e} = \boldsymbol\mu - \mathbf{X}\boldsymbol\gamma\) sînt zero, cu \(\mathbf{X} = [\mathbf{1}, \mathbf{B}]\)
Aici GRS respinge restricțiile modelului cu factori tranzacționați (\(\boldsymbol\alpha = \mathbf{0}\))
relația transversală cu prime libere poate fi doar aproximativă: se estimează valoarea pseudo-adevărată, care minimizează erorile de evaluare
Zgomotul din \(\hat{\mathbf{B}}\) se înmulțește cu \(\mathbf{e}\) și adaugă un termen de varianță (Kan, Robotti & Shanken (2013))
Scriem ambele etape ca un singur sistem GMM exact identificat (Aprofundări)
varianța sandwich cu jacobianul complet este cea robustă
Cu \(\mathbf{e} = \mathbf{0}\) în jacobian se obține versiunea pentru un model corect specificat, robustă la heteroscedasticitate, a lui Jagannathan & Wang (1998)
matricea \(\mathbf{S}\) a momentelor fără autocovarianțe: robustă la specificare greșită, nu și la autocorelație; cu laguri Newey–West, și HAC
FF5 pe cele 25 de portofolii (Secțiunea 6): erorile standard robuste, fără laguri (cu 6 laguri: RMW \(3{,}0\%\), CMA \(3{,}1\%\))
CMA: \(2{,}2\% \to 2{,}7\%\)
termenul liber: \(3{,}3\% \to 3{,}8\%\); HML: schimbare sub \(0{,}05\) puncte procentuale
măsoară cît de departe este factorul stohastic de actualizare (stochastic discount factor, SDF) al modelului de cel mai apropiat SDF care evaluează corect toate activele; cu randamente în exces, normalizarea este \(\mathbb{E}[m] = 1\). Aceeași matrice de ponderare se folosește pentru toate modelele, deci distanțele sînt comparabile, iar statistica testului are o limită \(\chi^2\) ponderată. Pentru selecția dintre foarte multe modele, Bryzgalova, Huang & Julliard (2023) fac media pe aproximativ \(2 \times 10^{15}\) modele factoriale, robust la factori slabi, iar Kozak, Nagel & Santosh (2020) aplică shrinkage coeficienților SDF și găsesc că sînt suficiente cîteva componente principale ale randamentelor anomaliilor.
cît de departe este SDF-ul modelului de cel mai apropiat SDF care evaluează corect toate activele
Randamente în exces \(\mathbf{R}^e_t\) cu normalizarea \(\mathbb{E}[m] = 1\)
Pentru randamente brute \(\mathbf{R}_t\): \(\mathbf{e} = \mathbb{E}[m\mathbf{R}] - \mathbf{1}\), iar SDF-ul are nevoie de o scală liberă (\(\mathbb{E}[m] = 1/(1 + R_f)\))
Aceeași matrice de ponderare pentru orice model, deci distanțele sînt comparabile
Statistica de test are o limită \(\chi^2\) ponderată
Feng, Giglio & Xiu (2020) întreabă dacă un factor nou aduce informație dată fiind grădina zoologică de factori (factor zoo) existentă. LASSO (Least Absolute Shrinkage and Selection Operator) este o regresie a cărei penalizare face exact zero coeficienții variabilelor neimportante. În dubla selecție, un prim LASSO alege factorii existenți care explică randamentele medii ale activelor de test, un al doilea pe cei corelați cu factorul nou, iar apoi coeficientul SDF al factorului nou este testat controlînd pentru toți factorii selectați. Majoritatea factorilor noi se dovedesc redundanți, o concluzie compatibilă cu studiul de caz: factor zoo este foarte redundant, iar cîteva teme poartă informația.
Pe scurt
Feng, Giglio & Xiu (2020): aduce un factor nou informație suplimentară față de factorii deja cunoscuți?
LASSO cu dublă selecție (Least Absolute Shrinkage and Selection Operator)
LASSO: regresie cu o penalizare care pune exact la zero coeficienții variabilelor neimportante, deci selectează variabilele
Pasul 1: dintre sute de factori existenți, LASSO îi alege pe cei care explică randamentele medii ale activelor de test
Pasul 2: un al doilea LASSO îi alege pe cei corelați cu factorul nou, ca omiterea lor să nu distorsioneze rezultatul
Pasul 3: se testează coeficientul factorului nou în SDF, controlînd pentru toți factorii aleși în pașii 1 și 2
Rezultat: majoritatea factorilor noi sînt redundanți
Doar cîțiva factori noi explică randamente pe care cei vechi nu le explică
Onatski (2010) consideră un factor real dacă valoarea lui proprie stă clar în afara intervalului în care cad valorile proprii ale zgomotului. Pentru zgomot i.i.d. standardizat, suportul Marchenko–Pastur este aproximativ \([(1-\sqrt{N/T})^2, (1+\sqrt{N/T})^2] = [0{,}86; 1{,}15]\) pentru \(N = 11\),\(T = 2\,073\), iar a doua valoare proprie a sectoarelor, 1,06, cade înăuntru; reperul este doar ilustrativ, pentru că prima valoare proprie este 7,26. Penalizarea Bai–Ng pentru acest panel este 0,219 pe factor, iar \(IC_{p2}(k)\) pentru \(k = 0, \dots, 5\) este 0, −0,86, −0,97, −1,12, −1,14 și −1,17, scăzînd pînă la \(k_{\max} = 5\): penalizarea este prea mică pentru a opri adăugarea factorilor slabi. Trebuie raportate intervalul estimațiilor și sensibilitatea la \(k_{\max}\), nu un singur număr.
Pe scurt
Onatski (2010): un factor este real dacă valoarea lui proprie iese clar dintr-un interval
intervalul în care cad valorile proprii ale zgomotului
Pentru zgomot i.i.d. standardizat, suportul spectral asimptotic (Marchenko–Pastur) este aproximativ \([(1-\sqrt{N/T})^2,\,(1+\sqrt{N/T})^2]\): un reper ilustrativ, nu testul Onatski
\(= [0{,}86;\ 1{,}15]\) pentru \(N = 11\), \(T = 2\,073\)
a doua valoare proprie, \(1{,}06\), este în interval
reperul presupune că toate seriile sînt zgomot; aici prima valoare proprie este \(7{,}26\), deci reperul nu clasifică direct a doua componentă
regula Kaiser (\(\ell_k > 1\)) reține două componente, dar nu stabilește dacă a doua este semnificativă
Bai & Ng (2002): cu \(N = 11\), \(T = 2\,073\), penalizarea din \(IC_{p2}\) este \(0{,}219\) pe factor
Pe sectoare, criteriul \(IC_{p2}(k)\) pentru \(k = 0, \dots, 5\)
PCA cu primă de risc (risk-premium PCA, RP-PCA (Risk-Premium Principal Component Analysis, analiza componentelor principale cu primă de risc)) a lui Lettau & Pelger (2020) ia componentele principale ale matricei \(\frac1T\mathbf{X}^\top\mathbf{X} + \gamma\,\bar{\mathbf{x}}\bar{\mathbf{x}}^\top\), unde \(\mathbf{X}\) conține randamentele în exces, iar \(\bar{\mathbf{x}}\) mediile lor; \(\gamma = -1\) dă PCA pe covarianță, iar \(\gamma > -1\) favorizează și factorii care explică randamentele medii, ceea ce în datele lor dă rapoarte Sharpe mai mari și erori de evaluare mai mici. Estimatorul în trei etape al lui Giglio & Xiu (2021) obține prima unui factor observat cînd modelul omite factori: PCA pe activele de test, o regresie transversală a mediilor pe valorile beta latente și o regresie a factorului observat pe factorii latenți. Ambele păstrează baza statistică a PCA, dar urmăresc randamentele medii, iar IPCA adaugă caracteristicile activelor.
Pe scurt
RP-PCA (Risk-Premium Principal Component Analysis, analiza componentelor principale cu primă de risc; Lettau & Pelger (2020))
componentele principale ale matricei \(\frac1T \mathbf{X}^\top\mathbf{X} + \gamma\,\bar{\mathbf{x}}\bar{\mathbf{x}}^\top\)
\(\mathbf{X}\): matricea \(T \times N\) a randamentelor în exces, \(\bar{\mathbf{x}}\): mediile lor, \(\gamma\): ponderea randamentelor medii
\(\gamma = -1\) dă PCA pe covarianță
\(\gamma > -1\) favorizează și factorii care explică randamentele medii
În datele autorilor, metoda găsește factori cu rapoarte Sharpe mai mari și erori de evaluare mai mici decît PCA
IPCA leagă componentele principale de sortările după caracteristici, cu valori beta variabile în timp și puțini factori. Pentru criptoactive, factorii piață, mărime și momentum evaluează secțiunea transversală a criptomonedelor (Liu, Tsyvinski & Wu, 2022), iar reducerea dimensiunii pe caracteristicile randamentelor criptoactivelor și ale activelor tradiționale este studiată de Pele et al. (2023) și Jheng et al. (2026).
Pe scurt
IPCA leagă PCA (statistica) de sortările după caracteristici (Fama–French)
Cei 153 de factori ai studiului de caz sînt 138 din lista lui Hou, Xue & Zhang (2020) plus 15 din literatura mai largă, cu randamente americane din 1926 și pentru majoritatea piețelor dezvoltate din 1986, toate în dolari americani, în exces față de titlurile de stat americane pe termen scurt. În fiecare țară și lună, acțiunile sînt sortate în treimi cu praguri calculate fără micro-caps, ponderate cu capitalizarea winsorizată la percentila 80 a NYSE și deținute o lună, cu cel puțin 5 acțiuni pe fiecare parte și 60 de observații lunare. Cele 13 teme provin din gruparea ierarhică a reziduurilor CAPM cu metoda Ward; cum Ward cere distanțe euclidiene, distanța de corelație este \(\sqrt{2(1-\rho_{ij})}\) pentru serii standardizate.
randamente americane din 1926, majoritatea piețelor dezvoltate din 1986
toate în dolari americani, în exces față de rata titlurilor de stat americane pe termen scurt
Construcția, în fiecare țară și lună
treimi după caracteristică, cu praguri calculate fără firmele foarte mici (microcapitalizări)
ponderi după capitalizarea plafonată la percentila 80 a NYSE
perioada de deținere: o lună
cel puțin 5 acțiuni pe fiecare parte și 60 de observații lunare
Teme: 13 grupe de factori americani (Secțiunea II.B)
grupare ierarhică, cu distanța \(1 - \) corelația reziduurilor CAPM și metoda Ward (unește grupele care cresc cel mai puțin varianța din interiorul grupelor)
Ward cere distanțe euclidiene: pentru serii standardizate, \(d_{ij} = \sqrt{2(1-\rho_{ij})}\); autorii: R ward.D cu \(1-\rho\); în SciPy, ward cu \(\sqrt{2(1-\rho)}\) (echivalentul R: ward.D2)
În ierarhia lucrării, \(\alpha_i = c_j + s_n + w_i\) pentru tema \(j\), semnalul \(n\) și factorul \(i\), cu varianța a priori \(\boldsymbol\Omega = \mathbf{M}\mathbf{M}^\top\tau_c^2 + \mathbf{Z}\mathbf{Z}^\top\tau_s^2 + \mathbf{I}\tau_w^2\), unde \(\mathbf{M}\) și \(\mathbf{Z}\) sînt matrice 0/1 care leagă fiecare factor de tema și semnalul său. Media a posteriori este \((\boldsymbol\Omega^{-1} + T\boldsymbol\Sigma^{-1})^{-1}T\boldsymbol\Sigma^{-1}\hat{\boldsymbol\alpha}\), cu \(\boldsymbol\Sigma\) covarianța reziduală, iar în versiunea empirical Bayes \(\tau_c\),\(\tau_s\),\(\tau_w\) se estimează prin verosimilitate maximă din \(\hat{\boldsymbol\alpha} \sim N(\mathbf{0}, \boldsymbol\Omega + \hat{\boldsymbol\Sigma}/T)\).(3.30) este cazul particular cu un singur factor.
Cu OLS se replică 98 din cei 119 factori americani, iar corecția Benjamini–Yekutieli cere \(|t| > 2{,}7\). Rata bayesiană a descoperirilor false (false discovery rate, FDR) este 0,1%, cu intervalul de 95% \([0; 1\%]\), iar ponderea așteptată a factorilor adevărați este 94%. Rata de replicare este 77,3% pentru acțiunile mega și 79,8% pentru cele mari, deci rezultatul nu vine doar din firmele cele mai mici, iar 11 din cele 13 teme au o rată de cel puțin 50%, excepțiile fiind îndatorarea redusă și mărimea. Pe 1972–2020, în SUA, raportul Sharpe lunar de tangență este 0,13 pentru piață și 0,80 cu toți factorii.
În replicarea din curs, Benjamini–Yekutieli dă cea mai mică rată, ca în rezultatele americane ale lucrării. Emisiunile nete de acțiuni (net share issues) sînt atrase spre media temei lor, de la 0,44% la 0,27% pe lună, cu o abatere standard a posteriori de 0,07%–0,10%, sub SE OLS de 0,11%, pentru că fiecare factor împrumută informație de la ceilalți factori ai temei. Dispersiile a priori estimate sînt \(\hat\tau_c = 0{,}28\%\) și \(\hat\tau_w = 0{,}04\%\) pe lună, față de 0,35% și 0,21% în lucrare; cu 15 semnale rămîne puțină dispersie specifică factorilor. Cele 15 semnale cad în 8 din cele 13 teme, 5 în valoare, 3 în risc scăzut și 2 în investiții.
Pe scurt
Benjamini–Yekutieli dă cea mai mică rată, ca în rezultatele americane din articol (Figura 1)
Emisiunile nete de acțiuni sînt trase spre media temei lor
de la \(0{,}44\%\) la \(0{,}27\%\) pe lună
Abaterea standard a posteriori este \(0{,}07\%\)–\(0{,}10\%\), sub eroarea standard OLS de \(0{,}11\%\)
fiecare factor împrumută informație de la ceilalți factori ai temei
Dispersia a priori: \(\hat\tau_c = 0{,}28\%\), \(\hat\tau_w = 0{,}04\%\) pe lună
față de \(0{,}35\%\) și \(0{,}21\%\) raportate în Tabelul I al articolului
cu 15 semnale rămîne puțină dispersie specifică factorilor
Teme: cele 15 semnale se încadrează în 8 dintre cele 13 teme ale articolului
CAPM este singurul model de referință, așa că factorii de îndatorare redusă nu au alfa CAPM semnificativ, dar contribuie în combinație cu celelalte teme;
Toate caracteristicile sînt construite după aceeași regulă, uneori altfel decît în lucrarea originală;
Factorii încercați, dar nepublicați ar deplasa distribuția a priori, coborînd rata americană la 81,5% și 79,8% în scenariile lui Harvey, Liu & Zhu (2016).
Replicarea din curs poate fi completată la seminar justificînd fiecare semn din lucrarea originală, comparînd dendrograma cu temele lucrării și adăugînd FDR bayesian și panta după eșantion.
Pe scurt
Limite precizate de autori
CAPM este singurul model de referință: factorii de îndatorare redusă nu au alfa CAPM semnificativ, dar contribuie cînd sînt combinați cu celelalte teme (Secțiunea III.A)
Toate caracteristicile sînt construite după aceeași regulă, uneori altfel decît în articolul original (Secțiunea II.C)
Factorii încercați, dar nepublicați, ar schimba distribuția a priori: în scenariile lui Harvey, Liu & Zhu (2016), rata pentru SUA scade la \(81{,}5\%\), respectiv \(79{,}8\%\) (Figura 10)
Primele prompturi ale buclei descoperirii acoperă literatura despre scăderea după publicare și replicarea anomaliilor, ipotezele concurente (data mining, arbitrajul informat de publicare și riscul variabil în timp) și codul pentru regresia factorului momentum pe variabile dummy pentru perioada de după eșantion și pentru cea de după publicare, cu erori Newey–West. Fiecare DOI returnat se verifică în Crossref, fiecare cifră principală se confruntă cu rezumatul, iar întîi se replică un număr cunoscut: pentru momentum, \(t = 5{,}53\) înainte de 2000 și 0,75 după.
Pe scurt
Literatură
Rezumă dovezile din 2016 încoace despre scăderea după publicare și replicarea randamentelor anomaliilor. Pentru fiecare lucrare: DOI, eșantion, numărul de factori, estimația principală, identificarea scăderii. Marchează intrările nesigure.
Verificați fiecare DOI în Crossref
Verificați fiecare cifră principală în rezumat
Ipoteză
Compară căutarea oportunistă în date, arbitrajul bazat pe informația publicată și riscul variabil în timp ca explicații ale scăderii. Pentru fiecare: tiparul prezis între perioadele din eșantion, după eșantion și după publicare, și între acțiunile cu limite mari și cele cu limite mici ale arbitrajului.
Date și cod
Încarcă factorul lunar de momentum din Kenneth French Data Library; din 1965, regresează MOM pe o variabilă dummy după eșantion (1990-01 pînă la 1993-03) și una după publicare (din 1993-04), cu erori Newey-West.
Replicați întîi o cifră cunoscută: momentum \(t = 5{,}53\) înainte de 2000 și \(0{,}75\) după (graficul pe subperioade)
Prompturile următoare scriu un plan de robustețe preînregistrat, cu o singură dată de publicare pe factor, corecția Holm între factori, excluderea crahului momentum din 2009, data working paper-ului și o perioadă placebo 1927–1962, și cer critica unui referent pentru un rezultat pe un singur factor cu \(t = -1{,}45\) și puterea lui de a detecta o scădere de 58%. Raportul dă media in-sample, ambele variabile dummy cu erori Newey–West, perioada placebo și versiunea datelor; factorii agregați cer erori robuste la corelația dintre factori și la autocorelare. Asistentul AI propune variantele de robustețe, dar cercetătorul alege dinainte care sînt raportate, iar prompturile care au influențat o decizie intră în AI_USE.md.
Pe scurt
Robustețe
Scrie un plan de robustețe preînregistrat: cîte o dată de publicare pentru fiecare factor, corecția Holm între factori, excluderea crahului de momentum din 2009, data documentului de lucru în locul datei din revistă și perioada 1927-1962 ca placebo pentru Mkt-RF, SMB, HML și MOM (RMW și CMA încep în iulie 1963).
Critică
Evaluează critic: un factor, o dată de publicare, t = -1,45. Care este puterea de a detecta o scădere de 58%? De ce o schimbă combinarea mai multor anomalii?
Raport
Media în eșantion, ambele variabile dummy cu erori Newey–West, placebo-ul, versiunea datelor (data descărcării)
Factori combinați: erori robuste la corelația dintre factori în aceeași lună și la autocorelație
Prompturile care au influențat o decizie intră în AI_USE.md
Data evenimentului trebuie citită din lucrarea însăși, pentru că sfîrșitul eșantionului, working paper-ul și numărul revistei sînt date diferite. Lista factorilor se fixează dinainte și se aplică Holm sau BH pe toți, ca niciun factor să nu fie ales după ce i s-a văzut scăderea. Randamentele factorilor sînt autocorelate și expuse crahurilor, ceea ce cere erori Newey–West și o reestimare fără 2009; biblioteca de factori este revizuită retroactiv, așa că se notează data descărcării și se reproduc statisticile \(t\) pe subperioade din capitol. Cu un singur factor, puterea este mică și \(H_0\) este rar respinsă, deci se raportează intervalul de încredere al scăderii, nu doar semnul ei.
Pe scurt
Data greșită a evenimentului
data încheierii eșantionului, data difuzării documentului de lucru și data publicării în revistă sînt diferite
test: citiți-le din lucrarea însăși
Alegerea factorului după ce s-a văzut că a scăzut: fixați dinainte lista factorilor
Aplicați Holm sau BH pe toți factorii
Randamente autocorelate, cu crahuri: erori Newey–West
Reestimați fără anul 2009
Versiunile datelor: biblioteca de factori este revizuită retroactiv
test: notați data descărcării
reproduceți statisticile \(t\) pe subperioade din capitol
Putere mică: cu un singur factor, \(H_0\) se respinge rar
Raportați intervalul de încredere al scăderii, nu doar semnul ei
Primele răspunsuri privesc un beta de 0,90: intervalul clasic, cu multiplicatorul 1,96, este \([0{,}802; 0{,}998]\), cu limita superioară foarte aproape de 1, dar sub 1, în timp ce intervalul Newey–West \([0{,}724; 1{,}076]\) îl conține pe 1, iar eroarea de raportat este Newey–West, pentru că HAC schimbă varianța estimată, nu estimația OLS. Urmează beta Vasicek pentru un beta brut de 1,6 cu SE 0,2 și 0,1 (1,40 și 1,53), comparat cu valoarea Blume de 1,40 indiferent de precizie, și un beta Dimson de 0,80. La verificarea GRS, \(W = 0{,}59 < 2{,}53\) nu este respins, pentru că cîștigul observat de 0,040 este sub cel așteptat de 0,071, în timp ce același decalaj cu \(T = 650\) dă \(W = 6{,}31 > 2{,}39\) și respingerea ipotezei nule.
Clasic: \(0{,}90 \pm 1{,}96 \times 0{,}05 = [0{,}802; 0{,}998]\): limita superioară este foarte aproape de 1, dar sub 1
Newey–West: \(0{,}90 \pm 1{,}96 \times 0{,}09 = [0{,}724; 1{,}076]\), conține 1: nicio dovadă că acțiunea are o sensibilitate la piață mai mică (riscul total include și componenta idiosincratică)
Raportați Newey–West: reziduurile sînt heteroscedastice și autocorelate; HAC schimbă varianța estimată, nu estimația OLS
Estimația mai zgomotoasă este contractată mai puternic; Blume dă \(0{,}33 + 0{,}67 \times 1{,}6 = 1{,}40\) indiferent de precizie
Beta Dimson: \(0{,}25 + 0{,}55 + 0{,}00 = 0{,}80\); prețul acțiunii încorporează randamentul pieței cu o zi întîrziere, deci panta din aceeași zi pierde partea de \(0{,}25\)
Răspunsurile despre prime dau o SE Fama–MacBeth de 0,15% și \(t = 3{,}33\), iar corecția Shanken crește SE la 0,166% și reduce \(t\) la 3,02, în timp ce pentru un factor tranzacționat corecția este neglijabilă (\(c = 0{,}012\)); un \(R^2\) transversal de −3 apare cînd interceptul este fixat, pentru că, cu intercept liber, OLS poate doar să micșoreze suma pătratelor erorilor. Pentru cele cinci p-value-uri, regula naivă găsește 4 descoperiri, Bonferroni 1, Holm 2, BH 4 și Benjamini–Yekutieli 1; probabilitatea a cel puțin unei respingeri false în cinci teste independente la 5% este \(1 - 0{,}95^5 = 0{,}23\). O căutare printre candidați cere BH, care controlează rata descoperirilor false, iar afirmația că niciun factor nu este fals cere Holm sau Bonferroni, care controlează probabilitatea a cel puțin unei erori în familia de teste (family-wise error rate, FWER).
\(c = 0{,}5^2/1^2 = 0{,}25\); \(\operatorname{Var}_{\text{Sh}} = 1{,}25 \times (0{,}0225 - 0{,}0025) + 0{,}0025 = 0{,}0275\), SE \(0{,}166\%\), \(t = 3{,}02\): doar puțin peste 3
Factor tranzacționat: \(c = 0{,}25/4{,}5^2 = 0{,}012\), deci corecția este neglijabilă
Media \(4\%\): SST \(= 4 + 0 + 4 = 8\), SSE \(= 16 + 0 + 16 = 32\), \(R^2 = 1 - 32/8 = -3\); cu termen liber, pantele zero dau deja SSE \(=\) SST, iar OLS poate doar să micșoreze SSE
Cursurile avansate Quantinar despre metoda generalizată a momentelor și despre analiza statistică multivariată extind materialul despre GMM și PCA din capitol. Toate graficele și tabelele sînt reproduse de Quantlet-urile Capitolului 3, iar datele factorilor provin din Kenneth French Data Library.
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?The European Journal of Finance, 29(10), 1064–1105.
NASDAQ: National Association of Securities Dealers Automated Quotations — bursa americană NASDAQ (cotații automate ale Asociației Naționale a Dealerilor de Valori Mobiliare)
NYSE: New York Stock Exchange — Bursa din New York
OLS: Ordinary Least Squares — metoda celor mai mici pătrate
OMV: Österreichische Mineralölverwaltung — Administrația Austriacă a Petrolului (grupul OMV)
PC1: first Principal Component — prima componentă principală
PC2: second Principal Component — a doua componentă principală
PC3: third Principal Component — a treia componentă principală
PCA: Principal Component Analysis — analiza componentelor principale
PRDS: Positive Regression Dependence on a Subset (of p-values) — dependența pozitivă de regresie pe o submulțime (a valorilor p)
RMSE: Root Mean Squared Error — rădăcina erorii pătratice medii
RMW: Robust Minus Weak (profitability factor) — factorul profitabilitate: firme robuste minus slabe
ROE: Return On Equity — rentabilitatea capitalului propriu
RP-PCA: Risk-Premium Principal Component Analysis — analiza componentelor principale cu primă de risc
SDF: Stochastic Discount Factor — factorul stocastic de actualizare
SE: Standard Error — eroarea standard
SMB: Small Minus Big (size factor) — factorul mărime: firme mici minus mari
SML: Security Market Line — dreapta pieței titlurilor
SPDR: Standard & Poor’s Depositary Receipts — certificate de depozit Standard & Poor’s (familia de ETF-uri SPDR)
SSE: Sum of Squared Errors — suma pătratelor erorilor
SST: Total Sum of Squares — suma totală a pătratelor abaterilor de la medie
TSFM: Time-Series Factor Momentum — momentum-ul factorilor în serie de timp
SUA: Statele Unite ale Americii
UMD: Up Minus Down (momentum factor) — factorul momentum: cîștigători minus perdanți
Întrebare pentru sală Pe eșantionul iulie 1963–iulie 2026, ce se întîmplă cu diferența small-value minus small-growth cînd trecem de la randamentele medii în exces la alfa CAPM?
Răspuns
Diferența crește de la aproximativ 9,46 la 12,00 puncte procentuale pe an: randamentele medii sînt 3,9% pentru small-growth și 13,3% pentru small-value, iar alfa CAPM −6,3% și +5,7%. Beta small-growth este aproximativ 1,42, iar beta small-value 1,06; CAPM scade o componentă de piață mai mare din randamentul small-growth. Ajustarea nu scade aceeași sumă din ambele randamente.
ETF-uri din SUA: prețuri EODHD ajustate pentru dividende; randamentele în exces folosesc rata fără risc din Kenneth French Data Library. Factorii Fama–French, momentum, reversal și cele 25 de portofolii mărime × B/M: Kenneth French Data Library. Beta Dimson: date simulate.


 Eugene F. Fama.
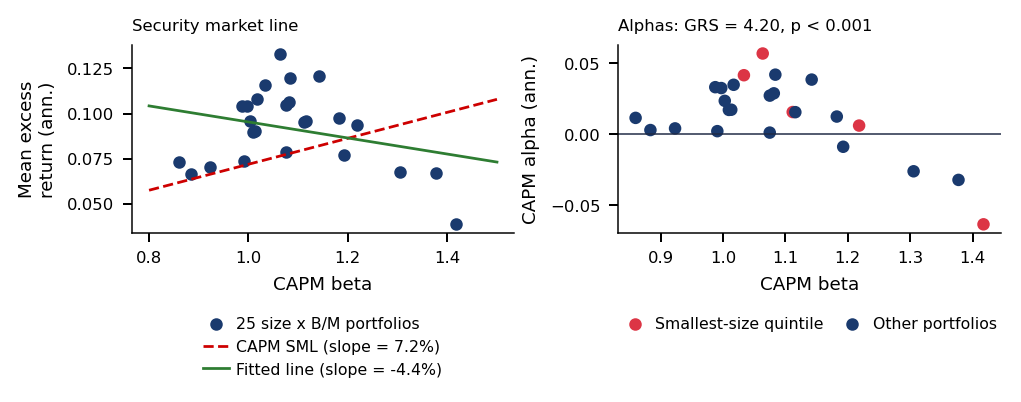
 MFM_ch3_frontier
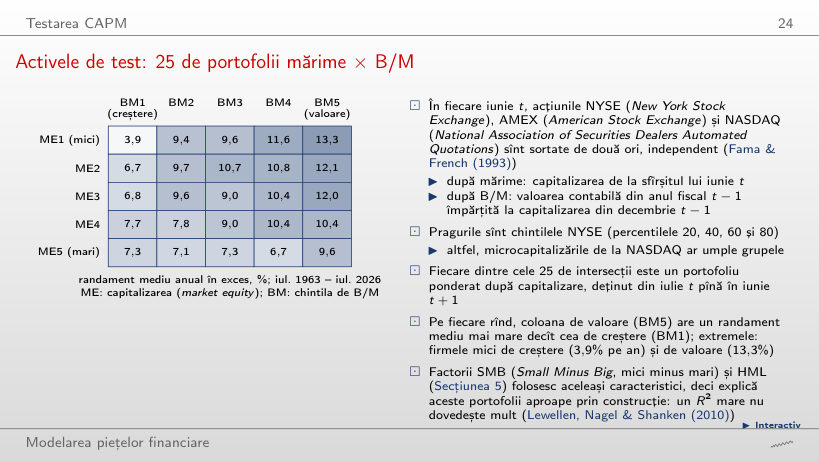
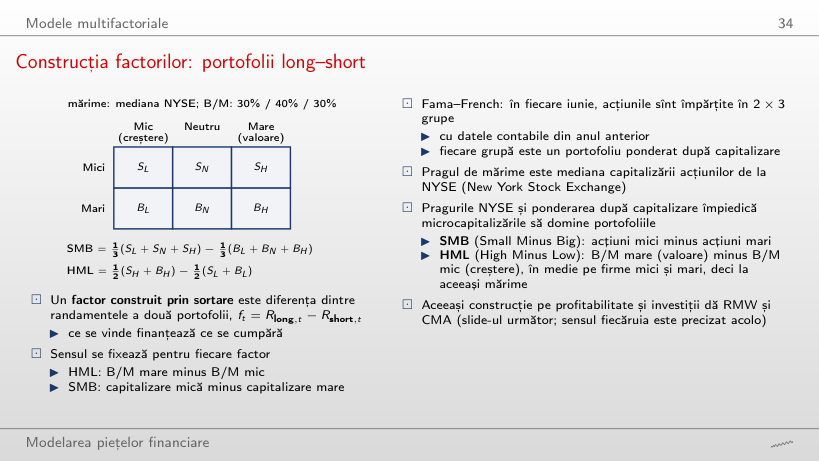
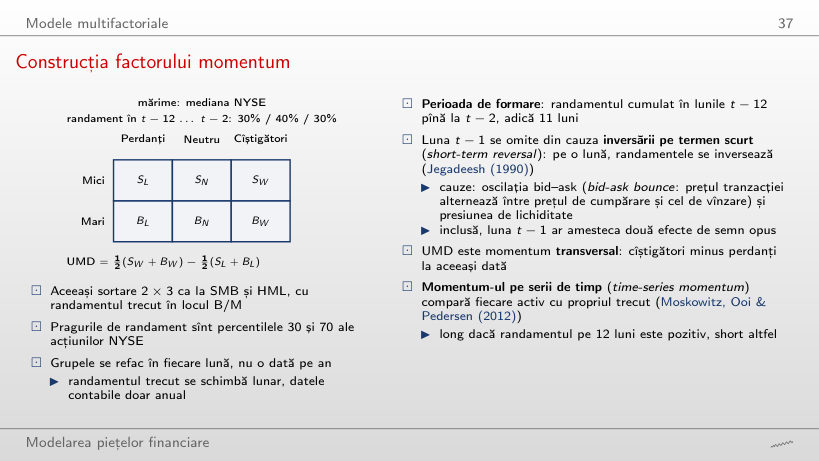
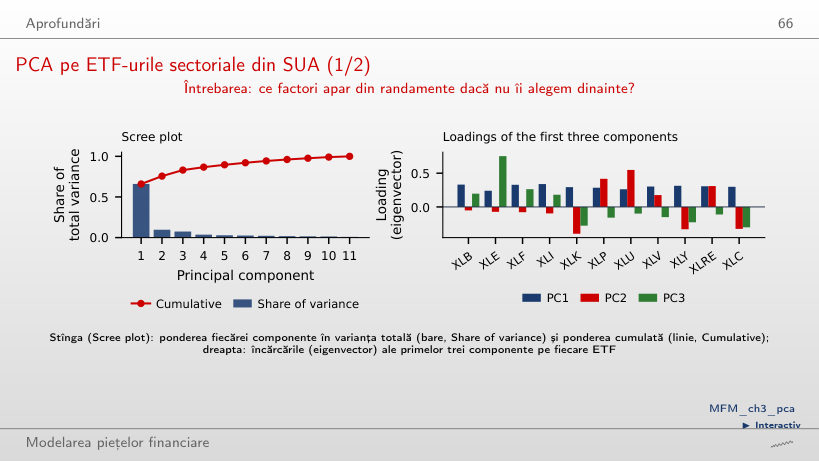
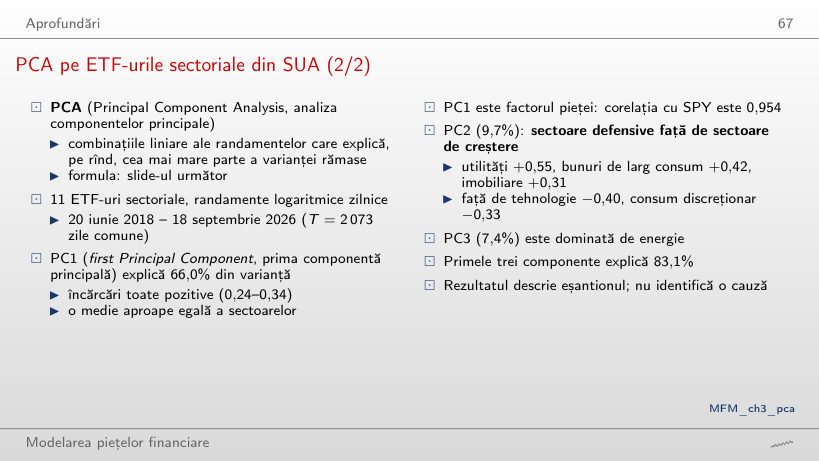
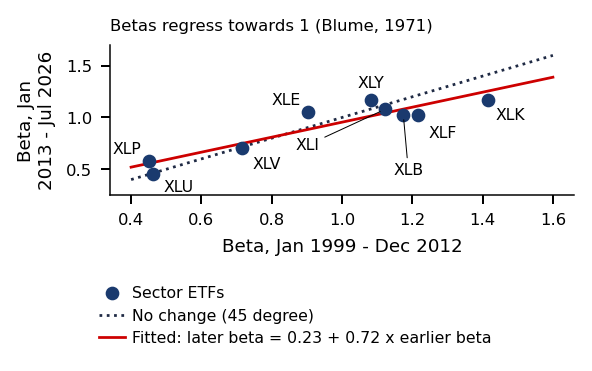
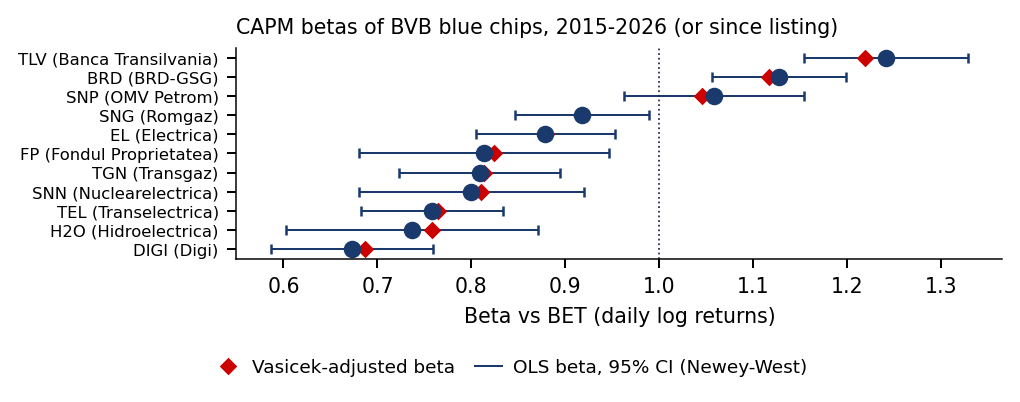 Legenda: OLS beta, 95% CI: beta OLS cu intervalul de încredere (CI, confidence interval) de 95%, erori Newey–West; Vasicek-adjusted beta: beta ajustat Vasicek
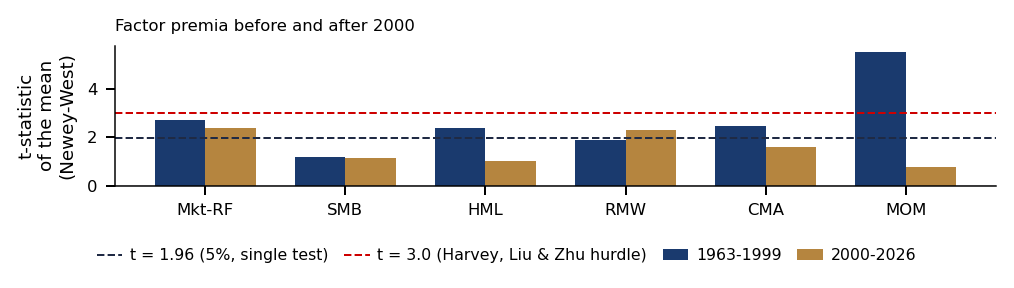

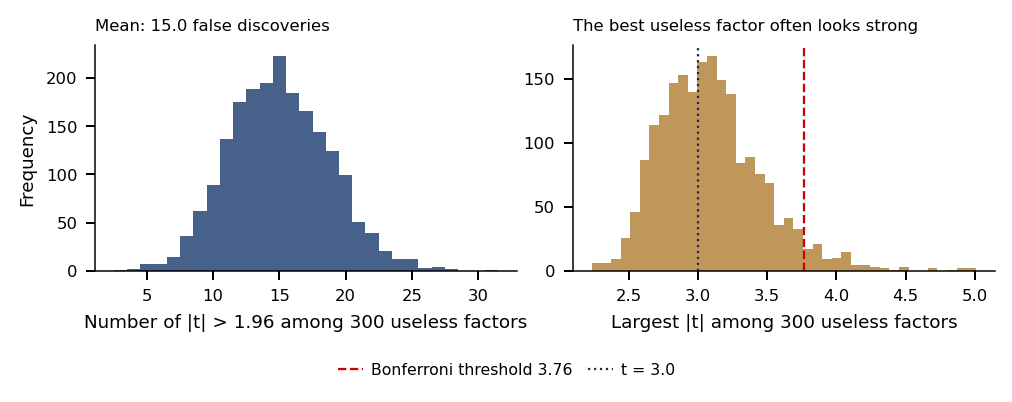 Legenda: false discoveries: descoperiri false; The best useless factor often looks strong: cel mai bun factor inutil pare adesea puternic; Bonferroni threshold: pragul Bonferroni lll
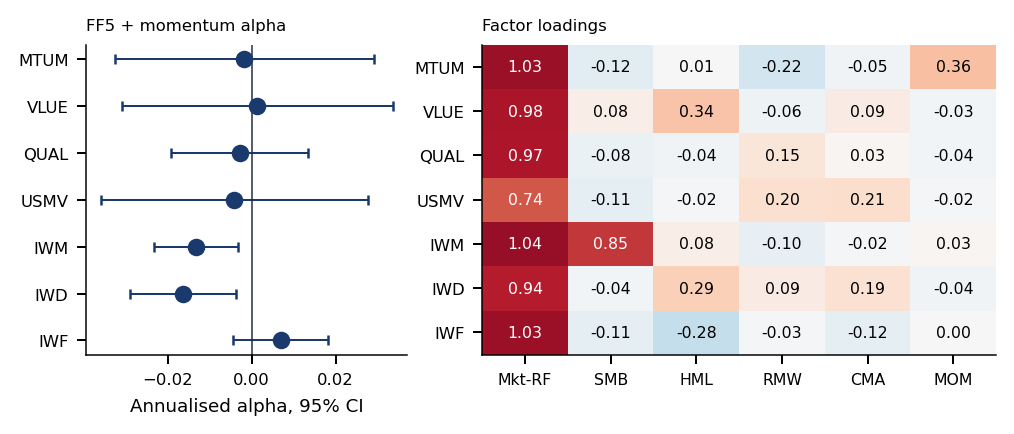
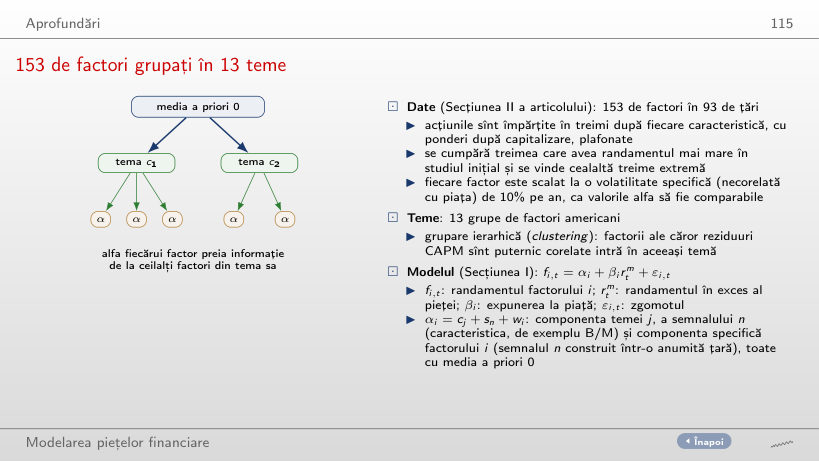
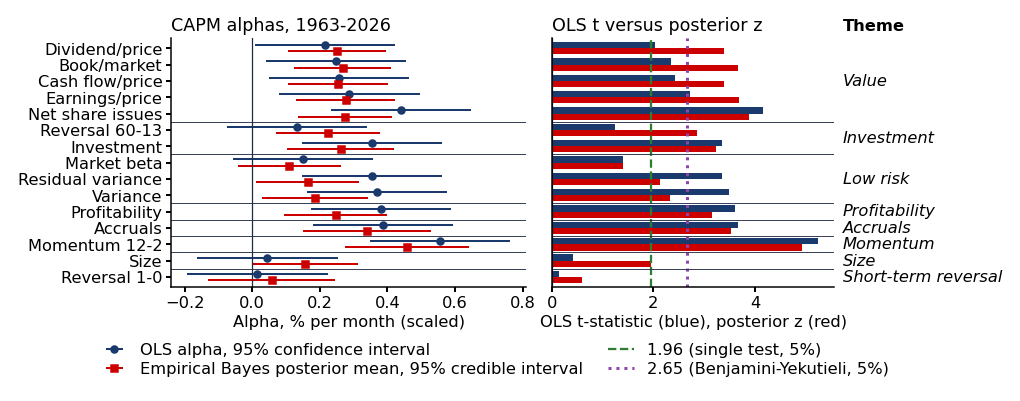 Legenda: OLS alpha, 95% confidence interval: alfa OLS cu intervalul de încredere; Empirical Bayes posterior mean, 95% credible interval: media a posteriori Bayes empiric cu intervalul de credibilitate; OLS t versus posterior z:
 Generalized Method of Moments