Capitolul 7: Ipoteza piețelor eficiente, mersul aleator și testele VR
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
OLS: Ordinary Least Squares (metoda celor mai mici pătrate)
PP: Phillips–Perron (unit-root test) — testul de rădăcină unitară Phillips–Perron
PX: Prague Stock Exchange index (index Burzy cenných papírů Praha) — indicele Bursei din Praga
RW1: Random Walk 1 (i.i.d. increments) — mersul aleator 1 (creșteri i.i.d.)
RW2: Random Walk 2 (independent increments) — mersul aleator 2 (creșteri independente)
RW3: Random Walk 3 (uncorrelated increments) — mersul aleator 3 (creșteri necorelate)
SFE: Statistics of Financial Markets, Exercises (Quantlet collection of the textbook) — colecția de Quantlet-uri a manualului Statistics of Financial Markets
SUA: Statele Unite ale Americii
UE: Uniunea Europeană
VR: Variance Ratio (raportul varianțelor)
WIG20: Warszawski Indeks Giełdowy 20 (indicele celor mai mari 20 de companii de la Bursa din Varșovia)
Ne pot spune prețurile de ieri ceva despre randamentul de mîine? Dacă ar putea, o regulă simplă de tranzacționare ar aduce bani fără un risc suplimentar, iar investitorii care ar folosi-o ar muta prețurile pînă cînd tiparul ar dispărea. O piață în care prețurile trecute nu conțin nicio informație exploatabilă se numește eficientă în sens slab. Capitolul 4 a definit mersul aleator (random walk) și martingalul ca modele de probabilitate; acest capitol le transformă în ipoteze și le testează pe prețurile zilnice ale S&P 500, DAX, indicelui BET al Bursei de Valori București, Bitcoin și a patru acțiuni de la București.
Testele răspund la trei întrebări diferite. Testele de rădăcină unitară (unit root) întreabă dacă prețurile logaritmice rătăcesc fără să revină la un nivel; așa se întîmplă în toate seriile capitolului. Testele de autocorelație și testele variance ratio întreabă dacă randamentele pot fi anticipate din randamentele trecute. Aici răspunsul depinde de piață și de perioadă: S&P 500 arată o ușoară mean reversion (revenire la medie), cu un raport al varianțelor pe cinci zile de 0,856, iar BET arată momentum, cu un raport al varianțelor pe douăzeci de zile de 1,517, concentrat în primii lui ani. DAX și Bitcoin nu arată nicio previzibilitate care să reziste unui test robust la volatility clustering.
Capitolul arată și de ce alegerea testului contează la fel de mult ca datele. Randamentele zilnice au volatility clustering, iar testele clasice, construite pentru randamente independente, îl interpretează ca previzibilitate: într-o simulare a unor randamente imprevizibile prin construcție, testul variance ratio homoscedastic respinge în 17,1% din cazuri, în loc de 5%. Cu teste robuste și cu teste comune pe mai multe orizonturi, majoritatea piețelor par astăzi aproape eficiente, iar previzibilitatea care rămîne este mică în raport cu costurile de tranzacționare.
Raportul varianțelor VR(q) al randamentelor logaritmice zilnice pentru orizonturi q de la 2 la 40 de zile de tranzacționare, pentru S&P 500, DAX, BET și Bitcoin; zona umbrită este banda de 95% a testului robust \(Z^*\), liniile întrerupte banda de 95% a testului care presupune randamente i.i.d. Valoarea 1 corespunde mersului aleator; valorile sub 1 arată că mișcările zilnice sînt parțial anulate, cele peste 1 că ele continuă.
Rezultatele învățării
Enunțați cele trei forme ale eficienței pieței și explicați de ce orice test al eficienței este un test comun.
Deosebiți RW1, RW2, RW3 și martingalul și precizați care dintre ele sînt încălcate de volatility clustering.
Citiți un ACF de selecție cu banda de încredere potrivită și calculați statisticile Box–Pierce, Ljung–Box și runs.
Aplicați și combinați testele ADF, Phillips–Perron și KPSS pe prețuri și pe randamente.
Calculați un raport al varianțelor și testul lui robust, pentru un orizont și pentru mai multe orizonturi împreună.
Judecați, pe date reale, care piețe par eficiente și dacă acest lucru se schimbă în timp.
Planul capitolului
Previzibilitatea prețurilorArgumentul economic împotriva previzibilității, istoria de la Bachelier la Fama și o primă privire asupra mersurilor aleatoare și a prețurilor reale.
Piețe eficienteDefiniția eficienței, cele trei forme ale ei, modelul jocului echitabil, problema ipotezei comune și paradoxul Grossman–Stiglitz.
Ipotezele mersului aleatorMersul aleator al prețurilor logaritmice, ipotezele RW1, RW2, RW3, martingalul și regula rădăcinii pătrate a timpului.
AI pentru descoperire științificăO întrebare deschisă despre eficiența BET după 2020, contribuția posibilă a AI și verificările necesare.
RezumatRezultatele principale, formulele și întrebări de autoevaluare.
Previzibilitatea prețurilor
Întrebarea capitolului este veche. Secțiunea prezintă argumentul economic pentru care o previzibilitate a prețurilor nu ar trebui să dureze, urmărește ideea variațiilor aleatoare ale prețurilor de la Bachelier, în 1900, pînă la Samuelson și Fama, în 1965, și se încheie cu două imagini ale datelor reale care arată de ce este nevoie de un test formal.
Să presupunem că prețurile trecute ar anticipa randamentele viitoare, de exemplu că o creștere într-o zi ar fi urmată de regulă de o creștere în ziua următoare. O regulă simplă, cumpărarea după fiecare creștere, ar aduce atunci bani fără niciun risc suplimentar. Investitorii ar descoperi regula și ar folosi-o, iar cumpărările lor ar împinge prețul de azi pînă la nivelul așteptat pentru mîine. Tiparul ar dispărea chiar prin tranzacțiile care îl exploatează. Într-o piață competitivă, previzibilitatea prețurilor se autodistruge.
Dovezile despre investitorii profesioniști confirmă acest argument. Jensen (1968) a studiat fondurile de investiții americane din perioada 1945–1964 și a constatat că, în medie, ele nu au obținut mai mult decît un portofoliu buy-and-hold cu risc comparabil, după deducerea costurilor. Patru decenii mai tîrziu, Fama & French (2010) au constatat că doar puține fonduri au o abilitate suficient de mare încît să își acopere costurile. Dacă profesioniștii cu resurse mari bat rar piața, este puțin probabil ca o regulă construită doar pe prețurile trecute, disponibile oricui, să reușească.
Argumentul are atît critici, cît și susținători, iar Malkiel (2003) oferă o sinteză echilibrată a ambelor tabere. Fotografia arată ringul de tranzacționare al Bursei din New York în 1963, în perioada în care se contura studiul statistic al variațiilor de preț.
Pe scurt
Dacă prețurile trecute ar anticipa randamentele viitoare, o regulă simplă ar aduce bani fără risc
investitorii ar folosi regula; tranzacțiile lor ar muta prețurile pînă cînd tiparul dispare
Dovezile despre investitorii profesioniști
fondurile de investiții nu au obținut, în medie, randamente mai mari decît o strategie buy-and-hold, după deducerea costurilor Jensen (1968)
puține fonduri au o abilitate suficient de mare încît să își acopere costurile Fama & French (2010)
Primul model matematic al prețurilor îi aparține lui Louis Bachelier, în teza Théorie de la spéculation(Bachelier, 1900). Bachelier a modelat variația unui preț ca sumă a multor șocuri mici aleatoare, ceea ce face variația aproximativ Normală și varianța ei proporțională cu timpul scurs. A doua lui concluzie a fost economică: cîștigul așteptat al speculatorului este zero. Ambele idei revin în acest capitol, prima ca mers aleator, a doua ca martingal.
Lucrarea lui Bachelier a rămas aproape necunoscută timp de o jumătate de secol. Latura empirică a reapărut odată cu Kendall (1953), care a studiat 22 de serii de prețuri britanice, indici ai prețurilor acțiunilor și prețuri ale mărfurilor. Kendall căutase cicluri; în locul lor, seriile „rătăceau”, iar variațiile de la o săptămînă la alta semănau cu extrageri independente.
Roberts (1959) a adăugat o observație metodologică. El a simulat mersuri aleatoare și a arătat că ele prezintă aceleași „tipare” pe care analiștii tehnici, cei care anticipează prețurile din grafice, le văd în prețurile reale. Un tipar pe grafic nu este, așadar, o dovadă de previzibilitate, pentru că și hazardul pur produce astfel de tipare. Slide-ul următor repetă experimentul lui Roberts pe date actuale.
Întrebare pentru sală Patru mersuri aleatoare cu pași Normali i.i.d. (media și abaterea standard ale S&P 500) și S&P 500 însuși. Butonul ▶ desenează traiectoriile an cu an, din 1991 pînă în 2026. La sfîrșitul lui 2008, cîte dintre cele patru mersuri aleatoare sînt deasupra S&P 500?
Răspuns
Trei. La sfîrșitul lui 2008 S&P 500 este la 0,91 (logaritmul prețului minus valoarea de start), iar mersurile simulate la 1,12, 1,24, 2,69 și 0,65. În septembrie 2026 doar unul (4,50) este deasupra S&P 500 (3,06). Scăderile din 2000–2002 și 2008 au mărimea episoadelor pe care le produce și zgomotul pur: o singură traiectorie nu separă S&P 500 de un mers aleator.
Graficul arată cinci traiectorii ale prețului logaritmic din 1990, fiecare pornind de la 0, astfel încît axa verticală măsoară randamentul logaritmic cumulat. Patru traiectorii sînt mersuri aleatoare simulate, cu pași zilnici Normali i.i.d. (independenți și identic distribuiți), cu media 0,033% și abaterea standard 1,13% pe zi, valorile S&P 500 în aceeași perioadă. A cincea traiectorie este prețul logaritmic al S&P 500 minus prima lui valoare.
Întrebare pentru sală: fără legendă, ați putea spune care traiectorie este cea reală? Greu. Traiectoriile simulate conțin avînturi lungi, stagnări de un deceniu și reveniri care seamănă cu episoadele istoriei financiare, deși nu sînt nimic mai mult decît zgomot. Valorile lor finale, randamentele logaritmice cumulate pe întreaga perioadă, se află între 2,76 și 4,50, iar S&P 500, cu 3,06, se află în acest interval.
Traiectoria reală se deosebește doar prin cîteva căderi bruște, în 2008 și în 2020, un semn al grupării mișcărilor mari, la care capitolul revine în secțiunea despre ACF. Acest lucru privește mărimea mișcărilor, nu direcția lor. Fiindcă ochiul nu poate separa traiectoria reală de zgomotul pur, întrebarea previzibilității cere teste formale, iar restul capitolului le construiește.
Pe scurt
Patru mersuri aleatoare cu pași Normali i.i.d. (media \(0{,}033\%\), abaterea standard \(1{,}13\%\) pe zi, ca la S&P 500) și prețul logaritmic S&P 500 din 1990
Întrebare pentru sală: fără legendă, ați putea spune care traiectorie este cea reală?
Răspuns: greu; avînturile și căderile lungi apar și în zgomotul pur (valori finale: \(2{,}76\)–\(4{,}50\); S&P 500: \(3{,}06\))
Paul Samuelson a dat motivul economic pentru care prețurile ar trebui să se comporte ca un mers aleator (Samuelson, 1965). Dacă prețul conține deja tot ce anticipează investitorii, următoarea variație nu poate fi anticipată: orice parte previzibilă ar fi fost deja inclusă, prin tranzacții, în prețul de azi. Formal, prețul este un martingal, \(E[P_{t+1} \mid \mathcal{F}_t] = P_t\), unde \(\mathcal{F}_t\) este informația disponibilă la momentul \(t\); Capitolul 4 a definit martingalele în această formă.
Argumentul răstoarnă o intuiție obișnuită. Variațiile aleatoare ale prețurilor nu sînt semnul unei piețe haotice sau iraționale; ele sînt semnul unei piețe care funcționează, în care informația nouă intră în prețuri repede și complet. Titlul lucrării lui Samuelson, „Proof that properly anticipated prices fluctuate randomly” (demonstrația că prețurile anticipate corect fluctuează aleator), enunță acest rezultat.
În același an, Fama (1965) a oferit corespondentul empiric. În randamentele zilnice ale celor 30 de acțiuni din indicele Dow Jones Industrial Average, el nu a găsit aproape deloc autocorelație: randamentul unei zile spunea aproape nimic despre randamentul zilei următoare.
Pe scurt
Paul Samuelson Samuelson (1965): dacă prețurile conțin deja tot ce anticipează investitorii, următoarea variație este imprevizibilă
formal: prețul este un martingal, \(E[P_{t+1} \mid \mathcal{F}_t] = P_t\) (Capitolul 4)
\(\mathcal{F}_t\): informația disponibilă la momentul \(t\)
Caracterul aleator al variațiilor de preț este semnul unei piețe care funcționează, nu al haosului
Fama (1965): randamentele zilnice ale celor 30 de acțiuni Dow Jones nu arată aproape deloc autocorelație
Întrebare pentru sală Regula rădăcinii pătrate a timpului dă pentru S&P 500 o abatere standard pe 250 de zile de 1,1337% × √250 = 17,92%. Abaterea standard a randamentelor pe 250 de zile, calculată direct din sumele suprapuse, este mai mare sau mai mică?
Răspuns
Mai mică: 15,66%, adică 0,874 din valoarea regulii. Randamentele zilnice ale S&P 500 sînt ușor negativ autocorelate (ρ̂(1) = −0,079, VR(250) = 0,785), deci mișcările zilnice se anulează parțial în timp. BET, cu ρ̂(1) = 0,156, arată efectul invers: 35,91% față de 23,38% (de 1,54 ori). Regula presupune randamente necorelate; scalarea VaR sau a volatilității cu √q moștenește această ipoteză.
Întrebare pentru sală Corelația dintre randamentul de azi și cel de ieri este −0,079 pentru S&P 500 și 0,156 pentru BET. Butonul ▶ mută lagul de la 1 la 10. Cît devine corelația BET la lagul 2, între randamentul de azi și cel de acum două zile?
Răspuns
0,033, de aproape cinci ori mai mică; la lagul 3 este −0,008, la lagul 5 0,031, la lagul 10 0,004. Pentru S&P 500 corelația la lagul 2 este −0,004. Dependența randamentelor BET stă aproape toată la lagul 1, cum produce tranzacționarea redusă: o știre intră în indice pe parcursul a două zile.
Graficul este cel mai simplu test al previzibilității. Fiecare punct asociază randamentul unei zile (axa orizontală, în %) cu randamentul zilei următoare (axa verticală, în %). Dreapta neagră este dreapta celor mai mici pătrate a randamentului de azi în funcție de cel de ieri. Pentru că ambele randamente provin din aceeași serie și au aceeași varianță, panta ei este egală cu autocorelația de ordinul întîi \(\hat\rho(1)\), corelația dintre randamentele consecutive.
Pentru S&P 500, \(\hat\rho(1) = -0{,}079\): dreapta coboară ușor, deci o creștere tinde să fie urmată de o mică scădere, iar o scădere de o mică creștere, o ușoară revenire. Pentru BET, \(\hat\rho(1) = 0{,}156\): dreapta urcă, deci mișcările tind să continue, o ușoară continuare. În ambele panouri, norul de puncte este aproape rotund, iar dreapta explică doar o mică parte din variația randamentului de azi.
Sînt aceste valori diferite de zero sau ar putea apărea din întîmplare într-o serie fără dependență? Pentru a răspunde, este nevoie de distribuția de selecție a lui \(\hat\rho(1)\) în ipoteza lipsei de previzibilitate, pe care o derivă secțiunea despre ACF, și de teste care folosesc mai multe laguri deodată, construite în secțiunea care îi urmează.
Pe scurt
Fiecare punct: (randamentul de ieri, randamentul de azi); dreapta: cele mai mici pătrate; panta ei este prima autocorelație \(\hat\rho(1)\)
S&P 500: \(\hat\rho(1) = -0{,}079\) (o ușoară revenire); BET: \(\hat\rho(1) = 0{,}156\) (o ușoară continuare); sînt aceste valori diferite de zero?
Argumentul economic spune că o previzibilitate exploatabilă ar trebui să dispară prin tranzacționare, iar dovezile despre administratorii de fonduri îl susțin. Bachelier, Kendall, Roberts, Samuelson și Fama au transformat acest argument în ipoteza variațiilor aleatoare ale prețurilor. O primă privire asupra datelor arată traiectorii care nu se pot deosebi de mersuri aleatoare simulate și autocorelații de ordinul întîi mici, de semne opuse, pentru S&P 500 și BET. Secțiunea următoare precizează ce este o piață eficientă.
Piețe eficiente
Secțiunea definește eficiența pieței, deosebește cele trei forme ale ei după mulțimea de informații implicată și scrie eficiența ca model al unui joc echitabil. Apoi explică două limite ale conceptului: orice test este și un test al unui model al randamentelor așteptate, iar eficiența perfectă este imposibilă din punct de vedere logic atunci cînd informația costă.
Potrivit lui Fama (1970), o piață este eficientă dacă prețurile „reflectă pe deplin” informația disponibilă \(\Omega_t\). Sensul operațional al definiției este că nicio regulă de tranzacționare bazată pe \(\Omega_t\) nu cîștigă mai mult decît randamentul care îi compensează riscul. EMH (efficient market hypothesis, ipoteza pieței eficiente) este ipoteza că piețele reale au această proprietate.
Dacă prețurile reflectă deja \(\Omega_t\), ele se mișcă doar cînd apar știri: informație care nu era în \(\Omega_t\). Știrile sînt imprevizibile prin definiție, fiindcă o informație previzibilă ar face deja parte din \(\Omega_t\). Variațiile de preț, dincolo de compensarea riscului, sînt așadar imprevizibile pe baza lui \(\Omega_t\).
Eficiența este întotdeauna relativă la o mulțime de informații. Cu cît \(\Omega_t\) este mai mică, cu atît afirmația este mai slabă și mai ușor de testat. Eficiența nu înseamnă nici că randamentele sînt zero: randamentul așteptat remunerează riscul, iar randamentul zilnic mediu al S&P 500, de circa 0,033%, este pe deplin compatibil cu eficiența. Eficiența exclude un randament previzibil peste această compensare.
Pe scurt
EMH (efficient market hypothesis, ipoteza pieței eficiente) Fama (1970): prețurile „reflectă pe deplin” informația disponibilă \(\Omega_t\)
nicio regulă de tranzacționare care folosește \(\Omega_t\) nu cîștigă mai mult decît randamentul care îi compensează riscul
prețurile se mișcă doar la știri: informație care nu era în \(\Omega_t\)
Eficiența este relativă la o mulțime de informații
cu cît \(\Omega_t\) este mai mică, cu atît afirmația este mai slabă și testul mai ușor
Eficient nu înseamnă „randamente zero”: randamentul așteptat remunerează riscul
Tabelul ordonează trei forme ale eficienței după mărimea mulțimii de informații. În forma slabă, \(\Omega_t\) conține prețurile și randamentele trecute, deci analiza tehnică și tiparele grafice nu pot aduce randamente în exces; testele tipice sînt testele de autocorelație, testele runs și testele variance ratio. În forma semi-tare, \(\Omega_t\) conține toată informația publică, deci nici analiza fundamentală a datelor publice nu poate aduce randamente în exces; testul tipic este studiul de eveniment. În forma tare, \(\Omega_t\) conține toată informația, inclusiv cea privată; ea se testează pe randamentele insiderilor și ale administratorilor profesioniști de fonduri.
Formele sînt incluse una în alta: eficiența tare implică eficiența semi-tare, care implică eficiența slabă, pentru că fiecare mulțime de informații o conține pe cea precedentă. Respingerea formei slabe le respinge, așadar, pe toate trei, în timp ce nerespingerea formei slabe nu spune nimic despre formele mai puternice.
Acest capitol testează mai ales forma slabă. Prețurile trecute sînt date gratuite pentru oricine, iar un test care le folosește doar pe ele nu are nevoie de un model al valorilor fundamentale (Fama, 1970; Fama, 1991).Ultima secțiune principală tratează formele semi-tare și tare.
Pe scurt
Forma
Mulțimea de informații \(\Omega_t\)
Strategii fără randamente în exces
Testul tipic
Slabă
prețurile și randamentele trecute
analiza tehnică, tiparele grafice
autocorelație, runs, variance ratio
Semi-tare
toată informația publică
analiza fundamentală a datelor publice
studii de eveniment
Tare
toată informația, inclusiv cea privată
informația privilegiată
randamentele insiderilor și ale administratorilor de fonduri
Formele sînt incluse una în alta: tare \(\Rightarrow\) semi-tare \(\Rightarrow\) slabă; respingerea formei slabe le respinge pe toate trei
Acest capitol testează mai ales forma slabă: prețurile trecute sînt date gratuite pentru oricine Fama (1970), Fama (1991)
Eficiența poate fi scrisă ca o afirmație despre erorile de prognoză. Fie \(r_{t+1}\) randamentul unui activ și \(E[r_{t+1} \mid \Omega_t]\) randamentul lui așteptat de echilibru, randamentul care îi remunerează riscul. Randamentul în exces, sau surpriza, este diferența dintre cele două, iar piața este un joc echitabil (fair game) dacă această surpriză are media condiționată zero:
Altfel spus, erorile de prognoză sînt nule în medie, orice am ști la momentul \(t\). Consecința pentru tranzacționare rezultă din legea așteptărilor iterate. O regulă care investește suma \(w(\Omega_t)\), aleasă cu informația momentului \(t\), cîștigă \(E[w(\Omega_t)\, z_{t+1}] = E[w(\Omega_t)\, E[z_{t+1} \mid \Omega_t]] = 0\) peste echilibru. Nicio regulă bazată pe \(\Omega_t\) nu depășește compensarea riscului.
În cazul cel mai simplu, randamentul așteptat este o constantă \(\mu\), astfel încît \(E[r_{t+1} \mid \Omega_t] = \mu\), iar randamentele minus \(\mu\) formează un șir de diferențe de martingal (martingale difference sequence). Definiția nu cere nimic altceva. Ea nu cere nici varianță constantă, nici distribuția Normală, iar de aceea cozile groase (heavy tails) și volatility clustering, faptele stilizate din Capitolul 2, sînt compatibile cu eficiența.
Pe scurt
Fie \(r_{t+1}\) randamentul unui activ și \(E[r_{t+1} \mid \Omega_t]\)randamentul așteptat de echilibru (randamentul care îi remunerează riscul)
Modelul jocului echitabil (7.1) conține randamentul așteptat de echilibru \(E[r_{t+1} \mid \Omega_t]\), care nu se observă. Pentru a testa eficiența, el trebuie specificat printr-un model de echilibru: o medie constantă, CAPM (capital asset pricing model, modelul de evaluare a activelor financiare) sau un model cu factori.
Orice test al eficienței este, așadar, un test comun (joint test) al eficienței și al modelului randamentelor așteptate (Fama, 1991). O respingere poate însemna că piața este ineficientă sau că modelul randamentelor așteptate este greșit; datele nu pot spune care dintre ele. Eficiența luată separat, fără un model, nu poate fi respinsă niciodată.
Pentru randamentele zilnice, problema este mică. Randamentele așteptate zilnice sînt foarte mici, circa 0,033% pentru S&P 500, față de o abatere standard zilnică de 1,13%, astfel că orice model rezonabil al randamentelor așteptate dă aproape același răspuns. Testele acestui capitol folosesc o medie constantă, iar concluziile lor nu depind de această alegere.
Pe scurt
Pentru a testa eficiența trebuie să știm randamentul așteptat de echilibru \(E[r_{t+1} \mid \Omega_t]\)
pentru asta ne trebuie un model de echilibru: medie constantă, CAPM (capital asset pricing model, modelul de evaluare a activelor financiare), modele cu factori
Orice test al eficienței este un test comun al eficienței și al modelului Fama (1991)
o respingere poate însemna o piață ineficientă sau un model greșit al randamentelor așteptate
eficiența, luată separat, nu poate fi respinsă niciodată
Pentru randamentele zilnice problema contează puțin: randamentele așteptate zilnice sînt foarte mici (circa \(0{,}033\%\) pentru S&P 500), deci orice model rezonabil dă aproape același răspuns
Grossman & Stiglitz (1980) au semnalat o dificultate logică a ideii de piață perfect eficientă. Informația costă: trebuie colectată și analizată. Dacă prețurile ar reflecta perfect toată informația, nimeni nu ar fi plătit pentru a o colecta, pentru că prețul ar conține deja tot ce află cel care o colectează. Atunci nimeni nu ar mai colecta-o, iar prețurile nu ar mai putea s-o reflecte.
Concluzia este că o piață poate fi doar aproape eficientă. În echilibru, prețurile trebuie să lase mici ineficiențe care să plătească investitorilor informați costul informației lor. Prețurile reflectă atunci informația suficient de bine încît investitorii neinformați să nu poată profita, dar nu atît de bine încît investitorii informați să-și piardă motivația.
Paradoxul schimbă întrebarea empirică. În locul întrebării „este piața eficientă, da sau nu?”, întrebarea devine „cît de eficientă, unde și cînd?”. Această perspectivă duce la ipoteza piețelor adaptive din secțiunea despre eficiența pe piețe și în timp.
Premiul Nobel pentru Economie din 2013 a fost împărțit de Eugene Fama și Robert Shiller, împreună cu Lars Peter Hansen, pentru analiza empirică a prețurilor activelor. Fama și Shiller sînt adesea prezentați ca adversari. Lucrările lui Fama arată că prețurile sînt greu de anticipat pe zile și săptămîni; lucrările lui Shiller arată că prețurile oscilează prea mult față de valorile fundamentale, precum dividendele și profiturile.
Amîndoi au dreptate, pe orizonturi diferite. Randamentele pe termen scurt sînt aproape imprevizibile, cum confirmă testele acestui capitol. Randamentele pe termen lung sînt parțial previzibile din indicatorii de evaluare, precum raportul dintre preț și dividende: cînd prețurile sînt mari în raport cu valorile fundamentale, randamentele anilor următori tind să fie mai mici. Un indicator de evaluare care revine lent la media lui implică o componentă previzibilă foarte mică în randamentele zilnice, invizibilă la orizontul zilnic, care se acumulează în decursul anilor.
Acest capitol lucrează cu randamente zilnice, deci testează latura dezbaterii asociată cu Fama: previzibilitatea din prețurile trecute pe orizonturi scurte.
Amîndoi au dreptate, pe orizonturi diferite: randamentele pe termen scurt sînt aproape imprevizibile; cele pe termen lung sînt parțial previzibile din indicatorii de evaluare
Sinteza secțiunii
O piață eficientă este o piață în care prețurile reflectă o mulțime de informații \(\Omega_t\), astfel încît nicio regulă bazată pe \(\Omega_t\) nu cîștigă mai mult decît compensarea riscului. Cele trei forme diferă prin mulțimea de informații și sînt incluse una în alta. Scrisă ca joc echitabil, eficiența cere doar ca surprizele să aibă media condiționată zero, nu varianță constantă sau distribuția Normală. Orice test este un test comun cu un model al randamentelor așteptate, o problemă mică pentru datele zilnice, iar informația costisitoare face imposibilă eficiența perfectă. Secțiunea următoare traduce eficiența în formă slabă în ipoteze statistice precise.
Ipotezele mersului aleator
Eficiența în formă slabă devine testabilă doar atunci cînd este scrisă ca ipoteză despre procesul prețurilor logaritmice. Secțiunea definește mersul aleator cu tendință, deosebește trei ipoteze de mers aleator, de la cea mai puternică la cea mai slabă, le leagă de martingal și derivă regula rădăcinii pătrate a timpului care decurge din ele.
Modelul mersului aleator pentru prețurile logaritmice
în care creșterile \(\varepsilon_t\) au media 0, iar randamentul logaritmic \(r_t\) este tendința plus un șoc imprevizibil. Prin substituții succesive se obține \(p_t = p_0 + \mu t + \sum_{s=1}^{t} \varepsilon_s\): prețul logaritmic este valoarea inițială plus o tendință liniară plus suma tuturor șocurilor trecute. Fiecare șoc este permanent, pentru că rămîne în toate prețurile ulterioare și nu este niciodată anulat.
Dacă \(\varepsilon_t\) sînt necorelate, cu varianța \(\sigma^2\), varianțele sumei se adună. Atunci \(E[p_t] = p_0 + \mu t\) și \(\mathrm{Var}(p_t - p_0) = t\sigma^2\): incertitudinea asupra prețului logaritmic crește liniar cu orizontul. Același lucru este valabil pentru randamentele pe mai multe zile. Randamentul pe \(q\) zile \(r_t(q) = r_t + \dots + r_{t-q+1}\) are \(\mathrm{Var}(r_t(q)) = q\sigma^2\), proprietate pe care se construiește testul variance ratio.
Modelul este scris pentru prețurile logaritmice, nu pentru prețuri. Un mers aleator în \(P_t\) ar putea deveni negativ, în timp ce \(P_t = e^{p_t}\) este întotdeauna pozitiv; iar randamentele logaritmice se adună în timp (Capitolul 1), astfel că randamentul pe \(q\) zile este exact suma randamentelor zilnice.
Pe scurt
Prețul logaritmic \(p_t = \ln P_t\); mers aleator cu tendință (drift)\(\mu\): \(p_t = \mu + p_{t-1} + \varepsilon_t\)
randamentul \(r_t = p_t - p_{t-1} = \mu + \varepsilon_t\): creșterile \(\varepsilon_t\) au media 0
prin recurență: \(p_t = p_0 + \mu t + \sum_{s=1}^{t} \varepsilon_s\): fiecare șoc este permanent
Dacă \(\varepsilon_t\) sînt necorelate, cu varianța \(\sigma^2\):
\(E[p_t] = p_0 + \mu t\) și \(\mathrm{Var}(p_t - p_0) = t\sigma^2\): incertitudinea crește cu orizontul
randamentul pe \(q\) zile \(r_t(q) = r_t + \dots + r_{t-q+1}\) are \(\mathrm{Var}(r_t(q)) = q\sigma^2\)
Prețuri logaritmice, nu prețuri: \(P_t\) nu poate deveni negativ, iar randamentele logaritmice se adună în timp (Capitolul 1)
Modelul (7.2) nu este încă o singură ipoteză: el depinde de ce se presupune despre creșterile \(\varepsilon_t\).Campbell, Lo & MacKinlay (1997) deosebesc trei versiuni. RW1 presupune creșteri i.i.d., \(\varepsilon_t \sim \mathrm{IID}(0, \sigma^2)\). Este versiunea cea mai puternică: cu creșteri independente și identic distribuite, nicio funcție a trecutului nu anticipează vreo funcție a viitorului, nici randamentul, nici pătratul lui, nici semnul lui.
RW2 presupune creșteri independente, dar nu identic distribuite. Ea permite varianței să se schimbe în timp, de exemplu între regimuri calme și agitate, cu condiția ca aceste schimbări să nu poată fi anticipate din trecut. RW3 presupune doar creșteri necorelate, \(\mathrm{Cov}(\varepsilon_t, \varepsilon_{t-k}) = 0\) pentru orice \(k \ne 0\). Este versiunea cea mai slabă: permite dependența pătratelor, \(\mathrm{Cov}(\varepsilon_t^2, \varepsilon_{t-k}^2) \ne 0\), adică volatility clustering.
Ipotezele sînt incluse una în alta: RW1 implică RW2, care implică RW3. Testele RW3 folosesc doar autocorelațiile randamentelor, iar testele din secțiunile următoare diferă mai ales prin ipoteza, dintre cele trei, pe care o presupun sub ipoteza nulă.
Pe scurt
RW1 (creșteri i.i.d.): \(\varepsilon_t\) independente și identic distribuite, \(\varepsilon_t \sim \mathrm{IID}(0, \sigma^2)\)Campbell, Lo & MacKinlay (1997)
cea mai puternică: nicio funcție a trecutului nu anticipează vreo funcție a viitorului
RW2 (creșteri independente): \(\varepsilon_t\) independente, dar nu identic distribuite
permite varianței să se schimbe în timp într-un mod care nu poate fi anticipat din trecut (regimuri)
RW3 (creșteri necorelate): \(\mathrm{Cov}(\varepsilon_t, \varepsilon_{t-k}) = 0\) pentru orice \(k \ne 0\)
cea mai slabă: permite \(\mathrm{Cov}(\varepsilon_t^2, \varepsilon_{t-k}^2) \ne 0\), adică volatility clustering
Incluse una în alta: RW1 \(\Rightarrow\) RW2 \(\Rightarrow\) RW3; testele RW3 folosesc doar autocorelațiile randamentelor
Tabelul compară cele trei ipoteze cu martingalul, proprietate cu proprietate. Toate patru fac randamentele necorelate, \(\mathrm{Corr}(r_t, r_{t-k}) = 0\). Toate, cu excepția RW3, fac media condiționată imprevizibilă, \(E[r_t \mid \text{trecut}] = \mu\). RW3 o face „nu mereu”, pentru că un proces poate fi necorelat și totuși să aibă o medie care depinde neliniar de trecut, ceea ce o corelație nu detectează.
Rîndurile despre varianță separă ipotezele. Doar RW1 are varianță constantă. RW2 permite varianței să se schimbe, dar nu într-un mod anticipat de randamentele trecute, deci exclude volatility clustering. RW3 și martingalul admit volatility clustering, iar randamentele generate de un model GARCH le satisfac pe amîndouă. GARCH (generalised autoregressive conditional heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată, Capitolul 9) este modelul standard al volatility clustering: varianța de mîine depinde de șocurile de azi, în timp ce media rămîne imprevizibilă.
Concluzia pentru testare este că eficiența în formă slabă cere doar un martingal, sau RW3, nu RW1. Un test a cărui ipoteză nulă este RW1 poate respinge din cauza volatility clustering, chiar într-o piață în care randamentele sînt perfect imprevizibile.
GARCH (generalised autoregressive conditional heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată): varianța de mîine depinde de șocurile de azi; media rămîne imprevizibilă
Eficiența în formă slabă cere doar un martingal (sau RW3), nu RW1
Cu o tendință, procesul care trebuie examinat este prețul logaritmic minus tendința lui. Procesul \(\{p_t - \mu t\}\) este un martingal dacă \(E[p_{t+1} - \mu(t+1) \mid \mathcal{F}_t] = p_t - \mu t\), forma condiției lui Samuelson pentru prețurile logaritmice (Samuelson, 1965). Echivalent, \(E[r_{t+1} - \mu \mid \mathcal{F}_t] = 0\): randamentele minus \(\mu\) sînt un șir de diferențe de martingal, adică jocul echitabil (7.1) cu un randament așteptat constant.
Martingalul se află între ipotezele de mers aleator. O diferență de martingal cu varianță finită este necorelată, pentru că \(E[(r_{t+1} - \mu)(r_{t+1-k} - \mu)] = E[(r_{t+1-k} - \mu)\,E[r_{t+1} - \mu \mid \mathcal{F}_t]] = 0\), deci martingalul implică RW3. RW1 și RW2 implică martingalul, fiindcă niște creșteri independente cu media 0 au media condiționată 0. Reciproca nu este adevărată: un martingal poate avea varianța previzibilă, pe care RW1 și RW2 o exclud.
Întrebare pentru sală: este volatility clustering în contradicție cu eficiența în formă slabă? Răspunsul este nu. Volatility clustering respinge RW1 și RW2, pentru că varianța randamentului de mîine depinde de randamentul de azi. Dar o varianță previzibilă nu face randamentul previzibil: a ști că ziua de mîine va fi agitată nu spune dacă prețul va crește sau va scădea. Martingalul și RW3 rămîn valabile, iar odată cu ele și eficiența în formă slabă.
Pe scurt
\(\{p_t - \mu t\}\) este un martingal dacă \(E[p_{t+1} - \mu(t+1) \mid \mathcal{F}_t] = p_t - \mu t\)Samuelson (1965)
echivalent, \(E[r_{t+1} - \mu \mid \mathcal{F}_t] = 0\): randamentele minus \(\mu\) sînt o diferență de martingal
o diferență de martingal cu varianță finită este necorelată: martingal \(\Rightarrow\) RW3
RW1 și RW2 implică martingalul; reciproca nu este adevărată: un martingal poate avea varianța previzibilă
Întrebare pentru sală: este volatility clustering în contradicție cu eficiența în formă slabă?
Răspuns: nu; respinge RW1 și RW2, dar o varianță previzibilă nu face randamentul previzibil; martingalul și RW3 rămîn valabile
Regula varianței \(\mathrm{Var}(r_t(q)) = q\sigma^2\) a mersului aleator dă abaterea standard a randamentului pe \(q\) zile, \(\mathrm{sd}(r_t(q)) = \sigma\sqrt{q}\). Pentru S&P 500 din 1990, abaterea standard zilnică este \(\hat\sigma = 1{,}1337\%\).
Pas cu pas: pentru o săptămînă, \(q = 5\) zile de tranzacționare, factorul este \(\sqrt{5} = 2{,}236\), iar abaterea standard săptămînală este 2,53%. Pentru o lună, \(q = 20\), factorul este \(\sqrt{20} = 4{,}472\), iar abaterea standard lunară este 5,07%. Pentru un an, \(q = 250\), factorul este \(\sqrt{250} = 15{,}811\), iar abaterea standard anuală este 17,92%. Aceasta este regula rădăcinii pătrate a timpului (square-root-of-time rule), folosită pentru a scala VaR și volatilitatea de la un orizont la altul, de exemplu de la un VaR 1% zilnic la un VaR 1% pe zece zile.
Regula cere randamente necorelate. Dacă randamentele sînt autocorelate pozitiv, varianța sumei depășește \(q\sigma^2\), iar regula subestimează riscul pe orizonturi lungi; dacă sînt autocorelate negativ, regula îl supraestimează. Testul variance ratio măsoară cu cît greșește regula.
Pe scurt
S&P 500 din 1990: abaterea standard zilnică \(\hat\sigma = 1{,}1337\%\)
în ipoteza de mers aleator, \(\mathrm{sd}(r_t(q)) = \sigma\sqrt{q}\)
o lună, \(q = 20\): \(1{,}1337 \times 4{,}472 = 5{,}07\%\)
un an, \(q = 250\): \(1{,}1337 \times 15{,}811 = 17{,}92\%\)
Aceasta este „regula rădăcinii pătrate a timpului”, folosită pentru a scala VaR și volatilitatea
Dacă randamentele sînt autocorelate, regula nu mai funcționează: testul variance ratio din secțiunea 7 măsoară cu cît
Sinteza secțiunii
Mersul aleator al prețurilor logaritmice face fiecare șoc permanent, iar varianța randamentului pe \(q\) zile egală cu \(q\sigma^2\). RW1, RW2 și RW3 presupun, în ordine, creșteri i.i.d., independente și necorelate; martingalul se află între RW2 și RW3. Volatility clustering respinge RW1 și RW2, dar nu și martingalul, astfel că ipoteza nulă potrivită pentru eficiența în formă slabă este martingalul sau RW3. Secțiunea următoare introduce instrumentul care măsoară corelația în timp, funcția de autocorelație.
Zgomotul alb și funcția de autocorelație
Funcția de autocorelație (ACF, autocorrelation function) descrie cît de puternic este corelată o serie cu propriul trecut. Secțiunea definește zgomotul alb și ACF-ul de selecție, arată ACF-ul unui zgomot alb simulat și al proceselor AR și MA, apoi citește ACF-ul randamentelor zilnice, cu o bandă de încredere care ține sau nu seama de volatility clustering.
Pentru o serie staționară \(x_t\), autocovarianța la lagul \(k\) este \(\gamma(k) = \mathrm{Cov}(x_t, x_{t-k})\), iar autocorelația este \(\rho(k) = \gamma(k)/\gamma(0)\). ACF-ul este funcția \(k \mapsto \rho(k)\),\(k = 1, 2, \dots\); el rezumă, lag cu lag, dependența liniară a seriei de propriul trecut.
Zgomotul alb (white noise) este o serie cu media 0, varianța constantă \(\sigma^2\) și \(\rho(k) = 0\) pentru orice \(k \ne 0\). Zgomotul i.i.d. este zgomot alb, iar zgomotul alb gaussian este i.i.d. \(N(0, \sigma^2)\). Zgomotul alb nu trebuie însă să fie independent: randamentele GARCH sînt zgomot alb, fiind necorelate și avînd varianța necondiționată constantă, dar nu sînt i.i.d., pentru că pătratele lor sînt corelate. Zgomotul alb este analogul lui RW3 pentru creșteri, iar zgomotul i.i.d. analogul lui RW1.
ACF-ul de selecție estimează \(\rho(k)\) din \(T\) observații:
Pentru date i.i.d., \(\hat\rho(k)\) urmează aproximativ legea \(N(0, 1/T)\), deci banda de 95% este \(\pm 1{,}96/\sqrt{T}\). O autocorelație de selecție aflată în afara acestei benzi este semnificativă la 5% în ipoteza unor date i.i.d.
Întrebare pentru sală Pentru n = 1 000 de extrageri, banda de 95% este ±0,062 și 0 din 30 de autocorelații de selecție ies din ea. Butonul ▶ folosește doar primele n extrageri, de la 100 la 1 000. Pentru n = 100, cu banda ±0,196, cîte autocorelații ies din bandă?
Răspuns
Una: cea mai mare în modul este 0,223. Cu 30 de laguri ne așteptăm la 1,5 depășiri doar din întîmplare, la orice n: banda se lărgește ca 1/√n, iar autocorelațiile de selecție ale zgomotului alb sînt mai mari în același ritm. La n = 400 iese tot una, la celelalte valori ale lui n niciuna.
Panoul din stînga arată 1 000 de extrageri din \(N(0, 1)\), reprezentate ca serie în timp. Nimic din ele nu este previzibil, și totuși ochiul găsește scurte „tendințe” și „perioade calme”. Panoul din dreapta arată autocorelațiile de selecție \(\hat\rho(1), \dots, \hat\rho(30)\) ale acestor extrageri, cu banda de 95% \(\pm 1{,}96/\sqrt{1000} = \pm 0{,}062\) desenată cu linii întrerupte.
Toate cele 30 de autocorelații de selecție se află în interiorul benzii. Acest lucru nu este garantat nici pentru un zgomot alb perfect: banda este trasată separat pentru fiecare lag, deci fiecare autocorelație iese din ea cu probabilitatea 5%. Cu 30 de laguri, ne așteptăm la circa 1,5 autocorelații în afara benzii doar din întîmplare.
Observația contează la citirea ACF-ului randamentelor. Una sau două autocorelații în afara benzii, la laguri izolate, sînt ceea ce produce hazardul cînd se examinează multe laguri. Un test comun pe multe laguri, subiectul secțiunii următoare, răspunde corect la întrebare.
Pe scurt
Stînga: 1 000 de extrageri din \(N(0, 1)\) (ca în SFEtimewn); dreapta: \(\hat\rho(1), \dots, \hat\rho(30)\) cu banda \(\pm 1{,}96/\sqrt{1000} = \pm 0{,}062\)
Aici 0 din 30 de autocorelații ies din bandă; cu 30 de laguri ne așteptăm la circa 1,5 doar din întîmplare
Forma ACF-ului arată tipul de dependență. În procesul AR(1) (autoregresiv) \(x_t = \alpha x_{t-1} + \varepsilon_t\), cu \(|\alpha| < 1\), autocorelațiile scad geometric, \(\rho(k) = \alpha^k\). Cu \(\alpha = 0{,}9\), de exemplu, \(\rho(3) = 0{,}9^3 = 0{,}729\); cu \(\alpha < 0\), semnele alternează.
În procesul AR(2) \(x_t = \alpha_1 x_{t-1} + \alpha_2 x_{t-2} + \varepsilon_t\), prima autocorelație este \(\rho(1) = \alpha_1/(1 - \alpha_2)\), iar celelalte urmează recurența \(\rho(k) = \alpha_1\rho(k-1) + \alpha_2\rho(k-2)\). Cu \(\alpha_1 = 0{,}5\) și \(\alpha_2 = 0{,}4\),\(\rho(1) = 0{,}5/0{,}6 = 0{,}833\) și \(\rho(2) = 0{,}5 \times 0{,}833 + 0{,}4 = 0{,}817\): dependența este puternică și scade lent.
În procesul MA(1) (moving average, medie mobilă) \(x_t = \varepsilon_t + \beta\varepsilon_{t-1}\), două valori consecutive au un șoc comun, deci \(\rho(1) = \beta/(1 + \beta^2)\), iar valorile aflate la două sau mai multe perioade distanță nu au niciunul, deci \(\rho(k) = 0\) pentru \(k \ge 2\). Cu \(\beta = 0{,}5\),\(\rho(1) = 0{,}5/1{,}25 = 0{,}40\). În general, un proces MA(\(q\)) are un ACF care se anulează după lagul \(q\). Scăderea lentă indică o dependență de tip AR, anularea bruscă o dependență de tip MA, iar absența oricărei autocorelații un zgomot alb.
Întrebare pentru sală Punctele roșii sînt ACF-ul de selecție al unei traiectorii simulate de 1 000 de valori. Butonul ▶ folosește doar primele n valori, de la 50 la 1 000. Pentru AR(1) cu α = 0,9, cît de departe ajunge ACF-ul de selecție de cel teoretic la n = 50?
Răspuns
Pînă la 0,40 (cea mai mare abatere pe lagurile 1–20), față de 0,08 la n = 1 000. Banda zgomotului alb pentru n = 50 este ±0,28 (1/√50 = 0,14), dar abaterea este mai mare, pentru că varianța lui ρ̂(k) a unui proces persistent depășește 1/T. Pentru MA(2), abaterea maximă este 0,19 la n = 50 și 0,06 la n = 1 000.
Cele șase panouri compară ACF-ul teoretic (barele) cu ACF-ul de selecție al unei traiectorii simulate de 1 000 de valori (punctele) pentru șase procese: AR(1) cu \(\alpha = 0{,}9\) și cu \(\alpha = -0{,}9\), AR(2) cu \(\alpha_1 = 0{,}5\) și \(\alpha_2 = 0{,}4\), MA(1) cu \(\beta = 0{,}5\) și cu \(\beta = -0{,}5\) și MA(2) cu \(\beta_1 = 0{,}5\) și \(\beta_2 = 0{,}4\). Axa orizontală este lagul \(k\), de la 1 la 20.
ACF-ul de selecție urmează îndeaproape ACF-ul teoretic în fiecare panou. AR(1) cu \(\alpha = 0{,}9\) scade lent, AR(1) cu \(\alpha = -0{,}9\) alternează semnul, iar AR(2) rămîne ridicat pe multe laguri. Procesele MA se anulează: după lagul 1 pentru MA(1), după lagul 2 pentru MA(2). La lagurile la care valoarea teoretică este zero, valorile de selecție se împrăștie în jurul lui zero în limite de circa \(\pm 0{,}06\), zgomotul de selecție calculat pe slide-ul anterior.
Un mers aleator este limita \(\alpha \to 1\) a procesului AR(1). ACF-ul lui nu ar scădea deloc, pentru că \(\alpha^k = 1\) pentru orice \(k\): fiecare șoc trecut este prezent integral în valoarea de azi. De aceea prețurile logaritmice nu se studiază cu ACF-ul, ci cu testele de rădăcină unitară din secțiunea despre rădăcini unitare, iar ACF-ul se aplică randamentelor.
Pe scurt
Bare: \(\rho(k)\) teoretic; puncte: ACF-ul de selecție al unei traiectorii simulate de 1 000 de valori (SFEacfar1, SFEacfar2, SFEacfma1, SFEacfma2)
Un mers aleator este limita \(\alpha \to 1\) a AR(1): ACF-ul lui nu ar scădea deloc
Întrebare pentru sală Din 1990, S&P 500 are 9 autocorelații (din 20) în afara benzii i.i.d. și 3 în afara benzii robuste. Butonul ▶ mută începutul eșantionului spre 2022. Ce se întîmplă cu ρ̂(1) al S&P 500 pe eșantionul care începe în 2016?
Răspuns
Devine mai negativ: −0,142, față de −0,079 din 1990, cu 13 laguri în afara benzii i.i.d. și 7 în afara benzii robuste. Pe eșantionul care începe în 2022, ρ̂(1) este doar −0,015. Pe ferestre mobile (secțiunea „Eficiența pe piețe și în timp”) revenirile S&P 500 sînt cele mai puternice în crize: eșantionul din 2016 include 2020, cel din 2022 nu.
Graficul arată ACF-ul de selecție al randamentelor logaritmice zilnice pentru patru serii, S&P 500, DAX, BET și Bitcoin, la laguri de 1 pînă la 20 de zile. Barele sînt autocorelațiile de selecție \(\hat\rho(1), \dots, \hat\rho(20)\). Liniile întrerupte sînt banda i.i.d. \(\pm 1{,}96/\sqrt{T}\) de pe primul slide al secțiunii; zona umbrită este o bandă robustă, definită pe slide-ul următor, care ține seama de volatility clustering.
Două trăsături ies în evidență. Autocorelațiile sînt mici, aproape toate în limitele \(\pm 0{,}05\), mult mai mici decît cele ale proceselor AR de pe slide-ul anterior. Iar cele două benzi diferă: banda robustă este mai largă decît banda i.i.d. la laguri mici, mai ales pentru S&P 500, astfel că unele autocorelații se află în afara benzii i.i.d., dar în interiorul celei robuste.
Cea mai înaltă bară a graficului este autocorelația BET la lagul 1, care se află mult în afara ambelor benzi. S&P 500 are o primă autocorelație negativă, tot în afara ambelor benzi, în timp ce primele autocorelații ale DAX și Bitcoin se află în interiorul benzii robuste. Slide-ul următor dă valorile.
Pe scurt
Bare: \(\hat\rho(1), \dots, \hat\rho(20)\); linia întreruptă: banda i.i.d. \(\pm 1{,}96/\sqrt{T}\); zona umbrită: banda robustă (slide-ul următor)
Autocorelațiile de ordinul întîi sînt \(-0{,}079\) pentru S&P 500, \(-0{,}009\) pentru DAX, \(0{,}156\) pentru BET și \(-0{,}022\) pentru Bitcoin. Doar S&P 500 și BET ies în evidență la lagul 1, cu semne opuse: o ușoară revenire la S&P 500 și o ușoară continuare la BET.
Banda i.i.d. presupune \(\mathrm{Var}(\hat\rho(k)) = 1/T\), ceea ce este adevărat pentru randamente i.i.d., dar nu și în prezența volatility clustering. Banda robustă a lui Lo & MacKinlay (1988) înlocuiește \(1/T\) cu \(\hat\delta(k)/T\), astfel că banda devine \(\pm 1{,}96\sqrt{\hat\delta(k)/T}\), cu
Pentru randamente i.i.d., \(\hat\delta(k) \approx 1\), iar cele două benzi coincid. Cu volatility clustering, randamentele mari în modul urmează după randamente mari în modul, astfel că produsele \(e_t^2 e_{t-k}^2\) sînt mari mai des decît ar implica independența, iar \(\hat\delta(k) > 1\). Pentru S&P 500 la lagul 1, banda robustă este \(\pm 0{,}046\) în loc de \(\pm 0{,}020\), de peste două ori mai largă.
Alegerea benzii schimbă concluzia. Din cele 20 de laguri ale S&P 500, 9 se află în afara benzii i.i.d., dar doar 3 în afara benzii robuste. Banda i.i.d. testează RW1, banda robustă testează RW3, ipoteza care contează pentru eficiență.
Pe scurt
Primele autocorelații: S&P 500 \(-0{,}079\), DAX \(-0{,}009\), BET \(0{,}156\), Bitcoin \(-0{,}022\)
doar S&P 500 și BET ies în evidență la lagul 1, cu semne opuse
randamente i.i.d.: \(\hat\delta(k) \approx 1\); volatility clustering: randamentele mari în modul urmează după randamente mari în modul, deci \(\hat\delta(k) > 1\)
S&P 500 la lagul 1: \(\pm 0{,}046\) în loc de \(\pm 0{,}020\)
S&P 500, numărul de laguri (din 20) aflate în afara benzii: 9 cu banda i.i.d., 3 cu banda robustă
Banda i.i.d. testează RW1; banda robustă testează RW3, ipoteza care contează pentru eficiență
Întrebare pentru sală Cu T = 1 000 și autocorelațiile 0,06, −0,04 și 0,03, QLB(3) = 6,12 < 7,81: nu respingem. Butonul ▶ crește T pînă la 5 000, cu aceleași autocorelații. De la ce T respinge testul la 5%?
Răspuns
De la T = 1 500 (în pașii de 500): QLB(3) = 9,17 > 7,81, p = 0,027. Statistica crește aproape proporțional cu T (30,52 la T = 5 000); pragul exact este în jur de T = 1 280. Autocorelațiile sînt aceleași; cu mai multe date ele sînt estimate mai precis și se separă de zero. În eșantioanele lungi, autocorelații mici devin semnificative, fără să fie mai mari.
Teste pe randamentele zilnice (p-value sub 0,05 cu roșu)
Întrebare pentru sală Cu m = 10 laguri, QLB clasic respinge pentru toate cele opt serii, Q̃ robust doar pentru S&P 500 și BET. Butonul ▶ mărește m pînă la 30. Cu m = 30, pentru ce serii respinge Q̃ robust?
Răspuns
Doar pentru BET (Q̃(30) = 67,9 > 43,77). S&P 500 nu mai respinge: Q̃(30) = 39,7, pentru că autocorelația lui de la lagul 1 se diluează printre 29 de laguri aproape nule; slide-ul spune același lucru: un m mai mare diluează un efect de scurtă durată. QLB clasic respinge la m = 30 pentru cinci serii, cu o distribuție χ² care nu ține seama de volatility clustering.
Întrebare pentru sală Pe tot eșantionul, BET are 3 278 de secvențe față de 3 606 așteptate (z = −7,75), iar S&P 500 4 738 față de 4 596 (z = 2,97). Butonul ▶ mută începutul eșantionului spre 2022. Pe eșantionul care începe în 2022, rămîne vreuna dintre aceste două respingeri?
Răspuns
Doar cea a BET, mult mai slabă: z = −2,03, față de 0,06 pentru S&P 500. Semnele BET persistă și în anii recenți, dar mult mai puțin decît pe tot eșantionul; la S&P 500 alternanța semnelor dispare. Din 2022, BRD are z = −3,79.
Întrebare pentru sală ACF-ul lui |rt| pentru S&P 500 este 0,27 la lagul 1, 0,22 la lagul 20 și 0,09 la lagul 100. Butonul ▶ mărește puterea d din |rt|d pînă la 2 (randamentele la pătrat). Ce se întîmplă cu autocorelația la lagul 100 cînd d trece de la 1 la 2?
Răspuns
Scade: 0,039 pentru d = 2, față de 0,092 pentru d = 1; la lagul 1 crește puțin (0,311 față de 0,275). Puterile mari dau pondere cîtorva zile extreme, iar autocorelația lor se stinge mai repede. Pentru orice d mărimea randamentelor rămîne corelată, deci RW1 și RW2 sînt respinse.
Graficul reprezintă două tipuri de ACF de selecție pînă la lagul 100, pentru S&P 500, BET și Bitcoin: ACF-ul randamentelor în modul \(|r_t|\) (linii continue) și ACF-ul randamentelor înseși (linii punctate). Randamentul în modul măsoară mărimea unei mișcări, indiferent de direcția ei.
Contrastul este puternic. Autocorelațiile randamentelor rămîn aproape de 0 la toate lagurile, cu excepția primului lag pentru BET și S&P 500. Autocorelațiile randamentelor în modul sînt pozitive și scad foarte lent: pentru S&P 500, 0,27 la lagul 1, 0,22 la lagul 20 și încă 0,09 la lagul 100. Mărimea mișcării de azi este legată de mărimea mișcărilor din ultimele luni.
Mișcările mari urmează după mișcări mari, în orice direcție. Acesta este volatility clustering, iar el respinge la prima vedere RW1 și RW2, pentru că amîndouă exclud orice dependență a pătratelor sau a valorilor în modul. Graficul nu spune nimic despre RW3 și martingal, pentru că acestea privesc direcția mișcărilor, nu mărimea lor. Capitolele 8 și 9 măsoară și modelează această dependență a volatilității.
Pe scurt
ACF-ul lui \(|r_t|\): S&P 500 \(0{,}27\) la lagul 1, \(0{,}22\) la lagul 20, \(0{,}09\) la lagul 100; randamentele însele: linii punctate în jurul lui 0
Mișcările mari urmează după mișcări mari: RW1 și RW2 sînt respinse la prima vedere; graficul nu spune nimic despre RW3 și martingal
Zgomotul alb nu are autocorelație, dar nu trebuie să fie independent. ACF-ul de selecție are o bandă i.i.d. \(\pm 1{,}96/\sqrt{T}\) și o bandă robustă care se lărgește în prezența volatility clustering; procesele AR au un ACF care scade, procesele MA unul care se anulează. Randamentele zilnice au autocorelații mici, cu un prim lag negativ la S&P 500 și unul pozitiv la BET, în timp ce valorile lor în modul sînt corelate puternic și persistent. Secțiunea următoare transformă aceste observații în teste formale.
Testarea autocorelației
Citirea autocorelațiilor lag cu lag lasă deschisă întrebarea cîte depășiri ar produce hazardul. Secțiunea construiește teste care combină multe laguri într-o singură statistică, testele portmanteau Box–Pierce și Ljung–Box și o versiune robustă la volatility clustering, le aplică pe opt serii și adaugă testul runs, care folosește doar semnele randamentelor.
Un test portmanteau testează \(m\) autocorelații împreună. Ipoteza lui nulă este \(H_0: \rho(1) = \dots = \rho(m) = 0\), față de alternativa că cel puțin un \(\rho(k)\) diferă de zero. Denumirea vine de la portmanteau, un geamantan mare în care încap multe autocorelații deodată.
Statistica Box–Pierce (Box & Pierce, 1970) însumează pătratele autocorelațiilor de selecție, \(Q_{BP}(m) = T\sum_{k=1}^{m} \hat\rho(k)^2\), unde \(T\) este numărul de randamente și \(m\) numărul de laguri testate. Cum fiecare \(\sqrt{T}\hat\rho(k)\) este aproximativ Normală standard pentru randamente i.i.d., suma pătratelor urmează aproximativ legea \(\chi^2(m)\). Pătratele fac ca autocorelațiile pozitive și negative să conteze la fel. Statistica LB (Ljung–Box) (Ljung & Box, 1978) ponderează fiecare lag cu numărul lui de termeni:
care este mai aproape de legea \(\chi^2(m)\) în eșantioane mici. Pentru randamente i.i.d., ambele statistici urmează aproximativ legea \(\chi^2(m)\), iar \(H_0\) se respinge la 5% dacă \(Q > \chi^2_{0{,}95}(m)\); pentru \(m = 10\),\(\chi^2_{0{,}95}(10) = 18{,}31\). Capitolul folosește \(m = 10\), două săptămîni de tranzacționare. Alegerea implică un compromis: un \(m\) mai mare acoperă mai multe laguri, dar diluează un efect de scurtă durată, pentru că o singură autocorelație mare este atunci mediată cu multe autocorelații apropiate de zero.
Pe scurt
\(H_0\): \(\rho(1) = \dots = \rho(m) = 0\); \(H_1\): cel puțin un \(\rho(k) \ne 0\); un singur test pentru \(m\) laguri împreună
„portmanteau”: un geamantan în care încap multe autocorelații deodată
Fie \(T = 1000\) de randamente zilnice cu autocorelațiile de selecție \(\hat\rho(1) = 0{,}06\),\(\hat\rho(2) = -0{,}04\) și \(\hat\rho(3) = 0{,}03\), testate cu \(m = 3\). Termenii \(T\hat\rho(k)^2\) sînt 3,6, 1,6 și 0,9, iar suma lor este statistica Box–Pierce \(Q_{BP}(3) = 6{,}10\). Statistica Ljung–Box ponderează fiecare pătrat cu \(T(T+2)/(T-k)\):\(Q_{LB}(3) = 1000 \times 1002 \times (0{,}06^2/999 + 0{,}04^2/998 + 0{,}03^2/997) = 6{,}12\), aproape aceeași valoare într-un eșantion de această mărime.
Valoarea critică este \(\chi^2_{0{,}95}(3) = 7{,}81\), mai mare decît 6,12, deci \(H_0\) nu se respinge la 5%. Lagurile luate separat duc la aceeași concluzie: \(\hat\rho(1) = 0{,}06\) se află chiar în interiorul benzii \(\pm 1{,}96/\sqrt{1000} = \pm 0{,}062\), iar nici testul comun nu respinge.
Aceleași autocorelații într-un eșantion de \(T = 5000\) dau o statistică de circa cinci ori mai mare, pentru că \(Q\) este proporțional cu \(T\), iar respingerea este clară. În eșantioanele lungi, autocorelațiile mici devin semnificative. Semnificația statistică într-o serie zilnică lungă spune, așadar, puțin despre mărimea efectului, observație care revine atunci cînd semnificația este comparată cu costurile de tranzacționare.
Pe scurt
\(T = 1000\) de randamente zilnice, \(\hat\rho(1) = 0{,}06\), \(\hat\rho(2) = -0{,}04\), \(\hat\rho(3) = 0{,}03\); testăm cu \(m = 3\)
Decizia: \(\chi^2_{0{,}95}(3) = 7{,}81 > 6{,}12\): nu respingem \(H_0\) la 5%
observație: \(\hat\rho(1) = 0{,}06\) se află chiar în interiorul benzii \(\pm 1{,}96/\sqrt{1000} = \pm 0{,}062\); nici testul comun nu respinge
Cu aceleași autocorelații și \(T = 5000\), \(Q\) este de cinci ori mai mare și respingerea este clară: în eșantioanele lungi, autocorelațiile mici devin semnificative
Un test portmanteau robust la volatility clustering
Legea \(\chi^2\) a lui \(Q_{LB}\) se bazează pe \(\mathrm{Var}(\hat\rho(k)) = 1/T\), condiție adevărată pentru randamente i.i.d. și falsă în prezența volatility clustering. Cu volatility clustering, autocorelațiile de selecție variază mai mult decît permite \(1/T\), iar \(Q_{LB}\) respinge un martingal adevărat mult prea des.
Remediul propus de Escanciano & Lobato (2009) este împărțirea fiecărei autocorelații la pătrat la propria varianță \(\hat\delta(k)/T\), cu \(\hat\delta(k)\) din banda robustă (7.4):
aproximativ, pentru un șir de diferențe de martingal cu momentul de ordinul patru finit. Cu randamente i.i.d., \(\hat\delta(k) \approx 1\) și \(\tilde Q \approx Q_{BP}\), deci nu se pierde nimic atunci cînd nu există volatility clustering.
Regula pentru lucrul aplicat decurge din ipotezele mersului aleator: RW1 se testează cu \(Q_{LB}\), iar martingalul, adică eficiența în formă slabă, cu \(\tilde Q\).
Pe scurt
Distribuția \(\chi^2\) a lui \(Q_{LB}\) cere \(\mathrm{Var}(\hat\rho(k)) = 1/T\): condiție adevărată pentru randamente i.i.d., falsă în prezența volatility clustering
atunci \(Q_{LB}\) respinge un martingal adevărat mult prea des
Statistica robustă: împărțim fiecare \(\hat\rho(k)^2\) la propria varianță \(\hat\delta(k)/T\)Escanciano & Lobato (2009)
\(\tilde Q(m) = \sum_{k=1}^{m} \dfrac{T\hat\rho(k)^2}{\hat\delta(k)} \sim \chi^2(m)\) pentru o diferență de martingal cu momentul de ordin patru finit
cu randamente i.i.d., \(\hat\delta(k) \approx 1\) și \(\tilde Q \approx Q_{BP}\)
Regula: testăm RW1 cu \(Q_{LB}\); testăm martingalul (eficiența în formă slabă) cu \(\tilde Q\)
Tabelul aplică testele pe opt serii de randamente logaritmice zilnice: S&P 500 și DAX din 1990, BET din 1997, Bitcoin din 2014 și patru acțiuni de la BVB (Bursa de Valori București) din 2010: Banca Transilvania (TLV), OMV Petrom (SNP), BRD – Groupe Société Générale (BRD) și Transgaz (TGN). Coloanele dau numărul de randamente \(T\), prima autocorelație \(\hat\rho(1)\), statistica Ljung–Box \(Q_{LB}(10)\) și p-value-ul ei, statistica robustă \(\tilde Q(10)\) și p-value-ul ei, statistica Ljung–Box a randamentelor la pătrat și statistica \(z\) a testului runs, cu p-value-ul ei.
Cele două teste portmanteau nu sînt de acord. Testul Ljung–Box clasic respinge la 5% pentru toate cele opt serii, cu p-value-uri de la sub 0,001 pînă la 0,030. Testul robust respinge doar pentru S&P 500, cu \(\tilde Q(10) = 18{,}8\) și un p-value de 0,043, și pentru BET, cu \(\tilde Q(10) = 42{,}9\) și un p-value sub 0,001. Pentru celelalte șase serii, respingerea testului clasic se explică prin volatility clustering, nu prin randamente previzibile.
Coloana randamentelor la pătrat arată de ce. Statisticile Ljung–Box ale lui \(r_t^2\) sînt uriașe peste tot, de la 213 pentru Bitcoin pînă la 8 015 pentru S&P 500, față de o valoare critică de 18,31 la 5%. RW1 și RW2 sînt respinse pentru fiecare serie, în timp ce martingalul este respins doar pentru S&P 500 și BET. Testul runs, prezentat pe slide-ul următor, respinge la 5% pentru S&P 500, BET, Bitcoin și BRD.
Pe scurt
\(T\)
\(\hat\rho(1)\)
\(Q_{LB}(10)\)
p
\(\tilde Q(10)\)
p
\(Q_{LB}(10)\), \(r^2\)
runs \(z\)
p
S&P 500
9 240
\({-0{,}079}\)
\(90{,}8\)
\(<\) 0,001
\(18{,}8\)
0,043
\(8015\)
\({2{,}97}\)
0,003
DAX
9 288
\({-0{,}009}\)
\(21{,}8\)
0,016
\(8{,}6\)
0,571
\(3747\)
\({1{,}73}\)
0,084
BET
7 243
\({0{,}156}\)
\(198{,}3\)
\(<\) 0,001
\(42{,}9\)
\(<\) 0,001
\(2500\)
\({-7{,}75}\)
\(<\) 0,001
Bitcoin
4 384
\({-0{,}022}\)
\(20{,}2\)
0,028
\(11{,}9\)
0,294
\(213\)
\({2{,}68}\)
0,007
TLV
3 788
\({0{,}010}\)
\(29{,}1\)
0,001
\(13{,}2\)
0,210
\(481\)
\({-1{,}68}\)
0,093
SNP
3 815
\({-0{,}015}\)
\(20{,}7\)
0,023
\(9{,}9\)
0,446
\(505\)
\({1{,}72}\)
0,085
BRD
3 771
\({0{,}032}\)
\(19{,}9\)
0,030
\(10{,}8\)
0,375
\(416\)
\({-3{,}04}\)
0,002
TGN
3 725
\({0{,}055}\)
\(28{,}7\)
0,001
\(12{,}3\)
0,263
\(639\)
\({1{,}49}\)
0,136
LB clasic: toate cele opt serii resping la 5%; \(\tilde Q\) robust: doar S&P 500 (p-value: 0,043) și BET (p-value: \(<\) 0,001)
Randamentele la pătrat: \(Q_{LB}\) uriaș peste tot: RW1 și RW2 sînt respinse pentru fiecare serie (volatility clustering)
Începutul seriilor: S&P 500 și DAX 1990; BET 1997; Bitcoin 2014; acțiuni BVB 2010 (TLV fără 30–31 mai 2016, o eroare de date, Capitolul 2)
Testul runs al lui Wald & Wolfowitz (1940) privește doar semnele randamentelor. O secvență (run) este un șir de randamente cu același semn: șirul \(+ + - + + + - -\) are 4 secvențe. Fie \(R\) numărul observat de secvențe. Pentru că folosește doar semnele, testul este neparametric: nu face nicio ipoteză despre distribuția randamentelor și este insensibil la cozile groase și la schimbările de volatilitate.
Cu \(n_1\) randamente pozitive și \(n_2\) negative, \(n = n_1 + n_2\), numărul de secvențe în ipoteza de independență are
Prea puține secvențe (\(z < 0\)) înseamnă că semnele persistă, o dependență pozitivă; prea multe secvențe (\(z > 0\)) înseamnă că semnele alternează, o dependență negativă.
BET are 3 278 de secvențe față de 3 606 așteptate, deci \(z = -7{,}75\): creșterile tind să urmeze după creșteri, iar scăderile după scăderi. S&P 500 are 4 738 de secvențe față de 4 596 așteptate, deci \(z = 2{,}97\): semnele alternează mai des decît ar implica hazardul. Ambele direcții corespund lui \(\hat\rho(1)\), continuare la BET și revenire la S&P 500, deși testul runs ajunge la ele doar din semne.
Pe scurt
Un run (secvență): un șir de randamente cu același semn; \(+ + - + + + - -\) are 4 secvențe Wald & Wolfowitz (1940)
\(R\): numărul observat de secvențe
testul folosește doar semnele: este neparametric, insensibil la cozile groase și la volatilitate
Cu \(n_1\) randamente pozitive și \(n_2\) negative, \(n = n_1 + n_2\), în ipoteza de independență:
Testele portmanteau combină \(m\) autocorelații într-o singură statistică, cu o lege aproximativ \(\chi^2(m)\). Testul Ljung–Box clasic presupune randamente i.i.d. și respinge pentru toate cele opt serii; statistica robustă \(\tilde Q\) respinge doar pentru S&P 500 și BET. Randamentele la pătrat sînt puternic autocorelate peste tot, deci RW1 și RW2 nu sînt valabile, în timp ce martingalul rezistă pentru majoritatea seriilor. Testul runs confirmă revenirea la S&P 500 și continuarea la BET. Secțiunea următoare trece de la randamente la prețurile logaritmice înseși.
Rădăcini unitare: prețuri față de randamente
Mersul aleator face prețurile logaritmice nestaționare și randamentele staționare. Secțiunea definește seriile staționare și integrate, arată de ce distincția contează prin regresia falsă, prezintă testele Dickey–Fuller, Phillips–Perron și KPSS, le aplică pe prețuri și pe randamente și explică de ce o rădăcină unitară în prețuri nu dovedește eficiența.
O serie este (slab) staționară dacă media și varianța ei sînt constante, iar \(\mathrm{Cov}(x_t, x_{t-k})\) depinde doar de lagul \(k\), nu de data \(t\). Într-o serie staționară șocurile se sting, iar seria revine la media ei; notația este \(I(0)\), integrată de ordinul 0.
O serie este integrată de ordinul 1, \(I(1)\), dacă nu este staționară, dar prima ei diferență \(\Delta x_t = x_t - x_{t-1}\) este. Mersul aleator este exemplul standard: prețul logaritmic \(p_t\) rătăcește fără să revină la vreun nivel, în timp ce diferența lui \(\Delta p_t = r_t\) este staționară.
Cele două cazuri sînt separate de un singur parametru în modelul AR(1) \(p_t = \phi\,p_{t-1} + \varepsilon_t\). Cu \(|\phi| < 1\), procesul este un AR(1) staționar; cu \(\phi = 1\), el este un mers aleator, cazul rădăcinii unitare. Denumirea vine de la ecuația caracteristică \(1 - \phi z = 0\), a cărei rădăcină este \(z = 1/\phi\), egală cu 1 cînd \(\phi = 1\). Întrebarea acestei secțiuni este dacă prețurile logaritmice sînt \(I(1)\), iar randamentele \(I(0)\).
Pe scurt
Serie (slab) staționară: medie constantă, varianță constantă, \(\mathrm{Cov}(x_t, x_{t-k})\) depinde doar de \(k\)
șocurile se sting; seria revine la media ei; notația \(I(0)\)
Integrată de ordinul 1, \(I(1)\): nu este staționară, dar prima ei diferență \(\Delta x_t = x_t - x_{t-1}\) este
mersul aleator este \(I(1)\): \(p_t\) nu revine la o medie, iar \(\Delta p_t = r_t\) este staționar
Rădăcină unitară (unit root): în \(p_t = \phi\,p_{t-1} + \varepsilon_t\), cazul \(\phi = 1\); \(|\phi| < 1\) dă un AR(1) staționar
denumirea: rădăcina ecuației \(1 - \phi z = 0\) este \(z = 1/\phi = 1\)
Întrebarea acestei secțiuni: sînt prețurile logaritmice \(I(1)\) și randamentele \(I(0)\)?
Întrebare pentru sală Pentru prețul logaritmic BET, regresia Dickey–Fuller cu constantă și fără laguri dă τ = −0,09. Butonul ▶ trece prin cele opt serii; curba arată τ pentru L = 0–40 laguri ale diferențelor. Respinge testul cu constantă rădăcina unitară pentru vreo serie, la vreun L?
Răspuns
Nu. Cel mai mic τ cu constantă este −1,41 (Bitcoin, L = 20), departe de −2,86; pentru TLV, SNP, BRD și TGN τ este chiar pozitiv. Prețurile cresc în timp, deci specificația potrivită are constantă și tendință: cu ea, TLV coboară sub −3,41 la 12 din cele 16 valori ale lui L (τ = −3,46 la L = 20, ordinul ales de AIC).
Întrebare pentru sală Cu T = 500, regresia unui mers aleator pe altul, independent, dă |t| > 1,96 în 90% din cele 2 000 de repetări. Butonul ▶ mărește T la 1 000 și 2 000 (T ≠ 500: rulări suplimentare ale codului din curs). Se apropie proporția respingerilor de 5% cînd T crește?
Răspuns
Nu, crește: 92,7% la T = 1 000 și 94,5% la T = 2 000 (77,3% la T = 100); |t| > 40 apare în 21,6% din regresii la T = 2 000. În regresia în niveluri, statistica t crește odată cu T, deci mai multe date fac relația falsă mai convingătoare. R² median rămîne între 0,16 și 0,18. Pe diferențe, proporția rămîne între 5,1% și 6,0% pentru orice T.
Panoul din stînga arată două mersuri aleatoare independente, \(y_t\) și \(x_t\), de lungime \(T = 500\). Ele nu au nicio legătură între ele, și totuși pe porțiuni lungi se mișcă împreună, doar pentru că fiecare se îndepărtează mult de punctul de plecare. Panoul din dreapta arată ce se întîmplă cînd se estimează regresia lui \(y_t\) pe \(x_t\) în 2 000 de repetări: histograma statisticii \(t\) a pantei, pentru regresii în niveluri și în diferențe, comparată cu densitatea \(N(0, 1)\).
În niveluri, statistica \(t\) depășește 1,96 în modul în 90% din repetări, iar \(R^2\) median este 0,17: o „relație” care nu există. Histograma se întinde pe valori mult dincolo de orice cuantilă Normală; \(|t| > 40\) apare în 2,6% din repetări, valori care se află în afara intervalului desenat. Aceasta este regresia falsă (spurious regression) a lui Granger & Newbold (1974): cu variabile \(I(1)\), testul \(t\) obișnuit nu are o distribuție Normală și respinge aproape întotdeauna absența unei relații.
În diferențe, \(|t| > 1{,}96\) apare în 5,5% din repetări, aproape de nivelul nominal de 5%, iar histograma se potrivește cu densitatea Normală. Lecția este că trebuie testată existența rădăcinii unitare înainte de a estima regresii între niveluri și că, atunci cînd seriile sînt \(I(1)\), se lucrează cu randamente.
Pe scurt
Estimăm regresia unui mers aleator pe altul, independent (\(T = 500\), 2 000 de repetări) Granger & Newbold (1974)
\(|t| > 1{,}96\) în 90% din cazuri, \(R^2\) median \(= 0{,}17\): o „relație” care nu există
Pe diferențe: \(|t| > 1{,}96\) în 5,5% din cazuri, cum este de așteptat
lecția: testați existența rădăcinii unitare înainte de a estima regresii în niveluri (\(|t| > 40\) în 2,6% din cazuri, valori care nu apar în grafic)
unde \(\Delta p_t = p_t - p_{t-1}\), iar \(c\) este o constantă. Un \(\gamma\) negativ readuce \(p_t\) spre un nivel; \(\gamma = 0\) îl lasă să rătăcească. Testul este unilateral, cu \(H_0: \gamma = 0\) (rădăcină unitară) față de \(H_1: \gamma < 0\) (staționară). Statistica este \(\tau = \hat\gamma/\mathrm{SE}(\hat\gamma)\), raportul \(t\) obișnuit din OLS (ordinary least squares, metoda celor mai mici pătrate).
În ipoteza \(H_0\),\(\tau\) nu urmează o lege \(t\) sau Normală, din același motiv ca în regresia falsă: regresorul \(p_{t-1}\) este el însuși un mers aleator. Valorile critice ale lui \(\tau\) sînt mai negative. La 5%, ele sînt \(-2{,}86\) cu constantă și \(-3{,}41\) cu constantă și tendință (MacKinnon, 1996), față de \(-1{,}645\) pentru un test Normal unilateral.
Regresia are trei specificații: fără constantă, cu o constantă \(c\) sau cu o constantă și o tendință \(c + bt\), iar valorile critice depind de alegere. Prețurile logaritmice cresc în timp, deci pentru ele testul folosește o constantă și o tendință; randamentele nu au tendință, deci pentru ele folosește doar o constantă.
Pe scurt
Scădem \(p_{t-1}\): \(\Delta p_t = c + \gamma\, p_{t-1} + \varepsilon_t\) cu \(\gamma = \phi - 1\)Dickey & Fuller (1979)
\(\Delta p_t = p_t - p_{t-1}\); \(c\): o constantă; \(\gamma < 0\) readuce \(p_t\) spre un nivel
\(H_0\): \(\gamma = 0\) (rădăcină unitară); \(H_1\): \(\gamma < 0\) (staționară); un test unilateral
statistica: \(\tau = \hat\gamma/\mathrm{SE}(\hat\gamma)\), raportul \(t\) obișnuit din OLS (ordinary least squares, metoda celor mai mici pătrate)
În ipoteza \(H_0\), \(\tau\)nu urmează o lege \(t\) sau Normală: valorile ei critice sînt mai negative
valorile critice de 5% MacKinnon (1996): \(-2{,}86\) cu constantă, \(-3{,}41\) cu constantă și tendință (distribuția Normală: \(-1{,}645\))
Trei specificații: fără constantă; constanta \(c\); constantă și tendință \(c + bt\)
prețurile logaritmice cresc în timp: folosim constantă și tendință; randamentele: doar constantă
Dacă randamentele sînt autocorelate, erorile din (7.8) sînt și ele autocorelate, iar valorile critice nu mai sînt valabile. Testul ADF (augmented Dickey–Fuller, Dickey–Fuller augmentat) al lui Said & Dickey (1984) adaugă în regresie laguri ale diferențelor, care preiau această autocorelație:
unde \(bt\) este o tendință liniară, iar \(\delta_j\) sînt coeficienții celor \(L\) laguri ale diferenței. Statistica \(\tau\) și valorile critice rămîn aceleași. Numărul de laguri \(L\) se alege prin AIC (Akaike information criterion, criteriul informațional Akaike, Capitolul 6), cu cel mult \(12(T/100)^{1/4}\) laguri.
Exemplul lucrat aplică versiunea cea mai simplă prețului logaritmic BET: o constantă, fără laguri și \(T = 7 243\) de observații zilnice. OLS dă \(\hat\gamma = -0{,}0000138\), cu eroarea standard \(\mathrm{SE}(\hat\gamma) = 0{,}000158\), deci estimația este foarte mică în raport cu eroarea ei standard, iar \(\tau = -0{,}09\). Valoarea este mult peste valoarea critică de 5% \(-2{,}86\), deci rădăcina unitară nu se respinge.
În acest exemplu, statistica este mult peste și valoarea critică Normală \(-1{,}645\), astfel că cele două distribuții duc la aceeași decizie. Ele diferă pentru valori ale lui \(\tau\) cuprinse între \(-2{,}86\) și \(-1{,}645\): acolo un test \(t\) obișnuit ar respinge rădăcina unitară, iar testul Dickey–Fuller nu. Folosirea distribuției greșite dă răspunsul greșit tocmai în aceste cazuri.
Pe scurt
ADF (augmented Dickey–Fuller, Dickey–Fuller augmentat) Said & Dickey (1984): adăugăm laguri ale diferențelor ca să eliminăm autocorelația din \(\varepsilon_t\)
aici nici un test \(t\) obișnuit (valoarea critică \(-1{,}645\)) nu ar respinge; dar un \(\tau\) între \(-2{,}86\) și \(-1{,}645\) ar fi respins cu valoarea critică greșită (Normală) și păstrat cu cea corectă
Testul PP (Phillips–Perron) (Phillips & Perron, 1988) tratează autocorelația altfel decît ADF. El estimează regresia Dickey–Fuller fără laguri și corectează statistica \(\tau\) pentru autocorelația și heteroscedasticitatea erorilor. Corecția folosește o varianță pe termen lung (long-run variance) cu ponderi Bartlett (Newey & West, 1987),
unde \(\hat\gamma(j)\) sînt autocovarianțele reziduurilor. Ponderile scad liniar, ceea ce păstrează estimația pozitivă. PP are aceeași ipoteză nulă și aceleași valori critice ca ADF.
Testul KPSS (Kwiatkowski–Phillips–Schmidt–Shin) (Kwiatkowski et al., 1992) inversează ipotezele: \(H_0\) este staționaritatea, în jurul unei constante sau al unei tendințe, iar \(H_1\) este rădăcina unitară. Statistica este \(\mathrm{KPSS} = \sum_{t=1}^{T} S_t^2/(T^2\hat\lambda^2)\), unde \(S_t\) sînt sumele parțiale ale reziduurilor dintr-o regresie pe o constantă (sau pe o constantă și o tendință), iar \(\hat\lambda^2\) este varianța lor pe termen lung. O serie staționară are sume parțiale care rămîn mici; o rădăcină unitară le face să rătăcească, iar statistica crește. Staționaritatea se respinge la 5% dacă KPSS depășește 0,463 cu constantă sau 0,146 cu tendință.
Cele două tipuri de teste se folosesc împreună pentru că pun întrebări opuse. ADF și PP întreabă dacă există dovezi împotriva rădăcinii unitare; KPSS întreabă dacă există dovezi împotriva staționarității. Dacă ADF nu respinge și KPSS respinge, seria este \(I(1)\); dacă ADF respinge și KPSS nu, ea este \(I(0)\); dacă ambele resping sau niciunul nu respinge, dovezile sînt neconcludente.
Pe scurt
PP (Phillips–Perron) Phillips & Perron (1988): regresia Dickey–Fuller fără laguri; \(\tau\) este corectat pentru autocorelație și heteroscedasticitate
corecția folosește o varianță pe termen lung cu ponderi Bartlett Newey & West (1987); aceeași \(H_0\) și aceleași valori critice ca ADF
varianța pe termen lung \(\hat\lambda^2 = \hat\gamma(0) + 2\sum_{j=1}^{L}\left(1 - \frac{j}{L+1}\right)\hat\gamma(j)\), cu \(\hat\gamma(j)\) autocovarianțele reziduurilor
Întrebare pentru sală Cu lățimea de bandă din curs (l = 38 pentru S&P 500), KPSS respinge staționaritatea prețurilor pentru toate cele opt serii; KPSS pe prețul S&P 500 este 2,23. Butonul ▶ schimbă lățimea de bandă l a varianței pe termen lung, începînd cu l = 0. Cît este KPSS pentru prețul S&P 500 la l = 0?
Răspuns
86,0. Un preț integrat are autocovarianțe mari și pozitive; fără ele, λ̂² este doar varianța reziduurilor și subestimează de zeci de ori varianța pe termen lung. Statistica scade cînd l crește, dar la l = 80 este încă 1,09 > 0,146. Pe randamente, KPSS rămîne sub 0,463 pentru orice l: concluzia I(1) pentru prețuri și I(0) pentru randamente nu depinde de lățimea de bandă.
Întrebare pentru sală Pentru BET, ADF pe prețul logaritmic este −1,73 (p = 0,736) și KPSS 2,30: prețul este I(1). Butonul ▶ trece prin cele opt serii. Pentru care serie testele pe prețul logaritmic nu dau concluzia I(1)?
Răspuns
TLV: ADF = −3,46 < −3,41 (p = 0,044) respinge rădăcina unitară, iar KPSS = 0,57 > 0,146 respinge staționaritatea în jurul tendinței. Testele se contrazic: un caz neconcludent, nu o dovadă de revenire la tendință. Pentru celelalte șapte serii ADF nu respinge și KPSS respinge. Randamentele sînt I(0) pentru toate cele opt.
Panoul din stînga arată prețul logaritmic al BET din 1997, cel din dreapta randamentele lui logaritmice zilnice, în %. Prețul logaritmic urcă de sub 6 pînă peste 10, cu o cădere lungă în 2008–2009, și nu se stabilizează niciodată în jurul unui nivel. Randamentele fluctuează în jurul lui zero, cu o medie constantă, în perioadele calme și în cele agitate.
Testele confirmă ce sugerează panourile. Pentru prețul logaritmic, ADF nu respinge rădăcina unitară, cu un p-value de 0,736, iar KPSS respinge staționaritatea: prețul logaritmic este \(I(1)\). Pentru randamente, ADF respinge rădăcina unitară, iar KPSS nu respinge staționaritatea: randamentele sînt staționare, \(I(0)\). Titlurile panourilor dau statisticile, ADF \(-1{,}73\) și KPSS 2,30 pentru prețul logaritmic, ADF \(-13{,}6\) și KPSS 0,12 pentru randamente; slide-ul următor le raportează pe toate.
Căderea din 2008 pare o abatere temporară de la o tendință crescătoare. Testele spun altceva: șocurile din acea perioadă au fost permanente, iar prețul logaritmic nu a revenit la dreapta de tendință pe care o urmase înainte de criză.
Tabelul raportează statisticile ADF, PP și KPSS pentru cele opt serii, pe prețul logaritmic cu constantă și tendință și pe randamente cu constantă. Valorile critice de 5% sînt \(-3{,}41\) pentru ADF și PP cu tendință și \(-2{,}86\) cu constantă; pentru KPSS ele sînt 0,146 cu tendință și 0,463 cu constantă.
Pentru prețurile logaritmice, ADF și PP nu resping rădăcina unitară pentru nicio serie, cu excepția TLV, a cărei statistică ADF de \(-3{,}46\) este chiar sub \(-3{,}41\), cu un p-value de 0,044; statistica ei PP, \(-3{,}35\), nu respinge. KPSS respinge staționaritatea pentru toate seriile, cu statistici între 0,57 și 2,50, toate peste 0,146. Prețurile logaritmice sînt \(I(1)\).
Pentru randamente, ADF și PP resping foarte puternic rădăcina unitară, cu statistici ADF între \(-12{,}96\) și \(-59{,}46\) și statistici PP între \(-57{,}83\) și \(-105{,}05\). KPSS nu respinge niciodată staționaritatea, cu statistici între 0,04 și 0,29, toate sub 0,463 și cu p-value-uri peste 0,10. Randamentele sînt \(I(0)\). Fiecare serie a capitolului are structura mersului aleator: un preț logaritmic nestaționar ale cărui diferențe sînt staționare.
Pe scurt
preț logaritmic (constantă, tendință)
randamente (constantă)
ADF
PP
KPSS
ADF
PP
KPSS
S&P 500
\({-1{,}47}\)
\({-1{,}57}\)
\({2{,}23}\)
\({-17{,}61}\)
\({-105{,}05}\)
\({0{,}12}\)
DAX
\({-2{,}69}\)
\({-2{,}65}\)
\({0{,}94}\)
\({-23{,}30}\)
\({-97{,}40}\)
\({0{,}04}\)
BET
\({-1{,}73}\)
\({-1{,}54}\)
\({2{,}30}\)
\({-13{,}65}\)
\({-74{,}47}\)
\({0{,}12}\)
Bitcoin
\({-1{,}48}\)
\({-1{,}54}\)
\({1{,}81}\)
\({-20{,}16}\)
\({-67{,}84}\)
\({0{,}13}\)
TLV
\({-3{,}46}\)
\({-3{,}35}\)
\({0{,}57}\)
\({-12{,}96}\)
\({-60{,}79}\)
\({0{,}23}\)
SNP
\({-0{,}80}\)
\({-0{,}74}\)
\({2{,}50}\)
\({-19{,}50}\)
\({-62{,}71}\)
\({0{,}29}\)
BRD
\({-2{,}18}\)
\({-2{,}19}\)
\({1{,}64}\)
\({-59{,}46}\)
\({-59{,}53}\)
\({0{,}29}\)
TGN
\({-0{,}96}\)
\({-0{,}92}\)
\({0{,}71}\)
\({-39{,}90}\)
\({-57{,}83}\)
\({0{,}22}\)
Valori critice de 5%: ADF și PP \(-3{,}41\) (tendință), \(-2{,}86\) (constantă); KPSS \(0{,}146\) (tendință), \(0{,}463\) (constantă)
Prețurile logaritmice: nicio respingere ADF/PP cu excepția TLV (ADF p = 0,044); KPSS respinge staționaritatea peste tot: prețurile sînt \(I(1)\)
Randamentele: ADF și PP resping puternic; KPSS nu respinge niciodată (p \(>\) 0,10): randamentele sînt \(I(0)\)
O rădăcină unitară în prețuri este necesară pentru un mers aleator, dar nu suficientă. Fie randamente care urmează procesul AR(1) \(r_t = 0{,}3\,r_{t-1} + \varepsilon_t\). Prețul logaritmic este atunci \(I(1)\), pentru că diferențele lui sînt staționare, dar creșterile lui sînt previzibile: 30% din randamentul fiecărei zile se transmite zilei următoare. ADF, care întreabă doar dacă nivelul prețului are o rădăcină unitară, nu poate deosebi această serie de un mers aleator. BET este un caz real: are rădăcină unitară și randamente autocorelate.
Argumentul invers este mai puternic. Un preț staționar, fără rădăcină unitară, ar contrazice eficiența, pentru că prețurile ar reveni la un nivel previzibil, iar un investitor ar putea cumpăra sub el și vinde peste el. TLV este cel mai aproape de acest caz, pentru că ADF respinge rădăcina unitară la 5% cu tendință; dar și KPSS respinge staționaritatea, deci cazul este neconcludent, nu o regulă profitabilă.
Testele de rădăcină unitară au, în plus, putere mică împotriva unui \(\phi\) apropiat de 1: o serie staționară cu \(\phi\) puțin sub 1 se deosebește greu de un mers aleator în eșantioane de lungime realistă. Întrebarea eficienței privește creșterile și cere teste pe randamente, precum testele de autocorelație din secțiunea anterioară și testele variance ratio din secțiunea următoare.
Pe scurt
O rădăcină unitară în prețuri este necesară pentru un mers aleator, dar nu suficientă
exemplu: \(r_t = 0{,}3\,r_{t-1} + \varepsilon_t\) face din \(p_t\) o serie \(I(1)\) ale cărei creșteri sînt previzibile
ADF nu o poate deosebi de un mers aleator; BET are rădăcină unitară și randamente autocorelate
Un preț staționar (fără rădăcină unitară) ar contrazice eficiența: prețurile ar reveni la un nivel previzibil
TLV: ADF respinge la 5% cu tendință, iar KPSS respinge și el: un caz neconcludent, nu o regulă profitabilă
Testele de rădăcină unitară au putere mică împotriva unui \(\phi\) apropiat de 1: întrebarea eficienței privește creșterile și cere teste pe randamente
Sinteza secțiunii
Prețurile logaritmice sînt \(I(1)\), iar randamentele \(I(0)\) în toate cele opt serii: ADF și PP nu resping rădăcina unitară în prețuri (TLV este o excepție la limită), iar KPSS respinge staționaritatea lor, în timp ce pentru randamente concluziile se inversează. Regresiile între niveluri pot produce relații false, iar statistica Dickey–Fuller cere propriile valori critice. O rădăcină unitară în prețuri este compatibilă cu eficiența, dar nu o dovedește, pentru că și creșterile previzibile produc o rădăcină unitară. Secțiunea următoare testează creșterile cu raportul varianțelor.
Testul variance ratio
Mersul aleator implică faptul că varianța randamentelor crește liniar cu orizontul. Raportul varianțelor (variance ratio) compară cei doi membri ai acestei relații și rezumă multe autocorelații într-un singur număr. Secțiunea îl definește, prezintă estimatorul Lo–MacKinlay și testele lui homoscedastic și robust, arată prin simulare de ce este nevoie de testul robust și extinde testul la mai multe orizonturi și la un orizont ales de date.
În ipoteza de mers aleator, \(\mathrm{Var}(r_t(q)) = q\,\mathrm{Var}(r_t)\): varianța randamentului pe \(q\) zile este de \(q\) ori varianța zilnică. VR (variance ratio, raportul varianțelor) compară cei doi termeni. Pentru o serie staționară de randamente, varianța unei sume de \(q\) randamente este \(q\gamma(0) + 2\sum_{k=1}^{q-1}(q-k)\gamma(k)\), iar împărțirea la \(q\gamma(0)\) dă (Lo & MacKinlay, 1988; Campbell, Lo & MacKinlay, 1997)
Valoarea are o interpretare directă. \(\mathrm{VR}(q) = 1\) corespunde unui mers aleator, iar RW1, RW2 și RW3 dau toate 1, pentru că toate trei anulează autocorelațiile. \(\mathrm{VR}(q) > 1\) înseamnă autocorelație pozitivă, momentum: mișcările continuă, deci varianța pe \(q\) zile depășește \(q\) varianțe zilnice. \(\mathrm{VR}(q) < 1\) înseamnă autocorelație negativă, mean reversion: mișcările sînt parțial anulate, deci varianța pe \(q\) zile este mai mică.
Raportul rezumă \(q - 1\) autocorelații cu ponderi care scad liniar cu lagul. Cînd autocorelațiile sînt mici, dar au același semn pe multe laguri, raportul le acumulează, astfel că are mai multă putere împotriva autocorelațiilor mici și persistente decît testele pe laguri separate. El măsoară și direct cu cît greșește regula rădăcinii pătrate a timpului din secțiunea despre mersul aleator.
Pe scurt
În ipoteza de mers aleator, \(\mathrm{Var}(r_t(q)) = q\,\mathrm{Var}(r_t)\); VR (variance ratio, raportul varianțelor) compară cei doi termeni
Primele patru autocorelații de selecție ale S&P 500 sînt \(\hat\rho(1) = -0{,}079\),\(\hat\rho(2) = -0{,}004\),\(\hat\rho(3) = -0{,}006\) și \(\hat\rho(4) = -0{,}022\). Pentru \(q = 2\), formula (7.11) are un singur termen, cu ponderea \(2(1 - 1/2) = 1\), deci \(\mathrm{VR}(2) = 1 + \hat\rho(1) = 0{,}921\).
Pentru \(q = 5\), ponderile \(2(1 - k/5)\) sînt 1,6, 1,2, 0,8 și 0,4 pentru lagurile 1–4, deci \(\mathrm{VR}(5) = 1 + 1{,}6\hat\rho(1) + 1{,}2\hat\rho(2) + 0{,}8\hat\rho(3) + 0{,}4\hat\rho(4) = 0{,}855\). Primul lag contribuie cel mai mult, dar cele trei mici autocorelații negative care urmează împing raportul și mai jos sub 1.
Estimatorul Lo–MacKinlay de pe slide-ul următor, calculat direct din sumele randamentelor pe aceleași date, dă \(\mathrm{VR}(2) = 0{,}922\) și \(\mathrm{VR}(5) = 0{,}856\). Cele două forme diferă doar prin corecții de eșantion mic. Interpretarea este că varianța săptămînală a S&P 500 reprezintă circa 0,856 din suma a cinci varianțe zilnice: mișcările zilnice sînt parțial anulate în decurs de o săptămînă.
Pe scurt
\(\hat\rho(1), \dots, \hat\rho(4)\) pentru S&P 500: \(-0{,}079\); \(-0{,}004\); \(-0{,}006\); \(-0{,}022\)
aproape aceleași cifre: cele două forme diferă doar prin corecții de eșantion mic
Interpretare: varianța săptămînală reprezintă circa \(0{,}856\) din suma a cinci varianțe zilnice: mișcările zilnice ale S&P 500 sînt parțial anulate într-o săptămînă
Lo & MacKinlay (1988) estimează raportul varianțelor din \(T\) randamente cu media \(\hat\mu\) și din sumele suprapuse pe \(q\) zile \(r_t(q)\). Varianța randamentelor pe o zi este \(\hat\sigma_a^2 = \frac{1}{T-1}\sum_t (r_t - \hat\mu)^2\), iar varianța sumelor pe \(q\) zile, împărțită la \(q\), este \(\hat\sigma_c^2(q) = \frac{1}{m}\sum_t (r_t(q) - q\hat\mu)^2\), unde \(m = q(T - q + 1)(1 - q/T)\) corectează deplasarea creată de sumele suprapuse. Estimatorul este \(\widehat{\mathrm{VR}}(q) = \hat\sigma_c^2(q)/\hat\sigma_a^2\).
De aici rezultă două teste. Testul homoscedastic, valabil sub RW1, standardizează abaterea de la 1 prin varianța ei pentru randamente i.i.d.; testul robust, valabil sub RW3 și martingal, folosește o varianță care ține seama de volatility clustering:
Ambele statistici urmează aproximativ legea \(N(0, 1)\) sub ipotezele lor nule.
Varianța robustă \(\hat\theta(q)/T\) rezultă din (7.11):\(\widehat{\mathrm{VR}}(q) - 1\) este o sumă ponderată de autocorelații de selecție, cu ponderile \(2(q-j)/q\), iar fiecare autocorelație are varianța \(\hat\delta(j)/T\), cu \(\hat\delta(j)\) din banda ACF robustă (7.4). Cu randamente i.i.d., \(\hat\delta(j) \approx 1\) și \(Z^*(q) \approx Z(q)\). Fotografia îl arată pe Andrew W. Lo de la MIT (Massachusetts Institute of Technology), unul dintre cei doi autori ai testului.
Pe scurt
Cu \(T\) randamente, media \(\hat\mu\) și sume pe \(q\) zile suprapuse Lo & MacKinlay (1988):
Întrebare pentru sală Din ACF-ul S&P 500, VR(5) = 1 + 1,6ρ̂(1) + 1,2ρ̂(2) + 0,8ρ̂(3) + 0,4ρ̂(4) = 0,855, iar estimatorul Lo–MacKinlay dă 0,856. Butonul ▶ mărește q pînă la 20. Cît de mult diferă cele două valori la q = 20?
Răspuns
Foarte puțin: 0,768 din ACF și 0,767 cu estimatorul Lo–MacKinlay, o diferență de 0,0005. Pentru BET, la q = 20: 1,514 și 1,517. Cele două forme diferă doar prin corecțiile de eșantion mic, care contează puțin cu T = 9 240 și q = 20.
Întrebare pentru sală Pentru S&P 500 la q = 2, Z(2) = −7,54 și Z*(2) = −3,37: statistica homoscedastică este de 2,24 ori mai mare în modul. Butonul ▶ mărește q pînă la 40. La q = 40, mai respinge Z* mersul aleator pentru S&P 500?
Răspuns
Nu: Z*(40) = −1,81, deși Z(40) = −3,70 respinge încă. La q = 40, Z* respinge doar pentru BET. Raportul Z/Z* rămîne între 2,0 și 2,3 la toate orizonturile: volatility clustering dublează abaterea standard a lui VR(q) estimat, iar Z(q) nu ține seama de ea.
Întrebare pentru sală Sub un martingal GARCH(1,1) cu α = 0,12 și β = 0,86, Z(2) respinge ipoteza nulă adevărată în 17,1% din cazuri, Z*(2) în 4,7%. Butonul ▶ schimbă reacția α de la 0 la 0,12, cu β = 0,86 fix (α ≠ 0,12: rulări suplimentare ale simulării din curs). La α = 0,09, cît de des respinge Z(2)?
Răspuns
În 9,0% din cazuri; la α = 0,06 în 6,2%, la α = 0 în 4,8%. Distorsiunea crește repede cînd α + β se apropie de 1 (0,95 la α = 0,09, 0,98 la α = 0,12), pentru că volatilitatea devine foarte persistentă. Z*(2) rămîne între 4,3% și 4,9% pentru toate valorile lui α.
Mărimea (size) unui test este frecvența cu care respinge o ipoteză nulă adevărată; un test de 5% ar trebui să respingă o \(H_0\) adevărată în 5% din eșantioane. Graficul raportează mărimile testelor \(Z\) și \(Z^*\) într-o simulare: 1 000 de eșantioane de \(T = 2000\) de randamente în care \(H_0\) este adevărată, generate fie ca randamente Normale i.i.d., fie dintr-un model GARCH(1,1) cu \(\alpha = 0{,}12\) și \(\beta = 0{,}86\). Randamentele GARCH sînt necorelate, dar au volatility clustering; \(\alpha\) măsoară reacția varianței la șocul de ieri, iar \(\beta\) persistența ei. Barele dau procentul de respingeri la nivelul de 5% pentru \(q = 2\), 5 și 10; linia întreruptă marchează 5%.
Cu randamente i.i.d., ambele teste resping în circa 5% din cazuri, cum și trebuie. Cu randamente GARCH, testul homoscedastic \(Z(2)\) respinge în 17,1% din eșantioane, de peste trei ori nivelul nominal, în timp ce testul robust \(Z^*(2)\) respinge doar în 4,7%. Imaginea este similară pentru \(q = 5\) și \(q = 10\):\(Z\) respinge mult prea des, iar \(Z^*\) rămîne la 5% sau puțin sub.
Consecința pentru lucrul empiric este directă. Aplicat pe randamente cu volatility clustering, \(Z\) „găsește” o ineficiență care nu este decît volatility clustering. Doar \(Z^*\) testează ipoteza care contează pentru eficiență, iar toate rezultatele empirice ale acestui capitol îl folosesc.
Pe scurt
1 000 de eșantioane de \(T = 2000\) de randamente cu \(H_0\) adevărată: Normale i.i.d. și GARCH(1,1) (\(\alpha = 0{,}12\), \(\beta = 0{,}86\))
GARCH: randamente necorelate, dar cu volatility clustering (\(\alpha\): reacția la șocul de ieri, \(\beta\): persistența)
i.i.d.: ambele resping circa 5%; GARCH: \(Z(2)\) respinge în 17,1% din cazuri, \(Z^*(2)\) doar în 4,7%
Mărimea unui test: cît de des respinge o \(H_0\) adevărată; \(Z\) „găsește” o ineficiență care nu este decît volatility clustering
Întrebare pentru sală Pe tot eșantionul, 10 din cele 32 de statistici Z* din tabel depășesc 1,96 în modul. Butonul ▶ mută începutul eșantionului spre 2022. Pe eșantionul care începe în 2010, cîte rămîn?
Răspuns
Trei: S&P 500 la q = 2 și Transgaz la q = 2 și 5 (pentru Transgaz eșantionul începe oricum în 2010). BET nu mai respinge la niciun orizont. Cu statistica homoscedastică Z ar fi 13, pentru că Z ignoră volatility clustering. La 32 de teste independente la 5% ne-am aștepta în medie la 1,6 respingeri false.
Întrebare pentru sală Cu orizonturile 2, 5, 10, 20 (m = 4), valoarea critică Chow–Denning la 5% este 2,49 și testul respinge pentru S&P 500, BET și Transgaz. Butonul ▶ schimbă mulțimea de orizonturi. Cu toate orizonturile 2, …, 20 (m = 19), care serii mai resping?
Răspuns
S&P 500 și BET. Valoarea critică crește la 3,00, iar Transgaz, cu CD = 2,77, nu o mai depășește. Mai multe orizonturi înseamnă mai multe ocazii pentru o respingere falsă, deci un prag mai mare; CD crește doar dacă orizonturile adăugate au un |Z*| mai mare.
Întrebare pentru sală Din 1990, VR(40) este 0,724 pentru S&P 500 și 1,743 pentru BET, iar Z* respinge pentru BET la toate cele 39 de orizonturi. Butonul ▶ mută începutul eșantionului spre 2022. Pe eșantionul care începe în 2010, mai respinge Z* momentumul BET la vreun orizont q = 2, …, 40?
Răspuns
Nu: VR(40) al BET scade la 1,193 și niciun Z*(q) nu depășește 1,96. Momentumul BET vine din primii ani (1997–2006, ρ̂(1) = 0,270). S&P 500 respinge din 2010 la un singur orizont din 39, cu VR(40) = 0,663, sub valoarea din 1990: revenirea la medie rămîne, dar banda robustă se lărgește odată cu eșantionul mai scurt.
Graficul reprezintă \(\mathrm{VR}(q)\) pentru orizonturi \(q\) de la 2 la 40 de zile de tranzacționare, pentru S&P 500, DAX, BET și Bitcoin. Zona umbrită este banda de 95% a testului robust \(Z^*\) în jurul lui 1, liniile întrerupte banda de 95% a testului homoscedastic \(Z\). Un raport aflat în afara zonei umbrite respinge mersul aleator la 5% pentru acel orizont.
S&P 500 scade sub 1 la orice orizont și rămîne sub banda robustă: mean reversion, care se adîncește repede în primele două săptămîni și mai lent după aceea. BET crește continuu cu orizontul, de la 1,517 la 20 de zile pînă la 1,743 la 40 de zile, mult peste ambele benzi: momentum. DAX și Bitcoin rămîn în interiorul benzii robuste la orice orizont, deci pentru ele mersul aleator nu se respinge.
Cele două benzi diferă mult. Banda i.i.d. este mult mai îngustă, mai ales la orizonturi lungi, pentru că ignoră volatility clustering. Un test bazat pe ea ar declara semnificative mult mai multe orizonturi, ceea ce este respingerea excesivă de pe slide-ul anterior, văzută pe date reale.
Pe scurt
S&P 500: VR scade sub 1 la orice orizont (mean reversion); BET: VR crește continuu cu orizontul, 1,517 la 20 de zile și 1,743 la 40 de zile (momentum)
DAX și Bitcoin: în interiorul benzii robuste (zona umbrită) la orice orizont; banda i.i.d. (linia întreruptă) este mult mai îngustă
Tabelul dă \(\mathrm{VR}(q)\) și \(Z^*(q)\) pentru orizonturile \(q = 2\), 5, 10 și 20, pentru cele opt serii. Mersul aleator se respinge la 5% pentru un orizont dat dacă \(|Z^*| > 1{,}96\).
Pentru S&P 500, toate cele patru rapoarte sînt sub 1, de la 0,922 la două zile pînă la 0,767 la douăzeci de zile, iar toate cele patru statistici robuste, între \(-3{,}37\) și \(-2{,}06\), resping: mean reversion semnificativ la fiecare orizont. Pentru BET, toate cele patru rapoarte sînt peste 1, între 1,156 și 1,517, iar toate cele patru statistici, între 4,74 și 5,99, resping: momentum semnificativ la fiecare orizont. Pentru Transgaz (TGN), \(Z^*(2) = 2{,}05\) și \(Z^*(5) = 2{,}60\) resping, în timp ce orizonturile mai lungi nu. DAX, Bitcoin, TLV, SNP și BRD nu au nicio respingere.
Tabelul conține patru teste pe fiecare serie și 32 în total, iar cu cît se fac mai multe teste, cu atît apar mai multe orizonturi „semnificative” din întîmplare. O respingere la două orizonturi din patru, ca la Transgaz, cere un test care ține seama de comparațiile multiple. Slide-ul următor îl prezintă.
Pe scurt
VR(2)
VR(5)
VR(10)
VR(20)
\(Z^*(2)\)
\(Z^*(5)\)
\(Z^*(10)\)
\(Z^*(20)\)
S&P 500
\(0{,}922\)
\(0{,}856\)
\(0{,}783\)
\(0{,}767\)
\({-3{,}37}\)
\({-2{,}76}\)
\({-2{,}73}\)
\({-2{,}06}\)
DAX
\(0{,}990\)
\(0{,}968\)
\(0{,}932\)
\(0{,}925\)
\({-0{,}61}\)
\({-0{,}88}\)
\({-1{,}21}\)
\({-0{,}91}\)
BET
\(1{,}156\)
\(1{,}283\)
\(1{,}362\)
\(1{,}517\)
\({5{,}99}\)
\({5{,}25}\)
\({4{,}74}\)
\({4{,}94}\)
Bitcoin
\(0{,}977\)
\(0{,}991\)
\(1{,}027\)
\(1{,}094\)
\({-0{,}88}\)
\({-0{,}19}\)
\({0{,}37}\)
\({0{,}91}\)
TLV
\(1{,}009\)
\(0{,}997\)
\(0{,}954\)
\(0{,}995\)
\({0{,}34}\)
\({-0{,}04}\)
\({-0{,}48}\)
\({-0{,}04}\)
SNP
\(0{,}985\)
\(0{,}960\)
\(0{,}975\)
\(1{,}038\)
\({-0{,}53}\)
\({-0{,}68}\)
\({-0{,}29}\)
\({0{,}32}\)
BRD
\(1{,}032\)
\(1{,}083\)
\(1{,}078\)
\(1{,}107\)
\({1{,}28}\)
\({1{,}55}\)
\({0{,}97}\)
\({0{,}96}\)
TGN
\(1{,}055\)
\(1{,}150\)
\(1{,}142\)
\(1{,}166\)
\({2{,}05}\)
\({2{,}60}\)
\({1{,}69}\)
\({1{,}44}\)
\(|Z^*| > 1{,}96\): respingem mersul aleator la 5% pentru acel orizont
S&P 500: mean reversion semnificativ la toate cele patru orizonturi; BET: momentum semnificativ la toate patru
Testarea separată pentru \(q = 2\), 5, 10 și 20 la 5% dă o probabilitate mult mai mare de 5% de a obține cel puțin o respingere falsă. Pentru 4 teste independente ea ar fi \(1 - 0{,}95^4 = 18{,}5\%\); rapoartele varianțelor la orizonturi diferite sînt corelate pozitiv, deci valoarea reală este mai mică, dar tot mult peste 5%.
Testul CD (Chow–Denning) (Chow & Denning, 1993) ia o singură decizie pentru toate orizonturile. Statistica lui este cea mai mare statistică robustă în modul,
unde \(\Phi\) este funcția de repartiție (distribution function) Normală standard. Valoarea critică provine din legea modulului maxim studentizat (studentised maximum modulus), care tratează cele \(m\) statistici ca și cum ar fi independente și este, de aceea, conservatoare.
Pentru \(m = 4\) orizonturi la 5%, rezolvarea ecuației \((2\Phi(c) - 1)^4 = 0{,}95\) dă \(c = 2{,}49\) în loc de 1,96. Mersul aleator se respinge dacă cel mai mare \(|Z^*|\) de pe cele patru orizonturi depășește 2,49. Pragul mai ridicat este prețul examinării mai multor orizonturi.
Pe scurt
Testarea separată pentru \(q = 2, 5, 10, 20\) la 5% crește mult probabilitatea de a obține cel puțin o respingere falsă
pentru 4 teste independente: \(1 - 0{,}95^4 = 18{,}5\%\)
Orizontul \(q\) al raportului varianțelor este o alegere a cercetătorului, iar orizonturi diferite pot da concluzii diferite. Testul VR automat al lui Choi (1999) îl alege din date. El scrie raportul ca sumă ponderată a tuturor autocorelațiilor de selecție, \(\mathrm{VR}(k) = 1 + 2\sum_{i=1}^{T-1} w(i/k)\,\hat\rho(i)\), cu ponderi \(w\) care scad lin, date de nucleul spectral pătratic (quadratic spectral kernel) al lui Andrews (1991). Lățimea de bandă (bandwidth) \(k\) joacă rolul orizontului și se alege prin regula dependentă de date a lui Andrews: ea crește cu autocorelația de ordinul 1 și cu \(T\). Statistica \(\sqrt{T/k}\,(\mathrm{VR}(k) - 1)/\sqrt2\) urmează aproximativ legea \(N(0, 1)\).
Pentru ca testul să fie robust la volatility clustering, Kim (2009) calculează p-value-ul lui prin wild bootstrap. Fiecare eșantion bootstrap este \(r_t^* = \eta_t(r_t - \bar r)\), cu \(\eta_t \sim N(0, 1)\) independente, iar procedura se repetă de 500 de ori. Înmulțirea fiecărui randament centrat cu un semn și o mărime aleatoare independente păstrează mărimea lui \(r_t\), și odată cu ea tiparul volatilității, dar distruge orice autocorelație. Statisticile bootstrap formează astfel o distribuție nulă în care randamentele sînt imprevizibile, dar volatilitatea se grupează ca în date.
Cele trei instrumente răspund la aceeași întrebare în trei moduri: \(Z^*(q)\) pentru un orizont ales dinainte, Chow–Denning pentru o mulțime de orizonturi și testul automat pentru un orizont ales de date.
Pe scurt
Orizontul \(q\) poate fi ales din date: testul VR automat Choi (1999)
\(\mathrm{VR}(k) = 1 + 2\sum_{i=1}^{T-1} w(i/k)\,\hat\rho(i)\), cu ponderi \(w\) care scad lin (nucleul spectral pătratic) Andrews (1991)
lățimea de bandă \(k\) crește cu autocorelația de ordinul 1 și cu \(T\); statistica \(\sqrt{T/k}\,(\mathrm{VR}(k) - 1)/\sqrt2 \approx N(0, 1)\)
p-value prin wild bootstrapKim (2009): reeșantionăm \(r_t^* = \eta_t(r_t - \bar r)\) cu \(\eta_t \sim N(0, 1)\), de 500 de ori
fiecare \(r_t^*\) păstrează mărimea lui \(r_t\) (volatilitatea), dar pierde orice autocorelație: o distribuție nulă robustă
Trei instrumente, o întrebare: \(Z^*(q)\) pentru un orizont ales, CD pentru o mulțime de orizonturi, testul automat pentru un orizont ales de date
Tabelul dă, pentru cele opt serii, numărul de randamente \(T\), statistica Chow–Denning pe \(q = 2\), 5, 10, 20 și p-value-ul ei, lățimea de bandă \(\hat k\) aleasă de testul automat, statistica automată și p-value-ul ei wild bootstrap.
Ambele teste resping mersul aleator pentru S&P 500 (CD 3,37, cu un p-value de 0,003; statistica automată \(-5{,}21\), cu un p-value de 0,006), pentru BET (CD 5,99 și statistica automată 8,86, ambele cu p-value-uri sub 0,001) și pentru Transgaz (CD 2,60, cu un p-value de 0,037; statistica automată 3,78, cu un p-value de 0,004). Niciunul nu respinge pentru DAX, Bitcoin, TLV, SNP și BRD. Lățimea de bandă se comportă cum a fost construită: este mare acolo unde prima autocorelație este mare, 5,6 pentru BET, și mică acolo unde ea este aproape zero, 1,7 pentru DAX.
O respingere nu înseamnă profit. O autocorelație de \(-0{,}079\), valoarea S&P 500, explică \(\hat\rho(1)^2\), adică mai puțin de 1%, din varianța randamentului de mîine. O regulă care ar exploata-o ar tranzacționa aproape zilnic, iar costurile de tranzacționare ar absorbi cea mai mare parte din cîștigul așteptat. Previzibilitatea statistică este o condiție necesară pentru o ineficiență în sens economic, nu una suficientă.
Pe scurt
\(T\)
CD
p
\(\hat k\)
VR automat
p (bootstrap)
S&P 500
9 240
\(3{,}37\)
0,003
\(3{,}7\)
\({-5{,}21}\)
0,006
DAX
9 288
\(1{,}21\)
0,644
\(1{,}7\)
\({-0{,}39}\)
0,608
BET
7 243
\(5{,}99\)
\(<\) 0,001
\(5{,}6\)
\({8{,}86}\)
\(<\) 0,001
Bitcoin
4 384
\(0{,}91\)
0,835
\(2{,}0\)
\({-1{,}01}\)
0,352
TLV
3 788
\(0{,}48\)
0,981
\(1{,}5\)
\({0{,}31}\)
0,718
SNP
3 815
\(0{,}68\)
0,937
\(1{,}7\)
\({-0{,}53}\)
0,562
BRD
3 771
\(1{,}55\)
0,403
\(2{,}3\)
\({1{,}58}\)
0,152
TGN
3 725
\(2{,}60\)
0,037
\(3{,}0\)
\({3{,}78}\)
0,004
Ambele teste resping pentru S&P 500, BET și Transgaz; niciunul nu respinge pentru DAX, Bitcoin, TLV, SNP și BRD
\(\hat k\) este mare unde prima autocorelație este mare (BET \(5{,}6\)) și mic unde ea este aproape 0 (DAX \(1{,}7\))
Interpretare: respingerea nu înseamnă profit
o autocorelație de \(-0{,}079\) explică \(\hat\rho(1)^2\), adică mai puțin de 1%, din varianța randamentului de mîine
costurile de tranzacționare absorb cea mai mare parte
Raportul varianțelor (7.11) compară varianța randamentelor pe \(q\) zile cu \(q\) varianțe zilnice și este egal cu 1 sub orice ipoteză de mers aleator. Testul homoscedastic \(Z\) respinge prea des în prezența volatility clustering, deci testul potrivit este \(Z^*\) robust; Chow–Denning combină mai multe orizonturi, iar testul automat lasă datele să aleagă unul. Toate testele sînt de acord: mean reversion la S&P 500, momentum la BET, un efect mai slab la Transgaz și nicio previzibilitate la DAX, Bitcoin, TLV, SNP și BRD. Secțiunea următoare întreabă dacă aceste concluzii sînt valabile pe alte piețe și în timp.
Eficiența pe piețe și în timp
Rezultatele de pînă acum acoperă eșantioane complete de pînă la 36 de ani. Secțiunea compară șaisprezece piețe în același deceniu recent, introduce ipoteza piețelor adaptive, care prevede că eficiența se schimbă în timp, și testează această predicție cu rapoarte ale varianțelor pe ferestre mobile și pe subperioade.
Întrebare pentru sală La q = 5, doar intervalele robuste de 95% ale PX (Z* = 2,08) și BET (Z* = 2,03) exclud valoarea 1. Butonul ▶ mărește orizontul q pînă la 20. La q = 20, ce piață exclude valoarea 1?
Răspuns
Doar Ethereum (VR(20) = 1,29, Z* = 2,45); PX și BET revin în interval. La q = 2 este S&P 500 (VR(2) = 0,86, Z* = −2,33). Fiecare orizont arată altă piață: cu 16 piețe și multe orizonturi, unele intervale exclud 1 din întîmplare, iar testul Chow–Denning pe patru orizonturi nu respinge pentru nicio piață.
Graficul compară raportul varianțelor pe cinci zile VR(5) pentru șaisprezece piețe, de la 19 septembrie 2016 pînă la 18 septembrie 2026. Fiecare punct este estimația, fiecare linie orizontală intervalul ei robust de 95%, iar linia verticală întreruptă marchează VR = 1, mersul aleator. Culorile separă piețele dezvoltate (S&P 500, Nikkei 225, Euro Stoxx 50, DAX), piețele emergente (printre ele BET, PX de la Praga, WIG20 de la Varșovia, BUX de la Budapesta, BIST 100 de la Istanbul, Shanghai Composite, Nifty 50, KOSPI, IPC Mexico și Bovespa) și piețele cripto (Bitcoin și Ethereum).
Folosirea aceluiași deceniu pentru toate piețele elimină diferențele de perioadă a eșantionului, care contează dacă eficiența se schimbă în timp. Piețele sînt ordonate după estimație, de la PX și BET în partea de sus, cu rapoarte de circa 1,2, pînă la S&P 500 în partea de jos, cu cel mai mic raport.
Majoritatea intervalelor conțin valoarea 1. Intervalele diferă și ca lățime: cele mai largi sînt ale S&P 500 și Bovespa, cele mai înguste ale Bitcoin și Ethereum. Slide-ul următor explică lățimea intervalului S&P 500.
Pe scurt
VR(5) cu intervalul robust de 95%, de la 19 septembrie 2016 pînă la 18 septembrie 2026: piețe dezvoltate, emergente și cripto
Doar două intervale exclud valoarea 1: PX, cu \(Z^*(5) = 2{,}08\), și BET, cu \(Z^*(5) = 2{,}03\), ambele cu rapoarte peste 1, adică momentum. Acestea sînt două piețe central-europene mai mici, ai căror indici conțin acțiuni mai puțin lichide.
Cu multe piețe se fac multe teste. Șaisprezece teste la 5% dau, în medie, 0,8 respingeri false chiar dacă fiecare piață este eficientă. Dacă testele ar fi independente, probabilitatea de a obține cel puțin o respingere falsă ar fi \(1 - 0{,}95^{16} = 56\%\). Două respingeri din șaisprezece sînt, așadar, dovezi slabe. Testul Chow–Denning pe patru orizonturi confirmă acest lucru: nicio piață nu respinge la 5%, cu p-value-uri de 0,159 pentru BET și 0,142 pentru PX.
S&P 500 are cel mai mic raport, VR(5) \(= 0{,}84\), dar cu un interval larg și \(Z^* = -1{,}22\), care nu respinge. Oscilațiile mari din 2020 măresc \(\hat\theta\), varianța robustă a raportului, și odată cu ea lățimea intervalului. Bitcoin și Ethereum au rapoarte apropiate de 1, ca piețele dezvoltate. În ultimul deceniu, majoritatea piețelor, inclusiv cele cripto, par aproape eficiente în formă slabă.
Pe scurt
Doar două intervale exclud valoarea 1: PX (\(Z^*(5) = 2{,}08\)) și BET (\(Z^*(5) = 2{,}03\)), ambele peste 1
două piețe central-europene mai mici, cu acțiuni mai puțin lichide în indice
Multe piețe, multe teste: 16 teste la 5% dau, în medie, 0,8 respingeri false
dacă testele ar fi independente, probabilitatea de a obține cel puțin o respingere falsă ar fi \(1 - 0{,}95^{16} = 56\%\)
Chow–Denning pe patru orizonturi: nicio piață nu respinge la 5% (BET p = 0,159, PX p = 0,142)
S&P 500: VR(5) \(= 0{,}84\), cel mai mic, dar cu un interval larg (\(Z^* = -1{,}22\)): oscilațiile mari din 2020 măresc \(\hat\theta\)
Bitcoin și Ethereum: VR(5) aproape de 1, ca pe piețele dezvoltate
AMH (adaptive markets hypothesis, ipoteza piețelor adaptive) a lui Lo (2004), dezvoltată în cartea Lo (2017), aplică piețelor idei din teoria evoluției. Piețele sînt ecosisteme de investitori care învață și se adaptează. Oportunitățile de profit apar, sînt exploatate de investitorii care le descoperă și dispar; eficiența nu este o proprietate fixă, ci se schimbă odată cu mediul. Crizele, tehnologia nouă, participanții noi și reglementarea pot îndepărta o piață de eficiență sau o pot readuce spre ea.
Ipoteza împacă paradoxul Grossman–Stiglitz cu dovezile empirice. Ineficiențele există pentru că cineva trebuie plătit pentru colectarea informației, dar ele nu sînt constante: cresc cînd condițiile se schimbă și se reduc pe măsură ce investitorii se adaptează.
Consecința ei testabilă este că previzibilitatea variază în timp. Kim, Shamsuddin & Lim (2011) găsesc acest lucru pe un secol de date din SUA, Urquhart & McGroarty (2016) pe mai multe piețe mari, iar Lim & Brooks (2011) sintetizează literatura despre evoluția eficienței în timp. Instrumentul este simplu: același test aplicat pe ferestre mobile.
Pe scurt
AMH (adaptive markets hypothesis, ipoteza piețelor adaptive) Lo (2004): piețele sînt ecosisteme de investitori care învață și se adaptează
oportunitățile de profit apar, sînt exploatate și dispar; eficiența se schimbă odată cu mediul
crizele, tehnologia nouă, participanții noi și reglementarea îndepărtează piața de eficiență sau o readuc spre ea
Consecința testabilă: previzibilitatea variază în timp
Întrebare pentru sală La q = 5, S&P 500 respinge în 2002–2013 (Z*(5) = −2,53). Butonul ▶ mărește q la 10 și 20. La q = 20, mai respinge vreo subperioadă a S&P 500?
Răspuns
Niciuna: Z*(20) = −1,33, −1,54 și −0,91, deși VR(20) = 0,72 în 2002–2013, mai departe de 1 decît VR(5) = 0,80. Varianța lui VR(q) crește cu q, iar cu circa 3 000 de zile pe subperioadă intervalul robust devine larg. Doar BET 1997–2006 respinge la q = 20 (Z*(20) = 5,14).
Întrebare pentru sală Pe ferestre de 500 de zile, 29% dintre ferestrele BET și 4% dintre ferestrele S&P 500 resping la 5%. Butonul ▶ mărește fereastra la 750, 1 000 și 1 500 de zile. Ce se întîmplă cu ponderea ferestrelor S&P 500 care resping, la 1 500 de zile?
Răspuns
Crește la 20%, toate cu VR < 1. O fereastră lungă estimează mai precis aceeași autocorelație negativă mică, deci o separă mai ușor de zero; la 250 de zile ponderea este 1,6%. Ferestrele consecutive au în comun 1 479 din 1 500 de zile, deci ponderea descrie datele, nu este un test.
Graficul aplică testul variance ratio pe ferestre mobile de 500 de zile de tranzacționare, circa doi ani. O fereastră nouă începe la fiecare 21 de zile de tranzacționare, circa o lună, iar fiecare fereastră este datată la sfîrșitul ei. Panoul de sus arată VR(5) în fiecare fereastră, panoul de jos statistica robustă \(Z^*(5)\), pentru S&P 500 din 1990, BET din 1997 și Bitcoin din 2014; liniile întrerupte marchează VR = 1 în panoul de sus și \(\pm 1{,}96\) în panoul de jos.
O fereastră în care \(Z^*(5)\) se află peste 1,96 arată momentum semnificativ în cei doi ani ai ei; una în care se află sub \(-1{,}96\) arată mean reversion semnificativ. Traiectoria statisticii în timp arată cînd a fost previzibilă fiecare piață și în ce direcție.
Cele trei piețe se comportă diferit. BET pornește mult peste 1 și scade în trepte, cu episoade ulterioare peste 1. S&P 500 rămîne în cea mai mare parte sub 1, cu punctul cel mai de jos în jurul crizei din 2008. Bitcoin fluctuează în jurul lui 1. Slide-ul următor dă valorile.
Pe scurt
VR(5) și \(Z^*(5)\) pe ferestre de 500 de zile de tranzacționare (circa doi ani), o fereastră nouă la fiecare 21 de zile, datată la sfîrșitul ferestrei
Pentru BET, VR(5) ajunge la 1,80 în fereastra care se termină în 2000, un momentum puternic în primii ani ai indicelui. După 2008, raportul este mai aproape de 1, cu excepția unor episoade scurte, precum cel din jurul anilor 2013–2014. Pe întregul eșantion, 29% dintre ferestre resping mersul aleator la 5%, toate cu VR peste 1, adică momentum.
Pentru S&P 500, VR(5) se află mai ales sub 1. Valoarea cea mai mică, 0,59, apare în fereastra care se termină în 2008 și acoperă criza financiară. Doar 4% dintre ferestre resping, toate cu VR sub 1: revenirile sînt cele mai puternice în crize, cînd volatilitatea este mare și prețurile depășesc nivelul de echilibru. Pentru Bitcoin, nicio fereastră nu respinge din 2016, în 185 de ferestre.
Aceste ponderi trebuie citite cu atenție. Ferestrele consecutive au în comun 479 din cele 500 de zile, deci statisticile lor sînt puternic dependente, iar ponderea ferestrelor care resping nu este frecvența de respingere a unor teste independente. Ea descrie cum s-a schimbat previzibilitatea în timp, nu testează dacă s-a schimbat.
Pe scurt
BET: VR(5) pînă la 1,80 în fereastra care se termină în 2000; mai aproape de 1 după 2008, cu excepția unor episoade scurte
29% dintre ferestre resping la 5%, toate cu VR \(> 1\) (momentum)
S&P 500: VR(5) mai ales sub 1; cel mai mic, 0,59, în fereastra care se termină în 2008
4% dintre ferestre resping, toate cu VR \(< 1\): revenirile sînt cele mai puternice în crize
Bitcoin: nicio fereastră nu respinge din 2016 (185 de ferestre)
Atenție: ferestrele consecutive au în comun 479 din 500 de zile; ponderea ferestrelor care resping este o descriere, nu un test
Tabelul împarte fiecare eșantion în trei subperioade de lungimi apropiate, care nu se suprapun. Pentru fiecare dă numărul de randamente \(T\), prima autocorelație, VR(5), \(Z^*(5)\) și p-value-ul testului Chow–Denning pe patru orizonturi.
Pentru BET, prima perioadă, 1997–2006, arată un momentum puternic: \(\hat\rho(1) = 0{,}270\), VR(5) \(= 1{,}50\),\(Z^*(5) = 6{,}15\) și un p-value Chow–Denning sub 0,001. În 2007–2016, prima autocorelație scade la 0,066 și nimic nu este semnificativ. Din 2017, VR(5) \(= 1{,}20\) este tot peste 1, iar \(Z^*(5) = 2{,}04\) depășește ușor 1,96, dar testul comun nu respinge (p-value 0,154).
Pentru S&P 500, autocorelația negativă apare abia după 2002: în 1990–2001, \(\hat\rho(1) = 0{,}017\) și VR(5) \(= 0{,}96\), în timp ce în 2002–2013, \(\hat\rho(1) = -0{,}100\), VR(5) \(= 0{,}80\) și testul comun respinge (p-value 0,010), iar în 2014–2026, \(\hat\rho(1) = -0{,}124\), VR(5) \(= 0{,}85\) și p-value-ul testului comun este 0,080. Bitcoin nu are nicio respingere în vreuna dintre subperioadele de după 2014, cu VR(5) între 0,98 și 1,01; Urquhart (2016) a găsit ineficiență în primii lui ani, înainte de începutul eșantionului acestui capitol.
Pe scurt
perioada
\(T\)
\(\hat\rho(1)\)
VR(5)
\(Z^*(5)\)
CD p
BET
1997–2006
2 306
\({0{,}270}\)
\(1{,}50\)
\({6{,}15}\)
\(<\) 0,001
BET
2007–2016
2 516
\({0{,}066}\)
\(1{,}08\)
\({0{,}82}\)
0,262
BET
2017–2026
2 421
\({0{,}064}\)
\(1{,}20\)
\({2{,}04}\)
0,154
S&P 500
1990–2001
3 025
\({0{,}017}\)
\(0{,}96\)
\({-0{,}62}\)
0,334
S&P 500
2002–2013
3 019
\({-0{,}100}\)
\(0{,}80\)
\({-2{,}53}\)
0,010
S&P 500
2014–2026
3 196
\({-0{,}124}\)
\(0{,}85\)
\({-1{,}30}\)
0,080
Bitcoin
2014–2017
1 201
\({0{,}028}\)
\(0{,}98\)
\({-0{,}23}\)
0,983
Bitcoin
2018–2021
1 461
\({-0{,}058}\)
\(0{,}98\)
\({-0{,}21}\)
0,374
Bitcoin
2022–2026
1 722
\({-0{,}026}\)
\(1{,}01\)
\({0{,}18}\)
0,924
BET: momentum puternic în 1997–2006 (\(\hat\rho(1) = 0{,}270\)), mult mai slab după aceea
din 2017 VR(5) este tot peste 1, dar testul comun nu respinge
S&P 500: autocorelația negativă apare după 2002
Bitcoin: nicio respingere în vreuna dintre subperioadele de după 2014; Urquhart (2016) a găsit ineficiență în primii lui ani
Explicația principală a momentumului din primii ani ai BET este tranzacționarea redusă (thin trading): în primii ani, multe acțiuni din indice se tranzacționau doar de cîteva ori pe zi, unele nici măcar zilnic. Un preț de închidere putea fi atunci vechi de cîteva ore, un preț neactualizat (stale price) care nu reflecta încă știrile de după-amiază. Știrile intrau în indice pe parcursul mai multor zile, pe măsură ce fiecare acțiune se tranzacționa.
Indicele arată atunci autocorelație pozitivă chiar dacă fiecare acțiune este eficientă. Randamentul de azi al indicelui conține o parte din știrile de ieri, prin acțiunile ale căror prețuri nu fuseseră actualizate ieri, și este deci corelat cu randamentul de ieri al indicelui. Mecanismul explică de ce momentumul apare în indicele unei piețe mici și se estompează pe măsură ce tranzacțiile devin mai frecvente.
Piața s-a schimbat după 2007: mai multă lichiditate, investitori străini, aderarea României la UE (Uniunea Europeană) și reclasificarea de către FTSE Russell la statutul de piață Secondary Emerging, în vigoare din 2020 (FTSE Russell, 2019). Scăderea autocorelației BET de la 0,270 la circa 0,06 urmează aceste schimbări. Pele & Mazurencu-Marinescu (2012) studiază crahurile de la Bursa de Valori București. Fotografia arată Palatul Bursei din București.
Pe scurt
Tranzacționare redusă (thin trading): puține tranzacții pe zi la multe acțiuni din indice
un preț de închidere poate fi stale (neactualizat de cîteva ore); știrile intră în indice pe parcursul mai multor zile
indicele arată atunci autocorelație pozitivă chiar dacă fiecare acțiune este eficientă
Schimbările de după 2007
mai multă lichiditate, investitori străini, aderarea la UE, reclasificarea de către FTSE Russell la statutul Secondary Emerging (2020) FTSE Russell (2019)
În ultimul deceniu, doar PX și BET resping mersul aleator la cinci zile, iar nicio piață nu respinge atunci cînd mai multe orizonturi sînt testate împreună. Pe perioade mai lungi, previzibilitatea se schimbă, cum prevede ipoteza piețelor adaptive: BET a avut un momentum puternic în 1997–2006, explicat prin tranzacționarea redusă, care s-a estompat pe măsură ce piața s-a dezvoltat; S&P 500 a dobîndit mean reversion după 2002, cel mai puternic în crize; Bitcoin nu arată previzibilitate din 2014. Secțiunea următoare trece de la prețurile trecute la informația publică și la cea privată.
Forma semi-tare, forma tare și anomalii
Forma slabă folosește doar prețurile trecute. Secțiunea prezintă instrumentele pentru cele două forme mai puternice, studiile de eveniment și randamentele insiderilor și ale administratorilor de fonduri, apoi examinează anomaliile calendaristice, tipare ale randamentelor pe care eficiența nu le prevede, la S&P 500 și BET.
Studiul de eveniment (event study) este testul standard al formei semi-tari, prezentat de MacKinlay (1997) și în capitolul 4 din Campbell, Lo & MacKinlay (1997). El întreabă cît de repede absoarbe un preț o știre publică, precum anunțul unor rezultate financiare sau al unei fuziuni. Randamentul anormal (abnormal return) este randamentul minus randamentul prevăzut de un model, de exemplu randamentul pieței, și se cumulează pe o fereastră în jurul anunțului. Într-o piață eficientă, randamentul anormal cumulat sare în ziua știrii și nu are nicio derivă ulterioară; o derivă lentă ar însemna că știrea a fost absorbită treptat și că s-ar fi putut tranzacționa pe baza ei.
Cercetările recente aplică metoda la viteze foarte diferite. Tak, Schlamp, Osterrieder & Pele (2026) măsoară în nanosecunde cît de repede absorb prețurile futures știrile la Eurex și la CME (Chicago Mercantile Exchange), iar Lin, Găman, Wang & Pele (2025) studiază reacțiile pieței la etapele de dezvoltare ale Ethereum.
Forma tare întreabă dacă cineva cu informație privată poate obține randamente în exces. Insiderii, managerii care tranzacționează acțiunile propriei companii, pot, iar de aceea tranzacționarea pe baza informațiilor privilegiate este ilegală. Administratorii profesioniști de fonduri, în majoritate, nu pot (Jensen, 1968; Fama & French, 2010). Forma tare nu este, așadar, valabilă pentru insideri, dar este aproximativ valabilă pentru investitorii profesioniști.
O anomalie este un tipar al randamentelor pe care modelul de echilibru nu îl explică. Trei anomalii calendaristice sînt clasice. Efectul de weekend este tendința randamentelor de luni de a fi mici sau negative (French, 1980). Efectul ianuarie este tendința randamentelor de a fi mai mari în ianuarie, mai ales la acțiunile mici (Rozeff & Kinney, 1976). Efectul de început de lună este concentrarea randamentelor în jurul primelor zile de tranzacționare ale lunii (Ariel, 1987).
Durează anomaliile? McLean & Pontiff (2016) constată că randamentele anomaliilor publicate scad după publicare, ceea ce este compatibil cu învățarea investitorilor și cu perspectiva adaptivă din secțiunea anterioară. Prin problema ipotezei comune, o anomalie poate dezvălui și un factor de risc lipsă, nu neapărat o ineficiență.
Căutarea anomaliilor are propriul pericol statistic, căutarea repetată în date (data mining). Cu destule împărțiri calendaristice, pe zile ale săptămînii, luni, zile ale lunii sau sărbători, unele vor părea semnificative din întîmplare. Harvey, Liu & Zhu (2016) numără sute de tipare testate pe secțiunea transversală a randamentelor și arată că un tipar nou are nevoie de o statistică \(t\) peste 3, nu 2, pentru a ține seama de aceste testări multiple.
Pe scurt
O anomalie: un tipar în randamente pe care modelul de echilibru nu îl explică
efectul de weekend: randamente mici sau negative lunea French (1980)
efectul ianuarie: randamente mai mari în ianuarie, mai ales la acțiunile mici Rozeff & Kinney (1976)
efectul de început de lună: randamente concentrate în jurul primelor zile de tranzacționare ale lunii Ariel (1987)
\[r_t = a + b\,\mathbf{1}\{\text{ianuarie}\}_t + u_t, \qquad t = \frac{\hat b}{\mathrm{SE}_{NW}(\hat b)}\]
Întrebare pentru sală Testul Wald al egalității mediilor pe zile ale săptămînii dă p = 0,69 pentru S&P 500 și 0,24 pentru BET (erori standard Newey–West cu 5 laguri). Butonul ▶ mută începutul eșantionului spre 2022. Coboară p-value-ul BET sub 0,05 pentru vreun început?
Răspuns
Nu: cel mai mic este 0,088, pentru eșantionul care începe în 2016; S&P 500 rămîne peste 0,62. Încercarea a 17 începuturi diferite este ea însăși o căutare repetată în date: chiar un p sub 0,05 la unul dintre ele nu ar fi o dovadă a unui efect de zi a săptămînii.
Graficul arată randamentul logaritmic zilnic mediu, în %, pentru fiecare zi a săptămînii, pentru S&P 500 și BET, cu intervale de 95%. Intervalele folosesc erori standard Newey–West (Newey & West, 1987), care țin seama de autocorelație și de heteroscedasticitate, ambele prezente în randamentele zilnice. Efectul de weekend ar apărea ca o bară de luni clar sub celelalte.
Testul anomaliei nu întreabă dacă o bară diferă de zero, pentru că un randament mediu pozitiv este de așteptat în fiecare zi, ci dacă mediile diferă de la o zi la alta. Testul Wald al egalității mediilor celor cinci zile dă un p-value de 0,69 pentru S&P 500 și de 0,24 pentru BET. BET are singura medie negativă, \(-0{,}019\%\) lunea, dar ea nu este semnificativă, iar intervalul ei este larg.
Nici efectul ianuarie nu se descurcă mai bine. La BET, randamentul mediu din ianuarie este 0,185% pe zi față de 0,036% în celelalte luni, cu \(t = 1{,}72\) și un p-value de 0,09; pentru S&P 500, p-value-ul este 0,59. Niciun efect calendaristic nu rezistă la 5% în aceste date, ceea ce concordă cu constatarea că anomaliile publicate slăbesc în timp.
Pe scurt
Randamentul zilnic mediu pe zile ale săptămînii, cu intervale de 95% (erori standard Newey–West Newey & West (1987))
testul Wald al egalității mediilor pe zile: S&P 500 p = 0,69, BET p = 0,24
BET lunea: \(-0{,}019\%\), singura medie negativă, dar nesemnificativă
ianuarie: BET \(0{,}185\%\) pe zi față de \(0{,}036\%\) (\(t = 1{,}72\), p = 0,09); S&P 500: p = 0,59
Niciun efect calendaristic nu rezistă la 5% în datele noastre
Studiile de eveniment testează forma semi-tare prin viteza cu care prețurile absorb știrile publice; forma tare nu este valabilă pentru insideri, dar este aproximativ valabilă pentru administratorii profesioniști de fonduri. Anomaliile calendaristice, precum efectul de weekend și efectul ianuarie, au fost documentate cu decenii în urmă, dar randamentele lor scad după publicare, iar căutarea lor este expusă riscului de data mining. La S&P 500 și BET, niciun efect al zilei săptămînii sau al lunii ianuarie nu este semnificativ la 5%.
AI pentru descoperire științifică
Instrumentele capitolului se pot aplica unor întrebări încă deschise. Secțiunea formulează o astfel de întrebare, despre eficiența pieței de la București după trecerea ei la statutul de piață emergentă, descrie cum ar putea instrumentele AI (inteligență artificială) să sprijine studiul ei, enumeră verificările de care are nevoie și propune un proiect.
A devenit BET mai eficient după trecerea României la statutul de piață Secondary Emerging de către FTSE Russell, în vigoare din septembrie 2020 (FTSE Russell, 2019)? Reclasificarea a adus fonduri indexate și investitori străini, care ar trebui să mărească lichiditatea și să reducă prețurile neactualizate care au produs momentumul din primii ani ai BET.
Datele nu răspund încă la întrebare. În cei cinci ani dinaintea reclasificării, prima autocorelație a fost \(\hat\rho(1) = -0{,}002\), iar VR(5) \(= 1{,}12\), cu \(Z^* = 0{,}80\). În cei cinci ani de după, \(\hat\rho(1) = 0{,}087\) și VR(5) \(= 1{,}18\), cu \(Z^* = 1{,}78\). Diferența dintre cele două rapoarte are \(z = 0{,}34\), deci nu există nicio dovadă de schimbare, în niciuna dintre direcții.
Întrebarea rămîne deschisă pentru că mai multe lucruri s-au petrecut în același timp: pandemia COVID-19 (coronavirus disease 2019), noile listări mari și volumele de tranzacționare mai mari. Nu este clar nici dacă unitatea potrivită de analiză este indicele sau fiecare acțiune, pentru că tranzacționarea redusă afectează indicele chiar dacă fiecare acțiune este eficientă. Instrumentele AI pot accelera un astfel de studiu; ele nu înlocuiesc verificarea lui (Wang et al., 2023).
Pe scurt
A devenit BET mai eficient după trecerea României la statutul de piață Secondary Emerging (septembrie 2020)?FTSE Russell (2019)
cinci ani înainte: \(\hat\rho(1) = -0{,}002\), VR(5) \(= 1{,}12\) (\(Z^* = 0{,}80\))
cinci ani după: \(\hat\rho(1) = 0{,}087\), VR(5) \(= 1{,}18\) (\(Z^* = 1{,}78\))
diferența celor două VR(5): \(z = 0{,}34\): nicio dovadă de schimbare
Întrebarea rămîne deschisă: pandemia COVID-19, noile listări mari și volumele mai mari s-au produs în același timp
care este unitatea potrivită de analiză, indicele sau fiecare acțiune?
Instrumentele AI pot accelera un astfel de studiu; nu înlocuiesc verificarea rezultatelor Wang et al. (2023)
Instrumentele AI ar putea contribui în trei etape. Pentru literatură, ele pot întocmi o listă a studiilor despre eficiența piețelor din Europa Centrală și de Est și a testelor folosite în ele. Pentru cod, pot scrie o primă versiune a testelor Lo–MacKinlay și VR automat pe ferestre mobile pentru acțiunile din BET, cu p-value-uri wild bootstrap. Pentru robustețe, pot propune variante: alte ferestre, alte orizonturi, BET-TR (BET Total Return, care include dividendele) în loc de BET și volumul tranzacțiilor ca variabilă de control.
Exemplul de prompt de pe slide cere calculul central: o funcție Python care calculează raportul varianțelor Lo–MacKinlay VR(5) și statistica \(z\) robustă la heteroscedasticitate pentru randamentele logaritmice zilnice ale BET pe ferestre mobile de 500 de zile și testează dacă raportul mediu diferă înainte și după 21 septembrie 2020.
Fiecare dintre aceste rezultate este o schiță. Slide-ul următor enumeră ce trebuie verificat înainte ca o schiță să devină un rezultat; promptul însuși conține una dintre capcane.
Pe scurt
Literatura: o listă a studiilor despre eficiența piețelor din Europa Centrală și de Est și a testelor folosite în ele
Cod: o primă versiune a testelor Lo–MacKinlay și VR automat pe ferestre mobile pentru acțiunile din BET, cu p-value-uri wild bootstrap
Robustețe: alte ferestre, alte orizonturi, BET-TR în loc de BET, volumul tranzacțiilor ca variabilă de control
Exemplu de prompt
Write a Python function that computes the Lo-MacKinlay variance ratio VR(5) and the heteroskedasticity-robust z-statistic for daily BET log returns on rolling 500-day windows, and test whether the mean VR differs before and after 21 September 2020.
Prima verificare privește statistica. Testul trebuie să fie \(Z^*\) robust, nu \(Z\) homoscedastic; o schiță care folosește \(Z\) va „găsi” o ineficiență care nu este decît volatility clustering, cum a arătat verificarea Monte Carlo. A doua verificare privește datele de intrare. Testul se aplică randamentelor logaritmice ale indicelui, nu nivelurilor prețurilor, iar un test de rădăcină unitară pe randamente nu este un test de eficiență, pentru că randamentele sînt staționare fie că sînt previzibile, fie că nu.
A treia verificare privește ferestrele mobile. Ferestrele consecutive se suprapun, deci un test \(t\) pe media statisticilor mobile, cum cere exemplul de prompt, tratează valori dependente ca independente și supraestimează dovezile. A patra verificare privește designul studiului: data evenimentului și lungimea ferestrei se fixează înainte de a vedea rezultatul, nu se aleg după ce s-au încercat mai multe variante.
Ultima verificare privește referințele. Instrumentele AI pot produce citări plauzibile ale unor lucrări care nu există; fiecare lucrare citată trebuie verificată, iar DOI-ul ei (digital object identifier) trebuie să trimită la lucrarea pe care pretinde că o identifică.
Pe scurt
Statistica: \(Z^*\) robust, nu \(Z\) homoscedastic; o ciornă care folosește \(Z\) va „găsi” ineficiență
Randamentele logaritmice ale indicelui, nu nivelurile prețurilor; un test de rădăcină unitară pe randamente nu este un test de eficiență
Ferestrele mobile se suprapun: un test \(t\) pe media statisticilor mobile tratează valori dependente ca independente
Data evenimentului și fereastra se fixează înainte de a vedea rezultatul
Referințele: fiecare lucrare citată trebuie să existe; verificați DOI-ul
Proiectul întreabă dacă piața de la București este azi mai eficientă decît în 2015 și dacă schimbarea, dacă există, apare în indice sau în acțiunile individuale. Datele sînt BET din 1997, BET-TR din 2014 și cele patru acțiuni BVB ale capitolului, TLV, SNP, BRD și TGN, din 2010, de la furnizorul de date de piață EODHD (EOD Historical Data).
Pașii urmează capitolul. Calculați VR(2) și VR(5) pe ferestre mobile, cu \(Z^*\) și testul Chow–Denning, pentru indice și pentru fiecare acțiune. Comparați perioada 2015–2020 cu perioada 2020–2025 printr-un bootstrap pe blocuri (block bootstrap) al diferenței, care păstrează dependența randamentelor în interiorul blocurilor. Repetați analiza pentru WIG20 și BUX, ca termeni de comparație: dacă toate trei piețele s-au schimbat în același timp, schimbarea este regională sau globală, nu specifică reclasificării României.
Livrabilele sînt un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele. Orice utilizare a instrumentelor AI trebuie declarată, împreună cu lista erorilor AI care au fost corectate.
Pe scurt
Întrebarea: este piața de la București mai eficientă azi decît în 2015?
o a doua întrebare: apare schimbarea în indice sau în acțiunile individuale?
date: BET din 1997, BET-TR din 2014, acțiuni BVB (TLV, SNP, BRD, TGN) din 2010 (EODHD)
Pași
VR(2), VR(5) mobile cu \(Z^*\) și testul Chow–Denning pentru indice și pentru fiecare acțiune
comparați 2015–2020 cu 2020–2025 printr-un bootstrap pe blocuri al diferenței
repetați pentru WIG20 și BUX, ca termeni de comparație: s-au schimbat toate în același timp?
Livrabil: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele
Declarați orice utilizare a instrumentelor AI și enumerați erorile acestora pe care le-ați corectat
Sinteza secțiunii
Întrebarea dacă BET a devenit mai eficient după 2020 folosește toate instrumentele capitolului: rapoartele varianțelor robuste, testele comune, ferestrele mobile și distincția dintre indice și acțiunile lui. Estimațiile dinainte și de după reclasificare nu diferă semnificativ, iar schimbările simultane fac întrebarea greu de tranșat. Instrumentele AI pot scrie o primă versiune a trecerii în revistă a literaturii și a codului, dar verificările privind statistica, datele de intrare, ferestrele suprapuse, designul și referințele rămîn sarcina cercetătorului.
Rezumat
Rezumatul adună rezultatele principale ale capitolului, formulele lui și trei întrebări de autoevaluare.
O piață este eficientă dacă prețurile reflectă informația; în forma slabă, prețurile trecute nu pot fi folosite pentru a obține randamente peste compensarea riscului. Ipoteza nulă potrivită pentru forma slabă este martingalul, sau RW3, nu RW1: volatility clustering respinge RW1 și RW2, dar nu este o ineficiență, pentru că o varianță previzibilă nu face randamentul previzibil.
Prețurile logaritmice sînt \(I(1)\), iar randamentele \(I(0)\) în toate seriile capitolului, dar rădăcina unitară, în sine, nu dovedește eficiența, pentru că și randamentele previzibile produc o rădăcină unitară în prețuri. Eficiența trebuie testată pe randamente, cu teste robuste: statistica portmanteau \(\tilde Q\) și statistica variance ratio \(Z^*(q)\). Mai multe orizonturi se combină cu testul Chow–Denning, sau datele aleg orizontul prin testul VR automat.
Dovezile sînt diferite de la o piață la alta, iar diferențele sînt instructive. S&P 500 revine ușor la medie, BET avea un momentum clar în primii ani, iar majoritatea piețelor par azi aproape eficiente; eficiența variază în timp, cum prevede ipoteza piețelor adaptive. Previzibilitatea statistică nu înseamnă profit: costurile de tranzacționare și riscul decid dacă un tipar previzibil poate fi exploatat.
Pe scurt
Piață eficientă: prețurile reflectă informația; forma slabă = prețurile trecute nu pot fi folosite pentru randamente în exces
Ipoteza nulă potrivită este martingalul (RW3), nu RW1: volatility clustering nu înseamnă ineficiență
Prețurile logaritmice sînt \(I(1)\), iar randamentele \(I(0)\) în toate seriile noastre; rădăcina unitară, în sine, nu dovedește eficiența
Folosiți teste robuste: \(\tilde Q\) și \(Z^*(q)\); combinați orizonturile cu Chow–Denning sau lăsați datele să aleagă (VR automat)
Dovezi: S&P 500 revine ușor la medie, BET avea momentum în primii ani, majoritatea piețelor sînt azi aproape eficiente; eficiența variază în timp
Previzibilitatea statistică nu înseamnă profit: costurile și riscul decid
Tabelul reunește formulele capitolului. Mersul aleator (7.2) dă \(\mathrm{Var}(r_t(q)) = q\sigma^2\). ACF-ul de selecție (7.3) se citește cu banda robustă \(\pm 1{,}96\sqrt{\hat\delta(k)/T}\) din (7.4). Statistica Ljung–Box (7.5) urmează aproximativ legea \(\chi^2(m)\) pentru randamente i.i.d., iar versiunea ei robustă este (7.6). Testul runs (7.7) compară numărul observat de secvențe cu \(E[R] = 2n_1n_2/n + 1\).
Pentru rădăcinile unitare, regresia ADF (7.9) dă statistica \(\tau = \hat\gamma/\mathrm{SE}(\hat\gamma)\), cu valorile critice Dickey–Fuller, iar statistica KPSS \(\sum_t S_t^2/(T^2\hat\lambda^2)\) testează ipoteza nulă inversată a staționarității, cu varianța pe termen lung (7.10).
Pentru raportul varianțelor, (7.11) scrie \(\mathrm{VR}(q)\) ca sumă ponderată de autocorelații, testul robust \(Z^*(q)\) și varianța lui \(\hat\theta(q)\) sînt date în (7.12), iar testul Chow–Denning (7.13) ia maximul lui \(|Z^*(q_i)|\) pe \(m\) orizonturi, cu \(P(\mathrm{CD} \le c) = (2\Phi(c) - 1)^m\).
Prima întrebare: \(\hat\rho(1) = 0{,}10\) și \(\hat\rho(k) = 0\) pentru \(k \ge 2\); ce ne spune VR(2)? Conform (7.11),\(\mathrm{VR}(2) = 1 + 0{,}10 = 1{,}10\): varianța pe două zile este cu 10% mai mare decît în cazul unui mers aleator, un semn de momentum.
A doua întrebare: ADF nu respinge pe prețurile logaritmice, iar KPSS respinge; este piața eficientă? Aceste rezultate spun doar că prețurile sînt \(I(1)\). Eficiența este o proprietate a creșterilor și cere teste pe randamente, precum ACF-ul și raportul varianțelor.
A treia întrebare: pentru S&P 500, statistica homoscedastică \(Z(q)\) este de circa două ori mai mare decît statistica robustă \(Z^*(q)\); pe care o raportăm? Statistica robustă \(Z^*(q)\). Volatility clustering mărește varianța lui \(\widehat{\mathrm{VR}}(q)\), pe care \(Z(q)\) o ignoră, deci \(Z(q)\) respinge prea des un martingal adevărat. Capitolul 8 trece la estimatorii de volatilitate și la volatility clustering însuși.
Pe scurt
Întrebare: \(\hat\rho(1) = 0{,}10\) și \(\hat\rho(k) = 0\) pentru \(k \ge 2\); ce ne spune VR(2)?
Răspuns: \(1 + 0{,}10 = 1{,}10\): varianța pe două zile este cu 10% mai mare decît în cazul unui mers aleator, deci momentum
Întrebare: ADF nu respinge pe prețurile logaritmice, iar KPSS respinge; este piața eficientă?
Răspuns: știm doar că prețurile sînt \(I(1)\); eficiența cere teste pe creșteri (ACF, VR)
Întrebare: pentru S&P 500, statistica homoscedastică \(Z(q)\) este de circa două ori mai mare decît statistica robustă \(Z^*(q)\); pe care o raportăm?
Răspuns: \(Z^*(q)\): volatility clustering mărește varianța lui \(\widehat{\mathrm{VR}}(q)\), pe care \(Z(q)\) o ignoră, deci \(Z(q)\) respinge prea des un martingal adevărat
Urmează: Capitolul 8, estimatori de volatilitate și volatility clustering
Sinteza secțiunii
Eficiența în formă slabă este o afirmație despre randamente, iar forma ei statistică potrivită este martingalul, care admite cozi groase și volatility clustering. Prețurile logaritmice au o rădăcină unitară în fiecare serie, dar testele care contează sînt cele pe randamente, robuste la volatility clustering: ele găsesc mean reversion la S&P 500, un momentum la BET care s-a estompat pe măsură ce piața s-a dezvoltat și nicio previzibilitate pe majoritatea celorlalte piețe de azi. Dacă un tipar rămas este o ineficiență depinde de costurile de tranzacționare și de risc, nu doar de p-value.
Randamente logaritmice zilnice, în %: S&P 500 și DAX din ianuarie 1990, BET din septembrie 1997, Bitcoin din septembrie 2014 (7 zile pe săptămînă), Banca Transilvania (TLV), OMV Petrom (SNP), BRD și Transgaz (TGN) din 2010, din prețul ajustat, pînă la 18 septembrie 2026; cele două zile greșite ale TLV din mai 2016 sînt eliminate. Comparația între piețe: 16 indici și criptomonede, 19 septembrie 2016 – 18 septembrie 2026. Prețuri de închidere EODHD. Mersurile aleatoare simulate, zgomotul alb, traiectoriile ARMA, regresiile false, simularea mărimii testelor Z și Z*, ordinele de lag ADF alese prin AIC și p-value-urile wild bootstrap sînt cele din curs (același cod, aceeași sămînță a generatorului); autocorelațiile, testele portmanteau și runs, regresiile Dickey–Fuller, PP, KPSS, rapoartele varianțelor, testul Chow–Denning, testul VR automat, ferestrele mobile, subperioadele și regresiile calendaristice sînt recalculate în browser din aceleași date. Alte lungimi T ale regresiei false, alte valori α ale simulării GARCH, alte lățimi de bandă, laguri, orizonturi și începuturi ale eșantionului sînt rulări suplimentare ale aceluiași cod.


 Efficiency of cryptocurrency markets – A GMM-based analysis
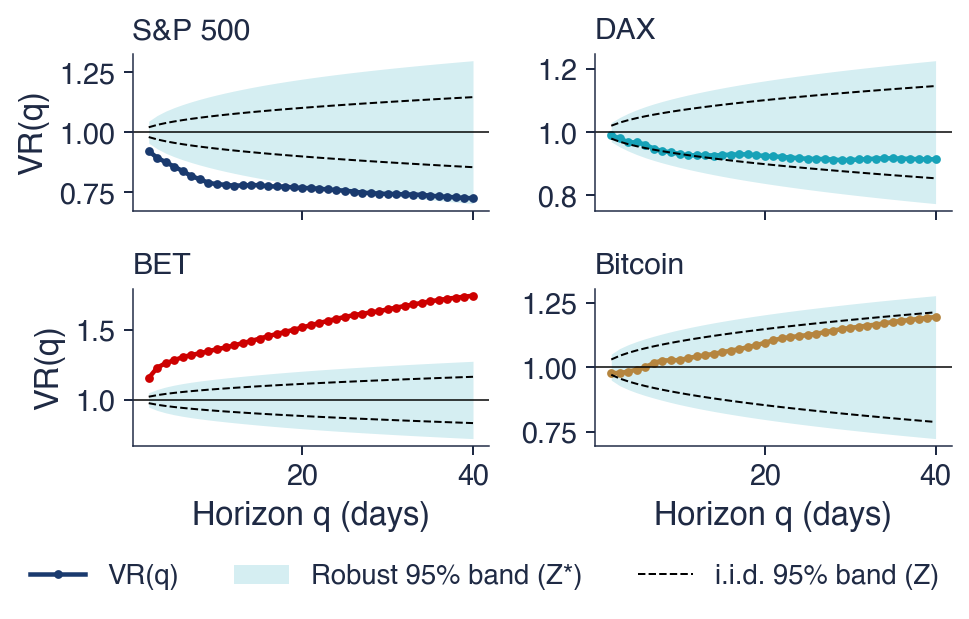
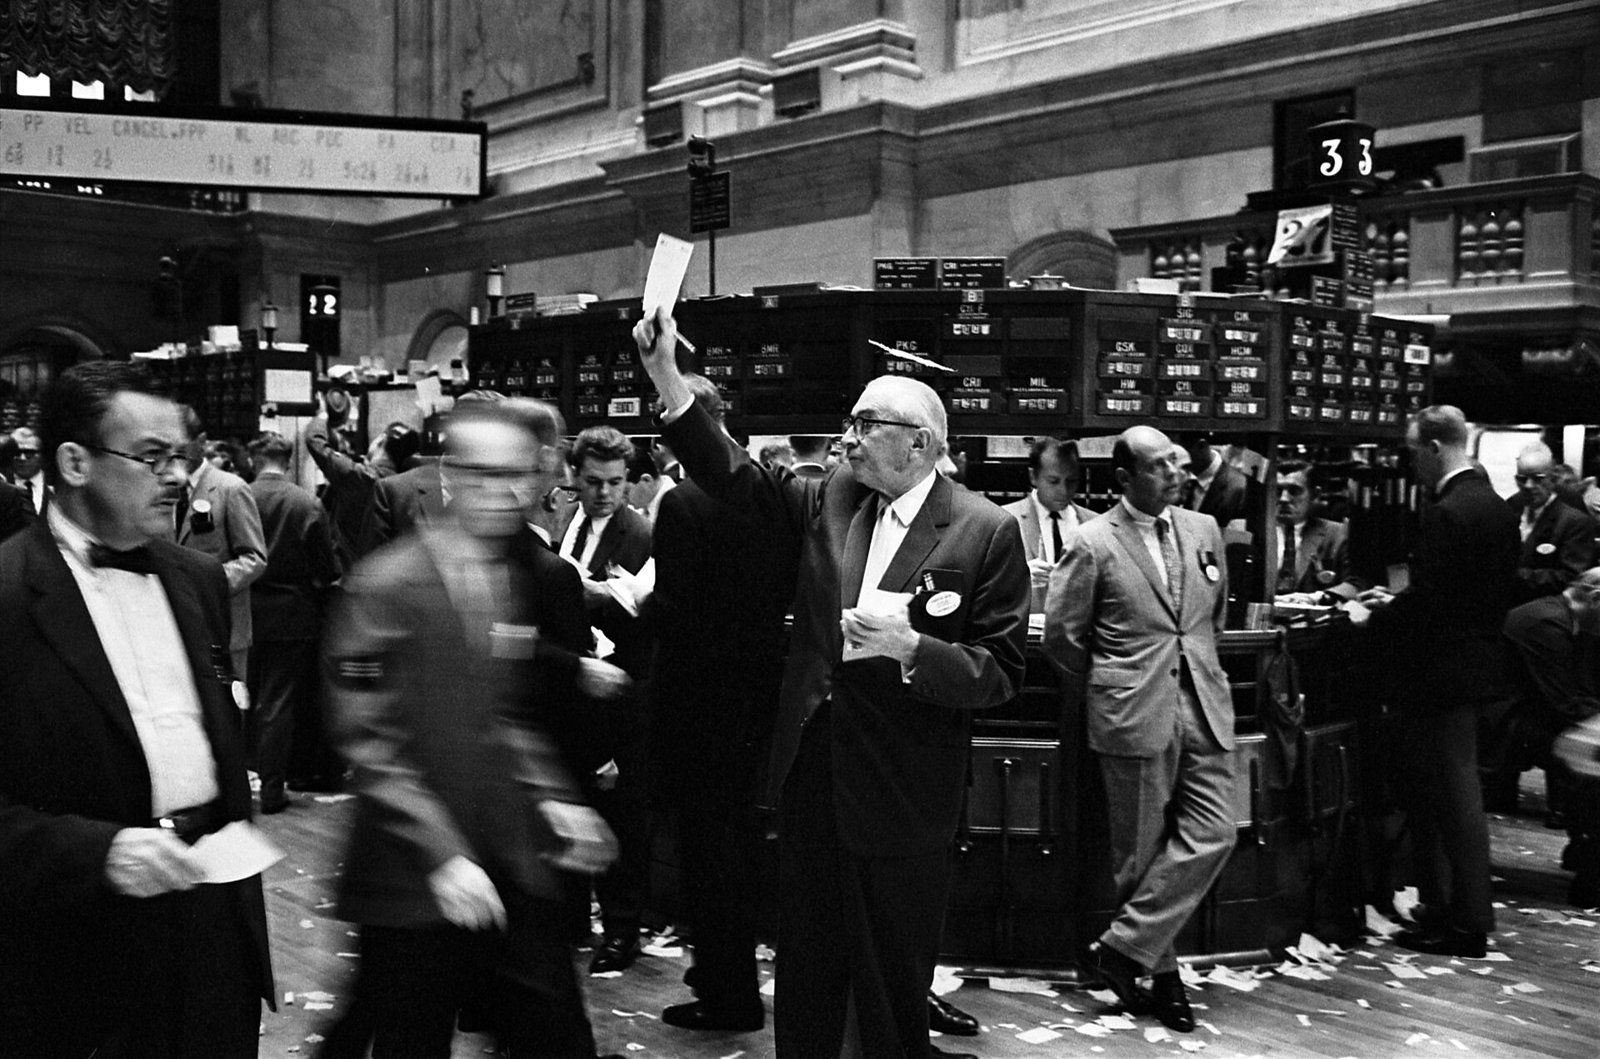
 SFM_ch7_random_walk