Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
OHLC: Open, High, Low, Close (deschidere, maxim, minim, închidere)
OMV: Österreichische Mineralölverwaltung (Administrația austriacă a uleiurilor minerale, grupul OMV)
QLIKE: Quasi-LIKElihood (loss function) — funcția de pierdere de tip cvasi-verosimilitate
RV: Realised Variance (varianța realizată)
SE: Standard Error (eroare standard)
SFE: Statistics of Financial Markets, Exercises (Quantlet collection of the textbook) — colecția de Quantlet-uri a manualului Statistics of Financial Markets
VIX: CBOE Volatility IndeX (indicele de volatilitate CBOE)
YZ: Yang–Zhang (volatility estimator) — estimatorul de volatilitate Yang–Zhang
Volatilitatea, adică abaterea standard a randamentelor, intră în aproape toate mărimile din finanțe: VaR și ES, raportul Sharpe, prețurile opțiunilor, marjele cerute de burse și mărimea pozițiilor de tranzacționare. Cu toate acestea, ea nu este observată niciodată. Fiecare zi produce un singur randament, iar volatilitatea acelei zile rămîne o mărime latentă, care trebuie estimată din prețuri. Întrebarea capitolului este cît de mare este riscul unui activ azi, dacă el poate fi măsurat doar indirect. Capitolul 7 a arătat că randamentele zilnice sînt aproape imprevizibile; acest capitol arată că mărimea lor nu este.
Capitolul măsoară volatilitatea în trei moduri. Primul face media pe multe zile, cu o fereastră mobilă sau cu media mobilă ponderată exponențial (EWMA, exponentially weighted moving average) din RiskMetrics. Al doilea folosește întreaga traiectorie a zilei, prin prețurile de deschidere, maxim, minim și închidere. Al treilea folosește randamentele din timpul zilei, prin varianța realizată. Fiecare cîștigă precizie în schimbul unei ipoteze: o fereastră mobilă plătește viteza de reacție cu zgomot, estimatorii de amplitudine sînt în simulare de 5–9 ori mai eficienți, dar omit mișcarea overnight, iar varianța realizată cere date intrazilnice, afectate de zgomotul de microstructură.
Datele arată apoi un set de regularități pe care orice model de volatilitate trebuie să le reproducă. Volatilitatea apare în grupuri: pentru S&P 500, toate cele 100 de autocorelații ale randamentelor zilnice în valoare absolută, pînă la lagul 100, sînt deasupra benzii de 95% pentru date independente. Ea revine la un nivel normal, cu un timp de înjumătățire de circa 1,7 luni pentru volatilitatea lunară. Volatilitatea implicită, măsurată prin VIX, a depășit volatilitatea realizată din luna următoare în 86% din zile, iar scăderile prețurilor cresc volatilitatea viitoare mai mult decît creșterile. Ultima secțiune compară prognozele cu funcții de pierdere robuste și arată că EWMA este mai bun decît o fereastră de 21 de zile, în timp ce VIX și EWMA nu pot fi deosebite statistic. Capitolul 9 transformă aceste măsurători în modelele ARCH și GARCH.
Randamentele logaritmice zilnice (%) ale S&P 500 și DAX din 1990, ale BET din 1997 și ale Bitcoin din 2014, pînă la 18 septembrie 2026; în toate cele patru serii, anii liniștiți alternează cu luni agitate.
Rezultatele învățării
Definiți volatilitatea, anualizați-o cu frecvența reală de tranzacționare și explicați de ce este o mărime latentă.
Calculați volatilitatea istorică și volatilitatea EWMA și alegeți o fereastră sau un factor de atenuare.
Calculați estimatorii Parkinson, Garman–Klass, Rogers–Satchell și Yang–Zhang și enunțați ipotezele lor.
Detectați volatility clustering cu ACF-ul randamentelor la pătrat, testul Ljung–Box și testul ARCH-LM.
Comparați volatilitatea implicită cu cea realizată și evaluați prognozele de volatilitate cu MSE și QLIKE.
EWMA și RiskMetricsRecurența EWMA, ponderile și timpul de înjumătățire, ghost effect al ferestrelor mobile și legătura cu GARCH.
Estimatori de amplitudine (range-based)Parkinson, Garman–Klass, Rogers–Satchell și Yang–Zhang, eficiența lor în simulare și comportamentul pe date OHLC reale.
Volatilitatea realizatăVarianța realizată din randamente intrazilnice, un exemplu simulat și zgomotul de microstructură.
Volatility clusteringACF-ul randamentelor în valoare absolută și la pătrat, un experiment de amestecare, testele Ljung–Box și ARCH-LM și legătura cu cozile groase.
Evaluarea prognozelor de volatilitateVariabile proxy, funcțiile de pierdere MSE și QLIKE, compararea a șase prognoze și alegerea factorului de atenuare.
AI pentru descoperire științificăO întrebare deschisă despre estimatorii de amplitudine pentru acțiunile puțin lichide de la București, ajutorul pe care îl poate da AI și verificările necesare.
RezumatRezultatele principale, formulele și întrebări de autoevaluare.
Volatilitatea: definiție și caracter latent
Secțiunea definește volatilitatea ca abatere standard a randamentelor, fixează unitățile ei de măsură și regula de anualizare și arată, pe patru piețe, că ea se schimbă în timp. Apoi separă volatilitatea condiționată a unei zile anume, care este obiectul de interes, de volatilitatea necondiționată, media ei pe termen lung, și explică de ce prima nu este niciodată observată direct.
Volatility clustering și utilizările volatilității
Mandelbrot (1963) a observat, studiind prețurile speculative, că variațiile mari de preț tind să fie urmate de variații mari, de orice semn, iar variațiile mici de variații mici. Mărimea mișcărilor este persistentă, chiar dacă direcția lor nu este. Fotografia de pe slide arată Bursa din Amsterdam pe 21 octombrie 1987, la două zile după crahul din 19 octombrie; în săptămînile care au urmat, piețele au rămas agitate, iar zilele cu variații mari în ambele sensuri au venit una după alta.
Volatilitatea intervine în aproape toate mărimile folosite în finanțe. Măsurile de risc VaR și ES (Capitolul 10) sînt proporționale cu ea, iar raportul Sharpe din Capitolul 1 împarte randamentul în exces la ea. Prețurile opțiunilor depind de volatilitatea așteptată pînă la scadență, bursele stabilesc marjele în funcție de ea, iar administratorii de portofolii dimensionează pozițiile astfel încît riscul asumat să rămînă în limita unei ținte. O eroare în estimarea volatilității se propagă, așadar, în toate aceste mărimi.
Capitolul tratează două întrebări distincte. Prima este măsurarea: cum estimăm volatilitatea unei perioade din prețurile disponibile. A doua este dinamica: dacă volatilitatea de azi spune ceva despre cea de mîine, proprietate numită volatility clustering. Prima întrebare privește estimatorii; a doua privește structura de serie de timp descrisă de modelele din Capitolul 9.
Pe scurt
„Variațiile mari tind să fie urmate de variații mari, de orice semn, iar variațiile mici, de variații mici” Mandelbrot (1963)
după crahul din 19 octombrie 1987, piețele au rămas agitate săptămîni la rînd
Volatilitatea intervine în aproape toate mărimile din finanțe
Capitolul lucrează cu randamente logaritmice zilnice în procente, \(r_t = 100\,(\ln P_t - \ln P_{t-1})\), definite în Capitolul 1. Volatilitatea este abaterea standard (standard deviation) a randamentelor, \(\sigma = \sqrt{\mathrm{Var}(r_t)}\). Ea are unitatea de măsură a randamentului, procente pe zi, în timp ce varianța \(\sigma^2\) se măsoară în procente la pătrat. Distincția contează în practică: estimatorii din acest capitol lucrează cu varianțe, deoarece varianțele se adună în timp, iar rezultatele se raportează ca volatilități, deoarece acestea au unitatea de măsură a randamentelor.
Pentru a compara active și orizonturi, volatilitatea se exprimă pe an. Cu \(A\) observații pe an și randamente necorelate, varianța sumei a \(A\) randamente zilnice este suma varianțelor lor, deci
Numărul \(A\) este frecvența reală de tranzacționare a activului: circa 252 de zile pentru S&P 500, 250 pentru BET și 365 pentru Bitcoin, care se tranzacționează în fiecare zi. Aceasta este regula rădăcinii pătrate a timpului din Capitolul 7 și este valabilă doar pentru randamente necorelate; cu autocorelație pozitivă, varianța unei sume crește mai repede decît \(A\), iar cu autocorelație negativă, mai încet.
Volatilitatea măsoară dispersia în ambele sensuri: un cîștig mare contează la fel de mult ca o pierdere de aceeași mărime. Această simetrie o face ușor de estimat și de agregat, dar nu este singurul mod de a descrie incertitudinea randamentelor. Entropia informațională a distribuției randamentelor este o alternativă (Pele, Lazar & Dufour, 2017), iar măsurile de coadă VaR și ES din Capitolul 10 privesc doar pierderile.
Întrebare pentru sală Cea mai mare variație zilnică a Bitcoin este −46,5%, a S&P 500 −12,8%. Măsurată în abaterile standard ale propriei serii, care este mai extremă?
Răspuns
Bitcoin: 46,5/3,49 = 13,3 abateri standard, față de 12,8/1,13 = 11,3 la S&P 500, 9,5 la DAX și 8,9 la BET. Pentru distribuția Normală, probabilitatea unei variații de peste 9 abateri standard este de ordinul 10⁻¹⁹: excesul de boltire (10,9; 6,0; 9,9; 12,0) arată cozi groase pe toate cele patru piețe.
Exemplu lucrat: anualizarea
\[\sigma_{\text{an}} = \sigma_{\text{zi}}\sqrt{A}, \qquad A = \frac{n}{D/365{,}25}\]
Întrebare pentru sală Dacă folosim A = 252 pentru toate cele patru serii, cum se schimbă volatilitățile anualizate?
Răspuns
Bitcoin scade de la 66,6% la 55,3% (−16,9%, factorul √(252/365,3) = 0,831); S&P 500 rămîne 18,0%, DAX 21,8%, iar BET trece de la 23,4% la 23,5%, pentru că frecvența lor reală (251,7; 253,0; 249,9 observații pe an) este aproape de 252. Cu A = 252, Bitcoin ar părea mai puțin riscant cu o șesime.
Întrebare pentru sală Abaterea standard zilnică a S&P 500 din 1990 este 1,13%. Cîte dintre cele 9 240 de zile au |r| peste 5 abateri standard, adică peste 5,67%?
Răspuns
30 de zile, față de 0,0053 așteptate dacă randamentele ar urma distribuția Normală. DAX are 20 de astfel de zile, BET 31, Bitcoin 8. Cea mai mare variație a S&P 500 (−12,8% pe 16 martie 2020) reprezintă 11,3 abateri standard; pentru cele patru piețe valorile sînt între 8,9 și 13,3.
Graficul arată randamentele logaritmice zilnice, în procente, pentru patru piețe: S&P 500 și DAX din 1990, BET, principalul indice al Bursei de Valori București (BVB), din 1997, și Bitcoin din 2014; ultima observație este din 18 septembrie 2026. Fiecare panou are propria scală verticală: circa ±8% pentru cei doi indici ai piețelor dezvoltate, ±10% pentru BET și ±20% pentru Bitcoin. Scalele arată deja că cele patru piețe diferă prin nivelul riscului.
Forma celor patru serii este totuși aceeași. Anii liniștiți, în care randamentele zilnice rămîn într-o bandă îngustă, alternează cu luni agitate, în care variațiile mari în ambele sensuri se succed. Pentru S&P 500, perioadele agitate sînt concentrate în jurul anilor 2008 și 2020; DAX adaugă o perioadă lungă de agitație la începutul anilor 2000; BET este foarte volatil în primii ani și din nou în jurul perioadei 2008–2010.
Această alternanță este volatility clustering și apare deopotrivă la un indice american mare, la un indice european, pe o piață emergentă și la un activ digital. Caracterul ei universal este motivul pentru care face parte dintre faptele stilizate ale randamentelor financiare (Cont, 2001). Restul capitolului măsoară nivelul volatilității în fiecare moment și apoi testează formal dacă episoadele vizibile pe grafic sînt o proprietate a datelor sau o întîmplare.
Pe scurt
Randamente logaritmice zilnice în %: S&P 500 și DAX din 1990, BET din 1997, Bitcoin din 2014; ultima zi: 18 septembrie 2026
Anii liniștiți alternează cu luni agitate în toate cele patru serii
Tabelul rezumă cele patru serii. Volatilitatea anualizată este 18,0% pentru S&P 500, 21,8% pentru DAX, 23,4% pentru BET și 66,6% pentru Bitcoin, care este de peste trei ori mai volatil decît indicii bursieri. Cea mai mare variație zilnică este o scădere în fiecare serie: −12,8% pentru S&P 500 pe 16 martie 2020, −13,1% pentru DAX pe 12 martie 2020, −13,1% pentru BET pe 7 ianuarie 2009 și −46,5% pentru Bitcoin pe 12 martie 2020. Trei dintre cele patru recorduri cad în aceeași săptămînă din martie 2020.
Măsurate în abateri standard zilnice, aceste variații se află la aproximativ 8–13 abateri standard de medie; pentru S&P 500, de exemplu, scăderea de 12,8% este de circa 11,3 ori abaterea standard zilnică de 1,13%. În cazul distribuției Normale, astfel de variații sînt practic imposibile (Capitolul 2), și totuși fiecare piață are cel puțin una.
Ultima coloană dă excesul de boltire (excess kurtosis), adică boltirea minus 3, care este 0 pentru distribuția Normală: 10,9 pentru S&P 500, 6,0 pentru DAX, 9,9 pentru BET și 12,0 pentru Bitcoin. Toate cele patru valori indică cozi groase. Secțiunea 6 arată că volatility clustering este una dintre cauze: un amestec de zile liniștite și zile agitate produce cozi groase chiar dacă randamentul fiecărei zile urmează distribuția Normală.
Pe scurt
Volatilitate anuală
Cea mai mare variație zilnică
Data
Excesul de boltire
S&P 500
18,0%
\({-12{,}8}\%\)
16 martie 2020
10,9
DAX
21,8%
\({-13{,}1}\%\)
12 martie 2020
6,0
BET
23,4%
\({-13{,}1}\%\)
7 ianuarie 2009
9,9
Bitcoin
66,6%
\({-46{,}5}\%\)
12 martie 2020
12,0
Cele mai mari variații reprezintă 8–13 abateri standard: valori practic imposibile în cazul distribuției Normale (Capitolul 2)
Excesul de boltire este mult peste 0 (valoarea pentru distribuția Normală): cozi groase; secțiunea 6 arată că volatility clustering este una dintre cauze
Un model comod scrie randamentul ca o medie constantă plus un șoc a cărui mărime se schimbă zilnic,
\[r_t = \mu + \sigma_t z_t,\]
unde \(\mu\) este randamentul mediu, iar \(z_t\) sînt șocuri i.i.d. de medie 0 și varianță 1. Mărimea \(\sigma_t\) este volatilitatea condiționată (conditional volatility): \(\sigma_t^2 = \mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\), varianța randamentului condiționată de informația \(\mathcal{F}_{t-1}\) disponibilă la închiderea zilei \(t-1\). Volatilitatea necondiționată \(\sigma = \sqrt{\mathrm{Var}(r_t)}\) este nivelul ei mediu pe termen lung; cu o medie constantă, \(\sigma^2 = E[\sigma_t^2]\).
Volatilitatea condiționată este latentă: nu este observată niciodată, deoarece fiecare zi produce un singur randament. Cu \(\mu = 0\), randamentul la pătrat este o măsură nedeplasată a varianței condiționate, \(E[r_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\), dar una foarte zgomotoasă. Cum \(r_t^2 = \sigma_t^2 z_t^2\), eroarea de măsurare este factorul \(z_t^2\), care pentru șocuri Normale are varianța 2: zgomotul este mai mare decît semnalul. O zi liniștită poate apărea într-o perioadă agitată, iar o variație mare poate apărea într-una calmă.
Există trei moduri de a obține mai multă informație despre \(\sigma_t\), iar ele organizează capitolul. Primul face media pe multe zile, ca volatilitatea istorică și EWMA (secțiunile 2 și 3). Al doilea folosește întreaga traiectorie a zilei, prin prețurile maxim și minim (secțiunea 4). Al treilea folosește prețurile din timpul zilei pentru a calcula volatilitatea realizată (secțiunea 5). Fiecare cîștigă precizie sprijinindu-se pe o ipoteză suplimentară, iar o bună parte a capitolului discută cînd sînt valabile aceste ipoteze.
Pe scurt
Modelul: randamentul este o medie constantă plus un șoc a cărui mărime se schimbă zilnic: \(r_t = \mu + \sigma_t z_t\)
\(\mu\): randamentul mediu; \(z_t\): șocuri i.i.d., de medie 0 și varianță 1
\(\sigma_t\) este volatilitatea condiționată: \(\sigma_t^2 = \mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\), cu \(\mathcal{F}_{t-1}\) informația de la închiderea zilei \(t-1\)
volatilitatea necondiționată\(\sigma = \sqrt{\mathrm{Var}(r_t)}\) este nivelul ei mediu pe termen lung
Latentă: nu observăm niciodată \(\sigma_t\), ci doar un randament pe zi
\(r_t^2\) este o măsură nedeplasată, dar foarte zgomotoasă, a lui \(\sigma_t^2\) (cu \(\mu = 0\)): \(E[r_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\)
o zi liniștită poate apărea într-o perioadă agitată, și invers
Trei moduri de a obține mai multă informație despre \(\sigma_t\)
media pe multe zile: volatilitatea istorică, EWMA
întreaga traiectorie a zilei: prețurile maxim și minim
prețurile din timpul zilei: volatilitatea realizată
Pentru S&P 500 din 1990, abaterea standard zilnică este \(\hat\sigma = 1{,}1337\%\), iar indicele se tranzacționează în medie în \(A = 251{,}7\) zile pe an, circa 252. Conform (8.1), volatilitatea anuală este \(\hat\sigma_{\text{an}} = 1{,}1337 \times \sqrt{251{,}7} = 1{,}1337 \times 15{,}866 = 18{,}0\%\), valoarea din tabelul de mai sus.
Bitcoin se tranzacționează șapte zile pe săptămînă. Din 2014, abaterea lui standard zilnică este \(\hat\sigma = 3{,}4852\%\), iar anualizarea corectă folosește frecvența reală, \(A = 365{,}3\) zile pe an: \(3{,}4852 \times \sqrt{365{,}3} = 3{,}4852 \times 19{,}114 = 66{,}6\%\). Cu convenția de la acțiuni, de 252 de zile, se obține \(3{,}4852 \times \sqrt{252} = 3{,}4852 \times 15{,}875 = 55{,}3\%\), o volatilitate anuală subestimată cu peste 11 puncte procentuale, deoarece ignoră aproximativ o treime din zilele în care Bitcoin se tranzacționează efectiv.
Regula pentru comparații decurge de aici: anualizați fiecare serie cu propriul calendar, apoi comparați. Nici abaterile standard zilnice nu sînt direct comparabile, deoarece un randament zilnic acoperă o durată de tranzacționare diferită pe piețe diferite, iar o cifră anuală calculată cu un \(A\) greșit face ca o piață deschisă 24 de ore să pară mai puțin riscantă decît este.
Pe scurt
S&P 500 din 1990: abaterea standard zilnică \(\hat\sigma = 1{,}1337\%\), \(A = 251{,}7\) observații pe an (frecvența reală)
greșit, cu convenția de la acțiuni: \(3{,}4852 \times \sqrt{252} = 3{,}4852 \times 15{,}875 = 55{,}3\%\)
Pentru a compara active: anualizați fiecare serie cu propriul calendar, apoi comparați
Sinteza secțiunii
Volatilitatea este abaterea standard a randamentelor, măsurată în procente pe zi și anualizată cu rădăcina pătrată a numărului real de observații pe an. Pe cele patru piețe ea variază de la 18,0% pe an pentru S&P 500 la 66,6% pentru Bitcoin, cele mai mari variații zilnice se află la 8–13 abateri standard de medie, iar anii liniștiți alternează cu luni agitate. Volatilitatea condiționată a unei zile este latentă, iar un singur randament la pătrat o măsoară cu un zgomot mai mare decît semnalul. Secțiunea următoare începe cu cel mai simplu remediu, media pe o fereastră de zile trecute.
Volatilitatea istorică și alegerea ferestrei
Cea mai simplă estimare a volatilității curente este abaterea standard a celor mai recente randamente. Secțiunea definește această volatilitate istorică (pe fereastră mobilă), compară trei lungimi ale ferestrei pe S&P 500 din 1990 și cuantifică eroarea de selecție a unei volatilități estimate pe o fereastră scurtă, întîi pentru randamente Normale și apoi pentru randamente cu cozi groase.
unde \(\bar r_t\) este media acelorași \(n\) randamente, \(j\) arată cîte zile în urmă se află un randament (\(j = 0\) este chiar ziua \(t\)), iar \(\hat\sigma_t\) este estimarea disponibilă la închiderea zilei \(t\). Fereastra este mobilă (rolling window): în fiecare zi intră cel mai nou randament și iese cel mai vechi, astfel încît estimarea se bazează mereu pe același număr de zile.
Pentru datele zilnice, media se fixează adesea la zero, ceea ce dă \(\hat\sigma_t^2 = \frac{1}{n}\sum_{j=0}^{n-1} r_{t-j}^2\). Motivul este că media zilnică este foarte mică în raport cu abaterea standard: 0,03% față de 1,13% la S&P 500. Pe o fereastră de 21 de zile, media de selecție are o eroare standard de circa \(1{,}13/\sqrt{21} \approx 0{,}25\%\), mult mai mare decît media pe care o estimează, așa că scăderea ei adaugă zgomot fără să elimine vreo deplasare importantă.
Ferestrele uzuale sînt \(n = 21\) de zile de tranzacționare (o lună), \(n = 63\) (un trimestru) și \(n = 252\) (un an). Fiecare \(\hat\sigma_t\) se anualizează cu \(\sqrt{A}\) și se reprezintă în ultima zi a ferestrei. Reprezentarea la sfîrșitul ferestrei înseamnă că estimarea folosește doar informația disponibilă la acea dată, ceea ce o face utilizabilă ca prognoză a volatilității din ziua următoare.
Pe scurt
Volatilitatea istorică pe o fereastră cu ultimele \(n\) zile:
\(\hat\sigma_t = \sqrt{\dfrac{1}{n-1}\sum_{j=0}^{n-1}(r_{t-j} - \bar r_t)^2}\), cu \(\bar r_t\) media acelorași \(n\) randamente
\(j\): cîte zile în urmă se află randamentul (\(j = 0\) este ziua \(t\)); \(\hat\sigma_t\): estimarea la închiderea zilei \(t\)
fereastră mobilă: în fiecare zi intră cel mai nou randament și iese cel mai vechi
Varianta cu media zero: \(\hat\sigma_t^2 = \frac{1}{n}\sum_{j=0}^{n-1} r_{t-j}^2\)
pentru datele zilnice media este foarte mică în raport cu \(\sigma\) (\(0{,}03\%\) față de \(1{,}13\%\) la S&P 500); dacă o fixăm la 0, eliminăm o estimare zgomotoasă
Ferestre uzuale: \(n = 21\) (o lună), \(63\) (un trimestru), \(252\) (un an) de zile de tranzacționare
fiecare \(\hat\sigma_t\) se anualizează cu \(\sqrt{A}\) și se reprezintă în ultima zi a ferestrei
S&P 500: volatilitatea pe ferestre mobile de 21, 63 și 252 de zile
Întrebare pentru sală Coeficientul de boltire al S&P 500 este κ = 13,9. Care este eroarea standard relativă a unei volatilități calculate pe 21 de zile?
Răspuns
39,1%, de 2,54 ori mai mult decît 15,4% din formula pentru randamente Normale (raportul este √((κ − 1)/2)). Pentru ultima volatilitate pe 21 de zile, 9,6%, intervalul aproximativ de 95% este [6,7%; 12,5%] cu randamente Normale și [2,2%; 17,0%] cu boltirea observată. Chiar și cu n = 252, eroarea relativă rămîne 11,3%; 4,5% este valoarea pentru n = 252 cu randamente Normale.
Întrebare pentru sală În ce fereastră ați avea încredere în ziua de după un crah?
Răspuns
O fereastră scurtă sau EWMA: media pe o fereastră lungă include încă zilele liniștite dinaintea crahului. Fereastra de 21 de zile a urcat la 97,5% pe 6 aprilie 2020; cea de 252 de zile a atins maximul, 45,6%, abia pe 15 iulie 2009, la cîteva luni după vîrful crizei din 2008. Prețul reacției rapide este zgomotul: variația zilnică tipică a lui ln σ̂ este 6,7% la 21 de zile și 0,8% la 252 de zile.
Graficul arată volatilitatea anualizată a S&P 500 pe ferestre mobile, din 1990, pentru cele trei ferestre: 21 de zile cu roșu, 63 de zile cu albastru închis și 252 de zile cu verde. Linia orizontală punctată este volatilitatea pe întregul eșantion, 18,0%. Toate cele trei serii fluctuează în jurul acestei linii, dar cu amplitudini și momente foarte diferite.
Seria pe 21 de zile are vîrfurile cele mai ascuțite, peste 80% la sfîrșitul lui 2008 și aproape 100% în primăvara lui 2020, și revine repede după fiecare criză. Seria pe 63 de zile atinge vîrfuri mai mici și rămîne în urmă. Seria pe 252 de zile este cea mai netedă: a urcat la circa 45% abia în 2009, după faza cea mai grea a crizei financiare, și a rămas pe un platou ridicat din primăvara lui 2020 pînă în primăvara lui 2021, mult după ce piața se liniștise; apoi a scăzut brusc, cînd zilele de criză au ieșit din fereastra de un an.
Întrebarea pentru sală cere fereastra în care ați avea încredere în ziua de după un crah. Un mod de a gîndi este să vedeți ce conține fiecare estimare în acea zi: fereastra de 21 de zile este deja dominată de crah, în timp ce fereastra de 252 de zile încă face media dintre crah și circa 250 de zile liniștite dinaintea lui. Slide-ul următor dă răspunsul și cifrele din spatele lui.
Pe scurt
Volatilitatea S&P 500 pe ferestre mobile, anualizată; linia punctată: volatilitatea pe întregul eșantion, 18,0%
Întrebare pentru sală: în ce fereastră ați avea încredere în ziua de după un crah?
O fereastră scurtă reacționează repede, dar este zgomotoasă. Volatilitatea S&P 500 pe 21 de zile și-a atins maximul, 97,5%, pe 6 aprilie 2020, la cîteva săptămîni după crah, iar variația zilnică tipică a logaritmului ei, \(\ln\hat\sigma_t\), este 6,7%: estimarea se mișcă în fiecare zi cu cîteva procente din propriul nivel, chiar dacă pe piață nu se schimbă nimic. O fereastră lungă este netedă, dar lentă: volatilitatea pe 252 de zile și-a atins maximul de doar 45,6% pe 15 iulie 2009, la cîteva luni după vîrful crizei din 2008, iar logaritmul ei variază cu 0,8% pe zi.
Răspunsul la întrebare este deci o fereastră scurtă sau EWMA din secțiunea următoare, deoarece o fereastră lungă face încă media cu zilele liniștite dinaintea crahului. Alegerea depinde de scop. Pentru limitele zilnice de risc și pentru VaR este nevoie de o estimare rapidă; pentru planificarea capitalului se preferă adesea o fereastră lungă, tocmai pentru că se schimbă lent. Compromisul este unul între deplasare și varianță: cînd volatilitatea se schimbă, o fereastră lungă este deplasată spre trecut, iar una scurtă are o eroare de selecție mare.
La sfîrșitul eșantionului, cele trei ferestre dau 9,6% (21 de zile), 11,1% (63 de zile) și 12,9% (252 de zile), toate mult sub valoarea de 18,0% pe întregul eșantion. Ordinea arată că ultima lună a fost mai liniștită decît ultimul trimestru, care a fost mai liniștit decît ultimul an. Trei estimatori rezonabili dau astfel trei răspunsuri la întrebarea „cît de volatil este S&P 500 azi”, care diferă cu aproximativ o treime.
Pe scurt
Fereastra scurtă (\(n = 21\)): reacționează repede, dar este zgomotoasă
maximul 97,5% pe 6 aprilie 2020; variația zilnică tipică a lui \(\ln\hat\sigma_t\) este 6,7%
Fereastra lungă (\(n = 252\)): netedă, dar lentă
maximul doar 45,6%, atins pe 15 iulie 2009, la cîteva luni după vîrful crizei din 2008; variația zilnică 0,8%
Răspuns: o fereastră scurtă sau EWMA (secțiunea următoare), deoarece media pe o fereastră lungă include încă zilele liniștite dinaintea crahului
pentru planificarea capitalului se preferă o fereastră lungă: se schimbă lent
La sfîrșitul eșantionului: 9,6% (21 de zile), 11,1% (63 de zile), 12,9% (252 de zile)
Cu \(n\) randamente Normale i.i.d., varianța de selecție are o varianță de circa \(2\sigma^4/n\), iar metoda delta (delta method) transferă rezultatul la abaterea standard. Eroarea standard relativă a lui \(\hat\sigma\), adică abaterea standard a estimării de la un eșantion la altul împărțită la \(\sigma\), este atunci aproximativ \(\mathrm{SE}(\hat\sigma)/\sigma \approx 1/\sqrt{2n}\). Ea este 15,4% pentru \(n = 21\), 8,9% pentru \(n = 63\) și 4,5% pentru \(n = 252\): o estimare lunară are o incertitudine de circa o șesime din valoarea ei, iar înjumătățirea erorii cere de patru ori mai multe zile.
Cozile groase fac estimarea mai puțin precisă. Dacă randamentele au coeficientul de boltire (kurtosis) \(\kappa\), varianța varianței de selecție este de circa \((\kappa - 1)\sigma^4/n\), iar metoda delta dă \(\mathrm{SE}(\hat\sigma)/\sigma \approx \sqrt{(\kappa - 1)/(4n)}\). Pentru \(\kappa = 3\), valoarea distribuției Normale, cele două formule coincid. Pentru S&P 500, cu \(\kappa = 13{,}9\) (exces de boltire 10,9), eroarea relativă este 39% pentru \(n = 21\) și 11% pentru \(n = 252\), de peste două ori valorile din cazul Normal.
Exemplul rezolvat aplică aceste formule ultimei volatilități pe 21 de zile a S&P 500, 9,6%. Un interval aproximativ de 95%, estimarea plus sau minus 1,96 erori standard, este \([6{,}7\%; 12{,}5\%]\) pentru randamente Normale și \([2{,}2\%; 17{,}0\%]\) cu boltirea observată. Al doilea interval ajunge aproape pînă la nivelul pe termen lung de 18,0%. O volatilitate estimată din închiderile zilnice ale unei singure luni este o măsurătoare grosieră, iar această imprecizie motivează restul capitolului: o ponderare mai bună a trecutului și folosirea a mai multă informație din fiecare zi.
Pe scurt
Cu \(n\) randamente Normale i.i.d., eroarea standard relativă a lui \(\hat\sigma\) este \(\mathrm{SE}(\hat\sigma)/\sigma \approx 1/\sqrt{2n}\)
\(\mathrm{SE}(\hat\sigma)\): abaterea standard a estimării de la un eșantion la altul; împărțită la \(\sigma\), este o eroare relativă
pentru \(\kappa = 3\) (distribuția Normală) cele două formule coincid
Exemplu rezolvat: ultima volatilitate pe 21 de zile a S&P 500 este 9,6%
interval aproximativ de 95%, randamente Normale: \([6{,}7\%; 12{,}5\%]\); cu boltirea observată: \([2{,}2\%; 17{,}0\%]\)
Sinteza secțiunii
O fereastră mobilă estimează volatilitatea din ultimele \(n\) randamente, iar alegerea lui \(n\) este un compromis. Pentru S&P 500, fereastra de 21 de zile a atins 97,5% la cîteva săptămîni după crahul din 2020, în timp ce fereastra de 252 de zile a atins 45,6% la cîteva luni după criza din 2008. Fereastra scurtă este zgomotoasă: cu boltirea observată, eroarea ei standard relativă este 39%, iar ultima estimare lunară, 9,6%, are un interval de 95% între 2,2% și 17,0%. Secțiunea următoare înlocuiește ponderile egale ale unei ferestre cu ponderi care scad treptat spre trecut.
EWMA și RiskMetrics
Media mobilă ponderată exponențial (EWMA) dă cea mai mare pondere randamentelor recente și lasă ponderea celor vechi să scadă geometric. Secțiunea prezintă originea ei în sistemul RiskMetrics al J.P. Morgan, recurența și ponderile, o actualizare rezolvată pas cu pas, ghost effect pe care îl evită și locul ei ca un caz particular al modelului GARCH din Capitolul 9.
1994: RiskMetrics și estimarea zilnică a volatilității
În octombrie 1994, J.P. Morgan a lansat RiskMetrics și a publicat gratuit metodele și datele (J.P. Morgan/Reuters, 1996). Scopul era un etalon comun pentru riscul de piață, pe care orice bancă să-l poată folosi și compara. Sistemul oferea volatilitățile și corelațiile a peste 480 de serii, actualizate zilnic; fotografia arată clădirea J.P. Morgan de la 23 Wall Street, New York.
Metoda din spatele cifrelor este o medie mobilă ponderată exponențial a randamentelor la pătrat. Ea are un singur parametru, factorul de atenuare (decay factor) \(\lambda\), fixat la 0,94 pentru prognozele zilnice și la 0,97 pentru cele lunare. Pentru fiecare serie s-a calculat valoarea lui \(\lambda\) care minimizează rădăcina erorii pătratice medii a prognozelor de varianță, iar 0,94 este media ponderată a acestor valori pe toate seriile.
Alegerea unui singur parametru pentru toate seriile a fost deliberată. Nu cere nicio estimare, poate fi aplicată zilnic la sute de serii, iar folosirea aceluiași \(\lambda\) pentru toate seriile păstrează matricea de covarianță rezultată pozitiv semidefinită, astfel încît varianțele de portofoliu calculate din ea nu sînt niciodată negative. Transformînd volatilitatea într-un indicator publicat zilnic, RiskMetrics a făcut din VaR un calcul de rutină în bănci.
Pe scurt
J.P. Morgan a lansat RiskMetrics în octombrie 1994 și a publicat gratuit metodele și datele J.P. Morgan/Reuters (1996)
scopul: un etalon comun pentru riscul de piață, valabil pentru toate băncile
volatilitățile și corelațiile a peste 480 de serii, actualizate zilnic
Metoda: o medie mobilă ponderată exponențial (EWMA) a randamentelor la pătrat
un singur parametru, factorul de atenuare\(\lambda\): \(0{,}94\) pentru prognozele zilnice, \(0{,}97\) pentru cele lunare
pentru fiecare serie, \(\lambda\) minimizează rădăcina erorii pătratice medii a prognozelor de varianță; 0,94 este media ponderată pe toate seriile
Varianța de azi este o medie ponderată a varianței de ieri și a randamentului de ieri la pătrat. Factorul de atenuare \(\lambda\) este ponderea trecutului: o valoare apropiată de 1 dă o estimare netedă, care reacționează lent la randamentele noi. Cum \(\sigma_t^2\) folosește doar randamentele pînă în ziua \(t-1\), ea este prognoza varianței din ziua \(t\). Recurența pornește de la \(\sigma_1^2\) egal cu media primelor randamente la pătrat; ponderea acestei valori inițiale după \(t\) zile este \(\lambda^{t-1}\), deci efectul ei dispare după cîteva luni.
Înlocuind recurența în ea însăși de mai multe ori, obținem
Ponderile \((1-\lambda)\lambda^{j-1}\) scad geometric cu lagul \(j\) și au suma 1, deci EWMA este o medie ponderată a tuturor randamentelor trecute la pătrat. Un rezumat comod al memoriei este timpul de înjumătățire (half-life), lagul la care ponderea a scăzut la jumătate din valoarea inițială, \(\ln 0{,}5/\ln\lambda\).
O fereastră mobilă, prin contrast, dă ponderea \(1/n\) fiecăreia dintre ultimele \(n\) zile și 0 tuturor zilelor mai vechi. Ponderile ei sînt constante și apoi cad brusc la zero; ponderile EWMA sînt cele mai mari pentru ziua cea mai recentă și nu cad niciodată brusc. Această diferență de formă a ponderilor explică comportamentul diferit al celor doi estimatori după un șoc mare.
Întrebare pentru sală Cu σ²(t − 1) = 1,00 și r(t − 1) = −3%, λ = 0,94 dă σ²(t) = 1,48. Cît este σ²(t) cu λ = 0,80?
Răspuns
2,60 = 0,80 × 1 + 0,20 × 9, deci σ(t) = 1,61% pe zi. Un λ mai mic dă o pondere mai mare (1 − λ = 0,20) șocului de ieri: reacția este mai puternică, iar memoria mai scurtă (timpul de înjumătățire scade de la 11,2 la 3,1 zile). Varianta 1,40 uită să ridice randamentul la pătrat.
Întrebare pentru sală Pentru λ = 0,94, 99% din pondere se află în ultimele 74,4 zile. Cîte zile sînt necesare pentru λ = 0,99?
Răspuns
458,2 zile, aproape doi ani de tranzacționare: ln 0,01/ln 0,99. Timpul de înjumătățire este 69,0 zile, iar lagul mediu 100 de zile. Pentru orice λ, numărul de zile care poartă 99% din pondere este de 6,64 ori timpul de înjumătățire (ln 0,01/ln 0,5).
Graficul arată ponderea randamentului la pătrat de acum \(j\) zile. Curba roșie este EWMA cu \(\lambda = 0{,}94\), care pornește de la \(1 - \lambda = 0{,}06\) și scade repede; curba albastră este EWMA cu \(\lambda = 0{,}97\), care pornește de la 0,03 și scade mai încet; treapta verde este ponderea egală \(1/63\) a unei ferestre de 63 de zile, care cade la zero după ziua 63.
Pentru \(\lambda = 0{,}94\), timpul de înjumătățire este 11,2 zile, lagul mediu \(1/(1-\lambda)\) este 16,7 zile, iar 99% din pondere se află pe ultimele 75 de zile (74,4 rotunjit în sus). Pentru \(\lambda = 0{,}97\), timpul de înjumătățire este 22,8 zile, iar 99% din pondere se află pe ultimele 152 de zile. Estimatorul zilnic RiskMetrics este deci o medie cu memorie scurtă: jumătate din ponderea lui se află pe aproximativ ultimele unsprezece zile.
Ambele curbe EWMA intersectează linia ponderilor egale la un lag de circa 22 de zile. Înainte de acest lag, EWMA dă zilelor recente o pondere mai mare decît fereastra de 63 de zile; după el, una mai mică. EWMA se concentrează pe trecutul recent fără să uite complet trecutul mai îndepărtat, iar ponderile lui variază lin cu lagul, în loc să cadă brusc.
Pe scurt
\(\lambda = 0{,}94\): timp de înjumătățire 11,2 zile, lag mediu \(1/(1-\lambda) = 16{,}7\) zile, 99% din pondere în ultimele 75 de zile
\(\lambda = 0{,}97\): timp de înjumătățire 22,8 zile, 99% din pondere în ultimele 152 de zile
Să presupunem că varianța EWMA de ieri este \(\sigma_{t-1}^2 = 1{,}00\), în procente la pătrat, adică o volatilitate zilnică de 1%, iar randamentul de ieri este \(r_{t-1} = -3\%\), o variație de trei abateri standard. Cu \(\lambda = 0{,}94\), primul termen din (8.3) este \(\lambda\sigma_{t-1}^2 = 0{,}94 \times 1{,}00 = 0{,}94\), al doilea este \((1-\lambda)r_{t-1}^2 = 0{,}06 \times 9 = 0{,}54\), iar suma lor este \(\sigma_t^2 = 1{,}48\). Volatilitatea zilnică urcă la \(\sigma_t = 1{,}217\%\), adică \(1{,}217 \times \sqrt{252} = 19{,}3\%\) pe an.
Dacă ziua de azi este liniștită, \(r_t = 0\), actualizarea următoare păstrează doar primul termen: \(\sigma_{t+1}^2 = 0{,}94 \times 1{,}48 = 1{,}39\). Efectul șocului se atenuează cu 6% pe zi, ponderea \(1 - \lambda\) pe care EWMA o dă în fiecare zi noului randament la pătrat. El nu dispare niciodată brusc; scade geometric, cu un timp de înjumătățire de 11,2 zile.
O fereastră de 63 de zile tratează același șoc altfel. Azi adaugă \(9/63 = 0{,}14\) la varianță, aproximativ un sfert din reacția EWMA de 0,54, apoi păstrează această contribuție neschimbată timp de 63 de zile, după care o elimină dintr-odată. Fereastra reacționează deci prea puțin la început și prea brusc la sfîrșit; slide-ul următor arată cum arată acest sfîrșit brusc pe date reale.
Pe scurt
Varianța EWMA de ieri: \(\sigma_{t-1}^2 = 1{,}00\) (%\(^2\)), adică o volatilitate zilnică de 1%; randamentul de ieri: \(r_{t-1} = -3\%\)
Întrebare pentru sală De ce scade brusc linia albastră (fereastra de 63 de zile) la mijlocul lui iunie 2020, într-o zi liniștită?
Răspuns
Pe 15 iunie 2020, randamentul din 16 martie 2020 (−12,8%) a ieșit din fereastra de 63 de zile: volatilitatea pe fereastră a scăzut de la 50,4% la 43,0% într-o singură zi, fără nicio știre. Cu o fereastră de 21 de zile, aceeași zi de crah iese pe 15 aprilie 2020 (de la 78,8% la 64,0%), cu 126 de zile pe 14 septembrie 2020. EWMA s-a modificat în ziua respectivă cu doar −0,9 puncte procentuale.
Graficul acoperă S&P 500 din octombrie 2019 pînă în martie 2021. Linia albastru închis este volatilitatea pe fereastra mobilă de 63 de zile, linia roșie este volatilitatea EWMA cu \(\lambda = 0{,}94\), ambele anualizate, iar barele sînt randamentele zilnice în valoare absolută \(|r_t|\) pe aceeași scală anuală, \(|r_t|\sqrt{252}\). Bara cea mai înaltă, de peste 200%, este scăderea de 12,8% din 16 martie 2020.
Cei doi estimatori reacționează foarte diferit la crah. Linia roșie urcă abrupt la începutul lui martie, atinge vîrful în a doua jumătate a lunii și apoi scade treptat în aprilie, mai și iunie, pe măsură ce variațiile zilnice devin mai mici. Linia albastră urcă mai încet, rămîne pe un platou puțin peste 60% în aprilie și mai, cînd variațiile zilnice erau deja mult mai mici, apoi scade în trepte în iunie.
Întrebarea pentru sală cere motivul pentru care linia albastră scade brusc la mijlocul lui iunie 2020, într-o zi liniștită. Barele nu arată nimic neobișnuit în acea zi. Explicația nu se află în randamentul care a intrat în fereastră, ci în cel care a ieșit din ea.
Pe scurt
S&P 500: volatilitatea pe fereastra mobilă de 63 de zile și volatilitatea EWMA (\(\lambda = 0{,}94\)), anualizate; barele: \(|r_t|\) pe aceeași scală anuală
Întrebare pentru sală: de ce scade brusc linia albastră la mijlocul lui iunie 2020, într-o zi liniștită?
Pe 15 iunie 2020, randamentul din 16 martie 2020, −12,8%, a ieșit din fereastra de 63 de zile. Volatilitatea pe fereastra mobilă a scăzut de la 50,4% la 43,0% într-o singură zi, fără nicio știre. Acest artefact este ghost effect: un șoc vechi iese brusc din fereastră, iar estimarea sare într-o zi în care nu se întîmplă nimic. Un singur randament mare mișcă astfel o estimare pe fereastră mobilă de două ori: o dată cînd intră și încă o dată, 63 de zile mai tîrziu, cînd iese.
EWMA reacționează mai repede și uită treptat. Vîrful lui, 84,8%, a venit pe 24 martie 2020, în timp ce volatilitatea pe 63 de zile a atins un vîrf de doar 62,6%, pe 20 mai 2020, la două luni după crah. În ziua ghost effect, EWMA s-a modificat cu doar −0,9 puncte procentuale, scăderea geometrică obișnuită a unui șoc vechi.
Viteza are un preț. EWMA este mai zgomotos decît o fereastră lungă, deoarece jumătate din ponderea lui se află pe mai puțin de două săptămîni de date. În plus, nu are un nivel pe termen lung spre care să revină: după o criză, scade spre ce implică randamentele recente, iar prognoza lui pentru orice orizont viitor este egală cu valoarea de azi. Slide-ul următor arată că această proprietate decurge din locul EWMA în familia GARCH.
Pe scurt
Răspuns: pe 15 iunie 2020, randamentul din 16 martie 2020 (\(-12{,}8\%\)) a ieșit din fereastra de 63 de zile
volatilitatea pe fereastra mobilă a scăzut de la 50,4% la 43,0% într-o singură zi, fără nicio știre
acest artefact este ghost effect: un șoc vechi iese brusc din fereastră
EWMA reacționează mai repede și uită treptat
vîrful EWMA: 84,8% pe 24 martie 2020; vîrful pe 63 de zile: 62,6% abia pe 20 mai 2020
în ziua ghost effect, EWMA s-a modificat cu doar \(-0{,}9\) puncte procentuale
Costul reacției rapide: EWMA este mai zgomotos decît o fereastră lungă și nu are un nivel pe termen lung spre care să revină
unde \(\omega > 0\) este o constantă, \(\alpha\) este reacția la randamentul de ieri la pătrat, iar \(\beta\) este ponderea varianței de ieri. EWMA este cazul particular \(\omega = 0\),\(\alpha = 1 - \lambda\),\(\beta = \lambda\), deci \(\alpha + \beta = 1\). Un model GARCH cu \(\alpha + \beta = 1\) se numește GARCH integrat (IGARCH).
Diferența apare în prognozele făcute în ziua \(t\) pentru ziua \(t + h\). Cum \(E_t[r_{t+h-1}^2] = E_t[\sigma_{t+h-1}^2]\), unde \(E_t\) este media condiționată de informația din ziua \(t\), recurența EWMA dă \(E_t[\sigma_{t+h}^2] = E_t[\sigma_{t+h-1}^2]\), deci \(E_t[\sigma_{t+h}^2] = \sigma_{t+1}^2\) pentru orice \(h\): prognoza este constantă, iar nivelul de azi persistă la nesfîrșit. Pentru GARCH cu \(\alpha + \beta < 1\), același raționament dă \(E_t[\sigma_{t+h}^2] = \bar\sigma^2 + (\alpha + \beta)^{h-1}(\sigma_{t+1}^2 - \bar\sigma^2)\), o prognoză atrasă geometric spre varianța pe termen lung \(\bar\sigma^2 = \omega/(1 - \alpha - \beta)\).
Capitolul 9 estimează \(\omega\),\(\alpha\) și \(\beta\) prin verosimilitate maximă (maximum likelihood). Aici factorul de atenuare este fie fixat la valoarea RiskMetrics, fie ales după un criteriu de prognoză, ceea ce secțiunea 8 face cu funcția de pierdere QLIKE.
\(\omega > 0\): o constantă; \(\alpha\): reacția la randamentul de ieri la pătrat; \(\beta\): ponderea varianței de ieri
EWMA este cazul particular \(\omega = 0\), \(\alpha = 1 - \lambda\), \(\beta = \lambda\), deci \(\alpha + \beta = 1\) (GARCH „integrat”, IGARCH)
Consecințe pentru prognozele făcute în ziua \(t\) pentru ziua \(t + h\)
EWMA: constantă, \(E_t[\sigma_{t+h}^2] = \sigma_{t+1}^2\) pentru orice \(h\) (\(E_t\): media condiționată de informația din ziua \(t\)): nivelul de azi persistă la nesfîrșit
GARCH cu \(\alpha + \beta < 1\): atrasă spre varianța pe termen lung \(\omega/(1 - \alpha - \beta)\)
Capitolul 9 estimează \(\omega\), \(\alpha\), \(\beta\) prin verosimilitate maximă; aici \(\lambda\) este fixat sau ales după un criteriu de prognoză (secțiunea 8)
Sinteza secțiunii
EWMA actualizează varianța în fiecare zi ca medie ponderată a varianței de ieri și a randamentului de ieri la pătrat, (8.3). Cu valoarea RiskMetrics \(\lambda = 0{,}94\), jumătate din pondere se află pe ultimele 11,2 zile, iar 99% pe ultimele 75. În crahul din 2020, EWMA a atins vîrful de 84,8% pe 24 martie, cu două luni înaintea ferestrei de 63 de zile, și a evitat ghost effect care a coborît estimarea pe fereastră mobilă de la 50,4% la 43,0% într-o zi liniștită din iunie. Ca GARCH integrat, EWMA are prognoze constante și niciun nivel pe termen lung. Secțiunea următoare cîștigă precizie pe altă cale: folosind mai multe prețuri din fiecare zi.
Estimatori de amplitudine (range-based)
Randamentul închidere–închidere folosește două prețuri pe zi, în timp ce majoritatea surselor de date înregistrează și deschiderea, maximul și minimul. Secțiunea introduce notațiile pentru aceste prețuri, derivă estimatorul Parkinson din amplitudinea unei mișcări browniene, prezintă rafinările Garman–Klass, Rogers–Satchell și Yang–Zhang, le măsoară eficiența și deplasarea prin simulare și le compară pe date reale pentru cinci active.
Prețurile de deschidere, maxim, minim și închidere
Datele OHLC înregistrează, pentru fiecare zi \(t\), prețul de deschidere \(O_t\), prețul maxim \(H_t\), prețul minim \(L_t\) și prețul de închidere \(C_t\). Randamentul închidere–închidere folosește doar două prețuri pe zi, închiderile zilelor \(t-1\) și \(t\). Maximul și minimul conțin informație despre întreaga traiectorie a prețului în timpul zilei, pe care randamentul închidere–închidere o ignoră.
Toate mărimile sînt diferențe logaritmice în procente, măsurate față de deschiderea zilei \(t\):\(u_t = \ln(H_t/O_t)\) este mișcarea de la deschidere la maxim, \(d_t = \ln(L_t/O_t)\) mișcarea pînă la minim, iar \(c_t = \ln(C_t/O_t)\) mișcarea pînă la închidere. Prin construcție, \(d_t \le 0 \le u_t\) și \(d_t \le c_t \le u_t\). Randamentul overnight \(o_t = \ln(O_t/C_{t-1})\) acoperă perioada de la închiderea precedentă pînă la deschidere, astfel încît randamentul zilnic se descompune în \(r_t = o_t + c_t\). Amplitudinea (range) zilei este \(u_t - d_t = \ln(H_t/L_t)\).
Datele OHLC ale capitolului acoperă S&P 500 din 2008, DAX din 2006, Bitcoin din 2014 și acțiuni de la Bursa de Valori București din 2010. Fișierul BET conține doar prețuri de închidere, deci estimatorii de amplitudine nu pot fi calculați pentru indicele însuși.
Pe scurt
Datele OHLC: pentru fiecare zi \(t\), deschiderea \(O_t\), maximul \(H_t\), minimul \(L_t\) și închiderea \(C_t\)
randamentul închidere–închidere folosește 2 prețuri pe zi; \(H_t\) și \(L_t\) conțin informație despre întreaga traiectorie a zilei
Notații (diferențe logaritmice în %), fiecare față de deschiderea zilei \(t\):
Întrebare pentru sală S&P 500, 13 martie 2020: H = 2 711,33 și L = 2 492,37, deci ln(H/L) = 8,421%. Cît este volatilitatea zilnică Parkinson?
Răspuns
σ̂²_P = 8,421²/2,7726 = 25,57, deci σ̂_P = 5,06% pe zi. Amplitudinea depășește σ în medie de √(4 ln 2) = 1,67 ori, iar împărțirea la 4 ln 2 corectează exact acest lucru. Randamentul închidere–închidere al zilei a fost 8,88%, cu r² = 78,87, de trei ori estimarea Parkinson. Varianta 8,42% este amplitudinea nescalată, iar 3,04% împarte amplitudinea la 4 ln 2 fără rădăcina pătrată.
Întrebare pentru sală Bitcoin, 19 mai 2021: u = 1,390%, d = −33,626%, c = −14,894%. Cît este termenul Rogers–Satchell u(u − c) + d(d − c)?
Răspuns
652,5 (%²) = 1,390 × 16,284 + (−33,626) × (−18,732) = 22,6 + 629,9, deci σ̂_RS = 25,5% pe zi. Garman–Klass dă 527,4, Parkinson 442,2. Ziua a avut o tendință puternică (c = −14,9%), iar Rogers–Satchell, nedeplasat pentru orice tendință, dă cea mai mare estimare. Varianta 1 133 = u² + d² omite termenii cu c.
Exemplu lucrat: ponderea k și estimatorul Yang–Zhang
Întrebare pentru sală Pentru n = 21, k = 0,34/(1,34 + 22/20) = 0,139. Ce se întîmplă cu k cînd fereastra crește la 126 de zile?
Răspuns
k(126) = 0,34/(1,34 + 127/125) = 0,144, iar limita pentru n mare este 0,34/2,34 = 0,145; pentru n = 2, k = 0,078. Ponderea variază puțin cu n: Yang–Zhang este dominat de varianța nopții σ̂²_O și de termenul Rogers–Satchell, cu ponderea 1 − k ≈ 0,86.
Întrebare pentru sală S&P 500 pe 16 martie 2020: r = −12,765%, din care overnight o = −7,760%. Ce parte din r² = 163,0 reprezintă o²?
Răspuns
o² = 60,2, adică 37% din r². Restul nu se împarte simplu, pentru că r² = o² + c² + 2oc: aici c = −5,005%, c² = 25,0 și 2oc = 77,7. Estimatorii care ignoră noaptea (Parkinson 19,6, Garman–Klass 17,5, Rogers–Satchell 16,5) văd mai puțin de o optime din r²; overnight plus Rogers–Satchell dă 76,7. Varianta 61% compară randamentele, nu pătratele lor (7,760/12,765), iar 12% este raportul Parkinson/r².
Întrebare pentru sală Dacă saltul overnight crește de la 0,35% la 1%, ce se schimbă pentru această zi simulată?
Răspuns
Randamentul zilei r = o + c crește de la 0,985% la 1,635%, iar r² de la 0,970 la 2,672. Maximul, minimul și închiderea sînt măsurate față de deschiderea zilei, deci Parkinson (0,627), Garman–Klass (0,714) și Rogers–Satchell (0,681) rămîn aceleași: estimatorii de amplitudine nu văd varianța nopții.
Graficul arată un preț logaritmic simulat în timpul unei zile de tranzacționare: o mișcare browniană pe 390 de pași de un minut, durata unei ședințe de 6,5 ore, după un salt overnight de 0,35%. Axa verticală este prețul logaritmic față de închiderea precedentă, în procente. Punctul verde marchează deschiderea, la 0,35%, punctul portocaliu minimul, puțin sub închiderea precedentă, punctul roșu maximul, atins spre sfîrșitul zilei, iar punctul violet închiderea.
Închiderea păstrează doar punctul final al traiectoriei. Aici ea spune că prețul a terminat ziua peste închiderea precedentă și nimic despre drumul pînă acolo. Maximul și minimul rezumă traiectoria: distanța dintre ele arată cît de mult s-a deplasat prețul în timpul ședinței. Două zile cu aceeași închidere pot avea amplitudini foarte diferite, deci riscuri foarte diferite.
Aceasta este ideea estimatorilor de amplitudine. Extremele unei traiectorii aleatoare depind de volatilitatea ei pe toată ziua, nu doar de variația ei netă, așa că amplitudinea conține mai multă informație despre varianță decît un singur increment. Graficul arată și limita metodei: amplitudinea începe la deschidere, deci saltul overnight de 0,35% se află în afara ei.
Pe scurt
Preț logaritmic simulat (mișcare browniană, 390 de pași de un minut) după un salt overnight de \(0{,}35\%\): închiderea păstrează doar punctul final; maximul și minimul rezumă traiectoria
Două zile cu aceeași închidere pot avea amplitudini foarte diferite, deci riscuri foarte diferite
Pentru o mișcare browniană fără tendință (drift), cu varianța \(\sigma^2\) pe zi, pătratul amplitudinii are o medie egală cu un multiplu cunoscut al varianței, \(E[(u_t - d_t)^2] = 4\ln 2\;\sigma^2\)(Parkinson, 1980). Împărțind pătratul amplitudinii logaritmice la această constantă obținem un estimator nedeplasat al varianței zilnice,
iar pe \(n\) zile estimatorul este media acestor valori. Constanta \(4\ln 2 \approx 2{,}77\) este mai mare decît 1, deoarece amplitudinea unei traiectorii este, în medie, mai mare decît abaterea ei standard pe o zi.
Derivarea se sprijină pe ipoteze pe care piețele reale le satisfac doar aproximativ. Tranzacționarea trebuie să fie continuă în timpul zilei, astfel încît maximul și minimul observate să fie extremele reale ale traiectoriei; cu tranzacții discrete, amplitudinea observată este prea mică. Nu trebuie să existe tendință, deoarece o tendință lărgește amplitudinea în direcția ei. Și nu trebuie să existe salt overnight, deoarece amplitudinea vede doar ședința de tranzacționare.
Cînd ipotezele sînt îndeplinite, estimatorul Parkinson este mult mai precis decît randamentul la pătrat \(r_t^2\); o simulare din această secțiune măsoară cu cît. Logaritmul amplitudinii are și o altă utilizare: distribuția lui este aproape Normală, ceea ce îl face un input comod pentru estimarea modelelor de volatilitate stochastică (Alizadeh, Brandt & Diebold, 2002).
Pe scurt
Pentru o mișcare browniană fără tendință (drift), cu varianța \(\sigma^2\) pe zi: \(E[(u_t - d_t)^2] = 4\ln 2\;\sigma^2\)Parkinson (1980)
în cuvinte: pătratul amplitudinii logaritmice, rescalat astfel încît, în medie, să fie egal cu varianța
o zi: \(\hat\sigma_{P,t}^2 = \dfrac{(u_t - d_t)^2}{4\ln 2}\); pe \(n\) zile: media acestor valori
\(4\ln 2 \approx 2{,}77\): amplitudinea este, în medie, mai mare decît \(\sigma\)
Ipoteze
tranzacționare continuă în timpul zilei, deci maximul și minimul observate sînt extremele reale
fără tendință și fără salt overnight: amplitudinea reflectă doar ședința de tranzacționare
Mult mai precis decît \(r_t^2\): o simulare din această secțiune măsoară cu cît
Ponderile 0,5 și \(2\ln 2 - 1 \approx 0{,}386\) sînt alese astfel încît estimatorul să fie nedeplasat și apropiat de varianța minimă printre formele pătratice în \(u_t\),\(d_t\) și \(c_t\), în ipoteza absenței tendinței. Scăderea unui multiplu al lui \(c_t^2\) elimină partea din amplitudine explicată de mișcarea netă a zilei.
este nedeplasat pentru orice tendință \(\mu\). Fiecare termen înmulțește distanța de la deschidere la un extrem cu distanța de la închidere la același extrem, iar tendința se anulează în aceste produse. Estimatorul este util pentru activele cu o tendință puternică pe fereastra de estimare, de exemplu Bitcoin într-o perioadă de creștere puternică.
Ambii estimatori ignoră însă randamentul overnight \(o_t\). Ei măsoară doar varianța ședinței de tranzacționare, iar pentru o piață închisă peste noapte aceasta este doar o parte din varianța închidere–închidere de care are nevoie un manager de risc.
unde \(\hat\sigma_O^2\) și \(\hat\sigma_C^2\) sînt varianțele de selecție ale randamentelor overnight \(o_t\) și ale randamentelor deschidere–închidere \(c_t\), iar \(\hat\sigma_{RS}^2\) este media termenului Rogers–Satchell pe fereastră. Primul termen măsoară noaptea; ultimii doi măsoară ședința, ca medie ponderată a unei estimări deschidere–închidere și a uneia bazate pe amplitudine.
Estimatorul este nedeplasat atît în prezența tendinței, cît și a salturilor la deschidere, iar ponderea \(k\) este valoarea care îi minimizează varianța. Pentru o fereastră de 21 de zile, \(k = 0{,}34/(1{,}34 + 22/20) = 0{,}34/2{,}44 = 0{,}14\): varianța ședinței provine în cea mai mare parte, 86%, din termenul eficient Rogers–Satchell și doar 14% din varianța deschidere–închidere.
Pentru că folosește varianțe de selecție, estimatorul Yang–Zhang cere o fereastră de cel puțin \(n = 2\) zile. Estimatorii Parkinson, Garman–Klass și Rogers–Satchell funcționează și pentru o singură zi. Dintre cei patru estimatori de amplitudine, Yang–Zhang este singurul care vizează întreaga varianță închidere–închidere, inclusiv noaptea.
\(\hat\sigma_O^2\), \(\hat\sigma_C^2\): varianțele de selecție ale randamentelor overnight \(o_t\) și ale randamentelor deschidere–închidere \(c_t\); \(\hat\sigma_{RS}^2\): media termenului Rogers–Satchell
Proprietăți
nedeplasat cu tendință și cu salturi la deschidere; \(k\) minimizează varianța estimatorului
Pe 16 martie 2020, S&P 500 a avut cea mai mare scădere din eșantion. Închiderea precedentă a fost 2 711; indicele s-a deschis la 2 509, a atins un maxim de 2 563 și un minim de 2 381 și s-a închis la 2 386. În procente, randamentul overnight este \(o = -7{,}760\), mișcările față de deschidere sînt \(u = 2{,}145\),\(d = -5{,}223\) și \(c = -5{,}005\), iar randamentul închidere–închidere este \(r = o + c = -12{,}765\).
Estimările varianței pentru o zi, în procente la pătrat, diferă cu un ordin de mărime. Randamentul închidere–închidere la pătrat este \(r^2 = 163{,}0\). Estimarea Parkinson este \((7{,}368)^2/2{,}773 = 19{,}6\), estimarea Garman–Klass 17,5, iar estimarea Rogers–Satchell 16,5. Partea overnight singură este \(o^2 = 60{,}2\), iar partea overnight plus termenul Rogers–Satchell dă 76,7.
Cea mai mare parte a scăderii s-a produs overnight, înainte de deschidere: indicele pierduse deja 7,76% cînd a început tranzacționarea. Estimatorii care ignoră \(o_t\) nu surprind cea mai mare parte a riscului din această zi. Chiar și suma dintre partea overnight și cea a ședinței, 76,7, este mai mică decît jumătate din \(r^2\), deoarece \(r^2 = o^2 + c^2 + 2oc\) conține termenul încrucișat \(2oc = 2 \times (-7{,}76) \times (-5{,}00) \approx 77{,}6\): noaptea și ședința s-au mișcat în același sens, iar niciun estimator construit din părți separate pentru noapte și ședință nu vede acest termen.
partea overnight \(o^2 = 60{,}2\); overnight plus Rogers–Satchell: 76,7
Cea mai mare parte a scăderii s-a produs overnight, înainte de deschidere: estimatorii care ignoră \(o_t\) nu surprind cea mai mare parte a riscului din această zi
Eficiență, deplasare și raportul MSE (1 000 de ferestre)
Întrebare pentru sală Cu salt overnight, varianța estimării Parkinson este de 8,8 ori mai mică decît a CC, dar raportul MSE este doar 1,8. De ce?
Răspuns
MSE = varianță + deplasare². Cu salt overnight, Parkinson, GK și RS măsoară doar ședința și subestimează varianța cu circa 22%, iar eroarea lor pătratică medie este dominată de această deplasare, deși varianța lor este de 8,8–13,6 ori mai mică decît a CC. Yang–Zhang adaugă σ̂²_O: deplasarea −2% și raportul MSE 9,0.
Volatilitatea anualizată (%) pe eșantionul OHLC
Întrebare pentru sală Pentru S&P 500, YZ (16,3%) rămîne sub CC (19,9%), deși include varianța nopții. Ce explică diferența?
Răspuns
Var(r) = Var(o) + Var(c) + 2Cov(o, c), iar la S&P 500 corr(o, c) = 0,22; o explicație probabilă sînt prețurile stale (neactualizate) din deschiderea indicelui. La DAX și Bitcoin corelația este 0,02, iar raportul YZ/CC este 0,97 și 0,95. Ponderea nopții (13%) este deja inclusă în YZ, iar S&P 500 nu are zile cu H = L.
Întrebare pentru sală Cu ferestre de 21 de zile, Garman–Klass este de 9,3 ori mai eficient decît CC. Ce se întîmplă cu eficiența lui cînd fereastra are doar 5 zile?
Răspuns
Rămîne aproape aceeași: 10,3 la n = 5 și 8,0 la n = 63 (rulări suplimentare ale simulării). Ambele varianțe scad aproximativ ca 1/n, deci raportul lor se schimbă puțin: cîștigul de eficiență vine din informația dintr-o zi, nu din lungimea ferestrei. Cu salt overnight, deplasarea Parkinson, GK și RS rămîne în jur de −22% la orice n.
Simularea generează 1000 de ferestre de 21 de zile, cu o volatilitate reală cunoscută de 1% pe zi, adică 15,9% pe an. În fiecare zi, prețul logaritmic urmează o mișcare browniană pe 4680 de pași, unul la 5 secunde, astfel încît maximul și minimul observate să fie apropiate de extremele reale. Eficiența (efficiency) unui estimator este raportul \(\mathrm{Var}(\hat\sigma^2_{CC})/\mathrm{Var}(\hat\sigma^2)\), unde CC este estimatorul închidere–închidere: o eficiență de 5 înseamnă că estimatorul are o cincime din varianța estimatorului închidere–închidere.
Graficul arată distribuția estimărilor anualizate prin diagrame box plot; linia punctată este volatilitatea reală, 15,9%. În panoul din stînga, cu tranzacționare continuă și fără salt overnight, estimările închidere–închidere sînt foarte împrăștiate în jurul valorii reale, în timp ce cei patru estimatori de amplitudine sînt concentrați într-o bandă mult mai îngustă în jurul ei.
În panoul din dreapta, 20% din varianța zilnică apare overnight. Estimatorul închidere–închidere este la fel de împrăștiat ca înainte, dar rămîne centrat pe valoarea reală. Cutiile Parkinson, Garman–Klass și Rogers–Satchell rămîn înguste, dar s-au deplasat în jos, sub valoarea reală; doar cutia Yang–Zhang rămîne centrată pe 15,9%. Lățimea unei cutii măsoară precizia, poziția ei față de linia punctată măsoară deplasarea, iar slide-ul următor dă cifrele pentru amîndouă.
Pe scurt
1000 de ferestre de 21 de zile; volatilitatea reală \(1\%\) pe zi (\(15{,}9\%\) pe an); mișcare browniană intrazilnică pe 4680 de pași (unul la 5 secunde)
Eficiența unui estimator: \(\mathrm{Var}(\hat\sigma^2_{CC})/\mathrm{Var}(\hat\sigma^2)\), CC fiind estimatorul închidere–închidere; panoul din dreapta: 20% din varianța zilnică apare overnight
Cu tranzacționare continuă, eficiențele față de estimatorul închidere–închidere sînt 5,4 pentru Parkinson, 9,3 pentru Garman–Klass, 7,6 pentru Rogers–Satchell și 8,5 pentru Yang–Zhang. O lună de amplitudini conține deci tot atîta informație cît 5–9 luni de închideri. Deplasările mici, de −2% pînă la −3%, provin din grila discretă a simulării: chiar și la fiecare 5 secunde, traiectoria observată ratează o parte din extremele reale.
Un salt overnight schimbă imaginea. Parkinson, Garman–Klass și Rogers–Satchell subestimează varianța cu circa 22%: omit cele 20% din varianță care apar overnight, la care se adaugă mica deplasare de discretizare. Doar Yang–Zhang rămîne nedeplasat, cu −2%, iar estimatorul închidere–închidere are o abatere de 1%. Raportul MSE (mean squared error, eroarea pătratică medie), \(\mathrm{MSE}(CC)/\mathrm{MSE}\), combină deplasarea și varianța: el este 1,8 pentru cei trei estimatori ai ședinței și 9,0 pentru Yang–Zhang. Deplasarea consumă cea mai mare parte a cîștigului de eficiență al estimatorilor ședinței, deși aceștia rămîn mai buni decît estimatorul închidere–închidere.
Tranzacționarea rară este al treilea caz. Cu doar 26 de prețuri pe zi, maximul observat este sub maximul real, iar minimul observat peste minimul real, deci amplitudinea este prea mică: deplasările sînt −23% pentru Parkinson, −32% pentru Garman–Klass și Rogers–Satchell și −28% pentru Yang–Zhang, față de 0 pentru estimatorul închidere–închidere (Molnár, 2012). Un estimator precis, dar deplasat, poate fi în practică mai slab decît unul imprecis, dar nedeplasat.
Pe scurt
CC
Parkinson
GK
RS
YZ
Eficiența, tranzacționare continuă
1,0
5,4
9,3
7,6
8,5
Deplasarea (%), tranzacționare continuă
\({0}\)
\({-2}\)
\({-3}\)
\({-3}\)
\({-2}\)
Deplasarea (%), salt overnight
\({1}\)
\({-22}\)
\({-22}\)
\({-22}\)
\({-2}\)
Raportul MSE, salt overnight
1,0
1,8
1,8
1,8
9,0
Deplasarea (%), 26 de prețuri pe zi
\({0}\)
\({-23}\)
\({-32}\)
\({-32}\)
\({-28}\)
Cu tranzacționare continuă, estimatorii de amplitudine sînt de 5–9 ori mai eficienți: o lună de amplitudini conține tot atîta informație cît 5–9 luni de închideri
Cu salt overnight, Parkinson, GK și RS omit varianța nopții (deplasare de circa \(-22\%\)); doar YZ rămîne nedeplasat; raportul MSE (mean squared error, eroarea pătratică medie) = \(\mathrm{MSE}(CC)/\mathrm{MSE}\)
Cu puține tranzacții amplitudinea observată este prea mică: toți estimatorii de amplitudine subestimează (piețe puțin lichide) Molnár (2012)
Tabelul compară cei cinci estimatori pe întregul eșantion OHLC al cinci active, ca volatilități anualizate în procente; P înseamnă Parkinson. Pentru S&P 500 din 2008, estimatorul închidere–închidere dă 19,9%, Parkinson 15,4%, Garman–Klass 14,6%, Rogers–Satchell 14,4% și Yang–Zhang 16,3%. Pentru DAX din 2006, valorile sînt 20,9%, 16,7%, 16,6%, 16,6% și 20,3%. Pentru Bitcoin din 2014, ele sînt 66,6%, 63,5%, 62,4%, 62,5% și 63,2%.
Cele două acțiuni de la București sînt Banca Transilvania (TLV) și OMV Petrom (SNP), ambele din 2010. Pentru TLV, estimările sînt 26,6%, 21,5%, 20,6%, 21,0% și 25,6%; pentru SNP, 24,5%, 21,4%, 20,8%, 21,4% și 25,8%. Pentru acțiuni, deschiderea, maximul și minimul sînt ajustate pentru dividende și splituri cu același factor ca închiderea, iar zilele fără tranzacții sînt eliminate.
Ultimele două coloane ajută la explicarea diferențelor. Ponderea nopții, \(\hat\sigma_O^2/(\hat\sigma_O^2 + \hat\sigma_C^2)\), este fracțiunea din varianță care apare overnight: 13% pentru S&P 500, 31% pentru DAX, 0% pentru Bitcoin, 26% pentru TLV și 27% pentru SNP. Ultima coloană este corelația dintre randamentul overnight și cel deschidere–închidere, \(\mathrm{corr}(o, c)\): 0,22 pentru S&P 500, 0,02 pentru DAX și Bitcoin, −0,08 pentru TLV și −0,20 pentru SNP. Pe fiecare rînd, estimatorii ședinței se află sub estimatorul închidere–închidere.
Pe scurt
Din
CC
P
GK
RS
YZ
Ponderea nopții
\(\mathrm{corr}(o, c)\)
S&P 500
2008
19,9
15,4
14,6
14,4
16,3
13%
\({0{,}22}\)
DAX
2006
20,9
16,7
16,6
16,6
20,3
31%
\({0{,}02}\)
Bitcoin
2014
66,6
63,5
62,4
62,5
63,2
0%
\({0{,}02}\)
TLV
2010
26,6
21,5
20,6
21,0
25,6
26%
\({-0{,}08}\)
SNP
2010
24,5
21,4
20,8
21,4
25,8
27%
\({-0{,}20}\)
Volatilitatea anualizată (%) pe întregul eșantion OHLC; P = Parkinson; ponderea nopții \(= \hat\sigma_O^2/(\hat\sigma_O^2 + \hat\sigma_C^2)\)
Acțiuni: Banca Transilvania (TLV) și OMV Petrom (SNP); deschiderea, maximul și minimul ajustate cu același factor ca închiderea; zilele fără tranzacții sînt eliminate
Bitcoin se tranzacționează 24 de ore din 24, deci ponderea nopții este practic zero, iar toți cei cinci estimatori sînt apropiați, între 62,4% și 66,6%. Diferența rămasă provine din faptul că traiectoria zilei este observată prin tranzacții discrete, nu continuu, ceea ce face amplitudinea observată puțin prea mică, la fel ca în simulare.
Pentru DAX și pentru cele două acțiuni de la București, între un sfert și o treime din varianță apare overnight. Estimările Parkinson, Garman–Klass și Rogers–Satchell sînt mult sub estimatorul închidere–închidere, aproximativ cu ponderea nopții, în timp ce Yang–Zhang, care include noaptea, se apropie de el: 20,3% față de 20,9% pentru DAX și 25,8% față de 24,5% pentru SNP. Este cazul saltului overnight din simulare, observat pe date reale.
S&P 500 nu se încadrează în acest tipar: chiar și Yang–Zhang, 16,3%, rămîne mult sub estimatorul închidere–închidere, 19,9%. Randamentele overnight și cele deschidere–închidere sînt corelate pozitiv, 0,22. O explicație probabilă este modul în care se calculează deschiderea indicelui: ea folosește ultimele prețuri ale tuturor acțiunilor componente, inclusiv prețuri neactualizate (stale prices) ale acțiunilor care încă nu s-au tranzacționat în acea dimineață, astfel încît o parte din știrile din timpul nopții intră în indice abia după deschidere. Cum \(\mathrm{Var}(r) = \mathrm{Var}(o) + \mathrm{Var}(c) + 2\,\mathrm{Cov}(o, c)\), o covarianță pozitivă se adaugă la varianța închidere–închidere, iar niciun estimator de amplitudine nu vede acest termen, ca în exemplul din 16 martie 2020. Lecția este să verificați ipotezele pe date înainte de a avea încredere într-un cîștig de eficiență.
Pe scurt
Bitcoin se tranzacționează 24 de ore din 24: ponderea nopții este aproape 0, iar toți cei cinci estimatori sînt apropiați
diferența rămasă: traiectoria zilei este observată prin tranzacții discrete, nu continuu
DAX și acțiunile BVB: între un sfert și o treime din varianță apare overnight
Parkinson, GK și RS sînt mult sub CC; YZ, care include varianța nopții, este apropiat de CC
S&P 500: chiar și YZ (16,3%) rămîne sub CC (19,9%)
randamentele overnight și cele deschidere–închidere sînt corelate pozitiv (0,22); o explicație probabilă: deschiderea indicelui folosește prețuri stale (neactualizate) ale acțiunilor care încă nu s-au tranzacționat
\(\mathrm{Var}(r) = \mathrm{Var}(o) + \mathrm{Var}(c) + 2\,\mathrm{Cov}(o, c)\): niciun estimator de amplitudine nu vede termenul de covarianță
Lecția: verificați ipotezele pe date înainte de a avea încredere într-un cîștig de eficiență
\[\mathrm{RV}_t = \sum_{i=1}^{M} r_{t,i}^2, \qquad M = 390/m\]
Întrebare pentru sală Ziua 1: √RV din randamente de 5 minute este 1,151%, iar volatilitatea reală 1,000%. Ce dă √RV din randamente de un minut?
Răspuns
1,051% (390 de randamente, eroarea +5,1%). Simularea nu are zgomot de microstructură, deci RV converge către varianța integrată cînd M crește: pe cele 60 de zile, eroarea relativă absolută medie scade de la 5,9% (5 minute) la 2,9% (un minut). Cu zgomot, signature plot arată efectul opus la intervalele scurte.
Întrebare pentru sală Cu fereastra de 21 de zile, variația zilnică tipică a logaritmului estimării este 7,0% pentru CC și 4,4% pentru Parkinson. Cum se schimbă aceste valori pentru o fereastră de 5 zile?
Răspuns
Ambele cresc mult: 30,3% pentru CC, 13,9% pentru Parkinson și 14,8% pentru YZ; la 63 de zile scad la 2,8% și 2,0%. Avantajul estimatorilor de amplitudine este mai mare pe ferestrele scurte: raportul CC/Parkinson este 2,2 la n = 5, 1,6 la n = 21 și 1,4 la n = 63.
Graficul arată volatilitatea anualizată pe 21 de zile a S&P 500 din 2019, calculată cu cei cinci estimatori: estimatorul închidere–închidere ca linie groasă albastru închis, iar Parkinson, Garman–Klass, Rogers–Satchell și Yang–Zhang ca linii mai subțiri. Cele două vîrfuri sînt crahul din martie 2020, cînd estimatorul închidere–închidere a ajuns aproape de 100%, în timp ce Yang–Zhang și mai ales cei trei estimatori ai ședinței au avut vîrfuri mult mai joase, și turbulențele de pe piață din aprilie 2025.
Pe întreaga perioadă, mediile sînt 16,3% pentru estimatorul închidere–închidere, 12,5% pentru Parkinson și 14,7% pentru Yang–Zhang. Liniile estimatorilor de amplitudine sînt și mai netede: variația zilnică tipică a estimării logaritmice este 4,4% pentru Parkinson și pentru Yang–Zhang, față de 7,0% pentru estimatorul închidere–închidere. Cîștigul de eficiență din simulare apare astfel pe date reale ca o estimare mai puțin zgomotoasă.
Cele două trăsături trebuie citite împreună. Estimările bazate pe amplitudine sînt mai puțin zgomotoase, dar sistematic mai mici decît cele închidere–închidere, iar diferența este cea mai mare tocmai în crize, cînd salturile overnight sînt mari și corelate cu ședința următoare. Pentru managementul riscului, o estimare netedă este utilă doar dacă nivelul ei este corect; Yang–Zhang recuperează o parte din diferență adăugînd noaptea, dar la S&P 500 nu toată.
Pe scurt
Volatilitatea pe 21 de zile, anualizată, calculată cu cei cinci estimatori; medii din 2019: CC 16,3%, Parkinson 12,5%, YZ 14,7%
Liniile estimatorilor de amplitudine sînt mai netede: variația zilnică tipică a estimării logaritmice este 4,4% pentru Parkinson și 4,4% pentru YZ, față de 7,0% pentru CC
Estimatorii de amplitudine folosesc deschiderea, maximul, minimul și închiderea fiecărei zile. În simulare, ei sînt de 5–9 ori mai eficienți decît estimatorul închidere–închidere, dar Parkinson, Garman–Klass și Rogers–Satchell omit varianța nopții, cu o deplasare de circa −22% cînd 20% din varianță apare overnight, iar toți subestimează cînd tranzacțiile sînt puține. Yang–Zhang adaugă noaptea și rămîne nedeplasat. Pe date reale, estimatorii coincid pentru Bitcoin, care se tranzacționează non-stop, în timp ce la S&P 500 o corelație pozitivă între noapte și ședință ține chiar și estimarea Yang–Zhang sub cea închidere–închidere. Secțiunea următoare face un pas mai departe și folosește prețuri din interiorul zilei.
Volatilitatea realizată
Cu prețuri intrazilnice, varianța unei zile poate fi măsurată din multe randamente mici, în loc de un singur randament zilnic sau de o singură amplitudine. Secțiunea definește varianța realizată și limita ei, varianța integrată, arată într-o simulare cît de bine urmărește ea volatilitatea reală și explică de ce eșantionarea prea deasă o înrăutățește, din cauza zgomotului de microstructură.
Împărțim ziua \(t\) în \(M\) intervale, de exemplu \(M = 78\) de intervale de cinci minute într-o ședință de 6,5 ore, și notăm cu \(r_{t,i}\) randamentul logaritmic al intervalului \(i\),\(i = 1, \dots, M\). Varianța realizată (realised variance) a zilei este suma randamentelor intrazilnice la pătrat,
\[\mathrm{RV}_t = \sum_{i=1}^{M} r_{t,i}^2,\]
(8.10)
iar volatilitatea realizată este \(\sqrt{\mathrm{RV}_t}\). Fiecare randament intrazilnic la pătrat are media egală cu varianța intervalului său, astfel încît suma lor estimează varianța întregii zile din \(M\) observații, nu dintr-una singură.
Andersen, Bollerslev, Diebold & Labys (2003) și Barndorff-Nielsen & Shephard (2002) arată că, atunci cînd \(M \to \infty\),\(\mathrm{RV}_t\) converge către varianța integrată (integrated variance) a zilei \(t\), integrala varianței instantanee pe parcursul zilei, adică varianța reală a acelei zile. Cu suficiente date intrazilnice, volatilitatea devine aproape observabilă: fiecare zi are o măsură aproape fără eroare a propriei varianțe.
Aceasta schimbă modul în care poate fi studiată volatilitatea. Varianța realizată se folosește la evaluarea prognozelor (secțiunea 8) și la prognoza directă a volatilității, de exemplu cu modelul HAR al lui Corsi (2009), care regresează volatilitatea realizată pe propriile ei medii din ziua, săptămîna și luna precedente. Pele & Mazurencu-Marinescu-Pele (2019) folosesc prețuri Bitcoin de înaltă frecvență pentru a studia riscul zilnic. Datele cursului sînt zilnice, așa că următoarele două slide-uri folosesc prețuri simulate la un minut pentru a arăta comportamentul varianței realizate.
Pe scurt
Împărțim ziua \(t\) în \(M\) intervale (de exemplu \(M = 78\) de randamente de cinci minute \(r_{t,i}\) într-o ședință de 6,5 ore)
\(r_{t,i}\): randamentul logaritmic al intervalului \(i\) din ziua \(t\), \(i = 1, \dots, M\)
Întrebare pentru sală Eroarea relativă absolută medie este 6% pentru RV la 5 minute, 23% pentru Parkinson și 58% pentru |r|. Cît devine eroarea RV dacă folosim randamente pe 390 de minute, adică un singur randament pe zi?
Răspuns
58%, ca |r|: cu M = 1, RV este chiar r², iar corelația cu volatilitatea reală scade la 0,59. La un minut eroarea este 3%, cu corelația 0,997. Parkinson (23%) folosește doar maximul și minimul și se află între cele două extreme.
Simularea generează 60 de zile, fiecare cu 390 de randamente de un minut. Volatilitatea zilnică se schimbă de la o zi la alta: logaritmul ei urmează un proces AR(1) cu persistența 0,9. Pe grafic, linia neagră este volatilitatea zilnică reală, linia roșie rădăcina pătrată a varianței realizate la cinci minute, linia verde întreruptă rădăcina pătrată a estimării Parkinson, iar punctele albastre randamentul zilnic în valoare absolută \(|r_t|\). Volatilitatea rămîne aproape de 1% în cea mai mare parte a eșantionului și apoi crește brusc la de cîteva ori acest nivel.
Cele trei măsuri diferă mult ca acuratețe. Eroarea relativă absolută medie este 6% pentru RV la cinci minute, 23% pentru Parkinson și 58% pentru \(|r_t|\); corelațiile cu volatilitatea reală sînt 0,995, 0,94 și 0,59. Linia roșie aproape că nu se distinge de cea neagră, linia verde o urmează cu erori vizibile, iar punctele albastre sînt foarte împrăștiate în jurul ei.
Ordinea urmează cantitatea de informație folosită de fiecare măsură. RV la cinci minute face media a 78 de randamente la pătrat pe zi, Parkinson folosește cele două extreme ale traiectoriei, iar \(|r_t|\) folosește un singur număr. Un singur randament zilnic poate fi aproape de zero într-o zi agitată și mare într-una liniștită, motiv pentru care \(|r_t|\) este cea mai slabă dintre cele trei măsuri.
Pe scurt
60 de zile simulate, fiecare cu 390 de randamente de un minut; logaritmul volatilității zilnice urmează un proces AR(1) (persistența \(0{,}9\))
Eroarea relativă absolută medie: RV la 5 minute 6%, Parkinson 23%, \(|r_t|\) 58%; corelația cu valoarea reală: 0,995; 0,94 și 0,59
Întrebare pentru sală Cu zgomot de 0,025%, RV la un minut supraestimează varianța de 1,79 ori. De cîte ori o supraestimează dacă zgomotul se dublează, la 0,05%?
Răspuns
De 4,16 ori în simulare și de 4,15 ori după formula 1 + 2M × varianța zgomotului/varianța reală, cu M = 390: excesul de 0,79 crește cu pătratul zgomotului, la circa 4 × 0,79 = 3,16. La 5 minute (M = 78) raportul este 1,62. Fiecare randament observat la pătrat conține, în medie, de două ori varianța zgomotului.
Prețurile observate nu sînt exact prețurile eficiente. Ele conțin zgomot de microstructură (microstructure noise): oscilația între prețurile bid și ask, rotunjirea la pasul de cotare și alte efecte ale mecanismului de tranzacționare. În simulare, prețul logaritmic observat este egal cu cel real plus un zgomot independent cu abaterea standard 0,025%. Fiecare randament observat conține atunci diferența a doi termeni de zgomot, iar fiecare randament la pătrat crește, în medie, cu dublul varianței zgomotului. Deplasarea RV este deci proporțională cu numărul de randamente \(M\): cu cît eșantionăm mai des, cu atît devine mai mare.
Signature plot arată media raportului dintre RV și varianța reală în funcție de intervalul de eșantionare, pe o scală logaritmică. Fără zgomot (albastru închis), raportul este aproape de 1 la orice interval. Cu zgomot (roșu), RV la un minut supraestimează varianța de 1,79 ori, RV la cinci minute de 1,15 ori, iar deplasarea aproape dispare la intervale de 30 de minute sau mai mari. La cele mai lungi intervale rămîn puține randamente în fiecare zi, iar estimarea devine din nou zgomotoasă.
Alegerea intervalului de eșantionare este deci un compromis: eșantionarea deasă reduce eroarea de selecție, dar crește deplasarea produsă de zgomot. În lucrările empirice, signature plot al datelor se folosește pentru a alege un interval la care curba se aplatizează. Liu, Patton & Sheppard (2015) compară un număr mare de măsuri realizate pe multe active și arată că RV la cinci minute este greu de depășit.
Pe scurt
Prețurile observate = prețurile reale + zgomot de microstructură (oscilația între bid și ask, pasul de cotare), aici cu abaterea standard \(0{,}025\%\); fiecare randament la pătrat crește atunci, în medie, cu dublul varianței zgomotului
Cu zgomot, RV la un minut supraestimează varianța de 1,79 ori; la 5 minute: 1,15; signature plot arată RV în funcție de intervalul de eșantionare
Varianța realizată adună randamentele intrazilnice la pătrat, (8.10), și converge către varianța integrată a zilei pe măsură ce eșantionarea devine mai fină. Într-o simulare, RV la cinci minute urmărește volatilitatea reală cu o eroare relativă absolută medie de 6%, față de 23% pentru Parkinson și 58% pentru randamentul zilnic în valoare absolută. Zgomotul de microstructură limitează cîștigul: cu un zgomot de 0,025%, RV la un minut supraestimează varianța cu 79%, iar RV la cinci minute cu 15%. Secțiunea următoare trece de la măsurarea volatilității la dinamica ei.
Volatility clustering
Volatility clustering este tendința variațiilor mari de a urma după variații mari și a celor mici de a urma după variații mici. Secțiunea îl introduce prin modelul ARCH al lui Engle, îl arată în autocorelațiile randamentelor în valoare absolută și la pătrat pentru trei piețe, demonstrează printr-un experiment de amestecare că este o proprietate a ordinii randamentelor, prezintă două teste formale, testul Ljung–Box pe randamentele la pătrat și testul ARCH-LM, le aplică pe șase serii și arată că volatility clustering este una dintre sursele cozilor groase.
Volatility clustering înseamnă că perioadele cu randamente mari în valoare absolută alternează cu perioade cu randamente mici (Mandelbrot, 1963; Cont, 2001). Randamentele însele sînt aproape necorelate (Capitolul 7), dar valorile lor absolute \(|r_t|\) și pătratele lor \(r_t^2\) sînt puternic autocorelate. Cele două fapte nu se contrazic: randamentele pot fi necorelate fără să fie independente, deoarece dependența se află în momentele lor de ordinul doi, nu în medii.
Engle (1982) a propus primul model al acestei dependențe. În modelul lui ARCH (autoregressive conditional heteroskedasticity, heteroscedasticitate condiționată autoregresivă), varianța de azi depinde de șocurile la pătrat de ieri, astfel încît \(\sigma_t\) variază în timp într-un mod previzibil. Engle a primit în 2003 Premiul Nobel pentru economie, împărțit cu Clive Granger (Nobel Prize, 2003); prelegerea lui Nobel, Engle (2004), trece în revistă felul în care modelul a fost primit și extins. Fotografia îl arată în 2017.
Această secțiune testează dacă volatility clustering este prezent în date; încă nu îl modelează. Testele pun o întrebare simplă, dacă randamentele la pătrat din trecut prezic randamentul la pătrat de azi, iar Capitolul 9 construiește modelele ARCH și GARCH, care descriu cum anume îl prezic.
Pe scurt
Volatility clustering: perioadele cu randamente mari în valoare absolută alternează cu perioade cu randamente mici Mandelbrot (1963), Cont (2001)
randamentele sînt aproape necorelate (Capitolul 7), dar \(|r_t|\) și \(r_t^2\) sînt puternic autocorelate
Robert F. Engle Engle (1982): varianța de azi depinde de șocurile la pătrat de ieri: ARCH
primul model în care \(\sigma_t\) variază în timp într-un mod previzibil
Premiul Nobel pentru economie (2003), împărțit cu Clive Granger Nobel Prize (2003); prelegerea Nobel a lui Engle: Engle (2004)
Această secțiune: testele pentru volatility clustering; Capitolul 9: modelele
Autocorelațiile lui |r| și r² (în afara benzii: din 100 de laguri)
Întrebare pentru sală La lagul 1, pentru ce putere d este cea mai mare autocorelația lui |r|d a BET?
Răspuns
d = 1,00 (0,414): |r| este mai autocorelat decît r² (0,333), efectul Taylor. Optimul depinde însă de serie și de lag: la lagul 1, d = 1,75 pentru S&P 500 și 0,75 pentru Bitcoin; la lagul 10, 1,25, 0,75 și 0,50. Puterile mari dau o pondere mare cîtorva zile extreme.
Întrebare pentru sală Pe eșantionul din curs, toate cele 100 de autocorelații ale lui |r| ale S&P 500 sînt în afara benzii. Cîte rămîn în afara benzii dacă eșantionul începe în 2010?
Răspuns
72 pentru |r| și 40 pentru r². Banda ±1,96/√T se lărgește de la ±0,020 la ±0,030 cînd T scade de la 9 240 la 4 202, iar ρ̂₁₀₀(|r|) scade de la 0,09 la 0,02. La lagurile mici volatility clustering rămîne evident; pentru BET din 2010, 53 de laguri ale lui |r| sînt în afara benzii.
Graficul arată funcția de autocorelație (ACF, autocorrelation function, Capitolul 7) de selecție a randamentelor \(r_t\), a randamentelor la pătrat \(r_t^2\) și a randamentelor în valoare absolută \(|r_t|\), pentru lagurile de la 1 la 100 de zile, în trei panouri: S&P 500, BET și Bitcoin. Banda colorată este \(\pm 1{,}96/\sqrt{T}\), cu \(T\) numărul de randamente: regiunea în care ar cădea circa 95% dintre autocorelațiile de selecție ale unor date i.i.d.
Autocorelațiile randamentelor, linia subțire albastru închis, rămîn în cea mai mare parte în interiorul benzii, cu excepția primului lag. Autocorelațiile randamentelor în valoare absolută și la pătrat, liniile roșie și verde, sînt mult deasupra ei. Pentru S&P 500, toate cele 100 de autocorelații ale lui \(r_t^2\) și toate cele 100 ale lui \(|r_t|\) sînt deasupra benzii, iar la lagul 100 autocorelația lui \(|r_t|\) este încă 0,09.
Graficul condensează mesajul secțiunii. Semnul randamentului de mîine nu poate fi prezis din trecut, dar mărimea lui poate, iar această previzibilitate durează luni de zile. O variație mare azi crește probabilitatea unei variații mari mîine și în săptămînile următoare, fără să spună în ce direcție va fi.
Pe scurt
ACF de selecție (funcția de autocorelație, Capitolul 7) pentru \(r_t\), \(r_t^2\) și \(|r_t|\), lagurile 1–100, cu banda de 95% \(\pm 1{,}96/\sqrt{T}\) pentru date i.i.d.
S&P 500: toate cele 100 de autocorelații ale lui \(r_t^2\) și \(|r_t|\) sînt deasupra benzii; la lagul 100, \(|r_t|\) are încă \(0{,}09\)
Tabelul dă principalele autocorelații. Pentru randamentele în valoare absolută, autocorelația de ordinul întîi \(\hat\rho_1(|r|)\) este 0,27 pentru S&P 500, 0,41 pentru BET și 0,21 pentru Bitcoin; la lagul 10, valorile sînt 0,28, 0,23 și 0,12, iar la lagul 100 sînt 0,09, 0,11 și 0,02. Pentru randamentele la pătrat, \(\hat\rho_1(r^2)\) este 0,31, 0,33 și 0,14, iar \(\hat\rho_{10}(r^2)\) este 0,24, 0,18 și 0,04. Numărul de laguri, din 100, la care autocorelația lui \(|r_t|\) iese din bandă este 100 pentru S&P 500 și BET și 92 pentru Bitcoin.
Scăderea este lentă. Pentru un proces a cărui autocorelație ar scădea geometric de la 0,27 la lagul 1, autocorelația la lagul 10 ar fi \(0{,}27^{10}\), practic zero; pentru S&P 500 ea este încă 0,28. Un șoc de volatilitate rămîne vizibil după luni de zile, proprietate pe care Capitolul 11 o studiază sub numele de memorie lungă (long memory).
Mai apar două regularități. Efectul Taylor (Ding, Granger & Engle, 1993) este constatarea că \(|r_t|\) este mai autocorelat decît \(r_t^2\): el apare la 96% dintre laguri pentru S&P 500 și la toate lagurile pentru BET și Bitcoin. Bitcoin are și un volatility clustering mai slab în pătrate, cu doar 26 din 100 de laguri în afara benzii pentru \(r_t^2\): ridicarea la pătrat dă cîtorva zile extreme o pondere dominantă în autocorelația de selecție, iar valorile absolute, care le ponderează mai puțin, arată dependența mai clar.
Pe scurt
\(\hat\rho_1(|r|)\)
\(\hat\rho_{10}(|r|)\)
\(\hat\rho_{100}(|r|)\)
\(\hat\rho_1(r^2)\)
\(\hat\rho_{10}(r^2)\)
Laguri în afara benzii, \(|r|\)
S&P 500
\(0{,}27\)
\(0{,}28\)
\(0{,}09\)
\(0{,}31\)
\(0{,}24\)
100/100
BET
\(0{,}41\)
\(0{,}23\)
\(0{,}11\)
\(0{,}33\)
\(0{,}18\)
100/100
Bitcoin
\(0{,}21\)
\(0{,}12\)
\(0{,}02\)
\(0{,}14\)
\(0{,}04\)
92/100
Scădere lentă: un șoc de volatilitate se vede încă după luni de zile; Capitolul 11 numește acest fenomen memorie lungă
Efectul Taylor: \(|r_t|\) este mai autocorelat decît \(r_t^2\) (96% dintre laguri la S&P 500, toate lagurile la BET și Bitcoin) Ding, Granger & Engle (1993)
Bitcoin: volatility clustering mai slab în \(r_t^2\) (26 din 100 de laguri în afara benzii): cîteva zile cu variații extreme domină pătratele
Întrebare pentru sală S&P 500, T = 9 240: ρ̂₁, ρ̂₂, ρ̂₃ ale lui r² sînt 0,311; 0,408; 0,250. Cît este Q(3)?
Răspuns
Termenii T(T + 2)ρ̂²/(T − k) sînt 892; 1 540; 579, deci Q(3) = 3 012, mult peste χ²0,95(3) = 7,81. Q(3) pentru randamente este 57,7: respinge și el, dar este de 52 de ori mai mic. Varianta 8 958 uită să ridice autocorelațiile la pătrat, iar 0,33 uită factorul T(T + 2)/(T − k).
Întrebare pentru sală S&P 500, q = 5: R² = 0,2412 și n = 9 235. Cît este statistica LM?
Răspuns
LM = 9 235 × 0,2412 = 2 227, față de χ²0,95(5) = 11,07 (p < 0,001). R² spune că circa un sfert din variația lui e²ₜ de la o zi la alta este anticipată de ultimele cinci zile. Varianta 4 535 folosește R în loc de R², iar 1,21 înmulțește R² cu q în loc de n.
Teste pe randamentele zilnice (cu roșu: p-value sub 0,05)
Întrebare pentru sală Bitcoin are excesul de boltire 12,0, dar cea mai mică statistică ARCH-LM(5) din tabel: 115, față de 2 227 la S&P 500. De ce?
Răspuns
LM = nR²: Bitcoin are mai puțin de jumătate din observațiile S&P 500 (4 379 față de 9 235 în regresie), iar R² este 0,026 față de 0,241, pentru că cîteva zile extreme domină regresia pătratelor. Testul respinge totuși puternic (p < 0,001), iar Q(10) pentru |r|, mai puțin sensibil la zilele extreme, este 1 086. Q(10) pentru r respinge și el în toate cele șase serii (p ≤ 0,028), dar este de 10,5–171,7 ori mai mic decît pentru r².
Întrebare pentru sală Amestecarea zilelor una cîte una duce ρ̂₁(|r|) de la 0,27 la −0,02. Ce se întîmplă dacă amestecăm blocuri de cîte 5 zile consecutive?
Răspuns
ρ̂₁(|r|) rămîne 0,23, pentru că patru din cinci perechi de zile consecutive rămîn în același bloc, dar Q(10) pentru r² scade de la 8 015 la 1 413: lagurile mai lungi decît blocul își pierd structura. Cu blocuri de 63 de zile, ρ̂₁(|r|) = 0,27 și Q(10) = 7 038. Excesul de boltire rămîne 10,9 în toate cazurile.
Un experiment simplu arată de unde vine volatility clustering. Graficul ia aceleași randamente S&P 500 și le așază într-o ordine aleatoare. Seria amestecată are exact aceeași distribuție ca originalul, deci același exces de boltire, 10,9, dar episoadele de volatilitate din jurul anilor 2008 și 2020 au dispărut: zilele extreme sînt acum împrăștiate uniform în eșantion. Panourile din dreapta arată ACF-ul lui \(|r_t|\) pentru cele două ordini.
Statisticile confirmă ce arată graficul. Autocorelația de ordinul întîi a lui \(|r_t|\) este 0,27 în ordinea reală și −0,02 după amestecare. Statistica Ljung–Box \(Q(10)\) a randamentelor la pătrat, introdusă pe slide-ul următor, este 8 015 în ordinea reală și 6,3 după amestecare, sub valoarea critică de 5%, 18,31.
Volatility clustering este deci o proprietate a ordinii randamentelor, nu a distribuției lor. Amestecarea distruge orice formă de dependență în timp și păstrează intactă distribuția marginală, așa că seria amestecată arată cum ar arăta orice statistică în ipoteza de independență. Aceasta este și logica unui test de permutare (permutation test): compararea statisticii observate cu valorile ei pe multe amestecări dă un test de independență fără ipoteze despre distribuție.
Pe scurt
Aceleași randamente S&P 500 într-o ordine aleatoare: aceeași distribuție și aceeași boltire (excesul de boltire 10,9), dar fără volatility clustering
\(\hat\rho_1(|r|)\): \(0{,}27\) în ordinea reală, \(-0{,}02\) după amestecare; Ljung–Box \(Q(10)\) pentru \(r_t^2\): 8 015 față de 6,3
Volatility clustering este o proprietate a ordinii randamentelor, nu a distribuției lor
unde \(T\) este numărul de randamente, \(m\) numărul de laguri testate, iar \(\hat\rho_k(r^2)\) autocorelația de selecție a lui \(r_t^2\) la lagul \(k\). Statistica este o sumă ponderată a pătratelor primelor \(m\) autocorelații, deci \(Q(m) \ge 0\), iar valorile mari indică pătrate autocorelate. Testul respinge ipoteza nulă la pragul de 5% dacă \(Q(m)\) depășește cuantila de 95% \(\chi^2_{0{,}95}(m)\).
Pentru S&P 500, cu \(T = 9\,240\) și \(m = 3\), primele trei autocorelații ale lui \(r_t^2\) sînt 0,311, 0,408 și 0,250. Fiecare termen \(T(T+2)\hat\rho_k^2/(T-k)\) este aproximativ \(T\hat\rho_k^2\); cei trei termeni sînt 892, 1 540 și 579, iar suma lor este \(Q(3) = 3\,012\), mult peste \(\chi^2_{0{,}95}(3) = 7{,}81\). Ipoteza nulă este respinsă. Într-un eșantion de această mărime, o singură autocorelație de 0,3 este deja o dovadă copleșitoare.
Aceeași statistică aplicată randamentelor \(r_t\), ca în Capitolul 7, pune o altă întrebare: dacă media randamentului de mîine este previzibilă. Aplicată lui \(r_t^2\), ea întreabă dacă varianța este previzibilă. Cele două teste pot da răspunsuri opuse pe aceleași date, iar pentru randamentele financiare de obicei așa se întîmplă.
Pe scurt
\(H_0\): fără volatility clustering, \(\mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\) constantă, deci \(r_t^2\) este necorelat
Al doilea test, propus de Engle (1982), regresează randamentele centrate la pătrat \(e_t^2\), cu \(e_t = r_t - \bar r\) și \(\bar r\) media de selecție, pe \(q\) dintre propriile lor laguri:
cu coeficienții de regresie \(c_0, \dots, c_q\) și eroarea \(u_t\). Ipoteza nulă a absenței efectelor ARCH este \(c_1 = \dots = c_q = 0\). Statistica multiplicatorului Lagrange (LM, Lagrange multiplier) este
\[\mathrm{LM} = n R^2 \sim \chi^2(q) \text{ în ipoteza } H_0,\]
(8.12)
unde \(n\) este numărul de observații din regresie, iar \(R^2\) coeficientul ei de determinare. Ca test de tip multiplicator Lagrange, el cere doar estimarea regresiei auxiliare prin metoda celor mai mici pătrate, nu și a modelului ARCH însuși.
Pentru S&P 500 cu \(q = 5\), regresia are \(n = 9\,235\) de observații, cu cinci mai puține decît randamentele, din cauza lagurilor, iar \(R^2 = 0{,}241\). Statistica este \(\mathrm{LM} = 9\,235 \times 0{,}241 = 2\,227\), mult peste \(\chi^2_{0{,}95}(5) = 11{,}07\): efectele ARCH sînt puternice. \(R^2\), care se află între 0 și 1, este proporția din varianța lui \(e_t^2\) explicată de propriul trecut; aici circa un sfert din variația de la o zi la alta a randamentelor la pătrat poate fi anticipată din ultimele cinci zile.
Ambele teste sînt instrumente de diagnostic. Ele arată că volatility clustering există, nu cum trebuie modelat. Alegerea modelului, estimarea lui și verificarea faptului că a eliminat volatility clustering din reziduurile standardizate sînt subiectul Capitolului 9.
Pe scurt
Regresia auxiliară a randamentelor centrate la pătrat \(e_t^2\), \(e_t = r_t - \bar r\), pe \(q\) dintre propriile lor laguri Engle (1982):
Tabelul aplică testele pe șase serii: S&P 500 (\(T = 9\,240\) de randamente zilnice), DAX (9 288), BET (7 243), Bitcoin (4 384) și acțiunile de la București TLV (3 788) și SNP (3 815). Valorile critice de 5% sînt \(\chi^2_{0{,}95}(10) = 18{,}31\) pentru \(Q(10)\) și \(\chi^2_{0{,}95}(5) = 11{,}07\) pentru ARCH-LM(5). Toate statisticile calculate pe \(r^2\) și pe \(|r|\) resping ipoteza nulă, cu p sub 0,001.
Statisticile pe pătrate și pe valori absolute sînt mari peste tot. \(Q(10)\) pentru \(r^2\) variază între 213 pentru Bitcoin și 8 015 pentru S&P 500, iar \(Q(10)\) pentru \(|r|\), mai mare în fiecare serie, cum prezice efectul Taylor, între 944 pentru SNP și 8 323 pentru S&P 500. Prin comparație, \(Q(10)\) pe randamentele însele este mic: 90,8 pentru S&P 500, 21,8 pentru DAX, 198,3 pentru BET, 20,2 pentru Bitcoin, 29,1 pentru TLV și 20,7 pentru SNP. Aceste valori depășesc 18,31, dar sînt cu unul pînă la două ordine de mărime sub statisticile pe pătrate, iar testul Ljung–Box standard pe randamente respinge el însuși prea des cînd volatilitatea apare în grupuri. Valoarea cea mai mare, pentru BET, corespunde unei autocorelații de ordinul întîi de 0,156, un efect cunoscut al tranzacționării nesincrone (non-synchronous trading) a acțiunilor din indice. Previzibilitatea mediei este slabă; cea a mărimii este puternică peste tot.
Statisticile ARCH-LM(5) sînt 2 227 pentru S&P 500, 1 209 pentru DAX, 1 057 pentru BET, 115 pentru Bitcoin, 253 pentru TLV și 234 pentru SNP. Bitcoin și cele două acțiuni de la București au cele mai mici valori, deși au cele mai groase cozi, cu excese de boltire de 12,0, 13,5 și 8,9. O parte din diferență vine din eșantioanele mai scurte, deoarece LM este proporțional cu \(n\), dar și \(R^2\) este mult mai mic: cîteva zile extreme domină regresia randamentelor la pătrat și reduc proporția din varianță pe care o explică.
Pe scurt
\(T\)
\(\hat\rho_1(r)\)
\(Q(10)\), \(r\)
\(\hat\rho_1(r^2)\)
\(Q(10)\), \(r^2\)
\(Q(10)\), \(|r|\)
ARCH-LM(5)
Exc. boltire
S&P 500
9 240
\({-0{,}079}\)
\(90{,}8\)
\(0{,}311\)
8 015
8 323
2 227
\(10{,}9\)
DAX
9 288
\({-0{,}009}\)
\(21{,}8\)
\(0{,}155\)
3 747
5 794
1 209
\(6{,}0\)
BET
7 243
\({0{,}156}\)
\(198{,}3\)
\(0{,}333\)
2 500
5 184
1 057
\(9{,}9\)
Bitcoin
4 384
\({-0{,}022}\)
\(20{,}2\)
\(0{,}137\)
213
1 086
115
\(12{,}0\)
TLV
3 788
\({0{,}010}\)
\(29{,}1\)
\(0{,}122\)
481
1 179
253
\(13{,}5\)
SNP
3 815
\({-0{,}015}\)
\(20{,}7\)
\(0{,}195\)
505
944
234
\(8{,}9\)
Valori critice de 5%: \(\chi^2_{0{,}95}(10) = 18{,}31\) pentru \(Q(10)\), \(\chi^2_{0{,}95}(5) = 11{,}07\) pentru ARCH-LM(5); toate statisticile pentru \(r^2\) și \(|r|\) resping, cu p \(<\) 0,001
\(Q(10)\) pentru \(r\) respinge și el la 5% în toate cele șase serii (\(p \le 0{,}028\)), dar este mult mai mic decît pentru \(r^2\) (raportul dintre cele două este între 10,5 și 171,7): previzibilitatea mediei este slabă (Capitolul 7), cea a mărimii este puternică peste tot
Bitcoin, Banca Transilvania (TLV) și OMV Petrom (SNP) au cele mai mici valori ARCH-LM, deși au cozi groase: \(\mathrm{LM} = nR^2\) crește cu lungimea eșantionului, iar aceste serii sînt mai scurte; și \(R^2\) este mai mic (0,026; 0,067; 0,061 față de 0,241 la S&P 500): cîteva zile extreme domină regresia și reduc \(R^2\)
Întrebare pentru sală Zilele agitate au abaterea standard de 3 ori mai mare decît cele liniștite. Pentru ce pondere p a zilelor agitate este boltirea amestecului cea mai mare?
Răspuns
La p = 0,1, cu boltirea 8,33; la p = 0,5 boltirea este 4,92, iar la p = 0,02, 5,80. Cînd p tinde spre 0 sau spre 1, amestecul devine o singură distribuție Normală, cu boltirea 3. Pentru raportul 2 și p = 0,2, ca pe slide, boltirea este 4,69.
Panoul din stînga arată de ce volatility clustering produce cozi groase chiar dacă fiecare zi urmează distribuția Normală. Să presupunem că zilele liniștite au abaterea standard 1, zilele agitate abaterea standard 2, iar o proporție \(p = 0{,}2\) dintre zile sînt agitate. Condiționat de \(\sigma\), randamentul urmează distribuția Normală, deci \(E[r^4 \mid \sigma] = 3\sigma^4\), iar coeficientul de boltire al amestecului este \(3E[\sigma^4]/E[\sigma^2]^2\). Aici \(E[\sigma^2] = 0{,}8 \times 1 + 0{,}2 \times 4 = 1{,}6\) și \(E[\sigma^4] = 0{,}8 \times 1 + 0{,}2 \times 16 = 4{,}0\), deci boltirea este \(3 \times 4{,}0/1{,}6^2 = 4{,}69\), peste valoarea Normală de 3. Din inegalitatea lui Jensen, \(E[\sigma^4] \ge E[\sigma^2]^2\), cu egalitate doar dacă \(\sigma\) este constant: orice variație a volatilității crește boltirea. Curbele arată boltirea în funcție de \(p\) pentru zile agitate de 2, 3 și 4 ori mai volatile decît cele liniștite; efectul este cel mai puternic cînd zilele agitate sînt rare și foarte diferite de cele liniștite.
Panoul din dreapta arată același mecanism în modelul GARCH(1,1) din (8.5), cu șocuri Normale. Coeficientul lui de boltire este
și este finit doar dacă numitorul este pozitiv. Pentru \(\alpha = 0{,}10\) și \(\beta = 0{,}85\), boltirea este 3,77. Curbele arată că ea crește exploziv odată cu reacția \(\alpha\), cu atît mai devreme cu cît \(\beta\) este mai mare: pentru \(\beta = 0{,}9\) devine infinită la un \(\alpha\) de circa 0,09.
Volatility clustering explică astfel o parte din excesul de boltire găsit în secțiunea 1. Nu îl explică neapărat în întregime: boltirea GARCH de 3,77 pentru parametri tipici este mult sub boltirea de 13,9 a S&P 500, unul dintre motivele pentru care Capitolul 9 ia în calcul și șocuri cu distribuții cu cozi groase.
Pe scurt
Stînga: zile liniștite cu abaterea standard 1, zile agitate cu abaterea standard 2 (ponderea \(p = 0{,}2\)): \(E[\sigma^2] = 1{,}6\), \(E[\sigma^4] = 4{,}0\), coeficientul de boltire \(3E[\sigma^4]/E[\sigma^2]^2 = 4{,}69\), deși randamentul fiecărei zile urmează distribuția Normală
Dreapta: coeficientul de boltire al unui GARCH(1,1), \(3 + 6\alpha^2/(1 - \beta^2 - 2\alpha\beta - 3\alpha^2)\), ca în SFEkurgarch; \(\alpha = 0{,}10\), \(\beta = 0{,}85\): 3,77 (Capitolul 9)
Randamentele sînt aproape necorelate, dar valorile lor absolute și pătratele lor sînt autocorelate pe durata mai multor luni: pentru S&P 500, toate cele 100 de autocorelații ale lui \(|r_t|\) sînt deasupra benzii de 95%, iar autocorelația la lagul 100 este încă 0,09. Amestecarea zilelor elimină această dependență și păstrează distribuția, deci volatility clustering este o proprietate a ordinii randamentelor. Testul Ljung–Box pe randamentele la pătrat, (8.11), și testul ARCH-LM, (8.12), resping absența volatility clustering în toate cele șase serii, cu p sub 0,001, iar un amestec de zile liniștite și agitate produce cozi groase chiar cu zile Normale. Secțiunea următoare privește volatilitatea pe orizonturi lungi, corespondentul ei implicit din prețurile opțiunilor și reacția ei asimetrică la scăderi.
Comportamentul pe termen lung, VIX și efectul de levier
Secțiunea examinează alte trei regularități ale volatilității. În trei decenii, volatilitatea se schimbă mult, dar revine mereu la un nivel normal. Volatilitatea implicită, măsurată prin VIX, este de obicei mai mare decît volatilitatea care urmează, o diferență care reflectă o primă de risc. Iar volatilitatea reacționează mai puternic la scăderi decît la creșteri de aceeași mărime, efectul de levier, pe care secțiunea îl măsoară cu corelații, medii condiționate și o regresie neparametrică.
Întrebare pentru sală Din 1990, AR(1) al logaritmului volatilității lunare a S&P 500 are φ̂ = 0,67 și timpul de înjumătățire 1,7 luni. Ce dă același AR(1) dacă eșantionul începe în 2010?
Răspuns
φ̂ = 0,53 (SE 0,06) pe 201 luni, timpul de înjumătățire 1,1 luni și nivelul pe termen lung 12,9%; din 2000, φ̂ = 0,66. Eșantionul din 2010 nu conține criza lungă din 2008–2009, iar episodul din 2020 a fost scurt, deci revenirea la medie pare mai rapidă.
Panoul din stînga arată volatilitatea fiecărui an calendaristic, anualizată, pentru cele patru piețe. Pentru S&P 500 ea variază între 7% în 2017 și 41% în 2008; pentru BET, între 10% în 2017 și 43% în 2008; pentru Bitcoin, între 42% în 2025 și 94% în 2017. DAX urmează îndeaproape S&P 500, cu un vîrf mai înalt la începutul anilor 2000. Volatilitatea nu este constantă de la un an la altul, iar anii cu volatilitate mare sînt comuni piețelor: 2008 iese în evidență la toți cei trei indici bursieri, iar 2020 la S&P 500 și DAX.
Panoul din dreapta privește persistența de la o lună la alta. Fiecare punct este o lună a S&P 500: pe axa orizontală, logaritmul volatilității realizate din luna precedentă, calculată din randamentele zilnice, pe axa verticală, cel din luna curentă. Linia întreruptă este bisectoarea, dreapta de 45 de grade, iar linia roșie este relația AR(1) estimată, cu panta \(\hat\phi = 0{,}67\).
Linia roșie este mai plată decît bisectoarea. O lună cu volatilitate mare tinde să fie urmată de o lună mai apropiată de medie, iar la fel se întîmplă după o lună cu volatilitate mică. Dacă volatilitatea ar fi un mers aleator, punctele s-ar împrăștia în jurul bisectoarei, iar un nivel de criză ar persista, în medie, la nesfîrșit. Panta mai mică decît 1 este semnul revenirii la medie, pe care slide-ul următor o cuantifică.
Pe scurt
Stînga: volatilitatea fiecărui an calendaristic (anualizată, %); dreapta: logaritmul volatilității realizate lunare a S&P 500 (din randamente zilnice) față de luna precedentă
S&P 500: de la 7% (2017) la 41% (2008); BET: de la 10% (2017) la 43% (2008); Bitcoin: de la 42% (2025) la 94% (2017)
Volatilitatea se schimbă în timp, dar nu se îndepărtează la nesfîrșit: revine la un nivel normal, cum a arătat Schwert (1989) pentru randamentele acțiunilor americane. Regresia AR(1) a logaritmului volatilității realizate lunare a S&P 500 pe valoarea din luna precedentă, pe 441 de luni, dă \(\hat\phi = 0{,}67\), cu eroarea standard 0,04. Coeficientul \(\hat\phi\) este ponderea estimată a logaritmului volatilității din luna precedentă; o valoare apropiată de 1 ar însemna o revenire lentă la medie, iar 0,67 se află la multe erori standard sub 1.
Din regresie decurg două cifre. Timpul de înjumătățire al unui șoc de volatilitate, durata după care jumătate dintr-o abatere de la nivelul pe termen lung a dispărut, este \(\ln 0{,}5/\ln\hat\phi = 1{,}7\) luni. Nivelul pe termen lung implicat de regresie este de circa 13,5% pe an. O lună de criză este urmată astfel de o revenire treptată la normal în cîteva luni, nu de o schimbare permanentă.
Distribuția volatilității lunare are o asimetrie puternică la dreapta, cu un coeficient de asimetrie (skewness) de 3,3, în timp ce logaritmul ei este mult mai simetric, cu asimetria 0,6 (Andersen, Bollerslev, Diebold & Ebens, 2001). Cîteva luni de criză ridică media, 15,3%, peste mediană, 12,9%. De aceea modelele volatilității sînt adesea scrise pentru \(\ln\sigma_t\), ceea ce păstrează și volatilitatea automat pozitivă. Revenirea la medie este exact ceea ce îi lipsește modelului EWMA și ceea ce are GARCH cu \(\alpha + \beta < 1\) (Capitolul 9).
Pe scurt
Volatilitatea se schimbă în timp, dar nu se îndepărtează la nesfîrșit: revine la un nivel normal Schwert (1989)
AR(1) pentru logaritmul volatilității realizate lunare a S&P 500 (441 de luni): \(\hat\phi = 0{,}67\) (SE 0,04)
\(\hat\phi\): ponderea estimată a logaritmului volatilității din luna precedentă; o valoare apropiată de 1 înseamnă o revenire lentă la medie
timpul de înjumătățire al unui șoc de volatilitate: \(\ln 0{,}5/\ln\hat\phi = 1{,}7\) luni; nivelul pe termen lung circa 13,5%
Opțiunile se tranzacționează la bursă din 1973, cînd membrii bursei Chicago Board of Trade au înființat CBOE (Chicago Board Options Exchange); fotografia arată agenți de bursă la Chicago Board of Trade în mai 1973. Prețul unei opțiuni depinde de volatilitatea pe care piața o așteaptă pînă la scadență: cu cît volatilitatea așteptată este mai mare, cu atît valorează mai mult dreptul de a cumpăra sau de a vinde la un preț fixat. Volatilitatea implicită (implied volatility) este volatilitatea care, introdusă într-o formulă de evaluare a opțiunilor, reproduce prețul observat.
VIX, introdus în 1993 (Whaley, 1993), măsoară volatilitatea așteptată a S&P 500 pentru următoarele 30 de zile calendaristice, calculată din prețurile unei game de opțiuni pe S&P 500 (Cboe, 2026). El se exprimă în procente anualizate: un VIX de 20 înseamnă o volatilitate așteptată de circa \(20/\sqrt{12} \approx 5{,}8\%\) pe o lună.
VIX este numit „indicele fricii”, deoarece crește brusc cînd acțiunile scad (Whaley, 2009). Spre deosebire de estimatorii din secțiunile anterioare, care privesc înapoi la prețurile trecute, VIX privește înainte: este prețul pe care piața îl pune pe volatilitatea viitoare. Slide-urile următoare compară acest preț cu volatilitatea care a urmat efectiv.
Pe scurt
Opțiunile se tranzacționează la bursă din 1973, cînd membrii bursei Chicago Board of Trade au înființat CBOE (Chicago Board Options Exchange)
prețul unei opțiuni depinde de volatilitatea pe care piața o așteaptă pînă la scadență
volatilitatea implicită: volatilitatea care, introdusă într-o formulă de evaluare a opțiunilor, dă prețul observat
VIX, introdus în 1993 Whaley (1993): volatilitatea așteptată a S&P 500 pentru următoarele 30 de zile calendaristice, din prețurile opțiunilor pe S&P 500 Cboe (2026)
exprimat în procente anualizate: VIX \(= 20\) înseamnă circa \(20/\sqrt{12} \approx 5{,}8\%\) pe o lună
numit „indicele fricii”: crește brusc cînd acțiunile scad Whaley (2009)
VIX și volatilitatea realizată în următoarele h zile
Întrebare pentru sală Din 1990, VIX explică R² = 0,52 din volatilitatea realizată a următoarelor 21 de zile, față de 0,44 pentru volatilitatea realizată trecută. Ce se întîmplă dacă eșantionul începe în 2010?
Răspuns
Ambele R² scad, la 0,37 și 0,26, iar VIX rămîne mai informativ; regresia devine realizată = −0,16 + 0,81 VIX. După 2010 sînt mai puține episoade lungi de volatilitate ridicată, deci mai puțină variație de explicat. Panta sub 1 arată că VIX este informativ, dar deplasat ca prognoză.
Întrebare pentru sală Linia roșie (VIX) este de obicei deasupra sau dedesubtul celei albastre (volatilitatea realizată din următoarele 21 de zile)?
Răspuns
Deasupra, în 86% din cele 9 199 de zile; media VIX este 19,4%, media volatilității realizate 15,3%, o diferență de 4,1 puncte. Este prima de risc a varianței: investitorii plătesc pentru a fi asigurați împotriva salturilor de volatilitate. Cu h = 63 de zile, VIX este deasupra în 82% din zile.
Graficul arată VIX cu roșu și, cu albastru închis, volatilitatea realizată a S&P 500 în următoarele 21 de zile de tranzacționare, \(\sqrt{(A/21)\sum_{j=1}^{21} r_{t+j}^2}\), anualizată la fel ca VIX. Cele două serii sînt aliniate astfel încît, la fiecare dată, linia albastră arată rezultatul pe care VIX-ul acelei date încerca să-l anticipeze. VIX și-a atins maximul, 82,7, pe 16 martie 2020.
Cele două linii se mișcă împreună. Ambele au cele mai înalte vîrfuri în toamna lui 2008 și în martie 2020 și vîrfuri comune mai mici în jurul anilor 1998, 2002, 2011, 2015 și 2025. În perioadele calme, cum sînt mijlocul anilor 1990, 2005–2006 și 2017, ambele sînt joase; în crize, ambele cresc în cîteva zile.
Întrebarea pentru sală cere dacă linia roșie este de obicei deasupra sau sub cea albastră. Înainte de răspuns, ajută să priviți o opțiune ca pe o asigurare: ce ar cere vînzătorul unei asigurări împotriva volatilității, în comparație cu pierderile pe care se așteaptă ca asigurarea să le acopere?
Pe scurt
VIX și volatilitatea realizată a S&P 500 în următoarele 21 de zile de tranzacționare, \(\sqrt{(A/21)\sum_{j=1}^{21} r_{t+j}^2}\); maximul VIX: 82,7 pe 16 martie 2020
Întrebare pentru sală: linia roșie este de obicei deasupra sau sub cea albastră?
Linia roșie este de obicei deasupra. VIX a depășit volatilitatea realizată din următoarele 21 de zile de tranzacționare în 86% din cele 9 199 de zile, iar media VIX, 19,4%, este cu 4,1 puncte peste media volatilității realizate, 15,3%. Această diferență este prima de risc a varianței (variance risk premium): investitorii plătesc pentru a fi asigurați împotriva salturilor de volatilitate, astfel încît opțiunile sînt evaluate la o volatilitate mai mare decît cea care se așteaptă să se materializeze, cum documentează Carr & Wu (2009) și Bollerslev, Tauchen & Zhou (2009).
Ca prognoză, VIX este informativ, dar deplasat. Regresia volatilității realizate viitoare pe VIX dă realizată \(= -1{,}72 + 0{,}88\,\)VIX, cu \(R^2 = 0{,}52\). O prognoză nedeplasată ar avea interceptul 0 și panta 1; cu aceste estimări, un VIX de 20 prognozează o volatilitate realizată de circa 15,9%. Volatilitatea realizată din ultimele 21 de zile explică mai puțin din viitor, \(R^2 = 0{,}44\), deci prețul de piață conține informație pe care randamentele trecute nu o conțin.
Variațiile zilnice ale logaritmului VIX și randamentele zilnice ale S&P 500 au o corelație de −0,71: frica crește cînd prețurile scad. Această relație negativă puternică dintre randamente și variațiile volatilității așteptate duce direct la subiectul următor, efectul de levier.
Pe scurt
Răspuns: deasupra; VIX a depășit volatilitatea realizată din următoarele 21 de zile în 86% din cele 9 199 de zile
media VIX 19,4% față de media volatilității realizate 15,3%: o diferență de 4,1 puncte
Efectul de levier (leverage effect) este constatarea că randamentele negative sînt urmate de o volatilitate mai mare decît randamentele pozitive de aceeași mărime (Christie, 1982). Au fost propuse două explicații. Explicația prin levier spune că scăderea prețului acțiunii crește raportul dintre datorii și capitalul propriu, deci acțiunea firmei devine mai riscantă. Explicația prin feedback de volatilitate (volatility feedback) inversează cauzalitatea: cînd volatilitatea așteptată crește, investitorii cer un randament mai mare, deci prețul trebuie să scadă azi, cum argumentează French, Schwert & Stambaugh (1987) și Bekaert & Wu (2000).
O măsură simplă a efectului este corelația \(\mathrm{corr}(r_t, |r_{t+j}|)\) pentru \(j = 1, 2, \dots\), unde \(j\) este numărul de zile în avans, iar corelația se calculează pe toate zilele \(t\). O valoare negativă înseamnă că o scădere azi anunță agitație în zilele următoare. Într-un model simetric, în care randamentele pozitive și negative de aceeași mărime au același efect asupra volatilității viitoare, această corelație este zero.
Capitolul 2 a întîlnit o asimetrie în distribuția randamentelor, prin coeficientul lor de asimetrie. Aici asimetria se află în dinamica volatilității: aceeași variație în valoare absolută are consecințe diferite în funcție de semnul ei. Următoarele două slide-uri măsoară această asimetrie în date, întîi cu corelații și medii condiționate, apoi cu o regresie neparametrică.
Pe scurt
Efectul de levier: randamentele negative sînt urmate de o volatilitate mai mare decît randamentele pozitive de aceeași mărime Christie (1982)
explicația prin levier: scăderea prețului acțiunii crește raportul datorii/capital propriu, deci acțiunea devine mai riscantă
Întrebare pentru sală Pe întregul eșantion, corr(r_t, |r_t+1|) este −0,122 la S&P 500 și −0,073 la BET. Ce se întîmplă cu BET dacă eșantionul începe în 2010?
Răspuns
Efectul devine mai puternic: corelația este −0,141, iar raportul dintre media lui r²ₜ₊₁ după o zi de scădere și după o zi de creștere urcă de la 1,41 la 1,86. La S&P 500 corelația rămîne −0,122. Bitcoin are cea mai slabă asimetrie (raportul 1,06).
Graficul arată \(\mathrm{corr}(r_t, |r_{t+j}|)\) pentru \(j = 1, \dots, 10\) zile în avans, pe patru piețe. Pentru S&P 500, DAX și BET, toate cele zece corelații sînt negative; pentru S&P 500 corelația este −0,122 la \(j = 1\) și scade doar lent în valoare absolută odată cu orizontul. Pentru Bitcoin, corelațiile sînt mici și au semne diferite, pozitive la lagurile 8 și 9.
Sensul invers dă o comparație utilă. Corelația dintre randamentul de ieri în valoare absolută și randamentul de azi, \(\mathrm{corr}(|r_{t-1}|, r_t)\), este doar 0,025 pentru S&P 500. Mărimea variației de ieri nu spune aproape nimic despre semnul randamentului de azi, în timp ce semnul randamentului de azi spune ceva despre mărimea variațiilor care urmează: asimetria merge de la randamente spre volatilitatea viitoare.
O a doua măsură împarte media lui \(r_{t+1}^2\) după o zi de scădere la media lui după o zi de creștere. Raportul este 1,51 pentru S&P 500, 1,46 pentru DAX, 1,41 pentru BET și 1,06 pentru Bitcoin: pentru cei trei indici bursieri, varianța zilei următoare este cu 40–50% mai mare după o scădere decît după o creștere, în timp ce pentru Bitcoin efectul aproape lipsește. Diferența este compatibilă cu explicația prin levier, care privește firme finanțate parțial prin datorii; Bitcoin nu are un bilanț.
Pe scurt
\(\mathrm{corr}(r_t, |r_{t+j}|)\), \(j = 1, \dots, 10\); S&P 500: \(-0{,}122\) la \(j = 1\); în sens invers, \(\mathrm{corr}(|r_{t-1}|, r_t) = 0{,}025\)
Media lui \(r_{t+1}^2\) după o zi de scădere împărțită la cea după o zi de creștere: S&P 500 1,51, DAX 1,46, BET 1,41, Bitcoin 1,06
Întrebare pentru sală De ce minimul volatilității condiționate a S&P 500 este la x ≈ 0,65%, nu la 0?
Răspuns
Din cauza asimetriei: după o zi de creștere moderată urmează, în medie, ziua cea mai liniștită, iar după o scădere de aceeași mărime una mai agitată; σ̂(−2%) = 1,61% față de σ̂(+2%) = 1,16% (raportul 1,39), la DAX 1,79% față de 1,43%. Media randamentelor, 0,03% pe zi, este prea mică pentru a explica deplasarea. Cu h = 0,01 minimul se mută la 0,17%, cu h = 0,10 la 1,61%, dar σ̂(−2%) > σ̂(+2%) rămîne.
Efectul de levier poate fi măsurat și fără a presupune o formă funcțională. Fie \(\hat m_1(x)\) și \(\hat m_2(x)\) regresiile liniare locale ale lui \(r_t\) și \(r_t^2\) pe randamentul de ieri \(r_{t-1} = x\), cu nucleu cvartic și lățimea de bandă 0,04 pe randamente zecimale. Volatilitatea condiționată de randamentul de ieri este atunci
rădăcina pătrată a momentului condiționat de ordinul doi minus pătratul mediei condiționate.
Graficul arată \(\hat\sigma(x)\) pentru S&P 500 și DAX, pentru \(x\) între aproximativ −5% și 5%. Ambele curbe au forma literei U: variațiile mari de orice semn sînt urmate de o volatilitate mai mare. Dar curbele nu sînt simetrice. Pentru S&P 500, \(\hat\sigma(-2\%) = 1{,}61\%\), față de \(\hat\sigma(+2\%) = 1{,}16\%\), iar minimul este la \(x \approx 0{,}7\%\), nu la 0: după o creștere moderată urmează ziua cea mai liniștită.
Curba este o estimare a curbei de impact al știrilor (news impact curve), relația dintre știrile de azi și volatilitatea de mîine. Un model GARCH simetric implică o parabolă centrată în zero, deoarece varianța lui depinde doar de \(r_{t-1}^2\). Datele mută minimul spre dreapta și fac ramura stîngă mai abruptă, iar aceasta este forma pe care modelele GARCH asimetrice din Capitolul 9 sînt construite să o reproducă.
Pe scurt
\(\hat\sigma(x) = \sqrt{\hat m_2(x) - \hat m_1(x)^2}\), \(\hat m_1\), \(\hat m_2\): regresii liniare locale ale lui \(r_t\) și \(r_t^2\) pe \(r_{t-1} = x\) (nucleu cvartic, lățimea de bandă \(0{,}04\) pe randamente zecimale, ca în SFEvolnonparest)
S&P 500: \(\hat\sigma(-2\%) = 1{,}61\%\) față de \(\hat\sigma(+2\%) = 1{,}16\%\); minimul este la \(x \approx 0{,}7\%\), nu la 0: un impact asimetric al știrilor
Volatilitatea anuală variază mult, între 7% și 41% pentru S&P 500 din 1990, dar revine la un nivel normal: coeficientul AR(1) al logaritmului volatilității lunare este 0,67, adică un timp de înjumătățire de 1,7 luni. VIX a depășit volatilitatea realizată din luna următoare în 86% din zile, în medie cu 4,1 puncte, o primă de risc a varianței, și prognozează volatilitatea realizată mai bine decît volatilitatea trecută. Scăderile cresc volatilitatea viitoare mai mult decît creșterile: după o zi de scădere, varianța zilei următoare este de circa 1,5 ori mai mare pentru S&P 500, iar curba neparametrică de impact al știrilor este asimetrică. Secțiunea următoare întreabă cum se decide care prognoză a volatilității este cea mai bună.
Evaluarea prognozelor de volatilitate
O prognoză a volatilității nu poate fi comparată cu volatilitatea reală, deoarece aceasta nu este observată niciodată. Secțiunea explică felul în care prognozele sînt evaluate față de o variabilă proxy zgomotoasă, ce funcții de pierdere dau ordinea corectă în ciuda zgomotului, cum se compară șase prognoze ale S&P 500 începînd din 2010, cum s-au comportat ele în 2020 și cum poate fi ales factorul de atenuare EWMA după un criteriu de prognoză.
O prognoză \(h_t\) a varianței \(\sigma_t^2\) se face la închiderea zilei \(t-1\), iar valoarea reală \(\sigma_t^2\) nu este observată niciodată. Prognoza se compară, așadar, cu o variabilă proxy (proxy) \(\hat\sigma_t^2\): o mărime măsurabilă, nedeplasată condiționat, \(E[\hat\sigma_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\). Variabila proxy este corectă în medie, dar conține zgomot, iar zgomotul afectează orice măsură a calității prognozei.
Variabilele proxy din acest capitol merg de la zgomotoase la precise: randamentul la pătrat \(r_t^2\), un estimator de amplitudine și varianța realizată. Cu \(r_t^2\), chiar și o prognoză perfectă pare slabă, deoarece \(r_t^2 = \sigma_t^2 z_t^2\), iar factorul \(z_t^2\) domină variația de la o zi la alta. Andersen & Bollerslev (1998) au arătat că valorile mici ale lui \(R^2\) obținute de prognozele GARCH față de randamentele la pătrat nu înseamnă modele proaste: cu varianța realizată ca variabilă proxy, aceleași prognoze explică o parte mare din variație.
cu interceptul \(a\), panta \(b\) și eroarea \(u_t\). O prognoză bună are \(a \approx 0\) și \(b \approx 1\): este nedeplasată și se mișcă unu la unu cu variabila proxy. \(R^2\) măsoară ce parte din variația variabilei proxy este explicată de prognoză. Cum zgomotul variabilei proxy limitează \(R^2\)-ul care poate fi atins, regresia compară prognozele între ele pe aceeași variabilă proxy; ea nu le măsoară calitatea în termeni absoluți.
Pe scurt
O prognoză \(h_t\) a lui \(\sigma_t^2\) se face la închiderea zilei \(t-1\); valoarea reală \(\sigma_t^2\) nu este observată niciodată
comparăm \(h_t\) cu o variabilă proxy\(\hat\sigma_t^2\): o mărime măsurabilă cu \(E[\hat\sigma_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\)
Variabile proxy, de la zgomotoase la precise: \(r_t^2\), un estimator de amplitudine, varianța realizată
cu \(r_t^2\) chiar și o prognoză perfectă pare slabă: Andersen & Bollerslev (1998) au arătat că un \(R^2\) mic nu înseamnă un model prost
Prognozele se ordonează după pierderea lor medie pe zilele de evaluare; o valoare mai mică este mai bună (Patton, 2011). Cu \(h_t\) prognoza varianței și \(\hat\sigma_t^2\) variabila proxy, pierderea dintr-o zi este \(L = (\hat\sigma_t^2 - h_t)^2\) pentru eroarea pătratică medie (MSE) și
\[L = \frac{\hat\sigma_t^2}{h_t} + \ln h_t\]
(8.14)
pentru QLIKE (quasi-likelihood, cvasi-verosimilitate). QLIKE este, pînă la constante, opusul log-verosimilității Normale a unui randament cu varianța \(h_t\): densitatea \(N(0, h_t)\) în \(r_t\) are logaritmul \(-\tfrac12\ln(2\pi) - \tfrac12\ln h_t - r_t^2/(2h_t)\).
Ambele funcții de pierdere (loss functions) sînt robuste: cu o variabilă proxy zgomotoasă, dar nedeplasată, ele ordonează prognozele la fel cum le-ar ordona varianța reală. Pentru QLIKE, aceasta decurge din \(E[\hat\sigma_t^2/h_t + \ln h_t \mid \mathcal{F}_{t-1}] = \sigma_t^2/h_t + \ln h_t\), minimizată în \(h_t = \sigma_t^2\); zgomotul variabilei proxy adaugă varianță pierderii medii, dar nu îi mută minimul. Pierderile calculate pe \(\sqrt{h_t}\) sau pe \(\ln h_t\), cum este eroarea pătratică a volatilității, nu sînt robuste: zgomotul variabilei proxy le mută minimul departe de varianța reală, iar ele pot prefera prognoza greșită.
Exemplul rezolvat arată cum ponderează cele două pierderi erorile. Fie varianța reală și variabila proxy egale cu 1 și două prognoze, \(h = 0{,}5\) și \(h = 2\), fiecare greșită de două ori. MSE este \((1 - 0{,}5)^2 = 0{,}25\) față de \((1 - 2)^2 = 1\): penalizează mai mult supraestimarea. QLIKE este \(1/0{,}5 + \ln 0{,}5 = 2 - 0{,}693 = 1{,}307\) față de \(1/2 + \ln 2 = 0{,}5 + 0{,}693 = 1{,}193\), în comparație cu minimul 1 în \(h = 1\): penalizează mai mult subestimarea, eroarea costisitoare în managementul riscului, deoarece o varianță subestimată subestimează VaR. În plus, QLIKE depinde de eroarea de prognoză doar prin raportul \(\hat\sigma_t^2/h_t\), astfel încît zilele liniștite și cele agitate cîntăresc comparabil, în timp ce MSE este dominată de cele cîteva zile cu cele mai mari varianțe.
Pe scurt
Pierderea medie pe zilele de evaluare; o valoare mai mică este mai bună Patton (2011)
\(L\): pierderea dintr-o zi; \(h_t\): prognoza varianței; \(\hat\sigma_t^2\): variabila proxy
Ambele sînt robuste: cu o variabilă proxy zgomotoasă, dar nedeplasată, ordonează prognozele la fel ca varianța reală
pierderile calculate pe \(\sqrt{h_t}\) sau pe \(\ln h_t\) nu sînt robuste și pot prefera prognoza greșită
Exemplu rezolvat: varianța reală și variabila proxy egale cu 1; două prognoze, \(h = 0{,}5\) și \(h = 2\)
MSE: \((1 - 0{,}5)^2 = 0{,}25\) față de \((1 - 2)^2 = 1\): MSE penalizează mai mult supraestimarea
QLIKE: \(1/0{,}5 + (-0{,}693) = 1{,}307\) față de \(1/2 + 0{,}693 = 1{,}193\): QLIKE penalizează mai mult subestimarea, eroarea costisitoare în managementul riscului
Tabelul compară șase prognoze ale varianței S&P 500 pentru ziua următoare, pe 4 202 zile începînd din 2010: ferestre mobile de 21, 63 și 252 de zile, EWMA cu \(\lambda = 0{,}94\) și \(\lambda = 0{,}97\) și VIX. Prognoza VIX este \(\mathrm{VIX}^2/A\), care transformă volatilitatea implicită anualizată într-o varianță zilnică. Variabila proxy este \(r_t^2\); variabila proxy de amplitudine din ultimul rînd este \(o_t^2\) plus termenul Garman–Klass, care adaugă noaptea la o estimare eficientă a ședinței.
După MSE, cea mai bună este prognoza VIX (16,70), urmată de EWMA 0,94 (17,77), fereastra de 21 de zile (18,99), EWMA 0,97 (19,02), fereastra de 63 de zile (20,77) și fereastra de 252 de zile (21,43). După QLIKE, ordinea este VIX (0,799), EWMA 0,94 (0,808), EWMA 0,97 (0,844), fereastra de 21 de zile (0,876), fereastra de 63 de zile (0,914) și fereastra de 252 de zile (1,099). Cele două pierderi coincid pentru primele două locuri și pentru ultimele, dar inversează fereastra de 21 de zile și EWMA 0,97.
Dacă o diferență între pierderile medii este semnificativă se decide cu testul Diebold–Mariano (DM) (Diebold & Mariano, 1995), un test \(t\) pentru media diferențelor zilnice de pierdere, cu o eroare standard care ține seama de autocorelația lor. Pentru QLIKE, EWMA 0,94 față de fereastra de 21 de zile dă \(t = -4{,}50\) (p < 0,001), iar VIX față de EWMA 0,94 dă \(t = -0{,}32\) (p = 0,751). EWMA este deci mai bun decît fereastra de 21 de zile, VIX și EWMA nu diferă semnificativ, iar fereastra lungă este cea mai slabă. \(R^2\)-ul Mincer–Zarnowitz cu variabila proxy \(r^2\) variază între 0,25 pentru VIX și 0,01 pentru fereastra de 252 de zile; variabila proxy de amplitudine crește fiecare valoare, la 0,42 pentru VIX și 0,29 pentru EWMA 0,94, dar lasă ordinea neschimbată.
Pe scurt
21 de zile
63 de zile
252 de zile
EWMA 0,94
EWMA 0,97
VIX
MSE
18,99
20,77
21,43
17,77
19,02
16,70
QLIKE
0,876
0,914
1,099
0,808
0,844
0,799
MZ \(R^2\), proxy \(r^2\)
0,14
0,05
0,01
0,17
0,11
0,25
MZ \(R^2\), proxy de amplitudine
0,24
0,09
0,02
0,29
0,19
0,42
Prognoze ale varianței pentru ziua următoare, pentru 4 202 de zile, începînd din 2010; proxy \(r_t^2\); prognoza VIX: VIX\(^2/A\); proxy de amplitudine: \(o_t^2\) plus termenul Garman–Klass
Testul DM (Diebold–Mariano) al egalității QLIKE Diebold & Mariano (1995): EWMA 0,94 față de 21 de zile \(t = -4{,}50\) (p \(<\) 0,001); VIX față de EWMA 0,94 \(t = -0{,}32\) (p = 0,751)
EWMA este semnificativ mai bun decît fereastra de 21 de zile; VIX și EWMA nu diferă semnificativ; fereastra lungă este cea mai slabă; o variabilă proxy precisă crește fiecare \(R^2\), dar nu schimbă ordinea
Întrebare pentru sală Varianța reală și variabila proxy sînt egale cu 1, iar prognozele sînt h = 0,5 și h = 2. Ce prognoză preferă fiecare funcție de pierdere?
Răspuns
MSE preferă h = 0,5 (0,25 față de 1), QLIKE preferă h = 2 (1,193 față de 1,307): MSE penalizează mai mult supraestimarea, QLIKE subestimarea, eroarea costisitoare în managementul riscului. QLIKE are minimul la h = proxy. MSE devine indiferent între cele două prognoze la proxy = 1,25, iar QLIKE la proxy = 2 ln 2/1,5 = 0,924.
Prognoze ale varianței pentru ziua următoare (cu verde: cea mai mică pierdere)
Întrebare pentru sală Cu proxy r², din 2010, ce prognoză a varianței pentru ziua următoare are cel mai mic QLIKE?
Răspuns
VIX (0,799), urmat de EWMA 0,94 (0,808), dar diferența nu este semnificativă: testul DM dă t = −0,32 (p = 0,751). EWMA 0,94 este semnificativ mai bună decît fereastra de 21 de zile (t = −4,50, p < 0,001), iar fereastra de 252 de zile este cea mai slabă (1,099). Cu proxy de amplitudine, VIX coboară pe locul cinci (0,635): acest proxy este în medie mai mic decît r² (0,82 față de 1,18), pentru că nu vede Cov(o, c), iar VIX, care depășește deja volatilitatea realizată, pierde cel mai mult.
Întrebare pentru sală În 2020, VIX și EWMA au atins vîrful în martie, iar fereastra de 252 de zile pe 29 decembrie. Cum arată vîrfurile în 2008?
Răspuns
EWMA 79,0% pe 29 octombrie, VIX 80,9% pe 21 noiembrie, fereastra de 252 de zile 41,1% pe 31 decembrie. Fereastra lungă cumulează șocurile și scade doar cînd acestea ies din ea, deci vîrful ei vine tîrziu și este mai mic. QLIKE mediu în 2008: 3,132 pentru fereastra de 252 de zile, 2,420 pentru EWMA, 2,350 pentru VIX.
Graficul urmărește în 2020 trei prognoze ale volatilității S&P 500 pentru ziua următoare, anualizate: fereastra de 252 de zile cu verde, EWMA cu \(\lambda = 0{,}94\) cu roșu și VIX cu albastru închis; barele sînt randamentele zilnice în valoare absolută \(|r_t|\), pe aceeași scală anuală. Toate trei încep anul sub 15%.
Prognozele au reacționat la crah cu viteze diferite. VIX a început să crească cu o zi de tranzacționare înaintea primei scăderi mari din februarie 2020, deoarece prețurile opțiunilor răspund la știri pe măsură ce acestea apar. EWMA a crescut imediat după scădere, de îndată ce un randament mare la pătrat a intrat în recurență, și și-a atins vîrful în martie. Fereastra de 252 de zile s-a mișcat lent, și-a atins vîrful abia vara și a rămas aproape de el pînă la sfîrșitul anului, mult după ce variațiile zilnice deveniseră mici.
După vîrf, EWMA a rămas deasupra VIX în aprilie și mai, deoarece scade mecanic cu 6% pe zi, în timp ce VIX a scăzut de îndată ce piața s-a liniștit. Din vară, EWMA a fost sub VIX, care și-a păstrat prima, și sub fereastra de 252 de zile, care încă includea crahul din martie. Cele trei prognoze diferă cel mai mult tocmai în perioadele în care prognozele contează cel mai mult.
Pe scurt
Prognozele volatilității S&P 500 pentru ziua următoare în 2020 (anualizate): fereastra de 252 de zile, EWMA (\(\lambda = 0{,}94\)) și VIX; barele: \(|r_t|\)
VIX a început să crească cu o zi de tranzacționare înaintea primei scăderi mari din februarie 2020; EWMA a crescut imediat după ea; fereastra de 252 de zile s-a mișcat lent și a rămas aproape de vîrf pînă la sfîrșitul anului
Întrebare pentru sală Cu evaluarea din 2010, cel mai bun λ pentru S&P 500 este 0,925. Ce λ alege QLIKE dacă evaluarea începe în 2022?
Răspuns
0,940, valoarea RiskMetrics (diferența de QLIKE la 0,94 este sub 0,001); din 2020, 0,920; din 2016, 0,930. Pentru BET cel mai bun λ este între 0,885 și 0,900, pentru Bitcoin între 0,970 și 0,995. Un singur λ pentru toate activele și perioadele este un compromis comod, nu un optim.
Graficul arată QLIKE-ul mediu al prognozelor EWMA pentru ziua următoare, cu variabila proxy \(r_t^2\), în funcție de factorul de atenuare \(\lambda\) între 0,80 și 0,995, minus minimul lui, astfel încît fiecare curbă atinge zero în valoarea ei optimă. Evaluarea începe în 2010 pentru S&P 500 și BET și în 2016 pentru Bitcoin. Linia verticală întreruptă marchează valoarea RiskMetrics, 0,94.
Cel mai bun factor de atenuare este 0,925 pentru S&P 500, 0,885 pentru BET și 0,970 pentru Bitcoin. Curbele sînt plate în jurul minimelor și cresc abrupt cînd \(\lambda\) se apropie de 1, așa că o memorie prea lungă costă mult mai mult decît una puțin prea scurtă. Pentru S&P 500, valoarea RiskMetrics 0,94 crește QLIKE-ul mediu cu doar 0,002 față de valoarea optimă.
Un singur \(\lambda\) pentru toate activele este deci un compromis comod, nu un optim. BET preferă o memorie mai scurtă decît RiskMetrics, iar Bitcoin una mai lungă. Alegerea unui parametru după pierderea de prognoză urmează același principiu ca alegerea unui model după performanța în afara eșantionului (out-of-sample); Capitolul 9 estimează în schimb parametrii GARCH prin verosimilitate maximă, ceea ce, pentru șocuri Normale, revine la minimizarea QLIKE în eșantion.
Pe scurt
QLIKE mediu al prognozelor EWMA pentru ziua următoare (proxy \(r_t^2\), din 2010; Bitcoin din 2016) minus minimul lui, pentru \(\lambda\) între 0,80 și 0,995
Cel mai bun \(\lambda\): S&P 500 0,925, BET 0,885, Bitcoin 0,970; valoarea RiskMetrics 0,94 are un QLIKE mai mare cu doar 0,002 la S&P 500
Un singur \(\lambda\) pentru toate activele este un compromis comod, nu un optim
Prognozele de volatilitate se compară cu o variabilă proxy, iar doar pierderile robuste, ca MSE și QLIKE, le ordonează corect în ciuda zgomotului variabilei proxy. Pentru S&P 500 din 2010, VIX și EWMA 0,94 au cele mai mici pierderi și nu diferă semnificativ, EWMA este mai bun decît fereastra de 21 de zile, iar fereastra de 252 de zile este cea mai slabă; o variabilă proxy mai precisă crește fiecare \(R^2\) Mincer–Zarnowitz, dar lasă ordinea neschimbată. Factorul de atenuare EWMA optim diferă de la o piață la alta, de la 0,885 pentru BET la 0,970 pentru Bitcoin, în timp ce valoarea RiskMetrics 0,94 costă puțin pentru S&P 500.
AI pentru descoperire științifică
Secțiunea pornește de la o întrebare deschisă ridicată de rezultatele capitolului: dacă estimatorii de amplitudine ajută la Bursa de Valori București, unde multe acțiuni se tranzacționează rar. Ea arată unde pot ajuta instrumentele AI un cercetător care o studiază și ce verificări nu pot înlocui.
Ajută estimatorii de amplitudine la Bursa de Valori București, unde multe acțiuni se tranzacționează rar? Teoria din secțiunea 4 indică ambele sensuri. Amplitudinile sînt de 5–9 ori mai eficiente decît închiderile cînd tranzacționarea este continuă, dar tranzacționarea rară micșorează amplitudinea observată, astfel încît estimatorii devin deplasați în jos.
Datele a patru acțiuni mari de la București arată ambele forțe. Din 2010, ponderea zilelor cu tranzacții, dar cu închiderea neschimbată, este 9% pentru TLV, 8% pentru SNP, 10% pentru BRD și 10% pentru TGN, un semn direct al tranzacționării rare. Raportul dintre volatilitatea Parkinson și cea închidere–închidere este 0,81 pentru TLV, 0,87 pentru SNP, 0,90 pentru BRD și 0,87 pentru TGN, față de 0,78 pentru S&P 500, deci raportul singur nu măsoară lipsa de lichiditate: la S&P 500 el reflectă noaptea și termenul de covarianță. În prognozele pentru ziua următoare cu o fereastră de 21 de zile, QLIKE-ul mediu al estimatorului închidere–închidere față de Yang–Zhang este 2,022 față de 2,039 pentru TLV, un mic avantaj pentru închidere–închidere, și 1,750 față de 1,636 pentru TGN, un avantaj clar pentru Yang–Zhang.
Răspunsul diferă de la o acțiune la alta, iar motivul rămîne o întrebare deschisă. Candidații sînt lichiditatea, licitația de deschidere (opening auction), care determină cum se formează prețul de deschidere, și mărimea mișcării overnight. Instrumentele AI pot accelera un studiu al acestei întrebări, dar rezultatele lui trebuie verificate în continuare (Wang et al., 2023).
Pe scurt
Ajută estimatorii de amplitudine la Bursa de Valori București, unde multe acțiuni se tranzacționează rar?
teoria: amplitudinile sînt de 5–9 ori mai eficiente; dar tranzacționarea rară micșorează amplitudinea observată (secțiunea 4)
zile cu tranzacții, dar cu închiderea neschimbată, din 2010: TLV 9%, SNP 8%, BRD 10%, TGN 10%
Un asistent AI poate ajuta în trei etape. Pentru literatură, poate lista studiile despre volatilitatea de amplitudine și cea realizată pe piețe emergente și puțin lichide, cu datele și estimatorii folosiți de fiecare, ceea ce dă un punct de plecare pentru compararea bursei de la București cu piețe asemănătoare. Pentru cod, poate scrie o primă versiune a celor cinci estimatori, a prognozelor pe ferestre mobile și a comparațiilor QLIKE pentru toate acțiunile din BET. Pentru robustețe, poate propune și implementa variante: grupe de lichiditate formate după volumul tranzacționat, alte lungimi ale ferestrei și cele două jumătăți 2016–2020 și 2021–2026.
Exemplul de prompt de pe slide este precis: numește cei patru estimatori de amplitudine, fereastra de 21 de zile, datele de intrare, orizontul de prognoză, funcția de pierdere și variabila proxy. Un prompt precis produce cod care poate fi verificat față de definițiile din acest capitol; unul vag produce cod ale cărui alegeri rămîn ascunse.
Rezultatul fiecărei etape este o ciornă. Lista de lucrări trebuie verificată referință cu referință, iar codul trebuie testat pe rezultate cunoscute, de exemplu reproducînd tabelul celor cinci estimatori pentru S&P 500 și cele două acțiuni de la București înainte de a-l aplica întregului indice.
Pe scurt
Literatura: o listă a studiilor despre volatilitatea de amplitudine și cea realizată pe piețe emergente și puțin lichide, cu datele și estimatorii folosiți
Cod: o primă versiune a celor cinci estimatori, a prognozelor pe ferestre mobile și a comparațiilor QLIKE pentru toate acțiunile din BET
Robustețe: grupe de lichiditate după volum, alte ferestre, cele două jumătăți 2016–2020 și 2021–2026
Exemplu de prompt
Write a Python function that computes the Parkinson, Garman-Klass, Rogers-Satchell and Yang-Zhang variance on rolling 21-day windows from daily open, high, low and close prices, and compares their next-day forecasts with QLIKE against squared close-to-close returns.
Mai multe erori sînt frecvente în codul generat cu AI pentru estimatorii de amplitudine. Constantele sînt prima sursă: \(4\ln 2\) la Parkinson, (8.6),\(2\ln 2 - 1\) la Garman–Klass, (8.7), și ponderea \(k\) la Yang–Zhang, (8.9), care depinde de lungimea ferestrei. O ciornă care împarte la \(\ln 2\) în loc de \(4\ln 2\) sau care fixează \(k = 0{,}34\) este greșită, iar eroarea schimbă nivelul fiecărei estimări.
Datele cer aceeași atenție. Pentru acțiuni, deschiderea, maximul și minimul trebuie ajustate pentru dividende și splituri cu același factor ca închiderea; altfel, fiecare zi ex-dividend creează un salt overnight artificial. Anualizarea trebuie să folosească frecvența reală de tranzacționare: 365 de zile pentru criptoactive și circa 250 pentru acțiunile de la București.
Prognozele nu trebuie să folosească informație din viitor (look-ahead): prognoza pentru ziua \(t\) poate folosi doar datele pînă în ziua \(t-1\), iar o eroare de o zi într-o fereastră mobilă face o prognoză să pară mult mai bună decît este. În sfîrșit, fiecare lucrare citată de un instrument AI trebuie să existe; verificarea DOI-ului fiecărei referințe este testul cel mai simplu, deoarece referințele inventate, cu titluri plauzibile, sînt o eroare cunoscută a modelelor de limbaj.
Pe scurt
Constantele: \(4\ln 2\) la Parkinson, \(2\ln 2 - 1\) la Garman–Klass, \(k\) la Yang–Zhang; o primă versiune cu \(\ln 2\) sau cu \(k = 0{,}34\) este greșită
Prețurile acțiunilor: deschiderea, maximul și minimul trebuie ajustate pentru dividende și splituri cu același factor ca închiderea
Anualizarea cu frecvența reală: 365 pentru cripto, circa 250 pentru acțiunile BVB
Fără informație din viitor: prognoza pentru ziua \(t\) folosește doar datele pînă în ziua \(t-1\)
Referințele: fiecare lucrare citată trebuie să existe; verificați DOI-ul
Proiectul întreabă ce estimator zilnic de volatilitate ar trebui să folosească un manager de risc din România. Datele sînt acțiuni de la Bursa de Valori București din 2010, TLV, SNP, BRD, TGN și altele cu date OHLC, cu S&P 500 și DAX ca termeni de comparație, toate de la furnizorul de date EODHD.
Pașii urmează capitolul. Calculați cei cinci estimatori pe ferestre de 21 de zile și variantele lor EWMA și produceți prognoze pentru ziua următoare. Evaluați prognozele cu QLIKE și MSE față de variabila proxy \(r_t^2\), testați diferențele cu teste Diebold–Mariano și raportați rezultatele pe grupe de lichiditate. În final, legați cîștigul estimatorului Yang–Zhang față de cel închidere–închidere de ponderea zilelor fără volum și de ponderea nopții în varianță.
Livrabilele sînt un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele. Orice utilizare a AI se declară, împreună cu erorile AI găsite și corectate.
Pe scurt
Întrebarea: ce estimator zilnic de volatilitate ar trebui să folosească un manager de risc din România?
date: acțiuni BVB din 2010 (TLV, SNP, BRD, TGN și altele cu date OHLC), S&P 500 și DAX ca termeni de comparație (EODHD)
Pași
cei cinci estimatori pe ferestre de 21 de zile; variantele EWMA ale fiecăruia; prognoze pentru ziua următoare
QLIKE și MSE cu proxy-ul \(r_t^2\); teste Diebold–Mariano; rezultate pe grupe de lichiditate
legați cîștigul YZ față de CC de ponderea zilelor fără volum și de ponderea nopții
Livrabile: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele
Declarați orice utilizare a instrumentelor AI și enumerați erorile acestora pe care le-ați corectat
Sinteza secțiunii
La Bursa de Valori București, cîștigul adus de estimatorii de amplitudine depinde de acțiune: Yang–Zhang îmbunătățește prognozele pentru ziua următoare la TGN, dar nu la TLV, iar între 8% și 10% din zilele cu tranzacții au o închidere neschimbată. Răspunsul la întrebare cere măsuri de lichiditate, o tratare atentă a deschiderii și a nopții și prognoze fără informație din viitor; instrumentele AI pot scrie o primă versiune a codului și a căutării bibliografice, iar cercetătorul verifică constantele, ajustările și referințele.
Rezumat
Rezultatele capitolului se reduc la cîteva afirmații despre felul în care se măsoară volatilitatea și cum se comportă ea, un set de formule și trei întrebări de autoevaluare.
Volatilitatea este abaterea standard a randamentelor. Ea este latentă, variază în timp și se anualizează cu rădăcina pătrată a numărului real de observații pe an. O fereastră mobilă plătește viteza de reacție cu zgomot și produce ghost effect cînd șocurile vechi ies din ea; EWMA cu \(\lambda = 0{,}94\) reacționează repede și uită treptat.
Estimatorii de amplitudine folosesc traiectoria zilei și sînt mult mai eficienți decît estimatorul închidere–închidere, dar salturile overnight și tranzacționarea rară îi deplasează în jos; Yang–Zhang adaugă noaptea. Varianța realizată din randamente la cinci minute face volatilitatea aproape observabilă. Volatilitatea apare în grupuri: randamentele în valoare absolută și la pătrat sînt autocorelate pe durata mai multor luni, iar testul Ljung–Box pe randamentele la pătrat și testul ARCH-LM detectează acest lucru.
Pe termen lung, volatilitatea revine la un nivel normal; VIX depășește de obicei volatilitatea realizată care urmează; iar scăderile cresc volatilitatea viitoare mai mult decît creșterile. Prognozele se compară cu o variabilă proxy și cu pierderi robuste, cum este QLIKE, iar diferențele dintre ele se testează înainte de a declara un cîștigător.
Pe scurt
Volatilitatea este abaterea standard a randamentelor; este latentă și variază în timp; se anualizează cu frecvența reală
La ferestrele istorice, viteza de reacție se plătește cu zgomot; EWMA (\(\lambda = 0{,}94\)) reacționează repede și evită ghost effect
Estimatorii de amplitudine folosesc traiectoria zilei: mult mai eficienți, dar deplasați de salturile overnight și de tranzacționarea rară; Yang–Zhang adaugă varianța nopții
Volatility clustering: \(|r_t|\) și \(r_t^2\) sînt autocorelate; se detectează cu Ljung–Box pe \(r_t^2\) și cu ARCH-LM
Volatilitatea revine la medie; VIX depășește de obicei volatilitatea realizată; scăderile cresc volatilitatea viitoare
Comparați prognozele cu pierderi robuste (QLIKE) și o variabilă proxy; testați diferențele
Tabelul adună formulele capitolului. Anualizarea, (8.1), înmulțește volatilitatea zilnică cu rădăcina pătrată a numărului de observații pe an. Recurența EWMA, (8.3), actualizează varianța în fiecare zi cu ponderea \(1 - \lambda\) pe cel mai nou randament la pătrat, iar timpul ei de înjumătățire este \(\ln 0{,}5/\ln\lambda\).
Cei patru estimatori de amplitudine folosesc mișcările de la deschidere la maxim, la minim și la închidere: Parkinson, (8.6), folosește doar amplitudinea; Garman–Klass, (8.7), adaugă mișcarea deschidere–închidere; Rogers–Satchell, (8.8), este nedeplasat în prezența tendinței; iar Yang–Zhang, (8.9), adaugă varianța overnight. Varianța realizată, (8.10), adună randamentele intrazilnice la pătrat.
Statistica McLeod–Li, (8.11), și statistica ARCH-LM, (8.12), testează prezența volatility clustering, ambele cu distribuții \(\chi^2\) în ipoteza nulă. Pierderile MSE și QLIKE, (8.14), evaluează prognozele de varianță față de o variabilă proxy; ambele sînt robuste la zgomotul variabilei proxy.
Prima întrebare dă o acțiune cu maximul 102 și minimul 98 într-o zi și cere volatilitatea ei zilnică Parkinson. Amplitudinea logaritmică este \(\ln(102/98) = 4{,}00\%\), iar conform (8.6) varianța este \(4{,}00^2/2{,}77\), deci volatilitatea zilnică este \(\sqrt{4{,}00^2/2{,}77} = 2{,}40\%\).
A doua întrebare presupune că testul Ljung–Box pe randamente nu respinge ipoteza nulă, în timp ce același test pe randamentele la pătrat o respinge puternic. Concluzia este că media este imprevizibilă, iar varianța este previzibilă: volatility clustering fără autocorelația randamentelor, tiparul tuturor seriilor din acest capitol.
A treia întrebare cere motivul pentru care EWMA cu \(\lambda = 0{,}94\) nu poate anticipa revenirea volatilității la nivelul normal. Ca model GARCH, el are \(\omega = 0\) și \(\alpha + \beta = 1\), deci prognozele lui sînt constante la orice orizont. Capitolul următor, Capitolul 9, introduce modelele ARCH și GARCH, ale căror prognoze revin la un nivel pe termen lung.
Pe scurt
Întrebare: o acțiune are \(H = 102\), \(L = 98\) într-o zi; care este volatilitatea zilnică Parkinson?
Randamente logaritmice zilnice, în %: S&P 500 și DAX din ianuarie 1990, BET din septembrie 1997, Bitcoin din septembrie 2014 (7 zile pe săptămînă), Banca Transilvania (TLV) și OMV Petrom (SNP) din 2010, din prețul ajustat, pînă la 18 septembrie 2026; cele două zile greșite ale TLV din mai 2016 sînt eliminate. Prețuri OHLC: S&P 500 din 2008, DAX din 2006, Bitcoin din 2014, TLV și SNP din 2010 (acțiunile ajustate cu factorul prețului de închidere). VIX: închiderile zilnice, pe calendarul S&P 500. Prețuri EODHD. Ziua simulată OHLC, simularea eficienței (1 000 de ferestre), prețurile simulate la un minut și amestecarea randamentelor sînt cele din curs (același cod, aceeași sămînță a generatorului); volatilitățile, estimatorii de amplitudine, autocorelațiile, testele Ljung–Box și ARCH-LM, volatilitățile anuale și lunare, comparația cu VIX, corelațiile de levier, curbele neparametrice și pierderile prognozelor sînt recalculate în browser din aceleași date. Alte semințe, alte ferestre ale simulării, alte niveluri ale zgomotului, amestecarea pe blocuri, alte începuturi ale eșantionului, alte orizonturi, laguri și lățimi de bandă sînt rulări suplimentare ale aceluiași cod.


 Applied Time Series Analysis with Python
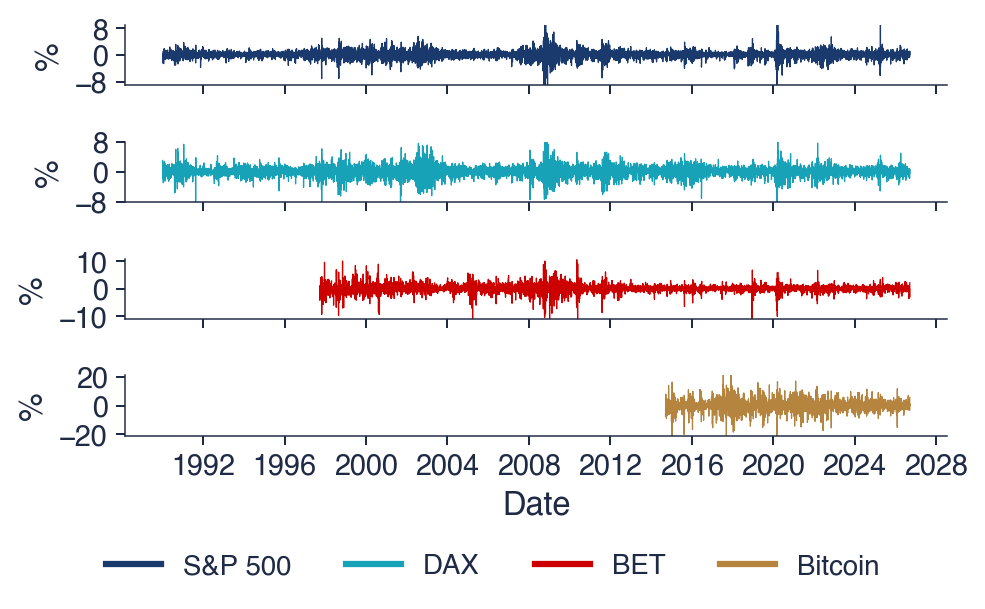
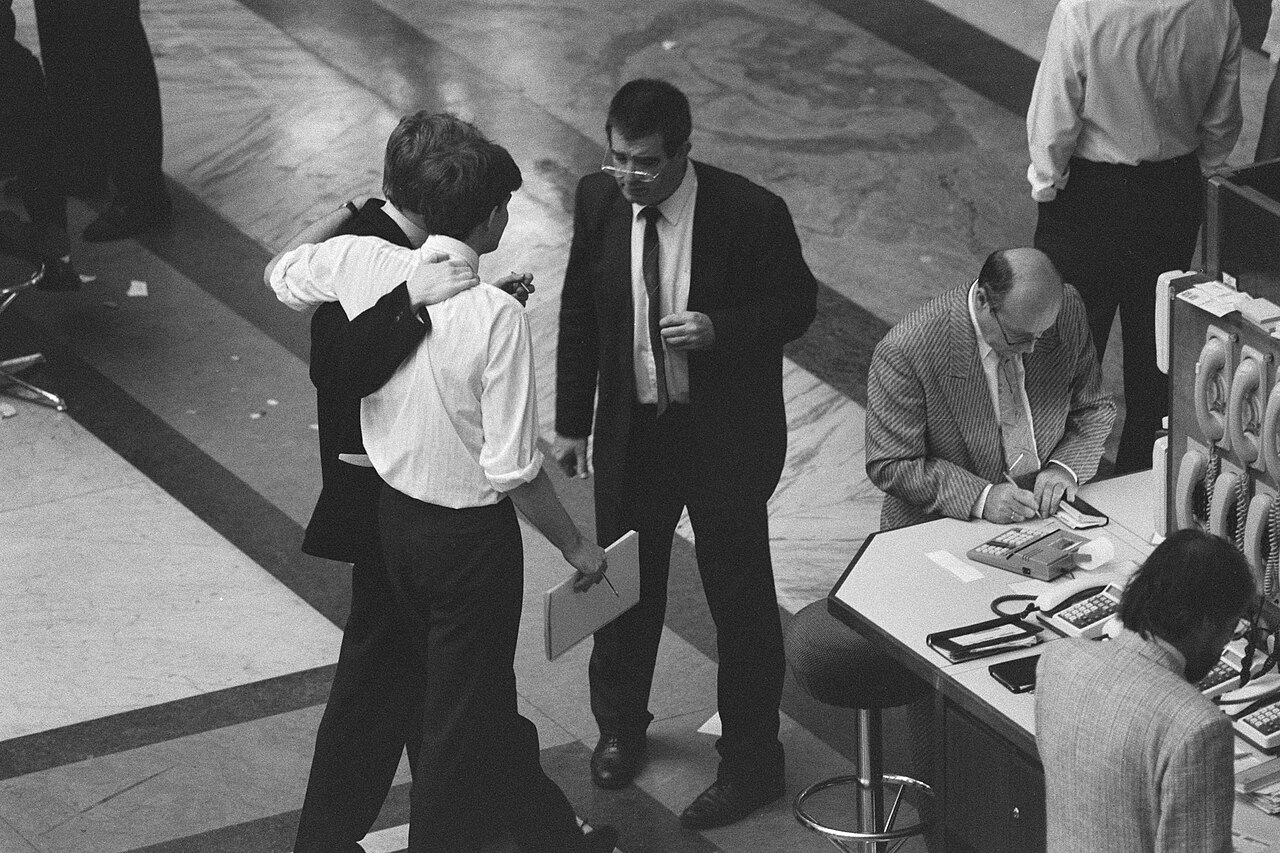
 SFM_ch8_returns_volatility