Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Un fapt stilizat (stylised fact) este o regularitate statistică calitativă a randamentelor, observată pe multe active, piețe și perioade (Cont, 2001). Faptele stilizate sînt proprietățile pe care orice model al randamentelor trebuie să le reproducă, iar modelul cu randamente independente și identic distribuite (i.i.d.), cu distribuția Normală, nu reproduce majoritatea lor. Capitolul le testează din nou pe cinci piețe cu reguli de cotare și calendare diferite, S&P 500 (Standard & Poor's), BET-TR (BET Total Return, index, indicele BET cu dividendele reinvestite), Bitcoin, EUR (euro, moneda euro)/RON și aurul, cu prețuri de închidere zilnice pînă la 18 septembrie 2026.
Regularitatea descrisă de Mandelbrot (1963) este gruparea volatilității (volatility clustering): direcția randamentelor nu se repetă, dar mărimea lor da. Pentru randamentele logaritmice zilnice ale S&P 500 din 1990–2026, autocorelația de lag 1 este −0,08; din 100 de laguri, 20 ies din banda i.i.d., dar doar 7 din banda robustă. Autocorelațiile randamentelor absolute sînt pozitive la toate cele 100 de laguri: 0,27 la lagul 1, 0,22 la lagul 20 și încă 0,09 la lagul 100. Randamentele sînt deci aproape necorelate, dar nu independente, fiindcă independența cere corelație nulă între orice funcții ale randamentelor.
Distribuția are cozi groase, iar agregarea o apropie încet de distribuția Normală. Excesul de kurtosis al S&P 500 scade de la 10,9 pentru randamentele zilnice la 1,6 pentru cele pe 60 de zile, iar distribuția Normală rămîne respinsă și la acest orizont (\(z = 4{,}1\)). Parametrul de memorie lungă al lui \(|r_t|\),\(\hat d\), este între 0,35 și 0,50 pe toate cele cinci piețe, la cel puțin 8 erori standard de zero. O scădere lentă a autocorelației empirice nu dovedește însă, singură, memoria lungă: rupturile structurale ale nivelului volatilității dau același tipar.
Autocorelațiile randamentelor zilnice ale S&P 500, 1990–2026, la lagurile 1–100: stînga randamentele \(r_t\), mijloc randamentele absolute \(|r_t|\), dreapta pătratele \(r_t^2\); zona albastră este banda de 95% sub ipoteza i.i.d., iar liniile sînt banda robustă. Graficul interactiv: „Faptele 1 și 6: randamente necorelate, dar dependente” →
Rezultatele învățării
Calculați și agregați randamente simple și logaritmice.
Calculați momente, cuantile și estimatorul Hill.
Interpretați lipsa corelației: ea nu înseamnă independență.
Interpretați teste cu distribuții de referință valide.
Calculați volatilitatea din prețurile de deschidere, maxim, minim și închidere.
Interpretați o ipoteză propusă de un asistent AI (Artificial Intelligence, inteligență artificială).
Prețuri și randamenteRandamente simple și logaritmice, anualizarea, CAGR (Compound Annual Growth Rate, rata anuală compusă de creștere) și volatility drag.
Distribuție și coziCozi groase, teste clasice, estimatorul Hill și asimetria cîștig/pierdere.
Dependența și mecanismele eiRandamente necorelate, dar dependente, intermitența, gaussianitatea prin agregare, leverage effect și legătura volum–volatilitate.
Capitolul studiază proprietățile statistice pe care randamentele le au în comun pe piețe foarte diferite. Aceste proprietăți nu sînt deduse dintr-un model, ci măsurate, iar fiecare dintre ele este o ipoteză care poate fi testată din nou pe date noi. Secțiunea definește noțiunea de fapt stilizat, grupează faptele în patru familii și descrie cele cinci piețe pe care sînt testate.
Un fapt stilizat (stylised fact) este o regularitate statistică calitativă a randamentelor, observată pe multe active, piețe și perioade (Cont, 2001). Cuvîntul „calitativă” contează: un fapt stilizat spune că cozile sînt mai groase decît ale distribuției Normale sau că autocorelația randamentelor absolute este pozitivă pe multe laguri, dar nu fixează o valoare a parametrului valabilă pe orice piață. Fiindcă regularitățile sînt empirice, fiecare rămîne o ipoteză care trebuie testată din nou pe fiecare piață și la fiecare frecvență (Ratliff-Crain, Van Oort, Koehler & Tivnan, 2025).
Ideea centrală a capitolului privește două obiecte diferite. Randamentele înseși au o autocorelație liniară slabă, deci direcția lor se prognozează greu din propriul trecut. Mărimea lor, măsurată prin randamentele absolute sau pătratice, este puternic persistentă și, prin urmare, în mare măsură predictibilă. Un model care tratează randamentele ca extrageri independente și identic distribuite (i.i.d.) din distribuția Normală nu poate reproduce această combinație și nici majoritatea celorlalte fapte.
Faptele stilizate joacă astfel rolul unui etalon: un model al randamentelor este credibil doar dacă datele simulate cu el au aceleași regularități ca datele observate. Demonstrațiile rezultatelor folosite în capitol sînt adunate în Anexă.
Pe scurt
Rezultatele învățării
calculați și agregați randamente simple și logaritmice
calculați momente, cuantile și estimatorul Hill
interpretați lipsa corelației: nu este independență
interpretați teste cu distribuții de referință valide
calculați volatilitatea din deschidere, maxim, minim și închidere
interpretați o ipoteză a unui asistent de inteligență artificială (AI)
Aprofundări și Anexa: lectură pentru familiarizare
Definiție
Un fapt stilizat este o regularitate statistică calitativă a randamentelor
observată pe multe active, piețe și perioade Cont (2001)
Lista lui Cont (2001) conține unsprezece fapte, pe care tabelul le așază în patru grupe:
Distribuția necondiționată: cozile groase (faptul 2), asimetria dintre cîștiguri și pierderi (faptul 3), apropierea lentă de distribuția Normală atunci cînd randamentele sînt agregate pe orizonturi mai lungi, adică gaussianitatea prin agregare (aggregational Gaussianity, faptul 4), și cozile groase care rămîn după corecția pentru volatilitate (faptul 7).
Un singur fapt, absența autocorelației liniare a randamentelor (faptul 1).
Dependența volatilității: intermitența (intermittency), adică episoade de volatilitate ridicată separate de perioade calme (faptul 5), volatility clustering (faptul 6), scăderea lentă a autocorelației randamentelor absolute (faptul 8) și asimetria dintre scalele de timp mari și mici (faptul 11).
Legăturile dintre randamente și alte variabile: leverage effect, prin care volatilitatea crește mai mult după scăderi decît după creșteri (faptul 9), și corelația dintre volumul tranzacționat și volatilitate (faptul 10).
Capitolul testează din nou faptele pe cinci piețe, cu date pînă în septembrie 2026, și adaugă fiecăruia inferența de care are nevoie: statistica, ipoteza nulă și o distribuție de referință care rămîne validă cînd randamentele sînt dependente și au cozi groase. Primele dovezi empirice se datorează lui Mandelbrot (1963) și Fama (1965); o tratare de manual se găsește la Franke, Härdle & Hafner (2019). Exemplele detaliate și subiectele avansate sînt adunate în Aprofundări, după Concluzii.
Cele cinci serii diferă prin ce se cotează, în ce monedă și după ce calendar. S&P 500 este un indice de preț american, în dolari, observat în zilele de tranzacționare din SUA (Statele Unite ale Americii) din 1990, cu 9 245 de randamente zilnice; pentru el sînt disponibile și deschiderea, maximul și minimul. BET-TR este indicele BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București) al Bursei de Valori București (BVB) cu dividendele reinvestite (total return), în lei, observat în zilele de tranzacționare ale BVB din septembrie 2014, cu 2 992 de randamente. Bitcoin este un preț în dolari, tranzacționat în fiecare zi a săptămînii, tot din septembrie 2014, cu 4 384 de randamente.
EUR/RON este cursul de referință al Băncii Naționale a României (BNR), în lei pe euro, din iulie 2005, în zilele lucrătoare din România, cu 5 352 de randamente. Leul se află în regim de managed float: cursul se formează pe piață, dar banca centrală intervine. Se folosește cursul de referință, nu cotațiile interbancare, pentru că în mai mulți ani acestea au avut o autocorelație de lag 1 între −0,4 și −0,7, generată de erori de cotare, nu de comportamentul cursului. Aurul este prețul spot în dolari pe uncie, cotat doar în zilele lucrătoare, din 1990, cu 9 559 de randamente.
Toate seriile folosesc prețuri de închidere zilnice pînă la 18 septembrie 2026, iar randamentele logaritmice sînt calculate pe calendarul propriu al fiecărei serii; \(T\) este numărul de randamente. Fiindcă calendarele diferă, o „zi” înseamnă o zi de tranzacționare pentru S&P 500 și BET-TR, o zi calendaristică pentru Bitcoin și o zi lucrătoare pentru aur. Acest lucru contează la anualizare, tratată în secțiunea următoare.
Pe scurt
Serie
Tip de preț
Tip, monedă
Calendar
Eșantion
\(T\)
S&P 500
închidere zilnică (plus deschidere, maxim, minim)
indice de preț, USD (US dollar, dolarul american)
zilele de tranzacționare din SUA
1990–2026
9 245
BET-TR
închidere zilnică
randament total, RON (Romanian leu, leul românesc)
zilele de tranzacționare ale Bursei de Valori București (BVB)
sept. 2014 – 2026
2 992
Bitcoin
închidere zilnică
preț, USD
în fiecare zi, 24/7
sept. 2014 – 2026
4 384
EUR/RON
cursul de referință al Băncii Naționale a României (BNR)
lei pe euro, managed float
zilele lucrătoare din România
iul. 2005 – 2026
5 352
Aur
închidere zilnică
spot, USD pe uncie
doar zilele lucrătoare
1990–2026
9 559
Prețuri de închidere zilnice pînă la 18 septembrie 2026
randamente logaritmice, fiecare serie pe propriul calendar
\(T\): numărul de randamente
BET-TR: indicele BET (Bucharest Exchange Trading), indicele de referință al BVB (Bursa de Valori București), cu dividendele reinvestite (randament total, total return)
Managed float (flotare administrată): cursul se formează pe piață, cu intervenții ale băncii centrale
folosim cursul de referință BNR (Banca Națională a României): cotațiile interbancare EUR (moneda euro)/RON (euro/leu) au, în mai mulți ani, o autocorelație de lag 1 între \(-0{,}4\) și \(-0{,}7\), generată de erori de cotare
Sinteza secțiunii
Faptele sînt regularități calitative, grupate după distribuție, dependența randamentelor, dependența volatilității și legăturile cu alte variabile. Cele cinci piețe acoperă un indice de acțiuni, un indice de randament total al unei piețe emergente, un criptoactiv, un curs de schimb administrat și o marfă, așa că un fapt valabil pe toate este puțin probabil să fie un artefact al microstructurii unei singure piețe.
Prețuri și randamente
Toate statisticile capitolului sînt calculate din randamente, nu din prețuri. Secțiunea definește cele două tipuri de randament, simplu și logaritmic, arată care se adună în timp și care se adună între active și cum se transformă valorile zilnice în valori anuale. Ultima parte separă media aritmetică de rata de creștere compusă: diferența dintre ele, volatility drag, crește cu pătratul volatilității și este mare pentru Bitcoin.
Randament simplu sau logaritmic: ce se adună în timp și ce se adună între active
Fie \(P_t\) prețul de închidere al zilei \(t\) și \(D_t\) dividendul plătit în intervalul \((t-1, t]\). Randamentul simplu și randamentul logaritmic sînt
unde a doua egalitate din (1.1) are loc cînd nu se plătește dividend. Cu dividende, o serie de randament total sau o serie de prețuri ajustate, cum este BET-TR, le include în preț.
Cele două randamente se agregă în direcții diferite. Pe \(k\) perioade, indexate de \(j = 0, \dots, k-1\), randamentul simplu este produsul \(\prod_{j}(1 + R_{t-j}) - 1\), iar randamentul logaritmic este suma \(\sum_j r_{t-j}\): randamentele logaritmice sînt aditive în timp. Între active situația se inversează. Dacă \(R_{i,t}\) este randamentul simplu al activului \(i\) și \(w_i\) ponderea lui în valoarea portofoliului, cu \(\sum_i w_i = 1\), randamentul portofoliului este exact \(R_{p,t} = \sum_i w_i R_{i,t}\); pentru randamentele logaritmice relația are loc doar aproximativ.
Și domeniile diferă: un randament simplu nu poate scădea sub −100%, pe cînd un randament logaritmic ia orice valoare reală. Randamentele simple se folosesc de aceea pentru portofolii și pentru raportarea performanței, iar cele logaritmice pentru dinamica unui singur activ și pentru argumentele bazate pe teorema limită centrală (central limit theorem, CLT), care privește sume.
Fie \(A\) numărul de intervale de randament dintr-un an: 252 pentru acțiuni și EUR/RON (zile de tranzacționare), 365 pentru Bitcoin, care se tranzacționează în fiecare zi, și aproximativ 260 pentru aur, numărul efectiv de cotații din zilele lucrătoare. Media anuală a randamentelor logaritmice este \(\mu_{\text{ann}} = A\,\bar r\), cu \(\bar r = T^{-1}\sum_{t} r_t\). Ea este rata logaritmică de creștere și cere doar o medie constantă. Raportul Sharpe folosește în schimb media anuală a randamentelor simple, \(A\bar R\), care este mai mare.
Volatilitatea anualizată este
\[\sigma_{\text{ann}} = \sqrt{A}\,\hat\sigma,\]
(1.2)
unde \(\hat\sigma\) este abaterea standard zilnică de selecție. Regula (1.2) este exactă doar cînd randamentele sînt necorelate serial și au varianță constantă: atunci varianțele zilnice se adună, iar varianța anuală este \(A\hat\sigma^2\). Cu autocorelație, factorul \(\sqrt{A}\) nu mai este exact. Dacă autocorelația de lag 1 a EUR/RON, \(\hat\rho_1 = 0{,}17\), ar fi parametrul unui proces AR(1), volatilitatea anualizată ar fi de circa 5,3% în loc de 4,4%.
Scalarea corectă depinde de întreaga structură de autocovarianțe, nu doar de lagul 1. Pentru EUR/RON, autocorelațiile negative de la alte laguri compensează valoarea pozitivă de la lagul 1, așa că o corecție AR(1) exagerează efectul; derivarea este în Anexă, iar calculul empiric în Capitolul 0 și în Seminarul 1.
Pe scurt
\(A\): numărul de perioade de randament dintr-un an
252 pentru acțiuni și EUR/RON (zile de tranzacționare), 365 pentru cripto (tranzacționate în fiecare zi), \(\approx 260\) pentru aur (cotațiile efective din zilele lucrătoare)
\(\mu_{\text{an}} = A\,\bar r\), cu \(\bar r = \frac1T\sum_{t=1}^{T} r_t\): media anuală a randamentelor logaritmice
rata de creștere logaritmică
presupune doar o medie constantă
raportul Sharpe folosește media anuală a randamentelor simple, \(A\bar R\), mai mare
\(\sigma_{\text{an}} = \sqrt{A}\,\hat\sigma\), cu \(\hat\sigma\) abaterea standard empirică zilnică
exactă doar pentru randamente necorelate serial, cu varianță constantă
atunci varianțele zilnice se adună, iar varianța anuală este \(A\,\hat\sigma^2\)
cu autocorelație, factorul \(\sqrt{A}\) nu mai este exact: dacă \(\hat\rho_1 = 0{,}17\) al EUR/RON ar fi parametrul unui model autoregresiv de ordinul 1, AR(1), volatilitatea anualizată ar fi de circa \(5{,}3\%\) în loc de \(4{,}4\%\) (Anexă)
scalarea empirică cere întreaga structură de autocovarianțe: pentru EUR/RON, autocorelațiile negative de la alte laguri compensează lagul 1 (Capitolul 0; Seminarul 1, A7)
CAGR și frîna volatilității: de ce media aritmetică supraestimează creșterea
Rata anuală de creștere compusă (Compound Annual Growth Rate, CAGR) este randamentul anual constant care duce prețul de la \(P_0\), la începutul eșantionului, la \(P_T\), la sfîrșitul lui, în \(Y\) ani:
\[\text{CAGR} = (P_T/P_0)^{1/Y} - 1.\]
(1.3)
Ea este media geometrică anuală a factorilor de creștere și este mărimea pe care a trăit-o efectiv un investitor care a deținut activul pe toată perioada.
Pe scară logaritmică, rata de creștere compusă este media aritmetică minus jumătate din varianță:
unde \(\mu_{\text{arith}}\) este media aritmetică anuală a randamentelor simple, iar \(\sigma^2\) varianța lor anuală. Membrul stîng este rata de creștere cu capitalizare continuă, media anuală a randamentelor logaritmice \(A\bar r\). Diferența dintre media aritmetică și cea geometrică se numește volatility drag; pe scară logaritmică este aproximativ \(\sigma^2/2\), deci crește cu pătratul volatilității. Două active cu aceeași medie aritmetică pot avea așadar creșteri pe termen lung foarte diferite.
Pe scurt
CAGR (Compound Annual Growth Rate): randamentul anual constant care duce prețul de la \(P_0\) la \(P_T\)
\[ \text{CAGR} = (P_T/P_0)^{1/Y} - 1 \]
\(P_0\), \(P_T\): prețul la începutul și la sfîrșitul eșantionului
\(Y\): numărul de ani
CAGR este media geometrică anuală a factorilor de creștere
Pe scară logaritmică, rata de creștere compusă este media aritmetică minus jumătate din varianță:
\(\mu_{\text{aritm}}\): media aritmetică anuală a randamentelor simple; \(\sigma^2\): varianța lor anuală
\(\ln(1 + \text{CAGR})\): rata de creștere compusă continuu, adică media anuală a randamentelor logaritmice \(A\bar r\)
frîna volatilității (volatility drag): diferența dintre media aritmetică și cea geometrică; pe scară logaritmică este \(\approx \sigma^2/2\) și crește cu pătratul volatilității
Tabelul aplică (1.4) pe două serii cu volatilități foarte diferite. Pentru S&P 500 în 1990–2026 (\(A = 252\)), media aritmetică este 9,95% pe an, iar volatilitatea 17,97%, deci \(\sigma^2/2 = 1{,}61\) puncte procentuale (pp); media anuală a randamentelor logaritmice este 8,33%, iar CAGR 8,69%. Pentru Bitcoin în 2014–2026 (\(A = 365\)), media aritmetică este 65,2%, volatilitatea 66,2%, iar \(\sigma^2/2 = 21{,}9\) pp; media anuală a randamentelor logaritmice este 43,1%, iar CAGR 53,9%.
Drag-ul pe scară logaritmică, \(\mu_{\text{arith}} - \ln(1 + \text{CAGR})\), este apropiat de \(\sigma^2/2\): 1,62 pp pentru S&P 500 și 22,1 pp pentru Bitcoin. Drag-ul măsurat față de CAGR însuși, \(\mu_{\text{arith}} - \text{CAGR}\), este mai mic, 1,26 pp și 11 pp, fiindcă \(\text{CAGR} = e^{\ln(1+\text{CAGR})} - 1\) este mai mare decît logaritmul său; pentru Bitcoin, \(e^{0{,}431} - 1 = 53{,}9\%\). Pentru Bitcoin cele două diferențe sînt în raport de unu la doi, așa că o valoare raportată ca „drag” trebuie să spună ce diferență măsoară.
Verificarea de la sfîrșitul slide-ului inversează relația. Aurul are un CAGR de 6,7% și o volatilitate de 16,3%; din (1.4),\(\mu_{\text{arith}} \approx \ln 1{,}067 + 0{,}163^2/2 = 6{,}5\% + 1{,}3\% \approx 7{,}8\%\). Cu rata fără risc zero, raportul Sharpe este \(\mu_{\text{arith}}/\sigma\), iar valoarea de 0,48 din tabelul din anexă dă aceeași cifră, \(0{,}48 \times 16{,}3\% \approx 7{,}8\%\).
Pe scurt
\(\mu_{\text{aritm}}\)
\(\sigma\)
\(\sigma^2/2\)
\(\ln(1+\text{CAGR})\)
CAGR
S&P 500 1990–2026 (\(A = 252\))
9,95%
17,97%
1,61 pp
8,33%
8,69%
Bitcoin 2014–2026 (\(A = 365\))
65,2%
66,2%
21,9 pp
43,1%
53,9%
Frîna pe scară logaritmică, \(\mu_{\text{aritm}} - \ln(1+\text{CAGR})\), este apropiat de \(\sigma^2/2\)
\(1{,}62\) pp (puncte procentuale) pentru S&P 500
\(22{,}1\) pp pentru Bitcoin
Frîna față de CAGR, \(\mu_{\text{aritm}} - \text{CAGR}\): \(1{,}26\) pp și \(11\) pp
mai mic, deoarece \(\text{CAGR} = e^{\ln(1+\text{CAGR})} - 1\) este peste logaritmul său: \(e^{0{,}431} - 1 = 53{,}9\%\)
cînd o valoare este numită „frînă”, precizați care dintre cele două diferențe este
Verificare: aurul are CAGR \(6{,}7\%\) și \(\sigma = 16{,}3\%\). Estimați \(\mu_{\text{aritm}}\)
răspuns: \(\ln 1{,}067 + 0{,}163^2/2 = 6{,}5\% + 1{,}3\% \approx 7{,}8\%\); cu \(r_f = 0\), raportul Sharpe este \(\mu_{\text{aritm}}/\sigma\), deci \(0{,}48 \times 16{,}3\% \approx 7{,}8\%\) (tabelul din anexă)
Graficul arată cele cinci serii în două forme. Panourile din stînga arată prețurile pe scară logaritmică, pe care o rată de creștere constantă apare ca o dreaptă; panourile din dreapta arată randamentele logaritmice zilnice \(r_t\), în procente, pe aceeași axă a timpului.
Cursorul fixează un prag pentru \(|r_t|\) și marchează zilele în care randamentul absolut îl depășește; butonul ▶ ridică pragul pas cu pas. Comparația piețelor la același prag arată cît de diferite sînt scalele lor de variație.
Întrebare pentru sală Cît de des variază cursul EUR/RON cu peste 1% într-o zi?
Răspuns
În 1,4% din zile, față de 25,5% din zile pentru S&P 500 și 60,8% pentru Bitcoin. Sub distribuția Normală cu volatilitatea zilnică a EUR/RON, 0,28%, o variație de peste 1% ar apărea doar în 0,03% din zile. Cea mai slabă zi a Bitcoin, 12 martie 2020, are randamentul logaritmic −46,5%: prețul se înmulțește cu e−0,465, deci scade cu 37,2%.
Prețurile au tendință și nu sînt staționare, pe cînd randamentele oscilează în jurul unei medii mici. Randamentele mari nu sînt răspîndite uniform în timp: se grupează în cîteva episoade, cele mai vizibile fiind 2008 și martie 2020. EUR/RON se mișcă cu mai mult de 1% doar în 1,4% din zile; cea mai mare mișcare zilnică din grafic este randamentul logaritmic de −46,5% al Bitcoin din 12 martie 2020.
Graficul ilustrează primul motiv pentru care lucrăm cu randamente: prețurile, pe scară logaritmică, au tendință și sînt nestaționare, deci momentele lor de selecție nu estimează mărimi fixe ale populației. Randamentele logaritmice zilnice, în schimb, oscilează în jurul unei medii mici în comparație cu dispersia lor.
Panourile randamentelor arată deja două dintre faptele stilizate studiate mai departe. Perioadele calme alternează cu cele agitate, ceea ce este intermitența, iar zilele extreme se grupează în timp, în jurul anului 2008 și al lunii martie 2020, ceea ce este volatility clustering. Piețele diferă mult și ca scală: EUR/RON se mișcă cu mai mult de 1% doar în 1,4% din zile.
Un randament logaritmic se transformă în variație de preț prin exponențială. Pe 12 martie 2020, Bitcoin a avut un randament logaritmic de −46,5%; cum prețul se înmulțește cu \(e^{r_t}\), el a scăzut cu \(1 - e^{-0{,}465} = 37{,}2\%\). La mișcări mari cele două randamente diferă substanțial, deci tipul de randament trebuie precizat întotdeauna.
Pe scurt
Stînga: prețuri pe scală logaritmică: serii cu tendință, nestaționare
Dreapta: randamentele logaritmice zilnice
fluctuează în jurul unei medii mici
perioadele calme alternează cu cele agitate
valorile extreme apar grupat (2008, martie 2020)
EUR/RON variază cu peste \(1\%\) doar în \(1{,}4\%\) din zile
Bitcoin, 12 martie 2020: randament logaritmic \(-46{,}5\%\)
prețul se înmulțește cu \(e^{r_t}\), deci scade cu \(1 - e^{-0{,}465} = 37{,}2\%\)
Secțiunea tratează forma distribuției necondiționate a randamentelor zilnice. Introduce asimetria și kurtosisul, graficul cuantilă–cuantilă și trei teste clasice, apoi măsoară direct grosimea cozilor cu tail index-ul și estimatorul Hill. Tail index-ul răspunde la o întrebare la care kurtosisul nu poate răspunde: ce momente ale distribuției sînt finite. Ultima parte testează dacă pierderile mari sînt mai frecvente decît cîștigurile mari.
Faptul 2, cozi groase: întrebarea și instrumentele
Întrebarea faptului 2 este dacă zilele extreme sînt mai frecvente decît sub o distribuție Normală cu aceeași medie și aceeași varianță. Trei instrumente răspund la ea, fiecare cu cerințele lui:
Kurtosisul de selecție \(\hat K\), împreună cu testul de normalitate Jarque–Bera (JB) (Jarque & Bera, 1980). O valoare \(\hat K > 3\) indică cozi mai groase decît ale distribuției Normale. Inferența despre kurtosis însuși, de exemplu o eroare standard a lui \(\hat K\), cere un moment de ordinul opt finit, \(\mathbb{E}\,r^8 < \infty\), și devine nesigură cînd tail index-ul este în jur de 3. Testul JB nu este afectat la fel: ipoteza lui nulă este „randamente i.i.d. cu distribuția Normală”, sub care toate momentele există, deci valorile critice rămîn valide. Cozile groase din ipoteza alternativă doar fac respingerea mai probabilă. Testarea normalității distribuției marginale, cu dependență în timp admisă, cere o altă calibrare (Bai & Ng, 2005).
Graficul cuantilă–cuantilă (quantile–quantile plot, QQ plot), mulțimea punctelor \((\Phi^{-1}(p_i), z_{(i)})\) cu \(p_i \approx (i - \frac12)/T\),\(i = 1, \dots, T\). Aici \(z_{(i)}\) este al \(i\)-lea cel mai mic randament standardizat, iar \(\Phi^{-1}\) funcția cuantilă a distribuției Normale standard. Sub distribuția Normală punctele stau pe dreapta \(y = x\); cozile groase le îndepărtează de ea la ambele capete.
Tail index-ul \(\alpha\), estimat prin metoda Hill din cele mai mari valori ale lui \(|r_t|\). Spre deosebire de kurtosis, el nu cere momente finite.
Pe scurt
Întrebarea: sînt zilele extreme mai frecvente decît sub distribuția Normală?
distribuția Normală de referință are aceeași medie și aceeași varianță
Kurtosisul\(\hat K\) (slide-ul următor) și testul de normalitate Jarque–Bera (JB)
\(\hat K > 3\) indică cozi mai groase decît la distribuția Normală
inferența despre kurtosis (eroarea standard a lui \(\hat K\)) cere \(\E r^8 < \infty\); cu indicele cozii (tail index) \(\alpha \approx 3\) (mai jos) devine nesigură
testul JB (testul de normalitate Jarque–Bera) al ipotezei nule „i.i.d., distribuția Normală” rămîne calibrat: sub \(H_0\) toate momentele există
cozile groase ale alternativei duc la respingere, fără să invalideze valorile critice sub \(H_0\)
pentru normalitatea distribuției marginale, cu dependență în timp, calibrarea trebuie adaptată (Bai & Ng (2005))
Graficul cuantilă–cuantilă (graficul QQ, Quantile–Quantile plot): punctele \(\big(\Phi^{-1}(p_i),\ z_{(i)}\big)\), cu \(p_i \approx (i - \tfrac12)/T\), \(i = 1, \dots, T\)
\(z_{(i)}\): a \(i\)-a cea mai mică valoare a randamentului standardizat; \(\Phi^{-1}\): funcția cuantilă a distribuției Normale standard
sub distribuția Normală punctele stau pe dreapta \(y = x\); cozile groase le îndepărtează de ea la ambele capete
Indicele cozii\(\alpha\), estimat cu metoda Hill din cele mai mari valori \(|r_t|\)
Asimetria (skewness) și kurtosisul descriu forma unei distribuții după eliminarea poziției și a scalei. Cu randamentul standardizat \(z_t\), asimetria și kurtosisul de selecție sînt
\[z_t = \frac{r_t - \bar r}{\hat\sigma}, \qquad \hat S = \frac1T\sum_{t=1}^{T} z_t^3, \qquad \hat K = \frac1T\sum_{t=1}^{T} z_t^4.\]
(1.5)
Pentru distribuția Normală, \(S = 0\) și \(K = 3\), deci excesul de kurtosis \(K - 3\) este zero.
O asimetrie negativă, \(\hat S < 0\), înseamnă că coada stîngă este mai lungă și pierderile mari domină cîștigurile mari. Un kurtosis peste 3 înseamnă mai multă masă de probabilitate atît în centru, cît și în cozi decît sub distribuția Normală cu aceeași varianță și, corespunzător, mai puțină la distanțe intermediare. Fiindcă ambele statistici din (1.5) sînt medii ale unor puteri mari, cîteva zile extreme le pot domina, motiv pentru care precizia lor depinde de momente de ordin superior.
Pe scurt
Asimetria empirică \(\hat S\) și kurtosisul empiric \(\hat K\) ale randamentului standardizat \(z_t\)
\[ z_t = \frac{r_t - \bar r}{\hat\sigma}, \qquad \hat S = \frac1T\sum_{t=1}^{T} z_t^3, \qquad \hat K = \frac1T\sum_{t=1}^{T} z_t^4 \]
\(\hat S < 0\): coada stîngă este mai lungă, pierderile mari domină
\(\hat K > 3\): mai multă masă în centru și în cozi decît la distribuția Normală
Graficul compară distribuția randamentelor zilnice standardizate cu două referințe. Panoul din stînga este o histogramă, cu densitatea distribuției Normale de aceeași varianță și cu cea a unei distribuții Student-\(t\); panoul din dreapta este QQ plot-ul față de distribuția Normală.
Meniul alege piața, iar cursorul fixează gradele de libertate \(\nu\) ale distribuției Student-\(t\), de la 2,2 la 30; butonul ▶ parcurge valorile lui \(\nu\). Pe măsură ce \(\nu\) crește, densitatea Student-\(t\) se apropie de cea Normală.
Întrebare pentru sală Distribuția Student-t se potrivește bine histogramei S&P 500. Înseamnă asta că descrie corect și cozile?
Răspuns
Nu neapărat. Potrivirea centrului nu garantează potrivirea cozilor: histograma este dominată de centrul distribuției, unde se află aproape toate zilele. Pentru S&P 500, frecvența empirică a lui |z| > 4 este 0,67%, față de 0,006% sub distribuția Normală și aproximativ 0,84% sub Student-t la ν = 2,8 afișat inițial. QQ plot-ul și estimarea Hill, α̂ = 3,07 la k/n = 2,5%, oferă diagnostice suplimentare. Nici potrivirea unui singur prag nu validează întreaga coadă.
Pe fiecare piață, histograma are un vîrf mai înalt și cozi mai groase decît densitatea Normală, iar în QQ plot punctele se îndepărtează de dreapta \(y = x\) la ambele capete. O distribuție Student-\(t\) cu puține grade de libertate se potrivește centrului distribuției mult mai bine decît distribuția Normală. Dacă se potrivește și cozilor este o întrebare separată, judecată mai jos cu estimatorul Hill.
Histogramele arată că randamentele standardizate au un vîrf mai înalt și cozi mai groase decît distribuția Normală cu aceeași varianță. QQ plot-urile arată aceeași trăsătură sub formă de cuantile: punctele se îndepărtează de dreapta \(y = x\) în ambele cozi, deci cuantilele empirice extreme sînt mai departe de zero decît cuantilele Normale.
O distribuție Student-\(t\) se potrivește centrului distribuției mult mai bine decît distribuția Normală. Această potrivire bună în centru spune însă puțin despre cozi, care conțin puține observații și cîntăresc puțin în potrivirea de ansamblu. Cozile sînt de aceea examinate separat, cu un estimator care folosește doar cele mai mari observații; precizia momentelor este discutată în Anexă.
Pe scurt
Histogramele: randamentele standardizate au un vîrf mai înalt și cozi mai groase decît distribuția Normală
distribuția Normală de referință are aceeași varianță
Graficele QQ: punctele se abat de la dreapta \(y = x\) în ambele cozi
O distribuție Student-\(t\) descrie centrul distribuției mult mai bine decît distribuția Normală
dacă descrie și cozile este o întrebare separată, la care răspunde estimatorul Hill
Trei noțiuni sînt necesare pentru a citi testele care urmează. ARCH (AutoRegressive Conditional Heteroskedasticity) desemnează o varianță care depinde de randamentele trecute (Engle, 1982). Volatility clustering este corespondentul empiric: zilele cu mișcări mari tind să urmeze zilelor cu mișcări mari. Un proces ARCH generează volatility clustering, iar testele de mai jos verifică dacă datele îl conțin.
Tail index-ul \(\alpha\) măsoară cît de repede scade probabilitatea valorilor extreme. Pentru un prag pozitiv \(x\) și o constantă de scală \(c > 0\),
Un \(\alpha\) mic înseamnă o coadă groasă: probabilitatea din (1.6) scade încet pe măsură ce \(x\) crește. Momentul de ordinul \(p\),\(\mathbb{E}|r_t|^p\), este finit doar pentru \(p < \alpha\). Estimările din acest capitol dau \(\alpha \approx 3\), deci varianța este finită, dar momentul de ordinul patru, pe care se sprijină kurtosisul și mai multe teste uzuale, s-ar putea să nu fie.
Pe scurt
ARCH (heteroscedasticitate condiționată autoregresivă): varianța de azi depinde de randamentele trecute
Volatility clustering: zilele cu variații mari tind să fie urmate de zile cu variații mari
Indicele cozii\(\alpha\) măsoară cît de repede scade probabilitatea valorilor extreme
unde \(\hat\rho_k\) este autocorelația de selecție dintre \(r_t\) și \(r_{t-k}\). Sub ipoteza nulă a lipsei autocorelației, statistica este \(\chi^2_m\), cu valoarea critică de 5% egală cu 18,3 pentru \(m = 10\). Aplicată lui \(r_t\),(1.8) testează faptul 1; aplicată lui \(r_t^2\), testează volatility clustering.
Testul ARCH-LM, un test de tip multiplicator Lagrange (Lagrange multiplier, LM), verifică dacă randamentele pătratice sînt predictibile din propriul trecut. Cu reziduurile \(\hat\varepsilon_t = r_t - \bar r\), statistica este \(T R^2\) din regresia lui \(\hat\varepsilon_t^2\) pe \(\hat\varepsilon_{t-1}^2, \dots, \hat\varepsilon_{t-q}^2\), cu \(q = 5\) laguri; distribuția ei de referință este \(\chi^2_q\), cu valoarea critică de 5% egală cu 11,1. În toate cele trei teste, valorile mari resping ipoteza nulă.
Tabelul rezumă randamentele logaritmice zilnice ale celor cinci piețe. Randamentele medii zilnice sînt mici, de la 0,007% pentru EUR/RON la 0,118% pentru Bitcoin, în comparație cu abaterile standard zilnice, de la 0,28% (EUR/RON) la 3,49% (Bitcoin). Anualizate cu (1.2), volatilitățile sînt 18,0% pentru S&P 500, 15,5% pentru BET-TR, 66,6% pentru Bitcoin, 4,4% pentru EUR/RON și 16,3% pentru aur. Asimetria este negativă pentru cele patru active cotate în prețuri și pozitivă, 0,73, pentru EUR/RON, unde o creștere a cursului înseamnă o depreciere a leului.
Ca statistici descriptive, cifrele arată cozi groase peste tot: excesul de kurtosis este între 9,3 (aur) și 17,8 (BET-TR). Statistica Ljung–Box \(Q(10)\) pentru \(r_t^2\) este de 10 pînă la 90 de ori mai mare decît pentru \(r_t\), de exemplu 8 018 față de 91,6 pentru S&P 500. Mărimea randamentelor este deci mult mai predictibilă decît direcția lor.
Ca inferență, toate p-valorile i.i.d. din tabel sînt sub 0,03, dar ele sînt valide doar pentru randamente i.i.d. cu momentele pe care le cere fiecare test. Testul Ljung–Box pentru \(r_t^2\) și testul ARCH-LM cer cel puțin un moment de ordinul patru finit, iar estimările Hill de mai jos îl pun sub semnul întrebării. Statisticile mari sînt deci dovezi descriptive puternice, dar p-valorile lor exacte nu trebuie luate literal.
Pe scurt
S&P 500
BET-TR
Bitcoin
EUR/RON
Aur
Observații
9 245
2 992
4 384
5 352
9 559
Medie (% pe zi)
0,033
0,077
0,118
0,007
0,025
Abatere standard (% pe zi)
1,13
0,98
3,49
0,28
1,01
Volatilitate anualizată (%)
18,0
15,5
66,6
4,4
16,3
Asimetrie
\(-0{,}36\)
\(-1{,}40\)
\(-0{,}70\)
\(0{,}73\)
\(-0{,}23\)
Exces de kurtosis
10,9
17,8
12,0
15,1
9,3
Randament log min / max (%)
\(-12{,}8\) / \(11{,}0\)
\(-11{,}9\) / \(6{,}7\)
\(-46{,}5\) / \(22{,}5\)
\(-2{,}5\) / \(2{,}9\)
\(-11{,}1\) / \(10{,}4\)
Jarque–Bera
45 805
40 433
26 482
51 575
34 732
Ljung–Box \(Q(10)\), \(r_t\)
91,6
70,0
20,2
221,7
32,1
Ljung–Box \(Q(10)\), \(r_t^2\)
8 018
714
213
2 420
1 049
ARCH-LM (5 laguri)
2 229
371
115
871
483
Descriptiv: cozi groase pe toate piețele (exces de kurtosis 9,3–17,8)
\(Q(10)\) pe \(r_t^2\) este de 10–90 de ori mai mare decît pe \(r_t\)
mărimea randamentelor este mult mai predictibilă decît direcția lor
Inferențial: toate valorile p (p-values) calculate sub ipoteza i.i.d. sînt sub 0,03
dar sînt valide doar pentru randamente i.i.d. cu momentele necesare
Ljung–Box pe \(r_t^2\) și ARCH-LM presupun cel puțin moment de ordin patru finit, pus sub semnul întrebării de estimările Hill
Tail index-ul \(\alpha\) al lui \(X = |r_t|\) determină ce momente există: \(\alpha > 2\) implică o varianță finită, \(\alpha > 4\) un kurtosis finit. Cozile de tip lege putere (power law) ale randamentelor au fost susținute primele de Mandelbrot (1963) și Fama (1965). Legea putere exactă este coada Pareto,
\[P(X > x) = (x/u)^{-\alpha}, \qquad x \geq u,\]
(1.9)
unde \(u\) este pragul de la care legea are loc.
Estimatorul Hill (Hill, 1975) estimează \(\alpha\) doar din cele mai mari \(k\) observații. Fie \(X_{(1)} \geq X_{(2)} \geq \dots \geq X_{(n)}\) statisticile de ordine descrescătoare ale celor \(n\) observații. Numărul observațiilor din coadă este \(k\), iar \(X_{(k+1)}\) joacă rolul pragului \(u\) din (1.9). Alegerea lui \(k\) este un compromis: un \(k\) mic păstrează doar observațiile unde legea putere este o aproximare bună, dar dă o estimare zgomotoasă, pe cînd un \(k\) mare reduce varianța, dar include observații din centrul distribuției, unde legea nu mai are loc.
Fiecare termen \(\ln(X_{(i)}/X_{(k+1)})\) măsoară, pe scară logaritmică, cu cît depășește pragul a \(i\)-a cea mai mare valoare. Sub coada Pareto (1.9), aceste depășiri logaritmice au în medie valoarea \(1/\alpha\), ceea ce motivează (1.10). Depășirile mari indică o coadă groasă și, prin urmare, un \(\hat\alpha_k\) mic.
Eroarea standard este aproximativ \(\text{SE}(\hat\alpha_k) \approx \hat\alpha_k/\sqrt{k}\), iar un interval de încredere (IÎ) de 95% este \(\hat\alpha_k \pm 1{,}96\,\text{SE}\). Această aproximare presupune observații independente în coadă și o coadă Pareto exactă. Extremele randamentelor se grupează în timp, iar gruparea face ca eroarea standard reală să fie mai mare; Anexa discută acest caz.
Pe scurt
Estimatorul Hill este inversul mediei depășirilor logaritmice peste prag
Un exemplu cu cinci numere face concretă formula (1.10). Cele mai mari cinci valori ale lui \(|r_t|\) dintr-un eșantion, în procente, sînt 4,0, 3,0, 2,5, 2,2 și 2,0. Cu \(k = 4\), pragul este \(X_{(5)} = 2{,}0\), iar cele patru depășiri logaritmice sînt \(\ln 2 = 0{,}693\),\(\ln 1{,}5 = 0{,}405\),\(\ln 1{,}25 = 0{,}223\) și \(\ln 1{,}1 = 0{,}095\). Media lor este \(1{,}417/4 = 0{,}354\), deci \(\hat\alpha_4 = 1/0{,}354 = 2{,}82\).
Eroarea standard este \(\text{SE} \approx 2{,}82/\sqrt{4} = 1{,}41\), iar IÎ de 95% este \([0{,}06;\ 5{,}59]\). Cu doar patru puncte în coadă, estimarea nu spune aproape nimic despre \(\alpha\); de aceea tabelele capitolului folosesc valori ale lui \(k\) de ordinul sutelor.
Verificarea de pe slide privește invarianța la scală. Dacă fiecare valoare se dublează, ca pentru o piață de două ori mai volatilă, \(\hat\alpha_4\) nu se schimbă, fiindcă rapoartele \(X_{(i)}/X_{(5)}\) rămîn aceleași. Tail index-ul descrie forma cozii, nu scala ei. Un exercițiu complet pe date de piață se află în Seminarul 1 (A5).
Pe scurt
Date ilustrative: cele mai mari cinci valori \(|r_t|\) dintr-un eșantion, în %: \(4{,}0;\ 3{,}0;\ 2{,}5;\ 2{,}2;\ 2{,}0\)
luăm \(k = 4\), deci pragul este \(X_{(5)} = 2{,}0\)
Un Hill plot arată \(\hat\alpha_k\) în funcție de numărul \(k\) al observațiilor din coadă. Dacă peste un anumit prag coada este apropiată de una Pareto, graficul este aproximativ orizontal pe un interval de valori ale lui \(k\), iar nivelul acestei porțiuni este estimarea. Un grafic care continuă să se deplaseze arată că pragul ales se află încă într-o zonă în care legea putere nu are loc.
În graficul interactiv, panoul din stînga arată Hill plot-urile lui \(|r_t|\) pentru cele cinci piețe, iar panoul din dreapta estimările cu intervalele lor de încredere; cursorul fixează fracțiunea din coadă \(k/n\), de la 0,5% la 10%, iar ▶ o deplasează pe acest interval.
Întrebare pentru sală Pentru Bitcoin, α̂ = 4,22 la k/n = 2,5%. Este suficient pentru a afirma că momentul de ordinul patru este finit?
Răspuns
Nu. Intervalul i.i.d. aproximativ de 95%, [3,43; 5,01], include valori sub și peste 4; intervalul construit cu SE bootstrap pe blocuri include și el 4. În plus, Hill plot-ul Bitcoin nu este stabil în jurul pragului ales. Excesul de kurtosis empiric pozitiv nu stabilește dacă momentul populației este finit. La același prag, α = 4 este în afara intervalelor de 95% pentru celelalte patru piețe; concluzia rămîne condiționată de aproximarea Pareto a cozii și de pragul k/n.
La \(k = 2{,}5\%\) din \(n\), estimările pentru \(|r_t|\) sînt 3,1 pentru S&P 500, 2,7 pentru BET-TR, 4,2 pentru Bitcoin, 2,8 pentru EUR/RON și 3,3 pentru aur. Pentru fracțiuni din coadă între 1% și 5%, estimările rămîn între 2,3 și 3,5, cu excepția Bitcoin, unde variază între 3,1 și 4,2. Cozile sînt modelate cu teoria valorilor extreme în Capitolul 7.
Pe scurt
\(\hat\alpha\) pentru \(|r_t|\) la \(k = 2{,}5\%\) din \(n\)
Tabelul raportează estimările Hill ale tail index-ului lui \(|r_t|\) la \(k = 2{,}5\%\) din \(n\), cu două erori standard. Eroarea standard i.i.d. \(\hat\alpha/\sqrt{k}\) dă, de exemplu, \(\hat\alpha = 3{,}07\), cu SE 0,20 și IÎ de 95% \([2{,}68;\ 3{,}47]\) pentru S&P 500 (\(n = 9\,245\),\(k = 231\)). Pentru BET-TR, cu doar 2 992 de observații, \(k = 74\), iar IÎ este \([2{,}06;\ 3{,}28]\); pentru Bitcoin, \([3{,}43;\ 5{,}01]\); pentru EUR/RON, \([2{,}34;\ 3{,}30]\); pentru aur, \([2{,}89;\ 3{,}73]\).
A doua eroare standard provine din bootstrap-ul pe blocuri mobile (moving-block bootstrap), care reeșantionează blocuri de zile consecutive și păstrează astfel gruparea extremelor. Cu blocuri de 20 de zile și 500 de reeșantionări, erorile standard bootstrap sînt de 1,1 pînă la 1,6 ori mai mari decît cele i.i.d.: 0,33 în loc de 0,20 pentru S&P 500 și 0,45 în loc de 0,31 pentru BET-TR. Ignorarea dependenței extremelor face deci ca estimările să pară mai precise decît sînt.
Pe scurt
\(|r_t|\), \(k = 2{,}5\%\) din \(n\)
\(n\)
\(k\)
\(\hat\alpha\)
SE i.i.d.
CI 95% (i.i.d.)
SE bootstrap pe blocuri
S&P 500
9 245
231
3,07
0,20
\([2{,}68;\ 3{,}47]\)
0,33
BET-TR
2 992
74
2,67
0,31
\([2{,}06;\ 3{,}28]\)
0,45
Bitcoin
4 384
109
4,22
0,40
\([3{,}43;\ 5{,}01]\)
0,47
EUR/RON
5 352
133
2,82
0,24
\([2{,}34;\ 3{,}30]\)
0,28
Aur
9 559
238
3,31
0,21
\([2{,}89;\ 3{,}73]\)
0,24
Bootstrap-ul pe blocuri suprapuse păstrează gruparea valorilor extreme
blocuri de 20 de zile, 500 de reeșantionări
SE bootstrap sînt de 1,1–1,6 ori mai mari decît cele i.i.d.
Valoarea \(\alpha = 4\), limita pentru un moment de ordinul patru finit, se află în afara tuturor intervalelor de încredere din tabel, cu excepția celui al Bitcoin, iar acest lucru rămîne valabil și cînd intervalele folosesc eroarea standard bootstrap. Estimările pun deci sub semnul întrebării existența momentului de ordinul patru al randamentelor zilnice. Concluzia depinde de aproximarea Pareto a cozii și de pragul folosit, \(k = 2{,}5\%\) din \(n\).
Valoarea \(\alpha = 2\), limita pentru o varianță finită, se află în afara tuturor intervalelor i.i.d. Cu eroarea standard bootstrap, doar BET-TR o atinge: limita inferioară a intervalului său este \(2{,}67 - 1{,}96 \times 0{,}45 = 1{,}79\).
Estimarea de 4,2 a Bitcoin este luată la un prag la care Hill plot-ul său nu este încă orizontal. La un prag comun, cele două cozi ale sale dau 2,71 pentru pierderi și 3,36 pentru cîștiguri, valori comparabile cu cele ale celorlalte piețe. Consecința practică este că statisticile care cer un moment de ordinul patru finit, cum sînt erorile standard ale kurtosisului sau benzile robuste pentru autocorelația lui \(r_t^2\), trebuie citite cu prudență.
Pe scurt
\(\alpha = 4\) este în afara tuturor intervalelor, cu excepția celui pentru Bitcoin
inclusiv cînd intervalul se construiește cu SE bootstrap
estimările pun sub semnul întrebării existența momentului de ordinul patru
concluzia este condiționată de aproximarea Pareto a cozii și de pragul folosit (\(k = 2{,}5\%\) din \(n\))
consecința: kurtosisul și testele pe \(r_t^2\) nu au inferență standard (tabelul din Aprofundări)
\(\alpha = 2\) este în afara fiecărui interval i.i.d.
cu SE bootstrap, doar intervalul BET-TR îl include: limita inferioară \(\hat\alpha - 1{,}96\,\text{SE} = 2{,}67 - 1{,}96 \times 0{,}45 = 1{,}79\)
Valoarea \(4{,}2\) pentru Bitcoin corespunde unui prag la care graficul Hill (Hill plot) nu este încă plat
la un prag comun, coada pierderilor dă \(2{,}71\), iar cea a cîștigurilor \(3{,}36\) (Anexă)
Faptul 3 întreabă dacă pierderile mari sînt mai frecvente decît cîștigurile de aceeași mărime. Instrumentul este funcția de supraviețuire (survival function) empirică, \(\hat P(X > x) = T^{-1}\,\#\{t : X_t > x\}\), proporția zilelor în care \(X_t\) depășește \(x\), calculată separat pentru pierderi, \(X_t = -r_t\), și pentru cîștiguri, \(X_t = r_t\). Pe scară log–log, o coadă Pareto (1.9) este o dreaptă cu panta \(-\alpha\), așa că cele două curbe pot fi comparate atît ca nivel, cît și ca pantă.
Statistica testului compară cuantilele extreme ale celor două cozi:
\[\Delta = -q_{0{,}01} - q_{0{,}99},\]
(1.11)
unde \(q_p\) este cuantila de ordin \(p\) a randamentelor zilnice. Primul termen, \(-q_{0{,}01}\), este VaR 1% (Value-at-Risk), pierderea zilnică depășită cu probabilitatea 1% (Capitolul 7); al doilea este cîștigul depășit cu probabilitatea 1%. Un \(\Delta\) pozitiv înseamnă că pierderea de 1% este mai mare decît cîștigul de 1%.
Ipoteza nulă \(H_0: \Delta = 0\) este respinsă dacă IÎ de 95% obținut prin moving-block bootstrap nu conține zero; blocurile, de 20 de zile, păstrează gruparea zilelor extreme. Pentru cozile îndepărtate, dincolo de cuantilele de 1%, se compară tail index-urile Hill ale pierderilor, \(\alpha_-\), și ale cîștigurilor, \(\alpha_+\), la același prag \(u\).
Pe scurt
Întrebarea: sînt pierderile mari mai frecvente decît cîștigurile de aceeași mărime?
Funcția de supraviețuire empirică \(\hat P(X > x) = \frac1T\,\#\{t : X_t > x\}\)
\(X_t = -r_t\) pentru pierderi și \(X_t = r_t\) pentru cîștiguri
pe scară log–log, o coadă Pareto \(P(X > x) = (x/u)^{-\alpha}\) apare ca o dreaptă cu panta \(-\alpha\)
Statistica\(\Delta = -q_{0,01} - q_{0,99}\)
\(\Delta > 0\) înseamnă că pierderea de 1% este mai mare decît cîștigul de 1%
\(-q_{0,01}\) este VaR (Value-at-Risk) 1%, pragul de pierdere zilnică depășit cu probabilitatea de 1% (Capitolul 7)
Testul: \(H_0: \Delta = 0\) este respinsă dacă CI de 95% prin bootstrap pe blocuri suprapuse nu conține 0
blocuri de 20 de zile
blocurile păstrează gruparea zilelor extreme
Pentru cozile îndepărtate: indicii Hill ai cozilor \(\alpha_-\) (pierderi) și \(\alpha_+\) (cîștiguri), la același prag \(u\)
Graficul are două panouri. Panoul din stînga arată funcțiile de supraviețuire empirice ale pierderilor și cîștigurilor pe scară log–log, cu pragul pe axa orizontală și probabilitatea de a-l depăși pe axa verticală. Panoul din dreapta compară, pentru cele cinci piețe, cuantila pierderilor \(-q_p\) cu cuantila cîștigurilor \(q_{1-p}\).
Meniul alege piața pentru panoul din stînga, iar cursorul fixează probabilitatea din coadă \(p\), de la 0,1% la 5%; ▶ parcurge valorile lui \(p\).
Întrebare pentru sală Pe S&P 500, VaR 1% este mai mare decît cuantila de 99% a cîștigurilor. Este diferența semnificativă?
Răspuns
Diferența nu este semnificativă la pragul de 5%: Δ = 3,15 − 2,97 ≈ 0,18 pp, iar intervalul bootstrap pe blocuri de 95%, [−0,12; 0,49] pp, conține 0. O diferență punctuală pozitivă și predominanța pierderilor pe alte piețe nu înlocuiesc inferența pentru S&P 500. Dintre cele cinci piețe, numai EUR/RON are un interval care exclude 0: Δ ≈ −0,17 pp, cu intervalul [−0,35; −0,07] pp.
Pentru S&P 500, curba pierderilor este deasupra curbei cîștigurilor: pierderile de o anumită mărime sînt mai frecvente decît cîștigurile de aceeași mărime. La \(p = 1\%\),\(\Delta = 3{,}15 - 2{,}97 = 0{,}18\) pp, dar IÎ bootstrap de 95%, \([-0{,}12;\ 0{,}49]\) pp, conține zero, deci asimetria la această cuantilă nu este semnificativă.
În panoul din stînga, funcția de supraviețuire a pierderilor S&P 500 este deasupra celei a cîștigurilor. În panoul din dreapta, VaR 1%, \(-q_{0{,}01}\), depășește cuantila cîștigurilor de 1%, \(q_{0{,}99}\), pe patru din cele cinci piețe, deci \(\Delta > 0\) pe toate patru; dar pe toate patru intervalul de încredere de 95% conține zero. Pentru S&P 500, \(\Delta = 3{,}15 - 2{,}97 = 0{,}18\) pp, cu IÎ \([-0{,}12;\ 0{,}49]\) pp. Direcția faptului 3 apare deci în date, dar la cuantila de 1% diferența nu este semnificativă.
EUR/RON este excepția: \(\Delta = -0{,}17\) pp, cu IÎ \([-0{,}35;\ -0{,}07]\) pp. Creșterile cursului, adică deprecierile leului, sînt semnificativ mai mari decît scăderile. Pentru un curs de schimb, „pierderea” și „cîștigul” depind de sensul poziției, așa că semnul asimetriei nu are o interpretare universală.
În cozile îndepărtate, indicii Hill sînt mai categorici pentru două piețe. La un prag comun, coada pierderilor este mai groasă pentru BET-TR, cu \(\hat\alpha_- = 2{,}20\) față de \(\hat\alpha_+ = 3{,}06\) și \(z = -2{,}7\) cu erori standard block bootstrap, și, la limită, pentru Bitcoin, cu 2,71 față de 3,36 și \(z = -1{,}9\). Pe fiecare piață, un model cu distribuția Normală și varianța corectă subestimează ambele cuantile extreme.
Pe scurt
Stînga: funcțiile de supraviețuire ale S&P 500, pe scară log–log
curba pierderilor stă peste cea a cîștigurilor
Dreapta: \(-q_{0,01}\) (VaR 1%, roșu) și \(q_{0,99}\) (verde) pe cele cinci piețe
\(\Delta > 0\) pe 4 din 5 piețe, dar CI de 95% conține 0 pe toate patru
Randamentele zilnice ale tuturor celor cinci piețe au cozi groase: exces de kurtosis între 9,3 și 17,8 și tail index-uri în jur de 3. Estimările pun sub semnul întrebării existența unui moment de ordinul patru finit, ceea ce limitează validitatea testelor bazate pe randamentele pătratice. Pierderile extreme depășesc cîștigurile extreme pe patru piețe, dar diferența la cuantila de 1% nu este semnificativă; coada pierderilor este semnificativ mai groasă doar pentru BET-TR.
Dependența și mecanismele ei
Secțiunea trece de la distribuția randamentului dintr-o singură zi la dependența dintre zile. Separă direcția randamentelor, care aproape nu se repetă, de mărimea lor, care se repetă puternic, și construiește inferența necesară: benzi de respingere care rămîn valide în prezența volatility clustering. Examinează apoi intermitența, apropierea lentă de normalitate prin agregare și două legături cu alte variabile, leverage effect și relația dintre volum și volatilitate.
Faptele 1 și 6: întrebările, statisticile și benzile
Faptul 1 întreabă dacă direcția randamentelor se repetă. Statistica lui este autocorelația de selecție \(\hat\rho_k(r)\) dintre \(r_t\) și \(r_{t-k}\) la lagul \(k\), măsurat în zile. Faptul 6, volatility clustering, întreabă dacă mărimea randamentelor se repetă, iar statisticile lui sînt autocorelațiile \(\hat\rho_k(|r|)\) și \(\hat\rho_k(r^2)\). Randamentul pătratic se leagă direct de varianță, ca în modelele ARCH și GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată); randamentul absolut cere mai puține momente. Autocorelația de selecție a lui \(|r_t|\) are o limită Normală cînd \(\alpha > 4\), cea a lui \(r_t^2\) doar cînd \(\alpha > 8\)(Davis & Mikosch, 1998).
La fiecare lag se testează \(H_0: \rho_k = 0\), respinsă cînd \(\hat\rho_k\) iese dintr-o bandă de 95%. Banda este centrată în zero, valoarea sub \(H_0\), deci este o bandă de respingere, nu un interval de încredere, care ar fi centrat în \(\hat\rho_k\).
Se folosesc două benzi. Banda i.i.d., \(\pm 1{,}96/\sqrt{T}\), este validă pentru randamente independente. Banda robustă, \(\pm 1{,}96\sqrt{\hat\tau_k}\), ține cont de volatility clustering: sub heteroscedasticitate condiționată, varianța lui \(\hat\rho_k\) este mai mare decît \(1/T\), iar \(\hat\tau_k\) o estimează. Construcția ei este în Aprofundări.
Pe scurt
Faptul 1: se repetă direcția randamentelor?
statistica: \(\hat\rho_k(r)\), autocorelația dintre \(r_t\) și \(r_{t-k}\), la lagul \(k\) (în zile); în funcție de \(k\): funcția de autocorelație (ACF, AutoCorrelation Function)
Faptul 6: se repetă mărimea lor (gruparea volatilității)?
statisticile: \(\hat\rho_k(|r|)\) și \(\hat\rho_k(r^2)\)
\(r_t^2\) este legat direct de varianță, ca în modelele ARCH și GARCH (ARCH generalizat, Generalised ARCH)
\(|r_t|\) cere mai puține momente: ACF (AutoCorrelation Function, funcția de autocorelație) a lui \(|r_t|\) are o limită Normală pentru \(\alpha > 4\), cea a lui \(r_t^2\) doar pentru \(\alpha > 8\)Davis & Mikosch (1998)
Testul la fiecare lag: \(H_0: \rho_k = 0\), respinsă cînd \(\hat\rho_k\) iese dintr-o bandă de 95%
banda este centrată în 0, valoarea sub \(H_0\): este o bandă de respingere, nu un interval de încredere (acesta ar fi centrat în \(\hat\rho_k\))
Două benzi: i.i.d., \(\pm 1{,}96/\sqrt{T}\), și robustă la gruparea volatilității, \(\pm 1{,}96\sqrt{\hat\tau_k}\) (Aprofundări)
Graficul arată autocorelațiile la lagurile 1–100 pentru trei transformări ale randamentelor zilnice: randamentele \(r_t\) (stînga), randamentele absolute \(|r_t|\) (mijloc) și pătratele \(r_t^2\) (dreapta). Zona colorată este banda de 95% sub ipoteza i.i.d., iar liniile marchează banda robustă.
Meniul alege piața, iar cursorul mută începutul eșantionului între 1990 și 2020; ▶ parcurge anii de început. Scurtarea eșantionului lărgește benzile și arată cît din tipar depinde de episoadele de criză.
Întrebare pentru sală În eșantionul complet S&P 500, 7 dintre cele 100 de autocorelații ies din benzile robuste de 95%. Ce concluzie este justificată?
Răspuns
Benzile sînt punctuale și aproximative. Sub ipotezele de calibrare, aproximativ 5 depășiri din 100 sînt așteptate în medie chiar sub ipoteza nulă; aceasta nu este o limită garantată. Pagina găsește 20 de depășiri cu banda i.i.d. și 7 cu banda robustă. Autocorelația mică nu implică independență: autocorelațiile lui |rt| și rt2 sînt pozitive la toate cele 100 de laguri. Validitatea benzilor rămîne condiționată de ipotezele asupra momentelor și dependenței.
Pentru S&P 500 în 1990–2026, barele din panoul din stînga sînt mici, iar cele din panourile din mijloc și din dreapta sînt pozitive la fiecare lag și scad încet. Depășirile benzilor sînt punctuale: fiecare este un test separat de 5%, iar numărul lor nu înlocuiește un test comun pe toate lagurile.
Pentru randamentele S&P 500 din 1990–2026, autocorelația de lag 1 este \(\hat\rho_1 = -0{,}08\). Din 100 de laguri, 20 ies din banda i.i.d., dar doar 7 din banda robustă. La nivelul de 5%, circa 5 laguri din 100 ar ieși din bandă din întîmplare, deci, în afară de lagul 1, faptul 1 se confirmă odată ce inferența ține cont de volatility clustering.
Autocorelațiile lui \(|r_t|\) și \(r_t^2\) sînt pozitive la toate cele 100 de laguri, ceea ce este faptul 6; la lagul 1, \(\hat\rho_1(|r|) = 0{,}27\). Benzile pentru aceste serii cer un moment de ordinul patru finit, pe care estimările Hill îl pun sub semnul întrebării, așa că dovada vizuală este mai puternică decît orice test individual.
Autocorelațiile randamentelor sînt în general mici, cu excepții precum S&P 500 și EUR/RON, dar randamentele nu sînt independente. Independența cere corelație nulă între orice pereche de funcții ale randamentelor, iar valorile absolute sînt clar corelate. Modelul care reproduce acest tipar este
\[r_t = \sigma_t\,\varepsilon_t,\]
(1.12)
unde \(\sigma_t\) este volatilitatea condiționată din ziua \(t\), determinată de randamentele trecute, iar \(\varepsilon_t\) sînt șocuri i.i.d. cu media 0 și varianța 1. În (1.12) semnul lui \(r_t\) este imprevizibil, pe cînd mărimea lui moștenește persistența lui \(\sigma_t\); modelele GARCH de această formă sînt subiectul Capitolului 5.
Intermitența înseamnă că volatilitatea vine în episoade separate de perioade calme. Graficul o măsoară cu volatilitatea pe o fereastră rolling de 63 de zile, \(\sqrt{A}\) înmulțit cu abaterea standard a randamentelor zilnice din fereastră, reprezentată pe scară logaritmică pentru cele cinci piețe. Cursorul schimbă fereastra între 10 și 250 de zile, iar ▶ parcurge lungimile ferestrei: o fereastră mai lungă netezește mai puternic variațiile de la o zi la alta.
Un model cu volatilitate constantă ar da o linie aproape orizontală, cu zgomot de selecție în jurul ei. Datele arată în schimb perioade calme lungi întrerupte de vîrfuri, cu vîrfuri comune în 2008–2009 și în martie 2020.
Întrebare pentru sală Ce efect are, în general, mărirea ferestrei de la 63 la 250 de zile asupra seriei volatilității rolling?
Răspuns
Fereastra mai lungă netezește în general seria, dar reacționează mai lent la schimbări persistente ale volatilității. Factorul de anualizare nu elimină efectul lungimii ferestrei. Nu însumăm volatilități: recalculăm abaterea standard din observațiile fiecărei ferestre. Pentru EUR/RON, media volatilității pe ferestre de 63 de zile scade de la 5,8% înainte de iulie 2013 la 2,0% după; în curs, testul de ruptură în varianță datează schimbarea la 27 iunie 2013, cu volatilitatea subeșantioanelor de 6,6% înainte și 2,2% după.
EUR/RON iese în evidență: volatilitatea lui a scăzut puternic după iunie 2013, sub regimul de managed float al BNR. O asemenea schimbare a nivelului volatilității este o ruptură structurală, nu un episod, și contează mai departe pentru interpretarea memoriei lungi.
Pe scurt
Episoade de volatilitate ridicată separate de perioade calme
modelele cu volatilitate constantă nu pot reproduce acest tipar
Volatilitatea pe o fereastră mobilă (rolling window) de 63 de zile: \(\sqrt{A}\times\) abaterea standard, scară logaritmică
vîrfuri comune: 2008–2009, martie 2020
Volatilitatea EUR/RON a scăzut puternic după iunie 2013, sub regimul de managed float al BNR
Faptul 4 privește randamentele pe orizonturi mai lungi. Randamentul logaritmic pe \(h\) zile este suma randamentelor zilnice, \(r_t(h) = r_t + \dots + r_{t-h+1}\), iar întrebarea este dacă distribuția lui se apropie de distribuția Normală pe măsură ce \(h\) crește, cum sugerează teorema limită centrală.
Statistica este excesul de kurtosis \(\hat K(h) - 3\) al sumelor pe blocuri care nu se suprapun, calculat din \(n_h\) blocuri. Se folosesc blocuri fără suprapunere pentru ca observațiile din statistică să nu aibă randamente zilnice comune. Sub ipoteza nulă că \(r_t(h)\) este i.i.d. cu distribuția Normală, toate momentele există și
Un \(z\) pozitiv mare în (1.13) respinge normalitatea la orizontul \(h\). Numărul de blocuri \(n_h\) scade pe măsură ce \(h\) crește, deci la orizonturi lungi testul folosește mai puține observații.
Pe scurt
Întrebarea: se apropie randamentele pe \(h\) zile, \(r_t(h) = r_t + \dots + r_{t-h+1}\), de distribuția Normală cînd \(h\) crește?
Statistica: excesul de kurtosis \(\hat K(h) - 3\) al sumelor pe blocuri care nu se suprapun
Graficul reprezintă excesul de kurtosis \(\hat K(h) - 3\) în funcție de orizontul \(h\), în zile de tranzacționare, cu o linie punctată la zero, valoarea pentru distribuția Normală; un al doilea panou arată histograma randamentelor pe \(h\) zile pentru o piață. Meniul alege această piață, iar cursorul orizontul; ▶ parcurge orizonturile.
Întrebare pentru sală Pentru Bitcoin, la h = 60, statistica bazată pe kurtosis este z ≈ 0,10. Ce putem concluziona folosind pragul aproximativ de 5% din pagină?
Răspuns
|z| ≈ 0,10 este sub 1,96, deci nu respingem ipoteza nulă prin acest diagnostic. Nerepingerea nu demonstrează nici normalitatea, nici independența. La h = 60, pragul este depășit pentru S&P 500 (excesul de kurtosis scade de la 10,9 la 1,6, nh = 154, z = 4,1), BET-TR (z = 3,0) și EUR/RON (z = 20). Calibrarea z = (K̂ − 3)/√(24/nh) este asimptotică și presupune observații i.i.d. din distribuția Normală sub ipoteza nulă.
La \(h = 60\) de zile, adică un trimestru pentru S&P 500 și două luni pentru Bitcoin, excesul de kurtosis al S&P 500 scade de la 10,9 la 1,6 (\(n_h = 154\),\(z = 4{,}1\)), iar cel al Bitcoin de la 12,0 la 0,1 (\(n_h = 73\),\(z = 0{,}1\)). Normalitatea este încă respinsă la \(h = 60\) pentru S&P 500, BET-TR (\(z = 3{,}0\)) și EUR/RON (exces de kurtosis 10,5, \(z = 20\)), dar nu pentru Bitcoin și aur. Pentru Bitcoin și aur nu respingem ipoteza nulă i.i.d. cu distribuția Normală; aceasta nu dovedește că randamentele lor pe 60 de zile urmează distribuția Normală sau că sînt independente. Teorema limită centrală acționează încet aici, fiindcă randamentele zilnice sînt dependente și au cozi groase.
Pe scurt
Graficul: \(\hat K(h) - 3\) în funcție de \(h\), în zile de tranzacționare
linia punctată: distribuția Normală
La \(h = 60\) (un trimestru pentru S&P 500, două luni pentru Bitcoin)
Faptul 9 întreabă dacă volatilitatea crește mai mult după scăderi decît după creșteri. Statistica este corelația încrucișată dintre randamentul de azi și mărimea randamentului de peste \(k\) zile:
\[L(k) = \text{corr}(r_t, |r_{t+k}|).\]
(1.14)
O valoare negativă a lui (1.14) pentru \(k > 0\) înseamnă că după scăderi \(|r_t|\) crește, adică volatilitatea crește. Lagurile negative, \(k < 0\), servesc drept control: mărimea randamentelor trecute nu ar trebui să prezică semnul randamentului de azi.
Se testează \(H_0: L(k) = 0\), cu \(z = \hat L(k)/\text{SE}\) comparat cu \(\pm 1{,}96\). Eroarea standard i.i.d., \(1/\sqrt{T}\), ignoră volatility clustering, deci banda \(\pm 1{,}96/\sqrt{T}\) este prea îngustă. Eroarea standard robustă (HAC, heteroskedasticity and autocorrelation consistent) este \(\sqrt{\hat\tau}\), unde \(\hat\tau\) este varianța pe termen lung Newey–West a lui \(u_t = x_t y_{t+k}/(s_x s_y)\), împărțită la \(T\), calculată cu ponderi Bartlett și \(L = \lfloor 4(T/100)^{2/9} \rfloor\) laguri. Aici \(x_t = r_t - \bar r\),\(y_t = |r_t| - \overline{|r|}\), iar \(s_x\),\(s_y\) sînt abaterile lor standard.
Eroarea standard robustă presupune o dependență slabă a produselor \(u_t\). Chiar cînd \(L(k) = 0\), aceste produse pot fi autocorelate din cauza volatility clustering, iar autocorelațiile lor pînă la lagul \(L\) intră în eroarea standard.
Pe scurt
Întrebarea: crește volatilitatea mai mult după scăderi decît după creșteri?
corelația dintre randamentul de azi și mărimea randamentului de peste \(k\) zile
\(L(k) < 0\) pentru \(k > 0\): după scăderi, \(|r_t|\) crește, adică volatilitatea crește
\(k < 0\) este un control: mărimea randamentelor trecute nu ar trebui să prezică semnul celui de azi
Testul: \(H_0: L(k) = 0\), cu \(z = \hat L(k)/\text{SE}\) comparat cu \(\pm 1{,}96\)
SE i.i.d. \(= 1/\sqrt{T}\): ignoră gruparea volatilității, deci banda \(\pm 1{,}96/\sqrt{T}\) este prea îngustă
SE robustă HAC (la heteroscedasticitate și autocorelație) \(= \sqrt{\hat\tau}\): \(\hat\tau\) este varianța de termen lung Newey–West (Bartlett, \(\ell = \lfloor 4(T/100)^{2/9} \rfloor\) laguri) a lui \(u_t = x_t y_{t+k}/(s_x s_y)\), împărțită la \(T\)
\(x_t = r_t - \bar r\), \(y_t = |r_t| - \overline{|r|}\); \(s_x\), \(s_y\): abaterile lor standard
presupune dependență slabă a lui \(u_t\): chiar cu \(L(k) = 0\), produsele \(u_t\) pot fi autocorelate, iar autocorelațiile lor pînă la lagul \(\ell\) intră în SE
Graficul arată \(\hat L(k)\) pentru laguri între −20 și 20 de zile. Zona colorată este banda i.i.d., iar liniile banda robustă. Un al doilea panou grupează zilele după randamentul de azi, în grupe de cîte 5% din observații, și arată media lui \(|r_{t+k}|\) în fiecare grupă. Meniul alege piața, iar cursorul lagul \(k\), de la 1 la 20; ▶ parcurge lagurile.
Întrebare pentru sală Mediile lui |rt+1| sînt 1,40% după cele mai slabe 5% dintre zile și 1,04% după cele mai bune 5%. Demonstrează această comparație că semnul randamentului contează la aceeași mărime a șocului?
Răspuns
Nu. Comparația arată o asociere descriptivă între grupul randamentului curent și mărimea randamentului următor. Grupurile de aceeași frecvență nu au neapărat același |rt|. L(1) = −0,12, cu z ≈ −5,4 folosind SE robustă, nu înlocuiește o comparație la aceeași mărime a șocului. Pe EUR/RON semnul este inversat: L(1) = +0,10 (z = 2,5).
Pentru S&P 500, barele de la lagurile pozitive sînt negative și ies din banda robustă, iar cele de la lagurile negative rămîn în interiorul ei. În al doilea panou, grupele zilelor cu scăderi și cele ale zilelor cu creșteri pot diferi prin mărimea randamentului inițial, așa că panoul descrie o asociere și nu izolează efectul semnului.
Pentru S&P 500, \(L(1) = -0{,}12\), cu \(z = -5{,}4\) folosind eroarea standard robustă; corelația este încă −0,07 la \(k = 10\), iar pentru \(k < 0\) nicio valoare nu este semnificativă. Eroarea standard robustă cere ea însăși un moment de ordinul patru finit, pe care estimările Hill îl pun sub semnul întrebării, deci valorile \(z\) sînt aproximative. Efectul apare și la BET-TR, cu \(L(1) = -0{,}12\)(\(z = -2{,}4\)), și la Bitcoin, cu \(-0{,}07\)(\(z = -2{,}4\)); pentru aur, \(-0{,}02\)(\(z = -0{,}8\)), nu respingem \(L(1) = 0\).
EUR/RON are semnul invers, \(L(1) = +0{,}10\)(\(z = 2{,}5\)): volatilitatea crește după deprecierile leului, adică după creșterile cursului.
Rezultatul susține o asociere, nu un mecanism. Se dau de obicei două explicații: levierul financiar al firmelor (financial leverage), al căror capital propriu devine mai riscant după o scădere a valorii lui (Christie, 1982), și modelul volatilității întîrziate (retarded volatility model) al lui Bouchaud, Matacz & Potters (2001). Modelele GARCH asimetrice, precum GJR-GARCH (Glosten–Jagannathan–Runkle) și EGARCH (GARCH exponențial), reproduc efectul și sînt tratate în Capitolul 5.
Pe scurt
Graficul: \(\hat L(k)\) pentru \(k\) între \(-20\) și \(20\)
zona albastră: banda i.i.d.
liniile: banda robustă
S&P 500: \(L(1) = -0{,}12\) (\(z = -5{,}4\), SE robustă)
SE robustă presupune moment de ordin patru finit, pus sub semnul întrebării de estimările Hill
încă \(-0{,}07\) la \(k = 10\)
la \(k < 0\), nicio valoare semnificativă
\(L(1)\) pe BET-TR, Bitcoin și aur
BET-TR: \(L(1) = -0{,}12\) (\(z = -2{,}4\))
Bitcoin: \(-0{,}07\) (\(z = -2{,}4\))
aur: \(-0{,}02\) (\(z = -0{,}8\); nu respingem \(L(1) = 0\))
Faptul 10 întreabă dacă zilele cu volum tranzacționat neobișnuit de mare sînt și zile cu mișcări mari de preț. Volumul are o tendință puternică pe termen lung, așa că mai întîi i se elimină tendința. Cu \(V_t\) volumul tranzacționat în ziua \(t\), volumul anormal (abnormal volume) este logaritmul volumului minus media lui mobilă pe 250 de zile:
Statistica este corelația de ranguri Spearman, \(\rho_S = \text{corr}(\text{rank}(\tilde v_t), \text{rank}(|r_t|))\), cu valori în \([-1, 1]\). Lucrul cu ranguri o face robustă la cozile groase ale ambelor serii și la relațiile monotone neliniare dintre ele.
Ipoteza nulă \(H_0: \rho_S = 0\) este respinsă dacă IÎ de 95% obținut prin moving-block bootstrap nu conține zero. Blocurile de 20 de zile păstrează persistența atît a volumului anormal, cît și a randamentelor absolute, pe care un bootstrap i.i.d. ar distruge-o.
Pe scurt
Întrebarea: coincid zilele cu volum neobișnuit de mare cu zilele cu variații mari ale prețului?
Volumul anormal: \(\tilde v_t = \ln V_t - \frac{1}{250}\sum_{j=0}^{249}\ln V_{t-j}\)
\(V_t\): volumul tranzacționat în ziua \(t\); media mobilă pe 250 de zile elimină tendința pe termen lung a volumului
Statistica: corelația de rang Spearman \(\rho_S = \text{corr}\big(\text{rang}(\tilde v_t),\ \text{rang}(|r_t|)\big) \in [-1, 1]\)
rangurile o fac robustă la cozile groase ale ambelor serii și la relațiile monotone neliniare
Testul: \(H_0: \rho_S = 0\) este respinsă dacă CI de 95% prin bootstrap pe blocuri suprapuse nu conține 0
blocuri de 20 de zile
blocurile păstrează persistența ambelor serii
Faptul 10: volumul și volatilitatea evoluează împreună
Graficul este un nor de puncte, cu un punct pentru fiecare zi: volumul anormal \(\tilde v_t\) din (1.15) pe axa orizontală și \(|r_t|\) pe scară logaritmică pe axa verticală. Meniul alege S&P 500 sau Bitcoin, iar cursorul fixează fereastra mediei mobile a volumului, de la 20 la 500 de zile; ▶ parcurge ferestrele.
Întrebare pentru sală Corelația Spearman pozitivă dintre volumul anormal și |rt| arată că volumul mare provoacă variații mari ale prețului?
Răspuns
Nu. La fereastra de 250 de zile, corelația este 0,25 pentru S&P 500, cu intervalul [0,22; 0,28], și 0,39 pentru Bitcoin, cu intervalul [0,34; 0,44]. Intervalele susțin o asociere pozitivă, nu o explicație cauzală. Rangurile nu elimină factorii comuni sau cauzalitatea inversă. Pentru Bitcoin, volumul raportat de burse include wash trading.
Corelația de ranguri este \(\hat\rho_S = 0{,}25\) pentru S&P 500, cu IÎ de 95% \([0{,}22;\ 0{,}28]\), și \(0{,}39\) pentru Bitcoin, cu IÎ \([0{,}34;\ 0{,}44]\): o relație pozitivă și semnificativă pe ambele piețe. O corelație contemporană nu identifică direcția cauzalității. Ipoteza amestecului de distribuții (mixture-of-distributions hypothesis) a lui Clark (1973) atribuie atît mișcările de preț, cît și volumul unui factor comun, fluxul de informație; dovezile empirice sînt trecute în revistă de Karpoff (1987). Pentru Bitcoin, volumul este raportat de bursele de criptoactive și constă parțial din wash trading, tranzacții fictive în care cumpărătorul și vînzătorul coincid (Cong, Li, Tang & Yang, 2023), deci seria lui de volum este măsurată cu erori.
Pe scurt
Axele: volumul anormal \(\tilde v_t\) (orizontal) și \(|r_t|\) pe scară logaritmică (vertical); un punct este o zi
\(\hat\rho_S = 0{,}25\) pentru S&P 500 și \(0{,}39\) pentru Bitcoin: relație pozitivă și semnificativă
CI: \([0{,}22;\ 0{,}28]\) pentru S&P 500, \([0{,}34;\ 0{,}44]\) pentru Bitcoin
Randamentele sînt aproape necorelate, dar puternic dependente: mărimea lor este persistentă, volatilitatea vine în episoade, crește după scăderi pe piețele de acțiuni și se mișcă împreună cu volumul tranzacționat. Agregarea pe 60 de zile reduce kurtosisul, dar nu îl elimină pe trei din cele cinci piețe. Toate aceste trăsături indică modele în care volatilitatea \(\sigma_t\) din (1.12) variază în timp, subiectul Capitolului 5.
Persistența și limitele inferenței
Secțiunea precedentă a arătat că randamentele sînt aproape necorelate, în timp ce valorile lor absolute sînt autocorelate pozitiv. Această secțiune întreabă cît durează dependența. Răspunsul separă două familii de modele: modelele cu memorie scurtă (short memory), în care autocorelațiile lui \(|r_t|\) scad exponențial, și modelele cu memorie lungă (long memory), în care ele scad hiperbolic. Secțiunea întreabă și ce putere a mărimii randamentelor este cea mai persistentă, iar la final prezintă două fapte despre distribuția condiționată a randamentelor și despre interacțiunea scalelor de timp.
Fie \(\rho_k\) autocorelația lui \(|r_t|\) la lagul \(k\). Un proces are memorie scurtă cînd autocorelațiile sînt absolut sumabile, \(\sum_k |\rho_k| < \infty\). Exemplul standard este scăderea exponențială, \(\rho_k \approx c\,\phi^k\), cu \(c > 0\) și \(0 < \phi < 1\), tiparul implicat de un model GARCH(1,1) (generalised autoregressive conditional heteroskedasticity), studiat în Capitolul 5. Sub scăderea exponențială, dependența la lagul 100 este neglijabilă dacă \(\phi\) nu este foarte apropiat de 1.
\[\rho_k \approx c\,k^{2d-1}, \qquad 0 < d < \tfrac12.\]
(1.16)
În (1.16),\(d\) este parametrul de memorie (memory parameter). Exponentul \(2d - 1\) se află între \(-1\) și \(0\), deci autocorelațiile scad mai încet decît \(1/k\), iar suma lor diverge, \(\sum_k \rho_k = \infty\). Un \(d\) mai mare înseamnă o scădere mai lentă. Valoarea \(d = 0\) corespunde memoriei scurte, iar \(d \ge \frac12\) unei serii care nu mai este staționară.
Testul privește deci un singur parametru: estimăm \(d\) și testăm \(H_0: d = 0\) față de memoria lungă. Estimatorii folosiți în capitol sînt semiparametrici: folosesc doar partea de frecvență joasă a periodogramei, unde domină memoria lungă, și nu cer un model complet pentru dinamica pe termen scurt. Ei sînt descriși în Aprofundări.
Pe scurt
Întrebarea: cît de repede scade \(\rho_k\), autocorelația lui \(|r_t|\) la lagul \(k\), cînd \(k\) crește?
Memorie scurtă: \(\sum_k |\rho_k| < \infty\)
de exemplu, scădere exponențială \(\rho_k \approx c\,\phi^k\), cu \(c > 0\) și \(0 < \phi < 1\) (GARCH(1,1), Capitolul 5)
Memorie lungăDing, Granger & Engle (1993): scădere hiperbolică \(\rho_k \approx c\,k^{2d-1}\), cu \(0 < d < \frac12\)
\(d\): parametrul de memorie; un \(d\) mai mare înseamnă o scădere mai lentă, iar \(\sum_k \rho_k = \infty\)
Testul: estimăm \(d\) și testăm \(H_0: d = 0\) (memorie scurtă)
Graficul arată funcția de autocorelație (ACF, autocorrelation function) de eșantion a lui \(|r_t|\) pentru cele cinci piețe ale capitolului, la lagurile 1–250. Axa orizontală, lagul, are scară logaritmică, ceea ce desface lagurile scurte și le comprimă pe cele lungi. Pe această scară, scăderea exponențială se curbează brusc în jos, în timp ce scăderea hiperbolică coboară treptat.
În versiunea interactivă, meniul alege piața pentru care se desenează curbele de referință, iar cursorul fixează parametrul de memorie \(d\) al referinței hiperbolice. Referința exponențială este ajustată pe lagurile 1–20. Comparînd cele două curbe de referință cu ACF empirică la laguri lungi, se vede ce formă de scădere este mai apropiată de date.
Întrebare pentru sală Dovedește scăderea lentă a ACF lui |rt| existența memoriei lungi?
Răspuns
Nu. Pentru S&P 500, ACF a lui |rt| este aproximativ 0,27 la lagul 1, 0,22 la lagul 20 și 0,09 la lagul 100. La laguri mari depășește curba exponențială ajustată aici pe lagurile 1–20. Tiparul este compatibil cu memoria lungă, dar poate apărea și din rupturi ale nivelului volatilității. Nici estimarea Whittle local d̂ ≈ 0,48 nu exclude singură această explicație; pe cele cinci piețe, estimatorii semiparametrici dau d̂ între 0,35 și 0,50.
Pentru S&P 500, ACF a lui \(|r_t|\) este aproximativ 0,27 la lagul 1, 0,22 la lagul 20 și 0,09 la lagul 100. La laguri lungi ea rămîne peste referința exponențială ajustată pe lagurile 1–20. Tiparul este compatibil cu memoria lungă, dar graficul singur nu o dovedește: schimbările nivelului volatilității produc aceeași scădere lentă.
Graficul are pe axa verticală ACF a lui \(|r_t|\), iar pe axa orizontală lagul, de la 1 la 250 de zile de tranzacționare, pe scară logaritmică. Pentru S&P 500, autocorelația este 0,27 la lagul 1, 0,22 la lagul 20 și încă 0,09 la lagul 100, adică după aproximativ cinci luni de tranzacționare. BET-TR, indicele de randament total al Bursei de Valori București, scade cel mai repede dintre cele cinci serii.
O scădere empirică lentă nu dovedește încă memoria lungă. Rupturile structurale (structural breaks), adică salturile bruște ale nivelului volatilității, o imită: dacă volatilitatea este mare cîțiva ani și mică alți cîțiva, \(|r_t|\) este corelat cu \(|r_{t-k}|\) la toate lagurile din interiorul unui regim, chiar dacă dinamica din fiecare regim are memorie scurtă (Diebold & Inoue, 2001),(Mikosch & Stărică, 2004). Distincția dintre cele două explicații este discutată în Anexa despre memorie lungă sau rupturi.
Pe scurt
Graficul: ACF a lui \(|r_t|\) (vertical) în funcție de lag (orizontal, scară logaritmică), lagurile 1–250
S&P 500: \(0{,}27\) la lagul 1, \(0{,}22\) la lagul 20, încă \(0{,}09\) la lagul 100
BET-TR scade cel mai repede
O scădere lentă a ACF empirice nu dovedește, în sine, memoria lungă
rupturile structurale (salturi ale nivelului volatilității) dau același tipar
Tabelul dă două estimări semiparametrice ale lui \(d\) pentru \(|r_t|\) pe fiecare piață: estimatorul Whittle local (local Whittle) (Robinson, 1995) și estimatorul log-periodogramă (log-periodogram) (Geweke & Porter-Hudak, 1983). Ambele folosesc primele \(m\) frecvențe Fourier, cu lățimea de bandă \(m = T^{0{,}65}\), unde \(T\) este volumul eșantionului; \(m\) variază de la 181 pentru BET-TR la 386 pentru aur.
Estimările sînt apropiate între estimatori și între piețe. Estimarea Whittle locală este 0,48 pentru S&P 500, 0,37 pentru BET-TR, 0,35 pentru Bitcoin, 0,39 pentru EUR/RON și 0,40 pentru aur; estimările log-periodogramă diferă cu cel mult 0,04. Cu erori standard (SE) între 0,03 și 0,05, fiecare \(\hat d\) se află la cel puțin 8 erori standard de \(d = 0\), deci memoria scurtă este respinsă pe toate cele cinci piețe, cu ambii estimatori.
Estimările pentru S&P 500, 0,48 și 0,50, se află la limita staționarității, \(d = \frac12\). Acesta este al doilea motiv de prudență: schimbările rare ale nivelului volatilității produc și ele \(\hat d > 0\) fără memorie lungă, deci mărimea lui \(\hat d\) nu discriminează între memoria lungă și rupturi. Testul respinge memoria scurtă cu volatilitate constantă; nu identifică alternativa.
Pe scurt
\(|r_t|\), \(m = T^{0,65}\)
S&P 500
BET-TR
Bitcoin
EUR/RON
Aur
\(m\)
378
181
232
265
386
Whittle local \(\hat d\) (SE)
0,48 (0,03)
0,37 (0,04)
0,35 (0,03)
0,39 (0,03)
0,40 (0,03)
Log-periodogramă \(\hat d\) (SE)
0,50 (0,03)
0,41 (0,05)
0,35 (0,04)
0,38 (0,04)
0,42 (0,03)
Fiecare \(\hat d\) este la cel puțin 8 SE de \(d = 0\) (memorie scurtă), cu ambii estimatori
S&P 500 este aproape de limita de staționaritate: pentru \(d \geq \frac12\) seria nu mai este staționară
Volatility clustering se poate măsura pe randamentele absolute, pe pătratele randamentelor sau pe orice altă putere a lui \(|r_t|\). Efectul Taylor (Taylor effect) întreabă care putere este cea mai persistentă. Statistica este autocorelația transformării putere,
privită ca funcție de \(\delta\), la un lag \(k\) fixat. Cazul \(\delta = 1\) dă randamentele absolute, iar \(\delta = 2\) pătratele randamentelor.
Taylor (1986) a documentat că \(\rho_k(\delta)\) este maximă pentru o putere \(\delta\) apropiată de 1, nu pentru \(\delta = 2\), iar Granger & Ding (1995) au numit această regularitate efectul Taylor. O lectură practică: pătratele, care dau o pondere mare cîtorva zile extreme, sînt o măsură mai zgomotoasă a volatilității persistente decît valorile absolute.
Efectul motivează modelele power-GARCH, care specifică dinamica lui \(\sigma_t^\delta\) cu un \(\delta\) estimat, în loc să impună \(\delta = 2\) (Capitolul 5). El motivează și măsurile de volatilitate bazate pe valori absolute.
Pe scurt
Întrebarea: ce putere a mărimii randamentelor este cea mai persistentă?
Statistica: \(\rho_k(\delta) = \text{corr}(|r_t|^\delta, |r_{t-k}|^\delta)\), în funcție de puterea \(\delta > 0\)
Graficul arată autocorelația (1.17) în funcție de puterea \(\delta\). În versiunea interactivă, meniul alege piața, iar cursorul lagul \(k\), de la 1 la 100 de zile. Panoul din stînga desenează \(\rho_k(\delta)\) în funcție de \(\delta\) pentru lagul ales, iar panoul din dreapta arată unde se află maximul cînd lagul se schimbă.
Întrebare pentru sală La lagul 1, autocorelația lui |rt|δ pe S&P 500 este aproximativ 0,316 pentru δ = 1,75 și 0,311 pentru δ = 2. Este demonstrat că prima valoare este mai mare în populație?
Răspuns
Nu. Maximul pe grila de puteri folosită de pagină este la δ = 1,75, pentru lagul 1. Diferența față de δ = 2 este aproximativ 0,005, dar pagina nu estimează incertitudinea acestei diferențe. Poziția maximului este descriptivă; nici superioritatea, nici egalitatea în populație nu rezultă din grafic. Maximul se mută cu lagul: δ = 2 la lagul 2, 1,5 la lagul 5 și 1,25 la lagul 20.
Pentru S&P 500 la lagul 1, autocorelația lui \(|r_t|^\delta\) este aproximativ 0,316 pentru \(\delta = 1{,}75\) și 0,311 pentru \(\delta = 2\). Pe grila de puteri, maximul este deci la \(\delta = 1{,}75\), dar diferența de circa 0,005 nu are o măsură a incertitudinii și este descriptivă. Poziția maximului se mută odată cu lagul: \(\delta = 2\) la lagul 2, 1,5 la lagul 5 și 1,25 la lagul 20.
Graficul static desenează \(\rho_k(\delta)\) pentru lagurile 1, 5 și 20; stelele marchează maximul fiecărei curbe, iar linia punctată marchează \(\delta = 1\). Pentru S&P 500, maximul este la \(\delta = 1{,}75\) la lagul 1, la \(1{,}5\) la lagul 5 și la \(1{,}25\) la lagul 20.
La cele trei laguri din grafic, maximul se află sub 2 și se apropie de 1 cînd lagul crește. Tiparul nu este valabil la orice lag: la lagul 2 maximul este chiar la 2. La lagul 1 maximul este mai aproape de 2 decît de 1, deci la laguri scurte dovezile pentru \(\delta \approx 1\) sînt mixte.
Poziția maximului este o estimare punctuală fără eroare standard, iar comparația cu \(\delta = 1\) este descriptivă. Un test formal ar avea nevoie de distribuția de eșantionare a lui \(\rho_k(\delta)\) la puteri mari, care depinde de momente ale lui \(|r_t|\) de ordinul \(4\delta\). Estimările de coadă ale capitolului pun la îndoială existența acestor momente; Anexa despre inferența fără momente discută consecințele.
Pe scurt
Graficul: \(\rho_k(\delta)\) pentru lagurile 1, 5 și 20
stelele marchează maximul
linia punctată: \(\delta = 1\)
S&P 500: maximul la \(\delta = 1{,}75\) (lagul 1), \(1{,}5\) (lagul 5) și \(1{,}25\) (lagul 20)
la cele trei laguri din grafic maximul este sub 2 și se apropie de 1 cînd lagul crește; nu la orice lag (la lagul 2 este chiar 2)
la lagul 1 maximul este mai aproape de 2 decît de 1: dovezile pentru „\(\delta \approx 1\)” sînt mixte la laguri scurte
Poziția maximului este o estimare punctuală, fără eroare standard
Faptul 7 privește distribuția randamentelor după eliminarea volatility clustering. Estimăm un model de volatilitate, de exemplu un model GARCH (Capitolul 5), și standardizăm randamentele cu volatilitatea estimată, \(\hat z_t = r_t/\hat\sigma_t\), unde \(\hat\sigma_t\) este volatilitatea estimată de model pentru ziua \(t\). O parte din cozile groase ale lui \(r_t\) provine din amestecul perioadelor calme cu cele agitate, deci kurtosisul lui \(\hat z_t\) este mai mic decît al lui \(r_t\). El rămîne totuși peste 3, valoarea pentru distribuția Normală. Modelele de volatilitate au nevoie, de aceea, de inovații (innovations) cu cozi groase, de exemplu distribuția Student-\(t\), eventual asimetrică.
Faptul 11 privește interacțiunea scalelor de timp. Volatilitatea măsurată pe o săptămînă prognozează volatilitatea zilnică mai bine decît prognozează volatilitatea zilnică volatilitatea săptămînală. O interpretare este că investitorii cu orizonturi diferite reacționează la frecvențe diferite, iar volatilitatea agregată pe intervale mai lungi contează pentru toți. Modelul autoregresiv heterogen al volatilității realizate (HAR-RV, heterogeneous autoregressive model of realised volatility, Capitolul 9) include această asimetrie printr-o regresie pe componente zilnice, săptămînale și lunare. Volatilitatea realizată (realised volatility) se calculează din suma pătratelor randamentelor intraday.
Cele două fapte se întîlnesc în datele de înaltă frecvență. Andersen, Bollerslev, Diebold & Ebens (2001) arată că randamentele zilnice standardizate cu volatilitatea realizată calculată din date intraday sînt apropiate de distribuția Normală. O măsură a volatilității care folosește informația din interiorul zilei elimină mai mult din grosimea cozilor decît un model care folosește doar închiderile zilnice.
Pe scurt
Faptul 7: cozi groase condiționate
Estimăm un model de volatilitate, de exemplu GARCH (Capitolul 5)
și standardizăm: \(\hat z_t = r_t/\hat\sigma_t\), cu \(\hat\sigma_t\) volatilitatea estimată de model pentru ziua \(t\)
Kurtosisul lui \(\hat z_t\) este mai mic decît al lui \(r_t\), dar rămîne peste 3 (literatură; netestat aici)
Modelele necesită inovații cu cozi groase (distribuția Student-\(t\), eventual asimetrică)
Faptul 11: asimetria scalelor de timp
Volatilitatea săptămînală prognozează volatilitatea zilnică mai bine decît reciproc
Investitorii cu orizonturi diferite reacționează la frecvențe diferite
Modelul autoregresiv heterogen al volatilității realizate (HAR-RV, Capitolul 9)
volatilitatea realizată este suma pătratelor randamentelor intrazilnice (intraday)
Randamentele standardizate cu volatilitatea realizată din date intrazilnice sînt apropiate de distribuția Normală
Autocorelațiile lui \(|r_t|\) scad lent pe toate cele cinci piețe, iar estimările semiparametrice ale parametrului de memorie se află între 0,35 și 0,50. Atît memoria lungă, cît și rupturile structurale explică acest tipar, iar estimările nu le separă. Efectul Taylor se verifică doar parțial la laguri scurte, iar dovezile pentru el sînt descriptive. Standardizarea cu o estimare a volatilității subțiază cozile, dar nu le elimină.
Particularități ale piețelor
Faptele stilizate sînt comune celor cinci piețe, dar mărimea lor și unele semne depind de organizarea fiecărei piețe. Secțiunea reunește diferențele pe care le-au arătat tabelele capitolului și asociază fiecăreia o posibilă explicație instituțională.
Bitcoin se tranzacționează 24 de ore din 24, în fiecare zi, deci factorul de anualizare este \(A = 365\), nu 252. Volatilitatea lui anualizată este 66,6%, față de 18,0% pentru S&P 500, iar cea mai slabă zi are randamentul logaritmic −46,5%. Leverage effect, corelația negativă dintre randamentul de azi și volatilitatea de mîine, este slab, −0,07. ACF a lui \(|r_t|\) la lagul 100 este 0,02, față de 0,09 pentru S&P 500. O explicație posibilă este absența îndatorării corporative: volatilitatea crește după mișcările mari de orice semn, nu în principal după pierderi.
Cursul EUR/RON este fixat zilnic de Banca Națională a României (BNR), în regim de flotare controlată (managed float). Volatilitatea lui este mică, 4,4% pe an, dar excesul de kurtosis este 15,1, iar cele mai mari variații, +2,9% și −2,5%, au avut loc în octombrie 2008. Autocorelația de lag 1 a randamentelor este \(\hat\rho_1 = +0{,}17\), compatibilă cu ajustări distribuite pe mai multe zile.
BET-TR este indicele de randament total al unei piețe clasificate între frontieră și emergentă. Asimetria (skewness) lui este −1,40. Cea mai slabă zi, −11,9% pe 19 decembrie 2018, a urmat anunțului din 18 decembrie privind taxa pe activele bancare, Ordonanța de urgență 114/2018. Autocorelația de lag 1 este \(+0{,}06\). Explicațiile posibile sînt șocurile de politică economică și tranzacționarea nesincronă (non-synchronous trading) a componentelor indicelui (Campbell, Lo & MacKinlay (1997), cap. 3): cînd unele acțiuni nu se tranzacționează în fiecare zi, indicele încorporează informația cu întîrziere, iar randamentele lui devin autocorelate pozitiv.
Aceste explicații sînt ipoteze, nu cauze identificate. Tabelul arată și că volatilitatea mică nu înseamnă tail risk mic, cum ilustrează EUR/RON. Cozile groase și volatility clustering apar pe toate cele cinci piețe, în timp ce autocorelația randamentelor și asimetria răspunsului la șocuri depind de cadrul instituțional.
Pe scurt
Piață
Trăsătură instituțională
Diferențe
Explicație posibilă
Bitcoin
tranzacționat 24/7; \(A = 365\)
volatilitate 66,6% față de 18,0% (S&P 500); cea mai slabă zi \(-46{,}5\%\); efect de levier slab (\(-0{,}07\)); ACF a lui \(|r_t|\) la lagul 100: \(0{,}02\) (S&P 500: \(0{,}09\))
fără îndatorare corporativă; volatilitatea crește după variații mari de orice semn
EUR/RON
curs de referință zilnic BNR, managed float
volatilitate 4,4%, dar exces de kurtosis 15,1; \(\hat\rho_1 = +0{,}17\); cele mai mari variații în octombrie 2008 (\(+2{,}9\%\), \(-2{,}5\%\))
ajustări ale cursului distribuite pe mai multe zile
BET-TR
randament total, piață de frontieră/emergentă
asimetrie \(-1{,}40\); cea mai slabă zi \(-11{,}9\%\) pe 19 dec. 2018 (taxa pe activele bancare anunțată pe 18 dec., Ordonanța de urgență 114/2018); \(\hat\rho_1 = +0{,}06\)
Volatilitatea mică nu înseamnă risc de coadă (tail risk) mic
Cozile groase și gruparea volatilității apar pe toate cele cinci piețe
autocorelația și asimetria depind de cadrul instituțional
Volatilitatea din deschidere, maxim, minim și închidere
Pînă aici volatilitatea a fost estimată doar din prețurile de închidere: o observație pe zi. Majoritatea furnizorilor de date raportează și deschiderea, maximul și minimul fiecărei zile. Secțiunea arată cîtă informație adaugă aceste prețuri, în ce ipoteze și ce se întîmplă cînd ipotezele nu se verifică pe datele reale ale unui indice.
Întrebarea este cît de precis se poate estima volatilitatea unei zile dacă, pe lîngă închidere, folosim și deschiderea, maximul și minimul. Cele patru prețuri ale zilei \(t\) se abreviază OHLC (open, high, low, close): \(O_t\) este deschiderea, \(H_t\) maximul, \(L_t\) minimul și \(C_t\) închiderea.
Randamentul close-to-close folosește doar două puncte ale traiectoriei prețului, cîte unul pe zi. Maximul și minimul rezumă întreaga traiectorie a sesiunii de tranzacționare. Într-o zi volatilă, range-ul \(H_t/L_t\) este mare chiar dacă închiderea este egală cu deschiderea, astfel că un estimator close-to-close înregistrează o zi liniștită, iar un estimator bazat pe range una agitată. Estimatorii bazați pe range (range-based estimators) folosesc deci mai mult din informația produsă în timpul zilei.
Graficul următor arată o zi simulată. Axa verticală este logaritmul prețului față de închiderea precedentă \(c_{t-1}\), în procente, iar saltul de peste noapte (overnight gap) \(o_t - c_{t-1}\), mișcarea dintre închiderea precedentă și deschidere, apare în stînga deschiderii.
Pe scurt
Întrebarea: cît de precis putem estima volatilitatea unei zile dacă folosim și deschiderea, maximul și minimul?
Graficul desenează o traiectorie intraday simulată a logaritmului prețului pentru o sesiune de 390 de minute. Saltul de peste noapte apare în stînga deschiderii; maximul și minimul curente sînt marcate pe măsură ce traiectoria avansează. În versiunea interactivă, cursorul parcurge minutele zilei, butonul ▶ rulează sesiunea, iar butonul de sub grafic generează o altă zi simulată.
Întrebare pentru sală Într-o zi, prețul de închidere este egal cu cel de deschidere. Spune ceva range-ul zilei despre volatilitate?
Răspuns
Da. Dacă închiderea este egală cu deschiderea, randamentul intraday este zero, dar range-ul ht − lt poate fi mare. Randamentul close-to-close poate rămîne nenul dacă a existat un salt overnight. Pentru log-prețul modelat prin mișcare browniană fără drift, E[(ht − lt)2] = 4 ln 2 · σ2, unde σ2 este varianța pe durata sesiunii. În modelul ideal fără salturi overnight, estimatorul Parkinson al varianței are eficiență relativă de circa 5 față de close-to-close.
Într-o zi în care închiderea este egală cu deschiderea, randamentul intraday este zero, dar range-ul \(h_t - l_t\) poate fi mare, iar randamentul close-to-close poate fi diferit de zero dacă a existat un salt peste noapte. Pentru un logaritm al prețului care urmează o mișcare browniană fără drift, \(\mathbb{E}[(h_t - l_t)^2] = 4\ln 2\,\sigma^2\), unde \(\sigma^2\) este varianța pe durata sesiunii. În acest model ideal, fără salturi peste noapte, estimatorul Parkinson din frame-urile următoare este de aproximativ 5 ori mai eficient decît estimatorul close-to-close.
Literele mici notează logaritmii prețurilor: \(o_t = \ln O_t\),\(h_t = \ln H_t\),\(l_t = \ln L_t\) și \(c_t = \ln C_t\). Range-ul logaritmic al zilei \(t\) este \(h_t - l_t = \ln(H_t/L_t) \ge 0\), aproximativ diferența procentuală dintre maximul și minimul zilei.
Pentru ziua \(t\) se pot forma trei randamente logaritmice: randamentul close-to-close \(c_t - c_{t-1}\), randamentul de peste noapte \(o_t - c_{t-1}\) și randamentul din timpul zilei \(c_t - o_t\). Primul este suma celorlalte două. Estimatorul close-to-close al volatilității este abaterea standard a lui \(c_t - c_{t-1}\), cu o singură observație pe zi.
Estimatorii se compară prin eficiența (efficiency) lor relativă față de estimatorul close-to-close:
În (1.18),\(\hat\sigma^2_{CC}\) este estimarea close-to-close a varianței, iar \(\hat\sigma^2_X\) cea a estimatorului \(X\), ambele pe același număr de zile. O eficiență de 5 înseamnă că estimatorul \(X\) atinge precizia estimatorului close-to-close cu de 5 ori mai puține zile. Pentru o volatilitate care variază în timp, acest lucru contează direct: o fereastră mai scurtă urmărește schimbările mai repede.
Constanta provine din distribuția amplitudinii unei mișcări browniene. Dacă logaritmul prețului urmează o mișcare browniană (Brownian motion) fără drift, cu varianța zilnică \(\sigma^2\), atunci \(\mathbb{E}[(h_t - l_t)^2] = 4\ln 2\,\sigma^2\), deci împărțirea la \(4\ln 2\) face estimatorul nedeplasat. Estimatorul (1.19) este o varianță zilnică, calculată pe \(n\) zile; volatilitatea anuală este \(\sqrt{A\,\hat\sigma^2_P}\), cu \(A\) numărul de zile de tranzacționare dintr-un an.
Ipoteza este o mișcare browniană, random walk-ul în timp continuu din Capitolul 11, fără drift și fără salturi peste noapte. În această ipoteză, eficiența estimatorului Parkinson față de close-to-close este de aproximativ 5, cum se arată în Seminarul 1, A8. Un drift deplasează estimatorul, iar un salt peste noapte îi rămîne invizibil, deoarece amplitudinea se măsoară în interiorul sesiunii.
Estimatorii lui Garman & Klass (1980),Rogers & Satchell (1991) și Yang & Zhang (2000) relaxează pe rînd aceste ipoteze: Garman–Klass adaugă deschiderea și închiderea, Rogers–Satchell rămîne nedeplasat în prezența unui drift, iar Yang–Zhang include și randamentul de peste noapte. Formulele lor sînt în Anexă.
Pe scurt
Parkinson, Parkinson (1980): estimează varianța zilnică doar din amplitudinea zilnică
pentru o mișcare browniană cu varianța zilnică \(\sigma^2\), \(\E[(h_t - l_t)^2] = 4\ln 2\,\sigma^2\): împărțirea la \(4\ln 2\) face estimatorul nedeplasat
\(\hat\sigma^2_P\) este o varianță zilnică (\(n\) zile); volatilitatea anuală este \(\sqrt{A\,\hat\sigma^2_P}\)
Ipoteza: o mișcare browniană fără drift și fără salturi peste noapte
mișcarea browniană: mers aleator (random walk) în timp continuu (Capitolul 11)
eficiența față de close-to-close: circa 5 (Seminarul 1, A8)
Graficul aplică cinci estimatori indicelui S&P 500: close-to-close, Parkinson, Garman–Klass, Rogers–Satchell și Yang–Zhang. Panoul din stînga arată volatilitatea anualizată calculată pe ferestre mobile; panoul din dreapta arată netezimea relativă a fiecărui estimator, definită în frame-ul următor. În versiunea interactivă, cursorul fixează lungimea ferestrei, de la 5 la 126 de zile, iar meniul alege perioada afișată: criza COVID-19 (iulie 2019 – iunie 2021), criza financiară globală (2008–2009) sau întregul eșantion, 2008–2026.
Întrebare pentru sală Care dintre explicațiile de mai jos descrie o limită a estimatorului Parkinson față de close-to-close?
Răspuns
Parkinson folosește numai range-ul intraday și nu include explicit randamentul overnight. Yang–Zhang îl include, deci aceeași explicație nu i se aplică. Pentru indicele S&P 500, slide-urile arată și problema stale open. Mediile pe ferestre de 21 de zile, în 2008–2026, sînt 16,4% pentru close-to-close, 13,0% pentru Parkinson și 13,9% pentru Yang–Zhang. Nici eficiența, nici netezimea nu impun o medie mai mică; indicatorul de netezime din pagină este un raport al varianțelor variațiilor zilnice ale estimărilor.
Parkinson folosește doar range-ul intraday și nu include randamentul de peste noapte, pe care Yang–Zhang îl include. În medie pe ferestre de 21 de zile din 2008–2026, estimările sînt 16,4% pentru close-to-close, 13,0% pentru Parkinson și 13,9% pentru Yang–Zhang. Nici o eficiență mai mare, nici o netezime mai mare nu implică o medie mai mică; diferența reflectă ceea ce lasă deoparte fiecare estimator.
Pe ferestre de 21 de zile din 2008–2026, volatilitatea anualizată medie a S&P 500 este 16,4% close-to-close, 13,9% pentru Yang–Zhang, 13,0% pentru Parkinson, 12,4% pentru Garman–Klass și 12,3% pentru Rogers–Satchell. Estimatorii bazați doar pe range dau valori mai mici, deoarece nu surprind salturile de peste noapte: mișcarea dintre închiderea precedentă și deschidere face parte din randamentul close-to-close, dar nu și din range-ul intraday. Yang–Zhang, care adaugă randamentul de peste noapte, se află între ele. Pentru indice mai există o problemă, deschiderea stale (stale open), discutată în Anexă.
Panoul din dreapta compară estimatorii prin netezimea lor relativă (relative smoothness):
\[S(X) = \left[\frac{\text{abaterea std. a variațiilor zilnice, estimarea close-to-close}}{\text{abaterea std. a variațiilor zilnice, estimarea } X}\right]^2.\]
(1.20)
Măsura (1.20) este egală cu 1 pentru close-to-close; valori mai mari înseamnă că estimarea sare mai puțin de la o zi la alta. După această măsură, seriile estimate din range sînt de 3–4 ori mai netede.
Netezimea este o proprietate a estimărilor, nu o dovadă de eficiență în sine. Eficiența (1.18) compară varianța fiecărui estimator în jurul lui \(\sigma\) adevărat, care nu se observă în datele reale; netezimea compară doar cît se mișcă estimările. Un estimator deplasat poate fi foarte neted.
Pe scurt
Volatilitatea anualizată medie pe ferestre de 21 de zile, 2008–2026
Estimatorii bazați pe range folosesc traiectoria zilei și, în modelul brownian fără salturi, sînt de aproximativ 5 ori mai eficienți decît estimatorul close-to-close. Pe indicele S&P 500 ei dau valori mai mici, deoarece nu surprind randamentul de peste noapte. Alegerea estimatorului depinde deci de faptul dacă mișcarea de peste noapte face parte din riscul de măsurat.
Randament ajustat la risc și drawdown
Secțiunea trece de la proprietățile statistice ale randamentelor la măsurile folosite pentru a rezuma performanța: drawdown-ul maxim și raportul Sharpe. Ambele sînt estimări. Secțiunea dă fiecăreia un reper sau o eroare standard și arată de ce un grafic risc–randament nu ordonează, singur, cele cinci piețe.
Întrebarea este dacă cea mai adîncă scădere observată este mai mare decît ar produce un random walk cu același drift și aceeași volatilitate. Drawdown-ul, definit în Capitolul 0, este distanța relativă a prețului față de maximul atins pînă atunci, \(DD_t = P_t/\max_{s\le t}P_s - 1 \in [-1, 0]\), iar drawdown-ul maxim este \(MDD = \min_t DD_t\). Pe scară logaritmică,
Reperul lui Magdon-Ismail, Atiya, Pratap & Abu-Mostafa (2004) tratează \(\ln P_t\) ca un random walk gaussian cu driftul anual \(\mu\) și volatilitatea anuală \(\sigma\), observat pe \(Y\) ani. Fără drift, \(\mathbb{E}[D] = \sqrt{\pi/2}\,\sigma\sqrt{Y}\), deci drawdown-ul maxim așteptat crește proporțional cu \(\sqrt{Y}\). Cu un drift pozitiv, valoarea așteptată crește doar ca \(\ln Y\):
o aproximare valabilă pentru \(\mu^2 Y/(2\sigma^2)\) mare. Un drift pozitiv îndepărtează prețul de vechile maxime, astfel că noile scăderi adînci devin mai rare pe măsură ce eșantionul crește.
Reperul arată că drawdown-ul maxim depinde de lungimea eșantionului și de volatilitate. Un drawdown adînc pe un eșantion lung al unui activ volatil nu este, în sine, anormal. Testul calculează p-value-ul \(P(D \ge D_{\text{obs}})\) sub reper, din 5 000 de traiectorii simulate cu driftul și volatilitatea estimate.
Pe scurt
Întrebarea: este cea mai adîncă scădere observată mai mare decît ar produce un mers aleator?
mers aleator cu același drift și aceeași volatilitate
Graficul desenează curba underwater \(100\,DD_t\) a fiecărei piețe, în procente: zero la fiecare nou maxim și negativă între maxime. În versiunea interactivă, cursorul mută sfîrșitul eșantionului lună cu lună, astfel încît curba poate fi urmărită prin fiecare criză.
Întrebare pentru sală Ce creștere este necesară pentru a recupera drawdown-ul S&P 500 din 2007–2009?
Răspuns
+131%. Indicele a scăzut de la 1 565,15 (9 octombrie 2007) la 676,53 (9 martie 2009), adică cu 56,8%, iar după o scădere x revenirea la vîrf cere o creștere de 1/(1 − x) − 1. Drawdown-ul pe scară logaritmică, −ln(1 − 0,568) = 0,84, nu este creșterea necesară: e0,84 − 1 = 131%.
S&P 500 a scăzut de la 1 565,15 pe 9 octombrie 2007 la 676,53 pe 9 martie 2009, un drawdown de 56,8%. Revenirea la maxim după o scădere \(x\) cere o creștere de \(1/(1-x) - 1\), aici +131%. Drawdown-ul pe scară logaritmică, \(-\ln(1 - 0{,}568) = 0{,}84\), nu este creșterea necesară: \(e^{0{,}84} - 1 = 131\%\).
Graficul arată curbele underwater \(100\,DD_t\), iar legenda dă drawdown-ul maxim al fiecărei piețe. Bitcoin atinge −83%, S&P 500 −57%, aurul −45%, BET-TR −31%, în martie 2020, iar EUR/RON −16%. Ordinea urmează volatilitatea doar aproximativ: BET-TR, cu o volatilitate apropiată de cea a S&P 500, are un drawdown maxim mult mai mic pe un eșantion mai scurt, ceea ce este compatibil cu dependența lui (1.22) de \(Y\).
Pentru S&P 500, cea mai adîncă scădere a durat de la 9 octombrie 2007, la 1 565,15, pînă pe 9 martie 2009, la 676,53, o pierdere de 56,8%. Recuperarea înseamnă revenirea prețului la vîrful anterior. Deoarece pierderile și cîștigurile se compun, după o scădere \(x\) este necesară o creștere de \(1/(1-x) - 1\), aici \(1/(1 - 0{,}568) - 1 = +131\%\). Asimetria crește repede cu mărimea scăderii, motiv pentru care drawdown-urile cîntăresc mult în evaluarea unei investiții. Durata recuperărilor este discutată în Anexă.
Pe scurt
Graficul: curbele underwater \(100\,DD_t\) (%)
legenda dă MDD-ul (Maximum DrawDown, drawdown-ul maxim) fiecărei piețe
În (1.23),\(r_f\) este rata dobînzii fără risc (risk-free rate), fixată la \(r_f = 0\) în acest capitol, pentru ca cele cinci piețe, cotate în monede diferite, să fie tratate la fel. Numărătorul folosește \(\mu_{\text{an}} = A\bar R\), media anualizată a randamentelor simple, unde \(\bar R\) este media lor zilnică. Numitorul, \(\sigma_{\text{an}}\), este volatilitatea anualizată a randamentelor simple.
Alegerea randamentelor simple contează. Pentru S&P 500 în 1990–2026, \(\mu_{\text{an}} = 9{,}95\%\) și \(\sigma_{\text{an}} = 17{,}97\%\), deci \(SR = 0{,}55\). Cu media randamentelor logaritmice, \(A\bar r = 8{,}33\%\), s-ar obține \(8{,}33/17{,}97 = 0{,}46\). Media logaritmică este mai mică cu aproximativ jumătate din varianță, volatility drag-ul din secțiunile anterioare, iar amestecarea celor două convenții schimbă raportul. Măsurile înrudite, rapoartele Sortino și Calmar, sînt în Anexă.
Un raport Sharpe este o estimare și are nevoie de o eroare standard. Pentru randamente i.i.d. din distribuția Normală, metoda delta (delta method) dă varianța raportului zilnic estimat (Lo, 2002),
cu \(Y = T/A\) ani, deoarece raportul zilnic este mic. Precizia depinde de durata eșantionului, nu de frecvența observațiilor: datele zilnice pe 12 ani dau aproximativ aceeași eroare standard ca datele lunare pe 12 ani.
Tabelul aplică (1.25). S&P 500 și aurul, cu 36,7 ani, au erori standard de 0,17; BET-TR și Bitcoin, cu 12,0 ani, 0,29; EUR/RON, cu 21,2 ani, 0,22. Raportul BET-TR, 1,34, și raportul Bitcoin, 0,98, sînt deci mult mai puțin precise decît cele ale S&P 500, 0,55, și aurului, 0,48.
Formula presupune un moment de ordinul patru finit, pus sub semnul întrebării de estimările Hill ale capitolului, și ignoră dependența serială. Erorile standard sînt deci aproximări. Comparația dintre BET-TR și S&P 500 este detaliată în Anexă.
Pe scurt
Metoda delta, sub ipoteza randamentelor i.i.d. din distribuția Normală Lo (2002)
\(SR_d\): raportul Sharpe zilnic, estimat prin \(\widehat{SR}_d\), cu \(\text{Var}(\widehat{SR}_d) \approx (1 + SR_d^2/2)/T\)
anualizat, \(SR_{\text{an}} = \sqrt{A}\,SR_d\): \(\text{SE}(\widehat{SR}_{\text{an}}) \approx \sqrt{A(1 + SR_d^2/2)/T} \approx 1/\sqrt{Y}\), cu \(Y = T/A\) ani
precizia depinde de durata eșantionului, nu de frecvența observațiilor
SE presupune moment de ordin patru finit, pus sub semnul întrebării de estimările Hill
Graficul plasează fiecare piață după volatilitatea anualizată, pe axa orizontală cu scară logaritmică, și după rata anuală compusă de creștere (CAGR, compound annual growth rate), pe axa verticală. Etichetele dau raportul Sharpe, eroarea lui standard și drawdown-ul maxim. În versiunea interactivă, cursorul fixează un început comun pentru toate eșantioanele, între 1990 și 2022, astfel încît piețele pot fi comparate pe aceiași ani.
Întrebare pentru sală Arată graficul că BET-TR a fost cea mai bună investiție dintre cele cinci?
Răspuns
Nu. Graficul compară eșantioane diferite și serii care nu au același tratament al dividendelor sau aceeași monedă. Includerea dividendelor în BET-TR este corectă pentru randamentul total; comparația cu un indice S&P 500 fără dividende este neomogenă. Separat, folosirea rf = 0 în locul unei rate fără risc pozitive mărește raportul Sharpe calculat. Din 2015, pagina dă Sharpe 1,38 pentru BET-TR, 1,05 pentru Bitcoin și 0,73 pentru S&P 500, cu SE individuale de aproximativ 0,29 sub ipotezele formulei i.i.d. Normale. Inferența asupra diferențelor cere și covarianța estimărilor.
Graficul compară eșantioane diferite și serii care tratează diferit dividendele și monedele. BET-TR include dividendele, ceea ce este corect pentru un randament total, dar este comparat cu un indice de preț al S&P 500. Folosirea lui \(r_f = 0\) crește, în plus, raportul Sharpe calculat. Cu un început comun în 2015, pagina dă rapoarte Sharpe de 1,38 pentru BET-TR, 1,05 pentru Bitcoin și 0,73 pentru S&P 500, fiecare cu o eroare standard de aproximativ 0,29 după formula i.i.d. Normală. Un test al diferențelor ar avea nevoie și de covarianța dintre estimări.
Axele sînt volatilitatea anualizată, pe orizontală cu scară logaritmică, și CAGR, pe verticală. Etichetele raportează raportul Sharpe cu eroarea lui standard, calculată din (1.25) pentru randamente simple i.i.d. din distribuția Normală, și drawdown-ul maxim; tabelul complet este în Anexă.
Graficul nu este un clasament, din trei motive:
Perioadele de eșantionare diferă între piețe, iar (1.25) arată cît de mult depinde precizia de durată.
Cu \(r_f = 0\), raportul Sharpe al BET-TR este supraestimat față de cel al S&P 500: seria S&P 500 nu include dividendele, BET-TR le include și este în lei, iar dobînzile pe termen scurt în lei au fost mult peste cele în dolari pe durata eșantionului.
Cozile groase și asimetria negativă fac raportul Sharpe, care folosește doar primele două momente, să supraevalueze performanța.
Un raport Sharpe trebuie deci raportat împreună cu măsuri ale cozii: drawdown-urile, VaR 1% (value at risk, pierderea depășită cu probabilitatea 1%) și tail index-ul \(\hat\alpha\).
Pe scurt
Axele: volatilitatea anualizată (orizontal, scară logaritmică) și CAGR (vertical)
Etichetele: raportul Sharpe, eroarea lui standard (SE) și MDD
Drawdown-ul maxim depinde de volatilitate și de lungimea eșantionului, iar un random walk cu același drift și aceeași volatilitate este reperul după care se judecă; cu driftul estimat, drawdown-ul maxim al niciunei piețe nu este neobișnuit, cu p-value-uri de la 0,07 pentru BET-TR la 0,52 pentru aur. Raportul Sharpe are o eroare standard de aproximativ \(1/\sqrt{Y}\), deci 12 ani de date lasă o incertitudine de circa 0,29. Pentru piețe cu eșantioane, monede și tratament al dividendelor diferite, graficul risc–randament descrie; nu ordonează.
Studii de caz: volatilitatea dependentă de traiectorie și randamentul de peste noapte
Două lucrări recente leagă faptele stilizate ale capitolului de întrebări de cercetare deschise. Ele întreabă:
Cît din volatilitate explică doar randamentele trecute.
În ce ore ale zilei se cîștigă randamentul pieței.
Pentru fiecare lucrare, secțiunea prezintă întrebarea, metoda, rezultatul principal, replicarea din curs și limitele.
Studiu de caz (1/4): cît din volatilitate explică doar randamentele trecute?
Guyon & Lekeufack (2023), în Quantitative Finance, pornesc de la lucrarea lui Bollerslev, Hood, Huss & Pedersen (2018) despre relația dintre randamentele trecute și volatilitatea viitoare. Întrebarea lor de cercetare are două părți: ce proporție din volatilitatea unui indice bursier este explicată doar de randamentele lui zilnice trecute și ce formă funcțională are această dependență. Volatility clustering și leverage effect din secțiunile anterioare sugerează că randamentele trecute conțin informație despre volatilitate; lucrarea măsoară cîtă.
Lucrarea modelează separat trei variabile dependente, în Secțiunile 3.4–3.5:
VIX, indicele de volatilitate al bursei Cboe (Chicago Board Options Exchange): volatilitatea implicită a S&P 500 pe următoarele 30 de zile, calculată din prețurile opțiunilor. Volatilitatea implicită (implied volatility) este volatilitatea pentru care un model de evaluare a opțiunilor reproduce prețurile observate ale opțiunilor, deci măsoară volatilitatea anticipată de piață (Capitolul 12).
VIX9D, aceeași măsură pe un orizont de 9 zile.
Volatilitatea realizată a zilei următoare, calculată din randamente pe 5 minute.
Modelul, din Anexă, scrie volatilitatea ca funcție liniară de două caracteristici ale randamentelor trecute: o sumă ponderată a randamentelor, care surprinde trendul, și o sumă ponderată a pătratelor randamentelor, care surprinde volatilitatea trecută. Ponderile scad cu lagul după nuclee (kernels) ai căror parametri se estimează.
ce proporție din volatilitatea unui indice bursier este explicată doar de randamentele lui zilnice trecute?
ce formă funcțională are această dependență?
Metoda: volatilitatea, funcție liniară de trendul recent și de volatilitatea recentă, ambele medii ponderate ale randamentelor trecute (Aprofundări)
Trei variabile dependente, modelate separat (Secțiunile 3.4–3.5 din lucrare)
VIX (indicele de volatilitate al bursei Cboe): volatilitatea implicită a S&P 500 pe următoarele 30 de zile, calculată din prețurile opțiunilor
volatilitatea implicită: volatilitatea pentru care un model de evaluare a opțiunilor reproduce prețurile observate ale opțiunilor, adică volatilitatea anticipată de piață (Capitolul 12)
VIX9D: aceeași măsură, pe un orizont de 9 zile
volatilitatea realizată a zilei următoare, calculată din randamente pe 5 minute
Tabelul raportează coeficientul de determinare \(R^2\) al modelului pe eșantionul de antrenare și pe cel de test, pentru volatilitatea implicită (Tabelul 2 din lucrare) și pentru volatilitatea realizată (Tabelul 4). Pentru S&P 500 și VIX, lucrarea obține \(R^2 = 0{,}946\) la antrenare și \(0{,}855\) la test; replicarea din curs obține \(0{,}947\) și \(0{,}863\). VIX9D dă \(0{,}876\) și \(0{,}914\), Euro Stoxx 50 \(0{,}929\) și \(0{,}913\), iar Nikkei 225 \(0{,}890\) și \(0{,}800\). Numai randamentele trecute ale indicelui explică 80–92% din varianța volatilității implicite out-of-sample; FTSE 100 (Financial Times Stock Exchange, FTSE Russell, index provider, furnizorul de indici FTSE Russell) și DAX (Deutscher Aktienindex, indicele bursier german) sînt în Anexă.
Pe datele cursului, rădăcina erorii pătratice medii (RMSE, root mean squared error) a VIX estimat este \(0{,}020\), aproximativ 2 puncte VIX, la antrenare și \(0{,}034\) la test. Scorurile pentru volatilitatea realizată sînt mai mici: \(0{,}654\) out-of-sample pentru S&P 500, \(0{,}682\) pentru Euro Stoxx 50 și \(0{,}504\) pentru Nikkei 225. Volatilitatea realizată din randamente pe 5 minute este o variabilă explicată zgomotoasă, cum notează Remarca 3 din lucrare, deci o parte din varianța ei nu poate fi prognozată de niciun model.
Rezultatul susține o asociere: randamentele trecute prezic volatilitatea out-of-sample. El nu identifică ce cauzează volatilitatea, deoarece aceleași randamente trecute reflectă și știrile care au mișcat prețurile.
Pe scurt
Volatilitate implicită (lucrarea, Tabelul 2)
Volatilitate realizată (lucrarea, Tabelul 4)
Indice
\(R^2\) antrenare
\(R^2\) test
\(R^2\) antrenare
\(R^2\) test
S&P 500 (VIX)
0,946
0,855
0,738
0,654
S&P 500 (VIX), replicarea noastră
0,947
0,863
–
–
S&P 500 (VIX pe 9 zile)
0,876
0,914
–
–
Euro Stoxx 50
0,929
0,913
0,672
0,682
Nikkei 225
0,890
0,800
0,563
0,504
Numai randamentele trecute ale indicelui explică 80–92% (la cei cinci indici ai lucrării) din varianța volatilității implicite în afara eșantionului de estimare (out-of-sample)
FTSE 100 (indicele bursier britanic, Financial Times Stock Exchange) și DAX (Deutscher Aktienindex, indicele bursier german; \(R^2\) test 0,918, maximul) în Anexă
Pe datele noastre (S&P 500 și VIX): RMSE (rădăcina erorii pătratice medii) \(0{,}020\) (2 puncte VIX) la antrenare și \(0{,}034\) la test
Scorurile pentru volatilitatea realizată sînt mai mici
volatilitatea realizată pe 5 minute este o variabilă explicată zgomotoasă (Remarca 3 din lucrare)
Tipul de dovadă: asociere
randamentele trecute prezic volatilitatea în afara eșantionului; asta nu identifică ce o cauzează
Studiu de caz (3/4): VIX observat și VIX estimat din randamentele S&P 500
Graficul compară VIX observat cu VIX estimat din randamentele trecute ale S&P 500. Coeficienții sînt estimați pe 2000–2018 și evaluați pe perioada de test, ianuarie 2019 – mai 2022. În versiunea interactivă, cursorul scurtează istoricul de randamente care intră în model, de la 1 000 de zile pînă la cîteva zile, iar coeficienții se reestimează pentru fiecare alegere.
Întrebare pentru sală Dacă reducem istoricul de la 1.000 la 5 randamente și reestimăm coeficienții β pe 2000–2018, ce R2 obținem pe testul 2019 – mai 2022?
Răspuns
Cu 5 randamente, R2 pe test este 0,695, față de 0,863 cu 1.000 de randamente. Valoarea 0,947 este R2 la antrenare pentru istoricul de 1.000 de randamente. Ponderea de aproximativ 20% a primelor 5 zile în nucleul de 1.000 de zile nu este R2: pagina renormalizează nucleele și reestimează β. Calculul pentru VIXt folosește rt, rt−1, …; nu este o prognoză a VIXt făcută la t−1.
Cu un istoric de 5 randamente, \(R^2\) de test este 0,695, față de 0,863 cu 1 000 de randamente; valoarea 0,947 este \(R^2\) de antrenare pentru istoricul de 1 000 de randamente. Primele 5 zile primesc aproximativ 20% din ponderea nucleului de 1 000 de zile, dar această pondere nu este un \(R^2\): pagina renormalizează nucleele și reestimează coeficienții. Valoarea estimată pentru \(\text{VIX}_t\) folosește \(r_t, r_{t-1}, \dots\), deci nu este o prognoză făcută la \(t-1\). Subperioadele și nucleele sînt în Anexă.
Nucleele atribuie ponderi zilnice \(K(i\Delta t)\Delta t\) randamentelor trecute, desenate pe scară log–log. Nucleul de trend \(K_1\) are parametrii estimați \(\hat\alpha_1 = 1{,}13\) și \(\hat\delta_1 = 0{,}022\), față de \(1{,}06\) și \(0{,}020\) în Tabelul 3 din lucrare; nucleul de volatilitate \(K_2\) are \(\hat\alpha_2 = 1{,}58\) și \(\hat\delta_2 = 0{,}050\), față de \(1{,}60\) și \(0{,}052\). Un nucleu de tip putere (power-law kernel) combină orizonturile scurte și lungi într-o singură funcție: ultimele 5 zile concentrează 20% din ponderea lui \(K_2\), iar lagurile de peste 250 de zile primesc încă 10%. Este aceeași combinație de reacție rapidă și scădere lentă ca în ACF a lui \(|r_t|\).
Autorii declară limitele în Secțiunea 5 a lucrării. O mică parte exogenă a volatilității rămîne neexplicată de randamentele trecute. Raportul dintre VIX observat și VIX estimat revine în timp în jurul lui 1, iar modelarea lui necesită un factor stocastic. Modelul este deci în mare parte, dar nu în întregime, dependent de traiectorie (path-dependent).
O extindere deschisă este întrebarea dacă aceeași formulă descrie volatilitatea realizată a lui Bitcoin sau a BET-TR, două piețe cu instituții diferite și, cum s-a văzut mai sus, cu leverage effect diferit.
Pe scurt
Ponderile zilnice \(K(i\Delta t)\Delta t\), pe scară log–log
nucleul \(K\) dă ponderea fiecărei zile trecute: \(K_1\) pentru randamente (trendul), \(K_2\) pentru pătratele lor (volatilitatea)
\(\alpha\): viteza de scădere a ponderilor; \(\delta\): decalajul, în ani (alte mărimi decît indicele cozii și puterea din efectul Taylor)
Bondarenko & Muravyev (2023), în Journal of Financial and Quantitative Analysis, folosesc contractele futures E-mini pe S&P 500, tranzacționate aproape 24 de ore din 24, pentru a întreba dacă randamentul mediu al pieței depinde de ora din zi. Întrebarea diferă de Faptul 1 al capitolului: randamentele necorelate privesc prognoza randamentului unei zile date, în timp ce aici întrebarea privește media pe un interval fix din fiecare zi.
Rezultatul principal este că cele 4 ore din jurul deschiderii piețelor europene acoperă întregul randament mediu al pieței. Raportul Sharpe al acestor 4 ore este 1,6, iar randamentul lor rămîne mare și după costurile de tranzacționare. În celelalte 20 de ore, media este zero, estimată cu mult zgomot.
Autorii propun explicația că investitorii europeni procesează informația acumulată peste noapte. În acord cu această explicație, incertitudinea din prețurile futures pe VIX crește peste noapte și scade în jurul deschiderii europene. Rezultatul contează pentru modelare: un model cu randamente i.i.d. în timpul zilei repartizează media uniform pe ore, ceea ce datele contrazic.
Graficul descompune randamentul logaritmic zilnic al SPY, fondul tranzacționat la bursă (ETF, exchange-traded fund) pe S&P 500, într-o parte de peste noapte, de la închiderea precedentă la deschidere, și o parte din timpul zilei, de la deschidere la închidere. Sumele cumulate ale celor două părți arată unde s-a cîștigat randamentul ultimelor trei decenii. În versiunea interactivă, cursorul mută începutul eșantionului între 1993 și 2020.
Întrebare pentru sală Media anualizată a randamentului logaritmic intraday SPY este 0,8%, cu t Newey–West = 0,33. Ce concluzie este justificată la pragul bilateral de 5%?
Răspuns
|t| = 0,33 nu depășește pragul asimptotic 1,96. Estimarea pozitivă nu este suficient de precisă pentru a respinge media zero; nerespingerea nu dovedește că media este zero. Separat, media overnight este 7,7% pe an (t = 4,6), iar aproximativ 91% din randamentul logaritmic cumulat al prețului SPY provine din overnight; dividendele, 1,8% pe an, sînt contabilizate distinct.
Media anualizată a randamentului logaritmic din timpul zilei este 0,8%, cu statistica \(t\) Newey–West 0,33. La pragul bilateral de 5%, \(|t| = 0{,}33\) nu depășește 1,96, deci nu respingem media zero; aceasta nu dovedește că media este zero. Media de peste noapte este 7,7% pe an (\(t = 4{,}6\)), iar aproximativ 91% din randamentul logaritmic cumulat al prețului SPY provine de peste noapte. Dividendele, 1,8% pe an, sînt contabilizate separat.
Lucrarea măsoară randamentele pe intervale din cele 24 de ore de tranzacționare ale contractului futures, care nu plătește dividende. Replicarea din curs folosește prețurile zilnice ale SPY între 1 februarie 1993 și 18 septembrie 2026, 8 466 de zile. Folosește SPY, nu indicele, deoarece deschiderea indicelui S&P 500 este adesea stale, cum se discută în Aprofundări. Cu \(O_t\) și \(C_t\) prețurile de deschidere și de închidere, randamentele de peste noapte și din timpul zilei sînt \(r^{\text{on}}_t = \ln(O_t/C_{t-1})\) și \(r^{\text{id}}_t = \ln(C_t/O_t)\). Dividendele intră ca \(d_t = \ln(f_t/f_{t-1})\), unde \(f_t\) este raportul dintre prețul de închidere ajustat și prețul de închidere, iar
\[r^{\text{on}}_t + r^{\text{id}}_t + d_t = \text{randamentul logaritmic total de la o închidere la următoarea}.\]
Replicarea diferă de lucrare într-un punct important. Intervalul de peste noapte, 16:00–9:30 ora New York-ului, include deschiderea europeană, dar și alte ore, deci cu date zilnice cele 4 ore ale lucrării nu pot fi izolate. Replicarea testează de aceea o afirmație mai slabă: dacă randamentul mediu se cîștigă în principal în afara sesiunii americane.
Media anualizată este de 252 de ori media zilnică, iar statistica \(t\) folosește eroarea standard Newey–West robustă la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent), ca la leverage effect. O extindere pe o piață deschisă 24/7 folosește bare Bitcoin de 5 minute din august 2024 pînă în septembrie 2026, 749 de zile, și compară randamentul din sesiunea americană, 9:30–16:00 ora New York-ului în zilele lucrătoare, cu restul zilei.
Pe scurt
Lucrarea: randamente pe intervale din cele 24 de ore ale contractului futures, care nu plătește dividende
Replicarea din curs: SPY (SPDR S&P 500 ETF Trust), un fond tranzacționat la bursă (ETF, Exchange-Traded Fund) pe indicele S&P 500, prețuri zilnice, 1 februarie 1993 – 18 septembrie 2026, 8 466 de zile
SPY, nu indicele: deschiderea indicelui S&P 500 este adesea un preț neactualizat (stale) (Aprofundări)
peste noapte \(r^{\text{on}}_t = \ln(O_t/C_{t-1})\); în timpul zilei \(r^{\text{id}}_t = \ln(C_t/O_t)\); \(O_t\), \(C_t\): prețul de deschidere și de închidere
dividendele \(d_t = \ln(f_t/f_{t-1})\), cu \(f_t\) = prețul de închidere ajustat / prețul de închidere
\(r^{\text{on}}_t + r^{\text{id}}_t + d_t\) = randamentul logaritmic total, de la o închidere la următoarea
Randamentul de peste noapte al SPY are media 7,7% pe an (\(t = 4{,}6\)), volatilitatea 10,6% și raportul Sharpe 0,73. Randamentul din timpul zilei are media 0,8% pe an (\(t = 0{,}33\)), volatilitatea 15,2% și raportul Sharpe 0,05. Rapoartele Sharpe sînt calculate din randamente logaritmice, cu \(r_f = 0\), iar dividendele adaugă 1,8% pe an. Din randamentul logaritmic cumulat al prețului, 91% s-a obținut peste noapte.
Rezultatul este stabil pe subperioade. Media de peste noapte este pozitivă în toate trei: 10,9%, 4,6% și 7,5% pe an. Ea este semnificativă la 5% în 1993–2004 (\(t = 4{,}3\)) și în 2016–2026 (\(t = 2{,}1\)), dar nu și în 2005–2015 (\(t = 1{,}7\)). Media din timpul zilei nu este semnificativă la 5% în nicio subperioadă (\(|t| \le 1{,}38\)). În 23 din 34 de ani calendaristici, randamentul de peste noapte îl depășește pe cel din timpul zilei. Pentru Bitcoin, media este −3,6% pe an în sesiunea americană și 20,9% în restul zilei, cu \(|t| \le 1{,}0\): cu doi ani de date, diferența nu se poate distinge de zero.
Rezultatul susține o regularitate a mediei, stabilă pe subperioade și compatibilă cu lucrarea. Nu este o strategie: media este 3,1 puncte de bază (0,031%) pe noapte, iar un cost dus-întors de 3 puncte de bază o anulează. Nici nu stabilește cauza: explicația prin rezolvarea incertitudinii aparține autorilor și cere date intraday pe futures. Urmează o propunere de proiect: cu barele SPY de 5 minute, în ce oră a sesiunii americane se pierde sau se cîștigă media?
Pe scurt
SPY peste noapte: media \(7{,}7\%\) pe an (\(t = 4{,}6\)), volatilitatea \(10{,}6\%\), raportul Sharpe \(0{,}73\)
SPY în timpul zilei: media \(0{,}8\%\) pe an (\(t = 0{,}33\)), volatilitatea \(15{,}2\%\), raportul Sharpe \(0{,}05\)
rapoarte Sharpe din randamente logaritmice, cu \(r_f = 0\); dividendele adaugă \(1{,}8\%\) pe an
91% din randamentul logaritmic cumulat al prețului s-a obținut peste noapte
Media de peste noapte este pozitivă în toate cele trei subperioade: \(10{,}9\%\), \(4{,}6\%\) și \(7{,}5\%\) pe an
semnificativă la 5% în 1993–2004 (\(t = 4{,}3\)) și 2016–2026 (\(t = 2{,}1\)), nu și în 2005–2015 (\(t = 1{,}7\))
media din timpul zilei nu este semnificativă la 5% în nicio subperioadă (\(|t| \le 1{,}38\))
în 23 din 34 de ani calendaristici, randamentul de peste noapte îl depășește pe cel din timpul zilei
Bitcoin: \(-3{,}6\%\) pe an în sesiunea americană, \(20{,}9\%\) în restul zilei; \(|t| \le 1{,}0\)
cu doi ani de date, diferența nu se poate distinge de zero
Tipul de dovadă: o regularitate a mediei, stabilă pe subperioade, compatibilă cu lucrarea
nu o strategie: media este \(3{,}1\) puncte de bază (0,031%) pe noapte, iar un cost dus-întors de 3 puncte de bază o anulează
nu cauza: explicația prin rezolvarea incertitudinii este a autorilor și cere date intraday pe futures
Propunere de proiect: cu barele SPY de 5 minute, în ce oră a sesiunii americane se pierde sau se cîștigă media?
Randamentele trecute explică cea mai mare parte a variației volatilității implicite, prin nuclee care combină orizonturi scurte și lungi, dar rămîne o componentă stocastică. Randamentul mediu al SPY se cîștigă în principal peste noapte, o regularitate stabilă pe subperioade, dar prea mică pe noapte pentru a rezista costurilor de tranzacționare. În ambele cazuri, dovezile susțin o asociere, nu un mecanism cauzal.
Implicații pentru modelare
Faptele stilizate devin cerințe pe care un model al randamentelor trebuie să le satisfacă. Secțiunea le reunește într-un singur tabel și leagă fiecare cerință de capitolul cursului care o tratează.
Tabelul leagă dovezile din cele cinci piețe de cerințele pentru model:
Excesul de kurtosis bazat pe cuantile (Crow–Siddiqui) este pozitiv pe toate cele cinci piețe, iar estimările Hill ale tail index-ului se află între aproximativ 2,3 și 3,5, cu 4,2 pentru Bitcoin; modelele au nevoie de inovații cu cozi groase, inclusiv condiționat (Capitolul 5 și Capitolul 7, pentru teoria valorilor extreme).
ACF a lui \(|r_t|\) rămîne pozitivă pe orizonturi de mai multe luni, iar \(\hat d\) se află între 0,35 și 0,50; modelele au nevoie de volatilitate persistentă și variabilă în timp, cu memorie lungă sau rupturi (Capitolul 5, Capitolul 9).
Statistica leverage la lagul 1, \(L(1) = -0{,}12\) pentru S&P 500 și BET-TR, este inversată pentru EUR/RON; modelele au nevoie de un răspuns asimetric la șocurile negative acolo unde efectul există, ca în GJR-GARCH și EGARCH (Capitolul 5).
Autocorelația de lag 1 este semnificativă cu erori standard robuste doar pentru S&P 500 și EUR/RON și mică economic pe toate piețele; randamentele sînt aproximativ necorelate, dar microstructura pieței contează (Capitolul 2, Capitolul 10).
Asimetria bazată pe cuantile este negativă doar pentru S&P 500, deci asimetria depinde de piață (Capitolele 7–8).
Random walk-ul cu creșteri i.i.d. din distribuția Normală, lumea lui Bachelier, Black și Scholes, este incompatibil cu Faptele 2, 3 și 5–11. Faptele 1 și 4 sînt satisfăcute trivial în el. Semnificația testului ARCH-LM (testul multiplicatorului Lagrange pentru heteroscedasticitate condiționată autoregresivă, Lagrange multiplier test for autoregressive conditional heteroskedasticity) susține volatility clustering descriptiv, dar, cu momente de ordinul patru îndoielnice, nu este o dovadă formală.
Pe scurt
Dovezi (cinci piețe)
Cerința pentru model
Capitolul din curs
exces de kurtosis pe cuantile (Crow–Siddiqui, Aprofundări) \(> 0\) pe toate piețele; Hill \(\hat\alpha \approx 2{,}3\)–\(3{,}5\) (Bitcoin: \(4{,}2\))
Un mers aleator cu creșteri i.i.d. din distribuția Normală este incompatibil cu Faptele 2, 3 și 5–11
lumea Bachelier–Black–Scholes
Faptele 1 și 4 sînt satisfăcute trivial
Un test ARCH-LM semnificativ susține, descriptiv, existența grupării volatilității
momentul de ordinul patru este îndoielnic, deci nu este o dovadă formală
AI pentru descoperire științifică
Secțiunea finală aplică instrumentele capitolului unei întrebări deschise, folosind un asistent de inteligență artificială (AI) ca sursă de ipoteze și de literatură. Întrebarea este dacă tail index-urile sînt stabile în timp; exemplul este Bitcoin înainte și după lansarea ETF-urilor spot. Secțiunea arată verificările care transformă o ipoteză plauzibilă într-un test și ce permite și ce nu permite să concluzionăm un rezultat nesemnificativ.
Întrebare deschisă: sînt indicii cozii stabili în timp?
Tail index-ul \(\alpha\) este de obicei tratat ca o constantă a unei piețe. Criptoactivele și-au schimbat însă structura în scurta lor istorie: contractele futures au apărut în 2017, ETF-urile spot pe Bitcoin în ianuarie 2024, iar pe piață au intrat deținători instituționali. Liu & Tsyvinski (2021) arată că randamentele criptomonedelor nu sînt explicate de factorii de risc ai acțiunilor, ai valutelor sau ai metalelor prețioase, iar Pele et al. (2023) găsesc că un factor de coadă distinge criptomonedele de celelalte clase de active. Dacă coada este o trăsătură distinctivă a criptoactivelor, o schimbare a structurii pieței o poate modifica.
Un asistent AI a propus următoarea ipoteză: după lansarea ETF-urilor spot în ianuarie 2024, intrarea investitorilor instituționali a redus grosimea cozilor distribuției randamentelor Bitcoin, adică a crescut tail index-ul \(\alpha\). Ipoteza este plauzibilă și testabilă, ceea ce o face un punct de plecare util, dar rămîne o afirmație de verificat.
Pe scurt
Indicele cozii \(\alpha\) este de obicei tratat ca o constantă
Bucla de descoperire începe cu literatura. Asistentului i se cer lucrări cu evaluare inter pares și cu identificatori DOI (digital object identifier), iar cercetătorul verifică apoi fiecare DOI, deoarece referințele inventate sînt o eroare cunoscută. Metoda relevantă este testul de punct de schimbare (change-point test) pentru tail index al lui Hoga (2017), valid în condiții de dependență \(\beta\)-mixing. \(\beta\)-mixing este o formă de dependență care se atenuează cu distanța în timp, ca în modelele GARCH, deci testul nu cere randamente i.i.d.
Pasul următor enumeră ipotezele concurente. O schimbare a tail index-ului înseamnă o schimbare a formei cozii. O simplă scădere a volatilității nu modifică \(\alpha\), deoarece tail index-ul este invariant la scală. Zgomotul de eșantionare poate produce o schimbare aparentă într-un eșantion scurt. Testul trebuie să distingă prima ipoteză de celelalte două.
Pasul de date și cod începe cu replicarea estimărilor Hill ale capitolului, 4,2 pentru Bitcoin și 3,1 pentru S&P 500. Alegerile analizei se fixează dinainte: numărul de observații din coadă \(k = 2{,}5\%\) din \(n\), data rupturii 11 ianuarie 2024, erori standard bootstrap pe blocuri și un activ placebo. Fixarea lor înainte de a vedea rezultatele împiedică alegerea pragului sau a datei care dă răspunsul dorit.
Pe scurt
Literatură: cereți lucrări cu evaluare inter pares, cu DOI (Digital Object Identifier, identificatorul digital al unei publicații), apoi verificați fiecare DOI
Hoga (2017): teste de punct de schimbare pentru indicele cozii, valide în condiții de dependență \(\beta\)-mixing
\(\beta\)-mixing: dependența se atenuează pe măsură ce distanța în timp crește, de exemplu în modelele GARCH
Ipoteze concurente
o schimbare a formei cozii
doar o scădere a volatilității (scala nu modifică \(\alpha\))
zgomot de eșantionare
Date și cod: replicați întîi estimările Hill ale capitolului (Bitcoin \(4{,}2\), S&P 500 \(3{,}1\))
Stabilite înaintea analizei
\(k = 2{,}5\%\) din \(n\), data rupturii 11 ianuarie 2024
SE bootstrap pe blocuri, un activ placebo (aceeași analiză pe un activ pentru care ipoteza nu prevede o schimbare)
Mini studiu de caz: coada Bitcoin după lansarea ETF-urilor spot
Testul folosește estimarea Hill pentru \(|r_t|\), cu \(k = 2{,}5\%\) din \(n\), înainte și după ruptură. Ipotezele sînt \(H_0: \alpha_{\text{după}} = \alpha_{\text{înainte}}\) față de alternativa unilaterală \(H_1: \alpha_{\text{după}} > \alpha_{\text{înainte}}\), iar statistica este
unde \(s_{\text{înainte}}\) și \(s_{\text{după}}\) sînt erorile standard obținute prin bootstrap pe blocuri suprapuse (moving-block bootstrap), cu blocuri de 20 de zile. Sub \(H_0\),\(z\) este aproximativ \(N(0,1)\), iar \(H_0\) se respinge la 5% dacă \(z > 1{,}645\).
Înainte de ruptură, din septembrie 2014 pînă pe 10 ianuarie 2024, cu \(k = 85\),\(\hat\alpha = 4{,}16\), cu \(s = 0{,}52\). După ruptură, din 11 ianuarie 2024 pînă în septembrie 2026, cu \(k = 24\),\(\hat\alpha = 4{,}31\), cu \(s = 0{,}91\). Statistica (1.27) este \(z = 0{,}15\), mult sub 1,645, deci nu respingem \(H_0\). Testul placebo folosește S&P 500 între 17 septembrie 2014 și 18 septembrie 2026, cu aceeași dată a rupturii și \(k = 58\) înainte și 16 după: \(\hat\alpha\) trece de la 2,82 la 2,86, cu \(z = 0{,}03\).
Rezultatul susține doar o descriere. Este o comparație înainte/după cu putere mică, cum arată frame-ul următor, și nu măsoară efectul ETF-urilor, deoarece în aceeași perioadă au avut loc și alte schimbări.
Pe scurt
Test: estimatorul Hill pentru \(|r_t|\), \(k = 2{,}5\%\) din \(n\)
\(H_0: \alpha_{\text{după}} = \alpha_{\text{înainte}}\) față de \(H_1: \alpha_{\text{după}} > \alpha_{\text{înainte}}\)
\(z = (\hat\alpha_{\text{după}} - \hat\alpha_{\text{înainte}}) / \sqrt{s_{\text{înainte}}^2 + s_{\text{după}}^2}\), cu \(s\) erorile standard prin bootstrap pe blocuri suprapuse (blocuri de 20 de zile)
sub \(H_0\), \(z \approx N(0,1)\): respingem \(H_0\) la 5% dacă \(z > 1{,}645\)
Schimbarea minimă detectabilă (MDE, minimum detectable effect) arată cît de mare ar trebui să fie o schimbare reală pentru ca testul să o găsească. Pentru un test unilateral la 5% cu putere de 80%,
unde 1,645 și 0,842 sînt cuantilele \(N(0,1)\) pentru nivelul unilateral de 5% și pentru puterea de 80%, iar \(1{,}05 = \sqrt{0{,}52^2 + 0{,}91^2}\) este eroarea standard a diferenței. Aproximarea prin distribuția Normală este grosieră cu doar 24 de observații în coadă după ruptură.
O schimbare de 2,6 este mare în comparație cu estimări ale tail index-ului de aproximativ 4. Datele nu pot deci distinge o coadă neschimbată de o subțiere puternică a cozii. Un rezultat nesemnificativ nu dovedește absența efectului. Soluțiile sînt așteptarea unor date suplimentare sau un panel de active, astfel încît eroarea standard a diferenței să scadă.
Pe scurt
Schimbarea minimă detectabilă, test unilateral la 5% cu putere de 80%
\((1{,}645 + 0{,}842) \times 1{,}05 = 2{,}6\): creșterea lui \(\alpha\) pe care testul o detectează cu probabilitatea de 80%
\(1{,}645\) și \(0{,}842\): cuantilele \(N(0,1)\) pentru nivelul unilateral de 5% și puterea de 80%
\(1{,}05 = \sqrt{0{,}52^2 + 0{,}91^2}\): eroarea standard a diferenței
aproximarea prin distribuția Normală este grosieră cînd coada conține doar 24 de observații
datele nu pot distinge o coadă neschimbată de o subțiere puternică a cozii
Un rezultat nesemnificativ nu dovedește absența efectului
sînt necesare date suplimentare sau un panel de active
Întrebarea proiectului este dacă tail index-ul pentru Bitcoin și Ethereum s-a schimbat odată cu instituționalizarea, marcată de contractele futures din 2017 și de ETF-urile spot din 2024. Analiza folosește atît randamentele brute, cît și randamentele standardizate cu un model GARCH, ceea ce separă o schimbare a formei cozii de o schimbare a scalei, și tratează separat coada pierderilor și coada cîștigurilor. Bitcoin folosește seria din curs. Ethereum nu face parte din panelul celor cinci piețe; seria lui zilnică este în `data/market/ETH-USD.CC.csv`, iar sursa, ora și fusul orar al închiderii și moneda (USD) trebuie documentate înainte de estimare.
Proiectul replică mai întîi tabelul Hill al capitolului și rezultatele mini studiului de caz. Apoi preînregistrează, într-un commit făcut înainte de obținerea rezultatelor, ipotezele \(H_0\) și \(H_1\), regula de alegere a lui \(k\), datele rupturilor și bootstrap-ul. Raportul implementează testul de punct de schimbare al lui Hoga (2017) ca Quantlet și dă estimările, ambele erori standard și schimbarea minimă detectabilă.
Prompturile folosite se notează în `AI_USE.md`, iar fiecare eroare depistată în răspunsurile asistentului, de exemplu o eroare standard i.i.d. sau o dată a rupturii aleasă după date, în `AI_ERRORS.md`. Prompturile reutilizabile și verificările sînt în Anexă.
Pe scurt
Întrebare: s-a schimbat indicele cozii pentru Bitcoin și Ethereum odată cu instituționalizarea?
instituționalizarea: futures în 2017, ETF-uri spot în 2024
randamente brute și randamente standardizate cu GARCH (forma cozii față de scală)
coada pierderilor și coada cîștigurilor, separat
Bitcoin folosește seria din curs; Ethereum nu face parte din panelul celor cinci piețe (seria zilnică: data/market/ETH-USD.CC.csv): documentați sursa, ora și fusul orar al închiderii și moneda (USD) înainte de estimare
Replicați întîi: tabelul Hill al capitolului și rezultatele mini studiului de caz
Preînregistrare, depusă în repository înainte de obținerea rezultatelor
\(H_0\), \(H_1\), regula pentru \(k\), datele rupturilor și bootstrap-ul
Raport: testul de punct de schimbare al lui Hoga (2017), implementat ca Quantlet
estimări, ambele SE, schimbarea minimă detectabilă
Jurnal: prompturile în AI_USE.md
fiecare eroare depistată (de exemplu, o SE i.i.d. sau o dată a rupturii aleasă după date) în AI_ERRORS.md
prompturi reutilizabile (Anexă) și verificări (Anexă)
Concluzii
Concluziile reunesc ce a stabilit capitolul pe cele cinci piețe și traduc rezultatele în alegeri pentru analiza randamentelor.
Ce reținem: mărimea randamentelor se poate prognoza, direcția aproape deloc
Autocorelațiile randamentelor sînt în general mici, cu excepții pentru S&P 500 și EUR/RON, dar mărimea randamentelor este predictibilă: randamentele absolute sînt autocorelate pozitiv pe orizonturi de mai multe luni. Cozile groase sînt regula, cu tail index-uri în jur de 3. Condiționat de aproximarea Pareto a cozii și de pragurile alese, estimările pun sub semnul întrebării existența momentului de ordinul patru, iar inferența bazată pe kurtosis devine atunci nesigură.
Volatilitatea este persistentă, cu memorie lungă sau rupturi structurale, iar pe piețele de acțiuni reacționează asimetric la pierderi. Fiecare test al capitolului se sprijină pe o distribuție de referință, iar datele pot încălca ipotezele acesteia; benzile robuste, bootstrap-ul pe blocuri și măsurile bazate pe cuantile au fost introduse din acest motiv.
Trei întrebări verifică ideile principale. De ce are o mixtură cu \(\sigma_t\) extras independent în fiecare zi cozi groase, dar nu volatility clustering? De ce scade statistica Ljung–Box a S&P 500 de la \(Q(10) = 91{,}6\) la \(\tilde Q(10) = 19{,}0\) cu erori standard robuste? De ce se poate estima tail index-ul cu estimatorul Hill cînd existența kurtosisului este îndoielnică? Capitolul următor întreabă dacă randamentele sînt predictibile (Capitolul 2).
Pe scurt
Idei principale
Autocorelațiile randamentelor sînt în general mici, cu excepții (S&P 500, EUR/RON), dar mărimea randamentelor este predictibilă
Cozile groase sînt regula: indici ai cozii în jur de 3
estimările, condiționat de aproximarea de coadă și de pragurile folosite, pun sub semnul întrebării existența momentului de ordinul patru
inferența bazată pe kurtosis devine nesigură
Volatilitatea este persistentă (memorie lungă sau rupturi)
pe piețele de acțiuni, volatilitatea reacționează asimetric la pierderi
Fiecare test se bazează pe o distribuție de referință ale cărei ipoteze pot fi încălcate de date
Întrebări pentru sală
De ce are o mixtură cu \(\sigma_t\) extras independent în fiecare zi cozi groase, dar nu gruparea volatilității (Aprofundări)?
De ce scade statistica S&P 500 de la \(Q(10) = 91{,}6\) la \(\tilde Q(10) = 19{,}0\) cu erori standard robuste (Aprofundări)?
De ce se poate estima indicele cozii cu estimatorul Hill cînd existența kurtosisului este îndoielnică?
Pentru cozi, capitolul alege estimatorul Hill cu \(k = 2{,}5\%\) din \(n\) și erori standard bootstrap pe blocuri, împreună cu cuantile precum VaR 1%, nu kurtosisul. Pentru dependență, folosește benzile robuste, nu pe cele i.i.d.: pentru S&P 500, 7 laguri din 100 ies din banda robustă și 20 din banda i.i.d. Pentru modelare, cere volatilitate variabilă în timp și inovații cu cozi groase (Capitolul 5).
Aceste alegeri sînt valabile în anumite condiții. Coada trebuie să fie aproximativ Pareto, cu un Hill plot plat în jurul pragului ales. Testele pe \(r_t^2\) și \(|r_t|\), precum și erorile standard ale rapoartelor Sharpe, presupun un moment de ordinul patru finit, pus sub semnul întrebării de estimările Hill.
Fiecare alegere are un rezultat care ar face-o de nesusținut. La un singur prag s-ar renunța dacă Hill plot-ul nu se stabilizează: pentru Bitcoin, \(\hat\alpha = 4{,}2\) la \(k = 2{,}5\%\), dar la un prag comun estimările sînt 2,71 pentru pierderi și 3,36 pentru cîștiguri. Evitarea kurtosisului n-ar mai fi necesară dacă intervalele bootstrap pentru \(\alpha\) s-ar afla în întregime peste 4 pe toate piețele. Inovațiile cu cozi groase ar fi inutile dacă kurtosisul lui \(\hat z_t = r_t/\hat\sigma_t\) ar fi apropiat de 3.
Pe scurt
Ce aleg
pentru cozi: estimatorul Hill (\(k = 2{,}5\%\) din \(n\)) cu SE bootstrap pe blocuri și cuantile (VaR 1%), nu kurtosisul
pentru dependență: benzile robuste, nu cele i.i.d. (S&P 500: 7 laguri din 100 ies din banda robustă, 20 din cea i.i.d.)
pentru modelare: volatilitate variabilă în timp și inovații cu cozi groase (Capitolul 5)
În ce condiții
coada este aproximativ Pareto, iar graficul Hill este plat în jurul pragului ales
testele pe \(r_t^2\) și \(|r_t|\) și SE ale rapoartelor Sharpe presupun moment de ordin patru finit, pus sub semnul întrebării de estimările Hill
Ce rezultat m-ar face să renunț
la un singur prag: un grafic Hill care nu se stabilizează (Bitcoin: \(4{,}2\) la \(k = 2{,}5\%\); la un prag comun, \(2{,}71\) pentru pierderi și \(3{,}36\) pentru cîștiguri)
la evitarea kurtosisului: intervale bootstrap pentru \(\alpha\) aflate în întregime peste 4, pe toate piețele
la inovațiile cu cozi groase: un kurtosis al lui \(\hat z_t = r_t/\hat\sigma_t\) apropiat de 3
Aprofundări
Cadrele acestei părți extind subiecte tratate pe scurt în corpul capitolului. Ele privesc diferența dintre randamentele simple și cele logaritmice, precizia estimărilor de momente și metoda delta, ipotezele testelor Jarque–Bera, Ljung–Box și ARCH-LM, măsurile de asimetrie și kurtosis bazate pe cuantile, distribuția Student-\(t\) și alegerea lui \(k\) pentru estimatorul Hill, inferența asupra autocorelațiilor în prezența heteroscedasticității condiționate, mixturile de distribuții Normale, estimarea parametrului de memorie \(d\) și sensibilitatea lui la rupturi structurale, estimatorii de volatilitate bazați pe range, reperele pentru drawdown și alte rapoarte de performanță, precum și detaliile studiului de caz despre volatilitatea dependentă de traiectorie al lui Guyon & Lekeufack (2023).
De ce randamentul logaritmic este mereu sub cel simplu
Randamentul logaritmic \(r = \ln(1+R)\) este strict mai mic decît randamentul simplu \(R\) pentru orice \(R \neq 0\), deoarece logaritmul este concav și \(\ln(1+x) < x\) pentru \(x > -1\),\(x \neq 0\). Pentru variații mici diferența este de ordinul doi: un randament simplu de \(+1\%\) corespunde unui randament logaritmic de \(0{,}995\%\). La scăderi mari ea devine importantă: un randament simplu de \(-50\%\) înseamnă un randament logaritmic de \(-69{,}3\%\). Exemplul unui preț care trece de la 100 la 110 și apoi la 99 arată de ce distincția contează în timp. Randamentele simple, \(+10\%\) și \(-10\%\), au suma zero, deși valoarea a scăzut cu \(1\%\), pentru că \(1{,}1 \times 0{,}9 = 0{,}99\); randamentele logaritmice, \(9{,}53\%\) și \(-10{,}54\%\), au suma \(-1{,}01\% = \ln 0{,}99\), adică variația reală pe scară logaritmică (Campbell, Lo & MacKinlay, 1997),(Franke, Härdle & Hafner, 2019).
Pe scurt
\(r = \ln(1+R) < R\) pentru orice \(R \neq 0\), deoarece \(\ln(1 + x) < x\) pentru \(x > -1\), \(x \neq 0\) (logaritmul este concav)
Diferența este neglijabilă pentru variații mici și mare pentru scăderi mari
\(R = +1\%\) dă \(r = 0{,}995\%\)
\(R = -50\%\) dă \(r = -69{,}3\%\)
Exemplu: prețul trece de la 100 la 110, apoi la 99 (Seminarul 1, A1)
randamentele simple \(+10\%\) și \(-10\%\) au suma \(0\), dar valoarea scade cu \(1\%\): \(1{,}1 \times 0{,}9 = 0{,}99\)
randamentele logaritmice \(9{,}53\%\) și \(-10{,}54\%\) au suma \(-1{,}01\% = \ln 0{,}99\)
Panoul din stînga al graficului reprezintă randamentul logaritmic în funcție de cel simplu: cele două coincid doar în jurul lui zero. Panoul din dreapta aplică distincția pentru Bitcoin în 2014–2026, perioadă în care averea s-a multiplicat de 176,9 ori. Suma randamentelor logaritmice zilnice este logaritmul acestui multiplicator, \(\ln 176{,}9 = 5{,}18\), deoarece randamentele logaritmice se adună în timp. Suma randamentelor simple zilnice dă în schimb \(1 + \sum_t R_t = 8{,}83\), un multiplicator de 20 de ori mai mic decît cel real. Randamentele simple se agregă între active, cele logaritmice în timp; agregarea cu tipul greșit produce, pentru un activ volatil, erori de această mărime.
Pe scurt
Stînga: \(r \approx R\) doar pentru variații mici
Dreapta: Bitcoin 2014–2026 a multiplicat valoarea investiției de \(176{,}9\) ori, adică \(\sum_t r_t = \ln 176{,}9 = 5{,}18\)
suma randamentelor logaritmice zilnice este \(\ln(P_T/P_0)\), logaritmul multiplicatorului
adunarea randamentelor simple zilnice dă \(1 + \sum_t R_t = 8{,}83\), de 20 de ori mai puțin decît multiplicatorul real
Eroarea standard (standard error, SE) a mediei de eșantion este \(\sigma/\sqrt{T}\), estimată cu \(\hat\sigma\). Pe cele cinci piețe, mediile zilnice sînt de 13 pînă la 40 de ori mai mici decît volatilitatea zilnică, deci, raportat la propria mărime, media este momentul estimat cu cea mai mică precizie. Pentru S&P 500, cu \(T = 9\,245\) de zile, randamentul logaritmic mediu zilnic este \(0{,}033\% \pm 0{,}023\%\) (interval de încredere de 95%, \(\pm 1{,}96\) SE), iar raportul SE\(/|\bar r|\) este de circa 0,36. Pentru date i.i.d. (independente și identic distribuite) din distribuția Normală, \(\sqrt{T}\,\hat S\) tinde la \(N(0,6)\), iar \(\sqrt{T}(\hat K - 3)\) la \(N(0,24)\), ceea ce dă erori standard de 0,025 pentru asimetrie (skewness) și de 0,051 pentru kurtosisul S&P 500. Momentele superioare au o altă problemă: în prezența cozilor groase (heavy tails), aceste erori standard pot să nici nu existe.
Pe scurt
Eroarea standard (SE) a mediei: \(\text{SE}(\bar r) = \sigma/\sqrt{T}\), estimată cu \(\hat\sigma\)
mediile zilnice sînt de 13 pînă la 40 de ori mai mici decît \(\hat\sigma\): raportat la mărimea sa, media este momentul estimat cel mai imprecis
S&P 500: \(\bar r = 0{,}033\% \pm 0{,}023\%\) pe zi (interval de încredere de 95%, \(\pm 1{,}96\,\text{SE}\)), \(T = 9\,245\); \(\text{SE}/|\bar r| \approx 0{,}36\)
Pentru date i.i.d. din distribuția Normală: \(\sqrt{T}\,\hat S \to N(0, 6)\) și \(\sqrt{T}(\hat K - 3) \to N(0, 24)\)
deci \(\text{SE}(\hat S) \approx \sqrt{6/T}\) și \(\text{SE}(\hat K) \approx \sqrt{24/T}\): \(0{,}025\) și \(0{,}051\) pentru S&P 500
Momentele superioare au altă problemă: SE poate să nici nu existe (secțiunea despre cozi)
Metoda delta (delta method) dă distribuția asimptotică a unei funcții netede de un estimator. Dacă \(\sqrt{T}(\hat\theta - \theta) \to N(0, v)\) și \(g\) este derivabilă, dezvoltarea Taylor de ordinul întîi \(g(\hat\theta) \approx g(\theta) + g'(\theta)(\hat\theta - \theta)\) implică \(\sqrt{T}\,(g(\hat\theta) - g(\theta)) \to N(0, g'(\theta)^2 v)\). Asimetria și kurtosisul de eșantion sînt rapoarte de momente de eșantion, deci erorile lor standard rezultă din această regulă. Limita Normală cere ca momentele care intră în varianța \(v\) să existe: pentru date i.i.d. din orice distribuție, \(\E r^6 < \infty\) pentru \(\hat S\) și \(\E r^8 < \infty\) pentru \(\hat K\). Dacă randamentele îndeplinesc aceste condiții este o întrebare empirică, la care răspund estimările tail index-ului din capitol.
Pe scurt
Metoda delta dă eroarea standard a unei funcții de un estimator
Fiecare test clasic are o ipoteză nulă și, separat, condiții în care distribuția lui de referință \(\chi^2\) este valabilă:
Testul Jarque–Bera (JB) (Jarque & Bera, 1980) are ca ipoteză nulă randamente i.i.d. din distribuția Normală; în prezența cozilor groase, în eșantioane mari respinge aproape sigur.
Testul Ljung–Box (LB) (Ljung & Box, 1978) testează autocorelații nule, dar limita lui \(\chi^2\) presupune date i.i.d., nu doar necorelate, așa că volatility clustering îl face să respingă prea des.
Testul ARCH-LM (Engle, 1982) are o ipoteză nulă i.i.d. a cărei limită \(\chi^2_q\) cere o varianță finită a lui \(r_t^2\),\(\E r^4 < \infty\), adică un tail index \(\alpha > 4\); sub o dependență de tip GARCH, autocorelațiile de eșantion ale lui \(r_t^2\) au limită Normală doar dacă \(\E r^8 < \infty\)(Davis & Mikosch, 1998).
Cu tail index-uri în jur de 3, întrebarea nu este cum se calculează statistica, ci dacă distribuția ei de referință rămîne valabilă pentru randamente.
sub \(H_0\) i.i.d.: \(\E r^4 < \infty\) (\(\alpha > 4\))
\(\alpha \approx 3 < 4\): valori critice nesigure
Două condiții de momente pentru ARCH-LM, în două situații diferite
sub ipoteza nulă i.i.d.: limita \(\chi^2_q\) cere o varianță finită a lui \(r_t^2\), adică \(\E r^4 < \infty\)
sub dependență de tip GARCH: ACF empirică a lui \(r_t^2\), pe care se bazează statistica, folosește limita Normală standard sub condiția de moment \(\E r^8 < \infty\) (\(\alpha > 8\)) Davis & Mikosch (1998)
Problema nu este calculul statisticii, ci validitatea distribuției ei de referință pentru randamente
Pentru S&P 500 în 1990–2026, cu \(T = 9\,245\) de zile, asimetria de eșantion este \(\hat S = -0{,}364\), iar excesul de kurtosis \(\hat K - 3 = 10{,}88\). Termenul de asimetrie al statisticii JB este \(\hat S^2/6 = 0{,}022\), iar termenul de kurtosis \(10{,}88^2/24 = 4{,}93\), deci \(JB = 9\,245 \times (0{,}022 + 4{,}93) \approx 45\,800\), față de valoarea critică de 5,99 a distribuției \(\chi^2_2\) la 5%. Aproape întreaga statistică provine din termenul de kurtosis: abaterea de la distribuția Normală se află în cozi, nu în asimetrie.
Pe scurt
Valoarea critică \(\chi^2_2\) la 5%: 5,99
S&P 500, 1990–2026: \(T = 9\,245\), \(\hat S = -0{,}364\), \(\hat K - 3 = 10{,}88\)
termenul de asimetrie \(\hat S^2/6 = 0{,}132/6 = 0{,}022\)
termenul de kurtosis \(10{,}88^2/24 = 118{,}4/24 = 4{,}93\)
\(JB = 9\,245 \times (0{,}022 + 4{,}93) \approx 45\,800\), față de valoarea critică \(5{,}99\)
Aproape întreaga valoare a statisticii provine din termenul de kurtosis
abaterea de la normalitate provine din cozi, nu din asimetrie
Sub ipoteza nulă a testului JB toate momentele există, așa că p-value-ul lui este valid pentru ipoteza nulă comună „i.i.d. și distribuție Normală”. Cînd cozile sînt groase, statistica crește odată cu \(T\); aceasta este puterea testului, nu un p-value invalid. O respingere nu arată care parte a ipotezei comune este încălcată, distribuția marginală sau independența. Testele doar pentru distribuția marginală, studentizate cu varianțe HAC (robuste la heteroscedasticitate și autocorelație, heteroskedasticity and autocorrelation consistent), sînt prezentate în Anexă.
Pe scurt
Sub ipoteza nulă toate momentele există
deci valoarea p este validă pentru ipoteza nulă comună „i.i.d. și distribuție Normală”
în prezența cozilor groase, JB crește odată cu \(T\)
acesta este un efect al puterii testului, nu o valoare p greșită
O respingere nu arată ce parte a ipotezei este încălcată
poate fi încălcată distribuția marginală sau ipoteza de independență
teste pentru distribuția marginală cu varianțe HAC (robuste la heteroscedasticitate și autocorelație): Anexă
Măsurile de formă bazate pe cuantile nu au nevoie de momente (Kim & White, 2004). Fie \(q_p\) cuantila de ordin \(p\) a randamentelor, cu \(q_{0.5}\) mediana. Asimetria Hinkley, \((q_{0.95} + q_{0.05} - 2q_{0.5})/(q_{0.95} - q_{0.05})\), compară lungimea cozii din dreapta, \(q_{0.95} - q_{0.5}\), cu cea a cozii din stînga, \(q_{0.5} - q_{0.05}\); ia valori în \([-1, 1]\), iar o valoare negativă indică o coadă stîngă mai lungă. Excesul de kurtosis Crow–Siddiqui, \(K_{CS} = (q_{0.975} - q_{0.025})/(q_{0.75} - q_{0.25}) - 2{,}91\), compară lățimea cozilor cu lățimea centrului, unde 2,91 este valoarea raportului pentru distribuția Normală. Ambele măsuri sînt zero pentru distribuția Normală, iar un \(K_{CS}\) pozitiv indică cozi mai groase.
Pe scurt
Două măsuri bazate pe cuantile Kim & White (2004), care nu presupun existența momentelor
\(q_p\): cuantila de ordin \(p\) a randamentelor, valoarea sub care se află o proporție \(p\) din zile
\(q_{0,5}\): mediana
Asimetria Hinkley compară lungimile celor două cozi față de mediană
Intervalele de încredere (confidence intervals, CI) de 95% ale măsurilor bazate pe cuantile se obțin prin bootstrap pe blocuri suprapuse (moving-block bootstrap). Procedura reeșantionează blocuri de 20 de zile consecutive, de 1 000 de ori, și recalculează măsura pe fiecare serie reeșantionată; blocurile păstrează dependența din interiorul lor, inclusiv volatility clustering. Intervalele sînt valide pentru randamente staționare, slab dependente, cu densitate pozitivă în cuantilele folosite. Un CI care nu conține zero indică o abatere semnificativă de la distribuția Normală.
Pe scurt
Intervalele de încredere (CI) de 95% se obțin prin bootstrap pe blocuri suprapuse
se reeșantionează blocuri de 20 de zile consecutive (1 000 de reeșantionări)
măsura se recalculează pe fiecare serie reeșantionată
blocurile păstrează dependența din interiorul lor
Procedura este validă pentru randamente staționare, slab dependente, cu densitate pozitivă în aceste cuantile
Un CI care nu conține 0 indică o abatere semnificativă de la distribuția Normală
Tabelul pune alături măsurile bazate pe momente și cele bazate pe cuantile pentru cele cinci piețe. Excesul de kurtosis Crow–Siddiqui este pozitiv pe toate cele cinci, de la 1,06 pentru BET-TR la 4,87 pentru EUR/RON, și niciun interval de 95% nu conține zero: cozile groase se confirmă fără a ne baza pe momente care s-ar putea să nu existe. Asimetria este altă poveste. Asimetria Hinkley este semnificativ negativă doar pentru S&P 500, \(-0{,}064\), cu CI \([-0{,}092;\ -0{,}041]\). Asimetria bazată pe momente a BET-TR, \(-1{,}40\), provine din cîteva zile, printre care 19 decembrie 2018, iar măsura bazată pe cuantile are un CI care conține zero.
Pe scurt
Asimetrie (momente)
Hinkley [CI 95%]
Exces kurt.
Exces Crow–Siddiqui [CI 95%]
S&P 500
\(-0{,}36\)
\(-0{,}064\)\([-0{,}092;\ -0{,}041]\)
10,9
\(1{,}54\)\([1{,}29;\ 1{,}79]\)
BET-TR
\(-1{,}40\)
\(-0{,}036\)\([-0{,}085;\ 0{,}025]\)
17,8
\(1{,}06\)\([0{,}73;\ 1{,}43]\)
Bitcoin
\(-0{,}70\)
\(-0{,}018\)\([-0{,}069;\ 0{,}032]\)
12,0
\(2{,}25\)\([1{,}88;\ 2{,}64]\)
EUR/RON
\(0{,}73\)
\(0{,}041\)\([-0{,}022;\ 0{,}093]\)
15,1
\(4{,}87\)\([3{,}74;\ 6{,}13]\)
Aur
\(-0{,}23\)
\(0{,}004\)\([-0{,}025;\ 0{,}030]\)
9,3
\(1{,}47\)\([1{,}29;\ 1{,}73]\)
Excesul de kurtosis bazat pe cuantile (Crow–Siddiqui) este pozitiv pe toate cele cinci piețe
niciun CI nu conține 0
Asimetria negativă bazată pe cuantile este semnificativă doar pentru S&P 500
asimetria bazată pe momente a BET-TR (\(-1{,}40\)) provine din cîteva zile extreme (19 decembrie 2018)
Distribuția Student-\(t\) a fost propusă ca model cu cozi groase pentru randamente de Praetz (1972). Densitatea ei este proporțională cu \((1 + (x-\mu)^2/(\nu s^2))^{-(\nu+1)/2}\), cu centrul \(\mu\), scala \(s > 0\) și gradele de libertate \(\nu > 0\); un \(\nu\) mic înseamnă cozi groase, iar pentru \(\nu \to \infty\) distribuția tinde la distribuția Normală. Coada scade ca \(P(X > x) \propto x^{-\nu}\), deci există doar momentele de ordin mai mic decît \(\nu\): varianța \(s^2\nu/(\nu-2)\) cere \(\nu > 2\), iar excesul de kurtosis \(6/(\nu-4)\) cere \(\nu > 4\).
Pe scurt
Distribuția Student-\(t\), Praetz (1972): un model cu cozi groase pentru randamente, cu densitatea
Sub distribuția Normală, 0,27% din zile se află dincolo de \(3\sigma\); pe cele cinci piețe proporția observată este între 1,42% (aur) și 2,06% (EUR/RON), de cinci pînă la opt ori mai mare. O zi dincolo de \(5\sigma\) ar trebui să apară o dată la 6 900 de ani de tranzacționare, în timp ce eșantioanele conțin între 10 (Bitcoin) și 30 (S&P 500) astfel de zile. Gradele de libertate \(\hat\nu\) ale distribuției Student-\(t\), estimate prin verosimilitate maximă (maximum likelihood), variază de la 1,2 (EUR/RON) la 3,1 (BET-TR). Verosimilitatea maximă ajustează întreaga distribuție, așa că numeroasele randamente mici domină estimarea, iar o ajustare slabă în centru mută \(\hat\nu\). Pentru EUR/RON, \(\hat\nu = 1{,}2\) reflectă faptul că 57% din variațiile zilnice sînt sub 0,1%, la care se adaugă salturi rare, nu doar forma cozilor.
Pe scurt
S&P 500
BET-TR
Bitcoin
EUR/RON
Aur
Zile dincolo de \(3\hat\sigma\) (%)
1,55
1,44
1,82
2,06
1,42
Zile dincolo de \(5\hat\sigma\) (număr)
30
12
10
29
26
Număr așteptat sub distribuția Normală, \(>5\hat\sigma\)
0,005
0,002
0,003
0,003
0,005
Grade de libertate Student-\(t\)\(\hat\nu\) (verosimilitate maximă)
2,8
3,1
2,2
1,2
2,9
Sub distribuția Normală
\(0{,}27\%\) din zile sînt dincolo de \(3\sigma\) (observat: de 5–8 ori mai mult)
o zi de \(5\sigma\) apare în medie o dată la 6 900 de ani de tranzacționare (observat: 10–30 de zile)
\(\hat\nu\) se obține prin verosimilitate maximă, pe întreaga distribuție
se aleg \(\mu\), \(s\) și \(\nu\) care fac datele observate cele mai probabile
numeroasele randamente mici domină estimarea, deci o ajustare slabă în centru deplasează \(\hat\nu\)
EUR/RON: \(\hat\nu = 1{,}2\), deoarece \(57\%\) din variațiile zilnice sînt sub \(0{,}1\%\), la care se adaugă salturi rare
Estimatorul Hill folosește cele mai mari \(k\) observații, peste pragul \(u = X_{(k+1)}\). Un \(k\) mic dă puține observații în coadă și o varianță mare, cu SE \(\approx \alpha/\sqrt{k}\); un \(k\) mare include observații din centru, unde coada nu mai este de tip Pareto, și deplasează (bias) \(\hat\alpha\). Ghidul obișnuit este Hill plot-ul, graficul lui \(\hat\alpha_k\) în funcție de \(k\), citit în zona în care este plat. Capitolul fixează regula înainte de estimare, \(k = 2{,}5\%\) din \(n\), mijlocul intervalului 1–5% în care Hill plot-urile sînt aproximativ plate, și raportează ca verificare de robustețe cel mai mic și cel mai mare \(\hat\alpha_k\) din acest interval. Distribuția Student-\(t\) are tail index-ul \(\alpha = \nu\), dar, estimată pe întreaga distribuție, descrie greșit cozile: pentru EUR/RON estimarea Hill este 2,8, iar \(\hat\nu = 1{,}2\).
Pe scurt
Alegerea lui \(k\), adică a pragului \(u = X_{(k+1)}\)
un \(k\) mic: puține observații în coadă, deci varianță mare (\(\text{SE} \approx \alpha/\sqrt{k}\))
un \(k\) mare: intră observații din centrul distribuției, unde coada nu mai este Pareto, deci \(\hat\alpha\) este deplasat
se citește nivelul din zona în care graficul Hill (\(\hat\alpha_k\) în funcție de \(k\)) este plat
Regula capitolului, fixată înaintea estimării: \(k = 2{,}5\%\) din \(n\)
mijlocul intervalului 1–5% în care graficele Hill sînt aproximativ plate
Robustețea: raportăm și cel mai mic și cel mai mare \(\hat\alpha_k\) pentru \(k\) între 1% și 5% din \(n\)
Distribuția Student-\(t\) are indicele cozii \(\alpha = \nu\), dar estimată pe întreaga distribuție descrie greșit cozile
pentru EUR/RON, \(\hat\alpha = 2{,}8\) (Hill), iar \(\hat\nu = 1{,}2\)
ACF (funcția de autocorelație, autocorrelation function) reunește autocorelațiile de eșantion \(\hat\rho_k = \sum_t x_t x_{t-k}/\sum_t x_t^2\) ale randamentelor centrate \(x_t = r_t - \bar r\), reprezentate în funcție de lagul \(k\). Pentru randamente necorelate a căror varianță condiționată se modifică, \(\hat\rho_k\) este aproximativ \(N(0, \tau_k)\)(Romano & Thombs, 1996), cu \(\tau_k\) estimat prin \(\hat\tau_k = \sum_t x_t^2 x_{t-k}^2/(\sum_t x_t^2)^2\). Pentru randamente i.i.d., \(T\tau_k = 1\), ceea ce dă banda clasică \(\pm 1{,}96/\sqrt{T}\). În prezența volatility clustering, \(T\tau_k > 1\): banda clasică este prea îngustă și declară prea des autocorelații semnificative.
Pe scurt
ACF (funcția de autocorelație): autocorelațiile empirice \(\hat\rho_k\), reprezentate în funcție de lagul \(k\)
Tabelul dă autocorelația de lag 1, factorul de inflație a varianței \(T\hat\tau_1\) și statisticile \(t\) calculate cu varianța i.i.d. și cu cea robustă. Factorul de inflație variază de la 2,43 (aur) la 6,85 (EUR/RON), iar statisticile \(t\) robuste sînt pe măsură mai mici decît cele i.i.d. Pentru S&P 500, statistica Ljung–Box este \(Q(10) = 91{,}6\), în timp ce statistica robustă este \(\tilde Q(10) = 19{,}0\), cu p-value 0,041. Cu erori standard robuste, doar S&P 500 (\(t = -3{,}4\)) și EUR/RON (\(t = 4{,}7\)) păstrează o autocorelație de lag 1 semnificativă, și în ambele cazuri ea este mică din punct de vedere economic; pentru BET-TR, statistica \(t\) i.i.d. de 3,3 scade la 1,6.
Un randament care este un șoc Normal înmulțit cu o volatilitate aleatoare independentă, \(r_t = \sigma_t \varepsilon_t\) cu \(\varepsilon_t \sim N(0,1)\), are kurtosisul
Egalitatea din mijloc în (1.29) folosește \(\E[\varepsilon_t^4] = 3\),\(\E[\varepsilon_t^2] = 1\) și independența dintre \(\sigma_t\) și \(\varepsilon_t\); inegalitatea este inegalitatea lui Jensen, \(\E[X^2] \geq \E[X]^2\), aplicată pentru \(X = \sigma_t^2\). Egalitatea are loc doar dacă \(\sigma_t\) este constantă, deci orice variație a volatilității creează exces de kurtosis, deși fiecare randament este Normal condiționat de volatilitatea lui.
Pe scurt
Modelul: randamentul este un șoc Normal înmulțit cu o volatilitate aleatoare
Să presupunem că volatilitatea zilnică este 1% în 90% din zile și 3% în 10% din zile. În unități de \((1\%)^4\),\(\E[\sigma^4] = 0{,}9 \cdot 1 + 0{,}1 \cdot 81 = 9{,}0\), iar \(\E[\sigma^2] = 0{,}9 + 0{,}1 \cdot 9 = 1{,}8\), deci, după (1.29),\(K = 3 \cdot 9{,}0/3{,}24 = 8{,}33\), un exces de kurtosis de 5,33, deși randamentul fiecărei zile este Normal distribuit condiționat de \(\sigma\). Calculul leagă cozile groase (Faptul 2) de volatility clustering (Faptul 6). Reciproca nu este adevărată: o mixtură extrasă independent în fiecare zi produce cozi groase fără niciun clustering, deci cozile groase singure nu identifică dinamica volatilității.
Pe scurt
Exemplu: \(\sigma = 1\%\) în 90% din zile și \(3\%\) în 10% din zile
Memoria lungă (long memory) are o definiție în domeniul frecvenței: densitatea spectrală \(f(\lambda)\), contribuția ciclurilor de frecvență \(\lambda\) la varianța seriei, crește nelimitat la frecvențe joase,
cu \(G > 0\). Estimatorii semiparametrici folosesc (1.30) doar la cele mai joase \(m\) frecvențe Fourier \(\lambda_j = 2\pi j/T\). Estimatorul Whittle local (local Whittle) (Robinson, 1995) satisface \(\sqrt{m}(\hat d - d) \to N(0, \frac14)\), deci SE-ul lui este \(1/(2\sqrt{m})\); regresia pe log-periodogramă (log-periodogram regression) (Geweke & Porter-Hudak, 1983) are SE \(\pi/\sqrt{24m}\). Lățimea de bandă \(m = T^{0{,}65}\) echilibrează două erori: un \(m\) mic mărește SE-ul, iar un \(m\) mare include frecvențe la care dinamica pe termen scurt (GARCH) deplasează \(\hat d\).
Pe scurt
Memoria lungă în domeniul frecvenței: densitatea spectrală crește nelimitat la frecvențe joase
Schimbări rare ale nivelului volatilității pot produce o ACF a lui \(|r_t|\) care scade lent și o estimare \(\hat d > 0\) fără nicio memorie lungă (Diebold & Inoue, 2001),(Mikosch & Stărică, 2004). Verificarea localizează o ruptură (structural break) în varianță cu testul sumei cumulate a pătratelor al lui Inclán & Tiao (1994) și reestimează \(d\) prin Whittle local de o parte și de alta a rupturii. Tabelul dă data rupturii, volatilitatea anualizată înainte și după ea și cele două estimări ale lui \(d\) cu erorile lor standard, pentru \(|r_t|\) pe cele cinci piețe. Pentru S&P 500 ruptura cade pe 20 iulie 1998, cu volatilitatea în creștere de la 12,6% la 19,3%; pentru Bitcoin, pe 19 iunie 2022, cu volatilitatea în scădere de la 74,9% la 47,7%.
Pe scurt
Schimbări rare ale nivelului volatilității produc o ACF a lui \(|r_t|\) care scade încet
În fiecare subeșantion, \(\hat d\) rămîne la cel puțin trei SE deasupra lui zero; cazul cel mai slab este Bitcoin după 2022, cu \(0{,}15/0{,}05 = 3\). O singură ruptură nu explică, așadar, memoria randamentelor absolute. Pentru S&P 500 după 1998, \(\hat d = 0{,}51\) se află peste limita de staționaritate \(\frac12\), dar la mai puțin de un SE de ea, și trebuie interpretat cu prudență. Estimarea se modifică și între subeșantioane, de la 0,39 la 0,15 pentru Bitcoin, deci rămîn posibile mai multe rupturi sau un \(d\) variabil în timp, iar datele rupturilor sînt descriptive, nu evenimente identificate.
Pe scurt
\(\hat d\) rămîne cu cel puțin 3 SE peste 0 în fiecare subeșantion
cel mai slab caz: Bitcoin după 2022, \(0{,}15/0{,}05 = 3\)
o singură ruptură nu explică persistența
S&P 500 după 1998: \(\hat d = 0{,}51\), peste limita de staționaritate \(\frac12\)
la mai puțin de o SE de limită
interpretați cu prudență
\(\hat d\) se schimbă (Bitcoin \(0{,}39 \to 0{,}15\))
rămîn posibile rupturi multiple sau un \(d\) variabil în timp
Tabelul pune fiecare statistică folosită în capitol în dreptul condiției de momente de care are nevoie și al estimărilor Hill ale tail index-ului, între 2,3 și 3,5 (4,2 pentru Bitcoin):
Media și varianța există, dar converg lent.
ACF a lui \(|r_t|\), benzile ACF robuste și \(\tilde Q\) au nevoie de \(\alpha > 4\) pentru limite Normale, ceea ce este îndoielnic.
Kurtosisul, ACF a lui \(r_t^2\), ARCH-LM și \(Q\) pe \(r_t^2\) au nevoie de \(\alpha > 4\) ca să existe și de \(\alpha > 8\) pentru limite Normale sub o dependență de tip GARCH, iar asimetria are nevoie de \(\alpha > 6\); niciuna nu are aici o inferență standard. Cînd momentul de ordinul patru este infinit, ACF de eșantion a lui \(r_t^2\) converge lent către o limită care nu este Normală (Davis & Mikosch, 1998), deci banda \(\pm 1{,}96/\sqrt{T}\) și p-value-urile pentru \(Q\) pe \(r_t^2\) și ARCH-LM nu sînt de încredere.
Cuantilele, numărul de zile din cozi și estimatorul Hill nu au nevoie de momente.
Concluzia calitativă că volatilitatea formează clustere este robustă; valorile numerice exacte nu sînt, iar unul dintre motivele efectului Taylor este că \(|r_t|\) are nevoie de mai puține momente finite decît \(r_t^2\).
Pe scurt
Statistica
Condiție
Pentru Hill \(\hat\alpha \approx 2{,}3\)–\(3{,}5\) (Bitcoin: \(4{,}2\))
Media, varianța lui \(r_t\)
\(\alpha > 2\)
finite, convergență lentă
ACF a lui \(|r_t|\), benzi ACF robuste, \(\tilde Q\)
\(\alpha > 4\) pentru limite Normale
discutabilă
Kurtosis, ACF a lui \(r_t^2\), ARCH-LM, \(Q\) pe \(r_t^2\)
\(\alpha > 4\) pentru existență (și pentru \(\chi^2\) al ARCH-LM sub i.i.d.), \(\alpha > 8\) pentru limite Normale sub dependență de tip GARCH
fără inferență standard
Asimetrie
\(\alpha > 6\) pentru o limită Normală
fără inferență standard
Cuantile, frecvența depășirilor, Hill \(\hat\alpha\)
nu cere momente
valide, cu SE robuste la dependență
Cînd momentul de ordinul patru este infinit, ACF empirică a lui \(r_t^2\) converge lent
unde \(o_t\),\(h_t\),\(l_t\) și \(c_t\) sînt logaritmii prețurilor de deschidere, maxim, minim și închidere din ziua \(t\). Ponderile \(\frac12\) și \(2\ln 2 - 1 \approx 0{,}386\) fac din (1.31) estimatorul cu varianță minimă din clasa sa, derivat de Garman și Klass. El se bazează pe aceleași ipoteze ca estimatorul Parkinson, fără drift și fără salturi peste noapte, iar eficiența lui față de estimatorul close-to-close este de 7 pînă la 8.
Pe scurt
Garman–Klass, Garman & Klass (1980): combină amplitudinea cu variația de la deschidere la închidere
Cele două produse din (1.32) măsoară cît de departe au ajuns maximul și minimul față de deschidere și de închidere; ambele sînt nenegative, deoarece \(l_t \leq o_t, c_t \leq h_t\). Pentru o mișcare browniană cu drift, media lor este exact varianța zilnică. Ca și Garman–Klass, estimatorul ignoră saltul de peste noapte dintre închiderea anterioară și deschidere.
Pe scurt
Rogers–Satchell, Rogers & Satchell (1991): nedeplasat în prezența unui drift nenul (tendința așteptată a logaritmului prețului)
Aici \(\hat\sigma^2_{\text{noapte}}\) și \(\hat\sigma^2_{\text{desch-închid}}\) sînt varianțele de eșantion ale randamentelor de peste noapte și de la deschidere la închidere, iar \(\hat\sigma^2_{RS}\) este (1.32). Ponderea \(k\), de circa 0,145 pentru \(n\) mare și fără legătură cu \(k\)-ul estimatorului Hill, dă varianța minimă printre estimatorii independenți de drift și robuști la salturile de la deschidere. Estimatorii bazați pe range duc spre volatilitatea realizată calculată din date intraday, subiectul Capitolului 9.
Pe scurt
Yang–Zhang, Yang & Zhang (2000): adaugă saltul de peste noapte (de la închidere la deschidere)
\(\hat\sigma^2_{\text{noapte}}\): varianța empirică a lui \(o_t - c_{t-1}\), randamentul de peste noapte
\(\hat\sigma^2_{\text{desch-închid}}\): varianța empirică a lui \(c_t - o_t\)
\(k\): ponderea care dă varianța minimă printre estimatorii independenți de drift și robuști la salturile de la deschidere (alt \(k\) decît cel din estimatorul Hill); \(k \approx 0{,}145\) pentru \(n\) mare
Estimatorii bazați pe amplitudinea zilnică fac legătura cu volatilitatea realizată din date intraday (Capitolul 9)
Graficul compară patru volatilități anualizate, în procente, pentru indicele S&P 500 și pentru SPY, fondul tranzacționat la bursă (exchange-traded fund, ETF) care îl replică, în 2008–2026. Volatilitatea close-to-close, mediată pe ferestre de 21 de zile, este aproape aceeași pentru cele două, 16,4% și 16,2%. Estimarea Yang–Zhang este 13,9% pentru indice și 16,8% pentru SPY. Volatilitatea de peste noapte pe întregul eșantion este 6,7% pentru indice și 12,0% pentru SPY, în timp ce volatilitatea de la deschidere la închidere este 17,3% pentru indice și 15,2% pentru SPY. O parte din mișcarea de peste noapte a indicelui apare, așadar, în interiorul zilei de tranzacționare.
Deschiderea indicelui se calculează din primele prețuri ale componentelor lui. La 9:30 multe acțiuni nu s-au tranzacționat încă, așa că în deschidere intră prețul lor de închidere anterior: deschiderea este învechită (stale open). SPY, în schimb, se deschide la un preț tranzacționat. Zilele în care deschiderea indicelui este egală cu închiderea precedentă reprezentau circa 96% din zile în 1996–2005, încă 16% în 2007 și 3,5% în 2008–2026, cu pînă la 26% în 2012–2013; de aceea estimatorii bazați pe range folosesc doar datele din 2008 încoace. Un stale open mută o parte din mișcarea de peste noapte în timpul zilei, așa că Yang–Zhang scade sub close-to-close doar pentru indice. Estimatorii care folosesc deschiderea au nevoie de un instrument tranzacționat.
Pe scurt
Deschiderea neactualizată: prețul de deschidere al indicelui este calculat din ultimele prețuri ale componentelor
la 9:30 multe acțiuni nu s-au tranzacționat încă și intră cu prețul de închidere anterior
SPY, ETF-ul care replică S&P 500, are un preț de deschidere rezultat din tranzacții
Ponderea zilelor cu deschiderea egală cu închiderea precedentă
circa \(96\%\) în 1996–2005 și încă \(16\%\) în 2007
\(3{,}5\%\) în 2008–2026 (pînă la \(26\%\) în 2012–2013): estimatorii bazați pe amplitudinea zilnică folosesc doar datele din 2008 încoace
O deschidere neactualizată transferă o parte din variația de peste noapte în intervalul de tranzacționare
volatilitatea de peste noapte: \(6{,}7\%\) pentru indice, \(12{,}0\%\) pentru SPY
Yang–Zhang coboară sub close-to-close doar în cazul indicelui
pentru estimatorii care folosesc deschiderea, folosiți un instrument tranzacționat (Seminarul 1, B15)
Drawdown-ul maxim logaritmic \(D = -\ln(1 + MDD)\) poate fi comparat cu valoarea lui așteptată pentru un random walk gaussian cu aceeași volatilitate și același orizont. Reperul fără drift, \(\mu = 0\), supraestimează \(\E[D]\) de aproximativ două ori, deoarece un drift pozitiv limitează adîncimea scăderilor: pentru S&P 500 el dă 1,37, față de 0,84 observat (un MDD de \(-57\%\)). Cu driftul estimat, formula și simularea sînt foarte apropiate (0,65 și 0,66 pentru S&P 500), iar niciun drawdown maxim observat nu este neobișnuit: p-value-urile \(P(D \geq D_{\text{obs}})\) variază de la 0,07 (BET-TR) la 0,52 (aur). Reperul ignoră cozile groase și volatility clustering, deci este doar un prim termen de comparație. Drawdown-ul maxim crește și cu lungimea eșantionului, așa că se compară doar orizonturi egale.
Pe scurt
S&P 500
BET-TR
Bitcoin
EUR/RON
Aur
\(D\) observat (MDD)
0,84 (\(-57\%\))
0,37 (\(-31\%\))
1,80 (\(-83\%\))
0,17 (\(-16\%\))
0,59 (\(-45\%\))
\(\E[D]\), \(\mu = 0\)
1,37
0,67
2,89
0,26
1,24
\(\E[D]\), \(\mu = \hat\mu\): formula / simulare
0,65 / 0,66
0,26 / 0,26
1,48 / 1,55
0,14 / 0,15
0,62 / 0,64
valoarea p, \(P(D \geq D_{\text{obs}})\)
0,17
0,07
0,26
0,29
0,52
Reperul fără drift supraestimează \(\E[D]\) de circa două ori
un drift pozitiv limitează adîncimea scăderilor
Cu driftul estimat, niciun MDD nu este neobișnuit: valoarea p între \(0{,}07\) (BET-TR) și \(0{,}52\) (aur)
Reperul ignoră cozile groase și gruparea volatilității, deci este doar un prim termen de comparație
MDD crește odată cu lungimea eșantionului: comparați doar orizonturi egale (Anexă)
Durata recuperării este timpul de la vîrf pînă cînd prețul atinge din nou acel vîrf. Adîncimea și durata sînt riscuri diferite. Drawdown-ul maxim al aurului, \(-45\%\), din septembrie 2011 pînă în decembrie 2015, a fost mai puțin adînc decît cel al lui Bitcoin, \(-83\%\), dar vîrful a fost recuperat abia în iulie 2020, după 8,9 ani, față de 3,0 ani pentru Bitcoin. BET-TR arată o recuperare rapidă, în formă de V, în 2020, cu vîrful recuperat după 0,9 ani, în timp ce S&P 500 a avut nevoie de 5,5 ani după scăderea din 2007–2009. Pentru EUR/RON, un drawdown este o scădere a euro față de leu.
Pe scurt
Durata recuperării: timpul de la vîrf pînă cînd prețul atinge din nou acest nivel
MDD
Vîrf
Minim
Vîrf recuperat
S&P 500
\(-57\%\)
oct. 2007
mar. 2009
mar. 2013 (5,5 ani)
BET-TR
\(-31\%\)
ian. 2020
mar. 2020
dec. 2020 (0,9 ani)
Bitcoin
\(-83\%\)
dec. 2017
dec. 2018
nov. 2020 (3,0 ani)
EUR/RON
\(-16\%\)
dec. 2005
iul. 2007
ian. 2008 (2,0 ani)
Aur
\(-45\%\)
sept. 2011
dec. 2015
iul. 2020 (8,9 ani)
Adîncimea și durata sînt dimensiuni distincte ale riscului
drawdown-ul aurului a fost mai puțin adînc decît al lui Bitcoin, dar a durat de trei ori mai mult
Recuperări rapide în formă de V (BET-TR 2020)
față de perioade lungi underwater, sub vîrful anterior (aur 2011–2020)
Pentru EUR/RON un „drawdown” este o scădere a euro față de leu
Abaterea pierderilor (downside deviation) \(\sigma^-\) face media pe toate cele \(T\) zile, zilele pozitive contînd ca zero, iar \(A\) este numărul de perioade pe an. Pentru S&P 500, \(\sigma^-_{\text{an}} = 12{,}68\%\) și \(SoR = 0{,}78\). Raportul Calmar împarte rata anuală compusă de creștere (CAGR, compound annual growth rate) la valoarea absolută a drawdown-ului maxim; pentru S&P 500 el este \(8{,}69\%/56{,}78\% = 0{,}15\), valoare determinată de un singur episod. Raportul nu are o teorie de eșantionare utilizabilă, deoarece drawdown-ul maxim de la numitor crește cu lungimea eșantionului.
Pe scurt
Raportul SortinoSortino & van der Meer (1991): numărătorul raportului Sharpe, la numitor doar volatilitatea pierderilor
\(\sigma^-\): downside deviation zilnică (în seminar: semiabaterea inferioară \(\hat\sigma_D\)); media este pe toate cele \(T\) zile, iar zilele pozitive contribuie cu 0
Testarea diferenței dintre două rapoarte Sharpe în prezența volatility clustering cere metode HAC sau bootstrap studentizat pe blocuri (Ledoit & Wolf, 2008). Ambele au totuși nevoie de momente de ordinul patru finite, pe care estimările Hill le pun la îndoială. Pe zilele de tranzacționare comune din 2014–2026, raportul Sharpe al BET-TR îl depășește pe cel al S&P 500 cu 0,61, cu \(z = 1{,}75\) și p-value 0,08; intervalul de încredere de 95% prin bootstrap pe blocuri este \([-0{,}01;\ 1{,}21]\). La pragul de 5% nu respingem egalitatea rapoartelor Sharpe.
Pe scurt
În prezența grupării volatilității: teste HAC sau bootstrap studentizat pe blocuri Ledoit & Wolf (2008)
și ele cer momente de ordinul patru finite, pe care estimările Hill le pun la îndoială
Guyon & Lekeufack (2023) se întreabă dacă un singur model poate reproduce simultan trei fapte stilizate: volatility clustering (Faptul 6), scăderea lentă a autocorelației lui \(|r_t|\) (Faptul 8) și leverage effect (Faptul 9). Întrebarea contează pentru modelare. Dacă volatilitatea este în mare parte o funcție de traiectoria trecută a prețului, ea este în mare parte endogenă, iar un model de volatilitate dependentă de traiectorie (path-dependent volatility, PDV) are nevoie de puțină aleatoritate suplimentară, spre deosebire de modelele de volatilitate stocastică din Capitolele 11–12. Datele sînt închiderile zilnice a cinci indici: S&P 500, Euro Stoxx 50, FTSE 100, DAX și Nikkei 225. Eșantionul de antrenare merge de la 1 ianuarie 2000 la 31 decembrie 2018, iar cel de test de la 1 ianuarie 2019 la 15 mai 2022.
Pe scurt
Cerința: un singur model trebuie să reproducă simultan
gruparea volatilității (Faptul 6)
scăderea lentă a autocorelației lui \(|r_t|\) (Faptul 8)
efectul de levier (Faptul 9)
Relevanța: dacă volatilitatea este în mare parte o funcție de traiectoria prețului, ea este în mare parte endogenă
un model de volatilitate dependentă de traiectorie (PDV) necesită doar o componentă aleatoare suplimentară redusă
spre deosebire de modelele cu volatilitate stocastică (Capitolele 11–12)
Variabila dependentă \(\sigma_t\) este, de exemplu, VIX la închiderea zilei \(t\). Componenta de trend \(R_{1,t}\) se construiește din randamentele trecute, iar componenta de volatilitate \(\Sigma_t\) din pătratele lor. Randamentele sînt simple, \(r_{t_i} = S_{t_i}/S_{t_{i-1}} - 1\), unde \(S_{t_i}\) este nivelul indicelui la închiderea zilei \(t_i \leq t\); aceasta este notația lucrării, în timp ce în restul capitolului \(r_t\) desemnează randamentul logaritmic.
Pe scurt
Ecuația (3.7) din lucrare: volatilitatea de azi este o funcție liniară de două rezumate ale randamentelor trecute
\(\sigma_t\): variabila dependentă, de exemplu VIX la închiderea zilei \(t\)
\(S_{t_i}\): nivelul indicelui la închiderea zilei \(t_i\)
\(t_i \le t\) parcurge zilele de pînă la \(t\), inclusiv
\(r_{t_i} = S_{t_i}/S_{t_{i-1}} - 1\): randamentul simplu al zilei \(t_i\) (notația lucrării; în restul capitolului \(r_t\) este randamentul logaritmic)
\(R_{1,t}\): componenta de trend, construită din randamentele trecute
\(\Sigma_t\): componenta de volatilitate, construită din pătratele randamentelor trecute
Un nucleu (kernel) \(K(\tau)\) dă ponderea unei zile de vîrstă \(\tau = i\Delta t\), cu \(\Delta t = 1/252\) pentru o zi veche de \(i\) zile de tranzacționare; ponderile zilnice \(K(i\Delta t)\Delta t\) sînt pozitive și au suma 1. Lucrarea folosește o lege de putere decalată în timp (time-shifted power law, TSPL), ecuația ei (3.9):
unde \(Z_{\alpha,\delta}\) normalizează ponderile pe ultimele 1 000 de zile. Exponentul \(\alpha\) stabilește cît de repede scad ponderile, iar decalajul \(\delta\), măsurat în ani, cît de puternic se concentrează ponderea pe ultimele cîteva zile; \(\delta = 0{,}05\) ani înseamnă circa 12,6 zile de tranzacționare. Forma rezultată pune o pondere mare pe ultimele cîteva zile, o memorie scurtă, și are o coadă de tip lege de putere care scade lent, compatibilă cu scăderea lentă a ACF lui \(|r_t|\). Trunchiat la 1 000 de zile, nucleul nu produce singur memorie lungă asimptotică. Modelul are două nuclee, \(K_1\) pentru trend, cu parametrii \((\alpha_1, \delta_1)\), și \(K_2\) pentru volatilitate, cu \((\alpha_2, \delta_2)\); aici \(\alpha\),\(\delta\) și \(K\) nu sînt tail index-ul, puterea din efectul Taylor sau kurtosisul.
Pe scurt
Un nucleu\(K(\tau)\) dă ponderea unei zile vechi de \(\tau\), cu \(\tau = i\Delta t\) pentru o zi veche de \(i\) zile și \(\Delta t = 1/252\)
Ponderile zilnice \(K(i\Delta t)\Delta t\) sînt pozitive și însumează 1 (axa verticală a graficului nucleelor)
Lucrarea folosește o lege de putere decalată în timp (TSPL), ec. (3.9)
unde \(t - t_i\) este vîrsta zilei \(t_i\), în ani. \(R_{1,t}\) este negativ după o serie de scăderi și pozitiv după o serie de creșteri; \(\Sigma_t\) este o volatilitate istorică ponderată. Deoarece ponderile au suma 1, ambele sînt medii ponderate, anualizate cu 252 și \(\sqrt{252}\). Un \(\beta_1\) negativ înseamnă că volatilitatea crește după scăderi, adică leverage effect; un \(\beta_2\) pozitiv înseamnă că o volatilitate recentă mare ridică volatilitatea de azi, adică volatility clustering, ca în GARCH; \(\beta_0 > 0\) asigură o parte din nivel. Estimarea \(\hat\beta_2 = 0{,}87\) este sub 1 ca rezultat empiric, nu ca restricție: VIX se mișcă mai puțin decît unu la unu cu \(\Sigma_t\).
Pe scurt
Componenta de trend: o sumă ponderată a randamentelor trecute
Modelul are șapte parametri, \(\beta_0, \beta_1, \beta_2, \alpha_1, \delta_1, \alpha_2, \delta_2\), estimați prin cele mai mici pătrate neliniare (nonlinear least squares) pe eșantionul de antrenare, adică prin minimizarea lui \(\sum_t (\sigma_t - \hat\sigma_t)^2\), unde \(\hat\sigma_t\) este valoarea modelului pentru ziua \(t\). Ajustarea se evaluează separat pe eșantionul de antrenare și pe cel de test, cu două măsuri. Rădăcina erorii pătratice medii, \(\text{RMSE} = \sqrt{\frac1T \sum_t (\sigma_t - \hat\sigma_t)^2}\) (root mean squared error), este eroarea tipică în unități de volatilitate, unde 0,01 înseamnă un punct VIX. Coeficientul de determinare, \(R^2 = 1 - \sum_t(\sigma_t - \hat\sigma_t)^2 / \sum_t(\sigma_t - \bar\sigma)^2\), compară această eroare cu variația VIX în jurul mediei sale \(\bar\sigma\).
Pe scurt
Șapte parametri: \(\beta_0, \beta_1, \beta_2, \alpha_1, \delta_1, \alpha_2, \delta_2\)
estimați prin cele mai mici pătrate neliniare pe eșantionul de antrenare: se minimizează \(\sum_t (\sigma_t - \hat\sigma_t)^2\)
\(\hat\sigma_t\): valoarea dată de model pentru ziua \(t\)
Parametrii sînt estimați pe eșantionul de antrenare, 1 ianuarie 2000 – 31 decembrie 2018 (4 779 de zile de tranzacționare), apoi menținuți fixați; graficul hașurează perioada de test. După perioada de test, de la 16 mai 2022 la 18 septembrie 2026, modelul fixat are \(R^2 = 0{,}740\) și RMSE 0,026. Eroarea este mai mică decît înainte, dar și VIX a variat mai puțin, cu o abatere standard de 5,0 puncte față de 9,3, așa că \(R^2\) scade. Raportul dintre VIX observat și cel estimat arată unde greșește modelul: media lui este 0,85 în aprilie–mai 2020 și 1,16 din octombrie 2020 pînă în mai 2022, iar pe 8 aprilie 2025 VIX a închis la 52,3, față de 39,2 estimat.
Pe scurt
Parametrii estimați pe eșantionul de antrenare, 1 ian. 2000 – 31 dec. 2018 (4 779 de zile de tranzacționare), apoi menținuți fixați
Zona umbrită: eșantionul de test
După eșantionul de test, 16 mai 2022 – 18 sept. 2026: \(R^2 = 0{,}740\), RMSE \(0{,}026\)
RMSE mai mic, dar VIX a variat mai puțin (abaterea standard 5,0 față de 9,3 puncte), deci \(R^2\) scade
Raportul dintre VIX observat și estimat
media \(0{,}85\) în aprilie–mai 2020
media \(1{,}16\) din octombrie 2020 pînă în mai 2022
8 aprilie 2025: VIX \(52{,}3\) față de \(39{,}2\) estimat
Graficul reprezintă ponderile zilnice \(K(i\Delta t)\Delta t\) în funcție de lagul \(i\), în zile de tranzacționare, cu ambele axe pe scară logaritmică, pentru cele două nuclee reestimate pe datele cursului și pentru valorile din Tabelul 3 al lucrării. Nucleul de trend \(K_1\) are \(\alpha_1 = 1{,}13\),\(\delta_1 = 0{,}022\) pe datele cursului și \(\alpha_1 = 1{,}06\),\(\delta_1 = 0{,}020\) în lucrare; nucleul de volatilitate \(K_2\) are \(\alpha_2 = 1{,}58\),\(\delta_2 = 0{,}050\), respectiv \(\alpha_2 = 1{,}60\),\(\delta_2 = 0{,}052\). Cele două estimări ale fiecărui nucleu aproape coincid. O dreaptă pe scara log–log este o lege de putere; după aproximativ 100 de zile, nucleul de volatilitate scade mai repede decît cel de trend, așa că componenta de trend păstrează relativ mai multă pondere pe zilele vechi.
Anexa reunește formulele cu ipotezele lor, materiale istorice despre tickerul bursier și despre autorii din spatele faptelor stilizate, studii ulterioare ale faptelor lui Cont, varianța randamentelor pe mai multe zile în prezența autocorelației, teoria din spatele testului JB, a testului portmanteau robust și a estimatorului Hill, formulele de estimare pentru \(d\), detalii despre piețe, drawdown-ul maxim al unei mișcări browniene, raportul Sharpe dincolo de distribuția Normală, detaliile estimării și alte rezultate ale studiului de caz, precum și prompturile și verificările buclei de descoperire.
Fișa de formule pune fiecare formulă a capitolului alături de ipoteza în care este valabilă:
Regula \(\sqrt{A}\) de anualizare a volatilității cere randamente necorelate cu varianță constantă;
Limitele \(\chi^2\) ale JB și \(Q(m)\) cer randamente i.i.d., iar cea a lui \(\tilde Q(m)\) un moment de ordinul patru finit și termeni încrucișați nuli;
SE-ul estimatorului Hill presupune o coadă Pareto cu observații independente;
Estimatorul Parkinson presupune lipsa driftului și a salturilor de peste noapte;
Raportul Sharpe se calculează pe randamente simple, cu \(\mu = A\bar R\), nu pe media logaritmică, iar SE-ul lui de circa \(1/\sqrt{Y}\), cu \(Y\) lungimea eșantionului în ani, este valabil pentru randamente i.i.d. Normale.
Înainte de calculatoare, tranzacțiile ajungeau la brokeri ca prețuri tipărite pe o bandă de hîrtie (ticker tape); fotografia arată un ticker bursier proiectat de Thomas Edison. O închidere zilnică este un singur instantaneu al acestui flux de prețuri, iar alegerea instantaneului, o închidere, un fixing sau un instantaneu la miezul nopții, influențează randamentele calculate din el (Capitolul 0). Prețurile la nivelul tranzacțiilor individuale sînt subiectul microstructurii pieței, în Capitolul 10.
Trei nume stau în spatele reperelor cu care se compară randamentele. Carl Friedrich Gauss este asociat cu distribuția Normală, reperul de la care randamentele se abat. Louis Bachelier a modelat prețurile ca random walk în teza sa (Bachelier, 1900). William S. Gosset, care a publicat sub pseudonimul „Student”, a derivat distribuția Student-\(t\)(Student, 1908), astăzi un model pentru cozi groase.
Vilfredo Pareto a descris veniturile mari prin legi de putere (power laws), strămoșul modelelor cu cozi groase. Mandelbrot (1963) a găsit cozi groase în prețurile bumbacului, pe care distribuția Normală nu le descrie. Exponentul \(\alpha\) al acestor legi de putere este tail index-ul pe care capitolul îl estimează prin metoda Hill.
Ratliff-Crain, Van Oort, Koehler & Tivnan (2025) testează din nou toate cele unsprezece fapte ale lui Cont (2001) pe randamentele intraday ale acțiunilor din Dow 30, din octombrie 2018 pînă în martie 2019, și găsesc dovezi concludente pentru opt fapte și niciun sprijin pentru celelalte trei. Chakraborti, Toke, Patriarca & Abergel (2011) trec în revistă faptele empirice ale randamentelor și ale registrului de ordine, de la frecvențe intraday la frecvențe mai joase. Alte direcții de cercetare merg dincolo de Student-\(t\) cu distribuțiile alfa-stabile, al căror tail index este sub 2 (Pele, 2014), propun măsuri ale riscului de coadă bazate pe entropie ca alternativă la kurtosis (Pele, Lazar & Dufour, 2017) și găsesc aceleași fapte la criptoactive, împreună cu un factor de coadă care le distinge de celelalte clase de active (Pele et al., 2023).
unde \(\sigma^2\) este varianța zilnică, iar \(\rho_j\) autocorelația la lagul \(j\). Fără autocorelație, (1.38) se reduce la \(h\sigma^2\), regula \(\sqrt{h}\) pentru volatilitate. Raportul de varianță (variance ratio) \(VR(h)\), varianța sumei pe \(h\) zile împărțită la \(h\sigma^2\), este peste 1 cînd autocorelația netă este pozitivă și sub 1 cînd este negativă; volatilitatea pe orizontul \(h\) este valoarea dată de regula \(\sqrt{h}\) înmulțită cu \(\sqrt{VR(h)}\).
Pe scurt
Varianța unei sume de \(h\) randamente zilnice depinde de autocorelații
Pentru un model autoregresiv de ordinul 1, AR(1), cu \(\rho_j = \rho^j\) și \(|\rho| < 1\),\(\sqrt{VR(h)}\) tinde la \(\sqrt{(1+\rho)/(1-\rho)}\) cînd \(h\) crește. Dacă autocorelația de lag 1 a EUR/RON, 0,17, este tratată ca parametru AR(1), factorul este 1,19, ceea ce ar ridica volatilitatea anuală de la 4,4% la circa 5,3%; pentru S&P 500, cu \(\rho_1 = -0{,}079\), factorul este 0,92. Folosirea autocorelației de eșantion de lag 1 ca parametru AR(1) este o ipoteză pe care trebuie să o susțină întreaga ACF. Pentru EUR/RON, autocorelațiile negative de la lagurile 2–4 compensează lagul 1, iar randamentele lunare dau tot 4,4% (Capitolul 0). Testele variance ratio sînt tratate în Capitolul 2.
Pe scurt
Model autoregresiv de ordinul 1, AR(1), cu \(\rho_j = \rho^j\): \(\sqrt{VR(h)} \to \sqrt{(1+\rho)/(1-\rho)}\) cînd \(h\) crește
\(\rho\): autocorelația de lag 1, \(|\rho| < 1\)
EUR/RON, \(\rho_1 = 0{,}17\) tratat ca parametru AR(1): factorul de corecție \(1{,}19\) (\(4{,}4\% \to\) circa \(5{,}3\%\))
S&P 500, \(\rho_1 = -0{,}079\): factorul de corecție \(0{,}92\)
Utilizarea autocorelației empirice de lag 1 ca parametru AR(1) este o ipoteză de modelare
Testul JB este un test al multiplicatorului Lagrange (Lagrange multiplier) (Jarque & Bera, 1980). Pentru randamente i.i.d. din distribuția Normală, \(\sqrt{T}(\hat S, \hat K - 3)\) tinde la \(N(0, \text{diag}(6, 24))\): cele două statistici sînt asimptotic independente, cu varianțele \(6/T\) și \(24/T\), iar JB este suma pătratelor lor standardizate, deci \(\chi^2_2\). O dependență de tip GARCH schimbă varianțele lui \(\hat S\) și \(\hat K\), așa că o respingere amestecă distribuția marginală cu independența. Bai & Ng (2005) testează asimetria, kurtosisul și normalitatea distribuției marginale a unei serii de timp cu statistici studentizate cu varianțe HAC; testele lor separate pentru \(S = 0\) și \(K = 3\) cer \(\E r^6 < \infty\) și \(\E r^8 < \infty\).
pentru randamente i.i.d. din distribuția Normală, \(\sqrt{T}\,(\hat S, \hat K - 3) \to N\big(0, \text{diag}(6, 24)\big)\), de unde rezultă distribuția \(\chi^2_2\)
\(\hat S\) și \(\hat K\) sînt asimptotic independente, cu varianțele \(6/T\) și \(24/T\): JB este suma pătratelor celor două statistici standardizate
Dependența de tip GARCH modifică \(\text{Var}(\hat S)\) și \(\text{Var}(\hat K)\)
o respingere nu separă abaterile distribuției marginale de lipsa independenței
Bai & Ng (2005): teste de asimetrie, kurtosis și normalitate pentru distribuția marginală a unei serii de timp
studentizate cu varianțe HAC
testele lor separate de asimetrie și kurtosis (ipoteza nulă \(S = 0\) sau \(K = 3\), fără normalitate) necesită \(\E r^6 < \infty\) și \(\E r^8 < \infty\)
Limita \(\chi^2_m\) a lui \(\tilde Q(m)\) (Lobato, Nankervis & Savin, 2001) cere \(\E r^4 < \infty\) și termeni încrucișați nuli, \(\E[x_t^2 x_{t-k} x_{t-l}] = 0\) pentru lagurile \(k \neq l\); atunci \(\hat\rho_k\) de la laguri diferite sînt asimptotic necorelate. Dalla, Giraitis & Phillips (2022) păstrează doar termenii încrucișați semnificativi în covarianța lui \(\hat\rho_k\), iar pentru S&P 500, BET-TR și Bitcoin nu există niciunul. Deoarece \(\hat\tau_k\) este varianța sub \(\rho_k = 0\), compararea unui \(\rho_1\) nenul între perioade cere în schimb SE-ul HAC al pantei din regresia lui \(r_t\) pe \(r_{t-1}\).
Estimatorul Hill este estimatorul de verosimilitate maximă al unei cozi Pareto peste \(u = X_{(k+1)}\), condiționat de \(u\)(Hill, 1975). Dacă \(k \to \infty\),\(k/n \to 0\) și coada este Pareto pînă la un termen de ordinul doi care dispare cînd \(x \to \infty\), atunci \(\sqrt{k}(\hat\alpha_k - \alpha) \to N(0, \alpha^2)\), ceea ce dă SE-ul \(\alpha/\sqrt{k}\); dacă \(k\) crește prea repede, apare un termen de deplasare. Sub o dependență de tip GARCH, \(\hat\alpha\) rămîne consistent, dar extremele formează clustere, iar varianța lui depășește \(\alpha^2/k\)(Hsing, 1991).Drees, Resnick & de Haan (2000) reprezintă \(\hat\alpha\) în funcție de \(\log k\), ceea ce dilată zona valorilor mici ale lui \(k\), unde se află de fapt coada. Gabaix & Ibragimov (2011) estimează \(\alpha\) ca panta regresiei lui \(\ln(i - \frac12)\) pe \(\ln X_{(i)}\),\(i = 1, \dots, k\); decalajul cu \(\frac12\) reduce deplasarea în eșantioane mici, iar SE-ul este \(\hat\alpha\sqrt{2/k}\).
Pe scurt
Estimatorul Hill este estimatorul de verosimilitate maximă pentru o coadă Pareto peste pragul \(u = X_{(k+1)}\), condiționat de \(u\) (Seminarul 1, A11)
Dacă \(k \to \infty\) și \(k/n \to 0\), iar coada este Pareto pînă la un termen de ordinul doi
Deoarece \(P(|X| > x) = P(X > x) + P(X < -x)\), randamentul absolut are tail index-ul cozii mai groase, \(\min(\alpha_-, \alpha_+)\), unde \(\alpha_-\) corespunde pierderilor, iar \(\alpha_+\) cîștigurilor. La același \(k\), cele trei estimări nu sînt comparabile, deoarece cele mai mari \(k\) valori ale lui \(|r_t|\) provin din ambele cozi; de aceea tabelul folosește un prag comun \(u\), cel mai mic dintre cele două praguri unilaterale la \(k = 2{,}5\%\) din \(n\). La acest prag comun, estimarea pentru \(|r_t|\) se află între cei doi indici unilaterali. Pierderile au coada mai groasă pe patru piețe, de exemplu 2,20 față de 3,06 pentru BET-TR, în timp ce pentru EUR/RON coada cîștigurilor este mai groasă, 2,04 față de 2,63. Estimarea de 4,2 pentru Bitcoin la \(k = 2{,}5\%\) din partea principală reflectă o deplasare de ordinul doi; la pragul comun ea este 3,02, iar ambii indici unilaterali trebuie raportați.
Estimarea de referință a capitolului este indicele Hill al lui \(|r_t|\) la \(k = 2{,}5\%\) din \(n\), ca în tabelul din partea principală. Valoarea \(k\) de la pragul comun din cadrul anterior iese din intervalul 1–5%, fiind între 5,1% (BET-TR) și 5,5% (S&P 500 și EUR/RON) din \(n\), așa că intră zile mai puțin extreme, iar \(\hat\alpha\) poate fi deplasat. Pentru EUR/RON estimarea scade de la 2,82 la 2,28, deoarece intră de peste două ori mai multe zile din coadă (295 față de 133) și deoarece coada mai groasă a cîștigurilor, \(\hat\alpha_+ = 2{,}04\), domină \(|r_t|\). Diferența reflectă sensibilitatea la prag, nu o a doua estimare a aceleiași mărimi; tabelul cu prag comun răspunde la altă întrebare, care dintre cele două cozi este mai groasă.
Pe scurt
Estimarea capitolului este cea fixată dinainte: \(|r_t|\) la \(k = 2{,}5\%\) din \(n\) (tabelul din partea principală)
La pragul comun, \(k\) pentru \(|r_t|\) iese din intervalul 1–5% din partea principală
calculată la frecvențele Fourier \(\lambda_j = 2\pi j/T\),\(j = 1, \dots, m\), cu \(m = T^{0{,}65}\) și \(x_t\) seria centrată, aici \(|r_t|\) minus media lui. Regresia pe log-periodogramă (Geweke & Porter-Hudak, 1983) regresează \(\ln I(\lambda_j)\) pe \(-2\ln(2\sin(\lambda_j/2))\). Motivul este că, din (1.30),\(\ln f(\lambda) \approx \ln G - 2d\ln\lambda\), iar \(2\sin(\lambda/2) \approx \lambda\) la frecvențe joase; panta este \(\hat d\), cu SE \(\pi/\sqrt{24m}\).
Estimatorul Whittle local (Robinson, 1995) minimizează o funcție obiectiv construită din aproximarea (1.30), după ce constanta \(G\) a fost eliminată analitic:
\[\hat d = \arg\min_d \Big[\ln\Big(\frac1m\sum_{j=1}^m \lambda_j^{2d} I(\lambda_j)\Big) - \frac{2d}{m}\sum_{j=1}^m \ln\lambda_j\Big].\]
(1.40)
El satisface \(\sqrt{m}(\hat d - d) \to N(0, \frac14)\), deci SE-ul lui este \(1/(2\sqrt{m})\), și este robust la abaterile de la normalitate. Un \(m\) mai mare reduce SE-ul, dar lasă dinamica pe termen scurt (GARCH) să deplaseze \(\hat d\).
Pe scurt
Whittle local Robinson (1995): \(\hat d\) minimizează o funcție obiectiv construită din aproximarea \(f(\lambda) \approx G\lambda^{-2d}\)
Criptoactivele formează o clasă de active cu un profil statistic propriu (Härdle, Harvey & Reule, 2020): randamentele lor au o expunere mică la factorii de risc ai piețelor tradiționale (Liu & Tsyvinski, 2021), iar factorii de coadă, de memorie și de momente le clasifică drept o clasă separată (Pele et al., 2023); modelarea criptoactivelor și indicele CRIX (CRypto IndeX) sînt tratate de Härdle, Chen & Overbeck (2017) și în Capitolul 16. EUR/RON este cursul de referință al Băncii Naționale a României (BNR) începînd cu 1 iulie 2005, cu perioade lungi de calm întrerupte de ajustări bruște. Pentru BET-TR, taxa pe activele bancare anunțată pe 18 decembrie 2018 și adoptată pe 28 decembrie 2018 prin Ordonanța de urgență a Guvernului (OUG) 114/2018 arată cum șocurile de politică economică produc prăbușiri de o zi fără creșteri comparabile. Tranzacționarea nesincronă (non-synchronous trading), faptul că nu toate componentele unui indice se tranzacționează în fiecare moment, face ca indicele să reflecte știrile cu întîrziere și creează autocorelație pozitivă (Campbell, Lo & MacKinlay, 1997).
Pentru o mișcare browniană fără drift a logaritmului prețului, cu volatilitatea anuală \(\sigma\) pe un orizont de \(T\) ani, drawdown-ul maxim logaritmic \(D = -\ln(1 + MDD)\) are media (Magdon-Ismail, Atiya, Pratap & Abu-Mostafa, 2004)
\[\E[D] = \sqrt{\pi/2}\,\sigma\sqrt{T},\]
(1.41)
cu \(\sqrt{\pi/2} \approx 1{,}25\); aici \(T\) este orizontul în ani, iar \(MDD = e^{-D} - 1\). Cu un drift pozitiv, \(\E[D]\) crește doar ca \(\ln T\). Pentru aur în 1990–2026, cu \(\sigma = 16{,}3\%\) și \(T = 36{,}7\) ani, (1.41) dă \(\E[D] = 1{,}24\), dublul valorii observate de 0,592 (un MDD de \(-44{,}7\%\)); cu driftul observat, de 6,5% pe an, \(\E[D]\) este de circa 0,62 după formulă și 0,64 prin simulare, aproape de valoarea observată. Deoarece \(\E[D]\) crește cu orizontul, drawdown-urile și rapoartele Calmar din eșantioane de lungimi diferite nu sînt comparabile.
Pe scurt
Mișcare browniană fără drift a logaritmului prețului, cu volatilitatea anuală \(\sigma\), pe \(T\) ani
aici \(T\) este orizontul în ani, nu numărul de zile
Drawdown-ul maxim logaritmic\(D = -\ln(1 + MDD) \geq 0\), cea mai mare scădere a logaritmului prețului, are
unde \(S\) și \(K\) sînt asimetria și kurtosisul randamentelor zilnice. Pentru distribuția Normală, cu \(S = 0\) și \(K = 3\),(1.42) se reduce la formula lui Lo (2002). Asimetria negativă și kurtosisul mare cresc varianța cînd \(SR_d > 0\), dar pe cele cinci piețe erorile standard se modifică cu cel mult 0,02. Tabelul dă CAGR și rapoartele Sharpe, Sortino și Calmar ale fiecărei piețe; BET-TR are cel mai mare raport Sharpe, 1,34, iar EUR/RON cel mai mic, 0,43. Raportul Sharpe deflatat (deflated Sharpe ratio), care corectează pentru abaterile de la normalitate și pentru testarea multiplă, este tratat în Capitolul 13.
Guyon & Lekeufack (2023) folosesc două tipuri de variabile țintă: indicele de volatilitate implicită pe 30 de zile al fiecărui indice bursier, împreună cu VIX pe 9 zile, și volatilitatea realizată a zilei \(t+1\). Nucleele sînt TSPL din (1.36), normalizate pe fereastra de 1 000 de zile, iar cei șapte parametri se estimează prin cele mai mici pătrate neliniare pe eșantionul de antrenare, pornind de la o regresie lasso pe variabile construite cu nuclee exponențiale. Pornind de la valorile din Tabelul 3 al lucrării, reestimarea pe datele cursului dă \(\hat\beta_0 = 0{,}052\) (lucrarea: 0,057), \(\hat\beta_1 = -0{,}090\)(\(-0{,}095\)),\(\hat\beta_2 = 0{,}868\) (0,82) și \(\hat\alpha_1 = 1{,}13\) (1,06). VIX pe 9 zile există doar din 2011, deci eșantionul lui de antrenare este mai scurt.
Pe scurt
Variabile explicate (Secțiunile 3.4–3.5 din lucrare)
indicele de volatilitate implicită pe 30 de zile al fiecărui indice și VIX pe 9 zile
volatilitatea realizată a zilei \(t+1\)
Nucleele, ec. (3.9) din lucrare: \(K(\tau) = Z^{-1}_{\alpha,\delta}(\tau + \delta)^{-\alpha}\), normalizate pe fereastra de 1 000 de zile
Estimare: \((\beta_0, \beta_1, \beta_2, \alpha_1, \delta_1, \alpha_2, \delta_2)\) prin cele mai mici pătrate neliniare pe eșantionul de antrenare
pornind de la o regresie lasso pe variabile construite cu nuclee exponențiale
Replicarea noastră
între paranteze, valorile din Tabelul 3 al lucrării
Tabelul dă valorile \(R^2\) din lucrare pentru încă doi indici. Pentru volatilitatea implicită (Tabelul 2 al lucrării), modelul atinge 0,925 pe antrenare și 0,870 pe test pentru FTSE 100, respectiv 0,934 și 0,918 pentru DAX; pentru volatilitatea realizată (Tabelul 4) valorile sînt mai mici, între 0,557 și 0,722. Pentru toate variabilele țintă, \(\alpha_2\) estimat se află între 1,2 și 2,3 (Tabelele 3 și 5), ceea ce lucrarea descrie drept memorie lungă aproape de criticitate. Eliminarea lui \(\Sigma_t\) afectează cel mai mult ajustarea, iar modelul depășește două modele de referință ARCH și patru modele publicate dependente de traiectorie.
Pe scurt
Volatilitate implicită (lucrarea, Tabelul 2)
Volatilitate realizată (lucrarea, Tabelul 4)
Indice
\(R^2\) antrenare
\(R^2\) test
\(R^2\) antrenare
\(R^2\) test
FTSE 100
0,925
0,870
0,650
0,617
DAX
0,934
0,918
0,722
0,557
Pentru toate variabilele explicate, \(\alpha_2 \in [1{,}2;\ 2{,}3]\) (Tabelele 3 și 5 din lucrare)
memorie lungă aproape de pragul critic (Secțiunea 3.2)
Eliminarea lui \(\Sigma_t\) deteriorează cel mai mult calitatea ajustării
Modelul are performanțe superioare față de modelele de referință (Figurile 3.8–3.9 și Anexa C din lucrare)
Dincolo de cadrul cursului, lucrarea construiește și o versiune markoviană cu patru factori a modelului, condusă de o mișcare browniană (Secțiunea 4.6). În formularea autorilor, ea produce traiectorii ale volatilității care arată rough. Exponentul Hurst \(H\) măsoară rugozitatea unei traiectorii: mișcarea browniană are \(H = 0{,}5\), iar \(H < 0{,}5\) înseamnă o traiectorie mai rugoasă. Modelul nu are volatilitate rugoasă (rough volatility) încorporată; rugozitatea traiectoriilor vine din dependența volatilității de randamentele trecute.
Pe scurt
Dincolo de acest curs (opțional): versiunea markoviană cu 4 factori
generată de mișcări browniene (Secțiunea 4.6 din lucrare)
produce traiectorii ale volatilității care arată aspră (rough), în formularea autorilor
aspră: traiectorie cu exponentul Hurst \(H < 0{,}5\); mișcarea browniană are \(H = 0{,}5\)
modelul nu are volatilitatea aspră construită în el: neregularitatea vine din dependența de traiectorie
Cadrul dă prompturi reutilizabile pentru fiecare etapă a buclei de descoperire, aplicate unei posibile schimbări a cozii lui Bitcoin după lansarea ETF-urilor spot în 2024. Promptul de literatură cere lucrări evaluate de colegi (peer-reviewed) din 2015 încoace despre variația în timp sau rupturile tail index-urilor, cu teste valide sub o dependență de tip GARCH, și cere DOI-ul fiecărei lucrări și semnalarea intrărilor nesigure. Promptul de ipoteze întreabă ce implică explicațiile concurente pentru estimarea Hill pe randamentele brute și pe cele standardizate cu GARCH. Prompturile pentru date, robustețe și critică fixează estimatorul (\(k = 2{,}5\%\) din \(n\), ruptura pe 11 ianuarie 2024, SE prin bootstrap pe blocuri), un plan de robustețe preînregistrat, cu o dată placebo și un activ placebo, și o întrebare despre puterea designului cu 24 de observații în coadă după ruptură.
Pe scurt
Literatură
Găsește lucrări cu evaluare inter pares, din 2015 încoace, despre variația în timp sau rupturile structurale ale indicilor cozii randamentelor, cu teste valide sub dependență de tip GARCH.
Pentru fiecare: DOI, estimator, test, date.
Marchează referințele de care nu ești sigur.
Ipoteză
Formulează ipoteze concurente pentru o schimbare a cozii randamentelor Bitcoin după lansarea ETF-urilor spot în 2024.
Ce implică fiecare pentru estimarea Hill a indicelui cozii, pe randamentele brute și pe cele standardizate cu GARCH?
Date și cod
Folosește prețurile zilnice de închidere ale Bitcoin (în USD); randamente logaritmice pe propriul calendar;
estimarea Hill a indicelui cozii pentru |r|, cu k = 2,5% din n, înainte și după 11 ianuarie 2024; erori standard prin bootstrap pe blocuri suprapuse.
Robustețe
Scrie un plan preînregistrat: k de la 1% la 5% din n, coada pierderilor și coada cîștigurilor, reziduuri standardizate GARCH, blocuri de 10 pînă la 50 de zile, o dată placebo și un activ placebo.
Critică
Evaluează acest plan de cercetare ca un recenzent.
Cu 24 de observații în coadă după ruptură, ce putere are testul față de o schimbare de 1 a indicelui cozii?
Fiecare verificare acoperă un mod în care o analiză a tail index-ului asistată de AI poate greși. Seria de randamente trebuie să reproducă înainte de orice tabelul Hill al capitolului. Regula pentru \(k\) trebuie fixată dinainte, cu Hill plot-ul arătat pentru 1–5% din \(n\). SE-ul i.i.d. \(\hat\alpha/\sqrt{k}\) ignoră volatility clustering: pentru S&P 500 în 17 septembrie 2014 – 10 ianuarie 2024, SE-ul prin bootstrap pe blocuri este 0,817, față de 0,370, de 2,2 ori mai mare. Data unei rupturi trebuie fixată de eveniment sau testată cu un test de tip sup pentru punct de schimbare, cu propriile valori critice (Hoga, 2017). Tick-urile eronate creează cozi false, așa că cele mai mari zece valori \(|r_t|\) trebuie puse în corespondență cu evenimente datate. Puterea redusă se raportează prin schimbarea minimă detectabilă: 2,8 SE ale diferenței pentru un test bilateral la 5% cu putere de 80%, 2,5 SE pentru un test unilateral.
Pe scurt
Serie greșită de randamente sau de prețuri: reproduceți întîi tabelul Hill al capitolului
Alegerea lui \(k\) după ce vedeți rezultatul
fixați regula (\(k = 2{,}5\%\) din \(n\)) dinainte
prezentați graficul Hill pentru 1–5%
Erori standard i.i.d.: \(\hat\alpha/\sqrt{k}\) ignoră gruparea volatilității
comparați cu un bootstrap pe blocuri
S&P 500, 17 sept. 2014–10 ian. 2024: SE bootstrap \(0{,}817\), față de \(0{,}370\) i.i.d., de \(2{,}2\) ori mai mare
Data rupturii aleasă după inspectarea datelor
folosiți o dată fixată de eveniment
sau un test de punct de schimbare de tip sup, cu propriile valori critice Hoga (2017)
Cotațiile eronate creează cozi false
listați cele mai mari zece valori \(|r_t|\) și asociați fiecăreia un eveniment datat
Putere mică: raportați schimbarea minimă detectabilă
\(2{,}8\) SE ale diferenței pentru un test bilateral la 5% cu putere de 80%
Lista rezumă practicile de lucru cu date din capitol:
Cunoașteți datele: indice de preț sau indice total return, prețuri ajustate sau brute, fixing sau preț tranzacționat și, unde există, cursuri oficiale de referință, ca pentru EUR/RON;
Curățați datele înainte de modelare: zile fără tranzacționare, sărbători, cotații învechite și erori evidente, cu cele mai mari variații puse în corespondență cu evenimente reale;
Folosiți randamente logaritmice pentru dinamica unui singur activ și randamente simple pentru portofolii;
Raportați cuantilele, numărul de zile din cozi și tail index-ul alături de kurtosis;
Anualizați cu numărul corect de perioade, 252 sau 365, ținînd cont că regula \(\sqrt{A}\) cere randamente necorelate cu varianță constantă;
Publicați codul și datele ca Quantlets.
Pe scurt
Cunoașteți-vă datele
indice de preț sau de randament total
prețuri ajustate sau brute
fixing sau preț tranzacționat
cursuri oficiale de referință, acolo unde există (EUR/RON)
Curățați înainte de a modela
zile fără tranzacții, sărbători, cotații neactualizate, erori evidente
asociați cele mai mari variații unor evenimente identificabile
Folosiți randamente logaritmice pentru dinamica unui activ, randamente simple pentru portofolii
Raportați statistici robuste: cuantile, frecvența depășirilor și indicele cozii \(\hat\alpha\) alături de kurtosis
Anualizați cu atenție
252 sau 365 de perioade pe an
regula \(\sqrt{A}\) presupune randamente necorelate cu varianță constantă
Reproductibilitate: cod și date pe GitHub, ca Quantlet-uri
Trei cursuri de pe Quantinar extind capitolul: Statistics of Financial Markets, Tukey's g- and h-transformations și Applied Time Series Analysis with Python. Toate graficele și tabelele capitolului sînt reproduse de Quantlet-urile din depozitul cursului. Lecturile recomandate sînt Cont (2001),Franke, Härdle & Hafner (2019) și capitolele 1–2 din Campbell, Lo & MacKinlay (1997).
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?. The European Journal of Finance, 29(10), 1064–1105.
Prețuri de închidere zilnice pînă la 18 septembrie 2026: S&P 500, BET-TR, Bitcoin, aur spot și VIX din EODHD; EUR/RON: cursul de referință BNR. Studiul de caz 2: SPY (deschidere, închidere, închidere ajustată) și barele Bitcoin de 5 minute, din EODHD. Randamente logaritmice, fiecare serie pe propriul calendar.


 Benoît Mandelbrot.
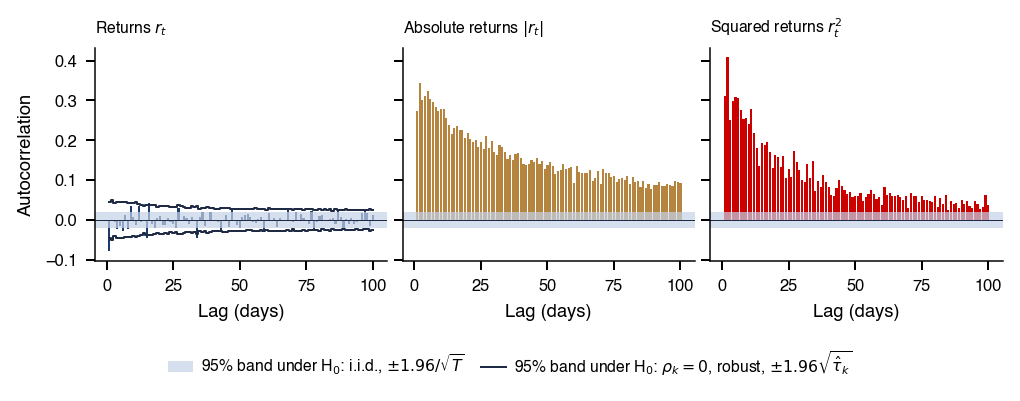
 MFM_ch1_returns
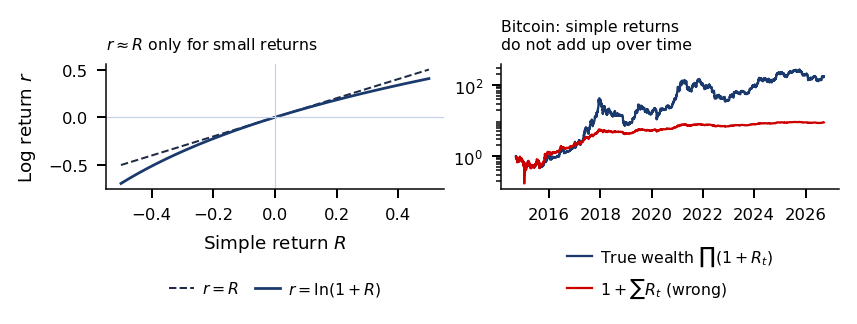

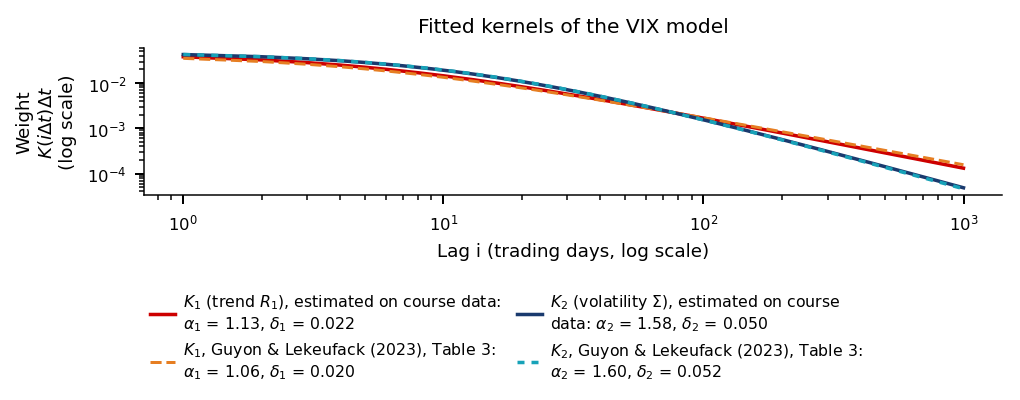
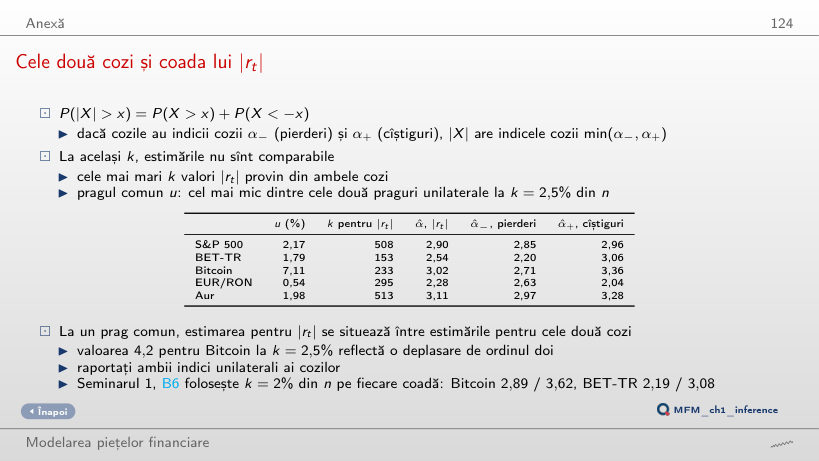
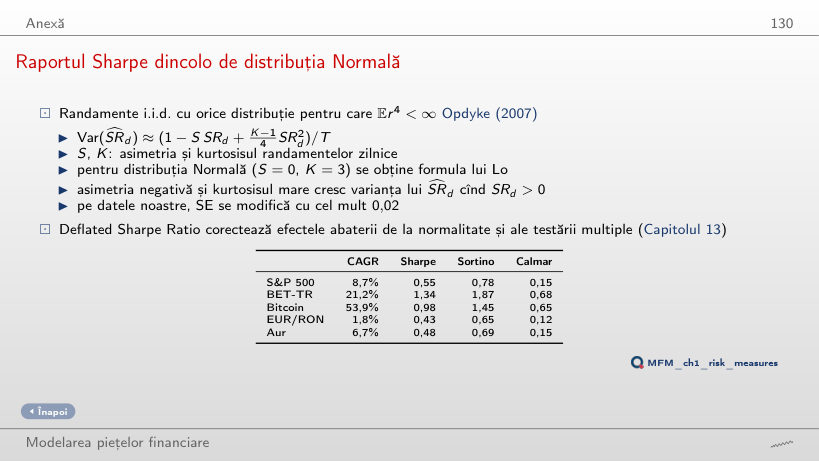
 Statistics of Financial Markets