Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Poate o regulă estimată să depășească ponderile egale?
“The process of selecting a portfolio may be divided into two stages. The first stage starts with observation and experience and ends with beliefs about the future performances of available securities.” — Markowitz (1952)
16 active și 60 de luni de date: 152 de parametri de estimat, 16 medii și 136 de varianțe și covarianțe
2 000 de portofolii tangente simulate: raportul Sharpe estimat are mediana \(1{,}56\)
raportul Sharpe adevărat, calculat cu parametrii populației, are mediana \(0{,}30\)
96% dintre ele au un Sharpe adevărat sub cel al ponderilor egale, 1/N (\(0{,}54\))
În afara eșantionului (out-of-sample), pe 16 ETF-uri, înainte de costuri: Sharpe \(0{,}76\) pentru 1/N, între \(0{,}20\) și \(0{,}36\) pentru regulile GMV
ETF: Exchange-Traded Fund, fond tranzacționat la bursă
GMV: portofoliul de varianță minimă globală (global minimum-variance)
The process of selecting a portfolio may be divided into two stages. The first stage starts with observation and experience and ends with beliefs about the future performances of available securities.
Articolul lui Markowitz (1952) tratează doar a doua etapă: alegerea portofoliului pe baza opiniilor despre titluri. Cînd mediile și covarianțele randamentelor sînt cunoscute, ea are soluții în formă închisă, de exemplu portofoliul de varianță minimă globală (GMV, global minimum-variance) și portofoliul tangent (tangency portfolio). În aplicații, prima etapă înseamnă estimarea acestor parametri din date. Pentru 16 active trebuie estimați 152 de parametri, 16 medii și 136 de varianțe și covarianțe, dintr-o fereastră de 60 de observații lunare. Optimizatorul atribuie ponderi mari exact activelor ale căror parametri sînt estimați cu cele mai mari erori.
Simularea din capitol măsoară efectul acestor erori. Parametrii adevărați sînt momentele celor nouă sectoare din SUA, iar fiecare eșantion simulat are 60 de luni. Pentru 2 000 de portofolii tangente estimate, valoarea absolută a raportului Sharpe (Sharpe ratio) estimat in-sample, \(|\hat\theta|\), are mediana 1,56, iar raportul Sharpe adevărat, calculat cu parametrii populației, are mediana 0,30. Dintre aceste portofolii, 96% au un raport Sharpe adevărat mai mic decît cel al ponderilor egale, 1/N, care este 0,54. În aceeași simulare, portofoliul medie–varianță (MV) estimat depășește 1/N abia cu ferestre de 480 de luni.
Backtest-ul out-of-sample pe date reale duce la aceeași concluzie. Averea portofoliului MV nerestricționat ajunge la zero în toate cele trei universuri americane. În universul combinat de 16 ETF-uri (Exchange-Traded Fund, fond tranzacționat la bursă), înainte de costuri, 1/N are un raport Sharpe de 0,76, iar regulile GMV între 0,20 și 0,36. Regula MV-LO, portofoliul tangent long-only, are cea mai bună estimație punctuală, 0,81, dar nu mai depășește 1/N la costuri de peste circa 22 de puncte de bază (bp, basis points). Capitolul studiază de aceea corecțiile datelor de intrare și regulile bazate pe risc, care reduc efectul erorii de estimare, și testele care decid dacă diferența față de 1/N rămîne semnificativă după corecția pentru testarea multiplă (multiple testing).
Eroarea de estimare (estimation error) în 25 de eșantioane simulate de 60 de luni din cele nouă sectoare din SUA: frontierele estimate (roșu) se află deasupra frontierei adevărate (albastru), iar aceleași portofolii, evaluate cu parametrii adevărați (verde), se află sub ea; pe axa orizontală este volatilitatea anualizată, pe cea verticală media anualizată a randamentelor în exces. Graficul interactiv: „Maximizarea erorii: frontiere estimate față de frontiere realizate (1/2)” →
Rezultatele învățării
Derivați portofoliile GMV și tangent și deplasarea raportului Sharpe in-sample.
Calculați ponderile cu contribuții egale la risc (ERC, equal risk contribution) și raportul Sharpe net de costuri.
Interpretați de ce erorile de estimare favorizează regula 1/N.
Interpretați un test al raportului Sharpe după corecția pentru testarea multiplă.
Evaluarea în afara eșantionuluiProtocolul de backtesting, turnover și costuri, testul diferenței de Sharpe și testarea multiplă.
Un portofoliu de blue chips BVBAceleași reguli pe opt acțiuni de la Bursa de Valori București, comparate cu BET-TR (BET Total Return, index, indicele BET cu dividendele reinvestite).
Capitolul tratează alegerea ponderilor unui portofoliu de active riscante. Teoria clasică dă portofoliul optim în formă închisă, ca funcție de mediile și de covarianțele randamentelor. În practică acești parametri nu se cunosc, ci se estimează din date, iar erorile de estimare se transmit în ponderi. Reperul (benchmark) folosit pe tot parcursul capitolului este regula ponderilor egale, 1/N, care nu estimează nimic. Întrebarea este dacă vreo regulă estimată o depășește out-of-sample, după costurile de tranzacționare.
Un portofoliu de \(N\) active este un vector de ponderi \(\mathbf{w} = (w_1, \dots, w_N)^\top\) cu \(\mathbf{w}^\top\mathbf{1} = 1\), unde \(\mathbf{1}\) este vectorul de unu. Cînd mediile și covarianțele randamentelor sînt cunoscute, portofoliul optim are formă închisă. Dificultatea apare cînd ele se înlocuiesc cu estimări: optimizatorul atribuie ponderi mari exact activelor ale căror medii și covarianțe sînt estimate cu cele mai mari erori.
Dimensiunea problemei arată de ce erorile sînt mari. Pentru 16 active trebuie estimate 16 medii și 136 de varianțe și covarianțe distincte, adică 152 de parametri. Cu o fereastră de 60 de observații lunare, numărul parametrilor depășește de peste două ori numărul observațiilor. Întrebarea capitolului este dacă o regulă estimată în aceste condiții poate depăși ponderile egale out-of-sample, după costuri.
Pe scurt
Optimul este simplu, estimarea nu
Un portofoliu este un vector de ponderi \(\mathbf{w} = (w_1,\dots,w_N)^\top\) cu \(\mathbf{w}^\top\mathbf{1} = 1\)
Optimul are formă închisă cînd mediile și covarianțele sînt cunoscute, dar estimarea lui este dificilă
Optimizatorul atribuie ponderi mari exact acolo unde erorile de estimare sînt cele mai mari
16 active: \(16\) medii \(+\ 136\) varianțe și covarianțe \(= 152\) de parametri, estimați din 60 de observații lunare
Întrebarea capitolului: poate o regulă estimată să depășească ponderile egale în afara eșantionului, după costuri?
Optimizarea medie–varianță (mean–variance optimisation) cu parametri cunoscuți: portofoliul de varianță minimă globală (GMV), portofoliul tangent, frontiera și restricțiile asupra ponderilor.
Măsurarea riscului de estimare și explicarea motivului pentru care rapoartele Sharpe calculate in-sample sînt prea optimiste.
Trei corecții ale datelor de intrare: shrinkage-ul matricei de covarianță, restricțiile și modelul Black–Litterman.
Regulile care folosesc doar matricea de covarianță \(\boldsymbol\Sigma\): contribuțiile egale la risc (ERC, equal risk contribution) și Hierarchical Risk Parity (HRP).
Evaluarea out-of-sample a regulilor, cu turnover, costuri de tranzacționare, teste ale diferenței dintre rapoarte Sharpe și corecțiile Holm și Benjamini–Hochberg pentru testarea multiplă (multiple testing).
Aplicarea metodelor pe acțiuni de la Bursa de Valori București (BVB).
După acest traseu urmează două studii de caz, despre costuri și despre gestionarea după volatilitate, și o secțiune despre cercetarea asistată de inteligența artificială (AI) și despre data snooping. Exemplele detaliate sînt în Aprofundări, iar demonstrațiile și tabelele complete în Anexă. Manualul de referință este Franke, Härdle & Hafner (2019), Partea I.
Pe scurt
Traseul de bază
Medie–varianță: ponderile de varianță minimă globală (GMV) și tangente, frontiera, restricțiile
Riscul de estimare: de ce rapoartele Sharpe în eșantion (in-sample) sînt prea optimiste
Trei corecții ale datelor de intrare: contracția (shrinkage) covarianței, restricțiile, Black–Litterman
Reguli care folosesc doar \(\boldsymbol\Sigma\): equal risk contribution (ERC) și Hierarchical Risk Parity (HRP)
Evaluarea în afara eșantionului: turnover și costuri, teste ale diferenței de Sharpe, Holm și Benjamini–Hochberg
Aplicația pe Bursa de Valori București (BVB)
Exemplele detaliate și subiectele avansate sînt în Aprofundări, după Concluzii
butonul din subsol duce la ele, iar butonul Înapoi revine la slide-ul de plecare
Pentru aprofundare
Studii de caz: costuri, gestiunea volatilității
Cercetarea asistată de inteligența artificială (AI) și căutarea repetată în aceleași date (data snooping)
Universul sectoarelor conține 9 ETF-uri sectoriale din SUA, cu randamente din ianuarie 1999 pînă în iulie 2026. Un ETF (exchange-traded fund) este un fond tranzacționat la bursă care replică un indice.
Universul multi-active conține 8 ETF-uri, cu randamente din mai 2007 pînă în iulie 2026: trei de acțiuni, două de titluri de stat, două de credit și unul de aur.
Universul combinat reunește cele 9 sectoare și cele 7 ETF-uri multi-active diferite de SPY, care replică indicele S&P 500 (Standard & Poor's), în total 16 ETF-uri.
Universul BVB conține 8 blue chips de la BVB, în lei, din octombrie 2014 pînă în august 2026, împreună cu indicii BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București) și BET-TR.
Cele trei universuri americane diferă prin structura corelațiilor. Sectoarele sînt active asemănătoare, cu corelații mari. Universul multi-active cuprinde clase cu corelații de semn opus, de exemplu acțiunile și titlurile de stat. Universul combinat ridică \(N\) la 16 și accentuează astfel eroarea de estimare. Eșantioanele încep la lansarea ETF-urilor sectoriale, în decembrie 1998, și a lui HYG (iShares iBoxx High Yield Corporate Bond ETF, ETF de obligațiuni corporative americane cu randament ridicat, sub rating investițional), în aprilie 2007.
Randamentele sînt simple și lunare, calculate din prețurile de la sfîrșitul lunii, cu dividendele reinvestite. BET (Bucharest Exchange Trading), indicele de referință al BVB, este un indice de preț, iar BET-TR (total return) reinvestește dividendele. Pentru universurile americane, randamentele în exces (excess returns) se calculează față de titlul de stat american cu scadența de o lună (T-bill), iar reperul este regula 1/N. Ea atribuie ponderi egale, \(w_i = 1/N\), reechilibrate lunar, fără nicio estimare. Pentru BVB, reperul este BET-TR și se adoptă convenția \(R_f = 0\).
Pe scurt
Univers
Active
Randamente
Monedă
Sectoare
9 ETF-uri sectoriale din SUA
1999/01 – 2026/07
USD (US dollar, dolarul american)
Multi-active
8 ETF-uri: acțiuni (3), titluri de stat (2), credit (2), aur
2007/05 – 2026/07
USD
Combinat
9 sectoare \(+\) cele 7 ETF-uri multi-active, fără SPY (S&P 500) (16 ETF-uri)
2007/05 – 2026/07
USD
România
8 blue chips BVB; indicii BET și BET-TR
2014/10 – 2026/08
RON (Romanian leu, leul românesc)
ETF (exchange-traded fund): fond tranzacționat la bursă, care replică un indice
De ce trei universuri
sectoarele sînt active asemănătoare, cu corelații mari
multi-active cuprinde clase cu corelații de semn opus (acțiuni și titluri de stat)
combinatul ridică \(N\) la 16 și accentuează eroarea de estimare
Începutul eșantioanelor: lansarea ETF-urilor sectoriale (decembrie 1998) și a lui HYG (obligațiuni corporative cu randament ridicat, high yield; aprilie 2007)
Randamente lunare simple din prețurile de sfîrșit de lună, cu dividendele reinvestite
BET (Bucharest Exchange Trading), indicele de referință al BVB, este indice de preț; BET-TR (total return) reinvestește dividendele
Randamente în exces față de titlul de stat la o lună al Statelor Unite ale Americii (SUA) (Kenneth French Data Library)
Fie \(P_{i,t}\) prețul activului \(i\) la sfîrșitul lunii \(t\), ajustat pentru dividende și alte distribuții; BET rămîne un indice de preț. Randamentul simplu (total) este \(R_{i,t} = P_{i,t}/P_{i,t-1} - 1\), iar randamentul în exces este \(R^e_{i,t} = R_{i,t} - R_{f,t}\), unde \(R_{f,t}\) este rata fără risc (risk-free rate). În seminar, aceleași mărimi se notează \(r_t\) și \(r^e_t\). Randamentul logaritmic \(\ln(P_{i,t}/P_{i,t-1}) = \ln(1 + R_{i,t})\) se adună în timp, dar nu între active. Portofoliile folosesc de aceea randamente simple: randamentul portofoliului este exact \(R_{p,t} = \sum_i w_i R_{i,t}\).
Pentru un portofoliu de \(N\) active, \(\mathbf{w}\) este vectorul ponderilor, \(\boldsymbol\mu\) vectorul randamentelor (în exces) așteptate, \(\mathbf{1}\) vectorul de unu și \(\boldsymbol\Sigma\) matricea de covarianță \(N\times N\) a randamentelor. Media portofoliului este \(\mathbf{w}^\top\boldsymbol\mu\), iar varianța lui este \(\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\).
Raportul Sharpe (Sharpe ratio) al portofoliului \(p\) (Sharpe, 1966) este \(SR_p = \mathbb{E}[R^e_p]/\sigma(R^e_p)\), randamentul mediu în exces pe unitatea de volatilitate \(\sigma\). Cifrele lunare se anualizează înmulțind media cu 12, iar volatilitatea și raportul Sharpe cu \(\sqrt{12}\). Fie \(W_t\) averea la momentul \(t\). Drawdown-ul maxim, \(\min_t (W_t/\max_{s\le t}W_s - 1)\), este cea mai mare scădere relativă a averii față de un maxim anterior.
O evaluare este out-of-sample (OOS) cînd ponderile deținute în luna \(t\) folosesc doar date pînă în luna \(t-1\); este in-sample cînd aceleași date servesc la estimare și la evaluare. Regulile comparate în capitol sînt:
MV (mean–variance), portofoliul tangent calculat din momentele de eșantion;
GMV, portofoliul de varianță minimă globală;
MV-LO și GMV-LO, versiunile lor long-only (LO), fără vînzări în lipsă;
GMV-LW, portofoliul GMV calculat cu matricea de covarianță supusă shrinkage-ului Ledoit–Wolf (LW);
MV-LO și GMV-LO (Global Minimum-Variance portfolio, Long-Only, portofoliul de varianță minimă globală, doar poziții long): versiunile lor doar cu poziții long (long-only, LO), adică fără vînzări în lipsă (\(w_i \ge 0\))
GMV-LW: GMV cu contracția Ledoit–Wolf (LW) a covarianței
ERC (equal risk contribution) și HRP: reguli bazate pe risc
1/N: ponderi egale
Sinteza secțiunii
Datele acoperă trei universuri americane cu structuri de corelație diferite și un univers românesc. Toate regulile se compară cu 1/N, iar comparația principală este out-of-sample. Secțiunea următoare derivă regulile cu parametri cunoscuți, iar secțiunea despre riscul de estimare arată ce se pierde cînd parametrii se estimează.
Optimizarea medie–varianță
Această secțiune rezolvă problema alegerii portofoliului în ipoteza că parametrii sînt cunoscuți. Există \(N\) active riscante, cu vectorul randamentelor în exces așteptate \(\boldsymbol\mu\) și matricea de covarianță \(\boldsymbol\Sigma\), presupusă pozitiv definită. Un portofoliu este un vector de ponderi \(\mathbf{w}\) cu \(\mathbf{w}^\top\mathbf{1} = 1\); media lui este \(\mathbf{w}^\top\boldsymbol\mu\), iar varianța \(\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\). Orizontul are o singură perioadă, ponderile negative sînt permise pînă la ultima parte a secțiunii și nu există costuri de tranzacționare.
Problema alegerii după medie și varianță este cea a lui Markowitz (1952). Rezultatele sînt formule în formă închisă: portofoliul de varianță minimă globală (GMV), portofoliul tangent (tangency portfolio) și frontiera de varianță minimă (minimum-variance frontier) (Merton, 1972). Toate se exprimă prin \(\boldsymbol\Sigma^{-1}\) și prin trei scalari, \(A\),\(B\) și \(C\). Ele descriu alegerea unui investitor care cunoaște \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\). În aplicații acești parametri se estimează, iar secțiunile următoare arată cît se degradează aceleași formule cînd primesc estimări. Versiunea cu parametri cunoscuți este reperul față de care se măsoară această pierdere.
Markowitz (1952) a formulat alegerea portofoliului ca un compromis între doi parametri ai distribuției randamentului portofoliului: media și varianța. Dacă \(\mathbf{R}\) este vectorul randamentelor celor \(N\) active, randamentul portofoliului este \(R_p = \mathbf{w}^\top\mathbf{R}\), cu media \(\mathbf{w}^\top\boldsymbol\mu\) și varianța \(\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\). Celelalte caracteristici ale distribuției, de exemplu asimetria și cozile, nu intră în criteriu.
Frontiera de varianță minimă se obține fixînd o medie-țintă \(m\) și căutînd portofoliul complet investit (fully invested) cu cea mai mică varianță:
În (4.1), restricția \(\mathbf{w}^\top\mathbf{1} = 1\) cere ca întreaga avere să fie investită în cele \(N\) active, iar restricția \(\mathbf{w}^\top\boldsymbol\mu = m\) fixează media. Funcția obiectiv este strict convexă, deoarece \(\boldsymbol\Sigma\) este pozitiv definită, iar restricțiile sînt liniare. Dacă \(\boldsymbol\mu\) nu este proporțional cu \(\mathbf{1}\), pentru fiecare \(m\) există deci un singur portofoliu optim. Varianța lui, notată \(\sigma^2(m)\), descrie o curbă în planul (volatilitate, medie).
Faptul că \(\boldsymbol\mu\) conține randamente în exces nu schimbă această problemă. Deoarece ponderile însumează 1, trecerea la randamente totale adaugă aceeași constantă \(R_f\) la media oricărui portofoliu admisibil: frontiera se translatează pe verticală, iar ponderile ei rămîn aceleași.
Nu toate punctele curbei sînt alegeri raționale. Curba are un punct de varianță minimă, portofoliul GMV, cu media \(\mu_{\text{GMV}}\). Pentru o medie-țintă \(m < \mu_{\text{GMV}}\) există un portofoliu cu aceeași varianță și cu o medie mai mare, simetricul lui față de \(\mu_{\text{GMV}}\); simetria rezultă din forma închisă (4.11) a frontierei, derivată mai jos. De aceea doar ramura superioară, \(m \ge \mu_{\text{GMV}}\), este frontiera eficientă (efficient frontier).
A doua formulare pornește de la preferințe. Un investitor cu aversiunea la risc (risk aversion) \(\gamma > 0\) rezolvă
fiecare unitate de varianță îl costă \(\gamma/2\) unități de medie. Pentru fiecare \(\gamma\) soluția lui (4.2) se află pe ramura eficientă. Cînd \(\gamma\) parcurge \((0, \infty)\), soluția parcurge întreaga ramură, cu GMV ca limită pentru \(\gamma \to \infty\). Soluția explicită, (4.13), folosește scalarii \(A\),\(B\) și \(C\) și este dată la frontiera în formă închisă.
Problema nu impune semnul ponderilor. O pondere negativă \(w_i < 0\) este o vînzare în lipsă (short selling): investitorul împrumută activul \(i\), îl vinde și folosește încasarea pentru a cumpăra alte active. Formulele închise din această secțiune presupun că vînzările în lipsă sînt permise și nu costă nimic; restricția \(w_i \ge 0\) apare în ultima parte a secțiunii.
Pe scurt
Întrebarea secțiunii: ce ponderi alegem dacă \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\) sînt cunoscute?
Markowitz (1952): investitorii țin cont de media și de varianța randamentelor portofoliului
Frontiera de varianță minimă: varianța minimă pentru fiecare medie-țintă \(m\)
ramura ei superioară, \(m \ge \mu_{\text{GMV}}\) (media portofoliului GMV), este frontiera eficientă
restricțiile: media-țintă \(m\) și investirea integrală (ponderile însumează 1)
Forma cu utilitate, aversiunea la risc \(\gamma > 0\): \(\max_{\mathbf{w}}\ \mathbf{w}^\top\boldsymbol\mu - \frac{\gamma}{2}\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\) cu \(\mathbf{w}^\top\mathbf{1} = 1\)
Cazul cu două active arată mecanismul diversificării fără algebră matriceală. Fie \(w\) ponderea activului 1 și \(1-w\) ponderea activului 2, cu volatilitățile \(\sigma_1\) și \(\sigma_2\) și corelația \(\rho\). Varianța portofoliului este
iar media lui este liniară în \(w\). Corelația intră doar prin termenul încrucișat. Cu cît \(\rho\) este mai mic, cu atît este mai mică varianța oricărui portofoliu cu \(0 < w < 1\).
Condiția de ordinul întîi \(\mathrm{d}\sigma_p^2/\mathrm{d}w = 0\) se scrie
Numitorul din (4.4) este varianța diferenței \(R_1 - R_2\), pozitivă în afara cazului degenerat \(\rho = 1\),\(\sigma_1 = \sigma_2\), deci \(w^*\) este un minim. Numărătorul arată că \(w^*\) este negativă cînd \(\rho > \sigma_2/\sigma_1\). Dacă activul mai volatil este suficient de corelat cu celălalt, varianța minimă cere vînzarea lui în lipsă.
Două cazuri limită ale lui (4.3) fixează intuiția. Pentru \(\rho = 1\),\(\sigma_p = |w\sigma_1 + (1-w)\sigma_2|\): cînd \(0 \le w \le 1\), volatilitatea portofoliului este media ponderată a volatilităților și diversificarea nu reduce riscul. Pentru \(\rho = -1\),\(\sigma_p = |w\sigma_1 - (1-w)\sigma_2|\), care se anulează la \(w = \sigma_2/(\sigma_1 + \sigma_2)\): două active riscante perfect negativ corelate formează un portofoliu fără risc.
Graficul interactiv are pe axa orizontală volatilitatea anualizată, iar pe axa verticală media anualizată a randamentelor totale. Cele două active sînt SPY (acțiuni americane) și TLT (titluri de stat americane pe termen lung), cu parametri estimați pe date lunare din perioada 2002–2026. Fiecare curbă conține portofoliile cu \(0 \le w \le 1\) pentru o corelație dată. Curba întreruptă corespunde corelației 1, iar curba continuă corelației alese cu primul cursor. Rombul marchează portofoliul de varianță minimă cu ponderea SPY între 0 și 1, iar punctul roșu portofoliul cu ponderea SPY aleasă cu al doilea cursor. Butonul ▶ scade corelația de la 1 la −1.
Întrebare pentru sală Volatilitățile anuale sînt 14,7% pentru SPY și 13,5% pentru TLT. Butonul ▶ scade corelația dintre ele de la 1 la −1. Cum se schimbă volatilitatea portofoliului de varianță minimă?
Răspuns
Scade de la 13,5% pînă la zero. La corelația 1, portofoliul de varianță minimă este numai TLT; sub corelația 0,92 (raportul 13,5/14,7) include și SPY. La corelația estimată, −0,10, are 46% în SPY și o volatilitate de 9,4%. La −1, cu 48% în SPY, volatilitatea este zero. Volatilitatea portofoliului este media ponderată a volatilităților doar cînd corelația este 1.
Pe date, volatilitățile anuale sînt 14,7% pentru SPY și 13,5% pentru TLT, iar corelația estimată este \(\rho = -0{,}10\). Formula (4.4) dă \(w^* = 46\%\) în SPY și o volatilitate de 9,4%, mai mică decît volatilitatea fiecăruia dintre cele două active.
Cînd corelația scade de la 1 la −1, volatilitatea portofoliului de varianță minimă scade de la 13,5% la zero. La corelații mari, minimul cu ponderi între 0 și 1 este numai TLT, deoarece \(w^*\) ar fi negativ. SPY intră în portofoliu sub pragul \(\rho = \sigma_{\text{TLT}}/\sigma_{\text{SPY}} = 13{,}5/14{,}7 \approx 0{,}92\). La \(\rho = -1\), ponderea SPY este 48%, iar volatilitatea este zero.
Corelația dintre acțiuni și titluri de stat variază în timp, iar modelele ei sînt subiectul Capitolului 6. Cu \(N\) active, același mecanism acționează prin toate covarianțele, iar partea următoare scrie problema în formă matriceală.
Portofoliul de varianță minimă globală (GMV, global minimum-variance portfolio) este punctul cel mai din stînga al frontierei. Dintre toate portofoliile complet investite, el are cea mai mică varianță, oricare ar fi media. Problema renunță la restricția asupra mediei și păstrează doar bugetul:
Fie \(\lambda\) multiplicatorul Lagrange (Lagrange multiplier) al restricției de buget (budget constraint) din (4.5). Lagrangianul este \(\mathcal{L}(\mathbf{w}, \lambda) = \mathbf{w}^\top\boldsymbol\Sigma\mathbf{w} - \lambda(\mathbf{w}^\top\mathbf{1} - 1)\), iar gradientul lui în raport cu \(\mathbf{w}\) este \(2\boldsymbol\Sigma\mathbf{w} - \lambda\mathbf{1}\). Anularea gradientului dă \(\mathbf{w} = \tfrac{\lambda}{2}\boldsymbol\Sigma^{-1}\mathbf{1}\); inversa există deoarece \(\boldsymbol\Sigma\) este pozitiv definită. Înmulțind la stînga cu \(\mathbf{1}^\top\) și folosind bugetul, se obține
Obiectivul este convex, iar restricția este liniară, deci condiția de ordinul întîi este și suficientă: punctul găsit este minimul unic. Același punct este vîrful frontierei în formă închisă din Merton (1972),(4.11) de mai jos.
Din (4.6), ponderea activului \(i\) este proporțională cu suma elementelor de pe linia \(i\) a matricei \(\boldsymbol\Sigma^{-1}\). Nimic în formulă nu impune semnul acestei sume, așa că GMV poate conține poziții short, ca în exemplul cu două active pentru \(\rho > \sigma_2/\sigma_1\). Media portofoliului este \(\mu_{\text{GMV}} = \mathbf{w}_{\text{GMV}}^\top\boldsymbol\mu = B/A\), cu \(B = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\); scalarul \(B\) reapare la portofoliul tangent.
Soluția (4.6) nu conține \(\boldsymbol\mu\). Mediile se estimează mult mai imprecis decît covarianțele (Merton, 1980); argumentul este prezentat în secțiunea următoare. De aceea GMV reapare în capitol în variantele GMV-LO (long-only) și GMV-LW, cu shrinkage-ul covarianței al lui Ledoit & Wolf (2004b).
Pe scurt
Problema: \(\min_{\mathbf{w}} \mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\) cu \(\mathbf{w}^\top\mathbf{1} = 1\), \(\boldsymbol\Sigma\) pozitiv definită
Lagrangianul \(\mathcal{L} = \mathbf{w}^\top\boldsymbol\Sigma\mathbf{w} - \lambda(\mathbf{w}^\top\mathbf{1} - 1)\), \(\lambda\): multiplicatorul Lagrange al restricției de buget
Condiția de ordinul întîi \(2\boldsymbol\Sigma\mathbf{w} = \lambda\mathbf{1}\), deci \(\mathbf{w} = \tfrac{\lambda}{2}\boldsymbol\Sigma^{-1}\mathbf{1}\)
Bugetul dă \(\tfrac{\lambda}{2} = 1/A\), cu \(A = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\mathbf{1}\)
Portofoliul tangent este portofoliul complet investit cu cel mai mare raport Sharpe (Sharpe, 1966). Aici \(\boldsymbol\mu\) trebuie să fie vectorul randamentelor așteptate în exces față de rata fără risc, deoarece raportul Sharpe măsoară media în exces pe unitatea de volatilitate. Problema este
Funcția \(S\) nu depinde de scara lui \(\mathbf{w}\), ci doar de direcția și de semnul lui: pentru orice \(c \neq 0\),\(S(c\,\mathbf{w}) = \operatorname{sign}(c)\,S(\mathbf{w})\). Restricția de buget din (4.7) fixează deci doar scara, iar problema se reduce la alegerea unei direcții. Gradientul lui \(S\) este
iar anularea lui dă condiția \(\boldsymbol\mu = \frac{\mathbf{w}^\top\boldsymbol\mu}{\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}}\,\boldsymbol\Sigma\mathbf{w}\). Factorul din fața lui \(\boldsymbol\Sigma\mathbf{w}\) este un scalar, deci \(\mathbf{w} \propto \boldsymbol\Sigma^{-1}\boldsymbol\mu\). Împărțind la suma componentelor, se obține
\[\mathbf{w}_{\text{MV}} = \frac{\boldsymbol\Sigma^{-1}\boldsymbol\mu}{B}, \qquad B = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu.\]
(4.8)
Valoarea maximă rezultă din inegalitatea Cauchy–Schwarz. Fie \(\boldsymbol\Sigma^{1/2}\) rădăcina pătrată simetrică a lui \(\boldsymbol\Sigma\). Din \(\mathbf{w}^\top\boldsymbol\mu = (\boldsymbol\Sigma^{1/2}\mathbf{w})^\top(\boldsymbol\Sigma^{-1/2}\boldsymbol\mu)\) rezultă
deci \(|S(\mathbf{w})| \le \theta\), cu \(\theta^2 = \boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\). Egalitatea are loc doar pentru \(\mathbf{w}\) proporțional cu \(\boldsymbol\Sigma^{-1}\boldsymbol\mu\): direcția \(\boldsymbol\Sigma^{-1}\boldsymbol\mu\) atinge \(+\theta\), iar direcția opusă atinge \(-\theta\). Spre deosebire de GMV, rezultatul depinde atît de \(\boldsymbol\mu\), cît și de \(\boldsymbol\Sigma\).
Normalizarea la buget din (4.8) poate inversa direcția. Media lui \(\mathbf{w}_{\text{MV}}\) este \(\theta^2/B\), iar volatilitatea lui este \(\theta/|B|\), deci raportul lui Sharpe este \(\operatorname{sign}(B)\,\theta\). Dacă \(B > 0\),\(\mathbf{w}_{\text{MV}}\) este portofoliul cu Sharpe maxim. Dacă \(B < 0\), împărțirea la \(B\) inversează semnul, iar \(\mathbf{w}_{\text{MV}}\) este portofoliul complet investit cu cel mai mic raport Sharpe, \(-\theta\). Dacă \(B = 0\), direcția optimă are suma ponderilor zero și nu poate fi scalată astfel încît ponderile să însumeze 1.
Semnul lui \(B\) are o interpretare directă. Din partea precedentă, \(B = A\,\mu_{\text{GMV}}\) cu \(A > 0\), deci \(B > 0\) exact cînd portofoliul GMV are randament așteptat în exces pozitiv. Un calcul care aplică \(\boldsymbol\Sigma^{-1}\boldsymbol\mu/B\) fără să verifice semnul lui \(B\) poate produce portofoliul cu Sharpe minim. Cu parametri estimați, numitorul \(\mathbf{1}^\top\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\mu}\) poate fi aproape de zero, iar ponderile tangente estimate au atunci cozi foarte groase (anexa despre distribuția ponderilor).
Pe scurt
Problema: \(\max_{\mathbf{w}} \mathbf{w}^\top\boldsymbol\mu/\sqrt{\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}}\) cu \(\mathbf{w}^\top\mathbf{1} = 1\), \(\boldsymbol\mu\) randamentele așteptate în exces
Condiția de ordinul întîi: \(\boldsymbol\mu = \dfrac{\mathbf{w}^\top\boldsymbol\mu}{\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}}\,\boldsymbol\Sigma\mathbf{w}\), deci \(\mathbf{w} \propto \boldsymbol\Sigma^{-1}\boldsymbol\mu\)
Bugetul dă \(\mathbf{w}_{\text{MV}} = \boldsymbol\Sigma^{-1}\boldsymbol\mu/B\), cu \(B = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\)
Tobin (1958) adaugă un activ fără risc (risk-free asset) cu randamentul \(R_f\). În planul (volatilitate, medie în exces), acest activ se află în origine. Un portofoliu care investește fracțiunea \(\alpha \ge 0\) în portofoliul riscant \(\mathbf{w}\) și restul în activul fără risc are media în exces \(\alpha\,\mathbf{w}^\top\boldsymbol\mu\) și volatilitatea \(\alpha\sqrt{\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}}\). Combinațiile se află deci pe o semidreaptă din origine, cu panta egală cu raportul Sharpe al lui \(\mathbf{w}\). Semidreapta cea mai abruptă trece prin portofoliul tangent și are panta \(\theta\) din (4.9);\(\alpha > 1\) înseamnă împrumut la rata \(R_f\).
În continuare presupunem \(B > 0\), astfel încît portofoliul tangent complet investit are raportul Sharpe \(+\theta\). Fie \(m_T\) și \(\sigma_T\) media în exces și volatilitatea lui. Un investitor cu aversiunea la risc \(\gamma\) alege \(\alpha\) maximizînd \(\alpha m_T - \frac{\gamma}{2}\alpha^2\sigma_T^2\), de unde
\[\alpha^* = \frac{m_T}{\gamma\,\sigma_T^2}.\]
(4.10)
Deoarece \(m_T > 0\), soluția (4.10) respectă restricția \(\alpha \ge 0\); pentru un fond riscant oarecare, cu această restricție, soluția este \(\alpha^* = \max\{0,\ m_T/(\gamma\sigma_T^2)\}\). După (4.10), aversiunea la risc schimbă doar proporția investită în partea riscantă, nu și compoziția acesteia: aceasta este separarea în două fonduri (two-fund separation). Dacă toți investitorii folosesc aceleași \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\), toți dețin același portofoliu riscant. Aici este puntea spre modelul de evaluare a activelor financiare (CAPM), tratat în Capitolul 3.
Fără activ fără risc, frontiera are o formă închisă (Merton, 1972). Problema cu două restricții are lagrangianul
iar condiția de ordinul întîi dă \(\mathbf{w} = \lambda_1\boldsymbol\Sigma^{-1}\boldsymbol\mu + \lambda_2\boldsymbol\Sigma^{-1}\mathbf{1}\). Cu \(A\) și \(B\) din părțile anterioare și cu \(C = \boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu = \theta^2\), cele două restricții devin un sistem liniar \(2\times 2\):
\[\lambda_1 C + \lambda_2 B = m, \qquad \lambda_1 B + \lambda_2 A = 1.\]
Soluția este \(\lambda_1 = (Am - B)/D\) și \(\lambda_2 = (C - Bm)/D\), cu \(D = AC - B^2\). Varianța minimă rezultă din \(\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w} = \mathbf{w}^\top(\lambda_1\boldsymbol\mu + \lambda_2\mathbf{1}) = \lambda_1 m + \lambda_2\):
Condiția \(D > 0\) este tot o inegalitate Cauchy–Schwarz, de data aceasta pentru produsul scalar definit de \(\boldsymbol\Sigma^{-1}\):\(B^2 = (\mathbf{1}^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu)^2 \le (\mathbf{1}^\top\boldsymbol\Sigma^{-1}\mathbf{1})(\boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu) = AC\). Egalitatea are loc doar dacă \(\boldsymbol\mu\) este proporțional cu \(\mathbf{1}\). În acel caz toate portofoliile complet investite au aceeași medie, iar frontiera se reduce la portofoliul GMV.
A doua formă din (4.11) arată geometria. În planul \((\sigma^2, m)\),\(\sigma^2(m)\) este o parabolă cu vîrful în \((1/A,\ B/A)\), adică în portofoliul GMV. În planul \((\sigma, m)\) al graficelor, aceeași relație este o hiperbolă. Curba este simetrică față de \(m = B/A\), ceea ce justifică alegerea ramurii superioare ca frontieră eficientă.
Ponderile de pe frontieră combină două portofolii deja calculate. Deoarece \(\boldsymbol\Sigma^{-1}\mathbf{1} = A\,\mathbf{w}_{\text{GMV}}\) și \(\boldsymbol\Sigma^{-1}\boldsymbol\mu = B\,\mathbf{w}_{\text{MV}}\), pentru \(B \neq 0\)
\[\mathbf{w}(m) = \lambda_1 B\,\mathbf{w}_{\text{MV}} + \lambda_2 A\,\mathbf{w}_{\text{GMV}}, \qquad \lambda_1 B + \lambda_2 A = 1.\]
(4.12)
Coeficienții din (4.12) însumează 1, dar unul dintre ei poate fi negativ. Mai general, oricare două portofolii distincte de pe frontieră o generează pe toată (Merton, 1972).
Aceeași algebră completează formularea cu utilitate (4.2) din prima parte a secțiunii. Condiția ei de ordinul întîi dă
Portofoliul \(\mathbf{w}_\gamma\) din (4.13) are forma \(\lambda_1\boldsymbol\Sigma^{-1}\boldsymbol\mu + \lambda_2\boldsymbol\Sigma^{-1}\mathbf{1}\), deci se află pe frontieră. Media lui scade de la \(+\infty\) spre \(B/A\) cînd \(\gamma\) crește de la 0 spre \(\infty\), așa că soluțiile parcurg ramura eficientă.
Tobin (1958): se adaugă un activ fără risc cu randamentul \(R_f\)
fiecare investitor deține același portofoliu riscant, portofoliul tangent, combinat cu numerar sau cu împrumut
aversiunea la risc schimbă doar combinația: separarea în două fonduri, puntea spre modelul de evaluare a activelor financiare (CAPM, Capital Asset Pricing Model; Capitolul 3)
Merton (1972): cu vînzări în lipsă, frontiera este o hiperbolă
\(\boldsymbol\Sigma\) pozitiv definită, \(\boldsymbol\mu\) neproporțional cu \(\mathbf{1}\)
\(A\) și \(B\) ca pe cele două slide-uri anterioare
Formulele se aplică acum celor nouă ETF-uri sectoriale din SUA, cu randamente lunare în exces din ianuarie 1999 pînă în iulie 2026 (\(T = 331\) de luni). Parametrii \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\) se înlocuiesc cu media și matricea de covarianță de eșantion, calculate pe tot eșantionul. Imaginea este deci in-sample: ponderile sînt alese cu aceleași date pe care sînt evaluate, ca și cum investitorul ar fi cunoscut din 1999 mediile și covarianțele realizate pînă în 2026.
Mediile lunare sînt anualizate cu factorul 12, iar volatilitățile și rapoartele Sharpe cu factorul \(\sqrt{12}\); axele sînt în zecimale. Pe graficul interactiv, curba „Frontier, short sales allowed” este frontiera fără restricții, iar curba „Frontier, long-only” este frontiera cu \(w_i \ge 0\). Cercurile marchează sectoarele individuale, iar cele două stele marchează portofoliile tangente, cu și fără vînzări în lipsă. Panta dreptei care unește originea cu o stea este raportul Sharpe al portofoliului respectiv. Graficul de bare de dedesubt dă ponderile celor două portofolii tangente.
Cursorul alege cîte sectoare intră în optimizare, iar ▶ le adaugă pe rînd; curba „Frontier, all 9 sectors” rămîne ca reper. Frontiera long-only se află la dreapta frontierei fără restricții sau o atinge, deoarece mulțimea portofoliilor admisibile este mai mică.
Întrebare pentru sală Cu vînzări în lipsă permise, deține portofoliul tangent o poziție long în fiecare sector cu randament mediu pozitiv?
Răspuns
Nu. Portofoliul tangent este short pe XLF (−37%) și XLB (−21%), deși ambele au medii pozitive. Semnul unei ponderi depinde de întregul vector al mediilor și de covarianțe: corelația 0,85 a lui XLB cu XLI (Industrial Select Sector SPDR Fund, ETF pe sectorul industrial) sau raportul Sharpe mic al lui XLF nu îl explică singure. Restricția long-only scade raportul Sharpe de la 0,66 la 0,61.
Raportul Sharpe anualizat este 0,66 pentru portofoliul tangent, 0,57 pentru GMV, a cărui volatilitate este 11,1%, și 0,54 pentru 1/N. Tangentul atinge acest maxim prin poziții short pe financiar (\(-0{,}37\)) și pe materiale (\(-0{,}21\)), deși ambele sectoare au medii pozitive. Cea mai mare poziție long este în sănătate (\(+0{,}37\)).
Din (4.8), semnul unei ponderi depinde de întregul vector \(\boldsymbol\Sigma^{-1}\boldsymbol\mu\), nu doar de media sectorului. Corelația 0,85 dintre materiale și industrie sau raportul Sharpe mic al financiarului nu explică, fiecare în parte, pozițiile short.
Cu restricția long-only, raportul Sharpe al portofoliului tangent scade la 0,61. Materialele, financiarul și industria primesc pondere exact zero: restricția \(w_i \ge 0\) este activă pentru ele, iar optimul se află pe marginea mulțimii admisibile, într-o soluție de colț (corner solution).
Diferența dintre 0,66 și 0,54 este cîștigul celei mai bune combinații fixe a sectoarelor, aleasă cu toată istoria cunoscută dinainte. O regulă care estimează parametrii numai din trecut nu are această informație. Secțiunea următoare măsoară cît pierde o astfel de regulă.
Pe scurt
Randamente lunare în exces, ianuarie 1999 – iulie 2026 (\(T = 331\))
axele anualizate, în zecimale
Toți parametrii estimați pe tot eșantionul: o imagine în eșantion
Formulele de pînă aici permit orice pondere. Restricția de bază este long-only (LO): \(w_i \ge 0\) pentru fiecare activ. Alte restricții liniare limitează concentrarea: plafoane pe poziții, de exemplu \(w_i \le 0{,}2\), și plafoane pe grupuri, \(\sum_{i\in G} w_i \le c_G\), unde \(G\) este un grup de active (un sector sau o clasă de active), iar \(c_G\) este plafonul lui.
Limita de levier privește expunerea brută (gross exposure) \(\sum_i |w_i|\). Deoarece ponderile însumează 1,
\[\sum_i |w_i| = 1 + 2\sum_i \max(-w_i, 0),\]
(4.14)
deci expunerea brută depășește 1 cu dublul sumei pozițiilor short. Din (4.14), restricția \(\sum_i |w_i| \le L\) cu \(L = 1\) este deci echivalentă cu interzicerea vînzărilor în lipsă.
Cu inegalități, formulele închise nu mai sînt valabile. Condițiile de optimalitate adaugă cîte un multiplicator \(\lambda_i \ge 0\) pentru fiecare restricție \(w_i \ge 0\), nul cînd restricția nu este activă (\(w_i > 0\)). Care restricții sînt active nu se știe dinainte, ci rezultă din soluție. Pentru GMV, problema long-only (GMV-LO) este
Obiectivul rămîne pătratic și convex, iar restricțiile sînt liniare, la fel ca pentru frontiera long-only. Problema este una de programare pătratică (quadratic programming), rezolvată numeric.
Restricțiile nu pot îmbunătăți optimul in-sample: pe sectoarele din SUA, Sharpe-ul tangentului scade de la 0,66 la 0,61. Out-of-sample, efectul poate fi invers. Frost & Savarino (1988) au arătat că restricționarea ponderilor a îmbunătățit rezultatele out-of-sample. Jagannathan & Ma (2003) au explicat mecanismul: soluția lui (4.15) este portofoliul GMV (4.6) al unei matrice de covarianță modificate. O restricție activă \(w_i \ge 0\) echivalează cu micșorarea covarianțelor estimate ale activului \(i\), adică cu un shrinkage al matricei de covarianță. Demonstrația și un exemplu cu două active sînt în secțiunea despre shrinkage (Restricțiile ca formă de shrinkage).
Pe scurt
Long-only (LO): \(w_i \ge 0\)
Fără formă închisă, se rezolvă prin programare pătratică
Limite pe poziții: \(w_i \le 0{,}2\)
Limite pe sectoare sau clase de active: \(\sum_{i\in G} w_i \le c_G\), \(G\) un grup de active, \(c_G\) plafonul lui
Limită de levier: \(\sum_i |w_i| \le L\)
\(\sum_i |w_i|\) este expunerea brută
\(L = 1\) înseamnă fără vînzări în lipsă
Frost & Savarino (1988): restricționarea ponderilor a îmbunătățit rezultatele în afara eșantionului
Cu parametri cunoscuți, alocarea medie–varianță are soluții explicite. Portofoliul GMV (4.6) folosește doar covarianțele. Portofoliul tangent (4.8) are raportul Sharpe maxim \(\theta = \sqrt{\boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu}\) numai dacă \(B > 0\). Frontiera (4.11) este o hiperbolă determinată de \(A\),\(B\) și \(C\), iar oricare două portofolii distincte ale ei o generează (Merton, 1972). Cu un activ fără risc, toți investitorii combină același portofoliu tangent cu activul fără risc (Tobin, 1958). Restricțiile asupra ponderilor elimină formele închise și cer programare pătratică.
Pe sectoarele din SUA, chiar cu parametrii estimați pe tot eșantionul, portofoliul tangent ridică raportul Sharpe doar de la 0,54 (1/N) la 0,66. Toate formulele secțiunii presupun \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\) cunoscute. Secțiunea următoare le înlocuiește cu estimări și arată cum se transmit erorile de estimare în ponderi și în raportul Sharpe.
Riscul de estimare
Secțiunea precedentă a presupus că \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\) sînt cunoscute. Aici ele se înlocuiesc cu estimări de eșantion (plug-in estimates), iar întrebarea este cît pierde portofoliul optim prin această înlocuire. Răspunsul are patru părți:
Mediile se estimează mult mai imprecis decît varianțele, indiferent de frecvența datelor.
Simularea arată că frontierele estimate sînt sistematic prea optimiste, iar portofoliile alese pe ele au performanțe adevărate slabe.
Merton (1980) compară precizia cu care se pot estima media și varianța randamentelor. Fie un eșantion de \(Y\) ani, observat de \(h\) ori pe an, cu randamente i.i.d. din distribuția Normală (o difuzie, diffusion), cu media anuală \(\mu\) și varianța anuală \(\sigma^2\). Fiecare dintre cele \(hY\) randamente are media \(\mu/h\) și varianța \(\sigma^2/h\). Estimatorul natural al mediei anuale este suma tuturor randamentelor împărțită la \(Y\), iar varianța lui este \(hY(\sigma^2/h)/Y^2\). Pentru varianță, estimatorul de eșantion are, sub distribuția Normală, varianța aproximativă \(2\sigma^4/(hY)\):
Argumentul folosește incrementările aditive ale unui model de difuzie cu parametri constanți. Prima relație din (4.16) nu depinde de \(h\): într-un astfel de model, creșterea frecvenței pe un interval calendaristic fix nu reduce varianța estimatorului mediei, iar precizia lui crește doar cu lungimea eșantionului, în ani. A doua relație tinde la zero cînd \(h \to \infty\): în modelul idealizat, varianța se poate estima oricît de precis pe un interval fix, dacă observațiile sînt suficient de dese. Pentru randamente simple, randamentul anual realizat este \(\prod_t(1 + R_t) - 1\), nu suma randamentelor lunare. Fără ipoteza de normalitate, \(\operatorname{Var}(\hat\sigma^2) \approx (\kappa - 1)\sigma^4/(hY)\), unde \(\kappa\) este kurtosisul (kurtosis) randamentelor; pentru distribuția Normală, \(\kappa = 3\). Formula generală presupune că momentul de ordin patru este finit, ipoteză pusă sub semnul întrebării în Capitolul 1.
Pentru SPY, cu \(Y = 24\) de ani și \(\sigma = 14{,}7\%\), eroarea standard (standard error) a mediei anuale este \(0{,}147/\sqrt{24}\), adică 3,0%. Intervalul de încredere de 95% pentru media estimată de 11,7% este [5,8%; 17,6%]: datele sînt compatibile cu medii care diferă de trei ori. Din (4.16), o eroare standard de 1% ar cere \((0{,}147/0{,}01)^2\), adică circa 217 ani de date.
Chopra & Ziemba (1993) au măsurat consecința pentru alegerea portofoliului: în configurațiile analizate de autori, erorile de estimare a mediilor costă de circa zece ori mai mult decît cele ale varianțelor. De aici rezultă că regulile care nu folosesc medii estimate, ca GMV și regulile de risk parity, sînt mai robuste la eroarea de estimare decît portofoliul tangent.
Graficul interactiv aplică simularea descrisă în introducerea secțiunii. Primul panou are pe axa orizontală volatilitatea anualizată și pe axa verticală media anualizată a randamentelor în exces. Curba albastră este frontiera adevărată, calculată cu parametrii populației. Fiecare curbă roșie este frontiera estimată dintr-un eșantion simulat, iar curba verde pereche conține aceleași portofolii, evaluate cu parametrii adevărați: este frontiera realizată (realised frontier).
Lista derulantă alege lungimea eșantionului, implicit 60 de luni, cursorul alege cîte dintre cele 25 de eșantioane sînt desenate, iar butonul „Alte eșantioane” extrage altele. Al doilea panou este histograma raportului Sharpe adevărat al portofoliului tangent estimat, pe 500 de eșantioane; linia 1/N marchează raportul Sharpe al ponderilor egale, iar linia întreruptă „optimum” pe cel al portofoliului tangent adevărat.
Întrebare pentru sală Cu 60 de luni de date, cît de des depășește portofoliul tangent estimat regula 1/N?
Răspuns
În aproximativ 4% dintre eșantioane. În simularea din pagină, 18 dintre cele 500 de portofolii (3,6%) depășesc 1/N; în cea din curs, cu 2.000 de portofolii, 4%. Mediana raportului Sharpe evaluat cu parametrii adevărați este 0,30, față de 0,54 pentru 1/N. Raportul Sharpe estimat în eșantion are mediana 1,51 în pagină; în curs, mediana valorii lui absolute, |θ̂|, este 1,56.
Frontierele roșii se află deasupra frontierei adevărate, iar cele verzi se află toate sub ea. În simularea din pagină, 18 dintre cele 500 de portofolii tangente estimate, adică 3,6%, au un raport Sharpe adevărat mai mare decît 1/N. Mediana raportului Sharpe in-sample cu semn este 1,51, iar cea a raportului Sharpe adevărat este 0,30, față de 0,54 pentru 1/N.
Michaud (1989) a numit optimizatorii medie–varianță maximizatori ai erorii de estimare (estimation-error maximisers). Optimizatorul caută combinația cu cel mai mare raport Sharpe estimat. Activele ale căror medii sînt supraestimate sau ale căror covarianțe sînt subestimate par mai atractive decît sînt, iar optimizatorul le alege tocmai pe ele. Frontiera estimată reflectă deci, pe lîngă parametrii adevărați, și cele mai favorabile erori de estimare ale eșantionului.
Simularea din curs folosește 2 000 de portofolii tangente estimate din eșantioane de 60 de luni. Mediana lui \(\hat\theta\), valoarea absolută a raportului Sharpe in-sample, este 1,56 pe an. Evaluate cu parametrii adevărați, aceleași portofolii au un raport Sharpe cu semn median de 0,30, deși optimul adevărat este 0,66. Dintre ele, 96% au un raport Sharpe adevărat mai mic decît cel al lui 1/N, 0,54, iar 7,5% au un raport Sharpe adevărat negativ.
O parte din aceste rezultate provine din problema de semn discutată la portofoliul tangent. În 11% dintre eșantioane, \(\hat B = \mathbf{1}^\top\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\mu} < 0\), unde \(\hat{\boldsymbol\mu}\) și \(\hat{\boldsymbol\Sigma}\) sînt estimările de eșantion. În aceste eșantioane, formula tangentă (4.8) aplicată estimărilor dă portofoliul cu raportul Sharpe minim estimat. Raportul Sharpe in-sample cu semn al portofoliului normalizat la buget este deci \(\operatorname{sign}(\hat B)\,\hat\theta\), iar cînd \(\hat B < 0\),\(\hat\theta\) nu este raportul Sharpe al portofoliului complet investit ales.
Pe scurt
Michaud (1989): optimizatorii sînt maximizatori ai erorii de estimare
Simularea arată că raportul Sharpe maxim estimat este mult prea mare. Kan & Zhou (2007) dau expresia exactă a acestei deplasări. Randamentele în exces sînt i.i.d. \(N(\boldsymbol\mu, \boldsymbol\Sigma)\), observate \(T\) luni, pentru \(N\) active. Fie \(\hat{\boldsymbol\mu}\) și \(\hat{\boldsymbol\Sigma}\) estimatorii de verosimilitate maximă (maximum likelihood), iar
pătratul raportului Sharpe maxim in-sample, estimatorul direct (plug-in) al lui \(\theta^2 = \boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\) din (4.9).
Sub aceste ipoteze, \(\hat{\boldsymbol\mu} \sim N(\boldsymbol\mu, \boldsymbol\Sigma/T)\), iar \(T\hat{\boldsymbol\Sigma}\) are o distribuție Wishart (Wishart distribution) cu \(T-1\) grade de libertate, analogul matriceal al distribuției \(\chi^2\); cei doi estimatori sînt independenți. Pentru \(T > N + 2\), momentul Wishart invers este \(\mathbb{E}[\hat{\boldsymbol\Sigma}^{-1}] = \frac{T}{T-N-2}\boldsymbol\Sigma^{-1}\) (anexa despre momentele Wishart). Condiționînd pe \(\hat{\boldsymbol\mu}\) și folosind \(\mathbb{E}[\mathbf{x}^\top\mathbf{K}\mathbf{x}] = \operatorname{tr}(\mathbf{K}\operatorname{Var}(\mathbf{x})) + \mathbb{E}[\mathbf{x}]^\top\mathbf{K}\,\mathbb{E}[\mathbf{x}]\) pentru vectorul aleator \(\mathbf{x} = \hat{\boldsymbol\mu}\) și matricea fixă \(\mathbf{K} = \boldsymbol\Sigma^{-1}\), unde \(\operatorname{tr}\) este urma, se obține
\[\mathbb{E}[\hat\theta^2] = \frac{T}{T-N-2}\Big(\theta^2 + \frac{N}{T}\Big) = \frac{T\theta^2 + N}{T - N - 2}, \qquad T > N + 2.\]
(4.17)
Ecuațiile (4.17) și (4.18) folosesc estimatorul covarianței cu divizorul \(T\). Pentru estimatorul cu divizorul \(T-1\), folosit în simulare, media lui \(\hat\theta^2\) este \(\frac{T-1}{T-N-2}\big(\theta^2 + \frac{N}{T}\big)\). Formula (4.17) conține două surse de deplasare în sus. Termenul \(N/T\) provine din zgomotul mediilor estimate: chiar cu \(\theta = 0\), cele \(N\) medii estimate nu sînt toate nule, iar optimizatorul le exploatează. Factorul \(T/(T-N-2) > 1\) provine din inversarea covarianței estimate. Ambele cresc cu raportul \(N/T\).
Pe sectoarele din SUA, cu \(N = 9\),\(T = 60\) și \(\theta = 0{,}66\) pe an în simulare, factorul \(T/(T-N-2)\) este 1,22, iar (4.17) dă \(\sqrt{12\,\mathbb{E}[\hat\theta^2]} = 1{,}65\) pe an. Această cifră este o medie pătratică, nu o mediană. Mediana simulată din partea precedentă, 1,56, este mai mică, deoarece distribuția lui \(\hat\theta\) are asimetrie la dreapta.
\(\hat\theta^2 = \hat{\boldsymbol\mu}^\top\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\mu}\): pătratul raportului Sharpe maxim în eșantion, din \(\hat{\boldsymbol\mu}\) și \(\hat{\boldsymbol\Sigma}\) de verosimilitate maximă
\(\theta^2\): valoarea lui adevărată
\[ \mathbb{E}[\hat\theta^2] = \frac{T}{T-N-2}\Big(\theta^2 + \frac{N}{T}\Big) = \frac{T\theta^2 + N}{T - N - 2}, \qquad T > N + 2 \]
Sectoare: \(N = 9\), \(T = 60\), în simulare \(\theta = 0{,}66\) pe an
\(\sqrt{12\,\mathbb{E}[\hat\theta^2]} = 1{,}65\) pe an, o medie pătratică, nu o mediană
mediana simulată \(1{,}56\) este mai mică: \(\hat\theta\) are asimetrie la dreapta
Estimatorul (4.18) poate fi negativ, deși \(\theta^2 \ge 0\); atunci \(\sqrt{\hat\theta^2_u}\) nici nu este real. Trunchierea la zero dă un estimator nenegativ, dar deplasat în sus. Estimatorul real și nenegativ \(\sqrt{\max(0,\ \hat\theta^2_u)}\) al lui \(\theta\) nu este, în general, nedeplasat.
Pe sectoarele din SUA, pe tot eșantionul (\(T = 331\)) și sub ipoteza i.i.d. Normală, corecția deplasării lui \(\hat\theta^2\) reduce estimația punctuală echivalentă a raportului Sharpe de la 0,66, valoarea estimată direct, la circa 0,31 pe an. Corecția privește \(\theta^2\), nu un anumit portofoliu: ea nu arată ce parte din raportul Sharpe observat al portofoliului tangent provine din zgomot.
Ponderile tangente de eșantion se pot obține și printr-o regresie (Britten-Jones, 1999). Fie \(\mathbf{r}_t\) vectorul randamentelor în exces din luna \(t\) și \(u_t\) eroarea regresiei. Regresia constantei 1 pe randamentele în exces, fără termen liber, prin metoda celor mai mici pătrate (OLS, ordinary least squares), dă coeficienții \(\mathbf{b}\), iar
Ponderile (4.19) sînt ponderile tangente de eșantion, deoarece coeficienții OLS sînt proporționali cu \(\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\mu}\). Avantajul formulării este că inferența asupra ponderilor devine inferență asupra coeficienților unei regresii: testul \(t\) al lui \(b_i = 0\) verifică dacă activul \(i\) are pondere zero în portofoliul tangent. Derivarea și testele pe sectoare sînt în anexa despre regresia Britten-Jones.
Pe scurt
Estimatorul nedeplasat al lui \(\theta^2\): \(\hat\theta^2_u = \big[(T-N-2)\,\hat\theta^2 - N\big]/T\)
Poate fi negativ
Trunchierea la zero dă un estimator nenegativ, dar deplasat în sus, iar \(\sqrt{\hat\theta^2_u}\) nu este nedeplasat pentru \(\theta\)
Sectoare, tot eșantionul (\(T = 331\)), sub ipoteza i.i.d. Normală: corecția deplasării lui \(\hat\theta^2\) reduce estimația punctuală echivalentă a Sharpe de la \(0{,}66\) (estimat direct) la circa \(0{,}31\) pe an
corecția privește \(\theta^2\): nu arată ce parte din Sharpe-ul observat provine din zgomot
Simulările de pînă aici folosesc parametri cunoscuți și randamente Normale. Graficul interactiv arată același fenomen pe date reale. Pentru fiecare lună, ponderile MV și GMV-LW ale celor nouă sectoare se estimează pe cele 60 de luni anterioare, adică pe o fereastră rolling (rolling window) de 60 de luni.
Primul panou arată, pentru luna aleasă cu cursorul, ponderile celor două reguli, sector cu sector; axa verticală este în procente. Al doilea panou arată, pentru toate lunile, expunerea brută, suma valorilor absolute ale ponderilor, pe o scară logaritmică; linia punctată marchează luna aleasă. Butonul ▶ parcurge lunile.
Întrebare pentru sală Cît de mari devin ponderile medie–varianță estimate lunar pe ultimele 60 de luni?
Răspuns
În iulie 2026, ultima lună, expunerea brută (suma valorilor absolute ale ponderilor) este 7,1 pentru MV și 1,9 pentru GMV-LW: shrinkage nu elimină pozițiile short. Pe toată perioada, medianele sînt 4,9 pentru MV și 1,5 pentru GMV-LW. Cea mai mare pondere MV, în valoare absolută, este 26; în 90% dintre luni expunerea brută MV depășește 3.
În iulie 2026, ultima lună, expunerea brută este 7,1 pentru MV și 1,9 pentru GMV-LW. Shrinkage-ul covarianței nu elimină pozițiile short ale lui GMV-LW, dar le menține de cîteva ori mai mici decît pe cele ale lui MV.
Fereastra de 60 de luni este una dintre cele două ferestre folosite de DeMiguel, Garlappi & Uppal (2009), care folosesc 60 și 120 de luni. Alegerea ferestrei este un compromis: o fereastră mai lungă reduce eroarea de estimare, iar una mai scurtă urmărește mai repede schimbările de regim. Best & Grauer (1991) au arătat că o mică schimbare într-o singură medie estimată mută multe ponderi ale portofoliului optim. Fereastra rolling produce exact astfel de schimbări: de la o lună la alta, o observație intră în fereastră și una iese.
Pe cele nouă sectoare, expunerea brută mediană a lui MV este \(\sum_i |w_i| = 4{,}9\) și depășește 3 în 90% din luni. Din (4.14), o expunere brută de 4,9 înseamnă poziții short care însumează aproape două ori averea investită. Cea mai mare pondere individuală a lui MV ajunge la 26 în valoare absolută.
Salturile extreme apar în 2004–2006 și în 2009. În acele ferestre, numitorul \(\mathbf{1}^\top\hat{\boldsymbol\Sigma}^{-1}\hat{\boldsymbol\mu}\) al ponderilor tangente este aproape de zero, iar ponderile au cozi foarte groase. Numitorul este negativ în 12 dintre cele 271 de ferestre; în aceste luni MV deține portofoliul cu raportul Sharpe minim estimat.
GMV-LW, care nu folosește mediile și aplică shrinkage covarianței, are o expunere brută mediană de 1,5, iar cea mai mare pondere a lui este 0,94. Ponderile instabile ale lui MV înseamnă turnover mare, deci costuri mari de tranzacționare, analizate în secțiunea despre evaluarea out-of-sample.
Pe scurt
Nouă ETF-uri sectoriale, fereastră mobilă (rolling window) de 60 de luni
Dacă eroarea de estimare provine din lungimea finită a eșantionului, o fereastră suficient de lungă ar trebui să o elimine. Graficul interactiv măsoară cît de lungă trebuie să fie. Parametrii populației sînt din nou momentele sectoarelor, iar pentru fiecare lungime a ferestrei se simulează 300 de eșantioane.
Primul panou are pe axa orizontală lungimea ferestrei de estimare \(T\), în luni, pe scară logaritmică, iar pe axa verticală mediana raportului Sharpe adevărat al fiecărei reguli: MV, MV-LO, GMV, GMV-LW și ERC. Linia orizontală întreruptă marchează raportul Sharpe al lui 1/N. Cursorul alege fereastra, marcată cu o linie verticală punctată, iar al doilea panou dă histograma raportului Sharpe adevărat al lui MV pentru acea fereastră, cu liniile lui 1/N și ale optimului. Butonul ▶ parcurge ferestrele.
Întrebare pentru sală Care este prima fereastră testată la care mediana raportului Sharpe MV depășește 1/N în această simulare?
Răspuns
Dintre ferestrele testate, prima este de 480 de luni: mediana raportului Sharpe MV este 0,55, față de 0,54 pentru 1/N; la 240 de luni este încă 0,48. GMV trece de 1/N de la 120 de luni, iar ERC este peste 1/N la toate ferestrele, pentru că nu folosesc mediile estimate.
Dintre ferestrele testate, prima la care mediana raportului Sharpe MV depășește 1/N este de 480 de luni: 0,55, față de 0,54. La 240 de luni mediana este încă 0,48. GMV trece de 1/N de la 120 de luni, iar ERC este peste 1/N la toate ferestrele; niciuna dintre aceste două reguli nu folosește mediile estimate.
DeMiguel, Garlappi & Uppal (2009) compară 14 modele de alocare cu 1/N pe 7 seturi de date. Niciun model nu depășește consecvent 1/N, nici după raportul Sharpe, nici după randamentul echivalent cert (certainty-equivalent return), nici după turnover. Pentru un investitor cu aversiunea la risc \(\gamma\), randamentul echivalent cert al unui portofoliu cu media \(\mu_p\) și varianța \(\sigma_p^2\) este
randamentul fără risc care îi aduce aceeași utilitate medie–varianță ca (4.2). În calibrarea lor, cu 25 de active, regula medie–varianță ar avea nevoie de o fereastră de estimare de circa 3 000 de luni pentru a depăși 1/N.
Simularea din curs repetă argumentul pe cele nouă sectoare. MV depășește 1/N abia la o fereastră de 480 de luni, adică 40 de ani, cu un raport Sharpe adevărat median de 0,55 față de 0,54. Cu fereastra de 60 de luni folosită în backtesting, mediana este doar 0,31. Regulile MV-LO, GMV și GMV-LW sînt aproape de 1/N de la 60 de luni, iar ERC, cu un raport Sharpe adevărat median de 0,56, este aproape insensibilă la lungimea ferestrei.
Diferența dintre reguli urmează argumentul lui Merton: regulile care nu folosesc medii estimate evită sursa principală a erorii. În această calibrare, 1/N este aproape eficient: raportul lui Sharpe, 0,54, este aproape de cel al portofoliului tangent adevărat, 0,66, deci spațiul de cîștig pentru orice regulă estimată este mic. Rezultatul provine dintr-o simulare cu parametri cunoscuți și randamente Normale, nu dintr-un test empiric; testele empirice sînt în secțiunea despre evaluarea out-of-sample.
Pentru o fereastră de 60 de luni, eroarea de estimare domină alegerea medie–varianță. Mediile se estimează imprecis oricît de des ar fi observate (4.16), raportul Sharpe maxim estimat este deplasat în sus cu termenii din (4.17), iar portofoliile tangente estimate au, în mediană, un raport Sharpe adevărat de 0,30, sub cel al lui 1/N, 0,54. Pe date reale, ponderile MV ating o expunere brută mediană de 4,9. În simulare, MV depășește 1/N abia cu o fereastră de 480 de luni.
Regulile care nu folosesc medii, GMV, GMV-LW și ERC, sînt aproape de 1/N de la ferestre scurte. Secțiunile următoare corectează datele de intrare ale optimizării: shrinkage-ul covarianței, restricțiile și modelul Black–Litterman, care micșorează mediile estimate spre o referință de echilibru.
Contracția covarianței
Secțiunea precedentă a arătat că formulele medie–varianță, aplicate unor parametri estimați, transmit erorile de estimare în ponderi. Această secțiune se ocupă de a doua intrare a formulelor, matricea de covarianță. Portofoliul GMV (4.6) nu folosește mediile, dar folosește inversa \(\boldsymbol\Sigma^{-1}\), iar inversa amplifică tocmai erorile pe care matricea de covarianță de eșantion (sample covariance matrix) le face sistematic: valorile ei proprii sînt mai dispersate decît cele adevărate.
Secțiunea are trei părți:
Problema, descrisă prin spectrul matricei de eșantion și prin banda de zgomot Marchenko–Pastur.
Estimatorul de shrinkage al lui Ledoit și Wolf, care trage matricea de eșantion spre o țintă structurată, aplicat sectoarelor din SUA.
Restricția long-only din (4.15), introdusă în secțiunea precedentă ca restricție asupra ponderilor, acționează și ea ca un shrinkage al covarianțelor (Jagannathan & Ma, 2003).
Fie \(\mathbf{S}\) matricea de covarianță de eșantion a \(N\) active, calculată din \(T\) observații. Fiind simetrică și pozitiv semidefinită, ea are descompunerea spectrală \(\mathbf{S} = \sum_{k=1}^{N} \lambda_k \mathbf{u}_k\mathbf{u}_k^\top\), cu valorile proprii (eigenvalues) \(\lambda_1 \ge \dots \ge \lambda_N \ge 0\) și vectorii proprii (eigenvectors) ortonormați \(\mathbf{u}_k\). Dacă \(\lambda_N > 0\), inversa este
Din (4.21), fiecare direcție \(\mathbf{u}_k\) intră în inversă cu ponderea \(1/\lambda_k\). Direcțiile cu cea mai mică varianță estimată primesc cea mai mare greutate, iar un optimizator care folosește \(\mathbf{S}^{-1}\), de exemplu în \(\mathbf{w}_{\text{GMV}} \propto \mathbf{S}^{-1}\mathbf{1}\), pune ponderi mari pe combinațiile de active care par aproape fără risc în eșantion. Cît de mult amplifică inversa erorile se măsoară prin numărul de condiționare (condition number), raportul \(\lambda_1/\lambda_N\) dintre cea mai mare și cea mai mică valoare proprie.
Problema nu ar fi gravă dacă valorile proprii de eșantion ar fi estimatori buni ai celor adevărate. Ele sînt însă prea dispersate: cele mai mari valori proprii de eșantion tind să fie prea mari, iar cele mai mici prea mici. În cazul extrem, matricea centrată (demeaned) pe medii are rangul cel mult \(T-1\), deoarece cele \(T\) abateri de la medie însumează zero. Pentru \(T \le N\),\(\mathbf{S}\) este singulară: cel puțin o valoare proprie este zero, iar (4.21) nu există.
Reperul cantitativ pentru această dispersie vine de la Marčenko & Pastur (1967). Dacă randamentele sînt independente și identic distribuite, cu \(\boldsymbol\Sigma = \sigma^2\mathbf{I}\)(\(\mathbf{I}\) fiind matricea identitate), toate valorile proprii adevărate sînt egale cu \(\sigma^2\). Cînd \(N\) și \(T\) cresc împreună, cu \(N/T \to c \in (0, 1)\), valorile proprii de eșantion nu se concentrează în \(\sigma^2\), ci acoperă intervalul
unde \(\lambda_-\) și \(\lambda_+\) sînt marginile suportului distribuției limită a valorilor proprii în modelul de zgomot independent. În eșantioane finite, valorile proprii extreme fluctuează în jurul acestor repere. Lățimea benzii depinde doar de raportul \(c\): cu cît sînt mai puține observații pe activ, cu atît este mai largă.
Pentru 16 active și o fereastră de 60 de luni, \(c = 16/60 = 0{,}27\). Pentru o matrice de corelație (\(\sigma^2 = 1\)),(4.22) dă banda \([0{,}23;\ 2{,}30]\): zgomotul singur produce un raport de zece între valorile proprii extreme, deși toate valorile proprii adevărate sînt egale. Laloux et al. (1999) au folosit această bandă pentru a separa structura de zgomot: valorile proprii din afara benzii sînt candidate la structură, iar cele din interior nu se pot deosebi de zgomot doar prin această comparație.
Pe scurt
Întrebarea secțiunii: cum estimăm \(\boldsymbol\Sigma\) astfel încît \(\hat{\boldsymbol\Sigma}^{-1}\) să nu amplifice zgomotul?
Valorile proprii de eșantion sînt prea dispersate: cele mari prea mari, cele mici prea mici
Numărul de condiționare măsoară cît amplifică \(\boldsymbol\Sigma^{-1}\) zgomotul
cea mai mare valoare proprie împărțită la cea mai mică
Optimizatorii inversează \(\boldsymbol\Sigma\), deci pun ponderi mari pe direcțiile cu cea mai mică varianță estimată
Matricea de eșantion centrată are rangul cel mult \(T-1\)
este singulară, deci neinversabilă, ori de cîte ori \(T \le N\)
\(\lambda_-\), \(\lambda_+\): cea mai mică și cea mai mare valoare proprie produse de zgomotul pur
\(c = 16/60 = 0{,}27\): banda \([0{,}23; 2{,}30]\) pentru o matrice de corelație (\(\sigma^2 = 1\)), un raport de zece între extreme, generat numai de zgomot
Laloux et al. (1999): valorile proprii din afara benzii sînt candidate la structură
cele din interior nu se pot deosebi de zgomot doar prin această comparație
Valorile proprii de eșantion și banda de zgomot (1/2)
Graficul aplică reperul (4.22) matricelor de corelație ale randamentelor lunare în exces, pe ultima fereastră de 60 de luni (august 2021 – iulie 2026). Pe axa orizontală este rangul valorii proprii, iar pe axa verticală, în scară logaritmică, valoarea proprie a matricei de corelație. Banda colorată este intervalul \([\lambda_-, \lambda_+]\) pentru \(\sigma^2 = 1\); punctele albastre sînt valorile proprii din bandă, iar romburile roșii cele din afara ei.
Selectorul de date alege universul combinat (16 ETF-uri), sectoarele (9 ETF-uri) sau zgomotul pur: 16 serii simulate independente, cu matricea de corelație adevărată egală cu identitatea. Pentru zgomotul pur, cursorul fixează lungimea \(T\) a eșantionului simulat, iar ▶ crește \(T\) pas cu pas. Comparația dintre zgomotul pur și datele reale arată cît din dispersia valorilor proprii observate poate fi produsă de eroarea de eșantionare singură.
Folosirea matricei de corelație, nu a celei de covarianță, face ca reperul să fie \(\sigma^2 = 1\) pentru toate activele: fiecare serie standardizată are varianța 1, iar urma (trace) matricei de corelație este egală cu \(N\).
Întrebare pentru sală Cîte dintre cele 16 valori proprii ale matricei de corelație se află deasupra benzii Marchenko–Pastur?
Răspuns
Una singură, 9,02: factorul comun al pieței, care explică 56% din varianța totală. Pentru N = 16 și T = 60, banda este [0,23; 2,30]. O singură valoare proprie depășește limita superioară; nouă sînt în bandă, iar șase sînt sub limita inferioară.
În universul combinat, o singură valoare proprie, 9,02, depășește limita superioară \(\lambda_+\). Ea corespunde factorului comun al pieței (market mode), care explică 56% din urma matricei, adică din varianța totală standardizată. Nouă valori proprii se află în bandă, iar șase sînt sub limita inferioară \(\lambda_-\). Pe cele nouă sectoare, valoarea proprie a pieței este 5,2, cu \(\lambda_+ = 1{,}92\).
Simularea zgomotului pur arată că, pentru \(T\) mic, valorile proprii ale unor serii independente se împrăștie pe aproape toată banda, iar banda se îngustează spre 1 cînd \(T\) crește. Valorile proprii reale aflate în bandă nu pot fi deci interpretate, numai pe baza acestei comparații, ca structură.
Pe scurt
Matrice de corelație ale randamentelor lunare în exces, ultima fereastră de 60 de luni
august 2021 – iulie 2026, cu banda colorată \([\lambda_-, \lambda_+]\) pentru \(\sigma^2 = 1\)
Doar valoarea proprie a pieței depășește \(\lambda_+\)
\(9{,}0\) (\(56\%\) din urma matricei) la 16 ETF-uri, \(5{,}2\) la nouă sectoare (unde \(\lambda_+ = 1{,}92\))
Comparația cu \(\sigma^2 = 1\) ignoră faptul că factorul pieței absoarbe o parte din varianța totală. Laloux et al. (1999) rescalează de aceea varianța zgomotului la \(\sigma^2 = 1 - \lambda_1/N\), partea din urmă care nu este explicată de cea mai mare valoare proprie \(\lambda_1\). Cu această corecție banda se deplasează în jos, iar trei valori proprii o depășesc, atît în universul combinat, cît și pe sectoare.
Partea de jos a spectrului este cea care contează pentru optimizare. Șase dintre cele 16 valori proprii se află sub banda inițială, calculată cu \(\sigma^2 = 1\): ele sînt direcții cu varianță standardizată foarte mică în eșantion. Un exemplu este combinația long TLT și short IEF, cu pozițiile scalate cu volatilitățile celor două fonduri: ambele dețin titluri de stat americane, cu scadențe diferite, iar diferența lor variază puțin.
Din (4.21), aceste direcții primesc cea mai mare greutate în \(\mathbf{S}^{-1}\), iar portofoliul GMV pune ponderi mari pe ele. Dacă varianța lor este subestimată în eșantion, este subestimat și riscul GMV: portofoliul pare mai puțin riscant decît va fi în afara eșantionului.
Pe scurt
Cu zgomotul rescalat la \(\sigma^2 = 1 - \lambda_1/N\) (Laloux et al. (1999)), trei valori proprii depășesc banda în fiecare univers
Șase din 16 valori proprii sînt sub bandă: direcții de varianță standardizată mică în eșantion
de exemplu long TLT și short IEF (iShares 7–10 Year Treasury Bond ETF, ETF de obligațiuni de stat americane cu scadența 7–10 ani), scalate cu volatilitățile lor
GMV pune ponderi mari pe aceste combinații
dacă varianța lor este subestimată, este subestimat și riscul GMV
Shrinkage-ul înlocuiește matricea de eșantion \(\mathbf{S}\) printr-o combinație convexă a ei cu o țintă structurată (shrinkage target) \(\mathbf{F}\):
Parametrul \(\delta\) din (4.23) este intensitatea de shrinkage (shrinkage intensity). Ținta are puțini parametri liberi: este estimată cu eroare mică, dar este în general greșit specificată. Matricea de eșantion are \(N(N+1)/2\) parametri liberi: este nedeplasată, dar are eroare de estimare mare. Combinația schimbă o parte din eroarea de estimare pe o deplasare (bias) față de matricea adevărată.
Ledoit și Wolf au propus trei ținte:
Covarianța implicată de modelul cu un singur indice (single-index model) (Ledoit & Wolf, 2003);
unde \(s_{ij}\) sînt elementele lui \(\mathbf{S}\), iar \(\bar r\) este corelația medie de eșantion. Alegerea ei pentru sectoarele din SUA are două motive: toate sectoarele sînt acțiuni din SUA, cu corelații apropiate, iar ținta nu cere alegerea unui indice de piață.
Intensitatea se alege astfel încît să minimizeze distanța pătratică așteptată, în norma Frobenius (Frobenius norm), dintre \(\hat{\boldsymbol\Sigma}_{\text{LW}}\) și \(\boldsymbol\Sigma\). Logica se vede într-un caz simplificat, cu \(\mathbf{F}\) fixată și \(\mathbb{E}[\mathbf{S}] = \boldsymbol\Sigma\). Atunci \(\hat{\boldsymbol\Sigma}_{\text{LW}} - \boldsymbol\Sigma = (1-\delta)(\mathbf{S} - \boldsymbol\Sigma) + \delta(\mathbf{F} - \boldsymbol\Sigma)\), termenul încrucișat are media zero, iar
minimizată de \(\delta = \mathbb{E}\|\mathbf{S} - \boldsymbol\Sigma\|^2 / (\mathbb{E}\|\mathbf{S} - \boldsymbol\Sigma\|^2 + \|\mathbf{F} - \boldsymbol\Sigma\|^2)\): ponderea țintei crește cu zgomotul lui \(\mathbf{S}\) și scade cu eroarea de specificare a țintei. Ledoit & Wolf (2004b) tratează cazul în care și ținta este estimată din aceleași date și înlocuiesc mărimile necunoscute cu estimatori consistenți. Rezultatul este
În (4.25),\(\hat\pi\) este suma varianțelor asimptotice ale elementelor lui \(\mathbf{S}\), iar \(\hat\rho\) suma covarianțelor lor asimptotice cu elementele țintei; diferența \(\hat\pi - \hat\rho\) este zgomotul estimat al lui \(\mathbf{S}\). Numitorul \(\hat\gamma = \|\mathbf{F} - \mathbf{S}\|^2\) măsoară distanța observată dintre țintă și matricea de eșantion; el nu are legătură cu aversiunea la risc \(\gamma\) din (4.2). Pentru \(N\) fix și o țintă care rămîne greșit specificată, intensitatea tinde, în condiții uzuale, la zero, de ordinul \(1/T\). Concluzia nu este generală cînd dimensiunea crește odată cu eșantionul sau cînd ținta este corect specificată. Trunchierea la \([0, 1]\) păstrează combinația convexă. Formulele complete sînt în anexă.
Pe scurt
Contracția: matricea de eșantion \(\mathbf{S}\) este trasă spre o țintă structurată \(\mathbf{F}\)
Graficul interactiv aplică (4.23) cu ținta (4.24) matricei de covarianță a celor nouă ETF-uri sectoriale, estimată pe ultimele 60 de luni. Primul panou dă valorile proprii anualizate, ordonate după rang, în scară logaritmică: matricea de eșantion pe ultimele 60 de luni (linie punctată), matricea de eșantion pe toate lunile (linie întreruptă) și matricea după shrinkage, cu intensitatea \(\delta\) aleasă cu cursorul (linie continuă).
Al doilea panou dă ponderile portofoliului GMV (4.6) calculate cu matricea după shrinkage. Al treilea panou dă intensitatea Ledoit–Wolf \(\delta^*\) din (4.25), estimată pe ferestre rolling de 60 de luni; linia orizontală punctată marchează valoarea \(\delta\) aleasă. Butonul ▶ crește \(\delta\) de la 0 la 1.
Întrebare pentru sală Ce se întîmplă cu valorile proprii extreme cînd δ crește?
Răspuns
Cea mai mică valoare proprie crește (de la 0,0036 la 0,0058 pentru δ = 0,25), iar numărul de condiționare scade de la 52 la 32,1. Intensitatea Ledoit–Wolf estimată pe ultimele 60 de luni este 0,24, pentru care numărul de condiționare este 32,5. Cea mai mare valoare proprie aproape nu se schimbă (de la 0,1861 la 0,1871). Nici la δ = 1 valorile proprii nu devin egale: ținta cu corelație constantă are numărul de condiționare 21. Ponderile GMV devin mai puțin extreme.
Cînd \(\delta\) crește, cea mai mică valoare proprie crește (de la 0,0036 la 0,0058 pentru \(\delta = 0{,}25\)), iar numărul de condiționare scade de la 52 la 32,1. Cea mai mare valoare proprie aproape nu se schimbă (de la 0,1861 la 0,1871). Concavitatea celei mai mici valori proprii și convexitatea celei mai mari, ca funcții de matrice simetrice, dau limite pentru valorile proprii extreme ale combinației:
Ambele limite se îmbunătățesc dacă \(\lambda_{\min}(\mathbf{F}) \ge \lambda_{\min}(\mathbf{S})\) și \(\lambda_{\max}(\mathbf{F}) \le \lambda_{\max}(\mathbf{S})\). În exemplul analizat, numărul de condiționare scade în principal prin creșterea valorii proprii minime.
Intensitatea estimată pe ultimele 60 de luni este 0,24, pentru care numărul de condiționare este 32,5. Nici la \(\delta = 1\) valorile proprii nu devin egale: ținta cu corelație constantă păstrează varianțele diferite ale sectoarelor și are numărul de condiționare 21. Ponderile GMV devin mai puțin extreme, deoarece direcțiile cu varianță mică primesc, prin (4.21), o greutate mai mică în inversă.
Pe ultima fereastră, august 2021 – iulie 2026, intensitatea optimă este \(\delta^* = 0{,}24\). Cele mai mici valori proprii cresc; cea mai mare rămîne aproape neschimbată, iar a doua scade de la 0,073 la 0,063. Numărul de condiționare scade de la 51,6 la 32,5. Ca reper, matricea de eșantion pe toate cele 331 de luni are numărul de condiționare 48,7: un eșantion mai lung reduce zgomotul, dar valoarea rămîne apropiată de cea a ferestrei de 60 de luni.
Pe ferestre rolling de 60 de luni, \(\delta^*\) are media 0,43 și variază între 0,19 și 1,00. Valoarea 1, adică înlocuirea completă a matricei de eșantion cu ținta, apare o singură dată, în fereastra încheiată în octombrie 2008. Explicația se citește în (4.25): luna crizei triplează zgomotul estimat \(\hat\pi\) al lui \(\mathbf{S}\), iar distanța \(\hat\gamma\) pînă la țintă rămîne aproape aceeași, deci raportul \(\hat\kappa/T\) depășește 1 și este trunchiat.
Intensitatea este deci o mărime estimată, care variază în timp. Ea răspunde nu doar lungimii ferestrei, ci și observațiilor extreme din fereastră, care măresc incertitudinea elementelor lui \(\mathbf{S}\).
Pe scurt
Nouă ETF-uri sectoriale, randamente lunare în exces
Jagannathan & Ma (2003) au arătat că portofoliul GMV long-only (4.15) este egal cu portofoliul GMV fără restricții al unei matrice de covarianță modificate. Problema long-only are lagrangianul
unde \(\lambda_0\) este multiplicatorul restricției de buget, iar \(\boldsymbol\lambda = (\lambda_1, \dots, \lambda_N)^\top \ge \mathbf{0}\) este vectorul multiplicatorilor restricțiilor \(w_i \ge 0\). Condițiile Karush–Kuhn–Tucker (KKT conditions) cer \(\mathbf{S}\mathbf{w} = \lambda_0\mathbf{1} + \boldsymbol\lambda\) și complementaritatea \(\lambda_i w_i = 0\) pentru fiecare \(i\), deci \(\boldsymbol\lambda^\top\mathbf{w} = 0\):\(\lambda_i > 0\) doar unde restricția este activă (binding), adică unde \(w_i = 0\).
Cu bugetul \(\mathbf{1}^\top\mathbf{w} = 1\) și complementaritatea, \(\tilde{\mathbf{S}}\mathbf{w} = \mathbf{S}\mathbf{w} - \boldsymbol\lambda(\mathbf{1}^\top\mathbf{w}) - \mathbf{1}(\boldsymbol\lambda^\top\mathbf{w}) = \lambda_0\mathbf{1} + \boldsymbol\lambda - \boldsymbol\lambda - \mathbf{0} = \lambda_0\mathbf{1}\). Aceasta este condiția de ordinul întîi a problemei GMV (4.5) pentru matricea \(\tilde{\mathbf{S}}\): soluția long-only satisface condiția GMV fără restricții a lui \(\tilde{\mathbf{S}}\).
Din (4.26), pentru fiecare pereche de active ajustarea covarianței este \(\lambda_i + \lambda_j\), iar pe diagonală este \(2\lambda_i\): o restricție activă pe activul \(i\) scade toate covarianțele lui. Restricțiile active se determină împreună, prin rezolvarea problemei long-only. Setul lor nu se obține, în general, prin eliminarea ponderilor negative din soluția fără restricții, deoarece reoptimizarea modifică simultan toate ponderile. Ajustarea reduce covarianțele estimate ale activelor atinse, ca un shrinkage; această regularizare poate reduce riscul out-of-sample, fără să identifice separat eroarea fiecărei covarianțe.
Consecința este că o restricție „greșită”, în sensul că investitorul care cunoaște \(\boldsymbol\Sigma\) nu ar avea motiv s-o impună, poate reduce riscul out-of-sample. Efectul este cel mai mare cînd covarianțele sînt estimate din puține observații, adică exact cînd zgomotul din \(\mathbf{S}\) este mare.
Pe scurt
Jagannathan & Ma (2003): GMV long-only este egal cu GMV fără restricții al unei matrice de covarianță modificate
Mecanismul din (4.26) se poate urmări pe două active, cu volatilitățile \(\sigma_1 = 25\%\) și \(\sigma_2 = 10\%\) și corelația \(\rho = 0{,}5\). Elementele matricei sînt \(s_{11} = 0{,}0625\),\(s_{22} = 0{,}0100\) și \(s_{12} = \rho\sigma_1\sigma_2 = 0{,}0125\). Formula (4.4) dă ponderea GMV fără restricții a primului activ:
Activul volatil este vîndut în lipsă deoarece corelația depășește raportul volatilităților, \(\rho > \sigma_2/\sigma_1\): el evoluează puternic împreună cu celălalt, iar poziția short reduce varianța. Volatilitatea portofoliului este 9,93%.
Cu restricția long-only, \(w_1 \ge 0\) devine activă, iar soluția este \(\mathbf{w} = (0, 1)\), cu volatilitatea 10%. Condiția de ordinul întîi dă \(\mathbf{S}\mathbf{w} = (s_{12}, s_{22}) = (0{,}0125;\ 0{,}0100) = \lambda_0\mathbf{1} + \boldsymbol\lambda\). Deoarece \(w_2 > 0\), complementaritatea cere \(\lambda_2 = 0\), deci \(\lambda_0 = 0{,}0100\) și \(\boldsymbol\lambda = (0{,}0025;\ 0)\).
Matricea modificată din (4.26) are \(\tilde s_{12} = 0{,}0125 - 0{,}0025 = 0{,}0100\),\(\tilde s_{11} = 0{,}0625 - 2(0{,}0025) = 0{,}0575\) și \(\tilde s_{22} = 0{,}0100\). Corelația scade de la 0,5 la \(0{,}0100/\sqrt{0{,}0575\times0{,}0100} \approx 0{,}42\), iar varianța primului activ scade și ea. Pentru \(\tilde{\mathbf{S}}\), numărătorul formulei GMV este \(\tilde s_{22} - \tilde s_{12} = 0{,}0100 - 0{,}0100 = 0\), deci \(w_1^* = 0\): GMV fără restricții al matricei modificate este exact soluția long-only.
Restricția long-only corectează doar covarianțele activelor pe care le atinge, cu o cantitate determinată de multiplicatori. Shrinkage-ul neliniar, prezentat în anexă, corectează separat fiecare valoare proprie și păstrează vectorii proprii de eșantion; pe datele capitolului, niciunul dintre estimatori nu domină, iar alegerea se face out-of-sample.
Matricea de covarianță de eșantion are valori proprii prea dispersate, iar inversa ei, prin (4.21), pune cea mai mare greutate pe direcțiile cu varianța cea mai subestimată. Banda Marchenko–Pastur (4.22) dă reperul: pentru 16 active și 60 de luni, zgomotul singur produce un raport de zece între valorile proprii extreme, iar pe datele capitolului o singură valoare proprie depășește banda, în timp ce șase se află sub ea.
Shrinkage-ul (4.23) spre ținta cu corelație constantă (4.24) ridică valorile proprii mici și reduce numărul de condiționare al matricei sectoarelor de la 51,6 la 32,5, cu intensitatea estimată \(\delta^* = 0{,}24\) pe ultima fereastră. Restricția long-only acționează ca un shrinkage al covarianțelor activelor vîndute în lipsă (Jagannathan & Ma, 2003). Toate aceste corecții privesc \(\boldsymbol\Sigma\).Secțiunea următoare aplică aceeași idee mediilor, a căror eroare de estimare este mult mai mare.
Black–Litterman
Secțiunea despre riscul de estimare a arătat că problema principală a portofoliului tangent (4.8) sînt mediile estimate: ele sînt imprecise, iar optimizatorul le amplifică. Shrinkage-ul covarianței nu rezolvă această problemă. Black & Litterman (1992) aplică ideea de shrinkage mediilor: mediile folosite în optimizare sînt trase spre cele implicate de un portofoliu de referință (benchmark portfolio), iar abaterea de la ele se face doar prin opiniile (views) explicite ale investitorului, ponderate cu încrederea în ele.
De la contracția covarianței la contracția mediilor
Întrebarea secțiunii este ce medii folosim dacă mediile de eșantion sînt prea imprecise. Răspunsul lui Black & Litterman (1992) pornește de la optimizarea inversă (reverse optimisation). Un investitor medie–varianță cu aversiunea la risc \(\delta_{\text{RA}}\) și cu acces la numerar, deci fără restricția de buget din (4.2), maximizează \(\mathbf{w}^\top\boldsymbol\mu - \frac{\delta_{\text{RA}}}{2}\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}\). Condiția de ordinul întîi \(\boldsymbol\mu = \delta_{\text{RA}}\boldsymbol\Sigma\mathbf{w}\) dă ponderile în active riscante
Optimizarea inversă citește (4.27) de la dreapta la stînga. În locul întrebării „ce ponderi sînt optime pentru mediile date?”, ea pune întrebarea „pentru ce medii este optim un portofoliu dat?”. Dacă portofoliul de referință \(\mathbf{w}_b\) trebuie să fie optim, mediile sînt
Vectorul \(\boldsymbol\pi\) din (4.28) conține randamentele în exces implicite (implied excess returns), numite și randamente de echilibru. Componenta \(i\) este proporțională cu covarianța dintre activul \(i\) și portofoliul de referință, \((\boldsymbol\Sigma\mathbf{w}_b)_i\). Cu ponderile pieței ca referință, \(\boldsymbol\pi\) sînt randamentele implicate de CAPM, tratat în Capitolul 3. Pentru calculul lui \(\boldsymbol\pi\) nu este nevoie de nicio medie estimată, ci doar de \(\boldsymbol\Sigma\), care se estimează mult mai precis.
Pentru sectoarele din SUA, capitalizările sectoarelor nu sînt disponibile, așa că portofoliul de referință este 1/N, iar aversiunea la risc este \(\delta_{\text{RA}} = 2{,}5\); rolul acestui parametru este discutat în anexă. Al doilea pas al metodei adaugă opiniile investitorului. Fără opinii, mediile sînt \(\boldsymbol\pi\), iar (4.27) redă exact portofoliul de referință.
Graficul interactiv pornește de la mediile implicite \(\boldsymbol\pi\) ale celor nouă sectoare, cu 1/N ca portofoliu de referință, și adaugă o singură opinie relativă: XLK (tehnologie) depășește XLU (utilități) cu un randament dat pe an. Primul cursor fixează mărimea opiniei. Al doilea fixează incertitudinea ei, \(\boldsymbol\Omega\), ca multiplu al varianței a priori a portofoliului opiniei; la stînga opinia este aproape sigură, la dreapta aproape ignorată. Butonul ▶ reduce incertitudinea de la valoarea maximă la cea minimă.
Panoul din stînga dă mediile anualizate ale randamentelor în exces: cele implicite (a priori) și cele a posteriori, după combinarea cu opinia. Panoul din dreapta dă ponderile portofoliului de referință 1/N și ponderile Black–Litterman din (4.32).
Întrebare pentru sală Opinia este că XLK depășește XLU cu 3% pe an. Cum se schimbă ponderile celorlalte șapte sectoare?
Răspuns
Nu se schimbă. Ponderea XLK crește și ponderea XLU scade cu aceeași cantitate, 3,3 puncte procentuale. Diferența a posteriori XLK − XLU este 2,6% pe an, între media a priori de 2,2% și opinia de 3%. Mediile celorlalte sectoare se modifică prin corelațiile cu XLK și XLU, dar ponderile lor rămîn 1/N.
Cu opinia de 3% pe an, ponderile celorlalte șapte sectoare rămîn la 1/N. Ponderea XLK crește, iar ponderea XLU scade cu aceeași cantitate, 3,3 puncte procentuale. Explicația este forma echivalentă (4.31) a mediei a posteriori: ajustarea mediilor este proporțională cu \(\boldsymbol\Sigma\mathbf{P}^\top\), iar în ponderi factorul \(\boldsymbol\Sigma\) se simplifică cu \(\boldsymbol\Sigma^{-1}\) din (4.32). Ponderile se modifică doar pe direcția \(\mathbf{P}^\top\) a portofoliului opiniei, adică \(+1\) pe XLK și \(-1\) pe XLU.
Diferența a posteriori XLK − XLU este 2,6% pe an, între media a priori de 2,2% și opinia de 3%. Cu incertitudinea implicită a opiniei, egală cu varianța a priori a portofoliului opiniei, cele două surse primesc ponderi egale, iar diferența a posteriori este mijlocul \((2{,}2\% + 3\%)/2\). Mediile celorlalte sectoare se modifică și ele, prin corelațiile cu XLK și XLU, dar ponderile lor nu.
Matricea \(\boldsymbol\Sigma\) este estimată din randamentele lunare în exces din august 2016 pînă în iulie 2026, adică 120 de luni, cealaltă lungime de fereastră folosită de DeMiguel, Garlappi & Uppal (2009). Graficul static compară trei vectori de medii anualizate: mediile implicite \(\boldsymbol\pi\), mediile Black–Litterman după opinie și mediile de eșantion pe 10 ani. Panoul ponderilor compară 1/N, Black–Litterman și portofoliul MV construit cu mediile de eșantion.
Opinia este una relativă: XLK minus XLU \(= 3\%\) pe an, cu portofoliul opiniei \(+1\) XLK, \(-1\) XLU. Diferența implicită XLK − XLU este 2,2%, iar după combinarea cu opinia devine 2,6%. Ponderea XLK crește de la 11,1% la 14,4%, ponderea XLU scade de la 11,1% la 7,8%, iar celelalte ponderi rămîn neschimbate. Calculul de mînă este exercițiul A7 din Seminarul 4.
Comparația cu mediile de eșantion arată ce evită metoda. Media de eșantion a lui XLK este 21,3% pe an, iar ponderile MV devin \(+115\%\) în XLK, \(-68\%\) în XLY (Consumer Discretionary Select Sector SPDR Fund, ETF pe sectorul bunurilor de consum ciclice) și \(-45\%\) în XLB. Pozițiile short mari nu provin dintr-o opinie a investitorului, ci din diferențele dintre mediile de eșantion pe 10 ani, amplificate prin \(\boldsymbol\Sigma^{-1}\); normalizarea la buget din (4.8) produce ponderile raportate.
Pe scurt
Stînga: mediile, anualizate
implicite \(\boldsymbol\pi\), Black–Litterman după opinie și de eșantion pe 10 ani
Dreapta: ponderile 1/N, Black–Litterman și MV cu mediile de eșantion
\(\boldsymbol\Sigma\) din randamentele lunare în exces, august 2016 – iulie 2026 (120 de luni)
unde scalarul \(\tau > 0\) măsoară incertitudinea asupra lui \(\boldsymbol\pi\) relativ la covarianța randamentelor. Cele \(K\) opinii se scriu \(\mathbf{q} = \mathbf{P}\boldsymbol\mu + \boldsymbol\varepsilon\), cu \(\boldsymbol\varepsilon \sim N(\mathbf{0}, \boldsymbol\Omega)\) independentă de \(\boldsymbol\mu\). Matricea \(\mathbf{P}\) are dimensiunea \(K \times N\), iar linia ei \(k\) este portofoliul opiniei \(k\);\(\mathbf{q}\) conține randamentele afirmate în opinii, iar \(\boldsymbol\Omega\) incertitudinea lor. Pe sectoarele din SUA, \(K = 1\), iar \(\mathbf{P}\) are \(+1\) pe XLK, \(-1\) pe XLU și zero în rest.
Ambele componente ale modelului au distribuții Normale, iar eroarea opiniilor este independentă de distribuția a priori. Atunci precizia (precision), inversa varianței, a distribuției a posteriori (posterior) este suma preciziilor: \(\mathbf{M}^{-1} = (\tau\boldsymbol\Sigma)^{-1} + \mathbf{P}^\top\boldsymbol\Omega^{-1}\mathbf{P}\). Media a posteriori este media celor două surse, ponderată cu preciziile:
O formă echivalentă, care nu cere inversarea lui \(\tau\boldsymbol\Sigma\), scrie media a posteriori ca medie a priori plus o corecție proporțională cu diferența dintre opinii și ceea ce implică distribuția a priori pentru portofoliile opiniilor:
unde a doua egalitate folosește (4.28) și (4.31). Pentru optimizarea fără constrîngeri suplimentare, cu acces la numerar și cu aceeași matrice \(\boldsymbol\Sigma\) în optimizare, ponderile se abat de la \(\mathbf{w}_b\) doar pe direcțiile date de \(\mathbf{P}^\top\), iar abaterea crește cu distanța \(\mathbf{q} - \mathbf{P}\boldsymbol\pi\) dintre opinii și mediile implicite. Folosirea covarianței predictive \(\boldsymbol\Sigma + \mathbf{M}\) sau introducerea restricțiilor asupra ponderilor poate modifica acest rezultat.
Cazurile limită arată rolul lui \(\boldsymbol\Omega\). Pentru \(\boldsymbol\Omega \to \mathbf{0}\), opiniile se impun exact, \(\mathbf{P}\boldsymbol\mu_{\text{BL}} = \mathbf{q}\); pentru \(\boldsymbol\Omega \to \infty\), ele sînt ignorate, iar \(\boldsymbol\mu_{\text{BL}} = \boldsymbol\pi\). Încrederea într-o opinie este dată de \(\boldsymbol\Omega\) relativ la \(\tau\boldsymbol\Sigma\), nu de \(\tau\) singur (anexa despre cazurile limită, \(\delta_{\text{RA}}\) și \(\tau\)). Același estimator este soluția unei regresii mixte estimate prin cele mai mici pătrate generalizate (GLS, generalised least squares), în care distribuția a priori și opiniile sînt observații ale lui \(\boldsymbol\mu\)(Theil & Goldberger, 1961); derivarea este în anexă.
Cu un singur activ, (4.30) este o medie ponderată a doi scalari. Fie \(\pi = 5\%\),\(\tau\sigma^2 = 0{,}00128\) și opinia \(8\%\) cu varianța \(0{,}0004\). Ponderea opiniei este raportul dintre precizia ei și precizia totală, \(0{,}00128/(0{,}00128 + 0{,}0004) = 0{,}76\), deci \(\mu_{\text{BL}} = 7{,}29\%\). Opinia primește ponderea mai mare deoarece varianța ei este mai mică decît incertitudinea a priori.
Pe scurt
A priori: \(\boldsymbol\mu \sim N(\boldsymbol\pi, \tau\boldsymbol\Sigma)\)
\(\tau\) scalează incertitudinea asupra lui \(\boldsymbol\pi\)
Black–Litterman înlocuiește mediile de eșantion prin media a posteriori (4.30), o medie ponderată cu preciziile dintre mediile implicite (4.28) și opiniile investitorului (Black & Litterman, 1992). Mediile implicite nu cer estimarea niciunei medii, ci doar a lui \(\boldsymbol\Sigma\), iar fără opinii portofoliul optim este chiar portofoliul de referință. Din (4.32), fără restricții suplimentare și cu aceeași \(\boldsymbol\Sigma\) în optimizare, o opinie modifică doar ponderile activelor din portofoliul ei.
Pe sectoarele din SUA, opinia XLK minus XLU \(= 3\%\) mută diferența implicită de la 2,2% la 2,6% și ponderile XLK și XLU cu cîte 3,3 puncte procentuale, în timp ce mediile de eșantion pe 10 ani ar produce poziții de \(+115\%\) în XLK și \(-68\%\) în XLY. Metoda face shrinkage al mediilor spre un portofoliu de referință ales de investitor. Secțiunea următoare renunță complet la medii și construiește portofolii doar din riscul activelor.
Risk parity și Hierarchical Risk Parity
Secțiunile precedente au arătat că estimarea mediilor este principala sursă de eroare în ponderile medie–varianță, iar inversarea matricei de covarianță amplifică erorile din \(\hat{\boldsymbol\Sigma}\). Regulile din această secțiune ocolesc ambele probleme. Ele folosesc numai matricea de covarianță și nu cer inversarea ei: ponderile se aleg astfel încît riscul portofoliului să fie distribuit într-un mod fixat dinainte între active sau între grupuri de active.
Secțiunea tratează două reguli:
Regula contribuțiilor egale la risc (ERC, equal risk contribution) pornește de la descompunerea volatilității portofoliului în contribuțiile activelor și cere ca acestea să fie egale (Maillard, Roncalli & Teïletche, 2010).
Hierarchical Risk Parity (HRP) ordonează activele după un arbore de corelații și împarte capitalul recursiv între grupuri (López de Prado, 2016).
Ambele produc numai ponderi pozitive și nu folosesc randamentele așteptate. Prețul este că niciuna nu este optimă în sens medie–varianță decît în ipoteze speciale.
Întrebarea secțiunii este dacă se pot construi ponderi numai din \(\boldsymbol\Sigma\), fără medii și fără inversarea lui \(\boldsymbol\Sigma\). Punctul de plecare este observația că ponderea unui activ în capital nu spune ce parte din riscul portofoliului provine din acel activ. Un activ volatil și corelat cu celelalte poate genera o parte din risc mult mai mare decît ponderea lui.
Graficul interactiv folosește cele opt ETF-uri multi-active. Graficul de sus arată, pentru fiecare activ, două bare: ponderea și cota din riscul portofoliului; linia punctată marchează nivelul \(1/N\). Cursorul alege iterația unui algoritm care pornește de la ponderile egale (iterația 0) și ajustează ponderile pînă cînd contribuțiile la risc devin egale, adică pînă la portofoliul ERC; butonul ▶ parcurge iterațiile. Graficul de jos compară, pentru 1/N, GMV long-only, ERC și HRP, ponderile (stînga) și contribuțiile la risc (dreapta), stivuite pe active.
Întrebare pentru sală În portofoliul 1/N, acțiunile și obligațiunile high yield au jumătate din capital. Ce parte din risc generează?
Răspuns
69%. Dacă se folosesc numai varianțele individuale, fără covarianțe, partea lor ar fi 64%. Contribuțiile egale la risc (ERC) mută capital spre titlurile de stat: IEF primește 25,1%, iar contribuția fiecărui activ la risc devine 12,5%.
În portofoliul 1/N, acțiunile și obligațiunile high yield primesc jumătate din capital, dar generează 69% din risc. Partea lor ar fi 64% dacă s-ar folosi numai varianțele individuale, fără covarianțe; diferența provine din corelațiile pozitive dintre aceste active.
Pe măsură ce algoritmul avansează, capitalul se mută spre titlurile de stat, cu volatilitate mică. În portofoliul ERC, IEF primește 25,1% din capital, iar fiecare activ contribuie cu 12,5% la risc.
Pe scurt
Întrebarea secțiunii: putem construi ponderi doar din \(\boldsymbol\Sigma\), fără medii și fără a inversa \(\boldsymbol\Sigma\)?
Covarianța folosită este cea de eșantion, calculată pe tot eșantionul, din mai 2007 pînă în iulie 2026 (\(T = 231\) de luni). Volatilitățile anuale ale celor opt ETF-uri variază de la 6,7% (IEF) la 21,1% (EEM). Imaginea este deci in-sample, ca frontiera sectoarelor din secțiunea medie–varianță: ea descrie structura ponderilor, nu performanța lor.
Cele patru reguli distribuie riscul foarte diferit. GMV long-only pune 73% în IEF, 22% în HYG și 5% în SPY; celelalte cinci active au pondere zero, deci restricția \(w_i \ge 0\) este activă pentru ele. ERC dă cea mai mare pondere lui IEF (25%), dar păstrează toate activele. HRP se află între cele două, cu cele mai mari ponderi în IEF (35%) și LQD (23%).
Volatilitățile anuale ale celor patru portofolii sînt 9,4% pentru 1/N, 7,9% pentru ERC, 7,1% pentru HRP și 5,8% pentru GMV long-only. Ordinea dintre 1/N, ERC și GMV long-only este cea prevăzută de teoria din partea următoare: ERC se află între portofoliul cu ponderi egale și cel de varianță minimă.
Pe scurt
Opt ETF-uri multi-active, covarianța pe tot eșantionul, mai 2007 – iulie 2026 (\(T = 231\))
volatilitățile variază de la \(6{,}7\%\) (IEF) la \(21{,}1\%\) (EEM)
Stînga: ponderile; dreapta: cota fiecărui activ din risc
cota: \(w_i(\boldsymbol\Sigma\mathbf{w})_i/\sigma_p^2\) (slide-ul următor), în zecimale (\(0{,}5 = 50\%\))
1/N: acțiunile și obligațiunile high yield (HYG) primesc jumătate din pondere, dar generează \(69\%\) din risc
ERC (contribuții egale la risc): fiecare activ contribuie cu \(12{,}5\%\)
IEF primește cea mai mare pondere (\(25\%\))
GMV long-only: \(73\%\) IEF, \(22\%\) HYG, \(5\%\) SPY, cinci active cu pondere zero
HRP (Hierarchical Risk Parity): cele mai mari ponderi sînt IEF (\(35\%\)) și LQD (\(23\%\))
Volatilitatea portofoliului \(\sigma_p(\mathbf{w}) = \sqrt{\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w}}\) este o funcție omogenă de gradul întîi în ponderi (homogeneous of degree one): \(\sigma_p(c\,\mathbf{w}) = c\,\sigma_p(\mathbf{w})\) pentru orice \(c > 0\). Derivînd această identitate în raport cu \(c\) în \(c = 1\) se obține teorema lui Euler (Euler's theorem) pentru funcții omogene. Deoarece \(\partial\sigma_p/\partial w_i = (\boldsymbol\Sigma\mathbf{w})_i/\sigma_p\), rezultă
Mărimea \(RC_i\) din (4.33) este contribuția la risc (risk contribution) a activului \(i\): ponderea lui înmulțită cu volatilitatea marginală (marginal volatility) \(\partial\sigma_p/\partial w_i\). Contribuțiile însumează exact volatilitatea portofoliului, iar cota procentuală a activului \(i\) este \(RC_i/\sigma_p = w_i(\boldsymbol\Sigma\mathbf{w})_i/\sigma_p^2\). Termenul \((\boldsymbol\Sigma\mathbf{w})_i\) este covarianța dintre randamentul activului \(i\) și randamentul portofoliului, deci cota poate fi negativă pentru un activ cu covarianță negativă cu portofoliul.
Exemplul numeric folosește un portofoliu 50/50 în SPY și IEF, cu momente anualizate din date lunare 2002–2026: \(\sigma_1^2 = 0{,}02166\),\(\sigma_2^2 = 0{,}00441\) și \(\sigma_{12} = -0{,}00098\). Atunci \((\boldsymbol\Sigma\mathbf{w})_1 = 0{,}01034\) și \((\boldsymbol\Sigma\mathbf{w})_2 = 0{,}00172\), iar \(\sigma_p^2 = 0{,}5 \times 0{,}01034 + 0{,}5 \times 0{,}00172 = 0{,}00603\), adică \(\sigma_p = 7{,}76\%\). Cotele din risc sînt 85,8% pentru SPY și 14,2% pentru IEF: jumătate din capital în acțiuni produce aproape tot riscul.
Bugetarea riscului (risk budgeting) inversează întrebarea: se fixează dinainte bugetele \(b_i \ge 0\), cu \(\sum_i b_i = 1\), și se caută ponderile pentru care cota fiecărui activ din risc este egală cu bugetul lui. ERC este cazul particular cu bugete egale.
Pe scurt
Volatilitatea este omogenă de gradul întîi în ponderi (Euler)
Portofoliul ERC al lui Maillard, Roncalli & Teïletche (2010) cere \(RC_i = RC_j\) pentru orice \(i\) și \(j\). Condiția este un sistem neliniar în \(\mathbf{w}\), dar soluția se obține dintr-o problemă convexă în ponderi nenormalizate \(\mathbf{y}\):
Gradientul obiectivului din (4.34) are componentele \((\boldsymbol\Sigma\mathbf{y})_i - 1/(N y_i)\). Anularea lor dă \(y_i(\boldsymbol\Sigma\mathbf{y})_i = 1/N\) pentru orice \(i\). După normalizarea \(\mathbf{w} = \mathbf{y}/s\), cu \(s = \mathbf{1}^\top\mathbf{y}\), produsele \(w_i(\boldsymbol\Sigma\mathbf{w})_i = 1/(N s^2)\) sînt egale, deci și contribuțiile \(RC_i\) din (4.33) sînt egale, fiecare \(\sigma_p/N\). Termenul logaritmic tinde la \(+\infty\) cînd un \(y_i\) tinde la zero, așa că minimul se află în interiorul domeniului și toate ponderile sînt strict pozitive.
Pentru \(\boldsymbol\Sigma\) pozitiv definită, forma pătratică este strict convexă, iar \(-\ln y_i\) este convexă. Obiectivul este deci strict convex și tinde la infinit la frontiera domeniului, ceea ce garantează existența și unicitatea soluției. Volatilitățile respectă ordinea \(\sigma_{\text{GMV}} \le \sigma_{\text{ERC}} \le \sigma_{1/N}\)(Maillard, Roncalli & Teïletche, 2010): ERC este un compromis între ponderile egale în capital și varianța minimă.
Cu două active, condiția ERC are o formă explicită. Egalitatea \(w_1(\boldsymbol\Sigma\mathbf{w})_1 = w_2(\boldsymbol\Sigma\mathbf{w})_2\) se scrie \(w_1^2\sigma_1^2 + w_1w_2\sigma_{12} = w_2^2\sigma_2^2 + w_1w_2\sigma_{12}\). Termenul de covarianță se reduce, iar pentru ponderi pozitive rămîne \(w_1\sigma_1 = w_2\sigma_2\), adică
ponderi invers proporționale cu volatilitatea (inverse-volatility weights), pentru orice corelație \(\rho \in (-1, 1)\). Pentru SPY (volatilitate 14,7%) și IEF (6,6%), ERC deține 31% SPY, are volatilitatea 6,1%, iar fiecare activ contribuie cu 50% la varianță. Cu mai mult de două active, corelațiile intră în soluție: ponderile invers proporționale cu volatilitatea dau ERC dacă matricea de corelație are sume egale pe rînduri, iar corelațiile toate egale sînt un caz particular (alte reguli bazate pe risc).
ERC nu folosește mediile, dar poate coincide cu portofoliul tangent (Maillard, Roncalli & Teïletche, 2010). Dacă matricea de corelație are sume egale pe rînduri și, în plus, rapoartele Sharpe individuale sînt egale și pozitive, portofoliul cu ponderi invers proporționale cu volatilitatea este atît ERC, cît și tangent. Acestea sînt condiții suficiente, nu necesare. În general, ERC renunță la o parte din raportul Sharpe in-sample în schimbul unor ponderi care nu depind de mediile estimate.
HRP, propusă de López de Prado (2016), construiește ponderile în trei pași, fără inversarea matricei de covarianță și numai cu ponderi pozitive. Deoarece nu se inversează nimic, metoda funcționează și cînd \(\boldsymbol\Sigma\) este singulară, de exemplu cînd numărul activelor depășește numărul observațiilor din fereastră.
Pasul 1 construiește un arbore. Pentru fiecare pereche de active se calculează distanța de corelație (correlation distance) \(d_{ij} = \sqrt{(1 - \rho_{ij})/2}\), unde \(\rho_{ij}\) este corelația activelor \(i\) și \(j\); distanța este 0 pentru \(\rho_{ij} = 1\) și 1 pentru \(\rho_{ij} = -1\). Apoi se compară profilurile întregi de distanțe: \(\tilde d_{ij}\) este distanța euclidiană dintre coloanele \(i\) și \(j\) ale matricei \(\mathbf{D} = (d_{ij})\),
Două active sînt apropiate după \(\tilde d_{ij}\) din (4.36) dacă se corelează în același fel cu toate celelalte active. Gruparea ierarhică prin legătură simplă (single linkage) unește repetat cele mai apropiate două grupuri, distanța dintre grupuri fiind cea mai mică distanță dintre membrii lor. Rezultatul este o dendrogramă (dendrogram), arborele unirilor succesive.
Pasul 2, cvasi-diagonalizarea (quasi-diagonalisation), ordonează activele ca frunzele arborelui, astfel încît activele asemănătoare sînt vecine. În această ordine, covarianțele mari se concentrează lîngă diagonala matricei.
Pasul 3 este bisecția recursivă (recursive bisection). Lista ordonată se împarte în două jumătăți. În fiecare jumătate \(j\) se formează portofoliul cu ponderi proporționale cu inversul varianțelor individuale, \(\tilde w_i \propto 1/\sigma_i^2\), cu varianța \(V_j = \tilde{\mathbf{w}}_j^\top\boldsymbol\Sigma_j\tilde{\mathbf{w}}_j\), unde \(\boldsymbol\Sigma_j\) este covarianța activelor din jumătatea \(j\). Cele două jumătăți primesc fracțiunile
din capitalul nodului curent, iar procedura se repetă în fiecare jumătate pînă rămîn active individuale. Din (4.37), jumătatea cu varianța mai mică primește mai mult capital. Covarianțele intră numai în varianțele \(V_j\) ale portofoliilor de grup, prin produse de forma \(\tilde{\mathbf{w}}^\top\boldsymbol\Sigma\tilde{\mathbf{w}}\), niciodată printr-o inversă.
Aceeași distanță de corelație și arborele de acoperire minim (minimum spanning tree) au fost folosite de Mantegna (1999) pentru a descrie ierarhia unei piețe de acțiuni. Metodele de grupare ierarhică sînt tratate în manualul lui Härdle & Simar (2019), la analiza cluster (cluster analysis).
Pe scurt
HRP (López de Prado (2016)): trei pași, fără inversarea matricei, toate ponderile pozitive
funcționează chiar dacă \(\boldsymbol\Sigma\) este singulară
Exemplul folosește universul combinat: nouă sectoare din SUA și șapte ETF-uri multi-active, cu date lunare din mai 2007 pînă în iulie 2026. Pe graficul interactiv, harta de culori (heatmap) arată matricea de corelație a celor 16 active, iar graficul de bare dedesubt arată ponderile în ordinea frunzelor arborelui. Cursorul parcurge pașii algoritmului: la primul pas corelațiile apar în ordinea inițială a activelor, la al doilea în ordinea frunzelor, iar pașii următori aplică pe rînd nivelurile bisecției recursive. La ultimul pas apar și ponderile GMV long-only, pentru comparație. Butonul ▶ parcurge toți pașii.
Întrebare pentru sală De ce HRP nu inversează matricea de covarianță?
Răspuns
HRP ordonează activele după arborele de corelații, calculează varianța fiecărui portofoliu de grup cu ponderi inverse varianței individuale și împarte recursiv capitalul între grupuri. Covarianțele intră în calculul acestor varianțe, fără inversarea matricei, care amplifică erorile de estimare. GMV long-only pune ponderi nenule pe doar 5 dintre cele 16 ETF-uri.
Ponderile HRP nu cer inversarea matricei de covarianță, deoarece algoritmul împarte capitalul recursiv între grupuri, după varianța portofoliului fiecărui grup. Covarianțele intră în aceste varianțe, nu într-o inversă, iar inversarea este operația care amplifică erorile de estimare.
Arborele are o structură economică clară. Cea mai apropiată pereche este TLT–IEF (\(\tilde d = 0{,}29\)), cele două ETF-uri de titluri de stat, iar aurul se alătură ultimul (\(\tilde d = 0{,}96\)). Grupul de acțiuni conține sectoarele ciclice, EFA (iShares MSCI EAFE ETF, ETF pe acțiunile piețelor dezvoltate din afara Americii de Nord), EEM și creditul high yield. Sectoarele defensive (utilități, bunuri de consum de bază, sănătate) și energia i se alătură tîrziu.
Toate cele 16 ponderi HRP sînt pozitive; cele mai mari sînt IEF (26,7%), LQD (17,6%) și HYG (12,6%). GMV long-only pune 75,6% în IEF și are pondere nenulă doar pe cinci active. Ambele reguli favorizează obligațiunile, dar HRP păstrează toate activele în portofoliu.
Pe scurt
Nouă sectoare și șapte ETF-uri multi-active, lunar, mai 2007 – iulie 2026
Cea mai apropiată pereche este TLT–IEF (\(\tilde d = 0{,}29\))
Aurul se alătură ultimul (\(\tilde d = 0{,}96\))
Grupul de acțiuni: sectoarele ciclice, EFA (iShares MSCI EAFE ETF, ETF pe acțiunile piețelor dezvoltate din afara Americii de Nord), EEM și creditul high yield
Sectoarele defensive (utilități, bunuri de consum de bază, sănătate) și energia i se alătură tîrziu
HRP: toate cele 16 ponderi sînt pozitive
cele mai mari sînt IEF \(26{,}7\%\), LQD \(17{,}6\%\) și HYG \(12{,}6\%\)
GMV long-only: \(75{,}6\%\) în IEF și doar cinci active cu pondere nenulă
Regulile bazate pe risc construiesc ponderile numai din \(\boldsymbol\Sigma\). Descompunerea Euler (4.33) atribuie fiecărui activ o contribuție la risc, iar ERC egalează aceste contribuții prin problema convexă (4.34); cu două active, ERC înseamnă ponderi invers proporționale cu volatilitatea (4.35). HRP înlocuiește inversarea matricei cu un arbore de corelații și cu bisecția recursivă (4.37). Pe cele opt ETF-uri multi-active, volatilitatea scade de la 9,4% (1/N) la 7,9% (ERC), 7,1% (HRP) și 5,8% (GMV long-only).
Aceste rezultate sînt in-sample și privesc doar riscul. Dacă evitarea mediilor estimate și a inversării matricei aduce un raport Sharpe mai mare decît 1/N, cînd ponderile se calculează numai din trecut, este întrebarea secțiunii următoare.
Evaluarea în afara eșantionului
Toate comparațiile de pînă aici au folosit parametri estimați pe tot eșantionul. Această secțiune evaluează regulile așa cum le-ar fi aplicat un investitor: ponderile fiecărei luni se calculează numai din datele disponibile la momentul deciziei, iar performanța se măsoară în lunile următoare, out-of-sample.
Secțiunea are două părți:
Protocolul de backtesting și rezultatele: evoluția averii, rapoartele Sharpe în cele trei universuri, turnover-ul și efectul costurilor de tranzacționare.
Întrebarea dacă diferențele observate față de 1/N sînt mai mari decît variația de eșantionare. Pentru aceasta se folosesc inferența pentru un raport Sharpe (Lo, 2002), testele pentru diferența a două rapoarte Sharpe (Jobson & Korkie, 1981; Ledoit & Wolf, 2008), bootstrap-ul pe blocuri și corecțiile pentru testare multiplă.
Întrebarea secțiunii este dacă o regulă estimată depășește ponderile 1/N atunci cînd ponderile folosesc doar datele disponibile la momentul deciziei. Ponderile lunii \(t\) se calculează din lunile \(t-60, \dots, t-1\), o fereastră rolling de 60 de luni, una dintre ferestrele folosite de DeMiguel, Garlappi & Uppal (2009). Portofoliul se reechilibrează (rebalancing) lunar, la frecvența datelor; costul reechilibrării nu intră în randamentele brute, ci se măsoară separat, prin turnover.
Sînt comparate opt reguli. 1/N are ponderi egale. MV este portofoliul tangent (4.8) cu media și covarianța de eșantion ale ferestrei, iar MV-LO este portofoliul tangent long-only. GMV este portofoliul de varianță minimă globală (4.6) cu covarianța de eșantion, GMV-LO varianta long-only (4.15), iar GMV-LW folosește covarianța cu shrinkage Ledoit–Wolf. ERC și HRP sînt regulile bazate pe risc din secțiunea precedentă.
O regulă a cărei avere ajunge la zero, adică are într-o lună o pierdere de 100% sau mai mare, este lichidată (liquidated). Randamentele ei ulterioare nu mai sînt rezultatul unei investiții, așa că regula nu intră în comparațiile de Sharpe, în analiza costurilor și în teste.
Regulile se aplică în trei universuri. Pe sectoare, perioada out-of-sample este ianuarie 2004 – iulie 2026, 271 de luni, iar prima fereastră acoperă 1999–2003. Universurile multi-active și combinat au perioada out-of-sample mai 2012 – iulie 2026, 171 de luni.
Măsura principală este raportul Sharpe anualizat, \(\sqrt{12}\,\bar r^e/\hat\sigma(r^e)\), unde \(\bar r^e\) și \(\hat\sigma(r^e)\) sînt media și abaterea standard ale randamentelor lunare în exces ale regulii. Drawdown-ul maxim se calculează din averea obținută cu randamente totale. Fiecare diferență de Sharpe față de 1/N este însoțită de un test, iar familia de teste este corectată pentru testare multiplă.
Pe scurt
Întrebarea secțiunii: depășește o regulă estimată ponderile 1/N?
cînd ponderile folosesc doar datele disponibile la momentul deciziei
Ponderile lunii \(t\) folosesc doar lunile \(t-60, \dots, t-1\) (fereastra mobilă de 60 de luni)
Graficul arată averea fiecărei reguli împărțită la averea unui cont în titluri de stat pe termen scurt (T-bills), pe scară logaritmică; o curbă care urcă are randamente peste rata fără risc. Selectorul alege universul, primul cursor costul pe unitate de turnover (în puncte de bază), iar al doilea cursor ultima lună afișată. Butonul ▶ desenează evoluția progresiv, de la prima lună out-of-sample. O regulă lichidată apare în legendă cu data lichidării.
Întrebare pentru sală Care regulă are cel mai mare raport Sharpe out-of-sample în universul multi-active?
Răspuns
MV-LO, cu 0,80, urmată de 1/N cu 0,52 și ERC cu 0,49. MV fără restricții este lichidată în septembrie 2025, după o pierdere lunară de peste 100%: averea ei ajunge la zero, deci nu intră în clasament.
În universul multi-active, înainte de costuri, MV-LO are cel mai mare raport Sharpe out-of-sample, 0,80, urmată de 1/N cu 0,52 și ERC cu 0,49. MV fără restricții eșuează complet: turnover-ul ei este de 44 de ori averea pe lună, iar în septembrie 2025 este lichidată, după o pierdere lunară de peste 100%. Averea ei ajunge la zero, deci nu intră în clasament.
Regulile GMV au cea mai mică volatilitate, între 3,8% și 5,4% pe an, dar și rapoarte Sharpe scăzute, între 0,27 și 0,37. Ele pun ponderi mari pe titlurile de stat, iar randamentele în exces ale acestora au fost ușor negative după mai 2012: \(-0{,}5\%\) pe an pentru TLT și \(-0{,}2\%\) pentru IEF. Varianța minimă a fost atinsă, dar cu un randament în exces apropiat de zero.
Avantajul lui MV-LO față de 1/N poate reflecta o regulă mai bună sau doar o perioadă favorabilă. Graficul nu poate separa cele două explicații; răspunsul vine de la testele din a doua parte a secțiunii.
Pe scurt
Axa verticală: averea relativă la un cont în titluri de stat (T-bills), pe scară logaritmică
opt ETF-uri multi-active, înainte de costuri
MV eșuează complet
turnover de \(44\) de ori averea pe lună
lichidată în septembrie 2025, după o pierdere lunară de peste \(100\%\)
MV-LO are cel mai mare Sharpe (\(0{,}80\)), urmat de 1/N (\(0{,}52\)) și ERC (\(0{,}49\))
Regulile GMV: cea mai mică volatilitate (\(3{,}8\%\)–\(5{,}4\%\)), Sharpe scăzut (\(0{,}27\)–\(0{,}37\))
Pun ponderi mari pe titlurile de stat
randamentele lor în exces au fost ușor negative după mai 2012 (TLT \(-0{,}5\%\), IEF \(-0{,}2\%\) pe an)
Graficul compară rapoartele Sharpe anualizate, înainte de costuri, ale celor șapte reguli care nu sînt lichidate, în cele trei universuri. Cursorul mută începutul perioadei de evaluare; fiecare bară folosește lunile de la acel an pînă în iulie 2026, iar butonul ▶ avansează începutul an cu an. MV lipsește din grafic, deoarece averea ei ajunge la zero în toate universurile. Tabelele complete, cu medii, volatilități, turnover și drawdown, sînt în anexă.
Întrebare pentru sală Rămîne ordinea regulilor aceeași dacă evaluarea începe mai tîrziu?
Răspuns
Nu. Ordinea depinde de perioada evaluată. Pe sectoare, HRP depășește 1/N cînd evaluarea începe în 2004 (0,70 față de 0,66), dar rămîne sub 1/N cînd începe în 2019 (0,79 față de 0,80). MV fără restricții lipsește din grafic: averea ei ajunge la zero în toate cele trei universuri.
Ordinea regulilor depinde de perioada evaluată. Pe sectoare, HRP depășește 1/N cînd evaluarea începe în 2004 (0,70 față de 0,66), dar rămîne sub 1/N cînd evaluarea începe în 2019 (0,79 față de 0,80).
MV este lichidată în martie 2009 pe sectoare, în septembrie 2025 pe multi-active și în ianuarie 2023 pe universul combinat. Pe sectoare, toate celelalte reguli au un raport Sharpe aflat la cel mult 0,07 de cel al lui 1/N. Raportul Sharpe al lui 1/N este aici 0,66 (2004–2026), nu 0,54 ca în simulările din secțiunea despre riscul de estimare (1999–2026), deoarece perioadele diferă.
Pe universul combinat, raportul Sharpe este 0,76 pentru 1/N, 0,81 pentru MV-LO și 0,71 pentru ERC, iar regulile GMV au valori între 0,20 și 0,36. Regulile diferă mult și prin turnover: pe sectoare, turnover-ul lunar mediu este 0,02 pentru 1/N, 0,03 pentru ERC, 0,14 pentru GMV-LW și 0,23 pentru MV-LO. Diferențele de turnover devin diferențe de randament net odată ce tranzacțiile costă.
Ponderile stabilite la o reechilibrare nu rămîn constante pînă la următoarea. Activele cu randamente mari își măresc ponderea, iar cele cu randamente mici și-o micșorează. Dacă \(w_{i,t}\) este ponderea activului \(i\) la începutul lunii \(t\) și \(R_{i,t}\) randamentul lui total în luna \(t\), ponderea de la sfîrșitul lunii este
Numitorul din (4.38) este \(1 + R_{p,t}\), unu plus randamentul total al portofoliului. Turnover-ul \(TO_{t+1}\) este fracțiunea din avere tranzacționată pentru a trece de la ponderile modificate de randamente, \(w^+_{i,t}\), la ponderile-țintă ale lunii următoare, \(w_{i,t+1}\), însumată pe toate cele \(N\) active.
Exemplul folosește 1/N pe sectoare. În ianuarie 2004, XLB a avut randamentul \(-4{,}4\%\), iar XLK \(+4{,}3\%\), iar randamentul total al portofoliului 1/N a fost 1,18% (1,11% în exces, plus 0,07% randamentul titlului de stat). Ponderile inițiale de 11,11% s-au modificat la 10,50% pentru XLB și la 11,45% pentru XLK:
Revenirea la ponderi egale în februarie 2004 tranzacționează \(TO = 0{,}019\), adică 1,9% din avere. Și 1/N tranzacționează: reechilibrarea vinde activele care au crescut peste medie și cumpără activele care au rămas în urmă. XLB și XLK contribuie cu \(|0{,}1111 - 0{,}1050| + |0{,}1111 - 0{,}1145| = 0{,}0061 + 0{,}0034 = 0{,}0095\), iar celelalte șapte sectoare, împreună, cu circa 0,009. MV-LO, reestimat pe noua fereastră, tranzacționează 0,748 în aceeași lună: ponderile-țintă ale regulilor estimate se schimbă de la o lună la alta odată cu fereastra, nu doar prin drift.
Costurile de tranzacționare se modelează ca un cost proporțional \(c\) pe unitatea de avere tranzacționată:
\[R^{\text{net}}_{p,t} = R_{p,t} - c\,TO_t.\]
(4.39)
Un punct de bază (basis point, bp) este 0,01%, deci un cost de 20 bp înseamnă \(c = 0{,}002\). La acest cost, tranzacția din februarie 2004 costă MV-LO \(0{,}002 \times 0{,}748 = 0{,}15\%\) din avere și 1/N doar \(0{,}002 \times 0{,}019 = 0{,}004\%\). Costul se plătește în fiecare lună, deci diferența dintre turnover-urile medii se acumulează pe toată perioada de evaluare.
Pe scurt
Revenirea la 1/N în februarie 2004 tranzacționează \(TO = 0{,}019\)
și 1/N tranzacționează: vinde cîștigătorii și cumpără perdanții
XLB și XLK contribuie cu \(|0{,}1111 - 0{,}1050| + |0{,}1111 - 0{,}1145| = 0{,}0061 + 0{,}0034 = 0{,}0095\)
celelalte șapte sectoare, împreună, cu circa \(0{,}009\)
MV-LO, reestimat pe noua fereastră, tranzacționează \(0{,}748\) în aceeași lună
Randamentul net cu costul \(c\) pe unitate tranzacționată: \(R^{\text{net}}_{p,t} = R_{p,t} - c\,TO_t\)
1 punct de bază (bp) \(= 0{,}01\%\), deci \(20\) bp înseamnă \(c = 0{,}002\)
La 20 bp, tranzacția din februarie costă MV-LO \(0{,}002 \times 0{,}748 = 0{,}15\%\) din avere
Graficul interactiv aplică (4.39) tuturor lunilor out-of-sample. Graficul din stînga arată raportul Sharpe net (axa verticală) în funcție de costul \(c\), de la 0 la 100 bp pe unitate de turnover (axa orizontală); linia punctată verticală marchează costul ales cu cursorul. Graficul din dreapta arată turnover-ul lunar mediu al fiecărei reguli, pe scară logaritmică. Selectorul alege universul, iar butonul ▶ crește costul treptat. La costul \(c\), media randamentului scade cu \(c\) înmulțit cu turnover-ul mediu. Modificarea raportului Sharpe depinde și de volatilitatea randamentului net, deci turnover-ul nu determină singur panta curbei.
Întrebare pentru sală La ce cost pe unitate de turnover devine negativ raportul Sharpe net al lui GMV în universul combinat?
Răspuns
La circa 29 bp: costul mediu lunar egalează atunci media randamentului brut în exces al GMV, care tranzacționează în medie 24% din avere pe lună, astfel încît Sharpe-ul net ajunge la zero. GMV-LW trece sub zero la circa 58 bp, iar MV-LO coboară sub 1/N la circa 22 bp. 1/N scade doar de la 0,76 la 0,75 la 50 bp. MV lipsește: este lichidată în ianuarie 2023.
În universul combinat, raportul Sharpe net al lui GMV devine negativ la circa 29 bp. La acest cost, costul mediu lunar egalează media randamentului brut în exces al lui GMV, care tranzacționează în medie 24% din avere pe lună. GMV-LW trece sub zero la circa 58 bp, iar MV-LO coboară sub 1/N la costuri de peste circa 22 bp. MV lipsește din grafic, fiind lichidată în ianuarie 2023.
Turnover-ul lunar mediu variază de la 0,02 (1/N) la 0,24 (GMV). Regulile cu turnover mic aproape nu sînt afectate: raportul Sharpe al lui 1/N scade doar de la 0,76 la 0,75 la 50 bp, iar curba lui ERC este aproape orizontală. Pentru regulile estimate, turnover-ul mare este o a doua sursă de pierdere, pe lîngă eroarea de estimare.
Pe scurt
Universul combinat (16 ETF-uri)
stînga: Sharpe-ul net (vertical) în funcție de costul \(c\), 0–100 bp pe unitate de turnover (orizontal)
Un raport Sharpe estimat este o statistică, cu eroare de eșantionare. Fie \(SR = \mu/\sigma\) raportul Sharpe lunar adevărat, cu \(\mu\) și \(\sigma\) media și abaterea standard ale randamentului lunar în exces, și \(\widehat{SR} = \hat\mu/\hat\sigma\) estimatorul lui din \(T\) luni. Lo (2002) arată că, pentru randamente i.i.d. din distribuția Normală,
Varianța asimptotică din (4.40) rezultă prin metoda delta (delta method). Sub distribuția Normală, \(\hat\mu\) și \(\hat\sigma\) sînt asimptotic independente, cu \(\operatorname{Var}(\hat\mu) \approx \sigma^2/T\) și \(\operatorname{Var}(\hat\sigma) \approx \sigma^2/(2T)\). Derivatele lui \(\mu/\sigma\) sînt \(1/\sigma\) și \(-\mu/\sigma^2\), deci \(\operatorname{Var}(\widehat{SR}) \approx 1/T + SR^2/(2T)\). Primul termen provine din imprecizia mediei, al doilea din imprecizia volatilității. Fără ipoteza Normală, eroarea standard presupune un moment de ordin patru finit al randamentelor, ipoteză pusă sub semnul întrebării în Capitolul 1.
Pentru 1/N pe sectoare, cu \(T = 271\), raportul Sharpe lunar estimat este 0,191, iar eroarea standard din (4.40) este 0,061. Anualizat cu \(\sqrt{12}\), raportul Sharpe este 0,66, iar eroarea standard 0,21, așa că intervalul de încredere de 95% este \(0{,}66 \pm 1{,}96 \times 0{,}21\), adică \([0{,}25;\ 1{,}08]\). Chiar după 271 de luni, raportul Sharpe al lui 1/N este estimat imprecis.
Anualizarea cu \(\sqrt{q}\), cu \(q = 12\) luni pe an, este exactă doar dacă randamentele lunare nu sînt autocorelate. Suma a \(q\) randamente lunare are media \(q\mu\) și varianța \(\sigma^2\big[q + 2\sum_{k=1}^{q-1}(q-k)\rho_k\big]\), unde \(\rho_k\) este autocorelația randamentelor lunare la lagul \(k\). Raportul lor dă \(SR(q) = \eta(q)\,SR\), cu
Fără autocorelație, (4.41) se reduce la \(\sqrt{q}\). Autocorelațiile pozitive scad factorul \(\eta\), iar cele negative îl cresc.
Pentru 1/N pe sectoare, \(\rho_1 = -0{,}03\), iar suma ponderată \(\sum_{k=1}^{11}(12-k)\rho_k\) este \(-0{,}50\). Atunci \(\eta = 12/\sqrt{12 - 2 \times 0{,}50} = 12/\sqrt{11{,}0} = 3{,}62\), în loc de \(\sqrt{12} = 3{,}46\), iar raportul Sharpe anual devine \(0{,}191 \times 3{,}62 = 0{,}69\). Acesta este raportul Sharpe al sumei celor 12 randamente lunare, nu al randamentului anual compus \(\prod_t(1 + R_t) - 1\).
Pe scurt
Lo (2002), randamente i.i.d. din distribuția Normală: \(\sqrt{T}(\widehat{SR} - SR) \to N\big(0,\ 1 + SR^2/2\big)\)
cu \(SR\) lunar și \(T\) numărul de luni
eroarea standard este \(\sqrt{(1 + SR^2/2)/T}\)
fără ipoteza Normală, eroarea standard presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
1/N pe sectoare, \(T = 271\): \(\widehat{SR}\) lunar \(= 0{,}191\), eroarea standard \(0{,}061\)
Comparația cu 1/N privește diferența \(\Delta = SR_1 - SR_2\) dintre rapoartele Sharpe a două strategii evaluate pe aceleași luni, cu ipoteza nulă \(H_0\colon SR_1 = SR_2\). Cele două serii de randamente sînt corelate, așa că estimatorii celor două rapoarte Sharpe nu sînt independenți, iar eroarea standard a diferenței trebuie să țină seama de această corelație.
Testul clasic este cel al lui Jobson & Korkie (1981), în forma corectată de Memmel, redată de Ledoit & Wolf (2008). Pentru randamente i.i.d. din distribuția Normală, statistica este
unde \(\hat\rho\) este corelația randamentelor celor două strategii, iar rapoartele Sharpe au aceeași frecvență ca cele \(T\) observații; anualizarea diferenței cere anualizarea corespunzătoare a erorii standard. Corelația mare reduce primul termen al varianței diferenței. Cînd \(\rho \to 1\), întreaga expresie tinde la zero numai dacă și rapoartele Sharpe sînt egale. Pentru strategii cu rapoarte Sharpe apropiate, corelația mare poate permite estimarea precisă a diferenței.
Randamentele financiare pot prezenta dependență temporală și abateri de la distribuția Normală. Ledoit & Wolf (2008) propun o variantă robustă, tot prin metoda delta. Fie \(r_{1t}\) și \(r_{2t}\) randamentele în exces ale celor două strategii, cu mediile \(\mu_1\) și \(\mu_2\), și \(\mathbf{v} = (\mu_1, \mu_2, \mathbb{E}[r_1^2], \mathbb{E}[r_2^2])\) vectorul primelor două momente necentrate. Diferența rapoartelor Sharpe este o funcție netedă de aceste momente:
În (4.43),\(\hat{\boldsymbol\Psi}\) este o estimare HAC (heteroskedasticity and autocorrelation consistent) a covarianței pe termen lung a celor patru momente, iar \(\nabla f\) este gradientul lui \(f\); calculul pas cu pas este în anexă. Estimatorul HAC tratează heteroscedasticitatea și autocorelația, dar nu și condiția de moment: testul presupune în continuare un moment de ordin patru finit, ipoteză pusă sub semnul întrebării în Capitolul 1.
Pe scurt
\(H_0\): \(SR_1 = SR_2\) pentru două strategii evaluate pe aceleași luni
Testul HAC se bazează pe aproximarea Normală a statisticii \(\hat\Delta/\text{SE}(\hat\Delta)\), care poate fi imprecisă în eșantioane finite. Bootstrap-ul, introdus de Bradley Efron în 1979, înlocuiește aproximarea asimptotică cu distribuția statisticii pe reeșantionări ale datelor. Randamentele lunare sînt însă dependente, de exemplu prin volatility clustering, iar reeșantionarea lunilor individuale ar distruge această dependență. De aceea se reeșantionează blocuri de luni consecutive, prin bootstrap-ul pe blocuri (block bootstrap) al lui Künsch (1989).
Ledoit & Wolf (2008) (Secțiunea 3.2.2) folosesc blocuri circulare de perechi\((r_{1t}, r_{2t})\): un bloc care depășește sfîrșitul eșantionului continuă de la începutul lui, iar cele două strategii sînt reeșantionate în aceleași luni, astfel încît corelația dintre ele se păstrează. În fiecare extragere \(m\) se calculează diferența \(\hat\Delta^{*m}\) și eroarea ei standard \(s(\hat\Delta^{*m})\), iar statistica este
cu \(M = 4\,999\) de extrageri. Centrarea în \(\hat\Delta\) face ca distribuția bootstrap să imite distribuția statisticii sub ipoteza nulă, iar împărțirea la eroarea standard face statistica studentizată (studentized).
Sub condițiile de regularitate și cu o eroare standard consistentă, statistica studentizată este asimptotic pivotală (asymptotically pivotal): distribuția ei limită nu conține parametri necunoscuți. Pentru astfel de statistici, bootstrap-ul poate îmbunătăți, în eșantion finit, aproximarea Normală a testului HAC. Termenul \(+1\) din numărătorul și numitorul lui (4.44) include statistica observată printre cele \(M + 1\) valori comparate.
Lungimea blocului se alege prin calibrarea din Ledoit & Wolf (2008), Algoritmul 3.1, descrisă în anexă: se alege lungimea pentru care intervalul bootstrap are acoperirea efectivă cea mai apropiată de 95%. Pentru toate cele șase reguli pe sectoare, blocul ales are lungimea 1. Blocurile de lungime 1 nu păstrează dependența dintre luni, iar alegerea lor prin calibrare nu demonstrează independența randamentelor. Pentru regulile multi-active și combinate, lungimea este între 1 și 10, cel mai des 10.
Graficul interactiv aplică bootstrap-ul pe blocuri unei comparații alese din selector: GMV-LW pe sectoare, ERC pe multi-active, GMV-LW și MV-LO în universul combinat, fiecare minus 1/N. Histograma arată diferențele bootstrap centrate, \(\Delta^* - \hat\Delta\), ale rapoartelor Sharpe anualizate, obținute cu blocuri circulare de lungimea aleasă pentru acea comparație. Linia roșie marchează diferența observată, iar liniile întrerupte cuantilele de 2,5% și 97,5% ale distribuției bootstrap. Cursorul alege numărul de extrageri, iar butonul ▶ îl crește treptat, astfel încît histograma se stabilizează.
Întrebare pentru sală Este diferența dintre GMV-LW și 1/N pe sectoare semnificativă?
Răspuns
Nu. Diferența rapoartelor Sharpe este −0,02, cu p = 0,93 (HAC) și p = 0,94 (bootstrap). Un p-value mare nu este probabilitatea ca diferența să fie reală. Histograma arată diferențe bootstrap centrate; p-value-ul raportat provine din testul bootstrap studentizat. Niciuna dintre regulile estimate nu bate 1/N semnificativ în cele trei universuri.
Pe sectoare, diferența dintre rapoartele Sharpe ale lui GMV-LW și 1/N este \(-0{,}02\), cu \(p = 0{,}93\) (HAC) și \(p = 0{,}94\) (bootstrap). Diferența nu este semnificativă la 5%. Un p-value mare nu este probabilitatea ca diferența să fie reală. El compară magnitudinea statisticii studentizate observate cu distribuția ei aproximată sub ipoteza nulă: o statistică cel puțin la fel de mare în valoare absolută ar fi frecventă dacă cele două rapoarte Sharpe ar fi egale.
Histograma interactivă este a diferențelor nestudentizate; p-value-ul raportat provine din testul bootstrap studentizat (4.44). Niciuna dintre regulile estimate nu depășește semnificativ 1/N în cele trei universuri.
Graficul static al slide-ului arată distribuția bootstrap a diferenței studentizate, \((\Delta^* - \hat\Delta)/s(\Delta^*)\), pentru două comparații. Statisticile observate \(\hat\Delta/s(\hat\Delta)\) sînt \(-0{,}09\) pentru GMV-LW pe sectoare și \(-0{,}57\) pentru ERC pe multi-active, iar valorile critice bootstrap sînt \(\pm 1{,}99\) și, respectiv, \(\pm 2{,}11\). Ambele statistici observate se află mult în interiorul regiunii de nerespingere.
Pe sectoare, diferența GMV-LW minus 1/N este \(-0{,}02\), cu intervalul de 95% \([-0{,}36;\ 0{,}33]\); p-value-ul HAC este 0,93, iar cel bootstrap 0,94, cu blocuri de lungime 1. Pe multi-active, diferența ERC minus 1/N este \(-0{,}03\), cu intervalul \([-0{,}15;\ 0{,}08]\), p-value HAC 0,61 și bootstrap 0,58, cu blocuri de lungime 10. ERC este atît de corelat cu 1/N încît intervalul este îngust, așa cum prevede (4.42) pentru \(\hat\rho\) apropiat de 1, dar intervalul conține totuși zero.
Pe sectoare, nicio regulă nu diferă de 1/N la nivelul de 5%. Cel mai mic p-value îl are ERC, cu o diferență de \(+0{,}04\) și p-value HAC 0,09. Pe multi-active, avantajul de \(+0{,}29\) al lui MV-LO din graficul averii nu este semnificativ: p-value-ul HAC este 0,12, iar cel bootstrap 0,16. Ambele tipuri de p-value presupun un moment de ordin patru finit, ipoteză pusă sub semnul întrebării în Capitolul 1.
Pe scurt
Axa orizontală: \((\Delta^* - \hat\Delta)/s(\Delta^*)\), distribuția bootstrap a diferenței studentizate față de 1/N
Fiecare dintre cele șase reguli estimate care nu sînt lichidate se compară cu 1/N în fiecare dintre cele trei universuri. Rezultă 18 teste bilaterale, cu ipotezele nule \(H_0\colon \Delta_k = 0\),\(k = 1, \dots, 18\). Tabelul slide-ului reține șase dintre ele; toate cele 18 sînt în anexă.
Nicio regulă nu depășește semnificativ 1/N în niciun univers. Fără ajustare pentru testare multiplă, la nivelul de 5%, unele reguli au un raport Sharpe semnificativ mai mic decît 1/N: trei după testul HAC (GMV, GMV-LO și GMV-LW în universul combinat) și trei după bootstrap (HRP pe multi-active, GMV și GMV-LW în universul combinat). Cele două teste nu resping exact aceleași ipoteze, deoarece folosesc erori standard diferite și aproximări diferite ale distribuției.
Regulile GMV au risc mic, dar un randament și mai mic, iar raportul lor Sharpe rămîne sub cel al lui 1/N. În universul combinat, diferența față de 1/N este \(-0{,}56\) pentru GMV și GMV-LW și \(-0{,}40\) pentru GMV-LO.
Pe scurt
Univers
Regula minus 1/N
\(\hat\Delta\)
\(p\) HAC
\(p\) bootstrap
Sectoare
ERC
\(+0{,}04\)
\(0{,}0915\)
\(0{,}1296\)
Multi-active
HRP
\(-0{,}16\)
\(0{,}0720\)
\(0{,}0460\)
Combinat
GMV
\(-0{,}56\)
\(0{,}0304\)
\(0{,}0496\)
Combinat
GMV-LO
\(-0{,}40\)
\(0{,}0477\)
\(0{,}0804\)
Combinat
GMV-LW
\(-0{,}56\)
\(0{,}0238\)
\(0{,}0322\)
Combinat
MV-LO
\(+0{,}05\)
\(0{,}8175\)
\(0{,}8180\)
Nicio regulă nu depășește semnificativ 1/N în niciun univers
Fără ajustare pentru testare multiplă, la \(5\%\): reguli cu Sharpe semnificativ mai mic decît 1/N
trei după testul HAC (GMV, GMV-LO, GMV-LW combinat)
trei după bootstrap (HRP multi-active; GMV, GMV-LW combinat)
Regulile GMV au risc mic, dar un randament și mai mic
Tabelul arată 6 dintre cele 18 teste bilaterale, \(H_0\): \(\Delta_k = 0\)
6 reguli \(\times\) 3 universuri; toate 18 în Anexă
Cu 18 teste la nivelul de 5% fiecare, unele respingeri apar din întîmplare chiar dacă toate ipotezele nule sînt adevărate. Corecția Holm, prezentată pe slide-ul următor, controlează probabilitatea unei respingeri false în întreaga familie. Aplicată tuturor celor 18 teste, ea dă cel mai mic p-value ajustat 0,43 pentru testul HAC (\(18 \times 0{,}024\)) și 0,58 pentru bootstrap (\(18 \times 0{,}032\)). După corecție, nicio diferență nu rămîne semnificativă. Aceeași problemă a testelor multiple apare la evaluarea factorilor, în Capitolul 3.
O întrebare distinctă privește cea mai bună dintre cele 21 de configurații (7 reguli \(\times\) 3 universuri). Cel mai mare raport Sharpe dintr-o mulțime de încercări este deplasat în sus chiar dacă toate rapoartele Sharpe adevărate sînt zero. Raportul Sharpe deflatat (DSR, deflated Sharpe ratio) al lui Bailey & López de Prado (2014) corectează această deplasare. Pe calendarul comun mai 2012 – iulie 2026, cîștigătorul este MV-LO pe sectoare. DSR-ul lui este aproximativ \(0{,}94 < 0{,}95\) dacă numărul efectiv de încercări este luat egal cu 21; rezultatul se schimbă pentru alte valori.
Verdictul DSR depinde însă de numărul efectiv de încercări independente, iar configurațiile sînt puternic corelate (anexă). DSR folosește și kurtosis-ul cîștigătorului, deci presupune un moment de ordin patru finit, ipoteză pusă sub semnul întrebării în Capitolul 1.
Rezultatele susțin o comparație între proceduri: regulile sînt evaluate pe aceleași luni și pe aceleași active, în eșantioanele analizate. Ele nu arată că o regulă este superioară sau inferioară lui 1/N în afara acestor eșantioane.
Pe scurt
Holm pe toate cele 18: cea mai mică valoare p ajustată este \(0{,}43\) (HAC, \(18 \times 0{,}024\)) și \(0{,}58\) (bootstrap, \(18 \times 0{,}032\))
nicio diferență nu rămîne semnificativă (slide-ul următor; Capitolul 3)
O întrebare distinctă privește cea mai bună dintre cele 21 de configurații (7 reguli, fără MV, \(\times\) 3 universuri)
raportul Sharpe deflatat (DSR, deflated Sharpe ratio, Bailey & López de Prado (2014)), probabilitatea ca Sharpe-ul cîștigătorului să nu fie doar noroc, pe calendarul comun mai 2012 – iulie 2026: \(0{,}94 < 0{,}95\) pentru MV-LO pe sectoare
verdictul depinde însă de numărul efectiv de încercări (Anexă)
DSR folosește kurtosis-ul cîștigătorului, deci presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
regulile sînt evaluate pe aceleași luni și active, în eșantioanele analizate
Două măsuri ale erorii se folosesc pentru o familie de teste. Rata erorii pe familie (FWER, family-wise error rate) este probabilitatea a cel puțin unei respingeri false în familie. Rata descoperirilor false (FDR, false discovery rate) este proporția așteptată de respingeri false printre respingeri. Controlul FWER este mai strict; controlul FDR acceptă cîteva respingeri false în schimbul unei puteri mai mari.
Ambele proceduri pornesc de la cele \(m\) p-value-uri ordonate crescător, \(p_{(1)} \le \dots \le p_{(m)}\). Procedura Holm controlează FWER sub orice formă de dependență între teste, iar procedura Benjamini–Hochberg (BH) a lui Benjamini & Hochberg (1995) controlează FDR. P-value-urile ajustate sînt
Holm înmulțește cel mai mic p-value cu \(m\), ca procedura Bonferroni, dar următoarele cu \(m - 1\),\(m - 2\) și așa mai departe; maximul cumulat de sus în jos păstrează ordinea p-value-urilor ajustate. BH înmulțește \(p_{(j)}\) cu \(m/j\) și ia minimul cumulat de jos în sus. Se respinge ipoteza unde \(\tilde p < 0{,}05\) pentru Holm, respectiv unde \(\tilde p\) este sub FDR-ul ales pentru BH.
BH controlează FDR pentru p-value-uri valide sub independență sau sub o formă de dependență pozitivă, condiția PRDS (positive regression dependency on a subset). Corelațiile pozitive dintre strategii nu demonstrează singure că PRDS este îndeplinită. Sub dependență arbitrară se folosesc Holm, care dă rezultatul principal al capitolului, sau procedura Benjamini–Yekutieli.
Tabelul aplică (4.45) celor mai mici patru p-value-uri HAC bilaterale, cu \(m = 18\). Pentru Holm, \(18 \times 0{,}0238 = 0{,}428\) (GMV-LW, combinat), \(17 \times 0{,}0304 = 0{,}516\) (GMV, combinat), \(16 \times 0{,}0477 = 0{,}763\) (GMV-LO, combinat), iar \(15 \times 0{,}0720\) depășește 1 și se trunchiază la 1,00 (HRP, multi-active). Pentru BH, produsele \(\tfrac{18}{j}\,p_{(j)}\) sînt 0,428, 0,273, 0,286 și 0,324. Minimul luat de jos în sus face ca primele două p-value-uri ajustate să fie amîndouă 0,273, așa că nu există nicio respingere nici la un FDR de 10%.
Pe scurt
FWER (family-wise error rate): probabilitatea a cel puțin unei respingeri false în familie
FDR (false discovery rate): proporția așteptată de respingeri false printre respingeri
Se ordonează cele \(m\) valori p, \(p_{(1)} \le \dots \le p_{(m)}\)
Holm (controlează FWER sub orice dependență): \(\tilde p_{(i)} = \max_{j \le i} \min\{1, (m - j + 1)\,p_{(j)}\}\)
BH controlează FDR pentru valori p valide, sub independență sau sub condiția PRDS (dependență pozitivă, Benjamini & Yekutieli (2001)); corelațiile pozitive dintre strategii nu demonstrează singure PRDS
sub dependență arbitrară: Holm (rezultatul principal) sau Benjamini–Yekutieli
se respinge unde \(\tilde p < 0{,}05\) (Holm) sau \(\tilde p <\) FDR-ul ales (BH)
Cele mai mici patru valori p HAC bilaterale, \(m = 18\)
Testul
\(p_{(j)}\)
Holm
\(\tfrac{18}{j}\,p_{(j)}\)
Combinat, GMV-LW
\(0{,}0238\)
\(18 \times 0{,}0238 = 0{,}428\)
\(0{,}428\)
Combinat, GMV
\(0{,}0304\)
\(17 \times 0{,}0304 = 0{,}516\)
\(0{,}273\)
Combinat, GMV-LO
\(0{,}0477\)
\(16 \times 0{,}0477 = 0{,}763\)
\(0{,}286\)
Multi-active, HRP
\(0{,}0720\)
\(\min\{1; 15 \times 0{,}0720\} = 1{,}00\)
\(0{,}324\)
BH ia minimul de jos în sus: primele două devin amîndouă \(0{,}273\)
nicio respingere la un FDR de \(10\%\)
Sinteza secțiunii
Evaluarea out-of-sample schimbă imaginea din secțiunile in-sample. MV fără restricții este lichidată în toate cele trei universuri. Celelalte reguli estimate nu depășesc semnificativ 1/N: pe sectoare toate se află la cel mult 0,07 de 1/N, iar avantajul de \(+0{,}29\) al lui MV-LO pe multi-active are p-value HAC 0,12. Turnover-ul (4.38) și costul proporțional (4.39) reduc și mai mult avantajul regulilor estimate, în timp ce 1/N și ERC aproape nu sînt afectate.
Inferența arată de ce diferențele observate nu sînt concludente. Eroarea standard a unui raport Sharpe (4.40) este mare chiar după 271 de luni, testele pentru diferențe (4.42) și (4.43) țin seama de corelația dintre strategii, iar bootstrap-ul pe blocuri (4.44) tratează dependența în timp. După corecția Holm pe cele 18 teste, nicio diferență față de 1/N nu rămîne semnificativă, iar DSR-ul celei mai bune configurații depinde de numărul efectiv de încercări. Condițiile de moment privesc testele Sharpe care furnizează p-value-urile: ele presupun un moment de ordin patru finit al randamentelor. Ajustarea Holm cere doar validitatea acestor p-value-uri, fără o ipoteză proprie asupra momentelor randamentelor.
Un portofoliu de blue chips BVB
Secțiunile precedente au comparat regulile de alocare pe trei universuri de ETF-uri din SUA. Această secțiune aplică aceleași reguli unui investitor în lei care deține blue chips de la Bursa de Valori București (BVB). Reperul nu mai este 1/N, ci indicele BET-TR, varianta de randament total a indicelui BET, care include dividendele. Întrebarea este dacă o regulă de alocare estimată pe aceste acțiuni depășește indicele, iar testele sînt cele din secțiunea despre evaluarea out-of-sample.
Universul conține opt blue chips care au istoric complet din octombrie 2014: TLV (Banca Transilvania, BVB ticker, Banca Transilvania, simbolul bursier BVB), SNP (OMV Petrom, BVB ticker, OMV Petrom, simbolul bursier BVB), BRD (BRD–Groupe Société Générale, BVB ticker, BRD–Groupe Société Générale, simbolul bursier BVB), TGN (Transgaz, BVB ticker, Transgaz, simbolul bursier BVB), SNG (Romgaz, BVB ticker, Romgaz, simbolul bursier BVB), SNN (Nuclearelectrica, BVB ticker, Nuclearelectrica, simbolul bursier BVB), EL (Electrica, BVB ticker, Electrica, simbolul bursier BVB) și TEL (Transelectrica, BVB ticker, Transelectrica, simbolul bursier BVB). Eșantionul este mai scurt decît cele din SUA, așa că fereastra de estimare are 36 de luni, nu 60. Cu 60 de luni, primul portofoliu ar fi construit mai tîrziu și ar rămîne doar 83 de luni out-of-sample. Cu 36 de luni, primul portofoliu se formează în octombrie 2017.
Se compară șase reguli: 1/N, MV-LO, GMV-LO, GMV-LW, ERC și HRP. Lipsesc portofoliile medie–varianță (MV) și GMV fără restricții. Pe ferestre de 36 de luni, cu opt active, ponderile lor ar fi extreme, din aceleași motive ca în secțiunea despre riscul de estimare: matricea de covarianță de eșantion este estimată din puține observații, iar inversa ei amplifică erorile.
Reperul este BET-TR, deoarece un investitor care deține acțiunile încasează și dividendele. Indicele de preț BET apare doar pentru a arăta cît contează dividendele: o comparație cu BET ar favoriza orice portofoliu de acțiuni care plătesc dividende.
Datele nu conțin o serie a ratei pieței monetare în lei, așa că rapoartele Sharpe se calculează cu \(R_f = 0\), adică din randamente totale, nu din randamente în exces. Scăderea unei rate fără risc pozitive și constante ar reduce raportul Sharpe fără să modifice volatilitatea, deci rapoartele Sharpe din această secțiune nu se compară direct cu cele din SUA. Dragotă, Şerbănescu & Pele (2008) analizează diversificarea portofoliilor și cotele de piață ale societăților românești de asigurări; contextul diferă de evaluarea pe acțiuni BVB prezentată aici.
Pe scurt
Întrebarea secțiunii: bate o regulă de alocare indicele BET-TR pe blue chips BVB?
pentru un investitor în lei
Opt blue chips (acțiunile marilor companii, cele mai lichide) cu istoric complet din octombrie 2014, cu simbolurile bursiere BVB: Banca Transilvania (TLV), OMV (Österreichische Mineralölverwaltung, Administrația austriacă a uleiurilor minerale, grupul OMV) Petrom (SNP), BRD–Groupe Société Générale (BRD), Transgaz (TGN), Romgaz (SNG), Nuclearelectrica (SNN), Electrica (EL), Transelectrica (TEL)
Fereastră de 36 de luni, nu 60
cu 60 de luni ar rămîne doar 83 de luni în afara eșantionului
primul portofoliu în octombrie 2017
Reguli: 1/N, MV-LO, GMV-LO, GMV-LW, ERC, HRP
fără MV și GMV nerestricționate, ale căror ponderi ar fi extreme pe ferestre de 36 de luni
Reper: BET-TR (randament total, cu dividende)
BET apare doar pentru a arăta efectul dividendelor
Rapoarte Sharpe cu \(R_f = 0\), deci mai mari decît Sharpe-ul din randamente în exces
Graficul interactiv arată valoarea a 1 RON investit în octombrie 2017 în fiecare regulă și în cei doi indici, out-of-sample pînă în august 2026 (107 luni), înainte de costuri. Linia groasă este BET-TR, iar linia punctată BET. Cursorul „Pînă în luna” oprește evaluarea la o lună aleasă, iar ▶ parcurge lunile; sub grafic apar regula cu cel mai mare raport Sharpe pînă la acea lună și raportul Sharpe al lui BET-TR.
Întrebarea graficului privește comparația dintre MV-LO și BET-TR și ce se poate spune despre ea pe baza celor 107 luni.
Întrebare pentru sală Ce susține comparația dintre MV-LO și BET-TR?
Răspuns
MV-LO are raportul Sharpe 1,66 față de 1,45 pentru BET-TR, dar diferența nu este semnificativă (p = 0,44, HAC). Un test nesemnificativ nu arată că cele două rapoarte Sharpe sînt egale în populație: arată doar că datele nu le separă. 1/N are 1,41, iar ERC 1,38.
BET-TR are o medie de 24,7% pe an și o volatilitate de 17,0%. Cu \(R_f = 0\), raportul Sharpe este chiar raportul lor, 1,45. Fără dividende, indicele BET are media 17,8% și Sharpe 1,06. Regulile care nu folosesc mediile estimate rămîn aproape de BET-TR: 1/N are 1,41, ERC 1,38, iar HRP 1,31.
MV-LO are Sharpe 1,66, cu 0,21 peste BET-TR. Diferența nu este semnificativă: p-value-ul testului HAC este 0,44, iar cel al bootstrap-ului 0,53. Datele și testele folosite nu oferă dovezi suficiente ale unei diferențe, fără să demonstreze egalitatea rapoartelor Sharpe. GMV-LW are Sharpe 0,83, cu 0,63 sub BET-TR: \(p_{\text{HAC}} = 0{,}0504\) și \(p_{\text{bootstrap}} \approx 0{,}10\), deci niciun test nu respinge la 5%. Ambele teste presupun un moment de ordinul patru finit al randamentelor, ipoteză pusă sub semnul întrebării în Capitolul 1.
Diversificarea este limitată de corelația medie a celor opt acțiuni, 0,44. Portofoliul de varianță minimă se concentrează: ultimul GMV-LO alocă 70% în TLV. Rezultatul compară proceduri de alocare pe același eșantion de 107 luni, iar ordinea lor nu este stabilită statistic.
Pe scurt
Graficul: valoarea a 1 leu (RON) investit în octombrie 2017
în afara eșantionului pînă în august 2026 (107 luni), înainte de costuri
BET-TR: media \(24{,}7\%\) pe an, volatilitatea \(17{,}0\%\), Sharpe \(1{,}45\)
BET (fără dividende): media \(17{,}8\%\), Sharpe \(1{,}06\)
Sharpe apropiate de BET-TR: 1/N \(1{,}41\), ERC \(1{,}38\), HRP \(1{,}31\)
MV-LO: Sharpe \(1{,}66\), cu \(0{,}21\) peste BET-TR (\(p\) HAC \(= 0{,}44\), bootstrap \(0{,}53\))
GMV-LW: Sharpe \(0{,}83\), cu \(0{,}62\) sub BET-TR (\(p\) HAC \(= 0{,}050\), bootstrap \(0{,}10\))
valorile p presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Corelația medie a celor opt acțiuni, \(0{,}44\), limitează diversificarea
ultimul GMV-LO alocă \(70\%\) în TLV (Seminarul 4, C2)
Pe blue chips BVB, nicio regulă nu depășește semnificativ BET-TR. Regulile bazate pe risc și 1/N au rapoarte Sharpe apropiate de indice, MV-LO are cel mai mare Sharpe, dar diferența are \(p = 0{,}44\), iar GMV-LW rămîne în urmă. Imaginea repetă concluzia din SUA cu un eșantion și mai scurt, 107 luni, și cu o rată fără risc nulă. Secțiunea următoare trece la două articole recente care pun întrebarea alocării cu costuri de tranzacționare și cu ponderi care variază în timp.
Studii de caz: frontiera implementabilă și portofoliile gestionate după volatilitate
Această secțiune analizează două articole recente care extind problema medie–varianță în direcții pe care backtest-ul capitolului le tratează doar parțial:
Jensen, Kelly, Malamud & Pedersen (2026) introduce costurile de tranzacționare care cresc cu mărimea investitorului și definește frontiera care poate fi efectiv atinsă după costuri.
Formulele din secțiunea medie–varianță nu au costuri. Jensen, Kelly, Malamud & Pedersen (2026) întreabă ce regulă de alocare rămîne eficientă cînd costurile cresc cu mărimea investitorului. Contextul este construcția portofoliilor din prognoze de randament obținute prin machine learning (ML), pe o piață în care fiecare tranzacție are impact asupra prețului (price impact).
Obiectul central este frontiera eficientă implementabilă (implementable efficient frontier, ec. 12 din articol). Pentru fiecare volatilitate \(\sigma\), ea dă cel mai mare randament așteptat net de costurile de tranzacționare:
În (4.46),\(\pi_t\) este vectorul ponderilor activelor riscante la momentul \(t\), în notația articolului; nu trebuie confundat cu randamentele implicite \(\boldsymbol\pi\) din Black–Litterman. \(r^{\text{net}}_{t+1}\) este randamentul în exces al portofoliului, net de costurile de tranzacționare, iar \(k(\sigma)\) este cel mai bun randament net așteptat la volatilitatea \(\sigma\). În această formulare, \(\sigma^2\) măsoară media varianței condiționale a portofoliului; ea nu coincide, în general, cu varianța necondiționată a randamentelor nete.
Propoziția 1 a articolului arată că raportul Sharpe net \(k(\sigma)/\sigma\) scade de-a lungul frontierei. Fără costuri și cu un activ fără risc, raportul Sharpe este același pentru orice volatilitate: panta \(\theta\) din (4.9). Cu costuri, o volatilitate mai mare cere poziții și tranzacții mai mari, iar acestea costă mai mult decît proporțional. Tot din acest motiv, un investitor mai mare are o frontieră mai joasă.
Pe scurt
Întrebare: ce regulă de alocare rămîne eficientă?
cînd costurile de tranzacționare cresc cu mărimea investitorului
În (4.47),\(g_t\) aplică ponderilor lunii trecute drift-ul produs de randamente, deci \(g_t\pi_{t-1}\) este portofoliul deținut înainte de tranzacționare, iar \(\pi_t - g_t\pi_{t-1}\) este tranzacția. \(V_i\) este volumul zilnic mediu în dolari (average daily dollar volume) al activului \(i\), deci tranzacționarea unui activ mai puțin lichid costă mai mult. Factorul \(W_t\) face costul relativ să crească cu averea: aceeași tranzacție, exprimată în ponderi, mișcă prețul mai mult pentru un investitor mai mare.
Cu costuri pătratice, regula optimă este cea a lui Gârleanu & Pedersen (2013): investitorul parcurge prin tranzacții doar o parte din distanța pînă la un portofoliu-țintă (aim portfolio) \(A_t\),
\[\pi_t = m\,g_t\pi_{t-1} + (\mathbf{I}-m)A_t.\]
(4.48)
Ținta \(A_t\) este prospectivă: o medie ponderată a portofoliilor Markowitz curente și a celor viitoare așteptate. Ponderarea reflectă persistența semnalelor și fricțiunile, așa că \(A_t\) nu este, în general, portofoliul Markowitz curent. În (4.48),\(m\) este o matrice \(N\times N\) a ritmurilor de tranzacționare (trade rates, ec. 14 din articol), deci și \(\mathbf{I}-m\) este o matrice; simbolul nu are legătură cu media-țintă \(m\) din (4.1). În cazul scalar din Gârleanu & Pedersen (2013),\(m\) este partea păstrată din poziția veche în fiecare perioadă.
Regula Portfolio-ML a articolului învață ținta \(A_t\) direct din semnale, printr-o regresie ridge: cele mai mici pătrate cu o penalizare pe mărimea coeficienților. Obiectivul regresiei nu este eroarea de prognoză a randamentelor, ci utilitatea portofoliului netă de costuri.
Pe scurt
Costul ca fracțiune din averea \(W_t\) (ec. 4, 7), pătratic în tranzacție
Rezultatele sînt cele din Tabelul 2 al lui Jensen, Kelly, Malamud & Pedersen (2026): net de costuri, pe perioada 1981–2020, pentru un investitor cu aversiunea la risc \(\gamma = 10\). Utilitatea (ec. 11 din articol) este randamentul net anual minus \(\tfrac{\gamma}{2}\) înmulțit cu varianța anuală, adică forma criteriului (4.2) aplicată randamentelor nete.
Regula Markowitz-ML aplică optimizarea medie–varianță prognozelor ML și ignoră costurile. Înainte de costuri are raportul Sharpe 2,06, dar turnover-ul 79,36 și levierul (leverage) 74,61 îi fac randamentul net extrem de negativ.
Portfolio-ML are raportul Sharpe net 1,33 și utilitatea 0,086, cu un randament net de 15%, o volatilitate de 11% și un cost de 0,6% pe an. Static-ML*, care ține cont de costuri doar pe o singură perioadă, are Sharpe net 0,81 și utilitatea 0,030; asteriscul marchează un nivel suplimentar de calibrare. Multiperiod-ML*, cu 12 orizonturi, are 0,83 și 0,020. Ponderile egale 1/N și portofoliul pieței au Sharpe net 0,54 și 0,51, dar utilitate negativă, −0,051 și −0,033.
Doar regulile care țin cont de costuri au utilitate pozitivă. Rezultatul compară proceduri pe aceleași date, iar articolul declară și o limită: pe cele mai mici 20% dintre acțiuni, Portfolio-ML rămîne sub Multiperiod-ML* și Static-ML*. O replicare la scară redusă pe datele cursului este în anexă.
Al doilea studiu de caz întreabă dacă raportul Sharpe crește atunci cînd investitorul reduce expunerea în perioadele cu volatilitate mare. Răspunsul poate fi afirmativ doar dacă volatilitatea măsurată prezice riscul lunii următoare, iar randamentul așteptat nu crește proporțional cu varianța. Dacă media condițională este constantă, ponderea optimă dintr-un singur activ riscant, \(\alpha^*\) din (4.10), este invers proporțională cu varianța condițională.
În (4.49),\(r_{k,t+1}\) este randamentul în exces al factorului \(k\) în luna \(t+1\), iar \(\sigma^2_{k,t}\) este varianța randamentelor zilnice ale factorului în luna \(t\), cunoscută la momentul deciziei. Constanta \(c\) dă lui \(r^{\sigma}_k\) aceeași volatilitate ca lui \(r_k\); nu este costul \(c_t\) din (4.47). Investitorul nu deține doar \(r^{\sigma}_k\), ci combinația medie–varianță a lui \(r_k\) și \(r^{\sigma}_k\).
Dovezile ulterioare sînt mixte. Cederburg, O'Doherty, Wang & Yan (2020) arată că, out-of-sample, versiunile gestionate nu bat sistematic strategiile neschimbate, iar eroarea de estimare a ponderilor combinației contează. Barroso & Detzel (2021) arată că, după costurile de tranzacționare, cîștigul nu rămîne robust pentru majoritatea factorilor studiați.
DeMiguel, Martín-Utrera & Uppal (2024) pun aceeași întrebare pentru un portofoliu de mai mulți factori. Afirmația articolului este că portofoliul condițional medie–varianță (conditional mean–variance, CMV) bate portofoliul necondiționat (unconditional mean–variance, UMV) out-of-sample și net de costuri. În Tabelul II, cu nouă factori pe perioada 1977–2020, CMV are Sharpe net 1,062, față de 0,940 pentru UMV, cu \(p = 0{,}006\).
Pe scurt
Întrebare: crește raportul Sharpe dacă investitorul reduce expunerea cînd volatilitatea este mare?
da, dacă volatilitatea măsurată prezice riscul lunii următoare, iar randamentul așteptat nu crește proporțional cu varianța
\(r_{k,t+1}\): randamentul în exces al factorului \(k\) în luna \(t+1\)
\(\sigma^2_{k,t}\): varianța randamentelor zilnice ale factorului \(k\) în luna \(t\)
\(c\): constanta care dă lui \(r^{\sigma}_k\) aceeași volatilitate ca lui \(r_k\)
investitorul deține combinația medie–varianță a lui \(r_k\) și \(r^{\sigma}_k\)
Cederburg, O'Doherty, Wang & Yan (2020): în afara eșantionului, versiunile gestionate nu bat sistematic strategiile neschimbate; eroarea de estimare a ponderilor combinației contează
Barroso & Detzel (2021): după costurile de tranzacționare, cîștigul nu rămîne robust pentru majoritatea factorilor studiați
Replicarea din curs aplică ambele întrebări, cea pentru un activ și cea pentru portofoliu, universurilor capitolului. Graficul interactiv are două panouri. Primul dă raportul Sharpe out-of-sample al fiecărui activ din universul ales: bara albastră pentru activul neschimbat, bara roșie pentru combinația medie–varianță estimată a lui \(r_k\) și \(r_k/\sigma^2_k\) din (4.49); pe universul multi-active, perioada este mai 2012 – iulie 2026. Al doilea panou dă raportul Sharpe out-of-sample al portofoliilor UMV, CFW (the UMV portfolio scaled by its volatility, portofoliul UMV scalat cu volatilitatea lui) și CMV în cele patru universuri (sectoare, multi-active, combinat și BVB); liniuța marchează valoarea netă de costul ales.
CFW este scalarea întregului portofoliu UMV după volatilitatea lui, ca la Moreira & Muir (2017). Lista derulantă alege universul primului panou, cursorul alege costul pe unitate de turnover, iar ▶ crește costul de la 0 la 100 bp. Sub grafic apar rapoartele Sharpe nete și costul la care avantajul CMV față de UMV dispare.
Întrebare pentru sală Pe universul multi-active, gestionarea după volatilitate scade Sharpe-ul la 6 dintre cele 8 ETF-uri luate separat. Poate portofoliul condițional al tuturor activelor (CMV) să depășească totuși portofoliul necondiționat (UMV)?
Răspuns
Da, dar diferența nu este semnificativă. CMV are Sharpe brut 0,685, față de 0,551 pentru UMV, cu p bootstrap unilateral de 0,25, pentru că ponderile relative ale activelor se schimbă cu volatilitatea pieței. CMV are Sharpe brut mai mare decît UMV în toate cele patru universuri, dar în niciunul diferența nu este semnificativă. CMV tranzacționează 1,08 din avere pe lună, față de 0,21 pentru UMV, iar la 42 bp pe unitate de turnover avantajul dispare.
Pentru activele individuale, combinația gestionată după volatilitate are un raport Sharpe estimat mai mic în 22 dintre cele 25 de cazuri (sectoare, multi-active, BVB). Pentru EFA, raportul Sharpe scade de la 0,50 la 0,05, iar pentru aur (GLD) de la 0,35 la −0,04. Șapte dintre scăderi au \(p < 0{,}05\) în teste HAC individuale, neajustate, dar niciuna nu rămîne semnificativă după corecția Holm pe familia celor 25 de comparații: cel mai mic p-value ajustat este 0,16.
Pentru toate activele împreună, imaginea se inversează. CMV are cel mai mare Sharpe brut în fiecare univers: 0,59 față de 0,45 pentru UMV pe sectoare, 0,69 față de 0,55 pe multi-active, 0,69 față de 0,67 pe universul combinat și 1,32 față de 1,29 pe BVB. Mecanismul diferă de cel pentru un activ: în CMV, ponderile relative ale activelor se schimbă cu volatilitatea pieței.
Pe universul multi-active, CMV are Sharpe brut 0,685, față de 0,551 pentru UMV, cu p-value bootstrap unilateral 0,25. Diferența nu este semnificativă în niciun univers. CMV tranzacționează 1,08 din avere pe lună, față de 0,21 pentru UMV, iar la 42 bp pe unitate de turnover avantajul dispare. CFW, scalarea portofoliului întreg, rămîne sub UMV în toate cele patru universuri.
Pe scurt
Stînga: Sharpe-ul OOS al fiecărui ETF multi-active, mai 2012 – iulie 2026
albastru: activul neschimbat; roșu: combinația medie–varianță estimată a lui \(r_k\) și \(r_k/\sigma^2_k\) (ec. 1)
Dreapta: Sharpe-ul în afara eșantionului al portofoliilor UMV, CFW (portofoliul UMV scalat cu volatilitatea lui) și CMV în cele patru universuri; liniuța: net de 10 bp
Un activ singur: gestionarea scade Sharpe-ul la 22 dintre cele 25 de active (sectoare, multi-active, BVB)
EFA: de la \(0{,}50\) la \(0{,}05\); aur (GLD): de la \(0{,}35\) la \(-0{,}04\)
șapte scăderi au \(p < 0{,}05\) în teste HAC individuale, neajustate
niciuna după Holm pe familia celor 25 de comparații: cea mai mică valoare p ajustată este \(0{,}16\)
Toate activele împreună: CMV are cel mai mare Sharpe brut în fiecare univers
sectoare \(0{,}59\) față de \(0{,}45\) (UMV); multi-active \(0{,}69\) față de \(0{,}55\)
combinat \(0{,}69\) față de \(0{,}67\); BVB \(1{,}32\) față de \(1{,}29\)
CFW, scalarea întregului portofoliu UMV ca la Moreira & Muir (2017), rămîne sub UMV în toate cele patru universuri
În CMV (ec. 2–6 din DeMiguel, Martín-Utrera & Uppal (2024)), ponderea factorului \(k\), decisă la sfîrșitul lunii \(t\) și aplicată randamentului \(r_{k,t+1}\), este o funcție liniară de inversul volatilității pieței:
\[\theta_{k,t} = a_k + \frac{b_k}{\sigma_t}.\]
(4.50)
În (4.50),\(\sigma_t\) este volatilitatea realizată (realised volatility) a pieței în luna \(t\), calculată din randamentele zilnice. Un coeficient \(b_k > 0\) înseamnă o expunere mai mică la factorul \(k\) cînd piața este volatilă. Randamentul poziției este \(\theta_{k,t}\,r_{k,t+1} = a_k\,r_{k,t+1} + b_k\,r_{k,t+1}/\sigma_t\), deci CMV este un portofoliu static în randamentele extinse \((r_{k,t+1},\ r_{k,t+1}/\sigma_t)\). Coeficienții \(\eta = (a, b)\), cu \(a_k, b_k \ge 0\), rezolvă o problemă medie–varianță cu costuri:
unde \(\boldsymbol\mu\) și \(\boldsymbol\Sigma\) sînt media și covarianța randamentelor extinse, iar \(\widehat{TC}\) este costul mediu de tranzacționare. UMV este aceeași problemă (4.51) cu \(b_k = 0\). CFW este combinația medie–varianță a lui UMV cu UMV împărțit la varianța lui din luna trecută, adică regula (4.49) aplicată întregului portofoliu (Moreira & Muir, 2017).
În articol, costul fiecărei acțiuni vine din spread-ul estimat lunar, iar tranzacțiile se compensează între factori (trading diversification). Fereastra de estimare este extinsă (expanding window), prima avînd 120 de luni.
Replicarea din curs păstrează structura și schimbă datele. „Factorii” sînt randamentele în exces ale ETF-urilor, adică poziții finanțate la rata T-bill; pentru BVB, randamentele sînt în lei, cu \(R_f = 0\), ca în restul capitolului. Piața este SPY pentru universurile din SUA și BET-TR pentru BVB. Fereastra este extinsă, prima de 60 de luni (36 pentru BVB), deci perioadele out-of-sample sînt aceleași ca în backtest-ul capitolului. Ponderile se optimizează fără costuri, ca în Tabelul III, coloanele 1–3, iar costul se aplică după aceea: \(c = 10\) bp pe unitate de turnover, cu turnover-ul calculat pe ETF, astfel încît tranzacțiile se compensează. Regula de lichidare a capitolului nu intervine: nicio regulă nu pierde 100% într-o lună.
Testele sînt două: bootstrap-ul staționar (stationary bootstrap) unilateral al articolului, cu bloc mediu 5 și 10 000 de extrageri, și testul HAC bilateral al capitolului.
Pe scurt
CMV (ec. 2–6): ponderea factorului \(k\), decisă la sfîrșitul lunii \(t\) și aplicată randamentului \(r_{k,t+1}\), este \(\theta_{k,t} = a_k + b_k/\sigma_t\)
\(\sigma_t\): volatilitatea realizată a pieței în luna \(t\), din randamentele zilnice
\(b_k > 0\): expunere mai mică la factorul \(k\) cînd piața este volatilă
notația articolului: \(\theta\) nu este aici Sharpe-ul maxim, \(\eta\) nu este factorul lui Lo; \(\eta = (a, b)\); \(\boldsymbol\mu\), \(\boldsymbol\Sigma\): media și covarianța randamentelor extinse \((r_{k,t+1},\ r_{k,t+1}/\sigma_t)\); \(\widehat{TC}\): costul mediu de tranzacționare
UMV: aceeași problemă, cu \(b_k = 0\)
CFW: combinația medie–varianță a lui UMV cu UMV împărțit la varianța sa din luna trecută (Moreira & Muir (2017))
Articolul: costul fiecărei acțiuni din spread-ul estimat lunar; tranzacțiile se compensează între factori (trading diversification)
Articolul: fereastră extinsă (expanding window), prima de 120 de luni
Replicarea din curs: „factorii” sînt randamentele în exces ale ETF-urilor (poziții finanțate la rata T-bill)
BVB: randamente în lei, cu \(R_f = 0\), ca în restul capitolului
piața: SPY pentru universurile din SUA, BET-TR pentru BVB
fereastră extinsă, prima de 60 de luni (BVB: 36), deci aceleași perioade în afara eșantionului ca backtest-ul capitolului
ponderile optimizate fără costuri, ca în Tabelul III, coloanele 1–3
costul: \(c = 10\) bp pe unitate de turnover, cu turnover-ul calculat pe ETF (tranzacțiile se compensează)
regula de lichidare a capitolului: nicio regulă nu pierde \(100\%\) într-o lună, deci nicio regulă nu este lichidată
Teste: bootstrap-ul staționar unilateral al articolului (bloc mediu 5, 10 000 de extrageri) și testul HAC bilateral al capitolului
Diferența de Sharpe brut CMV − UMV este pozitivă în toate cele patru universuri. Pe sectoare, cu 271 de luni, este 0,14, cu p-value bootstrap unilateral 0,13 și p-value HAC bilateral 0,26. Pe multi-active, cu 171 de luni, este 0,13 (0,25; 0,46). Pe universul combinat, cu 171 de luni, este 0,02 (0,46; 0,92), iar pe BVB, cu 107 luni, 0,03 (0,30; 0,55). Niciuna dintre cele patru diferențe nu este semnificativă la 10%.
CMV tranzacționează mai mult și folosește mai mult levier. Pe multi-active, turnover-ul lunar este 1,08 față de 0,21, iar suma medie a ponderilor în valoare absolută este 4,8 față de 3,3. Costul pe unitate de turnover la care avantajul CMV dispare este 45 bp pe sectoare, 42 bp pe multi-active, 49 bp pe BVB și doar 7 bp pe universul combinat. La 10 bp, CMV rămîne sub UMV pe universul combinat: Sharpe net 0,646 față de 0,655.
Direcția din articol apare în toate cele patru universuri: CMV peste UMV, iar combinația gestionată a unui singur activ sub activul neschimbat. Rezultatul compară proceduri și privește această implementare (ETF-uri, fereastră extinsă, \(\gamma = 5\)). El nu arată că gestionarea după volatilitate nu ajută în general.
Pe scurt
Diferența de Sharpe brut CMV \(-\) UMV, din valori nerotunjite (\(p\) bootstrap unilateral; \(p\) HAC bilateral)
sectoare, 271 de luni: \(0{,}14\) (\(0{,}13\); \(0{,}26\))
multi-active, 171 de luni: \(0{,}13\) (\(0{,}25\); \(0{,}46\))
combinat, 171 de luni: \(0{,}02\) (\(0{,}46\); \(0{,}92\))
Replicarea are 8–16 ETF-uri și 107–271 de luni, față de nouă factori long-short pe 528 de luni în articol. Eșantioanele sînt deci mult mai mici decît cel al articolului. P-value-urile presupun, ca peste tot în capitol, un moment de ordinul patru finit, ipoteză pusă sub semnul întrebării în Capitolul 1.
Finanțarea levierului este simplificată. Pe BVB, levierul este finanțat la \(R_f = 0\), deci media este supraestimată. În SUA, levierul (expunere medie 3,3–4,8 pe multi-active) este finanțat la rata T-bill; un spread de împrumut ar reduce media mai mult decît cîțiva bp de cost de tranzacționare. Costul constituirii inițiale a pozițiilor nu este inclus.
Compensarea tranzacțiilor între factori contează și în articol. Fără ea, CMV pierde: Sharpe net 0,613 față de 0,710 (Tabelul III, panoul C, coloanele 1–3, optimizare fără costuri).
Pe scurt
8–16 ETF-uri și 107–271 de luni, față de nouă factori long-short pe 528 de luni
Valorile p presupun moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
BVB: levierul este finanțat la \(R_f = 0\), deci media este supraestimată
SUA: levierul (expunere medie \(3{,}3\)–\(4{,}8\), multi-active) este finanțat la rata T-bill; un spread de împrumut ar reduce media mai mult decît cîțiva bp de tranzacționare
Costul constituirii inițiale a pozițiilor nu este inclus
În articol, fără compensarea tranzacțiilor între factori, CMV pierde: Sharpe net \(0{,}613\) față de \(0{,}710\) (Tabelul III, panoul C, coloanele 1–3, optimizare fără costuri)
Sinteza secțiunii
Ambele studii de caz mută accentul de pe ponderile optime pe ponderile care pot fi tranzacționate. La Jensen, Kelly, Malamud & Pedersen (2026), regulile care ignoră costurile au rapoarte Sharpe brute mari și utilitate netă negativă, iar doar regulile care țin cont de costuri au utilitate pozitivă. La DeMiguel, Martín-Utrera & Uppal (2024), gestionarea după volatilitate a portofoliului de factori crește raportul Sharpe în articol. Pe datele cursului, direcția se păstrează în toate cele patru universuri, dar cîștigul este mic, nesemnificativ și sensibil la costuri: pe universul combinat dispare la 7 bp. Ambele concluzii sînt comparații între proceduri, valabile pentru implementarea studiată.
AI pentru descoperire științifică
Această secțiune formulează o întrebare deschisă a capitolului ca ipoteză testabilă și descrie cum poate fi cercetată cu un asistent AI. Întrebarea este dacă vreo regulă estimată depășește 1/N out-of-sample, net de costuri, după ce se ține seama de toate testele încercate. Secțiunea dă verificările pe care cercetătorul trebuie să le facă asupra rezultatelor asistentului, un mini studiu de caz pe backtest-ul capitolului și o idee de proiect.
Depășește vreo regulă de alocare estimată ponderile 1/N out-of-sample, net de costuri?
Rămîne superioară după ce se iau în calcul toate regulile, ferestrele și universurile încercate?
Rezultatele diferă între universuri, criterii de evaluare și costuri. Ledoit & Wolf (2017) arată că shrinkage-ul neliniar al lui \(\boldsymbol\Sigma\) îmbunătățește GMV out-of-sample pe secțiuni transversale mari. Kan, Wang & Zhou (2022) derivă strategii de combinare care țin seama de riscul de estimare în absența unui activ fără risc. Tu & Zhou (2011) studiază combinarea strategiilor optimizate cu ponderile egale. Harvey & Liu (2015) arată că rezultatele backtest-urilor trebuie ajustate pentru numărul de specificații încercate.
Fie \(\Delta_k\) diferența dintre raportul Sharpe al regulii \(k\) și cel al lui 1/N, pentru fiecare dintre cele 18 perechi (regulă, univers). Ipoteza nulă este \(H_0\):\(\Delta_k \le 0\) pentru toate cele 18 perechi, iar alternativa \(H_1\):\(\Delta_k > 0\) pentru cel puțin un \(k\). Testul fixează pentru toată familia fie rata erorilor pe familie (family-wise error rate, FWER), fie rata falselor descoperiri (false discovery rate, FDR), ca în Testarea multiplă a regulilor de portofoliu.
Bucla de cercetare se parcurge o dată cu un asistent AI, cu prompturile din anexă: literatură cu DOI (Digital Object Identifier, identificatorul digital al unei publicații) și ipoteze concurente, cod pe datele lunare ale cursului cu o familie de teste preînregistrată, apoi o critică în stilul unui recenzent. \(H_0\) ar fi respinsă de un \(\hat\Delta_k\) pozitiv care rămîne semnificativ după corecția pentru toată familia, după costuri și pe un al doilea eșantion.
Pe scurt
Întrebări
depășește vreo regulă de alocare estimată ponderile 1/N în afara eșantionului, net de costuri?
rămîne superioară după ce se iau în calcul toate regulile, ferestrele și universurile încercate?
Dovezile actuale sînt contradictorii
Contracția neliniară a lui \(\boldsymbol\Sigma\) îmbunătățește GMV în afara eșantionului pe secțiuni transversale mari: Ledoit & Wolf (2017)
Un backtest scris cu ajutorul unui asistent are aceleași capcane ca orice backtest, iar verificarea lor rămîne sarcina cercetătorului:
Eroarea de tip look-ahead: ponderile lunii \(t\) construite cu randamentele aceleiași luni. Testul este verificarea explicită că ultima dată de estimare este înainte de \(t\).
Survivorship bias și, mai general, selecția: o listă de ETF-uri aleasă azi conține doar fondurile care au supraviețuit. Testul este folosirea universului disponibil la fiecare dată, inclusiv a ETF-urilor delistate ulterior, sau declararea limitei.
Testarea multiplă: 6 reguli pe 3 universuri dau deja 18 teste. Testul este raportarea p-value-urilor ajustate Holm, care controlează FWER, sau Benjamini–Hochberg, care controlează FDR (Benjamini & Hochberg, 1995).
Puterea (power): pentru MV-LO minus 1/N pe universul multi-active, \(\hat\Delta\) are o eroare standard HAC de 0,18 pe 171 de luni. Efectul minim detectabil (minimum detectable effect) trebuie calculat înainte de a rula testele.
Tipul randamentului: portofoliile agregă randamente simple, iar rapoartele Sharpe folosesc randamente în exces. O lună recalculată pas cu pas verifică ambele convenții.
Referințele inventate: un link DOI nefuncțional sau un titlu diferit de cel al articolului. Afirmația sprijinită pe o astfel de referință se elimină, iar eroarea se înregistrează în AI_ERRORS.md.
Pe scurt
Deplasarea de anticipare (look-ahead bias): ponderile lunii \(t\) construite cu randamentele aceleiași luni
test: verificați că ultima dată de estimare este înainte de \(t\)
Deplasarea de supraviețuire (survivorship bias) și selecția: o listă de ETF-uri aleasă azi
test: folosiți universul disponibil la fiecare dată, inclusiv ETF-urile delistate ulterior, sau declarați limita
Testare multiplă: 6 reguli \(\times\) 3 universuri dau deja 18 teste
test: valori p ajustate Holm (FWER) sau Benjamini–Hochberg (FDR)
Putere: pentru MV-LO minus 1/N pe multi-active, \(\hat\Delta\) are o eroare standard HAC de \(0{,}18\) pe 171 de luni
test: calculați efectul minim detectabil înainte de a rula testele
O propunere tipică a asistentului este: „MV-LO depășește 1/N pe universul multi-active”. Afirmația este una de superioritate, deci testul este unilateral, cu \(H_0\):\(\Delta \le 0\) și p-value-ul
\[p = 1 - \Phi\big(\hat\Delta/\text{SE}\big),\]
(4.52)
unde \(\Phi\) este funcția de repartiție a distribuției Normale standard, iar SE (Standard Error, eroare standard) eroarea standard a lui \(\hat\Delta\).
Replicarea dă \(\hat\Delta = +0{,}29\), cu eroarea standard HAC 0,18. Din (4.52),\(z = 0{,}2863/0{,}1836 = 1{,}56\) și \(p = 1 - \Phi(1{,}56) = 0{,}06\). P-value-ul HAC bilateral este 0,12, iar cel bootstrap 0,16. Chiar fără corecție pentru testare multiplă, diferența nu este semnificativă la 5%.
Puterea arată de cîte date ar fi nevoie. Presupunînd că eroarea standard scade ca \(1/\sqrt{T}\), iar efectul și varianța pe termen lung rămîn stabile, numărul de luni pentru care un test unilateral la nivelul \(\alpha\) are puterea 0,8 pentru \(\Delta = 0{,}29\) este
cu \(T_{\text{obs}} = 171\) lunile observate. La \(\alpha = 5\%\),\(171\,\big[(1{,}645 + 0{,}842) \times 0{,}1836/0{,}2863\big]^2 \approx 435\) de luni, circa 36 de ani. La pragul Bonferroni \(5\%/18\), care coincide cu primul prag al procedurii Holm, \(z_{1-\alpha} = 2{,}77\), iar (4.53) dă circa 919 luni, adică 77 de ani. Acestea sînt scenarii de putere bazate pe estimațiile curente.
Pe scurt
O propunere tipică a asistentului: „MV-LO depășește 1/N pe universul multi-active”
Ipoteza corectă privește familia, nu cîștigătorul: 18 teste, 6 reguli pe 3 universuri, cu p-value-urile unilaterale ale tuturor în anexă. Doar 7 dintre cele 18 diferențe sînt pozitive. Cele 3 p-value-uri HAC bilaterale sub 0,05 corespund toate unor diferențe negative, care nu pot respinge o ipoteză nulă de superioritate.
Cel mai mic p-value unilateral este 0,046 (ERC pe sectoare). După ajustare, devine 0,82 cu Holm și 0,53 cu Benjamini–Hochberg, deci nu există nicio descoperire la un FDR de 10%.
În Testarea multiplă a regulilor de portofoliu, cel mai mic p-value ajustat Holm este 0,43, nu 0,82. Diferența vine din direcția testului. Acolo testele sînt bilaterale, iar cel mai mic p-value aparține unei pierderi semnificative. Aici o pierdere are un p-value unilateral mare, circa \(1 - p_{\text{bilateral}}/2\), de exemplu 0,99 pentru GMV-LW pe universul combinat. Diferențele negative rămîn în familia celor 18 teste, dar p-value-urile lor unilaterale mari nu produc respingeri. Cel mai mic p-value unilateral aparține unui cîștig, 0,046, iar Holm îl înmulțește cu 18.
Interpretarea este că datele nu permit ordonarea acestor reguli. Intervalul bootstrap pentru MV-LO, \([-0{,}13;\ 0{,}70]\), este compatibil atît cu pierderi, cît și cu cîștiguri mari. Nerespingerea nu dovedește egalitatea, iar rezultatul rămîne o comparație între proceduri.
Pe scurt
Testați familia, nu cîștigătorul: 18 teste (6 reguli \(\times\) 3 universuri)
Proiectul pornește de la cele două dovezi din Întrebări deschise și pune două întrebări:
Depășește shrinkage-ul neliniar al lui Ledoit & Wolf (2017) ponderile 1/N pe cele 16 ETF-uri ale capitolului, după costuri de 10–50 bp?
Depășește o combinație între o strategie optimizată și 1/N, construită după Tu & Zhou (2011), reperul 1/N pe aceleași ETF-uri, după aceleași costuri?
Primul pas este replicarea: rezultatele pe universul combinat (Sharpe 1/N 0,76, MV-LO 0,81) și p-value-urile ajustate din mini studiul de caz. Urmează preînregistrarea (pre-registration), înainte de orice rezultat: ipotezele, familia de teste, rata de eroare și puterea, plus un placebo, ponderi long-only aleatoare cu același turnover.
Raportul conține codul pe datele lunare ale cursului, un tabel cu toate specificațiile și o autocritică în stilul unui recenzent. Prompturile se păstrează în AI_USE.md, iar fiecare eroare depistată, împreună cu verificarea care a depistat-o, în AI_ERRORS.md.
Pe scurt
Întrebări
depășește contracția neliniară (Ledoit & Wolf (2017)) ponderile 1/N pe cele 16 ETF-uri ale capitolului, după costuri de 10–50 bp?
depășește o combinație între o regulă optimizată și 1/N (Tu & Zhou (2011)) ponderile 1/N pe aceleași ETF-uri, după aceleași costuri?
Replicați întîi
rezultatele pe universul combinat (Sharpe 1/N \(0{,}76\), MV-LO \(0{,}81\))
valorile p ajustate din mini studiul de caz
Preînregistrați, înainte de orice rezultat
ipotezele, familia de teste, rata de eroare și puterea
un placebo: ponderi long-only aleatoare cu același turnover
Raportați
cod pe datele lunare ale cursului
un tabel cu toate specificațiile
o autocritică în stilul unui recenzent
Jurnal: prompturile în AI_USE.md
Fiecare eroare depistată și verificarea care a depistat-o în AI_ERRORS.md
Sinteza secțiunii
Întrebarea dacă o regulă estimată bate 1/N se formulează ca test asupra unei familii de 18 ipoteze, nu asupra regulii cu cel mai bun rezultat. Pe datele capitolului, cel mai mic p-value unilateral, 0,046, devine 0,82 după Holm și 0,53 după Benjamini–Hochberg, iar pentru diferența MV-LO minus 1/N ar fi nevoie de circa 435 de luni pentru puterea 0,8 la 5%. Asistentul AI poate parcurge bucla de cercetare, de la literatură la cod și critică, dar verificările de look-ahead, selecție, testare multiplă, putere și referințe rămîn ale cercetătorului.
Concluzii
Capitolul a pornit de la formulele medie–varianță cu parametri cunoscuți și a arătat cum se degradează ele cînd parametrii sînt estimați din ferestre scurte. În cele trei universuri americane, niciuna dintre cele șase reguli estimate incluse în familia de teste, MV-LO, GMV, GMV-LO, GMV-LW, ERC și HRP, nu depășește semnificativ 1/N după ajustarea Holm. Exemplul Black–Litterman ilustrează construirea ponderilor, fără o evaluare out-of-sample comparabilă. Această secțiune transformă rezultatele într-o decizie practică și dă verificările finale.
Decizia are trei părți: ce regulă aleg, în ce condiții este valabilă alegerea și ce rezultat m-ar face să renunț la ea.
Regula implicită este 1/N. Nu estimează nimic, are turnover lunar 0,02 și este greu de depășit după costuri. ERC este alegerea dacă riscul trebuie echilibrat între active: o abatere moderată de la 1/N, cu turnover 0,03; HRP tranzacționează mai mult. GMV sau GMV-LW se aleg doar dacă obiectivul este riscul minim: ele minimizează varianța calculată cu matricea folosită în optimizare, fără ca volatilitatea lor out-of-sample să fie garantat minimă, iar pe 16 ETF-uri raportul lor Sharpe rămîne sub cel al lui 1/N (0,20 față de 0,76). În backtest-ul și implementarea capitolului, MV fără restricții este lichidată în toate cele trei universuri.
Alegerea depinde de condiții. Cu ferestre de 60 de luni și 8–16 active, eroarea de estimare domină: în simulare, MV depășește 1/N abia la 480 de luni. La costuri de peste circa 22 bp, MV-LO, cea mai bună estimație punctuală, nu mai depășește 1/N pe 16 ETF-uri. Black–Litterman este util doar cu opinii a căror matrice de încredere \(\boldsymbol\Omega\) este fixată prudent; fără restricții suplimentare, el modifică doar ponderile activelor din opinii. Concluziile sînt specifice eșantioanelor analizate: sectoare 2004–2026, multi-active și combinat 2012–2026.
Decizia ar trebui revizuită dacă o regulă estimată ar avea \(\hat\Delta > 0\) față de 1/N, semnificativ după Holm sau Benjamini–Hochberg pe toată familia de teste, iar cîștigul ar rămîne net de costuri și pe un al doilea eșantion.
Pe scurt
Ce aleg
1/N ca regulă implicită: nu estimează nimic, are turnover lunar \(0{,}02\) și este greu de depășit după costuri
ERC dacă vreau riscul echilibrat între active: o abatere moderată de la 1/N, cu turnover \(0{,}03\) (HRP tranzacționează mai mult)
GMV sau GMV-LW doar dacă obiectivul este riscul minim: cea mai mică volatilitate, dar Sharpe sub 1/N pe 16 ETF-uri (\(0{,}20\)–\(0{,}36\) față de \(0{,}76\))
nu aleg MV nerestricționată: averea ei ajunge la zero în toate cele trei universuri
În ce condiții
ferestre de 60 de luni și 8–16 active: eroarea de estimare domină (în simulare, MV depășește 1/N abia la 480 de luni)
costuri de peste circa 22 bp: MV-LO, cea mai bună estimație punctuală, nu mai depășește 1/N pe 16 ETF-uri
Black–Litterman doar cu opinii a căror încredere \(\boldsymbol\Omega\) este fixată prudent: modifică doar activele din opinii
Verificările rapide aplică rezultatele capitolului unor cifre alese astfel încît calculul să se poată face de mînă: trei reguli pe două active, optimismul raportului Sharpe estimat direct și banda Marchenko–Pastur. Fiecare verificare indică slide-ul pe care se sprijină, iar răspunsurile sînt în anexă.
Pe scurt
Trei reguli, două active: \(\sigma_1 = 30\%\), \(\sigma_2 = 15\%\), \(\rho = 0{,}2\)
calculați ponderile și volatilitățile GMV, ERC și 1/N
A doua parte privește distribuția a posteriori Black–Litterman cu o singură opinie, inferența pentru un singur raport Sharpe și ajustările Holm și Benjamini–Hochberg pentru patru teste. Răspunsurile sînt în anexă.
Pe scurt
O opinie, un activ: \(\pi = 4\%\), \(\tau\sigma^2 = 0{,}0009\), opinia \(10\%\)
media a posteriori și ponderea opiniei pentru \(\Omega = 0{,}0009\) și pentru \(\Omega = 0{,}0003\) (Opiniile și distribuția a posteriori)
Un raport Sharpe: \(\widehat{SR}\) lunar \(= 0{,}15\), \(T = 120\), i.i.d. din distribuția Normală
Sharpe-ul anual și intervalul lui de 95%
este semnificativ pozitiv? (Inferența pentru un raport Sharpe)
Patru teste: \(p = 0{,}004;\ 0{,}020;\ 0{,}030;\ 0{,}300\)
valorile p ajustate Holm și Benjamini–Hochberg
cîte respingeri la \(5\%\) cu fiecare? (Holm și Benjamini–Hochberg)
Rolul erorii standard în testul diferenței de Sharpe (testul HAC).
Legăturile duc la modelele factoriale din Capitolul 3, la volatilitatea și corelația variabile în timp din Capitolele 5 și 6, la riscul de portofoliu din Capitolul 7 și la machine learning pentru randamente și portofolii din Capitolul 13.
Pe scurt
Întrebări de recapitulare
De ce supraestimează Sharpe-ul tangent în eșantion pe cel realizabil?
De ce poate o diferență mică de Sharpe între ERC și 1/N să fie aproape semnificativă, iar una mai mare între GMV și 1/N nu?
pe sectoare
testul HAC: comparați erorile standard \(0{,}023\) și \(0{,}159\) din tabelul din Anexă
Legături cu alte capitole
Capitolul 3: portofoliul tangent, CAPM și modelele factoriale de covarianță
Capitolele 5–6: volatilitate și corelație variabile în timp pentru ponderi dinamice
Capitolul 7: Value-at-Risk și Expected Shortfall de portofoliu
Capitolul 13: machine learning pentru randamente și portofolii
supraajustarea (overfitting) backtest-ului
Sinteza secțiunii
Pe datele capitolului, decizia practică este 1/N ca regulă implicită, ERC cînd contează echilibrul riscului și GMV sau GMV-LW cînd obiectivul este riscul minim. Concluzia ține de ferestrele de 60 de luni, de universurile de 8–16 active și de eșantioanele analizate. Ea se schimbă doar dacă o regulă estimată depășește 1/N după corecția pentru întreaga familie de teste, net de costuri și pe un al doilea eșantion.
Aprofundări
Cadrele acestei părți extind subiecte tratate pe scurt în corpul capitolului. Ele descriu în detaliu activele celor trei universuri, shrinkage-ul neliniar al valorilor proprii, cazurile limită ale modelului Black–Litterman și rolul parametrilor \(\delta_{RA}\) și \(\tau\), testul HAC pentru diferența de rapoarte Sharpe pas cu pas și comparația dintre articolul despre frontiera implementabilă al lui Jensen, Kelly, Malamud & Pedersen (2026) și aplicația din curs, cu rezultatele brute și nete de costuri pe datele cursului.
XLP (bunuri de consum de bază), XLU (utilități), XLV (sănătate), XLY (consum discreționar)
Multi-active
acțiuni: SPY (S&P 500), EFA (țări dezvoltate, fără SUA și Canada), EEM (piețe emergente)
obligațiuni: TLT (titluri de stat SUA, peste 20 de ani), IEF (titluri de stat SUA, 7–10 ani), LQD (investment grade), HYG (high yield)
aur: GLD
BVB (8 blue chips)
TLV Banca Transilvania, SNP OMV Petrom (OMV: Österreichische Mineralölverwaltung, grupul petrolier austriac), BRD BRD–Groupe Société Générale, TGN Transgaz
SNG Romgaz, SNN Nuclearelectrica, EL Electrica, TEL Transelectrica
Anexa conține derivările și tabelele complete la care trimite corpul capitolului: frontiera în formă închisă pas cu pas, momentele distribuției Wishart și distribuția ponderilor estimate, ponderile tangente obținute prin regresie (Britten-Jones, 1999), intensitatea optimă de shrinkage, modelul Black–Litterman ca estimare mixtă (GLS), alte reguli bazate pe risc, rezultatele out-of-sample pe fiecare univers, toate testele față de 1/N, detaliile bootstrap-ului, raportul Sharpe deflatat, activele digitale, metoda și rezultatele complete ale studiului de caz și prompturile buclei de descoperire.
Două restricții, doi multiplicatori: \(\mathcal{L} = \tfrac12\mathbf{w}^\top\boldsymbol\Sigma\mathbf{w} - \lambda_1(\mathbf{w}^\top\boldsymbol\mu - m) - \lambda_2(\mathbf{w}^\top\mathbf{1} - 1)\)
Condiția de ordinul întîi: \(\boldsymbol\Sigma\mathbf{w} = \lambda_1\boldsymbol\mu + \lambda_2\mathbf{1}\), deci \(\mathbf{w} = \lambda_1\boldsymbol\Sigma^{-1}\boldsymbol\mu + \lambda_2\boldsymbol\Sigma^{-1}\mathbf{1}\)
Restricțiile, cu \(A = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\mathbf{1}\), \(B = \mathbf{1}^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\)
\(C = \boldsymbol\mu^\top\boldsymbol\Sigma^{-1}\boldsymbol\mu\), \(D = AC - B^2\)
\[ \boldsymbol\mu^\top\mathbf{w} = \lambda_1 C + \lambda_2 B = m, \qquad \mathbf{1}^\top\mathbf{w} = \lambda_1 B + \lambda_2 A = 1 \]
Wishart: analogul matriceal al lui \(\chi^2\), cu \(T-1\) grade de libertate
Momentul Wishart invers, finit pentru \(T > N + 2\): \(\mathbb{E}[\hat{\boldsymbol\Sigma}^{-1}] = \frac{T}{T-N-2}\boldsymbol\Sigma^{-1}\)
o deplasare în sus care crește cu \(N/T\)
Condiționînd pe \(\hat{\boldsymbol\mu}\) se obține \(\mathbb{E}[\hat\theta^2]\) din curs (Seminarul 4, A8)
se folosește \(\mathbb{E}[\mathbf{x}^\top\mathbf{K}\mathbf{x}] = \operatorname{tr}(\mathbf{K}\operatorname{Var}(\mathbf{x})) + \mathbb{E}[\mathbf{x}]^\top\mathbf{K}\,\mathbb{E}[\mathbf{x}]\)
orice vector aleator \(\mathbf{x}\), matrice fixă \(\mathbf{K}\), \(\operatorname{tr}\): urma
Ponderile GMV cu \(\hat{\boldsymbol\Sigma}\) Wishart și \(T\) suficient de mare față de \(N\)
Acest capitol: 21 de configurații (7 reguli \(\times\) 3 universuri; fără MV, lichidată), aliniate pe calendarul comun mai 2012 – iulie 2026 (\(T = 171\))
cîștigătorul este MV-LO pe sectoare, cu Sharpe \(0{,}92\) pe an
Ca 21 de încercări independente: \(SR_0 = 0{,}48\) pe an, DSR \(= 0{,}94 < 0{,}95\)
Configurațiile sînt puternic corelate (pînă la \(0{,}99\)), deci numărul efectiv de încercări independente este mai mic
\(N = 8\) dă DSR \(0{,}98\), \(N = 3\) dă \(0{,}99\)
\(N\) efectiv tratează dependența dintre configurații, nu autocorelația randamentelor
DSR este o aproximare ilustrativă: o probabilitate calibrată doar sub ipotezele formulei
Holm ajustează întreaga familie de teste pe perechi față de 1/N
DSR compară performanța cîștigătorului cu efectul hazardului
Probabilitatea unei utilități mai mari pentru Portfolio-ML: aproximare Normală i.i.d., condiționată de procedura estimată, nu probabilitate a posteriori exactă
\(99{,}5\%\) față de Static-ML, \(99{,}9\%\) față de varianța minimă, \(93{,}4\%\) față de 1/N
Diferența de utilitate anuală, cu interval HAC de 95%
față de 1/N: \(0{,}28\)\([-0{,}18;\ 0{,}73]\); față de Static-ML: \(0{,}15\)\([-0{,}001;\ 0{,}30]\); față de varianța minimă: \(0{,}74\)\([0{,}25;\ 1{,}23]\)
un asistent AI (Claude, ChatGPT, Gemini, GitHub Copilot)
motoare de căutare a literaturii (Semantic Scholar, Elicit, Google Scholar)
Literatură
„Enumeră studiile publicate în reviste cu evaluare inter pares din 2015 încoace care compară regulile cu shrinkage sau bazate pe risc cu 1/N out-of-sample; pentru fiecare dă DOI, N, T, ipoteza de cost și testul.”
Verificați fiecare DOI în Crossref și deschideți tabelul citat
Ipoteze
„Dă trei explicații concurente pentru un cîștig de Sharpe față de 1/N (o \(\boldsymbol\Sigma\) mai bună, o primă de volatilitate redusă, noroc) și implicația testabilă a fiecăreia pentru turnover, subperioade și expunerile la factori.”
Date și cod
„Scrie cod Python care citește prețurile zilnice din datele cursului, aliniază prețurile pe zilele comune și rulează GMV-LW și 1/N cu o fereastră mobilă de 60 de luni; ponderile de la \(t\) pot folosi date doar pînă la \(t-1\).”
Replicați întîi: 1/N \(0{,}76\), GMV-LW \(0{,}20\) pe universul combinat
„Scrie o preînregistrare: familia de teste (reguli \(\times\) universuri \(\times\) ferestre \(\times\) costuri), rata de eroare (FWER sau FDR), subperioadele și un placebo, fixate înainte de a vedea vreun rezultat.”
Critică
„Joacă rolul unui recenzent sever: dă cele mai puternice trei motive pentru care cîștigul meu de Sharpe ar putea fi aparent și testul care l-ar demasca pe fiecare.”
Raport: fiecare specificație încercată, valori p ajustate, puterea testului, codul și seed-urile
Orice specificație aleasă după ce ați văzut rezultatele este exploratorie
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?. The European Journal of Finance, 29(10), 1064–1105.
XLP, XLU, XLV, XLY: Select Sector SPDR — bunuri de consum de bază, utilități, sănătate, consum discreționar
TLV: Banca Transilvania
SNP: OMV Petrom
BRD: BRD–Groupe Société Générale
TGN: Transgaz
SNG: Romgaz
SNN: Nuclearelectrica
EL: Electrica
TEL: Transelectrica
ETF-uri din SUA: randamente lunare în exces față de titlurile de stat pe o lună; prețuri EODHD, rata fără risc din Kenneth French Data Library. BVB: prețuri EODHD, în RON.


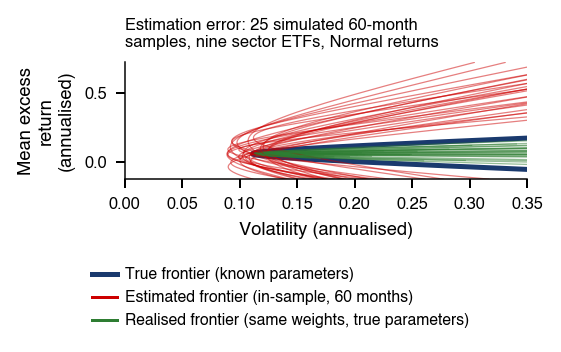
 MFM_ch4_two_asset
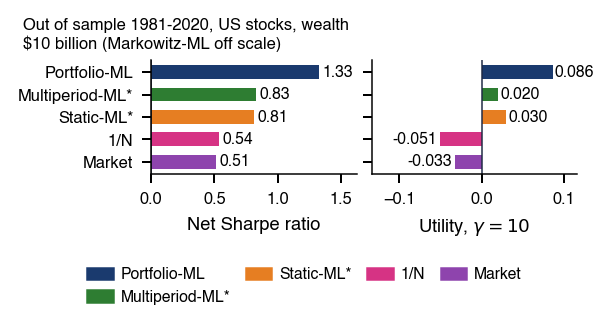
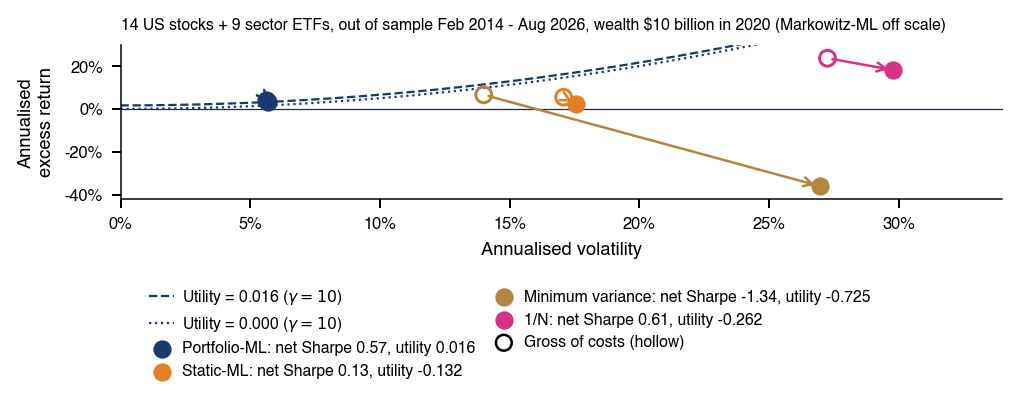
 Hierarchical Clustering