Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“These are mean zero, serially uncorrelated processes with nonconstant variances conditional on the past, but constant unconditional variances. For such processes, the recent past gives information about the one-period forecast variance.” — Engle (1982)
S&P 500 (Standard & Poor's): autocorelația de ordinul 1 este \(-0{,}099\) pentru randamentele zilnice și \(0{,}313\) pentru pătratele lor
semnul unui randament este aproape imprevizibil, mărimea lui nu
Testele ARCH (autoregressive conditional heteroskedasticity) resping dispersia constantă pe toate cele șase piețe ale capitolului
S&P 500: \(Q(10)\) pe \(r_t^2\) este 6 135, față de valoarea critică 18,3 la 5%
GARCH(1,1), modelul ARCH generalizat, cu inovații Student-t: persistența \(\hat\alpha+\hat\beta = 0{,}9948\) și timpul de înjumătățire 132 de zile pentru S&P 500
la Bitcoin și EUR (moneda euro)/RON estimarea atinge frontiera \(\alpha+\beta = 1\): în model, șocurile nu se disipă niciodată
În afara eșantionului (out-of-sample), 2016–2026 (2 693 de prognoze pe o zi pentru S&P 500): GARCH(1,1)-t are o pierdere QLIKE (quasi-likelihood) mai mică decît EWMA (media mobilă ponderată exponențial) și decît media lui \(r^2\) pe ultimele 20 de zile
statisticile Diebold–Mariano: \(t\) = 3,47 și 4,10
These are mean zero, serially uncorrelated processes with nonconstant variances conditional on the past, but constant unconditional variances. For such processes, the recent past gives information about the one-period forecast variance.
Engle (1982) a introdus procesele ARCH (autoregressive conditional heteroskedasticity): randamente necorelate serial, a căror dispersie condiționată depinde de șocurile trecute. De aici vine întrebarea capitolului: dacă trecutul recent spune ceva despre dispersia de mîine, cît de bine putem prognoza riscul? Pe S&P 500 (Standard & Poor's), autocorelația de ordinul 1 a randamentelor zilnice este −0,099, iar a pătratelor lor 0,313. Pentru pătrate, toate primele 50 de autocorelații ies din banda de ±0,024; pentru randamente, doar 15, și toate sînt mici. Testele de efecte ARCH resping dispersia constantă pe toate cele șase piețe ale capitolului: S&P 500, BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București), BET-TR (BET Total Return, index, indicele BET cu dividendele reinvestite), Bitcoin, EUR (euro, moneda euro)/RON și aur.
Modelul GARCH(1,1) al lui Bollerslev (1986) descrie această dependență printr-o singură recursie a dispersiei. Estimat cu inovații Student-t, el arată o persistență (persistence) apropiată de 1: pentru S&P 500, \(\hat\alpha+\hat\beta = 0{,}9948\), iar timpul de înjumătățire (half-life) al unui șoc de dispersie este de 132 de zile. La Bitcoin și EUR/RON estimarea atinge frontiera \(\alpha+\beta = 1\), deci în model șocurile nu se mai disipă. Lîngă această frontieră, metoda delta (delta method) dă intervale simetrice care pot conține timpi de înjumătățire negativi, iar testele obișnuite trebuie înlocuite cu teste la frontieră.
Prognozele sînt evaluate out-of-sample pe 2016–2026: 2 693 de prognoze pe o zi pentru S&P 500, cu parametrii reestimați în fiecare ianuarie. Pierderea QLIKE (quasi-likelihood) rămîne potrivită și cînd dispersia adevărată este înlocuită de un proxy zgomotos, \(r_t^2\). Cea mai mică pierdere QLIKE o are GJR-t (Glosten–Jagannathan–Runkle, asymmetric GARCH, GARCH asimetric Glosten–Jagannathan–Runkle) (0,731), modelul GARCH cu răspuns asimetric la șocurile negative. EWMA (exponentially weighted moving average) și media lui \(r^2\) pe ultimele 20 de zile pierd clar față de GARCH-t (statistici Diebold–Mariano 3,47 și 4,10), dar modelele din familia GARCH sînt greu de separat între ele. Capitolul tratează de aceea, pe lîngă modele, inferența: erorile standard robuste, testele la frontieră și mulțimea de modele de încredere (Model Confidence Set).
Prognozele pe o zi ale volatilității S&P 500, 2016–2026: prognoza GJR-GARCH-t (Glosten–Jagannathan–Runkle GARCH, GARCH asimetric Glosten–Jagannathan–Runkle) (roșu) și EWMA cu \(\lambda = 0{,}94\) (albastru închis), față de proxy-ul realizat \(|r_t|\sqrt{A}\),\(A = 251{,}5\) (puncte); pe axa verticală este volatilitatea anualizată, în procente. Graficul interactiv: „Prognoze în afara eșantionului: schema și traiectoriile, 2016–2026” →
Rezultatele învățării
Derivați dispersia de termen lung, kurtosis-ul și timpul de înjumătățire ale modelului GARCH(1,1).
Calculați prognoze ale dispersiei pe mai multe zile și teste LR (Likelihood Ratio, test, testul raportului de verosimilitate) la frontieră.
Interpretați estimările GARCH, GJR și EGARCH (Exponential GARCH, GARCH exponențial) pe șase piețe.
Interpretați comparațiile out-of-sample cu QLIKE, testul Diebold–Mariano și Model Confidence Set.
Dinamica dispersieiModelele ARCH și GARCH, staționaritatea, kurtosis-ul, persistența și timpul de înjumătățire.
Estimare și incertitudineVerosimilitatea Student-t, QMLE, metoda delta lîngă \(\alpha+\beta = 1\) și testele la frontieră.
Prognoze și rezultate pe piețePrognozele pe mai multe zile, structura la termen a volatilității și estimările pe șase piețe.
Asimetrie și alegerea modeluluiGJR-GARCH, EGARCH, curba de impact al știrilor și compararea modelelor prin BIC (Bayesian Information Criterion, criteriul informațional bayesian).
Inovații și diagnosticReziduurile standardizate: distribuția și volatility clustering rămas.
Capitolul modelează dispersia condiționată (conditional variance) a randamentelor zilnice: dispersia randamentului de mîine, dată fiind toată informația cunoscută la închiderea de azi. Punctul de plecare este o regularitate empirică de care depinde orice măsură a riscului. Variațiile mari de preț vin grupate, așa că mărimea randamentului de azi spune ceva despre mărimea celui de mîine, chiar dacă semnul lui nu spune aproape nimic. Secțiunea documentează această regularitate pe șase piețe și prezintă cele două teste care decid dacă ipoteza unei dispersii constante poate fi păstrată.
ARCH, heteroscedasticitatea condiționată autoregresivă (autoregressive conditional heteroskedasticity), denumește proprietatea ca dispersia randamentului să depindă de șocurile trecute. Nucleul capitolului urmează un singur fir:
Volatility clustering și testele de efecte ARCH;
Recursia GARCH (ARCH generalizat), cu persistența și timpul ei de înjumătățire;
Estimarea cu inovații Student-t;
Prognozele pe mai multe zile;
Variantele asimetrice (GJR și EGARCH);
Diagnosticul reziduurilor standardizate;
Evaluarea out-of-sample a prognozelor cu pierderea QLIKE și cu testele Mincer–Zarnowitz și Diebold–Mariano.
Modelul este doar jumătate din problemă; cealaltă jumătate este inferența despre el. Capitolul tratează de aceea teoria asimptotică a estimatorului de cvasi-verosimilitate maximă (QMLE, quasi-maximum likelihood estimator), metoda delta cînd persistența \(\alpha+\beta\) este aproape de 1, testele a căror ipoteză nulă se află pe frontiera spațiului parametrilor, testele pe reziduuri corectate pentru parametrii estimați și două proceduri de comparare a mai multor prognoze: testul Giacomini–White și Model Confidence Set. Două secțiuni de cercetare încheie nucleul: un model de volatilitate bazat pe un cvasi-scor (quasi score-driven) și o buclă de descoperire asistată de inteligența artificială (AI, artificial intelligence). Exemplele detaliate și subiectele avansate sînt în Aprofundări; manualele de referință sînt Franke, Härdle & Hafner (2019) și, pentru teoria matematică, Francq & Zakoïan (2019).
Pe scurt
ARCH (AutoRegressive Conditional Heteroskedasticity): dispersia depinde de șocurile trecute
Materia de bază
Gruparea volatilității și testele ARCH
Recursia GARCH, persistența și timpul de înjumătățire
Teoria asimptotică a QMLE (Quasi-Maximum Likelihood Estimator, cvasi-verosimilitate maximă), metoda delta lîngă \(\alpha+\beta = 1\), teste la frontieră, teste corectate pe reziduuri, Giacomini–White, Model Confidence Set
Două secțiuni de cercetare
Un model de volatilitate bazat pe un cvasi-scor
O buclă de descoperire asistată de inteligența artificială (AI)
Exemple detaliate și subiecte avansate: Aprofundări, după Concluzii
Rezultatele învățării
derivați dispersia de termen lung, kurtosis-ul și timpul de înjumătățire ale GARCH(1,1)
calculați prognoze ale dispersiei pe mai multe zile și teste LR (Likelihood Ratio, testul raportului de verosimilitate) la frontieră
interpretați estimările GARCH, GJR și EGARCH pe șase piețe
interpretați comparațiile în afara eșantionului cu QLIKE, DM (testul Diebold–Mariano de comparare a prognozelor) și Model Confidence Set
Aprofundări și Anexa: lectură pentru familiarizare
Crahul din 19 octombrie 1987 nu a fost o zi izolată: în zilele următoare, piețele au continuat să se miște mult, în ambele direcții. Regularitatea a fost descrisă cu mult înainte de apariția modelelor formale. Mandelbrot (1963) scria că „schimbările mari tind să fie urmate de schimbări mari, de orice semn”. Formularea separă două proprietăți ale unei serii de randamente care se confundă ușor: direcția următoarei variații și mărimea ei. Volatility clustering privește numai mărimea.
Volatility clustering este faptul stilizat 6 din Capitolul 1. Consecința lui practică este că volatilitatea intră în toate măsurile de risc folosite mai departe în curs: Value at Risk (Capitolul 7), ponderile portofoliului din Capitolul 4 și prețurile opțiunilor. Prognoza dispersiei de mîine este deci un input, nu un scop în sine. Capitolul pune două întrebări despre ea: cît de bună este prognoza și dacă este posibilă o inferență statistică validă despre modelul care o produce.
Graficul arată randamentele zilnice ale piețelor din capitol pe tot eșantionul. Perioadele calme, în care randamentele rămîn într-o bandă îngustă, alternează cu perioade agitate, în care randamente mari de ambele semne se succed. În versiunea interactivă, cursorul fixează un prag pentru randamentul absolut \(|r|\), în unități de abatere standard \(s\) a seriei; afișajul numără zilele de peste prag și ponderea celor urmate, în următoarele cinci zile, de o altă zi de același fel, comparată cu ponderea pe care ar da-o zile independente. Butonul ▶ crește pragul pas cu pas.
Întrebare pentru sală Pe S&P 500, cît de des este o zi cu |r| peste 3 abateri standard urmată, în următoarele 5 zile, de încă o astfel de zi?
Răspuns
În 62% din cazuri. Pragul este depășit în 105 zile (1,6% din zile); la zile independente, probabilitatea ar fi 8%. Proporția este 54% la BET și 32% la Bitcoin.
Pe S&P 500, pragul de trei abateri standard este depășit în 105 zile, 1,6% din eșantion. După o astfel de zi, în următoarele cinci zile urmează alta în 62% din cazuri; dacă zilele ar fi independente, probabilitatea ar fi de circa 8%. Ponderea este 54% pentru BET și 32% pentru Bitcoin. Zilele extreme sînt deci departe de a fi independente, deși, cum arată cadrele următoare, semnul lor este aproape imprevizibil.
Toate randamentele din capitol sînt randamente logaritmice zilnice în procente, \(r_t = 100\,(\ln P_t - \ln P_{t-1})\), unde \(P_t\) este prețul de închidere sau nivelul indicelui în ziua \(t\); ultima închidere este cea din 18 septembrie 2026. Cele șase serii au fost alese pentru regimurile lor diferite. S&P 500 este piața de referință globală, iar indicele BET (Bucharest Exchange Trading) piața locală de acțiuni, ambele din 2000. BET-TR, varianta de randament total (total return) a BET, cu dividendele reinvestite, începe în 2014. Bitcoin (BTC) începe la 17 septembrie 2014 și se tranzacționează șapte zile pe săptămînă. EUR/RON este cursul de referință al Băncii Naționale a României (BNR), un regim de managed float, din 2005, iar aurul (XAU/USD) este un activ de refugiu (safe haven), din 2000.
Indicii bursieri și aurul se tranzacționează doar în zilele lucrătoare, iar fișierele brute de prețuri conțin rînduri completate de furnizorul de date. O regulă euristică tratează ca zi completată de furnizor un rînd care repetă închiderea precedentă și nu arată tranzacții: volum raportat zero, open egal cu high, low și close, sau o copie exactă a rîndului precedent. Astfel de rînduri se elimină, cu motivul păstrat, și se verifică în calendarul bursei; o închidere care chiar nu s-a schimbat, un randament zero, se păstrează, iar un volum lipsă nu este tratat ca volum zero. Regula nu elimină nicio zi la S&P 500, BET și BET-TR și elimină 7 zile la aur.
Pe graficul cadrului precedent, anii calmi alternează cu luni agitate: 2008, martie 2020 și aprilie 2025 ies în evidență în toate cele trei serii afișate, S&P 500, BET și Bitcoin. Lista completă a seriilor, cu surse, dimensiunile eșantioanelor și momentele de selecție, este în Anexă.
Pe scurt
Randamente logaritmice zilnice \(r_t = 100\,(\ln P_t - \ln P_{t-1})\) în %, închideri pînă la 18 septembrie 2026
\(P_t\): prețul (nivelul indicelui) la închiderea zilei \(t\)
Șase serii, alese pentru regimuri de piață diferite
S&P 500 (piața de referință globală) și BET (piața locală), din 2000
BET-TR (BET cu dividendele reinvestite), din 2014
Bitcoin (BTC), din 17 septembrie 2014, cu toate cele 7 zile ale săptămînii
EUR/RON (cursul de referință BNR, regim de flotare controlată, managed float), din 2005
Aurul (XAU/USD), activ de refugiu, din 2000
Indici bursieri și aur: doar zilele lucrătoare
Regulă euristică: un rînd care repetă închiderea precedentă și nu arată tranzacții (volum raportat zero, open = high = low = close sau o copie a rîndului precedent) este tratat ca zi completată de furnizor
Astfel de rînduri se elimină, cu motivul păstrat, și se verifică în calendarul bursei; o închidere care chiar nu s-a schimbat (randament zero) se păstrează
Un volum lipsă nu este tratat ca volum zero
Zile eliminate: 0 la S&P 500, BET și BET-TR, 7 la aur
Pe grafic (S&P 500, BET, Bitcoin), perioadele calme alternează cu luni de volatilitate ridicată
Autocorelația de selecție la lagul \(k\),\(\hat\rho_k = \widehat{\mathrm{Corr}}(x_t, x_{t-k})\), măsoară dependența liniară dintre serie și propriul ei trecut. Calculată pentru \(x_t = r_t\), ea măsoară predictibilitatea randamentului însuși; calculată pentru \(x_t = r_t^2\), predictibilitatea mărimii lui. Banda de referință \(\pm 1{,}96/\sqrt{n}\), unde \(n\) este numărul de randamente, este intervalul punctual de 95% al lui \(\hat\rho_k\) pentru o serie i.i.d.; pentru S&P 500 ea este \(\pm 0{,}024\).
Graficul arată primele 50 de autocorelații ale randamentelor S&P 500 și ale pătratelor lor. În versiunea interactivă, selectorul alege seria, iar cursorul puterea \(\delta\) din \(|r|^\delta\), astfel încît aceeași comparație se poate face pentru randamentele absolute (\(\delta = 1\)) și pentru alte puteri; ▶ modifică \(\delta\) pas cu pas.
Întrebare pentru sală La lagul 1, autocorelația randamentelor S&P 500 este −0,099, iar cea a pătratelor lor 0,313; autocorelațiile pătratelor rămîn pozitive și persistente. Ce rezultă pentru modelare?
Răspuns
Dependența mărimii randamentelor poate exista fără o dependență liniară puternică a randamentelor. Toate cele 50 de autocorelații ale lui r² ies din banda ±0,024; la r ies 15 din 50, dar toate sînt mici. Autocorelația mică nu implică independență, iar autocorelația pătratelor nu măsoară precizia unei prognoze a semnului. Banda ±0,024 este un reper asimptotic punctual sub ipoteza i.i.d.
La lagul 1, autocorelația este \(-0{,}099\) pentru \(r_t\) și \(0{,}313\) pentru \(r_t^2\). Dintre primele 50 de autocorelații ale lui \(r_t\), 15 ies din banda \(\pm 0{,}024\), dar toate sînt mici; pentru \(r_t^2\) ies toate cele 50 și rămîn pozitive. Autocorelațiile mici ale randamentelor nu implică independență: dependența în mărimi poate coexista cu o dependență liniară aproape nulă în niveluri.
Aceleași serii au cozi groase. Excesul de kurtosis (excess kurtosis), kurtosis-ul minus 3, este 10,7 pentru S&P 500, 11,1 pentru BET și 12,0 pentru Bitcoin. Kurtosis-ul presupune un moment de ordin patru finit, pe care estimările cozilor din Capitolul 1 îl pun sub semnul întrebării. Mărimea de modelat este deci dispersia condiționată \(\sigma_t^2 = \mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\), unde \(\mathcal{F}_{t-1}\) este informația disponibilă la închiderea zilei \(t-1\).
Pe scurt
Autocorelația de selecție la lagul \(k\): \(\hat\rho_k = \widehat{\Corr}(x_t, x_{t-k})\), calculată pentru \(x_t = r_t\) și \(x_t = r_t^2\)
Banda \(\pm 1{,}96/\sqrt{n}\) (\(n\): numărul de randamente): intervalul de 95% al lui \(\hat\rho_k\) dacă seria ar fi i.i.d.
S&P 500, lagul 1: \(-\)0,099 pentru \(r_t\), 0,313 pentru \(r_t^2\)
La \(r_t\), 15 din 50 de autocorelații ies din banda \(\pm\)0,024, dar toate sînt mici
La \(r_t^2\), toate cele 50 ies din bandă
Cozi groase: exces de kurtosis (kurtosis minus 3) 10,7 (S&P 500), 11,1 (BET), 12,0 (Bitcoin)
Kurtosis-ul presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Mărimea modelată: \(\sigma_t^2 = \Var(r_t \mid \mathcal{F}_{t-1})\), cu \(\mathcal{F}_{t-1}\) informația de la închiderea zilei \(t-1\)
Ipoteza nulă a absenței volatility clustering afirmă că dispersia condiționată \(\mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\) este constantă. Sub ea, pătratele randamentelor sînt necorelate serial, iar ambele teste standard caută autocorelație în pătrate. Primul, propus de McLeod & Li (1983), aplică statistica Ljung–Box lui \(r_t^2\):
unde \(\hat\rho_k\) este autocorelația lui \(r_t^2\) la lagul \(k\), iar \(n\) dimensiunea eșantionului. Capitolul folosește \(m = 10\) laguri, două săptămîni de tranzacționare. Statistica măsoară mărimea comună a primelor \(m\) autocorelații; sub \(H_0\) ea este \(\chi^2_{10}\), iar valoarea critică de 5% este 18,3.
Al doilea este testul multiplicatorului Lagrange (LM, Lagrange multiplier) al lui Engle (1982). Fie \(\hat\varepsilon_t = r_t - \bar r\) randamentul centrat, cu \(\bar r\) media de selecție. Testul regresează \(\hat\varepsilon_t^2\) pe o constantă și pe \(\hat\varepsilon_{t-1}^2, \ldots, \hat\varepsilon_{t-5}^2\), cinci laguri sau o săptămînă de tranzacționare, și folosește \(LM = nR^2\), unde \(R^2\) este coeficientul de determinare al acestei regresii. Sub \(H_0\) cele cinci pante sînt nule, iar \(LM\) este \(\chi^2_5\), cu valoarea critică de 5% egală cu 11,1. Un \(LM\) mare înseamnă că pătratele șocurilor trecute prognozează pătratul șocului de azi.
Ambele statistici sînt măsuri globale (portmanteau) ale aceleiași trăsături. \(Q\) folosește direct autocorelațiile, LM o regresie; niciuna nu specifică forma dependenței, sarcină care revine modelelor din secțiunea următoare.
Pe scurt
\(H_0\): fără gruparea volatilității, \(\Var(r_t \mid \mathcal{F}_{t-1})\) constantă
Ambele teste caută autocorelație în pătratele randamentelor
McLeod–LiMcLeod & Li (1983): statistica Ljung–Box aplicată lui \(r_t^2\)
\(\hat\rho_k\): autocorelația lui \(r_t^2\) la lagul \(k\)
\(n\): volumul eșantionului
\(m = 10\) laguri: două săptămîni de tranzacționare
Măsoară mărimea comună a primelor \(m\) autocorelații
\(\chi^2_{10}\) sub \(H_0\)
Respingem dacă \(Q(10) > 18{,}3\) (5%)
Testul Lagrange Multiplier (LM) al lui EngleEngle (1982)
Regresăm \(\hat\varepsilon_t^2\) pe o constantă și pe \(\hat\varepsilon_{t-1}^2, \ldots, \hat\varepsilon_{t-5}^2\) (5 laguri: o săptămînă de tranzacționare)
\(\hat\varepsilon_t = r_t - \bar r\): randamentul centrat, \(\bar r\): media de selecție
\(LM = nR^2\), cu \(R^2\) coeficientul de determinare al acestei regresii
\(H_0\): toate cele cinci pante sînt 0
\(\chi^2_5\) sub \(H_0\)
Respingem dacă \(LM > 11{,}1\) (5%)
Un \(LM\) mare înseamnă că pătratele șocurilor trecute le prezic pe cele de azi
Pe toate cele șase piețe, fiecare statistică se află mult peste valoarea ei critică, cu toate valorile \(p\) sub 0,001. Pe S&P 500, \(Q(10)\) pe \(r_t^2\) este 6 135, față de valoarea critică 18,3, iar \(LM(5)\) este 1 685, față de 11,1. Volatility clustering apare la acțiuni, Bitcoin, EUR/RON și aur. Valorile \(p\) din \(\chi^2\) presupun cel puțin un moment de ordin patru finit al lui \(r_t\), pe care estimările Hill din Capitolul 1 îl pun la îndoială; la statistici de această mărime, totuși, decizia nu depinde de distribuția de referință exactă.
Mărimea statisticilor nu trebuie citită ca intensitate a efectului de la o serie la alta. \(Q\) și LM cresc cu dimensiunea eșantionului \(n\), deci nu sînt comparabile între serii de lungimi diferite: BET-TR și Bitcoin încep în 2014, celelalte serii în 2000 sau 2005. Autocorelația de ordinul 1 a lui \(r^2\) este măsura mai comparabilă; după ea, cele mai slabe efecte sînt la aur (0,110) și Bitcoin (0,137), iar cele mai puternice la EUR/RON (0,342) și BET (0,330).
Alternativa unui test ARCH este unilaterală, deoarece ponderile dispersiei nu pot fi negative, iar testul \(\chi^2\) bilateral risipește putere; testele scorului unilaterale sînt în Anexă. Rezultatul susține o descriere: dispersia condiționată nu este constantă pe niciuna dintre cele șase piețe.
Pe scurt
Toate statisticile sînt mult peste valorile critice (toate \(p < 0{,}001\))
Gruparea volatilității la acțiuni, Bitcoin, EUR/RON și aur
Valorile \(p\) (p-values) din legea \(\chi^2\) cer cel puțin un moment de ordinul patru finit al lui \(r_t\), pe care estimările Hill din Capitolul 1 îl pun sub semnul întrebării
Efectul cel mai slab, măsurat prin \(\hat\rho_1(r^2)\), apare la aur (0,110) și Bitcoin (0,137)
\(Q\) și LM cresc cu \(n\), deci nu se compară între serii de lungimi diferite
Cele șase piețe au în comun cele două trăsături pe care le modelează restul capitolului: randamente al căror semn este aproape imprevizibil și pătrate ale randamentelor cu autocorelații puternice, care scad încet. Testele ARCH resping peste tot dispersia constantă. Secțiunea următoare prezintă modelele care descriu această dependență.
Dinamica dispersiei
Secțiunea precedentă a arătat că mărimea randamentelor este predictibilă. Această secțiune scrie modele pentru dispersia condiționată și le deduce proprietățile: modelul ARCH, generalizarea lui GARCH, reprezentarea ARMA (AutoRegressive Moving Average, model, model autoregresiv cu medie mobilă) a pătratelor șocurilor, condițiile pentru o dispersie finită și un kurtosis finit, prognoza pe mai mulți pași și timpul de înjumătățire al unui șoc de dispersie. Secțiunea se încheie cu EWMA, reperul din industrie, care este un model GARCH fără revenire la medie (mean reversion).
Randamentul se descompune într-o medie și un șoc, \(r_t = \mu + \varepsilon_t\), iar șocul într-o scală și o inovație, \(\varepsilon_t = \sigma_t z_t\). Aici \(\mu\) este randamentul mediu, \(\varepsilon_t\) partea neașteptată a randamentului, \(\sigma_t\) volatilitatea condiționată, iar inovațiile \(z_t\) sînt i.i.d., cu media 0 și dispersia 1. Dispersia condiționată este \(\sigma_t^2 = \mathrm{Var}(r_t \mid \mathcal{F}_{t-1})\), iar dispersia necondiționată este media ei, \(\sigma^2 = \mathbb{E}\sigma_t^2\).
În modelul ARCH(\(q\)) al lui Engle (1982), dispersia de azi este o constantă plus o sumă ponderată a pătratelor ultimelor \(q\) șocuri:
În (5.2),\(q\) este numărul de laguri, \(\omega > 0\) pragul minim al dispersiei, iar \(\alpha_i \geq 0\) ponderea șocului de acum \(i\) zile. Restricțiile de semn garantează că dispersia este pozitivă. Un șoc mare ieri, un \(\varepsilon_{t-1}^2\) mare, crește dispersia de azi, deci volatility clustering este construit în model.
Pentru ARCH(1), aplicînd media se obține \(\sigma^2 = \omega + \alpha_1\sigma^2\), deci dispersia necondiționată este \(\sigma^2 = \omega/(1-\alpha_1)\), finită dacă \(\alpha_1 < 1\). Randamentele sînt necorelate serial, dar dispersia lor condiționată se mișcă odată cu trecutul, exact proprietatea citată la deschiderea capitolului. Engle a primit Premiul Nobel din 2003 pentru această lucrare; istoria este în Anexă.
Pe scurt
Cadrul: \(r_t = \mu + \varepsilon_t\), \(\varepsilon_t = \sigma_t z_t\), inovațiile \(z_t\) i.i.d. cu media 0 și dispersia 1
\(\mu\): randamentul mediu
\(\varepsilon_t\): șocul (partea neașteptată a randamentului)
Volatility clustering din datele reale durează luni de zile, așa că un model ARCH care îl reproduce are nevoie de un \(q\) mare și de mulți parametri. GARCH, heteroscedasticitatea condiționată autoregresivă generalizată (generalised autoregressive conditional heteroskedasticity), rezolvă problema lăsînd dispersia să depindă de propriul trecut. Modelul GARCH(1,1) al lui Bollerslev (1986) este
cu \(\omega > 0\),\(\alpha \geq 0\) și \(\beta \geq 0\). Parametrul \(\alpha\) măsoară reacția la știri, adică la ultimul pătrat al șocului, iar \(\beta\) memoria dispersiei trecute.
Înlocuind recursia în ea însăși, înapoi în timp, se obține, pentru \(\beta < 1\),
unde \(j\) este vechimea șocului în zile, iar \(\alpha\beta^{j-1}\) ponderea lui. GARCH(1,1) este deci un ARCH(\(\infty\)) cu ponderi care scad geometric, descris prin trei parametri în loc de mulți.
GARCH(\(p\),\(q\)) adaugă mai multe laguri: \(p\) laguri ale lui \(\sigma^2\) și \(q\) laguri ale lui \(\varepsilon^2\). În practică lagurile suplimentare ajută rar, iar GARCH(1,1) este modelul de bază al domeniului; Hansen & Lunde (2005) compară un număr mare de modele de volatilitate și constată că este greu de întrecut. Restul capitolului folosește peste tot ordinul (1,1).
O specificare completă are două părți: recursia dispersiei și distribuția inovației standardizate \(z_t\). Denumirile din capitol le numesc pe amîndouă. Numele modelului descrie dinamica dispersiei, iar un sufix descrie legea lui \(z_t\).
GARCH-N este GARCH cu inovații din distribuția Normală. GARCH-t este GARCH cu inovații Student-t, care permit cozi mai groase. GJR-t, sau GJR-GARCH-t, combină dispersia asimetrică a lui Glosten, Jagannathan și Runkle, tratată în secțiunea despre asimetrie, cu inovații Student-t. Aceeași convenție dă mai departe în capitol EGARCH-t și GJR-skewed-t.
Proprietățile modelului GARCH(1,1) se citesc cel mai ușor dintr-un model echivalent pentru pătratele șocurilor. Fie \(u_t = \varepsilon_t^2 - \sigma_t^2\), surpriza din pătratul șocului; prin construcție, \(\mathbb{E}[u_t \mid \mathcal{F}_{t-1}] = 0\). Adunînd \(u_t\) în ambii membri ai (5.3) și scriind \(\sigma_{t-1}^2 = \varepsilon_{t-1}^2 - u_{t-1}\), se obține
Ecuația (5.5) este un model autoregresiv cu medie mobilă (autoregressive moving average), ARMA(1,1), în \(\varepsilon_t^2\), cu coeficientul autoregresiv \(\alpha+\beta\) și coeficientul de medie mobilă \(-\beta\).
Consecința este că autocorelațiile lui \(\varepsilon_t^2\),\(\rho_k = \mathrm{Corr}(\varepsilon_t^2, \varepsilon_{t-k}^2)\), scad geometric, \(\rho_k = \rho_1 (\alpha+\beta)^{k-1}\). Dacă \(\mathbb{E}\varepsilon_t^4 < \infty\), prima autocorelație este \(\rho_1 = \alpha(1-\beta^2-\alpha\beta)/(1-\beta^2-2\alpha\beta)\); deducerea este exercițiul A6 din Seminarul 5. Deoarece \(\alpha+\beta\) determină cît de încet se stinge dependența în pătratele șocurilor, el se numește persistența (persistence) volatilității.
Pentru S&P 500, GARCH-N estimat prin QMLE Gaussian dă \(\hat\alpha = 0{,}120\) și \(\hat\beta = 0{,}860\). Autocorelațiile implicate sînt \(\rho_1 = 0{,}356\) și \(\rho_{10} = 0{,}298\), față de valorile de selecție \(\hat\rho_1 = 0{,}313\) și \(\hat\rho_{10} = 0{,}248\): modelul reproduce ordinul de mărime și scăderea lentă, dar supraestimează nivelul.
Atunci \(\varepsilon_t^2 = \omega + (\alpha+\beta)\,\varepsilon_{t-1}^2 + u_t - \beta\,u_{t-1}\)
Se obține adunînd \(u_t\) în ambii membri ai recursiei GARCH și scriind \(\sigma_{t-1}^2 = \varepsilon_{t-1}^2 - u_{t-1}\)
Un model AutoRegressive Moving Average, ARMA(1,1), în \(\varepsilon_t^2\) cu coeficientul autoregresiv \(\alpha+\beta\) și coeficientul de medie mobilă \(-\beta\)
Consecință: autocorelațiile lui \(\varepsilon_t^2\) scad geometric, \(\rho_k = \rho_1 (\alpha+\beta)^{k-1}\)
\(\rho_k = \Corr(\varepsilon_t^2, \varepsilon_{t-k}^2)\): autocorelația pătratelor șocurilor la lagul \(k\)
\(\rho_1 = \alpha(1-\beta^2-\alpha\beta)/(1-\beta^2-2\alpha\beta)\) dacă \(\E\varepsilon_t^4 < \infty\) (Seminarul 5, A6)
S&P 500, GARCH-N estimat prin QMLE Gaussian (\(\hat\alpha = 0{,}120\), \(\hat\beta = 0{,}860\)): \(\rho_1 = 0{,}356\) și \(\rho_{10} = 0{,}298\), față de valorile empirice \(\hat\rho_1 = 0{,}313\) și \(\hat\rho_{10} = 0{,}248\)
De aceea \(\alpha+\beta\) se numește persistența volatilității
Procesul este staționar în covarianță (covariance stationary) dacă \(\alpha + \beta < 1\). Aplicînd media în (5.3), cu \(\mathbb{E}\varepsilon_{t-1}^2 = \mathbb{E}\sigma_{t-1}^2\), rezultă \(\mathbb{E}\sigma_t^2 = \omega + (\alpha+\beta)\,\mathbb{E}\sigma_{t-1}^2\); punînd \(\mathbb{E}\sigma_t^2 = \mathbb{E}\sigma_{t-1}^2\) se obține dispersia de termen lung
În capitol, \(\sigma^2\) notează această dispersie de termen lung a modelului (Seminarul 5 scrie \(\bar\sigma^2\)),\(\hat\sigma^2 = \hat\omega/(1-\hat\alpha-\hat\beta)\) estimarea ei, iar \(s^2\) dispersia de selecție a lui \(r_t\).
Cazul de frontieră \(\alpha + \beta = 1\) este GARCH-ul integrat, IGARCH (integrated GARCH). Dispersia lui necondiționată este infinită, și totuși procesul nu este neapărat exploziv. Dacă \(\alpha > 0\) și \(z_t^2\) nu este degenerată, procesul rămîne strict staționar: condiția lui Nelson (1990),\(\mathbb{E}\ln(\alpha z_t^2 + \beta) < 0\), este îndeplinită prin inegalitatea lui Jensen, deoarece \(\mathbb{E}\ln(\alpha z_t^2 + \beta) < \ln \mathbb{E}(\alpha z_t^2 + \beta) = \ln(\alpha+\beta) = 0\). Staționaritatea în covarianță și staționaritatea strictă se despart deci exact acolo unde se află estimările mai multor serii din acest capitol.
O variantă practică folosește (5.6) invers. Fixarea dispersiei (variance targeting) impune \(\omega = s^2 (1-\alpha-\beta)\), astfel încît dispersia de termen lung să fie egală cu dispersia de selecție și să se estimeze doar \(\alpha\) și \(\beta\).
Pe scurt
Staționaritate în covarianță: \(\alpha + \beta < 1\), caz în care
Derivare: luăm media în recursie, \(\E\sigma_t^2 = \omega + (\alpha+\beta)\,\E\sigma_{t-1}^2\), și impunem \(\E\sigma_t^2 = \E\sigma_{t-1}^2\)
IGARCH (Integrated GARCH): \(\alpha + \beta = 1\)
Dispersia necondiționată este infinită
Totuși, dacă \(\alpha > 0\) și \(z_t^2\) este nedegenerat, procesul rămîne strict staționar: condiția \(\E\ln(\alpha z_t^2 + \beta) < 0\)Nelson (1990) este îndeplinită din inegalitatea lui Jensen, deoarece \(\E\ln(\alpha z_t^2 + \beta) < \ln(\alpha+\beta) = 0\)
Notație: \(\sigma^2\) este dispersia de termen lung a modelului (în Seminarul 5: \(\bar\sigma^2\)), \(\hat\sigma^2 = \hat\omega/(1-\hat\alpha-\hat\beta)\) estimarea ei
\(s^2\) este dispersia de selecție a lui \(r_t\)
Fixarea țintei dispersiei (variance targeting): \(\omega = s^2 (1-\alpha-\beta)\), deci se estimează doar \(\alpha\) și \(\beta\)
Fixarea dispersiei de termen lung la dispersia de selecție
Cu inovații Normale, randamentele GARCH(1,1) au totuși cozi groase. Kurtosis-ul \(K = \mathbb{E}\varepsilon_t^4 / (\mathbb{E}\varepsilon_t^2)^2\), egal cu 3 pentru distribuția Normală și mai mare decît 3 pentru cozi groase, este
finit numai dacă \((\alpha+\beta)^2 + 2\alpha^2 < 1\); deducerea este exercițiul A4 din Seminarul 5. ARCH(1) este cazul \(\beta = 0\):\(K = 3(1-\alpha^2)/(1-3\alpha^2)\), finit numai dacă \(\alpha < 1/\sqrt{3}\) și mai mare decît 3 ori de cîte ori \(\alpha > 0\).
Pentru S&P 500, GARCH-N estimat pe 2000–2026 dă \(\hat\alpha = 0{,}120487\) și \(\hat\beta = 0{,}860062\). Condiția de moment \((\hat\alpha+\hat\beta)^2 + 2\hat\alpha^2 = 0{,}990509\) este puțin sub 1, iar (5.7) dă \(K = 12{,}2\), față de un kurtosis de selecție al randamentelor de 13,7 (exces de kurtosis 10,7). Aproape de frontiera momentului, numitorul din (5.7) este o diferență mică, iar \(K\) este foarte sensibil la rotunjirea estimărilor; Anexa arată cît de sensibil.
Volatility clustering generează deci, singur, o mare parte din cozile groase ale randamentelor zilnice. Inovațiile \(z_t\) cu cozi groase pot contribui în plus, dar diferența dintre 12,2 și 13,7 nu este o descompunere identificată a cozilor pe cele două surse.
Pe scurt
Cu \(z_t\) Normal, kurtosis-ul lui \(\varepsilon_t\) este \(K = \dfrac{3\,[1-(\alpha+\beta)^2]}{1-(\alpha+\beta)^2-2\alpha^2}\)
\(K = \E\varepsilon_t^4 / (\E\varepsilon_t^2)^2\): 3 pentru distribuția Normală, peste 3 pentru cozi groase
\(K\) este finit doar dacă \((\alpha+\beta)^2 + 2\alpha^2 < 1\) (Seminarul 5, A4)
ARCH(1) este cazul \(\beta = 0\): \(K = 3(1-\alpha^2)/(1-3\alpha^2)\), finit doar dacă \(\alpha < 1/\sqrt{3}\): cozi groase chiar cu inovații Normale
Graficul compară două serii simulate cu aceeași dispersie necondiționată, egală cu 1. Panoul de sus arată randamente Normale i.i.d.; panoul de jos o traiectorie GARCH(1,1) cu \(\omega = 0{,}02\),\(\alpha = 0{,}10\) și \(\beta = 0{,}88\), cu benzile \(\pm 2\sigma_t\). În versiunea interactivă, primul cursor fixează reacția la știri \(\alpha\), iar al doilea persistența \(\alpha + \beta\), cu \(\omega = 1 - \alpha - \beta\), astfel încît dispersia necondiționată să rămînă 1; ▶ modifică parametrii pas cu pas.
Întrebare pentru sală Inovațiile z sînt Normale. Au randamentele unui GARCH(1,1) cu α = 0,10 și β = 0,88 cozi groase?
Răspuns
Da, distribuția necondiționată a randamentelor are exces de kurtosis teoretic de aproximativ 3,06. Momentul de ordin patru este finit deoarece 0,98² + 2 × 0,10² = 0,9804 < 1. Distribuția condiționată este Normală; distribuția necondiționată combină dispersii diferite. Excesul estimat este 0,40 pe cele 2 000 de zile din pagină și 2,47 pe traiectoria de un milion de zile din curs: kurtosis se estimează imprecis pe eșantioane scurte.
Perioadele calme și exploziile de volatilitate apar numai pe traiectoria GARCH, deși ambele serii au aceeași dispersie necondiționată. Inovațiile GARCH sînt Normale, dar randamentele au cozi groase: un amestec de distribuții Normale cu dispersii diferite are cozi mai groase decît orice distribuție Normală luată singură. Pentru acești parametri, \((\alpha+\beta)^2 + 2\alpha^2 = 0{,}98^2 + 2\times0{,}10^2 = 0{,}9804 < 1\), deci momentul de ordin patru este finit, iar excesul de kurtosis teoretic este de circa 3,06.
Kurtosis-ul de selecție este aici un estimator slab. Pe traiectoria de 2 000 de zile a paginii, excesul de kurtosis estimat este 0,40, iar pe o traiectorie simulată de un milion de zile este 2,47 (Anexă). Un kurtosis calculat din cîțiva ani de date este o bază slabă pentru a judeca dacă un model reproduce cozile.
Prognoza pe mai mulți pași rezultă din (5.3) prin medii condiționate iterate. Deoarece \(\mathbb{E}[\varepsilon_{t+h-1}^2 \mid \mathcal{F}_t] = \mathbb{E}[\sigma_{t+h-1}^2 \mid \mathcal{F}_t]\) pentru \(h \geq 2\),
unde \(h\) este orizontul de prognoză în zile, iar \(\sigma_{t+1}^2\) dispersia pentru ziua următoare, cunoscută la momentul \(t\). Distanța dintre prognoză și dispersia de termen lung scade în fiecare zi cu factorul \(\alpha+\beta\).
Timpul de înjumătățire (half-life) este numărul de zile după care a dispărut jumătate dintr-un șoc de dispersie. Din \((\alpha+\beta)^{h} = 0{,}5\) rezultă
Timpul de înjumătățire este de 13,5 zile pentru \(\alpha+\beta = 0{,}95\), de 69 de zile pentru 0,99 și de 138 de zile pentru 0,995. Modificări mici ale lui \(\alpha+\beta\) aproape de 1 implică deci timpi de înjumătățire foarte diferiți, deoarece \(\ln(\alpha+\beta)\) tinde la zero în numitorul din (5.9). Incertitudinea estimării lui \(\alpha+\beta\) contează deci mult pentru orice afirmație despre cît durează un șoc; secțiunea următoare o cuantifică, iar exercițiile A2 și B4 din Seminarul 5 o tratează pas cu pas.
Pe scurt
Prognoza pe mai mulți pași: \(\E[\sigma_{t+h}^2 \mid \mathcal{F}_t] = \sigma^2 + (\alpha+\beta)^{h-1} (\sigma_{t+1}^2 - \sigma^2)\)
\(h\): orizontul prognozei, în zile
\(\sigma_{t+1}^2\): dispersia pentru ziua următoare, cunoscută la \(t\)
Distanța față de dispersia de termen lung scade cu factorul \(\alpha+\beta\) în fiecare zi
Timpul de înjumătățire: numărul de zile după care jumătate dintr-un șoc de dispersie a dispărut
Un GARCH(1,1) ilustrativ, neestimat pe niciun set de date, face concrete formulele de prognoză. Cu \(\omega = 0{,}04\),\(\alpha = 0{,}08\) și \(\beta = 0{,}90\), persistența este \(p = \alpha+\beta = 0{,}98\), dispersia de termen lung \(\sigma^2 = 0{,}04/0{,}02 = 2\), iar timpul de înjumătățire \(\ln 0{,}5/\ln 0{,}98 \approx 34{,}3\) zile. Să presupunem că o zi agitată lasă \(\sigma_{t+1}^2 = 4\), dublul nivelului de termen lung. După (5.8), prognoza pentru ziua a doua este \(2 + 0{,}98 \times (4 - 2) = 3{,}96\): distanța pînă la \(\sigma^2\) scade cu 2% pe zi.
Riscul pe \(H\) zile cere dispersia sumei a \(H\) randamente zilnice. Șocurile zilnice sînt necorelate, deci această dispersie este suma prognozelor zilnice ale dispersiei, o sumă geometrică:
Pentru \(H = 5\),\(V_5 = 10 + 2 \times (1-0{,}98^5)/0{,}02 = 10 + 2 \times 4{,}804 = 19{,}61\). Regula rădăcinii pătrate a timpului (square-root-of-time rule), \(V_H = H\,\sigma_{t+1}^2\), care face volatilitatea pe \(H\) zile egală cu \(\sqrt{H}\) ori volatilitatea pe o zi, dă \(5 \times 4 = 20\): prea mult, deoarece ignoră scăderea prognozelor spre \(\sigma^2\).
După o zi calmă, \(\sigma_{t+1}^2 = 1\), aceeași formulă dă \(V_5 = 10 - 4{,}804 = 5{,}20\), peste valoarea dată de regulă, \(5 \times 1 = 5\). Acum regula dă prea puțin, ca în exemplul S&P 500 din secțiunea despre prognoze. Direcția erorii depinde numai de semnul lui \(\sigma_{t+1}^2 - \sigma^2\).
Regula rădăcinii pătrate a timpului, \(V_H = H\,\sigma_{t+1}^2\) (volatilitatea pe \(H\) zile este \(\sqrt{H}\) ori cea de o zi), dă \(5 \times 4 = 20\), prea mult
Exercițiu: refaceți calculul pentru \(H = 5\) după o zi calmă, \(\sigma_{t+1}^2 = 1\)
Răspuns: \(V_5 = 10 - 4{,}804 = 5{,}20 > 5\)
Deci acum regula subestimează, ca în cazul S&P 500 din secțiunea Prognoze
cu factorul de descreștere (decay factor) \(\lambda \in (0,1)\), fixat la \(\lambda = 0{,}94\) pentru date zilnice și randamente de medie zero. Ponderile pătratelor randamentelor trecute, \((1-\lambda)\lambda^{j-1}\), scad geometric, deci zilele cele mai recente contează cel mai mult. Comparația cu (5.3) arată că EWMA este un IGARCH(1,1) cu \(\omega = 0\),\(\alpha = 1-\lambda\) și \(\beta = \lambda\), fără niciun parametru de estimat.
Cele trei modele diferă prin prognozele pe mai mulți pași. Fie \(\mathbb{E}_t[\cdot] = \mathbb{E}[\cdot \mid \mathcal{F}_t]\) media condiționată de informația de la închiderea zilei \(t\). Sub EWMA prognoza este constantă, \(\mathbb{E}_t\sigma_{t+h}^2 = \sigma_{t+1}^2\) pentru orice \(h\). Sub IGARCH cu \(\omega > 0\) ea crește liniar, \(\mathbb{E}_t\sigma_{t+h}^2 = \sigma_{t+1}^2 + (h-1)\,\omega\). Sub un GARCH staționar ea este atrasă spre \(\sigma^2\) cu rata \(\alpha+\beta\), după (5.8).
Numai GARCH-ul staționar are revenire la medie: celelalte două duc nivelul de azi, sau mai mult, la orice orizont. EWMA servește drept reper fără parametri estimați în compararea prognozelor din secțiunea despre evaluarea prognozelor.
GARCH staționar: converge spre \(\sigma^2\) cu rata \(\alpha+\beta\)
EWMA servește drept reper în comparația prognozelor
Sinteza secțiunii
GARCH(1,1) descrie volatility clustering cu trei parametri. Persistența lui, \(\alpha+\beta\), determină scăderea autocorelațiilor pătratelor șocurilor, viteza revenirii la medie și timpul de înjumătățire; condiția \(\alpha+\beta < 1\) dă o dispersie finită, iar condiția mai tare \((\alpha+\beta)^2 + 2\alpha^2 < 1\) un kurtosis finit. EWMA este cazul particular fără revenire la medie. Secțiunea următoare estimează parametrii și măsoară cît de precis sînt cunoscuți.
Estimare și incertitudine
Parametrii unui model GARCH se estimează prin verosimilitate maximă, numeric, sub restricții de semn și de staționaritate. Din secțiunea precedentă decurg trei întrebări. Ce verosimilitate se folosește cînd inovațiile nu sînt Normale? Cît de precise sînt funcțiile de parametri, cum este timpul de înjumătățire, cînd persistența este aproape de 1? Cum se testează ipotezele cînd valoarea nulă se află pe frontiera spațiului parametrilor, ca la IGARCH? Secțiunea răspunde la ele pe S&P 500.
Estimarea prin verosimilitate maximă (MLE, maximum likelihood estimation) a lui \(\theta = (\mu, \omega, \alpha, \beta)\) se sprijină pe o observație simplă: dat \(\theta\), recursia (5.3) produce întreaga traiectorie \(\sigma_1^2(\theta), \ldots, \sigma_n^2(\theta)\). Fiecare zi contribuie cu densitatea lui \(\varepsilon_t = r_t - \mu\) condiționată de trecut, deci verosimilitatea se factorizează în timp. Cu inovații Normale, log-verosimilitatea este
Maximul nu are formă închisă. El se găsește prin optimizare numerică sub \(\omega>0\),\(\alpha,\beta\geq 0\) și \(\alpha+\beta\leq 1\). Pachetul Python `arch` impune \(\alpha+\beta \leq 1\), o mulțime închisă, așa că o estimare poate sta exact pe frontieră; așa se întîmplă la Bitcoin și EUR/RON în tabelul celor șase piețe.
Două detalii practice contează:
Recursia are nevoie de o valoare de pornire: \(\sigma_1^2\) este o estimare inversă (backcast) din primele pătrate ale reziduurilor, iar efectul ei se stinge cu rata \(\beta\).
Scala contează pentru optimizator: randamentele se măsoară în procente, astfel încît dispersia să fie de ordinul lui 1. EUR/RON are o abatere standard zilnică de circa 0,28%, deci se estimează pe \(10\,r_t\); pe randamentele nescalate, optimizatorul se oprește într-un optim local.
Pe scurt
Maximum Likelihood Estimation (MLE) a parametrilor \(\theta = (\mu, \omega, \alpha, \beta)\)
Dat fiind \(\theta\), recursia produce \(\sigma_1^2(\theta), \ldots, \sigma_n^2(\theta)\)
Fiecare zi contribuie cu densitatea lui \(\varepsilon_t\) condiționată de trecut: verosimilitatea se factorizează în timp
Fără formulă explicită: optimizare numerică sub restricțiile \(\omega>0\), \(\alpha,\beta\geq 0\), \(\alpha+\beta\leq 1\)
Pachetul arch impune \(\alpha+\beta \leq 1\), o mulțime închisă: o estimare poate fi chiar pe frontieră (Bitcoin și EUR/RON în tabelul celor șase piețe)
Inițializarea: \(\sigma_1^2\) este o valoare de pornire (backcast) din primele pătrate ale reziduurilor, al cărei efect dispare cu rata \(\beta\)
Scalarea: randamente în %, astfel încît dispersia să fie de ordinul 1
EUR/RON are o abatere standard zilnică de circa 0,28%, așa că se estimează pe \(10\,r_t\); pe randamentele nescalate, optimizatorul se oprește într-un optim local
Distribuția Normală pentru \(z_t\) este o alegere comodă, dar restrictivă. Trei alternative sînt standard, fiecare rescalată la dispersia 1. Inovația Student-t a lui Bollerslev (1987) este \(z_t = \sqrt{(\nu-2)/\nu}\; t_\nu\), unde \(t_\nu\) este o variabilă Student-t standard cu dispersia \(\nu/(\nu-2)\), astfel încît \(z_t\) are dispersia 1 pentru \(\nu > 2\). Gradele de libertate \(\nu\) controlează cozile: cu cît \(\nu\) este mai mic, cu atît cozile sînt mai groase, iar momentul de ordin patru există numai pentru \(\nu > 4\).
Distribuția skewed-t a lui Hansen (1994) adaugă un parametru de asimetrie \(\lambda \in (-1, 1)\); pentru \(\lambda < 0\) coada stîngă este mai lungă, deci pierderile mari sînt mai probabile decît cîștigurile mari. Distribuția erorii generalizate (GED, generalised error distribution) a lui Nelson (1991) are densitatea proporțională cu \(\exp(-\tfrac{1}{2}|z/\lambda_\nu|^{\nu})\), cu parametrul de formă \(\nu > 0\) și o constantă de scală \(\lambda_\nu\) care dă dispersia 1. Cazul \(\nu = 2\) este distribuția Normală, \(\nu = 1\) distribuția Laplace, iar \(\nu < 2\) dă cozi mai groase.
unde \(\Gamma\) este funcția gamma, iar \(\nu > 2\) gradele de libertate ale inovației de dispersie 1. Pentru \(\nu \to \infty\),\(\ell_t\) converge la contribuția Normală din (5.12).
Student-t este alegerea implicită dintr-un motiv practic: un singur parametru suplimentar, \(\nu\), dă cozi groase simetrice. Ultimul termen din (5.13) crește doar logaritmic în \(\varepsilon_t^2\), în timp ce termenul Normal \(\varepsilon_t^2/\sigma_t^2\) crește liniar, așa că o singură zi extremă influențează mai puțin estimările Student-t.
Pe scurt
Contribuția zilei \(t\) la log-verosimilitatea GARCH-t, modelul de bază al capitolului (\(\varepsilon_t = r_t - \mu\))
Estimatorul de cvasi-verosimilitate maximă Gaussian (QMLE Gaussian) maximizează verosimilitatea Normală (5.12) chiar dacă \(z_t\) nu este Normală (Bollerslev & Wooldridge, 1992).\(\ell(\theta)\) Normală se folosește drept criteriu de estimare, nu drept afirmație despre distribuția lui \(z_t\). Fie \(\theta_0\) valoarea adevărată a parametrului, iar \(\hat\theta\) estimarea, punctul de maxim al lui \(\ell\).
Pentru GARCH(1,1), QMLE este consistent, \(\hat\theta \to \theta_0\) cînd \(n \to \infty\), în patru condiții date de Berkes, Horváth & Kokoszka (2003) și Francq & Zakoïan (2004). Procesul trebuie să fie strict staționar, \(\mathbb{E}\ln(\alpha z_t^2 + \beta) < 0\). Valoarea adevărată \(\alpha_0\) trebuie să fie pozitivă, altfel \(\beta\) nu este identificat, iar \(\beta_0 < 1\). Valoarea adevărată trebuie să se afle într-o mulțime de parametri compactă, închisă și mărginită, iar \(z_t^2\) să nu fie degenerată, adică să nu fie o constantă.
Consistența nu cere nicio condiție de moment asupra lui \(\varepsilon_t\), deci este valabilă și pentru IGARCH. Condițiile de moment intervin abia la pasul următor, distribuția asimptotică și erorile standard, tratate în Aprofundări.
Tabelul prezintă estimările GARCH(1,1)-t pentru S&P 500, 2000–2026: \(\hat\omega = 0{,}0157\),\(\hat\alpha = 0{,}122\),\(\hat\beta = 0{,}872\),\(\hat\nu = 6{,}25\) și o medie \(\hat\mu = 0{,}079\%\) pe zi. Erorile standard robuste sînt apropiate de cele clasice: raportul este 1,06 pentru \(\hat\alpha\) și 1,08 pentru \(\hat\beta\). Tabelul complet, cu toate erorile standard, este în exercițiul B1 din Seminarul 5.
Estimările au o interpretare clară:
Valoarea mare a lui \(\hat\beta\) arată că domină memoria dispersiei trecute;
\(\hat\alpha\) este o reacție moderată la știri;
\(\hat\nu = 6{,}25\) grade de libertate indică cozi mult mai groase decît la distribuția Normală.
Persistența \(\hat\alpha+\hat\beta = 0{,}9948\) dă, după (5.9), un timp de înjumătățire de 132 de zile.
Volatilitatea de termen lung implicată este \(\sqrt{251{,}5\,\hat\omega/(1-\hat\alpha-\hat\beta)} = 27{,}4\%\) pe an, unde \(A = 251{,}5\) este numărul de randamente pe an. Ea se află mult peste volatilitatea de selecție de 19,2%. Motivul este numitorul din (5.6): împărțirea la \(1-\hat\alpha-\hat\beta\), un număr mic și estimat imprecis, face imprecis și nivelul de termen lung, cum arată cadrele următoare.
Pe scurt
Parametru
Estimare
SE (Standard Error, eroare standard) robustă
SE clasică
Raport
\(\omega\)
0,0157
\(\alpha\)
0,122
0,0107
0,0101
1,06
\(\beta\)
0,872
0,0103
0,0096
1,08
\(\nu\)
6,25
0,48
\(\alpha+\beta\)
0,9948
Media \(\hat\mu = 0{,}079\)% pe zi
SE (Standard Error): eroarea standard; Raport = SE robustă / SE clasică
Metoda delta (delta method) aproximează eroarea standard a unei funcții netede de parametri prin liniarizarea ei în jurul estimării. Graficul arată ce face această aproximare cu timpul de înjumătățire \(h(p) = \ln 0{,}5/\ln p\) al S&P 500, unde \(p = \alpha+\beta\). În versiunea interactivă, cursorul mută persistența \(p\) între 0,975 și 0,99995; panoul din stînga arată curba timpului de înjumătățire și tangenta metodei delta în punctul \(p\) ales, iar panoul din dreapta volatilitatea de termen lung implicată. Butonul ▶ mută \(p\) spre 1.
Întrebare pentru sală Timpul de înjumătățire estimat pentru S&P 500 este 132 de zile, cu o eroare standard de 118 zile, iar 132 ± 1,96 × 118 are limita inferioară −99 de zile. Înlocuim această limită negativă cu zero. Obținem astfel un interval cu acoperire de aproximativ 95% justificată?
Răspuns
Nu. Eliminarea valorilor negative nu justifică acoperirea intervalului. Problema este curbura lui h(p) lîngă 1: tangenta metodei delta coboară sub zero. Transformarea porțiunii p < 1 din intervalul pentru persistență, [0,9856; 1,0039], dă o limită inferioară de circa 48 de zile și nicio limită superioară finită; valorile p ≥ 1 nu descriu înjumătățirea unui șoc.
În estimarea \(\hat p = 0{,}994769\), curba \(h(p)\) este foarte abruptă și convexă, iar tangenta coboară sub zero în interiorul intervalului de 95% pentru \(p\). Intervalul simetric al metodei delta pentru timpul de înjumătățire, 132 ± 1,96 × 118 zile, are capătul inferior la −99 de zile. Trunchierea lui la zero nu repară acoperirea, deoarece problema este curbura lui \(h(p)\) aproape de 1, nu semnul capătului. Cadrul următor dă cifrele și alternativa.
Fie \(g(\theta)\) o funcție netedă de parametri, cu gradientul \(\nabla g\), de exemplu volatilitatea de termen lung sau timpul de înjumătățire. Metoda delta îi aproximează eroarea standard prin
\[\widehat{\mathrm{SE}}\,g(\hat\theta) \approx \sqrt{\nabla g^\top \hat V \nabla g},\]
(5.14)
unde \(\hat V\) este matricea de covarianță robustă a lui \((\hat\omega, \hat\alpha, \hat\beta)\). Pentru S&P 500, volatilitatea de termen lung este 27,4% pe an, cu o eroare standard de 11,0 puncte procentuale.
Pentru timpul de înjumătățire, \(h = \ln 0{,}5/\ln p\), cu \(p = \alpha+\beta\). În \(\hat p = 0{,}994769\), derivata este \(\partial h/\partial p = 25\,330\). Cu \(\widehat{\mathrm{SE}}(\hat p) = 0{,}0047\),(5.14) dă \(\widehat{\mathrm{SE}}(\hat h) \approx 118\) zile, iar \(\hat h \pm 1{,}96\,\widehat{\mathrm{SE}}\) conține timpi de înjumătățire negativi. Liniarizarea eșuează, pentru că \(h(p)\) este departe de a fi liniară pe domeniul valorilor plauzibile ale lui \(p\).
Remediul este construirea intervalului acolo unde estimatorul este aproximativ Normal, pentru \(p\), și transformarea lui. Intervalul de 95% \([0{,}9856; 1{,}0039]\) pentru \(p\) dă \(h \in [48; \infty)\) zile: timpul de înjumătățire este de cel puțin circa șapte săptămîni, fără o limită superioară finită, deoarece intervalul conține \(p = 1\). Dacă \(p = 1\) este plauzibil este o întrebare separată, care cere un test pe frontiera spațiului parametrilor.
Pe scurt
\(g(\theta)\): o funcție netedă de parametri, cu gradientul \(\nabla g\)
De exemplu volatilitatea de termen lung sau timpul de înjumătățire
Metoda delta: \(\widehat{\mathrm{SE}}\,g(\hat\theta) \approx \sqrt{\nabla g' \hat V \nabla g}\), cu \(\hat V\) covarianța robustă a lui \((\hat\omega, \hat\alpha, \hat\beta)\)
Pentru timpul de înjumătățire: \(p = \alpha+\beta\) și \(h = \ln 0{,}5/\ln p\)
Volatilitatea de termen lung este 27,4% anual, cu SE de 11,0 puncte procentuale
Timpul de înjumătățire: \(\partial h/\partial p = 25\,330\) la \(\hat p = 0{,}994769\)
\(\widehat{\mathrm{SE}}(\hat p) = 0{,}0047\), deci \(\widehat{\mathrm{SE}}(\hat h) \approx 118\) zile
\(\hat h \pm 1{,}96\,\widehat{\mathrm{SE}}\) conține timpi de înjumătățire negativi: liniarizarea eșuează
Transformăm în schimb intervalul pentru \(p\): \([0{,}9856; 1{,}0039]\) dă \(h \in [48; \infty)\)
Plauzibilitatea lui \(p = 1\) cere un test la frontieră (slide-urile următoare)
Statistica raportului de verosimilitate (LR, likelihood ratio) este \(LR = 2(\ell_1 - \ell_0)\), unde \(\ell_1\) și \(\ell_0\) sînt log-verosimilitățile maximizate fără și cu restricție. Distribuția ei sub ipoteza nulă depinde de locul valorii restrînse. Pentru o restricție interioară, cum este \(\gamma = 0\) în GJR față de GARCH, cu \(\alpha > 0\), se aplică \(\chi^2_1\) obișnuit, cu valoarea critică de 5% egală cu 3,84.
Cînd un parametru se află pe frontieră sub \(H_0\), iar ceilalți sînt identificați și interiori, limita este amestecul \(\tfrac12\chi^2_0 + \tfrac12\chi^2_1\) al lui Self & Liang (1987) și Andrews (2001). Cu probabilitatea 1/2, estimarea stă pe frontieră și \(LR = 0\), altfel \(LR\) este \(\chi^2_1\). Valoarea critică de 5% este 2,71. Aici intră două cazuri din capitol: inovații Normale față de Student-t, unde \(H_0\) este \(1/\nu = 0\), și IGARCH, \(\alpha + \beta = 1\).
Alte două cazuri au limite nestandard, care trebuie simulate. Dacă \(H_0\) lasă un parametru de deranj (nuisance parameter) neidentificat, ca în testul absenței efectelor ARCH, \(\alpha = 0\), care lasă \(\beta\) nedefinit, limita este nestandard (Andrews, 2001). Dacă mai multe frontiere sînt active simultan, de exemplu GJR cu \(\alpha_0 = 0\) sub \(H_0\) și un test al lui \(\gamma = 0\), limita este din nou nestandard. În GJR, \(\gamma\) este reacția suplimentară a dispersiei la șocurile negative, introdusă în secțiunea despre asimetrie.
Legea statisticii LR depinde de parametrul adevărat sub \(H_0\), nu de estimarea sub alternativă. Pe S&P 500, GARCH-t estimat sub \(\gamma = 0\) are \(\hat\alpha = 0{,}122 > 0\). O estimare \(\hat\alpha = 0\) în GJR afectează statistica Wald \(t\) pentru \(\alpha\), dar nu în mod automat legea LR pentru \(\gamma = 0\).
Pe scurt
Situația sub \(H_0\)
Exemplu
Likelihood Ratio (LR): \(LR = 2(\ell_1 - \ell_0)\)
Valoare critică 5%
Restricție interioară
GJR (GARCH asimetric) față de GARCH, \(\gamma = 0\) (cu \(\alpha > 0\))
\(\chi^2_1\)
3,84
Un parametru pe frontieră, ceilalți identificați și interiori
Normală față de Student-t (\(1/\nu = 0\)), IGARCH (\(\alpha + \beta = 1\))
GJR: \(\gamma\) este reacția suplimentară a dispersiei la șocurile negative (secțiunea Asimetrie)
Legea LR depinde de parametrul adevărat sub \(H_0\), nu de estimarea alternativei: pe S&P 500, GARCH-t estimat sub \(\gamma = 0\) are \(\hat\alpha = 0{,}122 > 0\)
\(\hat\alpha = 0\) în GJR afectează statistica Wald \(t\) pentru \(\alpha\), nu automat legea LR pentru \(\gamma = 0\)
Testarea la frontieră (2/2): de ce IGARCH este un caz de frontieră
IGARCH se află pe frontieră numai pentru că estimarea impune \(\alpha+\beta \leq 1\), cum face `arch`. Sub \(H_0\colon \alpha+\beta = 1\), estimarea nerestrînsă ar depăși 1 în circa jumătate din cazuri; restricția o fixează la 1, iar atunci \(LR = 0\). De aici provin amestecul și valoarea critică 2,71.
Fără această restricție, \(\alpha+\beta = 1\) se află în interiorul regiunii de staționaritate strictă, QMLE este și acolo asimptotic Normal (Lumsdaine, 1996), iar statistica LR s-ar compara cu \(\chi^2_1\), cu valoarea critică 3,84. Normalitatea QMLE nu ajunge însă pentru un test de cvasi-LR: limita \(\chi^2_1\) cere o densitate corect specificată sau o statistică corectată.
Testele Wald au propria problemă la frontieră. O statistică Wald \(t\) pentru o estimare aflată pe frontieră, cum este \(\hat\alpha = 0\), nu este \(N(0,1)\). Un bootstrap parametric pornit din \(\hat\theta\) este inconsistent cînd \(\theta_0\) se află pe frontieră (Andrews, 2000); eșantioanele bootstrap trebuie simulate sub \(H_0\). Testele pe datele capitolului sînt în Aprofundări.
Pe scurt
IGARCH este pe frontieră doar pentru că estimarea impune \(\alpha+\beta \leq 1\), ca în arch
Sub \(H_0\colon \alpha+\beta = 1\), estimarea nerestricționată ar depăși 1 în circa jumătate din cazuri
Restricția o fixează la 1 și atunci \(LR = 0\): de aici amestecul și pragul 2,71
Fără această restricție, \(\alpha+\beta = 1\) se află în interiorul regiunii de staționaritate strictă, QMLE rămîne asimptotic Normal acolo Lumsdaine (1996), iar LR s-ar compara cu \(\chi^2_1\) (3,84)
Normalitatea QMLE nu ajunge pentru un quasi-LR: legea \(\chi^2_1\) cere densitatea corect specificată sau o corecție a statisticii
Testul Wald \(t\) pentru o estimare la limită (de ex. \(\hat\alpha = 0\)) nu este \(N(0,1)\)
Bootstrap-ul parametric din \(\hat\theta\) (eșantioane simulate din modelul estimat) este inconsistent cînd \(\theta_0\) este pe frontieră Andrews (2000)
Parametrii GARCH se estimează maximizînd o verosimilitate Normală sau Student-t; QMLE Gaussian este consistent fără condiții de moment. Pentru S&P 500, persistența este 0,9948, iar timpul de înjumătățire 132 de zile, dar metoda delta eșuează aproape de \(p = 1\): un interval transformat din cel pentru \(p\) dă un timp de înjumătățire de cel puțin 48 de zile, fără limită superioară finită. Testele pentru IGARCH și pentru inovații Normale față de Student-t folosesc valoarea critică a amestecului, 2,71, cînd estimarea este restrînsă la spațiul parametrilor.
Prognoze și rezultate pe piețe
Această secțiune folosește estimările pentru prognoză:
Un exemplu lucrat pe S&P 500 calculează de mînă prognozele pe o zi și pe zece zile;
Structura la termen a volatilității le extinde pînă la un an;
Tabelul celor șase piețe și graficul persistenței compară estimările între piețe;
Comparația cu VIX (CBOE Volatility IndeX, indicele de volatilitate CBOE) pune volatilitatea GARCH lîngă prognoza pieței înseși.
Estimările GARCH(1,1)-t pentru S&P 500 sînt \(\hat\omega = 0{,}0157\),\(\hat\alpha = 0{,}122\),\(\hat\beta = 0{,}872\) și \(\hat\mu = 0{,}079\), cu persistența \(\hat p = \hat\alpha+\hat\beta = 0{,}994769\). Funcțiile de \(1 - \hat p\) trebuie calculate din estimările nerotunjite: cu valorile rotunjite afișate, \(1-\hat p = 0{,}006\), iar dispersia de termen lung ar fi 2,62 în loc de 3,00.
Ultima zi a eșantionului este \(T\) = 18 septembrie 2026. Reziduul este \(\hat\varepsilon_T = r_T - \hat\mu = 0{,}088\), iar dispersia filtrată este \(\hat\sigma_T^2 = 0{,}565\); dispersia filtrată este recursia (5.3) rulată pe tot eșantionul cu \(\hat\theta\) și citită în ultima zi. Prognoza pe o zi este atunci
adică 11,3% pe an. Ultima zi a fost calmă, așa că \(\hat\sigma_{T+1}^2\) se află mult sub nivelul de termen lung, iar prognozele pentru zilele următoare vor crește.
După nouă zile prognoza abia s-a îndepărtat de valoarea pe o zi, cum implică un timp de înjumătățire de 132 de zile.
Dispersia pe zece zile este suma prognozelor zilnice, \(\sum_{h=1}^{10} \hat\sigma_{T+h}^2 = 5{,}67\), adică o volatilitate pe zece zile de 2,38%. În formă închisă, după (5.10),\(10\,\hat\sigma^2 + (\hat\sigma_{T+1}^2 - \hat\sigma^2)\,(1-\hat p^{10})/(1-\hat p) = 29{,}95 + (0{,}509 - 2{,}995) \times 9{,}768 = 5{,}67\).
Regula rădăcinii pătrate a timpului dă \(\sqrt{10}\times0{,}714 = 2{,}26\%\). Aici ea dă prea puțin, deoarece \(\hat\sigma_{T+1}^2 < \hat\sigma^2\), iar volatilitatea este prognozată să crească; după o zi agitată, aceeași regulă ar da prea mult, ca în exemplul numeric.
Pe scurt
Dispersia de termen lung \(\hat\sigma^2 = \hat\omega/(1-\hat\alpha-\hat\beta) = 3{,}00\)
Ziua 10: \(\hat\sigma^2 + (\hat\alpha+\hat\beta)^{9}(\hat\sigma_{T+1}^2 - \hat\sigma^2)\)
Dispersia pe 10 zile \(\sum_{h=1}^{10} \hat\sigma_{T+h}^2 = 5{,}67\), volatilitatea 2,38%
Suma în formă închisă (exemplul numeric din secțiunea despre persistență): \(10\,\hat\sigma^2 + (\hat\sigma_{T+1}^2 - \hat\sigma^2)\,(1-\hat p^{10})/(1-\hat p)\)
Regula rădăcinii pătrate a timpului dă \(\sqrt{10}\times0{,}714 = 2{,}26\)% (\(\hat\sigma_{T+1} = 0{,}714\)%): o subestimare, deoarece \(\hat\sigma_{T+1}^2 < \hat\sigma^2\) și volatilitatea este prognozată în creștere
Structura la termen a volatilității (volatility term structure) arată, pentru fiecare orizont \(h\), volatilitatea medie prognozată pe următoarele \(h\) zile, dintr-o origine fixă, cu GARCH(1,1)-t. Ea se calculează ca \(\sqrt{A \cdot h^{-1}\sum_{j=1}^{h}\mathbb{E}_t[\sigma_{t+j}^2]}\), cu \(A\) numărul de randamente pe an: întîi se mediază prognozele zilnice ale dispersiei, apoi se extrage rădăcina pătrată. Linia punctată este nivelul de termen lung. În versiunea interactivă, cursorul mută originea prognozei pe ultimele zile ale lunilor, iar ▶ o deplasează înainte în timp.
Întrebare pentru sală Pe 18.09.2026, volatilitatea S&P 500 prognozată de GARCH(1,1)-t pentru ziua următoare este 11,3% pe an, iar la orizontul de 250 de zile curba arată 20,1%. Ce reprezintă valoarea de 20,1%?
Răspuns
Pagina calculează √(A · H−1 Σj=1H Et[σ2t+j]), unde A este numărul de randamente pe an. Media se face înainte de extragerea rădăcinii. La H = 250 rezultă 20,1%; valoarea nu este nici media volatilităților, nici volatilitatea ultimei zile. Prognoza crește spre nivelul de termen lung, 27,4%, pentru că nivelul curent este sub el. La aur curba scade de la 24,0% la 22,5%; la Bitcoin α̂ + β̂ = 1, iar valoarea la 250 de zile este 108,3%.
Din 18 septembrie 2026, curba S&P 500 crește de la 11,3% pentru ziua următoare la 20,1% în medie pe 250 de zile, spre nivelul ei de termen lung de 27,4%, deoarece volatilitatea curentă se află sub acesta. Valoarea de 20,1% nu este nici volatilitatea din ziua 250, nici o medie a volatilităților zilnice, ci rădăcina pătrată anualizată a dispersiei medii. Aurul, a cărui volatilitate curentă este peste nivelul de termen lung, are o curbă descrescătoare, de la 24,0% la 22,5%.
Pe scurt
Volatilitatea medie pe următoarele \(h\) zile, prognozată din 18.09.2026 (GARCH(1,1)-t)
Punctat: nivelul de termen lung
S&P 500: de la 11,3% pentru ziua următoare la 20,1% în medie pe 250 de zile
Pentru Bitcoin și EUR/RON, estimarea atinge frontiera \(\hat\alpha+\hat\beta = 1\), cazul IGARCH, cu \(\hat\omega > 0\); pentru EUR/RON, \(\hat\omega \approx 5\cdot10^{-8}\) în %\(^2\). După prognoza IGARCH din cadrul despre EWMA, prognoza dispersiei crește atunci liniar, cu \(\hat\omega\) pe zi, fără un nivel de termen lung spre care să revină.
Pentru Bitcoin, prognoza este 54,1% pentru ziua următoare și 108,3% în medie pe 250 de zile, circa opt luni calendaristice, deoarece Bitcoin se tranzacționează în fiecare zi. EUR/RON nu apare pe grafic. Această creștere nemărginită este o proprietate a estimării de frontieră, nu o prognoză utilizabilă.
Consecința ajunge în capitolele următoare. În backtesting-ul din Capitolul 8, prognozele GARCH nu sînt folosite în zilele în care estimarea nu este admisibilă: la Bitcoin în 1 660 din 3 384 de zile de evaluare, la EUR/RON în 20 din 4 352.
Pe scurt
Bitcoin și EUR/RON: estimarea atinge frontiera \(\hat\alpha+\hat\beta = 1\) (IGARCH)
Cu \(\hat\omega > 0\) (la EUR/RON, \(\hat\omega \approx 5\cdot10^{-8}\) în %\(^2\))
Deci prognoza dispersiei crește liniar cu \(\hat\omega\) pe zi
Bitcoin: 54,1% pentru ziua următoare, 108,3% în medie pe 250 de zile (circa 8 luni calendaristice)
EUR/RON nu apare în grafic
Această creștere nelimitată nu este o prognoză utilizabilă
În Capitolul 8, prognozele GARCH sînt retrase în zilele în care estimarea nu este admisibilă
Tabelul prezintă estimările GARCH(1,1)-t pentru cele șase serii. Volatilitatea de termen lung este în procente pe an, fiecare serie fiind anualizată cu propriul număr de observații pe an, și nu se raportează cînd \(\hat\alpha+\hat\beta \geq 0{,}999\). Pentru EUR/RON, \(\hat\omega\) este în %\(^2\), după estimarea pe \(10\,r_t\).
S&P 500, BET și aurul au persistența între 0,99 și 0,995, cu timpi de înjumătățire de 132, 74 și 109 zile. BET reacționează mai puternic la știri decît S&P 500, \(\hat\alpha = 0{,}192\) față de 0,122, și uită mai repede, \(\hat\beta = 0{,}799\) față de 0,872. BET-TR se deosebește, cu persistența 0,9188 și un timp de înjumătățire de 8 zile, dar acoperă doar 2014–2026; o comparație cu BET cere același eșantion. Bitcoin și EUR/RON stau pe frontiera IGARCH.
Gradele de libertate sînt toate mici: de la 3,18 la Bitcoin la 6,25 la S&P 500. La Bitcoin, \(\hat\nu < 4\) înseamnă că momentul de ordin patru al inovațiilor este infinit sub legea estimată, cu consecințe pentru inferență discutate în Aprofundări. Estimarea pentru EUR/RON este dominată de o singură zi: la 6 mai 2025, o variație de +1,20%, după zile de ±0,004%, dă un reziduu standardizat de 154. Tabelul susține o descriere a celor șase piețe.
Pe scurt
Serie
\(\hat\omega\)
\(\hat\alpha\)
\(\hat\beta\)
\(\hat\alpha+\hat\beta\)
\(h_{1/2}\) (zile)
\(\hat\nu\)
Vol. termen lung
S&P 500
0,0157
0,122
0,872
0,9948
132
6,25
27,4
BET
0,0448
0,192
0,799
0,9907
74
5,01
34,7
BET-TR
0,0755
0,206
0,713
0,9188
8
5,02
15,2
Bitcoin
0,1937
0,109
0,891
1,0000
\(\infty\)
3,18
–
EUR/RON
0,0000
0,123
0,877
1,0000
\(\infty\)
4,20
–
Aur
0,0107
0,050
0,944
0,9936
109
4,52
21,0
Volatilitatea de termen lung în % anual, fiecare serie anualizată cu frecvența ei
Semnul – apare cînd \(\hat\alpha+\hat\beta \geq 0{,}999\)
EUR/RON: \(\hat\omega\) în %\(^2\), după estimarea pe \(10\,r_t\)
S&P 500, BET și aur: persistență 0,99–0,995
BET reacționează mai puternic la știri (\(\hat\alpha = 0{,}192\)) și are o memorie mai scurtă decît S&P 500
BET-TR acoperă doar 2014–2026: comparația cu BET cere același eșantion
EUR/RON: pe 6 mai 2025, o variație de \(+\)1,20% după zile de \(\pm\)0,004% dă un reziduu standardizat de 154
Graficul reprezintă \((\hat\alpha+\hat\beta)^h\), partea dintr-un șoc de dispersie rămasă după \(h\) zile, pentru fiecare piață; linia întreruptă marchează jumătatea, deci fiecare curbă o traversează la timpul de înjumătățire din tabelul celor șase piețe. În versiunea interactivă, cursorul fixează orizontul \(h\) între 0 și 250 de zile, iar afișajul dă partea rămasă pe fiecare piață; ▶ mută orizontul înainte.
Întrebare pentru sală Dublăm mărimea șocului inițial de dispersie, păstrînd parametrii GARCH. Ce se întîmplă cu timpul său de înjumătățire?
Răspuns
Rămîne neschimbat. Efectul rămas este proporțional cu mărimea șocului inițial, dar fracția rămasă este ph. Timpul de înjumătățire depinde de p, nu de amplitudine: circa 132 de zile la S&P 500 și 8,18 zile la BET-TR. După 100 de zile rămîn 59% din șoc la S&P 500 și practic nimic la BET-TR. La Bitcoin și EUR/RON α̂ + β̂ = 1, deci în model șocurile nu se disipă.
Partea rămasă depinde numai de persistență, nu de mărimea șocului inițial. După 100 de zile rămîne 59% dintr-un șoc la S&P 500 și practic nimic la BET-TR, al cărui timp de înjumătățire este de 8,18 zile. La Bitcoin și EUR/RON curba rămîne la 1: în model, șocurile nu se disipă niciodată.
Persistența estimată mare are și o explicație alternativă. Salturile de nivel ale volatilității, cum este o schimbare de regim, pot imita o persistență mare într-un model GARCH estimat pe tot eșantionul (Lamoureux & Lastrapes, 1990); modelele ARCH cu schimbare de regim (Hamilton & Susmel, 1994) le separă. Timpii de înjumătățire trebuie deci raportați ca intervale, ca în exercițiul B4 din Seminarul 5, nu ca numere unice.
Pe scurt
\((\hat\alpha+\hat\beta)^h\): partea dintr-un șoc de dispersie rămasă după \(h\) zile
linia întreruptă: o jumătate
Timpii de înjumătățire: coloana \(h_{1/2}\) din tabelul celor șase piețe
La Bitcoin și EUR/RON șocurile nu se disipă niciodată în model
Schimbările structurale ale nivelului volatilității pot genera o persistență aparent mare Lamoureux & Lastrapes (1990)
VIX, indicele de volatilitate implicită pe 30 de zile al Chicago Board Options Exchange, calculat din prețurile opțiunilor.
Etichetele marchează trei episoade:
Lehman, falimentul Lehman Brothers din septembrie 2008;
COVID-19, crahul din martie 2020 provocat de boala coronavirus 2019;
Tariffs, anunțul tarifelor vamale americane din aprilie 2025.
În versiunea interactivă, cursorul modifică \(\alpha\), cu \(\beta\) fix la 0,872, astfel încît se vede efectul reacției la știri asupra traiectoriei filtrate, iar selectorul alege toată perioada sau unul dintre cele trei episoade. Afișajul dă corelația cu VIX, cele două medii și ponderea zilelor în care VIX este mai mare.
Întrebare pentru sală Corelația dintre volatilitatea GARCH(1,1)-t și VIX este 0,89, iar VIX este mai mare în medie: 19,8% față de 17,0%. Măsoară această diferență variance risk premium?
Răspuns
Nu. Prima de risc a dispersiei compară VIX² cu o prognoză a dispersiei pe 30 de zile sub probabilitatea reală, iar σ̂ este o volatilitate pe o zi, filtrată cu parametrii estimați pe tot eșantionul. VIX depășește volatilitatea GARCH în 84% din zile.
Cele două serii se mișcă foarte apropiat; cadrul următor cuantifică asocierea și explică de ce diferența dintre ele nu este o primă de risc măsurată.
Pe 2000–2026, corelația dintre volatilitatea GARCH și VIX este 0,89. Comparația este in-sample: \(\hat\sigma_t\) este filtrată cu parametri estimați pe tot eșantionul, deci nu este o prognoză out-of-sample. VIX este mai mare în medie, 19,8% față de 17,0%, și depășește volatilitatea GARCH în 84% din zile.
Diferența tentează să fie citită drept prima de risc a dispersiei (variance risk premium), dar nu o măsoară. Prima compară \(\text{VIX}^2\), media dispersiei pe 30 de zile sub probabilitatea neutră la risc, cu o prognoză a dispersiei pe 30 de zile sub probabilitatea reală. \(\hat\sigma_t\) filtrată este o volatilitate pe o zi, deci diferă atît orizontul, cît și măsura de probabilitate. Rezultatul susține o asociere între cele două măsuri.
Pe scurt
Corelația dintre cele două serii, 2000–2026: 0,89
\(\hat\sigma_t\) este filtrată cu parametrii estimați pe tot eșantionul (estimare în eșantion, in-sample), nu o prognoză în afara eșantionului
VIX este mai mare în medie: 19,8% față de 17,0%
VIX depășește volatilitatea GARCH în 84% din zile
Diferența nu măsoară prima de risc a dispersiei (variance risk premium)
Prima compară \(\text{VIX}^2\) cu o prognoză a dispersiei pe 30 de zile sub probabilitatea reală
Iar \(\hat\sigma_t\) este o volatilitate pe o zi
Tipul de dovadă: asociere (variabilele se mișcă împreună; nu dovedește o relație cauzală)
Prognozele GARCH(1,1)-t revin spre nivelul de termen lung cu viteza dată de persistență, așa că regula rădăcinii pătrate a timpului greșește într-o direcție care depinde de nivelul de azi față de cel de termen lung. Persistența este aproape de 1 la S&P 500, BET și aur și se află pe frontiera IGARCH la Bitcoin și EUR/RON, unde prognozele cresc nelimitat și nu sînt utilizabile. Volatilitatea GARCH filtrată urmărește îndeaproape VIX, dar diferența dintre ele nu este o primă de risc.
Asimetrie și alegerea modelului
GARCH(1,1) răspunde la pătratul șocului de ieri, deci o scădere și o creștere de aceeași mărime măresc dispersia de mîine cu aceeași cantitate. În datele de acțiuni, scăderile sînt urmate de o volatilitate mai mare decît creșterile de aceeași mărime, faptul stilizat 9 din Capitolul 1. Secțiunea adaugă semnul șocului în ecuația dispersiei în două feluri, prin modelele GJR și EGARCH, compară curbele lor de impact al știrilor, estimează asimetria pe șase piețe și alege între douăsprezece modele printr-un criteriu informațional.
Întrebarea este dacă volatilitatea crește mai mult după o scădere decît după o creștere de aceeași mărime. GARCH(1,1) nu poate răspunde, deoarece \(\varepsilon_{t-1}^2\) este același pentru \(-3\) și \(+3\). Modelul lui Glosten, Jagannathan & Runkle (1993) dă unui șoc negativ o pantă suplimentară \(\gamma\):
Știrile bune au panta \(\alpha\), iar cele proaste panta \(\alpha+\gamma\). Pozitivitatea cere \(\omega > 0\),\(\alpha \geq 0\),\(\alpha + \gamma \geq 0\) și \(\beta \geq 0\), deci \(\gamma\) poate fi și negativ.
Deoarece indicatorul este 1 în circa jumătate din zile, persistența este \(\alpha + \gamma/2 + \beta\) pentru \(z_t\) simetric. Pentru \(z_t\) asimetric, factorul \(1/2\) se înlocuiește cu \(\mathbb{E}[z_t^2\, 1(z_t < 0)]\), unde \(1(\cdot)\) este funcția indicatoare; deducerea este exercițiul A3 din Seminarul 5.
Pe S&P 500, estimările sînt \(\hat\alpha = 0{,}000\),\(\hat\gamma = 0{,}205\)(\(t = 10{,}0\)) și \(\hat\beta = 0{,}881\): șocurile pozitive nu au un efect măsurabil asupra dispersiei din ziua următoare, iar întreaga reacție la știri vine din șocurile negative. Simetria, \(H_0\colon \gamma = 0\), se poate testa prin statistica \(t\) sau printr-un test LR față de GARCH(1,1). Aici \(\hat\alpha = 0\) se află pe frontieră, deci testul \(t\) al lui \(\gamma\) nu este standard, iar legea \(\chi^2_1\) a testului LR pentru \(\gamma = 0\) presupune \(\alpha_0 > 0\);tabelul de decizie pentru testele la frontieră enumeră cazurile.
Două mecanisme sînt candidate pentru asimetrie, și niciunul nu este testat aici. Efectul de levier (leverage): scăderea prețului acțiunii crește raportul datorii/capitaluri proprii, iar acțiunea devine mai riscantă. Feedback-ul volatilității (volatility feedback): o volatilitate așteptată mai mare crește randamentele cerute, deci prețurile scad acum.
Pe scurt
Întrebarea: crește volatilitatea mai mult după o scădere decît după o creștere?
Șocuri de aceeași mărime (faptul stilizat 9, Capitolul 1)
GARCH(1,1) ignoră semnul: \(\varepsilon_{t-1}^2\) este același pentru \(-3\) și \(+3\)
GARCH-ul exponențial (EGARCH, exponential GARCH) al lui Nelson (1991) modelează logaritmul dispersiei și îl face să depindă de mărimea și de semnul șocului standardizat de ieri:
Aici \(z_{t-1} = \varepsilon_{t-1}/\sigma_{t-1}\) este șocul standardizat, iar \(|z_{t-1}| - \mathbb{E}|z_{t-1}|\) mărimea lui peste mărimea medie. Parametrul \(\alpha\) este efectul de mărime, iar \(\gamma\) efectul de semn; \(\gamma < 0\) înseamnă că șocurile negative cresc mai mult volatilitatea.
Forma logaritmică are două avantaje. Ea păstrează \(\sigma_t^2 > 0\) fără nicio restricție de semn asupra parametrilor, iar persistența este un singur număr, \(\beta\):\(|\beta| < 1\) dă staționaritatea log-dispersiei \(\ln\sigma_t^2\). Momentele randamentelor cer însă condiții separate; cu inovații Student-t, dispersia necondiționată poate fi infinită chiar dacă \(\nu > 4\).
Pe S&P 500, estimările sînt \(\hat\alpha = 0{,}138\),\(\hat\gamma = -0{,}165\)(\(t = -15{,}2\)) și \(\hat\beta = 0{,}979\). Efectul de semn este mai mare în valoare absolută decît efectul de mărime și este semnificativ. În `arch`, \(\mathbb{E}|z|\) este fixat la \(\sqrt{2/\pi}\), valoarea lui sub distribuția Normală, oricare ar fi legea inovațiilor.
Pe scurt
Exponential GARCH (EGARCH) modelează logaritmul dispersiei Nelson (1991)
În funcție de mărimea și de semnul șocului standardizat de ieri
Curba de impact al știrilor (news impact curve) a lui Engle & Ng (1993) arată dispersia din ziua următoare, \(\sigma_t^2\), ca funcție de șocul \(\varepsilon_{t-1}\), cu toate celelalte mărimi fixate. Aici \(\sigma_{t-1}^2\) este fixată la dispersia de selecție \(s^2 = 1{,}47\) (%\(^2\)), nu la dispersia de termen lung a fiecărui model, astfel încît cele trei curbe pornesc din același punct. În versiunea interactivă, primul cursor mută șocul \(\varepsilon_{t-1}\) între −6% și +6%, iar al doilea dispersia precedentă \(\sigma_{t-1}^2\); ▶ parcurge întregul domeniu al șocului.
Întrebare pentru sală Cu σ²(t−1) = 1,47 %², GJR-GARCH-t prognozează 3,16 %² după un șoc de −3% și 1,31 %² după unul de +3%. Păstrăm șocurile și dublăm dispersia anterioară, fără reestimare. Cum se schimbă diferența dintre cele două dispersii prognozate?
Răspuns
Rămîne aproximativ 1,85 %². Diferența este γ × 3² ≈ 1,846 %². Termenul βσ² anterior crește identic pentru ambele semne și se anulează din diferență. Dublarea nivelului anterior nu dublează asimetria; șocurile în procente rămîn fixe. La σ²(t−1) = 1,47, EGARCH dă 2,75 și 1,22, iar GARCH(1,1) dă 2,40 pentru ambele șocuri.
Pentru un șoc de −3%, dispersia prognozată este 3,16 la GJR și 2,75 la EGARCH; pentru +3% este 1,31 și 1,22; GARCH dă 2,40 pentru ambele. După știri proaste, prognoza este de 2,4 ori (GJR) și de 2,3 ori (EGARCH) mai mare decît după știri bune. Acestea sînt rapoarte de niveluri, nu de creșteri față de dispersia de pornire.
Dublarea dispersiei precedente nu dublează asimetria. La GJR, diferența dintre cele două prognoze este \(\gamma \times 3^2 \approx 1{,}85\) %\(^2\) oricare ar fi \(\sigma_{t-1}^2\), deoarece termenul \(\beta\sigma_{t-1}^2\) este același pentru ambele semne și se reduce în diferență. Alte exemple, crahul COVID-19 și traiectoriile de pe celelalte piețe, sînt în Aprofundări.
Pe scurt
Curba de impact a știrilorEngle & Ng (1993): \(\sigma_t^2\) ca funcție de \(\varepsilon_{t-1}\)
\(\sigma_{t-1}^2\) fixată la dispersia de selecție \(s^2\) = 1,47 (%\(^2\))
Nu la dispersia de termen lung a modelului
După un șoc de \(-3\)%: GJR 3,16, EGARCH 2,75
După un șoc de \(+3\)%: GJR 1,31, EGARCH 1,22
GARCH dă 2,40 pentru ambele șocuri
După știri proaste prognoza este de 2,4 ori (GJR) și de 2,3 ori (EGARCH) cea după știri bune
Tabelul prezintă estimările asimetriei pe cele șase piețe, toate cu inovații Student-t: \(\hat\gamma\) în GJR, cu statistica \(t\) robustă, statistica LR a GJR față de GARCH, cu valoarea ei \(p\), și \(\hat\gamma\) în EGARCH, cu \(t\) robust. Statistica LR este \(\chi^2_1\), cu valoarea critică 3,84, dacă densitatea Student-t este corectă. Statistica \(t\) robustă este \(N(0,1)\) numai cînd ceilalți parametri sînt interiori, ceea ce nu este cazul la GJR pentru S&P 500, unde \(\hat\alpha = 0\).
Condițiile de moment diferă de la un estimator la altul. QMLE Gaussian cere \(\mathbb{E} z_t^4 < \infty\); un MLE Student-t corect specificat nu cere. Cu o densitate greșită, însă, \(\hat\nu > 4\) singur nu garantează validitatea erorilor standard robuste (Fan, Qi & Xiu, 2014).
Știrile proaste cîntăresc mai mult, GJR \(\hat\gamma > 0\) și EGARCH \(\hat\gamma < 0\), pe patru piețe. Efectul este puternic la S&P 500 (GJR \(\hat\gamma = 0{,}205\), LR 236,2) și mai mic, dar semnificativ la 5%, la BET (LR 4,9, \(p = 0{,}026\)), BET-TR (10,3, \(p = 0{,}001\)) și EUR/RON (9,3, \(p = 0{,}002\)). La Bitcoin nu se detectează asimetrie (LR 0,7, \(p = 0{,}416\)). La aur semnul este inversat: GJR \(\hat\gamma = -0{,}043\) și EGARCH \(\hat\gamma = 0{,}038\), deci creșterile prețului aurului sînt urmate de o volatilitate mai mare.
Rezultatul susține o asociere. Efectul de levier la acțiuni și rolul de activ de refugiu al aurului sînt interpretări compatibile cu aceste semne, nu mecanisme testate.
Pe scurt
Serie
\(\hat\gamma_{GJR}\)
t
\(LR\) față de GARCH
valoarea \(p\)
\(\hat\gamma_{EGARCH}\)
t
S&P 500
0,205
10,0
236,2
\(<\) 0,001
\(-\)0,165
\(-\)15,2
BET
0,043
2,1
4,9
0,026
\(-\)0,028
\(-\)2,6
BET-TR
0,111
2,9
10,3
0,001
\(-\)0,063
\(-\)3,5
Bitcoin
\(-\)0,013
\(-\)0,7
0,7
0,416
0,015
1,2
EUR/RON
0,039
3,0
9,3
0,002
\(-\)0,040
\(-\)2,5
Aur
\(-\)0,043
\(-\)4,7
26,7
\(<\) 0,001
0,038
5,7
Toate modelele folosesc inovații Student-t
Coloanele t conțin statistici t robuste
\(LR \sim \chi^2_1\) (3,84) dacă densitatea Student-t este corectă
Statistica t robustă este \(N(0,1)\) doar cu ceilalți parametri interiori (nu la S&P 500 GJR, unde \(\hat\alpha = 0\))
Momentele: QMLE Gaussian cere \(\E z_t^4 < \infty\); MLE Student-t corect specificat nu o cere; cu densitatea greșită, \(\hat\nu > 4\) nu garantează singur erorile robuste Fan, Qi & Xiu (2014)
Știrile proaste contează mai mult (GJR \(\hat\gamma > 0\), EGARCH \(\hat\gamma < 0\))
Efect puternic la S&P 500
Mai mic, dar semnificativ la 5%, la BET, BET-TR și EUR/RON
La Bitcoin nu este detectat
La aur semnul este inversat
Tipul de dovadă: asociere
Efectul de levier la acțiuni și rolul de refugiu (safe haven) al aurului: interpretări compatibile cu semnele, nu mecanisme testate
Pe S&P 500 se estimează douăsprezece modele: trei ecuații ale dispersiei, GARCH, GJR și EGARCH, fiecare cu patru legi ale inovațiilor, Normală, Student-t, skewed-t și GED. Ele se compară prin criteriul informațional bayesian (BIC, Bayesian information criterion),
\[\text{BIC} = -2\ell + k\ln n,\]
(5.17)
unde \(\ell\) este log-verosimilitatea maximizată, iar \(k\) numărul de parametri. Tabelul dă \(\Delta\)BIC, BIC-ul fiecărui model minus cel mai mic BIC dintre cele douăsprezece, deci modelul preferat are \(\Delta\)BIC \(= 0\).
Criteriul informațional Akaike (Akaike information criterion), AIC \(= -2\ell + 2k\), penalizează mai puțin parametrii. Cu \(n = 6\,717\) randamente, \(\ln n \approx 8{,}8\), deci BIC penalizează fiecare parametru de 4,4 ori mai mult decît AIC și evită modelele supraparametrizate; capitolul alege după BIC.
Două alegeri contează. Inovațiile Student-t în locul celor Normale scad BIC-ul cu 276 pînă la 303, în funcție de ecuația dispersiei. Asimetria îl scade cu încă 227,4 (GJR) pînă la 272,4 (EGARCH) în coloana Student-t. Cîștigătorul este EGARCH cu inovații skewed-t. BIC-ul ordonează ajustarea in-sample, nu acuratețea prognozelor, iar secțiunea despre evaluarea prognozelor testează dacă aceste cîștiguri rezistă out-of-sample; comparația susține o ordonare a procedurilor. Exercițiul B3 din Seminarul 5 reestimează rîndul BET din tabelul asimetriei și explică deciziile LR, AIC și BIC.
Pe scurt
\(\Delta\)BIC
\(N(0,1)\)
Student-t
t asimetric
GED
GARCH(1,1)
650,2
347,1
307,9
339,6
GJR-GARCH(1,1)
395,3
119,8
49,6
140,8
EGARCH(1,1)
373,4
74,7
0,0
110,7
\(\Delta\)BIC: Bayesian Information Criterion minus cel mai mic BIC dintre cele 12 modele
BIC \(= -2\ell + k\ln n\) (\(k\) parametri)
0 = modelul preferat
Akaike Information Criterion, AIC \(= -2\ell + 2k\): alegem totuși prin BIC
Cu \(n = 6\,717\) (\(\ln n \approx 8{,}8\)), BIC penalizează fiecare parametru de 4,4 ori mai mult
Evită modelele supraparametrizate
Contează două decizii: inovațiile Student-t în locul celor Normale scad BIC cu 276–303
Asimetria îl mai scade cu 227–272 (coloana Student-t, GJR și EGARCH față de GARCH)
Modelul preferat: EGARCH cu inovații t asimetrice
BIC ordonează adecvarea în eșantion, nu acuratețea prognozelor
Secțiunea despre prognoze testează dacă aceste cîștiguri se păstrează în afara eșantionului
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
Seminarul 5, B3 reestimează rîndul BET din tabelul asimetriei și explică deciziile LR, AIC și BIC
Volatilitatea acțiunilor răspunde mai mult la scăderi decît la creșteri: pe S&P 500, panta GJR pentru șocurile pozitive este zero, iar întreaga reacție la știri vine din șocurile negative. Asimetria este semnificativă pe patru dintre cele șase piețe, absentă la Bitcoin și inversată la aur. După BIC, inovațiile Student-t și o ecuație asimetrică a dispersiei sînt cele două alegeri care contează, iar EGARCH cu inovații skewed-t are cea mai bună ajustare in-sample.
Inovații și diagnostic
Un model estimat implică reziduuri standardizate, \(\hat z_t = \hat\varepsilon_t/\hat\sigma_t\), care ar trebui să se comporte ca inovațiile i.i.d. ale modelului dacă specificarea este corectă. Secțiunea formulează verificările pe \(\hat z_t\), le aplică pe S&P 500 și compară cinci modele. Ea arată și limita acestor verificări: valorile lor critice \(\chi^2\) ignoră faptul că reziduurile depind de parametri estimați.
Întrebarea are două părți: a eliminat modelul ales toată dinamica din \(\hat z_t\), și are \(\hat z_t\) densitatea presupusă? Dacă modelul este corect, \(\hat z_t = \hat\varepsilon_t/\hat\sigma_t\) este aproape i.i.d., cu dispersia 1. Fiecare verificare are ipoteza nulă că modelul surprinde trăsătura respectivă:
Pentru ecuația mediei, \(Q(10)\) Ljung–Box pe \(\hat z_t\) caută autocorelație rămasă în niveluri.
Pentru ecuația dispersiei, \(Q(10)\) pe \(\hat z_t^2\) și LM(5) caută volatility clustering rămas.
Pentru distribuție, un grafic cuantilă–cuantilă (QQ, quantile–quantile) compară cuantilele empirice ale lui \(\hat z_t\) cu cele ale densității presupuse.
Asimetria rămasă în reziduuri se testează prin regresia sign-bias a lui Engle & Ng (1993):
unde \(S_{t-1}^- = 1\) dacă \(\hat\varepsilon_{t-1} < 0\) și 0 altfel, \(S_{t-1}^+ = 1 - S_{t-1}^-\), iar \(u_t\) este eroarea regresiei. Termenii de mărime folosesc reziduul nestandardizat \(\hat\varepsilon_{t-1}\), ca în ecuația 18 din lucrare.
Coeficientul \(b_1\) măsoară deplasarea de semn (sign bias): \(\hat z_t^2\) mai mare în medie după un șoc negativ; testul sign-bias este statistica \(t\) a lui \(b_1\). Coeficienții \(b_2\) și \(b_3\) măsoară deplasarea de mărime negativă și pozitivă (size bias). Testul comun folosește \(nR^2 \sim \chi^2_3\), cu valoarea critică de 5% egală cu 7,81; el este conservator, deoarece omite gradientul dispersiei estimate în raport cu parametrii.
Pe scurt
Întrebarea: a eliminat modelul ales toată dinamica din \(\hat z_t\), iar \(\hat z_t\) are densitatea presupusă?
Graficul compară reziduurile standardizate ale modelului GARCH(1,1) cu inovații Normale, estimat pe S&P 500, cu două legi de referință: distribuția Normală și o distribuție Student-t de dispersie 1. Panoul din stînga arată densitatea, cel din dreapta graficul QQ, în care abaterile de la diagonală în cozi arată unde reziduurile sînt mai extreme decît prevede legea de referință. În versiunea interactivă, cursorul fixează gradele de libertate \(\nu\) ale distribuției Student-t de referință; el schimbă distribuția de referință, nu reziduurile, iar ▶ parcurge \(\nu\) de la 3 la 30.
Întrebare pentru sală 16 reziduuri standardizate ale GARCH(1,1) cu inovații Normale sînt sub −4, față de 8,6 așteptate sub Student-t cu ν ≈ 6,25. Creștem ν la 30, păstrînd reziduurile și dispersia Student-t egală cu 1. Ce se schimbă sub pragul −4?
Răspuns
Sliderul schimbă distribuția de referință, nu reziduurile estimate. Cele 16 observații rămîn aceleași. Numărul așteptat sub Student-t scade de la circa 8,6 la circa 0,9 la ν = 30; sub distribuția Normală sînt așteptate 0,21. Excesul de kurtosis scade de la 10,7 (randamente) la 1,73 (reziduuri), dar normalitatea este respinsă clar: Jarque–Bera 1 156.
Sub \(-4\) se află 16 reziduuri standardizate. O distribuție Normală ar da 0,21 astfel de valori în acest eșantion, iar o distribuție Student-t cu \(\nu = 6{,}2\) ar da 8,6; la \(\nu = 30\), numărul așteptat scade la circa 0,9. Cele 16 observate nu se schimbă odată cu cursorul. Coada stîngă a reziduurilor este deci mai groasă decît la distribuția Normală și chiar decît la distribuția Student-t estimată în GARCH-t, ceea ce motivează distribuția skewed-t din cadrul următor.
Standardizarea prin volatilitatea GARCH elimină cea mai mare parte, dar nu tot excesul de kurtosis. Pentru reziduurile standardizate ale modelului GARCH(1,1) cu inovații Normale, excesul de kurtosis scade de la 10,7, pentru randamente, la 1,73, iar asimetria (skewness) este \(-0{,}53\). Statistica Jarque–Bera,
cu \(S\) asimetria și \(E\) excesul de kurtosis, este \(\chi^2_2\) sub ipoteza de normalitate, cu valoarea critică de 5% egală cu 5,99. Aici ea este 1 156, deci normalitatea este respinsă cu o marjă largă.
Abaterea se concentrează în coada stîngă. Există 16 reziduuri sub \(-4\), față de 0,21 așteptate sub distribuția Normală și 8,6 sub o distribuție Student-t cu \(\nu = 6{,}2\). Cel mai mic reziduu standardizat este \(\hat z = -6{,}6\), pe 27 februarie 2007. O coadă stîngă mai lungă este ceea ce descrie o distribuție skewed-t cu \(\hat\lambda = -0{,}155\): în estimarea EGARCH ea are \(\hat\nu = 7{,}5\) grade de libertate, și de aceea BIC preferă inovațiile skewed-t.
Pe scurt
Reziduurile standardizate ale GARCH(1,1) cu inovații Normale
Excesul de kurtosis scade de la 10,7 (randamente) la 1,73
Tabelul aplică verificările din cadrele precedente pe cinci modele ale S&P 500: GARCH-N, GARCH-t, GJR-t, EGARCH-t și GJR-skewed-t. Valorile critice de 5% sînt 18,3 pentru \(\chi^2_{10}\), 11,1 pentru \(\chi^2_5\), 7,81 pentru \(\chi^2_3\) și \(|t| > 1{,}96\) pentru statistica \(t\) sign-bias. Ele ignoră estimarea parametrilor, deci testele sînt conservatoare, cum se arată în Aprofundări.
În medie, \(Q(10)\) pe \(\hat z_t\) este între 19,4 și 27,4 la toate modelele, peste 18,3: rămîne puțină autocorelație pe care o medie constantă o ignoră. În dispersie, \(Q(10)\) pe \(\hat z_t^2\) scade de la 6 135 pe \(r_t^2\) la valori între 10 și 16, iar LM(5) nu este semnificativ. Aceste teste naive nu detectează volatility clustering rămas.
Asimetria este locul în care modelele diferă. Testul sign-bias comun respinge toate cele cinci modele la 5%: statistica este 40,6 la GARCH-t, 28,1 la GJR-t și 9,9 la EGARCH-t, cea mai mică, cu valoarea \(p\) 0,019. Statistica \(t\) sign-bias a lui \(b_1\) rămîne peste 1,96 la toate modelele, între 2,05 și 3,90. Cu \(n = 6\,717\) observații, efectele mici devin semnificative, iar mărimea economică a deplasării rămase trebuie judecată împreună cu valorile \(p\).
Standardizarea prin volatilitatea GARCH reduce excesul de kurtosis al S&P 500 de la 10,7 la 1,73, dar reziduurile păstrează o coadă stîngă lungă, pe care o distribuție Student-t simetrică o subestimează. La toate cele cinci modele nu se detectează volatility clustering în pătratele reziduurilor, rămîne puțină autocorelație în medie, iar testul sign-bias comun respinge încă la 5%. Referințele \(\chi^2\) naive sînt conservatoare.
Prognoza și evaluarea prognozelor
Ajustarea in-sample după BIC nu arată că un model prognozează mai bine. Secțiunea evaluează prognozele dispersiei pe o zi pentru S&P 500 out-of-sample, pe 2016–2026. Deoarece dispersia adevărată nu se observă niciodată, evaluarea folosește un proxy zgomotos, iar doar unele funcții de pierdere ordonează corect prognozele cu un astfel de proxy. Secțiunea prezintă aceste funcții de pierdere, regresia Mincer–Zarnowitz și testul Diebold–Mariano, descrie schema out-of-sample și raportează rezultatele.
Întrebarea este dacă cîștigurile BIC ale modelelor GJR și EGARCH rezistă out-of-sample. Volatilitatea nu se observă niciodată, deci prognozele se compară cu un proxy zgomotos, aici \(r_t^2\), deoarece capitolul nu folosește date intrazilnice; dispersia realizată din randamente intrazilnice este subiectul Capitolului 9. Pentru \(\mu = 0\),\(r_t^2 = \sigma_t^2 z_t^2\) este nedeplasat, \(\mathbb{E}[r_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\), dar foarte zgomotos. Chiar prognoza perfectă \(h_t = \sigma_t^2\) explică puțin din variația lui \(r_t^2\), un \(R^2\) mic, deoarece \(z_t^2\) este zgomotos (Andersen & Bollerslev, 1998). Pe S&P 500 media este ignorată: \(\hat\mu^2 = 0{,}0062\), față de o dispersie zilnică medie de 1,47 (%\(^2\)), o deplasare sub 1%.
Patton (2011) arată că doar unele funcții de pierdere ordonează corect prognozele cînd dispersia adevărată este înlocuită cu un proxy condiționat nedeplasat. Două dintre ele sînt eroarea pătratică medie (MSE, mean squared error), \((r_t^2 - h_t)^2\), și pierderea de cvasi-verosimilitate (QLIKE),
unde \(h_t\) este prognoza dispersiei pentru ziua \(t\). Două pierderi care par naturale nu sînt robuste: \((|r_t| - \sqrt{h_t})^2\) și \((\ln r_t^2 - \ln h_t)^2\). Ordonarea lor depinde de zgomotul din proxy, așa că pot prefera o prognoză deplasată.
QLIKE este, pînă la constante, minus log-verosimilitatea Normală (5.12). Valoarea ei medie este minimă în \(h_t = \sigma_t^2\) și penalizează subprognoza mai mult decît supraprognoza, deoarece termenul \(r_t^2/h_t\) crește nemărginit cînd \(h_t \to 0\).
Pe scurt
Întrebarea: se păstrează în afara eșantionului cîștigurile de BIC ale GJR și EGARCH?
Volatilitatea nu este observată niciodată: comparăm prognozele cu o aproximare zgomotoasă
Aici \(r_t^2\), deoarece nu folosim date intrazilnice (intraday)
\(r_t^2 = \sigma_t^2 z_t^2\) este nedeplasat (\(\E[r_t^2 \mid \mathcal{F}_{t-1}] = \sigma_t^2\) pentru \(\mu = 0\)), dar foarte zgomotos
Chiar și prognoza perfectă \(h_t = \sigma_t^2\) explică puțin din variația lui \(r_t^2\) (un \(R^2\) mic), deoarece \(z_t^2\) este zgomotos Andersen & Bollerslev (1998)
S&P 500: ignorăm media, deoarece \(\hat\mu^2 = 0{,}0062\) față de o dispersie zilnică medie de 1,47 (%\(^2\)), o deplasare sub 1%
Patton (2011): doar unele funcții de pierdere ordonează corect prognozele cu o aproximare zgomotoasă
Robuste: Mean Squared Error (MSE, eroarea pătratică medie) \((r_t^2 - h_t)^2\) și Quasi-Likelihood (QLIKE)\(r_t^2/h_t + \ln h_t\), cu \(h_t\) prognoza dispersiei pentru ziua \(t\)
Nerobuste: \((|r_t| - \sqrt{h_t})^2\) și \((\ln r_t^2 - \ln h_t)^2\): ordonarea lor depinde de zgomotul aproximării
QLIKE este (pînă la constante) minus log-verosimilitatea Normală
Valoarea sa așteptată este minimă pentru \(h_t = \sigma_t^2\)
Penalizează mai mult subestimarea
Evaluarea prognozelor: Mincer–Zarnowitz și Diebold–Mariano
O prognoză nedeplasată are \(a = 0\) și \(b = 1\). Ipoteza comună se testează printr-un test Wald cu erori standard consistente la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent), \(\chi^2_2\) sub \(H_0\). O pantă \(b < 1\) înseamnă prognoze prea dispersate: prea mari cînd sînt mari și prea mici cînd sînt mici.
Testul lui Diebold & Mariano (1995) verifică dacă două prognoze au aceeași pierdere medie. Fie \(L\) o funcție de pierdere, QLIKE sau MSE, iar \(h_t^A\),\(h_t^B\) prognozele modelelor A și B. Diferența de pierdere este \(d_t = L(r_t^2, h_t^A) - L(r_t^2, h_t^B)\), deci \(d_t < 0\) înseamnă că A a fost mai bun în ziua \(t\). Statistica Diebold–Mariano (DM) este
unde \(\bar d\) este media lui \(d_t\) pe zilele de prognoză, iar eroarea standard este HAC, deoarece \(d_t\) este autocorelat. Sub ipoteza de acuratețe egală, \(DM \approx N(0,1)\):\(DM < -1{,}96\) înseamnă că A este semnificativ mai bun, \(DM > 1{,}96\) că B este.
Legea \(N(0,1)\) presupune prognoze date. Pentru modele estimate și incluse unul în altul (nested), cum este GARCH-t în GJR-t, ea poate eșua, așa că statistica DM \(t\) se citește descriptiv pentru aceste perechi. Testul Giacomini–White (GW), care păstrează o distribuție de referință validă pentru modele incluse unul în altul, este în Aprofundări.
Schema produce 2 693 de prognoze pe o zi pentru S&P 500. Parametrii se reestimează în fiecare ianuarie pe toate datele de după 2000, o fereastră extinsă (expanding window), iar prognozele se actualizează zilnic, cu parametrii ficși în cursul anului. Ordinea în timp este strictă: \(h_t\) folosește date pînă la închiderea zilei \(t-1\) și se compară cu \(r_t^2\), deci modificarea lui \(r_t\) trebuie să lase \(h_t\) neschimbat. Se compară patru modele, GARCH-N, GARCH-t, GJR-t și EGARCH-t, împreună cu două repere fără parametri estimați: EWMA cu \(\lambda = 0{,}94\) și Hist-20, media lui \(r^2\) pe ultimele 20 de zile.
Graficul arată traiectoriile prognozelor GJR-GARCH-t și EWMA față de proxy-ul realizat \(|r_t|\sqrt{A}\), toate ca volatilitate anualizată. În versiunea interactivă, cursorul fixează factorul de descreștere \(\lambda\) al EWMA, iar selectorul perioada afișată, întregul interval 2016–2026 sau unul dintre anii 2020, 2022 și 2025; ▶ modifică \(\lambda\) pas cu pas.
Întrebare pentru sală Alegem λ = 0,93 deoarece minimizează QLIKE al EWMA pe grila evaluată în 2016–2026. Este QLIKE-ul obținut pe aceeași perioadă o evaluare out-of-sample a alegerii lui λ?
Răspuns
Nu. Prognozele pentru un λ fix folosesc trecutul, dar alegerea retrospectivă a lui λ folosește rezultatele întregii perioade. Minimul pe grilă este circa 0,812, față de 0,814 la λ = 0,94 și 0,731 pentru GJR-t. Evaluarea procedurii de selecție cere o perioadă separată sau selecție rolling. Față de GARCH-t, t DM al EWMA cu λ = 0,94 este 3,47.
Pe 2016–2026, QLIKE medie este 0,814 pentru EWMA cu \(\lambda = 0{,}94\) și 0,731 pentru GJR-t. Căutarea pe grila valorilor lui \(\lambda\) coboară pierderea EWMA doar la circa 0,812, tot mult peste GJR-t. Alegerea lui \(\lambda\) după QLIKE pe aceeași perioadă nu este o evaluare out-of-sample a acestei alegeri: prognozele pentru un \(\lambda\) fix folosesc numai date trecute, dar selecția folosește rezultatele întregii perioade.
Pe scurt
S&P 500: 2 693 de prognoze pe o zi
Reestimare în fiecare ianuarie pe toate datele din 2000 (fereastră în expansiune)
Actualizare zilnică cu parametri ficși
Alinierea în timp: \(h_t\) folosește datele pînă la închiderea zilei \(t-1\) și se compară cu \(r_t^2\)
Test de aliniere: dacă modificăm \(r_t\), \(h_t\) nu trebuie să se schimbe
Modele: GARCH-N, GARCH-t, GJR-t, EGARCH-t
Repere fără parametri estimați: EWMA (\(\lambda = 0{,}94\), factorul de descreștere) și Hist-20, media lui \(r^2\) pe ultimele 20 de zile
Întrebarea, și titlul lucrării lui Hansen & Lunde (2005), este dacă vreun model întrece GARCH(1,1). Graficul arată, pentru fiecare model, QLIKE medie minus cea a GARCH-t, cu statistica DM \(t\) calculată cu erori standard HAC și 5 laguri. În versiunea interactivă, selectorul schimbă pierderea între QLIKE și MSE, iar cursorul mută începutul perioadei de evaluare între 2016 și 2025.
Întrebare pentru sală Pentru GJR-t față de GARCH-t, diferența medie de QLIKE este −0,025, iar statistica DM este −1,22. Ce concluzie susțin aceste rezultate?
Răspuns
GARCH-t este imbricat în GJR-t, iar schema cu parametri estimați nu justifică automat referința Normală standard pentru DM. Diferența negativă descrie avantajul mediu observat. Nu demonstrează nici superioritate statistică, nici egalitatea acurateței. EWMA (t = 3,47) și Hist-20 (t = 4,10) au pierderi mai mari; cu MSE ordinea se schimbă: EGARCH-t are cea mai mică valoare, 21,30.
Cea mai mică QLIKE o are GJR-t, 0,731. În familia GARCH, statisticile DM \(t\) față de GARCH-t sînt între \(-1{,}47\) și \(-0{,}36\); ele sînt descriptive pentru perechile incluse una în alta, GARCH-N și GJR-t față de GARCH-t, în timp ce EGARCH-t nu este inclus în GARCH-t. Pentru GJR-t, diferența medie este \(-0{,}025\), cu DM \(t = -1{,}22\): un avantaj mediu observat, care nu stabilește nici superioritate, nici acuratețe egală.
Testul DM cere și momente finite și dependență limitată pentru diferența QLIKE, \(d_t = r_t^2(1/h_t^A - 1/h_t^B) + \ln(h_t^A/h_t^B)\). Condiția \(\mathbb{E} r_t^4 < \infty\) nu este cea relevantă, deoarece prognozele normalizează \(r_t^2\), iar erorile standard HAC nu repară momente care nu există.
Reperele sînt clar mai slabe: EWMA are DM \(t = 3{,}47\), iar Hist-20 \(t = 4{,}10\) față de GARCH-t. Revenirea la medie și parametrii estimați aduc un cîștig (Hansen & Lunde, 2005). Rezultatul susține o comparație de proceduri.
Pe scurt
QLIKE mediu minus cel al GARCH-t, cu \(t\) DM (HAC, 5 laguri)
Cel mai mic QLIKE: GJR-t (0,731)
Familia GARCH: \(t\) DM între \(-\)1,47 și \(-\)0,36, nesemnificative la 5%; descriptive pentru perechile imbricate (GARCH-N și GJR-t față de GARCH-t)
EGARCH-t nu este imbricat în GARCH-t
Testul DM cere momente finite și dependență limitată pentru \(d_t = r_t^2(1/h_t^A - 1/h_t^B) + \ln(h_t^A/h_t^B)\)
\(\E r_t^4 < \infty\) nu este condiția relevantă: prognozele normalizează \(r_t^2\); HAC nu repară momente inexistente
EWMA și Hist-20 sînt clar mai slabe (\(t\) = 3,47; 4,10)
Cu MSE ordinea se schimbă: EGARCH-t 21,30, GJR-t 21,80, GARCH-N 22,27 și GARCH-t 22,76, în %\(^4\). MSE ponderează puternic erorile pătratice din puținele zile cu dispersie extremă, QLIKE erorile relative din toate zilele, așa că cele două pierderi robuste nu trebuie să coincidă. În regresia MZ, ipoteza de nedeplasare nu este respinsă pentru prognozele de tip GARCH și este respinsă pentru Hist-20; toate statisticile sînt în Anexă.
Nerespingerea nedeplasării este o dovadă slabă: eroarea standard a lui \(b\) este 0,25 pentru GARCH-t. Inferența MZ cere momente finite ale scorului \((1, h_t)^\top u_t\), cu \(u_t = r_t^2 - a - b\,h_t\); chiar pentru prognoza ideală, termenul pantei implică \(\mathbb{E} h_t^4\). Condiția \(\mathbb{E} r_t^4 < \infty\) nu ajunge în general, HAC nu repară momente care nu există, iar cozile groase documentate în Capitolul 1 fac problema reală. Cîteva zile de criză determină \(b\), cum arată exercițiul B5 din Seminarul 5. Testul Giacomini–White, Model Confidence Set și prognozele pe o lună sînt în Aprofundări.
Pe scurt
Cu MSE ordinea se schimbă: EGARCH-t 21,30, GJR-t 21,80, GARCH-N 22,27, GARCH-t 22,76 (%\(^4\))
MZ: nedeplasarea nu este respinsă pentru prognozele de tip GARCH
Nerespingerea este o dovadă slabă: SE a lui \(b\) este 0,25 pentru GARCH-t
Inferența MZ cere momente finite pentru scorul \((1, h_t)'u_t\), \(u_t = r_t^2 - a - b\,h_t\); chiar pentru prognoza ideală, termenul pantei implică \(\E h_t^4\)
\(\E r_t^4 < \infty\) nu ajunge în general, iar HAC nu repară momente inexistente (cozile groase: Capitolul 1)
Out-of-sample, modelele GARCH întrec în QLIKE ambele repere fără parametri estimați, EWMA și Hist-20. În familia GARCH diferențele sînt mici și se schimbă cu pierderea: GJR-t este cel mai bun în QLIKE, EGARCH-t în MSE, iar statisticile DM din interiorul familiei sînt descriptive. Cîștigurile in-sample ale asimetriei după BIC se traduc deci în cîștiguri out-of-sample mici și nedecise statistic.
Extensii și limite
GARCH(1,1) lasă neexplicate mai multe trăsături ale datelor. Secțiunea examinează în detaliu două dintre ele, prețul riscului în ecuația mediei și forma funcției de autocorelație a randamentelor absolute, apoi enumeră limitele modelului găsite în capitol, fiecare cu dovezile ei și cu extensia pe care o motivează.
Întrebarea secțiunii este ce îi scapă modelului GARCH(1,1) și ce extensie răspunde fiecărei limite. Primul candidat este media. În modelul GARCH-in-Mean (GARCH-M) al lui Engle, Lilien & Robins (1987), volatilitatea condiționată intră în ecuația mediei,
\[r_t = c + \kappa\,\sigma_t + \varepsilon_t,\]
(5.23)
sau cu \(\kappa\,\sigma_t^2\) în locul lui \(\kappa\,\sigma_t\). Aici \(c\) este o constantă, iar \(\kappa\) prețul riscului, randamentul așteptat suplimentar pe unitatea de volatilitate. Un \(\kappa\) pozitiv înseamnă că investitorii cer un randament așteptat mai mare cînd riscul este mai mare, compromisul risc–randament (risk–return trade-off).
Pe S&P 500, GARCH(1,1)-t în medie dă \(\hat\kappa = 0{,}096\)(\(t = 3{,}03\)) cu \(\sigma_t\) și 0,028 (\(t = 2{,}36\)) cu \(\sigma_t^2\). Estimarea este pozitivă și semnificativă în acest eșantion, dar literatura este împărțită: Glosten, Jagannathan & Runkle (1993) au găsit o relație negativă. Un efect zilnic în medie este mic și fragil; el este sensibil la eșantion și la asimetria din ecuația dispersiei. Rezultatul susține o asociere.
Pe scurt
Întrebarea: ce nu descrie GARCH(1,1) și ce extensie răspunde fiecărei limite?
GARCH-in-Mean (GARCH-M)Engle, Lilien & Robins (1987): \(r_t = c + \kappa\,\sigma_t + \varepsilon_t\) (sau \(\kappa\,\sigma_t^2\))
\(c\): constantă
\(\kappa\): prețul riscului, randamentul așteptat suplimentar pe unitate de volatilitate
\(\kappa > 0\): investitorii cer un randament așteptat mai mare cînd riscul este mai mare (compromisul risc–randament)
S&P 500, GARCH(1,1)-t: \(\hat\kappa = 0{,}096\) (t = 3,03) cu \(\sigma_t\) în ecuația mediei
\(\hat\kappa = 0{,}028\) (t = 2,36) cu \(\sigma_t^2\) în ecuația mediei
Pozitiv și semnificativ în acest eșantion, dar rezultatele din literatură sînt contradictorii: Glosten, Jagannathan & Runkle (1993) au găsit o relație negativă
Funcția de autocorelație (ACF, autocorrelation function) a randamentelor absolute măsoară cît durează dependența în mărimile randamentelor. Pe S&P 500 ea este 0,289 la lagul 1, 0,083 la lagul 100 și 0,013 la lagul 250. Graficul o compară, pe scară logaritmică, cu ACF implicată de un GARCH(1,1)-t simulat și de FIGARCH (Fractionally Integrated GARCH, GARCH integrat fracționar). În versiunea interactivă, cursoarele fixează nivelul la lagul 1, \(\rho_1\), și rata de scădere \(p\) a unei curbe geometrice \(\rho_k = \rho_1 p^{k-1}\), iar ▶ modifică rata de scădere.
Întrebare pentru sală Pentru curba geometrică ρk = ρ₁pk−1, un p = 0,9948 dovedește existența memoriei lungi?
Răspuns
Nu. Persistența ridicată nu este același lucru cu memoria lungă. Pentru această curbă, suma autocorelațiilor este ρ₁/(1 − p), finită. Separat, potrivirea empirică este imperfectă: la ρ₁ = 0,289, minimizarea erorilor pătratice pe 250 de laguri dă p ≈ 0,9875, nu valoarea inițială 0,9948; curba scade prea repede la început (0,258 față de 0,295 la lagul 10) și prea încet apoi (0,156 față de 0,132 la lagul 50). Datele au 0,289 la lagul 1, 0,083 la lagul 100 și 0,013 la lagul 250.
GARCH(1,1)-t simulat supraestimează ACF la toate lagurile: 0,417 la lagul 1, 0,131 la lagul 100 și 0,020 la lagul 250. Problema este forma: un singur \(\alpha+\beta\) nu poate da simultan un nivel scăzut la lagul 1 și o scădere lentă. Cu \(\rho_1 = 0{,}289\), rata geometrică cea mai potrivită datelor prin cele mai mici pătrate pe 250 de laguri este \(p \approx 0{,}9875\), iar curba tot scade prea repede la început și prea încet după aceea. Persistența mare nu este memorie lungă: pentru \(p < 1\), autocorelațiile geometrice au o sumă finită, \(\rho_1/(1-p)\).
GARCH-ul fracționar integrat (FIGARCH, fractionally integrated GARCH) al lui Baillie, Bollerslev & Mikkelsen (1996) aplică filtrul \((1-L)^d\), cu operatorul de lag \(L x_t = x_{t-1}\) și \(d \in (0,1)\), care dă o scădere hiperbolică. Pe S&P 500, \(\hat d = 0{,}60\) (eroare standard 0,06), iar BIC este mai mic cu 34,9 decît la GARCH. Totuși FIGARCH supraestimează memoria și mai mult: 0,214 la lagul 100 și 0,144 la lagul 250. Niciun model cu o singură scală nu se potrivește la toate orizonturile; volatilitatea realizată și modelele autoregresive eterogene (HAR, heterogeneous autoregressive) din Capitolul 9 tratează această problemă.
Pe scurt
S&P 500, ACF (AutoCorrelation Function, funcția de autocorelație) a lui \(|r_t|\) (scară log): în date, 0,289 la lagul 1, 0,083 la lagul 100 și 0,013 la lagul 250
GARCH(1,1)-t simulat supraestimează ACF la toate lagurile
0,417 la lagul 1, 0,131 la lagul 100, 0,020 la lagul 250
Problema este forma: un singur \(\alpha+\beta\) nu dă simultan un nivel mic la lagul 1 și o scădere lentă
Tabelul reunește șase limite ale modelului GARCH(1,1), dovezile pentru fiecare în acest capitol și extensia care o tratează. Salturile de nivel umflă \(\alpha+\beta\)(Lamoureux & Lastrapes, 1990): BET-TR, pe 2014–2026, este mult mai puțin persistent decît BET, pe 2000–2026, un indiciu, dar nu o dovadă, deoarece diferă atît eșantionul, cît și indicele. Extensiile sînt GARCH-MIDAS (mixed data sampling), cu o componentă lentă de termen lung (Engle, Ghysels & Sohn, 2013), și schimbarea de regim (Hamilton & Susmel, 1994). GARCH reacționează cu o zi întîrziere: în crahul COVID-19, VIX s-a mișcat în aceeași zi, GARCH în ziua următoare. Realized GARCH adaugă o ecuație de măsurare pentru dispersia realizată (Hansen, Huang & Shek, 2012).
Un singur outlier poate determina actualizarea: reziduul EUR/RON de 154 din mai 2025. Modelele cu scor autoregresiv generalizat (GAS, generalised autoregressive score), cu un scor mărginit (Creal, Koopman & Lucas, 2013), îi limitează influența; studiul de caz de mai jos dezvoltă această idee. Forma ACF a lui \(|r_t|\) nu este reprodusă nici de GARCH-t, nici de FIGARCH, ceea ce motivează modelele HAR pe dispersia realizată. GARCH tratează cîte un activ, în timp ce portofoliile au nevoie de covarianțe: GARCH-ul multivariat și modelul corelației condiționate dinamice (DCC, dynamic conditional correlation) sînt subiectul Capitolului 6. În sfîrșit, prețurile administrate, ca EUR/RON, cu perioade lungi de calm urmate de salturi, cer modelarea intervențiilor ca salturi sau regimuri.
Fiecare extensie se judecă după același standard ca GARCH: out-of-sample, cu o pierdere robustă și cu Model Confidence Set. Ecuațiile modelelor sînt în Anexă.
Prețul riscului în medie este pozitiv în acest eșantion, dar fragil. ACF a randamentelor absolute scade mai încet decît permite GARCH la laguri lungi și pornește mai jos decît implică el la laguri scurte, iar FIGARCH supraestimează în schimb memoria lungă. Celelalte limite, salturile de nivel, reacția cu o zi întîrziere, outlierii, tratarea cîte unui singur activ și prețurile administrate, motivează fiecare o extensie anume.
Studii de caz: volatilitate bazată pe un cvasi-scor și ciclurile volatilității
Două lucrări recente extind cadrul GARCH pe direcțiile deschise de secțiunea precedentă:
Trei extensii de cercetare încheie capitolul, și fiecare se sprijină pe instrumente anume din secțiunile anterioare:
Modelul de volatilitate bazat pe un cvasi-scor este replicarea unui articol de revistă din 2023. El se sprijină pe densitatea Student-t, pe testele LR și variantele lor la frontieră și pe actualizarea bazată pe scor (GAS) din secțiunea despre extensii; exercițiul C3 din Seminarul 5 îl continuă.
Modelul ciclurilor volatilității, MF2-GARCH (multiplicative factor multi-frequency GARCH), adaugă o componentă lentă învățată din erorile de prognoză ale modelului GARCH și replică un articol de revistă din 2025. El se sprijină pe GJR-GARCH, QMLE, BIC, QLIKE și testul Diebold–Mariano.
AI pentru descoperire științifică este o buclă de cercetare condusă de un asistent și controlată prin verificări. Ea se sprijină pe schema out-of-sample, QLIKE, testul Diebold–Mariano și Model Confidence Set, iar lista ei de verificări susține auditul AI din exercițiul C1 din Seminarul 5 și proiectul de echipă.
Pe scurt
Volatilitate bazată pe un cvasi-scor: replicarea unui articol publicat în 2023
Se bazează pe: densitatea Student-t, testele LR și variantele lor la frontieră, actualizarea bazată pe scor (GAS) din secțiunea de extensii
Întrebarea lui Blasques, Francq & Laurent (2023) este dacă un model de volatilitate bazat pe scor trebuie să actualizeze \(\sigma_t^2\) cu scorul aceleiași densități care descrie randamentele. Într-un model bazat pe scor (GAS) (Creal, Koopman & Lucas, 2013), parametrul de mîine se mișcă în direcția care ar fi făcut observația de azi mai probabilă:
Aici \(y_t\) este randamentul, \(f_t\) parametrul variabil în timp, în acest caz dispersia, iar \(p(y_t \mid f_t)\) densitatea lui \(y_t\) dat fiind \(f_t\). Derivata \(\partial \log p/\partial f_t\) este scorul, \(S(f_t) > 0\) un factor de scalare, iar \(\omega\),\(\alpha\),\(\beta\) au aceleași roluri ca în GARCH.
Cu o densitate Student-t, același parametru \(\nu\) fixează atunci două lucruri diferite: grosimea cozilor lui \(z_t\) și cît de puternic este atenuat un șoc mare în actualizare. O densitate cu cozi groase impune o atenuare puternică, iar una cu cozi subțiri o atenuare slabă. Lucrarea întreabă dacă datele susțin această restricție.
Modelul GARCH(1,1)-t bazat pe un cvasi-scor (QSD, quasi score-driven), ecuația (30) din lucrare, scrie \(y_t = \sqrt{f_t}\,\epsilon_t\), unde \(\epsilon_t\) este o variabilă Student-t standardizată cu \(1/\xi\) grade de libertate; în notația capitolului, \(f_t\) este \(\sigma_t^2\), iar \(\epsilon_t\) este \(z_t\). Actualizarea dispersiei este
unde \(X_t\) este o variabilă exogenă, pătratul VIX la orizont zilnic, cu coeficientul \(\varpi\). Doi parametri au acum roluri separate: \(\xi\) este grosimea cozilor lui \(\epsilon_t\), cu \(\xi = 0\) cazul Normal, iar \(\zeta\) atenuarea valorilor mari ale lui \(\epsilon_t^2\) în actualizare.
Două modele cunoscute sînt cazuri particulare. Cu \(\zeta = 0\) ponderea este 1, iar (5.25) este GARCH(1,1)-t. Cu \(\zeta = \xi\) se obține Beta-t-GARCH, modelul bazat pe scor: pentru \(\zeta = \xi = 1/\nu\), înmulțind numărătorul și numitorul cu \(\nu\) rezultă \((1+\zeta)/(1-2\zeta+\zeta\epsilon_t^2) = (\nu+1)/(\nu-2+\epsilon_t^2)\), ponderea din scorul Student-t.
Datele sînt 400 de acțiuni din S&P 500, de la 3 ianuarie 1995, sau mai tîrziu, pînă la 28 februarie 2019, estimate prin verosimilitate maximă cu o medie AR(1). Două teste LR, pentru \(\zeta = 0\) și pentru \(\xi = \zeta\), se compară cu \(\chi^2_1\); metoda completă este în Anexă. Calibrarea se verifică prin transformarea integrală a probabilității (PIT, probability integral transform): \(u_t = F(y_t \mid \mathcal{F}_{t-1})\), funcția de repartiție estimată în randamentul observat, trebuie să fie i.i.d. uniformă pe \((0,1)\) dacă densitatea este corectă.
Pe scurt
Quasi Score-Driven (QSD) GARCH(1,1)-t, ec. (30) din lucrare
\(y_t = \sqrt{f_t}\,\epsilon_t\), \(\epsilon_t\) Student-t standardizat cu \(1/\xi\) grade de libertate
\(f_t\) este \(\sigma_t^2\), \(\epsilon_t\) este \(z_t\)
\(X_t\): o variabilă exogenă, pătratul VIX la orizont zilnic
\(\varpi\): coeficientul ei
\(\xi\): grosimea cozilor lui \(\epsilon_t\) (\(\xi = 0\): Normală)
\(\zeta\): atenuarea valorilor mari ale lui \(\epsilon_t^2\) în actualizare
\(\zeta = 0\): GARCH(1,1)-t
\(\zeta = \xi\): Beta-t-GARCH (bazat pe scor)
De ce: cu \(\zeta = \xi = 1/\nu\), înmulțind cu \(\nu\) obținem \(\dfrac{1+\zeta}{1-2\zeta+\zeta\epsilon_t^2} = \dfrac{\nu+1}{\nu-2+\epsilon_t^2}\), ponderea din scorul Student-t
Date: 400 de acțiuni din S&P 500, 3 ianuarie 1995 (sau mai tîrziu) – 28 februarie 2019
Verosimilitate maximă cu medie AR(1)
Testele LR pentru \(\zeta = 0\) și \(\xi = \zeta\), față de \(\chi^2_1\) (metoda completă: Anexă)
Testul Probability Integral Transform (PIT): \(u_t = F(y_t \mid \mathcal{F}_{t-1})\), funcția de repartiție estimată în randamentul observat, trebuie să fie i.i.d. uniformă pe \((0,1)\) dacă densitatea este corectă
QSD: rezultatele principale (lucrarea, Tabelele 4 și 6)
Tabelul dă ponderea celor 400 de acțiuni pentru care fiecare ipoteză este respinsă la 5%, cu inovații Student-t (Tabelul 4 din lucrare) și cu inovații skewed-t (Tabelul 6). În varianta asimetrică, \(\kappa\) este asimetria densității, iar \(\tau\) asimetria actualizării, iar \(\kappa = \tau = 0{,}5\) este cazul simetric.
Atenuarea șocurilor mari contează. În Tabelul 4, \(\zeta = 0\), actualizarea GARCH, este respinsă pentru 89,5% din acțiuni, iar toate valorile \(\hat\zeta\) sînt pozitive. Restricția bazată pe scor, \(\xi = \zeta\), este respinsă pentru 53,5%; cu inovații skewed-t, unde restricția include și \(\kappa = \tau\), ea este respinsă pentru toate acțiunile.
Faptul că învinge cele două modele incluse în el nu face modelul QSD adecvat. În Tabelul 4, testul PIT respinge GARCH(1,1) pentru 40,0% din acțiuni, Beta-t-GARCH pentru 46,0% și QSD pentru 45,7%. Rezultatul susține o comparație de proceduri, nu o validare a modelului QSD.
Pe scurt
Respinse la 5%, % din cele 400 de acțiuni
Student-t (Tabelul 4)
t asimetric (Tabelul 6)
LR, \(H_0\): \(\zeta = 0\) (actualizare GARCH)
\(89{,}5\)
\(98{,}8\)
LR, \(H_0\): \(\xi = \zeta\) (bazat pe scor; asimetric: și \(\kappa = \tau\))
\(53{,}5\)
\(100{,}0\)
Testul PIT: GARCH(1,1)
\(40{,}0\)
\(33{,}1\)
Testul PIT: Beta-t-GARCH
\(46{,}0\)
\(72{,}2\)
Testul PIT: QSD GARCH(1,1)
\(45{,}7\)
\(11{,}3\)
\(\kappa\): asimetria densității (aici nu prețul riscului din GARCH-M)
\(\tau\): asimetria actualizării
\(\kappa = \tau = 0{,}5\): cazul simetric (versiunea cu t asimetric, Tabelul 6)
Atenuarea șocurilor mari contează (Tabelul 4)
\(\zeta = 0\) este respinsă pentru majoritatea acțiunilor (primul rînd)
Toate valorile \(\hat\zeta\) sînt pozitive
Tipul de dovadă: comparație între proceduri
Faptul că depășește GARCH-t și Beta-t-GARCH nu face modelul QSD adecvat: testul PIT îl respinge pentru 45,7% din acțiuni (Tabelul 4)
Beta-t-GARCH atenuează prea mult șocurile mari (Fig. 2–3 din lucrare). Dintre acțiunile pentru care \(\hat\xi - \hat\zeta\) este semnificativ, \(\hat\xi > \hat\zeta\) la toate, cu o singură excepție. Mediana lui \(1/\hat\zeta\) este 9,48 în QSD, față de 5,07 în Beta-t-GARCH, unde se impune \(\zeta = \xi\). Grosimea cozilor și atenuarea șocurilor sînt doi parametri diferiți.
Varianta skewed-t (Fig. 5–6) arată pe unde intră efectul de levier. Asimetria actualizării, \(\hat\tau\), este mult sub 0,5, cu mediana 0,333, în timp ce asimetria densității, \(\hat\kappa\), rămîne aproape de 0,5. Efectul de levier intră deci prin ecuația de actualizare, nu prin densitate.
Calibrarea se îmbunătățește cu actualizarea asimetrică (Tabelul 6): testul PIT respinge modelul QSD doar pentru 11,3% din acțiuni, față de 72,2% pentru Beta-t-GARCH.
Pe scurt
Beta-t-GARCH atenuează excesiv (Fig. 2–3)
Acolo unde \(\hat\xi - \hat\zeta\) este semnificativă, \(\hat\xi > \hat\zeta\) pentru toate acțiunile, cu o excepție
Mediana lui \(1/\hat\zeta\): \(9{,}48\) în QSD, față de \(5{,}07\) în Beta-t-GARCH, unde \(\zeta = \xi\)
Grosimea cozilor și atenuarea șocurilor sînt parametri diferiți
t asimetric (Fig. 5–6)
\(\hat\tau\) mult sub \(0{,}5\) (mediana \(0{,}333\)), iar \(\hat\kappa\) rămîne aproape de \(0{,}5\)
Efectul de levier acționează prin ecuația de actualizare, nu prin densitate
Calibrarea (Tabelul 6)
Cu actualizarea t asimetrică, testul PIT respinge modelul QSD pentru doar \(11{,}3\%\) din acțiuni, față de \(72{,}2\%\) pentru Beta-t-GARCH
QSD: replicare pe 11 acțiuni (cf. lucrarea, Fig. 2)
Replicarea estimează modelul QSD pe 11 acțiuni mari din datele cursului. Graficul reproduce Fig. 2 din lucrare: cercurile arată \(\hat\xi - \hat\zeta\), cozi minus atenuare, pentru fiecare acțiune, pline dacă testul LR respinge \(\xi = \zeta\) la 5%, iar romburile arată \(\hat\zeta\), atenuarea șocurilor mari, cu \(\zeta = 0\) actualizarea GARCH-t. În versiunea interactivă, selectorul alege o acțiune, iar cursorul fixează \(\zeta\) fără reestimare; panoul din dreapta arată contribuția unui șoc standardizat la actualizare, în unități de \(\alpha f_t\).
Întrebare pentru sală Pentru Apple, creștem ζ de la 0,15 la 0,30, fără reestimare. Cum se schimbă contribuția unui șoc standardizat ε = 5 la actualizarea QSD?
Răspuns
Scade. Contribuția, exprimată în unități de αft, scade de la aproximativ 6,46 la 4,11. Pentru acest șoc mare, creșterea lui ζ întărește atenuarea. Parametrul ξ al densității rămîne separat de ζ în QSD. Pe cele 11 acțiuni, ξ̂ > ζ̂ la 10 (excepția este Cisco); testul LR respinge ξ = ζ la 5% pentru 8 acțiuni și ζ = 0 (actualizarea GARCH-t) pentru 9.
La 10 dintre cele 11 acțiuni, \(\hat\xi > \hat\zeta\); excepția este Cisco, cu \(\hat\xi = 0{,}193\) și \(\hat\zeta = 0{,}195\). Testul LR respinge \(\xi = \zeta\) la 5% pentru 8 acțiuni și \(\zeta = 0\) pentru 9. Pentru Apple, creșterea lui \(\zeta\) de la 0,15 la 0,30 reduce contribuția unui șoc \(\epsilon = 5\) de la circa 6,46 la 4,11 unități de \(\alpha f_t\): un \(\zeta\) mai mare înseamnă o atenuare mai puternică, în timp ce parametrul densității, \(\xi\), rămîne neschimbat. Eșantionul cursului și curbele de impact al știrilor sînt în Aprofundări.
Pe scurt
Cercuri: \(\hat\xi - \hat\zeta\) (cozi minus atenuare) pentru fiecare acțiune
Plin dacă LR respinge \(\xi = \zeta\) la 5%
Romburi: \(\hat\zeta\), atenuarea șocurilor mari (\(\zeta = 0\): GARCH-t)
\(\hat\xi > \hat\zeta\) la 10 din 11 acțiuni
Excepția este Cisco (\(\hat\xi = 0{,}193\), \(\hat\zeta = 0{,}195\))
Conrad & Engle (2025) observă că erorile de prognoză standardizate ale unui GARCH cu o singură componentă, \(r_t^2/\tilde h_t\), sînt predictibile din propria lor medie pe ultimele \(m\) zile: modelul subestimează volatilitatea luni de zile în recesiuni și o supraestimează în expansiuni. Acest lucru contează pentru prognozele riscului pe mai multe luni, care depind de nivelul spre care revine volatilitatea. GJR-GARCH revine întotdeauna la aceeași dispersie necondiționată, oricare ar fi faza ciclului.
Modelul MF2-GARCH scrie \(r_t = \mu + e_t\),\(e_t = \sqrt{h_t\,\tau_t}\,Z_t\), cu \(Z_t\) i.i.d., de medie 0, dispersie 1 și densitate simetrică. Dispersia are o componentă pe termen scurt și una pe termen lung:
unde \(\phi = \alpha + \gamma/2 + \beta\), astfel încît \(h_t\) are media 1, iar \(V^{(m)}_{t-1} = \frac{1}{m}\sum_{j=1}^{m} e_{t-j}^2/h_{t-j}\) este eroarea standardizată medie a lui \(h\) pe ultimele \(m\) zile. Componenta pe termen scurt este un GJR-GARCH; componenta pe termen lung se mișcă odată cu erorile recente ale acestui GARCH.
Pe S&P 500, ianuarie 1971 – iunie 2023, BIC-ul din lucrare alege \(m = 63\) de zile, un trimestru. Persistența este 0,924 pe termen scurt, \(\phi\), și 0,982 pe termen lung, \(\lambda_1 + \lambda_2\), față de 0,982 la GJR-GARCH. Out-of-sample, pe 2010–2019, rădăcina erorii pătratice medii (RMSE, root mean squared error) pentru luna 1 este cu 31,5% sub cea a prognozei istorice, un raport de 0,685, față de 0,798 la GJR-GARCH.
Pe scurt
Conrad & Engle (2025): erorile de prognoză standardizate ale unui GARCH cu o singură componentă, \(r_t^2/\tilde h_t\), sînt predictibile
predictorul este media lor pe ultimele \(m\) zile: modelul subestimează volatilitatea luni la rînd în recesiuni și o supraestimează în expansiuni
De ce contează: prognozele de risc pe mai multe luni depind de nivelul spre care revine volatilitatea
GJR-GARCH revine mereu spre aceeași dispersie necondiționată, oricare ar fi faza ciclului
componenta pe termen scurt: \(h_t = (1-\phi) + (\alpha + \gamma\,\mathbf{1}\{e_{t-1}<0\})\,e_{t-1}^2/\tau_{t-1} + \beta h_{t-1}\), cu \(\phi = \alpha + \gamma/2 + \beta\) și media 1
componenta pe termen lung: \(\tau_t = \lambda_0 + \lambda_1 V^{(m)}_{t-1} + \lambda_2 \tau_{t-1}\) (\(\lambda_i\): coeficienți, nu factorul EWMA)
\(V^{(m)}_{t-1} = \frac{1}{m}\sum_{j=1}^{m} e_{t-j}^2/h_{t-j}\): media erorilor standardizate ale lui \(h\) pe ultimele \(m\) zile
Cifrele lucrării, S&P 500, ianuarie 1971 – iunie 2023: BIC alege \(m = 63\) de zile (un trimestru)
persistența: \(0{,}924\) pe termen scurt (\(\phi\)) și \(0{,}982\) pe termen lung (\(\lambda_1 + \lambda_2\)), față de \(0{,}982\) în GJR-GARCH
în afara eșantionului, 2010–2019: RMSE (root mean squared error, rădăcina erorii pătratice medii) pe luna 1 este cu \(31{,}5\%\) sub cel al prognozei istorice (raportul \(0{,}685\); GJR-GARCH: \(0{,}798\))
S&P 500: componenta lentă a volatilității și prognozele pe luni
Graficul din stînga arată volatilitatea condiționată \(\sqrt{h_t\tau_t}\) și componenta pe termen lung \(\sqrt{\tau_t}\) ale modelului MF2-GARCH cu \(m = 63\), anualizate, pe 1990–2026. Graficul din dreapta arată QLIKE medie a fiecărui model împărțită la cea a prognozei istorice, media lui \(r_t^2\) pe ultimii 10 ani, pentru ziua următoare, săptămîna următoare și lunile 1–8. În versiunea interactivă, cursorul schimbă fereastra \(m\) a componentei pe termen lung, iar selectorul perioada de evaluare, 2010–2019, 2010–2026 sau ambele; ▶ modifică \(m\) pas cu pas.
Întrebare pentru sală Pe 2010–2026, pentru luna 8, QLIKE relativ este 0,911 la MF2-GARCH și 0,838 la GJR-GARCH; t DM pentru diferența MF2 (Multiplicative Factor multi-frequency, GARCH, GARCH multiplicativ cu componente de frecvențe diferite)−GJR este 0,99. Susține testul unilateral superioritatea GJR la 5%?
Răspuns
Nu. În aproximația asimptotică folosită în curs, pragul unilateral este 1,645. Statistica 0,99 nu îl depășește. GJR are pierdere medie mai mică în acest eșantion, fără dovadă de superioritate la 5%; aceasta nu demonstrează egalitatea. Pe 2010–2019 ordinea era inversă: 0,714 pentru MF2-GARCH și 0,806 pentru GJR-GARCH (t DM −2,66).
Componenta pe termen lung \(\sqrt{\tau_t}\) atinge un maxim de 30,8% la 4 iunie 2009 și un minim de 8,9% la 15 decembrie 2017. Pe 2010–2019, QLIKE relativă pentru luna 8 este 0,714 la MF2-GARCH și 0,806 la GJR-GARCH (DM \(t = -2{,}66\)). Pe 2010–2026 ordinea se inversează: 0,911 față de 0,838, cu DM \(t = 0{,}99\) pentru MF2 minus GJR. Față de pragul unilateral de 5%, 1,645, nici aceasta nu stabilește superioritatea modelului GJR; ea arată doar o pierdere medie mai mică în acest eșantion.
Pe scurt
Stînga: volatilitatea condiționată \(\sqrt{h_t\tau_t}\) și componenta pe termen lung \(\sqrt{\tau_t}\) ale MF2-GARCH cu \(m = 63\), anualizate, 1990–2026
\(\sqrt{\tau_t}\): maxim 30,8% (4 iunie 2009), minim 8,9% (15 decembrie 2017)
Dreapta: QLIKE mediu împărțit la cel al prognozei istorice (media lui \(r_t^2\) pe ultimii 10 ani), pentru ziua următoare, săptămîna următoare și lunile 1–8
Lucrarea estimează modelul prin QMLE Gaussian, cu erori standard Bollerslev–Wooldridge, și alege \(m\) după BIC pentru \(m \leq 160\). Prognozele pe \(s\) zile au o formă închisă (Teorema 2 din lucrare), cu \(\kappa = \mathbb{E}[Z_t^4]\) estimat in-sample. Out-of-sample, pe 2010–2023, lucrarea folosește o fereastră mobilă (rolling window), reestimează la fiecare 21 de zile de tranzacționare și realege \(m\) după BIC. Ținta este dispersia realizată din randamente la 5 minute plus randamentul overnight, iar pierderile sînt RMSE și QLIKE, relative la prognoza istorică.
Replicarea din curs folosește randamentele logaritmice zilnice ale S&P 500 de la 3 ianuarie 1990 pînă la 18 septembrie 2026, 9 245 de zile, cu aceeași specificare, MF2-GARCH-rw-\(m\), și același estimator, pe 36 de ani în loc de 52. Out-of-sample, pe 2010–2026, ea folosește o fereastră mobilă de 20 de ani, reestimare la fiecare 21 de zile și \(m = 63\), ales o singură dată după BIC pe 1990–2009. Ținta este suma pătratelor randamentelor zilnice, deoarece datele cursului nu au randamente la 5 minute înainte de 2020.
Pierderea este QLIKE \(= y/f - \ln(y/f) - 1\), cu \(y\) ținta și \(f\) prognoza; raportul QLIKE omite zilele cu \(y = 0\), 1 din 4 203 la orizontul de o zi. Testul Diebold–Mariano al MF2 față de GJR folosește diferența lui \(y/f + \ln f\), definită și pentru \(y = 0\), cu erori standard Newey–West și atîtea laguri cîte zile are ținta. Rezultatele pe 2010–2019 sînt comparabile cu Tabelul 4 din lucrare. Perioada 2010–2026 include șocul din martie 2020; în testele din Tabelul 5, lucrarea dă pondere zero zilelor cu dispersia realizată peste percentila 99.
Pe scurt
Lucrarea: QMLE Gaussian, erori standard Bollerslev–Wooldridge, \(m\) ales prin BIC pentru \(m \leq 160\)
prognozele pe \(s\) zile au formă închisă (Teorema 2), cu \(\kappa_z = \mathrm{E}[Z_t^4]\) estimat în eșantion
în afara eșantionului, 2010–2023: fereastră mobilă (rolling), reestimare la 21 de zile de tranzacționare, \(m\) reales prin BIC
ținta: dispersia realizată din randamente de 5 minute plus randamentul de peste noapte (overnight); pierderi RMSE și QLIKE, raportate la prognoza istorică
Replicarea din curs: S&P 500, randamente log zilnice, 3 ianuarie 1990 – 18 septembrie 2026 (9 245 de zile)
aceeași specificație (MF2-GARCH-rw-\(m\)) și același estimator, pe 36 de ani în loc de 52
în afara eșantionului: 2010–2026, fereastră mobilă de 20 de ani, reestimare la 21 de zile, \(m = 63\) ales o singură dată, prin BIC pe 1990–2009
ținta: suma pătratelor randamentelor zilnice; datele cursului nu au randamente de 5 minute înainte de 2020
QLIKE \(= y/f - \ln(y/f) - 1\) (\(y\) ținta, \(f\) prognoza): \(y/f + \ln f\) minus \(\ln y + 1\), care nu depinde de prognoză; raportul QLIKE omite zilele cu \(y = 0\): 1 din 4 203 la orizontul de o zi
test Diebold–Mariano MF2-GARCH față de GJR pe diferența lui \(y/f + \ln f\), definită și pentru \(y = 0\); Newey–West cu atîtea laguri cîte zile are ținta
Rezultatele pe 2010–2019 se compară cu Tabelul 4 al lucrării
2010–2026 include șocul din martie 2020; în testele din Tabelul 5, lucrarea dă pondere zero zilelor cu dispersia realizată peste percentila 99
MF2-GARCH: cîștigul de precizie pe orizonturi și perioade
In-sample, BIC alege din nou \(m = 63\); log-verosimilitatea crește cu 57,1 față de GJR-GARCH, iar BIC scade cu 96. Componenta rapidă are \(\hat\phi = 0{,}935\), un timp de înjumătățire de 10 zile, față de 0,978 și 32 de zile la GJR-GARCH. Componenta lentă are \(\hat\lambda_1 + \hat\lambda_2 = 0{,}989\), dar \(\mathbb{E}\tau_t\) urmează o recursie AR(63) a cărei rădăcină dominantă, 0,9966, corespunde asimptotic unei înjumătățiri în circa 204 zile. Un șoc într-o singură eroare zilnică ridică \(\tau_t\) timp de 63 de zile, iar efectul se înjumătățește apoi după încă 137 de zile. Estimările sînt \(\hat\lambda_1 = 0{,}067\) (eroare standard 0,051) și \(\hat\lambda_2 = 0{,}922\) (0,059), față de 0,112 (0,054) și 0,870 (0,062) în lucrare.
Out-of-sample, pe 2010–2019, QLIKE relativă pentru luna 8 este 0,714 la MF2-GARCH și 0,806 la GJR-GARCH (DM \(t = -2{,}66\)); lucrarea raportează 0,859 și 0,918. Pentru luna 1 cele două modele sînt egale în QLIKE, 0,578 și 0,576 (DM \(t = 0{,}07\)), iar RMSE relativă este 0,721 și 0,762. Pe 2010–2026, ordinea după QLIKE se inversează de la luna 1 la luna 8 (luna 8: 0,911 față de 0,838, DM \(t = 0{,}99\)), în timp ce RMSE relativă rămîne mai mică la MF2-GARCH pentru lunile 1–5 (luna 1: 0,916 față de 0,960, DM \(t = -1{,}16\)). Rezultatul susține o comparație de prognoze: direcția din lucrare se păstrează la orizonturi lungi pe 2010–2019, nu și pe 2010–2026.
Replicarea are patru limite. O țintă construită din randamente zilnice este mai zgomotoasă decît dispersia realizată, deci testele DM au mai puțină putere. Dispersia randamentelor este finită numai dacă \(\Gamma_m < 1\) (Teorema 1 din lucrare), o condiție în plus față de \(\phi < 1\) și \(\lambda_1 + \lambda_2 < 1\); aici \(\hat\Gamma_{63} = 0{,}883\) pe tot eșantionul și între 0,881 și 0,950 în cele 201 ferestre mobile. Estimarea \(\hat\alpha = 0{,}000\) se află pe frontieră (0,003 în lucrare), deci erorile standard obișnuite nu se aplică acestui parametru (Andrews, 2001). QMLE și pierderile în unități de dispersie cer un moment de ordin patru finit, pe care Capitolul 1 îl pune sub semnul întrebării; aici \(\hat\kappa = 5{,}03\).
Pe scurt
În eșantion, BIC alege tot \(m = 63\); log-verosimilitatea crește cu 57,1 față de GJR-GARCH, BIC scade cu 96
componenta rapidă: \(\hat\phi = 0{,}935\) (timp de înjumătățire 10 zile); GJR-GARCH: \(0{,}978\) (32 de zile)
componenta lentă: \(\hat\lambda_1 + \hat\lambda_2 = 0{,}989\), dar \(\E\tau_t\) urmează o recursie AR(63); rădăcina ei dominantă, 0,9966, corespunde asimptotic unei înjumătățiri în circa 204 de zile
un șoc într-o singură eroare zilnică ridică \(\tau_t\) timp de 63 de zile; efectul scade apoi la jumătate după încă 137 de zile
\(\hat\lambda_1 = 0{,}067\) (eroarea standard \(0{,}051\)), \(\hat\lambda_2 = 0{,}922\) (\(0{,}059\)); în lucrare: \(0{,}112\) (\(0{,}054\)) și \(0{,}870\) (\(0{,}062\))
2010–2019, QLIKE relativ pe luna 8: 0,714 pentru MF2-GARCH, 0,806 pentru GJR-GARCH (t DM \(-2{,}66\))
pe luna 1: 0,578 și 0,576 (t DM \(0{,}07\)); RMSE relativ pe luna 1: 0,721 și 0,762
în lucrare, QLIKE relativ pe luna 8: \(0{,}859\) și \(0{,}918\)
2010–2026: ordinea QLIKE se inversează de la luna 1 la luna 8 (luna 8: 0,911 față de 0,838, t DM \(0{,}99\))
RMSE relativ rămîne mai mic pentru MF2-GARCH pe lunile 1–5 (luna 1: 0,916 față de 0,960, t DM \(-1{,}16\))
Tipul de dovadă: o comparație de prognoze; direcția lucrării se regăsește la orizonturi lungi pe 2010–2019, nu și pe 2010–2026
Limitele
ținta din randamente zilnice este mai zgomotoasă decît dispersia realizată, deci testele DM au putere mai mică
dispersia randamentelor este finită doar dacă \(\Gamma_m < 1\) (Teorema 1 a lucrării), condiție în plus față de \(\phi < 1\) și \(\lambda_1 + \lambda_2 < 1\): \(\hat\Gamma_{63} = 0{,}883\) pe tot eșantionul, între 0,881 și 0,950 în cele 201 de ferestre mobile
\(\hat\alpha = 0{,}000\), la frontieră (în lucrare \(0{,}003\)): erorile standard obișnuite nu se aplică acestui parametru Andrews (2001)
QMLE și pierderile în unități de dispersie cer moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1; \(\hat\kappa_z = 5{,}03\)
Sinteza secțiunii
Modelul QSD separă grosimea cozilor inovației de atenuarea șocurilor mari; în lucrare și pe cele 11 acțiuni ale cursului, datele resping, pentru majoritatea acțiunilor, atît actualizarea GARCH, cît și restricția bazată pe scor, dar testul PIT respinge totuși toate cele trei modele Student-t pentru 40–46% din acțiuni. MF2-GARCH lasă volatilitatea să revină la un nivel mobil; pe datele cursului, cîștigurile lui apar la orizonturi lungi pe 2010–2019 și nu rezistă includerii perioadei 2020–2026.
AI pentru descoperire științifică
Partea de cercetare a capitolului se încheie cu o buclă în care un asistent AI propune, iar un cercetător verifică. Întrebarea deschisă privește chiar prognoza volatilității, iar mini-studiul de caz arată cum se testează o afirmație plauzibilă a unui asistent pe prognozele capitolului.
Două întrebări deschise decurg din evaluarea prognozelor. Întrec prognozele de machine learning sau cele bazate pe măsuri realizate un GARCH bine specificat pentru dispersia zilnică a acțiunilor, out-of-sample? Și rezistă răspunsul după ce se ține seama de numărul de modele comparate? Două lucrări le încadrează: Christensen, Siggaard & Veliyev (2023) găsesc că metodele de machine learning cu puțină calibrare sînt competitive cu modelele de tip HAR, iar Hansen, Lunde & Nason (2011) arată că Model Confidence Set este obiectul potrivit cînd concurează multe modele.
Înainte de orice calcul, afirmațiile se formulează formal. Cu \(d_t = L(r_t^2, h_t^A) - L(r_t^2, h_t^B)\), fiecare afirmație are propria ipoteză nulă și propria regulă. Egalitatea lui A și B este \(H_0\colon \mathbb{E} d_t = 0\), respinsă la 5% dacă \(|t_{DM}| > 1{,}96\). Superioritatea lui A este ipoteza unilaterală \(H_0\colon \mathbb{E} d_t \geq 0\), respinsă la 5% dacă \(t_{DM} < -1{,}645\). Apartenența la Model Confidence Set privește întreaga mulțime de modele, nu perechea A–B. Stabilitatea este un test separat al egalității lui \(\mathbb{E} d_t\) între subperioade fixate dinainte.
Pe scurt
Întrebări
depășesc prognozele bazate pe învățare automată sau pe măsuri realizate un GARCH bine specificat pentru dispersia zilnică a acțiunilor, în afara eșantionului?
rămîne răspunsul valabil după luarea în calcul a numărului de modele comparate?
În buclă, un asistent AI propune harta literaturii, ipoteze concurente, cod, un plan de robustețe și o critică în stilul unui referent. Cercetătorul verifică fiecare identificator DOI (Digital Object Identifier), identificatorul permanent al unei publicații, reproduce fiecare cifră și fixează planul înainte de prima rulare.
Prognozele de volatilitate cer cinci verificări specifice. Look-ahead: \(h_t\) nu trebuie să se schimbe cînd se schimbă \(r_t\). Pierderea trebuie să fie robustă la proxy-ul zgomotos, QLIKE sau MSE. Căutarea printre multe modele (model mining) trebuie controlată, prin Model Confidence Set sau printr-o corecție Bonferroni. Scala randamentelor și convergența optimizatorului trebuie verificate. Iar DOI-urile sau argumentele funcțiilor din `arch` inventate de asistent trebuie depistate; prompturile reutilizabile și lista completă de verificări sînt în Anexă.
Pe scurt
Bucla
Un asistent AI propune harta literaturii, ipoteze concurente, codul, un plan de robustețe și o critică în stilul unui referent
Cercetătorul verifică fiecare Digital Object Identifier (DOI, identificatorul permanent al publicației), reproduce fiecare cifră și fixează planul înainte de prima rulare
Verificări specifice prognozelor de volatilitate
Deplasarea de anticipare (look-ahead bias), adică folosirea unor informații indisponibile la data prognozei: \(h_t\) nu trebuie să se schimbe cînd se modifică \(r_t\)
O pierdere robustă la aproximare (QLIKE, MSE)
Căutarea modelelor: Model Confidence Set sau corecția Bonferroni (pragul de 5% împărțit la numărul de teste)
Scara și convergența optimizatorului
DOI-uri sau argumente ale funcțiilor din pachetul arch inventate de asistent (prompturi reutilizabile și lista completă de verificare: Anexă)
Mini-studiu de caz și un punct de plecare pentru proiect
O afirmație tipică a unui asistent este că „GJR-t întrece GARCH-t din cauza efectului de levier”. Mai întîi datele: cu \(d_t\) = QLIKE(GJR-t) − QLIKE(GARCH-t) pe cele 2 693 de zile din 2016–2026, \(\bar d = -0{,}025\) și DM \(t = -1{,}22\), deci nici prima jumătate a afirmației nu este stabilită. A doua jumătate sugerează o ipoteză auxiliară, care nu este o implicație necesară a efectului de levier: cîștigul ar trebui să apară după zilele de scădere.
Regresia pe tot calendarul, \(d_t = a + b\,1(r_{t-1} < 0) + u_t\), cu erori standard HAC și 5 laguri, dă \(\hat b = 0{,}019\) (eroare standard 0,041, \(t = 0{,}46\)). Nu există dovezi ale unei diferențe între cele 1 223 de zile de după o scădere și celelalte 1 470 de zile. Pe perioade, statistica \(t\) a diferenței medii este \(-0{,}02\) în 2016–2020 și \(-4{,}06\) în 2021–2026. Rezultatele sînt doar descriptive, deoarece modelele sînt incluse unul în altul, iar fereastra este extinsă; o continuare calibrată ar rula aceeași regresie într-un test GW cu fereastră fixă. Rezultatul susține o comparație de proceduri.
Punctul de plecare pentru proiect întreabă dacă prognozele de machine learning intră în Model Confidence Set alături de GARCH, GJR și EGARCH pentru S&P 500 și BET pe 2016–2026. Echipa replică întîi tabelul QLIKE și preînregistrează modelele, pierderile, împărțirile eșantionului și rata de eroare. Utilizarea AI se notează în `AI_USE.md`, iar fiecare eroare depistată în `AI_ERRORS.md`; descrierea completă este în Anexă.
Pe scurt
O afirmație tipică a unui asistent: „GJR-t depășește GARCH-t datorită efectului de levier”
\(d_t\) = QLIKE(GJR-t) \(-\) QLIKE(GARCH-t), 2 693 de zile, 2016–2026: \(\bar d = -0{,}025\), DM \(t = -1{,}22\)
O ipoteză auxiliară, nu o implicație necesară a efectului de levier: cîștigul apare după zilele de scădere
Regresie pe tot calendarul: \(d_t = a + b\,1(r_{t-1} < 0) + u_t\), HAC cu 5 laguri
\(\hat b = 0{,}019\) (SE 0,041, \(t = 0{,}46\)): nicio dovadă a unei diferențe între zilele de după o scădere (1 223) și celelalte (1 470)
Pe subperioade: \(t = -0{,}02\) în 2016–2020 și \(t = -4{,}06\) în 2021–2026
Doar descriptiv (modele imbricate, fereastră în expansiune)
Continuarea calibrată: aceeași regresie într-un test GW cu fereastră fixă
Tipul de dovadă: comparație între proceduri
Punct de plecare pentru proiect
Intră prognozele bazate pe învățare automată în Model Confidence Set alături de GARCH, GJR și EGARCH pentru S&P 500 și BET, 2016–2026?
Replicați întîi tabelul QLIKE
Pre-înregistrați modelele, pierderile, împărțirile și rata de eroare
Notați utilizarea AI în AI_USE.md și fiecare eroare depistată în AI_ERRORS.md (descrierea completă: Anexă)
Sinteza secțiunii
Afirmația asistentului nu rezistă pe datele capitolului: cîștigul QLIKE al GJR-t față de GARCH-t nu este semnificativ și nu apare după zilele de scădere. Bucla este utilă numai cu afirmații formale stabilite dinainte, o pierdere robustă la proxy, o corecție pentru numărul de modele și un cercetător care reproduce fiecare cifră.
Concluzii
Capitolul a pornit de la observația că mărimea randamentelor zilnice este predictibilă, iar semnul lor nu, și a construit în jurul ei cadrul GARCH: recursia, persistența și timpul de înjumătățire, estimarea cu inovații cu cozi groase, variantele asimetrice, diagnosticul și evaluarea out-of-sample. Secțiunea reunește rezultatele într-un flux de decizie și o decizie practică.
Detectarea volatility clustering, cu \(Q(10)\) pe \(r_t^2\) și testul LM; volatility clustering apare pe toate cele șase piețe, persistența este aproape de 1, iar la Bitcoin și EUR/RON estimarea atinge frontiera IGARCH.
Estimarea modelelor GARCH, GJR și EGARCH cu inovații Normale, Student-t și skewed-t, pe randamente în procente, verificînd convergența și orice parametru aflat pe frontieră.
Diagnosticul nivelului, al pătratelor și al semnelor lui \(\hat z_t\) și al celor mai mari valori ale lui, ținînd seama că testele naive sînt conservatoare.
Prognoza: recursia dă dispersiile pe mai mulți pași, iar regula rădăcinii pătrate a timpului ignoră revenirea la medie.
Compararea out-of-sample, cu QLIKE, testul GW cu fereastră mobilă și Model Confidence Set; GARCH întrece EWMA și Hist-20, iar modelele din familia GARCH sînt greu de separat.
Raportarea incertitudinii: erori standard robuste, valide dacă \(\mathbb{E} z_t^4 < \infty\), teste care țin seama de frontieră și timpi de înjumătățire ca intervale \([h_{lo}; \infty)\) cînd \(\alpha+\beta \approx 1\).
Pe scurt
1. Detectăm
\(Q(10)\) pe \(r_t^2\) și testul LM
Gruparea volatilității apare pe toate cele șase piețe
Persistența este aproape de 1
La Bitcoin și EUR/RON, estimarea atinge frontiera IGARCH
2. Estimăm
GARCH, GJR, EGARCH cu inovații Normale, Student-t, t asimetrice
Randamente în %
Verificăm convergența și parametrii la limită
3. Diagnosticăm
Nivelul, pătratele și semnele lui \(\hat z_t\), precum și cele mai mari valori
Testele naive sînt conservatoare
4. Prognozăm
Recursia dă dispersiile pe mai mulți pași
Regula rădăcinii pătrate a timpului ignoră revenirea la medie
5. Comparăm
În afara eșantionului: QLIKE, GW cu fereastră mobilă și Model Confidence Set
GARCH depășește EWMA și Hist-20
Modelele din familia GARCH sînt greu de departajat
6. Raportăm incertitudinea
SE robuste (valide dacă \(\E z_t^4 < \infty\)) și teste care țin cont de frontieră
Timpi de înjumătățire ca intervale \([h_{lo}; \infty)\) cînd \(\alpha+\beta \approx 1\)
Întrebările de verificare trimit la patru rezultate ale capitolului:
Eroarea regulii rădăcinii pătrate a timpului după o zi agitată (exemplul numeric);
Valoarea critică 2,71 a amestecului pentru un parametru aflat pe frontieră;
Timpii de înjumătățire negativi ai metodei delta;
Diferența dintre decalajul VIX–GARCH și prima de risc a dispersiei.
Răspunsurile scurte sînt în cadrul următor.
Capitolele următoare se sprijină pe aceste rezultate. Capitolul 6 extinde modelele la mai multe active, cu volatilitate multivariată și corelații dinamice (DCC). Capitolele 7 și 8 folosesc volatilitatea GARCH pentru Value at Risk și expected shortfall și le supun backtesting-ului, iar Capitolul 9 tratează volatilitatea realizată și memoria lungă. Seminarul 5 parcurge recursia dispersiei pas cu pas, GARCH-t și GJR pe date reale, un răspuns AI de auditat, teste bootstrap și comparații de prognoze.
Pe scurt
Întrebări de verificare
De ce supraestimează regula rădăcinii pătrate a timpului riscul pe 10 zile după o zi cu volatilitate ridicată?
De ce se compară testul LR al inovațiilor Normale față de Student-t cu 2,71 și nu cu 3,84?
De ce poate un interval simetric pentru timpul de înjumătățire să conțină valori negative?
De ce diferența dintre VIX și volatilitatea GARCH nu măsoară prima de risc a dispersiei?
Capitolele următoare
Capitolul 6: volatilitate multivariată și corelații dinamice (DCC)
Capitolele 7–8: Value at Risk și expected shortfall cu volatilitate GARCH și backtesting-ul lor
Capitolul 9: volatilitatea realizată și memoria lungă
După o zi agitată, \(\sigma_{t+1}^2\) depășește dispersia de termen lung \(\sigma^2\), iar prognozele zilnice scad spre \(\sigma^2\), deci suma lor este sub \(H\sigma_{t+1}^2\): regula rădăcinii pătrate a timpului supraestimează riscul pe mai multe zile (exercițiul A1 din Seminarul 5). În testul inovațiilor Normale față de Student-t, \(1/\nu = 0\) se află pe frontieră sub \(H_0\); în circa jumătate din eșantioane estimarea stă pe frontieră și \(LR = 0\), deci legea este \(\tfrac12\chi^2_0 + \tfrac12\chi^2_1\), a cărei valoare critică de 5% este 2,71.
Timpul de înjumătățire \(h = \ln 0{,}5/\ln p\) explodează cînd \(p \to 1\). Metoda delta îl înlocuiește cu o dreaptă, așa că \(\hat h \pm 1{,}96\,\widehat{\mathrm{SE}}\) ignoră curbura; trebuie transformat în schimb intervalul pentru \(p\) (exercițiul A2 din Seminarul 5). În sfîrșit, comparația corectă pentru prima de risc a dispersiei este între \(\text{VIX}^2\), media neutră la risc a dispersiei pe 30 de zile, și o prognoză GARCH a dispersiei pe 30 de zile sub probabilitatea reală; \(\hat\sigma_t\) este o volatilitate pe o zi, deci diferă atît orizontul, cît și probabilitatea.
Pe scurt
Regula rădăcinii pătrate a timpului
După o zi cu volatilitate ridicată, \(\sigma_{t+1}^2 > \sigma^2\), dispersia de termen lung
Prognozele zilnice scad spre \(\sigma^2\), deci suma lor este sub \(H\sigma_{t+1}^2\)
Sub \(H_0\), \(1/\nu = 0\) este pe frontieră: în circa jumătate din eșantioane estimarea este la limită și \(LR = 0\), deci legea este \(\tfrac12\chi^2_0 + \tfrac12\chi^2_1\), cu valoarea critică 2,71 la 5%
Comparația corectă: \(\text{VIX}^2\), media neutră la risc (risk-neutral) a dispersiei pe 30 de zile, față de o prognoză GARCH a dispersiei pe 30 de zile sub probabilitatea reală
\(\hat\sigma_t\) este o volatilitate pe o zi, deci diferă atît orizontul, cît și probabilitatea
Decizia are trei părți: ce aleg, în ce condiții și ce rezultat m-ar face să renunț. Alegerea este un model din familia GARCH cu inovații Student-t, iar pentru indicii bursieri GJR-t. GJR-t are cea mai mică QLIKE out-of-sample, 0,731, și o valoare \(p\) în Model Confidence Set de 1,000, în timp ce EWMA și Hist-20 sînt clar mai slabe (DM \(t\) = 3,47 și 4,10).
Alegerea este valabilă în patru condiții. Persistența GJR-t trebuie să fie sub 1: \(\hat\alpha+\hat\gamma/2+\hat\beta = 0{,}9835\) pentru S&P 500 și 0,9897 pentru BET. Restricțiile active trebuie raportate: pentru S&P 500, \(\hat\alpha = 0\) atinge frontiera \(\alpha \geq 0\), deci eroarea standard a lui \(\hat\alpha\) nu este cea obișnuită. Erorile standard MLE Student-t presupun densitatea corectă; altfel, erorile robuste cer momente finite ale scorului, pe care \(\hat\nu > 4\) singur nu le garantează. Iar \(Q(10)\) pe \(\hat z_t^2\) și LM(5) nu trebuie să detecteze volatility clustering rămas.
Două rezultate m-ar face să renunț la model:
O estimare pe frontiera \(\hat\alpha+\hat\beta = 1\), ca la Bitcoin și EUR/RON, unde prognoza dispersiei crește cu \(\hat\omega\) pe zi.
Ieșirea modelului din Model Confidence Set de 90% sau pierderea lui în fața EWMA în QLIKE out-of-sample.
Pe scurt
Ce aleg: un model din familia GARCH cu inovații Student-t; pentru indicii bursieri, GJR-t
GJR-t are cel mai mic QLIKE în afara eșantionului (0,731) și valoarea \(p\) 1,000 în MCS (Model Confidence Set, mulțimea de încredere a modelelor)
EWMA și Hist-20 sînt clar mai slabe (\(t\) DM = 3,47 și 4,10)
În ce condiții
Persistența GJR-t este sub 1: \(\hat\alpha+\hat\gamma/2+\hat\beta = 0{,}9835\) la S&P 500, \(0{,}9897\) la BET
Restricțiile active se raportează: la S&P 500, \(\hat\alpha = 0\) atinge limita \(\alpha \geq 0\), deci eroarea standard a lui \(\hat\alpha\) nu este cea obișnuită
Erorile standard ale MLE Student-t presupun densitatea corectă; altfel, erorile robuste cer momente finite ale scorului, pe care \(\hat\nu > 4\) nu le garantează singur
\(Q(10)\) pe \(\hat z_t^2\) și LM(5) nu mai detectează gruparea volatilității
Ce rezultat m-ar face să renunț
Estimarea atinge frontiera \(\hat\alpha+\hat\beta = 1\), ca la Bitcoin și EUR/RON: prognoza dispersiei crește atunci cu \(\hat\omega\) pe zi
Modelul iese din Model Confidence Set de 90% sau pierde în QLIKE în fața EWMA, în afara eșantionului
Sinteza secțiunii
Pentru dispersia zilnică a indicilor bursieri, alegerea capitolului este GJR-t: are cea mai mică QLIKE out-of-sample pe S&P 500 și rămîne în Model Confidence Set, în timp ce reperele fără parametri estimați sînt eliminate. Alegerea se sprijină pe o persistență sub 1, pe raportarea restricțiilor de frontieră și pe reziduuri fără volatility clustering și se abandonează cînd estimarea atinge frontiera IGARCH sau cînd modelul iese din Model Confidence Set.
Aprofundări
Cadrele din această parte extind subiecte tratate pe scurt în corpul capitolului: teoria asimptotică a QMLE Gaussian și eșecul ei cu cozi groase, testele la frontieră pe datele capitolului, crahul COVID-19 și traiectoriile volatilității pe celelalte piețe, diagnosticul reziduurilor cu parametri estimați, testul Giacomini–White, Model Confidence Set și prognozele pe o lună, precum și eșantionul cursului din studiul de caz QSD.
QMLE Gaussian: normalitatea asimptotică și erorile standard
Pentru GARCH-ul pur cu medie cunoscută, QMLE Gaussian al lui \(\vartheta = (\omega, \alpha, \beta)\) este asimptotic Normal dacă, pe lîngă condițiile de consistență, \(\vartheta_0\) este interior și \(\kappa_z = \mathbb{E} z_t^4 < \infty\):
Estimatorul sandwich \(\hat A^{-1}\hat B\hat A^{-1}\), cu \(A\) minus hessiana medie a lui \(\ell/n\) și \(B\) dispersia scorului pe observație, estimează \((\kappa_z - 1)J^{-1}\), în timp ce inversa hessianei singură estimează \(2J^{-1}\). Raportul dintre erorile standard robuste și cele clasice este deci \(\sqrt{(\kappa_z - 1)/2}\): 1 sub normalitate și peste 1 cu cozi groase. Variantele cu medie estimată, IGARCH și cazul exploziv sînt în Anexă.
Pe scurt
Normalitatea asimptotică a lui \(\vartheta = (\omega, \alpha, \beta)\) (GARCH pur, media cunoscută): adăugăm \(\vartheta_0\) interior și \(\kappa_z = \E z_t^4 < \infty\)
Pe S&P 500, GARCH(1,1) cu verosimilitate Normală lasă un kurtosis al reziduurilor \(\hat\kappa_z = 4{,}73\), deci teoria prevede un raport robust/clasic de \(\sqrt{(4{,}73-1)/2} = 1{,}37\), iar raportul observat este 1,37 atît pentru \(\hat\alpha\), cît și pentru \(\hat\beta\) (exercițiul A5 din Seminarul 5). La Bitcoin teoria eșuează: GARCH-t dă \(\hat\nu = 3{,}18 < 4\), sub care \(\mathbb{E} z_t^4 = \infty\); kurtosis-ul reziduurilor QMLE Gaussian nu se stabilizează (19,8 pe prima jumătate, 14,6 pe tot eșantionul), iar rapoartele observate, 2,51 pentru \(\hat\alpha\) și 2,01 pentru \(\hat\beta\), diferă de valoarea formulei, 2,61. În acest caz, Hall & Yao (2003) arată că QMLE Gaussian converge mai încet decît \(\sqrt{n}\), către o limită ne-Gaussiană, deci statisticile lui \(t\) robuste nu sînt valide; remediile sînt o cvasi-verosimilitate cu cozi groase, cu ajustarea ei de scală (Fan, Qi & Xiu, 2014), sau MLE Student-t, cu inferență bootstrap lîngă frontiere.
Raportul observat: 1,37 pentru \(\hat\alpha\) și 1,37 pentru \(\hat\beta\)
Bitcoin: GARCH-t dă \(\hat\nu = 3{,}18 < 4\) grade de libertate
Sub această lege \(\E z_t^4 = \infty\)
Condiția pentru normalitatea asimptotică a QMLE Gaussian nu este îndeplinită
Kurtosis-ul reziduurilor QMLE Gaussian nu se stabilizează: 19,8 pe prima jumătate, 14,6 pe tot eșantionul
Pe tot eșantionul, SE robustă / clasică: 2,51 pentru \(\hat\alpha\) și 2,01 pentru \(\hat\beta\), față de valoarea din formulă, \(2{,}61\), care presupune \(\kappa_z < \infty\)
Hall & Yao (2003): atunci QMLE Gaussian converge mai lent decît \(\sqrt{n}\)
Spre o distribuție-limită care nu este Normală
Statisticile \(t\) robuste ale QMLE Gaussian nu sînt valide
Testul LR al inovațiilor Normale față de Student-t în GARCH(1,1) dă 311,9 pentru S&P 500 și 1 082,0 pentru Bitcoin (exercițiul B6 din Seminarul 5), mult peste 2,71, deci amestecul contează doar în cazurile la limită. Testul IGARCH, \(H_0\colon \alpha+\beta = 1\) în GARCH-t, dă \(LR\) = 1,09 pentru S&P 500, cu valorile \(p\) 0,30 față de \(\chi^2_1\), 0,15 față de amestec și 0,17 printr-un bootstrap parametric sub \(H_0\) (998 de reestimări convergente din 999 de eșantioane simulate), și 1,14 pentru BET, cu valorile \(p\) 0,28, 0,14 și 0,17 (exercițiul B8). În bootstrap-ul sub \(H_0\), 53% din reestimările pentru S&P 500 au \(\hat\alpha+\hat\beta \geq 0{,}999\), adică stau pe frontieră, cum prevede amestecul. O rădăcină unitară în dispersie nu poate fi respinsă nici pentru S&P 500, nici pentru BET.
S&P 500, valorile \(p\): 0,30 (\(\chi^2_1\)), 0,15 (amestec), 0,17 (bootstrap parametric sub \(H_0\) pe statistica \(\hat\alpha+\hat\beta\), 998 de reestimări convergente din 999 de eșantioane simulate)
Graficul urmărește S&P 500 din ianuarie pînă în iulie 2020: \(|r_t|\) anualizat, volatilitățile GARCH-t și GJR-GARCH-t și VIX. La 24 februarie, cu \(r_t = -3{,}41\%\), VIX a urcat de la 17,1% la 25,0% în aceeași zi, în timp ce GARCH-t a urcat de la 12,2% la 22,5% abia în ziua următoare: GARCH reacționează la randamente, piețele evaluează imediat. După \(r_t = -12{,}8\%\) din 16 martie, ambele volatilități ating vîrful la 17 martie, 111% la GARCH-t și 127% la GJR-t, vîrful GJR fiind mai înalt pentru că șocurile au fost negative. Aceste traiectorii folosesc parametrii estimați pe tot eșantionul (2000–2026); o prognoză cu parametri estimați înainte de 2020, ca în exercițiul B5 din Seminarul 5, dă un alt vîrf.
Pe scurt
COVID-19, ianuarie–iulie 2020: \(|r_t|\) anualizat, volatilitatea GARCH-t și GJR-GARCH-t, VIX
24 februarie (\(r_t = -3{,}41\)%): VIX a trecut de la 17,1% la 25,0% în aceeași zi
GARCH-t de la 12,2% la 22,5% abia a doua zi
GARCH reacționează cu o zi întîrziere, piața include informația în preț imediat
După \(r_t = -12{,}8\)% pe 16 martie, vîrfuri pe 17 martie: GARCH-t 111%, GJR-t 127%
Vîrful GJR este mai ridicat, deoarece șocurile au fost negative
Parametrii sînt estimați pe tot eșantionul (2000–2026)
O prognoză cu parametri estimați înainte de 2020 (ca în Seminarul 5, B5) dă un vîrf diferit
Graficul arată traiectoriile volatilității GARCH pe celelalte patru piețe. La BET domină anul 2008, iar nivelul curent este 26,4%. La Bitcoin, intervalul obișnuit este 50–100%, iar cel mai înalt vîrf este în martie 2020. EUR/RON arată un calm administrat, cu explozii în 2022 și 2025, slab descris de un GARCH zilnic, iar aurul atinge un nou maxim de 53% în 2026. La Bitcoin și EUR/RON estimarea se află pe frontiera IGARCH, așa că traiectoriile lor sînt doar descriptive, cum s-a discutat la structura la termen.
Pe scurt
BET: anul 2008 domină, nivelul actual este 26,4%
Bitcoin: 50–100% este obișnuit
Cel mai înalt vîrf, în martie 2020
EUR/RON: perioade calme (managed float), întrerupte de episoade volatile în 2022 și 2025
Slab descrise de un GARCH zilnic
Aur: un nou maxim de 53% în 2026
Bitcoin și EUR/RON: estimarea este pe frontiera IGARCH
Deci traiectoriile sînt doar descriptive (structura la termen)
Reziduurile standardizate \(\hat z_t\) depind de \(\hat\theta\), deci statistica Ljung–Box pe \(\hat z_t^2\) nu este exact \(\chi^2_m\)(Li & Mak, 1994): dispersia estimată a absorbit deja o parte din dependența de la lagurile mici. Pe S&P 500, pentru QMLE Gaussian al GARCH(1,1), \(Q(10)\) naiv pe \(\hat z_t^2\) este 16,2, cu valoarea \(p\) 0,094, deci nu se respinge la 5%; corectat pentru parametrii estimați, este 19,0, cu valoarea \(p\) 0,041, deci se respinge, iar verdictul se schimbă. Testul naiv este conservator: sub \(H_0\) respinge mai rar decît nivelul nominal și are de aceea și mai puțină putere. Testul sign-bias comun are aceeași rezervă; matricea de corecție este în Anexă.
Pe scurt
\(\hat z_t\) depinde de \(\hat\theta\): statistica Ljung–Box pe \(\hat z_t^2\) nu este exact \(\chi^2_m\)Li & Mak (1994)
Motivul: dispersia estimată a preluat deja o parte din dependența de la lagurile mici
S&P 500, QMLE Gaussian pentru GARCH(1,1), \(Q(10)\) pe \(\hat z_t^2\)
Ljung–Box naiv: 16,2, valoarea \(p\) 0,094: nerespins la 5%
Corectat pentru parametrii estimați: 19,0, valoarea \(p\) 0,041: respins la 5%, verdictul se inversează
Testul naiv este conservator: sub \(H_0\) respinge mai rar decît nivelul nominal, deci are și putere mai mică
Testul comun de asimetrie are aceeași limită (matricea de corecție: Anexă)
Graficul compară, pentru lagurile 1–30 pe S&P 500, autocorelațiile lui \(r_t^2\), înainte de model, cu cele ale lui \(\hat z_t^2\) din GJR-GARCH-t. După model ele se află în interiorul benzii i.i.d., deci la aceste laguri nu se detectează dinamică rămasă a dispersiei. Banda este însă cea naivă, iar cu parametri estimați ea este prea largă la lagurile mici, cum arată cadrul precedent.
Pe scurt
S&P 500, lagurile 1–30: autocorelațiile lui \(r_t^2\) (înainte de model) și ale lui \(\hat z_t^2\) din GJR-GARCH-t
După model ele sînt în banda i.i.d.: la aceste laguri nu se mai detectează dinamică a dispersiei
Banda este cea naivă: cu parametri estimați este prea largă la laguri mici (slide-ul anterior)
Tabelul leagă tiparele reziduurilor de pe celelalte piețe de eșecuri posibile și de verificările următoare. La BET, \(Q(10)\) pe \(\hat z_t\) este 116,6, o autocorelație în medie care trimite la tranzacționarea rară (thin trading, Capitolul 2) și cere o medie AR(1). La Bitcoin, \(Q(10)\) pe \(\hat z_t^2\) este 4,7, iar testul sign-bias comun 1,3, fără respingere, dar cu \(\hat\nu = 3{,}18 < 4\) dispersia lui \(z_t^2\) este infinită, iar calibrarea \(\chi^2\) nu este justificată; următoarea verificare sînt testele pe \(|\hat z_t|\). La EUR/RON, excesul de kurtosis al reziduurilor este 3 190, dominat de un singur reziduu de 154; la aur, EGARCH lasă \(Q(10)\) pe \(\hat z_t^2\) = 48,6 în ciuda unui BIC bun. Cele mai mari reziduuri trebuie inspectate întotdeauna, pentru că o singură observație poate domina orice diagnostic.
Pe scurt
Piața
Tiparul reziduurilor
Problema posibilă
Verificarea următoare
BET
\(Q(10)\) pe \(\hat z\) = 116,6
autocorelație în medie (tranzacționare redusă, Capitolul 2)
model AutoRegressive AR(1) pentru medie
Bitcoin
\(Q(10)\) pe \(\hat z^2\) = 4,7, testul comun de asimetrie 1,3: nerespins
\(\hat\nu = 3{,}18 < 4\): \(\Var(z_t^2) = \infty\), deci calibrarea \(\chi^2\) nu este justificată
teste pe \(|\hat z_t|\)
EUR/RON
exces de kurtosis 3 190
un singur reziduu de 154 (mai 2025) domină
inspectarea celor mai mari reziduuri și un model cu scor mărginit
Aur
EGARCH: \(Q(10)\) pe \(\hat z^2\) = 48,6
grupare a volatilității rămasă, deși BIC este bun
alegere prin diagnostic, nu doar prin BIC
Examinați întotdeauna cele mai mari reziduuri: o singură observație poate domina toate diagnosticele
Cu parametri estimați, modele incluse unul în altul și o fereastră extinsă, diferența de pierdere degenerează sub \(H_0\), iar statistica DM nu mai este \(N(0,1)\), cum arată West (1996) și Clark & McCracken (2001). Testul lui Giacomini & White (2006) testează în schimb metoda de prognoză, adică modelul împreună cu o fereastră mobilă de \(W\) = 1 000 de zile, al cărei zgomot de estimare nu dispare, așa că testul se aplică și modelelor incluse unul în altul, în condiții de momente finite, dependență limitată și \(\Omega\) nesingulară. Cu \(Z_{t+1} = (1, d_t)^\top d_{t+1}\), media ei \(\bar Z\) pe cele \(n\) prognoze și momentul de ordinul doi necentrat \(\hat\Omega = n^{-1}\sum Z_{t+1}Z_{t+1}^{\top}\),
Cu șase modele, comparațiile cu GARCH-t înseamnă cinci teste, iar testele multiple măresc rata respingerilor false. Model Confidence Set (MCS) al lui Hansen, Lunde & Nason (2011) compară toate cele 15 perechi și elimină cel mai slab model pînă cînd acuratețea egală nu mai este respinsă. Mulțimea finală conține cel mai bun model cu probabilitatea de cel puțin \(1-\alpha\), aici cu \(\alpha = 10\%\). Valorile critice provin dintr-un bootstrap staționar (stationary bootstrap), care reeșantionează blocuri de lungime aleatoare, cu distribuție geometrică și medie de 10 zile, astfel încît dependența serială să se păstreze.
Pe scurt
Întrebarea: care modele rămîn candidate pentru „cel mai bun”, dacă le comparăm pe toate?
Cu șase modele, comparațiile față de GARCH-t înseamnă cinci teste
Testul GW, cu fereastră mobilă și 2 693 de prognoze ale fiecărui model față de GARCH-t, respinge acuratețea egală numai pentru EWMA (\(p = 0{,}004\)) și Hist-20 (\(p < 0{,}001\)). Model Confidence Set de 90%, pe pierderile QLIKE cu fereastră extinsă și cu bootstrap staționar, păstrează cele patru modele GARCH, cu GJR-t la \(p = 1{,}000\), și elimină EWMA (\(p = 0{,}008\)) și Hist-20 (\(p = 0{,}002\)). Concluzia este aceeași ca la DM; GW are inferență calibrată în condițiile teoremei sale, în timp ce MCS, construit pe fereastra extinsă, are aceeași rezervă ca DM. Tabelul complet și statistica MCS sînt în Anexă.
Pe scurt
Giacomini–White: fereastră mobilă, 2 693 de prognoze, fiecare model față de GARCH-t
Respinge doar EWMA și Hist-20
Model Confidence Set (MCS) 90%: fereastră în expansiune, QLIKE, bootstrap staționar
Păstrează cele patru modele GARCH, elimină EWMA și Hist-20
Aceeași concluzie ca testul DM
GW, cu fereastră mobilă, are inferența calibrată sub condițiile teoremei
MCS (fereastră în expansiune) se citește cu aceeași rezervă ca DM
Graficul compară prognoza GJR-t a dispersiei pe 22 de zile cu suma realizată a 22 de pătrate ale randamentelor, pe 122 de ferestre care nu se suprapun, în regresia \(\ln Y = a + b \ln \hat h + u\), unde \(Y\) este suma realizată, iar \(\hat h\) prognoza. \(R^2\) în logaritmi este 0,39, iar panta \(b = 0{,}77\) (eroare standard 0,07). Panta este doar descriptivă: deoarece \(\mathbb{E}[\ln Y \mid \mathcal{F}] \neq \ln \mathbb{E}[Y \mid \mathcal{F}]\),\(b < 1\) în logaritmi nu dovedește prognoze supradispersate.
Pe scurt
Prognoza GJR-t a dispersiei pe 22 de zile față de suma realizată a 22 de pătrate ale randamentelor
122 de ferestre nesuprapuse
Regresia \(\ln Y = a + b \ln \hat h + u\), \(Y\): suma realizată, \(\hat h\): prognoza
\(R^2\) în logaritmi 0,39
Panta în logaritmi \(b = 0{,}77\) (SE 0,07): doar descriptivă
Deoarece \(\E[\ln Y \mid \mathcal{F}] \neq \ln \E[Y \mid \mathcal{F}]\)
Deci \(b < 1\) nu dovedește prognoze prea dispersate
În niveluri, panta este doar 0,66, deoarece două ferestre COVID-19 domină regresia. Prognozele pe 22 de zile se compară de aceea prin QLIKE (Patton, 2011): GARCH-N 4,12, GARCH-t 4,13, GJR-t 4,14 și EWMA 4,26, valorile mai mici fiind mai bune. La o lună, asimetria GJR nu mai aduce un cîștig.
Pe scurt
În niveluri \(b\) este doar 0,66: două ferestre COVID-19 domină
De aceea comparăm prognozele pe 22 de zile cu QLIKE Patton (2011)
GARCH-N 4,12, GARCH-t 4,13, GJR-t 4,14, EWMA 4,26 (mai mic = mai bun)
Eșantionul cursului are 11 acțiuni mari, față de 400 în lucrare, din 1995 sau mai tîrziu pînă în februarie 2019, cu 4 986 pînă la 6 081 de randamente fiecare și \(X_t = \mathrm{VIX}_t^2/252\). Ipoteza \(\zeta = 0\) este respinsă pentru 9 din 11 acțiuni (89,5% în lucrare), iar \(\xi = \zeta\) pentru 8 din 11 (53,5% în lucrare). Mediana lui \(1/\hat\zeta\) este 21,4 în QSD față de 6,32 în Beta-t-GARCH, comparat cu 9,48 și 5,07 în lucrare. Unsprezece supraviețuitori selectați dau estimări imprecise și nereprezentative.
Pe scurt
Eșantionul cursului: 11 acțiuni mari (lucrarea: 400)
1995 (sau mai tîrziu) – februarie 2019, 4 986–6 081 randamente fiecare
\(X_t = \mathrm{VIX}_t^2/252\)
\(\zeta = 0\) respinsă pentru 9 din 11 (lucrarea: \(89{,}5\%\))
\(\xi = \zeta\) respinsă pentru 8 din 11 (lucrarea: \(53{,}5\%\))
Mediana lui \(1/\hat\zeta\): 21,4 (QSD) față de 6,32 (Beta-t-GARCH)
Graficul arată funcțiile de actualizare la cuantile ale celor 11 estimări, la un \(\alpha f_t\) comun: contribuția lui \(\epsilon_t\) la \(f_{t+1}\), în unități de \(\alpha f_t\), care este \(\epsilon_t^2\) la GARCH-t. Un șoc de 5 abateri standard adaugă 25 la GARCH-t, 12,6 la QSD median și 6,2 la Beta-t-GARCH median; la 10 abateri standard, 100, 18,8 și 7,0, față de limita \((1+\zeta)/\zeta\) = 7,3. Atenuarea QSD se află între GARCH-t și Beta-t-GARCH.
Pe scurt
Funcțiile de actualizare la cuantile ale celor 11 estimări, la același \(\alpha f_t\)
Contribuția lui \(\epsilon_t\) la \(f_{t+1}\), în unități de \(\alpha f_t\)
GARCH-t adaugă \(\epsilon_t^2\,\alpha f_t\)
Un șoc de 5 abateri standard adaugă \(25\) (GARCH-t), 12,6 (QSD median) și 6,2 (Beta-t-GARCH median)
Un șoc de 10 abateri standard adaugă \(100\) (GARCH-t), 18,8 (QSD median)
7,0 (Beta-t-GARCH median, cu limita \((1+\zeta)/\zeta\) = 7,3)
Atenuarea QSD este intermediară între GARCH-t și Beta-t-GARCH
Anexa conține tabelul datelor, testele scorului unilaterale, o notă despre Premiul Nobel din 2003, kurtosis-ul unei traiectorii simulate lungi, variantele teoremei QMLE, corecția Li–Mak, tabelele complete ale evaluării prognozelor, ecuațiile extensiilor, metoda completă a studiului de caz QSD, precum și prompturile și descrierea proiectului din bucla descoperirii.
Tabelul enumeră cele șase serii, cu proprietarul sau sursa, anul de început, numărul de observații, observațiile pe an, volatilitatea de selecție anualizată și excesul de kurtosis. S&P 500 are 6 717 observații din 2000, o volatilitate de 19,2% pe an și un exces de kurtosis de 10,7; Bitcoin, cu 365,3 observații pe an, are cea mai mare volatilitate, 66,6%, iar EUR/RON cea mai mică, 4,4%. BET-TR are cel mai mare exces de kurtosis, 17,8. Indicii bursieri și aurul se tranzacționează doar în zilele lucrătoare, iar fiecare volatilitate este anualizată cu propriul număr de observații pe an al seriei.
Pe scurt
Serie
Proprietar / sursă
Început
Obs.
Obs. pe an
Vol. (% anual)
Exces de kurtosis
S&P 500
S&P Dow Jones Indices
2000
6 717
251,5
19,2
10,7
BET
Bursa de Valori București
2000
6 670
249,8
22,1
11,1
BET-TR
Bursa de Valori București
2014
2 992
249,7
15,4
17,8
Bitcoin (BTC/USD)
burse cripto (compozit)
2014
4 384
365,3
66,6
12,0
EUR/RON, curs de referință
BNR
2005
5 352
252,4
4,4
15,1
Aur (XAU/USD)
piața spot
2000
6 949
260,2
17,6
7,7
Indici bursieri și aur: doar zilele lucrătoare
Vol.: volatilitatea de selecție anualizată cu numărul de observații pe an al fiecărei serii
Deoarece alternativa ARCH este unilaterală, \(\alpha_i \geq 0\), testul \(\chi^2\) bilateral risipește putere; Lee & King (1993) construiesc un test al scorului unilateral pe suma componentelor scorului, \(N(0,1)\) sub \(H_0\), care respinge numai în coada superioară. Față de GARCH(1,1), ipoteza nulă \(\alpha = 0\) lasă \(\beta\) neidentificat, problema Davies; statistica LM ARCH(\(q\)) este și testul scorului față de GARCH(\(p\),\(q\)), deci aceeași statistică servește ambelor alternative.
Pe scurt
Alternativa este unilaterală (\(\alpha_i \geq 0\)): testul \(\chi^2\) bilateral pierde putere
Lee & King (1993): test al scorului unilateral, construit pe suma componentelor scorului, \(N(0,1)\) sub \(H_0\), respinge doar în coada superioară
Față de GARCH(1,1), ipoteza nulă \(\alpha = 0\) lasă \(\beta\) neidentificat (problema Davies)
Statistica LM ARCH(\(q\)) este și testul scorului față de GARCH(\(p\),\(q\)): aceeași statistică servește ambele alternative (Lee & King (1993))
Robert Engle a primit Premiul Nobel pentru științe economice din 2003 „pentru metode de analiză a seriilor de timp economice cu volatilitate variabilă în timp (ARCH)”, împărțit cu Clive Granger, distins pentru cointegrare. Prelegerea lui Nobel (Engle, 2004) discută riscul și volatilitatea în practica financiară. Tim Bollerslev, doctorandul lui Engle, a generalizat ARCH la GARCH în 1986.
Pentru GARCH-N pe S&P 500, condiția de moment este 0,990509, deci \(K = 12{,}2\) are numitorul \(1 - 0{,}990509\); rotunjirea la \(\hat\alpha = 0{,}120\) și \(\hat\beta = 0{,}860\) dă 0,9892 și \(K = 11{,}0\), așa că astfel de funcții trebuie raportate din estimări nerotunjite. Pe un milion de zile simulate din GARCH(1,1) al cadrului de simulare, excesul de kurtosis este 2,47, față de valoarea teoretică 3,06, iar autocorelația de ordinul 1 a lui \(\varepsilon_t^2\) este 0,26. Kurtosis-ul de selecție converge încet, pentru că precizia lui depinde de momentul de ordin opt, infinit pentru acești parametri.
Pe scurt
S&P 500, GARCH-N: condiția de moment este \(0{,}990509\), deci \(K = 12{,}2\) are numitorul \(1 - 0{,}990509\)
Rotunjirea la \(\hat\alpha = 0{,}120\), \(\hat\beta = 0{,}860\) dă 0,9892 și \(K = 11{,}0\): raportați astfel de funcții din estimări nerotunjite
GARCH(1,1) simulat de pe slide-ul de simulare, un milion de zile
Exces de kurtosis 2,47 (teoretic 3,06)
Autocorelația de ordin 1 a lui \(\varepsilon_t^2\): 0,26
Kurtosis-ul de selecție converge încet: precizia lui depinde de momentul de ordin opt, infinit pentru acești parametri
Cu medie estimată, scorul primește termenul \(\varepsilon_t\,(\partial\mu_t/\partial\theta)/\sigma_t^2\), iar covarianța nu mai este \((\kappa_z - 1)J^{-1}\): blocul mediei depinde și de asimetria lui \(z_t\). În IGARCH, \(\alpha + \beta = 1\), staționaritatea strictă rămîne valabilă, iar QMLE rămîne consistent și asimptotic Normal (Lumsdaine, 1996). În cazul exploziv, \(\mathbb{E}\ln(\alpha z_t^2 + \beta) > 0\),Jensen & Rahbek (2004) estimează \((\alpha, \beta)\) cu \(\omega\) fixat, deoarece \(\omega\) nu poate fi estimat consistent.
Pe scurt
Media estimată: scorul capătă termenul \(\varepsilon_t\,(\partial\mu_t/\partial\theta)/\sigma_t^2\)
Covarianța nu mai este \((\kappa_z - 1)J^{-1}\): blocul mediei depinde și de asimetria lui \(z_t\)
Pentru vectorul \(\hat r = (\hat r_1, \ldots, \hat r_m)^\top\) al autocorelațiilor pătratelor reziduurilor, \(\sqrt{n}\,\hat r \to N(0, C)\), cu \(C = I - H^\top J^{-1}H/(\kappa_z - 1)\)(Li & Mak, 1994), unde coloana \(k\) a lui \(H\),\(H_k = \mathbb{E}[g_t (z_{t-k}^2 - 1)]\), măsoară cît din dependența de la lagul \(k\) absoarbe dispersia estimată, iar regula ARMA \(\chi^2_{m-p-q}\) nu se aplică. Cînd se estimează și \(\mu\),\(C\) provine din covarianța comună a lui \(\hat r\) și a scorului QMLE pentru \((\mu, \omega, \alpha, \beta)\), inclusiv termenii încrucișați cu \(\mathbb{E} z_t^3\). Pentru QMLE Gaussian al GARCH(1,1) pe S&P 500, \(C_{1,1} = 0{,}78\),\(C_{5,5} = 0{,}93\) și \(C_{10,10} = 0{,}97\): corecția este cea mai mare la lagurile mici, unde \(\hat\alpha\) a ajustat deja dependența, iar statistica corectată \(n\hat r^\top C^{-1}\hat r\) este \(\chi^2_{10}\) sub \(H_0\).
Pe scurt
Autocorelațiile pătratelor reziduurilor \(\hat r_k\): \(\sqrt{n}\,\hat r \to N(0, C)\), \(C = I - H'J^{-1}H/(\kappa_z - 1)\)Li & Mak (1994)
\(\hat r = (\hat r_1, \ldots, \hat r_m)'\)
\(I\): matricea identitate
\(C\): covarianța corectată, mai mică decît \(I\) pe diagonală
\(g_t\), \(J\): ca în teorema QMLE
\(H_k = \E[g_t (z_{t-k}^2 - 1)]\): cît din dependența de ordin \(k\) absoarbe dispersia estimată
regula ARMA \(\chi^2_{m-p-q}\) nu se aplică
Media \(\mu\) este și ea estimată: \(C\) se calculează din covarianța comună a lui \(\hat r\) și a scorului QMLE pentru \((\mu, \omega, \alpha, \beta)\), inclusiv termenii încrucișați cu \(\E z_t^3\)
Tabelul dă, pentru cele șase metode de prognoză, QLIKE și MSE medii pe cele 2 693 de zile, statistica DM \(t\) față de GARCH-t pe QLIKE, cu HAC și 5 laguri (negativă: modelul întrece GARCH-t), precum și panta MZ \(b\),\(R^2\) și valoarea \(p\) Wald pentru \(a = 0\),\(b = 1\).\(R^2\) din MZ variază de la 0,152 la Hist-20 la 0,293 la EGARCH-t, iar nedeplasarea este respinsă doar pentru Hist-20 (\(p = 0{,}03\)).
Tabelul dă QLIKE a fiecărui model pe fereastra mobilă de 1 000 de zile, reestimată în fiecare ianuarie, statistica \(t\) necondiționată (doar instrumentul 1, o statistică DM \(t\) pe pierderile cu fereastră mobilă, cu HAC și 5 laguri), statistica GW cu valoarea ei \(p\) și valoarea \(p\) din MCS. GW folosește momentul de ordinul doi necentrat, fără HAC, și se compară cu 5,99. MCS folosește pierderile QLIKE cu fereastră extinsă, statistica \(T_R\), cel mai mare \(|t|\) dintre diferențele de pierdere pe perechi, și un bootstrap staționar cu blocul mediu de 10 și 10 000 de extrageri.
Pe scurt
Model
QLIKE (W)
\(t\) necond.
\(GW\)
\(p\)
MCS \(p\)
GARCH-N
0,750
1,86
5,70
0,058
0,588
GARCH-t
0,743
–
–
–
0,341
GJR-t
0,737
\(-\)0,19
2,51
0,285
1,000
EGARCH-t
0,745
0,06
3,19
0,202
0,588
EWMA
0,814
3,19
11,31
0,004
0,008
Hist-20
0,888
3,87
16,35
\(<\) 0,001
0,002
\(GW\): statistica din textul principal, \(\chi^2_2\) sub \(H_0\) (5,99 la 5%)
În modelul bazat pe scor (GAS) (Creal, Koopman & Lucas, 2013),\(\sigma_{t+1}^2 = \omega + \alpha\,s_t + \beta\,\sigma_t^2\), unde \(s_t\) este scorul scalat al densității Student-t în raport cu \(\sigma_t^2\); scorul este mărginit în \(z_t\), așa că un outlier precum reziduul EUR/RON de 154 mișcă dispersia mult mai puțin decît în GARCH. Realized GARCH (Hansen, Huang & Shek, 2012) adaugă o ecuație de măsurare care leagă \(\sigma_t^2\) de o dispersie realizată, folosește informație intrazilnică și reacționează mai repede. GARCH-MIDAS (Engle, Ghysels & Sohn, 2013) scrie \(\sigma_t^2 = \tau_t\,g_t\), cu o componentă lentă de termen lung \(\tau_t\), determinată de date macroeconomice la o frecvență mai mică, și o componentă GARCH(1,1) de medie 1, \(g_t\); un nivel de termen lung mobil absoarbe salturile de nivel care împing \(\hat\alpha+\hat\beta\) spre 1.
GARCH-MIDAS (GARCH with Mixed Data Sampling, GARCH cu eșantionare mixtă a datelor, componentă de termen lung) Engle, Ghysels & Sohn (2013): \(\sigma_t^2 = \tau_t\,g_t\)
O componentă lentă de termen lung \(\tau_t\) determinată de date macro (frecvențe mixte)
\(g_t\): o componentă GARCH(1,1) de medie 1 pentru variațiile pe termen scurt
Un nivel de termen lung variabil în timp preia schimbările de nivel care deplasează \(\hat\alpha+\hat\beta\) spre 1
GARCH este determinat de \(\varepsilon_t^2\) oricare ar fi densitatea, așa că un șoc extrem izolat poate produce un răspuns excesiv al volatilității, care durează zile sau săptămîni (Secțiunea 1 din lucrare); cu o densitate asimetrică spre stînga, un model pur bazat pe scor crește volatilitatea mai mult după randamente pozitive, opusul efectului de levier (Exemplul 2). Modelele QSD, ecuația (3), actualizează \(f_{t+1} = \omega + \alpha\,\psi(y_t, X_t, f_t, \theta) + \beta f_t\), cu \(\psi\) scorul scalat al unei funcții de actualizare \(\rho\) care nu trebuie să fie egală cu \(\log p\), iar lucrarea demonstrează consistența, normalitatea asimptotică și limitele \(\chi^2\) ale testelor LR și LM (Secțiunea 3). La estimare, \(\zeta = 0\) este păstrat în interiorul spațiului parametrilor \(\zeta \in (-1, 1/2)\) prin ecuațiile (31)–(32), cu \(\Psi(x) = x\,(1-e^{-cx})/(1+e^{-cx})\),\(c = 1000\), aplicat ponderii. Testul PIT al lui Diebold, Gunther & Tay (1998), cu corecția lui Pierce (1982) pentru parametri estimați prin verosimilitate maximă, respinge dacă \(|\sum_t \hat u_t - T/2|/\sqrt{T(1/12 - B\,\mathcal{I}(\theta)^{-1}B^\top)} > 1{,}96\), unde \(\mathcal{I}\) este informația Fisher pe observație, iar \(T\) lungimea eșantionului; el detectează o medie PIT deplasată, nu orice abatere de la uniformitate.
Pe scurt
Motivația: GARCH este determinat de \(\varepsilon_t^2\) oricare ar fi densitatea
Deci un șoc extrem izolat poate produce o reacție excesivă a volatilității
Reacția durează zile sau săptămîni (Secțiunea 1 din lucrare)
Cu o densitate asimetrică la stînga, un model pur bazat pe scor crește volatilitatea mai mult după randamente pozitive: opusul efectului de levier (Exemplul 2)
Modelele QSD, ec. (3): \(f_{t+1} = \omega + \alpha\,\psi(y_t, X_t, f_t, \theta) + \beta f_t\), \(\psi\) scorul scalat al unei funcții de actualizare \(\rho\) care nu coincide neapărat cu \(\log p\)
Teoria: consistență, normalitate asimptotică, testele LR și LM cu limite \(\chi^2\) (Secțiunea 3)
Estimarea: \(\zeta = 0\) rămîne în interiorul spațiului parametrilor prin ec. (31)–(32)
Datele sînt 400 de acțiuni (Secțiunea 5 din lucrare); acțiunile cu mai puțin de 4 000 de observații sau cu probleme de convergență sînt eliminate. Varianta asimetrică, ecuația (47), folosește o distribuție Student-t asimetrică, cu asimetria \(\kappa\), pentru \(\epsilon_t\) și parametri separați \((\zeta, \tau)\) în actualizare; \(\tau < 0{,}5\) dă un efect de levier oricare ar fi \(\kappa\) (Secțiunea 5.2).
Pe scurt
Date: 400 de acțiuni (Secțiunea 5)
Se elimină acțiunile cu mai puțin de 4 000 de observații sau cu probleme de convergență
Varianta asimetrică, ec. (47): o distribuție Student-t asimetrică pentru \(\epsilon_t\), cu parametrul de asimetrie \(\kappa\), și parametri separați \((\zeta, \tau)\) pentru actualizare
\(\tau < 0{,}5\) produce efectul de levier oricare ar fi \(\kappa\) (Secțiunea 5.2)
Studiu de caz, un exemplu și limitele indicate de autori
Pentru Centene, 4 330 de zile, \(\hat\xi \approx 0{,}26\), circa 4 grade de libertate, în toate cele trei modele, dar \(\hat\zeta = 0{,}048\) (eroare standard 0,027), cu LR 8,81 (\(p = 0{,}003\)) pentru \(\xi = \zeta\) și 8,42 (\(p = 0{,}004\)) pentru \(\zeta = 0\) (Tabelul 5); după o zi de crah din martie–aprilie 2008, volatilitatea GARCH-t rămîne mult peste cea Beta-t-GARCH, iar QSD se află între ele (Fig. 4).
Autorii indică trei limite:
Cele trei modele Student-t nu trec testul PIT pentru 40,0–46,0% din acțiuni (Tabelul 4);
În recursia nemodificată (30), \(\zeta < 0\) sau \(\zeta > 1/2\) nu definește un model de volatilitate propriu-zis, iar \(\zeta = 1/2\) cu \(\varpi = 0\) este degenerat (Secțiunea 4.1);
Legea \(N(T/2, T/12)\) a lui \(\sum_t u_t\) este valabilă numai pentru parametri cunoscuți.
Dacă actualizarea QSD mărginită întrece GJR-GARCH-t în QLIKE out-of-sample, mai ales după martie 2020;
Dacă îmblînzește reziduul EUR/RON de 154.
Pe scurt
Centene, \(4\,330\) de zile: \(\hat\xi \approx 0{,}26\) (circa 4 grade de libertate) în toate cele trei modele, dar \(\hat\zeta = 0{,}048\) (SE \(0{,}027\))
LR \(8{,}81\) (\(p = 0{,}003\)) pentru \(\xi = \zeta\) și \(8{,}42\) (\(p = 0{,}004\)) pentru \(\zeta = 0\) (Tabelul 5)
După o zi de crah din martie–aprilie 2008 (Fig. 4)
Volatilitatea GARCH-t rămîne mult peste cea Beta-t-GARCH
QSD se află între ele
Limitele indicate de autori
Rezultatele mai bune decît cele ale GARCH-t și Beta-t-GARCH nu garantează adecvarea modelului QSD Student-t: testul PIT respinge cele trei modele pentru \(40{,}0\)–\(46{,}0\%\) din acțiuni (Tabelul 4)
În recursia nemodificată (30), \(\zeta < 0\) sau \(\zeta > 1/2\) nu definesc un model de volatilitate propriu-zis, iar \(\zeta = 1/2\) cu \(\varpi = 0\) este degenerat (Secțiunea 4.1)
Legea \(N(T/2, T/12)\) pentru \(\sum_t u_t\) este valabilă doar pentru parametri cunoscuți (corecția: slide-ul anterior)
Prompturile funcționează cu orice asistent AI și cu orice motor de căutare a literaturii. Promptul de literatură cere comparațiile out-of-sample ale prognozelor de dispersie GARCH, HAR și de machine learning de după 2015, cu DOI, activ, pierdere, test și orizont, după care fiecare DOI se verifică în Crossref, iar fiecare pierdere se verifică pentru robustețe la un proxy zgomotos (Patton, 2011). Promptul de ipoteze cere mecanismele concurente din spatele unui cîștig al asimetriei și ce prevede fiecare pentru \(d_t\) după semnul lui \(r_{t-1}\) și pe subperioade. Promptul de cod cere cod `arch` cu fereastră extinsă și fără look-ahead, iar prima verificare este replicarea valorilor QLIKE 0,756 (GARCH-t) și 0,731 (GJR-t) și a statisticii DM \(t = -1{,}22\).
Pe scurt
Instrumentele sînt interschimbabile
Un asistent AI (Claude, ChatGPT, Gemini, GitHub Copilot)
Instrumente de căutare a literaturii științifice (Semantic Scholar, Elicit, Google Scholar)
Literatura
„Listează comparațiile out-of-sample dintre prognozele dispersiei bazate pe GARCH, HAR și învățare automată publicate după 2015, cu DOI, activ, funcție de pierdere, test și orizont.”
Verificăm fiecare DOI în Crossref
Verificăm că pierderea este robustă la o aproximare zgomotoasă Patton (2011)
Ipoteze
„Pentru afirmația că asimetria îmbunătățește prognozele pe o zi, listează mecanismele concurente (leverage effect, feedback de volatilitate, cîteva zile de criză) și ce prezice fiecare pentru \(d_t\) după semnul lui \(r_{t-1}\) și pe subperioade.”
Date și cod
„Scrie cod Python cu arch care reestimează GARCH-t și GJR-t în fiecare ianuarie pe o fereastră în expansiune, din fișierele de prețuri zilnice ale cursului, și salvează prognozele dispersiei pe o zi; niciun parametru nu folosește date de după originea prognozei.”
Promptul de robustețe cere un plan preînregistrat: împărțiri după semnul lui \(r_{t-1}\) și pe subperioade, MSE pe lîngă QLIKE, orizontul de 22 de zile, lagul HAC și o corecție Bonferroni sau Model Confidence Set; un placebo cu împărțire aleatoare este calibrat numai dacă realocă blocuri de zile, păstrînd volatility clustering. Promptul de critică cere asistentului să acționeze ca referent asupra proxy-ului, a unui an de criză și a lagului HAC. Raportul enumeră toate împărțirile și pierderile încercate, valorile \(p\) ajustate, codul, semințele generatorului aleator și versiunile pachetelor; o specificare aleasă după vederea rezultatelor este exploratorie, iar dacă vreun an de criză poate fi exclus se stabilește dinainte.
Pe scurt
Robustețe
„Scrie un plan pre-înregistrat: împărțiri după semnul lui \(r_{t-1}\) și pe subperioade, MSE pe lîngă QLIKE, orizontul de 22 de zile, lagul HAC și o corecție Bonferroni sau Model Confidence Set.”
Un placebo cu împărțiri aleatoare este calibrat doar dacă realocă blocuri de zile, păstrînd gruparea volatilității
Critica
„Joacă rolul unui referent: ar putea aproximarea \(r_t^2\), un singur an de criză sau lagul HAC să creeze rezultatul meu? Propune cîte un test pentru a verifica fiecare explicație.”
Raportul
Toate împărțirile și pierderile încercate, valorile \(p\) ajustate, codul
Valorile de inițializare ale generatoarelor de numere aleatoare și versiunile pachetelor
O specificație aleasă după ce am văzut rezultatele este exploratorie și se raportează ca atare
Perioade influente: un an de criză poate domina \(\bar d\)
Raportăm subperioadele și declarăm dinainte dacă vreun an poate fi exclus
Ramura proiectului bazată pe dispersia realizată (HAR) folosește setul de date al cursului cu dispersii realizate la 5 minute pentru 40 de acțiuni americane mari, din ianuarie 2015 pînă în ianuarie 2026; nu există date intrazilnice pentru indicele S&P 500 sau pentru BET, deci această ramură se rulează acțiune cu acțiune. Echipa replică întîi tabelul QLIKE și împărțirile din mini-studiul de caz. Livrabilele sînt o preînregistrare de o pagină a modelelor, pierderilor, împărțirilor, ratei de eroare și a rezultatului care ar infirma afirmația, codul pe datele de piață ale cursului, Model Confidence Set la 10%, o autocritică în stilul unui referent și fișierele `AI_USE.md` și `AI_ERRORS.md`.
Pe scurt
Ramura cu dispersie realizată (HAR): 40 de acțiuni americane mari
Setul de date al cursului cu dispersii realizate la 5 minute, ianuarie 2015 – ianuarie 2026
Pentru indicele S&P 500 și pentru BET nu există date intrazilnice
Deci această ramură se aplică acțiune cu acțiune
Replicăm întîi tabelul QLIKE și împărțirile din mini-studiul de caz
Livrabile
O pre-înregistrare de o pagină: modele, pierderi, împărțiri, rata de eroare și ce ar infirma afirmația
Cod pe datele de piață ale cursului, Model Confidence Set la 10%, o autocritică în stilul unui referent
Cele două cărți de referință sînt Franke, Härdle & Hafner (2019), pentru capitolele despre modelele autoregresive integrate cu medie mobilă (ARIMA, autoregressive integrated moving average) și GARCH, și Francq & Zakoïan (2019), pentru teoria matematică a modelelor GARCH. Codul fiecărui grafic și tabel se află în Quantlet-urile capitolului, construite pe pachetul Python `arch`; lucrările înrudite despre entropie ca semnal de risc de coadă dincolo de dispersie sînt enumerate în cadru.
Pe scurt
Cărți
Franke, Härdle & Hafner (2019), capitolele despre AutoRegressive Integrated Moving Average (ARIMA) și GARCH pentru serii financiare
Mincer, J., Zarnowitz, V. (1969). The evaluation of economic forecasts. În J. Mincer (ed.), Economic Forecasts and Expectations: Analysis of Forecasting Behavior and Performance, NBER.
Randamente logaritmice zilnice în %, închideri pînă la 18 septembrie 2026: S&P 500, BET, BET-TR, Bitcoin, aur (XAU/USD) și VIX, prețuri EODHD; EUR/RON: cursul de referință BNR. Studiile de caz: 11 acțiuni din S&P 500, 1995–2019, și S&P 500, 1990–2026, prețuri EODHD.


 Robert F. Engle.
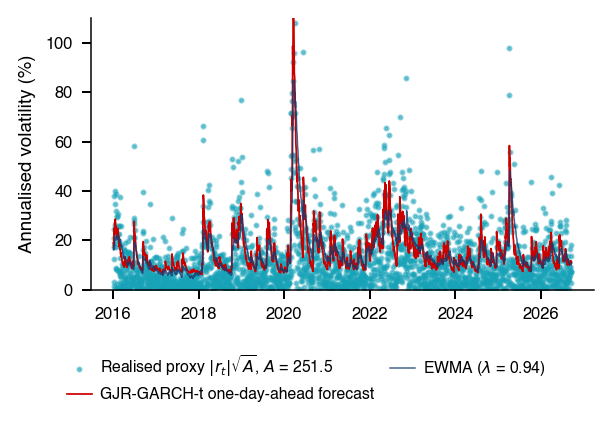
 MFM_ch5_arch_effects
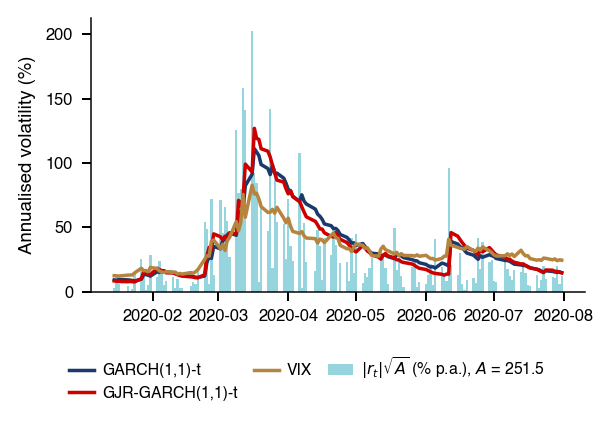
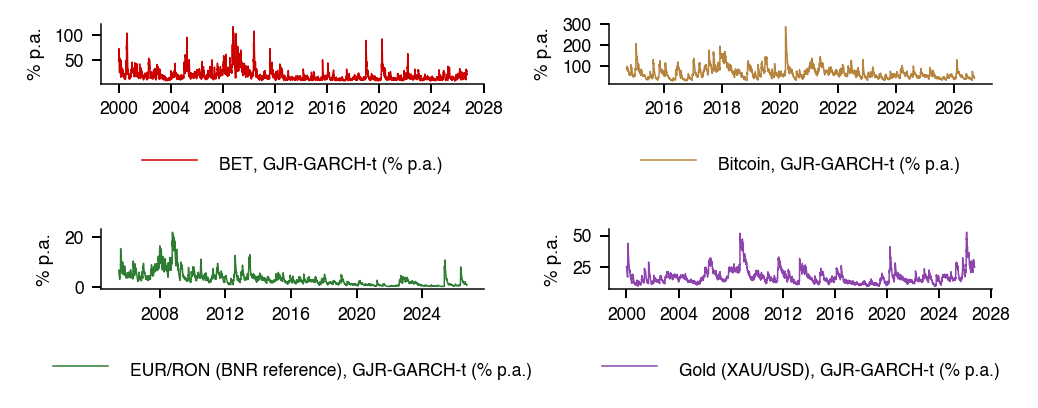
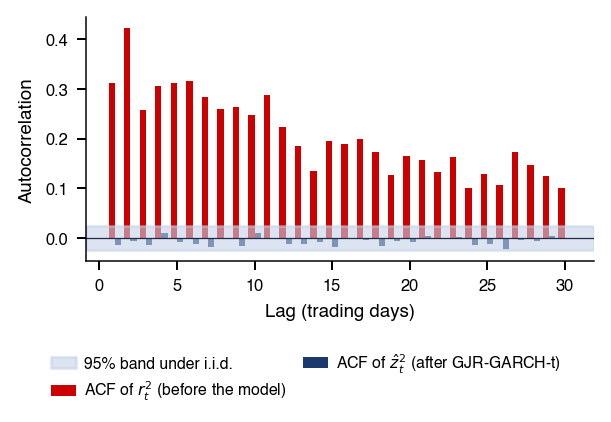
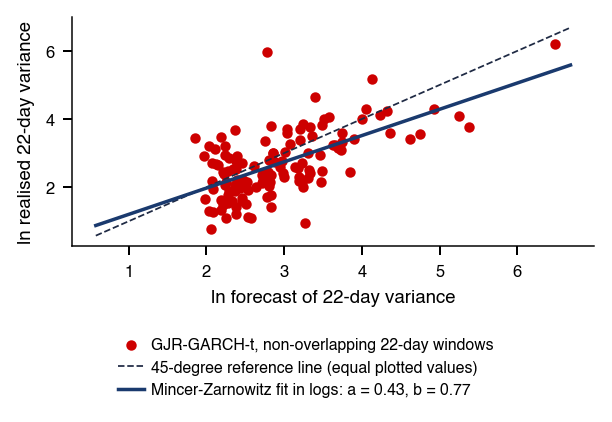
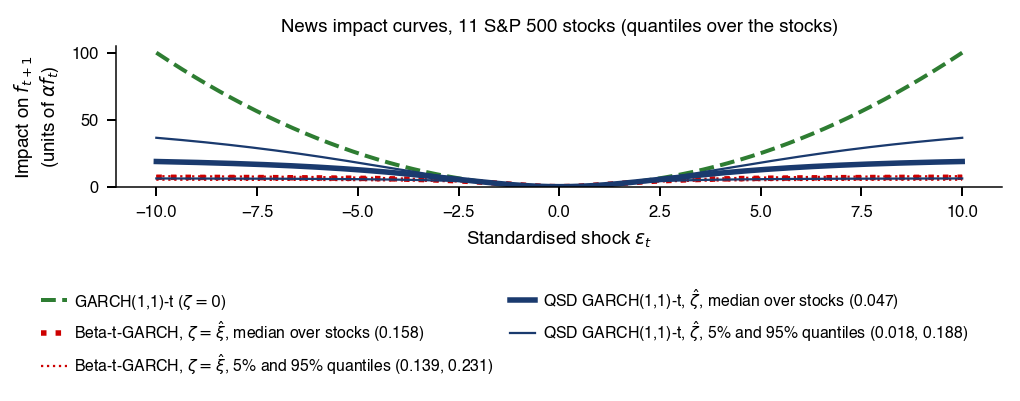
 Statistics of Financial Markets