Capitolul 6: Volatilitate multivariată și dependență
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“This paper shows that correlation coefficients are conditional on market volatility. Under certain assumptions, it is possible to adjust for this bias.” — Forbes & Rigobon (2002)
Un portofoliu 60/40 din două fonduri tranzacționate la bursă (ETF, exchange-traded funds): SPY (SPDR S&P 500 ETF Trust), pe indicele S&P 500 (Standard & Poor's 500), și TLT (iShares 20+ Year Treasury Bond ETF), pe obligațiuni de stat americane cu scadențe de peste 20 de ani
volatilitatea este 10,4% cu corelația din 2002–2021 (\(-0{,}40\)) și 13,2% cu cea din 2022–2026 (\(0{,}11\))
Corelația SPY–TLT pe 252 de zile a fost pozitivă în 6% din zile înainte de 2022 și în 81% din zile începînd din ianuarie 2022
2008: varianța randamentelor S&P 500 pe 2 zile a fost de 7,5 ori nivelul din anul calm
cu \(\beta\) constant, o corelație de 0,4 în perioada calmă se măsoară atunci ca 0,77
după corecția Forbes–Rigobon, nici creșterea din criză pentru Euro Stoxx 50, nici cea pentru BET (Bucharest Exchange Trading, indicele de referință al Bursei de Valori București) nu mai este semnificativă (bootstrap staționar: \(p = 0{,}98\) și \(0{,}62\))
JPM (JPMorgan Chase & Co., simbolul bursier NYSE) și BAC (Bank of America Corporation, simbolul bursier NYSE): cînd JPM are una dintre cele mai proaste 5% zile ale sale, BAC se află în propriile 5% cele mai proaste zile în aproximativ 61% din cazuri
This paper shows that correlation coefficients are conditional on market volatility. Under certain assumptions, it is possible to adjust for this bias.
Timp de douăzeci de ani, cînd acțiunile americane scădeau, obligațiunile de stat americane pe termen lung tindeau să crească. De aceea, un portofoliu cu 60% acțiuni și 40% obligațiuni era mai liniștit decît fiecare parte luată separat. În 2022 această legătură s-a inversat: de atunci, cele două scad adesea împreună.
Diferența se vede direct în risc. Cu legătura din 2002–2021, portofoliul 60/40 are o volatilitate anuală de 10,4%. Cu legătura din 2022–2026, același portofoliu are 13,2%. Riscul fiecărui activ este același în ambele calcule; s-a schimbat doar felul în care se mișcă împreună.
Calculul folosește două fonduri tranzacționate la bursă (ETF, exchange-traded fund) din Statele Unite ale Americii (SUA). SPY (SPDR S&P 500 ETF Trust, unde SPDR vine de la Standard & Poor's Depositary Receipts) urmărește indicele S&P 500 (Standard & Poor's 500), format din 500 de mari companii americane. TLT (iShares 20+ Year Treasury Bond ETF) deține obligațiuni de stat americane cu scadențe de peste 20 de ani.
Capitolul studiază această mișcare comună, măsurată în primul rînd prin corelație. El răspunde la patru întrebări:
Cît de precis putem măsura o corelație din randamente zilnice?
Cum urmărim o corelație care se schimbă de la o zi la alta?
Corelațiile cresc într-adevăr în crize, sau doar par să crească pentru că piețele devin mai agitate?
Ce se întîmplă în zilele extreme, pe care corelația nu le descrie bine?
Ultima întrebare are un exemplu clar. Cînd banca JPMorgan Chase & Co. (simbolul bursier JPM) are una dintre cele mai proaste 5% zile ale sale, Bank of America Corporation (simbolul bursier BAC) se află și ea în propriile 5% cele mai proaste zile în aproximativ 61% din cazuri. Pierderile mari vin împreună mult mai des decît ar sugera o corelație obișnuită.
AI pentru descoperire științificăInteligența artificială (AI, artificial intelligence) ca asistent de cercetare: va rămîne pozitivă corelația acțiuni–obligațiuni? Un mini-studiu de caz despre inflație.
SintezăLista de decizie, verificarea înțelegerii și decizia practică.
AprofundăriExemple detaliate și subiecte avansate.
Capitolul 5 a modelat riscul unui singur activ. Acest capitol privește mai multe active deodată și întreabă cum se mișcă ele împreună. Obiectul de studiu este matricea de covarianță \(\Sigma\) a randamentelor: pe diagonală stau varianțele, în afara ei covarianțele, din care se obțin corelațiile.
Corelația contează în trei situații: cînd calculăm riscul unui portofoliu, cînd acoperim o poziție (hedge) și cînd judecăm dacă o criză se transmite de la o piață la alta. În toate trei, corelația nu se observă direct. Ea se estimează din date și se schimbă în timp.
Cînd se mișcă piețele împreună și cît de sigure sînt estimările? (1/2)
Capitolul folosește rezultate din trei capitole anterioare:
Capitolul 1: randamentele zilnice au cozi groase, iar perioadele agitate vin grupate. Din acest motiv, intervalul de încredere clasic pentru o corelație este prea îngust.
Capitolul 4: matricea de covarianță \(\Sigma\) este datul de intrare al alegerii portofoliului.
Capitolul 5: modelul GARCH (generalised autoregressive conditional heteroskedasticity) descrie volatilitatea variabilă a unui singur activ.
Rezultatele de aici sînt folosite mai departe la riscul portofoliului, Value-at-Risk (VaR) și Expected Shortfall (ES), în Capitolul 7, la verificarea acestor măsuri (backtesting) în Capitolul 8 și la riscul sistemic în Capitolul 18. Exemplele detaliate și subiectele avansate sînt în Aprofundări, după Sinteză.
Diversificarea reduce riscul doar dacă activele nu se mișcă perfect împreună (Markowitz, 1952). Pentru două active cu ponderile \(w\) și \(1-w\), volatilitățile \(\sigma_1\),\(\sigma_2\) și corelația \(\rho\), varianța portofoliului este
\[\sigma_p^2 = w^\top\Sigma w = w^2\sigma_1^2+(1-w)^2\sigma_2^2+2w(1-w)\rho\,\sigma_1\sigma_2 .\]
(6.1)
Corelația apare într-un singur termen din (6.1), ultimul. Cu ponderi pozitive, o corelație mai mare înseamnă un portofoliu mai riscant. O corelație negativă face termenul negativ, deci cele două active își compensează parțial pierderile.
Exemplul capitolului folosește două fonduri tranzacționate la bursă (ETF, exchange-traded fund): SPY, pe indicele de acțiuni S&P 500, și TLT, pe obligațiuni de stat americane cu scadențe de peste 20 de ani. Pe iulie 2002 – septembrie 2026, volatilitatea anuală este 18,8% pentru SPY și 14,3% pentru TLT.
Un portofoliu 60/40 din cele două are volatilitatea 10,4% dacă folosim corelația din 2002–2021, egală cu \(-0{,}40\). Cu corelația din 2022–2026, egală cu \(0{,}11\), volatilitatea urcă la 13,2%. Volatilitățile celor două fonduri sînt aceleași în ambele calcule; diferă doar corelația.
Împărțirea eșantionului în ianuarie 2022, la începutul șocului inflaționist, este o convenție pentru ilustrare. Un test formal, prezentat în Aprofundări, plasează schimbarea mai devreme, în august 2020.
\(\sigma_1\), \(\sigma_2\): volatilitățile celor două active
\(\rho\): corelația dintre ele
Portofoliu 60/40 din SPY (fondul tranzacționat la bursă pe S&P 500) și TLT (fondul de obligațiuni de stat americane cu scadențe de peste 20 de ani)
Volatilități anualizate pe iulie 2002 – septembrie 2026: \(\sigma_1=18{,}8\%\) (SPY), \(\sigma_2=14{,}3\%\) (TLT); ponderi reechilibrate zilnic la 60/40
Separăm la ianuarie 2022, începutul șocului de inflație; testul de ruptură din Aprofundări datează schimbarea mai devreme, în august 2020
Volatilitatea portofoliului este 10,4% cu corelația din 2002–2021 (\(-0{,}40\)) și 13,2% cu cea din 2022–2026 (\(0{,}11\))
Rolul dependenței (2/2): acoperire, contagiune și covarianțe variabile
A doua utilizare a corelației este acoperirea riscului. Avem o poziție \(S\) și vrem să-i reducem riscul vînzînd un alt instrument \(F\), de exemplu un contract futures. Întrebarea este cît din \(F\) trebuie vîndut. Răspunsul care face varianța poziției acoperite cea mai mică posibilă este raportul de acoperire de varianță minimă (minimum-variance hedge ratio):
\[h^* = \rho\,\frac{\sigma_S}{\sigma_F},\]
(6.2)
adică panta regresiei randamentului \(r_S\) pe randamentul \(r_F\). Raportul din (6.2) este în valoare: cîte unități de valoare din \(F\) pe unitatea de valoare din \(S\). Pentru a obține numărul de contracte, se înmulțește cu \(P_S/P_F\), raportul prețurilor, inclusiv mărimea contractului.
Cu raportul optim, acoperirea elimină proporția \(\rho^2\) din varianță: cu cît corelația este mai mare în valoare absolută, cu atît acoperirea elimină mai mult risc. Dacă corelația se schimbă, raportul de ieri nu mai este optim azi. Un hedge care se ajustează în timp are nevoie de o corelație care se ajustează în timp, \(\rho_t\).
A treia utilizare privește crizele. Forbes & Rigobon (2002) numesc contagiune (contagion) o creștere semnificativă a legăturilor dintre piețe după un șoc. Interdependența înseamnă legăturile care există mereu, prin comerț, investitori comuni sau factori macroeconomici comuni. Corelațiile tind să crească exact cînd diversificarea ar fi cea mai utilă. Capitolul întreabă cît din această creștere este reală.
Cele trei utilizări au un punct comun, care este și ideea nouă a capitolului: matricea de covarianță nu este fixă. Ea are o valoare diferită la fiecare dată \(t\), notată \(\Sigma_t\).
Pe scurt
Hedging-ul (acoperirea riscului unei poziții cu o poziție opusă)
Ce valoare din instrumentul de hedging \(F\) vindem pentru fiecare unitate de valoare deținută în poziția \(S\), pentru a minimiza varianța
Raportul de hedging de varianță minimă \(h^*=\rho\,\sigma_S/\sigma_F\): panta regresiei lui \(r_S\) pe \(r_F\)
Estimat pe randamente, \(h^*\) este un raport de valori: numărul de unități din \(F\) pe unitatea din \(S\) este \(h^*P_S/P_F\) (\(P_S\), \(P_F\): prețurile, inclusiv mărimea contractului)
\(r_S\), \(r_F\): randamentele poziției și ale instrumentului de hedging
\(\sigma_S\), \(\sigma_F\): volatilitățile lor
Eficiența hedging-ului, \(\rho^2\): proporția din varianță eliminată
Dacă se schimbă corelația, acoperirea de ieri devine inadecvată astăzi: o acoperire dinamică cere un \(\rho_t\) dinamic
Graficul arată corelația dintre randamentele zilnice SPY și TLT, calculată pe o fereastră care se mută în timp. Banda din jurul ei este intervalul de încredere Fisher de 95%, construit ca și cum zilele ar fi independente și la fel distribuite (i.i.d.).
Primul cursor alege lungimea ferestrei, de la 63 la 756 de zile de tranzacționare. Al doilea alege ultima zi a ferestrei. Caseta de rezultate dă corelația ferestrei alese și intervalul ei, iar butonul ▶ mută fereastra prin eșantion. Benzile umbrite marchează trei episoade de stres: toamna 2008 – martie 2009, februarie–aprilie 2020 și ianuarie–octombrie 2022.
Întrebare pentru sală Corelația SPY–TLT a devenit pozitivă din 2022. Cu ponderi pozitive și volatilități neschimbate, ce face această creștere a corelației cu varianța unui portofoliu SPY–TLT?
Răspuns
O crește: termenul de covarianță al varianței portofoliului este 2w₁w₂σ₁σ₂ρ, deci cu ponderi pozitive crește odată cu ρ. Pe fereastra de 252 de zile, corelația a fost pozitivă în 6% din zile înainte de 2022 și în 81% din zile din ianuarie 2022, deci obligațiunile au compensat mai puțin pierderile din acțiuni. Explicația discutată în curs: șocurile de creștere economică mișcă acțiunile și obligațiunile în sensuri opuse, iar șocurile de inflație le mișcă în același sens. Graficul documentează schimbarea corelației; singur, nu identifică șocul care a produs-o.
Pe fereastra de 252 de zile, adică un an de tranzacționare, corelația a fost pozitivă în doar 6% din zilele de dinainte de 2022. Începînd din ianuarie 2022, a fost pozitivă în 81% din zile. După (6.1), această schimbare mărește riscul oricărui portofoliu SPY–TLT: obligațiunile mai compensează puțin din pierderile acțiunilor.
Pe fereastra de un an, corelația a coborît pînă la \(-0{,}77\) în august 2012 și a urcat pînă la \(0{,}32\) în iulie 2024. Timp de două decenii, obligațiunile pe termen lung au protejat portofoliile de acțiuni. Din 2022, ele s-au mișcat mai ales în același sens cu acțiunile.
O explicație des discutată este tipul șocului care domină piața. Un șoc de creștere economică mișcă acțiunile și prețurile obligațiunilor în sensuri opuse: veștile proaste scad acțiunile și urcă obligațiunile. Corelația este atunci negativă. Un șoc de inflație lovește ambele piețe în același sens, deci corelația devine pozitivă, ca în 2022. Graficul arată schimbarea, dar nu dovedește singur care a fost șocul; secțiunea despre AI revine la această întrebare.
Banda Fisher din grafic este prea îngustă. Ea presupune randamente cu distribuție Normală, fără cozi groase și fără perioade agitate grupate, iar randamentele zilnice nu arată așa. Secțiunea următoare calculează un interval care ține cont de aceste trăsături și arată cu cît este mai larg.
Pe scurt
Corelația randamentelor zilnice SPY și TLT, pe o fereastră mobilă de 252 de zile
banda: intervalul Fisher de 95% (definit în secțiunea următoare), valid pentru date i.i.d. (independente și identic distribuite)
Corelația intră în riscul portofoliului printr-un singur termen, în raportul de acoperire prin (6.2) și în discuția despre contagiune prin creșterea ei în crize. Pentru SPY și TLT, ea a fost negativă două decenii și a devenit în mare parte pozitivă din 2022. Urmează două întrebări: cît de precis putem estima o corelație și cum modelăm o matrice de covarianță care se schimbă.
Măsurarea covarianței și a incertitudinii ei
Înainte de a modela o matrice de covarianță care se schimbă în timp, trebuie să știm să o măsurăm. Secțiunea arată de ce corelația zilnică dintre piețe îndepărtate iese prea mică, cît de mare este eroarea unei corelații estimate și cum estimăm corelația de azi din zilele recente.
Secțiunea întreabă cum estimăm \(\Sigma\) și cît de sigură este fiecare corelație estimată. Apar trei capcane:
Orele de închidere diferă de la o piață la alta, deci corelația măsurată depinde de frecvența datelor.
Randamentele zilnice au cozi groase, iar perioadele agitate vin grupate (volatility clustering). Ambele trăsături schimbă incertitudinea estimării, iar intervalul clasic le ignoră.
Lungimea perioadei de estimare decide cît de repede observăm o schimbare de regim.
Pe scurt
Întrebarea secțiunii: cum estimăm \(\Sigma\) și cît de incertă este fiecare corelație estimată?
Prima capcană: orele de închidere diferă, deci frecvența datelor schimbă corelația
A doua capcană: cozile groase și gruparea volatilității pot modifica substanțial incertitudinea, pe care intervalul Fisher o ignoră
A treia capcană: lungimea ferestrei decide cît de repede vedem o schimbare de regim
Tranzacționarea asincronă și distorsiunea corelațiilor zilnice
Bursa de Valori București și bursele din zona euro se închid cu cîteva ore înaintea bursei din New York. O știre americană apărută după închiderea europeană intră în prețurile europene abia a doua zi. Acest decalaj se numește tranzacționare asincronă (asynchronous trading).
Cînd două piețe se mișcă în general în același sens, decalajul are două efecte. Corelația din aceeași zi iese mai mică decît legătura reală. Corelația decalată, dintre SUA ieri și Europa azi, iese pozitivă, pentru că o parte a reacției europene apare cu o zi întîrziere.
Există două soluții:
Folosim randamente pe perioade mai lungi, pe 2 zile sau săptămînale. Pe o perioadă mai lungă, o întîrziere de o zi contează mai puțin.
Adunăm corelația decalată la cea din aceeași zi: \(\rho_0+\rho_{+1}\). Aici \(\rho_0\) este corelația din aceeași zi, iar \(\rho_{+1}\) corelația dintre randamentele americane de ieri și cele europene de azi. Suma este doar o aproximare grosieră. Ea presupune un decalaj de o zi, fără autocorelație și cu varianțe egale.
Regula folosită în tot capitolul: aliniem întîi prețurile pe zilele în care ambele burse au tranzacționat și abia apoi calculăm randamentele.
Pe scurt
Orele de închidere diferă
Bursa de Valori București și bursele din zona euro se închid cu cîteva ore înaintea bursei din New York
Știrile din SUA (Statele Unite ale Americii) de după închiderea europeană intră în prețurile europene abia a doua zi
Consecință, la dependență pozitivă (ca între piețele de acțiuni)
corelația din aceeași zi este deplasată spre zero
corelația decalată este pozitivă
Soluții
Frecvență mai mică: randamente pe 2 zile sau săptămînale, în zilele comune de tranzacționare
Adăugarea termenului decalat: \(\rho_{0}+\rho_{+1}\) (\(\rho_0\): corelația din aceeași zi, \(\rho_{+1}\): SUA ieri cu Europa azi)
Suma \(\rho_0+\rho_{+1}\) este o aproximare grosieră a corelației sincrone, valabilă doar pentru un decalaj de o zi, fără autocorelație și cu varianțe egale
Regula folosită peste tot
întîi aliniem prețurile pe zilele comune de tranzacționare
apoi calculăm randamentele
Corelații zilnice, pe 2 zile și săptămînale, 2000–2026 (1/2)
Graficul compară corelațiile dintre SPY, Euro Stoxx 50 și BET, indicele principal al Bursei de Valori București. Fiecare corelație este calculată la trei frecvențe: randamente zilnice, pe \(k\) zile și săptămînale. Barele au intervale de încredere Fisher de 95%.
Cursorul alege orizontul \(k\) al randamentelor din mijloc, de la 1 la 20 de zile, iar butonul ▶ îl crește. Caseta de rezultate dă corelația fiecărei perechi la cele trei frecvențe și corelațiile decalate.
Întrebare pentru sală Corelația zilnică SPY–Euro Stoxx 50 este 0,59. De ce urcă la 0,79 pe randamente săptămînale?
Răspuns
Bursele din zona euro se închid înaintea celei din New York, deci știrile americane de după închiderea europeană intră în prețurile europene abia a doua zi. Corelația din aceeași zi este deplasată spre zero, iar corelația decalată (SPY ieri, Euro Stoxx 50 azi) este 0,20. Pe orizonturi mai lungi, decalajul de o zi cîntărește tot mai puțin.
Corelația SPY–Euro Stoxx 50 din aceeași zi este 0,59 și crește cu orizontul. Pe randamente mai lungi, întîrzierea de o zi a prețurilor europene contează tot mai puțin. Corelația decalată, SPY ieri cu Euro Stoxx 50 azi, este 0,20: o parte a legăturii apare abia a doua zi.
Pentru SPY și Euro Stoxx 50, corelația crește de la 0,59 pe randamente zilnice la 0,71 pe 2 zile și la 0,79 pe randamente săptămînale. Pentru SPY și BET, ea crește de la 0,22 zilnic la 0,38 săptămînal. Euro Stoxx 50 și BET se închid aproape în același timp, iar corelația lor se schimbă mai puțin, de la 0,33 la 0,41.
Corelația crește cel mai mult cu orizontul exact la perechile care se închid la ore diferite, ceea ce confirmă explicația. Datele săptămînale au însă un cost: ele dau 1 367 de observații în loc de 6 446, deci intervalele de încredere sînt mai largi. Alegerea frecvenței este un compromis: mai puțină distorsiune sau mai multă precizie.
Pe scurt
SPY, Euro Stoxx 50 și BET în zilele comune de tranzacționare
BET: indicele de referință al Bursei de Valori București
liniile verticale de pe bare: intervale Fisher de 95%
Corelația SPY–Euro Stoxx 50
\(0{,}59\) pe randamente zilnice, \(0{,}71\) pe randamente pe 2 zile și \(0{,}79\) pe randamente săptămînale
corelația dintre SPY de ieri și Euro Stoxx 50 de azi: \(0{,}20\)
Corelația SPY–BET
\(0{,}22\) pe randamente zilnice, față de \(0{,}38\) pe randamente săptămînale
corelația decalată (SPY ieri, BET azi): \(0{,}17\)
Euro Stoxx 50 și BET au închideri aproape sincrone
corelația lor este \(0{,}33\) zilnic și \(0{,}41\) săptămînal
Datele săptămînale sînt mai puțin afectate de asincronism
dar dau \(1\,367\) în loc de \(6\,446\) observații: intervale mai largi
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
Toate randamentele din capitol sînt logaritmice, \(r_t=\ln P_t-\ln P_{t-1}\), calculate după alinierea prețurilor pe zilele comune de tranzacționare. Fiecare aplicație folosește frecvența potrivită scopului ei:
Randamentele zilnice servesc acolo unde contează viteza de reacție: modelul de corelație dinamică, intervalele de încredere și acoperirea riscului.
Randamentele pe 2 zile servesc pentru testele de corelație în criză, pentru că absorb diferențele dintre orele de închidere. În acele teste, două randamente consecutive pe 2 zile au o zi comună, iar inferența trebuie să țină cont de această suprapunere. În graficul cu trei frecvențe, randamentele pe 2 zile nu se suprapun.
Randamentele săptămînale, calculate din închiderile de vineri, servesc pentru aplicațiile care combină multe fusuri orare: corelațiile în zilele extreme, integrarea piețelor și rețelele de bănci. Ele reduc distorsiunea, dar dau mai puține observații.
calculate după alinierea prețurilor pe zilele comune de tranzacționare
Zilnic: DCC, intervalele HAC (Heteroskedasticity and Autocorrelation Consistent, standard errors, erori standard robuste la heteroscedasticitate și autocorelație) și hedging-ul, unde contează viteza de reacție
HAC: eroare standard robustă la heteroscedasticitate și autocorelație, definită mai jos
Pe 2 zile: testele Forbes–Rigobon, pentru a absorbi diferențele dintre orele de închidere
în aceste teste randamentele pe 2 zile se suprapun: două randamente consecutive au o zi comună
în graficul cu trei frecvențe nu se suprapun
Săptămînal (închiderile de vineri): corelațiile de depășire, integrarea piețelor și rețelele de bănci
aplicații din secțiunile despre copule și aplicații, care combină fusuri orare diferite
Covarianța de selecție și inferența pentru o corelație (1/2): estimatorul și intervalul Fisher
Fie \(r_t\in\mathbb{R}^N\) vectorul celor \(N\) randamente din ziua \(t\),\(t=1,\dots,T\), și \(\bar r\) vectorul mediilor. Matricea de covarianță de selecție și corelația Pearson a activelor \(i\) și \(j\) sînt
Matricea are \(N(N+1)/2\) elemente distincte. Pentru \(N=500\) de active, asta înseamnă 125 250 de mărimi de estimat: numărul lor crește cu pătratul numărului de active.
Cît de sigură este o singură corelație estimată? Răspunsul clasic folosește transformarea Fisher, \(z=\operatorname{artanh}\hat\rho=\tfrac12\ln\frac{1+\hat\rho}{1-\hat\rho}\). Ea aduce corelația pe o scală pe care eroarea are aproximativ aceeași mărime, oricare ar fi \(\rho\). Dacă zilele sînt independente și randamentele au distribuție Normală,
\[z\approx N\!\big(\operatorname{artanh}\rho,\ 1/(T-3)\big), \qquad \text{interval de }95\%\text{: } \tanh\!\big(z\pm1{,}96/\sqrt{T-3}\big).\]
(6.3)
Pentru un an de date, \(T=252\), și \(\rho=0{,}5\), intervalul (6.3) are o semilărgime de aproximativ \(0{,}09\). Intervalul nu este simetric în jurul corelației estimate, pentru că funcția \(\tanh\) comprimă valorile apropiate de \(\pm1\).
Pe scurt
Matricea de covarianță de selecție și corelația Pearson pentru \(N\) active pe \(T\) zile
Randamentele zilnice nu sînt nici independente, nici Normale, deci avem nevoie de altă formulă pentru eroare. Metoda delta (delta method) scrie eroarea corelației estimate ca o medie a unor contribuții zilnice. Cu \(\tilde x_t\),\(\tilde y_t\) cele două randamente standardizate la media 0 și varianța 1,
unde \(\psi_t\) este contribuția zilei \(t\) la eroare. Eroarea standard (SE, standard error) a corelației vine din varianța acestor contribuții.
Două trăsături ale datelor schimbă această varianță. Cozile groase fac contribuțiile mai variabile. Perioadele agitate grupate fac contribuțiile din zile apropiate să depindă unele de altele. Estimatorul HAC (heteroskedasticity and autocorrelation consistent) ține cont de ambele (Newey & West, 1987). El adună covarianțele contribuțiilor pînă la \(L\) zile distanță, cu ponderi Bartlett. Regula uzuală \(L=\lfloor4(T/100)^{2/9}\rfloor\) dă \(L=9\) pentru \(T=4\,891\) și \(L=4\) pentru o fereastră de 252 de zile.
Pentru date independente și Normale, varianța contribuțiilor este \((1-\rho^2)^2\), exact varianța Fisher; derivarea este în Anexă. Eroarea standard HAC cere însă ca momentele de ordinul patru să fie finite, iar Capitolul 1 pune la îndoială această condiție.
Exemplul SPY–TLT din 2002–2021 arată mărimea efectului. Cu \(T=4\,891\) și \(\hat\rho=-0{,}403\), eroarea standard este 0,0120 după formula Fisher. Dacă luăm în calcul doar cozile groase (\(L=0\)), ea crește la 0,0217. Cu HAC și \(L=9\), ea este 0,0227. Aproape toată creșterea vine deci din cozile groase, nu din dependența dintre zile.
Pe scurt
Metoda delta: aproximăm liniar \(\hat\rho\), funcție netedă de momentele de selecție, și scriem eroarea \(\hat\rho-\rho\) ca o medie de contribuții zilnice \(\psi_t\)
\(\tilde x_t\), \(\tilde y_t\): cele două randamente standardizate la media 0 și varianța 1
\(\psi_t\): contribuția zilei \(t\) la eroarea de estimare
gruparea volatilității nu schimbă această formă, ci doar varianța lui \(\psi_t\)
Eroarea standard (SE, standard error) din varianța pe termen lung a lui \(\psi_t\): varianța plus autocovarianțele ei
Estimatorul HAC (heteroskedasticity and autocorrelation consistent) ponderează autocovarianțele pînă la lagul \(L\) cu ponderi descrescătoare (nucleul Bartlett, Newey & West (1987))
Condiții: staționaritate, momente de ordinul patru finite (puse sub semnul întrebării în Capitolul 1) și dependență slabă
Numărul de laguri după regula uzuală \(L=\lfloor4(T/100)^{2/9}\rfloor\): \(L=9\) pentru \(T=4\,891\), \(L=6\) pentru \(T=1\,182\), \(L=4\) pentru o fereastră de 252 de zile
Pentru perechi i.i.d. cu distribuția Normală, \(\Var(\psi_t)=(1-\rho^2)^2\), adică varianța Fisher
Cozile groase și GARCH pot modifica substanțial această varianță, în ambele sensuri (derivarea în Anexă)
Exemplu: SPY–TLT zilnic, 2002–2021 (\(T=4\,891\), \(\hat\rho=-0{,}403\)). Eroarea standard a lui \(\hat\rho\) este:
\(0{,}0120\) după formula Fisher
\(0{,}0217\) cu momentele de ordinul patru, fără autocorelație (\(L=0\))
Graficul compară cele două intervale de-a lungul corelației SPY–TLT calculate pe o fereastră mobilă. Panoul de sus arată corelația cu intervalul Fisher și intervalul HAC, ambele de 95%. Panoul de jos arată de cîte ori este mai lat intervalul HAC decît intervalul Fisher.
Selectorul alege lungimea ferestrei: 126, 252 sau 504 zile. Cursorul alege numărul de zile \(L\) din estimatorul HAC, de la 0 la 20, iar butonul ▶ îl crește. Caseta de rezultate dă mediana și cuantila de 90% a raportului lățimilor și proporția ferestrelor în care fiecare interval exclude zero.
Întrebare pentru sală Dacă alegem L = 0 (fără laguri), coincide intervalul HAC pentru corelația SPY–TLT cu intervalul Fisher?
Răspuns
Nu. Pe fereastra de 252 de zile, mediana raportului dintre lățimea intervalului HAC și a celui Fisher este 1,17 la L = 0, 1,24 la L = 4 și 1,39 la L = 20. Formula Fisher presupune perechi i.i.d. cu distribuția Normală bivariată; L = 0 elimină doar termenii cu lag, nu și momentele de ordinul patru din eroarea standard. Pe 2002–2021, eroarea standard a corelației este 0,0120 după Fisher și 0,0217 fără laguri. Cu L = 4, concluzia testului se schimbă în 8,2% din ferestre. Și intervalul HAC cere momente de ordinul patru finite, pe care Capitolul 1 le pune sub semnul întrebării: HAC tratează dependența, dar nu compensează lipsa momentelor.
Chiar cu \(L=0\), cele două intervale nu coincid. Pe fereastra de 252 de zile, mediana raportului lățimilor este 1,17 la \(L=0\), 1,24 la \(L=4\) și 1,39 la \(L=20\). Cozile groase lărgesc singure intervalul, iar dependența dintre zile îl lărgește în plus.
Pe fereastra de 252 de zile, cu \(L=4\), intervalul HAC este mai larg decît intervalul Fisher în 91% din ferestre. În mediană, el este de 1,24 ori mai lat.
Diferența schimbă concluziile. Corelația pare semnificativ diferită de zero în 73% din ferestre după Fisher și doar în 65% după HAC. Acestea sînt rezultate separate pentru fiecare fereastră, nu un test simultan.
Pe perioade întregi, eroarea standard HAC este de 1,9 ori cea Fisher în 2002–2021 și de 1,4 ori din 2022. Luînd în calcul doar cozile groase, raportul este deja 1,8 în prima perioadă și 1,28 în a doua. Cozile groase contează deci mai mult decît dependența dintre zile.
Regula pentru randamente zilnice: raportăm intervale HAC obținute prin metoda delta. Ele sînt valabile numai dacă momentele de ordinul patru sînt finite, iar estimările din Capitolul 1 pun acest lucru la îndoială. HAC tratează dependența în timp, dar nu poate repara lipsa momentelor.
Pe scurt
Corelația pe o fereastră mobilă de 252 de zile, din 5 în 5 zile
intervalul Fisher de 95%
intervalul HAC de 95% prin metoda delta (Bartlett, \(L=4\))
Intervalul HAC este mai larg decît cel Fisher în 91% din ferestre și mai îngust în 9%
raportul dintre lățimea HAC și lățimea Fisher: mediana \(1{,}24\), cuantila de 90% \(1{,}54\)
Corelația este semnificativ diferită de zero
în 73% din ferestre după Fisher și în 65% după HAC
concluzia testului se schimbă în 8,2% din ferestre
rezultate punctuale, fereastră cu fereastră, nu un test simultan
Pe perioadele întregi, raportul dintre SE HAC și SE Fisher
\(1{,}9\) în 2002–2021 și \(1{,}4\) din 2022
numai corecția pentru momentele de ordinul patru dă deja \(1{,}8\) în 2002–2021 (\(1{,}28\) din 2022)
cozile groase contează mai mult decît autocorelația
Regula pentru randamente zilnice: raportăm intervale HAC prin metoda delta
valabile sub staționaritate și dependență slabă
și numai dacă momentele de ordinul patru sînt finite, ceea ce estimările Hill din Capitolul 1 pun sub semnul întrebării
HAC tratează dependența, dar nu compensează lipsa momentelor
Cum estimăm matricea de covarianță de azi? Cel mai simplu răspuns folosește ultimele \(m\) zile, cu ponderi egale. Cu media fixată la zero, cum se obișnuiește pentru date zilnice,
unde \(r_s\) este vectorul randamentelor din ziua \(s\). Acest estimator nu dă niciodată unui portofoliu o varianță negativă: pentru orice vector de ponderi \(v\),\(v^\top\hat\Sigma_tv=\frac1m\sum_s(v^\top r_s)^2\ge0\). Matricea este însă singulară ori de cîte ori fereastra are mai puține zile decît active, \(m<N\).
Ponderile egale au un defect numit saltul la ieșirea din fereastră (ghost effect). O zi extremă rămîne în estimare cu aceeași pondere timp de \(m\) zile, apoi iese brusc, iar estimarea sare fără ca piața să se fi schimbat. Lungimea ferestrei fixează un compromis. O fereastră scurtă reacționează repede, dar este zgomotoasă. Una lungă este stabilă, dar vede tîrziu o schimbare de regim.
Pe scurt
Fereastra mobilă de lungime \(m\): \(\hat\Sigma_t=\frac1m\sum_{s=t-m}^{t-1} r_s r_s^\top\)
media fixată la zero pentru date zilnice
\(r_s\): vectorul randamentelor din ziua \(s\)
\(m\): numărul de zile trecute folosite
Pozitiv semidefinită
pentru orice vector de ponderi \(v\), \(v^\top\hat\Sigma_tv=\frac1m\sum_s(v^\top r_s)^2\ge0\)
deci orice varianță de portofoliu este \(\geq0\)
Singulară dacă \(m<N\)
pozitiv definită doar dacă cei \(m\) vectori de randamente generează \(\R^N\)
o matrice singulară nu se poate inversa, deci nu dă ponderi de varianță minimă
Saltul la ieșirea din fereastră (ghost effect): o zi extremă intră cu ponderea \(1/m\) și iese brusc după \(m\) zile
estimarea sare atunci, deși piața nu s-a schimbat
Compromisul
o fereastră scurtă reacționează repede, dar este zgomotoasă
una lungă este stabilă, dar vede tîrziu o schimbare de regim
Media mobilă ponderată exponențial (EWMA, exponentially weighted moving average), folosită în RiskMetrics (J.P. Morgan/Reuters, 1996), înlocuiește ponderile egale. Fiecare zi contează ceva mai puțin decît ziua de după ea:
unde \(\lambda\in(0,1)\) este factorul de descreștere (decay factor). Observația de acum \(k\) zile are ponderea \((1-\lambda)\lambda^{k-1}\). Valorile uzuale sînt \(\lambda=0{,}94\) pentru date zilnice și \(\lambda=0{,}97\) pentru date lunare. Cu \(\lambda=0{,}94\), ponderile se înjumătățesc la fiecare 11,2 zile, iar estimarea folosește efectiv circa 32 de zile.
Pentru că ponderile scad treptat, EWMA nu are acest salt la ieșirea din fereastră. Limitele lui: un singur \(\lambda\) guvernează toate varianțele și covarianțele, iar estimarea nu revine spre o valoare medie pe termen lung: (6.6) este un GARCH(1,1) integrat, fără constantă (Capitolul 5). Factorul \(\lambda\) joacă rolul lungimii ferestrei \(m\), cu același compromis între viteză și zgomot.
Graficul arată corelația SPY–TLT din 2019, estimată prin EWMA și printr-o fereastră mobilă, cu o fereastră de 250 de zile ca referință. Primul cursor alege factorul de descreștere \(\lambda\), de la 0,8 la 0,995. Al doilea alege lungimea ferestrei \(m\), de la 20 la 500 de zile. Butonul ▶ crește \(\lambda\).
Caseta de rezultate arată cît de repede și cît de zgomotos reacționează fiecare estimator: timpul de înjumătățire și eșantionul efectiv EWMA, variația zilnică a estimării și data la care se confirmă corelația pozitivă din 2022 (a 20-a zi consecutivă cu corelație pozitivă).
Întrebare pentru sală Cînd ▶ crește λ de la 0,94 spre 0,995, cum se mută data la care EWMA confirmă corelația pozitivă din 2022?
Răspuns
Mai tîrziu: a 20-a zi consecutivă cu corelație pozitivă este 10 mai 2022 la λ = 0,94 (secvența începe la 12 aprilie) și 9 decembrie 2022 la λ = 0,995, după fereastra de 250 de zile (8 decembrie). Ponderea celui mai recent produs de randamente este 1 − λ: 6% la λ = 0,94 și 0,5% la λ = 0,995; timpul de înjumătățire al ponderilor crește de la 11,2 la 138,3 zile. Viteza are un preț: abaterea standard a variației zilnice a corelației este 0,060 la λ = 0,94, 0,007 la λ = 0,995 și 0,0088 pentru fereastra de 250 de zile.
Un \(\lambda\) mai mare dă un semnal mai tîrziu. La \(\lambda=0{,}94\), corelația pozitivă din 2022 se confirmă la 10 mai. La \(\lambda=0{,}995\), se confirmă abia la 9 decembrie 2022, aproape odată cu fereastra de 250 de zile, care o confirmă la 8 decembrie. Motivul: cea mai recentă zi are ponderea \(1-\lambda\), adică 6% la \(\lambda=0{,}94\) și doar 0,5% la \(\lambda=0{,}995\).
Viteza se plătește cu zgomot. Variația zilnică a corelației estimate are abaterea standard 0,060 la EWMA cu \(\lambda=0{,}94\) și doar 0,0088 la fereastra de 250 de zile. La ambii estimatori, \(\lambda\) și \(m\) sînt alese de analist, nu estimate din date. Modelul din secțiunea următoare estimează din date cît de repede reacționează corelația și cît de mult își amintește trecutul.
Pe scurt
Doi estimatori EWMA (\(\lambda=0{,}94\) și \(0{,}97\)) și două ferestre mobile (60 și 250 de zile) pe aceleași date
Zgomotul: abaterea standard a variației zilnice a corelației estimate
0,060 pentru EWMA cu \(\lambda=0{,}94\)
0,032 pentru EWMA cu \(\lambda=0{,}97\)
0,0088 pentru fereastra de 250 de zile
Semnalul de regim: 20 de zile consecutive cu corelația pozitivă
EWMA (\(\lambda=0{,}94\)): începe la 12 aprilie 2022, confirmat la 10 mai
fereastra de 250 de zile: începe la 10 noiembrie, confirmat abia la 8 decembrie 2022
La EWMA și la ferestrele mobile, \(\lambda\) și \(m\) sînt aleși de analist, nu estimați
DCC (secțiunea următoare) estimează din date viteza de reacție și memoria corelației
Corelațiile zilnice dintre piețe din fusuri orare diferite ies prea mici. Randamentele pe perioade mai lungi corectează distorsiunea, dar dau mai puține observații. Pe randamente zilnice, intervalul Fisher este prea îngust, mai ales din cauza cozilor groase; intervalul HAC prin metoda delta este alegerea implicită, cu condiția ca momentele de ordinul patru să fie finite. Ferestrele mobile și EWMA estimează covarianța de azi, dar viteza lor de reacție este aleasă de analist. Secțiunea următoare o estimează din date.
GARCH multivariat și DCC
Această secțiune construiește un model în care matricea de covarianță se schimbă de la o zi la alta după o regulă estimată din date. Modelul GARCH din Capitolul 5 se poate extinde direct la o matrice, dar apar două probleme: numărul de parametri explodează, iar matricea obținută poate da varianțe negative unor portofolii.
Modelul DCC (dynamic conditional correlation) al lui Engle (2002) rezolvă ambele probleme. Ideea lui este să separe volatilitățile de corelații. Fiecare activ are propriul model GARCH pentru volatilitate, iar toate corelațiile sînt conduse de doar doi parametri.
De la volatilitate univariată la volatilitate multivariată (1/2): modelul
În Capitolul 5, randamentul unui singur activ era \(r_t=\sigma_t z_t\), cu \(\sigma_t^2=\omega+\alpha r_{t-1}^2+\beta\sigma_{t-1}^2\). Cu \(N\) active, volatilitatea \(\sigma_t\) devine o matrice de covarianță \(H_t\), iar vectorul randamentelor se scrie
deci \(\operatorname{Var}(r_t\mid\mathcal F_{t-1})=H_t\). Aici \(z_t\) sînt șocurile standardizate, \(\mathcal F_{t-1}\) este informația disponibilă pînă ieri, iar \(I_N\) matricea identitate. \(H_t\) este \(\Sigma_t\) din secțiunea anterioară, iar \(H_t^{1/2}\) o rădăcină pătrată a ei: \(H_t^{1/2}(H_t^{1/2})^\top=H_t\).
Un model bun pentru \(H_t\) trebuie să îndeplinească trei cerințe:
\(H_t\) este pozitiv definită la orice \(t\), deci orice portofoliu are varianță pozitivă.
Numărul de parametri rămîne mic.
Parametrii au o interpretare clară.
Parametrii se estimează maximizînd log-cvasi-verosimilitatea Gaussiană (Gaussian quasi-log-likelihood):
unde \(|H_t|\) este determinantul lui \(H_t\). Prefixul „cvasi” spune că formula Normală se poate folosi și cînd șocurile nu sînt Normale: estimările rămîn consistente dacă modelul pentru \(H_t\) este corect.
Pe scurt
Întrebarea secțiunii: cum modelăm o matrice de covarianță care se schimbă zilnic?
matricea trebuie să rămînă pozitiv definită și să aibă puțini parametri
În Capitolul 5 am modelat un singur activ: \(r_t=\sigma_t z_t\), \(\sigma_t^2=\omega+\alpha r_{t-1}^2+\beta\sigma_{t-1}^2\)
Cea mai generală extindere a GARCH este modelul VEC (GARCH multivariat vectorizat, construit pe operatorul vech, care așază elementele distincte ale matricei de covarianță într-un vector) al lui Bollerslev, Engle & Wooldridge (1988). În el, fiecare varianță și covarianță de azi poate depinde de toate produsele randamentelor de ieri și de toate elementele lui \(H_{t-1}\). Operatorul \(\operatorname{vech}\) așază într-un vector cele \(N(N+1)/2\) elemente distincte ale unei matrice simetrice:
Numărul de parametri crește ca \(N^4\), iar nimic nu garantează că \(H_t\) rămîne pozitiv definită.
Modelul BEKK (Baba–Engle–Kraft–Kroner) al lui Engle & Kroner (1995) scrie \(H_t=CC^\top+A^\top r_{t-1}r_{t-1}^\top A+B^\top H_{t-1}B\), cu \(C\) triunghiulară inferior și \(A\),\(B\) matrice \(N\times N\). Fiecare termen este o formă pătratică, deci \(H_t\) este pozitiv definită prin construcție. Parametrii cresc însă tot ca \(N^2\), iar elementele lui \(A\) și \(B\) sînt greu de interpretat.
Tabelul de pe slide numără parametrii. Pentru \(N=2\) active, VEC are 21, BEKK complet 11, iar DCC \(6+2\). Pentru \(N=50\), VEC are 3 252 525, BEKK 6 275, iar DCC doar \(150+2\). DCC folosește trei parametri GARCH pentru fiecare activ, deci \(3N\), plus cei doi parametri de corelație \(a\) și \(b\). Pentru portofolii mari, VEC și BEKK nu mai pot fi estimate în practică.
parametri: 3 în \(c\), \(3\times3=9\) în \(A\) și 9 în \(B\), deci 21 (tabelul din slide-ul anterior)
forma generală \(\operatorname{vech}(H_t)=c+A\operatorname{vech}(r_{t-1}r_{t-1}^\top)+B\operatorname{vech}(H_{t-1})\) este exact acest sistem, scris matriceal
Problema: nimic nu împiedică \(h_{12,t}^2>h_{11,t}h_{22,t}\), adică o „corelație” peste 1 în valoare absolută
de aici lipsa garanției caracterului pozitiv definit
Ideea: o varianță nu poate fi negativă dacă o scriem ca un pătrat
univariat: \(\alpha r_{t-1}^2=(a\,r_{t-1})^2\) cu \(a=\sqrt\alpha\), deci termenul de știri este mereu \(\ge0\)
BEKK face același lucru cu matrice: \(A^\top r_{t-1}r_{t-1}^\top A=(A^\top r_{t-1})(A^\top r_{t-1})^\top\), „pătratul” unui vector
Ce este \(A^\top r_{t-1}\): șocurile de ieri, amestecate
activul 1 primește \(a_{11}r_{1,t-1}+a_{21}r_{2,t-1}\): propriul șoc plus o parte din șocul celuilalt activ
cu \(A\) diagonală nu există amestec: fiecare activ reacționează doar la propriul șoc
Pătratul unui vector este întotdeauna o matrice de covarianță validă
pe diagonală stau pătrate (\(\ge0\)), iar „corelația” acestui termen este exact \(+1\) sau \(-1\), după semnul lui \(r_{1,t-1}r_{2,t-1}\)
la fel \(B^\top H_{t-1}B\) (o transformare a unei covarianțe valide) și \(CC^\top\); o sumă de covarianțe valide este validă
de aceea \(H_t\) rămîne pozitiv definită fără nicio restricție asupra parametrilor
Ce obținem: \(H_t\) = nivel de bază + reacția la știrile de ieri + memoria lui \(H_{t-1}\)
corelația lui \(H_t\) combină corelațiile celor trei termeni, cu ponderi date de contribuția fiecăruia la varianțe: știrile aduc \(\pm1\), deci zilele cu șocuri de același semn o împing în sus
Prețul: \(A\) și \(B\) au \(N^2\) elemente fiecare, iar un element nu descrie o singură varianță sau covarianță
de aceea în practică se folosește BEKK diagonal sau scalar (\(A=a\,I_N\), \(B=b\,I_N\)), apropiat ca spirit de DCC
Comparat cu VEC diagonal: aceeași formă, dar coeficienții covarianței nu mai sînt liberi
sînt produsele coeficienților din cele două ecuații de varianță: \(a_{11}a_{22}\) în locul lui \(a_2\), \(b_{11}b_{22}\) în locul lui \(b_2\)
\(A^\top r_{t-1}r_{t-1}^\top A\) și \(B^\top H_{t-1}B\) sînt forme pătratice, deci pozitiv semidefinite; cu \(CC^\top\) pozitiv definită, \(H_t\) rămîne pozitiv definită la orice \(t\)
7 parametri: 3 în \(C\) (triunghiulară inferior), 2 în \(A\), 2 în \(B\)
BEKK complet: \(A\), \(B\) matrice \(2\times2\) oarecare, deci \(3+4+4=11\) parametri
de exemplu \(h_{11,t}\) conține \((a_{11}r_{1,t-1}+a_{21}r_{2,t-1})^2\): depinde și de \(r_{2,t-1}^2\) și de \(r_{1,t-1}r_{2,t-1}\)
de aceea elementele lui \(A\) și \(B\) nu au o interpretare directă
Aici \(\sigma_{it}\) este volatilitatea GARCH a activului \(i\), iar \(R_t\) este matricea corelațiilor. Împărțind fiecare randament la volatilitatea lui obținem reziduurile standardizate \(\varepsilon_{it}=r_{it}/\sigma_{it}\).
Cel mai simplu model, cu corelație condiționată constantă (CCC, constant conditional correlation) al lui Bollerslev (1990), presupune că \(R_t=R\) nu se schimbă. Modelul DCC al lui Engle (2002) lasă și corelațiile să varieze. El aplică o recursie de tip GARCH unei matrice auxiliare \(Q_t\) și o transformă apoi într-o matrice de corelație \(R_t\):
cu \(a,b\ge0\) și \(a+b<1\). Parametrii se citesc ca în GARCH. \(a\) măsoară cît reacționează corelația la șocurile comune de ieri, \(b\) cît își amintește din trecut, iar \(a+b\) cît de persistentă este. A doua ecuație împarte \(Q_t\) la propria diagonală, astfel încît \(R_t\) are 1 pe diagonală și este o matrice de corelație validă.
Matricea \(\bar Q\) este nivelul spre care revine recursia. Ea are \(N(N-1)/2\) elemente libere. În practică se înlocuiește cu covarianța de selecție a reziduurilor standardizate, \(\hat{\bar Q}=\frac1T\sum_t\varepsilon_t\varepsilon_t^\top\); procedeul se numește țintirea corelației (correlation targeting). După el, doi parametri conduc toate cele \(N(N-1)/2\) corelații. Modelul este foarte economic, dar impune aceeași persistență tuturor perechilor de active.
O subtilitate are urmări mai jos: \(Q_t\) nu este matricea de corelație așteptată. Corelația așteptată este \(R_t\), deci \(\mathbb{E}_{t-1}[\varepsilon_t\varepsilon_t^\top]=R_t\ne Q_t\). Slide-ul Estimarea în doi pași (2/2) arată de ce contează acest lucru.
\(\bar Q\): matricea constantă (interceptul) a recursiei, cu \(N(N-1)/2\) elemente libere
Fixarea țintei (correlation targeting) o înlocuiește cu covarianța de selecție \(\hat{\bar Q}=\frac1T\sum_t\varepsilon_t\varepsilon_t^\top\) (consistența acestei alegeri: slide-ul „Estimarea în doi pași (2/2)”)
\(a\): reacția la produsul șocurilor de ieri; \(b\): memoria; \(a+b\): persistența, adică cît de încet revine corelația spre țintă
A doua relație rescalează \(Q_t\) astfel încît diagonala să fie 1: \(R_t\) este o matrice de corelație validă
Doi parametri guvernează toate cele \(N(N-1)/2\) corelații
parcimonios, dar toate perechile au aceeași persistență
\(Q_t\) este o pseudo-covarianță, nu o corelație: \(\E_{t-1}[\varepsilon_t\varepsilon_t^\top]=R_t\ne Q_t\)
o zi în care ambele active scad (sau cresc) puternic împinge corelația în sus, o zi cu semne opuse o împinge în jos; cu \(b\) mare, efectul dispare încet
În general (slide-ul anterior): aceleași recursii pentru toate cele \(N(N-1)/2\) perechi, scrise ca o singură ecuație matriceală în \(Q_t\)
Estimarea în doi pași (1/2): împărțirea verosimilității
Separarea volatilităților de corelații simplifică și estimarea. Înlocuim \(H_t=D_tR_tD_t\) și \(\varepsilon_t=D_t^{-1}r_t\) în (6.7). Determinantul se descompune ca \(|H_t|=|D_t|^2|R_t|\), iar forma pătratică devine \(r_t^\top H_t^{-1}r_t=\varepsilon_t^\top R_t^{-1}\varepsilon_t\). Adunînd și scăzînd \(\varepsilon_t^\top\varepsilon_t=r_t^\top D_t^{-2}r_t\), verosimilitatea se împarte în două:
Prima parte, \(\ell_V\), conține doar volatilitățile. Cum \(D_t\) este diagonală, ea este suma celor \(N\) log-verosimilități GARCH univariate, \(\sum_i\big[-\tfrac12\sum_t(\ln2\pi+\ln\sigma_{it}^2+r_{it}^2/\sigma_{it}^2)\big]\). A doua parte, \(\ell_C\), conține corelațiile și depinde de \((a,b)\) odată ce volatilitățile sînt date.
De aici rezultă estimatorul în doi pași:
Pasul 1 estimează separat cîte un model GARCH(1,1) pentru fiecare activ și păstrează volatilitățile \(\sigma_{it}\) și reziduurile standardizate \(\varepsilon_{it}\).
Pasul 2 fixează \(\bar Q\) la covarianța de selecție a reziduurilor și maximizează \(\ell_C\) după \((a,b)\).
Pe scurt
Log-verosimilitatea Gaussiană se împarte într-o parte de volatilitate și o parte de corelație
\(\ell_V\): partea de volatilitate, depinde doar de parametrii GARCH
\(\ell_C\): partea de corelație, depinde de \((a,b)\), date fiind volatilitățile
\(|D_t|\), \(|R_t|\): determinanții lui \(D_t\) și \(R_t\)
De unde vine împărțirea
înlocuim \(H_t=D_tR_tD_t\) și \(\varepsilon_t=D_t^{-1}r_t\) în log-cvasi-verosimilitatea din secțiunea anterioară
Determinantul: \(|H_t|=|D_t|^2\,|R_t|\), deci \(\ln|H_t|=2\ln|D_t|+\ln|R_t|\)
Forma pătratică: \(r_t^\top H_t^{-1}r_t=r_t^\top D_t^{-1}R_t^{-1}D_t^{-1}r_t=\varepsilon_t^\top R_t^{-1}\varepsilon_t\)
Adunăm și scădem \(\varepsilon_t^\top\varepsilon_t=r_t^\top D_t^{-2}r_t=\sum_i r_{it}^2/\sigma_{it}^2\): atunci \(\ell_V=\sum_i\big[-\tfrac12\sum_t(\ln2\pi+\ln\sigma_{it}^2+r_{it}^2/\sigma_{it}^2)\big]\), suma celor \(N\) log-verosimilități GARCH Gaussiene univariate
Țintirea corelației are un cost: estimatorul DCC standard este, în general, inconsistent. Motivul este subtilitatea de mai sus. Luînd media în (6.8), staționaritatea dă \((1-b)\,\mathbb{E}[Q_t]=(1-a-b)\,\bar Q+a\,\mathbb{E}[R_t]\). Covarianța de selecție a reziduurilor estimează \(\mathbb{E}[R_t]\). Ea este egală cu \(\bar Q\) numai dacă \(\mathbb{E}[Q_t]=\mathbb{E}[R_t]\), iar în general egalitatea nu are loc, pentru că \(R_t\) împarte \(Q_t\) la o diagonală aleatoare.
DCC-ul corectat (cDCC) al lui Aielli (2013) repară problema. El folosește în recursie \(\operatorname{diag}(Q_{t-1})^{1/2}\varepsilon_{t-1}\) în locul lui \(\varepsilon_{t-1}\). Atunci \(\mathbb{E}[Q_t]=\bar Q\), iar țintirea devine consistentă.
A doua dificultate privește erorile standard. Cele din pasul 2 tratează estimările din pasul 1 și pe \(\bar Q\) ca fiind cunoscute exact, deci le ignoră incertitudinea. Există două corecții: matricea sandwich a estimatorilor în doi pași (Newey & McFadden, 1994), dată în Anexă, și un bootstrap care reface ambii pași, descris tot acolo.
A treia dificultate privește testul. Modelul CCC este cazul \(a=0\). Sub ipoteza \(H_0\colon a=0\), parametrul \(b\) nu mai are niciun efect și nu poate fi estimat. Din acest motiv, distribuția \(\chi^2\) obișnuită a testului raportului de verosimilitate (LR, likelihood ratio) este doar orientativă. Capitolul obține valorile critice printr-un bootstrap care simulează date sub CCC.
Pe scurt
Fixarea țintei la covarianța de selecție face estimatorul DCC standard inconsistent în general
de ce: luăm media recursiei, folosind \(\E[\varepsilon_{t-1}\varepsilon_{t-1}^\top]=\E[R_{t-1}]\)
Staționaritatea dă \((1-b)\,\E[Q_t]=(1-a-b)\,\bar Q+a\,\E[R_t]\)
\(\hat{\bar Q}=\frac1T\sum_t\varepsilon_t\varepsilon_t^\top\) estimează \(\E[R_t]\), care este egală cu interceptul \(\bar Q\) doar dacă \(\E[Q_t]=\E[R_t]\)
Egalitatea nu are loc în general: \(R_t\) rescalează \(Q_t\) cu propria diagonală, aleatoare
DCC-ul corectat al lui Aielli (2013) folosește \(\operatorname{diag}(Q_{t-1})^{1/2}\varepsilon_{t-1}\) în locul lui \(\varepsilon_{t-1}\), astfel încît \(\E[Q_t]=\bar Q\), iar fixarea țintei rămîne consistentă
Erorile standard din pasul 2 tratează estimările GARCH și \(\bar Q\) drept cunoscute
propagăm eroarea lor cu matricea de covarianță de tip sandviș (sandwich) a ambilor pași, estimați împreună (Newey & McFadden (1994))
sau prin bootstrap pe ambii pași: reeșantionăm datele, reestimăm ambii pași și folosim dispersia estimărilor (Anexă)
Testul CCC față de DCC: \(H_0: a=0\)
sub \(H_0\), \(Q_t\) nu mai depinde de \(b\), deci \(b\) nu este identificat, iar distribuția \(\chi^2\) este doar orientativă
valoarea p (p-value) se obține prin bootstrap: simulăm date sub CCC și reestimăm
Modelul este estimat pe randamentele zilnice SPY și TLT, în procente, din 31 iulie 2002 pînă la 18 septembrie 2026, adică \(T=6\,073\) de zile. În pasul 1, ambele volatilități sînt foarte persistente: \(\alpha+\beta\) este 0,975 pentru SPY și 0,993 pentru TLT. Corelația medie a reziduurilor standardizate, care servește ca țintă, este \(\hat{\bar Q}_{12}=-0{,}248\).
În pasul 2, \(\hat a=0{,}0522\) și \(\hat b=0{,}9335\). Persistența corelației este deci \(a+b=0{,}986\): un șoc asupra corelației se stinge încet. O regulă aproximativă dă \(\ln0{,}5/\ln0{,}986\approx48\) de zile pînă la înjumătățire. Ea nu este exactă, pentru că \(Q_t\) nu este corelația așteptată; răspunsul efectiv al corelației se obține prin simulare.
Este DCC mai bun decît corelația constantă? Testul LR compară verosimilitățile celor două modele: \(LR=2(460{,}26-193{,}54)=533{,}4\). În 199 de seturi de date simulate sub CCC, cea mai mare statistică obținută este doar 15,7. Valoarea \(p\) bootstrap este deci \(1/(B+1)=0{,}005\), cea mai mică posibilă cu \(B=199\), iar CCC este respins. Tabelul de pe slide dă și trei erori standard pentru \(a\) și \(b\): din pasul 2, dintr-un bootstrap numai pe pasul 2 și dintr-un bootstrap pe ambii pași.
Pe scurt
Pasul 1: GARCH(1,1), randamente în %
\(\omega\)
\(\alpha\)
\(\beta\)
\(\alpha+\beta\)
SPY
0,0283
0,127
0,848
0,975
TLT
0,0057
0,049
0,943
0,993
Pasul 2: DCC(1,1) și trei erori standard
estimare
hessiană
boot. pasul 2
boot. ambii
\(a\)
0,0522
0,0059
0,0051
0,0052
\(b\)
0,9335
0,0084
0,0077
0,0077
\(a+b\)
0,9857
–
0,0038
0,0040
Date zilnice între 31 iulie 2002 și 18 septembrie 2026, \(T=6\,073\)
ținta \(\hat{\bar Q}_{12}=-0{,}248\)
Persistența \(a+b=0{,}986\)
indicatorul euristic \(\ln0{,}5/\ln0{,}986\approx48\) de zile, nu timpul exact de înjumătățire al lui \(Q_t\)
\(\E_t[\varepsilon_{t+1}\varepsilon_{t+1}^\top]=R_{t+1}\ne Q_{t+1}\), deci abaterea lui \(Q\) nu scade exact cu \((a+b)^h\)
răspunsul efectiv al corelației se obține prin simulare condiționată
Testul LR (Likelihood Ratio, testul raportului de verosimilitate) față de CCC: \(LR=2(\hat\ell^{DCC}-\hat\ell^{CCC})=2(460{,}26-193{,}54)=533{,}4\)
bootstrap pe ambii pași sub CCC (\(B=199\)): maximul simulat sub \(H_0\) este \(15{,}7\)
deci \(p=1/(B+1)=0{,}005\), cea mai mică valoare posibilă: CCC este respins
Cele trei erori standard sînt apropiate. Reestimarea modelelor GARCH în bootstrap mărește dispersia lui \(\hat a\) cu doar 2% și pe cea a lui \(\hat b\) cu 1%. Cu 199 de replicări, eroarea de simulare a unei astfel de dispersii este de circa 5%, deci diferențele sînt în limita zgomotului. Rezultatul nu se generalizează: în alte date, incertitudinea din pasul 1 poate conta mult.
Volatilitatea TLT este mai persistentă decît cea a SPY, dar reacționează mai puțin la știri, adică are un \(\alpha\) mai mic. Estimările de aici folosesc DCC-ul standard și ilustrează metoda; cu țintirea corelației ele sînt, în general, inconsistente, cum s-a arătat în Estimarea în doi pași (2/2).
Pe scurt
În acest experiment bootstrap, reestimarea GARCH crește dispersia lui \(\hat a\) cu 2% și a lui \(\hat b\) cu 1%
cu \(B=199\), eroarea Monte Carlo a unei abateri standard bootstrap este de circa 5%
aici incertitudinea din pasul 1 este deci mică, dar rezultatul nu este general: contribuția pasului 1 poate rămîne de ordinul întîi și cînd \(T\) crește
SE din hessiană depășesc abaterile standard bootstrap, dar aceasta nu dovedește că intervalele lor acoperă valoarea adevărată mai des decît nivelul nominal
Corelația SPY–TLT reacționează puțin la șocul unei zile (\(a\) mic), dar își păstrează mult timp nivelul (\(b\) mare)
Volatilitatea TLT este mai persistentă decît cea a SPY (\(\alpha+\beta\): 0,993 față de 0,975)
dar reacționează mai puțin la știri (\(\alpha\) mai mic)
Aceste estimări DCC standard ilustrează metoda: cu fixarea țintei, ele sînt în general inconsistente (Estimarea în doi pași (2/2))
Graficul compară corelația DCC(1,1) dintre SPY și TLT cu corelația pe fereastra mobilă de 252 de zile și cu ținta \(\hat{\bar Q}_{12}=-0{,}248\). Cele două cursoare schimbă reacția \(a\) și memoria \(b\), pornind de la valorile estimate. Traiectoria se recalculează din (6.8). Caseta de rezultate dă persistența, partea de corelație a log-verosimilității și statistica LR față de CCC.
Întrebare pentru sală Estimările DCC sînt a = 0,052 și b = 0,934. Ce spune suma lor?
Răspuns
Este persistența corelației: a + b = 0,986; indicatorul euristic ln 0,5 / ln(a + b) dă aproximativ 48 de zile, nu timpul exact de înjumătățire al lui Q_t, deoarece E_t[ε_{t+1}ε_{t+1}′] = R_{t+1}, nu Q_{t+1}. Testul LR față de corelația constantă dă 533,4; bootstrap-ul sub CCC dă p = 0,005, cea mai mică valoare posibilă cu B = 199. Sînt estimări DCC standard, o ilustrare a metodei: cu correlation targeting, ele sînt în general inconsistente.
Corelația DCC coboară pînă la \(-0{,}79\) în noiembrie 2011 și urcă pînă la \(0{,}49\) în mai 2026. În 2022, media ei este \(0{,}00\), față de \(-0{,}56\) în 2012. Din ianuarie 2022, traiectoria stă deasupra țintei în 92% din zile, față de 36% înainte.
O singură corelație de echilibru pentru tot intervalul 2002–2026 este deci greu de susținut. Testul de ruptură din Aprofundări datează schimbarea de regim.
Pe scurt
Corelația condiționată DCC(1,1), corelația pe fereastră mobilă de 252 de zile și ținta \(\hat{\bar Q}_{12}=-0{,}248\)
DCC standard ilustrează metoda, sub rezerva inconsistenței țintei (Estimarea în doi pași)
Corelația DCC variază între \(-0{,}79\) (2 noiembrie 2011) și \(0{,}49\) (21 mai 2026)
Ultima valoare: \(0{,}36\)
Corelația DCC medie
\(-0{,}54\) între 15 septembrie și 31 decembrie 2008
\(-0{,}56\) în 2012, \(0{,}00\) în 2022
Din ianuarie 2022 corelația DCC este deasupra țintei în 92% din zile, față de 36% înainte
Ipoteza unei singure corelații pe termen lung este deci discutabilă
Ajută o corelație dinamică la construirea unui portofoliu? Aplicația compară două portofolii zilnice SPY–TLT de varianță minimă. Ambele folosesc aceleași volatilități GARCH. Unul folosește corelația DCC, celălalt o corelație constantă. Graficele arată ponderea în SPY și volatilitatea anualizată. Cursorul alege corelația constantă, pornind de la valoarea pe tot eșantionul, iar butonul ▶ o modifică automat.
Întrebare pentru sală Volatilitatea in-sample a portofoliului de varianță minimă este 9,06% cu DCC și 9,10% cu GARCH și corelație constantă. Ce putem conclude despre performanța out-of-sample?
Răspuns
Nimic, din această comparație singură. Diferența este de aproximativ 0,04 puncte procentuale de volatilitate anualizată, iar parametrii sînt estimați pe tot eșantionul: rezultatul nu este o evaluare out-of-sample și nici un test de echivalență. Portofoliul 60/40 fix are 10,99%, deci cea mai mare parte a cîștigului vine din volatilitățile GARCH. Ponderile DCC diferă de cele cu corelație constantă în medie cu 1,9 puncte procentuale și cel mult cu 22 (8 iunie 2026). ▶ schimbă corelația constantă: la 0,90, volatilitatea cu corelație constantă urcă la 12,73%.
Cele două portofolii au aproape același risc: 9,06% cu DCC și 9,10% cu corelația constantă. Portofoliul fix 60/40 are 10,99%. Aproape tot cîștigul vine deci din volatilitățile GARCH, nu din corelația dinamică. O corelație constantă greșită costă însă: cu 0,90, volatilitatea urcă la 12,73%. Comparația folosește parametri estimați pe tot eșantionul, deci nu este o evaluare out-of-sample.
trunchiată la \([0,1]\), unde \(\sigma_{12,t}\) este covarianța condiționată. Varianta cu corelație constantă folosește corelația pe tot eșantionul 2002–2026, egală cu \(-0{,}30\).
Ponderile celor două variante diferă puțin: cu 0,019 în medie și cu cel mult 0,22. DCC adaugă puțin peste volatilitățile GARCH. Rezultatul este doar o ilustrare in-sample. Un test corect reestimează modelul pe ferestre care se extind în timp și include costurile de tranzacționare (Capitolul 4). Evaluarea out-of-sample este subiectul Capitolului 8, iar acoperirea out-of-sample din Aprofundări dă un prim exemplu.
Pe scurt
Ponderea SPY în portofoliul zilnic SPY–TLT de varianță minimă
\(w_t=(\sigma_{2t}^2-\sigma_{12,t})/(\sigma_{1t}^2+\sigma_{2t}^2-2\sigma_{12,t})\), trunchiată la \([0,1]\) (fără vînzări în lipsă)
DCC separă volatilitățile, modelate activ cu activ cu GARCH, de corelații, conduse de doar doi parametri. Împărțirea (6.9) a verosimilității dă estimatorul în doi pași. Cu țintirea corelației, estimatorul standard este în general inconsistent, iar DCC-ul corectat al lui Aielli (2013) repară problema. Pentru SPY și TLT, corelația este persistentă (\(a+b=0{,}986\)) și CCC este respins. Într-un portofoliu de varianță minimă, însă, aproape tot cîștigul vine din volatilități. Rămîne întrebarea din motivație: cît din creșterea corelațiilor în crize este reală?
Corelații în criză și distorsiunea Forbes–Rigobon
În crize, corelațiile măsurate sînt de obicei mai mari decît în perioadele calme. Secțiunea întreabă dacă legătura dintre piețe s-a schimbat sau doar piața în care a pornit criza a devenit mai agitată. Forbes & Rigobon (2002) arată cum se separă cele două explicații.
O corelație mare în criză trebuie comparată cu cea din perioada calmă. Chiar și o creștere are două explicații. Prima este contagiunea: mecanismul prin care o piață o influențează pe alta se schimbă. A doua este distorsiunea de volatilitate: mecanismul rămîne același, dar piața sursă devine mult mai volatilă.
După ce corectează această distorsiune, Forbes & Rigobon (2002) găsesc că cea mai mare parte a contagiunii aparente din crizele din 1987, 1994 și 1997 este de fapt interdependență, adică legătura obișnuită dintre piețe. O constatare înrudită privește asimetria. Longin & Solnik (2001) și Ang & Chen (2002) găsesc că corelațiile cresc pe piețele în scădere (bear markets), dar nu și pe cele în creștere (bull markets). Distribuția Normală nu poate produce o astfel de asimetrie. Fotografia arată sediul Lehman Brothers din New York la 15 septembrie 2008, ziua cererii de faliment.
Ideea se vede fără formule. Randamentul unei piețe are o parte venită din piața sursă și o parte proprie, zgomotul local. Corelația măsoară cît din mișcare vine din partea comună. Dacă piața sursă devine mult mai agitată, partea comună crește, iar zgomotul local rămîne la fel. Corelația crește, deși legătura dintre piețe nu s-a schimbat.
Formal, fie \(x_t\) randamentul pieței sursă și \(y_t\) randamentul celeilalte piețe:
Coeficientul \(\beta\) măsoară cît se transmite din \(x\) în \(y\) și este constant. Șocul propriu \(\varepsilon_t\) are varianța constantă \(\sigma_\varepsilon^2\), iar \(\sigma_x^2\) este varianța pieței sursă. Deoarece \(\varepsilon_t\) nu este corelat cu \(x_t\),\(\operatorname{Cov}(x_t,y_t)=\beta\sigma_x^2\) și \(\operatorname{Var}(y_t)=\beta^2\sigma_x^2+\sigma_\varepsilon^2\).
Raportul \(k\) compară partea transmisă din piața sursă cu zgomotul propriu; el se numește raport semnal–zgomot (signal-to-noise ratio). Echivalent, \(k=\rho^2/(1-\rho^2)\).(6.10) arată că varianța pieței sursă afectează corelația numai prin \(k\). Iar \(k\) crește cu \(\sigma_x^2\) chiar dacă \(\beta\) nu se schimbă.
Pe scurt
Modelul: \(y_t=\alpha+\beta x_t+\varepsilon_t\), \(\Cov(x_t,\varepsilon_t)=0\), \(\beta\) și \(\sigma_\varepsilon^2\) constante
\(x_t\): randamentul pieței-sursă
\(y_t\): randamentul celeilalte piețe
\(\beta\): coeficientul de transmitere
\(\varepsilon_t\): șocul propriu al lui \(y\), cu varianța \(\sigma_\varepsilon^2\)
\(\sigma_x^2\): varianța lui \(x\)
Două momente ale modelului
\(\Cov(x_t,y_t)=\beta\sigma_x^2\) și \(\Var(y_t)=\beta^2\sigma_x^2+\sigma_\varepsilon^2\), deoarece \(\varepsilon_t\) este necorelat cu \(x_t\)
În criză, notată cu indicele \(c\), singura schimbare este că varianța pieței sursă crește: \(\sigma_{x,c}^2=(1+\delta)\,\sigma_x^2\), cu \(\delta>0\) creșterea relativă. Atunci \(k_c=(1+\delta)k\), iar (6.10) dă \(\rho_c^2=(1+\delta)\rho^2/(1+\delta\rho^2)\). Rezultă corelația măsurată în criză:
Pentru \(0<|\rho|<1\),\(|\rho_c|>|\rho|\): corelația măsurată crește, deși \(\beta\) este același. Inversînd formula obținem corelația din criză corectată pentru volatilitate,
Un exemplu: fie o corelație calmă \(\rho=0{,}5\) și o varianță a sursei care se dublează (\(\delta=1\)). Atunci \(k=1/3\),\(k_c=2/3\) și \(\rho_c^2=0{,}4\), deci \(\rho_c=0{,}632\). Corelația a crescut cu \(0{,}13\) fără nicio schimbare a lui \(\beta\).(6.12) dă înapoi \(0{,}632/\sqrt{1+1\cdot(1-0{,}4)}=0{,}5\), valoarea calmă.
Pe scurt
În criză (indicele \(c\)): \(\sigma_{x,c}^2=(1+\delta)\,\sigma_{x}^2\)
\(\delta>0\): creșterea relativă a varianței pieței-sursă
nimic altceva nu se schimbă
Crește doar \(\sigma_x^2\), deci \(k_c=(1+\delta)\,k\) și
Atunci \(\rho_c=\rho\sqrt{\dfrac{1+\delta}{1+\delta\rho^2}}\), deci \(|\rho_c|>|\rho|\) pentru \(0<|\rho|<1\)
corelația măsurată crește în valoare absolută deși \(\beta\) este același
Inversînd: \(\rho^*=\dfrac{\rho_c}{\sqrt{1+\delta(1-\rho_c^2)}}\) este corelația din criză corectată pentru creșterea volatilității
Verificare rapidă: varianța pieței-sursă se dublează (\(\delta=1\)), iar \(\rho=0{,}5\)
\(k=0{,}25/0{,}75=1/3\), \(k_c=2/3\), \(\rho_c^2=(2/3)/(5/3)=0{,}4\), deci \(\rho_c=0{,}632\): o creștere de \(0{,}13\) fără nicio schimbare a lui \(\beta\)
Corecția: \(\rho^*=0{,}632/\sqrt{1+1\cdot(1-0{,}4)}=0{,}632/1{,}265=0{,}5\), deci regăsim valoarea din perioada calmă
Creșterea corelației cauzată numai de volatilitate
Graficul arată corelația măsurată în criză, \(\rho_c\) din (6.11), în funcție de \(\delta\), pentru trei corelații calme, cu \(\beta\) constant. Linia verticală marchează criza din 2008: varianța randamentelor S&P 500 pe 2 zile a fost atunci de 7,5 ori nivelul din anul calm, adică \(\delta=6{,}54\). Primul cursor alege \(\delta\), de la 0 la 10, iar al doilea corelația calmă. Butonul ▶ crește \(\delta\).
Întrebare pentru sală În criza din 2008, varianța randamentelor S&P 500 pe 2 zile a crescut de 7,5 ori (δ = 6,54); cu β neschimbat, o corelație necondiționată de 0,4 se măsoară în criză ca 0,77. Ce se întîmplă cu această corelație măsurată cînd ▶ crește δ pînă la 10?
Răspuns
Crește tot mai încet: 0,82 la δ = 10. Din ρ_c = ρ√((1 + δ)/(1 + δρ²)), corelația măsurată se apropie de 1 numai cînd δ → ∞. Varianța mai mare a pieței-sursă mărește ponderea factorului comun în varianța pieței-țintă, deși coeficientul de transmitere β și varianța șocului specific rămîn aceleași. La δ = 6,54, o corelație necondiționată de 0,2 se măsoară ca 0,49.
La \(\delta=6{,}54\), o corelație calmă de 0,4 se măsoară în criză ca 0,77. O corelație calmă de 0,2 devine 0,49. Dacă \(\delta\) crește mai departe, corelația măsurată continuă să urce, tot mai încet; ea se apropie de 1 numai cînd \(\delta\to\infty\). Cauza este cea de la început: crește partea comună, iar zgomotul propriu rămîne același.
Pe scurt
Corelația măsurată în criză \(\rho_c\) în funcție de \(\delta\), pentru trei corelații din perioada calmă
\(\beta\) este constant: crește doar volatilitatea pieței-sursă
Linia verticală: fereastra de criză din 2008
varianța randamentelor S&P 500 pe 2 zile a fost de \(7{,}5\) ori nivelul din anul calm (\(\delta=6{,}54\))
La acest \(\delta\), o corelație de \(0{,}4\) în perioada calmă se măsoară în criză ca \(0{,}77\)
una de \(0{,}2\) se măsoară ca \(0{,}49\)
Pentru un investitor: o creștere a corelației de această mărime în criză nu dovedește singură contagiune
Testul întreabă dacă corelația din criză, după ce scoatem efectul volatilității, este mai mare decît cea din perioada calmă. Are patru pași:
Se aleg piața sursă \(x\), o fereastră calmă și o fereastră de criză.
Se folosesc randamente pe 2 zile, ca diferențele dintre orele de închidere ale burselor să nu micșoreze corelația.
Se calculează creșterea varianței, \(\delta=\hat\sigma^2_{x,c}/\hat\sigma^2_{x,calm}-1\), și corelația corectată \(\rho^*\) din (6.12).
Se testează \(H_0\colon\rho^*\le\rho_{calm}\) cu statistici Fisher \(z\), ca la Forbes & Rigobon (2002).
Testul Fisher are două probleme: tratează \(\delta\) ca pe un număr cunoscut, deși este estimat, iar randamentele pe 2 zile se suprapun. Cu \(\delta\) fixat, \(\operatorname{Var}(\operatorname{artanh}\rho^*)\approx1/[n_c(1+\delta(1-\rho_c^2))]<1/n_c\), unde \(n_c\) este numărul de zile din criză, deci testul Fisher este prudent (conservator).
Pentru ambele probleme, capitolul folosește un bootstrap staționar (stationary bootstrap): eșantioane artificiale construite din blocuri de zile consecutive, de lungimi aleatoare, care păstrează dependența dintre zilele vecine. Lungimea medie a blocului este de 10 zile, iar numărul de eșantioane este \(B=1\,999\). Ferestrele calmă și de criză sînt reeșantionate împreună, iar testul privește diferența \(D=\rho^*-\rho_{calm}\).
Corecția este valabilă doar în trei ipoteze:
Nu există un șoc comun omis. Un factor global care lovește ambele piețe mărește și \(\sigma_\varepsilon\), nu doar \(\sigma_x\); atunci corecția este prea mare (Corsetti, Pericoli & Sbracia, 2005).
Piața \(y\) nu influențează înapoi piața sursă \(x\).
Varianța zgomotului propriu, \(\sigma_\varepsilon^2\), este aceeași în cele două perioade.
Contează și alegerea ferestrelor: concluzia se poate inversa dacă ferestrele se mută cu cîteva săptămîni.
Pe scurt
Procedura
Alegem piața-sursă \(x\), o fereastră calmă și una de criză
Folosim randamente pe 2 zile (orele de închidere diferă)
Calculăm \(\delta=\hat\sigma^2_{x,c}/\hat\sigma^2_{x,calm}-1\) și \(\rho^*\)
Testăm \(H_0: \rho^*\le\rho_{calm}\) (fără contagiune) cu statistici Fisher \(z\), convenția din Forbes & Rigobon (2002)
Inferența
Cu \(\delta\) fixat, \(\Var(\operatorname{artanh}\rho^*)\approx1/[n_c(1+\delta(1-\rho_c^2))]<1/n_c\) (\(n_c\): observațiile din criză): testul Fisher este conservator (respinge \(H_0\) prea rar)
Dar \(\delta\) este estimat și randamentele pe 2 zile se suprapun: folosim bootstrap staționar pe ferestrele calmă și de criză, reeșantionate împreună, și testăm \(D=\rho^*-\rho_{calm}\)
Bootstrap staționar: reeșantionează blocuri de zile consecutive (începuturi aleatoare, lungimi geometrice, în medie 10 zile; \(B=1\,999\) extrageri), păstrînd dependența serială din fiecare bloc
Ipoteze de reținut
Niciun șoc comun omis
un factor global care afectează ambele piețe crește atît \(\sigma_x\), cît și \(\sigma_\varepsilon\)
Aplicația ia S&P 500 ca piață sursă și compară corelația randamentelor pe 2 zile cu Euro Stoxx 50 și cu BET: în anul calm, în criză (brută) și în criză după corecția Forbes–Rigobon. Cursorul mută ambele ferestre cu pînă la opt săptămîni înainte sau înapoi. Caseta de rezultate dă cele trei corelații și valorile \(p\) pentru creșterea brută și pentru cea corectată. Calculul pas cu pas este în Aprofundări.
Ambele creșteri brute sînt semnificative la 5%, dar niciuna nu rezistă corecției. Pentru Euro Stoxx 50, valoarea \(p\) bootstrap a creșterii corectate este 0,98. Pentru BET, ea este 0,62. Incertitudinea despre \(\delta\) este mare: intervalul bootstrap de 90% este \([3{,}9;\ 9{,}6]\).
În ipotezele de mai sus, nu există deci dovezi de contagiune după corecție. Asta nu dovedește absența ei: o valoare \(p\) mare nu este probabilitatea ipotezei nule, iar testul are putere mică. În plus, în 2008 un șoc global a lovit toate piețele, deci corecția poate fi prea mare (Corsetti, Pericoli & Sbracia, 2005).
Întrebare pentru sală După corecția Forbes–Rigobon, testul unilateral al unei creșteri a corelației S&P 500–Euro Stoxx 50 dă p = 0,93. Ce concluzie susține?
Răspuns
Nu găsim dovezi de contagion, în ipotezele modelului: nu respingem ipoteza că corelația corectată nu a crescut. Corelația este 0,61 în anul calm, 0,80 în criză (creșterea brută are p = 0,005) și 0,44 după corecție. p = 0,93 vine din testul Fisher z unilateral calculat pe pagină; bootstrap-ul staționar din curs dă p = 0,98. Un p-value mare nu este probabilitatea ipotezei nule și nu dovedește absența contagion. La BET, 0,48 devine 0,20 (p = 0,55). Cifrele se schimbă cînd deplasăm ferestrele (▶), deci alegerea lor trebuie justificată.
Pentru Euro Stoxx 50, corelația este 0,61 în anul calm și 0,80 în criză, iar creșterea brută are \(p=0{,}005\). După corecție, corelația din criză scade la 0,44. Testul Fisher \(z\) calculat pe pagină dă \(p=0{,}93\) pentru creșterea corectată. Pentru BET, corelația de 0,48 din criză devine 0,20 după corecție. Cifrele se schimbă cînd ferestrele se mută, deci ferestrele trebuie justificate dinainte.
Sinteza secțiunii
O piață sursă mai volatilă mărește singură corelația măsurată, cum arată (6.11).(6.12) scoate acest efect. În 2008, creșterile brute ale corelațiilor S&P 500 cu Euro Stoxx 50 și cu BET sînt semnificative, dar cele corectate nu. Concluzia depinde de absența unui șoc comun, de ferestre și de o inferență care ține cont de \(\delta\) estimat. Secțiunea următoare privește zilele extreme, pe care nici corelația brută, nici cea corectată nu le descriu bine.
Copule și dependență în cozi
Riscul mare vine din zilele extreme: cît de probabil este ca două active să scadă puternic în aceeași zi? Corelația, un singur număr, nu răspunde bine la această întrebare.
Secțiunea măsoară întîi legătura din zilele extreme, apoi introduce copulele. Ideea lor: separăm modul în care se comportă fiecare activ singur de modul în care activele se mișcă împreună. Aplicația folosește două bănci americane, JPMorgan Chase (JPM) și Bank of America (BAC).
Longin & Solnik (2001) calculează corelația doar pe zilele, sau săptămînile, în care ambele randamente sînt extreme. Aceasta este corelația de depășire (exceedance correlation). Pentru coada pierderilor, la pragul \(q\),
unde \(F_x^{-1}(q)\) este cuantila de ordin \(q\) a lui \(x\). La \(q=0{,}10\), păstrăm doar săptămînile în care ambele randamente sînt printre cele mai slabe 10% ale lor. Corelația din coada cîștigurilor, \(\rho^+(q)\), se definește la fel, cu cele mai bune săptămîni.
Cînd păstrăm doar valorile extreme, corelația scade de la sine, chiar dacă legătura dintre active nu se schimbă. Pentru o distribuție Normală, \(\rho^\pm(q)\to0\) cînd \(q\to0\). Corelația de depășire a datelor se compară deci cu cea a unei distribuții Normale cu aceeași corelație, nu cu \(\rho\) calculat pe tot eșantionul.
Pe scurt
Întrebarea secțiunii: cît de probabile sînt pierderile extreme simultane?
și ce model al dependenței le poate reproduce, cînd corelația nu o poate face?
Corelația de depășire (exceedance correlation, Longin & Solnik (2001)): corelația condiționată de faptul că ambele randamente depășesc un prag
Graficul aplică (6.13) randamentelor săptămînale S&P 500 și Euro Stoxx 50 din 2000–2026, separat pentru pierderi comune și cîștiguri comune. Curba punctată este reperul: distribuția Normală cu aceeași corelație. Al doilea panou arată săptămînile selectate în norul de puncte. Cursorul alege pragul \(q\), de la 0,05 la 0,5, iar butonul ▶ îl modifică.
Întrebare pentru sală La q = 0,10, ce reprezintă valoarea 0,80 a curbei exceedance pentru pierderile comune S&P 500–Euro Stoxx 50?
Răspuns
Corelația Pearson a randamentelor săptămînale, calculată numai pe cele 86 de săptămîni în care ambele randamente sînt sub propria cuantilă de 10%. Nu este o probabilitate condiționată și nici o limită a dependenței în cozi. Pe cîștigurile comune corelația este 0,69 (70 de săptămîni). Distribuția Normală bivariată cu corelația necondiționată 0,78 dă, pentru aceeași selecție, doar 0,41.
La \(q=0{,}10\), corelația pierderilor comune este 0,80. Ea este calculată numai pe cele 86 de săptămîni în care ambii indici sînt sub propria cuantilă de 10%. Pentru cîștigurile comune, corelația este 0,69, pe 70 de săptămîni. Distribuția Normală dă pentru aceeași selecție doar 0,41.
Ambele cozi sînt deci mult deasupra reperului Normal, iar prăbușirile sînt comune mai des decît creșterile. Un singur coeficient nu poate descrie acest tipar. Avem nevoie de un model al întregii structuri de dependență: o copulă.
Pe scurt
Randamente săptămînale 2000–2026 (\(n=1\,393\))
în zilele comune de tranzacționare S&P 500 și Euro Stoxx 50
corelația pe tot eșantionul: \(\hat\rho=0{,}78\)
linia întreruptă: distribuția Normală bivariată cu aceeași corelație
La \(q=0{,}10\)
corelația pe pierderile comune: \(\rho^-=0{,}80\) (\(86\) săptămîni)
corelația pe cîștigurile comune: \(\rho^+=0{,}69\) (\(70\) săptămîni)
referința Normală la același \(q\): \(0{,}41\)
Ambele cozi sînt mult peste referința Normală
pierderile comune sînt mai puternic corelate decît cîștigurile comune
Un singur coeficient nu poate descrie acest lucru
este necesar un model al întregii structuri de dependență: o copulă (definită mai jos)
Ea măsoară doar legătura liniară. Dacă transformăm variabilele, de exemplu din randamente logaritmice în randamente simple, corelația se schimbă: în general \(\operatorname{Corr}(x,y)\ne\operatorname{Corr}(e^x,e^y)\).
Cunoscînd distribuția fiecărui activ și corelația, nu cunoaștem distribuția comună. Două portofolii cu aceleași active și același \(\rho\) pot avea Value-at-Risk foarte diferite (Capitolul 7).
Nu orice valoare din \([-1,1]\) este posibilă. Pentru distribuții date, corelația poate lua doar valori dintr-un interval \([\rho_{\min},\rho_{\max}]\), atins cînd o variabilă crește, respectiv scade, perfect odată cu cealaltă.
Un exemplu pentru a treia capcană: fie \(X=e^{\sigma_1Z}\) și \(Y=e^{\pm\sigma_2Z}\), cu \(Z\) Normal standard. Cu semnul plus, \(Y\) crește perfect odată cu \(X\); cu semnul minus, scade perfect. Corelația maximă posibilă este
iar pentru \(\rho_{\min}\) numărătorul devine \(e^{-\sigma_1\sigma_2}-1\). Pentru \(\sigma_1=1\) și \(\sigma_2=3\),\(\rho_{\max}=0{,}162\) și \(\rho_{\min}=-0{,}008\). Cele două variabile sînt perfect legate, una fiind funcție de cealaltă, și totuși corelația lor este aproape zero.
Două variabile legate perfect, cu corelație Pearson aproape nulă. Stînga: \(Y=X^2\), cu \(X\) Normal standard (1 000 de valori simulate). Dreapta: \(X=e^{Z}\) și \(Y=e^{3Z}\);\(Y\) crește de fiecare dată cînd crește \(X\), deci tau al lui Kendall este 1, dar corelația Pearson nu poate depăși 0,162.
Graficul arată două feluri în care corelația Pearson înșală. În stînga, \(Y\) se calculează exact din \(X\), dar legătura are formă de U: valorile mari ale lui \(Y\) apar atît pentru \(X\) foarte negativ, cît și pentru \(X\) foarte pozitiv. Corelația, care caută o dreaptă, iese aproape zero. În dreapta, cele două variabile cresc mereu împreună. Corelația rămîne totuși mică, pentru că cîteva valori uriașe ale lui \(Y\) domină calculul. O măsură bazată pe ordine, ca tau al lui Kendall, vede legătura perfectă: 1.
nu este invariantă la transformări monotone: \(\Corr(x,y)\ne\Corr(e^x,e^y)\)
Marginalele și corelația nu determină distribuția comună
Două portofolii cu aceleași marginale și același \(\rho\) pot avea Value at Risk foarte diferite (Capitolul 7)
Corelațiile posibile: pentru marginale date, \(\rho\in[\rho_{\min},\rho_{\max}]\)
atinse de perechi contramonotone (una este funcție descrescătoare de cealaltă) și comonotone (funcție crescătoare)
Exemplu cu distribuții lognormale: \(X=e^{\sigma_1Z}\), \(Y=e^{\pm\sigma_2Z}\), cu \(Z\) din distribuția Normală standard (cu \(+\) variabilele sînt comonotone, cu \(-\) contramonotone)
\(\rho_{\max}=\dfrac{e^{\sigma_1\sigma_2}-1}{\sqrt{(e^{\sigma_1^2}-1)(e^{\sigma_2^2}-1)}}\), iar \(\rho_{\min}\) se obține cu \(e^{-\sigma_1\sigma_2}\) la numărător
Pentru \(\sigma_1=1\) și \(\sigma_2=3\): \(\rho_{\max}=0{,}162\) și \(\rho_{\min}=-0{,}008\), deci variabile perfect dependente pot fi aproape necorelate
Soluția: separăm marginalele de structura de dependență (slide-ul următor)
1 500 de perechi simulate cu același \(\tau\) Kendall (0,5); fiecare rînd păstrează o copulă (Gaussiană sus, Student \(t\) cu \(\nu=4\) jos), fiecare coloană schimbă marginalele
Punctele închise: ambele active în cele mai proaste 5% zile, 34 de perechi la Gaussiana, 40 la copula \(t\)
Pentru fiecare zi, întrebăm unde se află randamentul de azi în propria lui istorie: este o zi slabă, una obișnuită sau una foarte bună? Răspunsul este un nivel de probabilitate între 0 și 1. Copula descrie doar cum se mișcă împreună aceste niveluri.
Formal, o copulă este o funcție de repartiție comună pe \([0,1]^d\) cu marginale uniforme, unde \(d\) este numărul de variabile. Teorema lui Sklar (1959) spune că orice distribuție comună \(F\), cu distribuțiile individuale (marginalele) \(F_1,\dots,F_d\), se scrie ca
unde \(u_i=F_i(x_i)\in[0,1]\) este nivelul de probabilitate al lui \(x_i\). Dacă marginalele sînt continue, copula \(C\) este unică. Invers, orice copulă combinată cu orice marginale dă o distribuție comună validă. Cu densități, \(f(x)=c\big(F_1(x_1),\dots,F_d(x_d)\big)\prod_i f_i(x_i)\), unde \(c\) este densitatea copulei; copula a două variabile care cresc perfect împreună nu are densitate.
(6.14) împarte modelarea în două. Marginalele poartă volatilitatea, asimetria și cozile groase ale fiecărui activ (Capitolele 1 și 5). Copula poartă toată dependența. Copula nu se schimbă dacă transformăm crescător fiecare variabilă, de exemplu dacă înlocuim randamentele cu rangurile lor.
Teorema lui Sklar pe date simulate (1 500 de perechi, tau al lui Kendall 0,5). Fiecare rînd folosește o singură copulă: Gaussiană sus, Student t cu \(\nu=4\) jos. Fiecare coloană folosește alte marginale. Punctele închise la culoare sînt perechile în care ambele variabile se află în cele mai slabe 5% valori ale lor.
Graficul se citește în două direcții. Pe orizontală, copula rămîne aceeași și se schimbă doar marginalele: norul de puncte își schimbă forma, dar punctele închise sînt exact aceleași perechi, pentru că rangurile nu se schimbă. Pe verticală, marginalele rămîn aceleași și se schimbă copula: sub copula t, colțul din stînga jos este mai aglomerat. Din 1 500 de perechi, 40 au ambele variabile în cele mai slabe 5% valori sub copula t și 34 sub copula Gaussiană.
Pentru un manager de risc, separarea are un avantaj practic. Modelul fiecărui activ (volatilitate, cozi groase) se poate alege și verifica separat. Copula se alege apoi numai pentru întrebarea „cît de des vin zilele proaste împreună?”.
Trei copule servesc drept repere. Independența este \(\Pi(u,v)=uv\). Mișcarea perfect împreună (comonotonia) este \(M(u,v)=\min(u,v)\), iar mișcarea perfect opusă (contramonotonia) este \(W(u,v)=\max(u+v-1,0)\). Orice copulă se află între ultimele două, \(W\le C\le M\) (marginile Fréchet–Hoeffding (Nelsen, 2006)).
Pe scurt
O copulă este o funcție de repartiție comună pe \([0,1]^d\) cu marginale uniforme: descrie doar legătura dintre variabile, după ce fiecare a fost adusă pe scara probabilităților \([0,1]\)
Sklar (1959): pentru orice repartiție comună \(F\) cu marginalele \(F_1,\dots,F_d\) există o copulă \(C\)
astfel încît \(F(x_1,\dots,x_d)=C\big(F_1(x_1),\dots,F_d(x_d)\big)\)
\(d\): numărul de variabile
\(F_i\): funcția de repartiție marginală a lui \(x_i\)
\(u_i=F_i(x_i)\in[0,1]\): nivelul ei de probabilitate
\(C\) este unică dacă marginalele sînt continue
Invers, orice copulă și orice marginale dau o repartiție comună validă
Cu densități: \(f(x)=c\big(F_1(x_1),\dots,F_d(x_d)\big)\prod_i f_i(x_i)\), \(c\) densitatea copulei, \(f_i\) densitățile marginale (copula comonotonă nu are densitate)
Marginalele conțin volatilitatea, asimetria și cozile groase ale fiecărui activ (Capitolele 1 și 5)
Copula conține toată dependența
este invariantă la transformări crescătoare ale fiecărei variabile, spre deosebire de \(\rho\)
Trei copule de referință și marginile Fréchet–Hoeffding \(W\le C\le M\) (Nelsen (2006))
Corelațiile de rang depind numai de copulă: ele folosesc doar ordinea observațiilor, nu valorile lor.
Tau al lui Kendall (Kendall, 1938) compară perechi de zile. O pereche de zile este concordantă dacă ambele active au crescut, sau ambele au scăzut, de la o zi la cealaltă. Pentru două extrageri independente \((X_1,Y_1)\) și \((X_2,Y_2)\),
adică proporția perechilor concordante minus proporția celor discordante. Rho al lui Spearman (Spearman, 1904) este corelația Pearson calculată pe ranguri, \(\rho_S=12\iint (C(u,v)-uv)\,du\,dv\). Ambele sînt 1 pentru \(M\), 0 pentru independență și \(-1\) pentru \(W\).
Un exemplu de calcul cu cinci zile. Randamentele, în procente, sînt \(-2;\ 1;\ 3;\ -1;\ 0{,}5\) pentru primul activ și \(-3;\ 2;\ 1;\ -0{,}5;\ -1\) pentru al doilea. Cu cinci zile se pot forma 10 perechi de zile. Pentru fiecare pereche ne întrebăm: în care dintre cele două zile are primul activ randamentul mai mare și este aceeași zi și pentru al doilea activ? Dacă da, perechea este concordantă; dacă nu, este discordantă.
Ziua 1 față de ziua 2: ambele active au randament mai mic în ziua 1 (\(-2<1\) și \(-3<2\)), deci perechea este concordantă.
Ziua 2 față de ziua 3: primul activ are mai mult în ziua 3 (\(3>1\)), al doilea mai puțin (\(1<2\)), deci perechea este discordantă.
La fel se verifică toate celelalte perechi. Doar perechile (2, 3) și (4, 5) sînt discordante; celelalte 8 sînt concordante.
Rezultatul este \(\hat\tau=(8-2)/10=0{,}6\). Calculul folosește numai ordinea randamentelor, nu mărimea lor. Dacă ziua 3 ar avea un randament de 30% în loc de 3%, \(\hat\tau\) ar rămîne 0,6, în timp ce corelația Pearson s-ar schimba mult.
Pentru familiile din capitol, (6.15) are forme închise în parametrul copulei \(\theta\):\(\tau=\frac2\pi\arcsin\rho\) pentru copulele Gaussiană și t, \(\theta/(\theta+2)\) pentru Clayton, \(1-1/\theta\) pentru Gumbel și o expresie cu funcția Debye \(D_1\) pentru Frank. Pentru copula Gaussiană, \(\rho_S=\frac6\pi\arcsin(\rho/2)\). Cu \(\rho=0{,}5\),\(\tau=1/3\) și \(\rho_S=0{,}483\). Inversînd aceste relații, obținem un estimator simplu al lui \(\theta\) din \(\hat\tau\) calculat pe date.
Pe scurt
Tau al lui Kendall (Kendall (1938)): perechi concordante minus perechi discordante
legătură numai în coada pierderilor: Clayton (Clayton, 1978);
legătură numai în coada cîștigurilor: Gumbel (Gumbel, 1960).
Copula Gaussiană este \(\Phi_{2,\rho}\big(\Phi^{-1}(u),\Phi^{-1}(v)\big)\): nivelurile \(u\) și \(v\) sînt transformate în scoruri Normale, apoi legate printr-o distribuție Normală bivariată cu corelația \(\rho\). Copula t face același lucru cu distribuția Student t cu \(\nu\) grade de libertate. Clayton, Gumbel și Frank au un singur parametru \(\theta\) și formule explicite.
Copulele Gaussiană și t se extind ușor la multe active, cu o matrice de corelație, și sînt alegerea obișnuită în sistemele de risc. Cînd \(\nu\to\infty\), copula t devine copula Gaussiană.
\(\Phi,\Phi^{-1}\), \(\Phi_{2,\rho}\): funcția de repartiție, cuantila și funcția de repartiție bivariată (corelația \(\rho\)) ale distribuției Normale
\(t_\nu\), \(t_{2,\rho,\nu}\): analoagele Student t cu \(\nu\) grade de libertate; \(\theta\): parametrul de dependență
De ce aceste cinci: acoperă cele patru tipare de dependență în cozi (tendința extremelor de a apărea împreună, definită mai jos)
niciuna (Gaussiană, Frank), ambele simetric (t), doar coada inferioară (Clayton), doar coada superioară (Gumbel)
Eliptice (Gaussiană, t): provin din distribuțiile Normală și Student t multivariate
se extind la \(d\) dimensiuni cu o matrice de corelație, alegerea standard în sistemele de risc
pentru \(\nu\to\infty\), copula t devine copula Gaussiană
Clayton, Gumbel și Frank aparțin familiei arhimediene (Archimedean copulas), \(C(u,v)=\varphi^{-1}\big(\varphi(u)+\varphi(v)\big)\), unde funcția generatoare \(\varphi\) este descrescătoare, cu \(\varphi(1)=0\). Ele au un singur parametru, formule închise și se simulează ușor. Sînt însă simetrice în cele două variabile, \(C(u,v)=C(v,u)\) (exchangeable). Pentru multe active, un singur parametru trebuie să descrie toate perechile, ceea ce se potrivește slab cu datele.
O copulă poate fi rotită cu \(180^\circ\), adică aplicată lui \((1-U,1-V)\). Rotația mută legătura dintr-o coadă în cealaltă: o familie făcută pentru prăbușiri comune poate descrie astfel creșteri comune. Densitățile și generatorii sînt în Anexă.
Pe scurt
De unde vin numele: copula Gaussiană este legătura dintr-o pereche cu distribuția Normală bivariată (corelația \(\rho\)), după ce fiecare variabilă este adusă pe \([0,1]\) cu \(\Phi\)
numele spune de unde vine legătura, nu că randamentele sînt Normale: marginalele pot fi oricare (copula, intuitiv)
copula Student \(t\): la fel, din distribuția \(t\) bivariată; Clayton, Gumbel și Frank poartă numele autorilor care le-au propus
Au un singur parametru, formă închisă și se simulează ușor
Dar sînt simetrice la permutarea variabilelor și puțin flexibile în dimensiuni mari
de exemplu, Clayton: \(\varphi(t)=(t^{-\theta}-1)/\theta\); Gumbel: \(\varphi(t)=(-\ln t)^\theta\)
numele: generatorul transformă combinarea în adunare; aplicată de \(n\) ori aceluiași \(u<1\), copula dă \(\varphi^{-1}(n\varphi(u))\to0\), ca în axioma lui Arhimede (\(n\varepsilon\) depășește orice prag pentru \(n\) suficient de mare)
Rotirea cu \(180^\circ\) transferă dependența în cozi în coada opusă
copula de supraviețuire a perechii \((1-U,1-V)\), unde \(U\) și \(V\) sînt variabilele uniforme ale copulei
de exemplu, Gumbel rotit are dependență doar în coada inferioară (crahuri comune)
Dependența în cozi răspunde la întrebarea: dacă un activ are o zi extrem de proastă, cît de probabil este ca și celălalt să aibă una? Coeficientul pentru coada inferioară este limita acestei probabilități cînd pragul devine tot mai extrem:
unde \(U=F_1(X_1)\),\(V=F_2(X_2)\), iar \(q\) este probabilitatea din coadă. Coeficientul pentru coada superioară, \(\lambda_U\), se definește la fel, cu cele mai bune zile.
Dacă \(\lambda>0\), extremele comune rămîn probabile oricît de extrem ar fi pragul. Dacă \(\lambda=0\), ele devin rare la limită (independență asimptotică). Dependența în cozi este o proprietate a copulei și nu se vede din \(\rho\). La un prag finit, \(C(q,q)/q\) este o probabilitate obișnuită, nu încă limita.
Formele închise sînt în tabelul de pe slide. Copulele Gaussiană și Frank au \(\lambda_L=\lambda_U=0\). Copula t are aceeași valoare în ambele cozi, \(2\,t_{\nu+1}\big(-\sqrt{(\nu+1)(1-\rho)/(1+\rho)}\big)\), unde \(t_{\nu+1}\) este funcția de repartiție Student t cu \(\nu+1\) grade de libertate. Ea crește cînd \(\nu\) scade sau \(\rho\) crește. Clayton are \(\lambda_L=2^{-1/\theta}\) și \(\lambda_U=0\), iar Gumbel \(\lambda_L=0\) și \(\lambda_U=2-2^{1/\theta}\).
Probabilitatea ca al doilea activ să fie în cele mai slabe \(q\) zile ale sale, știind că primul este în ale lui, pentru cinci copule cu același tau al lui Kendall (0,5). Pragul devine mai extrem spre dreapta. Liniile punctate sînt limitele \(\lambda_L\); linia întreruptă este independența.
Graficul arată ce înseamnă limita din (6.16). Să luăm pragul de 1%, adică ziua cea mai slabă din o sută. Sub copula Gaussiană, dacă primul activ are o astfel de zi, al doilea are și el una cu probabilitatea 0,273. Sub copula t, probabilitatea este 0,432, iar sub Clayton 0,707. La pragul de 0,1% (o zi din o mie), copula Gaussiană coboară la 0,165, în timp ce copula t rămîne la 0,408.
Diferența contează exact acolo unde contează riscul. Copula Gaussiană spune că, pe măsură ce criza devine mai gravă, șansa ca și celălalt activ să cadă puternic scade. Copula t spune că această șansă rămîne aproape constantă, în jur de 0,4. Datele JPM–BAC de mai jos sînt mai apropiate de a doua imagine.
Pe scurt
Întrebarea: dacă un activ are o zi extremă, cît de probabil este ca și celălalt să aibă una?
Graficul arată cîte 1 500 de perechi simulate din fiecare copulă, toate cu același tau al lui Kendall. Marginalele sînt aceleași peste tot (scoruri Normale), deci orice diferență din colțuri vine numai din copulă. Cursorul alege \(\tau\), de la 0,05 la 0,9, iar butonul ▶ îl crește. Caseta de rezultate dă parametrii copulelor și coeficienții de dependență în cozi.
Întrebare pentru sală Copula Gaussiană cu τ = 0,5 (ρ = 0,707) are λ_L = 0. Ce înseamnă aceasta pentru crahurile comune la pragul de 5%, U ≤ 0,05 și V ≤ 0,05?
Răspuns
Au probabilitate pozitivă: sub copula Gaussiană, P(U ≤ 0,05, V ≤ 0,05) ≈ 0,020, de opt ori mai mult decît 0,0025 la independență, iar C(q, q)/q ≈ 0,40 la q = 0,05. λ_L = 0 spune doar că C(q, q)/q → 0 cînd q → 0. Același τ nu fixează cozile: copula t cu ν = 4 are λ_L = λ_U = 0,40, Clayton are λ_L = 0,71, Gumbel are doar λ_U = 0,59, iar Gaussiana și Frank au λ = 0. Cînd ▶ crește τ pînă la 0,9, λ al Gaussienei rămîne 0.
Același \(\tau\) nu înseamnă aceleași cozi. La \(\tau=0{,}5\), copula t cu \(\nu=4\) are \(\lambda_L=\lambda_U=0{,}40\). Clayton are \(\lambda_L=0{,}71\), iar Gumbel \(\lambda_U=0{,}59\). Copulele Gaussiană și Frank au \(\lambda=0\).
În colțuri, norii Gaussian și Frank se răresc acolo. Norul t rămîne dens în ambele colțuri. Clayton este ascuțit în stînga jos, unde stau prăbușirile comune, iar Gumbel în dreapta sus. Chiar și cu \(\tau\) aproape de 0,9, \(\lambda\) Gaussian rămîne 0.
Atenție: \(\lambda_L=0\) nu înseamnă că prăbușirile comune sînt imposibile. Sub copula Gaussiană cu \(\tau=0{,}5\), probabilitatea ca ambele active să fie în cele mai slabe 5% zile este aproximativ 0,020. Este de opt ori mai mult decît 0,0025, valoarea sub independență. Valoarea \(\lambda_L=0\) spune doar că raportul \(C(q,q)/q\) tinde la zero pentru praguri tot mai extreme.
Pe scurt
1 500 de perechi simulate din fiecare copulă cu \(\tau=0{,}5\), pe marginale Normale \((\Phi^{-1}(u),\Phi^{-1}(v))\)
parametrii care dau \(\tau=0{,}5\): \(\rho=0{,}707\) pentru Gaussiană și t (copula t cu \(\nu=4\)), \(\theta=2{,}0\) pentru Clayton și Gumbel, \(\theta=5{,}74\) pentru Frank
În cozi: copulele Gaussiană și Frank devin rarefiate, copula t rămîne densă în ambele
Clayton se concentrează în coada inferioară (crahuri comune), Gumbel în coada superioară
Același tau al lui Kendall nu determină riscul extremelor simultane: contează familia copulei
Pasul 2, filtrul GARCH: \(-3\%\) înseamnă altceva într-o zi calmă decît în criză
împărțim fiecare randament la volatilitatea zilei, ca să comparăm zile din regimuri diferite
Pasul 3, rangurile: fiecare zi devine percentila ei în propria istorie a activului
nu presupunem nicio formă pentru marginale; o marginală greșită nu poate strica estimarea copulei
Pasul 4, verosimilitatea: pentru fiecare familie alegem parametrul care face cele mai probabile perechile de percentile observate
densitatea copulei este mare acolo unde punctele sînt dese, de exemplu în colțul zilelor proaste comune
Comparăm apoi familiile între ele: criteriul AIC (Akaike Information Criterion, criteriul informațional Akaike) penalizează parametrii în plus; pentru JPM și BAC cîștigă copula \(t\) (slide-urile următoare)
Pașii de la randamente la o copulă estimată, metoda folosită în aplicația JPM–BAC.
O copulă se poate estima în trei moduri. Cel mai direct este verosimilitatea maximă completă: estimăm marginalele și copula deodată. Metoda este eficientă, dar grea numeric, iar marginale greșite strică și copula.
Metoda IFM (inference functions for margins) a lui Joe (2005) lucrează în doi pași. Întîi estimăm un model pentru fiecare activ, de exemplu GARCH cu inovații Student t. Apoi transformăm fiecare randament în nivelul lui de probabilitate, \(\hat u_{it}=\hat F_i(x_{it})\), și estimăm copula pe aceste niveluri, maximizînd \(\sum_t\ln c(\hat u_{1t},\hat u_{2t};\theta)\).
A treia metodă, verosimilitatea maximă canonică (CML, canonical maximum likelihood) (Genest, Ghoudi & Rivest, 1995), nu mai cere un model pentru fiecare activ. Nivelul de probabilitate se obține direct din rang: unde se află randamentul de azi printre toate randamentele seriei. Aceste valori se numesc pseudo-observații (pseudo-observations):
Numitorul \(T+1\) ține valorile departe de 0 și 1, unde densitatea multor copule devine infinită. De exemplu, cu \(T=4\,202\) zile, ziua cu al 42-lea cel mai mic randament primește \(\hat u=42/4\,203\), adică aproximativ 1%: o zi din cele mai slabe 1%. Pentru că nu presupune nicio formă pentru marginale, CML nu poate greși la ele.
Pentru randamente, volatilitatea variabilă ar amesteca perioadele agitate cu legătura dintre active. De aceea fiecare serie este filtrată întîi cu GARCH, iar CML se aplică rangurilor reziduurilor standardizate. Ea presupune că reziduurile sînt i.i.d., ceea ce filtrul GARCH nu garantează singur.
Familiile comparate nu sînt, în general, cazuri particulare una a alteia. Ele se compară deci prin criteriile informaționale AIC \(=2k-2\ell\) (Akaike) și BIC \(=k\ln T-2\ell\) (bayesian), cu \(k\) numărul de parametri și \(\ell\) log-verosimilitatea. Pentru copula Gaussiană față de copula t, seminarul folosește un test al raportului de verosimilitate (LR) calibrat prin bootstrap. Copula Gaussiană este cazul-limită al copulei t cînd \(\nu\to\infty\), deci simulările bootstrap se fac la \(\nu=\infty\).
Pe scurt
Verosimilitate maximă completă: marginalele și copula estimate simultan
Eficientă, dar costisitoare computațional și sensibilă la erorile de specificare
IFM (funcții de inferență pentru marginale, Joe (2005)): doi pași
Pasul 1: estimăm marginale parametrice (de exemplu GARCH cu Student t)
Calculăm \(\hat u_{it}=\hat F_i(x_{it})\), unde \(\hat F_i\) este funcția de repartiție marginală estimată
Pasul 2: maximizăm \(\sum_t\ln c(\hat u_{1t},\hat u_{2t};\theta)\), unde \(c\) este densitatea copulei
Graficul arată cei doi pași pentru JPM și BAC, pe randamentele zilnice din 2010–2026 (\(T=4\,202\)), filtrate cu GARCH(1,1). Panoul din stînga arată reziduurile standardizate. Panoul din dreapta arată pseudo-observațiile (6.17) în pătratul unitate. Cursorul alege primul an al eșantionului, de la 2010 la 2024. Caseta de rezultate dă tau al lui Kendall, rho al lui Spearman și corelațiile copulei Gaussiene care le corespund.
Întrebare pentru sală Transformăm separat reziduurile GARCH ale JPM și BAC în ranguri împărțite la T + 1. Ce proprietate obținem fără o ipoteză suplimentară?
Răspuns
Marginale empirice pe grila uniformă 1/(T + 1), …, T/(T + 1), fără să alegem o distribuție marginală. Rangurile păstrează ordinea observațiilor; nu produc distribuția Normală și nici independență în timp. Filtrul GARCH reduce volatility clustering, iar inferența CML statică folosită aici presupune inovații i.i.d., deci adecvarea filtrării trebuie verificată. Măsurile de rang nu depind de marginale: pentru JPM și BAC, τ = 0,641 și ρ_S = 0,822.
Trecerea la ranguri face fiecare marginală uniformă, fără să alegem o distribuție. Rangurile păstrează doar ordinea observațiilor. Ele nu fac datele Normale și nici nu elimină dependența în timp; de aceea filtrul GARCH trebuie verificat separat.
Pentru JPM și BAC, \(\hat\tau=0{,}641\) și \(\hat\rho_S=0{,}822\). Ambele colțuri ale norului sînt dense: cele două bănci au des zile proaste împreună și zile bune împreună.
Pe scurt
JPMorgan Chase (JPM) și Bank of America (BAC), zilnic 2010–2026 (\(T=4\,202\)), filtrate GARCH(1,1)
Tau al lui Kendall: \(\hat\tau=0{,}641\)
Rho al lui Spearman: \(\hat\rho_S=0{,}822\)
Norul de puncte cu marginale uniforme este dens în ambele cozi: crahuri comune și creșteri comune
întrebarea următoare: ce familie de copule reproduce acest tipar?
Întrebarea: arată datele ca și cum ar fi fost generate de copula estimată?
Ideea testului Rosenblatt: dacă modelul este corect, fiecare pereche \((u,v)\) se transformă în două numere fără nicio legătură între ele
primul rămîne \(u\); al doilea spune unde cade \(v\) în distribuția pe care modelul o prevede pentru \(v\), știind \(u\)
cu un model bun, norul transformat umple pătratul \([0,1]^2\) uniform, fără zone mai dese
Statistica \(S_n\) măsoară cît de departe este norul transformat de un nor uniform: 0 la potrivire perfectă, valori mari la potrivire slabă
JPM și BAC: \(t\) 0,082, Frank 0,365, Gaussiană 0,968, Clayton 1,24, Gumbel 1,42
Valoarea \(p\) prin bootstrap: simulăm de \(B\) ori date din copula estimată, refacem tot calculul și numărăm cît de des \(S_n\) simulat este cel puțin cît cel observat
aici nicio simulare nu atinge valoarea observată, deci \(p\) este minimul posibil, \(1/(B+1)\): toate familiile sînt respinse
Cu 4 202 zile testul vede și abateri mici: o respingere spune că modelul nu este exact, nu cît de greșit este; pentru alegere folosim și AIC
Estimările copulelor și adecvarea lor: JPM și BAC (1/2)
Graficul compară cele cinci copule estimate prin CML pe datele JPM–BAC. Panoul din stînga arată cît de departe este fiecare familie de cea mai bună după AIC. Deasupra barelor sînt valorile \(p\) ale testului de adecvare (goodness of fit). Panoul din dreapta arată log-verosimilitatea copulei t în funcție de \(\nu\). Cursorul alege \(\nu\), de la 2,2 la 40, iar butonul ▶ îl crește.
Întrebare pentru sală Copula Student t are cel mai mic AIC, dar testul Rosenblatt o respinge la 5%. Ce statut are în comparația modelelor?
Răspuns
Este familia preferată de AIC dintre cele testate, cu adecvarea respinsă. AIC ordonează familiile, nu validează modelul: copula t are AIC-ul cu 309 puncte sub cel al copulei Gaussiene și cea mai mică statistică Rosenblatt, 0,082. Testul le respinge pe toate cinci, cu cel mai mic p-value posibil: 1/101 ≈ 0,010 pentru t (B = 100) și 1/201 ≈ 0,005 pentru celelalte (B = 200). Nici familia clasată a doua nu este adecvată. Pe măsură ce ν crește (▶), copula t se apropie de cea Gaussiană, iar avantajul AIC scade la 94 de puncte la ν = 40.
Copula t este cea mai bună după AIC, dar nici ea nu se potrivește datelor. Avantajul ei față de copula Gaussiană este de 309 puncte AIC. Testul de adecvare respinge însă toate cele cinci familii, fiecare cu cea mai mică valoare \(p\) posibilă în bootstrap. AIC doar ordonează familiile; nu arată că cea mai bună este și bună.
Cînd \(\nu\) crește, copula t se apropie de cea Gaussiană. La \(\nu=40\), avantajul ei în AIC scade la 94 de puncte.
Tabelul arată ce spune fiecare familie despre zilele extreme. Copula Gaussiană (\(\hat\rho=0{,}833\)) nu are dependență în cozi. Copula t (\(\hat\rho=0{,}842\),\(\hat\nu=4{,}24\)) dă \(\lambda_L=\lambda_U=0{,}531\). Clayton pune toată legătura în coada pierderilor, \(\lambda_L=0{,}748\). Gumbel o pune toată în coada cîștigurilor, \(\lambda_U=0{,}693\). Frank nu are dependență în cozi.
Testul Rosenblatt, descris în Aprofundări, le respinge pe toate. Statistica lui este cea mai mică pentru copula t, 0,082, și a doua pentru Frank, 0,365, deși Frank este doar a patra după AIC. Tabelul complet este în Anexă.
Pe scurt
\(\hat\theta\) sau \(\hat\rho\)
\(\hat\nu\)
\(\lambda_L\)
\(\lambda_U\)
Gaussiană
0,833
–
0,000
0,000
Student t
0,842
4,24
0,531
0,531
Clayton
2,384
–
0,748
0,000
Gumbel
2,587
–
0,000
0,693
Frank
9,152
–
0,000
0,000
\(\lambda_L\), \(\lambda_U\) din tabel: dependența în cozi implicată de parametrii estimați
Barele (slide-ul anterior) arată distanța AIC față de cel mai bun model
numerele de deasupra lor: valorile \(p\) bootstrap ale testului de adecvare (tabelul complet în Anexă)
Copula Student t are cel mai mic AIC, la mare distanță de celelalte
Testul Rosenblatt (Aprofundări) verifică dacă datele, transformate cu copula estimată, devin uniforme independente: respinge toate familiile
fiecare valoare \(p\) este minimul posibil, \(1/(B+1)\)
Statistica testului (mai mică înseamnă adecvare mai bună): t \(0{,}082\), Frank \(0{,}365\), Gaussiană \(0{,}968\), Clayton \(1{,}24\), Gumbel \(1{,}42\)
Frank este a doua după adecvare, dar a patra după AIC
Pentru un manager de risc: copula t este cea mai bună dintre cele cinci, dar nu este un model exact
Dependența în cozi se poate estima și direct din date. Graficul arată \(\hat\lambda_L(q)=\hat C(q,q)/q\) și \(\hat\lambda_U(q)\), calculate pe rangurile reziduurilor JPM–BAC, pentru \(q\) între 1% și 20%. Banda arată unde ar cădea același estimator în 90% din cazuri dacă datele ar veni din copula t estimată. Ea este calculată separat pentru fiecare prag, deci nu este o bandă simultană pentru toate pragurile. Cursorul alege \(q\), iar al doilea panou marchează zilele din coadă în norul de puncte.
Întrebare pentru sală Pe rangurile reziduurilor GARCH standardizate JPM–BAC, la q = 5%, λ_L(q) = 0,61 și λ_U(q) = 0,55. Arată această diferență o asimetrie între cozi?
Răspuns
Nu încă: diferența, 0,062, are intervalul bootstrap pe blocuri de 95% [−0,014; 0,138], care conține zero, deci asimetria nu este detectată statistic la acest prag. Banda [0,57; 0,65] este o bandă punctuală de 90%, simulată sub copula t estimată, cu parametrii fixați; ea compară fiecare coadă cu modelul, nu cozile între ele. Cînd JPM este în coada de jos a reziduurilor (210 zile), BAC este în propria coadă în 129 dintre ele.
La \(q=5\%\),\(\hat\lambda_L=0{,}61\) și \(\hat\lambda_U=0{,}55\). Din cele 210 zile în care JPM este în cele mai slabe 5% zile ale sale, BAC este și ea în propria coadă în 129, adică în aproximativ 61% din cazuri. Coada pierderilor se află în banda copulei t, \([0{,}57;\ 0{,}65]\). Coada cîștigurilor este sub bandă: creșterile comune sînt mai rare decît prevede modelul.
Este coada pierderilor mai puternică decît cea a cîștigurilor? Diferența este 0,062, dar intervalul ei de încredere de 95%, \([-0{,}014;\ 0{,}138]\), conține zero. Asimetria nu este deci dovedită statistic (Aprofundări). La \(q=1\%\), valorile sînt 0,52 și 0,43, dar în coadă rămîn doar 42 de zile, deci estimarea este imprecisă.
Pe scurt
\(\hat\lambda_L(q)=\hat C(q,q)/q\) și \(\hat\lambda_U(q)\) pentru \(q\) între 1% și 20%
banda: intervalul punctual de 90% pe date simulate din copula t estimată (parametri fixați, nesimultan pe praguri)
La \(q=5\%\): \(\hat\lambda_L=0{,}61\) și \(\hat\lambda_U=0{,}55\)
la \(q=1\%\): \(\hat\lambda_L=0{,}52\) și \(\hat\lambda_U=0{,}43\)
Cînd JPM are una dintre cele mai proaste 5% zile
BAC se află în propriile 5% cele mai proaste zile în aproximativ 61% din cazuri
Coada inferioară la 5%: în banda copulei t (\(0{,}57\)–\(0{,}65\))
Coada superioară (\(0{,}55\) la 5%): sub banda copulei t
cîștigurile comune sînt mai slabe decît prezice modelul
La \(q=1\%\) rămîn doar 42 de zile în coadă, deci estimarea este imprecisă
Tipul de dovadă: descriere
diferența \(\hat\lambda_L-\hat\lambda_U\) nu este semnificativă (Aprofundări)
Li (2000) a modelat neplățile comune din portofoliile de credite cu o copulă Gaussiană, cu un singur parametru de corelație calibrat pe prețurile pieței. Modelul a devenit standardul pentru evaluarea tranșelor obligațiunilor garantate cu datorii (CDO, collateralised debt obligations).
Modelul avea două slăbiciuni, ambele discutate în acest capitol. Prima: copula Gaussiană nu are dependență în cozi, deci subestimează probabilitatea ca foarte multe credite să intre în neplată deodată. A doua: corelația era fixă și calibrată în ani calmi, deși, cum arată secțiunile despre DCC și Forbes–Rigobon, corelațiile se schimbă de la un regim la altul.
Numărul de neplăți într-un portofoliu ipotetic de 100 de credite, fiecare cu probabilitatea de neplată 2%, legate printr-un factor comun cu corelația 0,3: copula Gaussiană față de copula t cu \(\nu=4\) (400 000 de simulări). Stînga: distribuția numărului de neplăți. Dreapta: probabilitatea de a avea cel puțin un anumit număr de neplăți, pe scară logaritmică.
Exemplul arată de ce prima slăbiciune a contat. Ambele modele au aceeași medie, 2 neplăți din 100, și aceeași corelație. Diferă doar copula. Sub copula t, cele mai multe scenarii sînt chiar mai liniștite: în 71% din ele nu apare nicio neplată, față de 48% sub copula Gaussiană. În schimb, scenariile proaste sînt mult mai probabile. Probabilitatea a cel puțin 20 de neplăți este 0,026 sub copula t și 0,0086 sub copula Gaussiană, de circa trei ori mai mică. Pentru cel puțin 30 de neplăți, valorile sînt 0,012 și 0,002.
O tranșă de rang superior (senior tranche) pierde bani doar în astfel de scenarii extreme. Evaluată cu copula Gaussiană, ea părea mult mai sigură decît era. Aceasta este, pe scurt, eroarea de model discutată după 2008.
Pe scurt
Li (2000) a modelat timpii pînă la faliment ai mai multor debitori cu o copulă Gaussiană
Un singur parametru de corelație, calibrat pe spread-urile de piață
Evalua portofolii întregi de credite și a devenit standardul pentru tranșele de obligațiuni garantate cu datorii (CDO)
Dependență asimptotică zero în cozi (\(\lambda_L=\lambda_U=0\))
pentru falimentele comune cele mai extreme dă probabilități mai mici decît modelele cu dependență în cozi calibrate pe aceleași date
O corelație statică, calibrată în anii calmi
aceleași probleme evidențiate în acest capitol de Forbes–Rigobon și de DCC
Lecția: pentru extremele comune este nevoie de o copulă cu dependență în cozi, reestimată cînd se schimbă regimul
Sinteza secțiunii
Pierderile mari ale acțiunilor americane și europene vin împreună mult mai des decît ar prevedea o distribuție Normală cu aceeași corelație. Copulele separă comportamentul fiecărui activ de legătura dintre active. Aceeași corelație de rang poate ascunde comportamente foarte diferite în zilele extreme. Pentru JPM și BAC, copula t descrie datele cel mai bine, dar nicio copulă statică nu trece testul de adecvare, iar diferența dintre coada pierderilor și cea a cîștigurilor nu este semnificativă.
Aplicații: Europa, România și bănci
Aplicațiile folosesc randamente săptămînale, la care diferența dintre orele de închidere ale burselor contează puțin. Secțiunea pune două întrebări:
A devenit piața românească de acțiuni mai legată de zona euro și de SUA?
Mai putem reduce riscul ținînd bănci din țări diferite atunci cînd vine un șoc global? Răspunsul folosește șase bănci, cîte două din SUA, zona euro și România.
Acțiuni din SUA, zona euro și România, 2000–2026 (1/2)
Graficul arată corelațiile randamentelor săptămînale S&P 500, Euro Stoxx 50 și BET pe o fereastră mobilă, 2000–2026, calculate din închiderile de vineri în zilele comune de tranzacționare. Cursorul alege lungimea ferestrei, de la 26 la 260 de săptămîni, iar butonul ▶ o mărește. Caseta de rezultate dă corelația Euro Stoxx 50–BET la cîteva date și pe subperioade.
Întrebare pentru sală Corelația Euro Stoxx 50–BET este 0,61 pe subperioada din 2020, dar 0,34 pe ultima fereastră de 104 săptămîni. Se contrazic cele două cifre?
Răspuns
Nu. 0,61 este corelația calculată din toate randamentele săptămînale de la începutul lui 2020; 0,34 folosește doar ultimele 104 săptămîni, pînă în septembrie 2026. Pe subperioade, corelația urcă de la 0,33 (2000–2009) la 0,45 (2010–2019) și 0,61 (din 2020). Pe fereastra rolling urcă în crize (0,76 la sfîrșitul lui 2021) și coboară după aceea, deci o parte din creștere poate fi distorsiunea de volatilitate Forbes–Rigobon. Niciuna dintre cifre nu identifică singură o schimbare structurală a integrării.
Legătura dintre bursa românească și zona euro a crescut de la un deceniu la altul. Corelația Euro Stoxx 50–BET este 0,33 în 2000–2009, 0,45 în 2010–2019 și 0,61 din 2020.
Pe ultima fereastră de 104 săptămîni, pînă în septembrie 2026, corelația este însă doar 0,34. Cele două cifre nu se contrazic: 0,61 folosește toate săptămînile de la începutul lui 2020, iar 0,34 numai ultimii doi ani. Pe fereastra mobilă, corelația sare în crize, pînă la 0,76 la sfîrșitul lui 2021, apoi revine.
Pe fereastra de 104 săptămîni, corelația Euro Stoxx 50–BET urcă și coboară odată cu crizele: 0,31 la sfîrșitul lui 2007, 0,65 la sfîrșitul lui 2009, 0,29 la sfîrșitul lui 2019 și 0,76 la sfîrșitul lui 2021. Corelația dintre S&P 500 și Euro Stoxx 50 rămîne mare, dar scade ușor pe aceleași subperioade: 0,84, 0,78 și 0,70.
Tiparul „salt în criză, apoi revenire parțială” are două explicații posibile: o integrare reală a pieței românești sau distorsiunea de volatilitate din secțiunea anterioară. Subperioadele care conțin crize nu pot separa singure cele două explicații; testul corectat Forbes–Rigobon este o cale de a le separa.
Pe scurt
Întrebarea secțiunii: este piața românească tot mai integrată cu cele mari?
și se mai poate diversifica între sistemele bancare în crize?
Corelații pe o fereastră mobilă de 104 săptămîni
din randamente săptămînale calculate cu închiderile de vineri, în zilele comune de tranzacționare
Corelația Euro Stoxx 50–BET calculată pe fiecare subperioadă întreagă: \(0{,}33\) în 2000–2009, \(0{,}45\) în 2010–2019 și \(0{,}61\) din 2020
corelația S&P 500–Euro Stoxx 50 în aceleași perioade: \(0{,}84\), \(0{,}78\) și \(0{,}70\)
Corelația Euro Stoxx 50–BET pe fereastra mobilă sare în crize și revine parțial după aceea
2008: de la 0,31 (sfîrșitul lui 2007) la 0,65 (sfîrșitul lui 2009)
2020: de la 0,29 (sfîrșitul lui 2019) la 0,76 (sfîrșitul lui 2021), apoi 0,34 în septembrie 2026
Integrare sau distorsiunea de volatilitate Forbes–Rigobon? (Seminarul C2)
în 2008, creșterea corelației BET–S&P 500 nu rămîne semnificativă după corecție (secțiunea Forbes–Rigobon)
Pentru un investitor din zona euro, BET diversifică în medie mai puțin decît în 2000–2009, și cel mai puțin în crize
Harta termică arată corelațiile randamentelor săptămînale a șase bănci: JPM și BAC în SUA, Deutsche Bank (DBK) și BNP Paribas (BNP) în zona euro, Banca Transilvania (TLV) și BRD–Groupe Société Générale (BRD) în România. Selectorul alege fereastra: toată perioada din ianuarie 2010 sau ultimele 52, 104 ori 156 de săptămîni. Cursorul alege ultima săptămînă a ferestrei, iar butonul ▶ mută fereastra prin eșantion.
Întrebare pentru sală Corelațiile cu băncile românești sînt cele mai mici din matrice (BNP–TLV 0,33, JPM–BRD 0,30). Ce putem conclude din heatmap despre cauza lor?
Răspuns
Heatmap-ul arată asocierea, nu cauza. Pe 871 de săptămîni (2010–2026), corelațiile sînt mari în interiorul regiunilor (JPM–BAC 0,86, DBK–BNP 0,75, TLV–BRD 0,65) și mici cu băncile românești (BNP–TLV 0,33, JPM–BRD 0,30). Factorii la nivel de țară (riscul suveran, dobînzile interne, reglementarea) sînt explicații plauzibile, dar matricea nu îi separă. Corelații medii mici nu înseamnă protecție în crize: în martie–iunie 2020, corelația medie dintre băncile românești și celelalte a urcat la 0,56 (blocul următor).
Băncile din aceeași regiune se mișcă strîns împreună. Pe toată perioada, corelația este 0,86 pentru JPM–BAC, 0,75 pentru DBK–BNP și 0,65 pentru TLV–BRD. Legăturile cele mai slabe sînt cu băncile românești, de exemplu 0,33 pentru BNP–TLV și 0,30 pentru JPM–BRD.
Harta arată asociere, nu cauză. Factorii de țară, cum sînt riscul suveran, dobînzile interne și reglementarea, sînt explicații plauzibile, dar matricea nu îi poate separa. Iar o corelație medie mică nu garantează protecție în crize, cum arată graficul următor.
Eșantionul are 871 de săptămîni, începînd cu 15 ianuarie 2010. Din fiecare sistem bancar sînt alese două dintre cele mai mari bănci listate, cu date continue din 2010. Harta are trei blocuri regionale clare. Băncile dintr-o țară au factori comuni, care cresc corelațiile din interiorul țării și le scad pe cele dintre țări.
Pe scurt
Întrebarea: se mișcă băncile mai mult cu țara lor decît cu băncile din alte regiuni?
Băncile
SUA: JPM și BAC
Zona euro: DBK (Deutsche Bank) și BNP (BNP Paribas)
România: TLV (Banca Transilvania) și BRD (BRD-Groupe Société Générale)
\(871\) săptămîni, din 15 ianuarie 2010
alegerea: două dintre cele mai mari bănci listate din fiecare sistem, cu date continue din 2010
Corelația dintre cele două bănci ale aceleiași regiuni
\(0{,}86\) în SUA, \(0{,}75\) în zona euro și \(0{,}65\) în România
Legăturile dintre regiuni sînt cele mai slabe pentru România
BNP–TLV \(0{,}33\), JPM–BRD \(0{,}30\)
Randamentele băncilor au factori comuni la nivel de țară
riscul suveran, dobînzile interne, reglementarea
rămîne această diversificare și în crize? (slide-ul următor)
Graficul arată corelația medie dintre perechile de bănci, pe o fereastră mobilă, în trei grupuri: în interiorul regiunilor (SUA, zona euro EA, România RO), între SUA și zona euro și între România și celelalte. Cursorul alege lungimea ferestrei, de la 26 la 156 de săptămîni, pornind de la 52. Butonul ▶ o mărește.
Întrebare pentru sală În martie–iunie 2020, media corelațiilor dintre băncile românești și celelalte, pe ferestre de 52 de săptămîni, a fost 0,56. Ce observații intră în aceste ferestre?
Răspuns
Și observații dinainte de martie 2020. Fiecare punct al seriei este media celor opt corelații România–SUA/zona euro, calculate pe ultimele 52 de săptămîni pînă la acea dată, deci ferestrele din martie–iunie 2020 încep în primăvara lui 2019. Media seriei este 0,56 în martie–iunie 2020 și 0,25 pe toată perioada, adică de peste două ori mai mică: diversificarea între sistemele bancare slăbește în șocurile globale. ▶ lungește fereastra: la 154 de săptămîni, valoarea din martie–iunie 2020 scade la 0,34, fiindcă fereastra cuprinde mai multe săptămîni calme.
În vremuri normale, băncile românești sînt slab legate de celelalte. Pe toată perioada, corelația medie este 0,73 în interiorul regiunilor, 0,59 între SUA și zona euro și doar 0,25 între România și celelalte.
În șocul global din martie–iunie 2020, mediile devin 0,87, 0,69 și 0,56: legătura României cu celelalte bănci s-a mai mult decît dublat. Fiecare punct al seriei pentru România este media a opt corelații, România–SUA și România–zona euro, calculate pe ultimele 52 de săptămîni pînă la acea dată. Ferestrele din martie–iunie 2020 conțin deci și săptămîni din 2019. Ultimele valori sînt 0,57, 0,40 și 0,15.
Lungimea ferestrei schimbă imaginea. Pe o fereastră de 154 de săptămîni, valoarea pentru România din martie–iunie 2020 scade la 0,34, pentru că fereastra conține mai multe săptămîni calme. Diversificarea între sisteme bancare funcționează în vremuri normale și slăbește exact în evenimentele sistemice, cînd ar fi cea mai utilă.
Pe scurt
Media corelațiilor pe perechi, pe 52 de săptămîni, ale randamentelor săptămînale
în interiorul regiunilor (în legendă: US: SUA, EA: zona euro, RO: România)
între SUA și zona euro, între România și celelalte
Media pe toată perioada
\(0{,}73\) în interiorul regiunilor, \(0{,}59\) între SUA și zona euro, \(0{,}25\) între România și celelalte
În martie–iunie 2020, aceleași medii au fost \(0{,}87\), \(0{,}69\) și \(0{,}56\)
într-un șoc global, legătura României a crescut de peste două ori
ultimele valori, în aceeași ordine: \(0{,}57\), \(0{,}40\) și \(0{,}15\)
Diversificarea între sisteme bancare funcționează în perioade normale
Un arbore de acoperire minim (minimum spanning tree) (Mantegna, 1999) rezumă o matrice de corelație păstrînd doar legăturile cele mai puternice. Întîi, fiecare corelație se transformă într-o distanță, mică pentru activele care se mișcă împreună:
\[d_{ij}=\sqrt{2(1-\rho_{ij})}.\]
Apoi arborele leagă toate cele \(N\) active prin \(N-1\) muchii, fără cicluri, cu distanța totală cea mai mică: aici 5 muchii pentru 6 bănci. Algoritmul ia distanțele în ordine crescătoare și respinge orice muchie care ar închide un ciclu. Distanța \(\sqrt{(1-\rho)/2}\) din Capitolul 4 dă același arbore, pentru că ambele distanțe cresc cu \(1-\rho\). Selectorul și cursorul aleg fereastra, ca la harta termică.
Întrebare pentru sală Putem obține arborele din figură alegînd pur și simplu cele cinci corelații cele mai mari?
Răspuns
Nu. Algoritmul ordonează distanțele d = √(2(1 − ρ)) și respinge muchiile care închid un ciclu. A cincea corelație ca mărime, BAC–BNP (0,64), închide ciclul JPM–BAC–BNP și este respinsă; România se leagă prin BNP–BRD (0,35). Muchiile arborelui: JPM–BAC (0,86), DBK–BNP (0,75), JPM–BNP (0,65), TLV–BRD (0,65) și BNP–BRD (0,35). Arborele este neorientat și contemporan, deci nu arată direcția transmiterii.
Arborele nu este format pur și simplu din cele mai mari cinci corelații. A cincea corelație ca mărime, BAC–BNP (0,64), ar închide ciclul JPM–BAC–BNP și este respinsă. Muchiile arborelui sînt JPM–BAC (0,86), DBK–BNP (0,75), JPM–BNP (0,65), TLV–BRD (0,65) și BNP–BRD (0,35). România se leagă deci de rețea prin BNP–BRD. Arborele nu arată direcția transmiterii; el dă doar ipoteze pentru măsurile de rețea din Capitolul 18.
Pe scurt
Arborele de acoperire minimă (Mantegna (1999)) pe \(d_{ij}=\sqrt{2(1-\rho_{ij})}\)
cele 5 legături care unesc toate cele 6 bănci fără cicluri, cu suma minimă a distanțelor
Bursa românească a devenit mai legată de zona euro de la un deceniu la altul. Salturile corelației în crize și revenirile de după se potrivesc însă atît cu o integrare reală, cît și cu distorsiunea de volatilitate. Băncile se grupează pe regiuni, iar cele românești sînt slab legate de celelalte în vremuri normale. În șocul din 2020, această legătură s-a mai mult decît dublat.
Studii de caz: volatilitatea comună globală și DCC în dimensiuni mari
Cele două studii de caz duc instrumentele capitolului în cercetarea recentă:
Există zile în care aproape toate piețele lumii devin agitate în același timp? Engle & Campos-Martins (2023) măsoară mărimea zilnică a unui astfel de șoc comun și o numesc COVOL global (common volatility).
Putem estima un model DCC pe sute de active? Pakel, Shephard, Sheppard & Engle (2021) arată că metoda obișnuită dă rezultate deplasate și propun o alternativă, verosimilitatea compusă.
Ambele studii sînt replicate sau adaptate pe datele cursului.
Studiu de caz (1/2): ce evenimente lovesc simultan toate piețele?
Într-un model DCC corect, reziduurile \(e_t\) satisfac \(\mathbb{E}_{t-1}(e_te_t^\top)=I\), unde \(e_t\) este vectorul celor \(N\) reziduuri din ziua \(t\), iar \(\mathbb{E}_{t-1}\) este media condiționată de informația de ieri. Altfel spus, reziduurile sînt necorelate și au varianța 1.
Necorelat nu înseamnă însă independent: reziduurile pot fi mari în aceleași zile. Lucrarea studiază covarianța pătratelor lor:
unde \(e_t^2\) este pătratul fiecărui element, iar \(\iota\) este vectorul de unu. Dacă un element din afara diagonalei, \(\Psi_{ij,t}\), este diferit de zero, activele \(i\) și \(j\) au șocuri mari în aceleași zile.
Este ideea efectului ARCH (autoregressive conditional heteroskedasticity) din Capitolul 5, privită între active, nu în timp: o zi agitată pentru un activ este agitată și pentru celelalte. Herskovic, Kelly, Lustig & Van Nieuwerburgh (2016) găsesc un astfel de factor comun în volatilitatea specifică a acțiunilor americane.
Modelul presupune că un singur factor, comun tuturor activelor, mărește sau micșorează varianța fiecărui reziduu:
\[e_{it}=\sqrt{s_ix_t+1-s_i}\;\varepsilon_{it},\]
(6.18)
cu \(\varepsilon_{it}\) i.i.d. \(\mathcal N(0,1)\),\(x_t>0\) și \(\mathbb{E}_{t-1}(x_t)=1\). Factorul \(x_t\) este COVOL global la pătrat din ziua \(t\); într-o zi cu șoc comun, \(x_t>1\). Încărcarea (loading) \(s_i\in[0,1]\) spune cît de sensibil este activul \(i\) la factor: varianța lui condiționată este \(g_{it}=1+s_i(x_t-1)\).
Din (6.18) se pot afla doar produsele \(s_i(x_t-1)\), deci scala trebuie fixată printr-o convenție. Cazul cel mai simplu este cel cu încărcări egale, \(s_i=1\). Atunci estimarea lui \(x_t\) este media pătratelor reziduurilor din acea zi, \(\hat x_t=\frac1N\sum_ie_{it}^2\).
Cu încărcări diferite, estimarea alternează doi pași de verosimilitate maximă. Primul estimează \(x_t\) pentru fiecare zi, din toate activele. Al doilea estimează \(s_i\) pentru fiecare activ, din toate zilele. Convenția este \(s^\top s=1\) și media lui \(x_t\) egală cu 1. Sub această convenție, încărcările sînt doar mărimi relative; încărcările egale ar fi \(s_i=1/\sqrt N\).
Testul pentru existența șocului comun folosește statistica \(\xi\), media standardizată a produselor \((e_{it}^2-1)(e_{jt}^2-1)\) pe zile și pe perechi de active. Dacă pătratele nu sînt legate, adică \(H_0\colon\Psi_{ij}=0\) pentru \(i\neq j\), statistica are distribuția Normală standard. Datele lucrării sînt 47 de ETF-uri pe țări listate la Bursa din New York (NYSE), 2000–2021, și 23 de serii americane pe clase de active; detaliile sînt în Anexă.
Figura reproduce Tabelul 8 din Engle & Campos-Martins (2023). El compară două explicații pentru șocurile de volatilitate ale indicelui mondial de acțiuni MSCI All Country World (ACWI, All Country World Index; MSCI este furnizorul de indici Morgan Stanley Capital International): COVOL, calculat din prețuri, și doi indici de incertitudine calculați din știri. Slide-ul următor citește tabelul.
Răspunsul este clar: COVOL explică mult mai mult. Regresiile folosesc 248 de luni, iar măsura lunară COVOL\(^2_m\) este media lunară a lui \(\hat x_t\) minus 1. Singur, COVOL dă pentru șocul de volatilitate ACWI \(R^2=0{,}404\), unde \(R^2\) este proporția din varianță explicată.
Indicii de știri explică mult mai puțin. Indicele de incertitudine a politicii economice (EPU, economic policy uncertainty) al lui Baker, Bloom & Davis (2016) are \(R^2=0{,}110\). Indicele de risc geopolitic (GPR, geopolitical risk) al lui Caldara & Iacoviello (2022) are \(R^2=0{,}005\). Adăugați lîngă COVOL, cei doi indici ridică \(R^2\) doar la 0,406.
Zilele cu cel mai mare șoc comun din lucrare sînt 9 martie 2020, cu \(\hat x_t=51{,}4\), și 24 iunie 2016, ziua de după votul pentru Brexit. Și 28 aprilie 2020 este o zi de vîrf, deși randamentul mediu a fost pozitiv, de 2,33%. COVOL măsoară deci cît de mare este șocul comun, nu dacă este bun sau rău.
Indicii de știri măsoară de ce se tem oamenii, COVOL șocurile care ajung în prețuri. Rezultatul susține o asociere. Pătratele rămîn corelate și după factor, posibil semnul unui al doilea factor. Replicarea pe ETF-urile cursului este în Aprofundări.
Al doilea studiu întreabă dacă DCC funcționează cu sute de active, cum cer VaR-ul și acoperirea unui portofoliu mare. Pakel, Shephard, Sheppard & Engle (2021) arată, pentru modelele BEKK scalar și cDCC, că metoda obișnuită dă estimări puternic deplasate ale parametrilor dinamici \((a,b)\) cînd numărul de active \(K\) crește. Metoda obișnuită este verosimilitatea completă, cu ținta de corelație (correlation targeting) fixată dinainte.
Cauza este chiar ținta. Matricea \(\bar Q\) conține \(K(K-1)/2\) corelații, estimate înainte de \((a,b)\). Numărul lor crește cu \(K\), iar erorile lor se adună în verosimilitate. Calculul este și lent: fiecare evaluare a verosimilității complete inversează \(T\) matrice de dimensiune \(K\times K\), deci costul crește cu \(K^3\).
Remediul este verosimilitatea compusă (CL, composite likelihood), suma verosimilităților perechilor de active:
unde fiecare pereche folosește doar blocul ei \(2\times2\) din \(\hat{\bar Q}\). Mulțimea \(\mathcal P\) conține fie toate cele \(K(K-1)/2\) perechi, fie numai perechile vecine \((1,2),(2,3),\dots,(K-1,K)\). Nicio matrice mare nu mai este inversată, iar teoria lucrării permite ca \(K\) să crească odată cu lungimea eșantionului \(T\). Lucrarea folosește acțiunile din S&P 100 și S&P 500, zilnic, pe 1997–2006.
Graficul compară trei metode de estimare a lui \(a\) și \(b\): verosimilitatea completă, CL pe toate perechile și CL pe perechile vecine. Activele sînt adăugate în ordinea alfabetică a simbolurilor; al doilea panou arată corelația condiționată medie a activelor obținută cu fiecare set de estimări. Cursorul alege numărul de active \(K\), iar butonul ▶ adaugă active unul după altul.
Întrebare pentru sală De ce depinde verosimilitatea compusă (CL) mai puțin decît verosimilitatea completă de erorile țintei Q̄ cînd crește numărul de active K?
Răspuns
Fiecare termen CL folosește doar un bloc 2 × 2 al țintei. Ținta Q̄ are K(K − 1)/2 corelații estimate înaintea lui (a, b), adică 1 128 la K = 48, iar verosimilitatea completă folosește toată matricea, cu toate erorile ei. Perechile CL nu sînt eșantioane independente: termenii bivariați sînt calculați din aceleași date. Estimările nu evoluează monoton: â cu verosimilitatea completă este 0,0099 la K = 2, 0,0157 la K = 5 și 0,0077 la K = 48, iar â CL pe toate perechile urcă la 0,0362. Cu estimările complete, corelația medie a celor 48 de active are abaterea standard în timp 0,034, față de 0,058 cu CL, iar indicatorul euristic de persistență ln 0,5 / ln(a + b) este 99 de zile, față de 31. Diferența este compatibilă cu mecanismul de mai sus, dar datele singure nu arată care estimare este mai aproape de adevăr. Simulările lui Pakel, Shephard, Sheppard și Engle (2021), pentru scalar BEKK și cDCC, susțin avantajul CL în modelele și configurațiile analizate; ele nu demonstrează absența deplasării în această adaptare pe DCC standard.
Fiecare termen CL folosește doar un bloc \(2\times2\) al țintei. Verosimilitatea completă folosește întreaga matrice, cu toate erorile ei: 1 128 de corelații la \(K=48\). Perechile CL nu sînt însă eșantioane independente, pentru că sînt calculate din aceleași date.
Estimările nu se mișcă monoton cu \(K\). Cu verosimilitatea completă, \(\hat a\) este 0,0099 la \(K=2\), 0,0157 la \(K=5\) și 0,0077 la \(K=48\). Cu CL pe toate perechile, \(\hat a\) urcă la 0,0362.
Diferența se potrivește cu mecanismul de mai sus, dar datele singure nu spun care estimare este mai aproape de adevăr. Simulările lui Pakel, Shephard, Sheppard & Engle (2021) susțin CL pentru BEKK scalar și cDCC, nu și pentru această adaptare pe DCC-ul standard.
Adaptarea folosește 48 de active listate în SUA din datele cursului, toate cu istoric complet de la 18 iulie 2013: 16 acțiuni și 32 de ETF-uri pe acțiuni, obligațiuni și mărfuri. Eșantionul are 3 245 de zile comune, pînă la 18 septembrie 2026.
Pasul 1 estimează un GARCH(1,1) cu inovații Normale pentru fiecare serie; pasul 2, DCC-ul cu țintă de corelație. Activele sînt adăugate în ordinea alfabetică a simbolurilor, ca în lucrare, cu \(K=2,3,5,10,15,\dots,40,48\). La \(K=2\) cele trei metode coincid, pentru că există o singură pereche. Ca verificare de robustețe, calculul se repetă pe 10 ordini aleatoare ale activelor pentru \(K\in\{5,10,20,30,40\}\); de aici vin benzile din grafic.
Adaptarea diferă de lucrare în trei privințe:
Cele 48 de active sînt de tipuri diferite, nu doar acțiuni, iar perioada este 2013–2026.
Modelul este DCC-ul standard al capitolului. Lucrarea analizează BEKK scalar și cDCC-ul lui Aielli (2013). Exercițiul este deci o comparație pe DCC-ul standard, nu o replicare a rezultatului teoretic.
Pentru CL nu se calculează erori standard, care ar cere o matrice de tip sandwich.
Pe scurt
Datele: toate cele 48 de acțiuni și ETF-uri listate în SUA din datele cursului cu istoric complet din 18 iulie 2013
16 acțiuni și 32 de ETF-uri pe acțiuni, obligațiuni și mărfuri
3 245 de zile comune, pînă la 18 septembrie 2026
Pasul 1: GARCH(1,1) cu distribuția Normală pe fiecare serie; pasul 2: DCC cu fixarea țintei, ca în secțiunea DCC
Secțiunea transversală crește în ordinea alfabetică a tickerelor, ca în articol
\(K=2,3,5,10,15,\dots,40,48\)
pentru fiecare \(K\): verosimilitatea completă, CL pe toate perechile și CL pe perechile contigue
la \(K=2\) cele trei estimatoare coincid: există o singură pereche
Robustețe: 10 ordini aleatoare ale activelor, pentru \(K\in\{5,10,20,30,40\}\) (benzile din grafic)
activele incluse și perechile contigue depind de ordine, iar rezultatul nu trebuie să depindă de ordinea alfabetică
Ce diferă față de articol
48 de active de tipuri diferite, nu doar acțiuni, și perioada 2013–2026
DCC-ul standard al capitolului, cu ținta egală cu covarianța reziduurilor standardizate; articolul analizează BEKK scalar și cDCC-ul lui Aielli (2013)
deci o adaptare comparativă pe DCC standard, nu o replicare a rezultatului teoretic
fără erori standard pentru CL, care ar cere o matrice sandviș
Rezultatul: cu verosimilitatea completă, corelațiile reacționează mult mai lent
La \(K=48\), verosimilitatea completă dă \(\hat a=0{,}0077\) și \(\hat b=0{,}9854\); eroarea standard (SE) a lui \(\hat a\), din hessiana pasului 2, este 0,0002. CL pe toate perechile dă \(\hat a=0{,}0362\) și \(\hat b=0{,}9420\). CL pe perechile vecine dă \(\hat a=0{,}0399\) și \(\hat b=0{,}9407\).
Pentru \(K\ge10\),\(\hat a\) rămîne între 0,008 și 0,012 cu verosimilitatea completă și între 0,029 și 0,036 cu CL pe toate perechile. La \(K=40\), pe cele 10 ordini aleatoare, \(\hat a\) este între 0,007 și 0,010 cu verosimilitatea completă și între 0,031 și 0,040 cu CL pe perechile vecine.
Un \(a\) mai mic înseamnă corelații care reacționează mai încet. Corelația condiționată medie a celor 48 de active are media 0,34, dar abaterea ei standard în timp este 0,034 cu verosimilitatea completă și 0,058 cu CL. Ea variază între 0,28 și 0,47 în primul caz și între 0,23 și 0,57 în al doilea. Timpul de înjumătățire al unui șoc, măsurat euristic prin \(\ln0{,}5/\ln(a+b)\), este de 99 de zile cu verosimilitatea completă și de 31 de zile cu CL.
Datele nu spun care \((a,b)\) este cel adevărat, iar un singur \((a,b)\) pentru 48 de active foarte diferite poate fi el însuși greșit. Testul decisiv, acoperirea și VaR-ul pe date noi (Capitolul 8), rămîne de făcut.
Pe scurt
La \(K=48\), verosimilitatea completă dă \(\hat a=0{,}0077\) (SE 0,0002) și \(\hat b=0{,}9854\)
CL pe toate perechile: \(\hat a=0{,}0362\), \(\hat b=0{,}9420\); CL pe perechile contigue: \(\hat a=0{,}0399\), \(\hat b=0{,}9407\)
SE: eroarea standard din Hessiana pasului 2
Pentru \(K\ge10\), \(\hat a\) al verosimilității complete rămîne între 0,008 și 0,012, iar \(\hat a\) CL pe toate perechile între 0,029 și 0,036
la \(K=40\), pe cele 10 ordini aleatoare: \(\hat a\) complet între 0,007 și 0,010, \(\hat a\) CL contigue între 0,031 și 0,040
Consecința: corelația medie condiționată a celor 48 de active (media pe perioadă 0,34)
abaterea ei standard în timp este 0,034 cu estimările complete și 0,058 cu CL
intervalul: 0,28–0,47 față de 0,23–0,57
indicatorul euristic \(\ln0{,}5/\ln(a+b)\), aproximativ zilele după care efectul unui șoc asupra corelației scade la jumătate: 99 de zile, respectiv 31 de zile
pentru un portofoliu mare, estimatorul ales decide cît de repede se adaptează corelațiile, deci VaR-ul și hedging-ul, după un șoc
Tipul de dovadă: comparație între proceduri
datele singure nu spun care \((a,b)\) este cel adevărat
simulările articolului susțin avantajul CL în modelele și configurațiile analizate; nu demonstrează absența deplasării în aplicația noastră
un singur \((a,b)\) pentru 48 de active diferite poate fi el însuși o specificare greșită
testul economic, hedging-ul și VaR-ul în afara eșantionului (Capitolul 8), rămîne de făcut
Sinteza secțiunii
COVOL global măsoară mărimea șocului de volatilitate comun tuturor piețelor. El explică mult mai mult din șocurile pieței mondiale decît indicii de știri. Cu multe active, verosimilitatea DCC completă dă pe datele cursului un \(\hat a\) mult mai mic decît verosimilitatea compusă, deci corelații care reacționează mult mai lent. Care estimare este corectă se poate decide doar printr-un test pe date noi.
AI pentru descoperire științifică
Ultima secțiune a parcursului principal ia o întrebare lăsată deschisă de capitol: va rămîne pozitivă corelația acțiuni–obligațiuni de după 2022, și are ea legătură cu inflația? Cu ajutorul unui asistent AI, secțiunea formulează o ipoteză testabilă, o testează pe datele cursului și enumeră verificările pe care cercetătorul trebuie să le facă înainte de orice concluzie.
O întrebare deschisă: va rămîne pozitivă corelația acțiuni–obligațiuni?
Întrebarea are trei părți: este corelația pozitivă un regim durabil, este el legat de inflație și se poate prognoza corelația? Campbell, Pflueger & Viceira (2020) leagă semnul corelației de felul în care inflația se mișcă față de producție și de regimul politicii monetare. Molenaar, Sénéchal, Swinkels & Wang (2024) extind dovezile la mai multe țări și la un istoric lung. Din secțiunile anterioare, corelația SPY–TLT este pozitivă din 2022, iar schimbarea ei este datată în august 2020.
O ipoteză testabilă leagă corelația din fiecare lună de inflația cunoscută la acel moment:
unde \(\rho_m\) este corelația lunară, calculată din randamente zilnice, \(\pi\) este inflația anuală din SUA măsurată prin indicele prețurilor de consum (CPI, consumer price index), iar \(u_m\) este eroarea. Transformarea \(\operatorname{artanh}\) este scala Fisher, pe care corelația nu mai este mărginită.
Ipoteza este că o inflație mai mare dă o corelație mai mare: \(H_0\colon\gamma_1=0\) față de \(H_1\colon\gamma_1>0\), cu o statistică \(t\) HAC. Respingerea ipotezei cere însă mai mult decît o pantă nesemnificativă. Ar trebui o pantă estimată precis în interiorul unei marje economice fixate dinainte (un test de echivalență), în perioade în care inflația a variat, dar politica monetară nu.
În această buclă de cercetare, asistentul AI propune, iar cercetătorul verifică. Asistentul produce harta literaturii, ipoteze concurente, codul, un plan de robustețe și o critică de tip recenzent. Cercetătorul verifică fiecare referință prin DOI (digital object identifier), reproduce întîi cifrele capitolului și fixează planul înainte de prima rulare. Prompturile sînt în Anexă.
Pe scurt
Întrebarea: este corelația pozitivă acțiuni–obligațiuni de după 2022 un regim durabil?
\(\rho_m\): corelația realizată lunară, în transformarea Fisher; \(u_m\): eroarea
\(\pi\): inflația anuală CPI (consumer price index) din SUA
\(H_0\): \(\gamma_1=0\), față de \(H_1\): \(\gamma_1>0\), cu statistica t HAC
Infirmarea: nesemnificația nu ajunge; trebuie un \(\gamma_1\) estimat precis în interiorul unei marje fixate dinainte (test de echivalență), cînd inflația a variat, dar regimul nu
Bucla: un asistent AI schițează, iar cercetătorul verifică
AI: harta literaturii, ipotezele concurente, codul, un plan de robustețe și o critică de referent
cercetătorul verifică fiecare DOI (Digital Object Identifier, identificatorul digital al unei publicații), replică întîi cifrele capitolului și fixează planul înainte de prima rulare
Graficul arată corelația lunară SPY–TLT, pe scala Fisher din (6.20), față de inflația decalată, cu dreapta de regresie; al doilea panou arată panta estimată și intervalul ei HAC de 95%. Cursorul alege ultima lună a eșantionului, iar butonul ▶ extinde eșantionul lună cu lună.
Întrebare pentru sală Panta corelației SPY–TLT (transformată Fisher) pe inflație este pozitivă și semnificativă pe tot eșantionul. Identifică această regresie un efect cauzal al inflației?
Răspuns
Nu. Variabila dependentă este z = artanh(ρ). Pe tot eșantionul panta este 0,056 unități z pe punct procentual de inflație (t = 2,97). Pe 2002–2021 este 0,002 (t = 0,07), cu intervalul HAC de 95% [−0,062; 0,067], care include și panta pe tot eșantionul: estimarea este imprecisă, deci nesemnificația nu dovedește un efect nul. O diferență de semnificație nu este un test al diferenței dintre pante. O singură schimbare de regim nu separă nivelul inflației de regimul politicii monetare.
Pe tot eșantionul, panta este pozitivă și semnificativă: 0,056 unități \(z\) pe punct procentual de inflație (\(t=2{,}97\)). Pe 2002–2021, panta este practic zero, 0,002 (\(t=0{,}07\)).
Asta nu înseamnă că înainte de 2022 inflația nu conta. Intervalul HAC de 95% pe 2002–2021, \([-0{,}062;\ 0{,}067]\), este larg și conține și panta de pe tot eșantionul. Lipsa semnificației nu dovedește deci un efect nul, iar o diferență de semnificație nu este un test al diferenței dintre pante. Regresia nu arată nici o relație cauzală.
Decalajul de două luni are un motiv practic: corelația lunii \(m\) se leagă de inflația cunoscută la începutul ei. CPI pentru luna \(m-1\) se publică abia la jumătatea lunii \(m\), deci ultima valoare cunoscută este \(\pi_{m-2}\). Regresia folosește însă ediția curentă a CPI, cu revizuirile incluse, deci testul este retrospectiv, nu în timp real.
Pe eșantionul complet de 288 de luni, \(\hat\gamma_1=0{,}056\) pe punct procentual, cu SE HAC 0,019, \(t=2{,}97\) și \(R^2=0{,}047\). Inflația explică puțin din variația lunară a corelației, dar panta este semnificativă. Corelația medie este \(-0{,}12\) în cele 89 de luni cu inflație peste 3% și \(-0{,}30\) în celelalte.
Pe 2002–2021 sînt 233 de luni, dintre care doar 53 cu inflație peste 3%. Pentru a compara formal pantele ar fi nevoie de un model cu un indicator de regim și un termen de interacțiune. O singură schimbare de regim nu poate separa inflația de regimul de politică (Campbell, Pflueger & Viceira, 2020). Rezultatul susține doar o asociere.
Pe scurt
Corelația lunară SPY–TLT din randamente zilnice față de inflația cunoscută la începutul lunii \(m\)
CPI pentru luna \(m-1\) apare abia la mijlocul lunii \(m\), deci ultima valoare cunoscută este \(\pi_{m-2}\)
folosim versiunea curentă a CPI, deci un test retrospectiv, nu în timp real
Pe tot eșantionul (288 de luni): \(\hat\gamma_1=0{,}056\) pe punct procentual de inflație
SE HAC 0,019, \(t=2{,}97\), \(R^2=0{,}047\)
corelația medie \(\rho\) este \(-0{,}12\) în lunile cu inflația peste 3% (89 de luni) și \(-0{,}30\) în celelalte luni
Numai pe 2002–2021 (233 de luni, dintre care 53 cu inflația peste 3%): \(\hat\gamma_1=0{,}002\), \(t=0{,}07\)
intervalul HAC de 95% pentru \(\gamma_1\) pe 2002–2021: \([-0{,}062;\ 0{,}067]\), care include și panta pe tot eșantionul
Nu găsim dovezi ale unei asocieri pozitive înainte de 2022, dar estimarea este imprecisă
deci nici nu infirmăm ipoteza: intervalul este prea larg pentru un test de echivalență
o diferență între pante ar cere un model cu indicator de regim și interacțiune
Înainte de orice afirmație, cercetătorul face mai multe verificări:
Nicio informație din viitor (look-ahead bias): datele se folosesc doar după publicare. Prețurile se aliniază pe zilele comune de tranzacționare.
Inflația se schimbă lent și are puține regimuri în eșantion. Analiza cere subeșantioane, erori HAC cu multe decalaje și un test placebo cu serii la fel de persistente, simulate.
Corelația crește mecanic cu volatilitatea (secțiunea Forbes–Rigobon), deci regresia controlează pentru volatilitatea realizată.
Măsurile și ferestrele se fixează dinainte, ca să nu se încerce multe variante pînă iese una semnificativă.
O referință cu un DOI care nu poate fi găsit, semn că a fost inventată, se elimină și se notează în AI_ERRORS.md.
Proiectul pornește de la o întrebare de prognoză: un DCC cu ținta dependentă de inflație și de dobînda de politică prognozează corelația SPY–TLT pe date noi mai bine decît DCC-ul simplu? Echipa reproduce întîi cifrele capitolului: \(a+b=0{,}986\),\(\bar Q_{12}=-0{,}25\) și panta \(\hat\gamma_1=0{,}056\). Livrabilele sînt o preînregistrare de o pagină, codul pe datele de piață ale cursului plus CPI, o comparație Diebold–Mariano a prognozelor (Diebold & Mariano, 1995), o autocritică în stilul unui recenzent și declarația de utilizare a AI din AI_USE.md.
Pe scurt
Verificări înaintea oricărei afirmații
Deplasarea de anticipare (look-ahead bias) și calendarele
calendarul publicărilor și versiunile datelor (decalajul tratează întîrzierea publicării, nu revizuirile)
aliniem prețurile pe zilele comune înainte de a calcula randamentele
Regresor persistent și puține regimuri: statistici t mari pot apărea din întîmplare
folosim subeșantioane, laguri HAC lungi și un placebo: inflația înlocuită cu serii simulate de aceeași persistență
Distorsiunea Forbes–Rigobon: control pentru volatilitatea realizată
Testare multiplă: fixăm dinainte măsurile și ferestrele
Referințe inventate
un DOI care nu duce la nicio lucrare este eliminat și notat în AI_ERRORS.md
Punct de plecare pentru proiect
Prognozează mai bine în afara eșantionului corelația SPY–TLT un DCC cu țintă variabilă?
reperul: DCC-ul simplu
ținta depinde de inflație și de dobînda de politică monetară
replicăm întîi: \(a+b=0{,}986\), \(\hat{\bar Q}_{12}=-0{,}248\) și panta \(\hat\gamma_1=0{,}056\)
Livrabile
o pre-înregistrare de o pagină: ipoteza, datele și testele, fixate înainte de prima rulare
codul pe datele de piață ale cursului plus CPI
testul Diebold–Mariano, care compară erorile de prognoză ale celor două modele, și o autocritică de referent
declarația folosirii AI, în AI_USE.md
Sinteza secțiunii
Corelația pozitivă SPY–TLT de după 2022 coincide cu inflația ridicată. Pe tot eșantionul, corelația crește semnificativ cu inflația. Înainte de 2022, panta este estimată imprecis, iar o singură schimbare de regim nu poate separa inflația de politica monetară. Asistentul AI accelerează drumul de la literatură la cod și critică; verificările rămîn ale cercetătorului.
Sinteză
Sinteza adună capitolul într-o listă de decizie, cinci întrebări de verificare și o decizie practică pentru covarianța zilnică și pentru pierderile extreme comune.
Lista de decizie: întrebare, estimator, incertitudine, eșec
Lista dă, pentru fiecare întrebare a capitolului, instrumentul, măsura incertitudinii și situația în care metoda eșuează.
S-a schimbat o corelație? Se folosește corelația Pearson pe prețuri aliniate, cu un interval HAC prin metoda delta. Intervalul Fisher eșuează cînd perioadele agitate vin grupate. Datele zilnice eșuează între fusuri orare diferite.
Ce covarianță folosim pentru riscul de azi? EWMA sau DCC, cu un bootstrap care repetă ambii pași ai estimării. Metoda eșuează cînd ținta pe termen lung \(\bar Q\) se mută odată cu regimul.
Cînd s-a rupt corelația? Testul Wied–Krämer–Dehling pe reziduuri GARCH răspunde. Valoarea lui \(p\) este aproximativă, pentru că reziduurile sînt estimate.
Este o creștere în criză contagiune? Se testează cu \(\rho^*\) Forbes–Rigobon și un bootstrap staționar care reestimează \(\delta\). Testul eșuează sub un șoc comun sau cînd piețele se influențează reciproc.
Cum modelăm extremele comune? Cu o copulă pe pseudo-observații GARCH, cu o matrice sandwich pentru ranguri sau un bootstrap parametric. Copula Gaussiană eșuează, pentru că dependența ei în cozi este \(\lambda=0\). O copulă fixă eșuează cînd dependența se schimbă în timp.
Capitolul 7 transformă covarianțele DCC și copulele simulate în VaR și ES de portofoliu.
Pe scurt
Întrebarea
Estimatorul
Incertitudinea
Eșuează cînd
S-a schimbat o corelație?
Pearson pe prețuri aliniate
HAC prin metoda delta
Fisher sub gruparea volatilității; date zilnice între fusuri orare
Covarianța pentru riscul de azi?
EWMA, DCC
bootstrap pe ambii pași
ținta \(\bar Q\) se modifică odată cu regimul
Cînd a avut loc ruptura?
Wied–Krämer–Dehling pe reziduuri GARCH
limita punții browniene
reziduuri GARCH estimate (valoare p aproximativă); varianțe nemodelate
Contagiune?
Forbes–Rigobon \(\rho^*\)
bootstrap staționar, \(\delta\) estimat
un șoc comun sau legătură inversă
Extreme comune?
copulă pe pseudo-observații GARCH
sandviș de rang, bootstrap parametric
copula Gaussiană (\(\lambda=0\)), copulă statică cînd dependența variază în timp
Urmează: Capitolul 7 transformă covarianțele DCC și copulele simulate în VaR și ES de portofoliu
Decizia are trei părți: ce aleg, în ce condiții și ce rezultat m-ar face să renunț.
Pentru covarianța zilnică aleg volatilități GARCH(1,1) cu o corelație DCC(1,1). Pentru SPY și TLT, \(a+b=0{,}986\), iar corelația constantă (CCC) este respinsă, cu \(p\) bootstrap \(0{,}005\). Pentru extremele comune aleg o copulă Student t pe pseudo-observații GARCH. Ea are cel mai mic AIC pentru JPM și BAC.
Alegerea este valabilă în trei condiții:
Prețurile sînt aliniate pe zilele comune; între fusuri orare se folosesc randamente pe 2 zile sau săptămînale.
Fiecare țintă \(\bar Q\) acoperă un singur regim. Corelația SPY–TLT are o ruptură în august 2020 și una posibilă, exploratorie, în iulie 2007.
Corelațiile se raportează cu intervale HAC prin metoda delta, valabile numai dacă momentele de ordinul patru sînt finite.
Două rezultate m-ar face să renunț:
Un cîștig DCC nesemnificativ pe date noi (out-of-sample). La acoperirea BET, DCC elimină 26,2% din varianță, iar acoperirea statică 24,7%, cu \(p\) unilateral \(0{,}098\). Atunci ajunge o corelație constantă pe regim.
O țintă \(\bar Q\) care se mută odată cu regimul. După 2022, corelația DCC stă deasupra țintei în 92% din zile.
Pe scurt
Ce aleg: volatilități GARCH(1,1) cu o corelație DCC(1,1) pentru covarianța zilnică
SPY–TLT: \(a+b=0{,}986\); CCC este respins (LR \(533{,}4\), valoarea p bootstrap \(0{,}005\))
Pentru extremele comune: o copulă Student t pe pseudo-observațiile GARCH (cel mai mic AIC la JPM–BAC)
În ce condiții
Prețuri aliniate pe zilele comune de tranzacționare; randamente pe 2 zile sau săptămînale între fusuri orare diferite
Un singur regim pentru ținta \(\bar Q\): corelația SPY–TLT are o ruptură în august 2020
O a doua ruptură, în iulie 2007, este doar o candidată exploratorie (Aprofundări)
Intervale HAC prin metoda delta pentru corelații, valabile doar cu momente de ordinul patru finite
Ce rezultat m-ar face să renunț
Un cîștig DCC care rămîne nesemnificativ în afara eșantionului, ca la hedging-ul BET (\(26{,}2\%\) față de \(24{,}7\%\) din varianță eliminată, valoarea p unilaterală \(0{,}098\)): atunci ajunge o corelație constantă pe regim
O țintă \(\bar Q\) care se mută cu regimul, ca după 2022 (traiectoria DCC deasupra țintei în 92% din zile): atunci estimăm ținta separat pe fiecare regim
Sinteza secțiunii
Capitolul alege o covarianță GARCH–DCC pentru riscul zilnic și o copulă t pentru extremele comune. Ambele cer prețuri aliniate între fusuri orare și intervale care țin cont de cozile groase. Alegerea se revizuiește dacă corelația dinamică nu aduce un cîștig semnificativ pe date noi sau dacă ținta pe termen lung se mută odată cu regimul.
Aprofundări
Această parte, opțională, dezvoltă subiecte tratate pe scurt în capitol: datarea unei rupturi a corelației, un hedging dinamic pe date noi, Bitcoin și acțiunile, exemplul Forbes–Rigobon din 2008, inferența pentru copule, o copulă t dinamică și replicarea COVOL.
Testarea corelației constante la o dată necunoscută
Dacă alegem data rupturii din grafic și o testăm apoi cu un test Fisher \(z\), testul respinge prea des: data a fost aleasă chiar din date. Tse (2000) propune un test de tip multiplicator Lagrange, calculat numai din modelul CCC estimat. Alternativa testată este \(\rho_{ij,t}=\rho_{ij}+\kappa_{ij}\,\varepsilon_{i,t-1}\varepsilon_{j,t-1}\), o corelație care reacționează la șocurile de ieri.
Wied, Krämer & Dehling (2012) compară corelația primelor \(j\) observații, \(\hat\rho_j\), cu corelația de pe tot eșantionul, \(\hat\rho_T\), pentru fiecare \(j\):
Aici \(\hat D^2\) este varianța pe termen lung a lui \(\hat\rho\), obținută prin metoda delta cu nucleul Bartlett și lățimea de bandă \(\lfloor T^{1/4}\rfloor\). Data de ruptură estimată este punctul în care se atinge maximul.
Dacă corelația, mediile și varianțele sînt constante, \(Q_T\) converge la \(\sup_{0\le s\le1}|B(s)|\). Aici \(B\) este o punte browniană (Brownian bridge), iar \(s=j/T\). Valoarea critică de 5% este 1,358. Testul cere varianțe constante, deci se aplică reziduurilor standardizate GARCH.
Cu \(T=6\,073\) și lățimea de bandă 8, \(Q_T=4{,}25\), mult peste valoarea critică 1,358, deci corelația constantă este respinsă (\(p<0{,}001\)).
Ruptura estimată este la 3 august 2020, nu în ianuarie 2022. Corelația reziduurilor este \(-0{,}36\) înainte și \(0{,}07\) după.
Testul se poate repeta pe fiecare subperioadă, o segmentare binară exploratorie. Înainte de ruptura principală, el dă \(Q=3{,}01\) și o ruptură posibilă la 9 iulie 2007. După ea, dă \(Q=1{,}56\), cu valoarea \(p\) nominală 0,015.
Legea limită este demonstrată pentru serii observate, deci pe reziduuri estimate valorile \(p\) sînt aproximative. În plus, testele pe segmente alese după prima ruptură nu păstrează nivelul global de 5%. Confirmarea cere un bootstrap al întregii proceduri.
Investitorul în BET se acoperă cu Euro Stoxx 50, pentru că nu există contracte futures lichide pe BET, iar cele două piețe se închid aproape în același timp.
Modelele se estimează pe date zilnice de la 5 ianuarie 2010 pînă la sfîrșitul lui 2019 (\(n=2\,491\)). Apoi se evaluează în 2020–2026 (\(n=1\,663\)), cu parametrii înghețați.
Acoperirea statică folosește panta din fereastra de estimare, \(h=0{,}337\). Acoperirea DCC folosește \(h_t=\rho_t\sigma_{S,t}/\sigma_{F,t}\) din (6.2), cu \(\hat a=0{,}009\) și \(\hat b=0{,}964\). În 2020–2026, raportul DCC are media 0,29 și variază între 0,13 și 0,84.
Cîștigul DCC este mic. Acoperirea statică elimină 24,7% din varianță, cea DCC 26,2%. Cea mai bună acoperire constantă aleasă ex post (\(h=0{,}41\)) elimină 25,6%. Testul Diebold & Mariano (1995) compară pătratele randamentelor acoperite, cu eroare standard HAC. El dă \(t=1{,}29\) și \(p\) unilateral 0,098, deci cîștigul nu este semnificativ la 5%.
Eșantionul folosește zilele comune de tranzacționare de la 18 septembrie 2014 (\(T=3\,018\)). Mișcările Bitcoin din weekend intră în randamentul de luni.
Corelația DCC medie este 0,04 înainte de 2020 și 0,31 din ianuarie 2020. Maximul este 0,55, la 19 mai 2022.
Corelația este foarte persistentă: \(a=0{,}015\) și \(b=0{,}982\), deci \(a+b=0{,}9968\). Corelația constantă (CCC) este respinsă: statistica LR este 105,6, iar valoarea \(p\) bootstrap este \(1/(B+1)=0{,}005\) pentru \(B=199\).
Corelația pe tot eșantionul, 0,24, ascunde aceste două regimuri. Liu & Tsyvinski (2021) și Pele et al. (2023) constată că pînă în 2018 criptomonedele erau puțin expuse factorilor pieței de acțiuni. După 2020, corelația DCC arată contrariul.
Pe scurt
Bitcoin și SPY în zilele comune de tranzacționare din 18 septembrie 2014 (\(T=3\,018\))
mișcările Bitcoin din weekend intră în randamentul de luni
Corelația DCC medie este \(0{,}04\) înainte de 2020 și \(0{,}31\) din ianuarie 2020
vîrful, \(0{,}55\), este atins pe 19 mai 2022
Corelația este foarte persistentă: \(a=0{,}015\), \(b=0{,}982\), \(a+b=0{,}9968\)
Testul LR față de CCC: \(105{,}6\)
bootstrap sub CCC (\(B=199\)): \(p=1/(B+1)=0{,}005\), minimul posibil
CCC este respins
De la activ de diversificare la activ de risc
corelația din tot eșantionul (\(0{,}24\)) ascunde două regimuri
Piața sursă este S&P 500, iar datele sînt randamente pe 2 zile. Anul calm este 14 septembrie 2007 – 12 septembrie 2008 (\(n=242\)). Criza este 15 septembrie 2008 – 31 martie 2009 (\(n=130\)).
Varianța S&P 500 a crescut de \(1+\delta=7{,}54\) ori, deci \(\delta=6{,}54\).
Pentru Euro Stoxx 50, corelația este \(\rho_{calm}=0{,}610\) în anul calm și \(\rho_c=0{,}804\) în criză. Formula (6.12) dă corelația corectată \(\rho^*=0{,}804/\sqrt{1+6{,}54\,(1-0{,}804^2)}=0{,}442\).
Pentru BET, \(\rho_{calm}=0{,}216\),\(\rho_c=0{,}485\) și \(\rho^*=0{,}198\).
Corelațiile brute din criză le depășesc mult pe cele calme; după corecție, ambele coboară sub ele.
Pe scurt
Pasul 1, piața-sursă: S&P 500
anul calm: 14 septembrie 2007 – 12 septembrie 2008 (\(n=242\) randamente pe 2 zile)
criza: 15 septembrie 2008 – 31 martie 2009 (\(n=130\))
Pasul 2: varianța S&P 500 în criză raportată la cea din anul calm, \(1+\delta=7{,}54\), deci \(\delta=6{,}54\)
Pasul 3: corecția \(\rho^*=\rho_c/\sqrt{1+\delta(1-\rho_c^2)}\) pentru fiecare piață (\(\rho_{calm}\), \(\rho_c\): corelațiile cu S&P 500 în anul calm și în criză)
Euro Stoxx 50: \(\rho_{calm}=0{,}610\), \(\rho_c=0{,}804\)
Ipoteza nulă este \(H_0\colon\rho_1\le\rho_{calm}\), cu \(\rho_1=\rho_c\) pentru testul brut și \(\rho_1=\rho^*\) pentru cel corectat. Statistica este \(z=(\operatorname{artanh}\rho_1-\operatorname{artanh}\rho_{calm})/\sqrt{1/(n_c-3)+1/(n_{calm}-3)}\), iar \(p=1-\Phi(z)\).
Randamentele pe 2 zile se suprapun, deci mărimile efective se iau la jumătate: \(n_{calm}=121\) și \(n_c=65\). Pentru perechi zilnice i.i.d. Normale, aproximarea Bartlett dă o mărime efectivă apropiată de \(2n/3\). Înjumătățirea este deci o convenție prudentă în acest caz de referință, nu o regulă generală.
Corecția schimbă concluzia:
Euro Stoxx 50: brut \(z=2{,}56\) și \(p=0{,}005\); corectat \(z=-1{,}49\) și \(p=0{,}932\).
BET: brut \(z=1{,}97\) și \(p=0{,}024\); corectat \(z=-0{,}12\) și \(p=0{,}548\).
Ignorarea suprapunerii exagerează dovezile. Cu toate cele 130 și 242 de randamente tratate ca independente, statistica brută pentru Euro Stoxx 50 ar fi \(z=3{,}66\)(\(p\approx0{,}0001\)).
Testul Fisher tratează \(\delta\) ca fiind cunoscut. Bootstrap-ul staționar din slide-ul despre 2008 îl reestimează la fiecare repetiție și dă \(p=0{,}98\) pentru Euro Stoxx 50 și \(p=0{,}62\) pentru BET.
Pe scurt
Test Fisher unilateral pentru \(H_0:\rho_1\le\rho_{calm}\), cu \(\rho_1=\rho_c\) (brut) sau \(\rho_1=\rho^*\) (corectat)
Randamentele pe 2 zile se suprapun, deci volumele eșantioanelor se ajustează
Folosim volumele efective \(n_{calm}=121\) și \(n_c=65\), jumătate din \(242\) și \(130\)
Pentru perechi zilnice i.i.d. Normale, aproximația Bartlett dă un volum efectiv apropiat de \(2n/3\), deci înjumătățirea este o alegere prudentă în acest caz de referință, nu o regulă generală
Euro Stoxx 50, brut: \(z=\dfrac{\operatorname{artanh}0{,}804-\operatorname{artanh}0{,}610}{\sqrt{1/62+1/118}}=2{,}56\)
valoarea p unilaterală: 0,005; cu \(\rho^*\), \(z=-1{,}49\) și \(p=0{,}932\)
\(\hat\tau\) al lui Kendall este o U-statistică (U-statistic), adică o medie pe toate perechile de observații. Eroarea ei standard vine din proiecția Hoeffding.
Parametrul copulei se obține inversînd legătura \(\tau(\theta)\) din (6.15):\(\hat\theta=g(\hat\tau)\). Eroarea standard a lui \(\hat\theta\) vine prin metoda delta (Genest & Rivest, 1993).
Pentru copulele eliptice, \(\tau=\frac2\pi\arcsin\rho\) pentru orice \(\nu\):\(\tau\) determină \(\rho\), dar niciodată \(\nu\).
Pentru JPM și BAC, \(\hat\tau=0{,}641\) (SE 0,0065) dă \(\hat\rho_\tau=\sin(\pi\hat\tau/2)=0{,}845\) (SE 0,0055). Valoarea este apropiată de estimarea CML, \(\hat\rho=0{,}842\) (SE 0,0053).
În CML, rangurile sînt ele însele estimate. Inversa hessianei ignoră această incertitudine, deci dă erori standard prea mici. Matricea sandwich a lui Genest, Ghoudi & Rivest (1995) adaugă termenii datorați rangurilor.
Corecția diferă de la caz la caz:
pentru \(\rho\) Gaussian al randamentelor săptămînale S&P 500–Euro Stoxx 50, SE crește cu 60%, de la 0,0086 la 0,0138;
pentru \(\rho\) al copulei t JPM–BAC, SE crește cu 17%, de la 0,0046 la 0,0053;
pentru \(\nu\), SE crește cu 1%.
Factorul de 1,60 este un semnal de specificare greșită. Dacă copula Gaussiană ar fi corectă, folosirea rangurilor ar înmulți SE cu \(\sqrt{1+\rho^2}\), adică 1,27 la corelația săptămînală 0,78 (Monte Carlo la \(\rho=0{,}8\): 1,28). Matricea sandwich rămîne validă și cînd copula este greșit specificată.
Chen & Fan (2006) arată că CML pe rangurile reziduurilor estimate are aceeași limită ca pe inovațiile adevărate. Condiția este ca inovațiile să fie i.i.d. cu copula \(C_\theta\) și GARCH corect specificat. Spre deosebire de DCC, pasul 1 nu cere corecție.
Dacă \((U,V)\sim C_\theta\), atunci \(E_1=U\) și \(E_2=h(V\mid U)=\partial C_\theta(U,V)/\partial u\) sînt uniforme independente. Aici \(h\) este funcția de repartiție a lui \(V\) condiționată de \(U\).
Statistica lui Genest, Rémillard & Beaudoin (2009) este \(S_n=n\int_{[0,1]^2}\big(D_n(e)-e_1e_2\big)^2de\). Ea compară proporția \(D_n(e)\) a perechilor cu \(E_1\le e_1\) și \(E_2\le e_2\) cu valoarea \(e_1e_2\) de sub independență. Valorile mari înseamnă o potrivire slabă.
Cum \(\theta\) este estimat, valoarea \(p\) vine dintr-un bootstrap parametric: simulăm din \(C_{\hat\theta}\), recalculăm rangurile, reestimăm și recalculăm \(S_n\);\(p=(1+\#\{S_n^{(b)}\ge S_n\})/(B+1)\).
Pentru JPM și BAC, \(B=200\) (100 pentru copula t). Cea mai mică valoare \(p\) posibilă este deci \(1/201\approx0{,}005\)(\(1/101\approx0{,}010\) pentru t).
Pe reziduuri GARCH, testele pe ranguri își păstrează limita (Rémillard, 2017). Cu \(T=4\,202\), testul detectează și abateri mici, dar o respingere nu spune ce lipsește din model.
Estimatorul din corpul capitolului este al lui Schmidt & Stadtmüller (2006):\(\hat\lambda_L=\frac nk\hat C_n(\frac kn,\frac kn)\). Aici \(n\) este mărimea eșantionului, \(k\) numărul de observații din coadă, iar \(\hat C_n\) copula empirică. Un \(k\) mai mare scade varianța, dar crește deplasarea.
Testul compară cele două cozi la un prag fix \(q\):\(H_0\colon\lambda_L(q)=\lambda_U(q)\). El compară probabilități la prag, nu limitele teoretice.
Incertitudinea vine din două bootstrap-uri. Primul reeșantionează perechi de reziduuri, cu rangurile recalculate și \(B=999\). Al doilea folosește blocuri staționare, cu lungimi medii de 1,6 și 1,0 zile, alese după regula lui Politis & White (2004).
Rezultatele:
la \(q=5\%\)(\(k=210\)), diferența este 0,062, cu intervalele de 95% \([-0{,}014;\ 0{,}148]\) (i.i.d.) și \([-0{,}014;\ 0{,}138]\) (blocuri);
la \(q=1\%\)(\(k=42\)), diferența este 0,095, cu intervalele \([-0{,}095;\ 0{,}286]\) și \([-0{,}119;\ 0{,}286]\).
Toate intervalele conțin zero: asimetria nu este detectată statistic. Testul nu validează copula t, respinsă de testul global de adecvare.
Copula statică presupune aceeași legătură între JPM și BAC în toată perioada, deși băncile se mișcă mai strîns împreună în crize
Ideea: lăsăm corelația copulei, \(\rho_t\), să se schimbe de la o zi la alta, așa cum GARCH lasă volatilitatea să se schimbe
Regula de actualizare (GAS): în fiecare zi întrebăm dacă perechea de azi \((\hat u_t,\hat v_t)\) ar fi fost mai probabilă cu o corelație mai mare sau mai mică, și mutăm puțin corelația în acea direcție
o zi în care ambele bănci au percentile extreme în același sens împinge corelația în sus; o zi cu mișcări opuse o împinge în jos
\(A\) spune cît reacționăm la ziua de azi (0,025, puțin), \(B\) cît păstrăm din trecut (0,9926, mult): corelația se mișcă lent
\(\tanh\) ține \(\rho_t\) între \(-1\) și 1
Rezultatul: \(\rho_t\) între 0,64 (2013) și 0,95 (2021); dependența în cozi \(\lambda_t\) între 0,28 și 0,69, față de 0,53 în copula statică
De ce contează: o parte din extremele comune ale copulei statice venea din amestecul perioadelor calme cu cele de criză (\(\hat\nu\) crește de la 4,24 la 5,35)
Figura arată corelația condiționată \(\rho_t\) și dependența în cozi \(\lambda_t\) a unei copule t dinamice, estimată pe pseudo-observațiile JPM–BAC. Episoadele de stres sînt umbrite.
Modelul este o copulă t GAS (generalised autoregressive score) (Creal, Koopman & Lucas, 2013), estimată pe aceleași pseudo-observații:
\(\rho_t=\tanh f_t\) și \(f_{t+1}=\omega+A\,s_t+Bf_t\).
Aici \(f_t\) este corelația transformată pe toată axa reală, \(\omega\) o constantă, \(s_t\) scorul logaritmului densității copulei în raport cu \(f_t\),\(A\) reacția la scor și \(B\) persistența.
Estimările sînt \(A=0{,}025\),\(B=0{,}9926\) și \(\nu=5{,}35\), față de \(\nu=4{,}24\) la copula statică. Corelația variază între 0,64 (23 mai 2013) și 0,95 (18 februarie 2021). Dependența în cozi \(\lambda_t\) variază între 0,28 și 0,69, față de 0,53 în cazul static.
Cînd \(\rho\) se poate mișca, \(\hat\nu\) crește. O parte din dependența în cozi a modelului static era, de fapt, variație în timp a corelației.
Statistica LR față de copula t statică este 245,5. Sub \(A=0\), parametrul \(B\) nu este identificat, deci valoarea \(p\) vine dintr-un bootstrap. Variația în timp este o explicație compatibilă cu respingerea tuturor familiilor statice.
Figura arată COVOL zilnic replicat, \(\hat x_t\), pentru ETF-urile cursului în 2000–2026. Romburile marchează cele 20 de date din Tabelul 15 al lui Engle & Campos-Martins (2023).
Replicarea folosește 20 de ETF-uri listate în SUA, de la 4 ianuarie 2000 pînă la 18 septembrie 2026, adică 6 717 zile. Media fiecărui ETF urmează un model autoregresiv de ordinul întîi (AR(1)) care include prima componentă principală (PC1). Varianțele sînt GARCH(1,1), iar estimarea alternează pașii din (6.18).
Pînă la 1 martie 2021, cele mai mari valori sînt:
9 noiembrie 2016: \(\hat x_t=49{,}8\), alegerile din SUA;
17 septembrie 2001: 42,9, redeschiderea piețelor după 11 septembrie;
9 martie 2020: 32,2, prăbușirea din pandemia COVID-19.
Replicarea regăsește zilele din lucrare: 13 dintre cele mai mari 20 de zile ale ei dinainte de martie 2021 se află printre cele 20 de date din Tabelul 15.
Cu \(s^\top s=1\) și media \(\hat x_t=1\), scala depinde de panel, deci nivelurile nu sînt comparabile cu cele din lucrare; ordinea zilelor este.
Cea mai mare valoare din tot eșantionul este la 6 noiembrie 2024 (51,1), ziua de după alegerile din SUA din 2024. Randamentul mediu al ETF-urilor a fost 0,95%: un șoc comun mare într-o zi de creștere.
Anexa adună derivările și tabelele complete la care trimite corpul capitolului: intervalul pentru o corelație, erorile standard ale DCC, testele de contagiune, copulele, studiul de caz COVOL și prompturile buclei descoperirii.
Aici \(\Omega\) este covarianța pe termen lung a lui \(m_t\). Ea se estimează HAC (Newey & West, 1987), adică robust la heteroscedasticitate și autocorelare. Forma cu funcția de influență, (6.4), dă același rezultat.
Rezultatul cere trei condiții: staționaritate, momente finite de ordin mai mare decît 4 și dependență slabă în timp. Dacă momentul de ordinul patru este infinit, limita Normală nu mai are loc. Un bootstrap obișnuit nu rezolvă automat această problemă.
Pe ultima fereastră de 252 de zile, încheiată la 17 septembrie 2026, \(\hat\rho=0{,}245\). Intervalul Fisher este \([0{,}13;\ 0{,}36]\), iar intervalul HAC este \([0{,}07;\ 0{,}41]\), vizibil mai larg. Pe tot eșantionul, intervalul HAC ajunge cel mult de 2,02 ori mai larg decît cel Fisher.
Pe scurt
\(\hat\rho=g(\hat m)\), unde \(\hat m\) este media empirică a lui \(m_t=(x_t,\,y_t,\,x_t^2,\,y_t^2,\,x_ty_t)\)
\(g\): funcția care transformă aceste cinci momente în corelație; \(\nabla g\): gradientul lui \(g\)
Metoda delta: \(\sqrt T(\hat\rho-\rho)\to N\big(0,\ \nabla g^\top\Omega\,\nabla g\big)\)
\(\Omega\): covarianța pe termen lung a lui \(m_t\), estimată HAC cu nucleu Bartlett și \(L\) laguri (Newey & West (1987))
Aceeași formă, cu contribuțiile zilnice \(\psi_t\) (funcția de influență): \(\hat\rho-\rho\approx\frac1T\sum_t\psi_t\) din textul principal
Condiții: staționaritate, momente finite de ordin mai mare decît 4 pentru \((x_t,y_t)\) și dependență slabă (mixing)
cu momente de ordinul patru infinite limita Normală nu mai este valabilă
nici bootstrap-ul obișnuit nu remediază automat lipsa momentelor: rezerva privește și bootstrap-ul Forbes–Rigobon și testele pe pierderi pătratice
Intervalul HAC, calculat pe scara Fisher: \(\tanh\big(\operatorname{artanh}\hat\rho\pm1{,}96\,\widehat{\mathrm{SE}}_{\mathrm{HAC}}/(1-\hat\rho^2)\big)\)
unde \(\widehat{\mathrm{SE}}_{\mathrm{HAC}}=\sqrt{\nabla\hat g^\top\hat\Omega\,\nabla\hat g/T}\); \(1/(1-\hat\rho^2)\) este derivata lui \(\operatorname{artanh}\) (metoda delta)
Intervalul Fisher clasic înlocuiește \(\widehat{\mathrm{SE}}_{\mathrm{HAC}}/(1-\hat\rho^2)\) cu \(1/\sqrt{T-3}\)
Exemplu: ultima fereastră mobilă de 252 de zile din textul principal, încheiată pe 17 septembrie 2026
\(\hat\rho=0{,}245\), intervalul Fisher [\(0{,}13\); \(0{,}36\)], intervalul HAC [\(0{,}07\); \(0{,}41\)]
cel mai mare raport dintre lățimea HAC și cea Fisher, pe toate ferestrele: \(2{,}02\)
Modelul BEKK (Engle & Kroner, 1995) dă o matrice de covarianță pozitiv definită prin construcție, dacă \(CC^\top\) este pozitiv definită. El are \(N(N+1)/2+2N^2\) parametri. Acești parametri sînt greu de interpretat, iar verosimilitatea devine plată cînd \(N\) este mare.
DCC are doar \(3N+2\) parametri: un GARCH univariat pentru fiecare varianță, plus cei doi parametri \(a\) și \(b\) ai corelațiilor.
Cei doi pași ai DCC pot fi scriși ca ecuații de estimare suprapuse. Prima este \(\sum_t s_{1t}(\theta_1)=0\), pentru parametrii GARCH și, cu ținta corelației (correlation targeting), pentru \(\operatorname{vech}\bar Q\). A doua este \(\sum_t s_{2t}(\theta_1,\theta_2)=0\), pentru \(\theta_2=(a,b)\).
Notăm \(A_{jk}=\mathbb{E}[\partial s_{jt}/\partial\theta_k^\top]\). Secțiunea 6 din Newey & McFadden (1994) dă varianța corectă
\(V_2=A_{22}^{-1}\Omega A_{22}^{-1\top}\),
unde \(\Omega\) este varianța pe termen lung a scorului ajustat \(u_t=s_{2t}-A_{21}A_{11}^{-1}s_{1t}\). Termenul \(A_{21}\) măsoară cît reacționează scorul corelației la parametrii GARCH. Erorile standard naive păstrează doar \(s_{2t}\) și omit această eroare transmisă din pasul 1.
Momentul țintei nu este o diferență de martingală, deci \(\Omega\) se estimează HAC. Engle & Sheppard (2001) derivă \(V_2\) pentru DCC. O alternativă mai simplă este bootstrap-ul întregii proceduri în doi pași.
Pe scurt
Întrebarea: cum includem în erorile standard ale lui \((a,b)\) eroarea de estimare din pasul 1?
Sistemul ecuațiilor de estimare
\(\sum_t s_{1t}(\theta_1)=0\) (pasul 1: GARCH și, cu fixarea țintei, \(\operatorname{vech}\bar Q\))
Bootstrap-ul folosit este parametric, pe reziduuri, cu \(B=199\) de replicări. Reziduurile sînt întîi decorelate cu factorul Cholesky al lui \(R_t\) și apoi reeșantionate. Inovațiile DCC se simulează apoi cu parametrii estimați \((\hat a,\hat b,\bar Q)\).
Există două variante. Varianta numai pentru pasul 2 reestimează doar \((a,b)\) pe inovațiile simulate. Varianta pe ambii pași reconstruiește randamentele cu modelele GARCH estimate și reestimează totul pe aceleași inovații: GARCH, \(\bar Q\) și \((a,b)\). Bootstrap-ul testului LR sub ipoteza CCC folosește același mecanism, cu \(a=b=0\).
Pe scurt
Scopul: erori standard pentru \((a,b)\) care includ incertitudinea ambilor pași; bootstrap parametric pe reziduuri, \(B=199\)
decorelăm reziduurile cu factorul Cholesky al lui \(R_t\) și le reeșantionăm
simulăm inovații DCC cu \((\hat a,\hat b,\bar Q)\)
Doar pasul 2: reestimăm \((a,b)\) pe inovațiile simulate
Ambii pași: reconstruim randamentele cu GARCH-ul estimat
reestimăm GARCH, \(\bar Q\) și \((a,b)\) pe aceleași inovații
Bootstrap-ul sub CCC pentru testul LR folosește același mecanism cu \(a=b=0\)
inovații cu corelație constantă, randamente GARCH simulate, ambii pași reestimați
Robert F. Engle a primit în 2003 Premiul Nobel pentru Științe Economice pentru modelele ARCH (Capitolul 5). Modelul său DCC (Engle, 2002) păstrează un GARCH univariat flexibil pentru fiecare varianță. Pentru corelații, adaugă o lege de mișcare simplă, care se poate estima ușor. Varianta corectată a lui Aielli (2013) face din \(\bar Q\) o țintă consistentă.
Corsetti, Pericoli & Sbracia (2005) arată că, atunci cînd un factor comun lovește toate piețele, corecția este excesivă. Testul înclină atunci spre concluzia „fără contagiune”. Autorii propun o variantă a testului bazată pe un model factorial.
Rigobon (2003) propune identificarea prin heteroscedasticitate (identification through heteroskedasticity). Ideea este că schimbarea varianței între regimuri identifică coeficientul structural \(\beta\), la fel cum o face un instrument într-o regresie cu variabile instrumentale. Critica factorului comun se aplică și crizei din 2008.
Copula t are o dependență în cozi cu atît mai mare cu cît numărul de grade de libertate \(\nu\) este mai mic.
Copulele arhimediene se construiesc dintr-o singură funcție, numită generator. Generatorii sînt \(\varphi(t)=(t^{-\theta}-1)/\theta\) pentru Clayton, \((-\ln t)^\theta\) pentru Gumbel și \(-\ln\frac{e^{-\theta t}-1}{e^{-\theta}-1}\) pentru Frank. Clayton are dependență în coada de jos, deci se potrivește prăbușirilor comune ale randamentelor. Gumbel are dependență în coada de sus, deci se potrivește extremelor comune ale pierderilor.
Rotația cu \(180^\circ\),\(\bar C(u,v)=u+v-1+C(1-u,1-v)\), mută dependența din cozi în colțul opus.
Tabelul completează tabelul din corpul capitolului cu trei coloane: log-verosimilitatea maximizată \(\ell\), distanța AIC față de cel mai bun model și valoarea \(p\) a testului de adecvare Rosenblatt.
Copula t este cea mai bună, cu \(\ell=2\,641{,}7\). Copula Gaussiană rămîne în urmă cu 309,3 puncte AIC. Urmează Gumbel, la 456,9, și Frank, la 499,8. Clayton este cea mai slabă, la 1 048,0 puncte. Fiecare valoare \(p\) este cea mai mică posibilă pentru numărul ei de eșantioane bootstrap.
Pe scurt
Copula
\(\hat\theta\) sau \(\hat\rho\)
\(\hat\nu\)
\(\ell\)
\(\Delta\)AIC
\(\lambda_L\)
\(\lambda_U\)
\(p\) adecvare
Gaussiană
0,833
–
2 486,0
309,3
0,000
0,000
0,005
Student t
0,842
4,24
2 641,7
0,0
0,531
0,531
0,010
Clayton
2,384
–
2 116,7
1 048,0
0,748
0,000
0,005
Gumbel
2,587
–
2 412,2
456,9
0,000
0,693
0,005
Frank
9,152
–
2 390,8
499,8
0,000
0,000
0,005
CML pe pseudo-observațiile reziduurilor GARCH
\(\ell\): log-verosimilitatea maximă; \(\lambda_L\), \(\lambda_U\): dependența în cozi implicată de parametri
\(\Delta\)AIC: distanța față de cel mai bun model
\(p\) de adecvare: testul Rosenblatt cu bootstrap parametric
Eroarea standard de tip plug-in înlocuiește \(C\) cu copula empirică. Inversarea lui \(\hat\tau\) dă o valoare de pornire robustă pentru maximizarea verosimilității.
Pentru estimatorul CML, Genest, Ghoudi & Rivest (1995) dau o matrice de tip sandwich, \(A^{-1}\Sigma A^{-1}\). Aici \(A\) este informația Fisher a copulei. \(\Sigma\) este varianța scorului lui \(\ln c\), plus doi termeni de corecție, \(W_1\) și \(W_2\), care țin cont că marginalele au fost estimate prin ranguri.
Pentru copula Gaussiană, varianța CML este \((1-\rho^2)^2\). Cu marginale cunoscute ar fi mai mică: \((1-\rho^2)^2/(1+\rho^2)\).
Pe scurt
\(\hat\tau\) este o U-statistică
proiecția Hoeffding dă \(\sqrt n(\hat\tau-\tau)\to N\big(0,\,16\Var[2C(U,V)-U-V]\big)\)
Modelul este \(r_{it}=\mu_i+\sigma_{it}\varepsilon_{it}\), cu volatilități GARCH și inovații i.i.d. legate prin copula \(C_\theta\).Chen & Fan (2006) arată că CML pe rangurile reziduurilor estimate are aceeași distribuție limită ca CML pe rangurile inovațiilor adevărate.
Un studiu Monte Carlo confirmă rezultatul. El folosește 500 de eșantioane de \(T=2\,000\), o copulă Gaussiană cu \(\rho=0{,}8\), inovații Student t(5) și modelele GARCH estimate pentru JPM și BAC. Abaterea standard a lui \(\hat\rho\) este 0,0081 cu inovațiile adevărate și 0,0082 cu reziduurile GARCH, practic aceeași.
Eroarea standard sandwich medie este 0,0081, deci corectă. Eroarea standard medie din inversa hessianei este 0,0063, deci prea mică.
Pe scurt
Modelul: \(r_{it}=\mu_i+\sigma_{it}\varepsilon_{it}\) cu \(\sigma_{it}\) GARCH
Inovațiile \((\varepsilon_{1t},\varepsilon_{2t})\) i.i.d. cu copula \(C_\theta\)
Chen & Fan (2006): CML pe rangurile reziduurilor estimate\(\hat\varepsilon_{it}\)
are aceeași distribuție limită ca CML pe rangurile inovațiilor adevărate \(\varepsilon_{it}\)
Monte Carlo: \(500\) eșantioane, \(T=2\,000\)
copulă Gaussiană \(\rho=0{,}8\), inovații Student t(5), GARCH ca cel estimat pentru JPM și BAC
Abaterea standard a lui \(\hat\rho\) în simulări: \(0{,}0081\) cu inovațiile adevărate și \(0{,}0082\) cu reziduurile GARCH
Media erorilor standard estimate: \(0{,}0081\) pentru matricea sandviș și \(0{,}0063\) pentru inversa hessianei
Concluzia: filtrarea GARCH practic nu schimbă precizia; matricea sandviș o estimează corect, inversa hessianei o subestimează
Schmidt & Stadtmüller (2006) dau condițiile în care estimatorul \(\hat\lambda_L\) din corpul capitolului este consistent și asimptotic Normal. Numărul \(k\) de observații din coadă trebuie să crească (\(k\to\infty\)), dar mai încet decît eșantionul (\(k/n\to0\)). Copula cozii trebuie să existe. În plus, deplasarea trebuie să dispară suficient de repede: \(\sqrt k\,A(n/k)\to0\), unde \(A(\cdot)\) măsoară cît de repede se apropie \(C(q,q)/q\) de \(\lambda_L\).
Bootstrap-ul i.i.d. al perechilor de reziduuri presupune o copulă a inovațiilor care nu se schimbă în timp. Bootstrap-ul staționar pe blocuri păstrează dependența în timp a diferenței dintre cei doi indicatori de coadă. Media acestei diferențe, împărțită la \(q\), estimează \(\lambda_L-\lambda_U\).
Pe scurt
Schmidt & Stadtmüller (2006): estimatorul \(\hat\lambda_L\) din textul principal este consistent și asimptotic Normal dacă
\(k\to\infty\), \(k/n\to0\) și copula de coadă există
este îndeplinită o condiție de ordinul doi pentru deplasare: \(\sqrt k\,A(n/k)\to0\)
\(A(\cdot)\): viteza cu care \(C(q,q)/q\) se apropie de \(\lambda_L\)
Bootstrap-ul i.i.d. al perechilor de reziduuri presupune o copulă statică a inovațiilor
Bootstrap-ul staționar pe blocuri păstrează dependența serială a diferenței
Verosimilitatea completă este lentă și deplasată cînd \(N\) este mare. Există două remedii: verosimilitatea compusă (Pakel, Shephard, Sheppard & Engle, 2021) și contracția neliniară a țintei în DCC-NL (DCC cu contracție neliniară, nonlinear shrinkage) (Engle, Ledoit & Wolf, 2019). Contracția (shrinkage) este cea din Capitolul 4.
Construcțiile vine (pair-copula constructions) (Aas, Czado, Frigessi & Bakken, 2009) obțin o copulă \(d\)-dimensională din \(d(d-1)/2\) copule bivariate, așezate în arbori imbricați. Fiecare pereche are propria familie și propriile cozi. Copulele arhimediene ierarhice (Okhrin, Okhrin & Schmid, 2013) grupează activele după tăria dependenței, de exemplu băncile dintr-o țară și țările dintr-o regiune.
Copulele cu parametri conduși de scor (Creal, Koopman & Lucas, 2013) se extind la multe active prin copule factoriale. Oh & Patton (2018) le folosesc pentru a măsura riscul sistemic variabil în timp din spread-urile credit default swap. Copulele condiționate pornesc de la Patton (2006).
Pe scurt
DCC pentru \(N\) mare: verosimilitatea completă este lentă și deplasată
Rețelele de corelații sînt un prim pas spre măsurile de risc sistemic din Capitolul 18. Aceste măsuri includ conectivitatea din cauzalitatea Granger (Billio, Getmansky, Lo & Pelizzon, 2012) și indicii de propagare (spillover) din descompunerile varianței (Diebold & Yilmaz, 2009). Mai includ CoVaR (Conditional Value-at-Risk of the system given an institution in distress, VaR-ul sistemului condiționat de dificultățile unei instituții) din regresii cuantilice (Adrian & Brunnermeier, 2016) și rețelele de evenimente din cozi, cum este Financial Risk Meter aplicat firmelor energetice din Uniunea Europeană (UE) (Toma, Dima, Grecu, Pele & Lessmann, 2026).
Lucrări înrudite studiază legătura dintre șocurile prețului petrolului și piața americană de acțiuni (Kilian & Park, 2009). Altele studiază dependența dintre prețurile energiei și piețele de acțiuni din UE, pe regiuni și grupuri industriale (Grecu, Cramer, Pele & Lessmann, 2025).
Rețelele de corelații moștenesc toate problemele corelațiilor: legăturile neliniare, variația în timp și cozile.
Pe scurt
Rețelele de corelații sînt primul pas spre măsurile de risc sistemic din Capitolul 18
COVOL măsoară un singur factor comun care mărește simultan volatilitatea tuturor piețelor. În modelul lui Engle & Campos-Martins (2023),\(\Psi_{ij,t}=s_is_jv_t\) pentru \(i\neq j\), cu \(v_t=\operatorname{Var}_{t-1}(x_t)\). Așadar \(\Psi\) are un singur factor, iar prima lui componentă principală dă valorile de pornire.
Dacă toate încărcările sînt egale, media transversală \(\hat x_t\) din corpul capitolului este chiar estimarea de verosimilitate maximă. În general, estimarea maximizează \(-\frac12\sum_{i,t}[\ln g_{it}+e_{it}^2/g_{it}]\). Ea alternează între \(x_t\) și \(s_i\), cu normalizările \(s^\top s=1\) și media lui \(x_t\) egală cu 1.
Lucrarea folosește 47 de ETF-uri pe țări, listate la NYSE, deci cu aceeași oră de închidere. Datele sînt randamente logaritmice zilnice în dolari americani (USD), între 2 iunie 2000 și 1 martie 2021. Media are o componentă AR(1) și doi factori: ACWI și PC1 al randamentelor ETF. Varianțele sînt GARCH(1,1). Lucrarea studiază și 23 de serii americane pe clase de active și verifică estimatorul și testul prin studii Monte Carlo.
Pe scurt
Modelul (ec. 8–11 din Engle & Campos-Martins (2023)): pentru \(i\neq j\), \(\Psi_{ij,t}=s_is_jv_t\), \(v_t=\operatorname{Var}_{t-1}(x_t)\)
\(e_{it}\): reziduul standardizat al activului \(i\); \(\Psi_{ij,t}=\operatorname{Cov}_{t-1}(e_{it}^2,e_{jt}^2)\)
deci \(\Psi\) are un singur factor, iar prima lui componentă principală dă valorile inițiale (ec. 12–13)
Încărcări egale (înainte de normalizarea \(s^\top s=1\)): \(g_{it}=x_t\), iar media transversală \(\hat x_t=\frac1N\sum_i e_{it}^2\) din textul principal este estimatorul de verosimilitate maximă (ec. 17)
Cele mai mari valori ale lui \(\hat x_t\) din lucrare sînt:
51,416 la 9 martie 2020: carantina din Italia și războiul prețului petrolului; randamentul mediu al ETF-urilor a fost \(-9{,}650\%\).
49,190 la 24 iunie 2016: Brexit.
39,457 la 5 august 2019: China își devalorizează moneda.
38,883 la 28 aprilie 2020: o vînzare masivă de acțiuni tehnologice; randamentul mediu a fost \(+2{,}334\%\).
30,077 la 17 septembrie 2001: redeschiderea NYSE după 11 septembrie.
PC1 (0,261) și ACWI (0,250) au cele mai mari încărcări. Franța (0,217) și Spania (0,200) au încărcări mari, iar Noua Zeelandă (0,065) și Polonia (0,080) au încărcări mici. Factorii au încărcări mai mari decît componentele specifice fiecărei piețe, deci corelațiile cresc odată cu COVOL.
În regresiile lunare pe COVOL\(^2_m\):
pătratul reziduului ACWI are panta 0,326 (SE 0,025, \(R^2=0{,}404\));
corelația medie pe perechi a ETF-urilor crește cu 0,053 pe unitate (SE 0,009);
variația VIX, indicele Cboe al volatilității implicite a S&P 500, are panta 4,034 (SE 0,249, \(R^2=0{,}517\)).
Pe scurt
Ziua
\(\hat x_t\)
\(\bar r_t\) (%)
Evenimentul (eticheta din articol)
9 martie 2020
\(51{,}416\)
\(-9{,}650\)
COVID-19: Italia în carantină; războiul prețului petrolului
24 iunie 2016
\(49{,}190\)
\(-7{,}270\)
Brexit
5 august 2019
\(39{,}457\)
\(-2{,}574\)
Războiul comercial: China își devalorizează moneda
28 aprilie 2020
\(38{,}883\)
\(2{,}334\)
COVID-19: vînzări masive de acțiuni tehnologice
17 septembrie 2001
\(30{,}077\)
\(-8{,}630\)
NYSE se redeschide după 11 septembrie
\(\bar r_t\): randamentul mediu al ETF-urilor de țară. Tabelul arată primele cinci dintre cele mai mari douăzeci de valori din tabelul 6 din Engle & Campos-Martins (2023)
Încărcările (tabelul 7): cele mai mari le au PC1 (\(0{,}261\)) și ACWI (\(0{,}250\))
printre țări: Franța \(0{,}217\) și Spania \(0{,}200\), față de Noua Zeelandă \(0{,}065\) și Polonia \(0{,}080\)
factorii au încărcări mai mari decît componentele idiosincratice, deci corelațiile cresc odată cu COVOL (ec. 41)
Regresiile pe COVOL\(^2_m\), media lunară a lui \(\hat x_t\) minus 1
Replicarea din curs urmează varianta pe clase de active a lucrării. Ea folosește ETF-uri listate în SUA din datele de piață ale cursului, toate cu aceeași oră de închidere. Acestea sînt 11 ETF-uri sectoriale; Russell 1000 creștere și valoare; Russell 2000; piețele dezvoltate și emergente din afara SUA; aur; obligațiuni de stat pe termen lung; obligațiuni corporative; țiței.
Folosește un singur factor, PC1, pe un panel neechilibrat. Calculează întîi \(\hat x_t\) cu încărcări egale, apoi rulează iterația alternantă. La final aplică testul \(\xi\) înainte și după împărțirea lui \(e_{it}^2\) la \(\hat g_{it}\).
Pentru comparație, Tabelul 15 al lucrării pune 9 noiembrie 2016 (43,04) și 9 martie 2020 (40,47) printre primele patru zile. Două serii ale lucrării lipsesc din datele cursului: dolarul și separarea creștere/valoare pentru Russell 2000.
Pe scurt
Replicare: versiunea pe clase de active (Secțiunea 9)
cu ETF-urile listate în SUA din datele de piață ale cursului, care se închid toate la aceeași oră
ETF-urile
11 sectoriale, Russell 1000 Growth și Value, Russell 2000
piețele dezvoltate și emergente din afara SUA
aur, obligațiuni de stat pe termen lung, obligațiuni corporative, petrol
Un singur factor, PC1, pe un panel neechilibrat
\(\hat x_t\) prin ec. 17, apoi iterația din Secțiunea 5.3
Testul \(\xi\) înainte și după împărțirea lui \(e_{it}^2\) la \(\hat g_{it}\) (Secțiunea 7.2)
Tabelul 15 din articol plasează între primele patru zile
9 noiembrie 2016 (\(43{,}04\)) și 9 martie 2020 (\(40{,}47\))
Dolarul și împărțirea Russell 2000 pe creștere/valoare nu sînt în datele cursului, deci panelul replicării diferă de cel din articol
Autorii indică două limite. Prima: după împărțirea la \(\hat g_{it}\), pătratele rămîn corelate, ceea ce sugerează un al doilea factor. COVOL cu mai mulți factori rămîne o problemă deschisă.
A doua limită privește numărul de piețe. Sub normalizarea \(s^\top s=1\), încărcările scad cînd \(N\) crește. Potrivirea dintre încărcările estimate și cele adevărate, \(R^2_s\), este 0,640 pentru \(N=50\) și \(T=1000\), față de 0,924 pentru \(N=10\). Testul pierde putere cînd încărcările sînt inegale, deci autorii recomandă \(T\ge1000\).
După eșantionul lucrării au avut loc două șocuri comune mari. Primul, la 3 aprilie 2025, a urmat anunțului tarifelor vamale americane: \(\hat x_t=16{,}2\), cu un randament mediu de \(-3{,}67\%\). Al doilea, la 10 noiembrie 2022, a urmat unei inflații americane mai mici decît se aștepta: \(\hat x_t=15{,}4\), cu un randament mediu de \(+4{,}56\%\).
Rămîn deschise două întrebări. Au alegerile, tarifele și știrile despre inflație un factor comun? Explică COVOL\(^2_m\) corelațiile DCC lunare dincolo de variația VIX?
Pe scurt
Limite menționate de autori
după împărțirea la \(\hat g_{it}\) pătratele sînt încă corelate, posibil un al doilea factor (Secțiunea 7.2)
COVOL multifactorial rămîne deschis (Secțiunea 9)
Cu \(s^\top s=1\) încărcările scad cînd \(N\) crește
\(R^2_s\): potrivirea dintre încărcările estimate și cele adevărate
\(R^2_s\) este \(0{,}640\) pentru \(N=50\), \(T=1000\), față de \(0{,}924\) pentru \(N=10\) (tabelul 2)
Testul pierde putere cînd încărcările diferă, deci autorii recomandă \(T\geq1000\)
După eșantionul articolului
3 aprilie 2025 (\(\hat x_t=16{,}2\), randamentul mediu \(-3{,}67\%\)), după anunțarea taxelor vamale ale SUA
10 noiembrie 2022 (\(\hat x_t=15{,}4\), \(+4{,}56\%\)), cînd inflația din SUA a ieșit sub așteptări
Întrebare deschisă (Seminarul C3)
au alegerile, taxele vamale și știrile despre inflație un singur factor comun?
Întrebare deschisă: explică COVOL\(^2_m\) corelațiile DCC lunare și după includerea variației VIX?
Prompturile de mai jos funcționează cu orice asistent AI și orice motor de căutare a literaturii.
Promptul pentru literatură cere studii din 2015 încoace despre factorii care determină corelația acțiuni–obligațiuni. Pentru fiecare studiu cere DOI-ul, eșantionul, măsura corelației, strategia de identificare și estimarea principală. Fiecare DOI se verifică apoi pe Crossref, iar estimarea se verifică în lucrare.
Promptul pentru ipoteze cere explicații concurente ale schimbării de semn din 2022. Pentru fiecare explicație cere ce prezice ea înainte de 2022 și pe date noi (out-of-sample).
Promptul pentru date cere cod care aliniază SPY și TLT pe zilele comune de tranzacționare și calculează corelațiile realizate lunare. Codul adaugă inflația CPI publicată înainte de începutul fiecărei luni. Prima verificare este replicarea valorilor \(-0{,}40\) (2002–2021) și \(0{,}11\) (2022–2026).
Pe scurt
Instrumentele sînt interschimbabile
un asistent AI (Claude, ChatGPT, Gemini, GitHub Copilot)
motoare de căutare a literaturii științifice (Semantic Scholar, Elicit, Google Scholar)
Literatura
„Listează studiile publicate după 2015 despre determinanții corelației acțiuni–obligațiuni, cu DOI, eșantion, măsura corelației, strategia de identificare și estimarea principală.”
Verificăm în Crossref fiecare DOI și verificăm estimarea în articol, nu în rezumat
Ipoteze
„Dă explicații concurente pentru schimbarea de semn din 2022 (nivelul inflației, regimul politicii monetare, un șoc al primei de termen, un episod izolat de înăsprire a politicii monetare) și ce implică fiecare pentru \(\rho\) înainte de 2022 și în afara eșantionului.”
Date și cod
„Scrie cod Python care aliniază prețurile ajustate SPY și TLT din datele de piață ale cursului pe zilele comune de tranzacționare, calculează corelațiile realizate lunare și adaugă inflația CPI din SUA publicată înainte de începutul fiecărei luni.”
Replicăm întîi corelația SPY–TLT medie: \(-0{,}40\) în 2002–2021 și \(0{,}11\) în 2022–2026
Promptul pentru robustețe cere un plan stabilit dinainte (preînregistrat). Planul include subeșantionul de dinainte de 2022, CPI de bază în loc de CPI total, randamente săptămînale în loc de zilnice, DCC în loc de corelația realizată, un control pentru volatilitatea realizată și lagul HAC 12.
Un test placebo înlocuiește \(\pi\) cu mersuri aleatoare simulate, de aceeași persistență. Motivul este că un regresor persistent poate produce din întîmplare statistici \(t\) mari.
Promptul pentru critică cere unui recenzent două răspunsuri. Este \(\gamma_1\) identificat de un singur episod? Ar explica distorsiunea de volatilitate Forbes–Rigobon rezultatul?
Raportul final enumeră toate măsurile de inflație, ferestrele și frecvențele încercate. El arată estimările pe subeșantioane lîngă cele de pe tot eșantionul. Orice specificație aleasă după vederea rezultatelor este marcată ca exploratorie. Seria de inflație este indicele prețurilor de consum pentru toți consumatorii urbani, publicat de U.S. Bureau of Labor Statistics.
Pe scurt
Robustețe
„Scrie un plan pre-înregistrat: subeșantionul de dinainte de 2022, inflația de bază în loc de cea totală, randamente săptămînale în loc de zilnice, DCC în loc de corelația realizată, control pentru volatilitatea realizată, lag HAC 12.”
Placebo: înlocuim \(\pi\) cu serii simulate de tip mers aleator (random walk), de aceeași persistență
Un regresor persistent poate da statistici t mari din întîmplare
Critica
„Joacă rolul unui referent: este \(\gamma_1\) identificat de un singur episod și l-ar explica distorsiunea de volatilitate Forbes–Rigobon? Indică testele care ar evidenția fiecare dintre aceste probleme.”
Raportul: fiecare măsură a inflației, fereastră și frecvență încercată
estimările pe subeșantioane, alături de cele pe tot eșantionul
orice specificație aleasă după ce am văzut rezultatele este exploratorie și se raportează ca atare
CML: Canonical Maximum Likelihood — verosimilitate maximă canonică (pe pseudo-observații)
CoVaR: Conditional Value-at-Risk — VaR-ul sistemului condiționat de starea unei instituții
COVID-19: COronaVIrus Disease 2019 — boala provocată de coronavirus, 2019
COVOL: COmmon VOLatility (global COVOL: the size of the volatility shock common to all assets) — volatilitatea comună (COVOL global: mărimea șocului de volatilitate comun tuturor activelor)
CPI: Consumer Price Index — indicele prețurilor de consum
DBK: Deutsche Bank AG (Xetra ticker) — Deutsche Bank AG (simbolul bursier Xetra)
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?. European Journal of Finance, 29(10), 1064–1105.
Prețuri zilnice EODHD: SPY, TLT, S&P 500, Euro Stoxx 50, BET și acțiunile JPMorgan Chase, Bank of America, Deutsche Bank, BNP Paribas, Banca Transilvania și BRD; pentru al doilea studiu de caz, cele 48 de acțiuni și ETF-uri listate în SUA din datele cursului cu istoric complet din iulie 2013. Inflația CPI din SUA: U.S. Bureau of Labor Statistics, prin FRED.


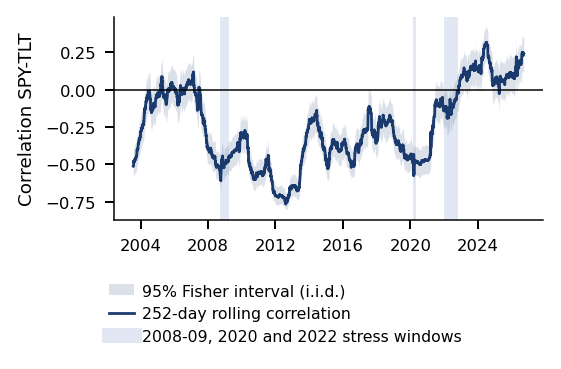
 MFM_ch6_spy_tlt_rolling
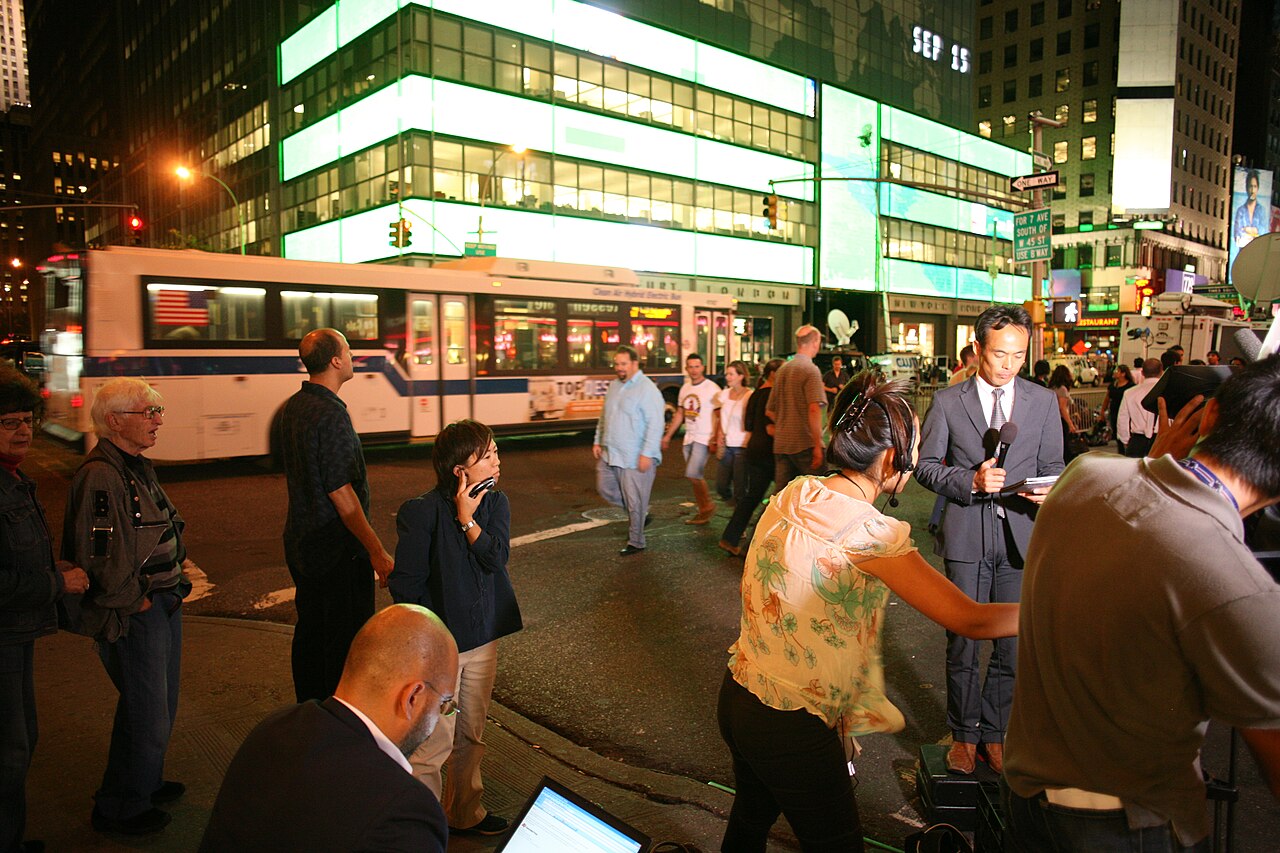
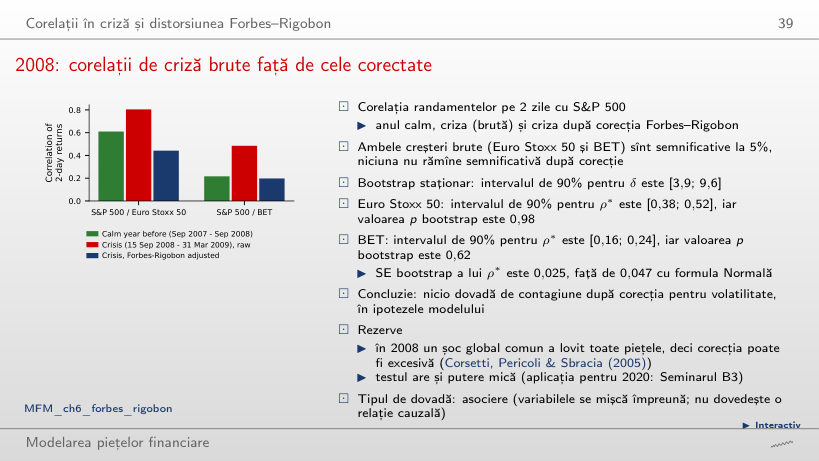
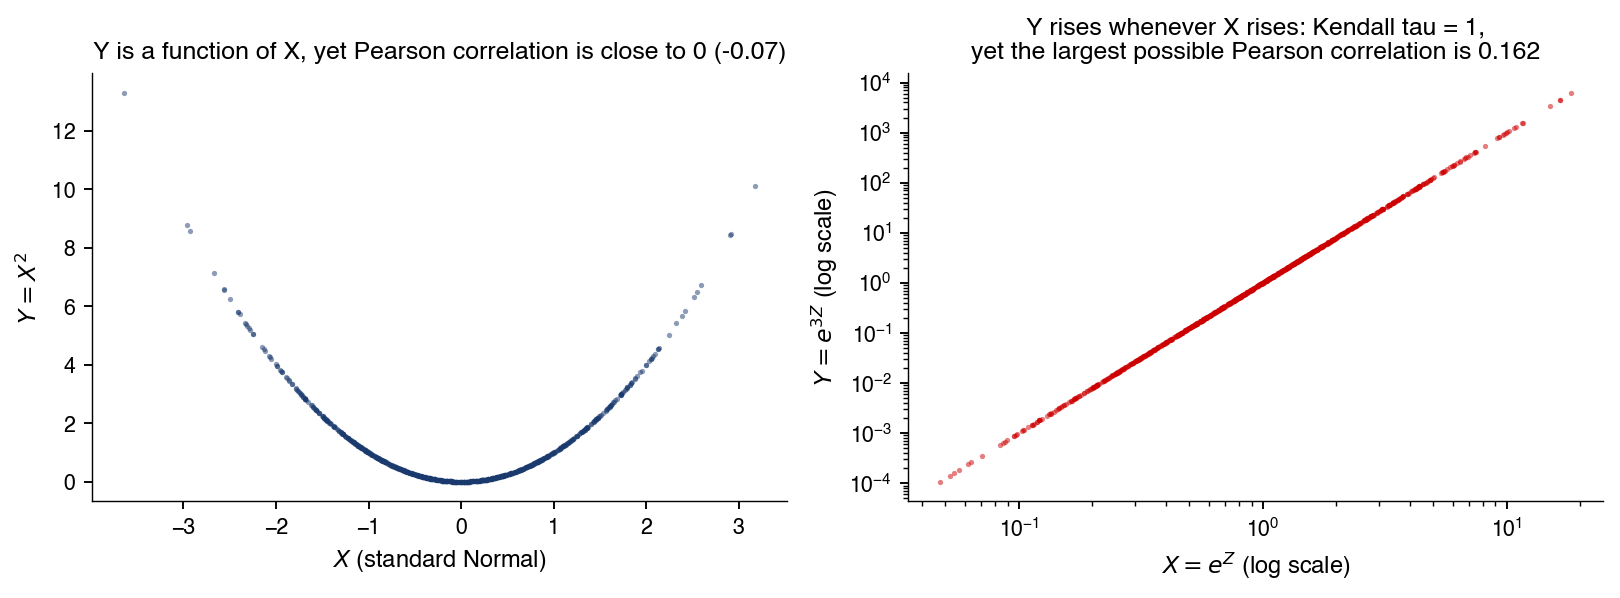
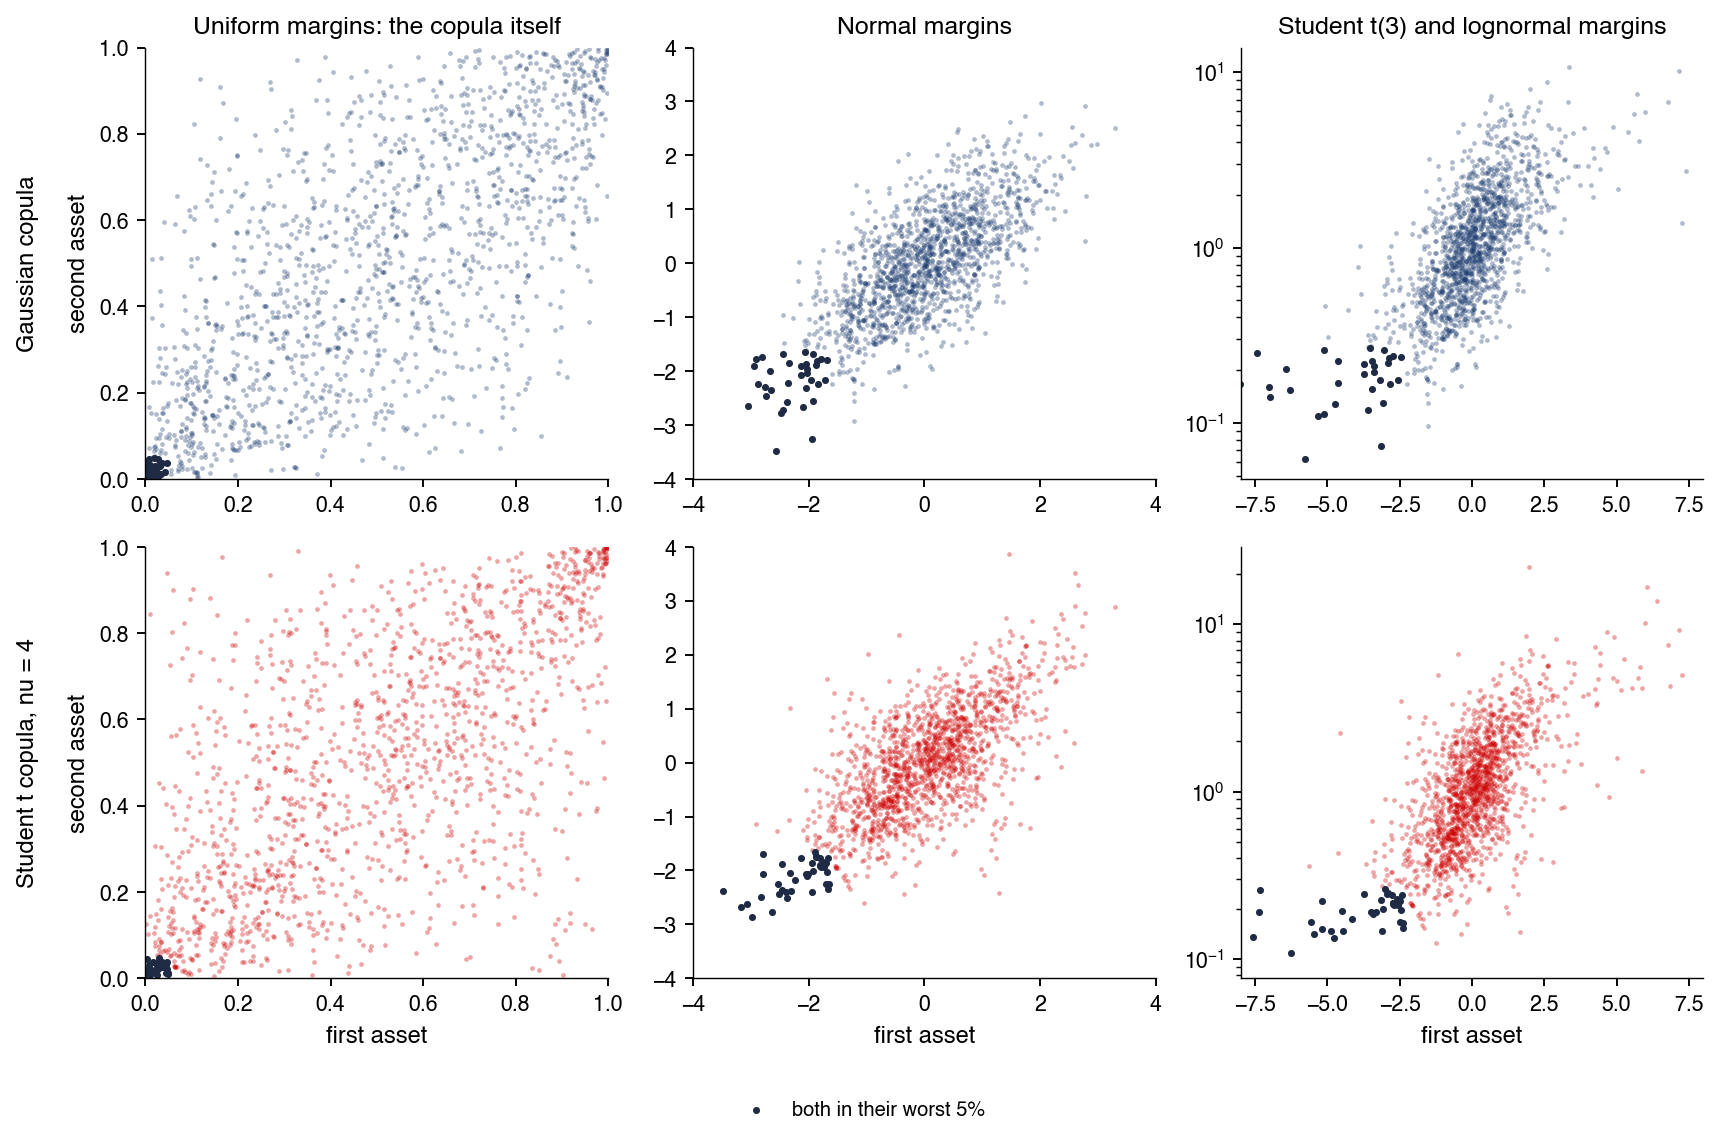
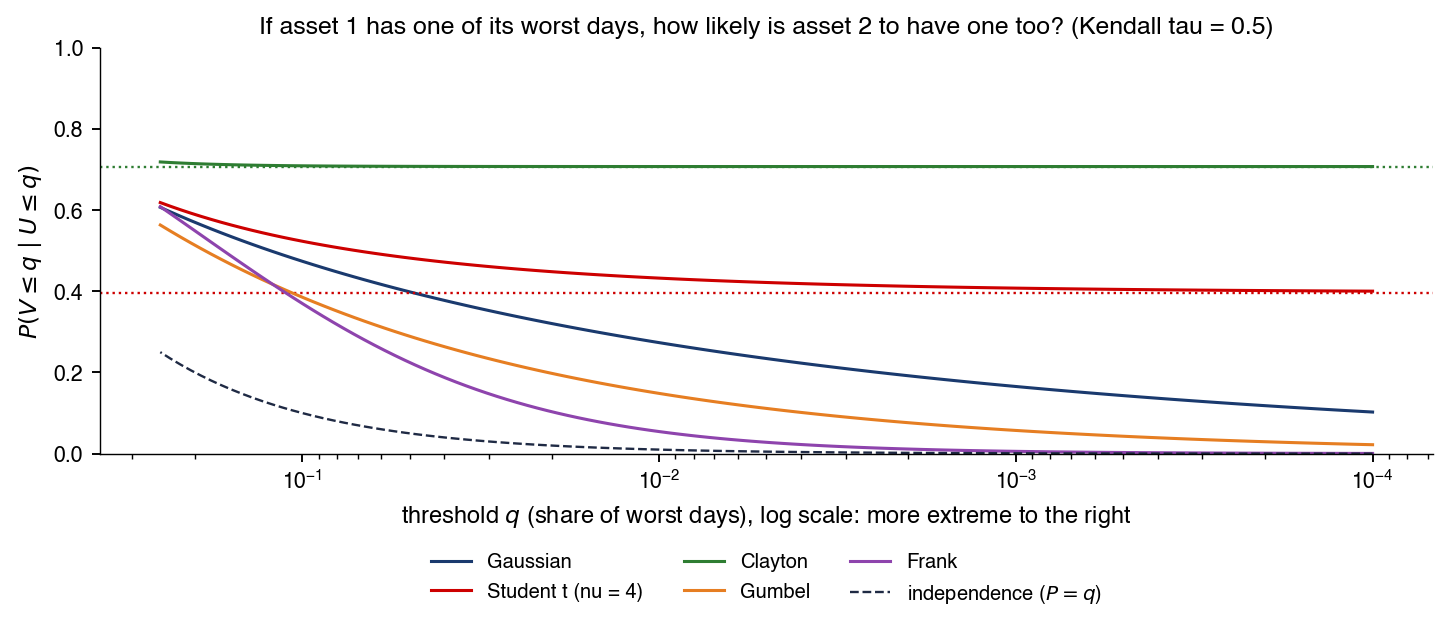
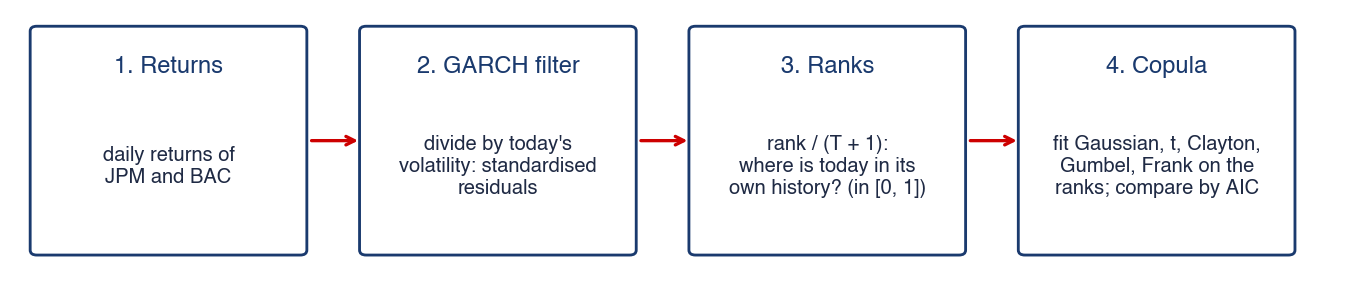
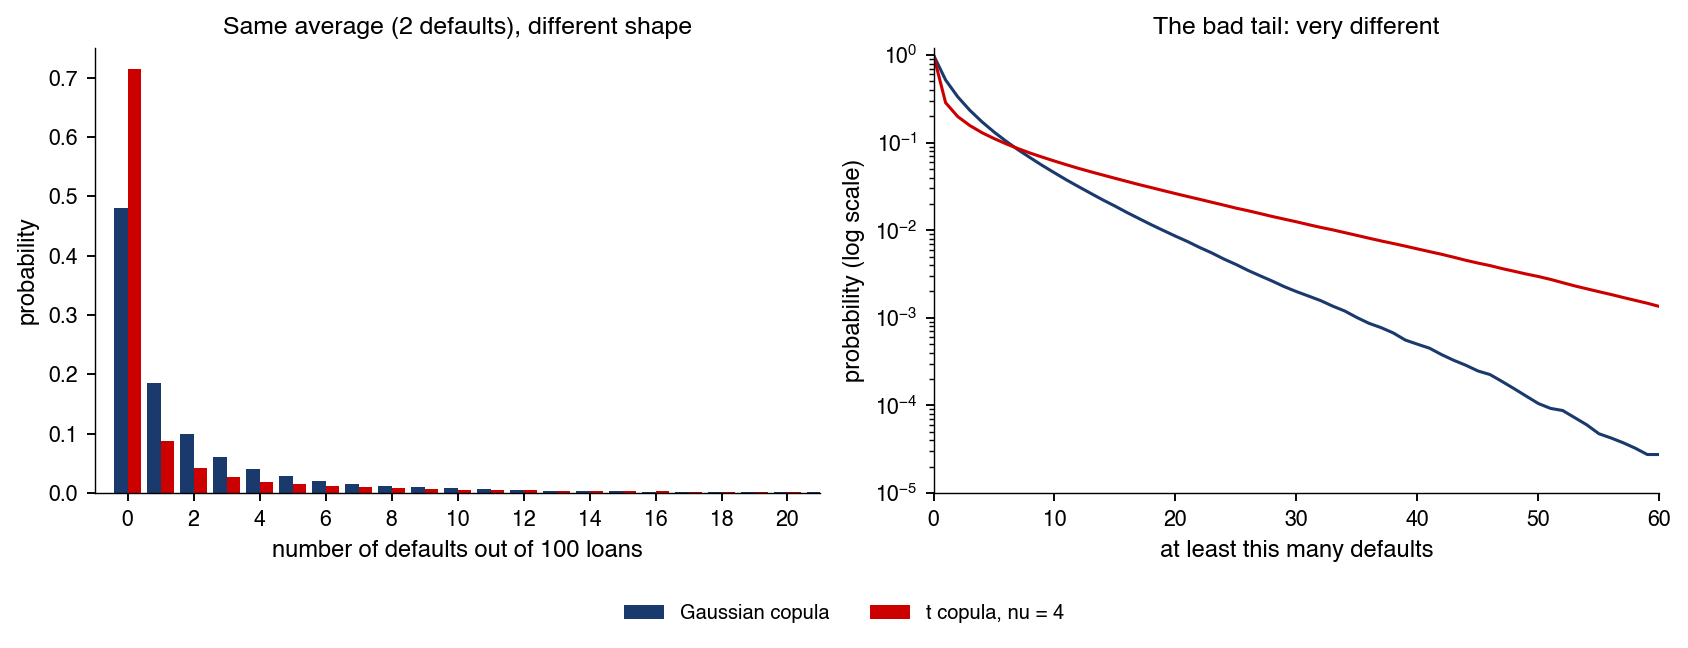
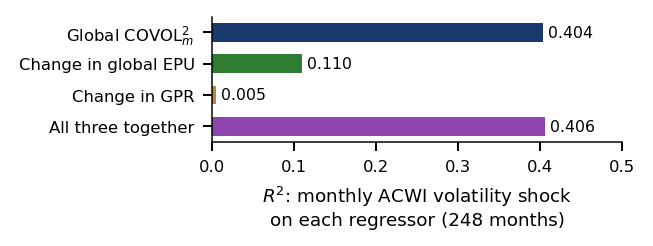
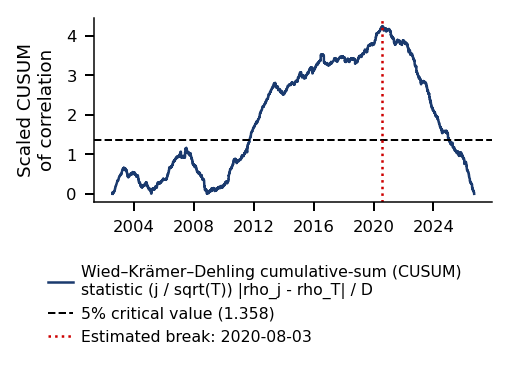
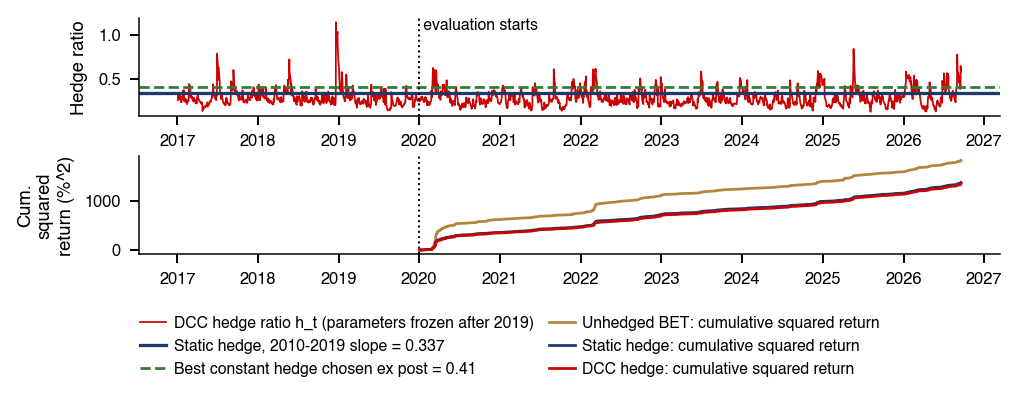
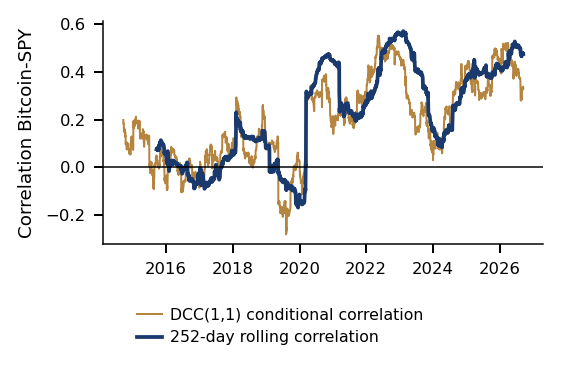
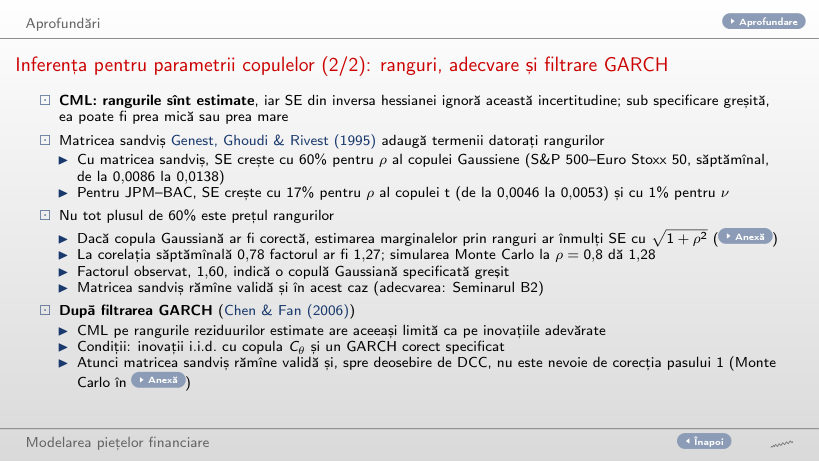
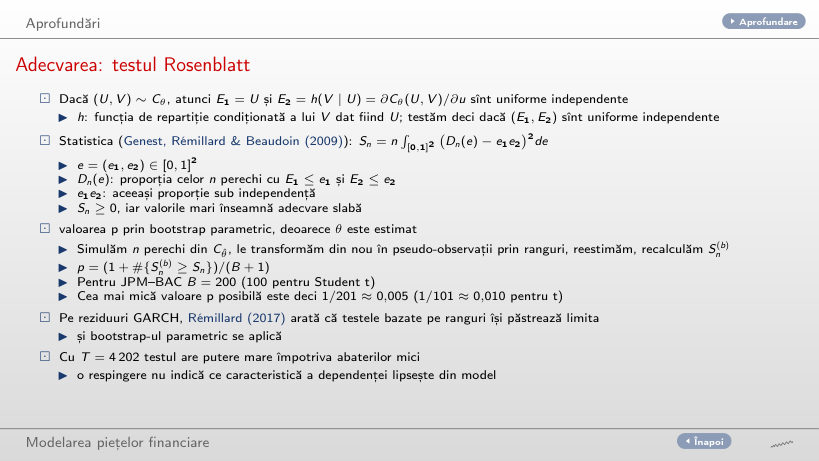
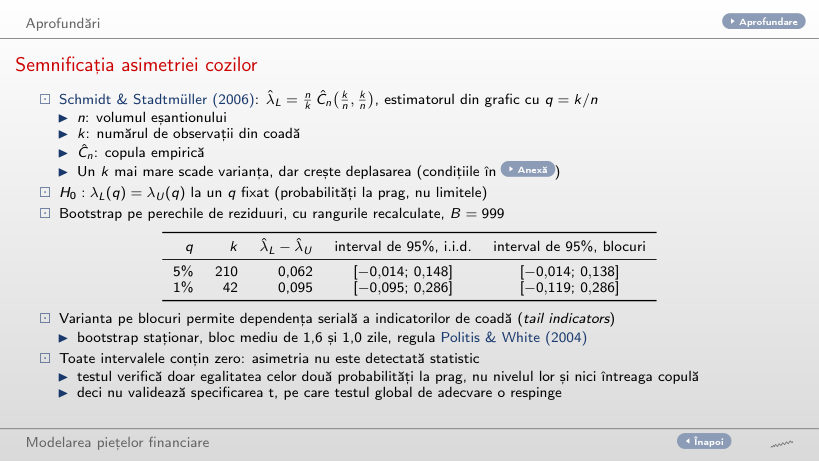
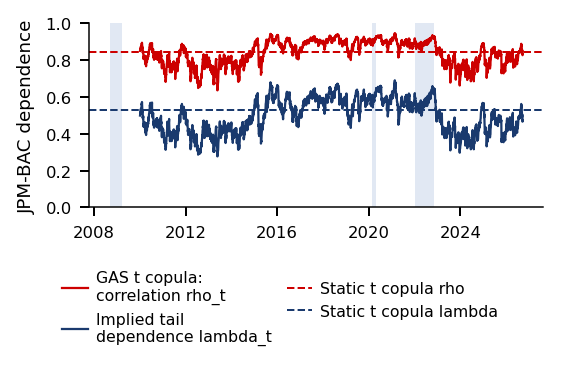
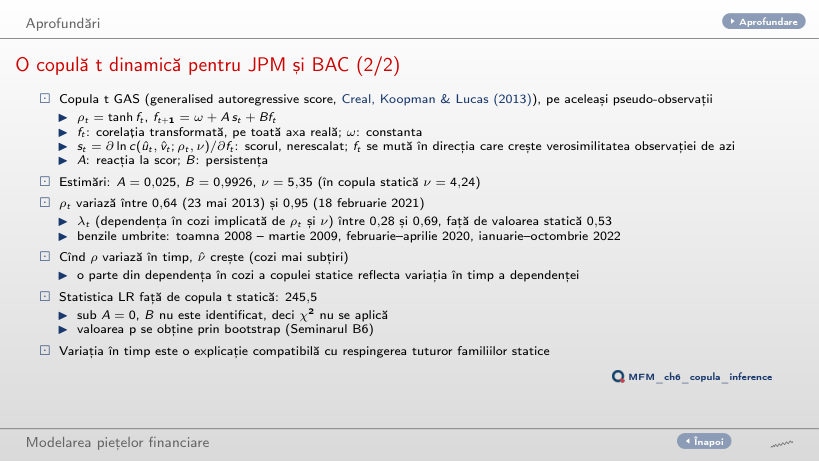
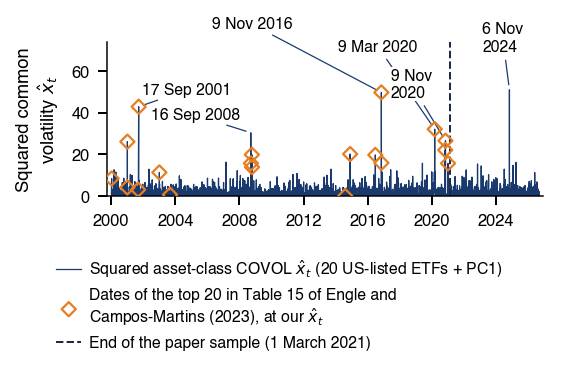
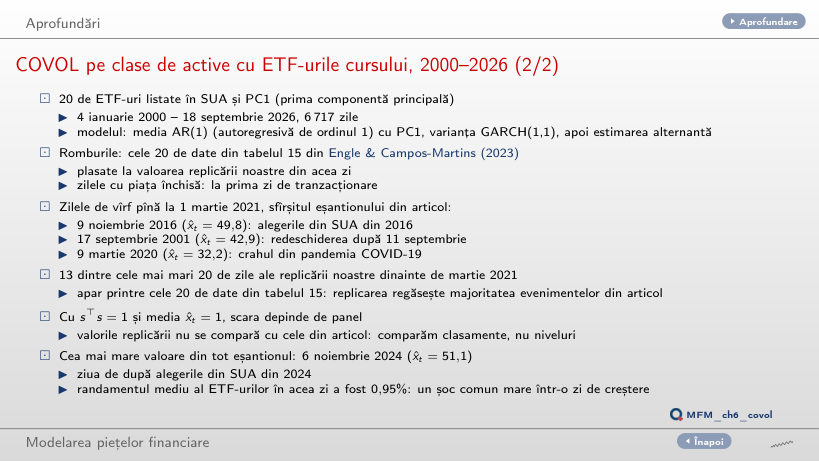
 Measuring Statistical Risk