Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Întrebarea: o serie staționară este corelată cu propriul trecut; ce model mic surprinde această memorie și o transformă în prognoze cu o incertitudine corect măsurată?
răspunsul lui Box și Jenkins: modelele ARMA(\(p,q\)), cîțiva parametri în locul infinității de ponderi Wold
Traseul capitolului
AR(\(p\)) și MA(\(q\)): staționaritate, invertibilitate, rădăcini caracteristice, ACF și PACF
ARMA(\(p,q\)): forma cauzală MA(\(\infty\)), răspunsurile la impuls, identificarea
estimarea (Yule–Walker, cele mai mici pătrate condiționate, verosimilitate maximă), AIC și BIC, diagnosticarea reziduurilor
prognoza și metoda Box–Jenkins pe PIB-ul și inflația României, BET, EUR/RON și petele solare
Seminarul 2 are loc înaintea acestui curs: dă formulele; aici le deducem și le aplicăm pe date
If we take a curve representing a simple harmonic function of the time, and superpose on the ordinates small random errors, the only effect is to make the graph somewhat irregular, leaving the suggestion of periodicity still quite clear to the eye.
Yule (1927) a pus acestei imagini în contrast un mecanism diferit: un pendul a cărui mișcare este perturbată de șocuri aleatoare. În prima imagine ciclul este o funcție fixă de timp, iar erorile doar îl estompează. În a doua, șocurile intră în dinamică, fiecare șoc schimbă traiectoria viitoare, iar seria este corelată cu propriul trecut. Yule a aplicat acest al doilea mecanism numărului anual de pete solare, cu doi coeficienți, și a obținut prima autoregresie. Capitolul pornește de la aceeași întrebare: o serie staționară este corelată cu propriul trecut și avem nevoie de un model mic, care să surprindă această memorie și să o transforme în prognoze cu o incertitudine onestă.
Descompunerea Wold din Capitolul 1 arată că orice proces staționar pur nedeterminist este o sumă ponderată infinită de șocuri trecute. Ea nu spune însă cum se estimează o infinitate de ponderi din \(T\) observații. Modelele ARMA(\(p,q\)) ale lui Box, Jenkins și Reinsel (2008) scriu aceste ponderi ca raport a două polinoame scurte, cu \(p + q + 2\) parametri. Capitolul derivă proprietățile lor (staționaritate, invertibilitate, autocorelații, răspunsuri la impuls), estimatorii, criteriile informaționale, testele pentru reziduuri și prognozele, apoi aplică întreaga metodă pe serii reale.
Aplicația principală este creșterea anuală a PIB-ului real al României, 106 trimestre, din T1 2000 pînă în T2 2026. Funcția ei de autocorelație se anulează după lagul 3, criteriul informațional bayesian (BIC, Bayesian information criterion) alege un model MA(3), iar MA(3) lasă reziduuri fără autocorelație, dar cu cozi groase din cauza anului 2020. Aceleași instrumente se aplică apoi inflației din România, randamentelor zilnice ale indicelui BET și ale cursului EUR/RON și petelor solare ale lui Yule.
Creșterea anuală a PIB-ului real al României, T1 2000–T2 2026, în % (sus), cu funcția de autocorelație (ACF) și funcția de autocorelație parțială (PACF) de selecție pentru laguri de la 1 la 16 trimestre (jos); liniile roșii punctate sînt banda \(\pm 1{,}96/\sqrt{T} = \pm 0{,}19\).
Ce veți putea face
Verificați staționaritatea unui AR(\(p\)) și invertibilitatea unui MA(\(q\)) din rădăcinile polinoamelor lor.
Derivați media, autocovarianțele și ponderile \(\psi\) pentru AR(1), AR(2), MA(\(q\)) și ARMA(1,1).
Identificați ordine candidate din ACF și PACF și alegeți între ele cu AIC și BIC.
Estimați modele ARMA prin Yule–Walker, cele mai mici pătrate condiționate și verosimilitate maximă și interpretați rezultatele.
Testați reziduurile cu Ljung–Box cu \(m - p - q\) grade de libertate și cu Jarque–Bera.
Prognozați cu modele ARMA, calculați intervalele și explicați revenirea la medie.
RezumatIdei de reținut, formule de reținut și autoevaluare.
De la Capitolul 1 la modelele ARMA
Secțiunea adună instrumentele din Capitolul 1 pe care le folosește capitolul și formulează problema pe care o rezolvă modelele ARMA: descompunerea Wold descrie orice proces staționar, dar cu o infinitate de ponderi.
Un proces \(X_t\) este slab staționar (weakly stationary) cînd media lui \(\mu\) este constantă, iar autocovarianța \(\gamma(h) = \mathrm{Cov}(X_t, X_{t+h})\) depinde doar de lagul \(h\), nu și de momentul \(t\). Funcția de autocorelație (ACF, autocorrelation function), \(\rho(h) = \gamma(h)/\gamma(0)\), aduce autocovarianțele pe intervalul \([-1, 1]\). Funcția de autocorelație parțială (PACF, partial autocorrelation function), \(\phi_{hh}\), măsoară corelația dintre \(X_t\) și \(X_{t+h}\) după ce s-a eliminat efectul liniar al valorilor intermediare \(X_{t+1}, \dots, X_{t+h-1}\). Aceste două funcții sînt instrumentele de identificare ale capitolului: forma lor indică modelul care trebuie estimat.
Zgomotul alb (white noise), \(\varepsilon_t \sim \mathrm{WN}(0, \sigma^2)\), are media 0, varianța \(\sigma^2\) și nicio autocorelație la laguri nenule. El este materia primă a tuturor modelelor din capitol: fiecare model este un filtru liniar aplicat unui zgomot alb. Operatorul lag (lag operator) mută o serie înapoi în timp, \(LX_t = X_{t-1}\) și \(L^kX_t = X_{t-k}\). Un polinom în \(L\), de exemplu \(1 - 0{,}5L\), acționează deci asupra unei serii ca o sumă ponderată a lagurilor ei, iar algebra polinoamelor (produse, rapoarte, rădăcini) devine algebra modelelor.
Descompunerea Wold (Wold, 1938) leagă aceste piese. Orice proces staționar pur nedeterminist (purely nondeterministic) se poate scrie ca \(X_t = \mu + \sum_{j \ge 0}\psi_j\varepsilon_{t-j}\), cu \(\psi_0 = 1\) și \(\sum_j\psi_j^2 < \infty\). Condiția „pur nedeterminist” exclude componentele pe care trecutul infinit le prezice exact, cum ar fi o sinusoidă fixă. Teorema spune că un astfel de proces este o medie mobilă de ordin infinit a șocurilor sale trecute; restul capitolului scrie această sumă cu puțini parametri.
Pe scurt
Staționaritatea slabă: media constantă \(\mu\) și autocovarianța \(\gamma(h) = \mathrm{Cov}(X_t, X_{t+h})\), care depinde doar de lagul \(h\)
ACF \(\rho(h) = \gamma(h)/\gamma(0)\); PACF \(\phi_{hh}\) = corelația dintre \(X_t\) și \(X_{t+h}\) după eliminarea efectului lui \(X_{t+1}, \dots, X_{t+h-1}\)
Zgomotul alb\(\varepsilon_t \sim \mathrm{WN}(0, \sigma^2)\): media 0, varianța \(\sigma^2\), fără autocorelație
operatorul lag: \(LX_t = X_{t-1}\), \(L^kX_t = X_{t-k}\); polinoamele în \(L\) acționează asupra seriilor
Descompunerea Wold (Wold (1938)): orice proces staționar pur nedeterminist este \(X_t = \mu + \sum_{j \ge 0}\psi_j\varepsilon_{t-j}\), \(\psi_0 = 1\), \(\sum_j\psi_j^2 < \infty\)
detalii și grafice: Capitolul 1, secțiunile despre operatorul lag, descompunerea Wold și ACF și PACF de selecție
Descompunerea Wold spune cum arată un proces staționar, nu cum îl estimăm. Ponderile \(\psi_1, \psi_2, \dots\) sînt o infinitate de necunoscute, iar eșantionul are doar \(T\) observații. Dacă trunchiem suma la un lag mare, rămîn tot mulți parametri, fiecare estimat cu o eroare mare.
Ideea este să scriem polinomul în lag \(\psi(L) = \sum_j\psi_jL^j\) ca raport a două polinoame scurte, \(\psi(L) = \theta(L)/\phi(L)\). Înmulțind ambii membri ai formei Wold cu \(\phi(L)\), obținem modelul ARMA(\(p,q\))
Modelul are \(p + q + 2\) parametri: cei \(p\) coeficienți autoregresivi, cei \(q\) coeficienți de medie mobilă, media \(\mu\) și varianța zgomotului \(\sigma^2\). Un singur parametru poate genera deja o infinitate de ponderi: \(1/(1 - 0{,}8L) = 1 + 0{,}8L + 0{,}64L^2 + \dots\).
Un raport a două polinoame de grad mic aproximează bine aproape orice \(\psi(L)\) netedă. El reproduce descreșteri geometrice, oscilații amortizate și ponderi care se opresc după un lag finit, adică formele întîlnite în practică. Principiul care ghidează alegerea lui \(p\) și \(q\) este parcimonia (parsimony): cel mai mic model ale cărui reziduuri sînt zgomot alb. Fiecare parametru suplimentar adaugă eroare de estimare, iar după ce reziduurile au devenit zgomot alb el nu mai îmbunătățește prognozele.
Pe scurt
Teorema Wold spune cum arată un proces staționar, nu cum îl estimăm
\(\psi_1, \psi_2, \dots\): o infinitate de necunoscute și doar \(T\) observații
Ideea: scriem \(\psi(L) = \sum_j\psi_jL^j\) ca raport a două polinoame scurte
Modelul autoregresiv AR(\(p\)) face ca valoarea de azi să depindă de ultimele \(p\) valori ale seriei și de un șoc nou: \(X_t = c + \phi_1X_{t-1} + \dots + \phi_pX_{t-p} + \varepsilon_t\). El provine de la Yule (1927) și din analiza petelor solare. Modelul de medie mobilă (moving average) MA(\(q\)) face ca valoarea de azi să depindă de ultimele \(q\) șocuri: \(X_t = \mu + \varepsilon_t + \theta_1\varepsilon_{t-1} + \dots + \theta_q\varepsilon_{t-q}\).Slutzky (1937) a arătat că astfel de sume de cauze aleatoare produc serii care par ciclice. Modelul ARMA(\(p,q\)) conține ambele părți; Box, Jenkins și Reinsel (2008), a căror primă ediție a apărut în 1970, l-au transformat într-o metodă completă de identificare, estimare, verificare și prognoză.
În forma autoregresivă, \(c\) este termenul liber (intercept), nu media. Aplicînd media ambilor membri și folosind staționaritatea (\(E[X_t] = E[X_{t-k}] = \mu\)), obținem \(\mu = c + (\phi_1 + \dots + \phi_p)\mu\), deci \(\mu = c/(1 - \phi_1 - \dots - \phi_p)\). Distincția contează în practică: pentru \(X_t = 2 + 0{,}8X_{t-1} + \varepsilon_t\) termenul liber este 2, iar media este 10, iar programele pot raporta oricare dintre ele.
Pe tot parcursul capitolului, \(\varepsilon_t\) este zgomot alb; acest lucru ajunge pentru medii, autocovarianțe și prognozele punctuale. Verosimilitatea și intervalele de prognoză cer mai mult: \(\varepsilon_t\) independente și identic distribuite (i.i.d.) \(N(0, \sigma^2)\). Diferența dintre cele două ipoteze apare în studiul de caz, unde reziduurile modelului pentru PIB sînt necorelate, dar nu urmează distribuția Normală: estimațiile punctuale rămîn valabile, intervalele construite cu distribuția Normală nu.
Pe scurt
AR(\(p\)), autoregresiv: valoarea de azi depinde de ultimele \(p\) valori ale seriei
ARMA(\(p,q\)): ambele părți; transformat într-o metodă completă de Box, Jenkins și Reinsel (2008) (prima ediție în 1970)
\(c\) este termenul liber; media este \(\mu = c/(1 - \phi_1 - \dots - \phi_p)\), nu \(c\)
Peste tot: \(\varepsilon_t \sim \mathrm{WN}(0, \sigma^2)\), iar pentru verosimilitate și intervale \(\varepsilon_t\) i.i.d. \(N(0, \sigma^2)\) (independente și identic distribuite)
Sinteza secțiunii
Descompunerea Wold garantează că orice proces staționar pur nedeterminist este un filtru aplicat unui zgomot alb, iar modelul ARMA (2.1) scrie acest filtru ca \(\theta(L)/\phi(L)\), cu \(p + q + 2\) parametri. Secțiunea următoare studiază separat partea autoregresivă, cea care urmează după ea partea de medie mobilă, iar a patra secțiune pe amîndouă împreună.
Modele autoregresive
Un model autoregresiv regresează seria pe propriul trecut. Secțiunea derivă momentele modelului AR(1), extinde condiția de staționaritate la AR(\(p\)) prin rădăcinile polinomului caracteristic, reprezintă modelele AR(2) staționare în planul coeficienților lor și arată proprietatea care identifică un AR(\(p\)) în date: PACF se anulează după lagul \(p\).
Modelul AR(1) este \(X_t = c + \phi X_{t-1} + \varepsilon_t\) sau, cu operatorul lag, \((1 - \phi L)X_t = c + \varepsilon_t\). Scris în abateri de la medie, \(X_t - \mu = \phi(X_{t-1} - \mu) + \varepsilon_t\): coeficientul \(\phi\) este partea din abaterea de azi față de medie care se păstrează și mîine. Cu \(\phi = 0{,}8\), o abatere de 2 astăzi se așteaptă să fie 1,6 mîine.
Substituind ecuația în ea însăși de \(k\) ori, exprimăm \(X_t\) printr-o valoare îndepărtată și șocurile dintre ele (primul rînd); pentru \(|\phi| < 1\) și \(k \to \infty\) obținem al doilea rînd:
Cînd \(|\phi| < 1\), termenul \(\phi^kX_{t-k}\) dispare: procesul își uită punctul de plecare. Limita este forma Wold cu \(\psi_j = \phi^j\), numită reprezentarea cauzală (causal representation) sau MA(\(\infty\)), pentru că \(X_t\) depinde doar de șocurile prezente și trecute.
Condiția \(|\phi| < 1\) este esențială. Cu \(\phi = 1\) modelul este mersul aleator (random walk) din Capitolul 1: șocurile nu se sting niciodată, varianța crește în timp și nu există o soluție staționară. Cu \(|\phi| > 1\) substituția înapoi explodează; o soluție staționară există doar dacă \(X_t\) este scris ca funcție de șocuri viitoare, ceea ce nu folosește la prognoza din trecut, așa că acest caz este exclus.
Pe scurt
\(X_t = c + \phi X_{t-1} + \varepsilon_t\), sau \((1 - \phi L)X_t = c + \varepsilon_t\)
\(\phi\): partea din abaterea de azi față de medie care se păstrează și mîine
dacă \(|\phi| < 1\): \(\phi^k \to 0\) și \(X_t = \dfrac{c}{1 - \phi} + \sum_{j=0}^{\infty}\phi^j\varepsilon_{t-j}\)
Aceasta este forma Wold cu \(\psi_j = \phi^j\): reprezentarea cauzală (MA(\(\infty\)))
cauzală = \(X_t\) depinde doar de șocurile prezente și trecute
\(\phi = 1\): mers aleator (Capitolul 1), fără soluție staționară; \(|\phi| > 1\): proces exploziv sau o soluție care depinde de șocuri viitoare, exclusă
Media se obține aplicînd media modelului. Aici se folosește staționaritatea: \(E[X_t] = E[X_{t-1}] = \mu\), deci \(\mu = c + \phi\mu\) și \(\mu = c/(1 - \phi)\). Varianța se obține la fel. Deoarece \(\varepsilon_t\) este necorelat cu \(X_{t-1}\), care după (2.2) depinde doar de șocurile pînă la \(t - 1\), varianța sumei este suma varianțelor: \(\gamma(0) = \phi^2\gamma(0) + \sigma^2\).
Varianța crește nelimitat cînd \(|\phi| \to 1\): o serie persistentă se îndepărtează mult de medie, deși fiecare șoc are aceeași varianță \(\sigma^2\). Autocovarianțele se obțin înmulțind \(X_t - \mu = \phi(X_{t-1} - \mu) + \varepsilon_t\) cu \(X_{t-h} - \mu\),\(h \ge 1\), și aplicînd media; termenul cu șocul dispare, pentru că \(\varepsilon_t\) este necorelat cu trecutul. Rezultă recurența \(\gamma(h) = \phi\gamma(h - 1)\), deci \(\gamma(h) = \phi^h\gamma(0)\) și \(\rho(h) = \phi^h\): ACF descrește geometric, cu semne alternante cînd \(\phi < 0\).
Un rezumat util al persistenței este timpul de înjumătățire (half-life) al unui șoc, orizontul \(h\) după care jumătate din efectul lui a dispărut: \(\phi^h = 1/2\), deci \(h = \ln 0{,}5/\ln\phi\) pentru \(0 < \phi < 1\). El transformă un coeficient într-un interval de timp care poate fi comparat între serii și frecvențe.
Pe scurt
Media: aplicăm media, \(\mu = c + \phi\mu\), deci \(\mu = c/(1 - \phi)\)
aici folosim staționaritatea: \(E[X_t] = E[X_{t-1}]\)
Varianța: \(\gamma(0) = \phi^2\gamma(0) + \sigma^2\), deoarece \(\varepsilon_t\) este necorelat cu \(X_{t-1}\)
Fie \(X_t = 2 + 0{,}8X_{t-1} + \varepsilon_t\), cu \(\sigma^2 = 1\). Modelul este staționar, deoarece \(|\phi| = 0{,}8 < 1\). Media lui este \(\mu = 2/(1 - 0{,}8) = 10\): termenul liber este 2, media este 10, iar confuzia dintre ele este o greșeală frecventă la citirea rezultatelor din programe.
Varianța este \(\gamma(0) = 1/(1 - 0{,}64) = 2{,}78\), deci seria are o abatere standard de aproximativ 1,67, mai mare decît abaterea standard 1 a unui singur șoc, pentru că șocurile trecute se cumulează. Autocorelația la lagul 3 este \(\rho(3) = 0{,}8^3 = 0{,}512\): observațiile aflate la trei perioade distanță au o corelație de 0,512.
Timpul de înjumătățire este \(\ln 0{,}5/\ln 0{,}8 = 3{,}11\) perioade: după aproximativ trei perioade, jumătate dintr-un șoc a dispărut. Ponderile \(\psi\) sînt \(1; 0{,}8; 0{,}64; 0{,}512; \dots\), deci un șoc unitar de azi crește \(X_{t+2}\) cu 0,64. Pentru un AR(1), răspunsul la impuls \(\psi_j\) și autocorelația \(\rho(j)\) sînt ambele egale cu \(\phi^j\); această coincidență este specifică modelului AR(1) și nu se păstrează la celelalte modele din capitol.
Întrebare pentru sală În Xt = 2 + 0,8Xt−1 + εt, termenul liber este 2. Este 2 media procesului?
Răspuns
Nu: μ = c/(1 − φ) = 2/0,2 = 10. Varianța este γ(0) = 1/(1 − 0,64) = 2,78, ρ(3) = 0,512, iar timpul de înjumătățire este 3,11 perioade. Cu același c și φ = 0,9, media urcă la 20, γ(0) la 5,26, iar timpul de înjumătățire la 6,58 perioade.
Întrebare pentru sală Cu aceleași 200 de șocuri, butonul ▶ crește φ din panoul din stînga de la 0 la 0,99; φ din celelalte două panouri urmează proporțional, pînă la 0,33 și −0,77. Ce se întîmplă în panoul din stînga cu ρ̂(1) și cu varianța de selecție?
Răspuns
Cresc amîndouă: ρ̂(1) urcă de la 0,10 la 0,95, iar varianța de selecție de la 1,04 la 14,5. Varianța teoretică, 1/(1 − φ²), crește mai repede: 5,26 la φ = 0,9 și 50,3 la φ = 0,99. La φ = 0,9, eșantionul dă 4,98, sub valoarea teoretică: o traiectorie scurtă a unui proces persistent nu acoperă toată variația lui. Cu φ = −0,7 semnul autocorelațiilor alternează: ρ̂(1) = −0,58, ρ̂(2) = 0,34; la capătul cursei, cu φ = −0,77, ρ̂(1) = −0,66 și ρ̂(2) = 0,44.
Graficul arată trei serii AR(1) simulate, de cîte 200 de observații, cu \(\phi = 0{,}9\),\(0{,}3\) și \(-0{,}7\). Toate trei sînt generate de aceleași 200 de șocuri, așa că orice diferență dintre traiectoriile din rîndul de sus provine numai din \(\phi\). Scara verticală este aceeași în cele trei panouri, ceea ce face vizibilă diferența de varianță.
Rîndul de jos arată, pentru lagurile de la 1 la 15, ACF de selecție a fiecărei traiectorii (bare) și ACF teoretică \(\rho(h) = \phi^h\) (puncte portocalii). Liniile roșii punctate sînt banda \(\pm 1{,}96/\sqrt{T}\), banda aproximativă de 95% pentru autocorelațiile de selecție ale unui zgomot alb. O bară în afara benzii este o autocorelație pe care această verificare o separă de zgomot; distanța dintre o bară și punctul ei este eroarea de selecție a unei singure serii de lungime 200.
Pe scurt
Aceleași 200 de șocuri, \(\phi = 0{,}9\); \(0{,}3\); \(-0{,}7\); jos: ACF de selecție (bare) și \(\rho(h) = \phi^h\) (puncte)
Cu \(\phi = 0{,}9\) seria face oscilații lungi departe de 0. Autocorelația ei de ordinul întîi, de selecție, este \(\hat\rho(1) = 0{,}88\), iar varianța de selecție este 4,98, față de valoarea teoretică \(1/(1 - 0{,}81) = 5{,}26\). Pe o fereastră de cîteva zeci de observații o astfel de serie pare un trend: persistența puternică și un trend determinist se deosebesc greu cu ochiul liber, motiv pentru care Capitolul 3 introduce teste formale.
Cu \(\phi = 0{,}3\) seria este apropiată de un zgomot alb: doar \(\hat\rho(1) = 0{,}35\) este clar în afara benzii, iar varianța de selecție este 1,18, față de 1,10 teoretic. Cu \(\phi = -0{,}7\) seria are o formă de zigzag: \(\hat\rho(1) = -0{,}58\) și \(\hat\rho(2) = 0{,}34\), cu semne alternante. În datele economice, autocorelația negativă apare la o depășire urmată de corecție sau la o eroare de măsurare corectată în perioada următoare.
În panoul pentru \(\phi = 0{,}9\), ACF de selecție se află sub cea teoretică la laguri mari. Cu \(T = 200\), autocorelațiile de selecție ale unei serii persistente sînt deplasate spre zero. Aceeași deplasare de eșantion mic afectează estimatorii lui \(\phi\), așa cum arată secțiunea despre estimare.
Pe scurt
\(\phi = 0{,}9\): abateri lungi de la 0; \(\hat\rho(1) = 0{,}88\) de selecție, varianța 4,98 (teoretic 5,26)
persistența puternică seamănă cu un trend pe ferestre scurte
\(\phi = 0{,}3\): aproape de zgomot alb; doar \(\hat\rho(1) = 0{,}35\) iese clar din bandă
Modelul AR(\(p\)) este \(\phi(L)X_t = c + \varepsilon_t\), cu polinomul caracteristic (characteristic polynomial) \(\phi(z) = 1 - \phi_1z - \dots - \phi_pz^p\) într-o variabilă complexă \(z\). Conform teoremei fundamentale a algebrei, polinomul se descompune în \(p\) factori liniari:
Valorile \(z_i\) sînt rădăcinile ecuației \(\phi(z) = 0\), iar \(\lambda_i\) sînt rădăcinile inverse (inverse roots). Fiecare factor \(1 - \lambda_iL\) este operatorul unui AR(1) cu coeficientul \(\lambda_i\), deci un AR(\(p\)) este un produs de \(p\) filtre AR(1), dintre care unele pot avea coeficienți complecși.
Condiția de staționaritate (cauzalitate) este ca toate rădăcinile să fie în afara cercului unitate (unit circle), \(|z_i| > 1\), sau, echivalent, ca toate rădăcinile inverse să fie în interiorul lui, \(|\lambda_i| < 1\); programele afișează de obicei rădăcinile inverse. Motivul este rezultatul pentru AR(1), aplicat fiecărui factor: \(1/(1 - \lambda L) = \sum_j\lambda^jL^j\) converge doar dacă \(|\lambda| < 1\), iar produsul celor \(p\) serii convergente este forma cauzală MA(\(\infty\)).
O rădăcină pe cercul unitate, \(|z| = 1\), de exemplu \(z = 1\), este o rădăcină unitară (unit root): procesul nu este staționar, iar Capitolul 3 tratează acest caz. O verificare rapidă necesară este \(\phi_1 + \dots + \phi_p < 1\), adică \(\phi(1) > 0\). Cum \(\phi(0) = 1 > 0\), o valoare \(\phi(1) \le 0\) ar plasa o rădăcină reală între 0 și 1, în interiorul cercului. Verificarea nu este suficientă: un model o poate trece și totuși să aibă o rădăcină în interiorul cercului, așa că rădăcinile trebuie calculate.
Pe scurt
\(\phi(L)X_t = c + \varepsilon_t\), cu \(\phi(z) = 1 - \phi_1z - \dots - \phi_pz^p\), un polinom într-un număr complex \(z\)
Ele definesc în planul \((\phi_1, \phi_2)\) un triunghi cu vîrfurile \((-2, -1)\),\((2, -1)\) și \((0, 1)\). Orice punct din interiorul triunghiului este un AR(2) staționar, iar orice punct din afara lui are cel puțin o rădăcină pe cercul unitate sau în interiorul lui.
Rădăcinile sînt complexe cînd \(\phi_1^2 + 4\phi_2 < 0\), sub o parabolă din interiorul triunghiului. ACF este atunci un cosinus amortizat: produce pseudo-cicluri cu lungimea medie de \(2\pi/\arccos\big(\phi_1/(2\sqrt{-\phi_2})\big)\) perioade, iar amplitudinea lor scade cu factorul \(\sqrt{-\phi_2}\) pe perioadă, modulul rădăcinilor inverse. Ciclurile sînt „pseudo” pentru că șocurile le schimbă continuu amplitudinea și faza; seria nu are o perioadă fixă, ci doar una tipică.
ACF a unui AR(2) rezultă din ecuațiile Yule–Walker: înmulțim modelul cu \(X_{t-h}\), aplicăm media și împărțim la \(\gamma(0)\).
Prima ecuație provine din \(\rho(1) = \phi_1 + \phi_2\rho(1)\), folosind \(\rho(-1) = \rho(1)\). A doua arată că ACF respectă aceeași recurență ca procesul fără șocuri, așa că forma ei (descreștere geometrică sau undă amortizată) este dată de rădăcinile lui \(\phi(z)\).
Pe scurt
\(X_t = \phi_1X_{t-1} + \phi_2X_{t-2} + \varepsilon_t\) este staționar dacă și numai dacă
Întrebare pentru sală Exemplul B are φ₁ = 1,0. Este procesul staționar?
Răspuns
Da. Discriminantul φ₁² + 4φ₂ = −1,4 este negativ, rădăcinile sînt complexe, 0,833 ± 0,986i, cu modulul 1,291 > 1 (rădăcinile inverse au modulul 0,775). Condițiile triunghiului sînt îndeplinite: 0,4 < 1, −1,6 < 1, 0,6 < 1. Invers, în exemplul C ambii coeficienți sînt sub 1, dar rădăcina 0,936 este în interiorul cercului unitate.
Întrebare pentru sală În exemplul C, φ₁ = 0,6 și φ₂ = 0,5 sînt amîndoi sub 1. Este procesul staționar?
Răspuns
Nu. φ₁ + φ₂ = 1,1 > 1, deci punctul este în afara triunghiului. Rădăcinile polinomului 1 − 0,6z − 0,5z² sînt −2,14 și 0,936; a doua este în interiorul cercului unitate (rădăcina inversă are modulul 1,068). Staționaritatea se citește din rădăcini, nu din coeficienți luați separat. B are rădăcini complexe, 0,833 ± 0,986i, cu modulul 1,291: ACF este o undă cu perioada 7,2 laguri, amortizată cu 0,775 pe lag.
Panoul din stînga desenează triunghiul de staționaritate (2.5), colorat, și parabola punctată \(\phi_1^2 + 4\phi_2 = 0\), care separă rădăcinile reale (deasupra ei) de cele complexe (sub ea). Sînt marcate patru modele: A cu \(\phi = (0{,}5; 0{,}3)\), B cu \((1{,}0; -0{,}6)\), C cu \((0{,}6; 0{,}5)\) și AR(2) estimat de Yule pentru petele solare, reluat în secțiunea 10. A se află în triunghi, în regiunea rădăcinilor reale, B și petele solare în triunghi, în regiunea rădăcinilor complexe, iar C chiar în afara laturii din dreapta.
Panoul din mijloc arată rădăcinile inverse \(\lambda_i\) în planul complex, împreună cu cercul unitate. Un model este staționar cînd toate punctele lui sînt în interiorul cercului. A are două rădăcini inverse reale în interior; B și petele solare au cîte o pereche de rădăcini inverse complex conjugate în interior; C are o rădăcină inversă pe axa reală, în afara cercului.
Panoul din dreapta arată ACF teoretică pentru A și B pînă la lagul 30. A descrește lent și neted; B oscilează cu amplitudine descrescătoare, cosinusul amortizat al rădăcinilor complexe.
Pe scurt
A: \(\phi = (0{,}5; 0{,}3)\); B: \((1{,}0; -0{,}6)\); C: \((0{,}6; 0{,}5)\); Sunspots: AR(2)-ul lui Yule, estimat în secțiunea 10
Mijloc: rădăcinile inverse \(\lambda_i\); staționar înseamnă în interiorul cercului
Modelul A are rădăcinile reale \(-2{,}84\) și \(1{,}17\), ambele în afara cercului unitate, deci este staționar. Autocorelațiile lui, din (2.6), sînt \(\rho(1) = 0{,}5/0{,}7 = 0{,}714\) și \(\rho(2) = 0{,}5\rho(1) + 0{,}3 = 0{,}657\): o descreștere lentă și netedă, dominată de rădăcina 1,17, cea mai apropiată de cerc.
Modelul B are rădăcinile complexe \(0{,}833 \pm 0{,}986\,i\), cu modulul \(1{,}291 > 1\), deci este staționar. ACF lui este o undă cu perioada de 7,2 laguri, amortizată cu factorul 0,775 pe lag. Un astfel de model generează un ciclu stochastic (stochastic cycle): oscilații cu o lungime tipică, dar cu amplitudine și momente aleatoare.
Modelul C are \(\phi_1 + \phi_2 = 1{,}1 > 1\), deci nu trece condiția necesară; o rădăcină este \(0{,}936 < 1\), în interiorul cercului, iar procesul este exploziv. Fiecare coeficient este sub 1, și totuși procesul explodează: staționaritatea este o proprietate a rădăcinilor, nu a coeficienților luați pe rînd. Rădăcinile complexe sînt mecanismul prin care modelele liniare produc ciclurile economice și, în secțiunea 10, ciclul solar de 11 ani.
Pe scurt
A: rădăcini reale \(\ensuremath{-}2{,}84\) și \(1{,}17\), ambele în afara cercului: staționar
Autocorelația parțială \(\phi_{hh}\) este ultimul coeficient din cea mai bună predicție liniară a lui \(X_t\) pe baza lui \(X_{t-1}, \dots, X_{t-h}\) (Capitolul 1). Nu este nevoie de cîte o regresie pentru fiecare \(h\): recurența Durbin–Levinson (Durbin, 1960) calculează toate valorile \(\phi_{hh}\) din ACF.
Pentru un AR(\(p\)) și \(h > p\), cea mai bună predicție liniară a lui \(X_t\) din \(h\) laguri este chiar modelul, \(\phi_1X_{t-1} + \dots + \phi_pX_{t-p}\): eroarea \(\varepsilon_t\) este necorelată cu toate valorile trecute, deci niciun lag suplimentar nu poate îmbunătăți predicția. Coeficienții lagurilor \(p + 1, \dots, h\) sînt așadar zero, de unde \(\phi_{hh} = 0\) pentru \(h > p\) și \(\phi_{pp} = \phi_p\).
Aceasta este regula de identificare pentru autoregresii: cînd ACF descrește treptat, iar PACF are \(p\) valori semnificative și apoi rămîne în bandă, candidatul este un AR(\(p\)). Pentru PACF de selecție a unui AR(\(p\)) la lagurile \(h > p\), banda este \(\pm 1{,}96/\sqrt{T}\). Cînd se examinează multe laguri, aproximativ o valoare din douăzeci iese întîmplător din bandă, așa că o valoare izolată aflată imediat în afara ei, la un lag mare, este o dovadă slabă.
Pe scurt
\(\phi_{hh}\) = ultimul coeficient din cea mai bună predicție liniară a lui \(X_t\) din \(X_{t-1}, \dots, X_{t-h}\) (Capitolul 1)
calculat din ACF prin recursia Durbin–Levinson (Durbin (1960))
Pentru un AR(\(p\)) și \(h > p\), cel mai bun predictor este chiar modelul: \(\phi_1X_{t-1} + \dots + \phi_pX_{t-p}\)
deci \(\phi_{hh} = 0\) pentru \(h > p\), iar \(\phi_{pp} = \phi_p\)
Regula de identificare: ACF descrește treptat, PACF are \(p\) valori semnificative și apoi rămîne în bandă: AR(\(p\))
banda pentru PACF de selecție a unui AR(\(p\)) la lagurile \(h > p\): \(\pm 1{,}96/\sqrt{T}\)
Un AR(\(p\)),\(\phi(L)X_t = c + \varepsilon_t\), este staționar dacă și numai dacă toate rădăcinile lui \(\phi(z)\) sînt în afara cercului unitate; verificarea coeficienților unul cîte unul nu ajunge. Media lui este \(\mu = c/\phi(1)\), iar ACF urmează recurența Yule–Walker (2.6), care produce o combinație de descreșteri geometrice (rădăcini reale) și unde amortizate (rădăcini complexe).
AR(1) este piesa de bază: \(\rho(h) = \psi_h = \phi^h\), iar timpul de înjumătățire al unui șoc este \(\ln 0{,}5/\ln\phi\). În date, un AR(\(p\)) se recunoaște după PACF, care se anulează după lagul \(p\).
Pe scurt
AR(\(p\)): \(\phi(L)X_t = c + \varepsilon_t\); staționar dacă și numai dacă toate rădăcinile lui \(\phi(z)\) sînt în afara cercului unitate
Media \(\mu = c/\phi(1)\); ACF din recurența Yule–Walker, o combinație de descreșteri geometrice și unde amortizate
AR(1): \(\rho(h) = \phi^h\), \(\psi_j = \phi^j\), timpul de înjumătățire \(\ln 0{,}5/\ln\phi\)
PACF se anulează după lagul \(p\): semnătura unui AR(\(p\))
Sinteza secțiunii
Modelele autoregresive descriu memoria prin valorile trecute ale seriei. Staționaritatea cere ca rădăcinile lui \(\phi(z)\) să fie în afara cercului unitate (2.4); pentru un AR(2), aceasta înseamnă triunghiul (2.5). Rădăcinile reale produc descreșteri geometrice ale ACF, cele complexe unde amortizate și cicluri stochastice. Semnătura unui AR(\(p\)) în date este o PACF care se anulează după lagul \(p\).Secțiunea următoare studiază cazul opus: memoria prin șocurile trecute.
Modele de medie mobilă
Un model de medie mobilă descrie seria ca o sumă ponderată a șocului curent și a ultimelor \(q\) șocuri. Un astfel de model este întotdeauna staționar, iar ACF lui se anulează după lagul \(q\). Problema nouă este invertibilitatea: două modele MA diferite pot avea aceleași autocorelații și este nevoie de o convenție pentru a alege între ele.
Modelul MA(\(q\)) este \(X_t = \mu + \theta(L)\varepsilon_t = \mu + \varepsilon_t + \theta_1\varepsilon_{t-1} + \dots + \theta_q\varepsilon_{t-q}\). El este o sumă Wold cu un număr finit de ponderi nenule, \(\psi_j = \theta_j\) pentru \(j \le q\) și 0 după aceea. O sumă finită de termeni de zgomot alb are întotdeauna medie constantă și varianță finită, deci un MA(\(q\)) este staționar pentru orice valori ale coeficienților.
Momentele rezultă din faptul că șocurile sînt necorelate. Cu \(\theta_0 = 1\),\(E[X_t] = \mu\) și
\[\begin{gathered}\gamma(h) = \sigma^2\sum_{j=0}^{q-h}\theta_j\theta_{j+h}, \quad 0 \le h \le q, \\ \gamma(h) = 0, \quad h > q.\end{gathered}\]
(2.7)
Două valori aflate la mai mult de \(q\) perioade distanță nu au niciun șoc comun, deci covarianța lor este zero.
Regula de identificare este imaginea în oglindă a regulii pentru AR: ACF se anulează după lagul \(q\), iar PACF descrește treptat. Pentru ACF de selecție la lagurile \(h > q\), formula lui Bartlett dă banda \(\pm 1{,}96\sqrt{(1 + 2\sum_{j=1}^{q}\hat\rho(j)^2)/T}\). Ea este mai largă decît \(\pm 1{,}96/\sqrt{T}\), deoarece varianța de selecție a unei autocorelații de după lagul \(q\) depinde de autocorelațiile pînă la lagul \(q\); cu banda îngustă, o ACF de selecție de dincolo de ordinul adevărat ar părea semnificativă prea des.
o sumă Wold finită: întotdeauna staționar, pentru orice \(\theta\)
Momentele (deduse în Seminarul 1 și în Capitolul 1): cu \(\theta_0 = 1\)
\(E[X_t] = \mu\); \(\gamma(h) = \sigma^2\sum_{j=0}^{q-h}\theta_j\theta_{j+h}\) pentru \(0 \le h \le q\); \(\gamma(h) = 0\) pentru \(h > q\)
Regula de identificare: ACF se anulează după lagul \(q\); PACF descrește treptat
imaginea în oglindă a regulii pentru AR(\(p\))
banda pentru ACF de selecție la lagurile \(h > q\) (Bartlett): \(\pm 1{,}96\sqrt{(1 + 2\sum_{j=1}^{q}\hat\rho(j)^2)/T}\), mai largă decît \(\pm 1{,}96/\sqrt{T}\)
Întrebare pentru sală Butonul ▶ crește θ de la 0 la 2. Poate un MA(1) să aibă ρ(1) mai mare decît 0,5?
Răspuns
Nu. ρ(1) = θ/(1 + θ²) are maximul 0,5 la θ = 1 și scade apoi: la θ = 2 este 0,4, la fel ca la θ = 0,5. La θ = ±0,8, valorile teoretice sînt ±0,488, iar cele de selecție, cu T = 300, sînt 0,56 și −0,51. ACF are o singură valoare nenulă, iar PACF descrește: φ̂₂₂ = −0,23 pentru θ = 0,8.
Graficul arată două serii MA(1) simulate, de cîte \(T = 300\) de observații, cu \(\theta = 0{,}8\) (rîndul de sus) și \(\theta = -0{,}8\) (rîndul de jos). Pentru fiecare, panoul din stînga este traiectoria, cel din mijloc ACF, iar cel din dreapta PACF, pentru lagurile de la 1 la 12; barele sînt valorile de selecție, punctele portocalii valorile teoretice, iar liniile roșii punctate banda \(\pm 1{,}96/\sqrt{T}\).
În ambele panouri ACF există o singură valoare clară, la lagul 1: pozitivă pentru \(\theta = 0{,}8\) și negativă pentru \(\theta = -0{,}8\). PACF nu se anulează: descrește, cu semne alternante pentru \(\theta = 0{,}8\) și cu toate valorile negative pentru \(\theta = -0{,}8\). Traiectoria cu \(\theta = 0{,}8\) este mai netedă, pentru că valorile vecine au în comun un șoc cu același semn; traiectoria cu \(\theta = -0{,}8\) este mai zimțată.
Pe scurt
\(T = 300\); ACF are o singură valoare semnificativă, PACF descrește (cu semne alternante cînd \(\theta > 0\))
Pentru un MA(1), (2.7) dă \(\rho(1) = \theta/(1 + \theta^2)\), adică \(\pm 0{,}488\) pentru \(\theta = \pm 0{,}8\), și \(\rho(h) = 0\) pentru \(h \ge 2\). Valorile de selecție sînt \(\hat\rho(1) = 0{,}56\) și \(-0{,}51\); diferențele față de \(\pm 0{,}488\) sînt eroare de selecție cu 300 de observații.
PACF nu se anulează: pentru \(\theta = 0{,}8\), valoarea de selecție la lagul 2 este \(\hat\phi_{22} = -0{,}23\). Motivul, dezvoltat în cadrele următoare, este că un MA(1) invertibil se poate scrie ca AR(\(\infty\)): fiecare valoare trecută a seriei conține puțină informație despre șocul curent, deci fiecare lag intră în cea mai bună predicție liniară cu un coeficient nenul.
Un MA(1) își amintește exact o perioadă: un șoc de azi afectează valoarea de mîine și apoi este uitat. Această structură apare în datele economice în mai multe feluri: la observațiile care se suprapun, ca ratele de creștere ale PIB-ului din secțiunea 9; la o eroare de măsurare care intră într-o observație și este corectată în următoarea; și la oscilația bid–ask (bid–ask bounce), în care prețurile tranzacțiilor alternează între prețul de cumpărare și cel de vînzare, așa că variațiile consecutive de preț sînt corelate negativ.
Întrebare pentru sală Butonul ▶ mută θ de la −3 la 3. Pentru ce valori este MA(1) invertibil și ce se întîmplă cu ponderile AR(∞) la θ = 2?
Răspuns
Pentru |θ| < 1. La θ = 2 ponderile (−θ)j sînt 1; −2; 4; −8, … și ajung la 256 la j = 8: șocurile nu pot fi reconstituite din trecutul seriei. Reprezentarea pereche, θ = 0,5 cu σ² = 4, are ponderile 1; −0,5; 0,25, … și aceleași γ(0) = 5, γ(1) = 2.
Întrebare pentru sală Ce altă valoare a lui θ dă același ρ(1) = 0,4 ca θ = 0,5 și pe care o păstrăm?
Răspuns
θ = 2 = 1/0,5. Cele două modele au aceeași ACF (cu σ² înmulțit cu θ²), deci datele nu le pot deosebi: o problemă de identificare. Convenția de invertibilitate, |θ| < 1, păstrează θ = 0,5.
Graficul reprezintă \(\rho(1) = \theta/(1 + \theta^2)\) pentru \(\theta\) între \(-4\) și \(4\). Banda colorată marchează regiunea invertibilă \(|\theta| < 1\), iar liniile roșii punctate marchează \(\pm 0{,}5\). Sînt evidențiate două puncte: \(\theta = 0{,}5\) și \(\theta = 2\), ambele cu \(\rho(1) = 0{,}4\).
Curba este impară în \(\theta\), atinge maximul 0,5 la \(\theta = 1\) și minimul \(-0{,}5\) la \(\theta = -1\) și tinde spre 0 cînd \(|\theta|\) crește. Orice valoare a lui \(\rho(1)\) strict între \(-0{,}5\) și \(0{,}5\), cu excepția lui 0, este atinsă de două ori: o dată în regiunea colorată și o dată în afara ei.
Pe scurt
\(\rho(1) = \theta/(1 + \theta^2)\) ca funcție de \(\theta\)
Cea mai mare valoare posibilă este \(|\rho(1)| = 0{,}5\), atinsă la \(\theta = \pm 1\). Ea rezultă din \((1 - |\theta|)^2 \ge 0\), care dă \(1 + \theta^2 \ge 2|\theta|\). Un MA(1) nu poate produce deci niciodată \(|\rho(1)| > 0{,}5\). Dacă o ACF de selecție arată \(\hat\rho(1) = 0{,}7\) și apoi nimic semnificativ, seria nu este un MA(1); candidații sînt un model AR sau un MA(\(q\)) cu mai mulți termeni.
Valorile \(\theta = 0{,}5\) și \(\theta = 2\) dau același \(\rho(1) = 0{,}4\). În general, \(\theta\) și \(1/\theta\) dau aceeași ACF: înlocuirea lui \(\theta\) cu \(1/\theta\) lasă neschimbat raportul \(\theta/(1 + \theta^2)\), iar autocovarianțele coincid și ele dacă \(\sigma^2\) este înmulțit cu \(\theta^2\). Datele nu pot deosebi cele două modele; aceasta este o problemă de identificare (identification problem).
Convenția care elimină ambiguitatea este invertibilitatea, \(|\theta| < 1\), subiectul cadrului următor.
Pe scurt
Maximul \(|\rho(1)| = 0{,}5\) în \(\theta = \pm 1\): un MA(1) nu poate produce niciodată \(|\rho(1)| > 0{,}5\)
dacă \(\hat\rho(1) = 0{,}7\) și apoi nimic: nu este un MA(1); încercați un AR sau un MA(\(q\)) cu mai mulți termeni
\(\theta = 0{,}5\) și \(\theta = 2\) dau același \(\rho(1) = 0{,}4\)
în general, \(\theta\) și \(1/\theta\) dau aceeași ACF (cu \(\sigma^2\) înmulțit cu \(\theta^2\))
datele nu le pot deosebi: o problemă de identificare
Convenția care elimină ambiguitatea: invertibilitatea, \(|\theta| < 1\) (slide-ul următor)
Pentru un MA(1) cu \(\mu = 0\), modelul poate fi rezolvat în raport cu șocul: \(\varepsilon_t = X_t - \theta\varepsilon_{t-1}\). Substituind repetat această expresie în ea însăși, obținem
Rearanjată, aceasta este o reprezentare AR(\(\infty\)),\(X_t = \theta X_{t-1} - \theta^2X_{t-2} + \dots + \varepsilon_t\), care explică de ce PACF a unui MA(1) nu se anulează niciodată.
Un model MA este invertibil (invertible) cînd șocurile lui pot fi recuperate din valorile trecute ale lui \(X\). Condiția este ca toate rădăcinile ecuației \(\theta(z) = 0\) să fie în afara cercului unitate; pentru MA(1) aceasta înseamnă \(|\theta| < 1\). Este aceeași algebră ca la staționaritatea unui AR, aplicată lui \(\theta(z)\) în loc de \(\phi(z)\).
Invertibilitatea este necesară din trei motive. Ea face modelul unic: dintre \(\theta\) și \(1/\theta\), doar unul este invertibil. Ea face posibilă prognoza: șocurile \(\varepsilon_t\) se calculează din date prin (2.8), iar prognozele le folosesc. De aceea programele raportează estimări invertibile, iar o rădăcină estimată apropiată de cercul unitate este un semnal de alarmă: este semnul tipic al supradiferențierii (over-differencing, Capitolul 1), deoarece diferențierea unei serii deja staționare creează o rădăcină MA egală cu 1.
Fie \(X_t = \varepsilon_t + 2\varepsilon_{t-1}\), cu \(\sigma^2 = 1\), și \(Y_t = u_t + 0{,}5u_{t-1}\), cu \(\mathrm{Var}(u_t) = 4\). Din (2.7),\(X\) are \(\gamma(0) = 1 \cdot (1 + 4) = 5\) și \(\gamma(1) = 2 \cdot 1 = 2\), iar \(Y\) are \(\gamma(0) = 4 \cdot (1 + 0{,}25) = 5\) și \(\gamma(1) = 0{,}5 \cdot 4 = 2\). Ambele au media zero.
Cele două procese au aceeași medie și aceleași autocovarianțe. Cu șocuri gaussiene, un proces staționar este complet determinat de media și autocovarianțele lui, așa că \(X\) și \(Y\) au aceeași distribuție: oricîte date am avea, nu le putem separa.
Doar \(Y\) este invertibil: \(u_t = Y_t - 0{,}5Y_{t-1} + 0{,}25Y_{t-2} - \dots\), o sumă convergentă. Pentru \(X\), aceeași sumă are ponderile \((-2)^j\) și explodează. Regula este să raportăm versiunea invertibilă, \(\theta = 0{,}5\) cu \(\sigma^2 = 4\). Șocurile ei \(u_t\) sînt erorile celei mai bune predicții cu un pas din trecutul seriei, motiv pentru care varianța zgomotului în versiunea invertibilă (4) este mai mare decît în cea neinvertibilă (1).
Un MA(\(q\)) este întotdeauna staționar; ACF lui se anulează după lagul \(q\), iar PACF descrește. Pentru un MA(1), \(\rho(1) = \theta/(1 + \theta^2)\), cel mult 0,5 în valoare absolută; o primă autocorelație mai mare exclude modelul MA(1).
Un MA este invertibil dacă și numai dacă rădăcinile lui \(\theta(z)\) sînt în afara cercului unitate; atunci el se poate scrie ca AR(\(\infty\)). Parametrii \(\theta\) și \(1/\theta\) sînt echivalenți din punctul de vedere al datelor și se raportează cel invertibil.
Pe scurt
MA(\(q\)) este întotdeauna staționar; ACF lui se anulează după lagul \(q\), PACF descrește
MA(1): \(\rho(1) = \theta/(1 + \theta^2)\), cel mult \(0{,}5\) în valoare absolută
Invertibil dacă și numai dacă rădăcinile lui \(\theta(z)\) sînt în afara cercului unitate; atunci MA = AR(\(\infty\))
\(\theta\) și \(1/\theta\) sînt echivalente observațional; îl păstrăm pe cel invertibil
Sinteza secțiunii
Modelul MA(\(q\)) are memorie finită: după (2.7), autocorelațiile lui sînt exact zero după lagul \(q\), iar această anulare îl identifică în date. Staționaritatea este automată; condiția care contează este invertibilitatea, care face modelul unic și permite calcularea șocurilor din date (2.8).Secțiunea următoare combină partea autoregresivă cu cea de medie mobilă.
Modele ARMA(\(p,q\))
Modelul ARMA(\(p,q\)) are atît o parte autoregresivă, cît și una de medie mobilă. Secțiunea formulează cele trei condiții ale lui (cauzalitate, invertibilitate, absența factorilor comuni), calculează răspunsul la impuls prin ponderile \(\psi\), derivă momentele modelului ARMA(1,1) și adună într-un singur tabel regulile de identificare din tot capitolul.
Trei condiții fac modelul bine definit; Brockwell și Davis (2016) le tratează în capitolul 3 al cărții lor. El este staționar și cauzal cînd rădăcinile lui \(\phi(z)\) sînt în afara cercului unitate; atunci \(X_t - \mu = \psi(L)\varepsilon_t\), cu \(\psi(L) = \theta(L)/\phi(L)\). Este invertibil cînd rădăcinile lui \(\theta(z)\) sînt în afara cercului unitate; atunci \(\pi(L)(X_t - \mu) = \varepsilon_t\), cu \(\pi(L) = \phi(L)/\theta(L)\). În sfîrșit, \(\phi(z)\) și \(\theta(z)\) nu trebuie să aibă nicio rădăcină comună, altfel modelul are mai mulți parametri decît procesul pe care îl descrie.
Avantajul combinării celor două părți se vede la ARMA(1,1). ACF lui descrește geometric cu rata \(\phi\), ca la un AR(1), dar prima ei valoare diferă de \(\phi\): se află sub \(\phi\) cînd \(\theta < 0\) și peste \(\phi\) cînd \(\theta > 0\). Un AR pur sau un MA pur ar avea nevoie de mulți termeni pentru a reproduce această formă; ARMA(1,1) o face cu doi coeficienți.
Pe scurt
\(\phi(L)(X_t - \mu) = \theta(L)\varepsilon_t\), adică
staționar și cauzal: rădăcinile lui \(\phi(z)\) în afara cercului unitate; atunci \(X_t - \mu = \psi(L)\varepsilon_t\), \(\psi(L) = \theta(L)/\phi(L)\)
invertibil: rădăcinile lui \(\theta(z)\) în afara cercului unitate; atunci \(\pi(L)(X_t - \mu) = \varepsilon_t\), \(\pi(L) = \phi(L)/\theta(L)\)
fără factori comuni: \(\phi(z)\) și \(\theta(z)\) nu au nicio rădăcină comună
ARMA(1,1) poate reproduce o ACF care descrește cu rata \(\phi\) pornind de la o primă valoare fixată de \(\theta\) (sub \(\phi\) dacă \(\theta < 0\), peste \(\phi\) dacă \(\theta > 0\)); un AR sau un MA pur ar avea nevoie de mulți termeni
Pentru ARMA(1,1), \(\psi_1 = \phi + \theta\) și \(\psi_j = \phi^{j-1}(\phi + \theta)\) pentru \(j \ge 1\). Cu \(\phi = 0{,}7\) și \(\theta = 0{,}4\):\(\psi_1 = 1{,}10\) și \(\psi_2 = 0{,}77\).
Ponderile au o interpretare directă: \(\psi_j = \partial X_{t+j}/\partial\varepsilon_t\), efectul unui șoc unitar de la momentul \(t\) asupra valorii de peste \(j\) perioade, cu toate celelalte șocuri fixate. Șirul \((\psi_j)\) este răspunsul la impuls (impulse response) al modelului. Același obiect determină varianța erorilor de prognoză (secțiunea 7) și, într-o formă multivariată, răspunsurile la impuls ale modelelor VAR din Capitolul 6.
Pe scurt
Din \(\phi(L)\psi(L) = \theta(L)\), egalăm coeficienții lui \(L^j\):
Întrebare pentru sală Pentru φ = 0,7 și θ = 0,4, cîte ponderi ψ acoperă cel puțin 95% din γ(0)/σ² = 3,37?
Răspuns
Cinci, ψ₀…ψ₄: suma cumulată a pătratelor ajunge la 3,236, adică 95,9%; cu ψ₀…ψ₃ ajunge la 91,7%. Numai ψ₁² = 1,21 reprezintă 35,9%, mai mult decît șocul curent (ψ₀² = 1, 29,7%), pentru că ψ₁ = φ + θ = 1,10 > 1.
Întrebare pentru sală Pentru φ = 0,7 și θ = 0,4, ACF pornește peste φ sau sub φ? Dar pentru θ = −0,4?
Răspuns
Peste: ρ(1) = 0,819 > 0,7. Diferența ρ(1) − φ = θ(1 − φ²)/(1 + 2φθ + θ²) are semnul lui θ, deci cu θ = −0,4 ACF pornește sub φ: ρ(1) = 0,360, ρ(2) = 0,252, iar γ(0) scade de la 3,37 la 1,18. În ambele cazuri raportul ρ(h)/φh este constant (1,169, respectiv 0,514): după lagul 1 ACF descrește ca la un AR(1).
Întrebare pentru sală În ARMA(1,1) cu φ = 0,7 și θ = 0,4, de ce este primul răspuns la impuls, ψ₁ = 1,10, mai mare decît 1?
Răspuns
ψ₁ = φ + θ = 0,7 + 0,4 = 1,1: șocul de ieri intră o dată prin termenul MA și o dată prin partea AR. De la j = 2, ψⱼ = φψⱼ₋₁: 0,77; 0,54; 0,38. Suma Σψⱼ² = 3,37 este varianța procesului în unități σ². La MA(2) răspunsul este exact zero după două perioade, iar la AR(2) cu rădăcini complexe își schimbă semnul: ψ₃ = −0,20, ψ₄ = −0,44. Butonul ▶ dă primului coeficient al celor patru modele (θ₁ la MA(2)) aceeași valoare, de la 0 la 0,95 și înapoi la 0,7: la AR răspunsul se prelungește, la MA(2) rămîne zero după j = 2.
Graficul arată \(\psi_j\) pentru \(j = 0, \dots, 15\), calculate cu recurența (2.10), pentru patru modele: AR(1) cu \(\phi = 0{,}8\), AR(2) cu \(\phi = (1{,}0; -0{,}6)\), MA(2) cu \(\theta = (0{,}6; 0{,}3)\) și ARMA(1,1) cu \(\phi = 0{,}7\),\(\theta = 0{,}4\). Fiecare răspuns începe cu \(\psi_0 = 1\), efectul imediat al șocului asupra valorii curente.
Înălțimea barei \(j\) este modificarea lui \(X_{t+j}\) după un șoc unitar la momentul \(t\). Suma pătratelor înălțimilor, înmulțită cu \(\sigma^2\), este varianța \(\gamma(0)\) a procesului, așa că un răspuns care se stinge lent înseamnă atît memorie lungă, cît și varianță mare.
Pe scurt
\(\psi_j\), \(j = 0, \dots, 15\), din recurența de mai sus
Pentru AR(1) răspunsul descrește geometric, \(\psi_j = 0{,}8^j\). Șocul nu dispare niciodată complet, dar se estompează suficient de repede pentru ca \(\sum_j\psi_j^2\) să fie finită, condiția din descompunerea Wold. Pentru AR(2) cu rădăcini complexe, \(\psi_2 = 0{,}4\), după care răspunsul își schimbă semnul: \(\psi_3 = -0{,}20\),\(\psi_4 = -0{,}44\). Un singur șoc creează un ciclu: seria întîi crește, apoi coboară sub medie, apoi revine.
Pentru MA(2) răspunsul este exact zero după două perioade: memoria modelului este finită. Pentru ARMA(1,1), termenul de medie mobilă ridică primul răspuns la \(\psi_1 = 1{,}10 > 1\), peste efectul imediat; după aceea preia partea autoregresivă, iar fiecare răspuns este 0,7 din cel precedent.
Aceste forme reapar în prognoză: viteza cu care descresc ponderile \(\psi_j\) este viteza cu care prognozele revin la medie și cu care intervalele de prognoză se lărgesc pînă la lățimea lor de termen lung.
Pe scurt
AR(1): descreștere geometrică \(0{,}8^j\); șocul nu dispare niciodată complet, dar se stinge suficient de repede pentru ca \(\sum\psi_j^2 < \infty\)
AR(2) cu rădăcini complexe: răspunsul își schimbă semnul, \(\psi_3 = \ensuremath{-}0{,}20\), \(\psi_4 = \ensuremath{-}0{,}44\): un șoc creează un ciclu
MA(2): exact zero după două perioade: memorie finită
ARMA(1,1): termenul MA ridică primul răspuns la \(\psi_1 = 1{,}10 > 1\); după aceea preia partea AR
În exemplu, \(\rho(1) = 0{,}819\) și \(\rho(2) = 0{,}7 \cdot 0{,}819 = 0{,}573\).
De la lagul 1 încolo, ACF descrește ca la un AR(1) cu coeficientul \(\phi\), dar valoarea de pornire este \(\rho(1) \ne \phi\): partea de medie mobilă mută doar punctul de pornire. Acesta este tiparul din tabelul de identificare pentru modelele ARMA: ACF descrește după lagul \(q - p\), aici după lagul 0, cu o primă valoare pe care partea AR singură nu ar da-o.
Fie \(X_t = 0{,}5X_{t-1} + \varepsilon_t - 0{,}5\varepsilon_{t-1}\). Cu operatorul lag, modelul este \((1 - 0{,}5L)X_t = (1 - 0{,}5L)\varepsilon_t\); simplificînd factorul comun (common factor), obținem \(X_t = \varepsilon_t\), un zgomot alb. Modelul ARMA(1,1) este o descriere supraparametrizată a unui proces fără nicio memorie.
Mai general, orice ARMA(1,1) cu \(\phi = -\theta\) este zgomot alb, oricare ar fi valoarea comună. Verosimilitatea este deci plată de-a lungul dreptei \(\phi = -\theta\), iar datele nu pot localiza parametrii pe ea: aceștia nu sînt identificați.
În rezultatele programelor, un factor comun apare ca estimări mari de semne opuse, de exemplu \(\hat\phi = 0{,}9\) și \(\hat\theta = -0{,}88\), cu erori standard foarte mari, și ca o log-verosimilitate care nu este mai bună decît a modelului mai mic. Remediul este să reducem \(p\) și \(q\) împreună și să preferăm cel mai mic model ale cărui reziduuri sînt zgomot alb.
Tabelul rezumă tiparele teoretice. Zgomotul alb nu are autocorelații semnificative în niciuna dintre funcții. Un AR(\(p\)) are o ACF care descrește (geometric sau ca o undă amortizată) și o PACF care se anulează după lagul \(p\). Un MA(\(q\)) are situația opusă: o ACF care se anulează după lagul \(q\) și o PACF care descrește. Un ARMA(\(p,q\)) are ambele funcții descrescătoare: ACF după lagul \(q - p\) și PACF după lagul \(p - q\), adică primele valori sînt fixate liber de partea MA, iar următoarele urmează recurența AR.
Ultimul rînd anticipează Capitolul 3: pentru o serie cu rădăcină unitară, ACF de selecție descrește foarte lent, aproape liniar, iar prima autocorelație parțială \(\hat\phi_{11}\) este apropiată de 1. O astfel de serie nu se modelează ca ARMA în niveluri; ea se diferențiază mai întîi.
Tabelul propune candidați; el nu alege modelul. Criteriile informaționale și diagnosticarea reziduurilor din secțiunile 5 și 6 decid între ei. Modelele ARMA mixte sînt cel mai greu de recunoscut cu ochiul liber, pentru că ambele funcții doar descresc.
Pe scurt
Modelul
ACF
PACF
Zgomot alb
niciun lag semnificativ
niciun lag semnificativ
AR(\(p\))
descrește (geometric sau undă amortizată)
se anulează după lagul \(p\)
MA(\(q\))
se anulează după lagul \(q\)
descrește
ARMA(\(p,q\))
descrește după lagul \(q - p\)
descrește după lagul \(p - q\)
Rădăcină unitară (cap. 3)
descreștere foarte lentă, aproape liniară
\(\hat\phi_{11} \approx 1\)
Tabelul propune candidați; criteriile informaționale și diagnosticarea decid (secțiunile 5–6)
Modelele ARMA mixte sînt greu de recunoscut din ochi: ambele funcții doar descresc
Întrebare pentru sală Pentru AR(2), cu T = 500, PACF de selecție iese din bandă numai la lagurile 1 și 2. Rămîne tiparul cu T = 100?
Răspuns
Da, pentru PACF: banda se lărgește la ±0,196 și PACF iese tot la lagurile 1 și 2. ACF iese la lagurile 1, 3, 4 și 5: descreșterea în formă de undă amortizată se vede și în eșantionul scurt. Pentru MA(2), cu T = 500, ACF iese la lagurile 1 și 2, iar PACF la lagurile 1–4: tabelul se citește invers.
Întrebare pentru sală Butonul ▶ crește T de la 50 la 500. Ce se întîmplă cu banda ±1,96/√T și cu valorile de selecție?
Răspuns
Banda se îngustează de la ±0,28 la ±0,09, iar valorile de selecție se apropie de cele teoretice. La T = 500, pentru AR(2), φ̂₂₂ = −0,56 față de φ₂₂ = −0,60; pentru MA(2), ρ̂(1) = 0,51 și ρ̂(2) = 0,15 față de 0,54 și 0,21. Cu eșantioane scurte, corelogramele unor modele diferite se pot confunda.
Graficul aplică tabelul la trei serii simulate, de cîte \(T = 500\) de observații: un AR(2) cu \(\phi = (1{,}0; -0{,}6)\), un MA(2) cu \(\theta = (0{,}6; 0{,}3)\) și un ARMA(1,1) cu \(\phi = 0{,}7\),\(\theta = 0{,}4\). Rîndul de sus arată ACF, iar cel de jos PACF, pentru lagurile de la 1 la 15.
În fiecare panou, barele sînt valorile de selecție din singura traiectorie simulată, punctele portocalii valorile teoretice, iar liniile roșii punctate banda \(\pm 1{,}96/\sqrt{T}\). Comparația dintre bare și puncte arată cît zgomot conține o corelogramă de selecție chiar și cu 500 de observații; numărarea barelor din afara benzii, funcție cu funcție, este pasul de identificare.
Pentru AR(2), PACF are două valori semnificative, a doua fiind \(\phi_{22} = \phi_2 = -0{,}60\), apoi rămîne la zero; ACF este o undă amortizată. Identificarea este ușoară: ordinul \(p\) se citește din PACF.
Pentru MA(2), ACF teoretică este \(\rho(1) = 0{,}538\),\(\rho(2) = 0{,}207\) și zero după aceea, iar PACF descrește lent. ACF de selecție la lagul 2 este doar puțin în afara benzii: cu date reale, un MA(1) și un MA(2) pot arăta la fel, iar alegerea dintre ele rămîne criteriilor informaționale.
Pentru ARMA(1,1), ambele funcții descresc. ACF arată ca a unui AR(1), iar PACF are o a doua valoare, mai mică și de semn opus. Un analist care citește doar PACF ar alege un AR(2) sau un AR(3): o aproximare bună, dar cu mai mulți parametri. Corelogramele de selecție sînt zgomotoase chiar cu \(T = 500\); cu 100 de observații trimestriale banda este mai largă, iar tiparele sînt mult mai puțin clare.
Pe scurt
AR(2): PACF are două valori semnificative, \(\phi_{22} = \phi_2 = \ensuremath{-}0{,}60\), apoi zero; ACF este o undă amortizată
Un ARMA(\(p,q\)),\(\phi(L)(X_t - \mu) = \theta(L)\varepsilon_t\), este cauzal cînd rădăcinile lui \(\phi(z)\) sînt în afara cercului unitate și invertibil cînd rădăcinile lui \(\theta(z)\) sînt în afara lui. Răspunsul lui la impuls, adică ponderile \(\psi\), rezultă din recurența (2.10).
Cele două polinoame nu trebuie să aibă factori comuni; o verosimilitate plată și estimări mari de semne opuse sînt simptomele unui factor comun. Identificarea folosește tabelul: o ACF care se anulează indică un MA, o PACF care se anulează un AR, două funcții descrescătoare un ARMA.
Pe scurt
ARMA(\(p,q\)): \(\phi(L)(X_t - \mu) = \theta(L)\varepsilon_t\); cauzal dacă \(\phi(z)\) are rădăcinile în afara cercului, invertibil dacă \(\theta(z)\) le are
Ponderile \(\psi\) prin recurența \(\psi_j = \theta_j + \sum\phi_i\psi_{j-i}\): răspunsul la impuls
Fără factori comuni; o verosimilitate plată și estimări opuse semnalează unul
ACF se anulează: MA; PACF se anulează: AR; ambele descresc: ARMA
Sinteza secțiunii
Modelul ARMA(\(p,q\)) combină un polinom AR scurt, care fixează descreșterea de termen lung a memoriei, cu un polinom MA scurt, care modelează primele laguri. Răspunsul la impuls (2.10) rezumă dinamica, iar pentru ARMA(1,1) autocorelațiile (2.11) descresc ca la un AR(1), dintr-un alt punct de pornire. Corelogramele doar sugerează ordine candidate. Secțiunea următoare estimează parametrii unui candidat, iar cea de după ea alege între candidați și verifică modelul ales.
Estimarea
După alegerea ordinelor candidate, parametrii trebuie estimați. Secțiunea prezintă trei estimatori: Yule–Walker, o metodă a momentelor; cele mai mici pătrate condiționate; și verosimilitatea maximă gaussiană exactă. Apoi compară comportamentul lor în eșantioane de 100 de observații.
Estimatorul Yule–Walker (Yule, 1927; Walker, 1931) este o metodă a momentelor (method of moments): înlocuiește autocorelațiile teoretice din ecuațiile Yule–Walker cu autocorelațiile de selecție și rezolvă sistemul în raport cu coeficienții. Se aplică doar modelelor AR pure. Este rapid și dă întotdeauna un model staționar, dar este mai puțin precis cînd o rădăcină este aproape de cercul unitate.
Metoda celor mai mici pătrate condiționate (conditional least squares) minimizează suma pătratelor șocurilor \(\sum_t\varepsilon_t^2\), tratînd primele observații ca fixe. Pentru un AR(\(p\)), aceasta este metoda celor mai mici pătrate (OLS, ordinary least squares) pentru \(X_t\) pe \(1, X_{t-1}, \dots, X_{t-p}\). Pentru modelele MA și ARMA șocurile nu sînt observate: ele se calculează recursiv, \(\varepsilon_t = X_t - \mu - \theta\varepsilon_{t-1} - \dots\), pornind de la \(\varepsilon_0 = 0\). Suma pătratelor este atunci o funcție neliniară de \(\theta\) și se minimizează numeric.
Verosimilitatea maximă gaussiană exactă (MLE, maximum likelihood estimation) maximizează densitatea comună a lui \((X_1, \dots, X_T)\) și folosește deci și informația din primele observații. Ea este metoda implicită a clasei ARIMA din statsmodels, care calculează verosimilitatea cu filtrul Kalman (Capitolul 10). În eșantioane mari, cei trei estimatori coincid pentru modelele AR pure; pentru modelele MA și ARMA, MLE este referința.
Pe scurt
Yule–Walker (metoda momentelor, Yule (1927); Walker (1931)): înlocuim \(\rho(h)\) cu \(\hat\rho(h)\) în ecuațiile Yule–Walker
doar pentru AR pur; rapid; dă întotdeauna un model staționar; mai puțin precis cînd rădăcinile sînt aproape de cerc
Cele mai mici pătrate condiționate: minimizăm \(\sum_t\varepsilon_t^2\), tratînd primele valori ca fixe
AR(\(p\)): metoda celor mai mici pătrate (OLS) pentru \(X_t\) pe \(1, X_{t-1}, \dots, X_{t-p}\)
MA și ARMA: reziduurile \(\varepsilon_t = X_t - \mu - \theta\varepsilon_{t-1} - \dots\) se calculează recursiv, pornind de la \(\varepsilon_0 = 0\); minimizare numerică
Verosimilitatea maximă exactă gaussiană (MLE): maximizăm densitatea comună a lui \((X_1, \dots, X_T)\)
folosește și primele observații; metoda implicită a lui ARIMA din statsmodels (filtrul Kalman, Capitolul 10)
În eșantioane mari, cele trei coincid pentru modelele AR pure; MLE este referința pentru MA și ARMA
Pentru un AR(\(p\)), înmulțind modelul cu \(X_{t-h}\), aplicînd media și împărțind la \(\gamma(0)\), obținem, pentru \(h = 1, \dots, p\), ecuațiile \(\rho(h) = \phi_1\rho(h - 1) + \dots + \phi_p\rho(h - p)\). Sub formă matriceală, ele sînt \(R\,\phi = \rho\), unde \(R\) este matricea \(p \times p\) cu elementele \(R_{ij} = \rho(|i - j|)\),\(\phi = (\phi_1, \dots, \phi_p)^\top\) și \(\rho = (\rho(1), \dots, \rho(p))^\top\). Estimatorul înlocuiește fiecare \(\rho(h)\) cu valoarea de selecție, marcată cu căciulă:
A doua formulă împarte varianța seriei în partea explicată de trecut, \(\hat\gamma(0)\hat\phi^\top\hat\rho\), și varianța șocului.
Pentru un AR(2), regula lui Cramer dă formule explicite: \(\hat\phi_1 = \hat\rho_1(1 - \hat\rho_2)/(1 - \hat\rho_1^2)\) și \(\hat\phi_2 = (\hat\rho_2 - \hat\rho_1^2)/(1 - \hat\rho_1^2)\). A doua este autocorelația parțială de selecție la lagul 2 din Capitolul 1, în acord cu rezultatul \(\phi_{pp} = \phi_p\). Gilbert Walker (1868–1958), al cărui portret însoțește slide-ul, a extins metoda lui Yule la autoregresii de orice ordin în 1931.
Creșterea anuală a PIB-ului real al României, T1 2000–T2 2026, studiată în secțiunea 9, are autocorelațiile de selecție \(\hat\rho(1) = 0{,}62\) și \(\hat\rho(2) = 0{,}40\) și varianța de selecție \(\hat\gamma(0) = 18{,}77\), cu împărțire la \(T\), ca în definiția din Capitolul 1. Determinantul lui \(\hat R\) este \(1 - \hat\rho_1^2 = 0{,}620\), calculat cu valoarea nerotunjită a lui \(\hat\rho(1)\).
Formulele lui Cramer dau \(\hat\phi_1 = 0{,}62\,(1 - 0{,}40)/0{,}620 = 0{,}600\) și \(\hat\phi_2 = (0{,}40 - 0{,}62^2)/0{,}620 = 0{,}027\). Varianța zgomotului, din (2.12), este \(\hat\sigma^2 = 18{,}77\,(1 - \hat\phi_1\hat\rho_1 - \hat\phi_2\hat\rho_2) = 11{,}62\), față de varianța 18,77 a seriei înseși.
Al doilea coeficient este practic zero: în familia AR, al doilea lag nu adaugă nimic, iar un AR(1) ar fi suficient. Yule–Walker nu întreabă însă dacă familia AR este cea potrivită. Secțiunea 9 arată că pentru această serie un MA(3) se potrivește mai bine.
Pe scurt
Creșterea anuală a PIB-ului real, T1 2000–T2 2026 (secțiunea 9): \(\hat\rho(1) = 0{,}62\), \(\hat\rho(2) = 0{,}40\), \(\hat\gamma(0) = 18{,}77\)
Verosimilitatea gaussiană a unui model ARMA se calculează prin descompunerea erorilor de predicție (prediction-error decomposition). Densitatea comună se descompune în densități condiționate, \(f(x_1, \dots, x_T) = \prod_t f(x_t \mid x_{t-1}, \dots, x_1)\), iar cu șocuri gaussiene fiecare factor este o densitate Normală cu media \(\hat x_{t|t-1}\), predicția cu un pas, și varianța \(v_t\), varianța erorii ei:
\[\ln L = -\frac12\sum_{t=1}^{T}\Big[\ln(2\pi v_t) + \frac{(x_t - \hat x_{t|t-1})^2}{v_t}\Big].\]
(2.13)
Varianțele \(v_t\) sînt mai mari pentru primele observații, care sînt prezise dintr-un trecut scurt sau inexistent.
Pentru un AR(1), descompunerea se poate scrie de mînă. Prima observație are distribuția staționară, \(X_1 \sim N(\mu, \sigma^2/(1 - \phi^2))\), iar fiecare observație următoare are \(X_t \mid X_{t-1} \sim N(c + \phi X_{t-1}, \sigma^2)\). Dacă renunțăm la primul factor, rămîne verosimilitatea condiționată, a cărei maximizare este metoda celor mai mici pătrate condiționate. Diferența dintre cei doi estimatori provine deci din prima observație și contează mai ales în eșantioane mici și cînd \(\phi\) este aproape de 1.
Erorile standard (se, standard errors) provin din curbura lui \(\ln L\) în punctul de maxim. Asimptotic, \(\mathrm{se}(\hat\phi) \approx \sqrt{(1 - \phi^2)/T}\) pentru un AR(1) și \(\mathrm{se}(\hat\theta) \approx \sqrt{(1 - \theta^2)/T}\) pentru un MA(1). Rapoartele \(t\),\(\hat\phi/\mathrm{se}\), se compară cu \(\pm 1{,}96\), ca în regresie. Formula pentru AR(1) tinde spre zero cînd \(|\phi| \to 1\); cadrele următoare arată că aproape de cercul unitate această aproximare este prea optimistă. Implicit, statsmodels raportează o altă estimare, eroarea standard OPG (outer product of gradients, produsul exterior al gradienților), construită din pătratele scorurilor fiecărei observații. Dacă modelul este corect, cele două estimări au aceeași limită; cînd erorile au cozi groase, erorile standard OPG sînt mai mici decît cele din curbură. Toate erorile standard din acest capitol sînt OPG.
Pe scurt
Verosimilitatea gaussiană prin descompunerea erorilor de predicție
\(f(x_1, \dots, x_T) = \prod_t f(x_t \mid x_{t-1}, \dots, x_1)\); fiecare factor este \(N(\hat x_{t|t-1}, v_t)\)
\(\ln L = -\tfrac12\sum_{t=1}^{T}\big[\ln(2\pi v_t) + (x_t - \hat x_{t|t-1})^2/v_t\big]\)
\(\hat x_{t|t-1}\): predicția cu un pas; \(v_t\): varianța erorii ei, mai mare pentru primele observații
AR(1) de mînă: \(X_1 \sim N(\mu, \sigma^2/(1 - \phi^2))\), apoi \(X_t \mid X_{t-1} \sim N(c + \phi X_{t-1}, \sigma^2)\)
dacă renunțăm la primul factor, obținem cele mai mici pătrate condiționate
Erorile standard (se, standard error) din curbura lui \(\ln L\); asimptotic
rapoartele \(t\), \(\hat\phi/\mathrm{se}\), se compară cu \(\pm 1{,}96\), ca în regresie
statsmodels raportează implicit erorile standard OPG (produsul exterior al scorurilor): aceeași limită dacă modelul este corect, dar mai mici decît cele din curbură cînd erorile au cozi groase; erorile standard din acest capitol sînt OPG
Întrebare pentru sală Slide-ul scrie 1 − ρ̂₁² = 0,620, dar 1 − 0,62² = 0,616. Care valoare este corectă?
Răspuns
0,620, calculată cu ρ̂₁ = 0,6167 nerotunjit; 0,616 vine din rotunjirea lui ρ̂₁ la 0,62. Cu valorile nerotunjite, φ̂₁ = 0,600, φ̂₂ = 0,027 și σ̂² = 11,62, ca în slide (γ̂(0) = 18,77, cu împărțire la T); cu 0,62 și 0,40 rotunjite ar ieși φ̂₁ = 0,604 și φ̂₂ = 0,025. Pe eșantionul care se oprește în T4 2019, φ̂₂ = 0,102.
Întrebare pentru sală Pentru AR(1) pe creșterea PIB-ului, statsmodels raportează se(φ̂) = 0,085, iar curbura log-verosimilității dă 0,076. Care valoare corespunde formulei √((1 − φ̂²)/T)?
Răspuns
Curbura: 0,076, față de 0,075 din formula asimptotică. Valoarea 0,085 este eroarea standard OPG (produsul exterior al gradienților), implicită în statsmodels. Concluzia nu se schimbă: φ̂ = 0,630, raportul t este 8,3 cu curbura, intervalul de 95% [0,481; 0,779].
Întrebare pentru sală Cu φ = 0,9 și T = 100, sînt estimatorii coeficientului AR(1) nedeplasați?
Răspuns
Nu. Mediile celor 400 de estimări sînt 0,853 (Yule–Walker), 0,864 (cele mai mici pătrate condiționate) și 0,866 (MLE), toate sub 0,9; aproximarea −(1 + 3φ)/T dă −0,037. Abaterile standard, 0,054–0,056, depășesc valoarea asimptotică 0,044. În simularea din browser cu T = 400, mediile urcă la 0,889–0,891. Pentru MA(1) cu θ = 0,5, mediile sînt 0,504 și 0,506.
Graficul arată distribuțiile estimațiilor pe 400 de eșantioane simulate, de cîte \(T = 100\) de observații. Panoul din stînga este un AR(1) cu \(\phi = 0{,}9\), estimat prin Yule–Walker (portocaliu), cele mai mici pătrate condiționate (albastru) și verosimilitate maximă gaussiană (roșu); panoul din dreapta este un MA(1) cu \(\theta = 0{,}5\), estimat prin cele mai mici pătrate condiționate și verosimilitate maximă. Linia verticală punctată marchează valoarea adevărată.
Poziția fiecărei histograme față de linia punctată arată deplasarea (bias) estimatorului, lățimea ei arată abaterea standard, iar forma ei arată dacă intervalele bazate pe aproximarea Normală sînt adecvate. Idealul este o histogramă simetrică, centrată pe linie; panoul din stînga se îndepărtează de acest ideal, cel din dreapta mult mai puțin.
Pe scurt
400 de eșantioane simulate, fiecare cu \(T = 100\); stînga: AR(1) cu \(\phi = 0{,}9\); dreapta: MA(1) cu \(\theta = 0{,}5\)
Pentru AR(1) cu \(\phi = 0{,}9\), mediile estimațiilor sînt 0,853 pentru Yule–Walker, 0,864 pentru cele mai mici pătrate condiționate și 0,866 pentru verosimilitatea maximă. Toți trei estimatorii sînt deplasați în jos. Aproximarea de manual a deplasării celor mai mici pătrate, \(-(1 + 3\phi)/T = -0{,}037\), este apropiată de deplasarea estimațiilor simulate prin cele mai mici pătrate. Yule–Walker are cea mai mare deplasare aproape de cercul unitate.
Abaterile standard ale estimațiilor sînt 0,056, 0,055 și 0,054, toate peste valoarea asimptotică 0,044. Distribuția este asimetrică spre stînga: estimațiile nu pot depăși cu mult valoarea 1 fără să iasă din regiunea de staționaritate, dar pot coborî mult sub 0,9. Intervalele asimptotice sînt deci prea optimiste aproape de \(\phi = 1\).
Pentru MA(1) cu \(\theta = 0{,}5\), mediile sînt 0,504 pentru cele mai mici pătrate condiționate, cu abaterea standard 0,097, și 0,506 pentru verosimilitatea maximă, cu abaterea standard 0,098; abaterea standard asimptotică este 0,087. Aici ambii estimatori sînt practic nedeplasați și ambii variază mai mult decît spune formula asimptotică. Regula practică este să folosim verosimilitatea maximă, iar Yule–Walker doar pentru valori de pornire rapide sau în scop didactic.
Pe scurt
AR(1), \(\phi = 0{,}9\): mediile 0,853 (Yule–Walker), 0,864 (cele mai mici pătrate condiționate), 0,866 (MLE)
toți trei sînt deplasați în jos; aproximarea de manual a deplasării celor mai mici pătrate este \(-(1 + 3\phi)/T = \ensuremath{-}0{,}037\)
Yule–Walker este cel mai deplasat aproape de cercul unitate
Abaterile standard 0,056; 0,055; 0,054, peste valoarea asimptotică 0,044
distribuția este asimetrică la stînga: intervalele asimptotice sînt optimiste aproape de \(\phi = 1\)
MA(1), \(\theta = 0{,}5\): cele mai mici pătrate condiționate 0,504 (abaterea standard 0,097), MLE 0,506 (0,098); valoarea asimptotică 0,087
Regula practică: folosiți MLE; Yule–Walker doar pentru valori de pornire rapide sau în scop didactic
Yule–Walker este o metodă a momentelor pentru modelele AR pure, \(\hat\phi = \hat R^{-1}\hat\rho\). Cele mai mici pătrate condiționate înseamnă OLS pentru un AR și o minimizare numerică pe șocuri calculate recursiv pentru un MA. Verosimilitatea maximă gaussiană exactă, calculată prin descompunerea erorilor de predicție (2.13), este standardul din programe.
În eșantioane mici, coeficienții AR persistenți sînt deplasați în jos, iar distribuția lor de selecție este asimetrică, așa că erorile standard asimptotice subestimează incertitudinea aproape de cercul unitate.
Pe scurt
Yule–Walker: momente, AR pur, \(\hat\phi = \hat R^{-1}\hat\rho\)
Cele mai mici pătrate condiționate: OLS pentru AR, o recurență pentru MA
MLE exactă gaussiană: descompunerea erorilor de predicție; standardul programelor
Coeficienții AR persistenți sînt deplasați în jos în eșantioane mici
Sinteza secțiunii
Cei trei estimatori coincid asimptotic pentru modelele AR pure și diferă în eșantioane mici: cu \(T = 100\) și \(\phi = 0{,}9\) toți sînt deplasați în jos, Yule–Walker cel mai mult. Verosimilitatea maximă (2.13) tratează modelele MA și ARMA și este metoda implicită. Estimarea unui model nu spune dacă el este cel potrivit: secțiunea următoare compară modelele candidate și testează reziduurile lor.
Selecția modelului și diagnosticarea
Corelogramele propun mai multe ordine candidate. Secțiunea alege între ele cu criterii informaționale (information criteria), care pun în balanță calitatea ajustării și numărul de parametri, și verifică modelul ales testînd dacă reziduurile lui se comportă ca un zgomot alb. Două experimente de simulare arată cît de des găsesc AIC și BIC ordinul adevărat și de ce testul Ljung–Box pentru reziduuri are nevoie de \(m - p - q\) grade de libertate.
Calitatea ajustării unui model, măsurată prin log-verosimilitatea maximizată \(\ln L\), crește cu fiecare parametru adăugat. Criteriile informaționale percep de aceea o penalizare pentru fiecare parametru. Fie \(k\) numărul parametrilor estimați (coeficienții \(\phi\) și \(\theta\),\(\mu\) și \(\sigma^2\)):
\[\begin{gathered}\mathrm{AIC} = -2\ln L + 2k, \\ \mathrm{AICc} = \mathrm{AIC} + \frac{2k(k + 1)}{T - k - 1}, \\ \mathrm{BIC} = -2\ln L + k\ln T.\end{gathered}\]
(2.14)
Criteriul informațional Akaike (AIC, Akaike information criterion) provine de la Akaike (1974), corecția lui pentru eșantioane mici, AICc, de la Hurvich și Tsai (1989), iar criteriul informațional bayesian (BIC) de la Schwarz (1978). Hirotugu Akaike, din fotografia de pe slide, a lucrat la Institutul de Matematică Statistică din Tokyo.
Cele două criterii diferă doar prin penalizarea pe parametru: 2 pentru AIC și \(\ln T\) pentru BIC. Cum \(\ln T > 2\) de îndată ce \(T \ge 8\), BIC penalizează mai puternic în orice eșantion realist și preferă modele mai mici. Se alege modelul cu valoarea cea mai mică. Pot fi comparate doar modele estimate pe aceleași observații: dacă, de exemplu, modele AR de ordine diferite sînt estimate prin cele mai mici pătrate condiționate, fiecare renunță la un alt număr de observații inițiale, iar verosimilitățile lor nu mai sînt comparabile.
Pe scurt
Ajustarea se îmbunătățește cu fiecare parametru; criteriile impun o penalizare pe parametru
BIC este consistent (consistent): dacă modelul adevărat se află printre candidați, probabilitatea ca BIC să îl aleagă tinde la 1 cînd \(T\) crește. Prețul este că, în eșantioane mici, penalizarea lui mare poate alege un model prea mic, care omite un coeficient real, dar mic.
AIC este construit pentru prognoză: el estimează calitatea așteptată a ajustării în afara eșantionului (out-of-sample), măsurată prin distanța Kullback–Leibler dintre model și distribuția adevărată. Nu este consistent: chiar cu \(T\) mare alege un model prea mare (overfitting) cu o probabilitate pozitivă, pentru că penalizarea 2 nu crește odată cu eșantionul.
În practică, așa cum arată Hyndman și Athanasopoulos (2021) și Hyndman și Khandakar (2008), căutările automate, de exemplu auto.arima în R sau pmdarima în Python, minimizează AICc pe o grilă de ordine \((p, q)\). Cînd AIC și BIC aleg modele diferite, se păstrează ambii candidați, iar diagnosticarea reziduurilor și prognozele în afara eșantionului decid între ei.
Pe scurt
BIC este consistent: dacă modelul adevărat se află printre candidați, BIC îl găsește cu probabilitate \(\to 1\)
dar poate alege un model prea mic cînd \(T\) este mic
AIC este orientat spre prognoză: estimează ajustarea așteptată în afara eșantionului (distanța Kullback–Leibler)
supraparametrizează cu probabilitate pozitivă, chiar pentru \(T\) mare
Întrebare pentru sală ARMA(1,3) are ln L mai mare decît MA(3) cu 1,54. De ce îl preferă BIC totuși pe MA(3)?
Răspuns
Parametrul în plus costă 2 în AIC și ln 106 = 4,66 în BIC, iar −2 ln L scade doar cu 3,07. AIC scade deci cu 1,07 (548,97 față de 550,04), BIC crește cu 1,59 (564,95 față de 563,36). AICc, cu corecția pentru T mic, dă 549,82 și 550,64.
Întrebare pentru sală Cu T = 1000, care criteriu găsește mai des ordinul adevărat p = 2?
Răspuns
BIC, în 98,6% dintre eșantioane, față de 74,4% pentru AIC, care alege un ordin prea mare în 25,6% din cazuri. Cu T = 100 ordinea se inversează: AIC 54,4%, BIC 47,4%, iar BIC alege un model prea mic în 50,4% din cazuri, pentru că φ₂ = 0,25 este greu de detectat în 100 de observații.
Experimentul simulează un AR(2) adevărat cu \(\phi = (0{,}5; 0{,}25)\), estimează modele AR(\(p\)) pentru \(p = 0, \dots, 6\) prin OLS pe același eșantion și înregistrează ordinul ales de fiecare criteriu. Fiecare panou folosește 500 de eșantioane: în stînga de lungime \(T = 100\), în dreapta de lungime \(T = 1000\).
Barele dau procentul de eșantioane în care AIC (albastru) sau BIC (roșu) a ales fiecare ordin; linia verde punctată marchează ordinul adevărat \(p = 2\). Masa de la \(p = 2\) reprezintă alegeri corecte, cea din stînga un model prea mic, iar cea din dreapta un model prea mare.
Pe scurt
Modelul adevărat AR(2), \(\phi = (0{,}5; 0{,}25)\); AR(\(p\)), \(p = 0, \dots, 6\), estimate prin OLS pe același eșantion; 500 de eșantioane pe panou
Cu \(T = 100\), AIC găsește \(p = 2\) în 54,4% dintre eșantioane, iar BIC în 47,4%. BIC alege un model prea mic în 50,4% dintre eșantioane: al doilea coeficient, \(\phi_2 = 0{,}25\), este mic în raport cu eroarea lui de selecție la 100 de observații, iar penalizarea BIC depășește adesea contribuția lui. AIC alege un model prea mare în 24,8% dintre eșantioane.
Cu \(T = 1000\), BIC găsește ordinul adevărat în 98,6% dintre eșantioane, iar AIC în 74,4%. Aceasta este consistența la lucru: BIC converge către modelul adevărat, în timp ce AIC alege încă un model prea mare în 25,6% dintre eșantioane.
Niciun criteriu nu dovedește ordinul. Cu date macroeconomice trimestriale, \(T\) este în jur de 100, iar ordinul rămîne incert. Cele două erori au costuri diferite: un model prea mare adaugă puțin zgomot de estimare în prognoze, în timp ce un model prea mic lasă autocorelație în reziduuri, pe care diagnosticarea din cadrul următor este făcută să o detecteze.
Pe scurt
\(T = 100\): AIC găsește \(p = 2\) în 54,4% din eșantioane, BIC în 47,4%
BIC alege un model prea mic în 50,4% din cazuri (valoarea mică \(\phi_2 = 0{,}25\) este greu de detectat); AIC alege unul prea mare în 24,8%
\(T = 1000\): BIC 98,6%, AIC 74,4%
BIC este consistent; AIC încă supraparametrizează în 25,6% din eșantioane
Niciun criteriu nu este o dovadă: cu date macroeconomice trimestriale (\(T \approx 100\)), ordinul este incert
Supraparametrizarea costă puțin în prognoză; un model prea mic lasă corelație în reziduuri, pe care o detectează diagnosticarea
Dacă modelul este corect specificat, reziduurile lui \(\hat\varepsilon_t\) se comportă ca un zgomot alb. Prima verificare este vizuală: graficul reziduurilor nu trebuie să arate tipare, schimbări de varianță sau valori extreme izolate. ACF a reziduurilor trebuie să rămînă în banda \(\pm 1{,}96/\sqrt{T}\), cu excepția a aproximativ un lag din douăzeci.
Testul portmanteau al lui Ljung și Box (1978) combină primele \(m\) autocorelații ale reziduurilor:
Ipoteza nulă este că modelul este corect. Estimarea celor \(p + q\) coeficienți consumă \(p + q\) grade de libertate (Box și Pierce, 1970). Numărul de laguri \(m\) trebuie să fie mult peste \(p + q\):\(m = 10\) pentru date anuale sau trimestriale și \(m = 2s\) pentru date sezoniere cu perioada \(s\)(Hyndman și Athanasopoulos, 2021).
Normalitatea se testează cu statistica Jarque–Bera (Jarque și Bera, 1987),\(\mathrm{JB} = \frac{T}{6}\big(S^2 + (K - 3)^2/4\big) \approx \chi^2(2)\), unde \(S\) este asimetria (skewness), iar \(K\) kurtosis-ul reziduurilor (0 și 3 pentru distribuția Normală), împreună cu un grafic cuantilă–cuantilă (QQ, quantile–quantile). Normalitatea se respinge la 5% dacă \(\mathrm{JB} > 5{,}99\), cuantila de 95% a lui \(\chi^2(2)\). Reziduurile care nu urmează distribuția Normală nu deplasează \(\hat\phi\), dar fac greșite intervalele de prognoză construite cu distribuția Normală. În sfîrșit, un test Ljung–Box pentru pătratele reziduurilor \(\hat\varepsilon_t^2\) detectează volatility clustering, subiectul Capitolului 5.
Pe scurt
Dacă modelul este corect, reziduurile \(\hat\varepsilon_t\) se comportă ca un zgomot alb
le reprezentăm grafic: fără tipare, fără schimbări de varianță, fără valori izolate foarte mari
ACF a reziduurilor în banda \(\pm 1{,}96/\sqrt{T}\), cu excepția a aproximativ 1 lag din 20
Ljung–Box pentru reziduuri (Ljung și Box (1978)): \(Q^*(m) = T(T + 2)\sum_{h=1}^{m}\hat\rho_{\hat\varepsilon}(h)^2/(T - h)\)
în ipoteza \(H_0\) (model corect), \(Q^*(m) \approx \chi^2(m - p - q)\) (Box și Pierce (1970)): estimarea a \(p + q\) coeficienți consumă \(p + q\) grade de libertate
alegem \(m\) mult peste \(p + q\): \(m = 10\) pentru date anuale sau trimestriale, \(m = 2s\) pentru date sezoniere (Hyndman și Athanasopoulos (2021))
Normalitatea: Jarque–Bera (Jarque și Bera (1987)) \(\mathrm{JB} = \frac{T}{6}\big(S^2 + (K - 3)^2/4\big) \approx \chi^2(2)\); graficul QQ
\(S\) = asimetria, \(K\) = kurtosis-ul (0 și 3 pentru distribuția Normală); respingem normalitatea la 5% dacă \(\mathrm{JB} > 5{,}99\), cuantila de 95% a lui \(\chi^2(2)\)
reziduurile ne-normale nu deplasează \(\hat\phi\), dar fac greșite intervalele construite cu distribuția Normală
Întrebare pentru sală Pentru AR(1), Ljung–Box cu m = 8 dă Q*(8) = 16,23. Respingem la 5% ipoteza că reziduurile sînt necorelate?
Răspuns
Da: cu 8 − 1 = 7 grade de libertate p = 0,023; și cu 8 grade de libertate (greșit) p = 0,039. La MA(3), Q*(8) = 5,35 cu 5 grade de libertate dă p = 0,375, deci nu respingem. Normalitatea este respinsă pentru ambele: Jarque–Bera 25,9 pentru AR(1) și 39,0 pentru MA(3), peste 5,99.
Întrebare pentru sală Reziduurile modelului adevărat ARMA(1,1) sînt testate cu Ljung–Box, m = 10, la 5%. Cît de des respinge testul cu 10 grade de libertate?
Răspuns
În 1,4% dintre eșantioane, nu în 5%: reziduurile estimate sînt mai puțin corelate decît un zgomot alb adevărat la primele laguri. Cu m − p − q = 8 grade de libertate, rata este 3,4%; pentru AR(1), 3,2% cu 10 și 4,8% cu 9. La m = 3 diferența crește: pentru ARMA(1,1), 0,2% cu 3 grade de libertate și 4,8% cu 1.
Experimentul aplică testul Ljung–Box la nivelul de 5% reziduurilor modelului adevărat, cu \(T = 200\) și \(m = 10\): 1 000 de eșantioane dintr-un AR(1) și 500 de eșantioane dintr-un ARMA(1,1). Pentru fiecare model, graficul arată rata de respingere cu \(m = 10\) grade de libertate (portocaliu) și cu \(m - p - q\) grade de libertate (albastru); linia roșie punctată marchează nivelul nominal de 5%.
Cum modelul estimat este chiar cel adevărat, ipoteza nulă este adevărată în fiecare eșantion. Un test cu mărimea corectă respinge în 5% dintre eșantioane, așa că o alegere bună a gradelor de libertate dă o bară care atinge linia punctată.
Pe scurt
Testul Ljung–Box la 5% pentru reziduurile modelului adevărat; 1 000 de eșantioane AR(1), jumătate pentru ARMA(1,1)
Cu \(m = 10\) grade de libertate testul respinge prea rar: în 3,2% dintre eșantioane pentru AR(1) și în 1,4% pentru ARMA(1,1), în loc de 5%. Reziduurile sînt ajustate: estimarea alege coeficienții astfel încît reziduurile să pară necorelate la primele laguri. Autocorelațiile lor sînt deci mai mici decît ale unui zgomot alb adevărat, iar \(Q^*\) este mai mic decît sugerează referința \(\chi^2(m)\).
Cu \(m - p - q\) grade de libertate, ratele de respingere sînt 4,8% și 3,4%, apropiate de nivelul nominal de 5%. Corecția contează mai ales cînd \(p + q\) este mare în raport cu \(m\): ea este mai mare pentru ARMA(1,1), cu doi coeficienți, decît pentru AR(1).
Funcția acorr_ljungbox din statsmodels folosește implicit \(m\) grade de libertate; corecția cere argumentul model_df = p + q. Cu grade de libertate greșite, p-value-urile sînt prea mari, iar un model prost pare acceptabil.
Pe scurt
Cu \(m = 10\) grade de libertate testul respinge prea rar: 3,2% (AR(1)) și 1,4% (ARMA(1,1)) în loc de 5%
reziduurile sînt ajustate astfel încît să pară necorelate la primele laguri: ACF lor este mai mică decît a unui zgomot alb adevărat
Cu \(m - p - q\): 4,8% și 3,4%, aproape de nivelul nominal de 5%
corecția contează cel mai mult cînd \(p + q\) este mare în raport cu \(m\)
Criteriile (2.14) sînt \(\mathrm{AIC} = -2\ln L + 2k\) și \(\mathrm{BIC} = -2\ln L + k\ln T\); cîștigă valoarea cea mai mică, iar BIC alege modele mai mici. BIC este consistent; AIC urmărește prognoza și uneori alege modele prea mari.
Reziduurile se verifică prin grafic, ACF lor, testul Ljung–Box (2.15) cu \(m - p - q\) grade de libertate, testul Jarque–Bera și testul Ljung–Box pentru pătratele reziduurilor. Un model trece verificarea cînd reziduurile lui sînt zgomot alb; normalitatea contează pentru intervale.
Pe scurt
AIC \(= -2\ln L + 2k\), BIC \(= -2\ln L + k\ln T\); cîștigă valoarea cea mai mică; BIC alege modele mai mici
BIC este consistent, AIC este orientat spre prognoză și uneori supraparametrizează
Reziduurile: grafic, ACF, Ljung–Box cu \(m - p - q\) grade de libertate, Jarque–Bera, Ljung–Box pe pătrate
Un model este acceptat cînd reziduurile lui sînt zgomot alb; normalitatea contează pentru intervale
Sinteza secțiunii
Selecția și verificarea sînt pași separați. Criteriile (2.14) ordonează candidații, BIC fiind consistent, iar AIC orientat spre prognoză; cu aproximativ 100 de observații, ambele ratează adesea ordinul adevărat. Diagnosticarea decide dacă modelul ales este adecvat, iar testul Ljung–Box (2.15) trebuie să folosească \(m - p - q\) grade de libertate pentru a avea mărimea corectă. Secțiunea următoare folosește un model adecvat pentru prognoză.
Prognoza cu modele ARMA
Scopul celor mai multe modele ARMA este prognoza. Secțiunea derivă prognoza punctuală optimă, varianța erorii ei și intervalele de prognoză și arată proprietatea comună tuturor modelelor staționare: prognozele lor revin la medie.
Prognoza lui \(X_{T+h}\) făcută la momentul \(T\) este media condiționată de trecut, \(\hat X_{T+h|T} = E[X_{T+h} \mid X_T, X_{T-1}, \dots]\). Dintre toate funcțiile de trecut, ea minimizează eroarea medie pătratică (MSE, mean squared error) \(E[(X_{T+h} - \hat X_{T+h|T})^2]\).
Pentru un model ARMA, media condiționată rezultă dintr-o rețetă simplă. Scriem modelul la momentul \(T + h\) și înlocuim șocurile viitoare \(\varepsilon_{T+j}\),\(j \ge 1\), cu 0, media lor condiționată, iar valorile viitoare \(X_{T+j}\) cu prognozele lor; valorile trecute și reziduurile trecute rămîn neschimbate. Prognozele se calculează recursiv pentru \(h = 1, 2, \dots\).
Pentru un AR(1), rețeta dă
\[\hat X_{T+h|T} = \mu + \phi^h(X_T - \mu).\]
(2.16)
Abaterea de la medie scade cu factorul \(\phi\) pe perioadă: aceasta este revenirea la medie (mean reversion) cu viteza \(\phi\). Pentru un MA(\(q\)), fiecare termen al modelului la \(T + h\), cu \(h > q\), este un șoc viitor, deci \(\hat X_{T+h|T} = \mu\): după \(q\) pași modelul nu mai știe nimic în afară de medie.
Pe scurt
Prognoza lui \(X_{T+h}\) făcută la momentul \(T\): \(\hat X_{T+h|T} = E[X_{T+h} \mid X_T, X_{T-1}, \dots]\)
minimizează eroarea pătratică medie (MSE) între toate funcțiile de trecut
Rețeta: scriem modelul la \(T + h\) și înlocuim
șocurile viitoare \(\varepsilon_{T+j}\), \(j \ge 1\), cu 0
valorile viitoare \(X_{T+j}\) cu prognozele lor; valorile trecute și reziduurile trecute rămîn neschimbate
AR(1): \(\hat X_{T+h|T} = \mu + \phi^h(X_T - \mu)\): revenirea la medie cu viteza \(\phi\)
MA(\(q\)): \(\hat X_{T+h|T} = \mu\) pentru \(h > q\): după \(q\) pași modelul nu mai conține altă informație decît media
Eroarea de prognoză rezultă din forma cauzală \(X_{T+h} = \mu + \sum_j\psi_j\varepsilon_{T+h-j}\). Prognoza păstrează termenii cu șocurile pînă la momentul \(T\), așa că eroarea este suma șocurilor viitoare, ponderate cu primele ponderi \(\psi\):
Varianța erorii \(\sigma_h^2\) crește cu orizontul \(h\).
Cu șocuri gaussiene, intervalul de prognoză de 95% este \(\hat X_{T+h|T} \pm 1{,}96\,\sigma_h\). La \(h = 1\) el este \(\pm 1{,}96\,\sigma\). Cînd \(h \to \infty\),\(\sigma_h^2 \to \sigma^2\sum_j\psi_j^2 = \gamma(0)\), varianța necondiționată: pe termen lung, intervalul de prognoză este banda distribuției necondiționate.
Intervalul lasă deoparte trei surse de incertitudine: parametrii sînt estimați (\(\hat\phi\) în loc de \(\phi\)), modelul însuși poate fi greșit, iar șocurile pot avea cozi mai groase decît distribuția Normală. Acoperirea efectivă a intervalelor nominale de 95% este de aceea, de obicei, sub 95%. În plus, erorile prognozelor făcute în același moment pentru orizonturile \(h\) și \(h + 1\) sînt corelate, pentru că au în comun șocurile \(\varepsilon_{T+1}, \dots, \varepsilon_{T+h}\): o traiectorie de prognoză prea ridicată la un orizont tinde să fie prea ridicată și la următorul.
Pe scurt
Din forma cauzală \(X_{T+h} = \mu + \sum_j\psi_j\varepsilon_{T+h-j}\):
Revenim la \(X_t = 2 + 0{,}8X_{t-1} + \varepsilon_t\), cu \(\sigma^2 = 1\) și media \(\mu = 10\), și presupunem că ultima valoare observată este \(X_T = 12\), cu două unități peste medie. Din (2.16), prognozele punctuale sînt \(\hat X_{T+1} = 10 + 0{,}8 \cdot 2 = 11{,}60\),\(\hat X_{T+2} = 10 + 0{,}64 \cdot 2 = 11{,}28\) și \(\hat X_{T+10} = 10{,}21\).
Varianțele erorilor rezultă din (2.17) cu \(\psi_1 = 0{,}8\):\(\sigma_1^2 = 1\) și \(\sigma_2^2 = 1 + 0{,}8^2 = 1{,}64\). Intervalele de 95% sînt \([9{,}64; 13{,}56]\) la \(h = 1\) și \([8{,}77; 13{,}79]\) la \(h = 2\): intervalul se lărgește, iar centrul lui se apropie de medie.
Pe termen lung, prognoza tinde spre media 10, iar abaterea standard a erorii de prognoză tinde spre \(\sqrt{\gamma(0)} = 1{,}67\), abaterea standard necondiționată calculată în primul exemplu rezolvat.
Pe scurt
\(X_t = 2 + 0{,}8X_{t-1} + \varepsilon_t\), \(\sigma^2 = 1\), \(\mu = 10\); ultima valoare \(X_T = 12\)
Întrebare pentru sală Pentru Xt = 2 + 0,8Xt−1 + εt, spre ce lățime tinde intervalul de prognoză de 95%?
Răspuns
Spre 2 × 1,96 × √γ(0) = 2 × 1,96 × 1,67 = 6,53. Lățimea este 3,92 la h = 1, 5,02 la h = 2 și 6,50 la h = 10: incertitudinea crește repede la primele orizonturi, apoi se stabilizează la cea necondiționată.
Întrebare pentru sală Pornind din XT = 3, ce valoare are prognoza după 5 perioade pentru AR(1) cu φ = 0,9 și pentru φ = 0,5?
Răspuns
1,77 pentru φ = 0,9 (eroarea standard 1,85) și 0,094 pentru φ = 0,5, practic media. Intervalul tinde spre banda necondiționată μ ± 1,96σX, cu σX = 2,29 pentru φ = 0,9 și 1,15 pentru φ = 0,5. La MA(1), numai primul pas este informativ, θεT = 1,2; de la h = 2 prognoza este media și intervalul are lățimea de lungă durată. Butonul ▶ mută XT de la 3 la −4 și înapoi: prognozele AR(1) revin la medie din orice punct de plecare, iar intervalele nu se schimbă, pentru că erorile standard nu depind de XT.
Graficul compară prognozele a trei modele pe orizonturile de la 0 la 20: un AR(1) cu \(\phi = 0{,}9\), un AR(1) cu \(\phi = 0{,}5\) și un MA(1) cu \(\theta = 0{,}6\) și ultimul șoc \(\varepsilon_T = 2\). În toate trei, ultima valoare este \(X_T = 3\), media este \(\mu = 0\), iar abaterea standard a șocului este \(\sigma = 1\).
Linia continuă este prognoza punctuală, zona colorată intervalul de 95%, iar liniile roșii punctate banda necondiționată \(\mu \pm 1{,}96\,\sigma_X\), unde \(\sigma_X\) este abaterea standard a procesului. Distanța prognozei față de 0 măsoară informația pe care prezentul o mai poartă despre viitor; diferența dintre intervalul colorat și banda punctată măsoară cît reduce prognoza incertitudinea față de situația în care am cunoaște doar distribuția necondiționată.
Pe scurt
Pornire din \(X_T = 3\), \(\mu = 0\), \(\sigma = 1\); linie întreruptă: banda necondiționată \(\mu \pm 1{,}96\,\sigma_X\)
Cu \(\phi = 0{,}9\) revenirea este lentă: după 5 perioade prognoza este încă 1,77, cu o eroare standard de 1,85. Intervalul se apropie de lățimea lui de termen lung, \(\pm 1{,}96 \times 2{,}29\), abia după multe perioade.
Cu \(\phi = 0{,}5\), prognoza după 5 perioade este 0,094, practic media. MA(1) are un singur pas informativ: prognoza la \(h = 1\) este \(\theta\varepsilon_T = 1{,}2\), iar de la \(h = 2\) încolo este media 0; intervalul sare la lățimea de termen lung la \(h = 2\).
Un model staționar prognozează întotdeauna revenirea la medie. Acest lucru este util pentru seriile care chiar revin, cum sînt spread-urile și ratele de creștere, și înșelător cînd media însăși se schimbă: modelul trage atunci prognozele spre un nivel care nu mai este valabil.
Pe scurt
\(\phi = 0{,}9\): revenire lentă; după 5 perioade prognoza este încă 1,77, eroarea standard 1,85
intervalul se apropie de \(\pm 1{,}96 \times 2{,}29\) abia după multe perioade
\(\phi = 0{,}5\): după 5 perioade prognoza este 0,094, practic media
MA(1): un singur pas informativ (\(\theta\varepsilon_T = 1{,}2\)), apoi media; intervalul atinge lățimea de lungă durată la \(h = 2\)
Un model staționar prognozează întotdeauna revenirea la medie: util pentru spread-uri și rate de creștere, înșelător dacă media se schimbă
Prognoza optimă \(\hat X_{T+h|T}\) înlocuiește șocurile viitoare cu 0 și valorile viitoare cu prognozele lor. Varianța erorii este \(\sigma^2\sum_{j<h}\psi_j^2\), așa că intervalele se lărgesc cu orizontul pînă la \(\pm 1{,}96\sqrt{\gamma(0)}\).
Prognozele revin la \(\mu\); pentru un MA(\(q\)) ele sînt egale cu \(\mu\) după \(q\) pași. Intervalele construite cu distribuția Normală ignoră incertitudinea parametrilor și a modelului și sînt de aceea prea înguste în practică.
Pe scurt
\(\hat X_{T+h|T}\): înlocuim șocurile viitoare cu 0 și valorile viitoare cu prognoze
Varianța erorii \(\sigma^2\sum_{j<h}\psi_j^2\); intervalele se lărgesc pînă la \(\pm 1{,}96\sqrt{\gamma(0)}\)
Prognozele revin la \(\mu\); prognozele MA(\(q\)) sînt egale cu \(\mu\) după \(q\) pași
Intervalele ignoră incertitudinea parametrilor și a modelului
Sinteza secțiunii
Prognoza unui model ARMA staționar este o revenire la medie cu viteza dată de ponderile \(\psi\),(2.16) pentru AR(1); varianța erorii (2.17) cumulează aceleași ponderi și tinde spre \(\gamma(0)\).Secțiunea următoare reunește identificarea, estimarea, verificarea și prognoza într-o singură metodă.
Metoda Box–Jenkins
Secțiunile anterioare furnizează piesele: identificarea din corelograme, estimarea, selecția, diagnosticarea și prognoza. Box și Jenkins le-au reunit într-o metodă iterativă, pe care studiul de caz din secțiunea 9 o aplică apoi pas cu pas.
George E. P. Box (1919–2013) a fost statistician la University of Wisconsin–Madison. Este cunoscut pentru fraza „Toate modelele sînt greșite, dar unele sînt utile” (All models are wrong, but some are useful). Gwilym M. Jenkins (1932–1982) a fost statistician la Lancaster University. Cartea lor Time Series Analysis: Forecasting and Control a apărut în 1970; a patra ediție, împreună cu Gregory Reinsel, este Box, Jenkins și Reinsel (2008).
Contribuția lor nu a constat în modele noi: autoregresiile provin de la Yule (1927), iar mediile mobile de la Slutzky (1937). Contribuția a fost o metodă: o buclă de identificare, estimare și verificare pe care orice analist o poate aplica unei serii. Testele pentru reziduuri ale lui Box și Pierce (1970) și Ljung și Box (1978) provin din acest program.
Fraza despre modelele greșite rezumă atitudinea metodei. Un model nu este judecat după faptul că ar fi adevărat, lucru pe care niciun eșantion finit nu îl poate stabili, ci după faptul că reziduurile lui sînt zgomot alb și prognozele lui sînt utile.
Pe scurt
George E. P. Box (1919–2013), statistician, Universitatea Wisconsin–Madison
„Toate modelele sînt greșite, dar unele sînt utile”
Gwilym M. Jenkins (1932–1982), statistician, Universitatea Lancaster
Diagrama arată metoda sub forma unei bucle. Pasul 0 pregătește seria: o reprezentăm grafic, o transformăm (de exemplu, logaritmăm) și o facem staționară. Pasul 1 identifică ordinele candidate \((p, q)\) din ACF și PACF. Pasul 2 estimează candidații prin verosimilitate maximă și îi compară cu AIC și BIC. Pasul 3 verifică modelul ales: graficele reziduurilor, testul Ljung–Box și rădăcinile ambelor polinoame. Dacă modelul trece verificarea, pasul 4 produce prognozele punctuale și intervalele; dacă nu, analistul se întoarce la identificare.
Pasul 0 ține de Capitolele 1 și 3: logaritmi, diferențe și teste de rădăcină unitară. Modelele ARMA cer o serie staționară, iar estimarea lor pe o serie cu rădăcină unitară produce estimări aproape de granița regiunii de staționaritate și prognoze înșelătoare.
Bucla se încheie cu cel mai mic model ale cărui reziduuri sînt zgomot alb și ale cărui rădăcini sînt bine în interiorul regiunii admisibile. Verificările în afara eșantionului, cu setul de antrenare și setul de test din Capitolul 0, completează metoda: un model care trece toate verificările în eșantion trebuie totuși să prognozeze mai bine decît reperele simple.
Metoda Box–Jenkins transformă rezultatele capitolului într-o procedură: pregătim seria, identificăm, estimăm, verificăm și ne întoarcem la identificare pînă cînd reziduurile sînt zgomot alb, apoi prognozăm și comparăm în afara eșantionului cu repere simple. Secțiunea următoare o aplică pentru creșterea PIB-ului României.
Studiu de caz: creșterea PIB-ului României
Studiul de caz aplică bucla Box–Jenkins creșterii anuale a PIB-ului real al României. Fiecare pas al metodei are cadrul lui: datele, identificarea din corelograme, estimarea și criteriile informaționale, diagnosticarea modelului ales și prognozele. Structura datelor explică ea însăși modelul pe care îl aleg criteriile.
Seria este PIB-ul real al României în volume înlănțuite (chain-linked volumes, prețurile din 2010), trimestrial și neajustat sezonier, publicat de Eurostat; sursa națională este Institutul Național de Statistică (INS). Volumele înlănțuite elimină efectul modificărilor de preț, așa că ratele de creștere măsoară modificări ale producției reale.
Analiza folosește rata anuală de creștere \(y_t = 100\,(\ln Y_t - \ln Y_{t-4})\), în %. Comparînd fiecare trimestru cu același trimestru din anul anterior, eliminăm tiparul sezonier, așa cum a arătat Capitolul 1. Eșantionul acoperă T1 2000–T2 2026, \(T = 106\) trimestre, cu media 3,29% și abaterea standard 4,35%. Valorile extreme sînt \(-9{,}9\%\) în T2 2020 și \(+12{,}5\%\) în T4 2004, iar ultima valoare este \(-2{,}0\%\).
Rata de creștere nu are trend, ceea ce susține tratarea ei ca serie staționară; testul formal este în Capitolul 3. Fotografia de pe slide arată clădirea Institutului Național de Statistică din București.
Pe scurt
PIB-ul real al României, volume înlănțuite (prețurile din 2010), trimestrial, neajustat sezonier; Eurostat, namq_10_gdp
sursa națională: Institutul Național de Statistică (INS)
Creșterea anuală \(y_t = 100\,(\ln Y_t - \ln Y_{t-4})\), în %: elimină sezonalitatea (Capitolul 1)
T1 2000–T2 2026: \(T = 106\) trimestre, media 3,29%, abaterea standard 4,35%
extremele: \(\ensuremath{-}9{,}9\%\) în T2 2020, \(+12{,}5\%\) în T4 2004; ultima valoare \(\ensuremath{-}2{,}0\%\)
Este staționară? Rata de creștere nu are trend; testul formal este în Capitolul 3
Întrebare pentru sală ACF a creșterii anuale a PIB se anulează după lagul 3. Rămîne tiparul dacă eșantionul se oprește în T4 2019, înainte de pandemie?
Răspuns
Da. Cu 80 de trimestre, primele autocorelații sînt 0,62; 0,45; 0,24, apoi 0,04 la lagul 4, sub banda de ±0,22. Pe tot eșantionul, cu 106 trimestre: 0,62; 0,40; 0,21 și −0,01. Tiparul vine din construcția seriei: rata anuală este suma a patru rate trimestriale, iar ratele consecutive au trei trimestre comune. Ljung–Box Q*(8) = 64,9 pe tot eșantionul.
Panoul de sus arată rata anuală de creștere, cu media ei de 3,29% (linie punctată). Se disting mișcările mari din eșantion: recesiunea din 2009–2010, căderea la \(-9{,}9\%\) din T2 2020, în timpul pandemiei, revenirea din 2021 și încetinirea de la sfîrșitul eșantionului, cu valori negative în ultimele trimestre.
Panourile de jos arată ACF și PACF de selecție pentru lagurile de la 1 la 16 trimestre, cu banda \(\pm 1{,}96/\sqrt{T} = \pm 0{,}19\). Valorile din afara benzii sînt cele pe care această verificare le separă de zgomot; ele se citesc cu ajutorul tabelului de identificare din secțiunea 4.
Pe scurt
Creșterea anuală a PIB-ului real al României, ACF și PACF cu \(\pm 1{,}96/\sqrt{T} = \pm 0{,}19\)
ACF are valorile 0,62, 0,40 și 0,21 la lagurile 1–3 și \(-0{,}01\) la lagul 4: se anulează după lagul 3. Conform tabelului de identificare, candidatul este un MA(3). PACF este 0,62 la lagul 1 și mică după aceea, cu excepția valorii 0,32 de la lagul 5. Citită singură, ea indică un AR(1); valoarea de la lagul 5 poate fi întîmplătoare sau un rest al tiparului sezonier.
Modelul MA(3) are o explicație structurală. Rata anuală de creștere este aproximativ suma a patru rate trimestriale de creștere, \(y_t \approx g_t + g_{t-1} + g_{t-2} + g_{t-3}\), unde \(g_t = 100\,(\ln Y_t - \ln Y_{t-1})\). Dacă ratele trimestriale \(g_t\) sînt apropiate de un zgomot alb (Seminarul 2, sarcina B2), două rate anuale aflate la un trimestru distanță au în comun trei dintre cei patru termeni trimestriali, cele aflate la două trimestre au în comun doi, cele aflate la trei trimestre unul, iar cele aflate la patru trimestre niciunul. Rezultatul este un MA(3) prin construcție.
Înainte de estimarea oricărui model, statistica Ljung–Box pentru seria însăși este \(Q^*(8) = 64{,}9\). Seria este puternic autocorelată, deci este nevoie de un model: media singură ar lăsa structură predictibilă în erori.
Pe scurt
ACF: \(0{,}62\); \(0{,}40\); \(0{,}21\), apoi \(\ensuremath{-}0{,}01\) la lagul 4: se anulează după lagul 3
candidat: MA(3)
PACF: \(0{,}62\) la lagul 1, apoi valori mici, cu excepția lui \(0{,}32\) la lagul 5
candidat: AR(1); lagul 5 poate fi întîmplător sau o urmă a sezonalității
Motivul pentru MA(3): \(y_t\) este suma a patru rate trimestriale de creștere, \(y_t \approx g_t + g_{t-1} + g_{t-2} + g_{t-3}\)
dacă \(g_t\) este aproape de un zgomot alb (Seminarul 2, B2), ratele anuale consecutive au trei trimestre comune: un MA(3) prin construcție
Ljung–Box \(Q^*(8) = 64{,}9\) pentru seria însăși: puternic autocorelată, deci este nevoie de un model
Tabelul compară șapte modele, toate estimate prin verosimilitate maximă gaussiană exactă pe aceleași 106 trimestre. Pentru fiecare, el dă numărul de parametri \(k\), log-verosimilitatea maximizată \(\ln L\), AIC, BIC, abaterea standard a reziduurilor \(\hat\sigma\) și p-value-ul testului Ljung–Box \(Q^*(8)\) pentru reziduuri, cu \(8 - p - q\) grade de libertate. Căutarea completă acoperă toate perechile \(p, q \le 3\).
Modelul care conține doar media, ARMA(0,0), are \(\ln L = -305{,}83\) și un p-value Ljung–Box sub 0,001. AR(1) ridică \(\ln L\) la \(-279{,}67\) și reduce \(\hat\sigma\) de la 4,33 la 3,38, dar reziduurile lui rămîn autocorelate, cu un p-value de 0,023. Adăugarea unui al doilea parametru, în AR(2) sau în ARMA(1,1), lasă \(\ln L\) la \(-279{,}66\): parametrul suplimentar este inutil, iar ambele teste pentru reziduuri resping în continuare la 5%.
MA(3) ajunge la \(\ln L = -270{,}02\), AIC 550,04, BIC 563,36, \(\hat\sigma = 3{,}07\) și un p-value Ljung–Box de 0,375. ARMA(1,3) are cel mai mic AIC, 548,97, mai mic cu doar 1,07, dar un BIC mai mare, 564,95. BIC alege deci MA(3), iar AIC alege ARMA(1,3); ARMA(2,3) nu este mai bun după niciun criteriu. AR(1), candidatul sugerat de PACF, este respins de diagnosticare.
Pe scurt
Modelul
\(k\)
\(\ln L\)
AIC
BIC
\(\hat\sigma\)
LB, p-value
ARMA(0,0)
2
\(\ensuremath{-}305{,}83\)
615,66
620,99
4,33
\(<\) 0,001
ARMA(1,0)
3
\(\ensuremath{-}279{,}67\)
565,33
573,32
3,38
0,023
ARMA(2,0)
4
\(\ensuremath{-}279{,}66\)
567,32
577,98
3,38
0,037
ARMA(1,1)
4
\(\ensuremath{-}279{,}66\)
567,32
577,98
3,38
0,013
ARMA(0,3)
5
\(\ensuremath{-}270{,}02\)
550,04
563,36
3,07
0,375
ARMA(1,3)
6
\(\ensuremath{-}268{,}48\)
548,97
564,95
3,02
0,648
ARMA(2,3)
7
\(\ensuremath{-}267{,}94\)
549,89
568,53
3,00
0,543
MLE exactă gaussiană pe aceleași 106 trimestre; LB = Ljung–Box \(Q^*(8)\) pentru reziduuri, cu \(8 - p - q\) grade de libertate; grila completă \(p, q \le 3\) în Quantlet
BIC alege MA(3); AIC alege ARMA(1,3), mai mic cu doar 1,07
AR(1), candidatul sugerat de PACF, lasă autocorelație: p-value-ul testului LB este 0,023
Modelul estimat este \(\hat y_t = 3{,}17 + \hat\varepsilon_t + 0{,}834\,\hat\varepsilon_{t-1} + 0{,}675\,\hat\varepsilon_{t-2} + 0{,}591\,\hat\varepsilon_{t-3}\), cu \(\hat\sigma = 3{,}07\). Erorile standard OPG sînt 1,03 pentru medie și 0,083, 0,102 și 0,082 pentru cei trei coeficienți MA, deci toți cei trei termeni MA sînt semnificativi.
Coeficienții scad de la 0,834 la 0,591. Ei sînt aproape de tiparul \((1, 1, 1)\), dar sub el; acest tipar ar rezulta din suprapunerea a patru trimestre dacă creșterea trimestrială ar fi exact zgomot alb. El ar plasa rădăcinile lui \(\theta(z) = 1 + z + z^2 + z^3\) pe cercul unitate; pentru modelul estimat, cel mai mic modul al rădăcinilor este 1,17, peste 1, deci modelul este invertibil.
În ARMA(1,3), primul coeficient MA este \(\hat\theta_1 = 1{,}019 > 1\), și totuși toate rădăcinile lui \(\theta(z)\) au modulul de cel puțin 1,10, așa că și acest model este invertibil: pentru \(q > 1\), invertibilitatea se citește din rădăcini, nu din coeficienți luați separat. Coeficientul lui AR este \(\hat\phi = -0{,}284\), cu eroarea standard 0,143: un parametru în plus pentru un cîștig mic, pe care BIC îl elimină. Creșterea medie este de 3,17% pe an, dar cu o eroare standard de 1,03: observațiile care se suprapun conțin mai puțină informație decît sugerează cele 106 trimestre.
Întrebare pentru sală Pe toată grila p, q ≤ 3, ce model are cel mai mic AICc și ce diferență are față de MA(3)?
Răspuns
ARMA(1,3), cu AICc 549,82 față de 550,64 pentru MA(3), o diferență de 0,82. Pe AIC, ARMA(2,3) este al doilea, la 0,92 de minim, înaintea lui MA(3) (1,07), iar ARMA(3,3) este la 2,37. Pe BIC, MA(3) are 563,36, iar ARMA(1,3) îl urmează la 1,59.
Întrebare pentru sală În ARMA(1,3), θ̂₁ = 1,019 > 1. Este modelul invertibil?
Răspuns
Da: rădăcinile polinomului θ(z) au modulele 1,102; 1,181; 1,181, toate peste 1. Pentru q > 1 invertibilitatea se citește din rădăcini, nu din coeficienți luați separat. Coeficientul AR, φ̂ = −0,284 cu se 0,143, are raportul t −1,98, abia peste pragul de 1,96.
Întrebare pentru sală Pentru MA(3), testul Ljung–Box cu m = 8 dă p = 0,375 cu 5 grade de libertate. Ce p-value ar da cu 8 grade de libertate?
Răspuns
0,720, o concluzie prea liniștitoare: gradele de libertate trebuie reduse cu numărul parametrilor ARMA estimați. Reziduurile nu sînt Normale: Jarque–Bera 39,0, p < 0,001, asimetria −0,75, kurtosis-ul 5,61; cel mai mare reziduu, −11,4 în T2 2020, are −3,89 abateri standard. AR(1) lasă corelație în reziduuri: Q*(8) = 16,2 cu 7 grade de libertate, p = 0,023.
Graficul are patru panouri. Cel din stînga sus arată reziduurile modelului MA(3) în timp, iar cel din dreapta sus ACF lor, cu banda \(\pm 1{,}96/\sqrt{T}\). Cel din stînga jos dă p-value-urile testului Ljung–Box pentru \(m = 4, \dots, 16\), fiecare cu \(m - 3\) grade de libertate, față de nivelul de 5% (linia punctată). Cel din dreapta jos este un grafic QQ Normal al reziduurilor standardizate.
Într-un grafic QQ, cuantilele de selecție ale reziduurilor sînt reprezentate în funcție de cuantilele distribuției Normale; dacă reziduurile urmează distribuția Normală, punctele se află pe linia roșie. Punctele de sub linie din colțul din stînga jos sînt reziduuri negative mai extreme decît permite distribuția Normală, adică o coadă stîngă groasă.
Pe scurt
Reziduurile, ACF lor, p-value-urile testului Ljung–Box pentru \(m = 4, \dots, 16\), cu \(m - 3\) grade de libertate, graficul QQ față de distribuția Normală
Reziduurile nu au autocorelație. Statistica Ljung–Box este \(Q^*(8) = 5{,}35\) cu 5 grade de libertate, cu un p-value de 0,375, iar testul pentru \(m = 16\) are un p-value de 0,525. Toate p-value-urile din grafic sînt peste 0,12. Cu 8 în loc de 5 grade de libertate, p-value-ul lui \(Q^*(8)\) ar fi 0,720, un rezultat care pare mai liniștitor decît justifică datele.
Reziduurile nu urmează distribuția Normală: statistica Jarque–Bera este 39,0, cu un p-value sub 0,001, asimetria este \(-0{,}75\), iar kurtosis-ul 5,61. Cel mai mare reziduu este \(-11{,}4\) în T2 2020, adică \(-3{,}89\) abateri standard: perioada de lockdown din pandemie, un șoc pe care niciun model construit pe PIB-ul trecut nu l-ar fi putut anticipa.
Testul Ljung–Box pentru pătratele reziduurilor are un p-value de 0,779, deci nu există volatility clustering la această frecvență. Verdictul este că MA(3) surprinde dependența din serie, dar intervalele construite cu distribuția Normală subestimează riscul recesiunilor.
Pe scurt
Fără autocorelație în reziduuri: \(Q^*(8) = 5{,}35\) cu 5 grade de libertate, p = 0,375; \(Q^*(16)\): p = 0,525
toate p-value-urile din grafic sînt peste 0,12; cu 8 în loc de 5 grade de libertate, p ar fi 0,720, prea liniștitor
Nu este Normal: Jarque–Bera 39,0, p \(<\) 0,001; asimetria \(-\)0,75, kurtosis-ul 5,61
cel mai mare reziduu: \(\ensuremath{-}11{,}4\) în T2 2020, \(-\)3,89 abateri standard: perioada de lockdown din pandemie
Pătratele reziduurilor: testul Ljung–Box dă p = 0,779, fără volatility clustering la această frecvență
Întrebare pentru sală De ce nu se mai lărgește intervalul MA(3) după h = 4, în timp ce intervalul AR(1) continuă să crească?
Răspuns
La MA(3), ψj = 0 pentru j > 3, deci σh rămîne σ̂√(1 + θ̂₁² + θ̂₂² + θ̂₃²) = 3,07 × √2,50 = 4,85 de la h = 4. La AR(1), σh crește de la 3,38 la 4,35 la h = 8. Lățimea intervalului de 95% trece de la 12,0 la 19,0 pentru MA(3) și de la 13,2 la 17,0 pentru AR(1). Cu originea în T4 2019, RMSE pe cele 8 trimestre observate este 7,41 pentru MA(3) și 7,06 pentru AR(1).
Întrebare pentru sală De la ce orizont devine constantă prognoza MA(3)?
Răspuns
De la al patrulea trimestru: −0,14; 1,81; 2,77, apoi media de 3,17%. După q = 3 pași modelul cunoaște doar media. AR(1) revine treptat: 2,99% după 8 trimestre, cu media 3,12%. Intervalele de 95% sînt [−6,1; 5,9] pentru un trimestru și [−6,3; 12,7] de la patru trimestre. Cu originea în T4 2019, ambele modele prognozează peste 3,8% pentru 2020, iar seria scade la −9,9% în T2 2020.
Graficul arată rata de creștere observată din 2016 și prognozele pentru T3 2026–T2 2028 din două modele: MA(3), ales de BIC (roșu), și AR(1) (albastru), fiecare cu intervalul de 95%.
Ambele prognoze pornesc puțin sub zero, aproape de ultimele valori observate, și urcă spre medie. MA(3) ajunge la medie după trei trimestre și rămîne apoi constant; AR(1) se apropie treptat de media lui. Cele două intervale colorate sînt largi în comparație cu mișcările seriei din ultimii ani și se suprapun aproape complet.
Pe scurt
Prognozele MA(3) (BIC) și AR(1) pentru T3 2026–T2 2028, cu intervale de 95%
MA(3) prognozează \(-0{,}14\%\),\(1{,}81\%\) și \(2{,}77\%\) pentru următoarele trei trimestre și apoi media, 3,17%, începînd cu al patrulea trimestru. Aceasta este exact regula pentru MA(\(q\)): după \(q = 3\) pași modelul cunoaște doar media.
AR(1) revine lin la media lui și ajunge la 2,99% după 8 trimestre, față de o medie de 3,12%. Cele două modele sînt de acord pe termen scurt și diferă prin viteza cu care uită încetinirea recentă.
Intervalele de 95% ale modelului MA(3) sînt \([-6{,}1; 5{,}9]\) pentru un trimestru înainte și \([-6{,}3; 12{,}7]\) începînd cu al patrulea trimestru, adică \(\pm 6{,}0\) și \(\pm 9{,}5\) puncte procentuale. Deoarece reziduurile au cozi groase, aceste intervale subestimează probabilitatea unei recesiuni adînci. Un model univariat nu poate anticipa un punct de întoarcere; el arată cît de neobișnuită ar fi următoarea valoare, dat fiind trecutul seriei.
Pe scurt
MA(3): \(\ensuremath{-}0{,}14\); \(1{,}81\); \(2{,}77\), apoi media de \(3{,}17\%\) începînd cu al patrulea trimestru
exact regula MA(\(q\)): după \(q = 3\) pași modelul cunoaște doar media
AR(1): o revenire netedă la medie, 2,99% după 8 trimestre (media 3,12%)
cele două modele coincid pe termen scurt și diferă prin viteza cu care se estompează efectul încetinirii recente
Intervalele: \([\ensuremath{-}6{,}1; 5{,}9]\) pentru un trimestru, \([\ensuremath{-}6{,}3; 12{,}7]\) începînd cu patru trimestre: \(\pm 6{,}0\) și \(\pm 9{,}5\) puncte procentuale
Un model univariat nu poate anticipa un punct de întoarcere; ne spune cît de neobișnuită ar fi următoarea valoare
Pentru creșterea anuală a PIB-ului trimestrial, ACF se anulează după lagul 3; BIC alege MA(3), iar AIC alege ARMA(1,3). MA(3) reflectă suprapunerea a patru trimestre în rata anuală de creștere: structura datelor explică modelul.
Reziduurile sînt zgomot alb, dar au cozi groase din cauza anului 2020, așa că intervalele construite cu distribuția Normală sînt prea înguste în crize. Prognozele ajung la medie după trei trimestre.
Pe scurt
Creșterea anuală a PIB-ului trimestrial: ACF se anulează după lagul 3, MA(3) după BIC, ARMA(1,3) după AIC
MA(3) reflectă suprapunerea a patru trimestre: structura datelor explică modelul
Reziduuri de tip zgomot alb, dar cozi groase (2020): intervalele sînt prea înguste în crize
Prognozele ajung la medie după trei trimestre
Sinteza secțiunii
Bucla Box–Jenkins aplicată creșterii PIB-ului se încheie cu un MA(3): corelogramele îl sugerează, BIC îl alege, testele Ljung–Box cu \(m - 3\) grade de libertate îl acceptă, iar construcția ratelor anuale de creștere îl explică. Diagnosticarea arată și limita lui, reziduurile cu cozi groase, care fac intervalele construite cu distribuția Normală prea înguste în recesiuni. Secțiunea următoare aplică aceleași instrumente unor serii de alte tipuri.
Alte serii reale
Metoda se aplică aici la trei serii cu caractere diferite: inflația lunară, foarte persistentă; randamentele zilnice ale indicelui BET și ale cursului EUR/RON, aproape imprevizibile în medie; și numerele istorice de pete solare ale lui Yule. Un ultim studiu de caz rezumă ce spun competițiile de prognoză despre modelele ARMA.
Întrebare pentru sală Spre ce valoare revine prognoza AR(2): spre ținta BNR sau spre media estimată?
Răspuns
Spre media estimată, 5,16%, care este media perioadei 2005–2026, nu spre ținta de 2,5%: de la 6,09% în august 2026 la 5,44% în septembrie și 5,13% în august 2028. φ̂₁ + φ̂₂ = 0,976, iar cea mai mare rădăcină inversă are modulul 0,963, deci revenirea este lentă. Testul Ljung–Box pe reziduuri respinge: Q*(12) = 71,6 cu 10 grade de libertate, p < 0,001.
Seria este rata pe 12 luni a indicelui armonizat al prețurilor de consum (HICP, harmonised index of consumer prices) pentru România, publicat de Eurostat, în %: 260 de luni pînă în august 2026. Ordinul AR este ales de BIC dintre \(p \le 6\).
Graficul arată rata inflației (roșu), prognoza AR(2) cu intervalele de 80% și 95% (zone colorate), media estimată de 5,16% (linie portocalie punctată) și ținta de inflație a Băncii Naționale a României (BNR), 2,5% ± 1 punct procentual (banda verde). Eșantionul include perioade de inflație negativă în jurul anilor 2015–2016 și vîrful din 2022–2023.
Pe scurt
IAPC (indicele armonizat al prețurilor de consum, Eurostat), rata pe 12 luni în %, 260 de luni pînă în august 2026; ordinul AR ales prin BIC dintre \(p \le 6\)
BIC este 495,7 pentru AR(1), 469,7 pentru AR(2) și 473,4 pentru AR(3), deci se alege AR(2). Coeficienții lui sînt \(\hat\phi_1 = 1{,}320\) (eroarea standard 0,057) și \(\hat\phi_2 = -0{,}344\) (eroarea standard 0,055). Suma lor este 0,976, iar cea mai mare rădăcină inversă are modulul 0,963.
Modelul este foarte aproape de o rădăcină unitară, ceea ce ridică întrebarea dacă inflația este staționară; testul este în Capitolul 3. Media estimată, 5,16%, cu eroarea standard 1,35, este media perioadei 2005–2026 și se află peste ținta BNR de 2,5% ± 1 punct procentual. Prognoza merge de la ultima valoare, 6,09%, la 5,44% luna următoare și la 5,13% în august 2028, cu un interval de 95% de \([-0{,}6; 10{,}9]\) la acest orizont. Modelul revine la media istorică, nu la țintă: el nu conține nicio informație despre politica monetară.
Diagnosticarea eșuează: statistica Ljung–Box este \(Q^*(12) = 71{,}6\), cu un p-value sub 0,001. Reziduurile sînt corelate la lagul 12, o consecință a efectelor de bază (base effects): un șoc de preț intră în rata pe 12 luni cînd se produce și iese din ea douăsprezece luni mai tîrziu. Modelarea acestei structuri sezoniere este o sarcină pentru Capitolul 4.
Pe scurt
BIC: 495,7 pentru AR(1), 469,7 pentru AR(2), 473,4 pentru AR(3): AR(2)
\(\hat\phi_1 = 1{,}320\) (0,057), \(\hat\phi_2 = \ensuremath{-}0{,}344\) (0,055); \(\hat\phi_1 + \hat\phi_2 = 0{,}976\), cea mai mare rădăcină inversă 0,963
Foarte aproape de o rădăcină unitară: este inflația staționară? Testul este în Capitolul 3
media estimată, \(5{,}16\%\) (eroarea standard 1,35), este media perioadei 2005–2026, peste ținta BNR de 2,5% \(\pm\) 1 p.p.
Prognoza: de la 6,09% la 5,44% luna viitoare și 5,13% în august 2028; intervalul de 95%: \([\ensuremath{-}0{,}6; 10{,}9]\)
modelul revine la media istorică, nu la țintă: nu conține informații despre politica monetară
Diagnosticarea eșuează: Ljung–Box \(Q^*(12) = 71{,}6\), p \(<\) 0,001: corelație la lagul 12 (efectele de bază ale ratei pe 12 luni), o temă pentru Capitolul 4
Întrebare pentru sală Slide-ul dă pentru BET raportul t = 20,9. Este acesta raportul t calculat cu eroarea standard clasică?
Răspuns
Nu. Eroarea standard din slide, 0,0052, este cea OPG, implicită în statsmodels; eroarea standard clasică, din curbura log-verosimilității, este 0,0122, apropiată de √((1 − φ̂²)/T) = 0,0122, iar raportul t este 9,0. Pentru EUR/RON, 12,6 în loc de 30,6. Coeficienții rămîn foarte semnificativi, dar R² este 1,2%, respectiv 2,9%.
Întrebare pentru sală Pentru BET, φ̂ = 0,109 este foarte semnificativ. Explică AR(1) o parte importantă din variația randamentelor zilnice?
Răspuns
Nu: R² este 1,2% pentru BET și 2,9% pentru EUR/RON. Rezultatul este real din punct de vedere statistic, dar mic din punct de vedere economic. Pătratele reziduurilor sînt puternic autocorelate (Ljung–Box Q*(10) = 2496 pentru BET și 2351 pentru EUR/RON), iar kurtosis-ul reziduurilor este 14,0 și 17,0: modelul descrie media, nu varianța.
Panourile din stînga arată ACF a randamentelor logaritmice zilnice ale indicelui BET al Bursei de Valori București și ale cursului EUR/RON, pentru laguri de la 1 la 20 de zile. Panourile din dreapta arată ACF a pătratelor reziduurilor unui AR(1) estimat pentru fiecare serie. Banda este \(\pm 1{,}96/\sqrt{T}\), foarte îngustă, pentru că ambele eșantioane au mii de observații.
În randamente, lagul 1 este clar pozitiv, iar celelalte laguri sînt mici, deși mai multe ies din banda îngustă. În pătratele reziduurilor toate lagurile sînt pozitive și mult în afara benzii: randamentele înseși sînt greu de prevăzut, dar mărimea lor nu.
Pe scurt
Stînga: ACF a randamentelor logaritmice zilnice; dreapta: ACF a pătratelor reziduurilor unui AR(1)
Tabelul prezintă modelul AR(1) pentru ambele serii. Pentru BET (6 670 de observații), \(\hat\phi = 0{,}109\), cu eroarea standard 0,005, raportul \(t\) 20,9 și un \(R^2\) de 1,2%. Pentru EUR/RON (5 352 de observații), \(\hat\phi = 0{,}170\), cu eroarea standard 0,006, raportul \(t\) 30,6 și un \(R^2\) de 2,9%. Acestea sînt erori standard OPG. Cu un kurtosis al reziduurilor de 14 și 17, ele sînt prea mici: erorile standard din curbura verosimilității sau cele robuste sînt de cîteva ori mai mari, dar ambii coeficienți rămîn semnificativi. Coeficienții sînt foarte semnificativi, dar explică doar 1–3% din varianță: efectul este real din punct de vedere statistic și mic din punct de vedere economic, odată ce se iau în calcul costurile de tranzacționare.
Statisticile Ljung–Box \(Q^*(10)\) pentru reziduuri, cu 9 grade de libertate, sînt 29,7 și 61,5, ambele cu p-value sub 0,001, deci AR(1) nu surprinde toată dependența din medie; BIC pe \(p, q \le 2\) alege ARMA(1,0) pentru BET și ARMA(2,1) pentru EUR/RON. Valoarea pozitivă a lui \(\hat\phi\) are explicații economice: ajustarea lentă a prețurilor pentru BET și un curs de schimb în regim de managed float pentru EUR/RON.
Statisticile Ljung–Box pentru pătratele reziduurilor sînt 2496 pentru BET și 2351 pentru EUR/RON, iar kurtosis-ul reziduurilor este 14,0 și 17,0. Media este modelată, varianța nu: mișcările mari se grupează în timp, iar combinația dintre modelele ARMA și GARCH din Capitolul 5 tratează acest aspect.
Pe scurt
BET
EUR/RON
Observații
6 670
5 352
\(\hat\phi\) (se OPG)
\(0{,}109\) (0,005)
\(0{,}170\) (0,006)
Raportul \(t\)
20,9
30,6
\(R^2\) (%)
1,2
2,9
LB \(Q^*(10)\) reziduuri, 9 g.l. (p)
29,7 (\(<\) 0,001)
61,5 (\(<\) 0,001)
LB \(Q^*(10)\) pătratele reziduurilor
2496
2351
Kurtosis-ul reziduurilor
14,0
17,0
Alegerea BIC, \(p, q \le 2\)
ARMA(1,0)
ARMA(2,1)
se: OPG; cu cozi groase (kurtosis 14,0 și 17,0) acestea sînt prea mici, iar erorile standard din curbură sau robuste sînt de cîteva ori mai mari, totuși \(\hat\phi\) rămîne semnificativ
\(\hat\phi\) foarte semnificativ, dar un \(R^2\) de 1–3%: real din punct de vedere statistic, mic din punct de vedere economic după costurile de tranzacționare
\(\hat\phi\) pozitiv: ajustarea lentă a prețurilor (BET), un curs de schimb în regim de managed float (EUR/RON)
Pătratele reziduurilor și kurtosis-ul: media este modelată, varianța nu; ARMA + GARCH în Capitolul 5
Yule (1927) a estimat prima autoregresie, pentru numerele anuale de pete solare ale lui Wolfer din perioada 1749–1924. Pînă atunci, ciclurile din date erau modelate ca sume de sinusoide, analizate cu periodograma. Yule a propus un mecanism diferit, un „pendul bombardat cu mazăre”: un oscilator amortizat, lovit de șocuri aleatoare. Ciclul provine din dinamica sistemului, iar neregularitatea lui din șocuri.
Un AR(2) estimat prin cele mai mici pătrate pe aceiași ani, 176 de observații, dă \(\hat\phi_1 = 1{,}336\) și \(\hat\phi_2 = -0{,}650\). Rădăcinile sînt complexe, iar modulul rădăcinilor inverse este 0,806. Perioada implicită, \(2\pi/\arccos\big(\hat\phi_1/(2\sqrt{-\hat\phi_2})\big)\), este de 10,57 ani: doi coeficienți regăsesc ciclul solar.
Walker (1931) a generalizat ecuațiile la AR(\(p\)), iar de atunci ele se numesc ecuațiile Yule–Walker. Aceste două articole marchează începutul analizei parametrice a seriilor de timp.
Pe scurt
Yule (1927) a estimat prima autoregresie: numerele anuale ale petelor solare ale lui Wolfer, 1749–1924
pînă atunci, ciclurile erau modelate ca sume de sinusoide (periodograma)
Yule: un „pendul bombardat cu mazăre”: un oscilator amortizat lovit de șocuri aleatoare
AR(2)-ul nostru, estimat prin cele mai mici pătrate pe aceiași ani (176 de observații, datele din statsmodels):
Întrebare pentru sală Ce perioadă a ciclului solar implică AR(2)-ul lui Yule estimat pe 1749–1924?
Răspuns
10,6 ani. Coeficienții estimați, φ̂₁ = 1,336 și φ̂₂ = −0,650, dau rădăcini complexe; perioada este 2π/arccos(φ̂₁/(2√−φ̂₂)) = 10,6, iar modulul rădăcinii inverse 0,806. Pe întregul eșantion, AR(2) explică 83% din varianță cu un an înainte, iar AIC și BIC aleg amîndouă p = 9 dintre p ≤ 10.
Panoul din stînga arată numerele anuale de pete solare pentru 1700–2008, 309 ani, împreună cu predicțiile cu un pas ale unui AR(2) estimat prin verosimilitate maximă pe întregul eșantion; zona colorată marchează eșantionul lui Yule, 1749–1924. Panoul din dreapta arată AIC și BIC pentru modele AR(\(p\)) cu \(p = 1, \dots, 10\), estimate pe întregul eșantion.
Predicțiile urmăresc îndeaproape ciclurile observate. În panoul din dreapta, ambele criterii scad brusc de la \(p = 1\) la \(p = 2\), rămîn aproximativ constante pentru cîteva ordine și ating minimul la \(p = 9\).
Pe scurt
Numerele anuale ale petelor solare, 1700–2008 (309 ani); AR(\(p\)) prin MLE pe întregul eșantion
AR(2) estimat pe întregul eșantion are \(\hat\phi = (1{,}391; -0{,}689)\), aproape de estimațiile lui Yule pe eșantionul mai scurt. El explică 83% din varianța numerelor de pete solare cu un an înainte. Predicțiile cu un pas urmăresc ciclul, dar rămîn în urmă la vîrfuri: modelul reacționează la un vîrf abia după ce l-a observat.
AIC și BIC aleg amîndouă \(p = 9\) dintre ordinele pînă la 10. Lagurile suplimentare surprind o trăsătură pe care AR(2) nu o poate reproduce: ciclul solar este asimetric, cu o creștere rapidă și o scădere lentă, în timp ce un AR(2) liniar generează oscilații simetrice.
Lecția depășește cazul petelor solare. Doi parametri surprind esența seriei, ciclul ei; mai multe laguri surprind detaliile; iar trăsăturile neliniare, cum este asimetria ciclului, sînt dincolo de modelele ARMA.
Pe scurt
AR(2) pe întregul eșantion: \(\hat\phi = (1{,}391; \ensuremath{-}0{,}689)\), apropiat de cel al lui Yule; explică 83% din varianță cu un an înainte
predicțiile cu un pas urmează ciclul, dar întîrzie la vîrfuri
AIC și BIC aleg amîndouă \(p = 9\) dintre \(p \le 10\)
ciclul este asimetric (creștere rapidă, scădere lentă), ceea ce un AR(2) liniar nu poate reproduce
Lecția: doi parametri surprind esențialul; mai multe laguri surprind detaliile; neliniaritatea depășește cadrul ARMA
Makridakis și Hibon (2000) prezintă competiția M3: 3 003 serii (anuale, trimestriale, lunare și altele), prognozate cu 24 de metode. Prognozele au fost comparate în afara eșantionului, cu mai multe măsuri de acuratețe și pe mai multe orizonturi.
Competiția a confirmat concluziile competițiilor M anterioare. Metodele sofisticate din punct de vedere statistic nu prognozează neapărat mai bine decît cele simple. Clasamentul metodelor depinde de măsura de acuratețe și de orizont, iar combinațiile de metode au rezultate bune.
Pentru modelele ARMA, consecința este că bucla Box–Jenkins trebuie să se încheie cu o comparație în afara eșantionului cu repere simple: media, ultima valoare și netezirea exponențială din Capitolul 0. Un model care trece toată diagnosticarea în eșantion nu a arătat încă că prognozează mai bine. Seminarul 2, sarcina C1, face această comparație pentru inflația din România.
Pe scurt
Makridakis și Hibon (2000): competiția M3, 3003 serii (anuale, trimestriale, lunare, altele), 24 de metode
prognoze comparate în afara eșantionului, după mai multe măsuri de acuratețe și orizonturi
Concluzii confirmate față de competițiile M anterioare
metodele sofisticate statistic nu prognozează neapărat mai bine decît cele simple
clasamentul depinde de măsura de acuratețe și de orizont; combinațiile de metode au rezultate bune
Consecințe pentru ARMA
bucla Box–Jenkins trebuie să se încheie cu o comparație în afara eșantionului cu repere simple (media, ultima valoare, netezirea exponențială din Capitolul 0)
Seminarul 2, C1 face această comparație pentru inflația din România
Inflația este descrisă de un AR(2) aproape de o rădăcină unitară; modelul revine la media istorică și lasă corelație în reziduuri la lagul 12. Randamentele zilnice au efecte AR semnificative, dar foarte mici, iar varianța lor cere modele GARCH.
AR(2) al lui Yule regăsește ciclul solar de 11 ani din rădăcini complexe. Competițiile de prognoză arată că orice model trebuie comparat cu repere simple.
Pe scurt
Inflația: AR(2) aproape de o rădăcină unitară; revine la media istorică; corelație reziduală la lagul 12
Randamentele zilnice: efecte AR semnificative, dar foarte mici; varianța cere GARCH
Petele solare: AR(2)-ul lui Yule dă ciclul de 11 ani din rădăcini complexe
Competițiile de prognoză: comparați întotdeauna cu repere simple
Sinteza secțiunii
Aceleași instrumente dau verdicte diferite pe serii diferite. Pentru inflație, AR(2) este aproape de o rădăcină unitară și nu trece diagnosticarea la lagul 12; pentru randamentele zilnice, coeficienții AR sînt semnificativi, dar explică puțin, iar dependența se află în varianță; pentru petele solare, doi coeficienți produc ciclul de 11 ani, iar nouă laguri îi descriu mai bine asimetria. Competițiile de prognoză adaugă ultima verificare: comparația cu repere simple în afara eșantionului.
Contribuția posibilă a AI
Instrumentele bazate pe inteligență artificială (AI, artificial intelligence) pot schița cod, pot oferi o a doua explicație a unei derivări și pot repeta bucla Box–Jenkins pe multe serii. Cele două cadre ale secțiunii descriu ce pot aduce și ce trebuie să verifice analistul înainte de a le folosi rezultatele.
Un asistent AI poate produce o primă variantă de cod care estimează modele ARMA(\(p,q\)) pe o grilă de ordine, tabelează AIC și BIC și rulează testele pentru reziduuri. Poate oferi și o a doua derivare a unui rezultat, de exemplu ACF a unui ARMA(1,1) sau motivul pentru care PACF a unui MA descrește, pe care cititorul o poate compara rînd cu rînd cu derivarea din curs.
Poate extinde o analiză la multe serii: aceeași buclă Box–Jenkins aplicată creșterii PIB-ului tuturor țărilor din Uniunea Europeană (UE), de exemplu, pentru a compara persistența ciclurilor lor economice.
Exemplul de prompt de pe slide arată nivelul de detaliu de care are nevoie o cerere utilă: sursa datelor, grila de ordine, criteriile, gradele de libertate ale testului Ljung–Box (model_df = p + q) și orizontul de prognoză. O cerere vagă lasă aceste alegeri pe seama instrumentului, iar valorile implicite sînt adesea chiar cele împotriva cărora avertizează cadrul următor.
Pe scurt
Cod: o primă versiune a unei bucle care estimează ARMA(\(p,q\)) pe o grilă, tabelează AIC și BIC și aplică testele pe reziduuri
Explicații: o a doua deducere a ACF pentru un ARMA(1,1) sau a motivului pentru care PACF a unui MA descrește
Explorare: aceeași buclă Box–Jenkins pe multe serii (creșterea PIB a tuturor țărilor UE), pentru a compara persistența
Exemplu de prompt
Write Python code with statsmodels that fits ARMA(p,q), p,q <= 3, to Romanian annual GDP growth from Eurostat, reports AIC, BIC and the Ljung-Box p-value with model_df = p + q, and forecasts 8 quarters from the BIC model.
Primele verificări privesc convențiile. Programele scriu polinomul MA fie ca \(\theta(L) = 1 + \theta L\) (așa face statsmodels), fie ca \(1 - \theta L\) (așa fac unele manuale), așa că semnul fiecărui \(\theta\) trebuie verificat. Constanta raportată de clasa ARIMA din statsmodels este media \(\mu\), nu termenul liber \(c\).
Următoarele verificări privesc inferența. Testul Ljung–Box pentru reziduuri trebuie să folosească \(m - p - q\) grade de libertate, iar toate modelele comparate prin criterii informaționale trebuie estimate pe același eșantion. Staționaritatea și invertibilitatea se citesc din rădăcinile ambelor polinoame, nu din mărimea coeficienților luați separat.
Ultimele verificări privesc metoda. Seria trebuie să fie staționară înainte de estimarea unui model ARMA (Capitolul 3), iar prognozele trebuie comparate cu repere simple. Orice referință citată de un instrument AI trebuie să existe; DOI-ul ei trebuie verificat.
Pe scurt
Convenția de semn pentru \(\theta\) și \(\phi\) în program (\(\theta(L) = 1 + \theta L\) în statsmodels, \(1 - \theta L\) în unele manuale)
Termenul liber sau media: const din ARIMA este media \(\mu\), nu \(c\)
Gradele de libertate ale testului Ljung–Box pentru reziduuri (\(m - p - q\)) și faptul că toate modelele sînt comparate pe același eșantion
Rădăcinile ambelor polinoame, nu mărimea coeficienților luați separat
Că seria este staționară înainte de estimarea unui ARMA (Capitolul 3) și că prognozele sînt comparate cu repere simple
Fiecare referință citată: trebuie să existe; verificați DOI-ul
Sinteza secțiunii
Instrumentele AI scurtează scrierea codului și pot repeta analiza pe multe serii, dar deciziile care fac o analiză ARMA corectă rămîn ale analistului: convențiile de semn, semnificația constantei, gradele de libertate ale testului pentru reziduuri, rădăcinile, staționaritatea seriei și comparația cu reperele simple.
Rezumat
Rezumatul adună rezultatele principale, formulele de reținut și trei întrebări de autoevaluare.
Modelul ARMA(\(p,q\)) înlocuiește suma Wold infinită cu un raport a două polinoame scurte, \(\theta(L)/\phi(L)\). El este staționar cînd rădăcinile lui \(\phi(z)\) sînt în afara cercului unitate, invertibil cînd rădăcinile lui \(\theta(z)\) sînt în afara lui și bine identificat cînd cele două polinoame nu au factori comuni. În date, o ACF care se anulează indică un MA, o PACF care se anulează un AR, iar două funcții descrescătoare un ARMA.
Modelele se estimează prin verosimilitate maximă, se aleg cu AIC sau BIC și se verifică cu testul Ljung–Box cu \(m - p - q\) grade de libertate. Prognozele lor revin la medie, iar intervalele se lărgesc pînă la \(\pm 1{,}96\sqrt{\gamma(0)}\), ignorînd incertitudinea parametrilor.
Pe datele reale, creșterea PIB-ului României este un MA(3) prin construcție, inflația este aproape de o rădăcină unitară, iar randamentele zilnice au nevoie de modele GARCH pentru varianța lor.
Pe scurt
ARMA(\(p,q\)) înlocuiește suma Wold infinită cu raportul a două polinoame scurte, \(\theta(L)/\phi(L)\)
Staționaritatea: rădăcinile lui \(\phi(z)\) în afara cercului unitate; invertibilitatea: rădăcinile lui \(\theta(z)\) în afara lui; fără factori comuni
ACF se anulează: MA; PACF se anulează: AR; ambele descresc: ARMA
Estimați prin MLE, alegeți cu AIC/BIC, verificați reziduurile cu Ljung–Box pe \(m - p - q\) grade de libertate
Prognozele revin la medie; intervalele se lărgesc pînă la \(\pm 1{,}96\sqrt{\gamma(0)}\) și ignoră incertitudinea parametrilor
Datele reale: creșterea PIB este un MA(3) prin construcție; inflația este aproape de o rădăcină unitară; randamentele cer GARCH
Tabelul adună formulele capitolului. Primele rînduri descriu modelele: ecuația ARMA și forma ei cauzală \(\psi(L) = \theta(L)/\phi(L)\); media, varianța și ACF a modelului AR(1); recurența Yule–Walker a modelului AR(2); prima autocorelație și condiția de invertibilitate a modelului MA(1); ponderile \(\psi\) și recurența ACF a modelului ARMA(1,1).
Ultimele rînduri descriu metoda: estimatorul Yule–Walker, criteriile informaționale, distribuția de referință a statisticii Ljung–Box și intervalul de prognoză \(\hat X_{T+h|T} \pm 1{,}96\,\sigma\sqrt{\sum_{j=0}^{h-1}\psi_j^2}\), care rezultă din varianța erorii (2.17).
Prima întrebare cere să stabilim dacă \(X_t = 1{,}2X_{t-1} - 0{,}32X_{t-2} + \varepsilon_t\) este staționar. Polinomul caracteristic se descompune ca \(1 - 1{,}2z + 0{,}32z^2 = (1 - 0{,}8z)(1 - 0{,}4z)\), deci rădăcinile sînt 1,25 și 2,5, ambele în afara cercului unitate, iar procesul este staționar. Rădăcinile inverse, 0,8 și 0,4, dau același răspuns, citit din interiorul cercului.
A doua întrebare descrie o serie a cărei ACF are o singură valoare semnificativă, \(\hat\rho(1) = -0{,}45\), și a cărei PACF descrește. Tiparul este cel al unui MA(1) cu \(\theta < 0\). Valoarea lui \(\theta\) rezolvă ecuația \(\theta/(1 + \theta^2) = -0{,}45\), o ecuație de gradul al doilea cu două rădăcini reale al căror produs este 1; se păstrează cea invertibilă, cu \(|\theta| < 1\).
A treia întrebare dă \(Q^*(10) = 15{,}2\) pentru reziduurile unui ARMA(2,1). Gradele de libertate sînt \(10 - 3 = 7\), iar cuantila de 95% a lui \(\chi^2(7)\) este 14,07, sub 15,2, deci testul respinge la 5%. Cu 10 grade de libertate, valoarea critică ar fi 18,31, iar modelul ar fi acceptat greșit. Capitolul 3 continuă cu rădăcinile unitare și modelele ARIMA, pentru cazul în care o rădăcină se află pe cercul unitate.
Pe scurt
Întrebare: este \(X_t = 1{,}2X_{t-1} - 0{,}32X_{t-2} + \varepsilon_t\) staționar?
Răspuns: \(1 - 1{,}2z + 0{,}32z^2 = (1 - 0{,}8z)(1 - 0{,}4z)\), rădăcinile 1,25 și 2,5, ambele în afara cercului: da
Întrebare: ACF a unei serii are o singură valoare semnificativă, \(\hat\rho(1) = -0{,}45\), iar PACF descrește. Ce model propuneți?
Răspuns: MA(1) cu \(\theta < 0\); rezolvăm \(\theta/(1 + \theta^2) = -0{,}45\) și păstrăm rădăcina invertibilă
Întrebare: un ARMA(2,1) lasă în reziduuri \(Q^*(10) = 15{,}2\). Respingem la 5%?
Răspuns: gradele de libertate \(10 - 3 = 7\), \(\chi^2_{0{,}95}(7) = 14{,}07 < 15{,}2\): respingem; cu 10 grade de libertate (valoarea critică 18,31) am accepta greșit
Urmează: Capitolul 3, rădăcini unitare și modele ARIMA: ce facem cînd o rădăcină se află pe cercul unitate
Sinteza secțiunii
Capitolul a construit modelul ARMA staționar pornind de la descompunerea Wold, i-a derivat proprietățile, l-a estimat, l-a verificat și l-a folosit pentru prognoză. Toate aplicațiile au presupus o serie staționară. Capitolul 3 tratează cazul exclus aici, o rădăcină pe cercul unitate, și modelele ARIMA care îl rezolvă prin diferențiere.
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. doi:10.1109/TAC.1974.1100705
Box, G. E. P., Jenkins, G. M., & Reinsel, G. C. (2008). Time Series Analysis: Forecasting and Control (4th ed.). Wiley. doi:10.1002/9781118619193
Box, G. E. P., & Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509–1526. doi:10.1080/01621459.1970.10481180
Brockwell, P. J., & Davis, R. A. (1991). Time Series: Theory and Methods (2nd ed.). Springer. doi:10.1007/978-1-4419-0320-4
Brockwell, P. J., & Davis, R. A. (2016). Introduction to Time Series and Forecasting (3rd ed.). Springer. doi:10.1007/978-3-319-29854-2
Durbin, J. (1960). The fitting of time-series models. Revue de lÍnstitut International de Statistique, 28(3), 233–244. doi:10.2307/1401322
Hamilton, J. D. (1994). Time Series Analysis. Princeton University Press. doi:10.2307/j.ctv14jx6sm
Huang, C., & Petukhina, A. (2022). Applied Time Series Analysis and Forecasting with Python. Springer. doi:10.1007/978-3-031-13584-2
Hurvich, C. M., & Tsai, C.-L. (1989). Regression and time series model selection in small samples. Biometrika, 76(2), 297–307. doi:10.1093/biomet/76.2.297
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3rd ed.). OTexts. otexts.com/fpp3
Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. doi:10.18637/jss.v027.i03
Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. doi:10.2307/1403192
Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. doi:10.1093/biomet/65.2.297
Makridakis, S., & Hibon, M. (2000). The M3-Competition: Results, conclusions and implications. International Journal of Forecasting, 16(4), 451–476. doi:10.1016/S0169-2070(00)00057-1
Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. doi:10.1214/aos/1176344136
Slutzky, E. (1937). The summation of random causes as the source of cyclic processes. Econometrica, 5(2), 105–146. doi:10.2307/1907241
Walker, G. (1931). On periodicity in series of related terms. Proceedings of the Royal Society of London, Series A, 131(818), 518–532. doi:10.1098/rspa.1931.0069
Wold, H. (1938). A Study in the Analysis of Stationary Time Series. Almqvist & Wiksell. archive.org
Yule, G. U. (1927). On a method of investigating periodicities in disturbed series, with special reference to Wolfer's sunspot numbers. Philosophical Transactions of the Royal Society A, 226, 267–298. doi:10.1098/rsta.1927.0007
Simulări: șocuri din distribuția Normală, generate cu seed-urile codului capitolului; cînd parametrii diferă de cei din curs, simularea se reface în browser. PIB: Eurostat, volume înlănțuite (2010), serie nesezonalizată, în versiunea folosită în curs. IAPC: Eurostat, pînă în august 2026. BET: EODHD; EUR/RON: cursul de referință BNR. Petele solare: setul de date din statsmodels, 1700–2008.
Bibliografie
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
Box, G. E. P., & Pierce, D. A. (1970). Distribution of residual autocorrelations in autoregressive-integrated moving average time series models. Journal of the American Statistical Association, 65(332), 1509–1526. https://doi.org/10.1080/01621459.1970.10481180
Box, G. E. P., Jenkins, G. M., & Reinsel, G. C. (2008). Time Series Analysis: Forecasting and Control (4th ed.). Wiley. https://doi.org/10.1002/9781118619193
Hurvich, C. M., & Tsai, C.-L. (1989). Regression and time series model selection in small samples. Biometrika, 76(2), 297–307. https://doi.org/10.1093/biomet/76.2.297
Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03
Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
Ljung, G. M., & Box, G. E. P. (1978). On a measure of lack of fit in time series models. Biometrika, 65(2), 297–303. https://doi.org/10.1093/biomet/65.2.297
Makridakis, S., & Hibon, M. (2000). The M3-Competition: Results, conclusions and implications. International Journal of Forecasting, 16(4), 451–476. https://doi.org/10.1016/S0169-2070(00)00057-1
Slutzky, E. (1937). The summation of random causes as the source of cyclic processes. Econometrica, 5(2), 105–146. https://doi.org/10.2307/1907241
Walker, G. (1931). On periodicity in series of related terms. Proceedings of the Royal Society of London, Series A, 131(818), 518–532. https://doi.org/10.1098/rspa.1931.0069
Yule, G. U. (1927). On a method of investigating periodicities in disturbed series, with special reference to Wolfer's sunspot numbers. Philosophical Transactions of the Royal Society A, 226, 267–298. https://doi.org/10.1098/rsta.1927.0007


 Applied Time Series Analysis with Python
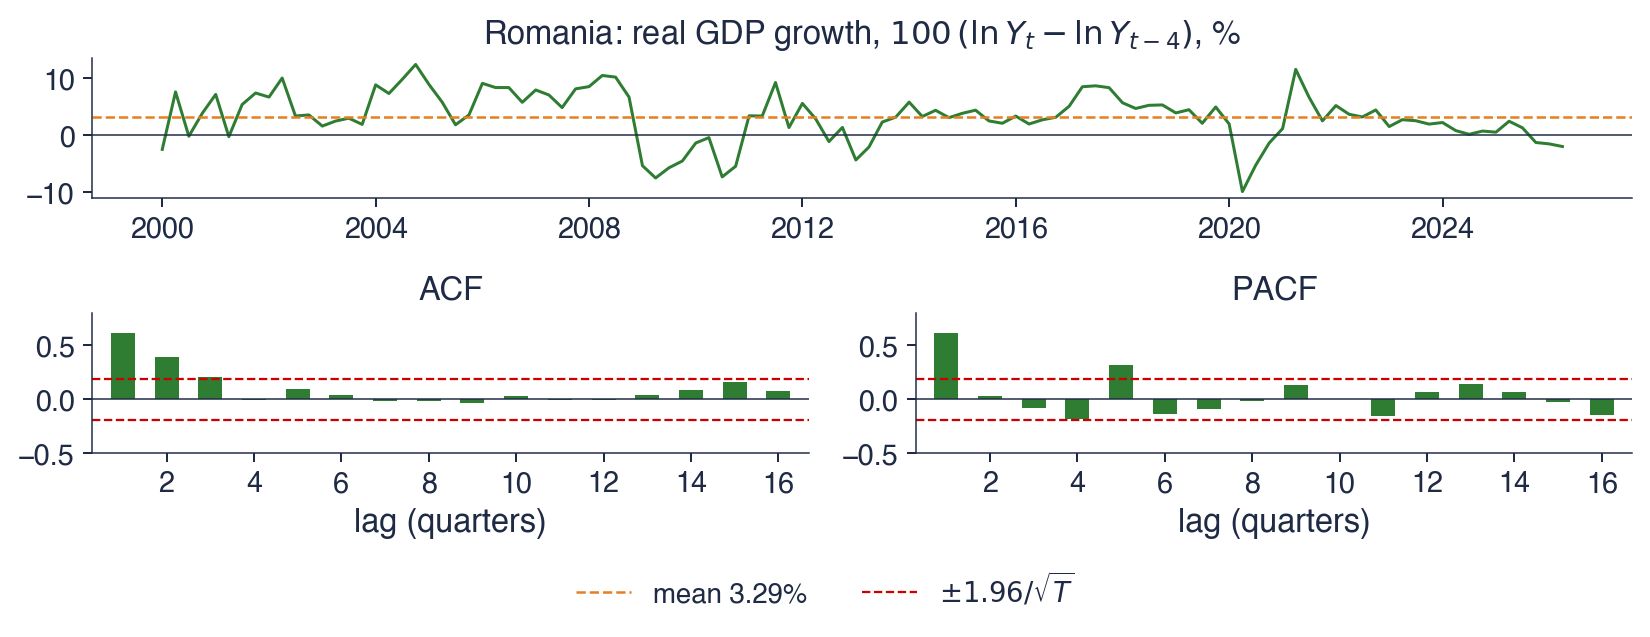
 TSA_ch2_ar_models