Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
Poate un singur model descrie prețurile la orice scară de timp?
“It is shown that common-stock prices, and the value of money can be regarded as an ensemble of decisions in statistical equilibrium, with properties quite analogous to an ensemble of particles in statistical mechanics.” — Osborne (1959)
Logaritmii prețurilor se comportă ca mișcarea browniană
mișcarea browniană geometrică (GBM) este modelul de preț din spatele Black & Scholes (1973)
It is shown that common-stock prices, and the value of money can be regarded as an ensemble of decisions in statistical equilibrium, with properties quite analogous to an ensemble of particles in statistical mechanics.
Osborne (1959) a descris logaritmii prețurilor acțiunilor cu instrumentele fizicii statistice: nu prețurile, ci logaritmii lor se comportă ca mișcarea browniană (Brownian motion). Modelul care rezultă, mișcarea browniană geometrică (GBM, geometric Brownian motion), este modelul de preț din spatele formulei Black & Scholes (1973). Prețurile sînt înregistrate zilnic sau la cîteva milisecunde, iar timpul continuu oferă un singur limbaj pentru toate aceste scări: calculul Itô (Itô calculus), ecuațiile diferențiale stocastice (SDE, stochastic differential equations) și schimbarea măsurii. Întrebarea capitolului este dacă un singur model poate descrie prețurile la orice scară de timp.
Randamentele logaritmice zilnice ale S&P 500 (Standard & Poor's) din 1990 resping GBM în două privințe. Excesul de kurtosis (excess kurtosis) este 10,9, în loc de 0, cea mai rea zi se află la −11,3 abateri standard, iar 62 de zile se află dincolo de ±4 abateri standard, față de 0,59 așteptate sub distribuția Normală. Autocorelația valorilor absolute ale randamentelor este 0,27 la lagul 1 și încă 0,14 la lagul 50, deci volatilitatea vine în grupuri (volatility clustering). Variația pătratică (quadratic variation) crește în trepte: între septembrie 2008 și martie 2009, 1,6% din zile aduc 15,2% din variația pătratică a întregului eșantion. Nici driftul nu se poate fixa din date: pentru o precizie de ±1 punct procentual, S&P 500 ar avea nevoie de 1 243 de ani de date, iar Bitcoin de 17 028 de ani.
Capitolul adaugă pe rînd revenirea la medie, salturile (jumps, modelul Merton) și volatilitatea stocastică (stochastic volatility, modelul Heston), apoi compară modelele estimate cu datele pe 100 de eșantioane simulate de cîte 9 245 de zile. Merton reproduce statistica Hill a cozii, 2,70 față de 2,56 în date, dar nu și volatility clustering. Heston reproduce volatility clustering, cu o autocorelație de 0,28 la lagul 1 față de 0,27 în date. Niciun model estimat nu atinge excesul de kurtosis al datelor, 10,88: Merton dă 3,66, iar Heston 3,21. Studiile de caz arată ce lipsește și modelelor cu un factor: pe SPY, estimatorul NLLS (non-linear least squares) robust la zgomot dă un exponent de roughness de −0,35, față de 0 pentru mișcarea browniană.
Modelele estimate confruntate cu randamentele zilnice ale S&P 500: autocorelația lui |r| pe lagurile 1–50 (stînga), excesul de kurtosis (mijloc) și statistica Hill pentru cele mai mari 5% dintre pierderi (dreapta); pentru GBM, Merton și Heston sînt medianele a 100 de simulări, cu intervale de 90%. Graficul interactiv: „Capacitatea modelelor de a reproduce S&P 500 (1/2)” →
Rezultatele învățării
Derivați soluții cu lema lui Itô și simulați o ecuație diferențială stocastică cu un ordin de eroare cunoscut.
Calculați estimări GBM, Ornstein–Uhlenbeck, Merton și Heston, cu erori standard care reflectă ce identifică eșantionul.
Interpretați ce caracteristică a datelor reproduce fiecare model și ce caracteristică nu reproduce niciunul.
Interpretați de ce evaluarea opțiunilor și modelele de dobîndă folosesc acest limbaj.
Mișcarea browniană geometricăGBM din lema lui Itô, estimarea prin verosimilitate maximă, precizia driftului și adecvarea pentru S&P 500.
Revenirea la medie: procesul Ornstein–UhlenbeckProcesul OU, discretizarea exactă ca AR(1) și modelele Vasicek și CIR (Cox–Ingersoll–Ross, model, modelul Cox–Ingersoll–Ross al ratei dobînzii) pe randamentul titlurilor de stat pe 3 luni.
Salturi: modelul MertonDifuzia cu salturi și estimările pentru S&P 500, BET (Bucharest Exchange Trading, index, indicele de referință al Bursei de Valori București) și Bitcoin.
Capitolul construiește un singur limbaj pentru prețuri observate la orice frecvență, în două părți:
Prima parte obține mișcarea browniană ca limită a unui random walk rescalat, dezvoltă calculul Itô pornind de la variația pătratică și îl folosește pentru a rezolva și a simula ecuații diferențiale stocastice: mișcarea browniană geometrică (GBM) pentru prețuri și procesul Ornstein–Uhlenbeck (OU) pentru variabile care revin la medie.
Partea a doua întreabă ce parametri identifică datele, schimbă măsura de probabilitate pentru a evalua active derivate și adaugă salturi și volatilitate stocastică.
Fiecare model este estimat pe aceleași date și apoi comparat cu S&P 500 pe trei repere.
Prețurile sînt înregistrate la frecvențe foarte diferite: închideri zilnice pentru istorii lungi, bare de cinci minute pentru ultimii ani și cotații la cîteva milisecunde pe piețele electronice. Un model formulat în timp continuu are implicații simultan la orice interval de eșantionare, deci un singur set de parametri trebuie să explice randamentele zilnice, randamentele intrazilnice și agregarea lor. Întrebarea capitolului este dacă un singur model poate face acest lucru.
Materialul are două părți:
Partea I tratează mișcarea browniană, calculul Itô, simularea, GBM și revenirea la medie (mean reversion).
Partea a II-a tratează estimarea difuziilor, schimbarea măsurii, salturile (modelul Merton) și volatilitatea stocastică (modelul Heston), urmate de compararea modelelor estimate cu datele, de două studii de caz și de o secțiune despre cercetarea asistată de inteligența artificială (AI).
Evaluarea opțiunilor, care folosește aceleași instrumente, este subiectul Capitolului 12.
Pe scurt
Ce explică modelele
Le poate descrie un singur model la orice scară de timp?
prețurile sînt înregistrate zilnic sau la cîteva milisecunde
Partea I: mișcarea browniană, calculul Itô, simularea, mișcarea browniană geometrică (GBM), revenirea la medie
Partea empirică folosește trei serii de randamente și două serii de niveluri. S&P 500 și BET (Bucharest Exchange Trading), indicele de referință al Bursei de Valori București (BVB), sînt indici bursieri; Bitcoin se tranzacționează șapte zile pe săptămînă. VIX, indicele de volatilitate Cboe calculat de Chicago Board Options Exchange (CBOE) din prețurile opțiunilor pe S&P 500, este folosit ca aproximare a varianței în modelul Heston. Rata pe termen scurt este randamentul titlurilor de stat americane pe 3 luni, seria DTB3 din Federal Reserve Economic Data (FRED). Perioadele, numărul de observații și regulile de curățare sînt în Aprofundări și în Anexă.
Pe scurt
VIX: Cboe Volatility Index — indice al volatilității implicite a indicelui S&P 500.
BET: Bucharest Exchange Trading (index) — indicele de referință al Bursei de Valori București.
BVB: Bursa de Valori București.
CBOE: Chicago Board Options Exchange — bursa de opțiuni din Chicago.
FRED: Federal Reserve Economic Data — baza de date economice a Rezervei Federale (St. Louis).
DTB3: 3-Month Treasury Bill: secondary market rate — codul FRED al randamentului titlurilor de stat americane pe 3 luni.
Exemplele detaliate și subiectele avansate sînt în Aprofundări, după Concluzii
butonul din subsol duce la ele, iar butonul Înapoi revine la slide-ul de plecare
Întrebarea capitolului este deci atît matematică, cît și empirică: fiecare model este judecat după caracteristicile datelor pe care le reproduce la frecvențele observate. Construcția începe cu cel mai simplu obiect în timp continuu, mișcarea browniană.
De la mersul aleator la mișcarea browniană
Mișcarea browniană (Brownian motion) este piesa de bază a tuturor modelelor din capitol. Secțiunea o obține ca limită a random walk-ului folosit pentru logaritmul prețului în Capitolul 2 și enumeră proprietățile care o fac în același timp ușor de manevrat și neobișnuită: incremente gaussiene independente, proprietatea de martingal, autosimilaritatea și traiectorii continue, dar nicăieri derivabile.
De la mersul aleator la mișcarea browniană: teorema lui Donsker (1/3)
Prețurile se mișcă în pași discreți, iar întrebarea este ce proces apare cînd pașii devin mai mici și mai frecvenți. Pornim de la random walk-ul \(S_0 = 0\),\(S_k = S_{k-1} + \xi_k = \xi_1 + \cdots + \xi_k\), în care pașii \(\xi_i\) sînt independenți și identic distribuiți (i.i.d.), cu media 0 și dispersia 1. În modelul pentru logaritmul prețului din Capitolul 2, \(\xi_k\) este randamentul standardizat al zilei \(k\).
Pentru a trece la timp continuu, punem \(n\) pași în fiecare unitate de timp și rescalăm:
\[W_n(t) = \frac{S_{\lfloor nt \rfloor}}{\sqrt{n}}, \qquad \operatorname{Var}\big(W_n(t)\big) = \frac{\lfloor nt \rfloor}{n} \to t,\]
(11.1)
unde \(\lfloor nt \rfloor\) este partea întreagă a lui \(nt\). Factorul \(\sqrt{n}\) este singurul care dă o limită nedegenerată: împărțirea la \(n\) ar trimite procesul la zero, iar fără nicio împărțire dispersia ar exploda. Pentru fiecare \(t\) fixat, teorema limită centrală (CLT, central limit theorem) dă \(W_n(t) \to N(0, t)\).
Teorema lui Donsker este mai puternică: \(W_n \Rightarrow W\), unde \(\Rightarrow\) notează convergența în distribuție a întregii traiectorii, nu doar a valorii la fiecare dată (Billingsley, 1999). Limita \(W\) este mișcarea browniană, oricare ar fi distribuția pașilor. Prin urmare, și funcționalele traiectoriei, cum este maximul ei, converg la cele ale mișcării browniene.
Pe scurt
Întrebarea: ce proces obținem cînd pașii devin tot mai mici și tot mai deși?
Graficul din stînga arată trei random walk-uri rescalate pe \([0, 1]\), cu \(n = 5\), 50 și 5 000 de pași; axa verticală este \(S_{\lfloor nt \rfloor}/\sqrt{n}\). Graficul din dreapta arată, în funcție de \(n\) pe o axă logaritmică, probabilitatea ca maximul lui \(W_n\) pe \([0, 1]\) să depășească nivelul \(a\), estimată din traiectorii simulate, cu interval de încredere (CI, confidence interval) de 95%. Linia orizontală este limita browniană dată de principiul reflexiei (reflection principle), \(P(\max_{t \le 1} W(t) > a) = 2\,(1 - \Phi(a))\), unde \(\Phi\) este funcția de repartiție a distribuției Normale standard. Cursorul fixează nivelul \(a\), iar butonul ▶ îl crește pas cu pas.
Întrebare pentru sală Pentru mișcarea browniană standard pe [0, 1], ridicăm pragul de la a = 1 la a = 2. Cît devine probabilitatea ca maximul traiectoriei să depășească pragul?
Răspuns
Circa 0,0455. Principiul reflexiei dă P(max W(t) > 2) = 2[1 − Φ(2)] ≈ 0,0455, față de 0,3173 la a = 1. Valoarea 0,0228 = 1 − Φ(2) privește doar W(1), nu maximul întregii traiectorii. Valoarea 0,1587 înjumătățește greșit probabilitatea de la pragul 1: probabilitatea nu este invers proporțională cu pragul. Pe pagină, la a = 2, random walk-ul cu n = 2 000 de pași dă 0,042. Curbele random walk ilustrează convergența către reperul brownian; ele nu provin din eșantionarea aceleiași traiectorii browniene.
La \(a = 1\), probabilitatea crește de la 0,220 pentru \(n = 5\) la 0,316 pentru \(n = 2000\), spre limita \(2(1 - \Phi(1)) = 0{,}3173\). Un random walk cu puțini pași subestimează maximul, pentru că nu vede valorile atinse între punctele grilei.
Pe măsură ce \(n\) crește, traiectoria în trepte devine continuă și neregulată, ca o traiectorie browniană. Probabilitățile din graficul din dreapta sînt estimate din 20 000 de traiectorii, iar convergența lor la limita browniană este lentă, de ordinul \(1/\sqrt{n}\).
Interpretarea financiară este directă. O grilă rară ratează maximul atins între observații, deci prețurile de închidere zilnice subestimează amplitudinea intrazilnică. Orice statistică ce depinde de extremele traiectoriei, cum sînt atingerea unei bariere sau un drawdown, este deplasată cînd e calculată din observații rare, iar deplasarea scade doar ca \(1/\sqrt{n}\).
Pe scurt
Stînga: trei mersuri aleatoare scalate pe \([0, 1]\), cu \(n = 5\), \(50\) și \(5\,000\) de pași
axa verticală este \(S_{\lfloor nt \rfloor}/\sqrt{n}\)
Cu \(n\) mare, traiectoria în trepte devine continuă și neregulată, ca o traiectorie browniană
Dreapta: \(P(\max_{t \le 1} W_n(t) > 1)\) în funcție de \(n\), pe o axă logaritmică
probabilitatea este estimată din 20 000 de traiectorii (CI de 95%)
Probabilitatea crește de la \(0{,}220\) (\(n = 5\)) la \(0{,}316\) (\(n = 2\,000\))
limita este valoarea din principiul reflexiei, \(2(1 - \Phi(1)) = 0{,}3173\)
\(\Phi\): funcția de repartiție a distribuției Normale standard
O grilă rară nu surprinde maximul atins între observații
Convergența este lentă, de ordinul \(1/\sqrt{n}\)
închiderile zilnice subestimează amplitudinea din timpul zilei
O mișcare browniană standard \((W_t)_{t \ge 0}\) este definită prin patru proprietăți:
\(W_0 = 0\);
incrementele pe intervale disjuncte sînt independente;
\(W_t - W_s \sim N(0, t - s)\) pentru \(s < t\);
traiectoriile sînt continue.
Existența ei a fost demonstrată de Wiener (1923). Pe o grilă, ea se simulează exact prin \(W_{t + \Delta t} = W_t + \sqrt{\Delta t}\,Z\), cu \(Z \sim N(0, 1)\).
Din definiție decurg mai multe proprietăți. Mișcarea browniană este un proces gaussian cu \(\operatorname{Cov}(W_s, W_t) = \min(s, t)\). Este un martingal: \(\mathbb{E}[W_t \mid \mathcal{F}_s] = W_s\), unde \(\mathcal{F}_s\) este informația disponibilă la \(s\); aceasta este versiunea în timp continuu a random walk-ului pieței eficiente din Capitolul 2. Este autosimilară (self-similar): pentru orice \(c > 0\), procesul rescalat \(\{c^{-1/2} W_{ct}\}\) este tot o mișcare browniană standard, deci o bucată mărită a unei traiectorii are aceeași lege ca traiectoria întreagă.
Ultima proprietate este cea care schimbă calculul. Traiectoriile sînt continue, dar nicăieri derivabile: raportul \((W_{t+h} - W_t)/h\) are abaterea standard \(1/\sqrt{h}\), care tinde la infinit cînd \(h \to 0\). Calculul obișnuit, care se sprijină pe derivate, nu se aplică traiectoriilor browniene. Traiectoriile și scalarea lor sînt ilustrate în Aprofundări.
Pe scurt
Mișcarea browniană standard: pornește din \(W_0 = 0\), cu incremente independente și traiectorii continue
incrementele sînt \(W_t - W_s \sim N(0, t - s)\) pentru \(s < t\)
Teorema lui Donsker justifică mișcarea browniană ca limită a oricărui random walk cu pași de dispersie finită. Traiectoriile ei sînt continue, dar prea neregulate pentru calculul obișnuit; secțiunea următoare măsoară această neregularitate și construiește calculul care îl înlocuiește.
Variația pătratică și calculul Itô
O traiectorie browniană are lungime infinită, dar o sumă a pătratelor incrementelor finită și deterministă. Secțiunea definește cele două noțiuni de variație, le măsoară pe simulări și pe S&P 500 și folosește variația pătratică pentru a construi integrala Itô și lema lui Itô, regula de derivare a funcțiilor compuse din calculul stocastic.
De ce eșuează calculul obișnuit pe o traiectorie browniană și ce îl înlocuiește? Luăm o grilă \(0 = t_0 < \cdots < t_n = T\) cu pasul \(\Delta t = T/n\) și incrementele \(\Delta W_k = W_{t_k} - W_{t_{k-1}}\).Variația totală (total variation) \(\sum_k |\Delta W_k|\), lungimea traiectoriei măsurată pe grilă, are media \(\sqrt{2nT/\pi}\), care tinde la infinit: o traiectorie browniană are lungime infinită.
Variația pătratică (quadratic variation) se comportă altfel:
unde \(Q_n = \sum_{k=1}^{n} (\Delta W_k)^2\). În (11.2), o sumă de termeni aleatori are o limită deterministă, pentru că dispersia ei se anulează pe măsură ce grila devine mai fină. Cu un an de date zilnice, eroarea relativă a lui \(Q_n\) este \(\sqrt{2/252}\), circa 9%. Aceasta este ideea din spatele varianței realizate (realised variance) din Capitolul 9.
Calculul Itô rezumă (11.2) prin notația \((\mathrm{d}W_t)^2 = \mathrm{d}t\): pe un interval scurt, pătratul incrementului nu este neglijabil față de lungimea intervalului, cum ar fi pentru o traiectorie derivabilă, ci egal cu ea la limită.
Pe scurt
Întrebarea: de ce nu se aplică calculul diferențial clasic unei traiectorii browniene?
Graficul din stînga urmărește o traiectorie browniană pe \([0, 1]\) observată pe grile de la 16 la 65 536 de intervale și arată suma \(\sum_k |\Delta W_k|^p\) în funcție de numărul de intervale. Cursorul fixează exponentul \(p\):\(p = 1\) dă variația totală, iar \(p = 2\) variația pătratică; butonul ▶ mută \(p\) de la 0,5 la 3. Graficul din dreapta arată suma cumulată a pătratelor randamentelor logaritmice zilnice ale S&P 500, \(\sum r_t^2\), împreună cu dreapta \(\sigma^2 t\) pe care ar produce-o GBM; selectorul evidențiază una dintre două perioade de criză.
Întrebare pentru sală Pentru o mișcare browniană standard pe [0, 1], fixăm p = 1,5. Dacă numărul intervalelor egale crește de patru ori, cu ce factor se modifică media sumei Σ|ΔW|^1,5?
Răspuns
Cu √2 ≈ 1,41. Media este n^(1 − p/2)·E|Z|^p, cu Z avînd distribuția Normală standard; pentru p = 1,5, factorul este 4^0,25 = √2. Factorul 4 ignoră micșorarea incrementelor; 1/√2 inversează sensul modificării. Relația privește media, nu o egalitate exactă pentru fiecare traiectorie: pe traiectoria din pagină, suma trece de la 9,75 cu 16 384 de intervale la 13,83 cu 65 536 de intervale (raport 1,42). Doar exponentul 2 dă o limită nedegenerată: Σ(ΔW)² tinde la T = 1 (1,006 pe grila cea mai fină), de aceea (dW)² = dt.
Pentru \(p = 2\), suma se stabilizează la 1,006 pe grila cea mai fină, aproape de \(T = 1\), în timp ce pentru \(p = 1\) continuă să crească: 205 pe grila cea mai fină, față de \(\sqrt{2n/\pi} = 204\). Doar exponentul 2 dă o limită care nu este nici zero, nici infinită.
Pe S&P 500, suma cumulată a pătratelor randamentelor logaritmice zilnice ajunge la 1,188 în 36,7 ani, ceea ce corespunde unei volatilități anuale medii de 18,0%. Sub GBM, cu volatilitate constantă \(\sigma\), variația pătratică ar crește de-a lungul dreptei \(\sigma^2 t\).
Datele nu urmează dreapta: suma crește în trepte. Între septembrie 2008 și martie 2009, 1,6% din zile aduc 15,2% din variația pătratică a întregului eșantion; între februarie și aprilie 2020, 0,5% din zile aduc 7,8%. Volatilitatea este deci ea însăși aleatoare. Modelul Heston din Secțiunea 10 îi dă o dinamică proprie.
Pe scurt
Stînga: o traiectorie browniană pe grile cu 16 pînă la 65 536 de intervale
variația pătratică se stabilizează la \(1{,}006\) (\(T = 1\))
variația totală continuă să crească, \(205\) față de \(\sqrt{2n/\pi} = 204\)
Dreapta: suma cumulată \(\sum r_t^2\) pentru S&P 500
suma este \(1{,}188\) în 36,7 ani (volatilitate medie \(18{,}0\%\))
sub mișcarea browniană geometrică ar urma dreapta \(\sigma^2 t\)
Suma crește în trepte
septembrie 2008 – martie 2009: \(1{,}6\%\) din zile, dar \(15{,}2\%\) din variația pătratică
februarie – aprilie 2020: \(0{,}5\%\) din zile, dar \(7{,}8\%\) din variația pătratică
volatilitatea este ea însăși aleatoare (Heston, Secțiunea 10)
Cîștigul obținut prin deținerea a \(H_t\) unități dintr-un activ al cărui preț se mișcă precum \(W\) este \(\int_0^T H_t\,\mathrm{d}W_t\). Integrala nu poate fi definită traiectorie cu traiectorie ca integrală Riemann–Stieltjes, deoarece variația totală a lui \(W\) este infinită. Integrala Itô o definește ca limită în medie pătratică a unor sume în care integrandul este evaluat în capătul stîng al fiecărui interval:
Integrandul trebuie să fie adaptat (adapted), adică \(H_t\) folosește doar informația disponibilă pînă la \(t\), și să satisfacă \(\mathbb{E}\big[\int_0^T H_t^2\,\mathrm{d}t\big] < \infty\). Capătul stîng are o semnificație financiară: poziția pe \([t_{k-1}, t_k]\) se alege înainte ca următoarea mișcare a prețului să fie cunoscută.
Pe scurt
Scopul: un sens pentru \(\int_0^T H_t\,\dd W_t\)
integrala este cîștigul din deținerea a \(H_t\) unități dintr-un activ cu prețul \(W\)
integrala Riemann–Stieltjes nu se aplică, deoarece variația totală este infinită
Integrala Itô: limita în medie pătratică a sumelor cu integrandul evaluat în capătul stîng
Integrala Itô are media zero, \(\mathbb{E}\big[\int_0^T H_t\,\mathrm{d}W_t\big] = 0\), iar momentul ei de ordinul doi este dat de izometria Itô (Itô isometry),
În plus, \(t \mapsto \int_0^t H_s\,\mathrm{d}W_s\) este un martingal: nicio strategie de tranzacționare într-un activ fără drift nu cîștigă în medie. Sub condiții de integrabilitate mai slabe, integrala este doar un martingal local; detaliile sînt în Anexă.
Alegerea punctului de evaluare contează. Integrala Stratonovich evaluează integrandul în media capetelor, \(\tfrac12(H_{t_{k-1}} + H_{t_k})\), și dă un alt număr, pentru că termenul suplimentar preia variația pătratică. Finanțele folosesc integrala Itô, deoarece o poziție evaluată în capătul drept ar folosi prețul de la \(t_k\) înainte ca acesta să fie cunoscut. Un exemplu rezolvat, \(\int_0^T W_t\,\mathrm{d}W_t\), este în Aprofundări.
Pe scurt
Media zero și izometria Itô
media zero: \(\E\left[\int_0^T H_t\,\dd W_t\right] = 0\)
Un proces Itô se scrie \(\mathrm{d}X_t = a_t\,\mathrm{d}t + b_t\,\mathrm{d}W_t\), notație prescurtată pentru \(X_t = X_0 + \int_0^t a_s\,\mathrm{d}s + \int_0^t b_s\,\mathrm{d}W_s\), cu un drift adaptat \(a_t\) și un coeficient de difuzie adaptat \(b_t\). Pentru o funcție \(f(t, x)\) continuu derivabilă o dată în \(t\) și de două ori în \(x\),lema lui Itô (Itô's lemma) (Itô, 1944) dă
unde \(f_t = \partial f/\partial t\),\(f_x = \partial f/\partial x\) și \(f_{xx} = \partial^2 f/\partial x^2\) sînt evaluate în \((t, X_t)\).
Lema rezultă dintr-o dezvoltare Taylor de ordinul doi, cu regulile de înmulțire \(\mathrm{d}t \cdot \mathrm{d}t = 0\),\(\mathrm{d}t \cdot \mathrm{d}W = 0\) și \(\mathrm{d}W \cdot \mathrm{d}W = \mathrm{d}t\). În calculul obișnuit, termenul de ordinul doi dispare; aici \((\mathrm{d}X_t)^2 = b_t^2\,\mathrm{d}t\) conform (11.2), deci termenul \(\tfrac{1}{2} b_t^2 f_{xx}\,\mathrm{d}t\) rămîne. Acest termen este întreaga diferență față de regula obișnuită de derivare a funcțiilor compuse și reapare în toate modelele capitolului. Versiunea multivariată, cu covariația pătratică, este în Aprofundări.
Pe scurt
Proces Itô: \(\dd X_t = a_t\,\dd t + b_t\,\dd W_t\)
driftul \(a_t\) și coeficientul de difuzie \(b_t\) sînt ambii adaptați
Prescurtare pentru \(X_t = X_0 + \int_0^t a_s\,\dd s + \int_0^t b_s\,\dd W_s\)
Lema lui Itô: pentru \(f(t, x)\) cu derivate continue, o dată în \(t\) și de două ori în \(x\)Itô (1944)
Variația pătratică, \((\mathrm{d}W)^2 = \mathrm{d}t\), este faptul pe care se sprijină restul capitolului: definește integrala Itô, adaugă termenul de ordinul doi în regula de derivare și, în date, arată că volatilitatea nu este constantă.
Ecuații diferențiale stocastice și simulare
Majoritatea modelelor din capitol sînt ecuații diferențiale stocastice (SDE, stochastic differential equations) ale căror drift și difuzie depind de starea curentă. Unele au soluții exacte, altele trebuie simulate pe o grilă. Secțiunea prezintă cele două scheme standard și măsura acurateței lor de-a lungul traiectoriilor.
Ecuații diferențiale stocastice și schema Euler–Maruyama
GBM, procesul Ornstein–Uhlenbeck și modelul Merton au distribuții de tranziție exacte, deci pot fi simulate pe orice grilă fără eroare de discretizare. Modelul Heston are o funcție caracteristică în formă închisă, dar nicio tranziție elementară ușor de simulat; simularea exactă există Broadie & Kaya (2006), dar este costisitoare. Condițiile de existență și unicitate a soluțiilor sînt în Anexă.
Cea mai simplă aproximare, schema Euler–Maruyama(Higham, 2001), îngheață coeficienții pe fiecare pas:
unde \(X_k\) este aproximarea la \(t_k = k\Delta t\), iar \(Z_k\) sînt i.i.d. \(N(0, 1)\). Întrebarea este cît de mare este eroarea de discretizare care rezultă.
Pe scurt
Întrebarea: cum simulăm un model a cărui tranziție (legea lui \(X_{t+\Delta t}\) dat fiind \(X_t\)) nu este ușor de simulat, ca Heston?
cu \(b' = \mathrm{d}b/\mathrm{d}x\). Corecția are media condiționată zero, pentru că \(\mathbb{E}[(\Delta W_k)^2] = \Delta t\), deci nu schimbă valoarea așteptată a pasului; ea îmbunătățește acuratețea fiecărei traiectorii.
Acuratețea traiectoriilor se măsoară prin eroarea tare (strong error), \(\mathbb{E}|X_T - X_T^{\Delta t}| \le C\,\Delta t^{\gamma}\), unde \(X_T\) este soluția exactă, \(X_T^{\Delta t}\) schema cu pasul \(\Delta t\),\(C\) o constantă și \(\gamma\) ordinul tare. Euler–Maruyama are \(\gamma = 1/2\), iar Milstein \(\gamma = 1\). Ordinul tare contează pentru mărimi care depind de traiectorie, cum sînt erorile de acoperire (hedging errors) și atingerea barierelor. Valorile așteptate ale funcțiilor de \(X_T\) depind în schimb de ordinul slab, discutat împreună cu o comparație numerică a celor două scheme în Aprofundări.
Modelele cu tranziții exacte se simulează fără eroare; celelalte se simulează cu Euler–Maruyama sau Milstein, a căror eroare de-a lungul traiectoriilor scade ca \(\Delta t^{1/2}\), respectiv ca \(\Delta t\). Primul model căruia i se aplică lema lui Itô este modelul de preț din secțiunea următoare.
Mișcarea browniană geometrică
Mișcarea browniană geometrică (GBM, geometric Brownian motion) este modelul de referință pentru prețuri: menține prețurile pozitive și dă randamente a căror distribuție nu depinde de nivelul prețului. Secțiunea o rezolvă cu lema lui Itô, o estimează prin verosimilitate maximă, arată cît de imprecis este identificat driftul și îi testează implicațiile pe S&P 500.
Mișcarea browniană geometrică (GBM) din lema lui Itô (1/2)
Un model de preț ar trebui să mențină prețurile pozitive și să dea randamente procentuale cu aceeași distribuție la orice nivel al prețului. GBM, propusă de Osborne (1959) și Samuelson (1965) și folosită de Black & Scholes (1973), satisface
Logaritmul prețului este o mișcare browniană cu drift, deci prețurile rămîn pozitive, iar simularea exactă cere doar extrageri din distribuția Normală.
Pe scurt
Întrebarea: ce model de preț rămîne pozitiv?
și dă randamente procentuale cu aceeași distribuție la orice nivel al prețului?
Conform (11.10), logaritmul prețului crește cu driftul logaritmic \(m = \mu - \sigma^2/2\), nu cu \(\mu\). Diferența provine din termenul de ordinul doi al lemei lui Itô, iar semnificația ei economică este că volatilitatea reduce creșterea averii investitorului median. Cu \(\sigma = 18\%\), costul este \(\sigma^2/2 = 1{,}6\) puncte procentuale pe an; cu \(\sigma = 67\%\), volatilitatea Bitcoin, ajunge la 22 de puncte procentuale pe an.
GBM are implicații testabile precise. Randamentele logaritmice \(r_t = \ln(S_t/S_{t - \Delta t})\) sînt i.i.d. \(N(m\Delta t, \sigma^2\Delta t)\) la orice frecvență. Prin urmare, asimetria (skewness) și excesul de kurtosis sînt zero, nu există autocorelație în \(r_t\),\(|r_t|\) sau \(r_t^2\), iar dispersia este proporțională cu orizontul. Restul secțiunii estimează modelul și verifică aceste implicații. Distribuția prețurilor viitoare sub GBM este ilustrată în Aprofundări.
Pe scurt
Logaritmul prețului crește cu driftul logaritmic \(m = \mu - \sigma^2/2\), nu cu \(\mu\)
volatilitatea reduce creșterea averii investitorului median
Cu \(\sigma = 18\%\), costul este \(\sigma^2/2 = 1{,}6\) puncte procentuale pe an
Cu \(\sigma = 67\%\) (Bitcoin), costul ajunge la 22 de puncte procentuale pe an
Implicații testabile: \(r_t = \ln(S_t/S_{t - \Delta t})\) i.i.d. \(N(m\Delta t, \sigma^2\Delta t)\) la orice frecvență
Asimetria și excesul de kurtosis sînt zero
Nu există autocorelație în \(r_t\), \(|r_t|\) sau \(r_t^2\)
Cu \(n\) randamente logaritmice la pasul \(\Delta t\), pe un eșantion de \(T = n\Delta t\) ani, estimarea prin verosimilitate maximă (MLE, maximum likelihood estimation) dă
unde \(\bar r\) este randamentul logaritmic mediu. Sub GBM, cei doi estimatori au precizii foarte diferite:
\[\mathrm{SE}(\hat\sigma) = \frac{\sigma}{\sqrt{2n}}, \qquad \mathrm{SE}(\hat m) = \frac{\sigma}{\sqrt{T}}.\]
(11.11)
Eroarea standard (SE, standard error) a lui \(\hat\sigma\) scade cu numărul de observații, în timp ce SE a lui \(\hat m\) depinde doar de durata calendaristică\(T\). Motivul este că \(\sum_t r_t = \ln(S_T/S_0)\): estimatorul driftului folosește doar primul și ultimul preț, oricîte prețuri s-ar afla între ele.
Tabelul confirmă asimetria pe cele trei piețe. SE este de 0,1–0,7 puncte procentuale pentru volatilitate, dar de 3–19 puncte procentuale pentru driftul logaritmic. Pentru S&P 500, pe 36,7 ani, \(\hat\sigma = 18{,}0\%\) cu SE 0,13 și \(\hat m = 8{,}3\%\) cu SE 3,0, deci \(\hat\mu = 8{,}3\% + 1{,}62\% = 10{,}0\%\) pe an. Pentru Bitcoin, pe 12,0 ani, driftul logaritmic de 43,1% are o SE de 19,2 puncte procentuale.
Erorile standard din (11.11) sînt condiționate de GBM. Dacă randamentele sînt independente, dar au excesul de kurtosis \(k\), SE a lui \(\hat\sigma\) crește de \(\sqrt{(k + 2)/2}\) ori, adică de 2,5 ori pentru S&P 500. Un bootstrap pe blocuri dă SE care țin cont și de dependență (Seminarul 11, B1). Cele două SE cer și condiții de moment diferite: SE a driftului cere doar dispersie finită, iar SE a volatilității cere un moment de ordinul patru finit, pus sub semnul întrebării pentru randamentele zilnice în Capitolul 1.
Pe scurt
Estimarea prin verosimilitate maximă (MLE) din \(n\) randamente logaritmice la pasul \(\Delta t\)
Graficul din stînga arată semilățimea intervalului de încredere de 95% pentru driftul logaritmic, \(1{,}96\,\hat\sigma/\sqrt{T}\), în funcție de numărul de ani de date, pentru fiecare piață; p.p. înseamnă puncte procentuale. Graficul din dreapta estimează driftul logaritmic și volatilitatea S&P 500 pe ferestre rolling, cu intervalele lor de 95%; cursorul fixează lungimea ferestrei între 1 și 20 de ani, iar butonul ▶ o lungește an cu an.
Întrebare pentru sală Comparăm două modele GBM cu parametri constanți: primul are σ = 20% și 10 ani de date, al doilea σ = 40% și 40 de ani de date. Cum se modifică semilățimea intervalului de 95% pentru driftul logaritmic, de la primul la al doilea?
Răspuns
Rămîne aceeași. Semilățimea este 1,96σ/√T: aproximativ 12,4 puncte procentuale în ambele cazuri. Dublarea volatilității compensează exact înjumătățirea lui 1/√T. «Se înjumătățește» ignoră modificarea volatilității; «se dublează» ignoră lungimea perioadei. Pentru S&P 500 (σ = 18%), 10 ani de date dau ±11,2 puncte procentuale, oricît de deasă este grila: cele 2 520 de randamente zilnice nu reduc această semilățime. Pe ferestre de 10 ani, driftul logaritmic variază între −6,0% (2009-03) și 15,8% (2000-09); cu această precizie, oscilațiile nu pot fi atribuite sigur unor schimbări ale driftului.
Cu ferestre de 10 ani, driftul logaritmic variază între −6,0% (fereastra care se încheie în martie 2009) și 15,8% (septembrie 2000), iar fiecare estimare are un interval de circa ±11 puncte procentuale. Volatilitatea rămîne între 14,1% și 22,3%.
Inversarea relației (11.11) dă durata necesară pentru o precizie dată. Un interval de 95% de ±1 punct procentual cere \((1{,}96\,\hat\sigma/0{,}01)^2\) ani de date: 1 243 de ani pentru S&P 500 și 17 028 de ani pentru Bitcoin. Eșantionarea mai deasă nu ajută, pentru că precizia depinde doar de \(T\).
Estimările rolling arată același lucru. Cu un interval de circa ±11 puncte procentuale, oscilațiile driftului pe 10 ani între −6,0% și 15,8% nu pot fi atribuite sigur unor schimbări ale driftului adevărat. Volatilitatea, între 14,1% și 22,3%, este estimată precis, dar în mod vizibil nu este constantă.
Evaluarea opțiunilor din Capitolul 12 ocolește această dificultate: sub măsura neutră la risc (risk-neutral measure), doar \(\sigma\) intră în preț, după cum arată teorema lui Girsanov din Secțiunea 8.
Pe scurt
Stînga: semilățimea CI de 95% pentru drift, în funcție de numărul de ani de date
Ani de date necesari pentru o precizie de \(\pm 1\) punct procentual
S&P 500: \((1{,}96\,\hat\sigma/0{,}01)^2 = 1\,243\) de ani de date
Bitcoin: 17 028 de ani
Dreapta: S&P 500 pe ferestre mobile (rolling) de 10 ani
Driftul logaritmic variază între \(-6{,}0\%\) (fereastra încheiată în 2009-03) și \(15{,}8\%\) (2000-09)
fiecare fereastră are un CI de circa \(\pm 11\) puncte
precizia redusă nu permite atribuirea sigură a oscilațiilor unor schimbări ale driftului
Volatilitatea rămîne între \(14{,}1\%\) și \(22{,}3\%\): precisă, dar nu constantă
Evaluarea opțiunilor din Capitolul 12 evită \(\mu\)
sub măsura neutră la risc intră doar \(\sigma\) (Girsanov, Secțiunea 8)
Graficul din stînga este un grafic cuantilă–cuantilă (QQ, quantile–quantile) al randamentelor logaritmice zilnice standardizate ale S&P 500 față de distribuția Normală; punctele aflate în afara diagonalei sînt cuantile pe care distribuția Normală nu le reproduce. Cursorul fixează un prag \(k\), în abateri standard, iar indicatorul numără zilele dincolo de \(\pm k\) față de numărul așteptat sub distribuția Normală. Graficul din dreapta arată funcția de autocorelație (ACF, autocorrelation function) a seriei alese cu selectorul, \(|r_t|\),\(r_t^2\) sau \(r_t\), cu banda de 95% a 200 de eșantioane GBM de aceeași lungime.
Întrebare pentru sală Cîte zile dincolo de ±4 abateri standard ar trebui să apară în 9 245 de zile, dacă randamentele ar avea distribuția Normală?
Răspuns
Circa 0,59 = 9 245 · 2(1 − Φ(4)), cu ambele cozi; o singură coadă ar da 0,29. În date sînt 62, iar cea mai rea zi este la −11,3 abateri standard; excesul de kurtosis este 10,9. ACF a lui |r| este 0,27 la lagul 1 și 0,14 la lagul 50, în timp ce banda GBM rămîne sub 0,024.
La \(k = 4\), 62 de zile se află dincolo de ±4 abateri standard, față de 0,59 așteptate sub distribuția Normală. ACF a lui \(|r_t|\) este 0,27 la lagul 1 și încă 0,14 la lagul 50, în timp ce banda GBM rămîne sub 0,024 în valoare absolută.
Datele resping prima implicație a GBM, randamentele cu distribuția Normală. Excesul de kurtosis este 10,9 în loc de 0, cea mai rea zi se află la −11,3 abateri standard, iar statistica Jarque–Bera (JB), care testează simultan asimetria zero și excesul de kurtosis zero, este 45 805, față de valoarea critică de 5% de 5,99 din distribuția \(\chi^2_2\). Cifra kurtosis-ului cere prudență: kurtosis-ul de eșantion estimează consistent un kurtosis finit doar dacă momentul de ordinul patru este finit, lucru pus sub semnul întrebării în Capitolul 1, iar inferența asupra lui cere de regulă un moment de ordinul opt finit.
Datele resping și a doua implicație, independența. Randamentele absolute sînt autocorelate pe cel puțin 50 de zile, mult în afara benzii produse de GBM. GBM eșuează astfel pe ambele fapte stilizate din Capitolul 1(Cont, 2001): cozile groase și volatility clustering.
Rezultatul este descriptiv: datele resping două implicații ale GBM fără a identifica mecanismul care le produce. Restul capitolului adaugă revenirea la medie, salturile și volatilitatea aleatoare și întreabă care dintre ele reproduce fiecare caracteristică. Formulele secțiunii sînt adunate într-o recapitulare.
Pe scurt
Stînga: graficul cuantilă–cuantilă (QQ) față de distribuția Normală
GBM dă prețuri pozitive și o soluție exactă, volatilitatea ei este estimată precis, dar driftul este identificat doar pe secole. Pe S&P 500 eșuează de două ori: cozile sînt mult mai groase decît sub distribuția Normală, iar randamentele absolute sînt persistente. Secțiunea următoare trece la variabile care nu se îndepărtează, ci revin la un nivel normal.
Revenirea la medie: procesul Ornstein–Uhlenbeck
Ratele dobînzii, indicii de volatilitate și spread-urile nu se îndepărtează precum prețurile acțiunilor; ele sînt trase înapoi spre un nivel normal. Procesul Ornstein–Uhlenbeck este cea mai simplă difuzie cu această proprietate. Secțiunea îl definește, arată că eșantioanele lui discrete urmează o autoregresie de ordinul 1, prezintă cele două modele clasice ale ratei pe termen scurt construite pe el și estimează modelul Vasicek pe randamentul titlurilor de stat americane pe 3 luni.
unde \(\theta\) este media pe termen lung, \(\kappa\) viteza de revenire la medie, iar \(\sigma\) volatilitatea. Deasupra lui \(\theta\), driftul este negativ, sub \(\theta\) este pozitiv: driftul acționează ca o forță care trage \(x\) înapoi spre \(\theta\), cu o intensitate proporțională cu distanța. Procesul este folosit pentru ratele dobînzii (Vasicek, 1977), volatilitate, spread-uri și prețurile mărfurilor.
Viteza se raportează de obicei ca timp de înjumătățire (half-life), \(\ln 2/\kappa\), timpul necesar pentru ca abaterea așteptată de la \(\theta\) să se înjumătățească. Cu \(\kappa = 0{,}5\) pe an, timpul de înjumătățire este 1,39 ani. Soluția ecuației (11.12), obținută cu lema lui Itô în trei pași, este derivată în Aprofundări: \(x_t\) are distribuția Normală, cu o medie condiționată care scade exponențial spre \(\theta\) și o dispersie care converge la \(\sigma^2/(2\kappa)\).
Pe scurt
Întrebarea: cum modelăm o variabilă care revine la un nivel normal?
Exemple: rata dobînzii sau VIX
Spre deosebire de prețul unei acțiuni, variabila nu se îndepărtează de acest nivel
Eșantionat cu pasul \(\Delta t\), procesul OU este exact un model autoregresiv de ordinul 1, AR(1):
\[\begin{gathered} x_{t+\Delta t} = a + b\,x_t + \varepsilon_t, \\ b = e^{-\kappa\Delta t}, \quad a = \theta(1 - b), \quad \operatorname{Var}(\varepsilon_t) = \frac{\sigma^2}{2\kappa}\,(1 - b^2). \end{gathered}\]
(11.13)
Erorile \(\varepsilon_t\) sînt i.i.d. cu distribuția Normală, deci estimatorul de verosimilitate maximă coincide cu metoda celor mai mici pătrate (OLS, ordinary least squares) a lui \(x_{t + \Delta t}\) pe \(x_t\). OLS dă termenul liber \(\hat a\), panta \(\hat b\) și abaterea standard a reziduurilor \(\hat s_\varepsilon\), iar relațiile (11.13) se inversează: \(\hat\kappa = -\ln\hat b/\Delta t\),\(\hat\theta = \hat a/(1 - \hat b)\) și \(\hat\sigma = \hat s_\varepsilon\sqrt{2\hat\kappa/(1 - \hat b^2)}\).
Erorile standard ale lui \(\hat\kappa\) și \(\hat\theta\) rezultă din metoda delta aplicată covarianței OLS a lui \((\hat a, \hat b)\). Pentru că \(\hat\kappa\) depinde doar de \(\hat b\), cu \(\partial\kappa/\partial b = -1/(b\Delta t)\), ajunge dispersia lui \(\hat b\) (Seminarul 11, A1).
Cu date zilnice, \(b = e^{-\kappa\Delta t}\) este foarte aproape de 1, deci regresia este aproape de o rădăcină unitară. Viteza \(\kappa\) este atunci estimată imprecis, din același motiv pentru care testele de rădăcină unitară au putere mică. Trei viteze de revenire sînt comparate pe traiectorii simulate în Aprofundări.
Pe scurt
Eșantionat la pasul \(\Delta t\), procesul Ornstein–Uhlenbeck (OU) este exact un model autoregresiv de ordinul 1 (AR(1))
În modelul Vasicek(Vasicek, 1977), rata pe termen scurt \(r_t\) este un proces OU. Distribuția ei este Normală, deci ratele negative au probabilitate pozitivă; pe termen lung, această probabilitate este \(\Phi(-\theta\sqrt{2\kappa}/\sigma)\). În schimb, prețurile și randamentele obligațiunilor au forme închise, derivate cu formula Feynman–Kac în Secțiunea 8.
Volatilitatea scade pe măsură ce rata se apropie de zero, iar rata rămîne strict pozitivă dacă \(2\kappa\theta \ge \sigma^2\), condiția Feller (Feller, 1951).
Care specificație este mai apropiată de date este o întrebare empirică. Chan, Karolyi, Longstaff & Sanders (1992) le includ pe amîndouă într-un model cu difuzia \(\sigma r^\gamma\); comparația pe randamentul titlurilor de stat face parte din Secțiunea 7 și din Aprofundări.
Pe scurt
Vasicek: rata pe termen scurt \(r_t\) este un proces OU Vasicek (1977)
Rata are distribuția Normală
Deci ratele negative au probabilitate pozitivă \(\Phi(-\theta\sqrt{2\kappa}/\sigma)\) pe termen lung
Prețurile și randamentele obligațiunilor în formă închisă (Feynman–Kac, Secțiunea 8)
Cox–Ingersoll–Ross (CIR): \(\dd r_t = \kappa(\theta - r_t)\,\dd t + \sigma\sqrt{r_t}\,\dd W_t\)Cox, Ingersoll & Ross (1985)
Volatilitatea scade lîngă zero
Rata rămîne pozitivă dacă \(2\kappa\theta \ge \sigma^2\) (condiția Feller) Feller (1951)
Graficul din stînga arată randamentul zilnic al titlurilor de stat americane pe 3 luni (DTB3) împreună cu media pe termen lung Vasicek estimată, \(\hat\theta\), și o bandă \(\hat\theta\) plus/minus două abateri standard staționare (s.d.). Graficul din dreapta arată estimarea lui \(\kappa\) cu intervalul ei de 95% pe subperioade. Cele două cursoare fixează începutul și sfîrșitul eșantionului de estimare, iar butonul ▶ extinde sfîrșitul an cu an.
Întrebare pentru sală Dovedește un κ̂ pozitiv pe 1954–2026 că rata pe termen scurt revine la medie?
Răspuns
Nu. κ̂ = 0,101 (SE 0,051) corespunde unui timp de înjumătățire de 6,8 ani, iar coeficientul AR(1) zilnic este 0,99960, aproape o rădăcină unitară. Pe subperioade, κ̂ este −0,034, 0,213 și 0,032, iar două dintre cele trei intervale includ zero. Intervalul asimptotic pe 1954–2026 exclude zero la limită (0,101 − 1,96 · 0,051 = 0,001), dar lîngă o rădăcină unitară distribuția lui κ̂ nu este Normală și este deplasată în sus; testul bootstrap al ipotezei random walk dă p-value = 0,287.
Pe întregul eșantion, 1954–2026, \(\hat\theta = 4{,}55\%\),\(\hat\kappa = 0{,}101\) (SE 0,051), un timp de înjumătățire de 6,8 ani, și \(\hat\sigma = 1{,}33\%\). Coeficientul AR(1) zilnic este \(\hat b = 0{,}99960\), aproape o rădăcină unitară.
Estimările depind puternic de perioadă. Pe trei subperioade, \(\hat\kappa\) este −0,034 în 1954–1979, o valoare negativă, deci explozivă, 0,213 în 1980–2007 și 0,032 în 2008–2026, iar două dintre cele trei intervale includ zero.
Intervalul asimptotic nu este un ghid de încredere aici. Sub ipoteza nulă random walk, \(\kappa = 0\), distribuția lui \(\hat\kappa\) nu este Normală și este deplasată în sus. Testul se face deci prin bootstrap parametric, cu 500 de random walk-uri de aceeași lungime ca datele. P-value-ul este 0,287: nu respingem random walk-ul, deci eșantionul nu stabilește revenirea la medie (Seminarul 11, B2).
Rezultatul este descriptiv. Deplasarea în sus a lui \(\hat\kappa\) în eșantioane persistente este cuantificată în Aprofundări, împreună cu o estimare OU pentru VIX.
Pe scurt
Stînga: randamentul zilnic al titlurilor de stat ale Statelor Unite (SUA) pe 3 luni (DTB3), 1954–2026
Media Vasicek pe termen lung \(\hat\theta = 4{,}55\%\)
Banda: \(\hat\theta\) plus/minus două abateri standard staționare (s.d.)
\(\hat\kappa = 0{,}101\) (SE \(0{,}051\)), adică un timp de înjumătățire de \(6{,}8\) ani
Volatilitatea \(\hat\sigma = 1{,}33\%\)
Coeficientul AR(1) zilnic \(\hat b = 0{,}99960\): aproape o rădăcină unitară
Dreapta: \(\hat\kappa\), cu CI de 95%, pe trei perioade
\(-0{,}034\) în 1954–1979 (exploziv)
\(0{,}213\) în 1980–2007 și \(0{,}032\) în 2008–2026
Două dintre cele trei CI includ zero
Testul ipotezei nule de mers aleator (\(\kappa = 0\)): bootstrap parametric cu 500 de mersuri aleatoare de aceeași lungime
Motivul: sub \(\kappa = 0\) distribuția lui \(\hat\kappa\) nu este Normală și este deplasată în sus
valoarea p (p-value) \(= 0{,}287\)
Eșantionul nu demonstrează revenirea la medie (Seminarul 11, B2)
Procesul OU dă tranziții exacte cu distribuția Normală și un AR(1) pentru eșantioanele discrete, deci estimarea lui se reduce la o regresie. Pe randamentul titlurilor de stat, viteza estimată este mică, instabilă de la o perioadă la alta și nu diferă semnificativ de zero în testul bootstrap. De ce viteza este atît de greu de estimat este subiectul secțiunii următoare.
Estimarea difuziilor: identificarea parametrilor
Estimările de pînă acum au un tipar comun: volatilitatea este precisă, în timp ce driftul GBM și viteza procesului OU nu sînt. Secțiunea explică tiparul prin două scheme asimptotice:
Asimptotica infill rafinează grila pe un orizont fix.
Asimptotica pe orizont lung (long span) prelungește orizontul.
Fiecare identifică alt set de parametri.
Asimptotica infill: efectul frecvenței de eșantionare
Ce parametri învățăm din eșantionarea mai deasă și care doar din mai mulți ani? În asimptotica infill, pasul \(\Delta\) tinde la zero pe un interval fix \([0, T]\). Pentru un proces Itô, variația pătratică realizată converge:
Variația pătratică și, în condiții de regularitate, \(b_t^2\) de-a lungul traiectoriei sînt identificate fără eroare la limită. Aceasta cere ca variația pătratică să fie observabilă: un proces Itô continuu, măsurat fără zgomot. Recuperarea întregii funcții de difuzie \(b(x)\) sau a parametrilor unei specificații date cere condiții suplimentare.
Eșantionarea mai deasă ajută deci volatilitatea \(\sigma\) a GBM (Secțiunea 5) și funcția de difuzie \(b(x)\) a unui model general, care poate fi estimată neparametric (Aprofundări).
Pe scurt
Întrebarea: ce parametri învățăm din observații mai dese și ce parametri doar din mai mulți ani?
Infill (umplerea intervalului): \(\Delta \to 0\) pe un \([0, T]\) fix
Driftul nu poate fi estimat consistent pe un orizont fix. Informația Fisher \(I(m) = -\mathbb{E}[\partial^2\ell/\partial m^2]\), unde \(\ell\) este log-verosimilitatea, mărginește dispersia oricărui estimator nedeplasat, \(\operatorname{Var}(\hat m) \ge 1/I(m)\). Pentru \(n\) randamente GBM,
deci informația crește cu orizontul \(T\), nu cu numărul de observații \(n\).
Viteza OU se comportă la fel. Dispersia ei asimptotică este \(\operatorname{Var}(\hat\kappa) \approx (e^{2\kappa\Delta} - 1)/(T\Delta)\), care tinde la \(2\kappa/T\) cînd \(\Delta \to 0\) (derivarea în Seminarul 11, A1). Nici deplasarea lui \(\hat\kappa\) nu scade cu eșantionarea mai fină (Yu, 2012): cînd \(\Delta \to 0\),\(b = e^{-\kappa\Delta} \to 1\), iar \(\hat\kappa\) este departe de distribuția Normală ori de cîte ori \(\kappa T\) este mic.
Driftul imprecis al GBM și \(\hat\kappa\) deplasat au deci aceeași cauză. Metodele de verosimilitate pentru difuzii neliniare și comparația Vasicek, CIR și CKLS (Chan–Karolyi–Longstaff–Sanders) pe randamentul titlurilor de stat sînt în Aprofundări.
Pe scurt
Orizont lung: \(T \to \infty\)
Driftul nu se poate estima consistent pe un orizont fix
Eșantionarea deasă identifică coeficientul de difuzie; driftul și viteza de revenire la medie sînt identificate doar de lungimea eșantionului. Un model estimat pe cîteva decenii de date dă volatilități precise și drifturi imprecise, oricare ar fi frecvența. Pentru evaluare, secțiunea următoare arată că driftul nu este necesar.
Schimbarea măsurii: Girsanov și Feynman–Kac
Prețurile activelor tranzacționate nu se calculează cu probabilitățile din lumea reală. Secțiunea arată de ce pe un exemplu cu o perioadă, enunță teorema lui Girsanov, care construiește măsura de evaluare în timp continuu, interpretează schimbarea driftului ca preț de piață al riscului (market price of risk) și derivă ecuația de evaluare cu formula Feynman–Kac.
De ce prețurile folosesc altă probabilitate: un exemplu pe o perioadă (1/2)
O acțiune costă 100 astăzi și mîine valorează fie 120 (creștere), fie 90 (scădere). Rata dobînzii este 0, iar probabilitatea reală a creșterii este \(p = 0{,}6\). Un activ derivat plătește 1 în starea de creștere și 0 în starea de scădere.
Activul derivat poate fi replicat cu \(\Delta\) acțiuni și \(B\) numerar. Condițiile \(120\Delta + B = 1\) și \(90\Delta + B = 0\) dau \(\Delta = 1/30\) și \(B = -3\), deci portofoliul de replicare costă \(100/30 - 3 = 1/3\). Orice alt preț ar permite un arbitraj: se cumpără varianta mai ieftină dintre activ și replica lui și se vinde cealaltă.
Același preț este o valoare așteptată, dar nu sub \(p\). Ponderea \(q = (100 - 90)/(120 - 90) = 1/3\) este singura cu \(120q + 90(1 - q) = 100\), adică singura probabilitate sub care acțiunea este evaluată la valoarea ei așteptată, iar prețul activului este \(q \cdot 1 = 1/3\). Probabilitatea reală \(p\) nu intervine.
Pe scurt
O acțiune costă 100 astăzi, iar mîine valorează 120 (creștere) sau 90 (scădere)
Rata dobînzii este 0
Probabilitatea reală a creșterii este \(p = 0{,}6\)
Un activ derivat plătește 1 la creștere și 0 la scădere
Îl replicăm cu \(\Delta\) acțiuni și suma \(B\) în numerar
\(120\Delta + B = 1\) și \(90\Delta + B = 0\) dau \(\Delta = 1/30\), \(B = -3\)
Replicarea costă \(1/3\), iar orice alt preț permite un arbitraj
De ce prețurile folosesc altă probabilitate: un exemplu pe o perioadă (2/2)
Exemplul se generalizează. Absența arbitrajului înseamnă că prețurile actualizate ale activelor tranzacționate sînt martingale sub o măsură de probabilitate \(Q\) echivalentă cu măsura reală \(P\): aceasta este teorema fundamentală a evaluării activelor (fundamental theorem of asset pricing, Capitolul 5 din Shreve (2004)). În timp continuu, teorema lui Girsanov construiește \(Q\).
Verificările de pe slide testează raționamentul. Dacă \(p = 0{,}9\), prețul activului derivat rămîne 1/3, pentru că \(p\) nu intervine. Dacă starea de scădere este 80 în loc de 90, atunci \(q = 20/40 = 1/2\), iar prețul devine 1/2: ponderile de evaluare depind de rezultatele posibile, nu de cît de probabile sînt.
Pe scurt
Același preț este valoarea așteptată sub \(q = (100 - 90)/(120 - 90) = 1/3\)
Este singura pondere cu \(120q + 90(1 - q) = 100\)
\(p\) nu intervine
În general: teorema fundamentală a evaluării activelor (Shreve (2004), cap. 5)
Absența arbitrajului înseamnă că prețurile actualizate ale activelor tranzacționate sînt martingale sub o măsură echivalentă \(Q\)
Girsanov construiește \(Q\) în timp continuu
Verificare: cît costă activul derivat dacă \(p = 0{,}9\)?
Răspuns: tot 1/3
Dar dacă starea de scădere este 80 în loc de 90?
Răspuns: cu 80, \(q = 20/40 = 1/2\), deci prețul este 1/2
Două măsuri sînt echivalente dacă dau probabilitatea zero acelorași evenimente. O măsură echivalentă \(Q\) se definește pornind de la \(P\) prin densitatea Radon–Nikodym
cu \(\theta_s\) adaptat. Deoarece \(Z_T > 0\) și \(\mathbb{E}^P[Z_T] = 1\), densitatea reponderează probabilitatea fiecărei traiectorii: \(Q(A) = \mathbb{E}^P[Z_T\,\mathbf{1}_A]\).
Girsanov (1960) arată că sub \(Q\) procesul \(\tilde W_t = W_t + \int_0^t \theta_s\,\mathrm{d}s\) este o mișcare browniană. O condiție suficientă este condiția Novikov, \(\mathbb{E}\big[e^{\frac{1}{2}\int_0^T \theta_s^2\,\mathrm{d}s}\big] < \infty\). Mai jos, \(\theta_s\) va fi prețul de piață al riscului.
Pe scurt
Măsura reală \(P\) și o măsură echivalentă \(Q\), legate prin densitatea Radon–Nikodym
Echivalentă: aceleași evenimente de probabilitate zero
Pentru procese Itô continue, se schimbă doar driftul. Coeficientul de difuzie și, odată cu el, variația pătratică sînt aceleași sub \(P\) și sub \(Q\); de aceea volatilitatea estimată din date istorice intră în prețuri, iar driftul nu.
Afirmația este specifică proceselor continue. Cu salturi (Secțiunea 9), \(Q\) poate schimba și intensitatea salturilor și distribuția mărimii lor, deci intensitatea \(\hat\lambda\) estimată din randamente nu este intensitatea care evaluează opțiunile. Cu volatilitate stocastică, \(P\) și \(Q\) ponderează diferit traiectoriile viitoare ale varianței, iar varianța istorică este un reper pentru varianța implicită, nu o calibrare a ei.
Pe scurt
Pentru \(\dd X = a\,\dd t + b\,\dd W\): \(\dd X = (a - b\,\Theta)\,\dd t + b\,\dd\tilde W\)
Pentru procesele Itô continue se schimbă doar driftul
Difuzia și variația pătratică sînt aceleași sub \(P\) și \(Q\)
Cu salturi (Secțiunea 9), \(Q\) poate schimba și intensitatea salturilor și distribuția mărimii lor
intensitatea salturilor \(\hat\lambda\), estimată din randamente, nu este cea care evaluează opțiunile
Cu volatilitate stocastică, \(P\) și \(Q\) ponderează diferit traiectoriile viitoare ale varianței
Varianța istorică este un reper, nu o calibrare
Prețul de piață al riscului: \(P\) față de \(Q\) (1/2)
Pentru GBM alegem constanta \(\theta = (\mu - r)/\sigma\),prețul de piață al riscului: driftul în exces pe unitatea de volatilitate. Conform (11.18), driftul sub \(Q\) este \(\mu S - \sigma S\theta = rS\), deci
iar prețul actualizat \(e^{-rt}S_t\) este un \(Q\)-martingal (Seminarul 11, A4).
Pentru S&P 500 pe 1990–2026, cu \(r\) randamentul mediu al titlurilor de stat pe 3 luni, \(\hat\theta = (10{,}0\% - 2{,}7\%)/18{,}0\% = 0{,}40\). Sub GBM, SE a lui este \(1/\sqrt{T} = 0{,}17\): prețul de piață al riscului este la fel de imprecis ca driftul. Dincolo de GBM, SE rezultă din metoda delta cu covarianța pe termen lung a momentelor de ordinul unu și doi ale randamentelor, ceea ce cere din nou un moment de ordinul patru finit, pus sub semnul întrebării în Capitolul 1.
Pe scurt
GBM: \(\Theta = (\mu - r)/\sigma\) este prețul de piață al riscului
Sub \(Q\), \(\dd S = rS\,\dd t + \sigma S\,\dd\tilde W\)
În modelele structurii la termen și ale volatilității, schimbarea măsurii mută nivelul pe termen lung. În modelul Vasicek cu prima de risc \(\lambda\sigma\),\(\kappa^Q = \kappa\) și \(\kappa\theta^Q = \kappa\theta - \lambda\sigma\), unde \(\theta\) și \(\theta^Q\) sînt nivelurile pe termen lung sub \(P\) și sub \(Q\). Nivelul care evaluează obligațiunile diferă deci de cel estimat pe seria ratei în Secțiunea 6. O primă la termen (term premium) pozitivă corespunde lui \(\lambda < 0\); atunci \(\theta^Q = \theta - \lambda\sigma/\kappa > \theta\), iar randamentele pe termen lung sînt mai mari.
În modelul Heston cu prima de risc a volatilității \(\lambda v_t\),\(\kappa^Q = \kappa + \lambda\) și \(\kappa^Q\theta^Q = \kappa\theta\); acest \(\lambda\) este un parametru separat. Un \(\lambda\) negativ înseamnă că investitorii plătesc pentru protecție împotriva varianței ridicate și dă \(\theta^Q > \theta\): prima de risc a varianței (variance risk premium) din Capitolul 9.
Pe scurt
Vasicek cu prima de risc \(\lambda\sigma\): \(\kappa^Q = \kappa\), \(\kappa\theta^Q = \kappa\theta - \lambda\sigma\)
\(\theta\), \(\theta^Q\): niveluri pe termen lung
Nivelul pe termen lung care evaluează obligațiunile diferă de cel estimat pe date (Secțiunea 6)
O primă de termen pozitivă înseamnă \(\lambda < 0\)
Atunci \(\theta^Q = \theta - \lambda\sigma/\kappa > \theta\), iar randamentele pe termen lung sînt mai mari
Heston cu prima de risc a volatilității \(\lambda v_t\) (alt \(\lambda\); \(v_t\): varianța, Secțiunea 10): \(\kappa^Q = \kappa + \lambda\), \(\kappa^Q\theta^Q = \kappa\theta\)
\(\lambda < 0\) (investitorii plătesc pentru protecția față de varianță) dă \(\theta^Q > \theta\)
Aceasta este prima de risc a varianței din Capitolul 9
Feynman–Kac: de la valori așteptate la PDE de evaluare
Sub \(Q\), prețul unui activ derivat este o valoare așteptată actualizată, iar formula Feynman–Kac (Kac, 1949) transformă această valoare așteptată într-o ecuație cu derivate parțiale (PDE, partial differential equation). Dacă \(\mathrm{d}X = a(X)\,\mathrm{d}t + b(X)\,\mathrm{d}\tilde W\) sub \(Q\), funcția
Aici \(u(t, x)\) este prețul la \(t\) al plății \(g(X_T)\) primite la \(T\), actualizat cu rata pe termen scurt \(r_s\).
Demonstrația folosește instrumentele capitolului. Prețul actualizat \(e^{-\int_0^t r_s\,\mathrm{d}s}\,u(t, X_t)\) este un \(Q\)-martingal, deci driftul lui, calculat cu lema lui Itô (11.5), trebuie să se anuleze; anularea driftului dă (11.19). Pe aceeași cale, Capitolul 12 deduce ecuația Black–Scholes.
Cea mai simplă aplicație este o obligațiune zero-cupon în modelul Vasicek: \(g = 1\) și \(X = r\). Rezolvarea ecuației (11.19) dă un preț exponențial-afin,
cu \(\tau = T - t\) (Seminarul 11, A6). Randamentele \(y(\tau) = (B(\tau)\,r - A(\tau))/\tau\) tind la \(\theta^Q - \sigma^2/(2\kappa^2)\) cînd scadența crește. Incertitudinea ratei coboară randamentele pe termen lung sub \(\theta^Q\), un efect de convexitate. Randamentul modelului este comparat cu randamentul observat al titlurilor de stat în Anexă.
Pe scurt
Dacă \(\dd X = a(X)\,\dd t + b(X)\,\dd\tilde W\) sub \(Q\)Kac (1949)
Trei rezultate rezumă secțiunea. Teorema lui Girsanov schimbă driftul \(a\) în \(a - b\,\theta\) și lasă neschimbată difuzia \(b\). Pentru GBM, alegerea \(\theta = (\mu - r)/\sigma\) transformă driftul \(\mu\) în \(r\), deci \(e^{-rt}S_t\) este un \(Q\)-martingal. Formula Feynman–Kac identifică prețul, valoarea așteptată sub \(Q\) a plății actualizate, cu soluția ecuației de evaluare (11.19).
Verificarea de pe slide aplică primele două rezultate. Cu \(\mu = 9\%\),\(\sigma = 20\%\) și \(r = 3\%\), prețul de piață al riscului este \(\theta = 0{,}06/0{,}20 = 0{,}30\); driftul sub \(Q\) este \(\mu - \sigma\theta = 9\% - 6\% = 3\% = r\), iar volatilitatea \(\sigma = 20\%\) rămîne neschimbată.
Pe scurt
Formulele de reținut
Girsanov: sub \(Q\), driftul \(a\) devine \(a - b\,\Theta\), iar difuzia \(b\) rămîne neschimbată
Absența arbitrajului face din prețuri valori așteptate sub o măsură echivalentă \(Q\). Pentru procese continue, trecerea de la \(P\) la \(Q\) doar deplasează driftul cu prețul de piață al riscului, deci prețurile depind de volatilitate, dar nu de driftul real, pe care datele îl identifică slab. Feynman–Kac transformă aceste valori așteptate în PDE, rezolvate în formă închisă pentru obligațiunea Vasicek. Următoarele două secțiuni renunță la continuitatea și la volatilitatea constantă a difuziilor folosite pînă acum.
Salturi: modelul Merton
Traiectoriile browniene sînt continue, dar prețurile sar la apariția știrilor. Secțiunea adaugă salturi Poisson compuse la GBM, scrie densitatea randamentului rezultată ca mixtură Poisson de densități Normale, estimează modelul pe trei piețe și compară densitatea estimată cu datele.
Ce model explică zilele de crah practic imposibile sub GBM? Pe 19 octombrie 1987, Dow Jones a scăzut cu 22,6%, circa 20 de abateri standard sub GBM cu volatilitate de 18%. O asemenea mișcare este o discontinuitate, iar un salt nu poate fi acoperit prin tranzacționare continuă (Merton, 1976).
Modelul Merton adaugă la logaritmul prețului un proces Poisson compus (compound Poisson):
unde \(N_t\) este un proces Poisson cu intensitatea \(\lambda\) (salturi pe an), mărimile salturilor \(Y_i \sim N(\mu_J, \sigma_J^2)\) sînt i.i.d., iar \(W\),\(N\) și \(Y\) sînt independente. Modelul are cinci parametri, \((m, \sigma, \lambda, \mu_J, \sigma_J)\).
Pe scurt
Întrebarea: ce model explică zilele de crah, practic imposibile sub GBM?
Traiectoriile browniene sînt continue, dar prețurile prezintă salturi la publicarea știrilor
Pe 19 octombrie 1987, Dow Jones a scăzut cu 22,6%
Adică circa 20 de abateri standard sub GBM cu volatilitate de 18%
Un salt nu poate fi neutralizat prin hedging cu tranzacționare continuă Merton (1976)
Condiționat de \(k\) salturi într-un interval de lungime \(\Delta t\), randamentul logaritmic are distribuția Normală \(N\big(m\Delta t + k\mu_J,\ \sigma^2\Delta t + k\sigma_J^2\big)\). Necondiționat, el este o mixtură Poisson de densități Normale, i.i.d. în timp:
\[f(r) = \sum_{k \ge 0} e^{-\lambda\Delta t}\,\frac{(\lambda\Delta t)^k}{k!}\;\varphi\big(r;\ m\Delta t + k\mu_J,\ \sigma^2\Delta t + k\sigma_J^2\big),\]
(11.22)
unde ponderea este probabilitatea Poisson a \(k\) salturi, iar \(\varphi(r; \text{medie}, \text{dispersie})\) este densitatea Normală.
Mixtura dă și simularea exactă a modelului: se extrage numărul de salturi \(N \sim \mathrm{Poisson}(\lambda\Delta t)\), apoi randamentul din distribuția Normală cu momentele condiționate. Momentele randamentului Merton sînt derivate din cumulanții lui în Aprofundări.
Pe scurt
Condiționat de \(k\) salturi, randamentul pe \(\Delta t\) are distribuția \(N\left(m\Delta t + k\mu_J,\ \sigma^2\Delta t + k\sigma_J^2\right)\)
Necondiționat, randamentul este o mixtură Poisson de densități Normale, i.i.d. în timp
\(f(r) = \sum_{k \ge 0} e^{-\lambda\Delta t}\frac{(\lambda\Delta t)^k}{k!}\,\varphi\left(r;\ m\Delta t + k\mu_J,\ \sigma^2\Delta t + k\sigma_J^2\right)\)
Ponderile sînt probabilitățile Poisson ale celor \(k\) salturi
\(\varphi(r; \text{medie}, \text{dispersie})\) este densitatea Normală
Parametrii sînt estimați prin maximizarea numerică a log-verosimilității lui (11.22), cu suma trunchiată la 12 salturi pe zi. Tabelul raportează volatilitatea difuziei \(\hat\sigma\), intensitatea salturilor \(\hat\lambda\) pe an cu SE în paranteză, media \(\hat\mu_J\) și abaterea standard \(\hat\sigma_J\) a salturilor, ponderea salturilor în dispersia randamentului și statistica raportului de verosimilitate (LR, likelihood ratio) față de GBM.
Salturile domină dispersia pe toate cele trei piețe: 71% pentru S&P 500, 73% pentru BET și 85% pentru Bitcoin. Estimarea preferă însă multe salturi mici, nu cîteva crahuri: circa 80–240 pe an, cu abateri standard ale salturilor de 1,44% pentru S&P 500, 2,07% pentru BET și 3,85% pentru Bitcoin și medii ale salturilor apropiate de zero.
Erorile standard cer două precizări:
Cele din paranteză provin din hessiană și sînt condiționate de modelul i.i.d., în jurul maximului local. SE sandwich ale lui \(\hat\lambda\), calculate din scoruri cu o covarianță HAC (heteroskedasticity and autocorrelation consistent), sînt mai mari: 28 pentru S&P 500, 12 pentru BET și 36 pentru Bitcoin.
Verosimilitatea este nemărginită(Honoré, 1998): dacă \(m\Delta t\) este egal cu un randament observat și \(\sigma \to 0\), densitatea acelei observații explodează. MLE este deci un maxim local.
Testul LR al GBM (\(\lambda = 0\)) față de modelul Merton este calculat pe regiunea \(\sigma \ge 5\%\), care exclude soluțiile degenerate. Statistica lui nu are distribuția obișnuită \(\chi^2_3\), din două motive:
\(\lambda = 0\) se află pe frontiera spațiului parametrilor;
sub ipoteza nulă, parametrii salturilor \(\mu_J\) și \(\sigma_J\) nu sînt identificați.
Valorile critice trebuie obținute prin bootstrap (Seminarul 11, B5). Testul privește existența salturilor, nu precizia parametrilor.
Pe scurt
LR (Likelihood Ratio): statistica raportului de verosimilitate.
\(\hat\sigma\) (%)
\(\hat\lambda\) (pe an)
\(\hat\mu_J\) (%)
\(\hat\sigma_J\) (%)
Ponderea salturilor în dispersie
LR
S&P 500
\(9{,}4\)
\(102\) (\(11\))
\(-0{,}16\)
\(1{,}44\)
\(71\%\)
2 401
BET
\(11{,}3\)
\(79\) (\(7\))
\(-0{,}09\)
\(2{,}07\)
\(73\%\)
2 326
Bitcoin
\(24{,}6\)
\(239\) (\(21\))
\(0{,}00\)
\(3{,}85\)
\(85\%\)
1 357
Log-verosimilitatea mixturii Poisson este maximizată numeric
Cel mult 12 salturi pe zi
În paranteze, SE din hessiană: condiționale pe modelul i.i.d., în jurul maximului local
SE sandwich pentru \(\hat\lambda\) (covarianță HAC, robustă la heteroscedasticitate și autocorelare): 28 (S&P 500), 12 (BET), 36 (Bitcoin)
Verosimilitatea este nemărginită, deci MLE este un maxim local Honoré (1998)
Cu \(m\Delta t\) egal cu un randament observat și \(\sigma \to 0\), acea densitate tinde la infinit
Testul LR față de GBM (\(\lambda = 0\)) este definit pe \(\sigma \ge 5\%\) și nu are distribuția \(\chi^2_3\)
Motivul: \(\lambda = 0\) este pe frontieră, iar \(\mu_J, \sigma_J\) nu sînt identificați
Valori critice bootstrap: Seminarul 11, B5; testul privește existența salturilor, nu precizia parametrilor
Estimarea favorizează multe salturi mici (circa 80–240 pe an), nu cîteva crahuri
Estimarea Merton pentru distribuția randamentelor (1/2)
Graficele arată densitatea randamentelor logaritmice zilnice pe o scală verticală logaritmică, pentru S&P 500 (stînga) și Bitcoin (dreapta): histograma datelor, densitatea Normală implicată de GBM și mixtura Merton estimată. Scala logaritmică face cozile vizibile; pe această scală, o densitate Normală este o parabolă. Cursorul înmulțește intensitatea estimată a salturilor \(\hat\lambda\) cu un factor între 0 și 1,15, iar butonul ▶ crește factorul pornind de la 0.
Întrebare pentru sală În modelul Merton, λ = 102 salturi pe an. Cu 252 de zile de tranzacționare pe an, care este probabilitatea să apară cel puțin un salt într-o zi?
Răspuns
Circa 33,3%. Numărul zilnic de salturi are distribuția Poisson cu media 102/252 = 0,405; probabilitatea cerută este 1 − exp(−102/252) ≈ 33,3%. Valoarea 40,5% confundă numărul mediu de salturi cu probabilitatea cel puțin unui salt; 66,7% este probabilitatea niciunui salt. Un salt al modelului nu este automat un crah: abaterea standard estimată a mărimii saltului este 1,44%. Salturile explică 71% din dispersie și ajustează forma distribuției marginale; ele nu reproduc volatility clustering. Excesul de kurtosis implicat este 3,7, față de 10,9 în date. La λ = 0, păstrînd media și dispersia modelului Merton estimat, log-verosimilitatea S&P 500 este 28 291, față de 29 500 la estimarea MLE; pentru GBM reestimat separat, este 28 300.
La intensitatea estimată, mixtura Merton urmărește vîrful și umerii histogramei mult mai bine decît densitatea Normală. La factorul 0, cu media și dispersia modelului estimat păstrate, log-verosimilitatea S&P 500 scade de la 29 500 la 28 291.
Pentru S&P 500, modelul estimat reproduce asimetria, −0,31 față de −0,36 în date, dar doar o parte din kurtosis: excesul lui de kurtosis este 3,7, față de 10,9 în date. Zilele cele mai extreme se află dincolo de ambele curbe estimate.
Intensitatea estimată, circa 102 „salturi” pe an, arată ce fac salturile în această estimare. Un model i.i.d. nu poate reprezenta perioade de volatilitate ridicată și scăzută, deci folosește salturi mici și frecvente pentru a imita volatilitatea variabilă. Un randament aflat departe în coadă poate fi un salt sau o mișcare obișnuită într-o perioadă volatilă, iar un model i.i.d. nu le poate distinge. Un test direct, care compară fiecare randament cu volatilitatea locală, este prezentat în Aprofundări.
Rezultatul este descriptiv: mixtura estimată descrie distribuția marginală mai bine decît GBM, fără a stabili că prețurile sînt discontinue.
Pe scurt
Densitatea randamentelor logaritmice zilnice, pe scară logaritmică
Curbele: histograma, distribuția Normală implicată de GBM și mixtura Merton estimată
Merton reproduce vîrful și regiunile adiacente mult mai bine
S&P 500: momentele implicate de modelul Merton, față de cele din date
Excesul de kurtosis implicat este \(3{,}7\), față de \(10{,}9\) în date
Asimetria implicată este \(-0{,}31\), față de \(-0{,}36\)
Zilele cele mai extreme se află dincolo de ambele curbe estimate
Circa \(102\) „salturi” pe an
Modelul folosește salturile pentru a imita volatilitatea variabilă
Un model i.i.d. nu poate distinge un salt de o perioadă volatilă
În modelul Merton, randamentul logaritmic mediu pe an este \(m + \lambda\mu_J\), deci \(m\) singur este doar driftul componentei de difuzie. Cumulanții de ordin superior provin doar din salturi, \(c_k = \lambda\Delta t\,\mathbb{E}[Y^k]\) pentru \(k \ge 3\), iar excesul de kurtosis \(c_4/c_2^2\) scade ca \(1/\Delta t\) pe măsură ce orizontul crește. Pe S&P 500, \(\hat m + \hat\lambda\hat\mu_J = 24{,}8\% + (-16{,}5\%) \approx 8{,}3\%\), același cu driftul logaritmic al GBM.
Verificarea de pe slide aplică această scalare. Dacă salturile dau un exces de kurtosis zilnic de 12 și randamentele sînt i.i.d., excesul de kurtosis al randamentelor pe 10 zile este \(12/10 = 1{,}2\): pe 10 zile, atît \(c_4\), cît și \(c_2\) cresc de 10 ori, deci \(c_4/c_2^2\) scade de 10 ori. Salturile contează cel mai mult la orizonturi scurte.
Randamentul logaritmic mediu este \(m + \lambda\mu_J\) pe an
Deci \(m\) singur este doar driftul părții de difuzie
Cumulanții de ordin superior provin doar din salturi: \(c_k = \lambda\Delta t\,\E[Y^k]\) pentru \(k \ge 3\)
Excesul de kurtosis \(c_4/c_2^2\) scade ca \(1/\Delta t\) cu orizontul
Din date: pentru S&P 500, \(\hat m + \hat\lambda\hat\mu_J = 24{,}8\% + (-16{,}5\%) \approx 8{,}3\%\)
La fel ca driftul logaritmic GBM
Verificare: salturile dau un exces de kurtosis zilnic de 12
Cît este pentru randamentele pe 10 zile, dacă randamentele sînt i.i.d.?
Răspuns: \(12/10 = 1{,}2\)
Pe 10 zile, atît \(c_4\), cît și \(c_2\) cresc de 10 ori, deci \(c_4/c_2^2\) scade de 10 ori
Sinteza secțiunii
Salturile dau modelului Merton cozi groase și, cu \(\mu_J < 0\), asimetrie negativă. Estimat pe date zilnice însă, modelul alege circa 80–240 de salturi mici pe an, semn că folosește salturile pentru a imita volatilitatea variabilă, și tot nu atinge kurtosis-ul datelor. Volatilitatea variabilă are nevoie de un model propriu.
Volatilitate stocastică: modelul Heston
Creșterea în trepte a variației pătratice din Secțiunea 3 arată că volatilitatea este aleatoare. Modelul Heston dă varianței o dinamică proprie, cu revenire la medie și corelată cu prețul. Secțiunea enunță modelul, explică cum trebuie tratată în simulare varianța de tip rădăcină pătrată și estimează parametrii din VIX.
Ce model generează volatility clustering și asimetrie negativă? GBM și Merton cu parametri constanți nu produc nici volatility clustering, nici dependență între randamente și volatilitate. Merton poate produce asimetrie marginală negativă, prin salturi cu \(\mu_J < 0\), dar aici ținta este asimetria negativă produsă de efectul de levier (leverage effect).
Modelul lui Heston (1993) are două SDE, una pentru logaritmul prețului și una pentru varianța instantanee \(v_t\):
cu \(\operatorname{Corr}(\mathrm{d}W^{(1)}, \mathrm{d}W^{(2)}) = \rho\). Varianța este un proces CIR, cu nivelul pe termen lung \(\theta\), viteza \(\kappa\) și volatilitatea volatilității (volatility of volatility) \(\xi\). Prima ecuație este logaritmul GBM din (11.10), cu \(\sigma^2\) înlocuit de \(v_t\). Sub condiția Feller \(2\kappa\theta \ge \xi^2\)(Feller, 1951), varianța nu atinge niciodată zero.
O corelație negativă \(\rho\) produce efectul de levier: o scădere a prețului mărește varianța care scalează mișcările următoare, deci pierderile mari tind să fie urmate de perioade mai volatile, iar randamentele au asimetrie negativă. Efectul este măsurat pe randamente simulate în Secțiunea 11.
Varianța de tip rădăcină pătrată cere atenție în simulare. Un pas Euler simplu poate face \(v\) negativ, așa că se folosește schema Euler cu trunchiere completă (full truncation), care înlocuiește \(v\) cu \(v^+ = \max(v, 0)\) în coeficienți (Lord, Koekkoek & van Dijk, 2010); schema pătratic-exponențială a lui Andersen (2008) este o alternativă. Randamentele zilnice cer mai mulți pași pe zi. Cu un singur pas, randamentul zilei are distribuția Normală condiționat de \(v\) de la începutul zilei, ceea ce elimină mecanismul intrazilnic prin care \(\rho\) influențează asimetria; asimetria necondiționată poate fi atunci mică, dar nu obligatoriu zero. Secțiunea 11 folosește 390 de pași pe zi, unul pe minut dintr-o sesiune de tranzacționare de 6,5 ore.
Pe scurt
Întrebarea: ce model generează gruparea volatilității și asimetria negativă?
aici, asimetria negativă produsă de efectul de levier
GBM și Merton cu parametri constanți nu produc gruparea volatilității și nici dependența randament–volatilitate
Merton poate produce asimetrie marginală negativă, prin salturi cu \(\mu_J < 0\)
Două SDE, pentru logaritmul prețului și pentru varianța instantanee \(v_t\)Heston (1993)
Varianța instantanee nu este observată. O aproximare practică este \(y_t = (\mathrm{VIX}_t/100)^2\), pătratul VIX, folosit în locul lui \(v_t\) în regresia CIR discretizată, fără termen liber suplimentar:
Împărțirea la \(\sqrt{y_t}\) face eroarea homoscedastică, deci OLS pe cei doi regresori dă \(\kappa\theta\) și \(\kappa\), iar abaterea standard a reziduurilor dă \(\xi\). Corelația \(\rho\) se estimează din randamentele zilnice ale S&P 500 și variațiile aproximării.
Pentru S&P 500 și VIX pe 1990–2026, estimările sînt \(\hat\kappa = 4{,}13\), un timp de înjumătățire de 42 de zile, \(\hat\xi = 0{,}56\) și \(\hat\rho = -0{,}69\). Nivelul pe termen lung implicat de VIX este \(\sqrt{\hat\theta} = 20{,}9\%\), peste volatilitatea realizată de 18,0%, iar raportul Feller al aproximării este \(2\hat\kappa\hat\theta/\hat\xi^2 = 1{,}16\).
Aproximarea nu este varianța. VIX este o valoare așteptată neutră la risc a varianței viitoare, afină în \(v_t\), iar această relație atenuează \(\hat\xi\) (Aprofundări). Pentru traiectoriile simulate, \(\theta\) este fixat deci la varianța realizată a S&P 500, nu la nivelul VIX.
Pe scurt
Folosim proxy-ul \(y_t = (\mathrm{VIX}_t/100)^2\) în locul lui \(v_t\)
estimăm regresia CIR discretizată, fără termen liber suplimentar
În modelul Heston, varianța este un proces CIR, \(\mathrm{d}v_t = \kappa(\theta - v_t)\,\mathrm{d}t + \xi\sqrt{v_t}\,\mathrm{d}W_t^{(2)}\), care rămîne pozitiv dacă \(2\kappa\theta \ge \xi^2\). Un \(\rho = \operatorname{Corr}(\mathrm{d}W^{(1)}, \mathrm{d}W^{(2)})\) negativ dă efect de levier, randamente cu asimetrie negativă și un skew descendent al volatilității implicite. Pătratul VIX satisface \((\mathrm{VIX}/100)^2 = a + b\,v_t\) cu parametri \(Q\), deci \(\kappa\) și \(\rho\) se transmit de la aproximare la varianță, în timp ce \(\xi\) este atenuat de \(b\).
Verificarea de pe slide aplică condiția Feller. Cu \(\kappa = 4\) și \(\theta = 0{,}04\), condiția este îndeplinită pentru \(\xi \le \sqrt{2 \cdot 4 \cdot 0{,}04} = \sqrt{0{,}32} \approx 0{,}57\); o volatilitate a volatilității mai mare permite varianței să atingă zero.
Pe scurt
Formulele de reținut
Varianța este un proces CIR, \(\dd v_t = \kappa(\theta - v_t)\,\dd t + \xi\sqrt{v_t}\,\dd W_t^{(2)}\)
procesul rămîne pozitiv dacă \(2\kappa\theta \ge \xi^2\)
\(\rho = \Corr(\dd W^{(1)}, \dd W^{(2)}) < 0\) dă efectul de levier și randamente cu asimetrie negativă
același semn negativ dă o înclinare descendentă (skew) a volatilității implicite
\((\mathrm{VIX}/100)^2 = a + b\,v_t\), cu \(a\), \(b\) din parametrii \(Q\) (nu coeficienții AR(1))
\(\kappa\) și \(\rho\) se păstrează, iar \(\xi\) este atenuat de \(b\)
Verificare: cu \(\kappa = 4\) și \(\theta = 0{,}04\), care este cel mai mare \(\xi\) pentru care este îndeplinită condiția Feller?
o volatilitate a volatilității mai mare permite varianței să atingă zero
Sinteza secțiunii
Heston dă volatilității o dinamică proprie: cu revenire la medie, cu un timp de înjumătățire de 42 de zile pe VIX, și corelată cu randamentele prin \(\hat\rho = -0{,}69\). VIX identifică viteza și corelația, dar nivelul și volatilitatea lui amestecă parametrii reali și pe cei neutri la risc. Secțiunea următoare întreabă dacă modelele estimate reproduc datele.
Compararea empirică a modelelor
Fiecare model a fost estimat separat. Secțiunea le compară pe o bază comună: randamentele simulate din GBM, Merton și Heston, la parametrii estimați, sînt confruntate cu S&P 500 pe trei repere, forma distribuției, volatility clustering și coada.
Ce model estimat reproduce randamentele S&P 500? Comparația folosește trei caracteristici ale randamentelor zilnice. Forma este măsurată prin asimetria \(c_3/c_2^{3/2}\) și excesul de kurtosis \(c_4/c_2^2\), unde \(c_k\) sînt cumulanții definiți în Aprofundări. Reperul de kurtosis estimează consistent un kurtosis finit doar cînd momentul de ordinul patru este finit, lucru pus sub semnul întrebării în Capitolul 1.
Clustering-ul este măsurat prin ACF a lui \(|r_t|\) la lagurile 1–20, care este zero pentru orice model i.i.d., inclusiv Merton. Coada este măsurată prin statistica Hill a celor mai mari \(k\) pierderi \(L_{(1)} \ge \cdots \ge L_{(k+1)}\):
Statistica Hill (11.24) estimează indicele de coadă (tail index) \(\alpha\) din \(P(L > x) \approx C x^{-\alpha}\) pentru \(x\) mare. Deoarece \(P(L > 2x)/P(L > x) \approx 2^{-\alpha}\), un \(\alpha\) mai mic înseamnă o coadă mai groasă. Cu \(\alpha = 2{,}56\), dublarea pierderii lasă \(2^{-2{,}56} \approx 0{,}17\) din frecvență; o coadă Normală lasă \(P(Z > 4)/P(Z > 2) \approx 0{,}0014\).
Estimarea depinde de numărul \(k\) de statistici de ordine folosite: pentru date este 2,97, 2,56 și 2,04 cînd \(k\) reprezintă 2,5%, 5% și 10% din randamente. Comparația de mai jos folosește \(k\) = 5%.
Pe scurt
Statistica Hill estimează \(\alpha\) din \(P(L > x) \approx C x^{-\alpha}\) pentru \(x\) mare
\(P(L > 2x)/P(L > x) \approx 2^{-\alpha}\), deci un \(\alpha\) mai mic înseamnă o coadă mai grea
Cu \(\alpha = 2{,}56\), dublarea pierderii păstrează \(2^{-2{,}56} \approx 0{,}17\) din frecvență
Cele trei grafice compară S&P 500 cu cele trei modele estimate: ACF a lui \(|r_t|\) la lagurile 1–50 (stînga), excesul de kurtosis (mijloc) și statistica Hill la \(k\) = 5% din randamente (dreapta). Pentru fiecare model, valorile sînt mediane pe eșantioanele simulate, cu intervale de 90%. Cursorul fixează cîte dintre cele 100 de simulări intră în mediane, selectorul arată simulările individuale ale unui model, iar butonul ▶ adaugă simulările una cîte una.
Întrebare pentru sală Permutăm aleator ordinea randamentelor din fiecare simulare Heston, păstrînd toate valorile. Ce se întîmplă, în mod obișnuit, cu ACF a lui |r| la lagul 1?
Răspuns
Ajunge în jurul lui zero. Permutarea distruge ordinea temporală care produce volatility clustering, deci ACF ajunge în jurul lui zero, cu fluctuații de eșantionare, ca la GBM și Merton. Valoarea 0,28 (mediana Heston fără permutare, față de 0,27 în date) presupune greșit că păstrarea distribuției empirice păstrează și dependența temporală. Excesul de kurtosis al fiecărei simulări rămîne neschimbat. Merton reproduce statistica Hill (2,70 față de 2,56) și asimetria (−0,32 față de −0,36). Cu acești parametri, niciuna dintre cele 100 de simulări ale celor trei modele nu atinge excesul de kurtosis din date, 10,88.
Doar Heston produce o ACF a lui \(|r_t|\) apropiată de date, 0,28 la lagul 1 față de 0,27. Merton este cel mai aproape în coadă, cu o statistică Hill de 2,70 față de 2,56. Cu toate cele 100 de simulări, niciunul dintre cele trei modele nu atinge excesul de kurtosis al datelor, 10,88.
Fiecare model este simulat de 100 de ori, cu eșantioane de 9 245 de zile, lungimea seriei S&P 500; tabelul raportează mediane și intervale de 90%, iar tabelul complet este în Anexă. Merton obține coada și asimetria, dar nu și clustering-ul: statistica Hill este 2,70 față de 2,56, iar asimetria −0,32 față de −0,36. Heston, cu parametrii din VIX, obține clustering-ul și o parte din asimetrie, −0,21 față de −0,36. Aproximarea de ordinul principal derivată în Aprofundări dă circa −0,20 la acești parametri; simularea folosește 390 de pași Euler cu trunchiere completă pe zi, însumați în randamente zilnice.
Niciun model estimat nu atinge kurtosis-ul datelor: 3,66 pentru Merton și 3,21 pentru Heston, față de 10,88. Studiile care estimează modele mai bogate, Andersen, Benzoni & Lund (2002) și Eraker, Johannes & Polson (2003), favorizează salturile și volatilitatea stocastică, modelul SVJ (stochastic volatility with jumps) al lui Bates (1996).
Comparația privește procedurile, adică modelele la parametrii estimați. Ea nu exclude orice membru al unei familii: un model Heston cu un raport Feller mai mic ar putea atinge kurtosis-ul datelor (Anexă).
Pe scurt
100 de eșantioane simulate de cîte 9 245 de zile din fiecare model estimat
mediane, intervale de 90%
statisticile comparate: ACF a lui \(|r_t|\) și excesul de kurtosis (\(10{,}88\) în date)
și statistica Hill pe \(k\) = 5% din randamente
Merton reproduce statistica Hill și asimetria, dar nu și gruparea volatilității
statistica Hill: \(2{,}70\), față de \(2{,}56\)
asimetria: \(-0{,}32\), față de \(-0{,}36\)
Heston, cu parametrii din VIX, reproduce gruparea volatilității și o parte din asimetrie
asimetria: \(-0{,}21\), față de \(-0{,}36\)
aproximarea de ordinul principal dă circa \(-0{,}20\) la acești parametri (Aprofundări)
simularea: 390 de pași Euler cu trunchiere completă pe zi, însumați în randamente zilnice
Niciun model estimat nu atinge excesul de kurtosis din date (tabelul complet: Anexa)
Tabelul leagă fiecare caracteristică a datelor de modelul care o produce, de ceea ce identifică datele despre acel model și de ceea ce rămîne nerezolvat:
GBM explică prețurile pozitive și scalarea cu \(\sqrt{t}\), cu un \(\sigma\) precis și un \(\mu\) identificat doar pe orizonturi foarte lungi, dar nu și cozile groase sau clustering-ul.
Familia OU (Vasicek, CIR, CKLS) explică revenirea la medie a ratelor și a VIX; funcția ei de difuzie este precisă, \(\kappa\) este deplasat în sus și cere un orizont lung, iar un singur factor este prea simplu pentru VIX.
Merton explică salturile de preț și cozile groase la orizonturi scurte; \(\lambda\) și \(\sigma_J\) sînt identificați doar sub randamente i.i.d., ponderea salturilor depinde de frecvență, iar clustering-ul lipsește.
Heston explică clustering-ul, efectul de levier și skew-ul volatilității implicite; VIX identifică \(\kappa\) și \(\rho\),\(\xi\) este atenuat, \(\theta^Q \neq \theta^P\), iar kurtosis-ul datelor nu este atins.
Modelul Bates, Heston cu salturi, tratează toate aceste caracteristici împreună, folosind randamentele și suprafețele de opțiuni, dar stările lui sînt latente și trebuie filtrate.
O caracteristică în plus rămîne în afara tuturor acestor modele cu un factor: roughness-ul și memoria lungă (long memory) a volatilității, subiectul primului studiu de caz.
Pe scurt
Caracteristica din date
Modelul
Parametri identificați
Nerezolvat
Prețuri pozitive, scalarea cu \(\sqrt{t}\)
GBM
\(\sigma\) precis; \(\mu\) doar pe orizonturi foarte lungi
cozi groase, gruparea volatilității
Revenirea la medie a dobînzilor și a VIX
OU, Vasicek, CIR, CKLS
\(b(r)\) precis; \(\kappa\) deplasat în sus, necesită un orizont lung
un singur factor, prea simplu pentru VIX
Salturi, cozi groase pe orizonturi scurte
Merton
\(\lambda\), \(\sigma_J\) doar sub randamente i.i.d.; ponderea salturilor depinde de frecvență
fără gruparea volatilității
Gruparea volatilității, efectul de levier, înclinarea volatilității implicite
Heston
\(\kappa\), \(\rho\) din VIX; \(\xi\) atenuat; \(\theta^Q \neq \theta^P\)
kurtosis-ul datelor
Toate cele de mai sus
Bates (Heston + salturi)
randamentele și suprafețele de opțiuni împreună
stări latente: este nevoie de filtrare
Niciunul dintre aceste modele cu un factor nu reproduce asperitatea la scară mică (roughness) și memoria lungă ale volatilității
ambele caracteristici sînt discutate în continuare
Sinteza secțiunii
La parametrii estimați, salturile reproduc coada, iar volatilitatea stocastică reproduce clustering-ul, dar niciuna nu atinge kurtosis-ul randamentelor zilnice ale S&P 500. Fiecare model răspunde la o parte din întrebarea capitolului; combinația dintre salturi și volatilitate stocastică este candidatul firesc următor.
Studii de caz: volatilitate aspră, persistență și explozii de drift
Două articole recente testează descrierea în timp continuu la scări mai fine:
Primul, Bennedsen, Lunde & Pakkanen (2022), întreabă dacă volatilitatea este simultan rough la laguri scurte și persistentă la laguri lungi, ceea ce niciun model cu un singur exponent Hurst nu permite.
Poate un singur proces să descrie o volatilitate neregulată la scări mici și persistentă la scări mari, așa cum sugerează scăderea lentă a ACF a VIX din Aprofundări? Instrumentul standard pentru neregularitate este mișcarea browniană fracționară (fractional Brownian motion) \(B^H\),\(0 < H < 1\), un proces gaussian cu \(B^H_0 = 0\) și
Pentru \(H = 1/2\), covarianța este \(\min(s, t)\), covarianța mișcării browniene. În general, incrementele au dispersia \(\mathbb{E}[(B^H_{t+h} - B^H_t)^2] = h^{2H}\). Pentru \(H < 1/2\), incrementele succesive sînt corelate negativ, iar traiectoriile sînt mai rugoase decît cele browniene; pentru \(H > 1/2\), sînt corelate pozitiv, iar traiectoriile sînt mai netede.
Pe scurt
Întrebarea: poate un singur proces descrie volatilitatea la ambele scări?
la scară mică, volatilitatea este neregulată
la scară mare, este persistentă (ACF a VIX, Secțiunea 6)
Mișcarea browniană fracționară\(B^H\), \(0 < H < 1\): un proces gaussian cu \(B^H_0 = 0\)
Procesul OU fracționar este ecuația OU (11.12) condusă de \(B^H\) în loc de \(W\). Un singur exponent \(H\) fixează atunci ambele capete ale ACF. La laguri scurte, variograma se comportă ca \(h^{2H} = h^{2\alpha + 1}\), unde \(\alpha = H - 1/2\) este indicele de roughness; \(\alpha < 0\) înseamnă traiectorii rugoase. La laguri lungi, ACF scade ca \(h^{2H - 2} = h^{-\beta}\), deci \(\beta = 2 - 2H\);\(\beta < 1\) dă o ACF neintegrabilă, adică memorie lungă.
Cele două caracteristici sînt legate între ele: roughness-ul (\(H < 1/2\)) implică \(\beta > 1\), memorie scurtă, iar memoria lungă (\(\beta < 1\)) implică \(H > 1/2\), traiectorii netede.
Pe scurt
OU fracționar: ecuația OU cu \(B^H\) în locul lui \(W\)
un singur \(H\) fixează ambele capete ale ACF
Laguri mici: variograma \(\E[(x_{t+h} - x_t)^2]\) se comportă ca \(h^{2H} = h^{2\alpha + 1}\)
deci indicele de asperitate este \(\alpha = H - 1/2\) (\(\alpha < 0\): volatilitate aspră, rough)
aici \(\alpha\) nu este indicele cozii din Secțiunea 11
Laguri mari: ACF scade ca \(h^{2H - 2} = h^{-\beta}\)
Verificarea de pe slide arată tensiunea. Un parametru de memorie lungă \(\beta = 0{,}18\) cere \(H = 1 - \beta/2 = 0{,}91\), deci \(\alpha = 0{,}41 > 0\): procesul este neted, nu rough. Un singur \(H\) nu poate reproduce ambele caracteristici.
Bennedsen, Lunde & Pakkanen (2022), în Journal of Financial Econometrics, tratează \(\alpha\) și \(\beta\) ca parametri separați. Articolul pornește de la Gatheral, Jaisson & Rosenbaum (2018), care modelează logaritmul volatilității ca proces OU fracționar cu \(H < 1/2\), modelul RFSV (rough fractional stochastic volatility); modelul cu memorie lungă al lui Comte & Renault (1998) folosește în schimb \(H > 1/2\). Articolul pune două întrebări:
dacă volatilitățile realizate sînt simultan rough și persistente;
dacă modelele care fixează separat \(\alpha\) și \(\beta\) prognozează mai bine.
Modelul, estimatorii și rezultatele articolului sînt în Anexă.
Pe scurt
Verificare: ce \(H\) dă \(\beta = 0{,}18\)? Este acel proces aspru?
Răspuns: \(H = 1 - \beta/2 = 0{,}91\), deci \(\alpha = 0{,}41 > 0\): neted, nu aspru
un singur \(H\) nu poate reproduce ambele trăsături
Replicarea folosește bare SPY de 5 minute, 1 468 de zile complete, din octombrie 2020 pînă în septembrie 2026; articolul studiază contractele futures E-mini S&P 500, iar SPY urmărește același indice. Logaritmul volatilității zilnice este măsurat ca \(x_t = \log\hat\sigma_t = \tfrac12\log \mathrm{BV}_t\), unde \(\mathrm{BV}_t\) este variația bipower (bipower variation) a celor 78 de randamente de cinci minute ale zilei, robustă la salturi (Barndorff-Nielsen & Shephard, 2004).
Panta OLS \(\hat a_1\) a lui \(\log\hat\gamma_2(k)\) pe \(\log k\), pentru \(k = 1, \dots, 6\), dă \(\hat\alpha = (\hat a_1 - 1)/2\). Varianta robustă la zgomot, prin cele mai mici pătrate neliniare (NLLS, non-linear least squares), estimează \(\hat\gamma_2(k) = b_0 + b_1 k^{2\alpha+1}\), unde constanta \(b_0\) preia zgomotul de măsurare din \(x_t\).
Persistența este estimată prin ajustarea ACF din clasa Cauchy, \(\rho(h) = (1 + |h|^{2\alpha+1})^{-\beta/(2\alpha+1)}\), care fixează separat \(\alpha\) și \(\beta\), pe primele \(\lceil n^{1/3}\rceil = 12\) laguri. Reperul cu memorie scurtă este un proces OU, cu ACF \(e^{-\kappa h}\).
Pe scurt
Date: bare de 5 minute pentru SPY (SPDR S&P 500 ETF Trust, fondul tranzacționat la bursă pe indicele S&P 500), 1 468 de zile complete (octombrie 2020 – septembrie 2026)
Graficul din stînga arată variograma empirică \(\hat\gamma_2(k)\) în funcție de \(k\) pe axe logaritmice, cu dreapta OLS și o dreaptă punctată de referință cu panta 1, roughness-ul mișcării browniene (\(\alpha = 0\)); o pantă mai mică înseamnă traiectorii mai rugoase. Graficul din dreapta arată ACF empirică a lui \(x_t\) pînă la lagul 100, cu curba Cauchy ajustată și o curbă exponențială. Primul cursor fixează numărul \(m\) de laguri folosite de OLS, al doilea numărul \(H\) de laguri folosite la ajustarea ACF, iar butonul ▶ crește \(H\).
Întrebare pentru sală Extindem ajustarea curbei exponențiale din grafic de la primele 12 laguri la primele 60. Ce compromis apare în apropierea de ACF empirică?
Răspuns
Ajustarea se îmbunătățește la lagul 100, dar se înrăutățește la lagul 1. Pentru curba desenată, A·exp(−κh), valoarea la lagul 100 crește de la circa 0,0014 la 0,073, apropiindu-se de 0,13 în date; la lagul 1 scade de la circa 0,661 la 0,484, îndepărtîndu-se de circa 0,73 în date. Ajustarea pe mai multe laguri nu garantează o apropiere mai bună la fiecare lag: o singură exponențială nu urmărește și scăderea rapidă de la primele laguri, și coada lentă. Reperul OU normalizat, exp(−κh), este distinct: cu panta estimată pe 12 laguri (timp de înjumătățire 11 zile) dă 0,002 la lagul 100, iar cu panta estimată pe 60 de laguri (36 de zile) dă 0,149. Clasa Cauchy dă β̂ = 0,26 și β̂* = 0,24, ambele sub 1, în acord cu memoria lungă; variograma dă α̂ = −0,32 (OLS) și −0,35 (NLLS), deci o traiectorie mai rugoasă decît cea browniană.
Cu setările implicite, estimarea OLS este \(\hat\alpha_{\mathrm{OLS}} = -0{,}32\), iar autocorelația empirică este încă 0,13 la lagul 100, unde o estimare OU dă 0,002. Extinderea ajustării exponențiale la mai multe laguri o îmbunătățește la lagul 100, dar o înrăutățește la lagul 1: o singură exponențială nu poate urmări și scăderea rapidă inițială, și coada lentă.
Variograma este mult mai plată decît reperul brownian. OLS dă \(\hat\alpha_{\mathrm{OLS}} = -0{,}32\), iar NLLS robust la zgomot dă \(\hat\alpha^*_{\mathrm{NLLS}} = -0{,}35\), aproape de valorile lui Bennedsen, Lunde & Pakkanen (2022) la o zi, −0,30 (OLS) și −0,33 (NLLS). În grafic, ajustarea NLLS folosește \(m = 15\) laguri; estimarea raportată este media ajustărilor pe 10–20 de laguri.
Volatilitatea este și persistentă. Autocorelația este 0,13 la lagul 100, în timp ce o estimare OU, cu un timp de înjumătățire de 11 zile, implică 0,002. Ajustarea Cauchy pe 12 laguri dă \(\hat\beta = 0{,}26\) și, robust la zgomot, \(\hat\beta^* = 0{,}24\); ambele sînt sub 1, în acord cu memoria lungă, dar fără a o dovedi.
Rezultatul este descriptiv și are limite. Barele sînt de 5 minute, fără pre-averaging, iar măsurile realizate estimează varianța integrată pe zi, nu varianța instantanee a modelului. Comparația cu întregul Tabel 3 al articolului este în Aprofundări.
Pe scurt
Stînga, asperitatea: variograma empirică \(\hat\gamma_2(k)\) în funcție de \(k\), pe axe logaritmice
dreapta punctată, cu panta 1, este asperitatea mișcării browniene (\(\alpha = 0\))
estimatorul OLS, pe \(k = 1, \dots, 6\), dă \(\hat\alpha_{\mathrm{OLS}} = -0{,}32\)
estimatorul NLLS robust la zgomot dă \(\hat\alpha^*_{\mathrm{NLLS}} = -0{,}35\)
Al doilea articol este Christensen, Oomen & Renò (2022), publicat în Journal of Econometrics. El folosește cotațiile a șase contracte futures ale Chicago Mercantile Exchange (CME) pe 2012–2017, iar pentru E-mini S&P 500 din 2010: E-mini S&P 500, nota de trezorerie pe 10 ani, euro, aur, țiței și porumb.
Întrebarea este dacă driftul \(\mu_t\) poate domina volatilitatea timp de cîteva minute. Pe orizonturi lungi, driftul este imprecis, ±11 puncte procentuale pe 10 ani (Secțiunea 5), dar un drift burst este un eveniment local: înainte de un moment \(\tau\),\(|\mu_t|\) crește ca \((\tau - t)^{-a}\), cu \(1/2 < a < 1\). Volatilitatea poate crește și ea, dar mai lent, iar prețul rămîne continuu, fără salt. Flash crash-urile din 6 mai 2010, pe acțiuni, și din 15 octombrie 2014, pe titlurile de stat americane, sînt exemplele articolului.
Afirmația principală a articolului, formulată în rezumatul lui, are trei părți:
drift bursts apar în medie o dată pe săptămînă, în toate cele patru clase de active;
cele mai multe sînt urmate de o revenire a prețului;
revenirea este mai puternică după drift bursts negative cu volum mare.
Graficul din stînga arată prețul SPY și statistica de drift burst \(T_t\) în ziua aleasă cu selectorul; implicit este 20 decembrie 2023, ziua cu cel mai mare \(|T_t|\) din eșantion, −3,83 la ora 15:00. Graficul din mijloc numără zilele cu \(\max_t |T_t| > c\) în funcție de pragul \(c\), în date și sub ipoteza nulă cu semne aleatoare, fără drift. Graficul din dreapta arată, pentru zilele cu \(\max_t |T_t|\) peste valoarea critică de 95%, randamentul din cele 15 minute de după vîrful lui \(|T_t|\) față de randamentul din cele 15 minute dinaintea lui; punctele din cadranele stînga-sus și dreapta-jos sînt reveniri. Cursorul fixează lățimea de bandă a driftului \(h\) în minute, iar butonul ▶ o crește.
Întrebare pentru sală Dintre cele 109 zile cu max |T_t| > 2,91, cîte sînt drift bursts?
Răspuns
Numărul de drift bursts adevărate nu este identificat de această procedură. Cele 109 zile sînt candidate; diferența 109 − 73,84 = 35,16 este un exces descriptiv față de nulul cu semne aleatoare, care păstrează modulele randamentelor, dar elimină driftul, asimetria salturilor și efectul de levier. Pragul este calibrat pentru aproximativ 5% depășiri ale maximului zilnic sub acest nul, nu pentru 5% alarme false printre zilele selectate și nici pentru orice proces fără drift burst. Nicio replicare din cele 200 nu atinge 109 zile (maximul este 100); p-value Monte Carlo este circa 0,005. Acest rezultat nu identifică mecanismul care produce excesul. Revenirea, prezentă în 65% din cele 80 de zile cu fereastră completă după vîrf, este tot descriptivă: vîrful este ales retrospectiv, iar sub ipoteza nulă, cu aceeași selecție, proporția medie este 56,5%; panta este doar 0,03, iar pe tranzacțiile E-mini S&P 500 articolul găsește −0,26.
Cu \(h\) = 15 minute, 109 zile depășesc valoarea critică de 2,91, față de 73,84 în medie sub ipoteza nulă. În aceste zile, prețul revine în 65% din cele 80 de zile cu fereastră completă după vîrf; slide-urile următoare arată de ce ambele cifre sînt descriptive.
Pe scurt
Stînga: prețul SPY și statistica de test \(T_t\) (definită pe slide-ul următor) pe 20 decembrie 2023, ziua cu cel mai mare \(|T_t|\) din eșantion (\(-\)3,83 la 15:00)
Mijloc: numărul de zile cu \(\max_t |T_t| > c\), în date și sub ipoteza nulă cu semne aleatoare (fără drift)
Dreapta: randamentul din cele 15 minute de după vîrful lui \(|T_t|\), față de cel din cele 15 minute dinainte, în zilele cu \(\max_t |T_t| > 2{,}91\)
Statistica articolului (ecuațiile 11–14) compară o estimare locală a driftului cu o estimare locală a volatilității, ambele calculate cu nucleul unilateral \(K(x) = e^{-|x|}\) pentru \(x \le 0\), care folosește doar trecutul:
cu \(K_2 = \int K^2 = 1/2\). Fără drift burst, \(T_t\) are asimptotic distribuția Normală standard; cu un drift burst, \(|T_t| \to \infty\). Articolul folosește \(h\) = 5 minute și \(h'\) = 25 de minute, cu pre-averaging și o corecție HAC pentru zgomotul de microstructură, numără drift bursts la praguri fixe între 4 și 6 și estimează alarmele false prin simulare.
Cursul adaptează statistica la bare de cinci minute, cu sumele începînd de la deschidere. Dispersia locală este \(\widehat s_j^2 = \sum_i u_{ij} r_i^2 / (\Delta\sum_i u_{ij})\), iar statistica \(T_j = \sum_i w_{ij} r_i \big/ \sqrt{\widehat s_j^2\,\Delta\sum_i w_{ij}^2}\), cu ponderile \(w_{ij} = e^{-(t_j - t_{i-1})/h}\) și \(u_{ij} = e^{-(t_j - t_{i-1})/h'}\). Numitorul este aleator și calculat din aceleași randamente, deci \(T_j\) nu are exact distribuția Normală, iar cu \(h/\Delta = 3\) bare aproximarea asimptotică nu este garantată. Valorile critice sînt deci calibrate prin simulare.
Pe scurt
Statistica din articol (ec. 11–14), cu nucleul \(K(x) = e^{-|x|}\) pentru \(x \le 0\) (doar trecutul)
\(T_t = \sqrt{h/K_2}\;\hat\mu_t/\hat\sigma_t\), cu \(K_2 = \int K^2 = 1/2\)
fără drift burst, \(T_t\) are asimptotic distribuția Normală standard; cu drift burst, \(|T_t| \to \infty\)
Articolul: \(h\) = 5 minute, \(h'\) = 25 minute, pre-mediere și corecție HAC (heteroskedasticity and autocorrelation consistent) pentru zgomotul de microstructură
articolul raportează numărul de drift bursts la praguri fixe, 4–6, și estimează prin simulare alarmele false
Cursul: o adaptare pe bare de cinci minute, cu sumele pornite de la deschiderea zilei
Replicarea folosește cele 1 468 de zile complete SPY din octombrie 2020 pînă în septembrie 2026, cu \(h\) = 15 minute (3 bare) și \(h'\) = 75 de minute, raportul 1:5 din articol. Statistica este calculată de 73 de ori pe zi, între 10:00 și 16:00. Nu se folosesc pre-averaging și nici corecția HAC, deoarece zgomotul este mic la 5 minute.
Distribuția sub ipoteza nulă se obține înmulțind randamentele cu semne aleatoare \(\pm 1\), în 200 de replicări. Aceasta păstrează modulele randamentelor și tiparul intrazilnic al volatilității, dar elimină driftul. Elimină însă și asimetria salturilor, dependența semnelor și efectul de levier, deci este mai restrînsă decît ipoteza „fără drift burst”; articolul folosește în schimb o ipoteză nulă de tip jump-diffusion.
Se folosesc două valori critice:
Valoarea 2,91 este cuantila de 95% a maximului zilnic \(\max_t |T_t|\) sub ipoteza nulă.
Aproximarea Gumbel dă 3,50, depășită doar în 0,12% din zilele simulate.
Un singur salt dă cel mult \(|T_t| = 2{,}74\), cînd randamentul saltului domină ambele sume de nucleu, deci un salt izolat nu poate depăși singur valoarea critică.
Pe scurt
SPY, 1 468 de zile complete (octombrie 2020 – septembrie 2026)
\(h\) = 15 minute (3 bare), \(h'\) = 75 de minute: raportul 1:5 din articol
73 de teste pe zi, 10:00–16:00
fără pre-mediere și fără HAC: zgomotul este mic la 5 minute
Ipoteza nulă: randamentele înmulțite cu semne aleatoare \(\pm 1\), 200 de replicări
păstrează modulele randamentelor și profilul intrazilnic, dar elimină driftul
elimină și asimetria salturilor, dependența semnelor și efectul de levier
este deci mai restrictivă decît „fără drift burst”; articolul folosește o ipoteză nulă de difuzie cu salturi
Valorile critice
\(2{,}91\): cuantila de 95% a lui \(\max_t |T_t|\) sub ipoteza nulă
aproximarea Gumbel a maximului: \(3{,}50\), depășită doar în \(0{,}12\%\) din zilele simulate
un singur salt dă cel mult \(|T_t| = 2{,}74\) atunci cînd randamentul saltului domină ambele sume ale nucleului, sub pragul de \(2{,}91\)
În date, 109 zile au \(\max_t |T_t| > 2{,}91\), față de 73,84 în medie sub ipoteza nulă. Niciuna dintre cele 200 de replicări nu atinge 109 (maximul este 100), deci p-value-ul Monte Carlo este \(p_{\mathrm{MC}} = 0{,}005\) sub ipoteza nulă cu semne aleatoare. La \(c = 3{,}22\), cuantila de 99%, sînt 23 de zile față de 14,96 (\(p_{\mathrm{MC}} = 0{,}030\)). Excesul descriptiv, 35,16 zile, nu estimează numărul de drift bursts adevărate. Pentru comparație, articolul găsește 202 drift bursts cu \(|T_t| > 4{,}5\) pe E-mini S&P 500 în 2010–2017, circa una la două săptămîni.
Zilele candidate sînt asimetrice: 73 din cele 109 au vîrful pe partea negativă (67%), în timp ce ipoteza nulă cu semne aleatoare este simetrică prin construcție. Prețul revine în 65% din cele 80 de zile cu fereastră completă după vîrf, dar aceasta este o statistică descriptivă. Vîrful este ales retrospectiv pe întreaga zi, deci randamentele de după el îi influențează alegerea; sub ipoteza nulă, cu aceeași selecție, proporția este în medie 56,5% și de cel puțin 65% în 12,4% din 1 000 de replicări.
Mărimile sînt mici. Prețul scade cu 43,8 puncte de bază (bp) în cele 15 minute pînă la vîrf, apoi recuperează 4,7 bp. Panta lui \(R^+\), randamentul de după vîrf, pe \(R^-\), randamentul dinaintea lui (ecuația 36 din articol), este 0,03 (t = 0,41), în timp ce articolul, pe E-mini cu \(|T_t| > 4\), găsește −0,26 (t = −12,05). Vîrfurile negative cu volum peste mediană, raportat la volumul mediu de la aceeași oră, arată −53,9 bp, apoi +6,4 bp (29 de zile); cele cu volum sub mediană arată −34,4 bp, apoi +3,1 bp (31 de zile).
Pe scurt
109 zile candidate cu \(\max_t |T_t| > 2{,}91\), față de \(73{,}84\) în medie sub ipoteza nulă
nicio replicare din 200 nu ajunge la 109 (maximum 100): \(p_{\mathrm{MC}} = 0{,}005\), sub nulul cu semne aleatoare
la \(c = 3{,}22\) (cuantila de 99%): 23 de zile, față de \(14{,}96\) (\(p_{\mathrm{MC}} = 0{,}030\))
excesul descriptiv, \(35{,}16\) zile, nu estimează numărul de drift bursts adevărate
articolul, pe E-mini S&P 500: 202 drift bursts cu \(|T_t| > 4{,}5\) în 2010–2017, circa unul la două săptămîni
73 din cele 109 zile au vîrful negativ (\(67\%\)); nulul cu semne aleatoare este simetric prin construcție
Revenirea apare în \(65\%\) din cele 80 de zile cu o fereastră completă după vîrf: statistică descriptivă
vîrful este ales retrospectiv, pe întreaga zi, deci randamentele de după vîrf influențează alegerea lui
sub ipoteza nulă, cu aceeași selecție: \(56{,}5\%\) în medie; cel puțin \(65\%\) în \(12{,}4\%\) din 1 000 de replicări: revenirea nu se distinge de nul
mărimea: \(-\)43,8 puncte de bază (bp) în 15 minute pînă la vîrf, apoi \(+4{,}7\) bp
Procedura este validată pe date simulate fără drift bursts: 50 de eșantioane de 1 468 de zile, cu bare de 5 minute. Sub Heston, cu parametrii din VIX, efect de levier \(\rho = -0{,}69\) și pași de un minut, excesul mediu este 1,2 zile (cuantila de 95%: 14,8), iar \(p_{\mathrm{MC}} \le 0{,}05\) în 8% din eșantioane. Adăugarea unor salturi Merton asimetrice, cu \(\hat\lambda\),\(\hat\mu_J\) și \(\hat\sigma_J\) estimați pe S&P 500, dă un exces mediu de 3,8 zile (cuantila de 95%: 17,5) și \(p_{\mathrm{MC}} \le 0{,}05\) în 12% din eșantioane. Proporția medie a revenirilor după vîrf este 56% fără salturi și 53% cu salturi.
Excesul din date, 35,16 zile, se află peste cuantila de 95% a ambelor modele simulate. Rezultatul este o descriere comparată cu ipoteze nule fără drift; el nu identifică mecanismul de lichiditate propus de articol.
Rămîn trei limite:
Puterea testului la 5 minute nu este estimată, deci puterea mică rămîne o limită anticipată.
Cu 50 de eșantioane, frecvențele de respingere au o eroare Monte Carlo de circa ±4 puncte procentuale.
29 de zile au vîrful în ultimele 15 minute ale sesiunii și nu au fereastră după vîrf.
Pe scurt
Aceeași procedură pe date simulate fără drift bursts: 50 de eșantioane de 1 468 de zile, bare de 5 minute
Heston cu parametrii din VIX, efect de levier (\(\rho = -0{,}69\)), pași de un minut
excesul mediu: \(1{,}2\) zile (cuantila de 95%: \(14{,}8\)); \(p_{\mathrm{MC}} \le 0{,}05\) în \(8\%\) din eșantioane
plus salturi Merton asimetrice (\(\hat\lambda\), \(\hat\mu_J\), \(\hat\sigma_J\) estimate pentru S&P 500)
excesul mediu: \(3{,}8\) zile (cuantila de 95%: \(17{,}5\)); \(p_{\mathrm{MC}} \le 0{,}05\) în \(12\%\) din eșantioane
revenirea medie după vîrf: \(56\%\) fără salturi și \(53\%\) cu salturi
Excesul din date, \(35{,}16\) zile, depășește cuantila de 95% din ambele modele simulate
Tipul de dovadă: o descriere, comparată cu ipoteze nule fără drift
nu identifică mecanismul de lichiditate din articol
Limite
puterea testului la 5 minute nu este estimată aici: o putere mică rămîne o limitare anticipată
cu 50 de eșantioane, frecvențele de respingere au o eroare Monte Carlo de circa \(\pm 4\) puncte procentuale
29 de zile au vîrful în ultimele 15 minute ale ședinței și nu au fereastră după vîrf
Sinteza secțiunii
Pe SPY, logaritmul volatilității este rough la laguri scurte, cu \(\hat\alpha\) între −0,35 și −0,32, și persistent la laguri lungi, cu \(\hat\beta^*\) = 0,24 sub 1, o combinație pe care nu o produce niciun model cu un singur exponent Hurst și niciun model OU cu un factor. Randamentele de cinci minute conțin mai multe zile cu drift local dominant decît generează ipotezele nule fără drift, dar excesul este descriptiv, iar revenirile sînt mult mai slabe decît în articol.
AI pentru descoperire științifică
Estimările capitolului lasă o întrebare deschisă: ce parte din traiectoria prețului este discontinuă? Secțiunea formulează întrebarea formal, descrie o buclă de cercetare cu un asistent AI, enumeră verificările pe care trebuie să le facă cercetătorul și parcurge un mini studiu de caz în care concluzia unui asistent este testată.
O întrebare deschisă: ce parte din variația prețului provine din discontinuități?
unde \(N_t\) numără salturile, cu intensitatea \(\lambda\), iar \(J_t\) este mărimea saltului. Mărimea de interes este ponderea în dispersie a termenului de salt.
Răspunsul depinde de frecvența de eșantionare și de model. MLE Merton zilnic din Secțiunea 9 atribuie salturilor 71% din dispersia S&P 500. Testul bipower pe 5 minute din Capitolul 9 atribuie salturilor 2,8% din dispersia SPY. Cele două cifre diferă de 25 de ori.
Datele mai fine micșorează și mai mult ponderea. Christensen, Oomen & Podolskij (2014) constată că la frecvența tranzacțiilor individuale (tick) majoritatea salturilor detectate la eșantionare mai rară dispar: sînt mișcări rapide, dar continue. Christensen, Oomen & Renò (2022) arată că drift bursts, trenduri scurte și explozive în \(\mu_t\), arată ca salturi în datele rare.
Formal, întrebarea este un test al ipotezei \(H_0\):\(\lambda = 0\), o traiectorie continuă cu volatilitate stocastică, față de \(H_1\):\(\lambda > 0\). Testul este nestandard, cu aceeași problemă de frontieră ca testul LR Merton din Secțiunea 9.
Fiecare eroare probabilă are un test. O ipoteză nulă pe frontieră, cu parametri neidentificați, cere un bootstrap parametric sub \(H_0\). Folosirea informației viitoare (look-ahead) în filtrul de volatilitate se evită standardizînd doar cu informația din \(\mathcal{F}_{t-1}\). Nepotrivirea frecvențelor se evită calculînd ponderile salturilor la fiecare frecvență pe un eșantion comun. O verosimilitate multimodală cere multe puncte de pornire și un profil în \(\lambda\). Iar cifrele inventate sînt excluse cerînd un tabel și un DOI pentru fiecare afirmație.
Pe scurt
Verificări: eroare și test
Frontieră, parametri neidentificați: bootstrap parametric sub \(H_0\)
Deplasarea de anticipare (look-ahead bias) în filtrul de volatilitate: standardizăm doar cu \(\mathcal{F}_{t-1}\)
Frecvențe diferite: ponderile salturilor la fiecare frecvență, pe un eșantion comun
Verosimilitate multimodală: multe puncte de start și profilul în \(\lambda\)
Cifre inventate: orice afirmație necesită un tabel și un DOI
Mini studiu de caz: salturi sau volatilitate stocastică deghizată?
O propunere tipică a unui asistent este că „71% din dispersie provine din salturi”. Ipoteza rivală este că mixtura Poisson preia volatilitatea variabilă în timp. Dacă este așa, standardizarea randamentelor cu o volatilitate cunoscută dinainte ar trebui să elimine salturile. Testul folosește volatilitatea EWMA (exponentially weighted moving average) cunoscută la \(t-1\), cu \(\lambda_{\mathrm{EWMA}} = 0{,}94\), valoarea RiskMetrics pentru date zilnice, și reestimează modelul Merton pe randamentele brute și pe cele standardizate, pe aceleași 8 995 de zile, eșantionul fără primele 250 de zile folosite la pornirea EWMA.
Standardizarea reduce excesul de kurtosis de la 11,0 la 2,9, iar statistica LR față de distribuția Normală de la 2 403 la 619. Totuși, \(\hat\lambda\) crește de la 100 la 124 pe an, cu o SE care crește de la 10 la 53, iar ponderea salturilor scade de la 71% la 51%. EWMA nu elimină neapărat toată heteroscedasticitatea și nu separă mecanic salturile de volatilitatea stocastică.
Interpretarea este limitată: intensitatea și ponderea estimate ale salturilor depind puternic de modul în care este specificată volatilitatea. Exercițiul compară două proceduri, același model Merton estimat pe randamente brute și pe randamente standardizate, și nu identifică structural discontinuitățile.
Pe scurt
O propunere tipică a asistentului: „71% din varianță provine din salturi”
Ipoteza rivală: mixtura Poisson absoarbe volatilitatea variabilă în timp
atunci standardizarea cu volatilitatea EWMA, cunoscută la \(t-1\), elimină salturile
EWMA: Exponentially Weighted Moving Average, medie mobilă ponderată exponențial
\(\lambda_{\mathrm{EWMA}} = 0{,}94\), valoarea RiskMetrics pentru date zilnice
Randamente nestandardizate
Standardizate EWMA
Excesul de kurtosis
\(11{,}0\)
\(2{,}9\)
LR, Merton față de distribuția Normală
\(2\,403\)
\(619\)
\(\hat\lambda\) pe an (SE)
\(100\) (\(10\))
\(124\) (\(53\))
Ponderea salturilor în varianță
\(71\%\)
\(51\%\)
Același eșantion: 8 995 de zile, fără primele 250 (inițializarea EWMA)
Standardizarea reduce excesul de kurtosis de la \(11{,}0\) la \(2{,}9\), dar \(\hat\lambda\) crește de la 100 la 124 pe an
EWMA nu elimină neapărat heteroscedasticitatea și nu separă mecanic salturile de volatilitatea stocastică
Interpretare: intensitatea și ponderea salturilor depind puternic de specificarea volatilității
Acest exercițiu nu identifică structural discontinuitățile
Tipul de dovadă: comparație între proceduri
același model Merton, estimat pe randamente nestandardizate și pe randamente standardizate EWMA
Proiectul întreabă ce parte din dispersia S&P 500 și a Bitcoin este discontinuă, cum depinde această pondere de frecvența de eșantionare și dacă „salturile” detectate sînt drift bursts. Toate frecvențele intrazilnice se construiesc din bare de 5 minute: SPY din octombrie 2020 pînă în septembrie 2026, 1 468 de zile complete de tranzacționare, și Bitcoin din septembrie 2024 pînă în septembrie 2026, 659 de zile UTC (Coordinated Universal Time, Temps Universel Coordonné, timpul universal coordonat) cu cel puțin 95% din cele 288 de bare (Capitolul 9); sînt disponibile și închiderile zilnice ale ambelor.
Deoarece barele Bitcoin acoperă doar doi ani, o comparație intrazilnică a celor două active folosește fereastra comună septembrie 2024 – septembrie 2026. O preînregistrare datată înainte de prima rulare fixează ipotezele, frecvențele, filtrele, testele și designul bootstrap. Livrabilele sînt enumerate în Aprofundări.
Pe scurt
Întrebări
ce parte din varianța S&P 500 și Bitcoin provine din salturi?
cum depinde această pondere de frecvența de eșantionare?
sînt „salturile” detectate drift bursts?
Date
bare de 5 minute pentru toate frecvențele intrazilnice
SPY: octombrie 2020 – septembrie 2026, 1 468 de zile complete de tranzacționare
Bitcoin: septembrie 2024 – septembrie 2026, 659 de zile UTC (Coordinated Universal Time, timpul universal coordonat) cu cel puțin 95% din cele 288 de bare (Capitolul 9)
închiderile zilnice S&P 500 și Bitcoin
Barele Bitcoin acoperă doi ani
comparația intrazilnică a celor două active folosește fereastra comună septembrie 2024 – septembrie 2026
O pre-înregistrare datată înainte de prima rulare
conține ipotezele, frecvențele, filtrele, testele și designul bootstrap
Ponderea salturilor în dispersie variază de la 71% în datele zilnice la 2,8% în datele de 5 minute, iar mini studiul de caz arată că și cifra zilnică se schimbă odată cu specificația volatilității. Întrebarea este deschisă, iar răspunsul cere teste preînregistrate la mai multe frecvențe, cu valori critice bootstrap.
Random walk-urile rescalate converg la mișcarea browniană (Donsker), iar variația ei pătratică \(t\) stă la baza calculului Itô. Lema lui Itô dă soluții exacte pentru GBM, procesul Ornstein–Uhlenbeck și modelul Merton; celelalte modele se simulează cu Euler–Maruyama sau Milstein, cu un ordin de eroare cunoscut.
Eșantionarea deasă fixează volatilitatea, dar driftul și viteza de revenire la medie cer orizonturi lungi, iar \(\hat\kappa\) este deplasat în sus. Absența arbitrajului face din prețuri valori așteptate actualizate sub \(Q\): teorema lui Girsanov schimbă doar driftul, iar formula Feynman–Kac transformă valoarea așteptată într-o PDE.
Pe scurt
Un mers aleator rescalat converge la mișcarea browniană (Donsker)
variația pătratică \(t\) a mișcării browniene stă la baza calculului Itô
Lema lui Itô dă soluții exacte (GBM, Ornstein–Uhlenbeck, Merton)
celelalte modele se simulează cu Euler–Maruyama sau Milstein, cu ordin de eroare cunoscut
Eșantionarea deasă identifică volatilitatea
driftul și viteza de revenire la medie necesită orizonturi lungi
\(\hat\kappa\) este deplasat în sus
Absența arbitrajului face din prețuri valori așteptate actualizate sub \(Q\)
Girsanov schimbă doar driftul
Feynman–Kac transformă valoarea așteptată într-o PDE
Pătratul VIX este o valoare așteptată sub \(Q\), afină în varianța Heston \(v_t\). În modelele estimate, salturile ajută la cozi, iar volatilitatea stocastică la clustering. Volatilitatea pare rough la laguri scurte și persistentă la laguri lungi, ceea ce un model OU cu un factor nu reproduce. Capitolul 12 folosește aceste instrumente pentru a evalua opțiunile prin replicare și pentru a citi suprafața de volatilitate.
Pe scurt
\((\mathrm{VIX}/100)^2\) este o valoare așteptată sub \(Q\), afină în \(v_t\)
În modelele estimate, salturile explică mai bine cozile
Pentru randamentele zilnice ale S&P 500, următorul model de estimat și validat este Bates, volatilitate stocastică cu salturi. Componenta Heston dă clustering-ul, cu o ACF a lui \(|r_t|\) de 0,28 la lagul 1 față de 0,27 în date, iar componenta Merton dă coada, cu o statistică Hill de 2,70 față de 2,56. \(\hat\lambda\) estimat descrie cozile groase, nu numărul de discontinuități. Volatilitatea se ia din eșantionarea deasă; driftul și \(\kappa\) doar din orizonturi lungi, raportate cu intervalele lor de încredere.
Alegerea este valabilă în două condiții:
parametrii sub \(P\) se folosesc pentru risc, iar parametrii sub \(Q\), din VIX și din suprafețele de opțiuni, pentru evaluare;
simularea folosește mulți pași pe zi, 390 pentru Heston, pentru că un singur pas elimină efectul lui \(\rho\) asupra asimetriei zilnice.
Alegerea ar fi abandonată dacă statistica Hill sau ACF a lui \(|r_t|\) simulate din modelul estimat ar fi departe de valorile din date, ori dacă autocorelația volatilității la laguri lungi ar depăși-o pe cea a unui singur factor la orizontul relevant. Pe SPY, autocorelația este 0,13 la lagul 100, față de 0,002 pentru o estimare OU; acolo unde acest orizont contează, este preferat un model rough și persistent.
Pe scurt
Ce aleg
pentru randamentele zilnice S&P 500, Bates (volatilitate stocastică cu salturi), ca următor model de estimat și validat
partea Heston reproduce gruparea volatilității: ACF a lui \(|r_t|\) la lagul 1 este \(0{,}28\), față de \(0{,}27\) în date
partea Merton reproduce coada: statistica Hill \(2{,}70\), față de \(2{,}56\)
\(\hat\lambda\) descrie cozile groase, nu numărul de discontinuități
volatilitatea din eșantionarea deasă; driftul și \(\kappa\) doar din orizonturi lungi, raportate cu CI
În ce condiții
parametri sub \(P\) pentru risc și sub \(Q\) (VIX, suprafețe de opțiuni) pentru evaluare
simulare cu mulți pași pe zi (390 pentru Heston): un singur pas elimină efectul lui \(\rho\) asupra asimetriei zilnice
Ce rezultat m-ar face să renunț
o statistică Hill sau o ACF a lui \(|r_t|\) simulată din modelul estimat, departe de valorile din date
o autocorelație a volatilității la laguri lungi peste cea a unui singur factor, la orizontul care contează
SPY arată deja acest semnal (\(0{,}13\) la lagul 100, față de \(0{,}002\) pentru un model OU): dacă acel orizont contează, aleg un model cu volatilitate aspră și persistentă
Sinteza secțiunii
Printre modelele capitolului nu se află un model unic pentru prețuri la orice scară de timp: GBM eșuează la cozi și clustering, Merton la clustering, Heston la kurtosis, iar toate modelele cu un factor la combinația dintre roughness-ul și persistența volatilității. Instrumentele sînt însă comune tuturor și sînt instrumentele evaluării opțiunilor din capitolul următor.
Aprofundări
Slide-urile din această parte extind subiecte tratate pe scurt în corpul capitolului: datele, traiectoriile browniene și o integrală Itô rezolvată, covariația pătratică, convergența slabă a schemelor, rezultatele lognormale, rezolvarea și estimarea procesului OU, verosimilitățile și estimările neparametrice pentru ratele pe termen scurt, momentele Merton și testul de salturi Lee–Mykland, ce identifică VIX în modelul Heston, modelele afine, limita de difuzie a GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată) și comparația studiului de caz despre rough volatility cu articolul.
Seriile zilnice sînt S&P 500 (9 245 de randamente, 1990–2026), BET (6 670, 2000–2026), Bitcoin (4 384, 2014–2026, șapte zile pe săptămînă), VIX (1990–2026) și rata DTB3 (1954–2026), cu valori de închidere pînă la 18 septembrie 2026. Randamentele logaritmice sînt calculate pe calendarul propriu al fiecărei serii; timpul este măsurat în ani, cu \(\Delta t = 1/252\) (Bitcoin: \(1/365\)), iar drifturile și volatilitățile sînt anualizate. Datele intrazilnice sînt bare SPY de 5 minute (octombrie 2020 – septembrie 2026, 1 468 de zile complete) și bare Bitcoin de 5 minute (septembrie 2024 – septembrie 2026, 659 de zile UTC cu cel puțin 95% din cele 288 de bare).
Pe scurt
Seria
Tip
Perioada
Observații / frecvență
S&P 500
indice bursier SUA
1990–2026
9 245
BET
indice bursier BVB
2000–2026
6 670
Bitcoin
cripto-activ, 7 zile din 7
2014–2026
4 384
VIX
indicele de volatilitate implicită al S&P 500 (CBOE)
1990–2026
zilnic
DTB3
randamentul titlurilor de stat SUA pe 3 luni (FRED)
1954–2026
zilnic
Valori zilnice de închidere pînă la 18 septembrie 2026, fiecare serie pe propriul calendar
Panoul din stînga arată cinci traiectorii browniene cu banda punctuală \(\pm 1{,}96\sqrt{t}\); panoul din dreapta întinde primul 1% dintr-o traiectorie de 100 de ori în timp și de 10 ori în spațiu.
Banda acoperă 95% din traiectorii la fiecare dată în parte, nu pe întreaga traiectorie, și se lărgește ca \(\sqrt{t}\), regula rădăcinii pătrate a timpului din Capitolul 7. Bucata mărită arată ca întreaga traiectorie, ceea ce înseamnă autosimilaritate; piețele reale o încalcă, pentru că cozile groase și clustering-ul depind de orizont (Capitolul 1).
Pe scurt
Stînga: cinci traiectorii cu banda punctuală \(\pm 1{,}96\sqrt{t}\)
banda acoperă 95% pentru fiecare \(t\) în parte, nu pentru întreaga traiectorie
Dreapta: o traiectorie și primul ei 1% din timp, mărit
mărirea este de 100 de ori pe axa timpului și de 10 ori pe axa valorilor
Banda se lărgește ca \(\sqrt{t}\) (regula rădăcinii pătrate a timpului din Capitolul 7)
Un segment mărit are același aspect ca întreaga traiectorie
Piețele reale încalcă autosimilaritatea
cozile groase și gruparea volatilității depind de orizont (Capitolul 1)
Graficul verifică identitatea pentru \(\int_0^T W_t\,\mathrm{d}W_t\) pe o traiectorie simulată (stînga) și diferența dintre sumele Stratonovich și Itô pe multe traiectorii (dreapta).
Scriind fiecare termen ca \(W_{t_{k-1}}\Delta W_k = \tfrac12(W_{t_k}^2 - W_{t_{k-1}}^2) - \tfrac12(\Delta W_k)^2\) și însumînd, obținem \(\int_0^T W_t\,\mathrm{d}W_t = \tfrac12 W_T^2 - \tfrac12 T\); termenul \(-\tfrac12 T\), absent în calculul obișnuit, este variația pătratică. Pe o traiectorie de 2 000 de pași, identitatea este respectată pînă la 0,038, iar pe 5 000 de traiectorii diferența Stratonovich–Itô are media 0,500 (teoretic \(T/2\)), în timp ce sumele Itô au media 0,007 și dispersia 0,520 (teoretic 0 și 1/2).
Covariația pătratică (quadratic covariation) \([X, Y]_t\) extinde variația pătratică la perechi de procese; pentru mișcări browniene corelate, \(\mathrm{d}[W^{(1)}, W^{(2)}]_t = \rho\,\mathrm{d}t\). Ea dă regula produsului \(\mathrm{d}(XY) = X\,\mathrm{d}Y + Y\,\mathrm{d}X + \mathrm{d}[X, Y]\) și formula Itô multivariată, al cărei termen de ordinul doi este \(\tfrac12\sum_{i,j} f_{x_i x_j}\,\mathrm{d}[X^i, X^j]_t\).
În modelul Heston, unde \(v\) este rata instantanee a variației pătratice a lui \(\ln S\), nu \(\operatorname{Var}(S_t)\), regula produsului dă \(\mathrm{d}(S_t v_t) = S_t\,\mathrm{d}v_t + v_t\,\mathrm{d}S_t + \rho\,\xi\,v_t S_t\,\mathrm{d}t\): corelația intră în driftul produsului.
Eroarea slabă (weak error), \(|\mathbb{E}[g(X_T^{\Delta t})] - \mathbb{E}[g(X_T)]| \le C\,\Delta t^{\beta}\), măsoară cît de aproape este distribuția simulată de cea adevărată. Atît Euler–Maruyama, cît și Milstein au ordinul slab \(\beta = 1\) pentru coeficienți netezi și o plată \(g\) netedă (Kloeden & Platen, 1992), ceea ce ajunge pentru prețurile opțiunilor europene; coeficienții de tip rădăcină pătrată (CIR, Heston), cuantilele precum Value-at-Risk (VaR) și atingerea barierelor pot converge mai lent. Schemele sînt testate pe ecuația \(\mathrm{d}X = \lambda X\,\mathrm{d}t + \mu X\,\mathrm{d}W\) din Higham (2001), cu \(\lambda = 2\),\(\mu = 1\),\(X_0 = 1\) și \(T = 1\).
Pe 20 000 de traiectorii browniene, ordinele tari estimate sînt 0,518 [0,512; 0,525] pentru Euler–Maruyama și 0,986 [0,984; 0,987] pentru Milstein; micile diferențe față de 1/2 și 1 provin din curbura de pas finit. Ordinul slab al Euler–Maruyama, calculat din media exactă, este 0,985, dar estimările Monte Carlo se aplatizează la pași mici, pentru că eroarea lor standard, circa 0,068, depășește deplasarea: mărimea eșantionului, nu pasul, este adesea constrîngerea activă (Glasserman, 2003).
Pe scurt
20 000 de traiectorii browniene pe o grilă fină de \(2^{11}\) pași, rărită la pași de la \(2^{-11}\) la \(2^{-5}\)
Ordinele tari: panta regresiei log-log, cu CI de 95% prin reeșantionarea traiectoriilor întregi
Cu \(\hat\mu = 10{,}0\%\) și \(\hat\sigma = 18{,}0\%\), randamentul brut pe zece ani este 2,71 la medie, 2,30 la mediană și 1,66 la mod. Pornind de la 7 650 pe 18 septembrie 2026, 90% din traiectorii se termină între 6 878 și 45 017; probabilitatea unei pierderi pe zece ani este 7,1%, iar probabilitatea de a termina sub medie este 61,2%, motiv pentru care mediana și cuantilele sînt mai informative decît media. Evantaiul este prea îngust în crize, pentru că GBM nu are nici cozi groase, nici clustering.
Pe scurt
GBM cu \(\hat\mu = 10{,}0\%\) și \(\hat\sigma = 18{,}0\%\) (1990–2026), pe \(T = 10\) ani
Sub GBM, \(\ln(S_T/S_0) \sim N(mT, \sigma^2 T)\): mediana crește cu \(m\), iar media cu \(\mu\);\(\mathrm{SE}(\hat\sigma)\) scade cu numărul de randamente, iar \(\mathrm{SE}(\hat m)\) doar cu numărul de ani acoperiți. Cu \(\sigma = 20\%\), SE a driftului logaritmic este 6,3 puncte procentuale după 10 ani și 3,2 după 40: un orizont de patru ori mai lung doar înjumătățește eroarea.
Lema lui Itô aplicată lui \(e^{\kappa t}x_t\) elimină termenii în \(x_t\); integrînd și înmulțind cu \(e^{-\kappa t}\) obținem \(x_t = \theta + (x_0 - \theta)e^{-\kappa t} + \sigma\int_0^t e^{-\kappa(t-s)}\,\mathrm{d}W_s\), o variabilă cu distribuția Normală a cărei dispersie rezultă din izometria Itô (11.4). Media condiționată este \(\theta + (x_0 - \theta)e^{-\kappa t}\), dispersia condiționată \(\sigma^2(1 - e^{-2\kappa t})/(2\kappa)\), iar distribuția staționară este \(N(\theta, \sigma^2/(2\kappa))\). Cu \(x_0 = 8\%\),\(\theta = 3\%\),\(\kappa = 0{,}5\) și \(\sigma = 1\%\),\(x_1\) are media 6,03% și abaterea standard 0,80%: după un an rămîne 61% din diferența inițială.
Pe scurt
Pasul 1: lema lui Itô pentru \(f(t, x) = e^{\kappa t}x\) (\(f_{xx} = 0\))
Trei traiectorii OU conduse de aceleași șocuri, pornind de la 8%, cu \(\theta = 3\%\) și \(\sigma = 1\%\), au timpi de înjumătățire de 3,47, 0,69 și 0,14 ani pentru \(\kappa = 0{,}2\), 1 și 5 și abateri standard staționare de 1,58%, 0,71% și 0,32%. Revenirea lentă arată ani de zile ca un random walk.
Pe scurt
Traiectorii OU cu aceleași șocuri, pornind de la 8%
\(\theta = 3\%\), \(\sigma = 1\%\)
Viteza de revenire: \(\kappa = 0{,}2\) (lentă), \(\kappa = 1\) sau \(\kappa = 5\) (rapidă)
Simulare exactă, cu pași zilnici
Timpii de înjumătățire
\(3{,}47\) ani pentru \(\kappa = 0{,}2\)
\(0{,}69\) ani pentru \(\kappa = 1\) și \(0{,}14\) ani pentru \(\kappa = 5\)
Cu \(\kappa = 5\), diferența de la 8% la 3% dispare aproape complet în cîteva luni
Abaterile standard staționare \(\sigma/\sqrt{2\kappa}\)
\(1{,}58\%\) pentru \(\kappa = 0{,}2\)
\(0{,}71\%\) pentru \(\kappa = 1\) și \(0{,}32\%\) pentru \(\kappa = 5\)
O revenire lentă nu se poate distinge de un mers aleator timp de mai mulți ani
În eșantioane finite, \(\hat\kappa\) supraestimează \(\kappa\) cu aproximativ \(4/T\), cu \(T\) în ani (Tang & Chen, 2009), pentru că panta OLS \(\hat b\) este deplasată spre zero într-un eșantion scurt și persistent. În 500 de eșantioane simulate de 72 de ani, cu estimările pe întregul eșantion ca valori adevărate, media lui \(\hat\kappa\) este 0,164, o deplasare de 0,063, apropiată de \(4/T = 0{,}055\), iar 78% din estimări depășesc valoarea adevărată. Deplasarea depinde de orizont, nu de frecvența de eșantionare.
Pe scurt
În eșantioane finite \(\hat\kappa\) supraestimează \(\kappa\) cu aproximativ \(4/T\) (\(T\) în ani) Tang & Chen (2009)
Simulare: luăm estimările pe întreaga perioadă drept valori adevărate
Generăm 500 de eșantioane de \(72\) de ani
Media lui \(\hat\kappa\) este \(0{,}164\), deci deplasarea este \(0{,}063\)
Aproximarea \(4/T = 0{,}055\) este apropiată de această deplasare
\(78\%\) dintre estimări depășesc valoarea adevărată (Seminarul 11, B2)
Sursa deplasării: panta OLS \(\hat b\) este deplasată spre zero într-un eșantion scurt și persistent
Panta lui \(x_{t+\Delta t}\) în funcție de \(x_t\)
\(\hat\kappa = -\ln\hat b/\Delta t\) transformă un \(\hat b\) prea mic într-un \(\hat\kappa\) prea mare
Deplasarea depinde de orizontul \(T\), nu de numărul de observații
Eșantionarea zilnică în locul celei lunare nu o elimină (Secțiunea 7)
Panoul din stînga arată VIX pe scală logaritmică, cu nivelul lui OU pe termen lung; panoul din dreapta compară ACF de eșantion a lui \(\ln \mathrm{VIX}\) cu ACF implicată de estimarea OU.
O estimare OU pentru \(\ln \mathrm{VIX}\) pe 1990–2026 dă \(\hat\kappa = 5{,}10\) (SE 0,53), un timp de înjumătățire de 34 de zile de tranzacționare, și un nivel pe termen lung \(e^{\hat\theta} = 18{,}2\); vîrfuri precum 82,7 pe 16 martie 2020 se estompează în cîteva săptămîni. La lagul 60 însă, autocorelația este 0,63 în date, față de 0,30 sub OU: după scăderea rapidă rămîne o componentă lentă, deci un singur factor OU este prea simplu, iar modelele cu doi factori, cu memorie lungă sau rough (Secțiunea 12) sînt candidați.
Pe scurt
Stînga: VIX 1990–2026 pe scară logaritmică
Nivelul OU pe termen lung: \(e^{\hat\theta} = 18{,}2\)
OU pentru \(\ln \mathrm{VIX}\): \(\hat\kappa = 5{,}10\) (SE \(0{,}53\))
Timpul de înjumătățire: \(34\) de zile de tranzacționare
Vîrfuri precum \(82{,}7\) (2020-03-16) se estompează în cîteva săptămîni
Dreapta: ACF empirică a lui \(\ln \mathrm{VIX}\), comparată cu ACF implicată de OU, \(e^{-\hat\kappa k \Delta t}\)
La lagul 60, autocorelația este \(0{,}63\) în date, dar \(0{,}30\) sub OU
După scăderea rapidă rămîne o componentă lentă
Un singur factor OU este prea simplu
Alternativele: modelele cu doi factori sau cu memorie lungă
Volatilitatea aspră (Secțiunea 12) este o opțiune distinctă
Volatilitatea care revine la medie este elementul de bază al modelului Heston
Traiectoria așteptată \(\theta + (x_0 - \theta)e^{-\kappa t}\), timpul de înjumătățire \(\ln 2/\kappa\) și abaterea standard staționară \(\sigma/\sqrt{2\kappa}\) rezumă procesul OU; el se estimează din panta AR(1), \(\hat\kappa = -\ln\hat b/\Delta t\), deplasată în sus în eșantioane scurte. Datele lunare cu \(\hat b = 0{,}95\) dau \(\hat\kappa = 0{,}616\) pe an și un timp de înjumătățire de 1,13 ani.
Pseudo-verosimilitatea Euler aproximează tranziția printr-o distribuție Normală cu media \(r_t + a(r_t)\Delta\) și dispersia \(b^2(r_t)\Delta\), cu o deplasare de ordinul \(\Delta\). Modelul CIR are o tranziție exactă: \(2c\,r_{t+\Delta}\), condiționat de \(r_t\), are distribuția \(\chi^2\) necentrală cu \(4\kappa\theta/\sigma^2\) grade de libertate (Cox, Ingersoll & Ross, 1985), iar condiția Feller este echivalentă cu cel puțin 2 grade de libertate. Difuziile generale folosesc dezvoltări Hermite în formă închisă ale densității de tranziție (Aït-Sahalia, 2002). Modelul CKLS, \(\mathrm{d}r = \kappa(\theta - r)\,\mathrm{d}t + \sigma r^{\gamma}\,\mathrm{d}W\)(Chan, Karolyi, Longstaff & Sanders, 1992), include Vasicek (\(\gamma = 0\)) și CIR (\(\gamma = 1/2\)); el este estimat prin cvasi-verosimilitate gaussiană, iar testele asupra lui \(\gamma\) folosesc erori standard sandwich cu o covarianță HAC a scorurilor (Newey & West, 1987).
Pe datele zilnice DTB3 (13 487 de observații) și pe valorile de sfîrșit de lună (647), verosimilitățile exactă și Euler dau valori ale lui \(\hat\kappa\) care diferă cu mai puțin de o eroare standard, deci eroarea de discretizare este mică față de incertitudinea de orizont lung. Volatilitatea crește cu nivelul: testele Wald HAC resping \(\gamma = 0\) la ambele frecvențe și \(\gamma = 1/2\) doar cu date zilnice. Perioada 2008–2026 este exclusă, pentru că zerourile exacte și cotațiile negative se află în afara domeniului acestor verosimilități.
Fără o formă funcțională, driftul și pătratul difuziei la fiecare nivel \(x\) se estimează prin medii nucleu ale incrementului următor și ale pătratului lui, cu ponderi Nadaraya–Watson mari în zilele în care rata este aproape de \(x\)(Stanton, 1997). Condițiile de moment sînt exacte doar cînd \(\Delta \to 0\), cu erori de ordinul \(\Delta\). Difuzia converge cu viteza infill, iar driftul doar cu viteza orizontului lung; rezultatele sînt valabile pentru procese nestaționare, dar recurente (Bandi & Phillips, 2003), iar testele neparametrice de specificare resping mult prea des cu date persistente (Pritsker, 1998).
Pe scurt
Fără o formă funcțională impusă: medii ponderate cu un nucleu ale incrementelor
Mediile se calculează în jurul fiecărui nivel \(x\)
\(\Delta r_t = r_{t+\Delta} - r_t\) este incrementul următor
\(w_t(x)\) este ponderea zilei \(t\), mare cînd \(r_t\) este aproape de \(x\)
Pe datele zilnice DTB3 din 1954–2007, cu o lățime de bandă de 0,44 puncte procentuale după regula lui Silverman, zero se află în banda punctuală de 95% a driftului la 97% din niveluri, în timp ce difuzia este precisă, cu o SE relativă mediană de 8%, și crește de la 0,5% la 4,7% (panta logaritmică 0,90). Nicio formă parametrică nu se potrivește la toate nivelurile: proporția nivelurilor aflate în bandă este 35% pentru CKLS, 7% pentru CIR și 5% pentru Vasicek.
Pe scurt
Date: DTB3 zilnic, 1954–2007, cu lățimea de bandă \(h = 0{,}44\) puncte procentuale
Regula lui Silverman: \(h = 1{,}06\,\hat s\,n^{-1/5}\), cu \(\hat s\) abaterea standard a ratei
Benzile punctuale de 95% sînt robuste la heteroscedasticitate, dar ignoră dependența serială
Driftul: valoarea zero se află în interiorul benzii la \(97\%\) din niveluri
Difuzia: eroarea standard relativă mediană este \(8\%\)
\(b(r)\) crește de la \(0{,}5\%\) la \(4{,}7\%\) (panta în logaritmi \(0{,}90\))
Nicio formă parametrică nu este compatibilă cu datele la toate nivelurile
Curba CKLS se află în interiorul benzii la \(35\%\) din niveluri
CIR la \(7\%\), iar Vasicek la \(5\%\) (ponderi descriptive)
Eșantionarea infill identifică coeficientul de difuzie prin (11.15); driftul și viteza se învață doar din mai mulți ani, cu \(I(m) = T/\sigma^2\) și \(\operatorname{Var}(\hat\kappa) \approx 2\kappa/T\), iar \(\hat\kappa\) depășește \(\kappa\) cu aproximativ \(4/T\). Eșantionarea acelorași 20 de ani zilnic în loc de lunar, cu de 21 de ori mai multe observații, reduce SE a lui \(\hat\sigma\) de circa \(\sqrt{21} \approx 4{,}6\) ori, dar abia o mișcă pe cea a lui \(\hat\kappa\).
Cumulanții \(c_k = K^{(k)}(0)\) ai funcției generatoare a cumulanților \(K(u) = \ln\mathbb{E}[e^{ur}]\) se adună pe componente independente; partea Normală nu contribuie peste \(k = 2\), iar o sumă Poisson compusă are cumulantul de ordinul \(k\) egal cu \(\lambda\Delta t\,\mathbb{E}[Y^k]\). Rezultă \(c_1 = m\Delta t + \lambda\Delta t\,\mu_J\),\(c_2 = \sigma^2\Delta t + \lambda\Delta t(\mu_J^2 + \sigma_J^2)\),\(c_3 = \lambda\Delta t(\mu_J^3 + 3\mu_J\sigma_J^2)\) și \(c_4 = \lambda\Delta t(\mu_J^4 + 6\mu_J^2\sigma_J^2 + 3\sigma_J^4)\).
Pe scurt
Cumulanții \(c_k\) ai randamentului pe \(\Delta t\)
Definiția: \(K(u) = \ln\E[e^{u r}]\) și \(c_k = K^{(k)}(0)\)
\(c_1\) media, \(c_2\) dispersia, \(c_3\) momentul centrat de ordinul trei
Cumulanții părților independente se adună
O parte Normală are \(c_k = 0\) pentru \(k \ge 3\)
Asimetria este negativă cînd \(\mu_J < 0\), excesul de kurtosis este pozitiv cu orice salt și scade ca \(1/\Delta t\) pe măsură ce orizontul crește. Cu \(\sigma = 15\%\),\(\lambda = 5\),\(\mu_J = -3\%\) și \(\sigma_J = 4\%\), excesul de kurtosis zilnic este 17,6, iar asimetria −2,07.
Pe scurt
Cumulantul de ordinul \(k\) al unei sume Poisson compuse este \(\lambda\Delta t\,\E[Y^k]\)
\(c_1 = m\Delta t + \lambda\Delta t\,\mu_J\), \(c_2 = \sigma^2\Delta t + \lambda\Delta t(\mu_J^2 + \sigma_J^2)\)
Lee & Mykland (2008) tratează un salt ca pe un randament foarte mare în raport cu volatilitatea locală: \(L_t = r_t/\hat\sigma_t\), cu \(\hat\sigma_t^2\) o variație bipower pe cele \(K = 16\) zile anterioare. Fără salturi, maximul lui \(|L_t|\) pe \(n\) zile, normalizat corespunzător, are o limită Gumbel, iar pragul de 1%, 4,60, se aplică statisticii normalizate, nu lui \(|L_t|\). Constantele de normalizare depind de numărul \(n\) de zile testate și de \(c = \sqrt{2/\pi}\), media lui \(|Z|\). Testul controlează asimptotic probabilitatea unui salt fals pe întregul eșantion, nu zi de zi.
Pe scurt
Ideea: un salt este un randament foarte mare raportat la volatilitatea localăLee & Mykland (2008)
La pragul asimptotic, testul marchează 32 de zile în S&P 500 (0,87 pe an, 84% negative) și 52 în Bitcoin (4,35 pe an, 52% negative). Cele mai mari mișcări ale S&P 500, din 2008 și 2020, nu sînt marcate, pentru că au venit în perioade agitate, în timp ce o mișcare de 1,2% într-o piață calmă, pe 14 octombrie 1993, este marcată. Zilele marcate diferă de intensitatea Merton estimată, ceea ce poate reflecta volatilitatea stocastică, drift bursts sau puterea mică de detecție în datele zilnice.
Pe scurt
S&P 500
Bitcoin
Zile marcate, prag asimptotic
32
52
Pe an
\(0{,}87\)
\(4{,}35\)
Negative (%)
\(84\)
\(52\)
Printre primele 10 mișcări
0
5
Peste pragul calibrat de 1%
3
10
Randamente logaritmice zilnice; pragul asimptotic de 1% funcționează aici ca filtru exploratoriu
S&P 500: cele mai mari mișcări (2008, 2020), produse în perioade turbulente, nu sînt marcate
În schimb, o mișcare de \(1{,}2\%\) într-o piață calmă este marcată (1993-10-14)
Zilele marcate diferă de intensitatea Merton estimată. Explicații posibile:
Cu \(K = 16\) zile, volatilitatea locală este zgomotoasă, iar în 2 000 de eșantioane i.i.d. cu distribuția Normală pragul asimptotic marchează cel puțin o zi în 96,6% din eșantioane, în medie 3,43 zile. Pragurile calibrate de 99%, 22,93 pentru S&P 500 și 19,61 pentru Bitcoin, marchează 3 și 10 zile. Sub Heston fără salturi, chiar și pragul calibrat sub i.i.d. este depășit în 44% din eșantioane, iar cu pragul calibrat sub Heston nicio zi a S&P 500 nu este marcată: cu date zilnice, zilele marcate sînt candidate pentru inspecție, nu salturi detectate la 1%.
Pe scurt
Pragul asimptotic presupune o volatilitate locală estimată precis; cu \(K = 16\) zile, \(\hat\sigma_t\) este zgomotos
în 2 000 de eșantioane i.i.d. cu distribuția Normală, de lungimea S&P 500, pragul \(4{,}60\) marchează cel puțin o zi în \(96{,}6\%\) dintre eșantioane
în medie \(3{,}43\) zile marcate pe eșantion, deși nu există salturi
Pragul calibrat: cuantila de 99% a maximului statisticii în aceleași eșantioane (același \(n\), același \(K\))
S&P 500: \(22{,}93\) (\(|L_t| > 11{,}6\)), față de \(4{,}60\) (\(|L_t| > 6{,}2\)); 3 zile marcate (2016-09-09, 2017-05-17, 2018-10-10)
Bitcoin: \(19{,}61\) (\(|L_t| > 10{,}6\)); 10 zile marcate
Dimensiunea sub volatilitate stocastică fără salturi: 200 de eșantioane Heston (parametrii din VIX, \(\rho = -0{,}69\), 390 de pași pe zi)
pragul asimptotic este depășit în \(100\%\) dintre eșantioane
pragul calibrat sub distribuția Normală i.i.d. este depășit în \(44\%\) dintre eșantioane
cu cuantila de 99% din eșantioanele Heston (\(48{,}7\)), nicio zi S&P 500 nu este marcată
Cu date zilnice, zilele marcate sînt candidate pentru inspecție, nu salturi detectate la nivelul de 1%
Sub \(Q\), pătratul VIX este varianța medie așteptată pe următorii \(\tau = 30/365\) ani, \(y_t = a + b\,v_t\), cu \(b = (1 - e^{-\kappa^Q\tau})/(\kappa^Q\tau) < 1\) și \(a = \theta^Q(1 - b)\). Regresia pe \(y_t\) recuperează deci viteza \(\kappa\) sub \(P\), aproximează \(\rho\), atenuează \(\xi\) și amestecă \(\theta^Q\) cu \(\theta^P\); o estimare corectă modelează direct dinamica lui \(y\) sau estimează împreună \(v_t\) și ecuația de observație.
Pe scurt
Sub \(Q\): \(y_t = \frac{1}{\tau}\E^Q\left[\int_t^{t+\tau} v_s\,\dd s \mid \mathcal{F}_t\right] = a + b\,v_t\), \(\tau = 30/365\) (Seminarul 11, A8)
Deoarece \(\mathrm{d}y_t = b\,\mathrm{d}v_t\), driftul lui \(y\) are aceeași viteză \(\kappa\), cu nivelul \(\theta_y = a + b\,\theta^P\), în timp ce egalarea difuziilor dă \(\xi_y = b\,\xi\sqrt{v_t/(a + b\,v_t)}\), egal cu \(b\,\xi\) la \(v_t = \theta^Q\).
Pe scurt
Pasul 1: \(y_t = a + b\,v_t\), cu \(a\) și \(b\) constante, deci \(\dd y_t = b\,\dd v_t\) sub \(P\)
\(\dd y_t = b\kappa(\theta^P - v_t)\,\dd t + b\,\xi\sqrt{v_t}\,\dd W_t^{(2)}\)
Pasul 2, driftul: \(b\kappa(\theta^P - v_t) = \kappa(\theta_y - y_t)\), cu \(\theta_y = a + b\,\theta^P\)
Cu \(\kappa^Q = 5\),\(b = 0{,}82\), iar \(\hat\xi = 0{,}56\) estimat corespunde lui \(\hat\xi/b = 0{,}68\) în jurul lui \(v_t = \theta^Q\); alte valori ale lui \(\kappa^Q\) sînt în Anexă. VIX singur nu identifică \(\kappa^Q\): este nevoie de o estimare comună \(P\)/\(Q\) cu prețurile opțiunilor (Chernov & Ghysels, 2000) sau de momentele varianței realizate (Bollerslev & Zhou, 2002).
Pe scurt
Cifre: cu \(\kappa^Q = 5\), \(b = 0{,}82\)
deci \(\hat\xi = 0{,}56\) corespunde lui \(\hat\xi/b = 0{,}68\) în jurul lui \(v_t = \theta^Q\)
Cu \(\hat\kappa\),\(\hat\xi\) și \(\hat\rho\) din VIX și cu \(\theta\) egal cu varianța realizată a S&P 500, volatilitatea apare în grupuri, iar scăderile de preț coincid cu vîrfurile de volatilitate; corelația simulată randament–varianță este −0,69. Raportul Feller este 0,86, sub 1, deci starea Euler latentă este nepozitivă în 1,4% din pași, iar trunchierea completă folosește \(\tilde v^+ = \max(\tilde v, 0)\) în drift, în difuzie și în pasul prețului.
Pe scurt
Trei traiectorii simulate pe cinci ani: sus prețul, jos volatilitatea \(\sqrt{v_t}\)
\(\hat\kappa\), \(\hat\xi\) (necorectat) și \(\hat\rho\) provin din VIX
\(\theta\) este varianța realizată a S&P 500
Gruparea volatilității este acum generată de model
Scăderile de preț coincid cu vîrfurile de volatilitate
Corelația simulată randament–varianță: \(-0{,}69\) (efectul de levier prin \(\rho\))
Raportul Feller \(2\hat\kappa\theta/\hat\xi^2 = 0{,}86 < 1\): varianța poate atinge zero
starea Euler latentă \(\tilde v\) este \(\le 0\) la \(1{,}4\%\) din pași
Graficul arată volatilitățile implicite Black–Scholes ale prețurilor call Heston în funcție de prețul de exercitare, pentru trei corelații (stînga) și trei scadențe (dreapta).
Volatilitatea implicită, valoarea \(\sigma\) care egalează prețul Black–Scholes cu un preț dat al opțiunii, este constantă în raport cu prețul de exercitare sub GBM. La trei luni, Heston cu \(\hat\rho = -0{,}69\) dă un skew descendent, 26,9% la 80% din spot, 20,0% la spot și 15,7% la 120%; \(\rho = 0\) dă un smile simetric, iar \(\rho = 0{,}50\) inversează skew-ul.
Pe scurt
Volatilitatea implicită: valoarea \(\sigma\) care egalează prețul Black–Scholes cu un preț dat al opțiunii
sub GBM, ea este constantă în raport cu prețul de exercitare
Aici, volatilitățile implicite sînt calculate din prețurile opțiunilor call Heston
Monte Carlo, 100 000 de traiectorii antitetice
Stînga, scadența de trei luni, cu \(\hat\rho = -0{,}69\): un înclinare descendent
volatilitatea implicită este \(26{,}9\%\) la un preț de exercitare de 80% din spot
\(20{,}0\%\) la spot și \(15{,}7\%\) la 120% din spot
Cu \(\rho = 0\): un zîmbet simetric (smile)
\(22{,}8\%\) la 80% din spot
\(20{,}1\%\) la spot și \(22{,}0\%\) la 120% din spot
Cu \(\rho = 0{,}50\): înclinarea se inversează
volatilitatea implicită crește cu prețul de exercitare
Skew-ul se aplatizează cu scadența, de la 27,9%–16,2% la o lună la 23,2%–17,0% la un an; evaluarea propriu-zisă cere parametri \(Q\) calibrați pe opțiuni (Capitolul 12).
Pe scurt
Dreapta: înclinarea se aplatizează odată cu scadența
la o lună, între 80% și 120% din spot: volatilitatea implicită scade de la \(27{,}9\%\) la \(16{,}2\%\)
la un an: doar de la \(23{,}2\%\) la \(17{,}0\%\)
Este doar o ilustrare
evaluarea necesită \(\kappa^Q\), \(\theta^Q\) calibrați pe prețurile opțiunilor (Capitolul 12)
În difuziile afine cu salturi (affine jump-diffusions) (Duffie, Pan & Singleton, 2000), driftul, dispersia și intensitatea salturilor sînt afine în stare, ca în Vasicek, CIR, Merton, Heston și Bates. Funcția caracteristică condiționată este atunci exponențial-afină, \(\exp(\alpha(\tau) + \beta(\tau)^\top X_t)\), cu \(\alpha\) și \(\beta\) soluții ale unor ecuații diferențiale Riccati, iar prețurile opțiunilor rezultă prin inversiune Fourier; obligațiunea Vasicek (11.20) este cazul cel mai simplu.
Cînd pasul scade, GARCH(1,1), modelul GARCH (generalised autoregressive conditional heteroskedasticity) din Capitolul 5, converge la o difuzie a varianței asemănătoare celei Heston, dar cu \(v_t\) în loc de \(\sqrt{v_t}\) în termenul de difuzie (Nelson, 1990). Viteza este \(\kappa \approx (1 - \alpha - \beta)/\Delta t\), deci \(\alpha + \beta = 0{,}99\) zilnic dă \(\kappa \approx 2{,}5\) pe an și un timp de înjumătățire de circa 70 de zile. GARCH și limita lui de difuzie nu sînt însă experimente statistice asimptotic echivalente (Wang, 2002).
Pe scurt
GARCH (Generalised Autoregressive Conditional Heteroskedasticity) descrie varianța condiționată din date discrete.
De la volatilitate condiționată la difuzii Nelson (1990)
Pe o zi, \(\sqrt{v_s} \approx \sqrt{v_0} + \tfrac12\xi W_s^{(2)}\), iar termenul încrucișat al randamentului zilnic dă \(\mathbb{E}[R^3] \approx \tfrac32\,\xi\rho\,v_0 h^2\), cu \(\operatorname{Var}(R) \approx v_0 h\). Asimetria este deci aproximativ \(\tfrac32\,\rho\,\xi\sqrt{h}/\sqrt{v_0}\): circa −0,20 cu \(\hat\rho = -0{,}69\),\(\hat\xi = 0{,}56\) și \(\sqrt{v_0} = 18{,}0\%\), față de o mediană simulată de −0,21 cu 390 de pași pe zi.
Pe scurt
Pe o zi, \(h = 1/252\), ignorînd termenii de drift de ordinul \(h\): \(R = \int_0^h \sqrt{v_s}\,\dd W_s^{(1)}\)
Lema lui Itô pentru \(\sqrt{v}\): \(\dd\sqrt{v_s} = \tfrac12\xi\,\dd W_s^{(2)} + O(\dd s)\)
deci \(\sqrt{v_s} \approx \sqrt{v_0} + \tfrac12\xi W_s^{(2)}\)
Graficul plasează estimările SPY la o zi (marcaje) pe estimările E-mini S&P 500 din Bennedsen, Lunde & Pakkanen (2022) pentru intervale de eșantionare de la 10 minute la o zi (linii).
În articol, \(\hat\alpha\) abia se mișcă odată cu \(\Delta\), de la −0,38 la −0,30, deci roughness-ul este o proprietate a procesului, iar SPY se încadrează în aceeași bandă. \(\hat\beta^*\) robust la zgomot este 0,17–0,18 la orice \(\Delta\), mult sub 1, în timp ce \(\hat\beta\) simplu este instabil. Comparația are limite: alt contract, altă perioadă și alt estimator, bare în locul tuturor tranzacțiilor, fără pre-averaging, iar măsurile realizate privesc varianța integrată, nu pe cea instantanee.
ponderea salturilor Merton de 71% pe datele zilnice S&P 500;
cele 0,87 zile marcate pe an de testul Lee–Mykland la pragul asimptotic;
ponderea bipower a salturilor de 2,8% pe datele SPY de 5 minute.
Livrabilele de bază, realizabile cu datele cursului, sînt ponderea bipower a salturilor și marcajele Lee–Mykland cu praguri calibrate prin simulare la 5, 15 și 30 de minute pe SPY și standardizarea EWMA din mini studiul de caz, repetată la fiecare frecvență.
Pe scurt
Replicați mai întîi
ponderea salturilor în varianță din modelul Merton: 71% (S&P 500, date zilnice)
zilele marcate de testul Lee–Mykland cu pragul asimptotic: \(0{,}87\) pe an
A doua întrebare este dacă drift bursts apar mai des sau mai rar în Bitcoin, care se tranzacționează non-stop, decît în SPY pe aceeași fereastră și dacă sînt urmate de reveniri; lățimile de bandă, ipoteza nulă și comparația sînt preînregistrate. O extensie opțională testează Heston față de Bates printr-un test LR bootstrap, ceea ce cere filtrarea varianței latente, de exemplu prin metoda Markov chain Monte Carlo (MCMC) a lui Eraker, Johannes & Polson (2003). Raportul cuprinde fiecare specificație încercată și o critică de tip referent, iar utilizarea AI se declară în fișierele AI_USE.md și AI_ERRORS.md.
Pe scurt
Apar drift bursts în Bitcoin, tranzacționat 24 de ore din 24, mai des sau mai rar decît în SPY?
a doua întrebare: sînt urmate de o revenire a prețului?
Date: bare Bitcoin de 5 minute, septembrie 2024 – septembrie 2026, 659 de zile UTC cu cel puțin 95% din cele 288 de bare (Capitolul 9)
barele SPY de 5 minute din aceeași fereastră
înainte de prima rulare: pre-înregistrați lățimile de bandă, ipoteza nulă (semne aleatoare) și comparația
explicați cum schimbă testul lipsa licitației de închidere și a pauzei peste noapte
Extensie opțională: un test LR bootstrap Heston (ipoteza nulă, fără salturi) față de Bates
Ambele verosimilități necesită filtrarea varianței latente
Anexa conține contextul istoric al modelelor capitolului, condițiile tehnice și curățarea datelor, rezultate suplimentare pentru ratele pe termen scurt, comparația randamentului Vasicek cu randamentele titlurilor de stat, corecția VIX și comparația completă a modelelor, lecturi suplimentare, metoda și rezultatele studiului de caz despre rough volatility și prompturile buclei de descoperire.
În 1827, botanistul Robert Brown a observat la microscop mișcarea neregulată a particulelor de polen. Bachelier (1900) a modelat prețurile obligațiunilor de stat franceze și ale opțiunilor pe ele ca un random walk în timp continuu, a cărui dispersie crește cu \(\sqrt{t}\), cu cinci ani înainte ca Einstein (1905) să explice mișcarea lui Brown prin ciocniri moleculare. Wiener (1923) a construit mișcarea browniană ca măsură de probabilitate pe traiectorii continue, procesul Wiener.
Căderea din 19 octombrie 1987, 22,6% într-o zi (Secțiunea 9), este o zi pe care distribuția Normală nu ar produce-o nici măcar o dată în vîrsta universului: prețurile sar, iar modelele continue au nevoie de salturi sau de inovații cu cozi groase.
Indicii bursieri sînt folosiți în zilele lucrătoare, cu cotațiile neschimbate (stale quotes) eliminate și randamentele zero autentice păstrate; Bitcoin se tranzacționează șapte zile pe săptămînă. Integrala Itô este definită pentru integranzi adaptați prin aproximare cu procese simple și este doar un martingal local cînd doar \(\int_0^T H_t^2\,\mathrm{d}t < \infty\) aproape sigur. O SDE are o soluție tare unică dacă coeficienții ei sînt lipschitzieni, cu creștere cel mult liniară (Kloeden & Platen, 1992); coeficienții de tip rădăcină pătrată nu sînt lipschitzieni în zero, dar au totuși soluții tari unice. Teorema lui Donsker este valabilă în spațiul traiectoriilor càdlàg cu topologia Skorokhod (Billingsley, 1999).
Pe scurt
Date: indicii bursieri în zilele lucrătoare, fără cotațiile neactualizate (stale)
cotație neactualizată: închidere neschimbată și nicio variație în cursul zilei (maxim = minim)
randamentele zero reale sînt păstrate
Bitcoin: 7 zile din 7
Integrala Itô: sumele cu capătul stîng converg pentru integranzi regulați
de exemplu, integranzi continui și adaptați
un \(H\) general se obține prin aproximare cu procese simple
dacă doar \(\int_0^T H_t^2\,\dd t < \infty\) aproape sigur, \(\int H\,\dd W\) este doar un martingal local
media acestui martingal local poate fi nenulă
SDE: soluție tare unică dacă \(a\), \(b\) sînt lipschitziene în \(x\), cu creștere cel mult liniară Kloeden & Platen (1992)
coeficienții de tip radical (CIR, Heston) nu sînt lipschitzieni în zero
au totuși soluții tari unice (condițiile Yamada–Watanabe)
Donsker: convergență în distribuție în spațiul traiectoriilor càdlàg Billingsley (1999)
Pe 1954–2026, rata DTB3 a variat între −0,05% (26 martie 2020) și 17,1% (11 decembrie 1980), iar 4,3% din zile au fost sub 0,05%. Modelul Vasicek estimat dă o probabilitate pe termen lung de 6,1% pentru o rată negativă; în 2008–2026 există 13 zerouri exacte și 8 cotații negative, în afara domeniului verosimilităților CIR și CKLS.
Pe scurt
DTB3, 1954–2026: rata a variat între \(-0{,}05\%\) (2020-03-26) și \(17{,}1\%\) (1980-12-11)
\(4{,}3\%\) din zile au fost sub 0,05%
Modelul Vasicek estimat dă o probabilitate pe termen lung de \(6{,}1\%\) pentru o rată negativă
În 2008–2026 apar 13 cotații exact zero și 8 negative
aceste cotații sînt în afara domeniului verosimilităților CIR și CKLS
În această perioadă, \(17\%\) din zile formează un regim aproape de zero, sub 0,05%
Testele Wald HAC asupra exponentului CKLS pe 1954–2007 resping \(\gamma = 0\) la ambele frecvențe și \(\gamma = 1/2\) cu date zilnice, dar nu resping \(\gamma = 1/2\) cu date lunare (0,5 față de 3,84); testul LR gaussian, care ignoră volatility clustering, îl respinge lunar. Chan, Karolyi, Longstaff & Sanders (1992) au găsit \(\hat\gamma \approx 1{,}5\) pentru 1964–1989.
Pe scurt
Testele CKLS pentru \(\gamma\), 1954–2007, Wald HAC cu \(11\) (zilnic) și \(6\) (lunar) laguri
\(\gamma = 0\) este respins: statistica Wald este \(545\) pe date zilnice și \(16\) pe date lunare
\(\gamma = 1/2\) este respins pe date zilnice: statistica \(67{,}0\), respectiv \(22{,}1\) cu \(55\) de laguri
\(\gamma = 1/2\) nu este respins pe date lunare: \(0{,}5\), față de valoarea critică 3,84
Testul LR gaussian respinge \(\gamma = 1/2\) și pe date lunare (statistica \(10{,}1\))
Cu estimările din Secțiunea 6, \(\lambda = 0\) și \(r = 3{,}99\%\), randamentul Vasicek pe 10 ani este 4,05%, față de un randament al titlurilor de stat pe 10 ani de 5,01% (seria FRED DGS10) pe 18 septembrie 2026, adică 4,95% cu capitalizare continuă. Conversia ratei de discont pe 91 de zile DTB3 la capitalizare continuă, 4,07%, ridică randamentul modelului la 4,10%.
Pe scurt
Obligațiunea Vasicek: randament pe 10 ani de \(4{,}05\%\)
cu estimările din Secțiunea 6, \(\lambda = 0\) și \(r = 3{,}99\%\)
Randamentul observat pe 10 ani (FRED DGS10) pe 2026-09-18: \(5{,}01\%\)
DGS10 este un randament la paritate cu cupon semestrial
cu compunere continuă: \(2\ln(1 + 5{,}01\%/2) = 4{,}95\%\)
DTB3 este o rată de discont pe 91 de zile: \(3{,}99\%\) înseamnă \(4{,}07\%\) cu compunere continuă
cu această rată, randamentul modelului urcă la \(4{,}10\%\)
Diferența scade doar de la 0,96 la 0,85 puncte procentuale și nu poate fi atribuită unei prime la termen, pentru că doar rata de pornire a fost convertită, DTB3 este o aproximare pe 3 luni a ratei instantanee, iar randamentele la paritate și cele zero-cupon nu sînt aliniate. În model, o primă la termen pozitivă cere \(\theta^Q > \hat\theta\);Stanton (1997) estimează neparametric și prețul de piață al riscului de dobîndă, iar Aït-Sahalia (1996) propune un test de specificare.
Pe scurt
Diferența scade doar de la \(0{,}96\) la \(0{,}85\) puncte procentuale
diferența dintre randamentul la paritate și cel zero-cupon nu este ajustată
Diferența rămasă nu poate fi atribuită unei prime de termen
doar rata inițială a fost convertită, nu și parametrii estimați pe serie
DTB3 este un proxy cu maturitatea de 3 luni pentru rata instantanee
comparația structurală: seria convertită înainte de estimare și randamente zero-cupon la aceeași maturitate
În model, o primă de termen pozitivă cere \(\theta^Q > \hat\theta\), adică \(\lambda < 0\): o implicație a modelului, nu un rezultat identificat aici
Estimarea neparametrică: Stanton (1997) estimează și prețul de piață al riscului de dobîndă
Primul tabel dă factorul de atenuare \(b\) și corecția locală \(\hat\xi/b\) pentru \(\kappa^Q\) între 1 și 10.
Al doilea tabel este comparația completă din Secțiunea 11: excesul de kurtosis, asimetria, statistica Hill și ACF a lui \(|r|\) pentru date și pentru medianele a 100 de simulări ale fiecărui model; un model Heston cu un raport Feller mai mic ar putea atinge kurtosis-ul, deoarece excesul de kurtosis pe orizont scurt este aproximativ \(3\xi^2/(2\kappa\theta)\).
Pe scurt
\(\kappa^Q\)
1
2,5
5
10
\(b\)
\(0{,}96\)
\(0{,}90\)
\(0{,}82\)
\(0{,}68\)
Corecție locală \(\hat\xi/b\)
\(0{,}58\)
\(0{,}62\)
\(0{,}68\)
\(0{,}82\)
Date
GBM
Merton
Heston
Exces de kurtosis
\(10{,}88\)
\(0{,}00\)
\(3{,}66\)
\(3{,}21\)
Asimetrie
\(-0{,}36\)
\(0{,}00\)
\(-0{,}32\)
\(-0{,}21\)
Statistica Hill
\(2{,}56\)
\(4{,}64\)
\(2{,}70\)
\(2{,}92\)
ACF a lui \(|r|\), lagul 1
\(0{,}27\)
\(0{,}00\)
\(0{,}00\)
\(0{,}28\)
ACF a lui \(|r|\), suma lagurilor 1–20
\(5{,}32\)
\(0{,}00\)
\(0{,}00\)
\(4{,}79\)
Corecția \(\hat\xi/b\) este exactă doar la \(v_t = \theta^Q\)
Coloanele modelelor sînt mediane din 100 de simulări
Un model Heston cu un raport Feller mai mic ar putea atinge excesul de kurtosis
excesul pe orizont scurt \(\approx 3\xi^2/(2\kappa\theta)\)
Coloana Heston: 390 de pași Euler pe zi
cu 780 de pași, fiecare mediană se schimbă cu mai puțin de \(0{,}01\)
Articolul modelează volatilitatea ca \(\sigma_t = \xi e^{X_t}\), cu \(X\) un proces brownian semistaționar (BSS, Brownian semistationary) cu nucleul \(g\). Nucleul Gamma dă roughness-ul \(\alpha\) cu memorie scurtă; nucleul putere, modelul Power-BSS, dă roughness și memorie lungă fixate separat, la fel ca clasa Cauchy gaussiană.
Roughness-ul este estimat din variograma lui \(\log\hat\sigma\) prin OLS și NLLS, iar parametrul de memorie prin potrivirea ACF a modelului cu cea empirică pe primele \(\lceil n^{1/3}\rceil\) laguri. Datele sînt toate tranzacțiile cu futures E-mini S&P 500 din 2011–2014 (996 de zile) și date zilnice pentru 1 944 de acțiuni americane lichide din 2003–2013.
Pe scurt
Pasul 1: \(\alpha\) din variograma lui \(\log\hat\sigma\), prin OLS (ec. (2.1)) și NLLS
ca în replicarea pe SPY
estimarea NLLS este media pentru \(m = 10, \dots, 20\) laguri (Secțiunile 2.1 și 3.1)
Pasul 2: \(\beta\), \(\gamma\) sau \(\lambda\) prin ajustarea ACF a modelului la cea empirică
pe primele \(\lceil n^{1/3}\rceil\) laguri (Secțiunile 2.2 și 4.1)
Date: tranzacțiile cu contractul futures E-mini S&P 500, 2011–2014 (996 de zile)
intervalul zilnic: 09:30–16:00 ora New York
Date zilnice pentru 1 944 de acțiuni americane lichide, 2003–2013 (Secțiunile 4.1 și 4.2)
Volatilitatea pe fiecare interval \(\Delta\), de la 10 minute la o zi, este măsurată prin variația bipower cu pre-averaging, robustă la salturi (Barndorff-Nielsen & Shephard, 2004) și cu zgomotul de microstructură atenuat, după eliminarea sezonalității intrazilnice cu forma Fourier flexibilă a lui Andersen & Bollerslev (1997).
Pe scurt
\(\hat\sigma^2_t\): variația bipower cu pre-mediere pe intervalul \(\Delta\), împărțită la \(\Delta\)
\(\Delta\) de la 10 minute la o zi (Secțiunile 4 și 4.1)
Variația bipower a celor \(M\) randamente \(r_j\) dintr-un interval: \(\mathrm{BV} = \frac{\pi}{2}\sum_{j=2}^{M}|r_j|\,|r_{j-1}|\)
Prognozele varianței însumate pe următorii 1–20 de pași folosesc o fereastră rolling de 200 de observații, out-of-sample din ianuarie 2013 pînă în decembrie 2014, față de modele rivale între care log-HAR (Corsi, 2009), ARFIMA (AutoRegressive Fractionally Integrated Moving Average, model, model autoregresiv cu medie mobilă, integrat fracționar) și RFSV. Ele sînt comparate prin pierderile MSE (Mean Squared Error, eroarea pătratică medie) și QLIKE (Quasi-LIKElihood, loss function, funcția de pierdere de tip cvasi-verosimilitate) și prin mulțimea de încredere a modelelor (MCS, model confidence set) a lui Hansen, Lunde & Nason (2011), ai cărei membri nu pot fi deosebiți la nivelul ales.
Pe E-mini, \(\hat\alpha\) se află între −0,38 și −0,30, iar \(\hat\beta^*\) robust la zgomot este 0,18 la orice interval între 10 minute și o zi: logaritmul volatilității este rough la toate scările și persistent.
Pe scurt
\(\log\sigma\), E-mini S&P 500 (Tabelul 3, Panoul A)
\(\hat\alpha_{\mathrm{OLS}}\)
\(\hat\alpha^*_{\mathrm{NLLS}}\)
\(\hat\beta^*_{\mathrm{Cauchy}}\)
\(\hat\lambda^*_{\mathrm{Gamma}}\)
\(\Delta = 10\) minute
\(-0{,}38\)
\(-0{,}38\)
\(0{,}18\)
\(0{,}02\)
\(\Delta = 65\) de minute
\(-0{,}30\)
\(-0{,}35\)
\(0{,}18\)
\(0{,}02\)
\(\Delta = 1\) zi
\(-0{,}30\)
\(-0{,}33\)
\(0{,}18\)
\(0{,}02\)
Volatilitatea este aspră la orice scară și persistentă: memorie lungă împreună cu asperitatea
aspră: \(\hat\alpha < 0\), mult mai aspră decît mișcarea browniană (\(\alpha = 0\))
Pe 1 944 de acțiuni americane, \(\hat\alpha^*\) se află în majoritate între −0,45 și −0,30, iar \(\hat\beta^*\) între 0 și 0,4, fără diferențe sistematice între sectoare. Zgomotul poate simula roughness-ul: cu \(\alpha = 0\) adevărat și zgomot, OLS dă în medie −0,47, iar NLLS 0,01. În prognoză, modelarea persistenței este utilă intrazilnic și la orizonturi lungi, iar RFSV este cel mai bun pentru prognozele zilnice la un pas.
Pe scurt
Pe 1 944 de acțiuni americane, ambele trăsături par universale (Figurile 4 și 5)
\(\hat\alpha^*\) este în general între \(-0{,}45\) și \(-0{,}30\)
\(\hat\beta^*\) este între \(0\) și \(0{,}4\)
nu apar diferențe sistematice între sectoare
Zgomotul poate imita asperitatea (Tabelul 1, Panoul C)
simulare: \(\alpha = 0\), observat cu raportul zgomot/semnal \(0{,}3\) la \(\Delta = 0{,}1\)
estimarea OLS medie este \(-0{,}47\)
estimarea NLLS medie este \(0{,}01\)
Prognozele: modelarea persistenței îmbunătățește prognozele intrazilnice și pe orizonturi lungi
pași de 15 minute, \(h = 20\), MSE (\(\times 10^{8}\)): \(0{,}038\) log-HAR, \(0{,}020\) RFSV, \(0{,}019\) Power-BSS (Tabelul 4, Panoul A)
la pași zilnici și \(h = 1\), RFSV este cel mai bun: \(0{,}493\) (\(\times 10^{9}\)) (Tabelul 5, Panoul B)
Pe barele SPY de 5 minute ale cursului, o aplicație ilustrativă măsoară volatilitatea pe intervale de 30 sau 65 de minute, ajustată sezonier (Andersen & Bollerslev, 1997), și compară rezultatele pentru roughness, memorie și prognoză cu tabelele 3 și 5 ale articolului. Barele în locul tuturor tranzacțiilor fac imposibil estimatorul cu pre-averaging, măresc zgomotul și lasă doar 13 randamente pe un interval de 65 de minute.
Pe scurt
Aplicație intrazilnică pe barele SPY de 5 minute din datele cursului
este ilustrativă, nu o replicare exactă
\(\hat\sigma^2_t\) este variația bipower a randamentelor la 5 minute din fiecare interval \(\Delta\) = 30 sau 65 de minute
Întrebarea deschisă este de ce memoria lungă îmbunătățește chiar și prognozele pe orizont scurt. Estimările rolling pe ferestre de 65 de minute din 2005–2014 au o mediană a lui \(\hat\alpha\) de −0,36, sînt mai puțin rough în 2007–2008 și 2011 și cresc cu logaritmul volumului; dacă Bitcoin, o piață care nu se închide niciodată, urmează același tipar este o întrebare deschisă.
Pe scurt
Întrebare deschisă: de ce îmbunătățește memoria lungă chiar și prognozele pe termen scurt?
Autorii lasă întrebarea pentru cercetări viitoare (Secțiunea 5.1.2)
Estimările \(\hat\alpha\) pe ferestre mobile indică o volatilitate mai puțin aspră în 2007–2008 și 2011 (Figura 3)
ferestrele: 65 de minute, 2005–2014
mediana \(\hat\alpha\) este \(-0{,}36\)
\(\hat\alpha\) crește cu logaritmul volumului, cu panta \(0{,}0091\) (Figura 6)
Se încadrează Bitcoin (barele de 5 minute), o piață care nu se închide niciodată, în acest tipar?
1. Literatura: grupăm estimările într-un tabel după frecvență
verificăm fiecare DOI pe Crossref (titlul trebuie să coincidă)
Prezintă într-un tabel estimările publicate ale ponderii salturilor în varianța indicilor bursieri, după frecvența de eșantionare (zilnic, 5 minute, tranzacție cu tranzacție) și metodă; dă cifra exactă, tabelul din care provine și DOI-ul.
2. Ipoteze concurente, cu implicații testabile distincte
Pentru trei procese care dau un exces de kurtosis zilnic în jur de 11 (salturi Merton, volatilitate Heston, drift bursts), derivează implicațiile pentru randamentele standardizate cu volatilitatea ex ante, pentru variația bipower față de varianța realizată și pentru drift chiar înaintea mișcărilor extreme.
3. Date și cod: replicăm întîi estimarea din capitol
Scrie cod Python care citește închiderile zilnice S&P 500 din datele cursului și estimează modelul Merton prin verosimilitate maximă (mixtură Poisson trunchiată la 12 salturi, mai multe puncte de start).
un plan de robustețe preînregistrat, cu valori critice bootstrap sub ipoteza nulă Heston;
critica unui referent asupra testului LR pentru \(\lambda = 0\);
un raport care enumeră fiecare frecvență, filtru și valoare critică, împreună cu codul și jurnalul AI.
Pe scurt
4. Robustețe, pre-înregistrată
Scrie un plan pre-înregistrat: standardizăm randamentele cu volatilitatea EWMA și GARCH cunoscută la t-1; împărțim 1990-2007 și 2008-2026; testăm Heston (fără salturi, ipoteza nulă) față de Bates (SVJ); valorile critice LR prin bootstrap parametric sub ipoteza nulă Heston.
5. Critica: cerem asistentului să conteste inferența
Joacă rolul unui recenzent: de ce testul LR pentru lambda = 0 este nestandard, care este distribuția de referință corectă și ar putea o mixtură Poisson cu salturi mici și frecvente să fie doar o inovație cu cozi groase?
CKLS: Chan–Karolyi–Longstaff–Sanders (model) — modelul Chan–Karolyi–Longstaff–Sanders al ratei dobînzii
CLT: Central Limit Theorem — teorema limită centrală
CME: Chicago Mercantile Exchange — Bursa de mărfuri din Chicago
DGS10: 10-Year Treasury Constant Maturity Rate (FRED series code) — randamentul titlurilor de stat americane cu scadența constantă de 10 ani (codul seriei FRED)
DOI: Digital Object Identifier — identificatorul digital al unui document
DTB3: 3-Month Treasury Bill: secondary market rate (FRED series code) — randamentul titlurilor de stat americane pe 3 luni pe piața secundară (codul seriei FRED)
ETF: Exchange-Traded Fund — fond tranzacționat la bursă
EWMA: Exponentially Weighted Moving Average — medie mobilă ponderată exponențial
FRED: Federal Reserve Economic Data — baza de date economice a Rezervei Federale (St. Louis)
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?. European Journal of Finance, 29(10), 1064–1105.
Samuelson, P.A. (1965). Rational theory of warrant pricing. Industrial Management Review, 6(2), 13–39; reprinted in Henry P. McKean Jr. Selecta (2015), Birkhäuser.
Randamente logaritmice zilnice pînă la 18 septembrie 2026: S&P 500 (din 1990) și Bitcoin (din 2014), prețuri EODHD. Randamentul titlurilor de stat SUA pe 3 luni: FRED, seria DTB3, 1954–2026. Studiile de caz: bare SPY de 5 minute, EODHD, octombrie 2020 – septembrie 2026. Simulările (random walk, mișcare browniană, GBM, Merton, Heston) folosesc aceleași seed-uri ca graficele din curs.


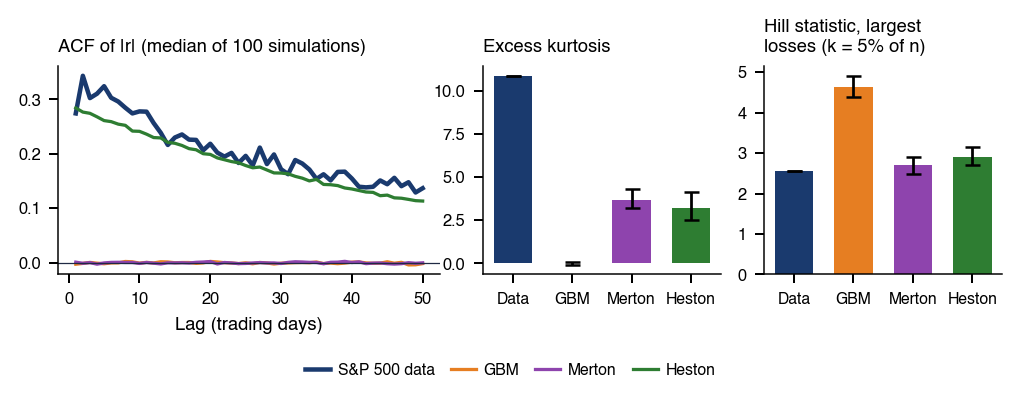
 MFM_ch11_donsker
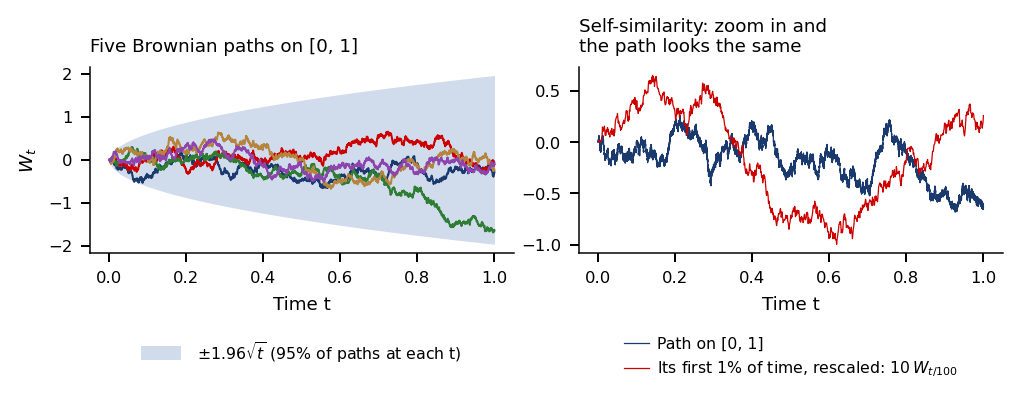
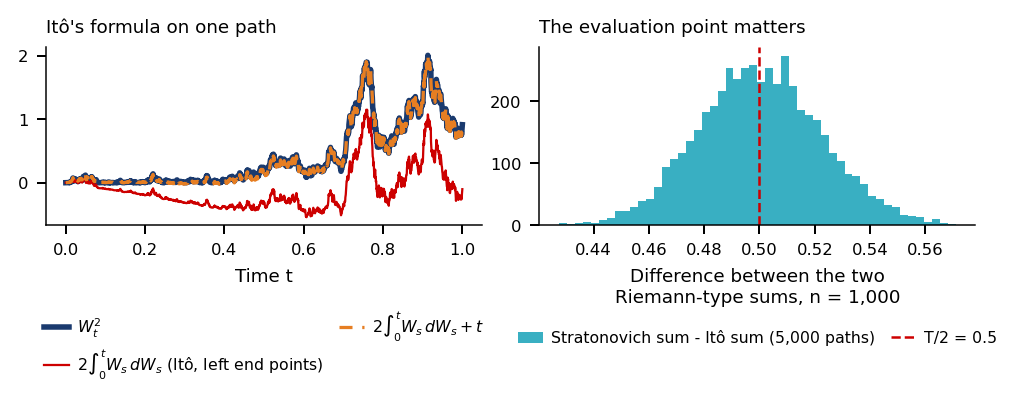
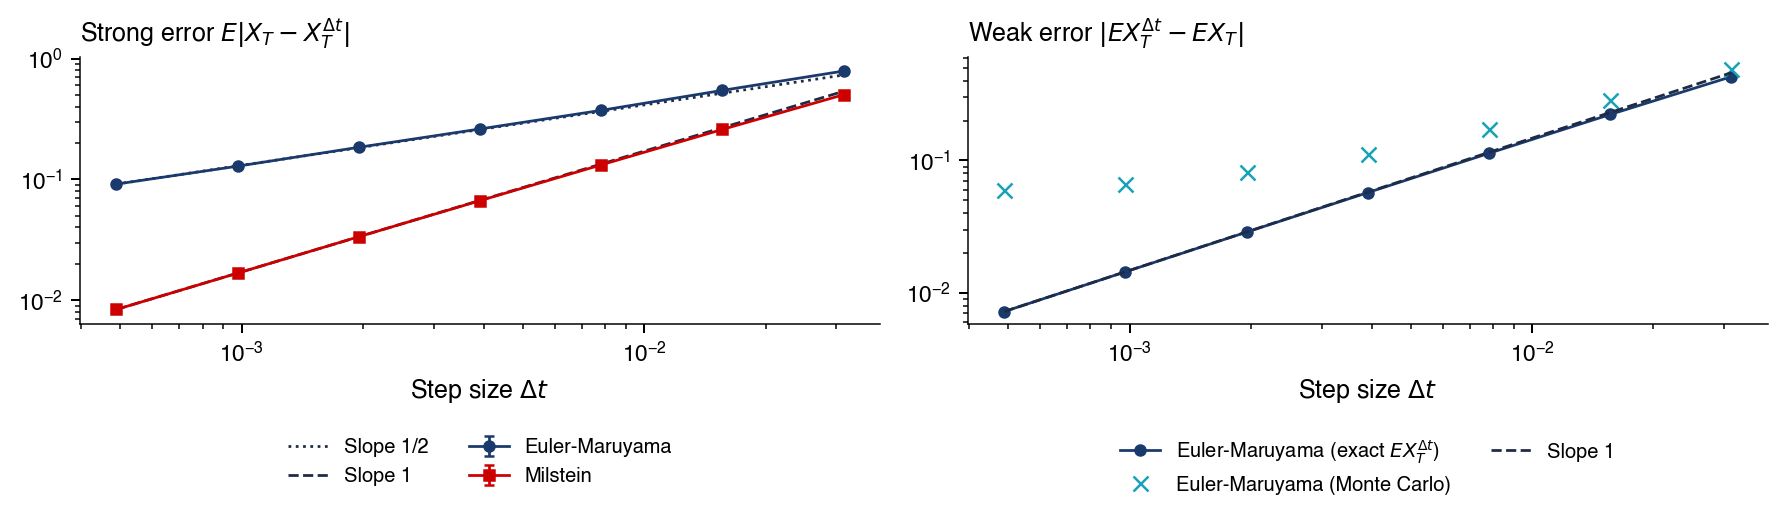
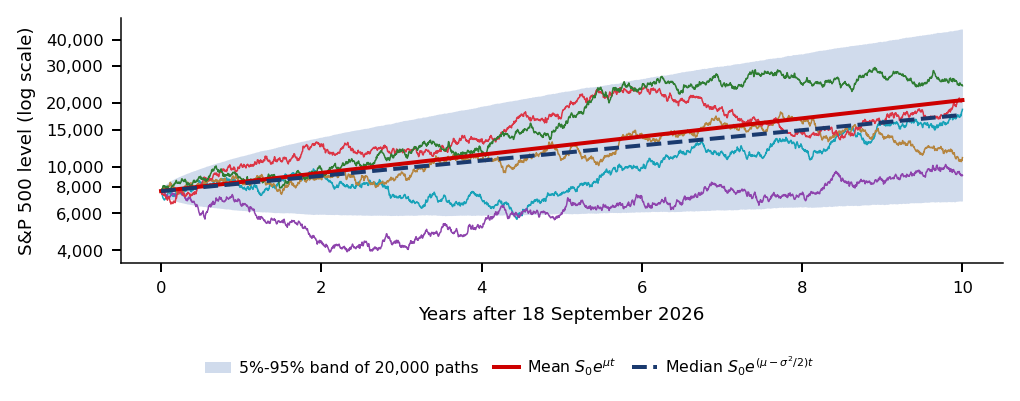
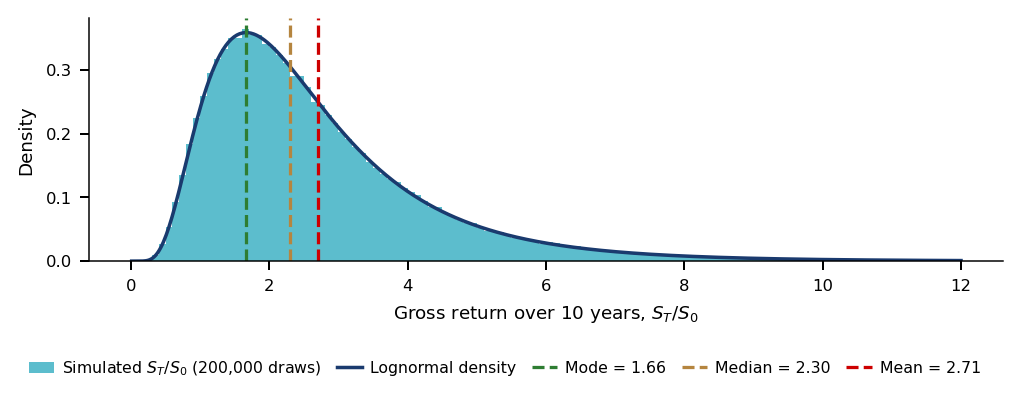
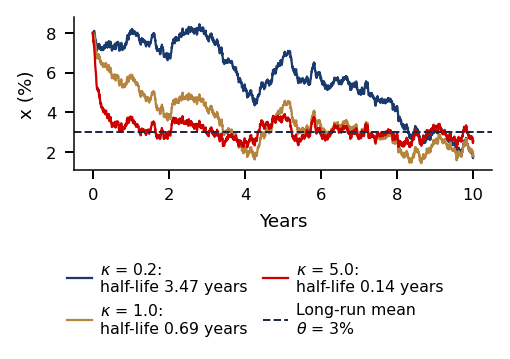
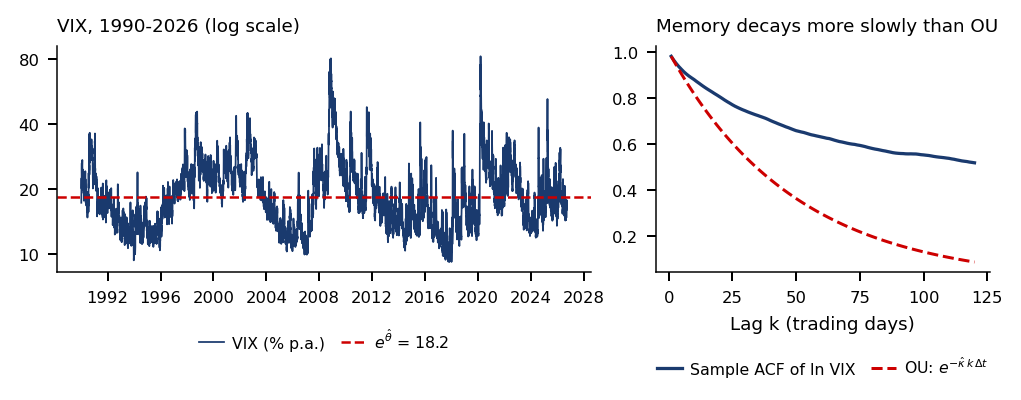
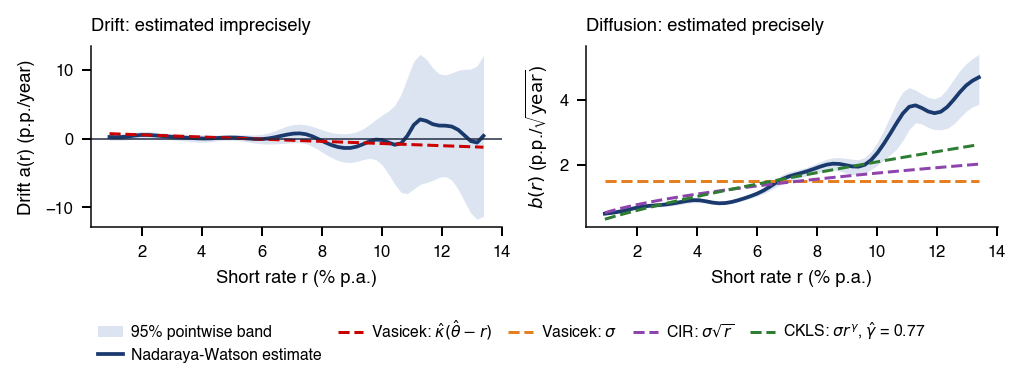
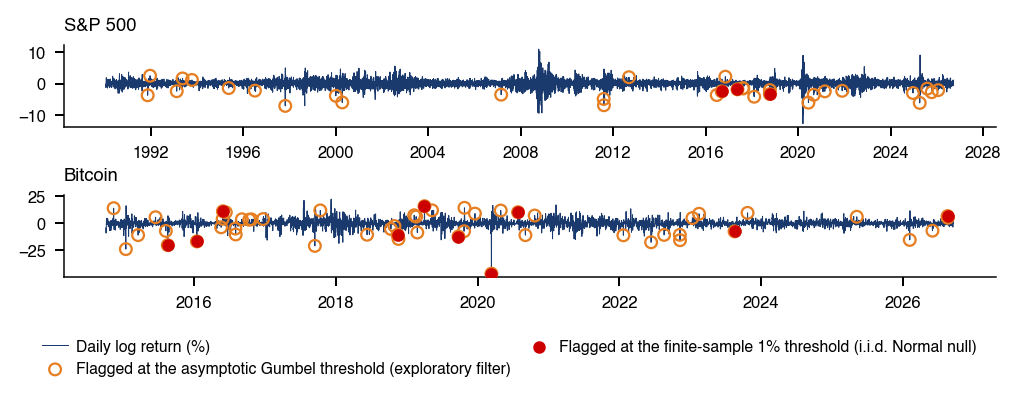
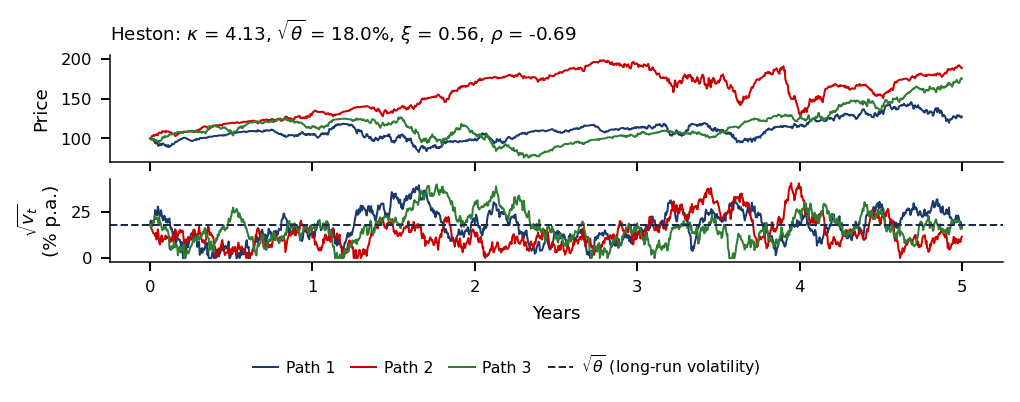
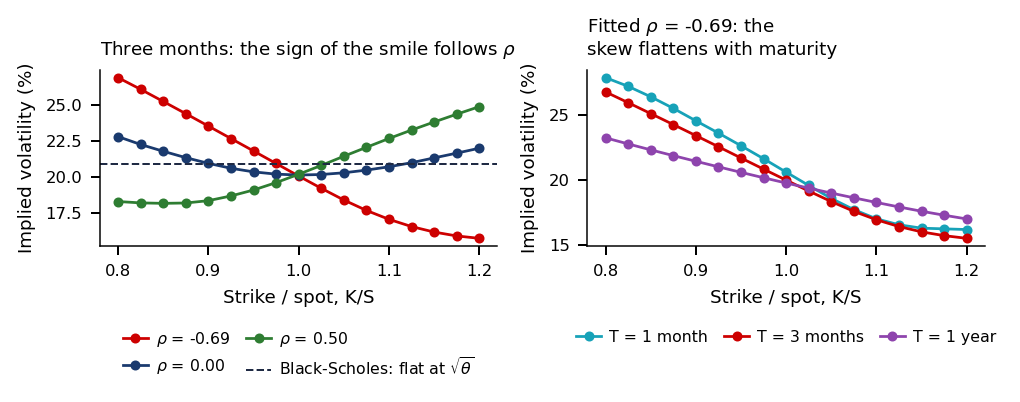
 Applied Computational Finance