Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“We present and justify a set of four desirable properties for measures of risk, and call the measures satisfying these properties ‘coherent.’ ” — Artzner, Delbaen, Eber & Heath (1999)
S&P 500 (Standard & Poor's), 2000–2026: VaR 1% istoric (Value-at-Risk, pierderea depășită în 1% din zile) este 3,45%
ES 1% (Expected Shortfall, pierderea medie în cel mai rău 1% dintre zile) este 5,03%; cea mai mare pierdere este 12,77% (16 martie 2020)
Două obligațiuni independente, fiecare pierde 100 cu probabilitatea 0,9%: VaR 1% este 0 pentru fiecare și 100 pentru portofoliu
ES 1% este 90 pentru fiecare obligațiune și 100,81 pentru portofoliu, sub suma de 180
Pe ultimele 500 de zile, ES 2,5% se sprijină pe doar \(n\alpha = 12{,}5\) pierderi
intervalul HAC (robust la heteroscedasticitate și autocorelare) are lățimea de 2,55 puncte procentuale
Zilele cu o pierdere peste VaR 1% pe o zi, 2006–2026 (ținta: 1%)
1,67% pentru simularea istorică pe 500 de zile, 1,54% pentru simularea istorică filtrată (FHS), 2,34% pentru GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată) cu șocuri Normale
Capitolul pornește de la întrebarea cît de mari sînt pierderile extreme de mîine și cît de precis le putem estima. Value-at-Risk (VaR) dă pragul de pierdere depășit cu o probabilitate mică, iar Expected Shortfall (ES) pierderea medie dincolo de acest prag. Pe pierderile zilnice ale S&P 500 (Standard & Poor's) din 2000–2026, VaR 1% istoric este 3,45%: pierderea l-a depășit în 68 din 6 717 zile. ES 1%, pierderea medie în cel mai rău 1% dintre zile, este 5,03%. Cea mai mare pierdere, 12,77% pe 16 martie 2020, înseamnă circa zece abateri standard; distribuția Normală descrie bine centrul, dar are o coadă mult prea subțire.
Artzner, Delbaen, Eber & Heath (1999) au formulat patru proprietăți pe care ar trebui să le aibă o măsură de risc și au numit coerente (coherent) măsurile care le satisfac. VaR încalcă una dintre ele, subaditivitatea (subadditivity). Două obligațiuni independente, fiecare cu o pierdere de 100 cu probabilitatea 0,9%, au fiecare VaR 1% egal cu 0, iar portofoliul lor are VaR 1% egal cu 100. O limită de VaR ar recompensa deci concentrarea. ES 1% este 90 pentru fiecare obligațiune și 100,81 pentru portofoliu, sub suma de 180. Precizia este a doua problemă: pe ultimele 500 de zile, ES 2,5% se sprijină pe doar 12,5 pierderi, iar intervalul lui HAC (heteroskedasticity and autocorrelation consistent) are o lățime de 2,55 puncte procentuale.
Riscul de mîine este o întrebare condiționată. Pe 2006–2026, proporția zilelor cu o pierdere peste VaR 1% pe o zi, cu ținta de 1%, este 1,67% pentru simularea istorică (historical simulation) pe 500 de zile, 1,54% pentru simularea istorică filtrată (FHS, filtered historical simulation) și 2,34% pentru GARCH (generalised autoregressive conditional heteroskedasticity) cu șocuri Normale. Fereastra istorică reacționează cu luni de întîrziere, iar depășirile ei se grupează în 2008 și 2020; VaR filtrat a atins 18,01% pe 18 martie 2020. Chiar și FHS are 80 de depășiri în 5 210 zile, față de 52,1 așteptate, iar testul Kupiec îi respinge acoperirea. Capitolul continuă cu teoria valorilor extreme, orizontul de 10 zile, contribuțiile la riscul unui portofoliu și regulile Basel.
VaR și ES condiționateSimularea istorică filtrată și modelarea directă a cuantilei (CAViaR).
Teoria valorilor extremeMaximele pe blocuri și distribuția GEV, depășirile peste prag și distribuția GPD (Generalised Pareto Distribution, distribuția Pareto generalizată), EVT (Extreme Value Theory, teoria valorilor extreme) condiționată.
Capitolul măsoară riscul unei poziții prin mărimea pierderilor ei mari și rare. Două numere fac acest lucru pe tot parcursul capitolului: Value-at-Risk (VaR), un prag de pierdere depășit cu o probabilitate mică, și Expected Shortfall (ES), pierderea medie dincolo de acest prag. Înainte de a le defini trebuie fixate patru convenții: ce serii studiem și în ce unități, cu ce semn scriem pierderea, pe cîte zile o măsurăm și cît de mică este probabilitatea cozii.
Cît de mari sînt pierderile extreme zilnice și cu ce precizie le putem estima?
Exemplul principal este S&P 500, cu date zilnice din 2000 pînă în 2026. Rezultatele sînt comparate cu alte patru serii: BET, indicele principal al Bursei de Valori București (BVB), Bitcoin, cursul EUR (euro, moneda euro)/RON și aurul. Pentru EUR/RON seria este cursul de referință al Băncii Naționale a României (BNR). Toate datele se opresc la 18 septembrie 2026; inventarul complet, cu numărul de zile al fiecărei serii, este în Anexă.
Randamentele sînt randamente log zilnice în procente, \(r_t = 100\,(\ln P_t - \ln P_{t-1})\), unde \(P_t\) este prețul de închidere din ziua \(t\). Selecția începe în 2000 pentru a cuprinde trei crize: 2000–2002, 2008 și 2020. O măsură a cozii la nivelul de 1% se sprijină pe cel mai rău 1% dintre zile, și doar o selecție care conține mai multe crize are destule pierderi extreme pentru a o estima.
Pe scurt
Exemplul principal: pierderile zilnice ale S&P 500, 2000–2026
Comparații pe BET, Bitcoin, EUR (moneda euro)/RON și aur
BET: indicele principal al Bursei de Valori București (BVB)
EUR/RON: cursul de referință al Băncii Naționale a României (BNR), în lei (RON) pentru un euro (EUR)
Date pînă la 18 septembrie 2026 (inventarul complet în Anexă)
Conducerea unei bănci și autoritățile de supraveghere au nevoie de un singur număr care să rezume riscul de piață al unui portofoliu de tranzacționare: o pierdere depășită doar rar. Numărul servește la două lucruri, la stabilirea limitelor de tranzacționare ale birourilor și la stabilirea capitalului care trebuie să absoarbă pierderile.
Randamentul poziției pe o zi este \(X_{t+1} = r_{t+1}\), randamentul log în procente, iar pierderea este opusul lui, \(L_{t+1} = -X_{t+1}\). Un \(L\) pozitiv înseamnă că poziția a pierdut bani. Deoarece \(r\) este un randament log, \(L\) este o pierdere log. Dacă \(V_t\) este valoarea poziției, pierderea în bani este \(V_t\,(1 - e^{-L_{t+1}/100})\), apropiată de \(V_t L_{t+1}/100\) cînd \(L\) este mic.
Folosim randamente log pentru că se adună de-a lungul zilelor, ceea ce cere orizontul \(h\); randamentele simple se adună între active, ceea ce cere portofoliul, iar secțiunea despre portofoliu trece la ele. Funcția \(L \mapsto 1 - e^{-L/100}\) este crescătoare, deci o cuantilă a pierderii log se transformă direct într-o cuantilă a pierderii în bani: VaR în bani este \(V_t(1 - e^{-\mathrm{VaR}_\alpha/100})\). ES este o medie, nu o cuantilă, iar transformarea nu trece prin ea; ES în bani se calculează scenariu cu scenariu și apoi se face media.
Convenția de semn a capitolului este că VaR și ES sînt numere pozitive atunci cînd reprezintă pierderi.
Pe scurt
Randamentul pe o zi: \(X_{t+1} = r_{t+1}\), randamentul log în %
Pierderea: \(L_{t+1} = -X_{t+1}\), o pierdere log
\(L > 0\) înseamnă că poziția a pierdut bani
În bani, cu \(V_t\) valoarea poziției: pierderea \(= V_t\,(1 - e^{-L_{t+1}/100}) \approx V_t L_{t+1}/100\) pentru \(L\) mic
De ce log: randamentele log se adună în timp, cele simple se adună între active
în timp: orizontul \(h\); între active: portofoliul
Transformarea \(L \mapsto 1 - e^{-L/100}\) este crescătoare
deci VaR în bani este \(V_t(1 - e^{-\VaR_\alpha/100})\)
ES în bani se calculează pe fiecare scenariu, apoi se face media
Convenția de semn: VaR și ES sînt numere pozitive atunci cînd sînt pierderi
Orizontul și nivelul: de ce 1 zi, 10 zile, 1% și 2,5%
Două alegeri definesc fiecare măsură de risc din capitol. Orizontul\(h\) este numărul de zile pe care se măsoară pierderea. O zi este orizontul limitelor de tranzacționare și al backtesting-ului, pentru că în fiecare zi apare o observație nouă. Zece zile este timpul pe care regulile Basel îl presupun necesar pentru lichidarea unei poziții (Basel Committee, 1996).
Nivelul\(\alpha\) este probabilitatea cozii, iar capitolul scrie „VaR 1%” și „ES 2,5%”. Nivelul \(\alpha = 1\%\) este nivelul VaR din amendamentul din 1996 la Acordul Basel (Basel Committee, 1996): în medie o depășire la 100 de zile. Nivelul \(\alpha = 2{,}5\%\) este nivelul ES din FRTB (Fundamental Review of the Trading Book) (Basel Committee, 2019). A fost ales pentru că, sub distribuția Normală, ES 2,5% este apropiat de VaR 1%, astfel încît schimbarea măsurii nu modifică singură capitalul pentru pozițiile cu cozi subțiri.
Pe scurt
Orizontul\(h\): numărul de zile pe care se măsoară pierderea
\(h = 1\) zi: orizontul limitelor de tranzacționare și al backtesting-ului (compararea prognozelor cu pierderile realizate), cu o observație nouă în fiecare zi
\(h = 10\) zile: timpul presupus de Basel pentru lichidarea unei poziții Basel Committee (1996)
Nivelul\(\alpha\): probabilitatea cozii
scriem „VaR 1%”, „ES 2,5%”
\(\alpha = 1\%\): nivelul VaR din amendamentul Basel din 1996 Basel Committee (1996), în medie o depășire la 100 de zile
ales pentru că, sub distribuția Normală, ES 2,5% este aproape egal cu VaR 1%
Sinteza secțiunii
Pierderile sînt pozitive, măsurate în procente log, pe una sau zece zile, la nivelurile 1% și 2,5%. Secțiunea următoare definește precis VaR și ES și le calculează pentru S&P 500.
VaR și Expected Shortfall
Secțiunea răspunde la două întrebări:
Ce pierdere este depășită doar într-o fracțiune \(\alpha\) dintre zile? Răspunde VaR, o cuantilă.
Cît se pierde, în medie, dincolo de ea? Răspunde ES, o medie a cozii.
Ambele sînt calculate pentru S&P 500, iar pentru distribuțiile Normală și Student-\(t\) sînt derivate forme închise.
Fie \(X\) randamentul poziției pe orizont și \(q_\alpha(X)\) cuantila lui de ordin \(\alpha\). Valoarea la risc (Value-at-Risk) la nivelul \(\alpha\) este
Pentru \(\alpha\) mic, cuantila \(q_\alpha(X)\) este negativă, deci schimbarea semnului din (7.1) face din VaR o pierdere pozitivă. Pentru o pierdere continuă \(L = -X\), același număr este cuantila superioară a pierderii, \(\mathrm{VaR}_\alpha = q_{1-\alpha}(L)\), și este depășit cu probabilitatea exact \(\alpha\). Pentru o distribuție oarecare, cu atomi, probabilitatea de a depăși VaR este cel mult \(\alpha\).
VaR 1% se citește astfel: cu probabilitatea 1%, pierderea de mîine va depăși \(\mathrm{VaR}_{1\%}\). Definiția nu spune nimic despre cît de mare este pierderea atunci cînd pragul este depășit. Două poziții cu același VaR pot avea pierderi foarte diferite în zilele cele mai rele, iar acest gol îl acoperă ES.
Pe scurt
Întrebarea secțiunii: ce pierdere este depășită doar în \(\alpha\) din zile?
și cît pierdem, în medie, dincolo de ea?
VaR la nivelul \(\alpha\): pierderea depășită cu probabilitatea \(\alpha\)
exact pentru \(L\) continuă, cel mult \(\alpha\) în general
unde \(u\) este variabila de integrare, o probabilitate a cozii între 0 și \(\alpha\). Deoarece fiecare \(\mathrm{VaR}_u\) cu \(u < \alpha\) este cel puțin \(\mathrm{VaR}_\alpha\), media satisface \(\mathrm{ES}_\alpha \ge \mathrm{VaR}_\alpha\): VaR privește intrarea în coadă, ES privește în interiorul ei.
Pentru o distribuție continuă, (7.2) este pierderea medie în zilele de dincolo de VaR, \(\mathrm{ES}_\alpha(X) = -\mathbb{E}[X \mid X \le q_\alpha(X)]\). Forma cu cuantile (7.2) este preferată pentru că rămîne corectă cînd distribuția are atomi, ca în exemplul celor două obligațiuni din secțiunea următoare, unde media condiționată ar da un rezultat greșit. Aceeași măsură apare sub numele de Conditional VaR (CVaR), Tail VaR și Average VaR în Rockafellar & Uryasev (2002) și Acerbi & Tasche (2002).
Pe scurt
Expected Shortfall (pierderea așteptată în coadă): media tuturor cuantilelor din coada de probabilitate \(\alpha\)
Întrebare pentru sală Mărim cu 1 pp fiecare dintre cele mai mari zece pierderi ale S&P 500, celelalte observații rămînînd neschimbate. Ce se întîmplă cu VaR 1% și ES 1% istorice?
Răspuns
VaR rămîne 3,45%, iar ES crește de la 5,03% la circa 5,18%. Cele zece pierderi modificate sînt deasupra observațiilor care determină cuantila, deci VaR nu se schimbă. ES 1% este media celor mai mari nα = 67,17 pierderi (ultima cu ponderea 0,17); toate cele zece intră cu ponderea 1, deci ES crește cu 10/67,17 ≈ 0,15 pp. VaR localizează pragul; ES ține cont și de severitatea pierderilor de dincolo de el. Distribuția Normală cu aceeași medie și abatere standard dă VaR 1% de 2,80% și ES 1% de 3,21%.
Graficul compară pierderile zilnice ale S&P 500 din 2000–2026 cu distribuția Normală cu aceeași medie și aceeași abatere standard. Panoul din stînga arată întreaga distribuție, iar cel din dreapta doar coada pierderilor mari, unde sînt marcate VaR și ES istorice. Cursorul fixează nivelul \(\alpha\), iar ▶ îl modifică pas cu pas; pentru fiecare nivel, textul de sub grafic dă VaR istoric, numărul zilelor în care a fost depășit și ES istoric, alături de valorile Normale.
VaR 1% istoric al S&P 500 este 3,45%: în 68 din 6 717 zile, adică 1,01% din selecție, pierderea a fost mai mare. ES 1% istoric, pierderea medie în cel mai rău 1% dintre zile, este 5,03%. La nivelul de 2,5%, VaR istoric este 2,51%, iar ES este 3,76%. Cea mai mare pierdere din selecție, 12,77% pe 16 martie 2020, în timpul crahului COVID-19, înseamnă circa zece abateri standard.
Distribuția Normală cu aceeași medie și abatere standard descrie bine centrul distribuției, dar are o coadă mult prea subțire, faptul stilizat documentat în Capitolul 1. Numerele descriu selecția: spun cît de mari au fost pierderile cele mai rele, nu cît de mari vor fi cele de mîine.
Pe scurt
Stînga: pierderile zilnice 2000–2026 față de distribuția Normală cu aceeași medie și abatere standard
Dreapta: coada distribuției
\(\VaR_{1\%}\) istoric \(= 3{,}45\%\): pierderea l-a depășit în 68 din 6 717 zile (\(1{,}01\%\))
\(\ES_{1\%} = 5{,}03\%\) este pierderea medie în cel mai rău 1% dintre zile
La nivelul 2,5%: VaR istoric este \(2{,}51\%\), iar ES este \(3{,}76\%\)
Cea mai mare pierdere: \(12{,}77\%\), pe 2020-03-16, adică circa zece abateri standard
crahul din pandemia COVID-19
Distribuția Normală se potrivește în centru, dar are cozi mult prea subțiri (Capitolul 1)
Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei)
Cazul Normal dă forme închise care servesc drept reper. Fie \(X \sim N(\mu, \sigma^2)\), iar \(\Phi\) și \(\varphi\) funcția de repartiție și densitatea distribuției Normale standard. Cuantila Normală standard este \(z_\alpha = \Phi^{-1}(\alpha) < 0\), de exemplu \(z_{1\%} = -2{,}326\). Deoarece \(q_\alpha(X) = \mu + \sigma z_\alpha\), VaR este media minus \(|z_\alpha|\) abateri standard, cu semnul schimbat.
Pentru ES, înlocuirea \(X = \mu + \sigma Z\) în media cozii dă \(\mathrm{ES}_\alpha = -\mu - \frac{\sigma}{\alpha}\int_{-\infty}^{z_\alpha} u\varphi(u)\,du\); deoarece \(\varphi'(u) = -u\varphi(u)\), integrala este egală cu \(-\varphi(z_\alpha)\). Rezultă
Ambele măsuri din (7.3) au aceeași formă: minus media plus un multiplu al lui \(\sigma\). ES înlocuiește factorul \(-z_\alpha\) cu factorul mai mare \(\varphi(z_\alpha)/\alpha\), forma de tip raport Mills (Mills ratio) a mediei cozii Normale.
Pe scurt
Cadrul: \(X \sim N(\mu, \sigma^2)\), un randament cu distribuția Normală, de medie \(\mu\) și abatere standard \(\sigma\)
\(\Phi\), \(\varphi\): funcția de repartiție și densitatea distribuției Normale standard \(N(0, 1)\)
\(z_\alpha = \Phi^{-1}(\alpha) < 0\): cuantila de ordin \(\alpha\) a distribuției Normale standard, de exemplu \(z_{1\%} = -2{,}326\)
VaR: media minus \(|z_\alpha|\) abateri standard, cu semn schimbat
\(\VaR_\alpha = -(\mu + \sigma z_\alpha)\)
ES: aceeași formă, cu factorul mai mare \(\varphi(z_\alpha)/\alpha\) în locul lui \(-z_\alpha\)
Constantele din (7.3) merită reținute. La 1%, \(-z_{1\%} = 2{,}326\) și \(\varphi(z_{1\%})/0{,}01 = 2{,}665\); la 2,5%, \(-z_{2{,}5\%} = 1{,}960\) și \(\varphi(z_{2{,}5\%})/0{,}025 = 2{,}338\). Sub distribuția Normală, ES 2,5% este deci aproape egal cu VaR 1%, 2,338 față de 2,326 abateri standard, calibrarea din spatele nivelului FRTB.
Pentru S&P 500, cu \(\hat\mu = 0{,}025\%\) și \(\hat\sigma = 1{,}213\%\), VaR 1% Normal este \(-0{,}025 + 1{,}213 \times 2{,}326 \approx 2{,}80\%\), față de 3,45% istoric; VaR istoric este de 1,24 ori cel Normal. Sub distribuția Normală și pentru o medie dată, VaR și ES nu conțin nicio informație în plus față de \(\sigma\): sînt multipli ficși ai lui. Orice comportament al cozii pe care datele îl arată dincolo de abaterea standard trebuie deci să vină dintr-un alt model.
Cea mai simplă alternativă cu cozi groase deplasează și rescalează o variabilă Student-\(t\):\(X = m + s\,T\), cu \(T \sim t_\nu\). Aici \(m\) este parametrul de locație, \(s > 0\) scala, iar \(\nu\) numărul gradelor de libertate; un \(\nu\) mai mic înseamnă cozi mai groase. Fie \(t_\alpha = t_\nu^{-1}(\alpha) < 0\) cuantila de ordin \(\alpha\) și \(g_\nu\) densitatea lui \(t_\nu\). VaR are aceeași formă ca pentru distribuția Normală, iar ES primește un factor suplimentar:
Factorul \((\nu + t_\alpha^2)/(\nu - 1)\) din (7.4) este mai mare decît 1 și reflectă coada groasă; ES există doar pentru \(\nu > 1\), altfel media cozii este infinită. Varianța lui \(X\) este \(s^2\nu/(\nu - 2)\) și există doar pentru \(\nu > 2\), deci scala \(s\) nu este abaterea standard. Estimarea pe S&P 500, pas cu pas, este în Aprofundări.
Pe scurt
Modelul: randamentul este o variabilă Student-\(t\) deplasată și rescalată, \(X = m + s\,T\) cu \(T \sim t_\nu\)
\(m\): parametrul de poziție
\(s > 0\): scala
\(\nu\): gradele de libertate, iar un \(\nu\) mai mic înseamnă cozi mai grele
\(t_\alpha = t_\nu^{-1}(\alpha) < 0\): cuantila de ordin \(\alpha\) a lui \(t_\nu\)
\(g_\nu\): densitatea lui \(t_\nu\)
VaR ca la distribuția Normală, cu \(t_\alpha\) în locul lui \(z_\alpha\)
ES primește un factor suplimentar \((\nu + t_\alpha^2)/(\nu - 1) > 1\), datorat cozii grele
VaR este o cuantilă, iar ES media cuantilelor de dincolo de ea. Pentru S&P 500, VaR 1% este 3,45%, iar ES 1% este 5,03%, ambele mult peste valorile Normale. Formulele Normală și Student-\(t\),(7.3) și (7.4), scriu ambele măsuri ca locație plus un multiplu al scalei. Secțiunea următoare întreabă care dintre cele două măsuri trebuie folosită drept capital.
Măsuri de risc coerente
O măsură de risc folosită pentru capital trebuie să se comporte rezonabil cînd pozițiile sînt scalate, deplasate sau combinate. Artzner, Delbaen, Eber & Heath (1999) au formulat patru axiome în acest sens, iar secțiunea arată că ES le satisface pe toate, în timp ce VaR poate încălca subaditivitatea. Două proprietăți completează comparația: robustețea (robustness), care favorizează VaR, și elicitabilitatea (elicitability), care determină cum pot fi evaluate prognozele fiecărei măsuri.
O măsură de risc (risk measure) \(\rho\) asociază unei pierderi \(L\), o variabilă aleatoare, capitalul care trebuie deținut pentru ea. Fie \(L_1, L_2\) două pierderi, \(c\) o sumă sigură și \(\lambda \ge 0\) un factor de scală. Măsura este coerentă (Artzner, Delbaen, Eber & Heath, 1999) dacă este monotonă, \(L_1 \le L_2 \Rightarrow \rho(L_1) \le \rho(L_2)\); invariantă la translație, \(\rho(L + c) = \rho(L) + c\); pozitiv omogenă, \(\rho(\lambda L) = \lambda\rho(L)\); și subaditivă,
\[\rho(L_1 + L_2) \le \rho(L_1) + \rho(L_2).\]
(7.5)
Fiecare axiomă are o citire directă. O poziție care pierde întotdeauna mai mult cere mai mult capital. Adăugarea unei pierderi sigure \(c\) crește capitalul exact cu \(c\). Dublarea poziției dublează capitalul. Iar, prin (7.5), combinarea a două poziții nu cere niciodată mai mult capital decît păstrarea lor separată: diversificarea nu adaugă risc.
Pe scurt
Întrebarea secțiunii: ce proprietăți trebuie să aibă un număr folosit drept capital?
astfel încît diversificarea să nu fie penalizată
O măsură de risc\(\rho\) asociază unei pierderi \(L\) (o variabilă aleatoare) un număr, capitalul necesar
Subaditivitatea are două consecințe practice. Pentru limite, garantează că riscul întregii bănci nu depășește suma limitelor de risc ale birourilor ei, \(\sum_i \rho_i\), și exclude arbitrajul de reglementare (regulatory arbitrage) prin împărțirea unei firme în unități capitalizate separat. Pentru optimizare, omogenitatea pozitivă și subaditivitatea fac împreună ca \(\rho\) să fie convexă în ponderile portofoliului, deci orice minim local al riscului este global. Unicitatea minimului ar cere convexitate strictă, pe care ES calculat din scenarii nu o are, fiind liniar pe porțiuni în ponderi.
VaR satisface primele trei axiome, dar în general nu și subaditivitatea. Excepția este clasa pierderilor eliptice în mod comun (jointly elliptical), cum sînt distribuțiile Normală sau Student-\(t\) multivariate, la niveluri \(\alpha < 50\%\). Acolo VaR și ES au ambele forma \(\mu_p + \sigma_p \times\) constantă, unde \(\mu_p\) și \(\sigma_p\) sînt media și abaterea standard a pierderii portofoliului (McNeil, Frey & Embrechts, 2015), iar subaditivitatea rezultă din cea a lui \(\sigma_p\). Rafinările pentru cozi groase sînt în Anexă.
Pe scurt
Limitele de risc
Prin subaditivitate, riscul întregii bănci nu depășește suma limitelor de risc ale birourilor de tranzacționare, \(\sum_i \rho_i\)
Fără arbitraj de reglementare prin divizarea firmei
Optimizare: omogenitate + subaditivitate \(\Rightarrow\) convexitate în ponderile portofoliului
Orice minim local este global
Unicitatea ar cere convexitate strictă, pe care ES pe scenarii nu o are (este liniar pe porțiuni)
VaR satisface primele trei axiome, dar nu și subaditivitatea în general
Excepție: pierderi cu distribuție eliptică comună (Normală sau Student-\(t\) multivariată) și \(\alpha < 50\%\), cînd VaR și ES sînt ambele \(\mu_p + \sigma_p\times\) constantă McNeil, Frey & Embrechts (2015)
\(\mu_p\), \(\sigma_p\): media și abaterea standard a pierderii portofoliului (rafinările pentru cozi grele: Anexă)
Contraexemplul standard folosește două obligațiuni independente, A și B. Fiecare pierde 100 dacă intră în default, cu probabilitatea \(p = 0{,}9\%\), și 0 în rest. Deoarece pierderea este discretă, ES trebuie calculat din forma cu cuantile (7.2), care pentru o pierdere discretă \(L\) dă
Primul termen din (7.6) adună pierderile strict dincolo de VaR; al doilea plasează restul probabilității \(\alpha\) a cozii chiar în VaR. Aici \(\mathbf{1}\{\cdot\}\) este funcția indicator.
Pentru o singură obligațiune, probabilitatea de a pierde 100 este 0,9%, nu peste 1%, deci cuantila de 1% a variației valorii este 0 și \(\mathrm{VaR}_{1\%}(A) = \mathrm{VaR}_{1\%}(B) = 0\). Din (7.6),\(\mathrm{ES}_{1\%}(A) = (100 \times 0{,}009 + 0 \times 0{,}001)/0{,}01 = 90\). Pentru portofoliu, probabilitatea de a pierde cel puțin 100 este \(1 - (1-p)^2 = 1{,}79\% > 1\%\), iar probabilitatea de a pierde 200 este doar \(p^2 = 0{,}0081\%\); cuantila de 1% este deci \(-100\) și \(\mathrm{VaR}_{1\%}(A + B) = 100\), mai mult decît suma \(0 + 0\) a valorilor individuale. ES se comportă cum cere axioma: \(\mathrm{ES}_{1\%}(A + B) = 100{,}81\), sub \(\mathrm{ES}_{1\%}(A) + \mathrm{ES}_{1\%}(B) = 180\).
Pe scurt
Obligațiunile A și B sînt independente
Fiecare pierde 100 cu probabilitatea \(p = 0{,}9\%\) (neplată) și 0 altfel
\(X\): variația valorii, \(X = -L\)
Formula generală pentru o pierdere discretă \(L = -X\): \(\ES_\alpha = \frac{1}{\alpha}\left(\E[L\,\mathbf{1}\{L > \VaR_\alpha\}] + \VaR_\alpha\,(\alpha - P(L > \VaR_\alpha))\right)\)
\(\mathbf{1}\{\cdot\}\): indicatorul, 1 dacă are loc condiția și 0 altfel
Primul termen: pierderile strict dincolo de VaR
Al doilea termen: restul probabilității cozii \(\alpha\), plasat chiar în VaR
O obligațiune: \(P(X \le -100) = p = 0{,}9\%\), nu peste \(1\%\), deci \(q_{1\%} = 0\) și \(\VaR_{1\%}(A) = \VaR_{1\%}(B) = 0\)
Graficul pune cele două măsuri alături pentru obligațiunile din cadrul anterior: cu albastru suma celor două măsuri individuale, cu roșu măsura portofoliului combinat. Cursorul modifică probabilitatea de default a fiecărei obligațiuni, iar ▶ o parcurge de la 0,1% la 2%.
Întrebare pentru sală Păstrăm cele două obligațiuni independente, cu pierderea 100 la fiecare default. Dacă probabilitatea de default a fiecăreia crește de la 0,9% la 1,1%, cît devine VaR 1% al portofoliului?
Răspuns
100. Probabilitatea ca cel puțin una să intre în default devine 2,19%, peste 1%, dar probabilitatea a două defaulturi este doar 0,012%, sub 1%; VaR 1% al portofoliului rămîne 100. Fiecare VaR individual devine 100, deci suma lor este 200 ≥ 100 și subaditivitatea este respectată: 200 este suma VaR-urilor individuale, nu VaR-ul portofoliului, iar 0 era VaR-ul individual la 0,9%. La 0,9% (slide-ul), probabilitatea cel puțin unui default este 1,79%, iar VaR-ul portofoliului, 100, depășește suma 0 + 0. În acest exemplu, VaR încalcă subaditivitatea doar cînd probabilitatea de default este între circa 0,5% și 1%. ES este subaditiv: la 0,9%, 100,8 pentru portofoliu, față de 90 + 90 = 180.
La probabilitatea de default de 0,9%, bara roșie a VaR, 100, depășește bara albastră, \(0 + 0\), ceea ce încalcă (7.5); pentru ES bara roșie, 100,81, este sub cea albastră, 180.
Consecința pentru administrarea riscului este că o limită exprimată prin VaR ar recompensa concentrarea: deținerea doar a obligațiunii A pare fără risc, deținerea ambelor nu. ES vede mărimea cozii și este coerent (Acerbi & Tasche, 2002). În practică VaR eșuează în acest fel pentru portofolii de credit, opțiuni și alte profiluri de plată asimetrice (skewed pay-offs), unde distribuția pierderii are o probabilitate mică de a avea o pierdere mare.
Pe scurt
Albastru: suma celor două măsuri individuale
Roșu: măsura portofoliului combinat
VaR sare de la \(0 + 0\) la 100 la reunirea obligațiunilor (contraexemplul de pe slide-ul anterior)
O limită VaR ar recompensa concentrarea: deținerea doar a obligațiunii A pare fără risc
Verificarea rapidă compară două poziții cu pierderi în procente, la nivelul \(\alpha = 10\%\). Poziția A are o pierdere uniformă pe \([0, 10]\); poziția B pierde 0 cu probabilitatea 0,95 și 20 cu probabilitatea 0,05. VaR și ES rezultă din definițiile (7.1) și (7.2), pentru B cu formula discretă (7.6). Scopul exercițiului este să vedem ce poziție consideră mai riscantă fiecare măsură și ce nu vede VaR. Răspunsurile sînt în Anexă.
Pe scurt
Două poziții, pierderi în %, nivelul \(\alpha = 10\%\)
A: pierderea \(L_A\) uniformă pe \([0, 10]\), toate valorile la fel de probabile
Calculează \(\VaR_{10\%}(A)\) și \(\ES_{10\%}(A)\) din definiții
B: pierdere 0 cu probabilitatea \(0{,}95\), pierdere 20 cu probabilitatea \(0{,}05\)
Calculează \(\VaR_{10\%}(B)\) și \(\ES_{10\%}(B)\) cu formula ES discretă de pe slide-ul celor două obligațiuni
Coerența nu este singura proprietate dorită a unei măsuri de risc; estimarea ei trebuie să fie și stabilă. Robustețea calitativă (qualitative robustness) (Cont, Deguest & Scandolo, 2010) cere ca o schimbare mică a distribuției datelor să schimbe doar puțin legea estimatorului. VaR istoric este robust calitativ la distribuțiile cu o cuantilă de ordin \(\alpha\) unică. ES istoric nu este: o singură pierdere extremă îl poate deplasa oricît de mult, cum arată secțiunea despre precizie.
Efectul se vede pe ultimele 500 de zile ale S&P 500. Eliminarea celei mai mari pierderi, 6,16% pe 4 aprilie 2025, mută ES 2,5% de la 2,98% la 2,64%, dar VaR 1% doar de la 2,73% la 2,68%. Compromisul este structural: subaditivitatea cere ca măsura să privească dincolo de cuantilă, și exact acest lucru o face sensibilă la observații izolate. FRTB l-a rezolvat folosind ES 2,5% pentru capital și păstrînd VaR pentru backtesting, pentru că VaR este robust și prognozele VaR pot fi comparate direct printr-un scor.
O prognoză se evaluează cu o funcție de scor (scoring function) \(S(v, X)\), o penalizare calculată din prognoza \(v\) și din rezultatul \(X\); o valoare mai mică înseamnă o prognoză mai bună. O măsură de risc este elicitabilă dacă este minimizatorul unic al lui \(\mathbb{E}[S(v, X)]\) pentru o anumită funcție \(S\), numită atunci strict consistentă (strictly consistent). VaR este elicitabil: cuantila \(q_\alpha(X)\) minimizează pierderea pinball (pinball loss) așteptată
care costă \(1 - \alpha\) pe unitate cînd \(X\) cade sub \(v\) și \(\alpha\) pe unitate cînd rămîne deasupra. Consistența strictă înseamnă că un prognozator care raportează altceva decît cuantila adevărată are un scor așteptat mai mare.
ES singur nu este elicitabil (Gneiting, 2011): nu există nicio funcție de scor strict consistentă doar pentru ES. Perechea (VaR, ES) este însă elicitabilă în comun (Fissler & Ziegel, 2016). Scoruri comune precum FZ0, scorul Fissler–Ziegel în forma lui Patton, Ziegel & Chen (2019), ordonează prognozele (VaR, ES). Pentru FZ0, \(S(cv, ce; cY) = S(v, e; Y) + \ln c\), deci diferențele de scor, nu scorul însuși, sînt omogene de gradul zero. Scorurile sînt folosite pentru estimarea modelelor în Anexă și pentru evaluarea prognozelor în Capitolul 8.
Pe scurt
O funcție de scor\(S(v, X)\): o penalizare calculată din prognoza \(v\) și din rezultatul \(X\)
o valoare mai mică înseamnă o prognoză mai bună
O măsură de risc este elicitabilă dacă minimizează unic \(\E[S(v, X)]\) pentru un scor \(S\)
un astfel de \(S\) se numește scor strict consistent
\(S(cv, ce; cY) = S(v, e; Y) + \ln c\): diferențele dintre scoruri, nu scorul însuși, sînt omogene de grad zero
Sinteza secțiunii
ES satisface cele patru axiome ale coerenței, VaR încalcă subaditivitatea, iar exemplul celor două obligațiuni arată că o limită de VaR poate recompensa concentrarea. În schimb, ES istoric nu este robust la o singură pierdere extremă, iar ES singur nu este elicitabil, în timp ce perechea (VaR, ES) este. FRTB folosește ES pentru capital și VaR pentru backtesting.
Metode de estimare
Secțiunea transformă definițiile în estimatori. Întrebarea este cum estimăm VaR și ES din date și cît depinde răspunsul de ipoteza făcută despre coadă. Simularea istorică (historical simulation) nu face nicio ipoteză; metodele Normală, Student-\(t\) și Cornish–Fisher impun o formă parametrică; metoda valorilor extreme, anunțată aici, modelează doar coada.
Simularea istorică ia ultimele \(n\) pierderi zilnice \(L_{t-n+1}, \dots, L_t\) și le ordonează, \(L_{(1)} \le \dots \le L_{(n)}\), unde \(L_{(i)}\) este a \(i\)-a cea mai mică pierdere. VaR este cuantila empirică de ordin \(1-\alpha\), interpolată liniar, iar ES integrează funcția cuantilă empirică pe cea mai rea fracțiune \(\alpha\) a pierderilor:
cu \(\ell = 1 + (n-1)(1-\alpha)\),\(j = \lfloor \ell \rfloor\) și \(m = \lfloor n\alpha \rfloor\). În estimatorul ES din (7.8), cele mai mari \(m\) pierderi primesc ponderea 1, iar următoarea, \(L_{(n-m)}\), ponderea fracționară \(n\alpha - m\). Un estimator alternativ face media celor \(k_\alpha\) pierderi egale cu sau mai mari decît \(\widehat{\mathrm{VaR}}_\alpha\); el diferă de (7.8) cînd \(n\alpha\) nu este întreg.
Lungimea ferestrei \(n\) pune în balanță viteza de reacție și precizia: 250 de zile reacționează mai repede, 1 000 de zile dau estimări mai precise. Cu \(n = 500\), doar 5 pierderi se află dincolo de VaR 1%, iar ES 2,5% dă ponderea 1 celor mai mari 12 pierderi și ponderea 0,5 celei de-a 13-a, deoarece \(n\alpha = 12{,}5\).
Metoda are două limite structurale:
Nicio pierdere mai mare decît cea mai rea din fereastră nu poate apărea în estimare.
O zi de crah intră în fereastră, rămîne acolo \(n\) zile și apoi iese, astfel încît VaR scade brusc într-o zi în care nu s-a întîmplat nimic: saltul la ieșirea din fereastră (ghost effect).
Pe scurt
Întrebarea secțiunii: cum estimăm VaR și ES din date?
și cît depinde rezultatul de ipoteza despre coadă?
Luăm ultimele \(n\) pierderi zilnice \(L_{t-n+1}, \dots, L_t\) și le ordonăm: \(L_{(1)} \le \dots \le L_{(n)}\)
\(L_{(i)}\): a \(i\)-a cea mai mică pierdere
\(\widehat{\VaR}_\alpha = L_{(j)} + (\ell - j)\,(L_{(j+1)} - L_{(j)})\), cu \(\ell = 1 + (n-1)(1-\alpha)\) și \(j = \lfloor \ell \rfloor\): cuantila empirică de ordin \(1-\alpha\), interpolată liniar
\(\widehat{\ES}_\alpha = \frac{1}{n\alpha}\big[\sum_{i=1}^{m} L_{(n-i+1)} + (n\alpha - m)\,L_{(n-m)}\big]\), cu \(m = \lfloor n\alpha \rfloor\): integrala funcției cuantilă empirice pe cea mai rea fracțiune \(\alpha\) a pierderilor
Cele mai mari \(m\) pierderi primesc ponderea 1, iar următoarea, \(L_{(n-m)}\), ponderea fracționară \(n\alpha - m\)
Alternativa, media depășirilor selectate: media simplă a celor \(k_\alpha\) pierderi \(\ge \widehat{\VaR}_\alpha\); diferă de \(\widehat{\ES}_\alpha\) cînd \(n\alpha\) nu este întreg
Alegerea ferestrei \(n\): un compromis între reacție și precizie
estimarea pe 250 de zile reacționează mai repede, iar cea pe 1 000 de zile este mai precisă
Cu \(n = 500\): 5 pierderi se află dincolo de VaR 1%
ES 2,5% dă ponderea 1 celor mai mari 12 pierderi și ponderea 0,5 celei de-a 13-a (\(n\alpha = 12{,}5\))
Nicio pierdere mai mare decît cea mai rea din fereastră nu poate apărea în estimare
Saltul la ieșirea din fereastră (ghost effect): după \(n\) zile, o zi de criză iese din fereastră și VaR scade brusc
Cornish–Fisher: corecția cuantilei Normale și limitele ei
Cu \(S = K = 0\),(7.9) redă VaR Normal. Pentru \(\alpha\) sub circa 4%, unde \(|z_\alpha| > \sqrt{3}\), asimetria negativă (o coadă stîngă lungă a randamentelor) și excesul pozitiv de kurtosis (cozi groase) împing \(\tilde z_\alpha\) mai jos decît \(z_\alpha\) și cresc VaR, în timp ce termenul în \(S^2\) acționează în sens opus; la \(\alpha = 5\%\) termenul de kurtosis are semnul opus. ES se obține numeric, ca medie a lui \(-(\mu + \sigma\tilde z_u)\) pentru \(u \in (0, \alpha)\).
Dezvoltarea este construită în jurul distribuției Normale și este precisă doar pentru \(S\) și \(K\) mici; pentru \(K\) mare, funcția \(z \mapsto \tilde z\) nici măcar nu este monotonă. S&P 500 are \(S = -0{,}35\) și \(K = 10{,}7\), mult în afara acestui domeniu, iar kurtosis-ul de selecție presupune el însuși un moment de ordinul patru finit, pe care Capitolul 1 îl pune la îndoială. Rezultatul este un VaR 1% Cornish–Fisher de 6,08%, față de 3,45% istoric: termenul de kurtosis supracorectează.
Pe scurt
Ajustăm cuantila Normală pentru asimetrie\(S = \E[(X - \mu)^3]/\sigma^3\) și excesul de kurtosis\(K = \E[(X - \mu)^4]/\sigma^4 - 3\)Cornish & Fisher (1938)
\(\tilde z_\alpha\): cuantila corectată; pentru \(S = K = 0\) se obține VaR Normal
Pentru \(\alpha\) sub circa \(4\%\) (\(|z_\alpha| > \sqrt{3}\)): \(S < 0\) (coada stîngă a randamentelor mai lungă) sau \(K > 0\) (cozi grele) împing \(\tilde z_\alpha\) sub \(z_\alpha\) și cresc VaR, iar termenul în \(S^2\) acționează în sens opus
La \(\alpha = 5\%\), termenul în \(K\) are semnul opus
ES: media lui \(-(\mu + \sigma\tilde z_u)\) pe \(u \in (0, \alpha)\), calculată numeric
O dezvoltare în jurul distribuției Normale: precisă doar pentru \(S\) și \(K\)mici
Pentru \(K\) mare, transformarea \(z \mapsto \tilde z\) nici măcar nu este monotonă (Seminarul 7, A6)
Randamentele S&P 500: \(S = -0{,}35\), \(K = 10{,}7\): mult în afara acestui domeniu
\(K\) de selecție presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
\(\VaR_{1\%}^{CF} = 6{,}08\%\) față de valoarea istorică \(3{,}45\%\): termenul de kurtosis supraestimează puternic VaR
Întrebare pentru sală Unde este mai mare diferența dintre cel mai mare și cel mai mic VaR estimat de cele cinci metode: la α = 5% sau la α = 0,1%?
Răspuns
La α = 0,1%: diferența este 11,34 pp (Cornish–Fisher 15,06% minus distribuția Normală 3,72%), față de 0,30 pp la α = 5%, unde toate cele cinci valori sînt între 1,67% și 1,97%. La α = 0,1%, VaR este 7,22% istoric, 7,04% cu EVT și 8,58% cu Student-t. Acolo unde datele sînt puține, ipotezele despre coadă decid estimarea: aceeași țintă statistică nu obligă modele diferite să dea valori apropiate.
Graficul compară cinci metode pe o gamă de probabilități ale cozii, pentru pierderile zilnice ale S&P 500 din 2000–2026. Axa orizontală dă \(\alpha\) de la 5% pînă la 0,1%, pe scară logaritmică; axa verticală dă VaR (panoul din stînga) și ES (panoul din dreapta), în procente. Metodele sînt simularea istorică (HS, historical simulation), distribuția Normală, distribuția Student-\(t\), Cornish–Fisher și teoria valorilor extreme (EVT, extreme value theory), aici o distribuție Pareto generalizată (GPD, generalised Pareto distribution) ajustată pe coadă, care este dezvoltată în secțiunea despre valori extreme. Cursorul mută un reper de-a lungul axei \(\alpha\), iar textul de sub grafic dă cele cinci valori ale VaR și ES la acel nivel.
La VaR 0,1%, o pierdere depășită în medie o dată la patru ani, metodele diferă puternic. Simularea istorică dă 7,22%, EVT 7,04%, distribuția Student-\(t\) 8,58%, iar Cornish–Fisher 15,06%. Distribuția Normală dă 3,72%, circa jumătate din valoarea istorică.
Diferența dintre metode crește pe măsură ce \(\alpha\) scade, mai mult pentru ES decît pentru VaR, pentru că ES depinde de toată coada de dincolo de cuantilă. EVT și simularea istorică sînt de acord pînă la 0,5%; sub acest nivel EVT extrapolează o coadă ajustată, în timp ce simularea istorică este limitată de cele cîteva observații cele mai mari. Comparația este între proceduri; o comparație pe cinci active este în Aprofundări.
Pe scurt
Axa orizontală: \(\alpha\) de la 5% la 0,1%, pe scară logaritmică
axa verticală: VaR (stînga) și ES (dreapta), pierderi zilnice S&P 500 2000–2026, în %
În legendă, HS (historical simulation) este simularea istorică
EVT: coada GPD, prezentată în secțiunea „Teoria valorilor extreme”
EVT: extreme value theory, teoria valorilor extreme
Simularea istorică este reperul, dar nu poate vedea dincolo de cea mai mare pierdere din fereastra ei. Distribuția Normală subestimează coada, Cornish–Fisher o supraestimează la un kurtosis atît de mare cît cel al randamentelor zilnice, iar diferențele dintre metode cresc pe măsură ce nivelul scade. Secțiunea următoare întreabă cît de precisă este oricare dintre aceste estimări.
Precizia estimărilor VaR și ES
Un VaR sau un ES estimat este o statistică, iar o altă selecție de aceeași lungime ar da un alt număr. Secțiunea derivă erori standard utilizabile pentru VaR și ES istorice, arată cum le lărgește volatility clustering și prezintă intervalele rezultate pentru S&P 500.
Pentru VaR presupunem pierderi i.i.d. (independente și identic distribuite) cu o densitate \(f\) continuă și pozitivă în \(\mathrm{VaR}_\alpha\). Eroarea standard (SE, standard error) a estimării istorice este
Factorul \(\sqrt{\alpha(1 - \alpha)/n}\) din (7.10) este SE a proporției zilelor de dincolo de VaR; împărțirea la densitatea \(f(\mathrm{VaR}_\alpha)\) transformă această eroare de probabilitate într-o eroare pe scara pierderilor. În coadă densitatea este mică, deci SE este mare.
Cu \(\sigma = 1{,}2\%\) și \(n = 500\), SE a VaR 1% este 0,20 puncte procentuale (pp) sub distribuția Normală și 0,43 pp sub o distribuție Student-\(t\) cu 4 grade de libertate (\(t_4\)) scalată la același \(\sigma\). Coada mai groasă are o densitate mai mică în cuantila ei de 1%, iar SE crește de peste două ori.
Pe scurt
Întrebarea secțiunii: cît s-ar schimba VaR și ES estimate pe o altă selecție de aceeași lungime?
VaR: pierderi i.i.d. (independente și identic distribuite) cu densitatea \(f\) continuă și pozitivă în \(\VaR_\alpha\)
Pentru ES, punctul de plecare este funcția de influență (influence function) a estimatorului istoric (Chen, 2008),\(\mathrm{IF}(x) = \mathrm{VaR}_\alpha + (x - \mathrm{VaR}_\alpha)_+/\alpha - \mathrm{ES}_\alpha\), unde \((y)_+ = \max(y, 0)\). Ea măsoară efectul unei observații suplimentare \(x\) asupra estimării și crește nemărginit în \(x\): o singură pierdere extremă poate deplasa ES oricît de mult. Dacă \(\mathbb{E}[L^2] < \infty\), eroarea standard este
Estimarea VaR nu adaugă niciun termen de ordinul întîi în (7.11), o consecință a reprezentării Rockafellar–Uryasev din Aprofundări. Așa cum arată Yamai & Yoshiba (2005) și Pele & Mazurencu-Marinescu-Pele (2026), pentru cozi de tip Pareto cu indicele cozii (tail index) \(a > 2\) eroarea relativă scade ca \(1/\sqrt{n\alpha}\), deci precizia este determinată de numărul observațiilor din coadă, nu de mărimea selecției.
Sub volatility clustering observațiile nu sînt independente. Varianțele din (7.10) și (7.11) se înlocuiesc atunci cu varianțele de termen lung HAC (Newey & West, 1987) ale seriilor \(\mathbf{1}\{L_t > \mathrm{VaR}_\alpha\}\) și \((L_t - \mathrm{VaR}_\alpha)_+\), sau intervalele se calculează printr-un bootstrap pe blocuri (block bootstrap). Ambele construcții sînt descrise în Aprofundări, iar derivările în Anexă.
Pe scurt
ESChen (2008): funcția de influență (influence function) \(\mathrm{IF}(x) = \VaR_\alpha + (x - \VaR_\alpha)_+/\alpha - \ES_\alpha\), nemărginită în \(x\)
\(\mathrm{IF}(x)\): efectul unei observații suplimentare \(x\) asupra estimării
\(\mathrm{IF}\) crește nelimitat cu \(x\), deci o singură pierdere extremă poate deplasa ES oricît de mult
Eroarea standard
Dacă \(\E[L^2] < \infty\): \(\mathrm{SE}(\widehat{\ES}_\alpha) \approx \dfrac{1}{\alpha}\sqrt{\dfrac{\Var((L - \VaR_\alpha)_+)}{n}}\) , unde \(\Var\) este dispersia
Estimarea VaR nu adaugă niciun termen de ordinul întîi (Rockafellar–Uryasev)
Înlocuim dispersiile cu dispersiile de termen lung HAC (consistente la heteroscedasticitate și autocorelare) Newey & West (1987) ale lui \(\mathbf{1}\{L_t > \VaR_\alpha\}\) și \((L_t - \VaR_\alpha)_+\)
Sau folosim un bootstrap pe blocuri, care reeșantionează blocuri de zile consecutive (derivările: Anexă)
Întrebare pentru sală În ES 2,5% istoric calculat pe ultimele 500 de zile, ce observații intră în media cozii?
Răspuns
Masa cozii este 500 × 0,025 = 12,5 observații: adunăm cele mai mari 12 pierderi și 0,5 din a 13-a, apoi împărțim la 12,5. Cu 13 ponderi egale, nivelul efectiv al cozii devine 13/500 = 2,6%. Intervalul HAC de 95% al acestui ES are lățimea de 2,55 pp, iar cel bootstrap pe blocuri 2,42 pp. Pe selecția 2000–2026, volatility clustering lărgește intervalul ES de la 0,60 pp (i.i.d.) la 1,00 pp (HAC), iar bootstrap-ul de la 0,62 pp la 1,17 pp.
Graficul arată intervalele de 95% pentru VaR 1% și ES 2,5% ale S&P 500, ca bare, cu estimările marcate prin linii negre. Fiecare interval este calculat cu formulele i.i.d. și HAC și cu bootstrap-ul i.i.d. și pe blocuri, pe întreaga selecție 2000–2026 și pe o fereastră recentă. Cursorul fixează lungimea \(n\) a acestei ferestre (rîndurile 2 și 4 ale graficului), iar ▶ parcurge lungimile, astfel încît se poate urmări efectul lui \(n\alpha\) asupra lățimii intervalelor.
Pe întreaga selecție, volatility clustering lărgește intervalul ES de la 0,60 pp cu formula i.i.d. la 1,00 pp cu HAC; bootstrap-ul se comportă la fel, 0,62 pp la reeșantionarea i.i.d. față de 1,17 pp pe blocuri. Pe ultimele 500 de zile, ES 2,5% se sprijină pe doar \(n\alpha = 12{,}5\) pierderi, iar intervalul lui HAC are lățimea de 2,55 pp. Tabelul complet este în Anexă.
Aceste intervale privesc VaR și ES necondiționate, riscul mediu pe selecție. Riscul de mîine este o întrebare condiționată, tratată în secțiunea următoare. Intervalul HAC pentru ES are și el condiții: un moment de ordinul doi finit al excesului peste VaR, \(\mathbb{E}[(L - v)_+^2] < \infty\), ceea ce cere un indice al cozii peste 2 (estimat în Capitolul 1), plus staționaritate și dependență slabă. Inferența GARCH prin cvasi-verosimilitate maximă, folosită în secțiunea următoare, are propria condiție, un moment de ordinul patru finit al inovațiilor standardizate \(z_t\).
Pe scurt
Intervale de 95% (bare), cu estimările marcate prin liniuțe negre
Pe selecția completă, gruparea volatilității lărgește intervalul ES
de la \(0{,}60\) pp (i.i.d.) la \(1{,}00\) pp (HAC)
Bootstrap-ul arată același efect: \(0{,}62\) pp i.i.d., față de \(1{,}17\) pp pe blocuri
Pe ultimele 500 de zile, ES 2,5% se sprijină pe doar \(n\alpha = 12{,}5\) pierderi
intervalul HAC are lățimea de \(2{,}55\) pp
Aceste intervale privesc VaR și ES necondiționate
Riscul de mîine este o întrebare condiționată (secțiunea următoare)
Intervalul HAC pentru ES cere moment de ordin doi finit al excesului peste VaR, \(\E[(L - v)_+^2] < \infty\) (indicele cozii peste 2, estimat în Capitolul 1), plus staționaritate și dependență slabă
inferența GARCH-QML (GARCH Quasi-Maximum Likelihood, estimarea GARCH prin cvasi-verosimilitate maximă) are alte condiții: moment de ordin patru finit al inovațiilor standardizate \(z_t\)
Verificarea rapidă aplică (7.10) unor pierderi zilnice i.i.d. Normale cu media 0 și \(\sigma = 1\%\), la nivelul \(\alpha = 5\%\), unde \(\mathrm{VaR}_{5\%} = 1{,}645\%\), iar densitatea în VaR este \(f(\mathrm{VaR}_{5\%}) = \varphi(1{,}645)/\sigma = 0{,}1031\). Ea cere SE și semilățimea intervalului de 95% cu 1 000 de zile, numărul de zile care înjumătățește SE și numărul de pierderi pe care le mediază ES 1% istoric cu 1 000 de zile. Răspunsurile sînt în Anexă.
Pe scurt
Pierderi zilnice i.i.d. Normale, cu media 0 și \(\sigma = 1\%\); nivelul \(\alpha = 5\%\)
deci \(\VaR_{5\%} = 1{,}645\%\)
densitatea în acest punct este \(f(\VaR_{5\%}) = \varphi(1{,}645)/\sigma = 0{,}1031\)
(a) Cu \(n = 1\,000\) de zile, care este SE a \(\VaR_{5\%}\) istoric și jumătatea lățimii intervalului de 95%?
(b) Cîte zile înjumătățesc această SE?
(c) Cu \(n = 1\,000\), din cîte pierderi este media \(\ES_{1\%}\) istoric și de ce este acesta un semnal de alarmă?
SE a VaR istoric depinde de densitatea din coadă, cea a ES de varianța excesului peste VaR, iar ambele cresc sub volatility clustering. Pe ultimele 500 de zile ale S&P 500, ES 2,5% se sprijină pe 12,5 pierderi, iar intervalul lui HAC are 2,55 pp. Orice VaR sau ES trebuie de aceea raportat împreună cu numărul observațiilor din coadă și cu un interval.
VaR și ES condiționate
Secțiunile anterioare au estimat distribuția necondiționată a pierderilor: riscul mediu pe mai mulți ani. Un birou de tranzacționare are nevoie de riscul de mîine, care depinde de volatilitatea de azi. Secțiunea adaptează VaR și ES la starea curentă a pieței în două moduri:
Simularea istorică filtrată (FHS, filtered historical simulation) combină un model de volatilitate cu distribuția empirică a șocurilor.
CAViaR modelează direct cuantila ca proces dinamic.
Ideea FHS (Barone-Adesi, Giannopoulos & Vosper, 1999; Hull & White, 1998) este să luăm forma șocurilor din istorie și scala lor dintr-un model de volatilitate. Modelul de volatilitate este GARCH (generalised autoregressive conditional heteroskedasticity) din Capitolul 5(Bollerslev, 1986), cu o medie condiționată AR(1) (autoregresivă de ordinul 1):
În (7.12),\(\mu_t\) este media condiționată, cu constanta \(c\) și coeficientul \(\phi\), iar \(\sigma_t\) volatilitatea condiționată. Șocurile \(z_t\) sînt i.i.d. cu media 0 și varianța 1, iar distribuția lor nu este specificată: aceasta este partea pe care o va furniza istoria. Constanta este \(\omega > 0\);\(\alpha_1 \ge 0\) măsoară reacția la pătratul surprizei de ieri, iar \(\beta_1 \ge 0\) ponderea varianței de ieri. Suma \(\alpha_1 + \beta_1\) este persistența, iar condiția \(\alpha_1 + \beta_1 < 1\) asigură o varianță necondiționată finită; o valoare apropiată de 1 înseamnă că șocurile de volatilitate se sting încet. Coeficientul \(\alpha_1\) nu trebuie confundat cu nivelul cozii \(\alpha\).
Pe scurt
Întrebarea secțiunii: cum adaptăm VaR și ES la volatilitatea de azi, nu la media ultimilor ani?
Modelul AR(1)-GARCH(1,1) este estimat prin cvasi-verosimilitate maximă (QML, quasi-maximum likelihood): verosimilitatea este Normală, dar estimările rămîn consistente cînd șocurile au o altă distribuție.
Se calculează reziduurile standardizate \(\hat z_t = (r_t - \hat\mu_t)/\hat\sigma_t\), aproximativ i.i.d., dar încă cu cozi groase.
Coada empirică a reziduurilor este rescalată cu prognoza volatilității de mîine:
Aici \(\hat\mu_{t+1}\) și \(\hat\sigma_{t+1}\) sînt prognozele modelului pentru mîine, \(\hat\xi_\alpha\) este minus cuantila empirică de ordin \(\alpha\) a reziduurilor, iar \(\bar z_\alpha\) media celei mai mici fracțiuni \(\alpha\) a reziduurilor, cu ponderea fracționară a simulării istorice (7.8). Metoda înlocuiește cuantila Normală \(z_\alpha\) a unui model GARCH-Normal cu una empirică, deci (7.13) păstrează dinamica volatilității din GARCH fără a impune o distribuție a șocurilor. O prognoză lucrată pentru următoarea zi de tranzacționare este în Aprofundări.
Pe scurt
Pasul 1: estimăm modelul AR(1)-GARCH(1,1) prin cvasi-verosimilitate maximă
verosimilitate Normală, robustă la alte distribuții ale șocurilor
Întrebare pentru sală În 2006–2026, care metodă se apropie mai mult de ținta de 1% a depășirilor VaR 1%?
Răspuns
FHS este cea mai apropiată de ținta de 1%: 80 din 5 210 zile, adică 1,54%, față de 1,67% pentru simularea istorică pe 500 de zile și 2,34% pentru GARCH cu șocuri Normale. Fereastra istorică se actualizează zilnic, dar dă ponderi egale observațiilor din regimuri de volatilitate diferite și se poate adapta lent; depășirile ei apar în grupuri, în 2008 și 2020. Apropierea frecvenței de 1% nu verifică singură independența depășirilor.
Graficul compară cele două metode pe S&P 500 în 2006–2026. Barele arată pierderea zilnică; liniile sînt prognozele VaR pentru ziua următoare, albastru închis pentru simularea istorică pe 500 de zile și roșu pentru FHS. Punctele albastre marchează pierderile peste VaR istoric, iar crucile roșii pierderile peste VaR FHS. Modelul GARCH este reestimat în fiecare ianuarie pe toate datele anterioare, deci fiecare prognoză folosește doar informația disponibilă la momentul ei.
Comenzile aleg nivelul VaR, lungimea ferestrei istorice (250, 500 sau 1 000 de zile) și data de sfîrșit a perioadei afișate; ▶ avansează data de sfîrșit, iar textul de sub grafic numără depășirile fiecărei metode pînă la acea dată.
Pe 5 210 zile din 2006–2026, cu ținta de 1%, proporția zilelor cu o pierdere peste VaR 1% este 1,67% pentru simularea istorică pe 500 de zile, 1,54% pentru FHS și 2,34% pentru GARCH cu șocuri Normale. Coada Normală a șocurilor GARCH este prea subțire, același defect observat necondiționat în secțiunile anterioare.
Depășirile metodei istorice se grupează în 2008 și 2020: fereastra reacționează cu luni de întîrziere la o creștere a volatilității. VaR filtrat reacționează în cîteva zile; a atins 18,01% pe 18 martie 2020 și își distribuie depășirile în timp. Dacă depășirile sînt independente și dacă proporțiile diferă semnificativ de 1% se testează în Capitolul 8. Rezultatul este o comparație de proceduri; aceeași schemă pentru Bitcoin este în Aprofundări.
Pe scurt
Linii: \(\VaR_{1\%}\) prognozat pentru ziua următoare; bare: pierderea zilnică
albastru închis pentru simularea istorică pe 500 de zile, roșu pentru FHS
Puncte: pierderile peste VaR
albastre: peste VaR istoric; cruciulițe roșii: peste VaR FHS
GARCH re-estimat în fiecare ianuarie pe toate datele anterioare
deci fiecare prognoză folosește doar informația disponibilă la momentul ei
Proporția zilelor cu pierdere peste VaR 1% în 2006–2026 (5 210 zile, cu ținta de \(1\%\))
\(1{,}67\%\) pentru simularea istorică pe 500 de zile, \(1{,}54\%\) pentru FHS
\(2{,}34\%\) pentru GARCH cu șocuri Normale
Depășirile VaR istoric apar în grupuri (2008, 2020)
fereastra reacționează cu luni de întîrziere
VaR FHS distribuie depășirile mai uniform în timp
a atins \(18{,}01\%\) pe 2020-03-18, la două zile după cea mai mare pierdere (teste în Capitolul 8)
CAViaR (Conditional Autoregressive Value at Risk) (Engle & Manganelli, 2004) renunță la modelul de volatilitate și lasă cuantila să urmeze propria recursie. În specificația cu valoare absolută simetrică (SAV, symmetric absolute value),
unde \(\beta_1 \in (0, 1)\) este persistența, iar \(\beta_2 > 0\) reacția la randamentul absolut de ieri; o mișcare mare de orice semn crește VaR. Recursia (7.14) reacționează liniar la \(|r_{t-1}|\), în timp ce GARCH reacționează la \(r_{t-1}^2\).
Parametrii se estimează prin regresie cuantilă (quantile regression) (Koenker & Bassett, 1978), minimizînd pierderea pinball (7.7) fără nicio ipoteză despre distribuția șocurilor:
unde \(q_t(\beta)\) este traiectoria cuantilei implicată de \(\beta = (\beta_0, \beta_1, \beta_2)\). Este elicitabilitatea transformată în estimator: scorul care identifică cuantila este obiectivul care ajustează modelul. Setările optimizatorului sînt în Anexă.
Pentru S&P 500 la \(\alpha = 1\%\), estimat pe 2000–2015 (4 024 de zile), \(\hat\beta_0 = 0{,}090\),\(\hat\beta_1 = 0{,}897\) și \(\hat\beta_2 = 0{,}246\). Timpul de înjumătățire al unui șoc asupra VaR este \(\ln 0{,}5/\ln\hat\beta_1 = 6{,}4\) zile.
SAV (symmetric absolute value, valoarea absolută simetrică): \(\beta_1 \in (0, 1)\) este persistența, iar \(\beta_2 > 0\) reacția la randamentul absolut de ieri
Întrebare pentru sală După un șoc, în cîte zile se înjumătățește efectul lui asupra VaR CAViaR estimat?
Răspuns
În circa 6,4 zile: timpul de înjumătățire este ln 0,5 / ln β₁, cu β₁ = 0,897. Out-of-sample, în 2016–2026, CAViaR și FHS au fiecare 35 de depășiri (1,30%), iar pierderea pinball medie este 0,039 pentru CAViaR și 0,037 pentru FHS.
Graficul compară CAViaR și FHS out-of-sample pe S&P 500 în 2016–2026. Linia albastră întreruptă este CAViaR, linia roșie FHS, iar barele arată partea pozitivă a pierderii zilnice; simularea istorică apare în textul de sub grafic, dar nu este desenată. Cele două cursoare modifică persistența \(\beta_1\) și reacția \(\beta_2\) din (7.14); constanta \(\beta_0\) este ajustată astfel încît nivelul VaR pe termen lung să rămînă cel estimat, iar ▶ modifică parametrii pas cu pas.
Schema diferă între cele două modele: CAViaR păstrează parametrii estimați pe 2000–2015, iar FHS este reestimat în fiecare ianuarie. Pe 2 693 de zile din 2016–2026, atît CAViaR, cît și FHS au 35 de depășiri ale VaR 1% (1,30%), iar simularea istorică pe 500 de zile are 38 (1,41%). Pierderea pinball medie, mai bună cînd este mai mică, este 0,039 pentru CAViaR, 0,037 pentru FHS și 0,052 pentru simularea istorică.
Crahul COVID-19 separă metodele. Între 20 februarie și 30 aprilie 2020 (50 de zile), CAViaR are 6 depășiri, FHS 3, iar simularea istorică 9. VaR maxim este 13,5% pentru CAViaR, 18,0% pentru FHS și 4,5% pentru simularea istorică: după un crah FHS sare mai sus, pentru că volatilitatea lui reacționează la pătratul randamentului. Numărul depășirilor nu arată singur că un model este mai bun; dacă diferențele sînt semnificative este o întrebare pentru Capitolul 8.
Pe scurt
Linia întreruptă albastră: CAViaR; linia roșie: FHS
barele: pierderea zilnică (partea pozitivă)
simularea istorică nu este desenată, doar raportată
S&P 500, 2016–2026 (2 693 de zile, în afara eșantionului de estimare, out-of-sample): CAViaR cu parametrii fixați pe 2000–2015
FHS re-estimat în fiecare ianuarie (o schemă diferită de re-estimare)
Rata depășirilor VaR 1%
\(1{,}30\%\) (35 de zile) pentru CAViaR, \(1{,}30\%\) (35) pentru FHS
\(1{,}41\%\) (38) pentru simularea istorică pe 500 de zile
Pierderea pinball medie, în aceeași ordine: \(0{,}039\), \(0{,}037\) și \(0{,}052\)
o valoare mai mică este preferabilă
Criza COVID-19, 20 februarie – 30 aprilie 2020 (50 de zile), pentru CAViaR, FHS și simularea istorică:
numărul de depășiri: 6, 3 și 9
VaR maxim: \(13{,}5\%\), \(18{,}0\%\) și \(4{,}5\%\)
După un crah, VaR FHS crește cel mai mult
Numărul de depășiri nu este suficient pentru a ierarhiza modelele
FHS ia scala riscului de mîine din GARCH și forma șocurilor din reziduuri; CAViaR modelează direct cuantila prin regresie cuantilă. Pe S&P 500, ambele aduc proporția depășirilor mai aproape de 1% decît simularea istorică și GARCH cu șocuri Normale, și ambele reacționează la crahuri în zile, nu în luni. Niciuna nu spune încă nimic despre pierderile de dincolo de cele mai mari reziduuri, subiectul secțiunii următoare.
Teoria valorilor extreme
Simularea istorică și FHS se opresc la cea mai mare observație din selecție. Teoria valorilor extreme (EVT, extreme value theory) dă un model parametric doar pentru coadă, justificat prin teoreme limită, nu printr-o presupunere despre întreaga distribuție. Secțiunea prezintă cele două abordări, maximele pe blocuri (block maxima) cu distribuția generalizată a valorilor extreme (GEV, generalised extreme value) și depășirile de prag (peaks over threshold) cu distribuția Pareto generalizată (GPD), apoi combină GPD cu filtrul GARCH.
Întrebarea este cît de mare este pierderea zilnică a S&P 500 depășită o dată la zece ani. Graficul este o histogramă a celei mai mari pierderi zilnice din fiecare lună calendaristică, 321 de luni din 2000–2026, cu o distribuție GEV estimată prin verosimilitate maximă (curba roșie). Comenzile aleg blocul (săptămîna, luna calendaristică, trimestrul, semestrul sau anul) și perioada de revenire în ani; textul de sub grafic dă parametrii estimați și nivelul de revenire.
Întrebare pentru sală Ce probabilitate atribuie GEV estimată pe maximele lunare evenimentului ca maximul unei luni să depășească nivelul de revenire la zece ani?
Răspuns
1/120 ≈ 0,83%. Blocurile sînt luni, deci zece ani înseamnă 120 de blocuri; nivelul de revenire 8,09% (ξ = 0,22) satisface P(maximul lunar > 8,09%) = 1/120 în modelul estimat. 1/10 confundă anii cu blocurile; 1/2 520 tratează zilele (252 pe an) drept blocuri. Nivelul nu înseamnă că depășirile apar periodic, iar o lună cu depășire poate avea mai multe zile peste prag. Patru dintre cele 321 de maxime lunare îl depășesc; cel mai mare maxim lunar observat este 12,77%.
Pentru blocuri lunare, estimările sînt \(\hat\xi = 0{,}22\), în domeniul Fréchet, cu locația \(\hat\mu = 1{,}37\) și scala \(\hat\sigma = 0{,}79\): o coadă de tip putere (power law). Nivelul de revenire (return level) la zece ani, linia întreruptă, este 8,09%, iar cel la treizeci de ani 10,95%; cel mai mare maxim lunar din selecție este 12,77%.
Maximele lunare nu dau direct un VaR zilnic. Conversia presupune zile independente, ipoteză încălcată de volatility clustering (Anexă). O a doua slăbiciune este că o singură valoare pe lună pierde majoritatea pierderilor mari; metoda depășirilor de prag le folosește pe toate.
Pe scurt
Întrebarea: cît de mare este pierderea zilnică pe care S&P 500 o depășește o dată la zece ani?
Histograma: cea mai mare pierdere zilnică din fiecare lună (321 de luni, 2000–2026)
curba roșie: GEV (Generalised Extreme Value, distribuția generalizată a valorilor extreme) estimată prin verosimilitate maximă
Estimări: \(\hat\xi = 0{,}22\) (tip Fréchet, deci o coadă de tip putere), \(\hat\mu = 1{,}37\), \(\hat\sigma = 0{,}79\)
Nivelul de revenire, depășit în medie o dată în perioada dată: \(8{,}09\%\) la 10 ani (linia întreruptă), \(10{,}95\%\) la 30 de ani
Cel mai mare maxim lunar observat: \(12{,}77\%\)
Maximele lunare nu dau direct un VaR zilnic
conversia presupune zile independente, ipoteză încălcată de gruparea volatilității (Anexă)
Împărțim selecția în blocuri de \(n\) zile și păstrăm maximul fiecărui bloc, \(M_n = \max(L_1, \dots, L_n)\). Teorema Fisher–Tippett–Gnedenko (Fisher & Tippett, 1928; Gnedenko, 1943) afirmă că, dacă pentru pierderi i.i.d. maximul normalizat \((M_n - b_n)/a_n\) are o limită nedegenerată, cu constantele de normalizare \(a_n > 0\) și \(b_n\), atunci limita este distribuția generalizată a valorilor extreme:
cu limita \(\exp\{-e^{-(x-\mu)/\sigma}\}\) pentru \(\xi = 0\). Aici \(\mu\) este locația, \(\sigma > 0\) scala, iar \(\xi\) forma. Teorema joacă pentru maxime rolul teoremei limită centrale: oricare ar fi distribuția pierderilor zilnice, într-o clasă largă, maximele blocurilor lungi au o distribuție de forma (7.15). Simbolurile \(\mu\),\(\sigma\) și \(\xi\) sînt folosite în alte părți ale capitolului cu alte sensuri; Anexa le enumeră.
Teorema Fisher–Tippett–Gnedenko Fisher & Tippett (1928), Gnedenko (1943): dacă \((M_n - b_n)/a_n\) are o limită nedegenerată pentru pierderi i.i.d., aceasta este distribuția generalizată a valorilor extreme (GEV, generalised extreme value)
\(a_n > 0\), \(b_n\): constante de normalizare, care rescalează și recentrează maximul
Forma \(\xi\) decide tipul cozii. Pentru \(\xi > 0\) (Fréchet), coada este de tip putere, cu indicele cozii \(1/\xi\), cazul randamentelor financiare. Pentru \(\xi = 0\) (domeniul Gumbel), excesele normalizate au o limită exponențială, ca pentru distribuția Normală și cea lognormală; în domeniul Gumbel, coada lognormală este totuși mai groasă decît orice coadă exponențială. Pentru \(\xi < 0\) (Weibull), coada este mărginită.
Nivelul de revenire pentru \(k\) blocuri este valoarea depășită în medie o dată la \(k\) blocuri:
Cu blocuri lunare, nivelul de revenire la zece ani din (7.16) folosește \(k = 120\).Embrechts, Klüppelberg & Mikosch (1997) și Longin (2000) consideră o lună, circa 21 de zile de tranzacționare, un compromis pentru mărimea blocului: blocurile mai lungi aduc maximul mai aproape de limita GEV, dar lasă mai puține maxime pentru estimare.
Pe scurt
Forma\(\xi\) determină tipul cozii
\(\xi > 0\): Fréchet, coadă de tip putere cu indicele cozii \(1/\xi\) (randamentele financiare)
\(\xi = 0\): domeniul Gumbel, excesele normalizate au limită exponențială (de ex. distribuția Normală, distribuția lognormală)
în domeniul Gumbel, coada lognormalei este totuși mai grea decît orice coadă exponențială
\(\xi < 0\): Weibull, coadă mărginită
Nivelul de revenire pentru \(k\) blocuri: depășit în medie o dată la \(k\) blocuri
Metoda depășirilor de prag (POT, peaks over threshold) fixează un prag ridicat \(u\) și modelează excesele\(Y = L - u\), condiționat de \(L > u\). Teorema Pickands–Balkema–de Haan (Pickands, 1975; Balkema & de Haan, 1974) afirmă că, pentru o clasă largă de distribuții, cînd \(u\) se apropie de capătul din dreapta al distribuției, excesele urmează o distribuție Pareto generalizată:
pentru \(y \ge 0\) și \(y < -\beta/\xi\) dacă \(\xi < 0\). Scala \(\beta > 0\) este mărimea tipică a unui exces, iar forma \(\xi\) este aceeași ca în GEV: \(\xi > 0\) înseamnă coadă groasă. Clasa de distribuții acoperită este aceeași cu domeniul de atracție al GEV, deci cele două teoreme descriu aceeași coadă din două unghiuri.
Pe scurt
Fixăm un prag ridicat \(u\)
Modelăm excesele\(Y = L - u\), condiționat de \(L > u\)
Teorema Pickands–Balkema–de Haan Pickands (1975), Balkema & de Haan (1974): pentru o clasă largă de distribuții, cînd \(u\) se apropie de capătul drept al distribuției, excesele urmează o distribuție Pareto generalizată
Fie \(N_u\) numărul depășirilor lui \(u\) printre \(n\) observații. Combinînd estimarea empirică \(N_u/n\) a lui \(P(L > u)\) cu GPD (7.17) pentru excese obținem estimatorii cozii (McNeil, Frey & Embrechts, 2015)
valabili pentru \(\alpha < N_u/n\) și \(\hat\xi \ne 0\), iar ES cere \(\hat\xi < 1\). În cuvinte, VaR este pragul plus cuantila GPD a excesului care lasă probabilitatea \(\alpha\) în coadă, iar ES adaugă la VaR excesul mediu de dincolo de VaR, care crește cu \(\hat\xi\);\(\hat\xi \ge 1\) ar însemna o medie infinită.
Pragul implică un compromis între deplasare și varianță (bias–variance trade-off). Un \(u\) mic folosește multe depășiri, dar încalcă teorema limită, valabilă doar cînd \(u\) crește; un \(u\) mare respectă teorema, dar lasă puține depășiri pentru estimarea lui \(\xi\) și \(\beta\).
Funcția de exces mediu (mean excess function) \(e(u) = \mathbb{E}[L - u \mid L > u]\) ghidează alegerea pragului; empiric, este media exceselor peste \(u\), reprezentată în funcție de \(u\). Pentru o coadă GPD ea este liniară:
\[e(u) = \frac{\beta + \xi (u - u_0)}{1 - \xi}, \qquad u \ge u_0,\ \xi < 1,\]
(7.19)
unde \(u_0\) este cel mai mic prag peste care GPD este valabilă, iar \(\beta\) scala GPD în \(u_0\). Panta \(\xi/(1 - \xi)\) din (7.19) este pozitivă pentru cozi groase și zero pentru cozi exponențiale. Regula practică este să alegem \(u\) acolo unde graficul devine aproximativ liniar, apoi să verificăm că \(\hat\xi\) este stabil pentru praguri apropiate.
Un al doilea instrument estimează forma direct din cele mai mari statistici de ordine. Estimatorul Hill (Hill, 1975), calculat pe cele mai mari \(k+1\) pierderi \(L^{(1)} \ge \dots \ge L^{(k+1)}\), este
Graficul reprezintă excesul mediu empiric al pierderilor zilnice ale S&P 500 în funcție de praguri care lasă deasupra între 20% și 0,5% dintre pierderi; linia roșie este GPD ajustată pe cele mai mari 5%. Cursorul modifică proporția pierderilor de deasupra pragului, iar textul de sub grafic dă estimările GPD, panta și excesul mediu la pragul ales.
Întrebare pentru sală Ce concluzie susține o porțiune aproximativ liniară și crescătoare a graficului excesului mediu?
Răspuns
Este compatibilă cu o coadă GPD cu 0 < ξ < 1: atunci excesul mediu este finit și liniar în prag, cu panta ξ/(1 − ξ) > 0; la ξ ≥ 1, excesul mediu teoretic este infinit. Estimarea curentă dă ξ = 0,19 și panta 0,23. La pragul u₀ = 1,85% (cele mai mari 5% dintre pierderi, 336 de depășiri), excesul mediu empiric este 1,09%, iar GPD dă 1,11%. Graficul susține această aproximație, dar nu o dovedește; alegerea pragului cere și verificarea stabilității parametrilor. Pentru o coadă exponențială, graficul ar fi orizontal.
Excesul mediu crește cu \(u\), ceea ce este compatibil cu o coadă GPD cu \(\xi > 0\) și nu cu linia orizontală a unei cozi exponențiale; concluzia trebuie totuși verificată prin stabilitatea parametrilor și prin alte diagnostice. Pragul ales, \(u_0 = 1{,}85\%\), este cuantila de 95% a pierderilor și lasă \(N_u = 336\) depășiri; deasupra lui graficul este aproximativ liniar. În apropierea lui \(u_0\), excesul mediu empiric este 1,09%, față de \(\hat\beta/(1 - \hat\xi) = 1{,}11\%\) din GPD estimată prin verosimilitate maximă, iar panta GPD \(\hat\xi/(1 - \hat\xi)\) este 0,23. Dincolo de VaR 1% punctele se împrăștie, pentru că fiecare mediază foarte puține pierderi. Estimatorul GPD, pas cu pas, este în Aprofundări.
Pe scurt
Pragurile sînt depășite de \(20\%\) pînă la \(0{,}5\%\) dintre pierderile zilnice
Linia roșie: GPD estimată pe cele mai mari \(5\%\)
Excesul mediu crește cu \(u\): compatibil cu o coadă GPD cu \(\xi > 0\)
nu linia orizontală a unei cozi exponențiale
de verificat prin stabilitatea parametrilor și alte diagnostice
Pragul \(u_0 = 1{,}85\%\) este cuantila 95% a pierderilor
lasă \(N_u = 336\) depășiri
deasupra lui, graficul este aproximativ liniar
Excesul mediu empiric în jurul lui \(u_0\) este \(1{,}09\%\)
GPD estimată prin verosimilitate maximă: \(\hat\beta/(1 - \hat\xi) = 1{,}11\%\)
Panta GPD: \(\hat\xi/(1 - \hat\xi) = 0{,}23\)
Dincolo de VaR 1% punctele au o dispersie mare: fiecare este media a foarte puține pierderi
Întrebare pentru sală VaR 1% din GPD este 10,23% pentru Bitcoin și 3,54% pentru S&P 500. Este suficient pentru a afirma că Bitcoin are parametrul de formă ξ mai mare?
Răspuns
Nu: VaR depinde de prag, de scală și de formă. Estimările formei sînt ξ = 0,16 (SE 0,078) pentru Bitcoin și ξ = 0,19 (SE 0,065) pentru S&P 500; diferența mare de VaR vine din scala mult mai mare a Bitcoin. Erorile standard individuale presupun depășiri independente, iar pagina nu calculează un test al diferenței dintre cele două ξ; nici estimările apropiate nu demonstrează forme egale. O concluzie inferențială cere incertitudinea diferenței, ținînd cont de dependența datelor.
Graficul arată, pe scară log–log, probabilitatea unei pierderi zilnice peste \(x\) pentru cele mai mari 5% dintre pierderile S&P 500 (stînga) și Bitcoin (dreapta). Fiecare panou compară coada empirică cu GPD estimată, cu distribuția Normală și cu distribuția Student-\(t\). Cursorul modifică proporția pierderilor folosite la estimarea GPD, ca în graficul excesului mediu.
Coada Normală cade mult sub date. Coada Student-\(t\), cu \(\nu = 2{,}7\), urmează GPD în interiorul datelor, dar este mai groasă dincolo de ele: indicele ei al cozii este 2,7, față de 5,3 pentru GPD. Pentru S&P 500, \(\hat\xi = 0{,}19\) (SE 0,065), un indice al cozii de 5,3. Pentru Bitcoin, \(\hat\xi = 0{,}16\) (SE 0,078), iar VaR 1% din GPD este 10,23%; estimările pentru toate cele cinci serii sînt în Anexă.
Eroarea standard \(\mathrm{SE}(\hat\xi) = (1 + \hat\xi)/\sqrt{N_u}\) presupune depășiri independente. Pierderile mari se grupează în timp, deci aceste SE sînt prea mici; indicele extremal care măsoară gruparea este în Aprofundări. Numerele descriu cozile celor două serii; o diferență de VaR nu implică singură o diferență de formă, pentru că VaR depinde și de prag și de scală.
Pe scurt
Scală log–log: probabilitatea unei pierderi zilnice peste \(x\), pentru cele mai mari \(5\%\) dintre pierderi
Coada Normală cade mult sub date
Coada Student-\(t\) (\(\nu = 2{,}7\)) urmează GPD în interiorul datelor
dincolo de date este mai grea: indicele cozii \(2{,}7\) față de \(5{,}3\)
S&P 500: \(\hat\xi = 0{,}19\) (SE \(0{,}065\)), deci indicele cozii este \(5{,}3\)
Bitcoin: \(\hat\xi = 0{,}16\) (SE \(0{,}078\)) și \(\VaR_{1\%} = 10{,}23\%\) (toate cele cinci serii: Anexă)
EVT condiționată (McNeil & Frey, 2000) este schema FHS cu un singur pas schimbat. Filtrul este același: un model AR(1)-GARCH(1,1) estimat prin QML dă reziduurile \(\hat z_t\) și prognozele \(\hat\mu_{t+1}\),\(\hat\sigma_{t+1}\). Pasul cozii folosește o GPD în locul cuantilei empirice \(-q_\alpha(\hat z)\). GPD este ajustată pe cele mai mari 10% dintre valorile \(-\hat z\), cu pragul \(u_z\) și \(N_z\) depășiri din \(n\) reziduuri, iar formulele POT (7.18) se aplică reziduurilor:
Pragul de 10% urmează McNeil & Frey (2000), care folosesc \(k = 100\) din 1 000 de reziduuri. Pragul poate fi mai mic decît pentru pierderile brute, pentru că reziduurile filtrate au cozi mai subțiri și extreme negrupate. Cîștigul lui (7.21) față de FHS este o coadă parametrică netedă dincolo de date, care contează cel mai mult departe în coadă, la VaR 0,5% sau 0,1%, unde există doar cîteva reziduuri. Pentru S&P 500, în prima zi de tranzacționare după 18 septembrie 2026, VaR 1% este 2,03% cu EVT condiționată și 1,97% cu FHS, al cărui interval bootstrap este \([1{,}90;\ 2{,}09]\%\).
Întrebare pentru sală Păstrăm aceleași prognoze GARCH ale mediei și volatilității. Ce schimbă EVT condiționată față de GARCH cu șocuri Normale?
Răspuns
Modelul cozii pierderilor standardizate. EVT condiționată păstrează filtrul GARCH și nivelul α, dar înlocuiește coada Normală a șocurilor standardizate cu o aproximație GPD. În 2018–2026 (2 190 de zile, 21,9 depășiri așteptate), frecvența depășirilor VaR 1% scade de la 2,42% (53 de zile) cu GARCH-Normal la 1,23% (27) cu EVT condiționată; simularea istorică pe 500 de zile are 1,60% (35). Comparația singură nu arată că întreaga specificație este corectă.
Graficul arată prognozele VaR pentru ziua următoare ale S&P 500 în 2018–2026, cu parametrii reestimați în fiecare ianuarie, pentru EVT condiționată, GARCH cu șocuri Normale și simularea istorică pe 500 de zile. Cursorul fixează nivelul VaR, iar textul de sub grafic numără depășirile fiecărei metode față de numărul așteptat.
Pe 2 190 de zile, cu ținta de 1%, proporția depășirilor este 1,23% pentru EVT condiționată, 2,42% pentru GARCH cu șocuri Normale și 1,60% pentru simularea istorică pe 500 de zile. GARCH cu șocuri Normale urmărește corect creșterile și scăderile riscului, dar VaR-ul lui este prea mic. EVT condiționată păstrează aceeași dinamică și corectează nivelul: contează coada șocurilor, nu doar scala lor. Comparația se sprijină doar pe proporțiile depășirilor; testele formale sînt în Capitolul 8.
Pe scurt
\(\VaR_{1\%}\) prognozat pentru ziua următoare, 2018–2026, cu parametrii re-estimați în fiecare ianuarie
Rata depășirilor (2 190 de zile, cu ținta de \(1\%\))
\(1{,}23\%\) pentru EVT condiționată, \(2{,}42\%\) pentru GARCH cu șocuri Normale
\(1{,}60\%\) pentru simularea istorică pe 500 de zile
GARCH cu șocuri Normale urmărește corect creșterile și scăderile riscului
dar VaR-ul lui este prea mic
EVT condiționată păstrează dinamica și corectează nivelul
contează coada șocurilor, nu doar scala lor
Tipul de dovadă: comparație între proceduri
doar ratele depășirilor; testele sînt în Capitolul 8
GEV descrie maximele pe blocuri, iar GPD excesele peste un prag ridicat; ambele sînt justificate prin teoreme limită și au în comun parametrul de formă \(\xi\). Pentru cele cinci serii ale capitolului, \(\hat\xi\) este între 0,15 și 0,21. Aplicată după un filtru GARCH, GPD dă EVT condiționată, care pe S&P 500 aduce proporția depășirilor VaR 1% la 1,23%, față de 2,42% pentru GARCH cu șocuri Normale.
Orizontul: regula rădăcinii pătrate
Reglementarea cere riscul pe zece zile, iar modelele sînt estimate pe date zilnice. Regula rădăcinii pătrate a timpului (square-root-of-time rule) înmulțește măsura pe o zi cu \(\sqrt{h}\). Secțiunea formulează ipotezele regulii, arată în ce sens o împinge fiecare abatere de la ele și măsoară raportul în date.
Întrebarea este cînd putem obține riscul pe \(h\) zile înmulțind riscul pe o zi cu \(\sqrt{h}\). Pentru pierderi zilnice i.i.d. \(N(0, \sigma^2)\), pierderea însumată pe \(h\) zile este \(N(0, h\sigma^2)\), iar
unde indicele superior arată orizontul. Regula (7.22) rezultă din faptul că abaterea standard a unei sume de \(h\) termeni i.i.d. crește ca \(\sqrt{h}\), iar sub distribuția Normală cu media zero VaR și ES sînt multipli ai abaterii standard. Ea cere deci patru ipoteze: media zero, lipsa autocorelației, volatilitate constantă și șocuri Normale.
Amendamentul Basel din 1996 a permis băncilor să scaleze VaR pe o zi cu \(\sqrt{10} = 3{,}162\)(Basel Committee, 1996). Fiecare dintre cele patru ipoteze este încălcată în date, cum au arătat Capitolele 1, 2 și 5; întrebarea este în ce sens greșește atunci regula.
Pe scurt
Întrebarea: cînd putem obține riscul pe \(h\) zile înmulțind riscul pe o zi cu \(\sqrt{h}\)?
Autocorelația schimbă varianța sumei: \(\operatorname{Var}(r_{t+1} + \dots + r_{t+h}) = h\sigma^2\,\mathrm{VR}(h)\), unde raportul varianțelor (variance ratio) \(\mathrm{VR}(h)\) din Capitolul 2 este 1 în lipsa autocorelației. Cu autocorelație pozitivă, \(\mathrm{VR}(h) > 1\) și \(\sqrt{h}\) subestimează varianța pe \(h\) zile. VaR și ES urmează varianța în acest fel doar într-o familie locație–scală, cum este distribuția Normală.
Volatility clustering acționează prin revenirea la medie a volatilității pe parcursul celor \(h\) zile. Cînd piața este calmă azi, volatilitatea este de așteptat să crească, varianța pe \(h\) zile depășește \(h\,\sigma_{t+1}^2\), iar \(\sqrt{h}\) înmulțit cu riscul condiționat pe o zi tinde să fie prea mic. Cînd piața este agitată, se întîmplă invers. Pentru cuantilă, spre deosebire de varianță, sensul trebuie verificat prin Monte Carlo filtrat.
Cozile groase acționează în sens opus. Pentru șocuri i.i.d. cu indicele cozii \(a > 2\), deci cu \(P(L > x)\) descrescînd ca \(x^{-a}\) (variație regulată, regular variation), cuantila sumei crește ca \(h^{1/a} < \sqrt{h}\) cînd \(\alpha \to 0\) cu \(h\) fix, iar \(\sqrt{h}\) poate supraestima cuantila din coada îndepărtată (Daníelsson, 2011). La nivelurile finite ale cursului, 1% și 2,5%, aceasta este o aproximare, nu o regulă. Cu salturi, regula poate greși mult riscul pe mai multe zile (Daníelsson & Zigrand, 2006).
Întrebare pentru sală Pentru BET, raportul dintre VaR 1% empiric pe 10 zile și √10 × VaR pe o zi este 1,22. Dacă randamentele nu ar avea autocorelație, ar deveni regula √h obligatoriu exactă pentru VaR?
Răspuns
Nu. Fără autocorelație și cu varianța constantă, varianța pe h zile este h ori cea zilnică, dar cuantila sumei depinde și de forma distribuției ei, care se schimbă cu h (cozi groase, volatility clustering). Regula este exactă, de exemplu, pentru pierderi i.i.d. cu distribuția Normală și media zero. În date, raportul la h = 10 este 1,22 pentru BET (autocorelația de ordinul 1: 0,109) și 1,05 pentru EUR/RON, deci regula subestimează riscul; pentru S&P 500 (0,95), aur (0,92) și Bitcoin (0,89) regula este conservatoare. Pentru S&P 500, Monte Carlo filtrat dă 6,29%, față de 6,22% pentru √10 × VaR filtrat pe o zi.
Panoul din stînga arată, pentru fiecare dintre cele cinci serii, VaR 1% empiric al pierderilor suprapuse pe \(h\) zile împărțit la \(\sqrt{h}\) înmulțit cu valoarea pe o zi; un raport peste 1 înseamnă că regula subestimează riscul pe \(h\) zile. Sumele suprapuse conțin mult mai puține observații independente decît sugerează numărul lor. Panoul din dreapta arată distribuția pierderii pe \(h\) zile a S&P 500 simulată prin Monte Carlo filtrat cu 200 000 de traiectorii (MC în legendă); textul de sub grafic compară VaR 1% al ei cu \(\sqrt{h}\) înmulțit cu VaR filtrat și cu VaR istoric pe o zi. Cursorul fixează orizontul \(h\).
La \(h = 10\), raportul este 1,22 pentru BET, a cărui autocorelație de ordinul 1 este 0,109, și 1,05 pentru EUR/RON: pentru aceste două serii \(\sqrt{h}\) este prea mic. Pentru S&P 500 (0,95), aur (0,92) și Bitcoin (0,89), regula este conservatoare.
Pentru S&P 500, VaR 1% pe 10 zile prin Monte Carlo filtrat este 6,29%, iar \(\sqrt{10}\) înmulțit cu VaR filtrat pe o zi dă 6,22%. Scalarea VaR istoric necondiționat pe o zi dă în schimb 10,92%. Diferența mare nu este deci între regulă și simulare, ci între riscul condiționat și cel necondiționat, într-o piață calmă. Metoda de simulare este descrisă în Aprofundări.
Pe scurt
Stînga: \(\VaR_{1\%}\) empiric al pierderilor suprapuse pe \(h\) zile, împărțit la \(\sqrt{h}\) ori valoarea pe o zi
sume suprapuse: mult mai puține observații independente
Dreapta: Monte Carlo filtrat (MC în legendă), 200 000 de traiectorii
La \(h = 10\), în panoul din stînga, \(\sqrt{h}\) este prea mic pentru BET și EUR/RON
raportul este \(1{,}22\) pentru BET (autocorelația de ordin 1: \(0{,}109\))
raportul este \(1{,}05\) pentru EUR/RON
Raportul este \(0{,}95\) pentru S&P 500, \(0{,}92\) pentru aur și \(0{,}89\) pentru Bitcoin
aici regula este conservatoare
\(\VaR_{1\%}\) pe 10 zile pentru S&P 500
\(6{,}29\%\) prin Monte Carlo filtrat
\(6{,}22\%\) ca \(\sqrt{10}\times\) VaR filtrat pe o zi și \(10{,}92\%\) ca \(\sqrt{10}\times\) VaR istoric pe o zi
Diferența mare față de \(10{,}92\%\) vine din trecerea de la VaR necondiționat (istoric) la VaR condiționat (filtrat)
Verificarea rapidă pornește de la un birou care raportează un VaR 1% pe o zi de 2%, calculat din pierderi i.i.d. Normale cu media 0. Ea cere VaR pe 10 zile după (7.22), VaR pe 10 zile cînd randamentele se dovedesc pozitiv autocorelate cu \(\mathrm{VR}(10) = 1{,}21\) și sensul erorii scalării cu \(\sqrt{10}\) cînd volatilitatea GARCH de azi este mult sub nivelul ei de termen lung. Răspunsurile sînt în Anexă.
Pe scurt
Un birou de tranzacționare raportează \(\VaR_{1\%} = 2\%\) pe o zi, din pierderi i.i.d. Normale cu media 0
(a) Cît este \(\VaR_{1\%}\) pe 10 zile după regula rădăcinii pătrate a timpului?
(b) Randamentele se dovedesc pozitiv autocorelate, cu \(\mathrm{VR}(10) = 1{,}21\), și rămîn Normale. Cît este acum \(\VaR_{1\%}\) pe 10 zile?
(c) Fără autocorelație, dar volatilitatea GARCH de azi este mult sub nivelul ei de termen lung. Este \(\sqrt{10}\times\) VaR condiționat pe o zi prea mic sau prea mare și de ce?
Regula \(\sqrt{h}\) este exactă doar pentru pierderi i.i.d. Normale cu media zero. Autocorelația pozitivă și o piață calmă o fac prea mică; cozile groase și o piață agitată o pot face prea mare. În date, raportul la zece zile variază de la 0,89 pentru Bitcoin la 1,22 pentru BET, iar pentru S&P 500 starea condiționată a pieței contează mult mai mult decît regula de scalare.
VaR de portofoliu și contribuțiile la risc
VaR și ES ale unui portofoliu sînt mai mici decît suma măsurilor individuale ale activelor lui, cu excepția cazului în care activele se mișcă perfect împreună. Secțiunea măsoară beneficiul diversificării pe un portofoliu de patru active și împarte riscul rămas între active prin alocarea Euler (Euler allocation).
Întrebarea este cît reduce diversificarea riscul și ce activ produce riscul care rămîne. Portofoliul, reechilibrat zilnic, conține:
SPY, un fond tranzacționat la bursă (ETF, exchange-traded fund) care replică S&P 500, cu ponderea 40%;
TLT, un ETF de obligațiuni de stat americane pe termen lung, cu 30%;
GLD, un ETF de aur, cu 20%;
Bitcoin, cu 10%.
Randamentele sînt randamente simple pe 3 017 zile comune din 2014–2026.
Graficul compară, pentru fiecare activ, ponderea lui (turcoaz), partea lui din VaR 1% Normal (albastru) și partea lui din ES 2,5% istoric (roșu). Cursorul modifică ponderea Bitcoin, restul rămînînd în proporția 40:30:20, iar ▶ o crește de la 0 la 30%.
Întrebare pentru sală ▶ crește ponderea Bitcoin în capital de la 10% la 30%, restul rămînînd în proporția 40:30:20. Ce se întîmplă cu partea Bitcoin din ES 2,5% istoric?
Răspuns
Crește de la 36,6% la 87,0%: ponderea în capital se triplează, partea din ES crește de 2,4 ori. Contribuția Euler la ES este ponderea înmulțită cu pierderea medie a Bitcoin în zilele din coada portofoliului, iar aceste zile se schimbă odată cu ponderea; partea din risc nu este ponderea în capital și nu crește proporțional cu ea. La ponderea din slide, 10%, Bitcoin aduce 37,8% din VaR 1% (Normal, Euler) și 36,6% din ES 2,5% (istoric); TLT, cu 30% din capital, aduce doar 6,6% din ES. Diversificarea reduce VaR 1% de la 3,11% (suma VaR-urilor individuale) la 1,77%.
VaR 1% al portofoliului este 1,77%, față de 3,11% nediversificat, o reducere de 43%; ES 2,5% al portofoliului este 2,16%, față de 3,88%, o reducere de 44%. Bitcoin reprezintă 10% din bani, dar aduce 37,8% din VaR și 36,6% din ES. TLT reprezintă 30% din bani și aduce doar 6,6% din ES: în cel mai rău 2,5% dintre zilele portofoliului a pierdut în medie 0,47%, mai puțin decît portofoliul. Numerele descriu selecția; volatilitățile, corelațiile și contribuțiile sînt în Anexă.
Pe scurt
Întrebarea: cît scade riscul prin diversificare și ce activ produce riscul rămas?
Fie pierderea portofoliului \(L_p = -w^\top R\), unde \(w\) este vectorul ponderilor, iar \(R\) vectorul randamentelor simple, cu matricea de covarianță \(\Sigma\);\(\sigma_i\) este abaterea standard a activului \(i\). Dacă randamentele sînt Normale și media este ignorată, VaR este un multiplu al abaterii standard a portofoliului:
Pentru ponderi long-only \(w \ge 0\), VaR nediversificat \(\sum_i z_{1-\alpha} w_i\sigma_i\), suma VaR-urilor individuale, este mai mare decît (7.23), cu excepția cazului în care toate corelațiile sînt 1. Diferența este beneficiul diversificării.
Pentru ponderi nenegative \(w \ge 0\), VaR nediversificat \(\sum_i z_{1-\alpha} w_i\sigma_i\) (suma VaR-urilor individuale) este mai mare, cu excepția corelațiilor egale cu 1
VaR marginal (marginal VaR) este variația VaR al portofoliului la o creștere marginală a ponderii \(w_i\). Derivînd (7.23) obținem \(\partial\mathrm{VaR}_\alpha/\partial w_i = z_{1-\alpha}(\Sigma w)_i/\sigma_p\), unde \((\Sigma w)_i\) este covarianța activului \(i\) cu portofoliul. Componenta VaR (component VaR) a activului \(i\) este
Componentele din (7.24) se adună la VaR prin teorema lui Euler pentru funcții omogene de gradul 1, \(\sum_i w_i\,\partial\rho/\partial w_i = \rho\)(Tasche, 2008). Pentru ES nu este nevoie de nicio ipoteză de distribuție cînd pierderile sînt continue: componenta este pierderea medie a activului \(i\) în zilele din coada portofoliului, \(C_i^{ES} = \mathbb{E}[-w_i R_i \mid L_p \ge \mathrm{VaR}_\alpha(L_p)]\), iar aceste componente se adună la \(\mathrm{ES}_\alpha(L_p)\). Istoric, \(C_i^{ES}\) se estimează ca media pe zilele din coadă, cu ponderile fracționare ale ES istoric. Un \(C_i\) negativ înseamnă că activul acoperă (hedges) portofoliul.
Omogenitatea de gradul 1 garantează că componentele Euler alocă întregul risc, dar și multe alte alocări se adună la el. Argumentul pentru Euler (Tasche, 2008) este că, pentru \(\rho\) diferențiabilă, este alocarea compatibilă cu RORAC (return on risk-adjusted capital): arată corect unde o pondere mai mare îmbunătățește randamentul pe unitatea de risc. Portofoliul cu ES minim pentru aceleași active este în Aprofundări.
Pe scurt
VaR marginal: variația VaR-ului portofoliului la o creștere marginală a ponderii \(w_i\)
VaR pe componente\(C_i = w_i\,\partial\VaR_\alpha/\partial w_i\): partea din VaR atribuită activului \(i\)
Teorema lui Euler pentru o funcție omogenă de grad 1: \(\sum_i w_i\,\partial\rho/\partial w_i = \rho\), deci componentele se adună, \(\sum_i C_i = \VaR_\alpha\)Tasche (2008)
ES, fără ipoteză de distribuție (pierderi continue)
pierderea medie a activului \(i\) în zilele din coada portofoliului
\(C_i^{ES} = \E[-w_i R_i \mid L_p \ge \VaR_\alpha(L_p)]\), \(\quad\sum_i C_i^{ES} = \ES_\alpha(L_p)\), estimată istoric ca media ponderată fracționar pe zilele din coadă (ponderile ES istoric)
Un \(C_i\) negativ înseamnă că activul acoperă riscul portofoliului
omogenitatea de grad 1 face ca suma contribuțiilor să fie riscul total, dar și alte reguli de alocare au această proprietate
Euler este caracterizată de compatibilitatea cu RORAC (return on risk-adjusted capital, randamentul capitalului ajustat la risc), pentru \(\rho\) diferențiabilă
adică arată corect unde o pondere mai mare îmbunătățește randamentul pe unitatea de risc
Pe portofoliul de patru active, diversificarea reduce VaR 1% cu 43% și ES 2,5% cu 44%. Alocarea Euler arată că Bitcoin, cu 10% din capital, poartă mai mult de o treime din riscul rămas, în timp ce TLT acționează aproape ca o acoperire în coadă.
Lichiditate și reglementare
Secțiunile anterioare au presupus că o poziție poate fi vîndută la prețul mediu și că riscul se măsoară cum îl definește capitolul. Secțiunea adaugă costul vînzării într-o piață sub stres și descrie cum măsura de reglementare a trecut de la VaR 1% în 1996 la ES 2,5% în FRTB.
Întrebarea este cît adaugă la VaR vînzarea poziției într-o piață sub stres. VaR presupune o vînzare la prețul mediu, \((\text{bid} + \text{ask})/2\). O vînzare imediată se face la bid și costă jumătate din spread-ul relativ (relative spread) \(S = (\text{ask} - \text{bid})/\text{mid}\), iar spread-ul se lărgește exact cînd piețele scad. Bangia, Diebold, Schuermann & Stroughair (2001) adaugă la VaR costul unui spread sub stres:
unde \(\mu_S\) și \(\sigma_S\) sînt media și abaterea standard a spread-ului \(S\) (aici \(S\) este spread-ul, nu asimetria), iar \(k\) este numărul de abateri standard care duc spread-ul la nivelul lui sub stres.
Pentru o poziție de 1 milion de lei în Banca Transilvania, VaR 1% istoric pe o zi, pe ultimele 496 de zile, este 3,16%. Cu valorile presupuse \(\mu_S = 0{,}5\%\),\(\sigma_S = 0{,}3\%\) și \(k = 3\),(7.25) dă un LVaR (Liquidity-adjusted Value-at-Risk, Value-at-Risk ajustat pentru lichiditate) de 3,86%, cu 22% mai mult. În bani, VaR este de circa 31 581 de lei, iar costul spread-ului \(\tfrac12(0{,}5 + 3 \times 0{,}3)\% = 0{,}70\%\), adică 7 000 de lei, deci LVaR este de circa 38 581 de lei.
Pozițiile mari mișcă și prețul, o formă de lichiditate endogenă (endogenous liquidity) pe care (7.25) nu o surprinde. De aceea FRTB tratează lichiditatea prin orizonturi de lichiditate de pînă la 120 de zile.
Pe scurt
Întrebarea: cît adaugă la VaR costul de a vinde poziția într-o piață agitată?
VaR presupune vînzarea la prețul mediu (mid) \(= (\text{bid} + \text{ask})/2\), dintre prețul oferit (bid) și cel cerut (ask)
o vînzare imediată se face la bid și costă jumătate din spread-ul relativ\(S = (\text{ask} - \text{bid})/\text{mid}\)
Spread-ul se lărgește tocmai în perioadele de scădere a pieței
Întrebare pentru sală ▶ crește nivelul ES de la 2,5% pînă la 5%, cu VaR fixat la 1%. Ce se întîmplă cu rapoartele ES / VaR 1% ale celor cinci active?
Răspuns
Scad sub 1: la ES 5%, rapoartele sînt între 0,81 (Bitcoin) și 0,86 (S&P 500), iar sub distribuția Normală cu media zero 0,887. ES ≥ VaR doar la același nivel α; ES 5% face media pe cel mai rău 5% dintre zile, o coadă mai puțin extremă decît cea a VaR 1%. La nivelul Basel, ES 2,5%, rapoartele sînt între 1,03 (Bitcoin) și 1,11 (BET): 1,09 pentru S&P 500, 1,10 pentru EUR/RON și 1,06 pentru aur. Reperul Normal cu media zero este φ(z₀,₉₇₅)/(0,025 × z₀,₉₉) = 2,338/2,326 ≈ 1,005; cu o medie nenulă, aceasta intră atît în ES, cît și în VaR, iar raportul se schimbă.
Graficul compară, pentru cinci active, VaR 1% istoric pe o zi cu ES 2,5%, pe pierderile zilnice ale întregii selecții; numărul de deasupra fiecărei perechi este raportul \(\mathrm{ES}_{2{,}5\%}/\mathrm{VaR}_{1\%}\). Cursorul crește nivelul ES de la 1% la 5%, cu VaR păstrat la 1%, iar textul de sub grafic compară raportul cu valoarea lui Normală.
Sub distribuția Normală raportul este \(2{,}338/2{,}326 \approx 1{,}005\), deci cele două măsuri cer același capital pentru cozi subțiri; sub distribuția Student-\(t\) este 1,01 la \(\nu = 30\) și 1,07 la \(\nu = 4\). În date, raportul este 1,09 pentru S&P 500, 1,11 pentru BET, 1,03 pentru Bitcoin, 1,10 pentru EUR/RON și 1,06 pentru aur. Trecerea de la VaR 1% la ES 2,5% crește deci măsura pe o zi cu 3–11%.
ES 2,5% nu trebuie neapărat să depășească VaR 1%: inegalitatea \(\mathrm{ES}_\alpha \ge \mathrm{VaR}_\alpha\) este garantată doar la același nivel \(\alpha\). Calibrarea pe perioada de stres și orizonturile de lichiditate din FRTB adaugă la capital mai mult decît schimbarea măsurii; detaliile sînt în Aprofundări.
Tabelul compară amendamentul din 1996 pentru riscul de piață (Basel Committee, 1996) cu FRTB (Basel Committee, 2019). În 1996 măsura era VaR 1%, calculat zilnic, pe zece zile, cu scalarea \(\sqrt{10}\) permisă și cel puțin un an de istorie. Capitalul era maximul dintre VaR de ieri și un multiplicator de cel puțin 3 înmulțit cu media VaR pe 60 de zile; multiplicatorul creștea cu 0 pînă la 1 după backtesting-uri slabe, conform zonelor semaforului (traffic-light zones) din Capitolul 8.
FRTB a înlocuit măsura cu ES 2,5%, calculat zilnic pentru fiecare birou de tranzacționare. Orizontul de bază este de zece zile, scalat prin orizonturile de lichiditate: 10 zile pentru acțiunile cu capitalizare mare, 20 pentru cele cu capitalizare mică și pînă la 120 de zile pentru spread-urile de credit. Modelul este calibrat pe cea mai severă perioadă de stres de 12 luni, iar multiplicatorul este \(m_c = 1{,}5\), crescut după backtesting-uri slabe. Backtesting-ul folosește în continuare VaR, la 1% și 2,5%, iar ES stabilește capitalul. Schimbările răspund criticii de după 2008: VaR ignoră mărimea pierderilor din coadă, iar ferestrele de un an uită crizele.
ES 2,5%, calculat zilnic pentru fiecare birou de tranzacționare
Orizontul
10 zile, cu scalarea prin \(\sqrt{10}\) permisă
bază de 10 zile, scalată prin orizonturi de lichiditate (acțiuni cu capitalizare mare 10, mică 20, spread-uri de credit pînă la 120 de zile)
Datele
cel puțin un an de istorie
calibrat pe cea mai severă perioadă de stres de 12 luni
Capitalul
max(VaR de ieri, multiplicator \(\ge 3\)\(\times\) media VaR pe 60 de zile), iar multiplicatorul crește cu 0–1 după rezultate slabe la backtesting (zonele semafor, Capitolul 8)
multiplicator \(m_c = 1{,}5\), crescut după rezultate slabe la backtesting
VaR 1% și VaR 2,5% pe o zi: VaR se testează, ES stabilește capitalul
Critica de după 2008
VaR ignoră mărimea pierderilor din coadă
ferestrele de un an exclud crizele mai vechi
Sinteza secțiunii
Lichiditatea adaugă la VaR costul unui spread sub stres, 22% în exemplul Banca Transilvania. Trecerea de la VaR 1% la ES 2,5% crește măsura pe o zi cu 3–11% pe activele capitolului; schimbările mai mari din FRTB vin din perioada de stres și din orizonturile de lichiditate.
Studii de caz: rețele neuronale și forma dinamică a cozii
Cele două studii de caz duc modelele de cuantilă condiționată ale capitolului în două direcții recente:
În Journal of Financial Econometrics, Chronopoulos, Raftapostolos & Kapetanios (2024) întreabă dacă prognoza VaR se îmbunătățește atunci cînd cuantila condiționată poate depinde de predictori într-un mod neliniar necunoscut, învățat de o rețea neuronală adîncă. Datele sînt randamentele log zilnice ale S&P 500 din septembrie 1985 pînă în august 2020, la nivelurile \(\alpha\) = 1%, 5% și 10%.
Predictorii \(x_t\) sînt volatilitatea unui model GARCH sau RiskMetrics și variabilele de stare ale CAViaR. Ultimele 2 000 de zile sînt păstrate out-of-sample, iar modelul este calibrat o singură dată pe o fereastră fixă (Anexă). Reperul este regresia cuantilă liniară (Koenker & Bassett, 1978) pe aceiași predictori, adică o specificație liniară de tip CAViaR; modelul rețelei este descris în Aprofundări.
Poate o rețea neuronală adîncă să îmbunătățească prognoza VaR învățînd o relație neliniară, cu formă necunoscută, între cuantila condiționată și predictori?
Date (Secțiunea 3 a articolului): randamentele log zilnice ale S&P 500
septembrie 1985 – august 2020
Niveluri: \(\alpha\) = 1%, 5%, 10%
Predictorii \(x_t\): volatilitatea GARCH sau RiskMetrics, variabilele de stare CAViaR
Ultimele \(2\,000\) de zile formează eșantionul de evaluare, în afara eșantionului de estimare
cu o singură fereastră fixă de calibrare (detaliile: Anexă)
Întrebare pentru sală Arată un RMSFE (Root Mean Squared Forecast Error, rădăcina erorii pătratice medii de prognoză) relativ sub 1 că rețelele adînci estimează mai bine cuantila condiționată?
Răspuns
Nu direct. Toate cele 20 de bare ale rețelelor adînci (inclusiv MIDAS adînc) sînt sub 1, între 0,014 și 0,850, dar RMSFE este minimizată de media condiționată, nu de cuantilă. Precizia unei prognoze de cuantilă se compară prin pierderea pinball. În plus, rezultatul provine dintr-o singură fereastră fixă de calibrare.
Graficul reproduce Tabelul 6 al lucrării la \(\alpha = 1\%\): rădăcina erorii pătratice medii de prognoză (RMSFE, root mean squared forecast error) a fiecărui model, relativ la regresia cuantilă liniară, pe scară logaritmică, cu linia întreruptă la 1. Barele de sub linie înseamnă o eroare mai mică decît a reperului. Cursorul alege unul dintre cele patru seturi de predictori sau pe toate.
Dintre modelele flexibile fără rețele, regresiile cuantile polinomiale și cu B-spline-uri și MIDAS liniar (mixed data sampling regression), 7 din 12 bare sînt la 1 sau peste. Toate cele 16 bare ale rețelelor adînci și cele 4 bare MIDAS adînc sînt sub 1, între 0,014 și 0,850, și toate sînt semnificative în testul Diebold–Mariano (DM), cu excepția MIDAS adînc pentru predictorii SAV.
Două precauții limitează interpretarea. RMSFE este minimizată de media condiționată, nu de cuantilă; precizia unei prognoze de cuantilă se măsoară prin pierderea pinball (7.7). Iar dacă o reducere a erorii de pînă la 98% rezistă la reestimarea pe fereastră mobilă rămîne o întrebare deschisă, pentru că provine dintr-o singură fereastră fixă de calibrare. Rezultatele compară proceduri și nu separă contribuțiile arhitecturii, ale penalizării și ale validării încrucișate (CV, cross-validation).
Pe scurt
Chronopoulos, Raftapostolos & Kapetanios (2024), Tabelul 6: RMSFE (Root Mean Squared Forecast Error, rădăcina erorii pătratice medii de prognoză) relativ la regresia cuantilă liniară, pe scară logaritmică
linia întreruptă marchează 1
Modelele flexibile fără rețele: 7 din 12 bare sînt la 1 sau peste
polinomial, B-spline, MIDAS liniar
MIDAS: mixed data sampling, regresie cu date de frecvențe diferite
Toate cele 16 bare ale rețelelor adînci și cele 4 ale MIDAS adînc sînt sub 1
între \(0{,}014\) și \(0{,}850\)
Toate sînt semnificative în testul DM (testul Diebold–Mariano de comparare a prognozelor), cu excepția MIDAS adînc pentru SAV
Atenție: RMSFE este minimizată de media condiționată, nu de cuantilă
Precizia cuantilelor cere pierderea pinball
Rămîne de văzut dacă reducerea maximă, de 98%, se păstrează la reestimarea pe o fereastră mobilă (rolling window)
reducerea a fost obținută cu o singură fereastră fixă de calibrare (Seminarul 7, C3)
Tipul de dovadă: comparație între proceduri
rezultatele nu separă contribuțiile arhitecturii, penalizării și validării încrucișate (CV)
În Journal of Business & Economic Statistics, D'Innocenzo, Lucas, Schwaab & Zhang (2024) lasă forma și scala cozii pierderilor să se schimbe de la o zi la alta. Pragul \(\tau_t\) este o cuantilă dinamică de 90% a pierderii, ca în Patton, Ziegel & Chen (2019). Depășirile pragului urmează o GPD cu forma \(\xi_t\) și scala \(\delta_t\), ambele actualizate după fiecare depășire prin scor, derivata log-verosimilității: un model bazat pe scor (score-driven).
Întrebarea contează pentru că EVT condiționată (McNeil & Frey, 2000) păstrează \(\xi\) fix. O coadă GPD condiționată cu \(\xi_t = 0{,}25\) are momente finite ale depășirii doar pentru ordinele \(p < 1/\xi_t = 4\), deci momentul ei de ordinul patru este infinit, în coada modelată, dar nu neapărat în distribuția necondiționată. Un \(\xi_t\) mai mare crește, de asemenea, ES mai mult decît VaR.
Pe S&P 500, din iulie 1962 pînă în decembrie 2020 (14 726 de zile, 1 495 de depășiri), lucrarea raportează că \(\xi_t\) variază între circa 0,05 și 0,25. Crahurile izolate, ca Black Monday din 1987 și flash crash-ul din 2010, cresc în principal \(\xi_t\), iar crizele lungi, 2008–2009 și COVID-19 din 2020, cresc în principal \(\delta_t\). 1,0% dintre pierderi depășesc VaR 1% filtrat.
Graficul arată traiectoriile modelului estimat pe datele cursului pentru S&P 500 în 2000–2026: VaR 1% (stînga), forma \(\xi_t\) (mijloc) și scala \(\delta_t\) (dreapta). Traiectoriile sînt filtrate in-sample, cu parametrii și cuantila inițială estimați pe întreaga selecție; dați fiind aceștia, recursia pentru \(\tau_t\),\(\xi_t\),\(\delta_t\), VaR și ES este cauzală. Banda din panoul din mijloc este intervalul raportat în lucrare, linia portocalie este valoarea constantă \(\xi = 0{,}056\) a modelului în care doar \(\delta_t\) este dinamic, iar liniile întrerupte sînt o GPD statică pe aceleași praguri, cu \(\hat\xi = 0{,}20\). Cursorul înmulțește pasul \(a_\xi\) al recursiei formei, valoarea 1 corespunzînd estimării.
Întrebare pentru sală Forma dinamică ξt adaugă 1,04 la log-verosimilitatea exceselor și doi parametri, față de modelul cu ξ constant și scala δt dinamică. Cu cît se schimbă AIC (Akaike Information Criterion, criteriul informațional Akaike)?
Răspuns
Crește cu circa 1,92: ΔAIC = 2 × 2 − 2 × 1,04 = 1,92, deci AIC dezavantajează modelul cu ξt dinamic (774 față de 772). −2,08 ignoră penalizarea parametrilor; 2,96 omite factorul 2 din termenul log-verosimilității. Log-verosimilitatea este −380,85 cu ξt și δt dinamice, față de −381,89 cu ξ constant (0,056) și δt dinamic. GPD statică are AIC 853, deci scăderea 853 → 774 vine din dinamica scalei δt. Cu aξ = 0, ξt rămîne fix la 0,083. VaR 1% filtrat este depășit în 61 din 6 717 zile (0,91%).
VaR 1% atinge maximul de 12,4% pe 17 martie 2020. Forma \(\xi_t\) variază între 0,016, pe 17 martie 2011, și 0,22, pe 18 septembrie 2001. Scala \(\delta_t\) variază între 0,30% și 3,15%, atins pe 17 martie 2020.
Pe scurt
Traiectorii filtrate retrospectiv, cu parametri și cuantilă de pornire estimate pe toată selecția; recursia pentru \(\tau_t\), \(\xi_t\), \(\delta_t\), VaR și ES este cauzală condiționat de aceștia
Stînga: VaR 1% atinge maximul de 12,4% pe 17 mart. 2020
Mijloc: \(\xi_t\) între 0,016 (17 mart. 2011) și 0,22 (18 sept. 2001)
banda: intervalul raportat în lucrare
linia portocalie: \(\xi = 0{,}056\), cînd doar \(\delta_t\) este dinamic
Dreapta: \(\delta_t\) între 0,30% și 3,15% (17 mart. 2020)
Liniile întrerupte: GPD statică pe aceleași praguri (\(\hat\xi = 0{,}20\))
unde \(\hat q_{0.9}\) este cuantila de 90% a pierderilor, iar \(a_\tau\),\(b_\tau\) minimizează pierderea pinball la 90%. Depășirea \(x_t = L_t - \tau_t > 0\) urmează o GPD\((\xi_t, \delta_t)\) cu \(f_t = (\ln\xi_t, \ln\delta_t)'\), actualizată prin \(f_{t+1} = \omega + A\,s_t + B\,f_t\), cu \(A = \mathrm{diag}(a_\xi, a_\delta)\) și \(B = \mathrm{diag}(b_\xi, b_\delta)\). Scorul \(s_t\) este scalat prin informația Fisher și este 0 în zilele fără depășire. Cu \(p_t\) proporția zilelor cu depășire pînă la \(t-1\), VaR și ES la nivelul \(\alpha\) rezultă din (7.18):
Replicarea folosește aceeași specificație pe datele cursului, 2000–2026, 6 717 zile și 680 de depășiri, în locul datelor CRSP (Center for Research in Security Prices) din 1962–2020. Stările sînt trunchiate numeric, \(\ln\xi_t \in [-6;\ 1{,}5]\) și \(\ln\delta_t \in [-6;\ 4]\), iar modelul este comparat prin criteriul informațional Akaike (AIC, Akaike information criterion) cu o GPD statică și cu un model cu \(\xi\) constant și \(\delta_t\) dinamic, pe aceleași praguri.
Aceeași estimare doar pe 2000–2015, cu 404 depășiri, nu este validată numeric. Acolo \(\xi_t\) stă la limita inferioară \(e^{-6} = 0{,}0025\) în 3 939 din 4 024 de zile și la limita superioară \(e^{1{,}5} = 4{,}48\) în 5 zile, în care ES este infinit. Cu limita inferioară mutată la \(e^{-12}\), optimul o urmează, iar log-verosimilitatea rămîne practic neschimbată. Limita exponențială, \(\xi = 0\) cu \(\delta_t\) dinamic, are un AIC de 454, față de 458 cu \(\xi_t\) dinamic și 515 pentru GPD statică.
\(\hat q_{0{,}9}\): cuantila de 90% a pierderilor; \(a_\tau\), \(b_\tau\) minimizează pierderea pinball la 90%
Excesul \(x_t = L_t - \tau_t > 0\) urmează o GPD\((\xi_t, \delta_t)\), cu \(f_t = (\ln\xi_t, \ln\delta_t)'\)
\(f_{t+1} = \omega + A\,s_t + B\,f_t\), cu \(A = \mathrm{diag}(a_\xi, a_\delta)\) și \(B = \mathrm{diag}(b_\xi, b_\delta)\)
\(s_t\): scorul scalat cu informația Fisher; \(s_t = 0\) în zilele fără exces
VaR și ES la nivelul \(\alpha\): \(\VaR_t = \tau_t + \dfrac{\delta_t}{\xi_t}\left[\left(\dfrac{\alpha}{p_t}\right)^{-\xi_t} - 1\right]\), \(\ES_t = \dfrac{\VaR_t + \delta_t - \xi_t\tau_t}{1 - \xi_t}\)
\(p_t\): proporția zilelor cu exces pînă la \(t-1\)
Replicarea: aceeași specificație, pe datele cursului (2000–2026, 6 717 zile, 680 de excese) în locul CRSP (Center for Research in Security Prices), 1962–2020
Tabelul compară estimările lucrării (1962–2020) cu cele pe datele cursului (2000–2026). Parametrii formei sînt \(a_\xi = 0{,}025\),\(b_\xi = 0{,}9993\) în lucrare și 0,130, 0,9975 pe datele cursului; parametrii scalei \(a_\delta = 0{,}112\),\(b_\delta = 0{,}995\) și 0,160, 0,986; parametrii pragului \(a_\tau = 0{,}241\),\(b_\tau = 0{,}989\) și 0,365, 0,985. Proporția pierderilor peste VaR 1% este 1,0% în lucrare și 0,91% (61 de zile) pe datele cursului.
Pe întreaga selecție a cursului, AIC, mai bun cînd este mai mic, este 774 cu \(\xi_t\) și \(\delta_t\) dinamice, 772 cu \(\xi\) constant și 853 pentru GPD statică. Dinamica formei adaugă doar 1,04 la log-verosimilitate pentru doi parametri în plus, deci scala cozii variază clar, iar dovezile pentru o formă variabilă sînt slabe. Episoadele indică același lucru doar în parte. După 11 septembrie 2001, \(\xi_t\) crește cu 113% și \(\delta_t\) cu 91%, iar după Brexit cu 189% și 114%, dar după flash crash \(\xi_t\) scade cu 12%, în timp ce \(\delta_t\) crește cu 18%. În septembrie 2008 – martie 2009, \(\xi_t\) scade cu 58% și \(\delta_t\) crește cu 113%; în februarie – aprilie 2020, \(\xi_t\) crește cu 60% și \(\delta_t\) cu 136%.
ES prognozat corespunde pierderilor realizate din coadă. În cele 163 de zile peste VaR 2,5%, ES 2,5% prognozat are media 3,18%, iar pierderea 3,18%; în cele 61 de zile peste VaR 1%, ES 1% prognozat are media 4,05%, iar pierderea 4,02%. Rezultatul este o descriere in-sample, pentru că parametrii folosesc întreaga selecție. Nu există o comparație out-of-sample pe 2016–2026, pentru că estimarea pe 2000–2015 nu este validată numeric (o GPD statică dă acolo \(\hat\xi = 0{,}12\)). Apropierea de \(\xi = 0\) nu împiedică singură prognoza: limita exponențială este o alternativă de testat.
Pe scurt
Mărimea
Lucrarea, 1962–2020
Datele cursului, 2000–2026
\(a_\xi\); \(b_\xi\) (forma)
0,025; 0,9993
0,130; 0,9975
\(a_\delta\); \(b_\delta\) (scala)
0,112; 0,995
0,160; 0,986
\(a_\tau\); \(b_\tau\) (pragul)
0,241; 0,989
0,365; 0,985
Pierderi peste VaR 1%
1,0%
0,91% (61 de zile)
Pierderea medie peste VaR 1%; ES 1% mediu pe toate zilele
3,54%; 3,12%
4,02%; 3,65%
AIC, mai mic este mai bine: 774 cu \(\xi_t\) și \(\delta_t\) dinamice, 772 cu \(\xi\) constant, 853 pentru GPD statică
Dinamica formei adaugă doar 1,04 la log-verosimilitate, pentru doi parametri în plus
Crahuri izolate: \(\xi_t\) crește mai mult decît \(\delta_t\) după 11 sept. 2001 (\(+\)113% față de \(+\)91%) și după Brexit (\(+\)189% față de \(+\)114%), dar nu după flash crash (\(-\)12% față de \(+\)18%)
Crize lungi: sept. 2008 – mart. 2009, \(\xi_t\)\(-\)58% și \(\delta_t\)\(+\)113%; febr. – apr. 2020, \(\xi_t\)\(+\)60% și \(\delta_t\)\(+\)136%
În cele 163 de zile peste VaR 2,5%, ES 2,5% prognozat este în medie 3,18%, iar pierderea medie 3,18%
În cele 61 de zile peste VaR 1%, ES 1% prognozat este în medie 4,05%, iar pierderea medie 4,02%
Tipul de dovadă: descriere în eșantion (in-sample; parametrii folosesc toată selecția)
limita: fără comparație în afara eșantionului pe 2016–2026, deoarece estimarea pe 2000–2015 eșuează numeric (GPD statică: \(\hat\xi = 0{,}12\))
apropierea de \(\xi = 0\) nu împiedică în sine prognoza: limita exponențială este o alternativă de testat
Sinteza secțiunii
Rețelele neuronale adînci pentru cuantile reduc puternic RMSFE relativ în singura fereastră de calibrare a lucrării, dar RMSFE nu este pierderea potrivită pentru cuantile, iar cîștigul la reestimare rămîne deschis. GPD bazată pe scor descrie datele cursului cu o scală clar variabilă în timp și o formă doar slab variabilă; AIC preferă o formă constantă.
AI pentru descoperire științifică
Un asistent AI (inteligență artificială) poate redacta o hartă a literaturii, cod și un raport de tip referent pentru o întrebare de cercetare. Secțiunea aplică bucla unei întrebări a capitolului: pot datele zilnice să ordoneze modelele de prognoză (VaR, ES)? Ea prezintă scorul și testul, verificările pe care trebuie să le facă cercetătorul și un mini-studiu de caz pe S&P 500.
Pot datele zilnice ordona modelele (VaR, ES)? (1/2): scorul și testul
Scorul FZ0 (Patton, Ziegel & Chen, 2019) este o penalizare comună pentru o prognoză (VaR, ES), dat fiind randamentul realizat, mai bună cînd este mai mică:
unde \(Y\) este randamentul realizat, iar \(v_t = -\mathrm{VaR}_{\alpha,t}\),\(e_t = -\mathrm{ES}_{\alpha,t}\) sînt cuantila și media cozii prognozate, ambele negative. Primul termen din (7.26) penalizează randamentele sub \(v\).
Două modele A și B se compară prin diferența zilnică a scorurilor \(d_t = S^A_t - S^B_t\). Ipoteza nulă a preciziei egale este \(H_0\):\(\mathbb{E}[d_t] = 0\), față de \(H_1\):\(\mathbb{E}[d_t] \ne 0\). Statistica Diebold–Mariano \(t = \bar d/\widehat{\mathrm{SE}}_{\mathrm{HAC}}(\bar d)\), cu \(\bar d\) media lui \(d_t\), este aproximativ \(N(0, 1)\) sub \(H_0\);\(t < -1{,}96\) înseamnă că A este semnificativ mai bun la 5%. Intervalul pentru \(\mathbb{E}[d_t]\) este raportat separat pe două subperioade fixate înaintea analizei, 2006–2015 și 2016–2026.
\(v_t = -\VaR_{\alpha,t}\) și \(e_t = -\ES_{\alpha,t}\): cuantila și media cozii prognozate, ambele negative
Primul termen penalizează randamentele sub \(v\)
Testul: \(d_t = S^A_t - S^B_t\), diferența zilnică dintre scorurile modelelor A și B
\(H_0\): \(\E[d_t] = 0\) (precizie egală) față de \(H_1\): \(\E[d_t] \ne 0\)
Statistica Diebold–Mariano \(t = \bar d/\widehat{\mathrm{SE}}_{\mathrm{HAC}}(\bar d)\), cu \(\bar d\) media lui \(d_t\), este aproximativ \(N(0, 1)\) sub \(H_0\)
Dacă \(t < -1{,}96\), modelul A este semnificativ mai bun la 5%
Raportăm intervalul pentru \(\E[d_t]\) separat pe subperioadele fixate înainte de analiză (2006–2015, 2016–2026)
Pot datele zilnice ordona modelele (VaR, ES)? (2/2): ce verifică cercetătorul
Întrebare pentru sală În 2016–2026, intervalul HAC de 95% pentru diferența medie a scorurilor FZ0, EVT condiționată minus FHS, este [−0,017; 0,004]. Ce concluzie permite?
Răspuns
Nu stabilește nici avantajul EVT, nici echivalența. Intervalul conține zero și diferențe de ambele semne (t = −1,18), deci avantajul EVT condiționate nu este semnificativ în 2016–2026. Regula pre-înregistrată cere t < −1,96 (test bilateral la 5%) în ambele subperioade; în 2006–2015, t = −2,32, iar pe 2006–2026, t = −2,59. Echivalența ar cere o marjă stabilită dinainte și o analiză dedicată. FHS față de GARCH–Normal îndeplinește regula: t = −3,23 și t = −3,38.
Graficul arată, pentru cele trei modele, intervalele HAC de 95% pentru diferența medie a scorurilor \(\mathbb{E}[d_t]\) în fiecare subperioadă (stînga) și diferența cumulată a scorurilor în timp (dreapta); cEVT este EVT condiționată, iar GARCH-N (GARCH with Normal innovations, GARCH cu inovații Normale) este GARCH cu șocuri Normale. Cursorul mută ultimul an al primei subperioade, iar textul de sub grafic arată dacă fiecare cîștig trece regula fixată înaintea analizei.
Afirmația testată este că EVT condiționată este cel mai bun model (VaR 1%, ES 1%) pentru S&P 500. Primul pas este replicarea: proporția depășirilor FHS de 1,54%, 80 din 5 210 zile în 2006–2026. Scorul FZ0 mediu este 1,267 pentru EVT condiționată, 1,282 pentru FHS și 1,453 pentru GARCH cu șocuri Normale.
Regula de decizie, fixată înaintea analizei, consideră un cîștig demonstrat doar dacă este semnificativ la 5% în ambele jumătăți pre-înregistrate; statistica \(t\) pe întreaga selecție este raportată, dar nu decide. Pentru FHS față de GARCH cu șocuri Normale, statisticile DM sînt \(t = -4{,}48\) pe 2006–2026, \(-3{,}23\) pe 2006–2015 și \(-3{,}38\) pe 2016–2026: forma șocurilor contează robust, iar șocurile Normale pierd în ambele jumătăți. Pentru EVT condiționată față de FHS, \(t = -2{,}59\),\(-2{,}32\) și \(-1{,}18\). Cîștigul EVT față de FHS este de zece ori mai mic, semnificativ în 2006–2015, dar nu și în 2016–2026, unde intervalul pentru \(\mathbb{E}[d_t]\) este \([-0{,}017;\ 0{,}004]\). Conform regulii, cîștigul nu este demonstrat, ceea ce nu dovedește că cele două modele sînt echivalente.
Pe scurt
Afirmația testată: „EVT condiționată este cel mai bun model (VaR 1%, ES 1%) pentru S&P 500”
Replicăm întîi rata de depășire FHS: 1,54% (80 din 5 210 zile, 2006–2026)
Scorul FZ0 mediu: 1,267 pentru EVT condiționată, 1,282 pentru FHS și 1,453 pentru GARCH–Normal
Barele: intervale HAC de 95% pentru \(\E[d_t]\)
în grafic, cEVT = EVT condiționată, iar GARCH-N = GARCH cu șocuri Normale
Statisticile \(t\) Diebold–Mariano:
o valoare negativă înseamnă că primul model are scorul mai bun; valoarea critică la 5% este \(-1{,}96\)
FHS față de GARCH–Normal: 2006–2026 \(t = -4{,}48\); 2006–2015 \(t = -3{,}23\); 2016–2026 \(t = -3{,}38\)
EVT condiționată față de FHS: 2006–2026 \(t = -2{,}59\); 2006–2015 \(t = -2{,}32\); 2016–2026 \(t = -1{,}18\)
Regula de decizie: un cîștig este considerat demonstrat doar dacă este semnificativ la 5%
semnificativ în ambele subperioade fixate înainte de analiză (pre-înregistrate)
Statistica \(t\) pe întreaga perioadă este raportată, dar nu este decisivă
Forma șocurilor contează, iar rezultatul este robust
șocurile Normale pierd în ambele jumătăți ale perioadei
Cîștigul EVT față de FHS este de zece ori mai mic
semnificativ în 2006–2015, dar nu și în 2016–2026 (\([-0{,}017; 0{,}004]\))
după regula de mai sus, cîștigul nu este demonstrat, dar nici echivalența celor două modele nu este dovedită
Punctul de plecare pentru proiectul de echipă întreabă dacă un model semiparametric dinamic (VaR, ES) depășește FHS și EVT condiționată out-of-sample la ES 2,5%, pe S&P 500, BET și Bitcoin. Modelul de testat este modelul GAS (generalised autoregressive score) cu un factor din Patton, Ziegel & Chen (2019), Secțiunea 2.3 a lucrării, estimat prin minimizarea pierderii FZ0 (7.26). Este o extensie opțională pentru aprofundare.
Proiectul începe prin replicarea VaR 1% FHS de 1,97% pentru S&P 500 și a ordonării FZ0 din mini-studiul de caz. Livrabilele sînt o pre-înregistrare de o pagină (modele, niveluri, scoruri, subperioade, puterea în zile din coadă și ce ar infirma afirmația), cod pe datele zilnice de piață ale cursului, un tabel al tuturor comparațiilor cu valori \(p\) ajustate și o autocritică în stilul unui referent. Prompturile și rezultatele acceptate se notează în AI_USE.md, iar fiecare eroare găsită în AI_ERRORS.md: un semn inversat, o etichetă de nivel greșită, look-ahead bias, un DOI inventat.
Pe scurt
Întrebarea: bate un model semiparametric dinamic (VaR, ES) Patton, Ziegel & Chen (2019) FHS și EVT condiționată?
prognoze în afara eșantionului, la ES 2,5%
Piețe: S&P 500, BET și Bitcoin
Modelul testat: modelul GAS (generalised autoregressive score, scor autoregresiv generalizat) cu un factor din Patton, Ziegel & Chen (2019) (Secțiunea 2.3 a articolului), estimat prin minimizarea pierderii FZ0
Statut: o extindere opțională, pentru aprofundare
Lista proiectelor de echipă din seminar: Seminarul 7, C2 și C3
Replicăm întîi: VaR 1% FHS pentru S&P 500 de 1,97% și ordonarea FZ0 din mini-studiul de caz
Livrabile
O pre-înregistrare de o pagină: modele, niveluri, scoruri, subperioade, putere (zile din coadă) și ce ar infirma afirmația
Codul, pe datele zilnice de piață ale cursului (punct de plecare: Quantlet)
Un tabel cu toate comparațiile și valorile p (p-values) ajustate
O autocritică în stilul unui referent
Notăm prompturile și rezultatele acceptate în AI_USE.md
Notăm fiecare eroare prinsă în AI_ERRORS.md
semn inversat, etichetă greșită a nivelului, deplasare de anticipare, DOI inventat
Sinteza secțiunii
Pe S&P 500, scorul FZ0 separă GARCH cu șocuri Normale de FHS în ambele jumătăți ale perioadei 2006–2026, dar nu și FHS de EVT condiționată. Cu regula fixată dinainte, cîștigul EVT nu este demonstrat. Verificările privind semnul, look-ahead bias, scorul, puterea și referințele rămîn ale cercetătorului.
Concluzii
Capitolul a estimat VaR și ES necondiționat, condiționat și în coada îndepărtată, le-a măsurat precizia, le-a scalat la zece zile și le-a alocat între active. Secțiunea transformă rezultatele într-o alegere a metodei, recapitulează întrebările principale și formulează decizia practică.
Tabelul asociază fiecărei situații o metodă și condiția în care metoda eșuează:
Pentru o verificare rapidă pe o istorie lungă și stabilă ajunge simularea istorică pe 500–1 000 de zile; ea eșuează cînd volatilitatea se schimbă și nu vede nimic dincolo de cea mai mare pierdere.
Pentru riscul zilnic după un șoc de volatilitate, alegerea este FHS sau EVT condiționată, cu un interval bootstrap; ea eșuează cînd modelul GARCH este greșit specificat.
Pentru VaR 0,5% și mai departe în coadă, și pentru testele de stres, GPD pe depășirile de prag, condiționată sau nu, extrapolează coada; ea eșuează cînd pragul este ales prost sau depășirile se grupează.
Pentru orizonturi de mai multe zile și opțiuni, Monte Carlo filtrat tratează dinamica și profilurile de plată neliniare, pînă cînd riscul modelului devine dominant. Pentru bugetarea riscului între birouri sau active, alocarea este dată de contribuțiile Euler la ES, cu punctul slab al puținelor zile din coadă din spatele fiecărei contribuții. Pentru capitalul de reglementare, regula este ES 2,5% pe zece zile într-o perioadă de stres, cu backtesting pe VaR; fereastra de stres este scurtă și zgomotoasă. În fiecare caz, estimarea trebuie raportată împreună cu numărul observațiilor din coadă și cu un interval.
Pe scurt
Situația
Metoda
Eșuează cînd
Verificare rapidă, istorie lungă și stabilă
Simulare istorică, 500–1 000 de zile
volatilitatea se schimbă, iar estimarea nu poate depăși cea mai mare pierdere observată
Riscul zilnic după un șoc de volatilitate
FHS sau EVT condiționată, cu interval bootstrap
modelul GARCH este greșit specificat
VaR 0,5% și mai adînc, teste de stres
Depășiri de prag (GPD), condiționate sau nu
prag ales greșit sau depășiri grupate
Orizont de mai multe zile, opțiuni
Monte Carlo filtrat
domină riscul de model
Bugetarea riscului pe birouri sau active
Contribuții Euler la ES
fiecare contribuție se bazează pe puține zile din coadă
Capitalul reglementat
ES 2,5%, 10 zile, perioadă de stres, backtesting pe VaR
fereastra de stres este scurtă și zgomotoasă
Orice VaR sau ES este o estimare
îl raportăm cu numărul de observații din coadă și un interval
Întrebări recapitulative și legătura cu Capitolul 8
Decizia are trei părți: ce metodă aleg, în ce condiții este valabilă alegerea și ce rezultat m-ar face să renunț la ea.
Pentru VaR 1% și ES 1% de mîine, alegerea este FHS, ca reper comparativ. Pentru S&P 500 după 18 septembrie 2026, ea dă un VaR 1% de 1,97%, cu intervalul de 90% \([1{,}90;\ 2{,}09]\%\), și un ES 1% de 2,56%. Avantajul FZ0 al FHS față de GARCH cu șocuri Normale este relativ și nu validează acoperirea nominală. EVT condiționată are un scor FZ0 mai bun decît FHS la 1% pe 2006–2026 (\(t = -2{,}59\)), dar nu și pe 2016–2026 (\(t = -1{,}18\)), iar la VaR 0,5% sau 0,1% are nevoie de o evaluare separată, pentru că rezultatele la 1% nu arată că EVT este mai bună acolo. Pentru ES 2,5% pe o fereastră istorică, alegerea este estimarea fracționară cu un interval HAC: pentru S&P 500, 3,76%, cu SE HAC de 0,26 pp pe 6 717 zile.
Alegerea este valabilă în patru condiții:
Diagnosticele trebuie să nu arate o dependență reziduală importantă la pragurile și lag-urile examinate: indicele extremal este 0,99 după filtrare, față de 0,19 înainte.
Trebuie să existe destule zile în coadă: pe 500 de zile, ES 2,5% se sprijină pe \(n\alpha = 12{,}5\) pierderi, iar intervalul lui HAC are 2,55 pp.
Intervalul HAC pentru ES cere un moment de ordinul doi finit al excesului peste VaR, adică un indice al cozii peste 2, plus staționaritate și dependență slabă.
Pentru scalarea cu \(\sqrt{10}\), lipsa autocorelației nu ajunge, pentru că volatilitatea de azi și cozile contează și ele; pentru BET, raportul empiric este 1,22.
Ar trebui să renunț la alegere în trei cazuri:
Acoperirea este respinsă de testul Kupiec din Capitolul 8. Acest lucru se întîmplă deja aici: 80 de depășiri în 5 210 zile, adică 1,54%, față de 52,1 așteptate (\(LR_{uc} = 12{,}97\),\(p = 0{,}0003\)), motiv pentru care FHS rămîne doar un reper comparativ.
Depășirile ei se grupează în testele de independență.
Într-o jumătate pre-înregistrată, FHS nu mai depășește GARCH cu șocuri Normale după scorul FZ0 (aici \(t = -3{,}23\) și \(t = -3{,}38\)).
Pe scurt
Ce aleg
pentru VaR 1% și ES 1% de mîine: FHS, ca reper comparativ; S&P 500 după 18 septembrie 2026: VaR 1% \(= 1{,}97\%\) (interval de 90%: \([1{,}90; 2{,}09]\%\)), ES 1% \(= 2{,}56\%\)
avantajul FHS la scorul FZ0 față de GARCH cu șocuri Normale este relativ și nu validează acoperirea nominală (rata de depășire de 1%)
EVT condiționată la 1%: scor FZ0 mai bun decît FHS pe 2006–2026 (\(t = -2{,}59\)), dar nu în 2016–2026 (\(t = -1{,}18\))
VaR 0,5% și VaR 0,1%: evaluare separată; rezultatele de la 1% nu arată superioritatea EVT la aceste niveluri
pentru ES 2,5% pe o fereastră istorică: estimarea fracționară cu interval HAC; S&P 500: \(3{,}76\%\), SE HAC \(0{,}26\) pp pe 6 717 zile
În ce condiții
diagnosticele nu indică dependență reziduală importantă la pragurile și lagurile examinate: indicele extremal este \(0{,}99\) după filtrare, față de \(0{,}19\) înainte
destule zile în coadă: pe 500 de zile, ES 2,5% se sprijină pe \(n\alpha = 12{,}5\) pierderi, iar intervalul HAC are \(2{,}55\) pp
intervalul HAC pentru ES cere moment de ordin doi finit al excesului peste VaR, \(\E[(L - v)_+^2] < \infty\) (indicele cozii peste 2, estimat în Capitolul 1), plus staționaritate și dependență slabă
scalarea cu \(\sqrt{10}\): lipsa autocorelației nu ajunge, contează și volatilitatea de azi și cozile; pentru BET raportul empiric este \(1{,}22\)
Ce rezultat m-ar face să renunț
acoperirea respinsă de testul Kupiec din Capitolul 8: aici deja \(1{,}54\%\), 80 de depășiri în 5 210 zile față de 52,1 așteptate (\(LR_{uc} = 12{,}97\), \(p = 0{,}0003\)), deci FHS rămîne doar reper comparativ
depășiri FHS grupate în testele de independență
o jumătate pre-înregistrată în care FHS nu mai bate GARCH cu șocuri Normale pe scorul FZ0 (aici \(t = -3{,}23\) și \(t = -3{,}38\))
Sinteza secțiunii
FHS este reperul comparativ pentru VaR și ES de mîine, EVT condiționată candidatul pentru coada îndepărtată, iar estimarea istorică cu un interval HAC alegerea pentru ES necondiționat. Fiecare număr se raportează cu numărul observațiilor din coadă și cu intervalul lui, iar decizia se revizuiește cînd backtesting-ul din Capitolul 8 o respinge.
Aprofundări
Cadrele din această parte extind subiecte tratate pe scurt în corpul capitolului: estimarea distribuției Student-\(t\) pas cu pas, reprezentarea Rockafellar–Uryasev a ES, metodele comparate pe cinci active, construcția intervalelor bootstrap și HAC, FHS pentru Bitcoin și prognoza de mîine cu incertitudinea ei, estimatorul GPD și indicele extremal, Monte Carlo filtrat, portofoliul cu ES minim, detaliile FRTB și modelul rețelei din primul studiu de caz.
Distribuția Student-\(t\) estimată pe S&P 500, pas cu pas
Estimarea distribuției Student-\(t\) pe randamentele zilnice ale S&P 500 dă \(\hat m = 0{,}068\),\(\hat s = 0{,}702\) și \(\hat\nu = 2{,}666\), o abatere standard implicită de 1,40%, față de 1,21% în selecție; în (7.4) intră scala \(\hat s\), nu abaterea standard. Cu \(t_{1\%} = -5{,}028\), VaR 1% este 3,46%, aproape de valoarea istorică, dar factorul cozii \((\hat\nu + t_{1\%}^2)/(\hat\nu - 1) = 16{,}77\) este mare pentru că \(\hat\nu\) este aproape de 2, iar ES 1% este 5,71%, față de 5,03% istoric.
Pe scurt
Estimările de verosimilitate maximă pe randamentele zilnice în %: \(\hat m = 0{,}068\), \(\hat s = 0{,}702\), \(\hat\nu = 2{,}666\)
Abaterea standard implicată \(\hat s\sqrt{\hat\nu/(\hat\nu - 2)} = 1{,}40\%\), nu \(\hat\sigma = 1{,}21\%\) din selecție
În formule intră scala \(\hat s\), nu \(\hat\sigma\)
Pentru a izola efectul formei cozii, două modele trebuie comparate la aceeași medie și aceeași abatere standard. Pentru o abatere standard de 2% și \(\nu = 4\), scala Student-\(t\) este \(s = 2\sqrt{(4-2)/4} = 1{,}414\%\), iar scala Normală 2%; cu \(s = 2\%\) în ambele, comparația ar amesteca un efect de scală cu un efect de formă. Modelele estimate separat pe aceleași date, ca în secțiunea Metode de estimare, au scale diferite și amestecă ambele efecte.
Pe scurt
Pentru a izola forma cozii, comparăm modelele la aceeași medie și aceeași abatere standard (Seminarul 7, A2)
Exemplu: medie zero, abatere standard \(2\%\) și \(\nu = 4\)
scala Student-\(t\) este \(s = 2\sqrt{(4-2)/4} = 1{,}414\%\), iar scala Normală este \(2\%\)
Cu \(s = 2\%\) în ambele modele, abaterea standard Student-\(t\) ar fi mai mare
diferența ar amesteca efectul scalei cu cel al formei cozii
Estimate separat pe aceleași date, cele două modele au scale diferite
diferențele din secțiunea „Metode de estimare” amestecă cele două efecte
minimul fiind atins în \(v = \mathrm{VaR}_\alpha(L)\);\(F(\mathrm{VaR}_\alpha)\) este formula discretă (7.6). Deoarece \(F\) este convexă în comun în ponderi și în \(v\) pentru pierderea unui portofoliu, (7.27) implică subaditivitatea și transformă minimizarea ES pe scenarii istorice într-o problemă de programare liniară. Pentru S&P 500 la 2,5%, minimizatorul este 2,51%, iar minimul 3,76%, adică VaR și ES istorice.
Graficul arată, pentru cele cinci serii și cele cinci metode de estimare, VaR 1% (bare pline) și ES 2,5% (bare hașurate), pe pierderile zilnice ale întregii selecții; CF înseamnă Cornish–Fisher, \(t\) distribuția Student-\(t\), iar XAU (gold, ISO 4217 code, one troy ounce, aur, codul ISO 4217, o uncie troy)/USD prețul aurului în dolari americani pe uncie troy.
Metoda Normală este prea mică pentru toate seriile; pentru Bitcoin, VaR 1% Normal este 7,99%, față de 10,51% istoric. Cornish–Fisher supracorectează pentru că excesul de kurtosis depășește 7 în toate seriile, dînd 7,25% față de 4,13% pentru BET. Distribuția Student-\(t\) eșuează pentru EUR/RON, unde \(\hat\nu = 1{,}25\) implică o varianță infinită și un ES 2,5% de 3,27%, față de 0,84% istoric, din cauza numeroaselor variații aproape nule ale cursului de referință. EVT rămîne aproape de simularea istorică pentru VaR 1% în toate cele cinci serii; tabelul complet este în Anexă.
Pe scurt
Barele pline arată \(\VaR_{1\%}\), iar cele hașurate \(\ES_{2{,}5\%}\)
Pierderi zilnice în %, pe selecțiile complete (toate cifrele în Anexă)
Bootstrap-ul i.i.d. extrage \(n\) pierderi cu întoarcere, recalculează estimarea de \(B = 2\,000\) de ori și ia cuantilele de 2,5% și 97,5%; bootstrap-ul pe blocuri mobile (moving-block bootstrap) extrage blocuri de 20 de zile consecutive, astfel încît fiecare reeșantionare păstrează volatility clustering. Varianța de termen lung HAC \(\hat\gamma_0 + 2\sum_{j=1}^{m}(1 - j/(m+1))\hat\gamma_j\) înlocuiește varianța i.i.d. \(\hat\gamma_0\) în (7.10) și (7.11), cu ponderi Bartlett și lag-ul \(m = \lfloor 4(n/100)^{2/9}\rfloor\), care este 10 pe întreaga selecție S&P 500. În exemplul \(\hat\gamma_0 = 1\),\(\hat\gamma_1 = 0{,}3\) și \(m = 1\), varianța de termen lung este 1,3, iar SE crește cu un factor de circa 1,14.
Pe scurt
Bootstrap (i.i.d.): extragem cu revenire \(n\) pierderi din selecție și recalculăm \(\widehat{\VaR}\) sau \(\widehat{\ES}\)
Repetăm de \(B = 2\,000\) de ori
Intervalul de 95% merge de la cuantila de \(2{,}5\%\) la cea de \(97{,}5\%\) a celor \(B\) valori recalculate
Bootstrap pe blocuri suprapuse: blocuri de 20 de zile consecutive în locul zilelor izolate
alăturăm \(n/20\) astfel de blocuri
Perioadele calme și cele agitate rămîn întregi în interiorul fiecărui bloc, deci fiecare reeșantionare păstrează gruparea volatilității
Dispersia de termen lung HAC a unei serii \(y_t\): \(\hat\gamma_0 + 2\sum_{j=1}^{m}\left(1 - \frac{j}{m+1}\right)\hat\gamma_j\)
aici \(y_t\) este \(\mathbf{1}\{L_t > \VaR_\alpha\}\) sau \((L_t - \VaR_\alpha)_+\)
\(\hat\gamma_j\): autocovarianța de selecție a lui \(y_t\) la lagul \(j\), iar \(\hat\gamma_0\) dispersia ei
Graficul repetă comparația dintre simularea istorică și FHS pentru Bitcoin, cu pierderile zilnice ca bare și VaR 1% pe o zi al celor două metode ca linii.
Pentru Bitcoin, prognozele încep în ianuarie 2017 și folosesc toate cele șapte zile ale săptămînii. Pe 3 548 de zile, proporția pierderilor peste VaR 1% este 1,16% pentru simularea istorică, 0,76% pentru FHS și 1,58% pentru GARCH cu șocuri Normale. VaR filtrat a atins 54,83% în martie 2020, după crahul din 12 martie 2020, o pierdere log de 46,47%, adică o scădere a prețului de 37,17%. Volatilitatea a scăzut după 2022, iar fereastra de 500 de zile o urmează cu o întîrziere mare; tratarea cripto-activelor ca o clasă distinctă de active este în Pele et al. (2023).
Pe scurt
Aceeași construcție, cu prognoze din ianuarie 2017, 7 zile pe săptămînă
Proporția zilelor cu pierderi peste VaR (3 548 de zile)
\(1{,}16\%\) pentru simularea istorică, \(0{,}76\%\) pentru FHS
\(1{,}58\%\) pentru GARCH cu șocuri Normale
VaR filtrat a atins \(54{,}83\%\) în martie 2020, după crahul din 2020-03-12
crahul: o pierdere log de \(46{,}47\%\), adică o scădere a prețului de \(37{,}17\%\)
Volatilitatea a scăzut după 2022
estimarea pe fereastra de 500 de zile se ajustează cu mare întîrziere
Pentru S&P 500, estimările AR(1)-GARCH(1,1) pe 2000–2026 sînt \(\hat\phi = -0{,}053\),\(\hat\omega = 0{,}025\),\(\hat\alpha_1 = 0{,}1204\) și \(\hat\beta_1 = 0{,}8604\), o persistență de 0,981. Pentru prima zi de tranzacționare după 18 septembrie 2026, prognozele sînt \(\hat\mu_{t+1} = 0{,}056\%\) și \(\hat\sigma_{t+1} = 0{,}725\%\), o piață calmă în comparație cu abaterea standard de selecție de 1,21%. Cuantila reziduurilor \(\hat\xi_{1\%} = 2{,}79\) depășește valoarea Normală 2,326, deci (7.13) dă VaR 1% \(= -0{,}056 + 0{,}725 \times 2{,}791 = 1{,}97\%\); media cozii reziduurilor, 3,604 (Normal: 2,665), dă ES 1% \(\approx 2{,}56\%\). VaR 1% istoric necondiționat este 3,45%, iar GARCH cu șocuri Normale dă 1,63% pentru aceeași zi.
Pasul ES: media celui mai mic 1% dintre reziduuri, cu semn schimbat, este \(3{,}604\) (Normală: \(2{,}665\)), deci \(\ES_{1\%,t+1} = -0{,}056 + 0{,}725 \times 3{,}604 \approx 2{,}56\%\)
VaR 1% istoric necondiționat: \(3{,}45\%\)
Cu GARCH cu șocuri Normale, VaR 1% pentru aceeași zi este \(1{,}63\%\)
VaR FHS are două date de intrare estimate (Francq & Zakoïan, 2015): parametrii GARCH, prin \(\hat\sigma_{t+1}\), și cuantila reziduurilor \(\hat\xi_\alpha\). Un bootstrap pe reziduuri (Christoffersen & Gonçalves, 2005) cu 999 de traiectorii dă pentru S&P 500 un interval de 90% de \([1{,}90;\ 2{,}09]\%\) în jurul valorii 1,97%. Dacă variază doar cuantila, intervalul este \([1{,}89;\ 2{,}03]\), iar dacă variază doar \(\sigma_{t+1}\),\([1{,}92;\ 2{,}02]\), deci cuantila reziduurilor, bazată pe circa 67 de reziduuri din coadă, este sursa mai mare. GARCH cu șocuri Normale, la 1,63%, este mult sub interval: alegerea modelului cozii contează mai mult decît eroarea de estimare a unui model dat.
parametrii GARCH \(\theta = (c, \phi, \omega, \alpha_1, \beta_1)\), care intră prin \(\hat\sigma_{t+1}\)
cuantila reziduurilor \(\hat\xi_\alpha\)
Bootstrap pe reziduuri Christoffersen & Gonçalves (2005): simulăm traiectorii AR(1)-GARCH(1,1) cu \(\hat z\) reeșantionate, re-estimăm pe fiecare traiectorie și prognozăm din istoria originală (algoritmul în Anexă)
S&P 500, 999 de traiectorii bootstrap: \(\VaR_{1\%}\) FHS \(= 1{,}97\%\)
intervalul de 90%: \([1{,}90; 2{,}09]\%\)
la 95%, fiecare coadă ar avea doar circa 25 de valori
Prima sursă de incertitudine: \(\hat\sigma_{t+1} = 0{,}725\%\), cu intervalul \([0{,}708; 0{,}743]\%\)
A doua sursă: \(\hat\xi_{1\%} = 2{,}79\), cu intervalul \([2{,}68; 2{,}88]\)
Intervalul VaR dacă variază doar cuantila: \([1{,}89; 2{,}03]\)
Intervalul VaR dacă variază doar \(\sigma_{t+1}\): \([1{,}92; 2{,}02]\)
Cuantila reziduurilor (circa 67 de reziduuri în coadă) este deci sursa principală de incertitudine
GARCH cu șocuri Normale (\(1{,}63\%\)) este mult sub interval
alegerea modelului pentru coadă contează mai mult decît eroarea de estimare a unui model dat
Estimatorul GPD (7.18) pe S&P 500 folosește \(n = 6\,717\) pierderi, pragul \(u = 1{,}852\%\) și \(N_u = 336\) depășiri, cu \(\hat\xi = 0{,}188\) și \(\hat\beta = 0{,}898\). Proporția depășirilor de dincolo de VaR 1% este \(67{,}17/336 = 0{,}200\), iar \(0{,}200^{-\hat\xi} = 1{,}353\), deci VaR 1% \(= 1{,}852 + 4{,}779 \times 0{,}353 \approx 3{,}54\%\), iar ES 1% \(= (3{,}540 + 0{,}550)/0{,}812 \approx 5{,}04\%\), față de 3,45% și 5,03% istoric.
Pentru pierderi staționare cu grupare, maximul a \(n\) zile se comportă ca cel a \(n\theta\) zile independente, unde \(\theta \in (0, 1]\) este indicele extremal (extremal index), iar \(1/\theta\) mărimea medie a unui grup (Embrechts, Klüppelberg & Mikosch, 1997). La pragul GPD, estimatorul pe intervale (Ferro & Segers, 2003) dă \(\hat\theta = 0{,}19\) pentru S&P 500, adică 62 de grupuri de cîte 5,4 depășiri în medie; o GPD pe maximele grupurilor dă \(\hat\xi = 0{,}152\) (SE 0,146), al cărui interval de 95% include 0. Pe reziduurile GARCH standardizate, \(\hat\theta = 0{,}99\): după filtrare depășirile nu se mai grupează, motiv pentru care EVT condiționată ajustează GPD după filtru.
Pe scurt
Pierderi staționare cu extreme grupate: dacă \(n P(L > u_n) \to \tau\), atunci \(P(M_n \le u_n) \to e^{-\theta\tau}\), \(\theta \in (0, 1]\)Embrechts, Klüppelberg & Mikosch (1997)
\(u_n\): un prag care crește cu \(n\)
\(\tau\): numărul mediu de depășiri ale lui \(u_n\) în \(n\) zile
\(M_n\): maximul celor \(n\) pierderi
\(\theta\): indicele extremal
\(1/\theta\): mărimea medie a unui grup de extreme
Pentru maxim, \(n\) zile dependente se comportă ca \(n\theta\) zile independente
S&P 500, pragul GPD (\(N = 336\) depășiri): estimatorul pe intervale Ferro & Segers (2003) dă \(\hat\theta = 0{,}19\)
adică 62 de grupuri de cîte 5,4 depășiri în medie
GPD estimată pe maximele grupurilor: \(\hat\xi = 0{,}152\) (SE \(0{,}146\)), față de \(0{,}188\) (SE \(0{,}065\)) pe toate depășirile
\(\hat\xi\) rămîne pozitiv, dar intervalul lui de 95% include acum 0
Pe reziduurile GARCH standardizate, \(\hat\theta = 0{,}99\)
după filtrare, depășirile pragului nu mai apar grupate (estimatorul și separarea grupurilor: Anexă)
\(\hat\theta \approx 1\) privește gruparea extremelor, nu independența întregii serii
De aceea, EVT condiționată estimează GPD pe reziduurile filtrate
Monte Carlo filtrat simulează \(M\) traiectorii viitoare din modelul estimat: pentru fiecare traiectorie extrage \(h\) șocuri cu întoarcere din reziduurile standardizate, actualizează zi de zi volatilitatea și randamentul cu recursia AR(1)-GARCH(1,1), pornind din starea de azi, și însumează pierderea pe \(h\) zile. VaR și ES sînt apoi estimările istorice pe cele \(M\) pierderi simulate, cu o eroare de simulare care scade ca \(1/\sqrt{M}\). Metoda tratează simultan autocorelația, volatility clustering, cozile groase și profilurile de plată neliniare.
Pe scurt
Simulăm multe traiectorii viitoare din modelul estimat
citim VaR și ES din pierderile simulate
tratează deodată autocorelația, gruparea volatilității și cozile grele, precum și cîștigurile neliniare (opțiuni)
Pentru fiecare traiectorie \(j = 1, \dots, M\) (\(M\): numărul de traiectorii simulate)
extragem \(z^{(j)}_{t+1}, \dots, z^{(j)}_{t+h}\) cu revenire din reziduurile standardizate \(\hat z\)
actualizăm \(\sigma^{(j)}\) și \(r^{(j)}\) zi de zi cu recursia AR(1)-GARCH(1,1), pornind de la starea de azi
agregăm: \(L^{(j)} = -\sum_{i=1}^h r^{(j)}_{t+i}\), pierderea pe \(h\) zile a traiectoriei \(j\) (\(i\): ziua din traiectorie)
\(\widehat{\VaR}_\alpha\), \(\widehat{\ES}_\alpha\) = estimările istorice pe cele \(M\) pierderi simulate
Cu \(N\) scenarii istorice, obiectivul Rockafellar–Uryasev (7.27) devine o problemă de programare liniară în ponderi, prag și cîte o variabilă auxiliară pentru fiecare scenariu (Rockafellar & Uryasev, 2000). Pentru cele patru active din secțiunea despre portofoliu, la 2,5%, ponderile long-only cu ES minim sînt 31%, 44%, 25% și 0% (SPY, TLT, GLD, Bitcoin), cu ES 2,5% de 1,67%, față de 2,16% pentru portofoliul 40/30/20/10. Varianța minimă long-only dă 35%, 43%, 22% și 0%, cu ES 2,5% de 1,68%: pentru aceste active cele două criterii aproape coincid, deși diferă pentru opțiuni și credit, iar mai multe portofolii pot atinge același minim.
Pe scurt
Cu \(N\) scenarii istorice \(R_s\), funcția Rockafellar–Uryasev devine o problemă de programare liniarăRockafellar & Uryasev (2000)
FRTB transformă un ES zilnic în capital în capitolul pentru riscul de piață (MAR, market risk) al cadrului Basel consolidat. Modelele interne sînt aprobate pe birouri de tranzacționare, un birou fiind un grup definit de traderi și conturi cu o singură strategie de afaceri (MAR12). În abordarea pe modele interne, modelul ES propriu al băncii, aprobat de supraveghetor, înlocuiește formulele standardizate, iar fiecare factor de risc primește un orizont de lichiditate (LH, liquidity horizon), timpul necesar pentru a ieși dintr-o poziție sau a o acoperi pe o piață sub stres, de 10, 20, 40, 60 sau 120 de zile (MAR33.12).
Pe scurt
Întrebarea: cum transformă FRTB un ES zilnic într-un capital?
un capital care ține cont de criză și de timpul de lichidare
MAR: capitolul despre riscul de piață din cadrul Basel consolidat
MAR12, MAR33 etc. sînt capitolele lui (MAR33: calculul cerințelor de capital în abordarea pe modele interne)
Trading desk (birou de tranzacționare): un grup bine delimitat de traderi și conturi
cu o singură strategie de afaceri
În FRTB, modelele interne se aprobă separat pentru fiecare birou (MAR12)
Abordarea bazată pe modele interne: capitalul din propriul model ES al băncii
model aprobat de autoritatea de supraveghere, în locul formulelor standardizate
Orizontul de lichiditate (LH): timpul necesar pentru a închide sau acoperi o poziție
pe o piață în criză, fără a-i mișca prețul
Fiecare factor de risc primește 10, 20, 40, 60 sau 120 de zile (MAR33.12)
ES din FRTB agregă valori ES pe 10 zile pe orizonturile de lichiditate: fiecare termen este ES pe 10 zile cînd se mișcă doar factorii de risc cu orizontul cel puțin \(\mathrm{LH}_j\), scalat cu \(\sqrt{(\mathrm{LH}_j - \mathrm{LH}_{j-1})/10}\). Modelul este calibrat pe perioada de stres de 12 luni, căutată cel puțin pînă în 2007, care dă portofoliului curent cel mai mare ES, iar capitalul este maximul dintre ultima valoare și \(m_c\) înmulțit cu media pe 60 de zile, cu \(m_c = 1{,}5\) plus 0 pînă la 0,5 după backtesting-uri slabe (MAR33.41–33.42). Cînd toți factorii au același orizont, formula se reduce la \(m_c \times \mathrm{ES}^{(10)}_{2{,}5\%}\sqrt{\mathrm{LH}/10}\).
Pe scurt
ES pe orizonturi de lichiditate, cu \(T = 10\) zile (MAR33): \(\ES = \sqrt{\ES_T(P)^2 + \sum_{j \ge 2}\left(\ES_T(P, j)\sqrt{(\mathrm{LH}_j - \mathrm{LH}_{j-1})/T}\right)^2}\)
\(\ES_T(P, j)\): ES pe 10 zile cînd se mișcă doar factorii de risc cu \(\mathrm{LH} \ge \mathrm{LH}_j\), ceilalți rămînînd constanți
\(\mathrm{LH}_1 = 10 < \mathrm{LH}_2 = 20 < \dots < \mathrm{LH}_5 = 120\) de zile
Perioada de stres: fereastra de 12 luni care dă portofoliului curent cel mai mare ES
căutată cel puțin pînă în 2007 (MAR33.6–33.7)
Calibrarea: \(\ES = \ES_{R,S}\,\ES_{F,C}/\ES_{R,C}\); \(R\)/\(F\): setul redus/complet de factori, \(S\): perioada de stres, \(C\): ultimele 12 luni
Multiplicatorul: capitalul este maximul dintre ultima valoare și \(m_c \times\) media pe 60 de zile
\(m_c = 1{,}5\) plus 0–0,5 după rezultate slabe la backtesting (MAR33.41–33.42)
Simplificarea didactică din Seminarul 7, C2: \(m_c \times \ES^{(10)}_{2{,}5\%}\sqrt{\mathrm{LH}/10}\)
este formula de mai sus cînd toți factorii au același LH
În modelul lui Chronopoulos, Raftapostolos & Kapetanios (2024) cuantila condiționată a randamentului este o rețea feed-forward \(G_\alpha(x_t, w)\) cu straturi ascunse ReLU (rectified linear unit), ale cărei ponderi minimizează pierderea pinball plus o penalizare opțională LASSO, ridge sau elastic net. Adîncimea, lățimea, rata de învățare și penalizarea se aleg prin validare încrucișată pe serii de timp. Ținta este cuantila randamentului zilnic peste 10 zile, iar evaluarea folosește RMSFE relativ la regresia cuantilă liniară, cu testul Diebold–Mariano pentru semnificație.
Pe scurt
Modelul (Ec. 5–10): cuantila condiționată a randamentului este o rețea neuronală a predictorilor
Anexa conține inventarul datelor, răspunsurile la verificările rapide, demonstrațiile și condițiile din spatele subaditivității, tabelele complete ale estimărilor și ale preciziei, prognozele condiționate pentru următoarea zi de tranzacționare și riscul lor de estimare, notațiile și detaliile din teoria valorilor extreme, datele portofoliului, calendarul reglementării, metoda și rezultatele complete ale primului studiu de caz și prompturile buclei descoperirii.
Capitolul folosește valori zilnice de închidere pînă la 18 septembrie 2026, ca randamente log zilnice în procente: S&P 500 (2000–2026, 6 717 zile), BET (6 670 de zile), Bitcoin (2014–2026, 4 384 de zile, șapte zile pe săptămînă), EUR/RON (cursul de referință BNR, 2005–2026, 5 352 de zile) și aurul (6 956 de zile lucrătoare). Portofoliul din SPY, TLT, GLD și Bitcoin folosește cele 3 017 zile în care există toate cele patru prețuri, cu prețurile ETF ajustate pentru dividende, iar exemplul de lichiditate folosește 496 de zile ale Banca Transilvania.
Pe scurt
Seria
Tip
Perioada
Zile
S&P 500
indice bursier SUA (Statele Unite ale Americii)
2000–2026
6 717
BET
indice bursier BVB
2000–2026
6 670
Bitcoin
cripto-activ, 7 zile din 7
2014–2026
4 384
EUR/RON
cursul de referință BNR
2005–2026
5 352
Aur
USD (US dollar, dolarul american) pe uncie troy, zile lucrătoare
2000–2026
6 956
Portofoliu
SPY, TLT, GLD (ETF-uri) și Bitcoin
2014–2026
3 017
Banca Transilvania
acțiune BVB (exemplul de lichiditate)
2024–2026
496
Valori zilnice de închidere pînă la 18 septembrie 2026
Răspunsurile aplică direct formulele capitolului. Pentru cele două poziții, VaR 10% este 9% pentru A și 0 pentru B, iar ES 10% este 9,5% pentru A și 10% pentru B: VaR consideră A mai riscantă, iar ES pe B, pentru că VaR nu vede niciodată șansa de 5% de a pierde 20. Pentru verificarea preciziei, SE a VaR 5% cu 1 000 de zile este de circa 0,067 pp; înjumătățirea ei cere 4 000 de zile; iar ES 1% mediază doar \(n\alpha = 10\) pierderi. Pentru verificarea orizontului, răspunsurile sînt 6,32%, apoi 6,96% cu \(\mathrm{VR}(10) = 1{,}21\), iar scalarea cu \(\sqrt{10}\) este probabil prea mică într-o piață calmă.
Pe scurt
Care poziție este mai riscantă?
A: \(\VaR_{10\%} = q_{0{,}9}(L_A) = 9\%\)
\(\ES_{10\%}\) = media lui \(L_A\) pe \([9, 10]\)\(= 9{,}5\%\)
VaR consideră A mai riscantă (\(9\) față de \(0\)), ES consideră B mai riscantă (\(10\) față de \(9{,}5\)): VaR nu vede șansa de \(5\%\) de a pierde 20
Demonstrația lui (7.27) pentru pierderi continue se sprijină pe convexitate: derivata la dreapta a lui \(F\) este \(1 - P(L > v)/\alpha\), nenegativă exact cînd \(v \ge \mathrm{VaR}_\alpha\), iar valoarea în minim este \(\mathbb{E}[L \mid L \ge \mathrm{VaR}_\alpha] = \mathrm{ES}_\alpha\). Minimizarea în \(v\) a unei funcții convexe în comun păstrează convexitatea în ponderi, iar împreună cu omogenitatea pozitivă aceasta demonstrează subaditivitatea.
VaR este subaditiv pentru pierderi eliptice în mod comun la \(\alpha < 0{,}5\)(McNeil, Frey & Embrechts, 2015), dar marginalele Normale sau Student-\(t\) singure nu ajung. Pentru pierderi cu variație regulată multivariată și indicele cozii peste 1, este subaditiv asimptotic, cînd \(\alpha \to 0\)(Daníelsson et al., 2013); indicii cozii din capitol, între 4,8 și 6,5, sînt în acest domeniu, dar rezultatul nu este o garanție la un nivel dat. Subaditivitatea eșuează pentru salturi discrete, cum sînt defaulturile, pentru cozi extrem de groase și pentru unele profiluri de plată ale opțiunilor, iar ES cere mai multe date decît VaR pentru aceeași precizie (Yamai & Yoshiba, 2005).
pentru pierderi cu variație regulată multivariată și indicele cozii peste 1
asimptotic, cînd \(\alpha \to 0\)
Indicii cozii estimați pentru acțiuni și cursuri de schimb sînt în acest domeniu (între 4,8 și 6,5 în secțiunea „Teoria valorilor extreme”), dar rezultatul este asimptotic, nu o garanție la un \(\alpha\) dat
Subaditivitatea nu se mai menține în trei situații
salturi discrete (neplăți)
cozi extrem de grele
unele cîștiguri din opțiuni
VaR față de ES în practică: ES are nevoie de mai multe date pentru aceeași precizie Yamai & Yoshiba (2005)
Cînd distribuțiile marginale \(F_1, \dots, F_d\) ale pierderilor sînt cunoscute, dar copula care le leagă nu este, VaR al sumei se află între o limită inferioară și una superioară luate peste toate copulele (Embrechts, Puccetti & Rüschendorf, 2013). Deoarece VaR nu este subaditiv, valoarea comonotonă (comonotone), suma VaR-urilor individuale, nu este capătul superior al acestui interval.
Algoritmul de rearanjare (rearrangement algorithm) calculează VaR în cel mai rău caz discretizînd coada fiecărui activ și reordonînd fiecare coloană față de suma celorlalte pînă cînd sumele pe rînduri devin plate. Pentru portofoliul 40/30/20/10 cu marginale empirice și \(N = 2\,000\) de puncte, VaR 1% zilnic este 1,95% cu dependența istorică, 3,63% sub comonotonie și 4,76% în cel mai rău caz, de 1,31 ori valoarea comonotonă. Riscul modelului de dependență în capitalul bazat pe VaR este deci de același ordin cu beneficiul diversificării.
Pe scurt
Algoritmul de rearanjare: discretizăm coada de dincolo de fiecare \(\VaR_\alpha(L_i)\) în \(N\) puncte (o coloană pe activ)
Ordonăm fiecare coloană invers față de suma celorlalte pînă cînd sumele pe rînduri devin uniforme
VaR maxim este aproximativ cea mai mică sumă pe rînd
Portofoliul 40/30/20/10 din secțiunea „VaR de portofoliu și contribuțiile la risc”
\(\VaR_{1\%}\) cu dependența istorică (cuantila empirică a pierderii portofoliului): \(1{,}95\%\)
Cu dependență comonotonă (suma VaR-urilor empirice individuale): \(3{,}63\%\)
În cazul cel mai rău: \(4{,}76\%\), adică de \(1{,}31\) ori valoarea comonotonă
Secțiunea „VaR de portofoliu și contribuțiile la risc” folosește formula Normală, de aceea dă \(1{,}77\%\) și \(3{,}11\%\) nediversificat pentru același portofoliu
Incertitudinea privind dependența afectează capitalul bazat pe VaR
cu un ordin de mărime comparabil cu beneficiul diversificării
Tabelul dă VaR 1% și ES 2,5% pentru cele cinci serii și cele cinci metode. Bitcoin are nevoie de o rezervă de circa trei ori mai mare decît S&P 500, iar EUR/RON de circa o cincime; excesul de kurtosis variază de la 7,7 pentru aur la 15,1 pentru EUR/RON, ceea ce explică de ce Cornish–Fisher supracorectează peste tot.
Pe scurt
\(\VaR_{1\%}\) (%)
\(\ES_{2{,}5\%}\) (%)
Ist.
Distr. Normală
\(t\)
CF
EVT
Ist.
Distr. Normală
\(t\)
CF
EVT
S&P 500
\(3{,}45\)
\(2{,}80\)
\(3{,}46\)
\(6{,}08\)
\(3{,}54\)
\(3{,}76\)
\(2{,}81\)
\(3{,}95\)
\(6{,}65\)
\(3{,}78\)
BET
\(4{,}13\)
\(3{,}19\)
\(4{,}06\)
\(7{,}25\)
\(4{,}22\)
\(4{,}57\)
\(3{,}21\)
\(4{,}76\)
\(7{,}93\)
\(4{,}58\)
Bitcoin
\(10{,}51\)
\(7{,}99\)
\(11{,}06\)
\(18{,}89\)
\(10{,}23\)
\(10{,}86\)
\(8{,}03\)
\(13{,}37\)
\(20{,}69\)
\(10{,}84\)
EUR/RON
\(0{,}76\)
\(0{,}64\)
\(1{,}36\)
\(1{,}43\)
\(0{,}78\)
\(0{,}84\)
\(0{,}65\)
\(3{,}27\)
\(1{,}60\)
\(0{,}84\)
Aur
\(3{,}04\)
\(2{,}50\)
\(3{,}00\)
\(4{,}64\)
\(3{,}07\)
\(3{,}23\)
\(2{,}51\)
\(3{,}27\)
\(5{,}02\)
\(3{,}23\)
Pierderi zilnice, selecțiile complete
CF: Cornish–Fisher
EVT: coada Pareto generalizată estimată pe cele mai mari \(5\%\) dintre pierderi
secțiunea „Teoria valorilor extreme”
Excesul de kurtosis pe serii
10,7 pentru S&P 500, 11,1 pentru BET, 12,0 pentru Bitcoin
15,1 pentru EUR/RON și 7,7 pentru aur
Bitcoin necesită o rezervă de aproximativ trei ori mai mare decît S&P 500
Pentru pierderi i.i.d. cu o densitate continuă și pozitivă în VaR, \(\sqrt{n}(\widehat{\mathrm{VaR}}_\alpha - \mathrm{VaR}_\alpha)\) este asimptotic Normal cu varianța \(\alpha(1 - \alpha)/f(\mathrm{VaR}_\alpha)^2\), de unde rezultă (7.10). ES istoric este și el asimptotic Normal (Chen, 2008), cu varianța \(\operatorname{Var}((L - \mathrm{VaR}_\alpha)_+)/\alpha^2\) și fără termen din estimarea VaR, pentru că \(\partial F/\partial v = 0\) în minimizatorul lui (7.27). Pentru o coadă de tip Pareto cu indicele \(a > 2\), SE este proporțională cu \(\mathrm{VaR}_\alpha/\sqrt{n\alpha}\)(Pele & Mazurencu-Marinescu-Pele, 2026).
Pe scurt
VaR: pentru pierderi i.i.d. cu densitatea \(f\) continuă și pozitivă în \(\VaR_\alpha\), \(\sqrt{n}\,(\widehat{\VaR}_\alpha - \VaR_\alpha) \to N\!\left(0, \dfrac{\alpha(1 - \alpha)}{f(\VaR_\alpha)^2}\right)\)
\(\to\): convergență în distribuție cînd \(n \to \infty\)
Dispersia limitei este dispersia asimptotică (avar), iar SE \(= \sqrt{\mathrm{avar}/n}\)
ES: estimatorul istoric este asimptotic Normal Chen (2008)
funcția de influență IF este cea de pe slide-ul „Erori standard pentru VaR și ES (2/2)”
Niciun termen din estimarea VaR: \(\partial F/\partial v = 0\) în \(v = \VaR_\alpha\)
Dacă \(\E[(L - \VaR_\alpha)_+^2] < \infty\), dispersia limitei lui \(\sqrt{n}(\widehat{\ES}_\alpha - \ES_\alpha)\) este \(\mathrm{avar} = \Var((L - \VaR_\alpha)_+)/\alpha^2\)
Coadă de tip Pareto cu indicele \(a > 2\), \(\alpha \to 0\): \(\Var((L - \VaR_\alpha)_+) \approx \frac{2\alpha\VaR_\alpha^2}{(a - 1)(a - 2)}\), deci SE \(\propto \VaR_\alpha/\sqrt{n\alpha}\) (\(\propto\): proporțional cu) Pele & Mazurencu-Marinescu-Pele (2026)
Tabelul complet al preciziei dă, pentru întreaga selecție și pentru ultimele 500 de zile, VaR 1% și ES 2,5% cu erori standard i.i.d. și HAC; pe întreaga selecție, ES 2,5% este 3,76%, cu SE 0,15 pp (i.i.d.) și 0,26 pp (HAC). Densitatea în VaR este estimată cu un nucleu Gaussian, iar lag-urile HAC sînt 10 și 5, cu nucleul Bartlett (Newey & West, 1994). Volatility clustering crește SE cu 46–73% pe întreaga selecție și cu 22–35% pe ultimele 500 de zile.
Pe scurt
\(n\)
\(\widehat{\VaR}_{1\%}\)
SE i.i.d.
SE HAC
\(\widehat{\ES}_{2{,}5\%}\)
SE i.i.d.
SE HAC
2000–2026
6 717
\(3{,}45\)
\(0{,}13\)
\(0{,}19\)
\(3{,}76\)
\(0{,}15\)
\(0{,}26\)
Ultimele 500 de zile
500
\(2{,}73\)
\(0{,}36\)
\(0{,}44\)
\(2{,}98\)
\(0{,}48\)
\(0{,}65\)
Densitatea \(f(\VaR)\) prin nucleu Gaussian, cu lățimea de bandă \(\hat\sigma\,(4/(3n))^{1/5}\)
HAC: nucleu Bartlett, lag 10 pe selecția completă și 5 pe ultimele 500 de zile Newey & West (1994)
Selecția completă, \(n = 6\,717\), \(\sigma = 1{,}2\%\): SE a \(\VaR_{1\%}\) ar fi
Filtrele GARCH ale celor cinci serii au persistența între 0,970 (Bitcoin) și 1,000 (EUR/RON). Pentru EUR/RON estimarea se află la frontiera GARCH integrat (integrated GARCH), deci nu există o varianță necondiționată finită, iar prognoza nu revine la un nivel de termen lung. Cuantilele reziduurilor \(-q_{1\%}(\hat z)\), între 2,68 și 2,88, depășesc toate valoarea Normală 2,326: șocurile filtrate au în continuare cozi groase.
Pe scurt
\(\hat\phi\)
\(\hat\alpha_1\)
\(\hat\beta_1\)
\(\hat\alpha_1 + \hat\beta_1\)
\(\hat\sigma\) (selecție)
\(\hat\sigma_{t+1}\)
\(-q_{1\%}(\hat z)\)
S&P 500
\(-0{,}053\)
\(0{,}1204\)
\(0{,}8604\)
\(0{,}981\)
\(1{,}21\)
\(0{,}73\)
\(2{,}79\)
BET
\(0{,}104\)
\(0{,}207\)
\(0{,}787\)
\(0{,}994\)
\(1{,}40\)
\(1{,}76\)
\(2{,}74\)
Bitcoin
\(-0{,}009\)
\(0{,}127\)
\(0{,}843\)
\(0{,}970\)
\(3{,}49\)
\(3{,}00\)
\(2{,}88\)
EUR/RON
\(0{,}089\)
\(0{,}148\)
\(0{,}852\)
\(1{,}000\)
\(0{,}28\)
\(0{,}08\)
\(2{,}80\)
Aur
\(-0{,}022\)
\(0{,}046\)
\(0{,}943\)
\(0{,}989\)
\(1{,}09\)
\(1{,}43\)
\(2{,}68\)
\(\hat\sigma_{t+1}\): prognoza pentru prima zi de tranzacționare de după 18 septembrie 2026, în %
Tabelul dă VaR 1% și ES 1% condiționate pentru următoarea zi de tranzacționare, prin GARCH cu șocuri Normale, FHS și EVT condiționată, alături de valorile istorice necondiționate. GARCH cu șocuri Normale este cea mai mică dintre cele trei metode condiționate pe fiecare rînd: volatilitatea singură nu creează coada.
Pe scurt
\(\VaR_{1\%}\) (%)
\(\ES_{1\%}\) (%)
GARCH
FHS
c-EVT
Ist.
GARCH
FHS
c-EVT
Ist.
S&P 500
\(1{,}63\)
\(1{,}97\)
\(2{,}03\)
\(3{,}45\)
\(1{,}88\)
\(2{,}56\)
\(2{,}56\)
\(5{,}03\)
BET
\(3{,}80\)
\(4{,}53\)
\(4{,}63\)
\(4{,}13\)
\(4{,}39\)
\(6{,}17\)
\(6{,}20\)
\(6{,}29\)
Bitcoin
\(6{,}89\)
\(8{,}56\)
\(8{,}68\)
\(10{,}51\)
\(7{,}90\)
\(12{,}23\)
\(12{,}19\)
\(14{,}30\)
EUR/RON
\(0{,}18\)
\(0{,}22\)
\(0{,}21\)
\(0{,}76\)
\(0{,}21\)
\(0{,}28\)
\(0{,}28\)
\(1{,}13\)
Aur
\(3{,}32\)
\(3{,}82\)
\(3{,}86\)
\(3{,}04\)
\(3{,}80\)
\(4{,}95\)
\(4{,}93\)
\(4{,}22\)
GARCH: GARCH cu șocuri Normale
c-EVT: teoria valorilor extreme condiționată (secțiunea „Teoria valorilor extreme”)
Ist.: necondiționat, întreaga selecție
GARCH cu șocuri Normale dă cea mai mică valoare dintre cele trei metode condiționate
VaR condiționat depinde de două obiecte estimate, parametrii GARCH și cuantila reziduurilor. Francq & Zakoïan (2015) le estimează împreună, ca parametru de risc (risk parameter), și obțin normalitatea asimptotică în condiții de staționaritate strictă, moment de ordinul patru finit al șocurilor și densitate pozitivă în cuantilă. Bootstrap-ul pe reziduuri al lui Christoffersen & Gonçalves (2005) reestimează modelul pe traiectorii simulate, dar face prognoza din istoria originală; cozile groase și asimetria îi încetinesc convergența, iar Spierdijk (2016) compară metode de construcție a intervalelor pentru VaR ARMA (AutoRegressive Moving Average, model, model autoregresiv cu medie mobilă)–GARCH exact în acest caz.
Estimarea CAViaR a lui Engle & Manganelli (2004) folosește \(10^4\) valori inițiale aleatoare, rafinează cele mai bune 10 și pornește recursia de la minus cuantila empirică a primelor 300 de randamente. Perechea (VaR, ES) poate fi ea însăși estimată minimizînd un scor comun strict consistent (Fissler & Ziegel, 2016): modele semiparametrice dinamice (Patton, Ziegel & Chen, 2019), recursii de tip CAViaR cu o verosimilitate Laplace asimetrică (Taylor, 2019) și regresie comună pe covariate (Dimitriadis & Bayer, 2019). Funcția de scor care ordonează prognozele este și obiectivul care estimează modelul.
Pe scurt
Setările de estimare din Engle & Manganelli (2004): \(10^4\) puncte de start aleatoare în \((0, 1)^3\)
cele mai bune 10 rafinate prin pași simplex și cvasi-Newton
Valoarea de pornire a recursiei: \(\VaR_1 = -\hat q_\alpha\)
cuantila empirică de ordin \(\alpha\) a primelor 300 de randamente, cu semn schimbat
Aceste zile rămîn în eșantionul de estimare
Perechea (VaR, ES) poate fi estimată prin minimizarea unui scor comun strict consistent Fissler & Ziegel (2016)
Capitolul 8 folosește aceleași scoruri pentru a evalua prognozele
Patton, Ziegel & Chen (2019): modele semiparametrice dinamice pentru (VaR, ES), de ex. cu dinamică GAS (generalised autoregressive score, scor autoregresiv generalizat), estimate prin minimizarea pierderii FZ0, pentru care sînt demonstrate consistența și normalitatea asimptotică
Taylor (2019): recursii de tip CAViaR pentru VaR și ES, estimate printr-o verosimilitate Laplace asimetrică
Dimitriadis & Bayer (2019): regresie liniară a cuantilei și a ES pe covariate (volatilitate realizată și implicită), cu erori standard
Firul comun: funcția de scor care ordonează prognozele este și funcția obiectiv care estimează modelul
Fisher & Tippett (1928) au arătat că maximul rescalat al multor variabile i.i.d. poate avea doar trei forme limită, iar Gnedenko (1943) a demonstrat riguros rezultatul. Emil Julius Gumbel a scris primul manual al domeniului (Gumbel, 1958) și l-a aplicat la inundații, secete și durate de viață; distribuția Gumbel este una dintre cele trei forme limită.
Cu zile independente, GEV lunară se transformă într-un VaR zilnic prin \(\mathrm{VaR}_\alpha \approx H^{-1}((1-\alpha)^n)\), cu \(n = 20{,}9\) zile de tranzacționare pe lună, ceea ce dă VaR 1% \(\approx 2{,}83\%\), sub valoarea istorică de 3,45%. Cu indicele extremal \(\hat\theta = 0{,}35\) la VaR 1%, răspunsul devine 4,14%, iar cu \(\hat\theta = 0{,}19\) devine 5,09%. Corecția mută răspunsul mai mult decît eroarea pe care o corectează, deci calea de la maximele pe blocuri la un VaR zilnic este fragilă.
Pe scurt
Zile independente: \(P(M_n \le x) \approx P(L \le x)^n\), deci \(\VaR_\alpha \approx H^{-1}((1-\alpha)^n)\)
\(n = 20{,}9\) zile de tranzacționare pe lună; \(H^{-1}\): funcția cuantilă a GEV estimate
\(\VaR_{1\%} \approx H^{-1}(0{,}810) = 2{,}83\%\) față de valoarea istorică \(3{,}45\%\); \(\VaR_{0{,}1\%} \approx 6{,}19\%\)
Gruparea volatilității încalcă ipoteza de independență, iar aproximarea subestimează aici VaR
Cu indicele extremal: \(P(M_n \le x) \approx F(x)^{n\theta}\), \(F\): funcția de repartiție a pierderii zilnice
Cu \(\hat\theta = 0{,}35\) (pragul la VaR 1%): \(\VaR_{1\%} \approx H^{-1}(0{,}929) = 4{,}14\%\), în loc de \(2{,}83\%\)
Cu \(\hat\theta = 0{,}19\) (pragul GPD): \(5{,}09\%\)
Corecția modifică rezultatul mai mult decît eroarea pe care o corectează: trecerea de la maximele pe blocuri la VaR zilnic este fragilă
Estimările GPD pentru cele cinci serii dau \(\hat\xi\) între 0,15 și 0,21, fiecare la mai mult de două erori standard i.i.d. deasupra lui 0, și indici ai cozii între 4,8 și 6,5. Cozile superioare estimate au momente de ordinul patru finite, dar fiecare interval de 95% pentru \(\xi\) trece de 0,25, deci momentele de ordinul patru finite nu pot fi confirmate; oricum, gruparea face erorile standard prea mici.
Pe scurt
\(u\) (%)
\(N_u\)
\(\hat\xi\)
SE\((\hat\xi)\)
\(\hat\beta\)
\(1/\hat\xi\)
\(\VaR_{1\%}\)
\(\ES_{1\%}\)
S&P 500
\(1{,}85\)
336
\(0{,}19\)
\(0{,}065\)
\(0{,}898\)
\(5{,}3\)
\(3{,}54\)
\(5{,}04\)
BET
\(1{,}93\)
334
\(0{,}21\)
\(0{,}066\)
\(1{,}196\)
\(4{,}8\)
\(4{,}22\)
\(6{,}34\)
Bitcoin
\(5{,}33\)
220
\(0{,}16\)
\(0{,}078\)
\(2{,}651\)
\(6{,}1\)
\(10{,}23\)
\(14{,}36\)
EUR/RON
\(0{,}38\)
268
\(0{,}18\)
\(0{,}072\)
\(0{,}217\)
\(5{,}5\)
\(0{,}78\)
\(1{,}14\)
Aur
\(1{,}68\)
348
\(0{,}15\)
\(0{,}062\)
\(0{,}759\)
\(6{,}5\)
\(3{,}07\)
\(4{,}22\)
\(\hat\xi\) între \(0{,}15\) și \(0{,}21\) pentru toate cele cinci serii: cozi grele peste tot
fiecare la peste două erori standard i.i.d. deasupra lui 0
Gruparea depășirilor face ca aceste SE să fie subestimate
Indicele cozii \(1/\hat\xi\) între \(4{,}8\) și \(6{,}5\)
cozile drepte estimate ale pierderilor au momente de ordinul patru finite
Dar fiecare interval de 95% pentru \(\xi\) trece de \(0{,}25\)
deci existența momentelor de ordinul patru nu este confirmată statistic (comparați cu Capitolul 1)
Estimatorul pe intervale al lui Ferro & Segers (2003) compară pătratul intervalului mediu dintre momentele depășirilor cu media pătratelor intervalelor: intervalele scurte din interiorul grupurilor împing \(\hat\theta\) sub 1. Separarea grupurilor (declustering) țintește apoi \(\lfloor\hat\theta N\rfloor + 1\) grupuri, despărțite de cele mai lungi intervale, iar GPD se ajustează pe maximele grupurilor. Pentru S&P 500, ținta este de 63 de grupuri, 62 după regula pentru egalități, iar la pragul VaR 1% istoric \(\hat\theta = 0{,}35\).
Pe scurt
Estimatorul pe intervaleFerro & Segers (2003) din cele \(N\) momente de depășire a lui \(u\) și intervalele \(T_i\) dintre ele
Estimatorul compară pătratul intervalului mediu cu media pătratelor intervalelor: intervalele scurte din interiorul grupurilor împing \(\hat\theta\) sub 1
Egalități: dacă al \((C - 1)\)-lea și al \(C\)-lea cel mai mare interval sînt egale, \(C\) se reduce pînă cînd diferă, deci numărul realizat de grupuri poate fi sub țintă
Estimăm GPD pe maximele grupurilor
S&P 500: \(\hat\theta N = 0{,}18738 \times 336 = 62{,}96\), deci ținta este \(C = \lfloor 62{,}96 \rfloor + 1 = 63\)
După regula egalităților rămîn 62 de grupuri
Cu pragul la VaR 1% istoric (\(u = 3{,}45\%\), \(N = 68\)): \(\hat\theta = 0{,}35\)
Tabelele dau volatilitățile zilnice și corelațiile pentru SPY, TLT, GLD și Bitcoin, precum și contribuțiile lor la VaR 1% Normal și la ES 2,5% istoric. SPY poartă o parte mai mare din ES istoric decît din VaR Normal, 45,4% față de 38,1%, pentru că pierderile lui se concentrează în zilele cele mai rele ale portofoliului mai mult decît arată covarianțele; a numi acest lucru dependență în cozi (tail dependence) ar cere analiza separată din Capitolul 6.
Pe scurt
Pondere
\(\sigma_i\) (%)
corel. SPY
corel. TLT
corel. GLD
SPY
\(40\%\)
\(1{,}10\)
\(1{,}00\)
TLT
\(30\%\)
\(0{,}93\)
\(-0{,}17\)
\(1{,}00\)
GLD
\(20\%\)
\(1{,}03\)
\(0{,}07\)
\(0{,}25\)
\(1{,}00\)
Bitcoin
\(10\%\)
\(4{,}14\)
\(0{,}23\)
\(-0{,}02\)
\(0{,}09\)
\(\sigma_i\) (%)
VaR marginal
\(C_i\)
cotă
\(C_i^{ES}\)
cotă
SPY
\(1{,}10\)
\(1{,}68\)
\(0{,}67\)
\(38{,}1\%\)
\(0{,}98\)
\(45{,}4\%\)
TLT
\(0{,}93\)
\(0{,}70\)
\(0{,}21\)
\(11{,}8\%\)
\(0{,}14\)
\(6{,}6\%\)
GLD
\(1{,}03\)
\(1{,}08\)
\(0{,}22\)
\(12{,}3\%\)
\(0{,}25\)
\(11{,}5\%\)
Bitcoin
\(4{,}14\)
\(6{,}68\)
\(0{,}67\)
\(37{,}8\%\)
\(0{,}79\)
\(36{,}6\%\)
Total
\(\sigma_p = 0{,}76\)
\(1{,}77\)
\(100\%\)
\(2{,}16\)
\(100\%\)
SPY are o cotă mai mare din ES 2,5% istoric decît din VaR 1% Normal
\(45{,}4\%\) față de \(38{,}1\%\)
pierderile lui se concentrează în zilele cele mai rele ale portofoliului mai mult decît indică covarianțele
Interpretarea drept dependență în coadă cere o analiză separată
Comitetul de la Basel pentru Supraveghere Bancară stabilește standardele globale de capital, pe care autoritățile naționale le transpun în lege, în UE (Uniunea Europeană) prin Regulamentul privind cerințele de capital. Riscul de piață a intrat în regulile de capital în 1996 (Basel Committee, 1996), cu modele VaR interne permise; FRTB a înlocuit VaR cu ES în abordarea pe modele interne în 2019 (Basel Committee, 2019). În UE, un regulament delegat din 2025 a amînat cerințele de fonduri proprii FRTB pînă la 1 ianuarie 2027, iar pînă atunci băncile aplică cadrul anterior, bazat pe VaR.
Studiul de caz folosește randamentele log zilnice ale S&P 500 din septembrie 1985 pînă în august 2020, \(T = 9\,053\), la nivelurile 1%, 5% și 10%. Urmînd Giacomini & Komunjer (2005), construiește patru seturi de predictori: volatilitatea GARCH(1,1), volatilitatea RiskMetrics cu factorul de descreștere 0,94, starea CAViaR SAV și starea CAViaR cu pantă asimetrică. Lucrarea notează cu \(\tau\) nivelul pe care acest capitol îl notează cu \(\alpha\).
Ultimele 2 000 de zile sînt out-of-sample, iar primele 7 053 calibrează modelul o singură dată, prin validare încrucișată pe serii de timp, după adîncime, lățime, rata de învățare, penalizare, mărimea lotului și dropout. Modelele concurente sînt regresia cuantilă liniară, regresiile cuantile polinomiale și cu B-spline-uri, MIDAS liniar și o rețea MIDAS adîncă. Evaluarea folosește RMSFE relativ la reperul liniar, testul DM (Diebold & Mariano, 1995) cu corecția lui Harvey, Leybourne & Newbold (1997) și testul de încorporare a prognozelor de cuantilă condiționată (CQFE, conditional quantile forecast encompassing) al lui Giacomini & Komunjer (2005).
Pe scurt
Schema de evaluare (Secțiunea 3.2 a articolului)
ultimele \(2\,000\) de zile formează eșantionul de evaluare
Primele \(7\,053\) sînt folosite pentru calibrarea unică a modelului (fereastră fixă)
CV (validare încrucișată) pentru serii de timp (Ec. 12): se exclud \(\delta = 5\) zile de fiecare parte a observației evaluate
Se aleg aleatoriu \(\kappa = 20\) de observații pentru testare
Grile: adîncimea și lățimea din \(\{1, 5, 10\}\), cîte cinci valori pentru rata de învățare și ponderea penalizării \(\lambda\) (alta decît \(\lambda\) RiskMetrics) în \([0{,}001; 0{,}01]\), dimensiunea lotului din \(\{10, 20\}\)
Antrenare: dropout de cel mult 20%, Adam (algoritm de optimizare stocastică cu pas adaptiv), oprire timpurie (Secțiunea 1.4 a articolului)
Modele comparate: regresia cuantilă liniară (modelul de referință)
regresiile cuantile polinomială și cu funcții B-spline, modelul MIDAS liniar (Ec. 18)
o rețea MIDAS adîncă
Evaluare (Secțiunea 3.3 a articolului): RMSFE relativ la reperul liniar
Testul CQFE (conditional quantile forecast encompassing) Giacomini & Komunjer (2005): verifică dacă o prognoză conține deja informația celeilalte, cu parametrul de netezire \(\eta = 0{,}005\)
Tabelul 6 complet la \(\alpha = 1\%\) arată toate cele 16 valori ale rețelelor adînci sub 1 și semnificative la 1% în testul DM. Pe toate nivelurile, rețelele adînci reduc eroarea cu 50–98%, iar MIDAS adînc cu 11–84%, cea mai bună penalizare depinzînd de setul de predictori. Regresiile polinomiale și cu spline-uri nu depășesc sistematic reperul liniar, iar MIDAS liniar ajunge la un raport de 4,918.
Pe scurt
\(\alpha = 1\%\)
Polin.
Spline
MIDAS
Adînc
LASSO
Ridge
Elnet
MIDAS adînc
GARCH
\(0{,}909\)
\(0{,}791\)
\(1{,}083\)
\(0{,}346\)
\(0{,}236\)
\(0{,}177\)
\(0{,}146\)
\(0{,}346\)
RiskMetrics
\(0{,}780\)
\(0{,}570\)
\(1{,}066\)
\(0{,}289\)
\(0{,}141\)
\(0{,}207\)
\(0{,}239\)
\(0{,}246\)
SAV
\(1{,}000\)
\(1{,}511\)
\(0{,}838\)
\(0{,}198\)
\(0{,}024\)
\(0{,}225\)
\(0{,}498\)
\(0{,}850\)
Pantă asim.
\(1{,}000\)
\(1{,}040\)
\(4{,}918\)
\(0{,}235\)
\(0{,}096\)
\(0{,}014\)
\(0{,}037\)
\(0{,}601\)
RMSFE relativ la regresia cuantilă liniară, \(\alpha = 1\%\) (Tabelul 6)
LASSO, Ridge și Elnet sînt rețele adînci penalizate
toate cele 16 valori ale rețelelor adînci sînt sub 1 și semnificative la 1% în testul DM
Pe toate nivelurile, rețelele adînci reduc eroarea cu 50%–98%, MIDAS adînc cu 11%–84%
Penalizarea cea mai bună se schimbă cu setul de predictori (elastic net pentru GARCH, LASSO pentru RiskMetrics și SAV, ridge pentru panta asimetrică)
La \(\alpha = 1\%\), regresiile polinomială și cu spline nu bat sistematic reperul liniar
4 rapoarte sub 1, 2 egale cu 1 și 2 peste 1
cel mai mare: \(1{,}511\); pînă la \(1{,}716\) la alte niveluri \(\alpha\) din Tabelul 6
MIDAS liniar ajunge la \(4{,}918\)
Rezultatele nu separă contribuțiile arhitecturii, penalizării și CV
În testul CQFE la \(\alpha = 1\%\) (Tabelul 7), blocul neliniar își încorporează rivalii de 757 de ori, iar blocul liniar de 173 de ori. Numeroasele perechi neconcludente arată că o combinație a prognozelor ar mai putea aduce informație.
Pe scurt
CQFE la \(\alpha = 1\%\) (Tabelul 7)
prognozele blocului neliniar înglobează informația din prognozele concurente în 757 de comparații
42 de rezultate nefavorabile și 751 neconcludente
Pentru blocul liniar: 173 de comparații favorabile, 15 nefavorabile și 170 neconcludente
Numeroasele perechi neconcludente arată că o combinație de prognoze ar putea aduce încă informație
O replicare pe datele cursului păstrează fereastra de evaluare a lucrării, ultimele 2 000 de randamente pînă la 31 august 2020, dar are 5 726 de zile de calibrare în loc de 7 053, pentru că seria S&P 500 a cursului începe în ianuarie 1990. Autorii menționează două limite: o singură fereastră fixă de estimare, pentru că recalibrarea pe 2 000 de zile este costisitoare computațional, și rețele care se supraajustează ușor și sînt interpretate doar prin valori SHAP (Shapley additive explanations) și derivate parțiale. Două extensii rămîn deschise: reestimarea pe fereastră mobilă pe 2020–2026 și pe BET, și o rețea antrenată pe pierderea FZ0 pentru a prognoza în comun (VaR, ES).
Pe scurt
Replicare pe datele zilnice de piață ale cursului
seria S&P 500 începe în ianuarie 1990, deci lipsește perioada 1985–1989 (o limită a datelor)
Păstrăm fereastra de evaluare din articol (ultimele \(2\,000\) de randamente pînă la 31 august 2020, de la 19 septembrie 2012): \(5\,726\) de zile de calibrare în loc de \(7\,053\)
Construim predictorii GARCH și SAV, estimăm regresia cuantilă liniară și regresia cuantilă cu o rețea neuronală adîncă la \(\alpha = 1\%\) și recalculăm rîndul GARCH din Tabelul 6 (Seminarul 7, C3: versiunea minimă; rîndurile complete în extinderea de replicare)
Limite menționate de autori
O singură fereastră de estimare: recalibrarea recursivă sau pe fereastră mobilă, repetată pentru \(2\,000\) de zile, necesită un volum mare de calcul (Secțiunea 3.2 a articolului)
Rețelele sînt predispuse la supraajustare (overfitting), de aici penalizările, dropout, CV și oprirea timpurie (Secțiunea 1.4 a articolului)
Rezultatul se interpretează doar prin valori SHAP (Shapley additive explanations, explicații aditive Shapley) și derivate parțiale (Secțiunea 4 a articolului)
Prompturile buclei descoperirii acoperă literatura, ipotezele, datele și codul. Fiecare prompt definește precis obiectul (funcția de scor, convenția de semn VaR \(= -q_\alpha\), testul HAC), iar fiecare rezultat este verificat: fiecare DOI este rezolvat în Crossref, iar proporția depășirilor FHS de 1,54% este replicată înainte de a calcula ceva nou.
Pe scurt
Instrumentele sînt interschimbabile
un asistent AI: Claude, ChatGPT, Gemini, GitHub Copilot
instrumente de căutare în literatura științifică: Semantic Scholar, Elicit, Google Scholar
Literatura
„Listează articolele publicate după 2015 despre backtesting-ul comparativ al perechii (VaR, ES) cu funcții de scor strict consistente: DOI, funcția de scor, testul, mărimea eșantionului și rezultatele privind puterea.”
Verificăm fiecare DOI în Crossref
Verificăm în articol convenția de semn a scorului
Ipoteze
„Pentru FHS, EVT condiționată și GARCH cu șocuri Normale, spune ce trăsături ale cozii surprinde fiecare și ce implică fiecare pentru diferențele FZ0 în anii calmi și în cei agitați.”
Date și cod
„Scrie cod Python care calculează pierderea FZ0 pentru prognozele zilnice VaR 1% și ES 1% pe S&P 500 din datele zilnice de piață ale cursului, cu convenția de semn VaR \(= -q_\alpha\), și un test Diebold–Mariano cu erori HAC.”
Replicăm întîi: rata de depășire FHS de 1,54% pe 5 210 zile (secțiunea „VaR și ES condiționate”)
A doua parte a buclei acoperă robustețea, critica și raportarea: un plan pre-înregistrat cu subperioade, niveluri, un al doilea scor și lag-uri HAC, o verificare a mărimii testului prin simulare, o critică în stilul unui referent și un raport al fiecărei perechi de modele, nivel și perioadă, cu numărul zilelor din coadă. Familia de teste se fixează dinainte, iar valorile \(p\) se ajustează; orice specificație aleasă după vederea rezultatelor se raportează ca exploratorie.
Pe scurt
Robustețe
„Scrie un plan pre-înregistrat: subperioadele 2006–2015 și 2016–2026, nivelurile 1% și 2,5%, FZ0 și un al doilea scor consistent, laguri HAC 5 și 20, un al doilea indice.”
Verificarea mărimii testului: simulăm dintr-un GARCH-t estimat și evaluăm două prognoze cu aceeași medie a scorului FZ0
Testul trebuie să respingă în circa 5% din simulări
Critica
„Joacă rolul unui referent: este ordonarea mea determinată de 2008 și 2020, de convenția de semn a scorului sau de ferestrele de estimare suprapuse? Indică un test care ar identifica fiecare dintre aceste probleme.”
Raportul: fiecare pereche de modele, nivel și perioadă
Numărul de zile din coadă pe care se bazează fiecare comparație
Testare multiplă: modele \(\times\) niveluri \(\times\) perioade \(\times\) active
fixăm familia dinainte și ajustăm valorile p
Un DOI care nu duce la nicio lucrare sau un scor atribuit greșit
renunțăm la afirmație și o notăm în AI_ERRORS.md
Fixăm planul înainte de prima rulare
orice specificație aleasă după ce am văzut rezultatele este exploratorie și se raportează ca atare
Daníelsson, J., Jorgensen, B.N., Samorodnitsky, G., Sarma, M., de Vries, C.G. (2013). Fat tails, VaR and subadditivity. Journal of Econometrics, 172(2), 283–291.
Pele, D.T., Wesselhöfft, N., Härdle, W.K., Kolossiatis, M., Yatracos, Y.G. (2023). Are cryptos becoming alternative assets?. European Journal of Finance, 29(10), 1064–1105.
Pierderi zilnice L = −r, în %, pînă la 18 septembrie 2026. S&P 500, BET, Bitcoin, aur (XAU/USD) și ETF-urile SPY, TLT, GLD: prețuri zilnice EODHD; EUR/RON: cursul de referință BNR. Studiile de caz: Tabelul 6 din Chronopoulos, Raftapostolos și Kapetanios (2024), Journal of Financial Econometrics; modelul GPD score-driven din D’Innocenzo, Lucas, Schwaab și Zhang (2024), Journal of Business & Economic Statistics, estimat pe datele cursului.


 Freddy Delbaen.
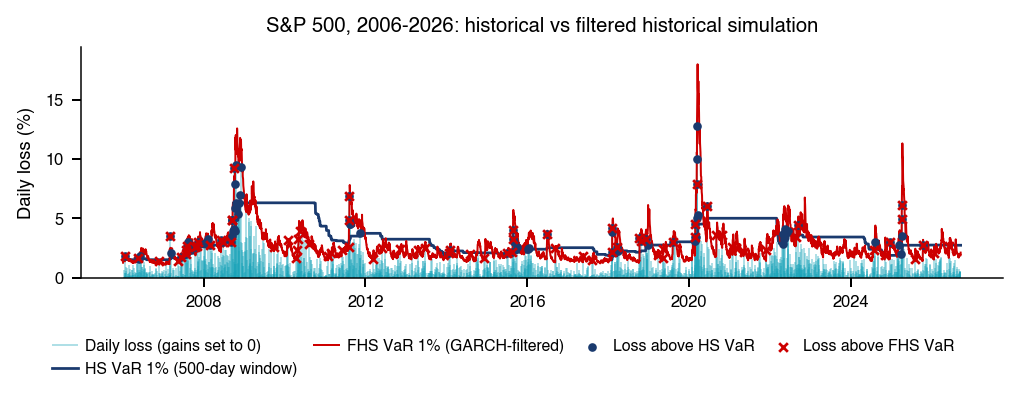
 MFM_ch7_loss_distribution
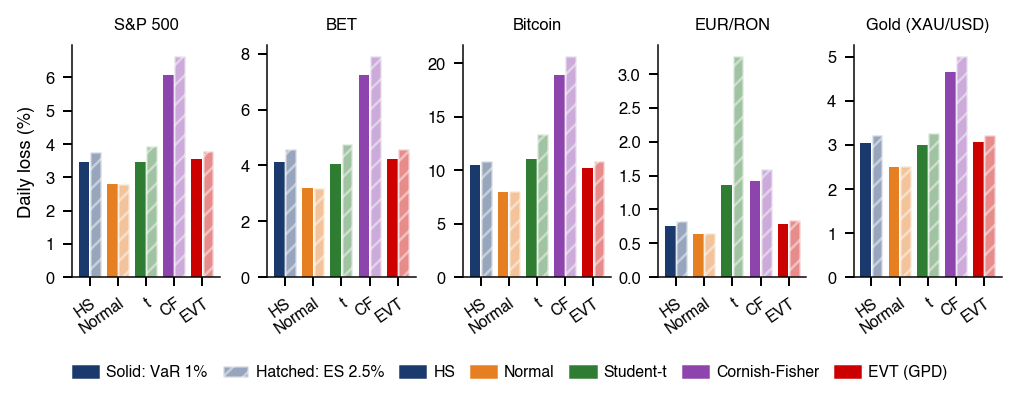
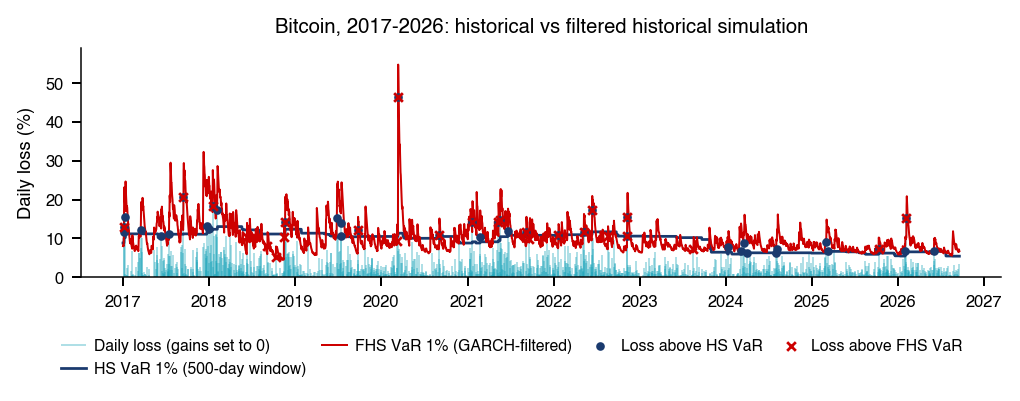
 Measuring Statistical Risk