Capitolul 2: Distribuții clasice și fapte stilizate
Daniel Traian PELE
Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
SFE: Statistics of Financial Markets, Exercises (Quantlet collection of the textbook) — colecția de Quantlet-uri a manualului Statistics of Financial Markets
Întrebarea de azi, traseul și rezultatele învățării
Pe 16 martie 2020, randamentul logaritmic al indicelui S&P 500 a fost de −12,8% într-o singură zi. Abaterea standard a randamentelor zilnice în perioada 2010–2026 este de 1,08%, deci scăderea a fost de aproximativ 11,8 abateri standard sub medie. Dacă randamentele zilnice ar urma distribuția Normală, probabilitatea unei asemenea zile ar fi de ordinul \(10^{-32}\). Totuși, zile de acest tip apar în fiecare criză importantă: 19 octombrie 1987, octombrie 2008, martie 2020, aprilie 2025.
Capitolul pornește de la modelul de referință al finanțelor cantitative clasice: randamente logaritmice independente, identic distribuite și Normale. Din el rezultă prețuri lognormale, iar teorema limită centrală pare să-l justifice. Capitolul măsoară apoi cît de departe sînt randamentele reale de acest model, cu momente de selecție, testul Jarque–Bera și QQ plots, și estimează o alternativă cu cozi groase, distribuția Student-t.
Datele sînt opt serii zilnice din perioada 2010–2026: S&P 500, DAX, BET, Bitcoin și patru acțiuni de la Bursa de Valori București (BVB). Pe ele se verifică șase fapte stilizate ale randamentelor, în sensul lui Cont (2001). O zi aflată la peste 4 abateri standard de medie ar trebui să apară, conform distribuției Normale, o dată la 63 de ani; în S&P 500 a apărut de 28 de ori din 2010.
Numărul zilelor aflate la peste 4 abateri standard de medie, pe axa verticală în scară logaritmică, pentru cele opt serii din perioada 2010–2026: barele pline arată zilele observate, iar barele hașurate numărul așteptat dacă randamentele ar fi Normale, între 0,18 și 0,28 zile.
Rezultatele învățării
Calculați probabilități și cuantile ale distribuțiilor Normală și lognormală.
Enunțați teorema limită centrală (CLT, central limit theorem) și precizați cînd funcționează aproximarea Normală.
Estimați asimetria și excesul de boltire și testați normalitatea cu testul Jarque–Bera.
Interpretați un QQ plot și estimați o distribuție Student-t prin metoda verosimilității maxime.
Verificați șase fapte stilizate ale randamentelor și explicați ce înseamnă fiecare pentru un model.
Planul capitolului
Importanța distribuțieiO zi de −11,8 abateri standard, la ce folosește o distribuție și modelul de referință i.i.d. Normal.
Distribuția NormalăDefiniția, proprietățile folosite în finanțe și cît de rare sînt variațiile mari conform ei.
Distribuția lognormalăDe la randamente logaritmice Normale la prețuri lognormale; media, mediana și modul.
Teorema limită centralăEnunțul, viteza convergenței și de ce nu garantează randamente zilnice Normale.
AI pentru descoperire științificăSe subțiază cozile Bitcoin? Utilizările posibile ale instrumentelor AI, verificările necesare și o idee de proiect.
RezumatFormulele capitolului și întrebări de autoevaluare.
Importanța distribuției
Distribuția randamentelor este punctul de plecare al aproape oricărui calcul din finanțele cantitative: probabilitatea unei pierderi mari, prețul unei opțiuni, intervalul de încredere al unei medii. Secțiunea arată, cu o singură zi din martie 2020, cît de mult greșește distribuția Normală în cozi, explică de ce această greșeală contează și formulează modelul de referință pe care restul capitolului îl testează.
Pe 16 martie 2020, la începutul pandemiei de COVID-19, indicele S&P 500 a scăzut cu 12,8%, măsurat ca randament logaritmic, într-o singură zi de tranzacționare. Pentru a judeca mărimea acestei scăderi, ea se raportează la variabilitatea obișnuită a indicelui. Media și abaterea standard a randamentelor logaritmice zilnice ale S&P 500 în perioada 2010–2026 sînt 0,045% și 1,084%, deci ziua de 16 martie 2020, cu un randament logaritmic de −12,77%, s-a aflat la \((-12{,}77 - 0{,}045)/1{,}084 = -11{,}8\) abateri standard de medie.
Dacă randamentele zilnice ar urma distribuția Normală cu această medie și această abatere standard, probabilitatea unei zile la fel de slabe ar fi de circa \(2 \times 10^{-32}\). Cu 252 de zile de tranzacționare pe an, o asemenea zi ar apărea mai rar de o dată la \(10^{29}\) ani. Nu este un caz izolat: zile de același tip au avut loc pe 19 octombrie 1987, în octombrie 2008, în martie 2020 și în aprilie 2025.
Argumentul este cel al oricărui test statistic. Un eveniment care, conform unui model, are o probabilitate de ordinul \(10^{-32}\) și care este totuși observat de mai multe ori în cîteva decenii nu este un accident al pieței, ci o dovadă împotriva modelului. Concluzia slide-ului, „greșit este modelul, nu piața”, este punctul de plecare al capitolului: trebuie măsurat cît de departe sînt randamentele reale de distribuția Normală și trebuie găsite modele care reproduc ce se observă.
Pe scurt
16 martie 2020: S&P 500 a scăzut cu \(-12{,}8\%\) (randament logaritmic) într-o singură zi
Media și abaterea standard zilnică 2010–2026: \(0{,}045\%\) și \(1{,}084\%\), deci scăderea a fost de \((-12{,}77 - 0{,}045)/1{,}084 = -11{,}8\) abateri standard
dacă randamentele ar urma distribuția Normală, probabilitatea unei asemenea zile ar fi de circa \(2 \times 10^{-32}\)
adică mai rar de o dată la \(10^{29}\) ani de tranzacționare
Totuși, asemenea zile au loc: 19 octombrie 1987, octombrie 2008, martie 2020, aprilie 2025
Concluzia: greșit este modelul, nu piața
Întrebare pentru sală: cît de des apare o zi de 4 sigma?
O zi de \(k\) sigma este o zi în care randamentul se află la mai mult de \(k\) abateri standard de medie, în oricare dintre direcții. Măsura este adimensională, deci permite compararea unor piețe cu volatilități foarte diferite, de exemplu un indice bursier și Bitcoin. Întrebarea pentru sală cere două estimări: cît de des ar apărea o zi de 4 sigma dacă randamentele ar fi Normale și cît de des apare de fapt în S&P 500.
Conform distribuției Normale, probabilitatea ca o variabilă să se afle la mai mult de 4 abateri standard de medie este de aproximativ \(6{,}3 \times 10^{-5}\). O zi de 4 sigma ar apărea deci o dată la 15 787 de zile de tranzacționare, adică aproximativ o dată la 63 de ani. Un investitor ar vedea, în medie, mai puțin de o asemenea zi în întreaga carieră.
În S&P 500, între 2010 și 2026, au existat 28 de zile de 4 sigma din 4 201 zile de tranzacționare: una la fiecare 150 de zile, adică aproximativ 1,7 zile pe an. Diferența față de distribuția Normală nu este de cîteva procente, ci de două ordine de mărime. Secțiunea despre faptele stilizate arată că raportul este de același ordin pe toate piețele studiate.
Pe scurt
O zi de \(k\) sigma: un randament zilnic aflat la mai mult de \(k\) abateri standard de medie
Ce credeți? Dacă randamentele zilnice ar fi Normale, cît de des ar apărea o zi de 4 sigma?
Ce credeți? Cît de des apare în S&P 500 din 2010?
Răspuns
distribuția Normală: o dată la 15 787 de zile de tranzacționare, cam o dată la 63 de ani
S&P 500: 28 de zile din 4 201, o dată la 150 de zile, cam 1,7 pe an
Prima utilizare este măsurarea riscului. Valoarea expusă la risc (VaR, Value at Risk) la nivelul 1%, notată VaR 1%, este pierderea depășită cu probabilitatea de 1%. Ea este o cuantilă a distribuției randamentelor: dacă \(q_{0{,}01}\) este cuantila de ordin 1% a randamentului, atunci \(\text{VaR}_{0{,}01} = -q_{0{,}01}\). Valoarea depinde aproape în întregime de forma cozii stîngi, deci o distribuție cu cozi prea subțiri produce un VaR prea mic. Măsurile de risc sînt tratate în Capitolul 10.
A doua utilizare este evaluarea instrumentelor derivate. Formula Black–Scholes presupune că prețul activului suport este lognormal la scadență, ceea ce echivalează cu randamente logaritmice Normale. O opțiune mult în afara banilor (deep out-of-the-money) plătește doar dacă prețul face o variație mare. Dacă variațiile mari sînt mai frecvente decît prevede distribuția Normală, aceste opțiuni valorează mai mult decît indică formula.
A treia utilizare este inferența. Testele \(t\) și intervalele de încredere obișnuite presupun normalitatea, cel puțin aproximativă, a statisticilor folosite. Cînd datele au cozi groase (heavy tails), erorile standard sînt nesigure în eșantioane mici, iar nivelurile nominale ale testelor nu mai sînt respectate. În toate cele trei cazuri, o distribuție greșită produce rezultate greșite chiar dacă datele sînt perfect corecte.
Pe scurt
Risc: probabilitatea unei pierderi mari
VaR 1% (Value at Risk, valoarea expusă la risc): pierderea depășită cu probabilitatea 1%; o cuantilă a distribuției (Capitolul 10)
Evaluare: formula Black–Scholes presupune prețuri lognormale
cozile mai groase fac mai valoroase opțiunile mult în afara banilor (deep out-of-the-money)
Inferență: testele \(t\) și intervalele de încredere presupun normalitate (aproximativă)
cozile groase fac erorile standard nesigure în eșantioane mici
O distribuție greșită produce rezultate greșite, chiar și cu date perfecte
Fie \(P_t\) prețul unui activ la sfîrșitul zilei \(t\) și \(r_t = \ln(P_t/P_{t-1})\) randamentul logaritmic. Avantajul randamentelor logaritmice este că se adună în timp: \(P_t = P_{t-1}e^{r_t}\), deci \(P_t = P_0 e^{r_1 + \dots + r_t}\). Prețul de la orice dată se obține din prețul inițial și suma randamentelor logaritmice intermediare.
Modelul de referință (benchmark) al capitolului presupune că randamentele \(r_t\) sînt i.i.d., adică independente și identic distribuite, cu distribuția Normală \(N(\mu, \sigma^2)\);\(\mu\) și \(\sigma^2\) sînt media și varianța zilnice ale randamentelor logaritmice. În acest model, logaritmul prețului este un mers aleator cu pași Normali, iar prețul urmează un mers aleator geometric (geometric random walk) și este lognormal (Osborne, 1959). Primul model de acest tip, formulat pentru variațiile aritmetice ale prețurilor, nu pentru randamentele logaritmice, aparține lui Bachelier (1900).
Modelul conține trei ipoteze distincte: normalitatea, distribuția identică în timp și independența. Capitolul le verifică pe rînd. Secțiunile despre momente, testarea normalității și distribuția Student-t privesc prima ipoteză; faptele stilizate despre volatility clustering și efectul de levier privesc celelalte două. Fiecare ipoteză încălcată cere o corecție diferită a modelului.
notație: i.i.d. = independente și identic distribuite
Modelul de referință: \(r_t\) i.i.d. \(N(\mu, \sigma^2)\)
\(N(\mu, \sigma^2)\): distribuția Normală cu media \(\mu\) și varianța \(\sigma^2\) (media și varianța zilnice ale randamentelor logaritmice)
prețurile urmează un mers aleator geometric; \(P_t\) este lognormal Osborne (1959)
primul model de acest fel, pentru variațiile aritmetice ale prețurilor: Bachelier (1900)
Capitolul verifică pe rînd ipotezele modelului de referință: normalitatea, distribuția identică și independența
Sinteza secțiunii
Modelul i.i.d. Normal atribuie unei zile ca 16 martie 2020 o probabilitate practic nulă, iar zilele de 4 sigma apar în S&P 500 de aproximativ o sută de ori mai des decît prevede el. Erorile din cozi se transmit direct în VaR, în prețurile opțiunilor și în inferență. Secțiunea următoare prezintă distribuția Normală în detaliu, pentru a vedea exact ce presupune modelul de referință.
Distribuția Normală
Distribuția Normală este modelul implicit al randamentelor în finanțele clasice și reperul față de care se măsoară toate abaterile din acest capitol. Secțiunea prezintă originea ei, definiția, proprietățile care au făcut-o atractivă în finanțe și, mai ales, cît de repede scad probabilitățile din cozile ei. Exemplul lucrat compară aceste probabilități cu frecvența pierderilor mari ale S&P 500 și BET.
Curba în formă de clopot are trei surse istorice. De Moivre a obținut-o în 1733 ca limită a probabilităților binomiale, deci ca aproximare a numărului de succese într-un număr mare de încercări. Gauss a folosit-o în 1809 pentru erorile observațiilor astronomice și a dedus din ea metoda celor mai mici pătrate: dacă erorile sînt Normale, estimatorul de verosimilitate maximă al parametrilor este cel care minimizează suma pătratelor erorilor. De aici și celălalt nume, distribuția gaussiană.
Laplace a demonstrat în 1810 o primă versiune a teoremei limită centrale, care explică de ce distribuția Normală apare ori de cîte ori o mărime este suma multor efecte mici și independente. Această justificare a fost transferată ulterior randamentelor, ca sume ale multor variații mici de preț.
În finanțe, distribuția Normală a devenit modelul implicit al randamentelor și din motive de comoditate: sumele de variabile Normale independente sînt tot Normale, deci randamentele pe mai multe zile și randamentele portofoliilor rămîn în aceeași familie. Restul capitolului arată ce costă această comoditate.
Pe scurt
De Moivre (1733) a obținut curba în formă de clopot ca limită a probabilităților binomiale
Gauss (1809) a folosit-o pentru erorile observațiilor astronomice și a dedus din ea metoda celor mai mici pătrate
Laplace (1810) a demonstrat o primă versiune a teoremei limită centrale
De aici și celălalt nume: distribuția gaussiană
În finanțe a devenit modelul implicit al randamentelor, pentru că sumele de variabile Normale rămîn Normale
O variabilă aleatoare \(X\) are distribuția Normală cu media \(\mu\) și varianța \(\sigma^2\), notată \(X \sim N(\mu, \sigma^2)\), dacă densitatea ei de probabilitate (PDF, probability density function) este
\[f(x) = \frac{1}{\sigma\sqrt{2\pi}} \exp\Big(-\frac{(x - \mu)^2}{2\sigma^2}\Big), \qquad x \in \mathbb{R}.\]
(2.1)
Parametrul \(\mu\) fixează poziția centrului, iar \(\sigma^2\) dispersia în jurul lui. În (2.1), densitatea depinde de \(x\) doar prin distanța standardizată \((x-\mu)/\sigma\), ridicată la pătrat în exponent.
Prin standardizare, \(Z = (X - \mu)/\sigma\) are distribuția Normală standard \(N(0, 1)\). Funcția ei de repartiție (CDF, cumulative distribution function), \(\Phi(z) = P(Z \le z)\), nu are formă închisă și se calculează numeric, cu tabele sau software. Orice probabilitate pentru \(X\) se reduce la \(\Phi\):\(P(X \le x) = \Phi\big((x - \mu)/\sigma\big)\).
Cuantila de ordin \(\alpha\) a lui \(X\) este valoarea \(x_\alpha\) pentru care \(P(X \le x_\alpha) = \alpha\); ea se obține ca \(x_\alpha = \mu + \sigma z_\alpha\), unde \(z_\alpha = \Phi^{-1}(\alpha)\) este cuantila distribuției Normale standard. Două valori apar constant în măsurarea riscului: \(z_{0{,}01} = -2{,}33\) și \(z_{0{,}05} = -1{,}64\). De exemplu, dacă randamentul zilnic este \(N(\mu, \sigma^2)\), VaR 1% este \(-(\mu + \sigma z_{0{,}01}) = 2{,}33\,\sigma - \mu\).
Pe scurt
\(X \sim N(\mu, \sigma^2)\) are PDF (probability density function, densitatea de probabilitate)
CDF (cumulative distribution function, funcția de repartiție) este \(\Phi(z) = P(Z \le z)\), fără formă închisă; se calculează cu tabele sau cu software
Probabilitățile lui \(X\) se obțin din \(Z\): \(P(X \le x) = \Phi\big((x - \mu)/\sigma\big)\)
Cuantila de ordin \(\alpha\): \(x_\alpha = \mu + \sigma z_\alpha\), valoarea pentru care \(P(X \le x_\alpha) = \alpha\)
Distribuția Normală este simetrică în jurul lui \(\mu\), deci media, mediana și modul coincid. Asimetria ei este 0, iar boltirea 3; ambele mărimi sînt definite în secțiunea despre momente și servesc acolo ca reper pentru randamentele reale.
Proprietatea cea mai folosită este închiderea la adunare. Dacă \(X \sim N(\mu_1, \sigma_1^2)\) și \(Y \sim N(\mu_2, \sigma_2^2)\) sînt independente, atunci \(X + Y \sim N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)\). În modelul de referință, randamentul logaritmic pe \(h\) zile este suma a \(h\) randamente zilnice i.i.d., deci \(r_t(h) \sim N(h\mu, h\sigma^2)\). Media crește proporțional cu \(h\), iar abaterea standard cu \(\sqrt{h}\): aceasta este regula rădăcinii pătrate a timpului (square-root-of-time rule) din Capitolul 1.
Mai general, orice combinație liniară a unor randamente cu distribuție Normală multivariată este Normală, deci randamentul oricărui portofoliu rămîne Normal. În sfîrșit, distribuția este complet determinată de doi parametri: cînd \(\mu\) și \(\sigma\) sînt cunoscuți, orice probabilitate și orice cuantilă se pot calcula. Aceeași proprietate este și o slăbiciune, pentru că forma cozilor este fixată odată cu media și varianța și nu poate fi ajustată separat.
Pe scurt
Simetrică în jurul lui \(\mu\): media = mediana = modul
Asimetria \(0\) și boltirea \(3\) (definite în secțiunea 5)
Închisă la adunare: dacă \(X \sim N(\mu_1, \sigma_1^2)\) și \(Y \sim N(\mu_2, \sigma_2^2)\) sînt independente, atunci \(X + Y \sim N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)\)
randamentul logaritmic pe \(h\) zile în modelul de referință: \(r_t(h) \sim N(h\mu, h\sigma^2)\)
volatilitatea crește cu \(\sqrt{h}\): regula rădăcinii pătrate a timpului din Capitolul 1
Orice combinație liniară de randamente cu distribuție Normală multivariată este Normală: randamentele portofoliilor rămîn Normale
Complet determinată de doi parametri: dacă știm \(\mu\) și \(\sigma\), putem calcula orice probabilitate
Distribuția Normală: P(|Z| > k) și cît de des apare o astfel de zi; zilele observate ale seriei alese
Ponderea zilelor aflate la cel mult k abateri standard de medie (regula 68–95–99,7)
Întrebare pentru sală După distribuția Normală, 68,27% din zile se află la cel mult o abatere standard de medie. Ce pondere din zilele S&P 500, 2010–2026, se află la cel mult o abatere standard de medie?
Răspuns
79,1%, mai mult decît după distribuția Normală. Cîteva zile extreme măresc abaterea standard, iar majoritatea zilelor sînt mici în raport cu ea: centrul distribuției este mai înalt. La cel mult două abateri standard ponderea este 95,3%, aproape de 95,45%; dincolo de trei abateri standard sînt 62 de zile în loc de 11,3. Pentru cele opt serii, ponderea la cel mult o abatere standard este între 75,7% (BRD) și 81,4% (BET).
Zile cu randamentul logaritmic sub −x%: observate și așteptate după distribuția Normală
Întrebare pentru sală S&P 500 are 49 de zile sub −3%, față de 10,5 așteptate după distribuția Normală cu aceeași medie și aceeași abatere standard. La Bitcoin, cu același prag de −3%, sînt mai multe sau mai puține astfel de zile decît așteaptă distribuția Normală a seriei?
Răspuns
Mai puține: 512 zile, față de 813 așteptate. Abaterea standard a Bitcoin este 3,49%, deci −3% se află la numai 0,89 abateri standard sub medie, între centru și coadă, unde randamentele cu cozi groase au mai puține zile decît distribuția Normală. Cozile groase apar la praguri de mai multe abateri standard: sub −10% (2,90 abateri standard), Bitcoin are 56 de zile, față de 8,1 așteptate. Un prag exprimat în % compară seriile numai dacă volatilitățile lor sînt apropiate.
Întrebare pentru sală După distribuția Normală, o zi dincolo de 3 abateri standard apare o dată la 370 de zile. Butonul ▶ mută pragul pînă la 6. De cîte ori mai rară este o zi dincolo de 4 abateri standard?
Răspuns
De circa 43 de ori. P(|Z| > 4) = 0,0063%, adică o zi din 15 787, aproximativ 63 de ani de tranzacționare cu 252 de zile pe an; P(|Z| > 3) = 0,27%, o zi din 370. Raportul densităților în 3 și 4, φ(3)/φ(4) = 33, nu este raportul probabilităților din coadă. La 6 abateri standard, distribuția Normală dă o zi din 507 milioane.
Graficul arată densitatea Normală standard în funcție de \(z = (x - \mu)/\sigma\). Zona albastră cuprinde valorile aflate la cel mult o abatere standard de medie, zona verde pe cele aflate între una și două abateri standard, iar zona maro pe cele aflate între două și trei. Probabilitățile cumulate sînt 68,27% în interiorul unei abateri standard, 95,45% în interiorul a două și 99,73% în interiorul a trei.
Restul de 0,27% se află dincolo de trei abateri standard, în ambele cozi: aproximativ o zi din 370. Pe grafic, curba pare să atingă axa orizontală deja la \(\pm 3\). Motivul este forma densității: dincolo de centru, ea scade ca \(e^{-z^2/2}\), adică mai repede decît orice exponențială în \(|z|\). Fiecare pas suplimentar spre cozi reduce probabilitatea mult mai mult decît precedentul.
Pentru randamente, această proprietate înseamnă că distribuția Normală atribuie variațiilor mari probabilități foarte mici. Tabelul următor cuantifică acest lucru.
Pe scurt
La cel mult 1, 2 și 3 abateri standard de medie: 68,27%, 95,45% și 99,73% din probabilitate
Dincolo de 3 abateri standard: o zi din 370; cozile distribuției Normale scad ca \(e^{-z^2/2}\), foarte repede
Tabelul dă, pentru \(k\) între 1 și 6, probabilitatea \(P(|Z| > k)\) ca o variabilă Normală standard să se afle la mai mult de \(k\) abateri standard de 0, precum și inversa ei exprimată în zile și în ani de tranzacționare, cu 252 de zile pe an. O variație de o abatere standard apare o dată la 3 zile, una de două abateri standard o dată la 22 de zile, iar una de trei abateri standard o dată la 370 de zile, adică aproximativ o dată la un an și jumătate.
Dincolo de acest prag, frecvențele scad brusc. O zi de 4 sigma, cu probabilitatea \(6{,}3 \times 10^{-5}\), apare o dată la 15 787 de zile, adică o dată la 63 de ani. O zi de 5 sigma apare o dată la 6 922 de ani, iar una de 6 sigma o dată la peste două milioane de ani. Fiecare abatere standard suplimentară face o variație de 7 pînă la 291 de ori mai rară, iar raportul crește odată cu \(k\), consecință directă a scăderii de tip \(e^{-z^2/2}\).
Conform acestui tabel, o zi de 6 sigma n-ar trebui să apară în toată istoria burselor. Tabelul din secțiunea despre faptele stilizate arată că S&P 500 a avut 8 asemenea zile numai după 2010. Comparația nu cere niciun test formal: diferența este de mai multe ordine de mărime.
Pe scurt
\(k\)
\(P(|Z| > k)\)
o dată la … zile de tranzacționare
o dată la … ani
1
\({0{,}3173}\)
3
0,013
2
\({0{,}0455}\)
22
0,087
3
\({2{,}7 \times 10^{-3}}\)
370
1,5
4
\({6{,}3 \times 10^{-5}}\)
15 787
63
5
\({5{,}7 \times 10^{-7}}\)
1 744 278
6 922
6
\({2{,}0 \times 10^{-9}}\)
506 797 346
2 011 101
\(P(|Z| > k)\): probabilitatea ca o variabilă Normală standard să se afle la mai mult de \(k\) abateri standard de 0
Anii sînt calculați cu 252 de zile de tranzacționare pe an
Fiecare abatere standard în plus face o variație de 7 pînă la 291 de ori mai rară
O zi de 6 sigma n-ar trebui să apară în toată istoria burselor
Exemplul compară frecvența prevăzută de distribuția Normală cu frecvența observată a pierderilor mari. Datele sînt cele 4 201 randamente logaritmice zilnice ale S&P 500 din perioada 2010–2026, cu media 0,045% și abaterea standard 1,08%. O pierdere mai mare de 3% corespunde valorii standardizate \(z = (-3 - 0{,}045)/1{,}08 = -2{,}81\). Conform distribuției Normale, probabilitatea ei este \(\Phi(-2{,}81) = 0{,}25\%\), deci numărul așteptat de asemenea zile în eșantion este 10,5. Numărul observat este 49, de aproape cinci ori mai mare.
Pentru pierderi mai mari de 5%, valoarea standardizată este \(z = -4{,}65\), iar numărul așteptat conform distribuției Normale este \(6{,}9 \times 10^{-3}\) zile: o asemenea zi ar trebui să lipsească din eșantion cu o probabilitate de peste 99%. În realitate au existat 8 astfel de zile. Pentru BET, numărul zilelor cu randamente sub −5% este 13, față de \(5{,}1 \times 10^{-3}\) zile așteptate.
Raportul dintre frecvența observată și cea prevăzută crește cu mărimea pierderii: de aproximativ 5 ori la pragul de 3% și de peste o mie de ori la pragul de 5%. Distribuția Normală descrie acceptabil zilele obișnuite, dar subestimează frecvența pierderilor mari cu cîteva ordine de mărime, adică exact în regiunea care contează pentru gestiunea riscului.
Pe scurt
S&P 500, 2010–2026: \(n = 4\,201\) randamente logaritmice zilnice, media \(0{,}045\%\), abaterea standard \(1{,}08\%\)
O pierdere mai mare de 3%: \(z = (-3 - 0{,}045)/1{,}08 = -2{,}81\)
distribuția Normală: \(\Phi(-2{,}81) = 0{,}25\%\), deci numărul așteptat de zile este \(10{,}5\)
numărul observat: 49 de zile
O pierdere mai mare de 5%: \(z = -4{,}65\)
distribuția Normală: \(6{,}9 \times 10^{-3}\) zile așteptate; zile observate: 8
BET: 13 zile sub \(-5\%\), față de \(5{,}1 \times 10^{-3}\) așteptate
Distribuția Normală subestimează frecvența pierderilor mari cu cîteva ordine de mărime
Distribuția Normală are doi parametri, este simetrică și este închisă la adunare; în modelul de referință, volatilitatea pe \(h\) zile crește cu \(\sqrt{h}\). Aceste proprietăți fac calculele simple și explică popularitatea ei în finanțe.
Slăbiciunea ei este forma cozilor. Densitatea scade ca \(e^{-z^2/2}\), iar o zi de 4 sigma ar trebui să apară o dată la 63 de ani. Randamentele reale au mult mai multe variații mari: S&P 500 a avut 49 de zile cu pierderi de peste 3%, față de 10,5 zile așteptate, și 8 zile cu pierderi de peste 5%, față de practic niciuna.
Pe scurt
Doi parametri, simetrică, închisă la adunare, volatilitatea crește cu \(\sqrt{h}\)
Cozile ei sînt subțiri: o zi de 4 sigma o dată la 63 de ani
Randamentele reale au mult mai multe variații mari decît permite ea
Sinteza secțiunii
Distribuția Normală este comodă, dar cozile ei sînt prea subțiri pentru randamentele zilnice. Pînă la trei abateri standard frecvențele prevăzute și cele observate sînt de același ordin; dincolo de acest prag diferența devine de mai multe ordine de mărime. Secțiunea următoare urmărește consecința modelului de referință pentru prețuri: dacă randamentele logaritmice sînt Normale, prețurile sînt lognormale.
Distribuția lognormală
Modelul de referință descrie randamentele logaritmice, dar investitorul este interesat de prețuri și de valoarea investiției. Dacă randamentele logaritmice sînt Normale, prețul la un orizont dat are distribuția lognormală. Secțiunea definește această distribuție, explică de ce media, mediana și modul ei diferă și aplică rezultatele la o investiție în indicele BET.
De la randamente logaritmice Normale la prețuri lognormale
O variabilă pozitivă \(Y\) are distribuția lognormală, \(Y \sim LN(m, s^2)\), dacă logaritmul ei este Normal: \(\ln Y \sim N(m, s^2)\). Parametrii \(m\) și \(s^2\) sînt media și varianța lui \(\ln Y\), nu ale lui \(Y\); această distincție este sursa celor mai frecvente greșeli de calcul. Densitatea se obține din densitatea Normală prin schimbarea de variabilă \(y = e^x\):
\[f(y) = \frac{1}{y\, s\sqrt{2\pi}} \exp\Big(-\frac{(\ln y - m)^2}{2s^2}\Big), \qquad y > 0.\]
(2.2)
Factorul \(1/y\) din (2.2) provine din schimbarea de variabilă și face densitatea asimetrică la dreapta.
În modelul de referință, \(\ln(P_T/P_0) = r_1 + \dots + r_T\) este o sumă de \(T\) randamente zilnice Normale i.i.d., deci \(\ln(P_T/P_0) \sim N(T\mu, T\sigma^2)\), unde \(T\) este orizontul în zile. Rezultă \(P_T/P_0 \sim LN(T\mu, T\sigma^2)\): raportul dintre prețul final și cel inițial este lognormal (Osborne, 1959).
Alegerea are o justificare economică. Un preț nu poate fi negativ, dar o variabilă Normală ia valori negative cu probabilitate pozitivă. Prețul lognormal este întotdeauna pozitiv, iar randamentul simplu corespunzător, \(R = e^r - 1\), este mai mare decît −1: un investitor fără îndatorare nu poate pierde mai mult decît a investit. Modelul Black–Scholes de evaluare a opțiunilor se bazează pe această distribuție.
Pe scurt
O variabilă pozitivă \(Y\) este lognormală, \(Y \sim LN(m, s^2)\), dacă \(\ln Y \sim N(m, s^2)\)
\(m\), \(s^2\): media și varianța lui \(\ln Y\), nu ale lui \(Y\)
Pentru \(Y \sim LN(m, s^2)\), cele trei măsuri ale poziției sînt diferite. Mediana, valoarea depășită cu probabilitatea 1/2, este \(e^m\), pentru că exponențiala păstrează ordinea și mediana lui \(\ln Y\) este \(m\). Modul, valoarea cu densitatea cea mai mare, este \(e^{m - s^2}\). Media și varianța sînt
Întotdeauna modul < mediana < media, ceea ce caracterizează o distribuție cu o coadă dreaptă lungă, adică cu asimetrie pozitivă.
Formula mediei din (2.3) rezultă din identitatea \(E[e^X] = e^{m + s^2/2}\) pentru \(X \sim N(m, s^2)\), care se demonstrează completînd pătratul în exponentul integralei; Seminarul 2 o deduce pas cu pas. Termenul suplimentar \(s^2/2\) dintre logaritmul mediei și logaritmul medianei este volatility drag din Capitolul 1, privit din perspectiva prețurilor: media valorii finale depășește valoarea tipică cu atît mai mult cu cît volatilitatea este mai mare.
Care dintre aceste mărimi contează depinde de întrebare. Mediana descrie rezultatul unui investitor tipic: jumătate dintre traiectoriile posibile se termină sub ea. Media este ridicată de cîteva traiectorii foarte favorabile și descrie rezultatul mediu al unui număr mare de investitori, nu pe al unuia anume.
Pe scurt
Dacă \(Y \sim LN(m, s^2)\):
mediana \(e^{m}\); modul \(e^{m - s^2}\); media \(E[Y] = e^{m + s^2/2}\)
modul: valoarea cea mai probabilă; mediana: valoarea depășită cu probabilitatea 1/2
întotdeauna modul \(<\) mediana \(<\) media: o coadă dreaptă lungă (asimetrie pozitivă)
Întrebare pentru sală Pentru 100 de lei investiți în BET, probabilitatea unei pierderi este 24,8% după un an și 1,5% după zece ani. Butonul ▶ crește orizontul pînă la 20 de ani. Care este probabilitatea unei pierderi după 20 de ani?
Răspuns
0,11%: Φ(−μ√T/σ) = Φ(−0,682 × √20) = Φ(−3,05). Media randamentului logaritmic crește cu T, iar abaterea lui standard cu √T, deci raportul μ√T/σ crește cu √T. Mediana devine 1 009,6, iar media 1 345,6: distanța dintre ele crește cu orizontul. Calculul presupune că media randamentului logaritmic din 2010–2026, 11,6% pe an, se menține și că randamentele logaritmice sînt Normale și independente; pentru S&P 500, același calcul dă 0,15%, pentru Bitcoin 0,19%.
Întrebare pentru sală Butonul ▶ crește s de la 0,1 la 1,5. Ce se întîmplă cu modul, mediana și media distribuției lognormale LN(0, s²)?
Răspuns
Mediana rămîne 1, deoarece em nu depinde de s. Media es²/2 crește pînă la 3,08, iar modul e−s² scade pînă la 0,105. La s = 1, media este 1,65, modul 0,37 și asimetria 6,18. Distanța dintre medie și mediană crește cu volatilitatea și cu orizontul, prin s = σ√T.
Graficul arată trei densități lognormale ale raportului \(x = P_T/P_0\), toate cu \(m = 0\) și cu \(s = 0{,}25\) (albastru), \(s = 0{,}5\) (roșu) și \(s = 1\) (verde). Deoarece \(m = 0\), mediana este 1 pentru toate trei curbele; linia punctată neagră o marchează. Liniile întrerupte, în culoarea fiecărei curbe, marchează mediile \(e^{s^2/2}\).
Pentru \(s = 0{,}25\), media este 1,03, iar modul 0,94: densitatea este aproape simetrică, iar cele trei măsuri ale poziției sînt apropiate. Pentru \(s = 1\), media urcă la 1,65, modul coboară la 0,37, iar asimetria ajunge la 6,18. Curba verde are vîrful mult la stînga medianei și o coadă dreaptă care se întinde dincolo de marginea graficului.
Parametrul \(s\) al raportului \(P_T/P_0\) este \(\sigma\sqrt{T}\), deci crește atît cu volatilitatea, cît și cu orizontul. Pe orizonturi lungi sau pentru active foarte volatile, distanța dintre medie și mediană devine mare, iar media încetează să fie un rezumat util al rezultatului tipic.
Pe scurt
\(m = 0\): mediana este 1 pentru toate cele trei curbe; liniile punctate marchează mediile
\(s = 0{,}25\): media \(1{,}03\), modul \(0{,}94\), aproape simetrică; \(s = 1\): media \(1{,}65\), modul \(0{,}37\), asimetria \(6{,}18\)
Orizonturi lungi sau volatilitate mare: distanța dintre medie și mediană crește
Exemplul aplică modelul lognormal unei investiții de 100 de lei în indicele BET. În perioada 2010–2026, randamentul logaritmic mediu anual al BET este \(\mu = 11{,}6\%\), iar volatilitatea anuală este \(\sigma = 16{,}9\%\); ambele sînt obținute din momentele zilnice, înmulțind media cu 250,6, numărul de zile de tranzacționare pe an ale BET în eșantion, și abaterea standard cu \(\sqrt{250{,}6}\). După un an, \(P_1/P_0 \sim LN(\mu, \sigma^2)\). Valoarea mediană a investiției este \(100e^{\mu} = 112{,}3\) lei, iar valoarea medie \(100e^{\mu + \sigma^2/2} = 113{,}9\) lei.
Probabilitatea unei pierderi după un an este probabilitatea unui randament logaritmic negativ, \(P(r < 0) = \Phi(-\mu/\sigma) = 24{,}8\%\): aproximativ un an din patru. Cuantila de 5% a valorii investiției este \(100e^{\mu - 1{,}645\sigma} = 84{,}9\) lei, unde \(-1{,}645 = z_{0{,}05}\); cu probabilitatea de 5%, investitorul pierde mai mult de 15,1 lei.
După 10 ani, \(P_{10}/P_0 \sim LN(10\mu, 10\sigma^2)\). Mediana devine 317,7 lei, media 366,8 lei, probabilitatea unei pierderi 1,5%, iar cuantila de 5% 131,6 lei. Probabilitatea unei pierderi este \(\Phi(-\sqrt{T}\,\mu/\sigma)\) și scade cu orizontul \(T\), pentru că media crește proporțional cu \(T\), iar abaterea standard doar cu \(\sqrt{T}\). Rezultatul depinde însă de două ipoteze: că media istorică de 11,6% pe an se menține și că randamentele logaritmice sînt Normale și independente. Toate slăbiciunile modelului Normal, documentate în restul capitolului, se transmit acestor cifre.
Pe scurt
BET, 2010–2026: randamentul logaritmic mediu anual \(\mu = 11{,}6\%\) și volatilitatea \(\sigma = 16{,}9\%\) (momentele zilnice \(\times\) 250,6 și \(\sqrt{250{,}6}\))
După un an, \(P_1/P_0 \sim LN(\mu, \sigma^2)\)
mediana \(100e^{\mu} = 112{,}3\); media \(100e^{\mu + \sigma^2/2} = 113{,}9\)
probabilitatea unei pierderi \(\Phi(-\mu/\sigma) = 24{,}8\%\); cuantila de 5% \(100e^{\mu - 1{,}645\sigma} = 84{,}9\)
Dacă randamentele logaritmice sînt Normale, prețurile sînt lognormale: pozitive și asimetrice la dreapta. Mediana \(e^m\) este mai mică decît media \(e^{m + s^2/2}\), iar diferența dintre logaritmii lor, \(s^2/2\), este volatility drag.
Pentru o investiție, media singură este un rezumat înșelător, mai ales pe orizonturi lungi. Un raport complet conține mediana, care descrie investitorul tipic, și o cuantilă joasă, de exemplu cea de 5%, care descrie scenariul nefavorabil.
Pe scurt
Randamente logaritmice Normale \(\Rightarrow\) prețuri lognormale: pozitive, asimetrice la dreapta
Mediana \(e^m\) sub media \(e^{m + s^2/2}\): diferența este volatility drag
Raportați mediana și o cuantilă joasă, nu doar media
Sinteza secțiunii
Distribuția lognormală este consecința directă a modelului de referință pentru prețuri. Ea explică de ce media și mediana unei investiții diverg pe orizonturi lungi și de ce probabilitatea unei pierderi scade cu orizontul. Toate aceste rezultate presupun însă randamente logaritmice Normale. Secțiunea următoare examinează argumentul teoretic invocat de obicei pentru această ipoteză: teorema limită centrală.
Teorema limită centrală
Justificarea clasică a distribuției Normale pentru randamente este teorema limită centrală: un randament zilnic este suma multor variații mici din timpul zilei, iar sumele de multe variabile i.i.d. cu varianță finită sînt aproximativ Normale. Secțiunea enunță teorema, arată prin simulare cît de repede funcționează și discută de ce condițiile ei pot să nu fie îndeplinite de randamente.
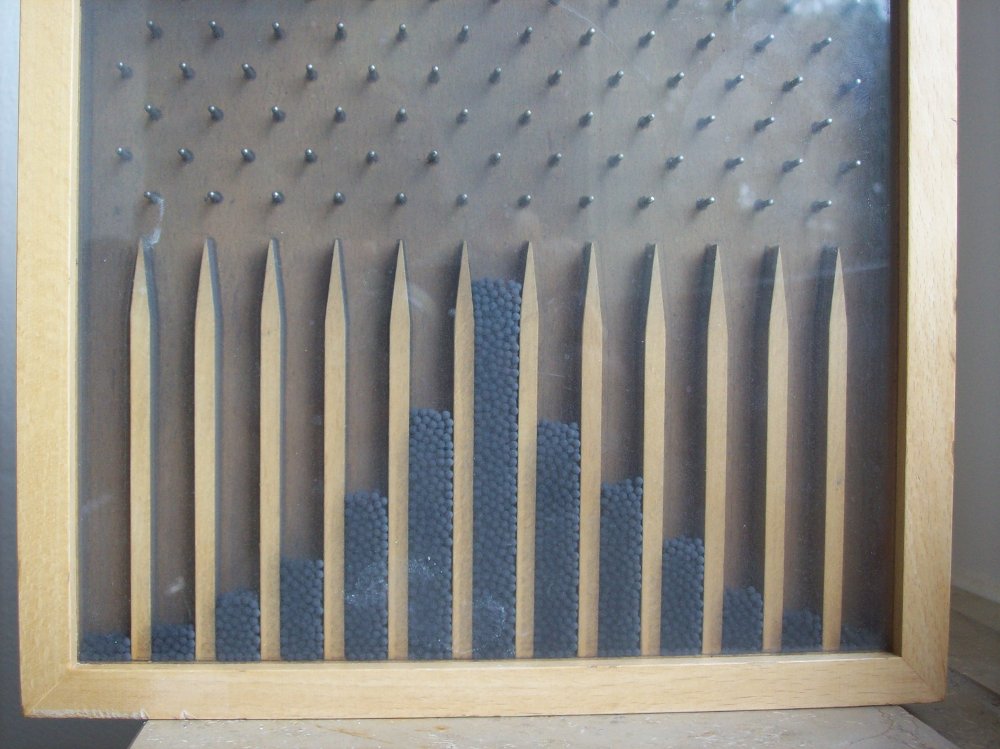
Tabla lui Galton, descrisă de Francis Galton în 1889, este un dispozitiv mecanic care ilustrează teorema limită centrală. Bilele cad printre rînduri de cuie; la fiecare cui, o bilă sare la stînga sau la dreapta cu probabilitatea 1/2, independent de celelalte ciocniri. Poziția finală a bilei este deci o sumă de multe șocuri mici și independente.
Numărul de deplasări la dreapta urmează o distribuție binomială, iar bilele acumulate în compartimentele de la bază formează o curbă în formă de clopot, apropiată de densitatea Normală. Fotografia arată o tablă după căderea bilelor: compartimentele centrale sînt cele mai pline, iar înălțimile scad simetric spre margini.
Același argument a fost aplicat randamentelor. Un randament logaritmic zilnic este suma randamentelor logaritmice ale multor intervale scurte din timpul zilei. Dacă aceste componente ar fi independente și identic distribuite, randamentul zilnic ar trebui să fie aproape Normal. Restul secțiunii precizează condițiile în care raționamentul este corect.
Pe scurt
Francis Galton (1889): bilele cad printre rînduri de cuie și sar la stînga sau la dreapta cu probabilitatea \(1/2\)
Poziția finală a unei bile este o sumă de multe șocuri mici independente
Bilele acumulate formează o curbă în formă de clopot: probabilități binomiale apropiate de densitatea Normală
Același argument a fost folosit pentru randamente: un randament zilnic este suma multor variații mici de preț din timpul zilei
Teorema limită centrală (CLT, central limit theorem) în forma Lindeberg–Lévy pornește de la variabile \(X_1, \dots, X_n\) i.i.d., cu media \(\mu\) și varianța finită \(\sigma^2\). Fie \(\bar X_n\) media lor. Atunci
unde \(\xrightarrow{d}\) desemnează convergența în distribuție (convergence in distribution): funcția de repartiție a membrului stîng se apropie, în fiecare punct, de \(\Phi\). Echivalent, suma \(X_1 + \dots + X_n\) are aproximativ distribuția \(N(n\mu, n\sigma^2)\).
Teorema are trei condiții: independența termenilor, distribuția lor identică și varianța finită. Distribuția termenilor poate fi oricît de departe de cea Normală, de exemplu discretă sau asimetrică; doar media standardizată devine Normală. Există versiuni care slăbesc primele două condiții, dar varianța finită nu poate fi eliminată: fără ea, limita, dacă există, nu mai este Normală.
Viteza convergenței este dată de marginea Berry–Esseen: eroarea maximă dintre funcția de repartiție a mediei standardizate și \(\Phi\) scade ca \(1/\sqrt{n}\) și crește cu asimetria lui \(X\). Teorema explică de ce distribuția Normală apare atît de des în date și de ce intervalele de încredere pentru o medie se construiesc cu cuantilele distribuției Normale, oricare ar fi distribuția datelor.
Pe scurt
CLT (Lindeberg–Lévy): \(X_1, \dots, X_n\) i.i.d. cu media \(\mu\) și varianța finită \(\sigma^2\)
\(\bar X_n\): media celor \(n\) variabile; \(\xrightarrow{d}\): convergență în distribuție, funcția de repartiție a membrului stîng se apropie de \(\Phi\)
echivalent, suma \(X_1 + \dots + X_n\) este aproximativ \(N(n\mu, n\sigma^2)\)
Întrebare pentru sală Pe slide p = 0,2, iar asimetria mediei standardizate este 0,27 pentru n = 30. Butonul ▶ scade p de la 0,5 la 0,02. Cu p = 0,02, este asimetria pentru n = 300 mai mică decît 0,27?
Răspuns
Nu. Asimetria mediei este (1 − 2p)/√(np(1 − p)) = 0,96/√5,88 = 0,40 pentru n = 300 și p = 0,02, mai mare decît 0,27 pentru n = 30 și p = 0,2. Asimetria scade ca 1/√n, dar pornește de la un nivel care depinde de p: cu cît p este mai departe de 0,5, cu atît trebuie mai multe extrageri. Pagina calculează distribuția exactă a mediei; ponderea peste 1,96 pentru p = 0,2 este 5,8%, 2,6% și 2,8% (n = 5, 30, 300), iar în cele 20 000 de simulări ale slide-ului 5,8%, 2,7% și 2,8%.
Simularea folosește o variabilă puternic asimetrică: o extragere Bernoulli cu probabilitatea de succes \(p = 0{,}2\). Pentru \(n = 5\), 30 și 300 de extrageri se calculează media standardizată din (2.4), iar experimentul se repetă de 20 000 de ori. Fiecare panou compară histograma celor 20 000 de medii standardizate (barele) cu densitatea \(N(0,1)\) (curba).
Pentru \(n = 5\), media ia doar șase valori posibile, iar histograma este vizibil asimetrică la dreapta. Ponderea valorilor peste 1,96, care ar trebui să fie 2,5% conform distribuției Normale, este 5,8%, mai mult decît dublă. Pentru \(n = 30\) ponderea scade la 2,7%, iar pentru \(n = 300\) este 2,8%; histograma devine practic suprapusă peste curbă.
Asimetria mediei a \(n\) extrageri Bernoulli(\(p\)) este \((1 - 2p)/\sqrt{np(1-p)}\). Pentru \(p = 0{,}2\), ea este 0,67 pentru \(n = 5\), 0,27 pentru \(n = 30\) și 0,09 pentru \(n = 300\): scade ca \(1/\sqrt{n}\), așa cum prevede marginea Berry–Esseen. Pentru o variabilă asimetrică, aproximarea Normală are nevoie de zeci de observații pentru a deveni acceptabilă în coadă.
Pe scurt
Media standardizată a \(n\) extrageri Bernoulli(\(0{,}2\)) (o variabilă asimetrică), 20 000 de simulări
Ponderea peste \(1{,}96\): 5,8% pentru \(n = 5\), 2,7% pentru \(n = 30\), 2,8% pentru \(n = 300\); distribuția Normală: 2,5%
Asimetria mediei, \((1 - 2p)/\sqrt{np(1-p)}\) cu \(p = 0{,}2\): \(0{,}67\), \(0{,}27\), \(0{,}09\); scade ca \(1/\sqrt{n}\)
Întrebare pentru sală Cu p = 0,1, butonul ▶ crește n de la 5 la 200. Regula practică cere np(1 − p) de cel puțin circa 9, adică n = 100. Ajunge eroarea maximă a CDF sub 0,01 pînă la n = 200?
Răspuns
Nu. Cu corecția de continuitate, eroarea maximă a CDF este 0,037 la n = 20, 0,017 la n = 100 și 0,012 la n = 200. Regula np(1 − p) ≥ 9 indică de unde aproximarea devine utilizabilă, nu o precizie garantată; eroarea scade lent, aproximativ ca 1/√n, cu mici oscilații de la un n la altul. Fără corecția de continuitate, eroarea la n = 20 este 0,177.
O variabilă binomială \(B(n, p)\) numără succesele în \(n\) încercări independente, fiecare cu probabilitatea de succes \(p\). Ea este o sumă de \(n\) variabile Bernoulli i.i.d., deci, conform teoremei limită centrale, \(B(n, p) \approx N\big(np, np(1-p)\big)\). Cele patru panouri compară probabilitățile binomiale (barele) cu densitatea Normală cu aceeași medie și varianță (curba), pentru \((n, p)\) egal cu \((5;\ 0{,}5)\),\((20;\ 0{,}5)\),\((20;\ 0{,}1)\) și \((100;\ 0{,}1)\).
O variabilă discretă se aproximează cu una continuă prin corecția de continuitate (continuity correction):
Termenul \(+0{,}5\) distribuie probabilitatea fiecărui întreg \(k\) pe intervalul \([k - 0{,}5;\ k + 0{,}5]\), astfel încît aria de sub densitate să corespundă barei respective.
Calitatea aproximării depinde de simetrie mai mult decît de \(n\). Cea mai mare eroare a funcției de repartiție este 0,001 pentru \(n = 20\),\(p = 0{,}5\), unde distribuția binomială este simetrică; 0,037 pentru \(n = 20\),\(p = 0{,}1\), unde ea este puternic asimetrică; și 0,017 pentru \(n = 100\),\(p = 0{,}1\). Regula practică cere ca varianța \(np(1-p)\) să fie mare, cel puțin aproximativ 9.
Pe scurt
\(B(n, p)\): numărul de succese în \(n\) încercări independente, cu probabilitatea de succes \(p\); \(B(n, p) \approx N\big(np, np(1-p)\big)\)
Corecția de continuitate: \(P(X \le k) \approx \Phi\big((k + 0{,}5 - np)/\sqrt{np(1-p)}\big)\); termenul \(+0{,}5\) distribuie fiecare întreg \(k\) pe intervalul \([k - 0{,}5; k + 0{,}5]\)
Cea mai mare eroare a CDF: \(0{,}001\) pentru \(n = 20, p = 0{,}5\); \(0{,}037\) pentru \(n = 20, p = 0{,}1\); \(0{,}017\) pentru \(n = 100, p = 0{,}1\)
Regulă practică: aproximarea este bună cînd \(np(1-p)\) este mare (cel puțin circa 9)
Un randament logaritmic zilnic este suma a mii de randamente logaritmice din timpul zilei. Întrebarea pentru sală este dacă teorema limită centrală garantează atunci randamente zilnice aproape Normale. Răspunsul este: nu neapărat, pentru că fiecare dintre cele trei condiții ale teoremei poate fi încălcată.
Prima condiție, independența, este contrazisă de gruparea zilelor calme și a celor agitate, documentată în secțiunea despre faptele stilizate: mărimea variațiilor de preț este autocorelată, chiar dacă semnul lor nu este. A doua condiție, distribuția identică, este contrazisă de faptul că volatilitatea diferă de la o zi la alta și de la o perioadă la alta, deci componentele din timpul zilei nu au aceeași distribuție în toate zilele.
A treia condiție, varianța finită, a fost pusă la îndoială de Mandelbrot (1963), care a propus pentru variațiile prețului bumbacului distribuții cu varianță infinită. Pentru sume de asemenea variabile, limita nu este distribuția Normală, ci o distribuție \(\alpha\)-stabilă, studiată în Capitolul 3. Teoria singură nu decide care condiție este încălcată și cît de mult; secțiunile următoare măsoară direct pe date cît de departe sînt randamentele de distribuția Normală.
Pe scurt
Un randament logaritmic zilnic este suma a mii de randamente logaritmice din timpul zilei
Ce credeți? Ar trebui atunci randamentele zilnice să fie aproape Normale?
Răspuns: nu neapărat; fiecare condiție a CLT poate fi încălcată
dependență: zilele calme și cele agitate apar grupat (secțiunea 8)
distribuție schimbătoare: volatilitatea diferă de la o zi la alta
varianță infinită: Mandelbrot (1963) a propus-o pentru prețurile bumbacului (Capitolul 3, distribuții \(\alpha\)-stabile)
Datele decid: secțiunile următoare măsoară cît de departe sînt randamentele de distribuția Normală
Sumele multor termeni i.i.d. cu varianță finită sînt aproximativ Normale, oricare ar fi distribuția termenilor. Convergența este mai lentă pentru variabile asimetrice: în simulare, media a 5 extrageri Bernoulli(0,2) are de peste două ori mai multe valori peste 1,96 decît prevede distribuția Normală. Pentru distribuția binomială, regula practică este \(np(1-p) \ge 9\).
Randamentele pot încălca oricare dintre cele trei condiții: independența, distribuția identică sau varianța finită. Teorema explică de ce distribuția Normală este un candidat natural, dar nu garantează că randamentele zilnice o urmează.
Pe scurt
Sumele multor termeni i.i.d. cu varianță finită sînt aproximativ Normale
Convergența este mai lentă pentru variabile asimetrice; \(np(1-p) \ge 9\) pentru distribuția binomială
Randamentele pot încălca independența, distribuția identică sau varianța finită
Sinteza secțiunii
Teorema limită centrală este argumentul teoretic al modelului de referință, dar el depinde de condiții pe care randamentele nu le îndeplinesc neapărat. Simulările arată și că, chiar cînd condițiile sînt îndeplinite, convergența în cozi poate fi lentă. Secțiunea următoare introduce instrumentele cu care forma unei distribuții se măsoară direct: asimetria și boltirea.
Momentele și forma unei distribuții
Media și varianța descriu poziția și dispersia unei distribuții, dar nu și forma ei. Secțiunea introduce două mărimi adimensionale care descriu forma: asimetria (skewness), bazată pe momentul centrat de ordinul trei, și boltirea (kurtosis), bazată pe momentul de ordinul patru. Pentru distribuția Normală ele au valorile fixe 0 și 3, deci abaterea lor de la aceste valori măsoară cît de departe sînt datele de modelul de referință. Secțiunea le estimează pentru cele opt serii ale capitolului și arată cît de sensibile sînt la cîteva observații.
Primele două momente sînt media \(\mu = E[X]\) și varianța \(\sigma^2 = E[(X - \mu)^2]\), unde \(E[\cdot]\) este valoarea așteptată. Următoarele două se definesc pe abaterile standardizate \((X - \mu)/\sigma\), deci nu depind de unitatea de măsură:
Asimetria \(\gamma_1\) folosește puterea a treia, care păstrează semnul fiecărei abateri. Abaterile mari negative și pozitive se compensează doar dacă distribuția este simetrică. O valoare \(\gamma_1 < 0\) indică o coadă stîngă mai lungă: pierderile mari sînt mai frecvente sau mai mari decît cîștigurile mari.
Boltirea \(\gamma_2\) folosește puterea a patra, care ignoră semnul și amplifică abaterile mari. Pentru distribuția Normală, \(\gamma_2 = 3\), de aceea se raportează de obicei excesul de boltire (excess kurtosis) \(\gamma_2 - 3\). Un exces pozitiv înseamnă cozi groase și un centru înalt și îngust; o asemenea distribuție se numește leptocurtică (leptokurtic). Ambele mărimi descriu forma, nu poziția sau scala. Puterea a patra are însă un cost: o singură abatere de 10 abateri standard contribuie la momentul de ordinul patru cît zece mii de abateri de o abatere standard, deci boltirea este foarte sensibilă la cîteva zile extreme.
Pe scurt
Media \(\mu = E[X]\); varianța \(\sigma^2 = E[(X - \mu)^2]\); \(E[\cdot]\) este valoarea așteptată
Întrebare pentru sală Pe slide, parametrul de formă α = 5 dă o densitate skew-Normal cu asimetria 0,85. Butonul ▶ crește α de la 0 la 20 (și coboară ν de la 40 la 4,5 în panoul din stînga). Ce asimetrie are densitatea la α = 20?
Răspuns
0,99. Asimetria familiei skew-Normal crește cu α, dar are o limită de circa 0,995: la α = 10 este 0,96, la α = 20 este 0,99. O asimetrie mai mare nu se poate obține cu această familie. Excesul de boltire al distribuției Student-t cu varianța 1 este 6/(ν − 4): 6 pentru ν = 5, 1 pentru ν = 10.
Panoul din stînga compară două densități cu aceeași medie, 0, și aceeași varianță, 1: distribuția Normală, cu exces de boltire 0, și distribuția Student-t cu 5 grade de libertate, rescalată la varianța 1, cu exces de boltire 6. Distribuția Student-t este definită în secțiunea 7. Deși varianțele sînt egale, formele diferă: curba Student-t are mai multă masă în centru și în cozi și mai puțină în umeri, zona aflată la aproximativ una–două abateri standard de medie.
Această redistribuire este interpretarea corectă a excesului de boltire. Boltirea nu măsoară doar „vîrful” distribuției, ci deplasarea masei din umeri simultan spre centru și spre cozi, la varianță constantă. O serie leptocurtică are deci mai multe zile foarte calme și mai multe zile extreme decît o serie Normală cu aceeași volatilitate.
Panoul din dreapta arată două densități skew-Normal, cu asimetria −0,85 (verde) și +0,85 (violet), alături de densitatea Normală (curba întreruptă). Densitatea cu asimetrie negativă are vîrful deplasat la dreapta și o coadă stîngă mai lungă; cea cu asimetrie pozitivă este imaginea ei în oglindă. Randamentele zilnice ale majorității seriilor din capitol au asimetrie negativă.
Pe scurt
Stînga: aceeași medie și varianță; curba Student-\(t(5)\) (secțiunea 7) are exces de boltire 6: mai multă masă în centru și în cozi, mai puțină în umeri
Dreapta: densități skew-Normal cu asimetria \(\pm 0{,}85\); curba punctată este distribuția Normală
Din \(n\) randamente \(r_1, \dots, r_n\), momentele centrate se estimează prin momentele de selecție \(m_k = \frac1n \sum_{t=1}^n (r_t - \bar r)^k\), media puterii \(k\) a abaterilor de la media de selecție \(\bar r\);\(m_2\) este varianța de selecție. Asimetria și excesul de boltire de selecție se obțin înlocuind în (2.5) momentele teoretice cu cele de selecție:
\[S = \frac{m_3}{m_2^{3/2}}, \qquad K = \frac{m_4}{m_2^2} - 3.\]
(2.6)
Dacă datele sînt i.i.d. Normale, cele două statistici sînt aproximativ Normale și independente: \(S \approx N(0, 6/n)\) și \(K \approx N(0, 24/n)\). Pentru \(n = 4\,201\), numărul randamentelor zilnice ale S&P 500, erorile standard sînt \(\sqrt{6/n} = 0{,}038\) pentru asimetrie și \(\sqrt{24/n} = 0{,}076\) pentru excesul de boltire. Aceste valori servesc la testarea normalității în secțiunea următoare.
Erorile standard de mai sus sînt valabile doar în ipoteza de normalitate. Varianța lui \(K\) depinde de momentul de ordinul opt al datelor; pentru date cu cozi groase acesta este foarte mare sau chiar infinit, iar eroarea standard reală a lui \(K\) este mult mai mare decît \(\sqrt{24/n}\).Seminarul 2 compară cele două erori standard pentru S&P 500.
Pe scurt
Momentele centrate de selecție: \(m_k = \frac1n \sum_{t=1}^n (r_t - \bar r)^k\), media puterii \(k\) a abaterilor de la medie (\(m_2\): varianța)
Asimetria de selecție \(S = m_3/m_2^{3/2}\); excesul de boltire de selecție \(K = m_4/m_2^2 - 3\)
Dacă datele sînt i.i.d. Normale: \(S \approx N(0, 6/n)\) și \(K \approx N(0, 24/n)\)
cu \(n = 4\,201\): erorile standard \(\sqrt{6/n} = 0{,}038\) și \(\sqrt{24/n} = 0{,}076\)
Aceste erori standard sînt valabile doar în ipoteza de normalitate; pentru date cu cozi groase sînt mult prea mici (Seminarul 2, B1)
Tabelul rezumă randamentele logaritmice zilnice ale celor opt serii ale capitolului: indicii S&P 500, DAX și BET, Bitcoin și patru acțiuni de la BVB, OMV Petrom (SNP), BRD, Nuclearelectrica (SNN) și Romgaz (SNG). Seriile încep în 2010, cu excepția Bitcoin, din 2014, și a SNN și SNG, din 2013. Coloanele dau numărul de observații \(n\), media și abaterea standard zilnice în procente, asimetria \(S\), excesul de boltire \(K\) și cel mai mic randament zilnic.
Toate seriile au exces de boltire între 5,1 (SNN) și 17,9 (BET). Comparația cu eroarea standard de 0,076 din ipoteza de normalitate arată cît de mari sînt aceste valori: chiar și cea mai mică depășește 0 cu zeci de erori standard. Volatilitățile sînt foarte diferite, de la 1,07% pe zi pentru BET la 3,49% pentru Bitcoin, dar forma cozilor este de același tip. Toate seriile, cu excepția SNN, au asimetrie negativă, cea mai pronunțată fiind a BET, −0,98.
Coloana minimelor leagă momentele de evenimente concrete. Cea mai slabă zi a S&P 500 este 16 martie 2020, cu −12,8%; a Bitcoin este 12 martie 2020, cu −46,5%; a BET este 19 decembrie 2018, cu −11,9%, ziua în care a fost anunțată Ordonanța de Urgență a Guvernului (OUG) 114, care introducea o taxă pe activele bancare. Asemenea zile contribuie în mare măsură la valorile asimetriei și ale excesului de boltire.
Pe scurt
Seria
din
\(n\)
Media %
Ab. std. %
Asim.
Exces bolt.
Min %
S&P 500
2010
4 201
\(0{,}045\)
\(1{,}08\)
\(-0{,}61\)
\(13{,}5\)
\(-12{,}8\)
DAX
2010
4 244
\(0{,}034\)
\(1{,}22\)
\(-0{,}45\)
\(7{,}4\)
\(-13{,}1\)
BET
2010
4 186
\(0{,}046\)
\(1{,}07\)
\(-0{,}98\)
\(17{,}9\)
\(-11{,}9\)
Bitcoin
2014
4 384
\(0{,}118\)
\(3{,}49\)
\(-0{,}70\)
\(12{,}0\)
\(-46{,}5\)
OMV Petrom (SNP)
2010
3 815
\(0{,}076\)
\(1{,}62\)
\(-0{,}54\)
\(8{,}9\)
\(-15{,}8\)
BRD
2010
3 771
\(0{,}044\)
\(1{,}66\)
\(-0{,}38\)
\(7{,}3\)
\(-18{,}2\)
Nuclearelectrica (SNN)
2013
2 911
\(0{,}099\)
\(1{,}52\)
\(0{,}27\)
\(5{,}1\)
\(-9{,}4\)
Romgaz (SNG)
2013
2 909
\(0{,}090\)
\(1{,}40\)
\(-0{,}34\)
\(5{,}3\)
\(-11{,}0\)
Toate seriile au exces de boltire între 5,1 (SNN) și 17,9 (BET): departe de 0
Toate seriile, cu excepția SNN, au asimetrie negativă
Cele mai slabe zile: S&P 500 pe 16 martie 2020, BET pe 19 decembrie 2018 (OUG 114, taxa pe activele bancare), Bitcoin pe 12 martie 2020
Întrebare pentru sală Fără perioada 20 februarie–30 aprilie 2020, excesul de boltire al S&P 500 scade de la 13,5 la 5,4. Ce se întîmplă cu excesul de boltire al BET?
Răspuns
Rămîne 18,0 (17,9 pe tot eșantionul). Cea mai slabă zi a BET, −11,9% pe 19 decembrie 2018 (OUG 114, taxa pe activele bancare), se află în afara acestei perioade. Boltirea de selecție depinde de cele cîteva zile extreme ale fiecărei serii, iar acestea diferă de la o piață la alta. Fără această perioadă, Bitcoin scade de la 12,0 la 5,4, iar DAX de la 7,4 la 3,1.
Întrebare pentru sală La −6%, densitatea estimată a randamentelor DAX este de 439 de ori mai mare decît densitatea Normală, cu lățimea de bandă dată de regula Scott. Ce se întîmplă cu acest raport dacă lățimea de bandă se înjumătățește?
Răspuns
Crește la circa 580; la un sfert din lățimea Scott ajunge la 1 100, iar la dublu este 522. În coadă sînt puține observații, iar estimarea densității acolo depinde de lățimea de bandă. Pentru orice lățime încercată, raportul rămîne de ordinul sutelor: concluzia că DAX are cozi mult mai groase decît distribuția Normală nu depinde de această alegere. Vîrful densității estimate scade de la 0,47 la 0,34 cînd lățimea crește de la 0,5 la 3 ori regula Scott.
Graficul compară distribuția randamentelor zilnice ale DAX cu densitatea Normală cu aceeași medie și aceeași abatere standard (curba roșie întreruptă). Distribuția empirică este reprezentată printr-un estimator nucleu al densității (kernel density estimator), adică o histogramă netezită. Panoul din stînga folosește scara liniară, care evidențiază centrul; panoul din dreapta folosește pe axa verticală scara logaritmică, care evidențiază cozile.
În centru, densitatea estimată are vîrful la 0,46, față de 0,33 pentru densitatea Normală. Ponderea zilelor aflate la cel mult o abatere standard de medie este 76,8%, față de 68,3% conform distribuției Normale. Randamentele DAX au deci mai multe zile calme decît prevede distribuția Normală cu aceeași volatilitate, iar această concentrare în centru este compensată de cozi mai groase.
Pe scara logaritmică, densitatea Normală este o parabolă orientată în jos și scade abrupt dincolo de ±4%. Densitatea estimată scade mult mai lent: la un randament de −6%, ea este de 439 de ori mai mare decît densitatea Normală. Oscilațiile de la capete provin din estimatorul nucleu, care are acolo foarte puține observații. Graficul arată pe date forma descrisă de excesul de boltire: centru mai înalt, umeri mai subțiri și cozi mai groase.
Pe scurt
Estimatorul nucleu al densității (o histogramă netezită) față de densitatea Normală cu aceeași medie și abatere standard
Centrul: vîrful densității 0,46 față de 0,33; 76,8% din zile în interiorul unei abateri standard, față de 68,3% pentru distribuția Normală
Cozile (scară logaritmică): la \(-6\%\) densitatea estimată este de 439 de ori mai mare decît densitatea Normală
Pentru că depinde de puterea a patra a abaterilor, boltirea poate fi modificată substanțial de cîteva observații eronate. Exemplul este acțiunea Banca Transilvania (TLV) în mai 2016. Între 27 și 31 mai, prețul de închidere a scăzut de la 2,83 la 2,09 lei, la data ex (ex-date) a unei distribuiri de acțiuni gratuite: scăderea nu este o pierdere pentru acționari, ci efectul mecanic al creșterii numărului de acțiuni.
Prețul ajustat ar trebui să elimine acest salt. În seria de prețuri ajustate folosită, valorile sînt însă 3,6014, apoi 3,0995, apoi 3,8060 lei, deci ajustarea a fost aplicată cu o zi mai tîrziu. Rezultatul sînt două randamente logaritmice consecutive false, de −15,0% și de +20,5%. Excesul de boltire al TLV în perioada 2010–2026 este 17,5 cu aceste două zile și 13,5 fără ele: două zile greșite din mii modifică boltirea cu aproximativ o treime.
Regula practică, formulată în Capitolul 1, este ca înainte de a calcula momente de ordin superior să se listeze cele mai mari variații ale seriei și să se verifice fiecare. Semnalul tipic al unei erori de ajustare este o pereche de salturi mari de semn opus în zile consecutive, care se anulează aproape complet. O criză reală produce de obicei mai multe zile agitate, nu un salt și revenirea lui imediată.
Pe scurt
Banca Transilvania (TLV), 27–31 mai 2016: prețul de închidere scade de la 2,83 la 2,09 lei, data ex a unei distribuiri de acțiuni gratuite
Prețul ajustat din datele noastre: 3,6014, apoi 3,0995, apoi 3,8060
randamente logaritmice \(-15{,}0\%\) și \(+20{,}5\%\) în două zile consecutive: ajustarea a fost aplicată cu o zi mai tîrziu
Excesul de boltire al TLV, 2010–2026: 17,5 cu aceste două zile, 13,5 fără ele
Două zile greșite din mii schimbă boltirea cu o treime: de aceea TLV nu apare în tabelele acestui capitol
Regula din Capitolul 1: listați cele mai mari variații și verificați-le pe fiecare, mai ales perechile de salturi de semn opus
Asimetria măsoară lipsa simetriei, iar excesul de boltire măsoară greutatea cozilor și înălțimea centrului față de distribuția Normală, la aceeași varianță. Ambele sînt adimensionale și au valoarea 0 pentru distribuția Normală.
Randamentele zilnice ale celor opt serii au în general asimetrie negativă și exces de boltire între 5 și 18. Pentru că depinde de puterea a patra, boltirea este determinată de cîteva zile extreme; acestea trebuie verificate înainte ca valoarea estimată să fie interpretată.
Pe scurt
Asimetria măsoară lipsa simetriei, excesul de boltire măsoară greutatea cozilor față de distribuția Normală
Randamentele zilnice: în general asimetrie negativă și exces de boltire între 5 și 18
Boltirea este determinată de cîteva zile: verificați-le înainte de a avea încredere în ea
Sinteza secțiunii
Momentele de ordin superior arată că randamentele reale au mai multe zile calme, mai multe zile extreme și, de regulă, o coadă stîngă mai lungă decît prevede distribuția Normală cu aceeași volatilitate. Valorile estimate sînt însă instabile, pentru că depind de cîteva observații. Secțiunea următoare transformă aceste măsuri într-un test formal al normalității și introduce un instrument grafic care arată unde anume greșește modelul.
Testarea normalității: Jarque–Bera și QQ plots
Secțiunea prezintă două instrumente complementare de verificare a normalității. Testul Jarque–Bera combină asimetria și excesul de boltire de selecție într-o singură statistică și dă un răspuns formal, de tip respingere sau nerespingere. Graficul cuantilă–cuantilă (QQ plot) compară cuantilele empirice cu cele ale modelului și arată în ce regiune a distribuției, centru, umeri sau cozi, apare abaterea.
Ipoteza nulă a testului este că datele provin dintr-o distribuție Normală, ceea ce implică asimetrie 0 și exces de boltire 0. Statistica Jarque–Bera (JB) (Jarque & Bera, 1980; Jarque & Bera, 1987) este
A doua formă din (2.7) arată construcția testului: fiecare dintre cele două statistici se standardizează cu eroarea ei standard din ipoteza de normalitate, iar rezultatele se ridică la pătrat și se adună.
În ipoteza nulă și pentru \(n\) mare, cele două statistici standardizate sînt aproximativ \(N(0,1)\) și independente, deci JB are aproximativ distribuția hi-pătrat cu două grade de libertate, \(\chi^2(2)\), distribuția sumei pătratelor a două variabile \(N(0,1)\) independente. Cuantila de 95% a acestei distribuții este 5,99, deci normalitatea se respinge la pragul de 5% dacă \(\text{JB} > 5{,}99\).
Statistica este 0 doar pentru o formă perfect Normală în sensul primelor patru momente, iar valorile mari indică asimetrie sau exces de boltire departe de 0. Testul este simplu, folosește doar două momente de selecție și este testul de normalitate raportat de regulă în finanțele empirice.
Pe scurt
\(H_0\): datele sînt Normale, deci asimetria \(= 0\) și excesul de boltire \(= 0\)
suma a două statistici standardizate la pătrat: \((S/\sqrt{6/n})^2 + (K/\sqrt{24/n})^2\)
În ipoteza \(H_0\) și pentru \(n\) mare: \(\text{JB} \sim \chi^2(2)\); respingem la 5% dacă \(\text{JB} > 5{,}99\)
\(\chi^2(2)\): distribuția hi-pătrat cu 2 grade de libertate, distribuția sumei pătratelor a două variabile \(N(0,1)\) independente; 5,99 este cuantila ei de 95%
JB \(= 0\) pentru o formă perfect Normală; valorile mari indică asimetrie sau exces de boltire departe de 0
Este simplu, folosește doar două momente și este testul raportat de regulă în finanțele empirice
Pentru randamentele zilnice ale S&P 500, \(n = 4\,201\), asimetria de selecție este \(S = -0{,}606\), iar excesul de boltire \(K = 13{,}49\). Factorul \(n/6\) este 700,17, termenul de asimetrie \(S^2\) este 0,3673, iar termenul de boltire \(K^2/4\) este 45,498. Rezultă \(\text{JB} = 700{,}17 \times (0{,}3673 + 45{,}498) = 32\,113\).
Valoarea critică la pragul de 5% este 5,99, deci normalitatea este respinsă, iar p-value-ul este practic zero. Descompunerea arată că aproape toată valoarea statisticii provine din termenul de boltire: asimetria contribuie cu mai puțin de 1%. Ce respinge testul în cazul S&P 500 sînt în principal cozile groase, nu lipsa simetriei.
Pentru celelalte serii, rezultatul este același. Statistica JB este 56 762 pentru BET, 9 909 pentru DAX și 26 482 pentru Bitcoin; pentru acțiunile BVB este 12 832 pentru SNP, 8 370 pentru BRD, 3 174 pentru SNN și 3 415 pentru SNG. Toate depășesc cu mult valoarea critică, deci normalitatea este respinsă la orice prag uzual pentru toate cele opt serii.
Prima limită ține de mărimea eșantionului. Cu mii de observații, testul are o putere foarte mare și respinge normalitatea chiar și pentru abateri mici, fără importanță practică. De aceea trebuie raportate mărimile lui \(S\) și \(K\), care spun cît de departe sînt datele de distribuția Normală, nu doar p-value-ul, care spune doar dacă abaterea este detectabilă.
A doua limită ține de ipoteza i.i.d. Erorile standard \(\sqrt{6/n}\) și \(\sqrt{24/n}\) presupun observații independente și Normale. Cînd randamentele prezintă volatility clustering, adică perioade calme și agitate care se succed, aceste erori standard sînt prea mici. Pentru S&P 500, intervalul de încredere de 95% pentru \(K\) calculat în ipoteza de normalitate este \([13{,}34;\ 13{,}64]\), iar un interval bootstrap, care ține seama de distribuția reală a datelor, este \([6{,}7;\ 20{,}6]\), de aproape cincizeci de ori mai larg. Excesul de boltire este sigur pozitiv, dar valoarea lui exactă este foarte imprecisă.
A treia limită este că o respingere arată doar că datele nu sînt Normale, fără să indice ce distribuție urmează. În plus, testul folosește doar două momente. Testele Kolmogorov–Smirnov și Anderson–Darling compară întreaga funcție de repartiție empirică cu cea a modelului și sînt prezentate în Capitolul 6.
Pe scurt
Cu mii de observații respinge chiar și abateri foarte mici
raportați mărimea lui \(S\) și \(K\), nu doar p-value-ul
Testul presupune date i.i.d.; cu volatility clustering, erorile standard ale lui \(S\) și \(K\) sînt prea mici
S&P 500: intervalul de 95% pentru \(K\) în ipoteza de normalitate: \([13{,}34; 13{,}64]\); intervalul bootstrap: \([6{,}7; 20{,}6]\) (Seminarul 2, B1)
Respingerea arată că datele nu sînt Normale, dar nu indică ce distribuție urmează
Alte teste (Kolmogorov–Smirnov, Anderson–Darling) compară întreaga CDF: Capitolul 6
Un grafic cuantilă–cuantilă (QQ plot, quantile–quantile plot) compară cuantilele empirice ale datelor cu cuantilele unui model (Wilk & Gnanadesikan, 1968). Datele se ordonează crescător, \(r_{(1)} \le r_{(2)} \le \dots \le r_{(n)}\), unde \(r_{(i)}\) este al \(i\)-lea cel mai mic randament. Fiecare \(r_{(i)}\) este cuantila empirică de ordin aproximativ \((i - 0{,}5)/n\), proporția datelor aflate sub el. Graficul reprezintă punctele \(\big(F^{-1}((i - 0{,}5)/n),\ r_{(i)}\big)\), unde \(F^{-1}\) este funcția cuantilă a modelului.
Dacă modelul este corect, cuantilele empirice și cele teoretice coincid aproximativ, iar punctele se află pe prima bisectoare. Abaterile au o interpretare geometrică directă. O formă de S, cu capătul stîng sub dreaptă și cel drept deasupra, înseamnă că cuantilele extreme ale datelor sînt mai departe de centru decît cele ale modelului, adică datele au cozi mai groase. Dacă doar un capăt se îndepărtează de dreaptă, distribuția datelor este asimetrică.
Spre deosebire de testul Jarque–Bera, care rezumă abaterea într-un singur număr, QQ plot-ul arată unde greșește modelul: în centru, în umeri sau în cozi. Același instrument se poate folosi cu orice model \(F\), nu doar cu distribuția Normală; secțiunea despre distribuția Student-t îl aplică unei distribuții Student-t estimate.
Pe scurt
Un QQ plot (quantile–quantile plot, graficul cuantilă–cuantilă) compară cuantilele empirice cu cele ale unui model Wilk & Gnanadesikan (1968)
Întrebare pentru sală Butonul ▶ mută începutul eșantionului pînă în 2024, cînd fiecare serie are doar între 600 și 1 000 de zile. Mai respinge testul Jarque–Bera normalitatea la 5% pentru toate cele opt serii?
Răspuns
Da. Din 2024, cea mai mică valoare JB este 33, la SNP (n = 632, S = −0,03, K = 1,1), peste valoarea critică 5,99; S&P 500 are încă 6 318, cu K = 14,9, din zilele din aprilie 2025. Cu cîteva sute de observații, un exces de boltire de circa 1 dă deja o valoare JB mult peste 5,99. Pe 2010–2026, JB este între 3 174 (SNN) și 56 762 (BET).
Întrebare pentru sală Butonul ▶ mută începutul eșantionului de la 2010 la 2024. Dacă eșantionul începe în 2021, după martie 2020, mai depășește cel mai mic randament standardizat al S&P 500 cuantila Normală corespunzătoare?
Răspuns
Da. De la începutul lui 2021, cel mai mic randament al S&P 500 este −6,2%, pe 4 aprilie 2025: −6,0 abateri standard, față de cuantila Normală −3,4. Pe tot eșantionul, ziua de 16 martie 2020 dă −11,8 față de −3,7. Martie 2020 mărește abaterea, dar nu o produce: și BET (−6,1) și Bitcoin (−5,8) rămîn departe de dreaptă după 2021.
Cele trei panouri arată randamentele zilnice standardizate ale S&P 500, BET și Bitcoin, pe axa verticală, față de cuantilele distribuției \(N(0,1)\), pe axa orizontală; linia întreruptă este prima bisectoare. Toate cele trei serii au forma de S descrisă anterior: în zona centrală punctele urmează dreapta, iar la ambele capete se îndepărtează de ea.
Mărimea abaterii se citește direct pe axe. Pentru S&P 500, cel mai mic randament standardizat este −11,8, în timp ce cuantila Normală corespunzătoare acestei poziții în eșantion este −3,7. Pentru BET, cel mai mic randament standardizat este −11,2, față de aceeași cuantilă Normală de −3,7. Cea mai slabă zi a fiecărei serii se află deci de trei ori mai departe de centru decît prevede distribuția Normală.
Cele două capete nu sînt simetrice. Coada stîngă se curbează mai mult decît cea dreaptă, ceea ce corespunde asimetriei negative măsurate în tabelul de momente. Graficul arată, așadar, aceleași două abateri ca testul Jarque–Bera, cozi groase și asimetrie negativă, dar le localizează în extremele distribuției.
Pe scurt
Randamente standardizate față de cuantilele \(N(0,1)\): toate trei se depărtează de dreaptă la ambele capete
S&P 500: cel mai mic randament standardizat \(-11{,}8\), unde cuantila Normală este \(-3{,}7\); BET: \(-11{,}2\) față de \(-3{,}7\)
Coada stîngă se curbează mai mult decît cea dreaptă: asimetrie negativă
Testul Jarque–Bera combină asimetria și excesul de boltire de selecție într-o statistică cu distribuția \(\chi^2(2)\) în ipoteza de normalitate. El respinge normalitatea pentru toate cele opt serii, iar pentru S&P 500 aproape toată valoarea statisticii provine din excesul de boltire.
Respingerea trebuie însoțită de mărimea abaterii, pentru că erorile standard din teoria Normală sînt prea mici pentru date cu cozi groase și volatility clustering. QQ plots arată unde greșește modelul; pentru randamentele zilnice, abaterea este în ambele cozi, mai pronunțată în cea stîngă.
Pe scurt
JB combină asimetria și boltirea; respinge normalitatea pentru toate seriile
Raportați mărimea abaterii; erorile standard din teoria Normală sînt prea mici
QQ plots arată unde greșește modelul: aici, în ambele cozi
Sinteza secțiunii
Testele formale și cele grafice ajung la aceeași concluzie: randamentele zilnice nu sînt Normale, iar abaterea principală este în cozi. QQ plot-ul sugerează și direcția de corecție: un model cu cozi mai groase decît distribuția Normală, dar cu un centru asemănător. Secțiunea următoare prezintă cel mai simplu model de acest tip, distribuția Student-t.
Distribuția Student-\(t\)
Distribuția Student-t adaugă distribuției Normale un singur parametru, gradele de libertate, care controlează grosimea cozilor. Pentru valori mari ale acestui parametru ea se apropie de distribuția Normală, iar pentru valori mici are cozi de tip putere. Secțiunea prezintă definiția și proprietățile ei, o estimează prin verosimilitate maximă pe cele opt serii ale capitolului și arată ce rămîne neexplicat.
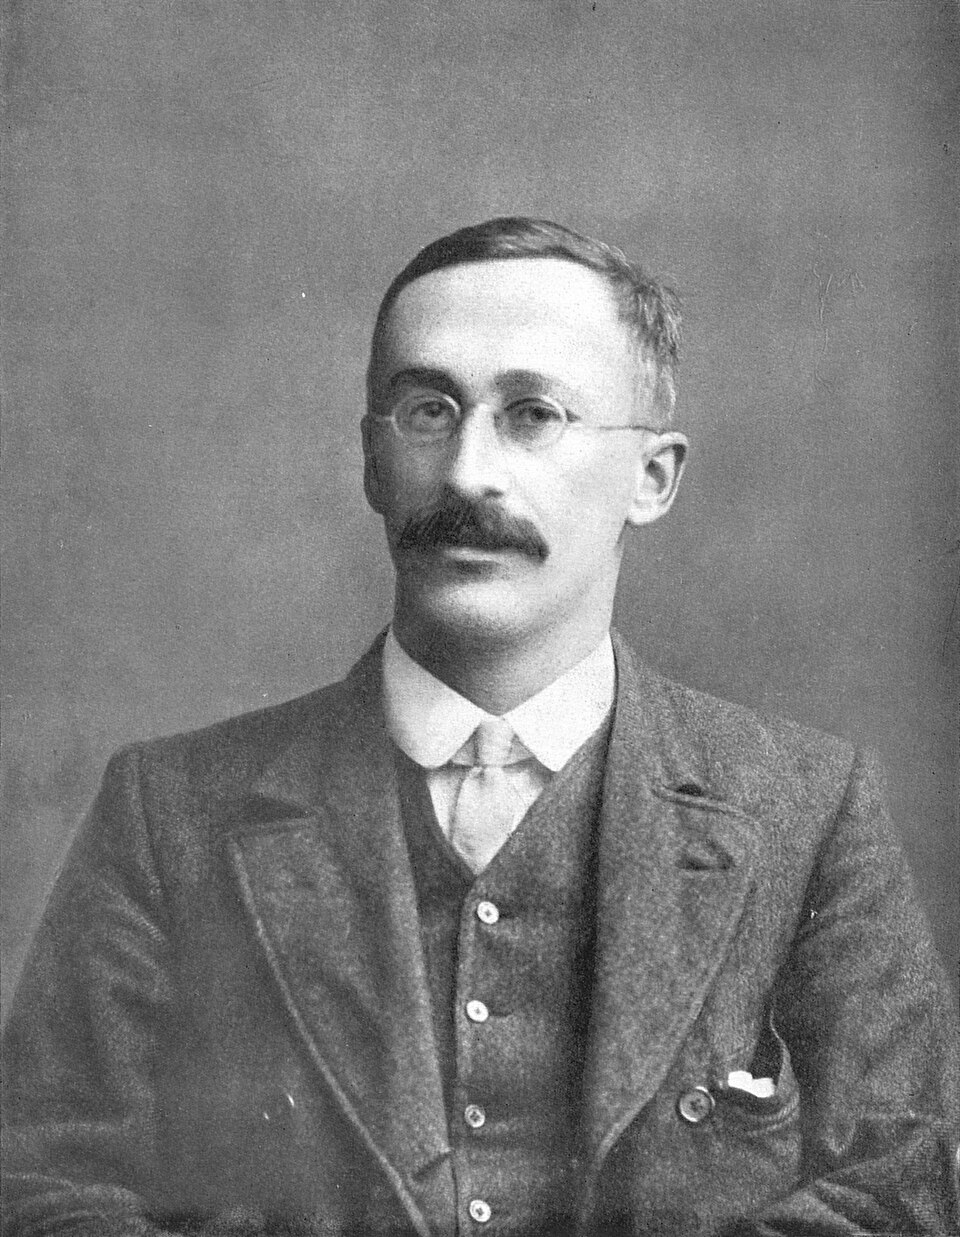
William Sealy Gosset a fost chimist și berar la fabrica Guinness din Dublin, unde lucra cu eșantioane mici de orz și hamei. Fabrica nu permitea angajaților să publice sub propriul nume, de aceea articolul lui din 1908 este semnat „Student” (Student, 1908).
Problema lui Gosset era inferența despre o medie cînd varianța este necunoscută și eșantionul mic. El a dedus distribuția statisticii \((\bar X - \mu)/(s/\sqrt n)\) pentru date Normale, unde \(s\) este abaterea standard de selecție. Deoarece \(s\) este ea însăși estimată, statistica are cozi mai groase decît distribuția Normală; aceasta este distribuția \(t\), folosită astăzi în orice test \(t\).
În finanțe, distribuția este folosită dintr-un alt motiv: ca model al randamentelor, tocmai pentru că are cozi mai groase decît distribuția Normală. Primele aplicații la prețurile acțiunilor sînt ale lui Praetz (1972) și Blattberg & Gonedes (1974).
Pe scurt
Chimist și berar la Guinness, Dublin, lucra cu eșantioane mici de orz și hamei
Fabrica de bere nu își lăsa angajații să publice sub propriul nume: a semnat „Student” Student (1908)
A dedus distribuția lui \((\bar X - \mu)/(s/\sqrt n)\) pentru date Normale: distribuția \(t\)
Fie \(Z \sim N(0,1)\) și \(V \sim \chi^2(\nu)\) independente, unde \(\chi^2(\nu)\) este distribuția sumei pătratelor a \(\nu\) variabile \(N(0,1)\) independente. Variabila \(T = Z/\sqrt{V/\nu}\) are distribuția Student-t cu \(\nu\) grade de libertate (degrees of freedom), \(T \sim t(\nu)\). Parametrul \(\nu > 0\) controlează grosimea cozilor. Densitatea este
unde \(\Gamma\) este funcția gamma, cu \(\Gamma(k) = (k-1)!\) pentru \(k\) întreg.
Construcția explică forma cozilor. Numărătorul \(Z\) este Normal, dar numitorul \(\sqrt{V/\nu}\) este aleator; cînd el ia valori mici, \(T\) ia valori mari. Distribuția \(t\) este deci o distribuție Normală a cărei scală variază aleator, o idee care reapare în modelele cu volatilitate variabilă.
Pentru randamente se folosește versiunea cu parametri de poziție și de scală, \(r = m + s\,T\), cu poziția \(m\), scala \(s\) și gradele de libertate \(\nu\). Cînd \(\nu \to \infty\),\(V/\nu \to 1\) și \(t(\nu) \to N(0,1)\): distribuția Normală este un caz limită al familiei Student-t. Estimarea lui \(\nu\) arată deci și cît de departe sînt datele de distribuția Normală.
Pe scurt
\(T = Z/\sqrt{V/\nu}\), cu \(Z \sim N(0,1)\) independentă de \(V \sim \chi^2(\nu)\): \(T \sim t(\nu)\)
\(\nu > 0\): gradele de libertate, care controlează cozile
\(\chi^2(\nu)\): distribuția sumei pătratelor a \(\nu\) variabile \(N(0,1)\) independente; \(\Gamma\): funcția gamma, \(\Gamma(k) = (k-1)!\) pentru \(k\) întreg
Momentele distribuției \(t(\nu)\) există doar pînă la un anumit ordin. Media este 0 dacă \(\nu > 1\), varianța este \(\nu/(\nu - 2)\) dacă \(\nu > 2\), iar excesul de boltire este \(6/(\nu - 4)\) dacă \(\nu > 4\). În general, momentele de ordin \(\nu\) și mai mare sînt infinite. Pentru \(\nu \le 4\) boltirea este infinită, iar pentru \(\nu \le 2\) chiar varianța este infinită.
Motivul este forma cozilor. Pentru \(x\) mare, \(P(|T| > x) \approx c\,x^{-\nu}\), cu \(c > 0\) o constantă: coada scade ca o putere a lui \(x\) (power-law tail). Dublarea lui \(x\) împarte probabilitatea din coadă la aproximativ \(2^{\nu}\), oricît de departe s-ar afla \(x\). Coada Normală scade ca \(e^{-x^2/2}\), mult mai repede decît orice putere. Exponentul \(\nu\) este și indicele cozii (tail index), care se estimează direct, fără a presupune o anumită distribuție, în Capitolul 5.
Varianța lui \(T\) este \(\nu/(\nu - 2)\), mai mare decît 1. Pentru a compara distribuția Student-t cu distribuția Normală la aceeași varianță, se folosește variabila rescalată \(T\sqrt{(\nu - 2)/\nu}\), care are varianța 1. Graficele următoare folosesc această rescalare, astfel încît diferențele să provină doar din formă.
Pe scurt
Media \(0\) dacă \(\nu > 1\); varianța \(\nu/(\nu - 2)\) dacă \(\nu > 2\); excesul de boltire \(6/(\nu - 4)\) dacă \(\nu > 4\)
Momentele de ordin \(\nu\) și mai mare sînt infinite
Întrebare pentru sală Cu ν = 5 și varianța 1, o zi dincolo de 4 abateri standard este de 56 de ori mai probabilă decît în cazul distribuției Normale. Butonul ▶ crește pragul pînă la 6. Ce se întîmplă cu acest raport?
Răspuns
Crește: 2 316 la 5 abateri standard și circa 290 000 la 6. Coada distribuției Student-t scade ca o putere, |x|−ν, iar coada Normală ca e−x²/2, deci raportul crește fără limită. La 6 abateri standard, P(|X| > 6) este 0,057% pentru t(5) și 0,0000002% pentru distribuția Normală.
Graficul compară densitatea Normală standard cu densitățile Student-t cu 3, 5 și 10 grade de libertate, toate rescalate la varianța 1. Pe scara liniară, din stînga, distribuțiile cu \(\nu\) mai mic au un centru mai înalt. Pe scara logaritmică, din dreapta, diferența se mută în cozi: densitatea Normală scade ca o parabolă, iar densitățile Student-t scad mult mai lent, ca o putere a lui \(|x|\).
Probabilitățile de coadă cuantifică diferența. La varianța 1, probabilitatea unei valori aflate la peste 4 abateri standard de 0 este 0,62% pentru \(t(3)\), 0,36% pentru \(t(5)\), 0,12% pentru \(t(10)\) și 0,0063% pentru distribuția Normală. Chiar și cu 10 grade de libertate, unde densitatea pare aproape Normală pe scara liniară, coada la 4 abateri standard este de aproximativ 19 ori mai groasă.
Pentru \(\nu = 5\), o zi de 4 sigma este de 56 de ori mai probabilă decît conform distribuției Normale. Cu 252 de zile de tranzacționare pe an, 0,36% înseamnă aproximativ o asemenea zi pe an, o frecvență de același ordin cu cea observată în S&P 500.
Pe scurt
\(\nu\) mai mic: centru mai înalt și cozi mai groase; pe scara logaritmică, cozile Normale scad ca o parabolă
Cei trei parametri \((\nu, m, s)\) se estimează prin metoda verosimilității maxime (MLE, maximum likelihood estimation): se aleg valorile care maximizează log-verosimilitatea
\[\ell(\nu, m, s) = \sum_{t=1}^n \ln f\big((r_t - m)/s;\ \nu\big) - n \ln s,\]
(2.9)
unde \(f(\cdot\,; \nu)\) este densitatea \(t(\nu)\) din (2.8). Termenul \(-n \ln s\) este jacobianul rescalării: densitatea lui \(r = m + sT\) este \(f\big((r - m)/s\big)/s\). Problema nu are soluție în formă închisă și se rezolvă cu un optimizator numeric; notebook-ul cursului folosește funcția scipy.stats.t.fit.
Pentru a compara modelul Student-t cu modelul Normal se folosește criteriul informațional Akaike (AIC, Akaike information criterion) (Akaike, 1974),\(\text{AIC} = 2k - 2\ell\), unde \(k\) este numărul de parametri estimați: 2 pentru distribuția Normală și 3 pentru distribuția \(t\). Termenul \(2k\) penalizează complexitatea, deci un model cu un parametru în plus este preferat doar dacă îmbunătățește log-verosimilitatea maximă cu mai mult de o unitate.
Se preferă modelul cu AIC mai mic. Diferența \(\Delta\text{AIC} = \text{AIC}_{\text{Normal}} - \text{AIC}_{t}\) este pozitivă cînd distribuția \(t\) este preferată, iar mărimea ei arată cît de clar. Primele rezultate empirice de acest tip pentru prețurile acțiunilor sînt ale lui Praetz (1972) și Blattberg & Gonedes (1974).
Pe scurt
MLE (maximum likelihood estimation, estimarea prin verosimilitate maximă): alegem \((\nu, m, s)\) care maximizează log-verosimilitatea
\(\ell(\nu, m, s) = \sum_{t=1}^n \ln f\big((r_t - m)/s; \nu\big) - n \ln s\)
\(f(\cdot; \nu)\): densitatea \(t(\nu)\); termenul \(-n \ln s\) corectează rescalarea randamentelor cu \(s\)
fără formă închisă: un optimizator numeric (scipy.stats.t.fit în notebook)
Tabelul dă, pentru fiecare dintre cele opt serii, gradele de libertate estimate \(\hat\nu\) și diferența \(\Delta\text{AIC}\) față de distribuția Normală. Toate valorile \(\hat\nu\) se află între 2,23, pentru Bitcoin, și 4,67, pentru BRD. Pentru indici, \(\hat\nu\) este 2,78 pentru S&P 500, 3,31 pentru DAX și 2,96 pentru BET.
Pentru 7 din cele 8 serii, \(\hat\nu < 4\), deci distribuția estimată are boltire infinită. Rezultatul pare să contrazică tabelul de momente, unde excesul de boltire de selecție este finit pentru fiecare serie. Contradicția este doar aparentă: boltirea de selecție este întotdeauna finită, dar cînd boltirea teoretică este infinită ea nu converge, ci depinde de cele mai extreme observații din eșantion. Aceasta explică sensibilitatea boltirii la cîteva zile și intervalul bootstrap foarte larg obținut pentru S&P 500. Pentru Bitcoin, \(\hat\nu = 2{,}23\) este aproape de 2, pragul sub care și varianța ar fi infinită.
Diferența \(\Delta\text{AIC}\) este de cel puțin 478, valoare atinsă de BRD, și ajunge la 1 454 pentru BET. Pe scara AIC, unde diferențele de cîteva unități sînt deja relevante, distribuția \(t\) este preferată distribuției Normale pentru toate seriile, fără nicio ambiguitate.
Pe scurt
Seria
\(\hat\nu\)
\(\Delta\)AIC
S&P 500
\(2{,}78\)
\(1213\)
DAX
\(3{,}31\)
\(739\)
BET
\(2{,}96\)
\(1454\)
Bitcoin
\(2{,}23\)
\(1335\)
OMV Petrom (SNP)
\(3{,}79\)
\(679\)
BRD
\(4{,}67\)
\(478\)
Nuclearelectrica (SNN)
\(3{,}08\)
\(541\)
Romgaz (SNG)
\(3{,}40\)
\(482\)
Toate valorile \(\hat\nu\) între 2,23 (Bitcoin) și 4,67 (BRD)
\(\hat\nu < 4\) pentru 7 din cele 8 serii: modelul estimat are boltire infinită
\(\Delta\)AIC este cel puțin 478: distribuția \(t\) este preferată distribuției Normale pentru toate seriile
Întrebare pentru sală Cu eșantionul din 2010, ν̂ este sub 4 pentru 7 din cele 8 serii. Butonul ▶ mută începutul eșantionului. Dacă eșantionul începe în 2021, pentru cîte serii este ν̂ sub 4?
Răspuns
Pentru 3: BET (3,76), Bitcoin (2,69) și SNN (3,03). S&P 500 trece de la 2,78 la 4,05, BRD de la 4,67 la 6,26. Fără 2020 cozile sînt mai subțiri, dar toate valorile ν̂ rămîn între 2,7 și 6,3, departe de distribuția Normală (ν → ∞), iar ΔAIC rămîne în favoarea distribuției t pentru fiecare serie (cel puțin 66, la SNP). ν̂ este o estimație care depinde de eșantion, mai ales de cele cîteva zile extreme pe care le conține.
Întrebare pentru sală Butonul ▶ fixează ν la valori de la 2,2 la 30 și reestimează locația și scala pentru S&P 500. Care valoare dă o log-verosimilitate mai mare: ν = 2,2 sau ν = 4?
Răspuns
ν = 2,2: log-verosimilitatea este −5 704,8, față de −5 714,6 la ν = 4. Maximul, −5 693,8, este la estimația ν̂ = 2,78, iar profilul nu este simetric în jurul ei: scade încet spre ν mic și mai repede spre ν mare. La ν = 30 log-verosimilitatea este −6 054,5, spre −6 301,2, valoarea distribuției Normale. Diferența de AIC dintre distribuția Normală și distribuția t este 12 606,4 − 11 393,6 = 1 212,8 în favoarea distribuției t.
Graficul compară histograma randamentelor zilnice ale S&P 500 cu densitatea Normală estimată (curba roșie întreruptă) și cu densitatea Student-t estimată, cu \(\hat\nu = 2{,}78\) (curba verde). Pe scara liniară, din stînga, histograma are un vîrf mult mai înalt decît densitatea Normală; densitatea \(t\) reproduce acest centru înalt.
Pe scara logaritmică, din dreapta, punctele reprezintă înălțimile barelor histogramei. Densitatea Normală scade abrupt dincolo de ±4% și atribuie randamentelor de ±10% densități practic nule, deși asemenea zile apar în date. Densitatea \(t\) urmează punctele observate pînă departe în cozi, datorită scăderii de tip putere.
Graficul arată de ce AIC preferă atît de clar distribuția \(t\). Log-verosimilitatea este o sumă pe toate observațiile; fiecare zi extremă, căreia distribuția Normală îi atribuie o densitate aproape nulă, adaugă un termen negativ foarte mare la log-verosimilitatea Normală. Un parametru suplimentar care face cozile mai groase elimină acești termeni.
Pe scurt
Scara liniară: distribuția \(t\) (\(\hat\nu = 2{,}78\)) reproduce centrul înalt, pe care distribuția Normală nu îl reproduce
Întrebare pentru sală Cu ν estimat (2,78), distribuția t prevede pentru S&P 500 un minim de −15,8%, sub minimul observat de −12,8%. Butonul ▶ fixează ν la valori mai mari. Pentru ce ν se apropie minimul prevăzut de cel observat?
Răspuns
Între ν = 3 și ν = 4. Cu locația și scala reestimate, minimul prevăzut este −13,6% la ν = 3 și −8,7% la ν = 4, față de −12,8% observat. Un ν mai mare înseamnă cozi mai subțiri. La ν = 4, centrul se potrivește la fel de bine, dar extremele observate ies din nou sub dreaptă; nicio valoare unică a lui ν nu potrivește simultan centrul și extremele.
Panourile arată QQ plots ale randamentelor zilnice ale S&P 500, BET și Bitcoin față de cuantilele distribuției Student-t estimate pentru fiecare serie, cu 2,8, 3,0 și respectiv 2,2 grade de libertate. Ambele axe sînt în procente. Comparativ cu QQ plots față de distribuția Normală, forma de S a dispărut: centrul și cozile moderate se află acum pe prima bisectoare.
La extreme apare o abatere de semn opus. Distribuția \(t\) estimată prevede minime mai mici decît cele observate: pentru S&P 500, cuantila teoretică corespunzătoare celui mai mic randament este −15,8%, față de minimul observat de −12,8%; pentru Bitcoin, −85,0% față de −46,5%. Pe grafic, punctele extreme se întorc spre centru: în capătul stîng se află deasupra bisectoarei, iar în cel drept sub ea.
Cu \(\hat\nu\) apropiat de 2, modelul are cozi atît de groase încît supraestimează cuantilele cele mai extreme. Un singur parametru trebuie să reproducă simultan centrul înalt, cozile moderate și extremele; estimatorul de verosimilitate maximă, dominat de numărul mare de observații din centru și din cozile moderate, alege un \(\nu\) care le potrivește pe acestea și greșește în sens opus la extreme.
Pe scurt
Centrul și cozile moderate se află acum pe dreaptă
Extremele: distribuția \(t\) estimată prevede minime mai mici decît cele observate: S&P 500 \(-15{,}8\%\) față de \(-12{,}8\%\); Bitcoin \(-85{,}0\%\) față de \(-46{,}5\%\)
Cu \(\hat\nu\) apropiat de 2, modelul supraestimează cuantilele cele mai extreme
Prima limită este simetria. Distribuția Student-t este simetrică în jurul poziției \(m\), deci nu poate reproduce asimetria negativă a randamentelor, vizibilă în tabelul de momente și în QQ plots. Există distribuții \(t\) asimetrice, care adaugă un parametru de asimetrie, dar ele depășesc cadrul acestui capitol.
A doua limită este independența. Un model în care randamentele sînt i.i.d. Student-t descrie distribuția marginală, dar nu și dinamica: în el, o zi agitată nu face mai probabilă o altă zi agitată, deci modelul nu are volatility clustering. Modelele GARCH cu erori \(t\) combină o distribuție condiționată cu cozi groase cu o volatilitate care variază în timp (Bollerslev, 1987); ele sînt tratate în Capitolul 9.
A treia limită este că un singur parametru \(\nu\) determină ambele cozi și centrul. Teoria valorilor extreme (extreme value theory) modelează fiecare coadă separat, folosind doar observațiile extreme (Capitolul 5). Cu toate aceste limite, distribuția Student-t rămîne cel mai simplu model cu cozi groase și o îmbunătățire mare față de distribuția Normală.
Pe scurt
Simetria: \(t\) nu poate reproduce asimetria negativă
există distribuții \(t\) asimetrice, dar depășesc cadrul acestui capitol
Independența: un model \(t\) i.i.d. nu are volatility clustering
Distribuția Student-t adaugă distribuției Normale un parametru, \(\nu\), care controlează cozile. Cozile ei sînt de tip putere, momentele de ordin cel puțin \(\nu\) sînt infinite, iar pentru \(\nu \to \infty\) ea devine distribuția Normală.
Pentru randamentele zilnice ale celor opt serii, \(\hat\nu\) estimat se află între 2 și 5, iar AIC preferă clar distribuția \(t\) pentru fiecare serie. Modelul nu surprinde însă asimetria și volatility clustering.
Pe scurt
Un parametru în plus, \(\nu\), controlează cozile; cozi de tip putere, distribuția Normală cînd \(\nu \to \infty\)
\(\hat\nu\) estimat între 2 și 5 pentru randamentele zilnice; AIC preferă clar \(t\)
Nu surprinde asimetria și volatility clustering
Sinteza secțiunii
Distribuția Student-t corectează principala abatere de la normalitate, cozile groase, cu un singur parametru suplimentar. Valorile estimate ale lui \(\nu\), de regulă sub 4, arată că randamentele zilnice au cozi atît de groase încît boltirea teoretică nu este nici măcar finită. Modelul tratează însă randamentele ca independente și simetrice. Secțiunea următoare reunește toate regularitățile empirice ale randamentelor sub forma faptelor stilizate și arată că independența și simetria sînt și ele încălcate.
Faptele stilizate ale randamentelor
Secțiunile anterioare au testat o singură ipoteză a modelului de referință, normalitatea. Secțiunea de față trece la o descriere completă a randamentelor, prin faptele stilizate: proprietăți statistice care apar pe multe piețe și în multe perioade. Șase dintre ele sînt verificate pe cele opt serii ale capitolului. Ele privesc cozile, schimbarea formei cu orizontul, autocorelația randamentelor și a mărimii lor și asimetria dintre scăderi și creșteri. Împreună, ele arată că modelul i.i.d. Normal încalcă nu doar normalitatea, ci și independența, și precizează ce trebuie să reproducă un model mai bun.
Un fapt stilizat (stylised fact) este o proprietate statistică comună multor active, piețe și perioade (Cont, 2001). Termenul subliniază că proprietatea este calitativă: „randamentele au cozi groase” este un fapt stilizat, „gradele de libertate sînt 3,2” nu este, pentru că valoarea exactă diferă de la o serie la alta. Tocmai această generalitate îi dă valoare: o proprietate care apare la acțiuni, indici, valute și criptomonede, în perioade diferite, nu poate fi un accident al unui eșantion.
Rama Cont enumeră unsprezece fapte stilizate; capitolul verifică șase dintre ele pe datele celor opt serii. Rolul lor este de criteriu pentru modele: un model bun al randamentelor trebuie să le reproducă. Modelul de referință i.i.d. Normal nu reproduce majoritatea lor, iar tabelul de la sfîrșitul secțiunii arată care modele reproduc fiecare fapt.
Primele rezultate empirice de acest tip sînt mult mai vechi decît termenul. Mandelbrot (1963) a documentat cozile groase și gruparea variațiilor mari în prețurile bumbacului, iar Fama (1965) a confirmat cozile groase pentru acțiunile din indicele Dow Jones.
Pe scurt
Un fapt stilizat: o proprietate statistică comună multor active, piețe și perioade Cont (2001)
Calitativ, nu exact: „cozi groase”, nu „\(\nu = 3{,}2\)”
Rama Cont enumeră unsprezece; noi verificăm șase pe datele noastre
Un model bun al randamentelor trebuie să le reproducă; modelul de referință i.i.d. Normal nu reproduce majoritatea lor
Primul fapt sînt cozile groase: variațiile mari sînt mult mai frecvente decît prevede distribuția Normală. Al doilea este gaussianitatea agregată (aggregational Gaussianity): randamentele pe orizonturi mai lungi, de exemplu lunare, sînt mai apropiate de distribuția Normală decît cele zilnice. Primele două fapte privesc distribuția marginală a randamentelor și modul în care ea depinde de orizont.
Al treilea fapt este absența autocorelației liniare: randamentele trecute aproape nu au putere de predicție pentru randamentele viitoare. Al patrulea este volatility clustering: variațiile mari sînt urmate de variații mari, de orice semn, iar cele mici de variații mici. Faptele 3 și 4 privesc dependența în timp și arată împreună că lipsa corelației nu înseamnă independență.
Al cincilea fapt este efectul de levier (leverage effect): scăderile de preț cresc volatilitatea viitoare mai mult decît creșterile de aceeași mărime. Al șaselea este asimetria cîștig/pierdere (gain/loss asymmetry): pierderile mari sînt mai mari și mai frecvente decît cîștigurile mari. Ultimele două fapte privesc asimetria, în dinamică și în distribuție. Fiecare fapt este verificat în continuare cu o statistică și un grafic.
Pe scurt
1. Cozi groase: variațiile mari sînt mult mai frecvente decît prevede distribuția Normală
2. Gaussianitate agregată (aggregational Gaussianity): randamentele pe orizonturi mai lungi sînt mai apropiate de distribuția Normală
3. Absența autocorelației liniare: randamentele trecute aproape nu au putere de predicție pentru cele viitoare
4. Volatility clustering: variațiile mari sînt urmate de variații mari, de orice semn
5. Efectul de levier (leverage effect): scăderile cresc volatilitatea viitoare mai mult decît creșterile
6. Asimetria cîștig/pierdere: pierderile mari sînt mai mari și mai frecvente decît cîștigurile mari
Faptul 1: cozile groase, numărul zilelor de \(k\) sigma
Tabelul numără, pentru S&P 500, DAX, BET și Bitcoin, zilele în care randamentul se află la mai mult de \(k\) abateri standard de medie, \(|r_t - \bar r| > k\,s\), pentru \(k\) de la 3 la 6, unde \(s\) este abaterea standard de selecție. Ultimul rînd dă numărul de zile așteptat conform distribuției Normale pentru un eșantion de 4 201 zile, cît are S&P 500: 11,34 zile dincolo de 3 abateri standard, 0,27 zile dincolo de 4, \(2{,}4 \times 10^{-3}\) zile dincolo de 5 și \(8{,}3 \times 10^{-6}\) zile dincolo de 6.
Diferența crește cu \(k\). Pentru S&P 500 sînt 62 de zile dincolo de 3 abateri standard, de aproximativ cinci ori mai multe decît cele așteptate, dar 28 de zile dincolo de 4 abateri standard, de 105 ori mai multe, și 8 zile dincolo de 6, cînd distribuția Normală nu prevede practic niciuna. Pentru BET, numărul zilelor dincolo de 6 abateri standard este 11. Comparația este conservatoare, pentru că abaterea standard de selecție este ea însăși mărită de zilele extreme, ceea ce reduce numărul zilelor care depășesc pragul.
Ultima coloană transformă comparația într-un test. Dacă randamentele ar fi Normale, numărul zilelor de 4 sigma ar urma aproximativ o distribuție Poisson cu media \(n \times 6{,}3 \times 10^{-5}\). Probabilitatea de a observa cel puțin atîtea zile cîte apar în date este \(2 \times 10^{-46}\) pentru S&P 500 și BET, \(1 \times 10^{-30}\) pentru DAX și \(6 \times 10^{-48}\) pentru Bitcoin. Ipoteza de normalitate este respinsă și de acest test, care folosește doar coada distribuției.
Pe scurt
Seria
\(n\)
\(>3\sigma\)
\(>4\sigma\)
\(>5\sigma\)
\(>6\sigma\)
p-value (Poisson, \(4\sigma\))
S&P 500
4 201
62
28
12
8
\({2 \times 10^{-46}}\)
DAX
4 244
56
20
5
4
\({1 \times 10^{-30}}\)
BET
4 186
70
28
16
11
\({2 \times 10^{-46}}\)
Bitcoin
4 384
80
29
10
4
\({6 \times 10^{-48}}\)
Distribuția Normală, \(n = 4\,201\)
\(11{,}34\)
\(0{,}27\)
\(2{,}4 \times 10^{-3}\)
\(8{,}3 \times 10^{-6}\)
\(>k\sigma\): numărul zilelor cu \(|r_t - \bar r| > k\,s\); ultimul rînd: numărul așteptat conform distribuției Normale
p-value: probabilitatea de a observa cel puțin atîtea zile de 4 sigma, dacă numărul lor urmează distribuția Poisson cu media \(n \times 6{,}3 \times 10^{-5}\) (ipoteza de normalitate)
S&P 500: de 105 de ori mai multe zile de 4 sigma decît permite distribuția Normală
Întrebare pentru sală La 4σ, S&P 500 are 28 de zile, față de 0,27 așteptate: p-value Poisson 2 × 10⁻⁴⁶. La 3σ are 62 de zile, față de 11,3 așteptate. Este p-value la 3σ mai mare sau mai mic decît la 4σ?
Răspuns
Mai mare: 1 × 10⁻²⁵. La 3σ se observă mai multe zile, dar raportul față de numărul așteptat este 5,5 în loc de 105, iar p-value depinde de cît de departe este numărul observat de λ, în raport cu dispersia distribuției Poisson. Ambele valori sînt mult sub orice prag uzual. La 5σ și 6σ, p-value pentru S&P 500 este 8 × 10⁻⁴¹ și 6 × 10⁻⁴⁶.
Întrebare pentru sală La 4 abateri standard, S&P 500 are 28 de zile, față de 0,27 așteptate după distribuția Normală. Butonul ▶ ridică pragul pînă la 6. Cîte zile dincolo de 6 abateri standard are S&P 500?
Răspuns
8 zile, față de 0,0000083 așteptate (o zi din 507 milioane). BET are 11, DAX 4, Bitcoin 4. Raportul dintre zilele observate și cele așteptate crește cu pragul: 5,5 la 3 abateri standard, 105 la 4, circa un milion la 6.
Graficul extinde comparația la toate cele opt serii. Pentru fiecare serie, bara plină arată numărul zilelor observate dincolo de 4 abateri standard, iar bara hașurată numărul așteptat conform distribuției Normale; axa verticală are scară logaritmică, pentru ca ambele să fie vizibile. Numerele așteptate se află între 0,18 și 0,28 zile, în funcție de lungimea seriei.
Pentru indici și Bitcoin, numărul observat este între 20 și 29 de zile, adică o zi de 4 sigma la fiecare 150–212 zile de tranzacționare. Pentru acțiunile BVB, care au serii mai scurte, numărul este între 10 și 17 zile. Pe scara logaritmică, distanța dintre bara plină și cea hașurată este de aproximativ două ordine de mărime pentru fiecare serie: cozile groase nu sînt o particularitate a unei piețe, ci o proprietate comună.
Distribuția Student-t estimată în secțiunea precedentă reproduce bine această frecvență. Conform ei, numărul așteptat de zile de 4 sigma este 34,9 pentru S&P 500 și 28,1 pentru BET, apropiat de cele 28 de zile observate pentru fiecare dintre cele două serii. Faptul 1 poate fi deci reprodus de o distribuție marginală cu cozi de tip putere, fără o dinamică specială.
Pe scurt
Zilele observate dincolo de 4 abateri standard (scară logaritmică), față de numărul așteptat conform distribuției Normale, între \(0{,}18\) și \(0{,}28\) zile
Indicii și Bitcoin: o zi de 4 sigma la fiecare 150–212 zile; acțiunile BVB: între 10 și 17 zile în total
Cu o distribuție Student-\(t\) estimată, numerele așteptate sînt apropiate de cele observate: S&P 500 34,9, BET 28,1 (Seminarul 2, B4)
Randamentul logaritmic pe \(h\) zile este suma randamentelor zilnice, \(r_t(h) = r_t + r_{t-1} + \dots + r_{t-h+1}\). Pentru a obține observații care nu se suprapun, sumele se calculează pe blocuri disjuncte de cîte \(h\) zile. Dacă se aplică teorema limită centrală, distribuția lui \(r_t(h)\) se apropie de distribuția Normală cînd \(h\) crește, iar excesul de boltire scade spre 0.
Faptul stilizat spune exact acest lucru: forma distribuției se schimbă cu orizontul și nu este aceeași la toate scările de timp (Cont, 2001). Proprietatea are o consecință pentru modele. Un model care păstrează aceeași formă la toate orizonturile, cum este modelul cu distribuții \(\alpha\)-stabile din Capitolul 3, nu o reproduce.
Verificarea are un cost statistic. Prin agregare, numărul observațiilor scade proporțional cu \(h\): pentru S&P 500, aproximativ 17 ani de date înseamnă 4 201 randamente zilnice, dar doar 200 de randamente lunare și 66 de randamente trimestriale. Chiar în ipoteza de normalitate, eroarea standard a excesului de boltire, \(\sqrt{24/n}\), este de aproximativ 0,6 pentru 66 de observații, iar pentru date cu cozi groase este mult mai mare. Estimările boltirii pe orizonturi lungi sînt deci foarte imprecise.
Pe scurt
Randamentul logaritmic pe \(h\) zile: \(r_t(h) = r_t + r_{t-1} + \dots + r_{t-h+1}\), calculat pe blocuri disjuncte
dacă se aplică CLT, distribuția lui \(r_t(h)\) se apropie de distribuția Normală cînd \(h\) crește
Faptul stilizat: forma se schimbă cu orizontul; nu este aceeași la toate scările de timp Cont (2001)
Prețul plătit: mai puține observații
S&P 500, 17 ani: 4 201 randamente zilnice, 200 de randamente lunare și 66 de randamente trimestriale
estimările boltirii pe orizonturi lungi sînt foarte imprecise
Randamente logaritmice pe h zile, blocuri disjuncte, din 2010
Întrebare pentru sală La h = 63 de zile (trimestre, între 46 și 69 de randamente pe serie), pentru cîte dintre cele opt serii respinge testul Jarque–Bera normalitatea la 5%?
Răspuns
Pentru 2: S&P 500 (p-value 0,00004) și DAX (0,002). Pentru celelalte șase, p-value este între 0,07 (BET) și 0,71 (SNG). La h = 21, testul respinge încă pentru 7 serii, toate în afară de BRD (0,16). Nerespingerea nu arată că randamentele trimestriale sînt Normale: cu mai puțin de 70 de observații, testul are putere mică.
Întrebare pentru sală Excesul de boltire al randamentelor zilnice ale S&P 500 este 13,5. Cît devine dacă eliminăm perioada 20 februarie–30 aprilie 2020, adică 50 dintre cele 4 201 zile?
Răspuns
Circa 5,4. Excesul de boltire lunar (h = 21) scade de la 3,7 la 0,8. Momentul de ordinul 4 depinde mult de cîteva valori extreme: 50 de zile, 1,2% din eșantion, explică mai mult de jumătate din excesul de boltire zilnic. Nici fără ele randamentele zilnice nu sînt Normale: 5,4 este mult peste 0.
Graficul arată excesul de boltire al randamentelor pe \(h\) zile pentru S&P 500, DAX, BET și Bitcoin, cu \(h\) egal cu 1, 2, 5, 10, 21 și 63 de zile, pe axa orizontală în scară logaritmică; linia întreruptă marchează valoarea 0 a distribuției Normale. Valorile pentru 21 și 63 de zile corespund aproximativ randamentelor lunare și trimestriale.
Tendința generală este descrescătoare. De la randamente zilnice la lunare și apoi trimestriale, excesul de boltire scade de la 13,5 la 3,7 și apoi la 1,5 pentru S&P 500, de la 17,9 la 8,3 și apoi la 0,6 pentru BET și de la 12,0 la 1,0 și apoi la 0,7 pentru Bitcoin. Scăderea este însă lentă și nemonotonă: pentru S&P 500, excesul de boltire al randamentelor pe 10 zile este mai mare decît al celor pe 2 sau 5 zile. Cauza este numărul mic de observații pe orizonturi lungi: o singură lună de crah, martie 2020, domină un eșantion de 200 de luni.
Pentru randamentele trimestriale, testul Jarque–Bera nu mai respinge normalitatea la pragul de 5% pentru BET, cu p-value 0,07, și pentru Bitcoin, cu p-value 0,22. Acest rezultat trebuie citit împreună cu puterea mică a testului pentru cîteva zeci de observații: nerespingerea nu dovedește normalitatea, dar arată că abaterea de la ea a devenit greu de detectat.
Întrebare pentru sală La h = 63 de zile (un trimestru, n = 66), mai respinge testul Jarque–Bera normalitatea randamentelor S&P 500 la 5%?
Răspuns
Da: p-value 0,00004, cu asimetria −1,13 și excesul de boltire 1,5. Pentru BET (p-value 0,07) și Bitcoin (0,22), testul nu mai respinge la acest orizont. Nerespingerea nu arată că randamentele trimestriale sînt Normale: cu 66 de observații, testul are putere mică.
Cele două panouri arată QQ plots față de distribuția Normală pentru randamentele standardizate ale S&P 500: în stînga cele 4 201 randamente zilnice, în dreapta cele 200 de randamente lunare, calculate pe blocuri de 21 de zile. Randamentele lunare sînt mult mai aproape de prima bisectoare decît cele zilnice: forma de S aproape a dispărut, iar abaterile maxime de la dreaptă sînt mult mai mici.
Randamentele lunare nu sînt totuși Normale. Asimetria lor este −1,18, iar excesul de boltire 3,7, pentru \(n = 200\). Punctul cel mai de jos, aflat vizibil sub dreaptă, este martie 2020. Agregarea a redus cozile groase, dar a păstrat și chiar a accentuat asimetria negativă.
Viteza mică a convergenței are o explicație teoretică. Teorema limită centrală presupune termeni independenți, dar randamentele zilnice sînt dependente prin volatility clustering, faptul 4: zilele agitate apar grupat, deci o lună agitată conține multe zile extreme de același tip. Dependența încetinește convergența sumei spre distribuția Normală.
Pe scurt
Randamentele lunare sînt mult mai aproape de dreaptă decît cele zilnice
Dar randamentele lunare nu sînt Normale: asimetria \(-1{,}18\), excesul de boltire \(3{,}7\), \(n = 200\); punctul cel mai de jos este martie 2020
Cauza convergenței lente: volatility clustering face randamentele zilnice dependente, ceea ce încetinește convergența din CLT
Funcția de autocorelație (ACF, autocorrelation function) este \(\rho(h) = \text{Corr}(r_t, r_{t-h})\), pentru lagurile \(h = 1, 2, \dots\), măsurate în zile. Ea ia valori în \([-1; 1]\) și se estimează prin
Pentru date i.i.d., \(\hat\rho(h) \approx N(0, 1/n)\), deci banda de 95% în jurul lui 0 este \(\pm 1{,}96/\sqrt{n}\). O autocorelație estimată în afara benzii este semnificativă la pragul de 5%.
Testul Ljung–Box (LB) (Ljung & Box, 1978) testează împreună primele \(m\) autocorelații, cu ipoteza nulă \(\rho(1) = \dots = \rho(m) = 0\). Statistica
adună pătratele autocorelațiilor, deci valorile mari arată că cel puțin un \(\rho(h)\) este diferit de 0. În ipoteza nulă, \(Q(m)\) are aproximativ distribuția \(\chi^2(m)\); pentru \(m = 10\), ipoteza se respinge la 5% dacă \(Q > 18{,}3\).
Explicația economică a absenței autocorelației este eficiența pieței. Dacă randamentele ar fi previzibile liniar, investitorii ar cumpăra înaintea creșterilor previzibile și ar vinde înaintea scăderilor, iar tranzacțiile lor ar elimina previzibilitatea. Ipoteza piețelor eficiente și testele ei sînt tratate în Capitolul 7.
Pe scurt
ACF (autocorrelation function, funcția de autocorelație): \(\rho(h) = \text{Corr}(r_t, r_{t-h})\), \(h = 1, 2, \dots\)
\(Q(m) = n(n+2)\sum_{h=1}^m \hat\rho(h)^2/(n - h) \sim \chi^2(m)\); pentru \(m = 10\), respingem dacă \(Q > 18{,}3\)
\(m\): numărul de laguri testate împreună; \(Q\) adună pătratele autocorelațiilor, deci valorile mari arată că un \(\rho(h) \neq 0\)
Explicația absenței: dacă randamentele ar fi previzibile, investitorii ar exploata acest lucru pînă cînd previzibilitatea dispare (piețe eficiente, Capitolul 7)
Faptele 3 și 4: ACF a randamentelor și a randamentelor absolute
Testul Ljung–Box pentru randamente și pentru randamentele absolute
Întrebare pentru sală Cu m = 10, testul Ljung–Box respinge absența autocorelației randamentelor la 5% pentru toate cele opt serii (Bitcoin: Q = 20,2, p-value 0,028). Fără perioada 20 februarie–30 aprilie 2020, pentru cîte serii mai respinge?
Răspuns
Pentru 6: Bitcoin (p-value 0,053) și BRD (0,059) nu mai resping. La S&P 500, Q(10) scade de la 199 la 32. Distribuția χ² a statisticii Q presupune randamente i.i.d.; cu volatility clustering testul respinge prea des, deci „semnificativ” este aici o concluzie slabă. Pentru randamentele absolute, Q(10) rămîne între 325 și 1 712 la toate seriile.
Întrebare pentru sală Pe tot eșantionul, ρ̂(1) al randamentelor S&P 500 este −0,11, iar banda de 95% este ±0,03. Cît devine ρ̂(1) fără perioada 20 februarie–30 aprilie 2020?
Răspuns
−0,04, aproape de marginea benzii ±0,03. Cea mai mare parte a valorii −0,11 vine din martie 2020, cînd scăderile mari și revenirile au alternat. Autocorelațiile randamentelor absolute rămîn mari și fără această perioadă. Puterea δ arată același lucru pentru |rt|δ: la S&P 500, autocorelația la lagul 10 este 0,20 pentru δ = 0,5, 0,26 pentru δ = 1 și 0,22 pentru δ = 2.
Panoul din stînga arată ACF a randamentelor zilnice ale S&P 500, BET și Bitcoin pentru lagurile 1–50; banda verde este banda de 95% în ipoteza de independență. Majoritatea autocorelațiilor se află în bandă sau foarte aproape de ea. La lagul 1, \(\hat\rho(1)\) este −0,11 pentru S&P 500, 0,03 pentru BET și −0,02 pentru Bitcoin.
Panoul din dreapta arată ACF a randamentelor absolute \(|r_t|\), o măsură a mărimii variației zilnice, fără semn. Imaginea este complet diferită: toate autocorelațiile sînt pozitive, aflate mult deasupra benzii, și scad lent. Pentru S&P 500, autocorelația randamentelor absolute este 0,31 la lagul 1, 0,26 la lagul 10 și 0,05 la lagul 50.
Comparația celor două panouri este argumentul central al acestei părți a secțiunii. Semnul randamentului de mîine este practic imprevizibil din trecut, dar mărimea lui este previzibilă: o zi cu variație mare face mai probabilă o altă zi cu variație mare, chiar și după cîteva săptămîni. Randamentele sînt deci aproape necorelate, dar nu independente.
Pe scurt
Stînga: randamentele; majoritatea autocorelațiilor sînt în bandă sau aproape de ea; S&P 500 \(\hat\rho(1) = -0{,}11\), BET \(0{,}03\), Bitcoin \(-0{,}02\)
Dreapta: randamentele absolute; toate pozitive, cu scădere lentă: S&P 500 \(0{,}31\) la lagul 1, \(0{,}26\) la lagul 10, \(0{,}05\) la lagul 50
Testul Ljung–Box cu 10 laguri, aplicat randamentelor, dă \(Q(10) = 199\) pentru S&P 500, 46 pentru BET și 20 pentru Bitcoin, față de valoarea critică 18,3. Formal, ipoteza de autocorelație nulă este respinsă pentru toate cele trei serii, deci unele autocorelații sînt semnificative statistic.
Există două motive pentru a nu exagera importanța acestui rezultat. Primul este mărimea economică: toate autocorelațiile estimate au \(|\hat\rho(h)| \le 0{,}11\), deci o predicție liniară bazată pe un singur lag explică cel mult 1,2% din varianța randamentului, înainte de costurile de tranzacționare. Al doilea este statistic: banda \(\pm 1{,}96/\sqrt{n}\) și distribuția \(\chi^2\) a lui \(Q\) presupun randamente i.i.d. Cu volatility clustering, varianța reală a lui \(\hat\rho(h)\) este mai mare, banda este prea îngustă, iar rezultatul „semnificativ” apare prea des.
Valoarea S&P 500 la lagul 1 ilustrează al doilea motiv. Ea provine mai ales din martie 2020, cînd scăderile foarte mari și revenirile foarte mari au alternat de la o zi la alta. Fără perioada 20 februarie–30 aprilie 2020, \(\hat\rho(1) = -0{,}04\). Teste ale previzibilității care rămîn valide în prezența volatility clustering, cum sînt testele raportului varianțelor (variance ratio tests), sînt prezentate în Capitolul 7.
Pe scurt
Ljung–Box \(Q(10)\) pentru randamente: S&P 500 199, BET 46, Bitcoin 20; valoarea critică 18,3
formal, unele autocorelații sînt semnificative
Două motive pentru a nu exagera importanța rezultatului
valorile sînt mici din punct de vedere economic: \(|\hat\rho(h)| \le 0{,}11\), deci se explică cel mult 1,2% din varianță
banda \(\pm 1{,}96/\sqrt{n}\) presupune randamente i.i.d.; cu volatility clustering este prea îngustă, deci „semnificativ” apare prea des
Valoarea S&P 500 la lagul 1 provine mai ales din martie 2020, cînd scăderile mari și revenirile au alternat: fără 20 februarie–30 aprilie 2020, \(\hat\rho(1) = -0{,}04\)
Teste robuste ale previzibilității (testele raportului varianțelor): Capitolul 7
Formularea clasică a faptului 4 îi aparține lui Mandelbrot (1963): variațiile mari tind să fie urmate de variații mari, de orice semn, iar variațiile mici tind să fie urmate de variații mici. Fenomenul se numește volatility clustering. El spune că semnul randamentului de mîine este imprevizibil, dar mărimea lui nu este.
Dovada empirică este ACF a randamentelor absolute, pozitivă pe toate cele 50 de laguri ale graficului anterior. Testul Ljung–Box cu 10 laguri, aplicat lui \(|r_t|\), dă \(Q(10) = 3\,859\) pentru S&P 500, \(2\,120\) pentru BET și \(1\,086\) pentru Bitcoin, de zeci pînă la sute de ori peste valoarea critică de 18,3. Dependența mărimii variațiilor este mult mai puternică decît orice dependență a randamentelor înseși.
Concluzia este că randamentele sînt necorelate, dar nu independente; corelația nulă exclude doar dependența liniară. Pentru modelul de referință, consecința este că ipoteza i.i.d. este falsă chiar dacă autocorelația randamentelor este aproape zero. Modelele care descriu acest fenomen sînt modelele ARCH (AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă) și GARCH (ARCH generalizat), în care varianța de mîine depinde de variațiile recente; ele sînt tratate în Capitolul 9.
Pe scurt
„Variațiile mari tind să fie urmate de variații mari – de orice semn –, iar variațiile mici tind să fie urmate de variații mici” Mandelbrot (1963)
Semnul randamentului de mîine este imprevizibil; mărimea lui nu este
Dovezi: ACF a lui \(|r_t|\) pozitivă pe 50 de laguri
Ljung–Box \(Q(10)\) pentru \(|r_t|\): S&P 500 3859, BET 2120, Bitcoin 1086
Deci randamentele sînt necorelate, dar nu independente
Întrebare pentru sală Cu o fereastră de 63 de zile (un trimestru), de cîte ori este mai mare cea mai mare abatere standard mobilă a S&P 500 decît cea mai mică?
Răspuns
De circa 12 ori: 3,94% pe zi în fereastra care se termină pe 20 mai 2020, față de 0,32% în fereastra care se termină pe 13 decembrie 2017. Raportul varianțelor este circa 154. La BET raportul abaterilor standard este 8,2, la Bitcoin 8,3. Volatilitatea unei zile depinde de perioada în care se află.
Graficul arată randamentele logaritmice zilnice, în procente, ale S&P 500 (sus), BET (mijloc) și Bitcoin (jos), seria Bitcoin începînd în 2014. Volatility clustering se vede direct: randamentele nu sînt răspîndite uniform în timp, ci formează perioade cu oscilații mari, separate de perioade lungi cu oscilații mici.
Perioadele agitate corespund unor evenimente cunoscute: 2010–2011, cu criza datoriilor suverane din zona euro; decembrie 2018 pentru BET, cu anunțarea taxei pe activele bancare; martie 2020, pe toate cele trei piețe, la începutul pandemiei; și aprilie 2025. Între ele există ani întregi în care variațiile zilnice rămîn mici.
Pentru modelare, graficul arată că volatilitatea unei zile depinde de perioada în care se află. O zi de −3% este un eveniment rar într-un an calm și unul obișnuit într-o lună de criză. Un model care atribuie aceeași distribuție fiecărei zile, cum este modelul de referință, ignoră această informație.
Pe scurt
Perioade agitate: 2010–2011 (criza datoriilor din zona euro), decembrie 2018 pentru BET, martie 2020 peste tot, aprilie 2025
Între ele, ani calmi: volatilitatea unei zile depinde de perioada în care se află
Efectul de levier se măsoară prin corelația dintre randamentul de azi și mărimea randamentului de peste \(k\) zile:
\[L(k) = \text{Corr}(r_t, |r_{t+k}|), \qquad k = 1, 2, \dots\]
(2.12)
O valoare \(L(k) < 0\) înseamnă că o scădere azi este urmată de variații mai mari decît o creștere de aceeași mărime. Dacă reacția volatilității ar fi simetrică, \(L(k)\) ar fi aproximativ 0.
Explicația care a dat numele fenomenului este levierul financiar (Christie, 1982). Cînd prețul acțiunii unei firme scade, valoarea capitalului propriu scade, iar raportul datorii/capital propriu crește. Aceleași riscuri ale activelor firmei sînt suportate de un capital propriu mai mic, deci acțiunea devine mai riscantă, iar volatilitatea ei crește.
O a doua explicație, volatility feedback, inversează cauzalitatea: o creștere a volatilității așteptate mărește randamentul cerut de investitori, ceea ce reduce prețul de azi. Ambele mecanisme produc o relație negativă între randamente și volatilitatea ulterioară. Modelele de volatilitate cu răspuns asimetric la șocuri, EGARCH (GARCH exponențial) și GJR-GARCH (modelul Glosten–Jagannathan–Runkle), sînt prezentate în Capitolul 9.
Întrebare pentru sală Butonul ▶ mută începutul eșantionului de la 2010 la 2022. Dacă eșantionul începe în 2021, rămîne media L(1..5) a S&P 500 negativă și în afara benzii de 95%?
Răspuns
Da. De la începutul lui 2021, media L(1..5) a S&P 500 este −0,10 (−0,12 pe tot eșantionul), iar banda este ±0,05. Efectul de levier nu vine dintr-o singură criză: fără 20 februarie–30 aprilie 2020, media pe tot eșantionul este −0,11. La Bitcoin, media rămîne aproape de zero în toate variantele.
Graficul arată \(L(k)\) pentru lagurile 1–20, pentru S&P 500, DAX, BET și Bitcoin; banda verde este banda de 95% în ipoteza de independență. Pentru cei trei indici bursieri, \(L(k)\) este negativ și în afara benzii pentru majoritatea primelor 20 de laguri. Media corelațiilor pe primele cinci laguri este −0,12 pentru S&P 500, −0,10 pentru DAX și −0,11 pentru BET.
Bitcoin se comportă diferit. Corelația la lagul 1 este −0,07, dar de la lagul 2 valorile se află în interiorul benzii, iar unele sînt chiar pozitive. Rezultatul este compatibil cu explicația prin levier financiar: în spatele Bitcoin nu există o firmă cu datorii și capital propriu, deci mecanismul de levier lipsește.
Comparația dintre indici și Bitcoin arată că nu toate faptele stilizate sînt universale în aceeași măsură. Cozile groase și volatility clustering apar pe toate piețele studiate, în timp ce efectul de levier depinde de natura activului.
Pe scurt
Indicii bursieri: \(L(k) < 0\) pentru majoritatea primelor 20 de laguri; media \(L(1..5)\): S&P 500 \(-0{,}12\), DAX \(-0{,}10\), BET \(-0{,}11\)
Bitcoin: \(L(1) = -0{,}07\), apoi în interiorul benzii: în spatele Bitcoin nu există o firmă cu datorii, deci mecanismul de levier lipsește
Întrebare pentru sală Faptul 5 se măsoară prin media L(1..5) a corelațiilor de levier; criteriul este o medie sub −1,96/√n. Pe tot eșantionul, pentru ce serii nu este îndeplinit criteriul?
Răspuns
Pentru SNP (−0,031, față de −0,032) și SNN (−0,025, față de −0,036). Bitcoin (−0,031, față de −0,030) și SNG (−0,039, față de −0,036) îl îndeplinesc la limită: cele patru valori, între −0,025 și −0,039, sînt toate aproape de prag, deci faptul 5 este la fel de slab pentru Bitcoin, SNP, SNN și SNG, în timp ce S&P 500, DAX și BET au între −0,10 și −0,12, iar BRD −0,05. Faptul 6 nu este îndeplinit doar la SNN, care are asimetrie pozitivă (0,27) și |q0,01|/q0,99 = 0,88; SNP (1,04) și SNG (1,02) sînt aproape de 1.
Întrebare pentru sală La 1%, pierderea depășită într-o zi din 100 este mai mare decît cîștigul la S&P 500, DAX, BET și Bitcoin. Butonul ▶ crește probabilitatea α de la 0,1% la 5% și coboară pragul k din panoul din dreapta la cuantila Normală corespunzătoare. La α = 5%, este pierderea mai mare decît cîștigul la toți cei patru indici?
Răspuns
Nu. La 5%, S&P 500 (1,65% față de 1,54%) și DAX (1,94% față de 1,82%) au încă pierderea mai mare, dar la BET (1,48% față de 1,52%) și Bitcoin (5,33% față de 5,35%) cîștigul este puțin mai mare. Asimetria cîștig/pierdere se vede în coada îndepărtată; la α = 0,1%, pierderea este mai mare la toți patru (S&P 500 6,14% față de 6,01%).
Panoul din stînga compară, pentru fiecare serie, mărimea pierderii depășite într-o zi din 100, adică minus cuantila de 1% a randamentelor (barele roșii), cu mărimea cîștigului depășit într-o zi din 100, adică cuantila de 99% (barele verzi). Pentru indici, pierderea este mai mare: 3,45% față de 2,66% pentru BET și 3,15% față de 2,61% pentru S&P 500.
Panoul din dreapta numără zilele extreme pe fiecare parte: zilele sub −4 abateri standard (roșu) și cele peste +4 abateri standard (verde). Pentru BET sînt 20 de zile în coada stîngă și 8 în cea dreaptă, pentru S&P 500 16 față de 12, iar pentru Bitcoin 18 față de 11. Pierderile extreme sînt deci atît mai mari, cît și mai frecvente decît cîștigurile extreme.
Excepția este SNN, singura serie cu asimetrie pozitivă în tabelul de momente: pentru ea, cuantila din dreapta este mai mare decît pierderea de la cuantila de 1%. Faptul 6 este legat de asimetria negativă măsurată în secțiunea despre momente și, prin efectul de levier, de dinamica volatilității: scăderile cresc volatilitatea, ceea ce face scăderile ulterioare mai mari.
Pe scurt
Stînga: la indici, pierderea depășită într-o zi din 100 este mai mare decît cîștigul depășit într-o zi din 100: BET 3,45% față de 2,66%, S&P 500 3,15% față de 2,61%
Dreapta: zile sub \(-4\sigma\) față de peste \(+4\sigma\): BET 20 față de 8, S&P 500 16 față de 12, Bitcoin 18 față de 11
Excepție: SNN, cu asimetrie pozitivă și cuantila din dreapta mai mare
Tabelul rezumă cele șase fapte pentru toate cele opt serii, fiecare printr-o statistică. Primele două coloane dau excesul de boltire al randamentelor zilnice (faptul 1) și al randamentelor pe 21 de zile (faptul 2). Urmează autocorelația randamentelor la lagul 1 (faptul 3) și a randamentelor absolute la lagul 10 (faptul 4), media lui \(L(k)\) pe lagurile 1–5 (faptul 5) și raportul dintre valoarea absolută a cuantilei de 1% și cuantila de 99% (faptul 6), care este mai mare decît 1 cînd pierderile extreme depășesc cîștigurile extreme.
Faptul 1 este valabil pentru toate seriile: excesul de boltire zilnic este de cel puțin 5,1. Faptul 3 este valabil doar aproximativ: autocorelația la lagul 1 este de cel mult 0,11 în valoare absolută, dar această valoare maximă, −0,11 pentru S&P 500, provine mai ales din martie 2020, iar SNN are 0,09. Faptul 4 este valabil peste tot, pentru că autocorelația randamentelor absolute la lagul 10 este pozitivă, între 0,08 și 0,26, dar este cel mai slab pentru SNN și SNG, ambele cu 0,08. Faptul 2 apare cu estimări imprecise: excesul de boltire scade de la orizontul zilnic la cel de 21 de zile pentru toate seriile, de exemplu de la 7,3 la 0,4 pentru BRD, dar rămîne 8,3 pentru BET.
Faptele 5 și 6 sînt clare pentru indici, cu \(\bar L(1..5)\) între −0,12 și −0,10 și rapoarte ale cuantilelor între 1,12 și 1,30. Faptul 5 este la fel de slab pentru Bitcoin, SNP, SNN și SNG, cu \(\bar L(1..5)\) între −0,04 și −0,03; BRD, cu −0,05, se află între cele două grupuri. Faptul 6 nu este valabil doar pentru SNN, al cărui raport de 0,88 este sub 1, și este aproape de 1 pentru SNP (1,04) și SNG (1,02). O comparație sistematică între distribuțiile randamentelor criptomonedelor și cele ale activelor tradiționale este făcută de Pele et al. (2023).
Pe scurt
Seria
Exces bolt.
Exces bolt., 21 de zile
\(\hat\rho_r(1)\)
\(\hat\rho_{|r|}(10)\)
\(\bar L(1..5)\)
\(|q_{0{,}01}|/q_{0{,}99}\)
S&P 500
\(13{,}5\)
\(3{,}7\)
\(-0{,}11\)
\(0{,}26\)
\(-0{,}12\)
\(1{,}21\)
DAX
\(7{,}4\)
\(5{,}5\)
\(0{,}01\)
\(0{,}16\)
\(-0{,}10\)
\(1{,}12\)
BET
\(17{,}9\)
\(8{,}3\)
\(0{,}03\)
\(0{,}20\)
\(-0{,}11\)
\(1{,}30\)
Bitcoin
\(12{,}0\)
\(1{,}0\)
\(-0{,}02\)
\(0{,}12\)
\(-0{,}03\)
\(1{,}07\)
OMV Petrom (SNP)
\(8{,}9\)
\(3{,}3\)
\(-0{,}02\)
\(0{,}13\)
\(-0{,}03\)
\(1{,}04\)
BRD
\(7{,}3\)
\(0{,}4\)
\(0{,}03\)
\(0{,}11\)
\(-0{,}05\)
\(1{,}07\)
Nuclearelectrica (SNN)
\(5{,}1\)
\(2{,}3\)
\(0{,}09\)
\(0{,}08\)
\(-0{,}03\)
\(0{,}88\)
Romgaz (SNG)
\(5{,}3\)
\(1{,}4\)
\(0{,}07\)
\(0{,}08\)
\(-0{,}04\)
\(1{,}02\)
Coloanele: excesul de boltire al randamentelor zilnice și pe 21 de zile; ACF a randamentelor la lagul 1 și a lui \(|r_t|\) la lagul 10; media \(L(k)\) pe lagurile 1–5; cuantila de 1% împărțită la cea de 99%
Faptul 1 este valabil pentru toate seriile, faptul 2 cu estimări imprecise; faptul 3 doar aproximativ, \(|\hat\rho_r(1)|\) pînă la \(0{,}11\) (S&P 500; SNN \(0{,}09\)); faptul 4 peste tot, cel mai slab pentru SNN și SNG (\(0{,}08\))
Faptul 5: clar pentru indici (între \(-0{,}12\) și \(-0{,}10\)), la fel de slab pentru Bitcoin, SNP, SNN și SNG (între \(-0{,}04\) și \(-0{,}03\)); faptul 6 nu este valabil pentru SNN (\(0{,}88\)), aproape 1 pentru SNP și SNG
O comparație între distribuțiile randamentelor criptomonedelor și cele ale activelor tradiționale: Pele et al. (2023)
Tabelul arată care dintre cele șase fapte sînt reproduse de patru clase de modele. Modelul i.i.d. Normal reproduce doar absența autocorelației; gaussianitatea agregată este satisfăcută trivial, pentru că randamentele sînt Normale la orice orizont. Modelul i.i.d. Student-t adaugă cozile groase, iar agregarea îl apropie de distribuția Normală, dar nu are nicio dinamică a volatilității.
Modelul GARCH cu erori Student-t reproduce primele patru fapte: varianța condiționată variabilă produce volatility clustering și contribuie la cozile groase ale distribuției marginale. Modelele EGARCH și GJR-GARCH adaugă un răspuns asimetric al volatilității la scăderi și creșteri, deci reproduc și efectul de levier. Asimetria cîștig/pierdere este reprodusă doar parțial: răspunsul asimetric al volatilității face asimetrice randamentele pe mai multe zile, dar randamentele zilnice rămîn simetrice dacă erorile nu sînt asimetrice. Aceste modele sînt subiectul Capitolului 9.
Consecința practică privește măsurile de risc. VaR 1% și pierderea așteptată în coadă (ES, Expected Shortfall) la nivelul 2,5%, tratate în Capitolul 10, moștenesc calitatea modelului din care sînt calculate. Un VaR calculat cu distribuția Normală este prea mic exact în crize, cînd cozile și volatilitatea contează cel mai mult. O măsură înrudită a riscului de coadă, bazată pe entropia informațională, este propusă de Pele, Lazar & Dufour (2017).
Pe scurt
Model
1
2
3
4
5
6
i.i.d. Normal
–
trivial
✓
–
–
–
i.i.d. Student-\(t\)
✓
✓
✓
–
–
–
GARCH cu erori \(t\) (cap. 9)
✓
✓
✓
✓
–
–
EGARCH, GJR-GARCH (cap. 9)
✓
✓
✓
✓
✓
(✓)
Coloanele: cele șase fapte în ordinea din această secțiune; (✓): doar pentru randamente pe mai multe zile, dacă erorile nu sînt asimetrice
Măsurile de risc (VaR 1%, ES 2,5%, Capitolul 10) moștenesc calitatea modelului: un VaR Normal este prea mic în crize
Cozile groase înseamnă o zi de 4 sigma la fiecare cîteva luni, în loc de una la cîteva decenii. Randamentele sînt aproape necorelate, dar mărimea lor este puternic autocorelată, deci randamentele nu sînt independente.
Pe orizonturi mai lungi, randamentele se apropie de distribuția Normală, dar lent, din cauza dependenței. Pentru indicii bursieri, scăderile cresc volatilitatea ulterioară, iar pierderile extreme sînt mai mari și mai frecvente decît cîștigurile extreme.
Pe scurt
Cozi groase: o zi de 4 sigma la fiecare cîteva luni, în loc de una la cîteva decenii
Randamentele sînt aproape necorelate, dar mărimea lor este puternic autocorelată
Pe orizonturi mai lungi, randamentele se apropie lent de distribuția Normală
Indicii bursieri: scăderile cresc volatilitatea, iar pierderile sînt mai mari decît cîștigurile
Sinteza secțiunii
Faptele stilizate arată că modelul de referință greșește în trei privințe: distribuția zilnică are cozi groase, randamentele nu sînt independente, iar scăderile și creșterile nu sînt simetrice. Distribuția Student-t corectează doar prima problemă; modelele GARCH, cu variantele lor asimetrice, le tratează pe următoarele. Secțiunea următoare pornește de la o întrebare deschisă despre cozi și arată cum poate fi studiată cu ajutorul instrumentelor de inteligență artificială.
AI pentru descoperire științifică
Secțiunea aplică instrumentele capitolului unei întrebări de cercetare deschise: se subțiază cozile distribuției randamentelor Bitcoin pe măsură ce piața se maturizează? Ea prezintă dovezile preliminare și motivele pentru care întrebarea rămîne deschisă, descrie unde pot ajuta instrumentele de inteligență artificială (AI, artificial intelligence) într-un asemenea studiu, ce trebuie verificat în rezultatele lor și propune o idee de proiect.
O întrebare de cercetare deschisă: evoluția cozilor Bitcoin
Ipoteza de lucru este că, pe măsură ce o piață se maturizează, prin mai mulți participanți, contracte futures și ETF-uri (exchange-traded funds, fonduri tranzacționate la bursă), cozile distribuției randamentelor ei s-ar putea subția. Graficul arată, pentru Bitcoin și pentru S&P 500 ca reper, excesul de boltire al randamentelor zilnice în fiecare an (sus) și gradele de libertate \(\hat\nu\) ale distribuției Student-t estimate separat pentru fiecare an (jos), cu valorile limitate la 30.
Pentru Bitcoin, în perioada 2015–2026, \(\hat\nu\) anual variază între 1,5 și 5,1. Corelația rangurilor dintre \(\hat\nu\) și an este 0,63, cu p-value 0,03: anii mai recenți tind să aibă grade de libertate mai mari, adică cozi mai subțiri. Rezultatul pare să susțină ipoteza.
Întrebarea rămîne totuși deschisă. Rezultatul se bazează pe 12 estimări anuale, fiecare imprecisă, pentru că un singur an conține puține zile extreme. Un an, 2020, are un exces de boltire de 51, determinat de o singură zi. Pentru o asemenea întrebare, instrumentele AI pot accelera colectarea literaturii, scrierea codului și analizele de robustețe, dar nu înlocuiesc verificarea rezultatelor (Wang et al., 2023).
Pe scurt
Pe măsură ce o piață se maturizează (mai mulți participanți, futures, ETF-uri), cozile ei s-ar putea subția
Bitcoin, 2015–2026: \(\hat\nu\) anual între 1,5 și 5,1; corelația rangurilor cu anul \(0{,}63\) (p-value \(0{,}03\))
De ce rămîne deschisă: 12 estimări anuale imprecise, un an (2020, exces de boltire 51) dominat de o singură zi
Instrumentele AI pot accelera un astfel de studiu; nu înlocuiesc verificarea lui Wang et al. (2023)
Primul domeniu este literatura. Un asistent AI poate găsi studiile despre indicii cozii (tail index) ai activelor cripto și poate rezuma metodele lor: ce estimatori folosesc, pe ce ferestre și cu ce date. Rezumatul economisește timp, dar fiecare referință trebuie verificată, pentru că asistenții pot produce citări inexistente.
Al doilea domeniu este codul. Un asistent poate scrie o primă versiune a estimărilor pe ferestre mobile pentru \(\nu\) și pentru excesul de boltire. Un exemplu de cerere (prompt) este: Write a Python function that fits a Student-t distribution to daily Bitcoin log returns on rolling 365-day windows and returns the degrees of freedom with a bootstrap 95% interval. Cererea precizează distribuția, datele, fereastra și forma rezultatului, inclusiv intervalul de încredere, ceea ce reduce ambiguitatea.
Al treilea domeniu este robustețea. Asistentul poate propune alte ferestre decît anul calendaristic, alte măsuri ale cozilor, de exemplu estimatorii din teoria valorilor extreme din Capitolul 5, și alte active cripto pe care să se repete analiza. Un rezultat care se menține în toate aceste variante este mult mai credibil decît unul obținut cu o singură specificație.
Pe scurt
Literatura: găsirea studiilor despre tail index-urile activelor cripto și rezumarea metodelor lor
Cod: o primă versiune a estimărilor pe ferestre mobile pentru \(\nu\) și excesul de boltire
Robustețe: propunerea altor ferestre, altor măsuri ale cozilor (Capitolul 5), altor active cripto
Exemplu de prompt
Write a Python function that fits a Student-t distribution to daily Bitcoin log returns on rolling 365-day windows and returns the degrees of freedom with a bootstrap 95% interval.
Prima verificare privește datele: aceeași coloană de preț și același calendar trebuie folosite pentru fiecare an, iar cele mai mari variații trebuie verificate, după regula din secțiunea despre momente. O singură eroare de date într-un an poate schimba \(\hat\nu\) al acelui an mai mult decît orice tendință reală.
A doua verificare privește estimarea. Optimizatorul numeric al verosimilității poate să nu conveargă, iar valori \(\hat\nu\) apropiate de 2 sau mai mari decît 30 trebuie reverificate: primele indică o varianță aproape infinită, ultimele o distribuție practic Normală, pentru care \(\nu\) este slab identificat. A treia verificare privește inferența: o singură estimare \(\hat\nu\) pe an este imprecisă, deci trebuie raportate intervale de încredere, nu doar estimări punctuale.
A patra verificare privește volatility clustering. Cozile distribuției anuale reflectă atît forma distribuției condiționate, cît și variația volatilității în cursul anului; un an mai calm, cu volatilitate mai stabilă, are cozi mai subțiri chiar dacă mecanismul nu s-a schimbat. Separarea celor două efecte cere modelele din Capitolul 9. Ultima verificare privește referințele: fiecare lucrare citată trebuie să existe, iar DOI-ul ei trebuie verificat.
Pe scurt
Datele: aceeași coloană de preț și același calendar pentru fiecare an; erori printre cele mai mari variații
Estimarea: a convers optimizatorul? \(\hat\nu\) aproape de 2 sau peste 30 trebuie reverificat
Inferența: o singură estimare \(\hat\nu\) pe an este imprecisă; raportați intervale, nu doar estimări punctuale
Volatility clustering: cozi anuale mai subțiri pot însemna doar ani mai calmi (Capitolul 9)
Referințele: fiecare lucrare citată trebuie să existe; verificați DOI-ul
Întrebarea proiectului este dacă se subțiază cozile activelor cripto pe măsură ce piețele lor se maturizează. Datele sînt seriile Bitcoin, Ethereum și Solana din datele cursului, cu S&P 500 ca reper pentru o piață matură.
Primul pas este estimarea lui \(\hat\nu\) și a excesului de boltire pe ferestre mobile de un an, cu intervale bootstrap. Al doilea pas este testarea existenței unui trend în aceste estimări și repetarea analizei pe randamente împărțite la o volatilitate mobilă, pentru a separa forma cozilor de volatility clustering. Al treilea pas compară numărul zilelor de 4 sigma pe an pentru activele cripto și pentru S&P 500.
Livrabilele sînt un tabel, un grafic și un paragraf care spune ce pot și ce nu pot arăta datele. Orice folosire a AI trebuie declarată, iar erorile AI corectate pe parcurs trebuie listate.
Pe scurt
Întrebarea: se subțiază cozile activelor cripto pe măsură ce piețele lor se maturizează?
date: Bitcoin, Ethereum și Solana din datele cursului; S&P 500 ca reper
Pași
estimați \(\hat\nu\) și excesul de boltire pe ferestre mobile de un an, cu intervale bootstrap
testați existența unui trend; repetați pe randamente împărțite la o volatilitate mobilă
comparați numărul zilelor de 4 sigma pe an cu S&P 500
Livrabile: un tabel, un grafic și un paragraf despre ce pot și ce nu pot arăta datele
Declarați orice folosire a AI și listați erorile AI pe care le-ați corectat
Sinteza secțiunii
Întrebarea despre cozile Bitcoin folosește toate instrumentele capitolului: excesul de boltire, distribuția Student-t estimată prin verosimilitate maximă, numărarea zilelor de 4 sigma și volatility clustering. Dovezile preliminare sînt compatibile cu cozi tot mai subțiri, dar 12 estimări anuale imprecise nu sînt suficiente pentru o concluzie. Instrumentele AI pot accelera un asemenea studiu; verificarea datelor, a estimării și a inferenței rămîne în sarcina cercetătorului.
Rezumat
Rezumatul adună formulele capitolului și propune trei întrebări de autoevaluare. Formulele acoperă cele trei părți ale capitolului: distribuțiile clasice, măsurarea abaterilor de la normalitate și faptele stilizate.
Primele trei rînduri ale tabelului descriu distribuțiile clasice. Densitatea Normală (2.1) este determinată de medie și varianță. Pentru distribuția lognormală, mediana \(e^m\) și media \(e^{m + s^2/2}\) diferă prin volatility drag. Teorema limită centrală (2.4) spune că media standardizată a unor variabile i.i.d. cu varianță finită converge în distribuție la \(N(0,1)\).
Următoarele rînduri măsoară abaterile de la normalitate. Asimetria și excesul de boltire de selecție, \(S = m_3/m_2^{3/2}\) și \(K = m_4/m_2^2 - 3\), intră în statistica Jarque–Bera \(\text{JB} = \frac{n}{6}(S^2 + K^2/4)\), care are aproximativ distribuția \(\chi^2(2)\) în ipoteza de normalitate. Distribuția Student-t(\(\nu\)) are varianța \(\nu/(\nu - 2)\) și excesul de boltire \(6/(\nu - 4)\), iar criteriul AIC \(= 2k - 2\ell\) compară modelele estimate prin verosimilitate maximă.
Ultimele rînduri servesc la verificarea faptelor stilizate. Autocorelația de selecție \(\hat\rho(h)\) și statistica Ljung–Box \(Q(m)\) testează dependența liniară a randamentelor și, aplicate lui \(|r_t|\), volatility clustering. Corelația de levier \(L(k) = \text{Corr}(r_t, |r_{t+k}|)\) măsoară efectul de levier.
Prima întrebare cere standardizarea unui randament. Dacă randamentele zilnice sînt \(N(0{,}05\%, 1\%^2)\), o zi de −3% se află la \(z = (-3 - 0{,}05)/1 = -3{,}05\) abateri standard de medie. Conform tabelului de frecvențe al distribuției Normale, o asemenea zi ar trebui să apară mai rar decît o dată pe an.
A doua întrebare aplică testul Jarque–Bera. Pentru \(n = 2\,500\),\(S = -0{,}5\) și \(K = 6\), statistica este \(\frac{2500}{6}(0{,}25 + 9) = 3\,854\), mult peste valoarea critică de 5,99, deci normalitatea este respinsă. Ca în exemplul S&P 500, termenul de boltire, 9, domină termenul de asimetrie, 0,25.
A treia întrebare aplică distribuția lognormală. Dacă randamentul logaritmic anual este \(N(5\%, 20\%^2)\), valoarea mediană a unei investiții de 100 după un an este \(100e^{0{,}05} = 105{,}1\), iar valoarea medie este \(100e^{0{,}05 + 0{,}02} = 107{,}3\), unde \(0{,}02 = 0{,}2^2/2\) este volatility drag. Capitolul următor, Capitolul 3, tratează distribuțiile \(\alpha\)-stabile, care renunță la ipoteza varianței finite.
Pe scurt
Întrebare: randamentele zilnice sînt \(N(0{,}05\%, 1\%^2)\); la cîte abateri standard se află o zi de \(-3\%\)?
Capitolul a pornit de la modelul i.i.d. Normal și a arătat, pe opt serii din perioada 2010–2026, că randamentele zilnice au cozi groase, nu sînt independente și sînt asimetrice. Distribuția Student-t descrie cozile; modelele de volatilitate condiționată din capitolele următoare descriu dependența și asimetria.
Randamente logaritmice zilnice, în %, din 2010 (Bitcoin din septembrie 2014, SNN și SNG din noiembrie 2013) pînă la 18 septembrie 2026. Prețuri EODHD: indicii și Bitcoin la închidere, acțiunile BVB ajustate pentru dividende și operațiuni corporative.


 Tukey's g- and h- transformations
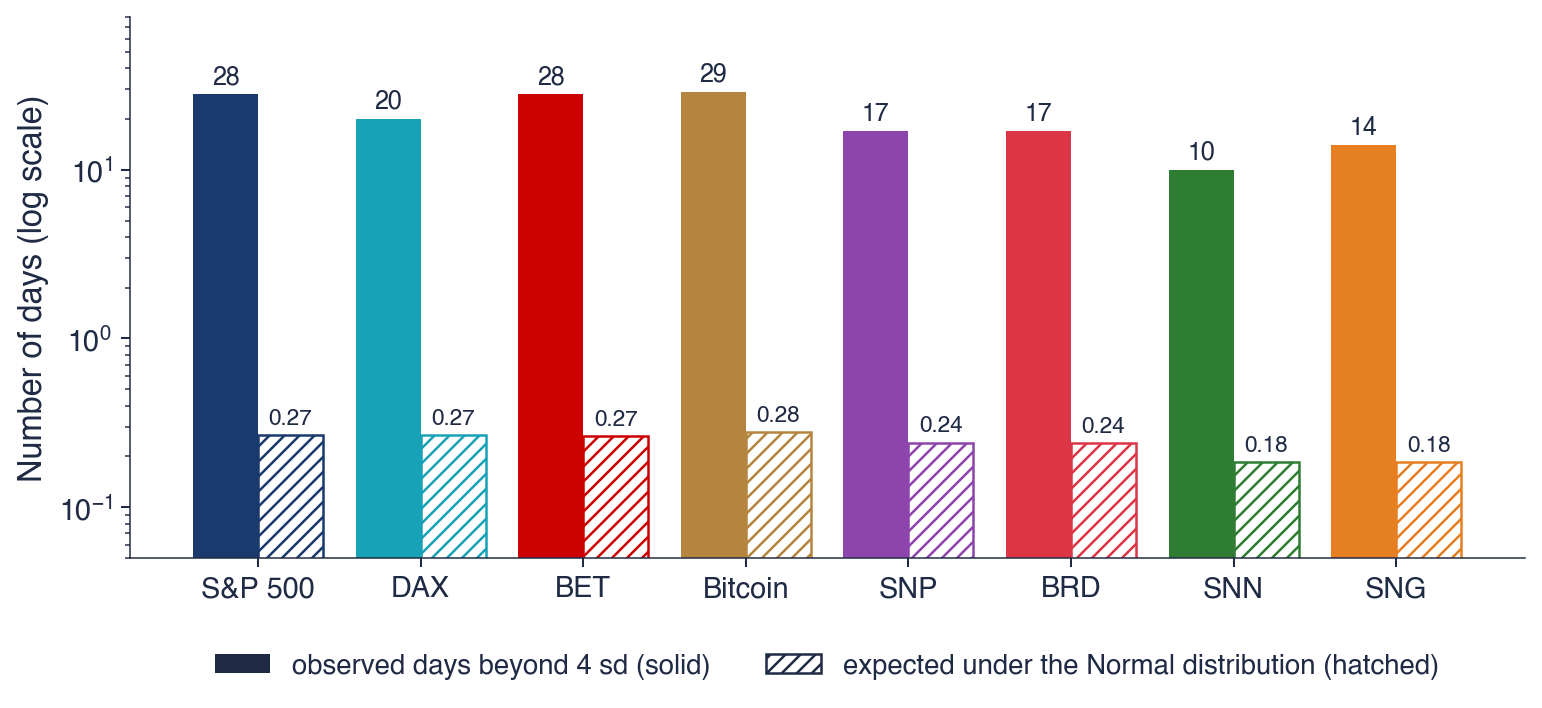
 SFM_ch2_normal_lognormal