Academia de Studii Economice din București IDA Institute Digital Assets Blockchain Research Center AI4EFin Artificial Intelligence for Energy Finance Academia Română, Institutul de Prognoză Economică MSCA Digital Finance
“We provide a framework for integration of high-frequency intraday data into the measurement, modeling, and forecasting of daily and lower frequency return volatilities and return distributions.” — Andersen, Bollerslev, Diebold & Labys (2003)
Varianța realizată (RV, realised variance), suma pătratelor randamentelor pe 5 minute, măsoară varianța fiecărei zile aproape fără model
volatilitatea anualizată calculată din RV medie: 12,9% pentru SPY (fondul tranzacționat la bursă pe S&P 500), 45,1% pentru Bitcoin
Randamentele peste noapte aduc 38% din varianța zilnică a SPY, deși piața este închisă 17,5 ore
Testele de salt pe 1 489 de zile SPY: 236 de respingeri la 5% fără corecție
17 după corecția de periodicitate și controlul FDR (false discovery rate)
În afara eșantionului (out-of-sample), SPY 2022–2026: modelul log-HAR (heterogeneous autoregressive) are o pierdere QLIKE (quasi-likelihood) de 0,310, față de 0,343 pentru GARCH(1,1)-t
We provide a framework for integration of high-frequency intraday data into the measurement, modeling, and forecasting of daily and lower frequency return volatilities and return distributions.
Volatilitatea determină riscul, prețurile opțiunilor și ponderile portofoliilor, dar nu este observată niciodată. Un randament zilnic este o singură extragere dintr-o distribuție a cărei dispersie vrem s-o estimăm, iar GARCH (Generalised AutoRegressive Conditional Heteroskedasticity, heteroscedasticitate condiționată autoregresivă generalizată) deduce varianța de azi din randamentele zilnice trecute, printr-un model. Întrebarea capitolului este cum măsurăm o volatilitate pe care nu o vedem. Ideea lui Andersen & Bollerslev (1998) este că suma pătratelor randamentelor intrazilnice măsoară varianța zilei aproape fără model; Andersen, Bollerslev, Diebold & Labys (2003) o folosesc apoi pentru a modela și a prognoza volatilitatea. Calculată din randamente pe 5 minute, volatilitatea anualizată din varianța realizată (RV, realised variance) medie este 12,9% pentru SPY, fondul tranzacționat la bursă pe S&P 500 (Standard & Poor's), și 45,1% pentru Bitcoin. Randamentele peste noapte aduc 38% din varianța zilnică a SPY, deși piața este închisă 17,5 ore.
Măsurarea are propriile probleme. Zgomotul de microstructură (microstructure noise) deplasează RV la frecvențe foarte mari; graficul de semnătură (signature plot) al SPY este aproape plat: 12,9% la 5 minute, 12,8% la 30 de minute și 13,0% la 130 de minute. Salturile (jumps) separă știrile de componenta continuă, dar testele zilnice trebuie corectate pentru testarea multiplă. Din 1 489 de teste zilnice pe SPY, 236 resping la 5% fără corecție; după corecția de periodicitate și controlul FDR (false discovery rate) rămîn 17 zile cu salt.
Măsurată zilnic, volatilitatea poate fi modelată direct. Modelul HAR (heterogeneous autoregressive) al lui Corsi (2009) explică RV de mîine prin mediile ei pe o zi, o săptămînă și o lună. Out-of-sample, pe 1 180 de prognoze pentru SPY în 2022–2026, log-HAR are o pierdere QLIKE (quasi-likelihood) de 0,310, față de 0,343 pentru GARCH(1,1)-t; testul Diebold–Mariano dă \(t = -2{,}30\) și \(p = 0{,}021\). Comparațiile prin MSE (Mean Squared Error, eroarea pătratică medie) nu sînt concludente, deoarece cîteva zile de criză domină erorile la pătrat. Capitolul se încheie cu întrebarea dacă volatilitatea este rough și cu cît din această rugozitate poate fi produsă de eroarea de măsurare.
Stînga: volatilitatea realizată a SPY (inclusiv noaptea) și prognozele GARCH(1,1)-t și log-HAR, anualizate, 2022–2026; dreapta: pierderea QLIKE cumulată a fiecărui model minus cea a log-HAR (o curbă crescătoare înseamnă că log-HAR este mai bun). Graficul interactiv: „Prognozele în timp (1/2)” →
Rezultatele învățării
Calculați varianța realizată zilnică, eroarea ei standard și un interval de încredere din prețurile intrazilnice.
Interpretați un grafic de semnătură ca diagnostic al zgomotului de microstructură.
Calculați testul de salt bazat pe raport, cu controlul FDR.
Calculați estimările log-HAR și interpretați persistența lor.
Derivați pierderea QLIKE din verosimilitatea Normală.
Interpretați comparațiile prognozelor de varianță: Diebold–Mariano, Mincer–Zarnowitz și Model Confidence Set.
Modelul HAR-RVHAR, log-HAR, estimările pe SPY și Bitcoin, HARQ (HAR model with Realised Quarticity, model HAR cu cvarticitatea realizată) și SHAR (Semivariance HAR model, model HAR cu semivarianțe).
Prognoze: HAR față de GARCHEvaluarea față de o țintă zgomotoasă, testele Diebold–Mariano și Mincer–Zarnowitz, Model Confidence Set.
Volatilitatea asprăMișcarea browniană fracționară, legea de scalare și problema identificării.
ConcluziiCe instrument cînd, verificări și decizia practică.
AprofundăriExemple detaliate și subiecte avansate.
AnexăTeoria asimptotică, estimatorii robuști la zgomot și la salturi și extensiile modelelor.
Motivație: măsurarea volatilității latente
Volatilitatea este un parametru al distribuției condiționate a randamentelor, nu o mărime observabilă. Toate modelele din capitolele anterioare au dedus-o indirect: GARCH din șirul randamentelor zilnice trecute, modelele VaR (Value-at-Risk, valoarea la risc) din această varianță condiționată. Capitolul de față pornește din direcția opusă. Prețurile intraday conțin sute de randamente pe zi, iar suma pătratelor lor dă o măsurare a varianței zilei care nu are nevoie aproape de niciun model. Secțiunea stabilește ce anume se măsoară, prin ce diferă această măsurare de o prognoză și ce date intraday folosește capitolul.
De la prețurile intraday la prognoza varianței (1/2)
Partea I tratează măsurarea și diagnosticul: varianța realizată (RV, realised variance) a unei zile, precizia ei, deplasarea pe care zgomotul de microstructură o produce la frecvențe mari de eșantionare și separarea salturilor de mișcările continue ale prețului.
Partea a II-a tratează modelarea și prognoza: faptele stilizate ale volatilității realizate, modelul autoregresiv heterogen (HAR, heterogeneous autoregressive) și comparația out-of-sample a prognozelor HAR cu cele ale modelelor GARCH (generalised autoregressive conditional heteroskedasticity) din capitolul 5.
Parcursul de bază este urmat de trei extensii:
rough volatility;
un studiu de caz despre învățarea automată față de HAR, împreună cu un al doilea despre varianțele parțiale;
cercetarea asistată de inteligența artificială (AI).
Exemplele detaliate se află în Aprofundări, iar teoria asimptotică, estimatorii robuști la zgomot și la salturi și extensiile modelelor în Anexă.
Pe scurt
Întrebările capitolului
Partea I, măsurare și diagnostic: varianța realizată și precizia ei, zgomotul de microstructură, salturile
Partea a II-a, modelare și prognoză: fapte stilizate, modelul HAR, evaluarea prognozelor față de GARCH
Volatilitatea intră în măsurarea riscului (capitolele 7 și 8), în evaluarea opțiunilor (capitolul 12) și în ponderile portofoliilor (capitolul 4), dar nu este observată niciodată. Un singur randament zilnic este o extragere dintr-o distribuție a cărei dispersie vrem s-o cunoaștem. Pătratul lui este o estimare nedeplasată, dar foarte zgomotoasă, a acestei dispersii, iar un model GARCH deduce de aceea varianța de azi dintr-un istoric lung de randamente zilnice, printr-o recursie parametrică.
Alternativa folosește informația din interiorul zilei. Între deschidere și închidere au loc sute de modificări de preț, iar suma pătratelor lor măsoară varianța acelei zile aproape fără model (Andersen & Bollerslev, 1998). Ideea pornește de la Merton (1980), care a arătat că varianța randamentelor, spre deosebire de medie, se estimează mai precis cînd același interval de timp este eșantionat mai des: precizia unei estimări a varianței crește cu numărul observațiilor, în timp ce precizia mediei depinde doar de lungimea intervalului.
Varianța realizată este o măsurare ex-post a zilei \(t\), disponibilă după închiderea acelei zile.
Varianța GARCH este o prognoză condiționată pentru ziua \(t\), făcută cu informația disponibilă la sfîrșitul zilei \(t-1\).
Prima răspunde la întrebarea „cît de variabilă a fost ziua?”, a doua la „cît de variabilă ne așteptăm să fie ziua?”. Evaluarea prognozelor din acest capitol o folosește pe prima pentru a o judeca pe a doua.
Cele două active principale au ceasuri de tranzacționare diferite. SPY este un fond tranzacționat la bursă (ETF, exchange-traded fund), un fond ale cărui unități se tranzacționează la bursă, care replică indicele bursier Standard & Poor's 500; se tranzacționează în sesiunea regulată americană, de la 09:30 la 16:00, ora New Yorkului. Bitcoin se tranzacționează continuu, iar zilele lui merg de la miezul nopții la miezul nopții în timpul universal coordonat (UTC). VIX, indicele de volatilitate al Chicago Board Options Exchange, este o măsură a volatilității așteptate obținută din prețurile opțiunilor și servește drept termen de comparație pentru volatilitatea realizată în secțiunea despre faptele stilizate.
Toate seriile se încheie la 18 septembrie 2026. Randamentele sînt randamente logaritmice în procente, \(r_i = 100(\ln P_i - \ln P_{i-1})\), unde \(P_i\) este prețul de la sfîrșitul barei \(i\). Orele din capitol și de pe grafice marchează sfîrșitul fiecărui interval de 5 minute: randamentul notat 09:35 este primul randament SPY al zilei, între 09:30 și 09:35. Descrierea completă a eșantioanelor se află în Aprofundări.
Pe scurt
SPY: un fond tranzacționat la bursă (ETF, exchange-traded fund) care urmărește indicele bursier Standard & Poor's 500
ETF: un fond ale cărui unități se tranzacționează la bursă
UTC înseamnă Coordinated Universal Time
zilele Bitcoin sînt delimitate de miezul nopții în acest fus orar
VIX: indicele de volatilitate (Volatility Index) al Chicago Board Options Exchange (CBOE)
o măsură a volatilității anticipate extrasă din prețurile opțiunilor
Toate seriile se opresc la 18 septembrie 2026
Randamentele sînt \(r_i = 100(\ln P_i - \ln P_{i-1})\), în %, unde \(P_i\) este prețul de la sfîrșitul barei \(i\)
Graficele și orele citate în acest capitol marchează sfîrșitul fiecărui interval de 5 minute
Volatilitatea este latentă; varianța realizată o măsoară ex-post din randamentele intraday, în timp ce GARCH o prognozează ex-ante din randamentele zilnice. Secțiunea următoare definește varianța realizată, o arată pe zile individuale și pe seriile zilnice ale SPY și Bitcoin și îi dă precizia.
Varianța realizată
Secțiunea definește obiectul măsurării, varianța integrată a unei zile, și estimatorul ei, varianța realizată. Cadrul este un model în timp continuu al logaritmului prețului, cu o volatilitate spot variabilă în timp. În acest model, suma pătratelor randamentelor intraday converge la varianța integrată cînd intervalul de eșantionare se micșorează, iar o teoremă limită centrală dă precizia măsurării într-o zi dată. Teoria este aplicată apoi pe SPY și Bitcoin: o zi extremă, seriile zilnice din 2020–2026 și împărțirea varianței SPY între sesiunea de tranzacționare și noapte.
Ziua \(t\) este împărțită în \(M\) intervale de aceeași lungime \(\Delta = 1/M\), măsurată în zile, cu randamentele intraday \(r_{t,i}\),\(i = 1, \dots, M\). Randamentul sesiunii este suma \(r_t = \sum_i r_{t,i}\), deoarece randamentele logaritmice se adună în timp. Varianțele sînt exprimate în \(\%^2\) pe zi; volatilitățile anualizate sînt \(\sqrt{252 \times \text{varianța}}\) pentru SPY, care se tranzacționează 252 de zile pe an, și \(\sqrt{365 \times \text{varianța}}\) pentru Bitcoin, care se tranzacționează în fiecare zi. Randamentul overnight al SPY, de la închiderea precedentă la deschidere, se află în afara barelor de 5 minute și este tratat separat.
Logaritmul prețului urmează difuzia
\[dp(s) = \mu(s)\,ds + \sigma(s)\,dW(s),\]
(9.1)
unde \(W\) este o mișcare browniană standard (capitolul 11), \(\mu(s)\) este drift-ul, iar \(\sigma(s)\) este volatilitatea spot (spot volatility). În (9.1),\(\sigma(s)\) este la rîndul ei un proces stochastic: se modifică în cursul zilei, de exemplu între deschidere și prînz, și de la o zi la alta.
Pe scurt
Întrebarea: cum transformăm randamentele de 5 minute ale unei zile într-o măsurare a varianței acelei zile?
Notații: ziua \(t\) are \(M\) intervale de lungime \(\Delta = 1/M\), randamente \(r_{t,i}\), randamentul zilnic \(r_t = \sum_i r_{t,i}\)
Varianțele sînt exprimate în %\(^2\)
Volatilitatea anualizată este \(\sqrt{252 \times \text{varianța}}\) pentru SPY și \(\sqrt{365 \times \text{varianța}}\) pentru Bitcoin
Randamentul SPY peste noapte (de la închidere la deschiderea următoare) nu face parte din bare
adică varianța spot acumulată de-a lungul zilei. În acest capitol, IV înseamnă întotdeauna varianța integrată, niciodată volatilitatea implicită. Dacă \(\sigma\) este independentă de \(W\) (fără efect de pîrghie, leverage) și drift-ul este nul sau determinat de traiectoria lui \(\sigma\), atunci, condiționat de traiectoria lui \(\sigma\), randamentul zilnic urmează distribuția Normală, \(r_t \mid \sigma \sim N(\int\mu, \mathrm{IV}_t)\). Randamentul zilnic este deci o extragere dintr-o distribuție Normală a cărei varianță este mărimea aleatoare (9.2).
Cu efect de pîrghie, adică atunci cînd șocurile lui \(\sigma\) sînt corelate cu \(W\), această normalitate condiționată nu mai are loc. Teoria limită a varianței realizate, prezentată mai jos, rămîne valabilă în cadrul semimartingalelor Itô, descris în Anexă.
Pe scurt
Logaritmul prețului în timp continuu: \(dp(s) = \mu(s)\,ds + \sigma(s)\,dW(s)\), cu \(W\) o mișcare browniană (Capitolul 11)
\(\sigma(s)\) este volatilitatea instantanee: se schimbă în cursul zilei și de la o zi la alta
Varianța integrată a zilei \(t\): mărimea pe care vrem să o măsurăm
\(\IV_t = \displaystyle\int_{t-1}^{t} \sigma^2(s)\,ds\): varianța instantanee acumulată pe parcursul zilei; în acest capitol IV înseamnă mereu varianța integrată (integrated variance), nu volatilitatea implicită
Dată fiind traiectoria lui \(\sigma\), randamentul zilnic urmează distribuția Normală: \(r_t \mid \sigma \sim N(\int\mu, \IV_t)\)
ipoteză: \(\sigma\) este independent de \(W\) (fără efect de levier, leverage effect: scăderile de preț nu cresc volatilitatea)
ipoteză: drift-ul este nul (sau determinat de traiectoria lui \(\sigma\))
Cu efect de levier (Anexă: semimartingale Itô) această normalitate condiționată nu mai are loc, dar teoria limită a varianței realizate (RV, slide-ul următor) rămîne valabilă
Varianța realizată a zilei \(t\) este suma pătratelor randamentelor intraday,
\[\mathrm{RV}_t = \sum_{i=1}^{M} r_{t,i}^2,\]
(9.3)
iar volatilitatea realizată este \(\sqrt{\mathrm{RV}_t}\). Folosim pătratele deoarece, pe un interval scurt, \(\mathbb{E}[r_{t,i}^2 \mid \sigma] \approx \sigma^2(s_i)\,\Delta\), astfel încît suma lor aproximează integrala (9.2). Convergența nu este totuși cea a unei sume Riemann: incrementele observate la pătrat sînt aleatoare, iar suma lor converge la variația pătratică (quadratic variation) a logaritmului prețului.
Drift-ul adaugă termeni de ordinul \(\Delta\) pe zi, care dispar cînd \(M \to \infty\); pentru SPY, randamentul mediu pe 5 minute este sub 1% din abaterea lui standard. În (9.3) nu se estimează niciun parametru, deci \(\mathrm{RV}_t\) este o măsurare fără model (model-free) a varianței unei zile.
Pătratul randamentului zilnic, \(r_t^2\), este cazul particular \(M = 1\). Cu drift nul, el este nedeplasat pentru \(\mathrm{IV}_t\), dar extrem de zgomotos; cîștigul adus de datele intraday este precizia, nu eliminarea unei deplasări.
De ce pătrate: mediile condiționate ale pătratelor incrementelor aproximează \(\int_{t-1}^{t} \sigma^2(s)\,ds\)
pe un interval scurt \(\E[r_{t,i}^2 \mid \sigma] \approx \sigma^2(s_i)\,\Delta\)
suma observată a pătratelor converge la variația pătratică; nu este o sumă Riemann
Variația pătratică a zilei \(t\), cu \(p = 100\ln P\): \([p]_t - [p]_{t-1} = \operatorname{plim}_{M \to \infty} \sum_{i=1}^{M} r_{t,i}^2 = \IV_t\) pentru un preț fără salturi Barndorff-Nielsen & Shephard (2002)
Drift-ul aduce termeni de ordinul \(\Delta\) pe zi, care dispar cînd \(M \to \infty\); pentru SPY, media randamentelor de 5 minute este sub 1% din abaterea lor standard
Fără parametri de estimat: \(\RV_t\) este o măsurare fără model a varianței unei zile
Randamentul zilnic la pătrat \(r_t^2\) este cazul particular \(M = 1\)
nedeplasat (cu drift nul), dar extrem de zgomotos
Randamentele la cinci minute din 7 aprilie 2025 (1/2)
Graficul interactiv arată o singură zi de tranzacționare a SPY, pe bare de 5 minute. Panoul din stînga arată traiectoria prețului, iar cel din dreapta suma cumulată a pătratelor randamentelor, care atinge RV-ul zilei la închidere. Lista derulantă alege ziua; implicit este 7 aprilie 2025, ziua cea mai volatilă din eșantion.
Întrebare pentru sală Pe 7 aprilie 2025, RV este 45,1 %², iar cel mai mare randament de 5 minute în valoare absolută aduce 18,3 %². Dacă numai acest randament și-ar dubla valoarea, cît ar deveni RV?
Răspuns
Circa 100,0 %². Contribuția acelui interval se înmulțește cu patru: 45,1 − 18,3 + 4 × 18,3 = 100,0 %². Valoarea 63,4 %² dublează contribuția la varianță în locul randamentului; 180,4 %² presupune dublarea tuturor randamentelor. În date, randamentul de +4,28% din intervalul care se încheie la 10:15 aduce 41% din RV a zilei.
În acea zi, SPY a deschis cu un randament logaritmic overnight de −3,27%, după anunțurile privind tarifele. Cele 78 de randamente pe 5 minute care au urmat dau \(\mathrm{RV} = 45{,}1\%^2\), adică o volatilitate realizată anualizată de \(\sqrt{252 \times 45{,}1} = 107\%\). Un singur randament, de +4,28%, în intervalul care se încheie la 10:15, a adus 41% din varianța realizată a zilei: suma cumulată face un salt la acea bară. De la deschidere la închidere, ziua s-a încheiat cu +3,09%. Randamentul zilnic ascunde oscilațiile intraday pe care RV le înregistrează.
Ziua arată ambele fețe ale RV. Pe de o parte, RV surprinde oscilațiile intraday pe care un singur randament de la deschidere la închidere, de +3,09%, le ascunde: traiectoria a trecut prin mișcări mari în ambele sensuri, iar fiecare dintre ele își adaugă pătratul la sumă. Pe de altă parte, măsurarea poate fi dominată de cîteva randamente. Cînd un singur interval aduce 41% din varianța zilei, precizia RV în acea zi este mai mică decît într-o zi cu randamente distribuite uniform, observație formalizată de intervalul de încredere de la sfîrșitul secțiunii.
Mișcarea overnight de −3,27% nu face parte din cele 78 de randamente intraday. Pentru o măsură a riscului zilnic total al SPY trebuie adăugat pătratul randamentului overnight, cum se arată două slide-uri mai jos.
Pe scurt
Stînga: SPY pe bare de 5 minute în cea mai volatilă zi din eșantion
Dreapta: suma cumulată a pătratelor randamentelor
SPY a deschis cu un randament logaritmic peste noapte de \(-3{,}27\%\), după anunțurile privind tarifele vamale
Graficul interactiv arată volatilitatea realizată zilnică a SPY și a Bitcoin, anualizată și calculată din randamente pe 5 minute: pentru SPY pe sesiunea regulată americană, pentru Bitcoin pe 24 de ore. Golul din octombrie 2025 corespunde unor date lipsă. Cursorul scoate din medie zilele cele mai volatile, pentru a arăta cît de sensibil este nivelul mediu la cîteva observații extreme.
Întrebare pentru sală Volatilitatea SPY calculată din RV medie este 12,9% pe an, iar mediana zilnică 9,7%. Cît scade prima valoare dacă excludem cele mai volatile 20 de zile?
Răspuns
La 11,9%: 20 de zile, adică 1,3% din cele 1 489, ridică volatilitatea calculată din RV medie cu 1,0 puncte procentuale. Media varianțelor este sensibilă la cîteva zile extreme, mediana nu. Pentru Bitcoin, aceleași 20 de zile excluse coboară valoarea de la 45,1% la 41,6%.
Pentru SPY, volatilitatea calculată din RV-ul mediu, \(\sqrt{252\,\overline{\mathrm{RV}}}\), este 12,9% pe an. Ziua mediană are 9,7%, iar intervalul de variație merge de la 2,3% la 106,7%. Pentru Bitcoin, valoarea corespunzătoare, \(\sqrt{365\,\overline{\mathrm{RV}}}\), este 45,1% pe an, cu o mediană de 37,8% și un maxim de 136,1% la 5 februarie 2026.
Volatilitatea calculată din varianța medie depășește volatilitatea zilnică mediană la ambele active. Motivul este asimetria la dreapta a RV: cîteva zile foarte volatile ridică media varianțelor, și deci rădăcina ei pătrată, mult peste ziua tipică. Mediana nu este sensibilă la aceste zile; media este.
Ambele serii prezintă volatility clustering: perioadele calme și cele agitate alternează, iar o zi volatilă este urmată de alte zile volatile. Este aceeași regularitate pe care o surprind modelele GARCH (capitolul 5). Diferența este că fiecare punct de pe grafic este măsurarea unei zile, nu rezultatul unui model estimat. Persistența acestor măsurători este cuantificată în secțiunea despre faptele stilizate.
Pe scurt
Volatilitate anualizată, calculată din randamente de 5 minute
SPY: pe sesiunea regulată din SUA (Statele Unite ale Americii)
Bitcoin: pe 24 de ore
golul din octombrie 2025 corespunde unor date lipsă
SPY: volatilitatea calculată din RV medie este \(\sqrt{252\,\overline{\RV}} = 12{,}9\%\) pe an
volatilitatea zilnică are mediana \(9{,}7\%\) și variază între \(2{,}3\%\) și \(106{,}7\%\)
Volatilitatea calculată din varianța medie depășește mediana: cîteva zile foarte volatile ridică media pătratică a volatilităților zilnice
Bitcoin: volatilitatea calculată din RV medie este \(\sqrt{365\,\overline{\RV}} = 45{,}1\%\) pe an
mediana zilnică este \(37{,}8\%\)
maximul, \(136{,}1\%\), a fost atins pe 2026-02-05
Ambele serii arată gruparea volatilității (volatility clustering), ca la GARCH (Capitolul 5)
dar fiecare punct este o măsurare, nu rezultatul unui model
SPY se tranzacționează 6,5 ore, dar prețul lui se schimbă și cînd piața este închisă: deschiderea diferă de închiderea precedentă. Graficul interactiv împarte varianța zilnică medie a SPY, anualizată, în varianța realizată intraday și pătratul randamentului overnight. Lista derulantă alege agregarea (pe an, pe trimestru sau pe lună), iar cursorul fixează un factor \(c\) cu care este scalată în sus RV-ul intraday, unul dintre modurile de a ține seama de noapte fără a o observa.
Întrebare pentru sală Volatilitatea calculată din RV intraday medie este 12,9% pe an. Dacă înmulțim fiecare RV intraday cu c = 1,62, aproximativ cît devine această volatilitate?
Răspuns
Circa 16,4%: volatilitatea se înmulțește cu √1,62, deci 12,9% × √1,62 ≈ 16,4% (readout-ul arată 16,5%, fiindcă pornește de la 12,93% nerotunjit). Valoarea 20,9% aplică factorul varianței direct volatilității; 10,1% este volatilitatea componentei overnight. Randamentele peste noapte aduc 38% din varianța zilnică SPY; scalarea egalează mediile varianțelor, nu reconstruiește componenta overnight a fiecărei zile.
Randamentele overnight aduc 38% din varianța zilnică a SPY, deși piața este închisă 17,5 ore. Anii 2020 și 2026 sînt incompleți. Factorul de scalare egalează varianțele medii; el nu reconstituie componenta overnight a fiecărei zile în parte.
Ponderea nopții reflectă modul în care sosește informația. Rezultatele companiilor, datele macroeconomice publicate înainte de deschidere și sesiunile asiatice și europene se acumulează cît timp piața americană este închisă și sînt încorporate în preț la deschidere, printr-un singur salt. Rezultatul este descriptiv: arată unde cade varianța, nu de ce are loc fiecare mișcare overnight.
Volatilitățile anualizate ale celor trei randamente sînt 16,6% de la închidere la închidere, 13,6% de la deschidere la închidere și 10,1% overnight. Pentru riscul zilnic, măsura relevantă este varianța totală\(\mathrm{RV}_t + r_{\text{overnight},t}^2\), a cărei medie anualizată corespunde unei volatilități de 16,4%. Alternativele sînt scalarea RV-ului intraday cu o constantă sau combinarea celor două părți cu ponderi optime (Hansen & Lunde, 2005). Aritmetica adunării varianțelor de zi și de noapte, și motivul pentru care \(13{,}6^2 + 10{,}1^2\) nu este suma corectă, se află în Aprofundări.
Pe scurt
SPY, varianța zilnică medie pe ani, anualizată
varianța realizată intraday plus randamentul peste noapte la pătrat
2020 și 2026 sînt ani incompleți
Randamentele peste noapte aduc 38% din varianța zilnică SPY, deși piața este închisă 17,5 ore
Știrile (rezultate financiare, date macroeconomice, sesiunile din Asia și Europa) se acumulează și sînt încorporate în preț la deschidere
Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei)
Volatilitatea anualizată a SPY
\(16{,}6\%\) de la închidere la închidere
\(13{,}6\%\) de la deschidere la închidere
\(10{,}1\%\) peste noapte
Pentru riscul zilnic folosim varianța totală: \(\RV_t + r_{\text{noapte},t}^2\)
media anualizată: \(16{,}4\%\), față de \(12{,}9\%\) doar din RV intraday
Alternative: scalarea RV intraday în sus sau ponderarea optimă a celor două părți Hansen & Lunde (2005)
RV este un estimator consistent al lui \(\mathrm{IV}_t\) cînd \(M \to \infty\), dar cu \(M = 78\) are o eroare de eșantionare. Teorema limită centrală (TLC) aplicabilă (feasible central limit theorem) a lui Barndorff-Nielsen & Shephard (2002) îi dă mărimea:
Varianța RV depinde de cvarticitatea integrată (integrated quarticity) \(\mathrm{IQ}_t = \int_{t-1}^{t}\sigma^4(s)\,ds\), pe care o estimează cvarticitatea realizată (realised quarticity) \(\mathrm{RQ}_t\). Din (9.5), eroarea standard este \(\mathrm{se}(\mathrm{RV}_t) = \sqrt{\tfrac{2}{3}\sum_i r_{t,i}^4}\). Apar puteri de ordinul patru deoarece varianța unui estimator al varianței depinde de momentul de ordinul patru al randamentelor.
Intervalul de încredere (IÎ) de 95% se construiește pe scară logaritmică, \(\mathrm{RV}_t \exp(\pm 1{,}96\,\mathrm{se}(\mathrm{RV}_t)/\mathrm{RV}_t)\), pentru a fi mereu pozitiv. Cu volatilitate constantă în cursul zilei, \(\mathrm{se}/\mathrm{RV} \approx \sqrt{2/M}\), adică 16% pentru \(M = 78\): varianța unei singure zile este măsurată cu o eroare relativă de aproximativ o șesime, mult mai mică decît cea a lui \(r_t^2\), dar departe de zero.
Limita din (9.5) are o subtilitate. Varianța asimptotică \(2\,\mathrm{IQ}_t\) este ea însăși aleatoare, astfel că limita lui \(\sqrt{M}(\mathrm{RV}_t - \mathrm{IV}_t)\) este o distribuție Normală mixtă. Înlocuirea lui \(\mathrm{IQ}_t\) cu estimarea \(\mathrm{RQ}_t\) este legitimă deoarece convergența este stabilă (stable convergence), adică are loc împreună cu orice variabilă definită pe traiectorie; enunțul formal se află în Anexă. Intervalele pentru SPY și zilele în care ele se lărgesc se află în Aprofundări.
Pe scurt
Teorema limită centrală (CLT, central limit theorem) pentru RV, în forma fezabilă (calculabilă din date) Barndorff-Nielsen & Shephard (2002)
Varianța realizată (9.3) măsoară fără parametri varianța integrată (9.2) a unei zile, iar TLC (9.5) îi dă precizia, o eroare relativă de circa 16% cu 78 de randamente și volatilitate intraday constantă. Pentru SPY, RV-ul mediu corespunde unei volatilități de 12,9% pe an, iar noaptea adaugă 38% din varianța zilnică. Secțiunea următoare arată de ce intervalul de eșantionare se oprește la 5 minute și nu la fiecare tranzacție.
Zgomotul de microstructură
TLC din secțiunea anterioară sugerează o eșantionare cît mai deasă, deoarece eroarea relativă scade ca \(\sqrt{2/M}\). Prețurile observate nu sînt însă prețul eficient din model: ele oscilează între bid și ask, se mișcă pe o grilă discretă de tick-uri și rămîn neactualizate între tranzacții. Secțiunea modelează aceste efecte ca zgomot aditiv, derivă deplasarea pe care o induc în RV și frecvența care echilibrează deplasarea cu eroarea de eșantionare și verifică pe datele cursului dacă eșantionarea la 5 minute este suficient de rară.
Dacă mai multe randamente micșorează eroarea relativă a RV, întrebarea firească este de ce nu folosim fiecare tranzacție. Răspunsul este că logaritmul prețului observat nu este logaritmul prețului eficient din (9.1). Modelul standard este
unde \(p^*_i\) este logaritmul prețului eficient (adevărat), \(r^*_i\) randamentul eficient, iar \(\varepsilon_i\) zgomotul din prețul observat. Sursele lui \(\varepsilon\) sînt oscilația bid–ask (bid–ask bounce), mărimea tick-ului, care face prețurile discrete, și cotațiile neactualizate (stale quotes); economia lor este subiectul capitolului 10.
Pe scurt
Întrebarea: de ce nu folosim fiecare tranzacție?
mai multe randamente micșorează eroarea relativă a RV (\(\sqrt{2/M}\))
Sursele lui \(\varepsilon\): oscilația între prețul de cumpărare (bid) și cel de vînzare (ask), pasul de cotare (discretizarea prețului), cotațiile neactualizate (stale) (Capitolul 10)
Urmînd pe Zhang, Mykland & Aït-Sahalia (2005) și pe Hansen & Lunde (2006), presupunem că zgomotul este i.i.d. cu varianța \(\omega^2\), independent de prețul eficient, și că o zi are \(n\) randamente. Cu drift nul și fără efect de pîrghie,
Fiecare randament la pătrat conține \(\mathbb{E}[(\varepsilon_i - \varepsilon_{i-1})^2] = 2\omega^2\) zgomot, deci deplasarea din (9.7)crește liniar cu frecvența de eșantionare. Randamentele alăturate au în comun termenul \(\varepsilon_{i-1}\), cu semne opuse, astfel că zgomotul induce și o autocorelație negativă de ordinul întîi, \(\mathrm{cov}(r_i, r_{i-1}) = -\omega^2\), semnătură folosită mai jos pentru a-l detecta.
Eroarea pătratică medie (MSE, mean squared error) a RV combină cele două efecte:
Primul termen este eroarea de discretizare, care scade cu \(n\); al doilea este pătratul deplasării, care crește cu \(n\). Minimizarea sumei lor dă numărul optim de randamente în sensul MSE, \(n^*\) din (9.8)(Bandi & Russell, 2008); derivarea se află în Anexă.
Un exemplu numeric fixează ordinele de mărime. Cu \(\mathrm{IV} = 1\%^2\) și volatilitate constantă în cursul zilei, \(\mathrm{IQ} = \mathrm{IV}^2 = 1\)(\(\%^4\)); cu \(\omega = 0{,}01\%\),\(\omega^2 = 10^{-4}\%^2\). Deplasarea \(2n\omega^2\) este atunci 0,016 la 5 minute (\(n = 78\)) și 4,680 la eșantionarea pe o secundă, de aproape cinci ori varianța măsurată. Numărul optim de randamente este \(n^* = 292\), un randament la fiecare 80 de secunde.
\(\E[\RV^{(n)}_t \mid \sigma] = \IV_t + 2n\omega^2\) (drift nul, fără efect de levier): fiecare randament la pătrat conține \(2\omega^2\) zgomot, deci deplasarea crește cu frecvența de eșantionare
Randamentele alăturate au în comun \(\varepsilon_{i-1}\), cu semne opuse: \(\mathrm{cov}(r_i, r_{i-1}) = -\omega^2\)
Numărul de randamente optim după MSE (eroarea pătratică medie), \(n^* = \left(\text{IQ}/(4\omega^4)\right)^{1/3}\)Bandi & Russell (2008): mai multe randamente reduc primul termen, dar îl cresc pe al doilea; derivarea în Anexă
Exemplu numeric, cu \(\IV = 1\%^2\) și \(\omega = 0{,}01\%\), deci \(\omega^2 = 10^{-4}\%^2\)
volatilitate constantă în cursul zilei, deci \(\text{IQ} = \IV^2 = 1\) (%\(^4\))
deplasarea \(2n\omega^2\) este \(0{,}016\) (%\(^2\)) la 5 minute (\(n = 78\)) și \(4{,}680\) la 1 secundă, mai mare decît IV însăși
Numărul optim de randamente este \(n^* = 292\), adică un randament la fiecare \(80\) secunde
Formula (9.8) nu poate fi aplicată direct: \(\omega^2\) și \(\mathrm{IQ}_t\) sînt necunoscute și diferă de la un activ la altul și de la o zi la alta. În plus, frecvența optimă scade repede cînd zgomotul crește. Cu \(\omega = 0{,}01\%\),\(n^* = 292\); cu \(\omega = 0{,}1\%\),\(n^* = 14\), un randament la aproximativ fiecare 29 de minute.
Răspunsul practic este eșantionarea rară (sparse sampling) la 5 minute, \(n = 78\) într-o sesiune de 6,5 ore. La această frecvență, deplasarea \(2n\omega^2\) rămîne mică pentru activele lichide, iar eroarea relativă de discretizare este \(\sqrt{2/78} = 16\%\). Costul este că majoritatea tranzacțiilor sînt ignorate. Liu, Patton & Sheppard (2015) compară aproape 400 de estimatori pe 31 de active și constată că RV pe 5 minute este rareori depășită. Datele cursului sînt bare de 5 minute, cea mai fină grilă disponibilă, deci întrebarea devine dacă 5 minute înseamnă o eșantionare suficient de rară pentru SPY și Bitcoin; răspunsul îl dă signature plot-ul.
Pe scurt
Întrebarea: ce frecvență alegem, cînd \(n^*\) depinde de \(\omega^2\) și de \(\text{IQ}_t\)?
ambele sînt necunoscute și diferite de la un activ la altul
Un signature plot arată volatilitatea implicată de RV-ul mediu în funcție de intervalul de eșantionare. Dacă zgomotul de tipul (9.6) contează, curba crește cînd intervalul se micșorează, deoarece deplasarea din (9.7) crește cu \(n\). Graficul interactiv arată volatilitatea anualizată din RV-ul mediu pentru SPY și Bitcoin, calculată pe o singură grilă și ca medie pe toate grilele decalate. Lista derulantă alege perioada, iar cursorul adaugă la logaritmul prețurilor un zgomot artificial i.i.d. cu abaterea standard \(\omega\), pentru a arăta cum ar arăta curba în prezența zgomotului.
Întrebare pentru sală În aproximația cu 78 de intervale pe zi, ce abatere standard ω a zgomotului independent adăugat log-prețurilor ridică volatilitatea SPY la 5 minute de la 12,9% la aproximativ 14,0% pe an?
Răspuns
Circa ω = 0,027%. Rezolvăm 252 × (RV medie + 2 × 78 × ω²) = 14² și obținem ω ≈ 0,02708%; pe slider, 0,027% dă 13,99%, iar 0,028% dă 14,07%. Valoarea 0,019% rezultă din folosirea greșită a lui 4nω²; 0,038%, din folosirea lui nω². Signature plot-ul real rămîne aproximativ plat, între 12,6% și 13,1%: compatibil cu o deplasare din zgomot la 5 minute mult mai mică, fără să excludă zgomotul.
Curba este aproape plată în funcție de intervalul de eșantionare. Pentru SPY, volatilitatea anualizată este 12,9% la 5 minute, 12,8% la 30 de minute și 13,0% la 130 de minute; pentru Bitcoin, 45,1% la 5 minute și 44,5% la 6 ore. Autocorelația de ordinul întîi a randamentelor pe 5 minute este −0,008 pentru SPY și 0,005 pentru Bitcoin. Niciun diagnostic nu arată zgomot la 5 minute. O curbă plată este compatibilă cu o deplasare mică din zgomot; nu dovedește absența zgomotului.
Diagnosticul are o limită intrinsecă. Barele de 5 minute pot diagnostica doar eșantionarea la 5 minute și la intervale mai mari; ele nu spun nimic despre zgomotul de la frecvențe mai mari, pentru care ar fi nevoie de date tick. Rezultatul susține o descriere: pe aceste active și pe acest eșantion, RV pe 5 minute nu arată o deplasare vizibilă din zgomot.
Estimatorii robuști la zgomot, calculați pe aceleași date SPY pe 5 minute, ilustrează această limită. Rapoartele lor față de RV sînt 0,84 pentru RV pe două scări pe grilele standard și 0,97 cînd primul și ultimul preț al zilei sînt adăugate fiecărei grile; 0,92 pentru nucleul realizat cu capete netezite (jittered end points) și 0,95 cu prețurile brute de la capete. Diferențele provin din estimatori, nu dintr-o deplasare măsurată a zgomotului: cu 78 de bare, versiunile teoretice pierd o parte din primul și ultimul interval al zilei, care sînt cele mai volatile. Ambii estimatori sînt descriși în Aprofundări.
Rezultatul concordă cu Liu, Patton & Sheppard (2015). Estimatorii robuști la zgomot sînt utili cînd zgomotul este mare față de semnal, ca la datele tick sau la nivel de secundă și la activele nelichide; pentru activele lichide eșantionate la 5 minute, RV simplă este greu de depășit.
Pe scurt
Volatilitatea anualizată din RV medie în funcție de intervalul de eșantionare
o singură grilă față de media grilelor decalate în timp (subeșantionare)
Volatilitatea rămîne aproximativ stabilă cînd intervalul de eșantionare crește: compatibil cu o deplasare redusă din zgomot, nu o dovadă că zgomotul lipsește
SPY: \(12{,}9\%\) la 5 minute, \(12{,}8\%\) la 30 de minute și \(13{,}0\%\) la 130 de minute
Bitcoin: \(45{,}1\%\) la 5 minute și \(44{,}5\%\) la 6 ore
Autocorelația de ordinul 1 a randamentelor de 5 minute este \(-0{,}008\) pentru SPY și \(0{,}005\) pentru Bitcoin: zgomotul i.i.d. ar face-o negativă (\(-\omega^2\)), deci la 5 minute nu se detectează
Limita acestor date: barele de 5 minute nu spun nimic despre zgomotul sub 5 minute
Estimatori robuști la zgomot (Aprofundări), ca raport față de RV pe SPY: diferențe între estimatori, nu o deplasare din zgomot măsurată
RV pe două scări, pe grilele standard: \(0{,}84\); cu primul și ultimul preț al zilei în fiecare grilă: \(0{,}97\)
nucleul realizat cu capete mediate (jittering): \(0{,}92\); cu prețurile brute de la capete: \(0{,}95\)
cu 78 de bare, variantele teoretice pierd o parte din primul și din ultimul interval al zilei, cele mai volatile
Zgomotul de microstructură face din RV un estimator deplasat la frecvențe mari, cu deplasarea \(2n\omega^2\) din (9.7), iar compromisul MSE (9.8) dă o frecvență optimă care scade repede cu zgomotul. Pe SPY și Bitcoin, signature plot-ul este aproape plat de la 5 minute în sus, deci RV pe 5 minute este măsurarea folosită în restul capitolului. Secțiunea următoare renunță la ipoteza că traiectoria prețului este continuă.
Salturi
Difuzia (9.1) are traiectorii continue, dar prețurile sar și la știri. Cu salturi, RV converge la varianța integrată plus suma pătratelor salturilor, iar cele două componente au conținut economic diferit: salturile sînt mai puțin persistente decît volatilitatea difuzivă și sînt evaluate diferit în opțiuni. Secțiunea introduce variația bipower, care estimează partea continuă, testul bazat pe raport pentru un salt într-o zi dată și controlul descoperirilor false cînd testul este repetat pe fiecare zi a eșantionului.
Întrebarea este cît din varianța unei zile provine din salturi și cum separăm salturile de difuzie. Adăugarea unui proces de salt \(J\) în model dă \(dp = \mu\,ds + \sigma\,dW + dJ\) (capitolul 11). Variația pătratică are atunci două părți,
unde \(\kappa_j\) sînt mărimile salturilor din ziua \(t\).
Separarea contează din două motive:
Salturile sînt mai puțin persistente decît componenta difuzivă a volatilității, astfel că un model de prognoză care le tratează la fel supraestimează persistența după o zi cu salt.
cu \(Z \sim N(0,1)\), astfel încît \(\mu_1 = 0{,}798\) și \(\mu_1^{-2} = \pi/2 = 1{,}571\); factorul \(M/(M-1)\) este o normalizare pentru eșantioane finite. Cazul de bază pentru (9.10) sînt salturile de activitate finită și absența zgomotului; alte situații cer condiții suplimentare.
Mecanismul este simplu. Un salt de activitate finită intră într-un singur randament. În RV acest randament este ridicat la pătrat, deci saltul contribuie cu \(\kappa^2\). În BV (Bipower Variation, variația bipower) el este înmulțit cu un randament vecin de mărime difuzivă, de ordinul \(\sqrt{\Delta}\), astfel că efectul lui dispare cînd \(M\) crește. Partea de salt a zilei se estimează prin \(\max(\mathrm{RV}_t - \mathrm{BV}_t, 0)\).
Un exemplu cu patru randamente arată calculul. Cu randamentele \(0{,}1;\ 0{,}1;\ 0{,}1;\ 1{,}0\) (%), \(\mathrm{RV} = 1{,}03\) și \(\mathrm{BV} = \frac{\pi}{2}\cdot\frac{4}{3}(0{,}01 + 0{,}01 + 0{,}10) = 0{,}25\), deci partea de salt este \(0{,}78\)(\(\%^2\)): ultimul randament aduce aproape tot RV-ul, dar puțin la BV.
Numărătorul din (9.11) este ponderea relativă a saltului în ziua respectivă, iar numitorul este eroarea ei standard sub ipoteza nulă a absenței salturilor. Constanta \(\theta\) este constanta varianței asimptotice, iar cvarticitatea tripower (tripower quarticity)
\[\mathrm{TQ}_t = M \mu_{4/3}^{-3}\frac{M}{M-2}\sum_i |r_{t,i}|^{4/3}|r_{t,i-1}|^{4/3}|r_{t,i-2}|^{4/3},\]
cu \(\mu_{4/3} = \mathbb{E}|Z|^{4/3}\), estimează cvarticitatea integrată robust la salturi.
Sub ipoteza nulă a absenței salturilor, \(z_t \to N(0,1)\). Un salt face ca \(\mathrm{RV}_t > \mathrm{BV}_t\) și \(z_t\) să fie mare și pozitiv, deci testul este unilateral. Zilele cu salt de pe slide-ul următor folosesc pragul \(\alpha = 0{,}1\%\), cu valoarea critică 3,09. Într-o zi semnificativă, partea de salt este \(J_t = \mathrm{RV}_t - \mathrm{BV}_t\), iar partea continuă \(C_t = \mathrm{RV}_t - J_t\); în celelalte zile \(J_t = 0\).
Graficul interactiv marchează zilele cu salt semnificativ pe seria RV zilnice. Punctele roșii sînt zilele cu salt, cu mărimea punctului proporțională cu partea de salt \(J_t\). Cursorul fixează pragul testului \(\alpha\), iar lista derulantă alege între absența corecției pentru testarea multiplă și regula Benjamini–Hochberg, explicată două slide-uri mai jos.
Întrebare pentru sală Dacă niciuna dintre cele 1 489 de zile SPY nu conține salturi și fiecare test respinge eronat cu probabilitatea de 5%, cîte respingeri false avem în medie, înaintea corecției pentru testarea multiplă?
Răspuns
Circa 74: media este 1 489 × 0,05 = 74,45, nu un număr garantat într-un eșantion; independența dintre zile nu este necesară pentru acest calcul al mediei. În date, testul fără corecția de periodicitate dă 236 de respingeri la 5%, iar Benjamini–Hochberg (FDR la 5%) păstrează 43. După corecția de periodicitate, Benjamini–Hochberg păstrează 17.
La pragul de 0,1%, SPY are 36 de zile cu salt din 1 489 (2,4%), iar salturile reprezintă 2,8% din varianța realizată totală. Într-o zi cu salt, saltul reprezintă în medie 36% din RV-ul acelei zile. Cea mai mare statistică, \(z = 5{,}2\), cade la 27 august 2021, în intervalul 10:00–10:05, în timpul discursului de la Jackson Hole al președintelui Rezervei Federale. Bitcoin are 67 de zile cu salt din 659 (10,2%), dar salturile reprezintă doar 1,8% din varianța lui.
Cele două piețe diferă prin tipul salturilor. Bitcoin are multe salturi mici în zile liniștite, adesea la sfîrșit de săptămînă, cînd o mișcare izolată domină o zi altfel calmă; ponderea relativă a saltului din (9.11) este atunci mare, deși saltul însuși este mic. De aceea Bitcoin are de peste patru ori ponderea zilelor cu salt a SPY, dar o pondere mai mică a varianței provenite din salturi.
Zilele agitate din aprilie 2025 nu sînt, în majoritate, zile cu salt. În acele zile au loc multe randamente mari la rînd, astfel că BV crește împreună cu RV, iar raportul rămîne mic. Testul detectează discontinuități izolate, nu zile volatile: o zi de turbulență susținută este clasificată drept difuzivă.
Pe scurt
Punctele roșii: zile cu salt semnificativ la nivelul de 0,1%
mărimea punctului este proporțională cu partea de salt \(J_t\)
SPY: 36 de zile cu salt din 1 489 (2,4%)
salturile reprezintă 2,8% din varianța realizată totală
într-o zi cu salt, saltul reprezintă în medie 36% din RV a zilei
cea mai mare statistică apare pe 2021-08-27 (\(z = 5{,}2\)), în intervalul 10:00–10:05, în timpul discursului președintelui Fed (Rezerva Federală a SUA) de la Jackson Hole
Bitcoin: 67 de zile cu salt din 659 (10,2%), dar doar 1,8% din varianță
multe salturi mici în zile liniștite (weekenduri), în care o singură mișcare izolată domină ziua
Zilele agitate din aprilie 2025 nu sînt în mare parte zile cu salt
Aplicat pe 1 489 de zile la pragul de 5%, testul respinge în 236 de zile. Dacă nicio zi nu ar conține un salt, ne-am aștepta la circa 74 de respingeri false. Întrebarea este care dintre cele 236 de respingeri sînt false. O parte din exces provine din sezonalitatea intraday (Aprofundări): volatilitatea este mai mare la deschidere și la închidere, ceea ce deplasează BV în jos și face ca testul să respingă prea des. Împărțirea randamentelor la factorul de periodicitate \(f_i\) al lui Boudt, Croux & Laurent (2011) reduce deja respingerile la 5% de la 236 la 169.
Problema rămasă este multiplicitatea. Benjamini & Hochberg (1995) controlează rata descoperirilor false (FDR, false discovery rate), proporția așteptată a respingerilor false în totalul respingerilor. Cele \(N\) valori \(p\) se ordonează, \(p_{(1)} \le \dots \le p_{(N)}\), și se resping cele mai mici \(k\), unde
\[k = \max\{\,j : p_{(j)} \le j\,q/N\,\},\]
(9.12)
iar \(q\) este FDR-ul țintă. Aici valoarea \(p\) a fiecărei zile este \(1 - \Phi(z_t)\), unilaterală, a statisticii de tip raport. Regula (9.12) asigură \(\mathbb{E}[\text{false}/\text{respingeri}] \le q\), raportul fiind considerat zero cînd nu se respinge nimic.
Garanția cere valori \(p\) valide, independente sau pozitiv dependente prin regresie pe submulțimea ipotezelor nule adevărate (PRDS, positive regression dependence on a subset) (Benjamini & Yekutieli, 2001). Testele zilnice de salt îndeplinesc aceste condiții doar aproximativ. Un exemplu lucrat cu cinci teste se află în Aprofundări.
Pe scurt
Din 1 489 de teste zilnice la nivelul de 5% rezultă 236 de respingeri: care dintre ele sînt false?
față de 74 așteptate dacă nu ar exista salturi
O parte din exces provine din sezonalitatea intraday: volatilitatea mai mare la deschidere și la închidere (Aprofundări)
împărțirea randamentelor la factorul de periodicitate \(f_i\)Boudt, Croux & Laurent (2011) reduce zilele respinse la 5% de la 236 la 169
\(k\) este cel mai mare indice pentru care \(p_{(k)} \le k q/N\), unde \(p_{(k)}\) este al \(k\)-lea cea mai mică valoare p, \(N\) numărul de teste, iar \(q\) nivelul FDR țintă
aici valoarea p a fiecărei zile este \(1 - \Phi(z_t)\), unilateral, pentru statistica raportului
FDR, \(\E[\text{false}/\text{respingeri}]\), rămîne \(\le q\) (false/respingeri \(:= 0\) cînd nu se respinge nimic)
Garanția cere valori p valide, independente sau cu dependență pozitivă prin regresie pe submulțimea ipotezelor nule adevărate (PRDS, positive regression dependency on a subset) Benjamini & Yekutieli (2001)
testele zilnice de salt îndeplinesc aceste condiții doar aproximativ
Numărul zilelor cu salt ale SPY depinde puternic de rata de eroare controlată. Pe 1 489 de zile, FDR la 5% reține 43 de zile cu salt, iar FDR la 1% reține 14. Corecția Bonferroni, care controlează probabilitatea a cel puțin unei respingeri false (FWER, family-wise error rate) la 5%, reține 7. Cu corecția de periodicitate urmată de controlul FDR la 5% rămîn 17 zile. Scăderea de la 236 de respingeri neajustate la 17 nu identifică respingerile false; ea spune cîte pot fi păstrate cu o rată de eroare controlată.
Rezultatul este descriptiv, dar concordă cu literatura. Bajgrowicz, Scaillet & Treccani (2016), pe eșantionul și cu testele lor, constată că fără controlul multiplicității majoritatea salturilor detectate sînt false, iar cele adevărate sînt rare și se grupează în jurul știrilor. Christensen, Oomen & Podolskij (2014), pe date tick, constată că majoritatea „salturilor” pe 5 minute sînt, la frecvența tick, explozii abrupte, dar continue, ale volatilității.
Un test zilnic răspunde la întrebarea dacă ziua \(t\) a conținut un salt. Localizarea saltului în cursul zilei cere un test intraday, cum este cel al lui Lee și Mykland din Anexă.
Pe scurt
SPY, 1 489 de zile, fără corecția de periodicitate: 43 de zile cu salt cu FDR la 5% și 14 cu FDR la 1%
Cu corecția Bonferroni (fiecare zi testată la \(5\%/1\,489\), FWER 5%) rămîn 7
FWER: probabilitatea de cel puțin o respingere falsă
Cu FDR la 5% după corecția de periodicitate rămîn 17
de la 236 de respingeri fără corecție la 17: scăderea nu arată care dintre respingeri erau false
Tipul de dovadă: descriere
Bajgrowicz, Scaillet & Treccani (2016), pe eșantionul și testele lor: fără corecție pentru testarea multiplă, majoritatea salturilor detectate sînt false
cele reale sînt rare și se concentrează în jurul anunțurilor
Christensen, Oomen & Podolskij (2014), pe datele lor tick cu tick: majoritatea „salturilor” de 5 minute sînt creșteri bruște, dar continue, ale volatilității
Un test zilnic răspunde la întrebarea „a conținut ziua \(t\) un salt?”
localizarea saltului în cursul zilei cere un test intraday (Lee–Mykland, Anexă)
Eroarea standard a RV folosește puteri de ordinul patru deoarece varianța RV este \(2\,\mathrm{IQ}_t/M\), iar cvarticitatea integrată se estimează prin \(\mathrm{RQ}_t\) din (9.5).
RV-ul intraday singur subestimează riscul zilnic al SPY deoarece randamentele overnight aduc 38% din varianța lui zilnică.
Eșantionarea la fiecare tick supraestimează varianța deoarece fiecare randament la pătrat adaugă \(2\omega^2\) zgomot, deci deplasarea \(2n\omega^2\) din (9.7) crește cu numărul randamentelor.
Pe scurt
De ce folosește eroarea standard a RV puterile a patra ale randamentelor?
Dispersia lui RV depinde de cvarticitatea integrată \(\text{IQ}_t\), estimată prin \(\text{RQ}_t = \frac{M}{3}\sum_i r_{t,i}^4\)
De ce este subestimat riscul zilnic al SPY dacă folosiți doar RV intraday?
Randamentele peste noapte aduc 38% din varianța zilnică a SPY
De ce supraestimează varianța eșantionarea fiecărei tranzacții?
Fiecare randament la pătrat adaugă \(2\omega^2\) zgomot, deci deplasarea \(2n\omega^2\) crește cu numărul de randamente
Un signature plot plat este compatibil cu o deplasare mică din zgomot la 5 minute și la intervale mai mari, dar nu exclude zgomotul și nu spune nimic despre zgomotul sub 5 minute. Variația bipower rămîne apropiată de IV într-o zi cu salt deoarece, cu salturi de activitate finită și fără zgomot, saltul intră într-un singur randament, ridicat la pătrat în RV, dar înmulțit cu un vecin mic în BV. Cu 1 489 de teste zilnice, \(p < 0{,}05\) într-o zi dată nu este o dovadă de salt: zilele fără salturi ar produce la acest prag circa 74 de respingeri false. FDR-ul controlează proporția așteptată a respingerilor false în totalul respingerilor, nu probabilitatea oricărei respingeri false.
Pe scurt
Ce vă spune un grafic de semnătură plat?
Este compatibil cu o deplasare redusă din zgomot la 5 minute și mai rar; nu exclude zgomotul
Ce nu vă spune?
Nu spune nimic despre zgomotul sub 5 minute
De ce rămîne variația bipower apropiată de IV într-o zi cu salt, iar RV nu?
Cu salturi de activitate finită și fără zgomot, saltul intră într-un singur randament: în RV la pătrat, în BV înmulțit cu un vecin mic
Cu 1 489 de teste zilnice de salt, de ce „\(p < 0{,}05\)” nu este o dovadă de salt?
La 5%, 1 489 de zile fără salturi ar da circa 74 de respingeri false
Ce controlează FDR?
FDR controlează proporția așteptată de respingeri false printre respingeri
Sinteza secțiunii
Variația bipower (9.10) estimează partea continuă a variației pătratice (9.9), iar statistica de tip raport (9.11) testează prezența unui salt într-o zi dată. Repetat pe 1 489 de zile, testul are nevoie atît de corecția de periodicitate, cît și de controlul FDR (9.12): pentru SPY, numărul scade de la 236 de respingeri la 17 zile cu salt. Secțiunea următoare trece de la măsurare la regularitățile seriei măsurate.
Fapte stilizate ale volatilității realizate
Avînd o măsurare zilnică a volatilității, îi putem studia proprietățile ca pe cele ale unei serii de timp observate. Secțiunea documentează patru regularități pe care un model de prognoză trebuie să le reproducă: distribuția aproape lognormală a RV, normalitatea aproximativă a randamentelor standardizate prin volatilitatea realizată, scăderea lentă a autocorelației lui log RV și diferența sistematică dintre volatilitatea implicită și cea realizată.
Graficul interactiv are două panouri. Panoul din stînga arată histograma log RV zilnice a SPY, împreună cu densitatea distribuției Normale ajustate. Panoul din dreapta arată randamentele de la deschidere la închidere scalate prin abaterea lor standard necondiționată (bare pline) și prin \(\sqrt{\mathrm{RV}_t}\) (contur). Lista derulantă alege activul, iar cursorul mută parametrul Box–Cox \(\lambda\) de la 0, logaritmul, la 1, nivelul RV.
Întrebare pentru sală Pentru SPY, asimetria log RV este 0,29 la λ = 0. Aproximativ cît devine dacă mutăm parametrul Box–Cox la λ = 1?
Răspuns
Circa 20,0. La λ = 1, transformarea este RV − 1, care păstrează asimetria RV (kurtosis-ul 550). Valoarea 3,9 corespunde lui λ = 0,5 (rădăcina pătrată); 0,29 corespunde logaritmului. Apropierea momentelor log RV de cele ale distribuției Normale (0 și 3) nu demonstrează normalitatea condiționată.
Asimetria și kurtosisul distribuției Normale sînt 0 și 3. Pentru SPY, RV are asimetria 20,0 și kurtosisul 550, în timp ce log RV are asimetria 0,29 și kurtosisul 3,21. Pentru Bitcoin, log RV are asimetria −0,27 și kurtosisul 3,33. Randamentele SPY de la deschidere la închidere au kurtosisul 15,73, iar după împărțirea la \(\sqrt{\mathrm{RV}_t}\) 2,66, cu abaterea standard 1,05; pentru Bitcoin, kurtosisul scade de la 7,56 la 2,77.
Volatilitatea trebuie modelată în logaritmi. Distribuția lui \(\ln \mathrm{RV}\) este apropiată de distribuția Normală pe ambele piețe, în timp ce RV în nivel este extrem de asimetrică și cu cozi grele. Momentele lui log RV apropiate de 0 și 3 nu demonstrează că distribuția condiționată este Normală, dar fac din modelele liniare cu erori normale o aproximare rezonabilă.
Cozile grele ale randamentelor zilnice (capitolul 1) provin, ex-post, în cea mai mare parte din volatilitatea variabilă. Împărțirea fiecărui randament la volatilitatea realizată a zilei elimină majoritatea excesului de kurtosis. Randamentele sînt atunci aproximativ un amestec (mixture) de distribuții Normale cu varianțele \(\mathrm{IV}_t\), cum implică modelul din secțiunea despre varianța realizată; amestecul este exact doar fără efect de pîrghie și fără salturi.
Cifrele de kurtosis au o rezervă. Kurtosisul de selecție poate fi calculat întotdeauna, dar dacă momentul de ordinul patru al populației este infinit, el nu estimează nicio mărime finită a populației (capitolul 1). Scăderea de la 15,73 la 2,66 descrie acest eșantion; nu este estimarea unui kurtosis al populației.
Pe scurt
Stînga: log RV zilnică pentru SPY și densitatea Normală
Asimetria și kurtosis-ul pentru SPY (pentru distribuția Normală: 0 și 3)
RV: asimetria \(20{,}0\) și kurtosis-ul \(550\)
log RV: asimetria \(0{,}29\) și kurtosis-ul \(3{,}21\)
Log RV pentru Bitcoin are asimetria \(-0{,}27\) și kurtosis-ul \(3{,}33\): de aceea modelăm volatilitatea pe scară logaritmică
Randamentele deschidere–închidere: kurtosis-ul scade de la \(15{,}73\) la \(2{,}66\) după împărțirea la \(\sqrt{\RV_t}\)
kurtosis-ul empiric se poate calcula și cînd momentul de ordin patru al populației este infinit; atunci nu estimează un kurtosis finit al populației (Capitolul 1)
abaterea standard după împărțire: \(1{,}05\)
Bitcoin: kurtosis-ul scade de la \(7{,}56\) la \(2{,}77\)
Cozile grele ale randamentelor zilnice (Capitolul 1) provin, ex post, în mare parte din volatilitatea variabilă
aproximativ un amestec de distribuții Normale cu varianțele \(\IV_t\)
exact doar fără efect de levier și fără salturi (secțiunea Varianța realizată)
Graficul interactiv arată funcția de autocorelație de selecție (ACF, autocorrelation function) pînă la 100 de zile pentru log RV a SPY, calculată pe varianța totală, pentru log RV a Bitcoin și pentru pătratele randamentelor zilnice ale SPY. Lista derulantă adaugă o comparație: un model autoregresiv de ordinul întîi, AR(1), cu coeficientul \(\rho\) ales din cursor, sau ACF-ul implicat de modelul log-HAR estimat pe SPY în secțiunea următoare.
Întrebare pentru sală Autocorelația log RV pentru SPY este 0,64 la lagul 1. Cît ar fi la lagul 22 pentru un AR(1) cu aceeași autocorelație la lagul 1?
Răspuns
Pentru AR(1), autocorelația la lagul k este ρᵏ: 0,64²² ≈ 0,000054. Valoarea 0,24 este autocorelația empirică la lagul 22, nu implicația AR(1); împărțirea la 22 folosește o regulă greșită. Modelul log-HAR estimat, privit ca AR(22), dă 0,63 la lagul 1 și 0,24 la lagul 22, ca datele, dar subestimează autocorelația la lagul 100: circa 0,02 față de 0,10.
Log RV a SPY este foarte persistentă: autocorelația ei este 0,64 la lagul 1, 0,24 la o lună și încă 0,10 la 100 de zile. Un AR(1) cu aceeași autocorelație de ordinul întîi ar scădea geometric, la \(0{,}64^{22} \approx 0{,}00005\) la o lună. Modelul log-HAR estimat, privit ca AR(22), dă 0,63 la lagul 1 și 0,24 la lagul 22, ca datele, dar circa 0,02 la lagul 100, față de 0,10 în date.
Pe scurt
Autocorelații pînă la 100 de zile
log RV pentru SPY (varianța totală) și Bitcoin
randamentele zilnice SPY la pătrat
Log RV pentru SPY: dependență foarte persistentă
\(0{,}64\) la lagul 1, \(0{,}24\) la o lună, încă \(0{,}10\) la 100 de zile
un model autoregresiv AR(1) ar scădea geometric: \(0{,}64^{22} \approx 0{,}00005\)
o funcție de autocorelație empirică este compatibilă cu memoria lungă (autocorelații care scad mai lent decît geometric), dar nu o poate dovedi
O ACF de selecție care scade atît de lent este compatibilă cu memoria lungă (long memory), dar nu o poate dovedi: o sumă de cîteva componente cu memorie scurtă și persistențe diferite produce aceeași imagine pe orizonturi finite. Modelul HAR din secțiunea următoare exploatează exact această observație.
Pătratele randamentelor zilnice arată aceeași persistență, ascunsă de zgomot: autocorelația lor de ordinul întîi este doar 0,20, deoarece fiecare \(r_t^2\) este o măsurare zgomotoasă a varianței zilei. Autocorelația lui \(r_t^2\) cere și un moment de ordinul patru finit, pe care capitolul 1 îl pune la îndoială. RV elimină cea mai mare parte a zgomotului de măsurare și dezvăluie persistența volatilității de fond.
ACF-ul Bitcoin are vîrfuri la lagurile 7, 14, 21 și așa mai departe: un ciclu săptămînal. RV-ul de la sfîrșitul săptămînii este doar 0,41 din cel din zilele lucrătoare; sîmbăta, volatilitatea anualizată este 27%, față de 48% miercurea. La sfîrșit de săptămînă nu se publică date despre acțiuni sau date macroeconomice și sînt mai puțini investitori instituționali.
Pe scurt
Randamentele zilnice la pătrat arată aceeași persistență, ascunsă de zgomot
autocorelația la lagul 1: \(0{,}20\)
autocorelația lui \(r_t^2\) presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
Bitcoin: vîrfuri la 7, 14, 21, … zile: un ciclu săptămînal
RV de weekend este doar \(0{,}41\) din RV din zilele lucrătoare (volatilitate anualizată de \(27\%\) sîmbăta, față de \(48\%\) miercurea)
fără știri bursiere și macroeconomice, cu mai puțini investitori instituționali
VIX este așteptarea pieței, implicată din opțiuni, privind volatilitatea S&P 500 în următoarele 30 de zile calendaristice. Graficul interactiv îl compară cu volatilitatea realizată a SPY în zilele de tranzacționare următoare. Panoul din stînga arată cele două serii, iar cel din dreapta diferența dintre ele. Cursorul fixează orizontul volatilității realizate, în zile de tranzacționare, iar al doilea cursor o dată marcată pe ambele panouri.
Întrebare pentru sală VIX depășește volatilitatea realizată în următoarele 21 de zile de tranzacționare în 88% din zile. Este suficient acest procent, singur, pentru a stabili că diferența medie este pozitivă?
Răspuns
Nu. Un număr mic de diferențe negative mari poate domina multe diferențe pozitive mici. În acest eșantion de 1 468 de zile, diferența medie este într-adevăr pozitivă, 4,36 puncte procentuale (19,52% față de 15,15%), dar aceasta rezultă din mărimea diferențelor, nu doar din frecvența semnelor. Este un decalaj ex post de volatilitate.
La un orizont de 21 de zile de tranzacționare, VIX are media 19,52%, față de 15,15% pentru volatilitatea realizată care a urmat. VIX a fost mai mare în 88% din cele 1 468 de zile, în medie cu 4,36 puncte procentuale. Această diferență ex-post medie este punctul de plecare pentru prima de risc a varianței.
Diferența are o interpretare economică, prima de risc a varianței (VRP, variance risk premium), studiată de Carr & Wu (2009) și de Bollerslev, Tauchen & Zhou (2009). Fie \(Q_t = \tfrac{252}{21}\sum_{j=1}^{21} V_{t+j}\) varianța totală anualizată din următoarele 21 de zile de tranzacționare. Prima este diferența dintre media ei sub măsura neutră la risc \(\mathbb{Q}\) și sub măsura fizică \(\mathbb{P}\),
deci diferența ex-post adaugă primei o eroare de prognoză. Semnul diferenței realizate într-o zi dată nu identifică semnul primei ex-ante, iar cifra de 88% singură nu arată nici măcar că diferența medie este pozitivă; o arată mărimea diferențelor. Rezultatul susține o descriere a eșantionului. Regresia varianței realizate pe \(\mathrm{VIX}^2\) se află în Aprofundări.
Pe scurt
Stînga: VIX și volatilitatea realizată SPY în următoarele 21 de zile de tranzacționare
Dreapta: diferența dintre ele
VIX a avut media \(19{,}52\%\), iar volatilitatea realizată ulterior a avut media \(15{,}15\%\)
VIX a fost mai mare în 88% din 1 468 de zile, în medie cu 4,36 puncte procentuale: diferența medie ex post de volatilitate
\(Q_{t} = \tfrac{252}{21}\sum_{j=1}^{21} V_{t+j}\): varianța totală anualizată în următoarele 21 de zile de tranzacționare
\(\text{VRP}_t = \E^{\mathbb{Q}}_t[Q_t] - \E^{\mathbb{P}}_t[Q_t]\): așteptarea neutră la risc (\(\mathbb{Q}\), din prețurile opțiunilor) minus cea reală (\(\mathbb{P}\)); VIX\(^2\) aproximează primul termen (Capitolul 12)
VIX\(_t^2 - Q_t \approx \text{VRP}_t + (\E^{\mathbb{P}}_t[Q_t] - Q_t)\): diferența ex post adaugă primei o eroare de prognoză
semnul diferenței realizate nu identifică semnul primei ex ante
Faptele stilizate ale volatilității realizate sînt patru:
Log RV este apropiată de distribuția Normală.
Randamentele standardizate prin volatilitatea realizată sînt apropiate de distribuția Normală.
Log RV este foarte persistentă, cu autocorelația 0,10 la 100 de zile pentru SPY.
VIX depășește în majoritatea zilelor volatilitatea realizată ulterior.
Primele trei fapte motivează un model liniar pentru \(\ln \mathrm{RV}\), cu o dependență care scade lent, construit în secțiunea următoare.
Modelul HAR-RV
Deoarece RV este observată zilnic, dinamica ei poate fi modelată prin regresie, nu printr-o recursie pentru o varianță latentă. Dificultatea este scăderea lentă a autocorelației: o autoregresie de ordin mic scade prea repede, iar o autoregresie lungă nerestricționată are prea mulți parametri. Modelul autoregresiv heterogen (HAR) al lui Corsi (2009) rezolvă această tensiune cu trei regresori: RV mediată pe o zi, pe o săptămînă și pe o lună. Secțiunea definește HAR și versiunea lui logaritmică, le estimează pe SPY și Bitcoin și introduce două extensii, HARQ și SHAR, care tratează eroarea de măsurare a RV și semnul randamentelor.
cu \(\mathrm{RV}^{(w)}_t = \frac{1}{5}\sum_{j=0}^{4}\mathrm{RV}_{t-j}\), media pe ultima săptămînă, și \(\mathrm{RV}^{(m)}_t = \frac{1}{22}\sum_{j=0}^{21}\mathrm{RV}_{t-j}\), media pe ultima lună. Coeficienții \(\beta_d\),\(\beta_w\) și \(\beta_m\) ponderează RV-ul de ieri și mediile săptămînală și lunară, \(\beta_0\) este o constantă, iar \(\varepsilon_{t+1}\) eroarea de prognoză. Bitcoin se tranzacționează în fiecare zi, așa că mediile lui săptămînală și lunară folosesc 7 și 30 de zile.
Motivația este ipoteza pieței heterogene (heterogeneous market hypothesis) a lui Müller et al. (1997): investitorii operează pe orizonturi diferite, zilnic, săptămînal și lunar, iar fiecare grup reacționează la volatilitatea de pe orizontul propriu. Acesta este „H”-ul din HAR, iar HAR-RV (Heterogeneous AutoRegressive model of Realised Volatility, model autoregresiv heterogen al volatilității realizate) desemnează modelul HAR al varianței realizate. Cîteva componente cu persistențe diferite aproximează, pe orizonturi finite, scăderea lentă a autocorelației observate. În sens asimptotic însă, un HAR staționar este o autoregresie finită și are memorie scurtă: imită memoria lungă fără s-o aibă.
Pe scurt
Întrebarea: cum prognozăm RV de mîine, cînd autocorelația lui \(\ln \RV\) scade foarte lent?
\(\RV^{(w)}_t = \frac{1}{5}\sum_{j=0}^{4}\RV_{t-j}\) (săptămîna), \(\RV^{(m)}_t = \frac{1}{22}\sum_{j=0}^{21}\RV_{t-j}\) (luna); Bitcoin se tranzacționează zilnic, deci folosim 7 și 30 de zile
\(\beta_d\), \(\beta_w\), \(\beta_m\) sînt ponderile RV de ieri și ale RV medii din ultima săptămînă și din ultima lună; \(\beta_0\) este constanta, iar \(\varepsilon_{t+1}\) eroarea de prognoză
Ipoteza pieței eterogene Müller et al. (1997): investitori cu orizonturi zilnice, săptămînale și lunare
de aici „H” (heterogen) din HAR-RV (Heterogeneous AutoRegressive model of Realised Volatility), modelul HAR al varianței realizate
cîteva componente cu persistență diferită aproximează persistența observată pe orizonturi finite
un HAR staționar este un AR finit: memorie scurtă în sens asimptotic
Modelul (9.14) este o autoregresie de ordinul 22, AR(22), cu doar trei pante libere. Dezvoltînd mediile, ponderea lagului 1 este \(\beta_d + \beta_w/5 + \beta_m/22\), ponderea fiecăruia dintre lagurile 2–5 este \(\beta_w/5 + \beta_m/22\), iar ponderea fiecăruia dintre lagurile 6–22 este \(\beta_m/22\). Ponderile pe laguri formează deci o funcție în trepte, descrescătoare la lagurile 1, 5 și 22. Dacă aceste 19 restricții de egalitate sînt valabile în date se testează în Anexă.
Modelul se estimează prin metoda celor mai mici pătrate (OLS, ordinary least squares). Erorile sînt heteroscedastice, deoarece varianța RV crește cu nivelul ei, și autocorelate, deoarece regresorii se suprapun. Inferența folosește de aceea erori standard Newey–West, consistente în prezența heteroscedasticității și a autocorelației (HAC, heteroskedasticity- and autocorrelation-consistent).
Pe scurt
Un AR(22) cu doar 3 pante libere
ponderea la lagul 1: \(\beta_d + \beta_w/5 + \beta_m/22\)
ponderea la lagurile 2–5: \(\beta_w/5 + \beta_m/22\)
ponderea la lagurile 6–22: \(\beta_m/22\)
Estimare prin OLS (ordinary least squares, metoda celor mai mici pătrate)
erorile sînt heteroscedastice și autocorelate, deci folosim erori standard Newey–West
Newey–West este o eroare standard HAC (heteroskedasticity and autocorrelation consistent), adică robustă la heteroscedasticitate și autocorelare
Secțiunea despre faptele stilizate a arătat că \(\ln \mathrm{RV}\) este apropiată de distribuția Normală, în timp ce RV are cozi foarte grele. Modelarea logaritmilor are trei avantaje:
Erorile sînt mai apropiate de distribuția Normală.
Prognoza \(\exp(\cdot)\) este întotdeauna pozitivă.
unde \(\overline{\ln \mathrm{RV}}^{(w)}_t = \frac{1}{5}\sum_{j=0}^{4}\ln \mathrm{RV}_{t-j}\) și \(\overline{\ln \mathrm{RV}}^{(m)}_t = \frac{1}{22}\sum_{j=0}^{21}\ln \mathrm{RV}_{t-j}\). Mediile logaritmilor sînt logaritmii mediilor geometrice ale varianțelor.
O prognoză pentru \(\ln \mathrm{RV}\) nu este o prognoză pentru RV: din inegalitatea lui Jensen, \(\exp(\hat y)\) subestimează media condiționată a RV. Dacă erorile sînt \(N(0, s^2)\), media condiționată este
\[\hat{\mathrm{RV}}_{t+1} = \exp\left(\hat y + \hat s^2/2\right),\]
(9.16)
unde \(\hat y\) este \(\ln \mathrm{RV}\) estimat, iar \(\hat s^2\) varianța reziduurilor. Pentru erori care nu urmează distribuția Normală, factorul de smearing\(\frac{1}{T}\sum_t e^{\hat\varepsilon_t}\) al lui Duan (1983) înlocuiește \(\exp(\hat s^2/2)\). Cu erori heteroscedastice, ambele corecții sînt aproximări.
Pe scurt
De ce logaritmi
\(\ln \RV\) este aproape Normală, iar RV are cozi foarte grele (slide-ul Distribuții)
prognoza \(\exp(\cdot)\) este întotdeauna pozitivă
Tabelul prezintă estimările lui (9.14) și (9.15) pe eșantioanele complete. Pentru SPY, variabila dependentă este varianța zilnică totală, RV intraday plus pătratul randamentului overnight, pe 1 467 de zile. Pentru Bitcoin este RV pe 24 de ore, pe cele 547 de zile în care sînt disponibili toți cei trei regresori HAR. Erorile standard Newey–West sînt în paranteze.
Erorile standard HAC se bazează pe două condiții: regresorii trebuie să fie ortogonali pe eroare, iar covarianța de termen lung a lui \(x_t\varepsilon_t\) trebuie să fie finită. În nivel, a doua condiție implică momentul de ordinul patru al RV, o cerință mult mai puternică decît un moment de ordinul patru finit al randamentelor (capitolul 1); în logaritmi este mult mai slabă. HAC corectează autocorelația și heteroscedasticitatea, nu endogenitatea.
Pe scurt
SPY, HAR
Bitcoin, HAR
niveluri
log
niveluri
log
\(\beta_0\)
\(0{,}273\)
\(-0{,}079\)
\(1{,}496\)
\(0{,}223\)
\((0{,}064)\)
\((0{,}027)\)
\((0{,}412)\)
\((0{,}094)\)
\(\beta_d\)
\(0{,}399\)
\(0{,}362\)
\(0{,}412\)
\(0{,}380\)
\((0{,}089)\)
\((0{,}037)\)
\((0{,}089)\)
\((0{,}041)\)
\(\beta_w\)
\(0{,}222\)
\(0{,}336\)
\(0{,}409\)
\(0{,}465\)
\((0{,}096)\)
\((0{,}048)\)
\((0{,}122)\)
\((0{,}080)\)
\(\beta_m\)
\(0{,}114\)
\(0{,}168\)
\(-0{,}065\)
\(-0{,}022\)
\((0{,}053)\)
\((0{,}044)\)
\((0{,}097)\)
\((0{,}098)\)
\(R^2\)
\(0{,}31\)
\(0{,}47\)
\(0{,}34\)
\(0{,}36\)
Eșantioanele complete
SPY: varianța zilnică totală (RV intraday plus randamentul peste noapte la pătrat), 1 467 de zile
Bitcoin: RV pe 24 de ore, 547 de zile în care sînt disponibili toți cei trei regresori HAR
Erorile standard Newey–West în paranteze
erorile HAC cer regresori ortogonali pe eroare și o covarianță pe termen lung finită a lui \(x_t\varepsilon_t\); pe niveluri, aceasta implică momentul de ordin patru al RV, nu al randamentelor (Capitolul 1)
HAC corectează autocorelarea și heteroscedasticitatea, nu endogenitatea
Pentru SPY, toate cele trei componente ale log-HAR sînt semnificative: \(\hat\beta_d = 0{,}362\),\(\hat\beta_w = 0{,}336\) și \(\hat\beta_m = 0{,}168\). Suma lor, persistența \(\hat\beta_d + \hat\beta_w + \hat\beta_m = 0{,}87\), arată că șocurile log-volatilității se sting lent, ca în GARCH (capitolul 5). Ponderea zilei de ieri este cel mai mare coeficient individual, dar mediile săptămînală și lunară poartă împreună mai mult de jumătate din persistență.
\(R^2\) este 0,47 pentru logaritmul varianței și 0,31 pentru varianța în nivel. Cele două cifre nu sînt comparabile, deoarece variabilele dependente diferă: un model logaritmic explică variația lui \(\ln \mathrm{RV}\), în care zilele extreme cîntăresc mult mai puțin. Alegerea dintre ele se face prin pierderile out-of-sample pe o țintă comună, în secțiunea următoare.
Pentru Bitcoin contează componentele zilnică și săptămînală, iar coeficientul lunar este apropiat de zero (\(-0{,}022\), eroarea standard 0,098). Eșantionul este scurt, de circa doi ani, iar ciclul săptămînal este puternic, deci media săptămînală preia cea mai mare parte a memoriei. Estimările descriu o asociere predictivă in-sample; ponderile pe laguri și valorile ajustate sînt prezentate în Aprofundări.
Pe scurt
SPY: toate cele trei componente sînt semnificative
Persistența log-HAR \(\hat\beta_d + \hat\beta_w + \hat\beta_m = 0{,}87\): șocurile se sting lent, ca la GARCH (Capitolul 5)
\(R^2 = 0{,}47\) pentru log-varianță și \(0{,}31\) pentru varianța pe niveluri
cele două valori nu sînt comparabile, deoarece variabilele dependente diferă
comparația se face prin pierderile în afara eșantionului pe o țintă comună (secțiunea Prognoze: HAR față de GARCH)
Bitcoin: componentele zilnică și săptămînală contează
coeficientul lunar este aproape de 0 (\(-0{,}022\), SE \(0{,}098\))
Eșantion scurt (547 de zile utilizabile din circa doi ani de date) și un ciclu săptămînal puternic: săptămîna preia cea mai mare parte a memoriei
Tipul de dovadă: asociere (variabilele se mișcă împreună; nu dovedește o relație cauzală)
o ajustare predictivă în eșantion (in-sample); decid pierderile în afara eșantionului
Două extensii ale HAR folosesc mai departe informația intraday. HARQ (Bollerslev, Patton & Quaedvlieg, 2016) pornește de la faptul că RV-ul de ieri este măsurat cu eroare, cu varianța \(\mathrm{Var}(\mathrm{RV}_t - \mathrm{IV}_t) \approx 2\,\mathrm{IQ}_t/M\), conform (9.5). Eroarea de măsurare dintr-un regresor îi atenuează panta, iar atenuarea este mai puternică în zilele cu eroare mare. HARQ permite pantei zilnice să varieze cu eroarea estimată:
Cu \(\beta_Q < 0\), RV-ul de ieri primește o pondere mai mică în zilele cu cvarticitate realizată mare, adică atunci cînd este măsurat mai puțin precis. Derivarea atenuării se află în Anexă.
SHAR (Patton & Sheppard, 2015) împarte RV-ul de ieri după semnul randamentelor intraday, folosind semivarianțele realizate (realised semivariances) \(\mathrm{RS}^{+}_t = \sum_i r_{t,i}^2\,\mathbf{1}\{r_{t,i} > 0\}\) și \(\mathrm{RS}^{-}_t = \sum_i r_{t,i}^2\,\mathbf{1}\{r_{t,i} < 0\}\), care însumate dau \(\mathrm{RV}_t\). Termenul zilnic \(\beta_d\mathrm{RV}_t\) din (9.14) devine \(\beta^{+}\mathrm{RS}^{+}_t + \beta^{-}\mathrm{RS}^{-}_t\). Ipoteza este că volatilitatea „rea”, din randamentele negative, prognozează mai multă volatilitate viitoare decît volatilitatea „bună”, deci \(\beta^{-} > \beta^{+}\). Estimările pe SPY se află în Anexă.
Pe scurt
HARQ (HAR model with Realised Quarticity, model HAR cu cvarticitatea realizată) Bollerslev, Patton & Quaedvlieg (2016): RV de ieri este măsurată cu eroare, iar eroarea atenuează panta zilnică
\(\beta_Q < 0\): ponderea RV de ieri scade în zilele cu cvarticitate realizată mare, adică cu eroare de măsurare mare
SHAR (Semivariance HAR model, model HAR cu semivarianțe) Patton & Sheppard (2015): semivarianțele realizate împart RV după semnul randamentului (Anexă)
motivul: volatilitatea „rea”, din randamente negative, prezice mai multă volatilitate viitoare decît cea „bună”, deci \(\beta^{-} > \beta^{+}\)
Sinteza secțiunii
HAR (9.14) și log-HAR (9.15) aproximează scăderea lentă a autocorelației volatilității cu trei medii ale RV trecute. Pe SPY, log-HAR are persistența 0,87 și toate cele trei componente semnificative; pe Bitcoin, componenta lunară este apropiată de zero. HARQ (9.17) și SHAR ajustează panta zilnică pentru eroarea de măsurare și pentru semnul randamentelor. Secțiunea următoare arată care model prognozează cel mai bine varianța de mîine.
Prognoze: HAR față de GARCH
Un model care se potrivește bine in-sample poate prognoza prost, așa că comparația se face out-of-sample: fiecare prognoză folosește doar datele disponibile în seara precedentă. Două trăsături ale problemei determină metoda. Ținta, varianța zilnică adevărată, nu este observată, deci prognozele se compară cu un proxy zgomotos, iar doar unele funcții de pierdere dau ordinea corectă la această substituție. Se compară mai multe modele deodată, deci testele pe perechi trebuie completate de o procedură care controlează comparațiile multiple.
Care model prognozează mai bine varianța realizată?
Ținta este varianța zilnică de mîine, prognozată doar cu datele disponibile în seara precedentă. Pentru SPY este varianța totală, între 3 ianuarie 2022 și 18 septembrie 2026, adică 1 180 de zile. Pentru Bitcoin, evaluarea începe la 1 martie 2025 și cuprinde 422 de zile.
Se compară cinci modele:
log-HAR și HAR folosesc varianța realizată din datele intraday și sînt reestimate zilnic pe o fereastră extinsă (expanding window).
GARCH(1,1) cu erori Student-\(t\) (Bollerslev, 1986; Bollerslev, 1987) folosește randamentele zilnice din 2000 pentru SPY și din 2014 pentru Bitcoin și este reestimat la fiecare 21 de zile.
EWMA, media mobilă ponderată exponențial (exponentially weighted moving average) cu factorul de descreștere \(\lambda = 0{,}94\) (capitolul 5), folosește randamentele zilnice.
„RV-ul de ieri”, un mers aleator pentru varianță, este ultimul termen de comparație.
Modelele diferă prin date de intrare, lungimea istoricului și frecvența reestimării. Rezultatele compară deci aceste proceduri implementate, nu arhitectura HAR ca atare cu GARCH ca atare.
Pe scurt
Ținta: varianța zilnică de mîine, prognozată doar cu datele disponibile în seara precedentă
SPY: varianța totală, de la 3 ianuarie 2022 pînă la 18 septembrie 2026 (1 180 de zile)
Bitcoin: de la 1 martie 2025 (422 de zile)
Cinci modele
log-HAR și HAR pe varianța realizată din date intraday, reestimate zilnic pe o fereastră de estimare care se extinde în timp
GARCH(1,1) cu erori Student-\(t\) pe randamente zilnice din 2000 (SPY) sau 2014 (Bitcoin), reestimat la fiecare 21 de zile (GARCH: Bollerslev (1986); erori Student-\(t\): Bollerslev (1987))
EWMA (media mobilă ponderată exponențial) pe randamente zilnice, cu factorul de atenuare \(\lambda = 0{,}94\) (Capitolul 5)
„RV de ieri” (mers aleator, random walk: prognoza este ultima RV observată)
Modelele, datele de intrare, lungimea istoricului și frecvența reestimării diferă: rezultatele compară aceste proceduri, așa cum sînt implementate, nu arhitectura HAR ca atare
Varianța adevărată nu este observată, deci o prognoză \(F_t\) se compară cu proxy-ul \(\mathrm{RV}_t\). O funcție de pierdere este robustă, în sensul lui Patton (2011), dacă ordinea prognozelor după pierderea așteptată calculată cu un proxy nedeplasat condiționat coincide cu ordinea calculată cu varianța adevărată. Doar pierderile robuste garantează că zgomotul proxy-ului nu schimbă prognoza cîștigătoare.
Două pierderi sînt robuste și sînt folosite peste tot. MSE, \((\mathrm{RV}_t - F_t)^2\), măsoară erorile în unități de varianță și este dominată de zilele cele mai volatile. Pierderea de cvasi-verosimilitate (quasi-likelihood),
depinde doar de raportul \(\mathrm{RV}_t/F_t\) și penalizează subestimarea mai mult decît supraestimarea. Ea provine din verosimilitatea Normală: pentru \(r \sim N(0, F)\), minus de două ori logaritmul densității este \(\ln F + r^2/F\) plus o constantă. Înlocuind \(r^2\) cu \(\mathrm{RV}_t\) și scăzînd minimul, atins la \(F_t = \mathrm{RV}_t\), obținem (9.18).
Pe scurt
Varianța adevărată nu este observată
comparăm prognozele \(F_t\) cu proxy-ul \(\RV_t\)
O funcție de pierdere este robustă dacă ordinea după pierderea așteptată obținută cu un proxy nedeplasat condiționat (dată fiind informația prognozelor) coincide cu ordinea obținută cu varianța adevărată Patton (2011)
De unde vine QLIKE: pentru \(r \sim N(0, F)\), \(-2\ln\) densitatea este \(\ln F + r^2/F\) plus o constantă; cu \(\RV_t\) în locul lui \(r^2\) și scăzînd minimul, atins la \(F_t = \RV_t\), obținem formula de mai sus
O greșeală frecventă este folosirea erorii absolute medii (MAE, mean absolute error) sau a MSE calculate pe volatilitate în loc de varianță: niciuna nu este robustă. Zgomotul proxy-ului explică și un vechi paradox. Față de \(r_t^2\), prognozele GARCH explicau doar cîteva procente din variație; față de RV, aceleași prognoze explică mult mai mult (Andersen & Bollerslev, 1998). Zgomotos era proxy-ul, nu modelul.
Pe scurt
Greșeală frecventă: MAE sau MSE pe volatilitate în loc de varianță nu sînt robuste
MAE: eroarea absolută medie
Andersen & Bollerslev (1998): față de \(r_t^2\), prognozele GARCH explicau cîteva procente din variație; față de RV aceleași prognoze explică mult mai mult: problema era zgomotul proxy-ului, nu modelul
Testul lui Diebold & Mariano (1995) (DM) compară pierderile așteptate a două prognoze. Cu diferența de pierderi \(d_t = L(\mathrm{RV}_t, F^A_t) - L(\mathrm{RV}_t, F^B_t)\), unde \(L\) este QLIKE sau MSE, statistica este
cu \(\bar d\) media lui \(d_t\) și \(\mathrm{se}_{\mathrm{NW}}\) eroarea ei standard Newey–West, necesară deoarece \(d_t\) este autocorelată (capitolul 8). Un \(t\) negativ înseamnă că modelul A are pierderea mai mică.
Statistica depinde de diferența medie și de cît de stabilă este diferența de la o zi la alta. Ignorînd autocorelația, cu \(T = 100\) de zile, o diferență cu media 0,01 și abaterea standard 0,02 dă \(t = 0{,}01/(0{,}02/\sqrt{100}) = 5\), în timp ce o diferență cu media 0,03 și abaterea standard 0,30 dă \(t = 1\). Două prognoze care se mișcă împreună au o diferență stabilă, astfel că o diferență medie mică între ele poate fi foarte semnificativă.
Limita \(N(0,1)\) cere o teoremă limită centrală pentru \(d_t\), cu o varianță de termen lung pozitivă. Cu QLIKE, \(d_t = \mathrm{RV}_t(1/F^A_t - 1/F^B_t) + \ln(F^A_t/F^B_t)\), deci momentele lui \(d_t\) depind și de prognozele de la numitori. Pentru modele imbricate (nested) cu parametri estimați, cum este HAR în SHAR sau în HARQ, \(d_t\) poate degenera sub ipoteza de acuratețe egală, iar \(N(0,1)\) este doar o aproximare convențională (Clark & McCracken). Alternative valide sînt ferestrele rolling de lungime fixă cu testul Giacomini–White (GW) sau un bootstrap care reestimează modelele.
diferența de pierdere: \(d_t = L(\RV_t, F^A_t) - L(\RV_t, F^B_t)\)
\(L(\RV_t, F_t)\) este pierderea (QLIKE sau MSE) a prognozei \(F_t\), \(\bar d\) media lui \(d_t\), iar \(\text{se}_{\text{NW}}\) eroarea ei standard Newey–West
\(t < 0\): modelul A are pierderea mai mică
Folosim o eroare standard HAC, deoarece \(d_t\) este autocorelat (Capitolul 8)
Ce determină \(t\): diferența medie și cît de stabilă este diferența de la o zi la alta
Verificare, ignorînd autocorelarea, \(T = 100\) de zile: o diferență cu media \(0{,}01\) și abaterea standard \(0{,}02\) dă \(t = 0{,}01/(0{,}02/\sqrt{100}) = 5\)
o diferență cu media \(0{,}03\) și abaterea standard \(0{,}30\) dă \(t = 1\)
două prognoze care se mișcă împreună au o diferență stabilă: o diferență medie mică poate fi atunci foarte semnificativă
Condiții: o teoremă limită centrală pentru \(d_t\), cu varianța pe termen lung pozitivă
QLIKE: \(d_t = \RV_t(1/F^A_t - 1/F^B_t) + \ln(F^A_t/F^B_t)\), deci momentele lui \(d_t\) depind și de prognozele de la numitor
modele imbricate (HAR în SHAR sau HARQ) cu parametri estimați: la acuratețe egală \(d_t\) poate degenera, iar \(N(0,1)\) este doar o aproximare convențională (Clark & McCracken)
alternative valide: ferestre mobile (rolling) de lungime fixă cu testul Giacomini–White (GW) sau un bootstrap care reestimează modelele
O prognoză poate avea o pierdere mai mică decît alta și totuși să fie sistematic deplasată. Regresia lui Mincer & Zarnowitz (1969) (MZ) verifică calibrarea:
\[\mathrm{RV}_t = a + b\,F_t + u_t,\]
(9.20)
unde \(a\) este interceptul, \(b\) panta, iar \(u_t\) eroarea. O prognoză calibrată satisface \(a = 0\) și \(b = 1\); o eroare medie nulă, \(\mathbb{E}[\mathrm{RV}_t - F_t] = 0\), nu implică acest lucru. Cu \(b < 1\), prognozele mari sînt urmate de medii realizate sub dreapta de 45°, iar cu \(b > 1\) de medii realizate deasupra ei. De exemplu, o prognoză de 2 în zilele calme și de 4 în zilele agitate, urmată de medii realizate de 1,5 și 4,5, are \(b = (4{,}5 - 1{,}5)/(4 - 2) = 1{,}5\) și \(a = 1{,}5 - 1{,}5 \times 2 = -1{,}5\).
Ipoteza comună \(a = 0\),\(b = 1\) se testează printr-un test Wald cu covarianță Newey–West, care cere ca \(u_t\) să fie ortogonală pe \((1, F_t)\) și o covarianță de termen lung finită a lui \((1, F_t)\,u_t\). Faptul că nu respingem ipoteza nu dovedește calibrarea. \(R^2\)-ul din (9.20) măsoară cît din variația RV explică prognoza și este plafonat de zgomotul din RV: nici varianța adevărată nu ar atinge 1 (Andersen & Bollerslev, 1998).
\(a\): termenul liber, \(b\): panta, \(u_t\): eroarea
O prognoză calibrată satisface \(a = 0\) și \(b = 1\) în această regresie liniară; \(\E[\RV_t - F_t] = 0\) singur nu implică acest lucru
\(b < 1\): prognozele mari sînt urmate de medii realizate sub dreapta de 45°
\(b > 1\): prognozele mari sînt urmate de medii realizate peste dreapta de 45°
Verificare: o prognoză de 2 în zilele calme și de 4 în zilele agitate, cu medii realizate de 1,5 și 4,5, are \(b = (4{,}5 - 1{,}5)/(4 - 2) = 1{,}5 > 1\) și \(a = 1{,}5 - 1{,}5 \times 2 = -1{,}5\)
Testul Wald comun folosește covarianța Newey–West: cere \(u_t\) ortogonal pe \((1, F_t)\) și o covarianță pe termen lung finită a lui \((1, F_t)\,u_t\)
Tabelul prezintă, pentru 1 180 de prognoze cu o zi înainte ale varianței zilnice totale a SPY, QLIKE și MSE medii ale fiecărui model, testele DM față de log-HAR, panta și \(R^2\)-ul MZ. Diferența DM este \(d_t = L(\text{log-HAR}) - L(\text{model})\), cu erori standard Newey–West, deci \(t < 0\) favorizează log-HAR. Condițiile pentru DM și MZ privesc diferențele de pierderi și erorile MZ, cum s-a arătat pe slide-urile anterioare, nu momentele randamentelor.
Dintre aceste proceduri, log-HAR are cea mai mică QLIKE, 0,310, și cea mai mică MSE, 4,15 (\(\%^4\)). QLIKE-ul lui este cu circa 10% sub cel al GARCH(1,1)-\(t\), 0,343, cu \(t = -2{,}30\)(\(p = 0{,}021\)). Față de EWMA și de RV-ul de ieri, cîștigul este foarte semnificativ (\(p < 0{,}001\)); față de HAR în nivel este doar marginal (\(t = -1{,}95\),\(p = 0{,}051\)).
Cu MSE, nicio diferență nu este semnificativă la 5%; EWMA este la limită, cu \(p = 0{,}050\). Cîteva zile de criză, din aprilie 2025, domină erorile la pătrat, așa că comparația prin MSE are putere mică: aceeași ordine sub QLIKE, care depinde de rapoarte, este mult mai informativă.
Pe scurt
Model
QLIKE
DM\(_{\text{QLIKE}}\)\(t\) (\(p\))
MSE (%\(^4\))
DM\(_{\text{MSE}}\)\(p\)
MZ \(b\)
MZ \(R^2\)
log-HAR
\(0{,}310\)
–
\(4{,}15\)
–
\(1{,}16\)
\(0{,}30\)
HAR
\(0{,}326\)
\(-1{,}95\) (\(0{,}051\))
\(4{,}48\)
\(0{,}117\)
\(0{,}75\)
\(0{,}26\)
GARCH(1,1)-\(t\)
\(0{,}343\)
\(-2{,}30\) (\(0{,}021\))
\(4{,}87\)
\(0{,}188\)
\(0{,}70\)
\(0{,}20\)
EWMA
\(0{,}393\)
\(-4{,}02\) (\(<0{,}001\))
\(5{,}14\)
\(0{,}050\)
\(0{,}74\)
\(0{,}14\)
RV de ieri
\(0{,}502\)
\(-5{,}95\) (\(<0{,}001\))
\(5{,}41\)
\(0{,}060\)
\(0{,}54\)
\(0{,}29\)
1 180 de prognoze pentru ziua următoare ale varianței zilnice totale
DM față de log-HAR: \(d_t = L(\text{log-HAR}) - L(\text{model})\), cu \(L\) = QLIKE sau MSE, Newey–West
\(t < 0\) favorizează log-HAR
condițiile pentru DM și MZ privesc diferențele de pierdere și erorile MZ (slide-ul Diebold–Mariano), nu momentele randamentelor
Dintre aceste proceduri, log-HAR are cele mai mici QLIKE și MSE
QLIKE este cu 10% sub GARCH(1,1)-\(t\)
Față de EWMA și RV de ieri cîștigul este foarte semnificativ; față de HAR pe niveluri doar marginal
Diferențele MSE nu sînt semnificative la 5% (EWMA la limită, \(p = 0{,}050\))
cîteva zile de criză (aprilie 2025) domină erorile la pătrat
Regresiile MZ adaugă calibrarea. Pentru log-HAR nu respingem ipoteza \(a = 0\),\(b = 1\)(\(p = 0{,}555\)), iar \(R^2\)-ul lui, 0,30, este mai mare decît al GARCH, 0,20. Panta log-HAR este \(b = 1{,}16\), peste 1: prognozele mari sînt însoțite de medii realizate puțin peste ele, la 0,66 erori standard de 1 (eroarea standard 0,25). GARCH are \(b = 0{,}70 < 1\): prognozele mari sînt însoțite de medii realizate puțin sub ele, tot nesemnificativ.
RV-ul de ieri are un \(R^2\) ridicat, 0,29, dar o pantă de 0,54. Se mișcă în direcția bună, dar prognozele lui mari se află mult deasupra mediilor realizate.
Rezultatul susține o comparație de proceduri pe acest eșantion și pentru această pierdere. Pentru Bitcoin, prezentat în Aprofundări, cîștigul log-HAR față de HAR în nivel nu este semnificativ (\(p = 0{,}223\)).
Pe scurt
Mincer–Zarnowitz: ipoteza \(a = 0, b = 1\) nu este respinsă pentru log-HAR (\(p = 0{,}555\))
\(R^2\) este mai mare decît pentru GARCH
log-HAR are \(b > 1\): prognozele mari sînt ușor sub mediile realizate (\(0{,}66\) erori standard de 1, SE \(0{,}25\))
GARCH are \(b < 1\): prognozele mari sînt ușor peste mediile realizate, tot nesemnificativ (\(b = 0{,}70\), SE \(0{,}24\); testul MZ comun: \(p = 0{,}355\))
RV de ieri are un \(R^2\) ridicat, dar \(b = 0{,}54\)
direcția este corectă, dar prognozele mari sînt mult peste mediile realizate
Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
pentru Bitcoin (Aprofundări), cîștigul log-HAR față de HAR pe niveluri nu este semnificativ (\(p = 0{,}223\))
Graficul interactiv arată prognozele în timp. Panoul din stînga conține volatilitatea realizată a SPY, inclusiv randamentul overnight, și prognozele GARCH(1,1)-\(t\) și log-HAR, anualizate. Panoul din dreapta arată pierderea cumulată a fiecărui model minus cea a log-HAR, deci o curbă crescătoare înseamnă că log-HAR este mai bun. Lista derulantă alege pierderea, QLIKE sau MSE, iar cursorul începutul evaluării.
Întrebare pentru sală Dacă evaluarea SPY începe în ianuarie 2024, cu aproximativ cît este QLIKE mediu al log-HAR mai mic decît al GARCH(1,1)-t, raportat la GARCH?
Răspuns
Cu circa 11,4%: 1 − 0,362/0,409 ≈ 0,114. Valoarea 12,9% folosește log-HAR la numitor; 9,6% este reducerea pe tot eșantionul, din 2022 (0,310 față de 0,343). Pentru evaluarea din 2024, t DM = −2,26, cu diferența definită ca pierderea log-HAR minus pierderea GARCH; concluzia privește SPY, această perioadă și pierderea QLIKE.
După un șoc, ambele prognoze cresc brusc, dar GARCH rămîne ridicat mai mult timp. În aprilie 2025, prognoza GARCH a rămas peste 40% pe an pînă la sfîrșitul lunii, în timp ce volatilitatea realizată era sub 20% de la mijlocul lunii. Diferența QLIKE cumulată crește constant, cu salturi în episoadele agitate. Cu evaluarea începînd din ianuarie 2024, QLIKE-ul mediu al log-HAR este 0,362, față de 0,409 pentru GARCH, cu DM \(t = -2{,}26\).
Diferența de comportament după șocuri provine din persistență. Persistența GARCH este apropiată de 1, deci un șoc mare se stinge lent în prognoză. log-HAR pune pondere pe mediile săptămînală și lunară, dar reacționează și la zilele cele mai recente și revine mai repede cînd volatilitatea realizată scade.
Diferența de pierdere cumulată crește constant, cu salturi în episoadele agitate, deci cîștigul nu se datorează unei singure zile. Dintre cele trei modele reprezentate față de log-HAR, EWMA pierde cel mai mult: un \(\lambda = 0{,}94\) fix reacționează prea puternic la zile izolate și nu revine la o medie de termen lung. Calibrarea celor două prognoze principale este arătată în Aprofundări.
Pe scurt
Stînga: volatilitatea realizată SPY (cu noaptea) și prognozele log-HAR și GARCH, anualizate
Dreapta: pierderea QLIKE cumulată a fiecărui model minus log-HAR (crescătoare = log-HAR mai bun)
După un șoc ambele prognoze cresc, dar GARCH rămîne ridicat mai mult
persistența GARCH este aproape de 1, iar log-HAR revine mai repede
aprilie 2025: GARCH peste 40% pe an pînă la sfîrșitul lunii
volatilitatea realizată sub 20% de la jumătatea lunii
Diferența cumulată de pierdere crește constant, cu salturi în episoadele agitate
cîștigul nu provine dintr-o singură zi
Dintre cele trei modele comparate în grafic cu log-HAR, EWMA pierde cel mai mult
un \(\lambda = 0{,}94\) fix reacționează prea mult la zile izolate
Testele DM pe perechi față de un singur termen de comparație nu spun care modele sînt la fel de bune, iar multe teste pe perechi fără controlul mărimii supraestimează dovezile (capitolul 8). Mulțimea de încredere a modelelor (MCS, model confidence set) a lui Hansen, Lunde & Nason (2011) este o procedură de comparații multiple. Pornind de la toate modelele, ea testează ipoteza abilității predictive egale; dacă ipoteza este respinsă, elimină modelul cel mai slab și repetă. Modelele rămase formează o mulțime care conține cel mai bun model cu o probabilitate asimptotică de cel puțin \(1 - \alpha\).
Testul folosește statistica de amplitudine (range statistic)
unde \(\bar d_{ij}\) este diferența medie de QLIKE dintre modelele rămase \(i\) și \(j\). Distribuția ei se obține printr-un block bootstrap cu blocuri de 20 de zile și 10 000 de replicări, deci cea mai mică valoare \(p\) raportabilă este de ordinul \(10^{-4}\). Ca la DM, bootstrap-ul cere o teoremă limită centrală pentru diferențele de pierderi, iar pentru SHAR și HARQ, care conțin HAR, distribuția de referință este o aproximare convențională.
Pe SPY, pe 1 180 de zile din 2022, MCS se aplică celor cinci modele plus SHAR și HARQ. Mulțimea de 90% este {log-HAR, SHAR}. Celelalte modele sînt eliminate în ordinea RV-ul de ieri, EWMA, HAR, apoi HARQ și GARCH, cu valori \(p\) MCS de la sub 0,001 la 0,095. HAR este eliminat înaintea GARCH deși QLIKE-ul lui mediu este mai mic; motivul este explicat în Aprofundări.
testăm egalitatea capacității predictive, eliminăm cel mai slab model, repetăm
statistica amplitudinii \(T_R = \max_{i,j} |\bar d_{ij}|/\widehat{\mathrm{se}}(\bar d_{ij})\), cu \(\bar d_{ij}\) diferența medie de pierdere dintre modelele \(i\) și \(j\) rămase în mulțime
distribuția lui \(T_R\): bootstrap pe blocuri de 20 de zile, 10 000 de replicări, deci cea mai mică valoare p raportabilă este de ordinul \(10^{-4}\)
ca la DM, bootstrap-ul cere o teoremă limită centrală pentru diferențele de pierdere QLIKE
SHAR și HARQ includ HAR: pentru aceste perechi, distribuția de referință este o aproximare convențională
mulțimea rămasă conține cel mai bun model cu probabilitate asimptotică \(\ge 90\%\)
SPY, 1 180 de zile din 2022: mulțimea de 90% este {log-HAR, SHAR}
O procedură de comparații multiple
multe teste DM pe perechi, fără controlul probabilității erorilor de tip I, ar exagera tăria dovezilor (Capitolul 8)
Out-of-sample pe SPY, log-HAR are cea mai mică QLIKE (0,310, față de 0,343 pentru GARCH(1,1)-\(t\),\(t = -2{,}30\)), este calibrat conform testului MZ și rămîne, împreună cu SHAR, în mulțimea de încredere de 90%. Comparațiile prin MSE nu sînt concludente, deoarece cîteva zile de criză domină erorile la pătrat. Ordinea privește aceste proceduri implementate, acest eșantion și pierderea QLIKE. Secțiunea următoare revine la seria măsurată și arată cît de aspre sînt traiectoriile ei.
Volatilitatea aspră
Modelul HAR descrie volatilitatea pe orizonturi de o zi și mai lungi. O altă literatură privește structura fină a traiectoriilor log-volatilității și le găsește mai aspre decît cele ale unei mișcări browniene, cu un exponent Hurst în jur de 0,1. Secțiunea definește mișcarea browniană fracționară și legea de scalare folosită pentru estimarea exponentului, o aplică pe SPY și Bitcoin și arată apoi de ce eroarea de măsurare a RV poate produce o asprime aparentă, ceea ce transformă întrebarea într-una de identificare.
Întrebarea este dacă traiectoriile log-volatilității sînt mai aspre decît cele ale unei mișcări browniene. Gatheral, Jaisson & Rosenbaum (2018) constată că log-volatilitatea se comportă ca o mișcare browniană fracționară (fractional Brownian motion) cu exponentul Hurst \(H \approx 0{,}1\). Exponentul Hurst clasifică traiectoriile: \(H = 0{,}5\) este mișcarea browniană obișnuită; cu \(H < 0{,}5\), incrementele sînt negativ corelate și traiectoriile sînt mai aspre; cu \(H > 0{,}5\), incrementele sînt pozitiv corelate, iar traiectoriile sînt mai netede și au tendință.
Miza este practică. Modelele de rough volatility reproduc forma zîmbetului volatilității implicite (implied volatility smile) la scadențe scurte (capitolul 12), pe care modelele clasice cu volatilitate difuzivă îl ajustează prost, iar valoarea lui \(H\) intră și în prognozele volatilității.
Pe scurt
Întrebarea: sînt traiectoriile log-volatilității mai aspre decît cele ale unei mișcări browniene?
Pentru \(H = 1/2\),(9.22) devine \(\min(t, s)\), covarianța mișcării browniene obișnuite. Incrementele sînt staționare, \(B_H(t+\Delta) - B_H(t) \sim N(0, \Delta^{2H})\) pentru orice \(t\).
Dacă log-volatilitatea urmează \(\ln\sigma_t = \text{const} + \nu B_H(t)\), modificarea ei pe \(\Delta\) zile are distribuția lui \(\nu\Delta^H Z\), cu \(Z \sim N(0, 1)\). Momentele empirice ale incrementelor,
cu \(\sigma_t = \sqrt{\mathrm{RV}_t}\), satisfac atunci o lege de scalare (scaling law): panta lui \(\ln m(q, \Delta)\) în funcție de \(\ln\Delta\) este \(\zeta_q = qH\). Estimatorul calculează pantele \(\zeta_q\) pentru \(q \in \{0{,}5;\ 1;\ 1{,}5;\ 2;\ 3\}\) și le regresează pe \(q\) prin origine, \(\hat H = \sum_q q\,\zeta_q / \sum_q q^2\).
Cazul \(q = 2\) dă intuiția. Pentru mișcarea browniană, \(m(2, \Delta) = \nu^2\Delta\), deci dublarea lui \(\Delta\) dublează \(m\) și \(\zeta_2 = 1 = 2 \times 0{,}5\). Cu \(H = 0{,}1\), dublarea lui \(\Delta\) înmulțește \(m(2, \Delta)\) doar cu \(2^{0{,}2} \approx 1{,}15\): cea mai mare parte a variației log-volatilității are loc deja la lagurile cele mai scurte.
Pe scurt
Mișcarea browniană fracționară \(B_H\), \(0 < H < 1\): un proces gaussian cu \(B_H(0) = 0\) și media 0
variația pe \(\Delta\) zile are distribuția lui \(\nu\Delta^H Z\), \(Z \sim N(0, 1)\)
Legea de scalare: \(m(q, \Delta) = \frac{1}{T}\sum_t |\ln\sigma_{t+\Delta} - \ln\sigma_t|^q\), cu \(\sigma_t = \sqrt{\RV_t}\), estimează \(\nu^q\,\E|Z|^q\,\Delta^{qH}\), deci panta lui \(\ln m(q, \Delta)\) pe \(\ln\Delta\) este \(\zeta_q = qH\)
Graficul interactiv aplică (9.23) pe SPY. Panoul din stînga arată \(\ln m(q, \Delta)\) în funcție de \(\ln \Delta\) pentru \(\Delta = 1, \dots, 30\) de zile, cîte o linie pentru fiecare ordin al momentului \(q\); panoul din dreapta arată pantele estimate \(\zeta_q\) în funcție de \(q\), a căror pantă prin origine este \(\hat H\). Cursorul alege intervalul de laguri folosit în regresie.
Întrebare pentru sală Cum se schimbă Ĥ pentru SPY dacă regresia folosește doar lagurile de la 5 la 30 de zile?
Răspuns
Scade, de la 0,106 (lagurile 1–30) la 0,089. Direcția este opusă celei sugerate de modelul simplificat m(2, Δ) = cΔ^(2H) + k, cu eroare i.i.d. independentă de log-volatilitatea latentă. Rezultatul nu susține acest mecanism simplu ca explicație suficientă; nu exclude orice eroare de măsurare și nu este, singur, un test formal. Pentru Bitcoin, Ĥ trece de la 0,071 la 0,068.
Punctele log–log se află aproape de drepte, iar pantele sînt aproape liniare în \(q\), cum cere legea de scalare, deși graficul singur nu o poate stabili. Cu lagurile 1–30, \(\hat H = 0{,}11\) pentru SPY, cu un IÎ de 95% prin block bootstrap de \([0{,}08; 0{,}13]\), și 0,07 pentru Bitcoin: mult sub 0,5. Restrîngerea regresiei la lagurile 5–30 coboară \(\hat H\) pentru SPY de la 0,106 la 0,089.
Pentru Bitcoin, calculul folosește doar perechile observate la fiecare lag calendaristic, deoarece unele zile lipsesc; interpolarea zilelor lipsă dă în schimb \(\hat H = 0{,}08\). Estimările pe ambele active sînt mult sub 0,5 și apropiate de valoarea lui Gatheral, Jaisson & Rosenbaum (2018). Rezultatul susține o descriere a scalării log-volatilității măsurate.
Problema este că \(\sigma_t\) din (9.23) nu este volatilitatea latentă, ci \(\sqrt{\mathrm{RV}_t}\), care o măsoară cu eroare. Următoarele două slide-uri arată cum eroarea de măsurare coboară \(\hat H\) și, de aceea, de ce estimarea singură nu dovedește că volatilitatea este rough.
Pe scurt
Stînga: \(\ln m(q, \Delta)\) față de \(\ln \Delta\) pentru SPY, \(\Delta = 1, \ldots, 30\) de zile
Dreapta: pantele \(\zeta_q\) față de \(q\)
Punctele pe scara log–log sînt apropiate de linii drepte, iar pantele sînt aproape liniare în \(q\)
compatibil cu legea de scalare, pe care graficul singur nu o poate stabili
\(\hat H = 0{,}11\) pentru SPY (CI bootstrap pe blocuri de 95% \([0{,}08; 0{,}13]\)) și \(0{,}07\) pentru Bitcoin: ambele mult sub 0,5
Pentru Bitcoin folosim doar perechile observate la fiecare decalaj calendaristic; dacă interpolăm zilele lipsă, obținem \(0{,}08\)
Problema: RV măsoară volatilitatea cu eroare
slide-urile următoare arată cum eroarea de măsurare coboară \(\hat H\)
Estimarea \(H \approx 0{,}1\) provine din RV, un proxy zgomotos al lui \(\sigma_t\) latent. Cont & Das (2024) arată că estimatorul de scalare aplicat volatilității realizate găsește asprime chiar cînd volatilitatea spot este netedă, deci rezultatul poate fi un artefact de estimare. Două abordări ulterioare tratează această problemă: Bolko, Christensen, Pakkanen & Veliyev (2023) folosesc metoda generalizată a momentelor (GMM, generalised method of moments) cu un model al erorii RV, iar Fukasawa, Takabatake & Westphal (2022) propun un estimator consistent în asimptotica de înaltă frecvență. Ambele găsesc totuși \(H < 0{,}5\).
Întrebarea formală este un model cu eroare de măsurare, \(\ln \mathrm{RV}_t^{1/2} = \ln\sigma_t + e_t\), unde \(\ln\sigma_t\) este fracționar cu indicele \(H\), iar \(e_t\) este eroarea de măsurare a RV. Se testează \(H_0\):\(H = 1/2\), volatilitate difuzivă clasică, față de \(H_1\):\(H < 1/2\). Problema de identificare este că un \(H\) mic și un \(\mathrm{Var}(e_t)\) mare aplatizează amîndouă \(m(2,\Delta)\) la lagurile scurte, așa că graficul de scalare singur nu le poate separa.
Asprimea pe orizonturi scurte nu contrazice persistența găsită mai devreme: asprimea pe termen scurt poate coexista cu memoria lungă (Bennedsen, Lunde & Pakkanen, 2022). Miza rămîne asimetria (skew) la scadențe scurte și prognozele volatilității, care depind de \(H\).
Pe scurt
Estimarea \(H \approx 0{,}1\) provine din RV, un indicator zgomotos al volatilității latente \(\sigma_t\)
Cont & Das (2024): estimatorul de scalare aplicat volatilității realizate găsește asprime chiar cînd volatilitatea instantanee este netedă: un artefact de estimare
Incrementul observat al log-volatilității este incrementul latent plus incrementul erorii, \((\ln\sigma_{t+\Delta} - \ln\sigma_t) + (e_{t+\Delta} - e_t)\). Dacă \(e_t\) este i.i.d. și independentă de \(\sigma\), varianțele se adună, iar \(\mathrm{Var}(e_{t+\Delta} - e_t) = 2\,\mathrm{Var}(e_t)\) pentru orice \(\Delta \ge 1\). Prin urmare,
\[m(2,\Delta) = c\,\Delta^{2H} + k, \qquad c = \nu^2,\ \ k = 2\,\mathrm{Var}(e_t),\]
(9.24)
iar constanta \(k\) nu crește cu \(\Delta\). Ea ridică \(m(2, \Delta)\) cel mai mult, în termeni relativi, la lagurile scurte și aplatizează acolo panta log–log.
Un exemplu simplu arată mărimea efectului. Cu \(H = 0{,}5\),\(c = 1\) și \(k = 1\),\(m(2,1) = 1 + 1 = 2\) și \(m(2,2) = 2 + 1 = 3\), deci panta log–log dintre lagurile 1 și 2 este \(\ln(3/2)/\ln 2 = 0{,}58\), iar \(\hat H = 0{,}58/2 = 0{,}29\) în loc de 0,5. La lagurile lungi, constanta contează mai puțin: de la \(\Delta = 20\) la 40, panta este \(\ln(41/21)/\ln 2 = 0{,}97\), iar \(\hat H = 0{,}48\).
Modelul (9.24) are o implicație testabilă: sub eroarea i.i.d., \(\hat H\) crește cînd lagurile scurte sînt scoase din regresie. Mini-studiul de caz din secțiunea despre AI pentru descoperire științifică face exact această verificare pe SPY.
dacă \(e_t\) este i.i.d. și independent de \(\sigma\), varianțele se adună: \(\mathrm{Var}(e_{t+\Delta} - e_t) = 2\,\mathrm{Var}(e_t)\) pentru orice \(\Delta \ge 1\)
de aici \(m(2,\Delta) = c\,\Delta^{2H} + k\), \(c = \nu^2\), \(k = 2\,\mathrm{Var}(e_t)\): o constantă care nu crește cu \(\Delta\)
Exemplu: \(H = 0{,}5\), \(c = 1\), \(k = 1\)
\(m(2,1) = 1 + 1 = 2\), \(m(2,2) = 2 + 1 = 3\): panta pe scara log–log este \(\ln(3/2)/\ln 2 = 0{,}58\), deci \(\hat H = 0{,}58/2 = 0{,}29\) în loc de 0,5
la laguri mari constanta contează mai puțin: de la \(\Delta = 20\) la 40, panta este \(\ln(41/21)/\ln 2 = 0{,}97\), \(\hat H = 0{,}48\)
Implicație testabilă: sub eroare i.i.d., \(\hat H\) crește cînd renunțăm la lagurile mici
mini-studiul de caz din secțiunea AI pentru descoperire științifică face exact această verificare pe SPY
Sinteza secțiunii
Legea de scalare (9.23) dă \(\hat H = 0{,}11\) pentru SPY și 0,07 pentru Bitcoin, mult sub valoarea 0,5 a mișcării browniene. Deoarece RV măsoară volatilitatea cu eroare, aceeași aplatizare la lagurile scurte poate apărea dintr-un termen de eroare constant (9.24), deci estimarea singură nu identifică asprimea. Secțiunea următoare trece la două lucrări recente despre prognoza varianței realizate.
Studii de caz: învățare automată și varianțe parțiale
Cele două studii de caz iau lucrări recente despre prognoza varianței realizate și le testează afirmațiile:
Primul, al lui Christensen, Siggaard & Veliyev (2023), compară metodele standard de învățare automată cu familia HAR pe 29 de acțiuni din indicele Dow Jones.
Al doilea preia întrebarea lui Bollerslev, Medeiros, Patton & Quaedvlieg (2022) dacă pragul 0 care definește semivarianțele este cel mai bun mod de a împărți RV-ul de ieri și o replică pe datele cursului pentru SPY și Bitcoin.
Studiu de caz: poate învățarea automată să întreacă HAR?
Christensen, Siggaard & Veliyev (2023) întreabă dacă metodele standard de învățare automată (ML, machine learning) prognozează varianța realizată zilnică mai bine decît familia HAR și, dacă da, de ce. Întrebarea este firească: HAR (Corsi, 2009) este liniar în trei medii ale RV, în timp ce RV este asimetrică la dreapta și persistentă, deci o funcție neliniară sau predictori dincolo de RV-ul trecut ar putea ajuta.
Datele sînt 29 dintre cele 30 de acțiuni din Dow Jones Industrial Average (DJIA), din ianuarie 2001 pînă în decembrie 2017, \(T = 4\,257\) zile, cu RV pe 5 minute (\(n = 78\)). Se compară două mulțimi de informație. \(\mathcal{M}_{\text{HAR}}\) conține RV zilnică, săptămînală și lunară. \(\mathcal{M}_{\text{ALL}}\) adaugă 9 predictori: volatilitatea implicită, VIX, volumul tranzacțiilor, momentum-ul și indici macroeconomici și de incertitudine. Modelele și evaluarea sînt descrise în Aprofundări.
motivul întrebării: HAR Corsi (2009) este liniar în trei medii ale RV, iar RV este asimetrică la dreapta și persistentă, deci o funcție neliniară sau alți predictori decît RV trecută pot îmbunătăți prognoza
Date: 29 dintre cele 30 de acțiuni din Dow Jones Industrial Average (DJIA)
ianuarie 2001 – decembrie 2017, \(T = 4\,257\) de zile
RV la 5 minute (\(n = 78\))
Mulțimi de informații: \(\mathcal{M}_{\text{HAR}}\) și \(\mathcal{M}_{\text{ALL}}\)
Graficul interactiv prezintă MSE out-of-sample al fiecărui model raportată la cea a HAR, în medie pe cele 29 de acțiuni DJIA, la orizonturi de o zi, o săptămînă și o lună. Eșantionul de test este ultimele 20% din perioada 2001–2017. Panoul din stînga folosește doar lagurile RV, cel din dreapta toți cei 12 predictori; HAR-X (HAR model with eXogenous predictors, modelul HAR cu predictori exogeni) este OLS pe toți predictorii. Lista derulantă evidențiază un model; valorile sub 1 înseamnă o MSE mai mică decît a HAR.
Întrebare pentru sală La orizontul de o lună, cu toți cei 12 predictori, random forest are MSE egal cu 0,604 din MSE al HAR. Cu cît este mai mic MSE-ul său, raportat la HAR?
Răspuns
Cu 39,6%: 100 × (1 − 0,604). Valoarea 60,4% este pierderea rămasă, nu reducerea; 65,6% exprimă cu cît MSE al HAR este mai mare, raportat la random forest. Urmează bagging (0,621); HAR-X, adică OLS cu aceiași predictori, are 1,290, iar HARQ 1,569. Clasamentul descrie aceste proceduri pe acest set de test; singur, nu identifică motivul diferențelor.
Cu toți cei 12 predictori, la orizontul de o lună, random forest are 0,604 din MSE-ul HAR, o reducere de 39,6%, urmat de bagging cu 0,621. HAR-X, adică OLS cu aceiași predictori, are 1,290, iar HARQ 1,569.
Doar cu lagurile RV, cele șase modele prezentate rămîn între 0,937 și 1,111 din MSE-ul HAR, la toate cele trei orizonturi. Trei medii ale RV lasă puțin de învățat unui model flexibil: RV-ul trecut este deja bine rezumat de o funcție liniară a mediilor lui.
Cu toți cei 12 predictori, cîștigul arborilor și al rețelelor crește cu orizontul. Random forest trece de la 0,901 la o zi la 0,796 la o săptămînă și 0,604 la o lună; rețeaua cu două straturi ascunse, mediată pe 10 estimări, \(\text{NN}_2^{10}\), de la 0,885 la 0,846 și 0,786. Autorii atribuie acest lucru persistenței mai mari a ajustărilor ML. Modelele liniare cu aceiași predictori se deteriorează: HAR-X trece de la 0,966 la 1,290, iar HARQ de la 1,289 la 1,569. Dintre modelele liniare, doar log-HAR rămîne sub 1 la toate orizonturile (0,901, 0,970 și 0,919).
Rezultatul susține o comparație de proceduri. Cifrele sînt medii ale rapoartelor MSE pe acțiuni, nu un test de semnificație al clasamentului (vezi Aprofundări), iar clasamentul depinde de împărțirea în eșantioane de antrenare și de test (Anexă).
Bollerslev, Medeiros, Patton & Quaedvlieg (2022) întreabă dacă semnul randamentului, adică pragul 0 al semivarianțelor, este cel mai bun mod de a împărți RV-ul de ieri pentru prognoză. SHAR (Patton & Sheppard, 2015) îl împarte în semivarianța negativă și cea pozitivă. Pragul 0 are o motivație economică, aversiunea față de pierderi, dar statistic este arbitrar.
Generalizarea este varianța parțială (PV, partial variance), partea din RV adusă de randamentele cuprinse între două praguri:
cu \(c_0 = -\infty\) și \(c_G = +\infty\). Cu \(G = 2\) și \(c_1 = 0\),(9.25) dă semivarianțele; cu \(G = 1\), chiar RV. În modelul PV(\(G\))-HAR, RV-ul de ieri din HAR este înlocuit cu cele \(G\) varianțe parțiale, iar componentele săptămînală și lunară rămîn RV. SV-HAR (HAR model with realised semivariances, SHAR, modelul HAR cu semivarianțe realizate, SHAR) este SHAR, iar RV-HAR (HAR model with realised variance, modelul HAR cu varianța realizată) este HAR.
Afirmațiile lucrării, pe SPY și 28 de acțiuni DJIA în perioada 1997–2013, sînt trei. Cu un singur prag, pragul 0 este greu de depășit. Două praguri, unul în coada stîngă și unul în cea dreaptă, îmbunătățesc semnificativ prognozele. Pentru matrice de covarianță mari, pragul 0 rămîne alegerea robustă.
PV(\(G\))-HAR: în HAR, RV de ieri este înlocuită de cele \(G\) varianțe parțiale
componentele săptămînală și lunară rămîn RV; în notația lucrării, SV-HAR (cu semivarianțe realizate) este SHAR, iar RV-HAR (cu varianța realizată) este HAR
Afirmațiile lucrării, pe SPY și 28 de acțiuni din DJIA, 1997–2013
cu un singur prag, pragul 0 este greu de întrecut
două praguri, unul în coada stîngă și unul în dreapta, îmbunătățesc semnificativ prognoza
pentru matrice de covarianță mari, pragul 0 rămîne alegerea robustă
Studiu de caz: pierderea în funcție de prag, SPY și Bitcoin
Graficul interactiv arată pierderea medie out-of-sample a PV(2)-HAR împărțită la cea a RV-HAR, în funcție de prag. Pragul este exprimat ca o cuantilă \(q\) a randamentelor pe 5 minute împărțite la \(\sqrt{\mathrm{RV}_t}\), pe axa orizontală; un raport sub 1 înseamnă o prognoză mai bună decît RV-HAR. Linia punctată este SV-HAR, cu pragul exact 0. Cursorul scoate din evaluare zilele cele mai volatile, păstrînd prognozele deja calculate.
Întrebare pentru sală Pentru SPY, SV-HAR are MSE egal cu 0,908 din MSE al RV-HAR. Ce se întîmplă cu acest raport dacă excludem din evaluare cele 10 zile cu cea mai mare RV, păstrînd prognozele deja calculate?
Răspuns
Urcă la 1,240: pe zilele rămase, SV-HAR are MSE cu circa 24% mai mare. Cele 10 zile excluse aduc 89% din eroarea pătratică totală a RV-HAR. Raportul QLIKE rămîne sub 1, la 0,937 (față de 0,954 pe tot eșantionul), dar aceasta este o constatare pentru acest eșantion, nu o garanție că QLIKE este imună la observații extreme.
Pentru SPY, pe 1 180 de zile din ianuarie 2022 pînă în septembrie 2026, raportul MSE rămîne între 0,892 și 0,909 pentru \(q\) între 0,25 și 0,60, în jurul valorii SV-HAR de 0,908. Pentru Bitcoin, pe 422 de zile din martie 2025 pînă în septembrie 2026, fiecare prag dă o MSE între 1,058 și 1,084 din cea a RV-HAR. Excluderea celor 10 zile SPY cu RV-ul cel mai mare ridică raportul MSE al SV-HAR la 1,240.
Pe scurt
Pierderea medie în afara eșantionului a PV(2)-HAR împărțită la cea a RV-HAR, pentru pragul \(q\) de pe axa orizontală
\(q\): cuantila randamentelor de 5 minute împărțite la \(\sqrt{\RV_t}\); sub 1, mai bine decît RV-HAR
linia întreruptă: SV-HAR, cu pragul exact 0
SPY, 1 180 zile (ian. 2022 – sept. 2026): raportul MSE stă între 0,892 și 0,909 pentru \(q\) de la 0,25 la 0,60, în jurul valorii SV-HAR (0,908)
Bitcoin, 422 zile (mar. 2025 – sept. 2026): orice prag dă un MSE între 1,058 și 1,084 din cel al RV-HAR
Pragul este definit ca o cuantilă, \(c_{t,g} = \sqrt{\mathrm{RV}_t}\;\hat Q(z;\, q_g)\) cu \(z = r_{t,i}/\sqrt{\mathrm{RV}_t}\), astfel încît același \(q\) urmează nivelul volatilității; \(q = 0{,}5\) dă practic semivarianțele. Lucrarea folosește SPY pe 4 202 zile, cu prognoze pe ferestre rolling de 1 000 de zile. În PV(3)-HAR, cele două praguri sînt alese prin validare încrucișată (CV, cross-validation) cu 5 grupuri pe grila \(q = 0{,}05;\ 0{,}10;\ \dots;\ 0{,}95\). Pierderile sînt MSE și QLIKE, iar testele sînt teste DM unilaterale.
Replicarea aplică aceeași construcție barelor de 5 minute ale cursului. Pentru SPY, ținta este RV intraday, de la 09:30 la 16:00, ca în lucrare, în timp ce slide-urile HAR ale capitolului adaugă randamentul overnight. Pentru Bitcoin este RV pe 24 de ore UTC, cu componente pe 7 și 30 de zile calendaristice. Modelele sînt reestimate zilnic pe o fereastră extinsă, cu cuantile calculate doar din zilele dinaintea prognozei. În PV(3)-HAR, perechea de cuantile este aleasă prin CV pe MSE la fiecare 21 de zile, iar o prognoză sub cel mai mic RV din fereastră este înlocuită cu acesta (insanity filter).
Diferențele față de lucrare sînt un eșantion de aproape trei ori mai scurt, lipsa acțiunilor DJIA individuale și teste DM bilaterale.
Pe scurt
Pragul ca cuantilă: \(c_{t,g} = \sqrt{\RV_t}\;\hat Q(z;\, q_g)\), unde \(z = r_{t,i}/\sqrt{\RV_t}\)
același \(q\) urmărește nivelul volatilității; \(q = 0{,}5\) dă practic semivarianțele
Lucrarea: SPY, 4 202 zile, prognoze pe ferestre mobile de 1 000 de zile
PV(3)-HAR: cele două praguri, alese prin validare încrucișată (CV, cross-validation) în 5 blocuri, pe grila \(q = 0{,}05; 0{,}10; \dots; 0{,}95\)
pierderi MSE și QLIKE; teste Diebold–Mariano (DM) unilaterale
Replicarea: aceeași construcție pe barele de 5 minute ale cursului
SPY: ținta este RV intraday (09:30–16:00), ca în lucrare; slide-urile HAR ale capitolului adaugă randamentul peste noapte
Bitcoin: RV pe 24 de ore UTC, componente pe 7 și 30 de zile calendaristice
fereastră extinsă, reestimare zilnică, cuantile doar din zilele dinaintea prognozei
PV(3)-HAR: perechea de cuantile aleasă prin CV (MSE) la fiecare 21 de zile
o prognoză sub cea mai mică RV din fereastră este înlocuită cu aceasta (filtru de plauzibilitate, insanity filter)
Diferențe: un eșantion de aproape 3 ori mai scurt, fără acțiunile individuale din DJIA, teste DM bilaterale
Studiu de caz: pragul zero și cîștigul concentrat în puține zile
Tabelul compară pierderile raportate la RV-HAR din lucrare și din replicare. Pentru SPY în 2022–2026, SV-HAR are o QLIKE mai mică decît RV-HAR, cu raportul 0,954 și DM \(t = -1{,}79\)(\(p = 0{,}073\)); în lucrare, cu un test unilateral, \(p = 0{,}005\). Pe întregul eșantion, pantele semivarianțelor sînt \(\beta^{-} = 1{,}44\) (eroarea standard 0,63) și \(\beta^{+} = -0{,}34\) (eroarea standard 0,39), în direcția prezisă de lucrare.
PV(3)-HAR nu întrece SV-HAR la QLIKE: DM \(t = +1{,}66\)(\(p = 0{,}10\)). În lucrare, PV(3)-HAR are pierderi mai mici decît SV-HAR, cu \(p = 0{,}011\) la MSE și 0,072 la QLIKE. Perechea de praguri aleasă prin CV este instabilă: perechea cea mai frecventă, (0,05; 0,95), este aleasă în 15 din 57 de selecții, iar pragurile medii sînt 0,23 și 0,74, față de 0,14 și 0,70 în lucrare.
Cîștigurile la MSE depind de puține zile. Cele 10 zile cu cel mai mare RV aduc 89% din eroarea pătratică a RV-HAR pe SPY. Fără ele, SV-HAR are o MSE de 1,240 și o QLIKE de 0,937 din cele ale RV-HAR: avantajul la MSE dispare, iar cel la QLIKE rămîne.
Pe scurt
Pierderea relativă la RV-HAR (MSE / QLIKE)
Lucrarea: SPY 1997–2013
SPY 2022–2026
Bitcoin 2025–2026
SV-HAR (pragul 0)
0,967 / 0,981
0,908 / 0,954
1,062 / 1,019
PV(3)-HAR (două praguri, CV)
0,950 / 0,971
0,815 / 1,013
1,145 / 1,061
SPY: SV-HAR are QLIKE mai mic decît RV-HAR, DM \(t = -1{,}79\) (\(p = 0{,}073\)); lucrarea (test unilateral): \(p = 0{,}005\)
pe tot eșantionul, cu ținta RV intraday: \(\beta^{-} = 1{,}44\) (SE 0,63) și \(\beta^{+} = -0{,}34\) (SE 0,39); în Anexă, cu ținta varianța totală, alte valori
PV(3)-HAR nu bate SV-HAR la QLIKE: DM \(t = +1{,}66\) (\(p = 0{,}10\))
în lucrare, PV(3)-HAR are pierderi mai mici decît SV-HAR: \(p = 0{,}011\) (MSE) și \(0{,}072\) (QLIKE)
perechea aleasă se schimbă: cea mai frecventă, (0,05; 0,95), în 15 din 57 selecții; cuantilele medii alese: 0,23 și 0,74 (lucrarea: 0,14 și 0,70)
Cele 10 zile cu cea mai mare RV aduc 89% din eroarea pătratică a RV-HAR pe SPY
fără ele, SV-HAR are MSE 1,240 și QLIKE 0,937 din cele ale RV-HAR: cîștigul MSE dispare
Rezultatul susține o comparație de proceduri de prognoză pe SPY. Pentru SV-HAR, cîștigul la QLIKE este reprodus, dar nu este semnificativ la 5%. Pentru PV(3)-HAR, cîștigul la QLIKE nu este reprodus; MSE-ul lui scade cu 18,5%, dar cîștigul este concentrat în zilele extreme și nu este semnificativ în aproximarea DM convențională (\(t = -0{,}97\),\(p = 0{,}33\)).
Inferența se lovește de problema modelelor imbricate de pe slide-ul DM: RV-HAR este SV-HAR sau PV(3)-HAR cu coeficienți zilnici egali, deci valorile \(p\) DM de mai sus, obținute cu fereastră extinsă, sînt o aproximare convențională. Cu o fereastră rolling de lungime fixă, de 287 de zile, testul Giacomini–White (GW) față de RV-HAR dă, la MSE, \(p = 0{,}34\) pentru SV-HAR și \(p = 0{,}35\) pentru PV(3)-HAR. Cu aceeași fereastră, QLIKE este mai mare decît pentru RV-HAR, cu rapoarte de 1,70 pentru SV-HAR și 3,23 pentru PV(3)-HAR. Și aceste teste cer o teoremă limită centrală pentru diferențele de pierderi, iar cu QLIKE momentele lor depind de prognozele de la numitori.
Limitele sînt lungimea evaluării, 4,7 ani de prognoze pentru SPY și 1,5 ani pentru Bitcoin, și dominarea MSE de către cîteva zile extreme.
Pe scurt
Tipul de dovadă: comparație între proceduri de prognoză pe SPY
SV-HAR: cîștigul la QLIKE se reproduce, nesemnificativ la 5%
PV(3)-HAR: cîștigul la QLIKE nu se reproduce
PV(3)-HAR: MSE scade cu 18,5%, dar avantajul este concentrat în zilele extreme și nu este semnificativ în aproximația DM convențională (\(t = -0{,}97\), \(p = 0{,}33\))
Inferența pentru modele imbricate: RV-HAR este SV-HAR sau PV(3)-HAR cu coeficienți zilnici egali
valorile p DM de mai sus (fereastră extinsă) sînt aproximația convențională
fereastră mobilă de lungime fixă, 287 de zile (Giacomini–White, GW): față de RV-HAR, MSE are \(p = 0{,}34\) pentru SV-HAR și \(p = 0{,}35\) pentru PV(3)-HAR
cu aceeași fereastră, QLIKE este mai mare decît la RV-HAR: raportul este 1,70 pentru SV-HAR și 3,23 pentru PV(3)-HAR
testele cer o teoremă limită centrală pentru diferențele de pierdere; la QLIKE, momentele lor depind și de prognozele de la numitor
Limite: prognoze pe 4,7 ani pentru SPY și 1,5 ani pentru Bitcoin; MSE dominat de cîteva zile extreme
Sinteza secțiunii
Învățarea automată întrece HAR pe acțiunile DJIA în principal cînd se adaugă predictori dincolo de RV-ul trecut și pe orizonturi mai lungi; doar cu lagurile RV, cîștigul este mic. Pe datele cursului, pragul 0 rezistă pentru SPY, dar cîștigurile varianțelor parțiale la MSE provin din cîteva zile extreme și nu sînt semnificative. Secțiunea următoare revine la întrebarea asprimii cu bucla descoperirii.
AI pentru descoperire științifică
Secțiunea aplică bucla de cercetare cu un asistent AI întrebării deschise a capitolului: dacă estimarea \(\hat H \approx 0{,}1\) este o proprietate a volatilității sau a erorii de măsurare a RV. Bucla are aceleași etape ca în celelalte capitole: literatura, ipotezele concurente, replicarea, robustețea și critica. Mini-studiul de caz verifică pe SPY o implicație testabilă, iar punctul de plecare pentru proiect transformă întrebarea într-un proiect de cercetare.
Întrebarea este dacă \(\hat H \approx 0{,}1\) este o proprietate a lui \(\sigma_t\) sau a erorii RV, \(e_t\). O trecere prin buclă cu un asistent AI începe cu literatura: asistentul tabelează estimările publicate ale lui \(H\), cu estimatorul, frecvența de eșantionare și tratarea erorii RV, iar fiecare DOI (digital object identifier) este verificat pe Crossref. Prompturile reutilizabile se află în Anexă.
Pasul următor formulează ipoteze concurente, fiecare cu forma ei pentru \(m(2,\Delta)\):
un model cu doi factori, unul dintre ei cu revenire rapidă la medie.
Înaintea oricărei extinderi se replică \(\hat H = 0{,}11\) din capitol. Ferestrele de laguri, măsurile volatilității și ajustarea cu un termen de zgomot constant \(k\) se fixează dinainte.
Pe scurt
Întrebarea: este \(\hat H \approx 0{,}1\) o proprietate a lui \(\sigma_t\) sau a erorii \(e_t\) din RV?
O trecere prin buclă cu un asistent AI (prompturi reutilizabile în Anexă)
Literatura: tabelăm estimările publicate ale lui \(H\) (estimator, frecvență, tratamentul erorii din RV)
Verificăm fiecare DOI (digital object identifier) pe Crossref
Ipoteze concurente, fiecare cu forma ei pentru \(m(2,\Delta)\): (i) log-volatilitate fracționară cu \(H = 0{,}1\), (ii) \(H = 0{,}5\) plus eroare i.i.d., (iii) un model cu doi factori, unul cu revenire rapidă la medie
Replicăm întîi \(\hat H = 0{,}11\) din capitol, apoi extindem analiza
Fixăm dinainte ferestrele de laguri, măsurile și ajustarea cu termen constant de zgomot \(k\)
Unele verificări îi revin cercetătorului, nu asistentului:
Eroarea proxy-ului: simulînd \(H = 0{,}5\) plus o eroare de aceeași mărime ca în date, procedura nu trebuie să returneze \(H \approx 0{,}1\); dacă o face, estimarea pe datele reale nu conține informație despre asprime.
Inferența: incrementele din (9.23) se suprapun, ceea ce invalidează erorile standard OLS ale lui \(\zeta_q\), deci este nevoie de un block bootstrap.
Raportarea: fiecare fereastră încercată trebuie raportată, nu doar cea care dă rezultatul cel mai curat.
Cifrele citate: asistenții afirmă adesea că „\(H \approx 0{,}1\) pentru toate activele”; fiecare astfel de cifră trebuie verificată în tabelul lucrării citate pentru ea.
Pe scurt
Verificări care revin cercetătorului
Eroarea indicatorului: simulăm \(H = 0{,}5\) plus eroare de aceeași mărime; procedura nu trebuie să producă \(H \approx 0{,}1\)
Incrementele suprapuse invalidează erorile standard OLS ale lui \(\zeta_q\): folosim bootstrap pe blocuri
Raportăm toate ferestrele încercate
Asistenții citează „\(H \approx 0{,}1\) pentru toate activele”: verificăm fiecare cifră în tabelul lucrării citate
Mini-studiu de caz: \(\hat H\) ca artefact al erorii i.i.d. (1/2)
O propunere tipică a unui asistent este că \(\hat H \approx 0{,}1\) provine din eroarea de măsurare i.i.d. a RV. Implicația testabilă rezultă din (9.24): sub eroarea i.i.d., \(\hat H\)crește cînd lagurile scurte sînt eliminate. Tabelul prezintă \(\hat H\) pe trei ferestre de laguri și din ajustarea lui (9.24) cu o constantă \(k\) pe lagurile 1–50, pentru o traiectorie simulată cu \(H = 0{,}5\) plus eroare și pentru SPY cu RV totală și cu RV intraday.
Prima coloană replică capitolul: \(\hat H = 0{,}106\) pentru RV totală a SPY. Rîndul simulat arată mecanismul: \(\hat H\) crește de la 0,18 cu lagurile 1–30 la 0,24 și 0,26 pe măsură ce lagurile scurte sînt eliminate, iar ajustarea cu \(k\) recuperează cea mai mare parte a distanței pînă la 0,5, cu 0,39. Este o singură traiectorie, nu un studiu de putere.
Pe scurt
O propunere tipică a asistentului: \(\hat H \approx 0{,}1\) provine din eroarea de măsurare i.i.d. din RV
implicația testabilă: \(\hat H\)crește cînd renunțăm la lagurile mici
\(\Delta \in [1, 30]\)
\([5, 30]\)
\([10, 50]\)
Ajustare cu \(k\), \([1, 50]\)
\(H = 0{,}5\) simulat plus eroare
\(0{,}18\)
\(0{,}24\)
\(0{,}26\)
\(0{,}39\)
SPY, RV totală
\(0{,}106\)
\(0{,}089\)
\(0{,}077\)
\(0{,}096\)
SPY, RV intraday
\(0{,}130\)
\(0{,}094\)
\(0{,}078\)
\(0{,}114\)
Prima coloană replică valoarea din capitol
Rîndul simulat arată mecanismul: \(\hat H\) crește
ajustarea cu \(k\) recuperează mare parte din distanța pînă la 0,5
o singură traiectorie, nu un studiu de putere
Mini-studiu de caz: \(\hat H\) ca artefact al erorii i.i.d. (2/2)
Pe SPY, tiparul este opus: \(\hat H\)scade cînd lagurile scurte sînt eliminate, de la 0,106 la 0,089 și 0,077 pentru RV totală, iar \(k\) estimat este 0. Ajustarea cu \(k\) dă \(\hat H = 0{,}096\), cu un IÎ de 95% prin block bootstrap de \([0{,}058; 0{,}268]\).
Interpretarea este limitată. Diagnosticul este ilustrativ și incompatibil cu explicația prin eroare i.i.d., dar o respingere formală ar cere un test calibrat prin simulare. Mecanismul de eroare non-i.i.d. al lui Cont & Das (2024) nu este testat de acest design. Rezultatul susține o descriere.
Pe scurt
SPY: \(\hat H\)scade cu fereastra, iar \(k\) estimat este 0
ajustarea cu \(k\) dă \(\hat H = 0{,}096\), cu CI bootstrap pe blocuri de 95% \([0{,}058; 0{,}268]\)
Interpretare: un diagnostic ilustrativ, incompatibil cu explicația prin eroare i.i.d.
o respingere formală cere un test calibrat prin simulare
mecanismul non-i.i.d. din Cont & Das (2024) nu este testat de acest design
Întrebarea proiectului este dacă asprimea volatilității SPY și Bitcoin rezistă unui estimator care modelează eroarea de măsurare a RV. Primul pas este replicarea, în exercițiul B9 din seminarul 9: \(\hat H = 0{,}11\) pentru SPY și 0,07 pentru Bitcoin din legea de scalare și \(\hat H = 0{,}18\) pentru \(H = 0{,}5\) simulat plus eroare.
Livrabilele sînt:
o preînregistrare (pre-registration) a ipotezelor, estimatorilor, ferestrelor de laguri, testelor și designului simulării, datată înaintea primei rulări;
fiecare prompt care a influențat o decizie în AI_USE.md
fiecare eroare a asistentului în AI_ERRORS.md
Sinteza secțiunii
Pe SPY, \(\hat H\) scade, în loc să crească, cînd lagurile scurte sînt eliminate, ceea ce este incompatibil cu eroarea de măsurare i.i.d. ca sursă a estimării asprimii, fără a fi un test formal. Dacă asprimea rezistă unui estimator care modelează eroarea rămîne o întrebare deschisă.
Concluzii
Concluziile reunesc instrumentele capitolului pe situații, întrebările care verifică înțelegerea și decizia practică, împreună cu condițiile în care ea este valabilă.
Tabelul pune în corespondență situații și instrumente. Pentru un activ lichid cu bare de 1–5 minute, RV pe 5 minute, subeșantionată, este suficientă. Pentru date tick sau o acțiune nelichidă, cum sînt multe la Bursa de Valori București (BVB), zgomotul este mare și este nevoie de pre-averaging sau de un nucleu realizat flat-top, împreună cu verificarea signature plot-ului; ratele lor de convergență se află în Anexă. Pentru riscul zilnic al unui activ tranzacționat la bursă, măsura este varianța totală, RV plus pătratul randamentului overnight. Pentru a separa salturile din știri de difuzie: BV sau MedRV, varianța realizată mediană (median realised variance, Anexă), cu testul de tip raport sub controlul FDR, și testul Lee–Mykland pentru localizarea în timp a saltului. Pentru prognozele zilnice sau săptămînale ale varianței: log-HAR, eventual cu salturi, efecte de sfîrșit de săptămînă sau RQ, cu GARCH ca termen de comparație. Pentru compararea prognozelor: QLIKE și MSE pe varianță, Diebold–Mariano, Mincer–Zarnowitz și mulțimea de încredere a modelelor.
Cel mai solid rezultat al capitolului este că, out-of-sample, log-HAR are o QLIKE mai mică decît GARCH(1,1)-\(t\) pe ambele piețe, în timp ce comparațiile prin MSE nu sînt concludente. Regula celor 5 minute este justificată doar dacă signature plot-ul este plat la 5 minute și la intervale mai mari. Numărul salturilor depinde de controlul FDR și de corecția de periodicitate.
Pe scurt
Situația
Instrumentul sugerat
Activ lichid, bare de 1–5 minute
RV la 5 minute, subeșantionată
Date tick cu tick sau o acțiune nelichidă (Bursa de Valori București, BVB)
Pre-averaging sau nucleu realizat flat-top (\(n^{-1/4}\); Parzen \(n^{-1/5}\); Anexă: ratele de convergență); verificați graficul de semnătură
Riscul zilnic al unui activ tranzacționat la bursă
Varianța totală: RV plus randamentul peste noapte la pătrat
Separarea salturilor din știri de difuzie
BV sau MedRV (varianța realizată bazată pe mediane; Anexă: estimatori robuști la salturi), testul raportului cu control FDR; Lee–Mykland pentru momentul saltului
Capitolul 10 studiază de unde provine zgomotul \(\varepsilon\) din acest capitol: registrele de ordine limită (limit order books), spread-urile bid–ask și mărimea tick-ului, împreună cu lichiditatea, impactul asupra pieței și tranzacționarea de înaltă frecvență pe bursele de acțiuni și de criptoactive.
Pe scurt
Întrebări de verificare
De ce \(R^2\) pentru log RV nu este comparabil cu \(R^2\) pentru RV pe niveluri?
slide-ul Interpretarea estimărilor HAR
De ce este QLIKE robustă la un indicator RV zgomotos, iar MSE pe volatilitate nu?
slide-ul Evaluarea față de o țintă zgomotoasă
De ce MCS indică o mulțime de modele, nu un cîștigător?
slide-ul Mulțimea de încredere a modelelor
Cum poate eroarea de măsurare din RV să facă volatilitatea să pară aspră?
slide-ul Cum aplatizează eroarea de măsurare legea de scalare
Pentru riscul zilnic, alegerea este varianța totală: RV pe 5 minute plus pătratul randamentului overnight, deoarece noaptea aduce 38% din varianța zilnică a SPY. Pentru varianța de mîine, alegerea este log-HAR: QLIKE-ul lui este 0,310, față de 0,343 pentru GARCH(1,1)-\(t\) pe SPY, și rămîne în mulțimea de încredere de 90%, împreună cu SHAR. Pentru zilele cu salt, alegerea este testul de tip raport cu corecția de periodicitate și controlul FDR: 17 zile din 1 489 pentru SPY, nu 236.
Aceste alegeri sînt valabile în anumite condiții:
Activul trebuie să fie lichid, cu un signature plot plat de la 5 minute în sus; datele tick sau o acțiune nelichidă cer pre-averaging sau un nucleu realizat.
Ordinea este valabilă pentru aceste proceduri implementate și pentru pierderea QLIKE; comparațiile prin MSE nu sînt concludente.
Valorile \(p\) DM și MCS cer o teoremă limită centrală pentru diferențele de pierderi QLIKE, iar pentru perechile imbricate, SHAR și HARQ față de HAR, ele sînt o aproximare convențională.
Două rezultate ar răsturna alegerile. Pentru RV pe 5 minute, un signature plot care crește cînd intervalul scade spre 5 minute, amprenta zgomotului. Pentru log-HAR, pe un eșantion nou, un test DM pe QLIKE care nu îl mai favorizează față de GARCH (aici \(t = -2{,}30\),\(p = 0{,}021\)) sau ieșirea lui din mulțimea de 90%.
Pe scurt
Ce aleg
pentru riscul zilnic, varianța totală: RV pe 5 minute plus randamentul peste noapte la pătrat (noaptea aduce 38% din varianța zilnică SPY)
pentru prognoza varianței de mîine, log-HAR: QLIKE \(0{,}310\) față de \(0{,}343\) pentru GARCH(1,1)-\(t\) pe SPY; rămîne în mulțimea de 90%, alături de SHAR
pentru zilele cu salt, testul raportului cu corecția de periodicitate și control FDR: 17 zile din 1 489 pentru SPY, nu 236
În ce condiții
un activ lichid, cu graficul de semnătură plat de la 5 minute în sus; datele tick cu tick sau o acțiune nelichidă cer pre-averaging sau un nucleu realizat
clasamentul este valabil pentru aceste proceduri implementate și pentru pierderea QLIKE; comparațiile după MSE nu sînt concludente
valorile p DM și MCS cer o teoremă limită centrală pentru diferențele de pierdere QLIKE; pentru perechile imbricate (SHAR, HARQ față de HAR) sînt o aproximare convențională
Ce rezultat m-ar face să renunț
la RV pe 5 minute: un grafic de semnătură care crește cînd intervalul scade spre 5 minute, amprenta zgomotului
la log-HAR: pe un eșantion nou, un test DM pe QLIKE care nu o mai favorizează față de GARCH (aici \(t = -2{,}30\), \(p = 0{,}021\)) sau ieșirea ei din mulțimea de 90%
Sinteza secțiunii
Varianța realizată transformă prețurile intraday într-o măsurare zilnică a volatilității, precisă la circa 16% cu 78 de randamente și fără deplasare din zgomot la 5 minute pe datele cursului. Salturile sînt rare odată ce multiplicitatea este controlată. log-HAR prognozează varianța de mîine mai bine decît GARCH sub QLIKE, iar asprimea volatilității rămîne o întrebare deschisă de identificare.
Aprofundări
Slide-urile din această parte dezvoltă subiecte tratate pe scurt în corpul capitolului: construcția eșantioanelor SPY și Bitcoin, suma varianțelor de zi și de noapte, intervalele de încredere pentru volatilitatea zilnică, sezonalitatea intraday, signature plot-ul într-o simulare, RV subeșantionată și RV pe două scări, nucleele realizate, regula Benjamini–Hochberg pe cinci teste, volatilitatea implicită ca prognoză, ponderile pe laguri și extensiile HAR, rezultatele prognozelor pentru Bitcoin, graficele Mincer–Zarnowitz, interpretarea valorilor \(p\) MCS și clasamentul celor 21 de modele din studiul de caz despre învățarea automată.
SPY are 78 de randamente pe 5 minute pe zi completă în 2020–2026, 1 489 de zile, și 42 în cele 12 zile cu închidere devreme; barele lipsă din interiorul unei zile preiau ultimul preț. Bitcoin are 288 de randamente pe zi în 2024–2026, 659 de zile, iar zilele cu mai puțin de 95% din bare sînt eliminate. Fără zilele incomplete, volatilitatea anualizată din RV-ul mediu este 12,97% în loc de 12,93% pentru SPY și 46,17% în loc de 45,08% pentru Bitcoin.
Pe scurt
Seria
Frecvența
Perioada
Zile
SPY (ETF)
bare de 5 minute, 09:30–16:00 ora New York
2020–2026
1 489
Bitcoin
bare de 5 minute, zile de 24 de ore (UTC)
2024–2026
659
SPY, Bitcoin
prețuri zilnice de închidere
2000/2014–2026
pentru GARCH
VIX
valoare zilnică la închidere
2020–2026
volatilitate implicită
SPY: 78 de randamente într-o zi completă și 42 (09:30–13:00) în cele 12 zile cu program redus
bara etichetată 13:00 începe după închidere: nu este un interval; primul ei preț este prețul de la 13:00 doar cînd bara de 12:55 lipsește
barele din afara grilei de 5 minute sînt eliminate
o bară lipsă din timpul zilei preia ultimul preț disponibil: 30 bare în 16 zile
Bitcoin: 288 de randamente pe zi
o bară lipsă preia ultimul preț, deci intervalul ei se contopește cu următorul: 1 347 de bare în 245 din 659 de zile
ziua începe la prețul de la 00:00 (deschiderea primei bare sau închiderea barei de 23:55 din ziua precedentă) și se termină la ultimul preț observat
fără zilele incomplete, volatilitatea anualizată devine \(12{,}97\%\) pentru SPY (în loc de \(12{,}93\%\)) și \(46{,}17\%\) pentru Bitcoin (în loc de \(45{,}08\%\))
zilele Bitcoin cu mai puțin de 95% din bare sînt eliminate: 88 din 747 de zile calendaristice, mai ales un gol de date în octombrie 2025
Anualizat, RV-ul intraday al SPY corespunde unei varianțe de 167 (\(\%^2\) pe an), iar varianța totală uneia de 270, deci partea overnight este 103, o volatilitate de circa 10,1% și o pondere de 38%. Pătratele volatilităților de la deschidere la închidere și overnight nu se adună la total, deoarece pătratul randamentului sesiunii conține produsele încrucișate ale randamentelor intraday, care sînt nule doar în medie și adaugă circa 17 în acest eșantion.
Pe scurt
SPY, varianțe anualizate (%\(^2\) pe an)
RV intraday: \(12{,}9\%\), varianța \(167\)
varianța totală \(\RV_t + r_{\text{noapte},t}^2\): \(16{,}4\%\), varianța \(270\)
partea de peste noapte: \(270 - 167 = 103\), adică \(\sqrt{103} \approx 10{,}1\%\); ponderea \(103/270 = 38\%\)
De ce nu \(13{,}6^2 + 10{,}1^2\)?
valoarea \(13{,}6\%\) de la deschidere la închidere ridică la pătrat randamentul întregii sesiuni, nu fiecare randament de 5 minute
\((\sum_i r_{t,i})^2 = \RV_t + 2\sum_{i<j} r_{t,i}\,r_{t,j}\): produsele încrucișate sînt nule doar în medie teoretică; în acest eșantion adaugă aproximativ \(17\) (\(13{,}6^2 \approx 184\))
volatilitatea de la închidere la închidere (\(16{,}6\%\)) conține și termenul încrucișat \(2\,r_{\text{noapte},t}\,r_{\text{deschidere-închidere},t}\)
Graficul arată volatilitatea realizată zilnică a SPY din martie pînă în mai 2025, cu banda ei de încredere de 95%, calculată din cvarticitatea realizată ca în (9.5) și transformată în volatilitate prin rădăcina pătrată a capetelor intervalului pentru varianță.
Mediana lui \(\mathrm{se}/\mathrm{RV}\) este 0,19, deci volatilitatea unei zile este cunoscută cu aproximativ ±20%, cu o lățime relativă mediană de 37%. La 9 aprilie 2025, ziua pauzei tarifare, volatilitatea este 72%, cu IÎ \([55\%, 93\%]\); intervalul se lărgește cînd cîteva randamente domină suma. În zilele cu salt, banda nu are acoperirea nominală, dar RV rămîne mult mai precisă decît \(r_t^2\), a cărui eroare relativă este de ordinul a 141%.
Pe scurt
SPY, martie–mai 2025
banda: intervalul de încredere de 95% pentru \(\sqrt{252\,\IV_t}\) din cvarticitatea realizată
Banda pentru volatilitate ia rădăcina pătrată a capetelor intervalului pentru varianță
\(\sqrt{\RV_t}\exp\left(\pm 0{,}98\,\text{se}(\RV_t)/\RV_t\right)\): semi-lățimea pe scara log se înjumătățește
SPY: volatilitatea unei zile este cunoscută cu aproximativ \(\pm 20\%\)
\(\text{se}/\RV\) median \(= 0{,}19\), deci factorii pentru volatilitate sînt \([0{,}83; 1{,}20]\)
lățimea relativă mediană: 37%
9 aprilie 2025: volatilitatea a fost \(72\%\), cu CI de 95% \([55\%, 93\%]\)
ziua în care a fost anunțată amînarea tarifelor
Intervalul se lărgește cînd cîteva randamente domină suma: \(\sum r^4\) crește mai repede decît \((\sum r^2)^2\)
Banda presupune un preț continuu și zgomot neglijabil
într-o zi cu salt, \(\sum r^4\) păstrează termenul \(\kappa^4\)
deci banda nu are acoperirea nominală nici pentru variația totală, nici pentru \(\IV_t\) (secțiunea Salturi)
RV rămîne totuși mult mai precisă decît \(r_t^2\)
eroarea relativă a lui \(r_t^2\) este de ordinul \(\sqrt{2} \approx 141\%\) sub distribuția Normală
SPY are o formă de U (Andersen & Bollerslev, 1997): 0,106% în primele 5 minute, 0,050% în jurul prînzului și 0,089% în ultimele 5 minute. Bitcoin este cel mai volatil la 14:00 UTC, aproape de deschiderea bursei americane, și cel mai liniștit la 10:00 UTC. RV însumează pe toată ziua și nu este deplasată de sezonalitate, dar variația bipower este, motiv pentru care testul de salturi folosește factorul de periodicitate al lui Boudt, Croux & Laurent (2011).
Pe scurt
Stînga: SPY, media \(|r_{t,i}|\) pe intervale de 5 minute ale zilei
doar zile complete
etichetele marchează sfîrșitul intervalului, ora New York
\(0{,}106\%\) în primele 5 minute, \(0{,}050\%\) la prînz, \(0{,}089\%\) în ultimele 5 minute
Deschiderea încorporează știrile de peste noapte; închiderea concentrează reechilibrările indicilor și ale fondurilor
Bitcoin se tranzacționează non-stop, dar este cel mai volatil la ora 14:00 UTC
14:00 UTC: în jurul deschiderii bursei din SUA (09:30 la New York: 13:30 UTC vara, 14:30 UTC iarna)
cel mai calm la 10:00 UTC, cînd volatilitatea este de 2,2 ori mai mică
RV însumează pe toată ziua, deci sezonalitatea nu o deplasează
în schimb, deplasează variația bipower (BV, bipower variation, definită în secțiunea Salturi) și face ca testul de salturi să respingă prea des
remediul, împărțirea randamentelor la un factor de periodicitate \(f_i\)Boudt, Croux & Laurent (2011), este aplicat testului de salturi în secțiunea Salturi (Anexă)
Graficul arată un signature plot pe 100 de zile simulate, cu un preț pe secundă: un preț eficient cu volatilitate zilnică aleatoare plus zgomot i.i.d. cu \(\omega = 0{,}01\%\).
Cu IV mediu adevărat 0,98, RV-ul prețurilor observate este 5,66 la o secundă, 1,06 la un minut și 0,98 la 5 minute, o deplasare care corespunde lui \(2n\omega^2\) din (9.7). Pe datele de o secundă, RV pe două scări dă 0,95, iar nucleul realizat 0,99, cu abateri standard ale erorii între zile de 0,150 și 0,045, față de 0,187 pentru RV pe 5 minute: folosirea tuturor datelor este utilă doar cu o corecție pentru zgomot.
Pe scurt
Un grafic de semnătură arată RV medie în funcție de intervalul de eșantionare
aici: 100 de zile simulate, un preț pe secundă
prețul eficient are volatilitate zilnică aleatoare, plus zgomot i.i.d., \(\omega = 0{,}01\%\)
IV medie adevărată este \(0{,}98\), iar RV calculată din prețurile observate este
\(5{,}66\) la 1 secundă, \(1{,}06\) la 1 minut și \(0{,}98\) la 5 minute
Deplasarea corespunde lui \(2n\omega^2\) (slide-ul De ce nu folosim fiecare tranzacție?)
Fără zgomot, RV este constantă în raport cu intervalul de eșantionare
creșterea la frecvențe mari este amprenta zgomotului
Estimatori robuști la zgomot pe date de 1 secundă: RV pe două scări \(0{,}95\), nucleul realizat \(0{,}99\)
abaterea standard a erorii pe zile: RV pe 5 minute \(0{,}187\), pe două scări \(0{,}150\), nucleu \(0{,}045\)
folosirea tuturor datelor aduce cîștig doar cu o corecție de zgomot
Subeșantionarea (subsampling) mediază RV pe \(K\) grile decalate, ceea ce păstrează deplasarea unei grile rare, dar îi reduce varianța. RV pe două scări (TSRV, two-scale realised variance) (Zhang, Mykland & Aït-Sahalia, 2005) scade un multiplu al RV calculate pe toate datele, care estimează termenul de zgomot \(2n\omega^2\), și elimină astfel deplasarea rămasă; în eșantioane mici se împarte la \(1 - \bar n/n\).
Pe scurt
Subeșantionarea: calculăm RV pe \(K\) grile decalate și facem media celor \(K\) valori
decalajele sînt \(0, 1, \ldots, K-1\); \(\RV^{(k)}_t\) este RV pe grila cu decalajul \(k\)
\(\RV^{\text{avg}}_t = \frac{1}{K}\sum_{k=0}^{K-1} \RV^{(k)}_t\): aceeași deplasare ca o singură grilă rară, varianță mai mică
\(\text{TSRV}_t = \RV^{\text{avg}}_t - \frac{\bar n}{n}\RV^{\text{all}}_t\), \(\bar n = K^{-1}\sum_k n_k\), \(n_k\): randamentele grilei \(k\); \(\RV^{\text{all}}_t\): RV pe toate cele \(n\) randamente, care estimează termenul de zgomot \(2n\omega^2\)
grilele standard (grila \(k\) folosește prețurile \(k, k+K, \ldots\)): \(\bar n = (n - K + 1)/K\), de exemplu \(73/6 = 12{,}17\) pentru \(n = 78\), \(K = 6\)
dacă adăugăm fiecărei grile primul și ultimul preț al zilei, \(\bar n = 83/6 = 13{,}83\), dar zgomotul comun de la capete nu mai dispare: o aproximare pentru eșantion finit, nu TSRV consistent
În eșantioane mici, TSRV se împarte la \(1 - \bar n/n\)
Nucleul realizat (realised kernel) al lui Barndorff-Nielsen, Hansen, Lunde & Shephard (2008) adaugă la RV autocovarianțele ponderate ale randamentelor, ceea ce anulează autocovarianța negativă de ordinul întîi creată de zgomot. Ponderile Parzen păstrează estimatorul pozitiv, lățimea de bandă crește cu raportul zgomot–semnal, iar netezirea capetelor (jittering) împiedică zgomotul lor să rămînă în estimare.
Funcția de ponderare Parzen \(k\): 1 în 0, descrește continuu pînă la 0 în 1; păstrează RK (estimatorul realised kernel al varianței, cu nucleu) pozitiv
Zgomotul face \(\gamma_1\) negativ
includerea acestui termen în estimatorul cu nucleu corectează deplasarea
Lățimea de bandă \(H\) (aici nu exponentul Hurst) crește cu raportul zgomot/semnal
\(H \approx 3{,}5\,\xi^{4/5} n^{3/5}\), cu \(\xi^2 = \omega^2/\sqrt{\text{IQ}}\) raportul zgomot/semnal
în codul cursului (pilot euristic): \(\hat\omega^2 = \RV/(2n)\), iar RV pe 20 de minute ține locul lui \(\sqrt{\text{IQ}}\)
Jittering: primul și ultimul preț sînt înlocuite cu mediile primelor și ultimelor două prețuri, astfel încît zgomotul de la capete nu rămîne în RK
Cu valorile \(p\) ordonate 0,003, 0,012, 0,024, 0,045 și 0,60 și \(q = 0{,}05\), pragurile din (9.12) sînt de la 0,01 la 0,05, iar regula respinge trei zile, față de patru fără corecție și una cu Bonferroni. Deoarece procedura este de tip step-up, o valoare \(p\) care nu trece de propriul prag poate fi totuși respinsă cînd una mai mare trece.
Pe scurt
Cinci zile, valori p ordonate \(0{,}003; 0{,}012; 0{,}024; 0{,}045; 0{,}60\)
cu \(q = 0{,}05\) și \(N = 5\), pragurile \(kq/N\) sînt \(0{,}01; 0{,}02; 0{,}03; 0{,}04; 0{,}05\)
Primele trei trec, al patrulea nu: \(k = 3\), respingem trei zile
\(0{,}024 \le 0{,}03\), dar \(0{,}045 > 0{,}04\)
Pe aceleași date, numărul de respingeri
fără corecție (\(p \le 0{,}05\)): 4
BH: 3
Bonferroni (\(p \le 0{,}05/5 = 0{,}01\)): 1
Procedura este step-up
cu valorile p \(0{,}003; 0{,}012; 0{,}032; 0{,}038; 0{,}60\), al treilea nu trece de propriul prag (\(0{,}032 > 0{,}03\))
dar al patrulea trece (\(0{,}038 \le 0{,}04\)), deci \(k = 4\) și respingem patru zile
Regresia varianței totale anualizate a SPY din următoarele 21 de zile de tranzacționare pe \(\mathrm{VIX}^2\) dă o pantă de 0,56, cu eroarea standard Newey–West 0,06, și \(R^2 = 0{,}23\): VIX este informativ, dar panta lui este sub 1. Nivelul este o întrebare separată, iar nici panta, nici diferența medie nu identifică prima condiționată de risc a varianței (9.13).
Pe scurt
Ca prognoză: regresăm \(\tfrac{252}{21}\RV_{t,t+21}\) pe VIX\(_t^2\)
VIX\(_t^2\): %\(^2\) anualizat; aproximări: 30 de zile calendaristice \(\approx\) 21 de zile de tranzacționare, opțiuni pe indicele S&P 500 (SPX, Cboe) față de SPY
panta \(0{,}56 < 1\), eroarea standard (SE, standard error) \(0{,}06\): Newey–West cu 20 de laguri, deoarece țintele pe 21 de zile se suprapun; \(0{,}05\) cu 7 laguri, \(0{,}06\) cu 42
panta sub 1 nu identifică o reacție excesivă a pieței și nici mecanismul primei
\(R^2 = 0{,}23\): VIX este informativ
nivelul este o întrebare separată: diferența medie ex post este de 4,36 puncte procentuale în volatilitate și 138,2 în varianță (%\(^2\) anualizat)
niciuna nu identifică prima condiționată: ambele adaugă eroarea de prognoză \(\E^{\mathbb{P}}_t[Q_t] - Q_t\)
aceeași distincție între pantă și nivel revine în testul Mincer–Zarnowitz
Graficul arată ponderile pe care log-HAR le pune pe fiecare zi trecută, pentru SPY și Bitcoin, și valorile ajustate ale log-HAR față de volatilitatea realizată a SPY în ultimele 250 de zile.
Pentru SPY, ponderea lagului 1 este \(0{,}362 + 0{,}067 + 0{,}008 = 0{,}437\), a fiecăruia dintre lagurile 2–5 este 0,075, iar a fiecăruia dintre lagurile 6–22 este 0,008: trei coeficienți imită scăderea lentă a ACF. Restricțiile HAR asupra unui AR(22) nu sînt respinse de un test Wald Newey–West (\(W = 18{,}2\),\(p = 0{,}51\)).
Pe scurt
Stînga: ponderile log-HAR pe fiecare zi trecută
Bitcoin: ferestre complete de 7 și 30 de zile
Dreapta: SPY, ultimele 250 de zile, volatilitatea realizată și valorile ajustate log-HAR
HAR-CJ (Andersen, Bollerslev & Diebold, 2007) folosește părțile continuă și de salt ale RV ca regresori separați. Alte extensii adaugă variabile dummy pentru sfîrșit de săptămînă sau sărbători, un termen de leverage pentru randamentele negative, volatilitatea implicită ca regresor suplimentar și regresii directe ale sumei RV pe următoarele \(h\) zile pentru prognoze pe mai mulți pași.
Pe scurt
HAR-CJ (HAR model with Continuous and Jump components, model HAR cu componentă continuă și componentă de salt) Andersen, Bollerslev & Diebold (2007): părțile continuă (\(C\)) și de salt (\(J\)) ca regresori separați
Pe 422 de prognoze cu o zi înainte ale RV pe 24 de ore a Bitcoin, log-HAR are din nou cea mai mică QLIKE, 0,282, cu circa 22% sub GARCH(1,1)-\(t\), care are 0,360 (\(t = -4{,}32\)). Față de HAR în nivel, diferența nu este semnificativă (\(p = 0{,}223\)), iar prognoza GARCH pe date zilnice este necalibrată, cu panta MZ 0,55.
Pe scurt
Model
QLIKE
DM\(_{\text{QLIKE}}\)\(t\) (\(p\))
MSE (%\(^4\))
DM\(_{\text{MSE}}\)\(p\)
MZ \(b\)
MZ \(R^2\)
log-HAR
\(0{,}282\)
–
\(26{,}6\)
–
\(0{,}82\)
\(0{,}38\)
HAR
\(0{,}408\)
\(-1{,}22\) (\(0{,}223\))
\(27{,}6\)
\(0{,}431\)
\(0{,}89\)
\(0{,}34\)
GARCH(1,1)-\(t\)
\(0{,}360\)
\(-4{,}32\) (\(<0{,}001\))
\(42{,}2\)
\(0{,}055\)
\(0{,}55\)
\(0{,}23\)
EWMA
\(0{,}346\)
\(-2{,}96\) (\(0{,}003\))
\(36{,}3\)
\(0{,}033\)
\(0{,}64\)
\(0{,}18\)
RV de ieri
\(0{,}466\)
\(-5{,}38\) (\(<0{,}001\))
\(35{,}0\)
\(0{,}061\)
\(0{,}58\)
\(0{,}33\)
422 de prognoze pentru ziua următoare ale varianței realizate pe 24 de ore
aceleași modele și teste ca pentru SPY
log-HAR are din nou cea mai mică QLIKE: cu 22% sub GARCH(1,1)-\(t\)
față de HAR pe niveluri diferența nu este semnificativă (\(p = 0{,}223\))
GARCH pe date zilnice nu este calibrat: MZ \(b = 0{,}55\) (\(p < 0{,}001\)): prognozele mari sînt urmate de medii realizate mai mici
HAR în nivel este mai slab decît GARCH la QLIKE (0,408 față de 0,360), deoarece după sfîrșiturile de săptămînă calme prognozează o varianță prea mică, iar QLIKE penalizează subestimarea. La MSE, doar EWMA este semnificativ mai slab decît log-HAR la 5%. Valorile MSE pentru Bitcoin și SPY nu sînt comparabile, deoarece MSE crește cu pătratul nivelului varianței, în timp ce QLIKE depinde doar de raport.
Pe scurt
HAR pe niveluri este mai slab decît GARCH după QLIKE (0,408 față de 0,360)
după weekenduri calme prognozează o varianță prea mică
QLIKE penalizează subestimarea
După MSE, doar EWMA este semnificativ mai slab decît log-HAR la 5% (\(p = 0{,}033\))
GARCH: \(p = 0{,}055\)
MSE pentru Bitcoin și pentru SPY nu sînt comparabile
MSE se măsoară în (%\(^2\))\(^2\) = %\(^4\) și crește cu pătratul nivelului varianței
QLIKE depinde doar de \(\RV_t/F_t\) și este comparabilă între piețe
Graficul reprezintă varianța realizată a SPY față de prognozele log-HAR și GARCH în 2022–2026, pe scări logaritmice, cu dreapta de 45 de grade punctată și regresia MZ estimată în nivel cu negru.
Prognozele log-HAR acoperă un interval mai larg și separă mai bine zilele calme de cele agitate. GARCH supraestimează varianța în zilele calme: prognozele lui scad rareori sub \(0{,}26\%^2\) pe zi, în timp ce log-HAR coboară pînă la \(0{,}14\%^2\). Norul de puncte este larg pentru ambele modele, deoarece varianța unei zile este greu de prognozat, iar RV este ea însăși măsurată cu eroare.
Pe scurt
SPY, 2022–2026: varianța realizată față de prognoză (scări log)
linie întreruptă: dreapta de 45 de grade
negru: regresia estimată pe niveluri
Prognozele log-HAR acoperă un interval mai larg
separă mai bine zilele calme de cele agitate
În zilele calme GARCH supraestimează varianța
prognozele GARCH coboară rar sub \(0{,}26\%^2\) pe zi (1% din zile)
log-HAR coboară pînă la \(0{,}14\%^2\)
Punctele sînt puternic dispersate în ambele grafice
O valoare \(p\) MCS este un maxim cumulat al valorilor \(p\) de la fiecare pas, deci crește de-a lungul ordinii de eliminare. HAR, cu QLIKE 0,326, este eliminat înaintea GARCH, cu 0,343, deoarece fiecare pas elimină modelul cu cea mai mare diferență standardizată de pierdere: SHAR și HAR au pierderi care se mișcă împreună, iar diferența dintre ele este foarte stabilă (DM \(t = -3{,}39\)), în timp ce diferențele GARCH sînt mai zgomotoase.
Pe scurt
O valoare p MCS este un maxim cumulat
dacă un model este eliminat la pasul \(k\), valoarea p MCS a modelului este \(\max_{j \le k} p_j\)
\(p_j\) este valoarea p a testului de egalitate de la pasul \(j\)
de aceea valorile p MCS cresc în ordinea eliminării, pe care tabelul o citește din ele
valorile egale (GARCH, HARQ) înseamnă că valoarea p proprie al pasului ulterior nu a fost mai mare, deci ordinea lor relativă nu reiese din tabel
un model rămîne în mulțimea de 90% dacă valoarea p MCS a modelului depășește 0,10
De ce este HAR (QLIKE \(0{,}326\)) eliminat înaintea GARCH (\(0{,}343\))?
fiecare pas elimină modelul cu cea mai mare diferență de pierdere standardizată față de ceilalți supraviețuitori
nu modelul cu cea mai mare pierdere medie
SHAR diferă de HAR doar prin termenul zilnic, deci pierderile lor se mișcă împreună, iar diferența este foarte stabilă: DM SHAR față de HAR \(t = -3{,}39\), \(p < 0{,}001\)
GARCH pierde mai mult în medie, dar diferențele lui sînt mai zgomotoase: față de log-HAR \(t = -2{,}30\), mai mic în valoare absolută decît diferența care separă HAR de SHAR (ca în verificarea de pe slide-ul Diebold–Mariano)
tabelul DM compară fiecare model doar cu log-HAR, deci nu arată perechea HAR–SHAR, motivul probabil al eliminării timpurii a HAR
Modelele lui Christensen, Siggaard & Veliyev (2023) sînt folosite cu un reglaj minim: familia HAR estimată prin OLS și regresii penalizate, ansambluri de arbori și rețele neuronale. Evaluarea folosește MSE out-of-sample raportată la cea a HAR, pe acțiuni și apoi în medie, cu teste DM pe fiecare acțiune și MCS la 90%.
Pe scurt
Modele, cu reglaj minim
familia HAR prin OLS și regresii penalizate
ansambluri de arbori (bagging, random forest, boosting) și rețele neuronale
Graficul ordonează cele 21 de modele după MSE raportată la HAR, la orizontul de o lună, cu toți cei 12 predictori, în medie pe cele 29 de acțiuni DJIA.
Ansamblurile de arbori conduc, cu random forest la 0,604 și bagging la 0,621. Toate cele opt rețele întrec HAR, între 0,786 și 0,964, dar adîncimea nu ajută, iar regresiile penalizate și extensiile liniare ale HAR pierd în fața HAR, între 1,107 și 1,569. Fiecare bară mediază rapoarte pe acțiuni și nu este un test de semnificație al clasamentului.
Anexa conține teoria asimptotică a varianței realizate, derivarea deplasării din zgomot și a frecvenței optime, tratarea sezonalității în testul de salturi, ratele de convergență ale estimatorilor robuști la zgomot, pre-averaging, covarianța realizată, localizarea intraday a salturilor, estimatorii robuști la salturi, testul Wald al restricțiilor HAR, eroarea de măsurare și HARQ, semivarianțele și modelele comune pentru randamente și RV, detaliile studiului de caz despre învățarea automată și prompturile buclei descoperirii.
Într-o semimartingală Itô, drift-ul și volatilitatea sînt adaptate, volatilitatea poate sări și poate depinde de \(W\), iar fără salturi ale prețului \(\sqrt{M}(\mathrm{RV}_t - \mathrm{IV}_t)\) converge la o distribuție Normală mixtă cu varianța aleatoare \(2\,\mathrm{IQ}_t\)(Barndorff-Nielsen & Shephard, 2002). Deoarece convergența este stabilă (Mykland & Zhang, 2009), standardizarea prin cvarticitatea realizată dă o limită Normală standard, iar versiunea pentru \(\ln \mathrm{RV}_t\) are o acoperire mai bună în eșantioane finite (Barndorff-Nielsen & Shephard, 2005).
\(\mu\), \(\sigma\) adaptate (cunoscute din trecut în fiecare moment)
\(\sigma\) càdlàg (continuă la dreapta, cu limite la stînga, deci poate avea salturi)
\(\sigma\) poate depinde de \(W\) (efect de levier)
Fără salturi: \(\sqrt{M}(\RV_t - \IV_t) \xrightarrow{\mathcal{L}\text{-}s} \text{MN}(0, 2\,\text{IQ}_t)\), o distribuție Normală mixtă: varianța ei, \(2\,\text{IQ}_t\), este ea însăși aleatoare Barndorff-Nielsen & Shephard (2002)
\(\text{IQ}_t = \int \sigma^4(s)\,ds\) este cvarticitatea integrată
convergența are loc împreună cu orice variabilă aleatoare măsurabilă în raport cu \(\sigma\)-algebra traiectoriei
De aceea \((\RV_t - \IV_t)/\sqrt{2\,\text{RQ}_t/M} \to N(0,1)\): studentizarea cu \(\sqrt{2\,\text{RQ}_t/M}\), unde \(\text{RQ}_t \to \text{IQ}_t\) este aleatoare, este legitimă doar sub convergența stabilă
În eșantioane finite: statistica \(t\) pentru \(\ln \RV_t\) are acoperire mai bună decît cea pe niveluri Barndorff-Nielsen & Shephard (2005)
Cu zgomot i.i.d. independent de prețul eficient, media condiționată a RV este \(\mathrm{IV} + 2n\omega^2\), iar RV pe toate tick-urile împărțită la \(2n\) estimează \(\omega^2\), nu IV. Derivarea MSE \(2\,\mathrm{IQ}/n + 4n^2\omega^4\) în raport cu \(n\) dă numărul optim de randamente \(n^*\) din (9.8)(Bandi & Russell, 2008).
Pe scurt
Randamentul observat \(r_i = r^*_i + \varepsilon_i - \varepsilon_{i-1}\), cu \(\varepsilon\) i.i.d. \((0, \omega^2)\), independent de \(p^*\)
Dată fiind traiectoria lui \(\sigma\) (drift nul, fără efect de levier: \(\sigma\) independent de \(W\)): \(\E[\RV^{(n)} \mid \sigma] = \sum_i \E[r^{*2}_i \mid \sigma] + \sum_i \E[(\varepsilon_i - \varepsilon_{i-1})^2] = \IV + 2n\omega^2\)
Din legea numerelor mari pentru termenii de zgomot, \(\RV^{(n)}/(2n) \xrightarrow{p} \omega^2\) cînd \(n \to \infty\): RV din toate tranzacțiile estimează zgomotul, nu IV Bandi & Russell (2008)
Sezonalitatea deplasează BV în jos, deoarece produsul volatilităților alăturate este cel mult media pătratelor lor, astfel că schimbările rapide de scară la deschidere și la închidere împing în sus \(\mathrm{RV} - \mathrm{BV}\), iar testul de tip raport respinge prea des. Factorul de periodicitate al lui Boudt, Croux & Laurent (2011) este 1,78 la deschidere, 0,73 la minim și 1,52 la închidere pentru SPY, iar după împărțirea randamentelor la el rămîn 21 de respingeri SPY la pragul de 0,1%.
Cu zgomot i.i.d., rata optimă de convergență este \(n^{-1/4}\), jumătate din exponentul obișnuit. RV pe mai multe scări, nucleul realizat flat-top și pre-averaging o ating, RV pe două scări converge cu \(n^{-1/6}\), iar nucleul Parzen cu \(n^{-1/5}\), în timp ce RV rară își păstrează deplasarea. Cu 23 400 de secunde pe zi, \(n^{1/4} \approx 12{,}4\), față de \(\sqrt{78} \approx 8{,}8\), o euristică compatibilă cu cîștigurile modeste găsite de Liu, Patton & Sheppard (2015).
Pre-averaging (Jacod, Li, Mykland, Podolskij & Vetter, 2009) înlocuiește randamentele cu medii locale ponderate a circa \(\theta\sqrt{n}\) randamente, care micșorează varianța zgomotului păstrînd semnalul, și corectează deplasarea rămasă din zgomot cu un multiplu al RV.
Estimatorul converge cu rata optimă \(n^{-1/4}\), iar același procedeu dă estimatori robuști la salturi și estimatori de covarianță. Este construit pentru date tick; pe bare de 5 minute rămîne puțin zgomot de mediat.
Pe scurt
Rata \(n^{-1/4}\)
același procedeu dă estimatori robuști la salturi (bipower cu pre-averaging) și estimatori de covarianță
Construită pentru date tick cu tick
pe bare de 5 minute rămîne puțin zgomot de mediat (graficul de semnătură empiric, secțiunea Zgomotul de microstructură)
Covarianța realizată cere ambele prețuri pe aceeași grilă; cu tranzacții asincrone, corelația măsurată scade spre zero la eșantionarea fină, efectul lui Epps (1979). Estimatorul lui Hayashi & Yoshida (2005) însumează produsele tuturor perechilor de randamente ale căror intervale se suprapun și este nedeplasat fără sincronizare, în absența zgomotului.
Pe scurt
Covarianța realizată \(\sum_i r^{(1)}_{t,i} r^{(2)}_{t,i} \to \int \sigma_{12}(s)\,ds\) cere prețurile ambelor active pe aceeași grilă
\(r^{(1)}, r^{(2)}\): randamentele activelor 1 și 2, \(\sigma_{12}(s)\): covarianța lor instantanee
Efectul Epps Epps (1979): corelația măsurată scade spre 0 cînd eșantionarea devine mai deasă, deoarece tranzacțiile sînt asincrone, iar ultimul preț este neactualizat
Hayashi & Yoshida (2005): însumăm produsele tuturor perechilor de randamente ale căror intervale de timp se suprapun
\(\sum_{i,j} r^{(1)}_i r^{(2)}_j\,\mathbf{1}\{(t_{i-1}, t_i] \cap (s_{j-1}, s_j] \neq \emptyset\}\): \((t_{i-1}, t_i]\), \((s_{j-1}, s_j]\): intervalele dintre tranzacțiile consecutive ale fiecărui activ
Estimatorul este nedeplasat fără sincronizare (în absența zgomotului)
Cu zgomot în plus: versiuni cu pre-averaging sau nuclee multivariate
aplicație: riscul intraday al portofoliilor (Capitolul 4)
Testul lui Lee & Mykland (2008) împarte fiecare randament la o estimare bipower locală a volatilității și compară cel mai mare raport în valoare absolută cu o limită Gumbel. Pentru SPY, cu randamentele împărțite la factorul de periodicitate, \(\alpha = 1\%\) și 115 441 de randamente, pragul este \(|L| > 5{,}41\).
\(\hat\sigma^2_{t,i}\): media bipower a celor \(K = 270\) de randamente anterioare (valoarea lor pentru date de 5 minute)
Fără salturi, \(\max_i |L_i|\) pe \(n\) randamente are o limită Gumbel: respingem dacă \((|L| - C_n)/S_n > -\ln(-\ln(1 - \alpha))\)
\(C_n = \sqrt{2\ln n} - \frac{\ln\pi + \ln\ln n}{2\sqrt{2\ln n}}\) și \(S_n = 1/\sqrt{2\ln n}\): constantele de centrare și de scalare ale limitei Gumbel
\(\hat\sigma^2\) al nostru include factorul \(\pi/2\), deci constanta \(c = \sqrt{2/\pi}\) din Lee & Mykland (2008) devine 1
Testul găsește 169 de salturi în 105 zile, 62 dintre ele miercurea între 14:00 și 15:00, cînd sînt publicate comunicatele și conferințele de presă ale Comitetului Federal pentru Piața Deschisă (FOMC, Federal Open Market Committee). Doar 10% dintre aceste zile sînt semnalate și de testul zilnic de tip raport, deoarece cele două teste pun întrebări diferite: un randament extrem față de volatilitatea locală sau o diferență zilnică între RV și BV.
Pe scurt
Testul găsește 169 de randamente de 5 minute cu salt (nu zile) în 105 zile, dintre care 62 miercurea între 14:00 și 15:00
atunci se publică comunicatele FOMC (Federal Open Market Committee, comitetul de politică monetară al Fed) (14:00) și au loc conferințele de presă (14:30)
Cel mai mare salt: \(L = -22{,}9\), pe 2025-10-29
Doar 10% din aceste zile sînt semnalate și de testul zilnic al raportului
Cele două teste pun întrebări diferite
Lee–Mykland: un randament extrem față de volatilitatea locală
testul raportului: un decalaj zilnic între RV și BV
RV trunchiată (Mancini, 2009) păstrează doar randamentele la pătrat aflate sub un prag care scade cu lungimea intervalului mai lent decît incrementele difuzive, astfel că randamentele difuzive sînt păstrate, iar salturile sînt eliminate.
Păstrăm doar randamentele la pătrat sub un prag: \(c\): un multiplu, \(\hat\sigma_t\): o volatilitate zilnică robustă la salturi, \(f_i\): factorul de periodicitate, \(\varpi\): exponentul lungimii intervalului \(\Delta\)
Incrementele difuzive sînt \(O_p(\Delta^{1/2})\) (de ordinul \(\sqrt{\Delta}\)) și ajung sub prag; salturile sînt \(O(1)\) și sînt eliminate
MedRV (Andersen, Dobrev & Schaumburg, 2012) folosește mediana a trei randamente absolute alăturate, astfel că un salt izolat nu intră niciodată în mediană. Două salturi alăturate pot intra totuși în ea.
\(\mathrm{med}\): mediana a trei randamente absolute consecutive; prima fracție face MedRV consistent pentru IV
Un randament izolat mai mare în valoare absolută decît ambii vecini nu intră în mediană (care trece la un vecin), deci un salt izolat mare este exclus, deși efectul lui nu dispare exact în eșantioane finite
MedRV este mai puțin sensibil decît BV la randamente nule izolate
Două salturi alăturate pot intra totuși în mediană
Însumată pe toate zilele SPY, fără test, ponderea salturilor în RV este 6,3% cu BV, 7,2% cu MedRV și 12,5% cu RV trunchiată, față de 2,8% doar pe zilele cu salt semnificativ. Aït-Sahalia & Jacod (2009) compară variațiile de putere la două frecvențe pentru a testa prezența salturilor.
Pe scurt
Ponderea părții de salt în RV pentru SPY, însumată pe toate zilele, fără test
partea de salt: RV minus estimatorul robust
6,3% cu BV, 7,2% cu MedRV și 12,5% cu TRV (Truncated Realised Variance, varianța realizată trunchiată)
pe zilele cu salt semnificativ: 2,8%
Pentru TRV, cu \(c = 3\) și \(\varpi = 0{,}49\), trunchierea acționează în 44% din zile
\(c\) este o alegere de reglaj
Aït-Sahalia & Jacod (2009): comparăm variațiile de putere \(\sum|r|^p\), \(p > 2\), la \(\Delta\) și \(k\Delta\)
raportul tinde la 1 cu salturi și la \(k^{p/2-1}\) fără
HAR impune 19 restricții de egalitate unui AR(22) pentru \(\ln \mathrm{RV}\). Pe logaritmul varianței totale a SPY, statistica Wald Newey–West este \(W = 18{,}2\), cu \(p = 0{,}51\), iar \(R^2\) este 0,477 pentru AR(22) față de 0,470 pentru HAR: HAR economisește 19 parametri aproape fără cost in-sample.
Dacă \(\mathrm{RV}_t = \mathrm{IV}_t + u_t\), cu varianța condiționată \(2\,\mathrm{IQ}_t/M\), panta OLS a lui \(\mathrm{RV}_{t+1}\) pe \(\mathrm{RV}_t\) este atenuată spre zero. Cînd eroarea de măsurare este mai mare, în zilele cu \(\mathrm{IQ}_t\) mare, raportul semnal–zgomot scade, iar HARQ aproximează ponderea descrescătoare prin \(\beta_d + \beta_Q\sqrt{\mathrm{RQ}_t}\), cu \(\beta_Q < 0\)(Bollerslev, Patton & Quaedvlieg, 2016).
Pe scurt
\(\RV_t = \IV_t + u_t\), cu \(\E[u_t \mid \sigma] = 0\) și \(\mathrm{Var}(u_t \mid \sigma) = 2\,\text{IQ}_t/M\)
CLT din secțiunea Varianța realizată
Dacă \(\IV_{t+1} = \beta_0 + \beta\,\IV_t + \eta_{t+1}\), OLS pentru \(\RV_{t+1}\) pe \(\RV_t\) dă \(\text{plim}\,\hat\beta = \beta\,\dfrac{\mathrm{Var}(\IV)}{\mathrm{Var}(\IV) + \E[2\,\text{IQ}/M]} < \beta\) pentru \(\beta > 0\): atenuare (\(\eta_{t+1}\): șocul asupra IV; plim: limita în probabilitate)
Dacă varianța semnalului nu crește cu \(\text{IQ}_t\), raportul semnal/zgomot al lui \(\RV_t\) scade cînd \(\text{IQ}_t\) este mare
Pe SPY în nivel, \(\hat\beta_Q = -0{,}0088\) (eroarea standard 0,0042) pentru RV intraday și \(-0{,}0022\) (0,0024) pentru varianța totală: semnul prezis de teorie, cu un efect mic. Pentru varianța totală, lăsarea ponderii să scadă cu RQ ridică panta zilnică de bază de la 0,399 în HAR la 0,542 în HARQ, în direcția prezisă de argumentul atenuării, dar în limita unei erori standard.
Pe scurt
SPY, regresie pe niveluri, cu erorile standard Newey–West în paranteze
\(\hat\beta_Q = -0{,}0088\) (\(0{,}0042\)) pentru RV intraday
\(\hat\beta_Q = -0{,}0022\) (\(0{,}0024\)) pentru varianța totală
Panta zilnică (RV intraday) \(1{,}13\) la mediana lui \(\sqrt{\text{RQ}}\), \(1{,}09\) la percentila 99: semnul prezis de teorie, un efect mic
Citim \(\hat\beta_d\) împreună cu celelalte pante
panta zilnică peste 1 (\(1{,}135\)) este parțial compensată de o pantă săptămînală negativă (\(-0{,}120\))
cele trei medii ale RV se suprapun prin construcție (fiecare conține RV de ieri), deci împărțirea între ele este imprecisă (SE pentru \(\hat\beta_d\): \(0{,}494\))
pantele însumează \(1{,}04\) (varianța totală: \(0{,}80\)), deci regresia pe niveluri pentru RV intraday este un diagnostic în eșantion pentru semnul lui \(\beta_Q\), nu un model de prognoză
Comparație pe aceeași țintă, varianța totală: HAR \(\hat\beta_d = 0{,}399\), HARQ \(\hat\beta_d = 0{,}542\)
dacă ponderea poate scădea cu RQ (Realised Quarticity, cvarticitatea realizată), panta zilnică de bază crește, în direcția prezisă de argumentul atenuării
Pe SPY în nivel, SHAR dă \(\hat\beta^- = 0{,}56\) (eroarea standard 0,23) și \(\hat\beta^+ = 0{,}21\) (0,18), deci volatilitatea rea este mai persistentă, ca la Patton & Sheppard (2015), dar testul Wald pentru \(\beta^+ = \beta^-\) are \(p = 0{,}35\): șase ani de date nu separă cele două pante.
Pe scurt
Semivarianțele realizate intră în SHAR Patton & Sheppard (2015): \(\beta_d\RV_t\) devine \(\beta^+\text{RS}^+_t + \beta^-\text{RS}^-_t\)
SPY, ținta varianța totală, regresie pe niveluri (randamentul peste noapte socotit ca încă un randament al zilei): \(\hat\beta^- = 0{,}56\) (\(0{,}23\)), \(\hat\beta^+ = 0{,}21\) (\(0{,}18\)); studiul de caz (ținta RV intraday) dă \(1{,}44\) și \(-0{,}34\)
Testul Wald pentru \(\beta^+ = \beta^-\) dă \(p = 0{,}35\)
Volatilitatea „rea” este mai persistentă, ca în Patton & Sheppard (2015), dar șase ani de date nu separă cele două pante
În comparația MCS, HARQ și SHAR sînt estimate pe niveluri cu filtrul din Bollerslev, Patton & Quaedvlieg (2016): prognozele care ies din intervalul \([\min, \max]\) al valorilor din eșantionul de estimare sînt înlocuite cu media eșantionului
Realized GARCH (Hansen, Huang & Shek, 2012) adaugă o ecuație de măsurare care leagă măsura realizată de varianța condiționată și le estimează pe amîndouă prin cvasi-verosimilitate maximă comună. Modelele HEAVY (Shephard & Sheppard, 2010) folosesc o ecuație de tip GARCH pentru varianța zilnică, condusă de RV întîrziată, și una pentru RV însăși, ceea ce dă prognoze consistente pe mai mulți pași.
Studiul de caz folosește 29 de acțiuni DJIA, fără Visa, între 29 ianuarie 2001 și 31 decembrie 2017, cu RV pe 5 minute din prețurile curățate ale tranzacțiilor NYSE (New York Stock Exchange, Bursa din New York). Eșantionul este împărțit în 70% antrenare (2 964 de zile), 10% validare (424) și 20% test (847), iar cei 9 predictori suplimentari acoperă informație la nivel de firmă, de piață și macroeconomică.
Pe scurt
Date: 29 dintre cele 30 de acțiuni DJIA (fără Visa), 29 ianuarie 2001 – 31 decembrie 2017
\(T = 4\,257\) de zile
RV calculată la 5 minute din prețurile tranzacțiilor de la New York Stock Exchange (NYSE), după filtrarea datelor
\(n = 78\) de randamente pe zi
Împărțire: antrenare 70% (\(2\,964\) de zile), validare 10% (\(424\)), test 20% (\(847\))
\(2\,964 + 424 + 847 = 4\,235\): primele 22 de zile servesc doar mediei lunare a RV
robustețe: antrenare \(1\,000\) sau \(2\,000\) de zile, validare \(200\)
volatilitatea implicită, indicator pentru zilele în care se anunță rezultatele financiare, momentum pe o săptămînă, variația logaritmului volumului tranzacționat în dolari
VIX, randamentul Hang Seng la pătrat, indicele condițiilor de afaceri, variația ratei la 3 luni a titlurilor de stat, indicele incertitudinii politicii economice
Modelele sînt cinci variante HAR estimate prin OLS pe o fereastră rolling, cinci regresii penalizate reglate pe eșantionul de validare, trei ansambluri de arbori și rețele neuronale cu unul pînă la patru straturi ascunse, fiecare estimată o dată sau mediată pe zece estimări. Evaluarea folosește MSE raportată la HAR, în medie pe acțiuni, teste DM unilaterale pe fiecare acțiune (Diebold & Mariano, 1995) și MCS la 90% (Hansen, Lunde & Nason, 2011).
Pe scurt
Modele: HAR, log-HAR, HAR cu efect de levier, SHAR și HARQ
estimate prin OLS pe o fereastră mobilă
Regresii penalizate: ridge, lasso, elastic net, lasso adaptiv și post-lasso
ridge: penalizare \(L_2\); lasso: \(L_1\); elastic net: o combinație
penalizarea este aleasă pe setul de validare
Arbori: bagging, random forest, gradient boosting
random forest cu valorile implicite ale lui Breiman: 500 de arbori, \(P/3\) predictori candidați la fiecare ramificare (\(P\): numărul de predictori), cel puțin 5 observații într-un nod
La o zi, doar cu lagurile RV, rețelele dau cîștigurile cele mai clare, de 1–5%, iar log-HAR abia întrece HAR; cu toți predictorii, elastic net ajunge la 0,916, iar HARQ face overfitting. În MCS la 90% cu toți predictorii, rețelele rămîn în mulțime pentru circa 80% dintre acțiuni, iar HAR pentru circa 20–40%, iar RV zilnică, RV săptămînală și volatilitatea implicită domină importanța variabilelor.
Pe scurt
Prognoze pentru ziua următoare, doar cu valorile întîrziate ale RV
MSE relativ la HAR: log-HAR \(0{,}995\), HARQ \(1{,}059\), random forest \(1{,}020\), rețele neuronale \(0{,}954\)–\(0{,}990\)
RV trecută conține puțină informație suplimentară
rețelele aduc cele mai clare cîștiguri (1–5%), log-HAR este superior HAR la limită
Prognoze pentru ziua următoare, cu toți cei 12 predictori: elastic net \(0{,}916\)
celelalte modele apar în graficul pe orizonturi al studiului de caz
Predictorii suplimentari aduc cel mai mult cu penalizare, neliniaritate sau transformarea logaritmică
HARQ supraajustează datele (overfitting)
MCS la 90%, cu toți predictorii
rețelele rămîn în mulțime pentru aproximativ 80% din acțiuni
HAR rămîne pentru aproximativ 20–40% din acțiuni
Importanța variabilelor, măsurată prin efectele locale acumulate: RV zilnică, RV săptămînală și volatilitatea implicită domină în toate cele patru modele prezentate
Random forest și rețelele atribuie volatilității implicite o importanță mai mare decît OLS cu toți predictorii și elastic net
O replicare pe datele cursului ar folosi RV pe 5 minute a SPY de la deschidere la închidere, împărțirea de robustețe a autorilor, cu 1 000 de zile de antrenare și 200 de validare, și VIX ca proxy pentru volatilitatea implicită a SPY, cu ceilalți predictori din FRED (Federal Reserve Economic Data) și fără variabila dummy pentru rezultatele financiare, care nu există pentru un fond.
Pe scurt
Replicare pe datele cursului: barele SPY de 5 minute
RV de la deschidere la închidere cu 78 de randamente pe zi
autorii raportează că SPY confirmă rezultatele pe acțiuni
Împărțirea de robustețe a autorilor: 1 000 de zile de antrenare, 200 de zile de validare, restul pînă la 18 septembrie 2026 ca set de test
Predictori: VIX (calculat din opțiunile pe indicele S&P 500; aproximează volatilitatea implicită a SPY, care ar cere opțiuni pe SPY), randamentul Hang Seng la pătrat, momentum și volum în dolari pentru SPY, rata titlurilor de stat și incertitudinea politicii economice (Federal Reserve Economic Data, FRED)
fără indicator de rezultate financiare pentru un fond
Extindere: lucrarea compară prognozele de varianță doar prin MSE
se păstrează avantajul ML la evaluarea prin QLIKE, robustă la eroarea de măsurare din RV Patton (2011)?
Autorii arată că reglajul este minim, că rețelele nu sînt reestimate în fereastra de test și că clasamentele depind de împărțirea eșantionului. Lucrarea ordonează prognozele doar după MSE; dacă avantajul ML rezistă la QLIKE, care este robustă la proxy-ul zgomotos (Patton, 2011), și dacă se menține pentru Bitcoin sînt extinderi deschise.
Pe scurt
Limite precizate de autori
Reglarea mai atentă a hiperparametrilor ar putea îmbunătăți rezultatele modelelor ML
Rețelele sînt antrenate o singură dată și nu sînt reestimate în fereastra de test
Clasamentele depind de împărțire: cu 1 000 de zile de antrenare criza financiară intră în setul de test, iar extensiile HAR sînt superioare HAR
Modelele HAR cu o componentă de salt separată nu sînt incluse
Efectele locale acumulate descriu comportamentul mediu al predicțiilor și pot omite efectele evenimentelor rare, precum anunțarea rezultatelor financiare
1. Literatura: sintetizăm rezultatele într-un tabel
apoi verificăm fiecare DOI pe Crossref (titlul trebuie să coincidă)
Tabelează estimările lui H publicate din 2018: estimatorul, frecvența de eșantionare, tratamentul erorii de măsurare din RV, estimarea punctuală și eroarea standard, DOI.
2. Ipoteze concurente, fiecare cu forma implicată a lui \(m(2,\Delta)\)
Derivează m(2, Delta) pentru trei procese care dau H în jur de 0,1 cu estimatorul de scalare: log-volatilitate fracționară cu H = 0,1; H = 0,5 plus eroare i.i.d.; un model cu doi factori, unul cu revenire rapidă la medie.
3. Date și cod: replicăm întîi cifra din capitol
Scrie cod Python care construiește varianța zilnică totală din barele SPY de 5 minute ale cursului (RV la 5 minute plus pătratul randamentului peste noapte, de la închiderea precedentă la deschidere), calculează m(q, Delta) pentru q în {0,5; 1; 1,5; 2; 3}, Delta = 1..30, și panta H. Ținta: \(\hat H = 0{,}11\)
Ultimele prompturi scriu un plan de robustețe preînregistrat, cu ferestrele de laguri, măsurile volatilității, ajustarea cu o constantă \(k\), intervale block bootstrap și o verificare a puterii, și cer cel mai puternic contraargument: ce structuri de eroare non-i.i.d. în log RV ar rezista corecției cu \(k\) constant.
Pe scurt
4. Robustețe, pre-înregistrată, cu o verificare a puterii
Scrie un plan pre-înregistrat: ferestre de laguri [1,30], [5,30], [10,50]; RV, variația bipower și RV subeșantionată la 30 de minute; ajustarea m(2, Delta) = c Deltâ(2H) + k; intervale bootstrap pe blocuri; mărimea și puterea prin simulare la H = 0,1 și 0,5.
5. Critica: cerem cel mai puternic contraargument
Joacă rolul unui referent: ce structuri de eroare non-i.i.d. în log RV (autocorelate, dependente de nivel, provenite din randamentele peste noapte sau din salturi) nu ar fi eliminate de corecția cu k constant și cum ai detecta fiecare?
6. Raportul: toate ferestrele și măsurile, intervalele bootstrap, designul simulării, codul și jurnalul AI
Informația intraday poate intra în prognozele de risc pentru Bitcoin; entropia randamentelor de înaltă frecvență a fost propusă ca un astfel de semnal Pele & Mazurencu-Marinescu-Pele (2019)
Cripto-activele formează o clasă de active distinctă după caracteristicile distribuțiilor randamentelor Pele et al. (2023)
SPY: bare de 5 minute din sesiunea regulată din SUA (09:30–16:00, ora New York), octombrie 2020 – septembrie 2026, și randamente zilnice ajustate; Bitcoin: bare de 5 minute pe zile UTC complete, septembrie 2024 – septembrie 2026; indicele VIX. Prețuri EODHD. Primul studiu de caz: tabelele 2–7 din Christensen, Siggaard și Veliyev (2023); al doilea studiu de caz: barele de 5 minute SPY și Bitcoin ale cursului.


 Torben G. Andersen.
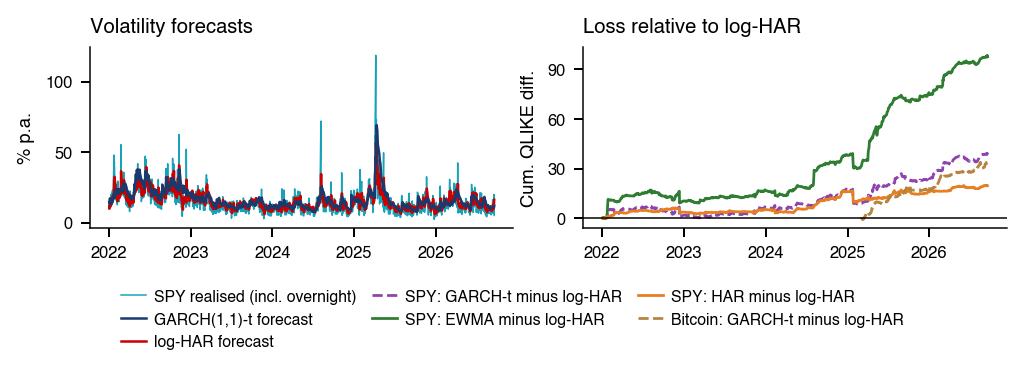
 MFM_ch9_intraday_day
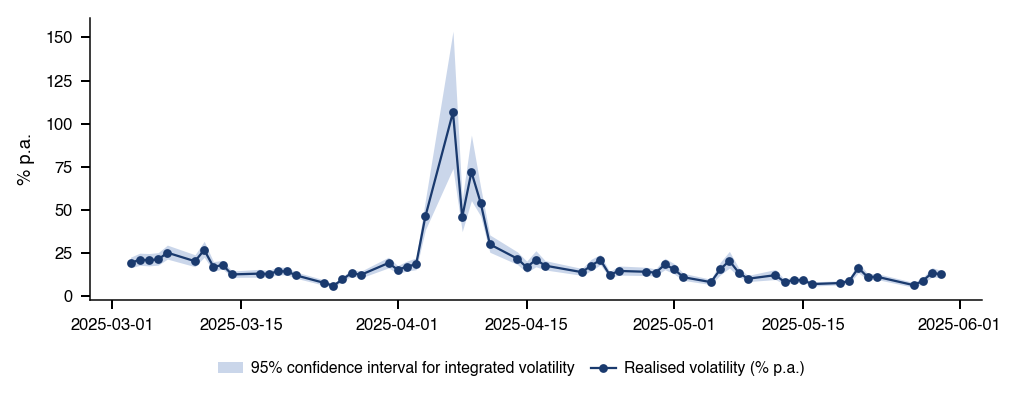
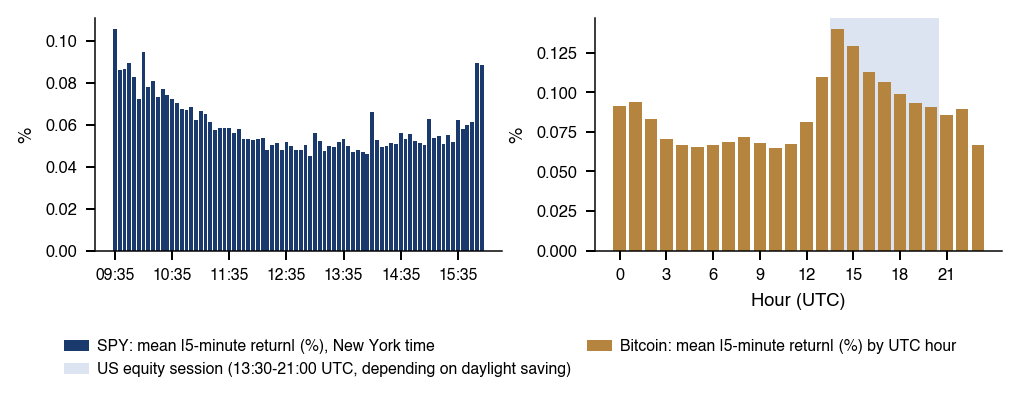
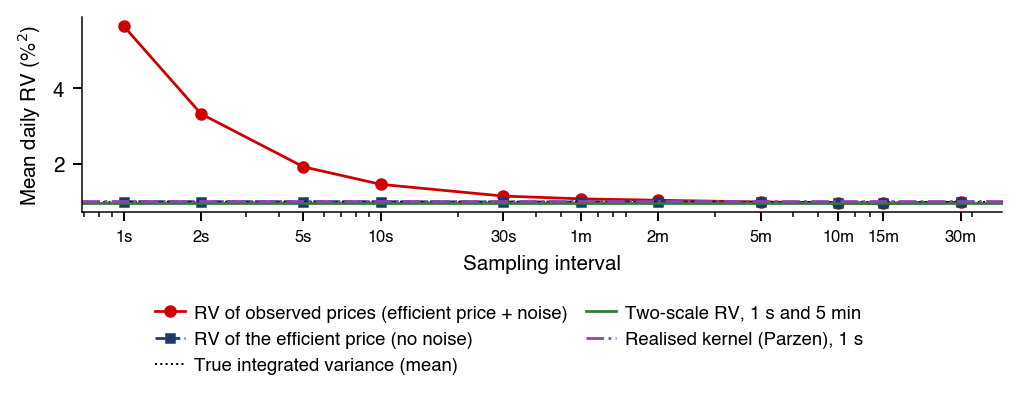
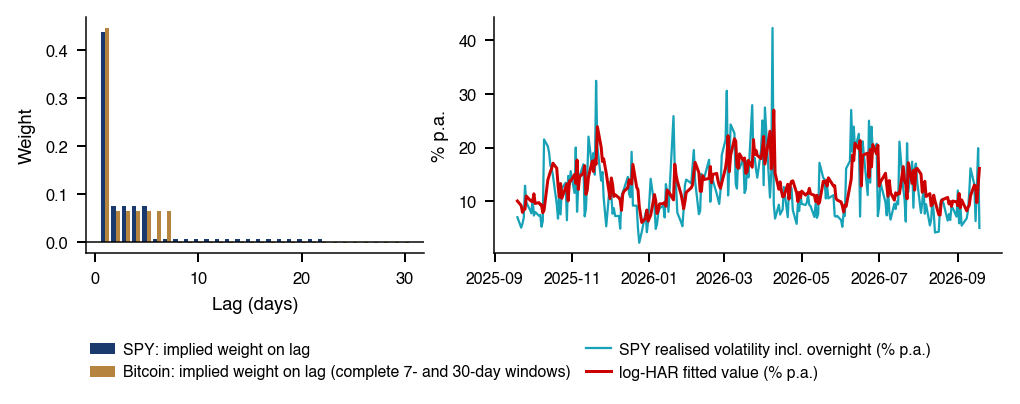
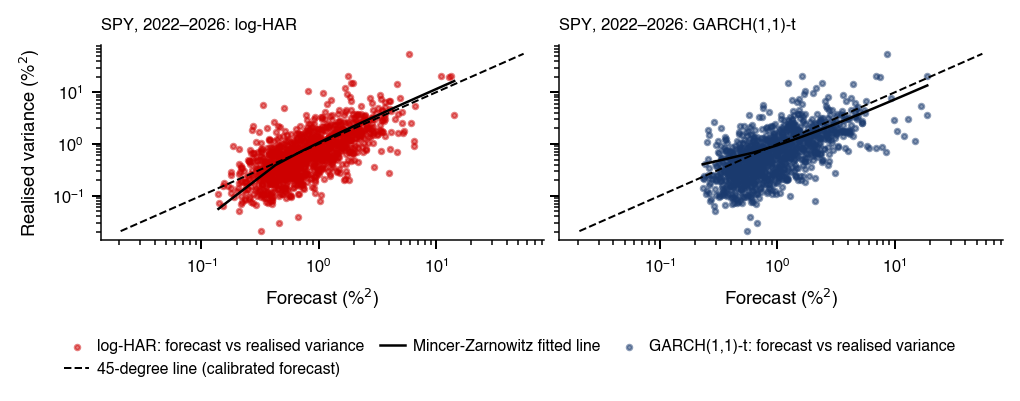
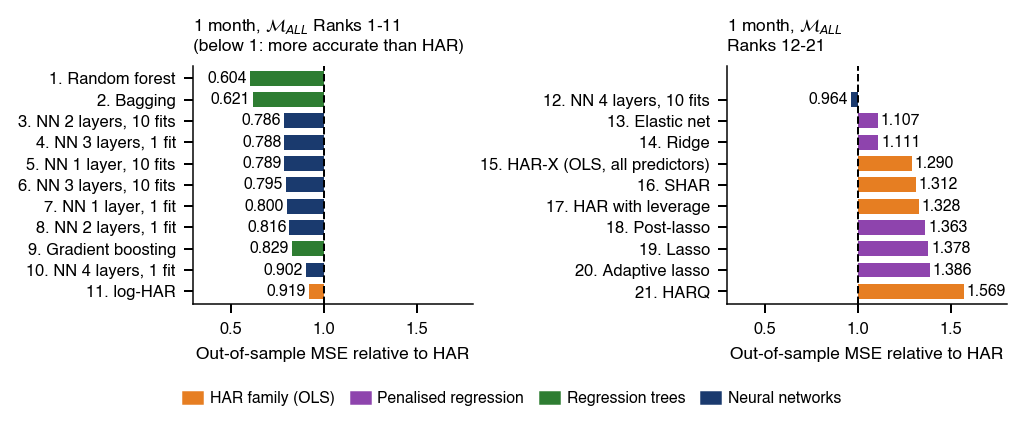
 Nonparametric and Semiparametric Models