Serii de timp

Capitolul 15: Recapitulare și pregătire pentru examen

Capitolul 15: Recapitulare și pregătire pentru examen

Daniel Traian PELE

Academia de Studii Economice din București
IDA Institute Digital Assets
Blockchain Research Center
AI4EFin Artificial Intelligence for Energy Finance
Academia Română, Institutul de Prognoză Economică
MSCA Digital Finance

Acronime folosite în acest material (1/4)

Slide 1 în PDF
  • ACF: Autocorrelation Function (funcția de autocorelație)
  • ADF: Augmented Dickey–Fuller (test) — testul Dickey–Fuller augmentat
  • AI: Artificial Intelligence (inteligență artificială)
  • AIC: Akaike Information Criterion (criteriul informațional Akaike)
  • AR: AutoRegressive (model) — model autoregresiv
  • ARCH: AutoRegressive Conditional Heteroskedasticity (heteroscedasticitate condiționată autoregresivă)
  • ARCH-LM: ARCH Lagrange Multiplier (test) — testul multiplicatorului Lagrange pentru efecte ARCH
  • ARFIMA: AutoRegressive Fractionally Integrated Moving Average (model) — model autoregresiv fracționar integrat cu medie mobilă
  • ARIMA: AutoRegressive Integrated Moving Average (model) — model autoregresiv integrat cu medie mobilă
  • ARMA: AutoRegressive Moving Average (model) — model autoregresiv cu medie mobilă
  • ASE: Academia de Studii Economice din București
  • BEKK: Baba–Engle–Kraft–Kroner (multivariate GARCH model) — modelul GARCH multivariat Baba–Engle–Kraft–Kroner
  • BET: Bucharest Exchange Trading (index) — indicele de referință al Bursei de Valori București
  • BIC: Bayesian Information Criterion (criteriul informațional bayesian al lui Schwarz)
  • BNR: Banca Națională a României
  • BVB: Bursa de Valori București
  • CCC: Constant Conditional Correlation (model) — model cu corelație condiționată constantă
  • DCC: Dynamic Conditional Correlation (corelație condiționată dinamică)

Acronime folosite în acest material (2/4)

Slide 2 în PDF
  • DHR: Dynamic Harmonic Regression (regresie armonică dinamică)
  • DLOG: Difference of the LOGarithm (EViews function) — diferența logaritmului (funcție EViews); DLOG(X,1,12) \(= \Delta\Delta_{12}\ln X\)
  • DM: Diebold–Mariano (test) — testul Diebold–Mariano de comparare a prognozelor
  • EC1: Error Correction term 1 (primul termen de corecție a erorii)
  • EC2: Error Correction term 2 (al doilea termen de corecție a erorii)
  • ECM: Error Correction Model (model cu corecția erorii)
  • ENTSO-E: European Network of Transmission System Operators for Electricity (rețeaua europeană a operatorilor de transport și de sistem pentru energie electrică)
  • EODHD: EOD Historical Data (market-data provider) — furnizor de date de piață
  • FEVD: Forecast Error Variance Decomposition (descompunerea varianței erorii de prognoză)
  • FRED: Federal Reserve Economic Data (baza de date economice a Rezervei Federale din St. Louis)
  • GARCH: Generalised AutoRegressive Conditional Heteroskedasticity (heteroscedasticitate condiționată autoregresivă generalizată)
  • GJR: Glosten–Jagannathan–Runkle (GARCH model) — modelul GARCH asimetric Glosten–Jagannathan–Runkle
  • GPH: Geweke–Porter-Hudak (estimator) — estimatorul Geweke–Porter-Hudak al parametrului de memorie lungă
  • HEGY: Hylleberg–Engle–Granger–Yoo (seasonal unit-root test) — testul Hylleberg–Engle–Granger–Yoo de rădăcină unitară sezonieră

Acronime folosite în acest material (3/4)

Slide 3 în PDF
  • HICP: Harmonised Index of Consumer Prices (indicele armonizat al prețurilor de consum)
  • HLN: Harvey–Leybourne–Newbold (small-sample correction of the DM test) — corecția Harvey–Leybourne–Newbold a testului DM pentru eșantioane mici
  • HP: Hodrick–Prescott (filter) — filtrul Hodrick–Prescott
  • IAPC: Indicele armonizat al prețurilor de consum
  • IPC: Indicele prețurilor de consum
  • IRF: Impulse Response Function (funcția de răspuns la impuls)
  • KPSS: Kwiatkowski–Phillips–Schmidt–Shin (test) — testul de staționaritate Kwiatkowski–Phillips–Schmidt–Shin
  • LB: Ljung–Box (test) — testul de autocorelație Ljung–Box
  • LPPL: Log-Periodic Power Law (legea de putere log-periodică)
  • LPPLS: Log-Periodic Power Law Singularity (model) — modelul singularității cu lege de putere log-periodică
  • LSTM: Long Short-Term Memory (network) — rețea cu memorie pe termen lung și scurt
  • MA: Moving Average (medie mobilă)
  • MAE: Mean Absolute Error (eroarea absolută medie)
  • MAPE: Mean Absolute Percentage Error (eroarea procentuală absolută medie)
  • MASE: Mean Absolute Scaled Error (eroarea absolută medie scalată)
  • NBER: National Bureau of Economic Research (biroul național de cercetare economică al SUA, care datează recesiunile)

Acronime folosite în acest material (4/4)

Slide 4 în PDF
  • OCSB: Osborn–Chui–Smith–Birchenhall (seasonal unit-root test) — testul Osborn–Chui–Smith–Birchenhall de rădăcină unitară sezonieră
  • OLS: Ordinary Least Squares (metoda celor mai mici pătrate)
  • PACF: Partial AutoCorrelation Function (funcția de autocorelație parțială)
  • PIB: Produsul intern brut
  • PPP: Purchasing Power Parity (paritatea puterii de cumpărare)
  • QQ: Quantile–Quantile (plot) — graficul cuantilă–cuantilă
  • RMSE: Root Mean Squared Error (rădăcina erorii pătratice medii)
  • ROBOR: Romanian Interbank Offer Rate (rata dobînzii la care băncile din România oferă depozite interbancare)
  • SAR: Seasonal AutoRegressive term (EViews) — termen autoregresiv sezonier (EViews)
  • SARIMA: Seasonal ARIMA (model) — model ARIMA sezonier
  • SE: Standard Error (eroare standard)
  • SES: Simple Exponential Smoothing (netezire exponențială simplă)
  • SIGMASQ: SIGMA SQuared, the innovation variance (EViews) — varianța inovațiilor (EViews)
  • SUA: Statele Unite ale Americii
  • TVA: Taxa pe valoarea adăugată
  • VAR: Vector AutoRegression (model vector autoregresiv)
  • VEC: Vector (half-vectorised) GARCH model (modelul GARCH vectorial, scris pe semivectorizarea vech)
  • VECM: Vector Error Correction Model (model vectorial cu corecția erorii)

Întrebarea de azi și traseul

Slide 5 în PDF

Întrebarea capitolului este ce spune întregul curs despre o serie de timp. Răspunsul nu este o listă de modele, ci o succesiune de întrebări: cum arată seria, este staționară, ce dependență are de propriul trecut, are sezonalitate, se schimbă varianța ei, se mișcă împreună cu alte serii și cît de bine poate fi prognozată. Fiecare capitol al cursului răspunde la una dintre aceste întrebări, iar recapitularea le pune în ordinea în care apar într-o analiză reală.

Traseul are trei părți. Prima trece prin harta cursului, prin cîte două slide-uri pentru fiecare capitol și prin sinteza testelor și a modelelor. A doua parcurge metoda Box–Jenkins pe inflația din România, pas cu pas. A treia descrie proiectul de echipă. Capitolele 11–14 sînt pentru studiu individual și apar în recapitulare doar prin ideile principale și prin legătura lor cu nucleul cursului.

Pe scurt

  • Întrebarea: ce spune întregul curs despre o serie de timp și cum se evaluează aceste cunoștințe la examen?
  • Traseul
    • Partea I: harta cursului, cîte două slide-uri de recapitulare pentru fiecare capitol, o sinteză a testelor și a modelelor
    • Partea a II-a: metoda Box–Jenkins de la un capăt la altul, pe inflația din România
    • Partea a III-a: examenul (format, criterii, opt probleme rezolvate), proiectul de echipă, prezența și quiz-urile
  • Capitolele 11–14 sînt pentru studiu individual
Întrebarea de azi și traseul Academia de Studii Economice din București Foto: Joe Mabel (2014); CC BY 3.0; Wikimedia Commons

Rezultatele învățării

Slide 6 în PDF

Primele trei rezultate privesc cursul ca întreg. Situarea unui capitol pe drumul de la descriere la prognoză înseamnă a ști ce întrebare a rămas deschisă la capitolul anterior și ce instrument nou o rezolvă: de exemplu, testele de rădăcină unitară din Capitolul 3 există pentru că modelele ARMA din Capitolul 2 presupun o serie staționară. Pentru fiecare capitol merită reținute trei lucruri: formula-cheie, faptul empiric principal din datele cursului și greșeala care apare cel mai des în aplicații.

Celelalte rezultate sînt practice. Metoda Box–Jenkins leagă într-o singură analiză transformarea, testele, identificarea, estimarea, verificarea și prognoza. Citirea rezultatelor obținute cu un program, estimări, teste și corelograme, cere de fiecare dată aceeași structură: ce ipoteză este testată, ce arată statistica și ce înseamnă decizia pentru serie, în trei pînă la cinci fraze. Ultimul rezultat privește proiectul de echipă, susținerea lui orală și declararea folosirii instrumentelor de inteligență artificială (artificial intelligence, AI).

Pe scurt

  • Situați fiecare capitol pe drumul de la descrierea unei serii la modelarea și prognoza ei
  • Reamintiți formula-cheie, faptul empiric principal și greșeala cea mai frecventă din fiecare capitol
  • Alegeți testul sau modelul potrivit pentru o întrebare dată despre o serie de timp
  • Aplicați metoda Box–Jenkins pe o serie reală: transformare, testare, identificare, estimare, verificare, prognoză
  • Citiți rezultatele obținute cu software (estimări, teste, corelograme) și interpretați-le în trei pînă la cinci fraze
  • Planificați proiectul de echipă, susținerea orală și declararea utilizării AI

Bibliografie și instrumente

Slide 7 în PDF

Manualul cursului este Huang și Petukhina (2022), care tratează metodele în Python; Hyndman și Athanasopoulos (2021) este un manual însoțitor gratuit, centrat pe prognoză. Pentru teorie, Brockwell și Davis (2016) și Hamilton (1994) dau demonstrațiile și proprietățile asimptotice ale estimatorilor, iar Box, Jenkins și Reinsel (2008) este sursa metodei aplicate în a doua parte a capitolului.

Quantlet-urile capitolului conțin codul cazului Box–Jenkins pe IAPC: fiecare tabel și fiecare grafic al secțiunii respective poate fi refăcut din date. Notebook-ul cursului adună tot cursul într-un singur fișier care rulează în Google Colab. Quiz-ul capitolului are 20 de întrebări extrase din toate capitolele și este util pentru a vedea ce idei trebuie recitite.

Pe scurt

Cincisprezece capitole au tratat o serie de timp din unghiuri diferite: componentele ei, staționaritatea, dependența de propriul trecut, rădăcinile unitare, sezonalitatea, varianța care se schimbă în timp, legăturile cu alte serii, memoria lungă, metodele de învățare automată și stările ascunse. Fiecare capitol a adus propriile formule, propriile teste și propriile capcane. Întrebarea acestui capitol este ce rămîne din toate acestea cînd o serie reală trebuie analizată de la un capăt la altul: ce întrebare se pune întîi, ce instrument răspunde la ea și cum se citește rezultatul.

Capitolul are două părți. Prima recapitulează cursul: o hartă a capitolelor, cîte două slide-uri pentru fiecare capitol, cu formulele-cheie, faptele empirice principale și greșelile cele mai frecvente, apoi o sinteză a testelor și a modelelor care leagă fiecare întrebare despre o serie de testul sau de modelul potrivit. A doua parte aplică metoda Box–Jenkins, în șase pași, pe indicele armonizat al prețurilor de consum (IAPC) al României, din ianuarie 2005 pînă în august 2026: transformare, teste, identificare, estimare, verificarea reziduurilor și prognoză.

Exemplul arată de ce pașii nu pot fi săriți. Modelul sugerat de corelogramă nu trece verificarea reziduurilor, iar modelul ales, deși are cele mai mici erori de prognoză pe eșantionul de test, nu se separă statistic de metodele naive pe 24 de luni. Cele mai mari erori vin din decizii fiscale și din prețul energiei, pe care un model univariat nu le poate anticipa.

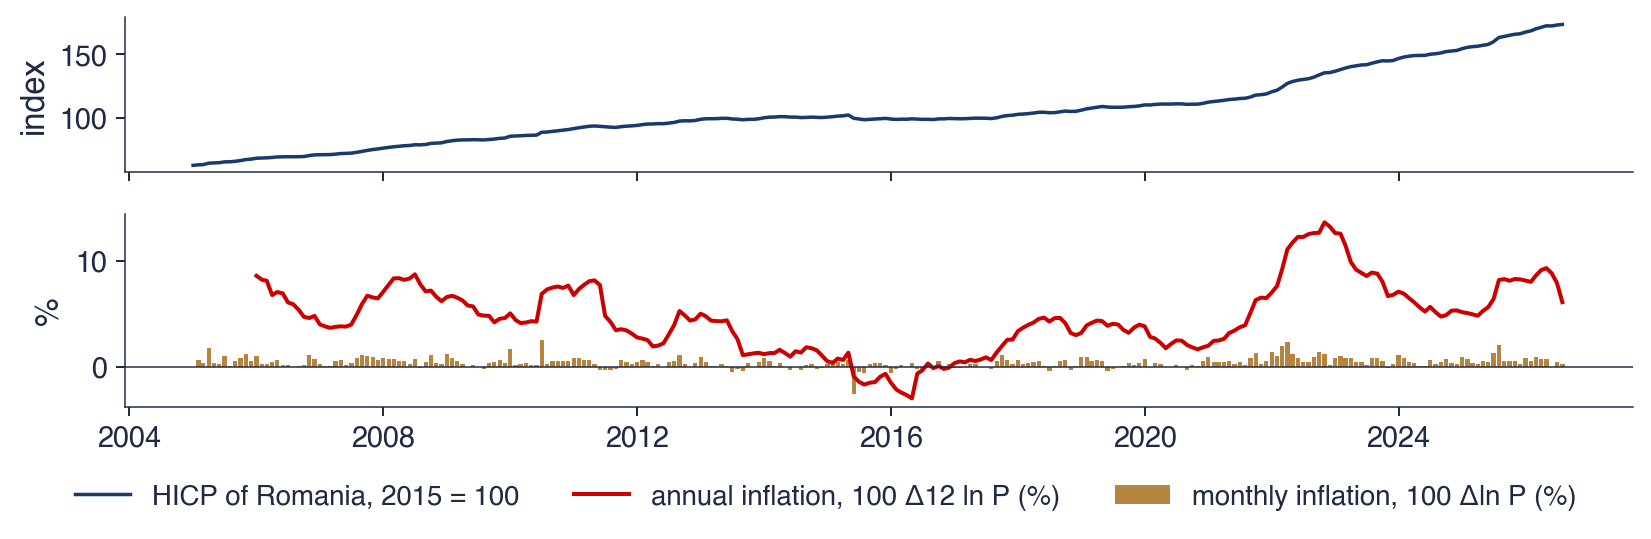
IAPC al României, ianuarie 2005 – august 2026. Sus: indicele, 2015 = 100. Jos: inflația lunară \(100\Delta\ln P_t\) (bare) și inflația anuală \(100\Delta_{12}\ln P_t\) (linia roșie), în procente.

Ce veți putea face

  • Situați fiecare capitol al cursului pe drumul de la descrierea unei serii la modelarea și prognoza ei.
  • Reamintiți formula-cheie, faptul empiric principal și greșeala cea mai frecventă din fiecare capitol.
  • Alegeți testul sau modelul potrivit pentru o întrebare dată despre o serie de timp.
  • Aplicați metoda Box–Jenkins pe o serie reală și interpretați fiecare rezultat în cîteva fraze.
  • Evaluați prognozele în afara eșantionului, față de repere simple, cu testul Diebold–Mariano.

Planul capitolului

  1. Harta cursuluiCum se leagă cele cincisprezece capitole și pe ce serii reale au fost ilustrate.
  2. Capitolele 0–3: descriere, staționaritate, ARMA, ARIMAComponente și netezire, staționaritate și corelogramă, modele ARMA, rădăcini unitare.
  3. Capitolele 4–7: sezonalitate, volatilitate, VAR, VECMSARIMA și evaluarea prognozelor, GARCH, VAR și cauzalitate Granger, cointegrare.
  4. Capitolele 8–10: memorie lungă, învățare automată, spațiul stărilorARFIMA, validarea walk-forward, filtrul Kalman și regimurile Markov.
  5. Capitolele 11–14: studiu individualFoundation models, analiză spectrală, bule LPPL, GARCH multivariat.
  6. Sinteza testelor și a modelelorDe la întrebarea despre serie la test și la decizie; convențiile cursului.
  7. Box–Jenkins de la un capăt la altul: inflația din RomâniaȘase pași pe IAPC: teste, corelogramă, candidați, reziduuri, prognoze.
  8. Proiectul de echipă și prezențaConținutul proiectului, criteriile, susținerea orală și declararea utilizării AI.
  9. Contribuția posibilă a AICe poate face un asistent și ce trebuie verificat.
  10. RezumatIdeile de reținut și autoevaluarea.

Harta cursului

Secțiunea arată cum se leagă capitolele între ele și pe ce serii reale au fost ilustrate metodele.

Harta cursului: Capitolele 0–14

Slide 8 în PDF

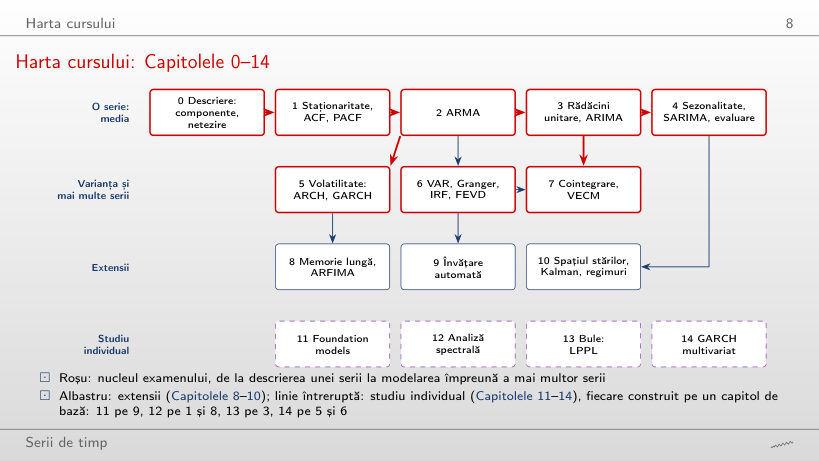
Diagrama așază capitolele pe patru rînduri. Primul rînd, o serie și media ei, merge de la Capitolul 0 (componente și netezire) la staționaritate și corelogramă, la modelele ARMA, la rădăcinile unitare și ARIMA și la sezonalitate și evaluarea prognozelor. Al doilea rînd, varianța și mai multe serii, conține volatilitatea ARCH și GARCH, modelele VAR și cointegrarea cu VECM. Chenarele roșii marchează acest nucleu, iar săgețile roșii arată dependențele principale: ARMA duce atît la ARIMA, cît și la GARCH, iar rădăcinile unitare duc la cointegrare.

Al treilea rînd conține extensiile, Capitolele 8–10: memoria lungă pornește de la volatilitate, învățarea automată de la VAR, iar spațiul stărilor de la sezonalitate și prognoză. Ultimul rînd, cu chenare punctate, conține capitolele pentru studiu individual. Fiecare este construit pe un capitol de bază: foundation models pe învățarea automată, analiza spectrală pe corelogramă și pe memoria lungă, bulele LPPL pe rădăcinile unitare, iar GARCH multivariat pe GARCH și pe VAR.

Citită de la stînga la dreapta, harta urmează ordinea unei analize: întîi descrierea, apoi întrebarea dacă seria este staționară, apoi un model pentru medie, apoi unul pentru varianță și, la final, modelarea mai multor serii împreună.

Seriile cursului

Slide 9 în PDF

Tabelul enumeră seriile pe care au fost ilustrate metodele, cu sursa lor, tema pe care o ilustrează și capitolele în care apar. Cele mai multe sînt românești. PIB-ul real trimestrial al României are trend, sezonalitate, o rădăcină unitară și schimbări de regim, deci servește în Capitolele 0–4 și în Capitolul 10. Inflația IAPC lunară ilustrează persistența, sezonalitatea și memoria lungă, iar ROBOR 3M (Romanian Interbank Offer Rate) și șomajul intră, alături de creștere și inflație, într-un VAR pentru economia României.

Cursul EUR/RON este exemplul unui mers aleator (random walk) greu de depășit în prognoză. Indicii bursieri BET, S&P 500 și DAX, zilnici, ilustrează volatility clustering și spillover-ul între piețe. Consumul de electricitate, zilnic și orar, are sezonalitate multiplă și se potrivește metodelor de învățare automată. Seriile clasice ale manualelor, Nilul, petele solare, randamentele obligațiunilor și PIB-ul SUA, permit compararea rezultatelor cu literatura.

Pe scurt

SeriaSursaTema ilustratăCap.
PIB-ul real al României (trimestrial)Eurostattrend, sezonalitate, rădăcină unitară, regimuri0–4, 10
Inflația IAPC a României (lunar)Eurostatpersistență, sezonalitate, memorie lungă2–4, 8
ROBOR 3M, șomajEurostatun VAR pentru economia României6
EUR/RONBNRun mers aleator greu de depășit0, 3, 5
BET, S&P 500, DAX (zilnic)EODHDvolatility clustering, spillover1, 5, 6
consumul de electricitate (zilnic, orar)ENTSO-Esezonalitate multiplă, învățare automată4, 9
Nilul, petele solare, randamentele și PIB-ul SUAstatsmodels, FREDexemplele clasice ale manualelor1, 2, 7, 8, 10

Sinteza secțiunii

Harta și seriile arată aceeași idee din două direcții: metodele cursului formează un drum, de la descriere la mai multe serii modelate împreună, iar fiecare metodă a fost învățată pe o serie care o face necesară.

Capitolele 0–3: descriere, staționaritate, ARMA, ARIMA

Primele patru capitole construiesc instrumentele pentru o singură serie și media ei: descrierea, staționaritatea, modelele ARMA și rădăcinile unitare.

Capitolul 0: introducere: componente și netezire exponențială (1/2)

Slide 10 în PDF

O serie se descompune într-un trend \(T_t\), o componentă sezonieră \(S_t\) și un rest \(R_t\). În modelul aditiv, \(y_t = T_t + S_t + R_t\), amplitudinea sezonieră este constantă în unități ale seriei; în modelul multiplicativ, \(y_t = T_t S_t R_t\), ea crește odată cu nivelul. Logaritmul transformă produsul în sumă, așa că un model multiplicativ pentru \(y_t\) este un model aditiv pentru \(\ln y_t\). Din acest motiv, aproape toate seriile macroeconomice ale cursului sînt analizate în logaritm.

Netezirea exponențială simplă (simple exponential smoothing, SES) actualizează un nivel cu o medie ponderată între observația nouă și nivelul anterior:

\[\ell_t = \alpha y_t + (1 - \alpha)\ell_{t-1}, \qquad \alpha \in (0, 1).\]
(15.1)

Un \(\alpha\) apropiat de 1 urmărește îndeaproape ultima observație, iar un \(\alpha\) mic netezește mult. Acuratețea se măsoară cu MASE (mean absolute scaled error): eroarea absolută medie (mean absolute error, MAE) a prognozei, împărțită la MAE a metodei naive sezoniere în eșantionul de estimare. O valoare sub 1 înseamnă că metoda bate reperul naiv; scalarea face comparabile serii cu unități diferite.

Pe scurt

  • Formule-cheie
    • aditiv \(y_t = T_t + S_t + R_t\) sau multiplicativ \(y_t = T_t S_t R_t\); logaritmul transformă un model în celălalt
    • SES \(\ell_t = \alpha y_t + (1 - \alpha)\ell_{t-1}\); MASE \(=\) MAE \(/\) MAE metodei naive sezoniere în eșantion
  • Notațiile
    • \(T_t\), \(S_t\), \(R_t\): trendul, componenta sezonieră și restul (componenta neregulată)
    • \(\ell_t\): nivelul netezit la momentul \(t\); \(\alpha \in (0, 1)\): ponderea celei mai noi observații; un \(\alpha\) mare urmărește îndeaproape datele
    • MAE: eroarea absolută medie; MASE sub 1: mai bun decît metoda naivă sezonieră

Capitolul 0: introducere: componente și netezire exponențială (2/2)

Slide 11 în PDF

PIB-ul României a crescut de 2,3 ori din 1995, adică 2,8% pe an, iar componenta sezonieră este mare: trimestrul I este cu circa 23,8% sub trend, iar trimestrul IV cu 20,7% peste. Pentru cursul EUR/RON, parametrul estimat al netezirii exponențiale este \(\hat\alpha = 1{,}00\), deci cea mai bună prognoză este ultima valoare observată, comportamentul unui mers aleator. Pentru consumul de electricitate, metoda Holt–Winters, care adaugă trend și sezonalitate, are MASE 0,51, față de 0,82 pentru metoda naivă.

Prima greșeală frecventă este judecarea unei prognoze pe datele folosite la estimare: în eșantion, un model mai complex se potrivește aproape întotdeauna mai bine, ceea ce nu spune nimic despre viitor. A doua este folosirea erorii procentuale absolute medii (mean absolute percentage error, MAPE) pentru serii care trec prin zero, cum este inflația lunară: împărțirea la valori apropiate de zero face eroarea arbitrar de mare. A treia este un model aditiv pentru o oscilație sezonieră care crește odată cu nivelul, situație în care logaritmul sau modelul multiplicativ este alegerea corectă.

Pe scurt

  • Fapte empirice
    • PIB-ul României a crescut de 2,3 ori din 1995 (2,8% pe an); trimestrul I este cu circa \(\ensuremath{-}23{,}8\%\), iar trimestrul IV cu \(+20{,}7\%\) față de trend
    • EUR/RON: \(\hat\alpha_{SES} = 1{,}00\), ultima valoare este cea mai bună prognoză; electricitatea: Holt–Winters are MASE 0,51, față de 0,82 pentru metoda naivă
  • Greșeli frecvente
    • judecarea unei prognoze pe datele folosite la estimare
    • MAPE pentru serii care trec prin zero (inflația lunară); un model aditiv pentru o oscilație sezonieră care crește odată cu nivelul

Capitolul 1: procese stochastice și staționaritate (1/2)

Slide 12 în PDF

Un proces este slab staționar (weakly stationary) dacă media lui este constantă, \(E X_t = \mu\), și dacă autocovarianța \(\mathrm{Cov}(X_t, X_{t+h}) = \gamma(h)\) depinde doar de distanța \(h\), nu de momentul \(t\). Staționaritatea face posibilă estimarea: dacă proprietățile seriei nu se schimbă în timp, observațiile din perioade diferite informează despre aceiași parametri. Autocorelația de selecție \(\hat\rho(h)\) se compară cu banda \(\pm 1{,}96/\sqrt{T}\), care este banda aproximativă de 95% pentru zgomot alb (white noise).

Testul Ljung–Box (Ljung și Box, 1978) combină primele \(m\) autocorelații într-o singură statistică:

\[Q^*(m) = T(T + 2)\sum_{h=1}^{m}\frac{\hat\rho(h)^2}{T - h} \sim \chi^2(m).\]
(15.2)

O valoare mare, adică un p-value mic, respinge ipoteza de zgomot alb. Mersul aleator \(X_t = X_{t-1} + \varepsilon_t\) este exemplul de bază al unei serii nestaționare: varianța lui, \(\mathrm{Var}(X_t) = t\sigma^2\), crește liniar în timp, deci nu există o varianță constantă care să poată fi estimată.

Pe scurt

  • Formule-cheie
    • staționaritate slabă: \(E X_t = \mu\), \(\mathrm{Cov}(X_t, X_{t+h}) = \gamma(h)\); \(\hat\rho(h)\) comparat cu \(\pm 1{,}96/\sqrt{T}\)
    • Ljung–Box \(Q^*(m) = T(T + 2)\sum_{h=1}^{m}\hat\rho(h)^2/(T - h) \sim \chi^2(m)\) Ljung și Box (1978); mers aleator \(\mathrm{Var}(X_t) = t\sigma^2\)
  • Notațiile
    • \(\mu\): media constantă; \(\gamma(h)\): autocovarianța la lagul \(h\), care depinde doar de \(h\); \(\hat\rho(h)\): autocorelația de selecție; \(T\): numărul de observații
    • \(Q^*(m)\): statistica Ljung–Box pe primele \(m\) laguri; o valoare mare (un p-value mic) respinge zgomotul alb
    • \(\sigma^2\): varianța șocurilor mersului aleator; \(\mathrm{Var}(X_t) = t\sigma^2\) crește cu \(t\), deci mersul aleator nu este staționar

Capitolul 1: procese stochastice și staționaritate (2/2)

Slide 13 în PDF

Randamentele zilnice ale BET au autocorelația de ordinul 1 egală cu 0,11, iar randamentele absolute au 0,40, ambele față de o bandă de \(\pm 0{,}024\). Diferența dintre cele două cifre este una dintre ideile centrale ale cursului: o serie poate fi aproape necorelată fără să fie independentă. Mărimea randamentelor este previzibilă chiar cînd semnul lor nu este, iar această observație pregătește modelele GARCH din Capitolul 5.

Pentru PIB-ul României, transformarea Box–Cox are parametrul estimat \(\hat\lambda = 0{,}02\), practic logaritmul. O diferențiere în plus aplicată unei serii deja staționare dă o autocorelație de ordinul 1 de \(-0{,}54\): supradiferențierea introduce o autocorelație negativă artificială, semnul unei rădăcini unitare în partea MA. Cealaltă greșeală frecventă este interpretarea unei singure bare din afara benzii ca semnal: la 20 de laguri, una iese din bandă din întîmplare, chiar pentru zgomot alb.

Pe scurt

  • Fapte empirice
    • randamentele BET: \(\hat\rho_1 = 0{,}11\), randamentele absolute \(\hat\rho_1 = 0{,}40\) (banda \(\pm 0{,}024\)): necorelat nu înseamnă independent
    • PIB-ul României: Box–Cox \(\hat\lambda = 0{,}02\), adică logaritmul; o diferențiere în plus dă \(\hat\rho_1 = \ensuremath{-}0{,}54\)
  • Greșeli frecvente
    • interpretarea unei singure bare din afara benzii ca semnal (una din douăzeci iese din întîmplare)
    • diferențierea unei serii care este deja staționară

Capitolul 2: modele ARMA (1/2)

Slide 14 în PDF

Modelul ARMA\((p, q)\) se scrie cu operatorul lag \(L\), definit prin \(LX_t = X_{t-1}\):

\[\phi(L)(X_t - \mu) = \theta(L)\varepsilon_t,\]
(15.3)

unde \(\phi(L)\) și \(\theta(L)\) sînt polinoamele AR și MA, de ordinele \(p\) și \(q\), iar \(\varepsilon_t\) este zgomot alb. Cele două cazuri simple dau tiparele de identificare: un AR(1) are autocorelațiile \(\rho(h) = \phi^h\), care scad geometric, iar un MA(1) are o singură autocorelație nenulă, \(\rho(1) = \theta/(1 + \theta^2)\), și se oprește brusc după lagul 1.

Între modelele candidate alegem cu criteriile informaționale. Criteriul Akaike (Akaike, 1974), \(\mathrm{AIC} = -2\ln\hat{\mathcal{L}} + 2k\), și criteriul Schwarz (Schwarz, 1978), \(\mathrm{BIC} = -2\ln\hat{\mathcal{L}} + k\ln T\), pornesc de la logaritmul verosimilității maxime și penalizează numărul \(k\) de parametri; valoarea mai mică este mai bună. Penalizarea BIC este mai mare decît cea AIC de îndată ce \(\ln T > 2\), adică pentru \(T \ge 8\), deci BIC alege modele mai mici. După estimare, testul Ljung–Box pe reziduuri folosește \(m - p - q\) grade de libertate, pentru că parametrii estimați absorb o parte din autocorelație.

Pe scurt

  • Formule-cheie
    • \(\phi(L)(X_t - \mu) = \theta(L)\varepsilon_t\); AR(1) \(\rho(h) = \phi^h\); MA(1) \(\rho(1) = \theta/(1 + \theta^2)\)
    • AIC \(= -2\ln\hat{\mathcal{L}} + 2k\) Akaike (1974), BIC \(= -2\ln\hat{\mathcal{L}} + k\ln T\) Schwarz (1978); verificarea reziduurilor \(Q^*(m) \sim \chi^2(m - p - q)\)
  • Notațiile
    • \(L\): operatorul lag, \(LX_t = X_{t-1}\); \(\phi(L)\), \(\theta(L)\): polinoamele AR și MA, de ordinele \(p\) și \(q\); \(\varepsilon_t\): zgomot alb
    • \(\ln\hat{\mathcal{L}}\): logaritmul verosimilității maxime; \(k\): numărul de parametri estimați; un AIC sau un BIC mai mic este mai bun
    • BIC penalizează parametrii mai mult decît AIC, deoarece \(\ln T > 2\) pentru \(T \ge 8\)

Capitolul 2: modele ARMA (2/2)

Slide 15 în PDF

Pentru creșterea anuală a PIB-ului României, BIC alege un MA(3). Explicația este construcția seriei: creșterea față de același trimestru al anului anterior se calculează pe ferestre de patru trimestre care se suprapun, iar suprapunerea produce o dependență care se oprește după trei laguri. Reziduurile modelului au un p-value Ljung–Box de 0,37, deci testul nu separă autocorelația rămasă de zgomot. Inflația din România se potrivește cu un AR(2) cu \(\hat\phi_1 + \hat\phi_2 = 0{,}976\), foarte aproape de o rădăcină unitară, iar petele solare au un ciclu AR(2) de 10,6 ani.

Prima greșeală frecventă este citirea ordinului AR din ACF: la un proces AR se oprește brusc PACF, nu ACF. A doua este testul Ljung–Box pe reziduuri cu \(m\) grade de libertate în loc de \(m - p - q\), care face testul prea îngăduitor. A treia este un factor comun în \(\phi(L)\) și \(\theta(L)\): dacă cele două polinoame au o rădăcină comună, ea se simplifică, iar modelul are parametri care nu pot fi identificați.

Pe scurt

  • Fapte empirice
    • creșterea anuală a PIB-ului României: MA(3) după BIC, efectul trimestrelor suprapuse; Ljung–Box pe reziduuri \(p = 0{,}37\)
    • inflația din România: AR(2) cu \(\hat\phi_1 + \hat\phi_2 = 0{,}976\), aproape de o rădăcină unitară; petele solare: un ciclu AR(2) de 10,6 ani
  • Greșeli frecvente
    • citirea ordinului AR din ACF (la un AR se anulează PACF)
    • Ljung–Box pe reziduuri cu \(m\) în loc de \(m - p - q\) grade de libertate; un factor comun în \(\phi(L)\) și \(\theta(L)\)

Capitolul 3: rădăcini unitare și modele ARIMA (1/2)

Slide 16 în PDF

Testul Dickey–Fuller augmentat (augmented Dickey–Fuller, ADF) (Dickey și Fuller, 1979) estimează regresia

\[\Delta y_t = c + bt + \gamma y_{t-1} + \sum_{j}\delta_j\Delta y_{t-j} + \varepsilon_t\]
(15.4)

și testează \(H_0\): \(\gamma = 0\), adică o rădăcină unitară (unit root). Diferențele cu lag, cu coeficienții \(\delta_j\), elimină autocorelația erorilor. Sub \(H_0\) statistica \(t\) a lui \(\gamma\) nu are distribuția Student, ci o distribuție proprie, cu valori critice mai negative. Testul KPSS (Kwiatkowski et al., 1992) inversează ipotezele: \(H_0\) este staționaritatea. Folosite împreună, cele două teste dau patru combinații de decizii, dintre care două sînt clare și două neconcludente.

Modelul ARIMA\((p, d, q)\) aplică un ARMA seriei diferențiate de \(d\) ori:

\[\phi(L)(1 - L)^d y_t = c + \theta(L)\varepsilon_t.\]
(15.5)

Cînd \(d \ge 1\), varianța erorii de prognoză crește cu orizontul \(h\) fără limită, deoarece șocurile au efect permanent asupra nivelului. Aceasta este diferența practică dintre un trend stochastic și unul determinist: în jurul unui trend determinist intervalele de prognoză rămîn de lățime mărginită.

Pe scurt

  • Formule-cheie
    • ADF: \(\Delta y_t = c + bt + \gamma y_{t-1} + \sum_j\delta_j\Delta y_{t-j} + \varepsilon_t\), \(H_0\): \(\gamma = 0\) Dickey și Fuller (1979); KPSS: \(H_0\) staționaritate Kwiatkowski et al. (1992)
    • ARIMA\((p,d,q)\): \(\phi(L)(1 - L)^d y_t = c + \theta(L)\varepsilon_t\); varianța prognozei crește cu \(h\) cînd \(d \ge 1\)
  • Notațiile
    • \(\Delta y_t = y_t - y_{t-1}\); \(c\): constanta; \(bt\): trendul determinist; \(\gamma = 0\) înseamnă rădăcină unitară
    • \(\delta_j\): coeficienții diferențelor cu lag, care elimină autocorelația erorilor
    • \(d\): numărul de diferențieri necesare pentru staționaritate; \((1 - L)^d\): diferența de ordinul \(d\); \(h\): orizontul de prognoză

Capitolul 3: rădăcini unitare și modele ARIMA (2/2)

Slide 17 în PDF

Pentru logaritmul PIB-ului României, statistica ADF este \(\tau = -2{,}31\), cu p-value 0,43, iar valoarea critică la 5% este \(-3{,}45\); rădăcina unitară nu este respinsă. Pentru creștere, \(\tau = -10{,}77\) respinge clar. Modelul rezultat este un ARIMA(0,1,0) cu derivă de 0,81% pe trimestru: un mers aleator cu creștere medie. Experimentul lui Granger și Newbold (1974) arată pericolul regresiilor între serii integrate: pentru două mersuri aleatoare independente, statistica \(t\) a pantei este semnificativă în 90% din regresii.

Testul ADF are putere mică: pentru \(\phi = 0{,}95\) și \(T = 100\), el respinge rădăcina unitară doar în 12,5% din cazuri. De aceea nerespingerea nu dovedește existența unei rădăcini unitare, ci arată doar că datele nu o pot separa de o rădăcină apropiată de 1. Celelalte greșeli frecvente sînt valorile critice Student sau Normale pentru statistica ADF și o regresie în niveluri între serii \(I(1)\) fără un test de cointegrare.

Pe scurt

  • Fapte empirice
    • logaritmul PIB-ului României: \(\tau = \ensuremath{-}2{,}31\) (\(p = 0{,}43\), valoarea critică la 5% \(\ensuremath{-}3{,}45\)); creșterea: \(\tau = \ensuremath{-}10{,}77\); ARIMA(0,1,0) cu derivă de 0,81% pe trimestru
    • două mersuri aleatoare independente: un \(t\) semnificativ în 90% din regresii Granger și Newbold (1974); puterea ADF doar 12,5% pentru \(\phi = 0{,}95\), \(T = 100\)
  • Greșeli frecvente
    • valori critice Student sau Normale pentru statistica ADF
    • interpretarea nerespingerii ca dovadă a rădăcinii unitare; o regresie în niveluri între serii \(I(1)\) fără test de cointegrare

Sinteza secțiunii

Primele patru capitole dau ordinea de lucru pentru o singură serie: transformarea care stabilizează varianța, testele care decid de cîte ori se diferențiază, corelograma care sugerează ordinele ARMA și criteriile informaționale care aleg între candidați, cu reziduurile verificate la sfîrșit.

Capitolele 4–7: sezonalitate, volatilitate, VAR, VECM

Capitolele 4–7 adaugă sezonalitatea și evaluarea prognozelor, apoi trec de la medie la varianță și de la o serie la mai multe.

Capitolul 4: sezonalitate și prognoză (1/2)

Slide 18 în PDF

Modelul SARIMA înmulțește un ARIMA obișnuit cu unul sezonier, scris în \(L^s\):

\[\phi(L)\Phi(L^s)(1 - L)^d(1 - L^s)^D y_t = \theta(L)\Theta(L^s)\varepsilon_t,\]
(15.6)

unde \(s\) este lungimea sezonului, 12 pentru date lunare, \(\Phi\) și \(\Theta\) sînt polinoamele sezoniere, iar \(D\) este numărul de diferențe sezoniere \((1 - L^s)\). Modelul „airline”, \((0,1,1)(0,1,1)_s\), cu o diferență obișnuită, una sezonieră și cîte un termen MA în fiecare parte, este punctul de plecare clasic pentru serii lunare cu trend și sezonalitate.

Pentru a compara două prognoze se folosește testul Diebold–Mariano (Diebold și Mariano, 1995). Pentru fiecare perioadă se calculează diferența pierderilor \(d_t = L(e_{1t}) - L(e_{2t})\), de exemplu diferența erorilor pătratice, iar statistica este media \(\bar d\) împărțită la eroarea ei standard, \(\bar d/\sqrt{\hat V/n}\), cu \(\hat V\) varianța pe termen lung a lui \(d_t\). Sub ipoteza acurateței egale statistica are aproximativ distribuția \(N(0, 1)\), deci \(|\mathrm{DM}| > 1{,}96\) respinge la 5%. Corecția lui Harvey, Leybourne și Newbold (1997) (HLN) ajustează statistica pentru eșantioane mici și o compară cu distribuția Student.

Pe scurt

  • Formule-cheie
  • Notațiile
    • \(s\): lungimea sezonului (12 pentru date lunare); \(\Phi(L^s)\), \(\Theta(L^s)\): polinoamele AR și MA sezoniere; \(D\): numărul de diferențe sezoniere \((1 - L^s)\)
    • \(e_{1t}\), \(e_{2t}\): erorile celor două prognoze; \(L(\cdot)\): funcția de pierdere, de exemplu pătratul; \(d_t\): diferența pierderilor; \(\bar d\): media ei; \(\hat V\): varianța ei pe termen lung, estimată; \(n\): numărul de prognoze
    • sub ipoteza acurateței egale, DM are aproximativ distribuția \(N(0, 1)\): \(|\mathrm{DM}| > 1{,}96\) respinge la 5%

Capitolul 4: sezonalitate și prognoză (2/2)

Slide 19 în PDF

Pentru seria pasagerilor aerieni, modelul airline are o MAPE de 8,5%, față de 15,5% pentru metoda naivă sezonieră. Paștele ortodox, care nu cade în aceeași lună în fiecare an, crește vînzările de alimente din România cu circa 5,9%; un astfel de efect de calendar intră în model ca o variabilă explicativă, nu prin diferențiere sezonieră. Pentru consumul zilnic de electricitate, regresia armonică dinamică (dynamic harmonic regression, DHR), cu termeni Fourier pentru sezonalitatea anuală, are MASE 0,89, față de 1,28 pentru metoda naivă sezonieră.

Prima greșeală frecventă este compararea AICc pentru modele cu \(d\) sau \(D\) diferite: diferențierea schimbă datele pe care este calculată verosimilitatea, deci criteriile nu mai sînt comparabile. A doua este judecarea prognozelor la o singură origine, care poate depinde de un singur episod neobișnuit; originile mobile dau o imagine mai stabilă. A treia este folosirea datelor ajustate sezonier într-un model SARIMA care trebuie să prognozeze datele brute.

Pe scurt

  • Fapte empirice
    • pasagerii aerieni: MAPE 8,5% pentru modelul airline, față de 15,5% pentru metoda naivă sezonieră
    • Paștele ortodox crește vînzările de alimente din România cu circa 5,9%; consumul zilnic: DHR are MASE 0,89, față de 1,28 (naiv sezonier)
  • Greșeli frecvente
    • compararea AICc pentru modele cu \(d\) sau \(D\) diferite
    • judecarea prognozelor la o singură origine; date ajustate sezonier într-o prognoză SARIMA a datelor brute

Capitolul 5: volatilitate condiționată: ARCH și GARCH (1/2)

Slide 20 în PDF

Modelul GARCH(1,1) (Engle, 1982; Bollerslev, 1986) scrie varianța condiționată ca funcție de șocul de ieri și de varianța de ieri:

\[\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2,\]
(15.7)

cu \(\omega > 0\), \(\alpha \ge 0\), \(\beta \ge 0\). Parametrul \(\alpha\) măsoară reacția la șocuri, iar \(\beta\) persistența. Dacă \(\alpha + \beta < 1\), varianța revine spre nivelul pe termen lung \(\bar\sigma^2 = \omega/(1 - \alpha - \beta)\), iar un șoc de volatilitate se înjumătățește în \(h_{1/2} = \ln 0{,}5/\ln(\alpha + \beta)\) perioade. Cu cît \(\alpha + \beta\) este mai aproape de 1, cu atît volatilitatea este mai persistentă.

Testul ARCH-LM verifică dacă varianța se schimbă: se regresează \(\varepsilon_t^2\) pe \(q\) laguri ale sale, iar \(nR^2\) are, sub ipoteza de varianță constantă, distribuția \(\chi^2(q)\). Modelul se folosește apoi pentru riscul de pierdere. Cu media condiționată \(\mu\), volatilitatea prognozată \(\sigma_{t+1}\) și cuantila de 1% \(q_{0{,}01}(z)\) a inovațiilor standardizate, VaR 1% este

\[\mathrm{VaR}_{1\%} = -\bigl(\mu + \sigma_{t+1}\,q_{0{,}01}(z)\bigr),\]

o pierdere pozitivă, depășită în medie într-o zi din o sută.

Pe scurt

  • Formule-cheie
    • GARCH(1,1) \(\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2\) Engle (1982), Bollerslev (1986); \(\bar\sigma^2 = \omega/(1 - \alpha - \beta)\), \(h_{1/2} = \ln 0{,}5/\ln(\alpha + \beta)\)
    • ARCH-LM \(= nR^2 \sim \chi^2(q)\); VaR 1% \(= -(\mu + \sigma_{t+1}q_{0{,}01}(z))\)
  • Notațiile
    • \(\sigma_t^2\): varianța condiționată; \(\varepsilon_{t-1}\): șocul de ieri; \(\omega > 0\): constanta; \(\alpha \ge 0\): reacția la șocuri; \(\beta \ge 0\): persistența
    • \(\bar\sigma^2\): varianța pe termen lung, definită doar dacă \(\alpha + \beta < 1\); \(h_{1/2}\): timpul de înjumătățire al unui șoc de volatilitate
    • ARCH-LM: \(R^2\) al regresiei lui \(\varepsilon_t^2\) pe \(q\) laguri ale sale, \(n\) observații; \(q_{0,01}(z)\): cuantila de 1% a inovațiilor standardizate \(z_t\); \(\mu\): media condiționată

Capitolul 5: volatilitate condiționată: ARCH și GARCH (2/2)

Slide 21 în PDF

Un GARCH(1,1) cu inovații Student are \(\alpha + \beta = 0{,}995\) pentru S&P 500, cu un timp de înjumătățire de 131 de zile, și \(0{,}991\) pentru BET, cu 74 de zile: volatilitatea este foarte persistentă pe ambele piețe. Modelul GJR, care adaugă un termen pentru șocurile negative, are pentru S&P 500 \(\hat\gamma = 0{,}21\), cu statistica \(t\) 10,0; scăderile de preț cresc volatilitatea mai mult decît creșterile de aceeași mărime, adică leverage effect. Kurtosis-ul este 13,7 pentru randamente și 5,0 pentru reziduurile standardizate: modelul explică o mare parte din cozile groase, dar nu pe toate.

Greșelile frecvente privesc formulele. Timpul de înjumătățire nu este \(1/(1 - \alpha - \beta)\), ci \(\ln 0{,}5/\ln(\alpha + \beta)\). Varianța pe termen lung nu există cînd \(\alpha + \beta \ge 1\), deci nu trebuie raportată. În curs, nivelul VaR este probabilitatea cozii, iar VaR este o pierdere pozitivă: se scrie VaR 1%, niciodată „VaR 99%”, iar o valoare negativă indică o greșeală de semn.

Pe scurt

  • Fapte empirice
    • GARCH(1,1)-\(t\): \(\alpha + \beta = 0{,}995\) pentru S&P 500 (timp de înjumătățire 131 de zile), \(0{,}991\) pentru BET (74 de zile)
    • S&P 500: GJR \(\hat\gamma = 0{,}21\) (\(t = 10{,}0\)); kurtosis-ul 13,7 pentru randamente, 5,0 pentru reziduurile standardizate
  • Greșeli frecvente
    • timpul de înjumătățire scris \(1/(1 - \alpha - \beta)\); o varianță pe termen lung raportată cînd \(\alpha + \beta \ge 1\)
    • „VaR 99%” sau un VaR negativ: în curs scriem VaR 1%, o pierdere pozitivă

Capitolul 6: modele VAR și cauzalitate Granger (1/2)

Slide 22 în PDF

Un VAR\((p)\) (Sims, 1980) modelează împreună \(K\) variabile, fiecare regresată pe \(p\) laguri ale tuturor:

\[\bY_t = \bc + \bA_1\bY_{t-1} + \dots + \bA_p\bY_{t-p} + \bepsilon_t.\]
(15.8)

Matricele \(\bA_i\) au dimensiunea \(K \times K\). Scris ca un VAR(1) de dimensiune \(Kp\), prin matricea companion, modelul este stabil dacă toate valorile proprii ale acestei matrice sînt în interiorul cercului unitate; atunci efectul oricărui șoc se stinge în timp.

Cauzalitatea Granger (Granger, 1969) întreabă dacă lagurile unei variabile \(x\) îmbunătățesc prognoza lui \(y\), dată fiind istoria lui \(y\). Testul compară suma pătratelor reziduurilor fără lagurile lui \(x\), \(RSS_R\), cu cea cu lagurile lui \(x\), \(RSS_U\):

\[F = \frac{(RSS_R - RSS_U)/p}{RSS_U/(T - Kp - 1)}.\]

Funcțiile de răspuns la impuls (impulse response functions, IRF) și descompunerea varianței erorii de prognoză (forecast error variance decomposition, FEVD) cer șocuri necorelate, obținute de obicei prin descompunerea Cholesky, care depinde de ordinea variabilelor.

Pe scurt

  • Formule-cheie
    • VAR\((p)\): \(\bY_t = \bc + \bA_1\bY_{t-1} + \dots + \bA_p\bY_{t-p} + \bepsilon_t\) Sims (1980); stabil dacă toate valorile proprii ale matricei companion sînt în interiorul cercului unitate
    • Granger \(F = [(RSS_R - RSS_U)/p]\,/\,[RSS_U/(T - Kp - 1)]\) Granger (1969); IRF și FEVD cu o ordine Cholesky
  • Notațiile
    • \(\bY_t\): vectorul celor \(K\) variabile; \(\bc\): constantele; \(\bA_i\): matricele \(K \times K\) ale coeficienților lagului \(i\); \(\bepsilon_t\): vectorul șocurilor
    • matricea companion scrie VAR(\(p\)) ca un VAR(1) de dimensiune \(Kp\)
    • \(RSS_R\), \(RSS_U\): sumele pătratelor reziduurilor fără și cu lagurile variabilei testate; \(p\): numărul de restricții

Capitolul 6: modele VAR și cauzalitate Granger (2/2)

Slide 23 în PDF

Un VAR(2) pentru România, cu creșterea economică, inflația și ROBOR 3M, arată că creșterea cauzează Granger ROBOR: statistica \(F\) este 7,26, cu p-value 0,001. Lagurile creșterii conțin deci informație despre dobînda interbancară viitoare, dincolo de propriul trecut al dobînzii. Indicele de spillover dintre S&P 500, DAX și BET, construit din FEVD, este în medie 26,4% și ajunge la 57,5% pe 17 martie 2020: în crize, o parte mult mai mare din variația fiecărei piețe vine din șocurile celorlalte.

Prima greșeală frecventă este interpretarea cauzalității Granger ca o cauzalitate în sens economic; testul măsoară doar predictibilitatea suplimentară, iar o a treia variabilă omisă poate produce rezultatul. A doua este raportarea IRF fără ordinea Cholesky folosită, deși răspunsurile se pot schimba odată cu ordinea. A treia este folosirea prea multor laguri pe un eșantion scurt: numărul de parametri crește cu \(K^2p\).

Pe scurt

  • Fapte empirice
    • VAR(2) pentru România (creștere, inflație, ROBOR 3M): creșterea cauzează Granger ROBOR, \(F = 7{,}26\), \(p =\) 0,001
    • spillover între S&P 500, DAX și BET: în medie 26,4%, 57,5% la 17 martie 2020
  • Greșeli frecvente
    • interpretarea cauzalității Granger drept cauzalitate (este doar predictibilitate suplimentară)
    • IRF raportate fără ordinea care stă la baza lor; prea multe laguri pentru un eșantion scurt

Capitolul 7: cointegrare și VECM (1/2)

Slide 24 în PDF

Două serii \(I(1)\) sînt cointegrate dacă o combinație liniară a lor este staționară. Metoda Engle–Granger (Engle și Granger, 1987) estimează relația prin OLS în niveluri, apoi aplică un test ADF reziduurilor, cu valorile critice MacKinnon, mai negative decît cele Dickey–Fuller, pentru că reziduurile provin dintr-o regresie estimată. În modelul cu corecția erorii, coeficientul \(\gamma < 0\) al dezechilibrului din perioada anterioară este viteza de ajustare, iar timpul de înjumătățire al unei abateri este \(\ln 0{,}5/\ln(1 + \gamma)\).

Modelul vectorial cu corecția erorii (vector error correction model, VECM) scrie diferențele în funcție de dezechilibrele din perioada anterioară și de dinamica pe termen scurt:

\[\Delta\mathbf y_t = \alpha\beta^\top\mathbf y_{t-1} + \sum_i\Gamma_i\Delta\mathbf y_{t-i} + \mathbf u_t.\]
(15.9)

Coloanele lui \(\beta\) sînt relațiile de echilibru, iar \(\alpha\) spune cît de repede reacționează fiecare variabilă la dezechilibru. Testul urmei al lui Johansen (1991), cu statistica \(-T\sum_{i>r}\ln(1 - \hat\lambda_i)\), testează succesiv rangurile \(r = 0, 1, \dots\); primul rang care nu este respins este rangul de cointegrare.

Pe scurt

  • Formule-cheie
    • Engle–Granger: OLS în niveluri, apoi ADF pe reziduuri cu valorile critice MacKinnon Engle și Granger (1987); timpul de înjumătățire al ECM \(\ln 0{,}5/\ln(1 + \gamma)\)
    • VECM \(\Delta\mathbf y_t = \alpha\beta^\top\mathbf y_{t-1} + \sum_i\Gamma_i\Delta\mathbf y_{t-i} + \mathbf u_t\); statistica urmei \(-T\sum_{i>r}\ln(1 - \hat\lambda_i)\) Johansen (1991)
  • Notațiile
    • ECM: \(\gamma < 0\) este viteza de ajustare spre echilibru
    • \(\beta\): vectorii de cointegrare (relațiile de echilibru); \(\alpha\): coeficienții de ajustare; \(\Gamma_i\): dinamica pe termen scurt; \(\mathbf u_t\): șocurile
    • \(\hat\lambda_i\): valorile proprii estimate, în ordine descrescătoare; \(r\): rangul de cointegrare testat; o statistică a urmei peste valoarea critică respinge rangul \(r\)

Capitolul 7: cointegrare și VECM (2/2)

Slide 25 în PDF

Pentru randamentele obligațiunilor SUA la 1, 5 și 10 ani, statistica urmei este 54,6 pentru \(r = 0\), peste valoarea critică de 29,8, iar pentru \(r \le 2\) este 3,12, sub valoarea critică de 3,84: rangul de cointegrare este 2. Trei dobînzi cu două relații de echilibru au o singură tendință stochastică comună, nivelul general al dobînzilor. Timpul de înjumătățire al corecției erorii pentru dobînda pe termen lung este de 20,8 luni.

Paritatea puterii de cumpărare (purchasing power parity, PPP) pentru leu nu este susținută: testul ADF pentru cursul real are p-value 0,24, deci rădăcina unitară nu este respinsă. Pentru pairs trading la Bursa de Valori București, raportul Sharpe al strategiei este 0,15 înainte de costuri și 0,05 după. Greșelile frecvente sînt valorile critice Dickey–Fuller pentru reziduurile Engle–Granger și un VAR în diferențe pentru serii cointegrate, care omite termenul de corecție a erorii și, odată cu el, informația pe termen lung.

Pe scurt

  • Fapte empirice
    • randamentele SUA la 1, 5 și 10 ani: urma 54,6 \(>\) 29,8 pentru \(r = 0\), 3,12 \(<\) 3,84 pentru \(r \le 2\): rangul 2; timpul de înjumătățire al ECM pentru dobînda lungă 20,8 luni
    • PPP pentru leu: ADF \(p = 0{,}24\) pentru cursul real, nestaționar; pairs trading la BVB: Sharpe 0,15 brut, 0,05 net
  • Greșeli frecvente
    • valorile critice Dickey–Fuller pentru reziduurile Engle–Granger (trebuie să fie mai negative)
    • un VAR în diferențe pentru serii cointegrate (omite termenul de corecție a erorii)

Sinteza secțiunii

Capitolele 4–7 extind modelul pentru o serie în trei direcții: sezonalitatea, cu SARIMA și evaluarea corectă a prognozelor; varianța, cu GARCH și VaR; și mai multe serii, cu VAR, cauzalitate Granger și, cînd seriile sînt integrate și legate printr-un echilibru, VECM.

Capitolele 8–10: memorie lungă, învățare automată, spațiul stărilor

Capitolele 8–10 extind nucleul cursului cu memoria lungă, metodele de învățare automată și modelele cu stări ascunse.

Capitolul 8: memorie lungă și ARFIMA (1/2)

Slide 26 în PDF

Între \(d = 0\), un proces staționar cu memorie scurtă, și \(d = 1\), o rădăcină unitară, există valori fracționare ale lui \(d\) (Granger și Joyeux, 1980; Hosking, 1981). Operatorul \((1 - L)^d\) se dezvoltă într-o serie infinită de laguri, cu ponderile date de recursia

\[\pi_k = \pi_{k-1}\,\frac{k - 1 - d}{k}, \qquad \pi_0 = 1.\]
(15.10)

Pentru \(0 < d < 1/2\) procesul este staționar, dar autocorelațiile scad hiperbolic, \(\rho(k) \sim Ck^{2d-1}\), nu exponențial ca la un ARMA: un șoc are efect pe sute de perioade.

Exponentul Hurst este \(H = d + 1/2\), peste 0,5 pentru memorie lungă; în curs este estimat cu statistica rescaled range (R/S). Procesul este staționar pentru \(d < 1/2\) și revine la medie pentru \(d < 1\), chiar dacă varianța lui nu mai este finită. Estimatorii GPH și Whittle local folosesc doar cele mai joase \(m\) frecvențe ale periodogramei, unde memoria lungă își lasă amprenta; alegerea lui \(m\) schimbă estimarea.

Pe scurt

  • Formule-cheie
    • \((1 - L)^d\) cu \(\pi_k = \pi_{k-1}(k - 1 - d)/k\) Granger și Joyeux (1980), Hosking (1981); \(\rho(k) \sim Ck^{2d-1}\); \(H = d + 1/2\)
    • staționar pentru \(d < 1/2\), cu revenire la medie pentru \(d < 1\); GPH și Whittle local folosesc cele mai joase \(m\) frecvențe
  • Notațiile
    • \(d\): ordinul de integrare fracționară; \(\pi_k\): ponderea lagului \(k\) în dezvoltarea lui \((1 - L)^d\)
    • \(C > 0\): o constantă; \(\rho(k) \sim Ck^{2d-1}\): ACF scade hiperbolic, nu exponențial
    • \(H\): exponentul Hurst, peste 0,5 pentru memorie lungă, estimat aici cu statistica rescaled range (R/S); \(m\): numărul de frecvențe joase folosite de GPH și Whittle local

Capitolul 8: memorie lungă și ARFIMA (2/2)

Slide 27 în PDF

Pentru inflația lunară din România, un ARFIMA(0,\(d\),0) cu \(\hat d = 0{,}31\) și eroarea standard 0,05 bate modelele ARMA atît după AIC, cît și după BIC: un singur parametru fracționar descrie persistența mai bine decît mai mulți termeni AR și MA. Pentru S&P 500, exponentul Hurst estimat cu R/S este 0,53 pentru randamente, aproape de 0,5, și 0,86 pentru randamentele absolute: memoria lungă este în volatilitate, nu în randamente.

Nilul arată capcana principală a capitolului. Pe toată seria, \(\hat d = 0{,}40\), dar după eliminarea rupturii din 1898, cînd nivelul seriei se schimbă, estimarea devine \(-0{,}17\). O ruptură sau o schimbare de regim produce în corelogramă aceeași scădere lentă ca memoria lungă. Celelalte greșeli frecvente sînt raportarea unei singure lățimi de bandă \(m\) și confundarea memoriei lungi a randamentelor cu cea a volatilității.

Pe scurt

  • Fapte empirice
    • inflația lunară din România: ARFIMA(0,\(d\),0) cu \(\hat d = 0{,}31\) (SE 0,05) bate ARMA după AIC și BIC
    • S&P 500: \(H\) (R/S) 0,53 pentru randamente, 0,86 pentru \(|r_t|\); Nilul: \(\hat d = 0{,}40\), dar \(\ensuremath{-}0{,}17\) după ruptura din 1898
  • Greșeli frecvente
    • o ruptură sau o schimbare de regim interpretată drept memorie lungă
    • o singură lățime de bandă \(m\); memoria lungă a randamentelor confundată cu memoria lungă a volatilității

Capitolul 9: învățare automată pentru serii de timp (1/2)

Slide 28 în PDF

Metodele de învățare automată prognozează de obicei direct: pentru fiecare orizont \(h\) se estimează o funcție separată a ultimelor \(p\) valori și a regresorilor cunoscuți în avans, cum este calendarul,

\[\hat y_{T+h} = \hat f_h(y_T, \dots, y_{T-p+1}, \mathbf z_{T+h}).\]

Regresiile penalizate controlează complexitatea: ridge adaugă la suma pătratelor erorilor termenul \(\lambda\sum\beta_j^2\) și micșorează toți coeficienții, iar lasso adaugă \(\lambda\sum|\beta_j|\) și anulează o parte dintre ei, deci selectează predictorii.

Descompunerea deplasare–varianță (bias–variance) explică de ce un model mai flexibil nu este automat mai bun: eroarea pătratică medie de prognoză pentru o observație nouă este

\[E(y_0 - \hat f)^2 = \text{deplasare}^2 + \mathrm{Var}(\hat f) + \sigma^2.\]

Flexibilitatea reduce deplasarea și crește varianța, iar \(\sigma^2\) nu poate fi eliminată de niciun model. Validarea trebuie să respecte ordinea timpului: validarea walk-forward estimează pe trecut și evaluează pe perioada imediat următoare, apoi avansează.

Pe scurt

  • Formule-cheie
    • prognoza directă \(\hat y_{T+h} = \hat f_h(y_T, \dots, y_{T-p+1}, \mathbf z_{T+h})\); ridge \(+\lambda\sum\beta_j^2\), lasso \(+\lambda\sum|\beta_j|\)
    • deplasare–varianță \(E(y_0 - \hat f)^2 = \text{deplasare}^2 + \mathrm{Var}(\hat f) + \sigma^2\); doar validare walk-forward
  • Notațiile
    • \(\hat f_h\): funcția estimată pentru orizontul \(h\); \(p\): numărul de laguri folosite; \(\mathbf z_{T+h}\): regresori cunoscuți, de exemplu calendarul
    • \(\lambda \ge 0\): intensitatea penalizării; \(\beta_j\): coeficienții; ridge îi micșorează, lasso îi anulează pe unii
    • \(y_0\): o observație nouă; \(\sigma^2\): varianța zgomotului, pe care niciun model nu o poate elimina

Capitolul 9: învățare automată pentru serii de timp (2/2)

Slide 29 în PDF

Pentru S&P 500, același model are \(R^2 = 0{,}37\) cu validare încrucișată \(k\)-fold aleatoare și \(-0{,}39\) cu validare walk-forward. Diferența este leakage: împărțirea aleatoare lasă modelul să învețe din observații ulterioare celor pe care le prognozează. Pentru semnul randamentelor, clasa majoritară este corectă în 54,4% din zile, iar un model de boosting doar în 52,5%. Pentru consumul zilnic de electricitate, ridge are MASE 0,90, iar o rețea LSTM (long short-term memory) 1,16, în acord cu concluzia competiției M4 (Makridakis, Spiliotis și Assimakopoulos, 2020) că metodele complexe nu bat automat metodele simple.

Greșelile frecvente sînt validarea încrucișată aleatoare și scalarea variabilelor pe tot eșantionul, ambele forme de look-ahead. Arborii de decizie nu pot extrapola: aplicați pe niveluri cu trend, prognozele lor rămîn în intervalul valorilor de antrenare, deci trendul trebuie eliminat înainte. Orice comparație are nevoie de un reper simplu, metoda naivă sau naivă sezonieră.

Pe scurt

  • Fapte empirice
    • S&P 500, același model: \(R^2 = 0{,}37\) cu \(k\)-fold aleator, \(\ensuremath{-}0{,}39\) walk-forward: leakage
    • semnul randamentelor: clasa majoritară 54,4%, boosting 52,5%; consumul zilnic: ridge MASE 0,90, LSTM 1,16 Makridakis, Spiliotis și Assimakopoulos (2020)
  • Greșeli frecvente
    • validarea încrucișată aleatoare și scalarea pe tot eșantionul (look-ahead)
    • arbori pe niveluri cu trend (nu pot extrapola); comparații fără un reper simplu

Capitolul 10: spațiul stărilor, filtrul Kalman și modele Markov switching (1/2)

Slide 30 în PDF

Un model în spațiul stărilor are două ecuații: o ecuație de măsurare, care leagă observația de o stare ascunsă, și o ecuație de tranziție, care descrie evoluția stării:

\[y_t = Z\alpha_t + \varepsilon_t, \qquad \alpha_{t+1} = T\alpha_t + R\eta_t.\]
(15.11)

Filtrul Kalman (Kalman, 1960) actualizează estimarea stării cînd sosește o observație nouă: \(a_{t|t} = a_t + K_tv_t\), unde \(v_t = y_t - Za_t\) este eroarea de predicție, iar cîștigul \(K_t = P_tZ'F_t^{-1}\) este ponderea acestei surprize. Cînd starea prezisă este incertă, \(P_t\) mare, cîștigul este mare și filtrul se bazează mai mult pe observație.

În modelul Markov switching (Hamilton, 1989), parametrii depind de un regim neobservat care trece dintr-o stare în alta cu probabilitățile \(p_{ij}\). Durata medie a regimului \(i\) este \(1/(1 - p_{ii})\), iar cu două regimuri ponderea pe termen lung a regimului 1 este

\[\pi_1 = \frac{1 - p_{22}}{2 - p_{11} - p_{22}}.\]

Pe scurt

  • Formule-cheie
    • \(y_t = Z\alpha_t + \varepsilon_t\), \(\alpha_{t+1} = T\alpha_t + R\eta_t\); \(K_t = P_tZ'F_t^{-1}\), \(a_{t|t} = a_t + K_tv_t\) Kalman (1960)
    • Markov switching: durate \(1/(1 - p_{ii})\), ergodic \(\pi_1 = (1 - p_{22})/(2 - p_{11} - p_{22})\) Hamilton (1989)
  • Notațiile
    • \(\alpha_t\): starea ascunsă (de exemplu nivelul); \(Z\), \(T\), \(R\): matricele cunoscute ale sistemului; \(\varepsilon_t\), \(\eta_t\): zgomotul de măsurare și cel al stării
    • \(a_t\), \(P_t\): starea prezisă și varianța ei; \(v_t = y_t - Za_t\): eroarea de predicție, cu varianța \(F_t\); \(K_t\): cîștigul Kalman, ponderea surprizei
    • \(p_{ii}\): probabilitatea de a rămîne în regimul \(i\); \(\pi_1\): ponderea pe termen lung a regimului 1

Capitolul 10: spațiul stărilor, filtrul Kalman și modele Markov switching (2/2)

Slide 31 în PDF

Pentru Nil, modelul cu nivel local are raportul semnal–zgomot estimat \(\hat q = \hat\sigma^2_\eta/\hat\sigma^2_\varepsilon = 0{,}097\): nivelul se schimbă puțin în raport cu zgomotul de măsurare. Cîștigul Kalman converge la \(\bar K = 0{,}267\), care este exact ponderea \(\alpha\) a netezirii exponențiale din Capitolul 0; netezirea exponențială este filtrul Kalman al modelului cu nivel local. Pentru PIB-ul SUA, regimurile estimate coincid cu datările recesiunilor NBER (National Bureau of Economic Research) în 90% din trimestre; pentru PIB-ul României, regimul stabil durează în medie 15,2 trimestre, iar cel volatil 11,2.

Prima greșeală frecventă este folosirea probabilităților netezite, care folosesc tot eșantionul, ca și cum ar fi fost cunoscute în timp real; pentru decizii în timp real contează probabilitățile filtrate. A doua este durata scrisă \(p_{ii}/(1 - p_{ii})\) în loc de \(1/(1 - p_{ii})\). A treia privește filtrul Hodrick–Prescott: ultima valoare a deviației de la trend este revizuită puternic cînd sosesc date noi, deci nu este o estimare în timp real.

Pe scurt

  • Fapte empirice
    • Nilul: \(\hat q = \hat\sigma^2_\eta/\hat\sigma^2_\varepsilon = 0{,}097\), cîștigul de echilibru \(\bar K = 0{,}267\), ponderea netezirii exponențiale
    • PIB-ul SUA: regimurile coincid cu datările NBER în 90% din trimestre; PIB-ul României: regimul stabil 15,2 trimestre, cel volatil 11,2
  • Greșeli frecvente
    • probabilități netezite folosite ca și cum ar fi fost cunoscute în timp real
    • durate scrise \(p_{ii}/(1 - p_{ii})\); ultima valoare a deviației HP interpretată ca estimare în timp real

Sinteza secțiunii

Extensiile au aceeași structură ca nucleul: fiecare introduce un model nou pentru o întrebare pe care modelele anterioare nu o puteau trata și vine cu o capcană specifică, ruptura confundată cu memoria lungă, look-ahead în validare și informația din viitor în probabilitățile netezite.

Capitolele 11–14: studiu individual

Ultimele patru capitole sînt pentru studiu individual. Recapitularea dă ideile lor principale și legătura cu nucleul cursului.

Capitolul 11: foundation models pentru serii de timp (studiu individual)

Slide 32 în PDF

Foundation models sînt modele transformer pre-antrenate pe un număr foarte mare de serii. Valorile unei serii sînt transformate în tokeni, prin scalare și cuantizare, sau împărțite în segmente consecutive (patching), iar modelul învață să continue secvența. Chronos, TimesFM, Moirai și Lag-Llama pot prognoza zero-shot, adică pe o serie pe care nu au văzut-o la antrenare, fără nicio estimare suplimentară, sau pot fi adaptate prin fine-tuning.

Legătura cu nucleul este dublă. Un astfel de model este un model global, estimat pe multe serii deodată, ca modelele de învățare automată din Capitolul 9. Prognozele lui se evaluează ca orice prognoză din Capitolul 4: același eșantion de test, MASE, scoruri pentru prognozele probabilistice și comparație cu repere simple.

Pe scurt

  • Idei principale
    • modele transformer pre-antrenate pe foarte multe serii: tokenizarea și împărțirea valorilor în segmente (patching)
    • Chronos, TimesFM, Moirai, Lag-Llama: prognoze zero-shot și fine-tuning
    • o comparație corectă: același eșantion de test, MASE, scoruri probabilistice, repere simple
  • Legătura cu nucleul cursului
  • Capitolele 11–14 sînt pentru studiu individual

Capitolul 12: analiză spectrală (studiu individual)

Slide 33 în PDF

Analiza spectrală descrie o serie staționară prin frecvențele care o compun. Transformata Fourier descompune seria în sinusoide, periodograma \(I(\nu_j)\) măsoară cît din varianță revine fiecărei frecvențe Fourier \(\nu_j\), iar densitatea spectrală este versiunea teoretică a periodogramei. Periodograma brută fluctuează mult, așa că se netezește, de exemplu prin metoda Welch. Filtrele, cum este Hodrick–Prescott, păstrează anumite frecvențe și le elimină pe celelalte, ceea ce face din ciclul economic o bandă de frecvențe.

Spectrul conține aceeași informație ca funcția de autocovarianță din Capitolul 1, dar ordonată pe frecvențe în loc de laguri. Memoria lungă din Capitolul 8 apare ca un pol al densității spectrale la frecvența zero. Coerența măsoară legătura dintre două serii pe fiecare frecvență, iar wavelets permit studiul frecvențelor care se schimbă în timp.

Pe scurt

  • Idei principale
    • transformata Fourier, periodograma \(I(\nu_j)\) și densitatea spectrală
    • periodograme netezite (Welch), filtre (Hodrick–Prescott) și ciclul economic
    • coerența dintre două serii; wavelets ca instrument timp–frecvență
  • Legătura cu nucleul cursului
  • Capitolele 11–14 sînt pentru studiu individual

Capitolul 13: bule speculative: modele LPPL (studiu individual)

Slide 34 în PDF

Capitolul 13 descrie bulele speculative ca o creștere superexponențială a prețurilor, mai rapidă decît orice creștere exponențială. Modelul LPPLS (log-periodic power law singularity) combină o lege de putere care duce la un timp critic cu oscilații log-periodice tot mai rapide. Estimarea are nevoie de condiții de filtrare care elimină ajustările fără sens economic, iar multe ferestre de estimare se combină într-un indicator de încredere, aplicat pe bule și crahuri istorice.

Legătura cu nucleul este testul Dickey–Fuller din Capitolul 3, folosit invers: testele de rădăcini explozive caută o rădăcină autoregresivă mai mare decît 1, în coada din dreapta. A doua legătură este volatilitatea dinaintea crahurilor, studiată cu instrumentele din Capitolul 5.

Pe scurt

  • Idei principale
    • bulele ca o creștere superexponențială a prețurilor
    • modelul LPPLS: o lege de putere plus oscilații log-periodice; estimare și condiții de filtrare
    • indicatorul de încredere LPPLS pe bule și crahuri istorice
  • Legătura cu nucleul cursului
    • rădăcini explozive, opusul rădăcinilor unitare (Capitolul 3); volatilitatea dinaintea crahurilor (Capitolul 5)
  • Capitolele 11–14 sînt pentru studiu individual

Capitolul 14: modele GARCH multivariate (studiu individual)

Slide 35 în PDF

Capitolul 14 trece de la volatilitatea unei serii la matricea de covarianță a mai multor serii, care se schimbă în timp. Problema principală este numărul de parametri, care crește foarte repede cu numărul de serii. Modelele VEC și BEKK modelează direct covarianțele, cu multe restricții, iar modelele CCC (constant conditional correlation) și DCC (dynamic conditional correlation) separă volatilitățile individuale de corelații. DCC se estimează în doi pași: întîi un GARCH pentru fiecare serie, apoi dinamica corelațiilor pe reziduurile standardizate.

Rezultatele sînt corelații dinamice, varianța unui portofoliu și VaR 1% al portofoliului. Legătura cu nucleul este directă: fiecare serie are propriul GARCH din Capitolul 5, iar perspectiva multivariată, cu matrice de coeficienți și numărul de parametri care crește rapid, este cea a modelului VAR din Capitolul 6.

Pe scurt

  • Idei principale
    • covarianțe și corelații variabile în timp; numărul de parametri crește foarte repede
    • VEC, BEKK, CCC și DCC; estimarea DCC în doi pași
    • corelații dinamice, varianța portofoliului și VaR 1%
  • Legătura cu nucleul cursului
  • Capitolele 11–14 sînt pentru studiu individual

Sinteza secțiunii

Capitolele pentru studiu individual folosesc aceleași idei ca nucleul în contexte noi: evaluarea în afara eșantionului pentru foundation models, autocovarianța citită pe frecvențe, testul Dickey–Fuller în coada din dreapta și GARCH extins la mai multe serii.

Sinteza testelor și a modelelor

Sinteza leagă fiecare întrebare despre o serie de testul care răspunde la ea și de decizia care urmează.

Teste și modele (1/2): serii univariate și media

Slide 36 în PDF

Tabelul are patru coloane: întrebarea, instrumentul, decizia și capitolul. Primele două rînduri privesc staționaritatea și tipul trendului. Graficul și ACF dau prima impresie, iar ADF și KPSS decid: cînd ADF respinge rădăcina unitară și KPSS nu respinge staționaritatea, seria este staționară. Cu trend inclus în regresie, același cuplu de teste decide între un trend determinist, care se elimină prin regresie, și unul stochastic, care se elimină prin diferențiere.

Sezonalitatea se vede în graficul sezonier și în ACF la lagurile \(s\) și \(2s\); testele OCSB și HEGY decid dacă este nevoie de o diferență sezonieră \(\Delta_s\) sau dacă variabilele dummy și termenii Fourier sînt suficienți. Ordinul ARMA se identifică din ACF și PACF și se alege cu AIC și BIC: modelul cu cel mai mic BIC dintre cele cu reziduuri zgomot alb. Reziduurile se verifică cu Ljung–Box cu \(m - k\) grade de libertate și cu Jarque–Bera pentru Normalitate. Ultimul rînd compară prognozele: un eșantion de test, origini mobile, MASE și testul Diebold–Mariano; dacă p-value-ul este peste 0,05, cele două prognoze nu se separă statistic.

Pe scurt

ÎntrebareaInstrumentulDeciziaCap.
Este seria staționară?grafic, ACF; ADF și KPSSADF respinge, KPSS nu: staționară1, 3
Trend: determinist sau stochastic?ADF și KPSS cu trendeliminarea trendului sau diferențierea3
Există sezonalitate?graficul sezonier, ACF la \(s\), \(2s\); OCSB, HEGY\(\Delta_s\) sau variabile dummy și termeni Fourier4
Ce model ARMA?ACF, PACF; AIC, BICcel mai mic BIC cu reziduuri zgomot alb2
Sînt reziduurile adecvate?Ljung–Box cu \(m - k\) grade de libertate; Jarque–Bera\(p > 0{,}05\): nu mai rămîne autocorelație2
Care prognoză este mai bună?eșantion de test, origini mobile; MASE, DMDM cu \(p < 0{,}05\); altfel egalitate0, 4

Teste și modele (2/2): varianța, serii multivariate și extensii

Slide 37 în PDF

Partea a doua începe cu varianța. Testul Ljung–Box pe randamentele la pătrat \(r_t^2\) și testul ARCH-LM verifică dacă varianța se schimbă; dacă testele resping, modelele potrivite sînt GARCH(1,1) cu inovații Student și GJR, pentru asimetrie. Pentru mai multe serii, întrebarea dacă \(x\) ajută la prognoza lui \(y\) are ca răspuns testul \(F\) de cauzalitate Granger într-un VAR. Efectul unui șoc se măsoară cu IRF și FEVD, cu benzi bootstrap și cu mai multe ordini Cholesky, pentru a vedea cît de mult depind rezultatele de ordine. Un echilibru pe termen lung se testează cu Engle–Granger sau Johansen, iar VECM dă relațiile \(\beta\), coeficienții de ajustare \(\alpha\) și timpul de înjumătățire.

Ultimele rînduri privesc extensiile. Memoria lungă se estimează cu GPH, Whittle local și ARFIMA, cu mai multe valori ale lui \(m\) și cu verificarea rupturilor. Pentru mulți predictori și efecte neliniare, ridge, lasso, arborii și boosting-ul se evaluează walk-forward, față de un reper. Pentru un nivel sau un regim ascuns, filtrul Kalman și Markov switching dau estimări filtrate pentru timp real și netezite pentru istorie.

Pe scurt

ÎntrebareaInstrumentulDeciziaCap.
Se schimbă varianța?Ljung–Box pe \(r_t^2\), ARCH-LMrespingem: GARCH(1,1)-\(t\), GJR5
Ajută \(x\) la prognoza lui \(y\)?VAR, testul Granger \(F\)\(p < 0{,}05\): cauzalitate Granger6
Ce efect are un șoc?IRF, FEVD (Cholesky)benzi bootstrap; încercați alte ordini6
Există un echilibru pe termen lung?Engle–Granger, JohansenVECM: \(\beta\), \(\alpha\), timpul de înjumătățire7
Memorie lungă?GPH, Whittle local, ARFIMAmai multe valori \(m\); verificați rupturile8
Mulți predictori, efecte neliniare?ridge, lasso, arbori, boostingwalk-forward față de un reper9
Un nivel sau un regim ascuns?filtrul Kalman, Markov switchingfiltrat pentru timp real, netezit pentru istorie10

Convențiile folosite în tot cursul

Slide 38 în PDF

Transformările sînt scrise mereu în aceeași formă. Logaritmul se înmulțește cu 100, astfel încît diferențele să fie aproximativ procente: \(100\Delta\ln y_t\) este creșterea față de perioada anterioară, iar \(100\Delta_{12}\ln y_t\) pentru date lunare și \(100\Delta_4\ln y_t\) pentru date trimestriale sînt ratele anuale. În rezultatele EViews, „DLOG(IPC,1,12)” înseamnă diferența obișnuită a diferenței sezoniere a logaritmului, \(\Delta\Delta_{12}\ln\) IPC.

Fiecare test se raportează la fel: ipoteza nulă, statistica, distribuția ei sub \(H_0\), valoarea critică sau p-value-ul și decizia la 5%, urmate de o frază despre ce înseamnă decizia pentru serie. Criteriile informaționale AIC, AICc și BIC se compară doar pe același eșantion și pentru aceleași \(d\) și \(D\), iar prognozele se judecă în afara eșantionului, față de metodele naivă și naivă sezonieră. Pentru risc, nivelul este probabilitatea cozii: VaR 1% este o pierdere pozitivă, \(\mathrm{VaR}_\alpha = -q_\alpha\), unde \(q_\alpha\) este cuantila de nivel \(\alpha\) a randamentului.

Pe scurt

  • Transformările
    • \(100\ln y_t\)
    • creșterea \(100\Delta\ln y_t\)
    • ratele anuale \(100\Delta_{12}\ln y_t\) (lunar), \(100\Delta_4\ln y_t\) (trimestrial)
    • „DLOG(IPC,1,12)” în rezultatele EViews înseamnă \(\Delta\Delta_{12}\ln\) IPC
  • Testele
    • precizăm \(H_0\), statistica, distribuția ei, valoarea critică sau p-value-ul, decizia la 5%
    • apoi o frază despre semnificația deciziei pentru serie
  • Alegerea modelului
    • AIC, AICc și BIC doar pe același eșantion și cu aceleași \(d\), \(D\)
    • prognozele se judecă în afara eșantionului, față de metodele naivă și naivă sezonieră
  • Riscul
    • nivelul este probabilitatea cozii: VaR 1%, o pierdere pozitivă, \(\mathrm{VaR}_\alpha = -q_\alpha\), \(q_\alpha\): cuantila de nivel \(\alpha\) a randamentului

Sinteza secțiunii

Sinteza transformă cursul într-o listă de întrebări cu răspunsuri verificabile. O analiză bună le parcurge în ordine, raportează fiecare test cu ipoteza lui nulă și decizia lui și respectă convențiile de transformare, de comparare a modelelor și de raportare a riscului.

Box–Jenkins de la un capăt la altul: inflația din România

Secțiunea aplică metoda Box–Jenkins, în șase pași, pe IAPC al României. Fiecare pas folosește instrumente din capitolele anterioare, iar fiecare decizie se sprijină pe un rezultat raportat.

Metoda în șase pași

Slide 39 în PDF

Metoda lui Box, Jenkins și Reinsel (2008) este o buclă, nu o rețetă liniară. Primul pas este graficul și transformarea: logaritmul pentru a stabiliza varianța, diferența obișnuită \(\Delta\) pentru trend și diferența sezonieră \(\Delta_{12}\) pentru sezonalitate. Al doilea pas aplică testele ADF și KPSS fiecărei transformări. Al treilea identifică ordinele din ACF și PACF ale seriei staționare, iar al patrulea estimează mai multe modele SARIMA candidate prin verosimilitate maximă și le compară cu AICc și BIC.

Al cincilea pas verifică reziduurile: autocorelația cu Ljung–Box, Normalitatea cu Jarque–Bera și valorile extreme. Dacă verificarea eșuează, analiza se întoarce la pasul 3. Al șaselea pas prognozează și evaluează: un eșantion de test păstrat deoparte, comparația cu reperele naive și abia apoi intervalele de prognoză. Datele sînt IAPC al României, de la Eurostat, din ianuarie 2005 pînă în august 2026, \(T = 260\) de luni.

Pe scurt

  1. Graficul și transformarea: logaritm, \(\Delta\), \(\Delta_{12}\)
  2. Testarea: ADF și KPSS pentru fiecare transformare
  3. Identificarea: ACF și PACF ale seriei staționare
  4. Estimarea: modele SARIMA candidate, prin verosimilitate maximă; AICc și BIC
  5. Verificarea: reziduurile (Ljung–Box, Jarque–Bera, valori extreme); înapoi la pasul 3 dacă eșuează
  6. Prognoza și evaluarea: un eșantion de test, repere, apoi intervale

Pasul 1: datele

Slide 40 în PDF
    Întrebare pentru sală ▶ mută începutul eșantionului pînă în 2020. Rămîne inflația medie din iunie negativă?
    Răspuns

    Nu: din 2020 iunie are în medie +0,28%, iar ianuarie rămîne luna cea mai mare (0,94%). Tiparul sezonier (ianuarie sus, iunie jos) se păstrează, dar nivelul crește odată cu inflația generală din 2021–2023; de aceea modelul lucrează cu Δ12, care elimină și nivelul, și sezonalitatea fixă.

      Întrebare pentru sală ▶ trece prin eșantioanele care se termină în decembrie 2012, …, 2025. Ce verdict primește inflația anuală Δ12 ln P pentru eșantioanele 2013–2021?
      Răspuns

      Rădăcină unitară: ADF nu respinge (p între 0,66 și 0,97), iar KPSS respinge (η între 0,59 și 1,48, peste 0,463). Rezultatul neconcludent din curs apare numai după 2022, cînd valul inflației adaugă variație. În aceiași ani Δ ln P primește „contradictoriu”: ambele teste resping, pentru că sezonalitatea și schimbările de nivel ale inflației lunare încalcă ipotezele ambelor teste.

        Întrebare pentru sală ▶ mută sfîrșitul eșantionului din august 2010 în august 2026. Cum se schimbă media inflației lunare?
        Răspuns

        Scade de la 0,52% (2005–2010) la 0,31% (pînă în august 2020), apoi urcă la 0,39% pe tot eșantionul: valul de inflație din 2021–2023 și șocul fiscal din 2025 ridică media. Minimul inflației anuale, −3,0% în mai 2016, cuprinde în fereastra de 12 luni reducerea TVA la alimente din iunie 2015; maximul, 13,6%, este în noiembrie 2022.

        Graficul are două panouri cu aceeași axă a timpului, din 2005 pînă în 2026. Panoul de sus arată nivelul IAPC, cu baza 2015 = 100: o linie care crește aproape continuu, cu o pantă mai mică între 2013 și 2017 și una mai mare după 2021. Panoul de jos arată, în procente, inflația lunară \(100\Delta\ln P_t\) ca bare și inflația anuală \(100\Delta_{12}\ln P_t\) ca linie roșie.

        Cele două măsuri ale inflației se citesc diferit. Barele lunare sînt mici și zgomotoase, cu cîteva valori izolate mari, care corespund modificărilor de taxe. Linia anuală, care adună ultimele douăsprezece luni, este netedă și arată episoadele mari: inflația ridicată dinainte de 2012, perioada cu valori negative din 2015–2016, vîrful din 2022 și o nouă creștere în 2025.

        Pe scurt

        • Sus: IAPC, 2015 = 100; jos: inflația lunară \(100\Delta\ln P_t\) (bare) și inflația anuală \(100\Delta_{12}\ln P_t\) (linie)
        TSA_ch15_box_jenkins

        Interpretarea datelor

        Slide 41 în PDF

        Indicele crește aproape în fiecare lună, deci logaritmul este scala firească: pe această scală, o creștere procentuală constantă devine o pantă constantă, iar diferențele sînt rate de creștere. Inflația lunară are media 0,39%, iar inflația anuală variază între \(-3{,}0\%\), în mai 2016, și 13,6%, în noiembrie 2022. Cu un interval atît de larg, o singură medie nu descrie bine seria, iar persistența episoadelor sugerează o rădăcină unitară sau aproape unitară.

        Sezonalitatea este vizibilă în mediile lunare ale inflației: ianuarie are în medie 0,74%, iar iunie \(-0{,}03\%\), din cauza prețurilor alimentelor proaspete. Un tipar sezonier în \(\Delta\ln P_t\) înseamnă că modelul va avea nevoie de diferența sezonieră \(\Delta_{12}\) sau de termeni sezonieri. Șocurile de preț vin în mare parte din decizii fiscale, care mută prețurile într-o singură lună. În iulie–august 2025, încetarea plafonării prețului la electricitate și creșterea TVA au dus inflația anuală de la 6,4% la 8,2%.

        Pe scurt

        • Trend
          • indicele crește aproape în fiecare lună
          • logaritmul este scala firească
          • inflația lunară are media 0,39%; inflația anuală variază între \(\ensuremath{-}3{,}0\%\) (mai 2016) și 13,6% (noiembrie 2022)
        • Sezonalitatea
          • ianuarie are în medie 0,74%, iunie \(\ensuremath{-}0{,}03\%\) (alimentele proaspete)
          • un tipar sezonier în \(\Delta\ln P_t\): vom avea nevoie de \(\Delta_{12}\) sau de termeni sezonieri
        • Șocurile
          • modificările de taxe mută prețurile într-o singură lună
          • iulie–august 2025: încetarea plafonării prețului la electricitate și creșterea TVA; inflația anuală de la 6,4% la 8,2%

        Pasul 2: teste de rădăcină unitară și de staționaritate

        Slide 42 în PDF

        Tabelul aplică ADF și KPSS pe patru transformări. Pentru \(100\ln P_t\), cu constantă și trend, ADF are \(\tau = -0{,}96\) și p-value 0,949, deci nu respinge rădăcina unitară, iar KPSS are \(\eta = 0{,}314\), peste valoarea critică 0,146, deci respinge staționaritatea: cele două teste sînt de acord că nivelul are o rădăcină unitară. Pentru inflația lunară \(\Delta\ln P_t\), ADF respinge, cu \(\tau = -4{,}00\) și p-value 0,001, iar KPSS nu respinge, cu 0,431 sub 0,463: seria este staționară, dar sezonieră.

        Inflația anuală \(\Delta_{12}\ln P_t\) dă un rezultat neconcludent: ADF nu respinge, cu \(\tau = -1{,}69\) și p-value 0,435, dar nici KPSS nu respinge, cu 0,424 sub 0,463. Situația este cea discutată în Capitolul 3: datele nu au destulă informație pentru a decide. Pentru \(z_t = \Delta\Delta_{12}\ln P_t\), ADF respinge clar, cu \(\tau = -4{,}83\) și p-value sub 0,001, iar KPSS are 0,113, mult sub valoarea critică.

        Decizia este \(d = 1\) și \(D = 1\): modelul se construiește pentru \(z_t\), singura transformare pe care ambele teste o declară staționară și care elimină și tiparul sezonier. Valorile critice ADF la 5% sînt \(-3{,}43\) cu trend și \(-2{,}87\) cu constantă, iar numărul de laguri este ales cu AIC.

        Pe scurt

        SeriaTermeniADF \(\tau\)\(p\)KPSS \(\eta\) (5%: val. critică)Verdict
        \(100\ln P_t\)const., trend\(\ensuremath{-}0{,}96\)0,9490,314 (0,146)rădăcină unitară
        \(\Delta\ln P_t\)const.\(\ensuremath{-}4{,}00\)0,0010,431 (0,463)staționară, sezonieră
        \(\Delta_{12}\ln P_t\)const.\(\ensuremath{-}1{,}69\)0,4350,424 (0,463)neconcludent
        \(z_t = \Delta\Delta_{12}\ln P_t\)const.\(\ensuremath{-}4{,}83\)\(<\) 0,0010,113 (0,463)staționară
        • ADF: \(H_0\) rădăcină unitară, laguri după AIC Dickey și Fuller (1979); KPSS: \(H_0\) staționaritate Kwiatkowski et al. (1992); valorile critice ADF la 5%: \(\ensuremath{-}3{,}43\) (cu trend), \(\ensuremath{-}2{,}87\) (cu constantă)
        • Inflația anuală: nici ADF, nici KPSS nu respinge: un rezultat neconcludent, ca în Capitolul 3
        • Decizia: \(d = 1\), \(D = 1\): modelăm \(z_t\), iar ambele teste arată că este staționară
        TSA_ch15_box_jenkins

        Pasul 3: identificarea din corelograma lui \(z_t\)

        Slide 43 în PDF
          Întrebare pentru sală ▶ trece prin φ = 0. Cît este atunci ρ12 teoretic pentru Θ = −0,867?
          Răspuns

          −0,49 = Θ/(1 + Θ2) = −0,867/1,752. Un MA(1) sezonier are o singură autocorelație sezonieră nenulă, la lagul 12, iar mărimea ei nu poate depăși 0,5 în modul; cu φ = 0 sateliții de la 11 și 13 dispar. Cu φ = 0,416 ei sînt aproximativ φ · ρ12, iar în eșantion ρ̂11 = −0,12 și ρ̂13 = −0,15, aproape de produsul ρ̂1ρ̂12 = −0,15.

            Întrebare pentru sală ▶ mută penalizarea c de la 2 la 9. Ce model are criteriul cel mai mic la c = 2 (AIC fără corecție)?
            Răspuns

            (2,1,1)(0,1,1)12, chiar modelul ales. Cu c = ln 223 = 5,41 (BIC) cîștigă (1,1,1)(0,1,1)12, care are un parametru mai puțin, dar pică testul Ljung–Box la lagul 12 (p = 0,029); de la c ≈ 5 în sus el rămîne primul. Modelul ales nu se schimbă pentru niciun c din grafic, pentru că este cel mai bun dintre modelele care trec verificarea.

              Întrebare pentru sală ▶ trece prin cele cinci modele din tabel. Care are cea mai mică rădăcină AR cea mai apropiată de 1?
              Răspuns

              (2,1,1)(0,1,1)12, cu modulul 1,034 (inversul 0,967), urmat de (1,1,2)(0,1,1)12 cu 1,035. Modelul identificat are o singură rădăcină AR, 2,40: un AR(1) cu φ = 0,42 nu poate reproduce persistența inflației. Rădăcinile MA sezoniere au toate modulul aproape 1 (1,006): Θ1 ≈ −1 aproape anulează Δ12.

                Întrebare pentru sală ▶ trece la Δ ln P (fără diferența sezonieră). Ce arată ACF la lagurile 12, 24 și 36?
                Răspuns

                0,25, 0,22 și 0,18, toate peste banda ±0,12 și descrescînd încet: tiparul sezonier nu a fost eliminat, deci este nevoie de Δ12. Pentru Δ12 ln P ACF începe la 0,98 și scade foarte încet (o rădăcină aproape unitară); abia z = ΔΔ12 ln P are o singură valoare sezonieră mare, −0,45 la lagul 12.

                Graficul are două panouri: în stînga ACF, în dreapta PACF ale lui \(z_t = \Delta\Delta_{12}\ln P_t\), pentru lagurile 1–36, cu \(T = 247\) de observații. Axa orizontală este lagul în luni, iar lagurile sezoniere 12, 24 și 36 sînt colorate în roșu. Liniile punctate verzi sînt banda \(\pm 1{,}96/\sqrt{T} = \pm 0{,}125\).

                În ACF se văd două grupuri: bare pozitive la lagurile 1–2 și 6–7, cea mai mare la lagul 1, și o bară negativă mare la lagul 12, însoțită de bare negative mai mici la lagurile vecine. În PACF, după bara de la lagul 1, cele mai vizibile sînt barele roșii negative de la 12, 24 și 36, care scad în mărime de la primul lag sezonier la următoarele.

                Pe scurt

                • ACF și PACF pentru \(z_t = \Delta\Delta_{12}\ln P_t\), lagurile 1–36, \(T = 247\); lagurile sezoniere în roșu; banda \(\pm 0{,}125\)
                TSA_ch15_box_jenkins

                Interpretarea corelogramei

                Slide 44 în PDF

                În partea obișnuită, \(\hat\rho_1 = 0{,}33\) și \(\hat\rho_2 = 0{,}16\), iar PACF are \(\hat\phi_{11} = 0{,}33\) și apoi valori mici: tiparul unui AR(1), cu PACF care se oprește după lagul 1. Este posibil și un MA(1), deoarece atît ACF, cît și PACF scad repede după lagul 1, iar cu o singură autocorelație mare cele două tipare sînt greu de separat.

                În partea sezonieră, ACF are \(-0{,}45\) la lagul 12 și apoi \(-0{,}01\) la lagul 24, deci se oprește după primul lag sezonier. PACF are \(-0{,}50\), \(-0{,}28\) și \(-0{,}29\) la lagurile 12, 24 și 36, adică scade treptat. O singură valoare sezonieră mare în ACF, cu o PACF sezonieră care descrește, este tiparul unui MA(1) sezonier, termenul care apare natural după o diferență sezonieră.

                Primul candidat este deci SARIMA\((1,1,0)(0,1,1)_{12}\) pentru \(\ln P_t\). Barele negative de la lagurile 11 și 13, vecine lagului sezonier, nu cer termeni separați: într-un model multiplicativ, autocorelația de la lagurile \(12 \pm 1\) este aproximativ produsul \(\rho_1\rho_{12}\).

                Pe scurt

                • Partea obișnuită
                  • \(\hat\rho_1 = 0{,}33\), \(\hat\rho_2 = 0{,}16\)
                  • PACF \(\hat\phi_{11} = 0{,}33\), apoi mici: un AR(1)
                  • este posibil și un MA(1): ACF și PACF scad amîndouă după lagul 1
                • Partea sezonieră
                  • ACF \(\ensuremath{-}0{,}45\) la lagul 12, apoi \(\ensuremath{-}0{,}01\) la 24
                  • PACF \(\ensuremath{-}0{,}50\), \(\ensuremath{-}0{,}28\), \(\ensuremath{-}0{,}29\) la 12, 24, 36
                  • o singură valoare sezonieră mare în ACF și o PACF sezonieră care descrește: un MA(1) sezonier
                • Primul candidat: SARIMA\((1,1,0)(0,1,1)_{12}\) pentru \(\ln P_t\); sateliții de la lagurile 11 și 13 sînt produsul \(\rho_1\rho_{12}\)

                Pasul 4: estimarea candidaților

                Slide 45 în PDF

                Identificarea dă un punct de plecare, nu un rezultat final, așa că au fost estimate toate cele 36 de modele SARIMA\((p,1,q)(P,1,Q)_{12}\) cu \(p, q \le 2\) și \(P, Q \le 1\), pe eșantionul de antrenare pînă în august 2024, cu \(T = 236\). Tabelul dă, pe primul rînd, modelul identificat, apoi, în ordinea BIC, celelalte patru modele cu cel mai mic BIC, cu numărul de parametri estimați, inclusiv varianța, AICc, BIC și p-value-urile testului Ljung–Box pe reziduuri la 12 și 24 de laguri, cu \(m - k\) grade de libertate, unde \(k\) este numărul de parametri ARMA.

                Modelul identificat, \((1,1,0)(0,1,1)_{12}\), are AICc 295,2 și BIC 305,3, dar p-value-urile Ljung–Box sînt 0,004 la ambele laguri: reziduurile lui sînt autocorelate. Modelul cu cel mai mic BIC, \((1,1,1)(0,1,1)_{12}\), cu 298,9, are p-value 0,029 la lagul 12, deci eșuează și el. Modelul \((2,1,1)(0,1,1)_{12}\) are BIC 299,4, foarte aproape de minim, cel mai mic AICc, 282,6, și p-value-uri de 0,233 și 0,237.

                Regula de alegere combină cele două criterii: cel mai mic BIC dintre modelele ale căror reziduuri trec testul. Modelul ales este \((2,1,1)(0,1,1)_{12}\). Diferența de BIC față de minim este mică, iar un model ale cărui reziduuri păstrează autocorelație nu poate fi folosit pentru prognoză, oricît de bine ar fi clasat.

                Pe scurt

                Modelulparam.AICcBICLB(12) \(p\)LB(24) \(p\)
                \((1,1,0)(0,1,1)_{12}\), identificat3295,2305,30,0040,004
                \({(1,1,1)(0,1,1)}_{12}\)4285,4298,90,0290,088
                \({(2,1,1)(0,1,1)}_{12}\)5282,6299,40,2330,237
                \({(1,1,2)(0,1,1)}_{12}\)5282,8299,60,2330,217
                \({(1,1,1)(1,1,1)}_{12}\)5287,7304,50,0170,070
                • Toate cele 36 de modele SARIMA\((p,1,q)(P,1,Q)_{12}\) cu \(p, q \le 2\), \(P, Q \le 1\), pe eșantionul de antrenare pînă în august 2024 (\(T = 236\)); primul rînd: modelul identificat, apoi celelalte patru modele cu cel mai mic BIC, în ordine
                • param.: toți parametrii estimați, inclusiv varianța; Ljung–Box pe reziduuri cu \(m - k\) grade de libertate, \(k\) = parametrii ARMA
                • Modelul identificat nu trece verificarea reziduurilor; cel mai mic BIC, \((1,1,1)(0,1,1)\), eșuează la lagul 12; modelul ales este \((2,1,1)(0,1,1)_{12}\), cel mai mic BIC dintre modelele care trec
                TSA_ch15_box_jenkins

                Pasul 4: modelul ales

                Slide 46 în PDF

                Modelul ales se scrie pentru \(z_t = \Delta\Delta_{12}\,100\ln P_t\):

                \[(1 - \phi_1L - \phi_2L^2)\,z_t = (1 + \theta_1L)(1 + \Theta_1L^{12})\,\varepsilon_t.\]
                (15.12)

                Estimările sînt \(\hat\phi_1 = 1{,}156\) (eroarea standard 0,149, \(z = 7{,}76\)), \(\hat\phi_2 = -0{,}183\) (eroarea standard 0,122, \(z = -1{,}50\), p-value 0,133), \(\hat\theta_1 = -0{,}856\) și \(\hat\Theta_1 = -0{,}935\), ambele cu p-value sub 0,001, iar varianța inovațiilor este 0,179. Coeficientul \(\phi_2\) nu se separă de zero la 5%, dar fără el reziduurile păstrează autocorelație, așa cum arată pasul anterior.

                Estimarea \(\hat\Theta_1\) este aproape de \(-1\). Factorul \((1 + \Theta_1L^{12})\) aproape anulează diferența sezonieră \((1 - L^{12})\), ceea ce înseamnă că tiparul sezonier este aproape fix de la un an la altul; variabilele dummy sezoniere ar fi o alternativă. Cea mai mică rădăcină a polinomului AR are modulul 1,034, foarte aproape de cercul unitate: șocurile inflației lunare sînt foarte persistente, rezultat care se potrivește cu AR(2) din Capitolul 2 și cu memoria lungă din Capitolul 8.

                Pe scurt

                ParametrulEstimareaSE\(z\)\(p\)
                \(\phi_1\) (ar.L1)\(1{,}156\)\(0{,}149\)\(7{,}76\)\(<\) 0,001
                \(\phi_2\) (ar.L2)\(\ensuremath{-}0{,}183\)\(0{,}122\)\(\ensuremath{-}1{,}50\)0,133
                \(\theta_1\) (ma.L1)\(\ensuremath{-}0{,}856\)\(0{,}099\)\(\ensuremath{-}8{,}61\)\(<\) 0,001
                \(\Theta_1\) (ma.S.L12)\(\ensuremath{-}0{,}935\)\(0{,}098\)\(\ensuremath{-}9{,}55\)\(<\) 0,001
                \(\sigma^2\)\(0{,}179\)
                • \((1 - \phi_1L - \phi_2L^2)\,z_t = (1 + \theta_1L)(1 + \Theta_1L^{12})\,\varepsilon_t\), \(z_t = \Delta\Delta_{12}\,100\ln P_t\)
                • \(\hat\Theta_1\) aproape de \(-1\): tiparul sezonier este aproape fix, iar \(\Delta_{12}\) aproape se anulează; variabilele dummy sezoniere ar fi o alternativă
                • Cea mai mică rădăcină AR are modulul 1,034: șocurile inflației sînt foarte persistente, ca în Capitolele 2 și 8
                TSA_ch15_box_jenkins

                Pasul 5: verificarea reziduurilor

                Slide 47 în PDF
                  Întrebare pentru sală ▶ mută m de la 6 la 36. Trece modelul ales (2,1,1)(0,1,1)12 testul Ljung–Box la 5% pentru fiecare m?
                  Răspuns

                  Nu: la m = 7 p = 0,025 și la m = 8 p = 0,048; la toate celelalte laguri, inclusiv 12 și 24 (cele din curs), p > 0,05. Modelul identificat pică la fiecare m între 6 și 36. Un test la mai multe laguri nu este independent: alegerea lui m schimbă verdictul la limită, de aceea cursul raportează două laguri fixate dinainte.

                    Întrebare pentru sală ▶ trece prin cele cinci modele din tabelul pasului 4. La care dintre ele scade kurtosis-ul reziduurilor sub 5?
                    Răspuns

                    La niciunul: kurtosis-ul rămîne între 9,5 și 10,0, iar Jarque–Bera între 390 și 454. Termenii AR și MA în plus elimină autocorelația, nu valorile extreme: reziduurile din iunie 2015 (−6,1σ) și iulie 2010 (5,3σ) vin din modificările TVA, pe care niciun model univariat nu le poate anticipa.

                    Graficul are trei panouri. Primul arată reziduurile standardizate ale modelului ales în timp, din 2006 pînă în 2024, cu liniile punctate la \(\pm 2\): cele mai multe valori stau în bandă, cu două excepții mari, un vîrf pozitiv în 2010 și unul negativ în 2015. Al doilea arată ACF a reziduurilor pentru lagurile 1–24, pentru ambele modele: barele aurii sînt ale modelului identificat, iar cele albastre ale modelului ales.

                    La modelul identificat, barele de la lagurile 6 și 7 și cea de la lagul 15 depășesc banda; la modelul ales ele scad, iar doar bara de la lagul 7 ajunge la marginea benzii. Al treilea panou este un QQ plot al reziduurilor față de distribuția Normală standard: punctele urmează linia roșie în centru, dar se depărtează de ea la ambele capete, cu cîteva valori extreme mult în afara liniei.

                    Pe scurt

                    • Reziduurile standardizate ale modelului ales; ACF a reziduurilor ambelor modele; QQ plot față de \(N(0, 1)\)
                    TSA_ch15_box_jenkins

                    Interpretarea verificării reziduurilor

                    Slide 48 în PDF

                    Testul Ljung–Box nu mai găsește autocorelație în reziduurile modelului ales: \(Q(12) = 10{,}49\), cu 8 grade de libertate și p-value 0,233, iar \(Q(24) = 24{,}13\), cu p-value 0,237. Modelul identificat avea p-value-uri de 0,004 la ambele laguri. Termenii AR și MA în plus reduc tocmai autocorelația de la lagurile 6–7, pe care modelul mai simplu o lăsa în reziduuri.

                    Reziduurile nu au însă distribuția Normală: statistica Jarque–Bera este 450, iar kurtosis-ul este 9,9, mult peste valoarea 3 a distribuției Normale. Cele mai mari două reziduuri au cauze cunoscute: iunie 2015, cu \(-6{,}1\sigma\), cînd TVA la alimente a fost redusă, și iulie 2010, cu \(5{,}3\sigma\), cînd TVA a fost crescută.

                    Consecința este împărțită. Prognozele punctuale sînt bune, deoarece reziduurile nu mai conțin dependență exploatabilă. Intervalele de prognoză calculate cu distribuția Normală sînt însă prea înguste în lunile în care se schimbă taxele. Variabilele dummy pentru modificările de taxe cunoscute ar elimina cele mai mari reziduuri și ar face intervalele mai credibile.

                    Pe scurt

                    • Nu mai rămîne autocorelație
                      • Ljung–Box \(Q(12) = 10{,}49\) (\(8\) grade de libertate, \(p = 0{,}233\)), \(Q(24) = 24{,}13\) (\(p = 0{,}237\))
                      • modelul identificat avea \(p = 0{,}004\) și 0,004: termenii AR și MA în plus reduc autocorelația de la lagurile 6–7
                    • Nu este Normal
                      • Jarque–Bera 450, kurtosis-ul 9,9
                      • cele mai mari două reziduuri: iunie 2015 (\(\ensuremath{-}6{,}1\sigma\), reducerea TVA la alimente) și iulie 2010 (\(5{,}3\sigma\), creșterea TVA)
                    • Consecința: prognozele punctuale sînt bune, dar intervalele Normale sînt prea înguste cînd se schimbă taxele; variabile dummy pentru modificările de taxe cunoscute ar ajuta

                    Pasul 6: prognoze

                    Slide 49 în PDF
                      Întrebare pentru sală ▶ mărește numărul de luni de test de la 6 la 24. Respinge testul Diebold–Mariano acuratețea egală față de naivul sezonier pentru vreo lungime?
                      Răspuns

                      Nu: cel mai mic p este 0,174, chiar la 24 de luni. Cu 11 luni statistica devine chiar pozitivă (0,10), pentru că erorile mari din iulie–august 2025 cad pe SARIMA. RMSE mai mic nu înseamnă o diferență semnificativă: pe un eșantion scurt varianța lui dt este mare.

                      Exemplu rezolvat

                      \[\begin{gathered}Y_t = 10 + 0{,}5\,t + u_t,\quad u_t = \phi u_{t-1} + \varepsilon_t\\ \hat Y_{T+h} = 10 + 0{,}5\,(T+h) + \phi^h u_T,\quad \mathrm{Var}(e_{T+h}) = \frac{1-\phi^{2h}}{1-\phi^2}\end{gathered}\]
                          Întrebare pentru sală ▶ mută φ pînă la 0,95. Cît este ρΔY(1) pentru φ = 0,95?
                          Răspuns

                          −0,025 = −(1 − φ)/2. Diferențierea unei serii staționare în jurul trendului dă un ARMA(1,1) cu θ = −1; pentru φ aproape de 1 rădăcina AR și rădăcina MA aproape se anulează și ACF a lui ΔY pare zgomot alb, deși ΔY rămîne neinvertibil. Cu φ = 0 corelația este −0,5, valoarea unui MA(1) cu θ = −1.

                          Exemplu rezolvat

                          \[\Delta y_t = c + bt + \gamma y_{t-1} + \sum_j \delta_j \Delta y_{t-j} + \varepsilon_t,\quad H_0:\ \gamma = 0;\qquad Q(m) = T(T+2)\sum_{k=1}^{m}\frac{\hat\rho_k^2}{T-k}\]
                              Întrebare pentru sală ▶ scurtează eșantionul pînă în 2019Q4 (fără pandemie). Trece creșterea testul Ljung–Box Q(8)?
                              Răspuns

                              Da: Q(8) = 4,18, p = 0,841, iar deriva este 1,00% pe trimestru (σ̂ = 2,49). Pe tot eșantionul, cu 2020 inclus, Q(8) = 7,28 (p = 0,506) și deriva 0,81%: căderea din 2020Q2 scade media, dar nu creează autocorelație. ADF pentru nivel rămîne nerespins (−2,08 în 2019Q4).

                              Exemplu rezolvat

                              \[z_t = \phi z_{t-1} + \Phi z_{t-12} - \phi\Phi z_{t-13} + \varepsilon_t,\qquad \Delta_{12}\ln P_{T+1} = \Delta_{12}\ln P_T + \hat z_{T+1}\]
                                  Întrebare pentru sală ▶ mută originea în august 2025 (prognoza pentru septembrie 2025, chiar după saltul TVA). Cum se compară prognoza de mînă cu valoarea realizată?
                                  Răspuns

                                  Prognoza este z = 0,753 și inflația anuală 8,93%; s-a realizat z = 0,090 și 8,26%. Termenul φzT duce saltul din august în septembrie, deși saltul a fost o decizie unică. Cu originea în iulie 2026 prognoza pentru august 2026 este 6,83%, față de 6,09% realizat: ieșirea saltului din fereastra de 12 luni este subestimată, pentru că |Φ̂| = 0,49 < 1.

                                  Exemplu rezolvat

                                  \[\frac{\partial i}{\partial \pi} = \frac{b_{\pi,1} + b_{\pi,2}}{1 - b_{i,1} - b_{i,2}},\qquad F = \frac{(RSS_R - RSS_U)/p}{RSS_U/(T - Kp - 1)}\]
                                      Întrebare pentru sală ▶ trece prin eșantioanele care se termină în 2015Q4, …, 2026Q2. Cum se schimbă efectul pe termen lung al inflației asupra ROBOR?
                                      Răspuns

                                      Pînă în 2022Q4 stă între 1,06 și 1,32 (1,27 în 2019Q4), apoi coboară la 0,91 în 2023Q4 și 0,90 în 2026Q2. Numitorul 1 − bi,1 − bi,2 rămîne între 0,03 și 0,09, deci mici schimbări ale coeficienților mută mult raportul. Testul Granger pentru g → i respinge pe toate eșantioanele (p ≤ 0,008).

                                      Exemplu rezolvat

                                      \[\Delta \mathbf{y}_t = \boldsymbol\alpha\,\boldsymbol\beta^\top \mathbf{y}_{t-1} + \dots,\qquad \mathbf{ec}_t \approx (\mathbf{I} + \boldsymbol\beta^\top\boldsymbol\alpha)\,\mathbf{ec}_{t-1},\qquad h_{1/2} = \frac{\ln 0{,}5}{\ln|\lambda|}\]
                                          Întrebare pentru sală ▶ mărește multiplicatorul lui α de la 0,25 la 2. Cît devine timpul de înjumătățire lent (22,1 luni în curs) cu α dublat?
                                          Răspuns

                                          10,9 luni, aproximativ jumătate: pentru valori proprii aproape de 1, ln λ ≈ −(1 − λ), iar 1 − λ este proporțional cu α. Componenta rapidă scade de la 9,0 la 4,3 luni. Cu α împărțit la 4 timpii devin 89,6 și 37,2 luni.

                                          Exemplu rezolvat

                                          \[\begin{gathered}\sigma^2_{t+1} = \omega + \alpha\varepsilon_t^2 + \beta\sigma_t^2,\qquad \bar\sigma^2 = \frac{\omega}{1-\alpha-\beta}\\ \mathrm{VaR}_{1\%} = -\left(\mu + \sigma_{t+1}\, t_\nu^{-1}(0{,}01)\sqrt{(\nu-2)/\nu}\right)\end{gathered}\]
                                              Întrebare pentru sală Puneți εt = +3 în loc de −3. Cît este σ2t+1?
                                              Răspuns

                                              Tot 2,5685: GARCH(1,1) depinde de εt2, deci o creștere de 3% și o scădere de 3% au același efect. Efectul de levier cere un model asimetric (GJR sau EGARCH, Capitolul 5). Cu εt = 0, σ2t+1 = 0,844, sub varianța de azi.

                                              Exemplu rezolvat

                                              \[\begin{gathered}\mathrm{RMSE} = \sqrt{\tfrac1n\sum e_t^2},\quad \mathrm{MASE} = \frac{\mathrm{MAE}}{\mathrm{MAE}_{\text{in}}}\\ d_t = e_{A,t}^2 - e_{B,t}^2,\quad DM = \frac{\bar d}{s_d/\sqrt n}\end{gathered}\]
                                                  Întrebare pentru sală ▶ înmulțește erorile metodei naive sezoniere cu un factor de la 0,5 la 2. De la ce factor respinge testul DM acuratețea egală la 5%?
                                                  Răspuns

                                                  De la aproximativ 1,35: DM = −2,33 la 1,2 și −2,63 la 1,4, față de valoarea critică 2,571 cu 5 grade de libertate. Cu șase luni chiar o metodă cu erori cu 40% mai mari abia se distinge; MASE sub 1 nu este o dovadă.

                                                  Exemplu rezolvat

                                                  \[\begin{gathered}K_t = \frac{P_t}{P_t + \sigma^2_\varepsilon},\quad \frac{\bar P}{\sigma^2_\varepsilon} = \frac{q + \sqrt{q^2 + 4q}}{2}\\ E(D_i) = \frac{1}{1 - p_{ii}},\quad \pi_1 = \frac{1 - p_{22}}{2 - p_{11} - p_{22}},\quad H = d + \tfrac12\end{gathered}\]
                                                      Întrebare pentru sală ▶ mută ση2 pînă la 4 (q = 1). Cît este cîștigul de echilibru?
                                                      Răspuns

                                                      0,618 = (1 + √5)/2 / (1 + (1 + √5)/2). Cu cît nivelul se mișcă mai mult față de zgomot, cu atît filtrul crede mai mult observația nouă. Primul pas rămîne Kt = 2/6 = 0,333, pentru că depinde doar de Pt = 2 și σε2 = 4; cîștigul converge apoi la valoarea de echilibru în cîțiva pași.

                                                        Întrebare pentru sală ▶ mută originea prognozei din august 2025 în august 2026. Cu originea în august 2025, cît prognozează modelul pentru inflația anuală din august 2026 (realizată: 6,1%)?
                                                        Răspuns

                                                        9,7%, cu intervalul de 95% [3,9; 15,5], care conține valoarea realizată. Modelul tratează o parte din salturile din iulie–august 2025 ca persistente (rădăcina AR 0,967) și nu știe că acestea au fost decizii fiscale unice; la originile următoare prognoza pe 12 luni coboară, cu oscilații, pînă la 6,3% din august 2026.

                                                        Graficul are două panouri. În stînga sînt prognozele pe un pas ale inflației lunare pe eșantionul de test, din septembrie 2024 pînă în august 2026, cu parametrii estimați doar pe eșantionul de antrenare: valorile observate (cercuri negre), prognozele SARIMA\((2,1,1)(0,1,1)_{12}\) (pătrate albastre) și prognozele naive sezoniere (triunghiuri aurii, linie întreruptă). Pentru cele mai multe luni, prognozele SARIMA sînt aproape de valorile observate; în iulie și august 2025 valorile observate cresc brusc, iar ambele prognoze rămîn mult sub ele.

                                                        Panoul arată și slăbiciunea metodei naive sezoniere: ea repetă valoarea din aceeași lună a anului anterior, deci în iulie și august 2026 copiază șocurile fiscale din 2025, în timp ce valorile observate revin la normal. În dreapta este inflația anuală din 2015 (linia roșie), cu prognozele pînă în august 2027 (linia albastră) și intervalul de 95% (zona gri), din modelul reestimat pe toate datele. Linia verde punctată marchează ținta de inflație a BNR, de 2,5%.

                                                        Pe scurt

                                                        • Stînga: prognoze pe un pas ale inflației lunare pe eșantionul de test (septembrie 2024 – august 2026), cu parametrii estimați pe eșantionul de antrenare
                                                          • dreapta: prognoze ale inflației anuale pînă în august 2027, cu intervale de 95%, modelul reestimat pe toate datele
                                                        TSA_ch15_box_jenkins

                                                        Interpretarea prognozelor

                                                        Slide 50 în PDF

                                                        Pe eșantionul de test de 24 de luni, modelul SARIMA are cele mai mici erori: rădăcina erorii pătratice medii (root mean squared error, RMSE) este 0,45, MAE este 0,28, iar MASE 0,66, față de 0,64, 0,42 și 0,99 pentru metoda naivă sezonieră și 0,51, 0,38 și 0,88 pentru metoda naivă. Testul Diebold–Mariano cu corecția HLN nu respinge însă acuratețea egală: statistica este \(-1{,}40\), cu p-value 0,174, față de metoda naivă sezonieră, și \(-0{,}47\), cu p-value 0,642, față de metoda naivă. Avantajul modelului nu se separă de zgomot pe acest eșantion.

                                                        Explicația ține de mărimea eșantionului și de natura erorilor. Douăzeci și patru de luni sînt puține pentru un test de acuratețe egală, iar cele mai mari erori vin din două luni: august 2025, cu inflația lunară observată de 2,07% față de prognoza de 0,47%, și iulie 2025, cu 1,34% față de 0,37%. Ele corespund unor decizii privind taxele și prețul energiei, pe care niciun model univariat nu le poate anticipa.

                                                        Inflația anuală a fost 6,1% în august 2026. Prognoza este 6,1% pentru septembrie 2026, cu intervalul de 95% între 5,3% și 6,9%, și 6,3% pentru august 2027, cu intervalul între 0,9% și 11,8%. Saltul de TVA din august 2025 iese din fereastra de douăsprezece luni în august 2026, ceea ce explică coborîrea inflației anuale observate la sfîrșitul eșantionului. Intervalul la douăsprezece luni este foarte larg, deoarece rădăcina AR aproape unitară face ca incertitudinea să se acumuleze aproape ca la un mers aleator.

                                                        Pe scurt

                                                        Inflația lunară, eșantion de testRMSEMAEMASE
                                                        SARIMA\((2,1,1)(0,1,1)_{12}\)0,450,280,66
                                                        naiv sezonier0,640,420,99
                                                        naiv0,510,380,88
                                                        • SARIMA are cele mai mici erori, dar testul Diebold–Mariano (HLN) nu respinge acuratețea egală: \(\ensuremath{-}1{,}40\) (\(p = 0{,}174\)) față de naivul sezonier, \(\ensuremath{-}0{,}47\) (\(p = 0{,}642\)) față de metoda naivă
                                                          • 24 de luni sînt puține; cele mai mari erori: august 2025 (2,07%, față de 0,47%) și iulie 2025 (1,34%, față de 0,37%): decizii privind taxele și energia pe care niciun model univariat nu le poate anticipa
                                                        • Inflația anuală: 6,1% în august 2026; prognoza 6,1% pentru septembrie 2026 [5,3; 6,9], 6,3% pentru august 2027 [0,9; 11,8]
                                                          • saltul TVA din august 2025 iese din fereastra de 12 luni în august 2026; intervalul la 12 luni este larg: o rădăcină aproape unitară în \(\Delta\ln P_t\)
                                                        TSA_ch15_box_jenkins

                                                        Recapitulare: Box–Jenkins pe inflația din România

                                                        Slide 51 în PDF

                                                        Graficul, transformarea și testele arată că \(\ln P_t\) are nevoie de o diferență obișnuită și de una sezonieră, \(d = 1\) și \(D = 1\). Corelograma lui \(z_t\) sugerează \((1,1,0)(0,1,1)_{12}\), dar verificarea reziduurilor respinge acest model, iar căutarea printre candidați duce la \((2,1,1)(0,1,1)_{12}\), cel mai mic BIC dintre modelele care trec testul Ljung–Box.

                                                        În afara eșantionului, modelul are erori mai mici decît reperele naive, dar cîștigul nu este semnificativ statistic pe 24 de luni, iar erorile sînt dominate de șocurile fiscale. Exemplul arată de ce bucla Box–Jenkins include întoarcerea la identificare și de ce evaluarea finală se face pe date pe care modelul nu le-a văzut.

                                                        Pe scurt

                                                        • Grafic, transformare, testare: \(\ln P_t\) are nevoie de \(d = 1\) și \(D = 1\)
                                                        • Corelograma sugerează \((1,1,0)(0,1,1)_{12}\); verificarea reziduurilor îl respinge; modelul ales este \((2,1,1)(0,1,1)_{12}\)
                                                        • În afara eșantionului, cîștigul față de metoda naivă sezonieră nu este semnificativ; șocurile fiscale domină erorile

                                                        Sinteza secțiunii

                                                        Cazul IAPC folosește aproape toată prima parte a cursului: logaritmul și diferențele din Capitolele 0–1, ADF și KPSS din Capitolul 3, corelograma și criteriile informaționale din Capitolul 2, SARIMA și testul Diebold–Mariano din Capitolul 4. Concluzia este una prudentă: un model bine construit și verificat dă prognoze punctuale bune, dar nu poate anticipa șocurile de politică fiscală, iar intervalele lui trebuie citite știind că reziduurile au cozi groase.

                                                        Examenul

                                                        Examenul scris are 70% din nota finală, iar proiectul de echipă are 20%; restul de 10% vine din prezență și din quiz-urile capitolelor. Această secțiune descrie examenul scris și prezintă opt probleme recapitulative, fiecare urmată de rezolvarea ei; secțiunea următoare descrie proiectul. Problemele urmează tipurile de subiecte ale examenului: o derivare scurtă, citirea unor rezultate obținute cu software și o prognoză calculată de mînă.

                                                        Examenul scris: formatul

                                                        Slide 52 în PDF

                                                        Examenul scris reprezintă 70% din nota finală și durează două ore. Are cinci subiecte, toate obligatorii, notate împreună cu 9 puncte, la care se adaugă un punct din oficiu.

                                                        Subiectele sînt de trei tipuri. Primul este o derivare scurtă: media și varianța unui proces, condiția de staționaritate, funcția de autocorelație sau forma procesului obținut după o transformare. Al doilea este interpretarea unor rezultate obținute cu software: estimări, teste, corelograme, tabele VAR și VECM. Al treilea cere alegerea unui model și o prognoză calculată de mînă din coeficienții estimați. Valorile critice necesare sînt tipărite în rezultate, ca în problemele din această secțiune.

                                                        Pe scurt

                                                        • 70% din nota finală; scris, 2 ore
                                                          • cinci subiecte, toate obligatorii; 9 puncte pentru subiecte plus 1 punct din oficiu
                                                        • Trei tipuri de subiecte
                                                          • o derivare scurtă: momente, staționaritate, ACF sau forma unui proces
                                                          • interpretarea rezultatelor obținute cu software: estimări, teste, corelograme, tabele VAR și VECM
                                                          • alegerea modelului și o prognoză calculată de mînă din rezultate
                                                        • Valorile critice necesare sînt tipărite în rezultate, ca în problemele de mai jos
                                                        Examenul scris: formatul Institutul Național de Statistică, București: sursa multor serii de examen Foto: Dan Mihai Pitea (2009); CC BY-SA 3.0; Wikimedia Commons

                                                        Conținutul evaluat

                                                        Slide 53 în PDF

                                                        Materia examenului este cea din cursurile și seminariile Capitolelor 0–10. Definițiile și formulele sînt cele de pe slide-urile „Noțiuni necesare azi” ale fiecărui seminar, iar calculele sînt de tipul celor din Partea A a seminariilor, făcute pe hîrtie.

                                                        O parte importantă a subiectelor este citirea rezultatelor: tabele ca cele din Partea B a seminariilor și din acest capitol. Rezultatele pot veni din EViews sau din Python, unde aceleași cifre poartă alte nume: coeficientul AR(1) apare în Python ca ar.L1, iar SAR(12) ca ar.S.L12. La examen nu se scrie cod.

                                                        Ponderea principală o au modelele ARIMA și SARIMA, rădăcinile unitare, modelele VAR și cauzalitatea Granger, cointegrarea și VECM și modelele GARCH. Capitolele 11–14 sînt pentru studiu individual.

                                                        Pe scurt

                                                        • Capitolele 0–10
                                                          • cursuri și seminarii
                                                          • definițiile și formulele de pe slide-urile „Noțiuni necesare azi” ale fiecărui seminar
                                                          • calculele din Partea A a seminariilor, pe hîrtie
                                                        • Citirea rezultatelor
                                                          • tabele ca în Partea B și ca în acest capitol
                                                          • rezultate EViews sau Python: aceleași cifre sub alte nume (AR(1), ar.L1; SAR(12), ar.S.L12)
                                                          • la examen nu se scrie cod
                                                        • Ponderea principală
                                                          • ARIMA și SARIMA, rădăcini unitare, VAR și cauzalitate Granger, cointegrare și VECM, GARCH
                                                          • Capitolele 11–14 sînt pentru studiu individual

                                                        Criterii de notare

                                                        Slide 54 în PDF

                                                        Un răspuns se evaluează pe trei componente. Prima este metoda: formula sau ecuația scrisă, cu cifrele înlocuite. O metodă corectă cu o greșeală de calcul primește cea mai mare parte a punctajului, pentru că raționamentul se vede din formulă.

                                                        A doua componentă este rezultatul: cifra, cu unitatea de măsură (procente, puncte procentuale, luni) și cu semnul ei. Pentru un test, rezultatul complet conține ipoteza nulă \(H_0\), statistica, valoarea critică sau p-value-ul și decizia.

                                                        A treia componentă este interpretarea, în trei pînă la cinci fraze, cu o parte statistică și una economică. O cifră corectă însoțită de o interpretare greșită nu primește tot punctajul. Interpretarea spune și ce nu poate arăta modelul: cauzalitatea în sens economic, rupturile structurale, deciziile viitoare de politică economică.

                                                        Pe scurt

                                                        • Metoda
                                                          • formula sau ecuația, cu cifrele înlocuite
                                                          • o metodă corectă cu o greșeală de calcul primește cea mai mare parte a punctajului
                                                        • Rezultatul
                                                          • cifra, cu unitatea de măsură (%, puncte procentuale, luni) și semnul ei
                                                          • pentru un test: \(H_0\), statistica, valoarea critică sau p-value-ul, decizia
                                                        • Interpretarea
                                                          • trei pînă la cinci fraze, statistice și economice
                                                          • o cifră corectă cu o interpretare greșită nu primește tot punctajul
                                                          • precizați ce nu poate arăta modelul (cauzalitatea, rupturile structurale, viitorul politicilor)

                                                        Tipuri de probleme

                                                        Slide 55 în PDF

                                                        Tabelul leagă fiecare tip de subiect de capitolele din care provine și de problema care îl ilustrează. Derivările (momente, staționaritate, diferențiere) și identificarea din corelogramă și din testele de rădăcină unitară vin din Capitolele 1–3 (Problemele 1 și 2), iar rezultatele SARIMA cu o prognoză de mînă din Capitolele 2–4 (Problema 3). Rezultatele VAR și testele Granger vin din Capitolul 6 (Problema 4), cointegrarea și VECM din Capitolul 7 (Problema 5), GARCH și VaR 1% din Capitolul 5 (Problema 6), iar evaluarea prognozelor, spațiul stărilor și regimurile din Capitolele 4 și 8–10 (Problemele 7 și 8).

                                                        Cele opt probleme sînt exemple de recapitulare, cu rezolvări complete; examenul are subiecte proprii. Exerciții suplimentare se găsesc în Partea A a fiecărui seminar, în Seminarul 15 și în setul de probleme de exercițiu, cu 25 de probleme și rezultatele lor numerice.

                                                        Pe scurt

                                                        TipulCapitoleExemplu în acest capitol
                                                        derivare: momente, staționaritate, diferențiere1–3Problema 1: trend plus erori AR(1)
                                                        corelogramă și test de rădăcină unitară: identificare1–3Problema 2: PIB-ul României
                                                        rezultate SARIMA și o prognoză de mînă2–4Problema 3: inflația din România
                                                        rezultate VAR și Granger6Problema 4: creștere, inflație, ROBOR
                                                        rezultate de cointegrare și VECM7Problema 5: randamentele SUA
                                                        rezultate GARCH și VaR 1%5Problema 6: BET
                                                        evaluarea prognozelor; spațiul stărilor și regimuri4, 8–10Problemele 7 și 8
                                                        • Cele opt probleme de mai jos sînt exemple de recapitulare, cu rezolvări complete; examenul are subiecte proprii
                                                        • Exerciții suplimentare: Partea A a fiecărui seminar, Seminarul 15 și setul de probleme de exercițiu (25 de probleme cu rezultatele numerice)

                                                        Problema 1: un trend cu erori AR(1)

                                                        Slide 56 în PDF

                                                        Seria este un trend liniar, \(Y_t = 10 + 0{,}5t + u_t\), peste care se suprapun erori AR(1), \(u_t = 0{,}6u_{t-1} + \varepsilon_t\), cu \(\varepsilon_t\) zgomot alb de varianță 1. La momentul \(T = 100\) se observă \(Y_T = 62\). Problema separă două tipuri de nestaționaritate care arată asemănător într-un grafic: un trend determinist cu abateri staționare și o rădăcină unitară.

                                                        Cerințele cer media și varianța lui \(Y_t\), forma procesului diferențiat \(\Delta Y_t\), prognoza pe unul și pe zece pași cu modelul corect și, în final, ce se întîmplă dacă seria este diferențiată. Toate cele patru puncte se rezolvă lucrînd cu componenta \(u_t\), singura parte aleatoare a seriei.

                                                        Pe scurt

                                                        • Context
                                                          • \(Y_t = 10 + 0{,}5t + u_t\), \(u_t = 0{,}6u_{t-1} + \varepsilon_t\), \(\varepsilon_t \sim WN(0, 1)\)
                                                          • La \(T = 100\) observăm \(Y_T = 62\)
                                                        • Cerințe
                                                          1. Calculați \(E(Y_t)\) și \(\mathrm{Var}(Y_t)\) și precizați dacă \(Y_t\) este staționar.
                                                          2. Arătați că \(\Delta Y_t\) este un ARMA(1,1) cu \(\theta = -1\) și calculați \(\rho_{\Delta Y}(1)\).
                                                          3. Prognozați \(Y_{T+1}\) și \(Y_{T+10}\) cu modelul corect și dați varianța erorii pe 10 pași.
                                                          4. Explicați ce nu este în regulă dacă analistul diferențiază \(Y_t\).

                                                        Problema 1: rezolvare

                                                        Slide 57 în PDF

                                                        Media \(E(Y_t) = 10 + 0{,}5t\) depinde de timp, deci \(Y_t\) nu este staționar. Varianța este cea a procesului AR(1), \(\mathrm{Var}(u_t) = 1/(1 - 0{,}6^2) = 1{,}5625\), constantă în timp. Seria este staționară în jurul trendului (trend-stationary): după scăderea trendului rămîne un proces staționar. Prin diferențiere, \(\Delta Y_t = 0{,}5 + \Delta u_t\), iar

                                                        \[(1 - 0{,}6L)\,\Delta u_t = (1 - L)\,\varepsilon_t,\]

                                                        adică un ARMA(1,1) cu \(\theta = -1\). Autocovarianțele lui sînt \(\gamma(0) = 1{,}25\) și \(\gamma(1) = -0{,}25\), deci \(\rho(1) = -0{,}20\). Rădăcina polinomului MA este 1, iar procesul diferențiat nu este invertibil. O autocorelație de ordinul 1 negativă și un coeficient MA estimat aproape de \(-1\) sînt semnele supradiferențierii (overdifferencing).

                                                        Prognoza folosește modelul corect, trendul plus AR(1). Abaterea de la trend la momentul \(T\) este \(u_T = 62 - 10 - 50 = 2{,}0\) și se stinge geometric, cu factorul 0,6 pe perioadă:

                                                        \[\begin{aligned} \hat Y_{T+1} &= 10 + 50{,}5 + 0{,}6 \cdot 2 = 61{,}70, \\ \hat Y_{T+10} &= 10 + 55 + 0{,}6^{10} \cdot 2 = 65{,}01. \end{aligned}\]

                                                        Varianța erorii pe zece pași este \((1 - 0{,}6^{20})/(1 - 0{,}36) = 1{,}562\), practic varianța lui \(u_t\): după zece perioade mai rămîne doar 0,012 din abatere, iar incertitudinea rămîne mărginită. Tratamentul urmează tipul trendului: dintr-o serie staționară în jurul trendului se elimină trendul, iar o serie cu rădăcină unitară se diferențiază (Capitolul 3).

                                                        Pe scurt

                                                        1. \(E(Y_t) = 10 + 0{,}5t\) depinde de \(t\): nestaționar; \(\mathrm{Var}(Y_t) = 1/(1 - 0{,}36) = 1{,}5625\) este constantă: staționar în jurul trendului
                                                        2. \(\Delta Y_t = 0{,}5 + \Delta u_t\) și \((1 - 0{,}6L)\Delta u_t = (1 - L)\varepsilon_t\): ARMA(1,1), \(\theta = -1\); \(\gamma(0) = 1{,}25\), \(\gamma(1) = \ensuremath{-}0{,}25\), \(\rho(1) = \ensuremath{-}0{,}20\)
                                                        3. \(u_T = 62 - 10 - 50 = 2{,}0\); \(\hat Y_{T+1} = 10 + 50{,}5 + 0{,}6 \cdot 2 = 61{,}70\); \(\hat Y_{T+10} = 10 + 55 + 0{,}6^{10} \cdot 2 = 65{,}01\); varianța \((1 - 0{,}6^{20})/(1 - 0{,}36) = 1{,}562\)
                                                        4. Rădăcina MA este 1: \(\Delta Y_t\) nu este invertibil; \(\hat\rho_1 < 0\) și un coeficient MA aproape de \(-1\) sînt semnele supradiferențierii
                                                        • Interpretare
                                                          • Un șoc se stinge: după 10 perioade mai rămîne doar \(0{,}012\) din abatere, iar varianța erorii rămîne mărginită
                                                          • Tratamentul urmează tipul trendului: eliminăm trendul dintr-o serie staționară în jurul trendului, diferențiem o serie cu rădăcină unitară (Capitolul 3)

                                                        Problema 2: identificarea PIB-ului României

                                                        Slide 58 în PDF

                                                        Datele sînt PIB-ul real al României, ajustat sezonier, din 2000Q1 pînă în 2026Q2 (Eurostat). Tabelul dă testele ADF și KPSS pentru logaritmul PIB-ului, \(100\ln Y_t\), cu constantă și trend, și pentru creșterea trimestrială \(g_t = 100\Delta\ln Y_t\), cu constantă. Statistica ADF este \(-2{,}31\), cu p-value 0,428, pentru nivel și \(-10{,}77\), cu p-value sub 0,001, pentru creștere; statistica KPSS este 0,198 pentru nivel, cu valoarea critică de 5% egală cu 0,146, și 0,263 pentru creștere, cu valoarea critică 0,463.

                                                        Pentru \(g_t\) se dau și primele două autocorelații, \(-0{,}05\) și \(-0{,}14\), egale cu autocorelațiile parțiale, banda de încredere \(\pm 0{,}19\) și statistica Ljung–Box \(Q(8) = 7{,}28\), cu p-value 0,506. Problema parcurge primii pași ai metodei Box–Jenkins: decizia de staționaritate cu două teste care au ipoteze nule opuse, identificarea modelului din corelogramă și interpretarea modelului estimat, a cărui derivă este 0,81, cu eroarea standard 0,30.

                                                        Pe scurt

                                                        SeriaTermeniADF \(\tau\)\(p\)val. critice 1%; 5%; 10%KPSSval. critică 5%
                                                        \(100\ln Y_t\)c, t\(\ensuremath{-}2{,}31\)0,428\(\ensuremath{-}4{,}05\); \(\ensuremath{-}3{,}45\); \(\ensuremath{-}3{,}15\)0,1980,146
                                                        \(100\Delta\ln Y_t\)c\(\ensuremath{-}10{,}77\)\(<\) 0,001\(\ensuremath{-}3{,}49\); \(\ensuremath{-}2{,}89\); \(\ensuremath{-}2{,}58\)0,2630,463
                                                        • Context
                                                          • PIB-ul real al României, ajustat sezonier (Eurostat), 2000Q1 – 2026Q2
                                                          • Creșterea \(g_t = 100\Delta\ln Y_t\): ACF \(\ensuremath{-}0{,}05\); \(\ensuremath{-}0{,}14\); PACF \(\ensuremath{-}0{,}05\); \(\ensuremath{-}0{,}14\) (lagurile 1, 2; banda \(\pm 0{,}19\)); Ljung–Box \(Q(8) = 7{,}28\), \(p = 0{,}506\); \(\chi^2_{0,95}(8) = 15{,}51\)
                                                        • Cerințe
                                                          1. Descrieți testul ADF și decideți dacă \(\ln Y_t\) și \(g_t\) sînt staționare.
                                                          2. Precizați dacă testul KPSS confirmă rezultatul.
                                                          3. Identificați procesul cu metoda Box–Jenkins.
                                                          4. Deriva estimată este \(0{,}81\) (SE \(0{,}30\)): scrieți modelul și interpretați deriva.

                                                        Problema 2: rezolvare

                                                        Slide 59 în PDF

                                                        Testul ADF (Dickey și Fuller, 1979) estimează regresia

                                                        \[\Delta y_t = c + bt + \gamma y_{t-1} + \sum_j \delta_j \Delta y_{t-j} + \varepsilon_t\]

                                                        și testează \(H_0\): \(\gamma = 0\), adică rădăcina unitară. Pentru nivel, \(-2{,}31\) este peste valoarea critică de 5%, \(-3{,}45\), deci rădăcina unitară nu se respinge; pentru creștere, \(-10{,}77\) este mult sub valoarea critică de 1%, \(-3{,}49\), și se respinge. Testul KPSS (Kwiatkowski et al., 1992) are ipoteza nulă inversă, staționaritatea: 0,198 depășește 0,146 și respinge staționaritatea nivelului, iar 0,263 este sub 0,463 și nu o respinge pentru creștere. Cele două teste duc la aceeași concluzie: \(\ln Y_t\) este \(I(1)\).

                                                        Toate autocorelațiile și autocorelațiile parțiale ale creșterii sînt în bandă, iar \(Q(8) = 7{,}28\) este sub valoarea critică 15,51: creșterea nu se separă de un zgomot alb în jurul mediei. Modelul identificat este ARIMA(0,1,0) cu derivă,

                                                        \[100\ln Y_t = 100\ln Y_{t-1} + 0{,}81 + \varepsilon_t,\]

                                                        cu abaterea standard a reziduurilor 2,47 și statistica \(t\) a derivei 2,72.

                                                        Deriva este creșterea medie: circa 0,81% pe trimestru, aproximativ 3,2% pe an. Surprizele trimestriale nu sînt previzibile din trecutul seriei, iar un șoc asupra nivelului este permanent: recesiunile din 2009 și 2020 au mutat definitiv traiectoria PIB-ului, spre deosebire de seria staționară în jurul trendului din Problema 1, unde abaterile se sting.

                                                        Pe scurt

                                                        1. ADF: \(\Delta y_t = c + bt + \gamma y_{t-1} + \sum\delta_j\Delta y_{t-j} + \varepsilon_t\), \(H_0\): \(\gamma = 0\) (rădăcină unitară); \(\ln Y_t\): \(\ensuremath{-}2{,}31 > \ensuremath{-}3{,}45\): nu se respinge; \(g_t\): \(\ensuremath{-}10{,}77 < \ensuremath{-}3{,}49\): se respinge
                                                        2. KPSS (\(H_0\): staționaritate): \(0{,}198 > 0{,}146\) respinge pentru nivel, \(0{,}263 < 0{,}463\) nu respinge pentru creștere: \(\ln Y_t \sim I(1)\)
                                                        3. ACF și PACF ale lui \(g_t\) sînt în bandă, \(Q(8) = 7{,}28 < 15{,}51\): creșterea este zgomot alb în jurul mediei
                                                        4. ARIMA(0,1,0) cu derivă: \(100\ln Y_t = 100\ln Y_{t-1} + 0{,}81 + \varepsilon_t\), \(\hat\sigma = 2{,}47\); \(t = 2{,}72\)
                                                        • Interpretare
                                                          • Economia crește cu circa 0,81% pe trimestru, adică aproximativ 3,2% pe an; surprizele trimestriale nu sînt previzibile
                                                          • Un șoc asupra nivelului este permanent: recesiunile din 2009 și 2020 au mutat definitiv traiectoria PIB-ului

                                                        Problema 3: rezultate SARIMA și o prognoză de mînă

                                                        Slide 60 în PDF

                                                        Seria este \(z_t = \Delta\Delta_{12}\,100\ln \mathrm{IAPC}_t\), logaritmul IAPC al României diferențiat o dată obișnuit și o dată sezonier (în EViews, „DLOG(IPC,1,12)”), din februarie 2006 pînă în august 2026, cu \(T = 247\) observații. Tabelul dă un model cu un termen AR(1) și unul SAR(12): \(\hat\phi = 0{,}353\), cu eroarea standard 0,054 și \(z = 6{,}53\), și \(\hat\Phi = -0{,}488\), cu eroarea standard 0,035 și \(z = -13{,}90\); varianța reziduurilor este 0,254, iar statistica Ljung–Box \(Q(12)\) este 22,64, cu p-value 0,012.

                                                        Pentru prognoză se dau valorile necesare: \(z = -1{,}814\) în august 2026, \(0{,}090\) în septembrie 2025 și \(1{,}794\) în august 2025; inflația anuală în august 2026 este 6,085%. Cerințele sînt ecuația modelului cu interpretarea coeficienților, testul de zgomot alb al reziduurilor și prognoza pentru septembrie 2026, întîi pentru \(z\), apoi pentru inflația anuală.

                                                        Pe scurt

                                                        Variabila dependentă: \(z_t\)CoeficientSE\(z\)\(p\)
                                                        AR(1)\(0{,}353\)\(0{,}054\)\(6{,}53\)\(<\) 0,001
                                                        SAR(12)\(\ensuremath{-}0{,}488\)\(0{,}035\)\(\ensuremath{-}13{,}90\)\(<\) 0,001
                                                        SIGMASQ\(0{,}254\)
                                                        Ljung–Box \(Q(12)\)\(22{,}64\)0,012
                                                        • Context
                                                          • \(z_t = \Delta\Delta_{12}\,100\ln \mathrm{IAPC}_t\) („DLOG(IPC,1,12)”), România, februarie 2006 – august 2026, \(T = 247\)
                                                          • Ultimele valori: \(z\) = \(\ensuremath{-}1{,}814\) (august 2026), \(0{,}090\) (septembrie 2025), \(1{,}794\) (august 2025); inflația anuală în august 2026: 6,085%
                                                        • Cerințe
                                                          1. Scrieți ecuația modelului și interpretați coeficienții.
                                                          2. Testați dacă reziduurile sînt zgomot alb.
                                                          3. Prognozați \(z\) și rata anuală a inflației pentru septembrie 2026.

                                                        Problema 3: rezolvare

                                                        Slide 61 în PDF

                                                        Modelul multiplicativ se scrie cu operatorul de întîrziere și apoi se desface produsul celor două polinoame:

                                                        \[\begin{aligned} (1 - \phi L)(1 - \Phi L^{12})\,z_t &= \varepsilon_t, \\ z_t = \phi z_{t-1} + \Phi z_{t-12} &- \phi\Phi z_{t-13} + \varepsilon_t. \end{aligned}\]

                                                        Valoarea \(\hat\phi = 0{,}353\) arată că o surpriză lunară continuă parțial în luna următoare, iar \(\hat\Phi = -0{,}488 < 0\) arată că o surpriză dintr-o lună se inversează parțial în aceeași lună a anului următor. Ambii coeficienți sînt semnificativi, iar rădăcinile AR inversate, 0,35 și 0,94, sînt sub 1, deci modelul este staționar. Statistica Ljung–Box (Ljung și Box, 1978) \(Q(12) = 22{,}64\) are \(12 - 2 = 10\) grade de libertate, numărul de laguri minus numărul de parametri ARMA estimați; cu p-value 0,012, ipoteza de zgomot alb se respinge la 5%. Modelul lasă o parte din autocorelație în reziduuri, la fel ca modelul sugerat de corelogramă la Pasul 5.

                                                        Prognoza pentru septembrie 2026 înlocuiește valorile trecute cu cele observate și șocul viitor cu media lui, zero; produsul coeficienților este \(\hat\phi\hat\Phi = -0{,}173\):

                                                        \[\begin{aligned} \hat z_{T+1} &= 0{,}353(-1{,}814) + (-0{,}488)(0{,}090) \\ &\quad - (-0{,}173)(1{,}794) \\ &= -0{,}641 - 0{,}044 + 0{,}310 = -0{,}375. \end{aligned}\]

                                                        Deoarece \(z_t\) este prima diferență a inflației anuale, \(\Delta_{12}\ln P_{T+1} = \Delta_{12}\ln P_T + z_{T+1}\), iar prognoza inflației anuale este \(6{,}085 - 0{,}375 = 5{,}71\%\). Inflația ar urma să scadă în continuare în septembrie 2026, pe măsură ce șocul fiscal din anul anterior iese din fereastra de douăsprezece luni. Autocorelația reziduală arată că un model mai bogat, ca la Pasul 4, ar schimba puțin prognoza, iar un interval de încredere de 95% are nevoie și de \(\hat\sigma\).

                                                        Pe scurt

                                                        1. \((1 - \phi L)(1 - \Phi L^{12})z_t = \varepsilon_t\), deci \(z_t = \phi z_{t-1} + \Phi z_{t-12} - \phi\Phi z_{t-13} + \varepsilon_t\)
                                                        2. \(\hat\phi = 0{,}353\): o surpriză lunară continuă și luna următoare; \(\hat\Phi = \ensuremath{-}0{,}488 < 0\): o surpriză dintr-o lună se inversează parțial în aceeași lună a anului următor; ambele semnificative; rădăcinile AR inversate 0,35 și 0,94 \(< 1\): staționar
                                                        3. Ljung–Box \(Q(12) = 22{,}64\) cu \(12 - 2 = 10\) grade de libertate, \(p = 0{,}012\): ipoteza de zgomot alb se respinge la 5%; modelul lasă o parte din autocorelație (comparați cu Pasul 5 de mai sus)
                                                        4. \(\hat z_{T+1} = 0{,}353(\ensuremath{-}1{,}814) + (\ensuremath{-}0{,}488)(0{,}090) - (\ensuremath{-}0{,}173)(1{,}794) = \ensuremath{-}0{,}641 + (\ensuremath{-}0{,}044) + 0{,}310 = \ensuremath{-}0{,}375\)
                                                        5. Inflația anuală: \(\Delta_{12}\ln P_{T+1} = \Delta_{12}\ln P_T + z_{T+1} = 6{,}085 + (\ensuremath{-}0{,}375) = 5{,}71\%\)
                                                        • Interpretare
                                                          • Se așteaptă ca inflația să scadă în continuare în septembrie 2026, pe măsură ce șocul fiscal de anul trecut iese din fereastra de 12 luni
                                                          • Autocorelația reziduală: un model mai bogat (ca la Pasul 4) ar schimba puțin prognoza; un interval de 95% are nevoie de \(\hat\sigma\)

                                                        Problema 4: rezultate VAR și cauzalitate Granger

                                                        Slide 62 în PDF

                                                        Modelul este un VAR(2) pentru România, din trimestrul 3 al anului 2005 pînă în trimestrul 2 al anului 2026 (\(T = 84\)), cu trei variabile: creșterea PIB-ului \(g\), inflația anuală \(\pi\) și rata dobînzii interbancare la trei luni, ROBOR 3M, notată \(i\). Primul tabel dă ecuația ROBOR: coeficienții celor două laguri ale fiecărei variabile, cu statisticile \(t\), constanta și \(R^2 = 0{,}93\).

                                                        Al doilea tabel dă trei teste de cauzalitate Granger: ipoteza că \(g\) nu cauzează Granger \(i\) are \(F = 7{,}26\) și p-value 0,001, ipoteza că \(\pi\) nu cauzează Granger \(i\) are \(F = 4{,}74\) și p-value 0,011, iar ipoteza că \(i\) nu cauzează Granger \(\pi\) are \(F = 0{,}89\) și p-value 0,417. Cerințele sînt definiția cauzalității Granger și citirea tabelului, ecuația ROBOR cu efectul pe termen lung al unei creșteri permanente a inflației cu 1 punct procentual și recalcularea primei statistici \(F\) din sumele pătratelor reziduurilor \(RSS_R = 69{,}268\) și \(RSS_U = 58{,}273\).

                                                        Pe scurt

                                                        Ecuația ROBORcoef. [\(t\)]coef. [\(t\)]
                                                        \(g_{t-1}\)\(0{,}142\) [\(3{,}49\)]\(g_{t-2}\)\(0{,}074\) [\(1{,}73\)]
                                                        \(\pi_{t-1}\)\(0{,}240\) [\(2{,}78\)]\(\pi_{t-2}\)\(\ensuremath{-}0{,}172\) [\(\ensuremath{-}1{,}89\)]
                                                        \(i_{t-1}\)\(1{,}042\) [\(10{,}16\)]\(i_{t-2}\)\(\ensuremath{-}0{,}119\) [\(\ensuremath{-}1{,}20\)]
                                                        constanta\(\ensuremath{-}0{,}109\) [\(\ensuremath{-}0{,}55\)]\(R^2\)0,93
                                                        Ipoteza nulă\(F\)\(p\)
                                                        \(g\) nu cauzează Granger \(i\)7,260,001
                                                        \(\pi\) nu cauzează Granger \(i\)4,740,011
                                                        \(i\) nu cauzează Granger \(\pi\)0,890,417
                                                        • Context
                                                          • VAR(2) pentru România, T3 2005 – T2 2026 (\(T = 84\)): creșterea PIB \(g\), inflația anuală \(\pi\), ROBOR 3M \(i\)
                                                        • Cerințe
                                                          1. Descrieți cauzalitatea Granger și interpretați tabelul.
                                                          2. Scrieți ecuația ROBOR și cuantificați efectul pe termen lung al unei creșteri permanente a inflației cu 1 pp asupra ROBOR.
                                                          3. Recalculați primul \(F\) din \(RSS_R = 69{,}268\) și \(RSS_U = 58{,}273\).

                                                        Problema 4: rezolvare

                                                        Slide 63 în PDF

                                                        Variabila \(x\) cauzează Granger variabila \(y\) dacă lagurile lui \(x\) îmbunătățesc prognoza lui \(y\), dată fiind istoria lui \(y\) (Granger, 1969); testul este un test \(F\) comun pentru toți coeficienții lagurilor lui \(x\) din ecuația lui \(y\). Creșterea și inflația ajută la prognoza ROBOR, cu p-value 0,001 și 0,011, iar ROBOR nu ajută la prognoza inflației, cu p-value 0,417. Prima statistică se reface din regresia restrînsă, fără cele două laguri ale lui \(g\), și din cea nerestrînsă, cu \(T - 7 = 77\) grade de libertate:

                                                        \[F = \frac{(69{,}268 - 58{,}273)/2}{58{,}273/77} = 7{,}26,\]

                                                        peste valoarea critică \(F_{0,95}(2, 77) = 3{,}12\), deci \(H_0\) se respinge.

                                                        Ecuația ROBOR este

                                                        \[\begin{aligned} i_t = {} & -0{,}109 + 0{,}142\,g_{t-1} + 0{,}074\,g_{t-2} \\ & + 0{,}240\,\pi_{t-1} - 0{,}172\,\pi_{t-2} \\ & + 1{,}042\,i_{t-1} - 0{,}119\,i_{t-2} + u_t. \end{aligned}\]

                                                        Pe termen lung, cu \(i_t = i_{t-1} = i_{t-2}\) și \(\pi_t = \pi_{t-1} = \pi_{t-2}\), efectul inflației asupra ROBOR este suma coeficienților lui \(\pi\) împărțită la unu minus suma coeficienților lui \(i\):

                                                        \[\begin{aligned} \frac{\partial i}{\partial \pi} &= \frac{0{,}2402 - 0{,}1718}{1 - 1{,}0424 + 0{,}1186} \\ &= \frac{0{,}0684}{0{,}0762} = 0{,}90 \text{ pp}, \end{aligned}\]

                                                        cu coeficienții luați cu patru zecimale, deoarece cu trei zecimale numitorul ar fi \(1 - 1{,}042 + 0{,}119 = 0{,}077\) în loc de 0,076.

                                                        Dobînda interbancară urmează economia și inflația, așa cum ar implica reacția unei bănci centrale; legătura inversă nu apare în datele trimestriale. Efectul pe termen lung împarte la 0,0762, un număr apropiat de zero, deci este imprecis. Cauzalitatea Granger înseamnă predictibilitate, nu dovada unui efect al politicii monetare.


                                                        Pe scurt

                                                        1. \(x\) cauzează Granger \(y\) dacă lagurile lui \(x\) îmbunătățesc prognoza lui \(y\), dată fiind istoria lui \(y\) (test \(F\) comun) Granger (1969)
                                                          • creșterea și inflația ajută la prognoza ROBOR (\(p =\) 0,001 și 0,011); ROBOR nu ajută la prognoza inflației (\(p = 0{,}417\))
                                                        2. \(i_t = \ensuremath{-}0{,}109 + 0{,}142g_{t-1} + 0{,}074g_{t-2} + 0{,}240\pi_{t-1} + (\ensuremath{-}0{,}172)\pi_{t-2} + 1{,}042i_{t-1} + (\ensuremath{-}0{,}119)i_{t-2} + u_t\)
                                                        3. Pe termen lung (\(i_t = i_{t-1}\), \(\pi_t = \pi_{t-1}\)): \(\partial i/\partial\pi = (0{,}2402 + (\ensuremath{-}0{,}1718))/(1 - 1{,}0424 - (\ensuremath{-}0{,}1186)) = 0{,}0684/0{,}0762 = 0{,}90\) pp
                                                        4. \(F = \frac{(69{,}268 - 58{,}273)/2}{58{,}273/77} = 7{,}26 > F_{0,95}(2, 77) = 3{,}12\): \(H_0\) se respinge
                                                        • Interpretare
                                                          • Dobînda interbancară urmează economia și inflația, așa cum ar implica reacția unei bănci centrale; legătura inversă nu se vede în datele trimestriale
                                                          • Efectul pe termen lung împarte la \(0{,}0762\), un număr apropiat de zero: este imprecis; cauzalitatea Granger înseamnă predictibilitate, nu dovada unui efect de politică

                                                        Problema 5: rezultate de cointegrare și VECM

                                                        Slide 64 în PDF

                                                        Datele sînt randamentele titlurilor de stat ale SUA la 1, 5 și 10 ani, lunare (FRED), din ianuarie 1960 pînă în septembrie 2026, modelate cu un VECM cu două laguri ale diferențelor. Testul urmei Johansen are statisticile 54,60 pentru \(r = 0\), 21,57 pentru \(r \le 1\) și 3,12 pentru \(r \le 2\), cu valorile critice de 5% egale cu 29,80, 15,49 și 3,84.

                                                        Ecuațiile de cointegrare estimate sînt \(\mathrm{EC1} = y^{(1)}_{t-1} - 1{,}045\,y^{(10)}_{t-1} + 1{,}223\) și \(\mathrm{EC2} = y^{(5)}_{t-1} - 1{,}044\,y^{(10)}_{t-1} + 0{,}587\). Al doilea tabel dă coeficienții de ajustare \(\alpha\), cu statisticile \(t\), pentru fiecare randament și fiecare relație. Cerințele sînt definiția cointegrării și rangul, partea de corecție a erorii din ecuația lui \(\Delta y^{(10)}_t\) cu precizarea randamentelor care se ajustează și interpretarea economică a relațiilor pe termen lung.

                                                        Pe scurt

                                                        Testul urmei Johansen\(r = 0\)\(r \le 1\)\(r \le 2\)
                                                        statistica54,6021,573,12
                                                        valoarea critică 5%29,8015,493,84
                                                        Ajustarea \(\alpha\) [\(t\)]\(\Delta y^{(1)}\)\(\Delta y^{(5)}\)\(\Delta y^{(10)}\)
                                                        EC1\(\ensuremath{-}0{,}021\) [\(\ensuremath{-}0{,}82\)]\(0{,}045\) [\(2{,}21\)]\(0{,}040\) [\(2{,}22\)]
                                                        EC2\(0{,}024\) [\(0{,}31\)]\(\ensuremath{-}0{,}122\) [\(\ensuremath{-}2{,}00\)]\(\ensuremath{-}0{,}077\) [\(\ensuremath{-}1{,}43\)]
                                                        • Context
                                                          • Randamentele titlurilor de stat ale SUA la 1, 5 și 10 ani (lunar, FRED), ianuarie 1960 – septembrie 2026, VECM cu două laguri ale diferențelor
                                                          • Ecuațiile de cointegrare: EC1 \(= y^{(1)}_{t-1} - 1{,}045\,y^{(10)}_{t-1} + 1{,}223\); EC2 \(= y^{(5)}_{t-1} - 1{,}044\,y^{(10)}_{t-1} + 0{,}587\)
                                                        • Cerințe
                                                          1. Definiți cointegrarea și decideți rangul.
                                                          2. Scrieți partea de corecție a erorii din ecuația pentru \(\Delta y^{(10)}_t\) și precizați care randamente se ajustează.
                                                          3. Interpretați economic relațiile pe termen lung.

                                                        Problema 5: rezolvare

                                                        Slide 65 în PDF

                                                        Seriile \(I(1)\) sînt cointegrate dacă o combinație liniară a lor este \(I(0)\) (Engle și Granger, 1987). Testul urmei (Johansen, 1991) se citește secvențial, de la \(r = 0\) în sus: \(54{,}60 > 29{,}80\) respinge \(r = 0\), \(21{,}57 > 15{,}49\) respinge \(r \le 1\), iar \(3{,}12 < 3{,}84\) nu respinge \(r \le 2\). Rangul este \(r = 2\): trei serii cu două relații de cointegrare au un singur trend stochastic comun.

                                                        Partea de corecție a erorii din ecuația randamentului la 10 ani este

                                                        \[\begin{aligned} \Delta y^{(10)}_t = {} & 0{,}040\,\mathrm{EC1}_{t-1} \\ & - 0{,}077\,\mathrm{EC2}_{t-1} + \dots \end{aligned}\]

                                                        Un randament se ajustează la o relație dacă coeficientul lui \(\alpha\) este semnificativ. Pe EC1, randamentele la 5 și 10 ani au \(|t| > 2\), iar randamentul la 1 an are \(|t| < 1\) pe ambele relații: dobînda scurtă nu se ajustează, adică este slab exogenă (weakly exogenous).

                                                        Coeficienții \(\beta\) apropiați de 1 arată că spread-urile \(y^{(1)} - y^{(10)}\) și \(y^{(5)} - y^{(10)}\) sînt staționare, cum implică ipoteza așteptărilor; timpii de înjumătățire ai abaterilor de la echilibru sînt 22,1 și 9,0 luni. Cele trei randamente au un singur trend comun, nivelul dobînzilor: curba se poate deforma, dar spread-urile revin la mediile lor. Dobînzile lungi sînt cele care se ajustează, deci piețele mută partea lungă a curbei spre partea scurtă, determinată de politica monetară.

                                                        Pe scurt

                                                        1. Seriile \(I(1)\) sînt cointegrate dacă o combinație liniară a lor este \(I(0)\) Engle și Granger (1987); urma: \(54{,}60 > 29{,}80\), \(21{,}57 > 15{,}49\), \(3{,}12 < 3{,}84\): rangul \(r = 2\), un singur trend stochastic comun Johansen (1991)
                                                        2. \(\Delta y^{(10)}_t = 0{,}040\,\mathrm{EC1}_{t-1} + (\ensuremath{-}0{,}077)\,\mathrm{EC2}_{t-1} + \dots\); pe EC1, randamentele la 5 și 10 ani au \(|t| > 2\), iar cel la 1 an are \(|t| < 1\) pe ambele relații: dobînda scurtă nu se ajustează (exogenitate slabă)
                                                        3. \(\beta \approx 1\): spread-urile \(y^{(1)} - y^{(10)}\) și \(y^{(5)} - y^{(10)}\) sînt staționare, cum implică ipoteza așteptărilor; timpii de înjumătățire ai erorilor de echilibru: 22,1 și 9,0 luni
                                                        • Interpretare
                                                          • Cele trei randamente au un singur trend comun (nivelul dobînzilor); curba se poate deforma, dar spread-urile revin la mediile lor
                                                          • Dobînzile lungi se ajustează: piețele mișcă partea lungă a curbei spre partea scurtă, determinată de politica monetară

                                                        Problema 6: rezultate GARCH și VaR 1%

                                                        Slide 66 în PDF

                                                        Modelul este un GARCH(1,1) (Bollerslev, 1986) cu inovații Student-\(t\), estimat pe randamentele logaritmice zilnice ale indicelui BET, în procente, din 2000, cu \(n = 6\,670\) observații. Estimările sînt \(\mu = 0{,}083\), \(\omega = 0{,}0448\), \(\alpha = 0{,}192\), \(\beta = 0{,}799\) și \(\nu = 5{,}011\) grade de libertate, cu erorile standard 0,010, 0,0088, 0,025, 0,024 și 0,308.

                                                        Azi, varianța condiționată este \(\sigma_t^2 = 1{,}0\), iar șocul zilei este \(\varepsilon_t = -3{,}0\); cuantila de 1% a distribuției \(t_5\) este \(-3{,}3649\), iar un an are circa 250 de zile de tranzacționare. Cerințele sînt persistența, timpul de înjumătățire și volatilitatea anuală pe termen lung, varianța de mîine \(\sigma_{t+1}^2\) și VaR 1% pe o zi cu cuantila \(t_5\) standardizată, comparat cu VaR-ul Normal.

                                                        Pe scurt

                                                        BET\(\mu\)\(\omega\)\(\alpha\)\(\beta\)\(\nu\)
                                                        estimare\(0{,}083\)\(0{,}0448\)\(0{,}192\)\(0{,}799\)\(5{,}011\)
                                                        SE\(0{,}010\)\(0{,}0088\)\(0{,}025\)\(0{,}024\)\(0{,}308\)
                                                        • Context
                                                          • GARCH(1,1) cu inovații Student-\(t\) pentru randamentele logaritmice zilnice ale BET în %, din 2000 (\(n = 6\,670\))
                                                          • Azi: \(\sigma_t^2 = 1{,}0\) și \(\varepsilon_t = -3{,}0\); \(t_5^{-1}(0{,}01) = \ensuremath{-}3{,}3649\); circa 250 de zile de tranzacționare pe an
                                                        • Cerințe
                                                          1. Calculați persistența, timpul de înjumătățire și volatilitatea anuală pe termen lung.
                                                          2. Calculați \(\sigma_{t+1}^2\).
                                                          3. Calculați VaR 1% pe o zi cu cuantila \(t_5\) standardizată și comparați-l cu cel Normal.

                                                        Problema 6: rezolvare

                                                        Slide 67 în PDF

                                                        Persistența este \(\alpha + \beta = 0{,}9907\), iar timpul de înjumătățire al unui șoc al volatilității este \(h_{1/2} = \ln 0{,}5/\ln 0{,}9907 = 74\) de zile de tranzacționare. Varianța pe termen lung este \(\bar\sigma^2 = \omega/(1 - \alpha - \beta) = 0{,}0448/0{,}0093 = 4{,}82\), iar volatilitatea anuală corespunzătoare este \(\sqrt{250 \times 4{,}82} = 34{,}7\%\). Cînd \(\alpha + \beta\) este aproape de 1, ambele cifre sînt foarte sensibile la a treia zecimală a coeficienților, de aceea persistența este dată cu patru zecimale: rotunjită la 0,991, ar da un timp de înjumătățire de 77 de zile și o varianță pe termen lung de 4,98. Volatilitatea pe termen lung, 34,7%, este mult peste cea de selecție, 22,1%, tocmai pentru că raportul \(\omega/(1 - \alpha - \beta)\) este foarte imprecis în această situație.

                                                        Varianța de mîine combină constanta, șocul de azi la pătrat și varianța de azi:

                                                        \[\begin{aligned} \sigma_{t+1}^2 &= 0{,}0448 + 0{,}19162 \times 9 + 0{,}7991 \times 1{,}0 \\ &= 0{,}0448 + 1{,}7246 + 0{,}7991 = 2{,}5685, \end{aligned}\]

                                                        deci \(\sigma_{t+1} = 1{,}603\%\). Scăderea de 3% de azi a mai mult decît dublat varianța pentru ziua următoare.

                                                        Distribuția \(t_\nu\) are varianța \(\nu/(\nu - 2)\), deci cuantila ei se rescalează cu \(\sqrt{(\nu - 2)/\nu} = \sqrt{3/5} = 0{,}7746\) pentru inovații cu varianța 1: \(q_{0,01}(z) = -3{,}3649 \times 0{,}7746 = -2{,}606\). Cu \(\mathrm{VaR}_\alpha = -q_\alpha\),

                                                        \[\begin{aligned} \mathrm{VaR}\ 1\% &= -\bigl(0{,}083 + 1{,}603 \times (-2{,}606)\bigr) \\ &= 4{,}09\%, \end{aligned}\]

                                                        față de 3,65% cu distribuția Normală. Cozile groase ridică VaR 1% peste valoarea Normală: o pierdere mai mare de 4,09% este așteptată într-o zi din 100.

                                                        Pe scurt

                                                        1. \(\alpha + \beta = 0{,}9907\); \(h_{1/2} = \ln 0{,}5/\ln 0{,}9907 = 74\) de zile; \(\bar\sigma^2 = 0{,}0448/(1 - 0{,}9907) = 4{,}82\), \(\sqrt{250 \times 4{,}82} = 34{,}7\%\) pe an
                                                        2. \(\sigma_{t+1}^2 = 0{,}0448 + 0{,}19162 \times 9 + 0{,}7991 \times 1{,}0 = 0{,}0448 + 1{,}7246 + 0{,}7991 = 2{,}5685\), \(\sigma_{t+1} = 1{,}603\%\)
                                                        3. \(q_{0,01}(z) = \ensuremath{-}3{,}3649 \times \sqrt{3/5} = \ensuremath{-}3{,}3649 \times 0{,}7746 = \ensuremath{-}2{,}606\); VaR 1% \(= -(0{,}083 + 1{,}603 \times (\ensuremath{-}2{,}606)) = 4{,}09\%\); Normal: \(3{,}65\%\)
                                                        • Interpretare
                                                          • Persistență aproape de 1: un șoc al volatilității se înjumătățește abia după circa 74 de zile de tranzacționare
                                                          • Volatilitatea pe termen lung (34,7%) este mult peste cea de selecție (22,1%): cînd \(\alpha + \beta \approx 1\), raportul \(\omega/(1 - \alpha - \beta)\) este foarte imprecis
                                                          • Factorul \(\sqrt{3/5} = \sqrt{(\nu - 2)/\nu}\) rescalează cuantila \(t_5\) la inovații cu varianța 1
                                                          • Cozile groase ridică VaR 1% peste valoarea Normală: o pierdere mai mare de 4,09% este așteptată într-o zi din 100

                                                        Problema 7: evaluarea prognozelor

                                                        Slide 68 în PDF

                                                        Două metode, un SARIMA și metoda naivă sezonieră, prognozează inflația lunară pe un eșantion de test de șase luni. Erorile SARIMA sînt 0,3, −0,5, 0,2, 0,6, −0,4 și 0,1, iar erorile metodei naive sezoniere sînt 0,5, −0,7, 0,6, 0,4, −0,9 și 0,3; eroarea absolută medie (mean absolute error, MAE) a metodei naive sezoniere în eșantion este 0,6. A doua parte privește un coleg care raportează \(R^2 = 0{,}37\) pentru un model boosting al randamentelor zilnice S&P 500, evaluat cu validare încrucișată aleatoare în 5 grupuri.

                                                        Cerințele sînt RMSE, MAE și MASE pentru ambele metode, statistica Diebold–Mariano pe erorile pătratice, \(\bar d/(s_d/\sqrt{n})\), cu decizia la 5% (valoarea critică \(t_{0,975}(5) = 2{,}571\)), și un comentariu despre \(R^2\)-ul raportat de coleg.

                                                        Pe scurt

                                                        Luna de test123456
                                                        erori, SARIMA\(0{,}3\)\(-0{,}5\)\(0{,}2\)\(0{,}6\)\(-0{,}4\)\(0{,}1\)
                                                        erori, naiv sezonier\(0{,}5\)\(-0{,}7\)\(0{,}6\)\(0{,}4\)\(-0{,}9\)\(0{,}3\)
                                                        • Context
                                                          • Prognoze ale inflației lunare pe un eșantion de test de șase luni; MAE în eșantion al metodei naive sezoniere este 0,6
                                                          • Un coleg raportează \(R^2 = 0{,}37\) pentru un model boosting al randamentelor zilnice S&P 500, cu validare încrucișată aleatoare în 5 grupuri
                                                        • Cerințe
                                                          1. Calculați RMSE, MAE și MASE pentru ambele metode.
                                                          2. Calculați statistica Diebold–Mariano pe erorile pătratice, \(\bar d/(s_d/\sqrt{n})\), și decideți la 5% (\(t_{0,975}(5) = 2{,}571\)).
                                                          3. Comentați valoarea \(R^2\) raportată de coleg.

                                                        Problema 7: rezolvare

                                                        Slide 69 în PDF

                                                        RMSE este rădăcina mediei erorilor pătratice, MAE media erorilor absolute, iar MASE împarte MAE din eșantionul de test la MAE în eșantion al metodei naive sezoniere, 0,6. Pentru SARIMA, RMSE este 0,389, MAE 0,350 și MASE 0,58; pentru metoda naivă sezonieră, 0,600, 0,567 și 0,94. Un MASE sub 1 arată că metoda are, în medie, erori mai mici decît reperul naiv.

                                                        Testul Diebold–Mariano (Diebold și Mariano, 1995) lucrează cu diferențele pierderilor, \(d_t = e_{A,t}^2 - e_{B,t}^2\), cu \(A\) SARIMA și \(B\) metoda naivă sezonieră: \(-0{,}16\), \(-0{,}24\), \(-0{,}32\), \(0{,}20\), \(-0{,}65\) și \(-0{,}08\). Media lor este \(\bar d = -0{,}208\), iar abaterea standard \(s_d = 0{,}281\), deci

                                                        \[\mathrm{DM} = \frac{\bar d}{s_d/\sqrt{n}} = \frac{-0{,}208}{0{,}281/\sqrt 6} = -1{,}82.\]

                                                        Cum \(|-1{,}82| < 2{,}571\), acuratețea egală nu se respinge: SARIMA bate în medie metoda naivă sezonieră, dar șase luni nu pot separa acest cîștig de zgomot.

                                                        Validarea încrucișată cu grupuri aleatoare pune zile din viitor în setul de antrenare, o formă de leakage. Validarea walk-forward, care respectă ordinea timpului, dă \(R^2 = -0{,}39\) pentru același model (Capitolul 9). Doar evaluarea în afara eșantionului, în ordinea timpului, este o dovadă a capacității de prognoză.

                                                        Pe scurt

                                                        1. SARIMA: RMSE 0,389, MAE 0,350, MASE 0,58; naiv sezonier: RMSE 0,600, MAE 0,567, MASE 0,94
                                                        2. \(d_t = e_{A,t}^2 - e_{B,t}^2\) (\(A\): SARIMA, \(B\): naiv sezonier): \(\ensuremath{-}0{,}16\); \(\ensuremath{-}0{,}24\); \(\ensuremath{-}0{,}32\); \(0{,}20\); \(\ensuremath{-}0{,}65\); \(\ensuremath{-}0{,}08\); \(\bar d = \ensuremath{-}0{,}208\), \(s_d = 0{,}281\); DM \(= \ensuremath{-}1{,}82\), \(|\ensuremath{-}1{,}82| < 2{,}571\): acuratețea egală nu se respinge
                                                        3. Grupurile aleatoare pun zile din viitor în setul de antrenare: leakage; validarea walk-forward dă \(R^2 = \ensuremath{-}0{,}39\) pentru același model (Capitolul 9)
                                                        • Interpretare
                                                          • MASE sub 1: SARIMA bate în medie metoda naivă sezonieră, dar șase luni nu pot arăta că acest cîștig este real
                                                          • Doar evaluarea în afara eșantionului, în ordinea timpului, este o dovadă a capacității de prognoză

                                                        Problema 8: spațiul stărilor, regimuri și memorie lungă

                                                        Slide 70 în PDF

                                                        Problema are trei părți independente. Prima privește modelul local level, cu varianța zgomotului de observație \(\sigma^2_\varepsilon = 4\) și varianța șocului nivelului \(\sigma^2_\eta = 1\); predicția nivelului este \(a_t = 10\), cu varianța \(P_t = 2\), iar observația este \(y_t = 13\). Se cer un pas de actualizare și de predicție Kalman, cîștigul de echilibru și ponderea netezirii exponențiale simple (SES) echivalente.

                                                        A doua parte privește creșterea PIB-ului României cu două regimuri, cu probabilitățile de a rămîne în regim \(p_{11} = 0{,}9108\) pentru regimul volatil și \(p_{22} = 0{,}9341\) pentru cel stabil (Capitolul 10); se cer duratele așteptate ale regimurilor și ponderea pe termen lung a regimului volatil. A treia parte privește inflația lunară din România, modelată ca ARFIMA(0,\(d\),0) cu \(\hat d = 0{,}31\) și eroarea standard 0,05 (Capitolul 8); se cer exponentul Hurst \(H\) și \(\rho(1)\), cu precizarea dacă seria este staționară și revine la medie.

                                                        Pe scurt

                                                        • Context
                                                          • Modelul local level: \(\sigma^2_\varepsilon = 4\), \(\sigma^2_\eta = 1\); predicția \(a_t = 10\), \(P_t = 2\); observația \(y_t = 13\)
                                                          • Creșterea PIB-ului României, două regimuri: \(p_{11} = 0{,}9108\) (volatil), \(p_{22} = 0{,}9341\) (stabil) (Capitolul 10)
                                                          • Inflația lunară din România: ARFIMA(0,\(d\),0) cu \(\hat d = 0{,}31\) (SE 0,05) (Capitolul 8)
                                                        • Cerințe
                                                          1. Aplicați un pas de actualizare și de predicție Kalman; calculați cîștigul de echilibru și ponderea SES echivalentă.
                                                          2. Calculați duratele așteptate ale celor două regimuri și ponderea pe termen lung a regimului volatil.
                                                          3. Calculați \(H\) și \(\rho(1)\) pentru modelul ARFIMA și precizați dacă inflația este staționară și cu revenire la medie.

                                                        Problema 8: rezolvare

                                                        Slide 71 în PDF

                                                        Filtrul Kalman (Kalman, 1960) compară observația cu predicția. Varianța erorii de predicție este \(F_t = P_t + \sigma^2_\varepsilon = 2 + 4 = 6\), cîștigul este \(K_t = P_t/F_t = 0{,}333\), iar surpriza este \(13 - 10 = 3\). Actualizarea dă \(a_{t|t} = 10 + 0{,}333 \times 3 = 11{,}00\) și \(P_{t|t} = 2(1 - 0{,}333) = 1{,}333\); în modelul local level nivelul prognozat rămîne \(a_{t+1} = 11{,}00\), iar varianța crește cu \(\sigma^2_\eta\), la \(P_{t+1} = 2{,}333\). Cu raportul semnal–zgomot \(q = \sigma^2_\eta/\sigma^2_\varepsilon = 0{,}25\), varianța de echilibru și cîștigul de echilibru sînt

                                                        \[\begin{aligned} \frac{\bar P}{\sigma^2_\varepsilon} &= \frac{q + \sqrt{q^2 + 4q}}{2} = 0{,}6404, \\ \bar K &= \frac{0{,}6404}{1{,}6404} = 0{,}390, \end{aligned}\]

                                                        iar \(\bar K\) este exact ponderea \(\alpha\) a netezirii exponențiale simple.

                                                        Într-un model cu schimbări de regim markoviene (Hamilton, 1989), durata unui regim are distribuție geometrică, cu media \(1/(1 - p_{ii})\): \(E(D_1) = 1/(1 - 0{,}9108) = 11{,}2\) trimestre pentru regimul volatil și \(E(D_2) = 15{,}2\) trimestre pentru cel stabil. Ponderea pe termen lung a regimului volatil este \(\pi_1 = (1 - p_{22})/(2 - p_{11} - p_{22}) = 0{,}425\): creșterea din România se află în regimul volatil aproximativ 42% din timp, perioade care acoperă tranziția, 2009 și 2020.

                                                        Pentru ARFIMA (Granger și Joyeux, 1980; Hosking, 1981), \(H = d + 0{,}5 = 0{,}81\) și \(\rho(1) = d/(1 - d) = 0{,}45\). Cum \(0 < d < 0{,}5\), inflația este staționară, cu memorie lungă, și revine la medie. Șocurile ei se sting lent, hiperbolic, iar prognozele revin la medie mai încet decît cele ale unui model AR.

                                                        Pe scurt

                                                        1. \(F_t = 2 + 4 = 6\), \(K_t = 2/6 = 0{,}333\); \(a_{t|t} = 10 + 0{,}333 \times 3 = 11{,}00\), \(P_{t|t} = 2(1 - 0{,}333) = 1{,}333\); \(a_{t+1} = 11{,}00\), \(P_{t+1} = 2{,}333\)
                                                        2. \(q = \sigma^2_\eta/\sigma^2_\varepsilon = 0{,}25\): \(\bar P/\sigma^2_\varepsilon = (q + \sqrt{q^2 + 4q})/2 = 0{,}6404\), \(\bar K = 0{,}6404/(1 + 0{,}6404) = 0{,}390 = \alpha_{SES}\)
                                                        3. \(E(D_1) = 1/(1 - 0{,}9108) = 11{,}2\) trimestre, \(E(D_2) = 15{,}2\) trimestre; \(\pi_1 = (1 - 0{,}9341)/(2 - 0{,}9108 - 0{,}9341) = 0{,}425\)
                                                        4. \(H = d + 0{,}5 = 0{,}81\); \(\rho(1) = d/(1 - d) = 0{,}45\); \(0 < d < 0{,}5\): staționar cu memorie lungă, cu revenire la medie
                                                        • Interpretare
                                                          • Filtrul mută nivelul cu o treime din surpriză; pe termen lung, ponderea este cea a netezirii exponențiale
                                                          • Pe termen lung, creșterea din România se află în regimul volatil aproximativ 42% din timp: tranziția, 2009 și 2020
                                                          • Șocurile inflației se sting lent, hiperbolic: prognozele revin la medie mai încet decît cele ale unui model AR

                                                        Sinteza secțiunii

                                                        Cele opt probleme acoperă tipurile de subiecte ale examenului scris: derivări pentru un proces dat, decizii de staționaritate și identificare, citirea rezultatelor SARIMA, VAR, VECM și GARCH, prognoze calculate de mînă și evaluarea prognozelor. Fiecare rezolvare are aceeași structură: formula cu cifrele înlocuite, rezultatul cu unitatea și semnul lui, decizia testului și o interpretare statistică și economică. Examenul scris dă 70% din nota finală; a doua componentă notată, proiectul de echipă, cu 20%, aplică aceleași metode pe date reale, cu cod, și este descrisă în secțiunea următoare.

                                                        Proiectul de echipă și prezența

                                                        Secțiunea descrie proiectul de echipă: ce conține, ce se predă, cum se evaluează și cum se declară folosirea instrumentelor AI.

                                                        Proiectul de echipă: conținut și livrabile

                                                        Slide 72 în PDF

                                                        Proiectul este o analiză făcută de o echipă de doi pînă la patru studenți, pe serii reale, cu metodele cursului. Punctul de plecare este o întrebare concretă, de exemplu prognoza cursului EUR/RON, modelarea inflației din România sau legătura dintre politica monetară și dobînzile bancare. Pentru o singură serie, analiza parcurge trendul și staționaritatea, netezirea, un model ARIMA sau SARIMA, împărțirea în set de antrenare și set de test, orizontul, prognozele punctuale și pe interval și comparația a două metode. Pentru mai multe serii, ea adaugă rădăcinile unitare, cointegrarea, un VAR sau un VECM, cauzalitatea Granger, IRF și FEVD.

                                                        Livrabilele sînt un repository al cărui cod reproduce, pornind de la date, fiecare rezultat numeric și fiecare grafic, un raport scurt, o prezentare și fișierul AI_USE.md. Raportul are structura unui articol scurt: întrebarea și literatura, sursele de date, modelele, concluziile și bibliografia.

                                                        Pe scurt

                                                        • 20% din nota finală
                                                          • o echipă de 2–4 studenți analizează serii reale cu metodele cursului
                                                          • o întrebare concretă: prognoza cursului EUR/RON, modelarea inflației din România, politica monetară și dobînzile bancare
                                                          • o serie: trend și staționaritate, netezire, ARIMA sau SARIMA, set de antrenare, set de test și orizont, prognoze punctuale și pe interval, comparația a două metode
                                                          • mai multe serii: rădăcini unitare, cointegrare, VAR sau VECM, cauzalitate Granger, IRF și FEVD
                                                        • Livrabile
                                                          • un repository al cărui cod reproduce, din date, fiecare rezultat numeric și fiecare grafic
                                                          • un raport scurt: întrebarea și literatura, sursele de date, modelele, concluziile, bibliografia
                                                          • o prezentare; fișierul AI_USE.md

                                                        Criterii de evaluare a proiectului și susținerea orală

                                                        Slide 73 în PDF

                                                        Primul criteriu este întrebarea: ea trebuie să fie clară, să poată primi un răspuns pe baza datelor și să fie utilă cuiva. „Poate un SARIMA să prognozeze inflația din România mai bine decît metoda naivă sezonieră?” este o întrebare, pentru că are un răspuns care poate ieși „da” sau „nu”, iar cazul Box–Jenkins din acest capitol arată cum se ajunge la el. „O analiză a inflației” nu este o întrebare, ci un subiect.

                                                        Celelalte criterii privesc metodele, verificările, interpretarea și reproductibilitatea: testul potrivit pentru întrebare, ales din sinteza testelor și a modelelor, diagnosticarea reziduurilor, evaluarea în afara eșantionului față de un reper, o interpretare care spune ce înseamnă cifrele și ce nu pot arăta datele și un repository care rulează de la date pînă la fiecare grafic. Proiectul se notează doar după susținerea orală, în care fiecare membru al echipei explică codul și rezultatele. O linie de cod pe care autorul ei nu o poate explica nu este considerată muncă proprie, indiferent dacă a fost scrisă cu sau fără ajutorul unui instrument AI.

                                                        Pe scurt

                                                        • Întrebarea
                                                          • clară, cu răspuns posibil pe baza datelor, utilă cuiva
                                                          • „Poate un SARIMA să prognozeze inflația din România mai bine decît metoda naivă sezonieră?” este o întrebare; „o analiză a inflației” nu este
                                                        • Metode, verificări, interpretare, reproductibilitate
                                                          • testul potrivit pentru întrebare (sinteza testelor și a modelelor); diagnosticarea reziduurilor; evaluare în afara eșantionului, față de un reper
                                                          • ce înseamnă cifrele și ce nu pot arăta datele; repository-ul rulează de la date pînă la fiecare grafic
                                                        • Susținerea orală
                                                          • proiectul se notează numai după prezentarea lui
                                                          • fiecare membru explică codul și rezultatele: ce calculează această linie? de ce acest test și nu altul?
                                                          • o linie de cod pe care nu o puteți explica nu este considerată muncă proprie, cu sau fără AI

                                                        Fișierul AI_USE.md

                                                        Slide 74 în PDF

                                                        Instrumentele AI sînt permise în proiect, cu condiția să fie declarate. Fișierul AI_USE.md înregistrează, pentru fiecare utilizare, instrumentul, prompt-ul, ce s-a păstrat din răspuns și ce s-a corectat. El conține și erorile instrumentului pe care echipa le-a găsit, împreună cu modul în care le-a găsit; această parte arată cel mai bine dacă rezultatele au fost verificate.

                                                        Responsabilitatea pentru fiecare cifră și fiecare referință rămîne a echipei. Fiecare cifră trebuie recalculată cu propriul cod, din date, iar fiecare referință trebuie verificată prin deschiderea identificatorului ei digital (digital object identifier, DOI) și compararea titlului. Erorile tipice ale instrumentelor AI în acest curs sînt adunate în slide-ul „Verificări necesare” din secțiunea următoare.

                                                        Pe scurt

                                                        • Instrumentele AI sînt permise și trebuie declarate
                                                          • pentru fiecare utilizare: instrumentul, promptul, ce s-a păstrat și ce s-a corectat
                                                          • erorile instrumentului AI pe care le-ați găsit și modul în care le-ați găsit
                                                        • Răspundeți pentru fiecare cifră și pentru fiecare referință
                                                          • fiecare cifră: recalculată cu propriul cod, din date
                                                          • fiecare referință: DOI-ul deschis și titlul verificat
                                                        • Erorile AI tipice din acest curs: slide-ul „Verificări necesare” din secțiunea despre AI

                                                        Nota finală

                                                        Slide 75 în PDF

                                                        Nota finală are trei componente. Examenul scris, dat în sesiune, are ponderea 70% și se notează după metodă, rezultat și interpretare. Proiectul de echipă, predat la finalul semestrului, are ponderea 20% și se notează după întrebare, metode, verificări și susținerea orală. Prezența la cursuri și seminarii, urmărită în fiecare săptămînă, și quiz-urile capitolelor de pe site au împreună ponderea 10%.

                                                        Examenul și proiectul verifică lucruri diferite. Examenul cere calcule pe hîrtie și citirea unor rezultate date, fără cod; proiectul cere aplicarea metodelor pe date reale, cu un cod care reproduce fiecare rezultat și pe care fiecare membru al echipei îl poate explica. Seminariile au rol de exercițiu și nu se notează, iar studenții nu predau nimic de la seminarii. Quiz-urile se rezolvă cu contul Google ASE, iar numele și scorul se înregistrează pentru notă.

                                                        Pe scurt

                                                        ComponentaPondereCîndCriterii
                                                        examenul scris70%sesiuneametodă, rezultat, interpretare
                                                        proiectul de echipă20%finalul semestruluiîntrebare, metode, verificări, susținere orală
                                                        prezența și quiz-urile10%în fiecare săptămînăprezența la cursuri și seminarii; quiz-urile capitolelor
                                                        • Seminariile au rol de exercițiu și nu se notează; studenții nu predau nimic de la seminarii
                                                        • Quiz-urile de pe site-ul cursului se rezolvă cu contul ASE; numele și scorul se înregistrează pentru notă

                                                        Sinteza secțiunii

                                                        Proiectul cere același lucru ca analiza IAPC din acest capitol: o întrebare precisă, metodele potrivite, verificări raportate și un cod care reproduce fiecare rezultat, explicat de autorii lui.

                                                        Contribuția posibilă a AI

                                                        Secțiunea descrie ce poate face un asistent AI pentru metodele cursului și ce trebuie verificat de fiecare dată.

                                                        Contribuția posibilă a AI

                                                        Slide 76 în PDF

                                                        Un asistent AI poate fi util în trei moduri. Pentru exercițiu, poate formula probleme noi, cu rezultate generate din date reale de propriul cod, nu inventate. Pentru explicații, poate da o a doua explicație, în alte cuvinte, pentru un tabel de rezultate, o derivare sau un test care nu a fost înțeles la prima lectură. Pentru proiect, poate scrie o primă versiune a codului pentru pașii Box–Jenkins, pentru o evaluare cu origini mobile sau pentru un VECM.

                                                        Prompt-ul de pe slide este un exemplu de cerere precisă. El numește sursa datelor și codul exact al seriei Eurostat, transformarea (\(100\ln\) IAPC), familia de modele și limitele ordinelor, eșantionul de antrenare, criteriile de comparare, gradele de libertate ale testului Ljung–Box și reperul pentru prognoză. Un prompt atît de precis produce cod care poate fi verificat pas cu pas, comparînd fiecare rezultat cu tabelele din secțiunea Box–Jenkins.

                                                        Pe scurt

                                                        • Exercițiu
                                                          • probleme noi în stilul examenului, cu rezultate generate din date reale de propriul cod
                                                        • Explicații
                                                          • o a doua explicație pentru un tabel de rezultate, o derivare sau un test pe care nu l-ați înțeles
                                                        • Proiect
                                                          • o primă versiune a codului pentru pașii Box–Jenkins, pentru o evaluare cu origini mobile, pentru un VECM
                                                        • Exemplu de prompt
                                                          • Write Python code that downloads the Romanian HICP from Eurostat (prc_hicp_minr, M.I15.TOTAL.RO), fits every SARIMA(p,1,q)(P,1,Q)12 with p, q <= 2 and P, Q <= 1 to 100 log HICP up to August 2024, reports AICc, BIC and Ljung-Box p-values with m - k degrees of freedom, and compares one-step forecasts with the seasonal naive method by MASE and the Diebold-Mariano test.

                                                        Verificări necesare

                                                        Slide 77 în PDF

                                                        Primele verificări privesc ipotezele și gradele de libertate. La ADF, ipoteza nulă este rădăcina unitară, iar la KPSS staționaritatea; un răspuns care le inversează duce la decizii opuse. Testul Ljung–Box pe reziduuri folosește \(m - k\) grade de libertate, iar testul Granger \(F\) folosește \(p\) și \(T - Kp - 1\). Semnele termenilor MA și ale coeficientului de corecție a erorii depind de convenția programului: EViews și Python le scriu diferit, deci un semn trebuie citit împreună cu ecuația pe care o folosește programul.

                                                        Celelalte verificări privesc convențiile și ordinea timpului. AIC și BIC se compară doar pentru aceleași \(d\) și \(D\), iar riscul se raportează ca VaR 1%, niciodată „VaR 99%”. Nicio informație din eșantionul de test nu are voie să intre în estimare, în scalarea variabilelor sau în alegerea modelului. Fiecare cifră trebuie recalculată cu propriul cod, iar fiecare referință verificată prin DOI.

                                                        Pe scurt

                                                        • Ipotezele nule: la ADF, \(H_0\) este rădăcina unitară, la KPSS staționaritatea; un răspuns care le inversează este greșit
                                                        • Gradele de libertate: Ljung–Box pe reziduuri folosește \(m - k\); testul Granger \(F\) folosește \((p, T - Kp - 1)\)
                                                        • Semnele: convențiile EViews și Python pentru termenii MA și pentru coeficientul de corecție a erorii
                                                        • Convențiile: AIC și BIC doar pentru aceleași \(d\) și \(D\); VaR 1%, niciodată „VaR 99%”
                                                        • Ordinea timpului: nicio informație din eșantionul de test în estimare, în scalare sau în alegerea modelului
                                                        • Fiecare cifră recalculată cu propriul cod; fiecare referință verificată prin DOI

                                                        Sinteza secțiunii

                                                        Un asistent scurtează scrierea codului și oferă explicații alternative, dar verificarea ipotezelor nule, a gradelor de libertate, a semnelor și a ordinii timpului rămîne responsabilitatea analistului.

                                                        Rezumat

                                                        Rezumatul adună ideile cursului într-o ordine de lucru și propune trei întrebări de autoevaluare.

                                                        Idei de reținut

                                                        Slide 78 în PDF

                                                        Analiza unei serii începe cu datele: graficul, componentele, transformarea potrivită și corelograma. Apoi \(d\) și \(D\) se decid cu ADF și KPSS împreună, ordinele se identifică din ACF și PACF, modelul se alege cu BIC, iar reziduurile se verifică înainte ca modelul să fie folosit. Cînd varianța se grupează în timp, ea se modelează cu GARCH; cînd mai multe serii se influențează, ele se modelează împreună, cu VAR sau, dacă sînt cointegrate, cu VECM.

                                                        Prognozele se judecă în afara eșantionului, față de repere simple. O potrivire mai bună în eșantion nu înseamnă o prognoză mai bună, iar un cîștig față de metoda naivă trebuie testat, nu doar observat. În proiect contează o întrebare clară și un răspuns onest, inclusiv atunci cînd răspunsul este că datele nu pot decide.

                                                        Pe scurt

                                                        • Întîi priviți datele: componente, transformări, corelogramă
                                                        • Decideți \(d\) și \(D\) cu ADF și KPSS împreună; identificați cu ACF și PACF; alegeți cu BIC; verificați reziduurile
                                                        • Modelați varianța cînd se grupează (GARCH); modelați mai multe serii împreună cu VAR sau VECM
                                                        • Judecați prognozele în afara eșantionului, față de repere simple; o potrivire mai bună în eșantion nu înseamnă o prognoză mai bună
                                                        • Examenul răsplătește metoda, rezultatul și interpretarea; proiectul răsplătește o întrebare clară, cu un răspuns onest

                                                        Autoevaluare

                                                        Slide 79 în PDF

                                                        Prima întrebare combină cele două teste de rădăcină unitară. Dacă ADF nu respinge rădăcina unitară, iar KPSS respinge staționaritatea, ambele teste indică o rădăcină unitară, deci seria se diferențiază. Este exact situația nivelului IAPC din pasul 2.

                                                        A doua întrebare aplică testul Ljung–Box pe reziduurile unui ARMA(1,1), cu \(Q(10) = 16\). Gradele de libertate sînt \(10 - 2 = 8\), iar valoarea critică a distribuției \(\chi^2(8)\) la 5% este 15,51. Statistica o depășește, deci rămîne autocorelație în reziduuri și modelul nu este adecvat.

                                                        A treia întrebare privește două serii \(I(1)\) cointegrate. Un VAR în diferențe nu este potrivit, deoarece omite termenul de corecție a erorii din (15.9) și pierde informația despre relația pe termen lung; modelul corect este VECM.

                                                        Pe scurt

                                                        • Întrebare: ADF nu respinge, iar KPSS respinge. Ce concluzie trageți?
                                                          • Răspuns: ambele indică o rădăcină unitară: diferențiem seria
                                                        • Întrebare: reziduurile unui ARMA(1,1) dau Ljung–Box \(Q(10) = 16\). Este modelul adecvat la 5%?
                                                          • Răspuns: cu \(10 - 2 = 8\) grade de libertate valoarea critică este 15,51: nu, rămîne autocorelație
                                                        • Întrebare: două serii \(I(1)\) sînt cointegrate. De ce nu un VAR în diferențe?
                                                          • Răspuns: omite termenul de corecție a erorii și pierde informația pe termen lung

                                                        Sinteza secțiunii

                                                        Cursul se reduce la o succesiune de întrebări cu instrumente precise: cum arată seria, de cîte ori trebuie diferențiată, ce dependență are, cum se schimbă varianța ei, cum se leagă de alte serii și cît de bine poate fi prognozată, totul verificat pe date pe care modelul nu le-a văzut.

                                                        IAPC al României (Eurostat prc_hicp_minr, 2015 = 100) este citit cu funcția capitolului pe 4 noiembrie 2026 și tăiat la august 2026, ultima lună din curs; valorile din ianuarie 2005 – august 2026 nu au fost revizuite și reproduc exact cifrele din curs. Estimările celor 36 de modele SARIMA, reziduurile lor și prognozele provin din codul capitolului (statsmodels SARIMAX). Problema 2 folosește PIB-ul real al României în versiunea din curs (Capitolul 3, citit din graficul vectorial al capitolului, deoarece Eurostat a revizuit seria), Problema 4 creșterea PIB, inflația și ROBOR 3M ale VAR-ului din Capitolul 6, Problema 5 randamentele titlurilor de stat ale SUA (FRED, pînă în septembrie 2026), Problema 6 estimările GARCH(1,1)-t ale BET din Capitolul 5. Browserul calculează corelogramele, testele Ljung–Box și Jarque–Bera, măsurile de acuratețe, testul Diebold–Mariano, regresiile OLS ale Problemei 4 și calculele de mînă. Variantele care nu apar în curs (alte capete ale eșantionului, alte origini ale prognozei, alte penalizări ale criteriului, alte laguri, alți parametri ai problemelor) sînt rulări suplimentare ale codului capitolului pe aceleași date; graficele din „Interpretarea datelor”, „Pasul 2”, „Interpretarea corelogramei”, „Pasul 4”, „Interpretarea verificării reziduurilor”, „Interpretarea prognozelor” și din rezolvările problemelor sînt grafice suplimentare pentru slide-uri care dau doar cifre.

                                                        Bibliografie