Statistica piețelor financiare

Capitolul 16: Recapitulare

Capitolul 16: Recapitulare

Daniel Traian PELE

Academia de Studii Economice din București
IDA Institute Digital Assets
Blockchain Research Center
AI4EFin Artificial Intelligence for Energy Finance
Academia Română, Institutul de Prognoză Economică
MSCA Digital Finance

Acronime folosite în acest material (1/3)

Slide 1 în PDF
  • ACF: Autocorrelation Function (funcția de autocorelație)
  • AD: Anderson–Darling (test) — testul Anderson–Darling
  • AI: Artificial Intelligence (inteligență artificială)
  • AIC: Akaike Information Criterion (criteriul informațional Akaike)
  • ARCH: AutoRegressive Conditional Heteroskedasticity (heteroscedasticitate condiționată autoregresivă)
  • ARCH-LM: ARCH Lagrange Multiplier (test) — testul multiplicatorului Lagrange pentru efecte ARCH
  • AUC: Area Under the (ROC) Curve (aria de sub curba ROC)
  • BET: Bucharest Exchange Trading (index) — indicele de referință al Bursei de Valori București
  • BIC: Bayesian Information Criterion (criteriul informațional bayesian)
  • CAGR: Compound Annual Growth Rate (rata anuală compusă de creștere)
  • CI: Confidence Interval (interval de încredere)
  • DFA: Detrended Fluctuation Analysis (analiza fluctuațiilor fără tendință)
  • EAD: Exposure At Default (expunerea la momentul nerambursării)
  • EGARCH: Exponential GARCH (GARCH exponențial)
  • EODHD: EOD Historical Data (market-data provider) — furnizor de date de piață
  • ES: Expected Shortfall (pierderea așteptată în coadă)

Acronime folosite în acest material (2/3)

Slide 2 în PDF
  • EVT: Extreme Value Theory (teoria valorilor extreme)
  • EWMA: Exponentially Weighted Moving Average (medie mobilă ponderată exponențial)
  • FHS: Filtered Historical Simulation (simularea istorică filtrată)
  • FPR: False Positive Rate (rata fals pozitivelor)
  • GARCH: Generalised AutoRegressive Conditional Heteroskedasticity (heteroscedasticitate condiționată autoregresivă generalizată)
  • GBM: Geometric Brownian Motion (mișcarea browniană geometrică)
  • GEV: Generalised Extreme Value (distribution) — distribuția generalizată a valorilor extreme
  • GJR: Glosten–Jagannathan–Runkle (asymmetric GARCH) — modelul GARCH asimetric Glosten–Jagannathan–Runkle
  • GPD: Generalised Pareto Distribution (distribuția Pareto generalizată)
  • GPH: Geweke–Porter-Hudak (log-periodogram estimator) — estimatorul Geweke–Porter-Hudak pe log-periodogramă
  • HAR: Heterogeneous AutoRegressive (model) — model autoregresiv heterogen
  • HS: Historical Simulation (simularea istorică)
  • IGARCH: Integrated GARCH (GARCH integrat)
  • JB: Jarque–Bera (test) — testul de normalitate Jarque–Bera

Acronime folosite în acest material (3/3)

Slide 3 în PDF
  • KS: Kolmogorov–Smirnov (test) — testul Kolmogorov–Smirnov
  • LDA: Linear Discriminant Analysis (analiza discriminantă liniară)
  • LGD: Loss Given Default (pierderea în caz de nerambursare)
  • LR: Likelihood Ratio (raportul de verosimilitate)
  • MDD: Maximum DrawDown (drawdown-ul maxim)
  • MES: Marginal Expected Shortfall (pierderea marginală așteptată în coadă)
  • NIG: Normal Inverse Gaussian (distribution) — distribuția Normală invers Gaussiană
  • PD: Probability of Default (probabilitatea de nerambursare)
  • QLIKE: Quasi-LIKElihood (loss function) — funcția de pierdere de tip cvasi-verosimilitate
  • QQ: Quantile–Quantile (plot) — graficul cuantilă–cuantilă
  • SE: Standard Error (eroare standard)
  • SR: Sharpe Ratio (raportul Sharpe)
  • SRISK: Systemic RISK (capital shortfall in a crisis) — deficitul de capital într-o criză
  • TPR: True Positive Rate — rata adevărat pozitivelor (sensibilitatea)
  • VR: Variance Ratio (raportul varianțelor)

Întrebarea de azi și traseul

Slide 4 în PDF
  • Întrebarea: ce spune întregul curs despre randamentele BET, S&P 500 și Bitcoin și cum se evaluează aceste cunoștințe la examen?
  • Traseul
    • Partea I: harta cursului, cîte două slide-uri de recapitulare pentru fiecare capitol, sinteza testelor și modelelor
    • Partea a II-a: examenul (format, criterii de notare, opt probleme rezolvate) și proiectul de echipă
    • Partea a III-a: contribuția posibilă a AI în propria cercetare

Rezultatele învățării

Slide 5 în PDF
  • Situați fiecare capitol pe drumul de la prețuri la măsurile de risc și numiți întrebarea la care răspunde
  • Reamintiți formula-cheie, faptul empiric principal și greșeala cea mai frecventă din fiecare capitol
  • Alegeți testul sau modelul potrivit pentru o întrebare dată despre o serie de randamente
  • Rezolvați pas cu pas probleme de tip examen și interpretați rezultatul în trei pînă la cinci fraze
  • Planificați proiectul de echipă, susținerea orală și declararea utilizării AI

Bibliografie și instrumente

Slide 6 în PDF

Our description emphasizes properties common to a wide variety of markets and instruments. We then show how these statistical properties invalidate many of the common statistical approaches used to study financial data sets …

— Cont (2001), Empirical properties of asset returns: stylized facts and statistical issues

Capitolele 0–15 au construit, pas cu pas, un lanț de la prețurile observate la măsuri de risc pe care le putem testa: randamente calculate corect, distribuții cu cozi groase (heavy tails), dependență în timp, modele de volatilitate și, la capăt, VaR (value at risk) și ES (expected shortfall) verificate prin backtesting. Acest capitol de recapitulare parcurge din nou lanțul, de data aceasta cu trei serii pe aceeași fereastră de timp: indicele american S&P 500, indicele BET (Bucharest Exchange Trading) al Bursei de Valori București și Bitcoin, între 5 ianuarie 2015 și 18 septembrie 2026.

Cele trei serii sînt foarte diferite ca nivel de risc: volatilitatea anuală este 17,7% pentru S&P 500, 15,5% pentru BET și 66,7% pentru Bitcoin. Faptele stilizate sînt însă aceleași: asimetrie negativă, exces de boltire peste 10, tail index-uri Hill între 2 și 3, randamente aproape necorelate și randamente absolute puternic autocorelate. Un VaR 1% calculat cu distribuția Normală este prea mic pentru toate trei, cu 18% pînă la 25%. Aceste regularități comune sînt motivul pentru care aceleași instrumente statistice funcționează pe o piață emergentă, pe cea mai mare piață de acțiuni din lume și pe o piață cripto.

Capitolul are trei părți. Prima reia fiecare capitol prin formula principală, faptul empiric principal și greșeala cea mai frecventă, apoi strînge testele și modelele într-o sinteză a metodelor. A doua prezintă evaluarea scrisă, opt probleme rezolvate complet și proiectul de echipă. A treia formulează o întrebare deschisă despre piața din România, la care metodele cursului pot contribui, și arată ce poate face un asistent AI (artificial intelligence) într-un astfel de proiect și ce trebuie verificat.

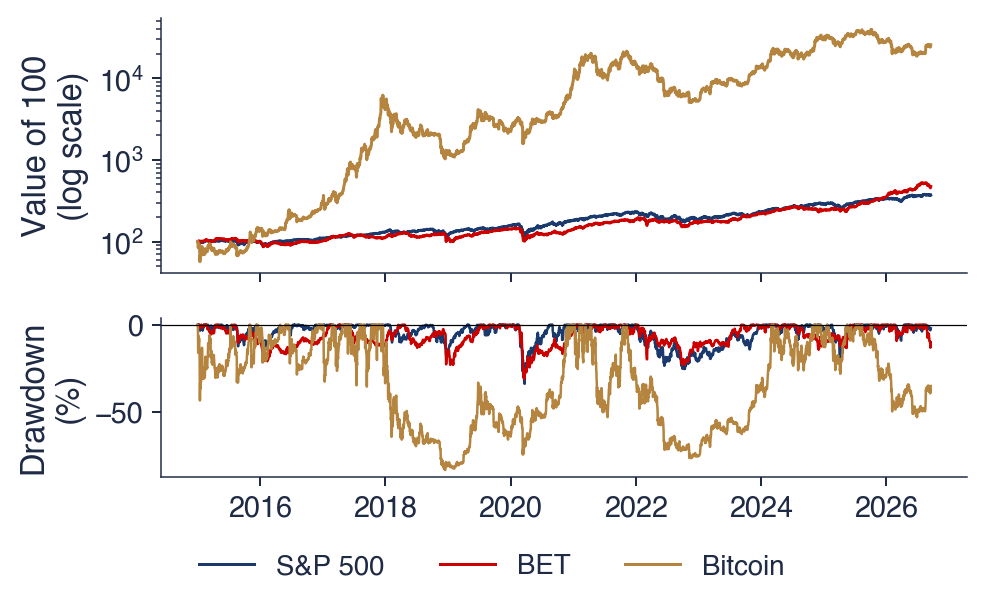
Sus: valoarea a 100 de unități investite la începutul lui 2015 în S&P 500 (albastru închis), BET (roșu) și Bitcoin (auriu), pe scală logaritmică. Jos: drawdown-ul fiecărei serii, în procente, față de maximul atins pînă la acea dată.

Rezultatele învățării

  • Situați fiecare capitol pe drumul de la prețuri la măsurile de risc și numiți întrebarea la care răspunde.
  • Reamintiți formula principală, faptul empiric principal și greșeala cea mai frecventă din fiecare capitol.
  • Alegeți testul sau modelul potrivit pentru o întrebare dată despre o serie de randamente.
  • Rezolvați pas cu pas probleme recapitulative și interpretați rezultatul în trei pînă la cinci fraze.
  • Planificați proiectul de echipă, susținerea orală și declararea utilizării AI.

Planul capitolului

  1. Harta cursuluiLegăturile dintre capitole, firul principal și cele trei serii comparate într-un singur tabel și în două grafice.
  2. Capitolele 0–3: date, randamente și distribuțiiRandamente, anualizare, drawdown, raportul Sharpe, momente, testul Jarque–Bera și legile α-stabile.
  3. Capitolele 4–7: probabilitate, cozi, alegerea modelului, eficiențăPortofolii, Monte Carlo, GBM, estimatorul Hill, EVT, criterii de selecție și testele raportului varianțelor.
  4. Capitolele 8–11: volatilitate, risc și memorieEWMA, GARCH, VaR și ES cu backtesting, exponentul Hurst.
  5. Capitolele 12–15: aplicațiiScoring de credit, învățare automată, active cripto și risc sistemic.
  6. Sinteza metodelorCe test sau model răspunde la ce întrebare, convențiile cursului și erorile metodologice frecvente.
  7. ExamenulFormatul, conținutul, criteriile de notare și opt probleme rezolvate.
  8. Proiectul de echipăLivrabile, criterii, susținerea orală și fișierul AI_USE.md.
  9. Instrumente AI pentru un proiect de cercetareO întrebare deschisă despre BET, etapele unui proiect de cercetare, ajutorul și verificările AI, o idee de proiect.
  10. RezumatIdeile principale și întrebări de autoevaluare.

Harta cursului

Secțiunea arată cursul ca întreg: cum se leagă capitolele, care este firul principal care duce de la prețuri la o măsură de risc testabilă și ce dau toate instrumentele cursului aplicate simultan pe S&P 500, BET și Bitcoin. Tabelul și cele două grafice de aici sînt rezultatele de referință ale capitolului; secțiunile următoare reiau fiecare capitol în parte.

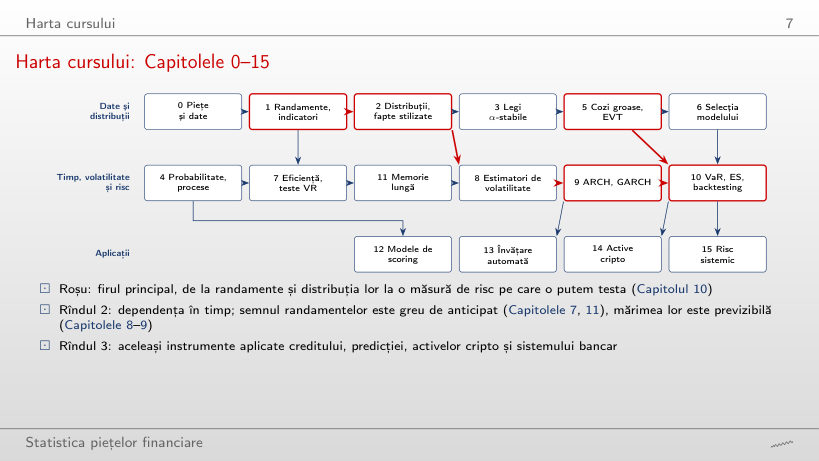
Harta cursului: Capitolele 0–15

Slide 7 în PDF

Diagrama așază cele șaisprezece capitole pe trei rînduri. Primul rînd, „Date și distribuții”, merge de la piețe și date (Capitolul 0) la randamente și indicatori, distribuții clasice și fapte stilizate, legi α-stabile, cozi groase și teoria valorilor extreme (EVT, extreme value theory) și selecția modelului. Al doilea rînd, „Timp, volatilitate și risc”, pornește de la probabilitate și procese stocastice, trece prin eficiența pieței, memoria lungă, estimatorii de volatilitate și modelele ARCH–GARCH și ajunge la VaR, ES și backtesting. Al treilea rînd, „Aplicații”, conține modelele de scoring, învățarea automată, activele cripto și riscul sistemic.

Săgețile roșii marchează firul principal: randamentele (Capitolul 1) și distribuția lor (Capitolul 2) duc, prin cozi groase și prin volatilitate, la o măsură de risc pe care o putem testa (Capitolul 10). Al doilea rînd separă două întrebări diferite despre dependența în timp: semnul randamentelor este greu de anticipat (Capitolele 7 și 11), în timp ce mărimea lor este previzibilă (Capitolele 8 și 9).

Rîndul aplicațiilor nu introduce o statistică nouă, ci reutilizează instrumentele primelor două rînduri. Scoring-ul de credit pleacă din probabilitate, învățarea automată pleacă din modelele de volatilitate, iar activele cripto și riscul sistemic pleacă din măsurile de risc ale Capitolului 10.

Structura cursului

Slide 8 în PDF

Lanțul are patru verigi. Prima sînt datele: prețuri dintr-o singură sursă, ajustate pentru dividende și split-uri, pe calendarul corect al pieței. Din ele se calculează randamentele logaritmice zilnice, în procente,

\[r_t = 100\,\ln\frac{P_t}{P_{t-1}},\]

unde \(P_t\) este prețul de închidere din ziua \(t\). A doua verigă este distribuția randamentelor (Capitolele 2–6): ea are cozi groase, așa că distribuția Normală este înlocuită de Student-\(t\), de legile stabile sau de EVT, iar alegerea dintre modele se face cu verosimilitatea, cu AIC (Akaike information criterion) și cu teste concentrate pe cozi.

A treia verigă este dependența în timp (Capitolele 7–11). Pentru medie, raportul varianțelor și exponentul Hurst arată că semnul randamentului de mîine este aproape imprevizibil. Pentru varianță, EWMA (exponentially weighted moving average) și GARCH (generalised autoregressive conditional heteroskedasticity) arată că mărimea lui este previzibilă. A patra verigă este riscul (Capitolul 10): VaR 1% și ES 2,5%, însoțite întotdeauna de backtesting.

Aplicațiile din Capitolele 12–15 refolosesc același lanț: date, distribuție, dependență, risc, evaluare. Un model de scoring, o prognoză obținută prin învățare automată sau o măsură a riscului sistemic se judecă tot prin incertitudinea estimărilor și prin performanța în afara eșantionului (out-of-sample).

Pe scurt

  • Datele (Capitolele 0–1): prețuri dintr-o singură sursă, ajustate, pe calendarul corect
    • randamente: \(r_t = \ln(P_t/P_{t-1})\), în % pe o zi
  • Distribuția (Capitolele 2–6): cozi groase, nu distribuția Normală
    • Student-\(t\), legi stabile, EVT; modelul se alege cu verosimilitatea, AIC și teste pentru cozi
  • Dependența în timp (Capitolele 7–11): semnul este aproape imprevizibil, mărimea este previzibilă
    • raportul varianțelor și exponentul Hurst pentru medie; EWMA și GARCH pentru varianță
  • Riscul (Capitolul 10): VaR 1% și ES 2,5%, cu backtesting
    • aplicațiile (Capitolele 12–15) refolosesc același lanț: date, distribuție, dependență, risc, evaluare

S&P 500, BET și Bitcoin în aceeași perioadă

Slide 9 în PDF

Randamente logaritmice zilnice pe fereastra aleasă (tabelul de pe slide pentru ianuarie 2015)

    Întrebare pentru sală Cu fereastra din ianuarie 2021 (▶, rulare suplimentară), mai respinge testul Ljung–Box Q(10) absența autocorelației randamentelor S&P 500?
    Răspuns

    Nu: Q(10) = 9,1 < 18,31 (p = 0,52), față de 236 pe fereastra din 2015, în timp ce pe rₜ² rămîne 291. Statistica mare din tabel vine în bună parte din zilele din martie 2020, cînd randamente mari de semne opuse au venit una după alta (ρ̂₁ = −0,13); volatility clustering se vede în orice fereastră.

      Întrebare pentru sală ▶ trece la nivelul α = 5%. Mai este VaR Normal prea mic față de VaR istoric?
      Răspuns

      Nu: la 5%, VaR Normal este prea mare, cu 7,8% (S&P 500: 1,79% față de 1,66%), 13,1% (BET) și 6,4% (Bitcoin). Distribuția randamentelor are mai multă masă în centru și în cozile extreme decît distribuția Normală cu aceeași varianță, așa că cele două cuantile se încrucișează între 1% și 5% (la 2,5%, pentru BET, diferența este −0,5%). VaR Normal subestimează riscul tocmai la nivelurile mici, cele folosite în reglementare.

        Întrebare pentru sală ▶ mută începutul ferestrei în ianuarie 2019 (rulare suplimentară). Care dintre cele trei drawdown-uri maxime se schimbă?
        Răspuns

        Doar cel al Bitcoin: −76,6% (de la 8 noiembrie 2021 la 21 noiembrie 2022) în loc de −83,4% (decembrie 2017 – decembrie 2018). S&P 500 (−33,9%) și BET (−31,1%) își păstrează minimul din 23 martie 2020, care rămîne în fereastră. Drawdown-ul maxim depinde de eșantion: el măsoară cea mai mare cădere observată, nu o proprietate fixă a activului.

        Graficul are două panouri cu aceeași axă orizontală, din 2015 pînă în 2026. Panoul de sus arată valoarea a 100 de unități investite la 2 ianuarie 2015 în S&P 500, BET și Bitcoin, pe o scală logaritmică cu reperele 100, 1 000 și 10 000. Scala logaritmică face comparabile variațiile procentuale: aceeași distanță verticală înseamnă aceeași creștere relativă, indiferent de nivel. Pe ea, S&P 500 și BET urcă pe linii apropiate, iar Bitcoin crește de peste 250 de ori, cu oscilații mult mai ample.

        Panoul de jos arată drawdown-ul fiecărei serii, adică distanța procentuală față de cel mai mare preț atins pînă atunci:

        \[D_t = \frac{P_t}{\max_{s \le t} P_s} - 1 \le 0.\]

        Drawdown-ul maxim (MDD, maximum drawdown) este \(-33{,}9\%\) pentru S&P 500 și \(-31{,}1\%\) pentru BET, ambele în martie 2020, la începutul pandemiei. Pentru Bitcoin este \(-83{,}4\%\), atins în decembrie 2018, iar panoul arată o a doua scădere de amploare comparabilă în 2022.

        Graficul reunește două idei din Capitolul 0. Un cîștig mare pe întreaga perioadă poate coexista cu pierderi intermediare care ar fi fost greu de suportat, iar riscul unei investiții nu se descrie doar prin volatilitate: drawdown-ul spune cît a pierdut efectiv un investitor care a cumpărat la vîrf.

        Pe scurt

        • 100 investiți la 2 ianuarie 2015 (scală logaritmică) și drawdown-ul \(P_t/\max_{s \le t}P_s - 1\)
        • Drawdown maxim: S&P 500 \(-33{,}9\%\), BET \(-31{,}1\%\) (ambele în martie 2020), Bitcoin \(-83{,}4\%\)
        SFM_ch16_course_summary

        Tabelul de sinteză al cursului

        Slide 10 în PDF

        Tabelul aplică instrumentele cursului pe randamentele logaritmice zilnice ale celor trei serii, fiecare pe propriul calendar, de la primul randament (5 ianuarie 2015 pentru S&P 500, 6 ianuarie pentru BET, 2 ianuarie pentru Bitcoin) pînă la 18 septembrie 2026: 2 943 de observații pentru S&P 500 (252 pe an), 2 925 pentru BET (250 pe an) și 4 278 pentru Bitcoin (365 pe an). Primele rînduri descriu performanța: randamentul logaritmic mediu este 11,2% pe an pentru S&P 500, 13,2% pentru BET și 47,4% pentru Bitcoin, iar volatilitățile sînt 17,7%, 15,5% și 66,7%. Raportul Sharpe, calculat cu o rată fără risc egală cu zero, este 0,72, 0,93 și 1,04, fiecare cu o eroare standard (SE, standard error) de 0,33–0,36.

        Rîndurile din mijloc descriu distribuția și dependența. Asimetria este negativă pentru toate trei serii (−0,64, −1,41 și −0,73), excesul de boltire este 15,8, 17,8 și 12,2, iar tail index-ul Hill al pierderilor, estimat cu 2,5% dintre observații în coadă, este 2,75, 2,19 și 2,67. Statistica Ljung–Box \(Q(10)\) este 236, 55 și 21 pentru randamente, dar 3 166, 701 și 211 pentru pătratele lor, față de valoarea critică 18,31 a distribuției \(\chi^2(10)\) la 5%. Raportul varianțelor pe cinci zile, VR(5), este 0,84, 1,17 și 0,99, cu statistici robuste \(Z^*(5)\) de −1,34, 1,93 și −0,22. Persistența GARCH(1,1)-\(t\), \(\alpha + \beta\), este 0,993, 0,925 și 1,000.

        Ultimele rînduri dau riscul și memoria. VaR 1% istoric este 3,29% pentru S&P 500, 2,72% pentru BET și 10,60% pentru Bitcoin, iar VaR 1% Normal este 2,55%, 2,23% și 7,99%. ES 2,5% istoric este 3,53%, 3,21% și 10,93%. Exponentul Hurst estimat prin metoda R/S (rescaled range) este 0,53, 0,59 și 0,59 pentru randamente și 0,84, 0,75 și 0,78 pentru randamentele absolute.


        Pe scurt

        Randamente logaritmice zilniceS&P 500BETBitcoin
        Observații (pe an)2 943 (252)2 925 (250)4 278 (365)
        Randament logaritmic mediu, % pe an\(11{,}2\)\(13{,}2\)\(47{,}4\)
        Volatilitate, % pe an\(17{,}7\)\(15{,}5\)\(66{,}7\)
        Raportul Sharpe (\(r_f = 0\)) \(\pm\) SE\(0{,}72 \pm 0{,}33\)\(0{,}93 \pm 0{,}35\)\(1{,}04 \pm 0{,}36\)
        Asimetrie; excesul de boltire\(-0{,}64\); \(15{,}8\)\(-1{,}41\); \(17{,}8\)\(-0{,}73\); \(12{,}2\)
        Tail index-ul Hill al pierderilor (\(k = 2{,}5\%\,n\))\(2{,}75\)\(2{,}19\)\(2{,}67\)
        Ljung–Box \(Q(10)\): \(r_t\); \(r_t^2\)\(236\); \(3166\)\(55\); \(701\)\(21\); \(211\)
        VR(5); \(Z^*(5)\) robust\(0{,}84\); \(-1{,}34\)\(1{,}17\); \(1{,}93\)\(0{,}99\); \(-0{,}22\)
        GARCH(1,1)-\(t\): \(\alpha + \beta\)\(0{,}993\)\(0{,}925\)\(1{,}000\)
        VaR 1%: istoric; Normal (%)\(3{,}29\); \(2{,}55\)\(2{,}72\); \(2{,}23\)\(10{,}60\); \(7{,}99\)
        ES 2,5%, istoric (%)\(3{,}53\)\(3{,}21\)\(10{,}93\)
        Hurst (R/S): \(r_t\); \(|r_t|\)\(0{,}53\); \(0{,}84\)\(0{,}59\); \(0{,}75\)\(0{,}59\); \(0{,}78\)
        • Fereastra: primul randament la 5 ianuarie 2015 (S&P 500), 6 ianuarie 2015 (BET), 2 ianuarie 2015 (Bitcoin) – 18 septembrie 2026; fiecare serie pe calendarul ei (Bitcoin: 365 de zile pe an); valoarea critică \(\chi^2(10)\) la 5%: \(18{,}31\)
        SFM_ch16_course_summary

        Interpretarea tabelului

        Slide 11 în PDF

        Prima lectură privește randamentul și riscul. Volatilitatea Bitcoin este de 3,8 ori mai mare decît a S&P 500 și de 4,3 ori mai mare decît a BET. Rapoartele Sharpe par să ordoneze cele trei investiții (1,04 pentru Bitcoin, 0,93 pentru BET, 0,72 pentru S&P 500), dar diferențele sînt mici față de erorile lor standard: un interval de încredere de 95% în jurul fiecărui raport acoperă și valorile celorlalte două. Pe aproape doisprezece ani de date, nu putem spune care dintre ele a avut cel mai bun raport între randament și risc.

        A doua lectură privește distribuția. Asimetria negativă, excesul de boltire peste 10 și tail index-urile între 2 și 3 spun același lucru: pierderile mari sînt mult mai frecvente decît prevede distribuția Normală. Consecința practică se vede în rîndul VaR: VaR 1% Normal este mai mic decît cel istoric cu 22% pentru S&P 500, cu 18% pentru BET și cu 25% pentru Bitcoin. Un model Normal subestimează sistematic pierderea din ziua rea.

        A treia lectură privește dependența. Statistica Ljung–Box pe \(r_t^2\) este de 10 pînă la 13 ori mai mare decît pe \(r_t\): volatilitatea, nu randamentul, are structură în timp. Testul robust al raportului varianțelor nu respinge mersul aleator la 5% pentru niciuna dintre serii (pentru BET, \(Z^*(5) = 1{,}93\) este chiar sub pragul 1,96), iar exponentul Hurst este mult peste 0,5 doar pentru randamentele absolute. Persistența volatilității este aproape de 1; pentru Bitcoin este exact 1, adică un model IGARCH (integrated GARCH), în care un șoc de volatilitate nu se stinge.

        Pe scurt

        • Randament și risc: Bitcoin are o volatilitate de circa patru ori mai mare decît a celor doi indici
          • rapoartele Sharpe sînt apropiate, dacă ținem seama de erorile lor standard
        • Distribuția: asimetrie negativă, exces de boltire peste 10, tail index-uri Hill între 2 și 3
          • VaR 1% Normal este prea mic cu 22% (S&P 500), 18% (BET) și 25% (Bitcoin)
        • Dependența: statistica Ljung–Box pe \(r_t^2\) este de multe ori mai mare decît pe \(r_t\)
          • testul VR robust nu respinge aici mersul aleator la 5%; \(H\) pentru \(|r_t|\) este mult peste 0,5
          • volatilitatea este persistentă: \(\alpha + \beta\) aproape de 1 (Bitcoin: un IGARCH, \(\alpha + \beta = 1\))

        Faptele stilizate: ACF a randamentelor și a randamentelor absolute

        Slide 12 în PDF
          Întrebare pentru sală Cu fereastra din ianuarie 2021 (▶, rulare suplimentară), care rapoarte Sharpe au un interval de 95% care conține 0?
          Răspuns

          S&P 500 (0,85, CI [−0,10; 1,81]) și Bitcoin (0,60, CI [−0,29; 1,49]); BET (1,53, CI [0,32; 2,74]) nu. Cu circa 5,7 ani de date, eroarea standard √((1 + SR²/2)/Y) este de aproape 0,5: chiar un Sharpe de 0,85 nu se separă de zero.

            Întrebare pentru sală ▶ trece la BET. Crește α̂ de la randamentele zilnice la cele lunare, ca la S&P 500 (1,54 → 1,82)?
            Răspuns

            Nu clar: 1,49 zilnic, 1,56 săptămînal, 1,50 lunar, iar intervalul lunar [1,33; 1,67] este larg; BET este excepția de pe slide. Varianța de selecție cumulativă a BET scade totuși de la 3,32 (2010) la 1,96 (2026) și se stabilizează, cum se întîmplă cu o varianță finită. Pentru Bitcoin, α̂ lunar atinge frontiera α = 2.

              Întrebare pentru sală Cu fereastra din ianuarie 2021 (▶, rulare suplimentară), ce devine ρ̂₁(|r|) pentru S&P 500?
              Răspuns

              Scade la 0,16, de la 0,36, pentru că zilele din martie 2020 au ieșit din eșantion; toate cele 50 de autocorelații ale lui |r| rămîn totuși pozitive. Mărimea autocorelației depinde de crizele din fereastră, semnul ei pozitiv persistent nu.

              Graficul are trei panouri, pentru S&P 500, BET și Bitcoin. Pe axa orizontală este lagul, de la 1 la 50 de zile, iar pe verticală este autocorelația. Barele albastre închise sînt autocorelațiile randamentelor \(r_t\), barele roșii sînt autocorelațiile randamentelor absolute \(|r_t|\), iar banda colorată din jurul lui zero este intervalul \(\pm 1{,}96/\sqrt{T}\), în interiorul căruia o autocorelație nu diferă semnificativ de zero în ipoteza de independență.

              Autocorelațiile randamentelor sînt mici și se află în mare parte în bandă; excepțiile cele mai vizibile sînt la S&P 500, unde primul lag este negativ. Autocorelațiile randamentelor absolute sînt pozitive pe toate cele 50 de laguri pentru S&P 500 și Bitcoin și pe 49 dintre ele pentru BET (la lagul 43 este −0,001), iar ele scad lent: la primul lag ele sînt 0,36 pentru S&P 500, 0,29 pentru BET și 0,22 pentru Bitcoin. Aceasta este forma grafică a volatility clustering: o zi agitată este urmată, cu o probabilitate mai mare, de alte zile agitate.

              Lecția graficului este că necorelat nu înseamnă independent. Absența autocorelației în \(r_t\) nu permite concluzia că randamentele sînt independente, pentru că o funcție a lor, \(|r_t|\), este puternic autocorelată. Această observație, una dintre faptele stilizate descrise de Cont (2001), justifică modelarea separată a varianței condiționate în Capitolele 8 și 9.

              Pe scurt

              • Randamentele: autocorelații mici și în mare parte în interiorul benzii \(\pm 1{,}96/\sqrt{T}\); randamentele absolute: pozitive la 50, 49 și 50 din cele 50 de laguri (BET, lagul 43: \(-0{,}001\))
              • Necorelat nu înseamnă independent: \(\hat\rho_1(|r|) = 0{,}36\) (S&P 500), \(0{,}29\) (BET), \(0{,}22\) (Bitcoin)
              SFM_ch16_course_summary

              Sinteza secțiunii

              Pe aceeași fereastră, S&P 500, BET și Bitcoin diferă prin nivelul riscului, dar au aceleași fapte stilizate: asimetrie negativă, cozi groase cu tail index între 2 și 3, randamente aproape necorelate și volatilitate persistentă. Distribuția Normală subestimează VaR 1% al tuturor celor trei serii, iar diferențele dintre rapoartele Sharpe nu sînt semnificative statistic.

              Capitolele 0–3: date, randamente și distribuții

              Primele patru capitole stabilesc obiectul de studiu: cum se obțin date curate, cum se transformă prețurile în randamente, cum se rezumă performanța unei investiții și ce formă are distribuția randamentelor. Fiecare capitol este reluat în două slide-uri: formulele principale cu notațiile lor, apoi faptele empirice și greșelile frecvente.

              Capitolul 0: introducere (1/2)

              Slide 13 în PDF

              Prima formulă a cursului este anualizarea volatilității. Dacă \(\sigma\) este abaterea standard a randamentelor zilnice și \(A\) este numărul de observații pe an, volatilitatea anualizată este \(\sigma_{\text{an}} = \sqrt{A}\,\sigma\). Regula rădăcinii pătrate vine din faptul că varianța unei sume de randamente necorelate este suma varianțelor, deci varianța anuală este de \(A\) ori cea zilnică. Valoarea lui \(A\) depinde de piață: circa 252 pentru acțiuni, care se tranzacționează doar în zilele lucrătoare, și 365 pentru activele cripto, care se tranzacționează în fiecare zi.

              A doua formulă este drawdown-ul, \(D_t = P_t/\max_{s \le t}P_s - 1\), unde \(P_t\) este prețul din ziua \(t\), iar \(\max_{s \le t}P_s\) este cel mai mare preț atins pînă în acea zi. Prin construcție \(D_t \le 0\): drawdown-ul este zero la un nou maxim și negativ în rest. Drawdown-ul maxim, \(\mathrm{MDD} = \min_t D_t\), este cea mai mare pierdere suferită de un investitor care a cumpărat la vîrf și a vîndut la minim.

              Cele două măsuri se completează. Volatilitatea descrie mărimea tipică a variațiilor zilnice, fără să țină seama de ordinea lor, în timp ce drawdown-ul depinde de succesiunea randamentelor: o serie de pierderi consecutive produce un drawdown mare chiar dacă fiecare pierdere, luată separat, este modestă.

              Pe scurt

              • Formule-cheie
                • volatilitatea anualizată \(\sigma_{\text{an}} = \sqrt{A}\,\sigma\), \(A\) = observații pe an (252 la acțiuni, 365 la cripto)
                • drawdown \(D_t = P_t/\max_{s \le t}P_s - 1\); drawdown maxim MDD \(= \min_t D_t\)
              • Notațiile
                • \(\sigma\): abaterea standard a randamentelor zilnice; \(A\): numărul de observații pe an
                • \(P_t\): prețul din ziua \(t\); \(\max_{s \le t}P_s\): cel mai mare preț pînă în ziua \(t\); \(D_t \le 0\)

              Capitolul 0: introducere (2/2)

              Slide 14 în PDF

              Din 2015, volatilitatea anuală a S&P 500 este 17,7%, iar a Bitcoin este 66,7%, aproape de patru ori mai mare. Cel mai sever episod din istoria BET a fost criza financiară globală: indicele a pierdut 82,5% între 24 iulie 2007 și 25 februarie 2009 și a revenit la vîrful din 2007 abia pe 16 martie 2021, după mai bine de treisprezece ani. Durata revenirii este o dimensiune a riscului pe care volatilitatea nu o surprinde.

              Greșelile frecvente ale acestui capitol privesc datele. Prețurile luate din mai multe surse pot avea ore de închidere, ajustări sau calendare diferite, iar o serie compusă din ele produce randamente false la punctele de îmbinare. Prețurile neajustate ale acțiunilor care plătesc dividende sau fac split-uri arată o scădere bruscă în ziua ajustării, deși investitorul nu a pierdut nimic.

              A doua greșeală privește verificarea. O cifră sau o referință bibliografică obținută cu un asistent AI trebuie recalculată, respectiv deschisă la sursă, înainte de a fi folosită: asistenții AI produc cu ușurință cifre plauzibile și referințe care nu există.

              Pe scurt

              • Fapte empirice
                • din 2015: volatilitate de 17,7% pe an pentru S&P 500 și de 66,7% pentru Bitcoin
                • BET: \(-82{,}5\%\) între 24 iulie 2007 și 25 februarie 2009; revenire la vîrf abia la 16 martie 2021
              • Greșeli frecvente
                • prețuri din mai multe surse amestecate sau prețuri neajustate pentru acțiuni cu dividende și split-uri
                • o cifră sau o lucrare de referință obținută cu AI și neverificată

              Capitolul 1: date, randamente și indicatori (1/2)

              Slide 15 în PDF

              Randamentul simplu este \(R_t = P_t/P_{t-1} - 1\), iar randamentul logaritmic este \(r_t = \ln(1 + R_t)\). Cele două au proprietăți de agregare diferite. Randamentele logaritmice se adună în timp, pentru că logaritmul unui produs de factori de creștere este suma logaritmilor. Randamentele simple se adună între active: randamentul unui portofoliu este media ponderată a randamentelor simple ale componentelor.

              Performanța pe termen lung se rezumă prin rata anuală compusă de creștere (CAGR, compound annual growth rate), \(\mathrm{CAGR} = (P_T/P_0)^{1/Y} - 1\), unde \(Y\) este numărul de ani. Raportul Sharpe, \(\mathrm{SR} = (\mu - r_f)/\sigma\), împarte randamentul în exces anual la volatilitatea anuală, iar eroarea lui standard este aproximativ

              \[\mathrm{SE}(\widehat{\mathrm{SR}}) \approx \sqrt{\frac{1 + \mathrm{SR}^2/2}{Y}},\]

              deci depinde de numărul de ani, nu de numărul de observații zilnice. Cu zece ani de date, eroarea standard este în jur de 0,3, de aceea rapoartele Sharpe ale unor investiții obișnuite se pot rareori distinge statistic.

              Volatility drag este diferența dintre media aritmetică a randamentelor și rata de creștere compusă, aproximativ \(\sigma^2/2\) pe an. El explică de ce o investiție volatilă crește mai încet decît sugerează randamentul ei mediu: o pierdere de 50% urmată de un cîștig de 50% lasă investitorul cu 75% din capital.

              Pe scurt

              • Formule-cheie
                • \(R_t = P_t/P_{t-1} - 1\), \(r_t = \ln(1 + R_t)\); randamentele logaritmice se adună în timp, cele simple între active
                • CAGR \(= (P_T/P_0)^{1/Y} - 1\); Sharpe \(= (\mu - r_f)/\sigma\), SE \(\approx \sqrt{(1 + \mathrm{SR}^2/2)/Y}\); volatility drag \(\approx \sigma^2/2\)
              • Notațiile
                • \(R_t\): randamentul simplu, \(r_t\): randamentul logaritmic al perioadei \(t\); \(P_0\), \(P_T\): primul și ultimul preț; \(Y\): numărul de ani
                • \(\mu\), \(\sigma\): media și volatilitatea anuale; \(r_f\): rata fără risc; SR: raportul Sharpe; SE: eroarea lui standard

              Capitolul 1: date, randamente și indicatori (2/2)

              Slide 16 în PDF

              Pentru BET din 2015, CAGR este 14,1%, volatilitatea anuală este 15,5%, iar raportul Sharpe este 0,93, cu un interval de încredere (CI, confidence interval) de 95% între 0,24 și 1,61. Intervalul este larg: cu aproape doisprezece ani de date, raportul Sharpe al BET este pozitiv cu certitudine statistică, dar valoarea lui exactă rămîne incertă.

              Bitcoin ilustrează volatility drag. Media aritmetică a randamentelor lui anuale este 69,5%, dar CAGR este doar 60,6%. Diferența de circa nouă puncte procentuale este costul volatilității mari: un investitor care a păstrat Bitcoin pe toată perioada a obținut rata compusă, nu media aritmetică.

              Greșelile frecvente decurg din aceste definiții. Adunarea randamentelor simple în timp, folosirea mediei aritmetice în locul CAGR pentru performanța realizată, anualizarea volatilității Bitcoin cu 252 de zile în loc de 365 și raportarea unui raport Sharpe fără eroarea lui standard duc, fiecare, la concluzii greșite despre performanță.

              Pe scurt

              • Fapte empirice
                • BET din 2015: CAGR 14,1%, volatilitate 15,5%, Sharpe 0,93, cu CI 95% [0,24; 1,61]
                • Bitcoin: media aritmetică 69,5% pe an, CAGR doar 60,6%: efectul volatility drag
              • Greșeli frecvente
                • adunarea randamentelor simple în timp; media randamentelor în locul CAGR
                • anualizarea cu 252 pentru Bitcoin; raportarea raportului Sharpe fără eroarea lui standard

              Capitolul 2: distribuții clasice și fapte stilizate (1/2)

              Slide 17 în PDF

              Forma distribuției se rezumă prin momentele centrate \(m_k = \frac1n\sum_t (r_t - \bar r)^k\). Asimetria este \(S = m_3/m_2^{3/2}\), iar excesul de boltire este \(K = m_4/m_2^2 - 3\); ambele sînt zero pentru distribuția Normală. Testul Jarque–Bera (JB) combină cele două abateri de la normalitate (Jarque & Bera, 1980):

              \[\mathrm{JB} = \frac{n}{6}\left(S^2 + \frac{K^2}{4}\right) \sim \chi^2(2).\]

              Statistica urmează distribuția \(\chi^2(2)\) în ipoteza de normalitate.

              Pentru cozi groase, alternativa clasică este distribuția Student-\(t\) cu \(\nu\) grade de libertate. Excesul ei de boltire este \(6/(\nu - 4)\) pentru \(\nu > 4\), deci un \(\nu\) mic înseamnă cozi groase, iar pentru \(\nu \le 4\) momentul de ordinul patru nu există. Dependența în timp se testează cu statistica Ljung–Box

              \[Q(m) = n(n+2)\sum_{h=1}^{m}\frac{\hat\rho(h)^2}{n - h},\]

              unde \(\hat\rho(h)\) este autocorelația de selecție la lagul \(h\), iar \(m\) este numărul de laguri; în ipoteza de absență a autocorelației, \(Q(m)\) urmează aproximativ o distribuție \(\chi^2(m)\).

              Pe scurt

              • Formule-cheie
                • \(S = m_3/m_2^{3/2}\), \(K = m_4/m_2^2 - 3\); \(\text{JB} = \frac{n}{6}(S^2 + K^2/4) \sim \chi^2(2)\) Jarque & Bera (1980)
                • Student-\(t(\nu)\): excesul de boltire \(6/(\nu - 4)\) pentru \(\nu > 4\); Ljung–Box \(Q(m) = n(n+2)\sum_h \hat\rho(h)^2/(n - h)\)
              • Notațiile
                • \(m_k = \frac1n\sum_t (r_t - \bar r)^k\): momentul centrat de ordin \(k\); \(S\): asimetria; \(K\): excesul de boltire (0 pentru distribuția Normală)
                • JB: Jarque–Bera, \(\chi^2(2)\) în ipoteza de normalitate; \(\nu\): gradele de libertate; \(\hat\rho(h)\): autocorelația la lagul \(h\); \(m\): numărul de laguri

              Capitolul 2: distribuții clasice și fapte stilizate (2/2)

              Slide 18 în PDF

              Pentru BET din 2010, asimetria este −0,98, excesul de boltire este 17,9, iar statistica Jarque–Bera este 56 762, cu mult peste orice valoare critică. Distribuția Student-\(t\) estimată are \(\hat\nu = 2{,}96\) grade de libertate, sub pragul de 4, ceea ce înseamnă că, dacă modelul este corect, momentul de ordinul patru nu este finit.

              Autocorelația de ordinul întîi a randamentelor BET este 0,03, aproape zero, dar a randamentelor absolute este 0,34. Cele două cifre rezumă două dintre cele șase fapte stilizate descrise de Cont (2001): absența autocorelației randamentelor și volatility clustering.

              Prima greșeală frecventă este confuzia dintre coeficientul de boltire, \(K + 3\), și excesul de boltire, \(K\): distribuția Normală are boltirea 3 și excesul 0. A doua este concluzia că randamentele sînt independente pentru că funcția de autocorelație (ACF, autocorrelation function) a lui \(r_t\) nu este semnificativă; independența cere ca și funcțiile neliniare ale randamentelor să fie necorelate.

              Pe scurt

              • Fapte empirice
                • BET din 2010: \(S = -0{,}98\), \(K = 17{,}9\), JB \(=\) 56 762; Student-\(t\) estimată: \(\hat\nu = 2{,}96\)
                • \(\hat\rho_1(r) = 0{,}03\), dar \(\hat\rho_1(|r|) = 0{,}34\): cele șase fapte stilizate din Cont (2001)
              • Greșeli frecvente
                • confuzia dintre coeficientul de boltire \(K + 3\) și excesul de boltire (distribuția Normală are boltirea 3 și excesul 0)
                • concluzia de independență trasă dintr-un ACF nesemnificativ al lui \(r_t\)

              Capitolul 3: distribuții \(\alpha\)-stabile (1/2)

              Slide 19 în PDF

              O distribuție este stabilă dacă suma unor copii independente are aceeași formă ca fiecare termen, după o schimbare de scală și de poziție:

              \[X_1 + \dots + X_n \overset{d}{=} n^{1/\alpha}X + d_n,\]

              unde \(\overset{d}{=}\) înseamnă egalitate în distribuție, \(d_n\) este o translație, iar \(\alpha \in (0, 2]\) este indicele de stabilitate. Pentru \(\alpha = 2\) se obține distribuția Normală. Pentru \(\alpha < 2\), cozile descresc ca o putere, \(P(X > x) \sim c\,x^{-\alpha}\), iar momentul de ordin \(p\) există doar pentru \(p < \alpha\); în particular, varianța este infinită.

              Familia are patru parametri: \(\alpha\) pentru cozi, \(\beta\) pentru asimetrie, \(\gamma\) pentru scală și \(\delta\) pentru poziție (Nolan, 2020). Aceiași parametri se pot defini în mai multe parametrizări, dintre care cele mai folosite sînt S0 și S1. Ele dau același \(\alpha\), \(\beta\) și \(\gamma\), dar parametrul de poziție \(\delta\) are sensuri diferite, de aceea parametrizarea trebuie precizată de fiecare dată.

              Pe scurt

              • Formule-cheie
                • \(X_1 + \dots + X_n \overset{d}{=} n^{1/\alpha}X + d_n\); cozi \(P(X > x) \sim c\,x^{-\alpha}\); \(E|X|^p < \infty\) doar pentru \(p < \alpha\)
                • patru parametri: \(\alpha\) (cozi), \(\beta\) (asimetrie), \(\gamma\) (scală), \(\delta\) (poziție), în S0 sau S1 Nolan (2020)
              • Notațiile
                • \(X_1, \dots, X_n\): copii independente ale lui \(X\); \(\overset{d}{=}\): aceeași distribuție; \(d_n\): o translație; \(\alpha \in (0, 2]\): indicele de stabilitate
                • \(c\): o constantă; \(p\): ordinul unui moment; S0, S1: două parametrizări ale aceleiași familii

              Capitolul 3: distribuții \(\alpha\)-stabile (2/2)

              Slide 20 în PDF

              Estimate prin verosimilitate maximă pe datele zilnice din 2000, legile stabile dau \(\hat\alpha = 1{,}49\) pentru BET, \(1{,}54\) pentru S&P 500 și \(1{,}41\) pentru Bitcoin. Valorile sînt apropiate de cele găsite de Mandelbrot (1963) pentru prețurile bumbacului și ar sugera că varianța randamentelor este infinită.

              Alte dovezi contrazic această concluzie. Varianța de selecție calculată pe eșantioane din ce în ce mai lungi se stabilizează, ceea ce nu s-ar întîmpla dacă varianța ar fi infinită. Agregarea dă un al doilea test: dacă randamentele zilnice ar fi stabile, \(\hat\alpha\) ar rămîne același pe randamentele lunare, iar dacă varianța este finită, el urcă spre 2. Pentru S&P 500 și Bitcoin, \(\hat\alpha\) crește cu orizontul (pînă la \(1{,}82\) pe date lunare pentru S&P 500); BET este excepția, cu \(\hat\alpha\) în jur de 1,50 și pe date lunare, pe un eșantion lunar scurt, cu o estimare imprecisă. Concluzia de ansamblu este cozi groase cu varianță finită: legea stabilă descrie bine corpul distribuției, nu și coada extremă.

              Greșelile frecvente decurg din proprietățile familiei. Abaterea standard nu poate fi folosită ca măsură a scalei atunci cînd \(\alpha < 2\), pentru că varianța nu există; scala este \(\gamma\). Iar parametrul \(\delta\) estimat de două programe nu poate fi comparat dacă ele folosesc parametrizări diferite.

              Pe scurt

              • Fapte empirice
                • verosimilitate maximă din 2000: \(\hat\alpha = 1{,}49\) (BET), \(1{,}54\) (S&P 500), \(1{,}41\) (Bitcoin), ca la bumbacul lui Mandelbrot (1963)
                • dar \(\hat\alpha\) crește cu orizontul (S&P 500: 1,82 pe date lunare), iar varianța de selecție se stabilizează: cozi groase cu varianță finită; BET este excepția (\(\hat\alpha = 1{,}50\) pe date lunare, fără o creștere clară)
              • Greșeli frecvente
                • folosirea abaterii standard ca scală cînd \(\alpha < 2\) (varianța nu există)
                • compararea lui \(\delta\) din două programe care folosesc parametrizări diferite

              Sinteza secțiunii

              Randamentele se calculează logaritmic, se anualizează cu frecvența reală a pieței și se raportează cu incertitudinea lor. Distribuția lor are asimetrie negativă și exces de boltire mare, ceea ce face ca testul Jarque–Bera să respingă normalitatea pentru toate seriile cursului. Legile α-stabile explică forma corpului distribuției, dar datele indică o varianță finită.

              Capitolele 4–7: probabilitate, cozi, alegerea modelului, eficiență

              Cele patru capitole reluate aici dau fundamentul probabilistic al cursului și răspund la trei întrebări empirice: cît de groase sînt cozile, ce distribuție descrie cel mai bine randamentele și dacă randamentele trecute ajută la prognoza celor viitoare.

              Capitolul 4: probabilitate (1/2)

              Slide 21 în PDF

              Varianța unei combinații liniare de două variabile este

              \[\begin{aligned} \Var(aX + bY) &= a^2\sigma_X^2 + b^2\sigma_Y^2 \\ &\quad + 2ab\,\Cov(X, Y), \end{aligned}\]

              unde \(a\) și \(b\) sînt ponderile, iar \(\sigma_X\) și \(\sigma_Y\) sînt abaterile standard. Termenul de covarianță explică diversificarea: cu o corelație mai mică decît 1, volatilitatea portofoliului este mai mică decît media ponderată a volatilităților. Cînd o probabilitate \(p\) este estimată prin simulare Monte Carlo cu \(N\) extrageri, estimarea este o proporție, iar eroarea ei standard este \(\sqrt{p(1 - p)/N}\).

              Mișcarea browniană geometrică (GBM, geometric Brownian motion) este modelul de bază pentru prețuri:

              \[S_t = S_0\exp\!\Big(\big(\mu - \tfrac{\sigma^2}{2}\big)t + \sigma W_t\Big),\]

              unde \(t\) este timpul în ani, \(\mu\) este tendința, \(\sigma\) este volatilitatea, iar \(W_t \sim N(0, t)\) este o mișcare browniană. Media prețului este \(S_0e^{\mu t}\), iar mediana este \(S_0e^{(\mu - \sigma^2/2)t}\), mai mică: distribuția log-normală a prețului este asimetrică la dreapta, iar cîteva traiectorii foarte bune trag media în sus.

              Pe scurt

              • Formule-cheie
                • \(\mathrm{Var}(aX + bY) = a^2\sigma_X^2 + b^2\sigma_Y^2 + 2ab\,\mathrm{Cov}(X, Y)\); eroarea Monte Carlo \(\sqrt{p(1 - p)/N}\)
                • GBM: \(S_t = S_0\exp((\mu - \sigma^2/2)t + \sigma W_t)\), media \(S_0e^{\mu t}\), mediana \(S_0e^{(\mu - \sigma^2/2)t}\)
              • Notațiile
                • \(a\), \(b\): ponderi; \(\sigma_X\), \(\sigma_Y\): abateri standard; \(p\): probabilitatea estimată; \(N\): numărul de extrageri Monte Carlo
                • GBM (mișcarea browniană geometrică): \(S_t\): prețul la momentul \(t\) (ani); \(\mu\): tendința; \(\sigma\): volatilitatea; \(W_t \sim N(0, t)\): o mișcare browniană

              Capitolul 4: probabilitate (2/2)

              Slide 22 în PDF

              Pe datele S&P 500 din 2000, o zi cu un randament sub −5% are frecvența empirică 0,34%. O distribuție Normală cu aceeași medie și aceeași volatilitate dă o probabilitate de 0,0017%, de 199 de ori mai mică. Diferența nu ține de un detaliu al estimării, ci de forma cozii: distribuția Normală descrește prea repede pentru a reproduce frecvența zilelor extreme.

              Al doilea fapt privește estimarea mediei. Randamentul mediu al S&P 500 din 2000 este 6,2% pe an, cu o eroare standard de 3,7%. Pentru ca media să fie semnificativă cu o statistică \(t = 3\) ar fi nevoie de circa 86 de ani de date. Media randamentelor este cel mai greu de estimat parametru din finanțe, pentru că eroarea ei standard scade doar cu rădăcina pătrată a numărului de ani.

              Greșelile frecvente sînt considerarea unor variabile necorelate drept independente, confuzia dintre media și mediana lui \(S_t\) într-un GBM și raportarea unei estimări Monte Carlo fără eroarea ei standard.

              Pe scurt

              • Fapte empirice
                • S&P 500 din 2000: o zi sub \(-5\%\) are frecvența 0,34%; distribuția Normală dă 0,0017%, de 199 de ori mai puțin
                • randament mediu 6,2% pe an, cu SE 3,7%: ar fi nevoie de circa 86 de ani de date pentru \(t = 3\)
              • Greșeli frecvente
                • variabile necorelate considerate independente; media lui \(S_t\) confundată cu mediana
                • o estimare Monte Carlo fără eroarea ei standard

              Capitolul 5: cozi groase și teoria valorilor extreme (1/2)

              Slide 23 în PDF

              Estimatorul Hill (Hill, 1975) măsoară cît de repede descresc cozile pierderilor. Dacă \(L_{(1)} \ge L_{(2)} \ge \dots\) sînt pierderile ordonate descrescător și \(k\) este numărul de observații din coadă,

              \[\hat\alpha_k = \left[\frac1k\sum_{i=1}^{k}\ln\frac{L_{(i)}}{L_{(k+1)}}\right]^{-1},\]

              cu eroarea standard aproximativă \(\mathrm{SE}(\hat\alpha_k) \approx \hat\alpha_k/\sqrt k\). Un \(\hat\alpha\) mic înseamnă cozi groase; parametrul de formă al cozii folosit în EVT este \(\xi = 1/\alpha\). Alegerea lui \(k\) este un compromis: un \(k\) mic dă o estimare zgomotoasă, un \(k\) mare include observații din corpul distribuției și deplasează estimarea.

              Metoda depășirilor de prag modelează pierderile peste un prag \(u\) cu distribuția Pareto generalizată (GPD, generalised Pareto distribution), cu scala \(\beta\) și forma \(\xi\). Dacă \(N_u\) dintre cele \(n\) pierderi depășesc pragul, VaR la nivelul \(\alpha\) este

              \[\mathrm{VaR}_\alpha = u + \frac{\beta}{\xi}\left[\left(\frac{n\alpha}{N_u}\right)^{-\xi} - 1\right],\]

              unde, de data aceasta, \(\alpha\) este nivelul VaR (de exemplu 1%), nu tail index-ul. A doua abordare a EVT, metoda maximelor pe blocuri (block maxima), ajustează distribuția generalizată a valorilor extreme (GEV, generalised extreme value) maximelor pierderilor pe perioade fixe.

              Pe scurt

              • Formule-cheie
                • Hill: \(\hat\alpha_k = [\frac1k\sum_{i=1}^k \ln(L_{(i)}/L_{(k+1)})]^{-1}\), SE \(\approx \hat\alpha/\sqrt{k}\) Hill (1975); \(\xi = 1/\alpha\)
                • GPD peste \(u\): VaR \(= u + \frac{\beta}{\xi}[(n\alpha/N_u)^{-\xi} - 1]\); GEV pentru block maxima
              • Notațiile
                • \(L_{(i)}\): a \(i\)-a cea mai mare pierdere; \(k\): numărul observațiilor din coadă; \(\xi = 1/\alpha\): parametrul de formă al cozii
                • GPD: \(u\): pragul; \(\beta\): scala; \(N_u\): pierderile peste \(u\) din cele \(n\); în formula VaR, \(\alpha\) este nivelul (1%), nu tail index-ul

              Capitolul 5: cozi groase și teoria valorilor extreme (2/2)

              Slide 24 în PDF

              Tail index-ul pierderilor este 2,57 pentru BET din 1997, cu un interval de încredere de 95% între 2,20 și 2,95, 2,97 pentru S&P 500 și 2,71 pentru Bitcoin. Toate valorile sînt între 2 și 3: varianța este finită, dar momentul de ordinul patru, deci boltirea, nu este. Rezultatul explică de ce excesul de boltire de selecție este atît de mare și de instabil.

              Consecința pentru risc se vede la niveluri foarte mici. Pentru BET, VaR 0,1% calculat cu EVT este 9,6%, iar distribuția Normală dă doar 4,5%, mai puțin de jumătate. Cu cît nivelul VaR este mai mic, cu atît distribuția Normală subestimează mai mult pierderea.

              Greșelile frecvente țin de aplicarea estimatorului. Alegerea lui \(k\) trebuie făcută pe graficul Hill, care arată \(\hat\alpha_k\) în funcție de \(k\), căutînd o zonă stabilă; \(\hat\alpha\) trebuie raportat cu intervalul lui; iar estimatorul se aplică pierderilor \(L = -r\), nu randamentelor, pentru că altfel descrie coada cîștigurilor.

              Pe scurt

              • Fapte empirice
                • tail index-ul pierderilor: BET 2,57 (CI 95% [2,20; 2,95], din 1997), S&P 500 2,97, Bitcoin 2,71
                • BET, VaR 0,1%: EVT 9,6%, distribuția Normală doar 4,5%
              • Greșeli frecvente
                • alegerea lui \(k\) fără graficul Hill; raportarea lui \(\hat\alpha\) fără interval
                • aplicarea estimatorului Hill pe randamente în loc de pierderi \(L = -r\)

              Capitolul 6: selecția modelului și managementul riscului (1/2)

              Slide 25 în PDF

              Pentru două modele imbricate, testul raportului de verosimilitate (LR, likelihood ratio) compară log-verosimilitățile maxime \(\ell_0\) a modelului restrîns și \(\ell_1\) a celui extins: \(LR = 2(\ell_1 - \ell_0)\) urmează aproximativ o distribuție \(\chi^2(k_1 - k_0)\), unde \(k_0\) și \(k_1\) sînt numerele de parametri. Pentru modele neimbricate se folosesc criteriile informaționale

              \[\mathrm{AIC} = -2\ell + 2k, \qquad \mathrm{BIC} = -2\ell + k\ln n,\]

              unde \(k\) este numărul de parametri și \(n\) volumul eșantionului; un AIC sau un BIC (Bayesian information criterion) mai mic indică un model mai bun. Ambele penalizează complexitatea, BIC mai puternic pentru eșantioane mari.

              Testele de potrivire compară funcția de repartiție empirică \(F_n\) cu modelul \(F\). Statistica Kolmogorov–Smirnov (KS), \(D_n = \sup_x|F_n(x) - F(x)|\), este cea mai mare distanță verticală dintre cele două și este dominată de centrul distribuției. Testul Anderson–Darling (AD) ponderează diferențele astfel încît cozile să conteze mai mult, ceea ce îl face mai potrivit pentru măsurile de risc.

              Pe scurt

              • Formule-cheie
                • \(LR = 2(\ell_1 - \ell_0) \approx \chi^2(k_1 - k_0)\) pentru modele imbricate; AIC \(= -2\ell + 2k\), BIC \(= -2\ell + k\ln n\)
                • KS: \(D_n = \sup_x|F_n(x) - F(x)|\); Anderson–Darling pune accentul pe cozi
              • Notațiile
                • \(\ell_0\), \(\ell_1\): log-verosimilitățile maxime ale modelului restrîns și ale celui extins; \(k_0\), \(k_1\), \(k\): numerele de parametri; \(n\): volumul eșantionului
                • \(F_n\): funcția de repartiție empirică; \(F\): modelul; \(D_n\): cea mai mare distanță verticală dintre ele; un AIC sau BIC mai mic este mai bun

              Capitolul 6: selecția modelului și managementul riscului (2/2)

              Slide 26 în PDF

              Pentru BET din 2000, statistica Anderson–Darling este 161 pentru distribuția Normală, 0,54 pentru Student-\(t\) și 0,40 pentru NIG (normal inverse Gaussian). Distribuția Normală este respinsă categoric, iar cele două distribuții cu cozi groase sînt mult mai aproape de date, NIG fiind ușor mai bună.

              Alegerea modelului schimbă riscul raportat. VaR 1% al BET este 3,19% cu distribuția Normală și între 3,74% și 4,94% cu modelele cu cozi groase. Diferența dintre modele este mai mare decît diferența dintre cele două margini ale intervalului de încredere al oricărei estimări, deci alegerea distribuției este o decizie de management al riscului, nu un detaliu tehnic.

              Două greșeli apar frecvent. Testul LR care compară Student-\(t\) cu distribuția Normală testează o valoare aflată la frontiera spațiului parametrilor (\(\nu = \infty\)), unde distribuția \(\chi^2\) obișnuită nu se aplică și valoarea critică trebuie corectată. La eșantioane mari, testele de potrivire resping toate modelele; atunci ele trebuie ordonate după criterii, nu abandonate.

              Pe scurt

              • Fapte empirice
                • BET din 2000, Anderson–Darling: Normală 161, Student-\(t\) 0,54, NIG 0,40
                • VaR 1% pentru BET: distribuția Normală 3,19%, modelele cu cozi groase 3,74–4,94%
              • Greșeli frecvente
                • testul LR la frontieră (de exemplu \(\nu = \infty\)) fără valoarea critică corectată
                • respingerea tuturor modelelor la \(n\) mare, fără ordonarea lor

              Capitolul 7: piețe eficiente, mers aleator și teste VR (1/2)

              Slide 27 în PDF

              Ipoteza piețelor eficiente în formă slabă spune că prețurile trecute nu permit prognoza randamentelor în exces (Fama, 1970). Ipoteza nulă testabilă este că randamentele formează o secvență de diferențe de martingal: media condiționată a randamentului de mîine, dată fiind istoria, nu depinde de această istorie.

              Testul raportului varianțelor (VR, variance ratio) compară varianța randamentelor pe \(q\) zile cu de \(q\) ori varianța zilnică. Pentru un mers aleator raportul este 1; în funcție de autocorelațiile \(\rho(k)\),

              \[\mathrm{VR}(q) = 1 + 2\sum_{k=1}^{q-1}\left(1 - \frac{k}{q}\right)\rho(k).\]

              Un VR peste 1 indică autocorelații pozitive (momentum), un VR sub 1 indică revenire la medie. Statistica robustă a lui Lo & MacKinlay (1988), \(Z^*(q) = (\widehat{\mathrm{VR}}(q) - 1)/\sqrt{\hat\theta/T}\), folosește o estimație \(\hat\theta\) a varianței care rămîne validă în prezența volatility clustering și urmează aproximativ distribuția \(N(0, 1)\) în ipoteza nulă; \(T\) este numărul de randamente.

              Pe scurt

              • Formule-cheie
                • eficiența în formă slabă: prețurile trecute nu prezic randamente în exces Fama (1970); ipoteza nulă: diferențe de martingal
                • \(\mathrm{VR}(q) = 1 + 2\sum_{k=1}^{q-1}(1 - k/q)\rho(k)\); statistica robustă \(Z^*(q) = (\widehat{\mathrm{VR}} - 1)/\sqrt{\hat\theta/T}\) Lo & MacKinlay (1988)
              • Notațiile
                • \(\rho(k)\): autocorelația la lagul \(k\); \(q\): orizontul raportului varianțelor; VR \(= 1\) pentru un mers aleator
                • \(T\): numărul de randamente; \(\hat\theta\): o estimație a varianței robustă la volatility clustering; \(Z^* \approx N(0, 1)\) în ipoteza nulă

              Capitolul 7: piețe eficiente, mers aleator și teste VR (2/2)

              Slide 28 în PDF

              Pentru BET din 1997, VR(5) este 1,28, iar statistica robustă \(Z^* = 5{,}25\) respinge mersul aleator: randamentele de pe piața românească au avut momentum. Pentru S&P 500 din 1990, VR(5) este 0,86, cu \(Z^* = -2{,}76\), o revenire la medie semnificativă. Pentru Bitcoin, \(Z^* = -0{,}19\), deci mersul aleator nu este respins.

              Prima greșeală frecventă este folosirea statisticii \(Z(q)\), construită pentru randamente independente și identic distribuite (i.i.d.), pe serii cu volatility clustering. Eroarea ei standard este prea mică în acest caz, așa că testul respinge prea des ipoteza nulă adevărată.

              A doua greșeală privește interpretarea. O rădăcină unitară în prețuri nu dovedește eficiența, pentru că și un preț cu randamente autocorelate poate avea rădăcină unitară. Iar o predictibilitate semnificativă statistic nu înseamnă profit: costurile de tranzacționare și riscul pot elimina cîștigul.

              Pe scurt

              • Fapte empirice
                • BET din 1997: VR(5) \(= 1{,}28\), \(Z^* = 5{,}25\) (momentum)
                • S&P 500 din 1990: VR(5) \(= 0{,}86\), \(Z^* = -2{,}76\) (revenire la medie); Bitcoin: \(Z^* = -0{,}19\)
              • Greșeli frecvente
                • statistica i.i.d. \(Z(q)\) pe randamente cu volatility clustering (respinge prea des)
                • rădăcina unitară a prețurilor considerată dovadă de eficiență; predictibilitatea considerată profit

              Sinteza secțiunii

              Probabilitatea dă instrumentele de bază ale cursului: varianța unui portofoliu, eroarea standard a unei simulări și proprietățile GBM. Tail index-urile pierderilor sînt între 2 și 3 pentru toate seriile cursului, iar modelele cu cozi groase dau un VaR 1% mai mare și mai realist decît distribuția Normală. Testele robuste ale raportului varianțelor resping mersul aleator pentru BET pe termen lung și pentru S&P 500 din 1990, dar nu pentru Bitcoin.

              Capitolele 8–11: volatilitate, risc și memorie

              Această parte a cursului tratează mărimea randamentelor, adică partea lor previzibilă: cum se estimează volatilitatea, cum se modelează dinamica ei, cum devine ea o măsură de risc verificabilă și dacă randamentele au memorie lungă.

              Capitolul 8: estimatori de volatilitate (1/2)

              Slide 29 în PDF

              Modelul EWMA al RiskMetrics (J.P. Morgan/Reuters, 1996) actualizează varianța zilnic,

              \[\sigma_t^2 = \lambda\sigma_{t-1}^2 + (1 - \lambda)r_{t-1}^2,\]

              unde \(\lambda \in (0, 1)\) este factorul de atenuare (decay factor). Ponderea unei observații vechi de \(j\) zile este proporțională cu \(\lambda^j\), iar timpul de înjumătățire, numărul de zile după care ponderea scade la jumătate, este \(\ln 0{,}5/\ln\lambda\).

              Estimatorii de amplitudine (range-based estimators) folosesc maximul \(H_t\) și minimul \(L_t\) ale zilei. Estimatorul Parkinson, \((\ln H_t - \ln L_t)^2/(4\ln 2)\), este mai precis decît pătratul randamentului de închidere, pentru că amplitudinea zilei conține mai multă informație decît două prețuri de închidere. Testul ARCH-LM (ARCH Lagrange multiplier) verifică existența volatility clustering: se regresează \(r_t^2\) pe \(q\) laguri ale sale, iar \(nR^2\) urmează o distribuție \(\chi^2(q)\) în ipoteza de varianță constantă.

              Pe scurt

              • Formule-cheie
                • EWMA: \(\sigma_t^2 = \lambda\sigma_{t-1}^2 + (1 - \lambda)r_{t-1}^2\), timp de înjumătățire \(\ln 0{,}5/\ln\lambda\) J.P. Morgan/Reuters (1996)
                • Parkinson: \((\ln H_t - \ln L_t)^2/(4\ln 2)\); ARCH-LM \(= nR^2 \sim \chi^2(q)\)
              • Notațiile
                • \(\lambda \in (0, 1)\): factorul de atenuare (decay); \(r_{t-1}\): randamentul de ieri; \(H_t\), \(L_t\): maximul și minimul zilei \(t\)
                • ARCH-LM: \(R^2\) al regresiei lui \(r_t^2\) pe \(q\) laguri ale sale, înmulțit cu \(n\); o valoare mare: volatility clustering

              Capitolul 8: estimatori de volatilitate (2/2)

              Slide 30 în PDF

              Pentru S&P 500, statistica Ljung–Box \(Q(10)\) este 91 pe randamente și 8 015 pe pătratele lor, față de valoarea critică 18,31. Diferența de aproape două ordine de mărime arată că dependența principală este în varianță. Cu \(\lambda = 0{,}94\), valoarea RiskMetrics pentru date zilnice, timpul de înjumătățire al EWMA este 11,2 zile.

              Avantajul EWMA față de o fereastră mobilă este absența efectului fantomă (ghost effect). Într-o fereastră de lungime fixă, toate observațiile au aceeași pondere, iar o zi extremă ridică brusc volatilitatea cînd intră în fereastră și o coboară la fel de brusc cînd iese, la o dată care nu are nicio legătură cu piața. În EWMA, ponderea zilei extreme scade treptat.

              A doua greșeală frecventă privește estimatorii de amplitudine aplicați prețurilor cu salturi overnight. Estimatorul Parkinson folosește doar amplitudinea din timpul ședinței și ignoră diferența dintre închiderea de ieri și deschiderea de azi, așa că subestimează volatilitatea; corecția Yang–Zhang include această componentă.

              Pe scurt

              • Fapte empirice
                • S&P 500: Ljung–Box \(Q(10)\) este 91 pe \(r_t\) și 8015 pe \(r_t^2\) (valoarea critică 18,31)
                • EWMA cu \(\lambda = 0{,}94\): timp de înjumătățire de 11,2 zile; fără ghost effect
              • Greșeli frecvente
                • fereastra mobilă de lungime fixă: o zi extremă intră și iese brusc din calcul (ghost effect)
                • estimatori de amplitudine pe prețuri cu salturi overnight, fără corecția Yang–Zhang

              Capitolul 9: modele ARCH și GARCH (1/2)

              Slide 31 în PDF

              Modelul GARCH(1,1) (Engle, 1982; Bollerslev, 1986) descrie varianța condiționată ca o funcție de șocul de ieri și de varianța de ieri:

              \[\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2,\]
              \[\bar\sigma^2 = \frac{\omega}{1 - \alpha - \beta},\]

              unde \(\omega\) este constanta, \(\alpha\) măsoară reacția la șocul de ieri \(\varepsilon_{t-1}\), \(\beta\) măsoară memoria, iar \(\bar\sigma^2\) este varianța pe termen lung, definită doar dacă \(\alpha + \beta < 1\).

              Prognoza varianței la orizontul \(h\), făcută în ziua \(t\), revine geometric la nivelul pe termen lung:

              \[E_t\,\sigma_{t+h}^2 = \bar\sigma^2 + (\alpha + \beta)^{h-1}\big(\sigma_{t+1}^2 - \bar\sigma^2\big).\]

              Persistența \(\alpha + \beta\) dă viteza revenirii, iar timpul de înjumătățire al unui șoc de volatilitate este \(\ln 0{,}5/\ln(\alpha + \beta)\). Spre deosebire de EWMA, care este cazul particular \(\omega = 0\), \(\alpha + \beta = 1\), GARCH are un nivel de echilibru către care converg prognozele pe termen lung.

              Pe scurt

              • Formule-cheie
                • GARCH(1,1): \(\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2\), \(\bar\sigma^2 = \omega/(1 - \alpha - \beta)\) Engle (1982), Bollerslev (1986)
                • prognoza \(E_t\sigma_{t+h}^2 = \bar\sigma^2 + (\alpha + \beta)^{h-1}(\sigma_{t+1}^2 - \bar\sigma^2)\); timp de înjumătățire \(\ln 0{,}5/\ln(\alpha + \beta)\)
              • Notațiile
                • \(\omega\): constanta; \(\alpha\): reacția la șocul de ieri, \(\varepsilon_{t-1}\); \(\beta\): memoria; \(\bar\sigma^2\): varianța pe termen lung
                • \(E_t\): prognoza făcută în ziua \(t\); \(h\): orizontul, în zile; \(\alpha + \beta\): viteza cu care prognoza revine la \(\bar\sigma^2\)

              Capitolul 9: modele ARCH și GARCH (2/2)

              Slide 32 în PDF

              Modelul GARCH(1,1) cu inovații Student-\(t\), estimat pe datele din 2000, are persistența 0,995 pentru S&P 500, cu un timp de înjumătățire de 131 de zile, și 0,991 pentru BET, cu 74 de zile. Un șoc de volatilitate se stinge deci în cîteva luni. Pentru Bitcoin, \(\alpha + \beta = 1{,}000\): modelul este un IGARCH, în care șocurile nu se sting, iar varianța pe termen lung nu este definită.

              Indicii de acțiuni au nevoie și de un termen asimetric: o scădere a prețului crește volatilitatea mai mult decît o creștere de aceeași mărime (leverage effect). Modelele GJR (Glosten–Jagannathan–Runkle) și EGARCH (exponential GARCH) adaugă acest efect.

              Greșelile frecvente sînt folosirea inovațiilor Normale pentru randamente cu cozi groase, raportarea unor erori standard nerobuste și calcularea varianței pe termen lung \(\omega/(1 - \alpha - \beta)\) atunci cînd \(\alpha + \beta \ge 1\), caz în care formula dă o valoare infinită sau negativă, fără sens.

              Pe scurt

              • Fapte empirice
                • GARCH(1,1)-\(t\) din 2000: \(\alpha + \beta = 0{,}995\) (S&P 500, timp de înjumătățire 131 de zile), \(0{,}991\) (BET, 74 de zile)
                • Bitcoin: \(\alpha + \beta = 1{,}000\), un IGARCH; indicii de acțiuni au nevoie de asimetrie (GJR, EGARCH)
              • Greșeli frecvente
                • inovații Normale pentru randamente cu cozi groase; erori standard nerobuste
                • raportarea varianței pe termen lung \(\omega/(1 - \alpha - \beta)\) cînd \(\alpha + \beta \ge 1\)

              Capitolul 10: VaR, ES și backtesting (1/2)

              Slide 33 în PDF

              Fie \(X\) randamentul unei poziții și \(q_\alpha\) cuantila lui de ordin \(\alpha\). Convenția cursului este

              \[\mathrm{VaR}_\alpha = -q_\alpha(X),\]
              \[\mathrm{ES}_\alpha = -\frac1\alpha\int_0^\alpha q_u\,du,\]

              deci VaR 1% este pierderea depășită în 1% dintre zile, scrisă ca număr pozitiv, iar ES 2,5% este media pierderilor din cele mai rele 2,5% dintre zile. Pentru o distribuție Normală cu media \(\mu\) și abaterea standard \(\sigma\), \(\mathrm{VaR}_\alpha = -(\mu + \sigma z_\alpha)\) și \(\mathrm{ES}_\alpha = -\mu + \sigma\varphi(z_\alpha)/\alpha\), unde \(z_\alpha\) este cuantila Normală standard și \(\varphi\) este densitatea Normală standard. Spre deosebire de VaR, ES este o măsură de risc coerentă (Artzner et al., 1999): ea respectă subaditivitatea, deci diversificarea nu poate crește riscul măsurat.

              Backtesting-ul compară prognozele VaR cu pierderile realizate. Dacă \(x\) dintre cele \(n\) zile sînt depășiri, rata observată este \(\hat\pi = x/n\), iar testul Kupiec (Kupiec, 1995) o compară cu ținta \(\alpha\):

              \[LR_{uc} = -2\ln\frac{(1-\alpha)^{n-x}\alpha^{x}}{(1-\hat\pi)^{n-x}\hat\pi^{x}}.\]

              Dacă modelul este corect, \(LR_{uc}\) urmează aproximativ distribuția \(\chi^2(1)\).

              Pe scurt

              • Formule-cheie
                • \(\mathrm{VaR}_\alpha = -q_\alpha(X)\), \(\mathrm{ES}_\alpha = -\frac1\alpha\int_0^\alpha q_u\,du\); Normal: \(-(\mu + \sigma z_\alpha)\), \(-\mu + \sigma\varphi(z_\alpha)/\alpha\)
                • Kupiec: \(LR_{uc} = -2\ln[(1-\alpha)^{n-x}\alpha^x/((1-\hat\pi)^{n-x}\hat\pi^x)] \sim \chi^2(1)\) Kupiec (1995); ES este coerent Artzner et al. (1999)
              • Notațiile
                • \(q_\alpha\): cuantila de ordin \(\alpha\) a randamentului \(X\); \(z_\alpha\): cuantila Normală standard; \(\varphi\): densitatea Normală standard
                • \(x\): depășirile în \(n\) zile; \(\hat\pi = x/n\): rata observată; \(LR_{uc}\) o compară cu ținta \(\alpha\)

              Capitolul 10: VaR, ES și backtesting (2/2)

              Slide 34 în PDF

              Pentru S&P 500, VaR 1% istoric este 3,46%, iar VaR 1% Normal este 2,80%, adică prea mic cu 19%. În backtesting-ul din 2005, rata depășirilor VaR 1% este 2,71% pentru modelul Normal, 1,41% pentru simularea istorică (HS, historical simulation), 1,74% pentru GARCH-\(t\) și 1,58% pentru simularea istorică filtrată (FHS, filtered historical simulation), față de ținta de 1%. Modelul Normal are aproape de trei ori mai multe depășiri decît ar trebui.

              Prima greșeală frecventă este de convenție: un VaR negativ sau formularea „VaR 99%”. În curs, VaR 1% se referă la probabilitatea cozii și este o pierdere pozitivă. A doua este scalarea VaR la 10 zile prin înmulțire cu \(\sqrt{10}\), care presupune randamente Normale i.i.d.; cu volatility clustering și cozi groase, regula poate fi mult în afara realității.

              A treia greșeală este verificarea doar a numărului de depășiri. Un model poate avea rata corectă, dar depășiri concentrate în cîteva săptămîni de criză, exact cînd riscul contează cel mai mult; de aceea gruparea depășirilor se testează separat.

              Pe scurt

              • Fapte empirice
                • S&P 500, VaR 1%: istoric 3,46%, Normal 2,80%, adică prea mic cu 19%
                • rata depășirilor din 2005: Normal 2,71%, HS 1,41%, GARCH-\(t\) 1,74%, FHS 1,58% (ținta 1%)
              • Greșeli frecvente
                • un VaR negativ sau „VaR 99%”: în curs scriem VaR 1%, o pierdere pozitivă
                • scalarea cu \(\sqrt{10}\) ca pentru randamente Normale i.i.d.; verificarea doar a numărului de depășiri, nu și a grupării lor

              Prognoze VaR 1% pentru BET: simulare istorică și EWMA-Normal

              Slide 35 în PDF

              Problemă de recapitulare: randamente și drawdown

              \[\begin{gathered} R_t = \frac{P_t}{P_{t-1}} - 1, \quad r_t = \ln(1 + R_t), \\ \text{CAGR} = \Big(\frac{P_3}{P_0}\Big)^{1/3} - 1, \quad \text{MDD} = \min_t\Big(\frac{P_t}{\max_{s \le t}P_s} - 1\Big) \end{gathered}\]
                  Întrebare pentru sală ▶ schimbă valoarea din anul 2. Dacă indicele coboară doar la 120 (rulare cu alte valori), ce devine CAGR?
                  Răspuns

                  Rămîne −1,35%: CAGR depinde doar de prima și de ultima valoare, (96/100)^(1/3) − 1. Se schimbă media aritmetică, (60 − 25 − 20)/3 = 5,00%, și drawdown-ul maxim, 96/160 − 1 = −40%.

                  Problemă de recapitulare: distribuție și cozi

                  \[\text{JB} = \frac{n}{6}\Big(S^2 + \frac{K^2}{4}\Big), \quad K = \frac{6}{\nu - 4}, \quad \hat\alpha = \Big[\frac{1}{k}\sum_{i=1}^{k}\ln\frac{L_{(i)}}{L_{(k+1)}}\Big]^{-1}\]
                      Întrebare pentru sală ▶ schimbă excesul de boltire. Dacă K scade de la 6 la 3, ce se întîmplă cu componenta boltirii din JB?
                      Răspuns

                      Scade la un sfert: 1000/24 × 9 = 375, față de 1500, pentru că K intră la pătrat; JB = 41,67 + 375 = 416,7, tot mult peste 5,99. Gradele de libertate ale distribuției Student-t cu același K cresc la ν = 4 + 6/3 = 6.

                      Problemă de recapitulare: portofoliu, Monte Carlo și GBM

                      \[\begin{gathered} \sigma_p^2 = w^2\sigma_1^2 + (1 - w)^2\sigma_2^2 + 2w(1 - w)\rho\,\sigma_1\sigma_2, \\ \text{SE} = \sqrt{\frac{p(1 - p)}{N}}, \quad P(S_1 < S_0) = \Phi\Big(-\frac{\mu - \sigma^2/2}{\sigma}\Big) \end{gathered}\]
                          Întrebare pentru sală ▶ trece prin corelații. Cît este volatilitatea zilnică a portofoliului la ρ = −1?
                          Răspuns

                          0,10%: σp² = 0,81 + 1,00 − 1,80 = 0,01. Cu ρ = −1 riscul nu dispare complet, pentru că cele două poziții nu se compensează exact: 0,6 × 1,5 = 0,9 față de 0,4 × 2,5 = 1,0. La ρ = 1, σp = 1,90%, egală cu media ponderată.

                          Problemă de recapitulare: autocorelație și raportul varianțelor

                          \[\begin{gathered} Q(m) = T(T + 2)\sum_{k=1}^{m}\frac{\hat\rho_k^2}{T - k}, \quad \mathrm{VR}(q) = 1 + 2\sum_{k=1}^{q-1}\Big(1 - \frac{k}{q}\Big)\hat\rho(k), \\ Z(q) = \frac{\widehat{\mathrm{VR}} - 1}{\sqrt{2(2q - 1)(q - 1)/(3qT)}} \end{gathered}\]
                              Întrebare pentru sală ▶ schimbă ρ̂(1). La ρ̂(1) = 0,09, respinge testul robust Z*(5) mersul aleator?
                              Răspuns

                              Da: VR(5) = 1 + 2 × 0,082 = 1,164 și Z*(5) = 0,164/0,065 = 2,52 > 1,96 (Z(5) = 3,74, Q(4) = 21,78). Cu ρ̂(1) = 0,06 diferența dintre cele două teste decidea rezultatul; aici autocorelația este destul de mare ca să fie respinsă și cu eroarea standard robustă.

                              Problemă de recapitulare: prognoze de volatilitate

                              \[\begin{gathered} \sigma_{t+1}^2 = \omega + \alpha\varepsilon_t^2 + \beta\sigma_t^2, \quad \bar\sigma^2 = \frac{\omega}{1 - \alpha - \beta}, \\ E_t\sigma_{t+h}^2 = \bar\sigma^2 + (\alpha + \beta)^{h-1}(\sigma_{t+1}^2 - \bar\sigma^2) \end{gathered}\]
                                  Întrebare pentru sală ▶ schimbă semnul și mărimea șocului. Cu εₜ = +2,5 în loc de −2,5, cît devine σ²ₜ₊₁?
                                  Răspuns

                                  Tot 2,1945: GARCH(1,1) folosește ε², deci un cîștig și o pierdere de aceeași mărime cresc varianța la fel. Asimetria (leverage effect) cere modele ca GJR sau EGARCH.

                                  Problemă de recapitulare: VaR, ES și backtesting

                                  \[\begin{gathered} \mathrm{VaR}_\alpha = -(\mu + \sigma z_\alpha), \quad \mathrm{ES}_\alpha = -\mu + \sigma\frac{\varphi(z_\alpha)}{\alpha}, \\ LR_{uc} = -2\ln\frac{(1 - \alpha)^{n - x}\alpha^x}{(1 - \hat\pi)^{n - x}\hat\pi^x} \end{gathered}\]
                                      Întrebare pentru sală ▶ crește numărul de depășiri. Ce apare primul: zona galbenă Basel sau respingerea Kupiec la 5%?
                                      Răspuns

                                      Zona galbenă, de la 5 depășiri; pe măsură ce depășirile cresc, testul Kupiec respinge abia de la 7 (LR = 5,50, p = 0,019; cu 6, LR = 3,56 și p = 0,059). În 250 de zile testul are putere mică, de aceea semaforul Basel penalizează mai devreme. Testul respinge și la 0 depășiri (LR = 5,03): prea puține depășiri arată un VaR prea prudent.

                                      Problemă de recapitulare: memorie lungă și scalarea riscului

                                      \[H = \frac{\log_{10}\big[(R/S)_{2000}/(R/S)_{20}\big]}{\log_{10}(2000/20)}, \quad d = H - 0{,}5, \quad \mathrm{VaR}^{(h)} = h^H\,\mathrm{VaR}^{(1)}\]
                                          Întrebare pentru sală ▶ schimbă R/S pentru n = 2000. Dacă este 40 în loc de 60, mai dă scalarea cu h^H un VaR pe 10 zile mai mare decît √h?
                                          Răspuns

                                          Nu: H = log₁₀(40/4,1)/2 = 0,495 < 0,5, deci 10^H = 3,12 și VaR = 7,81%, puțin sub 7,91% cu √10. Panta, nu creșterea lui R/S cu n, decide: R/S crește și pentru date fără memorie, cu exponentul 0,5.

                                          Problemă de recapitulare: scoring de credit și risc sistemic

                                          \[\begin{gathered} \text{TPR} = \frac{TP}{TP + FN}, \quad \text{FPR} = \frac{FP}{FP + TN}, \\ \text{EL} = \text{PD} \times \text{LGD} \times \text{EAD}, \quad \Delta\mathrm{CoVaR} = \hat b\,(q_{50\%} - q_{1\%}) \end{gathered}\]
                                              Întrebare pentru sală ▶ crește numărul creditelor performante marcate ca neperformante. Cu 120 (rulare cu alte valori), care rată nu se schimbă?
                                              Răspuns

                                              TPR, 60/90 = 66,7%: ea privește doar creditele neperformante. Acuratețea scade la (60 + 90)/300 = 50%, sub regula „mereu bun” (70%), FPR crește la 57,1%, iar precizia scade la 60/180 = 33,3%.

                                                Întrebare pentru sală Cu o fereastră de 250 de zile pentru simularea istorică (▶, rulare suplimentară), mai acceptă testul Kupiec VaR 1% al BET?
                                                Răspuns

                                                Nu: 38 de depășiri (1,57%, așteptat 24,2), LR = 6,76, p = 0,009. Cu 250 de zile, VaR 1% este a treia cea mai mică valoare din fereastră și coada este estimată din foarte puține observații; cu 500 de zile sînt 28 de depășiri (p = 0,450), cu 750 de zile 26.

                                                Graficul arată randamentele zilnice ale BET în procente (linia albastră subțire), din 2017 pînă în 2026, împreună cu două prognoze ale VaR 1%, desenate cu semnul minus, ca prag sub care un randament devine depășire. Linia aurie este simularea istorică pe ultimele 500 de zile, iar linia roșie este modelul EWMA-Normal cu \(\lambda = 0{,}94\). Punctele aurii și crucile roșii marchează depășirile celor două modele.

                                                Din 3 ianuarie 2017, pe 2 421 de zile, numărul așteptat de depășiri este 24,2. Simularea istorică are 28 de depășiri (1,16%), iar testul Kupiec nu respinge modelul (\(p = 0{,}450\)). EWMA-Normal are 55 de depășiri (2,27%), iar testul îl respinge cu \(p < 0{,}001\).

                                                Graficul arată și de ce. Linia EWMA urmărește furtunile: după șocurile din decembrie 2018, martie 2020 și februarie 2022 ea coboară imediat, dar cuantila Normală este prea mică, așa că pragul este depășit des. Linia HS are în medie rata corectă, dar se mișcă în trepte, cu întîrziere, iar depășirile ei vin grupate, cel mult 10 în 250 de zile. Niciunul dintre cele două modele nu reunește o volatilitate actualizată cu o coadă corectă; FHS sau GARCH-\(t\) fac acest lucru.

                                                Pe scurt

                                                • Din 3 ianuarie 2017, 2 421 de zile, 24,2 depășiri așteptate: HS 28 (1,16%, Kupiec \(p = 0{,}450\)), EWMA-Normal 55 (2,27%, \(p\) \(<\) 0,001)
                                                • EWMA urmărește furtunile, dar cuantila Normală este prea mică; HS are rata corectă, dar depășirile lui vin grupat (cel mult 10 în 250 de zile)
                                                SFM_ch16_course_summary

                                                Capitolul 11: ipoteza piețelor fractale și memoria lungă (1/2)

                                                Slide 36 în PDF

                                                Metoda R/S a lui Hurst (1951) împarte seria în blocuri de \(n\) zile și calculează, în fiecare bloc, amplitudinea abaterilor cumulate de la medie împărțită la abaterea standard. Media acestei statistici crește cu lungimea blocului ca o putere,

                                                \[(R/S)_n \propto n^{H},\]

                                                iar exponentul Hurst \(H\) se estimează din panta dreptei \(\log(R/S)_n\) în funcție de \(\log n\). \(H = 0{,}5\) corespunde absenței memoriei, \(H > 0{,}5\) indică persistență, iar parametrul fracționar este \(d = H - 0{,}5\).

                                                Exponentul Hurst schimbă regula de scalare a riscului: abaterea standard a randamentului pe \(h\) zile este \(\mathrm{sd}(r^{(h)}) = h^{H}\,\mathrm{sd}(r)\), iar regula rădăcinii pătrate este cazul \(H = 0{,}5\). Ipoteza piețelor fractale a lui Peters (1994) susține că o piață este stabilă atunci cînd pe ea activează investitori cu orizonturi foarte diferite, de la cîteva minute la cîțiva ani, care se asigură reciproc lichiditatea.

                                                Pe scurt

                                                • Formule-cheie
                                                  • \((R/S)_n \propto n^H\) Hurst (1951); \(H = 0{,}5\): fără memorie, \(H > 0{,}5\): persistență; \(d = H - 0{,}5\)
                                                  • scalarea riscului: \(\mathrm{sd}(r^{(h)}) = h^H\mathrm{sd}(r)\); piețele fractale au nevoie de multe orizonturi investiționale Peters (1994)
                                                • Notațiile
                                                  • \((R/S)_n\): amplitudinea rescalată (amplitudinea abaterilor cumulate împărțită la abaterea standard) pe blocuri de \(n\) zile
                                                  • \(H\): exponentul Hurst; \(d\): parametrul fracționar; \(r^{(h)}\): randamentul pe \(h\) zile; sd: abaterea standard

                                                Capitolul 11: ipoteza piețelor fractale și memoria lungă (2/2)

                                                Slide 37 în PDF

                                                Pentru BET, exponentul Hurst estimat prin R/S este 0,58 pentru randamente, la limita benzii Monte Carlo construite pentru serii fără memorie de aceeași lungime, iar testul Lo respinge absența memoriei: o persistență slabă. Pentru randamentele absolute, exponentul este 0,79. Pentru S&P 500, cifrele sînt 0,53 pentru randamente și 0,86 pentru randamentele absolute. Memoria lungă se află în volatilitate, nu în semnul randamentelor.

                                                Prima greșeală frecventă este compararea lui \(\hat H\) cu 0,5. Statistica R/S este deplasată în sus în eșantioane finite, așa că o serie fără memorie dă un \(\hat H\) peste 0,5; comparația corectă este cu o bandă Monte Carlo pentru același număr de observații \(N\).

                                                A doua greșeală este atribuirea memoriei lungi unor fenomene care o imită. Rupturile structurale, cum ar fi o schimbare a nivelului volatilității, și efectele GARCH produc autocorelații persistente ale randamentelor absolute și pot da un \(\hat H\) mare chiar dacă procesul nu are memorie lungă.

                                                Pe scurt

                                                • Fapte empirice
                                                  • BET: \(H\) (R/S) \(= 0{,}58\) pentru \(r_t\), la limita benzii Monte Carlo, iar testul Lo respinge: persistență slabă; \(0{,}79\) pentru \(|r_t|\)
                                                  • S&P 500: \(0{,}53\) pentru randamente, \(0{,}86\) pentru randamente absolute: memoria lungă se află în volatilitate
                                                • Greșeli frecvente
                                                  • compararea lui \(\hat H\) cu 0,5 în locul unei benzi Monte Carlo pentru același \(N\) (R/S este deplasat în sus)
                                                  • rupturi structurale sau efecte GARCH considerate memorie lungă

                                                Sinteza secțiunii

                                                Volatilitatea este partea previzibilă a randamentelor: EWMA o urmărește fără efect fantomă, iar GARCH adaugă un nivel pe termen lung și o persistență estimată, aproape de 1 pentru toate seriile cursului. Măsurile de risc VaR 1% și ES 2,5% trebuie verificate prin backtesting, iar pe BET simularea istorică trece testul Kupiec, în timp ce EWMA-Normal îl pică. Memoria lungă apare în randamentele absolute, nu în randamente.

                                                Capitolele 12–15: aplicații

                                                Ultimele patru capitole aplică instrumentele cursului la creditare, la prognoză prin învățare automată, la piața cripto și la stabilitatea sistemului bancar. În fiecare caz, întrebarea statistică este aceeași: cît de bine funcționează metoda în afara eșantionului și cît de incertă este estimarea.

                                                Capitolul 12: modele de scoring (1/2)

                                                Slide 38 în PDF

                                                Pierderea așteptată dintr-un credit (EL, expected loss) este produsul a trei factori,

                                                \[\mathrm{EL} = \mathrm{PD} \times \mathrm{LGD} \times \mathrm{EAD},\]

                                                unde PD (probability of default) este probabilitatea de nerambursare, LGD (loss given default) este proporția pierdută în caz de nerambursare, iar EAD (exposure at default) este expunerea la momentul nerambursării. Modelele de scoring estimează PD. Regresia logistică modelează logaritmul șanselor, \(\ln\frac{p}{1-p} = \beta_0 + x^\top\beta\), unde \(p\) este probabilitatea de nerambursare condiționată de caracteristicile \(x\), iar \(e^{\beta_j}\) este raportul șanselor asociat unei creșteri cu o unitate a variabilei \(j\).

                                                Capacitatea de discriminare se măsoară prin aria de sub curba ROC (AUC, area under the curve; ROC, receiver operating characteristic). AUC este probabilitatea ca un debitor rău ales la întîmplare să primească un scor de risc mai mare decît un debitor bun ales la întîmplare: 0,5 înseamnă nicio discriminare, 1 înseamnă discriminare perfectă. Coeficientul Gini este \(2\,\mathrm{AUC} - 1\). Alături de modelele statistice, cursul a prezentat scorul \(Z\) al lui Altman (1968), construit din indicatori contabili, și distanța pînă la nerambursare din modelul Merton, construită din prețurile acțiunilor.

                                                Pe scurt

                                                • Formule-cheie
                                                  • EL \(=\) PD \(\times\) LGD \(\times\) EAD; logit \(\ln\frac{p}{1-p} = \beta_0 + x^\top\beta\), \(e^{\beta_j}\) = raportul șanselor
                                                  • AUC \(= P(s_{\text{rău}} > s_{\text{bun}})\), Gini \(= 2\,\mathrm{AUC} - 1\); scorul \(Z\) Altman și distanța pînă la nerambursare Merton Altman (1968)
                                                • Notațiile
                                                  • EL: pierderea așteptată; PD: probabilitatea de nerambursare; LGD: pierderea în caz de nerambursare; EAD: expunerea la nerambursare
                                                  • \(p\): probabilitatea de nerambursare condiționată de \(x\); \(\beta_j\): un coeficient; \(s\): scorul unui debitor rău sau bun; AUC \(= 0{,}5\): nicio discriminare, 1: discriminare perfectă

                                                Capitolul 12: modele de scoring (2/2)

                                                Slide 39 în PDF

                                                Pe datele germane de credit, 1 000 de credite dintre care 300 formează eșantionul de test, regresia logistică are AUC 0,801, cu un interval de încredere de 95% între 0,75 și 0,85, și un coeficient Gini de 0,60. Intervalul, larg pentru o mărime care se raportează adesea cu trei zecimale, vine din dimensiunea mică a eșantionului de test.

                                                Discriminarea nu înseamnă calibrare. Un model poate ordona corect debitorii și totuși să dea probabilități de nerambursare sistematic prea mari sau prea mici; pentru calculul EL contează valorile, nu doar ordinea. Ambele proprietăți se verifică în afara eșantionului.

                                                Prima greșeală frecventă este judecarea unui model după acuratețe atunci cînd clasele sînt dezechilibrate: dacă majoritatea creditelor sînt bune, regula „mereu bun” are deja o acuratețe mare fără să identifice niciun debitor rău. A doua este alegerea pragului de clasificare fără a ține seama de costurile celor două erori; respingerea unui client bun și acceptarea unuia rău nu costă la fel.

                                                Pe scurt

                                                • Fapte empirice
                                                  • datele germane de credit (1000 de credite), eșantion de test de 300: AUC \(= 0{,}801\), CI 95% [0,75; 0,85], Gini 0,60
                                                  • discriminarea nu înseamnă calibrare: le verificăm pe amîndouă, în afara eșantionului
                                                • Greșeli frecvente
                                                  • acuratețea pe clase dezechilibrate (regula „mereu bun” are deja dreptate în majoritatea cazurilor)
                                                  • alegerea pragului fără costurile celor două erori

                                                Capitolul 13: învățare automată (1/2)

                                                Slide 40 în PDF

                                                Eroarea de prognoză pentru o observație nouă \(y_0\) se descompune în trei termeni:

                                                \[E\big(y_0 - \hat f\big)^2 = \text{deplasare}^2 + \Var(\hat f) + \sigma^2,\]

                                                unde \(\hat f\) este modelul estimat, iar \(\sigma^2\) este varianța zgomotului, care nu poate fi redusă. Metodele de învățare automată controlează compromisul dintre deplasare și varianță: ridge și lasso micșorează coeficienții (shrinkage), arborii de decizie și boosting-ul aleg singuri neliniaritățile, iar complexitatea se alege prin validare.

                                                Performanța se măsoară în afara eșantionului, față de un reper simplu \(\tilde y\) (Gu, Kelly & Xiu, 2020):

                                                \[R^2_{OOS} = 1 - \frac{\sum(y - \hat y)^2}{\sum(y - \tilde y)^2},\]

                                                unde sumele parcurg eșantionul de test. Un \(R^2_{OOS}\) negativ înseamnă că modelul prognozează mai slab decît reperul, ceea ce se întîmplă des pentru randamente.

                                                Pe scurt

                                                • Formule-cheie
                                                  • deplasare–varianță: \(E(y_0 - \hat f)^2 = \text{deplasare}^2 + \mathrm{Var}(\hat f) + \sigma^2\); ridge, lasso, arbori, boosting
                                                  • în afara eșantionului: \(R^2_{OOS} = 1 - \sum(y - \hat y)^2/\sum(y - \tilde y)^2\) față de un reper simplu \(\tilde y\) Gu, Kelly & Xiu (2020)
                                                • Notațiile
                                                  • \(y_0\): o observație nouă; \(\hat f\): modelul estimat; \(\sigma^2\): varianța zgomotului; \(\hat y\): prognoza
                                                  • \(\tilde y\): prognoza de referință; sumele parcurg eșantionul de test; \(R^2_{OOS} < 0\): mai slab decît reperul

                                                Capitolul 13: învățare automată (2/2)

                                                Slide 41 în PDF

                                                Pentru semnul randamentului zilnic al S&P 500 din 2008, regula naivă „mereu creștere” are o acuratețe de 54,4%, regresia logistică 53,8%, iar boosting-ul 52,1%. Modelele mai complexe nu bat reperul, în acord cu rezultatele de eficiență din Capitolul 7: semnul randamentelor este aproape imprevizibil.

                                                Pentru volatilitatea realizată, imaginea este diferită. Modelul HAR (heterogeneous autoregressive), care folosește volatilitatea medie din ultima zi, săptămînă și lună, are \(R^2_{OOS} = 0{,}61\) față de medie. Lasso reduce eroarea pătratică a HAR doar cu 7,1%: cea mai mare parte a predictibilității volatilității este captată de un model liniar simplu.

                                                Greșelile frecvente țin de ordinea temporală. Validarea încrucișată cu împărțire aleatoare amestecă trecutul cu viitorul și introduce look-ahead bias și scurgeri de informație (leakage); pe serii de timp, eșantionul de validare trebuie să urmeze celui de estimare. Iar raportarea celei mai bune dintre multe strategii încercate, fără deflatarea raportului Sharpe pentru numărul de încercări, supraestimează performanța.

                                                Pe scurt

                                                • Fapte empirice
                                                  • semnul randamentelor S&P 500 din 2008: „mereu creștere” 54,4%, logit 53,8%, boosting 52,1%
                                                  • volatilitatea realizată: HAR \(R^2_{OOS} = 0{,}61\) față de medie; lasso reduce eroarea pătratică a HAR doar cu 7,1%
                                                • Greșeli frecvente
                                                  • validarea încrucișată aleatoare pe serii de timp (look-ahead bias și leakage)
                                                  • raportarea celei mai bune dintre multe încercări fără deflatarea raportului Sharpe

                                                Capitolul 14: active cripto (1/2)

                                                Slide 42 în PDF

                                                Activele cripto se tranzacționează 365 de zile pe an, așa că volatilitatea lor se anualizează cu \(\sigma_{\text{an}} = \sqrt{365}\,\sigma\), unde \(\sigma\) este abaterea standard a randamentelor zilnice. Oferta de Bitcoin este fixată de protocol și limitată la 21 de milioane de monede (Nakamoto, 2008).

                                                Stablecoins sînt active cripto care urmăresc un preț fix de 1 USD. Abaterea de la paritate se măsoară în puncte de bază,

                                                \[d_t = 10\,000\,(P_t - 1),\]

                                                unde \(P_t\) este prețul stablecoin-ului în USD și un punct de bază este 0,01%. O valoare negativă înseamnă că stablecoin-ul se tranzacționează sub paritate, semn al neîncrederii în rezervele sau în mecanismul care îl susține.

                                                Pe scurt

                                                • Formule-cheie
                                                  • anualizăm cu 365 de zile: \(\sigma_{\text{an}} = \sqrt{365}\,\sigma\); oferta de Bitcoin limitată la 21 de milioane Nakamoto (2008)
                                                  • abaterea de la paritate a unui stablecoin \(d_t = 10\,000\,(P_t - 1)\) puncte de bază
                                                • Notațiile
                                                  • \(\sigma\): abaterea standard a randamentelor zilnice; activele cripto se tranzacționează 365 de zile pe an
                                                  • \(P_t\): prețul stablecoin-ului în USD; 1 punct de bază \(= 0{,}01\%\); \(d_t < 0\): sub paritate

                                                Capitolul 14: active cripto (2/2)

                                                Slide 43 în PDF

                                                Volatilitatea anuală a Bitcoin este 66,6% cînd se anualizează cu 365 de zile; folosirea greșită a 252 de zile ar da 55,3%, o subestimare cu circa 17%. Drawdown-ul maxim al Bitcoin este −83,4%. Corelația randamentelor Bitcoin cu S&P 500 a fost 0,02 înainte de 2020 și 0,39 după: Bitcoin a devenit un activ de risc care scade odată cu acțiunile, nu un activ de refugiu.

                                                Prima greșeală frecventă privește calendarul. Eliminarea weekendurilor din datele cripto aruncă o parte din variațiile reale ale prețului, iar alinierea randamentelor cripto și de acțiuni pe calendare diferite atribuie variația de sîmbătă și duminică randamentului de luni, ceea ce deformează corelația. Prețurile se aliniază pe zilele comune, apoi se calculează randamentele.

                                                A doua greșeală este un VaR Normal pentru o serie cu persistență GARCH egală cu 1 și tail index sub 3: ambele trăsături fac ca o cuantilă Normală cu volatilitate constantă să subestimeze pierderea.

                                                Pe scurt

                                                • Fapte empirice
                                                  • Bitcoin: volatilitate de 66,6% pe an cu 365 de zile (55,3% dacă se folosește greșit 252), drawdown maxim \(-83{,}4\%\)
                                                  • corelația cu S&P 500: 0,02 înainte de 2020, 0,39 după: nu este un activ de refugiu
                                                • Greșeli frecvente
                                                  • eliminarea weekendurilor din datele cripto sau alinierea randamentelor cripto și de acțiuni pe calendare diferite
                                                  • un VaR Normal pentru o serie cu \(\alpha + \beta = 1\) și tail index sub 3

                                                Capitolul 15: risc sistemic (1/2)

                                                Slide 44 în PDF

                                                CoVaR (conditional value at risk), propus de Adrian & Brunnermeier (2016), este VaR-ul sistemului financiar condiționat de situația în care o instituție se află la VaR-ul ei. Contribuția instituției la riscul sistemului este diferența dintre CoVaR-ul din starea de criză și cel din starea mediană. Dintr-o regresie cuantilică a randamentului sistemului pe randamentul băncii, cu panta \(b\),

                                                \[\Delta\mathrm{CoVaR} = b\,(q_{50} - q_\alpha),\]

                                                unde \(q_\alpha\) și \(q_{50}\) sînt cuantila de ordin \(\alpha\) și mediana randamentului băncii.

                                                Alte măsuri privesc aceeași întrebare din direcții diferite. MES (marginal expected shortfall) este pierderea medie a băncii în cele mai proaste zile ale pieței. SRISK (systemic risk) este capitalul care i-ar lipsi băncii într-o criză. Rețelele de cauzalitate Granger și tabelul de conectivitate al lui Diebold & Yilmaz (2012), construit din descompunerea varianței erorilor de prognoză, măsoară cît din volatilitatea fiecărei instituții vine de la celelalte.

                                                Pe scurt

                                                • Formule-cheie
                                                  • CoVaR: VaR-ul sistemului cînd o instituție se află la VaR-ul ei; \(\Delta\mathrm{CoVaR} = b\,(q_{50} - q_\alpha)\) dintr-o regresie cuantilică Adrian & Brunnermeier (2016)
                                                  • MES, SRISK, rețele Granger și tabelul de conectivitate Diebold–Yilmaz Diebold & Yilmaz (2012)
                                                • Notațiile
                                                  • \(b\): panta regresiei cuantilice a sistemului pe bancă; \(q_\alpha\), \(q_{50}\): cuantila de ordin \(\alpha\) și mediana randamentului băncii
                                                  • MES: pierderea medie a băncii în cele mai proaste zile ale pieței; SRISK: capitalul lipsă într-o criză

                                                Capitolul 15: risc sistemic (2/2)

                                                Slide 45 în PDF

                                                Pentru Banca Transilvania și indicele BET, VaR 1% al băncii este 5,23%, iar ΔCoVaR 1% este 3,31 puncte procentuale, cu un interval de încredere bootstrap de 95% între 2,35 și 4,78. Cînd banca trece de la starea mediană la starea de criză, VaR-ul pieței crește cu circa trei puncte procentuale. Pentru 11 bănci americane și europene, conectivitatea totală Diebold–Yilmaz este de circa 78%: în medie, cea mai mare parte a varianței erorilor de prognoză ale unei bănci vine de la șocurile celorlalte.

                                                Prima greșeală frecventă este ordonarea băncilor după propriul VaR. O bancă foarte volatilă, dar slab legată de restul sistemului, are un VaR mare și o contribuție mică la riscul sistemic; ΔCoVaR măsoară tocmai legătura, nu riscul individual.

                                                A doua greșeală privește comparația corelațiilor între perioade calme și de criză. Corelația crește mecanic atunci cînd volatilitatea crește, chiar dacă legătura dintre piețe nu se schimbă; ajustarea Forbes–Rigobon corectează acest efect înainte de a concluziona că a existat contagiune.

                                                Pe scurt

                                                • Fapte empirice
                                                  • Banca Transilvania și BET: VaR 1% 5,23%, \(\Delta\)CoVaR 1% 3,31 pp (CI 95% [2,35; 4,78])
                                                  • 11 bănci americane și europene: conectivitate totală de circa 78%
                                                • Greșeli frecvente
                                                  • ordonarea băncilor după propriul VaR: un VaR mare nu înseamnă neapărat o contribuție mare la riscul sistemului
                                                  • corelații comparate între perioade calme și de criză fără ajustarea Forbes–Rigobon

                                                Sinteza secțiunii

                                                Aplicațiile refolosesc același lanț statistic. Un model de scoring se judecă prin AUC, calibrare și costuri, în afara eșantionului; învățarea automată nu prognozează semnul randamentelor, dar prognozează bine volatilitatea; activele cripto cer calendarul de 365 de zile și modele cu cozi groase și persistență totală; riscul sistemic se măsoară prin legătura unei instituții cu sistemul, nu prin riscul ei individual.

                                                Sinteza metodelor

                                                Secțiunea rezumă cursul ca o listă de întrebări, fiecare cu instrumentul care îi răspunde, regula de decizie și capitolul în care a fost tratată. Ea se încheie cu convențiile de notație folosite în tot cursul și cu cele mai frecvente șase capcane.

                                                Sinteza metodelor (1/2): randamente, distribuții și cozi

                                                Slide 46 în PDF

                                                Primul tabel acoperă întrebările despre performanță și distribuție. Calitatea unei investiții se judecă prin CAGR, raportul Sharpe, raportul Sortino, care împarte randamentul în exces doar la volatilitatea randamentelor negative, și drawdown-ul maxim, comparate cu erorile lor standard și cu un reper (Capitolul 1). Normalitatea se testează cu Jarque–Bera și cu graficul cuantilă–cuantilă (QQ, quantile–quantile); ea se respinge la 5% cînd JB depășește 5,99, valoarea critică a distribuției \(\chi^2(2)\) (Capitolul 2).

                                                Grosimea cozilor se măsoară cu graficul Hill, cu GPD sau cu \(\alpha\) al unei legi stabile, iar regula de interpretare este că momentele de ordin \(p\) există doar pentru \(p < \alpha\) (Capitolele 3 și 5). Alegerea distribuției se face cu LR, AIC, BIC, KS și AD: se preferă modelul cu AIC minim, iar testul AD se folosește atunci cînd contează cozile (Capitolul 6).

                                                Ultimele două întrebări privesc probabilitățile mici și varianța. Frecvența unei pierderi de o anumită mărime se estimează cu funcția de repartiție empirică, cu EVT sau prin Monte Carlo, raportînd întotdeauna eroarea standard a estimării (Capitolele 4 și 5). Dacă varianța este finită se verifică cu graficul varianței cumulative și cu comportamentul lui \(\hat\alpha\) la agregare: o varianță de selecție care se stabilizează indică o varianță finită (Capitolul 3).

                                                Pe scurt

                                                ÎntrebareaInstrumentulDeciziaCap.
                                                Cît de bună a fost investiția?CAGR, Sharpe, Sortino, MDDcomparăm cu SE și un reper1
                                                Sînt randamentele Normale?JB, QQ plotrespingem dacă JB \(> 5{,}99\)2
                                                Cît de groase sînt cozile?graficul Hill, GPD, \(\alpha\) stabilmomentele există pentru \(p < \alpha\)3, 5
                                                Ce distribuție se potrivește?LR, AIC, BIC, KS, ADAIC minim; AD pentru cozi6
                                                Cît de rară este o pierdere de \(x\)?funcția de repartiție empirică, EVT, Monte Carloraportăm SE a estimării4, 5
                                                Este varianța finită?varianța cumulativă, agregarea lui \(\hat\alpha\)varianță de selecție stabilă: finită3

                                                Sinteza metodelor (2/2): dependență în timp, volatilitate și risc

                                                Slide 47 în PDF

                                                Al doilea tabel acoperă dependența în timp și riscul. Predictibilitatea randamentelor se testează cu ACF, cu Ljung–Box și cu statistica robustă \(Z^*(q)\) a raportului varianțelor, respingînd mersul aleator dacă \(|Z^*| > 1{,}96\) (Capitolul 7). Volatility clustering se detectează cu Ljung–Box pe \(r_t^2\) și cu ARCH-LM; dacă testele resping, varianța trebuie modelată (Capitolul 8). Prognoza volatilității de mîine se face cu EWMA, GARCH(1,1)-\(t\) sau GJR, iar prognozele se compară cu funcția de pierdere QLIKE (quasi-likelihood) față de un reper (Capitolele 8 și 9).

                                                Pierderea posibilă se măsoară prin VaR 1% și ES 2,5%, calculate prin simulare istorică, cu distribuția Student-\(t\), cu EVT sau prin FHS, și se verifică prin testul Kupiec, testul Christoffersen pentru gruparea depășirilor și semaforul Basel (Capitolul 10). Memoria lungă se estimează cu R/S, DFA (detrended fluctuation analysis), estimatorul GPH (Geweke–Porter-Hudak) și testul Lo, comparînd rezultatul cu o bandă Monte Carlo (Capitolul 11).

                                                Ultimele două rînduri sînt aplicațiile. Probabilitatea de nerambursare se modelează cu regresia logistică sau cu analiza discriminantă liniară (LDA, linear discriminant analysis) și se evaluează prin AUC și Gini, în afara eșantionului și ținînd seama de costuri (Capitolul 12). Importanța unei bănci pentru sistem se măsoară cu CoVaR, MES și SRISK, cu intervale de încredere bootstrap pentru ΔCoVaR (Capitolul 15).

                                                Pe scurt

                                                ÎntrebareaInstrumentulDeciziaCap.
                                                Sînt randamentele previzibile?ACF, Ljung–Box, VR robust \(Z^*(q)\)respingem dacă \(|Z^*| > 1{,}96\)7
                                                Există volatility clustering?Ljung–Box pe \(r_t^2\), ARCH-LMrespingem: modelăm varianța8
                                                Cît de volatil va fi mîine?EWMA, GARCH(1,1)-\(t\), GJRQLIKE față de un reper8, 9
                                                Cît putem pierde?VaR 1%, ES 2,5%: HS, \(t\), EVT, FHSKupiec, Christoffersen, semaforul Basel10
                                                Există memorie lungă?R/S, DFA, GPH, testul Locomparăm cu o bandă Monte Carlo11
                                                Cine va intra în nerambursare?logit, LDA, AUC, Giniîn afara eșantionului, cu costuri12
                                                Ce bancă contează pentru sistem?CoVaR, MES, SRISKCI bootstrap pentru \(\Delta\)CoVaR15

                                                Convențiile folosite în tot cursul

                                                Slide 48 în PDF

                                                Randamentele sînt randamente logaritmice zilnice, în procente, \(r_t = 100\,(\ln P_t - \ln P_{t-1})\). Excepția sînt portofoliile, pentru care se folosesc randamente simple, deoarece numai acestea se agregă liniar între active; înainte de calcul, prețurile activelor se aliniază pe zilele comune de tranzacționare.

                                                Anualizarea înmulțește media cu \(A\) și volatilitatea cu \(\sqrt{A}\), unde \(A\) este numărul real de observații pe an: circa 252 pentru acțiuni și indici și 365 pentru activele cripto. Nivelul unei măsuri de risc este probabilitatea cozii: VaR 1% și ES 2,5%, iar \(\mathrm{VaR}_\alpha = -q_\alpha > 0\) este o pierdere. În simularea istorică, VaR este a \(k\)-a cea mai mică valoare a randamentelor, cu \(k = \lceil n\alpha \rceil\).

                                                Orice test se raportează complet: ipoteza nulă \(H_0\), statistica, distribuția ei în ipoteza nulă, valoarea critică și decizia la 5%. Decizia este urmată de o frază despre ce înseamnă ea pentru date; o statistică fără interpretare nu răspunde la întrebarea pusă.

                                                Pe scurt

                                                • Randamentele: randamente logaritmice zilnice în %, \(r_t = 100\,(\ln P_t - \ln P_{t-1})\)
                                                  • portofolii: randamente simple, după alinierea prețurilor pe zilele comune
                                                • Anualizarea: media \(\times A\), volatilitatea \(\times\sqrt{A}\), cu \(A\) real
                                                  • \(A\): numărul de observații pe an: circa 252 pentru acțiuni și indici, 365 pentru cripto
                                                • Riscul: nivelul este probabilitatea cozii: VaR 1%, ES 2,5%
                                                  • \(\mathrm{VaR}_\alpha = -q_\alpha > 0\), o pierdere; simularea istorică cu \(k = \lceil n\alpha \rceil\)
                                                • Testele: precizăm \(H_0\), statistica, distribuția ei, valoarea critică și decizia la 5%
                                                  • apoi o frază despre semnificația deciziei pentru date

                                                Erori metodologice frecvente

                                                Slide 49 în PDF

                                                Primele trei erori privesc datele, distribuția și inferența. La date, randamentele trebuie calculate după alinierea prețurilor, nu aliniate după calcul; prețurile trebuie ajustate pentru dividende și split-uri; iar weekendurile nu se elimină din seriile cripto. La distribuție, distribuția Normală nu se folosește pentru cuantilele din coadă, iar boltirea nu se confundă cu excesul de boltire. La inferență, erorile standard calculate în ipoteza i.i.d. sînt prea mici în prezența volatility clustering, iar o statistică raportată fără eroarea ei standard nu poate fi interpretată.

                                                A patra eroare privește timpul: look-ahead bias apare atunci cînd parametrii estimați pe tot eșantionul sînt folosiți pentru a evalua prognoze făcute într-un moment în care acei parametri nu erau cunoscuți. A cincea privește riscul: semnul și nivelul VaR trebuie să respecte convenția cursului, iar ES nu se compară cu VaR calculat la alt nivel.

                                                A șasea eroare ține de interpretare. Semnificația statistică nu înseamnă importanță economică: pe un eșantion mare, un efect foarte mic devine semnificativ. Iar predictibilitatea nu înseamnă profit, pentru că o strategie trebuie să acopere costurile de tranzacționare și riscul asumat.

                                                Pe scurt

                                                • Datele: alinierea randamentelor în loc de prețuri; prețuri neajustate; weekenduri eliminate la cripto
                                                • Distribuția: distribuția Normală pentru cuantilele din coadă; confuzia dintre boltire și excesul de boltire
                                                • Inferența: erori standard i.i.d. în prezența volatility clustering; o statistică fără SE
                                                • Timpul: look-ahead bias, parametri estimați pe tot eșantionul și folosiți în trecut
                                                • Riscul: semnul și nivelul VaR; ES comparat cu VaR la niveluri diferite
                                                • Interpretarea: semnificația statistică luată drept importanță economică, predictibilitatea drept profit

                                                Sinteza secțiunii

                                                Fiecare întrebare a cursului are un instrument și o regulă de decizie: JB pentru normalitate, graficul Hill pentru cozi, \(Z^*(q)\) robust pentru predictibilitate, Ljung–Box pe \(r_t^2\) pentru volatility clustering, GARCH-\(t\) pentru prognoza volatilității, VaR 1% și ES 2,5% cu backtesting pentru risc. Convențiile comune și evitarea celor șase capcane fac rezultatele comparabile între capitole.

                                                Examenul

                                                Secțiunea descrie forma evaluării scrise și prezintă opt probleme recapitulative, fiecare urmată de rezolvarea completă. Problemele acoperă toate tipurile de calcul ale cursului și arată, pe cifre simple, cum se leagă un calcul de interpretarea lui.

                                                Examenul scris: formatul

                                                Slide 50 în PDF

                                                Evaluarea scrisă reprezintă 70% din nota finală, durează două ore și permite folosirea calculatorului. Toate subiectele sînt obligatorii și se notează cu 9 puncte, la care se adaugă un punct din oficiu.

                                                Valorile necesare calculelor sînt date odată cu subiectele: cuantile ale distribuției Normale și ale distribuției Student-\(t\), valori critice ale distribuției \(\chi^2\), logaritmi și radicali. Accentul cade astfel pe alegerea formulei și pe înțelegerea rezultatului, nu pe memorarea tabelelor statistice.

                                                Fiecare subiect are un context scurt, cifre, un tabel sau un grafic și una sau două cerințe. Răspunsul complet este un calcul urmat de o interpretare în trei pînă la cinci fraze, aceeași structură pe care o urmează rezolvările problemelor din această secțiune.

                                                Pe scurt

                                                • 70% din nota finală; scris, 2 ore; calculatorul este permis
                                                  • toate subiectele sînt obligatorii; 9 puncte plus 1 punct din oficiu
                                                • Valorile utile sînt date pe subiect
                                                  • cuantile ale distribuției Normale și Student-\(t\), valori critice \(\chi^2\), logaritmi și radicali
                                                • Fiecare subiect: un context scurt, cifre, un tabel sau un grafic, una sau două cerințe
                                                  • un calcul urmat de o interpretare în trei pînă la cinci fraze
                                                Examenul scris: formatul Academia de Studii Economice din București Foto: Joe Mabel (2014); CC BY 3.0; Wikimedia Commons

                                                Conținutul evaluat

                                                Slide 51 în PDF

                                                Materia acoperă cursurile și seminariile Capitolelor 0–15. Definițiile și formulele sînt cele de pe slide-urile „Noțiuni necesare azi” ale fiecărui seminar, iar calculele sînt de tipul celor din Partea A a seminariilor, făcute pe hîrtie.

                                                O a doua componentă este interpretarea rezultatelor obținute cu software: tabele și grafice de felul celor din Partea B a seminariilor, cu estimări, statistici de test, p-value-uri și rezultate de backtesting. Codul nu se scrie, dar rezultatul lui trebuie citit corect.

                                                A treia componentă este înțelegerea: de ce o metodă dă greș pe randamentele financiare, de exemplu un VaR Normal pe o serie cu cozi groase, și ce test răspunde la ce întrebare. Sinteza metodelor din secțiunea anterioară rezumă exact această corespondență.

                                                Pe scurt

                                                • Capitolele 0–15: cursuri și seminarii
                                                  • definițiile și formulele de pe slide-urile „Noțiuni necesare azi” ale fiecărui seminar
                                                  • calculele din Partea A a seminariilor, pe hîrtie
                                                • Interpretarea rezultatelor obținute cu software
                                                  • tabele și grafice ca în Partea B: estimări, statistici de test, p-value-uri, backtesting
                                                  • la examen nu se scrie cod
                                                • Înțelegere, nu memorare
                                                  • de ce o metodă dă greș pe randamentele financiare, ce test răspunde la ce întrebare

                                                Criterii de notare

                                                Slide 52 în PDF

                                                Un răspuns se evaluează pe trei componente. Prima este metoda: formula scrisă, cu cifrele înlocuite. O metodă corectă cu o greșeală de calcul primește cea mai mare parte a punctajului, pentru că arată că raționamentul este corect.

                                                A doua componentă este rezultatul: cifra, cu unitatea de măsură (procente, zile, lei) și cu semnul ei. Pentru un test, rezultatul complet conține ipoteza nulă \(H_0\), statistica, valoarea critică sau p-value-ul și decizia.

                                                A treia componentă este interpretarea, în trei pînă la cinci fraze, cu o parte statistică și una economică. Ea precizează ipotezele unei formule aproximative, de exemplu randamente i.i.d., distribuția Normală sau un eșantion mare. O cifră corectă însoțită de o interpretare greșită nu primește tot punctajul.

                                                Pe scurt

                                                • Metoda: formula, cu cifrele înlocuite
                                                  • o metodă corectă cu o greșeală de calcul primește cea mai mare parte a punctajului
                                                • Rezultatul: cifra, cu unitatea de măsură (%, zile, lei) și semnul ei
                                                  • pentru un test: \(H_0\), statistica, valoarea critică sau p-value-ul, decizia
                                                • Interpretarea: trei pînă la cinci fraze, statistice și economice
                                                  • precizați ipotezele unei formule aproximative (i.i.d., distribuția Normală, \(n\) mare)
                                                  • o cifră corectă cu o interpretare greșită nu primește tot punctajul

                                                Tipuri de probleme

                                                Slide 53 în PDF

                                                Tabelul grupează problemele recapitulative după tipul calculului și după capitolele din care provin. Randamentele, anualizarea și performanța vin din Capitolele 0 și 1 (Problema 1); momentele, normalitatea și cozile vin din Capitolele 2, 3, 5 și 6 (Problema 2); probabilitatea și simularea vin din Capitolul 4 (Problema 3).

                                                Eficiența și memoria lungă, din Capitolele 7 și 11, apar în Problemele 4 și 7; volatilitatea, din Capitolele 8, 9 și 14, în Problema 5; măsurile de risc și backtesting-ul, din Capitolul 10, în Problema 6; riscul de credit și riscul sistemic, din Capitolele 12, 13 și 15, în Problema 8.

                                                Cele opt probleme sînt exemple de recapitulare cu rezolvări complete. Fiecare folosește cifre simple, astfel încît calculul să poată fi refăcut cu un calculator, iar fiecare rezolvare se încheie cu interpretarea rezultatului.

                                                Pe scurt

                                                TipulCapitoleExemplu în acest capitol
                                                randamente, anualizare, performanță0, 1Problema 1: CAGR, drawdown, volatility drag
                                                momente, normalitate, cozi2, 3, 5, 6Problema 2: JB, Student-\(t\), Hill
                                                probabilitate și simulare4Problema 3: portofoliu, Monte Carlo, GBM
                                                eficiență și memorie7, 11Problemele 4 și 7: Ljung–Box, VR, Hurst
                                                volatilitate8, 9, 14Problema 5: GARCH, EWMA, anualizarea Bitcoin
                                                măsuri de risc și backtesting10Problema 6: VaR, ES, Kupiec, semaforul Basel
                                                risc de credit și risc sistemic12, 13, 15Problema 8: matricea de confuzie, EL, \(\Delta\)CoVaR
                                                • Cele opt probleme de mai jos sînt exemple de recapitulare, cu rezolvări complete; examenul are subiecte proprii

                                                Problema 1: randamente și drawdown

                                                Slide 54 în PDF

                                                Un indice valorează 100, 160, 64 și 96 la sfîrșitul anilor 0, 1, 2 și 3. Seria a fost aleasă astfel încît să conțină o creștere mare, o prăbușire și o revenire parțială, situația în care diferența dintre randamentele simple și cele logaritmice, ca și dintre media aritmetică și CAGR, devine evidentă.

                                                Cerințele merg de la definiții la interpretare. Se calculează randamentele simple și logaritmice ale celor trei ani, apoi randamentul total în două moduri, din suma randamentelor logaritmice și direct din prețuri. Urmează media aritmetică a randamentelor simple comparată cu CAGR și, în final, drawdown-ul maxim împreună cu cîștigul necesar pentru a reveni de la minim la vîrful anterior.

                                                Pe scurt

                                                • Context
                                                  • Un indice valorează 100, 160, 64 și 96 la sfîrșitul anilor 0, 1, 2 și 3
                                                • Cerințe
                                                  1. Calculați randamentele simple \(R_t\) și randamentele logaritmice \(r_t\) ale celor trei ani.
                                                  2. Calculați randamentul total în două moduri: din \(\sum_t r_t\) și din prețuri.
                                                  3. Calculați media aritmetică a lui \(R_t\) și CAGR, apoi explicați diferența.
                                                  4. Calculați drawdown-ul maxim și cîștigul necesar de la minim pînă la vîrful anterior.

                                                Problema 1: rezolvare

                                                Slide 55 în PDF

                                                Randamentele simple sînt 60%, −60% și 50%, iar cele logaritmice sînt \(\ln 1{,}6 = 0{,}470\), \(\ln 0{,}4 = -0{,}916\) și \(\ln 1{,}5 = 0{,}405\). Suma randamentelor logaritmice este \(-0{,}041 = \ln(96/100)\), deci randamentul total este \(e^{-0{,}041} - 1 = -4\%\), exact ca \(96/100 - 1\). Randamentele logaritmice se adună în timp; suma randamentelor simple, 50%, nu are nicio legătură cu rezultatul real.

                                                Media aritmetică a randamentelor simple este \((60 - 60 + 50)/3 = 16{,}67\%\), iar CAGR este \((96/100)^{1/3} - 1 = -1{,}35\%\). Indicele are un randament mediu pozitiv și totuși investitorul a pierdut bani: volatilitatea mare reduce creșterea compusă (volatility drag), iar media aritmetică nu descrie ce a obținut efectiv cineva care a păstrat investiția.

                                                Drawdown-ul maxim este \(64/160 - 1 = -60\%\), de la vîrful de la sfîrșitul primului an la minimul de la sfîrșitul celui de-al doilea. Pentru a reveni de la 64 la 160, indicele are nevoie de un cîștig de \(160/64 - 1 = 150\%\). Asimetria dintre pierdere și cîștigul necesar crește rapid cu mărimea pierderii, ceea ce face drawdown-urile mari atît de greu de recuperat.

                                                Pe scurt

                                                1. \(R = 60\%; -60\%; 50\%\); \(r = \ln 1{,}6 = 0{,}470\), \(\ln 0{,}4 = -0{,}916\), \(\ln 1{,}5 = 0{,}405\)
                                                2. \(\sum_t r_t = -0{,}041 = \ln(96/100)\), deci randamentul total este \(e^{-0{,}041} - 1 = -4\%\), la fel ca \(96/100 - 1\)
                                                3. media aritmetică \((60 - 60 + 50)/3 = 16{,}67\%\); CAGR \(= (96/100)^{1/3} - 1 = -1{,}35\%\)
                                                4. MDD \(= 64/160 - 1 = -60\%\); pentru revenirea de la 64 la 160, indicele are nevoie de \(160/64 - 1 = 150\%\)
                                                • Interpretare
                                                  • Un randament mediu pozitiv și totuși o pierdere de bani: volatilitatea reduce creșterea compusă (volatility drag)
                                                  • Randamentele logaritmice se adună în timp; cele simple nu

                                                Problema 2: distribuție și cozi

                                                Slide 56 în PDF

                                                Contextul este un eșantion de \(n = 1\,000\) de randamente zilnice, cu asimetria \(S = -0{,}5\) și excesul de boltire \(K = 6\), valori obișnuite pentru un indice bursier. Cele mai mari cinci pierderi, în procente, sînt 8,2, 6,5, 5,9, 5,1 și 4,6, iar valoarea critică a distribuției \(\chi^2(2)\) la 5% este 5,99.

                                                Cerințele leagă trei capitole. Testul Jarque–Bera, cu cele două componente ale lui, decide asupra normalității; distribuția Student-\(t\) cu același exces de boltire dă un număr de grade de libertate; estimatorul Hill cu \(k = 4\) dă tail index-ul. Ultima cerință întreabă ce momente ale pierderilor există și dacă o lege stabilă cu \(\alpha < 2\) este compatibilă cu rezultatul.

                                                Pe scurt

                                                • Context
                                                  • \(n = 1000\) de randamente zilnice cu asimetria \(S = -0{,}5\) și excesul de boltire \(K = 6\)
                                                  • Cele mai mari cinci pierderi, în %: \(8{,}2\); \(6{,}5\); \(5{,}9\); \(5{,}1\); \(4{,}6\); \(\chi^2_{0,95}(2) = 5{,}99\)
                                                • Cerințe
                                                  1. Calculați statistica Jarque–Bera și cele două componente ale ei, apoi decideți la 5%.
                                                  2. Determinați numărul de grade de libertate \(\nu\) al unei distribuții Student-\(t\) cu același exces de boltire.
                                                  3. Calculați estimarea Hill \(\hat\alpha\) cu \(k = 4\).
                                                  4. Precizați ce momente ale pierderilor există dacă \(\alpha = \hat\alpha\) și dacă o lege stabilă cu \(\alpha < 2\) este compatibilă cu acest rezultat.

                                                Problema 2: rezolvare

                                                Slide 57 în PDF

                                                Componenta asimetriei din statistica Jarque–Bera este \(\frac{1000}{6}\cdot 0{,}25 = 41{,}67\), iar componenta boltirii este \(\frac{1000}{24}\cdot 36 = 1\,500\). Suma, JB \(= 1\,541{,}7\), depășește cu mult 5,99, deci normalitatea se respinge. Componenta boltirii domină: cozile groase, nu asimetria, sînt motivul respingerii. Din \(6/(\nu - 4) = 6\) rezultă \(\nu = 5\) grade de libertate pentru distribuția Student-\(t\) cu același exces de boltire.

                                                Pentru estimatorul Hill cu \(k = 4\), pragul este a cincea pierdere, 4,6. Logaritmii rapoartelor sînt \(\ln(8{,}2/4{,}6) = 0{,}578\), \(\ln(6{,}5/4{,}6) = 0{,}346\), \(\ln(5{,}9/4{,}6) = 0{,}249\) și \(\ln(5{,}1/4{,}6) = 0{,}103\), cu media 0,3190, deci \(\hat\alpha = 1/0{,}3190 = 3{,}14\). Cu un tail index de 3,14 există momentele de ordin mai mic decît 3,14: media, varianța și asimetria; boltirea nu există. O lege stabilă cu \(\alpha < 2\), cu varianță infinită, ar avea cozi mai groase decît aceste date.

                                                Estimarea are o incertitudine mare. Cu \(k = 4\), eroarea standard este aproximativ \(\hat\alpha/\sqrt{4} = \hat\alpha/2\), deci aproximativ 1,6. În practică, \(k\) se alege din graficul Hill, pe un eșantion de pierderi suficient de mare pentru a avea o zonă stabilă.

                                                Pe scurt

                                                1. componenta asimetriei \(\frac{1000}{6}(0{,}25) = 41{,}67\); componenta boltirii \(\frac{1000}{24}(36) = 1500{,}0\); JB \(= 1541{,}7 > 5{,}99\): normalitatea se respinge
                                                2. \(6/(\nu - 4) = 6 \Rightarrow \nu = 5\)
                                                3. \(\ln(8{,}2/4{,}6) = 0{,}578\), \(\ln(6{,}5/4{,}6) = 0{,}346\), \(\ln(5{,}9/4{,}6) = 0{,}249\), \(\ln(5{,}1/4{,}6) = 0{,}103\); media \(0{,}3190\), deci \(\hat\alpha = 3{,}14\)
                                                4. există momentele de ordin \(p < 3{,}14\): media, varianța, asimetria; boltirea nu există; o lege stabilă cu \(\alpha < 2\) (varianță infinită) are cozi mai groase decît aceste date
                                                • Interpretare
                                                  • Componenta boltirii domină JB: cozile groase, nu asimetria, duc la respingerea normalității
                                                  • \(k = 4\) dă o estimare foarte zgomotoasă a lui \(\hat\alpha\) (SE \(\approx \hat\alpha/2\)); în practică, \(k\) se alege din graficul Hill

                                                Problema 3: portofoliu, Monte Carlo și GBM

                                                Slide 58 în PDF

                                                Problema are trei părți independente. Prima privește un portofoliu din două active, cu volatilități zilnice de 1,5% și 2,5%, corelația 0,3 și ponderile 60% și 40%; se cere volatilitatea zilnică a portofoliului și comparația ei cu media ponderată a volatilităților.

                                                A doua parte privește precizia unei simulări: un studiu Monte Carlo cu \(N = 10\,000\) de extrageri estimează o probabilitate de 1%, iar cerința este eroarea standard și un interval de încredere de 95%. A treia parte privește un preț care urmează un GBM cu tendința \(\mu = 8\%\), volatilitatea \(\sigma = 25\%\) pe an și \(S_0 = 100\); se cer media și mediana prețului peste un an și probabilitatea ca prețul să scadă sub valoarea inițială.

                                                Pe scurt

                                                • Context
                                                  • Două active: volatilități zilnice de \(1{,}5\%\) și \(2{,}5\%\), corelație \(0{,}3\), ponderi 60% și 40%
                                                  • Prețul unei acțiuni urmează un GBM cu \(\mu = 8\%\), \(\sigma = 25\%\) pe an, \(S_0 = 100\)
                                                • Cerințe
                                                  1. Calculați volatilitatea zilnică a portofoliului și comparați-o cu media ponderată a volatilităților.
                                                  2. Un studiu Monte Carlo cu \(N = 10\,000\) de extrageri estimează o probabilitate de 1%; calculați SE și un interval de 95%.
                                                  3. Calculați media și mediana lui \(S_1\), precum și \(P(S_1 < S_0)\).

                                                Problema 3: rezolvare

                                                Slide 59 în PDF

                                                Varianța zilnică a portofoliului este

                                                \[\begin{aligned} \sigma_p^2 &= 0{,}6^2 \cdot 1{,}5^2 + 0{,}4^2 \cdot 2{,}5^2 \\ &\quad + 2 \cdot 0{,}6 \cdot 0{,}4 \cdot 0{,}3 \cdot 1{,}5 \cdot 2{,}5 \\ &= 0{,}81 + 1{,}00 + 0{,}54 = 2{,}35, \end{aligned}\]

                                                deci volatilitatea este 1,53%. Media ponderată a volatilităților este 1,90%. Diferența este efectul diversificării: cu o corelație mai mică decît 1, portofoliul este mai puțin riscant decît media componentelor sale.

                                                Eroarea standard a estimării Monte Carlo este \(\sqrt{0{,}01 \cdot 0{,}99/10\,000} = 0{,}099\%\), iar intervalul de încredere de 95% este între 0,80% și 1,20%. Cu zece mii de extrageri, o probabilitate de 1% este estimată cu o eroare relativă de circa 10%; pentru probabilitățile din coada extremă, numărul de extrageri trebuie mărit mult.

                                                Pentru GBM, media prețului peste un an este \(100e^{0{,}08} = 108{,}33\), iar mediana este \(100e^{0{,}08 - 0{,}03125} = 105{,}00\). Prețul scade sub 100 dacă \(\ln(S_1/S_0) < 0\), iar această variabilă are media \(0{,}0488\) și abaterea standard \(0{,}25\), deci probabilitatea este \(\Phi(-0{,}0488/0{,}25) = \Phi(-0{,}195) = 42{,}3\%\). Deși prețul așteptat crește, un investitor pierde bani după un an cu o probabilitate de 42,3%.

                                                Pe scurt

                                                1. \(\sigma_p^2 = 0{,}81 + 1{,}00 + 0{,}54 = 2{,}35\), \(\sigma_p = 1{,}53\%\), sub media ponderată \(1{,}90\%\)
                                                2. SE \(= \sqrt{0{,}01 \times 0{,}99/10\,000} = 0{,}099\%\); interval \([0{,}80\%; 1{,}20\%]\)
                                                3. media \(100e^{0{,}08} = 108{,}33\); mediana \(100e^{0{,}08 - 0{,}03125} = 105{,}00\); \(P(S_1 < S_0) = \Phi(-0{,}0488/0{,}25) = \Phi(-0{,}195) = 42{,}3\%\)
                                                • Interpretare
                                                  • Diversificarea: cu \(\rho < 1\), portofoliul este mai puțin riscant decît media componentelor
                                                  • Un investitor într-un GBM pierde bani după un an cu probabilitatea de 42,3%, deși prețul așteptat crește

                                                Problema 4: autocorelație și raportul varianțelor

                                                Slide 60 în PDF

                                                Se dau \(T = 2\,500\) de randamente zilnice cu primele patru autocorelații de selecție 0,06, 0,02, −0,01 și 0,01. Valoarea critică a distribuției \(\chi^2(4)\) la 5% este 9,49, iar eroarea standard robustă la heteroscedasticitate a raportului varianțelor estimat \(\widehat{\mathrm{VR}}(5)\) este 0,065.

                                                Cerințele compară trei teste ale aceleiași ipoteze. Statistica Ljung–Box \(Q(4)\) testează absența autocorelației pe primele patru laguri. Raportul varianțelor \(\mathrm{VR}(5) = 1 + 2\sum_{k=1}^{4}(1 - k/5)\hat\rho(k)\) rezumă aceleași autocorelații într-un singur număr. Statistica i.i.d. \(Z(5)\), cu eroarea standard

                                                \[\mathrm{SE} = \sqrt{\frac{2(2q-1)(q-1)}{3qT}},\]

                                                și statistica robustă \(Z^*(5)\) testează dacă acest număr diferă de 1.

                                                Pe scurt

                                                • Context
                                                  • \(T = 2500\) de randamente zilnice; \(\hat\rho(1) = 0{,}06\), \(\hat\rho(2) = 0{,}02\), \(\hat\rho(3) = -0{,}01\), \(\hat\rho(4) = 0{,}01\); \(\chi^2_{0,95}(4) = 9{,}49\)
                                                  • Eroarea standard robustă la heteroscedasticitate a lui \(\widehat{\mathrm{VR}}(5)\) este \(0{,}065\)
                                                • Cerințe
                                                  1. Calculați statistica Ljung–Box \(Q(4)\) și decideți la 5%.
                                                  2. Calculați \(\mathrm{VR}(5) = 1 + 2\sum_{k=1}^{4}(1 - k/5)\hat\rho(k)\).
                                                  3. Calculați statistica i.i.d. \(Z(5)\), cu SE \(= \sqrt{2(2q-1)(q-1)/(3qT)}\), și statistica robustă \(Z^*(5)\), apoi decideți la 5%.

                                                Problema 4: rezolvare

                                                Slide 61 în PDF

                                                Statistica Ljung–Box este \(Q(4) = T(T+2)\sum_{k=1}^{4}\hat\rho_k^2/(T - k) = 10{,}51\), foarte apropiată de aproximarea \(T\sum_k\hat\rho_k^2 = 2\,500 \cdot 0{,}0042\). Deoarece \(10{,}51 > 9{,}49\), ipoteza de absență a autocorelației se respinge la 5%.

                                                Raportul varianțelor este

                                                \[\begin{aligned} \mathrm{VR}(5) &= 1 + 2(0{,}8 \cdot 0{,}06 + 0{,}6 \cdot 0{,}02 \\ &\quad - 0{,}4 \cdot 0{,}01 + 0{,}2 \cdot 0{,}01) \\ &= 1 + 2 \cdot 0{,}058 = 1{,}116. \end{aligned}\]

                                                O valoare peste 1 corespunde autocorelațiilor pozitive, adică momentum-ului.

                                                Eroarea standard i.i.d. este \(\sqrt{72/37\,500} = 0{,}0438\), deci \(Z(5) = 0{,}116/0{,}0438 = 2{,}65 > 1{,}96\), iar testul i.i.d. respinge mersul aleator. Statistica robustă este \(Z^*(5) = 0{,}116/0{,}065 = 1{,}78 < 1{,}96\) și nu îl respinge. Volatility clustering mărește artificial statistica \(Z(5)\), pentru că eroarea ei standard ignoră variația varianței în timp; decizia care se raportează este cea robustă.

                                                Pe scurt

                                                1. \(Q(4) = T(T+2)\sum_{k=1}^{4}\hat\rho_k^2/(T-k) = 10{,}51\), apropiat de \(T\sum_k\hat\rho_k^2\), cu \(\sum_k\hat\rho_k^2 = 0{,}0042\); \(10{,}51 > 9{,}49\): se respinge absența autocorelației
                                                2. \(\mathrm{VR}(5) = 1 + 2(0{,}8 \times 0{,}06 + 0{,}6 \times 0{,}02 - 0{,}4 \times 0{,}01 + 0{,}2 \times 0{,}01) = 1 + 2 \times 0{,}058 = 1{,}116\)
                                                3. SE \(= \sqrt{72/37\,500} = 0{,}0438\), \(Z(5) = 2{,}65 > 1{,}96\); \(Z^*(5) = (1{,}116 - 1)/0{,}065 = 1{,}78 < 1{,}96\) (robust)
                                                • Interpretare
                                                  • VR \(> 1\): autocorelație pozitivă (momentum); testul i.i.d. respinge mersul aleator
                                                  • Testul robust nu îl respinge: volatility clustering mărește artificial statistica \(Z(5)\); decizia care se raportează este cea robustă

                                                Problema 5: prognoze de volatilitate

                                                Slide 62 în PDF

                                                Un model GARCH(1,1) pentru randamente zilnice în procente are \(\omega = 0{,}03\), \(\alpha = 0{,}09\) și \(\beta = 0{,}89\). Azi, varianța condiționată este \(\sigma_t^2 = 1{,}8\), iar șocul zilei este \(\varepsilon_t = -2{,}5\), o scădere mare. A doua parte a problemei privește Bitcoin, cu o abatere standard zilnică de 3,5%.

                                                Cerințele parcurg utilizările modelului. Se calculează varianța de mîine și VaR 1% Normal pe o zi, cu medie zero și \(z_{0{,}01} = -2{,}326\); apoi persistența, timpul de înjumătățire, varianța pe termen lung și volatilitatea anuală pe termen lung; apoi prognoza varianței peste zece zile, comparată cu prognoza EWMA cu \(\lambda = 0{,}94\); în final, volatilitatea anuală a Bitcoin.

                                                Pe scurt

                                                • Context
                                                  • GARCH(1,1) pentru randamente zilnice în %: \(\omega = 0{,}03\), \(\alpha = 0{,}09\), \(\beta = 0{,}89\); azi \(\sigma_t^2 = 1{,}8\) și \(\varepsilon_t = -2{,}5\)
                                                  • Bitcoin: abaterea standard zilnică \(3{,}5\%\)
                                                • Cerințe
                                                  1. Calculați \(\sigma_{t+1}^2\) și VaR 1% Normal pe o zi (medie zero, \(z_{0,01} = -2{,}326\)).
                                                  2. Calculați persistența, timpul de înjumătățire, varianța pe termen lung și volatilitatea anuală pe termen lung.
                                                  3. Calculați \(E_t[\sigma_{t+10}^2]\) și prognoza EWMA cu \(\lambda = 0{,}94\).
                                                  4. Anualizați volatilitatea Bitcoin.

                                                Problema 5: rezolvare

                                                Slide 63 în PDF

                                                Varianța de mîine este

                                                \[\begin{aligned} \sigma_{t+1}^2 &= 0{,}03 + 0{,}09 \cdot 6{,}25 + 0{,}89 \cdot 1{,}8 \\ &= 0{,}03 + 0{,}5625 + 1{,}602 = 2{,}1945, \end{aligned}\]

                                                deci \(\sigma_{t+1} = 1{,}481\%\) și VaR 1% \(= 2{,}326 \cdot 1{,}481 = 3{,}45\%\). Persistența este \(\alpha + \beta = 0{,}98\), timpul de înjumătățire este \(\ln 0{,}5/\ln 0{,}98 = 34{,}3\) zile, varianța pe termen lung este \(0{,}03/0{,}02 = 1{,}50\), iar volatilitatea anuală pe termen lung este \(\sqrt{252 \cdot 1{,}50} = 19{,}44\%\).

                                                Prognoza la zece zile este

                                                \[\begin{aligned} E_t\sigma_{t+10}^2 &= 1{,}50 + 0{,}98^{9}(2{,}1945 - 1{,}50) \\ &= 2{,}079. \end{aligned}\]

                                                Ea a coborît de la 2,19 spre nivelul de echilibru 1,50, dar este încă departe de el. Prognoza EWMA este \(0{,}94 \cdot 1{,}8 + 0{,}06 \cdot 6{,}25 = 2{,}067\), aproape de cea GARCH la acest orizont. Diferența apare la orizonturi lungi: EWMA nu are un nivel pe termen lung, așa că prognoza ei rămîne aceeași pentru orice orizont, în timp ce prognoza GARCH revine la \(\bar\sigma^2\).

                                                Bitcoin se tranzacționează în fiecare zi, deci volatilitatea anuală este \(3{,}5\sqrt{365} = 66{,}9\%\). Cu 252 de zile s-ar obține greșit 55,6%. Un șoc negativ mare crește varianța de mîine, iar persistența \(\alpha + \beta\) stabilește cît timp durează efectul.

                                                Pe scurt

                                                1. \(\sigma_{t+1}^2 = 0{,}03 + 0{,}5625 + 1{,}602 = 2{,}1945\), \(\sigma_{t+1} = 1{,}481\%\); VaR 1% \(= 2{,}326 \times 1{,}481 = 3{,}45\%\)
                                                2. \(\alpha + \beta = 0{,}98\); \(h_{1/2} = \ln 0{,}5/\ln 0{,}98 = 34{,}3\) zile; \(\bar\sigma^2 = 0{,}03/0{,}02 = 1{,}50\); \(\sqrt{252 \times 1{,}50} = 19{,}44\%\) pe an
                                                3. \(E_t\sigma_{t+10}^2 = 1{,}50 + 0{,}98^9(2{,}1945 - 1{,}50) = 2{,}079\); EWMA: \(0{,}94 \times 1{,}8 + 0{,}06 \times 6{,}25 = 2{,}067\)
                                                4. Bitcoin se tranzacționează în fiecare zi: \(3{,}5 \times \sqrt{365} = 66{,}9\%\); cu 252, rezultatul ar fi greșit: \(55{,}6\%\)
                                                • Interpretare
                                                  • Un șoc negativ mare crește varianța de mîine; prognoza revine la \(\bar\sigma^2\) cu viteza \(\alpha + \beta\)
                                                  • EWMA nu are un nivel pe termen lung: prognoza ei rămîne constantă pentru orice orizont

                                                Problema 6: VaR, ES și backtesting

                                                Slide 64 în PDF

                                                O poziție de 1 000 000 de lei are randamente zilnice Normale cu media zero și abaterea standard 1,6%; densitatea Normală standard în 1,96 este \(\varphi(1{,}96) = 0{,}05845\). Pentru comparație se dau cele mai mici șapte dintre 250 de randamente istorice, în procente: −5,1, −4,4, −3,9, −3,6, −3,2, −3,0 și −2,9.

                                                Cerințele compară două metode de calcul și un test. Se calculează VaR 1% și ES 2,5% Normale, în procente și în lei, și VaR 1% pe 10 zile cu regula rădăcinii pătrate a timpului; apoi aceleași măsuri prin simulare istorică. Ultima cerință privește un model care are 6 depășiri ale VaR 1% în 250 de zile: statistica Kupiec, decizia la 5% și zona semaforului Basel.

                                                Pe scurt

                                                • Context
                                                  • O poziție de 1 000 000 de lei; randamente zilnice \(N(0; 1{,}6^2)\) în %; \(\varphi(1{,}96) = 0{,}05845\)
                                                  • Cele mai mici șapte dintre 250 de randamente istorice, în %: \(-5{,}1\); \(-4{,}4\); \(-3{,}9\); \(-3{,}6\); \(-3{,}2\); \(-3{,}0\); \(-2{,}9\)
                                                • Cerințe
                                                  1. Calculați VaR 1% și ES 2,5% Normale, în % și în lei, precum și VaR 1% pe 10 zile cu regula rădăcinii pătrate a timpului.
                                                  2. Calculați VaR 1% și ES 2,5% prin simulare istorică.
                                                  3. Un model are 6 depășiri ale VaR 1% în 250 de zile: calculați statistica Kupiec, decideți la 5% și precizați zona Basel.

                                                Problema 6: rezolvare

                                                Slide 65 în PDF

                                                Cu distribuția Normală, VaR 1% \(= 2{,}326 \cdot 1{,}6 = 3{,}72\%\), adică 37 222 de lei, iar ES 2,5% \(= 1{,}6 \cdot 0{,}05845/0{,}025 = 1{,}6 \cdot 2{,}338 = 3{,}74\%\), adică 37 405 lei. VaR pe 10 zile este \(\sqrt{10} \cdot 3{,}72 = 11{,}77\%\). Pentru distribuția Normală, ES 2,5% și VaR 1% sînt aproape egale.

                                                Prin simulare istorică, VaR 1% este a \(k = \lceil 2{,}5 \rceil = 3\)-a cea mai mică valoare, deci 3,9%, iar ES 2,5% este media celor mai mici \(k = \lceil 6{,}25 \rceil = 7\) randamente, \(26{,}1/7 = 3{,}73\%\). VaR istoric este mai mare decît cel Normal: coada istorică este mai groasă.

                                                Pentru testul Kupiec, log-verosimilitatea cu rata țintă este \(\ell_0 = 244\ln 0{,}99 + 6\ln 0{,}01 = -30{,}08\), iar cu rata observată \(\hat\pi = 6/250 = 0{,}024\) este \(\ell_1 = 244\ln 0{,}976 + 6\ln 0{,}024 = -28{,}31\). Statistica \(LR_{uc} = 2(\ell_1 - \ell_0) = 3{,}56\) este sub 3,84, valoarea critică a \(\chi^2(1)\), cu \(p = 0{,}059\), deci modelul nu este respins. Cu 6 depășiri, modelul se află însă în zona galbenă a semaforului Basel (5–9 depășiri), care cere deja un multiplicator de capital mai mare.

                                                Pe scurt

                                                1. VaR 1% \(= 2{,}326 \times 1{,}6 = 3{,}72\%\) (37 222 de lei); ES 2,5% \(= 1{,}6 \times 0{,}05845/0{,}025 = 1{,}6 \times 2{,}338 = 3{,}74\%\) (37 405 lei); 10 zile: \(\sqrt{10} \times 3{,}72 = 11{,}77\%\)
                                                2. \(k = \lceil 2{,}5 \rceil = 3\): VaR 1% \(= 3{,}9\%\); \(k = \lceil 6{,}25 \rceil = 7\): ES 2,5% \(= 26{,}1/7 = 3{,}73\%\)
                                                3. \(\ell_0 = 244\ln 0{,}99 + 6\ln 0{,}01 = -30{,}08\), \(\ell_1 = 244\ln 0{,}976 + 6\ln 0{,}024 = -28{,}31\); \(LR_{uc} = 3{,}56 < 3{,}84\) (\(p = 0{,}059\)): nu se respinge; zona galbenă (5–9 depășiri)
                                                • Interpretare
                                                  • Pentru distribuția Normală, ES 2,5% și VaR 1% sînt aproape egale; coada istorică este mai groasă
                                                  • Testul Kupiec nu respinge 6 depășiri, dar semaforul Basel cere deja un multiplicator de capital mai mare

                                                Problema 7: memorie lungă și scalarea riscului

                                                Slide 66 în PDF

                                                Statistica R/S medie a unor randamente zilnice este 4,1 pentru blocuri de \(n = 20\) de zile și 60,0 pentru blocuri de \(n = 2\,000\) de zile. VaR 1% pe o zi este 2,5%.

                                                Prima cerință estimează exponentul Hurst din panta lui \(\log(R/S)\) în funcție de \(\log n\) și parametrul fracționar \(d\). A doua scalează VaR la 10 zile în două moduri, cu \(h^H\) și cu \(\sqrt{h}\), și compară rezultatele. A treia cere verificările necesare înainte de a concluziona că seria are memorie lungă.

                                                Pe scurt

                                                • Context
                                                  • Statistica R/S medie a randamentelor zilnice este \(4{,}1\) pentru blocuri de \(n = 20\) de zile și \(60{,}0\) pentru \(n = 2000\)
                                                  • VaR 1% pe o zi \(= 2{,}5\%\)
                                                • Cerințe
                                                  1. Estimați \(H\) din panta lui \(\log(R/S)\) în funcție de \(\log n\), precum și parametrul fracționar \(d\).
                                                  2. Scalați VaR la 10 zile cu \(h^H\) și cu \(\sqrt{h}\), apoi comparați.
                                                  3. Precizați ce trebuie verificat înainte de a concluziona că există memorie lungă.

                                                Problema 7: rezolvare

                                                Slide 67 în PDF

                                                Cu două puncte, panta este

                                                \[H = \frac{\log_{10}(60{,}0/4{,}1)}{\log_{10}(2\,000/20)} = \frac{1{,}165}{2} = 0{,}583,\]

                                                iar parametrul fracționar este \(d = H - 0{,}5 = 0{,}083\).

                                                Scalat cu \(h^H\), VaR pe 10 zile este \(10^{0{,}583} \cdot 2{,}5 = 3{,}83 \cdot 2{,}5 = 9{,}56\%\); cu regula rădăcinii pătrate, \(\sqrt{10} \cdot 2{,}5 = 3{,}16 \cdot 2{,}5 = 7{,}91\%\). Dacă \(H > 0{,}5\), regula rădăcinii pătrate a timpului subestimează riscul pe mai multe zile, pentru că randamentele persistente se adună mai repede decît cele independente.

                                                Înainte de a accepta concluzia, \(\hat H\) trebuie comparat cu o bandă Monte Carlo construită pe date i.i.d. de aceeași lungime, deoarece statistica R/S este deplasată în sus. Rezultatul se verifică apoi cu testul Lo, pe subeșantioane și pe date permutate, care elimină memoria, dar păstrează distribuția; astfel se exclud rupturile structurale și efectele GARCH. Pe datele cursului, memoria lungă se află în \(|r_t|\), nu în \(r_t\) (Capitolul 11).

                                                Pe scurt

                                                1. \(H = \log_{10}(60{,}0/4{,}1)/\log_{10}(2000/20) = \log_{10}(14{,}63)/2 = 1{,}165/2 = 0{,}583\); \(d = H - 0{,}5 = 0{,}083\)
                                                2. \(10^{H} = 3{,}83\): VaR \(= 9{,}56\%\); \(\sqrt{10} = 3{,}16\): VaR \(= 7{,}91\%\)
                                                3. o bandă Monte Carlo pentru \(\hat H\) pe date i.i.d. de aceeași lungime (R/S este deplasat în sus), testul Lo, subeșantioane și date permutate (rupturi, GARCH)
                                                • Interpretare
                                                  • Cu \(H > 0{,}5\), regula rădăcinii pătrate a timpului subestimează riscul pe mai multe zile
                                                  • Pe datele cursului, memoria lungă se află în \(|r_t|\), nu în \(r_t\) (Capitolul 11)

                                                Problema 8: scoring de credit și risc sistemic

                                                Slide 68 în PDF

                                                Prima parte a problemei privește un eșantion de test de 300 de credite, dintre care 90 neperformante. La pragul ales, modelul marchează ca neperformante 60 dintre creditele neperformante și 42 dintre cele performante. Se cer acuratețea, rata adevărat pozitivelor (TPR, true positive rate), rata fals pozitivelor (FPR, false positive rate) și precizia, comparate cu regula „mereu bun”; apoi coeficientul Gini pentru AUC = 0,80 și pierderea așteptată pentru PD = 4%, LGD = 45% și EAD = 200 000 de lei.

                                                A doua parte privește riscul sistemic. Regresia cuantilică la 1% a randamentului sistemului pe randamentul unei bănci are constanta \(\hat a = -2{,}1\) și panta \(\hat b = 0{,}6\), iar cuantila de 1% a randamentului băncii este −5,0%, cu mediana 0,1%. Se cer CoVaR 1% al sistemului cînd banca este la VaR-ul ei și cînd este la mediană, precum și ΔCoVaR.

                                                Pe scurt

                                                • Context
                                                  • Un eșantion de test de 300 de credite, dintre care 90 neperformante; la pragul ales sînt marcate ca neperformante 60 dintre creditele neperformante și 42 dintre cele performante
                                                  • Regresia cuantilică la 1% a randamentului sistemului în funcție de randamentul unei bănci: \(\hat a = -2{,}1\), \(\hat b = 0{,}6\); banca: \(q_{0,01} = -5{,}0\%\), mediana \(0{,}1\%\)
                                                • Cerințe
                                                  1. Calculați acuratețea, rata adevărat pozitivelor (TPR), rata fals pozitivelor (FPR) și precizia, apoi comparați acuratețea cu regula „mereu bun”.
                                                  2. Calculați coeficientul Gini pentru AUC \(= 0{,}80\) și pierderea așteptată pentru PD \(= 4\%\), LGD \(= 45\%\), EAD \(= 200\,000\) de lei.
                                                  3. Calculați CoVaR 1% al sistemului cînd banca este la VaR-ul ei și la mediană, precum și \(\Delta\)CoVaR.

                                                Problema 8: rezolvare

                                                Slide 69 în PDF

                                                Creditele performante corect clasificate sînt \(210 - 42 = 168\), deci acuratețea este \((60 + 168)/300 = 76{,}0\%\). TPR este \(60/90 = 66{,}7\%\), FPR este \(42/210 = 20{,}0\%\), iar precizia, proporția creditelor neperformante printre cele marcate astfel, este \(60/102 = 58{,}8\%\). Regula „mereu bun” are acuratețea \(210/300 = 70{,}0\%\). Modelul este doar puțin mai precis decît regula naivă, dar găsește două treimi dintre creditele neperformante; de aceea el se judecă după AUC și după costurile erorilor, nu după acuratețe.

                                                Coeficientul Gini este \(2 \cdot 0{,}80 - 1 = 0{,}60\), iar pierderea așteptată este \(\mathrm{EL} = 0{,}04 \cdot 0{,}45 \cdot 200\,000 = 3\,600\) de lei.

                                                Cînd banca este la VaR-ul ei, CoVaR 1% al sistemului este \(-(-2{,}1 + 0{,}6 \cdot (-5{,}0)) = 5{,}10\%\); cînd banca este la mediană, este \(-(-2{,}1 + 0{,}6 \cdot 0{,}1) = 2{,}04\%\). Diferența, \(\Delta\mathrm{CoVaR} = 0{,}6 \cdot (0{,}1 - (-5{,}0)) = 3{,}06\) puncte procentuale, arată cu cît crește VaR-ul sistemului atunci cînd banca trece de la starea normală la dificultăți.

                                                Pe scurt

                                                1. acuratețea \((60 + 168)/300 = 76{,}0\%\); TPR \(= 60/90 = 66{,}7\%\); FPR \(= 42/210 = 20{,}0\%\); precizia \(60/102 = 58{,}8\%\); „mereu bun”: 70,0%
                                                2. Gini \(= 2 \times 0{,}80 - 1 = 0{,}60\); EL \(= 0{,}04 \times 0{,}45 \times 200\,000 = 3\,600\) de lei
                                                3. CoVaR \(= -(-2{,}1 + 0{,}6 \times (-5{,}0)) = 5{,}10\%\); la mediană: \(-(-2{,}1 + 0{,}6 \times 0{,}1) = 2{,}04\%\); \(\Delta\)CoVaR \(= 0{,}6 \times 5{,}1 = 3{,}06\) pp
                                                • Interpretare
                                                  • Modelul este doar puțin mai precis decît regula „mereu bun”, dar găsește două treimi dintre creditele neperformante: îl judecăm după AUC și costuri
                                                  • Dificultățile acestei bănci cresc VaR-ul sistemului cu 3,06 puncte procentuale

                                                Sinteza secțiunii

                                                Cele opt probleme acoperă toate tipurile de calcul ale cursului: randamente și drawdown, momente și cozi, portofolii și simulare, teste de eficiență, prognoze de volatilitate, VaR și backtesting, memorie lungă, scoring și risc sistemic. Fiecare rezolvare are aceeași structură: formula cu cifrele înlocuite, rezultatul cu unitatea și semnul lui, decizia testului și o interpretare statistică și economică.

                                                Proiectul de echipă

                                                Proiectul de echipă aplică metodele cursului pe o întrebare aleasă de echipă. Secțiunea descrie conținutul și livrabilele, criteriile de evaluare, susținerea orală și fișierul în care se declară folosirea instrumentelor AI.

                                                Proiectul de echipă: conținut și livrabile

                                                Slide 70 în PDF

                                                Proiectul reprezintă 20% din nota finală și este o analiză, făcută în echipă, a unor date reale de piață cu metodele cursului. El are o singură întrebare de cercetare, iar răspunsul folosește instrumentele cursului: randamente și indicatori, distribuții și cozi, teste de eficiență, volatilitate și măsuri de risc. Ideile de pornire se găsesc pe slide-ul „Idee de proiect” de la finalul fiecărui capitol și în Partea C a fiecărui seminar.

                                                Livrabilele sînt trei. Primul este un repository GitHub al cărui cod reproduce, din datele salvate, fiecare rezultat numeric și fiecare grafic. Al doilea este un raport scurt, însoțit de o prezentare a rezultatelor. Al treilea este fișierul AI_USE.md, în care este declarată fiecare utilizare a instrumentelor AI.

                                                Cerința de reproductibilitate are un motiv statistic. O cifră care nu poate fi recalculată din date nu poate fi verificată, iar o analiză care nu poate fi verificată nu poate fi crezută, indiferent cît de convingătoare pare.

                                                Pe scurt

                                                • 20% din nota finală: o analiză în echipă a unor date reale de piață, cu metodele cursului
                                                  • o singură întrebare de cercetare; randamente și indicatori, distribuții și cozi, teste de eficiență, volatilitate și măsuri de risc
                                                  • idei: slide-ul „Idee de proiect” de la finalul fiecărui capitol și Partea C a fiecărui seminar
                                                • Livrabile
                                                  • un repository GitHub al cărui cod reproduce, din datele salvate, fiecare rezultat numeric și fiecare grafic
                                                  • un raport scurt și o prezentare a rezultatelor
                                                  • fișierul AI_USE.md, în care este declarată fiecare utilizare a instrumentelor AI

                                                Criterii de evaluare a proiectului

                                                Slide 71 în PDF

                                                Primul criteriu este întrebarea: ea trebuie să fie clară, să poată primi un răspuns pe baza datelor și să fie relevantă pentru investitori sau pentru autorități. „Este BET azi mai puțin volatil decît în 2008?” este o întrebare, pentru că indică o mărime de comparat; „o analiză a BET” nu este, pentru că nu spune ce rezultat ar răspunde la ea.

                                                Al doilea criteriu sînt metodele și verificările. Testul trebuie să fie cel potrivit întrebării, așa cum îl indică sinteza metodelor, cu erori standard robuste și cu evaluare în afara eșantionului acolo unde există o prognoză. Robustețea se verifică schimbînd fereastra, seria sau estimatorul: un rezultat care dispare la o mică schimbare a alegerilor nu este un rezultat solid.

                                                Al treilea criteriu este interpretarea: ce înseamnă cifrele și ce nu pot arăta datele. Al patrulea este reproductibilitatea: repository-ul trebuie să ruleze de la datele salvate pînă la fiecare grafic.

                                                Pe scurt

                                                • Întrebarea: clară, cu răspuns posibil pe baza datelor, relevantă pentru investitori sau pentru autorități
                                                  • „Este BET azi mai puțin volatil decît în 2008?” este o întrebare; „o analiză a BET” nu este
                                                • Metodele și verificările
                                                  • testul potrivit pentru întrebare (sinteza metodelor); erori standard robuste; evaluare în afara eșantionului
                                                  • robustețe: altă fereastră, altă serie, alt estimator
                                                • Interpretarea: ce înseamnă cifrele și ce nu pot arăta datele
                                                  • Reproductibilitatea: repository-ul rulează de la datele salvate pînă la fiecare grafic

                                                Susținerea orală

                                                Slide 72 în PDF

                                                La susținere, fiecare membru al echipei explică codul și rezultatele. Întrebările tipice sînt ce calculează o anumită linie de cod, de unde provine o anumită cifră și de ce a fost ales un test și nu altul. O a doua categorie de întrebări privește sensibilitatea: ce se schimbă dacă se modifică fereastra, seria sau nivelul \(\alpha\).

                                                Regula de bază este că o linie de cod pe care autorul ei nu o poate explica nu este considerată muncă proprie. Regula se aplică la fel codului scris cu sau fără ajutorul unui asistent AI.

                                                Pregătirea constă în rularea din nou a repository-ului de la zero cu o zi înainte, pentru a verifica faptul că rezultatele se reproduc, și în cunoașterea definiției fiecărei cifre de pe slide-urile prezentării.

                                                Pe scurt

                                                • Fiecare membru explică codul și rezultatele
                                                  • întrebări tipice: ce calculează această linie? de unde provine această cifră? de ce acest test și nu altul?
                                                  • ce se schimbă dacă se modifică fereastra, seria sau nivelul \(\alpha\)?
                                                • O linie de cod pe care nu o puteți explica nu este considerată muncă proprie
                                                  • regula este aceeași pentru codul scris cu sau fără AI
                                                • Pregătirea
                                                  • rulați din nou repository-ul de la zero cu o zi înainte; cunoașteți definiția fiecărei cifre de pe slide-urile voastre

                                                Fișierul AI_USE.md

                                                Slide 73 în PDF

                                                Instrumentele AI sînt permise, cu condiția să fie declarate. Pentru fiecare utilizare, fișierul AI_USE.md consemnează instrumentul, promptul, ce s-a păstrat din răspuns și ce s-a corectat. El conține și erorile instrumentului AI descoperite de echipă, împreună cu modul în care au fost descoperite.

                                                Echipa răspunde pentru fiecare cifră și pentru fiecare referință. Fiecare cifră trebuie recalculată cu propriul cod, din datele cursului, iar pentru fiecare referință trebuie deschis DOI-ul (digital object identifier) și verificat titlul lucrării.

                                                Slide-ul enumeră erorile AI tipice pentru acest curs: „VaR 99%” raportat cu semn negativ, Bitcoin anualizat cu 252 de zile, referințe bibliografice inventate și un test aplicat cu distribuția greșită. Fiecare dintre ele încalcă una dintre convențiile cursului și poate fi găsită printr-o verificare simplă.

                                                Pe scurt

                                                • Instrumentele AI sînt permise și trebuie declarate
                                                  • pentru fiecare utilizare: instrumentul, promptul, ce s-a păstrat și ce s-a corectat
                                                  • erorile instrumentului AI pe care le-ați găsit și modul în care le-ați găsit
                                                • Răspundeți pentru fiecare cifră și pentru fiecare referință
                                                  • fiecare cifră: recalculată cu propriul cod, din datele cursului
                                                  • fiecare referință: DOI-ul deschis și titlul verificat
                                                • Erori AI tipice în acest curs
                                                  • „VaR 99%” cu semn negativ, Bitcoin anualizat cu 252 de zile, referințe inventate, un test cu distribuția greșită

                                                Sinteza secțiunii

                                                Proiectul de echipă răspunde la o singură întrebare clară, cu metodele potrivite și cu verificări de robustețe, într-un repository care reproduce fiecare rezultat. La susținere, fiecare membru explică codul și cifrele, iar orice utilizare a AI este declarată și verificată.

                                                Instrumente AI pentru un proiect de cercetare

                                                Fiecare capitol al cursului s-a încheiat cu o întrebare deschisă, la care metodele capitolului pot contribui. Întrebarea acestui capitol reunește mai multe instrumente: s-a schimbat comportamentul statistic al pieței din România de-a lungul timpului? Secțiunea descrie etapele unui proiect de cercetare, ce poate face un asistent AI, ce trebuie verificat și o idee de proiect.

                                                O întrebare de cercetare deschisă despre BET

                                                Slide 74 în PDF

                                                Întrebarea este dacă BET a devenit o piață „obișnuită”, cu proprietățile statistice ale piețelor dezvoltate. Pe toată perioada din 1997, raportul varianțelor VR(5) este 1,28, un momentum semnificativ, iar tail index-ul pierderilor este 2,57. Pe fereastra din 2015, VR(5) a scăzut la 1,17, cu \(Z^* = 1{,}93\), sub pragul de semnificație, dar tail index-ul este 2,19, deci cozile sînt chiar mai groase.

                                                Întrebarea rămîne deschisă din mai multe motive. Momentum-ul slăbește, dar cozile nu devin mai subțiri, așa că cele două dimensiuni ale „normalizării” nu merg împreună. O singură zi extremă, scăderea de −11,9% din 19 decembrie 2018, modifică vizibil estimarea cozii pe o fereastră scurtă. Iar crizele sînt puține și eșantioanele scurte, deci orice comparație între perioade are o incertitudine mare.

                                                Există și un motiv mai general. Menkveld et al. (2024) au dat aceleași date și aceeași întrebare mai multor echipe de cercetători și au găsit că rezultatele diferă mult de la o echipă la alta; variația provine din alegerile de metodă, nu din date, și au numit-o eroare nestandard (non-standard error). Pentru întrebarea despre BET, alegerea ferestrei, a lui \(k\) sau a estimatorului poate schimba răspunsul.

                                                Pe scurt

                                                • A devenit BET o piață „obișnuită”?
                                                  • din 1997: VR(5) \(= 1{,}28\) (momentum) și tail index-ul 2,57
                                                  • din 2015: VR(5) \(= 1{,}17\), \(Z^* = 1{,}93\), tail index-ul 2,19
                                                • Motivele pentru care întrebarea rămîne deschisă
                                                  • momentum-ul slăbește, dar cozile nu devin mai subțiri
                                                  • o singură zi extremă (\(-11{,}9\%\) la 19 decembrie 2018) modifică estimarea cozii; puține crize, eșantioane scurte
                                                • Echipe diferite, cu aceleași date, ajung la răspunsuri diferite: erorile nestandard Menkveld et al. (2024)
                                                O întrebare de cercetare deschisă despre BET Benoit Mandelbrot, care a arătat în 1963 că variațiile prețurilor au cozi groase Foto: Rama (2007); CC BY-SA 2.0 fr; Wikimedia Commons

                                                Etapele unui proiect de cercetare

                                                Slide 75 în PDF

                                                Proiectul are șase etape. Întrebarea se formulează într-o frază, împreună cu cifra care i-ar răspunde. Datele, adică seria, sursa, calendarul și fereastra, se fixează înainte de a vedea rezultatele, astfel încît alegerile să nu fie influențate de ele. Metoda este testul potrivit din trusa de instrumente, cu ipoteza nulă precizată.

                                                Urmează verificările: erori standard robuste, benzi Monte Carlo, subeșantioane și un al doilea estimator. Interpretarea dă răspunsul, incertitudinea lui și limitele lui. Ultimul pas este replicarea: o a doua persoană rulează codul și obține aceleași cifre.

                                                Un asistent AI poate accelera fiecare pas, dar nu înlocuiește niciuna dintre verificări. Wang et al. (2023) descriu cum poate contribui inteligența artificială la descoperirea științifică, de la generarea ipotezelor la analiza datelor; în fiecare etapă, rezultatul are nevoie de validare independentă.

                                                Pe scurt

                                                1. Întrebarea: o frază, cu o cifră care i-ar răspunde
                                                2. Datele: seria, sursa, calendarul, fereastra, fixate înainte de a vedea rezultatele
                                                3. Metoda: testul ales din sinteza metodelor, cu ipoteza nulă
                                                4. Verificările: SE robuste, bandă Monte Carlo, subeșantioane, alt estimator
                                                5. Interpretarea: răspunsul, incertitudinea lui, limitele lui
                                                6. Replicarea: o a doua persoană rulează codul și obține aceleași cifre

                                                Utilizări posibile ale instrumentelor AI

                                                Slide 76 în PDF

                                                Un asistent AI poate ajuta în patru locuri. Pentru literatură, el poate propune o primă listă de studii despre eficiența și cozile piețelor emergente, fiecare verificat apoi prin DOI. Pentru cod, poate scrie o primă versiune a estimărilor VR(5), Hill și GARCH pe ferestre mobile de 500 de zile.

                                                Pentru robustețe, poate construi o grilă de alegeri, cu fereastra, \(k\), nivelul \(\alpha\) și seria, și un singur tabel cu toate rezultatele, ceea ce face vizibilă eroarea nestandard a propriei analize. Pentru redactare, poate face un paragraf mai clar, dar numai după ce cifrele sînt finale.

                                                Promptul de pe slide cere cod Python care calculează pe ferestre mobile de 500 de zile de tranzacționare, deplasate cu 21 de zile, statistica robustă \(Z^*(5)\) a lui Lo și MacKinlay, tail index-ul Hill al pierderilor cu \(k\) egal cu 2,5% din fereastră și persistența GARCH(1,1)-\(t\) pentru randamentele logaritmice zilnice ale BET, apoi desenează cele trei serii cu benzile lor de 95%. Promptul precizează fiecare alegere metodologică, astfel încît rezultatul să poată fi verificat.

                                                Pe scurt

                                                • Literatura: o primă listă de studii despre eficiența și cozile piețelor emergente, fiecare verificat prin DOI
                                                • Codul: o primă versiune a estimărilor VR(5), Hill și GARCH pe ferestre mobile de 500 de zile
                                                • Robustețea: o grilă de alegeri (fereastra, \(k\), nivelul \(\alpha\), seria) și un singur tabel cu toate rezultatele
                                                • Redactarea: un paragraf mai clar, după ce cifrele sînt finale
                                                • Exemplu de prompt
                                                  • Write Python code that computes, on rolling windows of 500 trading days moved by 21 days, the Lo-MacKinlay robust variance-ratio statistic Z*(5), the Hill tail index of the losses with k = 2.5% of the window, and the GARCH(1,1)-t persistence for the daily log returns of the BET, and plots the three series with their 95% bands.

                                                Verificări necesare

                                                Slide 77 în PDF

                                                Prima verificare privește formulele: statistica raportului varianțelor trebuie să fie \(Z^*(q)\) robustă, nu \(Z(q)\), iar estimatorul Hill trebuie aplicat pierderilor \(L = -r\), cu \(k\) dat ca proporție din fereastră, astfel încît ferestrele să fie comparabile. A doua privește look-ahead bias: fiecare fereastră trebuie să folosească doar datele pînă în ultima ei zi.

                                                A treia privește benzile. Ferestrele mobile se suprapun, deci estimările succesive nu sînt dovezi independente; iar la un nivel de 5%, un rezultat din douăzeci iese semnificativ din întîmplare, așa că o singură fereastră în afara benzii nu dovedește o schimbare.

                                                Ultimele două verificări privesc cifrele și referințele. O fereastră se recalculează pas cu pas și se compară cu rezultatul codului. Fiecare lucrare citată trebuie să existe: se deschide DOI-ul și se verifică titlul.

                                                Pe scurt

                                                • Formulele: \(Z^*(q)\) robust, nu \(Z(q)\); estimatorul Hill pe pierderi \(L = -r\), cu \(k\) dat ca proporție din fereastră
                                                • Look-ahead: fiecare fereastră folosește doar datele pînă în ultima ei zi
                                                • Benzile: ferestrele suprapuse nu sînt dovezi independente; un rezultat din douăzeci este semnificativ din întîmplare
                                                • Cifrele: recalculați pas cu pas o fereastră și comparați
                                                • Referințele: fiecare lucrare citată trebuie să existe; deschideți DOI-ul și verificați titlul

                                                Idee de proiect

                                                Slide 78 în PDF

                                                Întrebarea proiectului este dacă BET a devenit mai eficient, mai puțin volatil și cu cozi mai subțiri între 2000 și 2026. Datele sînt seria BET din 1997, cu S&P 500 și DAX (Deutscher Aktienindex) ca repere, de la furnizorul EODHD (EOD Historical Data).

                                                Pașii folosesc patru capitole: raportul varianțelor robust (Capitolul 7), tail index-ul Hill (Capitolul 5), persistența GARCH (Capitolul 9) și exponentul Hurst (Capitolul 11), toate pe ferestre mobile. Fiecare estimare primește o bandă Monte Carlo sau bootstrap, iar aceeași analiză se face pentru repere. Datele de schimbare candidate, de exemplu 2008 sau 2020, se verifică față de benzi și se fixează înainte de inspecția graficelor, nu după.

                                                Livrabilul este un grafic cu patru panouri, un tabel și un paragraf despre ce pot și ce nu pot arăta datele. Orice utilizare a instrumentelor AI se declară, împreună cu erorile lor corectate.

                                                Pe scurt

                                                • Întrebarea: a devenit BET mai eficient, mai puțin volatil și cu cozi mai subțiri între 2000 și 2026?
                                                  • date: BET din 1997, cu S&P 500 și DAX ca repere (EODHD)
                                                • Pași
                                                  • VR(5) robust, tail index-ul Hill, persistența GARCH și exponentul Hurst pe ferestre mobile (Capitolele 5, 7, 9, 11)
                                                  • benzi Monte Carlo sau bootstrap; aceeași analiză pentru repere
                                                  • datele de schimbare (de exemplu 2008, 2020) verificate față de benzi, nu alese după inspecția graficelor
                                                • Livrabil: un grafic cu patru panouri, un tabel și un paragraf despre ce pot și ce nu pot arăta datele
                                                • Declarați orice utilizare a instrumentelor AI și enumerați erorile acestora pe care le-ați corectat

                                                Sinteza secțiunii

                                                Întrebarea dacă BET a devenit o piață „obișnuită” rămîne deschisă: momentum-ul a slăbit, dar cozile nu s-au subțiat, iar rezultatele depind de alegerile de metodă. Etapele unui proiect de cercetare fixează datele înainte de rezultate, cer verificări de robustețe și replicare, iar un asistent AI poate accelera fiecare pas, fără să înlocuiască vreuna dintre verificări.

                                                Rezumat

                                                Rezumatul strînge ideile principale ale întregului curs și le testează prin trei întrebări de autoevaluare.

                                                Idei de reținut

                                                Slide 79 în PDF

                                                Analiza începe de la randamente, nu de la prețuri: randamente logaritmice în procente, pe calendarul corect al pieței, anualizate cu frecvența reală. Distribuția lor are cozi groase, cu tail index între 2 și 4, asimetrie negativă și varianță finită, așa că distribuția Normală subestimează riscul. Semnul randamentelor este aproape imprevizibil, dar mărimea lor este previzibilă, prin volatility clustering și modele GARCH.

                                                Riscul se măsoară prin VaR 1% \(= -q_{1\%}\) și ES 2,5%, iar orice model de risc este urmat de backtesting. Orice rezultat are nevoie de incertitudinea lui: erori standard, teste robuste, benzi Monte Carlo și verificări în afara eșantionului.

                                                Ultima idee privește felul în care se judecă o analiză. Un calcul este complet atunci cînd are metoda, rezultatul și interpretarea; un proiect este bun atunci cînd pune o întrebare clară și îi dă un răspuns onest, cu limitele lui.

                                                Pe scurt

                                                • Randamente, nu prețuri: randamente logaritmice în %, calendarul corect, anualizare cu frecvența reală
                                                • Randamentele au cozi groase (tail index între 2 și 4), asimetrie negativă și varianță finită: distribuția Normală subestimează riscul
                                                • Semnul randamentelor este aproape imprevizibil; mărimea lor este previzibilă (volatility clustering, GARCH)
                                                • Riscul: VaR 1% \(= -q_{1\%}\) și ES 2,5%, urmate întotdeauna de backtesting
                                                • Orice rezultat are nevoie de incertitudinea lui: SE, teste robuste, benzi Monte Carlo, verificări în afara eșantionului
                                                • Examenul răsplătește metoda, rezultatul și interpretarea; proiectul răsplătește o întrebare clară, cu un răspuns onest

                                                Autoevaluare

                                                Slide 80 în PDF

                                                Prima întrebare: testul Ljung–Box nu respinge pe \(r_t\), dar respinge puternic pe \(r_t^2\). Ce înseamnă acest lucru? Randamentele sînt necorelate, dar nu independente: varianța lor are structură în timp (volatility clustering), deci varianța trebuie modelată, de exemplu cu GARCH.

                                                A doua întrebare: o lege stabilă estimată dă \(\hat\alpha = 1{,}5\), iar estimarea Hill este \(\hat\alpha = 3\). Care are dreptate în privința varianței? Estimarea Hill, care privește doar coada: varianța este finită. Legea stabilă descrie corpul distribuției, iar \(\alpha\) ei este influențat de forma centrului.

                                                A treia întrebare: un model are 1% depășiri ale VaR 1%, toate în martie 2020. Este un model VaR bun? Nu. Rata este corectă, dar depășirile sînt grupate, exact în perioada în care riscul a contat cel mai mult, iar testul Christoffersen respinge modelul.

                                                Pe scurt

                                                • Întrebare: Ljung–Box nu respinge pe \(r_t\), dar respinge puternic pe \(r_t^2\). Ce înseamnă acest lucru?
                                                  • Răspuns: randamentele sînt necorelate, dar nu independente: volatility clustering; modelăm varianța (GARCH)
                                                • Întrebare: o lege stabilă estimată dă \(\hat\alpha = 1{,}5\), iar estimarea Hill este \(\hat\alpha = 3\). Care are dreptate în privința varianței?
                                                  • Răspuns: estimarea Hill, care privește doar coada: varianța este finită; legea stabilă descrie corpul distribuției
                                                • Întrebare: un model are 1% depășiri, toate în martie 2020. Este un model VaR bun?
                                                  • Răspuns: nu: rata este corectă, dar depășirile sînt grupate; testul Christoffersen îl respinge

                                                Sinteza secțiunii

                                                Cursul se reduce la un lanț: date curate, randamente logaritmice, distribuții cu cozi groase, volatilitate previzibilă, VaR 1% și ES 2,5% verificate prin backtesting. Fiecare verigă are instrumentele ei, iar fiecare rezultat se raportează cu incertitudinea și cu interpretarea lui.

                                                Datele cursului din data/market (pînă la 18 septembrie 2026): închiderile zilnice ale S&P 500 și BET din ianuarie 2000 și ale Bitcoin din septembrie 2014. Browserul taie fereastra și recalculează randamentele, indicatorii de performanță, momentele, indicele Hill, ACF, testele Ljung–Box și VR, VaR și ES, exponentul Hurst, varianța de selecție cumulativă, prognozele VaR 1% și testul Kupiec. Estimațiile GARCH(1,1)-t vin din codul capitolului (Quantlets/Ch_16), estimările α ale legii stabile pe trei orizonturi din Capitolul 3 (Quantlets/Ch_03). Alte ferestre, niveluri α, ferestre ale simulării istorice și valori λ sînt rulări suplimentare ale aceluiași cod. Problemele de recapitulare pornesc de la cifrele de pe slide-uri.

                                                Bibliografie