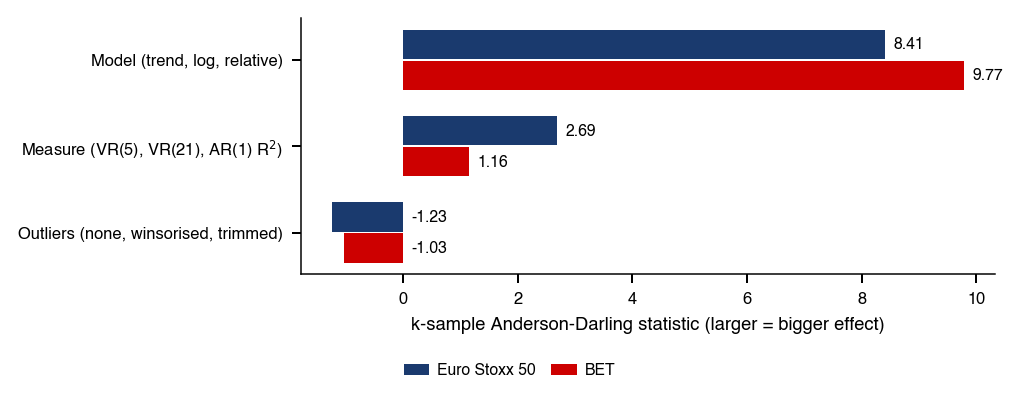Modelarea piețelor financiare

Capitolul 19: Recapitulare și prezentarea proiectelor

Capitolul 19: Recapitulare și prezentarea proiectelor

Daniel Traian PELE

Academia de Studii Economice din București
IDA Institute Digital Assets
Blockchain Research Center
AI4EFin Artificial Intelligence for Energy Finance
Academia Română, Institutul de Prognoză Economică
MSCA Digital Finance

In science, evidence is generated to test hypotheses in an evidence-generating process (EGP). We claim that EGP variation across researchers adds uncertainty—nonstandard errors (NSEs).

— Menkveld et al. (2024), Nonstandard errors

Întrebarea capitolului este cînd merită încredere un rezultat empiric despre piețe și cînd reflectă doar datele, felul în care a fost construită analiza sau norocul. În experimentul lui Menkveld et al. (2024), 164 de echipe de cercetare testează aceleași șase ipoteze pe aceleași date: toate tranzacțiile cu contractele futures pe indicele Euro Stoxx 50 din 2002–2018, 720 de milioane de înregistrări. Pentru eficiența pieței, estimarea mediană este −1,1% pe an, iar intervalul intercuartilic (IQR, interquartile range) al estimărilor dintre echipe este 6,7 puncte procentuale (pp). Eroarea standard (SE, standard error) mediană de 2,5% implică, sub distribuția Normală, un IQR de 3,4%, jumătate din 6,7 pp: dispersia dintre echipe este de două ori mai mare decît cea pe care ar produce-o doar eșantionarea.

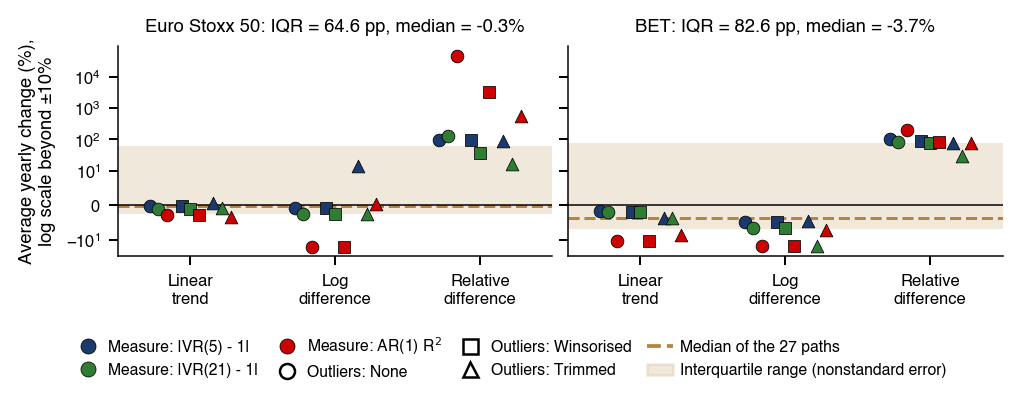
Același fenomen apare pe datele cursului. Un mini-multivers combină trei decizii, tratarea valorilor extreme, măsura ineficienței și modelul, în 27 de specificații pe indice, aplicate închiderilor zilnice din 2002–2018. IQR-ul tendinței anuale estimate este 64,6 pp pentru Euro Stoxx 50 și 82,6 pp pentru BET, indicele Bursei de Valori București, peste reperul datorat doar eșantionării, de 41,3 pp și, respectiv, 43,4 pp. Alegerea modelului determină dispersia: pentru cele nouă specificații cu tendință liniară, IQR-ul este de doar 2,6 pp și, respectiv, 6,7 pp.

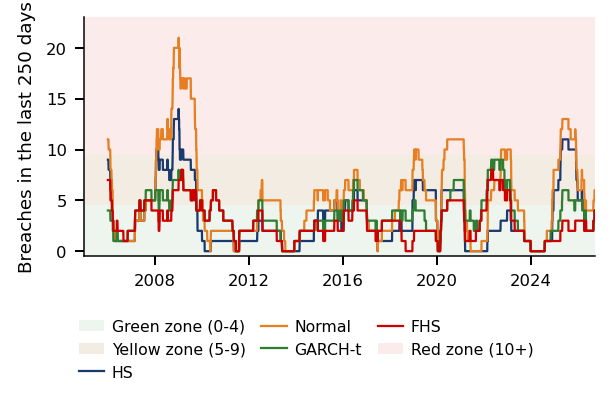
Prima parte a capitolului recapitulează capitolele 0–18 prin șase capcane și printr-un studiu de caz integrat, de la prețurile brute ale BET la un Value-at-Risk (VaR) de 1% validat prin backtesting. În cele 5 432 de zile de evaluare, modelul Normal este depășit în 2,25% din zile, de peste două ori mai des decît ar trebui, iar doar simularea istorică filtrată (FHS, filtered historical simulation), cu 1,23%, se află în intervalul binomial de 95%, [0,74%; 1,27%]. A doua parte pregătește proiectul de echipă: replicarea, preînregistrarea, grila de specificații și utilizarea declarată a AI (Artificial Intelligence, inteligență artificială).

Mini-multiversul pe datele cursului: tendința anuală estimată a ineficienței pentru Euro Stoxx 50 și BET în cele 27 de specificații pe indice; banda este IQR-ul, eroarea nestandard a multiversului.
Mini-multiversul pe datele cursului: tendința anuală estimată a ineficienței pentru Euro Stoxx 50 și BET în cele 27 de specificații pe indice; banda este IQR-ul, eroarea nestandard a multiversului. Graficul interactiv: „Mini-multivers pe datele cursului: 27 de specificații pe indice” →

Rezultatele învățării

  • Calculați, de la date, o prognoză de risc validată prin backtesting, cu inferență corectă.
  • Interpretați un rezultat empiric după ce verificați cele șase capcane în propriul cod.
  • Calculați puterea testului principal într-un plan de proiect cu replicare, identificare și grilă de specificații.

Aprofundările și Anexa sînt lectură pentru familiarizare.

Planul capitolului

  1. Criteriile unei concluzii empiriceÎntrebarea capitolului și structura lui.
  2. Structura cursuluiEtapele analizei și cinci întrebări pentru orice model.
  3. Recapitularea capitolelor 0–18Rezultatul central al fiecărui capitol.
  4. Erori metodologice frecventeLook-ahead bias, testarea multiplă, alinierea datelor, cozile groase, persistența și funcția de pierdere.
  5. Studiu de caz integrat: BETDe la prețurile brute la VaR 1% validat prin backtesting, în cinci pași.
  6. Studii de caz integrate: portofoliu, Bitcoin, investitor românAceeași procedură pe trei întrebări noi.
  7. Proiectul de echipăCei patru pași, standardul de replicare, criteriile de evaluare și livrabilele.
  8. Utilizarea AI în proiectPolitica AI și cele două fișiere obligatorii.
  9. Studiu de caz: erorile nestandardExperimentul #fincap și un mini-multivers pe datele cursului.
  10. AI pentru descoperire științificăO întrebare deschisă și bucla descoperirii.
  11. ConcluziiIdeile de reținut.
  12. AprofundăriExemple detaliate și subiecte avansate.
  13. AnexăGhidul proiectului, derivări și tabelele complete.

Criteriile unei concluzii empirice

Ultimul capitol obișnuit trece de la metode noi la întrebarea pe care fiecare capitol anterior a ridicat-o în treacăt: cînd este un rezultat empiric despre piețe o concluzie și cînd este un artefact al datelor, al designului sau al întîmplării. Capitolul recapitulează capitolele 0–18 prin această întrebare, izolează șase capcane care revin în ele și parcurge un studiu de caz integrat, înainte ca partea a doua să pregătească proiectul de echipă.

Ce face dintr-un rezultat o concluzie? (1/2)

Slide 2 în PDF

O estimație devine o concluzie doar dacă rezistă întrebărilor care ar putea-o explica altfel: dacă reflectă setul anume de date, o alegere de design făcută după ce datele au fost văzute sau norocul printre multe încercări. Capitolul tratează această întrebare ca subiect propriu, nu ca notă de subsol la o metodă.

Partea I prezintă cursul într-o singură imagine, recapitulează capitolele 0–18 și izolează șase capcane, apoi urmează un studiu de caz integrat de la prețurile brute ale BET, indicele de referință al Bursei de Valori București (BVB), pînă la o valoare la risc (VaR, value-at-risk) de 1% verificată prin backtesting. Firul principal este cel construit în capitolele despre volatilitate și risc: GARCH (generalised autoregressive conditional heteroskedasticity) prognozează volatilitatea, DCC (dynamic conditional correlation) corelațiile, iar VaR și ES (expected shortfall, pierderea medie dincolo de VaR) le transformă într-o pierdere. Partea a II-a tratează proiectul de echipă, folosirea inteligenței artificiale (AI, artificial intelligence) în proiect, un studiu de caz de cercetare despre erorile nestandard și bucla descoperirii cu AI; proiectul este descris pas cu pas în Anexă.

Pe scurt

Capitolul pe scurt
  • Întrebarea: cînd merită încredere un rezultat empiric despre piețe?
    • și cînd reflectă doar datele, felul în care a fost construită analiza sau norocul?
  • Partea I: cursul într-o singură imagine, recapitularea capitolelor 0–18
    • șapte capcane
    • un studiu de caz integrat, de la prețurile brute ale BET la un Value-at-Risk (VaR) de 1% validat prin backtesting
    • BET: indicele de referință al Bursei de Valori București (BVB)
  • Firul principal: GARCH prognozează volatilitatea, DCC corelațiile, iar VaR și ES le transformă într-o pierdere
    • GARCH: Generalised AutoRegressive Conditional Heteroskedasticity
    • DCC: Dynamic Conditional Correlation
    • ES: Expected Shortfall, pierderea medie dincolo de VaR
  • Partea a II-a: proiectul de echipă și AI (inteligența artificială) în proiect
    • un studiu de caz despre erorile nestandard
    • bucla de descoperire asistată de AI
    • ghidul proiectului pas cu pas: Anexă

Ce face dintr-un rezultat o concluzie? (2/2)

Slide 3 în PDF

Capitolul are trei obiective:

  1. Calcularea din date a unei prognoze de risc verificate prin backtesting, cu inferență validă.
  2. Interpretarea unui rezultat empiric după verificarea celor șase capcane în propriul cod.
  3. Calcularea puterii testului principal al unui proiect, într-un plan care include replicarea, identificarea și o grilă de specificații.

Aprofundările, aflate după Concluzii, și Anexa conțin exemple detaliate și subiecte avansate și sînt lectură de familiarizare.

Pe scurt

Rezultatele învățării
  • Calculați, de la date, o prognoză de risc validată prin backtesting, cu inferență corectă
  • Interpretați un rezultat empiric după ce verificați cele șapte capcane în propriul cod
  • Calculați puterea testului principal într-un plan de proiect cu replicare, identificare și grilă de specificații
  • Aprofundări și Anexa: lectură pentru familiarizare
  • Exemplele detaliate și subiectele avansate sînt în Aprofundări, după Concluzii
    • butonul din subsol duce la ele, iar butonul Înapoi revine la slide-ul de plecare

Structura cursului

Secțiunea așază cele optsprezece capitole pe o singură hartă și formulează întrebările la care trebuie să răspundă orice model din curs. Harta arată ce capitole se sprijină pe care; întrebările transformă harta într-o listă de verificare pentru proiect.

Structura cursului

Slide 4 în PDF

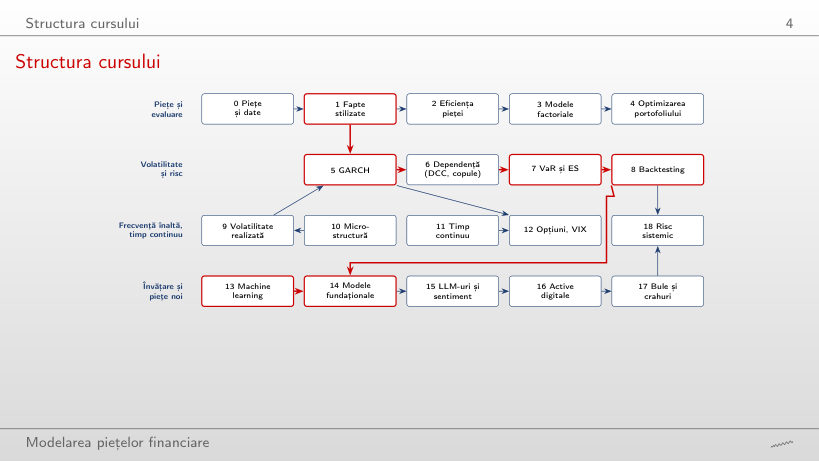
Diagrama așază capitolele pe patru rînduri: piețe și evaluare (capitolele 0–4), volatilitate și risc (5–8), frecvență înaltă și timp continuu (9–12), învățare automată și piețe noi (13–18). Săgețile arată ce capitol alimentează pe care, iar casetele și săgețile roșii marchează firul principal al cursului.

Ce leagă etapele analizei

Slide 5 în PDF

Traseul roșu merge de la faptele stilizate la prognoze de risc care pot fi testate. Capitolul 1 stabilește cozile groase, volatility clustering și aproape nicio predictibilitate liniară a randamentelor. Capitolele 5–8 se sprijină pe aceste fapte: GARCH dă volatilitatea condiționată \(\sigma_{t+1}\), VaR și ES o transformă într-o pierdere, iar backtesting-ul spune dacă prognozei i se poate acorda încredere.

Celelalte rînduri rafinează sau extind firul. Capitolele 9–12 măsoară mai bine volatilitatea, cu date intrazilnice, și o modelează în timp continuu, cu prețuri de opțiuni și VIX, indicele volatilității implicite a S&P 500 (Standard & Poor's). Capitolele 13–15 aduc modele flexibile, inclusiv modelele lingvistice mari (LLM, large language models), judecate cu instrumentele de evaluare din capitolul 8. Capitolele 16–18 aplică același set de instrumente cripto-activelor, bulelor și sistemului financiar în ansamblu, iar capitolul special 20 prognozează volatilitatea realizată cu semnătura traiectoriei (path signature), pe datele VOLARE (VOLatility Archive for Realized Estimates). Alte formule de inferență, pentru corecția Shanken, verosimilitatea cvasi-maximă (QMLE, quasi-maximum likelihood) și cuantila empirică, sînt în Anexă.

Pe scurt

  • Roșu: firul principal, de la faptele stilizate la prognoze de risc verificabile
    • Capitolul 1: cozi groase, gruparea volatilității (volatility clustering), aproape nicio predictibilitate liniară
    • Capitolele 5–8: GARCH dă \(\sigma_{t+1}\), VaR și ES dau pierderea
    • backtesting-ul arată dacă prognoza este fiabilă
  • Capitolele 9–12 măsoară volatilitatea mai precis și o modelează în timp continuu
    • date intraday, prețuri de opțiuni, VIX
    • VIX: indicele volatilității implicite a indicelui Standard & Poor's 500 (S&P 500)
  • Capitolele 13–15 aduc modele flexibile, inclusiv modele lingvistice mari (Large Language Models, LLM)
  • Capitolele 16–18 aplică aceleași instrumente activelor cripto, bulelor și întregului sistem financiar
  • Capitolul special 20: volatilitatea realizată prognozată cu semnătura traiectoriei
    • pe datele VOLARE (VOLatility Archive for Realized Estimates)
  • Formule de inferență suplimentare: covarianța Shanken, cvasi-verosimilitatea maximă (QMLE), cuantila empirică: Anexă

Cinci întrebări pentru orice model

Slide 6 în PDF

Cinci întrebări se aplică fiecărui model din curs:

  1. Pentru date: ce serii, ce calendar și ce ajustări, pentru dividende, divizări și sărbători.
  2. Pentru model: ce fapt stilizat surprinde și pe care îl ignoră.
  3. Pentru estimare: pe ce fereastră și cu ce informație disponibilă la momentul \(t\).
  4. Pentru evaluare: dacă prognoza este judecată out-of-sample, cu o funcție de pierdere potrivită țintei, de exemplu QLIKE (pierderea de cvasi-verosimilitate) pentru o varianță sau FZ0 (scorul Fissler–Ziegel) pentru o pereche (VaR, ES).
  5. Pentru incertitudine: dacă rezultatul are erori standard robuste, un bootstrap și un test față de un reper simplu.

Dacă lipsește un răspuns, rezultatul nu este încă o concluzie.

Pe scurt

Înainte de estimare
  • Date: ce serie, ce calendar, ce ajustări (dividende, split-uri, sărbători)?
  • Model
    • ce fapt stilizat surprinde?
    • ce fapt stilizat ignoră?
  • Estimare: pe ce fereastră, cu ce informație la momentul \(t\)?
După estimare
  • Evaluare: în afara eșantionului (out-of-sample), cu o funcție de pierdere potrivită țintei?
    • QLIKE (pierderea de cvasi-verosimilitate) pentru varianță
    • FZ0 (scorul Fissler–Ziegel) pentru perechea (VaR, ES)
  • Incertitudine: erori standard robuste, bootstrap, test față de un reper simplu?
  • Fără răspuns la fiecare întrebare, rezultatul nu este încă o concluzie

Recapitularea capitolelor 0–18

Fiecare slide al recapitulării dă rezultatul central al unui capitol, împreună cu formula din spatele inferenței și condiția în care aceasta este valabilă. O condiție care revine este un moment de ordinul patru finit al randamentelor, pus la îndoială de capitolul 1; recapitularea o semnalează peste tot unde se aplică.

Capitolul 0: Piețele financiare în 2026

Slide 7 în PDF

Capitolul 0 descrie piețe care combină burse, dealeri pe piața extrabursieră (over-the-counter), fonduri precum fondurile tranzacționate la bursă (ETF, exchange-traded funds), algoritmi și blockchain-uri. Din 2015 pînă în 2026, SPY (SPDR S&P 500 ETF Trust, fondul tranzacționat la bursă pe indicele S&P 500), ETF-ul pe S&P 500 cu dividendele reinvestite, a avut o rată anuală compusă de creștere (CAGR, compound annual growth rate) de 13,7% și o volatilitate anualizată de 17,6%; Bitcoin, în aceeași perioadă, un CAGR de 60,6% și o volatilitate de 66,7%. BET a pierdut 82,5% din iulie 2007 pînă în februarie 2009.

Pentru randamente logaritmice i.i.d., cu \(Y\) lungimea eșantionului în ani, \(T\) numărul de randamente zilnice și \(K\) kurtosis-ul populației, erorile standard ale mediei anualizate și ale volatilității sînt

\[\mathrm{SE}(\hat\mu_{\text{ann}}) = \frac{\sigma_{\text{ann}}}{\sqrt{Y}}, \qquad \mathrm{SE}(\hat\sigma) \approx \sigma\sqrt{\frac{K-1}{4T}}.\]
(19.1)

A doua formulă cere un moment de ordinul patru finit. Pentru SPY, \(\mathrm{SE}(\hat\mu_{\text{ann}}) \approx 5{,}1\%\) la o medie anualizată a randamentului logaritmic de 12,8%: mediile abia pot fi estimate, volatilitățile da.

Pe scurt

  • Piețele combină burse, dealeri extrabursieri, fonduri, algoritmi și blockchain-uri
    • fonduri tranzacționate la bursă (exchange-traded funds, ETF)
  • SPY, 2015–2026: CAGR de 13,7%, volatilitate anualizată de 17,6%
    • SPY: ETF pe S&P 500, cu dividende reinvestite
    • CAGR: Compound Annual Growth Rate, rata anuală compusă de creștere
  • Bitcoin, aceeași perioadă: CAGR de 60,6%, volatilitate anualizată de 66,7%
  • BET, iulie 2007 – februarie 2009: un drawdown de \(-82{,}5\%\)
  • Erorile standard ale mediei și volatilității estimate din randamente log i.i.d.
    • \(Y\): lungimea eșantionului în ani; \(T\): numărul de randamente zilnice; \(K\): kurtosis-ul populației
    \begin{equation*} \mathrm{SE}(\hat\mu_{\text{ann}}) = \frac{\sigma_{\text{ann}}}{\sqrt{Y}}, \qquad \mathrm{SE}(\hat\sigma) \approx \sigma\sqrt{\frac{K - 1}{4T}} \end{equation*}
    • \(\mathrm{SE}(\hat\sigma)\) presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
  • SPY: \(\mathrm{SE}(\hat\mu_{\text{ann}}) \approx 5{,}1\%\) pentru un randament log mediu anualizat de \(12{,}8\%\)
    • mediile abia pot fi estimate, volatilitățile da

Capitolul 1: Fapte stilizate și randamente

Slide 8 în PDF

Capitolul 1 arată că randamentele sînt necorelate, dar nu independente (Cont, 2001): mărimea lor este previzibilă, semnul lor în mare măsură nu. Tail index-ul \(\alpha\) descrie cît de repede scade probabilitatea unei pierderi peste \(x\), ca \(x^{-\alpha}\). Estimatorul Hill (Hill, 1975) folosește cele mai mari \(k\) pierderi, ordonate \(L_{(1)} \ge \dots \ge L_{(k+1)}\):

\[\hat\alpha = \Big[\frac{1}{k}\sum_{i=1}^{k}\ln\frac{L_{(i)}}{L_{(k+1)}}\Big]^{-1}, \qquad \mathrm{SE}(\hat\alpha) \approx \frac{\hat\alpha}{\sqrt{k}} \ \text{pentru pierderi i.i.d.}\]
(19.2)

Pentru BET, cu \(k = 153\), \(\hat\alpha = 2{,}39\), cu un interval de încredere (CI, confidence interval) de 95% prin block bootstrap de [2,12; 3,03]. Intervalul i.i.d. \(\hat\alpha \pm 1{,}96\,\hat\alpha/\sqrt{k} = [2{,}01;\ 2{,}77]\) este mai îngust, pentru că pierderile mari vin grupate. Cu \(\alpha < 4\), momentul de ordinul patru este probabil infinit. Zilele dincolo de \(5\sigma\) sînt de peste 1 000 de ori mai frecvente decît sub distribuția Normală, care dă \(2\Phi(-5) \approx 5{,}7 \times 10^{-7}\) pe zi, adică o astfel de zi la aproximativ 7 000 de ani.

Pe scurt

  • Randamentele sînt necorelate, dar nu independente Cont (2001)
    • mărimea lor este previzibilă, semnul aproape deloc
  • Indicele cozii (tail index) \(\alpha\): probabilitatea unei pierderi peste \(x\) scade ca \(x^{-\alpha}\)
  • Estimatorul Hill folosește cele mai mari \(k\) pierderi, ordonate \(L_{(1)} \ge \dots \ge L_{(k+1)}\) Hill (1975)
    \begin{equation*} \hat\alpha = \Big[\frac{1}{k}\sum_{i=1}^{k}\ln\frac{L_{(i)}}{L_{(k+1)}}\Big]^{-1}, \qquad \mathrm{SE}(\hat\alpha) \approx \frac{\hat\alpha}{\sqrt{k}} \ \text{pentru pierderi i.i.d.} \end{equation*}
  • BET, \(k = 153\): \(\hat\alpha = 2{,}39\), CI 95% prin bootstrap pe blocuri \([2{,}12; 3{,}03]\)
    • CI: Confidence Interval, interval de încredere
  • Intervalul i.i.d., \(\hat\alpha \pm 1{,}96\,\hat\alpha/\sqrt{k} = [2{,}01; 2{,}77]\), este mai îngust
    • pierderile mari vin în grupuri
  • \(\alpha < 4\): momentul de ordinul patru este probabil infinit
  • Zilele dincolo de \(5\sigma\) sînt de peste 1 000 de ori mai frecvente decît sub distribuția Normală
    • distribuția Normală dă \(2\Phi(-5) \approx 5{,}7 \times 10^{-7}\) pe zi
    • adică o asemenea zi la aproximativ 7 000 de ani

Capitolul 2: Eficiența pieței

Slide 9 în PDF

Ipoteza pieței eficiente afirmă că prețurile reflectă integral mulțimea de informații, iar orice test al predictibilității randamentelor anormale este un test comun al eficienței și al modelului randamentului așteptat (Fama, 1970). Raportul varianțelor pe \(q\) perioade și statistica lui robustă la heteroscedasticitate (Lo & MacKinlay, 1988) sînt

\[VR(q) = \frac{\mathrm{Var}(r_t + \dots + r_{t-q+1})}{q\,\mathrm{Var}(r_t)}, \qquad z^*(q) = \frac{\widehat{VR}(q) - 1}{\widehat{\mathrm{SE}}^{\,*}} \Rightarrow N(0,1),\]
(19.3)

iar \(z^*(q)\) cere un moment de ordinul patru finit. Mai multe orizonturi se testează simultan cu \(\max_q |z^*(q)|\) și valorile critice ale lui Chow & Denning (1993).

Ponderea ferestrelor mobile care resping mersul aleator este 6,7% pentru S&P 500, 22,4% pentru BET și 0,0% pentru Bitcoin. O respingere statistică nu este un profit exploatabil.

Pe scurt

  • Ipoteza piețelor eficiente: prețurile reflectă pe deplin informația disponibilă
  • Un test al predictibilității randamentelor anormale este un test comun Fama (1970)
    • al eficienței și al modelului de randament așteptat
  • Raportul varianțelor pe \(q\) perioade și statistica lui robustă la heteroscedasticitate Lo & MacKinlay (1988)
    \begin{equation*} VR(q) = \frac{\Var(r_t + \dots + r_{t-q+1})}{q\,\Var(r_t)}, \qquad z^*(q) = \frac{\widehat{VR}(q) - 1}{\widehat{\mathrm{SE}}^{\,*}} \Rightarrow N(0, 1) \end{equation*}
    • \(z^*(q)\) presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
  • Mai multe orizonturi deodată: \(\max_q |z^*(q)|\), cu valorile critice Chow–Denning Chow & Denning (1993)
  • Ponderea ferestrelor mobile (rolling) în care ipoteza mersului aleator (random walk) este respinsă
    • S&P 500 6,7%, BET 22,4%, Bitcoin 0,0%
  • O respingere statistică nu înseamnă profit exploatabil

Capitolul 3: Modele factoriale și evaluarea activelor

Slide 10 în PDF

Modelele factoriale afirmă că randamentele așteptate răsplătesc doar expunerea la factori sistematici. Testul GRS (Gibbons, Ross & Shanken, 1989) al ipotezei că toate interceptele, erorile de evaluare \(\hat\alpha\), sînt nule folosește \(T\) perioade, \(N\) active și \(K\) factori:

\[\mathrm{GRS} = \frac{T-N-K}{N}\,\frac{\hat\alpha^\top\hat\Sigma^{-1}\hat\alpha}{1 + \hat\mu_f^\top\hat\Omega^{-1}\hat\mu_f} \sim F(N,\, T-N-K),\]
(19.4)

unde \(\hat\mu_f\) sînt mediile factorilor, iar \(\hat\Sigma\) și \(\hat\Omega\) matricele de covarianță ale reziduurilor și ale factorilor. Distribuția \(F\) este exactă doar pentru erori i.i.d. cu distribuția Normală.

Pe 25 de portofolii după mărime și raportul valoare contabilă/valoare de piață, panta dreptei pieței titlurilor (SML, security market line) este −4,4%, iar GRS este 4,18, față de o valoare critică de 5% sub 1,6, deci modelul de evaluare a activelor financiare (CAPM, capital asset pricing model) este respins (\(p < 0{,}01\)). Pentru ETF-urile sectoriale, prima componentă principală, piața, explică 66% din varianță.

Pe scurt

  • Randamentele așteptate ar trebui să remunereze doar expunerea la factori sistematici
  • Testul GRS (testul Gibbons–Ross–Shanken): toate constantele (erorile de evaluare) \(\hat\alpha\) sînt zero Gibbons, Ross & Shanken (1989)
    • \(T\) perioade, \(N\) active și \(K\) factori
    \begin{equation*} \mathrm{GRS} = \frac{T - N - K}{N}\,\frac{\hat\alpha^\top\hat\Sigma^{-1}\hat\alpha}{1 + \hat\mu_f^\top\hat\Omega^{-1}\hat\mu_f} \;\sim\; F(N, T - N - K) \end{equation*}
    • \(\hat\mu_f\): mediile factorilor; \(\hat\Sigma\), \(\hat\Omega\): covarianțele reziduurilor și ale factorilor
    • \(F\) exactă doar pentru erori i.i.d. Normale
  • 25 de portofolii după mărime și raportul valoare contabilă/de piață
    • panta SML (security market line) este \(-4{,}4\%\)
  • GRS \(= 4{,}18\), față de o valoare critică de 5% sub 1,6
    • CAPM (Capital Asset Pricing Model) este respins (\(p < 0{,}01\))
  • ETF-uri sectoriale: prima componentă principală (piața) explică 66% din varianță

Capitolul 4: Optimizarea portofoliului

Slide 11 în PDF

Markowitz (1952) pune întrebarea corectă, dar eroarea de estimare domină răspunsul. Pentru randamente i.i.d. cu distribuția Normală pe \(T\) perioade, eroarea standard a raportului Sharpe pe perioadă (Lo, 2002) este

\[\mathrm{SE}(\widehat{SR}) \approx \sqrt{(1 + \widehat{SR}^2/2)/T},\]
(19.5)

care cere și ea un moment de ordinul patru finit. În eșantioane de 60 de luni, raportul Sharpe median în eșantion este 1,56, în timp ce raportul Sharpe adevărat median este doar 0,30, iar 96% dintre portofoliile de tangență estimate sînt de fapt mai slabe decît regula ponderilor egale 1/N (DeMiguel, Garlappi & Uppal, 2009), un reper greu de bătut.

Un portofoliu A se compară cu 1/N testînd \(SR_A - SR_B = 0\) cu inferență HAC (Heteroskedasticity and Autocorrelation Consistent, standard errors, erori standard robuste la heteroscedasticitate și autocorelație) sau cu un bootstrap studentizat (Ledoit & Wolf, 2008), nu comparînd două estimații punctuale.

Pe scurt

  • Markowitz formulează corect problema, dar eroarea de estimare domină soluția Markowitz (1952)
  • Eroarea standard a raportului Sharpe pe perioadă, pentru randamente i.i.d. Normale și \(T\) perioade Lo (2002)
    \begin{equation*} \mathrm{SE}(\widehat{SR}) \approx \sqrt{(1 + \widehat{SR}^2/2)/T} \end{equation*}
    • \(\mathrm{SE}(\widehat{SR})\) presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
  • Pe eșantioane de 60 de luni, raportul Sharpe median este 1,56 în eșantion (in-sample)
    • dar cel adevărat median este doar 0,30
  • 96% dintre portofoliile tangente estimate sînt inferioare portofoliului 1/N DeMiguel, Garlappi & Uppal (2009)
    • 1/N este un reper greu de depășit
  • Portofoliul A față de 1/N: testăm \(SR_A - SR_B = 0\) cu inferență HAC (Heteroskedasticity and Autocorrelation Consistent, erori standard robuste la heteroscedasticitate și autocorelație) sau bootstrap studentizat Ledoit & Wolf (2008)
    • nu comparăm două estimări punctuale

Capitolul 5: Volatilitate condiționată: GARCH

Slide 12 în PDF

Volatilitatea vine grupată, deci șocul de azi prezice varianța de mîine (Engle, 1982). Cu \(\varepsilon_t\) șocul și \(\alpha\), \(\beta\) ponderile ultimului șoc și ale ultimei varianțe, modelul GARCH(1,1) al lui Bollerslev (1986) și prognoza lui pe \(h\) zile sînt

\[\sigma_{t+1}^2 = \omega + \alpha\varepsilon_t^2 + \beta\sigma_t^2, \qquad \sigma_{T+h|T}^2 = \bar\sigma^2 + (\alpha+\beta)^{h-1}\big(\sigma_{T+1|T}^2 - \bar\sigma^2\big),\]
(19.6)

cu nivelul pe termen lung \(\bar\sigma^2 = \omega/(1-\alpha-\beta)\).

Persistența \(\alpha + \beta\) este rata cu care prognoza revine la \(\bar\sigma^2\), iar timpul de înjumătățire (half-life) este \(h_{1/2} = \ln 0{,}5/\ln(\alpha+\beta)\). Pentru S&P 500, 2000–2026, \(\alpha + \beta = 0{,}9948\), deci \(h_{1/2} = 132\) de zile. Pentru BET persistența nu poate fi separată de 1, subiectul capcanei despre persistența aproape de 1.

Pe scurt

  • Din cauza grupării volatilității, șocul de azi anticipează varianța de mîine Engle (1982), Bollerslev (1986)
  • Modelul GARCH(1,1) și prognoza lui pe \(h\) zile
    • \(\varepsilon_t\): șocul; \(\alpha\), \(\beta\): ponderile ultimului șoc și ale ultimei varianțe
    \begin{gather*} \sigma_{t+1}^2 = \omega + \alpha\,\varepsilon_t^2 + \beta\,\sigma_t^2, \qquad \bar\sigma^2 = \frac{\omega}{1 - \alpha - \beta} \\ \sigma_{T+h|T}^2 = \bar\sigma^2 + (\alpha + \beta)^{h-1}\big(\sigma_{T+1|T}^2 - \bar\sigma^2\big) \end{gather*}
  • Persistența \(\alpha + \beta\) este rata cu care prognoza revine la nivelul de termen lung \(\bar\sigma^2\)
    • timpul de înjumătățire este \(h_{1/2} = \ln 0{,}5/\ln(\alpha + \beta)\)
  • S&P 500, 2000–2026: \(\alpha + \beta = 0{,}9948\), deci \(h_{1/2} = 132\) de zile
  • Persistența BET nu poate fi separată de 1
    • capcana „Persistența aproape de 1”

Capitolul 6: Volatilitate multivariată și dependență

Slide 13 în PDF

Corelațiile se mișcă odată cu regimul macroeconomic, așa că diversificarea nu este garantată. Într-o criză corelația măsurată crește mecanic odată cu volatilitatea, de aceea testul se face pe corelația ajustată a lui Forbes & Rigobon (2002),

\[\rho^* = \frac{\rho}{\sqrt{1 + \delta(1-\rho^2)}},\]
(19.7)

unde \(\rho\) este corelația din criză, iar \(\delta\) creșterea relativă a varianței pieței-sursă de la perioada calmă la criză; testul pe \(\rho^*\) cere un moment de ordinul patru finit.

Corelația dintre SPY și TLT (iShares 20+ Year Treasury Bond ETF, ETF pe obligațiuni de stat americane cu scadențe de peste 20 de ani), ETF-ul pe obligațiuni americane pe termen lung, a crescut de la −0,40 la 0,11 după 2022, iar în aceeași perioadă volatilitatea unui portofoliu 60/40 a urcat de la 10,4% la 13,2%. Corelația DCC dintre Bitcoin și SPY a fost 0,04 înainte de 2020 și 0,31 de atunci.

Pe scurt

  • Corelațiile se schimbă odată cu regimul macroeconomic
    • diversificarea nu este garantată
  • Corelația din criză crește mecanic odată cu volatilitatea, deci testăm pe corelația ajustată Forbes & Rigobon (2002)
    \begin{equation*} \rho^* = \frac{\rho}{\sqrt{1 + \delta(1 - \rho^2)}} \end{equation*}
    • \(\rho\): corelația din criză
    • \(\delta\): creșterea relativă a varianței pieței-sursă de la perioada calmă la criză
    • testul pe \(\rho^*\) presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
  • SPY–TLT: \(\rho\) a urcat de la \(-0{,}40\) la \(0{,}11\) după 2022
    • TLT: ETF pe obligațiuni americane pe termen lung
  • Volatilitatea unui portofoliu 60/40 a crescut în același timp de la 10,4% la 13,2%
  • Corelația DCC dintre Bitcoin și SPY: 0,04 înainte de 2020 și 0,31 de atunci

Capitolul 7: VaR și Expected Shortfall

Slide 14 în PDF

VaR este o cuantilă a pierderii, iar ES, pierderea medie dincolo de ea, este o măsură de risc coerentă. Cu \(q_\alpha\) cuantila de ordin \(\alpha\) a randamentelor \(r\) și o distribuție continuă,

\[\mathrm{VaR}_\alpha = -q_\alpha, \qquad \mathrm{ES}_\alpha = -\mathbb{E}[r \mid r \le q_\alpha] = \frac{1}{\alpha}\int_0^\alpha \mathrm{VaR}_u\,du.\]
(19.8)

Pentru S&P 500 zilnic, VaR 1% istoric este 3,45%, iar ES 1% este 5,03%, în timp ce distribuția Normală dă un VaR 1% de doar 2,80%: cozile groase contează. Simularea istorică filtrată și teoria valorilor extreme (EVT, extreme value theory) condiționată reacționează la volatilitate în cîteva zile (McNeil & Frey, 2000).

Pe scurt

  • VaR este o cuantilă a pierderii
  • ES, pierderea medie dincolo de ea, este o măsură de risc coerentă
  • Definițiile, cu \(q_\alpha\) cuantila \(\alpha\) a randamentelor \(r\) (distribuție continuă)
    \begin{equation*} \VaR_\alpha = -q_\alpha, \qquad \ES_\alpha = -\E\big[r \mid r \le q_\alpha\big] = \frac{1}{\alpha}\int_0^\alpha \VaR_u\,du \end{equation*}
  • S&P 500, zilnic: VaR-ul istoric \(\VaR_{1\%} = 3{,}45\%\), iar \(\ES_{1\%} = 5{,}03\%\)
  • VaR-ul bazat pe distribuția Normală este de doar \(2{,}80\%\)
    • cozile groase contează
  • Simularea istorică filtrată și EVT (Extreme Value Theory, teoria valorilor extreme) condiționată reacționează la volatilitate în cîteva zile McNeil & Frey (2000)

Capitolul 8: Backtesting și evaluarea prognozelor de risc

Slide 15 în PDF

O prognoză VaR se verifică prin backtesting pe numărul și momentul depășirilor, cu testul de acoperire al lui Kupiec (1995) și testul de independență al lui Christoffersen (1998). Cu \(x\) depășiri în \(T\) zile și rata observată \(\hat\pi = x/T\), statistica Kupiec este

\[LR_{uc} = -2\ln\frac{(1-\alpha)^{T-x}\alpha^{x}}{(1-\hat\pi)^{T-x}\hat\pi^{x}} \sim \chi^2_1.\]
(19.9)

Statistica Christoffersen \(LR_{ind} \sim \chi^2_1\) compară rata depășirilor după o zi liniștită cu rata după o depășire; formula ei este dată la Pasul 4 al studiului de caz.

Pentru S&P 500, VaR 1%, 2007–2026, ratele depășirilor față de ținta de 1% sînt 2,70% pentru modelul Normal, 1,67% pentru simularea istorică (HS, historical simulation), 1,23% pentru simularea istorică filtrată (FHS, filtered historical simulation) și 1,15% pentru GARCH-EVT, un filtru GARCH cu o coadă din teoria valorilor extreme. Pe S&P 500 și pe BET cîștigă un filtru GARCH combinat cu o coadă flexibilă: FHS și GARCH-EVT.

Pe scurt

  • Testăm numărul și momentul depășirilor: acoperirea și independența Kupiec (1995), Christoffersen (1998)
  • Kupiec, cu \(x\) depășiri în \(T\) zile și rata observată \(\hat\pi = x/T\)
    \begin{equation*} LR_{uc} = -2\ln\frac{(1-\alpha)^{T-x}\alpha^{x}}{(1-\hat\pi)^{T-x}\hat\pi^{x}} \;\sim\; \chi^2_1 \end{equation*}
  • Christoffersen: \(LR_{ind} \sim \chi^2_1\) compară rata depășirilor după o zi fără depășire cu rata după o depășire
    • formula: Pasul 4 al studiului de caz
  • S&P 500, VaR 1%, 2007–2026: rata depășirilor (ținta: 1%)
    • Normal 2,70%
    • HS (simulare istorică) 1,67%
    • FHS (simulare istorică filtrată) 1,23%
    • GARCH-EVT (filtru GARCH cu o coadă din teoria valorilor extreme) 1,15%
  • Pe S&P 500 și BET, un filtru GARCH combinat cu o coadă flexibilă dă cele mai bune rezultate
    • FHS, GARCH-EVT

Capitolul 9: Volatilitate realizată

Slide 16 în PDF

Prețurile intrazilnice măsoară varianța zilnică prin varianța realizată, \(RV\). Modelul log-HAR (heterogeneous autoregressive) al lui Corsi (2009) aproximează persistența ei observată pe orizonturi finite:

\[\ln RV_{t+1} = b_0 + b_d\ln RV_t + b_w\,\overline{\ln RV}^{(5)}_t + b_m\,\overline{\ln RV}^{(22)}_t + u_{t+1},\]
(19.10)

cu \(\overline{\ln RV}^{(5)}_t\) și \(\overline{\ln RV}^{(22)}_t\) mediile lui \(\ln RV\) pe ultimele 5 și 22 de zile. Un HAR (Heterogeneous AutoRegressive, model, model autoregresiv heterogen) staționar este o autoregresie finită și are deci, asimptotic, memorie scurtă.

Pentru SPY, kurtosis-ul randamentelor de la deschidere la închidere este 15,73 și 2,66 după împărțirea la \(\sqrt{RV_t}\). Log-HAR bate GARCH(1,1)-\(t\) în QLIKE cu 10% pentru SPY (\(p = 0{,}021\)) și cu 22% pentru Bitcoin. Testul Diebold–Mariano (DM) pe QLIKE cere momente finite și dependență slabă a diferenței de pierderi \(d_t\), nu a randamentelor.

Pe scurt

  • Prețurile intraday măsoară varianța zilnică (\(RV\), Realised Variance, varianța realizată)
  • Modelul log-HAR (autoregresiv heterogen, Heterogeneous AutoRegressive) aproximează persistența ei observată pe orizonturi finite Corsi (2009)
    \begin{equation*} \ln RV_{t+1} = b_0 + b_d \ln RV_t + b_w\,\overline{\ln RV}^{(5)}_t + b_m\,\overline{\ln RV}^{(22)}_t + u_{t+1} \end{equation*}
    • \(\overline{\ln RV}^{(5)}_t\), \(\overline{\ln RV}^{(22)}_t\): media lui \(\ln RV\) pe ultimele 5 și 22 de zile
    • un HAR staționar este un model autoregresiv (AR) finit: memorie scurtă în sens asimptotic
  • SPY: kurtosis-ul randamentelor de la deschidere la închidere este 15,73
    • după împărțirea la \(\sqrt{RV_t}\) scade la 2,66
  • log-HAR reduce QLIKE față de GARCH(1,1)-\(t\)
    • cu 10% pentru SPY (\(p = 0{,}021\))
    • cu 22% pentru Bitcoin
    • testul DM (testul Diebold–Mariano de comparare a prognozelor) pe QLIKE cere momente finite și o dependență slabă pentru diferențialul de pierdere \(d_t\), nu pentru randamente

Capitolul 10: Microstructura pieței

Slide 17 în PDF

Prețurile se formează în registrele de ordine limită (limit order books), iar spread-ul bid–ask plătește procesarea ordinelor, stocul și selecția adversă. Oscilația între bid și ask (bid–ask bounce) face ca variațiile consecutive ale prețului de tranzacție, \(\Delta p_t\), să fie corelate negativ, de unde spread-ul Roll

\[s_{\text{Roll}} = 2\sqrt{-\mathrm{Cov}(\Delta p_t, \Delta p_{t-1})}.\]

Cînd covarianța din eșantion este pozitivă, estimatorul nu este definit, iar cît de des se întîmplă acest lucru trebuie raportat.

Raportul de nelichiditate Amihud, în puncte de bază (bp, basis points) la 1 milion de dolari americani (USD), este 0,0016 pentru SPY, 24,7 pentru Banca Transilvania și 1 024,0 pentru Transelectrica. Pentru SPY, bara de cinci minute de la deschidere se mișcă de 2,06 ori mai mult decît o bară de la mijlocul zilei.

Pe scurt

  • Prețurile se formează în registre de ordine limită
  • Spread-ul compensează costurile de procesare, riscul de inventar și selecția adversă
  • Spread-ul Roll: oscilația între bid și ask
    • face ca variațiile consecutive ale prețului de tranzacționare, \(\Delta p_t\), să fie negativ corelate
    \begin{equation*} s_{\text{Roll}} = 2\sqrt{-\Cov(\Delta p_t, \Delta p_{t-1})} \end{equation*}
  • Cînd covarianța empirică este pozitivă, estimatorul nu este definit
    • raportați cît de des se întîmplă
  • Raportul Amihud (puncte de bază, bp, la 1 milion de dolari americani, USD)
    • SPY 0,0016, Banca Transilvania 24,7, Transelectrica 1 024,0
  • SPY: variația prețului în primele 5 minute este de 2,06 ori mai mare
    • decît într-un interval de aceeași durată de la prînz

Capitolul 11: Modele în timp continuu

Slide 18 în PDF

Mișcarea browniană este limita mersurilor aleatoare cu pași din ce în ce mai mici, iar lema lui Itô rezolvă ecuațiile diferențiale stocastice ale prețurilor. Mișcarea browniană geometrică (GBM, geometric Brownian motion) implică randamente logaritmice cu distribuția Normală, pe care testul Jarque–Bera le verifică prin asimetria \(S\) și kurtosis-ul \(K\) din eșantion:

\[JB = \frac{T}{6}\Big(S^2 + \frac{(K-3)^2}{4}\Big) \sim \chi^2_2.\]
(19.11)

Pentru S&P 500 există 62 de zile dincolo de ±4 abateri standard, față de 0,59 așteptate sub GBM, iar indicele Hill al pierderilor S&P 500 este sub 4 (capitolele 1 și 16), deci momentul de ordinul patru este probabil infinit. Salturile se detectează cu diferența standardizată dintre varianța realizată și variația bipower \(BV\), robustă la salturi, care converge la \(N(0,1)\) (Barndorff-Nielsen & Shephard, 2006).

Pe scurt

  • Mișcarea browniană este limita unui mers aleator cu pași din ce în ce mai mici
  • Lema lui Itô rezolvă ecuațiile diferențiale stocastice ale prețurilor
  • Normalitatea randamentelor log ale mișcării browniene geometrice (Geometric Brownian Motion, GBM)
    • testul Jarque–Bera, cu \(S\) asimetria și \(K\) kurtosis-ul empiric
    \begin{equation*} JB = \frac{T}{6}\Big(S^2 + \frac{(K - 3)^2}{4}\Big) \;\sim\; \chi^2_2 \end{equation*}
  • S&P 500 față de GBM: 62 de zile dincolo de \(\pm 4\) abateri standard, față de 0,59 așteptate
  • Indicele Hill al cozii pierderilor S&P 500 este sub 4 (Capitolele 1 și 16)
    • momentul de ordinul patru este probabil infinit
  • Salturile: \((RV - BV)\) standardizat \(\Rightarrow N(0, 1)\) Barndorff-Nielsen & Shephard (2006)
    • \(BV\): variația bipower, robustă la salturi

Capitolul 12: Opțiuni și suprafața de volatilitate

Slide 19 în PDF

Black & Scholes (1973) evaluează opțiunile prin acoperire (hedging). Volatilitatea implicită, valoarea lui \(\sigma\) extrasă din prețurile opțiunilor, este o mărime neutră la risc, nu o prognoză a volatilității fizice. Prima de risc a varianței ex-ante este \(E_t^Q[RV_{t,t+21}] - E_t^P[RV_{t,t+21}]\), unde \(RV_{t,t+21}\) este varianța realizată în următoarele 21 de zile de tranzacționare; \(VIX_t^2\) estimează primul termen, în timp ce al doilea cere o prognoză.

Diferența realizată ex-post, \(VIX_t^2 - RV_{t,t+21}\), este cunoscută abia la \(t+21\), iar valorile consecutive se suprapun, așa că media ei cere erori standard Newey–West cu cel puțin 21 de laguri și un moment de ordinul patru finit. În 1990–2026, VIX mediu este 19,4, iar volatilitatea realizată medie în luna următoare 15,3. Diferența este pozitivă în 86% din zile, dar nu și în crahuri, iar semnul ei nu identifică semnul primei ex-ante.

Pe scurt

  • Black–Scholes evaluează opțiunile prin acoperirea riscului (hedging) Black & Scholes (1973)
    • volatilitatea implicită: valoarea lui \(\sigma\) extrasă din prețurile opțiunilor, o mărime neutră la risc, nu o prognoză a volatilității fizice
  • Prima de risc a varianței (ex ante): \(E_t^Q[RV_{t,t+21}] - E_t^P[RV_{t,t+21}]\)
    • \(VIX_t^2\) estimează primul termen, varianța așteptată neutră la risc pe luna următoare; al doilea cere o prognoză
    • \(RV_{t,t+21}\): varianța realizată în următoarele 21 de zile de tranzacționare
  • Diferența realizată ex post, cunoscută abia la \(t + 21\):
    \begin{equation*} VIX_t^2 - RV_{t,t+21} \end{equation*}
  • Valorile consecutive se suprapun, deci media cere erori Newey–West cu cel puțin 21 de laguri
    • eroarea standard a mediei presupune moment de ordin patru finit, pus sub semnul întrebării în Capitolul 1
  • 1990–2026: VIX-ul mediu este 19,4
    • volatilitatea realizată medie în luna următoare este 15,3
  • Diferența realizată ex post este pozitivă în 86% din zile, dar nu și în perioadele de crah
    • semnul ei nu identifică semnul primei ex ante

Capitolul 13: Machine Learning în finanțe

Slide 20 în PDF

Învățarea automată aduce modele flexibile pe date cu puțin semnal și mult zgomot (López de Prado, 2018), așa că partea specifică finanțelor este procesul de validare. Validarea încrucișată K-fold cu amestecare raportează o acuratețe de 69,4% pe zgomot pur, din cauza scurgerii de informație (leakage) din setul de test în cel de antrenare. Remediul este purjarea (purging), care elimină etichetele de antrenare suprapuse cu partea de test, și un embargo după partea de test.

Cînd o strategie este aleasă dintre \(N\), raportul Sharpe deflatat al lui Bailey & López de Prado (2014) testează \(SR > \mathbb{E}[\max_N \widehat{SR}]\), cel mai bun raport Sharpe estimat așteptat pentru \(N\) strategii fără abilitate, un prag care crește cu \(N\). Pentru diferențierea fracționară a S&P 500, un test de rădăcină unitară cu un lag respinge de la \(d^* = 0{,}25\); respingerea nu dovedește staționaritatea, pentru că ponderile filtrului finit au o sumă nenulă (0,178 la \(d = 0{,}25\)), iar corelația de 0,98 cu logaritmul prețului doar ilustrează componenta care rămîne. Niciun model nu bate regula naivă „mereu în sus”.

Pe scurt

  • Modelele sînt flexibile, dar semnalul este slab și zgomotul mare López de Prado (2018)
    • specificul finanțelor ține de procesul de validare
  • Validarea K-fold cu amestecare raportează o acuratețe de 69,4% pe zgomot pur
    • scurgerea de informație (leakage): date din setul de test ajunse în antrenare
  • Remediu: purging și embargo după setul de test
    • purging: eliminarea din antrenare a etichetelor care se suprapun cu testul
  • Selecția dintre \(N\) strategii: raportul Sharpe deflatat testează \(SR > \E[\max_N \widehat{SR}]\) Bailey & López de Prado (2014)
    • pragul: media celui mai mare Sharpe estimat dintre \(N\) strategii fără abilitate
    • pragul crește cu \(N\)
  • S&P 500, diferențiere fracționară de ordin \(d\): testul de rădăcină unitară cu un lag respinge de la \(d^* = 0{,}25\)
    • o respingere ADF (Augmented Dickey–Fuller, testul Dickey–Fuller augmentat) nu dovedește staționaritatea: filtrul finit are suma ponderilor nenulă (\(0{,}178\) la \(d = 0{,}25\)), deci seria păstrează o componentă proporțională cu log-prețul
    • corelația ei cu log-prețul, \(0{,}98\), doar ilustrează această componentă
  • Niciun model nu depășește regula naivă „piața crește mereu”

Capitolul 14: Deep learning și modele fundaționale pentru serii de timp

Slide 21 în PDF

Rețelele LSTM (long short-term memory) și Transformer învață din secvențe, iar modelele fundaționale (foundation models) prognozează zero-shot, fără antrenare pe seria analizată. Două modele se compară cu testul Diebold–Mariano (Diebold & Mariano, 1995) pe diferențele de pierderi \(d_t\),

\[t_{DM} = \frac{\bar d}{\sqrt{\hat\Omega/T}} \Rightarrow N(0,1),\]
(19.12)

unde \(\hat\Omega\) este varianța pe termen lung a lui \(d_t\), consistentă la heteroscedasticitate și autocorelație (HAC, heteroskedasticity and autocorrelation consistent).

Pentru volatilitatea realizată a SPY, QLIKE (mai mic este mai bine) este 0,223 pentru Chronos-2, 0,226 pentru log-HAR și 0,273 pentru GARCH-\(t\), pe grila exactă de 78 de bare de cinci minute; Chronos-2 și log-HAR nu diferă semnificativ (DM \(p = 0{,}539\)). VaR 1% al Chronos-2 fără recalibrare are 1,67% depășiri pe S&P 500. Cu multe modele candidate, mulțimea de încredere a modelelor (MCS, model confidence set) a lui Hansen, Lunde & Nason (2011) înlocuiește testele pe perechi.

Pe scurt

  • LSTM-urile (Long Short-Term Memory) și Transformerele învață din secvențe
  • Modelele fundaționale prognozează zero-shot
    • fără antrenare pe seria analizată
  • Testul Diebold–Mariano pe diferențele de pierdere \(d_t\) dintre două modele Diebold & Mariano (1995)
    • \(\hat\Omega\): dispersia de termen lung HAC a lui \(d_t\)
    \begin{equation*} t_{DM} = \frac{\bar d}{\sqrt{\hat\Omega/T}} \Rightarrow N(0, 1) \end{equation*}
  • Prognoza volatilității realizate a SPY, QLIKE (mai mic este mai bine)
    • Chronos-2 0,223, log-HAR 0,226, GARCH-\(t\) 0,273, pe grila exactă de 78 de bare de 5 minute
  • Chronos-2 și log-HAR nu diferă semnificativ (DM \(p = 0{,}539\))
    • testul DM pe QLIKE cere momente finite și o dependență slabă pentru diferențialul de pierdere \(d_t\), nu pentru randamente
  • VaR 1% din Chronos-2, fără recalibrare, pe S&P 500: rata depășirilor este 1,67%
  • Cu multe modele candidate: mulțimea de încredere a modelelor (MCS) Hansen, Lunde & Nason (2011)

Capitolul 15: LLM-uri și analiza sentimentului

Slide 22 în PDF

De la dicționare la FinBERT și LLM-uri, textul devine un număr. Regresia predictivă \(r_{t+1} = a + b\,S_t + \varepsilon_{t+1}\), cu \(S_t\) scorul de sentiment, are o problemă cunoscută (Stambaugh, 1999): un \(S_t\) persistent ale cărui inovații sînt corelate cu randamentele deplasează \(\hat b\) și testul lui \(t\).

Clasificatorii evaluați pe aceleași texte se compară pe perechi, cu testul exact McNemar. Pe titluri de știri financiare, Qwen 7B este mai precis decît Qwen 1.5B cu 21,5 puncte procentuale (McNemar \(p < 0{,}001\)). O strategie bazată pe sentimentul titlurilor are un raport Sharpe de +0,63 înainte de costuri și −1,48 după costuri, cu un cost de echilibru de 1,5 bp pe tranzacție.

Pe scurt

  • De la dicționare la FinBERT și la LLM-uri: textul este transformat într-o variabilă numerică
  • Regresia predictivă \(r_{t+1} = a + b\,S_t + \varepsilon_{t+1}\), cu \(S_t\) scorul de sentiment Stambaugh (1999)
    • un \(S_t\) persistent, cu inovații corelate cu randamentele, deplasează \(\hat b\) și testul \(t\)
  • Clasificatorii evaluați pe aceleași texte se compară împerecheat, cu testul McNemar exact
  • Qwen 7B față de Qwen 1.5B pe titluri financiare: acuratețea crește cu \(21{,}5\) puncte procentuale
    • McNemar \(p < 0{,}001\)
  • O strategie pe sentimentul titlurilor are un raport Sharpe de \(+0{,}63\) înainte de costuri
    • și de \(-1{,}48\) după costuri
  • Costul de tranzacționare care anulează cîștigul: \(1{,}5\) bp pe tranzacție

Capitolul 16: Active digitale și DeFi

Slide 23 în PDF

Studiul de caz al capitolului 16 (Pele et al., 2023) arată că cripto-activele formează o clasă distinctă de active, într-un spațiu de caracteristici în care un factor de coadă le separă, iar finanțele descentralizate (DeFi, decentralised finance) funcționează pe contracte inteligente. Pentru legătura dintre Bitcoin și S&P 500, statistica sup-Wald a lui Andrews (1993), cea mai mare statistică Wald pe datele candidate de ruptură, este 20,1, față de o valoare critică de 5% de 11,6. Statistica Wald cere \(\mathbb{E}[x_t^2u_t^2] < \infty\), o condiție de ordinul patru asupra regresorului și erorii. Ruptura estimată este pe 9 martie 2020, nu la lansarea ETF-urilor spot din 2024.

Tail index-ul Hill al pierderilor este 2,73 pentru Bitcoin, CI de 95% [2,12; 3,33], și 2,87 pentru S&P 500, CI de 95% [2,07; 3,67]. Diferența dintre ele, dintr-un block bootstrap comun, este −0,14, cu un CI de 95% de [−1,68; 0,71]. Intervalul conține 0, deci nu există dovezi că Bitcoin ar avea cozi mai groase; o nerespingere nu înseamnă egalitate, iar suprapunerea celor două intervale separate nu este un test al diferenței.

Pe scurt

  • Studiul de caz al capitolului (Pele et al. (2023)): criptomonedele formează o clasă de active distinctă
    • într-un spațiu al caracteristicilor în care un factor legat de cozi le separă
  • DeFi (Decentralised Finance, finanțele descentralizate) funcționează prin contracte inteligente
  • Legătura Bitcoin–S&P 500: sup-Wald \(20{,}1\) Andrews (1993)
    • sup-Wald: cea mai mare statistică Wald pe toate datele candidate de ruptură
    • valoarea critică de 5%: \(11{,}6\)
    • statistica Wald cere \(\E[x_t^2u_t^2] < \infty\) (regresor \(\times\) eroare), o condiție de ordin patru pusă sub semnul întrebării în Capitolul 1
  • Ruptura estimată: 9 mar. 2020, nu lansarea ETF-urilor din 2024
  • Indicele Hill al cozii pierderilor
    • Bitcoin \(2{,}73\), CI 95% \([2{,}12; 3{,}33]\)
    • S&P 500 \(2{,}87\), CI 95% \([2{,}07; 3{,}67]\)
  • Diferența Bitcoin \(-\) S&P 500, cu un bootstrap comun pe blocuri: \(-0{,}14\), CI 95% \([-1{,}68; 0{,}71]\)
    • intervalul conține 0: nicio dovadă că cozile Bitcoin sînt mai groase; nerespingerea nu înseamnă egalitate
    • suprapunerea celor două intervale nu este un test al diferenței

O bulă este o traiectorie a prețului care crește mai repede decît pot justifica fundamentele. GSADF, cea mai mare statistică ADF (augmented Dickey–Fuller) pe coada dreaptă pe toate fracțiile de eșantion \([r_1, r_2]\) de lungime cel puțin \(r_0\) (Phillips, Shi & Yu, 2015), este

\[GSADF = \sup_{r_2 \in [r_0,1]}\ \sup_{r_1 \in [0,\,r_2-r_0]} ADF_{r_1}^{r_2}.\]
(19.13)

Schimbările de volatilitate îi distorsionează nivelul, așa că se folosesc valori critice wild bootstrap. Pentru Bitcoin săptămînal, 2014–2026, GSADF este 3,85, față de o valoare critică wild bootstrap de 95% de 2,82 (2,27 prin Monte Carlo), deci sînt detectate episoade explozive. Testul unui regim Markov contra două pentru Bitcoin dă un raport de verosimilitate (LR, likelihood ratio) de 123,2, față de o valoare critică de 95% prin bootstrap parametric de 11,8 (\(p = 0{,}005\)).

Pe scurt

  • O bulă este o traiectorie a prețului care crește mai repede decît o pot justifica fundamentele
  • GSADF: cea mai mare statistică ADF pe coada din dreapta Phillips, Shi & Yu (2015)
    • pe toate fracțiunile de eșantion \([r_1, r_2]\) de lungime cel puțin \(r_0\)
    \begin{equation*} GSADF = \sup_{r_2 \in [r_0, 1]}\,\sup_{r_1 \in [0, r_2 - r_0]} ADF_{r_1}^{r_2} \end{equation*}
  • Schimbările de volatilitate distorsionează nivelul testului
    • valori critice prin wild bootstrap
  • Bitcoin 2014–2026 (săptămînal): GSADF \(3{,}85\) față de valoarea critică de 95% \(2{,}82\) din wild bootstrap (\(2{,}27\) Monte Carlo)
    • sînt detectate episoade explozive
  • Un regim față de două regimuri Markov pentru Bitcoin: \(LR = 123{,}2\)
    • față de valoarea critică de 95% din bootstrap parametric \(11{,}8\) (\(p = 0{,}005\))

Capitolul 18: Risc sistemic și rețele

Slide 25 în PDF

Riscul sistemic este riscul ca pierderile unei instituții să se propage întregului sistem. \(\Delta\)CoVaR (Conditional Value-at-Risk of the system given an institution in distress, VaR-ul sistemului condiționat de dificultățile unei instituții) măsoară schimbarea VaR-ului sistemului cînd instituția \(i\), cu randamentul \(X^i\), trece de la mediană la dificultate:

\[\Delta\text{CoVaR}^{i} = \text{CoVaR}_{\alpha}^{\,sys \mid X^i = -\mathrm{VaR}^i_\alpha} - \text{CoVaR}_{\alpha}^{\,sys \mid X^i = \text{median}}.\]
(19.14)

Pentru \(\Delta\)CoVaR 1% al unsprezece bănci, 4 dintre cele 25 de perechi din aceeași regiune diferă la 5%, și niciuna după corecția Holm; doar suprapunerea intervalelor nu ar fi ierarhizat niciuna.

LRMES, pierderea așteptată a unei bănci cînd piața scade cu peste 10% în 22 de zile, se simulează din modele GJR (Glosten–Jagannathan–Runkle, asymmetric GARCH, GARCH asimetric Glosten–Jagannathan–Runkle)–GARCH și DCC (Brownlees & Engle, 2017). Pentru JPMorgan, ea este 10,6% astăzi și a fost 23,7% cu informația din 31 martie 2020.

Pe scurt

  • Riscul sistemic: pierderile unei instituții care se propagă în tot sistemul
  • \(\Delta\)CoVaR: variația VaR-ului sistemului cînd instituția \(i\), cu randamentul \(X^i\), trece de la mediană la stres
    \begin{equation*} \Delta\text{CoVaR}^{i} = \text{CoVaR}_{\alpha}^{\,sys \mid X^i = -\VaR_\alpha^i} - \text{CoVaR}_{\alpha}^{\,sys \mid X^i = \text{median}} \end{equation*}
  • \(\Delta\)CoVaR 1% pentru unsprezece bănci: 4 din 25 de perechi din aceeași regiune diferă la 5%
    • 0 după corecția Holm
  • Comparația prin simpla suprapunere a intervalelor nu ar fi ierarhizat nicio pereche
  • LRMES, simulat din GJR–GARCH (GARCH asimetric Glosten–Jagannathan–Runkle) și DCC Brownlees & Engle (2017)
    • LRMES: pierderea așteptată a unei bănci cînd piața scade cu peste \(10\%\) în 22 de zile
    • JPMorgan \(10{,}6\%\) în prezent, față de \(23{,}7\%\) cu informația din 31 martie 2020

Sinteza secțiunii

Rezultatele capitolelor au aceeași structură: o estimație, o formulă pentru incertitudinea ei și o ipoteză în care formula este valabilă. Condiția momentului de ordinul patru revine la rapoartele varianțelor, rapoartele Sharpe, testele de corelație și statisticile Wald și este exact condiția pe care estimările de coadă din capitolul 1 o pun la îndoială.

Erori metodologice frecvente

Recapitularea arată aceleași greșeli revenind sub nume diferite. Secțiunea le adună în șase capcane, grupate după locul în care apar: în designul studiului, în date, în inferență și în evaluare, cu un remediu pentru fiecare.

Erori metodologice: deplasarea de anticipare și supraajustarea

Slide 26 în PDF

Look-ahead bias apare cînd o estimație pe tot eșantionul introduce viitorul într-o prognoză: orice parametru, prag sau scalare estimată pe întregul eșantion. Exemple sînt parametrii GARCH sau standardizarea calculate pe tot eșantionul și etichetele care se suprapun cu setul de test (capitolul 13); efectul asupra BET apare în studiul de caz. Remediul sînt ferestrele mobile sau extinse, purjarea și embargoul, precum și mulțimea de informații \(\mathcal{F}_{t-1}\) scrisă lîngă fiecare prognoză.

Overfitting-ul apare pentru că ajustarea în eșantion răsplătește zgomot care nu se va repeta out-of-sample (capitolul 4). Overfitting-ul în backtesting, încercarea multor strategii și păstrarea celei mai bune, este analizat de Bailey et al. (2017), iar raportul Sharpe deflatat corectează pentru numărul de încercări și pentru randamentele care nu urmează distribuția Normală (Bailey & López de Prado, 2014). Remediul este fixarea designului înaintea perioadei de test, raportarea fiecărui model încercat și compararea cu un reper simplu: 1/N, simularea istorică, mersul aleator sau log-HAR.

Pe scurt

  • Deplasarea de anticipare (look-ahead bias): o estimare pe tot eșantionul introduce informație din viitor
    • orice parametru, prag sau factor de scalare estimat pe tot eșantionul
    • Exemple: parametri GARCH sau standardizare pe tot eșantionul, etichete care se suprapun cu setul de test (Capitolul 13; efectul pe BET: studiul de caz)
    • Remediu: ferestre mobile sau în extindere, purging și embargo, mulțimea de informație \(\mathcal{F}_{t-1}\) scrisă lîngă fiecare prognoză
  • Supraajustarea (overfitting): ajustarea în eșantion recompensează zgomotul (Capitolul 4)
    • zgomotul nu se repetă în afara eșantionului
    • Supraajustarea backtest-ului: încercăm multe strategii și o păstrăm pe cea mai bună Bailey et al. (2017)
    • Raportul Sharpe deflatat corectează pentru numărul de încercări și pentru randamentele non-normale Bailey & López de Prado (2014)
    • Remediu: planul analizei fixat înainte de perioada de test, toate modelele încercate raportate, un reper simplu (1/N, simulare istorică, mers aleator, log-HAR)

Eroare metodologică: testarea multiplă (1/2)

Slide 27 în PDF

În capitolul 3, din 300 de factori inutili trec în medie 15,0 de pragul \(|t| > 1{,}96\), iar cel mai bun ajunge la \(|t| \approx 3{,}06\); de aceea literatura cere \(|t| > 3\) (Harvey, Liu & Zhu, 2016). Aceeași aritmetică se aplică anomaliilor de calendar, regulilor de tranzacționare și specificațiilor: fiecare test în plus adaugă o șansă de descoperire falsă. Remediul este numărarea testelor și corectarea pentru numărul lor.

Pe scurt

  • Capitolul 3: din 300 de factori fără putere explicativă, în medie 15,0 trec de \(|t| > 1{,}96\)
  • Anomalii de calendar, reguli de tranzacționare, specificații
    • fiecare test în plus adaugă o șansă de descoperire falsă
  • Remediu: numărați testele și corectați

Eroare metodologică: testarea multiplă (2/2)

Slide 28 în PDF

Cu \(m\) teste, valorile p ordonate \(p_{(1)} \le \dots \le p_{(m)}\) și nivelul \(a\), cele trei corecții standard resping \(H_{(i)}\) în următoarele condiții:

\[\begin{array}{ll} \text{Bonferroni:} & p_{(i)} \le a/m, \\ \text{Holm:} & p_{(j)} \le a/(m-j+1) \text{ pentru orice } j \le i, \\ \text{Benjamini–Hochberg:} & i \le \max\{k : p_{(k)} \le k\,a/m\}. \end{array}\]
(19.15)

Bonferroni și procedura Holm (Holm, 1979) controlează probabilitatea oricărei descoperiri false, rata erorii pe familie (FWER, family-wise error rate), iar Holm respinge cel puțin tot ce respinge Bonferroni. Procedura Benjamini–Hochberg (BH) (Benjamini & Hochberg, 1995) controlează ponderea așteptată a descoperirilor false printre respingeri, rata descoperirilor false (FDR, false discovery rate). Pentru prognoze, mulțimea de încredere a modelelor (Hansen, Lunde & Nason, 2011) înlocuiește multe teste pe perechi.

Pe scurt

  • Cu \(m\) teste, valorile p (p-values) ordonate \(p_{(1)} \le \dots \le p_{(m)}\) și nivelul \(a\), respingem \(H_{(i)}\) dacă
    \begin{equation*} \begin{array}{ll} \text{Bonferroni:} & p_{(i)} \le a/m \\ \text{Holm:} & p_{(j)} \le a/(m - j + 1) \text{ pentru orice } j \le i \\ \text{Benjamini--Hochberg:} & i \le \max\{k : p_{(k)} \le k\,a/m\} \end{array} \end{equation*}
    • Bonferroni și Holm Holm (1979) controlează probabilitatea oricărei descoperiri false (FWER)
    • Holm respinge cel puțin tot ce respinge Bonferroni
    • Benjamini–Hochberg (BH) Benjamini & Hochberg (1995) controlează ponderea așteptată a descoperirilor false printre respingeri (FDR)
    • Pentru prognoze: mulțimea de încredere a modelelor (MCS) în locul multor teste pe perechi Hansen, Lunde & Nason (2011)

Eroare de date: alinierea randamentelor în locul prețurilor

Slide 29 în PDF

Bitcoin se tranzacționează în fiecare zi, SPY doar în zilele lucrătoare. Procedura greșită calculează fiecare randament în propriul calendar și apoi păstrează zilele comune, astfel încît mișcările Bitcoin din weekend dispar. Procedura corectă păstrează zilele comune ale prețurilor și abia apoi calculează randamentele, astfel încît randamentul de luni acoperă intervalul vineri–luni pentru ambele active.

Diferența este mare. Pentru Bitcoin, 2020–2026, pe zilele comune, randamentul cumulat este 1 025% cu alinierea corectă și 680% cu cea greșită, iar abaterea standard a randamentelor de luni este 5,04% față de 3,83%: alinierea greșită ascunde riscul din weekend. Remediul este alinierea întîi a prețurilor pe zilele comune; o serie analizată singură rămîne în propriul calendar.

Pe scurt

  • Bitcoin se tranzacționează zilnic, SPY doar în zilele lucrătoare
    • Greșit: calculăm fiecare randament pe calendarul propriu, apoi păstrăm zilele comune: mișcările Bitcoin din weekend dispar
    • Corect: păstrăm zilele comune ale prețurilor, apoi calculăm randamentele: ziua de luni acoperă intervalul vineri–luni pentru ambele
  • Bitcoin, 2020–2026, în zilele comune: randament cumulat 1 025% (corect) față de 680% (greșit)
    • Abaterea standard a zilei de luni 5,04% (corect) față de 3,83% (greșit): alinierea greșită ascunde riscul din weekend
  • Remediu: aliniați întîi prețurile pe zilele comune
    • o serie analizată singură rămîne pe calendarul propriu

Eroare de inferență: ignorarea cozilor groase

Slide 30 în PDF

Erorile standard clasice presupun independența și momente finite ale mărimii analizate:

  • Pentru varianțe, autocorelații și rapoarte Sharpe, momentul de ordinul patru al randamentelor;
  • Pentru testul DM, momentele diferenței de pierderi;
  • Pentru QMLE gaussian, momentul de ordinul patru al inovațiilor standardizate.

Pentru BET, \(\hat\alpha = 2{,}39\), cu un CI de 95% de [2,12; 3,03] (capitolul 1), ceea ce, sub o coadă de tip Pareto, este compatibil cu un kurtosis infinit, fără să-l demonstreze. Excesul de kurtosis din eșantion, 11,1, nu estimează atunci niciun parametru finit, iar un interval bootstrap pentru el nu este valid (Athreya, 1987); trebuie raportat în schimb tail index-ul.

Remediile sînt erorile standard HAC, block bootstrap-ul acolo unde este valid și intervalele care respectă frontiera parametrului. Eroarea standard HAC Newey–West a unei medii \(\bar d\) (Newey & West, 1987) este \(\mathrm{SE}(\bar d) = \sqrt{\hat\Omega/T}\), cu

\[\hat\Omega = \hat\gamma_0 + 2\sum_{j=1}^{L}\Big(1 - \frac{j}{L+1}\Big)\hat\gamma_j,\]
(19.16)

unde \(\hat\gamma_j\) este autocovarianța din eșantion la lagul \(j\), iar \(L\) numărul de laguri; ponderile Bartlett garantează \(\hat\Omega \ge 0\). Aceeași varianță pe termen lung intră în testul Diebold–Mariano de la Pasul 5.

Pe scurt

  • Erorile standard clasice presupun independență și momente finite ale mărimii analizate
    • varianța, autocorelațiile și Sharpe: momentul de ordin patru al randamentelor; DM: momentele diferențialului de pierdere; QMLE Gaussian: momentul patru al inovațiilor standardizate
    • BET: \(\hat\alpha = 2{,}39\), CI 95% \([2{,}12; 3{,}03]\) (Capitolul 1): sub o coadă de tip Pareto, compatibil cu un kurtosis infinit, nu o dovadă
    • Excesul de kurtosis empiric (11,1) nu estimează un parametru finit dacă \(\alpha < 4\), iar un interval bootstrap pentru el nu este valid Athreya (1987): raportați indicele cozii
  • Remediu: erori HAC, bootstrap pe blocuri, intervale care respectă frontiera parametrilor
    • bootstrap pe blocuri acolo unde este valid
  • Eroarea standard HAC Newey–West a unei medii \(\bar d\) Newey & West (1987): \(\mathrm{SE}(\bar d) = \sqrt{\hat\Omega/T}\), cu
    \begin{equation*} \hat\Omega = \hat\gamma_0 + 2\sum_{j=1}^{L}\Big(1 - \frac{j}{L + 1}\Big)\hat\gamma_j \end{equation*}
    • \(\hat\gamma_j\): autocovarianța empirică la lagul \(j\); \(L\): numărul de laguri; ponderile Bartlett garantează \(\hat\Omega \ge 0\)
    • Aceeași dispersie de termen lung intră în testul Diebold–Mariano (Pasul 5)

Persistența aproape de 1: care frontieră? (1/2)

Slide 31 în PDF

Restricția \(p = \alpha + \beta \le 1\) asupra persistenței GARCH este o alegere, nu o proprietate a modelului. Interiorul ei dă o varianță necondiționată finită și un timp de înjumătățire finit, iar egalitatea este frontiera IGARCH (integrated GARCH). Fără restricție, un \(p\) puțin peste 1 este admisibil (Nelson, 1990): procesul poate fi încă strict staționar cînd \(E\ln(\alpha z_t^2 + \beta) < 0\), dar nu are varianță finită și nici timp de înjumătățire.

Pentru BET, \(\hat p = 0{,}9907\) se află în interiorul regiunii; dificultatea este că \(p\) adevărat poate fi egal cu 1. La \(p = 1\) estimatorul nu este aproximativ normal (Andrews, 1999), deci intervalul Wald [0,974; 1,007] este neinformativ sub restricție, nu greșit.

Pe scurt

  • \(p = \alpha + \beta \le 1\) este o restricție pe care o alegem, nu o proprietate a modelului GARCH
    • în interior, varianța necondiționată și timpul de înjumătățire sînt finite
    • egalitatea este frontiera IGARCH (GARCH integrat)
  • Fără restricție, un \(p\) puțin peste 1 este admisibil Nelson (1990)
    • procesul poate fi strict staționar, cînd \(E\ln(\alpha z_t^2 + \beta) < 0\)
    • dar nu are varianță finită și nici timp de înjumătățire
  • BET: \(\hat p = 0{,}9907\) se află în interiorul regiunii
    • dificultatea vine de la \(p\) adevărat, care poate fi egal cu 1
  • La \(p = 1\) estimatorul nu este aproximativ Normal Andrews (1999)
    • deci intervalul Wald [0,974; 1,007] nu este informativ sub restricția noastră, nu „greșit”

Persistența aproape de 1: care frontieră? (2/2)

Slide 32 în PDF

Testul raportului de verosimilitate pentru \(H_0: p = 1\) are distribuția de frontieră \(\tfrac12\chi^2_0 + \tfrac12\chi^2_1\), a cărei valoare critică de 5% este 2,71 în loc de 3,84. Pentru BET, \(LR = 1{,}01\), cu o valoare p de 0,16, deci nu respingem IGARCH. Intervalul de încredere din verosimilitatea profil (profile likelihood) în interiorul \(p \le 1\) este [0,975; 1], așa că timpul de înjumătățire este de cel puțin 27 de zile, fără o limită superioară finită.

Valorile critice de frontieră se aplică doar cînd parametrul adevărat se poate afla pe marginea spațiului parametrilor impus, nu de fiecare dată cînd o estimație este aproape de o limită oarecare.

Pe scurt

  • Testul raportului de verosimilitate pentru \(H_0\colon p = 1\) are distribuția de frontieră \(\tfrac12\chi^2_0 + \tfrac12\chi^2_1\)
    • valoarea critică de 5% este 2,71 în loc de 3,84
    • BET: \(LR = 1{,}01\), valoarea p 0,16, deci IGARCH nu este respins
  • CI din verosimilitatea profil, în spațiul \(p \le 1\): \([0{,}975; 1]\)
    • deci timpul de înjumătățire este de cel puțin 27 de zile, fără o limită superioară finită
  • Valorile critice de frontieră se aplică doar cînd parametrul adevărat poate fi pe marginea spațiului impus
    • nu ori de cîte ori o estimare este aproape de o limită

Eroare de evaluare: o funcție de pierdere care nu poate ierarhiza ținta

Slide 33 în PDF

O prognoză de varianță \(f_t\) se compară cu un indicator zgomotos \(\hat\sigma_t^2\), cum ar fi \(r_t^2\) sau \(RV_t\). Pierderea eroare pătratică medie (MSE, mean squared error) este \((\hat\sigma_t^2 - f_t)^2\), iar pierderea QLIKE este \(\hat\sigma_t^2/f_t - \ln(\hat\sigma_t^2/f_t) - 1\). Cu un indicator condiționat nedeplasat, MSE și QLIKE ierarhizează prognozele ca varianța adevărată (Patton, 2011); QLIKE depinde doar de raportul dintre indicator și prognoză, așa că zilele volatile cîntăresc mai puțin decît sub MSE. În capitolul 9, log-HAR bate GARCH în QLIKE, în timp ce comparația prin MSE este neconcludentă.

ES singur nu are o funcție de scor strict consistentă pe clasele largi uzuale de distribuții, dar perechea (VaR, ES) are una (Fissler & Ziegel, 2016): scorul FZ0 folosit la Pasul 5, combinat cu teste Diebold–Mariano. Precizia acestor comparații este limitată în eșantioane finite (Pele & Mazurencu-Marinescu-Pele, 2026). Remediul este alegerea funcției de pierdere înaintea comparației și declararea ei în raportul proiectului.

Pe scurt

  • Prognoza de varianță \(f_t\) se compară cu un proxy zgomotos \(\hat\sigma_t^2\) (\(r_t^2\) sau \(RV_t\))
    • pierderea MSE (Mean Squared Error): \((\hat\sigma_t^2 - f_t)^2\)
    • QLIKE: \(\hat\sigma_t^2/f_t - \ln(\hat\sigma_t^2/f_t) - 1\)
  • Cu un proxy condiționat nedeplasat, MSE și QLIKE ierarhizează prognozele la fel ca varianța adevărată Patton (2011)
  • QLIKE depinde doar de raportul proxy/prognoză, deci zilele volatile cîntăresc mai puțin decît la MSE
  • Capitolul 9: log-HAR bate GARCH în QLIKE, dar comparația în MSE nu este concludentă
  • ES singur nu are o funcție de scor strict consistentă (minimizată în medie doar de prognoza corectă) pe clasele largi obișnuite de distribuții
  • Perechea (VaR, ES) are una Fissler & Ziegel (2016): scorul FZ0 (Pasul 5)
  • Remediu: alegeți funcția de pierdere înainte de comparație și precizați-o în raportul proiectului

Sinteza secțiunii

Fiecare capcană are un test care poate fi rulat în propriul cod:

  • Recalcularea cu datele pînă la \(t\);
  • Numărarea testelor;
  • Alinierea prețurilor înaintea randamentelor;
  • Raportarea tail index-ului și a erorilor HAC;
  • Verificarea dacă parametrul adevărat se poate afla pe o frontieră;
  • Fixarea dinainte a funcției de pierdere.

Studiul de caz care urmează aplică aceste verificări unei singure serii.

Studiu de caz integrat: BET

Studiul de caz parcurge firul principal al cursului pe o serie românească, indicele BET. Pune o singură întrebare de risc, cît poate pierde mîine o poziție pe BET cu probabilitatea de 1%, și răspunde în cinci pași care folosesc patru capitole: faptele stilizate, volatilitatea GARCH, prognozele VaR, ratele depășirilor și o comparație formală a modelelor.

Studiu de caz integrat: metode din patru capitole (1/2)

Slide 34 în PDF

Întrebarea este cît poate pierde mîine o poziție pe indicele BET cu probabilitatea de 1% și ce prognoză a acestei pierderi ar fi meritat încredere în timp real în 2005–2026. Datele sînt valorile oficiale de închidere zilnice ale BET din 6 ianuarie 2000 pînă pe 18 septembrie 2026, adică 6 670 de randamente logaritmice zilnice.

Randamentul logaritmic în procente este \(r_t = 100\ln(P_t/P_{t-1})\), iar pierderea \(L_t = -r_t\). Înregistrările duplicate și rîndurile datate în weekend sînt eliminate, în timp ce zilele cu închidere neschimbată sînt păstrate.

Pe scurt

Întrebarea
  • Cît poate pierde mîine o poziție pe indicele BET, cu probabilitatea de 1%?
  • Pe ce prognoză a acestei pierderi ne-am fi putut baza în timp real, în 2005–2026?
Date
  • Indicele BET, valori oficiale zilnice de închidere, 6 ian. 2000 – 18 sept. 2026
    • 6 670 de randamente log zilnice
  • Randamentul log, în %: \(r_t = 100\ln(P_t/P_{t-1})\), iar pierderea \(L_t = -r_t\)
  • Eliminate: înregistrările duplicate și rîndurile datate în weekend
    • zilele cu închidere neschimbată rămîn

Studiu de caz integrat: metode din patru capitole (2/2)

Slide 35 în PDF

Studiul de caz combină patru capitole:

  • Capitolul 1 dă faptele stilizate, cu inferență robustă;
  • Capitolul 5 modelul GARCH(1,1) cu inovații Student-\(t\);
  • Capitolul 7 VaR 1% pe o zi din patru modele;
  • Capitolul 8 testele de acoperire și independență și zonele Basel.

O comparație formală a celor patru modele completează studiul, cu pierderea FZ0, teste Diebold–Mariano (DM) și mulțimea de încredere a modelelor.

Pe scurt

Cei cinci pași
  • Capitolul 1: fapte stilizate, cu inferență robustă
  • Capitolul 5: GARCH(1,1) cu inovații Student-\(t\)
  • Capitolul 7: VaR 1% pentru o zi, din patru modele
  • Capitolul 8: acoperire, independență și zonele Basel
  • Compararea formală a celor patru modele
    • pierderea FZ0, teste Diebold–Mariano (DM), mulțimea de încredere a modelelor

Semnificațiile simbolului \(\alpha\) în studiul de caz

Slide 36 în PDF

Litera \(\alpha\) are patru sensuri în studiul de caz:

  • La Pasul 1 este tail index-ul Hill al pierderilor, 2,39, rata cu care \(P(L > x)\) scade ca \(x^{-\alpha}\).
  • La Pasul 2 este ponderea GARCH a șocului pătratic de ieri, 0,192.
  • La Pașii 3–4 este nivelul VaR, probabilitatea promisă a depășirii, de 1%, care intră în \(LR_{uc}\) și în testul cuantilei dinamice (DQ, dynamic quantile).
  • La Pasul 5 este nivelul ES de 2,5% folosit pentru a evalua perechea (VaR, ES) cu scorul \(S(v, e; y)\).

Înainte de a înlocui un număr, trebuie să ne întrebăm la ce \(\alpha\) se referă formula: testul Kupiec cere \(\alpha = 0{,}01\), niciodată 2,39 sau 0,192. Și litera \(p\) are două sensuri, persistența GARCH \(p = \alpha + \beta\) și o valoare p.

Pe scurt

UndeSensul lui \(\alpha\)ValoareaIntră în
Pasul 1, Hillindicele cozii pierderilor\(2{,}39\)\(P(L > x)\) scade ca \(x^{-\alpha}\)
Pasul 2, GARCHponderea pătratului șocului de ieri\(0{,}192\)\(\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2\)
Pașii 3–4, VaR și Kupiecnivelul VaR: probabilitatea promisă a depășirii\(1\%\)\(LR_{uc}\), \(DQ\)
Pasul 5, FZ0 și ESnivelul ES cu care se evaluează perechea (VaR, ES)\(2{,}5\%\)\(S(v, e; y)\)
  • Înainte de a înlocui o cifră, întrebați-vă despre ce \(\alpha\) este vorba în formulă
    • testul Kupiec cere \(\alpha = 0{,}01\), niciodată \(2{,}39\) sau \(0{,}192\)
  • Și litera \(p\) are două sensuri aici
    • persistența GARCH \(p = \alpha + \beta\) și valoarea p a unui test

Pasul 1: ce măsurăm și cu ce test

Slide 37 în PDF

Pasul 1 măsoară două fapte stilizate:

  1. Cozile se măsoară prin tail index-ul Hill \(\hat\alpha\) al pierderilor (19.2), cu un CI de 95% prin block bootstrap.
  2. Volatility clustering se măsoară prin autocorelațiile lui \(|r_t|\) și se testează cu testul Ljung–Box pe \(r_t^2\),
\[Q(m) = T(T+2)\sum_{k=1}^{m}\frac{\hat\rho_k^2}{T-k} \sim \chi^2_m \ \text{sub } H_0,\]
(19.17)

unde \(H_0\) afirmă că primele \(m\) autocorelații sînt nule, iar \(\hat\rho_k\) este autocorelația din eșantion la lagul \(k\); aici \(m = 10\), deci valoarea critică de 5% este 18,3.

Graficul următor are două panouri: în stînga, cuantilele randamentelor standardizate față de cele ale distribuției Normale; în dreapta, funcția de autocorelație (ACF, autocorrelation function) a lui \(r_t\) și a lui \(|r_t|\).

Pe scurt

  • Cozile: indicele Hill \(\hat\alpha\) al cozii pierderilor, cu un CI 95% prin bootstrap pe blocuri
  • Gruparea volatilității: autocorelațiile lui \(|r_t|\) și testul Ljung–Box pe \(r_t^2\)
    \begin{equation*} Q(m) = T(T+2)\sum_{k=1}^{m}\frac{\hat\rho_k^2}{T-k} \;\sim\; \chi^2_m \ \text{sub } H_0 \end{equation*}
    • \(H_0\): primele \(m\) autocorelații sînt zero; \(\hat\rho_k\): autocorelația empirică la lagul \(k\)
    • aici \(m = 10\), deci valoarea critică de 5% este 18,3
  • Graficul următor
    • în stînga, cuantilele randamentelor standardizate față de cele ale distribuției Normale
    • în dreapta, ACF (funcția de autocorelație) a lui \(r_t\) și a lui \(|r_t|\)

Pasul 1: faptele stilizate ale BET

Slide 38 în PDF
    Întrebare pentru sală Tail index-ul Hill al pierderilor BET este 2,39. Ce spune această valoare despre kurtosis-ul randamentelor?
    Răspuns

    Pentru o coadă de tip Pareto cu indicele adevărat α < 4, momentul de ordin patru este infinit. Estimarea Hill 2,39 și intervalul de încredere de 95% [2,12; 3,03] susțin această interpretare, fără să o demonstreze. Dacă această ipoteză despre coadă este corectă, excesul empiric de kurtosis, 11,1, nu estimează un parametru finit; de aceea se raportează tail index-ul. Pragul 2 privește momentul de ordin doi; pentru momentul de ordin patru, pragul relevant este 4. Pe tot eșantionul sînt 51 de zile dincolo de ±4 abateri standard, față de 0,42 așteptate sub distribuția Normală.

    Panoul din stînga compară cuantilele randamentelor BET standardizate cu cuantilele Normale, astfel încît cozile groase apar ca puncte care se îndepărtează de diagonală la ambele capete. Panoul din dreapta arată ACF a randamentelor și a randamentelor absolute, cu o bandă calculată pentru date i.i.d.

    Pasul 1: citirea graficului

    Slide 39 în PDF

    Cozile sînt groase: tail index-ul Hill al pierderilor este \(\hat\alpha = 2{,}39\), cu un CI de 95% de [2,12; 3,03], așa că kurtosis-ul nu este raportat, deoarece \(\hat\alpha < 4\). Există 51 de zile dincolo de ±4 abateri standard, față de 0,42 așteptate sub distribuția Normală, iar cea mai mare pierdere zilnică este −13,1%, pe 7 ianuarie 2009.

    Volatilitatea vine grupată: ACF a lui \(|r_t|\) este 0,40 la lagul 1 și scade lent, iar statistica Ljung–Box \(Q(10)\) pe \(r_t^2\) este 2 440, față de valoarea critică 18,3; limita \(\chi^2\) uzuală a testului pe \(r_t^2\) cere un moment de ordinul opt finit. Autocorelația de ordinul întîi a randamentelor, 0,11, este tipică unei piețe mai puțin lichide (capitolele 2 și 10). Un VaR bazat pe distribuția Normală cu volatilitate constantă este de aceea prea mic în stres și prea mare în perioadele calme.

    Pe scurt

    • Cozi groase (stînga)
      • Indicele Hill al cozii pierderilor: \(\hat\alpha = 2{,}39\), CI 95% [2,12; 3,03]
      • kurtosis-ul nu se raportează, pentru că \(\hat\alpha < 4\)
      • 51 de zile dincolo de \(\pm 4\) abateri standard, față de 0,42 așteptate sub distribuția Normală
      • cea mai mare pierdere: \(-13{,}1\%\), pe 7 ian. 2009
    • Gruparea volatilității (dreapta)
      • ACF a lui \(|r_t|\) la lagul 1: 0,40, cu o scădere lentă (banda presupune randamente i.i.d.)
      • Ljung–Box \(Q(10)\) pe \(r_t^2\): 2 440, față de valoarea critică de 18,3
      • testul pe \(r_t^2\) cere moment finit de ordin opt pentru limita \(\chi^2\) obișnuită
    • Autocorelația de ordinul 1 a randamentelor: 0,11
    • Un VaR Normal cu volatilitate constantă este deci prea mic în stres și prea mare în perioadele calme
    MFM_ch19_case_study

    Pasul 2: volatilitatea GARCH(1,1)-\(t\)

    Slide 40 în PDF

    Pasul 2 ajustează un model GARCH(1,1) cu inovații Student-\(t\) pe randamentele logaritmice zilnice ale BET, 2000–2026, iar graficul arată randamentele cu banda \(\pm 2\hat\sigma_t\). Persistența \(\hat\alpha + \hat\beta\) determină cît durează un șoc de volatilitate, prin timpul de înjumătățire din recapitularea GARCH.

      Întrebare pentru sală În GARCH(1,1), efectul unui șoc asupra prognozei varianței se transmite cu factorul α + β = 0,9907 pe zi. După aproximativ cîte zile se înjumătățește acest efect?
      Răspuns

      După aproximativ 74 de zile de tranzacționare: ln 0,5 / ln 0,9907. Folosirea doar a lui β = 0,799 ignoră propagarea prin șocurile viitoare; 1/(1 − p) nu este formula timpului de înjumătățire. Persistența nu poate fi separată de 1: testul raportului de verosimilitate pentru p = 1 dă LR = 1,01, cu p-value 0,16. Intervalul profil pentru p, [0,975; 1], se transformă într-un interval pentru timpul de înjumătățire cu limita inferioară de aproximativ 27 de zile și fără limită superioară finită.

      Cu erori standard robuste, \(\hat\alpha = 0{,}192\) (0,025), \(\hat\beta = 0{,}799\) (0,024) și \(\hat\nu = 5{,}01\) grade de libertate, deci cozile rămîn groase și după filtrare. Persistența \(\hat\alpha + \hat\beta = 0{,}9907\) dă un timp de înjumătățire de aproximativ 74 de zile de tranzacționare, dar nu poate fi separată de 1, cum arată capcana despre persistența aproape de 1. Volatilitatea zilnică a atins maximul de 7,39% pe 15 octombrie 2008, iar la sfîrșitul eșantionului, pe 18 septembrie 2026, \(\hat\sigma_T = 1{,}67\%\).

      Pe scurt

      • Randamentele log zilnice ale BET cu \(\pm 2\hat\sigma_t\) dintr-un GARCH(1,1) cu inovații Student-\(t\), 2000–2026
        • Estimările, cu erorile standard robuste în paranteză: \(\hat\alpha = 0{,}192\) (0,025), \(\hat\beta = 0{,}799\) (0,024), \(\hat\nu = 5{,}01\)
        • \(\hat\nu\), gradele de libertate ale inovațiilor \(t\), este mic: cozi groase chiar după filtrare
      • Persistența \(\hat\alpha + \hat\beta = 0{,}9907\)
        • un timp de înjumătățire de aproximativ 74 de zile de tranzacționare
        • nu poate fi separată de 1 (capcana „Persistența aproape de 1”)
      • Volatilitatea condiționată zilnică a atins maximul de 7,39% pe 15 oct. 2008
        • la finalul eșantionului (18 sept. 2026), \(\hat\sigma_T = 1{,}67\%\)
      MFM_ch19_case_study

      Pasul 3: pierderi și VaR 1%, 2020–2026 (1/2)

      Slide 41 în PDF

      Pasul 3 compară două prognoze VaR 1% pe pierderile zilnice ale BET din 2020–2026, cu cîștigurile trunchiate la 0: VaR Normal estimat pe o fereastră de 500 de zile și VaR FHS, care scalează randamentele standardizate istorice cu volatilitatea GARCH. Punctele negre marchează pierderile peste VaR-ul FHS.

        Întrebare pentru sală În cele 1 675 de zile din 2020–2026 erau de așteptat aproximativ 17 depășiri ale VaR 1%. Care dintre cele două modele se apropie de acest număr?
        Răspuns

        FHS, cu 22 de depășiri; modelul Normal are 41. VaR-ul FHS a urcat la 11,6% pe 18 mar. 2020, în timp ce VaR-ul Normal, estimat pe 500 de zile, se ajustează lent, iar depășirile lui se grupează în primele săptămîni ale fiecărui episod de stres.

        FHS reacționează în cîteva zile și a atins 11,6% pe 18 martie 2020, în timpul crahului din pandemia COVID-19, în timp ce VaR Normal pe o fereastră de 500 de zile se ajustează lent.

        Pe scurt

        • Pierderile zilnice ale BET și prognozele VaR 1% Normal și FHS
          • cîștigurile sînt trunchiate la 0
        • Punctele negre marchează pierderile peste VaR-ul FHS
        • FHS reacționează în cîteva zile
          • a atins 11,6% pe 18 mar. 2020, în timpul crahului din pandemia COVID-19
          • VaR Normal pe o fereastră de 500 de zile se ajustează lent
        MFM_ch19_case_study

        Pasul 3: pierderi și VaR 1%, 2020–2026 (2/2)

        Slide 42 în PDF

        În cele 1 675 de zile din grafic erau de așteptat aproximativ 17 depășiri; FHS are 22, iar modelul Normal 41, iar depășirile modelului Normal se grupează în primele săptămîni ale fiecărui episod de stres. Ultima prognoză VaR este 4,48% pentru FHS și 2,18% pentru modelul Normal.

        Pe scurt

        • În cele 1 675 de zile erau de așteptat aproximativ 17 depășiri
          • depășirile efective au fost 22 (FHS) și 41 (Normal)
          • Depășirile modelului Normal se grupează în primele săptămîni ale fiecărui episod de stres
        • Ultima prognoză VaR: FHS 4,48%, Normal 2,18%

        Pasul 4: ratele depășirilor

        Slide 43 în PDF

        Graficul dă, pentru fiecare dintre cele patru modele, ponderea zilelor cu o pierdere peste prognoza VaR 1% în cele \(T = 5\,432\) de zile de evaluare ale Pasului 3. Banda bleu este intervalul binomial de 95% [0,74%; 1,27%] al ratei observate cînd rata adevărată este 1%.

          Întrebare pentru sală VaR 1%, 5 432 de zile de evaluare: citite separat, testele Kupiec la 5% resping HS, modelul Normal și GARCH-t. Se schimbă lista modelelor respinse dacă aplicăm corecția Holm (FWER 5%) celor patru teste?
          Răspuns

          Nu. P-value-urile Kupiec sînt sub 0,001 (Normal, 122 de depășiri), 0,001 (GARCH-t, 80), 0,002 (HS, 79) și 0,095 (FHS, 67). Holm le compară, în ordine, cu 0,05/4 = 0,0125, 0,05/3 ≈ 0,0167, 0,05/2 = 0,025 și 0,05: primele trei trec pragul, FHS nu. Corecția face testele mai stricte, deci nu poate adăuga respingeri. Rata FHS, 1,23%, este în banda binomială de 95% [0,74%; 1,27%]; nerespingerea nu demonstrează că rata adevărată este exact 1%. O rată peste 1% nu implică automat respingerea, iar apropierea numerică de 1% nu înlocuiește testul.

          Doar FHS, cu 1,23%, se află în interiorul benzii. Modelul Normal, cu 2,25%, depășește de peste două ori mai des decît ar trebui.

          Pe scurt

          • Ponderea zilelor cu pierdere peste prognoza VaR 1%, în cele \(T = 5\,432\) zile de evaluare din Pasul 3
          • Banda albastru deschis: intervalul binomial de 95% [0,74%; 1,27%] dacă rata adevărată este 1%
          • Doar FHS (1,23%) se află în bandă
            • modelul Normal (2,25%) este depășit de peste două ori mai des decît ar trebui
          MFM_ch19_case_study

          Pasul 5: rezultate

          Slide 44 în PDF

          Tabelul compară cele patru modele după patru criterii:

          1. Testul cuantilei dinamice (DQ) cu valoarea lui p;
          2. Scorul FZ0 mediu;
          3. Valoarea p a mulțimii de încredere a modelelor (MCS);
          4. Zona unui backtest comparativ al ES.

          Doar FHS trece testul DQ la 5% (\(p = 0{,}129\)); GARCH-\(t\) îl pică (\(p = 0{,}007\)) prin excesul de depășiri.

          La scorul FZ0, unde mai mic este mai bine, FHS (1,157) și GARCH-\(t\) (1,175) nu diferă semnificativ (DM \(t = 1{,}39\)) și ambele bat HS și modelul Normal (\(|t| > 4{,}9\)). Mulțimea de încredere a modelelor de 10% este {GARCH-t, FHS}, iar backtest-ul comparativ al ES plasează modelul Normal în zona roșie, iar GARCH-\(t\) și FHS în zona verde.

          Modelele filtrate GARCH sînt superioare, iar FHS rămîne singurul model nerespins de niciun test de acoperire, independență sau DQ. Rezultatul susține o comparație de proceduri; FZ0 evaluează perechea (VaR 2,5%, ES 2,5%), nu VaR 1% din Pașii 3–4.

          Pe scurt

          Model\(DQ\)\(p_{DQ}\)FZ0\(p_{MCS}\)Zona ES
          HS192,1\(<\)0,0011,4220,00standard
          Normal364,6\(<\)0,0011,4950,00roșu
          GARCH-t17,90,0071,1750,18verde
          FHS9,90,1291,1571,00verde
          • Doar FHS trece testul DQ (Dynamic Quantile, testul cuantilei dinamice) la 5% (\(p = 0{,}129\))
            • GARCH-\(t\) nu îl trece (\(p = 0{,}007\)) din cauza excesului de depășiri
          • FZ0 (mai mic este mai bun): FHS și GARCH-\(t\) nu diferă semnificativ (DM \(t = 1{,}39\))
            • ambele sînt superioare modelelor HS și Normal (\(|t| > 4{,}9\))
            • Mulțimea de încredere a modelelor la 10% este {GARCH-t, FHS}
          • Verificarea comparativă a ES, față de HS ca model standard: Normal roșu, GARCH-\(t\) și FHS verzi
          • Modelele cu filtru GARCH sînt superioare
            • FHS rămîne singurul model nerespins de niciun test (acoperire, independență, DQ)
          • Tipul de dovadă: comparație între proceduri (arată care metodă funcționează mai bine pe aceleași date, nu de ce)
            • FZ0 evaluează perechea (VaR 2,5%, ES 2,5%), nu VaR 1% din Pașii 3–4

          Puterea unui backtest: definiția

          Slide 45 în PDF

          Întrebarea este cît de des observă testul Kupiec că un model VaR 1% este greșit. La o rată adevărată a depășirilor \(\pi\), puterea lui este o probabilitate binomială exactă, cea a regiunii de respingere \(R_T\) a testului de 5%:

          \[\text{Puterea}(\pi) = \sum_{x \in R_T}\binom{T}{x}\pi^{x}(1-\pi)^{T-x}, \qquad R_T = \{x : LR_{uc}(x) > 3{,}84\}.\]
          (19.18)

          La \(\pi = 1\%\) aceeași sumă dă nivelul efectiv al testului nominal de 5%: 9,48% la \(T = 250\), unde \(R_T\) conține 0 depășiri și orice număr de la 7 în sus.

          Efectul minim detectabil (MDE, minimum detectable effect) este cea mai mică rată adevărată \(\pi > 1\%\) cu \(\text{Puterea}(\pi) \ge 80\%\). Puterea crește cu \(T\), pentru că eroarea standard a ratei observate \(\hat\pi\) este \(\sqrt{\pi(1-\pi)/T}\).

          Pe scurt

          • Întrebarea: dacă modelul VaR 1% greșește, cît de des observă testul Kupiec acest lucru?
          • Puterea la rata reală a depășirilor \(\pi\): o probabilitate binomială exactă
            • probabilitatea regiunii de respingere \(R_T\) a testului de 5%
            \begin{equation*} \text{Putere}(\pi) = \sum_{x \in R_T}\binom{T}{x}\pi^{x}(1 - \pi)^{T - x}, \qquad R_T = \{x : LR_{uc}(x) > 3{,}84\} \end{equation*}
            • La \(\pi = 1\%\), aceeași sumă dă mărimea efectivă (rata respingerilor unui model corect) a testului cu nivel nominal de 5%: 9,48% la \(T = 250\)
            • La \(T = 250\), \(R_T\) conține 0 depășiri și orice număr de cel puțin 7
          • Efectul minim detectabil (MDE): cea mai mică rată reală \(\pi > 1\%\) cu \(\text{Putere}(\pi) \ge 80\%\)
          • Puterea crește cu \(T\)
            • eroarea standard a ratei observate \(\hat\pi\) este \(\sqrt{\pi(1 - \pi)/T}\)

          Puterea de detecție a unui backtest: testul Kupiec

          Slide 46 în PDF

          Graficul arată puterea (19.18) a testului Kupiec de 5% în funcție de rata adevărată a depășirilor unui model VaR 1%, pentru mai multe lungimi ale eșantionului \(T\), de la un an Basel de 250 de zile pînă la cele 5 432 de zile ale studiului de caz.

            Întrebare pentru sală Presupunem depășiri independente, cu probabilitatea reală 2% pe zi, pentru un model VaR 1%. Cum se schimbă probabilitatea ca testul Kupiec de 5% să respingă modelul cînd ▶ mărește T de la 250 la 5 432 de zile?
            Răspuns

            Crește de la 24% la aproape 100% (78% la T = 1 000). La T = 250 testul respinge la 0 depășiri sau la cel puțin 7. Nivelul de 5% este nominal și privește ipoteza nulă; nici 1 − 5% nu este puterea. Cu pragul asimptotic 3,84, probabilitatea efectivă de respingere la rata nulă de 1% este 9,5% la T = 250. Pe grila paginii, prima rată reală detectată cu o putere de cel puțin 80% este 3,65% la T = 250 (un exces de 2,65 puncte procentuale peste țintă), 2,05% la T = 1 000 și 1,45% la T = 5 432. O nerespingere cu putere mică înseamnă „nicio dovadă”, nu „nicio problemă”.

            La \(T = 250\), o rată adevărată a depășirilor de 2% este detectată doar în 24% din cazuri. MDE, căutat pe o grilă cu pași de 0,05 puncte procentuale, este 3,65% la \(T = 250\), 2,05% la \(T = 1\,000\) și 1,45% la \(T = 5\,432\), iar chiar și la \(T = 5\,432\) o rată adevărată de 1,3% este detectată cu probabilitatea de doar 55%. O nerespingere cu putere mică înseamnă „nicio dovadă”, nu „nicio problemă”, de aceea puterea trebuie declarată înaintea testului.

            Pe scurt

            • Probabilitatea binomială exactă ca testul Kupiec de 5% să respingă un model VaR 1%
              • după rata reală a depășirilor
            • \(T = 250\) (un an Basel): o rată reală a depășirilor de 2% este detectată doar în \(24\%\) din cazuri
            • MDE, căutat pe o grilă cu pasul de 0,05 puncte procentuale
              • \(3{,}65\%\) la \(T = 250\), \(2{,}05\%\) la \(T = 1\,000\), \(1{,}45\%\) la \(T = 5\,432\)
              • Chiar la \(T = 5\,432\), o rată reală de 1,3% este detectată doar cu probabilitatea \(55\%\)
            • O nerespingere cu putere mică înseamnă „nicio dovadă”, nu „nicio problemă”
              • precizați puterea înaintea testului
            MFM_ch19_case_study

            Sinteza secțiunii

            Pe BET, filtrul GARCH cu randamente standardizate istorice (FHS) este singura prognoză VaR 1% pe care niciun backtest nu o respinge, în timp ce modelul Normal depășește de peste două ori mai des decît ar trebui. Calculul puterii arată cît de slabe ar fi aceste concluzii pe un singur an de date, motiv pentru care un proiect își declară dinainte puterea testului principal.

            Studii de caz integrate: portofoliu, Bitcoin, investitor român

            Studiul de caz BET a aplicat cinci pași unui singur indice. Cele trei studii din această secțiune aplică aceeași logică unor decizii practice: ce portofoliu de varianță minimă și ce prognoză VaR păstrăm, ce limită zilnică de pierdere stabilim pentru Bitcoin și dacă un investitor care își măsoară averea în lei trebuie să se acopere față de euro. Fiecare studiu își fixează întrebarea și regula de decizie înaintea cifrelor, combină mai multe capitole ale cursului și se încheie cu ce alegem, în ce condiții și ce ne-ar face să schimbăm alegerea.

            Portofoliul multi-active: întrebarea și regula de decizie

            Slide 47 în PDF

            Primul studiu întreabă ce portofoliu global de varianță minimă (GMV, global minimum-variance) din opt fonduri tranzacționate la bursă (ETF, exchange-traded funds) păstrăm și pe ce prognoză VaR 1% pe o zi ne bazăm. Universul este cel multi-active din capitolul 4, cu prețuri ajustate zilnice din aprilie 2007 pînă în iulie 2026:

            • Trei fonduri de acțiuni (SPY pentru SUA, EFA pentru piețele dezvoltate din afara SUA și EEM pentru piețele emergente);
            • Două fonduri de titluri de stat americane (TLT, peste 20 de ani, și IEF, 7–10 ani);
            • Două fonduri de obligațiuni corporative (LQD, investment grade, și HYG, high yield);
            • Fondul de aur GLD (SPDR Gold Shares, ETF pe aur).

            Evaluarea acoperă perioada 1 mai 2012–31 iulie 2026, adică 3 583 de zile.

            Patru capitole furnizează pașii:

            • Capitolul 4 dă ponderile GMV lunare din ultimele 60 de luni, cu matricea de covarianță de selecție sau cu estimatorul shrinkage al lui Ledoit & Wolf (2004).
            • Capitolul 6 dă covarianța condiționată \(H_t\) din GARCH(1,1) și modelul de corelație condiționată dinamică (DCC, dynamic conditional correlation) al lui Engle (2002), reestimat în fiecare ianuarie.
            • Capitolul 7 dă VaR 1% al portofoliului și contribuțiile la risc Euler.
            • Capitolul 8 dă testul de acoperire Kupiec și testele Christoffersen de independență și de acoperire condiționată.

            Regula de decizie este fixată dinainte. Pînă în 2018 portofoliul folosește varianta GMV cu volatilitatea mai mică, iar din 2019 alegerea este testată out-of-sample. Prognoza VaR nu trebuie respinsă la 5% de niciunul dintre cele trei teste; dacă trec mai multe, se alege cea cu VaR mediu mai mic.

            Pe scurt

            • Întrebarea: ce portofoliu de varianță minimă globală (GMV) ținem din opt ETF-uri și pe ce prognoză VaR 1% pentru o zi ne bazăm?
            • Universul multi-active din Capitolul 4, prețuri ajustate zilnice, apr. 2007 – iul. 2026
              • acțiuni: SPY (SUA), EFA (piețe dezvoltate fără SUA), EEM (piețe emergente)
              • obligațiuni de stat SUA: TLT (peste 20 de ani), IEF (7–10 ani)
              • obligațiuni corporative: LQD (calitate investițională, investment grade), HYG (randament ridicat, high yield); aur: GLD (SPDR Gold Shares)
            • Evaluarea: 1 mai 2012 – 31 iul. 2026, 3 583 de zile
            • Patru capitole
              • Capitolul 4: ponderi GMV lunare din ultimele 60 de luni, cu covarianța de eșantion sau cu contracția (shrinkage) Ledoit–Wolf Ledoit & Wolf (2004)
              • Capitolul 6: covarianța condiționată \(H_t\) din GARCH(1,1) și DCC Engle (2002), reestimată în fiecare ianuarie
              • Capitolul 7: VaR 1% al portofoliului și contribuțiile Euler la risc
              • Capitolul 8: testele Kupiec (acoperire) și Christoffersen (independență, acoperire condiționată)
            Regula de decizie
            • Ponderile: varianta GMV cu volatilitatea mai mică pînă în 2018; din 2019 testăm alegerea
            • Prognoza: un model VaR nerespins la 5% de niciunul dintre cele trei teste
            • La egalitate: modelul cu VaR-ul mediu mai mic

            Portofoliul multi-active: ponderi, VaR și contribuții la risc

            Slide 48 în PDF
              Întrebare pentru sală Ce mecanism poate contribui la subestimarea riscului de către DCC-FHS, deși DCC-FHS și DCC-Normal folosesc aceeași covarianță condiționată?
              Răspuns

              Istoria FHS reutilizează datele pe care au fost optimizate ponderile GMV, ceea ce poate face riscul istoric prea mic: media abaterilor standard ale randamentelor standardizate ale portofoliului în ferestrele FHS este 0,91, iar abaterea standard a randamentelor standardizate out-of-sample este 0,95. FHS înmulțește cuantila empirică a pierderilor standardizate cu volatilitatea curentă: VaR-ul mediu este 0,55%, față de 0,58% pentru DCC-Normal. DCC-FHS are 52 de depășiri, față de 35,8 așteptate (p Kupiec 0,011); DCC-Normal are 40 de depășiri și trece toate cele trei teste. Rezultatele susțin diagnosticul, fără să izoleze contribuția fiecărui mecanism. Comparația este retrospectivă: modelul VaR este ales pe aceeași perioadă pe care este evaluat.

              Graficul reunește cei trei pași ai studiului: volatilitatea pe un an mobil a celor două portofolii GMV, prognozele zilnice VaR 1% cu depășirile lor și ponderile Euler ale celor patru clase de active în riscul portofoliului. Cifrele sînt pe slide-ul următor.

              Portofoliul multi-active: pașii în cifre

              Slide 49 în PDF

              Pasul de portofoliu compară out-of-sample cele două estimări ale covarianței. Portofoliul GMV cu covarianța de selecție are o volatilitate zilnică anualizată de 4,13%, iar varianta Ledoit–Wolf 4,28%, cu o intensitate medie de shrinkage \(\delta = 0{,}17\). Shrinkage-ul aduce stabilitate: rulajul lunar (turnover) este 0,085 față de 0,135, iar expunerea brută a ponderilor țintă, \(\sum_i |w_i|\), are media 1,80 față de 2,42 și maximul 2,30 față de 3,78. Pînă în 2018 volatilitățile sînt 3,08% și 3,15%, deci regula alege covarianța de selecție; din 2019 sînt 4,87% și 5,07%.

              Pasul de risc prognozează volatilitatea portofoliului \(\sigma_{p,t} = \sqrt{w_t' H_t w_t}\) pentru ziua \(t\), cu \(w_t\) ponderile de la începutul zilei. La ultima reestimare, în ianuarie 2026 pe 4 712 zile, parametrii DCC sînt \(\hat a = 0{,}024\) și \(\hat b = 0{,}968\). Se compară trei prognoze VaR 1%:

              1. DCC-Normal, \(2{,}326\,\sigma_{p,t}\);
              2. DCC cu simulare istorică filtrată (FHS, filtered historical simulation), \(\sigma_{p,t}\) înmulțit cu cuantila de 99% a pierderii standardizate \(-r_{p,s}/\sigma_{p,s}\) din ultimele 1 000 de zile;
              3. Simularea istorică (HS, historical simulation), cuantila pierderilor din ultimele 500 de zile cu ponderile \(w_t\).

              Pe perioada de evaluare sînt așteptate 35,8 depășiri.

              Ponderea Euler a activului \(i\) în varianță, \(w_i (H_t w_t)_i / w_t' H_t w_t\), este și ponderea lui în VaR și în ES (expected shortfall) sub o distribuție eliptică. În medie pe perioada de evaluare, titlurile de stat poartă 69% din risc, creditul 17%, acțiunile 12% și aurul 2%. Pe 27 martie 2020, ziua cu cel mai mare \(\sigma_{p,t}\) (0,98%), creditul poartă 63% din risc cu o pondere de 25%.

              Pe scurt

              • (a) Capitolul 4: volatilitatea zilnică în afara eșantionului, anualizată (în grafic: pe o fereastră mobilă de un an)
                • GMV cu covarianța de eșantion: 4,13% pe an
                • GMV cu contracție Ledoit–Wolf: 4,28% pe an, cu intensitatea medie a contracției \(\delta = 0{,}17\)
                • turnover-ul lunar: 0,085 cu Ledoit–Wolf, față de 0,135
                • expunerea brută \(\sum_i |w_i|\) a ponderilor-țintă: media 1,80 cu Ledoit–Wolf, față de 2,42; maximul 2,30, față de 3,78
                • pînă în 2018: 3,08% față de 3,15%: regula alege covarianța de eșantion; din 2019: 4,87% față de 5,07%, deci alegerea se confirmă
              • (b) Capitolele 6–8: \(\sigma_{p,t} = \sqrt{w_t' H_t w_t}\), prognoza pentru ziua \(t\), cu \(w_t\) ponderile de la începutul zilei (rebalansare lunară, apoi evoluează cu prețurile)
                • DCC la ultima reestimare (ian. 2026, 4 712 zile): \(\hat a = 0{,}024\), \(\hat b = 0{,}968\)
                • DCC-Normal: \(\text{VaR} = 2{,}326\,\sigma_{p,t}\)
                • DCC-FHS: \(\sigma_{p,t}\) înmulțit cu cuantila de 99% a pierderii standardizate \(-r_{p,s}/\sigma_{p,s}\) din ultimele 1 000 de zile
                • HS: cuantila pierderilor din ultimele 500 de zile, cu ponderile \(w_t\)
                • 35,8 depășiri așteptate ale VaR 1%
              • (c) Capitolul 7: ponderea Euler \(w_i (H_t w_t)_i / w_t' H_t w_t\) a fiecărei clase de active în varianță
                • este și ponderea în VaR și ES pentru o distribuție eliptică
                • media pe evaluare: obligațiuni de stat 69%, credit 17%, acțiuni 12%, aur 2%
                • 27 mar. 2020, ziua cu \(\sigma_{p,t}\) maxim (0,98%): creditul are 63% din risc, cu o pondere de 25%

              Portofoliul multi-active: rezultatul și decizia

              Slide 50 în PDF

              Tabelul raportează, pentru cele trei prognoze VaR 1%, numărul și rata depășirilor, valorile p ale testelor Kupiec, de independență și de acoperire condiționată și VaR mediu. Doar DCC-Normal trece toate cele trei teste: 40 de depășiri (1,12%), Kupiec \(p = 0{,}492\), independență \(p = 0{,}083\), acoperire condiționată \(p = 0{,}175\), cu un VaR mediu de 0,58%. HS eșuează la independență (48 de depășiri, \(p < 0{,}001\)), iar DCC-FHS la acoperire și la independență (52 de depășiri, Kupiec \(p = 0{,}011\)). Istoria DCC-FHS aplică ponderile de azi datelor pe care au fost estimate, adică subestimarea în eșantion a riscului din capitolul 4: abaterea standard a lui \(r_{p,s}/\sigma_{p,s}\) este 0,91 în fereastra FHS și 0,95 în afara ei.

              Rezultatul susține o comparație retrospectivă a procedurilor, pe un singur portofoliu și o singură perioadă, iar modelul VaR este ales pe aceeași perioadă pe care este evaluat. Valoarea p a independenței pentru DCC-Normal, 0,083, este sub 10%; efectul minim detectabil (MDE, minimum detectable effect) al testului Kupiec la \(T = 3\,583\) este o rată a depășirilor de 1,55%, iar costurile de tranzacționare nu sînt incluse.

              Alegerea este portofoliul GMV cu covarianța de selecție și VaR 1% DCC-Normal, 0,64% pentru 31 iulie 2026, cu ponderi lunare și DCC reestimat anual, folosind doar informația disponibilă la data prognozei. Două rezultate ar răsturna-o:

              1. O respingere a independenței pe date noi;
              2. O limită de expunere brută \(c\), impusă în optimizare la fiecare reechilibrare și verificată zilnic, pe care portofoliul nu o poate respecta; GMV o încalcă pentru \(c < 3{,}78\) (3,86 pe ponderile zilnice), Ledoit–Wolf pentru \(c < 2{,}30\) (2,34).

              Pe scurt

              VaR 1%DepășiriRata\(p\) Kupiec\(p\) indep.\(p\) cond.VaR mediu
              DCC-Normal401,12%0,4920,0830,1750,58%
              DCC-FHS521,45%0,0110,0460,0050,55%
              HS, 500 de zile481,34%0,052\(<\)0,001\(<\)0,0010,63%
              • Tipul de dovadă: comparație retrospectivă între proceduri, pe un portofoliu și o perioadă
                • doar DCC-Normal trece toate cele trei teste; modelul VaR este ales pe aceeași perioadă pe care este evaluat
                • HS eșuează la independență, DCC-FHS la acoperire și la independență
                • istoria DCC-FHS aplică ponderile de azi pe datele din care au fost estimate (subestimarea riscului în eșantion din Capitolul 4)
                • abaterea standard a lui \(r_{p,s}/\sigma_{p,s}\): 0,91 în fereastra FHS, 0,95 în afara ei
              • Limite
                • valoarea \(p\) a testului de independență pentru DCC-Normal este 0,083, sub 10%
                • MDE-ul testului Kupiec la \(T = 3\,583\): 1,55%; fără costuri de tranzacționare
              • Ce aleg: GMV cu covarianța de eșantion și VaR 1% DCC-Normal (0,64% pentru 31 iul. 2026)
              • În ce condiții: ponderi lunare și DCC reestimat anual, doar cu informația disponibilă la data prognozei
              • Ce m-ar face să renunț
                • o respingere a independenței pe datele noi
                • o limită \(c\) a expunerii brute: se impune în optimizare la fiecare rebalansare și se verifică zilnic; GMV o depășește pentru \(c < 3{,}78\) (zilnic: 3,86), Ledoit–Wolf pentru \(c < 2{,}30\) (2,34)

              Bitcoin: întrebarea și regula de decizie

              Slide 51 în PDF

              Al doilea studiu adoptă perspectiva unui administrator de risc care deține Bitcoin: ce limită de pierdere pe o zi stabilește și ce semnal l-ar face să reducă poziția? Datele sînt închiderile zilnice din 18 septembrie 2014 pînă în 18 septembrie 2026, 4 384 de randamente, și barele de 5 minute pe zile UTC (Coordinated Universal Time) din 1 septembrie 2024 pînă în 17 septembrie 2026, 659 de zile complete.

              Cinci capitole furnizează instrumentele:

              • Faptele stilizate din capitolul 1;
              • Varianța realizată RV și prognozele log-HAR ale lui Corsi (2009) din capitolul 9;
              • Backtesting-ul VaR 1% din capitolul 8;
              • Spread-urile și indicatorul de nelichiditate Amihud din capitolul 10;
              • Testul de bulă GSADF cu datarea BSADF (Backward Sup Augmented Dickey–Fuller, statistic, statistica Dickey–Fuller augmentată supremă, calculată înapoi de la fiecare dată) a lui Phillips, Shi & Yu (2015) din capitolul 17.

              Limita zilnică este VaR 1% log-HAR dacă nu este respins la 5% și cere în medie mai puțin capital decît HS; altfel este VaR HS, folosit și în zilele fără prognoză log-HAR, cînd barele de 5 minute sînt incomplete. Poziția se reduce cînd BSADF rămîne peste valoarea critică wild bootstrap de 95% cel puțin 7 săptămîni la rînd, durata minimă a unui episod din capitolul 17, \(\lceil \ln T \rceil = 7\) săptămîni.

              Pe scurt

              • Întrebarea: un administrator de risc (risk manager) ține Bitcoin; ce limită de pierdere pentru o zi fixează și ce semnal l-ar face să reducă poziția?
              • Date
                • închideri zilnice, 18 sept. 2014 – 18 sept. 2026: 4 384 de randamente
                • bare de 5 minute pe zile UTC (Coordinated Universal Time), 1 sept. 2024 – 17 sept. 2026: 659 de zile complete
              • Cinci capitole
              Regula de decizie
              • Limita zilnică: VaR 1% log-HAR, dacă nu este respins la 5% și cere în medie mai puțin capital decît HS; altfel VaR-ul HS
              • În zilele fără prognoză log-HAR (bare de 5 minute incomplete): VaR-ul HS
              • Reducerea poziției: BSADF peste valoarea critică de 95% din wild bootstrap cel puțin 7 săptămîni la rînd
                • durata minimă a unui episod în Capitolul 17: \(\lceil \ln T \rceil = 7\) săptămîni

              Bitcoin: bule, VaR din volatilitatea realizată și lichiditate

              Slide 52 în PDF
                Întrebare pentru sală Evaluarea are 422 de zile. Cît de des ar respinge testul Kupiec de 5% un model VaR 1% care greșește cu o rată reală de 2%?
                Răspuns

                Doar cu probabilitatea 47%; efectul minim detectabil cu o putere de 80% este 2,70%. Ambele modele au 7 depășiri față de 4,2 așteptate (p = 0,214), deci diferența practică este capitalul: VaR mediu 5,29% pentru log-HAR, față de 6,24% pentru HS.

                Graficul arată cele trei intrări ale deciziei pentru Bitcoin: statistica BSADF față de valoarea ei critică wild bootstrap, prognozele VaR 1% log-HAR și HS cu depășirile lor și nelichiditatea Amihud pentru Bitcoin și SPY.

                Bitcoin: pașii în cifre

                Slide 53 în PDF

                Randamentele zilnice arată faptele stilizate din capitolul 1 într-o formă accentuată. Tail index-ul Hill al pierderilor este 2,71 (\(k = 109\), 2,5% din zile), volatilitatea anualizată este 66,6%, autocorelația lui \(|r_t|\) la lagul 1 este 0,21, iar 29 de zile se află dincolo de ±4 abateri standard, față de 0,28 așteptate sub distribuția Normală.

                Modelul log-HAR regresează \(\ln RV\) pe mediile lui pe 1, 7 și 30 de zile, cu \(R^2 = 0{,}36\) și coeficienții \(\hat\beta_d = 0{,}38\) (eroare standard Newey–West 0,04), \(\hat\beta_w = 0{,}47\) (0,08) și \(\hat\beta_m = -0{,}02\) (0,10). Prognozele pe fereastră extinsă încep la 1 martie 2025 și acoperă 422 de zile, ca în capitolul 9. VaR 1% este \(2{,}326\sqrt{\widehat{RV}_t}\), cu media 5,29% și valori între 1,99% și 14,45%, față de o medie de 6,24% pentru HS pe ultimele 500 de zile. Dintre cele 566 de zile calendaristice, 144 nu au prognoză log-HAR, deci evaluarea acoperă zile selectate după disponibilitatea datelor. Randamentul standardizat \(r_t/\sqrt{\widehat{RV}_t}\) are abaterea standard 1,00, excesul de kurtosis 2,54 și cuantila de 1% egală cu −2,52, față de −2,33 pentru distribuția Normală.

                Lichiditatea nu este o constrîngere. Nelichiditatea Amihud, în puncte de bază (bp) per 1 milion USD tranzacționat, este 0,0037 pentru Bitcoin în ultimii doi ani, față de 0,0016 pentru SPY; media ei lunară a scăzut de la 0,80 în primele 12 luni începînd din 2016 la 0,0040 în ultimele 12. Spread-urile estimate din date zilnice nu concordă: 85 bp pentru Roll, 81 bp pentru Corwin–Schultz și −8 bp pentru EDGE (Efficient Discrete Generalized Estimator). GSADF este 3,85, față de o valoare critică wild bootstrap de 95% de 2,82 (2,27 pentru Monte Carlo homoscedastic), cu episoade explozive în mai 2017–ianuarie 2018 și decembrie 2020–februarie 2021. Din 2022, BSADF a depășit valoarea critică wild doar în 6 săptămîni, cel mult 3 la rînd (maximul 1,47, pe 8 martie 2024), iar ultima valoare este −0,65, față de o valoare critică de 0,58.

                Pe scurt

                • Capitolul 1: randamentele zilnice (fără panou în grafic)
                  • indicele Hill al cozii pierderilor: 2,71 (\(k = 109\), 2,5% din zile)
                  • volatilitatea anualizată: 66,6%
                  • ACF a lui \(|r_t|\) la lagul 1: 0,21
                  • 29 de zile dincolo de \(\pm 4\) abateri standard, față de 0,28 sub distribuția Normală
                • (b) Capitolul 9: log-HAR pe \(\ln RV\), cu mediile pe 1, 7 și 30 de zile, \(R^2 = 0{,}36\)
                  • coeficienții, cu erorile Newey–West în paranteză: \(\hat b_d = 0{,}38\) (0,04), \(\hat b_w = 0{,}47\) (0,08), \(\hat b_m = \ensuremath{-}0{,}02\) (0,10)
                  • prognoze cu fereastră extinsă din 1 mar. 2025: 422 de zile, aceleași ca în Capitolul 9
                • (b) Capitolul 8: VaR 1% \(= 2{,}326\sqrt{\widehat{RV}_t}\), față de HS pe ultimele 500 de zile
                  • VaR-ul log-HAR: media 5,29%, între 1,99% și 14,45%; VaR-ul HS: media 6,24%
                  • 144 din cele 566 de zile calendaristice nu au prognoză log-HAR: evaluarea acoperă zilele selectate de disponibilitatea datelor
                  • \(r_t/\sqrt{\widehat{RV}_t}\): abaterea standard 1,00, excesul de kurtosis 2,54
                  • cuantila de 1% a lui \(r_t/\sqrt{\widehat{RV}_t}\): \(-\)2,52, față de \(-\)2,33 pentru distribuția Normală
                • (c) Capitolul 10: ilichiditatea Amihud, în bp per 1 mil. USD tranzacționat
                  • ultimii doi ani: 0,0037 pentru Bitcoin, 0,0016 pentru SPY
                  • media lunară: 0,80 în primele 12 luni din 2016, 0,0040 în ultimele 12 luni
                  • spread-urile din date zilnice nu concordă: Roll 85 bp, Corwin–Schultz 81 bp, EDGE (Efficient Discrete Generalized Estimator) \(-\)8 bp (EDGE estimează pătratul spread-ului, care iese negativ cînd varianța prețurilor domină)
                • (a) Capitolul 17: GSADF 3,85, față de valoarea critică de 95% 2,82 din wild bootstrap (Monte Carlo homoscedastic: 2,27)
                  • episoade explozive, cu valorile critice wild bootstrap: mai 2017 – ian. 2018 și dec. 2020 – feb. 2021
                  • din 2022: BSADF peste valoarea critică wild în 6 săptămîni, cel mult 3 la rînd (maximul 1,47, pe 8 mar. 2024)
                  • ultima valoare: \(-\)0,65, față de valoarea critică wild 0,58

                Bitcoin: rezultatul și decizia

                Slide 54 în PDF

                Pe cele 422 de zile cu bare complete, din 1 martie 2025 pînă în 17 septembrie 2026, atît VaR 1% log-HAR, cît și VaR HS au 7 depășiri față de 4,2 așteptate, cu Kupiec \(p = 0{,}214\), independență \(p = 0{,}604\) și acoperire condiționată \(p = 0{,}404\). Acoperirea este aceeași, iar VaR log-HAR este mai mic în medie cu 0,95 puncte procentuale. Testul de independență folosește doar cele 372 de perechi de zile calendaristice consecutive. Regula completă, cu HS în zilele fără prognoză, are 9 depășiri pe toate cele 566 de zile, față de 5,7 așteptate (Kupiec \(p = 0{,}194\), independență \(p = 0{,}589\)).

                Puterea este mică: MDE este o rată a depășirilor de 2,70%, iar o rată adevărată de 2% este detectată cu probabilitatea 47%. Sînt disponibili doar doi ani de bare de 5 minute, cuantila Normală subestimează coada (−2,52 față de −2,33), iar indicatorul Amihud folosește volumul raportat de burse agregate. Rezultatul susține o comparație retrospectivă a procedurilor.

                Alegerea este o limită zilnică egală cu VaR 1% log-HAR, 5,04% pentru 17 septembrie 2026, recalculată zilnic, cu condiția ca barele de 5 minute să acopere cel puțin 95% din zi și ca nelichiditatea să rămînă de ordinul celei a SPY. La 5 sau mai multe depășiri în 250 de zile, zona galbenă Basel din capitolul 8, limita trece la cuantila empirică a lui \(r_t/\sqrt{\widehat{RV}_t}\). Poziția se reduce cînd BSADF rămîne peste valoarea critică wild 7 săptămîni la rînd; pentru că monitorizarea săptămînală repetă testul, iar un prag punctual de 95% nu controlează alarmele false pe tot orizontul, semnalul se confirmă cu pragul pe familie din capitolul 17.

                Pe scurt

                VaR 1%DepășiriAșteptate\(p\) Kupiec\(p\) indep.\(p\) cond.VaR mediu
                log-HAR74,20,2140,6040,4045,29%
                HS, 500 de zile74,20,2140,6040,4046,24%
                • Tipul de dovadă: comparație retrospectivă între proceduri, pe 422 de zile cu bare complete (1 mar. 2025 – 17 sept. 2026)
                  • aceeași acoperire, cu un VaR mediu mai mic cu 0,95 puncte procentuale
                  • \(p\) indep.: doar cele 372 de perechi de zile calendaristice consecutive
                  • regula completă (HS în zilele fără prognoză), pe toate cele 566 de zile: 9 depășiri, față de 5,7 așteptate; \(p\) Kupiec 0,194, \(p\) indep. 0,589
                  • puterea este mică: MDE 2,70%; o rată reală de 2% este detectată cu probabilitatea 47% (puterea testului Kupiec)
                • Limite
                  • doar doi ani de bare de 5 minute
                  • cuantila Normală subestimează coada: \(-\)2,52, față de \(-\)2,33
                  • Amihud folosește volumul raportat de bursele agregate
                • Ce aleg: limita zilnică egală cu VaR 1% log-HAR (5,04% pentru 17 sept. 2026), recalculată zilnic
                • În ce condiții: barele de 5 minute acoperă cel puțin 95% din zi; ilichiditatea rămîne de ordinul celei a SPY
                • Ce m-ar face să renunț
                  • cel puțin 5 depășiri în 250 de zile (zona galbenă Basel, Capitolul 8): trec la cuantila empirică a lui \(r_t/\sqrt{\widehat{RV}_t}\)
                  • BSADF peste valoarea critică wild 7 săptămîni la rînd: reduc poziția
                  • monitorizarea săptămînală repetă testul: pragul punctual de 95% nu controlează alarmele false pe tot orizontul, deci confirm cu pragul pe familie din Capitolul 17

                Investitorul român: întrebarea și regula de decizie

                Slide 55 în PDF

                Al treilea studiu ia un investitor care își măsoară averea în lei și deține 50% BET și 50% Euro Stoxx 50, cumpărat în euro. Întrebarea este dacă trebuie să acopere riscul valutar EUR (euro, moneda euro)/RON (lei pe euro) al componentei în euro. Datele sînt închiderile zilnice ale celor doi indici și cursul de referință EUR/RON al Băncii Naționale a României (BNR), iulie 2005–septembrie 2026. Expunerile și acoperirea folosesc randamente săptămînale, de vineri pînă vineri, pentru că BNR fixează cursul la ora 13:00, iar bursele se închid la ore diferite.

                Cinci capitole furnizează pașii:

                • Rapoartele de varianță ale lui Lo & MacKinlay (1988) din capitolul 2;
                • Expunerile cu erori Newey–West din capitolul 3;
                • Volatilitatea GARCH(1,1)-\(t\) din capitolul 5;
                • Raportul de acoperire de varianță minimă \(h^*\) pe trei ani mobili din capitolul 6;
                • VaR 1% și ES 2,5% prin simulare istorică din capitolul 7.

                Reperul este rezultatul lui Campbell, Serfaty-de Medeiros & Viceira (2010): o valută corelată negativ cu acțiunile reduce riscul, deci acoperirea completă nu minimizează riscul. Se compară trei alegeri, cu \(h\) ponderea componentei în euro vîndută la termen (forward): fără acoperire (\(h = 0\)), \(h^*\) mobil și acoperire completă (\(h = 1\)). Regula alege varianta cu cel mai mic ES 2,5% săptămînal; dacă valorile ES diferă cu mai puțin de 0,25 puncte procentuale în fiecare perioadă, alege \(h = 0\), care nu cere contracte forward.

                Pe scurt

                • Întrebarea: un investitor care își măsoară averea în lei ține 50% BET și 50% Euro Stoxx 50, cumpărat în euro; acoperă riscul valutar al părții în euro, adică riscul cursului EUR/RON, numărul de lei românești (RON) pentru un euro (EUR)?
                • Date: BET și Euro Stoxx 50 (închideri zilnice), cursul de referință EUR/RON al BNR (Banca Națională a României), iul. 2005 – sept. 2026
                  • randamente săptămînale (vineri): BNR fixează cursul la 13:00, bursele închid la alte ore
                • Cinci capitole
                • Reperul Campbell, Serfaty-de Medeiros & Viceira (2010): o monedă corelată negativ cu acțiunile reduce riscul, deci acoperirea integrală nu minimizează riscul
                Regula de decizie
                • Trei variante, cu \(h\) partea în euro vîndută la termen (forward): \(h = 0\) (fără acoperire), \(h^*\) mobil, \(h = 1\) (acoperire integrală)
                • Alegem varianta cu ES 2,5% săptămînal cel mai mic
                • Dacă ES-urile diferă cu mai puțin de 0,25 puncte procentuale în fiecare perioadă: \(h = 0\), care nu cere contracte forward; trecem la \(h = 1\) după șase luni la rînd de corelație pozitivă pe trei ani între acțiuni și EUR/RON

                Investitorul român: eficiență, acoperire valutară și ES în lei

                Slide 56 în PDF
                  Întrebare pentru sală În comparația retrospectivă pentru aug. 2008 – sept. 2026, ce mecanism poate explica faptul că acoperirea integrală a riscului valutar nu a redus ES-ul portofoliului?
                  Răspuns

                  Asocierea negativă dintre randamentul Euro Stoxx 50 și variația EUR/RON (β = −0,52, t = −2,61) a compensat parțial pierderile: cînd EUR/RON crește, leul se depreciază, iar valoarea în lei a investiției în euro crește, celelalte condiții fiind neschimbate. Asocierea nu este o regulă valabilă în fiecare săptămînă. Volatilitatea EUR/RON este 4,6% pe an, față de 20,9% pentru Euro Stoxx 50. ES 2,5% săptămînal, aug. 2008 – sept. 2026: 9,60% fără acoperire, 9,67% cu acoperire integrală; în aug. 2008 – dec. 2012 ordinea se inversează (15,23% și 15,12%). Comparația retrospectivă nu înlocuiește regula de decizie din curs, care alege acoperirea integrală (h = 1).

                  Graficul arată intrările deciziei de acoperire: corelația pe trei ani mobili dintre Euro Stoxx 50 și variația EUR/RON, raportul de acoperire mobil \(h^*\) și ES 2,5% săptămînal al celor trei variante de acoperire.

                  Investitorul român: pașii în cifre

                  Slide 57 în PDF

                  Randamentele zilnice sînt testate cu statistica robustă a raportului de varianță \(z^*(q)\), care respinge mersul aleator la 5% cînd \(|z^*| > 1{,}96\). EUR/RON respinge puternic, cu \(z^*(2) = 4{,}76\), VR(2) = 1,17 și o autocorelație de ordinul întîi de 0,17; BET dă \(z^*(2) = 2{,}08\), dar testul comun Chow–Denning pe \(q = 2, 5, 10, 20\) dă \(p = 0{,}067\); Euro Stoxx 50 are \(|z^*(q)| \le 1{,}68\) și Chow–Denning \(p = 0{,}43\). Pentru că riscul zilnic al EUR/RON înmulțit cu \(\sqrt{h}\) subestimează riscul pe \(h\) zile, studiul lucrează pe săptămîni.

                  Expunerile sînt estimate pe 1 101 săptămîni, cu \(f = \Delta\)EUR/RON, deci \(f > 0\) înseamnă depreciere a leului. Euro Stoxx 50 în euro are \(\hat\beta = -0{,}52\) față de \(f\) (\(t = -2{,}61\)), iar BET are coeficienții 0,56 față de Euro Stoxx 50 (\(t = 7{,}4\)) și −0,54 față de \(f\) (\(t = -2{,}11\)), cu \(R^2 = 0{,}30\): leul se depreciază în săptămînile în care acțiunile scad. Modelele GARCH(1,1)-\(t\) dau o persistență EUR/RON de 1,000, la limita staționarității, și volatilități anualizate curente de 0,96% pentru EUR/RON (media 4,4%), 25,9% pentru BET (media 21,2%) și 13,8% pentru Euro Stoxx 50 (media 21,0%).

                  Raportul de acoperire de varianță minimă este \(h^* = \mathrm{Cov}(r^{RON}, f)/\mathrm{Var}(f)\), cu \(r^{RON} = r^{EUR} + f\) randamentul în lei al componentei în euro. Pe tot eșantionul \(h^* = 0{,}48\); pe trei ani mobili variază între −4,34 (iulie 2022) și 1,38 (martie 2026), cu ultima valoare 1,27, iar corelația pe trei ani dintre Euro Stoxx 50 și \(f\) este negativă în 93% din ferestre. ES 2,5% săptămînal al portofoliului 50/50, reechilibrat săptămînal, folosește randamentul simplu exact

                  \[R_p = \tfrac12\,(e^{b} - 1) + \tfrac12\,\big[e^{s+f} - 1 - h\,(e^{f} - 1)\big],\]
                  (19.19)

                  unde \(b\) și \(s\) sînt randamentele logaritmice ale BET și Euro Stoxx 50, iar forward-ul este pe valoarea nominală de la începutul săptămînii, cu cost de deținere (carry) nul; pierderea este \(L = -100\ln(1 + R_p)\), în puncte logaritmice.


                  Pe scurt

                  • (a) Capitolul 2: statistica robustă \(z^*(q)\) pe randamente zilnice; \(|z^*| > 1{,}96\) respinge mersul aleator la 5%
                    • EUR/RON: \(z^*(2) = 4{,}76\), cu VR(2) \(= 1{,}17\) și autocorelația de ordinul 1 egală cu 0,17
                    • BET: \(z^*(2) = 2{,}08\); testul Chow–Denning pe \(q = 2, 5, 10, 20\): \(p = 0{,}067\)
                    • Euro Stoxx 50: \(|z^*(q)| \le 1{,}68\); Chow–Denning: \(p = 0{,}43\)
                    • riscul zilnic al EUR/RON înmulțit cu \(\sqrt{h}\) subestimează riscul pe \(h\) zile, deci lucrăm pe săptămîni
                  • Capitolul 3: expunerile pe 1 101 săptămîni, cu \(f = \Delta\)EUR/RON (\(f > 0\): leul se depreciază)
                    • Euro Stoxx 50 în euro pe \(f\): \(\hat\beta = \ensuremath{-}0{,}52\) (\(t = \ensuremath{-}2{,}61\))
                    • BET pe Euro Stoxx 50 și \(f\): 0,56 (\(t = 7{,}4\)) și \(-\)0,54 (\(t = \ensuremath{-}2{,}11\)), \(R^2 = 0{,}30\)
                    • leul se depreciază în săptămînile în care acțiunile scad
                  • Capitolul 5: GARCH(1,1)-\(t\) pe randamente zilnice
                    • EUR/RON: persistența 1,000, la limita staționarității
                    • EUR/RON: volatilitatea azi 0,96% pe an, față de media 4,4%
                    • BET: 25,9% azi, față de media 21,2%
                    • Euro Stoxx 50: 13,8% azi, față de media 21,0%
                  • (b) Capitolul 6: \(h^* = \mathrm{Cov}(r^{RON}, f)/\mathrm{Var}(f)\), cu \(r^{RON} = r^{EUR} + f\) randamentul în lei al părții în euro
                    • pe tot eșantionul: \(h^* = 0{,}48\)
                    • pe ferestre mobile de trei ani: între \(-\)4,34 (iul. 2022) și 1,38 (mar. 2026); ultima valoare 1,27
                    • corelația pe trei ani dintre Euro Stoxx 50 și \(f\) este negativă în 93% din ferestre
                  • (c) Capitolul 7: ES 2,5% săptămînal al portofoliului 50/50, rebalansat săptămînal, pentru cele trei variante (tabelul de pe slide-ul următor)
                    • randamentul simplu exact \(R_p = \tfrac12(e^{b} - 1) + \tfrac12[e^{s + f} - 1 - h(e^{f} - 1)]\), cu \(b\), \(s\) randamentele log ale BET și Euro Stoxx 50; forward pe noționalul de la începutul săptămînii, cu carry zero
                    • pierderea, în puncte logaritmice: \(L = -100\ln(1 + R_p)\)

                  Investitorul român: rezultatul și decizia

                  Slide 58 în PDF

                  Tabelul dă ES 2,5% săptămînal al celor trei variante din (19.19) în trei perioade. În august 2008–septembrie 2026 (944 de săptămîni) este 9,60% fără acoperire, 9,62% cu \(h^*\) mobil și 9,67% cu acoperire completă; în 2008–2012 (228 de săptămîni) 15,23%, 15,20% și 15,12%; în 2020–2026 (351 de săptămîni) 8,43%, 8,43% și 8,47%. Valorile ES diferă cu cel mult 0,11 puncte procentuale, deci alegerea lui \(h\) a contat puțin pentru risc. Volatilitatea săptămînală anualizată este 4,6% pentru EUR/RON și 20,9% pentru Euro Stoxx 50, iar corelația negativă permite deprecierii leului să compenseze o parte din pierderile componentei în euro. Rezultatul susține o comparație a variantelor de acoperire pentru un singur portofoliu.

                  Limitele sînt economice. Costul acoperirii, diferențialul de dobîndă RON–EUR, nu se află în datele cursului; deprecierea leului a adăugat 1,55% pe an componentei în euro în iulie 2005–septembrie 2026, iar un forward o înlocuiește cu acest diferențial. \(h^*\) este instabil cînd \(\mathrm{Var}(f)\) este mică, ca în 2019–2022, adică riscul de estimare din capitolul 4, și acoperă doar componenta în euro: pentru întregul portofoliu, aproximarea liniară \(\mathrm{Cov}(b + s + f, f)/\mathrm{Var}(f)\) este −0,35.

                  Alegerea actuală este acoperirea completă, \(h = 1\). Corelația pe trei ani este pozitivă din 12 septembrie 2025 (0,037 la sfîrșitul eșantionului), ceea ce a declanșat regula de renunțare la \(h = 0\) pe 13 martie 2026, în timp ce \(h^*\) mobil, 1,27, ar vinde la termen mai mult decît componenta în euro. Alegerea rămîne valabilă cît timp corelația pe trei ani dintre acțiuni și EUR/RON rămîne pozitivă; o corelație negativă șase luni la rînd ar readuce investitorul la \(h = 0\).

                  Pe scurt

                  ES 2,5% săptămînalSăptămîni\(h = 0\)\(h^*\) mobil\(h = 1\)
                  aug. 2008 – sept. 20269449,60%9,62%9,67%
                  aug. 2008 – dec. 201222815,23%15,20%15,12%
                  ian. 2020 – sept. 20263518,43%8,43%8,47%
                  • Concluzia retrospectivă: ES-urile celor trei variante diferă cu cel mult 0,11 puncte procentuale, deci alegerea lui \(h\) a contat puțin pentru risc
                    • volatilitatea săptămînală anualizată: EUR/RON 4,6%, Euro Stoxx 50 20,9%
                    • corelația negativă face ca deprecierea leului să compenseze o parte din pierderile părții în euro
                  • Tipul de dovadă: comparație între variantele de acoperire, pentru un singur portofoliu
                  • Limite
                    • costul acoperirii, diferențialul de dobîndă dintre RON și EUR, nu este în datele cursului
                    • deprecierea leului a adus 1,55% pe an părții în euro (iul. 2005 – sept. 2026); un forward o înlocuiește cu acest diferențial
                    • \(h^*\) este instabil cînd \(\mathrm{Var}(f)\) este mic, ca în 2019–2022: riscul de estimare din Capitolul 4
                    • \(h^*\) acoperă partea în euro; pentru tot portofoliul, \(\mathrm{Cov}(b + s + f, f)/\mathrm{Var}(f) = \ensuremath{-}0{,}35\) (aproximare liniară)
                  • Ce aleg acum: acoperirea integrală (\(h = 1\))
                    • corelația pe trei ani este pozitivă după 12 sept. 2025 (0,037 la final): regula de renunțare la \(h = 0\) s-a declanșat pe 13 mar. 2026
                    • \(h^*\) mobil (1,27) ar vinde forward mai mult decît partea în euro
                  • În ce condiții: corelația pe trei ani dintre acțiuni și EUR/RON rămîne pozitivă
                  • Ce m-ar face să renunț: o corelație pe trei ani negativă timp de șase luni la rînd (revin la \(h = 0\))

                  Sinteza secțiunii

                  Cele trei studii urmează același șablon: o întrebare, o regulă de decizie fixată dinainte, pași din mai multe capitole și o decizie cu condițiile și regula ei de ieșire. În fiecare, dovada este o comparație retrospectivă a procedurilor pe un singur portofoliu sau activ, iar limitele, puterea mică, eșantioanele scurte sau costurile lipsă, sînt declarate lîngă decizie.

                  Proiectul de echipă

                  Proiectul este locul în care metodele cursului se aplică unei întrebări alese de echipă. Secțiunea prezintă cei patru pași, standardul de replicare, alegerea întrebării, criteriile de evaluare și calendarul.

                  Proiectul în patru pași

                  Slide 59 în PDF

                  Proiectul este un studiu empiric al unei întrebări despre piețele financiare, la care se răspunde cu metodele acestui curs. El reprezintă 70% din nota finală; testele scurte și activitatea de seminar reprezintă 20%, iar prezența 10%.

                  Are patru pași:

                  1. Echipa replică un tabel sau o figură completă dintr-o lucrare publicată sau din curs, celulă cu celulă.
                  2. Echipa extinde analiza cu date noi, o piață nouă, cum ar fi Bursa de Valori București (BVB) sau cripto, ori un eșantion mai recent, sub un plan de analiză preînregistrat (pre-analysis plan), consemnat într-un commit datat înainte de deschiderea perioadei de test; planul precizează ipoteza nulă, testul, funcția de pierdere, împărțirea eșantionului, strategia de identificare, puterea testului principal și grila de specificații cu corecția ei.
                  3. Echipa livrează un depozit GitHub care regenerează fiecare număr, cu fișierele `AI_USE.md` și `AI_ERRORS.md`.
                  4. Echipa prezintă lucrarea și o susține oral timp de 10 minute: fiecare membru explică un rezultat și răspunde la o întrebare de tipul „ce se schimbă dacă…”, iar notele pot diferi între membri.

                  Pe scurt

                  • Un studiu empiric al unei întrebări despre piețele financiare, cu metodele acestui curs
                    • 70% din nota finală
                    • quiz-uri și activitate la seminar 20%, prezență 10%, fără examen final
                  • 1. Replicați: un tabel sau o figură întreagă dintr-un articol publicat (sau din curs)
                    • celulă cu celulă (standardul: slide-ul următor)
                  • 2. Extindeți: date noi, altă piață (BVB, cripto) sau un eșantion mai recent
                    • după un plan de analiză fixat printr-un commit datat înainte de a deschide perioada de test
                    • Planul precizează ipoteza nulă, testul, funcția de pierdere, împărțirea eșantionului, strategia de identificare, puterea testului principal și grila de specificații cu corecția ei
                  • 3. Livrați pe GitHub: un repository care regenerează fiecare cifră
                  • 4. Prezentați și susțineți: prezentarea echipei, apoi o susținere orală de 10 minute
                    • Fiecare membru explică un rezultat și răspunde la o întrebare de tipul „ce se schimbă dacă...”
                    • Notele pot diferi între membri

                  Standardul de replicare

                  Slide 60 în PDF

                  Ținta replicării este un tabel sau o figură completă, identificată prin DOI, pagină și număr de tabel, nu un singur coeficient. Raportul compară celulă cu celulă valorile publicate cu cele ale echipei, dă diferența și explică fiecare abatere prin eșantion, filtru, furnizor de date sau definiție.

                  Replicările la scară mare arată de ce contează acest standard: multe anomalii se micșorează out-of-sample sau cu date mai bune (Hou, Xue & Zhang, 2020), în timp ce majoritatea factorilor se replică atunci cînd designul este corect (Jensen, Kelly & Pedersen, 2023). Reproductibilitatea cere un fișier de blocare a versiunilor pachetelor (lockfile), semințe aleatoare fixate, numele și datele seriilor și o singură comandă care regenerează fiecare număr. Echipe diferite care lucrează pe aceleași date diferă mai mult decît sugerează erorile lor standard (Menkveld et al., 2024), iar o muncă mai reproductibilă este asociată cu o diferență mai mică, cum arată studiul de caz al acestui capitol.

                  Pe scurt

                  • Ținta: un tabel sau o figură întreagă, cu DOI (Digital Object Identifier, identificatorul digital al unei publicații), pagină și numărul tabelului, nu un singur coeficient
                    • Raportați o comparație celulă cu celulă: valoarea publicată, valoarea dumneavoastră, diferența și motivul fiecărei abateri (eșantion, filtru, sursa datelor, definiție)
                  • Replicările la scară mare arată necesitatea acestui standard
                  • Reproductibilitate
                    • un fișier cu versiunile pachetelor, seed-uri aleatoare fixate, numele seriilor și datele lor
                    • o singură comandă care regenerează fiecare cifră
                    • Rezultatele unor echipe diferite care analizează aceleași date diferă mai mult decît sugerează erorile lor standard Menkveld et al. (2024)
                    • lucrările mai reproductibile sînt asociate cu o dispersie mai mică (studiul de caz de cercetare din acest capitol)

                  Alegerea întrebării

                  Slide 61 în PDF

                  O întrebare bună are patru proprietăți:

                  • Specifică (o piață, o perioadă, o mărime);
                  • Testabilă (o ipoteză nulă și un reper);
                  • Fezabilă (date care pot fi obținute și curățate în cîteva săptămîni, cum ar fi seturile de date ale cursului din depozitul GitHub, cursurile BNR, Federal Reserve Economic Data (FRED), Kenneth French Data Library sau DefiLlama);
                  • Relevantă (răspunsul contează pentru un investitor, o bancă sau un regulator).

                  Exemplele de pe slide arată cum se îngustează o întrebare. „Este Bitcoin riscant?” este prea vagă; „Au schimbat ETF-urile spot VaR 1% pe o zi al Bitcoin?” este mai bună, iar „Ce model îl prognozează cel mai bine din 2024?” poate urma. „Poate machine learning să prognozeze piața?” este prea largă; „Bate un model de boosting modelul log-HAR pentru volatilitatea BET din ziua următoare, în QLIKE, în 2018–2026?” este un proiect.

                  Pe scurt

                  O întrebare bună este
                  • Specifică: o piață, o perioadă, o mărime
                  • Testabilă: o ipoteză nulă și un reper
                  • Fezabilă: date pe care le puteți obține și curăța în cîteva săptămîni
                    • datele cursului, din repository-ul GitHub al cursului
                    • Banca Națională a României, BNR; Federal Reserve Economic Data, FRED; Kenneth French Data Library; DefiLlama
                  • Relevantă: răspunsul contează pentru un investitor, o bancă sau o autoritate
                  Exemple
                  • Prea vagă: „Este Bitcoin riscant?”
                    • Mai bună: „Au schimbat ETF-urile spot VaR 1% pe o zi al Bitcoin?”
                    • Apoi: „Ce model îl prognozează cel mai bine din 2024?”
                  • Prea largă: „Poate machine learning să prezică piața?”
                    • Mai bună: „Bate un model de boosting modelul log-HAR pentru volatilitatea BET de a doua zi, în QLIKE, 2018–2026?”

                  Criterii de evaluare a proiectului

                  Slide 62 în PDF

                  Nota are șase componente, fiecare legată de un pas:

                  1. Replicarea este judecată după reproducerea celulă cu celulă a unui tabel sau a unei figuri publicate, cu fiecare abatere explicată.
                  2. Întrebarea, datele și extinderea sînt judecate după o întrebare specifică și testabilă, cu date documentate și calendare aliniate.
                  3. Metodele și inferența sînt judecate după plan, identificare, putere, design în timp real, reper și o curbă a specificațiilor cu corecție.
                  4. Interpretarea și raportul sînt judecate după semnificația economică, limite și o concluzie onestă, în 8–12 pagini cu 10–15 referințe.
                  5. Depozitul GitHub este judecat după faptul că o singură comandă reproduce fiecare rezultat, cu lockfile și semințe, și după cele două fișiere AI.
                  6. Prezentarea și susținerea se notează individual: fiecare membru explică un rezultat și răspunde la întrebări de tipul „ce se schimbă dacă…”.

                  Pe scurt

                  ComponentăCriterii de evaluare
                  Replicare (pasul 1)Un tabel sau o figură publicată reprodusă celulă cu celulă; fiecare diferență explicată
                  Întrebare, date, extindere (pasul 2)Întrebare specifică și testabilă; date documentate și calendare aliniate
                  Metode și inferențăPlan, identificare, putere, procedură în timp real, reper, curba specificațiilor cu corecție
                  Interpretare și raportSemnificație economică, limitări, concluzie onestă; 8–12 pagini, 10–15 referințe
                  Repository GitHub (pasul 3)O singură comandă reproduce fiecare rezultat (fișier de versiuni, seed-uri); AI_USE.md, AI_ERRORS.md
                  Prezentare și susținere (pasul 4)Individual: un rezultat explicat, răspunsuri la „ce se schimbă dacă...”

                  Livrabile și calendar

                  Slide 63 în PDF

                  În prima săptămînă după acest capitol echipa se formează, își alege întrebarea, scrie o propunere de o pagină (Seminarul 19, C2) și deschide depozitul GitHub. Săptămînile 2–3 sînt pentru date și replicare, iar planul extinderii se consemnează într-un commit datat. Săptămînile 4–5 sînt pentru extindere, evaluare și verificările de robustețe. În ultimele săptămîni echipa scrie raportul de 8–12 pagini, completează depozitul cu un README și cele două fișiere AI, prezintă și susține lucrarea. Datele exacte se anunță la curs și la seminar.

                  Pe scurt

                  • Săptămîna 1 după acest capitol: echipa, întrebarea, propunerea de o pagină
                  • Săptămînile 2–3: datele, replicarea (pasul 1)
                    • planul extinderii, fixat în scris printr-un commit datat
                  • Săptămînile 4–5: extindere, evaluare, robustețe (pasul 2)
                  • Ultimele săptămîni: raportul de 8–12 pagini
                    • repository-ul cu README și cele două fișiere AI (pasul 3)
                    • prezentarea și susținerea orală (pasul 4)
                  • Datele exacte se anunță la curs și la seminar

                  Utilizarea AI în proiect

                  Politica AI și cele două fișiere obligatorii

                  Slide 64 în PDF

                  Asistenții AI sînt permiși pentru cod, depanare, căutarea literaturii și redactare. Utilizarea lor trebuie declarată, pentru că utilizarea nedeclarată a AI este considerată plagiat, și este verificată: echipa răspunde pentru fiecare rînd, iar o referință inexistentă este tratată ca date fabricate. În timpul susținerii orale nu se folosește AI, iar „a scris-o AI” nu este o explicație.

                  Două fișiere documentează utilizarea:

                  • `AI_USE.md` enumeră instrumentele și versiunile, cine le-a folosit și pentru ce, unde a fost păstrat cod sau text scris de AI și cum a verificat echipa tabelul replicat, datele, formulele și referințele.
                  • `AI_ERRORS.md` consemnează cel puțin trei situații în care asistentul a greșit: ce s-a cerut, ce a răspuns, ce era greșit, cum a aflat echipa și varianta corectă.

                  Erorile depistate sînt un punct forte al proiectului, nu o slăbiciune.

                  Pe scurt

                  Politica
                  • Permis: asistenți AI pentru cod, depanare, căutarea literaturii și redactare
                  • Declarat: utilizarea nedeclarată a AI este tratată ca plagiat
                  • Verificat: răspundeți pentru fiecare rînd
                    • o referință care nu există este tratată ca date fabricate
                  • Fără AI la susținerea orală: „L-a scris AI-ul” nu este o explicație
                  Cele două fișiere
                  • AI_USE.md: instrumentele și versiunile
                    • cine le-a folosit și pentru ce
                    • unde ați păstrat cod sau text scris de AI
                    • cum ați verificat tabelul replicat, datele, formulele și referințele
                  • AI_ERRORS.md: cel puțin trei locuri în care asistentul a greșit
                    • ce ați întrebat, ce a răspuns, ce era greșit, cum v-ați dat seama, varianta corectă
                  • Erorile detectate sînt un punct forte al proiectului, nu unul slab

                  Studiu de caz: erorile nestandard

                  Studiul de caz măsoară cît de mult depind concluziile din finanțele empirice de cercetător, nu de date. Rezumă un studiu în care multe echipe au testat aceleași ipoteze pe aceleași date, apoi repetă logica lui pe datele cursului, cu o grilă mică de parcursuri de analiză.

                  Impactul deciziilor cercetătorului (1/2)

                  Slide 65 în PDF

                  În Menkveld et al. (2024), publicat în Journal of Finance 79(3) ca Finance Crowd Analysis Project (#fincap), 164 de echipe de cercetare testează aceleași șase ipoteze pe aceleași date. Eroarea standard obișnuită măsoară incertitudinea provenită din eșantionare, procesul care generează datele. Eroarea nestandard (nonstandard error) măsoară incertitudinea provenită din parcursul de analiză ales de fiecare cercetător, procesul care generează dovezile.

                  În modelul lucrării, echipa \(j\) raportează \(X_j = e_j + \varepsilon_j\), unde \(e_j\) este efectul fix al cercetătorului asociat parcursului ales, iar \(\varepsilon_j\) eroarea de eșantionare. Eroarea nestandard este abaterea intercuartilică (IQR, interquartile range) a estimațiilor între echipe,

                  \[\mathrm{NSE} := Q_{0.75}(x) - Q_{0.25}(x),\]
                  (19.20)

                  unde \(Q_p(x)\) este cuantila de ordin \(p\) a estimațiilor echipelor \(x\). Se folosește IQR, nu abaterea standard, pentru că \(e_j\) poate avea cozi groase.

                  Pe scurt

                  • Menkveld et al. (2024): 164 de echipe de cercetare testează aceleași șase ipoteze pe aceleași date
                    • Journal of Finance 79(3)
                    • Finance Crowd Analysis Project, #fincap
                  • Eroarea standard
                    • Incertitudinea datorată eșantionării, în procesul de generare a datelor
                    • Eroarea nestandard: incertitudinea datorată deciziilor metodologice ale cercetătorului, în procesul de producere a dovezilor empirice
                    • Modelul: echipa \(j\) raportează \(X_j = e_j + \varepsilon_j\), \(e_j\) fiind efectul fix asociat deciziilor metodologice, iar \(\varepsilon_j\) eroarea de eșantionare
                    • Eroarea nestandard \(:= Q_{0{,}75}(x) - Q_{0{,}25}(x)\), intervalul intercuartilic (IQR) al estimărilor între echipe, \(Q_p(x)\) fiind cuantila \(p\) a estimărilor \(x\) ale echipelor
                    • IQR-ul, nu abaterea standard, pentru că \(e_j\) pot avea cozi groase

                  Impactul deciziilor cercetătorului (2/2)

                  Slide 66 în PDF

                  Datele sînt toate tranzacțiile cu contracte futures pe indicele Euro Stoxx 50 din 2002–2018, 720 de milioane de înregistrări. Cele șase ipoteze afirmă fiecare că nu există o tendință anuală într-o mărime de piață, cum ar fi eficiența pieței, spread-ul realizat sau ponderea clienților în volum, iar fiecare echipă raportează variația anuală medie în procente cu eroarea ei standard (SE). Studiul s-a desfășurat în 2021 în patru etape: analiză independentă, feedback de la colegi, partajarea celor mai bune cinci lucrări și estimațiile finale; detaliile designului sînt în Anexă.

                  Legătura cu acest capitol este directă. Fiecare proiect de echipă este un parcurs prin „grădina potecilor care se bifurcă” (garden of forking paths), iar preînregistrarea, grila de specificații și un depozit care rulează din nou fiecare număr sînt remediile cerute de curs.

                  Pe scurt

                  • Date
                    • Toate tranzacțiile cu contractele futures pe indicele Euro Stoxx 50, 2002–2018, 720 de milioane de înregistrări
                    • Șase ipoteze de tipul „nicio tendință anuală” (eficiența pieței, spread-ul realizat, ponderea clienților în volum, ...)
                    • Fiecare echipă raportează variația anuală medie în %, cu eroarea ei standard (SE)
                    • Patru etape în 2021: analiza independentă, feedbackul evaluatorilor, distribuirea celor mai bune cinci lucrări, estimările finale
                    • detaliile experimentului în Anexă
                  • Legătura cu acest capitol: fiecare proiect de echipă este o singură specificație
                    • din „grădina potecilor care se bifurcă” (garden of forking paths)
                    • Preînregistrarea, grila de specificații și un repository care regenerează fiecare cifră sînt remediile

                  Rezultatele principale: mărimea și calitatea

                  Slide 67 în PDF

                  Dispersia este mare. Pentru eficiența pieței, estimația mediană este −1,1% pe an, cu un IQR (19.20) de 6,7 puncte procentuale (pp); chiar și pentru ponderea clienților în volum, un raport simplu, IQR este 1,2 pp în jurul valorii de −3,3% (tabelul I, panoul C). SE median de 2,5% ar implica un IQR gaussian de \(1{,}35 \times 2{,}5 = 3{,}4\%\), jumătate din cele 6,7 pp observate, iar ipoteza nulă a lipsei de dispersie este respinsă pentru toate cele șase ipoteze, cu \(p < 0{,}0001\) (tabelul II).

                  Calitatea contează, dar nu elimină dispersia (tabelul III, fig. 2). O creștere cu o abatere standard a reproductibilității este asociată cu un IQR mai mic cu 25,0%, iar aceeași creștere a evaluării colegilor cu un IQR mai mic cu 33,3%; codul care rulează cap-coadă merge împreună cu răspunsuri mai apropiate de consens. Rezultatul susține o descriere a dispersiei dintre echipe; legătura cu calitatea este doar o asociere.

                  Pe scurt

                  • Mărimea
                    • Pentru eficiența pieței, estimarea mediană este \(-1{,}1\%\) pe an, cu un IQR de 6,7 puncte procentuale (pp)
                    • Chiar și pentru ponderea clienților în volum, un simplu raport, IQR-ul este 1,2 pp în jurul valorii \(-3{,}3\%\) (Tabelul I, Panoul C)
                    • SE-ul median de 2,5% implică, sub distribuția Normală, un IQR de \(1{,}35 \times 2{,}5 = 3{,}4\%\), jumătate din 6,7 pp
                    • Ipoteza nulă fără dispersie este respinsă pentru toate cele șase ipoteze, \(p < 0{,}0001\) (Tabelul II)
                  • Calitatea (Tabelul III, Fig. 2)
                    • o creștere cu o abatere standard a reproductibilității este asociată cu un IQR mai mic cu 25,0%
                    • aceeași creștere a notei evaluatorilor, cu un IQR mai mic cu 33,3%
                    • Codul care rulează integral, fără intervenție manuală, este asociat cu răspunsuri mai apropiate de consens
                  • Tipul de dovadă: descriere (arată ce s-a întîmplat în date, fără un test al cauzei)
                    • a dispersiei dintre echipe; legătura cu calitatea este doar o asociere

                  Mini-multivers pe datele cursului: designul

                  Slide 68 în PDF

                  Cursul repetă logica pe închideri zilnice din 2002–2018, fără completările artificiale din zilele fără tranzacționare (regula din capitolul 2). Grila încrucișează trei bifurcații, valorile extreme, măsura și modelul, în 27 de parcursuri de analiză, iar banda raportată este IQR între ele, eroarea nestandard a acestui multivers.

                  Măsurile ineficienței sînt abateri de la mersul aleator: \(|VR(q) - 1|\), unde \(VR(q)\) este raportul de varianță din capitolul 2 cu corecțiile Lo–MacKinlay la \(q = 5\) și 21 de zile, și \(R^2\) al unui model autoregresiv de ordinul întîi AR(1). O tendință pozitivă a acestor măsuri înseamnă o eficiență în scădere.

                  Pe scurt

                  • Închideri zilnice 2002–2018 din datele cursului, fără zilele fără tranzacționare completate artificial (regula din Capitolul 2)
                    • Deciziile: valori extreme \(\times\) măsură \(\times\) model, 27 de specificații
                    • Banda este IQR-ul, eroarea nestandard a multiversului
                  • Măsurile ineficienței
                    • \(|VR(q) - 1|\) (\(VR(q)\): raportul varianțelor din Capitolul 2, cu corecțiile Lo–MacKinlay, \(q = 5, 21\) zile) și \(R^2\) al unui model autoregresiv AR(1): abaterea de la mersul aleator
                    • O tendință pozitivă înseamnă o eficiență în scădere
                  MFM_ch19_nonstandard_errors

                  Mini-multivers pe datele cursului: 27 de specificații pe indice

                  Slide 69 în PDF
                    Întrebare pentru sală Pe toate cele 27 de specificații, IQR-ul estimărilor pentru Euro Stoxx 50 este 64,6 pp. ▶ restrînge grila, pe rînd, la un singur model al variației anuale. Cît devine IQR-ul celor nouă specificații cu tendință liniară?
                    Răspuns

                    Circa 2,6 pp (BET: 6,7 pp, față de 82,6 pp pe întreaga grilă). Cu diferențe relative, medianele sînt +98,7% și +80,3% pe an: modelul variației anuale separă cel mai mult distribuțiile estimărilor. Reperul de eșantionare, 1,35 × SE-ul median, este 41,3 pp pe întreaga grilă și 3,9 pp pentru cele nouă specificații cu tendință liniară. Comparația este descriptivă, nu o estimare a ponderii din dispersie datorate fiecărei alegeri.

                    Graficul arată, pentru Euro Stoxx 50 și BET, cele 27 de estimații ale tendinței din multivers, ordonate crescător, cu banda IQR; legenda definește \(VR(q)\), AR(1), IQR și pp.

                    Pe scurt

                    Legendă: \(VR(q)\), raportul varianțelor pe \(q\) zile; AR(1), modelul autoregresiv de ordinul 1; IQR, intervalul intercuartilic; pp, puncte procentuale. MFM_ch19_nonstandard_errors

                    Mini-multivers pe datele cursului: rezultatele

                    Slide 70 în PDF

                    IQR al estimațiilor este 64,6 pp pentru Euro Stoxx 50 și 82,6 pp pentru BET, în jurul unor mediane de −0,3% și −3,7% pe an. Bifurcația modelului creează dispersia: pe cele nouă parcursuri cu tendință liniară, IQR este doar 2,6 pp pentru Euro Stoxx 50 și 6,7 pp pentru BET, în timp ce diferențele relative explodează, cu mediane de +98,7% și +80,3% și valori de pînă la 48 415%.

                    Reperul de eșantionare este IQR gaussian, de 1,35 ori SE median: 41,3 pp pentru Euro Stoxx 50 și 43,4 pp pentru BET. IQR al multiversului îl depășește pentru ambii indici. Rezultatul susține o descriere a dispersiei pe cele 27 de parcursuri ale grilei, nu între echipe reale.

                    Pe scurt

                    • IQR-ul estimărilor: 64,6 pp pentru Euro Stoxx 50 și 82,6 pp pentru BET
                      • în jurul medianelor de \(-0{,}3\%\) și \(-3{,}7\%\) pe an
                    • Alegerea modelului determină dispersia
                      • Pentru cele nouă specificații cu tendință liniară, IQR-ul este de doar 2,6 pp pentru Euro Stoxx 50 și 6,7 pp pentru BET
                      • Cu diferențe relative, estimările cresc exploziv: medianele sînt \(+98{,}7\%\) (Euro Stoxx 50) și \(+80{,}3\%\) (BET), iar maximul ajunge la \(48\,415\%\)
                    • Reperul datorat doar eșantionării: IQR-ul sub distribuția Normală, adică \(1{,}35 \times\) SE-ul median
                      • \(41{,}3\) pp (Euro Stoxx 50) și \(43{,}4\) pp (BET)
                      • IQR-ul depășește acest reper pentru ambii indici
                    • Tipul de dovadă: descriere
                      • a dispersiei pe cele 27 de specificații ale grilei, nu a dispersiei dintre echipele reale

                    Limite și o extindere deschisă

                    Slide 71 în PDF

                    Autorii declară trei limite:

                    1. Multiversul lor acoperă doar cîteva bifurcații și explică slab estimațiile raportate;
                    2. Convingerile despre dispersie au fost cerute ca abateri standard, nu ca IQR;
                    3. Testul dispersiei presupune SE raportate consistente.

                    Replicarea din curs adaugă două:

                    1. Un multivers acoperă doar opțiunile din grila lui, așa că IQR al lui nici nu estimează, nici nu mărginește inferior dispersia dintre echipe reale.
                    2. Cu închideri zilnice nu pot fi rulate perechile de frecvențe intrazilnice din lucrare.

                    Extinderea deschisă întreabă dacă o grilă preînregistrată reduce eroarea nestandard a unei întrebări despre risc, măsurînd IQR al concluziilor despre VaR 1% pentru BET pe parcursuri justificabile.

                    Pe scurt

                    • Autorii: multiversul acoperă doar cîteva decizii metodologice și explică slab estimările raportate
                    • Autorii: echipelor li s-a cerut să anticipeze abaterea standard, nu IQR-ul
                    • Autorii: testul dispersiei presupune SE-uri raportate consistente
                    • Replicarea noastră: multiversul acoperă doar opțiunile din grilă
                      • deci IQR-ul său nu estimează și nu delimitează inferior dispersia dintre echipele reale
                    • Replicarea noastră: doar închideri zilnice
                      • deci perechile de frecvențe intrazilnice ale articolului nu pot fi rulate
                    • Extindere deschisă: reduce o grilă preînregistrată eroarea nestandard a unei întrebări de risc?
                      • Măsurați IQR-ul concluziilor VaR 1% pentru BET pe specificațiile justificabile

                    AI pentru descoperire științifică

                    Secțiunea aplică bucla de cercetare asistată de AI chiar proiectului de echipă: cît dintr-un rezultat vine din date și cît din cercetător, cum se potrivesc bucla și verificările ei cu calendarul proiectului și o replicare urmată de o extindere pe rezultatele cursului.

                    O întrebare deschisă

                    Slide 72 în PDF

                    Întrebarea deschisă este cît dintr-un rezultat ține de date și cît de cercetător. Replicarea nu este fără speranță: într-un model bayesian al replicării, majoritatea factorilor de evaluare a activelor se replică și funcționează out-of-sample în 93 de țări (Jensen, Kelly & Pedersen, 2023). Asistenții AI fac aproape gratuită orice specificație suplimentară, așa că potecile care se bifurcă se înmulțesc, dar la fel crește și posibilitatea de a le raporta pe toate.

                    Formal, concluzia trebuie să fie valabilă pe o mulțime preînregistrată \(\mathcal{S}\) de specificații justificabile, cu familia corectată pentru rata erorii pe familie (FWER, family-wise error rate) sau rata descoperirilor false (FDR, false discovery rate). Raportul dă distribuția rezultatului pe \(\mathcal{S}\), nu cea mai bună celulă.

                    Pe scurt

                    • Întrebarea deschisă: ce parte dintr-un rezultat se datorează datelor și ce parte cercetătorului?
                      • Replicarea este posibilă: într-un model bayesian al replicării, majoritatea factorilor de evaluare a activelor se replică și funcționează în afara eșantionului în 93 de țări Jensen, Kelly & Pedersen (2023)
                      • Asistenții AI reduc aproape la zero costul fiecărei specificații suplimentare: crește numărul specificațiilor posibile, dar și posibilitatea de a le raporta pe toate
                      • Formularea formală: concluzia trebuie să rămînă valabilă pe o mulțime preînregistrată \(\mathcal{S}\) de specificații justificabile, cu familia corectată (FWER sau FDR)
                      • Raportăm distribuția ei pe \(\mathcal{S}\), nu celula cea mai bună

                    Bucla descoperirii și verificările ei (1/2)

                    Slide 73 în PDF

                    Bucla urmează calendarul proiectului. În săptămîna 1 echipa formulează întrebarea cu \(H_0\) și \(H_1\); în săptămînile 1–2 parcurge literatura și fixează o țintă de replicare văzută în PDF-ul lucrării; în săptămîna 2 preînregistrează extinderea într-un commit datat, înaintea primului rezultat al extinderii. În săptămînile 2–3 replicarea devine un test care trece în depozit, în săptămînile 4–5 se rulează întreaga grilă, iar înaintea susținerii un examinator AI pune întrebări echipei.

                    Pe scurt

                    • Bucla
                      • Întrebarea și \(H_0\)/\(H_1\) (săptămîna 1)
                      • Literatura și ținta de replicare văzută în PDF (săptămînile 1–2)
                      • Preînregistrarea extinderii, fixată printr-un commit datat înaintea primului rezultat al extinderii (săptămîna 2)
                      • Replicarea ca test care trece în repository (săptămînile 2–3)
                      • Întreaga grilă (săptămînile 4–5)
                      • Un examinator AI înainte de susținere

                    Bucla descoperirii și verificările ei (2/2)

                    Slide 74 în PDF

                    Fiecare pas are o verificare făcută de cercetător:

                    • Numărul țintă trebuie să se afle în lucrare;
                    • Planul trebuie să preceadă primul fișier de rezultate în istoricul commit-urilor;
                    • Fiecare rulare trebuie consemnată și numărată;
                    • O clonă nouă trebuie să regenereze fiecare număr;
                    • Fiecare membru trebuie să poată deriva formula-cheie fără AI.

                    Prompturile pentru fiecare pas și testul pentru fiecare verificare sînt în Anexă.

                    Pe scurt

                    • Verificările cercetătorului
                      • Cifra-țintă se află în articol
                      • Planul precede primul fișier de rezultate în istoricul commit-urilor
                      • Fiecare rulare este jurnalizată și numărată
                      • O clonă nouă regenerează fiecare cifră
                      • Fiecare membru poate deduce formula-cheie fără AI (prompturi și teste: Anexă)

                    Mini studiu de caz: replicare și extindere (1/2)

                    Slide 75 în PDF

                    Ținta replicării este VaR 1% FHS pentru BET. Capitolul 8 raportează 59 de depășiri în 4 937 de zile (1,20%, Kupiec \(p = 0{,}181\)); studiul de caz al acestui capitol găsește 67 în 5 432 de zile (1,23%, \(p = 0{,}095\)). Modelul este același, dar evaluarea începe într-un caz în 2007 și în celălalt în 2005, cu setări diferite, așa că fiecare abatere trebuie documentată înainte ca o replicare să fie declarată eșuată.

                    O propunere tipică a unui asistent sună așa: „doar GARCH-EVT este calibrat corect pe ambele piețe”. Asistentul citește fiecare valoare p separat, la 5%, ignorînd faptul că testele formează o familie.

                    Pe scurt

                    • Replicăm: VaR 1% FHS pentru BET
                      • Capitolul 8 raportează 59 de depășiri în 4 937 de zile (\(1{,}20\%\), Kupiec \(p = 0{,}181\))
                      • Studiul de caz din acest capitol: 67 în 5 432 de zile (\(1{,}23\%\), \(p = 0{,}095\))
                      • Același model, alt început al evaluării (2007 față de 2005) și alte setări: documentăm orice diferență înainte de a declara o replicare eșuată
                    • O concluzie tipică propusă de asistent: „doar GARCH-EVT este calibrat corect pe ambele piețe”
                      • asistentul citește fiecare valoare p separat la 5%

                    Mini studiu de caz: replicare și extindere (2/2)

                    Slide 76 în PDF

                    Extinderea tratează cele 12 teste de acoperire condiționată din capitolul 8, pentru S&P 500 și BET și cîte șase modele, ca o singură familie; Bitcoin și EUR/RON rămîn în afara ei, pentru că pe aceste piețe lipsesc unele prognoze GARCH. La 5% există 8 respingeri fără corecție, 6 cu corecția Holm (FWER) și 7 cu procedura Benjamini–Hochberg (BH) la un FDR de 5%.

                    FHS eșuează doar pe S&P 500 (\(p = 0{,}040\)), iar în familia celor 12 această respingere nu mai este semnificativă, așa că după Holm atît FHS, cît și GARCH-EVT trec pe ambele piețe. Afirmația „FHS eșuează pentru S&P 500” depinde deci de faptul că testul este citit separat sau în familia lui. Rezultatul susține o comparație a procedurilor; în proiect, familia se fixează în plan înainte de a vedea rezultatele și se raportează ambele lecturi.

                    Pe scurt

                    • Extindem
                      • Cele 12 teste de acoperire condiționată din Capitolul 8 (S&P 500 și BET \(\times\) 6 modele) formează o familie
                      • Bitcoin și EUR/RON rămîn în afara familiei: pe aceste piețe, o parte din prognozele GARCH lipsesc (Capitolul 8)
                      • Respingeri la 5%: 8 fără corecție, 6 cu Holm (FWER), 7 cu Benjamini–Hochberg, BH (FDR 5%)
                      • FHS eșuează doar pe S&P 500 (\(p = 0{,}040\)); considerat în familia de 12 teste, nu mai este respins, deci după Holm FHS și GARCH-EVT trec pe ambele piețe
                    • Interpretare: „FHS eșuează pentru S&P 500” depinde de citirea testului separat sau în familia lui
                    • Tipul de dovadă: comparație între proceduri
                    • În proiect, fixați familia în plan înainte de rezultate și raportați ambele citiri

                    Planul final al echipei

                    Slide 77 în PDF

                    Planul final pornește de la ideea de proiect a echipei din Partea C a seminarelor, scrisă ca \(H_0\) și \(H_1\) împreună cu observația care ar infirma-o. Echipa replică întîi un tabel publicat, văzut în lucrare, și îl transformă într-un test care trece în depozit, apoi extinde analiza pe o grilă preînregistrată, cu familia corectată și distribuția completă raportată.

                    Livrabilele urmează calendarul: propunerea, ținta replicării și commit-ul de preînregistrare; testul de replicare care trece și grila de rezultate; simularea susținerii, raportul și susținerea orală. Jurnalul AI păstrează în `AI_USE.md` prompturile care au schimbat designul, iar în `AI_ERRORS.md` fiecare eroare depistată, cu testul care a depistat-o; șabloanele sînt în dosarul proiectului.

                    Pe scurt

                    • Întrebarea: ideea dumneavoastră din Partea C, scrisă ca \(H_0\)/\(H_1\), cu observația care ar infirma-o
                    • Replicați întîi: un tabel publicat, văzut în articol, transformat într-un test care trece în repository
                      • Apoi extindeți pe o grilă preînregistrată, cu familia corectată și distribuția completă raportată
                    • Livrabile de-a lungul calendarului
                      • propunerea și ținta de replicare, commit-ul de preînregistrare
                      • testul de replicare care trece, grila de rezultate
                      • susținerea de probă, raportul, susținerea orală
                    • Jurnalul AI (șabloanele sînt în folderul project al repository-ului)
                      • prompturile care au schimbat metodologia, în AI_USE.md
                      • fiecare eroare detectată, cu testul care a detectat-o, în AI_ERRORS.md

                    Concluzii

                    Idei de reținut

                    Slide 78 în PDF

                    Randamentele sînt greu de prognozat, riscul lor nu: volatilitatea, cozile și dependența pot fi prognozate. Fiecare model este judecat out-of-sample, față de un reper simplu și cu o funcție de pierdere potrivită țintei. Cozile groase schimbă inferența, așa că erorile robuste și bootstrap-ul înlocuiesc formulele de manual, intervalele se raportează, iar puterea se declară.

                    Cele mai multe rezultate greșite provin din design, nu din model: look-ahead bias, supraajustare (overfitting), testare multiplă și calendare nealiniate. Parcursul de analiză este el însuși o sursă de incertitudine, de aceea cursul cere preînregistrare, replicare și raportarea întregii grile. Instrumentele noi, machine learning (ML), modelele de fundație (foundation models) și modelele mari de limbaj (LLM, large language models), ridică ștacheta evaluării, nu o coboară.

                    Pe scurt

                    • Randamentele sînt greu de prezis, riscul lor nu
                      • volatilitatea, cozile și dependența pot fi prognozate
                    • Orice model este judecat în afara eșantionului, față de un reper simplu, cu o funcție de pierdere potrivită țintei
                    • Cozile groase schimbă inferența
                      • folosiți erori robuste și bootstrap
                      • raportați intervale, precizați puterea
                    • Cele mai multe rezultate greșite vin din felul în care este construită analiza, nu din model
                      • deplasare de anticipare, supraajustare, testare multiplă, calendare
                    • Parcursul analizei este el însuși o sursă de incertitudine
                      • preînregistrați, replicați, raportați toată grila
                    • Instrumentele noi (ML, modele fundaționale, LLM-uri) ridică exigența evaluării, nu o scad

                    Verificarea înțelegerii (1/2)

                    Slide 79 în PDF

                    Întrebările revin la cele cinci puncte de recapitulare ale capitolului:

                    1. De ce testul Kupiec folosește \(\alpha = 0{,}01\) și nu un parametru estimat;
                    2. De ce excesul de kurtosis de selecție al randamentelor BET nu estimează nimic;
                    3. De ce intervalul Wald pentru persistența GARCH nu este informativ după impunerea lui \(p \le 1\);
                    4. Ce înseamnă o nerespingere a testului Kupiec la \(T = 250\);
                    5. De ce IQR al unui multivers de 27 de parcursuri nu este eroarea nestandard a 164 de echipe.

                    Fiecare întrebare trimite la slide-ul care îi răspunde.

                    Verificarea înțelegerii (2/2)

                    Slide 80 în PDF

                    Seminarul 19 aplică acest capitol pe BET în exercițiile A1–A12, B1–B8 și C1–C3. Manualele cursului sînt Franke, Härdle & Hafner (2019), Härdle, Chen & Overbeck (2017), McNeil, Frey & Embrechts (2015) și Tsay (2010), iar codul și datele capitolului se află în dosarul Quantlets Ch_19 de pe GitHub.

                    Pe scurt

                    Pentru aprofundare

                    Două calcule pe cifre noi (1/2)

                    Slide 81 în PDF

                    Două exerciții folosesc cifre noi:

                    1. Un model VaR 1% cu \(x = 6\) depășiri în \(T = 400\) de zile: se cer statistica Kupiec \(LR_{uc}\) și o decizie la 5%.
                    2. O persistență GARCH(1,1) \(\alpha + \beta = 0{,}97\): se cer timpul de înjumătățire \(h_{1/2}\) și modul în care se schimbă cînd persistența este 0,985.

                    Pe scurt

                    Încercați
                    • 1. Un model VaR 1% are \(x = 6\) depășiri în \(T = 400\) de zile
                      • Calculați \(LR_{uc}\) cu formula Kupiec din recapitularea Capitolului 8 și decideți la 5%
                    • 2. Un GARCH(1,1) are \(\alpha + \beta = 0{,}97\)
                      • Calculați timpul de înjumătățire \(h_{1/2}\)
                      • Cum se schimbă dacă \(\alpha + \beta = 0{,}985\)?

                    Două calcule pe cifre noi (2/2)

                    Slide 82 în PDF

                    Cu \(\hat\pi = 6/400 = 1{,}5\%\), statistica Kupiec este

                    \[LR_{uc} = 2\big[(394\ln 0{,}985 + 6\ln 0{,}015) - (394\ln 0{,}99 + 6\ln 0{,}01)\big] = 0{,}88,\]
                    (19.21)

                    sub valoarea critică de 5% de 3,84, deci modelul nu este respins. La \(T = 400\) testul are putere mică, așa că rezultatul înseamnă „nicio dovadă”, nu „nicio problemă”. Timpii de înjumătățire sînt \(\ln 0{,}5/\ln 0{,}97 = 22{,}8\) zile și \(\ln 0{,}5/\ln 0{,}985 = 45{,}9\) zile: înjumătățirea lui \(1 - \alpha - \beta\) aproximativ dublează timpul de înjumătățire.

                    Pe scurt

                    Verificați răspunsul
                    • 1. \(\hat\pi = 6/400 = 1{,}5\%\)
                      \begin{equation*} LR_{uc} = 2\big[(394\ln 0{,}985 + 6\ln 0{,}015) - (394\ln 0{,}99 + 6\ln 0{,}01)\big] = 0{,}88 \end{equation*}
                      • Sub 3,84: nu se respinge
                      • La \(T = 400\) testul are putere mică, deci înseamnă „nicio dovadă”, nu „nicio problemă”
                    • 2. \(\ln 0{,}5/\ln 0{,}97 = 22{,}8\) zile și \(\ln 0{,}5/\ln 0{,}985 = 45{,}9\) zile
                      • Înjumătățirea lui \(1 - \alpha - \beta\) dublează aproximativ timpul de înjumătățire

                    Decizia practică

                    Slide 83 în PDF

                    Pentru un proiect despre risc, capitolul alege un filtru GARCH cu o coadă flexibilă, FHS, față de simularea istorică drept reper simplu. Pe BET, FHS este singurul model nerespins de niciunul dintre testele de acoperire, independență și cuantilă dinamică (DQ, dynamic quantile), iar mulțimea de încredere a modelelor de 10% pe scorul FZ0 este {GARCH-t, FHS}.

                    Alegerea este valabilă:

                    • Pentru prognoze în timp real, cu mulțimea de informație \(\mathcal{F}_{t-1}\) și parametri reestimați pe o fereastră mobilă;
                    • Pentru o evaluare cu putere suficientă (MDE Kupiec este 1,45% la \(T = 5\,432\), față de 3,65% la \(T = 250\));
                    • Pentru o funcție de pierdere și o familie de teste fixate în plan printr-un commit datat.

                    Trei rezultate ar răsturna-o:

                    1. O respingere care rezistă corecției Holm pe familia testelor de acoperire condiționată;
                    2. O concluzie care se schimbă pe grila de specificații preînregistrată;
                    3. O replicare a tabelului țintă cu abateri care nu pot fi explicate celulă cu celulă.

                    Pe scurt

                    • Ce aleg: pentru un proiect despre risc, un filtru GARCH cu o coadă flexibilă (FHS), comparat cu simularea istorică drept reper simplu
                      • pe BET, FHS este singurul model nerespins de acoperire, independență și DQ
                      • mulțimea de încredere a modelelor la 10% pe FZ0 este {GARCH-t, FHS}
                    • În ce condiții
                      • prognoze în timp real, cu informația \(\mathcal{F}_{t-1}\) și parametri reestimați pe o fereastră mobilă
                      • o evaluare cu putere suficientă: MDE-ul testului Kupiec este 1,45% la \(T = 5\,432\), față de 3,65% la \(T = 250\)
                      • funcția de pierdere și familia de teste fixate în plan printr-un commit datat
                    • Ce rezultat m-ar face să renunț
                      • o respingere care rămîne după corecția Holm pe familia testelor de acoperire condiționată
                      • o concluzie care se schimbă pe grila preînregistrată de specificații
                      • o replicare a tabelului-țintă cu abateri pe care nu le pot explica celulă cu celulă

                    Aprofundări

                    Aprofundările dau detaliile studiului de caz BET, un ghid al metodelor pentru proiect și celelalte rezultate ale studiului despre erorile nestandard. Sînt lectură de familiarizare.

                    Pasul 2: modelul GARCH(1,1)-\(t\)

                    Slide 84 în PDF

                    Pasul 2 al studiului BET folosește modelul GARCH(1,1) al lui Bollerslev (1986) cu inovații Student-\(t\): \(r_t = \mu + \varepsilon_t\), \(\varepsilon_t = \sigma_t z_t\) și \(\sigma_t^2 = \omega + \alpha\varepsilon_{t-1}^2 + \beta\sigma_{t-1}^2\), unde \(\sigma_t\) este cunoscut la \(t-1\), \(z_t\) este i.i.d. Student-\(t\) cu \(\nu\) grade de libertate, scalat la varianța 1, \(\alpha\) măsoară reacția la știri, iar \(\beta\) memoria. Modelul se estimează prin verosimilitate maximă, cu erori standard robuste (sandwich).

                    Pe scurt

                    • GARCH(1,1) din recapitularea Capitolului 5, cu inovații Student-\(t\) Bollerslev (1986)
                      \begin{equation*} r_t = \mu + \varepsilon_t, \qquad \varepsilon_t = \sigma_t z_t, \qquad \sigma_t^2 = \omega + \alpha\,\varepsilon_{t-1}^2 + \beta\,\sigma_{t-1}^2 \end{equation*}
                      • \(\sigma_t\): volatilitatea condiționată, cunoscută în \(t - 1\)
                      • \(z_t\): i.i.d. Student-\(t\) cu \(\nu\) grade de libertate, scalat la varianța 1
                      • \(\omega > 0\), \(\alpha, \beta \ge 0\): \(\alpha\) măsoară reacția la știri, \(\beta\) memoria
                      • un \(\nu\) mic înseamnă cozi groase
                    • Persistența \(\alpha + \beta\) și timpul de înjumătățire \(h_{1/2}\): formulele din recapitularea Capitolului 5
                    • Estimare prin verosimilitate maximă, cu erori standard robuste (sandviș)

                    Pasul 2: volatilitatea de azi și nivelul de termen lung (1/2)

                    Slide 85 în PDF

                    La sfîrșitul eșantionului, \(\hat\sigma_T = 1{,}67\%\) este cunoscut la \(T-1\), iar prognoza pentru ziua următoare folosește și ultimul randament, \(r_T = 2{,}17\%\): \(\hat\sigma_{T+1}^2 = 0{,}0448 + 0{,}192\,(2{,}17 - 0{,}08)^2 + 0{,}799 \times 1{,}67^2 = 3{,}11\), deci \(\hat\sigma_{T+1} = 1{,}76\%\). Varianța de termen lung implicată de model este \(\bar\sigma^2 = \omega/(1 - \alpha - \beta) = 0{,}0448/0{,}0093 = 4{,}82\), adică 2,20% pe zi (34,7% pe an), față de o abatere standard de selecție de 1,40% pe zi (22,1% pe an).

                    Pe scurt

                    • Două cifre la finalul eșantionului
                      • \(\hat\sigma_T\) este cunoscut în \(T - 1\)
                      • \(\hat\sigma_{T+1}\) folosește și ultimul randament \(r_T = 2{,}17\%\) și intră în VaR-ul de mîine
                      \begin{equation*} \hat\sigma_{T+1}^2 = \hat\omega + \hat\alpha\,(r_T - \hat\mu)^2 + \hat\beta\,\hat\sigma_T^2 = 0{,}0448 + 0{,}192\,(2{,}17 - 0{,}08)^2 + 0{,}799 \times 1{,}67^2 = 3{,}11 \end{equation*}
                      • Deci \(\hat\sigma_{T+1} = \sqrt{3{,}11} = 1{,}76\%\): un ultim randament mare ridică prognoza peste \(\hat\sigma_T = 1{,}67\%\)
                    • Varianța de termen lung implicată de model
                      \begin{equation*} \bar\sigma^2 = \frac{\omega}{1 - \alpha - \beta} = \frac{0{,}0448}{0{,}0093} = 4{,}82 \end{equation*}
                      • Randamentele sînt în %: \(\bar\sigma = 2{,}20\%\) pe zi (34,7% pe an), față de abaterea standard empirică de 1,40% pe zi (22,1% pe an)

                    Pasul 2: volatilitatea de azi și nivelul de termen lung (2/2)

                    Slide 86 în PDF

                    Diferența nu este o contradicție: numitorul \(1 - \alpha - \beta = 0{,}0093\) este mic și imprecis. Cu \(\omega\) fixat, o persistență de 0,9867 dă \(\bar\sigma^2 = 3{,}37\), iar 0,9947 dă 8,47, iar intervalul de încredere de profil ajunge la 1, unde \(\bar\sigma^2\) este infinită. Traiectoria prognozei revine geometric la nivelul de termen lung, \(\hat\sigma_{T+h}^2 = \bar\sigma^2 + (\hat\alpha + \hat\beta)^{h-1}(\hat\sigma_{T+1}^2 - \bar\sigma^2)\), care dă 3,40 la \(h = 21\), o volatilitate de 1,84%: după o lună prognoza a parcurs doar 17% din distanță, așa că se folosește traiectoria pe orizont scurt, iar nivelul de termen lung este tratat ca slab identificat.

                    Pe scurt

                    • De ce diferența nu este o contradicție: numitorul \(1 - \alpha - \beta = 0{,}0093\) este mic și imprecis
                      • Cu \(\omega\) fix, \(p = 0{,}9867\) dă \(\bar\sigma^2 = 3{,}37\), iar \(p = 0{,}9947\) dă 8,47
                      • CI din verosimilitatea profil ajunge la \(p = 1\), unde \(\bar\sigma^2\) este infinită
                      • Folosiți \(\hat\sigma_{T+1}\) și traiectoria prognozei pe orizonturi scurte
                      • Tratați nivelul de termen lung ca slab identificat
                    • Traiectoria prognozei revine geometric spre \(\bar\sigma^2\), cu rata \(\hat\alpha + \hat\beta\)
                      \begin{equation*} \hat\sigma_{T+h}^2 = \bar\sigma^2 + (\hat\alpha + \hat\beta)^{h-1}\big(\hat\sigma_{T+1}^2 - \bar\sigma^2\big), \qquad h = 21\colon\; 4{,}82 + 0{,}9907^{20}\,(3{,}11 - 4{,}82) = 3{,}40 \end{equation*}
                      • Deci \(\hat\sigma_{T+21} = 1{,}84\%\): după o lună, prognoza a parcurs doar 17% din distanța pînă la nivelul de termen lung

                    Pasul 3: patru prognoze VaR 1% (1/2)

                    Slide 87 în PDF

                    Pasul 3 compară patru prognoze VaR 1%. Cele necondiționate folosesc ultimele 500 de zile: HS ia cuantila empirică de 1% a pierderilor, iar modelul Normal \(\mathrm{VaR} = -(\hat\mu + \hat\sigma z_{0.01})\), cu \(z_{0.01} = -2{,}326\). Cele condiționate folosesc GARCH-\(t\) pe ultimele 1 000 de zile și scalează cuantila cu prognoza volatilității \(\hat\sigma_t\): GARCH-\(t\) folosește cuantila Student-\(t\) rescalată la varianța 1, iar FHS o înlocuiește cu cuantila empirică de 1% a reziduurilor standardizate (McNeil & Frey, 2000).

                    Pe scurt

                    • Necondiționate, pe ultimele 500 de zile: o singură cuantilă pentru toată fereastra
                      • HS (simulare istorică): pierderea \(L = -r\) depășită în 1% din ultimele 500 de zile (cuantila empirică)
                      • Normal: \(\VaR = -(\hat\mu + \hat\sigma z_{0{,}01})\), cu \(\hat\mu\), \(\hat\sigma\) media și abaterea standard empirice și \(z_{0{,}01} = -2{,}326\) cuantila de 1% a distribuției Normale standard
                    • Condiționate, GARCH-\(t\) pe ultimele 1 000 de zile
                      • cuantila se scalează cu prognoza volatilității de azi \(\hat\sigma_t\)
                      \begin{equation*} \textbf{GARCH-}t\colon\; \VaR_{t} = -\Big(\hat\mu + \hat\sigma_t\,t_\nu^{-1}(0{,}01)\sqrt{(\nu - 2)/\nu}\Big), \qquad \textbf{FHS}\colon\; \VaR_{t} = -\big(\hat\mu + \hat\sigma_t\,\hat q_{0{,}01}(z)\big) \end{equation*}
                      • \(t_\nu^{-1}(0{,}01)\): cuantila de 1% a unei distribuții Student-\(t\) cu \(\nu\) grade de libertate, iar factorul \(\sqrt{(\nu - 2)/\nu}\) o rescalează la varianța 1
                      • FHS (simulare istorică filtrată): \(\hat q_{0{,}01}(z)\), cuantila empirică de 1% a reziduurilor standardizate \(z_t = (r_t - \hat\mu)/\hat\sigma_t\), înlocuiește cuantila Student-\(t\) McNeil & Frey (2000)

                    Pasul 3: patru prognoze VaR 1% (2/2)

                    Slide 88 în PDF

                    Designul este în timp real: prognoza pentru ziua \(t\) folosește doar datele pînă la \(t-1\), GARCH se reestimează la fiecare 21 de zile de tranzacționare, iar \(\hat\sigma_t\) se actualizează zilnic. Evaluarea acoperă perioada 3 ianuarie 2005–18 septembrie 2026, \(T = 5\,432\) de zile, deci la 1% sînt așteptate circa 54 de depășiri. Modelele necondiționate reacționează doar pe măsură ce fereastra avansează, iar cele condiționate reacționează prin \(\hat\sigma_t\), în cîteva zile.

                    Pe scurt

                    • Procedură în timp real
                      • Prognoza pentru ziua \(t\) folosește doar datele pînă la \(t-1\)
                      • Parametrii GARCH sînt reestimați la fiecare 21 de zile de tranzacționare, iar \(\hat\sigma_t\) este actualizat zilnic
                    • Evaluare: 3 ian. 2005 – 18 sept. 2026, \(T = 5\,432\) zile
                      • O depășire în ziua \(t\): pierderea \(-r_t\) depășește \(\VaR_t\)
                      • Numărul așteptat de depășiri la 1%: \(0{,}01\,T \approx 54\)
                    • Modelele necondiționate reacționează doar pe măsură ce fereastra avansează
                      • cele condiționate reacționează prin \(\hat\sigma_t\), în cîteva zile

                    Pasul 4: cele trei backtest-uri

                    Slide 89 în PDF

                    Pasul 4 aplică trei backtest-uri:

                    1. Testul Kupiec întreabă dacă rata depășirilor este 1% (Kupiec, 1995).
                    2. Testul de independență Christoffersen întreabă dacă o depășire este mai probabilă după o depășire, comparînd ratele depășirilor \(\hat\pi_{01}\) după o zi liniștită și \(\hat\pi_{11}\) după o depășire, cu un raport de verosimilitate \(LR_{ind} \sim \chi^2_1\) (Christoffersen, 1998).
                    3. Testul comun de acoperire condiționată este \(LR_{cc} = LR_{uc} + LR_{ind} \sim \chi^2_2\), cu valoarea critică de 5% egală cu 5,99.

                    Pe scurt

                    • Testul de acoperire Kupiec Kupiec (1995): este rata depășirilor egală cu \(\alpha = 1\%\)?
                      • \(LR_{uc}\) din recapitularea Capitolului 8, respins la 5% cînd \(LR_{uc} > 3{,}84\)
                    • Testul de independență Christoffersen Christoffersen (1998): este o depășire azi mai probabilă după o depășire ieri?
                      \begin{equation*} LR_{ind} = -2\ln\frac{(1-\hat\pi)^{n_{00}+n_{10}}\,\hat\pi^{\,n_{01}+n_{11}}}{(1-\hat\pi_{01})^{n_{00}}\,\hat\pi_{01}^{\,n_{01}}\,(1-\hat\pi_{11})^{n_{10}}\,\hat\pi_{11}^{\,n_{11}}} \;\sim\; \chi^2_1 \end{equation*}
                      • \(n_{ij}\): numărul zilelor în starea \(j\) după o zi în starea \(i\) (1 = depășire, 0 = fără depășire)
                      • \(\hat\pi_{01} = n_{01}/(n_{00} + n_{01})\), \(\hat\pi_{11} = n_{11}/(n_{10} + n_{11})\): ratele depășirilor după o zi fără depășire și după o depășire
                      • \(\hat\pi = (n_{01} + n_{11})/(n_{00} + n_{01} + n_{10} + n_{11})\): rata pe cele \(T - 1\) tranziții, care diferă de \(x/T\) cu cel mult \(1/(T - 1)\)
                    • Testul comun: \(LR_{cc} = LR_{uc} + LR_{ind} \sim \chi^2_2\), cu valoarea critică de 5% egală cu 5,99

                    Pasul 4: testele de acoperire și independență

                    Slide 90 în PDF

                    Doar FHS nu este respins de niciunul dintre cele trei teste: 67 de depășiri (1,23%), cu valorile p 0,095, 0,267 și 0,134. HS (79 de depășiri, 1,45%) și modelul Normal (122, 2,25%) eșuează și la independență, pentru că depășirile lor se grupează, și petrec 5,5% și 18,6% dintre ferestrele de 250 de zile în zona roșie Basel (10 sau mai multe depășiri). GARCH-\(t\) trece testul de independență, dar are prea multe depășiri (80, \(p_{uc} = 0{,}001\)): coada Student-\(t\) nu este suficient de groasă la 1%.

                    Pe scurt

                    ModelDepășiriRata\(p_{uc}\)\(p_{ind}\)\(p_{cc}\)Zona roșie
                    HS791,45%0,002\(<\)0,001\(<\)0,0015,5%
                    Normal1222,25%\(<\)0,001\(<\)0,001\(<\)0,00118,6%
                    GARCH-t801,47%0,0010,8640,0050,0%
                    FHS671,23%0,0950,2670,1340,0%
                    • Zona roșie: ponderea ferestrelor de 250 de zile cu cel puțin 10 depășiri (semaforul Basel)
                    • Doar FHS nu este respins de niciunul dintre cele trei teste la 5%
                    • HS și Normal sînt respinse și de testul de independență, deoarece depășirile lor se grupează
                    • GARCH-\(t\): independența nu este respinsă, dar depășirile sînt prea multe
                      • coada Student-\(t\) nu este suficient de groasă la 1%

                    Pasul 4: depășirile din ultimele 250 de zile

                    Slide 91 în PDF

                    Graficul numără depășirile pe o fereastră mobilă de 250 de zile, cu zonele Basel verde, galbenă și roșie. Modelele Normal și HS intră în zona roșie în episoade, cînd depășirile lor se grupează; cele două modele filtrate GARCH nu intră niciodată în ea.

                    Pe scurt

                    Pasul 4: depășirile din ultimele 250 de zile
                    • Numărul depășirilor pe o fereastră mobilă de 250 de zile, cu zonele Basel verde, galbenă și roșie
                    • Normal și HS intră în zona roșie în episoade, cînd depășirile lor se grupează
                      • ponderile: ultima coloană a tabelului din Pasul 4
                    • Cele două modele cu filtru GARCH nu intră niciodată în ea
                    MFM_ch19_case_study

                    Deplasarea de anticipare în studiul de caz

                    Slide 92 în PDF

                    Look-ahead bias face ca prognozele să pară mai bune decît sînt. Cuantila HS pe tot eșantionul are prin construcție 1,01% depășiri, iar GARCH-\(t\) cu parametri estimați pe tot eșantionul are 1,31%, față de 1,47% cu estimare mobilă. Diferența este valoarea unei informații pe care nu o avea nimeni, iar doar rezultatul cu estimare mobilă este o dovadă despre un model de prognoză.

                    Pe scurt

                    Deplasarea de anticipare în studiul de caz
                    • Cuantila HS calculată pe tot eșantionul dă, prin construcție, 1,01% depășiri
                    • GARCH-\(t\) cu parametri estimați pe tot eșantionul: depășiri în 1,31% din zile
                      • față de 1,47% cu estimare pe fereastră mobilă
                    • Ambele par mai bune decît versiunile în timp real
                      • diferența măsoară valoarea unei informații indisponibile în timp real
                    • Doar rezultatul pe fereastră mobilă este o dovadă despre un model de prognoză
                    MFM_ch19_case_study

                    Pasul 5: trei instrumente pentru compararea formală (1/2)

                    Slide 93 în PDF

                    Pasul 5 folosește trei instrumente pentru o comparație formală. Testul cuantilei dinamice (DQ) al lui Engle & Manganelli (2004) regresează \(I_t - 0{,}01\) pe o constantă, patru indicatori decalați ai depășirilor și \(\mathrm{VaR}_t\), iar statistica lui Wald urmează \(\chi^2_6\) sub un model corect, deci detectează depășirile previzibile din trecut sau din nivelul VaR. Scorul FZ0 al lui Patton, Ziegel & Chen (2019), \(S(v, e; y) = -\mathbf{1}\{y \le v\}(v - y)/(\alpha e) + v/e + \ln(-e) - 1\) cu \(v = -\mathrm{VaR}\) și \(e = -\mathrm{ES}\), evaluează în fiecare zi o pereche (VaR, ES); el este strict consistent (Fissler & Ziegel, 2016), deci în medie perechea adevărată are scorul cel mai mic.

                    Pe scurt

                    • Testul Dynamic Quantile (DQ) Engle & Manganelli (2004): sînt depășirile previzibile?
                      • Regresăm \(I_t - 0{,}01\) (\(I_t = 1\) dacă pierderea depășește \(\VaR_t\), altfel 0) pe o constantă, pe \(I_{t-1}, \dots, I_{t-4}\) și pe \(\VaR_t\)
                      • \(DQ\), statistica Wald că cei șase coeficienți sînt zero, \(\sim \chi^2_6\) pentru un model corect
                      • Detectează depășiri previzibile din trecut sau din nivelul VaR, pe care testul Christoffersen (un singur lag) le poate rata
                    • Scorul FZ0 Patton, Ziegel & Chen (2019): o valoare pe zi pentru perechea de prognoze (VaR, ES)
                      \begin{equation*} S(v, e; y) = -\frac{\mathbf{1}\{y \le v\}(v - y)}{\alpha e} + \frac{v}{e} + \ln(-e) - 1 \end{equation*}
                      • un scor mai mic este mai bun
                      • \(\alpha = 2{,}5\%\): nivelul ES; \(y\): randamentul realizat
                      • \(v = -\VaR\), \(e = -\ES\): prognozele scrise ca cuantile ale randamentelor (\(e \le v < 0\))
                      • Strict consistent pentru (VaR, ES) Fissler & Ziegel (2016): în medie, perechea adevărată are scorul cel mai mic

                    Pasul 5: trei instrumente pentru compararea formală (2/2)

                    Slide 94 în PDF

                    Diferențele FZ0 dintre două modele se compară cu teste Diebold–Mariano (Diebold & Mariano, 1995), aproximativ \(N(0,1)\) sub ipoteza de acuratețe egală. Mulțimea de încredere a modelelor de 10% a lui Hansen, Lunde & Nason (2011) conține cel mai bun model cu probabilitatea 90%, iar un model rămîne în ea cît timp valoarea lui p este cel puțin 0,10. Backtest-ul ES comparativ al lui Nolde & Ziegel (2017), față de HS ca model standard, este roșu dacă modelul este semnificativ mai slab, verde dacă este semnificativ mai bun și galben în rest.

                    Pe scurt

                    • Teste Diebold–Mariano pe perechi Diebold & Mariano (1995): \(t_{DM}\) din recapitularea Capitolului 14
                      • \(d_t\): diferența FZ0 dintre cele două modele în ziua \(t\)
                      • \(t_{DM} \approx N(0, 1)\) la acuratețe egală
                    • Mulțimea de încredere a modelelor la 10% Hansen, Lunde & Nason (2011)
                      • conține cel mai bun model cu probabilitatea 90%
                      • un model rămîne în ea cît timp \(p_{MCS} \ge 0{,}10\)
                    • Verificarea comparativă a ES Nolde & Ziegel (2017), față de HS ca model standard
                      • roșu dacă modelul este semnificativ mai slab
                      • verde dacă este semnificativ mai bun
                      • galben în rest

                    Pasul 5: ce pereche de prognoze evaluează FZ0?

                    Slide 95 în PDF

                    FZ0 evaluează o a doua pereche de prognoze din aceleași patru modele, VaR 2,5% și ES 2,5%, la nivelul ES din Basel, pentru că scorul este consistent doar cînd \(v\) și \(e\) sînt cuantila și media cozii la același nivel. ES 2,5% al fiecărui model este pierderea medie dincolo de propriul VaR 2,5%, din aceeași distribuție a pierderilor:

                    • Pentru HS, cele mai mari 12 dintre 500 de pierderi plus jumătate din a 13-a, împărțite la 12,5;
                    • Pentru modelul Normal, \(-\hat\mu + 2{,}338\,\hat\sigma\);
                    • Pentru GARCH-\(t\) și FHS, \(\hat\sigma_t\) înmulțit cu media cozii distribuției Student-\(t\) sau a celor mai mici 25 dintre 1 000 de reziduuri standardizate.

                    Pe scurt

                    • O a doua pereche de prognoze, din aceleași patru modele: VaR 2,5% și ES 2,5%
                      • la nivelul ES din Basel, \(\alpha = 2{,}5\%\)
                      • Nu VaR 1% din Pașii 3–4: FZ0 este consistent doar cînd \(v\) și \(e\) sînt cuantila și media cozii la același nivel \(\alpha\)
                    • ES 2,5% al fiecărui model este pierderea medie dincolo de propriul VaR 2,5%
                      • din aceeași distribuție a pierderilor pe care modelul o folosește pentru VaR în Pasul 3
                      • HS: estimatorul din Capitolul 7; din cele 500 de pierderi, cele mai mari 12 plus jumătate din a 13-a, împărțite la 12,5
                      • Normal: \(\ES = -\hat\mu + \hat\sigma\,\varphi(z_{0{,}025})/0{,}025 = -\hat\mu + 2{,}338\,\hat\sigma\), cu \(\varphi\) densitatea Normală standard
                      • GARCH-\(t\): \(-\hat\mu\) plus \(\hat\sigma_t\) înmulțit cu media cozii superioare a distribuției Student-\(t\) rescalate la varianța 1
                      • FHS: opusul sumei dintre media condiționată și \(\hat\sigma_t\) înmulțit cu media celor mai mici 25 de reziduuri standardizate \(z_t\) din 1 000 (același estimator)

                    Pasul 5: prognozele ES 2,5% în cifre

                    Slide 96 în PDF

                    În medie pe cele 5 432 de zile de evaluare, prognozele VaR 1% și ES 2,5% sînt 3,66% și 3,99% pentru HS, 2,90% și 2,92% pentru modelul Normal, 2,95% și 3,08% pentru GARCH-\(t\) și 3,17% și 3,41% pentru FHS, în procente din poziție. Pentru modelul Normal raportul este \(2{,}338/2{,}326 \approx 1{,}005\), iar diferența dintre coloane crește cu greutatea cozii permise de model: circa 9% pentru HS, 7,5% pentru FHS, 4% pentru GARCH-\(t\) și 0,5% pentru Normal.

                    Pe scurt

                    ModelVaR 1% mediu (Pașii 3–4)ES 2,5% mediu (Pasul 5)
                    HS3,66%3,99%
                    Normal2,90%2,92%
                    GARCH-t2,95%3,08%
                    FHS3,17%3,41%
                    • Medii ale prognozelor zilnice pe cele \(T = 5\,432\) zile de evaluare, pierderi în % din poziție
                    • Modelul Normal: ES 2,5% / VaR 1% \(= 2{,}338/2{,}326 \approx 1{,}005\)
                      • raportul din tabel (2,92/2,90)
                      • un ES 1% ar fi cu aproximativ 15% mai mare
                    • Diferența dintre coloane crește cu grosimea cozii permise de model
                      • aproximativ 9% pentru HS și 7,5% pentru FHS (cozi empirice)
                      • 4% pentru GARCH-\(t\)
                      • 0,5% pentru modelul Normal

                    Metode: de la întrebare la capitol

                    Slide 97 în PDF

                    Tabelul asociază tipul întrebării de proiect cu capitolele din care pornesc metodele:

                    • Distribuția randamentelor și predictibilitatea: capitolele 1–2;
                    • Factorii și portofoliile: capitolele 3–4;
                    • Volatilitatea și corelația: capitolele 5, 6 și 9;
                    • Măsurile de risc și capitalul: capitolele 7–8;
                    • Lichiditatea, opțiunile și timpul continuu: capitolele 10–12;
                    • Prognoza cu ML, deep learning sau text: capitolele 13–15;
                    • Cripto, bulele și riscul sistemic: capitolele 16–18.

                    Întrebarea din Partea C a fiecărui seminar este un punct de plecare (tabelul din Anexă).

                    Pe scurt

                    Dacă întrebarea este desprePorniți de la
                    Distribuția randamentelor, cozi, predictibilitateCapitolele 1–2: momente, teste robuste, rapoarte ale varianțelor
                    Randamente așteptate, factori, portofoliiCapitolele 3–4: Fama–MacBeth, contracție, teste Sharpe în afara eșantionului
                    Volatilitate și corelațieCapitolele 5, 6, 9: GARCH, DCC, copule, log-HAR
                    Măsuri de risc și capitalCapitolele 7–8: FHS, EVT, backtest-uri, FZ0
                    Lichiditate, opțiuni, timp continuuCapitolele 10–12: Amihud, Black–Scholes, VIX, prima de risc a varianței
                    Prognoză cu machine learning (ML), deep learning sau textCapitolele 13–15: purged cross-validation (CV, validare încrucișată), modele fundaționale, sentiment
                    Cripto, bule, risc sistemicCapitolele 16–18: stablecoin-uri, GSADF, CoVaR, rețele
                    • Puncte de plecare: întrebarea din Partea C a fiecărui seminar (tabel în Anexă)
                      • O întrebare proprie este binevenită dacă răspunde celor cinci întrebări din acest capitol

                    Identificarea: de la corelație la o afirmație (1/2)

                    Slide 98 în PDF

                    Întrebările despre evenimente, de exemplu dacă ETF-urile spot, promovarea FTSE (Financial Times Stock Exchange, FTSE Russell, index provider, furnizorul de indici FTSE Russell) Russell sau o taxă bancară au schimbat o măsură de risc, au nevoie de un contrafactual. Cu o piață de control neatinsă de eveniment, estimația diferență-în-diferențe (difference-in-differences)

                    \[\hat\delta = \big(\bar Y_{\text{tratat}}^{\,\text{după}} - \bar Y_{\text{tratat}}^{\,\text{înainte}}\big) - \big(\bar Y_{\text{control}}^{\,\text{după}} - \bar Y_{\text{control}}^{\,\text{înainte}}\big)\]
                    (19.22)

                    este coeficientul \(\delta\) din \(Y_{it} = a + bD_i + cP_t + \delta D_iP_t + \varepsilon_{it}\), cu erori standard HAC; ea se bazează pe tendințe paralele (parallel trends), verificate pe perioada dinaintea evenimentului.

                    Pe scurt

                    • Întrebările despre evenimente cer un contrafactual
                      • de exemplu: „au schimbat ETF-urile spot, reclasificarea FTSE Russell sau o taxă bancară mărimea X?”
                      • O piață de control neafectată de eveniment: diferența în diferențe pe măsura de risc \(Y\) (de exemplu volatilitatea sau VaR 1%)
                        \begin{equation*} \hat\delta = \big(\bar Y_{\text{tratat}}^{\,\text{după}} - \bar Y_{\text{tratat}}^{\,\text{înainte}}\big) - \big(\bar Y_{\text{control}}^{\,\text{după}} - \bar Y_{\text{control}}^{\,\text{înainte}}\big) \end{equation*}
                      • Echivalent: \(\delta\) din regresia \(Y_{it} = a + b\,D_i + c\,P_t + \delta\,D_i P_t + \varepsilon_{it}\), cu \(D_i = 1\) pentru piața tratată, \(P_t = 1\) după eveniment și erori standard HAC
                      • Ipoteza de identificare: tendințe paralele (fără eveniment, \(Y\) ar fi evoluat la fel pe ambele piețe), verificată pe perioada dinaintea evenimentului

                    Identificarea: de la corelație la o afirmație (2/2)

                    Slide 99 în PDF

                    Alte designuri întăresc o afirmație despre un eveniment:

                    • Un control sintetic construit din mai multe piețe netratate (Abadie, Diamond & Hainmueller, 2010);
                    • Date placebo mutate cu un an mai devreme sau mai tîrziu;
                    • Cînd momentul este necunoscut, testul sup-Wald de ruptură al lui Andrews (1993), cu data estimată a rupturii raportată.

                    Întrebările de prognoză se evaluează doar out-of-sample, pe o perioadă de test declarată în plan, iar pentru că un eveniment înseamnă \(n = 1\), raportul spune ce poate și ce nu poate identifica designul.

                    Pe scurt

                    • Un control sintetic, construit din mai multe piețe neafectate de eveniment Abadie, Diamond & Hainmueller (2010)
                    • Date placebo: evenimentul mutat fictiv cu un an mai devreme sau mai tîrziu
                    • Dacă momentul este necunoscut: un test sup-Wald de ruptură Andrews (1993)
                      • cu data estimată a rupturii raportată, nu una impusă
                    • Întrebările de prognoză: doar în afara eșantionului, cu o perioadă de test declarată în plan
                    • Un singur eveniment înseamnă \(n = 1\)
                      • precizați ce poate și ce nu poate identifica studiul

                    Putere și robustețe fără p-hacking (1/2)

                    Slide 100 în PDF

                    Înaintea testului principal, proiectul își calculează efectul minim detectabil, cel mai mic efect detectat cu putere de 80% la 5%. Pentru o estimație aproximativ normală, \(\mathrm{MDE} = (z_{0.975} + z_{0.80})\,\mathrm{SE} = 2{,}80\,\mathrm{SE}\), iar cînd \(\mathrm{SE} = \sigma/\sqrt{T}\) eșantionul necesar este \(T_{\min} = (2{,}80\,\sigma/\delta)^2\). Livrabilul este o curbă a puterii testului principal, simulată la \(T\) al proiectului; eșantioanele scurte de cripto, ETF sau de după un eveniment fac ca multe întrebări să aibă putere insuficientă, cum arată MDE Kupiec de 3,65% la \(T = 250\).

                    Pe scurt

                    • Putere: înaintea testului principal, calculați efectul minim detectabil (MDE)
                      • MDE: cel mai mic efect pe care testul dumneavoastră îl detectează cu putere de 80% la 5%
                      • Pentru o estimare aproximativ Normală cu eroarea standard SE, un test bilateral de 5% și puterea 80%
                        \begin{equation*} \mathrm{MDE} = (z_{0{,}975} + z_{0{,}80})\,\mathrm{SE} = 2{,}80\,\mathrm{SE}, \qquad T_{\min} = \Big(\frac{2{,}80\,\sigma}{\delta}\Big)^2 \ \text{cînd } \mathrm{SE} = \sigma/\sqrt{T} \end{equation*}
                      • \(z_p\): cuantila \(p\) a distribuției Normale standard; \(\delta\): efectul căutat; \(\sigma\): abaterea standard a unei observații
                      • Livrabil: o curbă de putere simulată pentru testul principal la \(T\)-ul dumneavoastră
                      • Eșantioanele scurte de cripto, ETF-uri sau de după eveniment fac ca multe teste să aibă putere mică (Kupiec la \(T = 250\): MDE \(3{,}65\%\))

                    Putere și robustețe fără p-hacking (2/2)

                    Slide 101 în PDF

                    O curbă a specificațiilor estimează fiecare combinație justificabilă de fereastră, laguri, \(\alpha\) și început al eșantionului și reprezintă toate estimațiile ordonate, cu intervalele lor (Simonsohn, Simmons & Nelson, 2020); raportul dă împrăștierea, nu cea mai bună celulă. Familia se corectează cu Holm pentru orice descoperire falsă, cu Benjamini–Hochberg pentru ponderea lor sau cu testul de realitate bootstrap al lui White (2000) pentru data snooping, iar pragurile de semnificație trebuie să crească odată cu numărul de teste încercate (Harvey & Liu, 2020).

                    Pe scurt

                    • Curba specificațiilor (specification curve)
                      • estimați fiecare combinație justificabilă de fereastră, laguri, \(\alpha\) și început al eșantionului
                      • Reprezentați toate estimările ordonate, cu intervalele lor Simonsohn, Simmons & Nelson (2020)
                      • Raportați dispersia pe specificații, nu celula cea mai bună
                    • Corectați familia
                      • Holm pentru probabilitatea oricărei descoperiri false
                      • Benjamini–Hochberg pentru ponderea lor așteptată
                      • testul bootstrap reality check al lui White pentru căutarea repetată în aceleași date (data snooping) White (2000)
                      • Pragurile de semnificație trebuie să crească odată cu numărul de teste încercate Harvey & Liu (2020), Harvey (2017)

                    Evaluarea prognozelor în proiectele despre risc

                    Slide 102 în PDF

                    Proiectele despre risc evaluează volatilitatea cu o funcție de pierdere robustă, MSE sau QLIKE, față de un proxy condiționat nedeplasat, și compară multe modele cu mulțimea de încredere a modelelor a lui Hansen, Lunde & Nason (2011), nu după pierderea medie cea mai mică. VaR se evaluează cu teste de acoperire, independență și DQ, față de un reper cu testele de capacitate predictivă condiționată ale lui Giacomini & White (2006) și cu puterea fiecărui backtest declarată; ES se evaluează prin scorarea perechii (VaR, ES) cu FZ0 și cu backtest-urile comparative cu trei zone ale lui Nolde & Ziegel (2017). Studiul de caz integrat este șablonul.

                    Pe scurt

                    • Volatilitate: MSE sau QLIKE față de un proxy condiționat nedeplasat (eroare de evaluare)
                    • VaR: acoperire, independență și testul DQ Engle & Manganelli (2004)
                      • față de un reper, teste de capacitate predictivă condiționată Giacomini & White (2006)
                      • Precizați puterea fiecărui backtest la \(T\)-ul dumneavoastră
                    • ES: perechea (VaR, ES) evaluată cu FZ0
                    • Studiul de caz integrat (Pașii 1–5) servește drept model

                    Raportul și prezentarea (1/2)

                    Slide 103 în PDF

                    Raportul are șapte părți:

                    1. Introducerea, cu întrebarea, ipoteza și contribuția;
                    2. Literatura, cu 10–15 referințe cu link, dintre care cel puțin 3 din ultimii cinci ani;
                    3. Datele și replicarea, cu tabelul replicat celulă cu celulă;
                    4. Designul (plan, identificare, putere, reper, funcție de pierdere, teste);
                    5. Rezultatele cu incertitudinea lor;
                    6. Robustețea, cu curba specificațiilor și corecția ei;
                    7. O concluzie care dă răspunsul într-o propoziție, cu limitele lui.

                    Pe scurt

                    Raportul: un articol de 8–12 pagini
                    • 1. Introducere: întrebarea, ipoteza, contribuția
                    • 2. Literatură: 10–15 referințe cu link, cel puțin 3 din ultimii cinci ani
                    • 3. Date și replicare: surse, perioadă, reguli de curățare
                      • tabelul replicat, celulă cu celulă
                    • 4. Metodologie: plan, identificare, putere, reper, funcție de pierdere, teste
                    • 5. Rezultate, cu incertitudinea lor
                    • 6. Robustețe: curba specificațiilor, cu corecția
                    • 7. Concluzie: răspunsul într-o frază și limitele lui

                    Raportul și prezentarea (2/2)

                    Slide 104 în PDF

                    Prezentarea urmează aceeași ordine în circa zece slide-uri:

                    1. Întrebarea;
                    2. Datele, cu un grafic care arată problema;
                    3. Metoda și reperul;
                    4. Rezultatul principal cu incertitudinea lui;
                    5. Robustețea, limitele și răspunsul.

                    Fiecare slide are un singur mesaj, cu axe lizibile și legenda sub grafic; fiecare membru prezintă și poate răspunde la întrebări despre cod, iar susținerea orală urmează fără AI.

                    Pe scurt

                    Prezentarea (aproximativ 12 minute): slide-urile, în ordine
                    • Întrebarea (1 slide)
                    • Datele și un grafic care arată problema (2)
                    • Metoda și reperul (2)
                    • Rezultatul principal cu incertitudinea lui (2–3)
                    • Robustețe, limitări, răspuns (2)
                    • Un singur mesaj pe fiecare slide, axe lizibile, legenda sub grafic
                    • Fiecare membru prezintă și poate răspunde la întrebări despre cod
                      • apoi urmează susținerea orală, fără AI

                    Erori AI tipice în modelarea financiară (1/2)

                    Slide 105 în PDF

                    Trei erori sînt tipice pentru codul scris de AI:

                    1. Look-ahead bias: o statistică mobilă sau o scalare include ziua \(t\) în prognoza pentru ziua \(t\); schimbarea ultimei observații nu trebuie să mute prognoza pentru acea zi, iar o decalare cu o zi rezolvă problema.
                    2. Semnul VaR: cuantila randamentelor sau un cîștig este raportat drept pierdere; cu \(\mathrm{VaR}_\alpha = -q_\alpha(r)\), VaR este pozitiv ori de cîte ori \(q_\alpha(r) < 0\), iar un VaR 1% pe o zi al unui indice are cîteva procente.
                    3. Anualizarea: volatilitatea înmulțită cu 252 în loc de \(\sqrt{252}\) sau 252 de zile folosite pentru cripto, care se tranzacționează în fiecare zi.

                    Pe scurt

                    • Deplasarea de anticipare: o statistică pe fereastră mobilă sau o scalare care include ziua \(t\) în prognoza pentru ziua \(t\)
                      • Verificare: modificați ultima observație; prognoza pentru acea zi nu trebuie să se schimbe (corectură: .shift(1))
                    • Semnul VaR: cuantila 1% a randamentelor raportată drept VaR
                      • sau cuantila 99% a randamentelor (un cîștig) folosită ca pierdere
                      • Verificare: \(\VaR_\alpha = -q_\alpha(r)\) este pozitiv ori de cîte ori \(q_\alpha(r) < 0\)
                      • VaR 1% pe o zi al unui indice bursier este de cîteva procente
                    • Anualizare: volatilitatea înmulțită cu 252 în loc de \(\sqrt{252}\)
                      • sau 252 de zile folosite pentru cripto, care se tranzacționează zilnic
                      • Verificare: pe \(h\) perioade, mediile se scalează cu \(h\), volatilitățile cu \(\sqrt{h}\) (randamente i.i.d.)
                      • pentru cripto, 365 de zile

                    Erori AI tipice în modelarea financiară (2/2)

                    Slide 106 în PDF

                    Încă două erori completează lista:

                    1. Validarea încrucișată (CV, cross-validation) aleatoare pe serii de timp antrenează pe viitor; o validare walk-forward sau o CV purjată cu embargo o previne (López de Prado, 2018).
                    2. Referințele inventate, gradele de libertate greșite, setările implicite ale bibliotecilor nealese conștient și numerele declarate fără rularea codului se depistează căutînd fiecare DOI pe Crossref și găsind afirmația în lucrare, ca în exercițiul de critică a AI din fiecare seminar.

                    Pe scurt

                    • Validare încrucișată (CV) aleatoare pe serii de timp
                      • Validarea K-fold cu amestecare folosește informație din viitor (capcana metodologică, Capitolul 13)
                      • Verificare: există o dată de test anterioară unei date de antrenare? Folosiți evaluare pe ferestre succesive (walk-forward) sau purged CV cu embargo López de Prado (2018)
                    • Referințe inventate, grade de libertate greșite
                      • valori implicite din biblioteci pe care nu le-ați ales
                      • cifre raportate fără rularea codului
                      • Verificare: căutați fiecare DOI pe Crossref și găsiți afirmația în articol, ca în exercițiul de critică a unui răspuns AI din fiecare seminar (Partea C)

                    Rezultatele principale: feedback, convingeri și bifurcații

                    Slide 107 în PDF

                    În celelalte rezultate ale lucrării, feedback-ul de la etapa 1 la etapa 4 reduce IQR cu 47,2% și abaterea interdecilică cu 68,2%, deci evaluarea colegilor îngustează dispersia fără să o elimine. Abaterea standard a estimațiilor prezisă de echipe este cu 71,7% sub cea realizată. Alegerea modelului și frecvența de eșantionare mută cel mai mult estimațiile: un model al variațiilor relative dă o tendință anuală mediană de −23 000% pe date zilnice, −200% pe date lunare și −4,56% pe date anuale, o diferență de frecvență pe care diferențele logaritmice și tendințele liniare nu o au.

                    Pe scurt

                    • Feedbackul: de la etapa 1 la etapa 4, IQR-ul scade cu 47,2%
                      • intervalul interdecilic scade cu 68,2%
                      • evaluarea colegială reduce dispersia, dar nu o elimină
                    • Convingerile: abaterea standard a estimărilor anticipată de echipe este cu 71,7% sub cea observată
                    • Bifurcațiile: alegerea modelului și frecvența eșantionării modifică cel mai mult estimările
                      • Un model al variației relative dă o tendință anuală mediană de \(-23\,000\%\) pe date zilnice, \(-200\%\) lunar și \(-4{,}56\%\) anual
                      • Diferențele logaritmice se adună exact între frecvențe, iar tendința liniară este liniară în date, deci niciuna nu produce această abatere între frecvențe
                      • Pentru o măsură pozitivă, inegalitatea lui Jensen deplasează în sus variația relativă medie; valorile negative din articol cer alt mecanism (exemplul de mai jos)

                    De ce explodează variațiile relative: un exemplu simplu

                    Slide 108 în PDF

                    O măsură care revine la valoarea inițială, \(m = (1;\ 0{,}01;\ 1)\), are variații relative de −99% și +9 900%, cu media +4 900,5%, în timp ce variațiile ei logaritmice, \(\ln 0{,}01\) și \(\ln 100\), au media exact 0. Pentru o măsură pozitivă, inegalitatea lui Jensen împinge în sus media variațiilor relative, de aceea multiversul din curs explodează în sus; o tendință de −23 000% cere o măsură care își schimbă semnul în jurul lui zero sau variații zilnice adunate, nu compuse. Lecția pentru plan este să se verifice numitorii apropiați de zero și să se fixeze dinainte transformarea.

                    Pe scurt

                    • O măsură care revine la valoarea de pornire: \(m = (1;\ 0{,}01;\ 1)\)
                      • Variațiile relative \(m_t/m_{t-1} - 1\): \(-99\%\), apoi \(+9\,900\%\); media lor este \(+4\,900{,}5\%\)
                      • Variațiile logaritmice: \(\ln 0{,}01\), apoi \(\ln 100\); media lor este exact 0, răspunsul corect pentru o măsură fără tendință
                      • Pentru o măsură pozitivă, inegalitatea lui Jensen împinge în sus variația relativă medie (Anexă): multiversul cursului explodează în sus
                    • O măsură pozitivă nu poate scădea cu mai mult de \(100\%\)
                      • o tendință de \(-23\,000\%\) cere o măsură care își schimbă semnul aproape de zero (\(m_{t-1} = 0{,}001\), \(m_t = -0{,}2\) dă \(-20\,100\%\))
                      • sau variații zilnice adunate, nu compuse (250 de variații de \(-1\%\) însumează \(-250\%\))
                    • Lecția pentru planul dumneavoastră: inspectați numitorii aproape de zero
                      • fixați dinainte transformarea (diferențe logaritmice pentru măsuri pozitive sau tendință liniară)

                    Deciziile care modifică cel mai mult estimările: statistica folosită

                    Slide 109 în PDF

                    Bifurcațiile sînt ordonate cu statistica Anderson–Darling standardizată pentru \(k\) eșantioane, aplicată celor 27 de estimații grupate după opțiunea de la fiecare bifurcație. Valorile mai mari înseamnă grupuri mai separate, iar o valoare apropiată de 0 sau negativă înseamnă o separare nu mai mare decît la întîmplare. Pentru că cele 27 de estimații folosesc aceleași date, ordonarea este descriptivă, nu un test.

                    Pe scurt

                    • Statistica Anderson–Darling pentru \(k\) eșantioane a celor 27 de estimări
                      • grupate după opțiunea de la fiecare decizie
                      • Statistica compară distribuțiile celor \(k\) grupe: o valoare mai mare înseamnă grupe mai bine separate
                      • Este standardizată, deci centrată în 0 cînd grupele sînt egale: o valoare negativă (valorile extreme, mai jos) înseamnă o separare sub cea datorată hazardului
                    • O ierarhizare descriptivă, nu un test
                      • Cele 27 de estimări folosesc aceleași date

                    Deciziile care modifică cel mai mult estimările: rezultatele

                    Slide 111 în PDF

                    Statistica este 8,41 și 9,77 pentru bifurcația modelului, 2,69 și 1,16 pentru cea a măsurii și −1,23 și −1,03 pentru cea a valorilor extreme, pentru Euro Stoxx 50 și BET. Ordinea este aceeași ca în lucrare: alegerea modelului mută cel mai mult estimațiile, pe un indice mare din zona euro și pe un indice de piață de frontieră în 2002–2018. Un proiect trebuie să fixeze în plan modelul variației anuale și să raporteze întreaga grilă, cu bifurcația care o determină.

                    Pe scurt

                    • Valoarea statisticii pentru fiecare decizie, Euro Stoxx 50 și BET
                      • Modelul: \(8{,}41\) și \(9{,}77\)
                      • Măsura: \(2{,}69\) și \(1{,}16\)
                      • Tratarea valorilor extreme: \(-1{,}23\) și \(-1{,}03\)
                    • Aceeași ordine ca în articol: alegerea modelului modifică cel mai mult estimările
                      • atît pe un indice mare din zona euro, cît și pe BET, indicele unei piețe de frontieră în 2002–2018
                    • Pentru proiect: fixați în plan modelul variației anuale (diferențe logaritmice sau tendință liniară)
                      • raportați toată grila, cu decizia care o determină

                    Anexă

                    Anexa reunește formule de inferență pe capitole, ideile de proiect din seminare, reguli practice pentru proiect, designul studiului despre erorile nestandard și prompturile buclei descoperirii.

                    Inferența pe capitole: formule suplimentare

                    Slide 112 în PDF

                    Slide-ul adună formule de inferență pe care recapitularea le lasă deoparte:

                    • Pentru capitolul 3, erorile standard Fama–MacBeth ignoră faptul că beta sînt estimate, iar covarianța lui Shanken (1992) le corectează pentru un model specificat corect.
                    • Pentru capitolul 5, estimatorul de cvasi-verosimilitate maximă (QMLE, quasi-maximum likelihood) al GARCH are covarianța sandwich \(A^{-1}BA^{-1}\) (Bollerslev & Wooldridge, 1992), care se reduce la \(A^{-1}\) doar cînd inovațiile au kurtosis 3.
                    • Pentru capitolul 7, slide-ul dă varianța asimptotică a cuantilei empirice pentru randamente i.i.d.

                    Pe scurt

                    • Capitolul 3: erorile Fama–MacBeth ignoră faptul că beta sînt estimați
                      • covarianța Shanken, cu \(\hat\gamma\) primele de risc, \(\hat\Sigma_f\) covarianța factorilor și \(\hat V_{FM}\) covarianța Fama–MacBeth (FM) Shanken (1992)
                      \begin{equation*} \hat V_{\text{Sh}} = (1 + c)\big(\hat V_{FM} - \hat\Sigma_f/T\big) + \hat\Sigma_f/T, \qquad c = \hat\gamma^\top\hat\Sigma_f^{-1}\hat\gamma \end{equation*}
                      • valabilă pentru un model corect specificat; cu termen liber, \(\hat\Sigma_f\) se bordează cu zerouri pe linia și coloana termenului liber
                      • referința empirică din Capitolul 3: erorile Kan–Robotti–Shanken, robuste la specificare greșită, cu laguri Newey–West și sensibilitate la numărul lor
                    • Capitolul 5: QMLE (cvasi-verosimilitate maximă) pentru GARCH Bollerslev & Wooldridge (1992)
                      • \(A\): hessiana așteptată (semn schimbat); \(B\): varianța scorului
                      \begin{equation*} \sqrt{T}(\hat\theta - \theta) \Rightarrow N\big(0, A^{-1}BA^{-1}\big) \end{equation*}
                      • în blocul parametrilor varianței, \(A = B\) dacă \(\kappa_z = 3\): inovații Normale, dar nu numai
                      • altfel, erorile standard din hessiană (\(A^{-1}\)) sînt greșite; factorul \(\sqrt{(\kappa_z - 1)/2}\) privește doar QMLE Gaussian, nu estimatorul Student-\(t\)
                    • Capitolul 7: cuantila empirică, pentru randamente i.i.d. cu densitatea \(f(q_\alpha) > 0\)
                      • în coadă \(f\) este mică, deci VaR-ul istoric este zgomotos
                      \begin{equation*} \sqrt{T}(\hat q_\alpha - q_\alpha) \Rightarrow N\big(0,\ \alpha(1 - \alpha)/f(q_\alpha)^2\big) \end{equation*}

                    Idei de proiect, Partea C a fiecărui seminar (1/2)

                    Slide 113 în PDF

                    Prima jumătate a tabelului enumeră întrebările deschise din Partea C a seminarelor 0–7, fiecare cu link la seminarul ei: de la efectul ETF-urilor spot asupra corelației Bitcoin cu acțiunile pînă la capitalul de care are nevoie un portofoliu BVB comparativ cu un portofoliu S&P 500.

                    Idei de proiect, Partea C a fiecărui seminar (2/2)

                    Slide 114 în PDF

                    A doua jumătate enumeră întrebările din Partea C a seminarelor 8–16, de la modelul de risc care ar trebui certificat pentru portofoliul de tranzacționare al unei bănci românești pînă la întrebarea dacă Bitcoin este un activ alternativ, un activ de risc sau o acoperire.

                    De la idee la proiect

                    Slide 115 în PDF

                    O idee devine proiect în trei mișcări:

                    1. Se replică un tabel publicat din spatele ideii;
                    2. Ideea se îngustează la o piață, o perioadă și un număr;
                    3. Ideea se extinde cu o a doua piață, un model nou sau un eșantion mai recent.

                    De exemplu, Seminarul 8 devine întrebarea care dintre HS, FHS și GARCH-EVT dă un VaR 1% corect pentru un portofoliu 50/50 din BET și EUR în 2015–2026, iar un model de fundație din capitolul 14 poate fi adăugat ca filtru de volatilitate în FHS, cu analiza de referință păstrată drept reper.

                    Pe scurt

                    • Replicați mai întîi: un tabel sau o figură publicată dintr-un articol din spatele ideii (pasul 1)
                    • Restrîngeți-o: o piață, o perioadă, un număr de prognozat sau de testat
                      • Exemplu: Seminarul 8 devine „Care dintre HS, FHS și GARCH-EVT produce un VaR 1% corect pentru un portofoliu 50/50 format din BET și EUR (cursul EUR/RON) în 2015–2026?”
                    • Extindeți-o: o a doua piață, un model nou, un eșantion mai lung sau mai recent
                      • Exemplu: adăugați un model fundațional (Capitolul 14) ca filtru de volatilitate în FHS
                    • Păstrați analiza de referință ca reper și încercați să o îmbunătățiți în mod onest

                    Convențiile de date pentru proiect

                    Slide 116 în PDF

                    Proiectul folosește pe cît posibil datele cursului, împreună cu surse publice precum cursurile BNR, FRED, Kenneth French Data Library, DefiLlama și arhiva BVB. Se aplică convențiile cursului:

                    • Prețuri ajustate pentru ETF-uri și acțiuni și valori de închidere pentru indici, valute și cripto;
                    • Fără rîndurile din zilele de sărbătoare în care furnizorul a repetat prețul anterior și fără cotații de weekend pentru piețele închise;
                    • Anualizare cu frecvența reală;
                    • Alinierea mai multor active pe zilele comune de tranzacționare înainte de calculul randamentelor;
                    • Căutarea prețurilor eronate, pentru că salturile de ±50% în prețurile ajustate sînt de obicei erori de date.

                    Pe scurt

                    • Folosiți datele cursului unde se poate
                      • serii zilnice pentru indici, ETF-uri, acțiuni BVB, cripto și cursuri de schimb, plus date intraday
                      • Surse publice: cursurile de referință BNR, FRED, Kenneth French Data Library, DefiLlama; arhiva BVB pentru indicii românești
                    • Aplicați convențiile cursului
                      • Prețuri ajustate pentru ETF-uri și acțiuni, valori de închidere pentru indici, cursuri de schimb și cripto
                      • Eliminați zilele de sărbătoare în care furnizorul a repetat prețul anterior și cotațiile de weekend cînd piața este închisă
                      • Anualizați cu frecvența reală
                      • Mai multe active: aliniați întîi prețurile pe zilele comune, apoi calculați randamentele
                    • Căutați valorile eronate înainte de modelare
                      • salturile de \(\pm 50\%\) în prețurile ajustate sînt de obicei erori de date

                    Lista de verificare pentru evaluarea rezultatelor empirice

                    Slide 117 în PDF

                    O evaluare onestă:

                    • Fixează în plan ipoteza, reperul și funcția de pierdere, fereastra de estimare și perioada de test, numărul de modele cu corecția lor, identificarea și puterea;
                    • Raportează doar rezultate out-of-sample pentru afirmațiile despre prognoză;
                    • Dă fiecare număr principal cu o eroare standard, un interval sau o valoare p;
                    • Include costurile pentru strategiile de tranzacționare;
                    • Verifică subperioade și o a doua piață;
                    • Spune ce nu a funcționat și de ce.

                    Pe scurt

                    Înainte să vă uitați la rezultate
                    • Fixați în plan ipoteza, reperul și funcția de pierdere
                      • fereastra de estimare și perioada de test
                      • numărul de modele, cu corecția lor
                      • identificarea și puterea
                    Cînd raportați
                    • Doar rezultate în afara eșantionului pentru afirmații despre prognoză
                    • Fiecare rezultat principal însoțit de eroare standard, CI sau valoare p
                    • Costurile de tranzacționare pentru strategii
                    • Subperioade și o a doua piață pentru robustețe
                    • Ce nu a funcționat și de ce

                    Greșeli frecvente care costă puncte

                    Slide 118 în PDF

                    Proiectele pierd de obicei puncte în moduri previzibile:

                    • O întrebare care se schimbă după ce rezultatele sînt cunoscute;
                    • Ajustarea în eșantion prezentată drept putere de prognoză;
                    • Un reper lipsă sau ales intenționat slab;
                    • Numere fără incertitudine;
                    • Multe teste fără corecție;
                    • Grafice fără unități sau cu acronime neexplicate;
                    • Cod care nu rulează sau nu produce numerele raportate;
                    • Rezultate AI păstrate fără verificare.

                    Pe scurt

                    • O întrebare care se schimbă după ce se cunosc rezultatele
                    • Ajustarea în eșantion prezentată drept putere de prognoză
                    • Niciun reper sau un reper slab, ales pentru a fi ușor depășit
                    • Multe teste fără corecție
                    • Grafice fără unități, legende peste date, acronime neexplicate
                    • Cod care nu rulează sau cifre din raport pe care codul nu le produce
                    • Rezultate AI păstrate fără verificare
                      • utilizare nedeclarată, cod neverificat, referințe care nu există

                    Erori nestandard: datele și etapele

                    Slide 119 în PDF

                    Datele lui Menkveld et al. (2024) sînt toate tranzacțiile cu futures pe Euro Stoxx 50 din 2002–2018, 720 de milioane de înregistrări, fiecare parte fiind marcată drept client sau cont propriu. Cele șase ipoteze de „nicio tendință anuală” privesc eficiența pieței, spread-ul bid–ask realizat, ponderea clienților în volum, spread-ul realizat pe ordinele clienților, ponderea ordinelor la piață în ordinele clienților și veniturile brute din tranzacționare ale clienților, fiecare măsurată după alegerea echipei. Cele patru etape din 2021 au fost analiza independentă, feedback-ul de la doi evaluatori colegi, partajarea celor mai bune cinci lucrări și estimațiile finale.

                    Pe scurt

                    • Date: toate tranzacțiile cu contractele futures pe Euro Stoxx 50, 2002–2018
                      • 720 de milioane de înregistrări
                      • pentru fiecare parte se indică dacă operează pentru un client sau în cont propriu (Sec. I.A)
                    • Șase ipoteze „nicio tendință anuală”
                      • eficiența pieței, spread-ul bid–ask realizat, ponderea clienților în volum
                      • spread-ul realizat pe ordinele clienților, ponderea ordinelor la piață în ordinele clienților
                      • venitul brut din tranzacționare al clienților
                    • Fiecare echipă își alege propria măsură pentru fiecare mărime
                    • Patru etape în 2021 (Sec. I.A)
                      • analiza independentă (articol și cod), feedback de la doi evaluatori
                      • distribuirea celor mai bune cinci lucrări
                      • estimările finale, fără obligația de a furniza codul
                    • Un plan de analiză a fost înregistrat public înainte de începerea experimentului

                    Erori nestandard: calitatea și inferența

                    Slide 120 în PDF

                    Calitatea echipei este prima componentă principală a cinci indicatori, între care un scor de reproductibilitate de la 0 la 100 acordat de agenția de certificare Cascad și evaluarea colegilor, fără medie, iar regresiile cuantilice ale estimațiilor la percentilele 10–90 arată dacă IQR scade odată cu calitatea. Fiecare estimație este testată față de estimația mediană cu o corecție Bonferroni la un nivel pe familie de 0,5%, iar în analiza de tip multivers echipele își raportează alegerea la fiecare bifurcație din tabelul V, ordonată cu statistica Anderson–Darling pentru \(k\) eșantioane.

                    Pe scurt

                    • Calitatea
                      • Calitatea echipei: prima componentă principală a cinci indicatori
                      • scorul de reproductibilitate 0–100 acordat de agenția de certificare Cascad
                      • nota acordată de evaluatori, din care s-a scăzut media (Sec. I.B)
                      • Regresii cuantilice ale estimărilor la percentilele 10, 25, 50, 75 și 90
                      • un IQR care scade înseamnă o dispersie mai mică (Sec. I.C)
                    • Inferența
                      • Fiecare estimare este testată față de estimarea mediană, cu corecție Bonferroni la un nivel de semnificație de 0,5% pentru familia de teste (Sec. I.C)
                      • Analiza multivers: echipele raportează opțiunile metodologice din Tabelul V
                      • Statistica Anderson–Darling pentru \(k\) eșantioane ierarhizează deciziile după diferențele dintre distribuțiile estimărilor (Sec. II.C)

                    Erori nestandard, detaliile replicării

                    Slide 121 în PDF

                    Grila din curs preia trei bifurcații din tabelul V: valorile extreme (nicio prelucrare, winsorizare sau trunchiere la percentilele 2,5 și 97,5), măsura (\(VR(5)\), \(VR(21)\) sau \(R^2\) al AR(1)) și modelul (tendință liniară, diferență logaritmică sau diferență relativă). Diferențele relative explodează pentru că măsurile sînt apropiate de zero în unii ani: pentru \(m_t\) independente, \(\mathbb{E}(m_t/m_{t-1}) = \mathbb{E}m \cdot \mathbb{E}(1/m) \ge 1\), prin inegalitatea lui Jensen. Cele 27 de estimații sînt puternic corelate, așa că valorile critice și valorile p tabelate Anderson–Darling nu se aplică.

                    Pe scurt

                    • Deciziile metodologice (bifurcațiile) din Tabelul V
                      • Valorile extreme: nimic; măsura anuală winsorizată sau cu valorile din afara percentilelor 2,5 și 97,5 eliminate
                      • Măsura: raportul varianțelor zi la săptămînă, raportul varianțelor zi la lună, \(R^2\) al unui model autoregresiv AR(1)
                      • Modelul: tendință liniară, diferență logaritmică, diferență relativă
                      • Datele zilnice permit comparațiile zi–săptămînă și zi–lună (\(VR(5)\), \(VR(21)\)), iar variantele intrazilnice ale măsurii din Tabelul V necesită date intrazilnice
                    • Explozia diferențelor relative: \(m_t = |VR - 1|\) sau \(R^2\) este aproape de zero în unii ani (articolul: Fig. 7)
                      • Fără tendință, \(m_t\) staționar: panta liniară și variația logaritmică medie sînt centrate în zero
                      • dar pentru \(m_t\) independente, \(\E(m_t/m_{t-1}) = \E m \cdot \E(1/m) \ge 1\) (Jensen), deci variația relativă medie este pozitivă
                    • Statistica Anderson–Darling: cele 27 de estimări sînt puternic corelate
                      • deci valorile critice tabelate și valorile p nu se aplică

                    Bucla descoperirii, prompturi (1/2)

                    Slide 122 în PDF

                    Prompturile pentru primele săptămîni:

                    • Transformă o idee din Partea C în trei versiuni testabile, cu tabelul publicat pe care l-ar replica fiecare;
                    • Enumeră lucrările cele mai citate și cele mai recente, cu DOI, estimația principală, tabelul și eșantionul;
                    • Schițează ipoteze concurente și o preînregistrare a eșantionului, filtrelor, ferestrelor, testelor și corecției.

                    Fiecare DOI se verifică pe Crossref, iar echipa deschide singură tabelul.

                    Pe scurt

                    • Săptămîna 1, întrebarea: transformăm o idee în \(H_0\)/\(H_1\), cu o țintă de replicare
                      • „Iată ideea noastră din Partea C a Seminarului N. Dă trei versiuni mai precise și testabile, tabelul publicat pe care l-ar replica fiecare și seriile din datele cursului de care are nevoie.”
                    • Săptămînile 1–2, literatura și ținta: cifra de replicat este una pe care ați văzut-o în PDF
                      • „Listează cele mai citate și cele mai recente articole despre această întrebare, cu DOI; pentru fiecare, estimarea principală, tabelul și eșantionul.”
                      • Verificați fiecare DOI pe Crossref
                      • Căutați cu Semantic Scholar, Elicit sau Google Scholar; deschideți personal tabelul
                    • Săptămîna 2, ipoteze și preînregistrare, fixate printr-un commit datat înaintea primului rezultat
                      • „Pentru H0 și H1, listează ipotezele concurente și implicația care le separă; apoi scrie o preînregistrare: eșantion, filtre, ferestre, teste, corecție.”

                    Bucla descoperirii, prompturi (2/2)

                    Slide 123 în PDF

                    Prompturile ulterioare:

                    • Scriu o funcție care reproduce fiecare celulă a tabelului publicat, cu o aserțiune asupra toleranței acceptate;
                    • Întreabă ce concluzii ale întregii grile rezistă unei corecții Holm;
                    • Îi cer asistentului să joace rolul examinatorului de la susținerea orală, punînd cele mai grele zece întrebări fără să le răspundă.

                    Raportul dă distribuția rezultatelor pe grilă, cu prompturile în `AI_USE.md` și erorile depistate în `AI_ERRORS.md`.

                    Pe scurt

                    • Săptămînile 2–3, cod și replicare: tabelul replicat devine un test în repository
                      • „Scrie o funcție care reproduce fiecare celulă a tabelului publicat din datele cursului și o aserțiune cu toleranța pe care o acceptăm.”
                    • Săptămînile 4–5, extindere și robustețe: rulăm toată grila preînregistrată
                      • „Iată rezultatele tuturor specificațiilor analizate. Ce concluzii rămîn valabile după corecția Holm și pe care le-ar numi un recenzent căutare repetată în aceleași date?”
                    • Înainte de susținere, critica: asistentul întreabă, echipa răspunde fără AI, ca la susținerea propriu-zisă
                      • „Joacă rolul examinatorului la susținerea orală: pune cele mai dificile zece întrebări despre identificare, inferență și date. Nu răspunde la ele.”
                    • Raportul: distribuția rezultatelor pe grilă, nu celula cea mai bună
                      • prompturile în AI_USE.md
                      • erorile detectate în AI_ERRORS.md

                    Verificările cercetătorului

                    Slide 124 în PDF

                    Cercetătorul verifică cinci lucruri:

                    1. Ținta replicării există: numărul, tabelul și eșantionul provin din lucrare, nu din rezumatul asistentului, iar un al doilea membru găsește același număr acolo.
                    2. Planul a venit primul în istoricul commit-urilor.
                    3. Potecile care se bifurcă sînt numărate: fiecare rulare își consemnează configurația și rezultatul, iar raportul declară numărul lor și corectează familia.
                    4. Niciun număr nu este introdus de mînă, așa că o clonă nouă și o singură comandă regenerează fiecare număr.
                    5. Fiecare membru poate deriva formula-cheie și își poate apăra fiecare alegere.

                    Pe scurt

                    • Ținta de replicare există
                      • cifra, tabelul și eșantionul luate din articol, nu din rezumatul asistentului
                      • raportul citează pagina și tabelul, iar un al doilea membru găsește acolo aceeași cifră
                    • Planul precede rezultatele
                      • în istoricul commit-urilor, preînregistrarea extinderii precede primul fișier de rezultate al extinderii
                    • Bifurcațiile analizei (mai multe specificații încercate decît raportate)
                      • fiecare rulare își scrie configurația și rezultatul într-un jurnal
                      • raportul le dă numărul și corectează familia
                    • Reproductibilitatea (fără cifre introduse manual)
                      • o clonă nouă și o singură comandă regenerează fiecare cifră pînă la ultima zecimală raportată
                    • Înțelegerea: fiecare membru poate deduce formula-cheie și poate apăra fiecare alegere
                      • testul este o susținere de probă în echipă, fără AI, cu o săptămînă înaintea celei reale

                    Acronime

                    Acronime folosite în acest material (1/5)

                    Slide 125 în PDF
                    • ACF: AutoCorrelation Function — funcția de autocorelație
                    • ADF: Augmented Dickey–Fuller (test) — testul Dickey–Fuller augmentat
                    • AI: Artificial Intelligence — inteligență artificială
                    • AR: AutoRegressive model — model autoregresiv
                    • ASE: Academia de Studii Economice din București
                    • BET: Bucharest Exchange Trading (index) — indicele de referință al Bursei de Valori București
                    • BET-TR: BET Total Return (index) — indicele BET cu dividendele reinvestite
                    • BH: Benjamini–Hochberg (procedure) — procedura Benjamini–Hochberg
                    • BNR: Banca Națională a României
                    • BSADF: Backward Sup Augmented Dickey–Fuller (statistic) — statistica ADF supremă pe ferestre care se termină la data \(t\)
                    • BV: Bipower Variation — variația bipower
                    • BVB: Bursa de Valori București
                    • CAGR: Compound Annual Growth Rate — rata anuală compusă de creștere
                    • CAPM: Capital Asset Pricing Model — modelul de evaluare a activelor financiare
                    • CI: Confidence Interval — interval de încredere
                    • CoVaR: Conditional Value-at-Risk — VaR-ul sistemului condiționat de starea unei instituții
                    • COVID-19: COronaVIrus Disease 2019 — boala provocată de coronavirus, 2019
                    • CV: Cross-Validation — validare încrucișată

                    Acronime folosite în acest material (2/5)

                    Slide 126 în PDF
                    • DCC: Dynamic Conditional Correlation — corelație condiționată dinamică
                    • DeFi: Decentralised Finance — finanțele descentralizate
                    • DM: Diebold–Mariano (test) — testul Diebold–Mariano de comparare a prognozelor
                    • DOI: Digital Object Identifier — identificatorul digital al unei publicații
                    • DQ: Dynamic Quantile (test) — testul cuantilei dinamice
                    • EDGE: Efficient Discrete Generalized Estimator (of the bid-ask spread) — estimatorul discret generalizat eficient al spread-ului bid-ask
                    • EEM: iShares MSCI (Morgan Stanley Capital International, index provider, furnizorul de indici Morgan Stanley Capital International) Emerging Markets ETF — acțiuni din piețe emergente
                    • EFA: iShares MSCI EAFE (Europe, Australasia and Far East, MSCI index of developed markets outside North America, piețele dezvoltate din Europa, Australasia și Orientul Îndepărtat) ETF (developed markets outside the US and Canada) — acțiuni din țări dezvoltate, fără SUA și Canada
                    • ES: Expected Shortfall — pierderea așteptată în coadă
                    • ETF: Exchange-Traded Fund — fond tranzacționat la bursă
                    • EUR: euro, international currency code — euro, codul monetar internațional
                    • EVT: Extreme Value Theory — teoria valorilor extreme
                    • FDR: False Discovery Rate — rata descoperirilor false
                    • FHS: Filtered Historical Simulation — simulare istorică filtrată
                    • FM: Fama–MacBeth (regressions) — regresiile Fama–MacBeth
                    • FRED: Federal Reserve Economic Data — baza de date economice a Rezervei Federale (St. Louis)

                    Acronime folosite în acest material (3/5)

                    Slide 127 în PDF
                    • FTSE: Financial Times Stock Exchange (FTSE Russell, index provider) — furnizorul de indici FTSE Russell
                    • FWER: Family-Wise Error Rate — probabilitatea de cel puțin o eroare de tip I în familia de teste
                    • FZ0: Fissler–Ziegel loss, zero-homogeneous version — funcția de pierdere Fissler–Ziegel, varianta omogenă de grad zero
                    • GARCH: Generalised AutoRegressive Conditional Heteroskedasticity — heteroscedasticitate condiționată autoregresivă generalizată
                    • GARCH-EVT: GARCH filter combined with Extreme Value Theory for the tail — filtru GARCH combinat cu teoria valorilor extreme pentru coadă
                    • GBM: Geometric Brownian Motion — mișcarea browniană geometrică
                    • GJR: Glosten–Jagannathan–Runkle (asymmetric GARCH) — GARCH asimetric Glosten–Jagannathan–Runkle
                    • GLD: SPDR Gold Shares — ETF pe aur
                    • GMV: Global Minimum Variance (portfolio) — portofoliul de varianță minimă globală
                    • GRS: Gibbons–Ross–Shanken (test) — testul Gibbons–Ross–Shanken
                    • GSADF: Generalised Sup Augmented Dickey–Fuller (test) — testul Dickey–Fuller augmentat suprem generalizat
                    • HAC: Heteroskedasticity and Autocorrelation Consistent (standard errors) — erori standard robuste la heteroscedasticitate și autocorelație
                    • HAR: Heterogeneous AutoRegressive (model) — model autoregresiv heterogen
                    • HS: Historical Simulation — simulare istorică

                    Acronime folosite în acest material (4/5)

                    Slide 128 în PDF
                    • HYG: iShares iBoxx High Yield Corporate Bond ETF — ETF de obligațiuni corporative americane cu randament ridicat, sub rating investițional
                    • IEF: iShares 7–10 Year Treasury Bond ETF — ETF de obligațiuni de stat americane cu scadența 7–10 ani
                    • IGARCH: Integrated GARCH — GARCH integrat
                    • IQR: InterQuartile Range — intervalul intercuartilic
                    • JB: Jarque–Bera (test) — testul de normalitate Jarque–Bera
                    • LLM: Large Language Model — model lingvistic mare
                    • LQD: iShares iBoxx Investment Grade Corporate Bond ETF — ETF de obligațiuni corporative americane cu rating investițional
                    • LR: Likelihood Ratio — raportul de verosimilitate
                    • LRMES: Long-Run Marginal Expected Shortfall — pierderea marginală așteptată în coadă pe termen lung (într-o criză)
                    • LSTM: Long Short-Term Memory (network) — rețea cu memorie pe termen lung și scurt
                    • MCS: Model Confidence Set — mulțimea de încredere a modelelor
                    • MDE: Minimum Detectable Effect — efectul minim detectabil
                    • ML: Machine Learning — învățare automată
                    • MSE: Mean Squared Error — eroarea pătratică medie
                    • PDF: Portable Document Format — formatul de document portabil
                    • QLIKE: Quasi-LIKElihood (loss function) — funcția de pierdere de tip cvasi-verosimilitate

                    Acronime folosite în acest material (5/5)

                    Slide 129 în PDF
                    • QMLE: Quasi-Maximum Likelihood Estimator — estimatorul de cvasi-verosimilitate maximă
                    • RON: Romanian leu, international currency code — leul românesc, codul monetar internațional
                    • RV: Realised Variance — varianța realizată
                    • SADF: Sup Augmented Dickey–Fuller (test) — testul Dickey–Fuller augmentat suprem
                    • SE: Standard Error — eroare standard
                    • SML: Security Market Line — dreapta pieței titlurilor
                    • SPY: SPDR S&P 500 ETF Trust — ETF-ul pe indicele S&P 500
                    • SR: Sharpe Ratio — raportul Sharpe
                    • SRISK: Systemic RISK (capital shortfall measure) — deficitul de capital al unei bănci într-o criză sistemică
                    • SUA: Statele Unite ale Americii
                    • TLT: iShares 20+ Year Treasury Bond ETF — ETF pe obligațiuni americane pe termen lung
                    • USD: US dollar, international currency code — dolarul american, codul monetar internațional
                    • UTC: Coordinated Universal Time — timpul universal coordonat
                    • VaR: Value-at-Risk — valoarea la risc
                    • VIX: CBOE (Chicago Board Options Exchange, bursa de opțiuni din Chicago) Volatility IndeX — indicele de volatilitate CBOE
                    • VOLARE: VOLatility Archive for Realized Estimates (database) — arhiva de estimatori realizați ai volatilității (bază de date)
                    • VR: Variance Ratio — raportul varianțelor
                    • VRP: Variance Risk Premium — prima de risc a varianței

                    Indicele BET: valori oficiale zilnice de închidere, 6 ian. 2000 – 18 sept. 2026, randamente logaritmice în %. Prognozele VaR la o zi: fereastră rolling de 1 000 de zile (500 pentru HS și modelul Normal), GARCH reestimat la fiecare 21 de zile, evaluare din 3 ian. 2005. Mini-multiversul: închideri zilnice Euro Stoxx 50 (EODHD) și BET, 2002–2018. Studiile de caz integrate: opt ETF-uri multi-active (prețuri ajustate, 2007–2026), Bitcoin (închideri zilnice 2014–2026, bare de 5 minute 2024–2026), BET, Euro Stoxx 50 și cursul de referință EUR/RON al BNR (2005–2026).

                    Bibliografie